8. Ausführungsthreads
Dieses Kapitel führt die gleichzeitige Ausführung mehrerer Codeabschnitte innerhalb eines einzigen Programms ein: Threads (Ausführungsthreads) und die Werkzeuge zu ihrer Synchronisierung. Vor etwa zwanzig Jahren hatten die meisten Rechner nur einen Prozessor, und Parallelität war weitgehend eine vom Betriebssystem aufrechterhaltene Illusion. Heute hat selbst der einfachste Laptop mehrere Kerne: Mehrere Threads laufen tatsächlich gleichzeitig, wodurch die hier behandelten Synchronisierungsprobleme noch häufiger auftreten.
Kotlin hat auf der JVM keine eigenen Threads: Es verwendet die Threads von Java, die seit der ersten Version (1996) über die Klasse [Thread], das Schlüsselwort [synchronized], und die Methoden [wait] und [notify] der Klasse [Object] in Java integriert sind. Java 5 (2004) ergänzte das Paket [java.util.concurrent] und seine Unterpakete [java.util.concurrent.locks] und [java.util.concurrent.atomic]: Sperren, Semaphoren, nebenläufige Collections, Thread-Pools usw. Java 7 ergänzte das [Fork/Join]-Framework, Java 8 führte parallele Streams ein, und Java 21 führte virtuelle Threads ein; all dies hat die Art, wie Server geschrieben werden, grundlegend verändert. Java 25 führt schließlich gebundene Werte mit Gültigkeitsbereich ([ScopedValue]) ein. Alle diese Klassen des JDK-Frameworks sind in Kotlin direkt nutzbar: Das ist eine seiner großen Stärken. Die Kotlin-Standardbibliothek fügt dem einige Funktionen hinzu, die die Verwendung bequemer machen: die Funktion [thread] und die Erweiterungsfunktion [withLock] aus dem Paket [kotlin.concurrent], die Funktion [synchronized] sowie die Annotationen [@Volatile] und [@Synchronized] … Alle diese Werkzeuge behandeln wir in diesem Kapitel.
Threads sind jedoch nicht Kotlins letztes Wort zur nebenläufigen Programmierung: Seine native Lösung für Asynchronität sind Coroutinen, die in Kapitel 9 vorgestellt werden. Sie basieren auf Threads, und alles, was wir hier behandeln (kritische Abschnitte, Sichtbarkeit von Schreibzugriffen, Deadlocks usw.), bleibt wesentlich, um sie vollständig zu verstehen.
Die Beispiele befinden sich im Gradle-Projekt [08-threads]. Jedes Programm ist eine Datei in einem Paket mit seinem Namen ([threads01/Threads01.kt] im Paket [threads01] …) und wird mit [gradlew -q run -Pmain=threads01.Threads01Kt] oder über das grüne Dreieck in IntelliJ IDEA ausgeführt. Programmargumente werden mit der Option [--args] an Gradle übergeben: [gradlew -q run -Pmain=threads08.Threads08Kt --args="5"].
Ein Wort der Vorsicht vorab: Die Ergebnisse eines Multithreading-Programms unterscheiden sich von einem Lauf zum nächsten. Die Reihenfolge, in der Threads Zugriff auf den Prozessor erhalten, hängt vom Betriebssystem, von der Anzahl der Prozessoren und von der Auslastung des Rechners ab. Die in diesem Kapitel wiedergegebenen Ergebnisse wurden auf einem Linux-Rechner mit zwei Prozessoren gewonnen, der mit anderen sehr aktiven Programmen geteilt wurde. Wenn Sie die Beispiele ausführen, erhalten Sie ähnliche Ergebnisse, die aber selten identisch sein werden. Wir geben jeweils an, was reproduzierbar ist und was nicht.
8.1. Die Klasse Thread
Wenn eine Anwendung gestartet wird, läuft sie in einem Ausführungsfluss, einem Thread. Die Klasse, die einen Thread modelliert, ist die Klasse [java.lang.Thread] im JDK-Paket. Beachten Sie, dass Kotlin die Java-Accessoren [getXxx()] / [setXxx(…)] (und [isXxx()] für einen Boolean) als Eigenschaften darstellt: Wir schreiben [thread.name = "Main"] statt [thread.setName("Main")]. Die wichtigsten Konstruktoren, Eigenschaften und Methoden der Klasse sind die folgenden:
Mitglied | Rolle |
[Thread(task: Runnable)], [Thread(task: Runnable, name: String)] | erzeugt einen Thread, der die Methode [run] von [task] ausführt. [Runnable] ist das Java-Interface [void run()]: Dank der SAM-Konvertierung (Kapitel 7) kann man ihm ein Lambda [{ … }] oder eine Funktionsreferenz [::f] übergeben |
[thread(start, isDaemon, name, …) { … }] | (Kotlin-Bibliothek, Paket [kotlin.concurrent]) erzeugt einen Thread, der das Lambda ausführt, konfiguriert ihn mit benannten Argumenten und startet ihn standardmäßig sofort |
[Thread.ofPlatform()], [Thread.ofVirtual()] | (Java 21) liefern einen „Builder“ für Plattform-Threads oder virtuelle Threads, der konfiguriert werden kann (Name, Daemon usw.), bevor der Thread erzeugt wird |
[Thread.currentThread()] | der Thread, der den Code ausführt, der diese Methode aufgerufen hat |
[name] | der Name des Threads (eine veränderbare Eigenschaft), nützlich für die Nachverfolgung |
[threadId()] | (Java 19) eine eindeutige numerische Kennung des Threads vom Typ [Long]; sie ersetzt [getId()], das veraltet ist |
[isDaemon] | gibt an (unveränderlich), ob der Thread ein Daemon-Thread ist (siehe unten) |
[priority] | die Priorität des Threads, von 1 ([MIN_PRIORITY]) bis 10 ([MAX_PRIORITY]), wobei 5 ([NORM_PRIORITY]) der Standardwert ist |
[state], [isAlive] | Zustand des Threads ([NEW], [RUNNABLE], [BLOCKED], [WAITING], [TIMED_WAITING], [TERMINATED]); [isAlive] gibt an, ob er gestartet wurde und noch nicht beendet ist (schreibgeschützt) |
[isVirtual] | (Java 21) gibt an, ob der Thread ein virtueller Thread ist (schreibgeschützt) |
[start()] | Startet den Thread |
[join()], [join(duration: Duration): Boolean] | Der Thread T1, der [T2.join()] ausführt, ist blockiert, bis der Thread T2 beendet ist. Die zweite Form (Java 19) begrenzt die Wartezeit und gibt an, ob T2 beendet ist |
[Thread.sleep(ms: Long)], [Thread.sleep(d: Duration)] | der Thread, der die Methode ausführt, wird für [ms] Millisekunden (für die Dauer [d]) ausgesetzt. Er verliert die CPU, die einem anderen Thread zugeteilt wird |
[interrupt()], [isInterrupted] | fordert den Thread zur Unterbrechung auf; prüft, ob eine Unterbrechung angefordert wurde (siehe unten) |
Die Methoden [join] und [sleep] lösen die Exception [InterruptedException] aus, wenn der Thread während des Wartens unterbrochen wird. In Java ist dies eine geprüfte Exception (Checked Exception), die behandelt oder in einer [throws]-Klausel deklariert werden muss. Kotlin kennt keine geprüften Exceptions (Kapitel 3): Der Compiler erzwingt nichts. Das bedeutet nicht, dass man ignorieren darf, was diese Exception bedeutet: Darauf gehen wir im Abschnitt über das Unterbrechen von Threads ein.
Die Klasse [Thread] besitzt außerdem eine Methode [stop], die einen Thread zwangsweise beendete. Sie ist seit Java 1.2 veraltet und löst seit Java 20 lediglich die Exception [UnsupportedOperationException] aus: Das abrupte Anhalten eines Threads könnte die von ihm bearbeiteten Daten in einem inkonsistenten Zustand hinterlassen. Heute bitten wir einen Thread, sich kooperativ zu beenden, indem wir ihn unterbrechen: Das sehen wir uns etwas später an.
Hier eine erste Anwendung, die die Existenz eines Haupt-Ausführungsthreads zeigt – desjenigen, der die Funktion [main] ausführt. Das Programm [Threads01.kt] lautet wie folgt:
Ergebnisse:
Kommentare:
- Zeile 9: Es wird eine Referenz auf den Thread abgerufen, der das Programm ausführt;
- Zeilen 11–14: Wir zeigen seinen Namen an, ändern ihn (eine einfache Zuweisung an die Eigenschaft [name], die die Java-Methode [setName] aufruft) und zeigen ihn dann erneut an. Anfangs heißt der Haupt-Thread [main] (Zeile 1 der Ergebnisse): Der Java-Launcher hat ihm diesen Namen zugewiesen;
- Zeilen 15–22: einige Eigenschaften des Threads. Bei dieser Ausführung hat der Haupt-Thread die ID 3: Die virtuelle Maschine erzeugt vor der Ausführung von [main] einige Threads für ihre eigenen Zwecke, und diese ID kann sich von einer Java-Version zur anderen unterscheiden. Es ist weder ein Daemon-Thread ([isDaemon] hat den Wert [false]) noch ein virtueller Thread (diese beiden Begriffe besprechen wir später); seine Priorität ist die normale Priorität 5; er läuft gerade ([RUNNABLE]). Die Methode [toString] des Threads, aufgerufen durch das Template ["$main"] (Zeile 21), zeigt seine ID, seinen Namen, seine Priorität und den Namen seiner Thread-Gruppe ([main]) an;
- Zeile 22: Der Rechner, auf dem das Beispiel ausgeführt wurde, hat 2 Prozessoren;
- Zeilen 26–29: eine Schleife, die jede Sekunde eine Meldung ausgibt. [Thread.sleep(1000)] hält den Haupt-Thread für eine Sekunde an. In Java musste die Funktion [main] die geprüfte Exception [InterruptedException] in einer [throws]-Klausel deklarieren; in Kotlin ist das nicht erforderlich. Beachten Sie das Format [HH:mm:ss] (Stunden von 0 bis 23): Das Format [hh] würde Stunden von 1 bis 12 anzeigen.
8.2. Ausführungsthreads erzeugen
Es sind Anwendungen möglich, in denen Codeabschnitte „gleichzeitig“ in verschiedenen Ausführungsthreads laufen. Hat der Rechner weniger Prozessoren als ausführbereite Threads, teilen sich die Threads die Prozessoren: Jeder erhält sie der Reihe nach für einen kurzen Moment (einige Millisekunden). Auf einem Mehrprozessorrechner laufen mehrere Threads tatsächlich gleichzeitig. Die einem Thread zugeteilte Zeit hängt von verschiedenen Faktoren ab, darunter seine Priorität, die einen Standardwert hat, aber programmatisch festgelegt werden kann (Eigenschaft [priority]); dies ist lediglich ein Richtwert, den das Betriebssystem ignorieren darf (Linux ignoriert ihn standardmäßig). Ein Thread, der Zugriff auf den Prozessor hat, kann ihn vorzeitig freigeben:
- indem er auf ein Ereignis wartet (Beendigung eines anderen Threads mit [join], Warten auf ein Signal);
- indem er für eine festgelegte Dauer in einen Ruhezustand wechselt ([sleep]).
Ein Thread T wird zunächst erzeugt, zum Beispiel durch den Konstruktor [Thread(task, name)], wobei [task] ein Objekt ist, das das Java-Interface [Runnable] implementiert, dessen einzige Methode [void run()] ist. Mithilfe der in Kapitel 7 beschriebenen SAM-Konvertierung wird ein Lambda oder eine Funktionsreferenz vom Typ [() -> Unit] anstelle eines [Runnable] übergeben. In älterem Code begegnen uns auch von [Thread] abgeleitete Klassen, die dessen Methode [run] überschreiben: Das wird nicht empfohlen, da es die auszuführende Aufgabe mit den Mitteln ihrer Ausführung vermischt.
Das Erzeugen eines Threads startet ihn nicht:
- die Ausführung des Threads T wird durch [T.start()] gestartet: Die Methode [run] der Aufgabe, die dem Konstruktor von T übergeben wurde, wird dann vom Thread T ausgeführt. Der Code, der die Anweisung [T.start()] ausführt, wartet nicht auf das Ende von Thread T: Er geht sofort zur nächsten Anweisung über. Nun laufen zwei Threads parallel. Sie müssen oft miteinander kommunizieren, um den Fortschritt der gemeinsamen Arbeit zu verfolgen: Das ist das Problem der Thread-Synchronisierung;
- Einmal gestartet, läuft Thread T eigenständig. Er endet, wenn die von ihm ausgeführte Funktion beendet ist;
- wir können mit [T.join()] auf das Ende seiner Ausführung warten. Das ist eine blockierende Anweisung: Der Thread, der sie ausführt, ist blockiert, bis Thread T seine Arbeit beendet hat. Das ist eine grundlegende Synchronisierungsmethode.
Das Programm [Threads02.kt] lautet wie folgt:
Kommentare:
- Zeile 9: Der Haupt-Thread erhält einen Namen;
- Zeilen 12–14: Es werden 5 Threads erzeugt. Die Funktion [Array(5) { i -> … }] erzeugt ein Array mit 5 Elementen, wobei Element i der vom Lambda zurückgegebene Wert ist. Die Referenzen auf die Threads werden so in einem Array gespeichert, damit sie später abgerufen werden können. Jeder Thread führt die Funktion [display] in den Zeilen 26–33 aus;
- Zeile 14: Die Funktionsreferenz [::display] vom Typ [() -> Unit] wird automatisch in ein Objekt [Runnable] konvertiert: Die Funktion [display] hat keine Parameter und gibt kein Ergebnis zurück, genau wie [run]. In Java hätte man in einer kompakten Quelldatei [this::display] schreiben müssen; in Kotlin ist [display] eine Top-Level-Funktion, die einfach als [::display] bezeichnet wird. Der zweite Parameter des Konstruktors ist der Thread-Name;
- Zeilen 17–18: Die Threads werden gestartet. Diese Operation ist nicht blockierend: Thread Nr. i läuft parallel zum Haupt-Thread, der ihn gestartet hat;
- Zeile 22: Der Haupt-Thread erreicht das Ende des Programms;
- Zeilen 26–33: Die Funktion [display] zeigt den Namen und die ID des Threads an, der sie ausführt, sowie die Start- und Endzeit (auf die Millisekunde genau) der Ausführung;
- Zeile 32: Jeder Thread, der die Funktion [display] ausführt, pausiert für 1 Sekunde. Der Prozessor wird dann an einen anderen, auf den Prozessor wartenden Thread übergeben. Nach Ablauf der 1-Sekunden-Pause kann der pausierte Thread den Prozessor wieder erhalten. Er bekommt ihn, wenn er an der Reihe ist;
- Zeilen 37–42: Die Funktion [sleep] kapselt [Thread.sleep]. Der Kotlin-Compiler verlangt nicht, die Exception [InterruptedException] abzufangen, die [sleep] auslösen kann. Ließe man sie jedoch aus der von einem Thread ausgeführten Funktion entweichen, würde sie diesen Thread mit einer Fehlermeldung auf der Konsole beenden. Die Funktion [sleep] fängt sie daher ab und setzt das Interrupt-Flag des Threads zurück (Zeile 42); wir erklären diese Aktion im Abschnitt über Unterbrechungen. Der Name [_], der dem Parameter der Klausel [catch] gegeben wird, zeigt an, dass dieser Parameter nicht verwendet wird. Dieser kleinen Funktion begegnen wir in den meisten Programmen dieses Kapitels;
- Zeile 47: Die Funktion [time], als Ausdruck geschrieben ([= …]), gibt die aktuelle Uhrzeit im Format [HH:mm:ss.SSS] zurück ([SSS]: Millisekunden).
Ergebnisse:
Diese Ergebnisse sind sehr aufschlussreich:
- Erstens sehen wir, dass das Starten eines Threads nicht blockierend ist. Der Haupt-Thread hat 5 Threads gestartet und das Ende des Programms erreicht (Zeile 5), obwohl Thread 2 seine erste Meldung noch nicht angezeigt hatte;
- die Ausführungsreihenfolge der Threads ist unvorhersehbar: In diesem Lauf haben die Threads 3 und 4 ihre Startmeldungen vor Thread 0 angezeigt. Das Betriebssystem hat hier 6 Threads und 2 Prozessoren; es teilt die Prozessoren diesen Threads nach seinen eigenen Regeln zu;
- Wir stellen außerdem fest, dass die Reihenfolge der Ausgaben nicht immer der Reihenfolge der angezeigten Zeiten folgt: Der Haupt-Thread hat sein Ende um 14.490 angezeigt, nach Meldungen mit den Zeitstempeln 14.491 und 14.492. Die Zeit wird vor der Ausgabe berechnet, und in der Zwischenzeit kann ein anderer Thread auf die Konsole geschrieben haben. [println] (das [System.out.println] aufruft) ist threadsicher: Zwei von zwei Threads geschriebene Zeilen vermischen sich nicht, ihre Reihenfolge ist jedoch nicht garantiert;
- die IDs der erzeugten Threads (21 bis 25) zeigen, dass die virtuelle Maschine bereits etwa zwanzig Threads für ihre eigenen Zwecke erzeugt hatte (Garbage Collection, Just-in-Time-Compiler usw.);
- Jeder Thread pausiert mit [sleep] eine Sekunde und beendet dann die Ausführung der Funktion [display];
- Schließlich wurde das Programm nicht beendet, als der Haupt-Thread seine Arbeit abgeschlossen hatte: Die virtuelle Maschine wartete auf das Ende aller fünf Threads. Das liegt daran, dass diese Threads keine Daemon-Threads sind: Die virtuelle Java-Maschine wird beendet, wenn alle ihre Nicht-Daemon-Threads beendet sind.
Umgekehrt kann ein Thread als Daemon-Thread deklariert werden, indem man vor dem Start seine Eigenschaft [isDaemon] auf [true] setzt. Daemon-Threads sind Dienst-Threads, die das Beenden der virtuellen Maschine nicht verhindern: Wenn der letzte Nicht-Daemon-Thread endet, werden sie angehalten. Das Programm [Threads03.kt] erzeugt sie mithilfe der Funktion [thread] aus der Kotlin-Bibliothek:
Kommentare:
- Zeile 6: Die Funktion [thread] gehört zum Paket [kotlin.concurrent] der Standardbibliothek; sie muss importiert werden;
- Zeilen 13–16: Die Funktion [thread(…) { … }] erzeugt einen Thread, der den auf die Klammern folgenden Lambda-Ausdruck ausführt (die Syntax des „abschließenden Lambdas“, Kapitel 7). Alle ihre übrigen Parameter haben Standardwerte; die benötigten werden über benannte Argumente gesetzt: hier [isDaemon = true] und [name = "$i"]. Ihre Signatur lautet wie folgt: [fun thread(start: Boolean = true, isDaemon: Boolean = false, contextClassLoader: ClassLoader? = null, name: String? = null, priority: Int = -1, block: () -> Unit): Thread]. Standardmäßig ([start = true]) wird der Thread sofort gestartet; die Funktion gibt den erzeugten Thread zurück. Sie ist ein nützlicher Ersatz für die Java-Sequenz [var t = new Thread(…); t.setDaemon(true); t.start();]. Der Bereich [0..<5] (ganze Zahlen von 0 bis 4) entspricht [0 until 5];
- Zeile 21: Der Haupt-Thread wartet 100 ms, um den Threads Zeit zum Starten zu geben, und beendet sich dann.
Ergebnisse:
Alle 5 Threads haben die Ausführung begonnen, dann endete der Haupt-Thread (Zeile 6). Beachten Sie, dass seine Meldung mit dem Zeitstempel 15.819 nach den Meldungen mit den Zeitstempeln 15.827 bis 15.833 angezeigt wird: Er hatte die Zeit berechnet, bevor die anderen Threads etwas geschrieben haben. Die Daemon-Threads wurden dann während ihrer einsekündigen Ruhephase angehalten: Es werden keine Endmeldungen angezeigt. Auf einem stark ausgelasteten Rechner haben manche Threads nicht einmal Zeit, ihre Startmeldungen anzuzeigen, da 100 ms nicht genügen, damit sie den Prozessor erhalten: Ein anderer Lauf kann daher eine andere Anzahl von Startmeldungen ergeben, aber niemals Endmeldungen. Denselben Effekt erzielt man, wenn man [main] mit [exitProcess(0)] (Paket [kotlin.system], das [System.exit(0)] aufruft) beendet, was die virtuelle Maschine und damit alle Threads der Anwendung herunterfährt, ob Daemons oder nicht. Virtuelle Threads, die wir später besprechen, sind immer Daemon-Threads.
Will der Haupt-Thread auf das Ende der von ihm erzeugten Threads warten, verwendet er die Methode [join]. Das Programm [Threads04.kt] zeigt außerdem, wie man einen Thread eine Funktion mit Parametern ausführen lässt:
Kommentare:
- Zeilen 13–15: Die Funktion [map] wandelt den Bereich [0..<5] in eine Liste von 5 Threads um, die von der Funktion [thread] erzeugt und gestartet werden. [tasks] hat den Typ [List<Thread>];
- Zeile 15: Der Thread führt das Lambda [{ display(i, 1000L + 100 * i) }] aus. Diese Syntax erlaubt den Aufruf einer Funktion mit typisierten Parametern (hier ein [Int] und ein [Long]), während [run] keine hat;
- das Lambda verwendet direkt den Parameter [i] des Lambdas [map]. In Java hätte man eine Kopie der Schleifenvariablen verwenden müssen ([int number = i;]), da ein Java-Lambda nur Variablen verwenden kann, die effektiv final sind, und die Schleifenvariable [i] einer [for (int i = 0; …; i++)] -Schleife verändert wird. In Kotlin stellt sich dieses Problem hier nicht: [i] ist ein Parameter und damit unveränderlich, und dasselbe gilt für die Schleifenvariable [for (i in 0..<5)], die in jeder Iteration eine neue [val]-Variable ist. Kotlin erlaubt es einem Lambda auch, eine Variable [var] zu erfassen und zu verändern (Kapitel 7); eine von mehreren Threads gemeinsam genutzte Variable [var] wirft jedoch Probleme des gleichzeitigen Zugriffs auf, die wir später untersuchen. Die Falle, die wir vermieden haben, ist ein Klassiker: Ein Thread, der spät startet, darf nicht den Wert von [i] aus einer späteren Iteration lesen;
- Zeilen 19–21: Der Haupt-Thread wartet auf jeden der Threads. Er wird zuerst blockiert, bis Thread 0 fertig ist, dann bis Thread 1 usw. Wenn er die Schleife verlässt, sind die 5 von ihm gestarteten Threads beendet;
- Zeile 32: Die Aufgabe Nr. i schläft 1.000 + 100 × i Millisekunden, sodass die Threads in einer bekannten Reihenfolge enden.
Ergebnisse:
Die Startmeldungen erscheinen in beliebiger Reihenfolge, die Endmeldungen dagegen in numerischer Reihenfolge, da die Ruhezeiten aufsteigend sind: Dieser Teil des Ergebnisses ist reproduzierbar. Die letzte Zeile zeigt, dass der Haupt-Thread nach den von ihm gestarteten Threads endete, und zwar in dem Moment, in dem der letzte von ihnen endete.
8.3. Einen Thread anhalten: die Unterbrechung
Wie hält man einen Thread an, bevor er seine Arbeit beendet hat, zum Beispiel wenn der Benutzer einen lang laufenden Vorgang abbricht? Die JVM erlaubt es nicht, einen Thread abzuschießen; sie stellt einen kooperativen Mechanismus namens Unterbrechung bereit:
- Jeder Thread hat ein Interrupt-Flag, einen Boolean, der anfangs auf [false] gesetzt ist;
- Ein Thread namens T1, der den Thread T2 beenden möchte, ruft [T2.interrupt()] auf. Dadurch wird das Interrupt-Flag von T2 gesetzt. Das ist eine Aufforderung zur Beendigung: T2 wird nicht beendet; es ist Sache dieses Threads zu entscheiden, wann und wie er sich beendet, damit seine Daten in einem konsistenten Zustand bleiben;
- wenn T2 in einer Wartemethode blockiert ist ([sleep], [join], [wait] und die meisten blockierenden Methoden in [java.util.concurrent]), wird er aufgeweckt: Die Methode löst die Exception [InterruptedException] aus, und das Interrupt-Flag wird auf [false] zurückgesetzt;
- Wenn T2 Berechnungen durchführt, ohne jemals zu warten, muss er sein eigenes Flag mit [Thread.currentThread().isInterrupted] in regelmäßigen Abständen prüfen.
In Java deklarieren blockierende Methoden die geprüfte Ausnahme [InterruptedException]: Der Compiler verlangt vom Programmierer, zu entscheiden, was mit einer Stoppanforderung geschehen soll. Kotlin verlangt dies nicht, die Entscheidung muss aber trotzdem getroffen werden, und sie bleibt dieselbe. Es gibt zwei korrekte Reaktionen: die Ausnahme an den Aufrufer weiterreichen oder sie abfangen und die Aufgabe sauber beenden. Wenn keine der beiden Möglichkeiten besteht, wie in der Funktion [sleep] des Programms [Threads02.kt], wird das Flag über [Thread.currentThread().interrupt()] zurückgesetzt, damit der aufrufende Code die Anforderung weiterhin erkennen kann. Die einzige falsche Reaktion besteht darin, die Ausnahme zu ignorieren. Das Programm [Threads05.kt] zeigt alle drei Fälle:
Kommentare:
- Zeilen 10–21: Der Thread [sleeper] wird durch einen plattformspezifischen Thread-Builder erstellt und gestartet, [Thread.ofPlatform().name("sleeper")], dessen Methode [start] das auszuführende Lambda erhält (diese Builder stellen wir mit dem Programm [Threads06.kt] vor). Er verbringt die meiste Zeit in [Thread.sleep]. Die Schleife [while (true)] hat keine Abbruchbedingung: Es ist die Ausnahme [InterruptedException], die von [sleep] ausgelöst wird, wenn der Thread unterbrochen wird, und die die Schleife verlassen lässt (Zeile 19). Das Lambda ist eine [try]-Anweisung, die die gesamte Arbeit des Threads umschließt: Beim Empfang der Ausnahme gibt der Thread eine Meldung aus und endet dann;
- Zeilen 25–31: Der Thread [calculator] wartet nie. Er prüft sein Unterbrechungs-Flag bei jedem Schleifendurchlauf (Zeile 28). Die Java-Methode [isInterrupted()] wird von Kotlin als Boolean-Eigenschaft [isInterrupted] behandelt. Die Anzahl der Durchläufe wird mit der Kotlin-String-Funktion [format] ausgegeben, die die Formate von [String.format] verwendet: [%,d] gibt eine ganze Zahl mit dem Tausendertrennzeichen der aktuellen Sprache aus;
- Zeilen 34–40: Der Thread [deaf] fängt [InterruptedException] ab und macht weiter, als wäre nichts geschehen. Die Stoppanforderung geht verloren: Das ist der Fehler, den es zu vermeiden gilt. Es ist ein Daemon-Thread ([daemon()]), sodass das Programm enden kann, ohne auf ihn zu warten;
- Zeile 46: Der Haupt-Thread lässt die anderen Threads eine Sekunde lang laufen;
- Zeilen 48–50: Er fordert die drei Threads zum Stoppen auf;
- Zeilen 52–54: Er wartet höchstens eine Sekunde lang auf das Ende jedes Threads. Die Methode [join(Duration)] (Java 19) liefert [true] , wenn der Thread innerhalb dieser Zeit beendet wurde, und [false] andernfalls. [Duration.ofSeconds(1)] steht für eine Dauer von einer Sekunde (Klasse [java.time.Duration]).
Ergebnisse:
Die Threads [sleeper] und [calculator] endeten wenige Millisekunden nach der Anforderung; der Thread [deaf] ignorierte sie und war eine Sekunde später noch nicht beendet ([false], letzte Zeile). Die Anzahl der Durchläufe des Calculators schwankt von einem Lauf zum nächsten stark, je nach der ihm zugeteilten CPU-Zeit; der Rest des Ergebnisses ist reproduzierbar, bei den Zeilen 4 bis 6 bis auf eine Größenordnung.
Eine Unterbrechung ist der Mechanismus, der die gesamte Java-Bibliothek durchzieht: Wir werden später sehen, dass die Methode [cancel] einer Aufgabe ([Future]) und das abrupte Schließen eines Thread-Pools ([shutdownNow]) die betroffenen Threads unterbrechen. Die in Kapitel 9 behandelten Coroutinen haben einen eigenen Mechanismus – die Abbruchsteuerung (Cancellation), die ebenfalls kooperativ ist – sowie weitere Möglichkeiten, einen Vorgang zu beenden, etwa Timeouts.
8.4. Virtuelle Threads
Die bisher erstellten Threads sind Plattform-Threads: Jeder von ihnen ist eine Hülle um einen Betriebssystem-Thread, den er während seiner gesamten Lebensdauer belegt. Ein Betriebssystem-Thread ist eine teure Ressource: Seine Erstellung braucht Zeit, sein Stack reserviert Speicher (in der Größenordnung eines Megabytes), und das System kann nicht effizient mehr als einige Tausend davon verwalten. Ein Server, der jedem Client einen Thread zuweist (siehe das Diagramm im folgenden Abschnitt), verbringt jedoch die meiste Zeit mit Warten: auf die Antwort einer Datenbank, auf die nächste Anfrage des Clients … Während dieser Wartezeiten ist der System-Thread blockiert und nicht nutzbar.
Java 21 führte virtuelle Threads (JEP 444) ein, die in Kotlin unverändert verwendet werden können. Ein virtueller Thread ist ein [Thread]-Objekt wie jedes andere, wird aber von der Java Virtual Machine und nicht vom Betriebssystem verwaltet:
- Zur Ausführung wird ein virtueller Thread auf einem Plattform-Thread eingebunden (mounted), dem sogenannten „Carrier-Thread“. Die Carrier-Threads bilden einen kleinen Pool, dessen Größe standardmäßig der Anzahl der Prozessoren entspricht;
- wenn ein virtueller Thread blockiert ([sleep], Warten auf Netzwerk-E/A, eine Sperre, eine blockierende Warteschlange usw.), wird er ausgebunden (unmounted): Sein Stack wird im Speicher der virtuellen Maschine abgelegt, und der Carrier-Thread steht sofort für einen anderen virtuellen Thread zur Verfügung. Wenn die Wartezeit endet, wird der virtuelle Thread wieder an einen Carrier-Thread gebunden – nicht unbedingt an denselben;
- Ein virtueller Thread belegt einige Hundert Byte: Es lassen sich Millionen davon erstellen.
Kotlin-Coroutinen (Kapitel 9) beruhen auf einer ähnlichen Idee – einen wartenden Vorgang anzuhalten, ohne einen System-Thread zu blockieren –, werden aber vom Kotlin-Compiler und nicht von der virtuellen Maschine umgesetzt. Beide Ansätze vergleichen wir in Kapitel 9.
Das Programm [Threads06.kt] vergleicht den Start von 10.000 Plattform-Threads und 10.000 virtuellen Threads, die jeweils eine Sekunde lang schlafen:
Kommentare:
- Zeilen 7–8: Die Funktion [measure] wird zweimal aufgerufen – zuerst mit einem Plattform-Thread-Builder ([Thread.ofPlatform()]) und dann mit einem Builder für virtuelle Threads ([Thread.ofVirtual()]). Beide Builder haben den gemeinsamen Typ [Thread.Builder]; der übrige Code ist identisch. Ein Builder wird durch verkettete Aufrufe konfiguriert: [name("virtual")] legt den Namen des Threads fest; [name("", 0)] würde Threads anfordern, deren Namen aus einem Präfix gefolgt von einer bei 0 beginnenden Nummer bestehen; [daemon()] (nur für Plattform-Threads) fordert Daemon-Threads an. Seine Methode [start(Runnable)] erstellt einen Thread und startet ihn sofort; seine Methode [unstarted(Runnable)] erstellt ihn, ohne ihn zu starten;
- Zeilen 21–26: Die Funktion [measure] startet [nbThreads] Threads, die eine Sekunde lang schlafen, wartet auf ihr Ende und gibt die Gesamtdauer aus. Die Funktion [List(n) { … }] erzeugt die Liste der Threads, die von [builder.start { … }] erstellt und gestartet werden (ein Lambda, das in [Runnable] umgewandelt wird). Die Methode [System.nanoTime()] liefert eine Zeit in Nanosekunden, die ausschließlich zur Messung von Dauern dient;
- Zeilen 11–14: Ein virtueller Thread mit dem Namen [virtual] gibt vor und nach einer Schlafphase seine Textdarstellung aus;
- Zeile 17: Ein virtueller Thread ist immer ein Daemon-Thread.
Ergebnisse:
- 10.000 Plattform-Threads brauchten mehrere Sekunden für etwas, das eine Sekunde hätte dauern sollen: Das Erstellen der System-Threads und die Verwaltung ihrer Stacks waren sehr kostspielig. Mit 100.000 Threads würde das Programm wahrscheinlich wegen Speichermangels oder fehlender System-Threads scheitern;
- 10.000 virtuelle Threads erledigten dieselbe Aufgabe in knapp über einer Sekunde: Solange sie schliefen, belegten sie keine System-Threads. Die genauen Zeiten schwanken von Lauf zu Lauf, aber der Unterschied zwischen den beiden Thread-Arten ist reproduzierbar;
- die Textdarstellung eines virtuellen Threads ([VirtualThread[#…,virtual]]) gibt nach dem Zeichen [@] den Carrier-Thread an, auf dem er eingebunden ist: ein Thread aus dem Pool [ForkJoinPool-1], auf den wir später zurückkommen. In dieser Ausführung ging der virtuelle Thread auf dem Carrier [worker-2] schlafen und setzte seine Ausführung auf dem Carrier [worker-1] fort: Er wurde also tatsächlich ausgebunden und dann auf einem anderen Carrier wieder eingebunden (das hängt von der Ausführung ab).
Virtuelle Threads machen Berechnungen nicht schneller: Eine Berechnung, die den Prozessor ununterbrochen beschäftigt, ohne je zu warten, läuft in einem virtuellen Thread nicht schneller als in einem Plattform-Thread, und die Anzahl gleichzeitiger Berechnungen bleibt durch die Anzahl der Prozessoren begrenzt. Ihr Nutzen liegt darin, dass sich jeder Aufgabe, die die meiste Zeit mit Warten verbringt, ohne Kostenbedenken ein eigener Thread zuweisen lässt: Das ist bei Servern der Fall, im folgenden Abschnitt sowie in den Kapiteln 12 und 13. Alles, was wir zur Thread-Synchronisierung behandeln, gilt gleichermaßen für virtuelle Threads und Plattform-Threads.
8.5. Der Nutzen von Threads
Nachdem wir auf die Existenz eines Standard-Threads hingewiesen haben – desjenigen, der die Funktion [main] ausführt – und wissen, wie man weitere erstellt, wollen wir uns den Nutzen von Threads genauer ansehen. Sie haben zwei Hauptverwendungszwecke:
- alle Prozessoren der Maschine für eine zeitaufwendige Berechnung zu nutzen: Die Arbeit wird in Teile zerlegt, die verschiedenen Threads zugewiesen werden. Das tun wir mit parallelen Streams und dem [Fork/Join]-Framework am Ende dieses Kapitels;
- mehrere Aufgaben gleichzeitig auszuführen, insbesondere wenn einige davon hauptsächlich aus Warten bestehen (auf eine Netzwerkantwort, einen Lesezugriff auf die Festplatte oder eine Benutzereingabe). Das ist bei Client-Server-Internetanwendungen der Fall, die wir in Kapitel 12 behandeln.
In einer Client-Server-Internetanwendung antwortet ein Server auf einer Maschine S1 auf Anfragen von Clients auf entfernten Maschinen C1, C2, …, Cn:
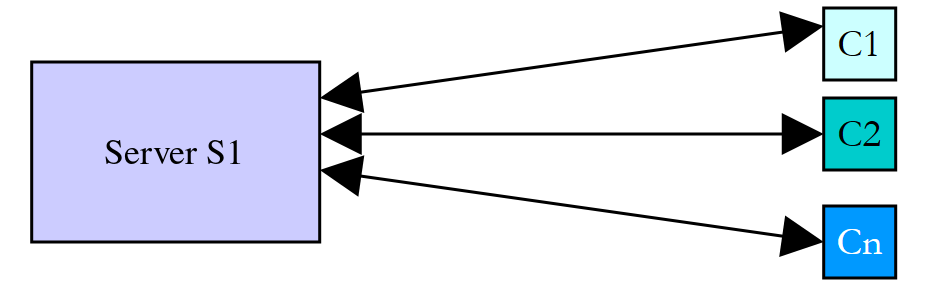
Wir nutzen jeden Tag Internetanwendungen, die diesem Muster folgen: Webservices, E-Mail, Dateiübertragungen usw. Im obigen Diagramm muss der Server S1 die Clients Ci gleichzeitig bedienen. Nehmen wir das Beispiel eines Dateiservers: Wir wissen, dass eine Übertragung mitunter mehrere Minuten dauern kann. Es kommt nicht infrage, dass ein einzelner Client den Server so lange blockiert. Eine übliche Lösung besteht darin, dass der Server so viele Ausführungs-Threads erstellt, wie es Clients gibt. Jeder Thread ist dann für die Bearbeitung eines bestimmten Clients zuständig:
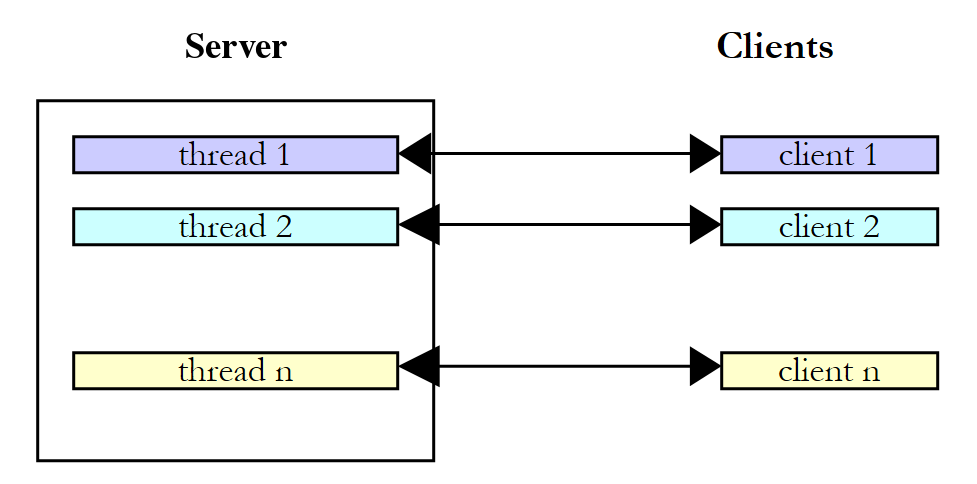
Bei Plattform-Threads verwendet der Server praktisch einen Thread-Pool – dazu später mehr –, dessen begrenzte Thread-Anzahl die Zahl der gleichzeitig bedienten Clients nach oben begrenzt. Mit virtuellen Threads wird das obige Schema wieder zur optimalen Lösung: ein virtueller Thread pro Client, selbst bei Zehntausenden von Clients, da ein wartender Client keinen System-Thread belegt. Das unterstützen JVM-Webserver wie Tomcat – den wir in Kapitel 13 verwenden werden – inzwischen. In Kotlin bieten die in Kapitel 9 behandelten Coroutinen eine weitere Lösung für dasselbe Problem: eine Coroutine pro Client.
8.6. Informationen zwischen Threads austauschen
In den bisherigen Beispielen führten Threads eine Funktion ohne Parameter oder ein Lambda aus, das eine Funktion mit Parametern aufrief. Da die Methode [run] von [Runnable] weder Parameter noch einen Rückgabewert hat, übergibt das Lambda dem gestarteten Thread Informationen: Es erfasst die Variablen, die es benötigt. Verweist die erfasste Variable auf ein Objekt, kann der gestartete Thread darin auch Ergebnisse ablegen, die der startende Thread liest. Das Programm [Threads07.kt] lautet wie folgt:
Kommentare:
- Zeilen 10–16: Die mit jedem Thread ausgetauschte Information ist ein [Data]-Objekt. Zwischen dem startenden und dem gestarteten Thread findet ein wechselseitiger Informationsaustausch statt. [start] und [duration] sind Eigenschaften vom Typ [val] , die im primären Konstruktor deklariert sind: Sie werden bei der Erstellung des Objekts ein für alle Mal festgelegt:
- [start]: die Startzeit der Ausführung des Threads, vom startenden Thread festgelegt;
- [duration]: Dauer des Schlafs des gestarteten Threads in Sekunden, vom startenden Thread festgelegt;
- [end]: die Endzeit der Ausführung des Threads, vom gestarteten Thread festgelegt. Dies ist eine [lateinit var]-Eigenschaft (Kapitel 4): Sie hat bei der Erstellung des Objekts keinen Wert, ist aber nicht vom Typ [LocalTime?]. Ein Lesezugriff vor der Zuweisung würde die Ausnahme [UninitializedPropertyAccessException] auslösen. Die entsprechende Java-Klasse war einschließlich ihrer Accessoren fast dreißig Zeilen lang;
- Zeilen 28–29: Ein [Data]-Objekt wird erstellt und der Liste [data] hinzugefügt;
- Zeile 31: Das Lambda [{ sleep(d) }] erfasst die Variable [d]: Der gestartete Thread führt die Funktion [sleep] aus den Zeilen 49–57 mit dem Objekt [d] als Parameter aus. Der Operator [+=] fügt den von der Funktion [thread] gelieferten Thread der veränderlichen Liste [tasks] hinzu;
- Zeilen 36–42: Der Haupt-Thread wartet auf das Ende jedes von ihm gestarteten Threads, ruft dann das [Data]-Objekt des Threads ab und gibt dessen Inhalt aus. Die Funktion [zip] kombiniert die beiden Listen zu einer Liste von Paaren ([Pair<Thread, Data>]), die die Schleife [for] in [(task, d)] zerlegt. Die tatsächliche Dauer wird von [Duration.between(d.start, d.end)] berechnet;
- Zeile 52: Die Eigenschaft [duration] des Parameters legt die Schlafdauer fest;
- Zeile 57: Die Eigenschaft [end] des Parameters wird befüllt.
Ergebnisse:
Dieses Beispiel zeigt, dass zwei Threads Informationen austauschen können:
- Der aufrufende Thread kann die Ausführung des aufgerufenen Threads steuern, indem er ihm Informationen übergibt;
- Der gestartete Thread kann dem startenden Thread Ergebnisse zurückgeben.
Damit der startende Thread weiß, wann die erwarteten Ergebnisse verfügbar sind, muss er benachrichtigt werden, wenn der gestartete Thread beendet ist. Hier hat er mit der Methode [join] auf das Ende des Threads gewartet. Dabei geht es nicht nur um den Zeitablauf: Wir werden im Abschnitt über die Annotation [@Volatile] sehen, dass ein Schreibvorgang eines Threads für einen anderen nicht zwangsläufig sichtbar ist. Das Java-Speichermodell, das für jedes von der JVM ausgeführte Programm – und damit auch für Kotlin-Programme – gilt, garantiert, dass alles, was ein Thread geschrieben hat, für den Thread sichtbar ist, der mit [join] auf sein Ende gewartet hat, und dass alles, was der aufrufende Thread vor [start] geschrieben hat, für den aufgerufenen Thread sichtbar ist. Weitere Möglichkeiten der Synchronisierung betrachten wir später.
Statt eines Lambdas könnten wir eine Klasse schreiben, die [Runnable] implementiert und deren Eigenschaften die ausgetauschten Informationen enthalten. Das Lambda ist knapper; es ist heute die gebräuchlichste Schreibweise. Um das Ergebnis einer Verarbeitung abzurufen, betrachten wir später auch die Schnittstelle [Callable<V>], deren Methode [call()] ein Ergebnis liefert, und in Kapitel 9 die Funktion [async] der Coroutinen, die ein verzögertes Ergebnis zurückgibt ([Deferred]).
8.7. Gleichzeitiger Zugriff auf gemeinsame Ressourcen
8.7.1. Nicht synchronisierter gleichzeitiger Zugriff
Im vorherigen Abschnitt wurden Informationen nur zwischen zwei Threads und zu ganz bestimmten Zeitpunkten ausgetauscht: Das war ein klassisches Beispiel für die Parameterübergabe. In anderen Fällen werden Informationen von mehreren Threads gemeinsam genutzt, die sie möglicherweise gleichzeitig lesen oder ändern wollen. Dann stellt sich die Frage der Integrität dieser Informationen. Angenommen, die gemeinsame Information ist eine Struktur S, die verschiedene Informationen I1, I2, …, In enthält:
- Ein Thread T1 beginnt mit der Aktualisierung der Struktur S: Er ändert das Feld I1 und wird unterbrochen, bevor er die vollständige Aktualisierung der Struktur S abgeschlossen hat;
- ein Thread T2, der dann den Prozessor erhält, liest die Struktur S, um Entscheidungen zu treffen. Er liest eine Struktur in einem instabilen Zustand: Einige Felder sind aktuell, andere nicht.
Diese Situation nennt man gleichzeitigen Zugriff auf eine gemeinsame Ressource – hier die Struktur S. Sie ist oft schwer zu beherrschen. Betrachten wir das folgende Beispiel, um die möglichen Probleme zu veranschaulichen:
- Eine Anwendung erzeugt n Threads, wobei n als Parameter übergeben wird;
- die gemeinsame Ressource ist ein Zähler, der von jedem erzeugten Thread erhöht werden muss;
- am Ende der Anwendung wird der Wert des Zählers ausgegeben. Er sollte also gleich n sein.
Das Programm [Threads08.kt] lautet wie folgt:
Kommentare:
- Zeilen 9–24: Die gemeinsame Ressource ist die Eigenschaft [value] des Singleton-Objekts [Counter] (Deklaration [object], Kapitel 4). Der Zähler ist in diesem Objekt gekapselt, mit der Funktion [increment] , die jeder Thread ausführt. Das Schlüsselwort [private set] (Zeile 12) macht die Eigenschaft von überall lesbar, aber nur innerhalb des Objekts änderbar: Das entspricht dem privaten Feld und seinem Accessor [getValue] in der Java-Version;
- Zeile 18: Der Zähler wird gelesen;
- Zeile 21: Der Thread pausiert für 1 Sekunde. Er verliert dadurch die CPU;
- Zeile 23: Der Zähler wird erhöht;
- Zeilen 30–34: Die Anzahl der Threads wird als Argument übergeben. Der Ausdruck [args.singleOrNull()?.toIntOrNull() ?: -1] liefert die ganze Zahl im einzigen Argument des Programms oder -1, wenn nicht genau ein Argument vorhanden ist ([singleOrNull] liefert dann [null]) oder wenn dieses Argument keine ganze Zahl ist ([toIntOrNull] liefert dann [null]). Die Bedingung [nbThreads !in 1..nbMaxThreads] weist daher sowohl ein fehlendes oder ungültiges Argument als auch eine Zahl außerhalb des Intervalls [1, 100] zurück. In Java musste man eine Methode schreiben, die [NumberFormatException] abfängt. Im Fehlerfall schreibt das Programm eine Meldung in die Fehlerausgabe ([System.err]) und endet mit dem Exit-Code 1 ([exitProcess(1)], aus dem Paket [kotlin.system]);
- Zeile 38: Jeder Thread führt die Funktion [increment] des Objekts [Counter] aus, auf die die gebundene Referenz [Counter::increment] verweist;
- Zeilen 39–41: Die Threads werden gestartet, und anschließend wartet der Haupt-Thread auf ihr Ende.
Die einsekündige Pause dient ausschließlich dazu, den Thread zu zwingen, zwischen dem Lesen und dem Schreiben des Zählers die CPU abzugeben. In der Praxis gibt es keine Garantie, dass ein Thread zwischen diesen beiden Zeitpunkten nicht unterbrochen wird, und auf einer Mehrprozessormaschine können zwei Threads den Zähler sogar genau gleichzeitig lesen. Die einsekündige Pause macht dieses Risiko lediglich sichtbar.
Mit Gradle werden Programmargumente über die Option [--args] übergeben. Ohne Argumente wird eine Fehlermeldung angezeigt (der Befehl [echo $?] der Linux-Shell zeigt den Exit-Code des zuletzt ausgeführten Programms an; unter Windows lautet er [echo %errorlevel%]). Damit der Exit-Code des Programms angezeigt wird – und nicht der von Gradle (das auch das Scheitern der Aufgabe [run] meldet) –, haben wir hier die kompilierte Klasse direkt mit dem Befehl [java] ausgeführt:
Mit 5 Threads:
Beim Betrachten dieser Ergebnisse wird klar, was geschieht:
- Ein erster Thread liest den Zähler. Er findet 0. Er pausiert für 1 s und verliert damit die CPU;
- ein zweiter Thread liest ebenfalls den Zählerwert. Er ist immer noch 0, da der vorherige Thread ihn noch nicht erhöht hat. Auch er pausiert für 1 Sekunde;
- in weniger als einer Sekunde haben alle 5 Threads Zeit, den Wert 0 zu lesen;
- beim Aufwachen erhöhen sie den gelesenen Wert 0 und schreiben alle den Wert 1 in den Zähler, wie die letzte Zeile (Zeile 11) bestätigt. Dieses falsche Ergebnis ist reproduzierbar: Nur die Reihenfolge der Threads ändert sich von einer Ausführung zur nächsten.
Man könnte einwenden, das Beispiel sei künstlich. Entfernen wir also die Pause und verwenden den Operator [++], der die Illusion einer einzelnen Anweisung erzeugt. Das Programm [Threads09.kt] lautet wie folgt:
Kommentare:
- Zeilen 11–12: Die Anzahl der Threads (standardmäßig 4) und die Anzahl der Erhöhungen pro Thread (standardmäßig 50 Millionen) können als Argumente übergeben werden. [args.getOrNull(0)] liefert das erste Argument oder [null] , falls es nicht existiert: Der Elvis-Operator [?:] liefert dann den Standardwert. Das Trennzeichen [_] macht die Konstante [50_000_000] lesbar;
- Zeile 19: Die Threads werden mit [Thread.ofPlatform().start { … }] erstellt und gestartet; sie brauchen keine Namen. Die Funktion [List(nbThreads) { … }] sammelt die erstellten Threads in einer Liste;
- Zeile 22: Jeder Thread erhöht den gemeinsamen Zähler ohne Pause;
- Zeilen 30–31: Im Formatstring gibt [%,d] eine ganze Zahl mit dem Tausendertrennzeichen der aktuellen Sprache aus (hier Englisch: ein Komma).
Ergebnisse:
Beim ersten Test gingen Dutzende Millionen Aktualisierungen verloren. Die höhere Operation [Counter.value++] wird tatsächlich in mehrere elementare Prozessorbefehle übersetzt: den Wert aus dem Speicher lesen, ihn in einem Register erhöhen und das Ergebnis in den Speicher schreiben. Lesen zwei Threads denselben Wert, bevor einer von ihnen seinen eigenen geschrieben hat, geht eine Erhöhung verloren, genau wie im vorherigen Beispiel.
Die Tests 2 und 3 verlangen eine Erklärung: Sie lieferten den exakten Wert. Die wahrscheinlichste Erklärung lautet wie folgt: Nach einer gewissen Ausführungszeit optimierte der Just-in-Time-Compiler (JIT) der virtuellen Maschine die Schleife [repeat(nbIncrements) { … }] (eine [inline]-Funktion, die der Kotlin-Compiler durch eine einfache Schleife ersetzt hat): Er stellte fest, dass kein anderer Thread während der Schleife auf den Zähler zugreifen sollte (nichts im Code verlangt dies), und legte den Zähler in einem Prozessorregister ab. Jeder Thread liest den Zähler dann einmal, addiert in seinem Register 50 Millionen hinzu und schreibt ihn am Ende einmal zurück. Überschneidet sich die Arbeit der Threads nicht – was hier der Fall war –, ist das Ergebnis korrekt; lesen dagegen alle vier Threads den Wert 0, bevor einer von ihnen geschrieben hat, gehen drei von vier Ergebnissen verloren – also auf einen Schlag 150 Millionen Aktualisierungen. In diesem Lauf verlor nur der erste Test – der größtenteils vor dieser Optimierung ausgeführt wurde – Aktualisierungen; in anderen Läufen können auch die Tests 2 und 3 Aktualisierungen verlieren, mitunter 150 Millionen auf einmal. Gerade das macht diese Fehler so gefährlich: Ein Programm kann monatelang laufen und dann an dem Tag versagen, an dem die Maschine stärker ausgelastet ist oder schneller läuft.
Woher kommt das Problem? Ein Thread las einen veralteten Wert, weil ein anderer Thread unterbrochen wurde oder gleichzeitig auf einem anderen Prozessor arbeitete, bevor er die Aktualisierung des Zählers abgeschlossen hatte. Damit kommen wir zu den Begriffen der kritischen Ressource und des kritischen Abschnitts in einem Programm:
- eine kritische Ressource ist eine Ressource, die jeweils nur von einem Thread gehalten werden kann. Hier ist die kritische Ressource der Zähler;
- ein kritischer Abschnitt eines Programms ist eine Folge von Anweisungen im Ausführungsfluss eines Threads, während der er auf eine kritische Ressource zugreift. Wir müssen sicherstellen, dass der Thread während dieses kritischen Abschnitts als Einziger Zugriff auf die Ressource hat.
Im Programm [Threads08.kt] ist der kritische Abschnitt der Code zwischen dem Lesen des Zählers und dem Schreiben seines neuen Wertes:
Um diesen Code auszuführen, muss garantiert sein, dass ein Thread als einziger läuft. Er darf unterbrochen werden, aber während dieser Unterbrechung darf kein anderer Thread denselben Code ausführen können. Die JVM stellt verschiedene Werkzeuge bereit, um den Eintritt in kritische Codeabschnitte auf einen Thread zu beschränken, und Kotlin bietet einige Funktionen, die deren Verwendung vereinfachen. Einige davon betrachten wir jetzt.
8.7.2. Die Funktion synchronized und die Annotation @Synchronized
In Java begrenzt der Block [synchronized] einen kritischen Abschnitt wie folgt: [synchronized (lock) { …critical section… }]. [lock] ist ein Objekt, das für alle Threads sichtbar ist, die den kritischen Abschnitt ausführen. Auf der JVM besitzt jedes Objekt eine interne Sperre, auch Monitor genannt. Der Block [synchronized] stellt sicher, dass nur ein Thread zur Zeit den Monitor des Objekts [lock] hält, das heißt, dass nur ein Thread zur Zeit den kritischen Abschnitt ausführt: Ein Thread, der auf einen von einem anderen Thread gehaltenen Monitor trifft, wird blockiert, bis der Monitor freigegeben wird. Der Monitor wird beim Verlassen des Blocks freigegeben, unabhängig davon, ob der Block normal oder aufgrund einer Ausnahme verlassen wird.
Kotlin hat kein Schlüsselwort [synchronized]. Stattdessen stellt die Standardbibliothek eine [synchronized] -Funktion bereit, deren Signatur [inline fun <R> synchronized(lock: Any, block: () -> R): R] lautet. Dank der Syntax des abschließenden Lambdas wird ihr Aufruf [synchronized(lock) { …critical section… }] genau wie der Java-Block geschrieben. Da die Funktion [inline] ist, ersetzt der Kotlin-Compiler den Aufruf durch den Rumpf des Lambdas, umgeben von denselben Anweisungen der JVM wie beim Java-Block ([monitorenter] / [monitorexit]): Zur Laufzeit gibt es keinen Unterschied. Die Funktion liefert den Wert des Lambdas, sodass wir [val v = synchronized(lock) { counter }] schreiben können.
Das vorherige Beispiel wird in [Threads10.kt] wie folgt umgeschrieben:
Kommentare:
- Zeile 13: [lock] ist das Objekt, das die Synchronisierung aller Threads ermöglicht. Es dient nur diesem Zweck: Es ist ein einfaches Objekt der Klasse [Any], der Wurzel der Kotlin-Klassen (dem Äquivalent von [Object]). Es ist eine Eigenschaft vom Typ [val]: Die Referenz darf sich nie ändern, sonst könnten zwei Threads zwei verschiedene Objekte sperren. Es ist privat: Kein Code außerhalb des Objekts [Counter] kann diese Sperre erwerben;
- Zeile 11: Der Zähler ist jetzt eine private Eigenschaft; von außen ist er nur über die Eigenschaft [value] zugänglich;
- Zeilen 16–17: Die Eigenschaft [value] hat kein Feld: Ihr Accessor [get] liest den Zähler unter dem Schutz der Sperre und liefert den Wert zurück, den die Funktion [synchronized] liefert, nämlich den Wert des Lambdas [{ counter }]. Das ist hier nicht unbedingt nötig, da der Haupt-Thread mit [join] auf das Ende der anderen Threads gewartet hat; es ist aber gute Praxis: Durch eine Sperre geschützte Daten müssen unter dem Schutz dieser Sperre gelesen und geschrieben werden;
- Zeilen 24–32: Der kritische Abschnitt der Funktion [increment] wird vom Aufruf der Funktion [synchronized] umschlossen. Der Thread hält die Sperre, während er eine Sekunde lang schläft: Die anderen Threads können nicht eintreten;
- Zeilen 52–55: Der Haupt-Thread wartet auf die Threads in der umgekehrten Reihenfolge ihrer Erstellung. Die Funktion [asReversed] liefert eine Sicht (View) auf die in umgekehrter Reihenfolge durchlaufene Liste, ohne sie zu kopieren.
Ergebnisse mit 3 Threads:
- Alle drei Threads fordern nahezu gleichzeitig den Eintritt in den kritischen Abschnitt an;
- nur einer tritt ein – hier Thread 2 (die Reihenfolge des Eintritts ist nicht garantiert: Nicht zwangsläufig tritt der zuerst Eingetroffene zuerst ein). Er liest den Zähler, schläft eine Sekunde, schreibt den neuen Wert und verlässt den kritischen Abschnitt;
- die beiden anderen Threads sind blockiert, bis der erste den kritischen Abschnitt verlässt, und gehen dann nacheinander hindurch. Jeder liest den vom vorherigen geschriebenen Wert. Beachten Sie (Zeilen 7–8), dass Thread 1 den Zähler las, bevor Thread 2 meldete, dass er den kritischen Abschnitt verlassen hat: Thread 2 hatte die Sperre tatsächlich freigegeben, zeigt seine Meldung aber erst nach dem Block [synchronized] an, und Thread 1 war schneller;
- der Haupt-Thread wartete auf das Ende von Thread 2. Nachdem er über dessen Ende benachrichtigt worden war, wartete er auf das Ende von Thread 1 und dann auf das von Thread 0;
- Die Anzahl der Threads ist korrekt (letzte Zeile). Unabhängig von der Reihenfolge, in der die Threads laufen, ist dieses Ergebnis reproduzierbar.
In Java kann das Schlüsselwort [synchronized] auch eine ganze Methode kennzeichnen. Kotlin stellt dafür die Annotation [@Synchronized] (Paket [kotlin.jvm], automatisch importiert) bereit: [@Synchronized fun m() { … }] erzeugt eine Java-Methode [synchronized], die einem [synchronized(this) { … }]-Aufruf entspricht, der den gesamten Funktionsrumpf umschließt. In einem [object] wie [Counter] ist das gesperrte Objekt das Singleton-Objekt selbst. Wir verwenden sie im Programm [Threads17.kt]. Das ist die kürzeste Syntax. Sie hat jedoch einen Nachteil: Das gesperrte Objekt ist von außen sichtbar, und externer Code kann dieselbe Sperre erwerben und unsere blockieren. Daher ist es oft vorzuziehen, ein privates Objekt zu sperren, wie im Beispiel. Aus demselben Grund sollten Sie niemals einen String sperren (identische String-Literale sind ein einziges, im ganzen Programm gemeinsam genutztes Objekt). Bei Zahlen geht Kotlin einen Schritt weiter als Java: Das Sperren eines *[Int]* – das in ein gemeinsam genutztes *[Integer]*-Objekt umgewandelt würde – ist ein Kompilierfehler (***[error: synchronizing on 'Int' is forbidden.]***), während Java bei Objekten „wertbasierter“ Klassen nur eine Warnung ausgibt.
Ein Thread, der bereits einen Monitor hält, kann einen [synchronized]-Block auf demselben Objekt erneut betreten, ohne sich selbst zu blockieren: Die Sperre wird als reentrant (wiedereintrittsfähig) bezeichnet. Eine [@Synchronized]-Funktion kann somit eine andere [@Synchronized]-Funktion desselben Objekts aufrufen.
8.7.3. Die Klasse ReentrantLock
Die [synchronized]-Sperre ist einfach, aber starr: Ein Thread, der auf einen Monitor wartet, wartet unbegrenzt, ohne nach einer bestimmten Zeit aufgeben zu können und ohne unterbrochen werden zu können. Die Klasse [java.util.concurrent.locks.ReentrantLock] (Java 5) ist eine explizite – ebenfalls wiedereintrittsfähige – Sperre, die diese Möglichkeiten bietet. Sie implementiert die Schnittstelle [Lock]. Wir verwenden die folgenden Konstruktoren und Methoden:
Element | Rolle |
[ReentrantLock()], [ReentrantLock(fair: Boolean)] | erstellt eine Sperre. Eine faire Sperre ([true]) wird den Threads in der Reihenfolge ihrer Anforderung zugeteilt; eine nicht faire Sperre (der Standard) ist schneller, aber ein Thread kann sich vordrängeln |
[lock()] | Der Thread T1, der [V.lock()], ausführt, fordert die Sperre V an. Wird V von keinem Thread gehalten, wird sie T1 zugeteilt. Führt dann ein Thread T2 dieselbe Operation aus, wird er blockiert: Eine Sperre kann nur einem Thread gehören. T2 wird entblockt, wenn T1 V freigibt. So können mehrere Threads blockiert sein, während sie auf V warten |
[tryLock(): Boolean], [tryLock(time: Long, unit: TimeUnit): Boolean] | fordert die Sperre sofort an oder wartet dabei höchstens [time]. Die Methode liefert [false] , wenn die Sperre nicht erworben werden konnte |
[lockInterruptibly()] | wie [lock], aber das Warten kann unterbrochen werden ([InterruptedException]) |
[unlock()] | Der Thread, der V hält, gibt sie frei. Einer der auf V wartenden Threads erwirbt sie dann |
[isHeldByCurrentThread] | gibt an, ob der aktuelle Thread die Sperre hält |
[newCondition(): Condition] | Erstellt eine der Sperre zugeordnete Bedingung (siehe unten) |
[withLock { … }] | (Kotlin-Bibliothek, Paket [kotlin.concurrent]) Erweiterungsfunktion für die Schnittstelle [Lock]: führt das Lambda aus, während die Sperre gehalten wird, und gibt sie am Ende frei, unabhängig davon, ob eine Ausnahme auftritt |
In Java folgt die Synchronisierung eines kritischen Abschnitts immer demselben Muster: [V.lock(); try { …critical section… } finally { V.unlock(); }]. Es ist wichtig, die Freigabe der Sperre nicht zu vergessen; andernfalls bleiben die darauf wartenden Threads dauerhaft blockiert. Deshalb wird die Sperre in einem [finally]-Block freigegeben, der unabhängig davon ausgeführt wird, ob eine Ausnahme auftritt oder nicht. Der Block *[synchronized] erledigt dies automatisch; bei *[ReentrantLock]* muss der Programmierer es selbst tun. Kotlin kann genau dasselbe schreiben, bietet aber in seiner Standardbibliothek eine bessere Lösung: die Erweiterungsfunktion [withLock]*, die dieses Muster ein für alle Mal umsetzt. Ihre Definition lautet im Wesentlichen wie folgt:
Dies ist eine [inline]-Funktion: Der Aufruf von [lock.withLock { … }] wird zur Kompilierzeit durch das Schema [lock] / [try] / [finally] / [unlock] ersetzt, ohne zusätzliche Kosten, und es wird unmöglich, [unlock] auszulassen. Es ist derselbe Mechanismus wie bei der Funktion [use], die die [try]-Anweisung mit einer Java-Ressource ersetzt (Kapitel 3). Das Programm [Threads11.kt] verwendet das vorherige Beispiel mit einer [ReentrantLock]:
Das Hauptprogramm ist das von [Threads08.kt]. Kommentare:
- Zeile 15: Das Objekt zur Thread-Synchronisierung ist jetzt eine faire Sperre, [ReentrantLock];
- Zeile 7: Die Erweiterungsfunktion [withLock] muss importiert werden;
- Zeile 26: Beginn des kritischen Abschnitts. Der Thread ist blockiert, bis die Sperre freigegeben wird;
- Zeilen 26–35: Da eine Sperre immer freigegeben werden muss, unabhängig davon, ob eine Ausnahme auftritt, ist der kritische Abschnitt das an
*[withLock]*übergebene Lambda, das die Sperre beim Verlassen des Lambdas freigibt. Die Meldung „verlässt den kritischen Abschnitt“ ist die letzte, die innerhalb des kritischen Abschnitts angezeigt wird; - Zeilen 18–19: Derselbe Mechanismus schützt das Lesen des Zählers. [withLock] liefert den Wert seines Lambdas: Der vom Accessor gelieferte Wert wird gelesen, während die Sperre gehalten wird. Die Java-Version musste für diesen einfachen Lesevorgang sieben Zeilen [try] / [finally] -Code schreiben.
Ergebnisse:
Die Ergebnisse ähneln den vorherigen: Die Threads durchlaufen den kritischen Abschnitt einzeln nacheinander, und der Endstand ist korrekt. Da die Sperre fair ist, erwarben die Threads sie in der Reihenfolge, in der sie sie angefordert hatten: der Reihenfolge ihrer Aufrufe von [lock], die die etwas früher berechneten Zeiten der Meldungen „wartet auf Erlaubnis“ nur annähernd wiedergeben (hier zeigte Thread 2 die späteste Zeit, rief aber [lock] als Erster auf).
Wann sollte man [ReentrantLock] statt [synchronized] verwenden? Wenn man eine seiner zusätzlichen Fähigkeiten braucht: Timeout ([tryLock], das wir verwenden werden, um Deadlocks zu vermeiden), unterbrechbares Warten, Fairness oder mehrere Bedingungen. Andernfalls funktioniert die Funktion [synchronized] sehr gut; mit [withLock] macht Kotlin die Verwendung beider Werkzeuge gleichermaßen einfach und sicher. Seit Java 24 verursacht [synchronized] bei virtuellen Threads keine Probleme mehr: Zuvor konnte ein virtueller Thread, der in einem [synchronized]-Block blockiert war, seinen Host-Thread nicht freigeben, weshalb [ReentrantLock] die bevorzugte Wahl war.
8.7.4. Prozesse synchronisieren: die Dateisperre
Die bisherigen Sperren synchronisieren Threads innerhalb derselben virtuellen Maschine, also innerhalb desselben Prozesses. Manchmal müssen verschiedene Prozesse eine Ressource wie eine Datei gemeinsam nutzen, oder man möchte verhindern, dass zwei Instanzen derselben Anwendung gestartet werden. Die JVM stellt kein benanntes, zwischen Prozessen geteiltes Synchronisierungsobjekt bereit; dafür verwendet man eine vom Betriebssystem verwaltete Dateisperre : die Klasse [java.nio.channels.FileLock]. Eine Sperre wird auf einer geöffneten Datei in Form eines [FileChannel]-Kanals erworben:
- [lock(): FileLock]: wartet, bis die Sperre verfügbar ist, und erwirbt sie;
- [tryLock(): FileLock?]: versucht, die Sperre ohne Warten zu erwerben, und liefert [null] , wenn sie von einem anderen Prozess gehalten wird. Kotlin behandelt den Rückgabewert dieser Java-Methode als plattformspezifischen Typ ([FileLock!]); der Programmierer muss ihn so behandeln, als könnte er [null] sein;
- [release()]: gibt die Sperre frei. Die Sperre wird auch freigegeben, wenn der Kanal geschlossen wird oder der Prozess endet, selbst bei abruptem Abbruch: Eine Sperre kann nicht „verwaist“ bleiben. Die Klasse [FileLock] implementiert die Schnittstelle [AutoCloseable]: Ihre Methode [close] ruft [release] auf, und die Kotlin-Funktion [use] kann die Sperre daher freigeben.
Das Programm [Threads12.kt] wird zweimal in zwei verschiedenen Prozessen gestartet, die sich einen kritischen Abschnitt teilen:
Kommentare:
- Zeile 13: Die als Sperre verwendete Datei. Alle Prozesse, die diese Datei sperren, synchronisieren sich miteinander. Sie liegt im Ordner für temporäre Dateien des Systems, der durch die Systemeigenschaft [java.io.tmpdir] ([/tmp] unter Linux) angegeben wird. Ihr Inhalt ist unerheblich: Sie kann leer bleiben;
- Zeile 18: Die Datei wird zum Schreiben geöffnet (eine exklusive Sperre setzt dies voraus) und erstellt, falls sie noch nicht existiert ([CREATE]). Die Konstanten der Aufzählung [StandardOpenOption] wurden einzeln importiert (Zeilen 6–7). Die Funktion [use] schließt den Kanal am Ende;
- Zeilen 21–24: Der Prozess versucht, die Sperre ohne Warten zu erwerben. Schlägt dies fehl ([tryLock] liefert [null]), führt der Elvis-Operator [?:] den Block [run] aus, der dies meldet und dann unbegrenzt auf die Sperre wartet: Der Wert des Blocks – die von [lock] gelieferte Sperre – wird zum Wert der Variablen [lock]. Diese Variable hat daher einen Nicht-Null-Typ;
- Zeilen 27–31: der kritische Abschnitt, der 3 Sekunden dauert, gefolgt von der Freigabe der Sperre durch die Funktion [use].
Eine Dateisperre gehört dem gesamten Prozess, nicht einem einzelnen Thread: Sie dient nicht zur Synchronisierung von Threads innerhalb desselben Prozesses (zwei Sperranforderungen auf dieselbe Datei innerhalb desselben Prozesses lösen die Ausnahme [OverlappingFileLockException] aus). Wir starten Prozess A, warten 1,5 Sekunden und starten dann Prozess B in einem zweiten Terminal. Ergebnisse von Prozess A:
Ergebnisse von Prozess B:
Prozess B erkannte die von Prozess A gehaltene Sperre und wartete. Er erwarb die Sperre wenige Millisekunden, nachdem A sie freigegeben hatte. Eine übliche Anwendung dieses Mechanismus besteht darin, den Start von zwei Instanzen derselben Anwendung zu verhindern: Die zweite Instanz, die die Sperre mit [tryLock] nicht erwerben kann, endet sofort.
8.7.5. Eine Barriere: die Klasse Semaphore
Ein Semaphor ist ein Zähler für Permits (oder Plätze). Die Klasse [java.util.concurrent.Semaphore] stellt die folgenden Methoden bereit:
Element | Rolle |
[Semaphore(permits: Int)], [Semaphore(permits: Int, fair: Boolean)] | erstellt einen Semaphor mit [permits] Permits; der zweite Parameter hat dieselbe Bedeutung wie bei [ReentrantLock] |
[acquire()] | erwirbt ein Permit. Sind keine Permits mehr vorhanden, wird der Thread blockiert, bis ein Permit zurückgegeben wird. Das Warten kann unterbrochen werden ([InterruptedException]) |
[acquireUninterruptibly()] | wie oben, aber das Warten kann nicht unterbrochen werden |
[tryAcquire(): Boolean], [tryAcquire(timeout: Long, unit: TimeUnit): Boolean] | Erhält ein Permit ohne Warten oder mit einer Wartezeit von höchstens [timeout]; liefert [false] im Fehlerfall |
[release()] | gibt ein Permit zurück (fügt es hinzu); einer der wartenden Threads kann es dann nehmen |
[availablePermits()] | die Anzahl der verfügbaren Permits |
Anders als eine Sperre gehört ein Permit keinem bestimmten Thread: Jeder Thread kann [release] aufrufen, auch wenn er nie ein Permit erworben hat. Ein mit null Permits erstellter Semaphor ist daher eine geschlossene Barriere, an der Threads, die [acquire] aufrufen, blockiert werden. Ein anderer Thread öffnet sie zum gegebenen Zeitpunkt durch Aufruf von [release]. Dieser Zeitpunkt hängt vollständig vom zu lösenden Problem ab. Der Thread, der das einzige Permit erworben hat, ist durch die Barriere gegangen, die sich hinter ihm geschlossen hat; indem er das Permit zurückgibt, öffnet er die Barriere für einen anderen Thread. Ersetzen wir im vorherigen Beispiel die Sperre durch eine solche Barriere, lautet der Code wie folgt ([Threads13.kt]):
Kommentare:
- Zeile 15: Die Barriere wird im geschlossenen Zustand erstellt. Der Haupt-Thread öffnet sie in Zeile 57;
- Zeile 53: Der Haupt-Thread wartet eine halbe Sekunde, damit die Threads Zeit haben, an der Barriere anzukommen;
- Zeile 22: Der für das Erhöhen des Zählers zuständige Thread fordert die Erlaubnis zum Eintritt in den kritischen Abschnitt an. Die verschiedenen Threads sammeln sich vor der geschlossenen Barriere an. Öffnet der Haupt-Thread sie, geht einer der wartenden Threads hindurch, und die Barriere schließt sich wieder. Die Methode [acquireUninterruptibly] macht den Thread während dieses Wartens unempfindlich gegenüber Unterbrechungen;
- Zeilen 23–35: Der kritische Abschnitt ist in ein
*[try]eingeschlossen, dessen*[finally]*-Klausel die Sperre freigibt. Die Kotlin-Standardbibliothek hat kein Äquivalent zu*[withLock]für Java-Semaphoren: Wir schreiben das Muster [try] / [finally] wie in Java (die Coroutinen-Bibliothek hat jedoch einen eigenen Semaphor mit einer Funktion [withPermit], die wir in Kapitel 9 behandeln); - Zeile 35: Wenn der Thread seine Arbeit beendet hat, öffnet er die Barriere wieder und lässt damit einen anderen Thread eintreten.
Ergebnisse:
Die Ergebnisse ähneln den vorherigen. Man sieht, dass die drei Threads an der Barriere warten, bis der Haupt-Thread sie öffnet (Zeile 4).
8.7.6. Die Klassen CountDownLatch und Semaphore
Zwei weitere Einsatzmöglichkeiten von Synchronisierungswerkzeugen ergänzen die vorherigen Beispiele.
Ein [java.util.concurrent.CountDownLatch]-Objekt ist ein Zähler: Es wird mit einem Anfangswert N erstellt; jeder Aufruf seiner Methode [countDown] verringert ihn; seine Methode [await] blockiert den aufrufenden Thread, bis der Zähler 0 erreicht. Hat er 0 erreicht, bleibt er dort: Die Barriere ist dauerhaft offen und lässt alle Threads passieren. Mit N = 1 dient er als „Startsignal“ für ein Rennen; mit N = Anzahl der Aufgaben ist er eine Möglichkeit, auf den Abschluss von N Aufgaben zu warten, von denen jede bei ihrem Ende [countDown] aufruft. Das Programm [Threads14.kt] lautet wie folgt:
Kommentare:
- Zeile 11: Der Countdown beginnt bei 1: Das Tor ist geschlossen;
- Zeilen 14–15: Die 4 Threads (die Läufer) werden von der Funktion [thread] erstellt und gestartet und von der Funktion [List(4) { i -> … }] in eine Liste aufgenommen;
- Zeile 20: Jeder Thread wartet, bis der Countdown 0 erreicht. Die Methode [await] kann [InterruptedException] auslösen; wird der Thread während des Wartens unterbrochen, scheidet er aus dem Rennen aus (Zeile 23);
- Zeile 32: Der Haupt-Thread verringert den Countdown nach einer Sekunde; er erreicht 0;
- Zeile 35: Die Eigenschaft [count] (die Java-Methode [getCount()]) liefert den aktuellen Wert des Countdowns.
Ergebnisse:
Die vier Läufer starteten nach dem Startsignal gemeinsam, innerhalb weniger Millisekunden. Ein [CountDownLatch] wird nur einmal verwendet; die Klasse [CyclicBarrier] bietet einen wiederverwendbaren Treffpunkt (die N Threads warten aufeinander und starten dann gemeinsam), und die Klasse [Phaser] verallgemeinert diese beiden Werkzeuge.
Kehren wir zum Semaphor in seiner häufigsten Verwendung zurück: Ein Semaphor mit N Permits lässt höchstens N Threads gleichzeitig in einen Codeabschnitt eintreten. Das ist nützlich, um den Zugriff auf eine nur begrenzt verfügbare Ressource zu beschränken (Datenbankverbindungen, gleichzeitige Anfragen an einen Server usw.). Das Programm [Threads15.kt] lautet wie folgt:
Kommentare:
- Zeile 11: Der Semaphor hat 2 Permits: 2 Plätze;
- Zeile 19: Ein Thread fordert einen Platz an. Ist einer verfügbar, nimmt er ihn und läuft weiter; andernfalls wird er blockiert, bis ein Platz frei wird;
- Zeile 22: die Anzahl der noch verfügbaren Plätze;
- Zeile 28: Der Thread gibt seinen Platz in einer [finally]-Klausel zurück.
Ergebnisse:
Alle fünf Threads fordern einen Platz an; zwei erhalten ihn sofort (hier die Threads 3 und 4), die anderen drei warten. Jedes Mal, wenn ein Thread seinen Platz freigibt, erhält ihn ein wartender Thread. Es befinden sich nie mehr als zwei Threads im Codeabschnitt. Beachten Sie, dass Thread 3 „freie Plätze: 0“ anzeigt, bevor Thread 4 „freie Plätze: 1“ anzeigt: Thread 4 hatte seinen Platz erworben und die Anzahl der freien Plätze als Erster gelesen, aber Thread 3 war beim Anzeigen seiner Meldung schneller. Ein Semaphor mit einem einzigen Permit wirkt wie eine Sperre, wie im Programm [Threads13.kt]. Bei virtuellen Threads ist der Semaphor das natürliche Werkzeug zur Begrenzung der Nebenläufigkeit: Statt die Anzahl der Threads zu begrenzen, erstellen wir pro Aufgabe einen virtuellen Thread und begrenzen mit einem Semaphor die Anzahl der Aufgaben, die gleichzeitig die knappe Ressource nutzen. Dasselbe tun wir in Kapitel 9 mit Coroutinen.
8.7.7. Sichtbarkeit von Schreibzugriffen: die Annotation @Volatile
Sperren dienen nicht nur dazu, eine Gruppe von Operationen unteilbar zu machen. Sie lösen ein zweites, heimtückischeres Problem: die Sichtbarkeit von Schreibzugriffen. Um schneller zu sein, legt der Prozessor Werte in seinen Registern und Caches ab, und der Compiler ordnet Lese- und Schreibzugriffe im laufenden Betrieb um oder eliminiert sie, wie wir beim Programm [Threads09.kt] gesehen haben. Das Ergebnis: Ein von einem Thread geschriebener Wert ist für einen anderen Thread möglicherweise erst später sichtbar – oder vielleicht nie.
Das Java-Speichermodell , das alle von der JVM ausgeführten Programme – einschließlich Kotlin-Programmen – bestimmt, definiert genau, wann ein Schreibzugriff garantiert sichtbar ist: wenn zwischen dem Schreib- und dem Lesezugriff eine „Happens-before“-Beziehung besteht. Die wichtigsten sind die folgenden:
- Alles, was ein Thread vor der Freigabe einer Sperre getan hat (Ende eines [synchronized]-Blocks, [unlock]), ist für den Thread sichtbar, der anschließend diese Sperre erwirbt;
- was der aufrufende Thread vor [start] getan hat, ist für den aufgerufenen Thread sichtbar; was ein Thread getan hat, ist für den Thread sichtbar, der über [join] auf sein Ende gewartet hat;
- ein Schreibzugriff auf ein [volatile] -Feld ist für jeden nachfolgenden Lesezugriff auf dieses Feld sichtbar;
- die Werkzeuge in [java.util.concurrent] bieten ähnliche Garantien: Was ein Thread vor [release()], [countDown()], oder dem Einfügen eines Elements in eine nebenläufige Collection getan hat, ist für den Thread sichtbar, der anschließend [acquire()], [await()], ausführt oder das Element abruft.
Besteht keine dieser Beziehungen, spricht man davon, dass das Programm einen „Data Race“ enthält, und es gibt keine Garantien. In Java wird ein Feld mit einem Schlüsselwort als [volatile] deklariert; Kotlin hat dieses Schlüsselwort nicht, aber eine Annotation, [@Volatile], die auf eine Eigenschaft [var] angewendet wird: Das Feld, das die Eigenschaft speichert, ist dann ein Java-Feld [volatile]. Das Programm [Threads16.kt] zeigt seinen Nutzen in einem häufigen Szenario: einem Flag, das einen Thread zum Stoppen auffordert.
Kommentare:
- Zeilen 9–14: die beiden Flags, die Eigenschaften des Singleton-Objekts [Flags] sind. Die automatisch importierte Annotation [@Volatile] (Zeile 13) legt fest, dass jeder Lesezugriff auf die Eigenschaft [volatileStop] aus dem Speicher lesen und jeder Schreibzugriff darauf sofort ausgeführt werden muss. Die Eigenschaft [stop] ist eine gewöhnliche Eigenschaft;
- Zeilen 19–24: Der Thread T1 läuft, solange die gewöhnliche Eigenschaft [Flags.stop] gleich [false] ist;
- Zeilen 27–32: Der Thread T2 tut dasselbe mit der flüchtigen Eigenschaft [Flags.volatileStop];
- Zeilen 38–39: Nach einer Sekunde setzt der Haupt-Thread beide Flags auf [true];
- Zeilen 41–43: Er wartet auf jeden der beiden Threads bis zu 2 Sekunden. Beide Threads sind Daemons, sodass das Programm enden kann, auch wenn einer von ihnen noch läuft.
Ergebnisse:
Der Thread T2 erhielt die Stoppanforderung sofort. Der Thread T1 dagegen erhielt sie nie: Er lief zwei Sekunden später noch und endete erst, als die virtuelle Maschine heruntergefahren wurde. Der Just-in-Time-Compiler stellte fest, dass die Schleife [while (!Flags.stop) { rounds++ }] [stop] nicht ändert und dass keine Synchronisierung ein erneutes Lesen verlangt; daher las er dieses Feld nur einmal vor der Schleife: Die Schleife wurde so zu einer Endlosschleife. Der Zugriff auf die Eigenschaft [stop] erfolgt über ihren Accessor [getStop], was aber keinen Unterschied macht: Der Just-in-Time-Compiler ersetzte den Aufruf des Accessors durch einen Lesezugriff auf das Feld. Dieses Verhalten ist mit der hier verwendeten HotSpot-Virtual-Machine reproduzierbar, aber nicht garantiert: Eine andere virtuelle Maschine oder eine andere Version könnte T1 anhalten lassen. Genau darin liegt das Problem: Ohne eine Happens-before-Beziehung ist das Verhalten des Programms undefiniert.
Die Annotation [@Volatile] garantiert Sichtbarkeit, aber nicht Atomarität: [value++] bei einer Eigenschaft [@Volatile] bleibt ein Lesezugriff gefolgt von einem Schreibzugriff, und zwei Threads können immer noch eine Aktualisierung verlieren. [@Volatile] eignet sich daher für ein Flag, das von einem Thread geschrieben und von anderen gelesen wird, aber nicht für einen gemeinsamen Zähler. Um einen Thread zu stoppen, ist die oben beschriebene Unterbrechung einem Flag tatsächlich vorzuziehen: Sie weckt auch einen Thread auf, der in einem Wartezustand blockiert ist.
8.7.8. Atomare Klassen
Das Paket [java.util.concurrent.atomic] (Java 5) stellt Klassen bereit, die einfache Operationen auf einer Variablen atomar machen: Die Operation wird vom Thread vollständig ausgeführt, ohne dass ein anderer Thread die Variable mitten in der Operation beobachten oder ändern könnte. Die bisherigen Werkzeuge ([synchronized], [ReentrantLock], [Semaphore]) sind alle dazu gedacht, eine Gruppe von Operationen atomar zu machen, auf Kosten der Blockierung anderer Threads. Bei einfachen, aber häufigen Operationen vermeiden atomare Klassen diese Blockierung durch spezielle Prozessorbefehle. Die wichtigsten Methoden der Klasse [AtomicInteger] sind die folgenden:
Methode | Rolle |
[get(): Int], [set(v: Int)] | liest und schreibt den Wert (mit der Semantik eines [volatile]-Feldes) |
[incrementAndGet(): Int], [decrementAndGet(): Int] | erhöhen (verringern) den Wert um 1 und liefern den neuen Wert |
[getAndIncrement(): Int], [getAndDecrement(): Int] | wie oben, liefern aber den vorherigen Wert (wie [x++] und [x--]) |
[addAndGet(delta: Int): Int] | addiert [delta] zum Wert und liefert den neuen Wert |
[getAndSet(v: Int): Int] | weist [v] zu und liefert den alten Wert |
[compareAndSet(expected: Int, new: Int): Boolean] | weist [new] nur zu, wenn der Wert [expected] ist; liefert [true] , wenn die Zuweisung stattgefunden hat |
[updateAndGet(f: IntUnaryOperator): Int] | ersetzt den Wert v atomar durch f(v) und liefert den neuen Wert; in Kotlin wird ihr ein Lambda übergeben: [a.updateAndGet { it * 2 }] |
Das Paket bietet außerdem [AtomicLong], [AtomicBoolean], [AtomicReference<V>] (eine atomare Referenz auf ein Objekt) und atomare Arrays ([AtomicIntegerArray] …). Die Klasse [LongAdder] (Java 8) ist ein Zähler für sehr häufige Aktualisierungen durch viele Threads: Statt einer einzigen Variablen, um die alle Threads konkurrieren, verteilt er die Erhöhungen auf mehrere Zellen, die erst summiert werden, wenn die Gesamtsumme angefordert wird ([sum]).
Die Standardbibliothek von Kotlin 2.4 hat ebenfalls eigene atomare Klassen, die allen Kotlin-Plattformen gemeinsam sind ([AtomicInt], [AtomicLong], [AtomicReference] … aus dem Paket [kotlin.concurrent.atomics]), die aber noch experimentell sind: Der Compiler verlangt ein ausdrückliches Opt-in ([@OptIn(ExperimentalAtomicApi::class)]). Für die JVM verwenden wir daher die aus dem JDK.
Das Programm [Threads17.kt] baut auf den Ergebnissen des Programms [Threads09.kt] auf und vergleicht sechs Arten, den gemeinsamen Zähler zu erhöhen:
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 33 34 35 36 37 38 39 40 41 42 43 44 45 46 47 48 49 50 51 52 53 54 55 56 57 58 59 60 61 62 63 64 65 66 67 68 69 70 71 72 73 74 75 76 77 78 79 80 81 82 83 84 85 86 87 88 89 90 91 92 93 94 95 96 97 98 99 100 101 102 103 | |
Kommentare:
- Zeilen 11–59: Das Objekt [Counter] fasst die Zähler und die sechs Erhöhungsfunktionen zusammen;
- Zeilen 12–14: Der Zähler ist [@Volatile]. Das verhindert die laufende Optimierung durch den Compiler, die wir bei [Threads09.kt] beobachtet haben: Jede Erhöhung liest tatsächlich aus dem Speicher und schreibt in ihn;
- Zeile 29: die nicht synchronisierte Erhöhung;
- Zeilen 33–35: die Erhöhung in einem kritischen Abschnitt, der durch die Funktion [synchronized] und eine private Sperre geschützt ist;
- Zeilen 40–42: Die Funktion [withSynchronizedAnnotation] ist mit [@Synchronized] annotiert: Ihr gesamter Rumpf ist ein kritischer Abschnitt, dessen Sperre das Objekt [Counter] selbst ist;
- Zeilen 46–48: die Erhöhung in einem kritischen Abschnitt, der durch eine [ReentrantLock] mithilfe der Funktion [withLock] geschützt ist;
- Zeile 54: atomare Erhöhung;
- Zeile 59: Erhöhung eines [LongAdder];
- Zeilen 71–79: Die Funktion [measure] wird mit sechs verschiedenen Erhöhungsfunktionen aufgerufen, die als gebundene Referenzen übergeben werden ([Counter::withoutSynchronization] …), und mit einer Funktion, die den resultierenden Wert vom Typ [() -> Long] liefert. Bei den ersten vier ist es das Lambda [value] in Zeile 71, das den [Int] -Wert des Zählers in [Long] umwandelt (in Kotlin gibt es keine implizite Konvertierung); beim [AtomicInteger] ist es ein abschließendes Lambda; beim [LongAdder] ist die Referenz [Counter.adder::sum] an die Methode [sum] eines bestimmten Objekts gebunden, die bereits einen [Long] liefert. In Java mussten die funktionalen Schnittstellen [Runnable] und [LongSupplier] gewählt werden; in Kotlin genügen die Funktionstypen [() -> Unit] und [() -> Long] ;
- Zeilen 83–102: Die Funktion [measure] startet [nbThreads] Threads, von denen jeder die erhaltene Funktion [nbIncrements] -mal aufruft, und misst die Gesamtzeit. Das Format [%,12d] richtet den Wert auf 12 Zeichen rechtsbündig aus, mit Tausendertrennzeichen; [%-23s] richtet den Methodennamen auf 23 Zeichen linksbündig aus;
- Zeilen 86, 90 und 99: Die Threads warten alle hinter einem
*[CountDownLatch]*, der geöffnet wird, sobald sie alle gestartet sind. So können sie ihre Arbeit gleichzeitig beginnen, wodurch ein gleichzeitiger Zugriff viel wahrscheinlicher ist, als wenn die Threads nacheinander gestartet würden. Wird das Warten unterbrochen, beendet die Anweisung [return@start] (Zeile 92) das an [start] übergebene Lambda: Innerhalb eines Lambdas würde ein einfaches [return] die umschließende Funktion verlassen, was hier nicht zulässig ist; deshalb verwenden wir ein Label, um anzugeben, welches Lambda wir verlassen (Kapitel 7).
Ergebnisse:
- Ohne Synchronisierung ist das Ergebnis erneut falsch: Die Annotation [@Volatile] hat [value++] nicht atomar gemacht. Die Anzahl der verlorenen Aktualisierungen schwankt von einer Ausführung zur nächsten stark;
- die anderen fünf Methoden liefern das richtige Ergebnis, und das ist reproduzierbar;
- atomare Klassen sind in diesem Lauf deutlich schneller als Sperren. Sperren sind hier teuer, weil vier Threads bei einer winzigen Operation ständig um sie konkurrieren. Die Funktion [synchronized] und die Annotation [@Synchronized] verursachen ähnliche Kosten: Sie sind zwei Implementierungen desselben Mechanismus, des Monitors der JVM. Die gemessenen Ausführungszeiten hängen stark von der Maschine und ihrer Auslastung ab (diese Maschine hatte nur zwei Prozessoren, die von anderen Programmen stark beansprucht wurden): Nur ihre Größenordnung ist aussagekräftig, und von einem Lauf zum nächsten ändert sich die Rangfolge ähnlicher Methoden. [LongAdder] war hier nicht der Schnellste: Mit zwei Prozessoren stören sich die Threads beim Zugriff auf die einzelne Variable eines [AtomicInteger] kaum. Sein Vorteil zeigt sich, wenn mehrere Prozessoren denselben Zähler erhöhen.
Die Methode [compareAndSet] („CAS“) ist der Baustein „sperrenfreier“ Algorithmen: Sie liest den Wert, berechnet den neuen und schreibt ihn nur, wenn sich die Variable in der Zwischenzeit nicht geändert hat; andernfalls beginnt sie von vorn. Das tut auch [updateAndGet], und die später vorgestellten nebenläufigen Collections machen reichlich Gebrauch davon.
8.8. Gleichzeitiger Zugriff auf mehrere gemeinsame Ressourcen
8.8.1. Deadlock
In unseren bisherigen Beispielen wurde eine einzige Ressource von den verschiedenen Threads gemeinsam genutzt. Die Situation wird komplizierter, wenn es mehrere Ressourcen gibt, die voneinander abhängen. Insbesondere kann ein Deadlock auftreten: Zwei Threads warten aufeinander. Betrachten wir die folgenden Aktionen, die nacheinander ablaufen:
- Ein Thread T1 erwirbt die Sperre V1, um auf eine gemeinsame Ressource R1 zuzugreifen;
- ein Thread T2 erwirbt die Sperre V2, um auf eine gemeinsame Ressource R2 zuzugreifen;
- Der Thread T1 fordert die Sperre V2 an. Er wird blockiert;
- der Thread T2 fordert die Sperre V1 an. Er wird blockiert.
Die Threads T1 und T2 warten unbegrenzt aufeinander. Es sind mehrere Lösungen möglich:
- beide Ressourcen gleichzeitig mit einer einzigen Sperre anfordern. Das ist nicht immer möglich, wenn dadurch eine kostspielige Ressource lange gesperrt wird;
- Sperren immer in derselben Reihenfolge erwerben: Wenn alle Threads V1 vor V2 erwerben, ist ein Deadlock ausgeschlossen. Das ist die am häufigsten verwendete Regel;
- Ein Thread, der V1 hält und V2 nicht erwerben kann, gibt V1 frei, um einen Deadlock zu vermeiden.
Das Programm [Threads18.kt] verursacht einen Deadlock und setzt die letzte Lösung um, indem es die Methode [tryLock] von [ReentrantLock] verwendet:
Kommentare:
- Zeilen 16–17: die Sperren der beiden Ressourcen. Es sind hier lokale Variablen, die von den Lambdas in den Zeilen 20 und 22 erfasst werden;
- Zeile 20: Der Thread T1, der von der Funktion [thread] erstellt und gestartet wird, erwirbt R1 und fordert dann R2 an; er wartet höchstens 2 Sekunden. Die Dauer wird als [2.seconds] geschrieben: Das ist ein Wert vom Typ [kotlin.time.Duration] aus der Kotlin-Standardbibliothek, konstruiert durch die Erweiterungseigenschaft [seconds] von [Int] (importiert aus [Duration.Companion]). Das entspricht dem Java-Ausdruck [Duration.ofSeconds(2)] ([java.time.Duration]), ist aber lesbarer;
- Zeile 22: Der Thread T2 erwirbt R2 und fordert dann R1 an – also in umgekehrter Reihenfolge; er wartet höchstens 5 Sekunden;
- Zeile 29: Die Funktion [work] erhält Sperren des durch die Schnittstelle [Lock] definierten Typs, die von [ReentrantLock] implementiert wird;
- Zeile 31: Der Thread erwirbt seine erste Ressource mit der oben beschriebenen Funktion [withLock]: Er gibt sie am Ende des Blocks in jedem Fall wieder frei;
- Zeile 35: Er wartet eine halbe Sekunde, wodurch der andere Thread Zeit hat, seine eigene erste Ressource zu erwerben: Der Deadlock ist dann garantiert;
- Zeile 38: Statt eines
*[lock], das unbegrenzt warten würde, fordert der Thread die zweite Sperre mit einer maximalen Wartezeit an. [tryLock] liefert [true] , wenn die Sperre erworben wurde, und [false] , wenn das Timeout abgelaufen ist. Das Timeout wird als Zahl und Einheit ausgedrückt ([TimeUnit.MILLISECONDS]); die Eigenschaft [inWholeMilliseconds] liefert die Dauer [timeout] in Millisekunden. Hier kann [withLock] nicht verwendet werden, da es [lock] aufruft: Sie müssen [try { … } finally { second.unlock() }]* selbst schreiben; - Zeile 43: Eine von [tryLock] erworbene Sperre muss durch [unlock] in einer [finally]-Klausel freigegeben werden;
- Zeilen 45–47: Konnte die zweite Sperre nicht erworben werden, bricht der Thread ab. Beim Verlassen des [withLock]-Blocks gibt er seine erste Ressource frei;
- Zeilen 49–50: [sleep] und [tryLock] mit Timeout können [InterruptedException] auslösen. Kotlin verlangt nicht, diese Ausnahme abzufangen (es hat keine geprüften Ausnahmen), aber ein gut geschriebener Thread tut dies und setzt das Unterbrechungs-Flag zurück, wie wir im Abschnitt über Unterbrechungen gesehen haben.
Ergebnisse:
Jeder der beiden Threads erhielt seine erste Ressource und forderte dann die zweite an: Sie befinden sich im Deadlock. Nach 2 Sekunden gibt T1 auf und gibt R1 frei; T2, der noch wartete, erhält R1 sofort und kann seine Arbeit erledigen. Ohne Timeout wäre das Programm nie beendet worden. Dieser Ablauf ist reproduzierbar; nur die Reihenfolge der Zeilen 1 und 2 sowie die der Zeilen 3 und 4 kann sich ändern (beachten Sie übrigens, dass die Zeiten in den ersten beiden Zeilen nicht geordnet sind: Ein Thread las die Zeit zuerst, aber der andere zeigte seine Meldung zuerst an). Wir hätten dieses Programm nicht mit der Funktion [synchronized] schreiben können, deren Wartezeit sich nicht begrenzen lässt.
Wenn ein Kotlin-Programm blockiert zu sein scheint, zeigt der Befehl [jcmd <pid> Thread.print] des JDK den Aufrufstack jedes seiner Threads an ([pid] ist die Prozess-ID, die vom Befehl [jcmd] ohne Parameter geliefert wird); er erkennt Deadlocks zwischen Sperren und meldet sie mit der Meldung „Found one Java-level deadlock“, gefolgt von den beteiligten Threads und Sperren. Der IntelliJ-Debugger (IDEA) bietet dieselbe Funktion (Schaltfläche Get Thread Dump ).
8.8.2. Ein Beispiel: Leser und Schreiber
Betrachten wir das folgende Beispiel:
- Wir haben ein Array, in das einige Threads Daten schreiben (die Schreiber) und andere sie lesen (die Leser);
- die Schreiber sind untereinander gleichberechtigt, schließen sich aber gegenseitig aus: Nur ein Schreiber zur Zeit kann Daten im Array ablegen;
- die Leser sind untereinander gleichberechtigt, schließen sich aber gegenseitig aus: Nur ein Leser zur Zeit kann die im Array gespeicherten Daten lesen;
- ein Leser kann nur dann Daten aus dem Array lesen, wenn ein Schreiber welche dort abgelegt hat, und ein Schreiber kann nur dann neue Daten im Array ablegen, wenn die bereits dort vorhandenen Daten von einem Leser gelesen wurden.
Es gibt zwei Arten gemeinsamer Ressourcen:
- das beschreibbare Array: Nur ein Schreiber zur Zeit darf darauf zugreifen;
- das lesbare Array: Nur ein Leser zur Zeit darf darauf zugreifen.
und eine Reihenfolge für die Nutzung dieser Ressourcen:
- Ein Leser muss immer auf einen Schreiber folgen;
- ein Schreiber muss immer auf einen Leser folgen, außer beim ersten Mal.
Der Zugriff auf diese beiden Ressourcen lässt sich mit zwei Barrieren vom Typ [Semaphore] steuern:
- Die Barriere [canWrite] steuert den Zugriff der Schreiber auf das Array;
- die Barriere [canRead] steuert den Zugriff der Leser auf das Array;
- Die Barriere [canWrite] wird im geöffneten Zustand erstellt (ein Permit), lässt den ersten Schreiber passieren und blockiert alle anderen;
- Die Barriere [canRead] wird im geschlossenen Zustand erstellt (kein Permit) und blockiert alle Leser;
- Hat ein Schreiber seine Arbeit beendet, öffnet er die Barriere [canRead] , um einen Leser hereinzulassen;
- Wenn ein Leser seine Arbeit beendet hat, öffnet er die Schranke [canWrite] , um einen Schreiber hereinzulassen.
Hier zeigt sich der Vorteil einer Schranke, die keinem Thread gehört: Die Schranke [canRead] wird von einem Leser geschlossen (der die Berechtigung entnimmt) und von einem Schreiber geöffnet (der sie zurückgibt). Mit einem Lock ist das unmöglich, da dieser nur von dem Thread freigegeben werden kann, der ihn hält. Das Programm [Threads19.kt] , das diese Synchronisation veranschaulicht, lautet wie folgt:
Kommentare:
- Zeilen 15–17: Erstellung und Start von zwei Leser-Threads, gefolgt von zwei Schreiber-Threads. Die Funktion [repeat] führt ihr Lambda [nbThreads] -mal aus und übergibt ihm die aktuelle Iterationsnummer. Es werden keine Referenzen auf die Threads gehalten: Der Haupt-Thread wartet nicht auf sie;
- Zeile 19: Der Haupt-Thread endet sofort. Der Prozess läuft weiter, bis alle vier Threads – die keine Daemons sind – beendet sind;
- Zeile 23: Die gemeinsam genutzte Ressource und ihre Synchronisation sind wie das Objekt [Counter] in den vorherigen Programmen in einem Singleton-Objekt zusammengefasst (Java verwendete eine verschachtelte Klasse mit Membern [static]);
- Zeile 25: Das Array [data], ein dreielementiges [IntArray] (kompiliert zu [int[]]), ist die von den Leser- und Schreiber-Threads gemeinsam genutzte Ressource;
- Zeile 27: Die Schranke [canRead] signalisiert den Lesern, dass sie das Array lesen dürfen. Sie wird von dem Schreiber geöffnet, der das Array gefüllt hat. Sie wird im geschlossenen Zustand erstellt: Zuerst muss ein Schreiber das Array füllen;
- Zeile 29: Die Schranke [canWrite] teilt den Schreibern mit, dass sie in das Array schreiben dürfen. Sie wird von dem Leser geöffnet, der das gesamte Array gelesen hat. Sie wird im geöffneten Zustand erstellt: Das Array ist von Anfang an beschreibbar;
- Zeile 36: Ein Leser wartet darauf, dass ein Schreiber signalisiert, dass das Array gefüllt wurde. Trifft dieses Signal ein, fährt nur einer der wartenden Leser fort;
- Zeilen 38–41: Das Array wird gelesen, mit einer halben Sekunde Pause bei jedem Element, um den Thread zur Abgabe der CPU zu zwingen;
- Zeile 44: Der Leser teilt den Schreibern mit, dass das Array gelesen wurde und erneut gefüllt werden kann;
- die Funktion
[write]ist symmetrisch zur Funktion[read]. Die Schleife in Zeile 55 durchläuft die Indizes des Arrays (***[data.indices]ist der Bereich***[0..2]); - Zeile 59: Die Zahlen werden zufällig vom Objekt [Random] der Kotlin-Standardbibliothek erzeugt ([kotlin.random.Random]). Die Funktion [nextInt(0, 1000)] liefert eine ganze Zahl aus dem Intervall [0, 1000[. Der Generator [Random] kann von mehreren Threads verwendet werden: Auf der JVM stützt er sich auf die Klasse [ThreadLocalRandom] (Java 7), die jedem Thread einen eigenen Generator zur Verfügung stellt, sodass die Threads nicht um einen einzigen Generator konkurrieren. Der Java-Code verwendete direkt [ThreadLocalRandom.current().nextInt(0, 1000)];
- Das Array [data] ist durch keinen Lock geschützt. Dennoch gibt es keinen Data Race: Die Schreibzugriffe des Schreibers gehen seinem [canRead.release()] voraus, das (Happens-before-Beziehung) dem [canRead.acquireUninterruptibly()] des Lesers und damit dessen Lesezugriffen vorausgeht.
Ergebnisse:
Folgende Punkte sind bemerkenswert:
- Es gibt immer nur einen Leser gleichzeitig, obwohl er im kritischen Abschnitt [read] die CPU verliert;
- Es gibt immer nur einen Schreiber gleichzeitig, obwohl er im kritischen Abschnitt [write] den Prozessor verliert;
- Ein Leser liest nur, wenn im Array etwas zu lesen ist;
- Ein Schreiber schreibt nur, wenn das Array vollständig gelesen wurde;
- Die Ausführungsreihenfolge lässt sich jedoch nicht steuern: Hier wurde der Leser R1 vor dem Leser R0 ausgeführt, obwohl R0 zuerst gestartet worden war; ebenso gab es keinen Grund, warum der Schreiber W0 vor dem Schreiber W1 laufen sollte. Eine andere Ausführung kann zu einer anderen Reihenfolge führen.
8.8.3. Die Methoden wait und notifyAll
Wenn im vorherigen Beispiel Schreiber an der Anweisung [canWrite.acquireUninterruptibly()] blockiert sind, wird einer von ihnen – irgendeiner – durch die Operation [canWrite.release()] freigegeben. Wenn Sie die Schranke für einen bestimmten Schreiber öffnen möchten, wird es komplizierter.
Stellen Sie sich als Analogie ein Amt mit Bedienschaltern vor. Wenn ein Kunde eintrifft, zieht er am Spender eine nummerierte Wartemarke und setzt sich dann hin. Die Kunden werden per Lautsprecher mit ihrer Nummer aufgerufen. Während des Wartens kann der Kunde tun, was er will: lesen oder dösen. Er wird jedes Mal geweckt, wenn der Lautsprecher eine Nummer ausruft. Ist es seine Nummer, steht der Kunde auf und geht zum Schalter; andernfalls widmet er sich wieder dem, was er zuvor getan hat. Ähnlich können wir bei Threads vorgehen. Nehmen wir das Beispiel der Schreiber:
Am Schalter | Bei Threads |
Mehrere Schreiber warten auf denselben Schalter | Ihre Threads sind blockiert |
Der Schalter wird frei, und die Nummer des nächsten Schreibers wird aufgerufen | Der Thread, der das Array gelesen hat, teilt den Schreibern mit, dass das Array verfügbar ist. Entweder dieser oder ein anderer Thread hat bestimmt, welcher Schreiber an der Reihe ist |
Jeder Schreiber prüft seine Nummer; nur der mit der aufgerufenen Nummer geht zum Schalter; die anderen kehren in die Warteschlange zurück | Jeder Thread prüft, ob er der ausgewählte ist. Wenn ja, passiert er die Schranke; andernfalls kehrt er in die Warteschlange zurück |
Die JVM ermöglicht es, dieses Szenario mit Methoden umzusetzen, die für jedes Java-Objekt verfügbar sind, da sie in der Klasse [java.lang.Object] definiert sind:
Methode | Rolle |
[wait()] | gibt den Monitor des Objekts zurück und blockiert den Thread, bis ein anderer Thread über [notify] oder [notifyAll] eine Änderung signalisiert; der Thread muss dann den Monitor wieder erlangen, bevor er fortfährt. Das Warten kann unterbrochen werden ([InterruptedException]) |
[wait(ms: Long)] | wie oben, mit einer maximalen Wartezeit |
[notify()] | weckt einen der Threads auf, die durch [wait] auf diesem Objekt blockiert sind |
[notifyAll()] | weckt alle Threads auf, die durch [wait] auf diesem Objekt blockiert sind |
In Kotlin sind diese Methoden nicht direkt zugänglich. Die Wurzelklasse von Kotlin ist [Any], nicht [Object]: Der Compiler bildet die beiden Typen aufeinander ab (ein *[Any] wird zu *[java.lang.Object]* kompiliert), aber *[Any] deklariert nur drei Funktionen: *[equals]*, [hashCode], und [toString]. Die Methoden [wait], [notify], und [notifyAll] (sowie [getClass]) wurden bewusst weggelassen: Die Kotlin-Entwickler waren der Ansicht, dass dieser Low-Level-Mechanismus nicht alle Objekte überladen sollte und dass es besser sei, die Werkzeuge aus [java.util.concurrent] zu verwenden. Wenn wir mit einem Token [val token = Any()] Folgendes schreiben:
antwortet der Compiler mit:
Um [wait] aufzurufen, benötigen Sie ein Objekt, dessen Typ aus Sicht des Compilers [java.lang.Object] ist. Sie können den Typ mit [(token as Object).wait()] umwandeln oder das Token direkt mit [Object()] erzeugen. In beiden Fällen gibt der Compiler eine Warnung aus:
Da unsere Programme mit der Option kompiliert werden, die Warnungen in Fehler umwandelt ([allWarningsAsErrors = true]), muss diese ausdrücklich deaktiviert werden, indem die Annotation [@Suppress("PLATFORM_CLASS_MAPPED_TO_KOTLIN")] an der Deklaration angebracht wird, die die Klasse [Object] verwendet ([PLATFORM_CLASS_MAPPED_TO_KOTLIN] ist der Name dieser Warnung: „Plattformklasse, die einer Kotlin-Klasse zugeordnet ist“). Das erledigen wir unten ein für alle Mal in der Deklaration des Tokens: Sein Typ ist dann [java.lang.Object], und die Aufrufe [token.wait()] und [token.notifyAll()] lösen keine Warnung mehr aus. Diese kleine Unbequemlichkeit ist beabsichtigt: In Kotlin wird die Schnittstelle [Condition] bevorzugt, die im folgenden Abschnitt vorgestellt wird. Dennoch ist es nützlich, [wait] und [notifyAll] zu kennen, die man in viel bestehendem Java-Code antrifft.
Wir beschreiben nun ein Standardmuster – das unter anderem im Buch von Brian Goetz et al., [Java Concurrency in Practice], vorgestellt wird –, mit dem sich Schrankenprobleme mit Zutrittsbedingungen lösen lassen.
Threads, die sich eine Ressource (den Zähler) teilen, greifen über ein Objekt darauf zu, das wir Token nennen: Es ist ein einfaches Objekt ([Object()]), dessen Monitor verwendet wird. Um die Schranke zum Zähler zu passieren, muss man das Token besitzen, und es gibt nur eines. Die Threads müssen das Token daher untereinander weiterreichen.
Um zum Schalter zu gelangen, fordert ein Thread zunächst das Token mit einem Block [synchronized(token) { … }] an. Erhält er das Token, prüft er in einer Schleife [while (!iAmTheExpectedOne) { token.wait() }], ob er die Bedingung erfüllt, um zum Schalter zu gehen, und geht dann – weiterhin innerhalb des Blocks [synchronized] – zum Schalter. Ist der Thread nicht der am Schalter erwartete, gibt er seinen Platz ab, indem er das Token über [token.wait()] zurückgibt und in den blockierten Zustand wechselt. Er wird geweckt, wenn ein anderer Thread eine Änderung der Zutrittsbedingung signalisiert; er erhält dann das Token zurück und prüft die Bedingung erneut. Deshalb ist der Test eine Schleife ([while]) und kein einfaches [if]. Es gibt einen zweiten, JVM-spezifischen Grund: Die Spezifikation erlaubt „Spurious Wakeups“ (unbegründetes Aufwachen), bei denen [wait] endet, ohne dass ein Thread [notify] aufgerufen hat; die Schleife macht sie unschädlich. Die Operation [token.wait()] kann nur von einem Thread ausgeführt werden, der den Monitor des Tokens hält; andernfalls wird eine Exception [IllegalMonitorStateException] ausgelöst. In diesem Schema wird das Token erst nach Abschluss der Transaktion freigegeben.
Der Thread, der die Zutrittsbedingung zum Zähler ändert, muss ebenfalls das Token halten und die wartenden Threads benachrichtigen: Innerhalb eines Blocks [synchronized(token) { … }] ändert er die Zutrittsbedingung zum Zähler und weckt dann die wartenden Threads mit [token.notifyAll()] auf.
Das Aufwecken der Threads bedeutet, dass die wartenden Threads zu Kandidaten für das Token werden; sie erhalten es nicht sofort. Das Token ist erst am Ende des Blocks [synchronized] verfügbar. Alle aufgeweckten Threads erhalten das Token dann der Reihe nach in unbestimmter Reihenfolge, wodurch sie die Gelegenheit haben, die Zutrittsbedingung erneut zu prüfen. Der erste, der die Bedingung erfüllt, behält das Token und geht zum Schalter.
Mit diesen Informationen können wir die Leser/Schreiber-Anwendung umschreiben, indem wir die Reihenfolge festlegen, in der Leser und Schreiber zu ihren jeweiligen Schaltern gehen ([Threads20.kt]):
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 33 34 35 36 37 38 39 40 41 42 43 44 45 46 47 48 49 50 51 52 53 54 55 56 57 58 59 60 61 62 63 64 65 66 67 68 69 70 71 72 73 74 75 76 77 78 79 80 81 82 83 84 85 86 87 88 89 90 91 92 93 94 95 96 97 98 99 100 101 102 103 104 105 106 107 108 109 110 111 112 113 114 115 116 117 118 119 120 121 122 123 124 125 126 127 128 129 130 131 132 133 134 | |
Der Zugang zum Lese-Schalter wird durch die folgenden Elemente bedingt:
- Zeile 39: das Token [canRead], dem (in Zeile 38) die Annotation vorausgeht, die die Warnung für die Klasse [Object] deaktiviert;
- Zeile 43: der boolesche Wert [readingAllowed];
- Zeile 48: die geordnete Liste der Namen der Leser. Die Leser gehen in der Reihenfolge dieser Liste zum Lese-Schalter;
- Zeile 45: [nextReader] ist der Index in dieser Liste des nächsten Lesers, der zum Schalter gehen darf.
Der Zugang zum Schreib-Schalter wird analog durch das Token [canWrite], den booleschen Wert [writingAllowed], die Liste [writeOrder], und den Index [nextWriter] gesteuert.
Das Hauptprogramm:
- Zeilen 14–16: Die Leser gehen in umgekehrter Reihenfolge ihrer Erstellung zum Schalter (R2, R1, R0), die Schreiber in der Reihenfolge ihrer Erstellung (W0, W1, W2). Die Listen werden von der Funktion [List] aufgebaut, die ihr Lambda für jeden Index aufruft. Der Java-Code verwendete einen Stream ([IntStream.range(0, nbThreads).mapToObj(…).toList()]);
- Zeile 17: Das Intervall [0..<nbThreads] schließt seine obere Grenze aus: Es entspricht [0 until nbThreads];
- Zeilen 23–24: Erstellung und Start der Leser, gefolgt von den Schreibern. Sie werden alle blockiert sein, da weder Lesen noch Schreiben erlaubt ist;
- Zeile 27: Das Schreiben wird freigegeben, und die Schreiber werden benachrichtigt, dass sich etwas geändert hat (Funktion [allowWriting], Zeilen 52–56).
Die Funktion [read]:
- Zeilen 65–87: Der gesamte Ablauf am Lese-Schalter wird durch den Block [synchronized] auf dem Token [canRead] gesteuert. Der Leser, der es erhält, behält es während seiner gesamten Zeit am Schalter;
- Zeilen 68–69: Ein Leser, der das Token erhalten hat, gibt es zurück, wenn das Lesen nicht erlaubt ist oder er nicht an der Reihe ist. Die Namen werden mit dem Operator [!=] verglichen, der die Inhalte vergleicht (er ruft [equals] auf);
- Zeilen 71–72: Wird der Thread beim Warten unterbrochen, bricht er ab. Das [return] steht hier im Lambda, das an [synchronized] übergeben wird; das ist erlaubt, weil [synchronized] eine Funktion vom Typ [inline] ist (Kapitel 7): Dieses [return] beendet die Funktion [read], und der Monitor wird dabei freigegeben;
- Zeilen 75–77: zum Schalter gehen (die Tabelle lesen);
- Zeilen 80–81: Der Leser ändert die Zutrittsbedingungen für den Lese-Port. Er hält weiterhin das Lese-Token, und diese Änderungen verhindern, dass andere Leser den Port nutzen;
- Zeilen 83–85: Der Leser ändert die Zutrittsbedingungen für den Schreib-Port und benachrichtigt alle wartenden Schreiber, dass sich etwas geändert hat. Dazu nimmt er das Token [canWrite]: Hier sehen wir, dass der Thread zwei Token gleichzeitig hält. Die Schreiber gehen in umgekehrter Reihenfolge vor (sie halten [canWrite] und fordern [canRead]an), was der oben beschriebenen Deadlock-Situation entspricht. Hier besteht jedoch kein Risiko: Ein Thread fordert das zweite Token erst am Ende seines Besuchs am Schalter an; die beiden Schalter sind nie gleichzeitig besetzt; und die anderen Threads halten ein Token nur so lange, wie sie zur Prüfung der Zutrittsbedingung benötigen, ohne das andere Token anzufordern.
Die Funktion [write] ist symmetrisch zur Funktion [read]. Beachten Sie die Verwendung von [notifyAll] anstelle von [notify], das nur einen einzigen Thread aufweckt: Wäre dieser Thread nicht der erwartete Schreiber, würde er wieder schlafen gehen, und der erwartete Schreiber könnte nie geweckt werden. Bei einer Zutrittsbedingung, die einen bestimmten Thread vorgibt, müssen Sie [notifyAll] verwenden.
Hier ein Ausführungsbeispiel:
Schreiber und Leser kommen an ihren Schaltern jeweils in der vorgegebenen Reihenfolge an die Reihe: W0, R2, W1, R1, W2, R0. Anders als beim vorherigen Programm ist diese Bearbeitungsreihenfolge reproduzierbar; nur die Reihenfolge der „started“-Meldungen variiert von einer Ausführung zur nächsten.
8.8.4. Bedingungen: Die Schnittstelle Condition
Die Methoden [wait] und [notifyAll] sind dem Monitor eines Objekts und damit den Blöcken [synchronized] zugeordnet. Für einen Lock [ReentrantLock] ist das Äquivalent die Schnittstelle [java.util.concurrent.locks.Condition]: Ein Objekt [Condition] wird von der Methode [newCondition()] des Locks erzeugt und stellt die Methoden [await()] (das Äquivalent von [wait]), [await(time: Long, unit: TimeUnit)], [signal()] (das Äquivalent von [notify]) und [signalAll()] (das Äquivalent von [notifyAll]) bereit. Für ihre Verwendung gelten dieselben Regeln: Der Thread muss den Lock halten, und die Zutrittsbedingung wird innerhalb einer Schleife [while] getestet. Es handelt sich um Standardmethoden einer Java-Schnittstelle: Kotlin ruft sie ohne Typumwandlung und ohne Warnungen auf. Dies ist die in Kotlin bevorzugte Lösung.
Der entscheidende Vorteil ist, dass ein einziger Lock mehrere Bedingungen haben kann – also mehrere getrennte Warteschlangen. In unserem Problem kann ein einziger Lock beide Zähler schützen, mit einer Bedingung für die Leser und einer für die Schreiber: Ein Leser, der fertig ist, weckt die Schreiber auf, und nur diese. Es gibt keine zwei Token mehr und damit keine verschachtelten Locks mehr, auf die man achten müsste. Das Programm [Threads21.kt] hat dasselbe Hauptprogramm wie [Threads20.kt]; sein Objekt [Board] lautet wie folgt:
Kommentare:
- Zeile 6: ein einziger, nicht fairer Lock;
- Zeilen 8–9: zwei aus diesem Lock erzeugte Bedingungen. Ihr Typ, [Condition], wird abgeleitet;
- Zeilen 20–24: Um das Schreib-Fenster zu öffnen, wird der Lock mit der Funktion [withLock] erworben, die Zutrittsbedingung geändert und die Schreiber mit [canWrite.signalAll()] aufgeweckt;
- Zeilen 32–53: Der Wechsel zum Lese-Fenster erfolgt, während der Lock gehalten wird. Die Funktion [withLock] ersetzt das Java-Schema [lock] / [try] / [finally] / [unlock];
- Zeilen 35–36: Bis er an der Reihe ist, wartet der Leser auf die Bedingung [canRead]. Die Methode [await] gibt den Lock während des Wartens frei und erwirbt ihn wieder, bevor sie die Kontrolle zurückgibt;
- Zeilen 38–40: Wird der Thread beim Warten unterbrochen, setzt er sein Unterbrechungs-Flag zurück und beendet sich. Da [withLock] eine Funktion vom Typ [inline] ist, beendet [return] die Funktion [read], und die Klausel [finally] innerhalb von [withLock] gibt den Lock dabei frei;
- Zeilen 51–52: Der Leser erteilt die Schreiberlaubnis und weckt die Schreiber auf. Er hält den Lock bereits, sodass er kein zweites Token erwerben muss.
Ergebnisse:
Das Verhalten ist identisch mit dem des vorherigen Programms: W0, R2, W1, R1, W2, R0.
8.8.5. Mehrere gleichzeitige Leser: ReadWriteLock
In den vorherigen Beispielen waren die Leser exklusiv. In vielen Anwendungen ist das unnötig restriktiv: Mehrere Threads können gleichzeitig Daten lesen, die niemand verändert. Nur Schreibzugriffe müssen exklusiv sein: Während ein Schreiber die Daten ändert, darf weder ein Leser noch ein anderer Schreiber darauf zugreifen. Dies ist das klassische Leser-Schreiber-Problem, das von der Schnittstelle [java.util.concurrent.locks.ReadWriteLock] gelöst wird. Ein Objekt [ReadWriteLock] stellt zwei verknüpfte Locks bereit:
- [readLock()]: der Lese-Lock, der von mehreren Threads gleichzeitig gehalten werden kann, solange kein Thread den Schreib-Lock hält;
- [writeLock()]: der Schreib-Lock, der exklusiv ist.
Die Kotlin-Standardbibliothek ergänzt zwei Erweiterungsfunktionen aus dem Paket [kotlin.concurrent] für die Klasse [ReentrantReadWriteLock] – die diese Schnittstelle implementiert –, die [withLock] entsprechen: [read { … }] führt den Block aus, während der Lese-Lock gehalten wird, und [write { … }] führt den Block aus, während der Schreib-Lock gehalten wird; beide geben den Lock am Ende des Blocks frei und liefern den Wert des Blocks zurück. Das Programm [Threads22.kt] lautet wie folgt:
Kommentare:
- Zeilen 28–52: Die gemeinsam genutzte Ressource ist ein Preiskatalog, der in einem veränderbaren Dictionary gespeichert ist, das von [mutableMapOf] erzeugt wird (Zeile 29) und eine [LinkedHashMap] ist;
- Zeile 31: die Klasse [ReentrantReadWriteLock];
- Zeilen 34–40: Die Funktion [readPrice] erwirbt einen Lese-Lock für einen Lesevorgang, der eine Sekunde dauert. Ihr Rumpf ist ein Ausdruck: der von [lock.read { … }] zurückgegebene Wert, also der Wert des letzten Ausdrucks im Block, [p]. Die Funktion [getValue] liefert den dem Schlüssel zugeordneten Wert und löst eine Exception [NoSuchElementException] aus, wenn der Schlüssel fehlt (der Operator [prices[article]] würde ein [Int?] liefern);
- Zeilen 45–53: Die Funktion [changePrice] erwirbt den Schreib-Lock für eine Änderung, die eine Sekunde dauert. Die Kotlin-Funktion [write] hat eine Besonderheit: Hält der Thread bereits den Lese-Lock, gibt sie ihn zuerst frei (andernfalls würde er sich selbst blockieren: Ein [ReentrantReadWriteLock] erlaubt keinen Wechsel vom Lese-Lock zum Schreib-Lock) und erwirbt ihn am Ende des Blocks erneut;
- Zeilen 14–17: Drei Leser lesen den Preis der Tastatur zweimal hintereinander;
- Zeilen 21–22: Ein Schreiber, der eine halbe Sekunde später gestartet wird, ändert diesen Preis;
- Zeile 24: Der Operator [+] erzeugt eine neue Liste aus den Lesern und dem Schreiber und wartet auf deren Ende.
Ergebnisse:
- Alle drei Leser lesen gleichzeitig (Zeilen 1–3 und 5–7): Mit einem Standard-Lock hätte die erste Lesereihe drei Sekunden statt einer gedauert;
- Der Schreiber, der eintraf, während die Lesevorgänge liefen, wartete, bis diese beendet waren. Danach änderte er den Preis allein;
- Die zweite Gruppe von Lesern, die nach dem Eintreffen des Schreibers begann, wartete, bis die Änderung abgeschlossen war, und las dann den neuen Preis. Der Lock [ReentrantReadWriteLock] verhindert somit, dass ein ununterbrochener Strom von Lesern einen Schreiber auf unbestimmte Zeit am Schreiben hindert: Ein Leser, der eintrifft, während ein Schreiber wartet, kommt nach dem Schreiber an die Reihe. Dieser Ablauf ist reproduzierbar; nur die Reihenfolge der Leser innerhalb jeder Gruppe variiert.
Ein Lese-Schreib-Lock ist nur sinnvoll, wenn Lesezugriffe zahlreich und ausreichend lang sind. Für sehr kurze Lesezugriffe bietet die Klasse [StampedLock] (Java 8) ein „optimistisches“ Lesen – ohne Lock –, das anschließend validiert wird. Und für eine Collection, die sehr oft gelesen, aber selten geändert wird, sind die im folgenden Abschnitt beschriebenen nebenläufigen Collections oft die beste Lösung.
8.9. Nebenläufige Collections
Die vorherigen Beispiele schützten sehr einfache gemeinsame Daten (einen Zähler, ein Array, ein kleines Dictionary). Wenn Threads sich eine Collection (Liste, Dictionary, Warteschlange) teilen, könnte man jeden Zugriff mit einem Lock schützen. Aber gewöhnliche veränderbare Collections – die von Kotlin ([mutableListOf], [mutableMapOf], [ArrayDeque]) ebenso wie die von Java ([ArrayList], [HashMap]) – sind nicht dafür ausgelegt, von mehreren Threads gleichzeitig verändert zu werden: Eine ungeschützte Verwendung kann zum Verlust von Elementen führen, unerwartete Exceptions ([ConcurrentModificationException]) auslösen oder sogar die interne Struktur der Collection beschädigen. Dasselbe gilt für die „schreibgeschützten“ Collections von Kotlin ([List], [Map]): Dieser Typ hindert den Code, der sie erhält, daran, die Collection zu ändern, garantiert aber nicht, dass niemand sonst sie ändert. Die Methoden [Collections.synchronizedList(…)], [Collections.synchronizedMap(…)] … verpacken eine gewöhnliche Collection in ein Objekt, in dem jede Methode vom Typ [synchronized] ist: Das ist sicher, aber alle Threads konkurrieren um einen einzigen Lock, und die Iteration über die Collection muss weiterhin manuell geschützt werden. Seit Java 5 bietet das Paket [java.util.concurrent] Collections, die dafür ausgelegt sind, ohne expliziten Lock von Threads gemeinsam genutzt zu werden. Die Kotlin-Standardbibliothek hat dafür auf der JVM kein Gegenstück: Wir verwenden direkt die des JDK, die die Schnittstellen [MutableList] und [MutableMap] implementieren … und daher genau wie Kotlin-Collections gehandhabt werden ([+=], [[ ]], [for], [filter], [map] …):
Collection | Rolle |
[ConcurrentHashMap<K, V>] | Ein Dictionary, dessen Operationen, einschließlich bedingter Aktualisierungen ([merge], [compute], [putIfAbsent] …), sicher und atomar sind. Mehrere Threads können es gleichzeitig lesen und ändern |
[ConcurrentSkipListMap<K, V>] | ein nach Schlüsseln sortiertes Dictionary |
[CopyOnWriteArrayList<E>] | eine Liste, die bei jeder Änderung ihr internes Array kopiert: Lesezugriffe und Durchläufe, die sehr schnell sind, werden nie durch Änderungen beeinträchtigt. Sie eignet sich für Listen, die häufig gelesen und selten geändert werden (zum Beispiel Playlists) |
[ConcurrentLinkedQueue<E>], [ConcurrentLinkedDeque<E>] | Eine Warteschlange (First-in-first-out), eine doppelseitige Warteschlange |
[BlockingQueue<E>] | eine Warteschlangen-Schnittstelle, die den Konsumenten blockiert, wenn die Warteschlange leer ist, und – bei begrenzter Kapazität – den Produzenten blockiert, wenn sie voll ist. Implementierungen: [ArrayBlockingQueue], [LinkedBlockingQueue], [PriorityBlockingQueue], [SynchronousQueue] … |
8.9.1. ConcurrentHashMap und CopyOnWriteArrayList
Im Programm [Threads23.kt] erzeugen vier Threads Zufallszahlen und zählen in einem gemeinsamen Dictionary, wie oft jede Zahl vorkommt:
Kommentare:
- Zeile 11: Das gemeinsame Dictionary ordnet jeder Ziffer die Anzahl ihrer Vorkommen zu. Die Typen [<Int, Int>] werden ausdrücklich angegeben, da das Dictionary leer erzeugt wird;
- Zeile 13: eine Liste, in die jeder Thread am Ende seiner Arbeit einen Bericht schreibt;
- Zeile 22: Die Methode [merge(key, value, function)] fügt den Schlüssel [digit] mit dem Wert 1 hinzu, falls er nicht existiert; andernfalls ersetzt sie seinen Wert v durch [function(v, 1)], hier die Addition, die durch die Referenz [Int::plus] auf die Funktion [plus] von [Int] (den Operator [+]) bezeichnet wird. In einer [ConcurrentHashMap] ist die Operation atomar. Wir könnten nicht [draws[digit] = (draws[digit] ?: 0) + 1] schreiben: Dieser Ausdruck liest den Wert und schreibt dann den neuen in zwei Operationen, und zwei Threads könnten wie im Beispiel [Threads09.kt] eine Aktualisierung verlieren;
- Zeile 26: Jeder Thread fügt seinen Bericht mit dem Operator [+=] (der Funktion [plusAssign] der veränderbaren Kotlin-Collections, die [add] aufruft) zur Liste hinzu. Die Funktion [format] von [String] formatiert die Meldung; das Format [%,d] fügt das Tausendertrennzeichen ein;
- Zeilen 32–33: Der Haupt-Thread durchläuft die Liste. Die Iteration über eine
*[CopyOnWriteArrayList]erfolgt auf einer Momentaufnahme des internen Arrays: Sie löst nie*[ConcurrentModificationException]aus, selbst wenn andere Threads die Liste während der Iteration ändern; - Zeilen 36–37: Die Erweiterungsfunktion [toSortedMap] kopiert das Dictionary in ein sortiertes Dictionary (eine [TreeMap]), um die Zahlen der Reihe nach anzuzeigen; die Schleife [for] zerlegt jeden Eintrag in Schlüssel und Wert;
- Zeile 39: die Summe der Werte, berechnet von der Funktion [sum] der Standardbibliothek (Java verwendete einen Stream);
- Zeile 42: Die Methode [computeIfAbsent(key, function)] liefert den dem Schlüssel zugeordneten Wert, nachdem sie ihn mit der Funktion berechnet und hinzugefügt hat, falls der Schlüssel nicht existierte; die Funktion ist hier ein abschließendes Lambda, das außerhalb der Klammern geschrieben wird. Wie bei [merge] bilden die Prüfung und das Hinzufügen eine einzige atomare Operation: Eine Prüfung mit [containsKey] gefolgt von einem [put] wäre nicht sicher, da ein anderer Thread den Schlüssel dazwischen hinzufügen könnte. Die Erweiterungsfunktion [getOrPut] von Kotlin, die wir bei gewöhnlichen Dictionaries verwendet haben, hat eine Version für nebenläufige Dictionaries ([ConcurrentMap]): Sie fügt nie einen zweiten Wert für einen bereits vorhandenen Schlüssel hinzu, aber ihr Lambda kann unnötigerweise aufgerufen werden, wenn zwei Threads gleichzeitig denselben Schlüssel hinzufügen. [computeIfAbsent] hat diesen Nachteil nicht.
Ergebnisse:
Die Gesamtzahl der Ziehungen ist korrekt: Es ging keine Aktualisierung verloren. Die Berichte erscheinen in der Reihenfolge, in der die Threads ihre Arbeit beendet haben; sie variiert von einer Ausführung zur nächsten, ebenso wie die Anzahl der Ziehungen pro Ziffer.
8.9.2. Produzenten und Konsumenten: BlockingQueue
Das Leser-Schreiber-Problem ist eine Variante des klassischen Produzenten-Konsumenten-Problems: Threads erzeugen Daten, die andere Threads verbrauchen. Die Schnittstelle [BlockingQueue<E>] löst es ohne explizite Synchronisationswerkzeuge:
- [put(element)] reiht ein Element in die Warteschlange ein. Hat die Warteschlange eine begrenzte Kapazität und ist voll, wird der Produzent blockiert, bis ein Platz frei wird;
- [take()] entnimmt das Element am Anfang der Warteschlange. Ist die Warteschlange leer, wird der Konsument blockiert, bis ein Element eintrifft;
- [offer(element, timeout, unit)] und [poll(timeout, unit)] tun dasselbe mit einer maximalen Wartezeit; [offer(element)] und [poll()], die kein Timeout haben, blockieren nie: Sie liefern im Fehlerfall [false] oder [null] (in Kotlin liefert [poll] einen Plattformtyp, [Int!], der wie ein [Int?] behandelt werden sollte).
Die Warteschlange weiß nicht, dass die Produktion beendet ist. Eine klassische Technik besteht darin, am Ende der Produktion einen speziellen Wert – im Englischen „Poison Pill“ genannt – in die Warteschlange zu legen: Der Konsument, der ihn entnimmt, weiß, dass er aufhören muss. Eine andere Technik besteht darin, die Konsumenten zu unterbrechen, da [take] unterbrechbar ist. Das Programm [Threads24.kt] lautet wie folgt:
Kommentare:
- Zeile 11: Der Wert, der das Ende der Produktion markiert. Dies ist eine Konstante auf oberster Ebene, die außerhalb jeder Klasse deklariert ist ([const val], Kapitel 3);
- Zeile 15: eine Warteschlange mit höchstens 3 Elementen. [ArrayBlockingQueue] speichert die Elemente in einem Array fester Größe; [LinkedBlockingQueue] hat standardmäßig eine unbegrenzte Kapazität. Die Variable wird mit dem Schnittstellentyp [BlockingQueue<Int>] deklariert, wodurch der Compiler den Typ der Elemente aus dem Konstruktor [ArrayBlockingQueue(3)] ableiten kann;
- Zeilen 19–29: Der Produzent legt die Zahlen 1 bis 8 im Takt von einer Zehntelsekunde in die Warteschlange, gefolgt von einer Endemarkierung für jeden Konsumenten (Zeile 28). Der Parameter [start = false] der Funktion [thread] erzeugt den Thread, ohne ihn zu starten: Er wird später zusammen mit den Konsumenten gestartet;
- Zeilen 36–48: Zwei Konsumenten entnehmen die Zahlen und benötigen 0,6 Sekunden für die Verarbeitung jeder Zahl. Sie konsumieren langsamer, als der Produzent produziert;
- Zeile 42: die blockierende Entnahme. Jede Zahl wird nur von einem der beiden Konsumenten entnommen;
- Zeile 43: Ein Konsument, der die Ende-Marke entnimmt, verlässt seine Schleife. Jeder Konsument entnimmt eine Marke, daher wird pro Konsument eine Marke hinterlegt;
- Der Produzent und die Konsumenten enthalten die Anweisung [try], da [put], [take], und [sleep] eine [InterruptedException] auslösen können. Kotlin verlangt dies nicht, aber ohne sie würde die Exception den Thread beenden und einen Aufrufstapel auf der Konsole ausgeben;
- Zeilen 56–58: Alle Threads starten und dann auf ihr Ende warten.
Ergebnisse:
Wir sehen, dass der Produzent die ersten Zahlen schnell hinzufügt und dann – sobald die Warteschlange 3 Elemente enthält – nur noch eine Zahl hinzufügt, wenn ein Konsument eine entnimmt: Er wird von [put] blockiert, wenn die Warteschlange voll ist. Die Konsumenten teilen sich die Zahlen untereinander auf und hören auf, wenn sie die Endemarkierung entnehmen. Dieser Rhythmus ist reproduzierbar; die Zuordnung jeder Zahl zu C1 oder C2 ist es jedoch nicht. Der Produzent zeigt „P has finished“ erst an, nachdem beide Endemarkierungen hinterlegt wurden, also nachdem C1 die Zahl 7 entnommen und einen Platz freigegeben hat. Wir stellen in den ersten beiden Zeilen außerdem fest, dass die Zahl 1 von C1 entnommen wurde, bevor P sein Einreihen anzeigt (daher „waiting elements: 0“), obwohl die von C1 gelesene Zeit früher ist als die von P gelesene: Jeder Thread liest die Zeit und gibt sie dann aus, und ein anderer Thread kann sich dazwischenschieben.
Wir werden diesem Muster im nächsten Kapitel bei den Coroutine-Channels ([Channel]) wieder begegnen, die das Coroutine-Äquivalent einer blockierenden Warteschlange sind: Ihre Operationen [send] und [receive] suspendieren die Coroutine, anstatt den Thread zu blockieren. Bei virtuellen Threads belegt ein Konsument, der auf [take] blockiert ist, keinen Systemthread.
8.10. Thread-Pools: ExecutorService
8.10.1. Das Prinzip
Bisher haben wir Threads verwaltet, indem wir sie erstellt und dann gestartet haben, entweder über [start()] oder die Funktion [thread]. Das Erstellen eines Plattform-Threads ist eine relativ teure Operation: Insbesondere muss das System ihm einen Stack zuweisen, und jeder Thread belegt Speicher, solange er existiert. Wir werden in Kapitel 10 sehen, dass es Verbindungspools gibt: Geöffnete Verbindungen werden in Reserve gehalten und an Threads verliehen, die sie anfordern, da das Öffnen einer Verbindung aufwendig ist. Ein ähnliches System gibt es für Threads: den Thread-Pool.
Die JDK-Klasse repräsentiert einen Thread-Pool über die Schnittstelle [java.util.concurrent.ExecutorService] (einen „Executor“): Es werden keine Threads mehr erstellt; stattdessen werden dem Executor Aufgaben zugewiesen, die er von seinen Threads ausführen lässt. Ein Thread, der eine Aufgabe abgeschlossen hat, wird nicht zerstört; er übernimmt die nächste Aufgabe. Die Klasse [ThreadPoolExecutor], die gängigste Implementierung, funktioniert wie folgt:
- Sie hat eine feste Anzahl von Threads („Core Pool Size“): Solange diese Anzahl nicht erreicht ist, löst jede neue Aufgabe die Erstellung eines neuen Threads aus;
- darüber hinaus werden Aufgaben in eine Warteschlange (eine [BlockingQueue]) gestellt, aus der die Threads sie entnehmen;
- Ist die Warteschlange voll, erstellt der Pool zusätzliche Threads bis zu einer maximalen Anzahl („Maximum Pool Size“). Diese zusätzlichen Threads werden zerstört, wenn sie länger als eine bestimmte Zeit inaktiv bleiben;
- Ist das Maximum erreicht und die Warteschlange voll, wird die Aufgabe abgelehnt: Standardmäßig löst die Methode, die sie eingereicht hat, die Exception [RejectedExecutionException] aus.
Der Thread-Pool bietet zwei Vorteile: Er spart Zeit für die Erstellung von Threads (wenige Threads können Hunderte von Anfragen bearbeiten), und durch die Begrenzung der Thread-Anzahl verhindert er, dass die Anwendung von zu vielen Anfragen überlastet wird.
Ein Executor wird über seine Methode [shutdown] beendet (er nimmt keine neuen Aufgaben mehr an, und seine Threads enden, sobald die bereits eingereichten Aufgaben abgeschlossen sind), gegebenenfalls gefolgt von [awaitTermination] (die auf das Ende der Aufgaben wartet), oder über [shutdownNow] (die die laufenden Aufgaben unterbricht). Ab Java 19 erweitert [ExecutorService] die Schnittstelle [AutoCloseable]: Ihre Methode [close] ruft [shutdown] auf und wartet dann auf das Ende aller Aufgaben. In Kotlin können Sie einen Executor daher in einem Block [use { … }] verwenden – der Erweiterungsfunktion von [AutoCloseable] , die die Anweisung [try] mit einer Java-Ressource ersetzt (Kapitel 3) –. Beim Verlassen des Blocks sind alle zugewiesenen Aufgaben abgeschlossen. Das Programm [Threads25.kt] lautet wie folgt:
Kommentare:
- Zeile 18: Der Pool hat 3 permanente Threads bei höchstens 5 Threads; jeder zusätzliche Thread, der 60 Sekunden lang inaktiv war, wird zerstört; die Aufgabenwarteschlange ist eine [ArrayBlockingQueue] mit 2 Plätzen (der Typ ihrer Elemente, [Runnable], wird aus dem Konstruktorparameter abgeleitet). Der Pool wird in einem Block [use] verwendet, der ihn [pool] nennt;
- Zeilen 20–25: 8 Jobs mit einer Dauer von jeweils 3 Sekunden werden dem Pool zugewiesen. Die Methode [execute(Runnable)] weist dem Pool eine Aufgabe zu, ohne zu warten; das Lambda [{ sleep(data, pool) }] wird in ein [Runnable] umgewandelt (SAM-Konvertierung, Kapitel 7);
- Zeile 21: Jeder Job erhält ein Objekt [Data]; dies ist eine Data Class (Zeile 13), die denselben Zweck erfüllt wie der Java-[record];
- Zeilen 24–25: Ein vom Pool abgelehnter Job löst die Exception [RejectedExecutionException] aus;
- Zeile 29: Das Verlassen des Blocks [use] schließt den Pool und wartet, bis die zugewiesenen Jobs abgeschlossen sind;
- Zeilen 35–48: der Job, der von einem Thread des Pools ausgeführt wird. Die Namen der Threads ([pool-1-thread-1] …) werden vom Pool vergeben;
- Zeile 39: der Zustand des Pools: die Anzahl der Threads, die Anzahl der Threads, die gerade eine Aufgabe ausführen, und die Anzahl der in der Warteschlange wartenden Aufgaben. Die Java-Methoden [getPoolSize], [getActiveCount] und [getQueue] werden von Kotlin als Properties behandelt: [poolSize], [activeCount], [queue];
- Zeile 52: Die Zeiten werden auf die Hundertstelsekunde genau angezeigt ([SS]).
Ergebnisse:
- Die Jobs 0, 1 und 2 wurden den drei dafür erstellten permanenten Threads zugewiesen;
- Die Jobs 3 und 4 wurden in die Warteschlange gestellt, die nun voll ist;
- Die Jobs 5 und 6 lösten die Erstellung von zwei zusätzlichen Threads aus ([pool-1-thread-4] und [pool-1-thread-5]): Sie starteten sofort, vor den Jobs 3 und 4, die in der Warteschlange warteten. Das ist die Regel für [ThreadPoolExecutor]: zuerst die Warteschlange, dann die zusätzlichen Threads – was oft überrascht;
- Der Job 7 wurde abgelehnt: 5 Threads belegt, Warteschlange voll;
- Die Jobs 3 und 4 mussten warten, bis ein Thread frei wurde, nachdem die ersten Jobs beendet waren: Hier verwendeten sie die Threads 4 und 5 wieder – die beiden zusätzlichen Threads, die zuerst frei wurden. Insgesamt benötigten sie ab ihrer Anforderung etwas mehr als 6 Sekunden: 3 Sekunden Wartezeit und 3 Sekunden Verarbeitung;
- Die Werte, die jeder Job beim Start anzeigt (Anzahl der Threads, Warteschlange), hängen vom genauen Zeitpunkt ab, zu dem er den Prozessor erhielt: Sie variieren von einer Ausführung zur nächsten, ebenso wie die von den Jobs 3 und 4 wiederverwendeten Threads. Das Ergebnis jedes Jobs (sofortige Ausführung, Warten in der Warteschlange oder Ablehnung) ist jedoch reproduzierbar.
Sie erstellen nur selten selbst einen *[ThreadPoolExecutor] : Die Klasse *[Executors] stellt Erzeugungsmethoden für gängige Fälle bereit:
Methode | Zurückgegebener Executor |
[newFixedThreadPool(n)] | ein Pool mit n permanenten Threads und einer Warteschlange unbegrenzter Kapazität |
[newCachedThreadPool()] | ein Pool ohne permanente Threads, der bei Bedarf beliebig viele Threads erstellt und diejenigen zerstört, die 60 Sekunden lang inaktiv bleiben |
[newSingleThreadExecutor()] | ein einzelner Thread, der die Aufgaben nacheinander in der Reihenfolge ihrer Einreichung ausführt |
[newScheduledThreadPool(n)] | Ein Pool, der Aufgaben verzögert oder periodisch ausführen kann (Schnittstelle [ScheduledExecutorService]) |
[newVirtualThreadPerTaskExecutor()] | (Java 21) ein Executor ohne Pool, der für jede Aufgabe einen neuen virtuellen Thread erstellt |
Der letzte Executor verdient eine Anmerkung: Virtuelle Threads werden nicht in einem Pool abgelegt. Sie sind so billig, dass für jede Aufgabe ein neuer erstellt wird; um den Ressourcenverbrauch zu begrenzen, verwendet man einen Semaphor, wie im Programm [Threads15.kt]. Bemerkenswert ist auch, dass die Coroutine-Bibliothek einen Executor in einen „Dispatcher“ umwandeln kann ([executor.asCoroutineDispatcher()]): Die Coroutinen aus Kapitel 9 laufen letztlich ebenfalls in Thread-Pools.
8.10.2. Aufgaben mit Ergebnissen: Callable und Future
Die Methode [execute] übergibt dem Pool ein [Runnable], das kein Ergebnis zurückgibt. Die Methode [submit(task)] akzeptiert auch ein [Callable<V>], eine funktionale Schnittstelle, deren Methode [call(): V] ein Ergebnis vom Typ V zurückgibt (in Java deklariert sie [throws Exception]; Kotlin ignoriert diese Deklaration). Sie liefert ein Objekt [Future<V>], mit dem Sie die Aufgabe verfolgen können:
Methode von Future<V> | Rolle |
[get(): V], [get(timeout: Long, unit: TimeUnit): V] | wartet auf den Abschluss der Aufgabe (höchstens [timeout]) und liefert ihr Ergebnis. Löst die Aufgabe eine Exception aus, löst [get] eine [ExecutionException] aus, die sie umhüllt (Property [cause]) |
[isDone(): Boolean] | zeigt an, ob die Aufgabe abgeschlossen ist (normal, aufgrund einer Exception oder eines Abbruchs); in Kotlin ist dies die Property [isDone] |
[state(): Future.State] | (Java 19) der Status der Aufgabe: [RUNNING], [SUCCESS], [FAILED], oder [CANCELLED] |
[resultNow(): V], [exceptionNow(): Throwable] | (Java 19) das Ergebnis oder die Exception einer bereits abgeschlossenen Aufgabe, ohne zu warten |
[cancel(mayInterruptIfRunning: Boolean): Boolean] | bricht die Aufgabe ab; wurde sie bereits gestartet und [mayInterruptIfRunning] ist gleich [true], wird der Thread, der sie ausführt, beendet |
Die Methode [invokeAll(collection of Callable)] des Executors reicht alle Aufgaben einer Collection ein, wartet auf den Abschluss aller und liefert die Liste ihrer [Future]-Werte in der Reihenfolge der Collection. Die Methode [invokeAny] liefert das Ergebnis der ersten erfolgreich abgeschlossenen Aufgabe und bricht die anderen ab. Das Programm [Threads26.kt] lautet wie folgt:
Kommentare:
- Zeile 15: ein Pool mit 2 Threads, erstellt mit [Executors.newFixedThreadPool(2)] und am Ende des Blocks [use] geschlossen;
- Zeilen 17–24: Jede Aufgabe ist ein Lambda, das den ausführenden Thread anzeigt, 0,5, 1 oder 1,5 Sekunden schläft und dann ein ganzzahliges Ergebnis liefert – den Wert seines letzten Ausdrucks. Die Funktion [List] erstellt die Liste der drei [Future<Int>]-Objekte, die von [submit] zurückgegeben werden;
- Zeile 18: Vorsicht bei der Überladung von
submit. Die Methode*[submit]existiert in mehreren Versionen, darunter***[submit(Runnable)]und***[submit(Callable<T>)]***. Bei einem Lambda wählt Java die Version [Callable], wenn das Lambda einen Wert zurückgibt. Kotlin hingegen betrachtet jedes Lambda als in [Runnable]* umwandelbar (wobei sein Wert ignoriert wird) und wählt [submit(Runnable)]! Wenn Sie***[val f = pool.submit { 10 }]schreiben, gibt der Compiler lediglich eine Warnung aus:
und [f.get()] liefert [null], das „Ergebnis“ eines [Runnable]. Die Version [Callable] erzwingen wir, indem wir das Typargument angeben, [submit<Int> { … }], wie hier gezeigt, oder indem wir ausdrücklich ein [Callable] erzeugen: [pool.submit(Callable { … })]. Das [Thread.sleep] in Zeile 22 muss nicht von einem [try] umgeben sein: Kotlin kennt keine geprüften Exceptions, und eine eventuelle [InterruptedException] würde im [Future] festgehalten;
- Zeile 28: Die Funktion [forEachIndexed] durchläuft die Liste und liefert den Index und das Element;
- Zeile 30: [future.get()] wartet auf das Ende der Aufgabe und liefert ihr Ergebnis; [future.state()] liefert ihren Status. Da [state] kein Accessor der Form [getXxx] ist, behandelt Kotlin es als Methode, nicht als Property;
- Zeile 37: eine Aufgabe, die die Funktion [fail] ausführt (Zeile 64), die eine Exception auslöst. Der Rückgabetyp von [fail] ist [Int]: Der Ausdruck [throw …] hat den Typ [Nothing], der mit allen Typen kompatibel ist;
- Zeilen 39–43: Die in der Aufgabe ausgelöste Exception geht nicht verloren; sie wird im Objekt [Future] gespeichert und dann in dem Thread, der das Ergebnis anfordert, erneut ausgelöst, eingehüllt in eine
*[ExecutionException], deren Property[cause]*(die Java-Methode*[getCause]*) die ursprüngliche Exception enthält. Diese Property hat den Typ [Throwable?]; der Operator [!!] stellt sicher, dass sie nicht [null] ist, was hier garantiert ist. Der Ausdruck [e::class.simpleName] liefert den Kurznamen der Klasse der Exception; - Zeilen 49–58: ein Executor, der pro Aufgabe einen virtuellen Thread erstellt. Die Aufgaben werden ausdrücklich als [Callable] erzeugt, mit dem SAM-Konstruktor [Callable { … }] (Zeile 51): Die Liste [jobs] hat daher den Typ [List<Callable<String>>]. Die Methode [invokeAll] (Zeile 56) weist dem Executor die drei Jobs zu und wartet auf deren Ende. Sobald die Aufgaben abgeschlossen sind, liefert [resultNow] ihre Ergebnisse sofort.
Ergebnisse:
- Die Aufgaben laufen in den Threads des Pools ([pool-1-thread-1] und [pool-1-thread-2]);
- Aufgabe 2 startete erst, nachdem Aufgabe 0 beendet war, und zwar in dem Thread, den Aufgabe 0 freigegeben hatte: Der Pool hat nur 2 Threads, und Aufgabe 2 wartete in der Warteschlange. Dieses Verhalten ist reproduzierbar;
- Die Ergebnisse werden nach dem Ende der Aufgaben abgerufen, und ihr Status ist [SUCCESS];
- Die Exception der fehlgeschlagenen Aufgabe wurde vom Haupt-Thread abgefangen, und der Status der Aufgabe ist [FAILED];
- Die drei Jobs des zweiten Teils wurden von drei verschiedenen virtuellen Threads ausgeführt, die auf die Carrier-Threads [ForkJoinPool-1-worker-1] und [ForkJoinPool-1-worker-2] aufgesetzt waren (die Verteilung auf die Carrier variiert von einer Ausführung zur anderen).
Einen Thread in [get] zu blockieren, um auf ein Ergebnis zu warten, ist einfach, aber man kann Verarbeitungsschritte nicht an den Abschluss einer Aufgabe ketten, ohne zu warten. Das folgende Kapitel stellt die JDK-Klasse [CompletableFuture] vor, die dies erlaubt, und vor allem die Lösung von Kotlin: Coroutinen mit [async] und [Deferred] (dem Äquivalent eines [Future] , auf dessen Ergebnis mit [await] gewartet wird, ohne einen Thread zu blockieren). Beachten Sie schließlich, dass Java 25 als Vorschau strukturierte Nebenläufigkeit ([StructuredTaskScope]) anbietet, die eine Gruppe von Teilaufgaben als eine einzige Arbeitseinheit behandelt (schlägt eine fehl, werden die anderen abgebrochen). Sie wird in diesem Kurs nicht verwendet: Die Kotlin-Coroutinen beruhen auf demselben Prinzip, das in Kotlin seit Langem Standard ist, und Kapitel 9 behandelt es ausführlich.
8.11. Datenparallelität
8.11.1. Parallele Streams
Kehren wir zur Hauptverwendung von Threads zurück: alle Prozessoren für eine zeitaufwendige Berechnung zu nutzen. Die Kotlin-Standardbibliothek bietet keine parallelen Operationen auf Collections: Ihre Funktionen ([filter], [map], [count] …) und ihre Sequenzen sind sequenziell. Ein Kotlin-Programm hat jedoch Zugriff auf die Stream-API von Java (Kapitel 5), deren Streams parallel ausgeführt werden können: Man ruft einfach [parallel()] auf einem Stream auf oder [parallelStream()] anstelle von [stream()] auf einer Collection (eine Kotlin-Liste ist eine [java.util.List]: Sie hat diese Methoden). Der Stream teilt die Daten dann in Abschnitte auf, lässt die Abschnitte von mehreren Threads verarbeiten und fügt anschließend die Teilergebnisse zusammen. Die verwendeten Threads stammen aus dem gemeinsamen Pool ([ForkJoinPool.commonPool()]), ergänzt um den Thread, der den Stream ausführt. Standardmäßig hat der gemeinsame Pool so viele Threads, wie es Prozessoren gibt, minus eins: Der aufrufende Thread übernimmt die Zählung.
Diese Streams eignen sich nur, wenn die Verarbeitung jedes Elements unabhängig von den anderen ist: Die Verarbeitungsreihenfolge ist nicht definiert, und wenn die Verarbeitung gemeinsame Daten aktualisiert, müssen diese geschützt werden. Das Programm [Threads27.kt] lautet wie folgt:
Kommentare:
- Zeilen 15–22: Die Primzahlen unterhalb von 5.000.000 werden mit einer gewöhnlichen Schleife [for] gezählt. Die Funktion [isPrime] (Zeilen 64–71) testet Teiler bis zur Quadratwurzel der Zahl: Das ist zeitaufwendig, und die Iterationen sind voneinander unabhängig. Die Dauer wird von der Funktion [measureTimedValue] der Standardbibliothek ([kotlin.time]) gemessen: Sie führt ihr Lambda aus und liefert ein Objekt [TimedValue], das den vom Lambda gelieferten Wert und die Dauer seiner Ausführung enthält (eine
*[Duration]*); dieses wird in zwei Variablen zerlegt. Die Property*[inWholeMilliseconds]liefert die Dauer in Millisekunden. Java maß die Dauer mit***[System.nanoTime()]**; - Zeile 25: dieselbe Berechnung im Kotlin-Stil: Die Funktion [count] des Intervalls [2..<N] zählt die Elemente, die das Prädikat erfüllen. Dies erfolgt sequenziell;
- Zeile 29: dieselbe Berechnung mit einem sequenziellen Java-Stream: [IntStream.range(2, N)] erzeugt die ganzen Zahlen von 2 bis N - 1, [filter] behält nur die Primzahlen, und [count] zählt sie (das Ergebnis ist ein [Long]). Das Lambda [{ isPrime(it) }] wird in einen [IntPredicate] umgewandelt, die von [filter] erwartete funktionale Schnittstelle;
- Zeilen 33–34: derselbe Stream, durch [parallel()] parallelisiert. Sonst muss nichts geändert werden: Jeder Thread zählt die Primzahlen in seinen Abschnitten, und der Stream addiert die Teilzählungen. Zwischen den Threads werden keine Daten geteilt;
- Zeilen 39–44: Um festzustellen, welche Threads ihre Arbeit erledigt haben, zählt der parallele Stream für jeden Thread die von ihm gefundenen Primzahlen und speichert sie in einer gemeinsamen [ConcurrentHashMap]. Dies sind gemeinsame Daten, die durch eine atomare Operation ([merge]) aktualisiert werden;
- Zeilen 48–52: Die Methode [parallelStream()] einer Kotlin-Liste von Dateinamen liefert einen parallelen Stream; [forEach] verarbeitet jede Datei (die Verarbeitung wird durch eine halbe Sekunde Pause simuliert). Bei einem parallelen Stream behält [forEach] die Reihenfolge der Liste nicht bei; [forEachOrdered] würde sie beibehalten, auf Kosten eines Teils der Parallelität;
- Zeile 55: die Anzahl der Threads im gemeinsamen Pool;
- Zeilen 59–60: Ausgabe eines Ergebnisses: [%-20s] richtet den Namen der Methode linksbündig auf 20 Zeichen aus.
Ergebnisse:
- Alle vier Versionen finden dieselbe Anzahl von Primzahlen;
- Zwei Threads beteiligten sich an der parallelen Verarbeitung: der Thread [main] und der einzige Thread des gemeinsamen Pools ([ForkJoinPool.commonPool-worker-1]): Auf dieser Maschine mit zwei Prozessoren hat der gemeinsame Pool nur einen Thread (letzte Zeile);
- Die Dateien werden paarweise im Abstand einer halben Sekunde und in einer Reihenfolge verarbeitet, die nicht der der Liste entspricht;
- Hier war der parallele Stream nicht schneller als die sequenziellen Versionen, sondern sogar die langsamste. Dies ist kein Mangel der Parallelverarbeitung: Zum Zeitpunkt des Tests führte die Maschine (2 Prozessoren) viele andere sehr aktive Programme aus (eine durchschnittliche Last von etwa zehn laufbereiten Threads für 2 Prozessoren), sodass der zweite Prozessor, auf den sich die Parallelverarbeitung stützte, nicht verfügbar war. Auch die gemessenen Ausführungszeiten schwankten bei allen Versionen von einem Lauf zum nächsten erheblich. Auf einer gering ausgelasteten Maschine mit n Prozessoren kann ein paralleler Thread wie dieser fast n-mal schneller sein als der sequenzielle. Man muss die Leistung stets unter realen Bedingungen messen, bevor man Schlüsse zieht: Die Parallelisierung hat ihren Preis (Aufteilung der Arbeit, Synchronisation, Zusammenführen der Ergebnisse), der sich nur lohnt, wenn die Verarbeitung jedes Elements genügend Rechenaufwand erfordert und Prozessoren zur Ausführung verfügbar sind.
Im nächsten Kapitel werden wir Berechnungen auch mit Coroutinen parallelisieren, indem wir sie auf dem Dispatcher [Dispatchers.Default] starten, dessen Threads ebenfalls so zahlreich sind wie die Prozessoren.
8.11.2. Teile und herrsche: ForkJoinPool und RecursiveTask
Parallele Streams beruhen auf dem Fork/Join-Framework (Java 7), das man auch direkt verwenden kann. Es eignet sich gut für „Teile-und-herrsche“-Algorithmen: Eine zu große Aufgabe wird in Teilaufgaben zerlegt, die wiederum zerlegt werden, bis die Teile klein genug sind, um direkt verarbeitet zu werden; die Ergebnisse der Teilaufgaben werden anschließend kombiniert. Eine Aufgabe ist eine Klasse, die von [RecursiveTask<V>] (eine Aufgabe, die ein Ergebnis vom Typ V liefert) oder von [RecursiveAction] (ohne Ergebnis) abgeleitet ist und für die die Methode [compute] überschrieben wird. In [compute] reicht die Methode [fork()] einer Teilaufgabe diese sofort beim Pool ein, und ihre Methode [join()] wartet auf ihr Ergebnis.
Die Aufgaben werden von einem [ForkJoinPool] ausgeführt, in dem jeder Thread eine eigene Aufgabenwarteschlange hat. Ein Thread, der nichts mehr zu tun hat, „stiehlt“ Aufgaben aus der Warteschlange eines anderen Threads („Work Stealing“): Die Last verteilt sich so automatisch. Die Threads, die die virtuellen Threads tragen, bilden ebenfalls einen [ForkJoinPool]: Diesen haben wir in der Textdarstellung der virtuellen Threads gesehen ([ForkJoinPool-1-worker-1]). Das Programm [Threads28.kt] zählt Primzahlen mithilfe einer rekursiven Aufgabe:
Kommentare:
- Zeilen 29–52: Die Aufgabe [CountPrimes] zählt Primzahlen im Intervall [start, end[. Sie ist von [RecursiveTask<Int>] abgeleitet: Die Java-Klasse ist abstrakt; ihr parameterloser Konstruktor ([RecursiveTask<Int>()]) wird im Klassenkopf aufgerufen. Die Grenzen [start] und [end] sind private Properties, die im primären Konstruktor deklariert werden;
- Zeilen 30–34: Die Klassenmitglieder sind im Companion Object zusammengefasst: der Schwellenwert [THRESHOLD] (unterhalb von 100.000 Zahlen wird ein Intervall direkt verarbeitet) und für jeden Thread die Anzahl der von ihm verarbeiteten Abschnitte ([chunks]). Fork/Join-Aufgaben sind serialisierbar; Java deklarierte eine Serialisierungs-Versionsnummer ([serialVersionUID]), die von seiner Kompilierungsoption [-Xlint:all] verlangt wurde. Der Kotlin-Compiler verlangt sie nicht, und wir werden diese Aufgaben nie serialisieren: Wir lassen sie weg;
- Zeile 37: die Neudefinition der Methode [compute], die in Java als [protected] deklariert ist: Die Neudefinition bleibt [protected], ohne dass wir es angeben müssen;
- Zeilen 39–41: Ein relativ kleiner Abschnitt wird sequenziell von der Funktion [count] innerhalb des Intervalls verarbeitet;
- Zeilen 44–46: Ein zu großer Abschnitt wird in zwei Teilaufgaben aufgeteilt. Der Ausdruck [(start + end) ushr 1] berechnet die Mitte mit einer vorzeichenlosen Rechtsverschiebung (die Infix-Funktion [ushr], die dem Java-Operator [>>>] entspricht), was einen Überlauf verhindert, wenn die Summe die Kapazität eines [Int] übersteigt;
- Zeile 48: Die linke Hälfte wird im Pool abgelegt: Ein anderer Thread kann sie übernehmen;
- Zeile 50: Die rechte Hälfte wird vom aktuellen Thread durch einen direkten Aufruf von [compute] verarbeitet. Es ist nicht nötig, beide Hälften dem Pool zuzuweisen: Der aktuelle Thread hätte sonst nichts mehr zu tun, als zu warten;
- Zeile 52: Der Thread wartet auf das Ergebnis der linken Hälfte (die er selbst verarbeitet, falls sie niemand „gestohlen“ hat) und kombiniert die beiden Ergebnisse;
- Zeile 12: Die Aufgabe wird zunächst vom gemeinsamen Pool ausgeführt. Die Methode [invoke(task)] reicht die Aufgabe ein und wartet auf ihr Ergebnis;
- Zeilen 16–20: Danach von einem Pool mit 4 Threads, der in einem Block [use] verwendet wird ([ForkJoinPool] ist ein [ExecutorService]). Die Property [stealCount] (Java-Methode [getStealCount]) liefert die Anzahl der Aufgaben, die ein Thread einem anderen gestohlen hat;
- Zeilen 23–24: die Verteilung der Abschnitte auf die Threads dieses Pools.
Ergebnisse:
- Der gemeinsame Pool war nicht schneller als eine sequenzielle Schleife (vergleichen Sie mit dem vorherigen Programm): Auf dieser Maschine hat er nur einen Thread, und der Haupt-Thread – der in [invoke] auf das Ergebnis wartet – beteiligt sich nicht an der Berechnung, wie er es bei einem parallelen Stream tut;
- Der Pool mit 4 Threads war schneller, weil er beide Prozessoren nutzen konnte, aber nicht doppelt so schnell, da die Maschine weiterhin durch andere Programme stark ausgelastet war. Mehr Threads als Prozessoren zu haben, bringt bei einer reinen Berechnung keinen Vorteil, kostet hier aber auch nicht viel;
- Die 64 Abschnitte (5.000.000 / 100.000, wegen der Halbierung auf die nächste Zweierpotenz aufgerundet) wurden durch Work Stealing auf die 4 Threads verteilt. Diese Verteilung variiert wie die Ausführungszeiten von einem Lauf zum nächsten; die Anzahl der Abschnitte und das Ergebnis der Berechnung sind reproduzierbar.
Parallele Streams genügen in den meisten Fällen; eine Fork/Join-Aufgabe schreibt man nur für einen rekursiven Algorithmus, der sich nicht leicht als Stream ausdrücken lässt (Sortieren, Baumtraversierung usw.).
8.12. Thread-lokale Daten
8.12.1. Das Prinzip
Betrachten wir eine Drei-Schichten-Anwendung:
Nehmen wir an, die Anwendung ist mehrbenutzerfähig, etwa eine Webanwendung. Jede Benutzeranfrage wird von einem Thread bearbeitet. Der Lebenszyklus des Threads ist wie folgt:
- Der Thread wird erstellt (virtueller Thread) oder aus einem Thread-Pool angefordert, um die Anfrage eines Benutzers zu bearbeiten;
- Benötigt diese Anfrage Daten, führt der Thread eine Funktion der Schicht [ui] aus, die eine Funktion der Schicht [business] aufruft, die ihrerseits eine Funktion der Schicht [dao] aufruft;
- Der Thread gibt dem Benutzer die Antwort zurück. Anschließend wird er entweder beendet oder an den Thread-Pool zurückgegeben.
Im zweiten Schritt kann es nützlich sein, dass der Thread über eigene Daten verfügt – also Daten, die nicht mit anderen Threads geteilt werden. Diese Daten könnten zum Beispiel dem Benutzer gehören, den der Thread gerade bedient, und in den verschiedenen Schichten [ui, business, dao] verwendet werden, ohne jeder Funktion als Parameter übergeben zu werden.
Das JDK stellt hierfür zwei Werkzeuge bereit, die Kotlin unverändert verwendet:
- die Klasse [ThreadLocal<T>] (Java 1.2): ein Objekt, dessen Wert – gelesen mit [get()] und geschrieben mit [set(value)] – für jeden Thread verschieden ist. Der Konstruktor [ThreadLocal.withInitial(factory)] liefert den Anfangswert für jeden Thread; die Methode [remove()] löscht den Wert des aktuellen Threads. Die abgeleitete Klasse [InheritableThreadLocal<T>] gibt den Wert des erzeugenden Threads an den neu erzeugten Thread weiter;
- die Klasse [ScopedValue<T>] (final in Java 25): ein Wert, der für einen begrenzten Codebereich an einen Thread gebunden ist und innerhalb dieses Bereichs nicht verändert werden kann.
8.12.2. Die Klasse ThreadLocal
Das Programm [Threads29.kt] vergleicht eine gewöhnliche Property, ein [ThreadLocal] und ein [InheritableThreadLocal]:
Kommentare:
- Zeilen 9–10: eine gewöhnliche Property des Objekts [Context]. Es gibt nur eine Instanz davon, die von allen Threads geteilt wird. Sie ist [@Volatile], damit jeder Thread den zuletzt von den anderen geschriebenen Wert sieht;
- Zeile 12: ein Objekt [ThreadLocal<Int?>]. Jeder Thread hat seinen eigenen Wert; solange ein Thread nicht darauf geschrieben hat, [get] liefert [null]. Wir deklarieren den Typ der Werte [Int?], damit der Compiler weiß, dass [get] den Wert [null] liefern kann: Bei [ThreadLocal<Int>] würde Kotlin das Ergebnis von
*[get]* als Plattformtyp (***[Int!]***) behandeln, bei dem es keine Prüfungen vornimmt; - Zeilen 14–15: ein Objekt [ThreadLocal<String>], das von [ThreadLocal.withInitial { … }] erzeugt wird. Das an diese Methode übergebene Lambda (umgewandelt in einen [Supplier]) wird ausgeführt, wenn ein Thread den Wert zum ersten Mal liest, ohne ihn geschrieben zu haben; es liefert den Anfangswert für diesen Thread. Hier liefert [get] nie [null]: Der Typ [String] ist gerechtfertigt. Kotlin stellt außerdem eine Erweiterungsfunktion [getOrSet { … }] bereit (Paket [kotlin.concurrent]), die den Wert des aktuellen Threads liefert, nachdem sie ihn mit dem Lambda initialisiert hat, falls er [null] ist;
- Zeile 17: ein Objekt [InheritableThreadLocal<String?>]: Bei der Erstellung eines Threads ist sein Anfangswert eine Kopie des Werts, den der erzeugende Thread zu diesem Zeitpunkt hatte;
- Zeilen 23–26: Der Haupt-Thread schreibt seine eigenen Werte;
- Zeilen 32–40: Jeder Thread schreibt seine eigenen Werte, außer dem Thread T2, der keinen Benutzer setzt, und dem Thread T1, der als einziger die Sprache ändert;
- Zeile 43: Jeder Thread wartet, bis die anderen geschrieben haben, bevor er die Werte erneut liest;
- Zeilen 54–57: die Daten, wie sie der aktuelle Thread sieht. Das Format [%-3d] akzeptiert einen Wert [null], den es als [null] anzeigt.
Ergebnisse:
- Die gewöhnliche Property [shared] hat für alle Threads denselben Wert: den zuletzt geschriebenen (in dieser Ausführung den des Threads T1; eine andere Ausführung kann einen anderen Wert liefern);
- [perThread] behielt in jedem Thread den Wert, den dieser Thread hineingeschrieben hatte;
- [user] hat den von jedem Thread geschriebenen Wert; der Thread T2, der nicht darauf geschrieben hatte, erhielt den Anfangswert, den das Lambda von [withInitial] lieferte;
- [language] ist gleich [fr] für die Threads T0 und T2, die ihn vom Haupt-Thread geerbt haben, ohne je darauf zu schreiben. Der Thread T1 änderte ihn nur für sich selbst auf [en] : Der Haupt-Thread und die anderen Threads sehen diese Änderung nicht;
- Mit Ausnahme des Werts von [shared] und der Reihenfolge der ersten drei Zeilen sind diese Ergebnisse reproduzierbar.
Ein [ThreadLocal] erfordert einige Vorsichtsmaßnahmen. Der Wert eines Threads existiert nur so lange wie der Thread selbst: Bei einem Thread-Pool bedient der Thread, der eine Anfrage bearbeitet, anschließend weitere Anfragen, und Sie müssen am Ende jeder Anfrage [remove] aufrufen; andernfalls fände die nächste Anfrage die Daten der vorherigen vor (und der Speicher würde nie freigegeben). Mit virtuellen Threads können Sie Millionen von Threads erstellen, jeder mit seiner eigenen Kopie der Daten: [InheritableThreadLocal] kopiert dann seine Werte in jeden von ihnen. Schließlich macht ein Wert, der von jeder Funktion innerhalb des Threads geändert werden kann, den Code schwer nachvollziehbar. Die Klasse [ScopedValue] vermeidet diese Probleme.
Die Coroutinen aus Kapitel 9 werfen ein besonderes Problem auf: Eine Coroutine kann die Ausführung in einem Thread beginnen und in einem anderen fortsetzen, und ein *[ThreadLocal] würde ihr nicht folgen. Um dies zu lösen, stellt die Coroutine-Bibliothek die Erweiterungsfunktion [asContextElement(value)] von [ThreadLocal] bereit, die den Wert von [ThreadLocal] in jedem Thread setzt, in dem die Coroutine ausgeführt wird; Coroutinen haben außerdem einen eigenen Mechanismus für Kontextdaten, den Coroutine-Kontext*. Darauf gehen wir im nächsten Kapitel ein.
8.12.3. Die Klasse ScopedValue
Ein Wert [ScopedValue<T>] wird gebunden an einen Wert für die Ausführung eines Codeabschnitts, seinen Gültigkeitsbereich (Scope):
- [ScopedValue.newInstance()] erzeugt einen gebundenen Wert, der typischerweise in einer Property auf oberster Ebene oder in der Property eines Objekts gespeichert wird und schreibgeschützt ist ([val]);
- [ScopedValue.where(sv, value).run(action)] führt die Aktion (ein [Runnable]) aus und bindet dabei [sv] an [value]. Solange die Aktion – und alle Funktionen, die sie aufruft – im aktuellen Thread ausgeführt wird, [sv.get()] liefert [value]. Wenn die Aktion endet, verschwindet die Bindung: Es gibt nichts aufzuräumen;
- [ScopedValue.where(sv, value).call(op)] führt dasselbe mit einer Operation aus, die ein Ergebnis zurückgibt;
- innerhalb des Gültigkeitsbereichs kann der Wert nicht verändert werden; er kann nur für einen verschachtelten Bereich an einen anderen Wert gebunden werden;
- [isBound()] gibt an, ob der Wert im aktuellen Thread gebunden ist (Kotlin behandelt dies als Eigenschaft [isBound]); [orElse(other)] liefert den gebundenen Wert oder, falls keiner gebunden ist, [other]. Außerhalb jedes Bereichs [get()] löst die Ausnahme [NoSuchElementException] aus.
Die Klasse [ScopedValue] ist seit Java 25 final: Ein für Java 25 kompiliertes Kotlin-Programm verwendet sie ohne besondere Optionen oder Warnungen. Das Programm lautet wie folgt:
Kommentare:
- Zeile 5: der gebundene Wert [USER], eine schreibgeschützte Eigenschaft auf oberster Ebene. Ihr Typ [ScopedValue<String>] wird deklariert: Die generische Methode [newInstance] kann ihn nicht ableiten;
- Zeilen 8–12: Außerhalb jedes Bereichs ist der Wert nicht gebunden, und [get] löst eine Ausnahme aus. Die Klasse [NoSuchElementException] muss nicht importiert werden: Kotlin behandelt sie als Typalias für die Standardbibliothek ([kotlin.NoSuchElementException]);
- Zeilen 16–17: Zwei virtuelle Threads führen die Funktion [process] aus, jeweils in einem Bereich, in dem [USER] an einen anderen Benutzer gebunden ist. Die Funktionsreferenz [::process] wird in [Runnable] umgewandelt;
- Zeilen 40–47: Die Funktion [process] (die Geschäftsschicht [business]) ruft die Funktion [dao] (die DAO-Schicht [dao]) auf, ohne ihr den Benutzer zu übergeben: Jede ruft ihn über [USER.get()] ab (Zeile 52);
- Zeilen 22–28: Ein Bereich, in dem [USER] gleich [admin] ist, enthält einen verschachtelten Bereich (Zeile 24), in dem es gleich [guest] ist. Nach Verlassen des verschachtelten Bereichs erhalten wir wieder [admin]. Eine Anmerkung zur Schreibweise [where(…).run { … }]: Die Kotlin-Standardbibliothek besitzt ebenfalls eine Funktion [run], die auf jedes Objekt anwendbar ist ([obj.run { … }]). Hier wird tatsächlich die Methode [run] der Klasse [ScopedValue.Carrier] aufgerufen, denn in Kotlin hat eine Member-Methode immer Vorrang vor einer Erweiterungsfunktion mit demselben Namen. Die Ergebnisse bestätigen dies: Wäre die Kotlin-Funktion [run] aufgerufen worden, wäre kein Wert gebunden worden, und [get] hätte eine Ausnahme ausgelöst;
- Zeilen 27–28: Ein innerhalb des Bereichs erzeugter Thread sieht die Bindung nicht: Anders als ein
*[InheritableThreadLocal]*wird ein[ScopedValue]nicht an Threads weitergegeben, die von*[Thread]erzeugt werden. Er wird jedoch an die Teilaufgaben der strukturierten Nebenläufigkeit weitergegeben ([StructuredTaskScope]*, in Java 25 als Vorschau verfügbar), die sicherstellt, dass diese Teilaufgaben vor dem Ende des Bereichs abgeschlossen sind; - Zeilen 32–33: [call] führt eine Operation innerhalb eines Bereichs aus und gibt deren Ergebnis zurück. Ihr Parameter hat den Typ [ScopedValue.CallableOp<T, X>], wobei [X] der Typ der Ausnahmen ist (in Java geprüfte Ausnahmen), die die Operation auslösen kann. Kotlin kann [X] aus dem Lambda nicht ableiten (es deklariert keine Ausnahmen); ohne die Typargumente meldet der Compiler:
Wir geben daher [call<String, RuntimeException>] an: Das Ergebnis ist ein [String], und die Operation löst keine geprüfte Ausnahme aus;
- Zeile 36: Nach den Bereichen ist der Wert nicht mehr gebunden.
Ergebnisse:
Die Meldungen der virtuellen Threads in den Zeilen 3–6 können in anderer Reihenfolge erscheinen (bob vor alice); der Rest ist reproduzierbar. Ein [ScopedValue] eignet sich für Kontextdaten, die „abwärts“ vom Aufrufer an die aufgerufenen Funktionen weitergereicht werden: authentifizierter Benutzer, Transaktion, regionale Einstellungen usw. Wenn eine aufgerufene Funktion die Daten für die weitere Verarbeitung ändern muss, ist ein [ThreadLocal] erforderlich.
8.12.4. Anwendung: eine Transaktion, die von mehreren Schichten gemeinsam genutzt wird
Betrachten wir die folgende dreischichtige Anwendung, in der die Schicht [dao] eine Tabelle von Artikeln verwaltet:
Nehmen wir an, die Schnittstelle der Schicht [dao] sieht zunächst wie folgt aus:
Später entsteht der Bedarf, eine Liste von Artikeln innerhalb einer Transaktion einzufügen, weil die Anforderung „alles oder nichts“ lautet: Entweder werden alle Artikel eingefügt oder keiner. Der Schnittstelle kann eine Funktion [insertArticles(articles: List<Article>)] hinzugefügt werden. Dann entsteht für eine andere Anwendung der Bedarf, eine Liste von Artikeln zu löschen, wiederum innerhalb einer Transaktion … Um unterschiedliche fachliche Anforderungen zu erfüllen, wird die Schicht [dao] wachsen. Wir können anders vorgehen:
- nur die Basisoperationen (Einfügen, Ändern, Löschen, Lesen eines Artikels) in die Schicht [dao] aufnehmen;
- Operationen, die mehrere Artikel gleichzeitig aktualisieren, in die Schicht [business] verlagern. Diese Operationen verwenden die Basisoperationen der Schicht [dao].
Der Vorteil dieser Lösung ist, dass dieselbe Schicht [dao] ohne Änderung mit verschiedenen Schichten [business] verwendet werden kann. Sie bringt jedoch eine Herausforderung bei der Verwaltung der Transaktion mit sich, die die atomar auszuführenden Aktualisierungen zusammenfasst:
- Die Transaktion muss von der Schicht [business] gestartet werden, bevor diese die Funktionen der Schicht [dao] aufruft;
- die Funktionen der Schicht [dao] müssen von der Existenz der Transaktion wissen, um daran teilnehmen zu können;
- die Transaktion muss von der Schicht [business] abgeschlossen werden (Commit oder Rollback).
Damit die Funktionen der Schicht [dao] von einer laufenden Transaktion wissen, könnte man die Transaktion jeder Funktion der Schicht [dao] als Parameter übergeben. Dieser Parameter würde dann in der Signatur der Schnittstellenfunktionen erscheinen und die Schnittstelle damit an eine bestimmte Datenquelle binden. Threadlokale Daten bieten eine elegantere Lösung: Die Schicht [business] legt die Transaktion in den threadlokalen Daten ab, und dort ruft die Schicht [dao] sie ab. Die Funktionssignaturen der Schicht [dao] müssen nicht geändert werden. Mehrere Threads (mehrere Benutzer) können gleichzeitig arbeiten: Jeder hat seine eigene Transaktion.
Datenbanken werden in den Kapiteln 10 und 11 behandelt. Um den Fokus auf Threads zu behalten, verwenden wir hier eine In-Memory-Tabelle und eine simulierte Transaktion. Das Programm [Threads31.kt] fasst alle Schichten in einer einzigen Quelldatei zusammen. Die Entitäten lauten wie folgt:
- Zeilen 2–3: Ein Artikel ist eine Datenklasse, deren Kennung [id] von der Schicht [dao] vergeben wird;
- Zeilen 7–29: eine simulierte Transaktion. Jede innerhalb der Transaktion vorgenommene Aktualisierung merkt sich die Operation, die zu ihrer Rücknahme nötig ist (Funktion [log]); [commit] bestätigt die Transaktion und ignoriert dabei diese Operationen; [rollback] macht sie rückgängig, indem die Rollback-Operationen vom letzten bis zum ersten ausgeführt werden. Eine Rollback-Operation ist eine Funktion vom Typ [() -> Unit]: In Kotlin ersetzt ein Funktionstyp das Java-Interface [Runnable]. Die Operationen werden in einem Stapel gespeichert, hier in einer
*[ArrayDeque]aus der Kotlin-Standardbibliothek (*[kotlin.collections.ArrayDeque], automatisch importiert): Die Funktion [addFirst] legt oben auf den Stapel, die Funktion [removeFirstOrNull] entnimmt oben und gibt [null] zurück, wenn der Stapel leer ist. In der Schleife [rollback] beendet der Elvis-Operator [?: break] die Schleife, wenn der Stapel leer ist; andernfalls wird die entnommene Operation durch [undo()] ausgeführt. Eine echte Datenbank arbeitet ähnlich, mit einem Transaktionsprotokoll; - Zeilen 8–13: Jeder Transaktion wird eine eindeutige Nummer zugewiesen, die schreibgeschützte Eigenschaft [number], die bei der Erzeugung des Objekts berechnet wird. Da Transaktionen von mehreren Threads gleichzeitig erzeugt werden können, ist der Zähler – im Companion Object gespeichert – ein [AtomicInteger], der atomar erhöht wird;
- Zeilen 35–37: die threadlokalen Daten, die von den Schichten gemeinsam genutzt werden: die aktuelle Transaktion des Threads oder [null] , falls es keine gibt, daher der Typ [ThreadLocal<Transaction?>].
Die Schicht [dao] lautet wie folgt:
- Zeilen 10–11: die Artikeltabelle, die von allen Threads gemeinsam genutzt wird. Der Zugriff darauf wird durch die Sperre in Zeile 11 geschützt;
- Zeile 16: Die Funktion [insertArticle] ruft eine eventuell von der Schicht [business] in den lokalen Daten des aktuellen Threads abgelegte Transaktion ab. Ihre Variable [transaction] hat den Typ [Transaction?];
- Zeile 18: Die Tabelle hat eine Eindeutigkeitsbedingung für Artikelnamen: Das Einfügen eines Artikels mit einem bereits vorhandenen Namen löst eine Ausnahme aus. Die Kotlin-Funktion [check] (Kapitel 3) löst eine [IllegalStateException] aus, mit der vom Lambda berechneten Meldung, wenn die Bedingung falsch ist; die Funktion [none] prüft, dass kein Element der Tabelle das Prädikat erfüllt;
- Zeilen 19–20: Der eingefügte Datensatz ist eine Kopie des empfangenen Datensatzes, mit einer von der Schicht [dao] vergebenen Kennung. Da eine schreibgeschützte Datenklasse nicht verändert werden kann, wird mit der Funktion [copy] ein neues Objekt erzeugt, das nur die benannte Eigenschaft ändert;
- Zeilen 22–23: Wenn es eine Transaktion gibt, nimmt die Schicht [dao] daran teil, indem sie festhält, wie das Einfügen rückgängig gemacht wird. Der sichere Aufruf [?.] ruft [log] nur auf, wenn [transaction] ungleich [null] ist. Das Rollback-Lambda, das als abschließendes Lambda übergeben wird, erfasst die Variable [inserted];
- Zeilen 25–28: Eine Trace-Ausgabe zeigt den Thread, den eingefügten Datensatz und eine eventuelle Transaktion. Im Zweig [else] weiß der Compiler, dass [transaction] nicht [null] ist (Smart Cast);
- Zeile 33: Die zurückgegebene Artikelliste ist eine Kopie der Tabelle ([table.toList()]), damit der Aufrufer sie nicht durchläuft, während ein anderer Thread sie verändert. Die Funktion [synchronized] gibt den Wert ihres Blocks zurück.
Die Schicht [business] lautet wie folgt:
- Zeile 9: Die Schicht [dao] wird durch den primären Konstruktor injiziert, wodurch sie zu einer privaten Eigenschaft wird;
- Zeilen 14–15: Die Funktion [insertArticlesInTransaction] startet eine Transaktion und speichert sie in den lokalen Daten des Threads;
- Zeile 19: Die Einfügefunktion der Schicht [dao] wird für jeden Artikel aufgerufen, ohne dass ihr die Transaktion übergeben wird;
- Zeile 21: Eine Pause simuliert eine Verarbeitung, damit ein anderer Thread Zeit hat, während der Transaktion einzugreifen (dritter Teil des Testprogramms);
- Zeile 23: Wenn das Programm diesen Punkt erreicht, ist keine Ausnahme aufgetreten: Die Transaktion wird bestätigt (Commit);
- Zeilen 25–29: Wenn eine Ausnahme auftritt, wird die Transaktion zurückgerollt, und die Ausnahme wird erneut an den Aufrufer ausgelöst;
- Zeile 32: In jedem Fall hat der Thread danach keine aktive Transaktion mehr: [remove()] löscht den Wert des Threads. Das ist unerlässlich, wenn der Thread wiederverwendet wird (ein Thread aus einem Pool);
- Zeilen 37–38: dasselbe Einfügen ohne Transaktion. Die gebundene Referenz [dao::insertArticle] verweist auf die Funktion [insertArticle] des Objekts [dao];
- Die letzten beiden Funktionen delegieren ihre Arbeit an die Schicht [dao], mit einem auf einen einzigen Ausdruck reduzierten Rumpf.
Das Testprogramm lautet wie folgt:
- Zeile 8: Es wird eine Liste mit zwei Artikeln gleichen Namens erzeugt. Das Einfügen des zweiten Artikels wird abgelehnt. Erfolgt das Einfügen außerhalb einer Transaktion, wird der erste Artikel eingefügt und bleibt in der Liste. Erfolgt es innerhalb einer Transaktion, wird der erste Artikel eingefügt und beim Rollback der Transaktion wieder entfernt;
- Zeilen 11–13: Die Liste wird außerhalb einer Transaktion eingefügt, anschließend wird die Tabelle angezeigt;
- Zeilen 16–19: wie oben, jedoch innerhalb einer Transaktion;
- Zeilen 22–31: Zwei Threads laufen gleichzeitig. Thread A fügt drei Artikel innerhalb einer Transaktion ein (der dritte verletzt die Eindeutigkeitsbedingung); währenddessen fügt Thread B, der eine Zehntelsekunde später gestartet wird, einen Artikel außerhalb einer Transaktion ein;
- Zeilen 36–40: Die Funktion [execute] führt eine Aktion vom Typ [() -> Unit] aus und zeigt eine eventuelle Ausnahme an, dem Threadnamen vorangestellt. Sie wird mit einem abschließenden Lambda aufgerufen: [executer { … }].
Ergebnisse:
- Das Einfügen außerhalb einer Transaktion hat den ersten Datensatz in der Tabelle belassen (Zeile 5). Die für eine Datenklasse generierte Funktion [toString] zeigt Namen und Wert jeder ihrer Eigenschaften an;
- Das innerhalb einer Transaktion durchgeführte Einfügen hat keine Artikel in der Tabelle hinterlassen: Der Artikel mit der Kennung 2 wurde durch das Rollback entfernt;
- Im dritten Teil hat Thread B den Bildschirm eingefügt, während die Transaktion 2 von Thread A lief: Er tat dies außerhalb einer Transaktion, da die Transaktion eine lokale Variable von Thread A ist. Das Rollback der Transaktion 2 hat die von A eingefügte Tastatur und Maus entfernt, nicht aber den von B eingefügten Bildschirm. Dieses Ergebnis ist reproduzierbar.
8.12.5. Fazit
Das vorangegangene Beispiel hat den Nutzen threadlokaler Daten für die Transaktionsverwaltung gezeigt. Es sollte nicht genau so nachgebaut werden, beschreibt aber zutreffend die Funktionsweise von Frameworks: Die Transaktionsverwaltung von Spring (Annotation [@Transactional]) legt die Transaktion und die Datenbankverbindung in einem [ThreadLocal] ab, das die Datenzugriffsschichten abfragen, ohne dass ihr Code die Transaktion handhaben muss; Hibernate kann die Arbeitssitzung ähnlich dem aktuellen Thread zuordnen. Wir kommen in Kapitel 11 auf diese Werkzeuge zurück. In neuem Code, insbesondere mit virtuellen Threads, ist ein *[ScopedValue]* der empfohlene Weg, solche Kontextinformationen weiterzureichen; bei Coroutinen übernimmt der Coroutine-Kontext diese Rolle (Kapitel 9).
8.13. Weiterführende Literatur
Die Thread-Synchronisation ist ein anspruchsvolles Gebiet. Dieses Kapitel hat die wichtigsten Werkzeuge vorgestellt; zum Weiterlesen:
- das Buch von Brian Goetz et al., [Java Concurrency in Practice] (Addison-Wesley), das trotz seiner Entstehung vor den virtuellen Threads weiterhin das maßgebliche Referenzwerk zum Thema ist. Seine Beispiele sind in Java, aber alles, was es sagt, gilt auch für Kotlin auf der JVM;
- der Abschnitt „Concurrency“ des Java-Tutorials von Oracle: Lesson: Concurrency – er ist alt, aber für die Grundlagen weiterhin zutreffend;
- die Dokumentation des Pakets [java.util.concurrent]: Package java.util.concurrent, deren Abschnitt „Memory Consistency Properties“ die „Happens-before“-Beziehungen zusammenfasst;
- die Dokumentation des Pakets [kotlin.concurrent] der Kotlin-Standardbibliothek ([thread], [withLock], [read], [write], [getOrSet] …): kotlin.concurrent;
- die Java Enhancement Proposals (JEP), die virtuelle Threads und Scoped Values eingeführt haben: JEP 444: Virtual Threads und JEP 506: Scoped Values.
In modernem Code werden Objekte ([Thread]) nur selten direkt manipuliert. In Java verwendet man bevorzugt Executors ([ExecutorService]), parallele Streams für Berechnungen und virtuelle Threads für Aufgaben, die mit Warten verbunden sind. Kotlin besitzt all diese Werkzeuge, bietet aber eine eigene Lösung, die im nächsten Kapitel vorgestellt wird: Coroutinen. Eine Coroutine ist eine Aufgabe, die sich selbst suspendieren kann (bei Netzwerk-, Datenbank- oder Dateizugriffen), ohne den ausführenden Thread zu blockieren, und danach fortgesetzt wird, gegebenenfalls in einem anderen Thread; die strukturierte Nebenläufigkeit stellt sicher, dass keine Coroutine vergessen wird und dass Fehler und Abbrüche korrekt weitergegeben werden. Die Konzepte dieses Kapitels bleiben dennoch unverzichtbar: Coroutinen laufen in Threads, und die Daten, die sie gemeinsam nutzen, müssen mit denselben Werkzeugen geschützt werden (Sperren, atomare Klassen, nebenläufige Collections) oder mit deren Entsprechungen für Coroutinen ([Mutex], [Channel] …).