10. Datenbankzugriff mit JDBC
10.1. Der JDBC-Treiber
Greifen wir die Schichtenarchitektur wieder auf, die seit Kapitel 6 wiederholt verwendet wurde. Bisher hat die [dao]-Schicht der [Tax]-Anwendung drei Arten von Datenquellen genutzt:
- im Code fest verdrahtete Daten ([HardwiredTax]);
- Daten aus einer Textdatei ([FileTax]);
- Daten aus einer JSON-Datei ([JsonTax]).
In diesem Kapitel untersuchen wir den Fall, dass die Daten aus einer Datenbank stammen. Die Architektur sieht dann wie folgt aus:
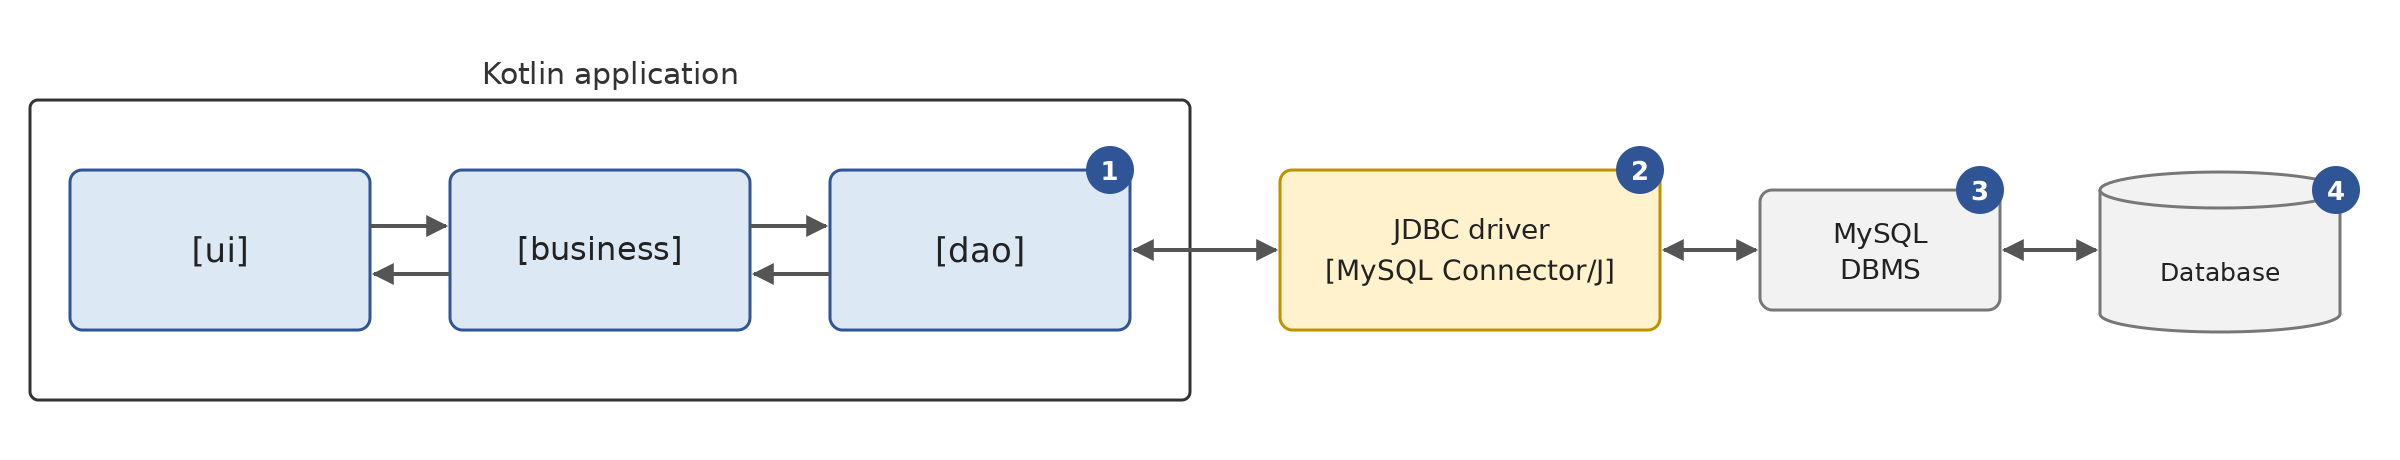
Im obigen Diagramm kommuniziert die [dao]-Schicht über eine für das verwendete DBMS spezifische Klassenbibliothek [2] mit dem [1] (Datenbankmanagementsystem) [3], das die Datenbank [4] verwaltet. Diese Bibliothek implementiert eine standardisierte API-Funktion der Java-Plattform, JDBC („Java DataBase Connectivity“), die seit Version 1.1 im Jahr 1997 Bestandteil des JDK ist. Man bezeichnet sie als JDBC-Treiber („JDBC driver“). Alle gängigen DBMS enthalten einen JDBC-Treiber, der als [.jar]-Archiv ausgeliefert wird.
Kotlin besitzt keine eigene API für den Datenbankzugriff: Ein Kotlin-Programm, das auf der JVM läuft, verwendet JDBC direkt, so wie es NIO-Dateien oder Threads des JDK verwendet. Das ist einer der großen Vorteile der Sprache: Alle für Java geschriebenen JDBC-Treiber – und alle darauf aufbauenden Bibliotheken – lassen sich unverändert nutzen. Wie wir im Verlauf dieses Kapitels sehen werden, bietet Kotlin eine prägnantere und sicherere Art, JDBC-Code zu schreiben: eine Funktion [use] zum Schließen von Ressourcen, Erweiterungsfunktionen zum Lesen von Ergebnissen, Datenklassen zur Darstellung von Zeilen und keine geprüften Ausnahmen.
JDBC ist in erster Linie eine Menge von Schnittstellen, die in den Paketen [java.sql] und [javax.sql] des Moduls [java.sql] im JDK definiert sind: [Connection], [Statement], [PreparedStatement], [ResultSet], [DataSource] … Ein JDBC-Treiber stellt Klassen bereit, die diese Schnittstellen implementieren. Der Anwendungscode hingegen interagiert nur mit den Schnittstellen: Er enthält in der Regel nicht die Namen der Klassen des Treibers. Das unterscheidet sich von anderen Plattformen, auf denen der Code oft direkt die für das jeweilige DBMS spezifischen Klassen verwendet ([MySqlConnection], [SqlConnection] … in C#): Auf der JVM ist die Abstraktion von Anfang an die Norm, und der Wechsel zu einem anderen DBMS bedeutet im Wesentlichen, den Treiber und die Adresse der Datenbank zu ändern, wie wir sehen werden. Dennoch hat jedes DBMS seinen eigenen SQL-Dialekt: Diese Unabhängigkeit hat ihre Grenzen, die wir ebenfalls untersuchen werden.
Wir verwenden ein einziges DBMS, MySQL 8, das der Anhang „Das DBMS MySQL mit Laragon“ unter Windows installiert, zusammen mit seinem offiziellen JDBC-Treiber, MySQL Connector/J, Version 9.7.0. Die Datenbanken werden durch SQL-Skripte erstellt, die mit dem Kommandozeilenclient [mysql] ausgeführt werden; der Anhang zeigt auch, wie man sie mit dem grafischen Client HeidiSQL erstellt, der in Laragon enthalten ist.
10.2. Die zwei Arten, eine Datenquelle zu nutzen
Auf eine Datenbank kann auf zwei verschiedene Arten zugegriffen werden:
- im verbundenen Modus;
- im getrennten Modus.
Im verbundenen Modus tut die Anwendung Folgendes:
- Sie öffnet eine Verbindung zur Datenquelle;
- sie arbeitet mit der Datenquelle im Lese-/Schreibmodus;
- sie schließt die Verbindung.
Im getrennten Modus tut die Anwendung Folgendes:
- Sie öffnet eine Verbindung zur Datenquelle;
- sie ruft eine Kopie aller oder eines Teils der Daten der Quelle in den Speicher ab;
- sie schließt die Verbindung;
- sie arbeitet mit der Kopie der Daten im Speicher, liest sie und schreibt in sie;
- nach Abschluss der Arbeit öffnet sie eine Verbindung, sendet die geänderten Daten an die Datenquelle, damit diese aktualisiert wird, und schließt die Verbindung.
Der verbundene Modus ist der Modus der Schnittstelle [ResultSet] von JDBC: Die Zeilen des Ergebnisses einer Abfrage werden gelesen, während die Verbindung geöffnet ist. Der getrennte Modus ist der der Schnittstelle [CachedRowSet] im Paket [javax.sql.rowset] (Java 5): eine Tabelle im Speicher, die aus einer Abfrage befüllt, offline geändert und anschließend mit ihren Änderungen an die Datenbank zurückgeschickt wird. Diese „RowSet“-Komponenten sind in JDK 25 noch vorhanden, werden in neuen Anwendungen aber kaum verwendet: Die Arbeit mit einer Kopie der Daten im Speicher und das spätere Speichern der Änderungen übernimmt heute ein ORM („Object-Relational Mapper“), der gewöhnliche Objekte statt Tabellenzeilen verarbeitet. Der am weitesten verbreitete ORM auf der JVM, Hibernate, ist Thema von Kapitel 11; er kann sowohl in Kotlin als auch in Java verwendet werden. Wir konzentrieren uns daher in erster Linie auf den verbundenen Modus – auf dem Hibernate aufbaut – und zeigen den getrennten Modus nur anhand eines Beispiels am Ende des Kapitels.
10.3. Grundlegende Konzepte der Arbeit mit einer Datenbank
10.3.1. Die Beispieldatenbank
Wir erläutern die wichtigsten Konzepte der Verwendung einer Datenbank anhand einer MySQL-Datenbank namens [dbarticles]. Sie enthält eine einzige Tabelle, [articles], in der jede Zeile einen Artikel eines Geschäfts beschreibt:
- [ID]: ein eindeutiger Bezeichner des Artikels, der der Primärschlüssel der Tabelle ist;
- [NAME]: der Name des Artikels, der ebenfalls eindeutig ist;
- [PRICE]: sein Preis;
- [CURRENTSTOCK]: sein aktueller Lagerbestand;
- [MINIMUMSTOCK]: der Mindestbestand, bei dessen Unterschreitung der Artikel nachbestellt werden muss.
Die Datenbank wird durch das folgende SQL-Skript erstellt: [sql/dbarticles.sql]:
- Zeile 5: Das Skript ist eine Textdatei in UTF-8-Kodierung. [SET NAMES utf8mb4] teilt dies dem Server mit; andernfalls könnten Akzentzeichen in den Daten (Zeilen 31–36) vom Client [mysql] falsch interpretiert werden;
- Zeilen 8–9: Die Datenbank wird gelöscht, falls sie existiert, und dann neu erstellt. Das Skript kann somit mehrfach ausgeführt werden, um die Datenbank in ihren Ausgangszustand zurückzuversetzen. [utf8mb4] ist die vollständige Unicode-Kodierung von MySQL (die veraltete Kodierung [utf8] von MySQL kodiert nur Zeichen mit bis zu drei Bytes);
- Zeile 12: [dbarticles] wird zur aktuellen Datenbank: Die folgenden SQL-Befehle werden darauf ausgeführt;
- Zeilen 15–27: die Definition der Tabelle [articles]:
- Zeile 16: Die Spalte [ID] ist der Primärschlüssel der Tabelle ([PRIMARY KEY]). Das MySQL-spezifische Attribut [AUTO_INCREMENT] gibt an, dass sein Wert beim Einfügen einer Zeile vom DBMS selbst erzeugt wird: 1, 2, 3 … Die anderen DBMS kennen äquivalente Konzepte, aber mit anderer Syntax ([IDENTITY] für SQL Server, [GENERATED … AS IDENTITY] für PostgreSQL und Oracle);
- Zeile 18: Der Preis ist eine exakte Dezimalzahl mit 10 Stellen, davon 2 Nachkommastellen. Vermeiden Sie für Beträge Gleitkommatypen wie [DOUBLE] (siehe den Unterschied zwischen [Double] und [BigDecimal] in Kapitel 3). Der SQL-Typ [DECIMAL] entspricht der Klasse [java.math.BigDecimal], die Kotlin unverändert verwendet;
- Zeilen 22–26: Integritätsbedingungen. [UNQ_NAME] verbietet, dass zwei Artikel denselben Namen haben; die [CHECK] -Bedingungen verbieten einen leeren Namen, einen negativen oder null betragenden Preis und einen negativen Lagerbestand. MySQL hat die [CHECK]-Bedingungen bis Version 8.0.16 stillschweigend ignoriert; seither werden sie durchgesetzt;
- Zeilen 30–36: Einfügen von sechs Zeilen. Die Spalte [ID] wird nicht initialisiert: Das DBMS weist ihr einen Wert zu.
Das Skript wird mit dem Kommandozeilenclient [mysql] im Ordner [sql] ausgeführt (der MySQL-Benutzer [root] hat in der Installation aus dem Anhang kein Passwort; andernfalls fügen Sie die Option [-p] hinzu, und der Client fragt danach):
Der Befehl zeigt nichts an, wenn alles gut geht. Sie können die Struktur und den Inhalt der Tabelle mit demselben Client überprüfen:
- Zeile 1: Die Option [-t] fordert eine tabellarische Anzeige an; die Option [-e] gibt die auszuführenden SQL-Befehle an, und die Option [--default-character-set=utf8mb4] stellt sicher, dass Akzentzeichen in einem UTF-8-Terminal korrekt angezeigt werden;
- Zeilen 3–9: die Struktur der Tabelle, ermittelt mit dem MySQL-Befehl [describe];
- Zeilen 12–19: der Inhalt der Tabelle. Die Werte der Spalte [ID] wurden vom DBMS erzeugt.
Ein Hinweis zur Groß- und Kleinschreibung: Spaltennamen sind immer unabhängig von der Groß-/Kleinschreibung ([name] und [NAME] bezeichnen dieselbe Spalte), aber Tabellennamen sind Dateinamen des Servers. Unter Windows wird nicht zwischen Groß- und Kleinschreibung unterschieden, unter Linux schon. Damit die Beispiele überall funktionieren, heißt die Tabelle [articles], in Kleinbuchstaben, und die Abfragen schreiben sie so.
Die Programme dieses Kapitels ändern die Tabelle [articles]. Die hier gezeigten Ergebnisse wurden erzielt, indem vor jedem Programm das Skript [dbarticles.sql] erneut ausgeführt wurde; Leser, die genau dieselben Ergebnisse reproduzieren möchten, sollten dasselbe tun.
Nun, da wir eine Datenbank haben, können wir sie nutzen. Bevor wir das tun, wiederholen wir einige Punkte zu SQL.
10.3.2. Die vier grundlegenden Befehle der Sprache SQL
SQL („Structured Query Language“) ist eine teilweise standardisierte Sprache zum Abfragen und Aktualisieren von Datenbanken. Alle DBMS-Dialekte halten den standardisierten Teil von SQL ein, fügen der Sprache aber proprietäre Erweiterungen hinzu, die ihre spezifischen Eigenschaften nutzen. Zwei Beispiele dafür sind uns bereits begegnet: Die automatische Erzeugung von Primärschlüsseln und die zulässigen Datentypen für Tabellenspalten hängen oft vom DBMS ab.
Die vier grundlegenden SQL-Befehle, die wir hier vorstellen, sind standardisiert und werden von allen DBMS akzeptiert:
Befehl | Rolle |
[select col1, col2, … from table1, table2, … where condition order by expression] | Die Abfrage zum Abrufen von Daten aus einer Datenbank. Nur die Schlüsselwörter [select] und [from] sind obligatorisch. Mit allen Tabellen, die auf das Schlüsselwort [from] folgen, wird ein Join durchgeführt; nur die Spalten, die auf das Schlüsselwort [select] folgen, bleiben erhalten; nur die Zeilen, die die Bedingung des Schlüsselworts [where] erfüllen, bleiben erhalten; die resultierenden Zeilen, sortiert nach dem Ausdruck im Schlüsselwort [order by], bilden das Ergebnis der Abfrage. Dieses Ergebnis ist eine Tabelle. |
[insert into table(col1, col2, …) values (val1, val2, …)] | Fügt eine Zeile in [table] ein. [(col1, col2, …)] gibt die Spalten der Zeile an, die mit den Werten [(val1, val2, …)] initialisiert werden sollen. |
[update table set col1=val1, col2=val2, … where condition] | Aktualisiert die Zeilen in [table] anhand von [condition] (alle Zeilen, wenn es kein [where] gibt). Für diese Zeilen wird die Spalte [coli] auf [vali] gesetzt. |
[delete from table where condition] | Löscht alle Zeilen aus [table] , die [condition] erfüllen (alle Zeilen, wenn es kein [where] gibt). |
Wir schreiben eine Konsolenanwendung, die SQL-Befehle an die Datenbank [dbarticles] sendet. Hier ein Beispiel für das Programm in Aktion (die über die Tastatur eingegebenen SQL-Befehle erscheinen nach dem Prompt „SQL query“; für dieses Dokument wurden sie dem Programm über eine Umleitung der Standardeingabe übergeben und anschließend nach dem Prompt, auf den sie antworten, wieder eingefügt); versuchen Sie, die abgesetzten SQL-Befehle und ihre Ergebnisse nachzuvollziehen:
- Zeile 2: die URL der Datenbank und der JDBC-Benutzer: Dies sind die Parameter für die Verbindung zur Datenbank;
- Zeile 4: Der Inhalt der Tabelle [articles] wird abgerufen;
- Zeile 17: Eine neue Zeile wird eingefügt. Beachten Sie, dass die Spalte [id] bei dieser Operation nicht initialisiert wird, da das DBMS ihren Wert erzeugt;
- Zeile 20: Überprüfung. Zeile 32: Die Zeile wurde tatsächlich hinzugefügt, mit [id] 7. Bei [select *] sind die Spaltennamen die der Tabelle, in Großbuchstaben;
- Zeile 34: Wir erhöhen den Preis des soeben hinzugefügten Artikels um 10 %;
- Zeile 43: Die Preiserhöhung hat tatsächlich stattgefunden;
- Zeile 45: Der zuvor hinzugefügte Artikel wird gelöscht;
- Zeile 48: Überprüfung, dass nur noch sechs Artikel vorhanden sind;
- Zeile 56: Das Programm akzeptiert nur die vier Befehle [select], [insert], [update], und [delete];
- Zeile 60: ein vom DBMS gemeldeter Fehler: Die Tabelle [article] existiert nicht;
- Zeile 63: Die Eindeutigkeitsbedingung [UNQ_NAME] verhindert das Hinzufügen eines zweiten Artikels [bike]. Die Fehlermeldungen von MySQL sind ebenso wie die des Treibers auf Englisch.
10.3.3. Die grundlegenden JDBC-Schnittstellen für den verbundenen Modus
Kehren wir zum Diagramm einer Anwendung zurück, die über einen JDBC-Treiber auf eine Datenbank zugreift:
Im verbundenen Modus tut die Anwendung Folgendes:
- Sie öffnet eine Verbindung zur Datenquelle;
- sie arbeitet mit der Datenquelle im Lese-/Schreibmodus;
- sie schließt die Verbindung.
An diesen Operationen sind im Wesentlichen drei Arten von Objekten beteiligt:
- die Verbindung ([Connection]), die die Eigenschaften und Methoden der Datenbankverbindung kapselt;
- der SQL-Befehl ([Statement] oder [PreparedStatement] für einen parametrisierten Befehl), der die Eigenschaften und Methoden des ausgeführten SQL-Befehls kapselt;
- das Ergebnis ([ResultSet]), das die Eigenschaften und Methoden des Ergebnisses eines SQL- oder [select]-Befehls kapselt.
Dies sind Schnittstellen aus dem Paket [java.sql]. Der MySQL-Treiber implementiert sie mit Klassen aus seinen eigenen Paketen ([com.mysql.cj.jdbc.ConnectionImpl], [ClientPreparedStatement], [ResultSetImpl] …), die die Anwendung nicht kennen muss: Sie erhält ihre Objekte über Methoden, die Schnittstellen zurückgeben. Die Verbindung wird von der Klasse [DriverManager] (oder von einer Datenquelle [DataSource], auf die wir später eingehen) geliefert, der SQL-Befehl wird von der Verbindung erzeugt, und das Ergebnis wird vom SQL-Befehl zurückgegeben.
Dies sind Java-Schnittstellen. Kotlin verwendet sie nach seinen üblichen Regeln für den Zugriff auf Java-Code: Ein Paar von Accessoren [getXxx] / [setXxx] wird als Eigenschaft [xxx] verwendet ([result.metaData] statt [result.getMetaData()], [connection.autoCommit = false] statt [connection.setAutoCommit(false)]), und die von einer Java-Methode zurückgegebenen Werte haben einen Plattformtyp (in Compilermeldungen als [String!] bezeichnet): Kotlin weiß nicht, ob sie [null] sein können, und überlässt es dem Entwickler, zu entscheiden, ob er sie als [String] oder als [String?] behandelt (Kapitel 3). Das ist wichtig für Spalten, die die SQL-Werte [NULL] enthalten können.
10.3.3.1. Die Schnittstelle Connection
Diese Schnittstelle dient der Verwaltung der Verbindung zur Datenbank. Eine Verbindung erhält man über die statische Methode [DriverManager.getConnection(url, user, password)], die als Parameter die URL der Datenbank im Format JDBC – zum Beispiel [jdbc:mysql://localhost:3306/dbarticles] – sowie die Anmeldedaten des Benutzers erwartet. Die zurückgegebene Verbindung ist bereits geöffnet. Die Methoden der Schnittstelle [Connection], die wir verwenden werden, sind die folgenden:
Methode | Rolle |
[createStatement] | Erzeugt einen SQL-Befehl, der dieser Verbindung zugeordnet ist. |
[prepareStatement] | [prepareStatement(sql)] erzeugt einen als [PreparedStatement] konfigurierten SQL-Befehl, der dieser Verbindung zugeordnet ist. |
[prepareCall] | [prepareCall("{call name(?, ?)}")] erzeugt einen [CallableStatement]-Befehl, der eine gespeicherte Prozedur der Datenbank ausführt. |
[autoCommit] | [autoCommit = false] (die Java-Methode [setAutoCommit]) startet eine Transaktion (siehe unten). |
[commit], [rollback] | bestätigt bzw. widerruft die aktuelle Transaktion. |
[metaData] | (die Java-Methode [getMetaData]) liefert ein Objekt [DatabaseMetaData], das das DBMS und den Treiber beschreibt. |
[isValid] | [isValid(seconds)] prüft, ob die Verbindung noch verwendbar ist. |
[close] | schließt die Verbindung samt den SQL-Befehlen und den von ihnen erzeugten Ergebnissen. |
Das Öffnen einer Verbindung hat folgende Form (die Codeausschnitte in diesem Absatz stammen aus der Datei [models/Models.kt] des Projekts, die kompiliert, aber nicht ausgeführt wird):
Die Typinferenz weist [connection] den Typ [Connection!] zu: eine Verbindung, die ohne Null-Prüfung verwendet werden kann ([getConnection] gibt niemals [null] zurück: Bei einem Fehler wirft sie eine Ausnahme).
10.3.3.2. Die Schnittstelle Statement
Diese Schnittstelle dient der Ausführung eines SQL-Befehls. Die Methoden dieser Schnittstelle, die wir verwenden werden, sind die folgenden:
Methode | Rolle |
[executeQuery] | [executeQuery(sql)] führt einen SQL-Befehl [select] aus. Er liefert ein [ResultSet]-Objekt, das das Ergebnis von [select] darstellt. |
[executeUpdate] | [executeUpdate(sql)] führt einen SQL-Befehl [update], [insert], [delete] (oder einen Definitionsbefehl wie [create table]) aus. Er liefert die Anzahl der von der Operation betroffenen Zeilen (Aktualisierungen, Einfügungen, Löschungen). [executeLargeUpdate] (Java 8) liefert diese Anzahl als [Long]. |
[execute] | [execute(sql)] führt einen beliebigen SQL-Befehl aus. Liefert [true], wenn der Befehl ein [ResultSet] erzeugt hat, das dann über die Eigenschaft [resultSet] abgerufen wird, [false], wenn er eine Zeilenanzahl erzeugt hat, die über die Eigenschaft [updateCount] abgerufen wird. |
[addBatch], [executeBatch] | fügen einen Befehl einem Batch hinzu bzw. führen den Batch aus (siehe unten). |
[generatedKeys] | (die Java-Methode [getGeneratedKeys]) liefert die vom DBMS bei einem [insert] generierten Primärschlüssel. |
[queryTimeout] | [queryTimeout = seconds] legt die maximale Ausführungszeit des Befehls fest. |
[close] | schließt den SQL-Befehl sowie sein [ResultSet]. |
Die Schnittstelle [PreparedStatement] ist von [Statement] abgeleitet: Sie ist ein parametrisierter SQL-Befehl, dessen Text bei der Erzeugung festgelegt wird und dessen Parametern durch [setXxx]-Methoden Werte zugewiesen werden. Wir untersuchen dies im Abschnitt „Parametrisierte Abfragen“. Die Ausführung von SQL-Befehlen ohne Transaktion hat folgende Form:
10.3.3.3. Die Schnittstelle ResultSet
Diese Schnittstelle kapselt die Ergebnisse eines SQL-[select]-Befehls. Ein [ResultSet]-Objekt stellt eine Tabelle mit Zeilen und Spalten dar, die sequentiell verarbeitet wird: zuerst die erste Zeile, dann die zweite und so weiter, ohne Möglichkeit zurückzugehen (dies ist der Standardtyp [TYPE_FORWARD_ONLY]; JDBC unterstützt auch in beiden Richtungen durchlaufbare Ergebnisse, die jedoch selten verwendet werden). Das [ResultSet] hat einen Cursor, der anfangs vor der ersten Zeile positioniert ist: Sie müssen [next] aufrufen, um die erste Zeile zu lesen. Die Methoden dieser Schnittstelle, die wir verwenden werden, sind die folgenden:
Methode | Rolle |
[next] | Wechselt zur nächsten Zeile der Ergebnistabelle. Liefert [true] , wenn die Zeile erfolgreich gelesen wurde, und [false] , wenn keine Zeilen mehr vorhanden sind. |
[getInt] | [getInt(i)] liefert den ganzzahligen Wert der Spalte mit der Nummer i in der aktuellen Zeile. Die Spalten werden ab 1 nummeriert, nicht ab 0. [getInt("name")] liefert den Wert der Spalte mit dem Namen [name]. Weitere ähnliche Methoden sind [getBoolean], [getBigDecimal], [getDouble], [getLong], [getString] … Da sie einen Parameter haben, wandelt Kotlin sie nicht in Eigenschaften um. |
[getObject] | [getObject(i)] liefert den Wert der Spalte i als [Any] (ein Java-[Object]) des vom Treiber gewählten Typs; [getObject(i, LocalDate::class.java)] liefert ihn im angeforderten Typ (in Kotlin bezeichnet [X::class.java] das Java-Objekt [Class] einer Klasse, das Java-[X.class]). |
[wasNull] | liefert [true] , wenn die zuletzt gelesene Spalte keinen Wert hatte, was durch den SQL-Wert [NULL] dargestellt wird. Methoden, die ein Objekt zurückgeben ([getString], [getBigDecimal], [getObject] …), liefern dann [null]; solche, die einen Basistyp zurückgeben ([getInt], [getDouble] …), liefern 0: Nur [wasNull] erlaubt es uns, 0 von [NULL] zu unterscheiden. |
[metaData] | (die Java-Methode [getMetaData]) liefert ein Objekt [ResultSetMetaData], das die Spalten des Ergebnisses beschreibt: [columnCount] (die Anzahl der Spalten), [getColumnLabel(i)] (der Name der Spalte Nr. i), [getColumnTypeName(i)] (ihr SQL-Typ) … |
[close] | schließt das Ergebnis. |
Die Verarbeitung eines [ResultSet]-Objekts sieht oft wie folgt aus:
Die Schleife [while (result.next())] ist dieselbe wie in Java: Wie wir sehen werden, wird sie in Kotlin ein für alle Mal in einer Erweiterungsfunktion geschrieben, statt in jeder Funktion, die ein Ergebnis liest, wiederholt zu werden.
Der Plattformtyp verdient hier einen Hinweis. Bei einer Spalte, die die SQL-Werte [NULL] akzeptiert, gibt [getString(i)] [null] zurück; wenn Sie [val name: String = result.getString(2)] schreiben, fügt Kotlin eine Prüfung ein und wirft bereits bei der Zuweisung eine [NullPointerException] mit der Meldung „getString(...) must not be null.“ Daher müssen Sie die Spaltenwerte, die *[NULL]* sein können, als [String?]*** deklarieren und sie anschließend mit den Operatoren ***[?.] und ***[?:]* aus Kapitel 3 verarbeiten. In unserer Tabelle sind alle Spalten [NOT NULL]: Das Problem tritt nicht auf.
Bei MySQL Connector/J werden die Ergebniszeilen standardmäßig alle vom Server in den Speicher der Anwendung übertragen, sobald die Abfrage ausgeführt wird; [next] durchläuft sie dann. Bei einem Ergebnis mit mehreren Millionen Zeilen können Sie den Treiber anweisen, sie erst beim Lesen zu empfangen (Parameter [useCursorFetch=true] der URL und [fetchSize = n] beim SQL-Befehl): Dies ist eine treiberspezifische Einstellung, die wir nicht verwenden werden.
10.3.4. Fehlerbehandlung
Die [dao]-Schicht kann beim Betrieb der Datenbank auf zahlreiche Fehler stoßen: Server nicht erreichbar, Datenbank nicht vorhanden, falsches Passwort, SQL-Syntaxfehler, Verletzung einer Integritätsbedingung usw. Diese werden als [SQLException]-Ausnahmen gemeldet. In Java ist [SQLException] eine geprüfte Ausnahme (Checked Exception): Alle Methoden von JDBC deklarieren sie in ihrer [throws]-Klausel, und der Java-Compiler verlangt, dass der aufrufende Code sie entweder abfängt oder seinerseits deklariert. Kotlin kennt keine geprüften Ausnahmen (Kapitel 3): Der Compiler stellt keine Anforderungen, und eine Kotlin-Funktion, die JDBC aufruft, muss nichts deklarieren. Das ist zugleich Freiheit und Verantwortung: Nichts weist den Entwickler darauf hin, dass eine Zeile fehlschlagen kann; er muss selbst entscheiden, wo Fehler behandelt werden. Eine [dao]-Schicht muss diese Fehler behandeln und, was auch geschieht, die erworbenen Ressourcen freigeben: Die Verbindung, der SQL-Befehl und das Ergebnis müssen geschlossen werden. Mit [finally]-Klauseln geschrieben – wie es in Java vor Java 7 üblich war – sieht der oben gezeigte Code zur Verarbeitung des Ergebnisses eines [select]-Befehls wie folgt aus:
Dieser Code ist umständlich: Die Verbindung muss als [var] vom Typ [Connection?] vor dem [try] deklariert werden, damit sie in der [finally]-Klausel sichtbar ist, und ihr Schließen kann selbst eine [SQLException] auslösen (Zeile 23), die in der [finally]-Klausel abgefangen werden muss. Beachten Sie den sicheren Aufruf [connection?.close()]: Konnte die Verbindung nicht geöffnet werden, ergibt [connection] den Wert [null], und es geschieht nichts.
Kapitel 3 hat die Kotlin-Lösung vorgestellt: Die Erweiterungsfunktion use, definiert für jedes *[AutoCloseable]-Objekt, führt den ihr übergebenen Block (das Lambda) aus und schließt das Objekt beim Verlassen des Blocks, unabhängig davon, wie der Block verlassen wird. Dies entspricht der Anweisung try-with-resources von Java. Die Objekte *[Connection]*, *[Statement], und *[ResultSet] implementieren die Schnittstelle *[AutoCloseable]:
- Zeilen 3–5: Drei Ressourcen werden geöffnet, jeweils mit einem
*[use]. Das geöffnete Objekt ist der Lambda-Parameter ([connection],[statement],[result]); wir geben ihm einen Namen, statt [it] zu verwenden, denn die drei Lambdas sind verschachtelt, und ein [it] würde sich auf das Objekt des innersten [use] beziehen. Anders alstry-with-resourcesin Java, das mehrere Ressourcen in seinen Klammern akzeptiert, behandelt*[use]nur eine Ressource: Deshalb verschachteln wir die[use]s. Die Ressourcen werden in umgekehrter Reihenfolge ihrer Öffnung geschlossen: zuerst das Ergebnis, dann der SQL-Befehl, dann die Verbindung. Eine Ausnahme, die beim Schließen geworfen wird, überdeckt nicht diejenige, die möglicherweise zum Verlassen des Blocks geführt hat: Sie wird ihr als „unterdrückte“ Ausnahme ([suppressedExceptions]) angehängt, wie in Java; - Zeile 13: Die Klausel [catch] fängt sowohl Verbindungs- und Ausführungsfehler als auch Fehler beim Schließen ab.
Da [use] eine [inline]-Funktion ist (Kapitel 7), ist ihr Block kein Lambda-Objekt: Er wird anstelle des Aufrufs kopiert, und eine im Block geschriebene [return]-Anweisung beendet die umgebende Funktion, nachdem die Ressource geschlossen wurde. Außerdem gibt [use] den Wert seines Blocks zurück: [val n = connection.createStatement().use { it.executeUpdate(sql) }] führt den Befehl aus, schließt das [Statement]-Objekt und gibt die Anzahl der geänderten Zeilen zurück. Wir werden diese beiden Eigenschaften häufig nutzen.
Der Nutzen von [use] liegt nicht nur in der Einsparung von Zeilen: Es erspart dem Entwickler, die Verbindung manuell zu schließen. Das Vergessen des Schließens einer Verbindung kann jedoch unbemerkt bleiben und die Anwendung scheinbar zufällig „abstürzen“ lassen, sobald das DBMS (oder der Connection-Pool, den wir später behandeln) die maximale Anzahl der offenen Verbindungen erreicht, die es unterstützt. Im weiteren Verlauf dieses Kurses wird jede JDBC-Ressource mit einer use-Anweisung geöffnet.
Die Klasse [SQLException] liefert drei Informationen über den Fehler, die Kotlin als Eigenschaften darstellt:
- [message]: die Fehlermeldung;
- [errorCode]: der DBMS-spezifische Fehlercode (die MySQL-Fehlernummer: 1049, 1062 …);
- [sqlState]: ein vom SQL-Standard definierter fünfstelliger Fehlercode („SQLSTATE“), der bei den häufigsten Fehlern allen DBMS gemeinsam ist: Die Klasse [42] bezeichnet einen Syntax- oder Zugriffsfehler, [23] eine Verletzung einer Integritätsbedingung, [08] einen Verbindungsfehler …
Beachten Sie die Eigenschaft [sqlState], die von der Java-Methode [getSQLState] abgeleitet ist: Beginnt ein Name mit mehreren Großbuchstaben, wandelt Kotlin sie in Kleinbuchstaben um, mit Ausnahme des letzten, wenn er das nächste Wort einleitet ([SQLState] wird zu [sqlState]). Seit Java 6 (JDBC 4.0) hat [SQLException] auch standardisierte abgeleitete Klassen, die die Treiber je nach Art des Fehlers auslösen. Die wichtigsten sind die folgenden:
Klasse | Fehler |
[SQLSyntaxErrorException] | SQL-Syntaxfehler, Tabelle oder Datenbank existiert nicht, unzureichende Berechtigungen (SQLSTATE, Klasse 42) |
[SQLIntegrityConstraintViolationException] | Verletzung einer Integritätsbedingung: doppelter Schlüssel, Fremdschlüssel, Spalte [NOT NULL] (SQLSTATE, Klasse 23) |
[SQLDataException] | Ungültige Daten: Wert zu groß, Konvertierung unmöglich (SQLSTATE, Klasse 22) |
[SQLTimeoutException] | Zeitüberschreitung ([queryTimeout]) |
[SQLTransactionRollbackException] | Transaktion vom DBMS zurückgerollt, zum Beispiel wegen eines Deadlocks |
[SQLNonTransientConnectionException], [SQLRecoverableException] | Verbindungsproblem |
Das Programm [Jdbc02.kt] löst verschiedene Fehler aus und zeigt sie an:
Ergebnisse:
Kommentare:
- Zeilen 10–12: die Verbindungsparameter der Datenbank, die am Anfang des Programms als Konstanten der obersten Ebene ([const val]) definiert sind, die privat für die Datei sind;
- Zeile 15: die MySQL-Fehlernummer „Duplicate entry“, wie sie in der MySQL-Dokumentation benannt ist;
- Zeilen 19–27: sechs Operationen, die fehlschlagen: Datenbank existiert nicht; Server nicht erreichbar (kein MySQL-Server lauscht auf Port 3399, was denselben Fehler wie bei einem angehaltenen Server erzeugt); Syntaxfehler; Tabelle existiert nicht; doppelter Artikelname; negativer Preis. Der Parameter [connectTimeout=5000] der URL in Zeile 20 begrenzt die Wartezeit beim Verbindungsaufbau auf 5 Sekunden (5000 ms);
- Zeile 31: Die Funktion [execute] führt den SQL-Befehl [query] auf der Datenbank aus, die durch die URL [url] angegeben wird;
- Zeilen 34–35: Die Verbindung und der SQL-Befehl werden durch zwei verschachtelte [use]-Aufrufe geöffnet. Der zweite passt in eine einzige Zeile: Das Lambda [{ statement -> statement.execute(query) }] enthält nur eine Anweisung;
- Zeile 35: Die Methode [execute] führt einen beliebigen SQL-Befehl aus: [select] oder [insert]. Wenn sie eine Ausnahme wirft, erscheint die Meldung „no error“ in Zeile 37 nicht;
- Zeile 39: ein [when] auf die Ausnahme, mit [is Type]-Klauseln (Kapitel 3);
- Zeile 41: Ein Guard ([if], Kotlin 2.2) ermöglicht die gesonderte Behandlung eines bestimmten Fehlers: einer Verletzung einer Integritätsbedingung ([SQLIntegrityConstraintViolationException]) mit dem MySQL-Code 1062, also einem doppelten Schlüssel. Dies entspricht dem Guarded Pattern [case … when …] aus dem [switch] von Java 21. In diesem Fall würde eine Anwendung eine für den Benutzer verständliche Meldung anzeigen;
- Zeilen 44–46: die übrigen Fehler. Die Ausnahmeklasse wird angezeigt ([ex.javaClass.simpleName]: [javaClass] liefert das Java-Objekt [Class]), der MySQL-Fehlercode und der SQLSTATE-Code, gefolgt von der ersten Zeile der Meldung: Manche Treibermeldungen erstrecken sich über mehrere Zeilen. Die Eigenschaft [message] hat den Typ [String?] (eine Ausnahme muss keine Meldung haben): Sie wird mit sicheren Aufrufen behandelt, [?.lineSequence()?.first()]; [lineSequence] zerlegt die Zeichenkette in eine Sequenz von Zeilen, von denen die erste mit [first] genommen wird. Wäre die Meldung [null], würde der Ausdruck zu [null] ausgewertet, und das Template würde „null“ anzeigen.
Die Ergebnisse zeigen, dass der MySQL-Treiber die Standardklassen verwendet: [SQLSyntaxErrorException] für eine nicht vorhandene Datenbank (1049), einen Syntaxfehler (1064) oder eine nicht vorhandene Tabelle (1146), die sämtlich vom SQLSTATE [42xxx] abgeleitet sind. Ein nicht erreichbarer Server erzeugt eine [CommunicationsException], eine Treiberklasse (abgeleitet von [SQLRecoverableException]): Es gibt keinen MySQL-Fehlercode, da der Server nicht geantwortet hat, aber der SQLSTATE [08S01] weist auf einen Verbindungsfehler hin. Eine Verletzung einer [CHECK]-Bedingung (Fehler 3819) ist einfach eine [SQLException] mit dem SQLSTATE [HY000] („general error“): MySQL weist ihr keinen SQLSTATE der Klasse 23 zu. Man kann sich daher nicht uneingeschränkt auf abgeleitete Klassen verlassen: Der Fehlercode und der SQLSTATE bleiben nützlich.
Eine [dao]-Schicht, die vom DBMS unabhängig bleiben möchte, verwendet nur die Standardklassen und den SQLSTATE; die Fehlercodes ([errorCode]) sind für jedes DBMS spezifisch.
Eine letzte Anmerkung zu geprüften Ausnahmen. Eine Kotlin-Funktion, die eine [SQLException] wirft, deklariert dies nirgends; wird sie aus Java-Code aufgerufen, kann der Java-Code die Ausnahme nicht mit einem [catch (SQLException e)] abfangen, das der Java-Compiler ablehnt, wenn keine der aufgerufenen Methoden sie deklariert. Wir fügen der Kotlin-Funktion daher die Annotation [@Throws(SQLException::class)] hinzu, die die von Java erwartete [throws]-Klausel erzeugt. Unsere Programme, die vollständig in Kotlin geschrieben sind, benötigen dies nicht.
10.3.5. Konfiguration des Beispielprojekts
Der JDBC-Treiber für MySQL ist eine auf Maven Central veröffentlichte Bibliothek, dem Bibliotheks-Repository, aus dem Gradle Abhängigkeiten bezieht (Kapitel 2). Der Ordner [10-jdbc] dieses Kapitels ist ein Gradle-Multiprojekt-Build (Kapitel 2): Die Programme dieses Kapitels bilden das Teilprojekt [jdbc], und die Anwendung [Tax] Version 6, die am Ende des Kapitels behandelt wird, besteht aus zwei weiteren Teilprojekten:
Die Datei [settings.gradle.kts] dieses Kapitels deklariert die Teilprojekte:
- Zeilen 3–6: das Plugin, mit dem Gradle das JDK selbst herunterladen kann, wenn es auf der Maschine keines findet (Kapitel 2);
- Zeile 11: das Teilprojekt [jdbc], dessen Ordner denselben Namen trägt;
- Zeilen 13–16: Version 6 der Anwendung [Tax], die am Ende des Kapitels vorgestellt wird.
Die Datei [build.gradle.kts] des Teilprojekts [jdbc] lautet wie folgt:
- Zeilen 2–5: das Kotlin-Plugin für die JVM, dessen Version vom Wurzelprojekt festgelegt wird (Kapitel 2), und das Plugin [application], das die Aufgabe [run] bereitstellt;
- Zeilen 15–23: die vier Bibliotheken des Projekts, die Gradle beim ersten Build von Maven Central herunterlädt:
- Zeile 17: der JDBC-Treiber für MySQL, MySQL Connector/J, mit den Koordinaten [com.mysql:mysql-connector-j]. Bis Version 8.0.30 wurde er unter den Koordinaten [mysql:mysql-connector-java] veröffentlicht, die in vielen Projekten noch zu finden sind. Ein Programm, das nur die Schnittstellen von JDBC verwendet, benötigt den Treiber nur zur Laufzeit: Er wird dann mit [runtimeOnly] deklariert, wodurch sichergestellt ist, dass im Code keine Treiberklassen versehentlich verwendet werden können. Wir deklarieren ihn mit [implementation], weil das Programm [Jdbc03] eine Klasse des Treibers verwendet, [MysqlDataSource], zu Demonstrationszwecken;
- Zeile 18: der Connection-Pool HikariCP, den wir im Programm [Jdbc03] verwenden werden;
- Zeile 21: HikariCP schreibt seine Logmeldungen über die API SLF4J („Simple Logging Facade for Java“), die eine Implementierung benötigt: Wir verwenden Logback, das nur zur Laufzeit erforderlich ist ([runtimeOnly]). Ohne sie würde SLF4J beim Start eine Warnung ausgeben. Die Datei [src/main/resources/logback.xml], die unten gezeigt wird, gibt nur Warnungen und Fehler aus;
- Zeile 23: die Coroutinen-Bibliothek kotlinx-coroutines (Kapitel 9), die vom Programm [Jdbc08Coroutines] verwendet wird, das JDBC-Anfragen in Coroutinen ausführt;
- Zeilen 27–33: der Compiler, konfiguriert wie in allen Projekten des Kurses: JDK 25, Warnungen werden als Fehler behandelt, Parameternamen bleiben in den kompilierten Klassen erhalten;
- Zeilen 38–40: Das von [gradlew run] ausgeführte Programm wird durch die Eigenschaft [main] festgelegt; standardmäßig ist dies [jdbc01.Jdbc01Kt];
- Zeilen 43–45: Das ausgeführte Programm kann über die Tastatur lesen, was [Jdbc01] erfordert;
- Zeilen 48–51: Von Gradle gestartete Programme schreiben ihre Ausgabe in UTF-8, damit Akzentzeichen unter Windows korrekt angezeigt werden (Kapitel 2).
Die Logback-Konfigurationsdatei lautet wie folgt:
- Zeilen 4–8: Meldungen werden im Format „Klasse Level - Meldung“ auf der Konsole ausgegeben;
- Zeile 9: Nur Meldungen mit dem Level [WARN] (Warnung) oder [ERROR] werden angezeigt. Mit dem Level [INFO] würden Sie die Start- und Stoppmeldungen des HikariCP-Pools sehen.
Für MySQL gibt es zwei gängige JDBC-Treiber:
- [com.mysql:mysql-connector-j] („Connector/J“), veröffentlicht von Oracle, dem Eigentümer von MySQL, unter der GPL v2 mit einer Ausnahme („Universal FOSS Exception“), die seine Verwendung mit Software erlaubt, die unter anderen freien Lizenzen vertrieben wird; eine kommerzielle Lizenz deckt alle übrigen Fälle ab. Dies ist der offizielle Treiber, den wir verwenden;
- [org.mariadb.jdbc:mariadb-java-client], der Treiber für MariaDB (eine freie Variante von MySQL), unter der LGPL lizenziert, der auch mit MySQL funktioniert.
Beide Treiber implementieren dieselben JDBC-Schnittstellen: Für den Wechsel von einem zum anderen müssen nur die Abhängigkeit in [build.gradle.kts] und der Anfang der URL geändert werden ([jdbc:mariadb:] statt [jdbc:mysql:]).
Ein historischer Hinweis: Bis Java 5 musste man die Treiberklasse vor dem Öffnen einer Verbindung laden, mit einer Anweisung wie [Class.forName("com.mysql.jdbc.Driver")], die man in vielen Beispielen im Internet noch findet. Seit Java 6 (JDBC 4.0) ist dies nicht mehr nötig: Jedes Treiberarchiv deklariert seine Klasse in einer Datei [META-INF/services/java.sql.Driver], und [DriverManager] lädt alle im Klassenpfad vorhandenen Treiber automatisch über den Service-Mechanismus ([ServiceLoader]).
Verbindungsparameter sollten in einer echten Anwendung nicht fest im Code stehen: Sie hängen von der Maschine ab, auf der die Anwendung installiert ist. Das erste Programm dieses Kapitels liest sie aus einer Properties-Datei (Kapitel 6), [dbarticles.properties], die sich im Ordner des Teilprojekts befindet:
- Zeile 2: die JDBC-URL der Datenbank. Eine JDBC-URL hat die Form [jdbc:subprotocol:details]. Das Subprotokoll identifiziert den Treiber ([mysql]), und die Details – deren Format vom Treiber abhängt – identifizieren die Datenbank. Bei MySQL sind dies:
- [//localhost]: der Name der Maschine, auf der sich das DBMS MySQL befindet – hier [localhost], also die Maschine, auf der das Programm läuft;
- [:3306]: der Port, auf dem der MySQL-Server auf Verbindungen wartet; Standard ist 3306;
- [/dbarticles]: der Name der Datenbank;
- Optional können nach einem Fragezeichen Treiberparameter in der Form [?param1=value1¶m2=value2] folgen. Wir werden [connectTimeout], [rewriteBatchedStatements], und [allowMultiQueries] begegnen;
- Zeile 3: der MySQL-Benutzer – hier [root] –, der Administrator des DBMS;
- Zeile 4: sein Passwort, hier leer gelassen.
Die Dokumentation von Connector/J enthält eine vollständige Liste der URL-Parameter: Connector/J Configuration Properties.
Die übrigen, kürzeren Programme dieses Kapitels speichern ihre Verbindungsparameter in Konstanten am Anfang des Programms, wie [Jdbc02.kt]: Das ist für Beispiele einfacher, sollte in einer echten Anwendung aber nicht so gemacht werden.
Um die Programme auszuführen, wechseln Sie in den Ordner [10-jdbc] und geben Sie ein:
Der erste Befehl führt [Jdbc01] aus, der zweite [Jdbc02]. Das Präfix [:jdbc:] bezeichnet die Aufgabe [run] im Teilprojekt [jdbc]; die Aufgabe [run] wird im Ordner des Teilprojekts ausgeführt, [10-jdbc/jdbc], in dem sich die Datei [dbarticles.properties] befindet. Die Option [-q] („quiet“) unterdrückt die Meldungen von Gradle: Es bleibt nur die Ausgabe des Programms. Natürlich können Sie die Programme auch aus IntelliJ IDEA starten, indem Sie auf das grüne Dreieck neben der Funktion [main] klicken (in diesem Fall müssen Sie das aktuelle Verzeichnis in der Startkonfiguration überprüfen). Im Folgenden geben wir nur noch die Ausgabe der Programme wieder.
10.3.6. Das Beispielprogramm
Das Programm [Jdbc01.kt], dessen Ausführung wir als Beispiel gesehen haben, lautet wie folgt (Hauptprogramm):
- Zeilen 5–8: die verwendeten JDBC-Schnittstellen und -Klassen, alle aus dem [java.sql]-Paket. Das Programm enthält den Namen keiner einzigen Klasse des MySQL-Treibers: Nur die aus der Konfiguration gelesene URL und JDBC verweisen auf MySQL;
- Zeile 16: die vier zulässigen SQL-Befehle in einer schreibgeschützten Menge, die mit [setOf] erzeugt wird (Kapitel 5);
- Zeilen 19–21: Die drei Verbindungsparameter werden in einer Datenklasse zusammengefasst. Anstatt jeder Funktion drei Zeichenketten zu übergeben, wie es das Java-Programm des Kurses tut, übergeben wir ein [ConnectionParameters]-Objekt, das weiß, wie es eine Verbindung öffnet: Seine Methode [connect] ruft [DriverManager.getConnection] mit den eigenen Eigenschaften auf. Der zurückgegebene Typ [Connection] wird ausdrücklich angegeben: Ohne diese Angabe würde die Funktion den Plattformtyp [Connection!] zurückgeben;
- Zeilen 25–29: Lesen der Properties-Datei, wie in Kapitel 6 beschrieben. Die Erweiterungsfunktion [bufferedReader] aus [kotlin.io.path] öffnet die Datei in UTF-8, und [use] schließt sie. [getProperty] gibt den Wert eines Schlüssels zurück oder [null] , wenn der Schlüssel fehlt: Ihr Kotlin-Typ ist [String?]. Da die URL erforderlich ist, löst der Elvis-Operator [?:] bei ihrem Fehlen eine [IOException] aus, sodass eine fehlende und eine unvollständige Datei auf dieselbe Weise behandelt werden können; [getProperty(key, default)] liefert für die beiden anderen Parameter einen Standardwert;
- Zeile 32: die Top-Level-Funktion [main] ohne Parameter, da das Programm seine Argumente nicht verwendet;
- Zeilen 34–38: [try] ist ein Ausdruck (Kapitel 3): Sein Wert ist der des [try]-Blocks, wenn alles gut geht; im Fehlerfall zeigt die [catch]-Klausel eine Meldung an und beendet das Programm mit [return]. Die Datei wird im aktuellen Ordner gesucht, d. h. in dem, aus dem das Programm gestartet wird: Das ist der Ordner des Unterprojekts, wenn Sie [gradlew :jdbc:run] eingeben;
- Zeile 45: die Schleife zur Eingabe der über die Tastatur eingegebenen SQL-Befehle und zu ihrer Ausführung in der Datenbank;
- Zeilen 47–48: [print] zeigt die Eingabeaufforderung an, ohne in die nächste Zeile zu wechseln, danach liest [readlnOrNull] eine über die Tastatur eingegebene Zeile; sie gibt [null] zurück, wenn die Standardeingabe geschlossen ist. Der sichere Aufruf [?.trim()] gefolgt von [orEmpty] wandelt dieses [null] in eine leere Zeichenkette um, die die Schleife in der nächsten Zeile beendet;
- Zeile 52: das erste Wort der Anfrage, das man erhält, indem man die Anfrage an Leerzeichen aufteilt (regulärer Ausdruck [\s+], Kapitel 5). Es wird für den Vergleich in Kleinbuchstaben umgewandelt, die Anfrage selbst wird jedoch nicht verändert: Die Umwandlung der gesamten Anfrage in Kleinbuchstaben würde das Einfügen eines Artikels namens „Bike“ verhindern;
- Zeilen 53–55: Ist die Anfrage ungültig, wird eine Fehlermeldung angezeigt, und das Programm geht zur nächsten Anfrage über. Der Operator [!in] ruft die Methode [contains] der Menge auf (Kapitel 4);
- Zeilen 58–61: Der SQL-Befehl wird ausgeführt. Seine Form hängt davon ab, ob es sich um einen [select]-Befehl oder um einen [insert]-, [update]- oder [delete] -Befehl handelt: Im ersten Fall ruft der Befehl Daten aus der Datenbank ab, ohne sie zu ändern; im zweiten Fall aktualisiert er die Datenbank, ohne Daten abzurufen. In beiden Fällen wird die Ausführung an eine Funktion delegiert, die die Verbindungsparameter und den auszuführenden SQL-Befehl erhält.
Beachten Sie das Fehlen jeglicher Ausnahmedeklarationen: In Java erfordert das Lesen der Datei, die [IOException] -Ausnahme abzufangen oder zu deklarieren. In Kotlin ist das eine Entscheidung: Wir fangen die [IOException] hier ab, weil wir an dieser Stelle wissen, was mit dem Fehler zu tun ist (den Benutzer benachrichtigen und anhalten).
10.3.7. Ausführen einer SELECT-Anfrage
Die Ausführung von SQL-Befehlen umfasst die folgenden Schritte:
- Verbindung zur Datenbank herstellen;
- die SQL-Befehle an die Datenbank senden;
- die Ergebnisse der SQL-Befehle verarbeiten;
- die Verbindung schließen.
Die Schritte 2 und 3 können wiederholt werden; die Verbindung wird erst am Ende der Datenbankverarbeitung geschlossen. Offene Verbindungen sind in einem DBMS begrenzte Ressourcen: Man muss sparsam mit ihnen umgehen und versucht stets, die Lebensdauer einer offenen Verbindung zu begrenzen. In unserem Programm wird die Verbindung nach jedem SQL-Befehl geschlossen, und für den nächsten Befehl wird eine neue Verbindung geöffnet.
Das Öffnen einer Verbindung ist jedoch aufwendig: Es erfordert den Aufbau einer Netzwerkverbindung zum Server, gegebenenfalls das Aushandeln einer Verschlüsselung und eine Authentifizierung. [DriverManager] tut nichts, um diese Kosten zu senken: Jeder Aufruf von [getConnection] öffnet eine neue Netzwerkverbindung, und jedes [close] schließt sie tatsächlich. Für ein interaktives Werkzeug wie dieses ist das kein Problem. Eine Anwendung, die viele SQL-Befehle ausführt – zum Beispiel ein Webserver –, verwendet stattdessen einen Verbindungspool: Wenn die Anwendung eine Verbindung schließt, schließt der Pool sie nicht wirklich, sondern nimmt sie wieder in den Pool auf; fordert die Anwendung eine neue Verbindung an, erhält sie eine der bereits aufgebauten Verbindungen aus dem Pool. Der Vorteil dieses Systems ist, dass es für den Entwickler transparent ist: Der Code, der Verbindungen mit [use] öffnet und schließt, muss nicht geändert werden. Wie man ihn verwendet, sehen wir im Abschnitt „Datenquellen und Verbindungspools“. Eine Verbindung zu Beginn jeder Operation zu öffnen und am Ende wieder zu schließen, ist daher bewährte Praxis.
Zunächst befassen wir uns mit der Ausführung der SQL-Befehle und [select]. Die Funktion [executeSelect] unseres Beispielprogramms und die von ihr verwendete Funktion [displayResultSet] lauten wie folgt:
- Zeile 2: Die Funktion erhält die Verbindungsparameter und den auszuführenden SQL-Befehl [select] [query] . Wie die beiden anderen Funktionen des Programms ist sie als [private] deklariert: Sie ist nur in der Datei [Jdbc01.kt] sichtbar;
- Zeilen 5–7: drei verschachtelte [use]-Anweisungen öffnen drei Ressourcen:
- Zeile 5: die Verbindung zur Datenbank, die man von [DriverManager] über die Methode [connect] erhält. [DriverManager] fragt jeden Treiber im Klassenpfad ab: Der erste, der die URL erkennt, öffnet die Verbindung. Hier werden die Verbindungsparameter verwendet, und hier treten Verbindungsfehler auf. Die Verbindung hat den Typ, den die Schnittstelle [Connection] definiert: Der Code weiß nicht, dass es sich um ein Objekt des MySQL-Treibers handelt;
- Zeile 6: der SQL-Befehl, ein [Statement]-Objekt, das von der Verbindung erzeugt wird. Derselbe Objekttyp dient zur Ausführung eines [select]-Befehls und eines [update]-, [insert]- und [delete] -Befehls;
- Zeile 7: Der [select]-Befehl wird von der Methode [executeQuery] ausgeführt, die ein [ResultSet]-Objekt zurückgibt;
- Zeile 9: Die Funktion [displayResultSet] ist für die Anzeige der Ergebnisse zuständig;
- Zeilen 13–14: Jede Datenbankoperation kann eine [SQLException] auslösen. Das ist hier umso wahrscheinlicher, als die vom Benutzer eingegebenen SQL-Befehle Syntaxfehler enthalten können. Wir müssen den Benutzer darüber informieren können: Die Ausnahme wird abgefangen und ihre Meldung angezeigt. Wenn die [catch]-Klausel ausgeführt wird – gleichgültig, ob die Ausnahme beim Verbinden, beim Ausführen oder beim Lesen der Zeilen entstanden ist –, haben die [use]-Anweisungen das Ergebnis, den SQL-Befehl und die Verbindung bereits geschlossen;
- Zeile 19: Die Funktion erhält ein [ResultSet]-Objekt. Seine Methoden können eine [SQLException] auslösen; in Java muss die entsprechende Methode diese als [throws SQLException] deklarieren. In Kotlin ist keine Deklaration nötig: Die Ausnahme wird einfach an die aufrufende Funktion weitergereicht, die sie abfängt;
- Zeilen 21–25: Die Spaltennamen der Ergebnistabelle von [select] werden angezeigt. Das sind die Spalten [coli] der Anfrage [select col1, col2, … from table …]. Sie werden von den Metadaten des Ergebnisses geliefert, einem [ResultSetMetaData]-Objekt, das man über die Eigenschaft [metaData] erhält: [columnCount] liefert die Anzahl der Spalten, und [getColumnLabel(i)] liefert den Namen der Spalte mit der Nummer i oder ihren Alias, falls die Anfrage einen angibt ([select count(*) as total …]). Da die Spalten ab 1 nummeriert sind, wird der Bereich [1..metadata.columnCount] (Zeile 22) gebildet, und dann wandelt [joinToString] (Kapitel 5) jede Nummer in einen Namen um und verkettet die Namen, getrennt durch Kommas. Ein Zwischenarray ist nicht nötig, anders als in der Java-Version. ["-".repeat(n)] erzeugt eine Zeichenkette aus n Bindestrichen;
- Zeilen 27–28: Wir durchlaufen die Ergebnistabelle und zeigen die Werte jeder Zeile durch Leerzeichen getrennt an, wobei derselbe Bereich [columns] und dieselbe Funktion [joinToString] verwendet werden;
- Zeile 28: Der Typ der Spalte i im Ergebnis ist unbekannt, weil die vom Benutzer eingegebene Anfrage unbekannt ist. Wir können daher nicht die Syntax [result.getXxx(i)] verwenden, bei der [Xxx] der Spaltentyp ist. Stattdessen verwenden wir [getObject(i)], das den Wert in Form eines [Any!] zurückgibt; das Template ["${result.getObject(it)}"] wandelt ihn mit seiner Methode [toString] in eine Zeichenkette um (und zeigt „null“ für einen SQL-Wert [NULL] an). Für die Spalte [price] vom SQL-Typ [DECIMAL(10,2)] ist das Objekt ein [BigDecimal] mit zwei Nachkommastellen, das seine Methode [toString] mit einem Dezimalpunkt anzeigt ([500.00]): Anders als [String.format] ist [toString] nicht von der Sprache des Arbeitsplatzrechners abhängig. Eine „französische“ Darstellung würde ["%.2f".format(price)] oder die Klasse [NumberFormat] (Kapitel 5) verwenden.
10.3.8. Ausführen einer Aktualisierungsanfrage: INSERT, UPDATE, DELETE
Der Code der Funktion [executeUpdate] lautet wie folgt:
Die Ausführung eines Aktualisierungsbefehls unterscheidet sich von der eines [select]-Befehls nur in der Methode, die für den SQL-Befehl verwendet wird: [executeQuery] für [select], [executeUpdate] für [update], [insert], [delete]:
- Zeilen 4–5: Diesmal gibt es nur zwei Ressourcen: die Verbindung und den SQL-Befehl;
- Zeile 7: Der Befehl [update], [insert] oder [delete] wird von der Methode [executeUpdate] ausgeführt. Bei Erfolg gibt diese Methode die Anzahl der aktualisierten ([update]), eingefügten ([insert]) oder gelöschten ([delete]) Zeilen zurück;
- Zeile 9: Diese Anzahl von Zeilen wird angezeigt.
Der Leser sei auf das Ausführungsbeispiel im Abschnitt „Die vier Grundbefehle der Sprache SQL“ verwiesen.
10.4. JDBC und Unabhängigkeit vom DBMS
10.4.1. Die aktuellen JDBC-Treiber
Der untersuchte Code enthält den Namen keiner einzigen Klasse des MySQL-Treibers: Er verwendet nur die Schnittstellen von [java.sql]. Damit er mit einem anderen DBMS funktioniert, genügt es grundsätzlich, den Treiber dieses DBMS zum Projekt hinzuzufügen und die JDBC-URL zu ändern. Hier sind die wichtigsten heutigen JDBC-Treiber, die alle auf Maven Central veröffentlicht sind:
DBMS | Gradle-Abhängigkeit | JDBC-URL | Hinweise |
MySQL | [com.mysql:mysql-connector-j] | [jdbc:mysql://host:3306/database] | Der offizielle Treiber, der in diesem Kurs verwendet wird |
MariaDB, MySQL | [org.mariadb.jdbc:mariadb-java-client] | [jdbc:mariadb://host:3306/database] | |
PostgreSQL | [org.postgresql:postgresql] | [jdbc:postgresql://host:5432/database] | |
SQL Server, Azure SQL | [com.microsoft.sqlserver:mssql-jdbc] | [jdbc:sqlserver://host:1433;databaseName=database] | der Microsoft-Treiber |
Oracle | [com.oracle.database.jdbc:ojdbc11] | [jdbc:oracle:thin:@//host:1521/service] | |
H2 | [com.h2database:h2] | [jdbc:h2:mem:database] oder [jdbc:h2:./file] | ein in Java geschriebenes DBMS, das in die Anwendung eingebettet ist: In-Memory- oder dateibasierte Datenbank, ohne Server; weit verbreitet für Tests |
SQLite | [org.xerial:sqlite-jdbc] | [jdbc:sqlite:file.db] | Eine Datenbank in einer Datei, ohne Server |
Beachten Sie, dass das Format der URL nach [jdbc:] für jeden Treiber spezifisch ist.
Die Struktur ist wie folgt:
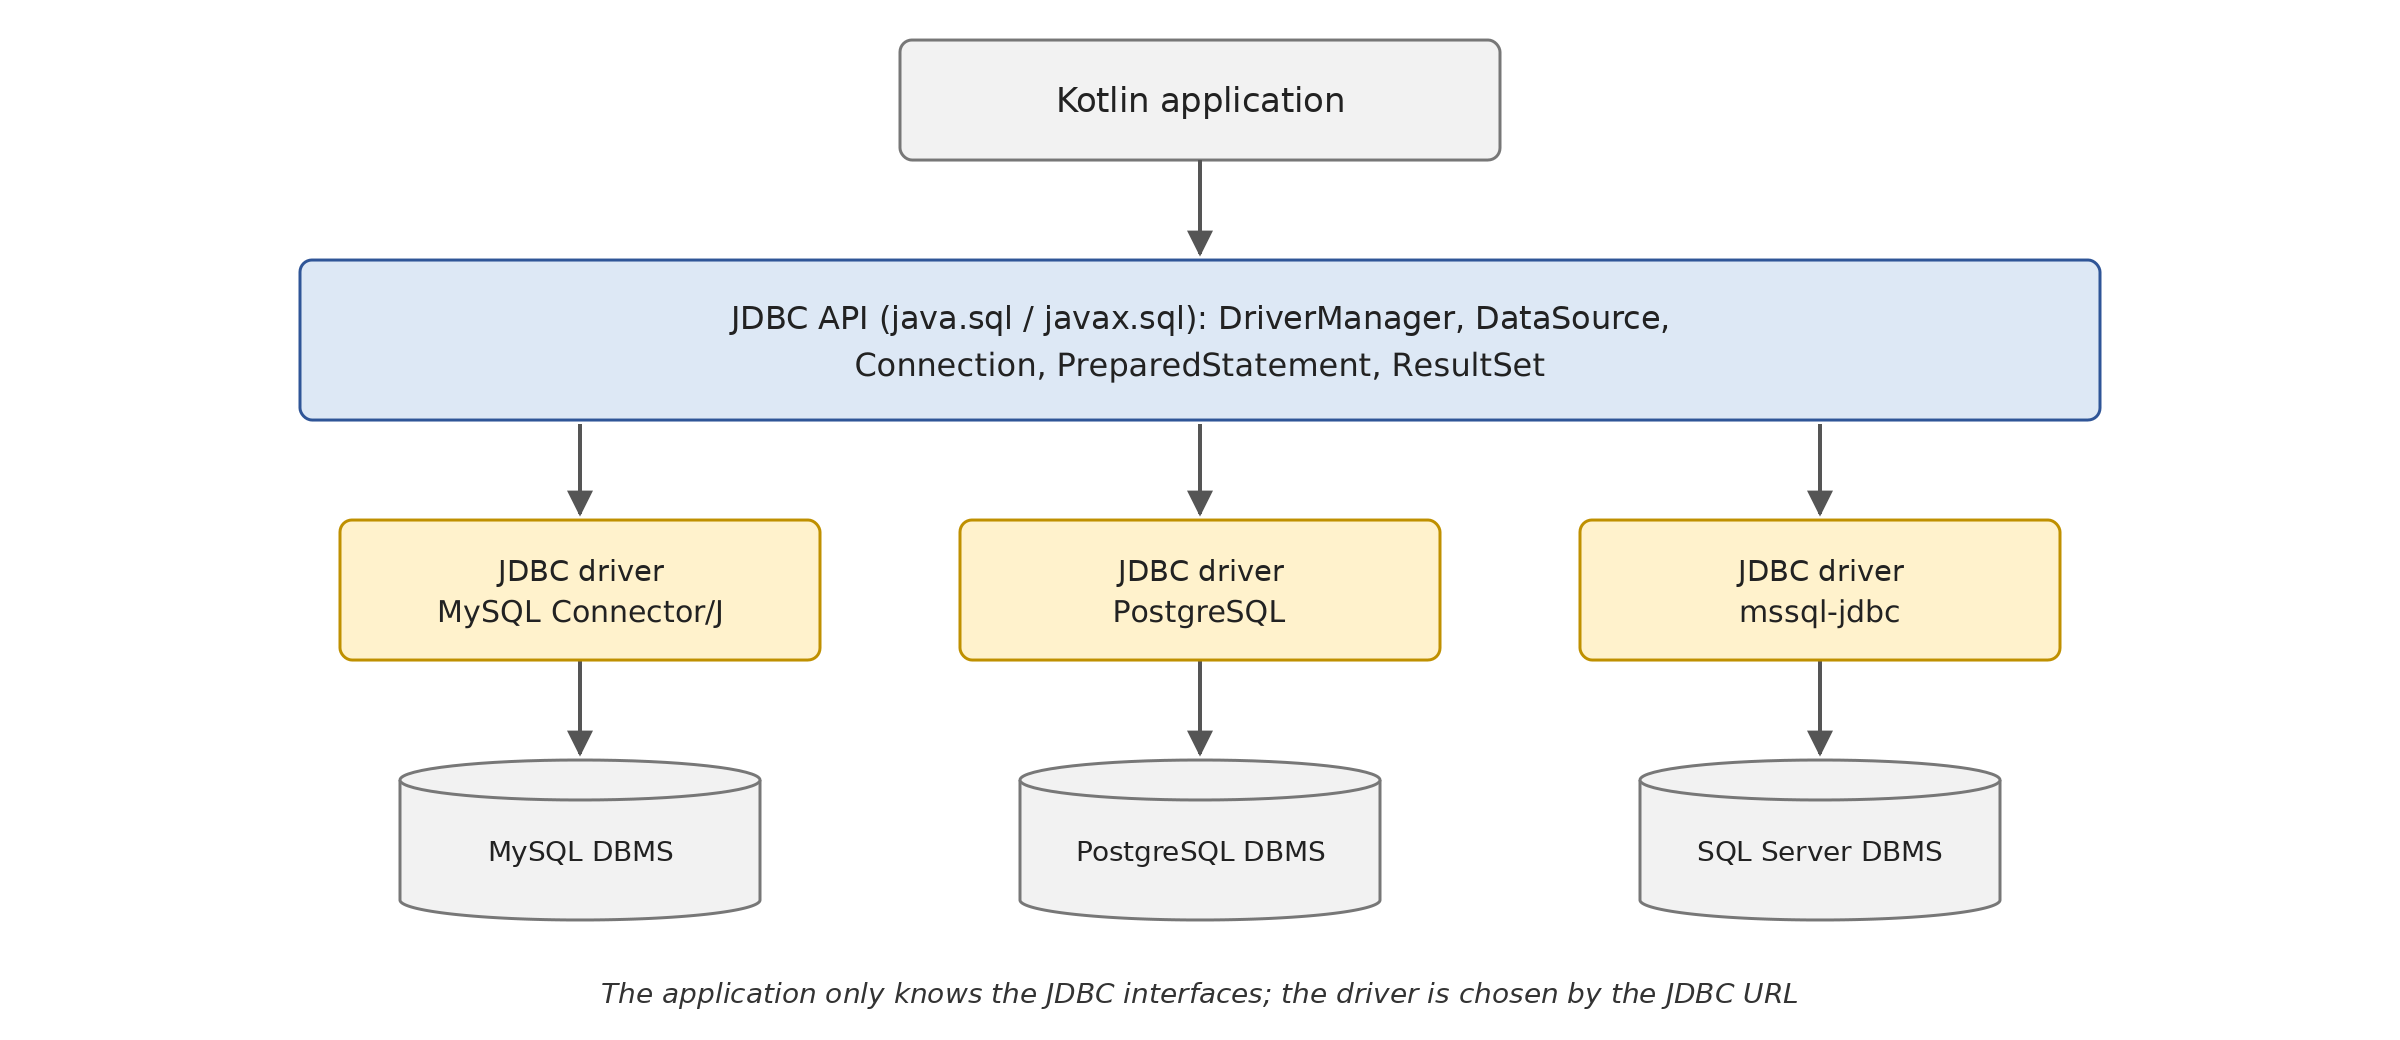
Die Anwendung kennt nur die Schnittstellen von JDBC. Die konkreten Objekte werden vom Treiber erzeugt, den [DriverManager] anhand der URL auswählt: Jeder im Klassenpfad vorhandene Treiber deklariert seine Hauptklasse, eine Implementierung der Schnittstelle [java.sql.Driver], deren Methode [connect(url, properties)] [null] zurückgibt, wenn die URL nicht für sie bestimmt ist ([acceptsURL(url)] erlaubt es auch, sie abzufragen). Das Programm [Jdbc03.kt] zeigt dies. Es erhält als Argument die JDBC-URL der Datenbank:
Ergebnisse bei Verwendung der URL von MySQL (Standardwert):
Ergebnisse bei Verwendung der URL einer Datenbank namens PostgreSQL, deren Treiber nicht im Klassenpfad liegt:
Hier besprechen wir den ersten Teil des Programms (die Funktion [main] bis Zeile 36 sowie die Funktion [displayArticles]); der zweite Teil wird im folgenden Abschnitt behandelt:
- Zeile 17: Die JDBC-URL der Datenbank, als Argument übergeben; andernfalls wird die MySQL-Standarddatenbank [dbarticles] verwendet. [firstOrNull] gibt das erste Element des Argument-Arrays zurück oder [null] , wenn es leer ist; der Elvis-Operator [?:] ersetzt dann [null] durch die Standard-URL. Mit Gradle wird das Argument über die Option [--args] übergeben;
- Zeilen 21–22: [DriverManager.drivers] (Java 9) gibt einen Stream ([Stream]) der geladenen Treiber zurück. Ein Java-Stream ist keine Kotlin-Collection, besitzt aber eine Methode [iterator()]: Das genügt der Kotlin-Schleife [for], um ihn zu durchlaufen. Für jeden Treiber gibt [driver.javaClass.name] den vollständigen Namen seiner Klasse zurück, und die Eigenschaften [majorVersion] und [minorVersion] (die Java-Methoden [getMajorVersion] und [getMinorVersion]) liefern seine Version. Im Klassenpfad ist nur ein Treiber vorhanden: der von MySQL, der Klasse [com.mysql.cj.jdbc.Driver], Version 9.7 (Zeile 3 der Ergebnisse);
- Zeile 27: [DriverManager] sucht einen Treiber, der die URL unterstützt. Ist das bei keinem der Fall, löst [getConnection] eine [SQLException] „No suitable driver found“ aus (Zeile 4 der zweiten Ergebnisse). Diesen Fehler erhalten Sie, wenn Sie die Treiberabhängigkeit in der Datei [build.gradle.kts] vergessen oder sich in der URL vertippt haben;
- Zeilen 28–31: Die Metadaten der Verbindung, ein [DatabaseMetaData]-Objekt, beschreiben das DBMS (Name, Version), den Treiber und die Version von JDBC, die er implementiert: JDBC 4.2, die Java-8-Version. Das JDK 25 definiert JDBC 4.3 (Java 9), das nur geringfügige Ergänzungen enthält; [DatabaseMetaData] beschreibt außerdem die Fähigkeiten des DBMS (Transaktionen, Batches usw.), seine Tabellen und deren Spalten. Alle diese Informationen erhält man über die parameterlosen Methoden [getXxx], die Kotlin als Eigenschaften darstellt ([databaseProductName], [driverVersion] …). Die Eigenschaft [jdbcMajorVersion] entspricht der Java-Methode [getJDBCMajorVersion]: Wie bei [sqlState] werden die anfänglichen Großbuchstaben in Kleinbuchstaben umgewandelt;
- Zeile 32: Ausführung einer parametrisierten Anfrage durch die Funktion [displayArticles];
- Zeilen 61–62: Die Anfrage hat einen Parameter, der mit [?] bezeichnet wird und seinen Wert von [setInt(1, 200)] erhält. Parametrisierte Anfragen werden weiter unten ausführlicher behandelt;
- Zeilen 64–65: Die Ergebnisse zeigen, dass die über die Schnittstellen verwendeten Objekte Objekte des MySQL-Treibers sind: [ConnectionImpl], [ClientPreparedStatement], [ResultSetImpl] (Zeile 6 der Ergebnisse);
- Zeilen 66–67: Da die Spaltentypen bekannt sind, werden die Methoden [getInt], [getString] und [getBigDecimal] verwendet, die direkt einen Wert des erwarteten Typs zurückgeben.
Damit dieses Programm mit PostgreSQL funktioniert, genügt es, die Abhängigkeit [runtimeOnly("org.postgresql:postgresql:…")] zur Datei [build.gradle.kts] hinzuzufügen und die Datenbank [dbarticles] in PostgreSQL anzulegen: [DriverManager] würde dann zwei Treiber finden und für eine URL [jdbc:postgresql:…] den von PostgreSQL auswählen. Auf dem Rechner, der zum Schreiben dieses Kurses verwendet wurde, ist nur MySQL installiert: Wir haben dies nicht ausprobiert.
10.4.2. Datenquellen und Verbindungspools
[DriverManager] ist der traditionelle Weg, eine Verbindung zu erhalten. Seit JDBC 2.0 verwenden Anwendungen stattdessen bevorzugt eine Datenquelle – ein Objekt, das die Schnittstelle [javax.sql.DataSource] implementiert. Eine Datenquelle wird einmalig konfiguriert (URL, Benutzername, Passwort, Treibereinstellungen) und liefert dann Verbindungen über ihre Methode [getConnection()] ohne Parameter (die Eigenschaft [connection] in Kotlin). Der Code, der die Datenquelle verwendet, kennt weder die URL noch die Zugangsdaten: In einer Anwendung wird die Datenquelle selbst im Dependency-Injection-Container registriert (Kapitel 6) und nicht die Verbindungsparameter. Es gibt zwei Hauptkategorien von Datenquellen:
- die von Treibern bereitgestellten, wie [com.mysql.cj.jdbc.MysqlDataSource] für MySQL. Wie [DriverManager] öffnen sie bei jedem Aufruf von [getConnection] eine neue Netzwerkverbindung;
- die, die einen Verbindungspool verwalten. Am häufigsten verwendet wird HikariCP, der Standard-Verbindungspool von Spring Boot. [getConnection] gibt eine Verbindung aus dem Pool zurück, und [close] gibt diese Verbindung an den Pool zurück, anstatt sie zu schließen.
Der zweite Teil des Programms, [Jdbc03], vergleicht die beiden (Zeilen 39–55 und die Funktion [measure]):
- Zeilen 40–43: eine Datenquelle [MysqlDataSource]. Die Scope-Funktion [apply] (Kapitel 7) führt den Block mit dem erzeugten Objekt als Empfänger ([this]) aus und gibt anschließend dieses Objekt zurück: So können Sie das Objekt unmittelbar nach seiner Erzeugung konfigurieren, ohne seinen Namen zu wiederholen. [user = "root"] ruft die Java-Methode [setUser] auf, und [password = ""] ruft die Methode [setPassword] auf. Für die URL müssen Sie [setURL(url)] aufrufen: Die Klasse [MysqlDataSource] hat zwei Paare von Zugriffsmethoden, [getUrl] / [setUrl] und [getURL] / [setURL], die beide zu einer Kotlin-Eigenschaft [url] würden; der Compiler weigert sich dann, [url = …] zu schreiben („overload resolution ambiguity between candidates“). Dies ist der einzige Teil des Programms, der eine Klasse des MySQL-Treibers referenziert: Für diese Klasse wird der Treiber mit [implementation] in [build.gradle.kts] deklariert;
- Zeile 45: Die Funktion [measure] erhält die Datenquelle als Typ der Schnittstelle [DataSource]: Sie wäre für jeden Treiber geeignet;
- Zeilen 48–52: Ein [HikariConfig]-Objekt enthält die Konfiguration des Pools: JDBC-URL, Zugangsdaten und die maximale Größe des Pools (5 Verbindungen; der Standardwert ist 10). Auch es wird mit [apply] konfiguriert, zusammen mit seinen Eigenschaften [jdbcUrl], [username], [password], und [maximumPoolSize]. HikariCP verwendet [DriverManager] , um seine Verbindungen zu öffnen: Es funktioniert mit jedem JDBC-Treiber;
- Zeile 54: Die Datenquelle [HikariDataSource] wird auf der Grundlage dieser Konfiguration erzeugt. Sie öffnet sofort ihre ersten Verbindungen. Da sie offene Verbindungen besitzt, muss sie am Ende des Programms geschlossen werden: [HikariDataSource] implementiert [Closeable], und [use] übernimmt dies;
- Zeilen 74–82: Die Funktion [measure] fordert bei der Datenquelle 100-mal eine Verbindung an ([repeat(100) { … }]) und schließt sie sofort wieder. Die Funktion [measureTime] aus [kotlin.time] führt den Block aus, den sie erhält, und gibt dessen Dauer zurück, ein [Duration]-Objekt, aus dem [inWholeMilliseconds] die Anzahl der Millisekunden ableitet (in Java berechnet man die Differenz zwischen zwei Aufrufen von [System.nanoTime] selbst). Der Block ändert die Variable [className], die mit [var] außerhalb des Blocks deklariert ist: Kotlin-Lambdas können die Variablen verändern, die sie einfangen (Kapitel 7), was Java verbietet. Die Ergebnisse sprechen für sich (Zeilen 10–11 der anfänglichen Ergebnisse): Ohne Pool dauert das Öffnen einer Verbindung für die Netzwerkverbindung und die Authentifizierung mehrere Dutzend Millisekunden; mit dem Pool ist die Verbindung in einem Bruchteil einer Millisekunde hergestellt. Die Dauern hängen vom Rechner ab und schwanken von einer Ausführung zur anderen, das Verhältnis bleibt aber ungefähr gleich;
- Zeile 79: Mit HikariCP ist die zurückgegebene Verbindung ein Objekt [HikariProxyConnection] – ein „Proxy“, der die Verbindung des Treibers umhüllt und dessen Methode [close] sie an den Pool zurückgibt.
Eine Anwendung, die viele Benutzer bedient, verwendet daher immer einen Verbindungspool. Auf einen Anwendungsfall kommen wir im Abschnitt über virtuelle Threads zurück.
10.4.3. Welche Abstraktionsebene sollte man wählen?
Die Unabhängigkeit von JDBC vom DBMS erscheint ideal. In der Praxis kann JDBC nicht alle Besonderheiten eines DBMS verbergen:
- Das SQL selbst unterscheidet sich von einem DBMS zum anderen, sobald man über die Grundbefehle hinausgeht: Erzeugung von Primärschlüsseln, Begrenzung der Anzahl zurückgegebener Zeilen ([limit 10] bei MySQL und PostgreSQL, [top 10] oder [offset … fetch] bei SQL Server), Spaltentypen, Datumsfunktionen usw.;
- die von [getObject] zurückgegebenen Typen können variieren: Wir werden sehen, dass [count(*)] bei MySQL einen [Long] zurückgibt;
- Fehlercodes ([errorCode]) sind für jedes DBMS spezifisch, und SQLSTATE-Werte werden nicht immer auf dieselbe Weise verwendet;
- die URL und die Konfigurationsparameter sind für jeden Treiber spezifisch.
Die Anfrageparameter sind dagegen einheitlich: JDBC schreibt die Notation [?] vor (Positionsparameter, ohne Namen), die jeder Treiber in die Syntax seines DBMS übersetzt.
Um diese Einschränkungen zu überwinden oder das Schreiben von JDBC-Code zu vereinfachen, verwendet man heute vor allem Folgendes:
- einen ORM – meist Hibernate, wie in Kapitel 11 behandelt –, bei dem die [dao]-Schicht Objekte verwaltet und ihre Anfragen in HQL schreibt, einer objektorientierten Abfragesprache; Hibernate erzeugt das für jedes DBMS spezifische SQL (seinen „Dialekt“);
- Bibliotheken, die das SQL beibehalten, aber den sich wiederholenden Code von JDBC beseitigen: Springs [JdbcTemplate] und [JdbcClient] (letzteres seit Spring Framework 6.1), die Zeilen von [select] direkt in Objekte umwandeln und [SQLException] in ungeprüfte Ausnahmen überführen; jOOQ, das SQL-Anfragen im Code mit Validierung durch den Compiler aufbaut und Erweiterungen für Kotlin bietet; MyBatis, das in XML-Dateien oder Annotationen geschriebene SQL-Anfragen mit Methoden verknüpft;
- Auf der Kotlin-Seite bietet Exposed, die Datenbankzugriffsbibliothek von JetBrains, beide Stile: eine in Kotlin geschriebene Abfragesprache ([Articles.selectAll().where { Articles.price greater 200 }]) und eine schlanke Objektschicht.
Diese Werkzeuge beruhen alle auf JDBC: JDBC zu verstehen bleibt nützlich, um nachzuvollziehen, was sie tun, und um Probleme mit ihnen zu beheben. Und wie wir sehen werden, genügen einige wenige Erweiterungsfunktionen, um den in Kotlin geschriebenen JDBC-Code deutlich weniger repetitiv zu machen.
10.5. Parametrisierte Anfragen
10.5.1. Das Konzept
Eine parametrisierte Anfrage ist eine SQL-Anweisung, in der bestimmte Werte durch Parameter ersetzt sind, deren Werte getrennt vom Text der Anfrage angegeben werden. Bei JDBC wird ein Parameter durch ein Fragezeichen [?] gekennzeichnet, und der SQL-Befehl ist ein Objekt [PreparedStatement], das mit [connection.prepareStatement(query)] erzeugt wird. Die Parameter werden durch ihre Position in der Anfrage bezeichnet, beginnend bei 1, und erhalten ihre Werte durch die Methoden [setXxx] des Befehls: [setString(1, "bike")], [setInt(2, 10)] … Da diese Methoden zwei Parameter haben, behandelt Kotlin sie nicht als Eigenschaften: Sie werden genau wie in Java aufgerufen.
Die folgenden Programme stellen eine Zeile der Tabelle [articles] durch ein [Article]-Objekt dar. Da diese Klasse von mehreren Programmen verwendet wird, ist sie zusammen mit Hilfsfunktionen im [common]-Paket des Projekts abgelegt. Die Datei [common/Article.kt] lautet wie folgt:
- Zeilen 7–12: eine Datenklasse (Kapitel 4), das Kotlin-Äquivalent zum [record] von Java: eine Klasse, deren primärer Konstruktor die Eigenschaften definiert – hier alle schreibgeschützt ([val]) – und für die der Compiler die Methoden [equals], [hashCode], [toString], [copy], und die [componentN]-Funktionen für die Destrukturierung generiert. Der Preis ist ein
*[BigDecimal], genau wie die entsprechende Spalte*[DECIMAL]. Das auf den letzten Parameter folgende Komma (Zeile 12) ist in Kotlin erlaubt: Es erleichtert das Hinzufügen eines Parameters und das Lesen der Unterschiede zwischen zwei Versionen der Datei; - Zeilen 16–21: eine Erweiterungsfunktion (Kapitel 4) der Schnittstelle [ResultSet]. Sie wird als Methode des Ergebnisses aufgerufen, [result.toArticle()], und wandelt dessen aktuelle Zeile in ein [Article]-Objekt um. In ihrem Rumpf ist [this] das [ResultSet]: [getInt("id")] ist ein Aufruf von [this.getInt("id")]. Die Spalten werden über ihre Namen identifiziert, ebenso wie die Argumente des Konstruktors (benannte Argumente, Kapitel 3): Man sieht auf einen Blick, welche Spalte welche Eigenschaft füllt. Die Funktion setzt voraus, dass das Ergebnis die Spalten [id], [name], [price], [currentstock] und [minimumstock] enthält; eine Anfrage, die diese Spalten nicht liefert, führt zu dem Fehler [SQLSyntaxErrorException] : „Column 'xxx' not found.“ Der Rückgabetyp wird nicht ausdrücklich angegeben: Die Funktion hat einen Ausdruckskörper ([= Article(…)]), aus dem der Compiler den Typ ableitet.
Die Schnittstelle [ResultSet] wurde offensichtlich nicht für unsere Artikel geschrieben: Die Erweiterungsfunktion erlaubt es uns, ihr in unserem Projekt die benötigte Operation hinzuzufügen, ohne eine Klasse abzuleiten oder wie in Java eine Hilfsklasse mit statischen Methoden zu schreiben (C# bietet dieselbe Möglichkeit mit seinen Erweiterungsmethoden). Ebenso fügt die Datei [common/ResultSets.kt] dem [ResultSet] zwei Funktionen hinzu, die alle seine Zeilen lesen, unabhängig vom Zeilentyp:
- Zeilen 8–13: Die generische Funktion [toList] durchläuft die Zeilen des Ergebnisses mit der Schleife [while (next())] und transformiert jede Zeile mit der als Parameter übergebenen Funktion [transformation] vom Typ [(ResultSet) -> T] (Kapitel 7). Sie gibt die Liste der resultierenden Objekte zurück. Das ist die Schleife, die man in Java typischerweise in jeder Methode schreibt, die ein Ergebnis liest; hier wird sie einmalig geschrieben. Da der letzte Parameter eine Funktion ist, wird der Aufruf mit einem Lambda nach den Klammern geschrieben, die entfallen können: [result.toList { it.toArticle() }] gibt eine [List<Article>] zurück;
- Zeilen 17–18: dasselbe in Form einer Sequenz (Kapitel 5), d. h. einer Folge von Elementen, die bei Bedarf berechnet werden. [generateSequence] konstruiert eine Sequenz aus einer Funktion, die jedes Mal aufgerufen wird, wenn das nächste Element angefordert wird; die Sequenz endet, wenn diese Funktion [null] zurückgibt. Hier geht die Funktion zur nächsten Zeile des Ergebnisses und gibt deren Transformation zurück oder [null] , wenn es keine Zeilen mehr gibt. Es werden keine Zeilen gelesen, bevor die Sequenz durchlaufen wird: Sie muss daher durchlaufen werden, bevor das Ergebnis geschlossen wird, also innerhalb des Blocks von dem [use] , das es geöffnet hat. Außerdem kann eine Sequenz nur einmal durchlaufen werden, da sich der Cursor von dem [ResultSet] nicht rückwärts bewegt.
[toList] eignet sich, wenn man die Zeilen an den Aufrufer zurückgeben möchte (die Liste überlebt das Schließen des Ergebnisses); [asSequence] eignet sich, wenn man die Zeilen verarbeitet, sobald sie eintreffen, ohne sie im Speicher anzusammeln.
Das Programm [Jdbc04.kt] implementiert parametrisierte Anfragen: Es leert die Tabelle [articles], fügt mit einer parametrisierten Anfrage fünf Datensätze ein und liest sie dann mit einer anderen parametrisierten Anfrage wieder aus:
Ergebnisse:
Kommentare:
- Zeilen 3–5: Die Klasse [Article] und die Erweiterungsfunktionen aus dem Paket [common] müssen importiert werden: Eine Erweiterungsfunktion ist nur dort sichtbar, wo sie importiert wird (oder innerhalb ihres eigenen Pakets);
- Zeile 21: Eine Liste mit fünf Elementen, die von [map] aus dem Bereich [1..5] erzeugt wird (Kapitel 5). [id] 0 ist ohne Bedeutung: Sie wird nicht in die Datenbank eingefügt. [BigDecimal(i * 100)] ruft den Konstruktor von [BigDecimal], der eine ganze Zahl erhält, auf;
- Zeile 25: Alle Datensätze werden aus der Tabelle gelöscht. Die Funktion [executeUpdate] (Zeile 77) gibt die Anzahl der gelöschten Zeilen zurück. Der Aufruf steht direkt im Template der angezeigten Zeichenkette, zwischen [${ }];
- Zeile 29: [forEach(::println)] zeigt jedes Element der Liste mithilfe einer Funktionsreferenz an (Kapitel 7). Die Ergebnisse zeigen die für die Datenklasse generierte Methode [toString] in der Form [Article(id=7, name=article1, …)] (ein Java-[record] zeigt [Article[id=7, …]] an);
- Zeile 39: die Funktion zum Einfügen einer Liste von Artikeln:
- Zeile 41: die Anfrage zum Einfügen eines Artikels. Sie hat vier Parameter, die mit [?] bezeichnet sind: den Namen (Parameter Nr. 1), den Preis (Nr. 2), den aktuellen Bestand (Nr. 3) und den Mindestbestand (Nr. 4);
- Zeile 43: [prepareStatement] erzeugt den konfigurierten Befehl. Das zweite Argument, [Statement.RETURN_GENERATED_KEYS], weist den Treiber an, die beim Einfügen vom DBMS generierten Primärschlüssel abzurufen;
- Zeilen 45–50: Die Artikel werden einzeln eingefügt. Jedem der vier Parameter wird durch die seinem Typ entsprechende Methode [setXxx] ein Wert zugewiesen, und dann wird die nun vollständige Anfrage von [executeUpdate] ausgeführt, diesmal ohne Argumente: Der Text der Anfrage wurde bei der Erzeugung des Befehls angegeben. Die Parameterwerte bleiben von einer Ausführung zur nächsten erhalten, bis sie geändert werden (oder bis [clearParameters] aufgerufen wird);
- Zeilen 52–54: Die Eigenschaft [generatedKeys] (die Java-Methode [getGeneratedKeys]) gibt in Form eines [ResultSet] den vom DBMS für die eingefügte Zeile generierten Primärschlüssel zurück. Auch dieses Ergebnis ist eine Ressource, die von [use] geschlossen wird. Die Ergebnisse zeigen die [id]-Werte 7 bis 11: MySQL verwendet die Werte 1 bis 6 der gelöschten Zeilen nicht erneut. So ermittelt man den Bezeichner einer soeben eingefügten Zeile;
- Zeile 62: die Funktion, die Artikel zurückgibt, deren Namen einem Muster [like] von SQL entsprechen (das Zeichen [%] steht für eine beliebige Zeichenfolge: [%3] bezeichnet Namen, die auf 3 enden):
- Zeilen 63–66: Die Anfrage hat einen Parameter, das Muster. Sie ist als Raw String geschrieben (Kapitel 5), der von drei Anführungszeichen begrenzt wird und sich über mehrere Zeilen erstrecken kann; [trimIndent] entfernt die gemeinsame Einrückung der Zeilen sowie die erste und die letzte leere Zeile. Lange Anfragen lesen sich so wie in einem SQL-Client, ohne Verkettung. Der zwischen den beiden Zeilen der Anfrage erhalten gebliebene Zeilenumbruch dient für SQL als Trennzeichen wie jedes andere;
- Zeile 69: Dem Parameter wird sein Wert zugewiesen;
- Zeile 71: Der Befehl wird ausgeführt, und dank der beiden Erweiterungsfunktionen wird jede Zeile des Ergebnisses zu einem [Article]-Objekt: [result.toList { it.toArticle() }]. Diese wenigen Zeilen ersetzen die veränderliche Liste, die [while]-Schleife und den Aufruf des Konstruktors in der Java-Version. Das innerste [use] gibt die Liste zurück (den Wert seines Blocks), und die Anweisung [return], die in den Lambdas von [inline]-Funktionen steht, beendet die Funktion [getArticles]: Die drei [use]-Anweisungen schließen dann der Reihe nach das Ergebnis, den SQL-Befehl und die Verbindung. Die zurückgegebene Liste hängt ihrerseits von keiner JDBC-Ressource mehr ab;
- Zeilen 77–79: Die Funktion [executeUpdate] hat einen Ausdruckskörper: Ihr Wert ist der des ersten [use], das der des zweiten ist, welcher die von [executeUpdate] zurückgegebene Zeilenanzahl ist. Das zeigt den Nutzen eines [use], das einen Wert zurückgibt.
Die Spalten werden in der Funktion [toArticle] über ihren Namen gelesen. Die Methoden [getXxx] akzeptieren auch die Spaltennummer: [getInt(1)], [getString(2)] … Der Zugriff über den Namen ist lesbarer und verkraftet Änderungen an der Anfrage besser; der Zugriff über die Nummer ist etwas schneller.
Der Name [PreparedStatement] („vorbereiteter“ Befehl) rührt daher, dass ein DBMS eine parametrisierte Anfrage „vorbereiten“ kann, d. h. sie einmalig kompiliert. Wenn ein DBMS einen SQL-Befehl ausführt, nimmt es vor der Ausführung eine Analyse und Optimierung vor (es erstellt einen „Ausführungsplan“). Eine parametrisierte Anfrage ist dazu gedacht, mehrfach mit verschiedenen Parametern ausgeführt zu werden, ihr Text ändert sich jedoch nicht: Diese Arbeit muss nur einmal erledigt werden. Bei MySQL Connector/J wird die Vorbereitung standardmäßig vom Treiber simuliert: Er fügt die – korrekt maskierten – Parameterwerte selbst in den Anfragetext ein, bevor er ihn sendet. Der Parameter [useServerPrepStmts=true] der URL bewirkt, dass er die vom MySQL-Server bereitgestellte Vorbereitung verwendet. In beiden Fällen ist der Kotlin-Code derselbe.
Die wichtigsten Entsprechungen zwischen den SQL-Typen von MySQL, den Methoden von JDBC und den Kotlin-Typen sind die folgenden:
MySQL-Spaltentyp | JDBC-Methoden | Kotlin-Typ |
[INT] | [setInt], [getInt] | [Int] ([java.lang.Integer] bei [getObject]) |
[BIGINT] | [setLong], [getLong] | [Long] |
[DECIMAL(p,d)] | [setBigDecimal], [getBigDecimal] | [BigDecimal] |
[DOUBLE] | [setDouble], [getDouble] | [Double] |
[VARCHAR(n)], Zeichenkette variabler Länge | [setString], [getString] | [String] ([String?] wenn die Spalte [NULL] zulässt) |
[DATETIME] | [setObject(i, value)], [getObject(i, LocalDateTime::class.java)] | [LocalDateTime] |
[DATE] | [setObject(i, value)], [getObject(i, LocalDate::class.java)] | [LocalDate] |
[BOOL] (Synonym für [TINYINT(1)]) | [setBoolean], [getBoolean] | [Boolean] |
Datumswerte werden durch die Klassen von [java.time] dargestellt (Kapitel 5), die JDBC seit Version 4.2 (Java 8) über [setObject] und [getObject] unterstützt. Die älteren Klassen [java.sql.Date], [java.sql.Time] und [java.sql.Timestamp], die von [java.util.Date] abgeleitet sind, und die Methoden [getDate], [getTimestamp] , die sie implementieren, sollten in neuem Code nicht mehr verwendet werden. Um einem Parameter den SQL-Wert [NULL] zuzuweisen, schreibt man [setNull(i, Types.INTEGER)], wobei die Klasse *[java.sql.Types]* (oder die Enumeration *[JDBCType]*, Java 8) den SQL-Typ des Parameters angibt. Um eine ganze Spalte zu lesen, die [NULL] zulässt, können Sie in Kotlin [result.getInt(i).takeUnless { result.wasNull() }] schreiben, was einen [Int?] zurückgibt – den gelesenen Wert – oder [null] , wenn die Spalte keinen Wert hatte.
10.5.2. Die SQL-Injection
Die Vorbereitung ist nicht der einzige Vorteil parametrisierter Anfragen, und auch nicht der wichtigste. Betrachten wir die Suche nach einem Artikel anhand seines Namens. Die String-Templates von Kotlin machen es sehr verlockend, den Text der Anfrage programmatisch zu konstruieren, indem man den Suchbegriff einfügt:
(dies ist eine der Zeilen des unten stehenden Programms [Jdbc05] ). Lautet der Name „bike“, wird die Anfrage zu:
Lautet der Name jedoch „diver's oxygen tanks“, wird sie zu:
und sie ist wegen des Apostrophs im Namen syntaktisch falsch. Es kommt noch schlimmer: Stammt der Name aus einer Benutzereingabe, könnte der Benutzer einen Text eingeben, der die Bedeutung der Anfrage verändert. Dies nennt man eine SQL-Injection, eine der häufigsten und schwerwiegendsten Sicherheitslücken in datenbankgestützten Anwendungen. Das Template ["… '$name'"] ist nichts anderes als eine besser lesbar geschriebene Verkettung: Es hat genau denselben Fehler wie das ["… '" + name + "'"] von Java, und gerade seine Lesbarkeit macht es noch gefährlicher, da der Code sauber aussieht. Das Programm [Jdbc05.kt] macht die Schwachstelle bei der Suche nach einem Artikel anhand seines Namens deutlich:
Ergebnisse:
Kommentare:
- Zeile 16: drei Namen, die ein Benutzer eingeben könnte: ein normaler Name, ein Name mit einem Apostroph und ein bösartiger Text;
- Zeilen 19 und 21: Jeder Name wird nacheinander an die beiden Suchfunktionen übergeben, die durch Funktionsreferenzen bezeichnet werden;
- Zeile 25: Die erste Suchfunktion fügt den Namen mithilfe eines String-Templates (Zeile 26) in den Text der Anfrage ein und wird von einem gewöhnlichen [Statement] ausgeführt:
- Zeile 3 der Ergebnisse: Mit einem normalen Namen funktioniert alles einwandfrei;
- Zeile 6: Der Apostroph im Namen beendet die SQL-Zeichenkette vorzeitig; die Anfrage ist fehlerhaft (Zeile 7). Ein Artikel, dessen Name einen Apostroph enthält, kann nicht gefunden werden;
- Zeile 8: Der Benutzer hat einen Text mit Apostrophen eingegeben, die so platziert sind, dass sie eine gültige Anfrage ergeben, für die aber die Bedingung [name = 'x' or '1'='1'] für alle Zeilen wahr ist: Die Anfrage gibt die gesamte Tabelle zurück (Zeile 15). Würde die Anfrage einen Benutzernamen und ein Passwort überprüfen, ermöglichte dasselbe Vorgehen dem Benutzer, sich anzumelden, ohne das Passwort zu kennen. Bei einem Treiber, der mehrere SQL-Befehle in einer einzigen Anfrage akzeptiert, könnte der Benutzer sogar nach einem Semikolon einen Befehl seiner Wahl anhängen, etwa einen [delete]. Connector/J lehnt dies standardmäßig ab (Parameter [allowMultiQueries=false]), was die Reichweite der Injection begrenzt, ohne sie zu beseitigen;
- Zeile 31: Das Ergebnis wird über eine Funktionsreferenz an die Funktion [display] übergeben: [use(::display)] ist gleichbedeutend mit [use { display(it) }];
- Zeile 40: Die zweite Funktion verwendet eine parametrisierte Anfrage (Zeilen 44–45). Der Wert des Parameters wird nie als SQL interpretiert: Er wird unabhängig von seinem Inhalt als Daten behandelt. Der Name mit einem Apostroph wird gefunden (Zeile 22 der Ergebnisse), und der bösartige Text ist einfach der Name eines Artikels, der nicht existiert (Zeile 25);
- Zeilen 55–59: Die Anzeige des Ergebnisses verwendet die Erweiterungsfunktion [asSequence] aus dem Paket [common]. Die Sequenz wandelt jede Zeile in eine Zeichenkette um; [onEach] zeigt jede Zeichenkette sofort an und gibt dieselbe Sequenz zurück, die [count] bis zum Ende durchläuft, um ihre Elemente zu zählen. Da eine Sequenz träge ist, ist es [count] , das das Lesen der Zeilen auslöst: Jede wird gelesen, angezeigt und gezählt, bevor die nächste gelesen wird, ohne Zwischenliste. Der Durchlauf erfolgt während des Aufrufs von [display], also innerhalb des Blocks von [use] , das das Ergebnis schließt, wie es sein soll.
Man könnte die Apostrophe „entschärfen“, indem man sie verdoppelt, aber die Regeln hängen vom DBMS ab, und man übersieht leicht einen Fall. Die Regel ist einfach: Werte, die vom Benutzer (oder von einer anderen externen Quelle) stammen, dürfen niemals in den Text einer SQL-Anfrage eingefügt werden, weder durch Verkettung noch über ein String-Template; man verwendet immer ein PreparedStatement und Parameter. Templates bleiben nützlich für die festen Teile einer Anfrage, die das Programm selbst auswählt (zum Beispiel ein Tabellen- oder Spaltenname aus einer bekannten Liste), aber niemals für Werte. Das interaktive Programm [Jdbc01.kt] hält diese Regel schon seiner Natur nach nicht ein: Es führt die vom Benutzer eingegebenen SQL-Befehle aus. Es ist ein Administrationswerkzeug, kein Beispiel, dem man folgen sollte.
10.6. Transaktionen
10.6.1. Allgemeines
Eine Transaktion ist eine Folge von SQL-Befehlen, die „atomar“ ausgeführt werden:
- entweder gelingen alle Operationen;
- oder eine von ihnen schlägt fehl, und dann werden alle vorangegangenen Operationen rückgängig gemacht.
Am Ende werden entweder alle Operationen einer Transaktion erfolgreich angewendet, oder keine. Das klassische Beispiel ist eine Banküberweisung: Die Abbuchung von einem Konto und die Gutschrift auf einem anderen müssen entweder beide erfolgen oder keine von beiden. Wenn die Anwendung die Transaktion selbst steuert, bestätigt sie sie mit einem Befehl [COMMIT] oder macht sie mit einem Befehl [ROLLBACK] rückgängig.
In unseren bisherigen Beispielen haben wir keine Transaktion verwendet. Und dennoch gab es Transaktionen, denn in einem DBMS wird ein SQL-Befehl immer innerhalb einer Transaktion ausgeführt. Wenn die Anwendung nicht selbst eine explizite Transaktion startet, verwendet das DBMS eine implizite Transaktion. Dann gibt es zwei Fälle:
- Jeder SQL-Befehl ist Teil einer Transaktion, die das DBMS vor dem Befehl öffnet und danach bestätigt. Man spricht vom Autocommit-Modus. Es verhält sich so, als würde die Anwendung für jeden SQL-Befehl eine Transaktion starten;
- das DBMS befindet sich nicht im Autocommit-Modus: Es startet mit dem ersten außerhalb einer Transaktion abgesetzten SQL-Befehl eine implizite Transaktion und überlässt es der Anwendung, sie abzuschließen. Alle folgenden SQL-Befehle sind Teil dieser impliziten Transaktion, die aufgrund verschiedener Ereignisse (Schließen der Verbindung, Beginn einer neuen Transaktion usw.) nach Regeln enden kann, die für das DBMS spezifisch sind. Dieser Modus sollte vermieden werden.
JDBC erzwingt den ersten Fall: Eine JDBC-Verbindung befindet sich beim Öffnen im Autocommit-Modus, unabhängig von der Einstellung des DBMS (MySQL befindet sich mit der Standard-Storage-Engine InnoDB ebenfalls im Autocommit-Modus).
Befehle verschiedener Benutzer werden gleichzeitig in parallel laufenden Transaktionen ausgeführt. Operationen einer Transaktion können Auswirkungen auf die einer anderen haben. Es gibt vier Isolationsstufen zwischen den Transaktionen verschiedener Benutzer:
- Read Uncommitted;
- Read Committed;
- Repeatable Read;
- Serializable.
Read Uncommitted
Diese Isolationsstufe ist auch als „Dirty Read“ bekannt. Hier ein Beispiel dafür, was in diesem Modus passieren kann:
- Ein Benutzer namens U1 startet eine Transaktion auf der Tabelle T;
- ein Benutzer namens U2 startet eine Transaktion auf derselben Tabelle T;
- Benutzer U1 ändert Zeilen der Tabelle T, hat die Änderungen aber noch nicht bestätigt;
- Der Benutzer U2 „sieht“ diese Änderungen und trifft Entscheidungen auf der Grundlage dessen, was er sieht;
- Benutzer U1 bricht seine Transaktion mit einem [ROLLBACK] ab.
In Schritt 4 hat Benutzer U2 eine Entscheidung auf der Grundlage von Daten getroffen, die sich später als falsch herausstellten.
Read Committed
Diese Isolationsstufe vermeidet die vorherige Falle: In Schritt 4 „sieht“ Benutzer U2 die Änderungen von Benutzer U1 an der Tabelle T nicht. Er sieht sie erst, nachdem U1 seine Transaktion mit einem [COMMIT] bestätigt hat. In diesem Modus kann jedoch die folgende Situation eintreten:
- ein Benutzer U1 startet eine Transaktion auf der Tabelle T;
- ein Benutzer U2 startet eine Transaktion auf derselben Tabelle T;
- Benutzer U2 führt ein [select] aus, um den Durchschnitt der Spalte C für die Zeilen von T zu berechnen, die eine bestimmte Bedingung erfüllen;
- Benutzer U1 ändert ([update]) bestimmte Werte der Spalte C von T und bestätigt die Änderungen ([commit]);
- Benutzer U2 wiederholt dasselbe [select] wie in Schritt 3. Er stellt fest, dass sich der Durchschnitt der Spalte C aufgrund der von U1 vorgenommenen Änderungen verändert hat.
Benutzer U2 sieht nun nur die von U1 bestätigten Änderungen, doch innerhalb derselben Transaktion liefern zwei identische Operationen unterschiedliche Ergebnisse. Diese Situation nennt man „Non-repeatable Read“. Sie ist problematisch für jeden, der eine konsistente Sicht auf die Tabelle T benötigt.
Repeatable Read
Bei dieser Isolationsstufe ist einem Benutzer garantiert, dass er bei Lesezugriffen auf die Datenbank dieselben Ergebnisse erhält, solange er innerhalb derselben Transaktion bleibt. Er arbeitet auf einem „Schnappschuss“ der Daten, der die Änderungen anderer Transaktionen nicht widerspiegelt, selbst wenn diese bestätigt wurden. Er sieht diese Änderungen erst, wenn er seine eigene Transaktion abgeschlossen hat.
Diese Isolationsstufe ist theoretisch noch nicht perfekt: Eine andere Transaktion kann Zeilen hinzufügen ([insert]), die die Bedingung aus Schritt 3 erfüllen, was das Ergebnis eines späteren Lesezugriffs verändern würde. Diese Zeilen nennt man „Phantomzeilen“ („Phantom Reads“). Dies ist die Standard-Isolationsstufe von MySQL (InnoDB), die bei einfachen Lesezugriffen auch Phantom Reads verhindert.
Serializable
In diesem Isolationsmodus sind die Transaktionen vollständig voneinander isoliert: Das Ergebnis zweier gleichzeitig ausgeführter Transaktionen ist dasselbe, als wären sie nacheinander ausgeführt worden. Um dies zu erreichen, sperrt das DBMS die gelesenen Daten und lässt Transaktionen, die versuchen, sie zu ändern, warten (oder scheitern). Diese Stufe verringert die Parallelität und damit die Leistung.
Die vier Isolationsstufen sind nicht in allen DBMS verfügbar. Die Standard-Isolationsstufe ist im Allgemeinen Read Committed (SQL Server, PostgreSQL, Oracle) oder Repeatable Read (MySQL). Die gewünschte Isolationsstufe kann von der Anwendung ausdrücklich angegeben werden.
10.6.2. Transaktionsverwaltung in der API
Bei JDBC werden Transaktionen von der Verbindung verwaltet. Es gibt kein „Transaktionsobjekt“: Eine Verbindung hat höchstens eine aktive Transaktion, und alle auf dieser Verbindung ausgeführten SQL-Befehle gehören zu ihr. Die relevanten Methoden der Schnittstelle [Connection] sind die folgenden. Kotlin behandelt die Java-Getter-Setter-Paare [getXxx] / [setXxx] als Eigenschaften (Kapitel 4): [connection.setAutoCommit(false)] wird als [connection.autoCommit = false] geschrieben, und [connection.getAutoCommit()] wird als [connection.autoCommit] geschrieben. Die linke Spalte zeigt die Kotlin-Form:
Methode oder Eigenschaft | Rolle |
[autoCommit] | [autoCommit = false] ([setAutoCommit(false)] in Java) verlässt den Autocommit-Modus: Die folgenden SQL-Befehle gehören zu einer Transaktion, die mit dem ersten von ihnen beginnt und mit [commit] oder [rollback] endet. Mit dem nächsten Befehl beginnt dann eine neue Transaktion. [autoCommit = true] kehrt in den Autocommit-Modus zurück und bestätigt dabei die laufende Transaktion. |
[commit()] | bestätigt die Transaktion: Die Ergebnisse der innerhalb der Transaktion abgesetzten SQL-Befehle werden endgültig und für andere Transaktionen sichtbar. |
[rollback()] | macht die Transaktion rückgängig: Die Ergebnisse der in der Transaktion abgesetzten SQL-Befehle werden zurückgenommen. |
[setSavepoint()] | setzt in der aktuellen Transaktion einen Sicherungspunkt (ein [Savepoint]-Objekt). Dies ist keine Zugriffsmethode (es gibt kein zugehöriges [getSavepoint]): Kotlin ruft sie als Funktion auf. |
[rollback(Savepoint)] | macht die seit dem Sicherungspunkt ausgeführten SQL-Befehle rückgängig, ohne die davor liegenden zurückzunehmen: Die Transaktion wird fortgesetzt. |
[transactionIsolation] | die Isolationsstufe der Transaktionen der Verbindung ([setTransactionIsolation] in Java). Sie muss gesetzt werden, bevor eine Transaktion beginnt. |
Die Isolationsstufe ist eine der Konstanten der Schnittstelle [Connection]:
Wert | Bedeutung |
[TRANSACTION_READ_UNCOMMITTED] | Eine Transaktion kann Daten lesen, die von einer anderen Transaktion geschrieben, von dieser aber noch nicht bestätigt wurden. Dies sollte vermieden werden. |
[TRANSACTION_READ_COMMITTED] | Die Transaktion kann keine Daten lesen, die von einer anderen Transaktion geschrieben, von dieser aber noch nicht bestätigt wurden. Daten, die innerhalb der Transaktion zweimal hintereinander gelesen werden, können sich jedoch ändern, weil eine andere Transaktion sie in der Zwischenzeit geändert haben kann; eine andere Transaktion kann auch Zeilen hinzugefügt haben (Geisterzeilen). |
[TRANSACTION_REPEATABLE_READ] | Die von der Transaktion gelesenen Daten ändern sich nicht, bis die Transaktion abgeschlossen ist. Theoretisch verhindert dies nicht, dass eine andere Transaktion Zeilen hinzufügt. |
[TRANSACTION_SERIALIZABLE] | Alles verhält sich so, als würde die Transaktion allein laufen. Das verringert die Leistung, weil die Transaktionen nicht mehr parallel laufen. |
Dies sind [static]-Konstanten einer Java-Schnittstelle: Kotlin verweist auf sie über den Namen der Schnittstelle, [Connection.TRANSACTION_READ_COMMITTED], genau wie auf die Mitglieder eines [companion object].
Eine Verbindung, die den Autocommit-Modus verlassen hat, muss geschlossen werden, nachdem ihre Transaktion bestätigt oder rückgängig gemacht wurde. Wird sie geschlossen, während noch eine Transaktion läuft, hängt das Ergebnis vom Treiber ab (Connector/J macht sie rückgängig): Man muss eine Transaktion immer ausdrücklich bestätigen.
10.6.3. Das Beispielprogramm
Das Programm [Jdbc06.kt] zeigt die Wirkung einer Transaktion:
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 33 34 35 36 37 38 39 40 41 42 43 44 45 46 47 48 49 50 51 52 53 54 55 56 57 58 59 60 61 62 63 64 65 66 67 68 69 70 71 72 73 74 75 76 77 78 79 80 81 82 83 84 85 86 87 88 89 90 91 92 93 94 95 96 97 98 99 100 101 102 103 104 105 106 107 108 109 110 111 112 113 114 115 116 117 118 119 120 121 122 123 124 125 126 127 128 129 130 131 132 133 134 135 136 137 138 139 140 141 142 143 144 145 146 147 148 149 150 151 152 153 154 155 156 157 158 159 160 161 162 163 164 165 166 167 168 169 170 171 172 173 174 175 176 177 178 179 | |
Ergebnisse:
Kommentare:
- Zeilen 21–23: Eine Liste mit zwei Artikeln mit demselben Namen, [article] ([Article] ist die Datenklasse des Pakets [common]). Die Eindeutigkeitsbedingung [UNQ_NAME] für die Tabelle [articles] verhindert, dass beide gleichzeitig in der Datenbank existieren: Das Einfügen des zweiten löst eine [SQLException] aus. Um die Wirkung einer Transaktion zu zeigen, werden die beiden Artikel auf vier verschiedene Arten eingefügt:
- zuerst außerhalb jeder expliziten Transaktion. Da sich die Verbindung im Autocommit-Modus befindet, wird jedes Einfügen in einer eigenen Transaktion ausgeführt. Der erste Datensatz wird eingefügt, der zweite nicht;
- danach innerhalb einer Transaktion, die beide Einfügungen umfasst. Da die zweite Einfügung fehlschlägt, wird die erste rückgängig gemacht: Am Ende wird keine der beiden Einfügungen durchgeführt;
- dann innerhalb einer Transaktion mit einem Sicherungspunkt vor jeder Einfügung: Das Fehlschlagen der zweiten Einfügung macht nur diese rückgängig, und die Transaktion wird mit der ersten bestätigt;
- schließlich in einer Transaktion, die von einer Funktion höherer Ordnung, [transaction], verwaltet wird, die wir im folgenden Absatz vorstellen;
- Zeilen 27–35: Die Tabelle wird geleert, dann werden beide Artikel ohne explizite Transaktion eingefügt. Da wir wissen, dass die zweite Einfügung eine Ausnahme auslöst, wird diese von einem [try] / [catch] abgefangen; schließlich wird die Tabelle angezeigt;
- Zeilen 37–40: Wir wiederholen dieselbe Abfolge, diesmal jedoch mit einer Transaktion. Die Ausnahme wird dieses Mal in der Funktion [insertArticlesInTransaction] behandelt;
- Zeilen 43–46: dasselbe gilt für die Sicherungspunkte;
- Zeile 65: die Einfüge-Funktion ohne Transaktion. Sie verwendet zwei Funktionen: [createInsertStatement] (Zeile 137), die den parametrisierten Einfügebefehl erzeugt, und [insertArticle] (Zeile 142), die den Parametern Werte zuweist und den Befehl ausführt. Die beiden verschachtelten [use]-Funktionen schließen den Befehl und danach die Verbindung, genau wie es das
try-with-resourcesvon Java tat; - Zeile 74: die Einfüge-Funktion innerhalb einer Transaktion:
- Zeile 77: die Isolationsstufe [TRANSACTION_READ_COMMITTED], die vor Beginn der Transaktion über eine Eigenschaftszuweisung gesetzt wird;
- Zeile 78: Die Verbindung verlässt den Autocommit-Modus; die Transaktion beginnt mit der ersten Einfügung;
- Zeilen 80–81: die Einfügungen;
- Zeile 84: Alles ist gut gegangen: Die Transaktion wird bestätigt, und die Einfügungen werden dauerhaft in die Datenbank übernommen;
- Zeilen 86–89: Eine Einfügung ist fehlgeschlagen: Die Transaktion wird rückgängig gemacht;
- Zeile 96: die Einfüge-Funktion mit Sicherungspunkten:
- Zeile 103: Vor jeder Einfügung wird ein Sicherungspunkt gesetzt. [setSavepoint] ist keine Eigenschaftszugriffsmethode (sie hat keine Parameter): Sie wird als Funktion aufgerufen;
- Zeile 108: Schlägt die Einfügung fehl, kehren wir zum Sicherungspunkt zurück: Nur die fehlgeschlagene Einfügung wird rückgängig gemacht, und die Schleife wird fortgesetzt;
- Zeile 113: Die Transaktion wird mit den erfolgreichen Einfügungen bestätigt;
- Zeilen 142–149: Die Funktion [with] aus der Standardbibliothek führt ihren Block mit dem Artikel als Empfänger aus: Innerhalb des Blocks bezeichnet [name] [article.name]. Die Funktion [displayArticles] verwendet es auf dieselbe Weise mit dem Anfrageergebnis (Zeile 171), wodurch vermieden wird, [result.] fünfmal zu wiederholen;
- Zeile 154: Wie alle Funktionen des Programms deklariert [executeUpdate] keine Ausnahmen: Kotlin kennt keine geprüften Ausnahmen (Kapitel 3), und die Klausel [throws SQLException], die Java für jede Methode verlangte, ist nicht mehr nötig. Die [SQLException] gelangt bis zum [try] in der Funktion [main] (Zeile 59).
In den Ergebnissen:
- Zeile 5: angezeigt vom Befehl [delete]: Die Tabelle enthielt sechs Zeilen;
- Zeile 7: die Ausnahme, die durch die zweite Einfügung verursacht wurde. Die Meldung zeigt, dass die Bedingung [UNQ_NAME] für die Tabelle [articles] nicht erfüllt war;
- Zeile 9: Die Tabelle ist nicht leer: Der erste Datensatz wurde eingefügt;
- Zeile 12: angezeigt vom Befehl [delete]: Die Tabelle enthielt eine Zeile;
- Zeile 13: Die erste Einfügung war erfolgreich … innerhalb der Transaktion;
- Zeile 14: die Meldung, die angezeigt wird, wenn die Transaktion fehlschlägt;
- Zeile 15: Die Tabelle ist leer: Das [rollback] der Transaktion hat die erste Einfügung rückgängig gemacht;
- Zeilen 19–21: Dank der Sicherungspunkte wurde die zweite Einfügung rückgängig gemacht und die Transaktion bestätigt;
- Zeile 23: Die Tabelle enthält den ersten Artikel. Sein [id] -Wert ist 11, nicht 8: Jeder Einfügeversuch – auch wenn er rückgängig gemacht oder abgelehnt wurde – hat einen Wert der Spalte [AUTO_INCREMENT] verbraucht, und MySQL verwendet diese Werte nicht erneut.
Bei MySQL macht das Fehlschlagen eines SQL-Befehls nur diesen Befehl rückgängig, und die Transaktion kann fortgesetzt werden: Der Sicherungspunkt ist hier also nicht unerlässlich. Das gilt nicht für alle DBMS: Bei PostgreSQL macht schon der kleinste Fehler die Transaktion unbrauchbar, bis sie rückgängig gemacht wird oder bis ein Sicherungspunkt erreicht ist. Der Code mit Sicherungspunkten funktioniert mit beiden.
10.6.4. Eine Funktion höherer Ordnung: transaction { }
Die Funktionen [insertArticlesInTransaction] und [insertArticlesWithSavepoint] folgen demselben Muster: Autocommit-Modus verlassen, die Arbeit ausführen, bestätigen und bei einer Ausnahme rückgängig machen. Dieses Muster ist immer dasselbe; nur die Aufgabe ändert sich: Das ist der typische Anwendungsfall einer Funktion höherer Ordnung (Kapitel 7), die die Aufgabe in Form eines Lambdas erhält, genau wie [use] die Aufgabe erhält, die vor dem Schließen einer Ressource auszuführen ist. Wir schreiben sie einmalig als Erweiterungsfunktion von [Connection] in der Datei [Transactions.kt] im Paket [common]:
- Zeile 11: Die Funktion [transaction] ist eine Erweiterungsfunktion der Schnittstelle [Connection]: Sie wird als Methode der Verbindung aufgerufen, [connection.transaction { … }]. Sie hat zwei Parameter:
- [isolation], die Isolationsstufe, vom Typ [Int?] und mit dem Standardwert [null] (in diesem Fall bleibt die Stufe der Verbindung unverändert);
- [block], die in der Transaktion auszuführende Aufgabe. Ihr Typ [Connection.() -> T] ist der eines Lambdas mit Empfänger: Innerhalb des Blocks ist [this] die Verbindung, und [prepareStatement(…)] kann statt [connection.prepareStatement(…)] geschrieben werden. Das ist der Mechanismus, den [with], [apply], und [buildList] in der Standardbibliothek verwenden. Der Block gibt einen Wert vom Typ [T] zurück, den [transaction] wiederum zurückgibt. Da der Block der letzte Parameter ist, wird er beim Aufruf nach den Klammern geschrieben oder ganz ohne Klammern, wenn er das einzige Argument ist;
- [inline]: Der Code der Funktion und der Code des Blocks werden an die Aufrufstelle kopiert (Kapitel 7): Für jede Transaktion wird kein Lambda-Objekt erzeugt. Allerdings kann ein Lambda, das an eine [inline]-Funktion übergeben wird, ein [return] enthalten, das die aufrufende Funktion verlässt (ein „nicht lokales“ Return, wie im Rumpf einer Schleife). Hier wäre das eine Falle: Ein
*[return]mitten im Block würde das*[try]verlassen, ohne weder[commit]noch*[rollback]*zu durchlaufen, und die Transaktion bliebe offen. Der Modifikator [crossinline] für den Parameter [block] verhindert dies. Der Compiler lehnt daher einen Block wie [connection.transaction { if (name.isEmpty()) return … }] ab:
Der Block endet daher immer mit dem Wert, den er zurückgibt (ein [return@transaction value] ist weiterhin erlaubt: Es verlässt nur das Lambda);
- Zeile 13: Wird eine Isolationsstufe angegeben, wird sie gesetzt, bevor die Transaktion beginnt;
- Zeilen 14–15: Der Modus der Verbindung wird gesichert, dann wird der Autocommit-Modus verlassen;
- Zeilen 17–19: Der Block wird ausgeführt, dann wird die Transaktion bestätigt und das Ergebnis des Blocks zurückgegeben;
- Zeilen 20–27: Löst der Block irgendeine Ausnahme aus, wird die Transaktion rückgängig gemacht und die Ausnahme erneut ausgelöst: Der Aufrufer erhält sie, als gäbe es die Funktion [transaction] nicht. Schlägt [rollback] selbst fehl (Verbindung verloren), darf seine Ausnahme die ursprüngliche, relevantere nicht verdecken: Sie wird ihr als unterdrückte Ausnahme ([addSuppressed]) angehängt, ähnlich wie das
try-with-resourcesvon Java oder die Kotlin-Funktion*[use]Ausnahmen von[close]*behandelt; - Zeilen 28–29: Der Autocommit-Modus wird in jedem Fall wiederhergestellt. Das ist bei einem Verbindungspool nützlich: Die an den Pool zurückgegebene Verbindung kehrt in ihren Ausgangszustand zurück.
Das Programm [Jdbc06] verwendet diese Funktion in seinem vierten Teil:
- Zeilen 2–11: Der Transaktionscode beschränkt sich auf die zu erledigende Arbeit. Der Block erhält die Verbindung als Empfänger ([createInsertStatement(this)]) und gibt die Anzahl der eingefügten Datensätze zurück, die zum Wert von [connection.transaction(…)] wird. Es werden keine Ausnahmen abgefangen: Im Fehlerfall wird die Transaktion rückgängig gemacht und die Ausnahme an den Aufrufer weitergereicht;
- In Teil 4 von [main] (erstes Listing oben) schlägt die zweite Einfügung in der Liste mit zwei Artikeln fehl: Die Funktion [transaction] macht die Transaktion rückgängig und löst die Ausnahme erneut aus, die der Aufrufer abfängt; er zeigt „transaction rolled back“ an (Zeile 28 der Ergebnisse); die Tabelle bleibt leer, da die Einfügung in Zeile 27 rückgängig gemacht wurde. Das Einfügen einer Liste mit einem einzigen Artikel, [articles.take(1)], gelingt (Zeilen 29–30): Die Tabelle enthält den Artikel (Zeile 32).
Die Funktion [transaction] umfasst zehn Zeilen Code, drückt aber in Kotlin das aus, was die Templates bieten: Spring stellt [TransactionTemplate] und die Annotation [@Transactional] bereit (Kapitel 11), und die in der Zusammenfassung vorgestellte Bibliothek Exposed von JetBrains hat zufällig eine Funktion namens [transaction { … }]. Wir werden sie in den Programmen [Jdbc08] und [Jdbc09] wiederverwenden.
10.7. Anfragen, die einen einzelnen Wert zurückgeben
Manche Anfragen geben nur einen Wert zurück, wie [select count(*) from articles]: eine einzelne Zeile mit einer einzelnen Spalte. JDBC hat dafür keine spezielle Methode: Wir führen die Anfrage mit [executeQuery] aus und lesen die erste Spalte der ersten Zeile des Ergebnisses. Das Programm [Jdbc07.kt] schreibt dafür zwei Funktionen und zeigt einige Möglichkeiten, sie zu verwenden:
Ergebnisse:
Kommentare:
- Zeile 53: Die Funktion [singleValue] führt die Anfrage aus und gibt die erste Spalte der ersten Zeile über [getObject(1)] zurück oder [null] , wenn die Anfrage keine Zeilen zurückgibt (Zeile 57). Ihr Rückgabetyp ist [Any?]: ein beliebiges Objekt oder [null]. Der Rumpf der Funktion ist ein Ausdruck: Die drei verschachtelten [use]-Anweisungen geben den Wert ihres Blocks zurück, und der Wert der [if]-Anweisung wird zum Wert der Funktion;
- Zeile 16: der Durchschnittspreis der Artikel. Der Ergebnistyp hängt vom SQL-Typ des Werts ab: Der Durchschnitt einer Spalte ([DECIMAL]) ist ein [BigDecimal], hier mit sechs Nachkommastellen (Zeile 2 der Ergebnisse). Die Funktion [type] (Zeile 74) gibt den einfachen Namen der Klasse des Objekts zurück, [it::class.simpleName], oder „null“;
- Zeile 18: die Anzahl der Artikel. MySQL gibt eine ganze Zahl vom Typ [BIGINT] zurück, die zu einem [java.lang.Long] wird, das Kotlin [Long] nennt (Zeile 3);
- Zeile 20: der Name des teuersten Artikels, eine Zeichenkette. Die Anfrage enthält eine Unterabfrage, die in Klammern steht;
- Zeile 22: Gibt die Anfrage keine Zeilen zurück, gibt die Funktion [null] zurück (Zeile 5);
- Zeile 24: Gibt die Anfrage eine Zeile zurück, deren Wert SQL oder [NULL] ist (das Maximum einer leeren Menge), gibt [getObject] ebenfalls [null] zurück (Zeile 6). Unsere Funktion unterscheidet also nicht zwischen den beiden Fällen – keine Zeile oder ein Wert [NULL]; wenn die Unterscheidung wichtig ist, muss man das Ergebnis von [next] selbst prüfen;
- Zeile 64: Eine zweite, generische Funktion gibt einen Wert des angeforderten Typs [T] zurück oder [null]. In Java müsste die entsprechende Methode den Typ als Parameter vom Typ [Class<T> type] akzeptieren, weil generische Typen zur Kompilierzeit gelöscht werden: Zur Laufzeit weiß die Methode nicht, was [T] ist. Eine [inline]-Funktion, deren Typparameter [reified] ist („reifiziert“, Kapitel 4), hat diese Einschränkung nicht: Ihr Code wird bei jedem Aufruf mit dem tatsächlichen Typ umgeschrieben, und [T::class.java] (Zeile 68) ist die Java-Klasse dieses Typs, die [getObject(1, type)] verwendet, um den Treiber um die Umwandlung des Werts zu bitten. Der Aufruf wird einfach als [typedSingleValue<BigDecimal>(…)] geschrieben;
- Zeilen 28–30: Der Treiber selbst wandelt den Wert in den angeforderten Typ um: den Durchschnitt in [BigDecimal], die Anzahl der Artikel ([BIGINT]) in [Int]. Da das Ergebnis vom Typ [BigDecimal?] ist, erfolgt der Aufruf von [setScale] – der den Durchschnitt auf zwei Nachkommastellen rundet – über den Operator [?.] (Zeile 7);
- Zeilen 32–33: Der Elvis-Operator [?:] ersetzt einen fehlenden Wert durch einen Standardwert: [maximum] hat den Typ [BigDecimal], der nicht nullable ist (Zeile 8);
- Zeile 37: Der sichere Typecast [as?] liefert [null] , statt eine Exception auszulösen, wenn das Objekt nicht vom angeforderten Typ ist: [nbArticles] ist kein [Int], aber ein [Long] (Zeile 9);
- Zeilen 39–40: Nach der Prüfung [is Number] wird [nbArticles] automatisch (per Smart Cast) umgewandelt in [Number] innerhalb des [if]-Blocks (intelligente Typumwandlung, Kapitel 4), und [toInt] kann dann aufgerufen werden. Das ist der robuste Weg, einen numerischen Wert zu behandeln, dessen genauer Typ unbekannt ist (Zeile 10);
- Zeile 43: Eine direkte Typumwandlung schlägt fehl, weil das Objekt ein [java.lang.Long] ist: Auf der JVM ist ein [Int] , das in einer Variablen vom Typ [Any?] gespeichert ist, ein [java.lang.Integer], und ein [Long] ist es nicht. Es wird eine [ClassCastException] instanziiert (Zeile 11): Ihre Meldung verweist auf die Java-Klassen [java.lang.Long] und [java.lang.Integer]. Dieser Code würde mit einem
DBMSfunktionieren, bei dem[count]eine Ganzzahl vom Typ[INT]liefert, scheitert aber mitMySQL: Dies ist ein Beispiel für die Eigenheiten von DBMS, die JDBC nicht verbirgt. Sicherer ist das Lesen mit [getInt], [getLong] oder mit der Funktion [typedSingleValue], die die Umwandlung dem Treiber überlässt; - Zeile 45: Kotlin kennt keine Mehrfach-[catch]-Klausel wie Javas [catch (SQLException | ClassCastException ex)]: Hier fangen wir ihre gemeinsame Klasse ab, [Exception]. Um mehrere Typen unterschiedlich zu behandeln, können Sie mehrere [catch]-Klauseln schreiben oder eine einzelne, gefolgt von einem [when (ex)] mit [is SQLException ->]-Zweigen.
Warum zwei Namen, [singleValue] und [typedSingleValue], statt zweier Überladungen von [singleValue] wie in Java? Weil beide Funktionen für die JVM dieselbe Signatur hätten: Da der Parameter vom Typ [T] entfällt, wird die generische Funktion wie die andere zu einer Funktion, die einen [String] entgegennimmt und ein [Object] zurückgibt. Der Compiler lehnt beide Deklarationen ab:
In Java wurden die beiden Methoden durch den Parameter [Class<T>] der zweiten unterschieden, den der reifizierte Typparameter in Kotlin überflüssig macht. (Die Annotation [@JvmName("…")] würde es erlauben, einer von ihnen einen anderen Namen für die JVM zu geben, aber ein anderer Name ist hier klarer.)
10.8. JDBC blockiert: virtuelle Threads und Coroutinen
10.8.1. Virtuelle Threads
Kapitel 9 hat gezeigt, dass E/A-Operationen in Anwendungen, die viele Benutzer bedienen (Server, Webdienste), keinen Anwendungs-Thread blockieren dürfen: Während ein SQL-Befehl auf dem Server ausgeführt wird, wartet der Thread, der ihn abgesetzt hat. Allerdings ist JDBC eine blockierende API: [getConnection], [executeQuery], [next], [commit] … geben die Kontrolle erst zurück, wenn das DBMS geantwortet hat. Es gibt keine asynchrone Version von JDBC: Ein Projekt für eine asynchrone API (ADBA) wurde 2019 aufgegeben, und die reaktive API R2DBC – die unabhängig vom JDK existiert – hat JDBC nicht abgelöst. Es gibt auch keine „suspendierende“ Version von JDBC für Coroutinen: Eine JDBC-Funktion, die innerhalb einer Coroutine aufgerufen wird, blockiert den Thread, der die Coroutine ausführt.
Seit Java 21 besteht die Lösung der Java-Plattform im virtuellen Thread (Kapitel 8): ein leichtgewichtiger, von der JVM verwalteter Thread, von dem Tausende erzeugt werden können. Wenn ein virtueller Thread auf eine Netzwerkantwort wartet, legt die JVM ihn beiseite und gibt den Systemthread frei, der ihn ausgeführt hat, sodass dieser einen anderen virtuellen Thread ausführen kann. Der Code bleibt sequenziell und blockierend – einfach zu schreiben und zu lesen –, doch das Warten verursacht keinen Mehraufwand mehr. Neuere JDBC-Treiber, darunter Connector/J 9, sind für den Betrieb mit virtuellen Threads geschrieben, und seit Java 24 (JEP 491) blockiert ein virtueller Thread, der in einem [synchronized]-Block wartet, den Systemthread nicht mehr. Kotlin, das auf der JVM läuft, profitiert davon, ohne etwas Besonderes tun zu müssen.
Eine Einschränkung bleibt: die Anzahl der Verbindungen. Tausend virtuelle Threads, die die Datenbank abfragen, haben nicht tausend Verbindungen; sie teilen sich die Verbindungen des Pools und warten, bis eine Verbindung frei wird. Das Programm [Jdbc08.kt] demonstriert dies mit einem HikariCP-Pool aus vier Verbindungen:
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 33 34 35 36 37 38 39 40 41 42 43 44 45 46 47 48 49 50 51 52 53 54 55 56 57 58 59 60 61 62 63 64 65 66 67 68 69 70 71 72 73 74 75 76 77 78 79 80 81 82 83 84 85 86 87 88 89 90 91 92 93 94 95 96 97 98 99 100 101 102 103 104 105 106 | |
Ergebnisse:
Kommentare:
- Zeilen 22–26: Konfiguration eines Pools mit höchstens vier Verbindungen. Im [apply]-Block ist [this] das Objekt [HikariConfig]: Die Accessoren [setJdbcUrl], [setUsername] … werden zu Eigenschaftszuweisungen;
- Zeile 30: die Datenquelle [HikariDataSource], die am Programmende durch [use] geschlossen wird;
- Zeilen 31–39: eine Update-Anweisung innerhalb einer Transaktion, auf einer Verbindung, die aus dem Pool bezogen wird ([dataSource.connection], die Eigenschaft, die [getConnection()] entspricht). Die Transaktion wird von der Funktion [transaction] im Paket [common] verwaltet: Der Block liefert die Anzahl der geänderten Zeilen, die zum Wert von [nbRows] wird. Das Schließen der Verbindung über [use] gibt sie an den Pool zurück. Die Ergebnisse zeigen, dass die drei Preise unter 200 Euro um 10 % erhöht wurden (Zeile 2 der Ergebnisse);
- Zeile 95: Die Funktion [getArticleSlowly] liest einen Artikel mit einer Abfrage, die eine Sekunde dauert: Die MySQL-Funktion [sleep(1)] (Zeile 98) wartet eine Sekunde, bevor sie 0 zurückgibt. Sie simuliert eine langsame Abfrage. Die aktuelle Ergebniszeile wird zu einem [Article] mittels der Erweiterungsfunktion [toArticle] aus dem Paket [common];
- Zeilen 42–50: sechs Artikel werden gleichzeitig gelesen:
- Zeile 43: Die Funktion [measureTime] aus der Standardbibliothek ([kotlin.time]) führt ihren Block aus und gibt dessen Dauer zurück, ein [Duration]-Objekt; [duration.toDouble(DurationUnit.SECONDS)] drückt sie in Sekunden aus. Das ist lesbarer als die Differenzen von [System.nanoTime()] im Java-Code;
- Zeile 44: [Executors.newVirtualThreadPerTaskExecutor] (Java 21, Kapitel 8) erzeugt einen Executor, der jede Aufgabe in einem neuen virtuellen Thread startet. Ein [ExecutorService] ist [AutoCloseable] seit Java 19: [use] schließt ihn am Ende des Blocks (Zeile 46), und seine Methode [close] wartet, bis alle Aufgaben abgeschlossen sind. Der Wert des Blocks für [use] – die Liste der Aufgaben – wird zu dem von [tasks];
- Zeile 45: [map] wandelt die Bezeichner 1 bis 6 in sechs Aufgaben um, die an den Executor übergeben werden. Jede Aufgabe ist ein Lambda, das in [Callable<Article>] umgewandelt wird (SAM-Konvertierung, Kapitel 7). Das Interface wird ausdrücklich genannt: [Callable { … }], denn [submit] existiert auch für ein [Runnable]. [submit] gibt ein [Future<Article>] zurück. Das Lambda verwendet die Variable [id] direkt: Anders als in Java, wo eine Kopie der Schleifenvariablen erforderlich war, gibt es diese Einschränkung in Kotlin nicht, und [id] ist ohnehin ein Lambda-Parameter, der für jedes Element ein anderer ist;
- Zeile 47: Die Artikel werden in der Reihenfolge der Aufgaben angezeigt. [Future.get] liefert das Ergebnis der Aufgabe; hat die Aufgabe eine Exception ausgelöst, wirft [get] eine [ExecutionException] , die sie kapselt (abgefangen in Zeile 89). In Java verlangte [get] außerdem, die geprüfte Exception [InterruptedException] zu deklarieren oder abzufangen; Kotlin kennt keine solche Pflicht;
- Zeilen 49–50: Gesamtdauer. Sechs nacheinander ausgeführte Ein-Sekunden-Anfragen würden sechs Sekunden dauern; gleichzeitig mit sechs Verbindungen ausgeführt, dauert es eine Sekunde. Mit vier Verbindungen dauert es etwa zwei Sekunden (Zeile 9 der Ergebnisse): Vier virtuelle Threads erhalten eine Verbindung und führen ihre Anfragen gleichzeitig aus, während die beiden anderen in [getConnection] darauf warten, dass eine Verbindung an den Pool zurückgegeben wird, und dann ihre eigenen ausführen. Die restliche Zeit entfällt auf das Öffnen der Verbindungen aus dem Pool. Ein Thread, der zu lange auf eine Verbindung wartet (standardmäßig 30 Sekunden, Einstellung [connectionTimeout] in HikariCP), erhält eine [SQLTransientConnectionException]. Die Funktion [format] verwendet die Locale des Rechners;
- Zeilen 52–57: ein einzelner Wert, der Lagerwert;
- Zeilen 62–84: Abbruch einer Abfrage, die zu lange dauert:
- Zeilen 65–68: Eine erste Verbindung verlässt den Autocommit-Modus und ändert Artikel Nr. 1, ohne ihre Transaktion zu committen. Das DBMS hat die geänderte Zeile bis zum Ende der Transaktion gesperrt;
- Zeilen 71–81: Eine zweite Verbindung versucht, dieselbe Zeile zu ändern. Sie muss auf das Ende der ersten Transaktion warten … das nie eintreten wird. [statement.queryTimeout = 1] (Zeile 75, [setQueryTimeout(1)] in Java) begrenzt die Ausführungszeit des Befehls auf eine Sekunde: Nach einer Sekunde weist Connector/J den Server an, die Anfrage abzubrechen (MySQL-Befehl [KILL QUERY]), und [executeUpdate] löst eine [SQLTimeoutException] aus, in diesem Fall die Klasse [MySQLTimeoutException] des Treibers (Zeile 11 der Ergebnisse). Ohne diesen Timeout hätte die Anfrage auf den Sperr-Timeout von MySQL gewartet – standardmäßig 50 Sekunden – und wäre dann fehlgeschlagen. Der Zeitmesser ist ein Zeitstempel ([TimeSource.Monotonic.markNow()]), und [elapsedNow] gibt die verstrichene Zeit an;
- Zeile 84: Die Transaktion [blocking] wird nie committet; sie wird zurückgerollt. Die Verbindung wird dann an den Pool zurückgegeben;
- Zeilen 87–89: zwei [catch]-Klauseln, die Javas Mehrfachklausel ersetzen.
Virtuelle Threads bieten einem kleinen Konsolenprogramm, das jeweils nur eine Aufgabe erledigt, keinen Vorteil: Sie machen keine Anfrage schneller. Sie erlauben es aber einer Serveranwendung, etwa den Spring-Boot-Webdiensten in Kapitel 13 (wo die Eigenschaft [spring.threads.virtual.enabled=true] genügt), mit gewöhnlichem JDBC-Code viele Benutzer gleichzeitig zu bedienen. Die Größe des Verbindungspools wird dann zum eigentlichen Regler für die Parallelität gegenüber der Datenbank.
10.8.2. Coroutinen
Eine mit Coroutinen geschriebene Kotlin-Anwendung (Kapitel 9) steht vor demselben Problem: JDBC fehlen suspendierende Funktionen. Der Aufruf von [executeQuery] in einer Coroutine, die vom Dispatcher [Dispatchers.Default] ausgeführt wird, würde einen der wenigen Threads dieses Dispatchers blockieren (ihre Anzahl entspricht der Zahl der CPU-Kerne), die für Berechnungen reserviert sind. Es gilt die in Kapitel 9 besprochene Regel: Ein blockierender Aufruf wird in [withContext(Dispatchers.IO) { … }]*** verpackt, das ihn auf einem Thread des Dispatchers *[IO]* ausführt – er ist zum Warten ausgelegt – und die aufrufende Coroutine währenddessen suspendiert. Dies führt *zu einer suspendierenden Funktion , die den blockierenden Aufruf verbirgt. Das Programm [Jdbc08Coroutines.kt] setzt Teil 2 des vorherigen Programms mit Coroutinen fort, und zwar mit drei verschiedenen Dispatchern. Es verwendet die Bibliothek kotlinx-coroutines, die in der Datei [build.gradle.kts] des Teilprojekts deklariert wird, durch [implementation("org.jetbrains.kotlinx:kotlinx-coroutines-core:1.11.0")]:
Ergebnisse:
Kommentare:
- Zeile 70: Das langsame Lesen eines Artikels ist nun eine suspendierende Funktion. Ihr Rumpf ist ein Aufruf von [withContext(dispatcher)] (Zeile 75): Der JDBC-Code, identisch mit dem des vorherigen Programms, läuft auf einem Thread des als Parameter übergebenen Dispatchers, während die aufrufende Coroutine suspendiert ist. Der vom Block zurückgegebene Wert – der Artikel – ist der von
*[withContext]*und damit der der Funktion. In der Praxis würde der Dispatcher fest in der Funktion verdrahtet (***[withContext(Dispatchers.IO)]***); hier ist er ein Parameter, damit mehrere Dispatcher verglichen werden können; - Zeile 54: Die Funktion [readSixArticles] liest die Artikel 1 bis 6 nebenläufig:
- Zeilen 60–61: Innerhalb eines Scopes namens [coroutineScope] (strukturierte Nebenläufigkeit, Kapitel 9) werden sechs Coroutinen durch [async] gestartet, und anschließend wartet [awaitAll] auf ihre sechs Ergebnisse. Scheitert eine von ihnen, werden die anderen abgebrochen, und die Exception wird an den Aufrufer weitergegeben;
- Zeile 63: die Namen der Artikel in der Reihenfolge ihrer Bezeichner (Zeilen 2, 4 und 6 der Ergebnisse);
- Zeile 24: Das Hauptprogramm ist eine Coroutine, die von [runBlocking] ausgeführt wird;
- Zeile 34: Die sechs Coroutinen führen ihren JDBC-Code auf den Threads des Dispatchers [IO] aus (bis zu 64 Threads). Wie bei virtuellen Threads laufen vier Anfragen gleichzeitig, und zwei warten auf eine Verbindung aus dem Pool: ungefähr zwei Sekunden (Zeile 3 der Ergebnisse), zuzüglich der Zeit zum Öffnen der Verbindungen aus dem Pool, die nur einmal anfällt;
- Zeile 36: [limitedParallelism(4)] erzeugt eine Sicht des Dispatchers [IO], die nicht mehr als vier Blöcke gleichzeitig ausführt (Kapitel 9). Bei einer Parallelität, die der Größe des Pools entspricht, wartet kein Thread in [getConnection]: Die überzähligen Coroutinen warten suspendiert, bis einer der vier Plätze frei wird, was keinen Thread-Overhead verursacht. Das ist bewährte Praxis, wenn viele Coroutinen auf die Datenbank zugreifen: ein Dispatcher, dessen Parallelität der des Verbindungspools entspricht. Die Ausführungszeit ist dieselbe (Zeile 5);
- Zeilen 38–39: ein Dispatcher, der jeden Block in einem neuen virtuellen Thread ausführt und aus dem Java-Executor erzeugt wird, und zwar mittels [asCoroutineDispatcher] (Kapitel 9), und der durch [use] geschlossen wird. Coroutinen und virtuelle Threads arbeiten zusammen: Coroutinen strukturieren den Code, während virtuelle Threads das Warten günstig machen (Zeile 7);
- Zeilen 41–49: Eine Warnung. [withTimeout(300)] bricht die Coroutine nach 300 ms ab, und die Exception [TimeoutCancellationException] wird tatsächlich ausgelöst (Zeile 8 der Ergebnisse) … aber nach einer Sekunde (Zeile 9). Das Beenden einer Coroutine ist kooperativ (Kapitel 9): Es wird nur an Suspendierungspunkten erkannt. Der JDBC-Code, der in [executeQuery] blockiert ist, hat jedoch keine solchen Suspendierungspunkte: Er durchläuft die gesamte Anfrage, und [withContext] gibt die Kontrolle erst danach ab, indem es die Exception wirft. Die Anfrage wurde auf dem Server nicht unterbrochen. Um die Dauer einer Anfrage wirklich zu begrenzen, muss man den Timeout von JDBC verwenden – [statement.queryTimeout = n] – wie im vorherigen Programm.
Beachten Sie, dass Coroutinen JDBC keine Asynchronität hinzufügen: Sie verlagern blockierende Aufrufe auf Threads, die zum Warten ausgelegt sind, wodurch sich der Datenbankzugriff in eine mit Coroutinen geschriebene Anwendung integrieren lässt (zum Beispiel einen Ktor-Server oder die suspend-fähigen Controller von Spring). Der tatsächliche Gewinn bei der Zahl der bedienten Benutzer kommt, wie in Java, von den virtuellen Threads und der Größe des Pools. Kapitel 9 hat einen allgemeineren Vergleich der beiden Modelle geliefert.
10.9. Batch-Ausführung
Jede Ausführung eines SQL-Befehls verursacht einen Hin- und Rückweg zwischen der Anwendung und dem Server. Müssen mehrere SQL-Befehle ausgeführt werden, können sie in einem einzigen Austausch an das DBMS gesendet werden, in Form eines Batches. JDBC unterstützt dies seit Version 2.0:
- bei einem [Statement] fügt [addBatch(sql)] dem Batch einen SQL-Befehl hinzu;
- bei einem [PreparedStatement] fügt [addBatch()] die aktuellen Parameterwerte dem Batch hinzu: Der Batch enthält denselben SQL-Befehl, ausgeführt mit verschiedenen Werten;
- [executeBatch] führt den Batch aus und gibt ein Array von Ganzzahlen zurück ([IntArray] in Kotlin): die Anzahl der Zeilen, die von jedem Befehl des Batches geändert wurden. Schlägt ein Befehl fehl, löst die Methode eine [BatchUpdateException] aus, deren Methode [getUpdateCounts] (die Eigenschaft [updateCounts] in Kotlin) die Ergebnisse der ausgeführten Befehle zurückgibt.
Das Programm [Jdbc09.kt] verwendet die folgenden Batches:
Ergebnisse:
Kommentare:
- Zeile 18: Die Methode [supportsBatchUpdates] der Verbindungsmetadaten ([connection.metaData], die Eigenschaft, die [getMetaData()] entspricht) gibt an, ob der Treiber Batches ausführen kann;
- Zeilen 20–31: ein Batch aus drei verschiedenen Update-Anweisungen, die dem Batch eines [Statement] mittels [addBatch] hinzugefügt werden:
- Zeile 29: Die drei Befehle werden ausgeführt. [executeBatch] liefert die Anzahl der von jedem geänderten Zeilen: eine Einfügung ([canoe]), eine Aktualisierung (der Bestand an Pfeilen, der unter dem Mindestbestand liegt) und eine Löschung ([pump]). Der Typ [IntArray] (Javas [int[]]), der inferiert wird, ist hier zu Erläuterungszwecken angegeben;
- Zeilen 30–31: [contentToString] zeigt den Inhalt des Arrays an ([toString] gibt bei einem Array nur dessen Adresse aus), und [sum], eine Erweiterungsfunktion für Arrays, berechnet die Summe seiner Elemente (Zeile 3 der Ergebnisse). Java verwendete [Arrays.toString] und [Arrays.stream(…).sum()];
- Zeilen 35–36: Die Funktion [insertBatch] wird zweimal aufgerufen, mit zwei verschiedenen URL-Funktionen;
- Zeile 73: Die Funktion [insertBatch] fügt [n] Artikel in einen Batch ein:
- Zeile 76: Die Funktion [measureTimedValue] aus [kotlin.time] führt ihren Block aus und gibt ein [TimedValue]-Objekt zurück, eine Datenklasse, die den vom Block zurückgegebenen Wert und die Dauer seiner Ausführung enthält; die Destrukturierung weist diese Werte zwei Variablen zu;
- Zeile 77: Die Einfügungen erfolgen innerhalb einer Transaktion, die von der Funktion [transaction] aus dem Paket [common] verwaltet wird, was zudem deutlich schneller ist, als jede Einfügung einzeln zu committen;
- Zeilen 81–87: Für jeden Artikel werden die Parameter mit ihren Werten belegt, und dann fügt [addBatch()] diese Werte dem Batch hinzu;
- Zeile 89: Der Batch wird ausgeführt; sein Ergebnis ist das des [use]-Blocks, dann des [transaction]-Blocks, der die Transaktion bestätigt, bevor er es zurückgibt, und schließlich des [measureTimedValue]-Blocks;
- Zeilen 93–95: Angezeigt werden die Anzahl der Einfügungen, die Datenbank (die dem letzten [/] der URL folgt, mittels [substringAfterLast]), die Dauer in Millisekunden und die ersten drei Elemente des von [executeBatch] zurückgegebenen Arrays ([take(3)] liefert eine Liste, die [println] in eckigen Klammern anzeigt);
- Zeilen 96–98: Die eingefügten Zeilen werden gelöscht, um die Tabelle in ihren vorherigen Zustand zurückzuversetzen. Da die Funktion [transaction] den Autocommit-Modus wieder aktiviert hat, wird die Löschung sofort nach ihrer Ausführung committet;
- Zeile 4 der Ergebnisse: Mit der einfachen URL sendet der MySQL-Treiber die 1.000 Einfügungen nacheinander: Der Batch bringt fast keinen Mehrwert. Jedes Element des Arrays ist 1;
- Zeile 5 der Ergebnisse: Mit dem [rewriteBatchedStatements=true]-Parameter der URL schreibt Connector/J den Batch in mehrere [insert into articles(…) values (…), (…), (…)…]-Befehle um, von denen jeder zahlreiche Zeilen einfügt. Die Ausführung ist zehn- bis zwanzigmal schneller. Die Array-Elemente haben dann den Wert -2, den Wert der Konstante [Statement.SUCCESS_NO_INFO]: Der Befehl war erfolgreich, aber der Treiber weiß nicht, wie viele Zeilen jedes Element des Batches geändert hat. Das ist eine wichtige Einstellung, die man kennen sollte: Ohne sie sind Batches mit MySQL kaum nützlich. Die Ausführungszeiten schwanken von Lauf zu Lauf; nur ihr Verhältnis ist aussagekräftig;
- Zeilen 41–63: zwei [select]-Befehle, die in einem einzigen Austausch gesendet werden:
- Zeile 43: Die Verbindung wird mit dem Parameter [allowMultiQueries=true] geöffnet, der mehrere durch Semikolons getrennte SQL-Befehle in einer einzigen Anfrage erlaubt. Wie wir gesehen haben, ist dies standardmäßig deaktiviert, um die Reichweite von SQL-Injections zu begrenzen;
- Zeilen 46–50: Die beiden Befehle, als Raw-String über zwei Zeilen geschrieben, werden von [execute] ausgeführt, das jeden Befehl akzeptiert;
- Zeile 53: Die Eigenschaft [resultSet] ([getResultSet()]) liefert das Ergebnis des ersten Befehls;
- Zeile 59: [getMoreResults] wechselt zum nächsten Ergebnis (es schließt das aktuelle Ergebnis und gibt [true] zurück, wenn das nächste Ergebnis ein [ResultSet] ist). Kotlin würde es erlauben, [statement.moreResults] wie bei einer Eigenschaft zu schreiben; das Lesen einer Eigenschaft sollte jedoch den Zustand eines Objekts nicht verändern, und der ausdrückliche Methodenaufruf macht deutlicher, was er tut;
- Zeilen 60–63: das Ergebnis der zweiten Abfrage: eine Zeile mit zwei Spalten, gespeichert in zwei Variablen über die Destrukturierung eines Paares ([a to b]).
Batches sind nützlich zum Einfügen und Aktualisieren großer Mengen von Datensätzen (z. B. beim Datenimport). Hibernate (Kapitel 11) kann sie ebenfalls verwenden.
10.10. Offline-Modus: CachedRowSet
Der Offline-Modus von JDBC beruht auf dem Interface [javax.sql.rowset.CachedRowSet], das von [ResultSet] abgeleitet ist: Ein [CachedRowSet] ist ein in den Speicher kopiertes Abfrageergebnis, das in beide Richtungen durchlaufen und offline geändert werden kann, woraufhin die Änderungen an die Datenbank zurückgeschickt werden. Das Programm [Jdbc10.kt] demonstriert dies:
Ergebnisse:
Kommentare:
- Zeilen 17–18: [RowSetProvider.newFactory] (Java 7) liefert eine Factory ([RowSetFactory]) für die verschiedenen RowSet-Typen des JDK; eine ihrer Methoden, [createCachedRowSet], erzeugt ein [CachedRowSet]. Ein [CachedRowSet] ist eine Ressource ([AutoCloseable], wie jedes [ResultSet]), die durch [use] geschlossen wird;
- Zeilen 20–23: [CachedRowSet] erhält die Verbindungsparameter und die Abfrage, die es füllen wird. Die Methoden [setUrl], [setUsername], [setPassword] und [setCommand] haben jeweils einen zugehörigen Accessor, [getXxx]: Kotlin stellt sie als Eigenschaften dar;
- Zeilen 25–26: Um die Änderungen an die Datenbank zurückschicken zu können, muss es die geänderte Tabelle und ihren Primärschlüssel kennen – hier die Spalte 1, [id]. [intArrayOf(1)] erzeugt das Array [int[]] , das die Java-Methode erwartet;
- Zeile 28: [execute] öffnet eine Verbindung, führt die Abfrage aus, kopiert alle Zeilen des Ergebnisses in den Speicher und schließt die Verbindung. Die übrige Arbeit erfolgt offline. [articles.size()] (Zeile 29) liefert die Anzahl der Zeilen: Da [size] kein Accessor für [getSize] ist, bleibt es eine Methode;
- Zeilen 32–39: Ein [CachedRowSet] ist ein [ResultSet]: Wir durchlaufen es mit [next] und lesen die Spalten mit [getXxx]. Die Methoden [updateXxx] ändern eine Spalte der aktuellen Zeile, und [updateRow] speichert die Änderung … in der Kopie im Speicher. Der Bestand an Pfeilen, der unter dem Mindestbestand liegt, wird auf 30 erhöht (Zeile 3 der Ergebnisse);
- Zeilen 43–51: Hinzufügen einer Zeile. Alle acht Aufrufe verwenden [CachedRowSet]: Die Funktion [with] bestimmt es zum Empfänger des Blocks, wodurch die Wiederholung von [articles.] entfällt. [moveToInsertRow] setzt den Cursor auf eine spezielle Zeile, die „Einfügezeile“, deren Spalten durch [updateXxx] festgelegt werden; [insertRow] fügt sie dem [CachedRowSet] hinzu, und [moveToCurrentRow] setzt den Cursor auf seine vorherige Position zurück. [CachedRowSet] verlangt einen Wert für alle [NOT NULL]-Spalten, einschließlich [id]: Der Wert 0, in eine [AUTO_INCREMENT]-Spalte eingefügt, weist MySQL an, einen zu erzeugen;
- Zeilen 54–56: [absolute(2)] setzt den Cursor auf die zweite Zeile, was durch [CachedRowSet] ermöglicht wird – der Cursor kann sich in jede Richtung bewegen –, und [deleteRow] löscht sie;
- Zeile 59: Die Datenbank wurde noch nicht geändert (Zeilen 5–11 der Ergebnisse);
- Zeilen 61–63: [acceptChanges] überträgt die Änderungen in die Datenbank: ein [update], ein [insert] und ein [delete], ausgeführt in einer Transaktion, die am Ende committet wird. Für jede geänderte Zeile prüft die JDK-Implementierung, dass die Datenbankzeile seit dem Lesen nicht von jemand anderem geändert wurde (eine „optimistische“ Prüfung); andernfalls löst sie eine [SyncProviderException] aus. Die parameterlose Version von [acceptChanges] öffnet die Verbindung selbst, belässt sie aber im Autocommit-Modus und ruft dann [commit] auf, was Connector/J ablehnt; deshalb wird ihr eine Verbindung übergeben, die den Autocommit-Modus verlassen hat;
- Zeile 66: Die Datenbank wurde geändert (Zeilen 12–18 der Ergebnisse).
[CachedRowSet] hat den Vorteil, eine Standard-API des JDK zu sein, doch seine Grenzen sind offensichtlich: Es manipuliert Zeilen sowie Spaltennamen oder -nummern statt Geschäftsobjekten; Änderungen erfolgen über eine Implementierung, bei der wir nur begrenzte Kontrolle über das SQL haben. Deshalb wird es heute selten verwendet: Das Arbeiten mit Objekten im Speicher und das anschließende Speichern der Änderungen ist die Domäne von ORM-Frameworks wie Hibernate (Kapitel 11).
10.11. Beispielanwendung – Version 6
Wir greifen die Beispielanwendung [Tax] wieder auf. Die letzte Version, Version 5, wurde in Kapitel 6 behandelt. Es war eine dreischichtige Anwendung, deren [dao]-Schicht ihre Daten aus einer Textdatei, einer JSON-Datei oder aus ihrem eigenen Code bezog und deren Schichten durch den Dependency-Injection-Container von Spring integriert wurden. Wir schreiben eine neue Schicht, [dao], die ihre Daten aus einer Datenbank, MySQL, bezieht:
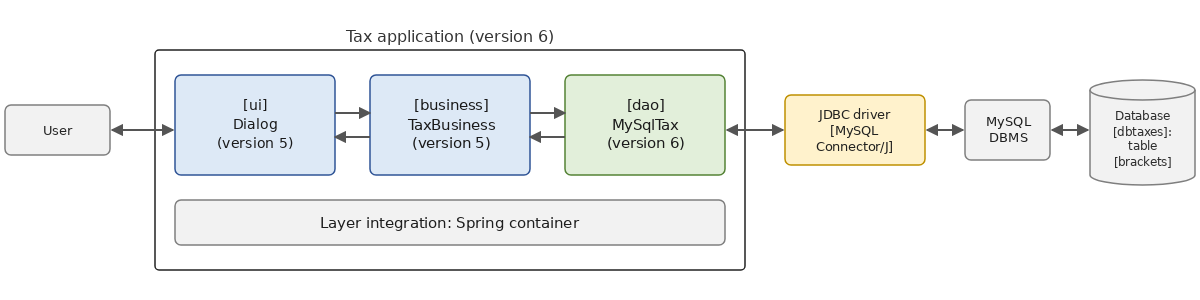
Wir übernehmen die Teilprojekte von Version 5 unverändert über Gradle-Abhängigkeiten und schreiben nur das Neue: die [dao]-Schicht und das Programm, das die Schichten integriert.
10.11.1. Die Datenbank
Die Steuerstufen sind in der Tabelle [brackets] einer MySQL-Datenbank namens [dbtaxes] gespeichert, die vom Skript [sql/dbtaxes.sql] erstellt wird:
- Zeilen 13–17: Die Tabelle [brackets] hat vier Spalten: den vom DBMS generierten Primärschlüssel [id], gefolgt von den drei Spalten [limits], [coeffr] und [coeffn], die eine Steuerstufe darstellen und vom Typ [DECIMAL] sind: Es handelt sich um Beträge und Koeffizienten, die exakt sein müssen. Sie werden in Kotlin als [BigDecimal] gelesen, dem Typ der Eigenschaften der Datenklasse [TaxBracket];
- Zeilen 19–26: die sieben Steuerstufen des Steuertarifs 2004 für die Einkommen des Jahres 2003, die seit Beginn des Kurses verwendet werden (dies ist eine Übung: Der Steuertarif ist nicht aktuell). Die Stufen sind in aufsteigender Reihenfolge ihrer Schwellenwerte aufgeführt, und die Spalte [id] spiegelt diese Reihenfolge wider;
- Zeilen 29–30: Anlegen eines MySQL-Benutzers [admtaxes] mit dem Passwort [pwdtaxes], dem alle Rechte ([GRANT ALL PRIVILEGES]) für alle Objekte der Datenbank [dbtaxes] ([dbtaxes.*]) und nur für diese Objekte gewährt werden. Die Anwendung läuft unter diesem Benutzer statt unter dem Administrator [root]: Würde das Passwort des Administrators kompromittiert, wäre nur die Datenbank [dbtaxes] gefährdet. [IF NOT EXISTS] erlaubt es, das Skript mehrfach auszuführen.
Das Skript wird vom Administrator ausgeführt:
Anschließend prüfen wir, ob der Benutzer [admtaxes] Zugriff auf die Stufen hat (die Option [-p] allein fordert zur Eingabe des Passworts auf, das bei der Eingabe nicht angezeigt wird):
10.11.2. Das Projekt TaxV6
Version 6 besteht aus zwei Gradle-Teilprojekten, die sich im Ordner [10-jdbc/TaxV6] des Builds des Kapitels befinden und die drei Teilprojekte von Version 5 verwenden:
Die Teilprojekte von Version 5 gehören nicht zum Build von Kapitel 10; sie sind Abhängigkeiten, wie der JDBC-Treiber oder Spring. Im Java-Kurs, der mit Maven aufgebaut war, mussten sie zuerst im lokalen Repository des Rechners installiert werden ([mvn install]). Gradle bietet einen direkteren Mechanismus, den „Composite Build“: Die Datei [settings.gradle.kts] aus Kapitel 10, der wir bereits begegnet sind, bindet den gesamten Build von Kapitel 6 ein:
- Zeilen 3–6: das Plugin, mit dem Gradle das JDK selbst herunterladen kann, wenn es auf dem Rechner keines findet (Kapitel 2);
- Zeile 11: das Teilprojekt mit den Programmen [Jdbc01] bis [Jdbc10];
- Zeile 13: die beiden Teilprojekte für Version 6. Der Ordner [TaxV6] enthält keine Datei [build.gradle.kts]: Er ist lediglich ein Gruppierungsordner, wie [TaxV5] in Kapitel 6;
- Zeile 16: Der Build von Kapitel 6 wird eingebunden. Wenn ein Teilprojekt in Kapitel 10 eine Abhängigkeit mit den Koordinaten [examples.tax:tax-business:5.0] deklariert, erkennt Gradle, dass ein Teilprojekt des eingebundenen Builds diese Koordinaten hat (die [group] , die in seiner [build.gradle.kts] in Kapitel 6 deklariert ist, und sein Name, [tax-business]; die Version ist unerheblich): Es ersetzt die Bibliothek durch dieses Teilprojekt, kompiliert es bei Bedarf und verwendet das Ergebnis. Eine vorherige Installation ist nicht erforderlich, und eine Änderung an Version 5 würde sich im nächsten Build niederschlagen.
Hier zeigt sich der Wert der Schichtenarchitektur. Die Schichten [business] und [ui] kennen nur das Interface [ITaxDao], das im Teilprojekt [tax-dao] von Version 5 definiert ist; die neue Schicht [dao] implementiert dieses Interface in einem neuen Teilprojekt. Keine einzige Codezeile von Version 5 wird geändert.
10.11.3. Die [dao]-Schicht
Die Datei [build.gradle.kts] im Teilprojekt [tax-dao-mysql] lautet wie folgt:
- Zeilen 3–4: das Kotlin-Plugin, dessen Version vom Wurzelprojekt festgelegt wird, und das Bibliotheks-Plugin, das die Konfiguration [api] hinzufügt;
- Zeilen 8–9: die Koordinaten der neuen Schicht, [examples.tax:tax-dao-mysql:6.0];
- Zeile 18: das Teilprojekt [tax-dao] von Version 5, das die Entitäten ([TaxBracket], [TaxException]) und das Interface [ITaxDao] enthält. Die Abhängigkeit wird über ihre Koordinaten deklariert, und der Composite Build löst sie auf. Sie wird mit [api] und nicht mit [implementation] deklariert: Die Klasse [MySqlTax] implementiert [ITaxDao], und ihre Eigenschaft [taxBrackets] hat den Typ [List<TaxBracket>], sodass ein Projekt, das [MySqlTax] verwendet, diese Typen zum Kompilieren benötigt;
- Zeile 20: der JDBC-Treiber für MySQL in der Konfiguration [runtimeOnly]: Er wird zur Kompilierzeit nicht verwendet, ist aber zur Laufzeit und beim Testen vorhanden. Das ist eine Garantie: Würde der Code irrtümlich eine Klasse des Treibers verwenden, würde er nicht kompilieren. Die Schicht [dao] hängt nur von JDBC ab. Projekte, die von [tax-dao-mysql] abhängen, erhalten den Treiber zur Laufzeit transitiv;
- Zeilen 22–26: nur zu Testzwecken die Schicht [business] von Version 5, [kotlin.test], und JUnit für Version 6;
- Zeilen 29–40: die Compiler- und Testkonfiguration, dieselbe wie in Kapitel 6.
Die Klasse [MySqlTax] implementiert das Interface [ITaxDao]:
- Zeile 1: Die Klasse befindet sich im Paket [tax.dao], wie die anderen Implementierungen von [ITaxDao], obwohl sie in einem anderen Teilprojekt liegt;
- Zeilen 12–17: Der primäre Konstruktor erhält die Verbindungsparameter und die Abfrage, die die Stufen liefert. Die Abfrage hat einen Standardwert, [DEFAULT_QUERY]: Wo Java zwei Konstruktoren benötigte – der zweite rief den ersten über [this(…)] auf –, genügt in Kotlin einer. Die Parameter sind keine Eigenschaften (sie haben weder [val] noch [var]): Sie werden nur zum Konstruieren des Objekts verwendet, und das Passwort wird nicht gespeichert;
- Zeile 20: die Eigenschaft des Interfaces [ITaxDao], die die Klasse überschreibt. Sie hat keinen Anfangswert: Ihr Wert wird im [init]-Block ein für alle Mal zugewiesen;
- Zeile 22: Die Stufen werden bei der Konstruktion des Objekts ein für alle Mal gelesen: Die Schicht [dao] ist in der Anwendung ein Singleton, und die Datenbank wird danach nicht mehr abgefragt. Eine von [DriverManager] geöffnete Verbindung genügt daher: Ein Verbindungspool wäre sinnlos;
- Zeilen 23–26: die Verbindung, der SQL-Befehl und das Ergebnis, eingeschlossen von drei verschachtelten [use]-Anweisungen, wie in den vorherigen Beispielen. [try] ist ein Ausdruck: Sein Wert – der der verschachtelten Blöcke – wird zum Wert von [brackets];
- Zeilen 28–30: Die Funktion [buildList] aus der Standardbibliothek konstruiert eine Liste: Innerhalb ihres Blocks ist [this] eine veränderbare Liste, der [add] pro Ergebniszeile eine Stufe hinzufügt; anschließend gibt sie diese Liste als Typ [List] zurück, schreibgeschützt. Der Typ der Variablen, [List<TaxBracket>], wird ausdrücklich angegeben: Der Compiler muss den Typ der Listenelemente kennen, bevor er den Block analysiert;
- Zeilen 36–38: Ein Fehler beim Datenbankzugriff wird in eine [TaxException] mit dem Code [ACCESS] gekapselt, genau wie [FileTax] und [JsonTax] es bei Ein-/Ausgabefehlern taten. Die Schicht [ui] muss weder die [SQLException] noch JDBC kennen;
- Zeilen 41–42: Eine leere Tabelle ist ein Datenfehler. Die [TaxException] aus Kapitel 6 hat nur einen Konstruktor, [TaxException(message, cause = null, code = 0)]: Um einen Code ohne Ursache zu erzeugen, muss das Argument [code] angegeben werden;
- Zeile 45: Die Eigenschaft erhält die Liste der Stufen;
- Zeilen 48–51: für diese Implementierung spezifische Fehlercodes, nach dem Vorbild derer von [FileTax] und [JsonTax]: 101 für einen Datenbankzugriffsfehler, 102 für fehlerhafte Daten. Es sind Konstanten ([const val]) des Companion-Objekts: Man verweist auf sie als [MySqlTax.ACCESS];
- Zeile 54: die Abfrage, die die Stufen liefert. Die Klausel [order by id] ist wichtig: Die Schicht [business] erwartet die Stufen in aufsteigender Reihenfolge der Grenzen, und ein [select] ohne [order by] liefert die Zeilen in einer Reihenfolge, die SQL nicht garantiert;
- Zeile 57: das Lesen einer Stufe, eine private Funktion des Companion-Objekts (sie verwendet keine Eigenschaften des Objekts):
- Zeilen 59–60: [getBigDecimal(i)] liest die Spalte mit der Nummer i als [BigDecimal]. Der deklarierte Typ, [List<BigDecimal?>], ist wichtig: Für Kotlin liefert eine Java-Methode einen Wert des „Plattformtyps“ [BigDecimal!], und Kotlin weiß nicht, ob er [null] sein kann. Allerdings [getBigDecimal] liefert [null] für einen SQL-Wert [NULL]: Indem wir Elemente vom Typ [BigDecimal?] deklarieren, zwingen wir den Compiler, uns diesen Fall prüfen zu lassen;
- Zeilen 61–63: Eine Abfrage, die weniger als drei Spalten oder eine nicht numerische Spalte liefert, verursacht eine [SQLException] in [getBigDecimal]: Auch das ist ein Datenfehler;
- Zeilen 65–67: Die Liste wird in drei Variablen destrukturiert; ein Wert vom Typ [null] ist ein Datenfehler;
- Zeile 70: Nach der Prüfung haben die drei Variablen den Typ [BigDecimal] und nicht mehr [BigDecimal?] (Smart Cast): Der Compiler akzeptiert ihre Übergabe an den Konstruktor von [TaxBracket], der Werte ungleich null erwartet. Ohne die Prüfung hätte er die Kompilierung verweigert. Die [TaxException], die von [readBracket] instanziiert wird, ist keine [SQLException]: Sie passiert das [catch] im Block [init], ohne abgefangen zu werden, und die drei [use]-Aufrufe schließen dennoch das Ergebnis, den Befehl und die Verbindung.
Beachten Sie, dass der Klassenname die einzige Stelle ist, an der MySQL vorkommt: Der Code verwendet nur die Interfaces von [java.sql]. Darauf kommen wir zurück.
10.11.4. Tests für die [dao]-Schicht
Die Tests der Schicht [dao] befinden sich im Ordner [src/test/kotlin] des Teilprojekts:
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 33 34 35 36 37 38 39 40 41 42 43 44 45 46 47 48 49 50 51 52 53 54 55 56 57 58 59 60 61 62 63 64 65 66 67 68 69 70 71 72 73 74 75 76 77 78 79 80 81 82 83 84 85 86 87 88 89 90 91 92 93 94 95 96 97 98 99 100 101 102 103 104 | |
- Zeilen 19–21: Die Tests verwenden die [dbtaxes]-Datenbank, die durch das Skript [dbtaxes.sql] erstellt worden sein muss. Es sind daher keine Unit-Tests im strengen Sinn mehr – diese würden eine Klasse isoliert testen –, sondern Integrationstests: Sie prüfen, dass die Schicht [dao] mit dem DBMS funktioniert. Für solche Tests verwendet man oft eine In-Memory-Datenbank H2, die zu Beginn der Tests erstellt wird, oder eine DBMS-Instanz, die von der Bibliothek Testcontainers in einem Docker-Container gestartet wird; hier verwenden wir einfach die MySQL-Datenbank des Rechners. JUnit erzeugt für jeden Test eine Instanz der Testklasse: Die drei Eigenschaften könnten auch Konstanten eines [companion object] sein;
- Zeilen 25–35: Die aus der Datenbank gelesenen Stufen sind die der „hartkodierten“ Version [HardwiredTax] … aber nicht im Sinne von [equals] (Zeile 29)! Die für eine Datenklasse generierte Methode [equals] vergleicht deren Eigenschaften mithilfe der Methode [equals] der jeweiligen Eigenschaft, und die von [BigDecimal] vergleicht den Wert und die Skalierung (die Anzahl der Nachkommastellen): Die aus der Datenbank gelesenen [BigDecimal]-Werte haben zwei Nachkommastellen ([4962.00]), ebenso wie die Spalte [DECIMAL(10,2)], wohingegen die in [HardwiredTax] keine haben ([4962]). [compareTo]dagegen vergleicht nur die Werte. Das ist eine klassische Falle von [BigDecimal] (Kapitel 3), die der Kotlin-Operator [==] nicht vermeidet, da er [equals] aufruft. Die Funktion [zip] (Zeile 32) paart Elemente gleichen Rangs aus den beiden Listen, die dann in [expected] und [read] destrukturiert werden;
- Zeilen 40–48: Die Schicht [business] von Version 5 berechnet die erwarteten Steuern mithilfe der neuen [dao]-Schicht. [@CsvSource] liefert die Parameter für die drei Testläufe; in Kotlin werden die Argumente einer Annotation mit Array-Typ einfach nacheinander aufgelistet ([value] ist ein [vararg]);
- Zeilen 53–59: Eine nicht vorhandene Datenbank führt zu einer [TaxException] mit dem Code [ACCESS]. [assertFailsWith<TaxException> { … }] aus [kotlin.test] führt den Block aus, prüft, dass er eine Exception dieses Typs auslöst, und gibt sie zurück. [assertIs<SQLException>(e.cause)] prüft, dass die Ursache eine [SQLException] (oder eine abgeleitete Klasse) ist;
- Zeilen 64–66: Dasselbe gilt für ein falsches Passwort;
- Zeilen 71–75: Ein nicht erreichbarer Server (auf Port 3399 lauscht kein Server) führt ebenfalls zu einem Zugriffsfehler;
- Tests für [incorrect query] (Zeile 80), [no bracket] (Zeile 89) und [NULL value] (Zeile 98): Eine Abfrage, die nur zwei Spalten liefert, keine Zeilen liefert oder eine Spalte mit dem Wert [NULL] hat, führt zu einer [TaxException] mit dem Code [DATA]. Der letzte Test übergibt die Abfrage über ein benanntes Argument, [query = "…"], was den Aufruf lesbarer macht.
Die Tests werden mit dem folgenden Befehl ausgeführt, der im Ordner [10-jdbc] eingegeben wird:
Gradle zeigt eine Zeile pro ausgeführtem Test an (die Reihenfolge, in der die Tests ausgeführt werden, entspricht nicht der Reihenfolge in der Datei), dank der Einstellung [testLogging { events("passed", "skipped", "failed") }] in der Datei [build.gradle.kts]. Beim parametrisierten Test nennt jede Zeile den Funktionsnamen, gefolgt von den Typen seiner Parameter, wie die JVM sie sieht ([(boolean, int, int, int)]: Kotlins [Boolean] und [Int] werden zu primitiven Typen kompiliert), gefolgt von der Ausführungsnummer in eckigen Klammern und den Namen und Werten der Parameter – wobei diese Werte in Anführungszeichen stehen –, wie sie in der Annotation [@CsvSource] erscheinen (Kapitel 6). Da jeder Wertesatz als ein Test zählt, sind alle zehn Tests bestanden.
10.11.5. Integration der Schichten
Das Teilprojekt [tax-ui-mysql] enthält das Programm, das die Schichten integriert. Seine Datei [build.gradle.kts] lautet wie folgt:
- Zeilen 2–4: das Kotlin-Plugin und das Plugin [application], das die Task [run] bereitstellt. Das Plugin [kotlin("plugin.spring")] ist nicht erforderlich: Das Programm hat keine von Spring annotierten Klassen ([@Configuration] …), daher registriert es die Schichten programmatisch;
- Zeile 16: die neue Schicht [dao], ein Teilprojekt gleicher Struktur, identifiziert über seinen Pfad. Transitiv wird der JDBC-Treiber für MySQL – der in diesem Teilprojekt mit [runtimeOnly] deklariert ist – zur Laufzeit in die Bibliotheken der Anwendung aufgenommen;
- Zeilen 18–19: die Schichten [business] und [ui] von Version 5, identifiziert über ihre Koordinaten und bereitgestellt durch den Composite Build. Das Teilprojekt [tax-ui] enthält die Hauptprogramme von Version 5, wir verwenden aber nur sein Objekt [Dialog];
- Zeile 21: der Dependency-Injection-Container von Spring, wie in Version 5;
- Zeilen 32–34: das Programm, das von [gradlew run] ausgeführt wird. Die Datei [Main.kt] aus dem Paket [tax.ui.mysql] erzeugt die Klasse [tax.ui.mysql.MainKt];
- Zeilen 37–39: Das Programm liest von der Tastatur;
- Zeilen 42–45: Die von Gradle gestarteten Programme schreiben ihre Ausgabe in UTF-8, damit Akzente unter Windows korrekt angezeigt werden (Kapitel 2).
Die Konfigurationsdatei [tax.properties] lautet wie folgt:
- Zeile 2: die Implementierung der Schicht [dao];
- Zeilen 3–5: die JDBC-URL der [dbtaxes]-Datenbank und die Zugangsdaten von [admtaxes];
- Zeile 6: die Abfrage, die die Stufen liefert. Ihre Aufnahme in die Konfiguration erlaubt es, eine andere Datenbank zu verwenden – sogar eine mit anders benannten Tabellen oder Spalten –, ohne den Code zu ändern.
Das Programm [Main.kt] ist das Programm von Version 5, mit Ausnahme der Registrierung der [dao]-Schicht:
- Zeile 1: Das Programm befindet sich in einem für Version 6 spezifischen Paket, [tax.ui.mysql], um Verwechslungen mit dem Programm [tax.ui.MainKt] von Version 5 zu vermeiden, das ebenfalls im Klassenpfad vorhanden ist;
- Zeile 21: die Konfigurationsdatei – [tax.properties] als Standardwert oder die als Argument übergebene – [firstOrNull] liefert [null] , wenn das Argument-Array leer ist, und der Elvis-Operator liefert dann den Standardnamen;
- Zeile 24: Wie in Version 5 ist [try] ein Ausdruck: Sein Wert ist der des letzten Ausdrucks im Block, die Schicht [business] , die aus dem Container bezogen wird (Zeile 50). Der [catch]-Block liefert keinen Wert: [exitProcess] hat den Typ [Nothing], gibt die Kontrolle also nie zurück;
- Zeilen 26–27: Lesen der Properties-Datei im aktuellen Ordner;
- Zeilen 28–33: die Parameter der Schicht [dao]. [getProperty] ist eine Java-Methode, die für eine fehlende Eigenschaft [null] zurückgibt: Ihr Kotlin-Typ ist [String!]. Bei der URL (Zeilen 29–30) behandelt der Elvis-Operator, gefolgt von einem [throw], das Fehlen als Fehler, und [url] hat den Typ [String] (nicht nullable). Die anderen Parameter haben einen Standardwert; für die Abfrage ist es die Konstante [DEFAULT_QUERY] aus [MySqlTax];
- Zeilen 38–42: die [dao]-Schicht wird im Spring-Container unter dem Interface [ITaxDao] registriert, mit einem Lambda, das sie gemäß der Konfiguration erzeugt: ein [MySqlTax] (Zeile 40) oder, zum Vergleich, die „hartkodierte“ Version aus Version 5 (Zeile 41). [registerBean] ist hier die Kotlin-Erweiterungsfunktion von Spring mit einem reifizierten Typparameter, die in Kapitel 6 verwendet wurde. Die [FileTax] und [JsonTax] -Implementierungen aus Version 5 könnten auf dieselbe Weise hinzugefügt werden: Sie befinden sich im Klassenpfad;
- Zeile 46: die [business]-Schicht von Version 5;
- Zeile 49: Beim Start des Containers erzeugt dieser die [dao]-Schicht und liest damit die Datenbank, gefolgt von der Schicht [business];
- Zeilen 51–54: Ein Konfigurations- oder Datenbankzugriffsfehler wird von der Funktion [displayError] des Objekts [Dialog] aus Version 5 angezeigt, und das Programm wird beendet;
- Zeile 58: der Dialog von Version 5, unverändert.
Um die Anwendung auszuführen, starten Sie die Task [run] des Teilprojekts [tax-ui-mysql] im Ordner [10-jdbc]; Gradle kompiliert Version 5 und die neue [dao]-Schicht nach Bedarf. Die Task [run] führt das Programm im Ordner des Teilprojekts aus, der die Konfigurationsdateien enthält. Führen Sie sie mit der Datei [tax.properties] aus (die Eingaben werden nach den Fragen wiedergegeben, wie in den vorherigen Kapiteln):
Wir sehen die Kontrollwerte des Kurses: 4.282 Euro für ein Paar mit zwei Kindern, 2.959 Euro für ein Paar mit drei Kindern und 11.519 Euro für eine alleinstehende Person ohne Kinder, bei einem Jahresgehalt von 60.000 Euro.
Mit der Datei [tax-base.properties], in der die URL auf eine Datenbank [dbtaxesunknown] verweist (die Option [--args] der Task [run] übergibt die Programmargumente):
- Zeilen 2–3: eine Spring-Logmeldung, die in die Fehlerausgabe geschrieben wird: Der Container meldet, dass die Erstellung der [dao]-Schicht fehlgeschlagen ist. Das war schon in Version 5 so;
- Zeilen 4–11: die Exception-Kette, die von [Dialog.displayError] angezeigt wird: Der Spring-Container hat die [TaxException]-Exception, die von der [dao]-Schicht ausgelöst wurde – und die ihrerseits die Exception [SQLException] des Treibers kapselt –, in eine [BeanCreationException]-Exception gekapselt. Der Benutzer [admtaxes] hat nur Rechte für die Datenbank [dbtaxes]: MySQL verweigert den Zugriff auf jede andere Datenbank, ob sie existiert oder nicht (Zeile 10).
Das Programm endet mit dem Code 1 ([exitProcess(1)]): Gradle betrachtet die Task [run] daraufhin als fehlgeschlagen und fügt eigene Meldungen hinzu, die hier nicht wiedergegeben sind.
Mit der Datei [tax-password.properties], die ein falsches Passwort enthält:
Mit der Datei [tax-server.properties], in der die URL den Port 3399 angibt, auf dem kein Server lauscht (so wäre es, wenn der MySQL-Server gestoppt wäre):
Die Exception-Kette zeigt hier, dass die Exception des Treibers selbst weitere Exceptions kapselt, bis hinunter zur Netzwerk-Exception [ConnectException]: Die Verbindung wurde abgelehnt.
Mit der Datei [tax-query.properties], deren Abfrage nur die Spalten [limits] und [coeffr] anfordert:
In allen Fällen hat die [dao]-Schicht die ursprüngliche Exception in eine [TaxException] gekapselt, die von der Funktion [Dialog.displayError] aus Version 5 angezeigt wird, und das Programm endet.
10.11.6. Die Datenbank wechseln
Die [dao]-Schicht ([MySqlTax]) verwendet nur die Interfaces von JDBC: Trotz ihres Namens ist sie nicht MySQL-spezifisch (ein Name wie [JdbcTax] wäre passender). Um eine PostgreSQL-Datenbank (oder SQL Server oder Oracle) zu verwenden, genügt es:
- in einer PostgreSQL-Datenbank die Stufentabelle anzulegen – zum Beispiel eine Tabelle namens [data] mit den Spalten [data1], [data2], [data3], um den Nutzen der Abfrage in der Konfiguration hervorzuheben;
- die Abhängigkeit des JDBC-Treibers für PostgreSQL hinzuzufügen, und zwar [runtimeOnly("org.postgresql:postgresql:…")] (oder [com.microsoft.sqlserver:mssql-jdbc], [com.oracle.database.jdbc:ojdbc11]);
- eine Konfigurationsdatei zu schreiben, die [tax.properties] ähnelt, etwa die Datei [tax-postgresql.properties] aus dem Teilprojekt:
Auf dem Rechner, der zum Schreiben dieses Kurses verwendet wurde, ist nur MySQL installiert: Wir haben diese Konfiguration nicht umgesetzt. Die Schichten [business] und [ui], die Klasse [MySqlTax] und das Programm [Main.kt] müssen nicht geändert werden: Nur die Konfiguration und der Treiber im Klassenpfad ändern sich. Beachten Sie, dass die Abfrage von [MySqlTax] keine Parameter hat und nur Standard-SQL-Funktionen verwendet: Deshalb kann sie von jedem DBMS ausgeführt werden. Eine funktionsreichere [dao]-Schicht (Suchen, Aktualisierungen) würde schnell auf die Besonderheiten des SQL-Dialekts jedes DBMS stoßen, wie weiter oben besprochen: Hier übernimmt ein ORM wie Hibernate.
10.12. Fazit
Dieses Kapitel hat den Datenbankzugriff über JDBC aus Kotlin behandelt:
- JDBC ist eine Menge von Interfaces ([Connection], [Statement], [PreparedStatement], [ResultSet], [DataSource] …) aus den Paketen [java.sql] und [javax.sql] , die von einem Treiber implementiert werden, der für jedes DBMS spezifisch ist (MySQL Connector/J für MySQL) und den [DriverManager] anhand der JDBC-URL der Datenbank auswählt. Kotlin hat keine eigene API: Es verwendet JDBC direkt, wobei seine Accessoren als Eigenschaften behandelt werden ([connection.autoCommit = false]);
- Eine Verbindung wird so spät wie möglich geöffnet und so früh wie möglich geschlossen, mittels der Funktion [use]; ein Verbindungspool wie HikariCP, über das Interface [DataSource], macht diese Praxis kostengünstig;
- [executeQuery] führt ein [select] aus und gibt ein [ResultSet], zurück, das zeilenweise mit [next] durchlaufen wird, wobei die Spalten, nummeriert ab 1, mit den Methoden [getXxx] gelesen werden; Erweiterungsfunktionen ([toList], [asSequence], [toArticle]) wandeln die Zeilen in Kotlin-Objekte um. [executeUpdate] führt ein [insert], [update], oder [delete] aus und gibt die Anzahl der geänderten Zeilen zurück;
- Fehler sind [SQLException]-Exceptions, die einen DBMS-spezifischen Fehlercode und einen standardisierten SQLSTATE-Code liefern. Sie müssen in Java behandelt werden, nicht jedoch in Kotlin, das keine Vorgaben macht: Es ist Sache des Entwicklers zu entscheiden, wo er sie abfängt, typischerweise in der Schicht [dao], die sie in eigene Exceptions kapselt;
- Externe Werte werden stets über die Parameter eines [PreparedStatement] übergeben und niemals in den Abfragetext eingefügt – weder durch Verkettung noch über ein String-Template –, was vor SQL-Injection schützt;
- Transaktionen ([autoCommit = false], [commit], [rollback], Savepoints) machen eine Folge von SQL-Befehlen atomar; eine Funktion höherer Ordnung wie unser [connection.transaction { … }] verbirgt die inneren Abläufe;
- JDBC blockiert: virtuelle Threads erlauben es, mit gewöhnlichem JDBC-Code viele Benutzer zu bedienen, innerhalb der Grenzen der Poolgröße; Coroutinen integrieren dies, indem sie Aufrufe in [withContext(Dispatchers.IO)] verpacken, vorzugsweise mit einer auf die Poolgröße begrenzten Parallelität. Batches ([addBatch], [executeBatch]) verringern die Zahl der Austausche mit dem Server;
- Der Offline-Modus ([CachedRowSet]) existiert, doch die Arbeit mit Objekten im Speicher ist inzwischen die Domäne von ORMs.
Version 6 der Anwendung [Tax] hat gezeigt, dass der Wechsel von einer Datei zu einer Datenbank dank der Schichtenarchitektur nur das Schreiben einer neuen [dao]-Schicht und eine Änderung der Konfiguration erfordert; das Build-System Gradle hat es uns erlaubt, Version 5 wiederzuverwenden, ohne sie zu kopieren oder zu installieren. Im nächsten Kapitel erstellen wir mit Hibernate, das die SQL-Befehle selbst generiert, eine siebte Version dieser Schicht.
Zwischen dem „rohen“ JDBC dieses Kapitels und einem vollständigen ORM wie Hibernate bietet das Kotlin- und Java-Ökosystem Bibliotheken auf mittlerer Ebene, die die Kontrolle über das SQL behalten und wiederholten Code beseitigen:
- Exposed, die Datenbankzugriffsbibliothek von JetBrains, in Kotlin geschrieben: Tabellen werden durch Kotlin-Objekte beschrieben, und Abfragen werden in einer dedizierten, typisierten Sprache (DSL) geschrieben, [Articles.selectAll().where { Articles.price less 200 }], innerhalb von [transaction { … }]-Blöcken; sie bietet außerdem eine Objektschicht (DAO), die einem ORM näherkommt;
- jOOQ, das aus dem Datenbankschema Java-Klassen generiert, die aus Kotlin verwendet werden können, und es erlaubt, SQL-Abfragen zu schreiben, die zur Kompilierzeit überprüft werden;
- Spring JDBC, dessen Interface [JdbcClient] (Spring 6.1) eine parametrisierte Abfrage ausführt und ihre Zeilen in einer einzigen fließenden Anweisung in Objekte umwandelt, während es Verbindungen, Schließvorgänge und Exceptions verwaltet.
Weiterführende Informationen:
- das JDBC-Tutorial von Oracle: JDBC Database Access (für Java 8 geschrieben, aber die API hat sich seither kaum verändert);
- die Dokumentation von MySQL Connector/J: MySQL Connector/J Developer Guide;
- die Dokumentation von HikariCP: HikariCP;
- SQL-Injection, erklärt von OWASP: SQL Injection Prevention Cheat Sheet;
- die Bibliothek Exposed: Exposed; jOOQ: jOOQ.