3. Die Grundlagen der Sprache Kotlin
3.1. Einführung
Wir beginnen damit, Kotlin als traditionelle Programmiersprache zu behandeln. Klassen behandeln wir im nächsten Kapitel. Ein Programm besteht aus zwei Dingen:
- Daten;
- den Anweisungen, die sie verarbeiten.
Wir bemühen uns im Allgemeinen, Daten von Anweisungen zu trennen:
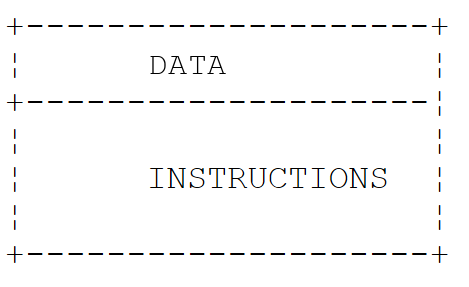
Alle Beispiele dieses Kapitels gehören zum Gradle-Projekt im Ordner [03-basics] des Kurscodes. Wie in Kapitel 2, „Einrichtung der Entwicklungsumgebung“, erwähnt, steht jedes Programm in einer Datei innerhalb eines Pakets, das nach dem Programm in Kleinbuchstaben benannt ist: Das Programm [Basics04.kt] liegt im Ordner [src/main/kotlin/basics04] und beginnt mit der Zeile [package basics04]. Sie können es ausführen, indem Sie in IntelliJ IDEA auf das grüne Dreieck am Rand neben der Funktion [main] klicken, oder auf der Kommandozeile im Projektordner mit dem Befehl [gradlew -q run -Pmain=basics04.Basics04Kt] ([./gradlew] unter Linux und macOS). Die Option [-q] („quiet“) unterdrückt die Meldungen von Gradle: Es bleibt nur die Ausgabe des Programms. Den Namen [basics04.Basics04Kt] erklären wir im nächsten Abschnitt. Die Beispiele laufen mit französischen Sprach- und Formatierungskonventionen (der „Locale“ fr-FR), genau wie auf einem französischen Windows-Rechner. Wir werden sehen, dass dies nur Zahlen und Datumsangaben betrifft, die mit einem bestimmten Format formatiert werden: Die einfache Umwandlung einer Gleitkommazahl in eine Zeichenkette verwendet immer einen Dezimalpunkt.
3.2. Das minimale Programm
3.2.1. Die Top-Level-Funktion main
Das Programm [Basics01.kt] lautet wie folgt:
Ergebnisse:
Kommentare:
- Zeile 2: das Paket des Programms. Ein Paket fasst zusammengehörige Deklarationen zusammen, so wie ein Ordner Dateien zusammenfasst. Der vollständige Name von allem, was in dieser Datei deklariert wird, beginnt mit [basics01.]. In Kotlin wird das Verzeichnis der Datei im Gegensatz zu Java nicht durch den Paketnamen vorgegeben; es ist jedoch üblich, beides in Übereinstimmung zu bringen, und das tun auch wir;
- Zeile 4: Die Funktion [main] ist der Einstiegspunkt des Programms. Das Schlüsselwort [fun] deklariert eine Funktion; [main()] hat keine Parameter und gibt keinen Wert zurück. Die Funktion steht direkt in der Datei, außerhalb jeder Klasse: Es ist eine Top-Level-Funktion. Der Rumpf der Funktion steht in geschweiften Klammern;
- Zeile 5: Die Funktion [println] gibt eine Zeile auf dem Bildschirm aus. Auch sie ist eine Top-Level-Funktion, deklariert im Paket [kotlin.io] der Kotlin-Standardbibliothek;
- Zeile 7: die Java-Version derselben Operation. [System] ist eine Klasse des JDK, [out] eines ihrer Felder, das die Standardausgabe (den Bildschirm) darstellt, und [println] ist eine Methode dieses Objekts. Kotlin nutzt alle Java-Klassen direkt: Das ist einer seiner großen Vorteile. Die Kotlin-Funktion [println] ist tatsächlich nur eine Kurzform für [System.out.println]; sie ist diejenige, die wir verwenden werden;
- Zeile 9: [words] ist eine Liste von Zeichenketten; Listen werden in Kapitel 5 behandelt. Das Schlüsselwort [val] deklariert eine Variable, deren Wert sich nicht ändert; wir haben ihren Typ nicht angegeben: Der Compiler leitet ihn aus dem Wert ab, hier [List<String>]. Die Funktion [listOf] gehört zum Paket [kotlin.collections], das ohne Import-Anweisung verwendet werden kann (siehe unten);
- Zeile 10: Eine Liste wird mit ihren Elementen in eckigen Klammern angezeigt;
- Anweisungen enden nicht mit einem Semikolon: Ein Zeilenumbruch genügt. Das Semikolon dient nur dazu, mehrere Anweisungen in einer Zeile zu schreiben. Zeilen, die mit // beginnen, sind Kommentare, die der Compiler ignoriert.
Mit zwei Kommandozeilenargumenten, die über die Option [--args] an Gradle übergeben werden:
Die Argumente werden ignoriert, weil die Funktion [main()] keine Parameter hat, die sie entgegennehmen könnten. Um sie zu verwenden, deklarieren Sie die Funktion als [fun main(args: Array<String>)]: Das Zeichenketten-Array [args] enthält dann die Kommandozeilenargumente. Wir kommen im Abschnitt „Argumente des Hauptprogramms“ darauf zurück.
3.2.2. Die Funktion main und ihre Argumente
Das Programm [Basics02.kt] lautet wie folgt:
Ergebnisse:
Kommentare:
- Zeile 4: Die Funktion [main] erhält die Kommandozeilenargumente im Parameter [args]. In Kotlin wird der Typ eines Parameters nach seinem Namen geschrieben, durch einen Doppelpunkt getrennt: [args: Array<String>] liest sich als „[args] vom Typ Array von Zeichenketten“. Das entspricht [String[] args] in Java;
- Zeile 6: Die Anzahl der Elemente des Arrays ist [args.size] (das Java-Äquivalent zu [args.length]). In der Zeichenkette wird [${args.size\}] durch den Wert des in geschweiften Klammern stehenden Ausdrucks ersetzt: Das ist ein String-Template, auf das wir später ausführlicher eingehen;
- Zeile 7: Die Funktion [contentToString] erzeugt eine Zeichenkette aus den Elementen eines Arrays. Sie ersetzt die Java-Methode [Arrays.toString] und benötigt wie die vorige Funktion keine Imports.
Wir haben keine Klassen geschrieben. Die Java Virtual Machine (JVM), die das Programm ausführt, kennt jedoch nur Klassen. Der Kotlin-Compiler fasst die Top-Level-Deklarationen einer Datei daher in einer Klasse zusammen, die er selbst erzeugt und nach der Datei benennt, gefolgt von [Kt]: Für die Datei [Basics02.kt] im Paket [basics02] ist das die Klasse [basics02.Basics02Kt]. Deshalb bezeichnet der Ausführungsbefehl das Programm als [-Pmain=basics02.Basics02Kt]. Sie können das überprüfen, indem Sie die Datei mit dem Kommandozeilen-Compiler [kotlinc] (Kapitel 2) kompilieren und dann die erzeugte Klasse mit dem Werkzeug [javap] aus dem JDK untersuchen:
- [kotlinc] hat eine einzige Zwischencode-Datei („Bytecode“) erzeugt, [Basics02Kt.class], im Paketverzeichnis;
- der Befehl [kotlinr] (der Kotlin-Launcher, Kapitel 2) führt diese Klasse aus, indem er die Kotlin-Standardbibliothek ([kotlin-stdlib.jar]) zum Klassenpfad hinzufügt;
- [javap] zeigt, dass die erzeugte Klasse [public final] ist und dass die Funktion [main] darin zu einer Methode [public static] geworden ist: genau die Methode [public static void main(String[] args)] , die die JVM erwartet. Für die JVM ist ein Kotlin-Programm nur eine weitere Java-Klasse;
- Beim Start mit dem einfachen Befehl [java] schlägt die Klasse fehl: Der erzeugte Code ruft Klassen der Kotlin-Standardbibliothek auf (hier [kotlin.jvm.internal.Intrinsics], die unter anderem prüft, dass die Parameter nicht gleich [null] sind), die im Klassenpfad fehlt. Gradle und IntelliJ IDEA fügen sie automatisch hinzu; ein eigenständiges Kotlin-Programm muss sie enthalten (Option [-include-runtime] von [kotlinc], Kapitel 2, oder Gradle-Skripte, siehe unten).
Für das Programm [Basics01.kt], dessen Funktion [main] keine Parameter hat, erzeugt der Compiler zusätzlich eine Methode [main(String[])] , die einfach die erste aufruft. Gradle legt die von ihm kompilierten Klassen im Ordner [build/classes/kotlin/main] des Projekts ab; Sie können sie dort nach einer Kompilierung untersuchen ([gradlew build]):
Ein Vergleich mit Java 25 ist aufschlussreich. Auch Java 25 erlaubt es, ein Programm ohne Klassendeklaration zu schreiben (eine „kompakte Quelldatei“ mit einer Methode namens [void main()]): Der Java-Compiler verpackt den Inhalt der Datei dann in eine implizite Klasse, die den Namen der Datei trägt. Kotlin tut dasselbe seit seiner ersten Version, mit zwei Unterschieden:
- Die erzeugte Klasse heißt [Basics02Kt] statt [Basics02], wodurch der Name [Basics02] für eine Klasse frei bleibt, die der Programmierer in derselben Datei selbst schreiben möchte. Mit der Annotation
***[@file:JvmName("ClassName")]*** am Anfang der Datei können Sie einen anderen Namen wählen; - Top-Level-Funktionen werden in [static]-Methoden kompiliert: Zum Aufruf von [main] wird kein Objekt erzeugt, während die Methode [void main()] in einer kompakten Java-Datei eine Instanzmethode ist. Vor allem aber ist diese Syntax in Kotlin nicht auf kleine Programme beschränkt: Top-Level-Funktionen, -Variablen und -Konstanten werden in allen Programmen häufig neben Klassen verwendet.
Die Funktion [main] kann nur die beiden bereits gesehenen Formen haben: [fun main()] und [fun main(args: Array<String>)]. Sie muss nicht als public deklariert werden: In Kotlin ist standardmäßig alles öffentlich.
3.2.3. Standardimporte
Das Programm [Basics01.kt] verwendet die Funktionen [println] und [listOf], und das Programm [Basics02.kt] verwendet die Funktion [contentToString], jeweils ohne [import]-Direktive. Das ist möglich, weil jede Kotlin-Datei automatisch die folgenden Pakete der Standardbibliothek importiert:
Damit stehen die Basistypen ([Int], [String] ... aus dem Paket [kotlin]), Listen, Mengen und Dictionaries ([kotlin.collections]), Konsolenein- und -ausgabe ([kotlin.io]), Intervalle ([kotlin.ranges]), Zeichenkettenfunktionen ([kotlin.text]) sowie Klassen des Java-Pakets [java.lang] ([System], [Math], [Thread] ...) zur Verfügung. Alle anderen Deklarationen müssen am Anfang der Datei unmittelbar nach der Zeile [package] importiert werden: eine Direktive pro Klasse oder Funktion ([import java.math.BigDecimal]) oder eine Direktive pro Paket ([import java.time.*]). Ein Äquivalent zur Direktive [import module java.base;] aus Java 25, die eine kompakte Java-Datei automatisch erhält, gibt es nicht: Ein Kotlin-Programm, das die Klassen [BigDecimal] oder [LocalDate] aus dem JDK verwendet, muss sie importieren. Eine Anmerkung zur Syntax: [import]-Direktiven enden wie andere Anweisungen nicht mit einem Semikolon.
3.3. Kotlin-Datentypen
Kotlin verwendet die folgenden Datentypen:
- ganze Zahlen, mit und ohne Vorzeichen;
- Gleitkommazahlen;
- Dezimalzahlen;
- Zeichen und Zeichenketten;
- Boolesche Werte;
- Objekte.
3.3.1. Vordefinierte Datentypen
Kotlin-Typ | Entsprechender Java-Typ | Dargestellte Daten | Literal-Suffix | Kodierung | Wertebereich |
[Char] | [char] / [Character] | Zeichen | 2 Bytes | Unicode-Zeichen (UTF-16), von '\u0000' bis '\uFFFF' | |
[Byte] | [byte] / [Byte] | ganze Zahl | 1 Byte | [-2⁷, 2⁷-1] oder [-128, 127] | |
[Short] | [short] / [Short] | ganze Zahl | 2 Bytes | [-2¹⁵, 2¹⁵-1] oder [-32768, 32767] | |
[Int] | [int] / [Integer] | ganze Zahl | 4 Bytes | [-2³¹, 2³¹-1] oder [-2147483648, 2147483647] | |
[Long] | [long] / [Long] | ganze Zahl | L | 8 Bytes | [-2⁶³, 2⁶³-1] oder [-9223372036854775808, 9223372036854775807] |
[UByte], [UShort], [UInt], [ULong] | (kein Äquivalent) | ganze Zahl ohne Vorzeichen | U, UL | 1, 2, 4, 8 Bytes | [0, 2⁸-1], [0, 2¹⁶-1], [0, 2³²-1], [0, 2⁶⁴-1] |
[Float] | [float] / [Float] | Gleitkommazahl | F | 4 Bytes | [1.4 10⁻⁴⁵, 3.4 10³⁸] im Absolutwert, 7 signifikante Stellen |
[Double] | [double] / [Double] | Gleitkommazahl | 8 Bytes | [4.9 10⁻³²⁴, 1.8 10³⁰⁸] im Absolutwert, 15 bis 16 signifikante Stellen | |
[Boolean] | [boolean] / [Boolean] | Boolescher Wert | nicht definiert | [true], [false] | |
[String] | [String] | Zeichenkette | Referenz auf eine Folge von Unicode-Zeichen | ||
[BigDecimal] (Java-Klasse) | [BigDecimal] | Dezimalzahl | variabel | exakte Dezimalzahl beliebiger Genauigkeit | |
[Any] | [Object] | Objektreferenz | Referenz auf ein Objekt beliebigen Typs |
Java unterscheidet zwischen den acht primitiven Typen ([int], [double] ...), deren Werte keine Objekte sind, und den Referenztypen (Klassen) und ordnet jedem primitiven Typ eine Wrapper-Klasse zu ([Integer] für [int] ...). Kotlin hebt diese Unterscheidung auf: In Kotlin ist jeder Wert ein Objekt. Der Typ [Int] ist eine Klasse mit Methoden; Sie können [3.plus(4)] oder [3.toString()] schreiben, was Java für das Literal 3 vom Typ [int] nicht erlaubt. Typnamen beginnen alle mit einem Großbuchstaben, genau wie Klassennamen.
Dies hat keine Auswirkungen auf die Laufzeitleistung. Der Compiler übersetzt eine Variable vom Typ [Int] nach Möglichkeit in eine Variable des primitiven Typs [int] der JVM und verwendet die Wrapper-Klasse *[java.lang.Integer] nur, wenn ein Objekt erforderlich ist: wenn der Wert an einen Parameter vom Typ [Any] (das Kotlin-Äquivalent der Java-Klasse [Object]) übergeben, in einer Liste gespeichert wird oder wenn er den Wert [null] haben kann (siehe unten). Boxing und Unboxing sind also weiterhin vorhanden, werden aber vom Compiler erledigt, sodass sich der Kotlin-Programmierer nicht darum kümmern muss. In Kotlin gibt es keinen Typ [Integer]: Es gibt nur [Int]*.
Die Größen in Bytes liefern die Konstanten [Int.SIZE_BYTES], [Long.SIZE_BYTES] ... (und [Int.SIZE_BITS] ... in Bits), die Bereichsgrenzen [Int.MIN_VALUE] und [Int.MAX_VALUE] usw.
Anders als Java kennt Kotlin ganze Zahlen ohne Vorzeichen: [UByte], [UShort], [UInt] und [ULong], die genauso groß sind wie ihre Gegenstücke mit Vorzeichen, aber nur positive Werte und null darstellen. Ihre Literale erhalten das Suffix U ([42U]) oder UL ([42UL]). Sie dienen vor allem zur Verarbeitung binärer Daten (Dateibytes, Adressen, Farben); gängige Berechnungen werden mit Typen mit Vorzeichen durchgeführt. Kotlin hat außerdem keinen Dezimaltyp: Beträge werden mit der Klasse [BigDecimal] aus dem Java-Paket [java.math] berechnet, die wir etwas später behandeln.
Das Programm [Basics03.kt] veranschaulicht diese verschiedenen Punkte:
Ergebnisse:
Kommentare:
- Zeile 4: Die Klasse [BigDecimal] gehört zum JDK; sie muss importiert werden;
- Zeile 7: Deklaration einer Variablen [integer] vom Typ [Int] mit dem Anfangswert 2. In Kotlin wird der Typ einer Variablen nach ihrem Namen geschrieben, durch einen Doppelpunkt getrennt. Wir werden sehen, dass der Typ meist weggelassen werden kann;
- Zeile 8: Das Suffix F ist erforderlich: Das Literal 10.5 hat den Typ [Double], und der Compiler weigert sich, es einer Variablen vom Typ [Float] zuzuweisen;
- Zeile 11: Das Literal 1000 wird für eine Variable vom Typ [Long] akzeptiert, weil der Compiler weiß, dass es sich um eine Konstante handelt, die in den Typ passt. Dasselbe gilt für die Zeilen 12–13 bei den Typen [Byte] und [Short]. Wie wir noch sehen werden, konvertiert Kotlin jedoch nie implizit eine Variable von einem numerischen Typ in einen anderen;
- Zeile 16: Eine [BigDecimal]-Zahl ist ein Objekt; hier wird sie aus einer Zeichenkette erzeugt, was einen exakten Wert garantiert. Kotlin hat keinen Operator [new]: Ein Objekt wird erzeugt, indem der Konstruktor seiner Klasse wie eine Funktion aufgerufen wird;
- Zeile 18: In einer Zeichenkette [$integer] wird durch den Wert der Variablen [integer] ersetzt, und [${typeName(integer)\}] durch den Wert des Ausdrucks, der zwischen den geschweiften Klammern steht. Diese String-Templates sind die Standardmethode zum Aufbau einer Zeichenkette in Kotlin; wir kommen im nächsten Abschnitt darauf zurück. [Int.SIZE_BYTES] ist die Größe eines [Int] in Bytes;
- Zeile 18: Die Funktion [typeName] (Zeilen 42–43) erwartet einen Parameter vom Typ [Any]. Der Parameter ist also ein Objekt, und der Wert [integer] wird in ein [java.lang.Integer]-Objekt verpackt. Die Funktion zeigt zwei Namen an: [o::class.qualifiedName] ist der vollständige Typname für Kotlin ([kotlin.Int]), und [o.javaClass.name] ist der Name der Klasse des Objekts für die JVM ([java.lang.Integer]). Wir sehen, dass [kotlin.Int], [kotlin.Double], [kotlin.String] ... zur Laufzeit durch Java-Klassen dargestellt werden;
- Zeile 21: Die Größe einer Zeichenkette im Speicher ist nicht zugänglich: [String] hat keine Konstante [SIZE_BYTES];
- Zeile 26: Die Größe eines Booleans ist von der JVM nicht definiert: [Boolean] hat keine Konstante [SIZE_BYTES];
- Zeile 27: [BigDecimal] ist eine Java-Klasse: Ihre beiden Namen sind identisch;
- Zeile 29: Das Literal 3 ist ein Objekt vom Typ [Int]: [3::class.simpleName] ist der Kurzname seines Typs, und seine Methoden [plus] und [toString] können aufgerufen werden. Wir werden in Kapitel 4 sehen, dass der Operator + lediglich eine andere Schreibweise für die Methode [plus] ist;
- Zeilen 31–33: die Konstanten [MIN_VALUE] und [MAX_VALUE] geben die Grenzen des Wertebereichs an. Hinweis: Bei Gleitkommazahlen ist [Double.MIN_VALUE] der kleinste streng positive Wert (4.9 × 10⁻³²⁴) und nicht die größte negative Zahl, nämlich [-Double.MAX_VALUE];
- Zeile 35: eine 32-Bit-Ganzzahl ohne Vorzeichen. Der Wert 4.000.000.000 überschreitet den Bereich von [Int], nicht aber den von [UInt], der bis 2³²-1 reicht;
- Zeilen 37–38: -1 wird als 32 auf 1 gesetzte Bits kodiert; die Funktion [toUInt] interpretiert sie als ganze Zahl ohne Vorzeichen, die gleich 2³²-1 ist;
- Zeilen 42–43: Eine Top-Level-Funktion der Datei. Der Rückgabetyp wird nach der Parameterliste angegeben: [: String]. Sie gibt ([return]) eine Zeichenkette zurück. Funktionen werden im Abschnitt „Parameterübergabe an eine Funktion“ beschrieben.
Beachten Sie, dass Gleitkommazahlen mit einem Dezimalpunkt angezeigt werden (10.5, -4.6), obwohl das Programm auf Französisch läuft. Die Umwandlung einer Zahl in eine Zeichenkette – ob mit einem Template, durch Konkatenation oder mit der Methode [toString] – hängt nicht von der Sprache des Benutzers ab: Sie liefert immer einen Dezimalpunkt. Nur numerische Formate wie %f, die wir später besprechen, folgen den Konventionen der Sprache.
3.3.2. Notation für Literale
Daten | Beispiele für Literale |
[Int] ganze Zahl (32 Bit) | 145, -7, 0xFF (hexadezimal), 0b1010_1010 (binär) |
Ganze Zahl [Long] (64 Bit), Suffix L | 100000L, 1_000_000_000_000L, 3_000_000_000 (zu groß für einen [Int]) |
ganze Zahl ohne Vorzeichen [UInt], [ULong], Suffix U, UL | 255U, 0xFFFF_FFFFU, 1UL |
Gleitkommazahl [Double] | 134.789, -45E-18 (-45 × 10⁻¹⁸), 10.0 |
Gleitkommazahl [Float], Suffix F oder f | 134.789F, -45E-18F |
Dezimalzahl [BigDecimal] | kein Literal: [BigDecimal("100000.50")] |
Zeichen [Char] | 'A', 'b', '\n', '\u00e9' |
Zeichenkette [String] | "today", "c:\\chap1", "$name is ${age + 10\} years old", raw string """c:\chap1""" |
Boolescher Wert [Boolean] | [true], [false] |
Datum | [LocalDate.of(1954, 10, 13)] (Jahr, Monat, Tag) für den 13.10.1954 |
Im Quellcode werden Gleitkommazahlen immer mit einem Dezimalpunkt geschrieben. Wie in Java können ganze Zahlen hexadezimal (Präfix [0x]) oder binär (Präfix [0b]) geschrieben werden, und Zifferngruppen können zur besseren Lesbarkeit durch das Zeichen _ getrennt werden: [1_000_000] ist die ganze Zahl eine Million. Kotlin unterscheidet sich in einigen Punkten von Java, wodurch ebenso viele Fallstricke entfallen:
- Ein ganzzahliges Literal ohne Suffix hat den Typ [Int], wenn es in diesen Typ passt, andernfalls den Typ [Long]: [3_000_000_000] ist ein [Long]. Java weist dieses Literal ohne das Suffix L zurück;
- Das Suffix L muss großgeschrieben werden: Der Compiler weist [100l] mit der Meldung [use 'L' instead of 'l'] zurück, weil l der Ziffer 1 zu sehr ähnelt;
- Es gibt keine Oktalschreibweise. Die Java-Falle, bei der 017 gleich 15 ist, gibt es nicht: Der Compiler weist 017 mit der Meldung [leading zeros are not allowed in integer literals] zurück;
- Es gibt kein Suffix „D“ für Gleitkommazahlen: Ein Literal mit Dezimalpunkt oder Exponent hat den Typ [Double]; 10.0 wird daher als 10.0 und nicht als 10D geschrieben;
- Ganze Zahlen ohne Vorzeichen haben eigene Suffixe, U und UL.
Ein String-Literal kann Escape-Sequenzen enthalten, die durch das Zeichen \ eingeleitet werden: "\n" steht für das Zeilenende-Zeichen und nicht für die Folge der beiden Zeichen \ und n, "\t" für einen Tabulator, "\"" für ein doppeltes Anführungszeichen, "\\" für das Zeichen \ selbst, "\$" für das Zeichen $ (siehe unten) und "\u00e9" für das Unicode-Zeichen mit dem Hexadezimalcode 00E9. Um den Windows-Pfad c:\chap1\paragraph3 zu schreiben, müssen Sie daher "c:\\chap1\\paragraph3" schreiben. Die Dateiklassen von Java akzeptieren unter Windows auch das Trennzeichen /: "c:/chap1/paragraph3" bezeichnet dieselbe Datei.
Zum Aufbau einer Zeichenkette aus mehreren Werten bietet Kotlin drei Methoden:
- String-Templates: In einer Zeichenkette wird [$name] durch den Wert der Variablen [name] ersetzt, und [${expression\}] durch den Wert eines beliebigen Ausdrucks: ["in 10 years he will be ${age + 10\}"]. Dies ist die lesbarste und am häufigsten verwendete Methode. Sie entspricht den interpolierten Strings von C#, etwa [$"..."]; Java hingegen kennt diese Funktion nicht (die in Java 21 und 22 als Vorschau vorgeschlagenen „String Templates“ wurden entfernt);
- Konkatenation mit dem Operator +: Ist der linke Operand eine Zeichenkette, wird der rechte Operand unabhängig von seinem Typ in eine Zeichenkette umgewandelt. Anders als in Java muss der linke Operand eine Zeichenkette sein: [10 + " years"] wird vom Compiler zurückgewiesen, weil der Typ [Int] keinen Operator + hat, der eine Zeichenkette akzeptiert;
- Die Formate: ["format".format(value1, value2, ...)] oder [String.format(format, value1, value2, ...)]. Dies sind die Java-Formate mit denselben Spezifizierern, die der Reihe nach durch die folgenden Werte ersetzt werden: %s (ein beliebiger, in eine Zeichenkette umgewandelter Wert), %d (eine ganze Zahl), %f (eine Gleitkommazahl), %.2f (eine Gleitkommazahl mit zwei Nachkommastellen), %x oder %X (eine ganze Zahl in hexadezimaler Darstellung), %,d (eine ganze Zahl mit Tausendertrennzeichen), %e (wissenschaftliche Notation), %n (ein Zeilenumbruch), %10s (eine auf 10 Zeichen rechtsbündig ausgerichtete Zeichenkette), %-10s (linksbündig) ... Numerische Formate folgen den Konventionen der Sprache des Benutzers. Sie werden verwendet, wenn die Darstellung von Zahlen gesteuert werden soll (Anzahl der Nachkommastellen, Ausrichtung); andernfalls genügt das Template.
Schließlich bietet Kotlin „Raw Strings“: Eine durch drei Anführungszeichen begrenzte Zeichenkette wie ["""..."""], kann sich über mehrere Zeilen erstrecken und Anführungszeichen enthalten; vor allem werden Escape-Sequenzen in Raw Strings nicht interpretiert: Das Zeichen \ wird unverändert übernommen, sodass Sie ["""c:\chap1"""] schreiben. Das ist sehr nützlich zum Schreiben von JSON, SQL, HTML oder regulären Ausdrücken (Kapitel 5). Raw Strings unterstützen Templates. Führende Leerzeichen bleiben unverändert erhalten; um den Text passend zum Code einzurücken, wenden Sie auf die Zeichenkette die Funktion [trimIndent()] an, die die allen Zeilen gemeinsamen Leerzeichen sowie die erste und die letzte Zeile entfernt, wenn sie leer sind, oder die Funktion [trimMargin()], die alles entfernt, was dem Zeichen | (dem „Rand“) vorausgeht. Die Textblöcke von Java 15 wurden nach diesem Vorbild entworfen; sie entfernen automatisch die gemeinsame Einrückung, interpretieren aber Escape-Sequenzen.
Das Programm [Basics04.kt] demonstriert diese verschiedenen Schreibweisen:
Ergebnisse:
Kommentare:
- Zeilen 4–6: Die vom Programm verwendeten Klassen des JDK werden importiert;
- Zeile 10: Vier Deklarationen in einer einzigen Zeile, durch Semikolons getrennt. [0xFF] ist 255 und [0b1010_1010] ist 170. Die Variablentypen sind nicht angegeben: Der Compiler leitet sie aus den Werten ab, hier [Int];
- Zeile 11: Das Suffix L macht aus 100000 einen [Long]. Das Literal 3_000_000_000, das für einen [Int] zu groß ist, ist auch ohne Suffix ein [Long];
- Zeile 14: zwei ganze Zahlen ohne Vorzeichen vom Typ [UInt]. 0xFFFF_FFFFU, bei dem alle 32 Bits auf 1 gesetzt sind, ist gleich 2³²-1;
- Zeile 17: -45E-18 wird als -4.5E-17 angezeigt: Es ist derselbe Wert, normalisiert. Die Gleitkommazahl 10.0 wird als 10.0 angezeigt: Die Umwandlung eines [Double] in eine Zeichenkette liefert immer mindestens eine Nachkommastelle;
- Zeile 19: Ein [BigDecimal] behält die Anzahl der Nachkommastellen bei, mit der er geschrieben wurde: 100000.50, nicht 100000.5;
- Zeile 22: Die Sequenz \u00e9 bezeichnet das Unicode-Zeichen mit dem Hexadezimalcode 00E9, also é;
- Zeile 26: ein Datum. Die Klasse [LocalDate] (Paket [java.time] des JDK) stellt ein Datum ohne Uhrzeit dar. Kotlin hat keine eigene Datumsklasse: Es verwendet die von Java. Ihre Umwandlung in eine Zeichenkette verwendet unabhängig von der Sprache das internationale Format ISO 8601 (Jahr-Monat-Tag). Wir behandeln Datumsangaben in Kapitel 5;
- Zeile 30: Jedes \\ steht für ein einzelnes Zeichen \;
- Zeile 32: ein Zeilenumbruch und ein Tabulator;
- Zeile 34: die Sequenzen \$ und \";
- Zeile 39: ein Template. [$name] und [$age] werden durch die Werte der Variablen ersetzt und [${age + 10\}] durch den Wert des Ausdrucks. Geschweifte Klammern sind immer dann erforderlich, wenn das, was auf das $ folgt, kein einfacher Variablenname ist;
- Zeile 40: derselbe Text, durch Konkatenation aufgebaut. Die Klammern um [(age + 10)] sind unerlässlich: Ohne sie würden die Operatoren + von links nach rechts ausgewertet, die Zeichenkette erhielte zuerst 23 und dann 10, und das Ergebnis wäre „in 10 years he will be 2310“. Das Template hat diese Falle nicht;
- Zeile 41: derselbe Text, mit einem Format aufgebaut;
- Zeile 43: einige Formatspezifizierer: %.1f (eine Nachkommastelle), %X (hexadezimal in Großbuchstaben), %,d (Tausendertrennzeichen). Diese Formate folgen den französischen Konventionen: einem Dezimalkomma und, als Tausendertrennzeichen, einem schmalen geschützten Leerzeichen. Die Funktion [format] der Kotlin-Bibliothek wird auf die Formatzeichenkette selbst angewendet; sie ruft die Java-Funktion [String.format] auf;
- Zeile 44: Die Funktion [toString(base)] wandelt eine ganze Zahl in eine Zeichenkette in einer beliebigen Basis um, hier 2; die Funktion [uppercase()] wandelt die Zeichenkette in Großbuchstaben um. Beachten Sie, dass ein Template Funktionsaufrufe enthalten kann;
- Zeile 45: ein benutzerdefiniertes Datumsformat: Wochentag (EEEE), Tag (d), Monat in Worten (MMMM), Jahr (yyyy). Die Namen der Tage und Monate sind auf Französisch, der Sprache des Benutzers. Beachten Sie, dass das Template Anführungszeichen innerhalb der geschweiften Klammern enthalten kann;
- Zeilen 48–53: ein Raw String über mehrere Zeilen. Die Anführungszeichen werden unverändert geschrieben, und \chap1 musste nicht als \\chap1 geschrieben werden. Die Funktion [trimIndent()] hat die acht allen Zeilen gemeinsamen Leerzeichen entfernt, ebenso die erste Zeile (die leer ist und direkt auf die öffnenden Anführungszeichen folgt) und die letzte Zeile (die vor den schließenden Anführungszeichen nur Leerzeichen enthält);
- Zeile 56: ein Raw String in einer einzigen Zeile, wodurch das Escapen der Anführungszeichen in JSON vermieden wird, mit zwei Templates;
- Zeilen 59–62: Die Funktion [trimMargin()] entfernt aus jeder Zeile die Leerzeichen und das Zeichen |, die den Rand markieren: Die drei nach dem | stehenden Leerzeichen bleiben erhalten. Da Escape-Sequenzen in einem Raw String nicht interpretiert werden, wird das Zeichen $ als [${'$'\}] geschrieben: ein Template, dessen Ausdruck das Zeichen '$' ist. Da auf das $ hier ein Zeilenumbruch folgt, hätte es auch allein stehen können; [$name] würde jedoch durch den Wert von [name] ersetzt. Seit Kotlin 2.2 können Sie der Zeichenkette auch mehrere $-Zeichen voranstellen: In [$$"""{ "$schema": "$$name" \}"""] sind zwei $-Zeichen erforderlich, um ein Template einzuleiten, und [$schema] bleibt unverändert.
3.3.3. Datendeklaration
3.3.3.1. Rolle von Deklarationen
Ein Programm manipuliert Daten, die durch einen Namen und einen Typ gekennzeichnet sind. Diese Daten werden im Speicher abgelegt. Beim Kompilieren des Programms weist der Compiler jedem Datum eine Speicherstelle zu, die durch eine Adresse und eine Größe gekennzeichnet ist. Er tut dies auf Grundlage der vom Programmierer vorgenommenen Deklarationen. Darüber hinaus ermöglichen diese Deklarationen dem Compiler, Programmierfehler zu erkennen. So wird die Operation [x = x * 2] als ungültig deklariert, wenn [x] eine Zeichenkette ist.
3.3.3.2. Schreibgeschützte und veränderliche Variablen
Kotlin hat zwei Schlüsselwörter zur Deklaration einer Variablen:
- [val] („value“) deklariert eine schreibgeschützte Variable: Ihr wird nur einmal ein Wert zugewiesen, und sie kann danach nicht mehr geändert werden. Das entspricht einer Java-Variablen [final];
- [var] („variable“) deklariert eine veränderliche Variable, der neue Werte zugewiesen werden können.
Die Syntax lautet wie folgt:
Der Typ wird meist weggelassen: Der Compiler leitet ihn dann aus dem Wert ab (Typinferenz). Das Kotlin-Schlüsselwort [var] hat also nicht dieselbe Bedeutung wie in Java 10: In Java bedeutet [var] „abgeleiteter Typ“; in Kotlin bedeutet es „veränderlich“, und der Typ kann bei [val] genauso abgeleitet werden wie bei [var]. Eine Variable, die ohne Initialisierung deklariert wird, muss einen expliziten Typ haben; sie kann erst verwendet werden, nachdem ihr ein Wert zugewiesen wurde (Meldung [variable 'b' must be initialized]).
Die Konvention in Kotlin lautet, alle Variablen mit [val] zu deklarieren und [var] nur dann zu verwenden, wenn sich der Wert der Variablen tatsächlich ändern soll. Das verbessert die Lesbarkeit des Programms: Wenn Sie ***[val total = ...]*** lesen, wissen Sie, dass *[total] diesen Wert behalten wird. IntelliJ IDEA hilft außerdem dabei, Variablen zu erkennen, die mit [var] deklariert wurden, aber eigentlich [val]* sein könnten.
Kotlin unterscheidet zwischen Groß- und Kleinbuchstaben: Die Variablen [END] und [end] sind verschieden. Per Konvention beginnt ein Variablenname mit einem Kleinbuchstaben, und jedes weitere Wort beginnt mit einem Großbuchstaben: [priceExclTax], [nbChildren].
3.3.3.3. Konstanten deklarieren
Eine Variable wie [val] ändert ihren Wert nicht, aber ihr Wert ist unter Umständen erst zur Laufzeit bekannt ([val today = LocalDateTime.now()]). Eine Konstante ist streng genommen ein zur Kompilierzeit bekannter Wert. Kotlin deklariert sie mit den Schlüsselwörtern [const val]:
Eine Konstante [const val] wird auf oberster Ebene der Datei (außerhalb von Funktionen) oder innerhalb eines [object] oder eines [companion object] deklariert, was wir in Kapitel 4 behandeln. Sie kann nur von einem Basistyp ([Int], [Double], [Boolean] ...) oder vom Typ [String] sein, und ihr Wert muss vom Compiler berechenbar sein. Zum Beispiel:
Der Compiler ersetzt dann jedes Vorkommen von [VAT_RATE] durch seinen Wert, genau wie der Java-Compiler es bei einem [static final]-Feld tut, das mit einer Konstanten initialisiert wird. Die folgenden Versuche werden zurückgewiesen:
(Das Ausrufezeichen in [LocalDate!] wird im nächsten Abschnitt erklärt). Warum Konstanten deklarieren?
- Das Programm ist leichter lesbar, wenn die Konstante einen aussagekräftigen Namen erhält;
- Das Programm lässt sich leichter ändern, wenn die „Konstante“ angepasst werden muss. Ändert sich der Mehrwertsteuersatz auf 0.25, ist nur die Anweisung zu ändern, die seinen Wert festlegt: [const val VAT_RATE = 0.25]. Wäre 0.2 explizit im Programm verwendet worden, müssten zahlreiche Anweisungen geändert werden.
Per Konvention wird der Name einer Konstante wie in Java in Großbuchstaben geschrieben, wobei die Wörter durch das Zeichen _ getrennt werden: [VAT_RATE], [MAX_VALUE]. Eine lokale Variable wie [val], behält einen normalen Namen.
Das Programm [Basics05.kt] lautet wie folgt:
Ergebnisse:
Kommentare:
- Zeile 7: eine Konstante auf oberster Ebene. Der Compiler legt sie in der Klasse [Basics05Kt] als Feld [public static final double] ab;
- Zeile 11: eine schreibgeschützte lokale Variable vom Typ [String] (abgeleitet);
- Zeile 13: eine veränderliche Variable. Das Literal 100.0 gibt [priceExclTax] den Typ [Double]. Mit [var priceExclTax = 100] hätte die Variable den Typ [Int], und die Zuweisung von 250.0 in Zeile 15 würde zurückgewiesen;
- Zeile 14: Das Ergebnis ist ein [Double], das mit mindestens einer Nachkommastelle angezeigt wird: 120.0;
- Zeile 15: [priceExclTax] wird ein neuer Wert zugewiesen;
- Zeile 19: ein explizit typisierter Datenwert;
- Zeile 20: Die Funktion [typeName] (Zeile 41) zeigt den Kurznamen ([simpleName]) und den vollständigen Namen ([qualifiedName]) des Typs ihres Parameters an;
- Zeile 22: ein implizit typisierter Wert. Da 3 vom Typ [Int] ist, ist [j] vom Typ [Int];
- Zeile 24: Da [LocalDateTime.now()] (das aktuelle Datum mit Uhrzeit) vom Typ [LocalDateTime] ist, ist [today] vom Typ [LocalDateTime]. Beachten Sie, dass das Programm wie in Java eine [static]-Methode einer Java-Klasse aufruft: [LocalDateTime.now()];
- Zeilen 26–29: Der abgeleitete Typ hängt von der Schreibweise des Literals ab: 3.5 ist ein [Double], 3.5F ist ein [Float], 10L ist ein [Long];
- Zeile 33: eine ohne Anfangswert deklarierte Variable; ihr Typ ist erforderlich. Obwohl sie als [val] deklariert ist, kann ihr später (Zeile 36) ein Wert zugewiesen werden, aber nur einmal. Kotlin erlaubt es nicht, mehrere Variablen in einer einzigen Anweisung zu deklarieren, wie in Javas [int a = 1, b, c = 3;]: Sie schreiben eine Deklaration pro Zeile oder mehrere durch Semikolons getrennte Deklarationen, wie im vorherigen Programm;
- Zeile 41: Eine Funktion, deren Rumpf auf einen einzigen Ausdruck reduziert ist, kann mit dem Gleichheitszeichen (=) anstelle von geschweiften Klammern als Ausdrucksrumpf geschrieben werden. Sie könnten sogar den Rückgabetyp weglassen, den der Compiler aus dem Ausdruck ableiten würde.
Eine Variable [val] kann nicht neu zugewiesen werden, und eine Variable [var] kann ihren Typ nicht ändern: Ihr Typ wurde durch ihre Deklaration festgelegt. Die folgenden Anweisungen werden daher vom Compiler zurückgewiesen:
3.3.4. Null-Sicherheit
Manchmal ist es nützlich, das Fehlen eines Werts ausdrücken zu können: ein unbekanntes Alter, ein leeres Feld in einer Datenbank oder eine erfolglose Suche. In Java kann jede Variable eines Referenztyps den Wert [null] haben, der „kein Objekt“ bedeutet. Der Zugriff auf ein Member einer solchen Variablen – zum Beispiel auf ihre Methode [length()] – verursacht einen Laufzeitfehler, eine [NullPointerException]: Das ist der häufigste Fehler in Java, weil der Java-Compiler nicht zwischen einer Referenz, die [null] sein kann, und einer, die es nicht sein kann, unterscheidet. Um das Fehlen eines Werts ohne [null] auszudrücken, hat Java 8 die Klasse [Optional<T>] hinzugefügt, eine „Box“, die entweder einen Wert enthält oder leer ist; und für eine Zahl verwendet Java die Wrapper-Klasse [Integer], die [null] aufnehmen kann, anstelle des primitiven Typs [int].
Kotlin löst dieses Problem im Typsystem selbst, und das ist einer seiner wichtigsten Beiträge. Ein gewöhnlicher Typ lässt den Wert null nicht zu: Eine Variable vom Typ [String] enthält immer eine Zeichenkette, und eine Variable vom Typ [Int] enthält immer eine ganze Zahl. Um [null] zuzulassen, müssen Sie dies ausdrücklich angeben, indem Sie ein Fragezeichen an den Typnamen anhängen: [String?] ist der Typ „Zeichenkette oder null“, und [Int?] ist der Typ „ganze Zahl oder null“. Man nennt diese „Nullable-Typen“. Der Compiler prüft dann, dass ein Member eines nullable Werts nicht verwendet werden kann, ohne zuvor den Fall [null] zu behandeln:
Kotlin bietet mehrere Möglichkeiten, einen nullable Wert zu verwenden:
- der [if (x != null)] -Test: In dem Zweig, in dem der Test wahr ist, weiß der Compiler, dass [x] nicht gleich [null] ist, und behandelt ihn als Wert vom Typ [String] (und nicht als [String?]). Dies ist bekannt als „Smart Cast“;
- der sichere Aufruf [x?.length]: Wenn [x] gleich [null] ist, wird der Ausdruck zu [null] ausgewertet, statt einen Fehler zu verursachen; andernfalls wird er zu [x.length] ausgewertet. Das Ergebnis hat daher den Typ [Int?];
- der Elvis-Operator [x ?: defaultValue]: Er wird zu [x] ausgewertet, wenn [x] nicht gleich [null] ist, andernfalls zu [defaultValue] (sein Name rührt von der Ähnlichkeit des Symbols „?“ mit der Frisur des Sängers im Profil her). Er wird oft mit dem sicheren Aufruf kombiniert: [x?.length ?: 0];
- die Funktion
**let**:***[x?.let { ... \\}]führt den Block in den geschweiften Klammern nur aus, wenn*[x]nicht gleich*[null]*ist; innerhalb des Blocks heißt der Wert [it] und hat einen nicht nullable Typ. Der Block ist ein Lambda**, ein Konzept, das wir in Kapitel 7 behandeln; - die Assertion [x!!]: Der Programmierer behauptet, dass [x] nicht gleich [null] ist. Trifft dies zu, hat [x!!] den Typ [String]; andernfalls wird eine [NullPointerException] ausgelöst. Sie sollte so wenig wie möglich verwendet werden: Sie ist eine bewusste Rückkehr zum Verhalten von Java.
Die Operatoren ?, ?: und !! werden im Abschnitt „Null-Operatoren“ ausführlicher behandelt. C# hat mit seinen „Nullable Reference Types“ (C# 8) einen ähnlichen Ansatz übernommen, und zwar in Form von Warnungen; in Kotlin sind dies Kompilierfehler.
In der Praxis ist der Fehler [NullPointerException] in Kotlin selten. Er kann heute nur noch in wenigen Fällen auftreten: bei der Verwendung von !!, bei einer ausdrücklich ausgelösten Exception und vor allem bei der Verwendung von Java-Code. Der Kotlin-Compiler weiß nicht, ob eine Java-Methode [null] zurückgeben könnte: Er weist ihr daher einen „Plattformtyp“ zu, der in Compilermeldungen als [String!] dargestellt wird (er kann im Code nicht geschrieben werden) und der als [String] oder als [String?] verwendet werden kann. Die Verantwortung liegt dann beim Programmierer. Wenn von einer Java-Methode bekannt ist, dass sie [null] zurückgeben kann, wird ihr Ergebnis in einer nullable Variablen gespeichert ([val path: String? = System.getenv("X")]): Der Compiler nimmt seine Prüfungen dann wieder auf. (Java-Methoden, die mit [@Nullable] oder [@NonNull] annotiert sind – zum Beispiel mit Annotationen des JSpecify-Projekts – erhalten einen spezifischen Kotlin-Typ, keinen Plattformtyp.)
Was geschieht mit den Wrapper-Klassen und mit [Optional]? Ein [Int] wird zu [int] kompiliert und ein [Int?] zu [java.lang.Integer] kompiliert, da nur eine Referenz den Wert [null] haben kann: Die Wrapper-Klassen sind vorhanden, aber der Compiler kümmert sich selbst darum. Die Klasse [Optional] bleibt verwendbar, da sie eine Java-Klasse ist, ist in Kotlin aber kaum nützlich: Ein [String?] sagt dasselbe wie ein [Optional<String>], ohne ein zusätzliches Objekt zu erzeugen, und die Operatoren ?. und ?: ersetzen ihre Methoden [map] und [orElse]. Funktionen der Kotlin-Bibliothek, die möglicherweise nichts zurückgeben, liefern [null]: [toIntOrNull()], [firstOrNull()], [readlnOrNull()] ...
Nullable Typen begegnen uns schon in den ersten Beispielen, denn die Funktion [readlnOrNull()], die eine über die Tastatur eingegebene Zeile liest, liefert [null] , wenn nichts mehr zu lesen ist (Ende des Eingabestroms). Das Programm [Basics06.kt] lautet wie folgt:
Ergebnisse bei Texteingabe über die Tastatur:
Ergebnisse, wenn der Benutzer Strg-D drückt (unter Windows Strg-Z gefolgt von der Eingabetaste), wodurch der Eingabestrom geschlossen wird:
Kommentare:
- Zeile 5: eine Funktion, die einen Vornamen oder [null] zurückgibt. Der Typ ihres Ergebnisses, [String?], informiert die Benutzer darüber. Der Ausdruck [if (...) "jean" else null] ist ein [if] , das einen Wert zurückgibt; wir kommen darauf zurück;
- Zeilen 9–10: zwei Variablen vom Typ [String?]. [firstName2] ist gleich [null]. Der Typ hätte weggelassen werden können: Er wäre aus dem Typ des Ergebnisses von [firstNameOf] abgeleitet worden;
- Zeile 11: Ein Template zeigt [null] für einen Null-Wert an; der Wert [null] wird mit dem Operator == geprüft;
- Zeilen 13–14: Innerhalb des [if]-Blocks ist [firstName1] vom Typ [String]: Seine Eigenschaft [length] (die Länge der Zeichenkette) kann sicher verwendet werden. Außerhalb des Blocks würde [firstName1.length] zurückgewiesen;
- Zeile 17: der sichere Aufruf. [firstName2?.length] ist gleich [null];
- Zeile 19: der Elvis-Operator. [firstName2 ?: "unknown"] ist "unknown", und [firstName2?.length ?: 0] ist 0;
- Zeilen 21–22: die Funktion [let]. Der erste Block wird mit [it] gleich "jean" ausgeführt; der zweite nicht;
- Zeilen 25–26: Die Funktion [toIntOrNull()] wandelt eine Zeichenkette in eine ganze Zahl um und gibt [null] zurück, wenn die Zeichenkette keine ganze Zahl darstellt. Der Typ [Int?] wird zu [java.lang.Integer] kompiliert;
- Zeile 27: Mit einem [Int?] kann man nicht rechnen; [unknownAge + 1] würde zurückgewiesen. Der Elvis-Operator liefert einen [Int]: 0, wenn [unknownAge] gleich [null] ist. Das Unboxing eines null-[Integer] – eine klassische Java-Falle – ist somit unmöglich;
- Zeile 30: Die Assertion !! auf einen Wert ungleich null angewendet: Sie gibt den Wert vom Typ [String] zurück;
- Zeilen 31–34: Die Assertion
!!, angewendet auf*[null], löst eine*[NullPointerException]aus. Die Struktur[try / catch]*, die den Fehler abfängt, wird später beschrieben; hier wird der vollständige Klassenname der Exception angezeigt.[NullPointerException]* ist eine Java-Klasse, auf die Kotlin mit demselben Namen verweist; - Zeile 38: Die Java-Methode [System.getenv] liefert den Wert einer Systemumgebungsvariablen oder [null] , wenn sie nicht existiert. Ihr Ergebnis hat den Plattformtyp [String!]: [path] hat daher diesen Typ;
- Zeile 39: Bei Verwendung als [String?] verhält sich [path] korrekt;
- Zeile 42: Bei Verwendung als [String] wird es vom Compiler akzeptiert, verursacht aber zur Laufzeit eine [NullPointerException] . Die von der JVM erzeugte Exception-Meldung (Eigenschaft [message]) gibt genau an, welcher Ausdruck [null] war. Hätten wir [val path: String? = System.getenv(...)] geschrieben, hätte der Compiler diese Zeile zurückgewiesen;
- Zeile 48: Die Funktion [print] schreibt auf den Bildschirm, ohne in die nächste Zeile zu wechseln; die Benutzereingabe folgt auf die Meldung;
- Zeile 49: Die Funktion [readlnOrNull()] liest die über die Tastatur eingegebene Zeile. Sie liefert einen Wert vom Typ [String?]: [null] , wenn der Eingabestrom geschlossen ist;
- Zeile 50: Der Wert [null] wird geprüft;
- Zeile 54: Im Zweig [else] ist [line] vom Typ [String]: [line.length] kann sicher verwendet werden.
3.3.5. Umwandlungen zwischen Zahlen und Zeichenketten
Umwandlung | Funktion |
Zahl -> Zeichenkette | [number.toString()], ein Template wie ["$number"], ["" + number], oder ein Format wie ["%d".format(number)] |
Zeichenkette -> int | [string.toInt()], [string.toIntOrNull()] |
Zeichenkette -> Long | [string.toLong()], [string.toLongOrNull()] |
Zeichenkette -> Double | [string.toDouble()], [string.toDoubleOrNull()] |
Zeichenkette -> Float | [string.toFloat()], [string.toFloatOrNull()] |
Zeichenkette -> BigDecimal | [string.toBigDecimal()], [string.toBigDecimalOrNull()] |
Zeichenkette -> Boolean | [string.toBoolean()], [string.toBooleanStrictOrNull()] |
Diese Umwandlungsfunktionen gehören zur Kotlin-Bibliothek (Paket [kotlin.text]) und werden direkt auf der Zeichenkette selbst aufgerufen: ["10".toInt()] statt der Java-Funktion [Integer.parseInt("10")], die weiterhin verwendbar bleibt. Es handelt sich um Erweiterungsfunktionen: Funktionen, die außerhalb der Klasse [String] geschrieben, aber genau wie deren Methoden aufgerufen werden. Wie man sie schreibt, lernen wir in Kapitel 4.
Die Umwandlung einer Zeichenkette in eine Zahl kann fehlschlagen, wenn die Zeichenkette keine gültige Zahl darstellt. Eine Funktion wie [toInt()] erzeugt dann einen Fehler, der als Exception bezeichnet wird – hier vom Typ [NumberFormatException] –, der das Programm beendet, wenn er nicht behandelt wird. Dieser Fehler lässt sich mit der folgenden [try / catch]-Klausel behandeln:
Löst die Funktion keine Exception aus, wird die Ausführung mit der nächsten Anweisung fortgesetzt; andernfalls wird sie im Rumpf der [catch]-Klausel und anschließend mit der nächsten Anweisung fortgesetzt. Auf die Behandlung von Exceptions kommen wir im entsprechenden Abschnitt zurück.
Kotlin bietet außerdem für jede Umwandlung eine Version, die keine Exception auslöst: [toIntOrNull()], [toDoubleOrNull()] ... liefern [null] , wenn die Umwandlung fehlschlägt. Ihre Rückgabewerte sind nullable ([Int?], [Double?] ...): Der Compiler verlangt daher, dass der Fehlschlag behandelt wird. In Kombination mit dem Elvis-Operator ermöglichen sie es, eine Umwandlung mit einem Standardwert in einer einzigen Zeile zu schreiben: [input.toIntOrNull() ?: 0]. Java hat kein Äquivalent; im Java-Kurs wurde eine eigene Methode geschrieben, die ein [OptionalInt] zurückgab.
Diese Funktionen akzeptieren ein führendes Vorzeichen + oder -, aber keine Leerzeichen oder Tausendertrennzeichen: Verwenden Sie die Funktion [trim()], um führende und nachgestellte Leerzeichen aus einer Eingabe zu entfernen, bevor Sie sie umwandeln.
Das Programm [Basics07.kt] demonstriert mehrere Techniken zur Umwandlung zwischen Zahlen und Zeichenketten. Die Funktion [display] zeigt den Wert ihres Parameters auf dem Bildschirm an:
Ergebnisse:
Kommentare:
- Zeilen 9–12: die umzuwandelnden Daten;
- Zeilen 15–18: vier Möglichkeiten, eine Zahl in eine Zeichenkette umzuwandeln. Die dritte verwendet ein Template, und die letzte verkettet eine leere Zeichenkette mit der Zahl. Das Template ist in Kotlin die gebräuchlichste Methode;
- Zeile 22: Ein Boolean wird als [true] oder [false] angezeigt;
- Zeilen 25–31: Wir behandeln die Exception, die [toInt()] auslösen kann. Die Variable [i1] wird mit [var] deklariert, weil sie in [try] einen neuen Wert erhält. [e.message] ist die der Exception [e] zugeordnete Fehlermeldung (die Java-Methode [getMessage()], in Kotlin als Eigenschaft betrachtet). Dies sind die Meldungen der Java-Methoden, die von den Kotlin-Funktionen aufgerufen werden: Sie sind auf Englisch;
- Zeile 45: [toDouble()] erwartet unabhängig von der Sprache des Benutzers immer einen Dezimalpunkt: Die Zeichenkette "100.87" wird auf allen Rechnern gleich interpretiert. So werden Zahlen korrekt aus Dateien oder beim Datenaustausch zwischen Programmen gelesen;
- Zeile 58: Folglich wird das Dezimalkomma zurückgewiesen;
- Zeile 65: Umwandlung einer Zeichenkette in [BigDecimal]; auch hier wird ein Dezimalpunkt erwartet. Es entspricht [BigDecimal("100.87")];
- Zeile 69: [toBoolean()] liefert [true] für die Zeichenkette "true" (ohne Beachtung der Groß-/Kleinschreibung) und [false] für jede andere Zeichenkette, einschließlich "yes". [toBooleanStrictOrNull()] akzeptiert nur „true“ und „false“ und liefert [null] für alles andere;
- Zeilen 72–78: Umwandlungen ohne Exception. [i2] und [i3] haben denselben Typ wie [Int?]; nach dem Test [i2 != null] kann [i2] als [Int] verwendet werden. In einer Zeichenkette wird ein Anführungszeichen als \" geschrieben;
- Zeile 80: eine Umwandlung mit einem Standardwert unter Verwendung des Elvis-Operators. Das Template enthält eine Zeichenkette, "12x", die selbst in Anführungszeichen steht: Das ist innerhalb der geschweiften Klammern erlaubt;
- Zeile 82: " 42 " wird nicht umgewandelt; nach [trim()] wird es umgewandelt;
- Zeile 85: [Locale.getDefault()] liefert die Locale des Programms – das heißt die Sprache und das Land des Benutzers, abgeleitet aus den Systemeinstellungen: hier fr-FR;
- Zeile 86: Ein Format verwendet die aktuelle Locale: Die Gleitkommazahl wird mit einem Dezimalkomma geschrieben;
- Zeile 87: Die Funktion [format] akzeptiert eine Locale als ersten Parameter. [Locale.ROOT] ist eine neutrale Locale, die unabhängig vom Rechner einen Punkt als Dezimaltrennzeichen verwendet. Sie dient zum Schreiben formatierter Zahlen in Dateien oder beim Datenaustausch zwischen Programmen, der nicht von der Sprache des Benutzers abhängen darf;
- Zeile 90: Um eine nach französischen Konventionen geschriebene Zahl zu lesen, verwenden Sie ein [NumberFormat]-Objekt (aus dem Paket [java.text] des JDK), das für die Locale [Locale.FRANCE] ermittelt wurde. Seine Methode [parse] liefert ein [Number]-Objekt und kann eine [ParseException] auslösen. In Java ist dies eine Checked Exception: Der Compiler verlangt, dass sie behandelt wird. Kotlin kennt keine Checked Exceptions: Der Compiler überlässt es dem Programmierer, ob er die Exception behandelt oder nicht. Wir kommen im Abschnitt über Exceptions darauf zurück;
- Zeile 91: [toDouble()] wandelt [Number] in [Double] um;
- Zeilen 95–96: eine Top-Level-Funktion. Funktionen können in beliebiger Reihenfolge vor oder nach [main] geschrieben werden. Sie gibt kein Ergebnis zurück: Der Rückgabetyp wird weggelassen (er ist tatsächlich vom Typ [Unit], dem Äquivalent von Javas [void]).
Beachten Sie, dass die Funktionen [toInt()], [toDouble()] ... und [toString()] die Sprache des Benutzers ignorieren (Dezimalpunkt), während die Formate und die Klasse [NumberFormat] sie berücksichtigen. Ein Programm, das Zahlen liest, muss immer wissen, nach welchen Konventionen sie geschrieben wurden.
3.3.6. Datenarrays
Ein Kotlin-Array ist ein Objekt, mit dem sich Daten desselben Typs unter einem einzigen Bezeichner zusammenfassen lassen. Kotlin unterscheidet zwei Arten von Arrays:
- Der generische Typ [Array<T>], ein Array von Elementen des Typs [T]: [Array<String>] ist ein Array von Zeichenketten. Er entspricht dem Java-Array aus [T[]]-Objekten ([String[]]);
- spezialisierte Typen für Basistypen: [IntArray], [LongArray], [DoubleArray], [BooleanArray], [CharArray] ... Ein [IntArray] entspricht dem Java-Array [int[]]: Seine Elemente sind primitive Werte, die im Speicher nebeneinander liegen. Man könnte [Array<Int>] schreiben, doch das wäre ein Array aus Objekten vom Typ [Integer] ([Integer[]]), was sperriger und langsamer ist: Für Zahlen werden spezialisierte Arrays bevorzugt.
Es gibt mehrere Möglichkeiten, ein Array zu erstellen:
Kotlin hat weder einen Operator [new] noch die Syntax [{0, 10, 20\}] zum Erstellen eines Arrays: Alles geschieht mit Funktionen ([arrayOf], [intArrayOf] ...) oder Konstruktoren ([IntArray(n)], [Array(n) { ... \}]). Ein [IntArray(n)] enthält n Nullen, ein [BooleanArray(n)] enthält n Werte [false]. Es gibt jedoch kein [Array<String>(n)] , dessen Elemente [null] wären: Das würde die Null-Sicherheit verletzen, da die Elemente vom Typ [String] sind. Sie müssen entweder den Wert jedes Elements angeben oder ausdrücklich ein Array nullable Elemente anfordern mit [arrayOfNulls<String>(n)] vom Typ [Array<String?>].
Die Anzahl der Elemente eines Arrays ist seine Eigenschaft [size] (das Java-Feld [length]). Die Syntax [array[i]] bezeichnet das Datenelement Nummer i, wobei i zum Intervall [0, size-1] gehört. Jeder Zugriff auf das Datenelement [array[i]] , bei dem i nicht in diesem Bereich liegt, löst eine [ArrayIndexOutOfBoundsException]-Exception aus. Die Eigenschaft [indices] ist der Bereich der gültigen Indizes (von 0 bis size-1), und [lastIndex] ist der letzte Index (size-1). Ein Array kann seine Größe nach der Erstellung nicht ändern: Für eine wachsende Sammlung wird eine Liste verwendet (Kapitel 5). Eine Variable [val], die auf ein Array verweist, kann nicht auf ein anderes Array verweisen, aber die Elemente des Arrays bleiben veränderbar.
Kotlin kennt auch keine echten zweidimensionalen Arrays: Ein Array mit zwei Indizes ist ein Array von Arrays, zum Beispiel ein [Array<DoubleArray>]. Die Syntax [array[i][j]] bezeichnet das Element j in Zeile i. [array.size] ist die Anzahl der Zeilen, und [array[i].size] ist die Anzahl der Elemente in Zeile i. Da jede Zeile ein eigenständiges Array ist, können die Zeilen unterschiedlich lang sein (man spricht dann von einem „gezackten Array“).
Die Kotlin-Bibliothek bietet eine breite Palette von Array-Funktionen, die die Methoden der Klasse [java.util.Arrays] ersetzen und weit über sie hinausgehen: [contentToString()], [contentDeepToString()], [contentEquals()], [first()], [last()], [getOrNull(i)], [copyOf()], [copyOfRange(start, end)], [sliceArray(range)], [sort()], [sorted()], [fill()], [sum()], [max()], [average()], [contains()] (geschrieben mit dem Operator [in]) ... Größtenteils entsprechen sie denen der Listen, die wir in Kapitel 5 untersuchen.
Das Programm [Basics08.kt] kombiniert diese verschiedenen Arrays:
Ergebnisse:
Kommentare:
- Zeile 6: ein initialisiertes Array von ganzen Zahlen vom Typ [IntArray];
- Zeile 7: Eine Schleife vom Typ [for] durchläuft die Array-Indizes von 0 bis [integers.lastIndex]. Die Schleife vom Typ [for] wird später vorgestellt;
- Zeile 8: In einem Template ist [$i] der Indexwert und [${integers[i]\}] der Elementwert. Für den Ausdruck [integers[i]] sind geschweifte Klammern erforderlich; die eckige Klammer, die auf [[$i] folgt, benötigt sie nicht, da sie nicht Teil eines Variablennamens sein kann;
- Zeile 12: ein zweidimensionales Array (2 Zeilen, 2 Spalten) vom Typ [Array<DoubleArray>]. Sie müssen -6.0 und nicht -6 schreiben: Die Funktion [doubleArrayOf] erwartet [Double], und Kotlin wandelt die ganze Zahl -6 nicht in eine Gleitkommazahl um (Java tut das);
- Zeilen 13–14: [reals.indices] durchläuft die Zeilen, [reals[i].indices] durchläuft die Spalten der Zeile i;
- Zeile 18: [contentDeepToString()] zeigt ein Array von Arrays an;
- Zeile 22: ein gezacktes Array mit 3 Zeilen. Der Konstruktor [Array(3) { i -> ... \}] erstellt ein Array mit 3 Elementen und berechnet den Wert jedes Elements, indem er den Block in den geschweiften Klammern mit dem Index [i] des Elements ausführt. Jedes Element ist hier selbst ein Array von Zeichenketten ([i + 1]), dessen Element mit dem Index [j] "name" gefolgt von i und j ist. Der Block in den geschweiften Klammern ist ein Lambda (Kapitel 7); vorerst genügt es, ihn als „für den Index i ist der Wert ...“ zu lesen. In Java waren dafür drei Schritte nötig: das Array der Zeilen erstellen, jede Zeile erstellen und dann die Elemente füllen;
- Zeile 30: ein Array aus 3 Booleans, die alle [false] sind;
- Zeile 31: ein Array aus 2 nullable Zeichenketten, die alle [null] sind;
- Zeile 36: Die Funktion [contentToString()] erstellt aus den Elementen des Arrays eine Zeichenkette. Würde man das Array direkt ausgeben ([println(values)]), erhielte man wie in Java einen Text wie [I@6328d34a (den Array-Typ und einen numerischen Code) statt seines Inhalts;
- Zeilen 38–39: das erste, das letzte und das vorletzte Element. Die Funktionen [first()] und [last()] ersetzen die Ausdrücke [values[0]] und [values[values.size - 1]]. Kotlin hat keinen vom Ende des Arrays aus gezählten Index (das C#-Äquivalent von [^1]);
- Zeile 41: die Elemente mit den Indizes 1 und 2. Wie bei [Arrays.copyOfRange] in Java ist die Endgrenze ausgeschlossen;
- Zeile 44: die Elemente mit den Indizes 2 bis [lastIndex]. [2..values.lastIndex] ist ein Bereich: die Menge der ganzen Zahlen von 2 bis 4 einschließlich. Die Funktion [sliceArray] liefert ein neues Array aus den Elementen, deren Indizes zum Bereich gehören. Bereiche werden zusammen mit der Schleife [for] eingeführt;
- Zeilen 47–48: [copyOfRange] erstellt eine Kopie; die Änderung von [extract] ändert [values] nicht;
- Zeile 50: die Summe, das Maximum und der Durchschnitt der Elemente. Der Durchschnitt ist ein [Double];
- Zeile 51: Der Operator [in] prüft, ob ein Wert im Array vorhanden ist;
- Zeile 54: ein Array von Objekten vom Typ [Array<String>];
- Zeile 55: [friends.getOrNull(5)] liefert [null] , statt eine Exception auszulösen, wenn der Index außerhalb der Grenzen liegt;
- Zeilen 58–60: Der Index 3 existiert nicht: Es wird eine [ArrayIndexOutOfBoundsException] ausgelöst, mit einer Meldung, die den falschen Index und die Array-Größe angibt.
3.4. Die grundlegenden Anweisungen von Kotlin
Es gibt zwei Arten:
- elementare Anweisungen, die vom Computer ausgeführt werden;
- Anweisungen, die den Programmablauf steuern.
Die grundlegenden Anweisungen werden verständlich, wenn man den Aufbau eines Mikrocomputers und seiner Peripheriegeräte betrachtet:
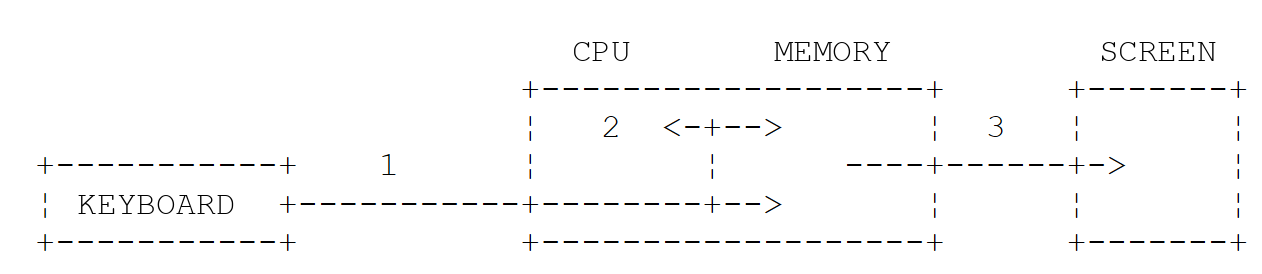
- 1: Lesen von Informationen von der Tastatur;
- 2: Verarbeiten von Informationen;
- 3: Schreiben von Informationen auf den Bildschirm.
3.4.1. Ausgabe auf den Bildschirm
Es gibt verschiedene Anweisungen zur Ausgabe auf den Bildschirm:
Dabei ist [expression] ein beliebiges Datum, das zur Anzeige auf dem Bildschirm in eine Zeichenkette umgewandelt werden kann. Alle Objekte haben eine Methode [toString()] , die diese Umwandlung durchführt. Die Funktion [println] schreibt den Wert und wechselt dann in die nächste Zeile; die Funktion [print] tut dasselbe, ohne in die nächste Zeile zu wechseln; [println()] ohne Parameter wechselt einfach in die nächste Zeile. Für formatierte Ausgaben verwenden Sie [println("format".format(value1, ...))] oder die Java-Methode [System.out.printf(format, value1, ...)].
Die Kotlin-Funktionen [println] und [print] (im Paket [kotlin.io]) schreiben in den Java-Stream [System.out]. Die Klasse [System] bietet über ihre statischen Felder [out] und [err] Zugriff auf zwei Ausgabeströme vom Typ [PrintStream]:
- [System.out.println()] schreibt in den Stream [out], die Standardausgabe, die normalerweise mit dem Bildschirm verbunden ist;
- [System.err.println()] schreibt in den Stream [err], die Fehlerausgabe, die ebenfalls normalerweise mit dem Bildschirm verbunden ist.
Die Kotlin-Bibliothek hat keine Funktion zum Schreiben in die Fehlerausgabe: [System.err.println] wird direkt verwendet. Die Streams [out] und [err] können zur Laufzeit in Dateien umgeleitet werden, wie wir gleich sehen werden.
3.4.2. Von der Tastatur eingegebene Daten lesen
Der Datenstrom der Tastatur wird durch das Java-Feld [System.in] dargestellt, das vom Typ [InputStream] ist. Dies ist ein Bytestrom, der sich nicht besonders bequem direkt verwenden lässt. Die Kotlin-Bibliothek stellt zwei Funktionen bereit, die eine Textzeile aus diesem Strom lesen:
Die auf der Tastatur eingegebene Zeile wird ohne das Zeilenende-Zeichen in der Variablen [line] gespeichert und kann dann vom Programm verarbeitet werden. Die beiden Funktionen unterscheiden sich nur in ihrem Verhalten am Ende des Eingabestroms (wenn der Benutzer Strg-D drückt, unter Windows Strg-Z gefolgt von der Eingabetaste, oder wenn die auf den Eingabestrom umgeleitete Datei erschöpft ist):
- [readln()] löst dann eine [ReadAfterEOFException]-Exception aus; sie liefert daher immer eine Zeichenkette vom Typ [String];
- [readlnOrNull()] liefert dann [null]; ihr Ergebnis hat den Typ [String?], was die Behandlung dieses Falls erfordert, wie es das Programm [Basics06.kt] getan hat.
Diese Funktionen zeigen keine Eingabeaufforderung an: Diese wird zuvor mit [print] angegeben. In älteren Programmen begegnet Ihnen möglicherweise auch die Funktion [readLine()], die sich wie [readlnOrNull()] verhält, sowie die Java-Klassen [BufferedReader] und [Scanner], die weiterhin verwendbar sind. Der Stream [System.in] kann wie die Streams [out] und [err] in eine Datei umgeleitet werden. Beachten Sie schließlich die Java-Klasse [Console], die man über [System.console()] erhält und deren Methode [readPassword] ein Passwort liest, ohne es anzuzeigen.
3.4.3. Beispiel für Ein-/Ausgabe
Das Programm [Basics09.kt] veranschaulicht Ein- und Ausgabeoperationen über Tastatur und Bildschirm:
Ergebnisse:
Kommentare:
- Zeile 6: [obj] ist eine Referenz auf ein Objekt der Klasse [Any], der Wurzelklasse aller Kotlin-Klassen ([Object] in Java). Das Objekt wird durch Aufruf des Konstruktors [Any()] ohne [new] erzeugt;
- Zeile 7: [obj] wird auf dem Bildschirm ausgegeben. Die Methode [obj.toString()] wird aufgerufen, um den anzuzeigenden Text abzurufen;
- Zeile 11: Es wird in den Stream [err] geschrieben;
- Zeile 12: dasselbe, aber mit einem Format. Der erste Parameter, "i=%d%n,", ist das Anzeigeformat; die anderen Parameter sind die anzuzeigenden Werte: %d wird durch den Wert von [i] ersetzt und %n durch das Zeilenende-Zeichen des Systems (\r\n unter Windows, \n unter Linux und macOS);
- Zeile 15: Eine Eingabeaufforderung wird angezeigt, ohne in die nächste Zeile zu wechseln;
- Zeile 16: liest die auf der Tastatur eingegebene Zeile. [line] ist vom Typ [String].
In den Ergebnissen:
- Zeile 2: die von Zeile 7 des Codes erzeugte Ausgabe. Die Methode [toString()] der Klasse [Any] liefert den vollständigen Klassennamen des Objekts, gefolgt vom Zeichen @ und einem hexadezimalen numerischen Code (seinem „Hashcode“), der sich von einer Ausführung oder einem Rechner zum anderen unterscheiden kann. Wir sehen, dass die Kotlin-Klasse
*[Any]*zur Laufzeit tatsächlich die Klasse*[java.lang.Object]* ist. Klassen überschreiben diese Methode in der Regel, um etwas Nützlicheres anzuzeigen, wie wir es in Kapitel 4 tun werden; - Zeilen 3–4: Die beiden Schreibvorgänge in den Stream [err] erscheinen auf dem Bildschirm genauso wie die aus dem Stream [out].
Schließt der Benutzer den Eingabestrom, statt eine Zeile einzugeben, löst [readln()] eine Exception aus, die das Programm beendet:
Auf die Exception-Meldung folgt der Aufrufstack („Stack Trace“): die Liste der Funktionen, die zum Zeitpunkt des Fehlers ausgeführt wurden, mit der jüngsten oben, jeweils mit Datei und Zeilennummer. Er zeigt, dass die Funktion [readln] (Datei [Console.kt] aus der Kotlin-Bibliothek) in Zeile 16 der Datei [Basics09.kt] aufgerufen wurde, über die Methode [main] der Klasse [Basics09Kt], die ihrerseits von der vom Compiler erzeugten Methode [main(String[])] aufgerufen wurde. (Bei [gradlew run] meldet Gradle außerdem, dass der Task [run] fehlgeschlagen ist; seine Meldungen werden hier nicht wiedergegeben.)
3.4.4. Ein-/Ausgabeumleitung
Windows, Linux und macOS kennen drei Standardgeräte:
- das Gerät Standardeingabe, das standardmäßig die Tastatur bezeichnet und die Nummer 0 trägt;
- das Gerät Standardausgabe, das standardmäßig den Bildschirm bezeichnet und die Nummer 1 trägt;
- das Gerät Standardfehlerausgabe, das standardmäßig den Bildschirm bezeichnet und die Nummer 2 trägt.
Auf der JVM schreibt der Schreibstream [System.out] (verbunden mit den Funktionen [println] und [print]) auf Gerät 1, der Schreibstream [System.err] schreibt auf Gerät 2, und der Lesestream [System.in] (verbunden mit den Funktionen [readln] und [readlnOrNull]) liest Daten von Gerät 0.
Wenn Sie ein Programm in einem Befehlsfenster ausführen, können Sie festlegen, welche Geräte für das ausgeführte Programm 0, 1 und 2 sind. Nach den Programmargumenten können Sie die Standard-Ein-/Ausgabegeräte in Dateien umleiten:
Umleitung | Bedeutung |
0<in.txt oder <in.txt | Der Standardeingabestrom Nr. 0 wird in die Datei in.txt umgeleitet. Im Programm liest der Stream [System.in] seine Daten daher aus der Datei in.txt |
1>out.txt oder >out.txt | leitet die Ausgabe Nr. 1 in die Datei out.txt um. Im Programm schreibt der Stream [System.out] seine Daten daher in die Datei out.txt |
1>>out.txt oder >>out.txt | Wie oben, aber die geschriebenen Daten werden an den aktuellen Inhalt der Datei out.txt angehängt |
2>err.txt | leitet die Ausgabe Nr. 2 in die Datei err.txt um. Im Programm schreibt der Stream [System.err] seine Daten daher in die Datei err.txt |
2>>err.txt | Wie oben, aber die geschriebenen Daten werden an den aktuellen Inhalt der Datei err.txt angehängt |
1>out.txt 2>err.txt | Die Geräte 1 und 2 werden beide in Dateien umgeleitet |
Beachten Sie, dass das Programm nicht geändert werden muss, um die Ein-/Ausgabeströme eines Programms in Dateien umzuleiten: Das Betriebssystem legt die Art der Geräte 0, 1 und 2 fest. Betrachten Sie das folgende Programm [Basics10.kt]:
Umleitungen gelten für das Programm, das durch den an der Eingabeaufforderung eingegebenen Befehl gestartet wird. Bei ***[gradlew run]*** ist dieses Programm Gradle selbst, das die Streams dann an das Kotlin-Programm weitergibt: Die Umleitung funktioniert in der Regel, aber die Dateien können auch Meldungen von Gradle erhalten (Warnungen, Kompilierfehler usw.). Um das Verhalten des Programms für sich allein zu beobachten, führen Sie es am besten außerhalb von Gradle aus. Wie wir in Kapitel 2 gesehen haben, erstellt der Task [installDist] eine installierbare Version des Projekts im Ordner [build/install/basics] (dessen Name, [basics], durch die Datei [settings.gradle.kts] festgelegt wird): ein Ordner namens [lib], der das Klassenarchiv des Projekts und die Kotlin-Standardbibliothek enthält, und ein Ordner namens [bin], der die Startskripte [basics] (Linux, macOS) und [basics.bat] (Windows) enthält. Das Skript startet die Klasse, die in der Datei [build.gradle.kts] bei der Erstellung festgelegt wurde; daher wird das Programm mit dem Befehl [installDist] ausgewählt:
Hier ist eine Sitzung in einem Linux-Terminal (bash) im Projektordner:
Kommentare:
- Zeile 1: Wir schreiben die Zeichenkette "test" in die Datei in.txt;
- Zeile 2: Anzeige des Inhalts der Datei in.txt zur Überprüfung;
- Zeile 4: Ausführung des Programms. Der Stream [System.in] wird in die Datei in.txt umgeleitet, der Stream [System.out] in die Datei out.txt und der Stream [System.err] in die Datei err.txt. Die Ausführung erzeugt keine Ausgabe;
- Zeilen 5–6: Der Inhalt der Datei out.txt zeigt, dass die Datei in.txt gelesen und das Schreiben in den Stream [out] nach out.txt umgeleitet wurde;
- Zeilen 7–8: entsprechende Überprüfung für die Datei err.txt;
- Zeilen 9–10: Nur der Stream [err] wird umgeleitet: Der Bildschirm zeigt nur den Schreibvorgang in den Stream [out] an;
- Zeilen 11–12: Nur der Stream [out] wird umgeleitet: Der Bildschirm zeigt nur den Schreibvorgang in den Stream [err] an.
Es ist offensichtlich, dass die Streams [out] und [err] nicht auf dieselben Geräte schreiben, da sie getrennt umgeleitet werden konnten. Der Stream [err] ist für Fehlermeldungen vorgesehen: So können Sie die Ausgabe eines Programms in eine Datei umleiten und dennoch seine Fehlermeldungen auf dem Bildschirm sehen.
Die Operatoren >, >> und 2> werden in der Windows-Eingabeaufforderung ([cmd]), in PowerShell und in bash gleich geschrieben. Der Operator < wird von [cmd] und bash erkannt, nicht aber von PowerShell, die ihn für eine künftige Verwendung reserviert: In PowerShell wird eine Datei über eine Pipe (|) an die Standardeingabe eines Programms gesendet. Die folgenden Befehle, die zur Veranschaulichung dienen (sie wurden für diesen Kurs nicht ausgeführt), bewirken unter Windows dasselbe wie die obige bash-Sitzung:
3.4.5. Zuweisung des Werts eines Ausdrucks an eine Variable
Hier befassen wir uns mit der Operation [variable = expression]. Der Ausdruck kann arithmetisch, relational, boolesch, eine Zeichenkette usw. sein.
3.4.5.1. Interpretation der Zuweisung
Die Operation [Variable = Ausdruck] läuft wie folgt ab:
- Die rechte Seite der Zuweisung wird ausgewertet: Das Ergebnis ist ein Wert V;
- der Wert V wird der Variablen zugewiesen.
In Java wie in C und C# ist eine Zuweisung selbst ein Ausdruck, dessen Wert V ist: Man kann also [V1 = V2 = Ausdruck] schreiben, was den Wert des Ausdrucks zuerst V2 und dann V1 zuweist, oder [if ((n = read()) > 0)], was gleichzeitig zuweist und auswertet. In Kotlin ist die Zuweisung eine Anweisung und kein Ausdruck: Sie hat keinen Wert und kann nicht dort stehen, wo ein Wert erwartet wird. Der Compiler lehnt daher Folgendes ab:
Mehrfachzuweisungen wie [V1 = V2 = Ausdruck] werden aus demselben Grund abgelehnt: Sie enthalten zwei Zuweisungen. Diese Entscheidung beseitigt eine häufige Fehlerquelle in C und Java: Die Verwechslung des Zuweisungsoperators = mit dem Vergleichsoperator == in einem Test wie [if (x = 0)] wird unmöglich.
3.4.5.2. Arithmetische Ausdrücke
In arithmetischen Ausdrücken werden die folgenden Operatoren verwendet:
Operator | Bedeutung |
+ | Addition |
- | Subtraktion |
* | Multiplikation |
/ | Division: Das Ergebnis ist der exakte Quotient, wenn mindestens einer der Operanden eine reelle Zahl ist. Sind beide Operanden ganze Zahlen, ist das Ergebnis der ganzzahlige Quotient. So ergibt 5/2 den Wert 2 und 5.0/2 den Wert 2.5 |
% | Rest der Division, unabhängig vom Typ der Operanden. Der Rest hat dasselbe Vorzeichen wie der Dividend: -5 % 2 ergibt -1. Der Operator % ist eine andere Schreibweise für die Funktion [rem] („remainder“, Rest): [a % b] ist gleichbedeutend mit [a.rem(b)]. Die Funktion [mod] liefert den Rest im mathematischen Sinn, mit dem Vorzeichen des Divisors: [(-5).mod(2)] ergibt 1 |
In Kotlin sind alle diese Operatoren eigentlich alternative Schreibweisen für Funktionen: [a + b] ist gleichbedeutend mit [a.plus(b)], [a - b] mit [a.minus(b)], [a * b] ist gleichbedeutend mit [a.times(b)], und [a / b] ist gleichbedeutend mit [a.div(b)]. Der Compiler übersetzt diese Operationen auf den Basistypen selbstverständlich ohne Funktionsaufrufe in die arithmetischen Anweisungen der JVM. Dieser Mechanismus erlaubt es jedoch, auch andere Klassen mit diesen Operatoren auszustatten (Operatorüberladung, Kapitel 4); die Kotlin-Bibliothek hat dies insbesondere für die Java-Klasse [BigDecimal]getan.
Es gibt verschiedene mathematische Funktionen. Kotlin fasst sie im Paket [kotlin.math] zusammen, das importiert werden muss ([import kotlin.math.*] oder [import kotlin.math.sqrt] ...). Hier einige davon:
Funktion | Bedeutung |
[sqrt(x)] | Quadratwurzel |
[cos(x)], [sin(x)], [tan(x)] | Kosinus, Sinus, Tangens (Winkel im Bogenmaß) |
[x.pow(y)] | x hoch y (y ist eine reelle oder ganze Zahl) |
[exp(x)] | Exponentialfunktion |
[ln(x)], [log10(x)], [log(x, base)] | natürlicher Logarithmus, dekadischer Logarithmus, Logarithmus zu einer beliebigen Basis |
[abs(x)] oder [x.absoluteValue], [max(x, y)], [min(x, y)] | Absolutwert, Maximum, Minimum (für die Typen Int, Long, Float, Double) |
[floor(x)], [ceil(x)], [truncate(x)] | untere ganze Zahl (Abrunden), obere ganze Zahl (Aufrunden), Abschneiden in Richtung null |
[x.roundToInt()], [x.roundToLong()] | auf die nächste ganze Zahl gerundet, wobei Werte genau in der Mitte aufgerundet werden |
[round(x)] | Rundung auf die nächste ganze Zahl, wobei Werte genau in der Mitte auf die nächste gerade Zahl gerundet werden (tatsächliches Ergebnis) |
[x.coerceIn(min, max)] | auf das Intervall [min, max] abgebildeter Wert |
[PI], [E] | die Konstanten π und e |
Dies sind Funktionen auf oberster Ebene (oder, wie [pow] und [roundToInt], Erweiterungsfunktionen, die auf der Zahl selbst aufgerufen werden): Sie werden ohne Präfix aufgerufen. So schreiben wir:
Die statischen Methoden der Java-Klasse [Math] ([Math.sqrt(y)], [Math.floorMod(-5, 2)] ...) können weiterhin ohne Import verwendet werden, da [Math] zum Paket [java.lang] gehört. Die vollständige Beschreibung des Pakets [kotlin.math] finden Sie in der Online-Dokumentation von Kotlin unter kotlinlang.org/api/core/kotlin-stdlib/kotlin.math/.
Reelle Zahlen vom Typ [Double] werden im Binärformat gespeichert: Die meisten Dezimalzahlen, etwa 0.1, werden nur angenähert. Für wissenschaftliche Berechnungen ist das unerheblich, für Geldbeträge jedoch inakzeptabel. Die Klasse [BigDecimal] (im Paket [java.math] des JDK) hingegen stellt eine Dezimalzahl exakt dar, mit so vielen Ziffern wie nötig. In Java werden Berechnungen mit diesen Methoden durchgeführt: [add], [subtract], [multiply], [divide] ... In Kotlin bleiben diese Methoden verfügbar, aber die Standardbibliothek ergänzt die Klasse um die Operatoren +, -, *, /, % und das unäre -: Man schreibt [a + b] statt [a.add(b)]. Außerdem ergänzt sie die Konvertierungsfunktionen ["0.1".toBigDecimal()] und [3.toBigDecimal()]. Ein [BigDecimal] ist unveränderlich: Eine Operation verändert das Objekt, auf das sie angewendet wird, nicht, sondern liefert ein neues Objekt zurück.
Das Programm [Basics11.kt] lautet wie folgt:
Ergebnisse:
Kommentare:
- Zeile 7: Alle Deklarationen des Pakets [kotlin.math] werden importiert;
- Zeile 11: Die Division zweier ganzer Zahlen ist eine ganzzahlige Division. Jede Operation steht in einem eigenen Template: Anders als bei der Java-Verkettung muss man sich keine Gedanken über die Operatorpriorität gegenüber dem Operator + machen, der die Zeichenkette aufbaut;
- Zeile 13: Der Rest hat dasselbe Vorzeichen wie der Dividend; der Operator % gilt auch für reelle Zahlen;
- Zeile 14: [rem] ist die Funktion des Operators %; [mod] liefert einen Rest mit dem Vorzeichen des Divisors, genau wie [Math.floorMod] in Java. Die Klammern in [(-5)] sind notwendig: [-5.mod(2)] würde als [-(5.mod(2))] interpretiert, da ein Funktionsaufruf mit dem Punktoperator Vorrang vor dem unären Minus hat;
- Zeile 17: Die Division einer reellen Zahl durch null verursacht keinen Fehler; sie liefert unendlich ([Infinity]) oder bei 0/0 den speziellen Wert [NaN] („Not a Number“). In [1 / zero]wird die ganze Zahl 1 durch eine reelle Zahl geteilt: Die Operation ist reell. Kotlin führt keine impliziten Konvertierungen zwischen numerischen Typen durch, aber arithmetische Operatoren akzeptieren Operanden unterschiedlicher Typen: Die Klasse [Int] besitzt eine Funktion [div(other: Double): Double];
- Zeilen 19–23: Die Division einer ganzen Zahl durch null löst dagegen eine [ArithmeticException] aus. Der Divisor wird durch Konvertierung der Zeichenkette "0" gewonnen, damit der Compiler seinen Wert nicht kennt;
- Zeilen 27–28: das obige Beispiel. [sqrt] erwartet und liefert einen [Double]: 2.0. Da Kotlin einen [Int] nicht implizit in einen [Double] konvertiert, würde [sqrt(4)] abgelehnt; wir schreiben [sqrt(4.0)];
- Zeile 30: Die Funktion [pow] wird auf der Zahl aufgerufen, die potenziert werden soll;
- Zeile 31: [absoluteValue] ist eine Erweiterungseigenschaft, die ohne Klammern verwendet wird;
- Zeile 34: [floor] rundet ab, [ceil] rundet auf, und [truncate] rundet in Richtung null. Um durch Abschneiden einer reellen Zahl eine ganze Zahl zu erhalten, konvertiert man sie mit [toInt()], wie wir später sehen werden;
- Zeile 36: [roundToInt] rundet auf die nächste ganze Zahl; ein Wert genau in der Mitte zwischen zwei ganzen Zahlen wird aufgerundet: 2.5 wird zu 3 und -2.5 wird zu -2. Das Ergebnis ist ein [Int]. So verhält sich auch [Math.round] in Java;
- Zeile 38: Beachten Sie, dass die Funktion [round] von Kotlin sich nicht wie [Math.round] in Java verhält: Sie rundet einen Wert genau in der Mitte auf die nächste gerade ganze Zahl („kaufmännisches“ Banker-Runden): 2.5 wird zu 2 und 3.5 wird zu 4. Das Ergebnis ist ein [Double]. Dies entspricht dem Verhalten von [Math.rint] in Java;
- Zeile 39: [coerceIn] bildet 150 auf das Intervall [0, 100] ab, genau wie [Math.clamp] (Java 21). Die Funktionen [coerceAtLeast] und [coerceAtMost] legen nur eine Grenze fest;
- Zeile 42: die Methoden der Java-Klasse [Math];
- Zeile 45: Operatorpriorität, siehe unten;
- Zeile 46: "x" + 1 + 2 wird von links nach rechts ausgewertet: "x" + 1 ergibt die Zeichenkette "x1", an die 2 angehängt wird. Um zuerst die Addition auszuführen, muss man "x" + (1 + 2) schreiben; mit einem Template würde man ["x${1 + 2\}"] schreiben;
- Zeile 49: 0.1 und 0.2 haben keine exakte binäre Darstellung: Ihre Summe ist nicht genau 0.3;
- Zeilen 51–52: zwei aus Zeichenketten erzeugte [BigDecimal] -Werte. Schreiben Sie nicht [BigDecimal(0.1)]: Der Parameter wäre der [Double]-Wert 0.1, dessen exakter Wert 0.1000000000000000055511151231257827021181583404541015625 ist. Die Funktion [0.1.toBigDecimal()], die die Zeichenkette "0.1" verwendet, funktioniert dagegen;
- Zeile 53: die exakte Addition, geschrieben mit dem Operator +;
- Zeilen 54–56: [3.toBigDecimal()] konvertiert eine ganze Zahl. Ein Produkt hat so viele Nachkommastellen wie die Summe der Nachkommastellen seiner beiden Faktoren: 59.97 × 1.2 = 71.964;
- Zeile 58: [setScale(2, RoundingMode.HALF_UP)] rundet auf zwei Nachkommastellen, wobei Werte genau in der Mitte zwischen zwei Ziffern von null weg gerundet werden: Dies ist die kaufmännische Rundung;
- Zeile 61: eine Falle. Der Operator / von Kotlin ruft die Methode [divide(divisor, RoundingMode.HALF_EVEN)] auf: Der Quotient behält die Anzahl der Nachkommastellen des Dividenden und wird auf den nächstgelegenen Wert gerundet. Da 10 keine Nachkommastellen hat, ergibt 10/3 den Wert 3; 10.00/3 ergibt 3.33;
- Zeile 63: die Java-Methode [divide] mit einer Genauigkeit, die durch [MathContext.DECIMAL64] (16 signifikante Stellen) festgelegt wird. Ohne Angabe von Genauigkeit oder Rundungsmodus würde die Methode [divide] eine [ArithmeticException] auslösen: [Non-terminating decimal expansion; no exact representable decimal result.], weil 10/3 keine endliche Dezimaldarstellung besitzt. Bei Divisionen von [BigDecimal] wählt man daher ausdrücklich die Genauigkeit oder die Anzahl der Nachkommastellen und den Rundungsmodus: [a.divide(b, 2, RoundingMode.HALF_UP)].
3.4.5.3. Operatoren bei der Auswertung arithmetischer Ausdrücke
Die Rangfolge der Operatoren bei der Auswertung eines arithmetischen Ausdrucks ist wie folgt (von der höchsten zur niedrigsten):
Operatoren innerhalb desselben Blocks [ ] haben dieselbe Priorität. Bei gleicher Priorität erfolgt die Auswertung von links nach rechts: 10 - 4 - 3 wird als (10 - 4) - 3 = 3 ausgewertet. Mit Klammern lässt sich eine andere Auswertungsreihenfolge festlegen.
3.4.5.4. Relationale Ausdrücke
Die Operatoren sind: <, <=, , !=, >, >=; Kotlin ergänzt === und ! (siehe unten). Ihre Priorität:
- >, >=, <, <=;
- , !=, =, !==.
Das Ergebnis eines relationalen Ausdrucks ist der Boolesche Wert [false] , wenn der Ausdruck falsch ist, andernfalls [true].
Vergleich zweier Zeichen
Es seien C1 und C2 zwei Zeichen. Sie können mit den Operatoren <, <=, ==, !=, >, >= verglichen werden. Dabei werden ihre Unicode-Codes verglichen, die Zahlen sind. Gemäß der Unicode-Reihenfolge gelten die folgenden Beziehungen:
Der Unicode-Code eines Zeichens [c] wird durch seine Eigenschaft [c.code] angegeben, die vom Typ [Int] ist. In Kotlin ist ein [Char] keine Zahl: Man kann weder ['a' + 'b'] schreiben noch ein Zeichen einer ganzzahligen Variablen zuweisen, was Java erlaubt.
Vergleich zweier Zeichenketten
Sie werden Zeichen für Zeichen verglichen. Die erste Ungleichheit zwischen zwei Zeichen führt zu einer Ungleichheit mit demselben Vorzeichen für die Zeichenketten. Betrachten wir den Vergleich der Zeichenketten "Cart" und "Cat":
Diese letzte Ungleichheit erlaubt den Schluss, dass "Cart" < "Cat" gilt. Betrachten wir nun den Vergleich der Zeichenketten "Cat" und "Catkin". Sie sind gleich, bis die Zeichenkette "Cat" erschöpft ist. In diesem Fall wird die erschöpfte Zeichenkette als die „kleinere“ erklärt. Wir haben also die Beziehung "Cat" < "Catkin".
Strukturelle Gleichheit und referenzielle Gleichheit
In diesem Punkt korrigiert Kotlin eine klassische Falle von Java. In Java vergleichen die Operatoren == und !=, auf zwei Zeichenketten – oder auf beliebige zwei Objekte – angewendet, die Referenzen: [s1 == s2] ist wahr, wenn die beiden Variablen auf dasselbe Objekt im Speicher verweisen, nicht wenn die beiden Zeichenketten dieselben Zeichen enthalten; um die Inhalte zu vergleichen, muss man [s1.equals(s2)] schreiben. In Kotlin gilt:
- Der Operator == vergleicht die Inhalte: [a == b] wird vom Compiler in einen Aufruf der Methode [a.equals(b)] übersetzt, dem ein Test auf [null] vorausgeht: Wenn [a] gleich [null] ist, ist [a == b] gleichbedeutend mit [b === null], ohne das Risiko einer [NullPointerException]. Dies ist die strukturelle Gleichheit; != ist ihre Negation;
- Der Operator === vergleicht Referenzen: [a === b] ist wahr, wenn [a] und [b] auf dasselbe Objekt verweisen. Dies ist die referenzielle Gleichheit; !== ist ihre Negation. Man braucht sie nur selten.
Bei primitiven Typen ([Int], [Double] ...) vergleicht == einfach die Werte. C# verhält sich bei Zeichenketten wie Kotlin: Sein Operator == vergleicht deren Inhalte.
Die Reihenfolge zweier Zeichenketten
Die Operatoren < <= > >= gelten für Zeichenketten ebenso wie für jedes vergleichbare Objekt: In Kotlin ist [a < b] eine andere Schreibweise für [a.compareTo(b) < 0]. Die Methode [compareTo] liefert eine ganze Zahl:
- null, wenn die beiden Zeichenketten gleich sind;
- positiv, wenn Zeichenkette 1 größer als Zeichenkette 2 ist;
- negativ, wenn Zeichenkette 1 kleiner als Zeichenkette 2 ist.
Die Kotlin-Funktionen [equals] und [compareTo] akzeptieren einen Parameter [ignoreCase], um die Groß- und Kleinschreibung zu ignorieren: [s1.equals(s2, ignoreCase = true)] (die Java-Funktionen [equalsIgnoreCase] und [compareToIgnoreCase]). Die Syntax [ignoreCase = true] ist die eines benannten Arguments, dem wir bei den Funktionen wieder begegnen werden.
[compareTo] vergleicht Unicode-Codes Zeichen für Zeichen: Sein Ergebnis ist die Differenz zwischen den Codes der ersten beiden verschiedenen Zeichen oder die Differenz der Längen, wenn eine der Zeichenketten der Anfang der anderen ist. Das ist keine lexikografische Ordnung: Da der Code von 'é' (233) größer ist als der von 'f' (102), steht "élan" hinter "face". Um Text zu sortieren, der für Benutzer bestimmt ist, verwendet man ein [Collator]-Objekt (aus dem Paket [java.text] des JDK), das die Sortierregeln einer bestimmten Sprache anwendet. [compareTo] bleibt die richtige Methode für Bezeichner, Schlüsselwörter und Dateinamen.
Das Programm [Basics12.kt] lautet wie folgt:
Ergebnisse:
Kommentare:
- Zeile 10: ein relationaler Ausdruck; [end] ist vom Typ [Boolean];
- Zeile 14: Zeichenvergleich;
- Zeile 15: Die Eigenschaft [code] eines Zeichens liefert seinen Unicode-Code (in Java schreibt man dies als [(int) 'A']);
- Zeile 20: Der Variablen [n] wird eine negative ganze Zahl zugewiesen, weil "cat" < "dog" gilt: die Differenz zwischen den Codes von 'c' (99) und 'd' (100);
- Zeile 21: Die Variable [equal] hat den Wert [true] , wenn die beiden Zeichenketten denselben Inhalt haben, andernfalls [false] ;
- Zeile 22: der Operator < auf zwei Zeichenketten angewendet;
- Zeile 23: Die Zeichenkette, die zuerst zu Ende ist, ist die kürzere; das Ergebnis ist die Differenz der Längen: 3 - 6. In einem Zeichenkettenliteral steht \" für ein Anführungszeichen;
- Zeile 26: Die Funktion [lowercase()] erzeugt zur Laufzeit ein neues Zeichenkettenobjekt, das "cat" enthält;
- Zeilen 27–28: [string1] und [string3] haben denselben Inhalt, verweisen aber auf zwei verschiedene Objekte: == liefert [true], === liefert [false]. [string1 === "cat"] ist hingegen wahr: Zwei identische Zeichenketten-Literale werden nur einmal im Speicher abgelegt;
- Zeile 30: Die Java-Methode [System.getProperty] liefert den Wert einer Eigenschaft der JVM oder [null] , wenn sie nicht existiert; ihr Ergebnis wird in einer Variablen vom Typ [String?] gespeichert;
- Zeile 31: Der Operator == akzeptiert links einen [null]-Wert: Er liefert [false], während der Java-Aufruf [absent.equals(string1)] eine [NullPointerException] auslösen würde;
- Zeile 34: 233 - 102 = 131: Für [compareTo] steht "élan" hinter "face";
- Zeile 35: 'C' (67) - 'c' (99) = -32;
- Zeilen 37–39: Ohne Berücksichtigung der Groß- und Kleinschreibung sind „Cat“ und „cat“ gleich;
- Zeilen 41–43: ein [Collator] für Französisch: „élan“ steht vor „face“, und „Cat“ steht hinter „cat“ (bei gleichen Buchstaben steht der Kleinbuchstabe vor dem Großbuchstaben). Die Methode [compare] liefert wie [compareTo] eine negative ganze Zahl, null oder eine positive ganze Zahl;
- Zeilen 46–48: Da == die Methode [equals] aufruft, erbt es deren Eigenschaften. Das Verhalten der Klasse [BigDecimal] berücksichtigt die Anzahl der Nachkommastellen: 2.0 und 2.00 sind für [equals] verschieden, für [compareTo] aber gleich und somit auch für die Operatoren <<, <=, >> und >=. Um zwei [BigDecimal]-Beträge zu vergleichen, sollten Sie daher [compareTo(...) == 0] verwenden und nicht ==.
3.4.5.5. Boolesche Ausdrücke
Es können die Operatoren AND (&&), OR (||) und NOT (!) verwendet werden. Das Ergebnis eines Booleschen Ausdrucks ist ein Boolescher Wert. Operatorpriorität:
- ! ;
- && ;
- ||.
Relationale Operatoren haben eine höhere Priorität als die Operatoren && und ||. Diese beiden Operatoren werten ihren rechten Operanden nur aus, wenn es nötig ist: In [a && b] wird b nicht ausgewertet, wenn a falsch ist; in [a || b] wird b nicht ausgewertet, wenn a wahr ist. Man spricht von „Kurzschlussauswertung“. Sie können daher bedenkenlos [text != null && text.length > 0] schreiben: Auf der rechten Seite weiß der Compiler, dass [text] ungleich [null] ist (Smart Cast). Die Funktionen [and] und [or] führen, auf zwei Boolesche Werte angewendet ([a and b], [a or b]), dieselbe Berechnung aus, werten aber immer beide Operanden aus; die Funktion [xor] ist das exklusive ODER. Der Test, ob ein Wert in einem Intervall liegt, lässt sich mit dem Operator [in] einfacher schreiben: [x in 2.0..4.0] ist wahr, wenn 2 ≤ x ≤ 4 gilt.
3.4.5.6. Bitweise Operationen
Kotlin besitzt keine symbolischen Operatoren für bitweise Operationen: Die Java-Operatoren << >> >>> & | ^ ~ werden durch Infix-Funktionen ersetzt, also Funktionen mit einem Argument, die zwischen ihren beiden Operanden ohne Punkt und ohne Klammern geschrieben werden: [i shl 4] ist eine andere Schreibweise für [i.shl(4)]. Es seien [i] und [j] zwei ganze Zahlen ([Int] oder [Long]):
Operation | In Java | Bedeutung |
i shl n | i << n | verschiebt i um n Bits nach links. Die nachrückenden Bits sind Nullen |
i shr n | i >> n | verschiebt i um n Bits nach rechts. Das Vorzeichenbit bleibt erhalten |
i ushr n | i >>> n | Vorzeichenlose Verschiebung nach rechts: Die nachrückenden Bits sind Nullen, auch wenn i negativ ist |
i and j | i & j | führt ein bitweises logisches UND von i und j aus |
i or j | i|j | führt ein bitweises logisches ODER von i und j aus |
i xor j | i ^ j | führt bitweise die exklusive ODER-Operation auf i und j aus |
i.inv() | ~i | bildet das Einerkomplement von i |
Verschiebungen sind nur für die Typen [Int] und [Long] definiert (und für die vorzeichenlosen Typen [UInt] und [ULong], bei denen die Verschiebung [shr] immer mit Nullen auffüllt): Bei einem [Short] oder einem [Byte] wird der Wert zuerst in [Int] konvertiert. Der Compiler lehnt daher [s shl 1] ab, wenn [s] ein [Short] ist: [unresolved reference 'shl' on receiver of type 'Short']. Diese Operationen dienen hauptsächlich der Bearbeitung binärer Daten; die expliziten Namen haben den Vorteil, nicht mit den Booleschen Operatoren && und || verwechselt zu werden.
Das Programm [Basics13.kt] lautet wie folgt:
Ergebnisse:
Kommentare:
- Zeilen 5–6: zwei ganze Zahlen vom Typ [Int] (32 Bit);
- Zeile 8: Der Formatbezeichner %08x gibt eine ganze Zahl achtstellig hexadezimal (x) aus, mit Nullen aufgefüllt (08), und stellt damit ihre 32 Bits dar: -13 wird zu fffffff3;
- Zeile 9: Eine Verschiebung von 100 (0x64) um 4 Bits nach links entspricht einer Multiplikation mit 2⁴ (0x640); eine Verschiebung nach rechts entspricht einer Division durch 2⁴ (0x6);
- Zeilen 10–11: UND, ODER, XOR (bitweises exklusives ODER) und das Einerkomplement. Beachten Sie, dass die Funktion [inv] wie eine gewöhnliche Methode aufgerufen wird, mit Punkt und Klammern;
- Zeile 12: Verschiebungen einer negativen Zahl. [shr] erhält das Vorzeichenbit: -13, um 2 Bits nach rechts verschoben, ergibt -4 (0xfffffffc);
- Zeile 14: Die Funktion [binary] (Zeilen 26–28) gibt die n niederwertigsten Bits einer ganzen Zahl aus. Das logische UND von i und j wird Bit für Bit überprüft;
- Zeilen 16–19: Die Verschiebung [shr] erhält das Vorzeichenbit von m, das negativ ist; die Verschiebung [ushr] füllt mit Nullen auf;
- Zeilen 21–22: eine vorzeichenlose ganze Zahl [UInt], deren höchstwertiges Bit 1 ist: Sie ist gleich 4.045.602.816, während ein [Int] mit denselben Bits negativ wäre. Ihre Verschiebung [shr] fügt Nullen ein. Die Funktion [toString(16)] schreibt sie hexadezimal;
- Zeile 26: Die Funktion [buildString] baut eine Zeichenkette durch aufeinanderfolgende Ergänzungen auf: Im folgenden Block fügt die Funktion [append] ein Element zu der Zeichenkette hinzu, die gerade aufgebaut wird. Sie wird in Kapitel 5 vorgestellt. Die Schleife [for (rank in n - 1 downTo 0)] durchläuft [rank] von n-1 bis 0 in absteigender Reihenfolge; die Schleifen werden später beschrieben;
- Zeile 28: [(value ushr rank) and 1] setzt das Bit Nr. [rank] an die niedrigste Stelle und trennt es dann von den anderen.
3.4.5.7. Kombination von Operatoren
[a = a + b] kann als [a += b] geschrieben werden; [a = a - b] kann als [a -= b] geschrieben werden. Dasselbe gilt für die Operatoren *, / und %. So kann [a = a / 2] als [a /= 2] geschrieben werden. Da bitweise Operationen Funktionen sind, haben sie keinen kombinierten Operator: Wir schreiben [a = a shl 2]. Wie einfache Zuweisungen sind zusammengesetzte Zuweisungen Anweisungen und keine Ausdrücke. Sie führen keine impliziten Konvertierungen durch: Wenn [s] ein [Short] ist, wird [s += 1] abgelehnt, ebenso wie [s = s + 1], weil das Ergebnis der Addition ein [Int] ist; wir schreiben [s = (s + 1).toShort()]. [Short] und [Byte] werden in Berechnungen tatsächlich nur selten verwendet.
3.4.5.8. Inkrement- und Dekrementoperatoren
Die Schreibweise [variable++] bedeutet [variable = variable + 1] oder [variable += 1]. Die Schreibweise [variable--] bedeutet [variable = variable - 1] oder [variable -= 1]. Sie gelten für eine Variable [var]. In einem Ausdruck haben diese Operatoren zwei Formen:
- [i++] (Postfix): Der Wert des Ausdrucks ist der Wert von i vor der Inkrementierung;
- [++i] (Präfix): Der Wert des Ausdrucks ist der Wert von
inach der Inkrementierung.
Kotlin hat sie beibehalten, obwohl die Zuweisung kein Ausdruck ist; Sie sollten sie jedoch nicht innerhalb größerer Ausdrücke verwenden, wo sie die Lesbarkeit beeinträchtigen.
3.4.5.9. Kein ternärer Operator: der if-Ausdruck
Java besitzt wie C und C# einen ternären Operator: Der Ausdruck [cond ? expr1 : expr2] ergibt [expr1] , wenn die Bedingung [cond] wahr ist, und andernfalls [expr2]. Kotlin besitzt keinen ternären Operator; der Compiler lehnt [val z = x > 4 ? x + 1 : x - 1] mit der Meldung [syntax error: Unexpected tokens (use ';' to separate expressions on the same line)] ab. Er braucht auch keinen, denn die Anweisung *[if] ist zugleich ein Ausdruck* mit einem Wert:
Der Ausdruck [if (cond) expr1 else expr2] wird wie folgt ausgewertet:
- Der Ausdruck [cond] wird ausgewertet. Er ist ein Boolescher Ausdruck;
- ist er wahr, ist der Wert des Ausdrucks der von [expr1], und [expr2] wird nicht ausgewertet;
- ist er falsch, geschieht das Gegenteil: Der Wert des Ausdrucks ist der von [expr2], und [expr1] wird nicht ausgewertet.
Die obige Operation weist der Variablen [i] den Wert j+1 zu, wenn j > 4 gilt, und andernfalls j-1. Das entspricht der Schreibweise [if (j > 4) i = j + 1 else i = j - 1], ist aber knapper, und [i] kann mit [val] deklariert werden. Wird [if] als Ausdruck verwendet, muss es einen [else]-Zweig haben, damit der Ausdruck in allen Fällen einen Wert ergibt. [if] finden wir im Abschnitt „Einfache Auswahlstruktur“ und [when] – das ebenfalls ein Ausdruck ist – im Abschnitt „Fallunterscheidung“.
3.4.5.10. Null-Operatoren
Anders als Java besitzt Kotlin eigene Operatoren für den Wert [null]. Wir sind ihnen im Abschnitt „Null-Sicherheit“ begegnet; hier eine Zusammenfassung. Es sei [a] ein Ausdruck, der null sein kann:
Operator | Bedeutung |
[a?.member] | Sicherer Aufruf: ergibt [a.member] , wenn a nicht [null] ist, und andernfalls [null] (der Member wird dann nicht ausgewertet: Eine Funktion wird nicht aufgerufen). Sichere Aufrufe lassen sich verketten: [a?.b?.c] ergibt [null] , sobald eines der Glieder [null] ergibt |
[a ?: b] | Elvis-Operator: ergibt a, wenn a ungleich [null] ist, und andernfalls b (b wird dann nur ausgewertet, wenn a gleich [null] ist). Er dient dazu, einen Ersatzwert bereitzustellen |
[a!!] | Assertion: ergibt a, wenn a ungleich [null] ist; löst andernfalls eine [NullPointerException] aus |
[a?.let { ... \}] | führt den Block, in dem der Wert von a [it] heißt, nur aus, wenn a ungleich [null] ist |
Dies sind die Entsprechungen der Operatoren ?. und ?? in C#. Java, das sie nicht besitzt, verwendet stattdessen den ternären Operator ([a != null ? a : b]), die Methode [Objects.requireNonNullElse(a, b)], die Klasse [Optional] und ihre Methode [map] . Die rechte Seite des Elvis-Operators kann auch eine Anweisung sein, die die normale Ausführung unterbricht: [val n = input ?: return] verlässt die Funktion, wenn [input] den Wert [null] ergibt, und [val n = input ?: throw IllegalArgumentException("missing input")] löst eine Ausnahme aus; auf diese Form kommen wir bei der Behandlung der Ausnahmen zurück.
Das Programm [Basics14.kt] kombiniert diese verschiedenen Operatoren:
Ergebnisse:
Kommentare:
- Zeile 5: eine Funktion, die für den Schlüssel "title" eine Zeichenkette und für jeden anderen Schlüssel [null] liefert. Sie versorgt das Programm mit Werten vom Typ [String?];
- Zeile 10: ein Boolescher Ausdruck;
- Zeile 12: derselbe Bereichstest, geschrieben mit dem Operator [in]; [valid xor true] ist das exklusive ODER zweier Boolescher Werte;
- Zeilen 15–26: Kombinierte Operatoren: 10 + 5 = 15, 15 × 2 = 30, 30 ÷ 4 = 7 (ganzzahlige Division), 7 % 4 = 3, 3 shl 2 = 12. Die Variable [a] wird mit [var] deklariert, da sich ihr Wert ändert;
- Zeile 30: [j] wird 5 zugewiesen, dann wird [i] auf 6 gesetzt;
- Zeile 31: [i] wird zu 7, dann wird [k] 7 zugewiesen;
- Zeilen 38–39: zwei [if]-Ausdrücke, die die ternären Operatoren von Java ersetzen;
- Zeilen 43–44: [input] ist gleich [null]: [name] wird „unknown“ zugewiesen. Sein Typ ist [String] und nicht [String?]: Der Elvis-Operator stellt sicher, dass [name] niemals [null] ist;
- Zeile 46: [age] vom Typ [Int?] ist gleich [null]: [displayedAge] vom Typ [Int] wird -1 zugewiesen. Es gibt kein Unboxing und kein Risiko einer Ausnahme;
- Zeilen 49–51: Die Zuweisung erfolgt nur, wenn [title] gleich [null] ist. Einfacher hätten wir dies als [val title = valueOf("subtitle") ?: "Untitled"] schreiben können;
- Zeile 56: [text] ist gleich [null]; [text?.length] ist gleich [null], ohne dass die Eigenschaft [length] gelesen wurde; ein Template gibt [null] aus;
- Zeile 58: [text] ist "Kotlin by example": Seine Länge beträgt 17. Der Elvis-Operator würde für den Wert [null] den Wert -1 liefern;
- Zeile 60: eine Kette sicherer Aufrufe. [split(" ")] zerlegt die Zeichenkette in eine Liste von Wörtern (Kapitel 5), [first()] liefert das erste Wort, und [uppercase()] wandelt es in Großbuchstaben um;
- Zeile 61: dieselbe Folge von Aufrufen auf einen Wert [null] angewendet: Es werden keine Aufrufe ausgeführt, der Ausdruck ergibt [null], und der Elvis-Operator ersetzt ihn durch "none";
- Zeile 63: die Assertion !!. [valueOf("title")] ist vom Typ [String?], aber der Programmierer weiß, dass es für den Schlüssel „title“ nicht gleich [null] ist; die Assertion erlaubt es, [length] direkt zu verwenden. Für den Schlüssel "author" hätte sie eine [NullPointerException] geliefert.
3.4.5.11. Allgemeine Operatorpriorität
Die folgende Tabelle listet die Operatorpriorität in Kotlin von der höchsten zur niedrigsten auf:
Operatoren | Assoziativität |
[x.y] [x?.y] [f(x)] [a[i]] [x++] [x--] [x!!] (postfix) | LR |
[+x] [-x] [!x] [++x] [--x] (präfix) | RL |
[as] [as?] (Typumwandlung) | LR |
[*] [/] [%] | LR |
[+] [-] | LR |
[..] [..<] (Intervalle) | LR |
Infix-Funktionen: [shl] [shr] [ushr] [and] [or] [xor] [downTo] [step] [until] ... | LR |
[?:] (Elvis) | LR |
[in] [!in] [is] [!is] | LR |
[<] [<=] [>] [>=] | LR |
[==] [!=] [===] [!==] | LR |
[&&] | LR |
[||] | LR |
[=] [+=] [-=] [*=] [/=] [%=] (Anweisungen) |
„LR“ bedeutet, dass bei Operatoren gleicher Priorität die Reihenfolge von links nach rechts gilt: Enthält ein Ausdruck Operatoren gleicher Priorität, wird der am weitesten links stehende Operator zuerst ausgewertet. „RL“ steht für die Reihenfolge von rechts nach links. Drei wichtige Punkte sind zu beachten:
- Infix-Funktionen haben eine niedrigere Priorität als arithmetische Operatoren: [1 shl 2 + 3] ist gleich [1 shl 5], also 32;
- sie haben eine höhere Priorität als Vergleiche: [x and 1 == 0] wird als [(x and 1) == 0] ausgewertet, was tatsächlich beabsichtigt ist (in Java wird [x & 1 == 0] abgelehnt, weil == eine höhere Priorität hat als &);
- der Elvis-Operator hat eine niedrigere Priorität als arithmetische Operatoren: [a ?: 0 + 1] wird als [a ?: (0 + 1)] ausgewertet. Um 1 zum Ergebnis zu addieren, muss man [(a ?: 0) + 1] schreiben, wie es das Programm [Basics06.kt] getan hat.
Im Zweifelsfall zögern Sie nicht, Klammern zu verwenden: Sie machen den Ausdruck auch leichter lesbar.
3.4.5.12. Typumwandlungen
In einem Ausdruck ist es möglich, die Kodierung eines Werts vorübergehend zu ändern. Man spricht von einer Änderung des Datentyps oder von „Type Casting“. Java tut dies auf zwei Arten:
- erweiternde Konvertierungen – etwa von einem [int] zu einem [long] oder einem [double] – werden vom Compiler automatisch durchgeführt;
- einschränkende Konvertierungen – die zu einem Informationsverlust führen können, etwa von einem [double] zu einem [int] – werden vom Programmierer mit der Schreibweise [(type) value] angegeben.
Kotlin ist strenger: Es führt keinerlei implizite Konvertierungen zwischen numerischen Typen durch, nicht einmal erweiternde. Jede Konvertierung muss ausdrücklich mit einer der Funktionen [toByte()], [toShort()], [toInt()], [toLong()], [toFloat()] oder [toDouble()] angefordert werden, über die jeder numerische Typ verfügt (und [toUInt()], [toULong()] ... für vorzeichenlose Typen). Der Compiler lehnt daher Folgendes ab:
Man muss [val l: Long = i.toLong()] schreiben. Diese Strenge verhindert, dass Konvertierungen ohne Wissen des Programmierers stattfinden, insbesondere solche, die ohne Warnung an Genauigkeit verlieren (etwa ein [long] , das in Java in [float] oder [double] konvertiert wird). Sie kennt zwei Ausnahmen:
- Ein Literal wird für jeden Typ akzeptiert, in den es passt: [val l: Long = 1000] und [val b: Byte = 5] werden akzeptiert;
- arithmetische Operatoren und Vergleiche akzeptieren Operanden unterschiedlicher numerischer Typen: [i + l], wobei [i] ein [Int] und [l] ein [Long] ist, hat das Ergebnis den Typ [Long]; [i * 1.5] ist ein [Double]. Dies ist keine implizite Konvertierung, sondern beruht darauf, dass die Klasse [Int] Funktionen wie [plus(other: Long): Long], [times(other: Double): Double] usw. besitzt.
Konvertierungen, die Informationen verlieren können, haben mit den Funktionen [toXxx()] dieselbe Wirkung wie Java-Typumwandlungen: [toInt()] schneidet, auf eine Gleitkommazahl angewendet, den Nachkommateil ab (in Richtung null); auf einen [Long] angewendet, behält es nur die niederwertigsten 32 Bits. Die Typumwandlung von Kotlin, der Operator [as], ist Objekten vorbehalten (Kapitel 4): [d as Int], wobei [d] ein [Double] ist, konvertiert eine Gleitkommazahl nicht in eine ganze Zahl: Der Compiler gibt eine Warnung aus ([this cast can never succeed. Use 'toInt' to perform numeric conversion.]), und zur Laufzeit würde eine Ausnahme ausgelöst ([ClassCastException]).
Zeichen sind keine Zahlen: Von einem Zeichen zu seinem Unicode-Code gelangt man über die Eigenschaft [code], von einem Code zu einem Zeichen über den Konstruktor [Char(code)]. Man kann jedoch eine ganze Zahl zu einem Zeichen addieren (['A' + 2] ergibt 'C') und zwei Zeichen voneinander subtrahieren (['C' - 'A'] ergibt 2).
Ein Überlauf bei einer Berechnung mit ganzen Zahlen oder bei einer Konvertierung zwischen ganzen Zahlen wird nie gemeldet: Das Ergebnis ist einfach falsch. Auch der Kotlin-Compiler meldet ihn nicht, selbst wenn nur Konstanten beteiligt sind ([Int.MAX_VALUE + 1]). Besteht dieses Risiko, sollten Sie die Berechnung mit einem größeren Typ durchführen ([Long], oder [BigInteger] aus dem JDK) oder die Methoden [addExact], [subtractExact], [multiplyExact], [toIntExact] ... der Java-Klasse [Math] verwenden, die eine [ArithmeticException] auslösen, wenn die Grenze überschritten wird. Die Kotlin-Bibliothek hat kein Äquivalent.
Das Programm [Basics15.kt] lautet wie folgt:
Ergebnisse:
Kommentare:
- Zeile 9: [f1] hat den Wert 0.0. Die Division 3/4 ist eine ganzzahlige Division, da beide Operanden vom Typ [Int] sind; ihr Ergebnis 0 wird anschließend von der Funktion [toFloat()] in [Float] konvertiert;
- Zeile 10: [i.toFloat()] ist der Wert von [i] , in [Float] konvertiert. Wir haben nun eine Division zwischen einer reellen Zahl vom Typ [Float] und einer ganzen Zahl vom Typ [Int], deren Ergebnis den Typ [Float] hat: Die Division der beiden reellen Zahlen wird ausgeführt, und [f2] hat den Wert 0.75. Bei der Operation [i.toFloat()] ist [i] ein Wert, der exakt als 4-Byte-Realzahl kodiert ist, während [i.toFloat()] derselbe Wert, kodiert als angenäherte 4-Byte-Realzahl, ist. Diese Umkodierung findet nur während der Berechnung statt: Die Variable [i] behält stets ihren Typ [Int];
- Zeilen 14–15: Upcasts, die ausdrücklich angefordert werden müssen;
- Zeilen 18–19: Operationen zwischen verschiedenen Typen. Der Ergebnistyp wird mit [::class.simpleName] angezeigt: [Long] und [Double];
- Zeile 24: Die Konvertierung einer reellen Zahl in eine ganze Zahl schneidet den Nachkommateil in Richtung null ab: 3.99 wird zu 3 und -3.99 wird zu -3;
- Zeile 25: Zum Runden verwenden wir [roundToInt()] aus dem Paket [kotlin.math], das in Zeile 4 importiert wird und direkt einen [Int] liefert;
- Zeile 27: 3 Milliarden überschreiten den Bereich von [Int]: Das Literal hat den Typ [Long], mit oder ohne das Suffix L;
- Zeile 28: 3 Milliarden passen nicht in einen [Int]: Nur die niederwertigsten 32 Bits bleiben erhalten, und das Ergebnis ergibt keinen Sinn mehr;
- Zeile 31: Eine Gleitkommazahl, die für einen [Int] zu groß ist, wird auf [Int.MAX_VALUE] reduziert; der Wert [NaN] wird zu 0;
- Zeilen 34–36: Konvertierungen zwischen Zeichen und Unicode-Codes sowie Zeichenarithmetik;
- Zeile 38: Die Funktion [digitToInt()] liefert den Wert einer Ziffer (7), nicht zu verwechseln mit ihrem Unicode-Code (55);
- Zeile 42: Der Überlauf bleibt unbemerkt: Das Ergebnis ist der kleinste [Int]-Wert. Dieselbe Berechnung mit [Long] liefert das richtige Ergebnis;
- Zeile 46: Mit [Math.addExact] löst der Überlauf eine [ArithmeticException] aus;
- Zeile 52: [Math.toIntExact] konvertiert einen [Long] in einen [Int] und löst ebenfalls eine Ausnahme aus, wenn der Wert nicht in einen [Int] passt.
3.5. Anweisungen zur Steuerung des Programmablaufs
3.5.1. Stopp
Die Funktion [exitProcess] aus dem Paket [kotlin.system] erlaubt es, die Ausführung eines Programms zu beenden:
[exitProcess] beendet den aktuellen Prozess und gibt die Kontrolle an den aufrufenden Prozess zurück, typischerweise den Kommandointerpreter. Der Wert von [status], der Rückgabecode genannt wird, kann vom Kommandointerpreter ausgewertet werden. Per Konvention zeigt 0 an, dass das Programm erfolgreich ausgeführt wurde, während jeder andere Wert einen Fehler signalisiert. Unter Windows steht der Rückgabecode in der Eingabeaufforderung in der Variablen [%ERRORLEVEL%] und in PowerShell in der Variablen [$LASTEXITCODE] zur Verfügung; unter Linux und macOS steht er in der Shell in der Variablen [$?]. So beendet [exitProcess(0)] die Ausführung des Programms mit dem Rückgabecode 0.
[exitProcess] ruft die Java-Methode [System.exit] auf, die auch direkt verwendet werden kann. Gegenüber dieser Methode hat es jedoch einen Vorteil: Sein Rückgabetyp ist [Nothing]. [Nothing] ist der Typ von Ausdrücken, die niemals einen Wert zurückgeben, weil sie nicht normal enden (Programmende, ausgelöste Ausnahme, Endlosschleife). Der Compiler weiß daher, dass die Anweisung nach einem Aufruf von [exitProcess] nie ausgeführt wird, und berücksichtigt dies bei seinen Prüfungen, wie wir sehen werden.
Ohne Aufruf von [exitProcess] endet ein Programm mit dem Rückgabecode 0, wenn seine Funktion [main] endet, gegebenenfalls mit einer [return]-Anweisung. Wird es durch eine Ausnahme beendet, die niemand abgefangen hat, gibt es diese Ausnahme aus und endet mit dem Rückgabecode 1. Wie in Java kann die Funktion [main] keine ganze Zahl zurückgeben: [exitProcess] ist die einzige Möglichkeit, den Rückgabecode festzulegen.
Das Programm [Basics16.kt] erhält seinen Rückgabecode als Argument:
Um den Rückgabecode anzuzeigen, muss das Programm der von der Shell gestartete Prozess sein. Mit [gradlew -q run -Pmain=basics16.Basics16Kt --args="3"] ist der gestartete Prozess Gradle: Ein Rückgabecode ungleich null lässt die Task [run] fehlschlagen, Gradle zeigt seine eigene Fehlermeldung an, und wir erhalten den Rückgabecode von Gradle. Wir erstellen daher mit dem Compiler [kotlinc] ein ausführbares Archiv, wie in Kapitel 2 ([kotlinc Basics16.kt -include-runtime -d basics16.jar]), und führen es mit [java -jar] aus.
Ergebnisse in einem Bash-Terminal:
Kommentare:
- Zeile 6: Die Funktion [main] erhält die Kommandozeilenargumente im Array [args]. Die Argumente des Programms sind unten aufgeführt;
- Zeile 10: [args.firstOrNull()] liefert das erste Argument oder [null] , wenn es keines gibt; der Operator [?.] ruft [toIntOrNull()] nur auf, wenn es nicht [null] ist, und [toIntOrNull()] liefert [null] , wenn die Zeichenkette keine ganze Zahl ist. Somit führen sowohl das Fehlen eines Arguments als auch ein nichtnumerisches Argument zu [null], das vom Typ [Int?] ist, ohne dass eine Ausnahme ausgelöst wird. Das entsprechende Java-Programm musste die Ausnahme [NumberFormatException] von [Integer.parseInt] abfangen;
- Zeile 13: Das Programm endet mit dem Rückgabecode 1. Die Fehlermeldung wird in die Fehlerausgabe [System.err] geschrieben;
- Zeile 16: Der Compiler weiß, dass wir diese Stelle nur erreichen, wenn [code] nicht [null] ist, da der [if]-Block mit dem Aufruf einer Funktion vom Typ [Nothing] endet. Die Variable [code], die als Typ [Int?] deklariert wurde, wird ab dieser Zeile daher als [Int] behandelt: Dies bezeichnet man als „Smart Cast“. Ohne ihn würde der Aufruf von [exitProcess(code)] in der nächsten Zeile – der einen [Int] erwartet – abgelehnt. In Java wusste der Compiler nicht, dass [System.exit] die Kontrolle nie zurückgibt, sodass danach eine überflüssige [return]-Anweisung eingefügt werden musste;
- Zeile 17: Beendigung mit dem als Argument übergebenen Rückgabecode. Die folgende Zeile wird nicht ausgeführt. Der Kotlin-2.4-Compiler akzeptiert sie ohne Warnung; IntelliJ IDEA markiert sie als „unreachable code“;
- Ergebnisse: Der Befehl [echo $?] zeigt den Rückgabecode des zuletzt ausgeführten Programms an: 3, dann in beiden Fehlerfällen 1.
3.5.2. Einfache Entscheidungsstruktur
Hinweise:
- Die Bedingung steht in runden Klammern. Sie muss vom Typ [Boolean] sein: Wie Java und anders als die Sprache C lehnt Kotlin [if (n)] ab, wenn [n] eine ganze Zahl ist;
- Aktionen werden nicht durch ein Semikolon abgeschlossen: In Kotlin beendet das Zeilenende die Anweisung. Das Semikolon dient nur dazu, mehrere Anweisungen in eine Zeile zu schreiben;
- geschweifte Klammern sind nur erforderlich, wenn es mehr als eine Anweisung gibt; sie werden jedoch oft auch bei einer einzelnen Anweisung verwendet, der Lesbarkeit wegen und um Fehler beim Hinzufügen einer Anweisung zu vermeiden. Wie in Java ist es üblich, die öffnende geschweifte Klammer ans Zeilenende zu setzen;
- die Klausel [else] kann entfallen;
- es gibt kein Schlüsselwort [then].
Das algorithmische Äquivalent dieser Struktur ist die Struktur if...then...else:
Beispiel:
Der Hauptunterschied zu Java besteht darin, dass [if] in Kotlin auch ein Ausdruck ist: Es liefert den Wert des ausgeführten Zweigs. Wir können daher [val max = if (a > b) a else b] schreiben. Deshalb besitzt Kotlin keinen ternären Operator [condition ? value1 : value2]: Das [if] dient als sein Äquivalent. Wird [if] als Ausdruck verwendet, muss es eine [else]-Klausel haben; andernfalls hätte es keinen Wert, wenn die Bedingung falsch ist.
Auswahlstrukturen können verschachtelt werden. Dies wirft manchmal das Problem auf, das das Programm [Basics17.kt] veranschaulicht:
Ergebnisse:
Kommentare:
- Zeilen 7–11: Auf welches [if] bezieht sich das [else] in Zeile 10? Die Regel lautet, dass sich ein [else] immer auf das nächstgelegene [if] bezieht: [if (n > 6)] in Zeile 8. Die Einrückung des Codes, die für den Compiler keine Bedeutung hat, wurde so gewählt, dass sie dies veranschaulicht;
- Zeilen 15–20: Hier wollten wir ein [else] neben [if (n2 > 1)], und nicht ein [else] neben [if (n2 > 6)] platzieren. Aufgrund der vorigen Regel müssen wir geschweifte Klammern um das [if (n2 > 1) { ... }] setzen;
- Zeilen 26–33: Eine Folge sich gegenseitig ausschließender Auswahlmöglichkeiten wird mit aufeinanderfolgenden [else if]-Anweisungen geschrieben. Die Bedingungen werden der Reihe nach geprüft; die erste, die zu true ausgewertet wird, bestimmt die auszuführende Aktion. Die Variable [honours] wird in Zeile 25 ohne Wert als [val] deklariert: Der Compiler prüft, dass ihr in jedem Zweig – und nur einmal – ein Wert zugewiesen wird, bevor sie in Zeile 35 verwendet wird. Im nächsten Abschnitt werden wir eine knappere Schreibweise für diese Folge von Auswahlmöglichkeiten sehen;
- Zeile 39: [if] wird als Ausdruck verwendet. Sein Wert – die ausgewählte Zeichenkette – wird [honours2] zugewiesen. So vermeidet man es, die Variable ohne Wert zu deklarieren;
- Zeile 42: [if] ersetzt den ternären Operator von Java, hier innerhalb eines String-Templates [${...}];
- Zeilen 44–49: Ist ein Zweig ein Block, so ist sein Wert der des letzten Ausdrucks im Block: [n] beim ersten Zweig, [n2] beim zweiten. Die vorangehenden Anweisungen werden normal ausgeführt.
3.5.3. Fallunterscheidung
3.5.3.1. Die Anweisung when
Kotlin hat keine [switch]-Anweisung. Sie wird durch die [when]-Anweisung ersetzt, die einfacher und leistungsfähiger ist. Ihre Syntax lautet wie folgt:
Hinweise:
- Der Steuerausdruck steht in runden Klammern. Er kann von beliebigem Typ sein: eine ganze Zahl, ein Zeichen, eine Zeichenkette, ein Enum-Wert sowie [Long], [Double], [Boolean] oder ein beliebiges Objekt. Die Werte werden mit dem Operator [==] verglichen, das heißt mit der Methode [equals];
- jede Klausel ordnet einer Aktion einen oder mehrere Werte zu, die durch Kommas getrennt sind. Die Aktion, die nach dem Pfeil [->] steht, ist eine einzelne Anweisung oder ein Block in geschweiften Klammern;
- die Werte vi sind nicht unbedingt Konstanten: Es können beliebige Ausdrücke sein, die in der Reihenfolge der Klauseln ausgewertet werden;
- nur die Aktion der ersten Klausel, für die ein Wert zutrifft, wird ausgeführt: Man muss weder [break] schreiben, noch gibt es ein Durchfallen von einer Klausel zur nächsten. Der klassische Fehler der historischen [switch]-Syntax von Java – das Vergessen von [break] – ist somit unmöglich. So funktioniert die in Java 14 eingeführte Pfeilsyntax, die in Kotlin die einzige verwendete Form ist;
- die Klausel [else] – das Äquivalent zu [default] in Java – kann entfallen, wenn [when] als Anweisung verwendet wird.
Algorithmisches Beispiel:
3.5.3.2. Der Ausdruck when und seine verschiedenen Klauseln
Sehr oft dient eine Fallunterscheidung allein dazu, einen Wert auszuwählen. Wie [if] kann [when] hierfür als Ausdruck verwendet werden:
Der Ausdruck [when] muss erschöpfend sein: Er muss für alle möglichen Werte des Steuerausdrucks einen Wert angeben, was in der Regel eine [else]-Klausel erfordert. Ohne sie lehnt der Compiler das Programm ab:
Die Klausel [else] ist nur dann unnötig, wenn der Compiler selbst überprüfen kann, dass alle Werte behandelt werden: bei einem Ausdruck vom Typ [Boolean] ([true] und [false]), bei einer Aufzählung (alle ihre Konstanten; siehe den Abschnitt über Aufzählungen weiter unten) oder bei einer versiegelten Klasse (Kapitel 4). Erfordert eine Klausel mehrere Anweisungen, schreibt man einen Block, dessen Wert der seines letzten Ausdrucks ist. Ein Äquivalent zur Java-Anweisung [yield] gibt es nicht.
Anstelle eines Werts kann eine Klausel Folgendes enthalten:
- einen Zugehörigkeitstest [in range]: [in 1..10 -> "small"] wird ausgewertet, wenn der Ausdruck zwischen 1 und 10 liegt. Für die Nichtzugehörigkeit schreiben wir [!in];
- einen Typtest [is Type]: [is String -> ...] wird ausgewählt, wenn das untersuchte Objekt vom Typ [String] ist. In der Aktion wird das Objekt dann automatisch als [String] behandelt (Smart Cast): Es ist nicht nötig, eine neue Variable einzuführen wie bei [case String s] in Java. [!is] prüft, dass ein Objekt nicht von einem bestimmten Typ ist;
- einen Guard: Seit Kotlin 2.2 kann eine Klausel um eine mit [if] eingeleitete Bedingung ergänzt werden: [is Int if o > 0 -> ...] wird nur für eine positive ganze Zahl ausgewertet. Dies entspricht den [when]-Guards in Java 21.
Schließlich kann [when] ohne Argument verwendet werden. In diesem Fall ist jede Klausel eine beliebige Boolesche Bedingung, und die erste wahre Bedingung wird ausgewählt. Dies ist eine besser lesbare Schreibweise für eine Folge von [if ... else if]-Klauseln.
Die Klauseln werden der Reihe nach ausgewertet: Die erste, die die Bedingung erfüllt, wird ausgewählt. Anders als [switch] in Java verarbeitet [when] in Kotlin sowohl primitive Typen ([Int], [Double] ...) als auch Objekte: Man muss nicht über einen [Integer] gehen, um eine ganze Zahl mit Guards zu klassifizieren.
Das Programm [Basics18.kt] lautet wie folgt:
Ergebnisse:
Kommentare:
- Zeilen 7–11: die Kotlin-Implementierung des obigen Algorithmus. Eine Klausel kann eine Zuweisung enthalten, wenn [when] als Anweisung verwendet wird;
- Zeile 8: [return] beendet die Funktion [main] und damit das Programm;
- Zeile 18: zwei Werte für dieselben Aktionen, durch ein Komma getrennt;
- Zeilen 23–26: ein [when]-Ausdruck auf eine Zeichenkette. Die [else]-Klausel macht ihn erschöpfend;
- Zeilen 30–35: eine Klausel, deren Aktion ein Block ist: Der Wert des letzten Ausdrucks des Blocks, [hours + 1] (Zeile 35), ist der Wert des Ausdrucks [when];
- Zeilen 71–76: Die Funktion [classify] sortiert eine ganze Zahl anhand von Intervallen. [Int.MIN_VALUE..<0] ist das Intervall der ganzen Zahlen vom kleinsten [Int] bis ausschließlich 0, das heißt der negativen ganzen Zahlen; [1..10] enthält die ganzen Zahlen von 1 bis einschließlich 10. Die Konstante 0 gehört zu den Intervallen. Die Klausel [else] behandelt die übrigen Werte, hier die ganzen Zahlen größer oder gleich 100. Der Rumpf der Funktion ist ein Ausdruck, der nach dem Zeichen [=] geschrieben wird: Auf diese Funktionen mit Ausdruckskörper kommen wir später zurück;
- Zeilen 48–52: ein [when] ohne Argument, das die Folge von [else if] aus dem Programm [Basics17.kt] umschreibt: Die erste wahre Bedingung weist dem Ausdruck ihren Wert zu;
- Zeile 56: ein Array von Objekten unterschiedlicher Typen. Der Typ seiner Elemente, [Any?] (ein beliebiges Objekt oder [null]), wird ausdrücklich angegeben: Ohne diese Angabe würde der Compiler aus den Werten einen komplexen Typ ableiten und das Programm ablehnen („type argument for reified type parameter 'T' was inferred to the intersection of ['Comparable<*>?' & 'Serializable?']“);
- Zeilen 79–84: Die Funktion [describe] wählt anhand des Objekttyps aus. In Zeile 80 ist der Wert [null] für [when] einfach ein weiterer Wert. In Zeile 81 kann der Guard [if o > 0] die Variable [o] mit 0 vergleichen, weil nach dem Test [is Int] die Variable [o] als [Int] behandelt wird. Entsprechend kann in Zeile 83 die Eigenschaft [length] der Zeichenkette ohne Umwandlung verwendet werden. Die Klausel ohne Guard, [is Int] (Zeile 82), muss nach der Klausel mit Guard stehen, die sie sonst verdecken würde. In Zeile 84 liefert [o::class.simpleName] den einfachen Namen der Klasse des Objekts: [Double];
- Zeilen 63–68: zwei Funktionen, die von der ersten aufgerufen werden, [when].
Die folgende Tabelle fasst die Entsprechungen zwischen den beiden Sprachen zusammen:
Java | Kotlin |
[switch (x) { case 1: ... break; default: ... }] | [when (x) { 1 -> ... ; else -> ... }] |
[case "saturday", "sunday" -> ...] | ["saturday", "sunday" -> ...] |
[default -> ...] | [else -> ...] |
[yield value;] | letzter Ausdruck im Block |
[case Integer i when i > 0 -> ...] | [is Int if x > 0 -> ...] |
[case null -> ...] | [null -> ...] |
(kein Äquivalent) | [in 1..10 -> ...] |
Kette von [if ... else if] | [when { condition -> ... }] |
3.5.4. Wiederholungsstrukturen
3.5.4.1. Bekannte Anzahl von Wiederholungen
Struktur for
Kotlin besitzt nicht die „dreiteilige“ Schleife von C und Java ([for (i = id; i <= if; i = i + ip)]). Seine [for]-Schleife durchläuft die Elemente eines Bereichs, eines Arrays oder einer Collection; sie entspricht der For-each-Schleife von Java. Um eine ganze Zahl zu durchlaufen, durchläuft man einen Bereich:
Hinweise:
- [id..if] ist der Bereich der ganzen Zahlen von [id] bis [if], einschließlich. [step ip] legt die Schrittweite der Folge fest; sie ist optional und beträgt standardmäßig 1;
- [id..<if], das auch als [id until if] geschrieben werden kann, ist das Intervall von [id] bis [if], ohne die Endpunkte. Es eignet sich, um die Indizes eines Arrays mit [n] Elementen zu durchlaufen: [for (i in 0..<n)];
- [if downTo id] ist die absteigende Folge von [if] bis [id];
- die Schleifenvariable [i] wird von [for] deklariert, ohne [val] oder [var]: Sie existiert nur innerhalb der Schleife und kann im Schleifenrumpf nicht verändert werden;
- geschweifte Klammern sind nur nötig, wenn es mehr als eine Aktion gibt.
Das algorithmische Äquivalent ist die Struktur „for“:
die sich in eine Struktur „while“ übersetzen lässt:
Intervalle sind keine Syntax, die der [for]-Schleife eigen ist: Es sind Objekte ([IntRange], [IntProgression], [CharRange] ...), die einer Variablen zugewiesen, an eine Funktion übergeben, mit dem Operator [in] ausgewertet ([if (x in 1..10)], wie bei [when]) oder mit Funktionen der Standardbibliothek bearbeitet werden können ([(1..10).sum()]). Es gibt auch Zeichenbereiche: ['a'..'z'].
Die for-Schleife über ein Array oder eine Collection
Die Syntax lautet wie folgt:
Hinweise:
- [collection] ist ein Array oder eine Collection iterierbarer Objekte (tatsächlich jedes Objekt, das eine Funktion [iterator()] besitzt). Collections ([List], [Set], [Map] ...) behandeln wir in Kapitel 5;
- der Typ von
*[variable]* wird aus dem Typ der Elemente der Collection abgeleitet: Er wird nicht ausdrücklich angegeben; - [variable] ist eine lokale Variable der Schleife, die nacheinander alle Werte der Collection annimmt. Sie ist schreibgeschützt, als wäre sie mit [val] deklariert: Ihr kann innerhalb der Schleife kein anderer Wert zugewiesen werden;
- Um die Indizes eines Arrays zu durchlaufen, verwendet man seine Eigenschaft [indices]: [for (i in array.indices)]; um sowohl den Index als auch das Element zu erhalten, verwendet man die Funktion [withIndex()]: [for ((i, element) in array.withIndex())].
Die Funktion repeat
Wenn Sie einen Anweisungsblock genau [n] -mal ausführen möchten, ist die Funktion [repeat] aus der Standardbibliothek am einfachsten:
Innerhalb des Blocks bezeichnet der Name [it] die Nummer der aktuellen Iteration von 0 bis n-1. Dieser Block ist tatsächlich ein Lambda – eine anonyme Funktion, die der Funktion [repeat] als Parameter übergeben wird: Lambdas behandeln wir in Kapitel 7.
3.5.4.2. Unbekannte Anzahl von Iterationen
While-Schleife
Die Schleife läuft, solange die Bedingung wahr ist. Die Schleife wird möglicherweise nie ausgeführt. Es gelten dieselben Hinweise wie für [for]. Die entsprechende algorithmische Struktur ist die Struktur while:
„Do While“-Schleife
Die Syntax lautet wie folgt:
Die Schleife läuft, bis die Bedingung zu false ausgewertet wird. Hier wird die Schleife mindestens einmal ausgeführt. Eine Besonderheit von Kotlin: Eine im Schleifenrumpf deklarierte Variable ist in der Bedingung des [while] sichtbar, sodass Sie [do { val line = readln() } while (line != "end")] schreiben können. Die entsprechende algorithmische Struktur ist die Struktur „repeat...until“:
Keine Struktur für „allgemeines for“
Die Java-Schleife [for (start_instructions; condition; end_of_loop_instructions)] gibt es in Kotlin nicht. Reicht ein Bereich nicht aus, schreiben wir die äquivalente [while]-Schleife:
3.5.4.3. Anweisungen zur Schleifensteuerung
Anweisung | Bedeutung |
[break] | Verlässt die Schleife [for], [while], [do ... while] |
[continue] | springt zur nächsten Iteration der Schleifen [for], [while], [do ... while] |
[break@label] | Verlässt die Schleife, der das Label [label@] vorangestellt ist, auch wenn die Anweisung in einer verschachtelten Schleife steht |
[continue@label] | springt zur nächsten Iteration der Schleife, der das Label [label@] vorangestellt ist |
Ein Label ist ein Bezeichner, gefolgt vom Zeichen [@], das vor der Schleife steht: [search@ for (...)]. Es wird ohne Leerzeichen nach [break] oder [continue] angegeben: [break@search]. In Java folgte auf das Label ein Doppelpunkt ([search:]).
3.5.4.4. Beispiele
Das Programm [Basics19.kt] lautet wie folgt:
Ergebnisse:
Kommentare:
- Zeilen 6–29: vier Möglichkeiten, die Summe der ersten 10 ganzen Zahlen zu berechnen;
- Zeilen 8–11: Die Schleife [for] durchläuft den Bereich [1..n] einschließlich 10. Die Schleifenvariable [i] existiert nur innerhalb der Schleife: Die in Zeile 13 deklarierte Variable [i] ist eine andere Variable;
- Zeilen 15–17: die äquivalente [while]-Schleife: Die Initialisierung, die Prüfung der Bedingung und die Inkrementierung von [i] werden ausdrücklich geschrieben. Dies ist die Kotlin-Übersetzung einer allgemeinen Java-[for]-Schleife;
- Zeile 24: [i++] liefert den Wert von [i] vor dessen Inkrementierung: [i] wird zu [sum] addiert, und anschließend wird [i] inkrementiert. Die Operatoren [++] und [--] gibt es sowohl in Kotlin als auch in Java;
- Zeile 29: Der Bereich [1..n] ist ein Objekt; seine Funktion [sum()] liefert die Summe seiner Elemente. Dies ist die idiomatischste Schreibweise in Kotlin. Die Klammern um den Bereich sind notwendig: Der Funktionsaufruf hat Vorrang vor dem Operator [..];
- Zeilen 33–36: die Berechnung von 5! = 1 × 2 × 3 × 4 × 5;
- Zeile 37: ein Intervall, dessen obere Grenze ausgeschlossen ist: [k] läuft von 0 bis 4. Besteht der Schleifenrumpf aus einer einzigen Anweisung, kann er in dieselbe Zeile wie das [for] geschrieben werden;
- Zeile 39: eine absteigende Folge von 10 bis 0 mit der Schrittweite 2;
- Zeile 41: ein Zeichenbereich;
- Zeilen 44–45: Der Block wird 3-mal ausgeführt; [it] nimmt nacheinander die Werte 0, 1 und 2 an;
- Zeilen 51–52: Die Schleife [for] durchläuft die Elemente des Arrays [friends];
- Zeilen 55–56: [friends.indices] ist der Bereich der Array-Indizes, hier [0..3] . Die Länge jedes Namens wird angezeigt;
- Zeilen 60–61: [friends.withIndex()] liefert Tupel aus (Index, Element). Die Syntax [(j, name)] zerlegt sie in zwei Variablen: Dies ist eine destrukturierende Zuweisung, auf die wir am Ende dieses Kapitels zurückkommen;
- Zeilen 65–74: [continue] springt bei geraden Zahlen zur nächsten Iteration; [break] beendet die Schleife, sobald [k] größer als 7 ist;
- Zeilen 80–86: eine Endlosschleife [while (true)], die über [break] verlassen wird. Diese Form ist praktisch, wenn die Abbruchbedingung mitten in der Schleife berechnet wird. Wir werden sie für Tastatureingaben verwenden;
- Zeilen 89–94: Suche der ersten negativen Zahl in einem zweidimensionalen Array, einem Array von Arrays ganzer Zahlen ([IntArray]). Das Label [search@] (Zeile 90) benennt die äußere Schleife; die Anweisung [break@search] (Zeile 94) verlässt beide Schleifen auf einmal. Ein einfaches [break] würde nur die innere Schleife verlassen. Kotlin besitzt keine [goto]-Anweisung: Labels erfüllen in diesem speziellen Fall diesen Zweck.
3.6. Ausnahmebehandlung
Viele Funktionen in Kotlin und Java können Ausnahmen, also Fehler, auslösen. Kann eine Funktion eine Ausnahme auslösen, sollte der Programmierer sie behandeln, um Programme fehlertoleranter zu machen: Ein abruptes Beenden einer Anwendung sollte stets vermieden werden.
3.6.1. Die Struktur try/catch/finally
Die Ausnahmebehandlung folgt diesem Schema:
Löst der Code im [try]-Block keine Ausnahme aus, wird mit der nächsten Anweisung fortgefahren; andernfalls wird der Rumpf des [catch]-Blocks ausgeführt und danach die nächste Anweisung. Beachten Sie folgende Punkte:
- [e] ist ein Objekt vom Typ [Exception] oder von einem abgeleiteten Typ. Wie bei jeder Kotlin-Deklaration steht der Name vor dem Typ: [e: Exception]. Es gibt viele Arten von Ausnahmen: [ArrayIndexOutOfBoundsException], [NumberFormatException], [ArithmeticException], [IllegalArgumentException], [IllegalStateException], [NullPointerException], [IOException] usw. Dies sind Java-Ausnahmeklassen, die Kotlin direkt verwendet (die gebräuchlichsten stehen unter demselben Namen auch im Paket [kotlin] ohne [import] zur Verfügung). Mit [catch (e: Exception)] geben Sie an, dass Sie alle Arten von Ausnahmen behandeln möchten. Kann der Code in der [try]-Klausel mehrere Arten von Ausnahmen erzeugen, sollten Sie die Ausnahme gegebenenfalls genauer behandeln, und zwar mit mehreren [catch]-Klauseln:
[catch]-Klauseln werden der Reihe nach ausgewertet; die erste, deren Typ zur Ausnahme passt, wird ausgeführt. Eine Klausel, die einen speziellen Ausnahmetyp behandelt, muss daher vor einer Klausel stehen, die einen allgemeineren Typ behandelt. Hinweis: Anders als der Java-Compiler weist der Kotlin-Compiler eine Klausel, die nie erreicht werden könnte, nicht zurück; es liegt am Programmierer, dies sicherzustellen (wir kommen darauf zurück);
- Kotlin kennt die Mehrfach-[catch]-Klausel von Java nicht ([catch (IOException | NumberFormatException e)]). Sie können mehrere Klauseln schreiben oder eine einzelne Klausel für einen allgemeineren Typ, in der Sie den Typ der Ausnahme prüfen, zum Beispiel mit einem [when];
- Sie können eine [finally]-Klausel zu den [try / catch]-Klauseln hinzufügen:
Ob eine Ausnahme auftritt oder nicht: Der Code in der [finally]-Klausel wird immer ausgeführt. Typischerweise schließt man hier eine Datei; wir werden sehen, dass es dafür mit der Funktion [use] eine einfachere Möglichkeit gibt;
- in der [catch]-Klausel möchten Sie das Ausnahmeobjekt unter Umständen nicht verwenden. In diesem Fall können Sie es _ nennen: [catch (_: NumberFormatException)], wobei das Zeichen _ eine anonyme Variable bezeichnet, die nicht verwendet wird;
- Eine Ausnahme besitzt eine Eigenschaft namens [message] (das Pendant zur Methode [getMessage()] in Java), die die Meldung mit den Einzelheiten des aufgetretenen Fehlers enthält. Sie ist vom Typ [String?]: Manche Ausnahmen haben keine Meldung. Um sie anzuzeigen, schreiben Sie:
- Die Methode [toString()] einer Ausnahme liefert den vollständigen Namen ihrer Klasse gefolgt von ihrer Meldung; ihre Methode [printStackTrace()] zeigt zusätzlich den Aufrufstapel an – das heißt die Liste der Funktionen, die zum Zeitpunkt des Fehlers ausgeführt wurden –, außerdem den Namen der Quelldatei und die Zeilennummer. Dies sind die nützlichsten Informationen für den Entwickler, sie sind jedoch nicht für den Benutzer bestimmt. In diesem Kurs zeigen wir meist den Namen der Ausnahmeklasse – [ex.javaClass.name] oder [ex.javaClass.simpleName] – und ihre Meldung an. [ex.javaClass] ist die Java-Klasse des Objekts, also die, die in Java von der Methode [getClass()] zurückgegeben wird;
- Schließlich, und das ist ein wichtiger Unterschied zu Java, ist [try] ein Ausdruck: Sein Wert ist der des letzten Ausdrucks im [try]-Block, wenn keine Ausnahme auftritt, und der des letzten Ausdrucks im [catch]-Block, wenn eine Ausnahme auftritt. Die Klausel [finally] hat auf diesen Wert keinen Einfluss. Wir können daher [val n = try { text.toInt() } catch (_: NumberFormatException) { 0 }] schreiben.
3.6.2. Ein erstes Beispiel
Das Programm [Basics20.kt] demonstriert eine Ausnahme, die durch den Zugriff auf ein nicht vorhandenes Array-Element ausgelöst wird:
Ergebnisse:
Kommentare:
- Zeile 16: Diese Anweisung löst eine Ausnahme aus, weil das Array [tab] kein Element mit dem Index 100 besitzt. Der Compiler prüft Indizes nicht, auch keine konstanten: Der Fehler wird erst zur Laufzeit von der Java Virtual Machine erkannt;
- Zeile 17: Die Klausel [catch (e: Exception)] fängt alle Ausnahmen ab;
- Zeile 18: Die Ausnahme ist vom Typ [java.lang.ArrayIndexOutOfBoundsException], und ihre Meldung nennt den falschen Index und die Größe des Arrays (vorletzte Zeile der Ergebnisse);
- Zeile 19: Die Funktion [main] wird verlassen und damit auch das Programm;
- Zeilen 20–21: Die Klausel [finally] wurde ausgeführt (letzte Zeile der Ergebnisse), obwohl die Klausel [catch] eine Anweisung [return] enthielt. Beachten Sie, dass die Klausel [finally] immer ausgeführt wird;
- Zeile 23: Wegen [return] wird diese Zeile nicht ausgeführt.
3.6.3. Eine kontrollierte Eingabe
Hier ein weiteres Beispiel, [Basics21.kt], in dem wir die Ausnahme behandeln, die bei der Umwandlung einer Zeichenkette, die keine ganze Zahl darstellt, in eine ganze Zahl entsteht:
Ergebnisse (die über die Tastatur eingegebenen Werte wurden in die Ausgabe eingefügt):
Kommentare:
- Zeile 7: Ist der Eingabestrom geschlossen, liefert [readlnOrNull] den Wert [null]: Der Operator [?:] ersetzt ihn durch eine leere Zeichenkette;
- Zeilen 11–21: Die Eingabeschleife für das Alter;
- Zeile 15: Die über die Tastatur eingegebene Zeile wird von der Funktion [toInt] in eine ganze Zahl umgewandelt. Diese Funktion löst eine Ausnahme vom Typ [NumberFormatException] aus, wenn die Umwandlung nicht möglich ist. Deshalb wurde die Operation in einen [try / catch]-Block gesetzt. Die Funktion [readln] dagegen löst eine Ausnahme aus, wenn der Eingabestrom geschlossen ist: Diese Ausnahme fangen wir nicht ab, da das Programm dadurch beendet würde;
- Zeile 16: Wenn wir diese Zeile erreichen, war die Umwandlung erfolgreich. Wir prüfen jedoch zusätzlich, ob die erhaltene ganze Zahl tatsächlich größer oder gleich 1 ist;
- Zeile 17: Wird eine Ausnahme vom Typ [NumberFormatException] ausgelöst, verzweigen wir zu [catch], wo nichts geschieht. Die boolesche Variable [ageOK], die mit [false] initialisiert wurde, bleibt somit auf [false]. Die Ausnahmevariable, die nicht verwendet wird, ist die anonyme Variable _. Es wird nur die erwartete Ausnahme abgefangen: Eine Klausel [catch (_: Exception)] würde auch Fehler verdecken, die nicht vorhergesehen wurden;
- Zeilen 20–21: Ist das Alter falsch, wird eine Fehlermeldung angezeigt;
- Zeilen 28–40: dieselbe Eingabe, geschrieben mit einem [try] als Ausdruck. Gelingt die Umwandlung, ist der Wert von [try] die erhaltene ganze Zahl; andernfalls ist es der Wert des [catch]-Blocks, 0, der vom Test in Zeile 37 abgelehnt wird. Die Endlosschleife [while (true)], die über [break] verlassen wird, erspart uns die boolesche Variable [ageOK]. Der Compiler weiß, dass die Schleife erst verlassen wird, nachdem [age2] ein Wert zugewiesen wurde; er erlaubt daher die Verwendung in Zeile 40, obwohl die Variable ohne Wert deklariert wurde.
Eine Zahl, die für ein [Int] zu groß ist – etwa 99999999999 –, löst ebenfalls eine [NumberFormatException] aus: Sie wird daher wie andere ungültige Eingaben behandelt (zweiter Durchlauf).
Eine Ausnahme zur Validierung einer Eingabe zu verwenden ist in Java üblich, doch Kotlin bietet eine bessere Lösung: Die Funktion [toIntOrNull()], die am Anfang dieses Kapitels vorgestellt wurde, liefert [null] , statt eine Ausnahme auszulösen. Wir würden dann [val age = readln().toIntOrNull()] gefolgt von [if (age != null && age >= 1)] schreiben, ohne [try]. So gehen wir in der folgenden Beispielanwendung vor. Ausnahmen sollten Ausnahmesituationen vorbehalten bleiben.
3.6.4. Mehrere catch-Klauseln und das Auslösen von Ausnahmen
Das Programm selbst kann mit der Anweisung [throw] eine Ausnahme auslösen:
Einen Operator [new] gibt es in Kotlin nicht: Ein Objekt wird einfach durch Aufruf des Konstruktors seiner Klasse erzeugt. Die Ausführung der aktuellen Funktion wird beendet, und die Ausnahme wird durch die aufrufenden Funktionen nach oben weitergereicht, bis eine [catch]-Klausel sie behandelt; geschieht dies nicht, wird das Programm beendet und zeigt die Ausnahme und den Aufrufstapel an. In einer [catch]-Klausel löst die Anweisung [throw e] die aktuelle Ausnahme erneut aus, zum Beispiel nach ihrer Protokollierung.
In Kotlin ist [throw] ein Ausdruck vom Typ [Nothing] (wie [exitProcess]). Er kann daher überall verwendet werden, wo ein Wert erwartet wird, zum Beispiel hinter dem Operator [?:]: [val name = input ?: throw IllegalArgumentException("missing name")].
Kotlin bietet wie Java keinen Filter für [catch]-Klauseln: Um eine Ausnahme nur in bestimmten Fällen zu behandeln, prüft man die Bedingung in der Klausel und löst die Ausnahme bei Bedarf erneut aus.
Für die gängigsten Prüfungen stellt die Kotlin-Standardbibliothek Funktionen bereit, die die Ausnahme für uns auslösen:
Funktion | Rolle |
[require(condition) { message }] | prüft ein Argument: Löst eine [IllegalArgumentException] mit der vom Block berechneten Meldung aus, wenn die Bedingung falsch ist |
[requireNotNull(value) { message }] | löst eine [IllegalArgumentException] aus, wenn [value] gleich [null] ist; andernfalls gibt sie den Wert als nicht nullbaren Typ zurück. Dies entspricht der Java-Methode [Objects.requireNonNull], die ihrerseits eine [NullPointerException] auslöst |
[check(condition) { message }] | prüft eine Bedingung: Löst eine [IllegalStateException] aus, wenn die Bedingung falsch ist |
[checkNotNull(value) { message }] | löst eine [IllegalStateException] aus, wenn [value] gleich [null] ist, und gibt andernfalls den Wert zurück |
[error(message)] | löst immer eine [IllegalStateException] aus; sie ist vom Typ [Nothing] und dient dazu, einen Fall zu kennzeichnen, der nicht eintreten sollte |
Die Meldung wird von einem Block (einem Lambda) erzeugt, der nur ausgeführt wird, wenn die Prüfung fehlschlägt: So wird keine Zeichenkette unnötig berechnet, wenn alles in Ordnung ist.
Das Programm [Basics22.kt] veranschaulicht diese Möglichkeiten:
Ergebnisse:
Kommentare:
- Zeile 5: simulierte Eingaben, gültig oder ungültig;
- Zeile 8: Die Funktion [readAge] (Zeilen 49–56) kann mehrere Arten von Ausnahmen auslösen;
- Zeile 10: Die Eingaben "abc", "" und "99999999999" lösen eine [NumberFormatException] aus;
- Zeilen 12–15: Da es keinen Filter gibt, wird die leere Eingabe innerhalb der [catch]-Klausel unterschieden;
- Zeile 17: die Ausnahme, die von [readAge] selbst ausgelöst wird;
- Zeile 26: [requireNotNull] löst eine [IllegalArgumentException] aus, wenn [name] gleich [null] ist; ihre Meldung ist die vom Block berechnete (Zeile 9 der Ergebnisse). Andernfalls gibt sie [name] mit dem Typ [String] zurück: Die Variable [valid] ist nicht nullbar;
- Zeile 54: Die Funktion [readAge] löst eine Ausnahme aus, wenn das Alter außerhalb der Grenzen liegt;
- Zeile 62: dieselbe Prüfung, geschrieben mit [require]. Die Bedingung verwendet den Operator [in] und einen Bereich;
- Zeile 68: [check] prüft, dass sich das Objekt in einem Zustand befindet, der die Operation zulässt;
- Zeile 71: [error] löst eine [IllegalStateException] aus. Da der Typ [Nothing] ist, kann sie einen Zweig eines [when]-Ausdrucks vom Typ [String] abschließen.
Die Reihenfolge der [catch]-Klauseln in den Zeilen 10 und 17 ist wichtig: Die Klasse [NumberFormatException] ist von der Klasse [IllegalArgumentException] abgeleitet (eine [NumberFormatException] ist ein Sonderfall eines fehlerhaften Arguments). Vertauscht man die beiden Klauseln, fängt die Klausel [IllegalArgumentException] auch die [NumberFormatException] ab, und die Klausel [NumberFormatException] wird nie mehr ausgeführt. Der Java-Compiler weist diese unerreichbar gewordene Klausel zurück ([error: exception NumberFormatException has already been caught]); der Kotlin-2.4-Compiler akzeptiert sie dagegen ohne Fehler oder Warnungen. Die leere Eingabe würde dann als [[] : NumberFormatException - For input string: ""] angezeigt, und der Fehler bliebe unbemerkt.
3.6.5. Keine geprüften Ausnahmen in Kotlin
Dies ist einer der auffälligsten Unterschiede zwischen Java und Kotlin. Ausnahmen sind Objekte, deren Klassen eine Hierarchie bilden. Es sind Java-Klassen: Die Klasse [kotlin.Throwable] ist lediglich ein anderer Name für [java.lang.Throwable], und dasselbe gilt für die Klassen [Exception], [RuntimeException], [IllegalArgumentException] ...:
- Die Wurzelklasse ist [Throwable];
- Die Klasse [Error] und ihre abgeleiteten Klassen kennzeichnen schwerwiegende Probleme der virtuellen Maschine ([OutOfMemoryError], [StackOverflowError] ...), die ein Programm normalerweise nicht abzufangen versucht;
- Die Klasse [RuntimeException] und ihre Ableitungen ([NullPointerException], [ArithmeticException], [ArrayIndexOutOfBoundsException], [IllegalArgumentException], [NumberFormatException], [IllegalStateException] ...) weisen in der Regel auf Programmierfehler oder fehlerhafte Daten hin;
- Die übrigen von [Exception] abgeleiteten Klassen ([IOException], [InterruptedException], [ParseException], [SQLException] ...) melden Vorfälle, die von der Umgebung des Programms verursacht werden (fehlende Datei, Netzausfall, Datenbank nicht verfügbar) und die ein ordentlich geschriebenes Programm vorhersehen muss.
In Java werden Ausnahmen dieser letzten Kategorie „geprüfte Ausnahmen“ (checked exceptions) genannt: Der Java-Compiler stellt sicher, dass eine Methode, die eine solche Ausnahme auslösen kann – direkt oder durch den Aufruf einer anderen Methode –, sie entweder mit einer [catch]-Klausel abfängt oder in ihrer Signatur mit dem Schlüsselwort deklariert [throws]:
Die Verantwortung wird dann an die aufrufenden Methoden weitergegeben, und so weiter. Von [RuntimeException] und [Error] abgeleitete Ausnahmen heißen „ungeprüft“ (unchecked): Sie können abgefangen werden, der Compiler verlangt dies jedoch nicht.
Kotlin kennt keine geprüften Ausnahmen. Wie in C# sind alle Ausnahmen ungeprüft: Der Compiler verlangt nie, dass eine Ausnahme abgefangen oder deklariert wird, und das Schlüsselwort [throws] existiert nicht. Eine von einer Java-Methode ausgelöste [IOException] ist für Kotlin einfach eine Ausnahme wie jede andere. Diese Entscheidung der Sprachentwickler beruht auf den Erfahrungen mit Java:
- In großen Programmen pflanzt sich die Pflicht zur Deklaration von Ausnahmen von Methode zu Methode fort, und die Methodensignaturen werden mit [throws]-Klauseln aufgebläht, die kaum Information liefern;
- Weil sie nicht wissen, was sie mit einer geprüften Ausnahme tun sollen, fangen viele Programmierer sie mit einem leeren [catch]-Block ab, nur um den Compiler zum Schweigen zu bringen: Der Fehler verschwindet stillschweigend, was das schlechteste denkbare Ergebnis ist;
- Geprüfte Ausnahmen vertragen sich schlecht mit Lambdas (Kapitel 7): Ein Lambda, das an eine Bibliotheksfunktion übergeben wird, kann ohne Verrenkungen keine geprüfte Ausnahme auslösen;
- Schließlich verwenden viele neuere Bibliotheken des Java-Ökosystems (Spring, Hibernate, die wir später einsetzen werden) bereits ausschließlich ungeprüfte Ausnahmen. Im Java-Kurs haben wir eine geprüfte Ausnahme häufig in eine ungeprüfte Ausnahme verpackt: In Kotlin ist das überflüssig.
Der Preis dafür ist, dass der Compiler uns nicht mehr daran erinnert, dass eine Funktion fehlschlagen kann: Der Programmierer muss selbst wissen, welche Ausnahmen eine Funktion auslösen kann (die Dokumentation gibt dies an), und sie dort abfangen, wo sie behandelt werden können.
Muss eine Kotlin-Funktion aus Java-Code aufgerufen werden, erzeugt die Annotation [@Throws(IOException::class)] im Bytecode die Klausel [throws IOException], die der Java-Compiler erwartet. Ohne sie wird ein Java-Programm, das die Funktion aufruft und die [IOException]-Ausnahme abfängt, vom Java-Compiler zurückgewiesen, der annimmt, dass die Ausnahme nicht auftreten kann ([error: exception IOException is never thrown in body of corresponding try statement]). Auf Kotlin-Aufrufer hat die Annotation keine Wirkung.
Das Programm [Basics23.kt]deckt die verschiedenen Fälle des entsprechenden Java-Programms ab:
Ergebnisse:
Kommentare:
- Zeilen 41–42: Die Erweiterungsfunktion [readText()] aus dem Paket [kotlin.io.path] (Kapitel 5) liest den gesamten Inhalt einer Datei, die durch einen Pfad [Path] angegeben wird; sie kann eine [IOException] auslösen. Die Funktion [readFile] fängt sie nicht ab und hat für Kotlin nichts zu deklarieren. Die Annotation [@Throws] ist für einen möglichen Java-Aufrufer vorhanden;
- Zeilen 12–16: Die Funktion [main] fängt [IOException] ab, weil sie es so wählt, nicht weil der Compiler es verlangt. Da die Datei nicht existiert, ist die ausgelöste Ausnahme eine
*[NoSuchFileException]*, eine von*[IOException]*abgeleitete Klasse, deren Meldung der Dateiname ist; - Zeilen 45–46: [Thread.sleep] hält das Programm für die angegebene Dauer in Millisekunden an; sie kann eine [InterruptedException] auslösen, die wir in Kapitel 8 behandeln. In Java ist dies eine geprüfte Ausnahme; in Kotlin erfordert die Funktion [pause] keine Deklaration;
- Zeile 19: Der Aufruf von [pause] ist nicht in einen [try / catch]-Block eingebettet. Das entsprechende Java-Programm musste dies tun;
- Zeile 50: Eine ganzzahlige Division kann eine [ArithmeticException] auslösen;
- Zeilen 22–25: Der Aufrufer fängt die Ausnahme ab, weil er es so wählt;
- Zeilen 53–57: In Java erlaubte es das Verpacken einer
*[IOException]in einer*[UncheckedIOException], sie in der Deklaration wegzulassen. In Kotlin entfällt dieser Grund, die Technik bleibt aber aus einem anderen Grund nützlich: Die neue Ausnahme trägt eine aussagekräftigere Meldung für den Aufrufer („unreadable configuration“), und die ursprüngliche Ausnahme wird ihr als Ursache übergeben; - Zeile 31: Die Eigenschaft [cause] (die Java-Methode [getCause()]) liefert die ursprüngliche Ausnahme. Sie ist vom Typ [Throwable?]: daher der Operator [?.];
- Zeilen 62–72: Die Funktion [ancestors] durchläuft die Kette der Elternklassen eines Objekts (Eigenschaft [superclass], die Java-Methode [getSuperclass()]) bis hinauf zur Klasse [Object], der Wurzel aller Java-Klassen. Die Variable [cls] ist vom Typ [Class<*>?] (eine Klasse beliebigen Typs oder [null]), weil [superclass] für die Klasse [Object] den Wert [null] liefert;
- Zeilen 34–36: Die Ergebnisse (die letzten drei Zeilen) spiegeln die oben beschriebene Hierarchie wider. In Kotlin ist die Wurzel aller Klassen [Any], die der Java-Klasse [Object] entspricht.
Entfernen wir die Annotation [@Throws] und sogar den [try / catch] aus der Funktion [main], wird das Programm vom Kotlin-Compiler weiterhin akzeptiert. Die nicht abgefangene Ausnahme würde das Programm dann beenden, das die Ausnahme und den Aufrufstapel anzeigen und mit dem Rückgabecode 1 enden würde. Für ein kleines Testprogramm ist das akzeptabel, für eine echte Anwendung jedoch nicht. In diesem Kurs fangen wir eine Ausnahme dort ab, wo wir wissen, wie sie zu behandeln ist.
3.6.6. Freigabe von Ressourcen: Die Funktion use
Eine Ressource (eine geöffnete Datei, eine Netzwerkverbindung, eine Datenbankverbindung) muss nach der Verwendung geschlossen werden, selbst wenn bei ihrer Verwendung ein Fehler auftritt. Sie kann in einer [finally]-Klausel geschlossen werden, was mehrere Codezeilen erfordert, die sich nur schwer fehlerfrei schreiben lassen. Java 7 hat hierfür das **try mit Ressourcen ([try (Type resource = ...) { ... }]*) eingeführt. Kotlin kennt diese Syntax nicht; stattdessen verwendet es eine einfache Funktion seiner Standardbibliothek, die Funktion *[use] :
Die Funktion [use] ist auf jede Ressource anwendbar, deren Typ die Java-Schnittstelle [AutoCloseable] (oder [Closeable], die davon abgeleitet ist) implementiert, eine Schnittstelle, die nur die Methode [close()] enthält; das trifft auf alle Java-Klassen für Dateien, Netzwerk und Datenbanken zu. Sie führt den ihr übergebenen Block aus (ein Lambda, Kapitel 7), dessen Parameter [r] auf die Ressource verweist, und schließt dann die Ressource (durch Aufruf ihrer Methode [close()]), unabhängig davon, ob der Block normal oder mit einer Ausnahme endet. Sie liefert den Wert des Blocks. Wird der Parametername weggelassen, wird die Ressource im Block mit [it] bezeichnet.
[use] ist eine Erweiterungsfunktion: eine in Kotlin geschriebene Funktion außerhalb der Schnittstelle [AutoCloseable], die aber so aufgerufen wird, als wäre sie eine Methode dieser Schnittstelle. Wie man solche Funktionen schreibt, lernen wir in Kapitel 4. Mehrere Ressourcen werden mit verschachtelten [use]-Blöcken behandelt: Die innerste wird zuerst geschlossen. Ein [use] kann in einem [try] -Block zusammen mit den Klauseln [catch] und [finally] stehen; diese werden ausgeführt, nachdem die Ressourcen geschlossen wurden.
Wir haben bereits erwähnt, dass Kotlin die Multi-catch-Funktion von Java nicht kennt ([catch (NumberFormatException | ArithmeticException e)]). Um mehrere Ausnahmetypen auf dieselbe Weise zu behandeln, fangen wir einen gemeinsamen Typ ab und sortieren die Ausnahmen dann mit einem [when].
Das Programm [Basics24.kt] lautet wie folgt:
Ergebnisse:
Kommentare:
- Zeilen 55–57: eine Demonstrationsressource. Es handelt sich um eine Datenklasse (Kapitel 4), eine sehr einfache Klasse, in der jedes Objekt einen Namen hat; sie implementiert die Schnittstelle [AutoCloseable], indem sie die Methode [override] [close()] neu definiert, die eine Meldung anzeigt;
- Zeilen 61–63: Die Funktion [openResource] zeigt eine Meldung an und erzeugt eine Ressource;
- Zeilen 8–9: Die Ressource [r] wird am Ende des Blocks automatisch geschlossen (Zeile 4 der Ergebnisse);
- Zeilen 14–17: zwei Ressourcen mit zwei verschachtelten [use]-Aufrufen. Während ihrer Verwendung wird eine Ausnahme ausgelöst (Zeile 17). Die Ergebnisse (Zeilen 5–11) zeigen, dass R3 vor R2 geschlossen wird und dass beide geschlossen werden, bevor die Klauseln [catch] und [finally] ausgeführt werden;
- Zeile 26: ein [BufferedReader] , der hier eine Zeichenkette liest, als wäre sie eine Datei. Die Erweiterungsfunktion [buffered()] erzeugt aus dem [StringReader] einen [BufferedReader], ohne dass man [BufferedReader(StringReader(...))] schreiben muss. Echte Dateien lesen wir in Kapitel 5;
- Zeile 29: [readLine()] liefert die nächste Zeile oder [null] am Ende des Textes. In Kotlin ist eine Zuweisung kein Ausdruck: Sie können nicht [while ((line = reader.readLine()) != null)] schreiben, wie es in Java möglich ist. Der Operator [?:] gefolgt von [break] (ein Ausdruck vom Typ [Nothing], ebenso wie [throw]) verlässt die Schleife, wenn [readLine()] den Wert [null] ergibt. Die Variable [line] ist dann vom Typ [String], der nicht nullbar ist. In Kapitel 5 betrachten wir Funktionen, die alle Zeilen ohne Schleife lesen ([readLines], [forEachLine], [useLines]);
- Zeile 34: [use] liefert den Wert seines Blocks – hier die Anzahl der von [readLines()] gelesenen Zeilen – nach dem Schließen des Readers;
- Zeilen 43–48: Ersatz für den Multi-catch-Block: Die gemeinsame Elternklasse [RuntimeException] wird abgefangen, dann wendet ein [when] dieselbe Behandlung auf die beiden erwarteten Typen an (ein [when]-Zweig kann mehrere [is]-Tests auflisten, durch Kommas getrennt). Die übrigen Ausnahmen werden erneut ausgelöst; unerwartete Fehler werden nicht unterdrückt;
- Zeile 46: [operation.contentToString()] liefert den Inhalt des Arrays in der Form „[10, zero]“, ähnlich wie [Arrays.toString] in Java. Die Eigenschaft [e.javaClass.simpleName] liefert den Namen der Ausnahmeklasse (Zeilen 16 und 17 der Ergebnisse).
3.7. Beispielanwendung - V1
Wir wollen ein Programm zur Berechnung der Steuer eines Steuerpflichtigen schreiben. Wir betrachten den vereinfachten Fall eines Steuerpflichtigen, der nur ein einziges Gehalt zu versteuern hat. Die Zahlen stammen aus der Steuertabelle 2004 für die Einkünfte des Jahres 2003 und werden unverändert verwendet: Dies ist eine Programmieraufgabe, keine Berechnung aktueller Steuern. Diese Anwendung dient uns als roter Faden: Wir werden in den folgenden Kapiteln auf sie zurückkommen und dabei Klassen, Dateien, eine Datenbank, Coroutinen und schließlich Netzwerkfunktionen einbauen.
- Wir berechnen die Anzahl der Anteile (Parts) des Arbeitnehmers: Anteile = nbChildren/2 + 1, wenn der Arbeitnehmer unverheiratet ist, nbChildren/2 + 2, wenn er verheiratet ist, wobei nbChildren die Anzahl der Kinder ist;
- hat er mindestens drei Kinder, erhält er einen zusätzlichen halben Anteil;
- sein zu versteuerndes Einkommen R wird als R = 0.72 * S berechnet, wobei S sein Jahresgehalt ist;
- sein Familienquotient wird als QF = R / Anteile berechnet;
- seine Steuer I wird anhand der folgenden Tabelle berechnet:
Grenze | coeffR | coeffN |
4962 | 0 | 0 |
8382 | 0.068 | 291.09 |
14,753 | 0.191 | 1,322.92 |
23,888 | 0.283 | 2,668.39 |
38,868 | 0.374 | 4,846.98 |
47,932 | 0.426 | 6,883.66 |
0 | 0.481 | 9,505.54 |
Jede Zeile hat 3 Felder. Um die Steuer I zu berechnen, suchen Sie die erste Zeile, in der QF kleiner oder gleich der Grenze ist. Ist zum Beispiel QF = 5.000, ist die gefundene Zeile:
Die Steuer I ist dann gleich 0.068 * R - 291.09 * Anteile, auf den nächsten Euro gerundet. Ist QF so beschaffen, dass die Bedingung QF <= Grenze nie erfüllt ist, werden die Koeffizienten der letzten Zeile verwendet: I = 0.481 * R - 9505.54 * Anteile. Die Grenze 0 in der letzten Zeile wird daher nie verwendet.
Die Berechnungen betreffen Beträge und Dezimalkoeffizienten: Wir führen sie mit der Java-Klasse [BigDecimal] aus, die Kotlin direkt verwendet – und sogar bequemer als Java: Die Kotlin-Standardbibliothek definiert die Operatoren [+], [-], [*] sowie die Vergleichsoperatoren [<], [>] ..., die auf jedes vergleichbare Objekt anwendbar sind. Das entsprechende Kotlin-Programm [Tax1.kt] lautet wie folgt:
Kommentare:
- Zeilen 10–12: Die drei Arrays vom Typ [BigDecimal] werden von der Funktion [decimals] (Zeilen 78–79) aus Zeichenketten erzeugt: Jeder Wert, etwa 0.068, ist somit exakt. Mit [Double] wäre 0.068 nur eine binäre Näherung. Die Funktion [decimals] akzeptiert eine beliebige Anzahl von Parametern ([vararg values: String]), die sie in einem Array erhält; diese Notation wird im Abschnitt „Übergabe von Parametern an eine Funktion“ erläutert. Das Ergebnis-Array wird mit [Array(size) { i -> value }] erzeugt, das jedes Element anhand seines Index berechnet;
- Zeile 15: Die Eingabe des Familienstands übernimmt die Funktion [readMaritalStatus] (Zeilen 55–60). Das Java-Programm führte alle Eingaben in seiner Methode [main] durch und verwendete dafür Variablen, die ohne Anfangswert deklariert wurden; in Kotlin ist jede Eingabe eine Funktion, die den eingegebenen Wert zurückgibt, und die Variablen [married], [nbChildren] und [salary] können [val] sein;
- Zeile 49: Die Funktion [read] zeigt die Eingabeaufforderung mit [print] (ohne Zeilenumbruch) an und liest die Antwort; ist der Eingabestrom geschlossen, wird der von [null] zurückgegebene Wert [readlnOrNull] durch eine leere Zeichenkette ersetzt. Die Funktion [trim()] entfernt die führenden und nachgestellten Leerzeichen der gelesenen Zeichenkette;
- Zeilen 56–60: eine Schleife [while (true)] , die über [return] verlassen wird, wenn die Antwort korrekt ist. Das [when] arbeitet mit der Antwort, die von [lowercase()] in Kleinbuchstaben umgewandelt wurde: So werden sowohl Y als auch y akzeptiert. In Kotlin werden Zeichenketten mit dem Operator [==] verglichen, der ihre Inhalte vergleicht (das tut auch [when]); die Java-Methode [equals] ist nicht nötig;
- Zeile 60: Fehlermeldungen werden in den Strom [System.err] geschrieben;
- Zeilen 66–73: Eingabe einer positiven ganzen Zahl oder null, verwendet für die Anzahl der Kinder und für das Gehalt: Das Java-Programm wiederholte dieselbe Schleife zweimal. [toIntOrNull()] liefert [null] , wenn die Eingabe keine ganze Zahl ist: Es gibt weder einen [try] noch eine Ausnahme zu behandeln. In Zeile 70 weiß der Compiler nach dem Test [number != null], dass [number] nicht [null] ist: Er akzeptiert den Vergleich [number >= 0] und die Anweisung [return number] in einer Funktion, die ein [Int] zurückgibt (Smart Cast);
- Zeile 22: Die Anzahl der Anteile wird als [BigDecimal] berechnet. Man kann nicht einfach [nbChildren / 2] schreiben: Ist nbChildren gleich 3, erhielte man 3/2, eine ganzzahlige Division, die 1 statt 1,5 ergäbe. Die Erweiterungsfunktion [toBigDecimal()] wandelt die ganze Zahl um, [divide(BigDecimal.TWO)] teilt sie exakt durch zwei, und der Operator [+] addiert 2 oder 1, je nachdem, was ein [if]-Ausdruck bestimmt. Hinweis: Der Kotlin-Operator [/] behält, auf [BigDecimal] angewendet, die Anzahl der Nachkommastellen des Dividenden bei und rundet das Ergebnis: [3.toBigDecimal() / 2.toBigDecimal()] ist 2, nicht 1,5. Für eine Division mit [BigDecimal] wird daher stets die Methode [divide] verwendet;
- Zeile 24: Ein [BigDecimal] ist unveränderlich: Der Operator [+=] verändert das Objekt nicht, sondern erzeugt ein neues Objekt [shares + BigDecimal("0.5")] und weist es der Variablen zu, daher die Deklaration [var] von [shares]. In Java hätte man [shares = shares.add(...)] schreiben müssen, und das Vergessen der Zuweisung war eine klassische Falle;
- Zeile 28: das zu versteuernde Einkommen, berechnet mit dem Operator [*];
- Zeile 31: der Familienquotient. Die Division des Einkommens durch 1,5 oder 3,5 Anteile ergibt im Allgemeinen keine endliche Dezimaldarstellung: Wir legen eine Genauigkeit fest, hier [MathContext.DECIMAL128] (34 signifikante Stellen), was mehr als ausreichend ist;
- Zeilen 35–37: Bestimmung der Steuerstufe. Die Suche endet bei der ersten Obergrenze, die größer oder gleich dem Familienquotienten ist, spätestens jedoch bei der letzten Steuerstufe, mit der Bedingung [i < limits.size - 1]. In Kotlin ist der Operator [>] auf [BigDecimal] anwendbar: [quotient > limits[i]] wird vom Compiler in [quotient.compareTo(limits[i]) > 0] übersetzt, so wie wir es in Java geschrieben hätten. Zwei [BigDecimal]-Ausdrücke vergleichen wir jedoch nicht mit [==], was [equals] aufruft und die Anzahl der Nachkommastellen berücksichtigt: 2.0 und 2.00 sind für [equals] nicht „gleich“;
- Zeile 41: Die Steuer wird von der Funktion [toInt()] auf den nächsten Euro abgeschnitten, wobei der Nachkommaanteil verworfen wird.
Hier einige Beispiele für die Ausgabe (die über die Tastatur eingegebenen Werte wurden in die Anzeige aufgenommen):
Bei einem Jahresgehalt von 60.000 Euro zahlt ein verheirateter Steuerpflichtiger mit 2 Kindern 4.282 Euro, mit 3 Kindern 2.959 Euro und eine alleinstehende Person ohne Kinder 11.519 Euro: Das sind die Ergebnisse der Java-Version. Im zweiten Durchlauf wird die Eingabe „60000 euros“ abgelehnt: [toIntOrNull] akzeptiert nur Zeichenketten, die eine exakte ganze Zahl darstellen (führende und nachgestellte Leerzeichen wurden von [trim()] entfernt).
3.8. Argumente des Hauptprogramms
Die Hauptfunktion [main] kann ein Array von Zeichenketten [Array<String>] als Parameter entgegennehmen. Dieses Array enthält die Kommandozeilenargumente, mit denen die Anwendung gestartet wurde. Starten wir also das Programm P mit dem Befehl:
und ist die Funktion [main] wie folgt deklariert:
haben wir args[0]="arg0", args[1]="arg1" und so weiter. Braucht das Programm seine Argumente nicht, schreiben wir einfach [fun main()], wie wir es bisher getan haben. Mit Gradle werden die für das Programm bestimmten Argumente der Aufgabe [run] über die Option [--args] als einzelne, in Anführungszeichen gesetzte Zeichenkette übergeben; die eigenen Optionen von Gradle (wie [-q] oder [-P]) werden daneben angegeben:
In IntelliJ IDEA werden die Argumente in der Ausführungskonfiguration des Programms eingegeben (im Feld „Program arguments“).
Hier ein Beispiel, [Basics25.kt]:
Ergebnisse:
Ein Argument, das Leerzeichen enthält, muss in Anführungszeichen gesetzt werden; innerhalb der Zeichenkette [--args] verwendet man einfache Anführungszeichen:
Ohne Argument ist das Array [args] leer; es ist nie gleich [null]:
Kommentare:
- Zeile 4: der Einstiegspunkt des Programms. Der Compiler erzeugt eine Klasse [Basics25Kt] mit einer Methode [public static void main(String[] args)]: Das ist exakt der Standard-Einstiegspunkt von Java;
- Zeile 5: Die Größe eines Arrays wird durch seine Eigenschaft [size] angegeben (in Java das Feld [length]);
- Zeilen 6–7: Durchlaufen der Array-Indizes.
In Java ist die Standardmethode [main] eine statische Methode einer Klasse. Kotlin kennt keine statischen Methoden; soll der Einstiegspunkt jedoch eine Klasse mit einem bestimmten Namen sein (zum Beispiel für ein Werkzeug, das dies verlangt), setzt man die Funktion [main] in ein Objekt, das mit dem Schlüsselwort [object] deklariert wird (Kapitel 4), und versieht sie mit der Annotation [@JvmStatic]. Das tut das Programm [Basics26.kt]:
Ergebnisse:
Kommentare:
- Zeile 4: ein Objekt [Basics26]. Der Compiler erzeugt eine Klasse [Basics26] mit einem einzigen Objekt;
- Zeilen 5–6: Die Annotation [@JvmStatic] weist den Compiler an, [main] zu einer statischen Methode der Klasse [Basics26] zu machen, was die Java Virtual Machine erwartet. Die auszuführende Klasse ist daher [basics26.Basics26], nicht [basics26.Basics26Kt];
- Zeilen 8–9: Durchlaufen des Arrays mit der Funktion [withIndex()], die sowohl den Index als auch das Element liefert.
Diese Form ist in Kotlin selten: Eine Funktion [main] auf oberster Ebene, außerhalb jeder Klasse, ist der Normalfall. Beachten Sie schließlich, dass die Funktion [main] wie in Java keinen Wert zurückgibt: Der Exit-Code des Programms wird mit [exitProcess] festgelegt.
3.9. Aufzählungen
Eine Aufzählung ist ein Datentyp, dessen Wertebereich aus einer Menge benannter Konstanten besteht. Betrachten wir ein Programm, das Prüfungsnoten verarbeiten muss. Es gibt fünf mögliche Bewertungen: Pass (bestanden), Fairly Good (ziemlich gut), Good (gut), Very Good (sehr gut) und Excellent (ausgezeichnet). Wir können dann für diese fünf Konstanten eine Aufzählung definieren:
Kotlin schreibt [enum class]***, wo Java [enum]* schreibt: [enum] ist kein reserviertes Schlüsselwort, sondern ein Modifikator** für eine Klassendeklaration. Konstantennamen werden üblicherweise in Großbuchstaben geschrieben. Eine Variable kann so deklariert werden, dass sie ihre Werte aus der Aufzählung bezieht:
Sie können eine Variable mit dem Operator == mit den verschiedenen möglichen Werten der Aufzählung vergleichen:
Wie in Java, und anders als in anderen Sprachen, in denen eine Aufzählung lediglich eine Menge benannter ganzer Zahlen ist, ist eine Kotlin-Aufzählung eine Klasse, die in eine von [java.lang.Enum] abgeleitete Klasse kompiliert wird und deren einzige Objekte die deklarierten Konstanten sind. Jede Konstante ist ein eindeutiges Objekt, das einmalig erzeugt wird. Jede Konstante kennt ihren Namen (Eigenschaft [name] oder [toString()]) und ihre Ordnungszahl in der Deklaration (Eigenschaft [ordinal], beginnend bei 0). Konstanten sind in dieser Reihenfolge vergleichbar: Sie können [m1 < m2] schreiben. Außerdem besitzt jede Aufzählung:
- [Honours.entries]: die (nicht veränderbare) Liste der Konstanten der Aufzählung [Honours] in der Reihenfolge ihrer Deklaration. Sie ist eine bessere Alternative zur Funktion [Honours.values()] – von Java geerbt und weiterhin verfügbar –, die bei jedem Aufruf ein neues Array erzeugt;
- [Honours.valueOf(name)]: gibt die Konstante mit dem Namen [name] zurück und löst eine [IllegalArgumentException] aus, wenn keine Konstante diesen Namen trägt.
Eine Aufzählung lässt sich nicht in eine ganze Zahl umwandeln und eine ganze Zahl nicht in eine Aufzählung: Wir verwenden [ordinal] und [entries].
Das Programm [Basics27.kt] veranschaulicht das soeben Beschriebene:
Ergebnisse:
Kommentare:
- Zeile 4: die Deklaration der Aufzählung. Sie steht am Anfang der Datei neben den Funktionen; alternativ kann sie wie eine Klasse (Kapitel 4) in einer eigenen Datei [Honours.kt] deklariert werden;
- Zeile 8: eine Variable vom Typ [Honours], wobei der Typ aus dem zugewiesenen Wert abgeleitet wird;
- Zeile 10: Eine Aufzählungskonstante wird über ihren Namen aufgeführt;
- Zeilen 16–17: die Liste der Konstanten, ihre Namen und ihre Ordnungszahlen;
- Zeile 20: die Umwandlung einer Ordnungszahl in eine Konstante: [entries] ist eine Liste, die wie ein Array indiziert wird;
- Zeile 23: die Umwandlung einer Zeichenkette in eine Aufzählungskonstante;
- Zeile 24: Konstanten werden anhand ihrer Deklarationsreihenfolge verglichen: GOOD kommt nach PASS. Der Operator [>] wird vom Compiler in einen Aufruf der Methode [compareTo] übersetzt, die man in Java schreiben müsste;
- Zeilen 25–28: [valueOf] unterscheidet Groß- und Kleinschreibung: „Good“ ist kein Konstantenname. Die Meldung der Ausnahme nennt den vollständigen Namen der Aufzählung, [basics27.Honours];
- Zeile 31: Um die Ausnahme zu vermeiden, können Sie die Konstante mit der Funktion [find] in [entries] suchen, die das erste Element liefert, das die zwischen geschweiften Klammern geschriebene Bedingung erfüllt (ein Lambda, Kapitel 7; dabei bezeichnet [it] das gerade untersuchte Element), oder [null] , wenn es keines gibt;
- Zeilen 34–37: Aufzählungen eignen sich gut für [when]-Ausdrücke. Da alle Konstanten behandelt werden, ist der Ausdruck auch ohne [else]-Zweig erschöpfend. Wird der Aufzählung später eine Konstante hinzugefügt, weist der Compiler den unvollständig gewordenen [when]-Ausdruck zurück und nennt dabei die ausgelassene Konstante. Zum Beispiel ohne Zeile 37: [error: 'when' expression must be exhaustive. Add the 'EXCELLENT' branch or an 'else' branch.]. Das ist ein guter Grund, in einem [else]-Zweig [when] für eine Aufzählung nicht zu verwenden. Anders als beim [switch] von Java wird den Konstanten der Name der Aufzählung vorangestellt; eine Anweisung [import basics27.Honours.*] würde es erlauben, ihre Namen allein zu schreiben;
- Zeile 40: Der vollständige Name der Aufzählung lautet [basics27.Honours]: Sie ist auf Dateiebene im Paket [basics27] deklariert. [Honours::class.java] ist die Java-Klasse der Aufzählung;
- Zeile 41: Die Elternklasse jeder Aufzählung ist [java.lang.Enum].
3.9.1. Erweiterte Aufzählungen
Da eine Aufzählung eine Klasse ist, kann sie Eigenschaften, einen Konstruktor und Methoden haben. Kotlin macht dies besonders knapp: Eigenschaften werden mit [val] in den Klammern hinter dem Namen der Aufzählung deklariert (der Primärkonstruktor, Kapitel 4), und jede Konstante wird durch Aufruf dieses Konstruktors mit den Werten erzeugt, die in Klammern hinter ihrem Namen stehen. Dies ist eine weit verbreitete Technik, die es überflüssig macht, separate Arrays mit den den Konstanten zugeordneten Werten zu verwalten.
Um eine Menge von Optionen darzustellen, etwa Dateizugriffsrechte (Lesen, Schreiben, Ausführen), kombinierte man früher Zweierpotenzen mit dem Operator [or] (bitweises ODER). Stattdessen verwenden wir eine Aufzählung und die Java-Klasse [EnumSet], eine Menge von Konstanten einer Aufzählung, die ebenso effizient ist wie eine bitweise Kombination (intern ist sie eine), aber viel lesbarer. Die Klasse [EnumMap] ist entsprechend ein Dictionary, dessen Schlüssel die Konstanten einer Aufzählung sind. Kotlin verwendet sie direkt.
Das Programm [Basics28.kt] lautet wie folgt:
Ergebnisse:
Kommentare:
- Zeile 8: Die Aufzählung und ihr Primärkonstruktor. Die Schlüsselwörter [val] machen [minimumGrade] und [label] zu schreibgeschützten Eigenschaften jeder Konstante. Das Java-Programm musste zwei Felder namens [private final] deklarieren, den Konstruktor schreiben, der sie initialisiert, und dann zwei Methoden, [getMinimumGrade] und [getLabel], zum Lesen: Kotlin erzeugt all dies selbst. Der Konstruktor einer Aufzählung ist privat: Sie können keine zusätzlichen Konstanten erzeugen;
- Zeilen 9–13: die Konstanten der Aufzählung, jeweils mit ihren zwei Parametern. Das Semikolon nach der letzten Konstante ist erforderlich, wenn danach Member folgen: Dies ist eines der ganz wenigen Semikolons, die in Kotlin erforderlich sind;
- Zeile 16: eine Methode, die auf eine Konstante angewendet wird ([m.next()]). Sie verwendet die Eigenschaft [ordinal] der Konstante und die Liste [entries]; [getOrNull] liefert das Element am angegebenen Index oder [null] , wenn der Index außerhalb der Grenzen liegt: Die letzte Konstante hat keinen Nachfolger. Der Rückgabetyp [Honour?] zeigt dies an;
- Zeilen 19–20: eine Funktion, die auf der Aufzählung selbst aufgerufen wird ([Honour.forGrade(grade)]), ähnlich einer statischen Methode in Java. Kotlin kennt keine statischen Methoden: Sie werden im Companion Object der Klasse ([companion object]) abgelegt, das in Kapitel 4 eingeführt wird. Da die Konstanten in aufsteigender Reihenfolge der Punktzahl deklariert sind, ist die letzte, deren Mindestpunktzahl erreicht ist, die richtige: [lastOrNull] liefert das letzte Element der Liste, das die Bedingung erfüllt, oder [null] , wenn es keines gibt. Das Ergebnis ist vom Typ [Honour?] oder [null] , wenn die Punktzahl kleiner als 10 ist: Wo Java ein [Optional] verwendete, nutzt Kotlin einen nullbaren Typ;
- Zeile 25: eine einfache Aufzählung für Zugriffsrechte;
- Zeilen 28–29: die Liste der Einträge mit ihren Eigenschaften: Wir schreiben [m.label], nicht [m.getLabel()];
- Zeile 31: ein Array reeller Zahlen [DoubleArray]. Die Punktzahlen werden als 12.0 und 19.0 geschrieben, nicht als 12 und 19: Kotlin wandelt ein [Int] nicht implizit in ein [Double] um;
- Zeile 33: Der Operator [?.] liest die Eigenschaft [label] nur, wenn [Honour.forGrade(grade)] nicht [null] ist; der Operator [?:] liefert andernfalls einen Text. Das entspricht dem [map(Honour::getLabel).orElse("no honours")] von Java;
- Zeile 38: eine Menge aus zwei Rechten;
- Zeile 39: Der Operator [in] prüft, ob eine Konstante zur Menge gehört, so wie man ein Bit prüfen würde. Er wird vom Compiler in einen Aufruf der Methode [contains] übersetzt;
- Zeilen 40–41: Konstanten werden der Menge hinzugefügt und aus ihr entfernt;
- Zeilen 43–44: die Menge aller Konstanten, die leere Menge und das Komplement einer Menge. [Permission::class.java] ist die Java-Klasse der Aufzählung, die diese Java-Methoden aufrufen ([Permission.class] in Java);
- Zeile 45: die Konstanten zwischen zwei Konstanten, in der Reihenfolge ihrer Deklaration;
- Zeilen 48–50: Eine [EnumMap] ordnet bestimmten Einträgen eine Menge von Elementen zu. Die Notation [headcounts[key] = value] ersetzt den Aufruf [headcounts.put(key, value)]. Die Schlüssel einer [EnumMap] werden stets in der Reihenfolge durchlaufen, in der die Konstanten deklariert sind: PASS erscheint vor GOOD, obwohl es später hinzugefügt wurde. Dictionaries werden in Kapitel 5 behandelt.
3.10. Übergabe von Parametern an eine Funktion
In Kotlin kann eine Funktion auf oberster Ebene einer Datei deklariert werden, außerhalb jeder Klasse, wie unsere Funktionen [main]: Sie heißen Top-Level-Funktionen. Eine innerhalb einer Klasse deklarierte Funktion ist eine Methode (Kapitel 4). Hier konzentrieren wir uns darauf, wie Parameter an eine Funktion übergeben werden. Betrachten wir die folgende Funktion:
In der Definition der Funktion in Zeile 1 wird [a] als formaler Parameter bezeichnet. Er dient ausschließlich der Definition der Funktion [changeInt]. Er hätte ebenso gut [b] heißen können. Sein Typ ist erforderlich: Typinferenz gilt nicht für Parameter. Betrachten wir nun einen Aufruf dieser Funktion:
Hier ist in der Anweisung in Zeile 2 [age] der aktuelle Parameter (auch Argument genannt), der seinen Wert an den formalen Parameter [a] übergibt. Uns interessiert, wie ein formaler Parameter den Wert eines aktuellen Parameters erhält.
3.10.1. Wertübergabe und unveränderliche Parameter
Wie Java kennt Kotlin nur einen Modus der Parameterübergabe: die Wertübergabe (Call by Value). Der Wert des aktuellen Parameters wird in den entsprechenden formalen Parameter kopiert. Es handelt sich um zwei getrennte Entitäten.
Kotlin geht einen Schritt weiter als Java: Ein formaler Parameter ist immer ein [val]. Ihm kann innerhalb der Funktion kein neuer Wert zugewiesen werden; es ist, als wären in Java alle Parameter als [final] deklariert. Die Frage „Kann die Funktion den aktuellen Parameter ändern, indem sie ihren formalen Parameter ändert?“ stellt sich somit gar nicht. Braucht die Funktion eine Variable, die sie verändert, deklariert sie eine lokale Variable, die mit dem Wert des Parameters initialisiert wird.
Ist der Parameter ein Array oder ein Objekt, ist der übergebene Wert die Referenz auf das Objekt: Der formale und der aktuelle Parameter verweisen dann auf dasselbe Objekt. Die Funktion kann dieses Objekt daher verändern, sofern es veränderbar ist, und der Aufrufer sieht die Änderung; sie kann jedoch nicht bewirken, dass die Variable des Aufrufers auf ein anderes Objekt verweist.
Kotlin unterstützt keine Übergabe per Referenz (Call by Reference), bei der der formale und der aktuelle Parameter ein und dieselbe Variable wären (wie die Parameter [ref] und [out] in C#): Eine Funktion kann keine lokale Variable ihres Aufrufers ändern und ihm auch keine Ergebnisse über ihre Parameter „zurückgeben“. Stattdessen verwenden wir:
- den Rückgabewert der Funktion, den der Aufrufer seiner Variablen zuweist;
- eine Datenklasse oder ein Tupel ([Pair], [Triple]), wenn die Funktion mehrere Werte zurückgeben muss;
- ein Array oder ein veränderbares Objekt , das als Parameter übergeben wird und in dem die Funktion ihre Ergebnisse ablegt.
Das Programm [Basics29.kt] veranschaulicht diese verschiedenen Fälle:
Ergebnisse:
Kommentare:
- Zeilen 8–10: Der Wert 20 des aktuellen Parameters [age] wurde in den formalen Parameter [a] kopiert (Zeile 53). Die Funktion kann [a] nicht ändern: Sie erzeugt eine lokale Kopie, [copy] (Zeile 55), die sie dann ändert. Der aktuelle Parameter bleibt unverändert;
- Zeilen 13–15: Die Funktion [changeInt2] (Zeilen 60–62) gibt einen neuen Wert zurück, den der Aufrufer seiner eigenen Variablen [age2] zuweist, die dafür als [var] deklariert ist;
- Zeile 51: Eine Datenklasse ([data class]) deklariert in einer einzigen Zeile eine Klasse, deren Objekte aus zwei unveränderlichen Werten bestehen, [succeeded] und [value]. Der Compiler fügt unter anderem eine Methode namens [toString()] hinzu, die ihre Komponenten anzeigt, sowie die Methoden [equals()] und [hashCode()]. Dies ist das Kotlin-Pendant zu den Records von Java; Datenklassen werden in Kapitel 4 behandelt. Ihre Komponenten sind Eigenschaften: Wir schreiben [c1.succeeded], nicht [c1.succeeded()] wie bei einem Record;
- Zeilen 18–22: Die Funktion [convert] (Zeilen 65–69) gibt zwei Informationen zurück – ob die Umwandlung erfolgreich war und den erhaltenen Wert –, zusammengefasst in einem einzigen Objekt [Conversion]. Ihr Rumpf ist ein [try]-Ausdruck, der zum einen oder zum anderen Objekt [Conversion] ausgewertet wird. Beachten Sie, dass man in Kotlin typischerweise eine Funktion vom Typ [Int?] schreiben würde, die im Fehlerfall [null] zurückgibt: Genau das tut [toIntOrNull()];
- Zeilen 26–28: Vertauschen zweier Werte. Eine Funktion [swap(a: Int, b: Int)] wäre für den Aufrufer nutzlos; daher werden die beiden Werte in einem Array abgelegt, das die Funktion [swap] (Zeilen 72–75) verändert;
- Zeilen 30–32: Zum Vertauschen zweier lokaler Variablen bietet Kotlin eine Redewendung: [x = y.also { y = x }]. Die Funktion [also] führt den Block aus, der den Wert von [x] [y] zuweist, und liefert dann den Wert von [y] vor der Ausführung des Blocks, der [x] zugewiesen wird. Funktionen wie [also] werden in Kapitel 7 behandelt;
- Zeilen 36–38: Die Array-Referenz wird per Wert übergeben. Die Funktion [modifyArray] arbeitet daher auf demselben Array wie der Aufrufer: Die Änderung durch [t[0]] (Zeile 80) ist für den Aufrufer sichtbar. Es ist jedoch unmöglich, [t] auf ein anderes Array verweisen zu lassen: [t] ist ein [val];
- Zeilen 41–43: Ein Objekt [StringBuilder] ist eine veränderbare Zeichenkette: Die Funktion [complete] (Zeilen 85–86) hängt Text an sie an, und der Aufrufer sieht das Ergebnis. Mit einem [String] wäre dies unmöglich gewesen: [String]-Objekte sind unveränderlich;
- Zeilen 46–47: Die Funktion [inclTax] (Zeilen 89–91) berechnet einen Preis einschließlich aller Steuern. Das Produkt zweier [BigDecimal]-Objekte hat so viele Nachkommastellen wie die Summe seiner beiden Faktoren: 100 × 1,2 = 120,0, angezeigt als 120.0.
Wird der Kommentar in Zeile 90 durch die Anweisung [amount = BigDecimal.ZERO] ersetzt, weist der Compiler das Programm zurück:
3.10.2. Standardwerte, benannte Argumente, Überladung, variable Parameteranzahl
Java kennt weder optionale Parameter noch benannte Argumente und muss sie durch Überladung von Methoden simulieren: mehrere Versionen derselben Methode, wobei die kurzen Versionen die vollständige Version mit Standardwerten aufrufen. Kotlin bietet wie C# beides:
- Ein Parameter kann einen Standardwert haben: [fun greet(name: String, greeting: String = "Hello")]. Der Aufrufer kann dann den entsprechenden aktuellen Parameter weglassen: [greet("Pierre")];
- Beim Aufruf der Methode kann ein Argument benannt werden: [greet("Pierre", upperCase = true)]. So können Sie einen Parameter mit Standardwert weglassen und trotzdem die nachfolgenden übergeben, Argumente in beliebiger Reihenfolge übergeben und vor allem den Aufruf lesbar machen: [upperCase = true] ist klarer als ein [true] , das isoliert in einer Argumentliste steht.
Standardwerte und benannte Argumente machen die meisten Überladungen – und die „Builder“ von Java – überflüssig. Überladung gibt es in Kotlin jedoch durchaus: Mehrere Funktionen können denselben Namen haben, wenn sich ihre Parameterlisten in Anzahl oder Typ der Parameter unterscheiden; der Compiler wählt anhand der aktuellen Parameter die passende aus. Dies kommt zum Einsatz, wenn die Verarbeitung vom Typ der Parameter abhängt. Damit eine Kotlin-Funktion mit Standardparametern aus Java mit weniger Argumenten aufgerufen werden kann, weist die Annotation [@JvmOverloads] den Compiler an, die entsprechenden Überladungen zu erzeugen.
Schließlich kann eine Funktion eine variable Anzahl von Parametern haben: Dem formalen Parameter wird das Schlüsselwort [vararg] vorangestellt, [vararg numbers: Int]. Der Aufrufer kann eine Liste von Werten übergeben – die auch leer sein darf –, die der Compiler in einem Array zusammenfasst; innerhalb der Funktion ist der Parameter ein Array ([IntArray] für [Int], [Array<String>] für [String] ...). Anders als in Java können Sie nicht direkt ein Array anstelle der Werteliste übergeben: Sie müssen es mit dem Spread-Operator ([*]) „ausbreiten“, [sum(*values)], was es auch erlaubt, Arrays und einzelne Werte zu mischen.
Das Programm [Basics30.kt] lautet wie folgt:
Ergebnisse:
Kommentare:
- Zeilen 33–35: eine einzige Funktion, [greet], in der zwei Parameter Standardwerte haben. Das Java-Programm benötigte drei überladene Methoden. Der Rumpf der Funktion gibt den Wert eines [if]-Ausdrucks zurück;
- Zeile 6: [greeting] und [upperCase] übernehmen ihre Standardwerte, "Hello" und [false];
- Zeile 7: [greeting] erhält „Good evening“, und [upperCase] erhält seinen Standardwert;
- Zeile 9: Dank des benannten Arguments übergeben wir [upperCase] , ohne [greeting] zu übergeben, das seinen Standardwert behält. In Java musste auch die Begrüßung übergeben werden;
- Zeile 11: Alle Argumente sind benannt, und zwar in einer anderen Reihenfolge als in der Deklaration;
- Zeilen 39–43: drei Funktionen [describe], die sich im Typ ihres Parameters unterscheiden. Es sind Funktionen mit Ausdruckskörper: Der Rumpf, der auf einen einzigen Ausdruck reduziert ist, steht unmittelbar hinter dem Zeichen [=], ohne geschweifte Klammern und ohne [return]. Der Rückgabetyp wird dann aus dem Ausdruck abgeleitet ([Unit] hier; der Typ von [println]: Die Funktion gibt keinen nützlichen Wert zurück);
- Zeilen 14–16: Der Compiler wählt die Funktion anhand des Typs des aktuellen Parameters aus. Das Zeichen ["] wird in einer Zeichenkette als [\"] geschrieben (Zeile 43);
- Zeilen 45–51: [sum] akzeptiert eine beliebige Anzahl ganzer Zahlen, die im Array [numbers] vom Typ [IntArray] empfangen werden;
- Zeilen 19–24: [sum] wird ohne Parameter aufgerufen, mit drei ganzen Zahlen, mit den Elementen eines Arrays, die der Operator [*] ausbreitet, und schließlich mit einer Kombination aus beiden Formen;
- Zeilen 26–29: Viele Kotlin-Funktionen haben eine variable Anzahl von Parametern: [listOf], [setOf], [arrayOf], [format], [maxOf] ... Die Erweiterungsfunktion [format] wird auf den Formatstring angewendet, nicht auf die Klasse [String] wie die statische Methode [String.format] von Java. Kotlin kennt keine statischen Methoden: [String.join(" - ", "a", "b", "c")] gibt es in Kotlin nicht (man würde [listOf("a", "b", "c").joinToString(" - ")] schreiben, Kapitel 5). Die von [setOf] erzeugte Menge entfernt das doppelte "a".
3.11. Lokale Funktionen und Tupel: die Lösungen von Kotlin
3.11.1. Lokale Funktionen, Lambdas und lokale Klassen
Anders als Java erlaubt Kotlin die Definition einer lokalen Funktion – also einer Funktion, die innerhalb einer anderen Funktion geschrieben wird und nur in deren Gültigkeitsbereich verwendbar ist. Das ist nützlich, um eine lange Funktion aufzuteilen, ohne die gesamte Datei mit sichtbaren Funktionen zu überladen. Eine lokale Funktion hat Zugriff auf die lokalen Variablen der sie umgebenden Funktion und kann sie verändern.
Innerhalb einer Funktion stehen Ihnen außerdem zur Verfügung:
- Lambdas, kleine anonyme Funktionen, die in einer Variablen gespeichert werden können: [val cube = { x: Int -> x * x * x }]. Die Variable hat dann einen Funktionstyp, in diesem Fall [(Int) -> Int], und das Lambda wird wie eine Funktion aufgerufen: [cube(3)]. Lambdas werden in Kapitel 7, „Funktionstypen, Lambdas und Ereignisse“, behandelt. Anders als in Java kann ein Kotlin-Lambda die lokalen Variablen [var] , die es umgeben, verändern;
- lokale Klassen, die innerhalb der Funktion deklariert werden und nur in ihr verwendbar sind.
3.11.2. Paare, Tripel, Destrukturierung und Datentypen
Andere Sprachen kennen Tupel, die mehrere Werte zusammenfassen, ohne dass ein Typ deklariert werden muss. Kotlin hat dafür keine eigene Syntax, aber seine Standardbibliothek stellt zwei generische Datenklassen bereit, [Pair<A, B>] und [Triple<A, B, C>], deren Komponenten [first], [second], und [third] heißen. Ein Paar wird mit [Pair(1, "one")] oder, besser lesbar, mit der Infix-Funktion [to] erzeugt: [1 to "one"].
Die Komponenten eines Paares, eines Tripels und jeder Datenklasse lassen sich mit einer Destrukturierungsdeklaration in einer einzigen Anweisung extrahieren: [val (number, name) = pair] deklariert zwei Variablen, die mit der ersten und zweiten Komponente initialisiert werden. Eine nicht benötigte Komponente wird durch _ ersetzt: [val (_, age, _) = triple]. Destrukturierung wird auch in einer Schleife verwendet, etwa bei [for] (wie wir es bei [withIndex()]gesehen haben), sowie in den Parametern eines Lambdas. Sie beruht auf der Position der Komponenten, nicht auf ihren Namen: [val (name, number) = pair] würde die Zahl in [name] ablegen.
Um einem Tupel benannte Komponenten zu geben, deklariert man eine Datenklasse: [data class Couple(val number: Int, val name: String)]. Das entspricht einem Java-Record, ist aber flexibler (eine Datenklasse kann Komponenten wie [var] haben, destrukturiert werden usw.). Tupel sind für den lokalen Gebrauch praktisch, wenn der Zusammenhang zwischen den beiden Werten offensichtlich ist; sobald eine öffentliche Funktion mehrere Werte zurückgibt, macht eine Datenklasse – deren Komponenten Namen haben – den Code besser lesbar.
Das Programm [Basics31.kt] lautet wie folgt:
Ergebnisse:
Kommentare:
- Zeile 6: eine lokale Funktion mit Ausdruckskörper, die in der Funktion [main] deklariert und in Zeile 7 aufgerufen wird;
- Zeile 9: ein Lambda. [{ x: Int -> x * x * x }] liest sich als „die Funktion, die einer ganzen Zahl x den Wert x * x * x zuordnet“. Der Typ der Variablen [cube] ist [(Int) -> Int] und wird vom Compiler abgeleitet;
- Zeile 10: Das Lambda wird wie eine Funktion aufgerufen. In Java musste man die Methode der funktionalen Schnittstelle kennen ([applyAsInt]);
- Zeilen 13–21: Die lokale Funktion [increment] und das Lambda [increment2] verändern beide die lokale Variable [counter] der Funktion [main]: 1 + 1 + 10 = 12. In Java konnte ein Lambda keine lokale Variable verändern, sodass man ein Array mit einem einzigen Element verwenden musste;
- Zeilen 24–29: eine lokale Klasse
*[Accumulator]*mit einer Eigenschaft*[total]und einer Methode*[add]. [private set] macht die Eigenschaft nur innerhalb der Klasse schreibbar: Sie kann von [main] aus gelesen (Zeile 35), aber nicht verändert werden. Klassen werden in Kapitel 4 behandelt; - Zeilen 32–34: Ein Objekt vom Typ [Accumulator] wird durch Aufruf seines Konstruktors erzeugt – ohne den Operator [new] –, anschließend wird seine Methode aufgerufen;
- Zeilen 38–40: zwei Paare, die mit dem [Pair]-Konstruktor und der Funktion [to] erzeugt wurden. Die Methode [toString()] eines Paares zeigt es in runden Klammern an;
- Zeilen 41–42: ein Tripel aus drei verschiedenen Typen;
- Zeile 44: Das Paar [pair2] wird in zwei Variablen zerlegt, [number] und [name];
- Zeile 46: Nur die zweite Komponente des Tripels wird behalten;
- Zeilen 49–50: Zerlegen jedes Paares einer Liste innerhalb der Schleife [for];
- Zeile 55: eine lokale Datenklasse;
- Zeile 57: Die Methode [toString()] einer Datenklasse zeigt den Klassennamen und ihre Komponenten an; die Eigenschaften [number] und [name] liefern die Komponenten;
- Zeilen 59–62: Nach der Prüfung [obj is Couple] wird [obj] als [Couple] behandelt (Smart Cast) und kann destrukturiert werden. Kotlin hat kein Äquivalent zu den Record-Patterns von Java 21 ([obj instanceof Couple(int number, String name)]), aber die Typprüfung mit anschließender destrukturierender Zuweisung führt zum selben Ergebnis;
- Zeilen 66–71: Die Funktionen [divide] und [minMax] (Zeilen 85–95) geben jeweils zwei Werte zurück: die erste in einer Datenklasse [IntegerDivision] (Zeile 83), die zweite als Paar. Der Aufrufer kann das Ergebnis destrukturieren (Zeilen 66 und 70) oder in einer Variablen speichern und die Komponentennamen verwenden (Zeilen 68–69);
- Zeilen 74–78: Vertauschen zweier Variablen mit einem Paar. Kotlin erlaubt es nicht, über Destrukturierung in einer einzigen Anweisung bestehenden Variablen zuzuweisen ([(a, b) = b to a] wird abgelehnt): Wir destrukturieren in zwei neue Variablen, die wir anschließend zuweisen. Die Redewendung [a = b.also { b = a }] im Programm [Basics29.kt] ist kürzer;
- Zeilen 92–93: eine [if]-Anweisung, deren einzige Aktion in derselben Zeile ohne geschweifte Klammern steht.
In einem größeren Programm definieren wir Klassen, die Daten und die Funktionen, die diese verarbeiten, zusammenfassen: Dies ist das Thema des nächsten Kapitels.