4. Klassen, Schnittstellen, Datenklassen
4.1. Objekte anhand von Beispielen
4.1.1. Überblick
Wir wollen die objektorientierte Programmierung nun anhand von Beispielen erkunden. Ein Objekt ist eine Entität, die Daten enthält, die ihren Zustand definieren (Felder, Attribute, Eigenschaften usw. genannt), sowie Funktionen (Methoden genannt). Ein Objekt wird auf der Grundlage einer Vorlage erzeugt, die Klasse genannt wird. So deklariert eine Klasse namens [C1] zwei Eigenschaften – [var p1: Type1] und [var p2: Type2] – und zwei Methoden – [fun m3(...): Type3 { ... }] und [fun m4(...): Type4 { ... }] –, alles eingeschlossen in die geschweiften Klammern der Deklaration [class C1 { ... }].
Aus der Klasse [C1] können wir viele Objekte erzeugen, etwa [o1], [o2], … Alle haben die Eigenschaften [p1], [p2], … und die Methoden [m3], [m4], … Für ihre Eigenschaften [pi] haben sie jedoch unterschiedliche Werte, sodass jedes seinen eigenen Zustand besitzt. Ist [o1] ein Objekt vom Typ [C1], bezeichnet [o1.p1] die Eigenschaft [p1] von [o1], und [o1.m3(...)] bezeichnet den Aufruf der Methode [m3] von [o1].
Betrachten wir ein erstes Objektmodell: die Klasse [Person].
4.1.2. Ein Programm aus mehreren Dateien
In den Beispielen des vorherigen Kapitels passte ein Programm in eine einzige Quelldatei. Von nun an kann ein Programm aus mehreren Quelldateien bestehen: zum Beispiel eine Klasse pro Datei plus das Hauptprogramm. Anders als Java verlangt Kotlin keinen Zusammenhang zwischen dem Namen einer Datei und den darin enthaltenen Klassen: Eine Datei kann mehrere Klassen und Top-Level-Funktionen enthalten. Üblich – und wir folgen dieser Konvention – ist es dennoch, eine wichtige Klasse in einer Datei abzulegen, die ihren Namen trägt: Die Klasse *[Person] liegt in der Datei *[Person.kt].
Die Programme dieses Kapitels sind im Gradle-Projekt [04-classes] zusammengefasst, das wie das des vorherigen Kapitels aufgebaut ist ([03-basics]): Jedes Programm ist ein Paket im Verzeichnis [src/main/kotlin]. Das Programm aus mehreren Dateien, das wir untersuchen, ist das Paket [persons]:
Beide Dateien beginnen mit der Zeile [package persons]: Sie gehören zum selben Paket und sind ohne import-Anweisung sichtbar. Die Datei [Main.kt] enthält die Top-Level-Funktion [main]; der Compiler legt sie in einer JVM-Klasse ab, die nach der Datei benannt ist, [MainKt], deren vollständiger Name [persons.MainKt] lautet. Diesen Namen übergibt man an Gradle, um das Programm auszuführen:
Gradle kompiliert alle Dateien des Projekts und führt dann die Methode [main] der angegebenen Klasse aus. In IntelliJ IDEA klicken Sie einfach auf das grüne Dreieck am Rand neben der Funktion [main]. Der Compiler schreibt für jede Klasse eine Datei [.class] (sie enthält den Zwischencode, den „Bytecode“ der JVM): hier [persons/Person.class] und [persons/MainKt.class], im Ordner [build] des Projekts.
4.1.3. Definition der Klasse Person
Die Definition der Klasse [Person] in der Quelldatei [Person.kt] lautet wie folgt:
- Zeile 1: Die Klasse gehört zum Paket [persons]. Pakete werden später in diesem Kapitel behandelt;
- Zeile 3: Der Klasse geht kein Sichtbarkeitsschlüsselwort voraus; sie ist öffentlich und kann von allen anderen Klassen verwendet werden. In Kotlin ist [public] die Standardsichtbarkeit;
- Zeilen 5–7: die drei Eigenschaften der Klasse. Das Schlüsselwort [var] gibt an, dass sie veränderbar sind (mit dem Schlüsselwort [val] wären sie schreibgeschützt). Kotlin verlangt, dass eine Eigenschaft initialisiert wird (hier mit dem leeren String und 0): Anders als in Java gibt es keine impliziten Standardwerte ([null], 0, [false]). Die Typen der Eigenschaften, [String] und [Int], werden wie bei einer lokalen Variablen aus diesen Anfangswerten abgeleitet;
- Zeilen 10–13: eine Methode, die den Zustand des Objekts setzt;
- Zeilen 17–18: eine Methode, die den Zustand des Objekts anzeigt.
Hier haben wir die Definition einer Klasse und damit eines Datentyps. Wenn wir Variablen dieses Typs erzeugen, bezeichnen wir sie als Objekte oder Instanzen der Klasse. Eine Klasse ist also ein Template, aus dem Objekte konstruiert werden. Per Konvention beginnt ein Klassenname mit einem Großbuchstaben ([Person]), während der Name einer Eigenschaft oder Methode mit einem Kleinbuchstaben beginnt ([firstName], [initialize]).
Kotlin verwendet den Begriff „Eigenschaften“ statt „Felder“: Wir werden etwas später sehen, dass eine Eigenschaft ein Feld samt zugehöriger Getter- und Setter-Methoden ist, ähnlich den Eigenschaften in C#. Eine private Eigenschaft, wie sie hier gezeigt wird, ist einfach ein Feld. Die Member einer Klasse können Daten (Eigenschaften) oder Methoden (Funktionen) sein. Diesen Membern kann eines der folgenden Schlüsselwörter vorangestellt sein:
Schlüsselwort | Zugriff |
[private] | Auf einen privaten Member kann nur über die eigenen Methoden der Klasse zugegriffen werden |
[protected] | Auf einen geschützten Member kann über die Methoden der Klasse und die ihrer abgeleiteten Klassen zugegriffen werden (siehe unten das Konzept der Vererbung). Anders als in Java ist er für andere Klassen des Pakets nicht zugänglich |
[internal] | Auf einen internen Member kann über jede Methode desselben Moduls zugegriffen werden, d. h. der Menge der gemeinsam kompilierten Dateien (ein Gradle-Projekt oder -Teilprojekt, ein Modul von IntelliJ IDEA) |
[public] | Auf einen öffentlichen Member kann über jede Methode zugegriffen werden, unabhängig davon, ob sie innerhalb der Klasse definiert ist oder nicht. Dies ist die Standard-Zugriffsebene, wenn kein Schlüsselwort angegeben wird |
Im Allgemeinen werden die Daten einer Klasse als privat deklariert, ihre Methoden dagegen als öffentlich. Das bedeutet, dass der Benutzer eines Objekts (der Programmierer):
- keinen direkten Zugriff auf die privaten Daten des Objekts hat;
- die öffentlichen Methoden des Objekts aufrufen kann, auch diejenigen, die Zugriff auf dessen private Daten bieten.
Die Reihenfolge, in der Member deklariert werden, ist beliebig. Beachten Sie, dass die Standard-Zugriffsebene öffentlich ist, anders als in Java, wo der Standard paketprivat ist: In Kotlin müssen Sie [private] ausdrücklich schreiben, um einen Member privat zu machen. Kotlin kennt keinen „Paket“-Zugriff; diesen Zweck erfüllt der Zugriff [internal] auf Modulebene.
Die Schlüsselwörter [private], [internal] und [public] gelten auch für Deklarationen auf oberster Ebene (Klassen, Funktionen und Eigenschaften, die außerhalb jeder Klasse definiert sind). Eine als [private] deklarierte Deklaration auf oberster Ebene ist nur innerhalb ihrer eigenen Datei sichtbar.
4.1.4. Die Methode initialize
Welche Rolle spielt die Methode [initialize]? Da [lastName], [firstName] und [age] private Member der Klasse [Person] sind, ist eine Anweisung wie [p1.firstName = "Jean"] im Hauptprogramm ungültig. Der Compiler lehnt sie ab:
Die Meldung gibt Datei, Zeile und Spalte des Fehlers an ([5:8]) und hebt ihn dann mit Zirkumflexzeichen hervor. In IntelliJ IDEA wird der Fehler schon bei der Eingabe rot unterstrichen, und Gradle zeigt dieselbe Meldung an, der [e:] und der vollständige Dateipfad vorangestellt sind. Die Meldung ist auf Englisch: Der Kotlin-Compiler liefert seine Meldungen nicht in französischer Übersetzung. Wir müssen ein Objekt vom Typ [Person] über eine öffentliche Methode initialisieren. Dafür ist die Methode [initialize] da. Wir schreiben [p1.initialize("Jean", "Dupont", 30)]. Diese Syntax ist gültig, weil [initialize] öffentlich zugänglich ist.
4.1.5. Ein Objekt erzeugen: kein Operator new
Es fehlt jedoch noch etwas. Das Objekt muss erzeugt werden. Im Programm [Main.kt] erzeugt der Ausdruck [Person()] ein Objekt vom Typ [Person]: Die Klasse wird wie eine Funktion „aufgerufen“. Kotlin kennt, anders als Java und C#, keinen Operator new . Das erzeugte Objekt ist noch nicht initialisiert: Seine Eigenschaften haben ihre Anfangswerte, nämlich den leeren String für [lastName] und [firstName], und 0 für [age].
Die Deklaration [val p1 = Person()] deklariert [p1] als Referenz auf dieses Objekt. Wenn wir die Variable ohne Initialisierung deklarieren, [val p1: Person]***, und dann ***[p1.initialize("Jean", "Dupont", 30)]*** schreiben, rufen wir die Methode [initialize] auf einem nicht existierenden Objekt auf, und der Compiler meldet den Fehler: Der Variablen [p1]* wurde kein Wert zugewiesen.
In Java können Sie [Person p1 = null;] schreiben, um anzugeben, dass die Variable noch auf kein Objekt verweist; der Aufruf [p1.initialize(...)] wird vom Compiler akzeptiert und löst zur Laufzeit eine [NullPointerException]-Ausnahme aus. Wie wir im vorherigen Kapitel gesehen haben, unterscheidet Kotlin zwischen Typen, die den Wert [null] zulassen, und solchen, die ihn nicht zulassen. Der Typ [Person] lässt ihn nicht zu:
Der Typ *[Person?]* akzeptiert ihn dagegen, der Compiler lehnt dann aber einen direkten Methodenaufruf ab:
Sie müssen [p1?.initialize(...)] schreiben, was die Methode nur aufruft, wenn [p1] nicht [null] ist, oder [p1!!.initialize(...)], was dem Compiler mitteilt, dass [p1] nicht [null] ist. Ist die Zusicherung im letzteren Fall falsch, wird zur Laufzeit die Java-Ausnahme ausgelöst:
Die meisten Fehler, die Java zur Laufzeit erkennt, werden also vom Kotlin-Compiler erkannt. Damit [p1] auf ein Objekt verweist, schreiben wir [val p1 = Person()]. Da [p1] nun auf ein Objekt verweist, ist die Initialisierungsanweisung für dieses Objekt, [p1.initialize("Jean", "Dupont", 30)], gültig.
4.1.6. Das Schlüsselwort this
Sehen wir uns den Code der Methode [initialize] an:
Die Anweisung [this.firstName = p] bedeutet, dass der Eigenschaft [firstName] des aktuellen Objekts ([this]) der Wert [p] zugewiesen wird. Das Schlüsselwort [this] bezeichnet das aktuelle Objekt: dasjenige, auf dem die Methode ausgeführt wird. Woher wissen wir das? Sehen wir uns an, wie das Objekt, auf das [p1] verweist, im aufrufenden Programm initialisiert wird: [p1.initialize("Jean", "Dupont", 30)]. Aufgerufen wird die Methode [initialize] des Objekts [p1] . Wenn innerhalb dieser Methode auf das Objekt [this] verwiesen wird, ist tatsächlich das Objekt [p1] gemeint.
Wenn eine Methode eines Objekts auf eine Eigenschaft [a] dieses Objekts verweist, ist die Schreibweise [this.a] implizit: Die Methode [initialize] hätte [firstName = p] und [lastName = n] schreiben können. Sie müssen [this] ausdrücklich verwenden, wenn ein Bezeichnerkonflikt vorliegt. Das ist bei der Anweisung [this.age = age] (Zeile 4) der Fall, wo [age] sich sowohl auf eine Eigenschaft des aktuellen Objekts als auch auf den von der Methode empfangenen Parameter [age] bezieht. Innerhalb der Methode bezeichnet der Name [age] allein den Parameter; die Eigenschaft muss als [this.age] angesprochen werden. Beachten Sie, dass ein Funktionsparameter schreibgeschützt ist: Die Anweisung [age = 0] innerhalb der Methode würde vom Compiler abgelehnt.
4.1.7. Ein Testprogramm
Hier ist ein kurzes Testprogramm. Es steht in der Quelldatei [Main.kt]:
- Zeile 4: Die Funktion [main] ist der Einstiegspunkt des Programms. Wie im vorherigen Kapitel ist sie eine Top-Level-Funktion, die außerhalb jeder Klasse geschrieben wird;
- Zeile 6: Erzeugung eines [Person]-Objekts, auf das [p1] verweist. Da die Klasse [Person] zum selben Paket gehört, wird sie erkannt, ohne importiert werden zu müssen. Der Typ von [p1], [Person], wird vom Compiler abgeleitet;
- Zeile 7: Initialisierung des Objekts;
- Zeile 8: Anzeige seines Zustands.
Ergebnisse:
4.1.8. Mehrere Klassen in einer einzigen Datei
Für ein kurzes Beispiel ist ein Paket mit mehreren Dateien unnötig groß. Wie im vorherigen Kapitel schreiben wir daher eine einzige Datei – zum Beispiel [Classes01.kt] –, die die Funktion [main], gegebenenfalls weitere Funktionen und die vom Programm benötigten Klassen enthält. Jede Datei wird in einem nach ihr benannten Paket abgelegt ([classes01]), sodass jedes Programm des Projekts seine eigene Klasse [Person] haben kann: Die Klasse [Person] in der Datei [Classes01.kt] hat den vollständigen Namen [classes01.Person]; die Klasse in der Datei [Classes02.kt] hat den vollständigen Namen [classes02.Person] und so weiter. Ausgeführt wird sie mit dem Befehl [gradlew -q run -Pmain=classes01.Classes01Kt].
Es ist wichtig zu verstehen, wie der Compiler eine solche Datei verarbeitet. Die Klassen in der Datei sind gewöhnliche Klassen auf oberster Ebene, genau so, als stünden sie in einer eigenen Datei; die Top-Level-Funktionen, darunter [main], werden in einer nach der Datei benannten Klasse zusammengefasst, [Classes01Kt]. Das Kompilieren der Datei zeigt dies:
Das hat eine Konsequenz, die Kotlin von Java unterscheidet. In Java sind die Klassen einer kompakten Quelldatei in einer impliziten Klasse verschachtelt und teilen ihre privaten Member mit der Methode [main] der Datei. In Kotlin gibt es keine umschließende Klasse: Ein [private] -Member einer Klasse bleibt für die Funktion [main] unzugänglich, selbst wenn sie in derselben Datei steht. Die kurzen Beispiele dieses Kapitels zeigen daher dieselben Kompilierfehler wie das Programm [persons].
4.1.9. Eine weitere Art der Initialisierung: Überladung
Fahren wir mit der Klasse [Person] fort und fügen ihr eine zweite Methode [initialize] hinzu. Das Programm [Classes01.kt] sieht wie folgt aus:
- Zeile 2: das Paket des Programms;
- Zeilen 4–10: das Hauptprogramm;
- Zeile 14: Die Klasse [Person] wird nach der Funktion [main] deklariert. In Kotlin spielt die Reihenfolge der Deklarationen in einer Datei keine Rolle;
- Zeilen 21–24: die Methode [initialize] aus dem vorherigen Abschnitt;
- Zeilen 28–31: eine zweite Methode [initialize].
Wir haben nun zwei Methoden mit dem Namen [initialize]: Das ist gültig, solange sie unterschiedliche Parameter (in Anzahl oder Typ) akzeptieren. Die Methode [initialize] wird als überladen bezeichnet. Der Compiler wählt anhand der tatsächlichen Parameter aus, welche Methode aufgerufen wird: [p1.initialize("Jean", "Dupont", 30)] (Zeile 6) ruft die erste auf, und [p2.initialize(p1)] (Zeile 9) ruft die zweite auf. Der Rückgabetyp allein genügt nicht, um zwei Methoden zu unterscheiden: Zwei Methoden mit demselben Namen und denselben Parametern, die sich nur im Rückgabetyp unterscheiden, würden abgelehnt. Wir werden sehen, dass in Kotlin Standardwerte für Parameter es oft überflüssig machen, mehrere Versionen derselben Methode zu schreiben.
Der Parameter der zweiten Methode ist eine Referenz ([p]) auf eine Person. Die Eigenschaften der Person ([p]) werden dann dem aktuellen Objekt ([this]) zugewiesen. Beachten Sie, dass die Methode [initialize] direkten Zugriff auf die Eigenschaften des Objekts [p] hat, obwohl sie privat sind (Zeilen 29–31). Das gilt immer: Eine Methode einer Klasse [C] hat Zugriff auf die privaten Member aller Objekte derselben Klasse [C].
Ergebnisse:
4.1.10. Konstruktoren der Klasse Person
Ein Konstruktor ist eine Funktion, die beim Erzeugen eines Objekts aufgerufen wird. Er dient im Allgemeinen dazu, das Objekt zu initialisieren. Er kann Parameter akzeptieren, gibt aber keinen Wert zurück. Wenn eine Klasse [C] einen Konstruktor mit n Parametern hat, wird das Erzeugen eines Objekts dieser Klasse als [val obj = C(arg1, arg2, ... argn)] geschrieben.
Wenn eine Klasse [C] einen oder mehrere Konstruktoren hat, muss einer dieser Konstruktoren verwendet werden, um ein Objekt dieser Klasse zu erzeugen. Wenn eine Klasse [C] keinen Konstruktor deklariert, hat sie einen Standardkonstruktor ohne Parameter, der nichts tut. Die Eigenschaften des Objekts behalten dann ihre Anfangswerte. So war es in den vorherigen Programmen, in denen wir [Person()] geschrieben haben.
Kotlin unterscheidet zwei Arten von Konstruktoren:
- den primären Konstruktor, höchstens einer pro Klasse, der im Klassenkopf unmittelbar nach dem Klassennamen deklariert wird: [class Person(firstName: String, lastName: String, age: Int)];
- sekundäre Konstruktoren, die im Rumpf der Klasse mit dem Schlüsselwort [constructor] deklariert werden. Hat eine Klasse einen primären Konstruktor, muss jeder sekundäre Konstruktor ihn aufrufen, entweder direkt oder über einen anderen sekundären Konstruktor.
Das Programm [Classes02.kt] stellt drei Konstruktoren für die Klasse [Person] bereit:
- Zeile 15: der primäre Konstruktor. Seinen drei Parametern geht [private val] voraus: Das ist eine Kurzschreibweise, die gleichzeitig einen Konstruktorparameter und eine private, schreibgeschützte Eigenschaft mit demselben Namen deklariert, die mit dem Wert des Parameters initialisiert wird. Die Klasse hat keine weiteren Eigenschaften: Diese werden im Kopf deklariert;
- Zeile 17: der sekundäre Kopierkonstruktor. Die Notation [: this(p.firstName, p.lastName, p.age)] ruft den Konstruktor derselben Klasse auf, der drei Parameter akzeptiert: [String], [String] und [Int] – in diesem Fall den primären Konstruktor. Man spricht hier von verketteten Konstruktoren. Dadurch wird der Initialisierungscode nur einmal geschrieben. Dieser Konstruktor hat keinen Rumpf: Er hat nichts weiter zu tun;
- Zeile 20: der sekundäre Konstruktor ohne Parameter, ebenfalls mit dem primären Konstruktor verkettet. Da die Klasse einen primären Konstruktor mit Parametern deklariert hat, besitzt sie keinen Standardkonstruktor mehr: Wenn wir [Person()] schreiben können wollen, müssen wir ihn deklarieren;
- Zeilen 4–10: Die drei Konstruktoren werden verwendet.
Die abgekürzte Notation in Zeile 15 entspricht der folgenden längeren Notation, in der die Parameter des primären Konstruktors – ohne *[val]* – einfach Parameter sind, die zur Initialisierung von Eigenschaften dienen, die im Rumpf der Klasse deklariert werden:
Das ist viel kürzer als die Java-Version, in der Sie die Felder deklarieren und dann einzeln im Konstruktor initialisieren müssen ([this.firstName = firstName;] …). Der primäre Konstruktor hat keinen Rumpf: Die Anweisungen, die beim Konstruieren des Objekts auszuführen sind, stehen in [init]-Blöcken, die wir etwas später behandeln. Wir werden auch sehen, dass Kotlin dank Standardwerten für Parameter oft keine sekundären Konstruktoren braucht: [class Person(..., private val age: Int = 0)] erlaubt es, sowohl [Person("Jean", "Dupont", 30)] als auch [Person("Jean", "Dupont")] zu schreiben.
Ergebnisse:
4.1.11. Objektreferenzen
Wir verwenden die Klasse [Person] aus dem vorherigen Programm, lassen aber ihren parameterlosen Konstruktor weg und nehmen die Methode [initialize(String, String, Int)] vom Anfang des Kapitels hinzu. Ihre Eigenschaften werden daher mit [var] statt mit [val] deklariert. Das Testprogramm lautet nun wie folgt [Classes03.kt]:
Die Funktion [print] (Zeilen 7, 10, …) schreibt ihren Parameter, ohne eine neue Zeile zu beginnen. Die beiden Anweisungen in diesen Zeilen sind durch ein Semikolon getrennt, das in Kotlin nur nötig ist, um mehrere Anweisungen in einer Zeile zu schreiben. Ergebnisse:
Wenn die Variable [p1] mit [val p1 = Person("Jean", "Dupont", 30)] (Zeile 6) deklariert wird, verweist [p1] auf das Objekt [Person("Jean", "Dupont", 30)] , ist aber nicht das Objekt selbst. In C würde man dies als Zeiger bezeichnen, also als Adresse des erzeugten Objekts. Wäre [p1] als [var p1: Person? = ...] deklariert und würden wir dann [p1 = null] schreiben, würde nicht das Objekt [Person("Jean", "Dupont", 30)] verändert, sondern die Referenz [p1] würde ihren Wert ändern. Das Objekt wäre „verloren“, wenn keine andere Variable darauf verwiese: Der von ihm belegte Speicher würde später vom Garbage Collector der Java Virtual Machine freigegeben, die Kotlin-Programme genauso ausführt wie Java-Programme.
Wenn wir [val p2 = p1] (Zeile 9) schreiben, initialisieren wir die Referenz [p2]: Sie „zeigt“ auf dasselbe Objekt (sie verweist auf dasselbe Objekt) wie die Referenz [p1]. Wenn Sie also das Objekt verändern, auf das [p1] „zeigt“ (bzw. verweist), verändern Sie auch das Objekt, auf das [p2] verweist (Zeilen 4–5 der Ergebnisse). Beachten Sie, dass [p1] und [p2] mit [val] deklariert sind: Das Schlüsselwort verbietet es, die in der Variablen enthaltene Referenz zu ändern, nicht aber, das referenzierte Objekt zu verändern, was der Aufruf von [p1.initialize(...)] tut (Zeile 15).
Wenn Sie [val p3 = Person(p1)] (Zeile 12) eingeben, wird ein neues Objekt [Person] erzeugt. Auf dieses neue Objekt verweist [p3]. Wenn Sie das Objekt verändern, auf das [p1] verweist, hat das keine Auswirkung auf das Objekt, auf das [p3] verweist (Zeile 6 der Ergebnisse).
Schließlich gibt in Zeile 22 der Operator [===], angewandt auf zwei Objektreferenzen, an, ob sie auf dasselbe Objekt verweisen: [p1] und [p2] verweisen auf dasselbe Objekt, während [p1] und [p3] auf zwei verschiedene Objekte verweisen, obwohl diese denselben Inhalt haben (Zeile 7 der Ergebnisse). Das ist der Operator [] in Java. In Kotlin vergleicht der Operator [] die Inhalte der Objekte, indem er ihre Methode [equals] aufruft: Wie man sie definiert, sehen wir später. Bei einer Klasse, die [equals] nicht definiert, wie in diesem Fall, vergleicht [p1 == p3] weiterhin die Referenzen und ergibt [false].
4.1.12. Übergabe von Objektreferenzen als Parameter
Im vorherigen Kapitel haben wir gesehen, dass Kotlin wie Java Funktionsparameter als Wert übergibt: Die Funktion erhält eine Kopie des Werts des tatsächlichen Parameters. Sehen wir uns an, was das bedeutet, wenn der Parameter eine Objektreferenz ist. Dazu verwenden wir die Klasse [StringBuilder] (eine Klasse des JDK, die Kotlin direkt verwendet). Ein [String]-Objekt kann nicht verändert werden: Eine Operation wie [s.uppercase()] gibt ein neues [String]-Objekt zurück. Ein [StringBuilder]-Objekt hingegen ist ein veränderbarer String: Seine Methode [append] hängt Zeichen an den String an, ohne ein neues Objekt zu erzeugen.
In Java wurde im Beispiel dem Parameter [sbf1] der aufgerufenen Funktion ein neues Objekt zugewiesen. Das ist in Kotlin nicht möglich: Ein Funktionsparameter ist schreibgeschützt, genau wie eine [val]-Variable. Der Compiler lehnt die Anweisung [sbf1 = StringBuilder("test1*****")] ab:
Das Programm [Classes04.kt] kopiert den Parameter [sbf1] daher in eine veränderbare lokale Variable:
- Zeilen 5–6: zwei Referenzen, [sb0] und [sb1], auf Objekte vom Typ [StringBuilder];
- Zeile 8: Diese werden an die Funktion [changeStringBuilder] übergeben, deren Ergebnis – eine dritte Referenz – [sb2] zugewiesen wird;
- Zeilen 13–24: eine Top-Level-Funktion mit den formalen Parametern [sbf0] und [sbf1]. Beim Start der Funktion sind [sbf0] und [sb0] zwei verschiedene Referenzen, die auf dasselbe Objekt zeigen: Die Referenz [sb0] wurde nach [sbf0] kopiert (Referenzen werden als Wert übergeben). Dasselbe gilt für [sbf1] und [sb1];
- Zeilen 19–20: Die lokale Variable [sbl] erhält zuerst die Referenz [sbf1], dann die Referenz auf ein neues Objekt. Das tat das Java-Programm mit dem Parameter [sbf1] selbst.
Ergebnisse:
Erläuterungen:
- [sb0] und [sbf0] sind zwei verschiedene Referenzen auf dasselbe Objekt. Dieses Objekt wurde über [sbf0] verändert (Zeile 16). Diese Änderung ist über [sb0] sichtbar (Zeile 4 der Ergebnisse);
- [sb1], [sbf1] und anfangs [sbl] sind drei verschiedene Referenzen auf dasselbe Objekt. [sbl] wird ein neuer Wert zugewiesen und verweist nun auf ein neues Objekt (Zeile 20). Das ändert weder den Wert von [sbf1] noch den von [sb1], die weiterhin auf das ursprüngliche, unveränderte Objekt verweisen (Zeilen 3 und 4 der Ergebnisse);
- eine Kotlin-Funktion kann den Wert einer Variablen des Aufrufers also nicht ändern. Um dem Aufrufer ein neues Objekt zu übergeben, gibt sie es als Ergebnis zurück (Zeilen 22 und 24). Bei mehreren Ergebnissen werden diese in einem Objekt zusammengefasst: einem Paar ([Pair]), wie im vorherigen Kapitel gesehen, oder einer Datenklasse (siehe unten).
Denken Sie daran, dass eine Funktion das Objekt , auf das ein Parameter verweist, verändern kann, nicht aber die Variable des Aufrufers, die die Referenz enthält. Wie Java und anders als C# übergibt Kotlin Parameter nicht per Referenz; es geht einen Schritt weiter als Java, indem es jede Zuweisung an einen Parameter verbietet, was Verwechslungen zwischen dem Parameter und der Variablen des Aufrufers verhindert.
4.1.13. Temporäre Objekte
In einem Ausdruck können Sie den Konstruktor eines Objekts ausdrücklich aufrufen: Das Objekt wird erzeugt, aber es gibt keine Variable, über die man später darauf zugreifen könnte (um es etwa zu verändern). Dieses temporäre Objekt wird zur Auswertung des Ausdrucks erzeugt und anschließend verworfen. Der von ihm belegte Speicherplatz wird später automatisch vom Garbage Collector freigegeben, dessen Aufgabe es ist, den Speicherplatz von Objekten freizugeben, auf die die Daten des Programms nicht mehr verweisen.
Betrachten wir das folgende Programm [Classes05.kt], in dem die Konstruktoren der Klasse [Person] eine Meldung anzeigen. Das ist eine Gelegenheit, den Initialisierungsblock [init] einzuführen:
- Zeile 5: Das Objekt [Person("Jean", "Dupont", 30)] wird konstruiert und dann an den Kopierkonstruktor übergeben, der ein zweites Objekt konstruiert; auf diesem Objekt wird anschließend die Methode [identify] aufgerufen. Auf keines der beiden Objekte verweist eine Variable;
- Zeilen 9–11: Da der primäre Konstruktor keinen Rumpf hat, stehen die Anweisungen, die beim Konstruieren des Objekts auszuführen sind, in einem [init]-Block. Eine Klasse kann mehrere [init]-Blöcke haben: Sie werden zusammen mit den Initialisierungen der im Klassenrumpf deklarierten Eigenschaften in der Reihenfolge ausgeführt, in der sie geschrieben sind. Sie sind Teil des primären Konstruktors und haben Zugriff auf dessen Parameter;
- Zeilen 15–16: Ein sekundärer Konstruktor kann einen Rumpf haben. Er wird nach dem Konstruktor ausgeführt, der durch [: this(...)] aufgerufen wird – hier der primäre Konstruktor mit seinen [init]-Blöcken.
Ergebnisse:
Die Ergebnisse zeigen die sequenzielle Konstruktion der beiden temporären Objekte. Das erste wird vom primären Konstruktor konstruiert (Zeile 1 der Ergebnisse). Das zweite wird vom sekundären Konstruktor konstruiert, der zunächst den primären Konstruktor aufruft – daher die Ausführung des [init]-Blocks (Zeile 2) – und dann seinen eigenen Rumpf ausführt (Zeile 3). In Java war der Kopierkonstruktor des Beispiels nicht mit dem primären Konstruktor verkettet und zeigte nur seine eigene Meldung an; in Kotlin durchläuft jedes Objekt den primären Konstruktor, sofern eine Klasse einen hat: Die [init]-Blöcke werden immer ausgeführt.
4.1.14. Eigenschaften: Getter- und Setter-Methoden
In Java ist es üblich, private Felder zu deklarieren und den Zugriff auf ihre Werte über öffentliche Methoden bereitzustellen: Getter wie [getAge()] und Setter wie [setAge(int)]. Diese Methoden werden von Hand geschrieben (oder von der Entwicklungsumgebung generiert), und der Benutzer der Klasse schreibt [p.setAge(p.getAge() + 1)]. Kotlin kennt wie C# Eigenschaften: Eine öffentliche Eigenschaft ist ein Datum, das der Benutzer wie ein Feld mit der Punktnotation liest und schreibt, das aber tatsächlich über einen Getter und einen Setter gelesen und geschrieben wird. Der Compiler generiert sie. Das Programm [Classes06.kt] demonstriert dies:
- Zeile 14: Die Klasse
*[Person]* passt in eine einzige Zeile. Den drei Parametern des primären Konstruktors geht*[var]*voraus: Das sind drei öffentliche Eigenschaften (Standardsichtbarkeit), die sowohl lesbar als auch schreibbar sind. Da die Klasse keinen Rumpf hat, entfallen die geschweiften Klammern; - Zeile 7: Lesen der Eigenschaften [p.firstName], [p.lastName] und [p.age]. Jede Leseoperation ist ein Aufruf des Accessors der Eigenschaft;
- Zeile 9: Schreiben der Eigenschaft [age], d. h. Aufruf ihres Setters.
Ergebnisse:
Das Werkzeug [javap] des JDK, das den Inhalt einer [.class]-Datei anzeigt, zeigt, was der Kotlin-Compiler für die Klasse [Person] generiert hat (die Option [-p] zeigt auch private Member an):
Jede Eigenschaft ergab ein privates Feld (Zeilen 3–5), einen öffentlichen Getter und einen öffentlichen Setter (Zeilen 7–12), die der in den Anfangstagen von Java festgelegten Namenskonvention „JavaBeans“ folgen: Der Getter der Eigenschaft [age] heißt [getAge], und ihr Setter heißt [setAge]; eine boolesche Eigenschaft, deren Name mit [is] beginnt – etwa [isActive] –, hat einen Getter mit demselben Namen, [isActive], und einen Setter namens [setActive]. Das ist wichtig: Viele Java-Bibliotheken (wie Jackson für JSON und Hibernate für Datenbanken, die wir später verwenden werden) stützen sich auf diese Konvention, um die Daten eines Objekts zu finden; sie finden die Daten von Kotlin-Objekten ohne Weiteres. Umgekehrt schreibt ein Kotlin-Programm, das eine Java-Klasse verwendet, [p.age] , um [p.getAge()] aufzurufen, und [p.age = 56] , um [p.setAge(56)] aufzurufen. Wir stellen außerdem fest, dass die Klasse und ihre Methoden [final] sind: Bei der Vererbung werden wir sehen, dass Klassen und Methoden in Kotlin standardmäßig final sind.
Die Notation [p.age = 56] ähnelt der Zuweisung an ein öffentliches Feld. Der Unterschied ist bedeutend: Da ein Setter verwendet wird, können wir – ohne etwas am Code der Benutzer der Klasse zu ändern – der Eigenschaft später einen Setter geben, der die Werte kontrolliert, die sie erhält. Das ist das Thema des folgenden Abschnitts. In Kotlin schreiben wir daher nie Accessoren oder Setter im Java-Stil: Wir deklarieren Eigenschaften.
4.1.15. Setter, die empfangene Werte validieren
Der Vorteil von Settern gegenüber öffentlichen Feldern ist die Möglichkeit, die den Feldern zugewiesenen Werte zu kontrollieren: Ein Setter kann den empfangenen Wert validieren und eine Ausnahme auslösen, wenn er ungültig ist. Kotlin erlaubt es, eine Eigenschaft mit einem benutzerdefinierten Getter ([get]) und einem benutzerdefinierten Setter ([set]) auszustatten. Betrachten wir das Programm [Classes07.kt]:
Die drei Eigenschaften haben einen benutzerdefinierten Setter, der den empfangenen Wert validiert:
- Zeilen 39–44: die Eigenschaft [firstName]. Auf ihre Deklaration folgt in den nächsten Zeilen die Definition ihres Setters, [set(value) { ... }]. Der Parameter [value] ist der der Eigenschaft zugewiesene Wert (der Name [value] ist wie in C# üblich); sein Typ ist der der Eigenschaft. Die Eigenschaft hat keinen benutzerdefinierten Accessor: Sie behält den generierten Accessor, der den gespeicherten Wert zurückgibt;
- Zeile 42: Die Funktion [require(condition) { message }], die im vorherigen Kapitel besprochen wurde, löst eine [IllegalArgumentException]-Ausnahme aus – die Ausnahme, die einen ungültigen Parameter signalisieren soll –, wenn die Bedingung falsch ist. Die Meldung, die vom Lambda-Ausdruck in geschweiften Klammern berechnet wird, wird nur in diesem Fall erstellt. Die Funktion [isNotBlank] gibt [true] zurück, wenn der String mindestens ein anderes Zeichen als ein Leerzeichen enthält. Der Wert [null] muss nicht wie in Java geprüft werden: Die Eigenschaft hat den Typ [String], nicht [String?], und der Compiler verbietet es, ihr [null] zuzuweisen;
- Zeile 44: In einem Getter oder Setter bezeichnet das Schlüsselwort [field] das Feld, das den Wert der Eigenschaft speichert (das sogenannte „Backing Field“). Schreiben Sie nicht [firstName = value]: Das wäre ein Aufruf des Setters selbst, der sich endlos selbst aufrufen würde;
- Zeilen 47–58: Die Eigenschaften [lastName] und [age] sind nach demselben Muster aufgebaut;
- Zeile 37: Die Klasse hat einen primären Konstruktor ohne Parameter. Die Anfangswerte der Eigenschaften ([""] und 0) werden den Feldern direkt zugewiesen, ohne die Setter zu durchlaufen;
- Zeilen 62–65: ein sekundärer Konstruktor, der das Objekt über die Setter initialisiert. So kann er die Prüfungen nutzen, die die Setter durchführen und die nur einmal geschrieben werden. Hier ist [this.firstName = firstName] der Aufruf des Setters der Eigenschaft [firstName] mit dem Wert des Parameters [firstName].
Warum schreiben wir nicht [class Person(firstName: String, lastName: String, age: Int)] mit Eigenschaften, die durch [var age = age] initialisiert werden? Weil die Initialisierung einer Eigenschaft bei ihrer Deklaration direkt das Feld betrifft, ohne den Setter aufzurufen: Ein Alter von -4 würde ohne Fehler akzeptiert. Um die vom primären Konstruktor empfangenen Werte zu prüfen, schreiben wir die Prüfungen in einen [init]-Block oder, wie hier gezeigt, leiten die Werte durch die Setter.
In Java mussten vom Konstruktor aufgerufene Setter als [final] deklariert werden: Andernfalls hätte eine abgeleitete Klasse sie neu definieren können, und der Konstruktor der Elternklasse hätte die neue Version schon aufgerufen, bevor der Konstruktor der abgeleiteten Klasse ausgeführt wurde. In Kotlin sind Klassen und ihre Member standardmäßig final: Diese Vorsichtsmaßnahme ist unnötig.
Ergebnisse:
Zeile 3 der Ergebnisse zeigt, dass die Zuweisung [p.age = -4] (Zeile 10) vom Setter abgelehnt wurde: [ex.message] ist die Meldung der Ausnahme. Zeilen 15–18: Ein Objekt wird mit dem parameterlosen Konstruktor erzeugt und dann über seine Setter initialisiert. Zeilen 21–23: Der Name, der ein Leerzeichen enthält, wird abgelehnt (Zeile 5 der Ergebnisse). Zeilen 29–30: Der Konstruktor mit drei Parametern lehnt einen leeren Vornamen ab (Zeile 6 der Ergebnisse).
Java kennt keine Objektinitialisierer – eine Syntax, mit der sich mehrere Eigenschaften direkt im Ausdruck setzen ließen, der das Objekt erzeugt. Kotlin kennt sie ebenfalls nicht, bietet aber zwei gleichwertige Lösungen: benannte Konstruktorparameter mit Standardwerten und die Funktion [apply]. Wir behandeln sie in den nächsten beiden Abschnitten.
4.1.16. Schreibgeschützte Eigenschaften und optionale Parameter
Einer mit [val] deklarierten Eigenschaft muss genau einmal ein Wert zugewiesen werden – bei ihrer Deklaration, im primären Konstruktor oder in einem [init]-Block –, und sie kann danach nicht mehr verändert werden. Der Compiler erzwingt dies. Das entspricht dem [final]-Feld in Java: Die Eigenschaft hat nur einen Getter, keinen Setter. Das Programm [Classes08.kt] veranschaulicht mehrere Fälle sowie Standardparameter und benannte Argumente:
- Zeile 33: Der Vorname ist eine [var]-Eigenschaft, also les- und schreibbar; Nachname und Stadt sind [val]-Eigenschaften, also schreibgeschützt. Der Konstruktor weist ihnen einen Wert zu, der danach nicht mehr geändert werden kann. Der Parameter [age] ohne [val] oder [var] ist einfach ein Konstruktorparameter;
- Zeilen 35–36: Die Eigenschaft [age] wird mit dem Parameter [age] initialisiert. Sie ist für alle lesbar, ihr Setter ist jedoch privat ([private set]): Sie kann nur von den Methoden der Klasse verändert werden, etwa von [growOlder] (Zeilen 43–44). Der Setter behält sein Standardverhalten: Er braucht keinen Rumpf;
- Zeilen 39–40: eine berechnete Eigenschaft. Sie hat einen benutzerdefinierten Accessor, [get() = ...], der ihren Wert bei jedem Lesen anhand der anderen Eigenschaften berechnet; sie hat kein Feld, in dem ein Wert gespeichert wäre. Für den Benutzer der Klasse unterscheidet nichts sie von einer anderen Eigenschaft: [p.identity] (Zeile 7). Das entspricht der Methode [getIdentity()] in der Java-Version;
- Zeilen 14–16: drei Anweisungen, die der Compiler aus den in den Kommentaren genannten Gründen ablehnt. Wenn wir die Kommentarzeichen entfernen, meldet der Compiler Folgendes (wir haben auch die in Zeile 24 erwähnte Anweisung [Contact(null)] einkommentiert):
- Zeile 49: Die Klasse [Contact] hat eine Pflichteigenschaft, email, und eine optionale Eigenschaft, phone. Dass die Eigenschaft phone optional ist, wird durch einen Standardwert für den Konstruktorparameter [phone] ausgedrückt: [val phone: String = "unknown"]. Wird das Argument weggelassen, wie in Zeile 19, nimmt der Parameter diesen Wert an. In Java, das keine optionalen Parameter kennt, war ein zweiter, mit dem ersten verketteter Konstruktor erforderlich; in Kotlin genügt ein einziger Konstruktor. Standardwerte werden auf dieselbe Weise für die Parameter jeder Funktion verwendet;
- Zeile 22: Die Argumente sind benannt: [phone = "02 41 00 00 00"]. Sie können dann in beliebiger Reihenfolge angegeben werden, und der Aufruf ist lesbarer, wenn mehrere Parameter denselben Typ haben. Benannte Argumente erlauben es auch, nur einen optionalen Parameter unter mehreren wegzulassen: Mit [f(a: Int = 0, b: Int = 0)] können Sie [f(b = 5)] schreiben;
- Zeilen 51–52: Dass die E-Mail-Adresse zwingend ist, wird zunächst durch den Parametertyp ausgedrückt: [String] akzeptiert den Wert [null] nicht, und der Aufruf [Contact(null)] wird zur Kompilierzeit abgelehnt (letzter Fehler oben). In Java musste dies zur Laufzeit geprüft werden ([Objects.requireNonNull]). Als Nächstes wird eine leere E-Mail-Adresse abgelehnt: Das ist die Aufgabe des Blocks [init], der beim Konstruieren des Objekts ausgeführt wird. In Zeile 26 wird eine E-Mail-Adresse abgelehnt, die aus einem einzigen Leerzeichen besteht.
Ergebnisse:
Beachten Sie, wie kurz die Deklarationen sind: Die Klasse [Person], die in Java mit ihren Gettern, Settern und der Validierung etwa fünfzig Zeilen umfasste, braucht in Kotlin nur etwa fünfzehn.
4.1.17. Die Funktionen apply und also statt fluenter Mutatoren
Wenn ein Objekt in Java viele optionale Felder hat, steigt die Zahl der Konstruktoren, und die Setter-Aufrufe werden länger. Eine gängige Technik besteht darin, dass jeder Setter das aktuelle Objekt ([this]) zurückgibt: Die Aufrufe lassen sich dann verketten – man spricht von „verketteten“ Methoden: [new Person().setFirstName("jean").setLastName("Dupont").setAge(30)]. In Kotlin machen Standardparameter und benannte Argumente diese Technik viel weniger nützlich. Und wenn Sie unmittelbar nach der Erzeugung eines Objekts mehrere seiner Eigenschaften setzen möchten, stellt die Standardbibliothek „Scope-Funktionen“ bereit, die mit jedem Objekt verwendet werden können, darunter [apply] und [also]. Das Programm [Classes09.kt] veranschaulicht sie und führt nebenbei die Eigenschaften [lateinit] ein:
- Zeilen 7–10: [obj.apply { ... }] führt den Block in geschweiften Klammern mit [obj] als aktuellem Objekt aus: Innerhalb des Blocks steht [firstName = " jean "] für [this.firstName = " jean "], wobei [this] die neue Person ist. Dann gibt [apply] das Objekt selbst zurück, das [p] zugewiesen wird. Die Zuweisung wirkt als Objektinitialisierer; jede Zuweisung läuft über den Setter der Eigenschaft und damit über dessen Validierungen;
- Zeilen 39–46: Die Setter für Vor- und Nachnamen weisen dem Feld den Wert zu, den die Funktion [validate] zurückgibt;
- Zeilen 64–66: Die identischen Validierungen für Vor- und Nachnamen sind in die Funktion [validate] ausgelagert. Sie verwendet keine Eigenschaften einer Person: Wir haben sie als Top-Level-Funktion umgesetzt, die als [private] deklariert und daher nur in der Datei [Classes09.kt] sichtbar ist. In Java hätte man sie als private statische Methode der Klasse implementieren müssen. Die Funktion [trim] entfernt führende und nachfolgende Leerzeichen aus dem String;
- Zeile 59: Der Typ der berechneten Eigenschaft [identity], [String], wird aus dem Ausdruck ihres Accessors abgeleitet;
- Zeilen 25–26: [obj.also { ... }] führt den Block aus und übergibt ihm das Objekt als Parameter, der als [it] bezeichnet wird, und gibt dann das Objekt zurück. Es dient für eine Nebenaktion – etwa eine Fortschrittsanzeige, wie hier gezeigt –, ohne die Aufrufkette zu unterbrechen. Hier gibt [apply] die Person zurück, [also] zeigt sie an und gibt sie dann seinerseits zurück, und sie wird [p2] zugewiesen. Zeile 25: Die drei Zuweisungen im [apply]-Block stehen in einer einzigen Zeile, durch Semikolons getrennt;
- Zeile 56: Einer Eigenschaft eines anderen Typs als [null] muss grundsätzlich bei der Erzeugung ein Wert zugewiesen werden. Das Schlüsselwort [lateinit] („späte Initialisierung“) hebt diese Anforderung auf: Die Eigenschaft [city] erhält ihren Wert erst später (Zeile 33). Wird vorher darauf zugegriffen, wird eine [UninitializedPropertyAccessException]-Ausnahme ausgelöst (Zeilen 29–31). [lateinit] gilt nur für eine Eigenschaft [var] eines Objekttyps, der nicht [null] ist ([String], aber nicht [Int] oder [String?]) und ohne benutzerdefinierte Accessoren oder Mutatoren. Sie wird verwendet, wenn der Wert nach der Konstruktion des Objekts bereitgestellt wird, zum Beispiel durch ein Dependency-Injection-Framework wie Spring (Kapitel 6) oder durch eine Initialisierungsmethode in einem Test. Innerhalb der Klasse gibt der Ausdruck [::city.isInitialized] an, ob der Eigenschaft ein Wert zugewiesen wurde.
Ergebnisse:
Der Vorname „jean“, der mit Leerzeichen drumherum eingegeben wurde (Zeile 8), wurde ohne sie gespeichert (Zeile 1 der Ergebnisse). Ungültige Änderungsversuche wurden abgelehnt, und die Person wurde nicht verändert (Zeilen 2–4 der Ergebnisse). Zeile 6 der Ergebnisse ist die Meldung der Ausnahme [UninitializedPropertyAccessException].
Es gibt drei weitere Scope-Funktionen: [let], im vorherigen Kapitel mit den Werten [null] gesehen, [run], und [with]. Sie unterscheiden sich darin, wie der Block auf das Objekt verweist ([this] oder [it]), und in dem, was sie zurückgeben (das Objekt oder das Ergebnis des Blocks):
Funktion | Objekt im Block | Ergebnis | Typische Verwendung |
[apply] | [this] | Das Objekt | Ein neu erzeugtes Objekt konfigurieren |
[also] | [it] | Das Objekt | Folgeaktion (Überwachung, Überprüfung) in einer Sequenz |
[let] | [it] | Das Ergebnis des Blocks | Einen Wert verarbeiten, der nicht [null] ist: [x?.let { ... }] |
[run] | [this] | Das Ergebnis des Blocks | Einen Wert aus einem Objekt berechnen |
[with] | [this] | Das Ergebnis des Blocks | [with(obj) { ... }]: Mehrere Aufrufe auf demselben Objekt |
Zum Erstellen komplexer Objekte verwendet Java häufig das Entwurfsmuster „Builder“: Eine Hilfsklasse mit fluenten Methoden sammelt Werte und konstruiert dann das endgültige Objekt. In Kotlin ersetzt ein Konstruktor mit benannten Parametern und Standardwerten dieses Muster in den meisten Fällen.
4.1.18. Klassenmember: das Companion-Objekt
Angenommen, wir möchten die Anzahl der in einer Anwendung erzeugten [Person]-Objekte zählen. Wir könnten selbst einen Zähler führen, laufen dann aber Gefahr, temporäre Objekte zu übersehen, die hier und da erzeugt werden. Sicherer scheint es, in den Konstruktor der Klasse [Person] eine Anweisung aufzunehmen, die einen Zähler erhöht. Dieser Zähler kann keine gewöhnliche Eigenschaft sein, da jedes Objekt seine eigenen Eigenschaften hat: Er ist eine Eigenschaft der Klasse selbst, nicht einer bestimmten Instanz dieser Klasse.
Java deklariert einen solchen Member mit dem Schlüsselwort [static]. Kotlin kennt kein Schlüsselwort [static]: Klassenmember werden in einem Companion-Objekt ([companion object { ... }]) deklariert, einem einzelnen Objekt, das an die Klasse gebunden und im Klassenrumpf deklariert ist. Seine Member werden mit dem Klassennamen verwendet: [Person.nbPersons], [Person.unknown()]. Hier ein Beispiel, [Classes10.kt]:
- Zeilen 31–37: das Companion-Objekt der Klasse [Person];
- Zeilen 33–34: die Klasseneigenschaft [nbPersons], mit 0 initialisiert (vom Typ [Long] aufgrund des Suffixes [L]). Sie ist für alle lesbar ([Person.nbPersons], Zeile 8), ihr Setter ist jedoch privat: Nur die Klasse [Person] kann sie verändern. Man muss nicht wie in Java ein privates Feld und eine statische Accessor-Methode [getNbPersons()] definieren;
- Zeile 37: eine Klassenmethode. Sie wird mit dem Klassennamen aufgerufen: [Person.unknown()] (Zeile 10). Eine Methode des Companion-Objekts hat kein aktuelles [Person]-Objekt: Sie kann die Eigenschaften einer Person nicht direkt verwenden. Eine Methode, die wie diese ein Objekt ihrer Klasse erzeugt und zurückgibt, nennt man eine „Factory“;
- Zeilen 21–22: Der Block [init] erhöht den Zähler. Er ist Teil des primären Konstruktors, und der Kopierkonstruktor – der mit dem primären Konstruktor verkettet ist – führt ihn daher ebenfalls aus.
Das letzte Element des Programms ist ein Singleton-Objekt, [Log], das mit dem Schlüsselwort [object] deklariert wird (Zeilen 42–48):
- Eine Deklaration wie [object Log { ... }] deklariert sowohl eine Klasse als auch ihre einzige Instanz, die bei der ersten Verwendung automatisch erzeugt wird. Es gibt keinen Konstruktor: Es kann kein weiteres [Log]-Objekt erzeugt werden. Auf das Objekt wird über seinen Namen verwiesen: [Log.write(...)];
- ein Objekt hat einen Zustand – hier die Nummer der zuletzt geschriebenen Meldung –, der von einem Aufruf zum nächsten erhalten bleibt;
- Ein Companion-Objekt ist ein Sonderfall eines Singleton-Objekts: eines, das an eine Klasse gebunden ist.
Ergebnisse:
Das Programm hat das in Zeile 7 erzeugte temporäre Objekt korrekt mitgezählt. Das Log hat seine beiden Meldungen nummeriert. Das Kompilieren erzeugt eine Klasse für das Companion-Objekt, [Person$Companion], neben den Klassen [Person], [Log], und [Classes10Kt]; eine Methode des Companion-Objekts ist für die JVM also eine Instanzmethode des Objekts [Person.Companion]. Damit ein Java-Programm sie als statische Methode aufrufen kann ([Person.unknown()] statt [Person.Companion.unknown()]), wird sie mit [@JvmStatic] annotiert.
Von Anfang an verwenden wir Funktionen, die in Java statische Methoden wären: [println], [readln] … In Kotlin sind dies Top-Level-Funktionen, die außerhalb jeder Klasse deklariert werden. So schreibt man in Kotlin, was Java als Hilfsklasse bezeichnet, etwa die Klasse [Math]: eine Datei mit Top-Level-Funktionen (die Standardbibliothek stellt [kotlin.math.sqrt] und [kotlin.math.PI] bereit) oder, wenn Sie Funktionen unter einem gemeinsamen Namen gruppieren möchten, ein [object]. Das Companion-Objekt ist Elementen vorbehalten, die wirklich klassenspezifisch sind: Factories, Konstanten und Zähler.
4.1.19. Ein Array von Personen
Ein Objekt ist ein Datum wie jedes andere, und daher lassen sich mehrere Objekte in einem Array zusammenfassen [Classes11.kt]:
- Zeile 6: erzeugt ein Array mit 3 Elementen. Die Funktion [arrayOfNulls<Person>(3)] initialisiert diese Elemente mit dem Wert [null], d. h., sie verweisen auf keine Objekte: Der Array-Typ ist daher [Array<Person?>], ein Array von Referenzen, die den Wert [null] enthalten können. Umgangssprachlich spricht man von einem „Array von Objekten“, obwohl es lediglich ein Array von Objektreferenzen ist. Die Erzeugung des Arrays – das selbst ein Objekt ist – erzeugt keine Objekte vom Typ seiner Elemente; das muss anschließend geschehen;
- Zeilen 7–9: Erzeugung der 3 Objekte vom Typ [Person];
- Zeilen 11–12: Anzeige des Inhalts des Arrays [friends]. Die Variable [friend] hat den Typ [Person?]: Der Compiler verlangt den sicheren Aufruf [friend?.identify()], der nichts tut, wenn [friend] gleich [null] ist.
Ergebnisse:
Der Elementtyp [Person?] zeigt an, dass ein in Java leer erzeugtes Array [null] enthält. In Kotlin wird dies vermieden, indem das Array gleich mit seinen Elementen erzeugt wird, wie im folgenden Abschnitt gezeigt.
4.1.20. Typableitung und Array-Initialisierung
Das Programm [Classes12.kt] demonstriert die Syntax, die das Erzeugen von Objekten und Arrays vereinfacht:
- Zeile 6: Der Typ der Variablen, [Person], wird aus dem Ausdruck abgeleitet, der sie initialisiert. Die Variable ist dennoch typisiert: [p1] kann nur auf eine Person verweisen. Das ist seit Beginn des Kurses die übliche Notation in Kotlin; das Java-Äquivalent ist das Schlüsselwort [var]. Kotlin geht einen Schritt weiter als Java: Die Typableitung gilt auch für Eigenschaften ([identity], Zeile 38) und für den Rückgabetyp von Funktionen, deren Rumpf ein Ausdruck ist;
- Zeile 36: Alle Eigenschaften haben einen Standardwert. Der primäre Konstruktor kann daher ohne Argumente aufgerufen werden, [Person()] (Zeile 7), und der Person werden dann ihre Eigenschaften zugewiesen (Zeilen 8–10). Es ist nicht nötig, einen parameterlosen Konstruktor zu deklarieren;
- Zeilen 12–16: ein Array, das von der Funktion [arrayOf(...)] erzeugt und gefüllt wird, die die Werte der Elemente erhält. Die Größe des Arrays ist die Anzahl der Werte; sein Typ, [Array<Person>], wird aus dem Typ der Werte abgeleitet: Die Elemente können nicht den Typ [null] haben. Ein abschließendes Komma (Zeile 16) ist in einer Argumentliste erlaubt, wie in jeder Parameterliste: Es erleichtert das Hinzufügen eines Elements;
- Zeile 18: Die Schleifenvariable [friend] hat den Typ [Person]: diesmal kein sicherer Aufruf;
- Zeile 22: ein spontan erzeugtes Array, das als Parameter übergeben wird. Man nennt es ein anonymes Array: Auf es verweist in der Funktion [main] keine Variable. Anders als in Java unterscheidet sich die Syntax nicht danach, ob das Array in einer Deklaration oder anderswo erzeugt wird;
- Zeile 24: Der Konstruktor [Array(size) { i -> ... }] erzeugt ein Array, in dem jedes Element vom Lambda anhand seines Index [i] berechnet wird;
- Zeilen 29–31: eine Top-Level-Funktion, die ein Array von Personen entgegennimmt.
Ergebnisse:
Wir werden Arrays von Objekten nur wenig verwenden: Das nächste Kapitel führt Listen ([List], [MutableList]) ein, die flexibler sind ([listOf(p1, p2)] wird wie [arrayOf(p1, p2)] geschrieben).
4.2. Vererbung anhand von Beispielen
4.2.1. Überblick
Hier behandeln wir das Konzept der Vererbung. Der Zweck der Vererbung ist es, eine bestehende Klasse so „anzupassen“, dass sie unseren Anforderungen entspricht. Angenommen, wir möchten eine Klasse [Teacher] erzeugen: Ein Lehrer ist eine besondere Art von Person. Er hat Attribute, die andere Personen nicht haben: zum Beispiel das Fach, das er unterrichtet. Er hat aber auch die Attribute, die alle Personen gemeinsam haben: Vorname, Nachname und Alter. Ein Lehrer ist also ein vollwertiges Mitglied der Klasse [Person] , hat aber zusätzliche Attribute. Statt eine Klasse [Teacher] von Grund auf neu zu erstellen, bauen wir lieber auf der bestehenden Klasse [Person] auf und passen sie an die Besonderheiten von Lehrern an. Das ermöglicht das Konzept der Vererbung.
Um anzugeben, dass die Klasse [Teacher] von der Klasse [Person]erbt, schreiben wir [class Teacher(...) : Person(...)]: Der Name der Elternklasse folgt wie in C# auf den Doppelpunkt, während Java [extends Person] schreibt.
[Person] wird als Elternklasse (oder Basisklasse oder Superklasse) bezeichnet, und [Teacher] wird als abgeleitete Klasse (oder Kindklasse oder Subklasse) bezeichnet. Ein [Teacher]-Objekt hat alle Merkmale eines [Person]-Objekts: Es hat dieselben Eigenschaften und Methoden. Diese Eigenschaften und Methoden der Elternklasse werden in der Definition der Kindklasse nicht wiederholt; wir geben lediglich die Eigenschaften und Methoden an, die die Kindklasse hinzufügt. Eine Kotlin-Klasse kann von nur einer Elternklasse erben.
Ein wichtiger Unterschied zu Java: In Kotlin ist eine Klasse standardmäßig final, d. h., man kann nicht von ihr erben. Damit eine Ableitung möglich ist, muss die Elternklasse als [open] („offen“) deklariert werden. Das ist eine bewusste Entscheidung der Sprachentwickler: Eine Klasse muss dafür konzipiert sein, dass von ihr abgeleitet wird, und wer sie schreibt, muss dies ausdrücklich angeben.
Die Beispiele in diesem Abschnitt sind zwei Programme aus mehreren Dateien in den Paketen [inheritance1] und [inheritance2]. Im Paket [inheritance1] ist die Klasse [Person] in [Person.kt] wie folgt definiert:
- Zeile 4: Die Klasse ist offen ([open]): Von ihr können Unterklassen abgeleitet werden. Der primäre Konstruktor hat drei Parameter, die keine Eigenschaften sind (kein [val] oder [var]);
- Zeilen 6–19: drei Eigenschaften, deren Setter den empfangenen Wert prüfen (siehe Programm [Classes07.kt]). Die identischen Prüfungen für Vor- und Nachnamen sind wie im Programm [Classes09.kt] in die private Funktion [validate] (Zeilen 42–44) ausgelagert;
- Zeile 23: Die Methode [identify] aus den ersten Beispielen wurde durch die berechnete Eigenschaft [identity] ersetzt, die die Identität der Person zurückgibt, statt sie anzuzeigen;
- Zeilen 26–31: Der [init]-Block des primären Konstruktors initialisiert das Objekt über die Setter der Eigenschaften, erhöht den Personenzähler und zeigt eine Folgemeldung an. Er steht nach den Eigenschaftsdeklarationen: Eigenschaftsinitialisierungen und [init]-Blöcke werden in der Reihenfolge ausgeführt, in der sie geschrieben sind, und eine Eigenschaft muss initialisiert worden sein (hier mit [""] oder 0), bevor sie verwendet werden kann;
- Zeilen 34–37: der Personenzähler aus dem Abschnitt über das Companion-Objekt.
Wir erstellen eine Klasse [Teacher] , die von der Klasse [Person] [Teacher.kt] erbt:
Die Klasse [Teacher] erweitert die Eigenschaften und Methoden der Klasse [Person] um Folgendes:
- Zeilen 5–6: Die Klasse [Teacher] wird von der Klasse [Person] abgeleitet. Der Kopf ist auf zwei Zeilen geschrieben, damit er auf die Seite passt;
- Zeile 5: eine Eigenschaft [section], im primären Konstruktor deklariert ([var section: Int]); sie ist die Nummer der Sektion, zu der der Lehrer innerhalb der Fakultät gehört (ungefähr eine Sektion pro Fach). Die Eigenschaft ist les- und schreibbar: Sie ersetzt Getter und Setter der Java-Version;
- Zeilen 9–10: ein [init]-Block, der eine Fortschrittsmeldung anzeigt.
4.2.2. Ein Teacher-Objekt erzeugen
Eine Kindklasse erbt die Konstruktoren ihrer Elternklasse nicht. Sie muss ihre eigenen Konstruktoren definieren. Der Kopf der Klasse [Teacher] lautet wie folgt:
Der primäre Konstruktor erhält vier Parameter ([firstName], [lastName], [age], [section]) und gibt drei davon ([firstName], [lastName], [age]) an seine Elternklasse weiter – hier die Klasse [Person] – mit der Syntax [: Person(firstName, lastName, age)] (Zeile 2). Wir wissen, dass diese Klasse einen Konstruktor [Person(String, String, Int)], hat, mit dem wir anhand der übergebenen Parameter eine Person erzeugen können. Sobald die Konstruktion des [Person]-Anteils abgeschlossen ist (Initialisierungen und [init]-Blöcke der Klasse [Person]), wird die Konstruktion des Objekts [Teacher] mit der Initialisierung seiner Eigenschaft [section] und der Ausführung seiner eigenen [init]-Blöcke fortgesetzt. Die Notation [: Person(firstName, lastName, age)] entspricht der Anweisung [super(firstName, lastName, age);] im Java-Konstruktor; hat die abgeleitete Klasse keinen primären Konstruktor, ruft jeder ihrer sekundären Konstruktoren den Konstruktor der Elternklasse über [constructor(...) : super(...)] auf.
Zusammenfassend gilt für den Konstruktor einer abgeleiteten Klasse:
- Er gibt an seine Elternklasse die Parameter weiter, die diese zu ihrer Konstruktion benötigt;
- er verwendet die übrigen Parameter, um seine eigenen Eigenschaften zu initialisieren.
Es wäre vielleicht vorzuziehen gewesen, die Eigenschaften [firstName], [lastName] und [age] direkt in der Klasse [Teacher] zu initialisieren, mit Anweisungen wie [this.firstName = firstName]. Das ist hier möglich, weil diese Eigenschaften öffentlich und veränderbar sind, wäre aber eine schlechte Lösung und wäre unmöglich, wenn sie privat wären: Die privaten Member der Klasse [Person] sind nur für Methoden der Klasse [Person] zugänglich. Alle anderen Objekte, auch Objekte abgeleiteter Klassen wie in diesem Fall, müssen über öffentliche (oder geschützte, etwa [protected]) Member darauf zugreifen. Vor allem muss der [Person]-Anteil des Objekts in jedem Fall durch einen Konstruktor der Klasse [Person] instanziiert werden. Wenn Sie [: Person()] ohne Argumente schreiben, meldet der Compiler, dass die Parameter für den Konstruktor der Elternklasse fehlen:
Die Verwendung des Konstruktors der Elternklasse ist also die richtige Lösung und das übliche Vorgehen: Beim Erzeugen eines Kindobjekts ruft man zuerst den Konstruktor des Elternobjekts auf und vervollständigt dann die Initialisierungen, die dem Kindobjekt eigen sind ([section] in unserem Beispiel).
Wenn Sie schließlich das Schlüsselwort [open] vor der Klasse [Person] weglassen, wird die Ableitung abgelehnt:
4.2.3. Geerbte Methoden
Die Klasse [Teacher] definiert keine Eigenschaft namens [identity]. Der Ausdruck [e.identity], wobei [e] ein Lehrer ist, bezieht sich daher auf die von der Klasse [Person] geerbte Eigenschaft [identity]: Sie ist öffentlich und wird durch Vererbung zu einer öffentlichen Eigenschaft der Klasse [Teacher]. Für Methoden gilt dasselbe. Das Testprogramm [Main.kt] des Pakets [inheritance1] lautet wie folgt:
- Zeile 5: Erzeugung eines Lehrers;
- Zeile 7: Anzeige der Identität des Lehrers, die über die von der Klasse [identity] geerbte Eigenschaft [Person] ermittelt wird;
- Zeile 9: die Eigenschaft [section], die der Klasse [Teacher] eigen ist;
- Zeilen 13–14: Aufruf der Funktion [display] (Zeilen 22–23) mit einem Lehrer und dann mit einer Person. Darauf kommen wir im nächsten Abschnitt zurück;
- Zeilen 16–17: Aufruf der Methode [toString] auf beiden Objekten. Auch darauf kommen wir zurück.
Ergebnisse:
Wir sehen:
- Ein Objekt [Person] (Zeile 1 der Ergebnisse) wurde vor dem Objekt [Teacher] (Zeile 2) konstruiert;
- [e.identity] lieferte die Identität des [Person]-Anteils des Lehrers, ohne seine Sektion (Zeile 3);
- der Personenzähler zählt auch den Lehrer mit (Zeile 10): Ein Lehrer ist eine Person.
Um die vollständige Identität eines Lehrers zu erhalten, muss die Klasse [Teacher] ihre eigene Eigenschaft [identity] definieren. Das macht das Paket [inheritance2].
4.2.4. Polymorphie
Betrachten wir eine Klassenhierarchie: C0 ← C1 ← C2 ← … ← Cn, wobei Ci ← Cj bedeutet, dass die Klasse Cj von der Klasse Ci abgeleitet ist. Das bedeutet, dass die Klasse Cj alle Merkmale der Klasse Ci plus zusätzliche besitzt. Seien Oi Objekte vom Typ Ci. Es ist gültig, [Oi = Oj] mit j > i zu schreiben. Denn durch Vererbung hat die Klasse Cj alle Merkmale der Klasse Ci plus zusätzliche. Ein Objekt Oj vom Typ Cj enthält daher ein Objekt vom Typ Ci. Die Operation [Oi = Oj] bewirkt, dass die Variable Oi vom Typ Ci auf das Objekt Oj verweist: Über sie kann nur auf die in der Klasse Ci definierten Member zugegriffen werden.
Die Tatsache, dass eine Variable Oi der Klasse Ci tatsächlich nicht nur auf ein Objekt der Klasse Ci, sondern auf jedes von der Klasse Ci abgeleitete Objekt verweisen kann, nennt man Polymorphie: die Fähigkeit einer Variablen, auf verschiedene Arten von Objekten zu verweisen.
Nehmen wir ein Beispiel und betrachten die Funktion [display] aus dem vorherigen Programm:
Wir können ihr entweder eine *[Person] oder einen *[Teacher] übergeben: Im letzteren Fall erhält der formale Parameter [p], der den Typ [Person] hat, einen Wert vom Typ [Teacher]. Da der Typ [Teacher] vom Typ [Person] abgeleitet ist, ist das gültig. Der Ausdruck [p.identity] verwendete hier die Eigenschaft [identity] der Klasse [Person], die einzige, die es im Programm gibt: Für den Lehrer (Zeile 6 der Ergebnisse) erhalten wir nur die Identität seines „Person“-Anteils.“ Sehen wir, was geschieht, wenn die Klasse [Teacher] ihre eigene Eigenschaft [identity] hat.
4.2.5. Methodenüberschreibung und dynamisches Binden
Im Paket [inheritance2] ist die Klasse [Person] dieselbe wie im Paket [inheritance1], mit zwei Änderungen:
- Zeile 2: Die Eigenschaft [identity] wird als [open] deklariert: Sie kann in einer abgeleiteten Klasse überschrieben werden. In Kotlin sind Methoden und Eigenschaften wie Klassen standardmäßig final: Nur die [open]-Member einer [open]-Klasse können überschrieben werden;
- Zeilen 4–5: eine Überschreibung der Methode [toString], die im folgenden Abschnitt besprochen wird.
In der Klasse [Teacher] wird die Eigenschaft [identity] wie folgt neu definiert:
- Zeile 13: Die Eigenschaft [identity] überschreibt die Eigenschaft der Elternklasse; sie hat denselben Namen und denselben Typ. Sie verwendet die Eigenschaft [identity] ihrer Elternklasse, bezeichnet als [super.identity], um den „Person“-Anteil abzurufen, und ergänzt ihn dann um die Sektion, die der Klasse [Teacher] eigen ist. Eine Methode wird auf dieselbe Weise neu definiert: gleicher Name, gleiche Parameter, gleicher Rückgabetyp und das Schlüsselwort [override];
- Zeile 13: Das Schlüsselwort [override] ist erforderlich. Es erfüllt denselben Zweck wie die in Java optionale Annotation [@Override]: Würde die Eigenschaft nichts neu definieren (z. B. wegen eines Tippfehlers im Namen oder eines abweichenden Typs), würde der Compiler den Fehler melden, statt stillschweigend einen neuen Member anzulegen. Umgekehrt wird eine Neudefinition ohne
*[override]* abgelehnt:
- und wenn die Eigenschaft [identity] der Klasse [Person] nicht als [open] deklariert ist, wird die Neudefinition abgelehnt:
- Zeile 3: Die Klasse [Teacher] wird nicht als [open] deklariert: Sie ist final, wie wir etwas später erläutern.
Betrachten wir ein [Teacher]-Objekt [E]. Dieses Objekt enthält ein [Person]-Objekt:
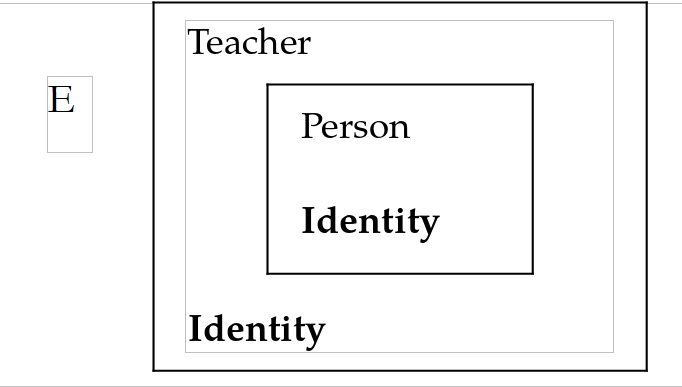
Die Eigenschaft [identity] ist sowohl in der Klasse [Teacher] als auch in ihrer Elternklasse [Person] definiert. Die von [p.identity] verwendete Version wird zur Laufzeit anhand des tatsächlichen Typs des Objekts bestimmt, auf das [p] verweist, und nicht zur Kompilierzeit anhand des deklarierten Typs der Variablen. Man nennt dies dynamisches Binden. Um [o.m()] auszuführen, sucht die virtuelle Maschine in der folgenden Reihenfolge nach einer Methode namens [m] :
- in der Klasse des Objekts [o];
- in ihrer Elternklasse, sofern sie eine hat;
- in der Elternklasse seiner Elternklasse, falls vorhanden;
- und so weiter.
Dasselbe gilt für eine Eigenschaft, bei der das Lesen den Aufruf ihres Accessors beinhaltet, der eine Methode ist. Die Vererbung erlaubt es Ihnen daher, in der Kindklasse Member neu zu definieren, die dieselbe Signatur haben wie die der Elternklasse. Dadurch können Sie die Kindklasse an ihre eigenen Bedürfnisse anpassen. Das Programm [Main.kt] aus dem Paket [inheritance2] lautet wie folgt:
Ergebnisse:
Diesmal hat in Zeile 3 der Ergebnisse die Funktion [display] die vollständige Identität des Lehrers korrekt angezeigt. Die Zeilen 11–13 des Programms zeigen: Bei Betrachtung über eine Variable vom Typ [Person] oder nach Umwandlung in [Person] mit dem Operator [as] (dem Äquivalent des Java-Operators [(Person)]) bleibt der Lehrer ein Lehrer: Es wird weiterhin die Eigenschaft [identity] der Klasse [Teacher] verwendet (Zeilen 6–7 der Ergebnisse). Die Umwandlung ändert den Typ der Referenz, nicht den des Objekts.
In dieser Hinsicht steht Kotlin C# näher als Java. In C# kann eine Methode nur überschrieben werden, wenn sie als virtuell deklariert ist ([virtual]), und das Überschreiben wird durch [override] gekennzeichnet; in Kotlin erfüllt [open] denselben Zweck wie [virtual]. In Java hingegen sind standardmäßig alle Methoden überschreibbar, außer denen, die als [final] deklariert sind. In allen Fällen ist die Bindung dynamisch, sobald die Methode überschrieben wurde.
4.2.6. Die Klasse Any und die Methode toString
Die Klasse [Any] ist die „Elternklasse“ aller Kotlin-Klassen. Wenn Sie also [class Person] schreiben, schreiben Sie implizit [class Person : Any()]. Sie entspricht der Java-Klasse [java.lang.Object]: Zur Laufzeit ist es für die JVM tatsächlich [Object].
Die Klasse *[Any] definiert drei Methoden, die allesamt *[open] sind und von denen alle Objekte erben:
- [toString(): String]: liefert eine textuelle Darstellung des Objekts. Standardmäßig ist dies der vollständige Klassenname des Objekts, gefolgt vom Zeichen [@] und einem hexadezimal geschriebenen Hashcode;
- [equals(other: Any?): Boolean]: gibt an, ob das Objekt dem Objekt [other] „gleich“ ist. Standardmäßig ist es nur sich selbst gleich: Die Methode vergleicht Referenzen, genau wie der Operator [===]. Diese Methode wird vom Operator [==] aufgerufen;
- [hashCode(): Int]: liefert einen Hashcode für das Objekt, den Dictionaries und Mengen verwenden (nächstes Kapitel). Die Methoden [equals] und [hashCode] werden später behandelt.
Die Methode [getClass()] der Java-Klasse [Object] ist keine Methode von [Any]: In Kotlin liefert der Ausdruck [obj::class] die Kotlin-Beschreibung der tatsächlichen Klasse des Objekts (vom Typ [KClass]), deren Eigenschaft [simpleName] der Klassenname ist; [obj::class.java] oder [obj.javaClass] liefert die Java-Beschreibung ([Class]).
Es war die Methode [toString] der Klasse [Any] , die bei den Aufrufen [e.toString()] und [p.toString()] aus dem Paket [inheritance1] verwendet wurde: [inheritance1.Teacher@2f0e140b] und [inheritance1.Person@7440e464] (Zeilen 8–9 der Ergebnisse; die Zahlen variieren von Ausführung zu Ausführung). Obwohl wir die Methode [toString] in den Klassen [Person] und [Teacher] nicht neu definiert haben, konnte die Methode [toString] der Klasse [Any] den tatsächlichen Klassennamen des Objekts anzeigen.
Im Paket [inheritance2] definiert die Klasse [Person] die Methode [toString] neu: [override fun toString() = identity]. Das Schlüsselwort [override] ist auch hier erforderlich. Kehren wir zum Programm [Main.kt] im Paket [inheritance2] zurück:
In Zeile 2 akzeptiert die Funktion [println(message: Any?)] einen Parameter vom Typ [Any?]; da [Any] die Oberklasse aller Klassen ist, kann daher jedes Objekt übergeben werden – hier ein [Teacher]. Sie gibt das Ergebnis der Methode [toString] des Objekts auf der Konsole aus. Da die Bindung dynamisch ist, wird die Methode [toString] des tatsächlichen Objekts verwendet – hier die von der Klasse [Person] geerbte. Diese Methode liefert [identity], eine neu definierte Eigenschaft: Für den Lehrer [e] wird somit die Eigenschaft [identity] der Klasse [Teacher] verwendet, wie Zeile 8 der Ergebnisse zeigt. Es ist daher nicht nötig, [toString] in der Klasse [Teacher] neu zu definieren.
Derselbe Mechanismus gilt für String-Templates: In ["... : $person"] (Zeile 7) wird das Objekt [person] durch seine Methode [toString] in einen String umgewandelt. Die Schleife in Zeile 6 durchläuft ein Array von Referenzen auf [Person], die tatsächlich auf Objekte unterschiedlicher Typen verweisen: [person::class.simpleName] liefert den tatsächlichen Klassennamen jedes Objekts (Zeilen 10–11 der Ergebnisse).
4.2.7. Finale, offene und versiegelte Klassen
Die Klasse [Teacher] im Paket [inheritance2] ist als [class Teacher(...) : Person(...)] deklariert, ohne das Schlüsselwort [open]: Sie ist final. Die Deklaration [class TeacherResearcher(...) : Teacher(...)] würde vom Compiler mit der bereits bekannten Meldung abgelehnt: [this type is final, so it cannot be extended]. In Java ist es umgekehrt: Eine Klasse ist standardmäßig offen, und mit dem Schlüsselwort [final] machen Sie sie final. Der Ansatz von Kotlin verhindert, dass versehentlich eine Klasse abgeleitet wird, die dafür nicht vorgesehen war. Dasselbe gilt für Member: Eine Methode oder Eigenschaft kann nur überschrieben werden, wenn sie als [open] deklariert ist. Ein Member, das ein anderes überschreibt ([override]), ist in weiteren abgeleiteten Klassen selbst überschreibbar, es sei denn, es ist als [final override] deklariert.
Zwischen einer für alle Ableitungen offenen Klasse und einer finalen Klasse bietet Kotlin – wie Java seit Version 17 – eine Zwischenlösung: die versiegelte Klasse ([sealed]), bei der alle direkt abgeleiteten Klassen zur Kompilierzeit bekannt sind. Das Programm [Classes13.kt] veranschaulicht dies:
- Zeile 33: Die Klasse [Person] ist versiegelt. Ihre direkten Unterklassen müssen im selben Paket und Modul wie sie deklariert werden (in einer beliebigen Datei dieses Pakets). Anders als in Java gibt es keine Liste zulässiger Klassen ([permits]): Sie umfasst alle Klassen des Pakets, die ihre direkten Unterklassen sind, hier [Teacher], [Student], und [Adjunct]. Eine versiegelte Klasse ist implizit abstrakt (siehe unten: Von dieser Klasse können keine Objekte erzeugt werden, nur von ihren abgeleiteten Klassen), und ihr Konstruktor ist geschützt: Er ist nur für abgeleitete Klassen gedacht;
- Zeile 34: Die Eigenschaft [identity] ist offen: Abgeleitete Klassen können sie neu definieren;
- Zeilen 38–43: Die Klassen [Teacher] und [Student] sind standardmäßig final. In Java muss eine von einer versiegelten Klasse abgeleitete Klasse als [final], [sealed], oder [non-sealed] deklariert werden; in Kotlin genügt die Standardregel;
- Zeile 47: Die Klasse [Adjunct] ist offen ([open]): Sie öffnet die Hierarchie wieder, sodass jede Klasse von ihr abgeleitet werden kann. Das entspricht [non-sealed] in Java. Eine dritte Möglichkeit besteht darin, sie selbst als [sealed] zu deklarieren. Die Klasse hat keinen Rumpf: Der Klasse [Person] ist nichts hinzuzufügen;
- Zeile 50: Die Klasse [Consultant] wird von [Adjunct] abgeleitet, was erlaubt ist;
- Zeilen 5–9: Der Array-Typ [Array<Person>] wird vom Compiler abgeleitet: Es ist der spezifischste gemeinsame Typ der vier Objekte;
- Zeilen 26–29: Der Ausdruck [when], den wir im vorigen Kapitel gesehen haben, prüft hier mit dem Operator [is] den Typ der Person. In jedem Zweig weiß der Compiler, dass [p] vom geprüften Typ ist: [p.section] wird im Zweig [is Teacher] ohne explizite Umwandlung akzeptiert. Das ist das „Smart Casting“, das am Ende des Kapitels ausführlicher erläutert wird. Vor allem aber hat der Ausdruck [when] keinen Zweig [else]: Da die Klasse [Person] versiegelt ist, weiß der Compiler, dass jede Person ein [Teacher], ein [Student] oder ein [Adjunct] ist und dass alle drei Fälle behandelt werden. Ein Consultant ist ein Adjunct: Er wird vom dritten Zweig behandelt;
- Zeilen 19–21: Die Java-Beschreibung der Klasse ([Person::class.java]) gibt an, ob sie versiegelt ist ([isSealed]), und listet ihre zulässigen direkten Unterklassen auf ([permittedSubclasses]). Für eine versiegelte Klasse erzeugt der Kotlin-Compiler dieselben Informationen wie der Java-Compiler: Für die JVM ist die Klasse [Person] eine versiegelte Java-Klasse.
Ergebnisse:
Wenn Sie eine von [Artist] abgeleitete Klasse [Person] in einem anderen Paket schreiben – hier im Paket [others] –, meldet der Compiler:
Und wenn wir den Zweig [is Adjunct] aus dem Ausdruck [when] entfernen, meldet der Compiler, dass nicht alle Fälle behandelt werden:
Wozu dient eine versiegelte Klasse? Sie erlaubt es dem Autor einer Klassenhierarchie, die Kontrolle über sie zu behalten: Der Autor weiß, dass jede [Person] ein [Teacher], ein [Student], oder ein [Adjunct] ist. Der Compiler weiß das ebenfalls und nutzt es im Ausdruck [when]: Wird später eine vierte, von [Person] abgeleitete Klasse hinzugefügt, werden bei der Kompilierung alle Ausdrücke [when] gemeldet, die sie nicht behandeln. Ein Zweig wie [else] hingegen würde dieses Versäumnis verdecken. Dieser Mechanismus gilt auch für Interfaces ([sealed interface]), die später behandelt werden, und ist in Kotlin eine sehr verbreitete Art, eine geschlossene Menge von Fällen zu modellieren: die möglichen Ergebnisse einer Operation (Erfolg, Misserfolg), die Zustände eines Bildschirms, zwischen zwei Programmen ausgetauschte Nachrichten …
4.3. Operatorüberladung
Einige Sprachen wie C# oder C++ erlauben es, die Bedeutung von Operatoren ([+], [==], [<] …) für eine Klasse neu zu definieren. Java erlaubt dies nicht: Sie müssen Methoden schreiben, etwa [a.add(b)] statt [a + b], [s1.equals(s2)] statt [s1 == s2], [a.compareTo(b) < 0] statt [a < b]. Kotlin erlaubt dies auf einfache und kontrollierte Weise: Jedem Operator entspricht eine Methode mit festem Namen, und Sie müssen lediglich eine Methode mit diesem Namen deklarieren, der das Schlüsselwort [operator] vorangestellt ist, damit der Operator mit Objekten dieser Klasse verwendbar ist. Der Ausdruck [a + b] wird vom Compiler somit in [a.plus(b)] übersetzt. Sie können keine neuen Operatoren erfinden und deren Rangfolge nicht ändern. Die wichtigsten Konventionen lauten wie folgt:
Ausdruck | Übersetzt in | Hinweis |
[a + b], [a - b], [a * b], [a / b], [a % b] | [a.plus(b)], [a.minus(b)], [a.times(b)], [a.div(b)], [a.rem(b)] | arithmetische Operatoren |
[-a], [+a], [!a] | [a.unaryMinus()], [a.unaryPlus()], [a.not()] | unäre Operatoren |
[a++], [a--] | [a.inc()], [a.dec()] | Die Methode liefert den neuen Wert |
[a += b] | [a.plusAssign(b)], oder andernfalls [a = a.plus(b)] | dasselbe gilt für [-=], [*=] … |
[a == b], [a != b] | [a?.equals(b) ?: (b === null)] | [equals] wird von [Any] geerbt: Es wird mit [override] neu definiert |
[a < b], [a <= b], [a > b], [a >= b] | [a.compareTo(b) < 0] … | [compareTo] liefert eine negative Ganzzahl, null oder eine positive Ganzzahl |
[b in a], [b !in a] | [a.contains(b)], [!a.contains(b)] | Zugehörigkeit |
[a[i]], [a[i] = v] | [a.get(i)], [a.set(i, v)] | Indexer (nächster Absatz) |
[a(x)] | [a.invoke(x)] | ein Objekt, das wie eine Funktion „aufgerufen“ wird |
[a..b] | [a.rangeTo(b)] | Intervalle |
[for (x in a)] | [a.iterator()] | Iteration |
Die Operatoren [===] und [!==], die Referenzen vergleichen, können nicht neu definiert werden. Die Klassen der Kotlin-Standardbibliothek verwenden diese Konventionen, und – dank Erweiterungsfunktionen (später in diesem Kapitel behandelt) – wendet Kotlin sie auch auf Klassen des JDK wie [BigDecimal] an. In einer Java-Klasse kann eine Methode mit dem erwarteten Namen und der erwarteten Signatur ([compareTo], [get] …) auch ohne das Schlüsselwort [operator] als Operator verwendet werden.
4.3.1. Ein Beispiel
Das Paket [lists] enthält eine Klasse namens [ListOfPersons], eine Liste von Personen, deren Methoden die Operatoren [+], [+=], [in], die Iteration und Indexer definieren. Die Klassen [Person] und [Teacher] in diesem Paket sind vereinfachte Versionen derjenigen im Paket [inheritance2]: Die Eigenschaften sind schreibgeschützt ([val]), und es gibt keine Validierungen, Fortschrittsmeldungen und Zähler mehr. Die Klasse [Person] erhält einen Vergleichsoperator, [Person.kt]:
- Zeile 10: Die Methode [compareTo], deklariert als [operator], definiert die vier Operatoren [<], [<=], [>], und [>=] zwischen zwei Personen: [p1 < p2] wird in [p1.compareTo(p2) < 0] übersetzt. Die Methode muss eine negative Ganzzahl zurückgeben, wenn das aktuelle Objekt dem Objekt [other] vorausgeht, null, wenn beide gleichwertig sind, und andernfalls eine positive Ganzzahl. Hier werden die Personen nach Alter verglichen: Die Methode [compareTo] für Ganzzahlen erledigt das.
Die Personen werden in einer veränderlichen Liste vom Typ [MutableList<Person>] gespeichert (Listen werden im nächsten Kapitel behandelt). Anstatt die Klasse [ListOfPersons] von einer Listenklasse erben zu lassen, legen wir die Liste in einer privaten Eigenschaft der Klasse ab. Man spricht hier von Komposition statt Vererbung: Die Klasse *[ListOfPersons]* stellt somit nur die Operationen bereit, die sie ausgewählt hat. Von der Liste verwenden wir nur die folgenden Elemente:
- die Methode [l.add(p)], die die Person [p] zur Liste [l] hinzufügt, und die Methode [l.addAll(l2)], die ihr alle Elemente der Liste [l2] hinzufügt;
- die Eigenschaft [l.size], die die Anzahl der Elemente der Liste [l] liefert, und die Eigenschaft [l.indices], den Bereich [0..size-1] ihrer Indizes;
- die Schreibweise [l[i]], die sich auf das Element Nummer i der Liste [l] bezieht, sowohl lesend als auch schreibend: Kotlin-Listen haben Indexer;
- die Methode [l.iterator()], die einen Iterator über die Elemente der Liste liefert, und die Methode [l.joinToString(...)], die aus den Elementen einen String erzeugt.
Die Definition der Klasse [ListOfPersons] lautet wie folgt: [ListOfPersons.kt]:
- Zeile 5: die Liste der Personen. Die Funktion [mutableListOf<Person>()] erzeugt eine leere, veränderliche Liste mit Elementen vom Typ [Person]. Das Schlüsselwort [val] zeigt an, dass die Eigenschaft immer auf dieselbe Liste verweist; der Inhalt der Liste kann sich ändern. Ein Import ist nicht nötig: Listen gehören zur Kotlin-Standardbibliothek und werden automatisch importiert;
- Zeile 8: die Anzahl der Personen als berechnete Eigenschaft;
- Zeilen 12–16: Die Methode [plus] definiert den Operator [+] für die Operation [l + p], wobei [l] vom Typ [ListOfPersons] und [p] vom Typ [Person] oder einer davon abgeleiteten Klasse ist. Sie erzeugt eine neue Liste (Zeile 13), kopiert die Personen der aktuellen Liste hinein (Zeile 14) und fügt dann die Person [p] hinzu (Zeile 15). Wie beim Operator [+] für Zahlen oder Strings werden die Operanden nicht verändert. Da die Liste [result] derselben Klasse angehört, hat die Methode Zugriff auf ihre private Eigenschaft [result.persons]. Die zurückgegebene Liste ist vom Typ [ListOfPersons], was es erlaubt, Operationen zu verketten, etwa in [l + p1 + p2];
- Zeilen 20–21: Die Methode [plusAssign] definiert den Operator [+=]: Sie verändert die aktuelle Liste, indem sie die Person [p] hinzufügt, und gibt nichts zurück;
- Zeile 25: Die Methode [contains] definiert den Operator [in]: ["leduc" in l] wird in [l.contains("leduc")] übersetzt. Der Parameter ist hier ein Name; es ist die Methode [indexOf], die im folgenden Absatz behandelt wird, die nach der Person sucht;
- Zeile 28: Die Methode [iterator] erlaubt es, die Liste mit einer Schleife [for (p in l)] zu durchlaufen. Sie gibt den privaten Iterator der Liste vom Typ [Iterator<Person>] nach außen, der nur lesenden Zugriff auf die Elemente erlaubt;
- Zeile 54: Wir definieren die Methode [toString] neu, um eine Liste von Personen in der Form (person1, person2, ...) anzuzeigen, wobei personi selbst das Ergebnis der Methode [toString] der Person ist. Die Methode [joinToString(separator, prefix, postfix)] für Listen erzeugt aus aufeinanderfolgenden Elementen – die durch ihre Methode [toString] in Strings umgewandelt werden – einen String, trennt sie durch das angegebene Trennzeichen (hier ein Komma) und schließt sie mit einem Präfix und einem Suffix ein (hier Klammern).
Beachten Sie, dass die Klasse [ListOfPersons] keinen Konstruktor hat. Sie verwendet daher den Standardkonstruktor, der keine Parameter hat und nichts weiter tut, als die Eigenschaft [persons] mit dem in ihrer Deklaration angegebenen Wert zu initialisieren. Die Zeilen 30–50 werden im folgenden Abschnitt behandelt.
Das Testprogramm [Main.kt] beginnt wie folgt:
- Zeilen 7–10: zwei Strings mit gleichem Inhalt, aber verschieden: Der String [s2] wird zur Laufzeit erzeugt. Der Operator [] vergleicht die Inhalte (er ruft [equals]* auf), während der Operator *[=] vergleicht die Referenzen. In Kotlin vergleicht man zwei Strings also mit [==], was in Java ein klassischer Fehler ist. Der Operator [<] vergleicht zwei Strings anhand der Reihenfolge ihrer Zeichencodes: Er ruft die Methode [compareTo] auf, die hier eine negative Zahl liefert, weil „jean“ vor „paul“ steht;
- Zeilen 11–13: Die Klasse [BigDecimal] aus dem JDK (exakte Dezimalzahlen, die wir für die Beträge verwenden werden) enthält nur Methoden: [add], [multiply], [negate], [compareTo]. Die Kotlin-Standardbibliothek ergänzt die Operatoren [+], [*], [-] …: Sie schreiben [a + b] statt [a.add(b)] und [-a] statt [a.negate()]. Die Vergleichsoperatoren hingegen verwenden direkt die Methode [compareTo] von [BigDecimal]. Der Import in Zeile 3 ist notwendig: [BigDecimal] ist eine Klasse des JDK;
- Zeilen 16–18: die Vergleichsoperatoren, die durch die Methode [compareTo] der Klasse [Person] definiert werden;
- Zeile 22: Erzeugung einer leeren Liste von Personen [l]. Die Variable ist als [var] deklariert: Ihr Wert wird sich ändern;
- Zeile 24: Hinzufügen zweier Personen mit dem Operator [+], der jedes Mal eine neue Liste liefert;
- Zeile 28: [l + p] erzeugt eine neue Liste, [l2]; die Liste [l] bleibt unverändert;
- Zeile 35: Ein Lehrer wird mit dem Operator [+=] hinzugefügt, also mit der Methode [plusAssign];
- Zeile 41: die Operatoren [in] und [!in];
- Zeilen 42–45: Durchlaufen der Liste mit einer Schleife [for] über die Methode [iterator] und die Eigenschaft [size];
- Zeile 26 und folgende: Ein String-Template, das ein Objekt enthält, verwendet die neu definierte Methode [toString] der Klasse [ListOfPersons].
Ergebnisse (Anfang):
Warum gibt es zwei Operatoren, wenn [l = l + p] dasselbe Ergebnis liefert wie [l += p]? Der Operator [+] erzeugt eine neue Liste, kopiert alle Personen aus [l] hinein, und anschließend verweist [l] auf diese neue Liste, während die alte der Garbage Collection überlassen wird. Der Operator [+=], definiert durch [plusAssign], fügt die Person der bestehenden Liste ohne Kopieren hinzu. Zeile 33 speichert eine zweite Referenz, [l3], auf die Liste [l]; nach der Operation [l3 += ...] verweisen beide Referenzen weiterhin auf dasselbe Objekt (Zeile 9 der Ergebnisse), und die hinzugefügte Person erscheint in [l] (Zeile 8), was beweist, dass die Liste nicht neu erzeugt wurde. Bei einer großen Liste oder innerhalb einer Schleife ist der Leistungsunterschied erheblich. Die Wahl zwischen den beiden Stilen spiegelt sich in der Bibliothek wider: Die unveränderlichen Objekte [String] und [BigDecimal] liefern neue Objekte; die veränderlichen Listen und [StringBuilder] werden modifiziert.
Warum wurde [l3 += ...] und nicht [l += ...] geschrieben? Weil [l] eine Variable vom Typ [var] ist: Für diese Variable könnte [l += p] ebenso gut [l.plusAssign(p)] wie auch [l = l.plus(p)] bedeuten, und der Compiler weigert sich, eine Wahl zu treffen:
Bei einer Variable wie [val] – oder [l3] – ist nur die erste Übersetzung möglich. In der Praxis definiert eine Klasse das eine oder das andere: [plus] für eine unveränderliche Klasse, [plusAssign] für eine veränderliche Klasse. Die Kotlin-Listen folgen dieser Regel: Eine [List] (schreibgeschützt) hat den Operator [+], eine [MutableList] hat den Operator [+=]; bei einer [MutableList] , auf die eine Variable vom Typ [var] verweist, meldet der Compiler dieselbe Mehrdeutigkeit.
Die Operatorüberladung sollte nicht übermäßig eingesetzt werden: Sie ist nur sinnvoll, wenn der Operator seine übliche Bedeutung behält (Addition, Vergleich, Zugehörigkeit usw.). In anderen Fällen ist eine Methode mit einem aussagekräftigen Namen vorzuziehen.
4.4. Indexer: die Operatoren get und set
Hier verwenden wir weiterhin die Klasse [ListOfPersons]. Wenn *[l]* ein Objekt vom Typ [ListOfPersons] ist, möchten wir die Person Nummer i der Liste *[l] sowohl lesend als auch schreibend über die Array-Schreibweise ***[l[i]]*** ansprechen können. C# nennt dies einen Indexer. Java erlaubt dies nicht: Die Schreibweise [[i]] ist in Java Arrays vorbehalten, und Methoden werden als [get(int i)] und [set(int i, value)] geschrieben. In Kotlin definieren diese beiden Methoden, wenn sie als [operator] deklariert sind, die Schreibweise [l[i]]: [l[i]] wird in [l.get(i)], und [l[i] = p] wird in [l.set(i, p)]* übersetzt. So werden Kotlin-Listen und Dictionaries wie Arrays verwendet.
- Zeile 2: Die Methode [get] liefert die Person Nr. i aus der privaten Liste [persons], die selbst über ihren Index identifiziert wird;
- Zeilen 4–5: Die Methode [set] weist ihr die Person [p] zu;
- Zeilen 9–11: ein zweiter, schreibgeschützter Indexer (es gibt keine Methode [set(String, Person)]). Der Index ist nicht zwingend eine Ganzzahl: [l["martin"]] liefert die Person mit dem Namen „martin“ oder [null] , wenn diese Person nicht in der Liste enthalten ist. Der Ergebnistyp [Person?] zeigt dies an. Die beiden Methoden [get] sind Überladungen: Der Compiler wählt anhand des Typs des Index. Ein Indexer kann auch mehrere Parameter haben: [m[i, j]] wird in [m.get(i, j)] übersetzt;
- Zeilen 15–21: Wir möchten außerdem die Position der Person mit einem bestimmten Namen in der Liste ermitteln können, oder -1, wenn diese Person nicht in der Liste enthalten ist. Der Name [indexOf] ist der der entsprechenden Methode für Listen und Strings. Die Schleife durchläuft die Indizes der Liste ([persons.indices]); die Namen werden mit dem Operator [==] verglichen (Zeile 17).
Das Testprogramm wird wie folgt fortgesetzt:
- Zeile 3: Aufruf der Methode [set];
- Zeile 5: Aufruf der Methode [get];
- Zeile 11: Aufruf der Methode [indexOf];
- Zeile 13: Aufruf der Methode [get] mit einem ganzzahligen Index;
- Zeile 20: Aufruf der Methode [get] mit einem Namen. Der Operator [?:] ersetzt das Ergebnis [null] durch eine Meldung.
Ergebnisse (Ende):
4.5. Wert und Referenz
4.5.1. Basistypen und Klassen
Andere Sprachen wie C oder C# bieten neben Klassen auch Strukturen an: Typen, deren Variablen die Daten direkt enthalten und nicht eine Referenz auf ein Objekt. Java kennt sie nicht: Es unterscheidet zwischen den acht primitiven Typen ([int], [double], [boolean] …), deren Variablen den Wert selbst enthalten, und Referenztypen (Klassen, Arrays …), deren Variablen eine Referenz auf ein Objekt enthalten. Auch Kotlin hat keine Strukturen und aus Sicht des Programmierers nicht einmal primitive Typen: Alles ist ein Objekt; [Int], [Double] und [Boolean] sind Klassen, deren Methoden ([10.toString()], [age.coerceAtLeast(0)]) aufgerufen werden. Wie wir im vorigen Kapitel gesehen haben, übersetzt der Compiler die Basistypen [Int], [Long], [Double], [Boolean], [Char] … jedoch nach Möglichkeit in die primitiven Typen der JVM ([int], [long] …): Eine Variable [Int] enthält dann den Wert selbst. Das Programm [Classes14.kt] verdeutlicht den Unterschied zu einer Klasse:
- Zeilen 39–41: eine Klasse mit zwei öffentlichen, veränderlichen Eigenschaften: [name], [age].
Ergebnisse:
Die Deklaration [val age1 = 10] (Zeile 6) reserviert eine Speicherstelle, die die Ganzzahl 10 enthält: Der Wert von [age1] ist die Ganzzahl selbst. Im Fall der Klasse wird das Objekt ([name], [age]) explizit durch den Aufruf des Konstruktors [CPerson()] erzeugt (Zeile 15). Das Objekt wird in einem vom Garbage Collector verwalteten Speicherbereich, dem Heap, abgelegt, und der Wert von [op1] ist die Adresse (die Referenz) dieses Objekts.
Wenn im Programm [var age2 = age1] geschrieben wird (Zeile 7), wird der Wert von [age1] – die Ganzzahl 10 – nach [age2] kopiert: Das ist eine Wertkopie. Eine Änderung von [age2] ändert [age1] nicht (Zeile 2 der Ergebnisse). Betrachten wir nun die Anweisung [val op2 = op1] (Zeile 20). Der Wert von [op1] wird nach [op2] kopiert, doch da dieser Wert die Adresse des Objekts ist, wird das Objekt selbst nicht dupliziert: [op1] und [op2] verweisen auf dasselbe Objekt. Wird das Objekt, auf das [op2] zeigt, geändert, ändert sich auch das Objekt, auf das [op1] zeigt, da es dasselbe ist (Zeilen 5–6 der Ergebnisse). Um ein zweites Objekt zu erhalten, müssen Sie es erzeugen und die Eigenschaften des ersten in es kopieren (Zeilen 30–32): Eine Änderung der Kopie ändert das Original nicht (Zeilen 7–8 der Ergebnisse).
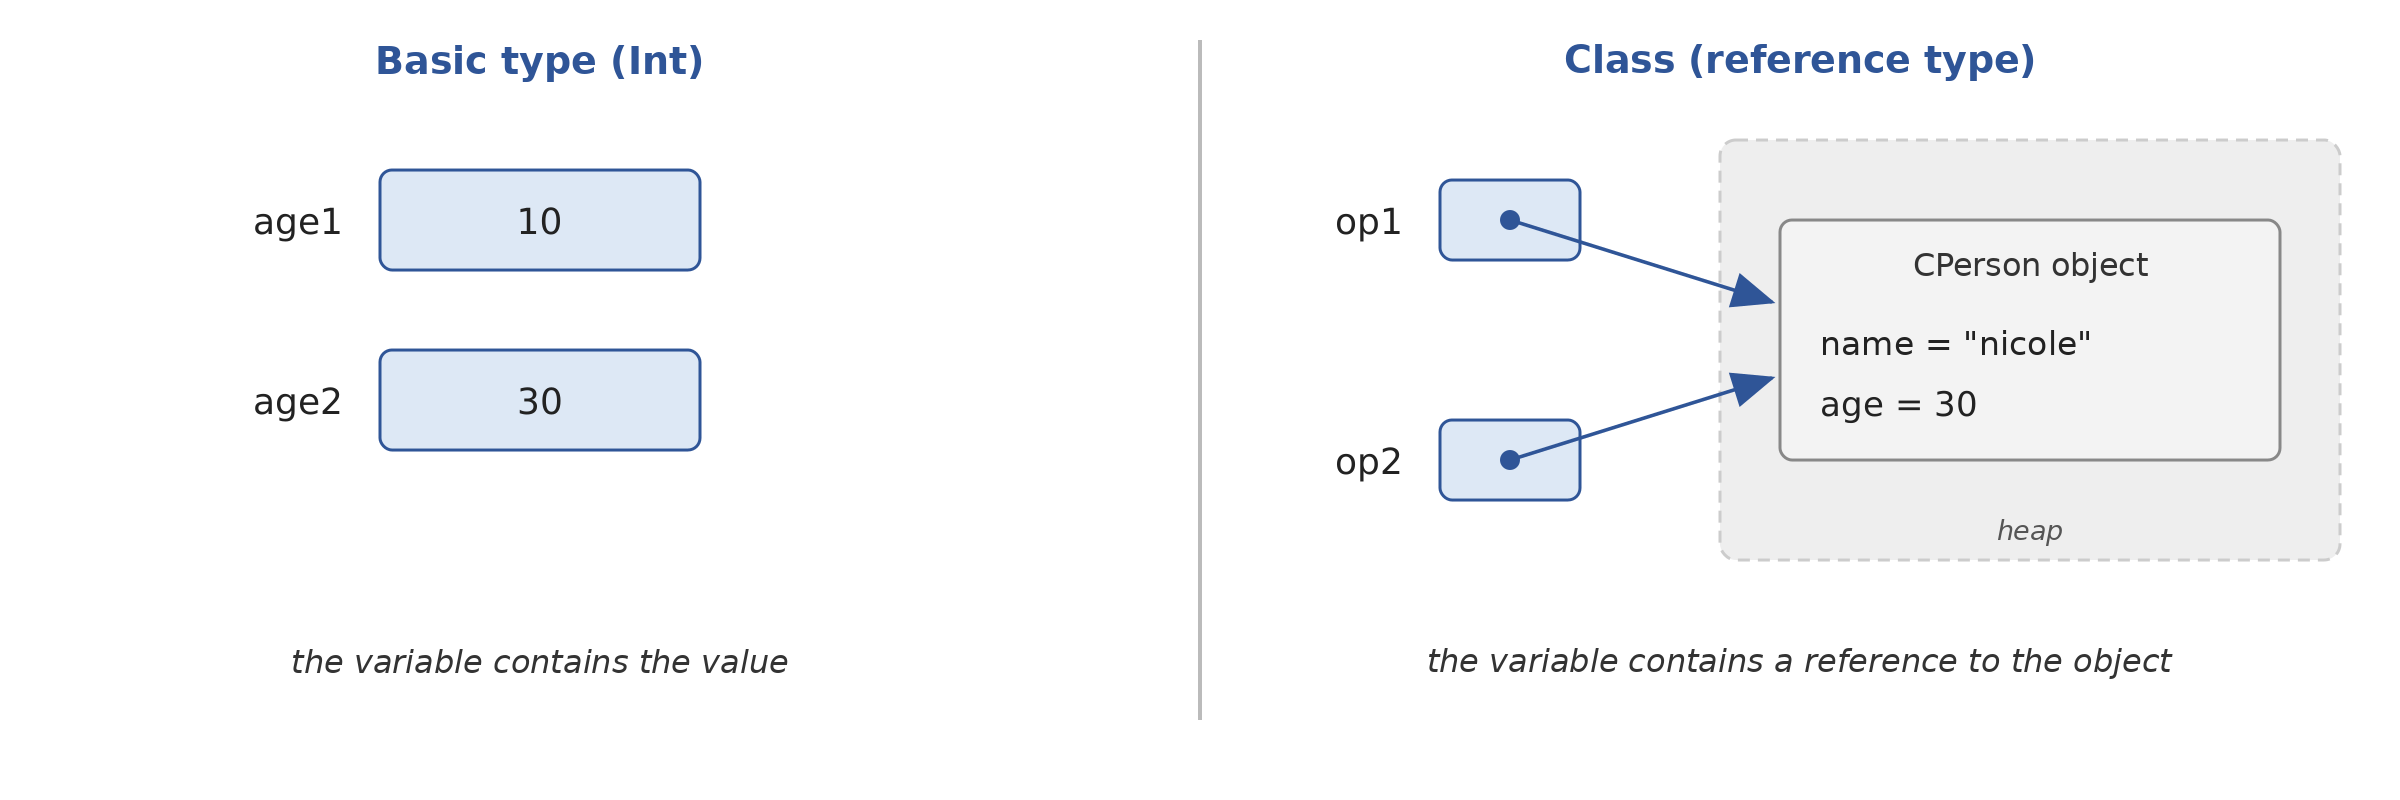
Aus diesen Erläuterungen können wir schließen:
- Der Wert einer Variablen eines Basistyps ([Int], [Double] …) ist die Dateneinheit selbst;
- Der Wert einer Variablen eines Klassentyps ist die Adresse des Objekts, auf das sie verweist;
- Zuweisung und Parameterübergabe kopieren immer den Wert der Variablen: bei einem Basistyp die Daten, bei einem Objekt die Referenz.
Der Compiler kann nicht immer einen primitiven Typ der JVM verwenden. Eine Variable vom Typ [Int?] muss einen Wert vom Typ [null] aufnehmen können, was ein [int] nicht kann, und ein Element einer Liste [List<Int>] muss ein Objekt sein (JVM-Generics akzeptieren nur Referenztypen; siehe unten): In diesen Fällen wird die Ganzzahl in ein Objekt [java.lang.Integer] verpackt, was Java „Autoboxing“ nennt. Der Kotlin-Programmierer muss sich darum nicht kümmern, mit einer Ausnahme: Er darf zwei Zahlen nicht mit dem Operator [===] vergleichen, da dieser die Referenzen der Objekte [Integer] vergleichen würde. Der Compiler gibt dafür eine Warnung aus ([identity equality for arguments of types 'Int?' and 'Int?' is prohibited]). Zahlen werden mit [==] verglichen, das immer die Werte vergleicht.
Um einen einfachen zusammengesetzten Datentyp (einen Punkt, eine Farbe, ein Datum, einen Betrag) darzustellen, der wie ein Wert behandelt wird, verwendet man unveränderliche Klassen: Ihre Objekte können nach der Erzeugung nicht mehr verändert werden. Das Teilen einer Referenz auf ein unveränderliches Objekt ist unbedenklich: Niemand kann es ändern, und das Objekt verhält sich dann wie ein Wert. Zwei Werkzeuge runden das System ab: die Methode [equals], die vom Operator [==] aufgerufen wird und zwei Objekte anhand ihres Inhalts vergleicht, und die Datenklassen ([data class]), die in einer einzigen Zeile eine unveränderliche Klasse deklarieren, die mit dieser Methode ausgestattet ist. Davon handeln die folgenden beiden Absätze.
4.5.2. Gleichheit zweier Objekte: equals und hashCode
Wie wir gesehen haben, gibt der Operator [===], auf zwei Referenzen angewendet, an, ob sie auf dasselbe Objekt verweisen. Der Operator [] ruft die Methode [equals] auf, und die von [Any]* geerbte Methode tut dasselbe wie *[=]. Damit zwei verschiedene Objekte mit demselben Inhalt als gleich gelten, muss eine Klasse die Methode [equals] und zwingend zusammen mit ihr die Methode [hashCode] neu definieren. Das Programm [Classes15.kt] zeigt dies:
- Zeilen 25–35: Die Methode [equals] überschreibt die der Klasse [Any]. Ihr Parameter hat den Typ [Any?]: Eine Person kann mit jedem beliebigen Objekt verglichen werden, sogar mit [null]. Die Methode folgt einem Standardmuster:
- Zeilen 27–28: Ein Objekt ist sich selbst gleich;
- Zeilen 31–32: Der Ausdruck [other !is Person] ist wahr, wenn [other] nicht auf ein Objekt vom Typ [Person] (oder einer abgeleiteten Klasse) verweist, insbesondere wenn es gleich [null] ist. Dann wird [false] zurückgegeben;
- Zeile 35: Die Eigenschaften werden verglichen. Nach dem Test in Zeile 31 weiß der Compiler, dass [other] eine [Person] ist: [other.age] kann ohne Umwandlung verwendet werden. Das ist der „Smart Cast“, den wir bereits beim Ausdruck [when] kennengelernt haben. Die Namen werden mit [==] verglichen, was die Methode [equals] für Strings aufruft;
- Zeile 39: Die Methode [hashCode] liefert eine aus denselben Eigenschaften berechnete Ganzzahl, hier mit der Methode [Objects.hash] des JDK (daher der Import in Zeile 4). Die Regel ist zwingend: Zwei Objekte, die im Sinne von [equals] gleich sind, müssen denselben Hashcode haben. Dictionaries und Mengen sortieren Objekte anhand dieses Codes ein und würden nicht mehr funktionieren, wenn die Regel nicht eingehalten würde;
- Zeile 11: [===] vergleicht Referenzen, während [==] Inhalte vergleicht. In Java würden wir [p1.equals(p2)] schreiben; in Kotlin schreiben wir [p1 == p2], was besser lesbar ist;
- Zeilen 15–17: Eine Menge [HashSet], die mit der Funktion [hashSetOf] erzeugt wird, enthält niemals zwei gleiche Objekte: Das Hinzufügen von [p2], das gleich [p1] ist, hat keine Wirkung, und die Suche nach einer neuen Person ([paul, 10]) mit dem Operator [in] ist erfolgreich;
- Zeilen 19–20: Die Funktion [find] der Collections liefert das erste Element, das die vom Lambda vorgegebene Bedingung erfüllt, oder [null] , falls es keines gibt (Lambdas werden in Kapitel 7 behandelt). Die Variable [unknown] ist daher gleich [null]. Der Operator [==] akzeptiert einen Operanden [null]: [a == b] wird in [a?.equals(b) ?: (b === null)] übersetzt. Anders als beim Java-Aufruf [a.equals(b)] muss man sich hier keine Sorgen um eine [NullPointerException] machen, wenn [a] gleich [null] ist.
Ergebnisse:
Das manuelle Schreiben von [equals] und [hashCode] ist mühsam und fehleranfällig; IntelliJ IDEA kann sie generieren (über das Menü „Code / Generate…“). Datenklassen hingegen stellen sie automatisch bereit.
4.5.3. Unveränderliche Objekte
Das Programm [Classes16.kt] bietet drei Möglichkeiten, unveränderliche Daten zu definieren:
- Zeilen 34–38: eine von Hand geschriebene unveränderliche Klasse. Ihre Eigenschaften sind schreibgeschützt ([val]); sie ist final – wie alle Kotlin-Klassen standardmäßig –, damit keine abgeleitete Klasse veränderlichen Zustand hinzufügen kann. Um einen Punkt zu „verschieben“, liefert die Methode [move] einen neuen Punkt zurück (Zeile 36). Die Anweisung [a.x = 5] (Zeile 6) würde vom Compiler abgelehnt: ['val' cannot be reassigned];
- Zeile 42: eine Datenklasse ([data class]). Der Kopf [data class Color(val r: Int, val g: Int, val b: Int)] deklariert eine Klasse mit drei Eigenschaften, einem Konstruktor mit drei Parametern und den Methoden [toString], [equals] und [hashCode], die alle die Eigenschaften des primären Konstruktors verwenden, sowie den Methoden [copy] und [component1], [component2] und [component3], die weiter unten vorgestellt werden. Dies ist das Kotlin-Äquivalent des Java-Records, der erst viel später erschien; da die Eigenschaften mit [val] deklariert sind, ist die Klasse unveränderlich;
- Zeile 13: Auf eine Eigenschaft wird über ihren Namen zugegriffen, [red.r];
- Zeile 14: Zwei Objekte mit demselben Inhalt sind im Sinne von [==] gleich, obwohl sie verschieden sind;
- Zeile 16: Da eine Datenklasse unveränderlich ist, kann sie nicht verändert werden; stattdessen wird eine Kopie erzeugt, in der bestimmte Eigenschaften geändert wurden. Dies ist die Aufgabe der generierten Methode [copy], bei der der Standardwert jedes Parameters der aktuelle Wert der Eigenschaft ist: Mit benannten Argumenten werden nur die Eigenschaften angegeben, die sich ändern. In Java müssen Sie „Wither“-Methoden ([withG(int g)] …) von Hand schreiben, um dasselbe Ergebnis zu erzielen;
- Zeile 19: Destrukturierung, wie im vorigen Kapitel anhand von Paaren besprochen: Die drei Variablen erhalten die Werte der drei Eigenschaften, in der vom Konstruktor vorgegebenen Reihenfolge. Dies beruht auf den generierten Methoden [component1], [component2] und [component3]. Die Variablennamen können frei gewählt werden: Wir haben [blue] geschrieben, weil [b] bereits verwendet wird;
- Zeilen 45–48: eine Wertklasse ([value class]), annotiert mit [@JvmInline]. Sie hat eine einzige Eigenschaft – hier eine Ganzzahl –, die sie „umhüllt“, um ihr einen eigenen Typ und eigene Validierungsregeln zu geben: Ein [Age] ist nicht irgendein [Int]; eine Funktion, die ein
*[Age]erwartet, akzeptiert kein Gewicht und keine Kinderzahl, und ein negatives Alter wird vom Block*[init]abgelehnt (Zeile 26). Der Vorteil der Wertklasse besteht darin, dass der Compiler sie zur Laufzeit in der Regel durch den umhüllten Wert ersetzt: Eine Variable vom Typ [Age] ist einfach ein [int] der JVM, ohne dass ein Objekt auf dem Heap erzeugt wird. Das bietet die Sicherheit eines eigenen Typs ohne dessen Kosten. Eine Wertklasse ist unveränderlich; für sie werden [toString], [equals] und [hashCode] generiert, genau wie bei einer Datenklasse.
Ergebnisse:
Die für eine Datenklasse generierte Methode [toString] zeigt den Klassennamen und ihre Eigenschaften an (Zeile 2 der Ergebnisse); dasselbe gilt für die Wertklasse (Zeile 6). Beachten Sie hier, dass eine Datenklasse die prägnanteste Art ist, ein kleines, unveränderliches Datenelement zu deklarieren: Diesen Typ werden wir für die Steuerstufen in der Beispielanwendung dieses Kapitels verwenden. Datenklassen werden später ausführlich behandelt.
4.6. Interfaces
4.6.1. Ein erstes Beispiel
Ein Interface ist eine Menge von Methodendeklarationen (und in Kotlin auch von Eigenschaftsdeklarationen), die einen Vertrag bildet. Eine Klasse, die sich dafür entscheidet, ein Interface zu implementieren, verpflichtet sich, eine Implementierung für alle im Interface definierten abstrakten Member bereitzustellen. Der Compiler überprüft diese Implementierung.
Hier ist zum Beispiel die (vereinfachte) Definition des Interfaces [Iterator<T>] aus der Kotlin-Standardbibliothek, das es erlaubt, die Elemente einer Collection zu durchlaufen: [interface Iterator<out T> { operator fun next(): T; operator fun hasNext(): Boolean }]. Die Methoden des Interfaces werden nur durch ihre Signaturen definiert: Sie haben keinen Rumpf und sind implizit öffentlich und abstrakt (das Schlüsselwort [out] wird im Abschnitt über Generics erklärt; das Schlüsselwort [operator] zeigt an, dass die Schleife [for] diese Methoden verwenden kann). Es sind die Klassen, die das Interface implementieren, die den Code für seine Methoden liefern. Eine Klasse namens [C] erklärt, dass sie das Interface implementiert, indem sie es nach dem Doppelpunkt aufführt, genau wie eine Elternklasse, aber ohne Klammern (ein Interface hat keinen Konstruktor): [class C : Iterator<String>], und sie muss dann die beiden Methoden [override fun hasNext(): Boolean { ... }] und [override fun next(): String { ... }] definieren. Während Java zwischen [extends] (Vererbung) und [implements] (Implementierung) unterscheidet, verwendet Kotlin wie C# denselben Doppelpunkt; das Schlüsselwort [override] ist erforderlich, um ein Interface-Member zu implementieren, genauso wie zum Überschreiben einer Methode der Elternklasse.
Eine verbreitete Konvention (die allerdings nicht allgemeingültig ist – weder das JDK noch die Kotlin-Bibliothek befolgen sie) besteht darin, einen Interface-Namen mit dem Buchstaben I beginnen zu lassen. Die folgenden Beispiele bilden das Paket [statistics] (Verzeichnis [src/main/kotlin/statistics]). Betrachten wir das folgende Interface [IStats.kt]:
Das Interface [IStats] hat:
- eine Eigenschaft [average]: den Mittelwert einer Reihe von Werten;
- eine Eigenschaft [standardDeviation]: die Standardabweichung dieser Reihe.
Beachten Sie, dass nirgends angegeben ist, auf welche Reihe von Werten sich dies bezieht. Es könnte der Notendurchschnitt einer Klasse sein, der monatliche Durchschnittsumsatz eines bestimmten Produkts, die Durchschnittstemperatur an einem bestimmten Ort … Das ist das Prinzip hinter Interfaces: Sie setzen die Existenz von Membern im Objekt voraus, nicht aber die bestimmter Daten.
Während das Java-Interface zwei Methoden deklarierte, [double average()] und [double standardDeviation()], deklariert das Kotlin-Interface zwei abstrakte Eigenschaften, [val average: Double] und [val standardDeviation: Double]. Eine Interface-Eigenschaft sagt nichts darüber aus, wie der Wert gewonnen wird: Eine implementierende Klasse kann ihn in einem Feld speichern, bei jedem Lesen über einen Accessor *[get]* berechnen oder beim ersten Lesen berechnen und dann speichern. Das zeigen die beiden folgenden Klassen. Eine Interface-Eigenschaft [val] verspricht nur Lesezugriff; eine Eigenschaft [var] würde zusätzlich Schreibzugriff versprechen.
Eine mögliche Implementierung des Interfaces [IStats] könnte eine Klasse sein, die die Noten der Schüler einer Klasse in einem bestimmten Fach speichert. Ein Schüler wird durch die folgende Datenklasse [Student] charakterisiert: [Student.kt]:
Der Schüler wird durch seinen Vor- und Nachnamen identifiziert. Die Datenklasse, die oben (im Abschnitt „Unveränderliche Objekte“) eingeführt wurde und später ausführlich behandelt wird, lässt sich in einer einzigen Zeile zusammenfassen: Sie ersetzt den Record der Java-Version. Eine Note wird durch die folgende Datenklasse dargestellt: [Grade] [Grade.kt]:
Die Note wird durch den benoteten Schüler und die Note selbst definiert. Die Klasse definiert die vom Compiler generierte Methode [toString] neu, um eine Note in der Form [firstName,lastName,value] anzuzeigen. Beachten Sie die Form [fun f() = expression]: Eine Funktion, deren Rumpf aus einem einzigen Ausdruck besteht, kann mit dem Symbol [=] ohne geschweifte Klammern und ohne [return] geschrieben werden; der Ergebnistyp wird dann aus dem Ausdruck abgeleitet.
Die Noten aller Schüler in einem bestimmten Fach werden in der folgenden Klasse [ArrayOfGrades] zusammengefasst:
- Zeile 7: Die Klasse [ArrayOfGrades] implementiert das nach dem Doppelpunkt aufgeführte Interface [IStats]. Sie muss daher die Eigenschaften [average] und [standardDeviation] implementieren. Ihr primärer Konstruktor deklariert zwei schreibgeschützte Eigenschaften: das Fach, in dem das Objekt die Noten speichert, und das Array der Noten;
- Zeilen 10–14: die Implementierung der beiden Interface-Eigenschaften, denen das Schlüsselwort [override] vorangestellt ist. Wir gehen hier davon aus, dass sich die dem Konstruktor übergebenen Noten danach nicht mehr ändern. Daher werden Mittelwert und Standardabweichung dieser Noten sofort berechnet und in den Feldern der Eigenschaften gespeichert: Die Initialisierer der Eigenschaften werden bei der Konstruktion des Objekts in der Reihenfolge ausgeführt, in der sie geschrieben sind, sodass die Berechnung der Standardabweichung den bereits berechneten Mittelwert verwenden kann. In Java wären dafür vier Felder ([final]) und ein Konstruktor nötig gewesen, um dasselbe Ergebnis zu erzielen;
- Zeile 11: [if] ist in Kotlin ein Ausdruck: Er ersetzt den Java-Operator [condition ? value1 : value2] und setzt den Mittelwert eines leeren Arrays auf -1. Die Erweiterungsfunktion [sumOf] für Arrays und Collections summiert die Werte, die das Lambda [{ it.value }] für jedes Element berechnet (Lambdas werden in Kapitel 7 behandelt; [it] bezeichnet dort das aktuelle Element): Sie ersetzt die kumulierende Schleife [for] der Java-Version;
- Zeile 14: [x.pow(2)] berechnet x², und [sqrt] berechnet die Quadratwurzel. Dies sind Funktionen aus dem Paket [kotlin.math], das in den Zeilen 3–4 importiert wird; sie ersetzen die statischen Methoden [Math.pow] und [Math.sqrt] aus Java (die weiterhin verwendbar sind);
- Zeile 16: Die Methode [toString] verwendet die Array-Erweiterungsfunktion [contentToString], die die Elemente des Arrays in eckigen Klammern, durch Kommas getrennt, zurückgibt, wobei jedes Element durch seine Methode [toString] in einen String umgewandelt wird, hier die der Klasse [Grade]. Das entspricht der statischen Methode [Arrays.toString] in Java. Die Methode [toString] eines Kotlin-Arrays zeigt wie die eines Java-Arrays nur seinen Typ und einen Hashcode an.
In der vorigen Klasse wurden die Noten in einem Array gespeichert. Es war nicht möglich, nach der Konstruktion des Objekts [ArrayOfGrades] eine neue Note hinzuzufügen. Wir schlagen nun eine zweite Implementierung des Interfaces [IStats] namens [ListOfGrades] vor, bei der die Noten diesmal in einer Liste gespeichert werden und nach der ersten Konstruktion der Objekte [ListOfGrades] und [ListOfGrades.kt] Noten hinzugefügt werden können:
- Zeile 7: Die Klasse [ListOfGrades] implementiert das Interface [IStats]. Dem Konstruktorparameter [grades] ist kein [val] vorangestellt: Er ist ein einfacher Parameter, der nur zur Initialisierung der Eigenschaft in Zeile 9 dient;
- Zeile 9: Die Noten werden nun in einer veränderlichen Liste abgelegt ([MutableList<Grade>]), einer Kopie der erhaltenen Liste, die die Erweiterungsfunktion [toMutableList] erzeugt. Kotlin unterscheidet zwischen schreibgeschützten Collections ([List]) und veränderlichen Collections ([MutableList]); die Kopie stellt sicher, dass der Aufrufer die vom Objekt gespeicherte Liste nicht hinter unserem Rücken verändern kann (siehe Kapitel 5);
- Zeilen 12–13: Die Liste wird als Typ [List<Grade>] nach außen gegeben, der schreibgeschützt ist: Externer Code kann die Noten lesen, aber keine neuen hinzufügen, ohne die Methode [add] aufzurufen. Dieses Paar aus einer privaten Eigenschaft [_grades] und einer öffentlichen Eigenschaft [grades] eines eingeschränkteren Typs ist ein verbreitetes Kotlin-Idiom, das als „Backing Property“ bekannt ist;
- Zeilen 20–24: Wir können nun zu den bereits gespeicherten Noten eine weitere hinzufügen. Mittelwert und Standardabweichung werden nicht mehr bei der Konstruktion berechnet, sondern bei Bedarf in den Accessoren der Interface-Eigenschaften: [average] (Zeilen 28–29) und [standardDeviation] (Zeilen 32–33). Einmal berechnet, werden diese Werte gespeichert, damit sie nicht bei jeder Abfrage neu berechnet werden: Man sagt, sie werden zwischengespeichert (Cache). Das Hinzufügen einer Note macht den Cache ungültig;
- Zeilen 16–17: der Cache. Sein Typ [Double?], ist ein Nullable-Typ (Kapitel 3): Der Wert [null] bedeutet „noch nicht berechnet“. Während Java die Wrapper-Klasse
*[Double]verwendete, um den Wert*[null]zu erhalten, fügt Kotlin dem Typ einfach ein Fragezeichen hinzu; - Zeile 29: Der Accessor liest sich wie folgt: der zwischengespeicherte Wert, falls er nicht [null] ist (Elvis-Operator [?:]), andernfalls das Ergebnis von
***[computeAverage()]***, das die Funktion*[also]im Cache speichert, bevor sie es zurückgibt. [x.also { ... }] führt den Block mit [it = x] aus und gibt dann [x] zurück: Sie dient dazu, einem Ausdruck eine Nebenaktion (hier das Zwischenspeichern) anzufügen. Der Compiler weiß, dass das Ergebnis des Ausdrucks nie [null] ist: Es hat den Typ [Double]*, wie es das Interface verlangt; - Zeilen 35–41: die beiden Berechnungen, geschrieben mit [sumOf]. Beachten Sie in Zeile 39 den Stil des „frühen Verlassens“: Die Funktion gibt sofort -1 zurück, wenn die Liste leer ist;
- Zeile 44: Die Methode [toString] einer Liste zeigt ihre Elemente in eckigen Klammern an, ohne dass eine spezielle Funktion nötig ist.
Ein Testprogramm könnte wie folgt aussehen, [Main.kt]:
- Zeile 5: erzeugt mit der Funktion [arrayOf] ein Array von Schülern;
- Zeile 6: Erzeugung eines Arrays von Noten. Die Noten werden als [14.0] geschrieben, nicht als [14]: Kotlin wandelt ein [Int] nicht implizit in a [Double] um, und der Konstruktor von [Grade] erwartet ein [Double];
- Zeile 8: ein Objekt [ArrayOfGrades], dessen Mittelwert und Standardabweichung in Zeile 10 angezeigt werden;
- Zeile 12: ein Objekt [ListOfGrades], dessen Mittelwert und Standardabweichung in Zeile 13 angezeigt werden. Die Erweiterungsfunktion [toList] wandelt das Array in eine Liste um; die Klasse [ListOfGrades] erzeugt davon eine veränderbare Kopie. In Java müssten Sie [new ArrayList<>(List.of(grades))] schreiben;
- Zeile 15: eine neue Note hinzufügen und dann die Anzeige aktualisieren;
- Zeilen 25–26: Die Funktion [displayStats] erhält als Parameter einen Typ [IStats], der ein Interface-Typ ist. Das bedeutet, dass der tatsächliche Parameter jedes Objekt sein kann, das das Interface [IStats] implementiert. Bei der Verwendung eines Datenobjekts eines Interface-Typs werden nur die Interface-Member genutzt, die dieses Objekt implementiert. Der Rest wird ignoriert. Diese Eigenschaft ähnelt dem Polymorphismus, den wir bei Klassen gesehen haben. Wenn eine Menge von Klassen Ci, die nicht durch Vererbung miteinander verwandt sind (und deshalb den auf Vererbung beruhenden Polymorphismus nicht nutzen können), eine Menge von Methoden mit derselben Signatur hat, kann es sinnvoll sein, diese Methoden in einem Interface I zusammenzufassen, das alle betroffenen Klassen implementieren. Instanzen dieser Klassen
Cikönnen dann als tatsächliche Parameter von Funktionen verwendet werden, die einen formalen Parameter vom TypIakzeptieren – also von Funktionen, die nur die im InterfaceIdefinierten Member der ObjekteCiverwenden und nicht die spezifischen Eigenschaften und Methoden der verschiedenen KlassenCi; - Zeilen 18–21: Eine Variable kann den Typ eines Interfaces haben. Sie kann dann auf jedes Objekt einer Klasse verweisen, die das Interface implementiert. Der Compiler erlaubt nur den Zugriff auf die Member des Interfaces (und auf die der Klasse
*[Any]*, wie etwa[toString]*). Der Typ muss hier angegeben werden; ohne ihn hätte der Compiler den Typ [ArrayOfGrades]* aus dem Anfangswert abgeleitet, und die Zuweisung in Zeile 20 wäre abgelehnt worden.
Das Paket enthält zwei Funktionen der obersten Ebene, [main] und [displayStats], die in der Datei [Main.kt] definiert sind: Die JVM-Klasse, die sie enthält, heißt daher [statistics.MainKt].
Ergebnisse:
In einem String-Template wird eine Zahl [Double] von der Methode [Double.toString] der JVM in einen String umgewandelt, die die Zahl unabhängig von der Sprache des Arbeitsplatzrechners immer mit Dezimalpunkt und mindestens einer Nachkommastelle schreibt (16.0). Für eine an die Landessprache angepasste Anzeige verwenden Sie ["%.2f".format(x)], wie im folgenden Beispiel.
Beachten Sie schließlich, dass Interfaces mehrfach implementiert werden können; das heißt, Sie können [class DerivedClass : BaseClass(), I1, I2, ..., In] schreiben, wobei die Ij Interfaces sind: Eine Klasse erbt von nur einer Klasse (deren Konstruktor aufgerufen wird, daher die Klammern), kann aber beliebig viele Interfaces implementieren. Ein Interface kann selbst von einem oder mehreren anderen Interfaces erben: [interface I3 : I1, I2].
4.6.2. Interface-Methoden mit Rumpf
Ein Kotlin-Interface kann für einige seiner Methoden eine Standardimplementierung bereitstellen: Man gibt ihnen einfach einen Rumpf, ohne ein besonderes Schlüsselwort (Java erfordert das Schlüsselwort [default]). Eine Klasse, die das Interface implementiert, kann diese Implementierung dann verwenden oder ihre eigene bereitstellen. Auf diese Weise lässt sich zum Beispiel einem bereits veröffentlichten Interface eine Methode hinzufügen, ohne dass alle Klassen, die es implementieren, geändert werden müssen. Eine Interface-Eigenschaft kann ebenso einen Standard-Accessor [get] haben. Ein Interface kann auch private Funktionen enthalten. Kotlin hat jedoch weder in Interfaces noch in Klassen statische Member ([static]): Ihre Rolle übernimmt das Companion-Objekt ([companion object]), das oben besprochen wurde und das ein Interface ebenso haben kann wie eine Klasse. Das Programm [Classes17.kt] liefert ein Beispiel:
- Zeilen 21–37: das Interface [IShape]:
- Zeile 23: eine abstrakte Methode [area], die implementiert werden muss;
- Zeile 26: eine Methode [description] mit einer Standardimplementierung. Diese Implementierung darf die anderen Methoden des Interfaces verwenden ([area], [formatNumber]). Der Ausdruck [this::class.simpleName] liefert den einfachen Namen der Klasse des Objekts ([Square]): [this::class] ist die Kotlin-Klasse ([KClass]) des Objekts, das Äquivalent zu [getClass()] in Java;
- Zeilen 29–30: eine Eigenschaft mit einem Standard-Accessor. Ein Interface hat keinen Zustand: Es kann keinen Wert speichern, und daher hat eine Interface-Eigenschaft nie ein Feld. Sie ist entweder abstrakt oder wird von einem Accessor berechnet;
- Zeile 33: eine private Funktion, auf die nur die Methoden des Interfaces zugreifen können. ["%.2f".format(value)] formatiert die Zahl mit zwei Nachkommastellen nach den Konventionen der Locale des Systems – hier dem französischen Dezimalkomma. Die String-Erweiterungsfunktion [format] ist das Kotlin-Äquivalent von [String.format];
- Zeilen 36–37: das Companion-Objekt des Interfaces. Seine Methode [unitSquare] wird über den Namen des Interfaces aufgerufen: [IShape.unitSquare()] (Zeile 8), genau wie die statische Methode in der Java-Version. Es ist eine Factory;
- Zeilen 42–43: Die Klasse [Square] implementiert nur [area]; die Methode [description] verwendet sie standardmäßig. Sie ist als [open] deklariert, weil später eine Klasse von ihr erbt. In Java hätte die Klasse [Square] als [static] deklariert werden müssen, weil das Interface die Quadrate erzeugt; in Kotlin sind in einer Datei deklarierte Klassen alle Klassen der obersten Ebene, sodass sich dieses Problem nicht stellt;
- Zeilen 47–50: Die Klasse [Circle] stellt ihre eigene Methode [description] bereit. Das Format [%s] fügt den durch [Double.toString] in einen String umgewandelten Radius ein („1.0“), während das Format [%.2f] die Fläche mit zwei Nachkommastellen einfügt. Die Konstante [PI] stammt aus dem Paket [kotlin.math];
- Zeile 14: Die Standardmethode wird von der Klasse [Square] wie jede andere Methode geerbt: Sie kann für eine Variable vom Typ [Square] aufgerufen werden;
- Zeilen 54–58: ein zweites Interface mit einer abstrakten Eigenschaft [color] und einer Standardmethode [description], die dieselbe Signatur hat wie die von [IShape];
- Zeilen 63–66: Die Klasse [ColoredSquare] leitet sich von [Square] ab (die [IShape] implementiert) und implementiert [IColored]. Sie erbt somit zwei Standardmethoden [description]. Der Compiler verlangt dann, dass die Klasse die Methode neu definiert; andernfalls lehnt er die Klasse ab (siehe unten). Die neue Methode kann mit der Syntax [super<Type>.method()] eine der geerbten Versionen aufrufen, wobei [Type] die Elternklasse oder das Interface ist, dessen Version gewünscht wird: In Zeile 64 kombiniert die Methode beide. Java schreibt [I1.super.method()];
- Zeile 63: Die abstrakte Eigenschaft [color] des Interfaces [IColored] wird direkt im primären Konstruktor durch [override val color: String] implementiert;
- Zeile 66: Die Eigenschaft [name] des Interfaces [IShape], die einen Standard-Accessor hatte, wird als Eigenschaft mit einem Feld neu definiert: Die Klasse selbst kann einen Wert speichern.
Ergebnisse:
Hier sind die Fehler, die der Compiler erzeugt, wenn eine Klasse [C] zwei Interfaces [I1] und [I2], implementiert, die jeweils eine Methode [fun f() = ...] haben, ohne sie neu zu definieren, und wenn ein Interface versucht, eine Eigenschaft zu initialisieren ([val counter: Int = 0]):
Anders als eine abstrakte Klasse hat ein Interface also keinen Zustand: Es kann keine gespeicherten Eigenschaften deklarieren. Konstanten, die in Java Felder [static final] des Interfaces sind, werden in Kotlin in dessen Companion-Objekt abgelegt ([const val]).
Für Leser, die von Java kommen, sei schließlich noch angemerkt, dass eine Kotlin-Interface-Methode mit Rumpf (seit Kotlin 2.2) in eine Methode [default] des generierten Java-Interfaces kompiliert wird: Eine Java-Klasse kann daher ein Kotlin-Interface implementieren, ohne diese Methoden neu zu schreiben.
4.7. Abstrakte Klassen
Eine abstrakte Klasse ist eine Klasse, die nicht instanziiert werden kann. Sie müssen abgeleitete Klassen erstellen, die dann instanziiert werden können. Abstrakte Klassen können dazu dienen, Code für eine ganze Reihe von Klassen auszulagern. Betrachten wir das folgende Beispiel, das das Paket [users] [User.kt] bildet:
- Zeile 4: Die Klasse wird mit dem Schlüsselwort [abstract] als abstrakt deklariert. Eine abstrakte Klasse ist implizit für die Vererbung offen: Das Hinzufügen von [open] ist nicht nötig;
- Zeilen 4–6: Der primäre Konstruktor der Klasse [User]. Diese Klasse speichert Informationen über die Benutzer einer Webanwendung. Die Anwendung kennt verschiedene Arten von Benutzern, die sich über einen Benutzernamen und ein Passwort authentifizieren (Zeilen 5–6). Diese beiden Angaben werden bei einigen Benutzern anhand eines Verzeichnisses (LDAP) überprüft, bei anderen anhand einer Datenbank usw. Damit der primäre Konstruktor sichtbar ist, müssen Sie nach dem Klassennamen ausdrücklich das Schlüsselwort [constructor] angeben: [protected constructor(...)]. Der Konstruktor ist [protected]: Er ist für die Konstruktoren abgeleiteter Klassen gedacht. Das Komma nach dem letzten Parameter (Zeile 6) ist erlaubt: Es erleichtert das spätere Hinzufügen eines Parameters;
- Zeile 10: Die Informationen werden von einer Methode namens [identify] überprüft. Da die Identifizierungsmethode auf dieser Ebene nicht bekannt ist, wird sie mit dem Schlüsselwort [abstract] als abstrakt deklariert (Zeile 15). Eine abstrakte Methode hat keinen Rumpf: Abgeleitete Klassen liefern ihn. Eine Klasse mit einer abstrakten Methode muss selbst als abstrakt deklariert werden. Die Methode [identify] gibt einen String zurück, der die Rolle des Benutzers angibt (im Grunde, wozu er berechtigt ist), oder [null] , wenn der Benutzer nicht erkannt wird: Ihr Typ ist daher [String?];
- Zeile 10: Wird der Benutzer nicht erkannt, wird eine Exception ausgelöst. Der Elvis-Operator [?:] wertet den Ausdruck zu der von [identify] zurückgegebenen Rolle aus, wenn sie nicht [null] ist, und führt andernfalls den Ausdruck auf der rechten Seite aus, hier [throw UnknownUserException(...)]. In Kotlin ist [throw] ein Ausdruck (vom Typ [Nothing]), was diese kompakte Syntax ermöglicht. Die Eigenschaft [role] hat den Typ [String] und ist nicht nullable: Der Compiler weiß, dass sie nicht [null] sein kann. Eine [throws]-Klausel ist nicht nötig: Kotlin kennt keine geprüften Exceptions (Kapitel 3);
- Zeile 12: die Methode
*[toString],* die eine Instanz der Klasse identifiziert.
Wir gehen hier davon aus, dass der Entwickler die Konstruktion von Instanzen der Klasse [User] und ihrer abgeleiteten Klassen kontrollieren möchte, vielleicht weil er sicherstellen will, dass eine Exception eines bestimmten Typs ausgelöst wird, wenn der Benutzer nicht erkannt wird. Abgeleitete Klassen können sich auf diesen Konstruktor stützen. Dazu müssen sie die Methode [identify] bereitstellen. Beachten Sie, dass die Initialisierung der Eigenschaft [role], die Teil der Konstruktion des Objekts ist, eine von den abgeleiteten Klassen neu definierte Methode aufruft, obwohl diese Klassen ihre eigene Initialisierung noch nicht durchgeführt haben: Die Methode *[identify] darf daher keine Eigenschaften der abgeleiteten Klasse verwenden, die noch nicht initialisiert wurden (eine nicht nullable Eigenschaft könnte dort sogar *[null] sein!). Diese Praxis sollte mit Vorsicht gehandhabt werden. Der Kotlin-Compiler meldet sie nicht; es ist IntelliJ IDEA, das sie durch eine Code-Inspektion hervorhebt („Leaking 'this' in constructor of non-final class“). Hier ist sie beabsichtigt und unbedenklich, weil die Methoden der abgeleiteten Klassen keine Eigenschaften verwenden.
Die Klasse [UnknownUserException] lautet wie folgt:
- Zeile 4: Sie leitet sich von der Klasse [Exception] ab (einem Alias für [java.lang.Exception]) und hat einen einzigen Konstruktor, der eine Fehlermeldung als Parameter erhält, die sofort an den Konstruktor der Elternklasse weitergereicht wird. Eine Zeile genügt. In Java ist eine von [Exception] abgeleitete Klasse eine geprüfte Exception (Checked Exception): Der Compiler überprüft, dass jede Methode, die sie auslösen kann, dies mit einer [throws]-Klausel deklariert. Kotlin führt diese Prüfung nicht durch: Alle Exceptions in Kotlin verhalten sich wie die ungeprüften Exceptions von Java. Soll eine Kotlin-Methode von Java-Code aus aufgerufen werden, der die Exception abfangen möchte, wird sie für Java mit der Annotation [@Throws(UnknownUserException::class)] markiert. Der Kotlin-Compiler verlangt auch keine Versionsnummer [serialVersionUID].
Wir leiten nun die Klasse [Administrator] von der Elternklasse [User] ab:
- Zeile 3: Der primäre Konstruktor reicht die erhaltenen Parameter einfach an seine Elternklasse weiter: [: User(login, password)]. Den Parametern [login] und [password] ist kein [val] vorangestellt: Es sind einfache Parameter, wobei die entsprechenden Eigenschaften in der Elternklasse deklariert sind;
- Zeilen 5–8: Die Methode [identify] der Klasse [Administrator]. Nehmen wir an, ein Administrator wird über ein Verzeichnis namens LDAP identifiziert. Diese Methode implementiert die abstrakte Methode [identify] ihrer Elternklasse. Sie behält die Zugriffsebene [protected] der Methode bei, die sie überschreibt: In Kotlin erbt eine überschreibende Methode standardmäßig die Sichtbarkeit der überschriebenen Methode (sie kann sie erweitern, aber nicht einschränken). Ihr Rückgabetyp ist
*[String]*, nicht*[String?]: Eine überschreibende Methode kann einen spezifischeren Typ zurückgeben als die Methode, die sie überschreibt, und ein*[String]ist ein Sonderfall von*[String?]*.
Die Klassen [Observer] und [Unknown] leiten sich ebenfalls von der Klasse [User] ab. Sie unterscheiden sich von der Klasse [Administrator] nur in ihrer Methode [identify]. Die Methode der Klasse [Observer] geht davon aus, dass ein Beobachter über eine Datenbank identifiziert wird, und gibt die Rolle „observer“ zurück:
Die Methode der Klasse [Unknown] gibt die Referenz [null] zurück, um anzuzeigen, dass der Benutzer nicht erkannt wurde; ihr Ergebnistyp ist daher [String?]:
Letztlich werden die Objekte [Administrator], [Observer], und [Unknown] durch denselben Code initialisiert, den der Elternklasse [User]. Diese Klasse verwendet die von diesen Klassen bereitgestellte Methode [identify]. Ein Testprogramm könnte wie folgt aussehen, [Main.kt]:
Beachten Sie, dass in den Zeilen 5 und 6 die Methode [User.toString()] von der Funktion [println] verwendet wird. In Zeile 7 löst der Konstruktor eine [UnknownUserException]-Ausnahme aus, die in Zeile 8 abgefangen wird: Das Objekt wird nicht erstellt, und [println] zeigt nichts an. Der [try]-Block ist vom Compiler nicht vorgeschrieben, anders als in Java: Ohne ihn würde die Ausnahme das Programm beenden. Zeile 11 wird, wenn man die Kommentierung aufhebt, vom Compiler abgelehnt, der zwei Gründe nennt:
Ein geschützter Konstruktor kann außerhalb abgeleiteter Klassen nicht aufgerufen werden, und vor allem kann kein Objekt einer abstrakten Klasse erzeugt werden.
Ergebnisse:
Eine abstrakte Klasse ähnelt einer Schnittstelle: Beide deklarieren Member, die andere Klassen implementieren müssen. Eine abstrakte Klasse kann jedoch einen Zustand (gespeicherte Eigenschaften), Konstruktoren und Code enthalten, der ihren abgeleiteten Klassen gemeinsam ist; dagegen kann eine Klasse nur von einer einzigen abstrakten Klasse erben, aber mehrere Schnittstellen implementieren. Beides wird oft kombiniert: Eine Schnittstelle definiert den Vertrag, während eine abstrakte Klasse, die sie implementiert, den mehreren Implementierungen gemeinsamen Code zusammenfasst. Genau das wird die Beispielanwendung in diesem Kapitel tun. Erinnern Sie sich schließlich daran, dass die zuvor behandelte versiegelte Klasse ([sealed class]) eine abstrakte Klasse ist, deren abgeleitete Klassen dem Compiler alle bekannt sind: Wir werden sie später mit dem Ausdruck [when] verwenden.
4.8. Generische Klassen, Schnittstellen und Funktionen
4.8.1. Generische Klassen und Funktionen
Angenommen, wir wollen eine Klasse [IntPair] schreiben, die zwei ganze Zahlen speichert und vertauschen kann: zwei Eigenschaften, [var first: Int] und [var second: Int], und eine Methode, [swap()], die ihre Werte mithilfe einer temporären Variablen vertauscht, [val temp]. Wollten wir anschließend ein Paar von Zeichenketten und dann ein Paar von Personen haben, müssten wir zwei weitere Klassen schreiben, [StringPair] und [PersonPair], die der vorherigen bis auf den Typ gleichen: [String] oder [Person] statt [Int].
Generische Klassen, Schnittstellen und Funktionen erfüllen den Bedarf an Code, der sich nur im Typ bestimmter Daten unterscheidet. Kotlin kennt sie seit seiner ersten Version; sie beruhen auf den Generics, die mit Java 5 (2004) in der JVM eingeführt wurden, und teilen mit diesen die Stärken und bestimmte Einschränkungen (Typlöschung, die später behandelt wird), bringen aber auch einige bemerkenswerte Verbesserungen mit (deklarationsseitige Varianz, reifizierte Typen). Es ist zu beachten, dass Kotlin wie Java die Parameterübergabe per Referenz nicht unterstützt: Eine Funktion kann die Werte zweier Variablen des Aufrufers nicht vertauschen, wohl aber zwei Elemente eines Objekts, eines Paares oder eines Arrays.
Das Programm [Classes18.kt] enthält eine generische Klasse, eine generische Funktion und eine zweite generische Klasse:
- Zeilen 44–58: Die Klasse [Pair] wird durch einen Typ parametrisiert, der mit [T] bezeichnet und in spitzen Klammern hinter dem Klassennamen angegeben wird. Sie können ihn beliebig benennen; üblicherweise ist es ein Großbuchstabe ([T] für Typ, [E] für Element, [K] und [V] für Schlüssel und Wert). Dieser Typ [T] wird dann in der Klasse wie jeder andere Typ verwendet: für die Konstruktorparameter, die beiden Eigenschaften und die temporäre Variable [temp] (Zeile 53), deren Typ der Compiler als [T] ableitet. Die Klasse [Pair] wird als generische Klasse bezeichnet;
- Zeilen 46–49: zwei Eigenschaften, die mit den gleichnamigen Konstruktorparametern initialisiert werden. Sie sind als [var] deklariert, weil die Methode [swap] sie ändert, aber ihr Accessor [set] ist privat ([private set]): Externer Code kann [pp.first] lesen, aber keinen Wert zuweisen. Das entspricht den privaten Feldern und ihren Accessoren [getFirst] und [getSecond] in der Java-Version;
- Zeilen 52–55: Vertauschen der beiden Elemente. Liebhaber von Kotlin-Idiomen schreiben dies manchmal in einer einzigen Zeile: [first = second.also { second = first }] ([also] gibt den Wert von [second] nach der Ausführung der Zuweisung im Block zurück). Die Version mit einer temporären Variablen ist besser lesbar;
- Zeile 7: Bei der Verwendung einer generischen Klasse, die durch Typen T1, T2, … parametrisiert ist, können diese Typen in spitzen Klammern angegeben werden. Hier ist [Pair<Int>] ein Paar ganzer Zahlen. Anders als Java, das [Pair<Integer>] verlangt und [Pair<int>] ablehnt, kennt Kotlin nur einen Typ, [Int]: Der Compiler verwendet überall dort, wo ein Objekt erforderlich ist, wie hier die Wrapper-Klasse
*[java.lang.Integer]*für dieJVM; - Zeilen 11 und 17: Meistens wird der Typ nicht angegeben; der Compiler leitet ihn aus den tatsächlichen Konstruktorparametern ab, hier [String] und dann [Person]. Das entspricht dem „Diamond“-Operator von Java [new Pair<>(...)], ist aber prägnanter;
- Zeile 21: Die Eigenschaft [first] eines [Pair<Person>] hat den Typ [Person], ohne Konvertierung;
- Zeilen 63–66: eine generische Funktion auf oberster Ebene. Der Typparameter [<T>] wird zwischen dem Schlüsselwort [fun] und dem Funktionsnamen deklariert. In Java war eine Klasse namens [Generic2] erforderlich, um die statische Methode aufzunehmen; in Kotlin kann eine Funktion außerhalb jeder Klasse existieren. Sie vertauscht die Elemente i und j eines Arrays mit Elementen vom Typ [T]. Der Typ [Array<T>] ist ein Kotlin-Array von Objekten (das Äquivalent zu [T[]] in Java);
- Zeile 26: Die Funktion [swap] wird aufgerufen, wobei der Typ [T] zwischen [<>] angegeben wird. Tatsächlich kann der Compiler [T] aus dem Typ der tatsächlichen Parameter ableiten. Daher ist die Syntax in Zeile 30 gültig, und sie wird in der Praxis verwendet. Beachten Sie, dass [arrayOf(1, 2, 3)] ein [Array<Int>] (ein Array von [Integer]-Objekten) erzeugt, auf das die Funktion angewendet wird; ein [IntArray]-Array (erzeugt mit [intArrayOf]), also ein Array primitiver ganzer Zahlen [int[]], würde nicht akzeptiert: Wie in Java kann sich ein Typparameter nicht auf einen primitiven Typ der JVM beziehen;
- Zeilen 70–86: Eine generische Klasse mit Zustand: ein Stapel von Elementen vom Typ [T]. Elemente werden oben auf den Stapel gelegt und von oben wieder entnommen. Die Elemente werden in einer veränderlichen generischen Liste vom Typ [MutableList<T>] (Zeile 72) gespeichert, die von der generischen Funktion [mutableListOf<T>()] erzeugt wird, welche ihrerseits durch den Typ des Stapels parametrisiert ist, [T]. Die Anzahl der Elemente ist eine berechnete Eigenschaft [size]. Die Funktion [removeLast] holt das letzte Element der Liste und gibt es zurück. Ein leerer Stapel löst eine [IllegalStateException]-Ausnahme aus, die Ausnahme, die geworfen wird, wenn von einem Objekt eine Operation verlangt wird, das sich nicht im erwarteten Zustand befindet: Genau diese Ausnahme wird von der Kotlin-Funktion [check(condition) { message }] geworfen, wenn die Bedingung falsch ist (Zeile 85);
- Zeile 34: ein Stapel von Personen. Hier muss der Typ angegeben werden, da der Compiler ihn nicht ableiten kann. Der Compiler garantiert, dass der Stapel nur Personen enthält: Die Anweisung in Zeile 40 wird, wenn man die Kommentierung aufhebt, abgelehnt ([argument type mismatch: actual type is 'String', but 'Person' was expected]). Die Methode [pop] gibt ein Objekt vom Typ [Person] zurück, ohne Konvertierung;
- Zeilen 91–92: Die Person ist eine Datenklasse, für die die Methode [toString] neu definiert wurde.
Ergebnisse:
4.8.2. Schranken generischer Parameter
In der Klasse [Pair<T>] weiß der Compiler nichts über den Typ [T]: Er erlaubt nur die Methoden der Klasse [Any] ([toString], [equals], [hashCode]), und selbst diese nur über den Operator [?.]: Standardmäßig kann [T] nämlich ein nullable Typ sein! Die implizite Schranke eines generischen Parameters ist [Any?]. Um andere Methoden zu verwenden, müssen Sie den generischen Parameter einschränken, indem Sie nach dem Doppelpunkt den Typ angeben, von dem er abgeleitet sein muss:
Einschränkung | Bedeutung |
[<T : SomeClass>] | T muss die angegebene Klasse oder eine davon abgeleitete Klasse sein |
[<T : Interface>] | T muss die angegebene Schnittstelle implementieren |
[<T> ... where T : I1, T : I2] | Mehrere Einschränkungen: Sie werden in einer [where]-Klausel aufgeführt, die vor dem Rumpf der Funktion oder Klasse steht |
[<T : Comparable<T>>] | eine Schranke, die T selbst verwendet: T muss mit T vergleichbar sein |
[<T : Any>] | T muss ein nicht nullbarer Typ sein |
Die Syntax entspricht der der Vererbung: Java schreibt [<T extends SomeClass>] und [<T extends SomeClass & I1 & I2>], während C# [where T : SomeClass] schreibt. Wie in Java gibt es keine Einschränkung, die einen parameterlosen Konstruktor verlangt: Sie können in einer generischen Klasse nicht [T()] schreiben (siehe Typlöschung weiter unten). Das Programm [Classes19.kt] verwendet eine Einschränkung:
- Zeile 8: ein Paar ganzer Zahlen. Anders als in der Java-Version ist hier kein Fehler zu melden: [Pair<Int>] ist erlaubt, und der Compiler verwendet im erzeugten Code die Klasse [Integer] ;
- Zeile 10: Da die implizite Schranke [Any?] ist, kann der Typ [T] ein nullable Typ sein: Das Paar [pn] enthält eine Zeichenkette und den Wert [null]. Um dies zu verhindern, hätten wir [class Pair<T : Any>] deklariert;
- Zeilen 46–49: Die generische Funktion [order] verlangt, dass der Typ [T] die Schnittstelle [IValue] (Zeilen 54–55) implementiert. Diese Schnittstelle hat eine Eigenschaft [value], die in Zeile 48 verwendet wird und den Wert des Objekts vom Typ [T] zurückgibt. Ohne die Schranke würde der Compiler den Ausdruck [pair.first.value] ablehnen: Nicht jeder Typ [T] hat eine Eigenschaft [value]. Die beiden Elemente des Paares werden nur vertauscht, wenn der Wert des ersten größer ist als der des zweiten: Die Funktion [order] sortiert die beiden Elemente aufsteigend nach Wert;
- Zeilen 59–68: Die Klasse [RandomValue] implementiert die Schnittstelle [IValue]. Der Wert einer Instanz ist eine Zufallszahl zwischen 0 und 99 (Zeile 61), geliefert von einem Zufallszahlengenerator der Klasse [kotlin.random.Random] , der von allen Instanzen gemeinsam genutzt wird: Er ist im Companion-Objekt der Klasse gespeichert (Zeile 68), das denselben Zweck erfüllt wie das statische Feld in der Java-Version. Dieser Generator wird mit einem festen „Seed“ initialisiert: Er erzeugt daher immer dieselbe Zahlenfolge, wodurch die Ergebnisse reproduzierbar sind. Dies ist nicht derselbe Algorithmus wie der der Klasse [java.util.Random]: Die resultierende Folge ist daher nicht dieselbe wie in der Java-Version. Wenn keine Reproduzierbarkeit erforderlich ist, wird der Standardgenerator [Random.Default] (zum Beispiel [Random.nextInt(100)]) verwendet; oder, für Sicherheitszwecke, die Klasse [java.security.SecureRandom];
- Zeilen 73–77: Die Klasse [StringValue] implementiert ebenfalls die Schnittstelle [IValue]: Der Wert einer Instanz ist die Länge der dem Konstruktor übergebenen Zeichenkette, die vom Property-Accessor berechnet wird;
- Zeilen 15–19: Paare von Objekten vom Typ [RandomValue] werden sortiert. Die Funktion [repeat(5) { ... }] führt den Block fünfmal aus;
- Zeilen 22–25: Ein Paar von Objekten vom Typ [StringValue] wird sortiert;
- Zeile 26: Wenn die Kommentierung dieser Zeile aufgehoben wird, meldet der Compiler, dass der Typ [Int] ungültig ist.
Ergebnisse:
Hier sind die Fehler, die beim Kompilieren auftreten, wenn die Kommentierung von Zeile 26 aufgehoben wird:
Der Compiler hat versucht, den Typ [T] abzuleiten: Die Einschränkung des Paares verlangt [T] = [Int], und die Schrankeneinschränkung verlangt, dass [T] die Schnittstelle [IValue] implementiert; da beide Einschränkungen unvereinbar sind, kann er keinen Typ [T] finden („uninferred T“). Wenn Sie den Typ selbst angeben – [order<Int>(pi)] –, ist die Meldung eindeutiger: [type argument is not within its bounds: type parameter 'T (of fun <T : IValue> order)' must be subtype of 'IValue', but actual: 'Int'].
4.8.3. Generische Schnittstellen: Comparable<T> und Comparator<T>
Um das Konzept einer generischen Schnittstelle zu veranschaulichen, sortieren wir eine Liste von Personen nach verschiedenen Kriterien. Dafür bietet Kotlin Funktionen für veränderliche Listen (und Arrays), die die Sammlung an Ort und Stelle sortieren, sowie Funktionen für alle Sammlungen, die eine neue, sortierte Liste zurückgeben, ohne das Original zu verändern. Wir verwenden mehrere davon:
- [list.sort()] sortiert die Liste gemäß der natürlichen Ordnung ihrer Elemente: Diese Elemente müssen die Schnittstelle [Comparable<T>] implementieren, deren einzige Methode [operator fun compareTo(other: T): Int] das aktuelle Objekt mit dem Objekt [other] vergleicht. Dies ist die Java-Schnittstelle [java.lang.Comparable], aus Sicht von Kotlin betrachtet;
- [list.sortWith(comparator)] sortiert die Liste gemäß der Ordnung, die durch ein Comparator-Objekt definiert wird, das die Schnittstelle [Comparator<T>] implementiert (ein Alias für [java.util.Comparator]), deren Methode [fun compare(a: T, b: T): Int] zwei Objekte vergleicht;
- [list.sortedWith(comparator)], [list.sortedBy { ... }] und [list.sortedByDescending { ... }] geben eine neue sortierte Liste zurück.
Die Methoden [compareTo] und [compare] folgen derselben Regel: Sie geben eine positive Zahl zurück, wenn x > y ist, 0, wenn x == y ist, und eine negative Zahl, wenn x < y ist. Es obliegt dem Entwickler, die Bedeutung der Operatoren <, == und > festzulegen. Sind zum Beispiel [p1] und [p2] zwei [Person]-Objekte, können wir festlegen, dass p1 > p2 gilt, wenn der Name von [p1] alphabetisch nach dem Namen von [p2] kommt. Das ergibt eine aufsteigende Sortierung nach den Namen der Personen. Wenn wir nach Alter sortieren wollen, legen wir fest, dass p1 > p2 gilt, wenn das Alter von [p1] größer ist als das Alter von [p2]. Für eine absteigende Sortierung genügt es, die Vorzeichen der Ergebnisse umzukehren.
Wir wissen nun genug, um eine Liste von Personen zu sortieren. Das Programm [Classes20.kt] lautet wie folgt:
- Zeilen 8–11: die veränderliche Liste von Personen. Die Java-Version sortierte ein Array; dieselben Funktionen [sort] und [sortWith] gibt es auch für Kotlin-Arrays;
- Zeilen 47–51: Die Klasse [Person] implementiert die generische Schnittstelle [Comparable<Person>]: Ihre Objekte sind mit anderen Personen vergleichbar. Ihre Methode [compareTo] (Zeile 49) definiert die natürliche Ordnung der Personen, in diesem Fall die Ordnung nach Alter. Die Methode [a.compareTo(b)] für ganze Zahlen gibt eine negative Zahl, null oder eine positive Zahl zurück, je nachdem, ob [a] kleiner, gleich oder größer als [b] ist: Genau das erwartet die Methode [compareTo] (Java schreibt [Integer.compare(a, b)]). Der Parameter heißt in der Schnittstelle [other] ; diesen Namen behalten wir beim Überschreiben bei, andernfalls würde der Compiler, der benannte Argumente erlaubt, eine Warnung ausgeben;
- Zeile 16: Sortierung in natürlicher Ordnung;
- Zeile 19: Sortierung der Liste von Personen nach Nachname und Vorname. Der Parameter der Funktion [sortWith] ist eine Instanz der Klasse [CompareNames], die die generische Schnittstelle [Comparator<Person>] implementiert;
- Zeilen 55–66: die Klasse [CompareNames]. Ihre Methode [compare] implementiert die Methode [compare(a: T, b: T)] der Schnittstelle [Comparator<T>], wobei [T] = [Person] ist. Zeichenketten werden nicht mit der Methode [compareTo] verglichen, die der Reihenfolge der Zeichencodes folgt (Großbuchstaben vor Kleinbuchstaben, Buchstaben mit Akzent nach „z“), sondern mit einem [java.text.Collator]-Objekt (Zeile 57), das die Sortierregeln für die französische Sprache anwendet. Kotlin verwendet hier direkt eine Klasse des JDK;
- Zeilen 22–24: Sortierung nach absteigendem Alter. Diesmal ist der Comparator ein anonymes Objekt: Der Ausdruck [object : Comparator<Person> { ... }] deklariert eine unbenannte Klasse, die die Schnittstelle [Comparator<Person>] implementiert, und erzeugt sofort eine Instanz dieser Klasse. Das entspricht der anonymen Klasse von Java ([new Comparator<Person>() { ... }]). Der Rumpf des Objekts stellt die Methode [compare] bereit. Ein anonymes Objekt erspart es, eine Klasse zu deklarieren, die nur einmal verwendet wird;
- Zeile 27: Die Methode [compareTo] der Schnittstelle [Comparable] ist als [operator] deklariert: Die Operatoren [<], [>], [<=] und [>=] können daher auf Personen angewendet werden ([p1 > p2] wird übersetzt in [p1.compareTo(p2) > 0]), wie wir es zuvor beim Überladen von Operatoren gesehen haben;
- Zeilen 29–30: Die Kotlin-Bibliothek erzeugt Comparatoren: [compareBy(comparator) { it.lastName }] gibt einen Comparator für Personen zurück, der ihre Namen (den vom Lambda berechneten Wert) mit dem angegebenen Comparator vergleicht, hier [Collator]; [thenBy(comparator) { it.firstName }] fügt ein zweites Kriterium hinzu, das bei Gleichheit im ersten Kriterium verwendet wird. Beide Typen von [compareBy] (das Element und der Schlüssel) werden zwischen spitzen Klammern angegeben, da der Compiler sie nicht allein aus dem Lambda ableiten kann. Ohne speziellen Comparator schreiben wir einfach [compareBy<Person> { it.lastName }.thenBy { it.firstName }]: Die Schlüssel werden dann in ihrer natürlichen Ordnung verglichen. Der Comparator [byNames] ist ein besserer Ersatz für die Klasse [CompareNames];
- Zeile 31: Die Funktion [sortedWith] gibt eine neue, nach dem Comparator sortierte Liste zurück; die Liste [persons] bleibt unverändert;
- Zeile 33: Die Funktion [sortedBy] sortiert nach dem vom Lambda-Ausdruck berechneten Schlüssel – hier dem Vornamen – in seiner natürlichen Ordnung ([sortedByDescending] würde absteigend sortieren);
- Zeile 35: Die ursprüngliche Liste wurde von den Funktionen [sortedWith] und [sortedBy] nicht verändert;
- Zeile 40: Die Funktion [repeat] wiederholt eine Zeichenkette: Die Titelzeile wird mit Strichen bis auf 50 Zeichen aufgefüllt.
Ergebnisse:
In diesem Fall enthielt die Java-Version drei Arten von Klassen, die innerhalb einer anderen Klasse deklariert sind. Kotlin kennt dieselben Arten, aber unter anderen Namen: Eine innerhalb einer anderen Klasse deklarierte Klasse ist standardmäßig verschachtelt (das Äquivalent zur Java-Klasse [static class]: Sie ist an kein Objekt der umschließenden Klasse gebunden); eine innere Klasse, die einem Objekt der umschließenden Klasse zugeordnet ist, wird mit dem Schlüsselwort [inner] deklariert ([inner class]); schließlich erzeugt der Ausdruck [object : ...] ein anonymes Objekt. In Kapitel 7 werden wir sehen, dass es für eine Schnittstelle mit nur einer abstrakten Methode, wie [Comparator], noch kürzer geht als mit einem anonymen Objekt: mit einem Lambda, [persons.sortWith { p1, p2 -> p2.age.compareTo(p1.age) }], oder, wie wir es gerade getan haben, mit einem aus einem Lambda erzeugten Comparator: [persons.sortWith(compareByDescending { it.age })].
4.8.4. Varianz, Projektionen und Typlöschung
Eine [MutableList<Int>] ist keine [MutableList<Number>], obwohl [Int] von [Number] abgeleitet ist: Wäre sie es, könnte man über eine Variable vom Typ [MutableList<Number>] einen [Double] zu einer Liste ganzer Zahlen hinzufügen. Der Typ [MutableList<T>] heißt invariant: Eine Funktion, die eine [MutableList<Number>] akzeptiert, lehnt eine [MutableList<Int>] ab. Eine schreibgeschützte Liste vom Typ [List<Int>] ist dagegen eine [List<Number>]: Da nichts hinzugefügt werden kann, besteht das vorherige Risiko nicht, und jede aus der Liste gelesene ganze Zahl ist tatsächlich eine Zahl. Der Typ [List<T>] heißt kovariant.
Dies ist ein bedeutender Unterschied zu Java. In Java sind alle generischen Schnittstellen invariant, und Sie müssen bei jeder Verwendung Wildcards schreiben: [List<? extends Number>] für eine Liste, aus der Sie lesen, [List<? super Integer>] für eine Liste, die Sie befüllen. Kotlin erlaubt es, die Varianz ein für alle Mal bei der Deklaration der Klasse oder Schnittstelle festzulegen: Dies ist die deklarationsseitige Varianz. Die Schnittstelle [List] ist als [interface List<out E>] deklariert: Das Schlüsselwort [out] bedeutet, dass der Typ [E] nur als „Ausgabe“ auftritt (als Ergebnis von Methoden und Eigenschaften vom Typ [val]), was den Typ kovariant macht. Ebenso ist die Schnittstelle [Comparable] als [interface Comparable<in T>] deklariert: Der Typ [T] tritt dort nur als „Eingabe“ auf (Parameter von [compareTo]), was den Typ kontravariant macht: Ein [Comparable<Number>] ist ein [Comparable<Int>] (wer beliebige Zahlen vergleichen kann, kann auch ganze Zahlen vergleichen). Der Compiler prüft, ob die Klasse ihre Deklaration einhält.
Für invariante Typen wie [MutableList] bietet Kotlin außerdem Typprojektionen, die den Wildcards von Java entsprechen:
Kotlin | Java | Bedeutung |
[MutableList<out Number>] | [List<? extends Number>] | Eine Liste von Elementen eines unbekannten Typs, der von [Number] abgeleitet ist: Sie können daraus [Number] lesen, aber keine Elemente hinzufügen |
[MutableList<in Int>] | [List<? super Integer>] | eine Liste von Elementen eines unbekannten Typs, von dem [Int] abgeleitet ist ([Int], [Number], [Any]): [Int] kann zu dieser Liste hinzugefügt werden |
[MutableList<*>] | [List<?>] | eine Liste von Elementen eines unbekannten Typs (Star-Projektion): Sie können [Any?] lesen |
Das Programm [Classes21.kt] veranschaulicht Varianz, Projektionen und eine Besonderheit der Generics in der JVM – die Typlöschung – sowie die teilweise Lösung dieses Problems durch Kotlin: reifizierte Typparameter:
- Zeilen 38–43: Die Funktion [sum] akzeptiert eine [List<Number>]; da [List] kovariant ist, akzeptiert sie daher eine Liste mit Elementen eines beliebigen von [Number] abgeleiteten Typs: [Int], [Double], [BigDecimal] … Sie liest die Elemente als [Number] und verwendet ihre Methode [toDouble]. Kotlin unterstützt wie Java keine generische Arithmetik: Sie können nicht [a + b] für zwei Objekte vom Typ [T] oder [Number] schreiben, daher die Verwendung von [Double]. Wo Java
***[List<? extends Number>]schreiben müsste, genügt der einfache Typ***[List<Number>]; - Zeilen 8–9: Dieselbe Funktion addiert eine Liste von [Int] zu einer Liste von [Double]. [listOf(...)] erzeugt eine schreibgeschützte Liste;
- Zeilen 47–49: Eine veränderliche Liste dagegen ist invariant. Um eine [MutableList<Int>] (Zeile 17) zu akzeptieren, deklariert die Funktion eine Projektion [MutableList<out Number>]. Sie kann Elemente als [Number] lesen, aber das Hinzufügen eines Elements (Zeile 48) wird abgelehnt: Der Compiler weiß nicht, ob es sich um eine Liste von [Int] oder [Double] handelt ([receiver type 'MutableList<out Number>' contains out projection which prohibits the use of 'fun add(element: E): Boolean']);
- Zeilen 53–55: Die Funktion [addIntegers] akzeptiert jede veränderliche Liste, die [Int] aufnehmen kann, in diesem Fall eine [MutableList<Number>] (Zeile 11). Wir folgen der Regel „Producer: [out], Consumer: [in]“: Eine Liste, aus der Elemente gelesen werden, wird mit [out] geschrieben, und eine Liste, die befüllt wird, mit [in]. Die Schlüsselwörter von Kotlin drücken direkt das aus, was Java mit [extends] und [super] ausdrückt;
- Zeilen 60–67: Die generische Funktion [max] gibt das größte Element einer Liste zurück. Die Schranke [T : Comparable<T>] verlangt, dass die Elemente untereinander vergleichbar sind; sie gilt sowohl für Zeichenketten als auch für ganze Zahlen (Zeile 19). In Java müssen Sie [T extends Comparable<? super T>] schreiben, um auch einen Typ zu akzeptieren, dessen Elternklasse vergleichbar ist; in Kotlin genügt [T : Comparable<T>], da die Schnittstelle [Comparable] kontravariant ist ([in T]). Die Funktion [first] gibt das erste Element der Liste zurück, und der Operator [>] ruft [compareTo] auf. (Die Kotlin-Bibliothek stellt bereits die Funktion [maxOf] und für Sammlungen [max()] bereit.);
- Zeile 71: unsere eigene kovariante Klasse. Der Typ
*[T]tritt dort nur als Ausgabe auf, als Typ einer Eigenschaft*[val]*. Zeile 21: Eine***[Box<Int>]wird daher dort akzeptiert, wo eine***[Box<Number>]erwartet wird. Wenn wir der Klasse eine Methode [fun replace(newValue: T)] hinzufügen, in der [T] als Eingabe auftritt, lehnt der Compiler die Klasse ab: [type parameter 'T' is declared as 'out' but occurs in 'in' position in type 'T (of class Box<out T>)']*; - Zeilen 74–75: Die Funktion [displaySize] akzeptiert eine Liste mit Elementen beliebigen Typs: [List<*>]. Sie kann keine Annahmen über ihre Elemente treffen, die sie als [Any?] liest. Die Funktion [firstOrNull] gibt das erste Element zurück oder [null] , wenn die Liste leer ist;
- Zeilen 27–29: Zur Laufzeit sind eine
***[ArrayList<String>]und eine***[ArrayList<Int>]zwei Objekte derselben Klasse*[java.util.ArrayList](*[javaClass]gibt die Java-Klasse eines Objekts zurück). Der Compiler prüft die generischen Typen und löscht sie dann: Der kompilierte Code kennt nur noch [ArrayList] und [Object], und wo nötig werden Konvertierungen eingefügt. Diese „Typlöschung“, die Java 2004 eingeführt hat, damit generischer Code mit bestehendem Code kompatibel bleibt, gilt auch für Kotlin, das Code für dieselbe JVM erzeugt. Das erklärt mehrere Einschränkungen: Sie können weder [T()] schreiben noch [o is List<String>] testen ([cannot check for instance of erased type 'List<String>']); Sie können jedoch [o is List<*>] testen; - Zeilen 79–81: Kotlin umgeht die Typlöschung bei den [inline]-Funktionen teilweise. Der Code einer [inline]-Funktion wird vom Compiler an jeder Aufrufstelle kopiert (wir kommen in Kapitel 7 darauf zurück): An dieser Stelle ist der Typ [T] bekannt. Wenn der Typparameter als [reified] („reifiziert“) deklariert ist, kann die Funktion ihn als echten Typ verwenden: um [it is T] zu testen (Zeile 79) oder um seine Klasse [T::class] zu erhalten (Zeile 81). Ohne [reified] wird der Test [it is T] abgelehnt: [cannot check for instance of erased type 'T (of fun <T> countOf)'];
- Zeilen 31–34: Verwendung reifizierter Funktionen. Der Typ wird zwischen spitzen Klammern angegeben: [countOf<String>(mixed)] zählt die Zeichenketten in der Liste. Die Kotlin-Bibliothek nutzt diesen Mechanismus intensiv, zum Beispiel in der Funktion [filterIsInstance<String>()], die die Elemente einer Sammlung, die Zeichenketten sind, als Typ [List<String>] zurückgibt.
Ergebnisse:
Anders als in anderen Sprachen wie C#, wo Schnittstellen abstrakte statische Member deklarieren können, um generische Berechnungen zu implementieren, erlaubt Kotlin es nicht, von einem Typ [T] eine „Klassenmethode“ zu verlangen: Die Member des Companion-Objekts einer Schnittstelle werden über den Namen der Schnittstelle aufgerufen und von den Klassen, die sie implementieren, nicht geerbt.
4.9. Pakete
Um eine Zeile auf dem Bildschirm auszugeben, verwenden wir die Funktion [println(...)]. Wenn wir ihre Definition in der Dokumentation der Kotlin-Bibliothek (kotlinlang.org/api) nachschlagen, stellen wir fest, dass sie zum Paket [kotlin.io] gehört. Das bedeutet, dass ihr vollständiger Name [kotlin.io.println] lautet und dass wir [kotlin.io.println(...)] schreiben könnten. Ein Kotlin-Paket enthält Klassen sowie Funktionen, Eigenschaften und Objekte der obersten Ebene. Mehrere Pakete werden automatisch in jede Kotlin-Datei importiert: [kotlin.*] ([Any], [String], [Int] …), [kotlin.io.*] ([println], [readln]), [kotlin.collections.*] ([List], [listOf] …), [kotlin.text.*] ([StringBuilder], [Regex] …), [kotlin.ranges.*], [kotlin.sequences.*], [kotlin.comparisons.*] ([compareBy] …), [kotlin.annotation.*] und, auf der JVM, [java.lang.*], und [kotlin.jvm.*]. Für alle anderen wird eine [import]-Klausel verwendet, die am Anfang der Datei nach der Paketdeklaration steht:
- [import java.text.Collator] importiert die Klasse [Collator] aus dem Paket [java.text] (ohne abschließendes Semikolon, wie bei allen Kotlin-Anweisungen);
- [import java.util.*] importiert alle öffentlichen Deklarationen des Pakets [java.util] bei Bedarf;
- [import kotlin.math.sqrt] importiert eine Funktion der obersten Ebene, die dann ohne ihr Paket verwendet werden kann: [sqrt(2.0)]. Kotlin benötigt die [import static]-Klausel von Java nicht: Klassen, Funktionen, Eigenschaften und sogar statische Member einer Java-Klasse ([import java.lang.Math.PI]) werden auf dieselbe Weise importiert;
- [import namespaces.e2.Person as PersonE2] importiert eine Deklaration unter einem anderen Namen – einem Alias –, der nur innerhalb dieser Datei gültig ist.
Wenn der Compiler auf einen einfachen Namen stößt, sucht er ihn im aktuellen Paket und unter den importierten Deklarationen. Eine [import]-Klausel fügt dem Programm nichts hinzu: Sie erspart es lediglich, die vollständigen Namen auszuschreiben.
Wenn Sie eine Klasse erstellen, legen Sie sie in einem Paket ab. Der Zweck von Paketen ist es, Namenskonflikte zwischen Klassen zu vermeiden, zum Beispiel wenn sie weitergegeben werden. Stellen Sie sich zwei Firmen E1 und E2 vor, die Klassen vertreiben, die in den Archiven [e1.jar] bzw. [e2.jar], verpackt sind. Angenommen, ein Kunde C erwirbt diese beiden Klassensammlungen, in denen beide Firmen eine Klasse namens [Person] definiert haben. Wenn die Firma E1 ihre Klassen in einem Paket namens [e1] und die Firma E2 ihre Klassen in einem Paket namens [e2] erstellt, heißen die beiden Klassen [Person] dann [e1.Person] und [e2.Person]. Der Client kann eine von ihnen importieren und sich auf die andere über ihren vollständigen Namen beziehen oder ihr einen Alias geben. Das Paket löst die Mehrdeutigkeit auf. Üblicherweise werden Paketnamen kleingeschrieben und beginnen mit dem umgekehrten Domänennamen der Organisation, die sie veröffentlicht ([com.mysql.cj.jdbc], [org.hibernate], [kotlinx.coroutines] …); für unsere Beispiele verwenden wir kurze Namen.
Um die Deklarationen einer Datei in einem Paket abzulegen, schreiben Sie am Anfang der Datei die Deklaration [package name]. Das haben wir seit Beginn dieses Kurses so gemacht: Jedes Programm befindet sich in einem Paket mit eigenem Namen. Anders als Java verlangt Kotlin keine Eins-zu-eins-Entsprechung zwischen Paketen und Ordnern, empfiehlt sie aber, und IntelliJ IDEA zeigt eine Datei an, die nicht richtig organisiert ist: Die Quelldateien des Pakets [namespaces.e1] befinden sich in einem Ordner namens [namespaces/e1], ausgehend vom Quellwurzelverzeichnis ([src/main/kotlin]). Das Paket [namespaces] und seine beiden Unterpakete veranschaulichen diese Konzepte:
Die erste Klasse [Person] [e1/Person.kt]:
- Zeile 2: die Paketdeklaration. Alle Deklarationen der Datei gehören zu diesem Paket: die Klasse [Person] und die Funktion der obersten Ebene [greet] (Zeile 9), deren vollständiger Name [namespaces.e1.greet] lautet. In der JVM wird diese Funktion in einer Klasse namens [namespaces.e1.PersonKt] abgelegt, die nach der Datei benannt ist.
Die zweite, [e2/Person.kt]:
- Zeile 4: eine Klasse namens [Person], die denselben Namen wie die vorherige trägt, sich aber in einem anderen Paket befindet;
- Zeile 9: eine Konstante mit der Sichtbarkeit [internal]: Sie ist nur für Deklarationen innerhalb desselben Moduls zugänglich. In Kotlin ist ein Modul eine Menge gemeinsam kompilierter Dateien: ein Gradle-Projekt (oder Teilprojekt), ein IntelliJ-IDEA-Modul … Hier ist es das Projekt [04-classes];
- Zeile 12: eine private Funktion der obersten Ebene: Sie ist nur für Deklarationen innerhalb ihrer eigenen Datei zugänglich. Der Versuch, sie aus [Main.kt] zu importieren, wird abgelehnt: [cannot access 'fun tool(): String': it is private in file].
Beide Klassen sind öffentlich, was die Standardsichtbarkeit in Kotlin ist (eine Java-Klasse ohne das Schlüsselwort [public] ist nur für Klassen ihres eigenen Pakets zugänglich). Fassen wir die vier Sichtbarkeitsstufen einer Deklaration der obersten Ebene zusammen:
Sichtbarkeit | Zugänglich von |
[public] (Standard) | überall |
[internal] | demselben Modul |
[private] | derselben Datei |
[protected] | (gilt nur für Member einer Klasse: die Klasse und ihre abgeleiteten Klassen) |
Kotlin hat kein Äquivalent zur „Paket“-Sichtbarkeit von Java – der Standardsichtbarkeit von Java-Deklarationen ohne Modifizierer: In Kotlin ist ein Paket lediglich ein Namensraum, und es ist das Modul, das festlegt, was eine Bibliothek ihren Nutzern zur Verfügung stellt. Das Hauptprogramm [Main.kt] lautet wie folgt:
- Zeile 4: Import der Klasse [namespaces.e1.Person];
- Zeile 6: Import der Funktion der obersten Ebene [greet], genau wie man eine Klasse importiert;
- Zeile 8: Import der Klasse [namespaces.e2.Person] unter dem Namen [PersonE2]. In dieser Datei bezieht sich der Name [PersonE2] auf diese Klasse. Java unterstützt keine Aliasse: Sie können einer Klasse in Java keinen anderen Namen geben. (Kotlin erlaubt es außerdem, einen Typalias für das gesamte Paket zu deklarieren, etwa [typealias PersonE2 = namespaces.e2.Person]: Wir haben dafür Beispiele gesehen, bei denen [Comparator] und [Exception] Aliasse für Java-Typen sind);
- Zeile 10: Import der Konstante [internal], was erlaubt ist, da sich [Main.kt] im selben Modul befindet;
- Zeile 12: Import der Funktion [sqrt] aus dem Paket [kotlin.math];
- Zeile 16: [Person] bezieht sich auf die Klasse [namespaces.e1.Person], die importiert wurde;
- Zeile 18: Der vollständige Name der Klasse [namespaces.e2.Person] beseitigt jede Mehrdeutigkeit;
- Zeile 20: Der Alias führt zum selben Ergebnis, ist aber lesbarer;
- Zeile 23: Aufruf der importierten Funktion;
- Zeilen 25–26: Die Eigenschaft [qualifiedName] der Kotlin-Beschreibung einer Klasse ([Person::class]) gibt ihren vollständigen Namen mit vorangestelltem Paket zurück. Die Eigenschaft [java] gibt die Java-Beschreibung der Klasse zurück ([java.lang.Class]), deren Methode [getPackageName] – in Kotlin als Eigenschaft [packageName] betrachtet – den Paketnamen zurückgibt;
- Zeilen 28–29: Die Methode [getModule] der Java-Klasse gibt das JPMS-Modul zurück, das die Klasse enthält (siehe unten);
- Zeilen 31–32: Die Klasse [StringBuilder] wird ohne Import erkannt (sie ist ein Alias, der im Paket [kotlin.text] für die Klasse [java.lang.StringBuilder] definiert ist);
- Zeile 34: Verwendung der importierten Funktion;
- Zeile 36: Verwendung der Konstante [internal].
Ergebnisse:
Wenn wir die Importe von [Person] durch die beiden Importe bei Bedarf [import namespaces.e1.*] und [import namespaces.e2.*] ersetzen, ohne den Alias, wird der Name [Person] mehrdeutig. Die beiden Importe heben sich gegenseitig auf, und der Compiler kann die Klasse nicht mehr finden:
Beachten Sie, dass ein Import mit Alias den ursprünglichen Namen in der Datei verdeckt: Mit der Klausel [import namespaces.e2.Person as PersonE2] kann sich der Name [Person] nun nur noch auf die Klasse im Paket [e1] beziehen, selbst wenn beide Pakete bei Bedarf importiert werden.
4.9.1. Module
Der Begriff Modul hat für einen Kotlin-Entwickler zwei Bedeutungen. Die erste haben wir gerade gesehen: das Kotlin-Modul, eine Menge gemeinsam kompilierter Dateien, die den Geltungsbereich von [internal] festlegt. Die zweite stammt aus Java: Seit Java 9 werden Pakete in Modulen zusammengefasst (dem „Java Platform Module System“, JPMS). Das JDK ist in Module unterteilt: [java.base] enthält die Kernpakete ([java.lang], [java.util], [java.math], [java.io] …), [java.sql] bietet den Datenbankzugriff, [java.net.http] ist der HTTP-Client und so weiter. Ein JPMS-Modul deklariert in einer Datei namens [module-info.java] seinen Namen, die Module, von denen es abhängt ([requires java.sql;]), und die Pakete, die es anderen Modulen zur Verfügung stellt ([exports tax.business;]). Ein Kotlin-Projekt kann ein solches Modul deklarieren (die in Java geschriebene Datei [module-info.java] wird neben den Kotlin-Quelldateien abgelegt und muss dann vom Modul [kotlin.stdlib] abhängen). Klassen einer Anwendung, die kein JPMS-Modul deklariert – wie unsere –, gehören zum unbenannten Modul (Zeile 5 der Ausgabe), das Zugriff auf alle Module hat. Das ist bei den meisten Anwendungen der Fall und bei allen in diesem Kurs: Die JPMS-Module sind vor allem für Bibliotheksautoren und für das JDK selbst von Interesse.
4.10. Datenklassen
Viele Klassen dienen ausschließlich dazu, Daten zu transportieren: eine Person, eine Note, eine Steuerstufe … Für diese schreiben wir immer denselben Code: schreibgeschützte Eigenschaften, eine Methode [toString], die sie anzeigt, sowie die Methoden [equals] und [hashCode]. Der primäre Konstruktor von Kotlin erspart Ihnen bereits, die Felder, den Konstruktor und die Accessoren zu schreiben; das Schlüsselwort [data], das vor [class] steht, weist den Compiler außerdem an, den Rest zu erzeugen. Datenklassen gibt es seit der ersten Version von Kotlin (2016); Java hat mit seinen Records 2021 nachgezogen. Wir sind ihnen bereits früher (im Abschnitt „Unveränderliche Objekte“) und seither mehrfach begegnet; das Programm [Classes22.kt] stellt sie ausführlicher vor:
- Zeilen 50–52: die Datenklasse [Person]. Die Deklaration [data class Person(val firstName: String, val lastName: String, val age: Int)] erzeugt aus den im primären Konstruktor deklarierten Eigenschaften:
- drei schreibgeschützte Eigenschaften [firstName], [lastName], [age] (was auch eine reguläre Klasse tut), auf die über ihre Namen zugegriffen wird: [r1.firstName] (Zeile 10);
- eine Methode [toString] , die den Klassennamen und ihre Eigenschaften anzeigt (Zeile 1 der Ergebnisse);
- die Methoden [equals] und [hashCode], die die Werte der Eigenschaften statt der Referenzen vergleichen;
- eine Methode [copy], die eine Kopie des Objekts erzeugt, deren Eigenschaften geändert werden können;
- die Methoden [component1], [component2] und [component3], die die Eigenschaften in der Reihenfolge ihrer Deklaration zurückgeben und die Destrukturierung ermöglichen;
- der primäre Konstruktor einer Datenklasse muss mindestens einen Parameter haben, und alle seine Parameter müssen Eigenschaften sein ([val] oder [var]). Es können Eigenschaften vom Typ [var] deklariert werden: Die Datenklasse ist dann veränderlich. Das ist erlaubt, aber nicht empfehlenswert, denn ein Objekt, dessen [hashCode] sich ändert, geht in einer Menge oder einem Dictionary, die es enthalten, verloren; Datenklassen sind unveränderlichen Daten vorbehalten;
- Zeile 52: Eine Datenklasse kann wie eine Klasse zusätzliche Methoden haben und Schnittstellen implementieren (Zeile 50);
- Zeile 12: [r1] und [r2] sind zwei verschiedene Objekte ([===], wo die Referenzen gleich sein müssen, ergibt [false]), aber sie sind im Sinne von [==] gleich, das [equals] aufruft, weil ihre Eigenschaften dieselben Werte haben. Ihre Hashcodes sind daher gleich. Bei einer gewöhnlichen Klasse vergleicht [equals] die Referenzen (Zeile 28);
- Zeile 14: Wenn die Kommentierung aufgehoben wird, wird diese Zeile abgelehnt: ['val' cannot be reassigned];
- Zeile 16: Eine unveränderliche Datenklasse kann nicht geändert werden; es wird eine geänderte Kopie erzeugt. Die generierte Methode [copy] hat einen Parameter pro Eigenschaft, dessen Standardwert der Wert der Eigenschaft im kopierten Objekt ist; mit einem benannten Argument werden nur die Eigenschaften angegeben, die sich ändern. Dies ist der Ausdruck [with], der in Java fehlte, wo man „Wither“-Methoden von Hand schreiben muss ([withAge(31)]);
- Zeile 20: Destrukturierung: Die Eigenschaften von
*[r1]werden in die Variablen*[firstName]*,*[lastName], und*[age]extrahiert. Der Compiler übersetzt diese Deklaration in [val firstName = r1.component1()], [val lastName = r1.component2()] usw.: Die Zuordnung beruht auf der Position und nicht auf dem Namen (in Zeile 22 wird die Methode [component2] direkt aufgerufen). Eine Eigenschaft kann mit dem Zeichen [_] übersprungen werden: [val (firstName, _, age) = r1]. Das entspricht dem Record-Pattern von Java 21 ([r1 instanceof Person(String firstName, String lastName, int age)]*); auf die Destrukturierung mit Musterfilterung kommen wir noch zurück; - Zeilen 56–57: Eine Datenklasse ist final; man kann sie nicht ableiten (das Schlüsselwort [open] ist hier verboten). Anders als ein Java-Record kann sie jedoch selbst von einer offenen, abstrakten oder versiegelten Klasse abgeleitet sein. Damit die Klassen [Person] und [Teacher] einen gemeinsamen Typ haben, lassen wir sie dieselbe Schnittstelle implementieren, hier [HasIdentity] (Zeilen 45–46). Die Klasse [Teacher] erbt somit die Eigenschaften der Person;
- Zeile 36: Die Gleichheit von Datenklassen berücksichtigt den tatsächlichen Typ der Objekte: Eine [Person] ist niemals gleich einem [Teacher], selbst wenn ihre gemeinsamen Eigenschaften gleich sind;
- Zeilen 38–40: Die gemeinsame Schnittstelle erlaubt es, beide Klassen polymorph zu behandeln. Der Typ der Liste, [List<HasIdentity>], wird vom Compiler abgeleitet: Es ist der spezifischste gemeinsame Typ der beiden Elemente;
- Zeile 61: eine gewöhnliche Klasse, die der Klasse [Person] ähnelt. Dank des primären Konstruktors passt auch sie in eine einzige Zeile … aber Gleichheit nach Wert, [toString], [copy] und Destrukturierung werden nicht bereitgestellt. In Java mussten Sie außerdem die Felder, den Konstruktor sowie die Getter und Setter schreiben.
Ergebnisse:
Beachten Sie, dass die Methode [toString] der Klasse [PersonC] dieselbe ist wie die der Klasse [Any]: der vollständige Klassenname, gefolgt von einem Hashcode, der sich von Ausführung zu Ausführung ändert (Zeile 8 der Ergebnisse), und dass die Gleichheit der beiden [PersonC]-Objekte false ist (Zeile 9). Das Format der Methode [toString] einer Datenklasse, [Person(firstName=Jean, lastName=Dupont, age=30)], unterscheidet sich leicht von dem eines Java-Records, [Person[firstName=Jean, lastName=Dupont, age=30]].
Fassen wir die Unterschiede zwischen einer regulären Klasse und einer Datenklasse zusammen:
Klasse | Datenklasse | |
Gleichheit: [==] ([equals]) | dasselbe Objekt (sofern nicht überschrieben) | gleiche Werte der Eigenschaften des primären Konstruktors, gleicher Typ |
[toString] | Klassenname und Hashcode | Klassenname und Eigenschaften |
Eigenschaften, Konstruktor | vom primären Konstruktor deklariert | vom primären Konstruktor deklariert (mindestens eine Eigenschaft, nur Eigenschaften) |
Zustand | veränderlich oder nicht | unveränderlich mit [val] (empfohlen); weitere Eigenschaften können im Rumpf deklariert werden |
geänderte Kopie | selbst zu schreiben | [copy(prop = value)] generiert |
Destrukturierung | selbst zu schreiben ([operator fun componentN]) | generiert |
Vererbung | von einer Klasse, von mehreren Schnittstellen; offen mit [open] | von einer Klasse, von mehreren Schnittstellen; immer final |
Eine Datenklasse wird für Daten verwendet, die durch ihren Wert definiert sind (eine aus einer Datenbank abgerufene Person, eine über das Netzwerk ausgetauschte Nachricht, eine Steuerstufe), während eine gewöhnliche Klasse für ein Objekt mit Identität und Verhalten verwendet wird (ein Berechnungsdienst, eine Verbindung, eine veränderliche Liste). In Kapitel 11 werden wir sehen, dass Hibernate-Entitäten, die eine Identität haben, keine Datenklassen sind. Hinweis: Eine Datenklasse mit Eigenschaften vom Typ [val] ist nur „oberflächlich“ unveränderlich: Verweist eine Eigenschaft auf ein veränderliches Objekt – zum Beispiel eine [MutableList] –, bleibt der Inhalt dieser Liste veränderlich. In diesem Fall verwenden wir schreibgeschützte Eigenschaften vom Typ [List], die mit einer Kopie initialisiert werden ([list.toList()]). Für Leser, die von Java kommen: Eine Datenklasse wird zu einer regulären, finalen Java-Klasse kompiliert (nicht zu einem Record); die Annotation [@JvmRecord] erlaubt es, sie bei Bedarf zu einem echten Java-Record zu kompilieren.
4.11. Konstruktoren von Datenklassen
Der primäre Konstruktor einer Datenklasse kopiert seine Parameter einfach in die Eigenschaften. Möglicherweise möchten Sie diese Parameter jedoch validieren oder normalisieren. Java bietet dafür bei Records den kompakten Konstruktor, der die Parameter vor dem Speichern ändern kann. Kotlin hat kein exaktes Äquivalent: Die Parameter einer Datenklasse sind ihre Eigenschaften und werden unverändert gespeichert. Dafür stehen uns die Mittel jeder Klasse zur Verfügung: der [init]-Block zur Validierung, sekundäre Konstruktoren und die Factorys des Companion-Objekts zur Normalisierung. Das Programm [Classes23.kt] veranschaulicht dies:
- Zeilen 36–37: Der Block [init] wird bei jeder Konstruktion ausgeführt, nachdem die Eigenschaften des primären Konstruktors initialisiert wurden. Er validiert das Objekt: Ein negatives Alter wird abgelehnt. Die Funktion [require(condition) { message }] wirft eine [IllegalArgumentException]-Ausnahme mit der vom Lambda berechneten Meldung, wenn die Bedingung falsch ist: Dies ist die Ausnahme für einen ungültigen Parameter. Alle Konstruktoren einer Klasse laufen über den primären Konstruktor und damit über den [init]-Block: Es gibt keine Möglichkeit, eine [Person] mit negativem Alter zu erzeugen, nicht einmal mit [copy], das ebenfalls den primären Konstruktor aufruft;
- Zeile 34: Der Block [init] kann die [val]-Eigenschaften des primären Konstruktors, die bereits initialisiert sind, nicht ändern. Um die Parameter zu normalisieren (hier die Leerzeichen um Vor- und Nachnamen zu entfernen), machen wir den primären Konstruktor privat ([private constructor]) und stellen stattdessen eine Factory-Methode bereit: die Funktion [create] des Companion-Objekts (Zeilen 50–51). Sie validiert und normalisiert die Parameter, bevor sie den primären Konstruktor aufruft, den sie aufrufen darf, da sie Teil der Klasse ist. Sie wird über den Klassennamen aufgerufen: [Person.create(" Jean ", "Dupont", 30)] (Zeile 7);
- Zeile 33: Die generierte Methode [copy] ruft den primären Konstruktor auf; wäre sie öffentlich, würde sie es erlauben, die Factory-Methode ([p.copy(firstName = " x ")]) zu umgehen. Die Annotation [@ConsistentCopyVisibility] weist den Compiler an, ihr die Sichtbarkeit des primären Konstruktors zu geben, die hier privat ist. Ohne sie gibt Kotlin 2.4 die Warnung [non-public primary constructor is exposed via the generated 'copy()' method of the 'data' class] aus und weist darauf hin, dass sich die Sichtbarkeit der generierten Methode [copy] in einer zukünftigen Version ändern wird (sie hat dann dieselbe Sichtbarkeit wie der Konstruktor);
- Zeile 41: ein sekundärer Konstruktor, der nur den Namen entgegennimmt. Wie jeder sekundäre Konstruktor einer Klasse mit primärem Konstruktor muss er den primären Konstruktor mit [: this(...)] aufrufen; um die Parameter zu berechnen, darf er Funktionen des Companion-Objekts aufrufen, sogar private ([validate]). Ein sekundärer Konstruktor kann öffentlich sein, wenn der primäre Konstruktor privat ist;
- Zeile 44: Eine Datenklasse ist unveränderlich: Altern bedeutet, eine neue Instanz zu erzeugen, was mit der Methode [copy] geschieht (privat, aber innerhalb der Klasse verwendbar);
- Zeilen 54–56: eine private Validierungsfunktion im Companion-Objekt. [isNotBlank()] gibt true zurück, wenn die Zeichenkette etwas anderes als Leerzeichen enthält; [trim()] entfernt führende und nachfolgende Leerzeichen der Zeichenkette. Die Fehlermeldung wird mit einem String-Template innerhalb des Lambdas aufgebaut, das an [require] übergeben wird: Sie wird nur berechnet, wenn ein Fehler auftritt;
- Zeilen 61–68: Eine Datenklasse kann zusätzlich zu den Eigenschaften ihres primären Konstruktors Eigenschaften haben, die in ihrem Rumpf deklariert sind – hier die berechnete Eigenschaft [distance]. Diese tragen nicht zu [toString], [equals], [hashCode] oder [copy] bei. Sie kann auch ein Companion-Objekt haben, hier mit der Eigenschaft [ORIGIN], die dem statischen Feld der Java-Version entspricht. (Anders als ein Record kann eine Datenklasse sogar im Rumpf gespeicherte Eigenschaften haben, was aber für unveränderliche Daten kaum nützlich ist.)
Ergebnisse:
Der Vorname, der mit Leerzeichen auf beiden Seiten übergeben wurde (Zeile 7), wurde ohne sie gespeichert (Zeilen 1 und 2 der Ergebnisse). Der [init]-Block ist der idiomatische Weg, um sicherzustellen, dass ein Objekt immer gültig ist; eine Factory mit privatem Konstruktor erlaubt es außerdem, die Daten zu normalisieren.
4.12. Erweiterungsfunktionen
Wie fügt man einer Klasse, die nicht geändert werden kann, eine Methode hinzu, etwa der Klasse [String]? Java bietet dafür keine eingebaute Lösung: Man schreibt statische Methoden, die in einer Hilfsklasse zusammengefasst werden ([Arrays], [Collections], [Objects], [Math] …), und ruft sie über ihren Klassennamen auf, wobei das Objekt als Parameter übergeben wird: [Tools.initials(p)]. Kotlin bietet, wie C# mit seinen Erweiterungsmethoden, Erweiterungsfunktionen: Funktionen, die außerhalb der Klasse deklariert sind und wie Methoden der erweiterten Klasse verwendet werden: [p.initials()]. Wir verwenden sie seit Beginn dieses Kurses: [toInt], [sumOf], [contentToString], [toMutableList], [repeat], [also] … sind Erweiterungsfunktionen der Kotlin-Bibliothek, die die Klassen des JDK ([String], Arrays, Sammlungen) erweitern, ohne sie zu ändern. Das Programm [Classes24.kt] zeigt, wie Sie eigene schreiben:
- Zeile 39: eine Erweiterungsfunktion für die Klasse [Person]. Dem Funktionsnamen wird der erweiterte Typ vorangestellt, der als Empfängertyp bezeichnet wird ([Person.]). Im Rumpf der Funktion bezeichnet [this] das Objekt, auf dem die Funktion aufgerufen wird – den Empfänger –, und seine Member sind wie in einer Methode ohne Präfix zugänglich: [firstName], [lastName]. [firstName[0]] gibt das erste Zeichen der Zeichenkette zurück, und [uppercaseChar()] wandelt es in einen Großbuchstaben um;
- Zeilen 42–46: zwei Erweiterungseigenschaften. Sie werden wie Funktionen mit einem Empfängertyp deklariert und müssen einen Accessor [get] haben: Eine Erweiterung fügt dem Objekt nichts hinzu, kann also keinen Wert speichern (eine Erweiterungseigenschaft hat kein Feld und keinen Initialisierer). Sie werden wie Eigenschaften gelesen: [p.isAdult], [p.fullName] (Zeile 12);
- Zeilen 49–51: zwei Erweiterungen der Klasse [String], die wie Methoden jeder Zeichenkette verwendet werden: ["jean".firstUpper()]. In [firstUpper] ist [this] die Zeichenkette selbst. Die Funktion [nbWords] zerlegt die Zeichenkette mit der Funktion [split], der ein regulärer Ausdruck ([Regex]) übergeben wird: ["\\s+"] steht für eine Folge von einem oder mehreren Leerzeichen (reguläre Ausdrücke werden in Kapitel 5 behandelt);
- Zeilen 54–55: eine Erweiterungseigenschaft einer Java-Klasse des JDK, [java.time.LocalDate]. Eine Erweiterung gilt für jeden Typ, auch für eine Java-Klasse oder eine finale Klasse. Beachten Sie, dass die Methode [getDayOfWeek] der Java-Klasse von Kotlin als Eigenschaft [dayOfWeek] behandelt wird;
- Zeile 58: eine Erweiterung eines nullable Typs, [Person?]. Sie kann auf einer Referenz auf [null] ohne den Operator [?.] aufgerufen werden (Zeile 22): Dadurch wird geprüft, ob [this] gleich [null] ist. Nach der Prüfung weiß der Compiler, dass [this] im [else]-Zweig nicht [null] ist, und erlaubt den Zugriff auf [firstName] (dies ist das Smart Casting, das der folgende Absatz genauer erklärt). Die Funktion [toString()] der Kotlin-Bibliothek, die auf einer Null-Referenz aufgerufen werden kann, ist wie folgt deklariert: [fun Any?.toString(): String];
- Zeilen 8–13: Erweiterungsfunktionen und -eigenschaften werden wie Member aufgerufen: [p.initials()], nicht [Tools.initials(p)];
- Zeilen 32–34: Wenn der Typ geändert werden kann, werden seine Methoden naturgemäß dort abgelegt: Die Factory [unknown] ist eine Funktion des Companion-Objekts der Klasse [Person] (Zeile 15);
- Zeilen 61–71: eine Klasse [Shape] und ihre abgeleitete Klasse [Square], jeweils ausgestattet mit einer überschriebenen Methode [category] und einer Erweiterungsfunktion [name]. In Zeile 25 verweist die Variable [shape], die als Typ [Shape] deklariert ist, auf ein [Square]: Der Aufruf [shape.name()] führt jedoch tatsächlich die Erweiterung von [Shape] aus. Die Auflösung von Erweiterungen ist statisch: Der Compiler wählt die Funktion anhand des deklarierten Typs der Variablen aus, nicht anhand des tatsächlichen Typs des Objekts zur Laufzeit. In Zeile 27 ist die Methode [category] polymorph: Es wird die Methode der Klasse [Square] ausgeführt.
Ergebnisse:
Dieses Verhalten erklärt sich dadurch, wie der Compiler eine Erweiterungsfunktion übersetzt: in eine statische Methode, deren erster Parameter der Empfänger ist. Die Funktion [fun Person.initials()] in der Datei [Classes24.kt] wird zur Java-Methode [public static final String initials(Person $this$initials)] der Klasse [classes24.Classes24Kt] (die Erweiterungseigenschaft *[isAdult] wird ebenso zu einer statischen Methode ***[isAdult(Person)]), und der Aufruf ***[p.initials()] wird zu ***[Classes24Kt.initials(p)]**. Mit anderen Worten: Kotlin schreibt die Java-Hilfsklasse für uns und macht ihre Verwendung lesbarer. Ein Java-Programm, das eine Kotlin-Bibliothek verwendet, ruft deren Erweiterungen auf diese Weise auf. Daraus ergeben sich mehrere Regeln:
- Eine Erweiterung hat nur Zugriff auf die öffentlichen Member des Empfängers: Sie kann seine privaten oder geschützten Member nicht sehen;
- Eine Erweiterung kann in einer abgeleiteten Klasse nicht überschrieben werden: Sie ist nicht polymorph;
- Hat die Klasse einen Member mit derselben Signatur, wird immer dieser Member aufgerufen, und der Compiler warnt, dass die Erweiterung überflüssig ist ([this extension is shadowed by a member: 'fun g(): Int' defined in 'C']);
- Um in einem anderen Paket verwendet zu werden, muss eine Erweiterung importiert werden, genau wie eine Funktion der obersten Ebene ([import tools.initials]).
Erweiterungsfunktionen gehören zu den charakteristischsten Merkmalen von Kotlin. Sie dienen dazu, Typen zu erweitern, über die wir keine Kontrolle haben, aber auch dazu, in unseren eigenen Klassen den Kern der Klasse (ihre Member) von Hilfsfunktionen zu trennen, die nur von außen auf sie zugreifen. In Kapitel 7 betrachten wir Lambdas mit Empfänger, die auf demselben Prinzip beruhen ([buildString { append(...) }]).
4.13. Pattern Matching bei Objekten
Der Ausdruck [when] ist nicht auf einfache Werte (Zahlen, Zeichenketten, Aufzählungen) beschränkt: Er gilt auch für Objekte. Sie können den Typ eines Objekts prüfen, eine Bedingung hinzufügen und das Objekt im richtigen Typ verwenden, ohne explizite Konvertierung – alles in einem einzigen Ausdruck. Streng genommen kennt Kotlin keine „Patterns“ wie Java 21: Es erreicht im Wesentlichen dasselbe Ergebnis mit dem Operator [is], Smart Casting und Destrukturierung. Das Programm [Classes25.kt] verwendet ein versiegeltes Interface und drei Datenklassen, die es implementieren:
- Zeilen 78–97: Ein versiegeltes Interface [Person] ([sealed interface]), implementiert von drei Datenklassen: [Individual], [Teacher] und [Student]. Wie eine versiegelte Klasse (siehe den Abschnitt „Finale, offene und versiegelte Klassen“) kann ein versiegeltes Interface nur von Klassen im selben Paket und im selben Modul implementiert werden: Der Compiler kennt daher alle seine Implementierungen, ohne dass sie explizit aufgelistet werden müssen, wie es die Java-Klausel [permits] verlangt. Das Interface deklariert die abstrakten Eigenschaften [firstName], [lastName] und [age]; die Datenklassen implementieren sie mithilfe von Eigenschaften ihres primären Konstruktors, denen [override] vorangestellt ist;
- Zeilen 5–13: eine Liste von Objekten verschiedener Typen, darunter eine ganze Zahl und die Referenz [null]. Ihr Typ ist [List<Any?>]: [Any?] ist der allgemeinste Typ von Kotlin, der jedes Objekt und den Wert [null] akzeptiert;
- Zeile 18: Der Ausdruck [o is Person] ist wahr, wenn [o] auf ein Objekt vom Typ [Person] verweist (er ist falsch, wenn [o] gleich [null] ist). Im folgenden Block weiß der Compiler, dass [o] eine [Person] ist: Er erlaubt [o.firstName] ohne Konvertierung. Dies ist das Smart Casting: Der Typ einer Variablen wird getestet, und die Variable selbst ändert ihren Typ dort, wo der Test garantiert wahr ist. Java 16 erreicht dasselbe Ergebnis, indem es eine neue Variable deklariert ([o instanceof Person p]); Kotlin braucht das nicht. Smart Casting gilt für lokale Variablen [val], für Variablen [var], die sich zwischen Test und Verwendung nicht geändert haben, und für Eigenschaften [val] im selben Modul ohne benutzerdefinierte Accessoren: Der Compiler muss sicher sein, dass sich der Wert zwischen Test und Verwendung nicht geändert haben kann;
- Zeile 26: Smart Casting gilt auch im restlichen Teil der Bedingung nach [&&];
- Zeilen 55–67: Der Ausdruck [when] mit Subjekt wertet die Zweige der Reihe nach aus und gibt den Wert zurück, der dem ersten zutreffenden Zweig zugeordnet ist:
- Zeile 56: ein Lehrer aus Abschnitt 27. In einem [is Type]-Zweig wird das Subjekt [o] per Smart Cast umgewandelt; die Klausel [if] fügt eine Bedingung hinzu, die Guard genannt wird (Kotlin 2.2) und dem [when] in den Java-Patterns entspricht;
- Zeile 57: jeder andere Lehrer. Die Reihenfolge ist wichtig: Stünde dieser Fall vor dem vorherigen, wäre Letzterer unerreichbar. Der Kotlin-Compiler meldet dies nicht (Java würde es ablehnen): Der Zweig würde einfach nie ausgewählt;
- Zeilen 58–60: ein Student, dessen Eigenschaften per Destrukturierung extrahiert werden: [val (firstName, _, _, major) = o] ruft [component1()] und [component4()] der Datenklasse auf ([_] ignoriert eine Eigenschaft). Das entspricht dem Record-Pattern von Java ([case Student(var firstName, _, _, var major)]), in zwei Schritten: der Typprüfung, gefolgt von der Destrukturierung. Ein Zweig kann einen Block enthalten; sein Wert ist der des letzten Ausdrucks im Block;
- Zeilen 62–63: ein Minderjähriger, dann jede andere Person;
- Zeile 64: eine Zeichenkette, deren Eigenschaft [length] verwendet werden kann;
- Zeile 65: eine positive ganze Zahl. Geprüft wird der Typ [Int], nicht [Integer] wie in Java;
- Zeile 66: der Fall [null], ein einfacher Wert, der mit dem Subjekt per [==] verglichen wird. Ohne diesen Fall würde die Null-Referenz in den [else]-Zweig fallen: Ein [when] auf einer Null-Referenz wirft nie eine Ausnahme;
- Zeile 67: Der Zweig [else] deckt alles Übrige ab. Ohne ihn würde der Compiler melden, dass der Ausdruck [when] nicht alle Fälle behandelt: Ein Ausdruck [when], der einen Wert zurückgibt, muss erschöpfend sein;
- Zeilen 71–74: ein [when] auf einer [Person], ohne ein [else]. Es ist dennoch erschöpfend: Da das Interface versiegelt ist, weiß der Compiler, dass eine Person ein [Individual], ein [Teacher] oder ein [Student] ist;
- Zeilen 44–51: explizite Typkonvertierungen. [o as Person] konvertiert [o] in [Person] und wirft eine [ClassCastException]-Ausnahme, wenn das Objekt keine Person ist (Zeile 48); dies entspricht [(Person) o] in Java. [o as? String] ist die „sichere“ Typkonvertierung: Sie gibt [null] zurück, statt eine Ausnahme zu werfen, was gut mit dem Elvis-Operator zusammenpasst ([o as? String ?: "default"]). Mit Smart Casting ist das selten nötig.
Ergebnisse:
Wenn Sie den Fall [Student] aus der Funktion [category] entfernen, meldet der Compiler dies:
Darin liegt der große Vorteil der Kombination aus versiegelten Typen (Sealed Types) und dem Ausdruck [when]: Wird der Hierarchie eine vierte Klasse hinzugefügt, meldet der Compiler alle Stellen mit [when] als zu vervollständigen. Beachten Sie außerdem, dass der [is]-Test den Typen entspricht, die die Schnittstelle implementieren: Die Schleife zur Typprüfung (Zeilen 16–20) hat die drei Personentypen erkannt. Der [when]-Test auf Typen ist ein nützlicher Ersatz für verschachtelte [if (o is ...)]-Tests; er sollte jedoch die Polymorphie nicht ersetzen: Hängt das Verhalten vom Typ des Objekts ab und haben Sie die Kontrolle über die Klassenhierarchie, ist eine in jeder Klasse neu definierte Methode oft die objektorientierte Lösung. Das Filtern mit [when] eignet sich gut für Datenhierarchien (versiegelte Datenklassen), auf denen Sie eine von diesen Daten getrennte Verarbeitungslogik schreiben möchten.
4.14. Behandlung des Wertes null
In Java kann jede Variable eines Referenztyps null sein, und die Verwendung einer Null-Referenz führt zur NullPointerException, dem häufigsten Laufzeitfehler. In Kapitel 3 haben wir gesehen, wie Kotlin damit umgeht: Der Compiler unterscheidet zwischen Typen, die [null] ([String?]) sein können, und solchen, die es nicht können ([String]), und erlaubt den Zugriff auf die Member einer nullable Referenz erst nach einer Prüfung oder über die Operatoren [?.], [?:], und [!!]. Wo Java die Klasse [Optional<T>], die Methoden [Objects.requireNonNull] und [Objects.requireNonNullElse] oder Annotationen wie die der Bibliothek JSpecify ([@Nullable], [@NullMarked]) verwendet, stützt sich Kotlin auf das Typsystem selbst. Hier vertiefen wir diese Konzepte im Kontext von Klassen: nullable Eigenschaften, spät initialisierte Eigenschaften und die Grenze zu Java-Code. Das Programm [Classes26.kt] verwendet das Beispiel der Java-Version:
- Zeilen 71–80: Die Klasse [Person] hat zwei erforderliche Eigenschaften vom Typ [String], die vom primären Konstruktor initialisiert werden, und eine optionale Eigenschaft [middleName] vom Typ [String?]: [null] bedeutet „kein zweiter Vorname“. Der Konstruktor muss seine Parameter nicht validieren, wie es die Java-Version mit [Objects.requireNonNull] tat: Der Compiler weist einen Aufruf von [Person(null, "Morel")] ([null cannot be a value of a non-null type 'String']) zurück. Der Fehler wird bereits vor der Ausführung erkannt;
- Zeile 11: Der Elvis-Operator [?:] liefert den linken Wert, wenn dieser nicht gleich [null] ist, andernfalls den rechten Wert. Das entspricht [Objects.requireNonNullElse(value, defaultValue)];
- Zeile 13: Der sichere Aufruf [?.] liefert [null] , wenn die Referenz [null] ist, andernfalls die Länge der Zeichenkette: [length] ist vom Typ [Int?]. Der direkte Zugriff auf [p.middleName.length] wird vom Compiler abgelehnt: [only safe (?.) or non-null asserted (!!.) calls are allowed on a nullable receiver of type 'String?'];
- Zeile 69: Die Funktion [find] liefert die gesuchte Person oder [null] , wenn sie sie nicht findet: Ihr Rückgabetyp [Person?] warnt den Aufrufer, dass das Ergebnis fehlen kann, und der Compiler verlangt, dass der Aufrufer diesen Fall behandelt, um die Person verwenden zu können. Das entspricht der Rolle von [Optional<Person>] in Java, jedoch ohne zusätzliche Objekte. Die Erweiterungsfunktion [firstOrNull] liefert das erste Element der Liste, das die Bedingung erfüllt, oder [null];
- Zeile 19: Das Vorhandensein eines Wertes wird durch den Vergleich mit [null] geprüft (das Äquivalent zu [isPresent()]);
- Zeile 20: Die Kombination aus [?.] gefolgt von [?:] wandelt jede vorhandene Person in ihren Vornamen um und liefert einen Standardwert. Das entspricht [found.map(Person::getFirstName).orElse(...)];
- Zeilen 23–24: Nach dem [found != null]-Test wandelt der Smart Cast [found] in [Person] um innerhalb des Blocks: [found.firstName] wird direkt aufgerufen. Der Smart Cast funktioniert hier, obwohl [found] eine Variable vom Typ [var] ist, weil sie zwischen dem Test und ihrer Verwendung nicht verändert wird;
- Zeilen 27–28: [x?.let { ... }] führt den Block nur aus, wenn [x] nicht gleich [null] ist; innerhalb des Blocks verweist [it] auf den Wert, der einen nicht nullbaren Typ hat. Das entspricht [ifPresent]. Dupont existiert und erhält einen neuen zweiten Vornamen; Durand existiert nicht, und die Anweisung bewirkt nichts;
- Zeile 31: [requireNotNull(value) { message }] liefert den Wert als nicht nullbaren Typ, wenn er nicht [null] ist, und wirft andernfalls eine [IllegalArgumentException] mit der angegebenen Meldung (Zeilen 34–36). Sie wird verwendet, wenn das Fehlen eines Wertes einen Fehler darstellt: Sie ist das Äquivalent zu [orElseThrow]. Ihr Gegenstück [checkNotNull], wirft eine [IllegalStateException];
- Zeilen 40–41: Der Operator [!!] prüft, ob die Referenz gleich [null] ist, und wirft in diesem Fall die Exception [NullPointerException] . Hier hat die Exception keine Meldung: Wir bevorzugen [requireNotNull] oder [checkNotNull], die eine Meldung mitliefern. Der Operator [!!] sollte Fällen vorbehalten bleiben, in denen Sie sich sicher sind ... und der Compiler dies nicht wissen kann;
- Zeile 76: Eine [lateinit]-Eigenschaft („spät initialisiert“). Eine nicht nullbare Eigenschaft muss normalerweise bei der Konstruktion initialisiert werden. Manche Werte sind jedoch erst später bekannt: eine von Spring injizierte Abhängigkeit (Kapitel 6), ein von einer Test-Initialisierungsmethode vorbereitetes Objekt usw. Anstatt die Eigenschaft als nullable zu deklarieren – und bei jeder Verwendung [?.] oder [!!] schreiben zu müssen –, deklarieren wir sie als [lateinit var]: Sie hat den Typ [String] und wird auch als solcher verwendet. Eine Eigenschaft mit dem Modifizierer [lateinit] muss eine [var] eines nicht nullbaren, nicht primitiven Typs sein ([lateinit var n: Int] ist verboten);
- Zeilen 50–51: Das Lesen einer [lateinit]-Eigenschaft vor ihrer Initialisierung wirft die [UninitializedPropertyAccessException], deren Meldung die Eigenschaft nennt; das ist klarer als eine später auftretende [NullPointerException] ;
- Zeilen 79–80: Der Ausdruck [this::email.isInitialized] gibt an, ob die Eigenschaft initialisiert wurde. [this::email] ist eine Eigenschaftsreferenz (Kapitel 7); dieser Test ist nur innerhalb der Klasse zulässig, die die Eigenschaft deklariert;
- Zeilen 58–62: die Grenze zu Java. Die Java-Methode [System.getenv(name)] liefert den Wert einer Umgebungsvariablen oder [null] , wenn sie nicht existiert; ihre Java-Signatur gibt dies dem Kotlin-Compiler jedoch nicht zu erkennen. Ihr Rückgabewert hat einen Plattformtyp, in Compiler-Meldungen und in IntelliJ IDEA als [String!] dargestellt: ein Typ, bei dem Kotlin nicht weiß, ob er nullable ist, und den es dem Entwickler erlaubt, auf eigenes Risiko als
*[String]oder als*[String?]zu verwenden. In Zeile 58 hat die Variable [variable] den Plattformtyp, und wir behandeln sie vorsichtig mit [?.]. In Zeile 61 sichern wir zu, dass sie nicht null ist, indem wir sie als [String] deklarieren: Der Compiler fügt dann eine Prüfung ein, und die [NullPointerException] wird sofort bei der Zuweisung geworfen, mit einer Meldung, die die fehlerhafte Methode benennt ([getenv(...) must not be null]), und nicht erst später bei der Verwendung. Ist der Java-Code annotiert ([@Nullable], [@NonNull] von JSpecify oder von JetBrains), berücksichtigt Kotlin dies, und der Typ ist kein Plattformtyp mehr: Das ist bei großen Teilen von Spring Framework 7 der Fall, das wir verwenden werden.
Ergebnisse:
Die Java-Klasse *[Optional]* bleibt in Kotlin verwendbar, wenn eine Java-Bibliothek eine solche liefert (die Erweiterungsfunktion ***[getOrNull()] aus dem Paket *[kotlin.jvm.optionals] wandelt sie dann in einen nullable Typ um), aber wir verwenden sie im Kotlin-Code nicht: Ein nullable Typ leistet dasselbe – vom Compiler geprüft – ohne ein Objekt zu erzeugen. In diesem Kurs deklarieren wir nur optionale Werte als nullable; wir bevorzugen stets vollständige Objekte (mit allen erforderlichen Werten konstruiert) gegenüber schrittweise befüllten Objekten; wir reservieren [lateinit] für Eigenschaften, die von einem Raster initialisiert werden, und wir behandeln Werte aus Java mit Vorsicht.
4.15. Beispielanwendung - V2
Wir greifen die im vorherigen Kapitel behandelte Steuerberechnung (Version 1) wieder auf und implementieren sie nun mit Klassen und Schnittstellen. Rufen wir uns die Problemstellung in Erinnerung. Wir wollen ein Programm schreiben, das die Steuer eines Steuerzahlers berechnet. Wir betrachten den vereinfachten Fall eines Steuerzahlers, der nur sein Gehalt zu deklarieren hat (der Steuertarif von 2004 für die Einkommen des Jahres 2003, unverändert übernommen: Dies ist eine Übung):
- Wir berechnen die Anzahl der Anteile des Arbeitnehmers: Anteile = nbChildren / 2 + 1, wenn er unverheiratet ist, nbChildren / 2 + 2, wenn er verheiratet ist, wobei nbChildren die Anzahl seiner Kinder ist;
- hat er mindestens drei Kinder, erhält er einen zusätzlichen halben Anteil;
- sein zu versteuerndes Einkommen R berechnet sich als R = 0,72 × S, wobei S sein Jahresgehalt ist;
- sein Familienquotient wird berechnet als QF = R / Anteile;
- seine Steuer I wird anhand der folgenden Tabelle berechnet:
threshold | coeffR | coeffN |
4962 | 0 | 0 |
8382 | 0.068 | 291.09 |
14,753 | 0.191 | 1,322.92 |
23,888 | 0.283 | 2,668.39 |
38,868 | 0.374 | 4,846.98 |
47,932 | 0.426 | 6,883.66 |
0 | 0.481 | 9,505.54 |
Jede Zeile hat drei Felder. Um die Steuer I zu berechnen, suchen Sie die erste Zeile, in der QF ≤ Grenzwert gilt. Ist beispielsweise QF = 5.000, wird die Zeile (8.382; 0,068; 291,09) gefunden. Die Steuer I ist dann gleich 0,068 × R - 291,09 × Anteile. Ist QF so beschaffen, dass die Bedingung QF ≤ Grenzwert nie erfüllt ist, werden die Koeffizienten der letzten Zeile verwendet, woraus sich die Steuer I = 0,481 × R - 9.505,54 × Anteile ergibt.
Die Anwendung erstellt das Paket [taxv2]. Die Berechnungsklassen sind in einem Unterpaket [taxv2.tax] organisiert:
Zunächst definieren wir einen Typ, der eine Zeile der vorherigen Tabelle kapseln kann [TaxBracket.kt]:
Wir verwenden eine Datenklasse:
- weil eine Stufe ein kleines Datenstück ohne Identität ist, das allein durch seinen Wert definiert wird und nach der Erzeugung nicht geändert werden sollte: Ihre Eigenschaften sind [val];
- weil der Compiler [toString], den Gleichheitsoperator, [copy], und die Destrukturierung aus einer einzigen Zeile heraus erzeugt.
Die Eigenschaften haben den Typ [BigDecimal] (Paket [java.math], daher der Import in Zeile 3): Kotlin verwendet diese Klasse direkt aus dem JDK. Die Typen [Float] und [Double] stellen Zahlen binär dar: Eine Dezimalzahl wie 0,068 hat in diesen Typen keine exakte Darstellung, und bei Berechnungen summieren sich kleine Rundungsfehler. Die Klasse [BigDecimal] stellt Dezimalzahlen exakt dar: Sie ist der Typ der Wahl für Geldbeträge. In Java besteht ihr Nachteil im Fehlen von Operatoren: Man muss [a.add(b)], [a.multiply(b)], [a.compareTo(b)] schreiben. Die Kotlin-Bibliothek ergänzt die Operatoren [+], [-], [*], [/], [%], sowie den unären Minusoperator; und da [BigDecimal] das Interface [Comparable] implementiert, gelten auch die Vergleichsoperatoren [<], [<=] ... Wir nutzen dies, mit einer Ausnahme: der Division.
Dann definieren wir eine Schnittstelle [ITax] , die die Steuer berechnen kann [ITax.kt]:
- Zeile 5: die Methode zur Berechnung der Steuer anhand von drei Angaben: dem Familienstand des Steuerzahlers, der Anzahl der Kinder und dem Jahresgehalt. Sie rundet die Steuer auf den nächsten vollen Euro ab.
Als Nächstes definieren wir eine abstrakte Klasse, die diese Schnittstelle implementiert [AbstractTax.kt]:
- Zeile 1: Die Klasse gehört zum Paket [taxv2.tax]; ihre Datei liegt im Ordner [taxv2/tax];
- Zeile 6: Die Klasse [AbstractTax] implementiert die Schnittstelle [ITax];
- Zeile 9: Die Tarifdaten werden durch eine geschützte abstrakte Eigenschaft bereitgestellt (die Java-Version verwendete eine abstrakte Methode [getTaxBrackets()]). Die Klasse [AbstractTax] weiß nicht, woher diese Daten stammen (im Code geschrieben, aus einer Datei gelesen, aus einer Datenbank usw.). Diese Aufgabe überlässt sie den abgeleiteten Klassen. Deshalb wird sie als abstrakt deklariert, was ihre Instanziierung verhindert. Die abstrakte Eigenschaft verpflichtet die abgeleiteten Klassen, die Steuerstufen bereitzustellen: Der Compiler überprüft dies. Ihr Typ [List<TaxBracket>], ist der einer schreibgeschützten Liste: Die Klasse kann den ihr bereitgestellten Tarif nicht verändern;
- Zeilen 12–25: Die Implementierung der Methode [calculate] der Schnittstelle [ITax]. Abgeleitete Klassen müssen diese Methode nicht überschreiben. Die Klasse [AbstractTax] dient somit als Basisklasse für die abgeleiteten Klassen: Sie enthält, was allen gemeinsam ist;
- Zeile 14: die Anzahl der Anteile. Die Erweiterungsfunktion [toBigDecimal()] wandelt eine ganze Zahl in [BigDecimal] um (wie [BigDecimal.valueOf(n)]); die Division durch [BigDecimal.TWO] ist exakt (3 / 2 = 1,5), im Gegensatz zur ganzzahligen Division durch [nbChildren / 2] (3 / 2 = 1). Der Ausdruck [if (married) 2 else 1] ergibt 2 für einen verheirateten Steuerzahler, andernfalls 1. Die Addition wird mit dem Operator [+] geschrieben. Die Division hingegen erfolgt mit der Java-Methode [divide] und nicht mit dem Operator [/]: Der Kotlin-Operator [/], angewendet auf [BigDecimal] , behält die Anzahl der Nachkommastellen des Dividenden bei und rundet das Ergebnis; [3.toBigDecimal() / BigDecimal.TWO] ergibt 2, nicht 1,5! Das ist eine bekannte Falle, die man am besten vermeidet, indem man Divisionen von [BigDecimal] stets mit [divide] schreibt, was dazu zwingt, über die gewünschte Genauigkeit nachzudenken;
- Zeilen 15–16: der zusätzliche halbe Anteil. Ein [BigDecimal] ist unveränderlich: [shares += x] wird umgewandelt in [shares = shares + x], wodurch ein neues Objekt erzeugt wird, das der Variablen zugewiesen wird; deshalb ist [shares] eine [var];
- Zeilen 19–20: zu versteuerndes Einkommen und Familienquotient. Dezimalkonstanten werden aus Zeichenketten erzeugt ([BigDecimal("0.72")]), damit sie exakt sind. Die Division eines [BigDecimal] kann unendlich viele Nachkommastellen ergeben (1 / 3): Wir geben die gewünschte Genauigkeit an, hier [MathContext.DECIMAL128] (34 signifikante Stellen);
- Zeile 23: Suche nach dem Intervall in einer einzigen Zeile. [brackets.dropLast(1)] liefert die Liste der Stufen ohne die letzte; [firstOrNull { quotient <= it.limit }] sucht die erste Stufe, deren Grenzwert größer oder gleich dem Familienquotienten ist (der Operator [<=] ruft [compareTo] auf), oder liefert [null] , wenn es keine gibt; der Elvis-Operator liefert dann die letzte Stufe ([brackets.last()]). Die Java-Version verwendete eine [for]-Schleife und ein [break]; die beiden Ausdrücke sind äquivalent;
- Zeile 25: Die Steuerberechnung, geschrieben mit den Operatoren [*] und [-], ist wesentlich lesbarer als [income.multiply(bracket.coeffR()).subtract(shares.multiply(bracket.coeffN()))]. Die Funktion [toInt] schneidet das Ergebnis auf seinen ganzzahligen Anteil ab.
Eine Klasse, die die Schnittstelle [ITax] implementiert, lässt sich durch Ableitung von der Klasse [AbstractTax] erstellen. Genau das tun wir jetzt mit [HardwiredTax.kt]:
- Zeilen 9–13: Die Klasse [HardwiredTax] legt die für die Steuerberechnung nötigen Daten fest im Code ab. Diese Daten liegen im Companion Object und werden von allen Instanzen gemeinsam genutzt, ähnlich den [static final]-Feldern in der Java-Version. Es handelt sich um Arrays von [Double] ([DoubleArray], erzeugt mit [doubleArrayOf]); ihre Elemente werden als [4962.0] und nicht als [4962] geschrieben, da es keine implizite Konvertierung von [Int] nach [Double] gibt. Konventionsgemäß werden Konstantennamen großgeschrieben;
- Zeilen 5–6: Die Implementierung der abstrakten Eigenschaft der Elternklasse, initialisiert bei der Konstruktion des Objekts. [LIMITS.indices] ist der Bereich der Array-Indizes (0..6); die Funktion [map] erzeugt für jeden von ihnen die Liste der Lambda-Ergebnisse, hier eine Stufe pro Index. Die Erweiterungsfunktion [Double.toBigDecimal()] wandelt einen [Double] über seine kürzeste Dezimaldarstellung in einen [BigDecimal] um: [0.068.toBigDecimal()] ist exakt 0,068, genau wie [BigDecimal.valueOf(0.068)] in Java. Verwenden Sie nicht den Konstruktor [BigDecimal(0.068)], der alle Nachkommastellen des angenäherten Binärwertes wiedergibt (0,068000000000000004884981308350688…);
- die von [map] gelieferte Liste wird als Typ [List<TaxBracket>] bereitgestellt, schreibgeschützt: Keine Klasse wird den Tarif über diese Eigenschaft verändern können (die Java-Version erzeugte eine schreibgeschützte Kopie mit [List.copyOf]). Die neu definierte Eigenschaft behält die Sichtbarkeit ([protected]) der abstrakten Eigenschaft bei.
Das nächste Kapitel führt weitere von [AbstractTax] abgeleitete Klassen ein, die die Stufen aus einer Textdatei oder aus JSON lesen: Sie müssen lediglich die Eigenschaft [taxBrackets] bereitstellen.
Ein Testprogramm könnte wie folgt aussehen [Main.kt]:
Das obige Programm ermöglicht es dem Benutzer, wiederholt Simulationen der Steuerberechnung durchzuführen.
- Zeilen 4–7: Das Hauptprogramm befindet sich im Paket [taxv2]; es importiert die beiden benötigten Typen aus dem Unterpaket [taxv2.tax]. Der Kopfkommentar darf vor der Paketdeklaration stehen;
- Zeilen 10–15: Die Hilfemeldung ist eine dateiprivate Top-Level-Eigenschaft, geschrieben als Raw String , begrenzt durch drei Anführungszeichen; die Zeichenkette darf sich über mehrere Zeilen erstrecken. Die Funktion [trimIndent()] entfernt die gemeinsame Einrückung der Zeilen sowie die erste und die letzte Zeile, wenn sie leer sind: Die Zeichenkette endet daher nicht mit einem Zeilenumbruch. Eine [const val]-Eigenschaft ist hier nicht möglich, da der Wert von einer Funktion berechnet wird;
- Zeile 19: Erzeugung eines Objekts [tax], das die Schnittstelle [ITax] implementiert. Dieses Objekt wird durch Instanziierung eines Typs [HardwiredTax] gewonnen, eines Typs, der die Schnittstelle [ITax] implementiert. Beachten Sie, dass wir den Typ
*[HardwiredTax]nicht vom Compiler aus der Variablen*[tax]*ableiten ließen; stattdessen haben wir ihr ausdrücklich den Typ*[ITax]zugewiesen. Damit geben wir an, dass uns nur die Methode [calculate] des Objekts [tax] interessiert und nicht der Rest. Um Daten aus einer Datei zu verwenden, genügt es, diese eine Zeile zu ändern; - Zeilen 22–56: die Schleife für die Simulationen der Steuerberechnung;
- Zeilen 24–25: Die drei für die Methode [calculate] erforderlichen Parameter werden in einer einzigen, über die Tastatur eingegebenen Zeile erfasst. [print] zeigt die Meldung ohne Zeilenumbruch an, dann liest [readlnOrNull()] eine Zeile; es liefert [null] , wenn die Standardeingabe geschlossen ist;
- Zeile 27: Die Erweiterungsfunktion [isNullOrBlank], definiert auf dem Typ [String?], ist wahr, wenn die Zeichenkette [null] ist oder nur Leerzeichen enthält; das Programm wird dann beendet. Nach diesem Test weiß der Compiler, dass [parameters] nicht [null] ist (die Funktion teilt ihm dies über einen „Contract“ mit): Dies erlaubt den Aufruf von [parameters.trim()] ohne [?.];
- Zeile 31: Die Funktion [split] zerlegt die von führenden und nachgestellten Leerzeichen befreite Zeile in Wörter, die durch ein oder mehrere Leerraumzeichen getrennt sind (regulärer Ausdruck ["\\s+"]). Sie liefert eine [List<String>], deren Größe mit [size] geprüft wird;
- Zeilen 38–39: Die Funktion [lowercase] wandelt die Zeichenkette in Kleinbuchstaben um; die Zeichenketten werden mit [==] und [!=] verglichen, die ihre Inhalte vergleichen;
- Zeilen 44–51: Die Funktion [positiveInteger] (Zeile 61) prüft, ob die letzten beiden Felder positive ganze Zahlen oder null sind. Sie liefert einen [Int?]: [null] signalisiert einen Fehler, während die Java-Version den Wert -1 lieferte. [toIntOrNull()] liefert [null] , wenn die Zeichenkette keine ganze Zahl darstellt (statt wie [Integer.parseInt] eine Exception zu werfen), und [takeIf { it >= 0 }] liefert den Wert, wenn die Bedingung erfüllt ist, und andernfalls [null]. Nach den Tests [nbChildren == null] and [salary == null], gefolgt von [continue], weiß der Compiler, dass die beiden Variablen nicht gleich [null] sind: Sie haben für den Rest der Schleife den Typ [Int] ;
- Zeile 56: Aufruf der Methode [calculate] des Objekts [tax], das die Schnittstelle [ITax] implementiert.
Hier ein Beispiel für die Ausführung des Programms, gestartet aus dem Projektordner [04-classes]. Die über die Umleitung der Standardeingabe bereitgestellten Eingaben wurden an den Stellen, an denen das Programm sie liest, in die Anzeige eingefügt, so wie sie bei der Eingabe über die Tastatur erscheinen würden:
Die Werte der Steuerberechnung sind korrekt: 4.282 Euro für einen verheirateten Steuerzahler mit zwei Kindern und einem Jahresgehalt von 60.000 Euro (Zeile 25 der Ergebnisse) und 2.959 Euro mit drei Kindern (Zeile 27). Ein unverheirateter Steuerzahler ohne Kinder zahlt bei gleichem Gehalt 11.519 Euro (Zeile 29). Das sind die Ergebnisse der Java-Version.
Im Vergleich zu Version 1 ist die Berechnung nun hinter einer Schnittstelle in Klassen gekapselt: Das Dialogprogramm kennt nur noch die Schnittstelle [ITax]. Die folgenden Versionen nutzen diese Trennung: Version 3 (nächstes Kapitel) ändert die Datenquelle, indem neue Klassen von [AbstractTax] abgeleitet werden, und danach wird die Anwendung in Schichten organisiert (Kapitel 6).