5. Häufig verwendete Kotlin-Klassen
Hier stellen wir einige häufig verwendete Klassen und Funktionen vor: Zeichenketten, Arrays, Collections, Dateien und reguläre Ausdrücke. Kotlin stellt dafür zwei Bibliotheken bereit: seine eigene Standardbibliothek (Pakete [kotlin.text], [kotlin.collections], [kotlin.io] ...), die den Basistypen Hunderte von Funktionen hinzufügt – die meisten davon in Form von Erweiterungsfunktionen (Kapitel 4) – und das JDK (die Java-API SE), das Kotlin direkt und ohne jede Anpassung verwendet. Hinzu kommen die funktionalen Operationen auf Collections ([filter], [map], [groupBy] ...) und die Sequenzen, die in Kotlin der übliche Weg sind, um die Elemente einer Collection zu suchen, zu sortieren, zu gruppieren oder umzuwandeln: Sie erfüllen denselben Zweck wie die Stream-API von Java. Zuvor haben wir gezeigt, wie man Informationen zu den Tausenden verfügbaren Klassen und Funktionen findet. Diese Ressource ist für Kotlin-Entwickler unverzichtbar, auch für erfahrene.
Die Beispiele in diesem Kapitel sind, mit Ausnahme der Beispielanwendung am Ende, Programme aus einer einzigen Datei, organisiert wie in Kapitel 3 im Gradle-Projekt [05-classes-kotlin] im Kurscode: Das Programm [Strings01.kt] liegt im Paket [strings01] (Ordner [src/main/kotlin/strings01]) und kann mit dem Befehl [gradlew -q run -Pmain=strings01.Strings01Kt] oder durch Klicken auf das grüne Dreieck in IntelliJ oder IDEA ausgeführt werden. Anders als in den vorherigen Kapiteln werden sie auf einem Rechner ausgeführt, der für Englisch konfiguriert ist (englische Locale). Beachten Sie, dass jede Kotlin-Datei automatisch die Pakete [kotlin.*], [kotlin.text.*], [kotlin.collections.*], [kotlin.ranges.*], [kotlin.sequences.*], [kotlin.io.*] ... sowie [java.lang.*] importiert: Funktionen der Standardbibliothek können daher ohne die [import]-Anweisung verwendet werden. Klassen aus den anderen Paketen des JDK ([java.util], [java.text], [java.time], [java.nio.file] ...) müssen dagegen importiert werden, während dies im Java-Kurs von den kompakten Quelldateien übernommen wurde.
5.1. Hilfe zu Kotlin-Klassen finden
Die Kotlin-Standardbibliothek enthält mehrere tausend Funktionen, und ein Kotlin-Programm für die JVM hat außerdem Zugriff auf die mehr als 4.000 öffentlichen Klassen des JDK. Niemand kennt sie alle: Kotlin-Entwickler schlagen ständig in der Dokumentation nach. Diese Dokumentation ist online kostenlos verfügbar und wird für jede Version auf dem aktuellen Stand gehalten.
5.1.1. Online-Dokumentation
Ausgangspunkt ist die Website kotlinlang.org von JetBrains. Dort finden Sie:
- die Referenz der Standardbibliothek: https://kotlinlang.org/api/core/kotlin-stdlib/. Sie beschreibt, Paket für Paket ([kotlin.text], [kotlin.collections], [kotlin.io] ...), alle Klassen, Schnittstellen und Funktionen der Bibliothek – einschließlich der Erweiterungsfunktionen –, geordnet nach dem Typ, den sie erweitern: Die Seite zu [String] listet somit sowohl ihre Member ([length], [get] ...) als auch die Dutzende Erweiterungsfunktionen auf, die auf sie anwendbar sind ([substringBefore], [padStart], [lines] ...);
- ein Suchfeld oben auf jeder Seite, in das Sie den Namen einer Klasse oder Funktion eingeben können ([buildString], [joinToString] ...);
- die Dokumentation der Sprache (Language Guide) mit Seiten zu Zeichenketten, Collections, Sequenzen und mehr sowie einer Seite „What’s New“, die die Neuerungen jeder Version beschreibt. Änderungen an der Sprache werden öffentlich in Form von Vorschlägen diskutiert, den KEEP (Kotlin Evolution and Enhancement Process), verfügbar unter github.com/Kotlin/KEEP;
- play.kotlinlang.org, die Kotlin-„Sandbox“: Hier können Sie im Browser ein Programm eingeben und ausführen, ohne etwas zu installieren.
Für die vom Kotlin-Programm verwendeten Klassen des JDK ([java.time.LocalDate], [java.text.Collator], [java.nio.file.Files] ...) bleibt die Referenz die der Java-SE-25-API: https://docs.oracle.com/en/java/javase/25/docs/api/. Sie beschreibt die Klassen in Java-Syntax, die umgedacht werden muss: Ein [int] entspricht einem [Int], ein [String[]] einem [Array<String>], eine Methode [getName()] wird als [name]-Eigenschaft verwendet ...
Die Seite zu einer Klasse oder Funktion, zum Beispiel kotlin.String, enthält:
- das Paket der Klasse und die Plattformen, auf denen sie existiert (Kotlin läuft auch auf JavaScript und als nativer Code: Manche Funktionen sind spezifisch für die JVM);
- ihre Deklaration, ihre Elterntypen und die Schnittstellen, die sie implementiert;
- eine allgemeine Beschreibung, oft mit ausführbaren Beispielen;
- eine Liste ihrer Konstruktoren, Eigenschaften, Funktionen, Member und Erweiterungen, gefolgt von Details zu jedem: Parameter, Rückgabewert, mögliche Exceptions und die Kotlin-Version, in der er eingeführt wurde (unter dem Abschnitt „Since Kotlin“).
Die Dokumentation ist auf Englisch. Eine Suche mit dem Funktionsnamen, dem „kotlin“ vorangestellt ist („kotlin joinToString“), führt in der Regel direkt auf die richtige Seite.
5.1.2. KDoc und die Hilfe des Editors
Wie Javadoc für Java wird diese Dokumentation aus Dokumentationskommentaren erzeugt, die im Quellcode stehen und in Kotlin KDoc heißen. Ein solcher Kommentar beginnt mit [/**] und steht unmittelbar vor einer Klasse, einer Eigenschaft oder einer Funktion. Die Funktion zur Steuerberechnung aus der Beispielanwendung dieses Kapitels könnte wie folgt dokumentiert werden:
Der Kommentar beginnt mit einem Zusammenfassungssatz; die [@param] -Tags beschreiben die Parameter, und [@return] beschreibt den Rückgabewert ([@throws] würde eine Exception beschreiben und [@property] eine Eigenschaft einer Klasse). Anders als Javadoc, das HTML-Tags verwendet, wird der Text eines KDoc-Kommentars in Markdown geschrieben: [*italic*], [**bold**], Listen und Links auf andere Elemente des Codes, die in eckigen Klammern stehen, etwa [[salary]] or [[TaxBracket]]. Das Dokka-Werkzeug von JetBrains, das dem Projekt als Gradle-Plugin hinzugefügt wird ([id("org.jetbrains.dokka")]), erzeugt HTML-Seiten, die denen der Kotlin-Referenz ähneln.
Der Code-Editor (IntelliJ IDEA, Visual Studio Code mit der Kotlin-Erweiterung) nutzt diese Kommentare und bietet unmittelbare Unterstützung, ohne den Code zu verlassen:
- Autovervollständigung: Nach der Eingabe von [aString.] schlägt der Editor eine Liste der auf das Objekt anwendbaren Eigenschaften und Funktionen vor, darunter Member und Erweiterungsfunktionen (Letztere sind durch den Typ gekennzeichnet, den sie erweitern, zum Beispiel [for String in kotlin.text]), zusammen mit ihren Parametern und Rückgabetypen;
- Schnelldokumentation: Fahren Sie mit der Maus über den Namen einer Klasse oder Funktion (oder drücken Sie in IntelliJ IDEA Strg+Q), um deren KDoc oder, bei einer Klasse des JDK, deren Javadoc anzuzeigen;
- Parameterhilfe: Wenn Sie die öffnende Klammer eines Aufrufs eingeben (oder in IntelliJ IDEA Strg+P drücken), zeigt der Editor die verschiedenen Überladungen der Funktion, Name und Rolle jedes Parameters sowie eventuelle Standardwerte an;
- Zur Definition springen (Strg+B in IntelliJ IDEA, F12 in VS Code): zeigt den Quellcode der Klasse oder Funktion an. Gradle lädt den Quellcode der Kotlin-Standardbibliothek herunter, und das JDK wird mit dem Quellcode seiner eigenen Bibliothek geliefert (Datei [lib/src.zip]): So können Sie den Code von [joinToString] oder [java.util.ArrayList] lesen, was sehr lehrreich ist. Der Code der Kotlin-Standardbibliothek ist oft sehr kurz, da er auf Klassen des JDK aufsetzt;
- Kotlin-Bytecode anzeigen (Menü Tools > Kotlin > Show Kotlin Bytecode , dann die Schaltfläche Decompile): zeigt in Form von äquivalentem Java-Code, was der Compiler aus dem Kotlin-Code erzeugt hat. So lässt sich nachvollziehen, was aus einer Erweiterungsfunktion, einer Eigenschaft oder einem [when] wird.
Schließlich: Um eine Funktion ohne ein eigenes Programm zu testen, bietet IntelliJ IDEA Scratch-Dateien (File > New > Scratch File > Kotlin): Sie geben dort Anweisungen ein, und deren Ergebnisse werden neben jeder Zeile angezeigt. In der Kommandozeile wertet der Launcher des Compilers (Kapitel 2) einen Ausdruck aus: [kotlinr -e 'println("abc".repeat(3))'] zeigt [abcabcabc] an.
5.2. Zeichenketten
5.2.1. Der Typ String
Der Typ [String] (Paket [kotlin]) repräsentiert Zeichenketten. Auf der JVM ist eine Kotlin-Zeichenkette ein [java.lang.String]-Objekt: Der Compiler bildet die beiden Typen aufeinander ab, und eine Zeichenkette wird ohne jede Konvertierung von Kotlin an Java (und umgekehrt) übergeben. Der Typ [String], wie Kotlin ihn sieht, hat jedoch nur vier Member ([length], [get], [subSequence], [compareTo]) und den Operator [plus]: Alle anderen Operationen sind Erweiterungsfunktionen der Standardbibliothek (Paket [kotlin.text]), die wie Methoden aufgerufen werden. Die Java-Methoden von [java.lang.String] , für die es ein Kotlin-Äquivalent gibt, sind ausgeblendet: ["abc".strip()] wird vom Compiler abgelehnt ([unresolved reference 'strip' on receiver of type 'String']); verwenden Sie stattdessen ["abc".trim()]. Hier einige Beispiele:
Eigenschaft oder Funktion | Rolle |
[length: Int] | Eigenschaft: Anzahl der Zeichen der Zeichenkette |
[operator fun get(index: Int): Char] | Zeichen Nr. [index]; das erste Zeichen hat die Nr. 0. Geschrieben als [s[index]] |
[startsWith(prefix: String, ignoreCase = false)] | liefert [true] , wenn die Zeichenkette mit [prefix] beginnt |
[endsWith(suffix: String, ignoreCase = false)] | liefert [true] , wenn die Zeichenkette mit [suffix] endet |
[contains(other: CharSequence, ignoreCase = false)] | liefert [true] , wenn die Zeichenkette [other] enthält; kann auch als [other in s] geschrieben werden |
[equals(other: String?, ignoreCase = false)] | liefert [true] , wenn die Zeichenkette denselben Inhalt wie [other] hat; der Operator [==] ruft [equals] auf |
[indexOf(string: String, startIndex = 0, ignoreCase = false)] | erstes Vorkommen von [string] in der Zeichenkette ab der Position [startIndex] oder -1. Eine weitere Überladung sucht nach einem Zeichen |
[lastIndexOf(char: Char, ...)] | Wie [indexOf] , liefert aber die letzte statt der ersten Position |
[joinToString(separator = ", ", prefix = "", postfix = "")] | Erweiterungsfunktion für Collections und Arrays: verkettet die Elemente und trennt sie durch [separator] |
[replace(oldChar: Char, newChar: Char, ignoreCase = false)] | Liefert eine Kopie der Zeichenkette, in der das Zeichen [oldChar] durch [newChar] ersetzt wurde; eine überladene Version ersetzt eine Zeichenkette durch eine andere |
[split(vararg delimiters: String, ...): List<String>] | die Zeichenkette wird als Folge von Feldern betrachtet, die durch eines der Trennzeichen [delimiters] getrennt sind, wörtlich genommen; das Ergebnis ist die Liste dieser Felder. Eine überladene Funktion akzeptiert einen regulären Ausdruck [Regex] |
[substring(startIndex: Int, endIndex: Int)] | eine Teilzeichenkette aus den Zeichen von Position [startIndex] (einschließlich) bis Position [endIndex] (ausschließlich); [substring(range: IntRange)] akzeptiert einen Bereich |
[substringBefore(delimiter)], [substringAfter(delimiter)] | der Teil der Zeichenkette vor beziehungsweise nach dem ersten Vorkommen von [delimiter] ([substringBeforeLast], [substringAfterLast]: das letzte) |
[lowercase()], [uppercase()] | wandelt die Zeichenkette in Klein- beziehungsweise Großbuchstaben um |
[trim()] | entfernt führende und nachgestellte Leerzeichen der Zeichenkette ([trimStart], [trimEnd]: nur auf einer Seite) |
[repeat(n: Int)] | wiederholt die Zeichenkette [n] -mal |
[reversed()] | kehrt die Zeichenkette um |
[isEmpty()], [isBlank()] | liefert [true] , wenn die Zeichenkette leer ist oder nur Leerzeichen enthält |
[lines(): List<String>] | liefert die Liste der Zeilen der Zeichenkette |
[format(vararg args: Any?)] | liefert die als Format verwendete Zeichenkette, in der die Platzhalter [%s], [%d] ... durch die Argumente ersetzt wurden |
Beachten Sie die zahlreichen Parameter [ignoreCase], die den Standardwert [false] haben: Kotlin benötigt nicht wie Java getrennte Methoden [equals] und [equalsIgnoreCase]; wir schreiben [s.equals(other, ignoreCase = true)] mit benannten Argumenten (Kapitel 3).
Wichtig ist, dass eine Zeichenkette vom Typ [String] unveränderlich ist; sie kann nach ihrer Erzeugung nicht mehr verändert werden. Liefert eine Funktion eine Zeichenkette, ist diese von der Zeichenkette verschieden, auf die die Funktion angewendet wurde. So liefert [s1.trim()] die Zeichenkette [s2], und [s1] und [s2] sind zwei verschiedene Zeichenketten: [s1] hat sich nicht verändert.
Eine Kotlin-Zeichenkette ist kein Array, aber dank des Operators [get] (Kapitel 4) können wir auf ihr n-tes Zeichen mit derselben Schreibweise zugreifen wie auf ein Array-Element, während Java eine andere Schreibweise erfordert. Ebenso ist die Anzahl der Zeichen die Eigenschaft [c.length], und die Größe eines Arrays ist die Eigenschaft [array.size]: Kotlin kennt nicht die Inkonsistenz von Java zwischen der Methode [length()] für Zeichenketten und dem Feld [length] für Arrays.
Das Programm [Strings01.kt] lautet wie folgt:
Ergebnisse:
Kommentare:
- Zeilen 7–8: length ist eine Eigenschaft, und der Operator [[10]] liefert das Zeichen Nr. 10, also das elfte Zeichen der Zeichenkette;
- Zeilen 10, 12: Eine erfolglose Suche liefert -1;
- Zeile 13: Die beiden Parameter von [substring] sind die Positionen des ersten beizubehaltenden Zeichens und des ersten Zeichens, das verworfen wird: Es werden die 7 Zeichen von Position 4 bis 10 geliefert. Das ist in Kotlin wie in Java die allgemeine Konvention zur Angabe eines Indexbereichs (Anfang eingeschlossen, Ende ausgeschlossen): Sie wird in vielen Funktionen verwendet;
- Zeile 14: Eine Überladung von
*[substring]akzeptiert ein Intervall*[IntRange]*(Kapitel 3), bei dem beide Endpunkte eingeschlossen sind: [4..10] bezeichnet dieselben Zeichen wie die Parameter [(4, 11)]. Wir hätten auch [4 until 11] oder [4..<11]* schreiben können; - Zeile 15: [uppercase] und [lowercase] (Kotlin 1.5) hängen nicht von der Sprache des Rechners ab (sie verwenden Unicode-Regeln, die sprachunabhängig sind); die älteren Java-Varianten [toUpperCase] und [toLowerCase], die davon abhingen (im Türkischen wird das kleine „i“ zu „İ“), sind in Kotlin veraltet (deprecated);
- Zeilen 18–22: Der Typ [String] hat keine Einfügefunktion: Wir verketten den Anfang der Zeichenkette, den einzufügenden Text und das Ende der Zeichenkette, oder wir verwenden [replaceRange], das die Zeichen eines Bereichs durch Text ersetzt: Das Ersetzen des leeren Bereichs ab Position 9 entspricht einem Einfügen. Wir werden sehen, dass die Klasse [StringBuilder] eine Funktion [insert] hat;
- Zeile 24: [split] zerlegt die Zeichenkette in Felder und liefert eine Liste ([List<String>], später beschrieben), kein Array wie in Java. Beachten Sie, dass dies ein wichtiger Unterschied zu Java ist: Bei einem [String]-Parameter wird das Trennzeichen in [split] wörtlich behandelt; um es zu einem regulären Ausdruck zu machen – den wir am Ende des Kapitels behandeln –, müssen Sie ein [Regex]-Objekt übergeben. [\s+] bezeichnet eine Folge von einem oder mehreren Leerraumzeichen (Leerzeichen, Tabulator, Zeilenumbruch usw.). Er wird in einem Raw String geschrieben, der durch drei Anführungszeichen begrenzt ist und in dem das Zeichen [\] ein gewöhnliches Zeichen ist und nicht verdoppelt werden muss (wir kommen später darauf zurück);
- Zeile 25: Die Eigenschaft [indices] einer Liste (oder eines Arrays) ist der Bereich ihrer Indizes, hier [0..5];
- Zeile 28: [joinToString] bewirkt das Gegenteil von [split]. Es ist eine Erweiterungsfunktion für Listen und Arrays, während Java die statische Methode [String.join] bereitstellt;
- Zeile 29: [trim] entfernt führende und nachgestellte Leerzeichen. Das [trim] von Kotlin erkennt alle Unicode-Leerzeichen (es verwendet die Funktion [Char.isWhitespace]): Es entspricht daher der Java-Methode [strip] und nicht der Java-Methode [trim], die nur die Leerzeichen des ASCII-Codes erkennt;
- Zeilen 31–35: einige Funktionen der Kotlin-Bibliothek, die in der Java-Klasse [String] kein direktes Äquivalent haben: [substringBefore] und [substringAfterLast] liefern, was vor dem ersten Leerzeichen und was nach dem letzten steht, ohne Positionen zu berechnen; [reversed] kehrt die Zeichenkette um; [count] zählt die Zeichen, die eine Bedingung erfüllen, die durch ein Lambdaausgedrückt wird: [{ it == 'e' }] ist eine anonyme Funktion, deren impliziter Parameter [it] das jeweils untersuchte Zeichen ist (Lambdas werden in Kapitel 7 behandelt). Da ihr Lambda das letzte Argument von [count] ist, wird es nach dem Funktionsnamen ohne Klammern geschrieben; [lines] zerlegt schließlich einen Text unabhängig vom verwendeten Zeilenende in Zeilen ([\n], [\r\n] oder [\r]) und liefert die Liste der Zeilen;
- Zeile 37: Alle vorherigen Funktionen haben neue Zeichenketten geliefert: [aString] wurde nicht verändert (letzte Zeile der Ergebnisse);
- Zeilen 41–42: eine Funktion höherer Ordnung, aufgerufen von der Funktion [main] wie in Kapitel 3.
5.2.2. Die Funktionen split und joinToString
Das Programm [Strings02.kt] geht näher auf das Zerlegen einer Zeichenkette in Felder ein. Leser, die Java kennen, werden zwei wesentliche Unterschiede zur Methode [split] von Java feststellen:
Ergebnisse:
Kommentare:
- Zeile 7: Die Felder sind durch das Zeichen [:] getrennt. Zwei aufeinanderfolgende [:] begrenzen ein leeres Feld (Zeile 3 der Ergebnisse), und das abschließende [:] in der Zeichenkette begrenzt ein fünftes – ebenfalls leeres – Feld, das beibehalten wird (Zeile 5 der Ergebnisse). Dies ist der erste Unterschied zu Java, wo die Methode
*[split]leere Felder am Ende entfernt: In Kotlin rekonstruiert*[joinToString]stets die ursprüngliche Zeichenkette (Zeile 6 der Ergebnisse). Das Verhalten von Kotlin ist konsistenter: Eine Zeichenkette mit n Trennzeichen ergibt stets n + 1 Felder. Um das Verhalten von Java nachzubilden, würde man [line.split(":").dropLastWhile { it.isEmpty() }] schreiben; - Zeile 8: Die Funktion [withIndex] ermöglicht es, eine Liste gleichzeitig mit Index und Element zu durchlaufen, wobei das Element über Destrukturierung (Kapitel 3) abgerufen wird;
- Zeile 15: Der optionale Parameter [limit] von [split] legt die maximale Anzahl der Felder fest: Das Zerlegen endet beim ersten Trennzeichen, und das letzte Feld enthält den gesamten Rest der Zeichenkette. Ein Trennzeichen dient beispielsweise dazu, den Namen eines Parameters von seinem Wert in einer [name=value]-Zeile zu trennen, wenn der Wert selbst das Trennzeichen enthalten kann. Beachten Sie, dass die Elemente einer Liste, die mit einem Template ([$fields]) ausgegeben wird, in eckigen Klammern und durch Kommas getrennt erscheinen: Das ist die [toString] -Darstellung von Listen;
- Zeile 19: der zweite Unterschied zu Java: Ein Trennzeichen vom Typ [String] wird wörtlich behandelt; um ein Trennzeichen durch einen regulären Ausdruck zu beschreiben, müssen Sie ein [Regex]-Objekt übergeben. [":+"] bezeichnet ein oder mehrere aufeinanderfolgende [:]-Zeichen. Die beiden aufeinanderfolgenden [:]-Zeichen bilden ein einziges Trennzeichen, und das dazwischenliegende leere Feld verschwindet; das letzte leere Feld bleibt jedoch erhalten;
- Zeile 24: [split] akzeptiert mehrere Trennzeichen ([vararg], Kapitel 3), Zeichen oder Zeichenketten: hier das Komma und das Semikolon. Die Funktion [map] wendet dann das Lambda [{ it.trim() }] auf jedes Feld an und liefert die Liste der Ergebnisse: In einer einzigen Anweisung erhalten wir die drei „bereinigten“ Felder. Die Funktionen [map], [filter], und ihre vielen Gegenstücke werden später in diesem Kapitel vorgestellt;
- Zeile 27: dasselbe Ergebnis mit einem regulären Ausdruck: Das Muster [\s*[,;]\s*] erfasst ein Komma oder Semikolon, vor und nach dem beliebig viele Leerzeichen stehen können; die die Trennzeichen umgebenden Leerzeichen werden mit ihnen entfernt. Die am Anfang und am Ende der Zeichenkette werden zuvor durch [trim] entfernt. Das Muster wird in einem Raw String geschrieben, ohne das [\] zu verdoppeln; die folgende Zeile verwendet ebenfalls einen Raw String, um das Muster unverändert anzuzeigen;
- Zeilen 32–36: Um sowohl die Leerzeichen um die Felder als auch die leeren Felder zu entfernen, können die Felder einzeln verarbeitet werden: Das aus zwei Leerzeichen zwischen zwei Kommas bestehende Feld ist nach [trim] leer und wird nicht übernommen. Die von [mutableListOf] erzeugte veränderbare Liste, in der die übernommenen Felder gespeichert werden, wird etwas später vorgestellt;
- Zeile 41: dasselbe Ergebnis in einer einzigen Anweisung: [map] entfernt die Leerzeichen jedes Feldes, dann behält [filter] nur die nicht leeren Felder. Das ist die idiomatische Schreibweise in Kotlin;
- Zeile 46: Das Trennzeichen [" | "] enthält das Zeichen [|], das in einem regulären Ausdruck eine besondere Bedeutung hat („oder“). Da das Trennzeichen wörtlich behandelt wird, sind keine besonderen Vorkehrungen nötig, während man in Java [split(Pattern.quote(" | "))] schreiben müsste. Wenn Sie aus beliebigem Text einen regulären Ausdruck bilden müssen, erfüllt die Funktion [Regex.escape] denselben Zweck wie [Pattern.quote];
- Zeilen 49–51: Anders als [String.join] in Java, das nur Zeichenketten akzeptiert, akzeptiert [joinToString] Elemente beliebigen Typs; hier ein Array von ganzen Zahlen [IntArray]: Jedes Element wird durch seine Funktion [toString] umgewandelt. Seine optionalen Parameter [prefix] und [postfix] fügen Text am Anfang und am Ende hinzu, und sein letzter Parameter [transform] ist ein Lambda, das jedes Element in Text umwandelt; hinter den Klammern geschrieben, erzeugt es die Texte „no.1“, „no.2“ usw. Was Java mit einem [StringJoiner] oder mit der Stream-API erledigt, lässt sich mit einem einzigen Aufruf erreichen.
5.2.3. Zeichenketten suchen und vergleichen
Der Vergleich von Zeichenketten ist subtiler, als es scheint: Sollen Groß- und Kleinbuchstaben unterschieden werden? Wie soll „éclair“ mit „essay“ verglichen werden? Und was vergleicht der Operator [==] eigentlich? In diesem letzten Punkt hat Kotlin eine bekannte Falle von Java beseitigt. Das Programm [Strings03.kt] zeigt die Funktionen zum Suchen und Vergleichen:
Ergebnisse:
Kommentare:
- Zeilen 3–4: Die vom Programm verwendeten Klassen des JDK müssen importiert werden;
- Zeilen 11–14: Standardmäßig führen [contains], [startsWith] und [endsWith] einen exakten Zeichen-für-Zeichen-Vergleich durch: „LANGUAGE“ wird nicht gefunden;
- Zeile 16: Diese Funktionen haben einen optionalen Parameter [ignoreCase], der angibt, dass die Groß- und Kleinschreibung ignoriert werden soll. Java hat kein Äquivalent: Beide Zeichenketten müssen in Kleinbuchstaben vorliegen;
- Zeile 18: Der Operator [in] ruft die Funktion [contains] auf (Kapitel 4): ["Kotlin" in title] liest sich ganz natürlich als „Kotlin ist im Titel enthalten“;
- Zeilen 19–21: Die Funktion [regionMatches] vergleicht einen Teil einer Zeichenkette mit einem Teil einer anderen Zeichenkette. Ihre Parameter sind die Startposition in der Zeichenkette, die andere Zeichenkette, die Startposition in der anderen Zeichenkette und die Anzahl der zu vergleichenden Zeichen; der letzte, optionale Parameter gibt an, ob die Groß- und Kleinschreibung ignoriert werden soll (in Java steht dieser Parameter in einer der Überladungen an erster Stelle);
- Zeilen 23–29: der wichtigste Teil dieses Programms. Eine Variable vom Typ [String] enthält eine Referenz auf ein Zeichenkettenobjekt (Kapitel 4). Die Variable [yes] verweist auf eine zur Laufzeit erzeugte Zeichenkette „yes“: Sie ist ein anderes Objekt als die Literal-Zeichenkette „yes“ im Programm. In Kotlin vergleicht der Operator [] den Inhalt: Er ruft die Funktion [equals] auf, und [yes == "yes"] ergibt [true] (Zeile 8 der Ergebnisse). Um Referenzen zu vergleichen – also festzustellen, ob zwei Variablen auf dasselbe Objekt verweisen –, hat Kotlin einen weiteren Operator, [=], und [yes === "yes"] ergibt [false] (Zeile 9 der Ergebnisse). In Java ist es umgekehrt: [] vergleicht dort Referenzen, und der häufige Fehler, [answer == "yes"] statt [answer.equals("yes")] zu schreiben gibt es in Kotlin nicht. Der Vergleich ohne Beachtung der Groß- und Kleinschreibung wird als [equals(..., ignoreCase = true)] geschrieben, was die korrekte Methode ist, um eine über die Tastatur in Groß- oder Kleinbuchstaben eingegebene Antwort „yes“ zu validieren. Den Operator [=] benötigen Sie bei Zeichenketten fast nie;
- Zeilen 32–37: Die Funktion [compareTo] liefert eine negative ganze Zahl, null oder eine positive ganze Zahl, je nachdem, ob die Zeichenkette der Parameter-Zeichenkette vorausgeht, ihr gleicht oder ihr folgt. Sie vergleicht die Zeichencodes: „éclair“ steht hinter „essay“, weil der Code des Zeichens „é“ (233) größer ist als der des Zeichens „e“ (101); hier liefert sie die Differenz der beiden Codes, 132. Da [String] das Interface [Comparable<String>] implementiert, gelten die Operatoren [<], [>], [<=] und [>=] auch für Zeichenketten und rufen [compareTo] auf: [a < b] ergibt [false]. Um Wörter nach den Regeln einer Sprache zu sortieren, wird ein Objekt [java.text.Collator] aus dem JDK verwendet: Für Französisch wird das Zeichen „é“ bei „e“ einsortiert, und „éclair“ steht vor „essay“ (Zeile 14 der Ergebnisse). Die von einem [Collator] vorgegebene Reihenfolge verwenden wir zum Sortieren von Wörtern, die für einen Benutzer bestimmt sind, und [compareTo] zum Vergleichen technischer Bezeichner (Dateinamen, Schlüssel usw.). Die Funktion [compareTo] hat ebenfalls einen Parameter [ignoreCase];
- Zeilen 40–48: [isEmpty] prüft auf eine leere Zeichenkette, und [isBlank] prüft auf eine leere Zeichenkette oder eine, die nur Leerzeichen enthält. Eine Zeichenkette kann auch fehlen: In diesem Fall hat ihre Variable den Typ [String?] und den Wert [null] (Kapitel 3). Hier liefert [System.getenv] – eine Java-Methode, die den Wert einer Umgebungsvariablen zurückgibt – [null] , weil die angeforderte Variable nicht existiert. Der Compiler verbietet den Aufruf von [absent.isBlank()], der eine [NullPointerException] auslösen könnte. Die Bibliothek stellt Erweiterungsfunktionen für den Typ [String?] bereit, die [null] akzeptieren: [isNullOrBlank] (und [isNullOrEmpty]) prüfen, was Java als [absent == null || absent.isBlank()] schreibt, und [orEmpty] liefert die Zeichenkette oder eine leere Zeichenkette, wenn sie [null] ist. Der sichere Aufruf [absent?.length] liefert [null];
- Zeile 51: [padStart] füllt eine Zeichenkette von links mit Leerzeichen oder dem angegebenen Zeichen ([padStart(5, '0')]) auf eine Länge von 8 Zeichen auf, und [padEnd] füllt sie von rechts auf; [repeat] wiederholt eine Zeichenkette. Die weiter unten gezeigten Formate ["%8s"] und ["%-8s"], hätten ebenfalls verwendet werden können.
5.2.4. Templates, Formate und Raw Strings
Seit Kapitel 3 erzeugen wir die auszugebenden Zeichenketten mit String-Templates: In einer Zeichenkette wird [$name] durch den Wert der Variablen [name] ersetzt, und [${expression}] durch den Wert eines beliebigen Ausdrucks. Das ist String-Interpolation, ein Feature, das Java nicht hat (ein Vorschlag, „String Templates“, wurde in Java 21 und 22 als Preview eingeführt, später aber wieder entfernt) und das C# als [$"{name}"] schreibt. Der Compiler wandelt ein Template in Verkettungen um: Es entsteht kein zusätzlicher Laufzeitaufwand.
Um Werte in Spalten auszurichten, die Anzahl der Nachkommastellen einer Zahl festzulegen oder ein Datum anzuzeigen, verwendet man außerdem Formate, entweder mit der Funktion [String.format] oder mit der auf das Format selbst angewendeten Erweiterungsfunktion [format] , die dasselbe bewirken (und die Java-Methode [String.format] aufrufen). Das Format ist eine Zeichenkette, in der [%[-][width][.precision]conversion] -Angaben festlegen, wo und wie die folgenden Parameter eingefügt werden. Das Programm [Strings04.kt] liefert Beispiele dafür, zusammen mit den rohen Kotlin-Zeichenketten:
Ergebnisse:
Kommentare:
- Zeile 17: ein Template: [$name] and [$age] werden durch die Werte der Variablen ersetzt und [${2026 - age}] durch den Wert des Ausdrucks. Geschweifte Klammern sind immer erforderlich, wenn das, was auf [$] folgt, kein einfacher Variablenname ist: [$person.name] würde den Wert von [person] gefolgt vom Text „.name“ einfügen, während [${person.name}] die Eigenschaft [name] einfügt;
- Zeile 19: Eine Breitenangabe richtet den Wert rechtsbündig in einem Feld von 10 Zeichen aus; mit vorangestelltem Zeichen [-] wird er linksbündig ausgerichtet;
- Zeilen 19–21: die gebräuchlichsten Konvertierungen:
Angabe | Bedeutung | Beispiel (englische Locale) |
[%s] | Zeichenkette; jedes Objekt wird durch seine Funktion [toString] umgewandelt | dupont |
[%d], [%5d] | ganze Zahl, gegebenenfalls 5 Zeichen lang | 45 |
[%05d] | ganze Zahl mit mindestens 5 Ziffern, mit Nullen aufgefüllt | 00045 |
[%X] | hexadezimale ganze Zahl ([%x]: in Kleinbuchstaben) | 2D |
[%.2f], [%12.2f] | reelle Zahl mit 2 Nachkommastellen, gegebenenfalls 12 Zeichen lang | 2345.68 |
[%,.2f], [%,d] | wie oben, mit Tausendertrennzeichen | 2,345.68 |
[%e] | reelle Zahl in wissenschaftlicher Notation | 2.345678e+03 |
[%n] | systemspezifischer Zeilenumbruch | |
[%%] | das Zeichen % | % |
- Zahlen werden gemäß der aktuellen Sprache formatiert, hier Englisch: Dezimalpunkt, Komma als Tausendertrennzeichen. Im Französischen ([Locale.FRANCE], Zeilen 29–32) ist das Tausendertrennzeichen ein schmales geschütztes Leerzeichen (Zeichen U+202F), das wie ein normales Leerzeichen aussieht, aber einen Zeilenumbruch mitten in einer Zahl verhindert; ebenso steht ein geschütztes Leerzeichen (U+00A0) vor dem Symbol € und dem Symbol %. Das sollte man beim Vergleich dieser Texte mit Zeichenketten berücksichtigen, die mit normalen Leerzeichen geschrieben sind. Die Parametertypen werden erst zur Laufzeit geprüft: Die Übergabe eines [Int] an die Konvertierung [%f] wirft eine [IllegalFormatConversionException];
- Zeile 23: ["...".format(...)] ist äquivalent zu [String.format("...", ...)] (und zur Java-Methode [formatted]). Da [if] in Kotlin ein Ausdruck ist (Kapitel 3), kann es einen Parameter liefern, während Java den Bedingungsoperator [? :] verwendet;
- Zeile 25: Ein Template formatiert keine Zahlen; es ruft die Funktion [toString] auf den Wert auf, die einen [Double] unabhängig von der Sprache des Rechners mit Dezimalpunkt und allen Nachkommastellen anzeigt. Für eine Anzeige, die für einen Benutzer bestimmt ist, werden Template und Format kombiniert: [${"%.2f".format(salary)}]. Eine Überladung von [format] nimmt als ersten Parameter die zu verwendende Sprache entgegen: [Locale.US] liefert einen Dezimalpunkt;
- Zeilen 29–32: Geldbeträge und Prozentwerte werden mit [java.text.NumberFormat]-Objekten aus dem JDK formatiert, die für eine bestimmte Sprache und ein bestimmtes Land bezogen werden ([Locale.FRANCE]). Das Prozentformat multipliziert den Wert mit 100. Beachten Sie Zeile 31: Die Java-Methode [setMinimumFractionDigits(2)] wird in Kotlin als Zuweisung an eine Eigenschaft verwendet. Kotlin behandelt die Java-Methodenpaare [getXxx()]/[setXxx(...)] als Eigenschaften [xxx];
- Zeilen 34–37: Die Datums-API [java.time] des JDK wird von einem [DateTimeFormatter]-Objekt formatiert, das aus einem Muster erzeugt wird: [dd] Tag, [MM] Monat, [yyyy] Jahr, [HH] Stunde, [mm] Minuten, [ss] Sekunden, [EEEE] ausgeschriebener Wochentag, [MMMM] ausgeschriebener Monat. Achten Sie auf die Groß- und Kleinschreibung: [MM] ist der Monat, [mm] sind die Minuten. Die Namen der Tage und Monate sind die der Alltagssprache. Templates können Ausdrücke enthalten, die ihrerseits Zeichenketten enthalten: ["[${date.format(DateTimeFormatter.ofPattern("dd/MM/yyyy"))}] "];
- Zeilen 40–43: Die Breitenangaben ermöglichen es, Daten in Spalten anzuzeigen;
- Zeile 47: In einer gewöhnlichen Zeichenkette leitet das Zeichen [\] eine Escape-Sequenz ein ([\n], [\t], [\"], [\$] ...); um das Zeichen [\] selbst zu erhalten, muss es verdoppelt werden;
- Zeile 50: Ein Raw String wird durch drei Anführungszeichen begrenzt. In Raw Strings gibt es keine Escape-Sequenzen: Das Zeichen [\] wird als gewöhnliches Zeichen behandelt. Das ist eine bequeme Möglichkeit, Windows-Pfade und reguläre Ausdrücke zu schreiben, was Java nicht bietet (seine Textblöcke behalten Escape-Sequenzen bei). Einen Zeilenumbruch wie [\n] können Sie hier jedoch nicht schreiben; dafür brauchen Sie einen echten Zeilenumbruch;
- Zeilen 54–61: Ein Raw String kann sich über mehrere Zeilen erstrecken und Anführungszeichen ohne Escape-Zeichen enthalten. Er bewahrt alles, was zwischen den Anführungszeichen steht, einschließlich der Code-Einrückung und der leeren Zeilen am Anfang und am Ende. Die Funktion [trimIndent] entfernt die erste und die letzte Zeile, wenn sie leer sind, und anschließend die allen Zeilen gemeinsame Einrückung (die der am wenigsten eingerückten Zeile): Der JSON-Text wird ohne den Code-Rand und ohne den abschließenden Zeilenumbruch angezeigt, woraus sich bei [println] das Ergebnis ergibt. Das entspricht den Textblöcken von Java 15, ist aber mit einer Bibliotheksfunktion umgesetzt. Anders als bei Java-Textblöcken funktionieren Templates in Raw Strings: ["$name"] and [${prices[0]}] werden durch ihre Werte ersetzt, wodurch [format] entfällt; das [\] in ["C:\data"] muss nicht verdoppelt werden;
- Zeile 59: Da es in einem Raw String keine Escape-Sequenzen gibt, können Sie nicht
***[\\$]schreiben, um ein*[$]gefolgt von einem Namen zu erhalten, ohne dass es als Template interpretiert wird: Stattdessen schreiben wir [${'$'}], ein Template, dessen Ausdruck das Zeichen [$] ist. Ab Kotlin 2.2 können wir der Zeichenkette auch mehrere [$]* voranstellen ([$$"""..."""]): Nur Folgen von zwei [$] leiten dann ein Template ein, was praktisch ist, um Text zu schreiben, der viele [$]* enthält; - Zeilen 64–68: Die Funktion [trimMargin] bietet eine andere Möglichkeit, den Rand festzulegen: Jede Zeile beginnt – gegebenenfalls nach Leerzeichen – mit einem Randzeichen (standardmäßig [|] ), und alles, was diesem Zeichen vorausgeht, einschließlich des Zeichens selbst, wird entfernt. Wählen Sie die lesbarere Funktion: [trimIndent] für unverändert kopierten Text und [trimMargin] wenn die erste Spalte des Textes deutlich sichtbar sein soll.
Es gibt außerdem die Klasse [java.text.MessageFormat], deren Formate Parameter über ihre Nummern ansprechen: [MessageFormat.format("{0} is {1} years old", name, age)]. Sie wird für Meldungen verwendet, die in mehrere Sprachen übersetzt werden, in denen die Reihenfolge der Parameter von Sprache zu Sprache variieren kann; in Kotlin wird sie genau wie in Java verwendet.
5.2.5. Die Klasse StringBuilder
Wir haben festgestellt, dass Funktionen des Typs [String] , die auf eine Zeichenkette [s1] angewendet werden, eine andere Zeichenkette [s2] liefern. Die Klasse [StringBuilder] erlaubt es, eine Zeichenkette zu verändern, ohne bei jeder Operation eine neue zu erzeugen. Das verbessert die Leistung beim Aufbau einer Zeichenkette durch viele aufeinanderfolgende Ergänzungen, da die Vermehrung sehr kurzlebiger Zeichenketten vermieden wird. In Kotlin für die JVM ist [kotlin.text.StringBuilder] ein Typalias ([typealias]) für die Klasse [java.lang.StringBuilder] des JDK: Es ist dieselbe Klasse, die die Standardbibliothek um einige Erweiterungsfunktionen ergänzt ([appendLine], den Operator [[]] ...). Sie kann ohne [import] verwendet werden.
Die Klasse unterstützt verschiedene Konstruktoren:
Konstruktor | Rolle |
[StringBuilder()] | erzeugt ein leeres Objekt mit einer Anfangskapazität von 16 Zeichen |
[StringBuilder(str: String)] | erzeugt das Objekt und initialisiert es mit [str]; die Anfangskapazität ist die Länge von [str] plus 16 |
[StringBuilder(capacity: Int)] | erzeugt ein leeres Objekt mit einer Anfangskapazität von [capacity] Zeichen |
Ein [StringBuilder]-Objekt speichert seine Zeichen in einem Array, dessen Größe – seine Kapazität – automatisch angepasst wird, wenn der Text wächst. Das Programm [Strings05.kt] veranschaulicht dieses Konzept der Kapazität:
Ergebnisse:
Kommentare:
- Zeile 5: Erzeugung eines [StringBuilder]-Objekts, das „test“ enthält: Seine Anfangskapazität beträgt 4 + 16 = 20 Zeichen. Wie bei jeder Klasse in Kotlin gibt es keinen Operator [new];
- Zeile 6: [length] ist die aktuelle Anzahl der Zeichen. Kotlin stellt sie als Eigenschaft (ohne Klammern) dar, wie bei [String]: Die Java-Methode [length()] der Schnittstelle [CharSequence] wird in Kotlin als Eigenschaft [length] behandelt. [capacity()], die nicht zu dieser Schnittstelle gehört und nicht der Konvention [getXxx()] folgt, bleibt eine Methode: Sie gibt die Anzahl der Zeichen an, die das Objekt aufnehmen kann, bevor sein Array erweitert werden muss;
- Zeile 7: Die Funktion [repeat] der Standardbibliothek führt das nachfolgende Lambda 10-mal aus (Kapitel 3);
- Zeile 8: [append] hängt eine Zeichenkette an das Ende des Textes an;
- Zeile 12: Erzeugung eines leeren [StringBuilder]-Objekts mit einer Anfangskapazität von 10, dem sofort „test“ hinzugefügt wird. Die Methode [append] liefert das Objekt selbst zurück: Sie kann direkt auf das Ergebnis des Konstruktors aufgerufen werden.
Die Ergebnisse, die mit denen des Java-Programms identisch sind, da es dieselbe Klasse ist, zeigen: Reicht die Kapazität nicht aus, wird sie etwas mehr als verdoppelt: Die neue Kapazität ist die alte multipliziert mit 2, plus 2 (20, 42, 86 beim ersten Objekt; 10, 22, 46 beim zweiten). Jede Erweiterung alloziert ein neues Array und kopiert die Zeichen hinein. Kennt man die ungefähre Größe des Textes im Voraus, vermeidet die Festlegung bei der Konstruktion diese aufeinanderfolgenden Erweiterungen.
Hier sind einige Funktionen der Klasse:
Funktion | Aufgabe |
[append(str: String?): StringBuilder] | hängt [str] an das Ende des Textes an. Überladen für die Typen [Int], [Double], [Char], [Boolean], [Any?]… |
[appendLine(value)] | Kotlin-Erweiterung: hängt [value] gefolgt von einem Zeilenumbruch [\n]an; ohne Parameter wird nur der Zeilenumbruch angehängt |
[insert(offset: Int, str: String?)] | Fügt [str] an der Position [offset] ein; überladen wie [append] |
[delete(start: Int, end: Int)] | löscht die Zeichen von Position [start] (einschließlich) bis [end] (ausschließlich); [deleteCharAt] löscht ein einzelnes Zeichen |
[replace(start: Int, end: Int, str: String)] | ersetzt die Zeichen von Position [start] (einschließlich) bis [end] (ausschließlich) durch [str] |
[reverse()] | kehrt die Reihenfolge der Zeichen um |
[sb[index]], [sb[index] = ch] | liest und ersetzt das Zeichen Nr. [index] (Operatoren [get] und [set]; [set] ist eine Kotlin-Erweiterung der Java-Methode [setCharAt]) |
[indexOf(str: String)] | Position von [str] im Text oder -1 |
[toString()] | gibt den Text als Zeichenkette [String] zurück |
Das Programm [Strings06.kt] verwendet diese sowie die Funktion [buildString], die in Kotlin die idiomatische Art ist, eine Zeichenkette zu erstellen:
Ergebnisse:
Kommentare:
- Zeile 6: Die Änderungsmethoden geben das [StringBuilder]-Objekt selbst zurück, sodass sie verkettet werden können. Verfolgen wir die Schritte: „test“ wird zu „testabCD " ([append]), dann "texyZTstabCD" ([insert] an Position 2), dann "xyZTstabCD " ([delete] für die Zeichen 0 und 1) und schließlich "XYZTstabCD" ([replace] für die Zeichen 0 und 1 mit "XY"). Beachten Sie, dass – anders als die Funktion [replace] von [String] – die Funktion von [StringBuilder] keinen Text sucht: Sie ersetzt einen Positionsbereich. [println] gibt das Objekt durch Aufruf seiner Funktion [toString] aus;
- Zeilen 8–9: Der Operator [[]] liest und ändert ein Zeichen wie bei einem Array; [str3[0] = 'x'] ruft [str3.setCharAt(0, 'x')] auf. Im Template ruft [$str3] die Funktion [toString] auf;
- Zeile 11: [reverse] kehrt den Text um. Für eine Zeichenkette [String] ist die Funktion [reversed], die in [Strings01.kt] zu sehen war, einfacher;
- Zeilen 14–16: Aufbau eines mehrzeiligen Textes durch aufeinanderfolgende Anfügungen – das ist der typische Einsatz von [StringBuilder]. Die Anfügungen werden in einer einzigen Codezeile verkettet;
- Zeilen 19–20: Die Funktion [joinTo] ist das Gegenstück zu [joinToString]: Statt eine neue Zeichenkette zu erzeugen, hängt sie die durch das Trennzeichen getrennten Elemente an einen vorhandenen [StringBuilder] an (genauer gesagt an ein beliebiges [Appendable]-Objekt); [appendLine] fügt anschließend einen Zeilenumbruch hinzu;
- Zeile 23: Eine formatierte Zeichenkette wird angehängt. Die Konvertierung [%f] erfordert eine reelle Zahl: Die Übergabe der ganzen Zahl [total] würde zur Laufzeit eine [IllegalFormatConversionException]-Exception auslösen, daher die Umwandlung [total.toDouble()];
- Zeile 25: Der endgültige Text wird als Zeichenkette [String] abgerufen;
- Zeilen 30–35: Die Funktion [buildString] erstellt einen [StringBuilder], führt das darauf folgende Lambda aus und gibt dann den aufgebauten Text als [String] zurück. Im Lambda ist der [StringBuilder] der implizite Receiver ([this]): Wir schreiben [appendLine(...)] statt [sb.appendLine(...)]. Diese Art von Lambda, genannt Lambda mit Receiver, wird in Kapitel 7 behandelt; sie ermöglicht es, sehr gut lesbare „Bausteine“ zu schreiben. Die Variable [table] ist ein unveränderlicher [String], der mit [val] deklariert wird, und der zwischenzeitliche [StringBuilder] ist nicht einmal sichtbar. Beachten Sie auch, wie [padStart] Zahlen in Spalten rechtsbündig ausrichtet;
- Zeile 40: Für eine Folge von Elementen, die durch ein Trennzeichen getrennt sind, mit Präfix und Suffix, bietet [joinToString] die Funktionalität der Java-Klasse [java.util.StringJoiner], die weiterhin verwendbar, aber in Kotlin kaum von Interesse ist.
Für wenige Verkettungen genügen der Operator [+] und die Templates: Der Compiler optimiert sie. [StringBuilder] (oder [buildString]) ist die bessere Wahl, wenn die Zahl der Anfügungen groß oder unbekannt ist, typischerweise innerhalb einer Schleife: Die Verkettung [s += ...] in einer Schleife mit n Durchläufen erzeugt n Zeichenketten und kopiert in jedem Durchlauf die gesamte zuvor aufgebaute Zeichenkette. In älterem Java-Code begegnet Ihnen möglicherweise die Klasse [StringBuffer], die dieselben Methoden wie [StringBuilder] hat, sie aber um den Preis eines gewissen Leistungsaufwands von mehreren Threads gleichzeitig nutzbar macht: Heute wird [StringBuilder] ihr vorgezogen.
5.2.6. Parsen einer Zeichenkette ohne Kopieren
Jeder Aufruf von [substring] oder [split] erzeugt neue Zeichenketten im Speicher. In leistungskritischem Code (etwa bei der Analyse großer Dateien oder Netzwerkanfragen) möchte man das Erzeugen neuer Zeichenketten vielleicht vermeiden. Weder Kotlin noch Java haben einen in die Sprache integrierten Typ „Teilzeichenkette“, aber mehrere Funktionen arbeiten auf einem Teil einer Zeichenkette, ohne ihn zu kopieren. Das Programm [Strings07.kt] vergleicht mehrere Möglichkeiten, eine Zeile im Format „Nachname:Vorname:Alter“ zu parsen:
Ergebnisse:
Kommentare:
- Zeile 10: der lesbarste und in Kotlin gebräuchlichste Ansatz: [split] liefert eine Liste aus drei Zeichenketten, die die Destrukturierung (Kapitel 3) drei Variablen zuweist; [toInt] wandelt anschließend das Alter in eine ganze Zahl um. Dabei werden jedoch eine Liste und drei Zeichenketten erzeugt;
- Zeilen 16–17: Bei [substring] erzeugt jeder Aufruf eine neue Zeichenkette, auch wenn sie wie beim Alter nur kurz verwendet wird;
- Zeile 21: Die Kotlin-Funktion [toInt] ist nur auf eine Zeichenkette anwendbar; die statische Methode [Integer.parseInt] des JDK hat jedoch eine Überladung (Java 9), die die Zeichen zwischen zwei Positionen der Zeichenkette mit der angegebenen Basis (hier 10) parst, ohne eine Teilzeichenkette zu erzeugen. Ein Kotlin-Programm kann sie direkt aufrufen: Genau darin liegt der Sinn der Interoperabilität mit Java;
- Zeile 23: [regionMatches], das wir bereits kennengelernt haben, vergleicht einen Teil der Zeichenkette mit einer anderen Zeichenkette, ohne ihn zu kopieren;
- Zeile 27: [CharBuffer.wrap] (Paket [java.nio] des JDK) liefert einen View der Zeichen 0 bis [p1] - 1 der Zeichenkette: ein Objekt, das keine Kopie der Zeichen enthält, aber einen Zugriff darauf bietet. Es implementiert die Schnittstelle [CharSequence], ebenso wie [String] und [StringBuilder]. Beachten Sie, dass die Funktion [subSequence] von [String], die zu dieser Schnittstelle gehört, kein View ist: Für eine Zeichenkette erzeugt sie eine Kopie der Zeichen, genau wie [substring] (bei einem
*[CharBuffer]liefert sie einen View). Kotlin behandelt die Java-Methode***[charAt]dieser Schnittstelle als Operator***[[]]und ihre Methode[length()]als Property*[length]; - Zeilen 30–31: Viele der Erweiterungsfunktionen von
*[kotlin.text]sind nicht auf*[String]*, sondern auf[CharSequence]definiert: [startsWith], [count], [contains], [indexOf], [split], [lines]… gelten daher auch für einen View oder für einen [StringBuilder], ohne ihn zuvor in einen [String] umzuwandeln. Reguläre Ausdrücke, die wir am Ende des Kapitels behandeln, akzeptieren ebenfalls eine [CharSequence]*; - Zeile 34: Der zweite Parameter von [indexOf] ist die Startposition der Suche;
- Zeile 37: Eine Zeichenkette wird nur erzeugt, wenn sie tatsächlich benötigt wird.
Diese Techniken sind Optimierungswerkzeuge: Für ein gewöhnliches Programm sind [split] und [substring] völlig ausreichend. Außerdem speichert die virtuelle Maschine Zeichenketten, die nur Zeichen des Latin-1-Zeichensatzes enthalten (wie bei französischem Text), mit einem Byte pro Zeichen statt zwei („Compact Strings“, Java 9), was den belegten Speicher halbiert; Kotlin-Zeichenketten, die Java-Zeichenketten sind, profitieren davon. Wir versuchen Kopien nur in Code zu vermeiden, der nachweislich leistungskritisch ist.
5.3. Arrays
5.3.1. Erweiterungsfunktionen für Arrays
Wir haben in Kapitel 3 gesehen, dass Kotlin zwei Arten von Arrays kennt: Arrays von Objekten [Array<T>] (erzeugt mit [arrayOf]) und Arrays primitiver Typen [IntArray], [DoubleArray], [CharArray]… (erzeugt mit [intArrayOf], [doubleArrayOf]…), die in Arrays primitiver Java-Typen kompiliert werden ([int[]], [double[]]…). In Java haben Arrays keine nützlichen Methoden: Abgesehen vom Feld [length] sind alle Operationen statische Methoden der Hilfsklasse [java.util.Arrays]. In Kotlin haben Arrays eine Property [size], die Operatoren [[]] und vor allem Dutzende Erweiterungsfunktionen der Standardbibliothek (Paket [kotlin.collections]), die wie Methoden aufgerufen werden: [array.sort()] statt [Arrays.sort(array)]. Mit ihnen lassen sich Arrays sortieren, Elemente darin suchen, Arrays kopieren, füllen … Sie existieren für jeden Array-Typ ([IntArray], [DoubleArray]…, [Array<T>]) und rufen meist über die JVM die Methoden der Klasse [Arrays] auf.
Funktion | Aufgabe |
[binarySearch(element, fromIndex = 0, toIndex = size)] | Gibt die Position von [element] im Array zurück, das sortiert sein muss; eine negative Zahl, wenn [element] fehlt |
[copyOf(newSize: Int)] | gibt ein neues Array mit [newSize] Elementen zurück, das die ersten Elemente des Arrays enthält und mit Nullen aufgefüllt ist, soweit nötig ([false] bei Booleans); bei einem [Array<T>] ist das Ergebnis ein [Array<T?>] , aufgefüllt mit [null]. Ohne Parameter wird eine Kopie derselben Größe zurückgegeben |
[copyOfRange(fromIndex: Int, toIndex: Int)] | gibt ein neues Array zurück, das aus den Elementen von [fromIndex] (einschließlich) bis [toIndex] (ausschließlich) besteht; [sliceArray(range)] leistet dasselbe mit einem Intervall |
[copyInto(destination, destinationOffset = 0, startIndex = 0, endIndex = size)] | kopiert die Elemente des Arrays in ein anderes, bereits existierendes Array (entspricht [System.arraycopy]) |
[contentEquals(other)] | gibt [true] zurück, wenn beide Arrays dieselben Elemente in derselben Reihenfolge enthalten |
[fill(element, fromIndex = 0, toIndex = size)] | Weist [element] allen Elementen des Arrays oder einem Indexbereich zu |
[sort()], [sort(fromIndex, toIndex)] | sortiert das Array oder einen Indexbereich nach der natürlichen Ordnung seiner Elemente; [sortWith(comparator)] sortiert ein Array von Objekten nach einem [Comparator] (Kapitel 4); [sortDescending()] sortiert in absteigender Reihenfolge |
[sorted()], [sortedWith(comparator)] | gibt eine sortierte Liste zurück, ohne das Array zu verändern |
[reverse()], [reversed()] | kehrt das Array um; gibt eine umgekehrte Liste zurück |
[contentToString()] | wandelt die Elemente des Arrays in eine Zeichenkette [[e1, e2, ...]] um; [contentDeepToString] leistet dasselbe für ein Array von Arrays |
[indexOf(element)], [lastIndexOf(element)], [contains(element)] | lineare Suche: erste oder letzte Position von [element] oder -1; Vorhandensein von [element] ([element in array]) |
[asList()] | gibt eine Liste zurück, die ein View des Arrays ist |
[toList()], [toMutableList()] | gibt eine neue, schreibgeschützte oder veränderbare Liste mit den Elementen des Arrays zurück |
[plus(element)] | gibt ein neues, um ein Element größeres Array zurück, das aus den Elementen des Arrays gefolgt von [element] besteht; geschrieben als [array + element] |
Hinzu kommen Funktionen, die Arrays und Collections gemeinsam sind ([sum], [max], [count], [filter], [map], [joinToString]…), die wir später behandeln.
Das Programm [Arrays01.kt] veranschaulicht die Verwendung einiger dieser Funktionen:
Kommentare:
- Zeile 4: eine Enumeration (Kapitel 3), auf Dateiebene deklariert;
- Zeilen 23–40: Die Funktion [input] erfasst die über die Tastatur eingegebenen Elemente eines Arrays. Da die Anzahl der Elemente nicht im Voraus bekannt ist, beginnt die Funktion mit einem leeren Array (Zeile 25) und erweitert es bei jeder neuen Eingabe um ein Element (Zeile 38). Die Größe eines Arrays wird bei seiner Erzeugung festgelegt: Der Operator [+] ([plus]) erzeugt tatsächlich ein neues, um ein Element größeres Array, kopiert die Elemente des alten Arrays hinein und fügt das neue Element hinzu; [elements += element] bedeutet hier [elements = elements + element], daher die Deklaration von [elements] mit [var]. Das entspricht, in einer einzigen Anweisung, den beiden Java-Anweisungen [elements = Arrays.copyOf(elements, elements.length + 1)] und [elements[elements.length - 1] = element]. Ein effizienterer Algorithmus würde den Platz in Gruppen von N Elementen reservieren. Ein Array ist nicht dafür gedacht, in der Größe verändert zu werden: Dieser Fall lässt sich besser mit einer veränderbaren Liste lösen, wie wir gleich sehen werden;
- Zeilen 32–35: die Umwandlung der eingegebenen Zeichenkette in eine Gleitkommazahl durch [toDoubleOrNull], das [null] zurückgibt, wenn die Zeichenkette keine Zahl ist (Kapitel 3). Nach der Prüfung [element == null] gefolgt von [continue] weiß der Compiler, dass [element] nicht [null] ist: Sein Typ wird zu [Double] (intelligente Typumwandlung), und es kann dem Array hinzugefügt werden. [toDoubleOrNull] hängt nicht von der Sprache des Rechners ab: Es erwartet immer einen Dezimalpunkt und lehnt die Eingabe „3,6“ ab (Zeile 4 der Ergebnisse);
- Zeilen 52–69: Die Funktion [search] durchsucht das Array nach über die Tastatur eingegebenen Werten. Die Funktion [when] (Zeile 64) wählt die Suchmethode anhand des angeforderten Typs aus; da sie auf einer Enumeration arbeitet und alle ihre Werte behandelt, benötigt sie den Zweig [else] nicht. Bei einem unsortierten Array wird eine lineare Suche durchgeführt, bei der die Elemente einzeln geprüft werden. Die Standardbibliothek hat keine Funktion [indexOf] für Arrays reeller Zahlen [DoubleArray]: Sie wurde entfernt, weil der Vergleich reeller Zahlen auf Gleichheit bei den Sonderwerten [NaN] und [-0.0] Probleme aufwirft; [elements.indexOf(element)] wird vom Compiler abgelehnt ([unresolved reference 'indexOf']). Wir verwenden daher [indexOfFirst], das die Position des ersten Elements zurückgibt, das die durch ein Lambda ausgedrückte Bedingung erfüllt, oder -1; anders als in Java muss die Suchfunktion nicht selbst geschrieben werden. Bei einem sortierten Array führen wir mit [binarySearch] eine binäre Suche durch, die den Suchbereich bei jedem Schritt halbiert: Sie findet ein Element unter einer Million in etwa zwanzig Vergleichen;
- Zeile 15: Das Array wird sortiert, hier nach der natürlichen Ordnung der Zahlen. [elements] wird mit [val] in [main] deklariert: Die Variable verweist immer auf dasselbe Array, aber sein Inhalt kann geändert werden. [val] macht die Referenz konstant, nicht das Objekt;
- Zeilen 44–47: Ausgabe eines Arrays. [println] gibt einen [Double] unabhängig von der Sprache des Rechners mit Dezimalpunkt und immer mit mindestens einer Nachkommastelle aus: -7 wird als -7.0 ausgegeben;
- Zeilen 74–76: [print] gibt die Eingabeaufforderung ohne Zeilenumbruch aus, dann liest [readlnOrNull] eine über die Tastatur eingegebene Zeile; es gibt [null] zurück, wenn die Standardeingabe erschöpft ist, zum Beispiel wenn sie aus einer Datei stammt. Der sichere Aufruf [?.trim()] und der Elvis-Operator [?: ""] liefern dann eine leere Zeichenkette.
Ergebnisse:
Wenn das gesuchte Element fehlt, gibt [indexOfFirst] -1 zurück und [binarySearch] eine negative Zahl (letzte Suche): Dies ist [-(p + 1)], wobei p die Position ist, an der das Element eingefügt werden müsste, damit das Array sortiert bleibt. Hier gilt -3 = -(2 + 1): Die Zahl 0 müsste an Position 2 eingefügt werden, zwischen -1.5 und 3.6. Achtung: [binarySearch] liefert bei einem unsortierten Array ein bedeutungsloses Ergebnis.
5.3.2. Weitere Array-Funktionen
Das Programm [Arrays02.kt] bietet weitere Erweiterungsfunktionen für Arrays:
Ergebnisse:
Kommentare:
- Zeile 9: [contentToString] gibt ein Array in einer einzigen Zeile aus. Die direkte Ausgabe eines Arrays mit [println(numbers)] oder ["$numbers"] ergäbe einen Text wie [[I@1b6d3586]]: den Typ ([[I]], ein Array von ganzen Zahlen der JVM) und eine Kennung des Objekts, ohne seine Elemente. Kotlin-Arrays sind Java-Arrays und haben dasselbe [toString];
- Zeile 12: Nur die Elemente mit den Indizes 1 bis 3 werden sortiert, wobei der zweite Index ausgeschlossen ist: 10, 30, 20 werden zu 10, 20, 30;
- Zeilen 16–17: [IntArray(5)] erzeugt ein Array aus 5 ganzen Zahlen mit dem Wert 0. [copyInto] kopiert die ersten 3 Elemente von [numbers] an den Anfang von [copy], während die übrigen Elemente ihren Anfangswert 0 behalten. Seine Parameter haben Standardwerte und werden hier benannt, wodurch der Aufruf deutlich lesbarer ist als der von [System.arraycopy(numbers, 0, copy, 0, 3)] in Java;
- Zeilen 20–21: [copyOf] und [copyOfRange] erzeugen ein neues Array. Ein Array, das länger ist als das Original, wird mit Nullen aufgefüllt;
- Zeilen 24–26: [fill] füllt das Array und setzt dann die Elemente mit den Indizes 1 und 2 (ohne Index 3) auf 0 zurück. Beachten Sie, dass die Reihenfolge der Parameter eine andere ist als in Java: Zuerst kommt der Wert, dann der Indexbereich;
- Zeilen 30–31: Bei Arrays – anders als bei Zeichenketten und Collections – arbeitet der Operator [] nicht inhaltlich: Er vergleicht Referenzen: Arrays haben keine Funktion [equals], die den Inhalt vergleicht. Der Compiler kennt dieses Problem und weist mit einer Warnung auf den wahrscheinlichen Fehler hin, wenn Sie [copy == other] schreiben: **[warning: '' on arrays compares only references. Replace '' with 'contentEquals' to compare the arrays' contents or use '=' to remove the warning.] (da unsere Projekte Warnungen als Fehler behandeln, schlägt die Kompilierung fehl). Wir schreiben daher [===] , um Referenzen zu vergleichen, und [contentEquals] , um Inhalte zu vergleichen. [contentEquals] wird hier in Infix*-Notation aufgerufen ([copy contentEquals other]*), ohne Punkt und Klammern, was der Modifizierer [infix] in seiner Deklaration erlaubt (Kapitel 4);
- Zeilen 34–36: Arrays von Objekten unterstützen die Suchfunktionen [indexOf] und [lastIndexOf] sowie den Operator [in] direkt. In Java muss man [Arrays.asList] verwenden, um darauf zuzugreifen;
- Zeilen 38–40: [asList] gibt eine [List] (im folgenden Abschnitt vorgestellt) zurück, die ein View des Arrays ist: Sie kopiert das Array nicht, sondern ermöglicht den Zugriff darauf über Listenfunktionen. Die Funktion [reverse] kehrt das Array selbst um; da die Liste ein View des Arrays ist, sind ihre Elemente umgekehrt (Zeile 10 der Ergebnisse). Anders als in Java gibt es [reverse] für alle Array-Typen, einschließlich [IntArray];
- Zeilen 42–44: [toList] liefert dagegen eine Kopie der Elemente des Arrays in Form einer Liste. Nach der Änderung des Array-Elements Nr. 0 spiegelt der View die Änderung wider, die Kopie jedoch nicht (Zeile 11 der Ergebnisse). Dieser Punkt ist wichtig: Ein View ist effizient, spiegelt aber alle Änderungen am Originalobjekt wider; eine Kopie ist davon unabhängig;
- Zeile 49: Ein Array von Zeichenketten wird nach der Reihenfolge der oben gesehenen Funktion [compareTo] sortiert, also nach Zeichencodes: Großbuchstaben (Codes 65 bis 90) stehen vor Kleinbuchstaben (97 bis 122), die vor Buchstaben mit Akzent (é: 233) stehen. „Zoé“ ist das erste Wort und „éclair“ das letzte. [sorted] liefert eine sortierte Liste und lässt das Array unverändert;
- Zeile 51: Um nach französischen Regeln zu sortieren, übergeben wir ein Objekt
[Collator]*– das ein*[Comparator]für Zeichenketten ist – an[sortWith]; das Array selbst wird sortiert; - Zeilen 55–56: Arrays teilen mit Collections auch gemeinsame Berechnungsfunktionen: Summe, Durchschnitt, Maximum, Anzahl der Elemente, die eine Bedingung erfüllen … Wir behandeln sie bei den Collections;
- Zeilen 59–62: Kotlin hat wie Java keine rechteckigen zweidimensionalen Arrays: Ein Array von Arrays wird mit [Array(2) { IntArray(3) }] erzeugt, einem Array aus 2 Elementen, von denen jedes durch das Lambda erzeugt wird: ein Array aus 3 ganzen Zahlen. [matrix.size] ist die Anzahl der Zeilen, [matrix[0].size] ist die Anzahl der Elemente in Zeile 0. [contentDeepToString] gibt ein Array von Arrays aus;
- Zeile 64: Allgemeiner nehmen die Konstruktoren [Array], [IntArray]… eine Größe und ein Lambda entgegen, das jedes Element anhand seines Index berechnet: hier die Quadrate der ganzen Zahlen von 0 bis 4.
Merken Sie sich, dass Arrays in Kotlin vor allem aus Leistungsgründen (Arrays primitiver Typen), für [vararg]-Argumente und für die Zusammenarbeit mit Java-Bibliotheken verwendet werden. Für alles andere werden Collections bevorzugt – insbesondere Listen, die im nächsten Abschnitt behandelt werden.
5.4. Collections
Neben Arrays bietet Kotlin verschiedene Collections zum Speichern von Elementmengen. Auf der JVM hat Kotlin die Collection-Klassen nicht neu geschrieben: Es verwendet die des Java- Collections Framework (Pakete [java.util], [ArrayList], [HashMap], [LinkedHashMap], [HashSet]…, ohne [import] verfügbar gemacht als Typaliasse des Pakets [kotlin.collections]. Stattdessen stellt es sie über seine eigenen Schnittstellen bereit, die um eine Unterscheidung herum organisiert sind, die Java in seinen Typen nicht trifft: schreibgeschützte Collections und veränderbare Collections.
Schnittstelle | Aufgabe | Implementierungen und Konstruktorfunktionen |
[List<E>] [MutableList<E>] | eine geordnete Folge von Elementen, auf die über ihre Position zugegriffen wird | [ArrayList]; [listOf], [mutableListOf], [arrayListOf], [buildList], [emptyList] |
[Set<E>] [MutableSet<E>] | eine Menge: keine Duplikate | [LinkedHashSet], [HashSet], [java.util.TreeSet]; [setOf], [mutableSetOf], [hashSetOf], [sortedSetOf] |
[Map<K, V>] [MutableMap<K, V>] | ein Dictionary: Paare aus (Schlüssel, Wert), wobei die Schlüssel eindeutig sind | [LinkedHashMap], [HashMap], [java.util.TreeMap]; [mapOf], [mutableMapOf], [hashMapOf], [sortedMapOf] |
[ArrayDeque<E>] | eine doppelseitige Warteschlange, verwendbar als Warteschlange oder als Stapel (eine Kotlin-spezifische Klasse) | [ArrayDeque] |
Die Schnittstellen [List] und [Set] sind von der Schnittstelle [Collection<E>] ([size], [isEmpty], [contains]…) abgeleitet, die ihrerseits von [Iterable<E>] abgeleitet ist, der Schnittstelle für Objekte, die mit einer [for]-Schleife durchlaufen werden können. Diese Schnittstellen haben nur lesende Funktionen: Eine [List<String>] hat weder eine Funktion [add] noch eine Funktion [remove]. Die Änderungsfunktionen ([add], [remove], [clear], [[i] = value]…) werden von den abgeleiteten Schnittstellen [MutableIterable], [MutableCollection], [MutableList], [MutableSet], und [MutableMap] deklariert. Eine [ArrayList] implementiert [MutableList] und damit auch [List]. Die Regel für [val] und [var] gilt somit auch für Collections: Der schreibgeschützte Typ wird gewählt, wann immer die Collection nicht verändert werden muss – zum Beispiel bei Funktionsparametern –, und der Compiler verbietet jede Änderung über diesen Typ.
Auf der JVM existieren diese Schnittstellen nur zur Kompilierzeit: [List] und [MutableList] werden beide in die Schnittstelle [java.util.List] kompiliert. Dadurch kann eine Kotlin-Liste ohne Konvertierung an eine Java-Methode übergeben werden – und umgekehrt. Eine von einer Java-Methode erhaltene Collection hat in Kotlin einen Plattformtyp, in Compilermeldungen dargestellt als [(Mutable)List<String!>] : Kotlin weiß nicht, ob sie veränderbar ist oder ob ihre Elemente vom Typ [null] sein können, und überlässt die Entscheidung dem Programmierer.
Wie in Java besteht die bewährte Vorgehensweise darin, Variablen und Parameter mit dem Typ einer Schnittstelle zu deklarieren und die Implementierung bei der Erzeugung zu wählen, meist über einen Konstruktor: [val cities: MutableList<String> = mutableListOf()]. Beachten Sie, dass die Konstruktorfunktionen von Kotlin für Mengen und Dictionaries Implementierungen wählen, die die Reihenfolge beibehalten, in der die Elemente hinzugefügt wurden ([LinkedHashSet], [LinkedHashMap]): ein Punkt, der ein Kotlin-Programm oft von seinem Java-Äquivalent unterscheidet, das stattdessen [HashSet] und [HashMap] verwendet.
Eine Collection enthält nur Objekte. Kotlin hat in der Sprache keine sichtbaren primitiven Typen, und wir schreiben [List<Int>]; in der JVM sind die Elemente einer solchen Liste jedoch [java.lang.Integer]-Objekte, und der Compiler wandelt beim Hinzufügen eines Elements automatisch ein [Int] in ein [Integer] um und beim Lesen umgekehrt („Boxing“ und „Unboxing“). Diese in Kotlin transparente Umwandlung hat denselben Mehraufwand wie in Java: Eine Liste mit einer Million ganzer Zahlen enthält eine Million [Integer]-Objekte. Für große Zahlenmengen ist ein [IntArray]-Array vorzuziehen.
Das Paket [java.util] enthält auch die Collections von Java 1.0: [Vector] (eine Liste), [Hashtable] (ein Dictionary) und [Stack] (ein Stapel). Diese sind veraltet: Da sie bei jeder Operation synchronisiert sind, sind sie langsamer als ihre Nachfolger und sollten nicht mehr verwendet werden. Was Javas Raw Types (eine generische Collection ohne Typparameter, [List] statt [List<String>]) betrifft, so gibt es sie in Kotlin nicht: Der Typparameter ist erforderlich oder wird vom Compiler abgeleitet.
5.4.1. Listen und die Klasse ArrayList
Die Klasse [ArrayList<E>] implementiert eine veränderbare Liste von Objekten des Typs [E], deren Größe sich während der Programmausführung ändert. Sie speichert ihre Elemente in einem internen Array, das sie automatisch vergrößert, ähnlich wie [StringBuilder]. Dies ist die Implementierung, die von [mutableListOf] und [arrayListOf] erzeugt wird. Die von [listOf] erzeugten schreibgeschützten Listen sind auf der JVM Listen fester Größe aus der Java-Bibliothek ([Arrays.asList] auf dem Argument-Array, eine spezialisierte Liste für ein einzelnes Element oder eine leere Liste). Das Element i einer Liste [l] wird mit [l[i]] gelesen und (wenn die Liste veränderbar ist) mit [l[i] = value] geändert: Die Operatoren [get] und [set] (Kapitel 4) ersetzen die Java-Methoden [get(i)] und [set(i, value)].
Hier sind einige Funktionen der Schnittstellen [List<E>] und [MutableList<E>]:
Funktion | Aufgabe |
[size: Int] | Property: Anzahl der Elemente der Liste; [indices] ist der Bereich der Indizes, [lastIndex] ist der letzte Index |
[l[index]], [getOrNull(index)], [getOrElse(index) { ... }] | liest das Element Nr. [index]; bei ungültigem Index wird eine [IndexOutOfBoundsException] ausgelöst, außer bei [getOrNull] (die [null] zurückgibt) und [getOrElse] (die den vom Lambda berechneten Wert zurückgibt) |
[first()], [last()], [firstOrNull()], [lastOrNull()] | das erste bzw. letzte Element; bei einer leeren Liste wird eine Exception ausgelöst, außer bei den Varianten [OrNull] |
[contains(element)] | gibt [true] zurück, wenn [element] in der Liste enthalten ist; geschrieben als [element in list] |
[indexOf(element)], [lastIndexOf(element)] | gibt die erste bzw. letzte Position von [element] in der Liste zurück, oder -1 |
[subList(fromIndex, toIndex)] | gibt einen View der Elemente von [fromIndex] (einschließlich) bis [toIndex] (ausschließlich) zurück; [slice(range)] gibt eine Kopie zurück |
[sorted()], [sortedDescending()], [sortedWith(comparator)], [reversed()] | gibt eine neue Liste zurück: sortiert, absteigend sortiert, sortiert nach [Comparator], umgekehrt |
[binarySearch(element)] | binäre Suche in einer sortierten Liste |
[toTypedArray()], [toMutableList()] | gibt die Elemente der Liste als Array bzw. als neue veränderbare Liste zurück |
[add(element)], [add(index, element)] | ([MutableList]) fügt [element] am Ende der Liste bzw. an der Position [index] ein; der Operator [+=] fügt ein Element oder eine Collection hinzu |
[addAll(elements)] | ([MutableList]) fügt die Elemente einer Collection am Ende der Liste hinzu |
[l[index] = element] | ([MutableList]) ersetzt das Element Nr. [index] |
[remove(element)], [removeAt(index)] | ([MutableList]) löscht das erste Vorkommen von [element] (ergibt [true] , wenn die Operation erfolgreich ist) bzw. das Element Nr. [index] (liefert das gelöschte Element) |
[removeFirst()], [removeLast()], [removeIf { ... }] | ([MutableList]) löscht das erste Element, das letzte Element bzw. die Elemente, die eine Bedingung erfüllen |
[clear()] | ([MutableList]) entfernt alle Elemente aus der Liste |
[sort()], [sortDescending()], [sortWith(comparator)], [reverse()], [shuffle()] | ([MutableList]) sortiert, kehrt um und mischt die Liste selbst |
Beachten Sie die Namenskonvention der Bibliothek, die wir bereits bei Arrays gesehen haben: Ein Verb ([sort], [reverse], [shuffle]) verändert die Collection selbst und existiert nur für veränderbare Collections; ein Partizip Perfekt ([sorted], [reversed], [shuffled]) gibt eine neue Collection zurück und lässt das Original unverändert. Die Funktionen der Java-Hilfsklasse [java.util.Collections] ([Collections.sort(list)]…) bleiben verwendbar, doch diese Erweiterungsfunktionen machen sie überflüssig.
Greifen wir das Beispiel von vorhin mit einem Array noch einmal auf und verarbeiten es nun mit einer veränderbaren Liste reeller Zahlen, [MutableList<Double>]. Da eine Liste einem Array ähnelt, ändert sich am Code nur wenig. Hier ist das Programm [Collections01.kt]:
Kommentare:
- Zeile 27: Die Liste wird leer durch die Funktion [mutableListOf] erzeugt, die eine [ArrayList] anlegt. Der Elementtyp [Double] wird als Typparameter der Funktion angegeben, da er sich aus einer leeren Liste nicht ableiten lässt; wir hätten auch [val elements: MutableList<Double> = mutableListOf()] oder [val elements = ArrayList<Double>()] schreiben können;
- Zeile 40: Es muss keine Vergrößerung mehr verwaltet werden; die Liste wächst automatisch. Wir hätten [elements += element] schreiben können: Bei einer veränderbaren Liste, die mit [val] deklariert ist, fügt der Operator [+=] das Element der Liste hinzu ([plusAssign]), während er bei dem mit [var] deklarierten Array aus [Arrays01.kt] ein neues Array erzeugt hat. Die Variable [elements] ist hier ein [val]: Sie verweist immer auf dieselbe Liste, deren Inhalt sich ändert;
- Zeile 25: Die Funktion [input] gibt eine veränderbare Liste zurück, weil das Hauptprogramm sie sortieren können muss;
- Zeile 11: Die Anzahl der Elemente der Liste ist die Property [size], genau wie bei Arrays. Anders als [StringBuilder] erlaubt [ArrayList] es nicht, ihre Kapazität zu ermitteln; die Methode [ensureCapacity] erlaubt nur, sie im Voraus festzulegen;
- Zeilen 17, 67, 68: Sortieren und binäre Suche werden von den Erweiterungsfunktionen [sort] und [binarySearch] der Liste ausgeführt, die lineare Suche von ihrer Funktion [indexOf]. Für eine Liste vom Typ [Double] existiert [indexOf] im Gegensatz zum Array [DoubleArray]: Sie vergleicht Elemente wie in Java mit ihrer Funktion [equals];
- Zeile 54: Die Funktion [search] verändert die Liste nicht: Ihr Parameter ist mit dem schreibgeschützten Typ [List<Double>] deklariert. Man kann ihr eine [MutableList<Double>] übergeben, die ein [List<Double>] ist. Würde sie versuchen, die Liste zu ändern – zum Beispiel mit [elements.add(element)] –, würde der Compiler dies ablehnen: [unresolved reference 'add' on receiver of type 'List<Double>']. Der Parametertyp dokumentiert und garantiert somit, dass die Funktion die Liste nicht verändert;
- Zeilen 46–49: Die generische Funktion [display] hat zwei Parameter:
- der erste ist ein auszugebender Text;
- der zweite ist ein Objekt, das die generische Schnittstelle [Iterable<T>] implementiert, deren einzige Funktion [operator fun iterator(): Iterator<T>] ist.
Die Schleife [for (element in elements)] ist für jedes Objekt gültig, das eine Funktion [operator fun iterator()] besitzt, sei sie ein Member oder eine Erweiterung: Das gilt für alle Collections, die [Iterable] implementieren, sowie für Arrays, Zeichenketten, Intervalle usw. Arrays implementieren [Iterable] nicht: Die Funktion [display] eignet sich nicht für ein Array, es sei denn, man übergibt ihr [array.asList()]. Wir kommen bei den Sequenzen auf diese Schnittstelle zurück.
Ergebnisse (in der Befehlszeile; Tastatureingaben erscheinen nach den Eingabeaufforderungen):
Die Ergebnisse sind dieselben wie beim Array.
5.4.2. Listenfunktionen
Das Programm [Collections02.kt] verwendet die übrigen Listenfunktionen:
Ergebnisse:
Kommentare:
- Zeile 6: [mutableListOf] erzeugt eine veränderbare Liste mit den angegebenen Elementen; der Typ der Elemente, [String], wird aus den Argumenten abgeleitet. Das entspricht dem Java-Code [new ArrayList<>(List.of("Paris", "Lyon", "Angers"))];
- Zeilen 10–12: drei Möglichkeiten, Elemente hinzuzufügen;
- Zeilen 14–15: Bei einer veränderbaren Liste fügen die Operatoren [+=] und [-=] ein Element (oder alle Elemente einer Collection) hinzu bzw. entfernen es;
- Zeile 19: Das Element Nr. 0 wird durch den Operator [[]] ersetzt, der die Funktion [set] aufruft;
- Zeilen 20–21: Der Operator [[]] liest ein Element; [first] und [last] liefern das erste bzw. das letzte Element, und die Property [lastIndex] entspricht [size - 1];
- Zeile 23: Ein ungültiger Index löst wie in Java eine [IndexOutOfBoundsException]-Exception aus. Die Funktionen [getOrNull] und [getOrElse] erlauben es, dies zu vermeiden: Die erste gibt [null] zurück, die zweite den von einem Lambda berechneten Wert, das den Index als Argument erhält. Im Template ist der Text
***[{ \\"?\\" }]einfach ein ausgegebener Text, während der Ausdruck***[cities.getOrElse(10) { "?" }]die Funktion aufruft; - Zeilen 26–27: Suche nach einem Element mit dem Operator [in] ([contains]) oder mit [indexOf];
- Zeile 30: [remove] gibt [true] zurück, wenn das Element gefunden und gelöscht wurde;
- Zeile 31: [removeAt] entfernt das Element an einer bestimmten Position und gibt es zurück;
- Zeilen 35–38: [sort] sortiert die Liste selbst nach der natürlichen Ordnung ihrer Elemente, wie sie durch [compareTo] definiert ist, und [reverse] führt die umgekehrte Sortierung durch;
- Zeile 39: [subList] liefert einen View der Elemente 1 und 2 (ohne 3), keine Kopie: Eine Änderung des Views würde die Liste ändern;
- Zeilen 42–44: [sorted] liefert eine neue sortierte Liste, und [sortedBy] liefert eine neue Liste, die nach einem Schlüssel sortiert ist, der durch einen Lambda-Ausdruck berechnet wird – hier die Länge der Namen. Die Sortierung ist stabil: Städte gleicher Länge (Tours, Lille, Brest) behalten ihre ursprüngliche Reihenfolge. Die Liste [cities] hat sich nicht geändert. [sortedBy] erspart das Schreiben eines [Comparator]; wir hätten auch [cities.sortedWith(compareBy({ it.length }, { it }))] schreiben können, um nach Länge und anschließend alphabetisch zu sortieren (Kapitel 4);
- Zeilen 47–48: Umwandlung einer Liste in ein Array und eines Arrays in eine Liste. Dank der Generics [reified] (Kapitel 4) kann [toTypedArray] ein Array von Zeichenketten in der richtigen Größe erzeugen, ohne die Hilfe, die die Java-Methode [toArray(String[]::new)] benötigt;
- Zeilen 52–54: eine vermiedene Java-Falle. In Java hat die Schnittstelle [List] zwei Methoden – [remove], eine nach Position und eine nach Wert –, und [numbers.remove(1)] entfernt, auf eine [List<Integer>] angewendet, das Element Nr. 1. Kotlin gibt den beiden Operationen unterschiedliche Namen: [removeAt] entfernt nach Position, und [remove] entfernt nach Wert. [numbers.remove(1)] entfernt daher tatsächlich den Wert 1;
- Zeilen 58–60: [listOf] erzeugt eine schreibgeschützte Liste; [days.add("thursday")] würde zur Kompilierzeit abgelehnt. Der Operator [+], ist dagegen verfügbar: Er erzeugt eine neue Liste aus den Elementen von [days] gefolgt von „thursday“, und [days] bleibt unverändert;
- Zeilen 64–65: [clear] leert die Liste; [isEmpty] prüft, ob sie leer ist;
- Zeile 68: Die Funktion [display] akzeptiert jedes Objekt ([Any], Kapitel 4): eine Liste von Zeichenketten, eine Liste ganzer Zahlen oder eine Zeichenkette. Eine Collection wird direkt ausgegeben: Ihre Funktion [toString] liefert ihre Elemente in eckigen Klammern.
5.4.3. Dictionaries: Map und MutableMap
Ein Dictionary ist eine Menge von Paaren aus (Schlüssel, Wert). Man kann es sich als Tabelle mit zwei Spalten vorstellen:
Schlüssel | Wert |
Schlüssel1 | Wert1 |
Schlüssel2 | Wert2 |
... | ... |
In der Schnittstelle [Map<K, V>] sind die Schlüssel vom Typ [K] und die Werte vom Typ [V]. Die Schlüssel sind eindeutig: Es kann nicht zwei identische Schlüssel geben (gemäß der Funktion [equals]). Ein solches Dictionary könnte so aussehen, wenn die Typen [K] und [V] Klassen darstellten:
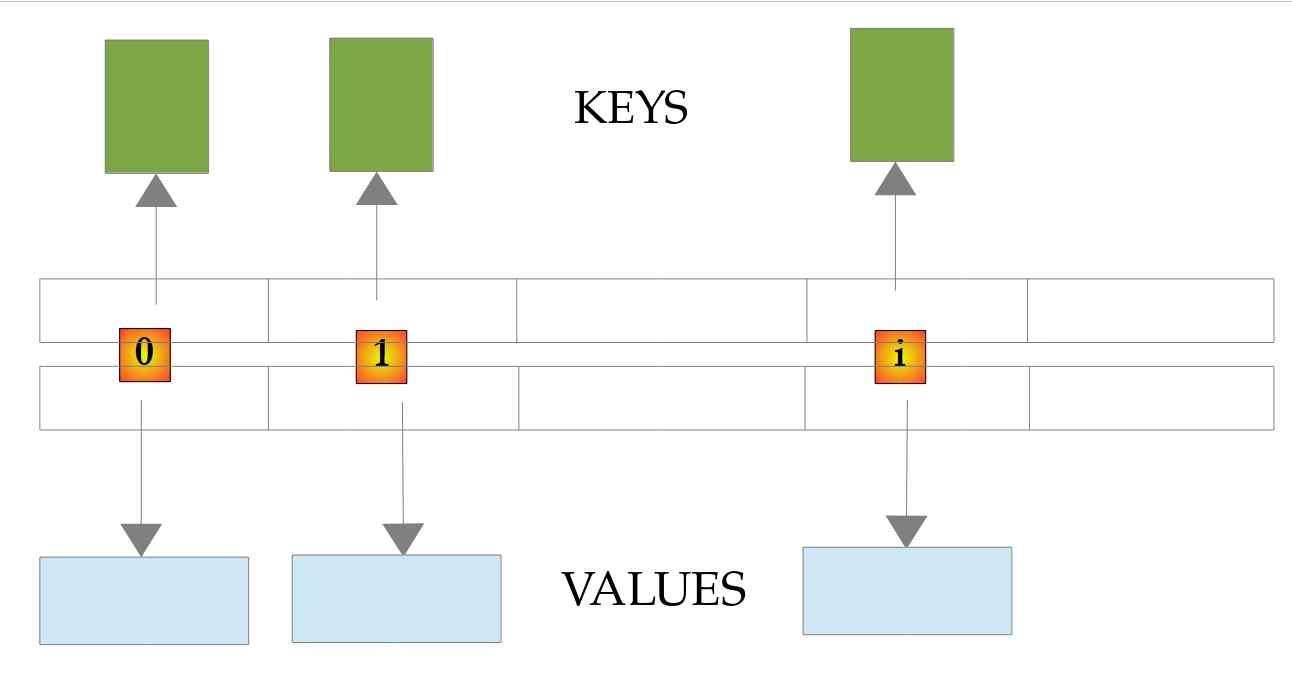
Wie bei Listen unterscheidet Kotlin zwischen der schreibgeschützten Schnittstelle *[Map<K, V>] und der veränderbaren Schnittstelle *[MutableMap<K, V>]. Die Implementierungen sind die von Java:
- Eine [HashMap] speichert ihre Schlüssel-Wert-Paare in einer Hashtabelle: Die Position eines Paares in der Tabelle wird anhand des Hashcodes seines Schlüssels berechnet (Funktion [hashCode], Kapitel 4). Der zu einem Schlüssel gehörende Wert lässt sich daher unabhängig von der Größe des Dictionarys sehr schnell abrufen. Dafür steht die Reihenfolge der Paare in der Tabelle in keinem Zusammenhang mit der Reihenfolge, in der sie hinzugefügt wurden;
- Eine [LinkedHashMap] ist eine [HashMap] , die zusätzlich ihre Paare in der Reihenfolge verkettet, in der sie hinzugefügt wurden: Sie ist genauso schnell, braucht etwas mehr Speicher und zählt ihre Paare in der Reihenfolge des Hinzufügens auf. Dies ist die Implementierung, die von den Erzeugungsfunktionen
***[mutableMapOf]und*[mapOf]*gewählt wird: Ein Kotlin-Dictionary behält daher standardmäßig die Reihenfolge bei, in der seine Schlüssel hinzugefügt wurden. Um eine [HashMap] zu erhalten, verwenden Sie [hashMapOf]* oder ihren Konstruktor.
Die Paare eines mit [mapOf] erzeugten Dictionarys werden als [key to value] geschrieben: [to] ist eine Infix-Funktion der Standardbibliothek, die ein [Pair(key, value)]-Paar erzeugt (Kapitel 3). Die wichtigsten Funktionen von Dictionaries sind die folgenden:
Funktion | Aufgabe |
[size] | Property: Anzahl der Paare aus (Schlüssel, Wert) im Dictionary |
[dict[key]] | gibt den mit [key] verbundenen Wert zurück, oder [null] , wenn der Schlüssel fehlt (Funktion [get]); der Ergebnistyp ist daher [V?] |
[getValue(key)] | gibt den mit [key] verbundenen Wert vom Typ [V] zurück; löst eine [NoSuchElementException]-Exception aus, wenn der Schlüssel fehlt |
[getOrDefault(key, defaultValue)], [getOrElse(key) { ... }] | gibt den mit [key] verbundenen Wert zurück, oder [defaultValue] bzw. den vom Lambda berechneten Wert, wenn der Schlüssel fehlt |
[containsKey(key)], [containsValue(value)] | gibt [true] zurück, wenn [key] ein Schlüssel des Dictionarys ist ([key in dict]) bzw. [value] einer seiner Werte ist |
[keys], [values], [entries] | Properties: die Menge der Schlüssel, die Collection der Werte, die Menge der Paare des Dictionarys; ein Paar [Map.Entry] hat die Properties [key] und [value] und lässt sich destrukturieren: [for ((key, value) in dict)] |
[dict[key] = value] | ([MutableMap]) verknüpft [value] mit [key]: Fügt das Paar hinzu, wenn der Schlüssel fehlt, und ersetzt andernfalls den Wert (Funktion [set]); [dict += key to value] bewirkt dasselbe |
[put(key, value)] | ([MutableMap]) bewirkt dasselbe, gibt aber den alten Wert zurück, oder [null] |
[putIfAbsent(key, value)] | ([MutableMap]) fügt das Paar nur hinzu, wenn der Schlüssel fehlt; gibt den vorhandenen Wert zurück, oder [null] |
[getOrPut(key) { ... }] | ([MutableMap]) gibt den mit [key] verbundenen Wert zurück; fehlt der Schlüssel, berechnet sie den Wert mit dem Lambda, fügt das Paar hinzu und gibt den Wert zurück |
[remove(key)] | ([MutableMap]) löscht das Schlüssel-Wert-Paar [key] und gibt seinen Wert zurück, oder [null]; [dict -= key] bewirkt dasselbe |
[clear()] | ([MutableMap]) löscht alle Einträge des Dictionarys |
Betrachten wir das Beispielprogramm [Collections03.kt]:
Kommentare:
- Zeile 6: ein Array von Zeichenketten, das zur Initialisierung des Dictionarys [<String, Int>] dient;
- Zeile 7: das leere Dictionary, erzeugt durch [mutableMapOf]: Es ist eine [LinkedHashMap];
- Zeile 9: dasselbe Dictionary, diesmal von einer [HashMap] implementiert und durch ihren Konstruktor erzeugt;
- Zeilen 10–13: Initialisierung der beiden Dictionaries aus dem Array von Zeichenketten. Jedes Element wird mit [split] zerlegt, und die Destrukturierung der entstandenen Liste weist ihre beiden Felder den Variablen [name] und [age] zu. Das Hinzufügen eines Paares wird als [dict[name] = value] geschrieben, genau wie die Zuweisung eines Array-Elements;
- Zeile 16: Ein Dictionary wird direkt ausgegeben, mit seinen Paaren in geschweiften Klammern. Die Paare von
[dict]erscheinen in der Reihenfolge ihres Hinzufügens; die von[dictHash]erscheinen in der Reihenfolge der Hashtabelle, die von den Hashcodes der Schlüssel abhängt (Zeile 1 der Ergebnisse): Eine*[HashMap]garantiert keine bestimmte Reihenfolge. Das Java-Programm dieses Kapitels, das eine [HashMap]* verwendet, gab seine Schlüssel in dieser zweiten Reihenfolge aus; - Zeile 18: die Anzahl der Paare im Dictionary;
- Zeilen 20–22: die Schlüssel und Werte des Dictionarys. Die Properties [dict.keys] und [dict.values] sind Collections und daher [Iterable]: Die Funktion [display], die wir bereits kennengelernt haben, ist geeignet;
- Zeilen 25–26: Durchlaufen der Schlüssel und Abrufen des Wertes jedes Schlüssels mit dem Operator [[]];
- Zeile 30: Entfernen eines Paares aus dem Dictionary;
- Zeilen 33–34: Ein Dictionary ist selbst keine Collection, aber die Schleife [for] weiß, wie sie es durchläuft: Die Bibliothek stellt ihr eine Erweiterungsfunktion [iterator] bereit, die seine Paare ([entries]) aufzählt. Jedes Paar vom Typ [Map.Entry<String, Int>] wird in [(key, value)] destrukturiert, mithilfe der Erweiterungsfunktionen [component1] und [component2] von [Map.Entry]. Dieser Ansatz ist effizienter als der vorherige, der den Wert jedes Schlüssels nachschlägt, und lesbarer als sein Java-Äquivalent ([for (Map.Entry<String, Integer> entry : dict.entrySet())], dann [entry.getKey()] und [entry.getValue()]);
- Zeile 37: [put] fügt ein Schlüssel-Wert-Paar hinzu oder ersetzt den Wert eines vorhandenen Schlüssels, ohne eine Exception auszulösen oder eine Warnung auszugeben; der zurückgegebene Wert – der alte Wert oder [null] – zeigt an, was geschehen ist. Wird dieser Wert nicht benötigt, verwenden Sie [dict[key] = value];
- Zeile 39: [putIfAbsent] ersetzt den Wert eines vorhandenen Schlüssels nicht;
- Zeilen 41–42: Das Lesen eines nicht vorhandenen Schlüssels verursacht keinen Fehler: Der Operator [[]] gibt [null] zurück. Sein Ergebnis hat den Typ [Int?], und der Compiler verlangt, dass der Fall [null] behandelt wird, bevor der Wert verwendet wird. [getOrDefault] und [getOrElse] erlauben es, den in diesem Fall zurückgegebenen Wert zu wählen, und der Operator [in] ([containsKey]) erlaubt es, die Existenz eines Schlüssels zu prüfen;
- Zeilen 44–47: der Standardweg, Vorkommen zu zählen: Wir addieren 1 zum Wert des Schlüssels, oder 0 + 1, wenn er fehlt, mithilfe des Elvis-Operators [?:]. Der Schlüssel „zoé“ ändert sich von 12 auf 13; der Schlüssel „léa“ wird mit dem Wert 1 angelegt. Auch die Java-Methode [merge] lässt sich verwenden: [dict.merge(name, 1, Int::plus)];
- Zeilen 49–50: [getOrPut] gibt den mit einem Schlüssel verbundenen Wert zurück; fehlt der Schlüssel, berechnet es mit dem Lambda einen Wert, fügt das Paar zum Dictionary hinzu und gibt den Wert zurück. Der Schlüssel „max“ wird mit dem Wert 30 angelegt; der Schlüssel „jean“ existiert bereits, und sein Wert 21 wird zurückgegeben, ohne dass das Lambda ausgeführt wird. Das ist die ideale Funktion für einen Cache oder um Elemente in Listen zu gruppieren: [groups.getOrPut(key) { mutableListOf() }.add(element)];
- Zeilen 52–53: ein schreibgeschütztes Dictionary, mit [mapOf] aus den Schlüssel-Wert-Paaren in [key to value] erzeugt. [capitals["Spain"] = "Madrid"] würde zur Kompilierzeit abgelehnt;
- Zeilen 55–65: Suche nach einem Schlüssel im Dictionary. [dict[searchedName]] liefert einen [Int?]: Der Fall [null] wird vor der Verwendung des Wertes geprüft; im Zweig [age != null] weiß der Compiler, dass [age] ein [Int] ist (intelligente Typumwandlung). In Java wird [int age = dict.get(searchedName);] kompiliert, löst aber bei einem fehlenden Schlüssel eine [NullPointerException]-Exception aus; in Kotlin wird [val age: Int = dict[searchedName]] zur Kompilierzeit abgelehnt.
Ergebnisse:
Anders als beim Java-Programm, bei dem [HashMap] die Schlüssel in unvorhersehbarer Reihenfolge aufzählte, werden die Schlüssel des Dictionarys in der Reihenfolge aufgezählt, in der sie hinzugefügt wurden: „zoé“ und „léa“ stehen am Ende. Wenn die Schlüssel sortiert bleiben sollen, verwenden Sie eine [TreeMap], die weiter unten gezeigt wird.
5.4.4. Weitere Collections
Die Kotlin-Standardbibliothek und das Paket [java.util] enthalten weitere Collections, die jeweils für einen bestimmten Zweck geeignet sind:
Klasse (Konstruktor) | Aufgabe |
[LinkedHashSet<E>] ([setOf], [mutableSetOf]) | eine Menge: keine Duplikate, sehr schnelle Prüfung der Zugehörigkeit; behält die Reihenfolge bei, in der ihre Elemente hinzugefügt wurden. Dies ist die Standardmenge von Kotlin |
[HashSet<E>] ([hashSetOf]) | eine ungeordnete Menge, etwas speichereffizienter |
[java.util.TreeSet<E>] ([sortedSetOf], [toSortedSet]) | eine Menge, deren Elemente sortiert gehalten werden |
[ArrayDeque<E>] | Eine Kotlin-spezifische Klasse ([kotlin.collections.ArrayDeque], nicht zu verwechseln mit [java.util.ArrayDeque]): eine doppelseitige Warteschlange, die zusätzlich [MutableList] implementiert. Als Warteschlange verwendet, werden die Elemente in der Reihenfolge entfernt, in der sie hinzugefügt wurden (FIFO, first in first out); als Stapel verwendet, wird das zuletzt hinzugefügte Element als erstes entfernt (LIFO, last in first out) |
[LinkedHashMap<K, V>] ([mapOf], [mutableMapOf]) | Ein Dictionary, das die Reihenfolge beibehält, in der seine Schlüssel hinzugefügt wurden. Dies ist das Standard-Dictionary von Kotlin |
[java.util.TreeMap<K, V>] ([sortedMapOf], [toSortedMap]) | ein Dictionary, dessen Schlüssel sortiert gehalten werden |
[java.util.PriorityQueue<E>] | eine Prioritätswarteschlange: Das entfernte Element ist das kleinste gemäß der Ordnung der Warteschlange |
[java.util.LinkedList<E>] | eine doppelt verkettete Liste: schnelles Einfügen und Löschen an den Enden und beim Durchlaufen |
Bei Mengen ist die Unterscheidung zwischen schreibgeschützt und veränderbar dieselbe wie bei Listen: [Set<E>] hat nur lesende Funktionen, während [MutableSet<E>] die Funktionen [add], [remove]… hinzufügt.
Das Programm [Collections04.kt] bietet einen kurzen Überblick über diese Collections:
Ergebnisse:
Kommentare:
- Zeilen 3–4: Die Klassen [PriorityQueue] und [TreeMap] des JDK haben in der Kotlin-Bibliothek keine Aliasse und müssen importiert werden. [ArrayDeque] ist kein Alias: Es ist die Kotlin-Klasse, die verwendet wird;
- Zeile 7: Ein Patient wird durch eine Datenklasse (Kapitel 4) dargestellt, das Äquivalent zum [record] von Java;
- Zeile 12: eine veränderbare Menge, mit drei Elementen initialisiert;
- Zeile 14: [add] gibt [false] zurück, wenn das Element bereits in der Menge enthalten ist, die unverändert bleibt;
- Zeilen 18–21: [setOf] erzeugt eine schreibgeschützte Menge. Die Infix-Funktionen [intersect] (Schnittmenge), [union] (Vereinigung) und [subtract] (Differenz) liefern eine neue Menge und verändern [languages] nicht: Anders als in Java mit [retainAll], [addAll] und [removeAll] muss man nicht auf einer Kopie arbeiten. Die erzeugte Menge behält die Reihenfolge der Elemente bei: zuerst die aus [languages], dann die aus [web] , die ursprünglich nicht darin enthalten waren;
- Zeilen 23–24: Ein [HashSet] gibt seine Elemente in einer bedeutungslosen Reihenfolge aus, nämlich der seiner Hashtabelle; ein [TreeSet] gibt sie sortiert aus;
- Zeile 26: [toSet] liefert eine Menge aus den Elementen einer Liste: Das ist der einfachste Weg, Duplikate zu entfernen und dabei die Reihenfolge des ersten Vorkommens beizubehalten ([distinct] würde eine Liste liefern);
- Zeilen 29–34: [ArrayDeque] wird als Warteschlange verwendet: [addLast] fügt ein Element am Ende der Warteschlange ein, [removeFirst] entfernt das älteste Element, und [first] ruft ein Element ab, ohne es zu entfernen. Die Ausdrücke in einem Template werden von links nach rechts ausgewertet: [first], dann die beiden [removeFirst], dann [size];
- Zeilen 37–42: [ArrayDeque] wird als Stapel verwendet: [addLast] legt ein Element auf den Stapel, [removeLast] nimmt das jüngste Element herunter, und [last] ruft die Spitze des Stapels ab. Die Java-1.0-Klasse [Stack] und sogar [java.util.ArrayDeque] mit ihren Methoden [push]/[pop]/[offer]/[poll] sind in Kotlin irrelevant: Die Namen [addFirst], [addLast], [removeFirst], [removeLast], [first] und [last] sind für [ArrayDeque] und für alle veränderbaren Listen dieselben;
- Zeilen 44–49: Bei einem leeren Stapel löst [removeLast] eine [NoSuchElementException]-Exception aus, während [removeLastOrNull] [null] zurückgibt. Das folgt der Namenskonvention der Bibliothek: Eine Funktion [xxx] löst eine Exception aus, wenn sie kein Ergebnis zurückgeben kann, während ihre Variante [xxxOrNull] [null] ([first]/[firstOrNull], [removeFirst]/[removeFirstOrNull], [toInt]/[toIntOrNull]…) zurückgibt. [e::class.simpleName] ist der einfache Name der Exception-Klasse (Kapitel 4);
- Zeilen 53–58: Die Paare einer [TreeMap] werden in der Reihenfolge der Schlüssel aufgelistet. Sie wird mit dem Operator [[]] befüllt, genau wie jedes veränderbare Dictionary. Die Sortierung der Schlüssel ermöglicht Operationen, die eine Hashtabelle nicht bieten kann: [firstKey] liefert den kleinsten Schlüssel, und [headMap] liefert den Teil des Dictionarys, dessen Schlüssel einem gegebenen Wert vorausgehen;
- Zeilen 60–61: [sortedMapOf] erzeugt aus nach Schlüsseln sortierten Paaren eine [TreeMap] ; [mutableMapOf] behält die Reihenfolge bei, in der die Elemente hinzugefügt wurden;
- Zeilen 64–75: Eine [PriorityQueue] muss ihre Elemente vergleichen können. Hier erhält sie einen [Comparator] , der Prioritäten vergleicht: [compareBy<Emergency> { it.priority }] (Kapitel 4) lautet „vergleiche Notfälle anhand ihrer Property [priority]“. Die Patienten werden in der Reihenfolge aufsteigender Priorität entlassen, unabhängig von der Reihenfolge ihrer Ankunft. Die Methode [poll] liefert das Element mit der niedrigsten Priorität oder [null] , wenn die Warteschlange leer ist: Der Elvis-Operator [?: break] verlässt dann die Schleife. Das ist idiomatische Syntax, da [break] in Kotlin ein Ausdruck ist. In Java würde man [while ((emergency = emergencies.poll()) != null)] schreiben; Kotlin erlaubt keine Zuweisungen innerhalb eines Ausdrucks.
5.4.5. Schreibgeschützte und unveränderliche Views sowie Kopien
Eine Klasse, die eine Collection verwaltet, muss sie oft nach außen zugänglich machen, ohne dass sie geändert werden darf. Java hat keine von [List] getrennte „schreibgeschützte“ Schnittstelle: Es verwendet unveränderliche Collections, die die vollständige Schnittstelle [List] implementieren, deren Änderungsmethoden aber zur Laufzeit eine [UnsupportedOperationException]-Exception auslösen. Kotlin begegnet diesem Bedarf in erster Linie über seine Typen: Man deklariert die Collection einfach mit dem Typ [List], und der Compiler verhindert jede Änderung. Es ist jedoch wichtig zu verstehen, was dieser Typ garantiert – und was nicht. Das Programm [Collections05.kt] zeigt die drei Möglichkeiten, eine Collection darzustellen: ein schreibgeschützter Typ, ein nicht veränderbarer View und eine Kopie:
Ergebnisse:
Kommentare:
- Zeilen 6–23: Die Klasse [Classroom] verwaltet eine Liste von Schülern. Die veränderbare Liste selbst ist privat; nur die Funktion [enroll] erlaubt es, sie zu ändern;
- Zeilen 11–12: Die Property [students] macht die Liste privat, ist aber mit dem Typ [List<String>] schreibgeschützt. Das ist die Standardpraxis in Kotlin: eine private veränderbare Liste und eine öffentliche schreibgeschützte Property. Externer Code kann die Liste lesen, aber [students.add("intruder")] wird zur Kompilierzeit abgelehnt ([unresolved reference 'add' on receiver of type 'List<String>']), während Java dies erst zur Laufzeit ablehnt;
- Zeile 36: Die Property [students] erzeugt kein Objekt; sie macht die private Liste selbst – eine [java.util.ArrayList] – sichtbar. Sie sieht daher die Änderungen der besitzenden Klasse (Zeile 3 der Ergebnisse);
- Zeilen 41–43: schreibgeschützt bedeutet nicht unveränderlich. Der Typ
*[List]verbietet die Änderung über diese Referenz, aber das Objekt ist eine vollständig veränderbare*[ArrayList]: Ein Cast auf [MutableList] (oder die Übergabe der Liste an eine Java-Methode, für die sie eine gewöhnliche [java.util.List] ist) erlaubt es, sie zu ändern, und der Schüler „intruder“ wird der Liste der Klasse hinzugefügt (Zeile 4 der Ergebnisse). Der schreibgeschützte Typ schützt vor Fehlern, nicht vor böswilliger Absicht; - Zeilen 15–16 und 44–48: Für vollständigen Schutz geben wir einen schreibgeschützten View zurück, der von der Methode [Collections.unmodifiableList] des JDK erzeugt wird: Selbst nach einem Typecast löst jeder Änderungsversuch eine [UnsupportedOperationException]-Exception aus. Wie der vorherige kopiert dieser View die Liste nicht und spiegelt die Änderungen der besitzenden Klasse wider;
- Zeilen 19–20 und 52–54: [toList] liefert dagegen eine Kopie der Liste: Die Liste [copy] sieht das Hinzufügen von „petit“ nicht. Eine Kopie ist vom Original unabhängig, hat aber ihren Preis: Der Getter erzeugt bei jedem Lesen der Property eine neue Liste;
- Zeilen 57–58: [mapOf] erzeugt wie [listOf] und [setOf] in einer einzigen Anweisung eine initialisierte Collection unter einem schreibgeschützten Typ: [grades["durand"] = 9] lässt sich nicht kompilieren ([no 'set' operator method providing array access]). Diese Collections entsprechen [List.of], [Set.of] und [Map.of] von Java, mit demselben Vorbehalt wie oben: Sie sind dem Typ nach schreibgeschützt, aber [mapOf] erzeugt eine gewöhnliche [LinkedHashMap];
- Zeilen 61–62: Die in Java mit
***[List.of]erzeugten Collections lehnen den Wert*[null]zur Laufzeit ab. In Kotlin bestimmt der Typ dies: Eine***[List<String>]kann kein[null]enthalten (der Compiler lehnt es ab), eine***[List<String?>]***dagegen schon. [filterNotNull] liefert eine Liste von Elementen, die nicht [null] sind, vom Typ [List<String>]*; - Zeilen 64–67 und 71–74: eine defensive Kopie. Die Klasse [Group] erhält in ihrem Konstruktor eine Liste; würde sie diese unverändert behalten, könnte derjenige, der sie ihr übergeben hat, sie anschließend ändern – hier, indem er „intruder“ zur Liste [members] hinzufügt. Der Konstruktorparameter [students] ist daher keine Property (ihm geht kein [val] voran): Er dient dazu, die Property [students] mit einer Kopie zu initialisieren. Die Gruppe ist vom Hinzufügen nicht betroffen (letzte Zeile der Ergebnisse). Dieses Vorgehen lässt sich bei den Properties des Primärkonstruktors einer Datenklasse nicht anwenden; erhält eine Datenklasse eine Collection, übergibt ihr der Aufrufer eine Collection, die er nicht mehr ändert – zum Beispiel eine, die mit [listOf] oder [toList] erzeugt wurde.
Der Typ [List<String>] legt also fest, was der Code, der ihn erhält, tun darf, nicht was die Liste tatsächlich ist. Für wirklich unveränderliche Collections gibt es die Bibliothek [kotlinx.collections.immutable] von JetBrains ([persistentListOf], [persistentMapOf]…), und man kann auch die unveränderlichen Collections von Java verwenden ([java.util.List.copyOf(list)]). Eine bewährte Vorgehensweise, in Kotlin wie in Java, besteht darin, Collections schreibgeschützt zu halten und jedes Mal eine neue Collection zu erzeugen, wenn man eine ändern möchte ([list + element], [list - element], [list.filter { ... }] …): Die Operatoren und Funktionen der Standardbibliothek machen dieses Vorgehen selbstverständlich.
5.4.6. Sortieren, erste und letzte Elemente, Iterieren
Das Programm [Collections06.kt] zeigt drei nützliche Aspekte der Arbeit mit Collections: Sortieren nach Kriterien, Zugriff auf die Endpunkte einer Collection (was Java 21 als Sequenced Collections bezeichnet) und das Entfernen von Elementen während einer Iteration:
Ergebnisse:
Kommentare:
- Zeile 8: Ein Student wird durch eine Datenklasse dargestellt;
- Zeile 11: die Funktion [names] gibt eine Liste der Namen der Studenten zurück. Die Funktion [map], die wir bereits verwendet haben, ohne sie vorzustellen, wendet ein Lambda auf jedes Element einer Collection an und gibt eine Liste der Ergebnisse zurück: In Java erfordert dies eine Schleife oder die Stream-API. Die Funktion ist als Funktion mit Ausdruckskörper ([= expression], Kapitel 3) geschrieben;
- Zeile 21: [sortBy] sortiert die Liste selbst anhand eines Schlüssels, den ein Lambda aus jedem Element extrahiert – hier der Name. Die Namen werden nach der natürlichen Ordnung von Zeichenketten verglichen: „Durand“, das mit einem Großbuchstaben beginnt, steht an erster Stelle, „élise“ an letzter;
- Zeile 23: [sortWith] sortiert anhand eines [Comparator]. Die Funktion [compareBy] (Kapitel 4) konstruiert einen Comparator aus der Funktion, die den Schlüssel extrahiert; eine überladene Methode nimmt als ersten Parameter den Comparator entgegen, der zum Vergleichen der Schlüssel verwendet werden soll, hier ein
*[Collator]: Die Reihenfolge entspricht der eines französischen Wörterbuchs. Das entspricht***[Comparator.comparing(Student::name, collator)]** in Java; - Zeile 25: Die Comparatoren werden wie folgt definiert: [compareByDescending] vergleicht die Noten in absteigender Reihenfolge, und [thenBy] fügt ein zweites Kriterium hinzu, nach dem Studenten mit derselben Note sortiert werden: ihre Namen, ohne Beachtung der Groß- und Kleinschreibung ([String.CASE_INSENSITIVE_ORDER]). Durand und Martin, die beide die Note 15 haben, werden nach Namen sortiert. Der Typparameter [<Student>] von [compareByDescending] ist hier erforderlich, weil der Compiler den Typ der Elemente in einem Ausdruck, der mit [thenBy] fortgesetzt wird, nicht ableiten kann;
- Zeilen 29–32: Die Funktionen [first] und [last] geben das erste beziehungsweise das letzte Element zurück, und [asReversed] gibt eine Sicht auf die Liste in umgekehrter Reihenfolge zurück, ohne sie zu kopieren ([reversed] würde eine umgekehrte Kopie zurückgeben). [first] und [lastOrNull] akzeptieren auch eine Bedingung: Sie geben das erste (beziehungsweise letzte) Element zurück, das sie erfüllt; [first] löst eine [NoSuchElementException]-Exception aus, wenn es kein solches Element gibt; [lastOrNull] gibt dann [null] zurück. Kotlin bietet diese Funktionen seit seiner ersten Version für alle Collections an: Die Methoden [getFirst], [getLast] und [reversed], die Java 21 seinen Sequenced Collections ([SequencedCollection], [SequencedSet], [SequencedMap]) hinzugefügt hat, bringen daher nicht viel Neues;
- Zeilen 33–36: [linkedSetOf] erzeugt ein [LinkedHashSet], das hier mit seinem Klassentyp deklariert ist. Wir können dann die Methoden verwenden, die Java 21 dieser Klasse hinzugefügt hat: [addFirst] fügt „Lyon“ am Anfang der Menge ein. Beachten Sie einen subtilen Punkt: Wenn eine Java-Klasse eine Methode mit demselben Namen wie eine Erweiterungsfunktion hat, hat die Member-Methode immer Vorrang (Kapitel 4). Hier ruft
[cities.reversed()]die Java-21-Methode[reversed]*auf, die eine umgekehrte Sicht auf die Menge zurückgibt, und nicht die Kotlin-Erweiterungsfunktion[reversed], die eine Liste zurückgeben würde. Dagegen ruft [cities.last()] die Kotlin-Erweiterung auf, die die Menge bis zu ihrem letzten Element durchläuft, weil die Java-Methode [getLast] heißt; Kotlin stellt sie als Eigenschaft bereit, [cities.last]*, die das letzte Element ohne Iteration zurückgibt. Die Ergebnisse sind dieselben; nur die Kosten unterscheiden sich; - Zeilen 37–39: eine
*[TreeMap]*, die mit den Schlüssel-Wert-Paaren eines Dictionarys initialisiert wird, und ihre Methoden[firstEntry],[lastEntry], und *[descendingMap]*(die Paare in absteigender Reihenfolge der Schlüssel betrachtet); - Zeilen 42–50: Eine Collection darf nicht verändert werden, während sie mit einer Schleife [for] durchlaufen wird: Der von der Schleife verwendete Iterator erkennt die Änderung und löst beim nächsten Element eine [ConcurrentModificationException]-Exception aus. Der Test wird an einer Kopie der Liste durchgeführt. Das Verhalten ist dasselbe wie in Java, da die Liste eine [ArrayList] ist;
- Zeilen 53–60: Ein korrekter Ansatz besteht darin, die Schleife explizit mit einem Iterator zu schreiben und das aktuelle Element mit der Methode [remove] des Iterators zu entfernen. Für eine veränderliche Liste [iterator] gibt die Funktion einen [MutableIterator] zurück, der über diese Funktion verfügt; ein gewöhnlicher [Iterator] (der einer [List]) hat sie nicht. Da Kotlin keine [for]-Schleife mit drei Klauseln kennt, wird die Schleife mit [while] geschrieben;
- Zeile 62: einfacher geht es mit der Funktion [removeAll] , die die Elemente entfernt, die eine Bedingung erfüllen, ausgedrückt durch ein Lambda [{ it.grade < 15 }], das sich lesen lässt als „die Funktion, die einem Studenten [it] den booleschen Wert [it.grade < 15] zuordnet“. Die Java-Methode [removeIf] kann ebenfalls verwendet werden, während [retainAll] dagegen die Elemente behält, die die Bedingung erfüllen. Lambdas werden in Kapitel 7 ausführlich behandelt; vorerst genügt es zu wissen, wie man sie liest. Wir werden ihnen im folgenden Abschnitt in jeder Zeile begegnen;
- Zeile 65: Die Funktion [forEach] führt ein Lambda für jedes Element aus; eine Schleife mit [for] würde genauso gut funktionieren. Die Ausgabe einer Datenklasse über ihre Funktion [toString] liefert den Klassennamen und die Werte ihrer Eigenschaften: [Student(name=Durand, grade=15)].
5.5. Operationen auf Collections und Sequenzen
Der Java-Kurs führte an dieser Stelle die Stream-API (Paket [java.util.stream]) ein, mit der sich die Elemente einer Collection verarbeiten lassen, als würde man eine Datenbank abfragen: filtern, sortieren, gruppieren, Summen berechnen … Kotlin braucht das nicht: In seiner Standardbibliothek sind diese Operationen Erweiterungsfunktionen der Collections selbst ([Iterable<T>], [List<T>], [Map<K, V>] …). Sie schreiben [persons.filter { it.age >= 18 }] dort, wo Java [persons.stream().filter(p -> p.age() >= 18).toList()] schreibt: Es ist kein Umweg über einen Stream und kein abschließender Collector nötig – das Ergebnis ist direkt eine Liste.
Diese Collection-Operationen sind unmittelbar: Jede durchläuft die gesamte Collection und erzeugt eine neue Collection. Um die verzögerte Auswertung von Java-Streams zu erreichen (bei der die Elemente einzeln und bei Bedarf berechnet werden, ohne Zwischen-Collections), bietet Kotlin Sequenzen ([Sequence<T>]) an, die dieselben Operationen unterstützen. Schließlich lassen sich Java-Streams auch aus Kotlin heraus verwenden, wie jede Klasse des JDK-Pakets: Darauf gehen wir am Ende des Abschnitts kurz ein.
Die Programme dieses Abschnitts behalten die Namen ihrer Java-Entsprechungen bei: [Streams01.kt] bis [Streams05.kt].
5.5.1. Die Schnittstellen Iterable und Iterator
Betrachten wir zunächst noch einmal die Schnittstelle [Iterable<T>], die Objekte definiert, die sich mit einer [for]-Schleife durchlaufen lassen. Wie in Java enthält sie nur eine abstrakte Methode, [iterator], die einen Iterator [Iterator<T>] zurückgibt: ein Objekt, das angibt, ob noch Elemente vorhanden sind ([hasNext]), und das nächste Element liefert ([next]).
Ein [Iterable]-Objekt muss seine Elemente nicht enthalten: Sein Iterator kann sie einzeln und bei Bedarf erzeugen. Das Programm [Streams01.kt] liefert dafür ein Beispiel, es führt die Kotlin-Generatoren ein – die Java nicht kennt – sowie eine unendliche Sequenz:
Ergebnisse:
Kommentare:
- Ab Zeile 37: Die Klasse
[Evens]implementiert die Schnittstelle*[Iterable<Int>]: Ihre Methode [iterator], die überschrieben wird ([override]), gibt einen Iterator zurück, der gerade Zahlen von 0 bis [max]* erzeugt. Sie erstellt keine Liste: Der Iterator speichert nur die nächste zu erzeugende Zahl (Zeile 44); - Zeile 42: Der Iterator ist ein anonymes Objekt: ein Objektausdruck [object : Iterator<Int> { ... }], der in einem einzigen Ausdruck eine unbenannte Klasse deklariert und instanziiert, die die Schnittstelle implementiert. Das entspricht der anonymen Java-Klasse [new Iterator<>() { ... }]. Er hat Zugriff auf die Eigenschaft [max] des Objekts [Evens];
- Zeilen 46–51: [hasNext] gibt an, ob noch ein Element zu erzeugen ist;
- Zeilen 54–61: [next] erzeugt das nächste Element. Wird es aufgerufen, wenn keine Elemente mehr vorhanden sind, muss es eine [NoSuchElementException] auslösen (in Kotlin ist [NoSuchElementException] ein Alias für die Java-Klasse [java.util.NoSuchElementException], verfügbar ohne [import]);
- Zeilen 7–8: Die Ergebnisse (Zeilen 2–11) zeigen, dass sich die Erzeugung eines Elements durch den Iterator und der Verbrauch dieses Elements durch die [for]-Schleife abwechseln;
- Zeilen 13–15: Was die [for]-Schleife tatsächlich tut: Sie fordert vom Objekt einen Iterator an, ruft [hasNext] so lange auf, wie diese Methode [true] zurückgibt, und holt jedes Element mit [next] ab;
- Zeilen 68–77: dieselben geraden Zahlen, erzeugt von einem Generator. Die Funktion [sequence] der Standardbibliothek nimmt einen Codeblock (ein Lambda) entgegen und gibt eine [Sequence<Int>]-Sequenz zurück. Jeder Aufruf von [yield(n)] (Zeile 74) übergibt ein Element an den Verbraucher und unterbricht den Block, der unmittelbar nach [yield] fortgesetzt wird, sobald das nächste Element angefordert wird. So können Sie einen Iterator als einfache Schleife schreiben, ohne den Zustand zwischen den Aufrufen von
*[next]selbst verwalten zu müssen. Das entspricht dem [yield return] von C#, das Java nicht kennt: Im Java-Kurs mussten die Studenten entweder die Iterator-Klasse schreiben oder [Stream.iterate]* verwenden. Dieser Unterbrechungsmechanismus ist der der Coroutinen, die wir in Kapitel 9 untersuchen werden; - Die Ergebnisse (Zeilen 22–29) zeigen, dass sich der Generator und die [for]-Schleife genau so abwechseln wie beim selbst geschriebenen Iterator: Nichts wird im Voraus erzeugt;
- Zeilen 26–27: eine unendliche Sequenz, die Fibonacci-Folge. [generateSequence(seed) { function }] liefert den Startwert, dann das Ergebnis der auf den Startwert angewendeten Funktion, dann das Ergebnis der auf dieses Ergebnis angewendeten Funktion und so weiter. Jedes Element ist hier ein Paar ([Pair<Long, Long>], erzeugt mit [to]) aus zwei aufeinanderfolgenden Zahlen der Folge; der Lambda-Ausdruck entpackt das empfangene Paar [(a, b)] und gibt das nächste Paar zurück. [map] behält nur die erste Zahl, [takeWhile] beendet die Sequenz bei der ersten Zahl, die größer als 100 ist, und [joinToString] verkettet die verbleibenden Zahlen mit einem Trennzeichen. Die Sequenz wird nie vollständig berechnet: Es werden nur die angeforderten Elemente berechnet;
- Zeile 31: Anders als in Java wird eine Zeichenkette direkt mit [for] Zeichen für Zeichen durchlaufen: Die Kotlin-Standardbibliothek definiert eine Funktion [operator fun CharSequence.iterator()];
- Zeilen 81–82: Das ist die allgemeine Regel: Die [for]-Schleife von Kotlin akzeptiert jedes Objekt, das eine Funktion [operator fun iterator()] (Member oder Erweiterung) besitzt, die ein Objekt zurückgibt, das über die Funktionen [operator fun hasNext()] und [operator fun next()] verfügt. Die Klasse [Counter] implementiert [Iterable] nicht; ihre Funktion [iterator], die als [operator] markiert ist, genügt ([(1..n).iterator()] ist der Iterator für das Intervall [1..n]). Dies ist eine Konvention, ähnlich denen für das in Kapitel 4 besprochene Überladen von Operatoren.
Zusammenfassend: Ein [Iterable] wird mit [for] durchlaufen, und mit [sequence { ... yield(x) ... }] oder [generateSequence] erhalten Sie sehr einfach ein Objekt, das seine Elemente bei Bedarf erzeugt. Dieser Mechanismus der Erzeugung bei Bedarf wird von allen Sequenzen verwendet.
5.5.2. Filtern, Projizieren, Sortieren
Die folgenden Beispiele arbeiten mit einer kleinen Liste von Personen. Eine Person wird durch eine Datenklasse ([data class]) dargestellt, die in Kapitel 4 eingeführt wurde und das Kotlin-Äquivalent der Java-Klasse [record] ist: In einer einzigen Zeile erhalten Sie eine Klasse mit einem Konstruktor und schreibgeschützten Eigenschaften ([p.lastName], [p.age] …), eine Methode [toString] , die die Eigenschaften ausgibt, einen Gleichheitsoperator, der ihre Werte vergleicht, und eine Funktion [copy].
Das Programm [Streams02.kt] demonstriert grundlegende Operationen auf Collections:
Ergebnisse:
Kommentare:
- Zeilen 6–13: die schreibgeschützte Liste von Personen, erzeugt mit [listOf]. Das Komma nach dem letzten Element („abschließendes Komma“) ist in Kotlin erlaubt: Es erleichtert das Hinzufügen eines Elements;
- Zeile 64: die Datenklasse [Person], auf Dateiebene neben den Funktionen deklariert;
- Zeile 17: Die Funktion [filter] filtert die Liste: Sie behält nur die Elemente, die eine Bedingung erfüllen. Diese Bedingung wird ihr in Form eines Lambdas übergeben [{ p -> p.age >= 18 }], „die Funktion, die für eine Person p den Booleschen Wert [p.age >= 18] zurückgibt“. [filter] ruft diese Funktion für jede Person auf. Wenn der letzte Parameter einer Funktion eine Funktion ist, wird das Lambda hinter den Klammern geschrieben, die entfallen, wenn sie leer sind: [persons.filter { ... }], nicht [persons.filter({ ... })];
- Das Ergebnis von
*[filter]ist eine neue Liste,[List<Person>]: Die Liste[persons]* bleibt unverändert. Das gilt für alle in diesem Abschnitt vorgestellten Operationen, die sowohl auf schreibgeschützte als auch auf veränderliche Listen angewendet werden können; - Zeilen 58–60: Die generische Funktion [display] durchläuft eine Collection mit [forEach] und gibt jedes Element aus; eine Person wird mit der Methode [toString] der Datenklasse ausgegeben: [Person(lastName=dupont, ...)] (runde Klammern, wo Java eckige verwendete);
- Zeile 21: Die Funktion [map] projiziert jedes Element auf einen neuen Wert, hier eine Zeichenkette. Das Ergebnis ist eine Liste [List<String>]. Ein Lambda mit nur einem Parameter darf den Parameternamen weglassen; in diesem Fall heißt er [it];
- Zeilen 25–28: Die Operationen geben Collections zurück, auf die weitere Operationen angewendet werden können. Operationen werden oft eine pro Zeile geschrieben: Diese Aufrufkette liest sich von oben nach unten wie ein Rezept. [Person::lastName] ist eine Eigenschaftsreferenz, eine Kurzschreibweise für das Lambda [{ it.lastName }];
- Zeile 28: [sorted] sortiert nach der natürlichen Ordnung der Elemente, hier der Zeichenketten ([sortedDescending] sortiert in umgekehrter Reihenfolge);
- Zeile 32: [sortedBy] sortiert nach einem Schlüssel, der von einem Lambda berechnet wird ([sortedByDescending] in absteigender Reihenfolge); [take(3)] behält die ersten drei Elemente;
- Zeile 35: Für die Sortierung nach mehreren Kriterien akzeptiert [sortedWith] einen [Comparator], der mit den in Kapitel 4 behandelten Kotlin-Funktionen konstruiert wird: [compareByDescending<Person> { it.age }] (Alter in absteigender Reihenfolge), gefolgt von [thenBy { it.lastName }] , um Personen desselben Alters zu unterscheiden. Durand und Laurent, die beide 32 Jahre alt sind, werden nach Namen sortiert. Der Typ [Person] muss für [compareByDescending] angegeben werden, weil der Compiler ihn nicht allein aus dem Lambda ableiten kann;
- Zeile 39: Zum Nummerieren übergibt [mapIndexed] dem Lambda zusätzlich zum Element selbst dessen Index; ähnlich gibt es [filterIndexed], [forEachIndexed] … Java müsste die Indizes mit einem [IntStream.range] durchlaufen;
- Zeilen 40–41: [withIndex] wandelt jedes Element in ein [IndexedValue]-Objekt um (Eigenschaften [index] und [value]), das gefiltert und dann in der Schleife in [(i, p)] entpackt werden kann;
- Zeilen 45–46: Eine Liste kann wie jede Collection beliebig oft durchlaufen werden: Das Ergebnis von [filter] ist eine echte Liste, keine ausstehende Berechnung;
- Zeilen 48–53: Ein Java-Stream ([java.util.stream.Stream]), den man mit der Methode [stream] der Liste erhält (eine Kotlin-Liste ist zur Laufzeit eine [java.util.List]), kann aus Kotlin heraus verwendet werden; Kotlin-Lambdas werden automatisch in funktionale Java-Schnittstellen umgewandelt. Er bleibt jedoch nur einmal verwendbar: Nachdem er von einer terminalen Operation (hier [count]) durchlaufen wurde, löst er eine [IllegalStateException] aus. [e.javaClass.simpleName] ist die Kotlin-Notation für [e.getClass().getSimpleName()].
Die Collection-Operationen von Kotlin unterscheiden daher nicht zwischen Zwischen- und Endoperationen: Jede liefert ein vollständiges Ergebnis. Diese Einfachheit hat ihren Preis: Eine Kette von n Operationen erzeugt n Zwischen-Collections. Bei kleinen Collections, die bei Weitem am häufigsten vorkommen, ist das kein Problem; bei großen Collections oder bei Operationen, die vorzeitig enden können, verwendet man Sequenzen (Programm [Streams05.kt]). Wie Java und anders als C# (LINQ) kennt Kotlin keine SQL-ähnliche Abfragesyntax: Verarbeitungen werden als Ketten von Funktionsaufrufen geschrieben.
5.5.3. Quantoren, Aggregate, Elementauswahl
Das Programm [Streams03.kt] enthält Operationen, die einen einzelnen Wert zurückgeben, und Operationen, die eine Teilmenge einer Collection auswählen:
Ergebnisse:
Kommentare:
- Zeilen 15–17: [any] gibt [true] zurück, wenn mindestens ein Element die Bedingung erfüllt, [all] , wenn alle sie erfüllen, und [none] , wenn keines sie erfüllt (die Methoden [anyMatch], [allMatch] und [noneMatch] der Java-Streams). Ohne Parameter gibt [any()] an, ob die Collection mindestens ein Element hat. In einem String-Template kann [${ ... }] einen beliebigen Ausdruck enthalten, auch einen Funktionsaufruf mit einem Lambda;
- Zeile 20: [count] zählt die Elemente; mit einer Bedingung zählt es diejenigen, die sie erfüllen, ohne dass zuvor gefiltert werden muss. Bei einer Collection ist die Eigenschaft [size] ist selbstverständlich [count()] vorzuziehen;
- Zeilen 21–23: [sumOf { it.age }] addiert einen für jedes Element berechneten Wert. Bei einer Collection von Zahlen ([List<Int>]) lassen sich die Funktionen [sum] und [average] direkt anwenden: Es ist nicht nötig, wie in Java den Umweg über einen spezialisierten Stream zu gehen ([mapToInt(...)] gefolgt von [IntStream]). [average] gibt einen [Double] zurück, der bei einer leeren Collection [NaN] („not a number“) ist. ["%.2f".format(x)] formatiert die Zahl gemäß der Systemsprache: daher der Dezimalpunkt;
- Zeile 24: [min] und [max] geben das kleinste und das größte Element einer Collection vergleichbarer Elemente zurück; [minOf { it.age }] gibt den kleinsten der berechneten Werte zurück. Diese Funktionen lösen eine [NoSuchElementException] aus, wenn die Collection leer ist; ihre Varianten [minOrNull], [maxOrNull], [minOfOrNull] … geben dann [null] zurück;
- Zeile 26: [minBy] und [maxBy] geben das Element (hier die Person) mit dem minimalen beziehungsweise maximalen Schlüssel zurück, nicht den Schlüsselwert selbst. Während Java ein [Optional<Person>] zurückgibt, das mit [get] geöffnet werden muss, gibt Kotlin direkt die Person zurück (und löst eine Exception aus, wenn die Collection leer ist; [minByOrNull] gibt dann [null] zurück);
- Zeilen 28–30: [fold] berechnet ein beliebiges Aggregat: Es beginnt mit einem Anfangswert (hier 0), ruft dann für jedes Element das Lambda mit dem vorherigen Ergebnis ([total]) und dem Element ([p]) auf und gibt das Endergebnis zurück. [reduce] macht dasselbe, verwendet aber das erste Element als Anfangswert: Hier wird in jedem Schritt der längere der beiden Namen behalten. [sum], [count], [max] … sind einfach Sonderfälle dieser beiden Funktionen;
- Zeilen 32–35: [first] gibt das erste Element zurück – mit einer Bedingung: das erste Element, das sie erfüllt. [last] gibt das letzte zurück;
- Zeilen 37–38: In Brest wohnt niemand. [firstOrNull] gibt dann [null] zurück: Der Rückgabetyp ist [Person?]. Wo Java ein [Optional] verwendet, nutzt Kotlin einen Nullable-Typ und dessen Operatoren: [brestResident?.lastName ?: "nobody"] gibt den Namen zurück, wenn es eine Person gibt, und andernfalls „nobody“. Das entspricht genau [map(Person::lastName).orElse("nobody")] in Java;
- Zeilen 39–43: [first] verlangt, dass es ein Element gibt; andernfalls löst es eine [NoSuchElementException] aus. Das verwendet man, wenn das Fehlen eines Werts ein Fehler ist; ist es normal, verwendet man [firstOrNull]. Dieselbe Namenskonvention gilt in der gesamten Bibliothek: [last]/[lastOrNull], [single]/[singleOrNull], [elementAt]/[elementAtOrNull], [getOrNull] (für einen Index) …;
- Zeilen 45–47: [single] verlangt, dass es genau ein Element gibt (das die Bedingung erfüllt); andernfalls löst es eine Exception aus. [singleOrNull] gibt [null] zurück, wenn es keines oder mehrere gibt, wie hier in Paris. Java-Streams haben keine Entsprechung;
- Zeile 50: [distinct] entfernt Duplikate (gemäß der Methode [equals]);
- Zeile 51: [distinctBy] entfernt Elemente, deren Schlüssel bereits vorgekommen ist: So behalten wir das erste Vorkommen jeder Stadt. Im Java-Kurs musste diese Operation selbst implementiert werden, mit einer Menge der bereits gesehenen Städte;
- Zeilen 54–58: [take(n)] behält die ersten n Elemente, während [drop(n)] sie überspringt ([limit] und [skip] in Java); [takeLast] und [dropLast] tun dasselbe, beginnen aber am Ende. In Kombination extrahieren [drop] und [take] eine „Seite“ von Ergebnissen; bei einer Liste extrahiert [slice(2..3)] direkt die Elemente eines Indexbereichs. [takeWhile] behält die Elemente, solange eine Bedingung wahr ist, und stoppt beim ersten Element, das sie nicht erfüllt; [dropWhile] macht das Gegenteil: Es überspringt diese Elemente und behält alle folgenden;
- Zeile 61: [chunked(3)] teilt die Collection in Listen mit je 3 Elementen auf, wobei die letzte Liste kürzer sein kann: Das ist Paginierung. Java 24 musste dafür „Gatherers“ einführen ([gather(Gatherers.windowFixed(3))]); Kotlin kennt [chunked] seit Version 1.2;
- Zeilen 62–63: [windowed(3)] erzeugt gleitende Fenster aus 3 aufeinanderfolgenden Elementen: die Elemente 0–2, dann 1–3, dann 2–4 … (das [windowSliding(3)] aus Java 24). Wie [chunked] akzeptiert [windowed] einen Lambda-Ausdruck, der jedes Fenster transformiert: Hier berechnen wir den gleitenden Durchschnitt der Alter von drei Personen.
5.5.4. Lokale Datenklassen, Gruppierungen, Joins
Das Programm [Streams04.kt] enthält komplexere Operationen. Während Java die meisten davon mit der terminalen Operation [collect] und den Collectors der Klasse [Collectors] ausführt, hat Kotlin für jede eine eigene Funktion:
Ergebnisse:
Kommentare:
- Zeile 22: eine lokale Datenklasse, die innerhalb der Funktion deklariert ist, in der sie verwendet wird (das Äquivalent des lokalen Records aus Java 16). Sie erlaubt es, Zwischenergebnissen einer Verarbeitung einen Namen und einen Typ zu geben, ohne eine Klasse auf Dateiebene deklarieren zu müssen: Zeile 26: Jede Person über 40 wird in ein [Summary] umgewandelt, das nur die relevanten Daten behält;
- Zeile 27: Der Lambda-Ausdruck entpackt das empfangene [Summary]: [(name, decade)] in Klammern deklariert zwei Parameter, die die beiden Eigenschaften des Objekts in der vom Konstruktor festgelegten Reihenfolge erhalten. Das ist für jede Datenklasse möglich (Kapitel 3) sowie für Tupel und Dictionary-Einträge;
- Zeile 31: [groupBy] gruppiert Elemente mit demselben Schlüssel, hier der Stadt. Das Ergebnis ist ein Dictionary [Map<String, List<Person>>]: Jeder Stadt ist eine Liste ihrer Einwohner zugeordnet. Die Dictionarys, die die Kotlin-Standardbibliothek erzeugt ([groupBy], [associate], [mapOf] …), sind [LinkedHashMap]: Sie behalten die Schlüssel in der Reihenfolge ihres ersten Auftretens. Java, das standardmäßig eine [HashMap] mit unvorhersehbarer Reihenfolge erzeugt, musste dies ausdrücklich anfordern ([LinkedHashMap::new]);
- Zeilen 32–34: Eine [for]-Schleife durchläuft die Einträge des Dictionarys, die in [(city, group)] entpackt werden. Für jede Gruppe werden ihre Größe, das Durchschnittsalter und die Namen ausgegeben; [joinToString(", ") { it.lastName }] verkettet die Namen mit einem Trennzeichen: Seine Lambda-Funktion wandelt jedes Element in eine Zeichenkette um, wodurch ein vorheriges [map] überflüssig wird;
- Zeile 37: Ein zweites, optionales Lambda transformiert die in jeder Gruppe einsortierten Elemente: Hier werden nur die Namen behalten (das ist der Java-Collector [mapping]);
- Zeilen 42–45: ein Join. Wie Java-Streams haben auch Kotlin-Collections keine Join-Operation; wir erreichen ihn mit [flatMap], dessen Lambda für jedes Element eine Liste zurückgibt: [flatMap] verkettet alle diese Listen. Jede Person wird hier durch die Liste der Städte mit demselben Namen (eine oder keine) ersetzt, in Zeichenketten umgewandelt. Wie bei einem inneren SQL-Join bleiben nur übereinstimmende Paare erhalten: Laurent, der in Lyon wohnt – das in der Städteliste fehlt –, erscheint nicht, ebenso wenig Brest, das keine Einwohner hat. Dieser Code durchläuft für jede Person die gesamte Städteliste;
- Zeilen 47–51: derselbe Join, aber effizienter. [associateBy { it.name }] erstellt ein Dictionary der Städte, in dem der Schlüssel der Name der Stadt und der Wert die Stadt selbst ist (der Java-Collector [toMap(City::name, v -> v)]); in diesem Dictionary suchen wir dann die Stadt jedes Erwachsenen. [citiesByName[p.city]] gibt eine [City?] oder [null] zurück, wenn die Stadt nicht gefunden wird; [?.let { ... }] erzeugt die Zeichenkette nur, wenn die Stadt gefunden wurde, und [mapNotNull] ist ein [map], das die Ergebnisse [null] aussortiert: Filtern und Projizieren erfolgen in einer einzigen Operation. Anders als [toMap] in Java meldet [associateBy] doppelte Schlüssel nicht: Der letzte Wert hat Vorrang;
- Zeilen 55–57: [associate] erstellt ein Dictionary aus einem Lambda, das für jedes Element ein Schlüssel-Wert-Paar zurückgibt, geschrieben als [it.lastName to it.age]. [associateWith] nimmt die Elemente als Schlüssel und berechnet die Werte: hier die Länge jedes Worts;
- Zeilen 58–59: [partition] teilt die Elemente anhand einer Bedingung in zwei Listen auf: die, die sie erfüllen, und die übrigen. Das Ergebnis ist ein Paar von Listen, das sofort in [(adults, minors)] entpackt wird; Java lieferte ein Dictionary mit den Schlüsseln [true] und [false] ([partitioningBy]);
- Zeilen 60–61: [zip] bildet Paare aus Elementen gleichen Rangs der beiden Collections und endet am Ende der kürzeren. Ohne Lambda gibt es eine Liste von Paaren zurück ([(1, a)] …); mit einem Lambda kombiniert es jedes Elementpaar – in diesem Fall zu einem Vornamen gefolgt von einem Nachnamen. Java-Streams haben keine Entsprechung;
- Zeile 64: die Elemente in jeder Gruppe zählen. [groupingBy { it.city }] erstellt die Gruppen nicht: Es gibt ein [Grouping]-Objekt zurück, das den Schlüssel für jedes Element berechnen kann; [eachCount] durchläuft dann die Collection einmal und zählt die Elemente für jeden Schlüssel (der Java-Collector [counting]). [toSortedMap] kopiert das Dictionary für die Ausgabe in ein nach Schlüsseln sortiertes Dictionary (eine [TreeMap]);
- Zeilen 65–66: einen Wert pro Gruppe summieren: Die Gruppen werden mit [groupBy] erstellt, dann transformiert [mapValues] jeden Wert des Dictionarys (hier eine Liste von Personen) in einen anderen Wert (hier die Summe ihrer Alter) und behält dabei die Schlüssel bei. Die Lambda-Funktion erhält einen Eintrag des Dictionarys, entpackt durch [(_, group)]: Der Unterstrich [_] zeigt an, dass uns der Schlüssel nicht interessiert;
- Zeilen 67–68: Ein [Grouping] hat außerdem [fold], [reduce] und [aggregate], die ein gruppenweises Aggregat in einem einzigen Durchlauf berechnen, ohne die Gruppenlisten zu erstellen: hier das Höchstalter jeder Stadt;
- Zeilen 71–72: noch einmal [flatMap] , das jede Stadt in eine Liste aus zwei verketteten Zeichenketten umwandelt; [flatten] „glättet“ eine Liste von Listen;
- Zeile 76: die Position jedes Elements in einer gefilterten Liste: [forEachIndexed] übergibt den Index an das Lambda. Java hätte den Stream in einer Liste speichern und dann deren Indizes durchlaufen müssen.
Die folgende Tabelle fasst die Entsprechungen zwischen den Java-Collectors und den Kotlin-Funktionen zusammen, denen wir in diesem Programm begegnet sind:
Java (Streams und Collectors) | Kotlin (Collections) |
[collect(toList())], [toList()] | Nicht nötig: Das Ergebnis ist bereits eine Liste; [toList()], [toMutableList()] zum Kopieren |
[groupingBy(f)] | [groupBy(f)]; [groupBy(f, g)] für [groupingBy(f, mapping(g, toList()))] |
[groupingBy(f, counting())] | [groupingBy(f).eachCount()] |
[groupingBy(f, summingInt(g))] | [groupBy(f).mapValues { (_, l) -> l.sumOf(g) }] |
[toMap(f, v -> v)] | [associateBy(f)] |
[toMap(f, g)] | [associate { f(it) to g(it) }], [associateBy(f, g)] |
[partitioningBy(p)] | [partition(p)] (ein Paar von Listen) |
[joining(", ")] | [joinToString(", ")] |
[flatMap(e -> stream)] | [flatMap { list }], [flatten()] |
5.5.5. Verzögerte Auswertung: Sequenzen
Operationen auf Collections werden sofort und jeweils vollständig ausgeführt. Operationen auf Sequenzen ([Sequence<T>]) werden nicht ausgeführt, wenn sie geschrieben werden, sondern wenn eine terminale Operation die Sequenz durchläuft: Das ist die verzögerte Auswertung, wie wir sie von Java-Streams kennen. Das Programm [Streams05.kt] vergleicht beide anhand von Lambdas, die ausgeben, was sie tun:
Ergebnisse:
Kommentare:
- Zeilen 13–16: Die Kette [filter] + [map] wird auf eine Liste angewendet. Die Lambdas geben eine Meldung aus, bevor sie ihren Wert zurückgeben: Der Rumpf eines Lambdas kann mehrere Anweisungen enthalten (hier durch ein Semikolon getrennt, da sie in derselben Zeile stehen), und zurückgegeben wird der Wert des letzten Ausdrucks: Es gibt kein [return];
- Zeilen 2–10 der Ergebnisse: [filter] untersucht die sechs Zahlen und erstellt eine Zwischenliste [[2, 4, 6]]; erst dann berechnet [map] die drei Quadrate und erstellt die Ergebnisliste. Jeder Schritt wird vollständig ausgeführt, bevor der nächste beginnt;
- Zeilen 20–29: dieselbe Verarbeitung auf einer Sequenz, die mit [numbers.asSequence()] erzeugt wird. Die Lambda-Ausdrücke sind hier über mehrere Zeilen geschrieben;
- Zeile 13 der Ergebnisse: Nach der Definition der Sequenz wurde noch nichts ausgegeben: Weder [filter] noch [map] hat bisher ein einziges Element untersucht. [evenSquares] enthält keine Ergebnisse, sondern die Beschreibung einer Berechnung;
- Zeilen 15–26 der Ergebnisse: Die Berechnung läuft während der terminalen Operation [forEach] (Zeile 33) ab, Element für Element: Jede Zahl durchläuft [filter], dann [map] , wenn sie gerade ist, und gelangt dann in [forEach] , bevor die nächste Zahl untersucht wird. Es wird keine Zwischenliste erstellt;
- Zeilen 36–39: Anders als ein Java-Stream kann eine aus einer Collection gewonnene Sequenz mehrfach durchlaufen werden: Jede terminale Operation (hier [toList] ) startet die Berechnung auf Grundlage des aktuellen Zustands der Collection von vorn. Die vor dem Hinzufügen der 10 erstellte Sequenz berücksichtigt diese daher. Java hätte ein Lambda speichern müssen, das den Stream neu erzeugt ([Supplier<Stream<Integer>>]); eine solche Sequenz ist bereits ein wiederverwendbares Muster. Manche Sequenzen werden jedoch nur einmal durchlaufen: etwa solche, die auf einem Iterator oder einem Eingabestrom aufbauen; [constrainOnce()] gibt eine Sequenz zurück, die beim zweiten Durchlauf eine [IllegalStateException] auslöst;
- Zeilen 42–44: [toList] führt die Verarbeitung aus und speichert deren Ergebnisse: [snapshot] ist eine Liste, die das Hinzufügen der 20 nicht sieht;
- Zeilen 48–50: [first] beendet die Iteration, sobald es ein Element erhält: Die auf 3 folgenden Zahlen werden nie untersucht. [any], [take], [takeWhile], [firstOrNull] … beenden die Iteration ebenfalls so früh wie möglich; dadurch lassen sich unendliche Sequenzen verarbeiten. Bei einer Liste hätte [filter { ... }.first()] alle acht Zahlen untersucht, bevor die erste zurückgegeben wird; deshalb schreiben wir stattdessen [first { ... }], das beim ersten gefundenen Element stoppt;
- Zeilen 55–58: Manche Zwischenoperationen können Elemente nicht einzeln verarbeiten: [sorted] muss alle Elemente kennen, um das kleinste zurückzugeben. [sequenceOf(3, 1, 2)] erstellt eine Sequenz aus Werten; die Operation [onEach], die auf jedes Element beim Durchlaufen ein Lambda anwendet, ohne es zu verändern (das Java-Äquivalent von [peek]), zeigt, dass alle drei Elemente von [sorted] empfangen werden, bevor es auch nur eines weitergibt;
- Zeilen 61–64: unendliche Sequenzen, erzeugt mit [generateSequence], dem wir zuvor in [Streams01.kt] begegnet sind: Zweierpotenzen, von denen die ersten zehn mit [take(10)] behalten werden, und ungerade Zahlen, unter denen wir die erste suchen, deren Quadrat 200 übersteigt. Eine Operation, die die gesamte Sequenz durchlaufen muss ([toList], [count], [sorted] …), würde bei einer unendlichen Sequenz nie enden: Sie muss zuvor begrenzt werden;
- Zeile 67: Java-Streams bleiben aus Kotlin heraus nutzbar, auch Streams von primitiven Typen ([IntStream], [LongStream], [DoubleStream]); [IntStream.rangeClosed(1, 10)] erzeugt die ganzen Zahlen von 1 bis 10. Zeile 68 zeigt dieselbe Berechnung in Kotlin über das Intervall [1..10]. In Kotlin gibt es keine spezialisierten Collections oder Sequenzen für primitive Typen: Eine [List<Int>] enthält [Integer]-Objekte. Für sehr große Zahlenmengen verwenden wir ein [IntArray]-Array (das selbst [filter], [map], [sum] … bereitstellt);
- Zeilen 71–72: Die Erweiterungsfunktionen [asSequence] und [asStream] aus dem Paket [kotlin.streams] (in Zeile 4 importiert) wandeln einen Java-Stream in eine Sequenz um und umgekehrt. Sie werden an der Schnittstelle zu einer Java-Bibliothek verwendet, die Streams erzeugt oder erwartet. [boxed] verwandelt einen [IntStream] in einen [Stream<Integer>].
Wann sollte man eine Sequenz statt einer Collection verwenden?
- Operationen auf Collections sind die Standardwahl: Sie sind bei kleinen und mittelgroßen Collections einfach und schnell, bei denen die Kosten der Zwischen-Collections vernachlässigbar sind;
- Wechseln Sie zu Sequenzen ([asSequence()]), wenn die Operationskette lang und die Collection groß ist (keine Zwischen-Collections) oder wenn die Verarbeitung vorzeitig enden kann ([first], [take], [any] …) oder wenn Elemente bei Bedarf erzeugt werden (unendliche Sequenzen, Generatoren, Zeilen einer großen Datei: Das werden wir mit [useLines] sehen);
- Java-Streams ([stream()]) sind in einem Kotlin-Programm kaum von Nutzen, außer für die Interaktion mit einer Java-Bibliothek und für ihre parallele Variante: Die Methode [parallelStream] einer Collection gibt einen Stream zurück, dessen Elemente von mehreren Threads gleichzeitig verarbeitet werden (Kapitel 8), was Sequenzen nicht können. Sie beschleunigt nur zeitaufwendige Operationen auf großen Datenmengen und erfordert Lambdas ohne Seiteneffekte: Sie sollte erst nach einer Abwägung ihres Nutzens eingesetzt werden.
Die folgende Tabelle vergleicht die drei Werkzeuge:
Kotlin-Collections | Kotlin-Sequenzen | Java-Streams | |
Auswertung | sofort, Operation für Operation | verzögert, Element für Element | verzögert, Element für Element |
Zwischen-Collections | eine pro Operation | keine | keine |
mehrfache Durchläufe | ja | Ja (außer bei Sequenzen, die nur einmal durchlaufen werden können) | nein: ein Stream pro Durchlauf |
unendliche Elemente | nein | ja ([generateSequence], [sequence]) | Ja ([Stream.iterate], [Stream.generate]) |
parallele Verarbeitung | nein | nein | Ja ([parallelStream]) |
primitive Typen | nein (außer Arrays [IntArray] …) | nein | ja ([IntStream] …) |
Diesen Operationen werden wir im weiteren Verlauf des Kurses immer wieder begegnen, und in Kapitel 7 werden wir sehen, wie funktionale Typen und die Funktionen höherer Ordnung, die sie verwenden, aufgebaut sind.
5.6. Textdateien
Kotlin hat keine eigene API für Dateien: Es verwendet die des JDK und ergänzt sie um Erweiterungsfunktionen, die ihre Verwendung vereinfachen. Zur Erinnerung: Java hat zwei APIs für Dateien: das Paket [java.io], das seit Java 1.0 verfügbar ist ([File], [FileReader], [FileInputStream] …), und das Paket [java.nio.file], das mit Java 7 eingeführt wurde ([Path], [Files] …), umfassender ist und eine bessere Fehlerberichterstattung bietet. Die Kotlin-Standardbibliothek bietet Erweiterungen für beide:
- Das Paket [kotlin.io] (automatisch importiert) erweitert die Klasse [java.io.File]: [File("infos.txt").readText()], [readLines()], [forEachLine { }], [useLines { }], [writeText(text)], [appendText(text)], [bufferedReader()], [printWriter()] …;
- das Paket [kotlin.io.path] (muss importiert werden) erweitert die Schnittstelle [java.nio.file.Path] um gleichnamige Funktionen und ergänzt eine Erzeugungsfunktion [Path("infos.txt")], den Operator [/] zum Zusammensetzen von Pfaden, Eigenschaften ([name], [extension] …) und Funktionen, die die der Klasse [Files] nachbilden ([exists], [createDirectories], [listDirectoryEntries], [walk] …).
Wie in Java ist [Path] heute die bevorzugte Option: Wir verwenden [kotlin.io.path]. Ein relativer Pfad wie [Path("infos.txt")] wird um das aktuelle Verzeichnis des Programms ergänzt – das Verzeichnis, aus dem es gestartet wurde.
Alle diese Funktionen verwenden standardmäßig die Kodierung UTF-8, unabhängig vom Betriebssystem, und tun dies seit der ersten Kotlin-Version; ein optionaler Parameter erlaubt es, eine andere anzugeben. Auf der Java-Seite ist die Standardkodierung für Klassen wie [java.io] ([FileReader], [PrintWriter] …) seit Java 18 (JEP 400) UTF-8; zuvor hing sie vom System ab (unter französischsprachigem Windows oft Windows-1252). Mit Kotlin und JDK 25 ist das kein Problem mehr.
Beachten Sie schließlich, dass Kotlin keine geprüften Exceptions kennt (Kapitel 3): E/A-Fehler werden durch Exceptions gemeldet, die von [java.io.IOException] abgeleitet sind und die der Compiler weder abzufangen noch zu deklarieren verlangt. Es liegt am Programmierer zu entscheiden, wo sie behandelt werden.
5.6.1. Eine Textdatei lesen
Mit der Klasse [java.io.BufferedReader] können Sie den Inhalt einer Textdatei zeilenweise lesen. Sie kann tatsächlich auch Datenströme verarbeiten, die keine Dateien sind (zum Beispiel eine Netzwerkverbindung). Sie liest die Datei blockweise und speichert diese in einem Puffer: Die meisten Lesevorgänge erfolgen im Speicher, ohne Zugriff auf die Festplatte. Kotlin ergänzt [Path] (und [File]) um Funktionen, die diesen Reader erzeugen oder für uns verwenden:
Funktion | Aufgabe |
[path.bufferedReader(charset = Charsets.UTF_8)] | öffnet die Datei [path] zum Lesen und gibt einen [BufferedReader] zurück; der optionale Parameter gibt die Kodierung an: [path.bufferedReader(Charsets.ISO_8859_1)] |
[reader.readLine(): String?] | gibt die nächste Zeile ohne das Zeilenendezeichen zurück oder [null] , wenn das Ende des Datenstroms erreicht ist (Java-Methode) |
[reader.lineSequence()], [reader.readLines()], [reader.readText()] | die verbleibenden Zeilen in Form einer Sequenz (bei Bedarf gelesen, nur einmal durchlaufbar) oder einer Liste; der gesamte verbleibende Text (Kotlin-Erweiterungen) |
[reader.close()] | schließt den Datenstrom und gibt die für seine Verwaltung belegten Ressourcen frei. Dies muss nach der Verarbeitung des Datenstroms geschehen, wofür die Funktion [use] sorgt |
[path.readText()], [path.readLines()] | öffnet die Datei, gibt ihren gesamten Inhalt zurück (eine Zeichenkette, eine Liste von Zeilen) und schließt sie |
[path.forEachLine { line -> ... }] | öffnet die Datei, ruft das Lambda für jede Zeile auf und schließt sie |
[path.useLines { lines -> ... }] | öffnet die Datei, übergibt die [Sequence<String>] ihrer Zeilen – bei Bedarf gelesen – an das Lambda, schließt die Datei und gibt das Ergebnis des Lambdas zurück |
Das Programm [Files01.kt] sieht wie folgt aus:
Kommentare:
- Zeilen 5–11: Die Erweiterungsfunktionen von [kotlin.io.path] müssen einzeln importiert werden (oder alle zusammen über [import kotlin.io.path.*], wie wir es später tun werden); IntelliJ und IDEA fügen diese Zeilen automatisch hinzu;
- Zeile 14: Die Funktion [main] erhält die Befehlszeilenargumente hier im Array [args];
- Zeile 16: gibt den Namen des aktuellen Ordners aus, also des Ordners, aus dem das Programm gestartet wurde. [Path("")] bezeichnet den aktuellen Ordner; [absolute()] wandelt ihn in einen vollständigen Pfad um, von dem die Eigenschaft [name] nur das letzte Element behält, um die Ergebnisse nicht mit einem vollständigen Pfad zu überfrachten;
- Zeile 18: Die gelesene Datei ist die als Argument übergebene oder [infos.txt]. [args.firstOrNull()] gibt das erste Argument zurück oder [null] , wenn es keines gibt; der Elvis-Operator [?:] liefert dann den Standardwert. Da es sich um einen relativen Pfad handelt, wird die Datei im aktuellen Verzeichnis gesucht;
- Zeile 22: [bufferedReader()] öffnet die Datei und gibt einen [BufferedReader] zurück. Die Erweiterungsfunktion [use] (Kapitel 3) führt das ihr übergebene Lambda aus und übergibt ihm das Objekt ([reader]) und schließt dieses Objekt beim Verlassen des Lambdas, selbst wenn darin eine Exception aufgetreten ist. Das ist das Kotlin-Äquivalent der Java-Anweisung [try] mit Ressourcen; sie gilt für jedes Objekt, das die Schnittstelle [AutoCloseable] (oder [Closeable]) implementiert, also eine Methode [close] besitzt, die Ressourcen freigibt (Datei, Netzwerkverbindung, Datenbankverbindung usw.);
- Zeilen 23–26: Die Datei wird zeilenweise gelesen. In Java schreiben wir [while ((line = reader.readLine()) != null)], aber in Kotlin ist eine Zuweisung kein Ausdruck: Sie kann nicht ausgewertet werden. Daher schreiben wir eine Endlosschleife und [val line = reader.readLine() ?: break]: [readLine] gibt einen [String?] zurück; wenn es [null] zurückgibt (Dateiende), führt der Elvis-Operator [break] aus, was die Schleife verlässt; andernfalls ist [line] ein nicht nullbarer [String]. Eine weitere, funktionalere Schreibweise ist [reader.lineSequence().forEach { println(it) }];
- Zeile 32: [readText] liest die gesamte Datei auf einmal und schließt sie. Zeile 36: [forEachLine] öffnet die Datei, ruft das Lambda für jede Zeile auf und schließt sie: Das ist das einzeilige Äquivalent von Lesen 1;
- Zeile 40: [useLines] öffnet die Datei und übergibt die Sequenz ihrer Zeilen an die Lambda-Funktion, die sie bei der Verarbeitung der Datei bei Bedarf liest; die Datei wird am Ende der Lambda-Funktion geschlossen, und [useLines] gibt das Ergebnis zurück (hier die Anzahl der nicht leeren Zeilen). So können Sie eine mehrere Gigabyte große Datei verarbeiten, indem Sie alle Operationen auf der Sequenz ausführen, ohne sie in den Speicher zu laden. Die Sequenz darf das Lambda nicht verlassen: Sobald die Datei geschlossen ist, kann sie nicht mehr durchlaufen werden;
- Zeilen 42–47: Ein-/Ausgabefehler werden durch Exceptions gemeldet, die von [java.io.IOException] abgeleitet sind. Eine fehlende Datei löst eine [NoSuchFileException] (abgeleitet von [java.nio.file]) aus, die ihrerseits diese Exception auslöst; deshalb muss sie zuerst abgefangen werden. Ihre Eigenschaft [file] (die Java-Methode [getFile]) gibt den Pfad der gesuchten Datei zurück. Funktionen, die [java.io.File] erweitern, melden denselben Fehler über eine [FileNotFoundException]. Der Compiler verlangt diese [catch]-Klauseln nicht: Ohne sie würde ein Fehler das Programm beenden und die Exception ausgeben.
Die Datei [infos.txt] sieht wie folgt aus:
Sie befindet sich im Stammverzeichnis des Gradle-Projekts [05-classes-kotlin], das das aktuelle Verzeichnis für den Befehl [gradlew run] ist:
Mit einer nicht vorhandenen Datei (die Programmargumente werden über die Option [gradlew run] mit [--args] übergeben):
Wenn statt einer Datei ein Ordner verwendet wird, führt das Lesen zu einer anderen Exception, [IOException], deren Meldung vom Betriebssystem stammt:
Diese Tests wurden unter Linux ausgeführt; unter Windows würde die Meldung für diesen letzten Fehler anders lauten. Wir legen die Datendateien für unsere Programme und die Beispielanwendung daher im Stammverzeichnis des Projekts ab. Wenn die Programme aus IntelliJ und IDEA gestartet werden, ist ebenfalls das Projektverzeichnis ihr aktuelles Verzeichnis.
5.6.2. Eine Textdatei schreiben
Mit der Klasse [java.io.BufferedWriter] können Sie in eine Textdatei schreiben. Wie [BufferedReader] verwendet sie einen Puffer und kann Datenströme verarbeiten, die keine Dateien sind.
Funktion | Aufgabe |
[path.bufferedWriter(charset = Charsets.UTF_8, vararg options)] | öffnet die Datei [path] zum Schreiben und gibt einen [BufferedWriter] zurück. Die Datei wird angelegt oder, falls sie bereits existiert, geleert. Optionale Parameter geben die Kodierung und den Öffnungsmodus an: [path.bufferedWriter(options = arrayOf(StandardOpenOption.APPEND))] hängt die Daten an das Ende der vorhandenen Datei an |
[writer.write(str)] | schreibt [str] in die Datei |
[writer.newLine()] | schreibt ein Zeilenendezeichen: das Standardzeichen des Systems, „\r\n“ unter Windows, „\n“ unter Linux und macOS |
[writer.flush()] | schreibt den Inhalt des Puffers in die Datei, ohne zu warten, bis er voll ist |
[writer.close()] | schließt den Datenstrom, nachdem der Inhalt des Puffers in die Datei geschrieben wurde. Muss nach der Verarbeitung des Datenstroms erfolgen: [use] übernimmt dies |
[path.writeText(text)], [path.appendText(text)] | legt die Datei an (oder überschreibt sie) und schreibt [text] hinein; hängt [text] an das Ende der Datei an |
[file.printWriter()] | (für [java.io.File]) öffnet die Datei und gibt einen [PrintWriter] zurück, der die Methoden [print], [println], und [printf] besitzt |
Schreibvorgänge in eine [BufferedWriter]-Datei erfolgen nicht sofort: Der Text wird zunächst in den Puffer geschrieben und dann in die Datei, wenn der Puffer voll ist, wenn er mit der Methode [flush] ausdrücklich geleert wird oder wenn der Datenstrom geschlossen wird. Das ist der effizienteste Modus für Dateien, weil er Festplattenzugriffe begrenzt. Er eignet sich nicht für alle Datenströme, insbesondere nicht für Netzwerkströme: In einem Dialog zwischen zwei Partnern muss das, was der eine schreibt, sofort vom anderen gelesen werden können, und der Puffer muss nach jeder Nachricht geleert werden. Die Klasse [java.io.PrintWriter], die wir später verwenden werden, ergänzt die Methoden [print], [println] und [printf] und kann ihren Puffer nach jedem [println] automatisch leeren (Konstruktor [PrintWriter(writer, true)]).
Das Programm [Files02.kt] sieht wie folgt aus:
Ergebnisse (die über die Tastatur eingegebenen Zeilen wurden nach den Eingabeaufforderungen eingegeben):
Kommentare:
- Zeile 15: [bufferedWriter()] legt die Datei an und gibt einen [BufferedWriter] zurück; auch hier schließt die Funktion [use] den Datenstrom beim Verlassen des Lambdas automatisch (schließende geschweifte Klammer in Zeile 28). Erst dieses Schließen schreibt den im Puffer verbliebenen Text in die Datei: Ohne es könnte die Datei unvollständig bleiben;
- Zeile 16: Die Standardkodierung des JDK ist UTF-8. Die Kotlin-Funktionen verwenden dagegen unabhängig von der Kodierung des JDK standardmäßig UTF-8;
- Zeilen 19–20: Die Eingabeaufforderung wird mit [print] ausgegeben, das keinen Zeilenumbruch erzeugt, und dann liest [readlnOrNull] eine Zeile von der Tastatur; es gibt [null] zurück, wenn die Standardeingabe geschlossen ist (Dateiende), daher [?.trim() ?: ""];
- Zeilen 25–26: schreibt eine Zeile in die Textdatei, gefolgt von einem Zeilenumbruchzeichen;
- Zeile 31: Die Funktion [fileSize] (die Java-Methode [Files.size]) gibt die Größe einer Datei in Byte zurück. Die 18 Byte setzen sich wie folgt zusammen: 16 Zeichen plus zwei Zeilenumbrüche von je einem Byte („\n“ unter Linux, wo die Tests ausgeführt wurden; unter Windows würde jeder Zeilenumbruch „\r\n“ 2 Byte belegen). Ein [Path]-Objekt, das in ein String-Template eingefügt wird, wird mit seiner Methode [toString] ausgegeben: dem Pfad;
- Zeile 33: Warum ein [try / catch], das der Compiler nicht verlangt? Wir könnten einen Dateinamen der Form [dir1/dir2/file] mit einem Verzeichnis [dir1/dir2] angeben, das nicht existiert, sodass die Datei nicht angelegt werden kann. Es würde dann eine [NoSuchFileException]-Exception ausgelöst, abgeleitet von [IOException]. Es gibt weitere mögliche Fehlerfälle (Festplatte voll, unzureichende Berechtigungen usw.). Ein Programm, das eine Datei schreibt, muss mit diesen Fehlern rechnen: [try / catch] wandelt sie hier in eine verständliche Meldung um, statt das Programm abstürzen zu lassen.
5.6.3. Pfade und Funktionen von kotlin.io.path
Für gängige Operationen ersparen die Funktionen von [kotlin.io.path] den Umgang mit Datenströmen: Eine einzige Funktion öffnet die Datei, liest oder schreibt sie vollständig und schließt sie dann. Sie erlauben auch, Dateien und Ordner anzulegen, zu kopieren, zu verschieben und zu löschen. Die meisten dieser Funktionen rufen eine Methode der Java-Klasse [Files] auf und sind dadurch benutzerfreundlicher: [path.exists()] statt [Files.exists(path)].
Funktion | Aufgabe |
[Path("data", "cities.txt")], [folder / "cities.txt"] | setzt einen Pfad mit dem Systemtrennzeichen zusammen (der Operator [/] ruft die Java-Methode [folder.resolve("cities.txt")] auf) |
[path.name], [path.nameWithoutExtension], [path.extension], [path.parent], [path.absolute()] | der Dateiname (mit beziehungsweise ohne Erweiterung), die Erweiterung, der Ordner und der vollständige Pfad |
[path.readText()], [path.readLines()], [path.useLines { }] | gibt den Inhalt der Datei als Zeichenkette, als Liste von Zeilen oder als Sequenz von bei Bedarf gelesenen Zeilen zurück |
[path.writeText(text)], [path.appendText(text)] | legt die Datei an (oder überschreibt sie) und schreibt [text] hinein; hängt [text] an das Ende der Datei an |
[path.writeLines(lines)], [path.appendLines(lines)] | schreibt beziehungsweise fügt eine Collection (oder Sequenz) von Zeilen hinzu, jeweils gefolgt von einem Zeilenumbruch |
[path.readBytes()], [path.writeBytes(bytes)] | liest und schreibt die Datei als Byte-Array |
[path.exists()], [path.isDirectory()], [path.fileSize()], [path.deleteExisting()], [path.deleteIfExists()], [path.copyTo(target)], [path.moveTo(target)] | prüft, ob eine Datei existiert; ob es ein Ordner ist; gibt ihre Größe zurück, löscht sie, kopiert sie oder verschiebt sie |
[path.createDirectories()] | legt den Ordner und seine übergeordneten Ordner an, falls sie nicht existieren |
[folder.listDirectoryEntries(glob)], [folder.walk()] | die Elemente des Ordners (eine Liste, gegebenenfalls gefiltert durch ein Muster wie ["*.txt"]), aus seiner gesamten Baumstruktur (eine Sequenz) |
Das Programm [Files03.kt] verwendet sie:
Ergebnisse:
Kommentare:
- Zeile 5: Alle Funktionen aus [kotlin.io.path] werden importiert;
- Zeilen 10–13: Der Operator [/] (Funktion [operator fun Path.div(other: String)]; siehe Überladen von Operatoren in Kapitel 4) setzt den Pfad [data/cities.txt] mit dem Pfadtrennzeichen des Systems zusammen. Die Kursübungen wurden unter Linux ausgeführt: Der resultierende Pfad ist [data/cities.txt]; unter Windows wäre er [data\cities.txt]. Pfade auf diese Weise zu konstruieren, statt Zeichenketten zu verketten, macht den Code portabel. Die Eigenschaften [name], [parent], [nameWithoutExtension], und [extension] zerlegen den Pfad; die letzten beiden gibt es in Java nicht, wo Sie den Punkt mit [lastIndexOf] suchen müssen;
- Zeile 16: Das Anlegen des Ordners [data] verursacht keinen Fehler, wenn er bereits existiert;
- Zeilen 19–26: Schreiben, Anhängen und Lesen, jeweils in einer einzigen Anweisung. [appendLines] schreibt jedes Element der Liste gefolgt von einem Zeilenumbruch;
- Zeilen 28–30: [useLines] stellt die Zeilen als Sequenz bereit: Sie werden im Verlauf der Schleife einzeln gelesen, und alle Sequenzoperationen können auf sie angewendet werden. So können wir eine mehrere Gigabyte große Datei verarbeiten, ohne sie in den Speicher zu laden, was [readLines] tun würde. Die Datei bleibt während der Iteration geöffnet, und [useLines] schließt sie am Ende des Lambdas: Das entspricht [Files.lines(path)] in einem [try] mit Ressourcen;
- Zeilen 33–37: Die Klasse [java.io.File] hat dieselben Erweiterungsfunktionen ([readText], [readLines], [writeText] …) und einige weitere, etwa [printWriter], das einen [PrintWriter] zurückgibt (Methoden [print] und [println]). Von einem [File] gelangt man zu einem [Path] über [toPath()] und umgekehrt über [toFile()];
- Zeilen 40–47: Derselbe Text „café“ wird mit drei Kodierungen geschrieben, anschließend werden die Bytes in den Dateien mit der Kotlin-Funktion [toHexString] hexadezimal ausgegeben, konfiguriert durch ein [HexFormat]-Objekt (in Großbuchstaben). Beachten Sie, dass die hier verwendete Klasse [HexFormat] die Kotlin-Klasse ist ([kotlin.text.HexFormat], automatisch importiert), nicht die Java-Klasse ([java.util.HexFormat]):
- in UTF-8, der Standardkodierung, belegen Zeichen mit Akzent 2 Byte (é = C3 A9) und die übrigen 1 Byte: 5 Byte für 4 Zeichen;
- in UTF-8 mit BOM (Byte Order Mark) beginnt die Datei mit den drei Bytes EF BB BF, die der Software anzeigen, dass die Datei in UTF-8 kodiert ist. Weder Java noch Kotlin schreiben von sich aus ein BOM: Man erhält es, indem man das Zeichen U+FEFF an den Anfang des Textes schreibt, notiert als ["\uFEFF"];
- in Latin-1 (ISO-8859-1), der traditionellen Kodierung für westeuropäische Texte, belegt jedes Zeichen ein Byte (é = E9). Das Kotlin-Objekt [Charsets] bietet Zugriff auf gängige Kodierungen ([UTF_8], [ISO_8859_1], [UTF_16] …), genau wie die Java-Klasse [StandardCharsets];
- Zeilen 50–57: Das Lesen einer Datei mit einer anderen Kodierung als der beim Schreiben verwendeten beschädigt Zeichen mit Akzent: Das Byte E9 am Ende der Datei ist in UTF-8 ungültig. Nicht alle Funktionen von [kotlin.io.path] verhalten sich gleich, wie die Ausführung zeigt: [readLines] (das [Files.readAllLines] aufruft) weist eine solche Datei zurück, indem es eine [MalformedInputException]-Exception auslöst (abgeleitet von [IOException]), während [readText] jedes ungültige Byte ohne Fehlermeldung durch das Zeichen � ersetzt. Wir haben überprüft, dass [useLines] und [forEachLine] ebenso streng sind wie [readLines] und dass [bufferedReader] und die Funktionen von [java.io.File] tolerant sind, genau wie [readText];
- Zeile 58: Mit der richtigen Kodierung gelesen, ist die Datei korrekt;
- Zeile 60: Beim Lesen erkennen weder Java noch Kotlin das BOM: Es wird als unsichtbares Zeichen am Anfang des Textes gelesen, der dadurch 5 statt 4 Zeichen hat. Wenn Sie UTF-8-Dateien lesen müssen, die mit einem BOM erzeugt wurden (von bestimmter Windows-Software), müssen Sie dieses Zeichen selbst entfernen ([text.removePrefix("\uFEFF")]). Heute ist die Regel einfach: Textdateien werden in UTF-8 ohne BOM geschrieben und gelesen;
- Zeilen 63–65: [exists] prüft, ob eine Datei existiert; [listDirectoryEntries("*.txt")] gibt eine Liste der Elemente des Ordners zurück, deren Namen dem Muster entsprechen (ein „Glob“: [*] steht für eine beliebige Zeichenfolge). Diese Funktion garantiert die Reihenfolge der Namen nicht: [sorted] sortiert sie. Anders als [Files.list] gibt sie eine Liste statt eines Streams zurück: Es muss nichts geschlossen werden;
- Zeilen 69–72: Löschen des Ordners. [deleteExisting] (die Java-Methode [Files.delete]) weigert sich, einen nicht leeren Ordner zu löschen: Wir durchlaufen die gesamte Baumstruktur mit [walk], das eine Sequenz zurückgibt. Standardmäßig gibt [walk] nur Dateien zurück; die Option [PathWalkOption.INCLUDE_DIRECTORIES] bewirkt, dass auch Ordner zurückgegeben werden. Die Pfade werden in umgekehrter Reihenfolge sortiert ([sortedDescending]), um den Inhalt eines Ordners vor dem Ordner selbst zu löschen. Kotlin hat außerdem eine Funktion [deleteRecursively()] , die all das erledigt, aber sie ist noch experimentell: Der Compiler verlangt, dass Sie sie mit der Annotation [@OptIn(ExperimentalPathApi::class)] ausdrücklich aktivieren.
Dateifunktionen blockieren den Thread, der sie aufruft, bis die Operation abgeschlossen ist. In Kapitel 9, das die Coroutinen behandelt, werden wir sehen, wie sich vermeiden lässt, ein Programm während einer langen E/A-Operation zu blockieren.
5.7. Binärdateien
5.7.1. Die Klassen DataOutputStream und DataInputStream
Die Klassen [java.io.DataOutputStream] und [java.io.DataInputStream] dienen zum Schreiben in und Lesen aus Binärdateien. In einer solchen Datei werden Daten nicht als Text, sondern in ihrer internen Form geschrieben: Ein [Int] belegt unabhängig von seinem Wert immer 4 Byte. Es handelt sich um Byte-Streams: Sie sind von den Klassen [OutputStream] und [InputStream] abgeleitet, während Text-Streams von [Writer] und [Reader] abgeleitet sind. Kotlin hat kein eigenes Äquivalent: Es verwendet die JDK-Klassen, zusammen mit einigen Erweiterungsfunktionen zu ihrer Erzeugung ([path.outputStream()], [path.inputStream()], [stream.buffered()] …) und der Funktion [use] , um sie zu schließen.
Betrachten wir die folgende Anwendung:
Die Textdatei [persons1.txt] im Stammverzeichnis des Projekts hat den folgenden Inhalt:
Das Programm [Files04.kt] sieht wie folgt aus:
Sehen wir uns die Operationen mit der Klasse [DataOutputStream] genauer an:
- Zeile 26: Das Objekt [DataOutputStream] wird um einen anderen Byte-Stream herum aufgebaut, nach dem Prinzip verschachtelter Streams (das Entwurfsmuster „Decorator“):
- [Path(binary).outputStream()] (die Java-Methode [Files.newOutputStream]) schreibt einen Byte-Stream in die Datei, die angelegt oder, falls sie bereits existiert, abgeschnitten wird;
- [buffered()] fügt ihm einen Puffer hinzu, sodass nicht bei jedem Schreibvorgang auf die Festplatte zugegriffen wird: Das ist eine Kotlin-Erweiterungsfunktion, die einen [BufferedOutputStream(this)] zurückgibt;
- [DataOutputStream] ergänzt Methoden zum Schreiben grundlegender Datentypen;
- Zeilen 62–63: die Schreiboperationen. Die Klasse [DataOutputStream] hat für jeden einfachen Datentyp eine Methode: [writeInt], [writeDouble], [writeLong], [writeBoolean], [writeUTF] für eine Zeichenkette …;
- Zeilen 25–27: Die drei Dateien werden durch drei verschachtelte Aufrufe von
*[use]geöffnet: Kotlin hat kein Äquivalent zur Java-Anweisung*[try], die mehrere durch Semikolons getrennte Ressourcen deklariert. Jedes [use] schließt seinen Stream beim Verlassen seines Lambdas: Die drei Dateien werden daher in der umgekehrten Reihenfolge ihrer Öffnung geschlossen, selbst wenn eine Exception auftritt. Das Schließen des äußeren Streams ([DataOutputStream]) schließt die darin enthaltenen Streams. Die Protokolldatei wird über einen [Writer] ([writer()]) geschrieben, der mit einem Puffer ([buffered()], das hier einen [BufferedWriter] zurückgibt) ausgestattet ist; - Zeile 22: Die Destrukturierung gilt auch für Arrays: Die ersten drei Elemente von
*[args]* werden in drei Variablen mit expliziten Namen gespeichert; - Zeilen 32–33: eine lokale Funktion (Kapitel 3), die innerhalb des Lambdas deklariert ist und eine Fehlermeldung in die Protokolldatei schreibt. Sie hat Zugriff auf die umgebenden Variablen ([logs], [lineNumber], [text]), sodass der Anfang der Meldung nicht wiederholt werden muss. [appendLine] ist eine Kotlin-Erweiterungsfunktion, die eine Zeichenkette gefolgt von einem Zeilenumbruch (["\n"], unabhängig vom System) in ein beliebiges [Appendable]-Objekt schreibt, also auch in jeden
*[Writer]*; - Zeile 35: Die Textdatei wird zeilenweise von [forEachLine] gelesen, einer Erweiterung von [BufferedReader] ([Reader]). Der Schleifenrumpf ist ein Lambda: Um zur nächsten Zeile zu wechseln, schreiben wir nicht [continue] , sondern [return@forEachLine] (Zeilen 39 und 45), ein Return mit Label, das die Ausführung des Lambdas für die aktuelle Zeile beendet. Ein einfaches [return] würde die Funktion [main] beenden;
- Zeile 41: Das Trennzeichen ist das Zeichen [:], umgeben von beliebig vielen Leerzeichen, die zusammen mit ihm entfernt werden. Die Kotlin-Funktion [split] erhält hier einen regulären Ausdruck ([Regex], der später in diesem Kapitel behandelt wird), geschrieben als Raw String ["""..."""] , in dem der Backslash nicht verdoppelt werden muss. Beachten Sie: [split(":")] mit einer Zeichenkette würde nach dieser Zeichenkette im Wortsinn trennen und nicht nach einem regulären Ausdruck, anders als die Java-Methode [split];
- Zeile 49: Entpacken einer Liste: Ihre zwei Elemente werden in zwei Variablen gespeichert;
- Zeile 55: Das Alter muss eine positive ganze Zahl oder null sein. Wo das Java-Programm eine Methode schreiben musste, die die Exception [NumberFormatException] abfängt, verwendet Kotlin [toIntOrNull], das [null] zurückgibt, wenn die Zeichenkette keine ganze Zahl ist; der Elvis-Operator ersetzt es dann durch -1, einen für ein Alter ungültigen Wert;
- Zeilen 20, 74, 77: [exitProcess(n)] (Paket [kotlin.system]) beendet das Programm mit dem Exit-Code n, den ein Skript prüfen kann (0: Erfolg; dies ist der Exit-Code eines Programms, dessen Funktion [main] normal endet). Es ruft [System.exit(n)] auf und hat den Rückgabetyp [Nothing]: Der Compiler weiß, dass die darauf folgenden Anweisungen nie ausgeführt werden.
Die drei Argumente des Programms werden über die Option [--args] von [gradlew run] übergeben. Die Ergebnisse sind die folgenden:
Die Protokolldatei [logs.txt] enthält Folgendes:
Ohne Argumente oder mit einer nicht vorhandenen Textdatei:
Der Inhalt der Binärdatei [persons1.bin] lässt sich mit dem Linux-Befehl [od] hexadezimal anzeigen (unter Windows erzeugt der PowerShell-Befehl [Format-Hex] eine ähnliche Anzeige):
Daran sieht man, wie [DataOutputStream] die Daten schreibt:
- Eine Zeichenkette wird von [writeUTF] geschrieben, vorangestellt ist ihre Länge in Bytes auf 2 Bytes: 00 04, gefolgt von den 4 Bytes von „paul“ (70 61 75 6c). Die Zeichen werden in einer Variante von UTF-8 codiert;
- Eine ganze Zahl [Int] wird auf 4 Bytes geschrieben, das höchstwertige Byte zuerst (die sogenannte „Big-Endian“-Reihenfolge, die in Netzwerkprotokollen verwendet wird): 10 wird als 00 00 00 0a geschrieben. Dieses Format ist auf allen Rechnern gleich: Eine Datei, die von [DataOutputStream] unter Windows geschrieben wurde, kann unter Linux gelesen werden;
- Die Daten werden fortlaufend geschrieben, ohne Trennzeichen oder Zeilenumbrüche: Die Datei ist 48 Bytes lang (letzte Zeile: Mit der Option [-A d] zeigt [od] die Positionen dezimal an).
Um diese Datei zu lesen, müssen Sie daher die genaue Reihenfolge und den Typ der geschriebenen Daten kennen. Zu jeder Methode [writeXX] von [DataOutputStream] hat die Klasse [DataInputStream] eine entsprechende Methode [readXX]: [readUTF], [readInt], [readDouble] … Sie kann jedoch nicht angeben, wie viele Bytes noch zu lesen sind: Eine von [DataInputStream] gelesene Datei muss mit der Anzahl der enthaltenen Datensätze beginnen oder so lange gelesen werden, bis die Exception [EOFException] auftritt, die das Ende des Datenstroms signalisiert. Eine Ausnahme sollte jedoch die Ausnahme bleiben, und das Ende einer Datei ist keine.
5.7.2. Die Klasse RandomAccessFile
Die Klasse [java.io.RandomAccessFile] liest und schreibt eine Datei mit direktem Zugriff: Sie können den Cursor an eine beliebige Stelle der Datei setzen, bevor Sie lesen oder schreiben. Sie besitzt dieselben Lese- und Schreibmethoden wie [DataInputStream] und [DataOutputStream] (sie implementiert dieselben Schnittstellen, [DataInput] und [DataOutput]) und zusätzlich:
Methode | Rolle |
[RandomAccessFile(name: String, mode: String)] | öffnet die Datei zum Lesen ([mode] "r") oder zum Lesen und Schreiben ("rw") |
[length(): Long] | die Dateigröße in Bytes |
[filePointer: Long] | die aktuelle Position in der Datei (die Java-Methode [getFilePointer], aus Kotlin als Property betrachtet) |
[seek(pos: Long)] | springt zur Position [pos] in der Datei |
Das Programm [Files05.kt] führt die umgekehrte Operation des vorherigen Programms aus: Es liest die Binärdatei, um eine Textdatei zu erzeugen. Wenn die entstandene Textdatei die korrekten Daten der Ursprungsdatei enthält, wissen wir, dass die Umwandlung Text → Binärdatei → Text gelungen ist.
Betrachten wir die Operationen mit der Klasse [RandomAccessFile] genauer:
- Zeile 24: Das [RandomAccessFile]-Objekt wird im schreibgeschützten Modus geöffnet („r“-Modus). Es implementiert [Closeable]: [use] schließt es. Die Textdatei wird von einem zweiten [use] geöffnet, das im ersten verschachtelt ist und vor diesem geschlossen wird;
- Zeile 28: Das Lesen wird fortgesetzt, bis die aktuelle Position in der Datei das Dateiende erreicht. Kotlin stellt Java-Methoden der Form [getXxx()] als Properties [xxx] dar: Wir schreiben [input.filePointer] und nicht [input.getFilePointer()]. Da [length] nicht die Form [getXxx] hat, bleibt es eine Methode;
- Zeilen 30–31: die Leseoperationen [readUTF] und [readInt]. Sie müssen in der Reihenfolge der Schreibvorgänge aufgerufen werden;
- Zeile 33: Schreiben einer Zeile in die Textdatei;
- Zeilen 39–40: direkter Zugriff: [seek] setzt die Position auf den Dateianfang zurück, und der erste Datensatz wird erneut gelesen. Wären alle Datensätze gleich groß, könnten wir den n-ten Datensatz direkt lesen, indem wir zur Position n × Größe springen: Das ist das Prinzip der Dateien mit direktem Zugriff, der Vorläufer der Datenbanken;
- Zeile 42: Die Exception [EOFException] signalisiert nun eine echte Anomalie: eine Datei, die mitten in einem Datensatz endet. Da die Exception selbst nicht verwendet wird, heißt sie [_];
- Zeile 46: [RandomAccessFile], eine Unterklasse von [java.io], meldet eine fehlende Datei über eine [FileNotFoundException], deren vom System bereitgestellte Meldung den Dateinamen enthält.
Führen wir das Programm mit der zuvor erzeugten Datei [persons1.bin] aus:
Der Inhalt von [persons2.txt] ist der folgende:
Wir finden die 4 gültigen Personen aus der Datei [persons1.txt] wieder. Bei einer Datei namens [truncated.bin], die aus den ersten 33 Bytes von [persons1.bin] besteht (Linux-Befehl [head -c 33 persons1.bin > truncated.bin]), schlägt das Lesen von Jacques’ Alter fehl:
Und mit einer nicht vorhandenen Datei:
Java besitzt auch einen Mechanismus zur binären Serialisierung von Objekten: Die Klassen [ObjectOutputStream] und [ObjectInputStream] schreiben und lesen ganze Objekte, sofern ihre Klasse die Schnittstelle [java.io.Serializable] implementiert. Er lässt sich aus Kotlin verwenden, wird aber heute nicht mehr empfohlen: Das Deserialisieren von Daten aus einer nicht vertrauenswürdigen Quelle hat zahlreiche Angriffe ermöglicht, da die Deserialisierung vom Angreifer gewählten Code ausführen kann. Stattdessen wird ein textbasiertes Format wie JSON bevorzugt.
5.7.3. JSON-Serialisierung mit Jackson
Eine Binärdatei Byte für Byte zu schreiben und zu lesen ist mühsam, und schon die kleinste Abweichung zwischen Schreiben und Lesen führt zu falschen Ergebnissen. Es ist im Allgemeinen vorzuziehen, Objekte zu serialisieren: sie automatisch in eine Zeichenfolge umzuwandeln und sie anschließend zu deserialisieren, um sie zu rekonstruieren.
JSON (JavaScript Object Notation) ist ein textbasiertes, für Menschen lesbares und universelles Format: Es ist das Austauschformat der Webservices (Kapitel 13) und vieler Konfigurationsdateien. Ein Objekt wird in geschweiften Klammern als Paare „Eigenschaft“: Wert geschrieben, ein Array in eckigen Klammern.
Weder die Java-Standardbibliothek noch die Kotlin-Standardbibliothek kann JSON lesen oder schreiben. Es wird eine externe Bibliothek verwendet. Ein Kotlin-Programm hat drei Möglichkeiten:
- Jackson, die am weitesten verbreitete Java-Bibliothek, die Spring Boot standardmäßig verwendet. Ihre Version 3 (2025) hat die Pakete geändert: [tools.jackson.*] statt [com.fasterxml.jackson.*] in Version 2, der man noch häufig begegnet; ihre Annotationen bleiben im Paket [com.fasterxml.jackson.annotation]. Wie jede Java-Bibliothek lässt sie sich direkt aus Kotlin verwenden: Sie ist die, die wir hier einsetzen, genau wie im Java-Kurs;
- Jackson wird durch das Modul [jackson-module-kotlin] ergänzt ([tools.jackson.module:jackson-module-kotlin] für Jackson 3), das ihr die Besonderheiten von Kotlin beibringt: Standardwerte von Parametern, Nullable-Typen, [object]-Klassen … Am Ende dieses Abschnitts sehen wir, was Jackson ohne dieses Modul fehlt;
- kotlinx.serialization, die Serialisierungsbibliothek von JetBrains, die für Kotlin geschrieben wurde: Ein Compiler-Plugin ([kotlin("plugin.serialization")]) erzeugt für jede mit [@Serializable] annotierte Klasse den Code, der sie serialisiert, ohne Reflection zur Laufzeit. Sie unterstützt Standardwerte und Nullable-Typen selbstverständlich und funktioniert auch außerhalb der JVM (Kotlin Multiplatform). Sie ist die natürliche Wahl für ein reines Kotlin-Projekt; Jackson bleibt die Wahl für Spring-Projekte und für Projekte, die Java und Kotlin mischen.
Eine externe Bibliothek wird in der Build-Datei des Projekts deklariert (Kapitel 2). Das Gradle-Projekt [05-classes-kotlin] deklariert die Abhängigkeit von Jackson in seiner Datei [build.gradle.kts]:
Kommentare:
- Zeilen 14–17: die Abhängigkeit von der Bibliothek [jackson-databind]. Gradle lädt sie aus dem zentralen Repository (Maven Central, Zeile 11) herunter, zusammen mit den Bibliotheken, von denen sie selbst abhängt ([jackson-core] und [jackson-annotations]);
- Zeile 27: Der Compiler bewahrt die Namen der Funktions- und Konstruktorparameter im Bytecode auf. Das ist hier unverzichtbar: Ohne das Kotlin-Modul erzeugt Jackson eine Datenklasse, indem es ihren primären Konstruktor aufruft, und anhand der Namen seiner Parameter ordnet es jeden einzelnen der gleichnamigen JSON-Eigenschaft zu. Dies entspricht der Option [-parameters] des Java-Compilers;
- Zeilen 31–34: Das von [gradlew run] ausgeführte Programm wird durch die Eigenschaft [main] der Befehlszeile festgelegt ([-Pmain=...]);
- Zeilen 42–45: Die von Gradle gestarteten Programme schreiben ihre Ausgabe in UTF-8, damit Umlaute und andere Sonderzeichen unter Windows korrekt angezeigt werden (Kapitel 2).
Das zentrale Objekt in Jackson ist [JsonMapper], das zwei Hauptmethoden besitzt:
Methode | Rolle |
[writeValueAsString(value: Any?): String] | gibt den JSON-Text zurück, der das Objekt [value] darstellt |
[readValue(content: String, valueType: Class<T>): T] | rekonstruiert ein Objekt vom Typ [T] aus dem JSON-Text [content]; löst eine [JacksonException] aus, wenn der Text fehlerhaft ist. Eine überladene Variante erhält statt einer [Class] eine [TypeReference] |
Das Programm [Files06.kt] verwendet sie:
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 33 34 35 36 37 38 39 40 41 42 43 44 45 46 47 48 49 50 51 52 53 54 55 56 57 58 59 60 61 62 63 64 65 66 67 68 69 70 71 72 73 74 75 76 77 78 79 80 81 82 83 84 85 86 87 88 89 90 91 92 93 94 95 96 97 98 99 100 101 102 103 104 105 106 107 | |
Es wird im Projektordner oder aus der IDE heraus ausgeführt:
Kommentare:
- Zeilen 3–13: Die verwendeten Jackson-Klassen. Anders als das Java-Programm, das ein eigenes Maven-Projekt sein musste, ist [Files06.kt] Teil des Gradle-Projekts des Kapitels, genau wie die anderen: Die Abhängigkeit von Jackson wird für das gesamte Projekt deklariert;
- Zeile 18: Die Datenklasse [Person], die serialisiert werden soll. Jackson kennt Kotlin nicht, aber es sieht, was der Compiler erzeugt hat: eine Java-Klasse mit den Zugriffsmethoden [getName], [getAge], [getHobbies] und einem Konstruktor mit drei Parametern. Jede Zugriffsmethode liefert eine JSON-Eigenschaft mit dem entsprechenden Namen ([getName] → [name]);
- Zeile 21: Die Annotation [@JsonProperty] legt den Namen der JSON-Eigenschaft auf [reference] statt auf [code] fest. Wird die Annotation an einen Parameter des primären Konstruktors gesetzt, der eine Property deklariert, könnte sie sich auf den Parameter, die Property, das Feld oder die Zugriffsmethode beziehen: Kotlin 2.4 wendet sie hier auf den Konstruktorparameter und auf das private Feld an, das die Property speichert (das haben wir im kompilierten Code mit dem Befehl [javap -v] überprüft; ältere Kotlin-Versionen wendeten sie nur auf den Parameter an). Jackson, das den Parameter, das Feld und die Zugriffsmethode [getCode] derselben Eigenschaft zuordnet, verwendet den Namen [reference] sowohl zum Schreiben als auch zum Lesen. Sie können das Ziel angeben: [@param:JsonProperty], [@get:JsonProperty], [@field:JsonProperty];
- Zeilen 40–41: Ein [JsonMapper] wird von einem Objekt-Builder erzeugt: [JsonMapper.builder()] liefert ein Objekt, dem die gewünschten Optionen übergeben werden, und [build] erzeugt dann den [JsonMapper]. Mit den Standardoptionen wird der Text in einer einzigen Zeile geschrieben, und Zeichen mit Akzenten werden unverändert ausgegeben (Zeile 1 der Ergebnisse). [persons[1]] ist die Kotlin-Variante von [persons.get(1)];
- Zeilen 43–44: Die Option [ESCAPE_NON_ASCII] weist das Programm an, Nicht-ASCII-Zeichen als Escape-Sequenzen zu schreiben: [é] wird zu [é]. Der Text bleibt korrekt, ist aber schwer lesbar; das ist nützlich, wenn der JSON-Text ein System passieren muss, das nur ASCII kennt;
- Zeile 47: Die Option [INDENT_OUTPUT] erzeugt eingerückten Text, der sich über mehrere Zeilen erstreckt. Eine Liste wird in ein JSON-Array serialisiert;
- Zeilen 49–52: Der JSON-Text wird von [writeText] in eine Textdatei geschrieben und dann zur Anzeige wieder gelesen: So wird die binäre Serialisierung heute ersetzt;
- Zeile 57: Die Deserialisierung rekonstruiert die Liste. Jackson erzeugt die [Person] -Objekte, indem es den Konstruktor der Datenklasse aufruft, dessen Parameter den gleichnamigen JSON-Eigenschaften zugeordnet werden. Bei einer Liste müssen Sie Jackson den Typ ihrer Elemente mitteilen. Der Ausdruck [List<Person>::class.java] existiert jedoch nicht: Generics werden zur Kompilierzeit gelöscht („Type Erasure“), in Kotlin wie in Java, und zur Laufzeit gibt es nur eine Klasse [List] ohne Typparameter. Der Trick mit [TypeReference] besteht darin, ein anonymes Objekt ([object : TypeReference<List<Person>>() {}]) einer von [TypeReference<List<Person>>] abgeleiteten Klasse zu erzeugen: Der Elterntyp einer Klasse bleibt im kompilierten Code erhalten, und Jackson kann ihn lesen;
- Zeilen 59–60: Die Schleife entpackt jede Person beim Lesen;
- Zeile 30: Kotlin erlaubt es, diesen Trick ein für alle Mal zu schreiben. [readJson] ist eine Erweiterungsfunktion von [JsonMapper] und [inline] mit einem Parameter vom Typ [reified] (Kapitel 4): Ihr Code wird bei jedem Aufruf kopiert, mit dem tatsächlichen Typ anstelle von [T]. Der Aufruf von [mapper.readJson<List<Person>>(text)] (Zeile 63) erzeugt daher ein Objekt namens [TypeReference<List<Person>>], nicht [TypeReference<T>]. Das Modul [jackson-module-kotlin] stellt eine ähnliche Funktion bereit, [readValue<T>()], sowie eine Funktion [jacksonTypeRef<T>()];
- Zeile 64: Bei einem Array, das einfacher ist, übergeben wir direkt die Klasse [Array<Person>::class.java] (das Java-Äquivalent [Person[].class]). Die nächste Zeile prüft, dass die beiden zurückgelesenen Listen gleich sind, im Sinne der Gleichheit von Datenklassen;
- Zeile 68: Serialisierung eines [Article]: Die Eigenschaft [reference] trägt den von der Annotation angegebenen Namen. Ein [BigDecimal] wird als JSON-Zahl geschrieben;
- Zeilen 70–74: Mit der Option [ACCEPT_CASE_INSENSITIVE_PROPERTIES] ignoriert Jackson beim Parsen die Groß- und Kleinschreibung der Eigenschaftsnamen: [REFERENCE] und [Price] werden akzeptiert. Der JSON-Text steht in einem Raw String ["""..."""], in dem Anführungszeichen nicht von einem Backslash eingeleitet werden müssen;
- Zeilen 76–82: Ein ungültiges JSON-Dokument – hier eine Zeichenkette, wo eine Zahl erwartet wird – löst eine von [JacksonException] abgeleitete Exception aus, genauer [InvalidFormatException]. In Jackson 3 sind diese Exceptions von [RuntimeException] abgeleitet, während sie in Jackson 2 von [IOException] abgeleitet waren; für Kotlin, das keine geprüften Exceptions kennt, ist der Unterschied nicht zu bemerken. [originalMessage] liefert die Meldung ohne die Lokalisierungsinformationen, die [location] und [pathReference] getrennt bereitstellen: Zeile 1, Spalte 23, Eigenschaft [age] der Klasse [Person]. Kotlin behandelt die Java-Methoden [getOriginalMessage()], [getLocation()], [getLineNr()] … als Properties.
Der letzte Teil des Programms zeigt, was Jackson ohne das Kotlin-Modul an Kotlin-Klassen nicht erkennt. Wir haben dies mit Jackson 3.1.5 überprüft:
- Zeile 87: Eine unbekannte JSON-Eigenschaft der Klasse ([city]) wird ignoriert. Dies ist eine Änderung in Jackson 3: Die Option [DeserializationFeature.FAIL_ON_UNKNOWN_PROPERTIES], die in Jackson 2 standardmäßig aktiviert war, ist in Jackson 3 standardmäßig deaktiviert; sie lässt sich mit [JsonMapper.builder().enable(DeserializationFeature.FAIL_ON_UNKNOWN_PROPERTIES)] wieder aktivieren, wenn das Dokument abgelehnt werden soll;
- Zeile 24: Die Klasse [Subscriber] hat Standardwerte für [age] (18) und [hobbies] (eine Liste mit „reading“). Diese Werte werden nicht vom Konstruktor selbst berechnet, sondern von einem zweiten, synthetischen Konstruktor, den der Compiler der Klasse hinzufügt und der von in Kotlin geschriebenen Aufrufen verwendet wird: Jackson, das den Hauptkonstruktor direkt per Reflection aufruft, ignoriert sie. Für eine im JSON-Dokument fehlende Eigenschaft übergibt es dem Konstruktor den „leeren“ Wert des Typs: [null] für ein Objekt und für einen primitiven Typ wie [Int] … einen Fehler, weil Jackson 3 die Option [FAIL_ON_NULL_FOR_PRIMITIVES] standardmäßig aktiviert (in Jackson 2 war sie deaktiviert, und es wurde 0 übergeben);
- Zeilen 90–97: Die vier Testdokumente liefern Folgendes (Zeilen 27–30 der Ergebnisse):
- ein vollständiges Dokument: Das Objekt wird normal erzeugt;
- ohne [hobbies]: Jackson übergibt [null] an den Parameter [hobbies], der den Non-Nullable-Typ [List<String>] hat. Der Kotlin-Konstruktor prüft seine Non-Nullable-Parameter und löst eine [NullPointerException] („Parameter specified as non-null is null“) aus, die Jackson als [ValueInstantiationException] weitergibt. Der Standardwert [listOf("reading")] wurde nicht verwendet;
- ohne [age]: [MismatchedInputException], es gibt keinen Wert für den primitiven Typ [int]. Der Standardwert 18 wurde nicht verwendet;
- mit ["name": null]: Dieselbe Konstruktorprüfung lehnt [null] für [name] ab. Dieses Verhalten ist eigentlich eine gute Nachricht: Die Sicherheit von Kotlin im Umgang mit [null] wird von Jackson nicht umgangen;
- Zeilen 27, 100–105: Eine boolesche Eigenschaft, deren Name mit [is] beginnt, wie [isActive], hat die Zugriffsmethode [isActive()] (Kotlin nennt sie nicht [getIsActive]); Jackson leitet gemäß den JavaBeans-Konventionen eine JSON-Eigenschaft [active] ab. Der Konstruktorparameter heißt jedoch [isActive]: Jackson kann diese Eigenschaft in dem Dokument, das es selbst geschrieben hat, nicht finden, und die Validierung schlägt fehl.
Das Modul [jackson-module-kotlin] behebt diese drei Probleme (Standardwerte werden verwendet, [isXxx]-Eigenschaften behalten ihre Namen, klare Fehlermeldungen bei [null]); auch kotlinx.serialization behandelt sie korrekt. Ohne sie gilt folgende Regel: Bei alleiniger Verwendung von Jackson darf sich eine für JSON bestimmte Datenklasse weder auf ihre Standardwerte noch auf Eigenschaftsnamen verlassen, die mit [is] beginnen. So gehen wir im weiteren Verlauf des Kurses vor, in dem unsere JSON-Klassen einfach bleiben.
Ein [JsonMapper] ist teuer in der Erzeugung, kann aber nach der Erzeugung wiederverwendet und von mehreren Threads gemeinsam genutzt werden: Ein Programm erzeugt typischerweise nur einen, der in einer Konstante abgelegt wird (eine Top-Level-Property oder eine Property eines [object]). Wir verwenden JSON in der Beispielanwendung am Ende des Kapitels und danach im gesamten Kurs.
5.8. Reguläre Ausdrücke
Die Kotlin-Standardbibliothek stellt die Klasse [kotlin.text.Regex] bereit, die die Verwendung regulärer Ausdrücke ermöglicht. Damit können Sie das Format einer Zeichenkette prüfen. Sie können zum Beispiel überprüfen, ob eine Zeichenkette, die ein Datum darstellt, tatsächlich das Format TT/MM/JJ hat. Dazu verwenden Sie ein Muster und vergleichen die Zeichenkette mit diesem Muster. In diesem Beispiel müssen T, M und J Ziffern sein. Das Muster für ein gültiges Datumsformat lautet also [\d\d/\d\d/\d\d], wobei das Symbol [\d] für eine Ziffer steht. Auf der JVM ist die Klasse [Regex] ein Wrapper um die Klasse [java.util.regex.Pattern] des JDK: Die Syntax der Muster und die Suchmaschine sind genau dieselben wie in Java; nur die Programmierschnittstelle ändert sich. Die in einem Muster verwendbaren Symbole sind die folgenden:
Zeichen | Beschreibung |
[\] | kennzeichnet das folgende Zeichen als Sonderzeichen oder als Literal. Zum Beispiel entspricht [n] dem Zeichen n, [\n] einem Zeilenumbruch, [\\] entspricht \, und [\(] entspricht ( |
[^] | entspricht dem Anfang der Zeichenkette |
[$] | entspricht dem Ende der Zeichenkette |
[*] | trifft null-, ein- oder mehrmals auf das vorhergehende Element zu. So trifft [zo*] auf z oder zoo zu |
[+] | trifft ein- oder mehrmals auf das vorhergehende Element zu. So trifft [zo+] auf „zoo“ zu, aber nicht auf „z“ |
[?] | trifft null- oder einmal auf das vorhergehende Element zu. Zum Beispiel trifft [a?ve?] auf „ve“ in „lever“ zu |
[.] | trifft auf jedes einzelne Zeichen zu, außer auf einen Zeilenumbruch |
[(pattern)] | sucht das Muster und speichert den Treffer (eine Gruppe). Die übereinstimmende Teilzeichenkette lässt sich über die Property [groupValues] oder [groups] aus dem Ergebnis extrahieren. Um Treffer mit Zeichen in Klammern zu finden, verwenden Sie [\(] oder [\)] |
[x|y] | trifft entweder auf x oder auf y zu. Zum Beispiel trifft [z|foot] auf z oder foot zu; [(z|f)oo] trifft auf zoo oder foo zu |
[{n}] | n ist eine nichtnegative ganze Zahl. Entspricht genau n-mal dem vorhergehenden Element. Zum Beispiel entspricht [o{2}] nicht dem o in Bob, aber den ersten beiden o in fooooot |
[{n,}] | trifft mindestens n-mal auf das vorhergehende Element zu. Zum Beispiel trifft [o{2,}] nicht auf das „o“ in „Bob“ zu, aber auf alle „o“ in „fooooot“. [o{1,}] ist gleichbedeutend mit [o+], und [o{0,}] ist gleichbedeutend mit [o*] |
[{n,m}] | trifft mindestens n-mal und höchstens m-mal auf das vorhergehende Element zu. Zum Beispiel trifft [o{1,3}] auf die ersten drei „o“ in „foooooot“ zu; [o{0,1}] ist gleichbedeutend mit [o?] |
[[xyz]] | Zeichenmenge: trifft auf eines der angegebenen Zeichen zu. Zum Beispiel trifft [[abc]] auf den Buchstaben „a“ in „plat“ zu |
[[^xyz]] | negierte Zeichenmenge: trifft auf jedes Zeichen zu, das nicht aufgeführt ist. Zum Beispiel trifft [[^abc]] auf „p“ in „plat“ zu |
[[a-z]] | Zeichenbereich: trifft auf jedes Zeichen im angegebenen Bereich zu, hier ein Kleinbuchstabe ohne Akzent |
[[^m-z]] | negierter Zeichenbereich: entspricht jedem Zeichen, das nicht zwischen m und z liegt |
[\b] | trifft auf eine Wortgrenze zu, das heißt auf die Position zwischen einem Wortzeichen und einem Nicht-Wortzeichen. Zum Beispiel trifft [er\b] auf „er“ in „lever“ zu, aber nicht auf „er“ in „verb“ |
[\B] | entspricht einer Position, die keine Wortgrenze ist. [en*t\B] entspricht „ent“ in „entry“ |
[\d] | trifft auf eine Ziffer zu; ist gleichbedeutend mit [[0-9]] |
[\D] | entspricht einem Zeichen, das keine Ziffer ist |
[\f], [\n], [\r], [\t] | entsprechen jeweils den Zeichen Seitenvorschub, Zeilenumbruch, Wagenrücklauf und Tabulator |
[\s] | entspricht jedem Leerraumzeichen: Leerzeichen, Tabulator, Seitenvorschub, Zeilenumbruch … Gleichbedeutend mit [[ \t\n\x0B\f\r]] |
[\S] | trifft auf jedes Zeichen zu, das kein Leerraumzeichen ist |
[\w] | trifft auf jedes Wortzeichen zu: standardmäßig ein Buchstabe ohne Akzent, eine Ziffer oder ein Unterstrich; gleichbedeutend mit [[a-zA-Z_0-9]]. Mit der Option [(?U)] (siehe unten) erkennt es auch Buchstaben mit Akzent |
[\W] | trifft auf jedes Zeichen zu, das kein Wortzeichen ist |
[\num] | num ist eine positive ganze Zahl: verweist auf die Gruppe mit der Nummer num. Zum Beispiel entspricht [(.)\1] zwei aufeinanderfolgenden identischen Zeichen |
[\xnn], [\unnnn] | entspricht dem hexadezimalen Zeichen nn (2 Ziffern) oder nnnn (4 Ziffern). Zum Beispiel entspricht [\x41] dem Zeichen A |
Ein Element in einem Muster kann einmal oder mehrfach vorkommen. Betrachten wir einige Beispiele mit dem Symbol [\d], das für eine einzelne Ziffer steht:
Muster | Bedeutung |
[\d] | eine Ziffer |
[\d?] | 0 oder 1 Ziffer |
[\d*] | 0 oder mehr Ziffern |
[\d+] | 1 oder mehr Ziffern |
[\d{2}] | 2 Ziffern |
[\d{3,}] | Mindestens 3 Ziffern |
[\d{5,7}] | zwischen 5 und 7 Ziffern |
Stellen wir uns nun ein Muster vor, das das erwartete Format einer Zeichenkette beschreiben kann:
Zielzeichenkette | Muster |
ein Datum im Format TT/MM/JJ | [\d{2}/\d{2}/\d{2}] |
eine Uhrzeit im Format hh:mm:ss | [\d{2}:\d{2}:\d{2}] |
eine ganze Zahl ohne Vorzeichen | [\d+] |
eine Folge von Leerzeichen, die auch leer sein kann | [\s*] |
eine ganze Zahl ohne Vorzeichen, der Leerzeichen vorangehen oder folgen können | [\s*\d+\s*] |
eine ganze Zahl, die ein Vorzeichen haben kann und der Leerzeichen vorangehen oder folgen können | [\s*[+-]?\s*\d+\s*] |
eine reelle Zahl ohne Vorzeichen, der Leerzeichen vorangehen oder folgen können | [\s*\d+(\.\d*)?\s*] |
eine reelle Zahl, die ein Vorzeichen haben kann und der Leerzeichen vorangehen oder folgen können | [\s*[+-]?\s*\d+(\.\d*)?\s*] |
eine Zeichenkette, die das Wort „just“ enthält | [\bjust\b] |
Beachten Sie, dass das Zeichen [|] innerhalb eckiger Klammern keine besondere Bedeutung hat: Das Muster [[+|-]], das manchmal für das Vorzeichen verwendet wird, akzeptiert vor einer Zahl auch das Zeichen |. Ebenso muss der Dezimalpunkt maskiert werden, [\.]: Ein nicht maskierter Punkt trifft auf jedes beliebige Zeichen zu.
Sie können festlegen, wo in der Zeichenkette nach dem Muster gesucht wird:
Muster | Bedeutung |
[^pattern] | Das Muster steht am Anfang der Zeichenkette |
[pattern$] | Das Muster steht am Ende der Zeichenkette |
[^pattern$] | Das Muster steht am Anfang und am Ende der Zeichenkette |
[pattern] | Das Muster wird an beliebiger Stelle der Zeichenkette gesucht, beginnend am Anfang der Zeichenkette |
gesuchte Zeichenkette | Muster |
eine Zeichenkette, die mit einem Ausrufezeichen endet | [!$] |
eine Zeichenkette, die mit einem Punkt endet | [\.$] |
eine Zeichenkette, die mit der Folge // beginnt | [^//] |
eine Zeichenkette, die aus einem einzigen Wort besteht, dem Leerzeichen vorangehen oder folgen können | [^\s*\w+\s*$] |
eine Zeichenkette, die aus genau zwei Wörtern besteht, denen Leerzeichen vorangehen oder folgen können | [^\s*\w+\s+\w+\s*$] |
eine Zeichenkette, die das Wort „secret“ enthält | [\bsecret\b] |
Teilmengen eines Musters können „extrahiert“ werden. So können wir nicht nur prüfen, ob eine Zeichenkette einem bestimmten Muster entspricht, sondern auch die Elemente aus ihr extrahieren, die den in Klammern gesetzten Teilmengen des Musters entsprechen. Wenn wir zum Beispiel eine Zeichenkette mit einem Datum im Format TT/MM/JJ analysieren und zusätzlich die Elemente TT, MM und JJ dieses Datums extrahieren wollen, verwenden wir das Muster [(\d\d)/(\d\d)/(\d\d)].
Nun muss das Muster noch im Code geschrieben werden. In einer gewöhnlichen Zeichenkette, die auf jeder Seite von einem einfachen Anführungszeichen begrenzt wird, ist das Zeichen [\] wie in Java ein Escape-Zeichen: Jedes [\] im Muster muss verdoppelt werden, und das Muster [\d+] wird als ["\\d+"] geschrieben. Kotlin bietet eine bessere Lösung: Raw Strings, die in dreifache Anführungszeichen eingeschlossen sind – denen wir bereits begegnet sind – und in denen [\] ein gewöhnliches Zeichen ist. Das Muster wird unverändert geschrieben: ["""\d+"""], und das Muster [\\], das das Zeichen \ darstellt, wird als ["""\\"""] statt als ["\\\\"] geschrieben. Das ist in Kotlin üblich, und wir halten uns daran. Eine Einschränkung: In einem Raw String leitet das Zeichen [$] gefolgt von einem Bezeichner oder einer geschweiften Klammer ein Template ein. Das [$] am Ende der Zeichenkette, gefolgt von Anführungszeichen, bereitet keine Probleme; für andere Fälle hat Kotlin 2.2 „Multi-Dollar“-Interpolationsstrings eingeführt, die wir im Programm [Regex03.kt] sehen werden. Der Editor erleichtert das Lesen: IntelliJ IDEA erkennt Zeichenketten, die an [Regex] oder [toRegex] übergeben werden, hebt sie als reguläre Ausdrücke hervor und erlaubt es, sie zu testen (Alt+Eingabe, Check RegExp).
5.8.1. Prüfen, ob eine Zeichenkette einem bestimmten Muster entspricht
Ein Muster wird zunächst kompiliert zu einem [Regex]-Objekt, das dann die Suchfunktionen bereitstellt. Während Java ein Zwischenobjekt [Matcher] verwendet, um den Zustand einer Suche zu speichern, liefert Kotlin die Ergebnisse direkt:
Funktion | Rolle |
[Regex(pattern: String)] | kompiliert das Muster [pattern]; löst eine [PatternSyntaxException] aus, wenn das Muster fehlerhaft ist |
[Regex(pattern, option)], [Regex(pattern, options)] | wie oben, mit einer [RegexOption]-Option oder einer Menge von [Set<RegexOption>] Optionen (siehe unten) |
[String.toRegex()] | Erweiterungsfunktion: ["""\d+""".toRegex()] ist gleichbedeutend mit [Regex("""\d+""")] |
[containsMatchIn(input)] | gibt [true] zurück, wenn die Zeichenkette [input] ein Vorkommen des Musters enthält |
[matches(input)] | gibt [true] zurück, wenn die gesamte Zeichenkette dem Muster entspricht |
[CharSequence.matches(regex)] | Infix-Erweiterungsfunktion von [String]: ["18/05/97" matches date] |
[toPattern()] | liefert das Objekt [java.util.regex.Pattern] , das vom Objekt [Regex] umhüllt wird |
Das Programm [Regex01.kt] lautet wie folgt:
Ergebnisse:
Kommentare:
- Zeile 6: Das Muster ist eine ganze Zahl ohne Vorzeichen, möglicherweise von Leerzeichen umgeben, die die gesamte Zeichenkette ausfüllt (Anker [^] und [$]). Dank des Raw Strings werden die [\] nicht verdoppelt: Das Muster steht genau so da, wie es in den Ergebnissen erscheint;
- Zeile 7: Das Muster wird vom Konstruktor der Klasse [Regex] kompiliert;
- Zeile 10: [containsMatchIn] sucht das Muster in der Zeichenkette. Die von Leerzeichen umgebene Zeichenkette „123a“ entspricht dem Muster nicht: Das Zeichen „a“ kann weder eine Ziffer noch ein Leerzeichen sein. Ohne die Anker [^] und [$] würde die Zeichenkette passen, da sie eine Zahl enthält. Das ist das Äquivalent zu [regex1.matcher(sample).find()] in Java;
- Zeile 17: Die Erweiterungsfunktion [toRegex] von [String] ist eine weitere Möglichkeit, ein Muster zu kompilieren;
- Zeilen 18–19: der Unterschied zwischen [containsMatchIn], das das Muster in der Zeichenkette sucht, und [matches], das verlangt, dass die gesamte Zeichenkette dem Muster entspricht, als wäre sie von [^] und [$] begrenzt;
- Zeilen 21–23: Die Erweiterungsfunktion [matches] von [String] nimmt ein [Regex]-Objekt entgegen; sie ist als [infix] deklariert und kann ohne Punkt und Klammern geschrieben werden (Zeile 22). Anders als Java bietet Kotlin keine Funktion [matches(String)] an, die das Muster als Zeichenkette entgegennähme und bei jedem Aufruf kompilierte: Der Aufruf ["5/1/01".matches("\\d{2}")] wird vom Compiler abgelehnt ([argument type mismatch: actual type is 'String', but 'Regex' was expected]). Das Muster muss explizit kompiliert werden, was dazu anregt, dies nur einmal zu tun;
- Zeilen 25–26: Das Objekt
[Regex]umhüllt ein Objekt[java.util.regex.Pattern]*, das von der Funktion*[toPattern]zurückgegeben wird. Der gesamte Java-Code derAPIbleibt somit zugänglich; umgekehrt wandelt die Erweiterungsfunktion [toRegex] von [Pattern] ein [Pattern] in ein [Regex] um. Wir verwenden dies im Programm [Regex06.kt].
5.8.2. Alle Vorkommen eines Musters in einer Zeichenkette finden
Die Funktion [find] liefert das erste Vorkommen des Musters in einer Zeichenkette oder [null] , wenn es keines gibt. Die Funktion [findAll] liefert alle Vorkommen als Sequenz ([Sequence], lazy ausgewertet: Jedes Vorkommen wird erst bei Anforderung gesucht). Ein Vorkommen ist ein [MatchResult]-Objekt, das Informationen über das gefundene Element liefert:
- [value]: der Text des Vorkommens, d. h. ein Element, das dem Muster entspricht;
- [range]: der Bereich [IntRange] der Positionen des Elements in der durchsuchten Zeichenkette; [range.first] ist die Position, an der das Element gefunden wurde, und [range.last] ist die Position seines letzten Zeichens;
- [next()]: das nächste Vorkommen oder [null] , wenn es keine weiteren gibt.
Das Programm [Regex02.kt] lautet wie folgt:
Ergebnisse:
Kommentare:
- Zeile 5: Das gesuchte Muster ist eine Folge von Ziffern;
- Zeile 7: die Zeichenkette, in der dieses Muster gesucht wird;
- Zeilen 10–15: Die Schleife [for] durchläuft die von [findAll] gelieferte Sequenz der Vorkommen. Jedes Vorkommen und seine Position werden angezeigt. Es gibt weder ein [Matcher]-Objekt noch wiederholte Aufrufe von [find] wie in Java;
- Zeilen 17–20: derselbe schrittweise Durchlauf: [find] liefert das erste Vorkommen vom Typ [MatchResult?], und [next] liefert das jeweils nächste, bis [null] erreicht ist. Innerhalb der Schleife weiß der Compiler, dass [result] nicht [null] ist (intelligente Typumwandlung, Kapitel 4). Die Anzeige von [range] zeigt die Positionsbereiche: 2..4 für 123;
- Zeile 24: Die Sequenz der Vorkommen eignet sich für alle Sequenzoperationen; hier summieren wir die gefundenen Zahlen mit [sumOf]. In Java müssen Sie die Methode [results] von [Matcher] verwenden, die einen Stream der Stream-API liefert;
- Zeile 26: Die Anzahl der Vorkommen des Musters [[aeiouy]], das einen Vokal bezeichnet, ist die Anzahl der Elemente der Sequenz, die von [count] geliefert wird.
5.8.3. Teile eines Musters abrufen
Wie erwähnt, werden die in Klammern eingeschlossenen Teile eines Musters gespeichert: Das sind die Gruppen. Ein [MatchResult]-Objekt stellt sie auf mehrere Arten bereit:
- [groups]: die Sammlung der Gruppen vom Typ [MatchGroupCollection]. Ihr Element Nr. 0 ist das gesamte Vorkommen; die folgenden Elemente sind die Gruppen Nr. 1, Nr. 2 usw. Jede Gruppe ist ein [MatchGroup]-Objekt, das die Properties [value] (der erfasste Text) und [range] (seine Positionen) besitzt; sie hat den Typ [MatchGroup?], da eine optionale Gruppe wie [(\.\d+)?] möglicherweise nichts erfasst;
- [groupValues]: die Liste der erfassten Texte vom Typ [List<String>]; eine Gruppe, die nichts erfasst hat, wird darin durch eine leere Zeichenkette dargestellt;
- [destructured]: die Gruppen Nr. 1 und folgende, bereit zum Entpacken: [val (h, m, s) = result.destructured].
Das Programm [Regex03.kt] verwendet sie:
Ergebnisse:
Kommentare:
- Zeile 12: Die Zeichenkette [sample4] wird mit dem Muster [regex3] verglichen; [find] sucht das erste Vorkommen des Musters und gibt [null] zurück, wenn keines gefunden wird. Der Test in Zeile 13 stellt dann fest, dass [result] bedenkenlos verwendet werden kann;
- Zeilen 16–17: Die Sammlung [groups] wird über ihren Index durchlaufen: Element Nr. 0 ist das gesamte Vorkommen, und die Elemente Nr. 1 bis Nr. 3 sind die Klammergruppen. Da die Elemente vom Typ [MatchGroup?] sind, wird mit dem Operator [?.] auf sie zugegriffen; hier haben alle Gruppen Text erfasst. [range.first] ist die Position dieses Textes innerhalb der durchsuchten Zeichenkette;
- Zeile 20: Die Property [destructured] erlaubt es, die Gruppen Nr. 1, Nr. 2 und Nr. 3 mithilfe der Destrukturierung (Kapitel 3) in einer einzigen Anweisung in drei Variablen zu übernehmen. Das ist der knappste Weg, ein Muster zu verarbeiten, dessen Gruppen man kennt;
- Zeile 27: Eine Gruppe kann benannt werden, mit der Syntax [(?<name>...)]. Hier erkennt das Muster ein Datum im Format T/M/JJJJ mit ein- oder zweistelligem Tag und Monat;
- Zeilen 32–34: Auf eine benannte Gruppe wird über ihren Namen statt über ihre Nummer verwiesen, mit dem Indexoperator [groups]: Der Code ist lesbarer und hängt nicht von der Reihenfolge der Klammern ab. Das Ergebnis hat den Typ [MatchGroup?] (ein unbekannter Name löst eine [IllegalArgumentException] aus; eine Gruppe, die nichts erfasst hat, liefert [null]); hier erfassen die drei Gruppen immer Text, wenn das Muster gefunden wird, und der Operator [!!] bringt diese Gewissheit zum Ausdruck;
- Zeilen 35–36: Die Klasse [java.time.LocalDate] stellt ein Datum ohne Uhrzeit dar. Es wird mit dem Muster [EEEE d MMMM yyyy] angezeigt: Der Wochentag erscheint auf Englisch. Kotlin verwendet die Klassen [java.time] und des JDK direkt;
- Zeile 41: Die Funktion [replace] ersetzt jedes Vorkommen des Musters durch eine Zeichenkette, in der [${name}] (oder [$1], [$2] … für nummerierte Gruppen) den Wert einer Gruppe bezeichnet. Die Datumsangaben werden so in das Format Jahr-Monat-Tag umgeformt. Aber in Kotlin ist [${year}] in einer Zeichenkette ein Template, das den Wert einer Variablen [year] einfügen würde! Wir könnten ["\${year}-\${month}-\${day}"] schreiben. Die Zeichenkette ist hier mit der Multi-Dollar-Interpolation von Kotlin 2.2 geschrieben: In einer Zeichenkette mit vorangestelltem [$$] wird ein Template als [$${...}] geschrieben, und das einzelne Zeichen [$] ist ein gewöhnliches Zeichen. Bei
***[$$$]*** wären drei nötig, und so weiter; - Zeilen 44–46: Eine Variante von
*[replace]nimmt ein Lambda (Kapitel 7) entgegen, das den Ersatztext aus jedem Vorkommen berechnet, in Form eines*[MatchResult]. Das nach den Klammern geschriebene Lambda, entsprechend der Kotlin-Konvention für den letzten Parameter einer Funktion, holt die Gruppen per Destrukturierung, baut das Datum zusammen und gibt seine normalisierte ISO-8601-Form zurück, die von der Funktion [toString] von [LocalDate] erzeugt wird: Tage und Monate sind immer zweistellig. Das entspricht der Methode*[replaceAll]von*[Matcher], die eine Funktion entgegennimmt (Java 9); - Zeilen 50–51: Die Funktion [matchEntire] verlangt wie [matches], dass die gesamte Zeichenkette dem Muster entspricht, liefert aber das Ergebnis des Vergleichs ([MatchResult]) oder [null] , wenn der Vergleich fehlschlägt: Das ist die Funktion, die man verwendet, um eine Zeichenkette zu prüfen und Teile daraus zu extrahieren. Hier wird die Property [groupValues] des Ergebnisses angezeigt: das gesamte Vorkommen, gefolgt vom Wert jeder Gruppe.
5.8.4. Ein Lernprogramm
Den regulären Ausdruck zu finden, der prüft, ob eine Zeichenkette einem bestimmten Muster entspricht, kann manchmal eine echte Herausforderung sein. Das Programm [Regex04.kt] lässt Sie üben. Es nimmt ein Muster und eine Zeichenkette als Eingabe entgegen und gibt an, ob die Zeichenkette dem Muster entspricht oder nicht.
Kommentare:
- Zeilen 15–19: Kompilierung des über die Tastatur eingegebenen Musters. Ein fehlerhaftes Muster löst eine [java.util.regex.PatternSyntaxException] aus: Die Klasse [Regex] reicht die Exception der Klasse [Pattern], die sie umhüllt, unverändert durch. Ihre Properties [description] und [index] (die Java-Methoden [getDescription] und [getIndex], von Kotlin als Properties behandelt) liefern die Fehlerbeschreibung und ihre Position im Muster. Ihre vollständige Meldung, die Property [message], erstreckt sich über mehrere Zeilen und zeigt das Muster mit einer Markierung unter dem Fehler an. Beachten Sie, dass [try] ein Ausdruck ist (Kapitel 3): Sein Wert ist der des [try]-Blocks, das [Regex]-Objekt, oder der des [catch]-Blocks. Dieser Block endet mit [continue], einem Ausdruck vom Typ [Nothing] , der nie einen Wert zurückgibt: Der Compiler schließt daraus, dass [regex] den Typ [Regex] hat;
- Zeilen 28–30: Die Suche wird nicht direkt auf der eingegebenen Zeichenkette ausgeführt, sondern auf einem [TimeLimitedString]-Objekt (Zeilen 55–69), das die Suchdauer auf eine Sekunde begrenzt: Dauert die Suche länger, wird eine [TimeoutExceededException] ausgelöst und in Zeile 40 abgefangen. Warum das nützlich ist und wie es funktioniert, sehen wir später. Die Zeitgrenze wird mit den Klassen [kotlin.time] der Standardbibliothek berechnet: [TimeSource.Monotonic.markNow()] ist die aktuelle Zeit, gemessen mit einer monotonen Uhr (unempfindlich gegenüber Änderungen der Systemzeit), und [1.seconds] ist eine Dauer vom Typ [Duration], geschrieben mit einer Erweiterungseigenschaft von [Int];
- Zeilen 35–36: Für jeden Treffer werden die Gruppen Nr. 1 und folgende angezeigt, sofern vorhanden: [drop(1)] schließt das Element Nr. 0 der Sammlung [groups] aus, nämlich das gesamte Vorkommen;
- Zeile 40: Der Name [_] zeigt an, dass die abgefangene Exception nicht verwendet wird;
- Zeilen 48–50: Anders als in den vorherigen Programmen werden aus der eingegebenen Zeile die Leerzeichen nicht entfernt; sie können Teil des Musters oder der zu testenden Zeichenkette sein. Am Ende des Eingabestroms liefert [readlnOrNull] den Wert [null], der durch eine leere Zeichenkette ersetzt wird, was das Programm beendet.
Hier ein Beispiel für den Ablauf des Programms (die aus einer Datei umgeleitete Eingabe wurde nach den Eingabeaufforderungen wieder eingefügt):
Die Muster [^\s*\d+\s*$] und [^\s*(\d+)\s*$] zeigen den Nutzen von Gruppen: Das erste erkennt die Zeichenkette „1456“ mit drei vorangestellten Leerzeichen, einschließlich der Leerzeichen; das zweite erlaubt es zusätzlich, die Zahl ohne die Leerzeichen zu extrahieren. Die Muster [^(a+)+$] und [^(a+)+\1$] werden weiter unten untersucht. Das letzte, fehlerhafte Muster wird abgelehnt: Es fehlt eine schließende Klammer („Unclosed group“), was die Engine an Position 4, am Ende des Musters, erkennt. Die Meldung der Exception, die vom JDK erzeugt wird, ist auf Englisch.
5.8.5. Die Funktion split
Die Funktion [split] der Klasse [String] ist uns bereits begegnet. Die Klasse [Regex] besitzt dieselbe Funktion, die das bereits kompilierte Muster verwendet:
Funktion | Rolle |
[split(input, limit = 0)] | Die Zeichenkette [input] wird in Felder zerlegt, wobei jedes Feld durch ein Trennzeichen getrennt ist, das dem Muster entspricht; liefert eine Liste [List<String>]. Ist [limit] positiv, legt es die maximale Anzahl von Feldern fest |
[splitToSequence(input)] | Wie oben, aber die Felder werden als lazy ausgewertete Sequenz geliefert |
[CharSequence.split(regex)] | Erweiterungsfunktion von [String]: [line.split(separator)] ist gleichbedeutend mit [separator.split(line)] |
Angenommen, eine Textdatei enthält Zeilen der Form field1, field2, ..., fieldn. Die Felder sind durch ein Komma getrennt, dem jedoch Leerzeichen vorangehen oder folgen können. Das Muster [\s*,\s*] beschreibt dieses Trennzeichen genau, wie das Programm [Regex05.kt] zeigt:
Ergebnisse:
Kommentare:
- Zeile 7: das Trennzeichen: ein Komma, dem beliebig viele Leerzeichen vorangehen und folgen. Die Leerzeichen werden zusammen mit dem Trennzeichen entfernt. Einmal kompiliert, kann das Muster beliebig viele Zeilen zerlegen, ohne erneut kompiliert zu werden: So zerlegt man alle Zeilen einer Datei;
- Zeile 9: Das Ergebnis von [split] ist eine Liste, die von [forEachIndexed] über ihre Indizes durchlaufen wird;
- Zeile 11: ein Trennzeichen, das mehrere Formen annehmen kann: ein Semikolon oder ein senkrechter Strich ([[;|]]) oder ([|]) eine Folge von Leerzeichen ([\s+]). Das Muster wird in Form eines [Regex]-Objekts an die Funktion [split] von [String] übergeben;
- Zeile 14: Beachten Sie , dass dies ein wichtiger Unterschied zu Java ist. Wenn die Kotlin-Funktion [split] eine Zeichenkette ([String]) erhält, wird diese als wörtliches Trennzeichen behandelt, nicht als Muster: ["1.5.2".split(".")] zerlegt die Zeichenkette am Punktzeichen und liefert [[1, 5, 2]]. In Java interpretiert die Methode [split] von [String] ihren Parameter immer als regulären Ausdruck, in dem der Punkt auf jedes Zeichen zutrifft: ["1.5.2".split(".")] liefert ein leeres Array – eine klassische Falle. In Kotlin ist kein Irrtum möglich: Ein Muster wird als [Regex]-Objekt übergeben, und eine Zeichenkette wird immer wörtlich genommen;
- Zeile 16: ein weiterer Unterschied zu Java: Leere Felder am Ende der Zeichenkette bleiben erhalten. Die Zeichenkette „a,b,,“ ergibt vier Felder, von denen die letzten beiden leer sind, während die Java-Methode [split] nur zwei liefert. Die Anzahl der Felder einer fehlerhaften Zeile wird so nie verfälscht: Eine Zeile, die mit einem überzähligen Trennzeichen endet, hat ein Feld zu viel;
- Zeile 17: Der Parameter [limit] begrenzt die Anzahl der Felder; das letzte Feld enthält dann den Rest der Zeichenkette;
- Zeile 18: [splitToSequence] liefert die Felder als Sequenz, auf die hier die Operation [map] angewendet wird, bevor sie in eine Liste umgewandelt wird. Die Felder werden nur nach Bedarf zerlegt, was bei einer sehr langen Zeichenkette nützlich ist, von der nur die ersten Felder verwendet werden. Das entspricht der Methode [splitAsStream] von [Pattern].
5.8.6. Vorkompilierte Muster, Optionen und zu lange dauernde Suchen
Anders als auf anderen Plattformen besitzen weder Java noch Kotlin einen Mechanismus, der den Code für eine Suche mit regulären Ausdrücken zur Kompilierzeit des Programms erzeugt: Ein Muster wird zur Laufzeit immer vom Konstruktor [Regex] geparst. Diese Kompilierung hat ihren Preis; daher ist es bewährte Praxis, jedes bekannte Muster einmal und für alle Mal im Voraus zu kompilieren und das [Regex]-Objekt in einer schreibgeschützten Property ([val]) abzulegen, entweder auf oberster Ebene oder in einem *[companion object], wie es das Programm *[Regex06.kt] tut. Vermeiden Sie insbesondere, ["""\\d+""".toRegex()] innerhalb einer Schleife zu schreiben: Das Muster würde bei jedem Durchlauf neu kompiliert. Ein [Regex]-Objekt ist unveränderlich und kann von mehreren Threads gleichzeitig verwendet werden: Anders als das Java-Objekt [Matcher] speichert es den Zustand einer Suche nicht, da jede Suche ihre eigenen Ergebnisse erzeugt.
Ergebnisse:
Kommentare:
- Zeilen 12–16: Die Muster des Programms werden einmal kompiliert und in Top-Level-Properties abgelegt, die wie bei Konstanten üblich in Großbuchstaben geschrieben sind. Sie können nicht als [const] deklariert werden: Das gilt nur für Werte einfacher Typen und Zeichenketten, die zur Kompilierzeit bekannt sind; ein [Regex]-Objekt wird zur Laufzeit erzeugt, bei der ersten Verwendung der Datei;
- Zeilen 20–23: Die Properties werden genauso verwendet wie die [Regex]-Objekte in den vorherigen Programmen. Die Funktion [let], aufgerufen mit dem Operator [?.], führt ihren Block nur aus, wenn [find] einen Treffer gefunden hat; Zeile 22 holt die drei benannten Gruppen in einer einzigen Anweisung, mithilfe einer [map]-Projektion gefolgt von einer Destrukturierung;
- Zeile 14: Der zweite Parameter des [Regex]-Konstruktors ist eine Option der Enumeration [RegexOption]. [IGNORE_CASE] unterscheidet nicht zwischen Groß- und Kleinschreibung: „YES“ und „Yes“ entsprechen dem Muster (Zeile 3 der Ergebnisse). Mehrere Optionen werden als Menge angegeben: [Regex(pattern, setOf(RegexOption.MULTILINE, RegexOption.IGNORE_CASE))], während Java ganze Zahlen mit dem Operator [|] kombiniert;
- Zeilen 31–33: Auf der JVM fügt Kotlin der Option [IGNORE_CASE] stets die Java-Option [UNICODE_CASE] hinzu; die Groß- und Kleinschreibung von Buchstaben mit Akzent wird ebenfalls ignoriert, „ÉCLAIR“ entspricht „éclair“ (Zeile 4 der Ergebnisse). In Java würde [CASE_INSENSITIVE] allein dies nicht leisten;
- Zeilen 35–36: [MULTILINE] lässt [^] und [$] am Anfang und Ende jeder Zeile der Zeichenkette zutreffen, statt nur am Anfang und Ende der Zeichenkette selbst. Mit den Standardoptionen erkennt [\w] jedoch nur Buchstaben ohne Akzent: Die Zeile „café: 3“ wird nicht erkannt (Zeile 5 der Ergebnisse);
- Zeile 38: Die Enumeration [RegexOption] enthält nicht die Java-Option [UNICODE_CHARACTER_CLASS], die [\w], [\d], [\s] und [\b] ihre Unicode-Bedeutung verleiht. Man erreicht dies, indem man [(?U)] an den Anfang des Musters schreibt: Buchstaben mit Akzent werden dann als Wortzeichen behandelt (Zeile 6 der Ergebnisse). Dies sollte bei jedem französischen Text verwendet werden;
- Zeilen 40–41: Eine andere Lösung besteht darin, das Muster mit der Java-Klasse [Pattern] zu kompilieren, die alle verfügbaren Optionen bietet (hier kombiniert mit dem Operator [or], dem bitweisen „Oder“ von Kotlin), und das [Pattern]-Objekt dann mit der Erweiterungsfunktion [toRegex] in ein [Regex] umzuwandeln (Zeile 7 der Ergebnisse). Die weiteren Optionen von [RegexOption] sind [DOT_MATCHES_ALL] ([.] entspricht dann auch einem Zeilenumbruch), [COMMENTS] (Leerzeichen im Muster werden ignoriert, sodass es in einem Raw String über mehrere Zeilen und mit Kommentaren geschrieben werden kann), [LITERAL] (das Muster ist reiner Text; siehe auch [Regex.escape] und [Regex.fromLiteral]), [UNIX_LINES], und [CANON_EQ];
- Zeile 43: Optionen können auch am Anfang des Musters geschrieben werden: [(?i)] für [IGNORE_CASE], [(?m)] für [MULTILINE], [(?s)] für [DOT_MATCHES_ALL], [(?U)] …;
- Zeilen 64–66: Die Funktion [display] durchläuft die Sequenz der [destructured]-Werte der Vorkommen und zerlegt jedes direkt in der [for]-Schleife: [(name, value)] sind die Gruppen 1 und 2.
Der Rest des Programms behandelt ein Sicherheitsproblem. Einige Muster sind pathologisch: Wenn man sie auf bestimmte Zeichenketten anwendet, zwingen sie die Engine für reguläre Ausdrücke, eine enorme Zahl von Möglichkeiten auszuprobieren, die Zeichenkette dem Muster zuzuordnen, bevor sie zu einem Ergebnis kommt. Die Java-Engine – die, die Kotlin auf der JVM verwendet – nutzt ein Verfahren namens „Backtracking“: Schlägt ein Versuch fehl, kehrt sie zur letzten getroffenen Wahl zurück und probiert eine andere aus. Das Muster [^(a+)+\1$] in Zeile 16 ist ein Beispiel dafür: Auf eine Folge von „a“, die mit einem anderen Zeichen endet, angewendet, probiert es jede mögliche Verteilung der „a“ auf die Wiederholungen der Gruppe und ihre Rückwärtsreferenz [\1] aus, bevor es das Scheitern feststellt, und die Zahl der Versuche vervielfacht sich mit jedem weiteren „a“. Man spricht von katastrophalem Backtracking. Wird ein solches Muster auf vom Benutzer eingegebene Zeichenketten angewendet, stellt es eine Sicherheitslücke dar (bekannt als ReDoS, „Regular Expression Denial of Service“): Schon wenige Anfragen genügen, um einen Server lahmzulegen.
- Zeilen 46–49: Die Suchdauer wird für 10, 15 und 20
agemessen. Die Funktion*[measureTimedValue]aus*[kotlin.time]führt den Block aus, den sie erhält, und liefert sowohl seinen Wert als auch seine Dauer, ein [Duration]-Objekt, in Form eines [TimedValue]-Objekts, das entpackt wird. Die Dauer steigt sehr schnell an (Zeilen 9–11 der Ergebnisse; die Dauer variiert von Ausführung zu Ausführung und von Rechner zu Rechner). Da sich die Ausführungszeit mit jedem weiterenaungefähr verdoppelt, würde die Suche mit 30amehrere Minuten dauern; - Zeilen 51–56: Weder die Klasse [Regex] noch die Klasse [Pattern] besitzt eine Timeout-Option. Es wird eine Standardtechnik angewendet: Die Suche wird in einem [TimeLimitedString]-Objekt ausgeführt (Zeilen 72–85), das die Schnittstelle [CharSequence] implementiert, die von den Funktionen von [Regex] akzeptiert wird. Die Engine für reguläre Ausdrücke liest die Zeichenkette Zeichen für Zeichen mit der Methode [charAt] der Java-Schnittstelle [CharSequence], die in Kotlin dem Operator [get] entspricht: Hier wird die Zeit geprüft und eine [TimeoutExceededException] ausgelöst (Zeile 89), wenn die Frist – die bei der Erzeugung des Objekts gespeichert wurde – verstrichen ist. Die Suche wird nach 100 ms abgebrochen;
- Zeilen 72–75: Die Klasse
*[TimeLimitedString]hat zwei Properties, den Text und die Frist, einen Zeitstempel der monotonen Uhr von*[kotlin.time]([ValueTimeMark]), dessen Funktion [hasPassedNow] angibt, ob sie überschritten wurde. Die Klausel [CharSequence by text] ist eine Delegation: Die Klasse implementiert die Schnittstelle [CharSequence], indem sie alle Member, die sie nicht überschreibt – hier die Property [length] –, an das Objekt [text] delegiert. Der Compiler erzeugt die Funktionen, die die Aufrufe weiterleiten; in Java müssen sie von Hand geschrieben werden. Die einzigen neu definierten Member sind der Operator [get], der die Zeit überwacht, und die Funktion [subSequence], die einen [TimeLimitedString] mit derselben Frist liefert. Die Funktion [toString], die Member von [Any] , aber nicht der Schnittstelle ist, wird nicht delegiert: Sie wird ebenfalls überschrieben; - Zeile 89: Die Exception [TimeoutExceededException] ist von [RuntimeException] abgeleitet. Da Kotlin keine geprüften Exceptions kennt, könnte jede Exception von [get] ausgelöst werden; die Ableitung von [RuntimeException] bleibt dennoch übliche Praxis, und Java-Code, der die Klasse aufruft, würde sie als ungeprüfte Exception behandeln. Das in Java-Exceptions vorhandene Feld [serialVersionUID] ist hier überflüssig: Der Kotlin-Compiler beanstandet sein Fehlen nicht;
- Zeilen 59–60: Die Java-Laufzeitumgebung kann einfache Fälle verschachtelter Wiederholungen erkennen und effizient behandeln: Das Muster [^(a+)+$], das bei anderen Laufzeitumgebungen problematisch ist, wird hier sofort aufgelöst. Es ist die Rückwärtsreferenz [\1] , die diese Optimierung beim Muster in Zeile 16 verhindert. Dauern vom Typ [Duration] werden mit dem Operator [<] verglichen.
Wichtig ist, sich vor Mustern mit verschachtelten Wiederholungen in Acht zu nehmen ([(a+)+], [(\w+\s?)*] …) und die Dauer von Suchen zu begrenzen, sobald das Muster oder die durchsuchte Zeichenkette von außerhalb des Programms stammt. Die possessiven Quantifizierer der Java-Engine ([a++], [a*+]), die Backtracking innerhalb des Elements verhindern, das sie wiederholen, erlauben ebenfalls das Schreiben sicherer Muster, sofern man ihre Bedeutung genau versteht.
5.9. Beispielanwendung – V3
Wir greifen die in Kapitel 3 (Version 1) und Kapitel 4 (Version 2) behandelte Anwendung wieder auf. Denken Sie daran, dass es sich um eine Übung handelt: Die verwendete Steuertabelle ist die von 2004 (auf Basis der Einkünfte von 2003), die seit dem ursprünglichen Kurs unverändert geblieben ist.
5.9.1. Daten in einer Datei
In Version 2 wurde die Steuerberechnung in der abstrakten Klasse [AbstractTax] ausgeführt, die wir hier im Paket [taxv3] des Projekts wiederverwenden: Wie in Java ist Version 3 in sich geschlossen und hängt nicht von den Klassen aus Kapitel 4 ab. Die Steuerstufen werden von einer abstrakten Property – einer schreibgeschützten Liste – bereitgestellt, und die Division erfolgt mit 16 signifikanten Stellen, was mehr als ausreichend ist:
Die Funktion [calculate] verwendet die Steuerstufen, die von der abstrakten Property [taxBrackets] geliefert werden (Zeile 10). Die Klasse [AbstractTax] weiß nicht, woher diese Stufen stammen: Es ist Sache der abgeleiteten Klassen, sie durch Überschreiben der Property bereitzustellen. In Version 2 hat die abgeleitete Klasse [HardwiredTax] sie direkt in ihren Code fest eingetragen. Die Berechnungen erfolgen mit exakten Dezimalzahlen [java.math.BigDecimal] (Kapitel 3), deren Handhabung die Kotlin-Standardbibliothek erleichtert:
- Die Erweiterungsfunktionen [toBigDecimal] von [Int] und [String] ersetzen [BigDecimal.valueOf(...)] und [new BigDecimal(...)] (["0.72".toBigDecimal()], Zeile 21);
- Die Operatoren [+], [-], [*] und [+=] sind für [BigDecimal] definiert (es handelt sich um Erweiterungsfunktionen [plus], [minus], [times], deklariert mit [operator], Kapitel 4): Zeile 26 liest sich wie die Formel, die sie berechnet;
- [BigDecimal] implementiert [Comparable<BigDecimal>]: Die Vergleichsoperatoren sind anwendbar ([quotient <= it.limit], Zeile 24) und rufen [compareTo] auf;
- Vorsicht ist jedoch beim Operator [/] geboten: Er ruft [divide(other, RoundingMode.HALF_EVEN)] auf, was die Anzahl der Nachkommastellen des Dividenden beibehält. Bei zwei ganzen Zahlen wird das Ergebnis auf die nächste ganze Zahl gerundet: [3.toBigDecimal() / 2.toBigDecimal()] ergibt 2, und [1.toBigDecimal() / 2.toBigDecimal()] ergibt 0. Die beiden Divisionen der Funktion werden daher mit der Methode [divide] umgesetzt: exakte Division durch 2 (Zeile 15), die eine Exception auslösen würde, wenn das Ergebnis kein endlicher Dezimalbruch wäre, und Division mit 16 signifikanten Stellen ([MathContext.DECIMAL64], Zeile 22);
- Zeile 24: Die Suche nach der Stufe wird mit Collection-Operationen geschrieben: [dropLast(1)] schließt die letzte Stufe aus, [firstOrNull] liefert die erste Stufe, deren Grenze vom Familienquotienten nicht überschritten wird, oder [null] , wenn es keine gibt, und der Operator [?:] wählt dann die letzte Stufe, [last()];
- [toInt] liefert den ganzzahligen Anteil des Ergebnisses (Methode [intValue] von [BigDecimal]).
Eine Stufe wird durch die Datenklasse [TaxBracket] dargestellt:
und die Berechnung wird durch die Schnittstelle [ITax] beschrieben, die hier durch einen KDoc-Kommentar dokumentiert ist – das Kotlin-Äquivalent zu Javadoc (dieselben Tags wie [@param] und [@return]):
Die neue Version speichert die Daten in einer Datei, sodass sich die Tabelle ändern lässt, ohne das Programm neu zu kompilieren. Wir schreiben zwei neue, von [AbstractTax] abgeleitete Klassen:
- [FileTax] liest die Stufen aus einer Textdatei [TaxData.txt];
- [JsonTax] liest sie aus einer JSON-Datei [TaxData.json].
Die Textdatei [TaxData.txt] enthält eine Stufe pro Zeile, im Format limit:coeffR:coeffN :
Die Zahlen in der Datei werden mit einem Dezimalpunkt geschrieben. Eine Datendatei darf nicht von der Sprache des lesenden Rechners abhängen: Eine Datei, die mit Dezimalkomma geschrieben und nach französischen Regeln interpretiert wird ([NumberFormat.getInstance(Locale.FRANCE)]), würde auf einem englischsprachigen Rechner abgelehnt oder, schlimmer noch, falsch interpretiert. Die Funktion [toBigDecimal] von [String]erwartet, wie [toDouble], immer einen Dezimalpunkt, unabhängig von der Sprache des Rechners. Das ist auch die Konvention bei JSON und den meisten Datenformaten.
Die Datei [TaxData.json] enthält dieselben Daten in Form eines JSON-Arrays von Objekten:
5.9.2. Fehler
Die Verarbeitung dieser Dateien kann an einer fehlenden Datei, einer fehlerhaften Zeile, einer falschen Zahl usw. scheitern. Wir erstellen eine eigene Exception-Klasse, um diese Fehler zu melden, [TaxException]. Sie wird auch für andere Datenquellen verwendet werden (hier die JSON-Datei, später Datenbanken). Sie trägt einen Fehlercode:
Kommentare:
- Zeile 6: Die gesamte Klasse passt in ihren Kopf. Der primäre Konstruktor erhält die Meldung, den Code und die Ursache des Fehlers; der Code wird zu einer schreibgeschützten Property ([val]), während die Meldung und die Ursache, die einfache Parameter sind, an den Konstruktor der Elternklasse
*[RuntimeException]*weitergegeben werden, die sie über die Properties*[message]* und*[cause]*verfügbar macht; - Der Parameter [cause], die Exception, die den Fehler verursacht hat, hat einen Standardwert, [null]: Ein einziger Konstruktor ersetzt die zwei Konstruktoren der Java-Version; [TaxException(message, code)] und [TaxException(message, code, e)] werden mit demselben Konstruktor definiert. Spätere Versionen der Anwendung übernehmen diese Exception, die einen ganzzahligen Code trägt, mit einem leicht abweichenden Konstruktor (Kapitel 6);
- Zeile 7: Die Klasse erweitert [RuntimeException]. Da Kotlin keine geprüften Exceptions kennt (Kapitel 3), legt die Wahl der Elternklasse hier keine Einschränkungen auf; für Java-Code, der die Klasse verwendet, ist [TaxException] jedoch eine ungeprüfte Exception, was das beabsichtigte Verhalten ist, wie wir sehen werden. Das Feld [serialVersionUID] der Java-Version ist überflüssig: Der Kotlin-Compiler gibt dazu keine Warnung aus.
Die möglichen Fehlercodes sind durch eine Enumeration definiert:
Erläuterungen:
- Zeilen 7–12: mögliche Fehlercodes:
- [ACCESS]: Fehler beim Zugriff auf die Datendatei;
- [LINE]: Zeile ohne die drei erwarteten Felder oder Datei ohne Stufen;
- [FIELD1], [FIELD2], [FIELD3]: Feld 1, 2 oder 3 einer Zeile ist fehlerhaft;
- [JSON]: Das JSON-Dokument ist fehlerhaft;
- Zeile 6: Eine Kotlin-Enumeration ([enum class], Kapitel 3) kann Eigenschaften, die in ihrem primären Konstruktor deklariert werden, sowie Funktionen besitzen. Jede Konstante wird mit ihrem ganzzahligen Wert in Klammern erzeugt; die Liste der Konstanten endet mit einem Semikolon, wenn weitere Member folgen;
- Zeilen 14–17: Einige Fehler können gleichzeitig auftreten; alle drei Felder einer Zeile können fehlerhaft sein. Daher sind die Codewerte Zweierpotenzen: Jeder entspricht einem Bit der Ganzzahl. Ein Fehler in den Feldern 2 und 3 ergibt den Code [8 or 16] = 24 ([or] ist der bitweise Operator „OR“ in Kotlin). Die Funktion [decode], die im [companion object] der Enumeration steht und mit [ErrorCode.decode(code)] aufgerufen wird, führt die Umkehroperation aus: Sie wandelt die Ganzzahl in die Menge der enthaltenen Codes um, indem sie jedes Bit mit dem Operator [and] testet. Die Eigenschaft [entries] (Kotlin 1.9) ist die Liste der Konstanten der Enumeration, und [filterTo] legt diejenigen, die die Bedingung erfüllen, in der übergebenen Sammlung ab, hier in einem leeren [java.util.EnumSet]. Diese auf die Konstanten einer Enumeration spezialisierte Sammlung speichert sie intern als Bits einer Ganzzahl; ihre Methode [toString] zeigt eine Kombination in der Form „[FIELD2, FIELD3]“ an. Ebenso gut könnten wir ein Kotlin-[Set<ErrorCode>] ([entries.filter { ... }.toSet()]) zurückgeben, das genauso angezeigt würde.
5.9.3. Die Klasse FileTax
Die Klasse [FileTax] liefert die aus einer Textdatei gelesenen Stufen:
Erläuterungen:
- Zeile 8: Die Klasse [FileTax] erbt von der Klasse [AbstractTax], so wie zuvor die Klasse [HardwiredTax] in Version 2. Ihr primärer Konstruktor erhält den Namen der Textdatei mit den Daten. Der Parameter [fileName], der ohne [val] deklariert ist, ist keine Eigenschaft: Er wird nur während der Konstruktion des Objekts verwendet;
- Zeilen 10–16: zwei reguläre Ausdrücke, die einmalig kompiliert und im [companion object] der Klasse abgelegt werden, dem Kotlin-Äquivalent zu den [private static final]-Konstanten von Java: der Feldtrenner für eine Zeile der Form limit:coeffR:coeffN (das Zeichen [:], vor und nach dem beliebig viele Leerzeichen stehen dürfen) sowie eine positive Zahl oder null, bestehend aus Ziffern, denen optional ein Punkt und weitere Ziffern folgen. Raw Strings vermeiden die Verdopplung von [\]. Die Liste [FIELD_CODES] ordnet jedem Feld einen Fehlercode zu;
- Zeile 20: die Eigenschaft, die die abstrakte Eigenschaft von [AbstractTax] neu definiert. Sie wird ohne Anfangswert deklariert: Sie wird im Block [init] initialisiert, wo der Compiler verlangt, dass ihr ein Wert zugewiesen wird – und zwar nur einer;
- Zeilen 22–43: Der Block [init] wird bei der Konstruktion des Objekts ausgeführt, ähnlich dem Rumpf eines Java-Konstruktors. Seine Aufgabe ist es, die Liste [taxBrackets] zu füllen;
- Zeile 25: der Dateiname ohne Pfad, der in Fehlermeldungen verwendet wird. Der Konstruktor kann nämlich einen vollständigen Pfad erhalten, der dem Benutzer nicht angezeigt werden muss. Die Funktion [Path] aus [kotlin.io.path] erzeugt das Objekt [java.nio.file.Path]; [fileName] ist die Java-Methode [getFileName] , die wie eine Eigenschaft behandelt wird;
- Zeilen 26–33: Lesen der Datei. Die Erweiterungsfunktion [useLines] von [Path] öffnet die Datei (in UTF-8), übergibt die Sequenz ihrer Zeilen an das Lambda und schließt die Datei anschließend, unabhängig davon, wie das Lambda verlassen wird – regulär oder durch eine Ausnahme. Das entspricht [try] mit Ressourcen in Java. Da das Lesen einer Textdatei sequenziell erfolgt, ist die Zeilenanzahl erst am Ende bekannt; die Sequenz eignet sich für die Textverarbeitung:
- [mapIndexed] ordnet jeder Zeile – deren Leerzeichen durch [trim] entfernt wurden – ihre Nummer zu (der Index beginnt bei 0, die Zeilennummerierung bei 1), und zwar in Form eines Paares [number to line];
- [filter] entfernt leere Zeilen; das Paar wird in die Parameter des Lambdas entpackt, [(_, line)], wobei die nicht benötigte Nummer durch [_] ersetzt wird;
- [map] wandelt jede Zeile mit der Funktion [bracket] in eine Stufe um;
- [toList] durchläuft die Sequenz und speichert die Stufen in einer Liste. Dieser Aufruf muss innerhalb des Lambdas erfolgen: Eine Sequenz wird verzögert ausgewertet, und eine von [useLines] unverändert zurückgegebene Sequenz würde erst nach dem Schließen der Datei durchlaufen;
- der Block [try] ist ein Ausdruck: Sein Wert ist die Liste der Stufen, die in der Variablen [brackets] gespeichert wird;
- Zeilen 35–37: Dateizugriffsfehler ([IOException] und ihre Varianten, etwa [NoSuchFileException] bei einer fehlenden Datei, [AccessDeniedException] bei unzureichenden Berechtigungen oder [MalformedInputException] bei einer Datei, die nicht in UTF-8 vorliegt) werden eingebettet in eine [TaxException] mit dem Code [ACCESS], wobei die ursprüngliche Ausnahme zu ihrer Ursache wird. Die von der Funktion [bracket] ausgelösten [TaxException]-Ausnahmen sind keine [IOException]-Ausnahmen: Sie werden von dieser [catch]-Klausel nicht abgefangen und verlassen den Konstruktor unverändert, wobei die Datei dennoch von [useLines] geschlossen wird;
- Zeilen 40–43: Eine leere Datei wird abgelehnt; andernfalls wird die Liste zum Wert der Eigenschaft [taxBrackets], was der Zweck des Blocks [init] war;
- Zeilen 49–51: Die Funktion [bracket] analysiert eine Zeile. Die Zeile wird mithilfe eines regulären Ausdrucks in Felder zerlegt; sind es nicht drei Felder, wird eine [TaxException]-Ausnahme mit dem Code [LINE] ausgelöst. Beachten Sie, dass [split] in Kotlin leere Felder am Ende beibehält: Eine Zeile, die mit einem überzähligen Trenner endet, „4962:0:0: “, hat vier Felder und wird abgelehnt, während die Java-Methode [split], die leere Felder am Ende entfernt, sie akzeptieren würde;
- Zeilen 54–58: Validierung der drei Felder. Die Funktion [zip] ordnet jedem Fehlercode das entsprechende Feld in Form von Paaren zu; [filter] behält die Felder, die nicht zum Muster [NUMBER] passen, und [fold] akkumuliert ihre Codes mit dem Operator [or], beginnend bei 0. Fehler werden so gesammelt gemeldet. Die Funktion [matches] verlangt, dass das gesamte Feld zum Muster [NUMBER] passt: keine Vorzeichen, Leerzeichen oder Kommas. Negative Zahlen werden somit abgelehnt, wodurch die Daten im selben Zug geprüft werden, in dem sie validiert werden;
- Zeilen 61–62: Die nun validierten Felder werden mit [BigDecimal] durch [toBigDecimal] umgewandelt, wobei unabhängig von der Sprache des Rechners ein Dezimalpunkt verwendet wird; die Liste der drei Zahlen wird entpackt, um die Stufe zu konstruieren.
Das Einkapseln von Low-Level-Ausnahmen ([IOException]) in eine anwendungsspezifische Ausnahme ([TaxException]) erlaubt es dem aufrufenden Code, unabhängig von der Datenquelle nur einen einzigen Ausnahmetyp zu behandeln: eine Textdatei, eine JSON-Datei und später im Kurs eine Datenbank. In Java ist dies auch der Grund, warum [TaxException] eine ungeprüfte Ausnahme ist: Eine geprüfte Ausnahme müsste von jeder Methode deklariert werden, die sie durchläuft, was den aufrufenden Code an die Details der Datenquelle binden würde. Kotlin, das keine geprüften Ausnahmen kennt, erzwingt diese Wahl nicht, aber die Kapselung bleibt ebenso wichtig: Der aufrufende Code muss die dateibezogenen Ausnahmen in der API nicht kennen.
5.9.4. Die Klasse JsonTax
Die Klasse [JsonTax] liefert die aus einer JSON-Datei gelesenen Stufen. Sie verwendet die Bibliothek Jackson 3, die bereits in der Datei [build.gradle.kts] des Projekts deklariert ist:
Erläuterungen:
- Zeile 15: Ein einziger [JsonMapper], der im [companion object] abgelegt ist, wird für alle [JsonTax]-Objekte verwendet. Die JSON-Eigenschaften [limit], [coeffR] und [coeffN] sind nach den Parametern des Konstruktors der Datenklasse [TaxBracket] benannt: Annotationen sind nicht nötig, da der Compiler diese Namen im kompilierten Code beibehält (Option [javaParameters = true] in der Datei [build.gradle.kts]) und Jackson 3 sie lesen kann;
- Zeilen 29–32: Lesen der Datei mit der Erweiterungsfunktion [readText] von [Path]; ein Zugriffsfehler wird wie in [FileTax] behandelt;
- Zeile 36: Eine einzige Anweisung wandelt den JSON-Text in ein Array von Stufen um; [Array<TaxBracket>::class.java] ist die Java-Klasse für das Array, äquivalent zu [TaxBracket[].class]. Jackson konstruiert jede Stufe durch Aufruf des Konstruktors der Datenklasse und wandelt die JSON-Zahlen ohne Genauigkeitsverlust in [BigDecimal] um. Da die Java-Methode [readValue] den Wert [null] zurückgeben kann (für das JSON-Dokument [null]), wird das Ergebnis in einer Variablen vom Typ [Array<TaxBracket>?] gespeichert: Ohne diese Deklaration würde Kotlin ihm einen „Plattformtyp“ zuweisen und wüsste nicht, ob dieser Typ [null] zulässt;
- Zeilen 37–40: Ein ungültiges Dokument löst eine [JacksonException] aus, die in eine [TaxException] mit dem Code [JSON] eingebettet wird. Die Meldung gibt die Fehlerposition an, die von der Eigenschaft [location] (Methode [getLocation]) geliefert wird; der Operator [?.] schützt vor einer unbekannten Position;
- Zeilen 43–49: Die Deserialisierung prüft das Format des Dokuments, nicht die Gültigkeit der Daten: Es bleibt zu prüfen, dass mindestens eine Stufe vorhanden ist (das Dokument [null] oder [[]] ist ein gültiges JSON), was [isNullOrEmpty] in einem einzigen Test erledigt, und dass keine Werte negativ sind, was die Operation [any] leistet, die direkt auf das Array angewendet wird. Nach dem ersten Test weiß der Compiler, dass [brackets] nicht [null] ist. Das Array wird schließlich mit [toList] in eine Liste umgewandelt;
- Zeile 18: die Funktion, die einen Wert prüft, geschrieben als Ausdruck.
Die Java-Version prüfte außerdem, dass keine Werte fehlen: Eine fehlende Eigenschaft eines JSON-Objekts weist der entsprechenden Komponente eines Records den Wert [null] zu. In Kotlin ist diese Prüfung überflüssig: Die Eigenschaften von [TaxBracket] haben den Typ *[BigDecimal]*, nicht ***[BigDecimal?]. Der Kotlin-Compiler fügt am Anfang des Konstruktors der Klasse für jeden nicht nullbaren Parameter eine Prüfung ein: Übergibt Jackson [null], löst der Konstruktor eine Ausnahme aus, die Jackson als [JacksonException] weitergibt. Die Sicherheit in Bezug auf *[null] erstreckt sich somit auch auf Objekte, die von einer Java-Bibliothek erzeugt werden: Eine unvollständige Stufe kann nicht existieren. Das werden wir später überprüfen.
Der Vergleich der beiden Klassen ist aufschlussreich: Mit einem strukturierten Datenformat und einer Bibliothek, die es versteht, erfordert das Parsen der Datei fast keinen Code. Beachten Sie, dass es ein Kotlin-spezifisches Jackson-Modul gibt, [jackson-module-kotlin], das Parameter-Standardwerte und nullbare Typen berücksichtigt und Funktionen wie [mapper.readValue<Array<TaxBracket>>(json)] anbietet, bei denen der Typ über einen generischen Parameter angegeben wird ([reified], Kapitel 4). JetBrains bietet außerdem eine eigene Serialisierungsbibliothek an, [kotlinx.serialization], die den Serialisierungscode zur Kompilierzeit mithilfe eines Compiler-Plugins erzeugt. Für eine so einfache Datenklasse wie [TaxBracket]genügt Jackson allein.
5.9.5. Das Hauptprogramm
Anders als die Java-Version, die Teil eines separaten Maven-Projekts war, ist Version 3 ein Programm aus mehreren Dateien innerhalb des Gradle-Projekts des Kapitels, organisiert in einem eigenen Paket, [taxv3]. Der relevante Teil des Projekts hat die folgende Verzeichnisstruktur:
Die Datendateien liegen im Stammverzeichnis des Projekts, neben der Datei [build.gradle.kts]: Dies ist das aktuelle Verzeichnis des Programms, wenn es mit dem Befehl [gradlew run] oder durch Klicken auf das grüne Dreieck in IntelliJ oder IDEA ausgeführt wird. Die Bibliothek Jackson ist in der Datei [build.gradle.kts] des Projekts deklariert, die von allen Programmen dieses Kapitels verwendet wird:
Das Hauptprogramm ist die Datei [Main.kt]; seine JVM-Klasse ist [taxv3.MainKt]:
Erläuterungen:
- Zeilen 9–13: der Hilfetext in einem Raw String, aus dem [trimIndent] die gemeinsame Einrückung und die erste, leere Zeile entfernt. Da das Ergebnis eines Funktionsaufrufs keine Kompilierzeitkonstante ist, kann die Eigenschaft nicht als [const] deklariert werden: [const val SYNTAX = """...""".trimIndent()] wird vom Compiler abgelehnt ([const 'val' initializer must be a constant value]). Der Prompt der Eingabeschleife, ein Zeichenkettenliteral, ist hingegen eine Konstante [const val] (Zeile 16);
- Zeile 20: der Trenner der eingegebenen Parameter, einmalig kompiliert;
- Zeile 24: Der Name der Datendatei wird als Argument übergeben; standardmäßig ist es [TaxData.txt]. [firstOrNull] liefert das erste Argument oder [null] , falls keines vorhanden ist; in diesem Fall wird es durch den Standardwert mithilfe des Operators [?:] ersetzt. Mit Gradle werden die Argumente des Programms über die Option [--args] übergeben: [gradlew -q run -Pmain=taxv3.MainKt --args="TaxData.json"];
- Zeilen 28–31: Ein [when]-Ausdruck (Kapitel 3) wählt anhand der Dateiendung, die mit [substringAfterLast] aus dem Dateinamen extrahiert wird, die zu instanziierende Klasse aus. Die beiden Zweige liefern Objekte unterschiedlicher Typen, [JsonTax] und [FileTax], beide vom Typ [ITax], der der deklarierte Typ der Variablen [tax] ist. Der Rest des Programms kennt nur die Schnittstelle [ITax] und weiß nicht, woher die Daten stammen;
- Zeilen 33–39: Die Erzeugung des Objekts kann eine [TaxException] auslösen, die angezeigt wird, bevor das Programm endet. Der Code wird in eine Menge von [ErrorCode] dekodiert, um im Klartext angezeigt zu werden; die ursprüngliche Ausnahme, falls vorhanden, wird durch ihren Typ angegeben: [e.cause?.let { ... } ?: ""] konstruiert den Text, wenn die Ursache existiert, und liefert andernfalls eine leere Zeichenkette. Die Funktion [exitProcess] aus der Standardbibliothek beendet das Programm; sie hat den Typ [Nothing]: Der Compiler weiß, dass sie die Kontrolle nie zurückgibt und dass die Variable [tax] daher nach dem Block [try] initialisiert ist. Die überflüssige Anweisung [return], die in der Java-Version auf [System.exit] folgte und vom Java-Compiler verlangt wurde, entfällt;
- Zeilen 43–75: Die Dialogschleife ist dieselbe wie in Version 2. Die von [readlnOrNull] gelesene Zeile ist am Ende des Datenstroms [null] , was dann durch eine leere Zeichenkette ersetzt wird (Zeile 46). Die Anzahl der Kinder und das Gehalt werden mit [toIntOrNull] umgewandelt, das [null] liefert, wenn die Zeichenkette keine Ganzzahl ist, und [takeIf { it >= 0 }] liefert ebenfalls [null] für eine negative Ganzzahl (Zeilen 63, 69): Ein einziger Test auf [null] erkennt beide Fehler. Der Ausdruck wird direkt geschrieben, ohne die Funktion [positiveInteger] aus Version 2 (oder die Funktion [integer] der Java-Version, die im Fehlerfall -1 zurückgab). Nach diesem Test weiß der Compiler, dass [nbChildren] und [salary] den Typ [Int] haben.
5.9.6. Ausführungen
Mit der Datei [TaxData.txt] als Standard (die aus einer Datei umgeleitete Eingabe wurde nach den Eingabeaufforderungen eingefügt):
Die Werte entsprechen denen der vorherigen Versionen: 4.282 Euro für ein Ehepaar mit 2 Kindern, 2.959 Euro für ein Ehepaar mit 3 Kindern und 11.519 Euro für eine alleinstehende Person ohne Kinder bei einem Jahresgehalt von 60.000 Euro. Fehlerhafte Eingaben werden wie in Version 2 gemeldet.
Mit der Datei [TaxData.json]:
Mit einer nicht vorhandenen Datei [xx.txt]:
Mit der folgenden Datei [TaxDataInvalid.txt], in der die dritte Zeile ein Dezimalkomma verwendet:
Die Felder 2 und 3 der Zeile 3 werden abgelehnt: Der Fehlercode ist die Kombination [[FIELD2, FIELD3]]. Feld 1 (14753), das keine Nachkommastellen hat, ist korrekt.
Mit der folgenden Datei [TaxDataInvalid.json], in der ein Koeffizient als Zeichenkette geschrieben ist:
Die Meldung von Jackson benennt den Fehler genau: Die Zeichenkette „0,068“ kann nicht in [BigDecimal] umgewandelt werden. Jackson akzeptiert eine Zeichenkette, wo eine Zahl erwartet wird, wenn sie eine gültige Zahl enthält („0.068“); abgelehnt wird das Dezimalkomma. Der Fehler liegt in Zeile 3 des Dokuments – da Jackson die Zeilen ab 1 nummeriert – und in Spalte 30, am Anfang des fehlerhaften Werts.
Schließlich mit der folgenden Datei [TaxDataIncomplete.json], in der die Eigenschaft [coeffR] der zweiten Stufe fehlt:
Es ist die vom Kotlin-Compiler dem Konstruktor der Datenklasse [TaxBracket] hinzugefügte Prüfung, die den Wert [null] für den Parameter [coeffR] ablehnt („Parameter specified as non-null is null“). Jackson meldet den Fehler als [ValueInstantiationException]-Ausnahme, abgeleitet von [JacksonException], die am Ende des unvollständigen Objekts liegt (Zeile 3, Spalte 37): Die unvollständige Stufe hat nie existiert, und es wurde kein Test dafür geschrieben.
5.10. Fazit
Dieses Kapitel hat die Kotlin-Klassen und -Funktionen vorgestellt, die in fast allen Programmen verwendet werden:
- unveränderliche Zeichenketten [String], die mit [==] verglichen werden (was [equals] aufruft), ihre zahlreichen Erweiterungsfunktionen, [buildString] und [StringBuilder] zum schrittweisen Aufbau, String-Templates, die Funktion [format] und Raw Strings ([trimIndent], [trimMargin]);
- Arrays ([Array], [IntArray] …) und ihre Funktionen;
- Kotlin-Collections – [List], [Set], [Map] –, die entweder schreibgeschützt oder veränderbar sind ([MutableList], [MutableSet], [MutableMap]), mit [listOf], [mutableListOf], [mapOf] … erzeugt werden und auf den Collections des JDK beruhen, sowie weitere Collections ([ArrayDeque], sortierte Mengen und Dictionaries …);
- funktionale Operationen auf Collections ([filter], [map], [sortedBy], [groupBy], [associate], [fold], [partition], [zip] …) und Sequenzen, einschließlich ihrer verzögert ausgewerteten Varianten, wobei die Java-Stream-API weiterhin nutzbar bleibt;
- Textdateien ([File], [Path], und die Erweiterungen von [kotlin.io] und [kotlin.io.path]: [readLines], [useLines], [writeText] …) standardmäßig in UTF-8 sowie Binärdateien ([DataOutputStream], [DataInputStream], [RandomAccessFile]) und die JSON-Serialisierung mit Jackson und Datenklassen;
- die regulären Ausdrücke der Klasse [Regex], geschrieben als Raw Strings, einmalig kompiliert und bei der Verarbeitung externer Daten gegen übermäßig lange Suchvorgänge geschützt.
Besonders bemerkenswert ist, wie Kotlin die Java-Plattform nutzt: Die Kotlin-Standardbibliothek ersetzt das JDK nicht, sondern erweitert es um Erweiterungsfunktionen ([readLines], [toBigDecimal], [toRegex] …), Operatoren ([BigDecimal]) und schreibgeschützte Schnittstellen, während Java-Klassen ([Path], [BigDecimal], [LocalDate], [Pattern], Jackson …) direkt verwendet werden können.
Die Beispielanwendung liest ihre Daten nun aus einer Textdatei oder aus JSON. Das folgende Kapitel gliedert sie in Schichtenum: Das Lesen der Daten, die Steuerberechnung und die Benutzerinteraktion werden zu unabhängigen Komponenten.