12. Programação web
12.1. Visão geral
12.1.1. Protocolos da Internet
Apresentamos aqui uma introdução aos protocolos de comunicação da Internet, também conhecidos como a pilha de protocolos TCP/IP (Transmission Control Protocol / Internet Protocol), nome derivado dos dois principais protocolos. É útil que o leitor tenha uma compreensão geral do funcionamento das redes — em particular dos protocolos TCP/IP — antes de abordar o desenvolvimento de aplicações distribuídas. Esta apresentação se baseia em um texto do guia de administração “Lan Workplace for DOS” da Novell (início dos anos 1990), mantendo sua estrutura e seu espírito, mas atualizado: a Internet de 2026 não é mais exatamente a mesma de 1990.
O conceito geral de criar uma rede de computadores heterogêneos nasceu de pesquisas conduzidas pela DARPA (Defense Advanced Research Projects Agency) nos Estados Unidos. A DARPA desenvolveu a pilha de protocolos conhecida como TCP/IP, que permite que máquinas heterogêneas se comuniquem entre si. Esses protocolos foram testados em uma rede chamada ARPAnet, que mais tarde se tornou a Internet (a ARPAnet adotou o TCP/IP em 1.º de janeiro de 1983). Os protocolos TCP/IP definem formatos e regras de transmissão e recepção independentes da arquitetura da rede e do hardware utilizado.
A rede concebida pela DARPA e gerenciada pelos protocolos TCP/IP é uma rede de comutação de pacotes. Uma rede desse tipo transmite informações em pequenos fragmentos chamados pacotes. Assim, se um computador transmite um arquivo grande, ele será dividido em pequenos pedaços enviados pela rede para serem remontados no destino. O TCP/IP define o formato desses pacotes, incluindo, em particular:
- a origem do pacote;
- seu destino;
- seu comprimento;
- seu tipo.
Os protocolos da Internet são descritos em documentos públicos chamados RFC (Request for Comments), publicados pela IETF (Internet Engineering Task Force) e disponíveis em www.rfc-editor.org. Citaremos alguns desses documentos ao longo deste capítulo.
12.1.2. O modelo OSI
Os protocolos TCP/IP seguem, em linhas gerais, o modelo aberto de rede conhecido como OSI (Open Systems Interconnection Reference Model), definido pela ISO (International Organization for Standardization). Esse modelo descreve uma rede ideal na qual a comunicação entre máquinas pode ser representada por um modelo de sete camadas:
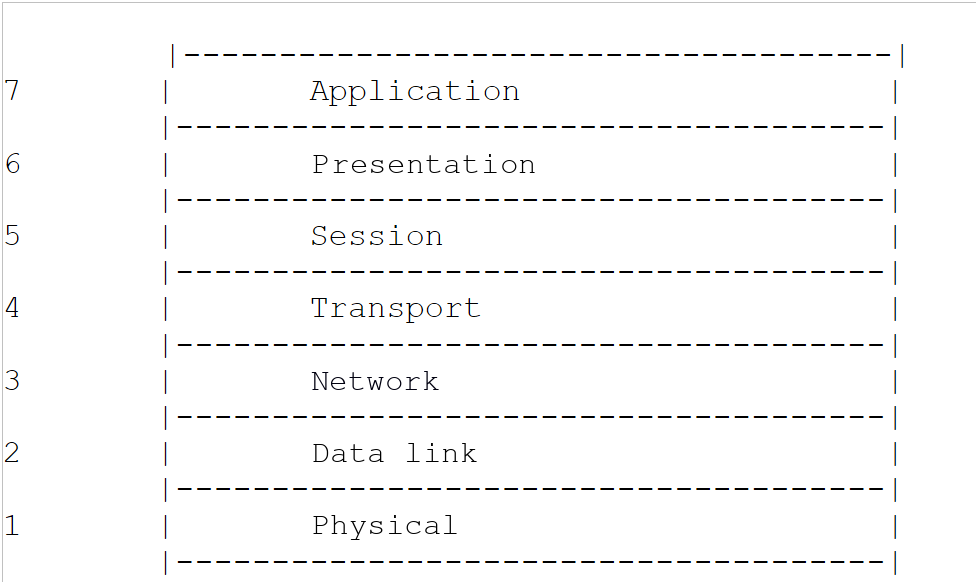
Cada camada recebe serviços da camada inferior e fornece seus próprios serviços à camada superior. Suponha que duas aplicações situadas em máquinas diferentes, A e B, queiram se comunicar: elas o fazem na camada de Aplicação. Não precisam conhecer todos os detalhes do funcionamento da rede: cada aplicação passa a informação que deseja transmitir à camada inferior, a camada de Apresentação. A aplicação só precisa, portanto, conhecer as regras de interface com a camada de Apresentação. Quando a informação está na camada de Apresentação, ela é repassada, segundo outras regras, à camada de Sessão, e assim por diante, até que a informação chegue ao meio físico e seja fisicamente transmitida à máquina de destino. Lá, ela sofrerá o processo inverso ao que sofreu na máquina de origem.
Em cada camada, o processo emissor responsável por enviar a informação a envia a um processo receptor da outra máquina que pertence à mesma camada. Ele o faz segundo certas regras conhecidas como protocolo da camada. A comunicação real desce pelas camadas da máquina A, atravessa a rede física e depois sobe pelas camadas da máquina B; no entanto, cada camada percebe que está se comunicando diretamente com a camada correspondente da outra máquina.
Os papéis das diferentes camadas são os seguintes:
Camada | Papel |
Física | Garante a transmissão de bits por um meio físico (cabo de cobre, cabo de fibra óptica, ondas de rádio). As principais considerações nesse nível são a codificação da informação em sinais e o método de transmissão. |
Enlace de dados | Abstrai as características físicas da camada Física. Divide a informação em quadros, detecta (e às vezes corrige) erros de transmissão e gerencia o acesso ao meio compartilhado. |
Rede | Gerencia o caminho que as informações enviadas pela rede devem seguir. É o que se chama de roteamento: determinar a rota que a informação deve percorrer para chegar ao destino. |
Transporte | Permite a comunicação entre duas aplicações, ao passo que as camadas anteriores permitiam apenas a comunicação entre máquinas. Um dos serviços prestados por essa camada é a multiplexação: a camada de transporte usa um único enlace de rede (de máquina a máquina) para transmitir dados pertencentes a várias aplicações. |
Sessão | Fornece serviços que permitem a uma aplicação abrir e manter uma sessão de trabalho em uma máquina remota. |
Apresentação | Padroniza a representação dos dados entre máquinas diferentes. Os dados da máquina A são “formatados” pela camada de Apresentação da máquina A segundo um formato padrão antes de serem enviados pela rede. Ao chegarem à camada de Apresentação da máquina de destino B — que os reconhece por seu formato padrão —, os dados são reformatados para que a aplicação da máquina B possa reconhecê-los. |
Aplicação | Nesse nível estão as aplicações geralmente mais próximas do usuário, como o e-mail, a Web ou a transferência de arquivos. |
12.1.3. O modelo TCP/IP
O modelo OSI é um modelo de referência que nunca foi implementado tal como é. A pilha de protocolos TCP/IP, que se tornou o padrão, é organizada em apenas quatro camadas:
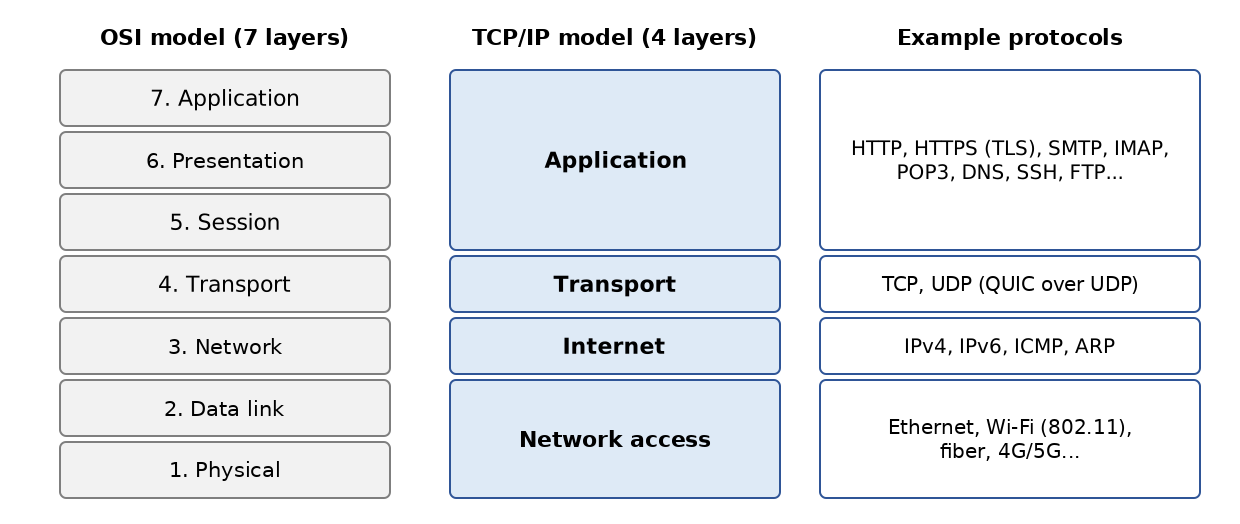
As camadas de Sessão e de Apresentação não existem como tal no TCP/IP: suas funções, quando necessárias, são assumidas pelas próprias aplicações ou por protocolos intermediários como o TLS (criptografia das trocas de dados), que se insere entre o TCP e a aplicação.
A camada de acesso à rede
Nas redes locais, a tecnologia dominante hoje é o Ethernet para conexões com fio e o Wi-Fi (padrões IEEE 802.11) para conexões sem fio. Outras tecnologias, como o Token Ring, desapareceram.
Ethernet é o nome dado a uma tecnologia de rede local de comutação de pacotes inventada na Xerox no início dos anos 1970 e padronizada pela Xerox, pela Intel e pela Digital Equipment em 1980 e, depois, pelo IEEE (padrão 802.3). O Ethernet original consistia em um cabo coaxial ao qual todas as máquinas estavam conectadas (topologia em barramento), com uma taxa de transmissão de 10 megabits por segundo:
Era uma rede de difusão (broadcast): uma máquina transmissora enviava pelo cabo uma informação que incluía o endereço da máquina de destino; todas as máquinas conectadas a recebiam, e apenas o destinatário a retinha. Como várias máquinas podiam decidir transmitir ao mesmo tempo, era preciso detectar colisões: este era o método de acesso CSMA/CD (Carrier Sense Multiple Access / Collision Detect). Cada transmissor escutava o cabo antes de transmitir (CSMA) e, durante a transmissão, verificava se o que passava pelo cabo era realmente o que havia transmitido; se não fosse, ocorrera uma colisão (CD): cada um interrompia a transmissão e tentava novamente após um atraso aleatório.
O Ethernet moderno evoluiu bastante: os dispositivos são conectados por cabos de par trançado ou de fibra óptica a um switch, que encaminha cada quadro à porta específica do destinatário. As conexões são full-duplex (transmissão e recepção simultâneas): não há mais colisões, e o CSMA/CD tornou-se obsoleto. As taxas típicas variam de 1 a 10 gigabits por segundo, e são muito mais altas em data centers.
O que não mudou foi o endereçamento de 48 bits: cada placa de rede tem um endereço, chamado de endereço físico ou endereço MAC (Media Access Control), geralmente escrito como seis bytes hexadecimais (por exemplo, [00:1A:2B:3C:4D:5E]). Ele é gravado na placa pelo fabricante, mas — ao contrário do que durante muito tempo se afirmou — pode ser modificado por software: os sistemas operacionais modernos chegam a usar endereços MAC aleatórios em redes Wi-Fi para impedir que um dispositivo seja rastreado de rede em rede.
A camada de Internet (camada de rede)
Os seguintes protocolos são encontrados nessa camada:
Protocolo | Papel |
IP (Internet Protocol) | entrega pacotes entre dois nós da rede, na versão 4 (IPv4) ou 6 (IPv6) |
ICMP (Internet Control Message Protocol) | facilita a comunicação entre o programa do protocolo IP de uma máquina e o de outra máquina. É, portanto, um protocolo de troca de mensagens de controle dentro do próprio protocolo IP |
ARP (Address Resolution Protocol) | associa o endereço IP de uma máquina ao endereço físico da máquina (no IPv6, esse papel é desempenhado pelo protocolo NDP, o Neighbor Discovery Protocol) |
O RARP (Reverse Address Resolution Protocol), que realizava a associação inversa, também é mencionado às vezes. Ele está obsoleto há muito tempo, substituído pelo DHCP, do qual falaremos mais adiante.
A camada de transporte
Essa camada inclui os seguintes protocolos:
Protocolo | Papel |
TCP (Transmission Control Protocol) | garante a entrega confiável e ordenada de informações entre duas aplicações |
UDP (User Datagram Protocol) | realiza a entrega não confiável de informações entre duas aplicações |
O protocolo QUIC (2021), no qual se baseia o HTTP/3, é um protocolo de transporte confiável e criptografado construído sobre o UDP.
A camada de aplicação
Aqui encontramos diversos protocolos, que detalharemos um pouco adiante:
Protocolo | Papel |
HTTP, HTTPS (HyperText Transfer Protocol) | O protocolo da Web: um cliente (navegador, aplicação) solicita recursos a um servidor web. O HTTPS é o HTTP criptografado com TLS |
DNS (Domain Name System) | converte um nome de host em um endereço IP |
SMTP (Simple Mail Transfer Protocol) | permite o envio de e-mails |
POP3, IMAP | permitem ler e-mails armazenados em um servidor |
SSH (Secure Shell) | permite conectar-se a uma máquina remota e executar comandos nela, usando criptografia. Substituiu o TELNET, que desempenhava a mesma função sem criptografia |
FTP (File Transfer Protocol), SFTP | permitem a transferência de arquivos |
DHCP (Dynamic Host Configuration Protocol) | permite que uma máquina obtenha automaticamente seu endereço IP e sua configuração de rede |
12.1.4. Como funcionam os protocolos da Internet
As aplicações desenvolvidas no ambiente TCP/IP geralmente utilizam vários dos protocolos desse ambiente. Um programa de aplicação se comunica com a camada mais alta dos protocolos. Essa camada repassa a informação à camada inferior, e assim por diante, até chegar ao meio físico. Ali, a informação é transferida fisicamente para a máquina receptora, onde passará pelas mesmas camadas — desta vez na ordem inversa — até chegar à aplicação destinatária da informação enviada. O diagrama a seguir mostra o caminho da informação:
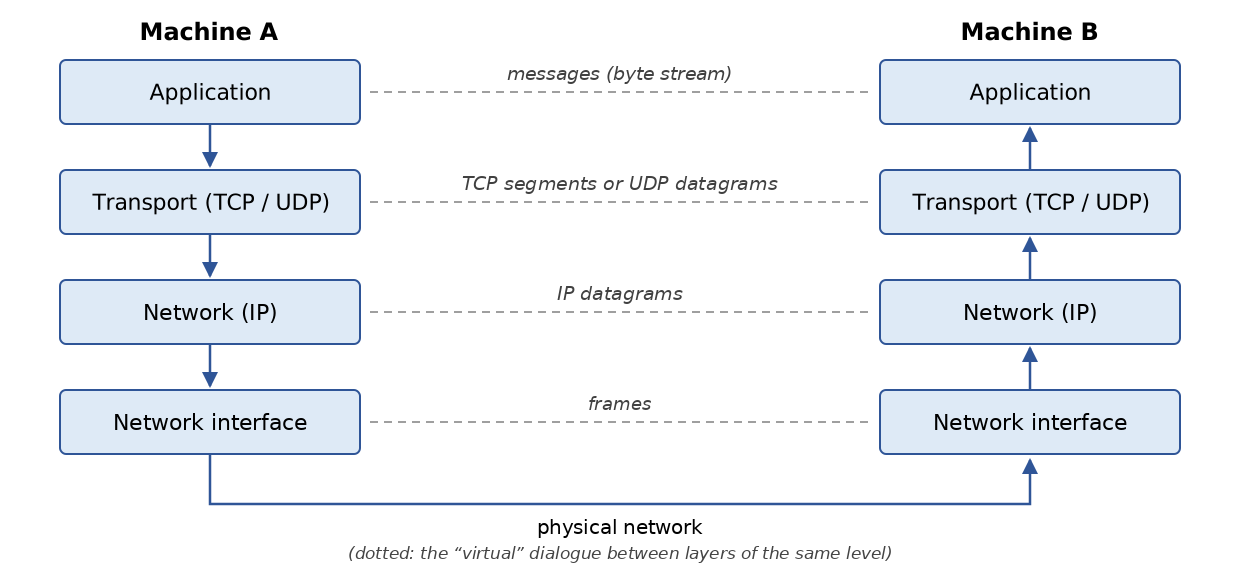
Vejamos um exemplo: uma aplicação que envia um arquivo a outra máquina usando o TCP.
- A aplicação entrega uma sequência de bytes a ser transmitida à camada de transporte;
- a camada de transporte divide essa sequência de bytes em segmentos TCP e adiciona ao início de cada segmento um cabeçalho contendo, entre outras coisas, os números das portas de origem e de destino, bem como um número de sequência. Os segmentos são repassados à camada de rede, regida pelo protocolo IP;
- a camada IP cria um pacote que encapsula o segmento TCP recebido. No cabeçalho desse pacote, ela coloca os endereços IP das máquinas de origem e de destino. Ela também determina o endereço físico da máquina à qual o pacote deve ser entregue (a própria máquina de destino ou um roteador). O pacote inteiro é repassado à camada de Acesso à rede, isto é, à placa de rede que conecta a máquina à rede física;
- ali, o pacote IP é, por sua vez, encapsulado em um quadro físico e enviado ao destinatário pelo meio;
- na máquina de destino, a camada de Acesso à rede realiza o processo inverso: ela desencapsula o pacote IP do quadro físico e o repassa à camada IP;
- a camada IP verifica se o pacote é válido: ela calcula uma soma de verificação (checksum) de seu cabeçalho, que deve coincidir com a que consta no cabeçalho do pacote. Se não for o caso, o pacote é descartado;
- se o pacote for considerado válido, a camada IP desencapsula o segmento TCP nele contido e o repassa para cima, à camada de transporte;
- a camada TCP também verifica uma soma de verificação do segmento. Se ela estiver correta, envia uma confirmação à máquina de origem; caso contrário, o segmento é ignorado (e será reenviado pela origem);
- usando os números de sequência, a camada TCP reordena os segmentos na ordem correta;
- resta à camada TCP apenas transmitir a parte de dados dos segmentos à aplicação de destino, identificada pelo número da porta de destino.
12.1.5. Questões de endereçamento na Internet
Um nó de rede pode ser um computador, uma impressora, um telefone, um dispositivo conectado — na verdade, qualquer coisa capaz de se comunicar usando os protocolos TCP/IP. Cada nó tem um endereço físico cujo formato depende do tipo de rede. Em uma rede Ethernet ou Wi-Fi, o endereço físico é codificado em 6 bytes.
O endereço Internet (IP) de um nó é um endereço lógico: ele é independente do hardware e da rede utilizada. No IPv4, é um endereço de 4 bytes que identifica ao mesmo tempo uma rede e um nó dessa rede. Costuma ser representado por quatro números — os valores dos quatro bytes — separados por um ponto. Por exemplo, o endereço da máquina chamada “Lagaffe” da Faculdade de Ciências de Angers foi durante muito tempo 193.49.144.1, e o da máquina chamada “Liny” era 193.49.144.9. Disso se podia deduzir que o endereço da rede local era 193.49.144.0 e que podia haver até 254 nós nessa rede.
Como os endereços IP são independentes da rede física, uma máquina da rede A pode se comunicar com uma máquina da rede B sem se preocupar com o tipo de rede em que esta se encontra: basta conhecer o seu endereço IP. O protocolo IP de cada rede cuida da conversão entre endereços IP e endereços físicos nos dois sentidos.
Todos os endereços IP públicos devem ser únicos. Sua alocação segue uma estrutura hierárquica: a IANA (Internet Assigned Numbers Authority) distribui blocos de endereços a cinco registros regionais, entre eles o RIPE NCC para a Europa, que os redistribuem a operadoras e grandes organizações. Essas entidades os atribuem então a seus clientes. O administrador de uma rede que recebeu o bloco de 193.49.144.0 a 193.49.144.255 pode atribuir os endereços de 193.49.144.1 a 193.49.144.254 como achar conveniente. Na França, o INRIA foi por muito tempo responsável pela atribuição de endereços; isso já não acontece há bastante tempo.
12.1.5.1. As classes de endereços IP e a notação CIDR
Um endereço IPv4 é uma sequência de 4 bytes escrita como I1.I2.I3.I4, que na verdade contém duas informações:
- o endereço da rede (os bits mais significativos);
- o endereço de um nó dentro dessa rede (os bits menos significativos).
Originalmente, o tamanho desses dois campos era determinado pelo valor do primeiro byte. Os endereços IP eram divididos em três classes principais:
Classe | Primeiro byte | Rede / Nó | Número de redes e de nós |
A | 1 a 126 (bit mais significativo 0) | R1.N1.N2.N3: rede de 1 byte (7 bits significativos), nó de 3 bytes | 126 redes de 2²⁴ - 2 nós (aproximadamente 16 milhões) |
B | 128 a 191 (10 bits mais significativos) | R1.R2.N1.N2: rede de 2 bytes (14 bits significativos), nó de 2 bytes | 2¹⁴ = 16.384 redes de 2¹⁶ - 2 = 65.534 nós |
C | 192 a 223 (110 bits mais significativos) | R1.R2.R3.N1: rede de 3 bytes (21 bits significativos), nó de 1 byte | 2²¹ redes (aproximadamente 2 milhões) com 254 nós |
Como o endereço da máquina Lagaffe é 193.49.144.1, o byte mais significativo é 193, que em binário é 11000001: a rede era uma rede de classe C.
Essa classificação se revelou rígida demais: uma organização com 300 máquinas era obrigada a usar uma rede de classe B, desperdiçando mais de 65.000 endereços. Desde 1993 (RFC 1518 e 1519), as classes foram abandonadas em favor do roteamento sem classes (CIDR, Classless Inter-Domain Routing). A fronteira entre a parte de rede e a parte de host pode ser fixada em qualquer bit; ela é indicada pelo comprimento do prefixo de rede, após uma barra:
- 193.49.144.0/24: os primeiros 24 bits designam a rede, e os últimos 8 bits designam o nó. Essa rede contém os endereços de 193.49.144.0 a 193.49.144.255;
- 10.0.0.0/8: uma rede com 2²⁴ endereços;
- 192.168.1.0/26: uma rede de 2⁶ = 64 endereços, de 192.168.1.0 a 192.168.1.63.
A antiga notação da máscara de sub-rede ainda é usada e expressa a mesma coisa: o prefixo /24 corresponde à máscara 255.255.255.0. Os termos “classe A, B, C” continuam de uso comum, mas já não correspondem a nenhum mecanismo real.
12.1.5.2. Endereços reservados, endereços privados e NAT
Certos endereços têm uma finalidade específica:
- um endereço cuja parte de host é composta inteiramente por 0s refere-se à própria rede: 193.49.144.0 é o endereço da rede 193.49.144.0/24;
- um endereço cuja parte de host é composta inteiramente por 1s é um endereço de broadcast: 193.49.144.255 refere-se a todos os hosts da rede 193.49.144.0/24. Esses dois endereços, portanto, não podem ser atribuídos a um nó: uma rede /24 com 256 endereços oferece apenas 254 endereços utilizáveis;
- os endereços 127.0.0.0/8, e na prática 127.0.0.1, são endereços de loopback: uma máquina os utiliza para se referir a si mesma sem passar pela rede. O nome [localhost] está associado a eles;
- os blocos 10.0.0.0/8, 172.16.0.0/12 e 192.168.0.0/16 (RFC 1918) são reservados para redes privadas: podem ser usados livremente dentro de uma empresa ou de uma casa, mas não são roteados na Internet;
- os blocos 192.0.2.0/24, 198.51.100.0/24 e 203.0.113.0/24 (RFC 5737) são reservados para documentação e exemplos.
O número de endereços IPv4 (2³², ou pouco mais de 4 bilhões) é insuficiente para todas as máquinas conectadas. O estoque central de endereços da IANA se esgotou em 2011, e o do RIPE NCC em 2019. A escassez foi contornada pela tradução de endereços de rede (NAT, Network Address Translation): os dispositivos de uma residência têm endereços privados (como 192.168.1.x), e o roteador que os conecta à Internet os “traduz” para o seu próprio endereço público único. A solução de longo prazo é o IPv6.
12.1.5.3. Os endereços IPv6
O IPv6 (RFC 2460 em 1998, hoje RFC 8200) codifica endereços em 128 bits, oferecendo 2¹²⁸ endereços possíveis — aproximadamente 3,4 × 10³⁸ —, de modo que não há mais motivo para se preocupar com escassez. Um endereço IPv6 é escrito como oito grupos de quatro dígitos hexadecimais separados por dois-pontos:
Os zeros à esquerda de cada grupo podem ser omitidos, e uma única sequência de grupos de zeros pode ser substituída por [::]. O endereço anterior é, portanto, escrito como [2001:db8::8a2e:0:370:7334]. O endereço de loopback, equivalente a 127.0.0.1, é [::1]. Em uma URL, o endereço IPv6 é colocado entre colchetes para evitar confundir seus dois-pontos com o que precede a porta: [http://[::1]:8080/].
O IPv6 traz outras simplificações: o cabeçalho do pacote tem comprimento fixo, a configuração automática de endereços é nativa e a tradução de endereços NAT deixa de ser necessária. Sua adoção foi lenta, mas uma parcela significativa e crescente do tráfego da Internet já passa pelo IPv6 (o Google, por exemplo, publica a proporção de seus usuários que o acessam por IPv6), e os principais provedores de acesso franceses o oferecem a seus assinantes. As duas versões coexistem: a maioria das máquinas tem endereços IPv4 e IPv6 (fala-se em “dual stack”), e os programas precisam ser capazes de lidar com ambos.
12.1.5.4. Protocolos de conversão entre endereços IP e endereços físicos
Vimos que, quando dados são transmitidos de uma máquina a outra, ao passar pela camada IP eles são encapsulados em pacotes. Esses pacotes têm a seguinte forma:
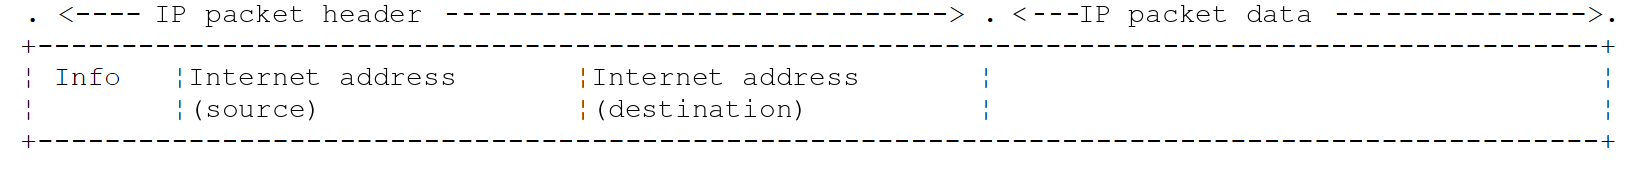
O pacote IP contém, portanto, os endereços IP das máquinas de origem e de destino. Quando esse pacote é repassado à camada responsável por enviá-lo pela rede física, informações adicionais são acrescentadas para formar o quadro físico que será enfim enviado pela rede. Por exemplo, o formato de um quadro em uma rede Ethernet é o seguinte:
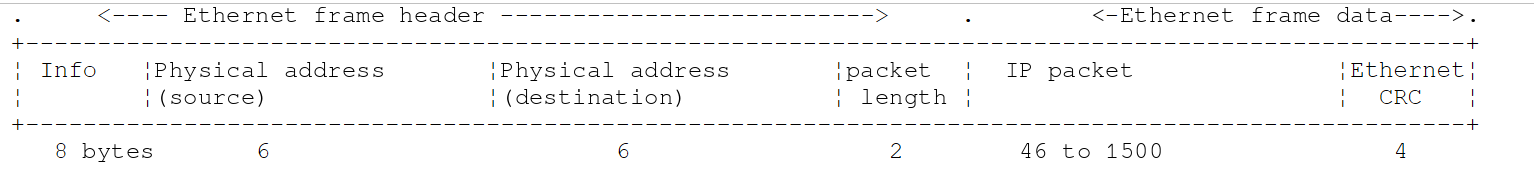
Os 8 primeiros bytes (preâmbulo) servem para sincronização; o campo de 2 bytes que precede os dados indica, na forma mais comum do quadro Ethernet, o tipo de protocolo transportado (IPv4, IPv6, ARP...) em vez do comprimento do pacote. No quadro final, são incluídos os endereços físicos das máquinas de origem e de destino (no quadro real, o endereço de destino precede o de origem, ao contrário da ordem mostrada no diagrama). Como obtê-los?
A máquina emissora, conhecendo o endereço IP da máquina com a qual deseja se comunicar, obtém o endereço físico dessa máquina por meio do protocolo ARP (Address Resolution Protocol):
- ela envia um tipo especial de pacote, chamado pacote ARP, contendo o endereço IP da máquina cujo endereço físico se procura. Ele também inclui seu próprio endereço IP, bem como seu endereço físico;
- esse pacote é enviado a todos os nós da rede local (broadcast);
- esses nós reconhecem a natureza especial do pacote. O nó que reconhece seu próprio endereço IP no pacote responde enviando seu endereço físico ao remetente. Ele pode fazê-lo porque encontrou no pacote o endereço IP e o endereço físico do remetente;
- o remetente recebe, portanto, o endereço físico que procurava. Ele o armazena em um cache para poder utilizá-lo mais tarde, caso outros pacotes precisem ser enviados ao mesmo destinatário.
No IPv6, o mesmo serviço é prestado pelo protocolo NDP (Neighbor Discovery Protocol), que se baseia em mensagens ICMPv6.
Resta a questão: como uma máquina conhece seu próprio endereço IP? Ele pode ser especificado em um arquivo de configuração da máquina — essa ainda é a prática para servidores. No entanto, quando um administrador precisa reorganizar a rede, modificar um a um os arquivos de configuração de todas as máquinas é trabalhoso e sujeito a erros. O protocolo RARP permitia que uma máquina solicitasse seu endereço IP a um servidor com base em seu endereço físico. Ele foi substituído pelo DHCP (Dynamic Host Configuration Protocol, RFC 2131): ao iniciar, a máquina envia uma solicitação em broadcast pela rede; um servidor (como um roteador doméstico ou um servidor dedicado em uma empresa) lhe atribui um endereço por um tempo limitado (uma concessão, ou lease), junto com o restante de sua configuração: prefixo de rede, endereço do roteador e endereços dos servidores DNS. O administrador só precisa então configurar o servidor DHCP. No IPv6, uma máquina também pode construir seu próprio endereço a partir do prefixo anunciado pelo roteador (autoconfiguração SLAAC).
12.1.6. A camada de rede, chamada de camada IP, da Internet
O protocolo IP define o formato que os pacotes devem ter e como devem ser tratados ao serem enviados ou recebidos. Esse tipo particular de pacote é chamado de datagrama IP. Já falamos dele:
O ponto importante é que, além dos dados a transmitir, o datagrama IP contém os endereços IP das máquinas de origem e de destino. Assim, a máquina de destino sabe quem lhe envia uma mensagem.
Ao contrário de um quadro de rede, cujo comprimento é determinado pelas características físicas da rede que ele percorre, o comprimento do datagrama IP é definido pelo software e será, portanto, o mesmo em diferentes redes físicas. Vimos que, ao descer da camada de rede para a camada física, o datagrama IP é encapsulado em um quadro físico.
Os quadros físicos viajam de nó em nó em direção ao destino, que pode não estar na mesma rede física que a máquina emissora. O pacote IP pode, portanto, ser encapsulado sucessivamente em diferentes quadros físicos nos nós que conectam duas redes de tipos diferentes. Também é possível que o pacote IP seja grande demais para ser encapsulado em um quadro físico (a carga útil de um quadro Ethernet é limitada a 1.500 bytes). No IPv4, o nó onde ocorre esse problema divide então o pacote IP em fragmentos, que só serão remontados no destino final. No IPv6, os roteadores não fragmentam mais os pacotes: cabe ao remetente determinar o tamanho máximo aceito ao longo do caminho e ajustar o tamanho de seus pacotes de acordo.
12.1.6.1. Roteamento
O roteamento é o método de direcionar os pacotes IP ao seu destino. Há dois métodos: o roteamento direto e o roteamento indireto.
Roteamento direto
O roteamento direto designa a transmissão de um pacote IP diretamente do remetente ao destinatário dentro da mesma rede:
- a máquina que envia um datagrama IP conhece o endereço IP do destinatário;
- ela obtém o endereço físico do destinatário por meio do protocolo ARP, ou de seu cache, se esse endereço já tiver sido obtido;
- ela envia o pacote pela rede a esse endereço físico.
Roteamento indireto
O roteamento indireto designa a transmissão de um pacote IP a um destino situado em uma rede diferente daquela a que o remetente pertence. Nesse caso, as partes de “rede” dos endereços IP das máquinas de origem e de destino são diferentes; a máquina de origem detecta isso comparando o endereço de destino com seu próprio prefixo de rede. Ela envia então o pacote a um nó especial chamado roteador, que conecta a rede local a outras redes e cujo endereço IP é conhecido pela máquina de origem (é o chamado gateway padrão, geralmente fornecido pelo DHCP). Um roteador está conectado a pelo menos duas redes e tem um endereço IP em cada uma delas:
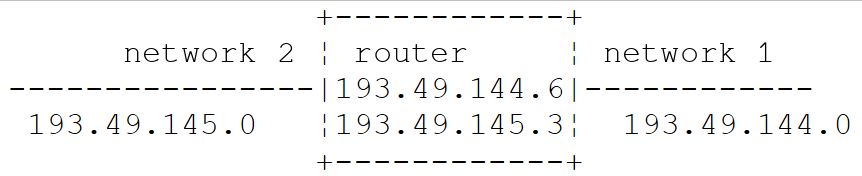
No nosso exemplo acima:
- a rede nº 1 tem o endereço 193.49.144.0/24 e a rede nº 2 tem o endereço 193.49.145.0/24;
- na rede nº 1, o roteador tem o endereço 193.49.144.6 e, na rede nº 2, tem o endereço 193.49.145.3.
O papel do roteador é pegar o pacote IP que recebe — contido em um quadro físico da rede nº 1 — e colocá-lo em um quadro físico que possa trafegar pela rede nº 2. Se o endereço IP de destino do pacote estiver na rede nº 2, o roteador o envia diretamente a ele; caso contrário, o envia a outro roteador que liga a rede nº 2 à rede nº 3, e assim por diante. Os roteadores da Internet trocam constantemente informações sobre as redes que conseguem alcançar (protocolos de roteamento como o BGP entre operadoras) para montar suas tabelas de roteamento.
12.1.6.2. Mensagens de erro e de controle
Também na camada de rede — e portanto no mesmo nível do protocolo IP — está o protocolo ICMP (Internet Control Message Protocol). Ele serve para enviar mensagens sobre o funcionamento interno da rede: nó inalcançável, pacote que atravessou roteadores demais etc. As mensagens ICMP são encapsuladas em pacotes IP e enviadas pela rede. As camadas IP dos diversos nós tomam as providências adequadas com base nas mensagens ICMP que recebem. Assim, uma aplicação nunca vê, ela própria, esses problemas específicos da rede. Os comandos [ping] (que enviam mensagens ICMP "Echo Request" e aguardam mensagens "Echo Reply") e [traceroute] / [tracert] (que exibe os roteadores atravessados) baseiam-se no ICMP.
12.1.7. A camada de transporte: os protocolos UDP e TCP
12.1.7.1. O protocolo UDP: User Datagram Protocol
O protocolo UDP permite uma troca de dados não confiável entre dois pontos; ou seja, não há garantia de que um pacote chegue ao destino, nem da ordem em que os pacotes chegam. A aplicação, se quiser, pode tratar isso por conta própria — por exemplo, aguardando uma confirmação após enviar uma mensagem antes de enviar a seguinte.
Até aqui, no nível da rede, falamos de endereços de máquinas, como o IP. No entanto, em uma mesma máquina podem coexistir vários processos ao mesmo tempo, e todos eles podem se comunicar entre si. Portanto, ao enviar uma mensagem, é preciso especificar não só o endereço IP da máquina de destino, mas também o "nome" do processo de destino. Esse nome é, na verdade, um número de 16 bits (de 1 a 65.535), chamado de número de porta. Certos números são reservados para aplicações padrão: porta 53 para DNS, 80 para HTTP, 443 para HTTPS, 25 para SMTP e assim por diante. As portas abaixo de 1024 são chamadas de "conhecidas" (well-known); no Linux, são necessários privilégios especiais para iniciar um serviço em uma delas. Os exemplos deste capítulo usam portas das faixas 27100–27199 e 27200–27299.
Os pacotes tratados pelo protocolo UDP são chamados de datagramas. Eles têm a seguinte forma:
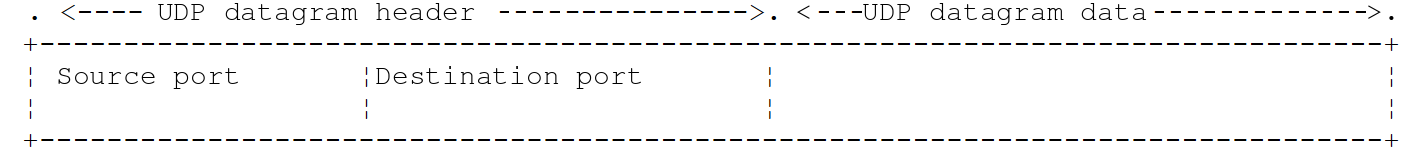
Esses datagramas são encapsulados em pacotes IP e, depois, em quadros físicos. O UDP é usado quando a velocidade importa mais que a confiabilidade, ou quando a própria aplicação lida com as perdas: DNS (uma pergunta, uma resposta), streaming de áudio e vídeo ao vivo, jogos online e o protocolo QUIC do HTTP/3.
12.1.7.2. O protocolo TCP: Transmission Control Protocol
Para comunicações seguras, o protocolo UDP é insuficiente: o desenvolvedor da aplicação precisa criar por conta própria um protocolo para verificar se os pacotes são encaminhados corretamente. O protocolo TCP evita esses problemas. Suas características são as seguintes:
- O processo que deseja transmitir dados primeiro estabelece uma conexão com o processo que receberá as informações a serem transmitidas. Essa conexão é estabelecida entre uma porta da máquina emissora e uma porta da máquina receptora por meio da troca de três segmentos (SYN, SYN-ACK, ACK: o "handshake de três vias"). Cria-se assim um circuito virtual entre as duas portas, que ficará reservado exclusivamente aos dois processos que estabeleceram a conexão;
- todos os bytes transmitidos pelo processo de origem chegam ao destino na ordem em que foram transmitidos, o que o protocolo UDP não garante, já que os pacotes podem seguir caminhos diferentes;
- A informação transmitida é contínua: é um fluxo de bytes. O processo transmissor envia as informações em seu próprio ritmo. Essas informações não são necessariamente enviadas imediatamente: o protocolo TCP pode esperar até ter dados suficientes para enviar. Os dados são colocados em uma estrutura chamada segmento TCP. Quando esse segmento está cheio, ele é transmitido à camada IP, onde é encapsulado em um pacote IP. Uma implicação importante para o programador: uma "linha" enviada de uma só vez pode chegar em vários pedaços, e várias linhas podem chegar juntas. Cabe à aplicação identificar os limites de suas mensagens (usaremos o caractere de fim de linha para isso);
- Cada segmento enviado pelo protocolo TCP é numerado. O protocolo TCP receptor verifica se está recebendo os segmentos em sequência. Para cada segmento recebido corretamente, ele envia uma confirmação ao remetente;
- se, após certo tempo, o protocolo TCP que enviou um segmento não receber a confirmação, ele retransmite o segmento em questão, garantindo assim a qualidade do serviço de entrega das informações;
- O circuito virtual estabelecido entre os dois processos que se comunicam é full-duplex: as informações podem trafegar nos dois sentidos simultaneamente. Assim, o processo de destino pode enviar confirmações mesmo enquanto o processo de origem continua enviando informações. Isso permite, por exemplo, que o protocolo TCP de origem envie vários segmentos sem esperar confirmações. Se, após certo tempo, perceber que não recebeu a confirmação de um segmento específico de número n, ele retomará a transmissão dos segmentos a partir desse ponto;
- O TCP também regula sua taxa de transmissão para evitar sobrecarregar o destinatário (controle de fluxo) ou a rede (controle de congestionamento).
12.1.8. A camada de aplicação
Acima dos protocolos UDP e TCP há diversos protocolos padrão:
TELNET e SSH
O TELNET permite que um usuário da máquina A se conecte à máquina B (frequentemente chamada de máquina hospedeira) como se tivesse um terminal conectado a ela. O TELNET se baseia no TCP. Suas trocas de dados, inclusive as senhas, são transmitidas em texto puro: ele foi substituído pelo SSH (Secure Shell), que oferece o mesmo serviço de forma criptografada e também é usado para transferência segura de arquivos (SFTP, SCP) e para criar túneis. O programa cliente [telnet] foi por muito tempo uma ferramenta prática para se comunicar "manualmente" com um servidor TCP: veremos como substituí-lo.
FTP (File Transfer Protocol)
Esse protocolo permite a troca de arquivos entre duas máquinas remotas, bem como operações com arquivos, como a criação de diretórios. Baseia-se no protocolo TCP. Assim como o TELNET, transmite as senhas em texto puro; está sendo abandonado em favor do SFTP e do HTTPS.
TFTP (Trivial File Transfer Protocol)
Esse protocolo é uma variante simplificada do FTP. Baseia-se no protocolo UDP. Ainda é usado para inicializar máquinas pela rede.
DNS (Domain Name System)
Quando um usuário quer trocar informações com uma máquina remota, precisa conhecer o endereço IP dela. É muito mais cômodo se referir a uma máquina por um nome do que pelo endereço IP. Isso levanta a questão da unicidade dos nomes: há bilhões de máquinas interconectadas. Poderíamos imaginar uma autoridade centralizada atribuindo os nomes, mas isso seria muito pesado. O controle dos nomes foi distribuído por domínios. Cada domínio é gerenciado por uma organização que tem total liberdade para escolher os nomes dentro do seu domínio. Assim, as máquinas da França costumam pertencer ao domínio [fr], gerenciado pela AFNIC (o INRIA o gerenciou até a criação da AFNIC em 1997). Para simplificar ainda mais, o controle é descentralizado em mais um nível: criam-se domínios dentro do domínio [fr]. Por exemplo, a Universidade de Angers possui o domínio [univ-angers.fr]; o departamento que o administra tem total liberdade para nomear os computadores da rede da universidade e para criar subdomínios.
O nome completo de uma máquina (FQDN, Fully Qualified Domain Name) especifica a hierarquia de domínios a que ela pertence, do mais específico ao mais geral: [www.univ-angers.fr]. Dentro de um domínio, muitas vezes é possível usar nomes relativos, que o sistema completa automaticamente.
Uma aplicação pode, portanto, se referir a uma máquina pelo nome. No fim das contas, porém, ainda é preciso obter o endereço IP dessa máquina. Suponha que você queira se comunicar da máquina A com a máquina B:
- A máquina A consulta primeiro um arquivo local de correspondência ([/etc/hosts] no Linux e no macOS, [C:\Windows\System32\drivers\etc\hosts] no Windows) e depois o seu cache;
- caso contrário, consulta o servidor DNS, cujo endereço consta em sua configuração (geralmente fornecido pelo DHCP). Ela envia uma requisição DNS contendo o nome da máquina procurada. Se o servidor consultado souber a resposta ou a tiver em cache, devolve à máquina A o endereço IP correspondente. Caso contrário, ele consulta por sua vez — a partir dos servidores raiz — os servidores responsáveis pelo domínio [fr], depois por [univ-angers.fr], e assim por diante, até obter a resposta, que será então repassada de volta até a máquina A.
O domínio DNS associa a um nome vários tipos de registros: A (endereço IPv4), AAAA (endereço IPv6), CNAME (alias para outro nome), MX (servidores de e-mail do domínio) etc.
HTTP e HTTPS (HyperText Transfer Protocol)
Esse é o protocolo da Web e, de longe, o mais usado hoje: não só pelos navegadores, mas também pelas aplicações que trocam dados (os serviços web tratados no próximo capítulo). Vamos examiná-lo em detalhes. O HTTPS é o HTTP transmitido por uma conexão criptografada com TLS (Transport Layer Security); essa é hoje a forma padrão da Web.
SMTP, POP3 e IMAP
O SMTP serve para enviar e-mails, enquanto o POP3 e o IMAP servem para ler os e-mails armazenados em um servidor. Também falaremos deles.
XDR, RPC, NFS
Por fim, mencionemos três protocolos definidos pela Sun Microsystems, a empresa que criou o Java: o XDR (eXternal Data Representation), que especifica uma representação de dados padrão, independente da máquina; o RPC (Remote Procedure Call), um protocolo de chamada de procedimento remoto baseado no XDR; e o NFS (Network File System), que permite que uma máquina "enxergue" o sistema de arquivos de outra máquina e se baseia no RPC. O NFS continua em uso no mundo Unix. O conceito de chamada de procedimento remoto foi adotado por numerosos sucessores; hoje, eles incluem os serviços web REST (baseados em HTTP) e o gRPC (baseado em HTTP/2).
12.1.9. Conclusão
Nesta introdução, apresentamos algumas das principais características dos protocolos da Internet. Para explorar esse campo com mais profundidade, o leitor pode consultar a obra de referência de Douglas Comer, *Internetworking with TCP/IP, Volume 1 ” (Pearson, 6ª edição) — cujas edições anteriores foram traduzidas para o francês —, bem como as RFCs citadas neste capítulo. Para o HTTP, a documentação da Mozilla em developer.mozilla.org/en-US/docs/Web/HTTP é uma excelente introdução.
12.2. Classes de gerenciamento de endereços IP
Uma máquina na Internet é identificada por um endereço IP, que pode assumir duas formas:
- IPv4: codificado em 32 bits e representado por uma cadeia da forma "I1.I2.I3.I4", em que In é um número entre 0 e 255;
- IPv6: codificado em 128 bits e representado por uma cadeia de oito grupos de dígitos hexadecimais separados por dois-pontos, como "2001:db8::8a2e:370:7334". Hoje não podemos mais ignorar esses endereços: nossos programas os aceitarão.
Uma máquina também pode ser identificada por um nome. Esse nome não é obrigatório, já que as aplicações usam, em última instância, sempre os endereços IP das máquinas. Os nomes existem para facilitar a vida dos usuários: é mais fácil pedir a um navegador a URL [https://kotlinlang.org] do que a URL formada a partir de um dos endereços IP desse site, que, aliás, muda conforme o local de onde a consulta é feita.
Uma máquina pode ter vários endereços IP: um endereço de loopback, um endereço por rede à qual está conectada, além de endereços IPv4 e IPv6.
A biblioteca padrão do Kotlin não oferece classes de rede próprias: na JVM, um programa Kotlin usa diretamente as do JDK, no pacote [java.net]. Todo este capítulo se baseia, portanto, nas mesmas classes que o curso de Java; o que muda é a forma de usá-las: propriedades em vez de acessores [getXxx], funções de extensão da biblioteca padrão, [use] para fechar recursos e a ausência de exceções verificadas.
Um endereço IP pode ser representado de duas maneiras:
- como uma cadeia como "I1.I2.I3.I4" ou "2001:db8::1";
- como um objeto do tipo [InetAddress] (pacote [java.net], que precisa ser importado: diferentemente de um arquivo-fonte compacto do Java, um arquivo Kotlin importa automaticamente apenas os pacotes [kotlin.*], [kotlin.collections.*], [kotlin.io.*], [kotlin.text.*]… e [java.lang.*]).
A classe InetAddress
A classe [InetAddress] não tem construtor público: suas instâncias são criadas por métodos estáticos construtores. Ela tem duas classes derivadas, [Inet4Address] e [Inet6Address], uma para cada versão do IP. Entre seus métodos estão os seguintes (o Kotlin trata os métodos sem parâmetros [getXxx()] e [isXxx()] como propriedades: escrevemos [address.hostAddress] em vez de [address.getHostAddress()], e [address.isLoopbackAddress]):
Método | Papel |
static InetAddress ofLiteral(String string) | (Java 22) converte um endereço IPv4 ou IPv6 escrito em dígitos em um objeto [InetAddress], sem nunca consultar o DNS; lança uma [IllegalArgumentException] se a cadeia não for um endereço IP. [Inet4Address.ofLiteral] e [Inet6Address.ofLiteral] aceitam apenas uma das duas versões |
static InetAddress getByName(String nameOrAddress) | devolve o endereço de uma máquina identificada pelo nome ou pelo endereço IP. Se a cadeia não for um endereço IP, o nome é procurado no DNS; lança uma [UnknownHostException] se a máquina não for encontrada |
static InetAddress[] getAllByName(String nameOrAddress) | Igual ao anterior, mas devolve todos os endereços IP da máquina (um [Array<InetAddress>] em Kotlin) |
static InetAddress getLocalHost() | o endereço da máquina em que o programa está sendo executado, junto com seu nome |
static InetAddress getLoopbackAddress() | o endereço de loopback (127.0.0.1 ou ::1). Um serviço associado a esse endereço aceita apenas clientes situados na mesma máquina que ele |
byte[] getAddress() | devolve os bytes do endereço (4 no IPv4, 16 no IPv6): propriedade [address] do tipo [ByteArray] em Kotlin |
String getHostAddress() | devolve o endereço em forma de texto: propriedade [hostAddress] |
String getHostName(), String getCanonicalHostName() | o nome da máquina (propriedades [hostName], [canonicalHostName]); se o objeto foi criado a partir de um endereço IP, esse nome é obtido por uma consulta "reversa" no DNS (o próprio endereço é devolvido se essa consulta falhar) |
boolean isLoopbackAddress(), isSiteLocalAddress(), isAnyLocalAddress()… | devolvem [true] se o endereço for um endereço de loopback, um endereço privado (10.x.y.z, 172.16.x.y a 172.31.x.y, 192.168.x.y), o endereço "curinga" 0.0.0.0 ou :: … (propriedades [isLoopbackAddress], [isSiteLocalAddress]…) |
Os métodos estáticos de uma classe Java são chamados em Kotlin da mesma forma que em Java, prefixados pelo nome da classe: [InetAddress.getByName("localhost")]. Eles não se tornam propriedades: escreve-se [InetAddress.getLoopbackAddress()].
Duas outras classes complementam [InetAddress]:
- [InetSocketAddress] representa um ponto de conexão: um endereço IP e um número de porta. Suas propriedades [address] e [port] fornecem essas duas informações. O construtor [InetSocketAddress(port)] associa a porta ao endereço curinga 0.0.0.0, que designa todos os endereços da máquina;
- [NetworkInterface] representa uma interface de rede da máquina (uma placa Ethernet, uma placa Wi-Fi, a interface de loopback etc.), junto com seus endereços IP.
O JDK, por outro lado, não tem uma classe que represente uma rede em notação CIDR, como 193.49.144.0/24: nós mesmos a escreveremos, na forma de uma data class que sobrecarrega o operador [in]. O programa [Internet01.kt] ilustra essas classes:
Resultados:
Comentários:
- linhas 3–6: as classes de [java.net] precisam ser importadas;
- linhas 12–13: as cadeias a serem analisadas, em uma lista somente leitura;
- linha 17: [InetAddress.ofLiteral] (Java 22) converte a cadeia em um objeto [InetAddress] se ela for um endereço IPv4 ou IPv6, e lança uma [IllegalArgumentException] caso contrário (linha 23). Como o objeto da exceção não é usado, ele é chamado de [_]: o compilador então sabe que ele é intencionalmente ignorado;
- linha 18: o operador [is] (o equivalente do [instanceof] do Java) distingue as duas versões do IP: o objeto devolvido é uma instância de [Inet4Address] ou de [Inet6Address]. Como o [if] do Kotlin é uma expressão, ele substitui o operador ternário do Java;
- linhas 19–20: a propriedade [address] (o método Java [getAddress]) devolve os bytes do endereço em um [ByteArray], que a função de extensão da biblioteca padrão do Kotlin [toHexString] exibe em hexadecimal; o parâmetro [HexFormat.UpperCase] exige letras maiúsculas. Trata-se do [HexFormat] do Kotlin (pacote [kotlin.text], importado automaticamente), que não deve ser confundido com a classe [java.util.HexFormat] usada no curso de Java. Vemos (linha 2 dos resultados) que 193.49.144.1 é composto pelos quatro bytes C1, 31, 90, 01 e (linha 5) que ::1 é composto por 15 bytes nulos seguidos de um byte de valor 1;
- linhas 21–22: a mensagem é construída com templates de string; [isLoopbackAddress] e [isSiteLocalAddress] (os métodos Java [isXxx()], tratados como propriedades booleanas) reconhecem os endereços de loopback e os endereços privados da RFC 1918;
- linha 4 dos resultados: uma surpresa. A cadeia "192.168.1" foi aceita e convertida em 192.168.0.1. De fato, [ofLiteral] aceita as formas abreviadas históricas de endereços IPv4 (nas quais o último número ocupa todos os bytes restantes). Para verificar se uma entrada é um endereço IPv4 completo, é preciso, portanto, verificar também se ela contém quatro números;
- linhas 5–6 dos resultados: os endereços IPv6 são reexibidos por [hostAddress] na forma completa, sem a abreviação [::] nem os zeros à esquerda: [0:0:0:0:0:0:0:1] para [::1]. O prefixo 2001:db8::/32 é, como 192.0.2.0/24 no IPv4, reservado para documentação;
- linhas 29–32: o método mais antigo [getByName] aceita um endereço IP ou um nome de máquina. Como a cadeia "256.1.1.1" não é um endereço IP válido (256 não cabe em um único byte), [getByName] a interpreta como um nome de host e consulta o DNS, que não a reconhece: o resultado é uma [UnknownHostException] (linha 9 dos resultados). [ofLiteral] foi adicionado no Java 22 para evitar essa consulta inesperada ao DNS. A mensagem da exceção aqui vem da biblioteca de sistema do Linux. A expressão [e::class.simpleName] é a referência de classe do Kotlin ([KClass]); ela substitui [e.getClass().getSimpleName()]. Observe que, como o Kotlin não tem exceções verificadas, não há obrigação de capturar a [UnknownHostException]: fazemos isso porque queremos exibi-la, não porque o compilador exige;
- Linha 36: o endereço de loopback. A exibição de um objeto [InetAddress] por [toString], chamado implicitamente pelo template [${…}], tem a forma [name/address], com o nome vazio se for desconhecido;
- linha 37: o endereço curinga 0.0.0.0, obtido aqui por um [InetSocketAddress] sem endereço. Como em C#, um objeto é criado sem a palavra-chave [new];
- linhas 40–43: objetos [InetSocketAddress] que associam um endereço e uma porta. Eles são exibidos (linhas 12–13 dos resultados) na forma [name/address:port]; em IPv6, o endereço é colocado entre colchetes;
- linhas 55–77: uma data class (Capítulo 4) que representa uma rede em notação CIDR. Ela é declarada no mesmo arquivo da função [main], logo após esta;
- linhas 57–61: a função [parse], situada no companion object, é chamada como um método estático do Java: [Network.parse("193.49.144.0/24")]. Ela analisa uma cadeia da forma [address/prefix]; a atribuição por desestruturação [val (ip, length) = cidr.split("/")] atribui os dois elementos da lista devolvida por [split] a duas variáveis;
- linhas 66–73: um endereço pertence à rede se os seus [prefix] bits mais significativos coincidirem com os do endereço da rede. O bit de número [bit] está no byte de número [bit / 8]; a máscara [0x80 shr (bit % 8)] o isola dentro desse byte. O Kotlin não tem os operadores [>>] e [&]: ele usa as funções infixas [shr] e [and], definidas em [Int] (daí a conversão [toInt()] dos bytes). O laço Java com seu [return false] é substituído pela função [all] aplicada ao intervalo [0 until prefix]: ela devolve [true] se a lambda for verdadeira para todos os bits e para no primeiro bit diferente;
- linha 66: como a função se chama [contains] e tem o modificador [operator], podemos escrever [address in network] (linha 49), como faríamos com uma coleção. Trata-se da sobrecarga de operadores do Capítulo 4, que o C# também suporta, mas o Java não. As linhas 14–15 dos resultados mostram que 193.49.144.1 pertence à rede 193.49.144.0/24 e que 193.49.145.3 (o endereço do roteador em nosso diagrama, em sua segunda rede) não pertence a ela. Esse é exatamente o teste que uma máquina faz para escolher entre roteamento direto e indireto;
- linha 77: a data class gera um [toString] na forma [Network(address=…, prefix=…)]; nós o redefinimos para exibir a notação CIDR.
DNS e interfaces de rede
A correspondência entre o IP e o nome da máquina é feita pelo DNS. Ele é consultado pelos métodos estáticos [getByName] e [getAllByName] de [InetAddress], já descritos; no sentido inverso, as propriedades [hostName] e [canonicalHostName] fazem uma consulta reversa. Esses métodos são bloqueantes: uma requisição DNS pode levar várias dezenas de milissegundos, ou até vários segundos se um servidor não responder, e durante esse tempo a thread chamadora fica bloqueada. O JDK não oferece uma versão assíncrona desses métodos; a solução é chamá-los em uma thread virtual (Capítulo 8), que praticamente não gera custo durante a espera, ou, em uma corrotina, envolvê-los em [withContext(Dispatchers.IO) { … }] (Capítulo 9). Desde o Java 18, também é possível substituir o mecanismo de resolução de nomes usado por [InetAddress] fornecendo sua própria implementação da interface [InetAddressResolver], o que é útil em testes.
A classe [NetworkInterface], com seu método estático [networkInterfaces], devolve um fluxo ([Stream]) das interfaces de rede da máquina; para cada uma, a propriedade [name] fornece o nome, [isUp] indica se ela está ativa e o método [inetAddresses] devolve um fluxo de seus endereços (IP). Em Kotlin, esses streams Java são convertidos em sequências Kotlin pela função de extensão [asSequence] (pacote [kotlin.streams]), de modo que as operações usuais possam ser aplicadas a eles ([filter], [joinToString]…).
O programa [Internet02.kt] exibe o nome e as interfaces de rede da máquina em que está sendo executado e, em seguida, lista interativamente as correspondências entre o nome da máquina e os endereços IP:
Resultados (a entrada foi redirecionada; reinserimos as entradas após cada prompt):
Comentários:
- linhas 14–15: o nome e o endereço da máquina local. Nossa máquina de teste é uma máquina virtual Linux chamada [vm]; para o leitor, será naturalmente o nome do próprio computador;
- linhas 17–21: as interfaces de rede ativas e seus endereços. O stream Java é convertido em uma sequência Kotlin por [asSequence]; mantemos as interfaces ativas com [filter { it.isUp \}] e depois exibimos cada uma com [forEach]. A versão Java precisava recorrer a um método auxiliar, [active]: [isUp] lança uma exceção verificada ([SocketException]), que a interface funcional [Predicate] não permite. Em Kotlin, que não tem exceções verificadas, [isUp] é escrito diretamente na lambda (se lançasse uma [SocketException], ela simplesmente se propagaria);
- linha 20: os endereços IP da interface são combinados em uma única cadeia por [joinToString], cujo separador padrão é [", "]; a lambda fornece a cadeia a ser usada para cada elemento. Isso equivale a [map(InetAddress::getHostAddress).collect(Collectors.joining(", "))];
- linhas 27–28: o prompt é exibido por [print] e, em seguida, [readlnOrNull] lê uma linha do teclado; ele devolve [null] se a entrada padrão estiver fechada. O operador [?.] chama [trim] e [lowercase] somente se a linha não for [null], e o operador Elvis [?:] substitui um [null] pela cadeia vazia;
- linha 33: a consulta ao DNS. Se o nome (ou endereço) for desconhecido, uma [UnknownHostException] é lançada (linha 38);
- linha 35: o nome da máquina. Se um endereço IP foi fornecido, [hostName] faz uma consulta reversa;
- linha 37: os endereços da máquina são combinados em uma única cadeia; [joinToString] aplica-se igualmente ao array devolvido por [getAllByName] e a coleções e sequências.
Os resultados merecem alguns comentários. Eles dependem da configuração da máquina: não espere obter exatamente os mesmos resultados na sua.
- Linhas 2–4: a máquina de teste tem duas interfaces ativas: [eth0], conectada à rede, e [lo], a interface de loopback. O nome da máquina está associado ao endereço 127.0.0.1 pelo arquivo [/etc/hosts];
- linhas 5–7: o nome [localhost] corresponde ao endereço de loopback 127.0.0.1. Em uma máquina com IPv6 ativo, ::1 também seria devolvido;
- linha 12: com o endereço IP, [hostName] fez uma consulta reversa e devolveu o nome associado ao endereço;
- linha 15: a consulta reversa de ::1 falhou porque o arquivo [/etc/hosts] da nossa máquina de teste não associa nenhum nome a esse endereço: [hostName] devolveu o próprio endereço. No Windows, o nome da máquina seria devolvido;
- linha 18: o nome [xx] é desconhecido. A mensagem da exceção vem da biblioteca de sistema do Linux; ela seria diferente no Windows.
Em uma máquina conectada à Internet, também é possível consultar um nome público como [kotlinlang.org]. Isso devolve endereços que variam conforme o local e o momento da consulta. Não reproduzimos esse resultado, pois nossa máquina de teste não tem acesso à Internet.
12.3. Fundamentos da programação web
12.3.1. Informações gerais
Considere a comunicação entre duas máquinas remotas, A e B:
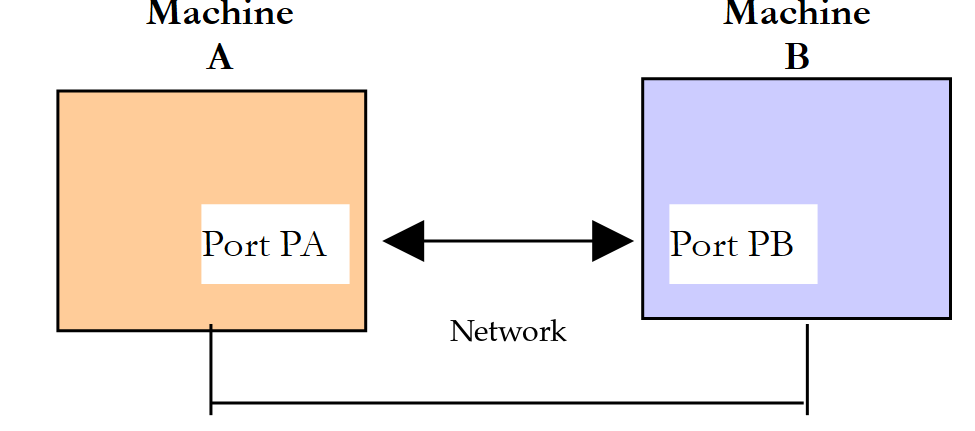
Quando uma aplicação AppA da máquina A quer se comunicar com uma aplicação AppB da máquina B na Internet, ela precisa conhecer várias coisas:
- o endereço IP ou o nome da máquina B;
- o número da porta usada pela aplicação AppB. Isso porque a máquina B pode hospedar muitas aplicações que funcionam na Internet. Quando recebe informações da rede, ela precisa saber a qual aplicação elas se destinam. As aplicações da máquina B acessam a rede por meio de interfaces chamadas de portas de comunicação. O número da porta de destino está contido no segmento recebido pela máquina B, para que ele seja entregue à aplicação correta;
- os protocolos de comunicação compreendidos pela máquina B. Em nosso estudo, usaremos apenas os protocolos TCP/IP;
- o protocolo de comunicação aceito pela aplicação AppB. De fato, as máquinas A e B vão "conversar" entre si. O que elas dizem será encapsulado nos protocolos TCP/IP. No entanto, quando a aplicação AppB, na outra ponta da cadeia, recebe a informação enviada pela aplicação AppA, ela precisa ser capaz de interpretá-la. É análogo a uma situação em que duas pessoas, A e B, se comunicam por telefone: a conversa é transportada pelo telefone, mas, se A fala francês e B não entende esse idioma, A e B não conseguirão ter uma conversa significativa. As duas aplicações que se comunicam devem, portanto, concordar sobre o tipo de comunicação que usarão. Por exemplo, a comunicação com um servidor web não é a mesma que a comunicação com um servidor de e-mail: esses dois serviços não aceitam os mesmos comandos. Eles têm protocolos de comunicação diferentes.
12.3.2. Características do protocolo TCP
Aqui, vamos nos concentrar apenas nas comunicações de rede que usam o protocolo de transporte TCP. Vamos rever suas principais características para os programadores:
- Primeiro é estabelecida uma conexão entre uma porta da máquina cliente e uma porta da máquina servidora. Ela é identificada por quatro informações: o endereço IP e a porta do cliente, e o endereço IP e a porta do servidor;
- a conexão transporta dois fluxos de bytes, um em cada sentido (full-duplex). Os bytes chegam na ordem em que foram transmitidos, sem perda nem duplicação;
- o TCP não conhece o conceito de mensagem: cabe ao protocolo de comunicação da aplicação delimitar requisições e respostas (por meio de uma quebra de linha, de um comprimento especificado, do fechamento da conexão etc.);
- Uma das duas partes fecha a conexão; a outra detecta isso quando chega ao fim do fluxo de leitura.
12.3.3. A relação cliente-servidor
A comunicação pela Internet costuma ser assimétrica: a máquina A inicia uma conexão para solicitar um serviço à máquina B. Ela especifica que quer estabelecer uma conexão com o serviço SB1 da máquina B. A máquina B aceita ou rejeita o pedido. Se aceitar, a máquina A pode enviar suas requisições ao serviço SB1. Essas requisições devem estar em conformidade com o protocolo de comunicação compreendido pelo serviço SB1. Estabelece-se assim um diálogo de requisição-resposta entre a máquina A, chamada de máquina cliente, e a máquina B, chamada de máquina servidora. Um dos dois parceiros fechará a conexão.
12.3.4. Arquitetura do cliente
A arquitetura de um programa de rede que solicita os serviços de uma aplicação servidora será a seguinte:
12.3.5. Arquitetura do servidor
A arquitetura de um programa que oferece serviços será a seguinte:
O programa servidor trata de maneira diferente o primeiro pedido de conexão de um cliente e suas solicitações de serviço subsequentes. O programa que escuta não presta o serviço ele próprio: se o fizesse, deixaria de escutar pedidos de conexão enquanto o serviço estivesse em andamento, e os outros clientes não seriam atendidos. Por isso, ele age de outra forma: assim que um pedido de conexão é recebido na porta de escuta e aceito, o servidor delega a outra thread a tarefa de prestar o serviço solicitado pelo cliente, pela conexão de serviço que acabou de ser estabelecida. Isso permite atender vários clientes ao mesmo tempo:
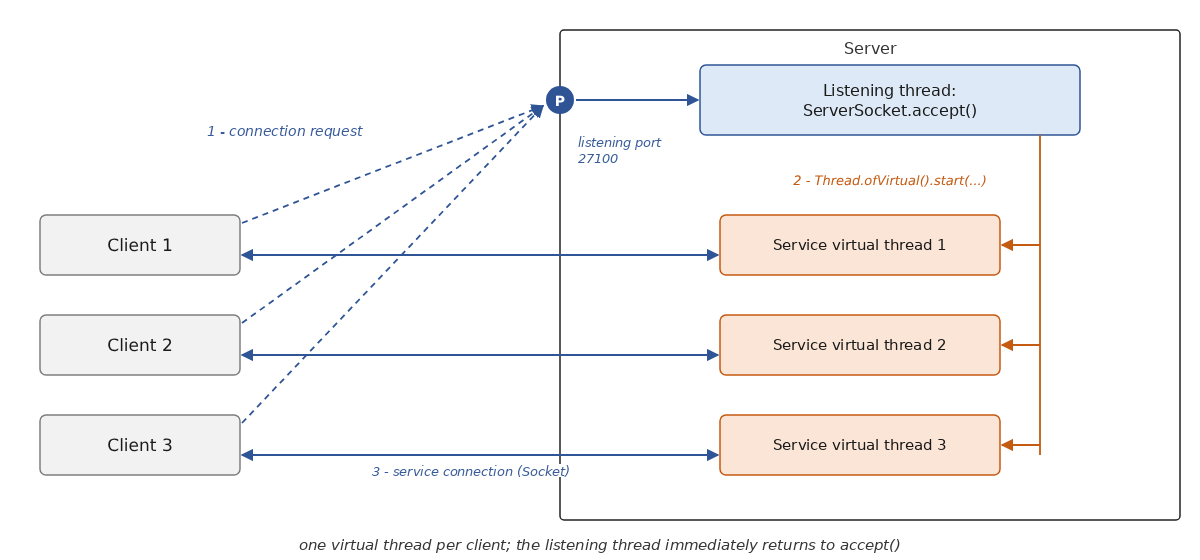
Às vezes se afirma que, no lado do servidor, a conexão de serviço usa uma porta diferente, escolhida aleatoriamente. Isso é incorreto: todas as conexões de serviço usam a porta de escuta do servidor; elas se distinguem umas das outras pelo endereço e pela porta do cliente, que são diferentes. Veremos isso na saída do nosso servidor de eco.
Uma thread de serviço terá a seguinte estrutura:
12.4. Explorando os protocolos de comunicação da Internet
12.4.1. Introdução
Quando um cliente se conecta a um servidor, estabelece-se um diálogo entre eles. A natureza desse diálogo constitui o que se chama de protocolo de comunicação do servidor. Entre os protocolos mais comuns da Internet estão os seguintes:
- HTTP: HyperText Transfer Protocol, o protocolo de comunicação com um servidor web (servidor HTTP);
- SMTP: Simple Mail Transfer Protocol, o protocolo de comunicação com um servidor de envio de e-mails (servidor SMTP);
- POP: Post Office Protocol, o protocolo de comunicação com um servidor de armazenamento de e-mails (servidor POP). É usado para recuperar os e-mails recebidos, não para enviá-los. O IMAP tem a mesma finalidade;
- FTP: File Transfer Protocol, o protocolo de comunicação com um servidor de armazenamento de arquivos (servidor FTP).
Esses protocolos, em suas versões históricas, caracterizam-se por serem baseados em texto: o cliente e o servidor trocam linhas de texto terminadas pelos dois caracteres \r\n (retorno de carro, avanço de linha). Se você tiver um cliente capaz de:
- estabelecer uma conexão com um servidor TCP;
- exibir no console as linhas de texto que o servidor lhe envia;
- enviar ao servidor as linhas de texto que o usuário digita no teclado,
então poderemos nos comunicar com um servidor TCP que use um protocolo baseado em texto, desde que conheçamos as regras desse protocolo.
O programa [telnet], que antigamente estava disponível em máquinas Unix e Windows, é um desses clientes; a ferramenta PuTTY, configurada no modo de conexão bruta (raw), é outro. O cliente [telnet] não vem mais instalado por padrão no Windows, e a maioria dos servidores públicos não aceita mais comunicação sem criptografia. Vamos proceder de outra forma:
- para o HTTP, usaremos a ferramenta [curl], disponível por padrão no Windows 10 e 11, no macOS e no Linux, que exibe os detalhes das trocas, e depois o cliente TCP genérico que escreveremos mais adiante neste capítulo. No Windows, o PowerShell e [curl] são aliases do comando [Invoke-WebRequest]: é preciso digitar [curl.exe];
- como não temos acesso a servidores reais, consultaremos um pequeno servidor web que nós mesmos escrevemos e que roda na máquina local;
- Para SMTP, POP e FTP, apresentaremos exemplos de diálogos em conformidade com as RFCs que definem esses protocolos.
12.4.2. Um servidor web de teste
Nosso servidor web de teste usa o pequeno servidor HTTP fornecido com o JDK, no módulo [jdk.httpserver] (pacote [com.sun.net.httpserver]). Apesar do nome do pacote, trata-se de uma classe de API pública e bem documentada, disponível desde o Java 6; ela é suficiente para escrever um servidor de teste em um único arquivo, sem nenhuma biblioteca, e um programa Kotlin a usa como qualquer outra classe do pacote do JDK. Os serviços web reais costumam usar um servidor completo como o Tomcat, que exploraremos com o Spring Boot no próximo capítulo. Você ainda não precisa entender este programa em detalhes — basta saber o que ele devolve. O programa [Internet03.kt] é o seguinte:
Comentários:
- Linhas 3–7: as classes do servidor HTTP, do JDK e de [java.net] são importadas. O módulo [jdk.httpserver] faz parte do JDK: não é necessário declarar dependências em [build.gradle.kts];
- Linhas 15–21: a página inicial, um pequeno documento HTML escrito com uma raw string [""" ... """], que evita o escape das aspas. A função [trimIndent] remove a indentação comum das linhas, bem como a primeira e a última linhas se estiverem vazias; a quebra de linha final do documento é então acrescentada. A constante é [private]: ela só é visível neste arquivo;
- linha 24: a porta de escuta, 27110 por padrão. [firstOrNull] devolve o primeiro argumento, ou [null] se não houver nenhum; o operador Elvis [?:] fornece então o valor padrão;
- linha 26: o servidor escuta no endereço de loopback 127.0.0.1: ele só é acessível a partir da própria máquina. O segundo parâmetro de [create] é o tamanho da fila de conexões (0: padrão do sistema);
- linha 28: todas as URLs que começam com [/] — e, portanto, todas as URLs — são delegadas à função [process]. O segundo parâmetro de [createContext] é um [HttpHandler], uma interface Java com um único método abstrato, [handle(HttpExchange)], que recebe a troca atual: a requisição do cliente e a resposta a ser construída. Graças à conversão SAM (Capítulo 7), passa-se a ele uma lambda — escrita após os parênteses; essa lambda chama [process], passando-lhe também a porta, uma variável local de [main] capturada pela lambda;
- linha 29: o servidor começa a rodar em suas próprias threads; a função [main] termina, mas o programa continua em execução até ser interrompido com Ctrl-C;
- linha 35: um [HttpExchange] deve ser fechado depois que a resposta é enviada. Ele implementa [AutoCloseable]: a função [use] o fechará ao fim do bloco, aconteça o que acontecer;
- Linhas 36–37: os métodos Java [getRequestMethod()] e [getRequestURI().getPath()] são tratados como propriedades. A comparação de cadeias é feita por [==] e [!=], que comparam o conteúdo (onde o Java exige [equals]);
- linhas 38–40: somente os métodos [GET] e [HEAD] são aceitos; os demais recebem uma resposta 405 (método não permitido);
- Linhas 42–55: seleção da resposta com base na URL, por meio de uma instrução [when] (o [switch] do Java). Os argumentos nomeados em [withSize = true] tornam as chamadas a [send] mais legíveis do que um booleano anônimo;
- linha 44: a URL [/] devolve a página inicial;
- linha 46: a URL [/hello?name=xx] devolve o texto [Hello xx!];
- linha 49: a URL [/old] provoca um redirecionamento temporário (código de status 302) para o endereço relativo [/hello?name=visitor];
- linha 51: a URL [/moved] provoca um redirecionamento permanente (código de status 301) para o endereço absoluto [http://localhost:27110/];
- linha 53: a URL redireciona para [/loop], que redireciona de volta para si mesma: um cliente que seguisse os redirecionamentos às cegas nunca pararia;
- linha 55: qualquer outra requisição de URL recebe uma resposta 404 (página não encontrada). O método [sendResponseHeaders(code, size)] envia a linha de status e os cabeçalhos; um tamanho igual a -1 significa que nenhum documento se segue;
- linha 59: cada requisição processada é exibida no console junto com o código de status da resposta;
- linhas 64–75: envio de um documento de texto. [toByteArray] codifica a cadeia em UTF-8, o conjunto de caracteres padrão dessa função do Kotlin. Os cabeçalhos da resposta são definidos por [exchange.responseHeaders["Content-Type"] = type] (linha 66): o objeto [Headers] tem um método Java [set(String, String)], e o Kotlin permite chamar esse método com a sintaxe de colchetes, semelhante a um indexador do C#. [sendResponseHeaders] envia então os cabeçalhos junto com o tamanho do documento, um [Long]: a conversão [toLong()] é explícita, pois o Kotlin nunca converte implicitamente um [Int] em um [Long]; por fim, o documento é escrito no fluxo [responseBody] (linha 75). Um tamanho 0 (linha 74) significa "tamanho desconhecido": o documento é então enviado em blocos (chunks), como veremos mais adiante. Para uma requisição [HEAD], nenhum documento é enviado, mas o tamanho que ele teria é informado (linhas 67–71);
- linhas 79–81: um redirecionamento, composto por um código de status e por um cabeçalho [Location] que informa o novo endereço;
- linhas 85–91: o valor de um parâmetro na URL. [rawQuery] devolve a parte da URL que vem depois de [?], ainda codificada, ou [null] se não houver nenhuma. O laço do programa Java é substituído por uma sequência de chamadas "seguras" [?.]: se [rawQuery] for [null], toda a cadeia é avaliada como [null], e o operador Elvis devolve o valor padrão. Caso contrário, a consulta é dividida em pares [name=value] ([split]), cada par é dividido em duas partes na primeira ocorrência de [=] ([limit = 2]), [firstOrNull] procura o primeiro par cujo nome corresponde ao solicitado (ou devolve [null]) e [let] decodifica seu valor com [URLDecoder.decode] (veremos mais adiante por que os valores são codificados). A função, reduzida a uma única expressão, é escrita com [=].
O servidor é iniciado em uma primeira janela de comando. Ele exibe:
As linhas 3–4 apareceram durante os testes descritos no parágrafo seguinte. O servidor é interrompido pressionando Ctrl-C.
12.4.3. O protocolo HTTP (HyperText Transfer Protocol)
Com o servidor em execução, usamos uma segunda janela de comando para solicitar a raiz ([/]) do site [http://localhost:27110] com a ferramenta [curl]. Sua opção [-v] (verbose) exibe todo o diálogo HTTP; a opção [-s] (silent) suprime a exibição do progresso da transferência:
Notas:
- As linhas que começam com [*] contêm informações do [curl]; as linhas que começam com [>] foram enviadas ao servidor; as que começam com [<] foram recebidas do servidor; a linha [{ [173 bytes data]] indica a chegada dos 173 bytes do documento, que é exibido no final;
- Linhas 2–6: o [curl] obteve os endereços de [localhost] (::1 para IPv6 e 127.0.0.1 para IPv4) e se conectou à porta 27110 do endereço 127.0.0.1;
- linhas 7–11: a requisição do cliente. Ela consiste em uma primeira linha com a sintaxe [method URL version] (aqui, o método [GET] é usado para solicitar o documento [/], isto é, a raiz do site, em HTTP/1.1), seguida de cabeçalhos HTTP da forma [Name: value], e termina com uma linha em branco;
- linha 8: o cabeçalho [Host] especifica a máquina e a porta consultadas; ele é obrigatório no HTTP/1.1, porque um mesmo servidor pode hospedar vários sites;
- linha 9: o identificador do software cliente;
- linha 10: os tipos de documento aceitos pelo cliente — neste caso, todos;
- Linhas 12–16: a resposta do servidor: uma linha de status e cabeçalhos, também seguidos de uma linha em branco;
- linha 12: a linha de status, com a sintaxe [version code message]. O código 200 indica que o documento solicitado foi encontrado;
- linha 13: a data e a hora do servidor, sempre em Tempo Universal Coordenado (GMT);
- linha 14: o tipo do documento (um documento HTML) e sua codificação (UTF-8);
- linha 15: o tamanho do documento em bytes. É assim que o cliente sabe onde o documento termina. Observe que o servidor do JDK escreve os nomes dos cabeçalhos com uma única letra maiúscula ([Content-type], [Content-length]): isso é irrelevante, pois os nomes dos cabeçalhos HTTP não diferenciam maiúsculas de minúsculas. Ele também não envia o cabeçalho opcional [Server], que a maioria dos servidores usa para se identificar ([Server: Apache], [Server: nginx]…);
- linha 18: no HTTP/1.1, a conexão permanece aberta por padrão após a resposta (modo "keep-alive"), para que outras requisições possam ser atendidas; o [curl] a deixa aberta e depois a fecha ao terminar;
- linhas 19–23: o documento enviado pelo servidor.
Agora vamos solicitar um documento que não existe:
- linha 7: solicitamos um documento inexistente;
- linha 12: o servidor respondeu com o código de status 404, que significa que o documento solicitado não foi encontrado;
- linha 14: o documento enviado está vazio. Nosso servidor, como muitos outros, não anexa nenhum documento a uma resposta 404; outros servidores enviam uma breve página explicativa. Um navegador que recebe uma resposta 404 sem documento exibe a sua própria página de erro.
Os códigos de status se dividem em cinco categorias: 1xx (informação), 2xx (sucesso, 200 OK), 3xx (redirecionamento, 301 e 302, que veremos mais adiante), 4xx (erro do cliente: 404 Not Found, 401 Unauthorized, 403 Forbidden…), 5xx (erro do servidor: 500 Internal Server Error…).
O navegador faz o mesmo que o [curl]: envia uma requisição HTTP, recebe os cabeçalhos e o documento e, em seguida, exibe o documento. As ferramentas de desenvolvedor do navegador (tecla F12, aba Rede) permitem ver os cabeçalhos trocados.
Algumas observações sobre o estado atual do HTTP:
- O HTTPS é hoje o padrão: os navegadores sinalizam um site que usa HTTP simples como "não seguro". Com o HTTPS, uma negociação TLS precede o diálogo HTTP, e tudo o que vem depois é criptografado. Portanto, não é mais possível se comunicar "manualmente" com um servidor HTTPS usando um simples cliente TCP. No entanto, ainda é possível observar o diálogo com o [curl], que realiza o handshake TLS e depois exibe os cabeçalhos em texto puro. Apenas a título ilustrativo (não reproduzimos o resultado, pois nossa máquina de teste não tem acesso à Internet), o comando seria [curl -v https://kotlinlang.org/];
- O HTTP/1.1 (hoje RFC 9112) é um protocolo baseado em texto, o que estamos estudando. O HTTP/2 (2015, hoje RFC 9113) mantém os mesmos métodos, cabeçalhos e códigos de status, mas os transmite em um formato binário comprimido e envia várias requisições simultaneamente por uma única conexão TCP. O HTTP/3 (2022, RFC 9114) faz o mesmo sobre o QUIC e, portanto, sobre o UDP. Navegadores e servidores escolhem automaticamente a versão mais recente que têm em comum; o [curl], sem nenhuma opção específica, usa o HTTP/1.1 para uma URL [http://].
12.4.4. O protocolo SMTP (Simple Mail Transfer Protocol)
Os servidores SMTP trocam e-mails entre si na porta 25. Um cliente de e-mail que envia uma mensagem a submete ao servidor SMTP do seu provedor na porta 587 (submissão, com passagem para o modo criptografado pelo comando [STARTTLS]) ou 465 (conexão criptografada desde o início), após se autenticar. Os provedores de acesso à Internet geralmente bloqueiam as conexões de saída para a porta 25 dos roteadores de seus assinantes, para limitar o spam enviado por máquinas infectadas: uma conexão sem criptografia com um servidor SMTP é hoje praticamente impossível a partir de um computador pessoal.
A seguir, a título ilustrativo, um diálogo SMTP típico, de acordo com a RFC 5321. Não se trata de uma execução: as linhas prefixadas com [C:] são enviadas pelo cliente, as prefixadas com [S:] pelo servidor, e os domínios [example.org] e [example.com] são reservados para exemplos:
- Linha 1: mensagem de boas-vindas do servidor. Cada resposta do servidor começa com um código de três dígitos: 2xx indica sucesso, 3xx significa "continue" e 4xx e 5xx indicam um erro;
- linha 2: o cliente se identifica. O comando [EHLO] substituiu o antigo comando [HELO]: ele pede ao servidor a lista das extensões que ele suporta;
- Linhas 3–6: a resposta do servidor, que se estende por várias linhas. O hífen após o código indica que a resposta continua; a última linha tem um espaço no lugar. Aqui, o servidor informa que aceita mensagens de até 10 MB, suporta o modo criptografado e aceita caracteres de 8 bits;
- linha 7: o endereço do remetente;
- linha 9: o endereço do destinatário (o comando pode ser repetido para vários destinatários);
- linha 11: o cliente anuncia a mensagem;
- linha 12: o servidor convida o cliente a enviar a mensagem e lembra como terminá-la;
- linhas 13–19: a mensagem, composta por cabeçalhos ([From], [To], [Subject]…), uma linha em branco e o corpo, terminando com uma linha contendo apenas um ponto;
- linha 20: o servidor aceitou a mensagem e a colocou em sua fila;
- Linhas 21–22: o cliente sinaliza que terminou; o servidor fecha a conexão.
12.4.5. O protocolo POP (Post Office Protocol)
Os servidores POP3 funcionam na porta 110, ou na porta 995 para uma conexão criptografada com TLS — a única opção oferecida atualmente pela maioria dos provedores, já que a senha é transmitida durante o diálogo. A seguir, um diálogo POP3 típico, em conformidade com a RFC 1939, apresentado com as mesmas convenções do anterior:
- linha 1: mensagem de boas-vindas do servidor. As respostas do POP3 começam com [+OK] (sucesso) ou [-ERR] (erro);
- linha 2: o cliente informa seu nome de usuário, isto é, o nome que usa para ler seus e-mails;
- linha 4: a senha do cliente (oculta aqui);
- linha 6: o cliente solicita a lista de seus e-mails;
- linhas 7–10: a lista das mensagens da caixa de correio do cliente, no formato [message number, size in bytes], terminando com uma linha contendo apenas um ponto;
- linha 11: a mensagem nº 2 é solicitada;
- linhas 12–23: a mensagem nº 2, com seus cabeçalhos, uma linha em branco e seu corpo, também terminando com um ponto;
- linhas 24–25: o cliente indica que terminou; o servidor fecha a conexão.
O POP3 foi concebido para baixar e-mails para o computador do usuário. Hoje ele enfrenta forte concorrência do IMAP (porta 143, ou 993 com TLS; RFC 9051), que deixa as mensagens no servidor e permite visualizá-las e organizá-las a partir de vários dispositivos, bem como por meio de clientes de e-mail baseados na web.
12.4.6. O protocolo FTP (File Transfer Protocol)
O protocolo FTP (RFC 959) é mais complexo que os descritos anteriormente: o diálogo (comandos e suas respostas) ocorre em uma conexão de controle aberta na porta 21 do servidor, e cada transferência de arquivo ou de lista de arquivos usa uma segunda conexão, aberta especificamente para essa finalidade. A seguir, um diálogo típico na conexão de controle:
- linha 2: conexão anônima, como a oferecida por servidores públicos de download;
- linha 8: o cliente pede ao servidor que abra uma porta para a conexão de dados. O servidor responde (linha 9) que está aguardando essa conexão na porta 40312;
- linha 10: o cliente solicita o arquivo [readme.txt]. O arquivo chega pela conexão de dados, e a conexão de controle recebe as respostas 150 (início da transferência) e 226 (fim da transferência).
Esses comandos podem ser vistos no log de um cliente como o FTP ou o FileZilla. No entanto, o FTP está se tornando obsoleto: ele transmite as senhas em texto puro, tem dificuldade para funcionar com firewalls por causa da segunda conexão, e os navegadores não o suportam desde 2021 (Chrome 88, Firefox 90). É preferível usar o SFTP, a transferência de arquivos via SSH, e o simples download via HTTPS.
12.5. Classes de programação para a Internet
12.5.1. Escolhendo a classe certa
O JDK oferece diversas classes para trabalhar com a rede. Estas são as usadas por um programa Kotlin: a biblioteca padrão do Kotlin não oferece nenhuma outra, e o diagrama a seguir, criado para o curso de Java, permanece portanto correto:
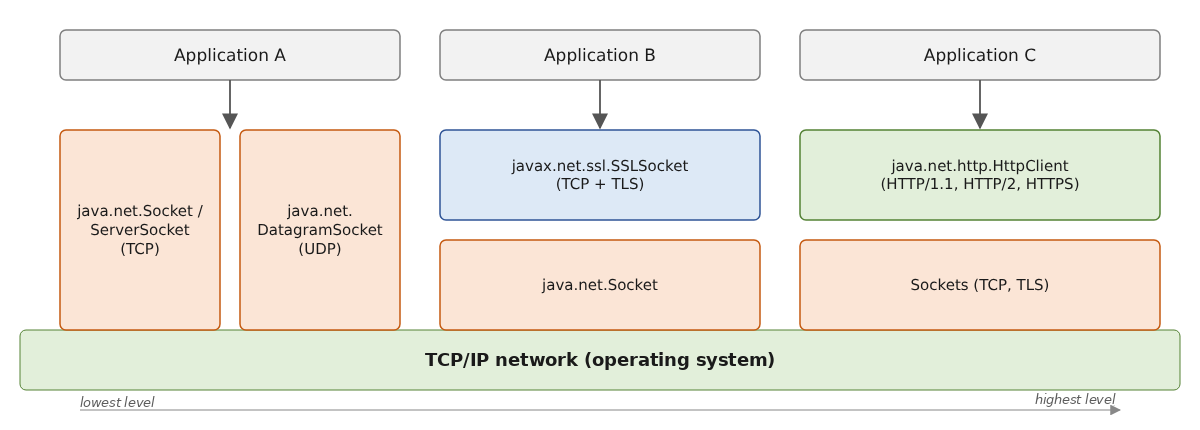
- A classe [Socket] (pacote [java.net]) representa a extremidade de uma conexão TCP. O termo inglês "socket" designa uma tomada elétrica; seu sentido foi estendido para designar um soquete de rede em software. Em uma comunicação TCP/IP entre duas máquinas, A e B, são dois sockets que se comunicam entre si. Um cliente cria um [Socket] para se conectar a um servidor; um servidor cria um [ServerSocket], que aguarda pedidos de conexão e fornece, para cada cliente aceito, um [Socket] ligado a esse cliente. Depois que a conexão é estabelecida, um [Socket] oferece dois fluxos de bytes — um para leitura e outro para escrita —, que são usados como fluxos de arquivo. É o caso da Aplicação A acima;
- a classe [DatagramSocket] permite enviar e receber datagramas UDP. Não a usaremos neste curso;
- as classes [SSLSocket] e [SSLServerSocket] (pacote [javax.net.ssl]) acrescentam criptografia TLS ao [Socket]: concluída a negociação TLS, elas são usadas exatamente como sockets comuns (Aplicação B acima);
- o JDK também oferece uma classe especializada em um protocolo: [HttpClient] (pacote [java.net.http], Java 11), que trata o protocolo HTTP nas versões 1.1 e 2, incluindo a criptografia TLS do HTTPS (Aplicação C acima). Ela substitui a classe [HttpURLConnection] do Java 1.1; voltaremos a ela na segunda parte deste capítulo. O JDK não tem uma classe para e-mail; a biblioteca Jakarta Mail é usada para isso.
As classes [Socket] e [ServerSocket] existem desde o Java 1.0. Suas operações são bloqueantes: [accept] bloqueia a thread chamadora até a chegada de um cliente; uma operação de leitura a bloqueia até a chegada de dados. O Java 1.4 acrescentou o pacote [java.nio.channels] ([SocketChannel], [ServerSocketChannel], [Selector]), que permite operações não bloqueantes, e o Java 7 introduziu os canais assíncronos ([AsynchronousSocketChannel]). Voltaremos a isso no fim deste capítulo, antes da aplicação de exemplo: desde a introdução das threads virtuais (Java 21), as classes mais simples [Socket] e [ServerSocket] são suficientes na maioria dos casos. São elas que usaremos.
Vale observar que o ecossistema Kotlin também tem suas próprias bibliotecas de rede, construídas sobre corrotinas (Capítulo 9): o Ktor, da JetBrains, oferece um cliente e um servidor HTTP, além de sockets "suspensos", e também funciona fora da JVM (Kotlin Multiplatform). Vamos nos concentrar nas classes do JDK, que são suficientes para nossas necessidades e que o leitor encontrará em qualquer programa JVM.
12.5.2. A classe Socket
A classe [Socket] é a escolha adequada na maioria dos casos para criar um cliente de um serviço TCP. Entre seus C construtores e M métodos, estão os seguintes (assinaturas Java; em Kotlin, os acessores sem parâmetros são usados como propriedades: [inputStream], [outputStream], [remoteSocketAddress], [soTimeout], [isClosed]…):
Membro | Tipo | Papel |
Socket(String machine, int port) | C | Estabelece uma conexão TCP com o serviço que roda na porta [port] da máquina [machine]. Por exemplo, [Socket("localhost", 27100)]. Lança uma [UnknownHostException] se a máquina for desconhecida e uma [ConnectException] se a conexão for recusada (ambas são [IOException]) |
Socket(), void connect(SocketAddress address, int timeout) | C, M | cria um socket não conectado e depois o conecta, aguardando no máximo [timeout] milissegundos: sem timeout, conectar-se a uma máquina que não responde pode levar várias dezenas de segundos |
InputStream getInputStream(), OutputStream getOutputStream() | M | os fluxos de bytes de leitura e escrita da conexão. São eles que viabilizam a comunicação cliente-servidor |
SocketAddress getLocalSocketAddress(), getRemoteSocketAddress() | M | as duas extremidades da conexão (endereço e porta) |
void setSoTimeout(int delay) | M | Tempo máximo de espera de uma leitura, em milissegundos: se for excedido, a leitura lança uma [SocketTimeoutException] (0, o valor padrão, significa "sem limite"); em Kotlin: [client.soTimeout = 5000] |
void shutdownOutput() | M | fecha apenas o fluxo de escrita: o parceiro percebe o fim do fluxo, mas você ainda pode ler a resposta dele |
void close(), boolean isClosed() | M | fecha a conexão e seus dois fluxos; [Socket] implementa [Closeable]e, portanto, [AutoCloseable]: em Kotlin, é usado com a função [use]. Uma operação de leitura em andamento em outra thread termina então com uma [SocketException] |
Os fluxos [getInputStream] e [getOutputStream] leem e escrevem bytes. Muitas aplicações cliente-servidor trocam linhas de texto. Por isso, é útil envolvê-los em objetos [BufferedReader], [PrintWriter] ou [BufferedWriter] — apresentados no Capítulo 5 — para ler e escrever essas linhas. A biblioteca padrão do Kotlin fornece funções de extensão para fluxos de bytes com essa finalidade: [stream.bufferedReader()] cria, em uma única etapa, tanto o [InputStreamReader] quanto o [BufferedReader] que o envolve, [stream.bufferedWriter()] faz o mesmo para a escrita, e [stream.reader()] e [stream.writer()] criam fluxos de caracteres sem buffer. Todas elas têm um parâmetro opcional de conjunto de caracteres; o padrão é UTF-8. Veja como o cliente de eco que escreveremos mais adiante ([Internet05.kt]) se conecta e cria seus fluxos:
- linha 2: a conexão com o servidor. A função [use] fechará a conexão — e, com ela, os dois fluxos — ao sair do bloco, aconteça o que acontecer: é o equivalente do [try] com recursos do Java. Fechar o socket é suficiente; não é necessário fechar seus fluxos separadamente;
- Linha 4: o fluxo de rede é convertido em um fluxo de caracteres com buffer pela extensão [bufferedReader], que consegue ler uma linha. O conjunto de caracteres não é especificado: é UTF-8, o valor padrão das extensões do Kotlin (e do JDK desde o Java 18), independentemente da configuração da máquina. As duas partes devem concordar sobre a codificação de caracteres que usam em suas trocas;
- linha 6: o segundo parâmetro ([true]) do construtor de [PrintWriter] ativa a descarga automática ("autoFlush"): cada chamada a [println] transmite imediatamente a linha para a rede, sem esperar o buffer interno encher. Esse ponto é importante. Em geral, quando um cliente envia uma linha de texto ao parceiro, ele espera uma resposta. Essa resposta nunca chegará se a linha permanecer no buffer da máquina emissora sem ser enviada. Sem autoFlush, é preciso chamar explicitamente [flush] após escrever uma requisição completa. O conjunto de caracteres é especificado explicitamente aqui ([Charsets.UTF_8]); o construtor [PrintWriter(stream, true)] usaria o conjunto de caracteres padrão do JDK, que — assim como o UTF-8 — também é o padrão desde o Java 18.
Para enviar uma linha de texto ao servidor, escrevemos [writer.println("some text")] e, para ler a resposta do servidor, [val response = reader.readLine()]. [readLine] passa a ser [null] quando o parceiro fechou a conexão e tudo o que ele enviou foi lido: isso marca o fim do fluxo. O Kotlin interpreta, portanto, o resultado como um [String?], o que exige o tratamento do caso [null]; o padrão mais comum é [val line = reader.readLine() ?: break] dentro de um laço [while (true)]. Quando todas as linhas precisam ser processadas até o fim do fluxo, a extensão [lineSequence] é ainda mais simples: [reader.lineSequence().forEach { line -> … \}] processa as linhas uma a uma conforme chegam (a sequência é preguiçosa) e para no fim do fluxo. No entanto, deve-se evitar [readLines] ou [readText], que esperam o parceiro fechar a conexão antes de devolver qualquer coisa.
Três pontos merecem atenção:
- O fim da linha. [println] termina a linha com o separador de linha do sistema ([System.lineSeparator()]), que é \r\n no Windows, mas apenas \n no Linux e no macOS. Os protocolos da Internet (HTTP, SMTP, POP, FTP) exigem \r\n. Alguns servidores toleram um \n isolado, outros não; um programa portátil que use um desses protocolos deve, portanto, escrever ele mesmo os finais de linha: [writer.write("$line\r\n")]. Na leitura, [readLine] e [lineSequence] aceitam \r\n, \n e \r indistintamente;
- Erros de escrita. Os métodos de [PrintWriter] nunca lançam [IOException]: um erro é simplesmente registrado, e o método [checkError] indica se algum ocorreu. Para um diálogo do tipo "uma requisição, uma resposta", isso não é um problema: uma conexão desfeita será detectada na leitura da resposta. Quando os erros de escrita precisam ser informados, usamos [BufferedWriter] (extensão [bufferedWriter()]), cujos métodos [write] e [flush] lançam uma [IOException]; [flush] deve então ser chamado após cada requisição. Lembre-se de que, em Kotlin, nenhuma exceção é verificada: o compilador nunca nos obriga a capturar uma [IOException]. Isso torna o código mais leve de escrever, mas cabe ao programador lembrar que uma operação de rede pode falhar a qualquer momento;
- operações bloqueantes. A construção de um [Socket], [readLine] e [println] bloqueia a thread que as executa até a operação terminar. Para um cliente que não tem nada a fazer senão aguardar a resposta do servidor, isso é exatamente o que se precisa. Quando ele precisa fazer duas coisas ao mesmo tempo (ler do teclado e da rede, por exemplo), uma dessas tarefas é delegada a outra thread, como faremos no cliente TCP genérico. Em um programa baseado em corrotinas (Capítulo 9), essas operações bloqueantes seriam executadas em [withContext(Dispatchers.IO) { … \}].
A arquitetura básica de um cliente TCP com o seguinte protocolo básico de comunicação com o servidor:
- o cliente envia uma requisição contida em uma única linha;
- o servidor envia uma resposta contida em uma única linha;
é, portanto, a seguinte: abrir o socket com [use] e criar seus dois fluxos; depois repetir "enviar uma requisição por [println], ler a resposta por [readLine]" até o fim do diálogo, interceptando as [IOException] : uma [UnknownHostException] ou uma [ConnectException] indica uma conexão que falhou (máquina desconhecida, nenhum serviço na porta solicitada etc.), enquanto uma [IOException] indica um erro durante a comunicação (conexão perdida etc.). Essa é a estrutura do cliente de eco que descreveremos na seção [A Client for the Echo Server].
12.5.3. A classe ServerSocket
A classe [ServerSocket] é a classe adequada na maioria dos casos para criar um serviço TCP. Entre seus C construtores e M métodos, estão os seguintes:
Membro | Tipo | Função |
ServerSocket(int port) | C | cria um serviço TCP que escuta as solicitações dos clientes na porta [port]— chamada de porta de escuta — em todos os endereços da máquina (IPv4 e IPv6). Lança uma [BindException] se a porta já estiver em uso |
ServerSocket(int port, int backlog, InetAddress address) | C | O mesmo que o anterior, mas escutando apenas no endereço [address] (por exemplo, o endereço de loopback, para aceitar apenas clientes da própria máquina). [backlog] é o número máximo de solicitações de conexão em espera para serem aceitas (50 por padrão) |
Socket accept() | M | espera uma solicitação de um cliente e a aceita. Retorna o [Socket] associado, no lado do servidor, à conexão de serviço aberta com esse cliente |
void close() | M | interrompe a escuta de solicitações de clientes; um [accept] em execução em outra thread é encerrado por uma [SocketException] |
SocketAddress getLocalSocketAddress() | M | o endereço e a porta de escuta ([localSocketAddress] como propriedade em Kotlin) |
Eis a estrutura básica de um servidor TCP, extraída do servidor de eco que descreveremos mais adiante ([Internet04.kt]):
- Linha 2: o serviço de escuta é criado para uma porta específica. Uma máquina tem pelo menos dois endereços IP: o endereço de loopback 127.0.0.1 e o endereço que ela possui na rede à qual está conectada. Pode ter outros se estiver conectada a várias redes. A menos que um endereço seja especificado, o serviço escuta em todos eles. Assim que é criado, o serviço começa a escutar, ou seja, a esperar solicitações de conexão dos clientes. [ServerSocket] também é [AutoCloseable]: [use] o fechará ao fim do bloco;
- Linha 4: um
*[ExecutorService]*(Capítulo 8) que cria uma thread virtual para cada tarefa submetida a ele. A partir do Java 19, [ExecutorService] é [AutoCloseable]: a função [use] também se aplica, portanto, e seu método [close] espera a conclusão de todas as tarefas submetidas. Onde o Java declara vários recursos em um único [try], o Kotlin aninha os blocos [use]; - linhas 10–17: o laço espera um cliente e inicia seu atendimento, repetindo o processo para cada novo cliente;
- linha 13: a solicitação de um cliente é aceita. [accept] retorna o que chamamos de [Socket] de serviço:
- o cliente fez sua solicitação por meio de seu próprio [Socket], que chamaremos de [RequestSocket];
- o servidor aceita essa solicitação com [accept], que cria um [Socket] do lado do servidor, que chamaremos de [ServiceSocket]. Agora temos uma conexão TCP aberta, com os sockets [RequestSocket] ↔ [ServiceSocket] em cada extremidade;
- a comunicação cliente/servidor que ocorre a seguir se dá por essa conexão. O serviço de escuta não participa mais dela;
- Linha 17: para permitir que o servidor atenda vários clientes ao mesmo tempo, o serviço é tratado por uma thread virtual. O servidor não a espera; ele volta imediatamente a esperar o próximo cliente. A lambda passada a
*[submit]captura a variável[number]*, que é uma cópia do número do cliente feita na linha 16. Em Kotlin, uma lambda pode capturar um [var] (o que o Java proíbe), mas aqui isso seria um erro: a lambda é executada depois, em outra thread, enquanto o laço pode já ter incrementado [clientNum]. Por isso damos a cada lambda sua própria cópia, um*[val]* que não mudará mais.
Sem o [ExecutorService], também podemos iniciar a thread virtual diretamente: [Thread.ofVirtual().start { serve(client, number) \}]. [ExecutorService] tem a vantagem, quando o servidor é encerrado, de esperar que todos os serviços em andamento terminem.
A função [serve], executada pela thread virtual, recebe o [Socket], que já está conectado ao cliente a ser atendido. Ela contém um código semelhante ao do cliente TCP: [client.use { … \}], criação dos fluxos, seguida de um laço “ler uma solicitação com [readLine], escrever a resposta com [println] ”, até que [readLine] retorne [null], isto é, até que o cliente feche a conexão. As exceções devem ser capturadas nessa função: ninguém espera o resultado da thread de serviço, e uma exceção não capturada ali passaria despercebida (seria apenas exibida na saída de erro). O compilador Kotlin não lembrará você disso, pois não há exceções verificadas: cabe ao programador ter isso em mente.
12.5.4. Uma thread por cliente: threads de plataforma ou threads virtuais?
Antes do Java 21, um servidor atribuía cada cliente a uma thread de plataforma, isto é, uma thread do sistema operacional, ou a uma thread de um pool de tamanho fixo ([Executors.newFixedThreadPool]). Essa thread realizava leituras e escritas bloqueantes: enquanto o cliente processava uma solicitação, sua thread permanecia bloqueada em [readLine]. Cada thread de plataforma consome memória (uma pilha reservada de aproximadamente 1 MB) e tempo de processador, pois o sistema precisa alternar entre elas. Com algumas dezenas de clientes, isso não é problema; com milhares de conexões simultâneas, um cenário comum em um servidor real, o servidor entra em colapso. Com um pool de threads limitado a 10 threads, o décimo primeiro cliente precisa esperar que um dos dez primeiros se desconecte.
Para contornar essa limitação, durante muito tempo foi preciso evitar as operações bloqueantes: os canais não bloqueantes de [java.nio] e seus [Selector], que permitem a uma única thread monitorar várias conexões, ou os canais assíncronos do Java 7, que chamam uma função de callback ao fim de cada operação. Essas técnicas são eficazes, mas difíceis de programar: a lógica da interação fica espalhada por várias funções. Elas são a base de bibliotecas como o Netty, usadas por muitos servidores. O Kotlin trouxe outra solução com as corrotinas (Capítulo 9): um código sequencial, escrito com funções [suspend], que o compilador transforma em uma máquina de estados; essa é a abordagem adotada pelo Ktor.
As threads virtuais (Java 21, Capítulo 8) mudaram o jogo. Uma thread virtual é gerenciada pela Máquina Virtual Java (JVM) e não pelo sistema operacional. Quando realiza uma operação de rede bloqueante, ela é “desacoplada” de sua thread transportadora, que pode então executar outra thread virtual; ela é reacoplada a uma thread transportadora quando os dados chegam. Algumas threads transportadoras, tantas quantos forem os núcleos do processador, bastam, assim, para atender milhares de clientes, e um cliente que não envia nada não consome quase nada: apenas algumas centenas de bytes de pilha. O código em si continua sendo o código simples e sequencial do modelo “uma thread por cliente”, sem sequer precisar marcar as funções [suspend]: as classes bloqueantes [Socket] e [ServerSocket] são usadas como estão. Este é o modelo que usaremos em todos os servidores deste capítulo: [ServerSocket.accept] na thread principal, com uma thread virtual por cliente.
12.6. Exemplos de clientes/servidores TCP
Os programas desta seção são arquivos [InternetNN.kt] do projeto Gradle [12-internet], cada um em seu próprio pacote ([internet04], [internet05]…). Eles são executados por [gradlew -q run -Pmain=internet04.Internet04Kt --args="..."] (ou clicando no triângulo verde do IntelliJ ou do IDEA, caso em que os argumentos são informados na configuração de execução). Os servidores e os clientes são iniciados em janelas de comando separadas na mesma máquina; as portas usadas têm a forma 271xx.
12.6.1. Um servidor de eco
Vamos escrever um servidor de eco, que será iniciado em uma janela de comando com:
O servidor roda na porta passada como argumento. Ele simplesmente devolve ao cliente cada linha que o cliente lhe envia, entre colchetes. O programa [Internet04.kt] é o seguinte:
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 33 34 35 36 37 38 39 40 41 42 43 44 45 46 47 48 49 50 51 52 53 54 55 56 57 58 59 60 61 62 63 64 65 66 67 68 69 70 71 72 73 74 75 76 77 78 79 80 81 82 83 84 85 86 87 88 89 90 91 92 93 94 95 96 97 98 99 100 101 102 103 104 105 106 107 | |
A estrutura do servidor de eco segue a arquitetura básica dos servidores TCP descrita anteriormente, com algumas adições:
- linhas 19–23: duas propriedades privadas de alto nível, no nível do arquivo ([private]: visíveis apenas para o próprio arquivo). O conjunto [connections] contém as conexões de serviço atuais; várias threads adicionam e removem elementos dele simultaneamente, portanto é um conjunto projetado para acesso concorrente, obtido por meio de [ConcurrentHashMap.newKeySet()] (Capítulo 8). Seu tipo é declarado explicitamente como [MutableSet<Socket>], pois o tipo do elemento não pode ser inferido a partir de uma chamada sem argumentos. O booleano [stopping] indica se foi solicitado o encerramento do servidor; ele é anotado com [@Volatile] porque é modificado por uma thread e lido por outras (é a palavra-chave Java [volatile]);
- linhas 27–30: a porta deve ser um inteiro entre 1 e 65.535. [args.singleOrNull()] retorna o único argumento, ou [null] se não houver exatamente um, e [toIntOrNull] retorna [null] se a string não for um inteiro: o método auxiliar [integer] do programa Java é desnecessário. Após a verificação, o compilador sabe que [port] não é [null] (smart cast);
- linhas 34–36: o serviço de escuta e o [ExecutorService], que cria uma thread virtual por cliente, cada um envolvido em seu próprio bloco [use];
- linha 38: o servidor é encerrado. Ctrl-C não permite que o programa execute uma função de sua escolha, como faria um manipulador de eventos; em vez disso, ele encerra a máquina virtual. No entanto, antes de encerrar, a máquina virtual executa os “shutdown hooks” registrados por [Runtime.getRuntime().addShutdownHook]. Nosso hook (linhas 66–73) é uma thread criada, mas não iniciada, pela função [thread(start = false) { … \}] de [kotlin.concurrent] (Capítulo 8): a máquina virtual a iniciará no encerramento. Ela registra que o encerramento foi solicitado (linha 70), fecha o serviço de escuta (linha 71) e depois espera a thread principal terminar (linha 73): a máquina virtual é encerrada assim que os blocos são concluídos. Enquanto o programa Java precisava capturar as exceções verificadas de [close] e [join] apenas para ignorá-las, o Kotlin não impõe essa exigência;
- linha 45: o fechamento do serviço de escuta faz a espera por um cliente falhar, disparando uma [SocketException], que é capturada na linha 51. Se o encerramento não foi solicitado, trata-se de um erro genuíno: ela é relançada (linha 53) para ser tratada pelo [catch] da linha 60;
- linha 56: todas as conexões de serviço ativas são fechadas; as threads de serviço, bloqueadas em uma operação de leitura, recebem uma [SocketException] e terminam. Ao sair do bloco [use] do [ExecutorService], seu método [close] espera todos os serviços terminarem antes que a função [main] termine.
A seção de “atendimento ao cliente”:
- Linha 79: o endereço e a porta do cliente, propriedade [remoteSocketAddress] (o método Java [getRemoteSocketAddress()], tratado como propriedade pelo Kotlin);
- linha 82: o socket do cliente é fechado quando o bloco termina, e seus fluxos são fechados junto com ele. O fluxo de leitura é criado pela extensão [bufferedReader] (UTF-8 por padrão); o fluxo de escrita é um [PrintWriter] com descarga automática, como no cliente de eco;
- Linha 90: a solicitação do cliente é lida. [readLine] retorna [null] quando o cliente fecha a conexão: o operador Elvis então executa [break], e o laço e o serviço terminam. Depois dessa linha, [request] é do tipo [String] e não [String?];
- linha 93: a solicitação é devolvida ao cliente, entre colchetes;
- linhas 97–101: uma [IOException] indica que o servidor foi encerrado, tendo fechado a conexão durante a leitura, ou que o cliente encerrou a conexão;
- linhas 103–105: o [finally] remove a conexão da lista de todas as conexões ativas e sinaliza o fim do serviço, qualquer que seja a causa.
Para ver o servidor em ação, precisamos de um cliente. Vamos escrevê-lo na próxima seção e apresentar os resultados em seguida.
12.6.2. Um cliente para o servidor de eco
Vamos agora escrever um cliente para o servidor anterior. Ele será chamado assim:
Ele se conecta à máquina [machine] na porta [port]e envia ao servidor as linhas de texto digitadas no teclado, que ele devolve como eco. O programa [Internet05.kt] é o seguinte:
A estrutura desse cliente segue a arquitetura básica proposta para os clientes TCP:
- linhas 14–19: [args.getOrNull(1)] retorna o segundo argumento, ou [null] se ele não existir; nenhuma exceção é possível;
- linhas 23–27: conexão ao servidor e criação dos fluxos; essas linhas já estão comentadas;
- linha 28: as duas extremidades da conexão são exibidas: [remoteSocketAddress] (o servidor) e [localSocketAddress] (o cliente). A porta do cliente foi escolhida pelo sistema;
- linhas 32–33: a solicitação é digitada no teclado. [readlnOrNull] retorna [null] se a entrada padrão for fechada (Ctrl-D no Linux, Ctrl-Z seguido de Enter no Windows);
- linha 35: a comparação com [bye]não diferencia maiúsculas de minúsculas ([equals(..., ignoreCase = true)], o equivalente Java de [equalsIgnoreCase]). Na segunda parte do teste, o compilador sabe que [request] não é [null]: o operador [||] avalia seu segundo operando somente se o primeiro for falso;
- linha 37: a solicitação é enviada ao servidor;
- linhas 39–42: a resposta é aguardada; [null] indica que o servidor fechou a conexão;
- linhas 47–48: erros de conexão e de troca de dados. [e::class.simpleName] é o nome curto da classe da exceção (o [e.getClass().getSimpleName()] do Java).
Eis os resultados obtidos com a seguinte configuração:
- o servidor está rodando na porta 27100 em uma janela de comando;
- na mesma máquina, dois clientes, A e B, são iniciados em duas outras janelas; o cliente B foi iniciado enquanto o cliente A ainda se comunicava com o servidor.
Para obter esses resultados, a entrada dos clientes foi enviada por redirecionamento da entrada padrão; ela foi reinserida após as perguntas que respondeu, exatamente como apareceria na tela se fosse digitada no teclado. Na janela do cliente A:
O cliente A enviou três linhas, que foram devolvidas como eco, e depois digitou [bye]: ele fechou a conexão sem enviar nada ao servidor.
Na janela do cliente B:
O cliente B enviou duas linhas; depois, antes de digitar a terceira, o servidor foi encerrado com Ctrl-C. A linha [line3B] foi enviada por uma conexão que já havia sido fechada pelo servidor: a leitura da resposta (linha 8 dos resultados) retornou [null].
Na janela do servidor:
- linha 2: o servidor está escutando na porta 27100 em todos os endereços da máquina, representados pelo endereço curinga 0.0.0.0;
- linhas 3 e 6: os dois clientes vieram da mesma máquina (127.0.0.1) usando portas diferentes, atribuídas pelo sistema. São essas portas que distinguem as duas conexões, ambas com destino à porta 27100 do servidor;
- linha 6: o cliente 1 (B) está sendo atendido enquanto o cliente 0 (A) ainda está sendo atendido, e as linhas 7–14 mostram que suas solicitações são processadas à medida que chegam: o servidor realmente atende vários clientes simultaneamente;
- linha 15: o servidor detectou que o cliente A fechou a conexão;
- linhas 16–18: Ctrl-C foi pressionado na janela do servidor. A tentativa de esperar um novo cliente falhou, e em seguida o atendimento ao cliente 1, que esperava uma linha, foi interrompido quando sua conexão foi fechada. O servidor foi encerrado corretamente.
Uma observação sobre o Ctrl-C. Quando iniciado por [gradlew run], o servidor não é o programa que recebe o Ctrl-C: é o Gradle, que por sua vez encerra o processo do servidor à sua maneira. Dependendo do sistema e da versão do Gradle, os blocos de encerramento do programa podem não ser necessariamente executados, e as três últimas linhas não seriam visíveis. Os resultados acima foram obtidos enviando o sinal de término (aquele disparado pelo Ctrl-C) diretamente ao processo Java do servidor, que é o que o Ctrl-C faz na janela de um programa iniciado pelo comando [java]. No IntelliJ e no IDEA, o botão de parar (o quadrado vermelho) também tenta primeiro encerrar o programa normalmente.
Eis o que acontece quando se tenta conectar a uma porta na qual nenhum serviço está escutando:
O construtor de [Socket] lançou uma [ConnectException]: a máquina respondeu, mas nenhum programa está escutando na porta 27199. A mensagem vem do sistema operacional; ela é diferente no Windows.
Por fim, se você iniciar o servidor em uma porta que já está em uso, por exemplo, em uma segunda janela enquanto o primeiro servidor ainda está rodando, a criação do [ServerSocket] falha:
12.6.3. Um cliente TCP genérico
Vamos escrever um cliente TCP genérico, que será iniciado assim:
Ele funcionará de modo semelhante aos clientes [telnet] e PuTTY: permitirá a comunicação com qualquer servidor TCP baseado em texto.
Na aplicação anterior, o protocolo de comunicação era conhecido: o cliente enviava uma única linha, e o servidor respondia com uma única linha. Cada serviço tem seu próprio protocolo específico, e também podem surgir as seguintes situações:
- o cliente deve enviar várias linhas de texto antes de receber uma resposta (uma solicitação HTTP);
- a resposta de um servidor pode consistir em várias linhas de texto (a resposta [EHLO] de um servidor SMTP, um documento HTML);
- o servidor pode falar primeiro (a mensagem de boas-vindas dos servidores SMTP e POP).
O ciclo “enviar uma única linha ao servidor / receber uma única linha enviada pelo servidor” nem sempre é adequado. Para tratar protocolos mais complexos que o protocolo de eco, o cliente TCP genérico executa duas atividades em paralelo, em duas threads:
- uma thread virtual lê as linhas de texto digitadas no teclado e as envia ao servidor;
- a thread principal lê as linhas de texto enviadas pelo servidor. Assim que recebe uma, a exibe no console. Ela só para quando a conexão é fechada.
O programa [Internet06.kt] é o seguinte:
- Linhas 28–32: o cliente se conecta ao servidor. [try] é uma expressão: seu valor é o do [Socket] criado; se a operação falhar, o bloco [catch] exibe o erro e sai da função [main] por meio de [return]. A variável [client] é, portanto, um [val], inicializado de uma vez por todas (em Java, ela tinha de ser declarada antes do [try]);
- linhas 35–37: o socket, que é fechado ao sair do bloco [use], e seus fluxos. O fluxo de escrita é um simples [OutputStreamWriter], criado pela extensão [writer()], cujos métodos lançam uma [IOException] em caso de erro;
- linha 40: a entrada do teclado é tratada por uma thread virtual, criada e iniciada por [Thread.ofVirtual().start] (Java 21), que executa a função [input] (linhas 55–70). A lambda Kotlin é convertida em [Runnable], a interface esperada por [start] (conversão SAM, Capítulo 7);
- linha 42: enquanto isso, a thread principal exibe cada linha enviada pelo servidor, precedida de [<--]. A extensão [lineSequence] transforma o fluxo em uma sequência preguiçosa de linhas: cada linha é lida quando [forEach] a solicita, isto é, assim que chega da rede, e a sequência termina no fim do fluxo, quando o servidor fecha a conexão (linha 43);
- linhas 45–48: quando o usuário digita [bye], a thread de entrada fecha a conexão (linha 70); a operação de leitura em andamento na thread principal termina então com uma [SocketException]. Isso não é um erro: a propriedade [end], definida pela thread de entrada (linha 69), confirma isso;
- Linha 51: quando o servidor fecha a conexão, a thread principal termina, mesmo que a thread de entrada ainda possa estar esperando uma linha digitada no teclado. Isso não é um problema: uma thread virtual é sempre uma “thread daemon”, e a máquina virtual para quando todas as threads não daemon terminam, neste caso, apenas a thread principal. Ao contrário do que seria necessário com uma thread comum, não há necessidade de parar a thread de entrada;
- linhas 58–63: a thread de entrada lê as linhas digitadas no teclado e as envia ao servidor. [generateSequence { readlnOrNull() \}] é a sequência das linhas digitadas, que termina quando a função retorna [null] (fim da entrada padrão); [takeWhile] a interrompe na primeira linha, [bye], que não é enviada. O laço [while] do programa Java é assim substituído por uma sequência de operações sobre uma sequência, avaliada de forma preguiçosa, linha a linha, conforme o usuário digita. As linhas enviadas terminam com \r\n, como exigem os protocolos que queremos explorar, e são imediatamente transmitidas à rede por [flush].
Agora podemos enviar manualmente uma solicitação HTTP ao nosso servidor web de teste ([Internet03.kt]), que está rodando em outra janela. As linhas precedidas por [<--] são as enviadas pelo servidor; as demais foram digitadas no teclado (novamente enviadas por redirecionamento e depois reinseridas em seus lugares):
- linhas 3–5: a solicitação, digitada no teclado: estamos solicitando o documento [/hello?name=Serge]. O cabeçalho [Connection: close] instrui o servidor a fechar a conexão depois de enviar sua resposta;
- linha 6: a linha em branco encerra a solicitação. Ela dispara a resposta do servidor;
- linha 7: o documento foi encontrado;
- linha 9: o servidor não especificou o tamanho do documento ([Content-length]); ele o envia em blocos (chunks), cada um precedido por seu tamanho em hexadecimal;
- linha 10: desta vez, o documento é texto simples;
- linhas 12–14: um único bloco de 0xc = 12 bytes, o texto [Hello Serge!], seguido por um bloco de tamanho zero que marca o fim do documento;
- linha 16: como solicitado, o servidor fechou a conexão. O cliente detectou isso e parou por conta própria, sem esperar que o usuário digitasse [bye].
Vamos tentar novamente sem o cabeçalho [Connection: close], solicitando a raiz do site:
- linha 9: o documento é anunciado junto com seu tamanho, 173 bytes. O cliente sabe, portanto, onde ele termina;
- Linhas 15–16: o documento foi recebido por inteiro, mas o servidor não fechou a conexão: no HTTP/1.1, ela permanece aberta por padrão para novas solicitações. O servidor espera uma nova solicitação; o usuário então digita [bye] para fechar a conexão.
Quando o servidor está indisponível, a conexão falha:
O leitor pode usar esse cliente TCP genérico com o servidor de eco ou, se tiver um servidor SMTP ou POP3 que aceite conexões não criptografadas (como um servidor de teste instalado localmente), para reproduzir os diálogos de exemplo mostrados acima.
12.6.4. Um servidor TCP genérico
Vamos agora nos concentrar em um servidor:
- que exibe na tela as linhas enviadas por seus clientes;
- que envia de volta, como respostas, as linhas de texto digitadas no teclado por um usuário. O usuário, portanto, faz o papel do servidor.
O programa é iniciado em uma janela de comando por meio de [gradlew -q run -Pmain=internet07.Internet07Kt --args="port"], em que [port] é a porta à qual os clientes devem se conectar. Os clientes são atendidos um após o outro, não em paralelo: o console não pode ser usado por dois clientes simultaneamente. Os clientes que se conectam nesse intervalo têm suas conexões estabelecidas pelo sistema, mas precisam esperar que o programa as aceite. Três atividades ocorrem em paralelo:
- uma thread virtual lê as linhas digitadas no teclado durante toda a execução do programa;
- para cada cliente, uma thread virtual lê as linhas enviadas pelo cliente e as exibe;
- a thread principal aceita os clientes e envia as linhas digitadas no teclado ao cliente atual. O usuário sinaliza com o comando [bye] que está fechando a conexão com o cliente.
A thread principal deve, portanto, esperar dois tipos de eventos: uma linha digitada no teclado ou a saída do cliente. As outras duas threads sinalizam esses eventos à thread principal colocando-os em uma fila bloqueante ([BlockingQueue], Capítulo 8), da qual a thread principal os retira um a um. O servidor só para quando o usuário pressiona Ctrl-C no teclado ou quando a entrada padrão é fechada. O programa [Internet07.kt] é o seguinte:
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 33 34 35 36 37 38 39 40 41 42 43 44 45 46 47 48 49 50 51 52 53 54 55 56 57 58 59 60 61 62 63 64 65 66 67 68 69 70 71 72 73 74 75 76 77 78 79 80 81 82 83 84 85 86 87 88 89 90 91 92 93 94 95 96 97 98 99 100 101 102 103 104 105 106 107 108 109 110 111 112 113 114 115 116 117 | |
- linhas 19–28: os três tipos de eventos, que implementam uma interface selada ([sealed], Capítulo 4): todas as suas implementações são conhecidas do compilador, pois devem estar no mesmo pacote e no mesmo módulo. [Input] e [ClientLeft] são data classes (os records do programa Java). [EndOfInput], que não contém dados, é um data object ([data object]): existe apenas uma instância dele, cujo método [toString] simplesmente retorna [EndOfInput];
- linha 31: a fila de eventos. [LinkedBlockingQueue] pode ser usada concorrentemente por várias threads sem nenhuma precaução especial;
- linha 41: o serviço de escuta, em todas as interfaces de rede da máquina;
- Linha 44: a thread virtual de leitura do teclado, que executa a função [readKeyboard] (linhas 103–105), passada por sua referência [::readKeyboard] (Capítulo 7). Ela coloca cada linha lida na fila e depois dispara o evento [EndOfInput] quando a entrada padrão é fechada. Ela é iniciada apenas uma vez: quando um cliente fecha a conexão, a operação de leitura do teclado em andamento será aproveitada pelo próximo cliente. Iniciar uma nova operação de leitura para cada cliente faria duas leituras competirem pelas mesmas teclas;
- linha 47: laço infinito de espera por clientes. O usuário interromperá o servidor com Ctrl-C;
- linha 50: espera por um cliente. Quando um cliente chega, o [Socket] retornado por [accept] representa o lado do servidor da conexão aberta com esse cliente;
- linha 54: a leitura das linhas enviadas pelo cliente é tratada por uma thread virtual, que executa a função [receive] (linhas 109–116). Quando a conexão é fechada, essa função coloca na fila um evento [ClientLeft] contendo o número do cliente;
- Linhas 57–64: a comunicação com o cliente é tratada pela função [serve]. A conexão é fechada ao sair do bloco [use]. [try] e [use] são expressões: [goOn] recebe o valor booleano retornado por [serve] ou, em caso de erro de escrita, o valor da última expressão do bloco [catch] ou [true] ;
- linha 67: espera o fim da thread de recepção com [join];
- linha 69: se a entrada padrão foi fechada, o servidor é encerrado;
- linhas 78–96: a função [serve] retira eventos da fila (linha 81) e os processa com uma expressão [when]. O sujeito do [when] é declarado dentro de seus parênteses ([val event = ...]), o que limita seu escopo ao [when]. Como a interface é selada, o compilador verifica se todos os casos são tratados: se o último ramo, [is Input], for removido, a compilação falha com a mensagem “'when' expression must be exhaustive. Add the 'is Input' branch or an 'else' branch.” O ramo anterior, que inclui uma guarda, não conta: ele não cobre todas as entradas possíveis. Os ramos:
- linha 82: [is ClientLeft] verifica o tipo do evento; dentro do ramo, [event] é tratado como um [ClientLeft] (smart cast), do qual a propriedade [clientNum] pode ser lida. A guarda [if event.clientNum == clientNum] (Kotlin 2.2) verifica se este é o cliente atual: ela serve ao mesmo propósito que a cláusula [when] dos padrões do Java;
- linha 87: um evento [ClientLeft] de outro cliente decorre de uma conexão fechada pelo próprio servidor (comando [bye]): ele é ignorado (bloco vazio);
- linha 88: fim da entrada padrão. Como [EndOfInput] é um objeto único, ele é comparado diretamente, sem [is];
- linhas 89–91: o comando [bye] fecha a conexão com o cliente atual;
- linhas 93–96: qualquer outra linha digitada é enviada ao cliente, terminada por \r\n.
O Kotlin não tem um equivalente aos record patterns do Java ([case ClientLeft(int number)]), que desconstroem o objeto dentro do padrão: verificamos o tipo com [is] e depois lemos as propriedades do objeto, que passam por cast automático. Uma declaração de desestruturação ([val (number) = event]) seria possível com uma data class, mas é desnecessária aqui.
Vamos usar esse servidor para simular um servidor web consultado por um cliente HTTP, no caso o [curl]. O servidor genérico está rodando na porta 27101. Em outra janela, pedimos ao [curl] a URL [http://localhost:27101/example.html]. [curl] então se conecta à porta 27101 da máquina [localhost] e solicita o documento [/example.html]. Eis a janela do servidor, onde a resposta digitada pelo usuário (enviada por redirecionamento) foi reinserida em seu lugar:
- linha 4: um cliente chegou;
- Linhas 6–10: vemos a solicitação HTTP enviada pelo [curl], terminada por uma linha em branco. Um navegador enviaria muitos outros cabeçalhos (idiomas e formatos aceitos, compressão, cookies etc.): o leitor pode testar isso solicitando a mesma URL em seu navegador;
- Linhas 11–17: o usuário ao teclado é aqui o verdadeiro servidor, e elabora a resposta manualmente. Ele se limita ao mínimo indispensável: uma linha de status, três cabeçalhos, uma linha em branco e o documento HTML. Não especifica o tamanho do documento ([Content-Length]), mas indica que fechará a conexão depois de enviá-lo ([Connection: close]). Isso basta: quando o cliente vir a conexão fechar, saberá que a resposta está completa;
- linhas 18–19: o usuário digitou [bye]: o servidor fecha a conexão com o cliente;
- linha 20: o servidor espera um novo cliente. Nós o interrompemos com Ctrl-C.
E eis o que o [curl] exibiu:
[curl] recebeu exatamente o que foi digitado na janela do servidor (linhas 12–16 e 19–20) e detectou que a conexão foi fechada (linha 18). Um navegador teria exibido a página HTML recebida, com o título [Generic server] na aba.
12.6.5. Um cliente web
No exemplo anterior, vimos os cabeçalhos HTTP enviados pelo [curl]. Vamos escrever um cliente web que recebe uma URL como parâmetro e exibe na tela tudo o que o servidor lhe envia. Supomos que o servidor oferece suporte ao protocolo HTTP/1.1. Nosso cliente enviará a seguinte solicitação:
- a primeira linha especifica o documento desejado;
- o cabeçalho [Host] identifica o servidor consultado;
- o cabeçalho [User-Agent] identifica nosso cliente;
- o cabeçalho [Connection] indica que queremos que o servidor feche a conexão depois de nos responder: leremos sua resposta até o fim do fluxo;
- a linha vazia encerra a solicitação.
Se, na primeira linha, substituirmos [GET] por [HEAD], o servidor nos enviará apenas os cabeçalhos HTTP de sua resposta, e não o documento.
Nosso cliente web será chamado assim: [gradlew -q run -Pmain=internet08.Internet08Kt --args="URL command"], em que [URL] é a URL desejada e [command] é uma das duas palavras-chave [GET] ou [HEAD]. O programa [Internet08.kt] é o seguinte:
Uma novidade deste programa é o uso da classe [URI] (pacote [java.net]). O programa recebe uma URL (Uniform Resource Locator), uma forma específica de URI (Uniform Resource Identifier), na forma [http://server:port/path?param1=val1¶m2=val2]. A classe [URI] decompõe essa string em seus diversos componentes:
- linhas 57–63: o construtor [URI(String)] analisa a string e lança uma [URISyntaxException] se ela não for uma URI válida; o método estático [URI.create] faz o mesmo lançando uma [IllegalArgumentException]. [try] é uma expressão cujo valor é a URI construída; em caso de erro, o bloco [catch] sai da função retornando [null]. O parâmetro de exceção não utilizado é chamado [_]. Em seguida, verificamos que a URI é absoluta (começa com um esquema), que o esquema é [http] (nosso cliente não sabe realizar a negociação TLS do [https]) e que ela se refere a uma máquina: [uri.takeIf { condition \}] retorna [uri] se a condição for verdadeira e [null] caso contrário. O tipo de retorno, [URI?], indica claramente que a função pode falhar. Uma vez construído o objeto [URI] , temos acesso aos diversos elementos da URI, que o Kotlin apresenta como propriedades (os métodos [getXxx] em Java). Assim, se o objeto [uri] foi construído a partir da string [http://localhost:27110/hello?name=Serge], temos:
- [uri.scheme]: http;
- [uri.host]: localhost;
- [uri.port]: 27110 (-1 se a porta não for especificada na URL; nesse caso, é a porta padrão do esquema: 80 para HTTP, 443 para HTTPS);
- [uri.rawAuthority]: localhost:27110;
- [uri.rawPath]: /hello;
- [uri.rawQuery]: name=Serge;
- As propriedades [path], [query]… retornam os mesmos elementos, mas decodificados (veremos adiante o que é a codificação de uma URL): para construir uma consulta, deve-se usar as versões “raw” ([rawXxx]);
- as propriedades que podem assumir o valor [null] ([host], [rawQuery]…) são tratadas pelo Kotlin como tendo um tipo de plataforma ([String!]): o compilador não sabe se o método Java pode retornar [null], e cabe ao programador testar isso, como mostrado aqui;
- linhas 67–69: o caminho e os parâmetros, como devem aparecer na solicitação; um caminho vazio se refere à raiz [/] do site: [ifEmpty { "/" \}] retorna a string se ela não estiver vazia e ["/"] caso contrário;
- linha 26: o comando, em maiúsculas, deve ser [GET] ou [HEAD];
- linhas 33–35: conexão ao servidor especificado pela URL, na porta 80 se a URL não especificar uma;
- linha 37: o fluxo de escrita é um [BufferedWriter] sem descarga automática, criado pela extensão [bufferedWriter()];
- linhas 39–44: a solicitação HTTP, construída como uma lista de suas linhas, unidas por [joinToString]: cada linha é seguida por \r\n (o separador) e a última por \r\n\r\n (o sufixo), o que acrescenta a linha vazia final. O HTTP exige que essas terminações de linha \r\n sejam escritas explicitamente. Observe a vírgula após o último elemento da lista, permitida pelo Kotlin, que facilita o acréscimo de uma linha;
- linha 47: a solicitação é enviada de uma só vez, depois de totalmente escrita;
- linha 49: a resposta é exibida até que o servidor feche a conexão. A referência de função [::println] é passada a [forEach] no lugar da lambda [{ println(it) \}].
Vamos obter apenas os cabeçalhos da raiz do nosso servidor de teste:
Recebemos a linha de status e os cabeçalhos, seguidos de uma linha em branco, mas não o documento. O cabeçalho [Content-length] indica o tamanho que o documento teria com o comando [GET]. Com o comando [GET] e um documento enviado em blocos:
As aspas que envolvem os argumentos de [--args] também protegem o caractere [?] da URL, ao qual certos interpretadores de comandos atribuem um significado específico. O documento ([Hello Serge!]) é definido pelos tamanhos de seus blocos, como já vimos. Nosso cliente exibe a resposta bruta; um verdadeiro cliente HTTP, por outro lado, deve reconstruir o documento a partir dos blocos.
Um documento inexistente:
Uma URL que está sendo redirecionada:
- Linha 2: o código 302 indica um redirecionamento: o documento solicitado está temporariamente em outro endereço. A mensagem que segue o código é arbitrária: o servidor do JDK escreve [Temporary Redirect]; outros servidores poderiam escrever [Found] (a mensagem da RFC) ou [Moved Temporarily];
- Linha 5: esse endereço é fornecido pelo cabeçalho [Location]. Aqui ele é relativo: o endereço completo é [http://localhost:27110/hello?name=visitor].
Nosso cliente parou aí. Um navegador web, por sua vez, teria solicitado automaticamente o novo endereço. É isso que o nosso próximo cliente fará.
Por fim, uma solicitação para a URL [https] é rejeitada (o servidor nem sequer é contatado, o que permite testar sem acesso à Internet):
12.6.6. Um cliente web que trata redirecionamentos
O cliente web anterior não trata um possível redirecionamento da URL que ele solicitou. Os códigos de status de redirecionamento são os seguintes:
Código | Significado |
301 Moved Permanently | O documento mudou de endereço permanentemente; um navegador pode salvar o novo endereço |
302 Found | O documento está temporariamente em outro endereço |
303 See Other | A resposta deve ser solicitada a outro endereço usando o método [GET] (usado após o envio de um formulário) |
307 Temporary Redirect, 308 Permanent Redirect | Igual a 302 e 301, mas o cliente deve reenviar a solicitação usando o mesmo método ([POST] continua sendo [POST]) |
Em todos os casos, o novo endereço é fornecido pelo cabeçalho [Location], em forma absoluta ou relativa. Detectar um redirecionamento pela presença de uma palavra como [moved] na linha de status seria pouco confiável: a mensagem que segue o código é arbitrária, e acabamos de ver que o servidor do JDK responde com [302 Temporary Redirect]. Baseamo-nos no próprio código de status.
O programa [Internet09.kt] é o seguinte:
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 33 34 35 36 37 38 39 40 41 42 43 44 45 46 47 48 49 50 51 52 53 54 55 56 57 58 59 60 61 62 63 64 65 66 67 68 69 70 71 72 73 74 75 76 77 78 79 80 81 82 83 84 85 86 87 88 89 90 91 92 93 94 95 96 97 98 99 100 101 102 103 104 105 106 107 108 109 110 111 112 113 | |
Em comparação com a versão anterior, as mudanças são as seguintes:
- linha 14: os códigos de status que indicam um redirecionamento, em um conjunto somente leitura criado por [setOf] (Capítulo 5);
- linha 17: o número máximo de redirecionamentos permitidos. Sem um limite, um servidor mal configurado poderia prender nosso cliente em um laço infinito (os navegadores desistem após cerca de vinte redirecionamentos);
- linhas 25–27: a URI muda a cada redirecionamento; ela é um [var]. Se tivesse sido declarada como no programa anterior, seu tipo seria [URI?], e o smart cast que se segue ao teste [uri == null] não se aplicaria dentro do laço, onde a variável é modificada: o compilador rejeitaria [fetch(uri, command)] (“argument type mismatch: actual type is 'URI?', but 'URI' was expected.”). Por isso declaramos o tipo [URI], que não aceita nulo, e o operador Elvis [?:] executa o bloco [run { … \}], que exibe o erro e sai da função, quando [parse] resulta em [null];
- linha 38: o código que antes era executado para uma única URL agora pode ser executado sucessivamente para várias URLs;
- linha 40: a função [fetch] obtém a URL atual, exibe a resposta e retorna a URL de redirecionamento, ou [null] se não houver redirecionamento, caso em que o operador Elvis sai do laço. Onde o Java usava um
*[Optional<String>], o Kotlin usa um tipo anulável,*[String?]; - linhas 42–44: o processo é abortado se o número máximo de redirecionamentos for atingido;
- linha 48: o método [resolve] da classe [URI] calcula a nova URL. Se [location] for um endereço absoluto, ele é usado como está; se for relativo, é completado com base na URL atual ([uri]). [resolve] lança uma [IllegalArgumentException] se o endereço for incorreto: ela é interceptada na linha 51, junto com a [IOException] da rede. O Kotlin não tem um [catch] múltiplo ([catch (IOException | IllegalArgumentException e)]): aqui, o ancestral comum delas, [Exception], é interceptado; para distinguir os dois casos, escreveríamos dois blocos [catch] ou um único [when (e)] dentro do bloco;
- linhas 59–95: a solicitação de uma URL:
- linha 75: a linha de status é lida, por exemplo, [HTTP/1.1 302 Temporary Redirect]. O operador Elvis substitui [null] (conexão fechada pelo servidor antes de qualquer resposta) por uma string vazia;
- Linhas 78–79: o código é extraído (o segundo campo da linha) e verificado para saber se é um dos códigos de redirecionamento. [getOrNull(1)?.toIntOrNull()] retorna [null] se o campo estiver ausente ou não for um inteiro, e o operador [in] (o método [contains] do conjunto) retorna [false] para [null];
- Linhas 82–89: os cabeçalhos são lidos até a linha em branco, por meio da sequência [generateSequence { reader.readLine() \}], que termina no fim do fluxo e é interrompida por [takeWhile] na primeira linha em branco (que é lida, mas não processada). Se houver redirecionamento, procuramos o cabeçalho [Location], ignorando maiúsculas e minúsculas, já que os nomes dos cabeçalhos HTTP não as diferenciam: [startsWith("Location:", ignoreCase = true)] substitui o [regionMatches] do Java, e [substringAfter(':')] devolve o que vem depois dos primeiros dois-pontos. A lambda de [forEach] modifica a variável local [location]: o Kotlin permite isso, mas o Java não;
- linhas 92–95: o restante da resposta é exibido e, em seguida, a URL de redirecionamento encontrada é retornada. O [return] colocado dentro do bloco [use] sai da função [fetch]: a lambda de [use] é “inline”, e um [return] sai da função envolvente (Capítulo 7) depois que o socket é fechado.
Vamos examinar novamente a URL [/old]:
- linhas 2–6: o redirecionamento temporário para um endereço relativo;
- linha 7: a nova URL, completada por [uri.resolve(location)];
- linhas 9–17: a resposta à nova URL. O documento, de 0xe = 14 bytes, foi enviado em blocos.
A URL [/moved] é redirecionada permanentemente para um endereço absoluto:
A URL [/loop] redireciona para si mesma:
Nosso cliente seguiu três redirecionamentos e depois desistiu (linha 24). Com o comando [HEAD], nenhum documento foi enviado.
O log do servidor web registrou todas as solicitações das seções [A web client] e [A web client that handles redirects]:
Para cada redirecionamento, ele mostra a solicitação que o provocou, seguida da solicitação ao novo endereço (linhas 7–8 e 9–10), e as quatro solicitações do laço interrompido (linhas 11–14).
Escrever um cliente HTTP baseado em TCP ajuda a entender o protocolo, mas um cliente real precisa tratar muitas outras coisas: criptografia TLS, transmissão em blocos, compressão, conexões persistentes, HTTP/2… A segunda parte deste capítulo apresenta a classe [HttpClient] do JDK, que cuida de tudo isso para nós e é usada diretamente pelo Kotlin.
12.7. Classes especializadas em um protocolo
Nos exemplos anteriores, o protocolo HTTP era tratado por meio de um cliente TCP: tínhamos de construir as solicitações nós mesmos, analisar as linhas de status e os cabeçalhos e tratar os redirecionamentos. Poderíamos ter construído um cliente SMTP ou POP da mesma maneira. Existem classes especializadas nesses protocolos: elas entendem o protocolo de comunicação entre o cliente e o servidor e poupam o desenvolvedor de ter de gerenciá-lo. Para HTTP, o JDK fornece a classe [HttpClient], que o Kotlin usa diretamente; para e-mail, usamos a biblioteca Java Jakarta Mail. Vamos apresentá-las agora.
Os programas desta segunda parte, assim como os da primeira, são pacotes do projeto Gradle [12-internet], numerados em sequência (de [internet10] a [internet19]). O arquivo [build.gradle.kts] do projeto já declara as duas bibliotecas necessárias a alguns desses programas: Jackson para JSON e Jakarta Mail para e-mail. Enquanto o curso de Java exigia um projeto Maven separado para cada um desses programas, aqui precisamos apenas de um pacote adicional. A aplicação de exemplo ao final do capítulo consiste em dois subprojetos Gradle, contidos na pasta [TaxV8]. As portas usadas têm a forma 272xx.
12.7.1. As classes URL e HttpURLConnection, agora obsoletas
Antes do Java 11, um programa na JVM que quisesse se comunicar via HTTP dispunha de duas classes, presentes desde as primeiras versões do Java:
- a classe [URL], cujo método [openStream] retornava, em uma única instrução, um fluxo de leitura para o documento especificado pela URL;
- a classe [HttpURLConnection], obtida por meio do método [openConnection] de [URL], que era mais flexível: permitia escolher o método HTTP ([GET], [HEAD], [POST]), adicionar cabeçalhos e ler o código de status e os cabeçalhos da resposta.
Essas classes ainda existem no Java 25, mas não envelheceram bem: [HttpURLConnection] é inteiramente síncrona, oferece suporte apenas ao HTTP/1.1, é usada por meio de uma sequência de chamadas com ordem fixa (definir os cabeçalhos antes de escrever o documento, ler o código de status antes do documento…) e informa códigos de erro por meio de exceções. Quanto aos construtores da classe [URL], que não analisavam corretamente todos os endereços URL, eles foram declarados obsoletos desde o Java 20: agora cria-se um objeto [URI] e, se necessário, converte-se por meio de seu método [toURL]. O compilador Kotlin leva em conta a anotação [@Deprecated] das classes Java: um pequeno programa [Old.kt] contendo a instrução [val url = URL("http://localhost:27210/")] provoca o seguinte aviso de compilação:
A mensagem indica que o recurso foi marcado como obsoleto no Java ([Deprecated in Java]); o tipo [String!] é um “tipo de plataforma”: o Kotlin não sabe se o parâmetro Java aceita [null]. Com a opção [allWarningsAsErrors = true] habilitada em nossos projetos, esse aviso na verdade impediria a compilação.
O Java 11 introduziu a classe [HttpClient] (no pacote [java.net.http]), concebida desde o início para HTTP/1.1 e HTTP/2, para solicitações tanto síncronas quanto assíncronas, e capaz de reutilizar suas conexões e de ser usada por várias threads simultaneamente. É a que se deve usar hoje, tanto em Kotlin quanto em Java. Não trataremos mais de [URL] e [HttpURLConnection] , pois o leitor ainda pode encontrá-las em código legado. Por fim, vale observar que o ecossistema Kotlin tem seus próprios clientes HTTP, como o Ktor Client (JetBrains), escrito com corrotinas e que também pode ser usado fora da JVM; aqui nos concentraremos na classe do JDK, que não requer nenhuma biblioteca e, como veremos, se integra muito bem às corrotinas.
12.7.2. A classe HttpClient
12.7.2.1. Um servidor web de teste
Para ilustrar os recursos do [HttpClient], precisamos de um servidor web mais completo que o da Parte 1 ([Internet03.kt]): ele deve aceitar formulários, trocar JSON e ser capaz de lidar com atrasos. Vamos então escrever um segundo servidor de teste, [Internet10], também baseado no servidor HTTP do JDK. Para trocar JSON, ele usa a biblioteca Jackson (Capítulo 5), declarada no [build.gradle.kts] do projeto. Novamente, não é necessário entender esse programa em detalhes: basta saber o que cada URL responde. O pacote [internet10] contém dois arquivos:
O tipo [Person] é uma data class:
Como no Capítulo 5, o Jackson usa o construtor primário da data class para criar objetos sem nenhum módulo adicional, usando os nomes de seus parâmetros, preservados no código compilado pela opção [javaParameters = true] do [build.gradle.kts].
O arquivo [Internet10.kt] é o seguinte:
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 33 34 35 36 37 38 39 40 41 42 43 44 45 46 47 48 49 50 51 52 53 54 55 56 57 58 59 60 61 62 63 64 65 66 67 68 69 70 71 72 73 74 75 76 77 78 79 80 81 82 83 84 85 86 87 88 89 90 91 92 93 94 95 96 97 98 99 100 101 102 103 104 105 106 107 108 109 110 111 112 113 114 115 116 117 118 119 120 121 122 123 124 125 126 127 128 129 130 131 132 133 134 135 136 137 138 139 140 141 142 143 144 145 146 147 148 149 150 151 152 153 154 155 156 157 158 159 | |
Comentários:
- Linhas 17–28: constantes do servidor declaradas no nível do arquivo: a página inicial, uma raw string cuja indentação é removida por [trimIndent], os tipos de documentos enviados ([const val]: constantes de compilação) e a expressão regular que reconhece o caminho [GET /api/persons/n], escrita como raw string para evitar ter de duplicar a barra invertida em [\d];
- linha 31: a porta, passada como argumento ou 27210 por padrão. [singleOrNull] retorna o único elemento do array, ou [null] se não houver exatamente um; o operador Elvis [?:] fornece então o valor padrão;
- Linha 33: todas as URLs são passadas ao método [process] de uma instância da classe [TestServer]. A referência [TestServer()::process] é convertida pelo Kotlin em [HttpHandler], a interface funcional Java esperada por [createContext] (conversão SAM, Capítulo 7);
- Linha 35: por padrão, o servidor do JDK processa todas as solicitações em uma única thread: uma solicitação lenta bloquearia todas as outras. Ele recebe um [ExecutorService] que executa cada solicitação em uma thread virtual. O par Java [getExecutor]/[setExecutor] é tratado pelo Kotlin como uma propriedade [executor], à qual se atribui um valor;
- Linhas 40–45: dados do servidor: um pequeno “banco de dados” de pessoas (uma lista editável), o lock que o protege e o objeto Jackson
*[JsonMapper], que converte objetos emJSONe vice-versa. Em Java, a função estática [main] criava uma instância da classe [Internet10]; em Kotlin, a função [main]* fica no nível do arquivo, e o estado do servidor é guardado em uma classe com nome descritivo; - Linhas 48–58: cada solicitação é registrada no console junto com a porta do cliente e o código de status da resposta. A porta do cliente nos permitirá determinar se duas solicitações usaram a mesma conexão TCP. A partir do Java 14, [HttpExchange] implementa [AutoCloseable]: a função Kotlin [use] a fecha ao fim da troca, assim como o [try] com recursos do Java;
- Linha 64: a “rota” da solicitação, formada por seu método e pelo caminho da URL ([GET /hello], [POST /form]…), sobre a qual é feito o [when] da linha 67. Um ramo pode listar vários valores separados por vírgulas;
- linha 69: a URL [/] gera um pequeno documento HTML;
- linhas 71–72: a URL [/hello?name=xx] produz o texto [Hello xx!];
- linhas 74–77: a URL [/headers] devolve ao cliente, em forma de texto, os cabeçalhos HTTP de sua solicitação, em ordem alfabética por meio de [toSortedMap], que copia o dicionário de cabeçalhos para um dicionário ordenado ([TreeMap] em Java). [joinToString] converte cada entrada, desestruturada em [(name, values)], em uma linha de texto e une as linhas com quebras de linha. Essa URL nos permitirá ver o que o [HttpClient] envia;
- linhas 79–81: um redirecionamento temporário para [/hello?name=visitor] e um redirecionamento que volta para si mesmo, como no servidor da Parte 1;
- linha 83: uma resposta 500 (erro interno do servidor);
- linhas 85–88: a URL ([/slow?seconds=n]) só responde depois de decorridos n segundos. A thread virtual que processa a solicitação fica suspensa nesse intervalo, sem bloquear nenhuma thread do sistema. [getValue] retorna o valor associado a uma chave e lança uma [NoSuchElementException] se a chave estiver ausente. Como o Kotlin não tem exceções verificadas, a [InterruptedException] que [Thread.sleep] pode lançar não precisa ser declarada nem capturada, como o código Java fazia;
- linhas 91–95: a URL [/form] recebe um formulário enviado pelo método [POST] e descreve o que recebeu;
- linhas 98–100: a URL [/text] recebe texto arbitrário via [POST] e o devolve em maiúsculas;
- linhas 103–124: o “banco de dados” de pessoas, trocado em formato JSON. [GET /api/persons] retorna a lista de pessoas, [GET /api/persons/n] retorna a pessoa de número n (ou uma resposta 404), [POST /api/persons] adiciona a pessoa enviada pelo cliente, atribui-lhe um número e responde com o código de status 201 (Created) e um cabeçalho [Location] contendo a URL da nova pessoa. Como várias solicitações podem ser processadas simultaneamente por threads diferentes, a lista é protegida por um lock. Em Kotlin, [synchronized(lock) { ... }] é uma função que executa o bloco mantendo o lock (Capítulo 8) e retorna o valor do bloco: a linha 119 a usa para obter a pessoa procurada. [writeValueAsString] converte um objeto em um documento JSON; [readValue] faz o inverso;
- linha 110: a pessoa criada é uma cópia da pessoa recebida com outro número: é a função [copy] das data classes, com um argumento nomeado. [maxOfOrNull] retorna o maior número, ou [null] se a lista estiver vazia;
- linha 112: a expressão [headers[name] = value] chama o método Java [set(String, String)] da classe [Headers]: o Kotlin permite usar um método Java como operador se ele tiver o mesmo nome e a mesma assinatura de um operador;
- Linha 118: [matchEntire] verifica se o caminho inteiro corresponde à expressão regular e retorna um [MatchResult] ou [null]; as chamadas seguras [?.] propagam esse [null], e [id] passa então a ser [null]: nenhuma pessoa será encontrada;
- linha 124: qualquer outra URL retorna uma resposta 404;
- linhas 131–149: envio de uma resposta e leitura do documento recebido. [toByteArray] e [decodeToString] usam UTF-8 por padrão;
- linhas 152–157: análise dos parâmetros de [name1=value1&name2=value2]. [associate] transforma cada par em uma entrada de dicionário ([name to value]), dentro de um [LinkedHashMap] que preserva a ordem dos parâmetros; [substringBefore] e [substringAfter] dividem o par em torno do primeiro caractere [=], sendo o segundo argumento de [substringAfter] o valor retornado se não houver sinal [=].
O servidor é iniciado em uma janela de comando a partir da pasta [12-internet]com [gradlew -q run -Pmain=internet10.Internet10Kt] e permanece em execução ali durante todos os testes desta seção. As solicitações que ele recebeu serão apresentadas no fim da seção.
12.7.2.2. Enviando uma solicitação e lendo o documento: send e BodyHandlers
O uso do [HttpClient] envolve três tipos:
- [HttpClient]: o próprio cliente, criado por [HttpClient.newHttpClient()] ou, para configurá-lo, por [HttpClient.newBuilder()...build()];
- [HttpRequest]: uma solicitação, também construída por um “construtor” ([builder]): [HttpRequest.newBuilder(uri)...build()]. Salvo indicação em contrário, trata-se de uma solicitação [GET];
- [HttpResponse<T>]: a resposta, retornada pelo método [send(request, handler)] do cliente. O segundo parâmetro, um [BodyHandler<T>], especifica o que fazer com o documento recebido; a classe [BodyHandlers] fornece os handlers mais comuns:
Handler | O documento é retornado como |
BodyHandlers.ofString() | string ([HttpResponse<String>]), decodificada conforme o conjunto de caracteres especificado pelo cabeçalho [Content-Type] |
BodyHandlers.ofByteArray() | array de bytes (uma imagem, por exemplo), visto pelo Kotlin como um [ByteArray] |
BodyHandlers.ofInputStream(), ofLines() | fluxo de bytes, ou fluxo ([Stream<String>] do Java, que [asSequence] converte em uma sequência Kotlin) de linhas, a ser lido à medida que o documento chega (por exemplo, um arquivo grande) |
BodyHandlers.ofFile(Path) | arquivo no qual o documento é armazenado |
BodyHandlers.discarding() | nenhum: o documento é ignorado |
O método [send] é síncrono: ele retorna a resposta quando seus cabeçalhos e, exceto no caso de fluxos, seu documento já chegaram. Ele lança uma [IOException] em caso de problema de comunicação, mas não para um código de status de erro: uma resposta 404 é tratada como qualquer outra resposta. Veremos mais adiante sua versão assíncrona, [sendAsync], e como esperá-la em uma corrotina.
O programa [Internet11.kt] é o seguinte:
Resultados (com o servidor [Internet10] rodando em outra janela):
Comentários:
- Linha 12: [HttpClient] não tem um endereço base para as URLs relativas: usamos o método [resolve] da classe [URI], como visto no cliente web da Parte 1, que completa uma URL relativa ([hello?name=Serge]) a partir da URI base para obter [http://localhost:27210/hello?name=Serge]. A barra final no endereço base é importante: sem ela, o último segmento do caminho seria substituído pela URL relativa;
- Linha 16: criação do cliente. A partir do Java 21, [HttpClient] implementa [AutoCloseable]: a função Kotlin [use] chama seu método [close] ao fim do bloco, mesmo que ocorra uma exceção; [close] espera a conclusão das solicitações em andamento e depois libera os recursos do cliente (conexões, threads). O cliente é o parâmetro [client] da lambda;
- Linhas 18–20: três instruções bastam para obter o documento: construir a solicitação, enviá-la e ler o documento da resposta ([body()]). [HttpClient] construiu a solicitação HTTP, estabeleceu uma conexão, analisou a resposta e decodificou o documento. [request] e [response] são declaradas com [var] porque são reatribuídas mais adiante; seu tipo ([HttpRequest], [HttpResponse<String>]) é inferido;
- Linhas 24–25: as linhas 4–8 dos resultados revelam o que o [HttpClient] envia por padrão: o cabeçalho obrigatório [Host] e um cabeçalho [User-Agent] indicando a versão do Java. Os cabeçalhos [Connection: Upgrade, HTTP2-Settings], [Upgrade: h2c], e [HTTP2-Settings] são mais surpreendentes: por padrão, o [HttpClient] prefere o HTTP/2 e sugere que o servidor passe para o HTTP/2 na conexão não criptografada ([h2c]). Nosso servidor, que reconhece apenas o HTTP/1.1, ignorou a proposta e respondeu com HTTP/1.1. Com uma URL [https], a versão do HTTP é negociada durante o estabelecimento da conexão TLS. Observe também que o servidor do JDK exibe os nomes dos cabeçalhos recebidos com uma única letra maiúscula ([User-agent]);
- linhas 28–32: uma solicitação construída com mais precisão: a versão do HTTP (1.1, o que elimina os cabeçalhos de transição para o HTTP/2) e dois cabeçalhos específicos dessa solicitação. [HttpClient] não tem cabeçalhos comuns a todas as solicitações: quando necessário, escreve-se uma função para construí-las. As linhas 10–12 dos resultados mostram que os cabeçalhos foram de fato recebidos pelo servidor;
- linhas 38–39: o documento é obtido em bytes; o tipo da variável, [ByteArray], que poderia ser inferido, é escrito aqui para facilitar a leitura. Observe a URL e [/]: uma URL relativa que começa com uma barra se refere à raiz do site a partir do endereço base;
- linhas 42–44: um documento inexistente. Nenhuma exceção é lançada: a resposta tem código de status 404 ([statusCode()]) e um documento vazio. Cabe ao programa verificar o código de status.
Observe que os métodos [body()], [statusCode()]… de [HttpResponse] são chamados com parênteses: eles não são acessores [getXxx], portanto o Kotlin não os trata como propriedades.
12.7.2.3. Solicitação e resposta: HttpRequest e HttpResponse
Vamos examinar mais de perto a configuração do cliente e da solicitação, bem como o conteúdo da resposta:
Membro | Função |
HttpClient.newBuilder() .followRedirects(Redirect r) .connectTimeout(Duration d) .version(Version v) .executor(Executor e) .proxy(ProxySelector p) .build() | Configuração do cliente: acompanhamento de redirecionamentos ([Redirect.NEVER] por padrão, [Redirect.NORMAL] para acompanhá-los, exceto de [https] para [http], [Redirect.ALWAYS]), tempo limite máximo de estabelecimento da conexão, versão preferida do HTTP, threads usadas para operações assíncronas, proxy… |
HttpRequest.newBuilder(URI uri) .GET() .POST(BodyPublisher p) .method(String method, BodyPublisher p) .header(String name, String value) .timeout(Duration d) .version(Version v) .build() | A requisição: método e documento enviados (para [POST] e [PUT]), cabeçalhos, tempo máximo de resposta ([HttpTimeoutException] se esse limite for excedido), versão do HTTP |
HttpResponse.statusCode(), version() | o código de status e a versão (HTTP) da resposta. Não há método para a mensagem que acompanha o código (ela não existe mais no HTTP/2) |
HttpResponse.headers() | os cabeçalhos da resposta, um objeto [HttpHeaders]: [firstValue(name)] retorna o primeiro valor de um cabeçalho (um `[Optional<String>]` do Java; `[firstValue(name).orElse(null)]` produz um `[String?]` mais natural em Kotlin), `[map()]` retorna todos os cabeçalhos na forma de um dicionário: chave → lista de valores |
HttpResponse.body() | o documento, no formato escolhido por [BodyHandler] |
HttpResponse.uri(), request(), previousResponse() | a URI da resposta e a requisição correspondente: em caso de redirecionamento, é a última requisição enviada; [previousResponse] retorna a resposta anterior (o redirecionamento) |
As assinaturas são apresentadas aqui com a notação da documentação Java do JDK, em que o tipo precede o nome do parâmetro.
Vamos retomar agora o cliente web da Parte 1 ([Internet08.kt], [Internet09.kt]), que era chamado com uma URL e o método [GET] ou [HEAD]. O programa [Internet12.kt] é o seguinte:
Comentários:
- Linha 26: como em [Internet08.kt], verificamos que a URL é válida com a função [parse] (linhas 79–85). Desta vez o esquema [https] é aceito: [HttpClient] sabe realizar a negociação do TLS. Em [parse], [try] é uma expressão: seu valor é a [URI] construída, e o bloco [catch] sai da função por meio de [return null]. [takeIf] retorna [URI] se a condição for verdadeira e [null] caso contrário. Depois do teste da linha 27, o compilador sabe que [uri] não é [null]: é uma conversão inteligente de tipo (smart cast), que também se aplica ao [catch] da linha 72;
- linha 40: o número de redirecionamentos seguidos não é uma propriedade do cliente, e sim uma propriedade de sistema da JVM, [jdk.httpclient.redirects.retrylimit], que limita o número total de requisições enviadas para uma URL solicitada (5 por padrão). Ela é lida uma única vez, quando [HttpClient] é usado pela primeira vez: aqui é definida por código antes de criar o cliente, mas também poderia ser especificada na JVM ([-Djdk.httpclient.redirects.retrylimit=4], por exemplo, na propriedade [jvmArgs] da tarefa [run] do Gradle);
- Linhas 43–46: o cliente segue os redirecionamentos (mas não os que o levariam de [https] para [http], o que resultaria na perda da criptografia) e espera até 5 segundos para que uma conexão seja estabelecida. Ele é fechado por [use];
- linhas 48–52: a requisição, com o método solicitado (nenhum documento a enviar: [noBody()]), um cabeçalho [User-Agent] e um tempo máximo de resposta de 10 segundos;
- linha 54: a requisição é enviada; a resposta fica disponível quando seus cabeçalhos e seu corpo foram recebidos;
- linha 56: a linha de status. [response.uri()] é a URL da última requisição: em caso de redirecionamento, difere da URL solicitada. [version()] retorna uma constante da enumeração [HttpClient.Version];
- Linha 60: os cabeçalhos da resposta, exibidos pela função [displayHeaders] (linhas 89–90). Um nome de cabeçalho pode ter vários valores: [map()] associa cada nome à sua lista de valores. A função lambda passada a [forEach] decompõe cada entrada do dicionário em [(name, values)];
- linhas 62–64: o documento só é exibido se o código de status indicar sucesso (família 2xx), conforme especificado pelo intervalo [200..299];
- linhas 67–74: erros. [HttpConnectTimeoutException] (conexão não estabelecida dentro do limite de tempo) é um tipo de [HttpTimeoutException] (resposta não recebida dentro do limite de tempo), que por sua vez é um tipo de [IOException]: o [catch] da classe mais especializada deve vir primeiro. Uma recusa de conexão resulta em uma [ConnectException]. O nome [_] indica que a exceção não é usada no bloco. Lembre-se de que o Kotlin não obriga a capturar essas exceções: cabe a você escolher se vai tratá-las.
Vamos solicitar a página raiz do site:
Encontramos as informações que obtínhamos ao analisar nós mesmos a resposta com o cliente TCP: a linha de status, os cabeçalhos de resposta [Content-Length], [Content-Type] e [Date], seguidos do documento. [HttpClient] lista os nomes dos cabeçalhos em minúsculas: é o formato exigido pelo HTTP/2, e [HttpHeaders] faz buscas sem diferenciar maiúsculas de minúsculas de qualquer forma.
Uma URL sujeita a um redirecionamento:
O redirecionamento foi seguido automaticamente: a resposta recebida é a da URL [/hello?name=visitor] (linha 2). Comparemos com a primeira parte: o cliente [Internet09.kt] tinha de ler a linha de status, extrair o código, procurar o cabeçalho [Location], calcular a nova URL e recomeçar, em um laço limitado a três redirecionamentos. Aqui, tudo isso é tratado por [HttpClient]. Para tratar os redirecionamentos você mesmo, basta não chamar [followRedirects]: a resposta 302 é então devolvida como está.
Um documento inexistente:
O código 404 está incluído na resposta, junto com seus cabeçalhos; o documento não é exibido. Nenhuma exceção foi lançada: cabe ao programa decidir o que fazer com uma resposta de erro.
A URL [/loop], que redireciona para si mesma:
Depois de quatro requisições, isto é, três redirecionamentos, [HttpClient] desiste e retorna a última resposta recebida, uma resposta 302.
Um erro de servidor:
Uma porta na qual nenhum servidor está escutando:
A conexão foi recusada ([ConnectException]). Por fim, uma URL [https] dirigida ao nosso servidor, que só fala HTTP em texto puro:
O cliente enviou a primeira mensagem da negociação do TLS; nosso servidor, que esperava uma linha de requisição (HTTP), não a entendeu e não respondeu. Após 5 segundos, como a conexão segura não havia sido estabelecida, o tempo limite de conexão expirou. Em uma máquina conectada à Internet, uma requisição como a URL [https://kotlinlang.org/] seria normalmente atendida em HTTP/2, se o servidor o permitir.
Uma última observação sobre proxies: são as máquinas pelas quais as estações de trabalho de uma rede corporativa costumam precisar passar para acessar a Web. Por padrão, [HttpClient] usa o proxy especificado pelas propriedades de sistema da máquina virtual [http.proxyHost], [http.proxyPort], [https.proxyHost], e [https.proxyPort] (e nenhum se não estiverem definidas). Você pode especificar outro com o método [proxy] do construtor do cliente: [HttpClient.newBuilder().proxy(ProxySelector.of(InetSocketAddress("proxy.example.org", 3128)))].
12.7.2.4. Envio de dados ao servidor: GET e POST
Um cliente pode enviar informações ao servidor de duas maneiras:
- com o método [GET], as informações fazem parte da URL: [/document?param1=value1¶m2=value2];
- com o método [POST], elas formam o documento anexado à requisição, depois da linha em branco que encerra os cabeçalhos. O cabeçalho [Content-Type] especifica seu formato. Para um formulário HTML, o documento tem o mesmo formato da seção de parâmetros de uma URL: [param1=value1¶m2=value2], com o tipo [application/x-www-form-urlencoded].
Nos dois casos, os valores precisam ser codificados: certos caracteres (espaços, [&], [=], [?], letras acentuadas etc.) não podem aparecer como estão em uma URL ou em um formulário. Para isso, usamos o método estático do Java [URLEncoder.encode(value, charset)], que gera o formato de formulário; [URLDecoder.decode], usado por nossos servidores de teste, faz a operação inversa.
O documento a ser enviado é fornecido à requisição por meio de um [BodyPublisher]; a classe [BodyPublishers] oferece os mais comuns:
Método | Documento enviado |
BodyPublishers.ofString(String text[, Charset charset]) | texto, codificado em UTF-8 por padrão. O tipo do documento é indicado por um cabeçalho [Content-Type] adicionado à requisição: [text/plain], [application/json], [application/x-www-form-urlencoded]… |
BodyPublishers.ofByteArray(byte[] bytes), ofFile(Path path), ofInputStream(...) | bytes arbitrários ([ByteArray] em Kotlin), um arquivo, um fluxo |
BodyPublishers.noBody() | nenhum documento |
Não há no JDK uma classe que construa um formulário: você mesmo constrói a string [name=value&...], o que as funções de coleção do Kotlin tornam muito simples. O programa [Internet13.kt] é o seguinte:
Resultados:
Comentários:
- Linha 16: uma função de extensão (Capítulo 4) do tipo [String], que codifica a string no formato de formulário. Ela permite escrever [name.encode()] em vez de [URLEncoder.encode(name, Charsets.UTF_8)]. O objeto Kotlin [Charsets] fornece os conjuntos de caracteres padrão ([Charsets.UTF_8] é o equivalente em Java de [StandardCharsets.UTF_8]);
- linha 19: um cliente que usa HTTP/1.1, para que as requisições não sugiram a mudança para HTTP/2;
- Linhas 21–22: o valor [Jean & Marie] é colocado na URL. Sem codificação, o caractere [&] seria interpretado como o separador entre dois parâmetros, e o servidor receberia o parâmetro [name] com o valor [Jean]. Na linha 2 dos resultados, vemos que o espaço virou [+] e o caractere [&] virou [%26]: é o código hexadecimal do caractere, precedido de [%]. [URLEncoder] gera o formato de formulário, em que o espaço é codificado como [+]; no caminho de uma URL, seria necessário [%20], mas na seção de parâmetros os servidores aceitam ambos;
- Linha 28: os campos do formulário, na forma de uma lista de pares (nome, valor) criados pela função infixa [to]. Uma lista preserva a ordem dos campos; um dicionário ([mapOf]) também a preservaria em Kotlin (é um [LinkedHashMap]), mas um formulário pode conter vários campos com o mesmo nome, o que uma lista de pares permite;
- Linha 30: o documento é construído por [joinToString]: cada par, decomposto em [(key, value)], torna-se [name=value], com nomes e valores codificados, e os elementos são unidos por [&]. Onde o Java exigia um [stream()], um [map] e um [Collectors.joining], uma única função basta. Na linha 4 dos resultados, encontramos o formato [name=value&name=value];
- linhas 32–37: o formulário é enviado pelo método [POST] para a URL [/form], junto com seu tipo. O servidor indica (linhas 5–6 dos resultados) que recebeu um documento do tipo [application/x-www-form-urlencoded] e que extraiu e decodificou dele os três campos;
- linhas 41–43: texto codificado em UTF-8, do tipo [text/plain]. O servidor o devolve em maiúsculas (linha 9 dos resultados): os caracteres acentuados foram transmitidos e recebidos corretamente.
Lembre-se da diferença entre [GET] e [POST]: um navegador exibe os parâmetros de uma requisição [GET] em sua barra de endereços, mas não os de uma requisição [POST]; além disso, uma requisição [GET] deve ser usada apenas para obter informações, enquanto uma requisição [POST] serve para enviar informações ou modificar o estado do servidor.
12.7.2.5. Troca de objetos no formato JSON
Hoje, as aplicações trocam a maior parte de seus dados no formato JSON, descrito no Capítulo 5. O JDK não tem uma biblioteca JSON: [HttpClient] transporta documentos JSON como strings, e o Jackson é usado na conversão entre objetos e JSON:
- No envio, [mapper.writeValueAsString(obj)] gera o documento JSON, que [BodyPublishers.ofString] envia com o cabeçalho [Content-Type: application/json];
- Na recepção, [mapper.readValue(json, Type::class.java)] converte o documento JSON recebido em um objeto. Para um tipo genérico como [List<Person>], usa-se um [TypeReference], que preserva o parâmetro de tipo removido pela JVM em tempo de compilação. Em Kotlin, uma função [inline] com um parâmetro de tipo reificado ([reified], Capítulo 4) permite esconder esse [TypeReference], como fizemos no Capítulo 5.
O programa [Internet14] é um pacote composto por dois arquivos: [Person.kt], que contém a mesma data class [Person] do servidor (no pacote [internet14]), e [Internet14.kt]:
Resultados:
Comentários:
- Linha 16: o [JsonMapper] do Jackson é criado uma única vez; ele pode ser usado por várias threads ao mesmo tempo;
- Linhas 55–64: a função [readJson] faz o equivalente a um método que “solicita uma URL e converte o documento JSON recebido em um objeto”: envia a requisição [GET] com o cabeçalho [Accept: application/json], verifica o código de status (linha 60) e converte o documento em um objeto do tipo solicitado (linha 64). Três características do Kotlin:
- é uma função de extensão de
*[HttpClient]: ela é chamada como um método do cliente ([client.readJson<Person>(...)]) e, em seu corpo, [send] é aplicado implicitamente ao cliente ([this]*); - seu parâmetro de tipo [T] é instanciado: como a função é copiada ([inline]) a cada chamada, [T] é substituído pelo tipo real. A expressão [object : TypeReference<T>() {}] cria uma instância de uma classe anônima derivada de [TypeReference], cujo tipo pai especifica o tipo real ([TypeReference<List<Person>>] na primeira chamada): esse é o artifício que permite ao Jackson determinar esse tipo em tempo de execução. Em Java, o chamador teria de criar essa instância ([new TypeReference<List<Person>>() {}]) ele mesmo a cada chamada;
- é privada: uma função pública [inline] não poderia usar as declarações privadas [BASE] e [MAPPER] do arquivo, já que seu código é copiado para os chamadores;
- é uma função de extensão de
- Linhas 21–23: a lista de pessoas. O documento JSON [[{"id":1,"name":"Dupont","age":42},...]] enviado pelo servidor é convertido diretamente em uma lista de objetos [Person]. O tipo solicitado é especificado entre sinais de menor e maior ([readJson<List<Person>>]); cada pessoa é exibida com o método [toString] gerado para a data class, na forma [Person(id=1, name=Dupont, age=42)];
- linha 26: uma única pessoa. Aqui, o tipo é especificado pelo tipo da variável, e o compilador infere o parâmetro [T] a partir de [readJson];
- linhas 30–38: o objeto [martin] é convertido em JSON e enviado ao servidor por [POST]. O servidor responde com o código de status 201 (Created) e o cabeçalho [Location], que fornece a URL do novo recurso (linha 7 dos resultados). [firstValue] retorna um [Optional] do Java, cujo valor é fornecido por [orElse], ou [?] se o cabeçalho estiver ausente;
- Linhas 40–41: o documento JSON recebido, primeiro em forma bruta e depois convertido em objeto. Os nomes das propriedades são os das propriedades da data class ([id], [name], [age]), no formato “camelCase”, seguindo as convenções da web;
- Linhas 44–48: uma pessoa inexistente: [readJson] dispara uma [IOException] para uma resposta 404.
Observe que o módulo [jackson-module-kotlin] ensina ao Jackson as particularidades do Kotlin (valores padrão de parâmetros, tipos anuláveis etc.) e fornece ele próprio uma função [readValue<T>] reificada, enquanto a biblioteca kotlinx.serialization da JetBrains oferece outra solução, sem reflexão (Capítulo 5). Voltaremos a essas técnicas no próximo capítulo, em que o servidor de cálculo de impostos se tornará um serviço web JSON.
12.7.2.6. Timeout, cancelamento e reutilização do cliente
O programa [Internet15.kt] ilustra quatro pontos importantes para o uso de [HttpClient] em uma aplicação real: reutilização do cliente, timeouts, cancelamento de requisições e requisições assíncronas. O método [sendAsync] de [HttpClient] é a versão assíncrona de [send]: ele envia a requisição e retorna imediatamente um [CompletableFuture<HttpResponse<T>>], que será completado quando a resposta chegar. O programa Java executava uma série de operações sobre esse *[CompletableFuture]* ([thenApply]*, [allOf]*, *[join]*); em Kotlin, ele é aguardado em uma corrotina (Capítulo 9) pela função de suspensão [await] do kotlinx.coroutines: a corrotina fica suspensa, sem bloquear nenhuma thread, até a resposta chegar, e o código assíncrono é escrito como um código sequencial. O programa é o seguinte:
Resultados:
Comentários:
- Linha 33: uma única instância de [HttpClient] é usada por todo o programa. Essa é a regra: um objeto [HttpClient] gerencia um pool de conexões e as reutiliza de uma requisição para a seguinte; ele foi projetado para ter vida longa e pode ser usado por várias threads ou corrotinas simultaneamente. Criar um [HttpClient] para cada requisição é um erro comum: cada instância abre suas próprias conexões, que o sistema mantém em reserva por algum tempo depois de fechadas (estado TIME_WAIT do TCP); um programa que faz muitas requisições acaba esgotando as portas disponíveis. Criamos um cliente em cada um dos programas anteriores porque eles faziam apenas algumas requisições antes de terminar;
- Linhas 24–25: cada requisição deve receber uma resposta em 2 segundos no máximo;
- linhas 37–38: três requisições consecutivas. Veremos no log do servidor que elas usaram a mesma conexão TCP;
- linhas 42–47: uma resposta que chega em 1 segundo, seguida de uma resposta que levaria 3 segundos: após 2 segundos, a requisição é abandonada e uma [HttpTimeoutException] é lançada (linha 9 dos resultados);
- linhas 28–29: a função de extensão [document], uma versão suspensa de [send]. [sendAsync] retorna imediatamente um [CompletableFuture]; a função [await] (pacote [kotlinx.coroutines.future]) suspende a corrotina chamadora até que ele esteja completo e então retorna a resposta, da qual [body()] extrai o documento. Se [CompletableFuture] falhar, [await] lança sua exceção; se a corrotina for abortada durante a espera, [await] aborta o [CompletableFuture]. Uma função marcada com [suspend] só pode ser chamada a partir de uma corrotina ou de outra função de suspensão;
- linha 52: o restante do programa é executado em uma corrotina. [runBlocking] faz a ponte entre o mundo bloqueante da função [main] e o das corrotinas: ele espera que todas as corrotinas lançadas em seu bloco terminem (concorrência estruturada, Capítulo 9);
- linhas 55–61: um cancelamento iniciado pelo programa. A requisição é lançada em uma corrotina por [async], que retorna imediatamente um [Deferred<String>]; após meio segundo ([delay(500)], que suspende a corrotina principal sem bloquear sua thread), o programa a cancela com [cancel]. Em uma aplicação interativa, esse seria o efeito de um botão rotulado [Cancel]. Cancelar a corrotina, que está suspensa em [await], cancela o [CompletableFuture] retornado por [sendAsync]; e, desde o Java 16, cancelar esse [CompletableFuture] encerra de fato a troca com o servidor. Chamar [await] em um [Deferred] cancelado lança uma [CancellationException]; a linha 11 dos resultados mostra que se trata, mais especificamente, de uma [JobCancellationException], uma classe interna do kotlinx.coroutines derivada de [CancellationException]. O código Java fazia a mesma coisa com um executor adiado ([CompletableFuture.delayedExecutor]) encarregado de chamar o método [cancel] de [CompletableFuture];
- linhas 66–69: quatro requisições lançadas simultaneamente no mesmo cliente, cada uma em sua própria corrotina ([async]): [map] retorna a lista dos quatro [Deferred<String>], e [awaitAll] espera pelos quatro documentos, retornados na ordem das requisições. As quatro corrotinas ficam suspensas durante a espera: elas não ocupam nenhuma thread, e a única thread de [runBlocking] basta para executá-las todas. A função [measureTime] da biblioteca padrão ([kotlin.time]) mede o tempo de execução de seu bloco e o retorna como um objeto [Duration] do Kotlin;
- linha 71: cada requisição leva um segundo no servidor; o processo inteiro levou um segundo (última linha dos resultados): as requisições foram tratadas em paralelo, tanto pelo cliente quanto pelo servidor. Em Java, o mesmo resultado exigia um stream de [CompletableFuture], um [CompletableFuture.allOf] sobre um array de [CompletableFuture] e um [join]; a versão Kotlin se lê como um simples laço.
Há, portanto, três maneiras de obter esse paralelismo com [HttpClient]: os métodos [CompletableFuture] de [sendAsync], que podem ser usados como estão a partir do Kotlin; o método síncrono [send], executado em threads virtuais; e as corrotinas, com [sendAsync(...).await()]. Em Kotlin, esta última é a abordagem mais natural, sobretudo quando as respostas precisam ser encadeadas a outras operações assíncronas, e é ela que dá acesso à concorrência estruturada e ao cancelamento cooperativo descritos no Capítulo 9 (por exemplo, [withTimeout] para limitar a duração de um conjunto de requisições).
O log do servidor [Internet10] mostra todas as requisições recebidas desde o início desta seção:
- linhas 3–7: as cinco requisições de [Internet11.kt] chegaram pela mesma conexão (mesma porta do cliente): o cliente a manteve aberta entre as requisições;
- linhas 9–10: a requisição redirecionada de [Internet12.kt] e a requisição ao novo endereço, feita automaticamente;
- linhas 12–15: a requisição inicial a [/loop] e os três redirecionamentos que se seguiram antes de a conexão ser abandonada;
- linhas 17–19: requisições de [Internet13.kt], na mesma conexão;
- linhas 20–23: requisições de [Internet14.kt];
- linhas 24–28: as requisições sucessivas de [Internet15.kt] usaram todas a mesma conexão. A requisição que foi lenta demais (linha 28) foi abandonada pelo cliente após 2 segundos: [HttpClient] fechou então a conexão. O servidor não percebeu: após 3 segundos, escreveu sua resposta em uma conexão que o cliente já havia fechado, e o sistema não informa erro para uma operação de escrita desse tipo. É por isso que o log mostra o código de status 200;
- linha 29: a requisição cancelada pelo programa deve ter aberto uma nova conexão, já que a anterior havia sido fechada. Mais uma vez, o servidor respondeu sem saber que a resposta não seria lida;
- as quatro últimas linhas: as quatro requisições simultâneas usaram quatro conexões diferentes, abertas especificamente para isso. No HTTP/1.1, uma conexão transporta apenas uma requisição por vez; o HTTP/2 permitiria enviar todas elas por uma única conexão.
Um programa que permanece em execução por muito tempo (um servidor, um serviço do sistema) deve levar em conta um último ponto: um [HttpClient] mantém suas conexões ociosas por certo tempo (30 segundos por padrão, ajustável pela propriedade de sistema [jdk.httpclient.keepalive.timeout]) antes de fechá-las. Em aplicações Spring, você também pode usar o cliente HTTP do framework, [RestClient] (construído sobre [HttpClient] ou outra biblioteca), que acrescenta a conversão automática de objetos em JSON; os clientes do próximo capítulo, por sua vez, usarão simplesmente [HttpClient] e o Jackson, exatamente como [Internet14].
12.7.3. Aplicação: um cliente proxy para um serviço web de tradução
Vamos agora demonstrar como [HttpClient] permite usar recursos da web, mesmo quando esses recursos não foram concebidos para uso por um programa.
12.7.3.1. A aplicação
Nos anos 2000, havia na Web sites de tradução gratuitos. O usuário digitava um texto, escolhia o sentido da tradução (“francês para inglês” etc.) em uma lista suspensa, clicava em um botão e recebia uma página HTML contendo a tradução. É possível escrever uma classe [TranslationService] que faz a mesma coisa por programa: ela constrói a URL da requisição, consulta o site e extrai a tradução da página HTML recebida com uma expressão regular. Uma interface gráfica ou outro programa pode então se apoiar nessa classe; fala-se aqui de um cliente “proxy”: a classe [TranslationService] faz as vezes do site e o esconde de seu usuário.
Como nossa máquina de teste não tem acesso à Internet, substituímos o site por um pequeno site local que imita os da época: ele tem o mesmo formulário (uma caixa de texto, uma lista suspensa à moda antiga com os sentidos de tradução) e exibe a tradução no mesmo lugar de sua página. Suas “traduções” são feitas palavra por palavra com pequenos dicionários: o que nos interessa é a técnica do cliente, não a qualidade da tradução. O cliente é usado por um programa de teste de console. A arquitetura é a seguinte:
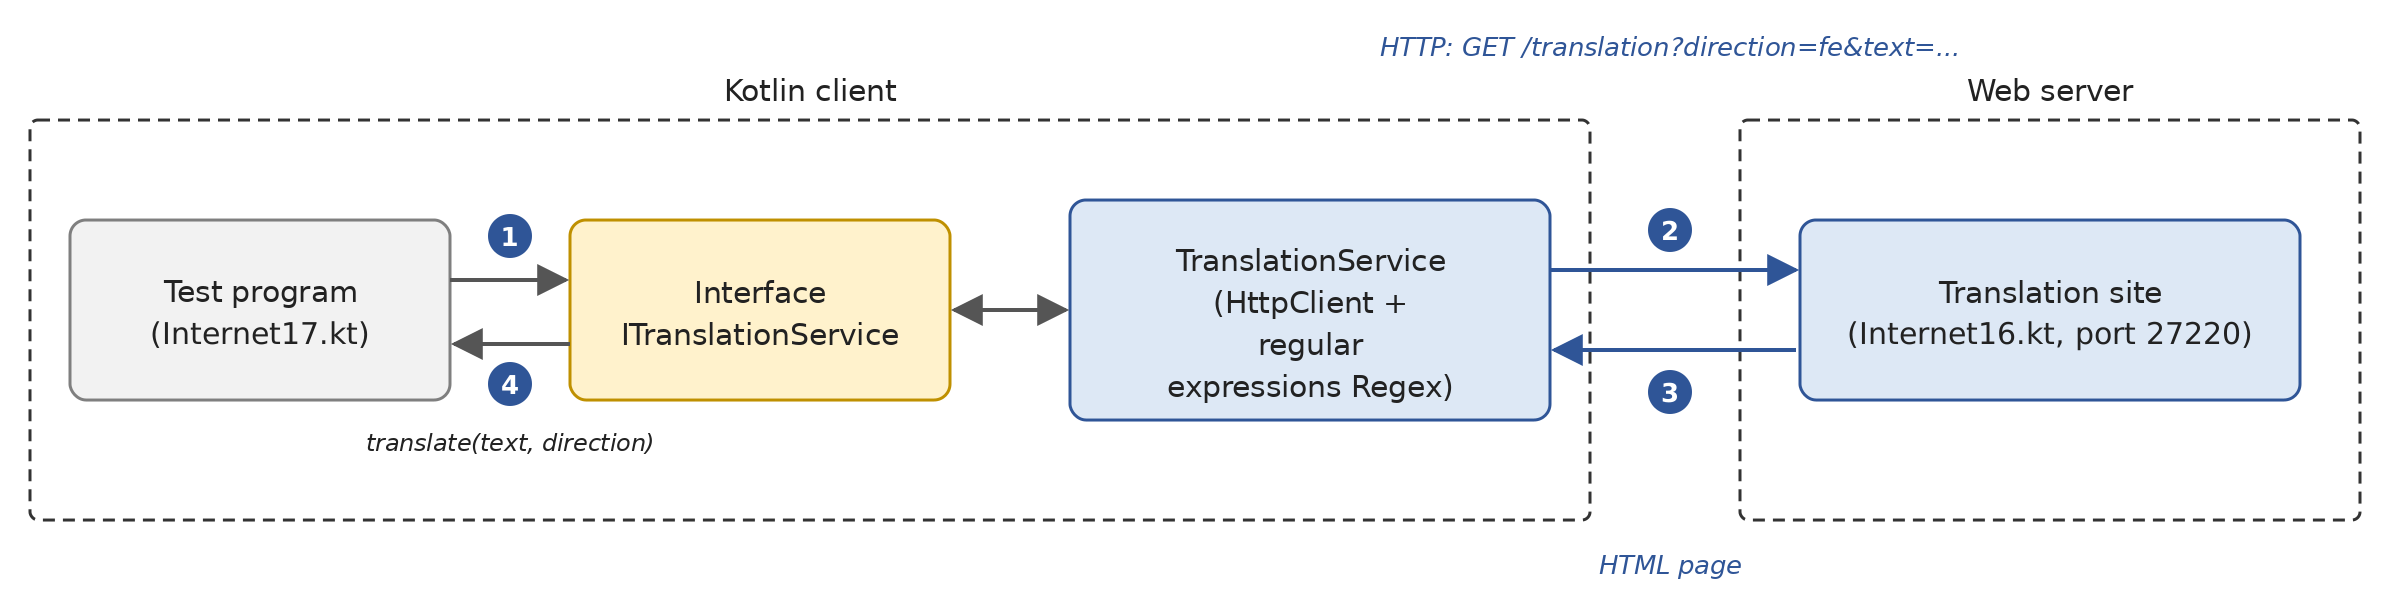
12.7.3.2. O site de tradução
O programa [Internet16.kt] é o seguinte:
Comentários:
- linha 14: um sentido de tradução é uma data class composta por um rótulo e um dicionário;
- Linhas 17–26: os três sentidos de tradução propostos, com seus códigos ([fe] para francês → inglês, [ef] para inglês → francês, [fs] para francês → espanhol), seus rótulos e seus dicionários. O dicionário de significados é um dicionário somente leitura, criado uma única vez por [mapOf], que preserva a ordem das entradas (o programa Java preenchia um [LinkedHashMap] em seu método [main]). Diferentemente do [Map.of] do Java, limitado a dez pares, [mapOf] aceita qualquer número de pares;
- linha 34: a única página do site, [/translation], é tratada pela função [translate], referenciada por [::translate]. Ela pode receber dois parâmetros: o sentido da tradução [direction] e o texto [text] (linhas 42–44);
- linha 45: a página é construída por [buildString], que fornece ao bloco um [StringBuilder] ([this]) e retorna a string construída. As partes fixas da página são strings brutas (raw strings) cuja indentação é removida por [trimIndent];
- linhas 57–58: a lista suspensa. Como nos sites da época, as tags [<option>] não são fechadas: o HTML dos sites reais nem sempre é muito limpo, e nosso cliente terá de contornar isso. O laço [for] decompõe cada entrada do dicionário em [(code, translator)];
- linha 67: o tradutor do sentido solicitado, ou [null] se o sentido estiver ausente ([direction] é [null]) ou for desconhecido;
- linhas 70–71: a tradução literal. A expressão regular [\p{L}+'?] (linha 29) designa uma palavra, isto é, uma sequência de letras ([\p{L}]), possivelmente seguida de um apóstrofo ([l'], [d']). Não usamos [\w]: por padrão, na JVM, [\w] designa apenas letras sem acento, dígitos e o caractere [_], e [été] não seria reconhecido como palavra. A função [replace] de [Regex] substitui cada palavra pelo resultado de uma lambda: sua tradução, ou a própria palavra se for desconhecida (operador Elvis). O texto retornado pela lambda é usado como está: diferentemente da função [replaceAll] de [Matcher] em Java, não é necessário escapar os caracteres [$] e [\] com [Matcher.quoteReplacement];
- linhas 73–74: a tradução é colocada dentro de uma tag [<div class="txtTrans">], como era comum nos sites da época. Ela é codificada pela função [encodeHtml] (linhas 91–93): os caracteres que têm significado em HTML ([<], [&]…) e os caracteres não ASCII são substituídos por entidades numéricas [&#nnn;]. O JDK não tem função de codificação HTML, e a biblioteca padrão do Kotlin também não: as aplicações web usam as fornecidas por seu framework. [codePoints()] retorna o stream ([IntStream]) dos pontos de código Unicode do texto; a expressão [c.toChar() in "<>&\"'"] verifica se um caractere pertence a uma string;
- linha 76: um sentido de tradução desconhecido resulta em uma página sem tradução;
- Linhas 98–101: análise dos parâmetros da URL. As chamadas seguras [?.] e o operador Elvis tratam o caso de uma URL sem parâmetros (caso em que [rawQuery] equivale a [null]).
Eis a página gerada com [curl] para traduzir [l'été sera chaud] para o espanhol, depois que o site foi iniciado por [gradlew -q run -Pmain=internet16.Internet16Kt]; observe a codificação do texto na URL:
Para escrever o cliente, precisamos:
- saber o que o site espera: uma requisição [GET /translation?direction=code&text=encoded text]. Em um site real, podemos descobrir isso olhando a URL exibida pelo navegador após uma tradução, ou o atributo [action] do formulário;
- saber onde, nas páginas recebidas, está a informação de que precisamos: os sentidos de tradução estão nas tags [<option value='code'>label] da lista suspensa (linhas 10–12 da página acima), e a tradução está na tag [<div class="txtTrans">] (linha 16). Isso se descobre exibindo o código-fonte da página no navegador.
Duas expressões regulares (Capítulo 5) permitem extrair essas informações:
- [<option[^>]*value='(\w+)'>([^<\r\n]+)]: uma tag [<option], seguida de caracteres diferentes de [>], [value='], o código (primeiro grupo), [>] e, em seguida, o rótulo, isto é, os caracteres que vêm até o próximo [<] ou o fim da linha (segundo grupo);
- [<div class="txtTrans">(.*?)</div>]: a tradução é o texto (primeiro grupo) entre a tag de abertura e a primeira tag [</div>] que se segue. O quantificador [*?] é “preguiçoso” (lazy): ele toma o menor número possível de caracteres.
No código Kotlin, vamos escrevê-las como raw strings ["""..."""]: as barras invertidas e as aspas não precisam ser escapadas, e a expressão é lida como está.
12.7.3.3. O cliente TranslationService
O arquivo [Internet17.kt] contém a interface [ITranslationService], sua implementação [TranslationService], a exceção [TranslationException], e o programa de teste. Em Kotlin, um arquivo pode conter qualquer número de classes e interfaces de nível superior, públicas ou não; em uma aplicação real, porém, a interface e sua implementação formariam uma biblioteca separada (um módulo Gradle, Capítulo 6). O programa [Internet17.kt] é o seguinte:
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 33 34 35 36 37 38 39 40 41 42 43 44 45 46 47 48 49 50 51 52 53 54 55 56 57 58 59 60 61 62 63 64 65 66 67 68 69 70 71 72 73 74 75 76 77 78 79 80 81 82 83 84 85 86 87 88 89 90 91 92 93 94 95 96 97 98 99 100 101 102 103 104 105 106 107 108 109 110 111 112 113 114 115 116 117 118 119 120 121 122 123 124 125 126 127 128 129 130 131 132 133 134 135 136 137 138 139 140 141 142 143 144 145 146 | |
Comecemos pela interface e pela exceção:
- linhas 55–61: a interface apresentada no programa. A propriedade abstrata
[translatedLanguages]é o dicionário dos sentidos de tradução aceitos pelo site, composto de entradas da forma*[fe]→[French to English]; onde o Java declarava um método [translatedLanguages()], uma interface Kotlin pode declarar uma propriedade, que as implementações devem fornecer. A função [translate] traduz o texto [text] no sentido de tradução de código [direction]. Ela é síncrona: um programa que queira executar várias traduções em paralelo as executará em threads virtuais, ou em corrotinas com [withContext(Dispatchers.IO)] (também seria possível escrever uma versão [suspend] baseada em [sendAsync(...).await()], como em [Internet15.kt]*); - linhas 65–66: a exceção específica do serviço, com um código de erro, inspirada em [TaxException] (Capítulo 6). Seu construtor primário declara a propriedade [code] ([val]) e passa a mensagem e a causa ([null] por padrão) ao construtor de [RuntimeException]: uma única linha substitui os dois construtores e o acessador [getCode] da versão Java. Como o Kotlin não tem exceções verificadas, a questão de “verificada ou não verificada” não se coloca; ele também não exige, como faz o [-Xlint:all] em Java, um número de versão de serialização.
A classe [TranslationService]:
- Linhas 70–74: o construtor primário é privado ([private constructor]). O serviço só pode ser criado depois de consultar o site; em vez de realizar essa operação de rede dentro de um construtor, usamos uma função de criação, [create]. Os três parâmetros do construtor são propriedades: o cliente HTTP e o endereço do site, que são privados, e a propriedade da interface [languesTraduites] ([override val]). O serviço não cria seu próprio [HttpClient]: ele o recebe do programa, que determina sua configuração e seu tempo de vida;
- Linha 77: o objeto companheiro contém o que era estático em Java: as expressões regulares, a função de construção [create] e a função [decodeHtml]. [create] é chamada pelo nome da classe: [TranslationService.create(client, siteUrl)];
- linhas 79–87: as expressões regulares apresentadas acima, compiladas uma única vez, e uma terceira para as entidades HTML, numéricas ([á]) ou nomeadas ([ç]), bem como as poucas entidades nomeadas que sabemos decodificar;
- linhas 90–106: criação do serviço. A lista de sentidos de tradução é obtida do próprio site, o que garante que esteja atualizada:
- linhas 91–94: a página do formulário é solicitada, sem parâmetros. [try] é uma expressão: seu valor, o da última expressão do bloco, é a página;
- linhas 95–96: um erro de comunicação é encapsulado em uma [TranslationException] com código 11;
- linhas 99–101: [findAll] retorna a sequência de correspondências da expressão regular na página; [associate] transforma cada correspondência em uma entrada de dicionário. [destructured] decompõe uma correspondência em seus grupos: o código (grupo 1) e o rótulo (grupo 2). A função [decodeHtml] (linhas 110–113) substitui as entidades HTML pelos caracteres que elas representam: [Français] torna-se [Français];
- linha 106: o dicionário retornado por [associate] é um [LinkedHashMap], que preserva a ordem das opções; ele é visto pelo tipo [Map], em modo somente leitura. O programa Java precisava envolvê-lo em [Collections.unmodifiableMap];
- linhas 118–144: a tradução:
- linhas 120–121: verificamos que o sentido de tradução solicitado existe ([!in] chama [containsKey]);
- linha 124: a URL a ser solicitada, com o texto codificado;
- linha 128: o handler [BodyHandlers.ofLines()] retorna a resposta assim que seus cabeçalhos chegam; seu documento é um stream Java ([Stream<String>]) de linhas, lidas à medida que chegam;
- Linhas 133–136: o stream, que é [AutoCloseable], é fechado por [use], o que libera a conexão. [asSequence] (pacote [kotlin.streams]) o apresenta como uma sequência Kotlin, que também é tardia (lazy). [firstNotNullOfOrNull] aplica a lambda a cada linha e para na primeira que produz um resultado diferente de [null]: o primeiro grupo da correspondência encontrada por [find]. A varredura é interrompida assim que a tradução é encontrada, e o restante da página nunca é lido. O resultado é a tradução decodificada, ou [null] se nenhuma linha contiver uma tradução: esse [String?] substitui o [Optional<String>] do código Java;
- linhas 138–140: um erro de comunicação resulta em uma exceção de código 11. Um erro durante a leitura do stream de linhas é sinalizado por uma [UncheckedIOException], já que os métodos de [Stream] não podem lançar uma exceção verificada em Java. O Kotlin não tem um [catch] múltiplo ([catch (IOException | UncheckedIOException e)] em Java): são necessários dois blocos [catch]. Observe também que a exceção [InterruptedException] de [send], que o Java exigia tratar, não é interceptada aqui: não se trata de um erro do serviço, e ela é repassada ao chamador;
- Linha 144: se a página foi lida por inteiro sem encontrar nenhuma tradução, [translation] é [null], e o operador Elvis lança uma exceção de código 12 ([throw] é uma expressão em Kotlin).
O programa de teste:
- linha 22: o endereço do site pode ser passado como argumento;
- linha 24: o cliente HTTP da aplicação;
- linha 26: criação do serviço. O tipo da variável, [ITranslationService], é especificado explicitamente: o programa só interage então com o serviço por meio de sua interface;
- linhas 30–36: alguns testes, incluindo dois casos de erro: um texto vazio e um sentido de tradução desconhecido. Cada teste é uma instância da data class [Trial] (linha 19), decomposta pelo laço [for] em [(text, direction)];
- Linha 49: a possível causa da exceção só é exibida se existir.
Resultados, com o site [Internet16.kt] iniciado em uma janela separada:
- Linhas 3–5: os sentidos de tradução foram lidos do formulário do site, e as entidades HTML foram decodificadas;
- linha 9: uma palavra desconhecida é reproduzida como está;
- linha 10: para um texto vazio, o site devolveu seu formulário sem tradução;
- linha 11: o sentido de tradução [fx] foi rejeitado pelo serviço sem consultar o site.
Se o site estiver indisponível:
Do lado do site, encontramos a requisição do [curl] vista acima, seguida das enviadas pelo cliente: a primeira para o formulário, as seguintes para as traduções (o sentido [fx], rejeitado pelo serviço, não gerou nenhuma requisição). [URLEncoder] codificou os espaços com [+], ao passo que a URL passada ao [curl], os codificou com [%20]:
12.7.3.4. Conclusão
Esta aplicação demonstrou que [HttpClient] permite aproveitar recursos da web. A técnica é sempre a mesma:
- determinar a URL a consultar. Em geral, ela é pré-configurada;
- consultá-la;
- encontrar o que procuramos na resposta do servidor por meio de expressões regulares.
Essa técnica, hoje conhecida como “web scraping”, é frágil: com o tempo, a URL consultada ou a estrutura da página podem mudar, e a expressão regular que encontrava o resultado pode deixar de funcionar. É uma boa ideia guardar essas informações em um arquivo de configuração, mas isso nem sempre basta; além disso, os termos de uso de muitos sites a proíbem. Uma análise robusta de uma página HTML seria, na verdade, mais bem feita com uma biblioteca especializada, como a biblioteca Java jsoup (que pode ser usada como está a partir do Kotlin), do que com expressões regulares. No próximo capítulo, veremos que existem na web recursos mais estáveis, concebidos para uso por programas: os serviços web. Os serviços de tradução atuais, por exemplo, oferecem todos uma interface desse tipo, que aceita e retorna JSON.
12.7.4. Um cliente SMTP com Jakarta Mail
Um cliente SMTP é um cliente de um servidor SMTP, um servidor de envio de e-mails, cujo protocolo apresentamos na Parte 1. Nem o JDK nem a biblioteca padrão do Kotlin têm uma classe para e-mail. A biblioteca padrão de fato da JVM é o Jakarta Mail (antes JavaMail), cuja implementação de referência se chama agora Eclipse Angus Mail; um programa Kotlin a usa como qualquer outra biblioteca Java. Ela encapsula as exigências de um cliente de e-mail: o desenvolvedor não precisa conhecer os detalhes do protocolo SMTP nem do formato de mensagem MIME. Suas principais classes são [Session] (a configuração), [MimeMessage] (uma mensagem), [InternetAddress] (um endereço de e-mail), [MimeMultipart] e [MimeBodyPart] (uma mensagem com várias partes, como texto e anexos) e [Transport], que envia a mensagem. Ela também pode ler e-mails em POP3 e IMAP, e trata a autenticação e a criptografia (TLS) exigidas pelos servidores reais.
Não podemos enviar e-mail a um servidor SMTP real: nossa máquina de teste não tem acesso à Internet e, como mencionamos, os provedores de acesso bloqueiam a porta 25. O e-mail será enviado a um pequeno servidor de teste, escrito em Kotlin e executado na máquina local, que exibirá tudo o que receber e não encaminhará nada. Para uso real, existem servidores de teste completos, como o Mailpit ou o GreenMail (escrito em Java), que também oferecem uma interface para visualizar as mensagens recebidas.
12.7.4.1. Um servidor de teste SMTP
Nosso servidor SMTP segue a estrutura do servidor de eco da Parte 1: um laço que espera por clientes, uma thread virtual por cliente e encerramento limpo por Ctrl-C. O serviço prestado a cada cliente é o diálogo SMTP mínimo apresentado na Parte 1. O programa [Internet18.kt] é o seguinte:
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 33 34 35 36 37 38 39 40 41 42 43 44 45 46 47 48 49 50 51 52 53 54 55 56 57 58 59 60 61 62 63 64 65 66 67 68 69 70 71 72 73 74 75 76 77 78 79 80 81 82 83 84 85 86 87 88 89 90 91 92 93 94 95 96 97 98 99 100 101 102 103 104 105 106 107 108 109 110 111 112 113 114 115 116 117 118 119 120 121 122 123 124 125 126 127 128 129 130 131 132 133 134 135 136 137 138 139 140 141 142 143 144 145 146 147 148 149 150 151 152 153 154 155 156 | |
Comentaremos apenas o que é novo em relação ao servidor de eco:
- linha 25: o servidor escuta apenas no endereço de loopback; somente programas da mesma máquina podem se conectar a ele. O segundo parâmetro (50) é o tamanho da fila de conexões;
- Linhas 71–74: uma função local (Capítulo 3), declarada dentro de [serve], que envia uma linha de resposta ao cliente, terminada por \r\n como exige o SMTP, e a exibe no console, precedida de [S:]. As linhas recebidas do cliente são exibidas precedidas de [C:], como nos diálogos de exemplo da Parte 1. A função local tem acesso à variável [writer] da função que a contém. O programa Java usava aqui uma lambda e precisava declarar sua própria interface funcional, [Responder], porque as interfaces funcionais do JDK ([Consumer<String>]…) não permitem a exceção verificada [IOException] lançada por [write]; em Kotlin, que não tem exceções verificadas, esse contorno é desnecessário;
- linhas 68–69: os fluxos de leitura e escrita do socket, em UTF-8 (o conjunto de caracteres padrão de [bufferedReader] e de [writer]). Eles não precisam ser fechados separadamente: fechar o socket com [use] os fecha;
- linhas 77–78: o cabeçalho da mensagem atual: o remetente anunciado por [MAIL FROM], do tipo [String?] já que pode ainda não ter sido anunciado, e os destinatários anunciados por [RCPT TO];
- linha 80: a mensagem de boas-vindas: no SMTP, o servidor fala primeiro;
- linha 82: leitura de um comando; o operador Elvis sai do laço quando o cliente fechou a conexão ([readLine] passa então a [null]). O Kotlin não permite atribuição dentro de uma condição ([while ((command = reader.readLine()) != null)] em Java); esta forma a substitui;
- linhas 85–87: o verbo do comando é formado por seus quatro primeiros caracteres ([EHLO], [MAIL], [RCPT]…), em maiúsculas. [take(4)] retorna os quatro primeiros caracteres, ou a string inteira se ela for mais curta. A função Kotlin [uppercase] é independente do idioma da máquina (ela usa [Locale.ROOT]): em turco, a versão em maiúscula de [i] não é [I], e o programa Java precisava especificar [Locale.ROOT]. [substringAfter(':')] retorna o que vem depois da primeira ocorrência do caractere [:] ([MAIL FROM:<address>]), ou a string inteira se não houver nenhum;
- Linhas 89–93: a resposta a
*[EHLO]é composta de várias linhas. Nela, o servidor lista suas capacidades: o tamanho máximo da mensagem ([SIZE]) e o suporte a caracteres codificados em 8 bits ([8BITMIME]*); - linhas 107–109: o comando [DATA] é rejeitado se o remetente ou os destinatários não tiverem sido especificados; [continue] passa ao comando seguinte. A partir do Kotlin 1.4, [break] e [continue] podem ser usados sem rótulo dentro de um [when] colocado em um laço;
- linhas 111–128: a própria mensagem. O servidor convida o cliente a enviá-la (código 354), depois lê e exibe todas as linhas até uma linha reduzida a um único ponto, e confirma o recebimento (código 250). Se o cliente fechar a conexão antes do fim da mensagem, ela é descartada (linhas 121–123);
- linhas 138–140: o cliente terminou; o servidor responde e fecha a conexão, saindo da função: [return], definido dentro da lambda de [use], sai da própria [serve] (retorno não local, permitido porque [use] é uma função [inline]), e [use] fecha o socket;
- linha 142: qualquer outro comando é rejeitado;
- linhas 50–56: encerramento por Ctrl-C, como no servidor de eco: a função [thread] de [kotlin.concurrent] cria a thread que é executada quando a JVM termina, sem iniciá-la ([start = false]), e [addShutdownHook] a registra.
Este servidor não faz muitas verificações e não trata as extensões [STARTTLS] e [AUTH]: basta ver o que o Jakarta Mail envia.
12.7.4.2. O cliente SMTP
O programa [Internet19] pede ao usuário os dados do e-mail (remetente, destinatários, assunto, anexos, corpo) e depois o envia ao servidor SMTP especificado como argumento. Ele usa a biblioteca Jakarta Mail, declarada no arquivo [build.gradle.kts] do projeto com a seguinte linha:
A dependência [angus-mail] fornece a implementação e, por dependência transitiva, a API e as bibliotecas [jakarta.mail], e [jakarta.activation] que ela usa. O código usa apenas a API, encontrada nos pacotes [jakarta.mail] e [jakarta.mail.internet]. O programa [Internet19.kt] é o seguinte:
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 33 34 35 36 37 38 39 40 41 42 43 44 45 46 47 48 49 50 51 52 53 54 55 56 57 58 59 60 61 62 63 64 65 66 67 68 69 70 71 72 73 74 75 76 77 78 79 80 81 82 83 84 85 86 87 88 89 90 91 92 93 94 95 96 97 98 99 100 101 102 103 104 105 | |
Comentários:
- linhas 23–27: o programa espera dois argumentos: o servidor SMTP e sua porta (de um a cinco dígitos, validada por uma expressão regular). A atribuição por desestruturação da linha 27 atribui os dois primeiros elementos do array a duas variáveis;
- linhas 30–40: o conteúdo do e-mail é digitado com a função [input] (linhas 102–104), que exibe o rótulo por [print] (sem quebra de linha) e depois lê uma linha por vez com [readlnOrNull], [null] no fim dos dados. O texto da mensagem é composto de várias linhas, terminadas por uma linha em branco: [generateSequence] produz a sequência das linhas lidas, até o primeiro [null]; [takeWhile] para na primeira linha em branco, e [joinToString] combina as linhas, cada uma seguida de uma quebra de linha. Como a sequência é tardia (lazy), nenhuma linha é lida depois da linha em branco;
- Linhas 44–48: a sessão de mensagens. Sua configuração é um objeto [Properties]: aqui, a máquina e a porta do servidor SMTP. A função [apply] executa seu bloco com o objeto como receptor ([this]) e depois retorna o objeto; [this["key"] = value] chama o método [put] do dicionário. Para um servidor real, acrescentaríamos [mail.smtp.auth=true], [mail.smtp.starttls.enable=true] (criptografia por [STARTTLS]) e forneceríamos o nome de usuário e a senha a [Transport.send];
- linhas 51–56: a mensagem, configurada em um bloco [apply]:
- linha 52: o remetente, um objeto [InternetAddress]. O segundo parâmetro do construtor ([true]) exige uma análise estrita do endereço, e [validate], chamado por [also] antes de o endereço ser passado a [setFrom], verifica além disso que ele tem a forma [name@domain]; um endereço incorreto dispara uma [AddressException];
- linhas 53–55: os destinatários, os do campo “Cc” (Carbon Copy, cópia) e os do campo “Bcc” (Blind Carbon Copy, cópia oculta). Os destinatários do campo “Bcc” recebem a mensagem, mas os demais destinatários não sabem disso. A função [addresses] (linhas 95–96) analisa uma lista de endereços separados por vírgulas com [InternetAddress.parse] e verifica cada um com [onEach], que aplica uma ação a cada elemento e retorna o próprio array. Seu tipo de retorno, [Array<out InternetAddress>], é o tipo que o Kotlin atribui ao array Java retornado por [parse]: um array do qual se pode ler [InternetAddress] (variância, Capítulo 4), aceito por [setRecipients];
- linha 56: o assunto, junto com seu conjunto de caracteres;
- linhas 59–63: a mensagem é composta de várias partes ([MimeMultipart]). A primeira é o texto, em UTF-8. O cabeçalho [Content-Transfer-Encoding: 8bit] especifica que ele deve ser transmitido como está, em modo de 8 bits (o servidor indicou que aceita isso); sem ele, o Jakarta Mail escolheria sua própria codificação (quoted-printable ou base64), o que dificultaria a leitura do texto na exibição do servidor;
- Linhas 65–69: os anexos, identificados por seus caminhos de arquivo. [filter] exclui os nomes vazios, e [map] cria uma parte para cada arquivo, que adiciona à mensagem, e retorna seu nome: [names] é a lista dos nomes dos anexos. Um caminho relativo é relativo à pasta atual; em nossos testes, o arquivo [attachment.txt] fica na raiz do projeto [12-internet], que é a pasta atual para [gradlew run]. [attachFile] cria uma seção cujo conteúdo será lido do arquivo no momento do envio;
- linha 74: envio da mensagem com o método estático [Transport.send], que se conecta ao servidor especificado pela sessão, executa o diálogo SMTP e transmite a mensagem no formato MIME;
- linhas 77–82: um resumo da transmissão. A função de extensão [list] de [MimeMessage] (linha 99) combina os endereços de uma categoria de destinatários em uma string com [InternetAddress.toString]; ela permite escrever [message.list(RecipientType.TO)]. [message.subject] chama o método [getSubject];
- Linhas 83–89: um endereço inválido dispara uma [AddressException]; um erro de envio dispara outra, [MessagingException], e a causa é exibida. Um anexo ausente só é detectado no momento do envio: ele dispara uma [MessagingException], cuja causa é uma [FileNotFoundException]. Como o Kotlin não tem [catch] múltiplo, todas as exceções são capturadas aqui; depois, um [when] sobre a exceção separa as duas categorias tratadas ([is MessagingException, is IOException]); as demais são relançadas por [throw e]. Esta é uma alternativa aos dois blocos [catch] de [Internet17.kt], que evita repetir o tratamento.
O servidor de teste SMTP é iniciado em uma janela de comando na porta 27225 por [gradlew -q run -Pmain=internet18.Internet18Kt]. Em outra janela, a partir da pasta [12-internet], uma mensagem é enviada a dois destinatários, com um destinatário em cópia, um em cópia oculta e um anexo (a entrada do teclado aparece depois de cada rótulo):
O arquivo [attachment.txt] contém duas linhas de texto. Eis o que o servidor exibiu:
Comentários:
- linha 5: o Jakarta Mail se identifica com o nome da máquina local, neste caso [localhost];
- Linhas 9–18: o envelope da mensagem: o remetente, seguido de todos os destinatários, inclusive o destinatário em cópia oculta ([eve@example.com]). O envelope determina a quem a mensagem é entregue;
- linhas 21–29: os cabeçalhos da mensagem, que compõem o que os destinatários verão: a data, o remetente, os destinatários [To] e [Cc], um identificador único da mensagem ([Message-ID]), o assunto… O destinatário em cópia oculta não está listado aqui: é assim que ele permanece oculto. A linha de assunto contém um caractere acentuado; como os cabeçalhos só podem conter caracteres ASCII, ele foi codificado segundo a RFC 2047: [=?UTF-8?Q?...?=] significa “texto codificado em UTF-8 em quoted-printable”, com cada byte não ASCII escrito como [=XX] em hexadecimal ([=C3=A9] para os dois bytes de [é]) e cada espaço como [_];
- Linhas 28–29: a mensagem está no formato MIME (Multipurpose Internet Mail Extensions, RFC 2045 e seguintes): ela é composta de várias partes ([multipart/mixed]), separadas por uma linha delimitadora ([boundary]) escolhida aleatoriamente pelo Jakarta Mail. Um cabeçalho longo demais pode continuar na linha seguinte, desde que ela comece com um espaço ou uma tabulação (neste caso, uma tabulação);
- linhas 31–39: a primeira parte, o texto da mensagem, em UTF-8 de 8 bits: ele é legível como está;
- Linhas 40–47: a segunda parte, o anexo. O Jakarta Mail reconheceu um arquivo de texto ([text/plain]) contendo apenas caracteres ASCII ([charset=us-ascii]) e o transmitiu como está ([7bit]); se contivesse outros caracteres, como [è], ele o teria codificado em quoted-printable, que deixa os caracteres ASCII sem codificação e codifica os demais ([=C3=A8] para [è]). Um arquivo binário (uma imagem, por exemplo) teria sido codificado em Base64, que representa bytes arbitrários com 64 caracteres do conjunto ASCII. O cabeçalho [Content-Disposition: attachment] indica que se trata de um anexo e fornece seu nome;
- linhas 48–49: o delimitador de fechamento, seguido de dois hifens, e depois a linha reduzida a um único ponto que encerra a mensagem;
- linha 50: nosso servidor recebeu uma mensagem para quatro destinatários;
- linhas 52–53: o Jakarta Mail encerra a sessão;
- linha 55: o servidor foi interrompido com Ctrl-C após os testes.
Um endereço inválido é rejeitado antes de qualquer mensagem ser enviada:
Se o servidor SMTP não estiver disponível, uma [MailConnectException], uma variante de [MessagingException], é lançada; ela é causada pela [ConnectException] do socket:
12.8. Programação de rede assíncrona: dos canais NIO às threads virtuais
Com exceção das requisições [sendAsync] de [HttpClient], os programas deste capítulo usam operações de rede bloqueantes, executadas por threads (threads virtuais nos servidores). Essa não é a única maneira de fazer, e o leitor encontrará em códigos existentes, em Java ou em Kotlin, os outros dois modelos que o JDK propunha antes do Java 21.
O primeiro, introduzido no Java 1.4, é o modelo de E/S não bloqueante do pacote [java.nio.channels]. Um [SocketChannel] configurado em modo não bloqueante ([channel.configureBlocking(false)]) devolve imediatamente o controle, haja ou não dados a ler; um objeto [Selector] permite que uma única thread monitore um grande número de canais e seja acordada quando um deles estiver pronto (uma nova conexão a aceitar, dados a ler, espaço onde escrever). O programa executa então um único laço que, a cada despertar, trata os canais prontos. Os dados são lidos em blocos, em buffers de bytes ([ByteBuffer]): cabe ao programa reconstituir as linhas, já que uma linha pode ser dividida entre dois blocos, e acompanhar, para cada cliente, o estado atual de seu diálogo.
O segundo, introduzido no Java 7 (NIO.2), é o dos canais assíncronos: [AsynchronousSocketChannel] e [AsynchronousServerSocketChannel]. Cada operação é iniciada com um objeto de callback ([CompletionHandler]), cujo método [completed] é executado por uma thread de um pool ao fim da operação. A conexão de um cliente é assim escrita como [channel.connect(address, null, handler)], e o método [completed] do handler deve iniciar a leitura seguinte, cujo método [completed] iniciará a próxima, e assim por diante. O código é extenso, e a lógica do diálogo fica espalhada por vários métodos de callback.
Os dois modelos são eficientes: permitem que poucas threads tratem milhares de conexões. Mas são difíceis de programar e de depurar; são usados principalmente por meio de bibliotecas como o Netty, no qual se baseiam muitos servidores. As threads virtuais do Java 21 tornaram essas técnicas desnecessárias para a maioria das aplicações: uma thread virtual bloqueada em uma operação de rede não bloqueia nenhuma thread do sistema, e o código se lê na ordem em que é executado, exatamente como um código síncrono. O cliente TCP genérico ([Internet06.kt]) é um exemplo disso: uma thread virtual lê do teclado enquanto a thread principal lê da rede, com simples chamadas a [readLine].
Tenha em mente que a assincronia oferece pouco benefício a um cliente com uma única conexão: sua thread não tem nada a fazer além de esperar a resposta. Ela é, porém, essencial para um servidor: um servidor que atende seus clientes com threads de plataforma bloqueadas prende uma thread do sistema por cliente; com threads virtuais ou canais não bloqueantes, bastam algumas threads do sistema para atender um grande número de clientes. É o que faz o servidor da aplicação de exemplo a seguir.
12.8.1. E as corrotinas?
O Kotlin tem sua própria solução para a assincronia: as corrotinas, tratadas no Capítulo 9. Podemos escrever o servidor de eco com elas? Sim, mas é preciso entender os benefícios. Os métodos de *[Socket]* e de *[ServerSocket]* ([accept]*, [readLine]*…) são bloqueantes, não de suspensão: uma corrotina que os chama bloqueia a thread que a executa. Por isso, como toda E/S bloqueante, eles são executados no dispatcher [Dispatchers.IO] (Capítulo 9), cujas threads são projetadas para essa finalidade. O programa [Internet04Coroutines.kt] é a versão “corrotinas” do servidor de eco [Internet04.kt]:
O arquivo [build.gradle.kts] do projeto declara para isso a dependência [implementation("org.jetbrains.kotlinx:kotlinx-coroutines-core:1.11.0")] (Capítulo 9). Essencialmente, apenas a função [main] mudou:
- Linha 39: o laço de espera por clientes é executado em uma corrotina, criada por [runBlocking], que bloqueia a thread principal até que todas as corrotinas lançadas em seu bloco tenham terminado: é a concorrência estruturada descrita no Capítulo 9. Ela substitui o [ExecutorService] da versão anterior, que esperava o término de todos os serviços antes de encerrar;
- Linha 44: a espera bloqueante por um cliente é executada por uma thread de
[Dispatchers.IO]. A corrotina principal fica suspensa durante esse tempo e depois retoma com o*[Socket]*retornado por[accept]*. Se [accept] lançar uma exceção (fechamento do serviço de escuta com Ctrl-C), [withContext]* a relança na corrotina principal, onde é interceptada na linha 50; - linha 48: cada cliente é atendido por uma corrotina filha, lançada em [Dispatchers.IO]. A função [serve] é exatamente igual à do servidor de threads virtuais: código bloqueante comum;
- linhas 50–55: no encerramento, as conexões em andamento são fechadas, como antes. Isso é essencial: o encerramento de corrotinas é cooperativo (Capítulo 9), e uma corrotina bloqueada em [readLine] nunca o perceberia. Fechar o socket faz a operação de leitura falhar, e a corrotina termina; [runBlocking] devolve então o controle;
- linha 77: o log mostra o nome da thread que executa o serviço.
O servidor está em execução na porta 27100; o cliente A envia duas linhas e depois digita [bye], o cliente B envia uma linha, e então o servidor é interrompido com Ctrl-C:
Na janela do cliente B, que digitou sua segunda linha depois que o servidor foi interrompido:
O comportamento é o de [Internet04.kt]. As linhas 3 e 6 do log mostram que os dois serviços são executados por threads do pool [DefaultDispatcher-worker-N], que [Dispatchers.IO] compartilha com [Dispatchers.Default]. E essa é a principal limitação desta versão: cada cliente conectado prende uma thread de plataforma, bloqueada em [readLine]. [Dispatchers.IO] tem apenas 64 por padrão: o 65º cliente (e) teria de esperar que um dos 64 primeiros se desconectasse. Poderíamos aumentar esse limite ([Dispatchers.IO.limitedParallelism(1000)]), mas isso nos faria voltar ao modelo “uma thread do sistema por cliente”. A solução, como vimos no Capítulo 9, é executar as corrotinas bloqueantes em um dispatcher cujas threads sejam virtuais: [Executors.newVirtualThreadPerTaskExecutor().asCoroutineDispatcher()]. O resultado é exatamente o mesmo servidor que [Internet04.kt], com a concorrência estruturada acrescentada.
Para que uma corrotina seja realmente suspensa — e não bloqueada — durante uma operação de rede, é necessária uma biblioteca cujas operações de E/S sejam funções [suspend], construídas sobre os canais não bloqueantes do NIO. É isso que, por exemplo, o módulo de rede do Ktor (o framework web da JetBrains) oferece, com sockets que permitem leituras suspensas linha a linha. Para um servidor como o nosso, que faz E/S bloqueante, as threads virtuais continuam sendo a solução mais simples; as corrotinas tornam-se particularmente úteis quando a aplicação já as utiliza (um cliente [HttpClient] com [sendAsync(...).await()], um aplicativo Android, um servidor Ktor etc.).
12.9. Aplicação de exemplo, versão 8: servidor de cálculo de imposto
12.9.1. A arquitetura da nova versão
Vamos retomar a aplicação de cálculo de imposto. Na versão 5 (Capítulo 6), ela era composta de três camadas, cada uma em seu próprio subprojeto Gradle: [dao] (as faixas de imposto), [business] (o cálculo) e [ui] (o diálogo no console), montadas pelo contêiner de injeção de dependência do Spring; as versões 6 e 7 substituíram a camada [dao] por um acesso a banco de dados. Partiremos da versão 5, mais simples de executar: a nova versão funcionaria da mesma forma com a camada [dao] das versões 6 e 7.
Implantaremos essa arquitetura em duas máquinas:
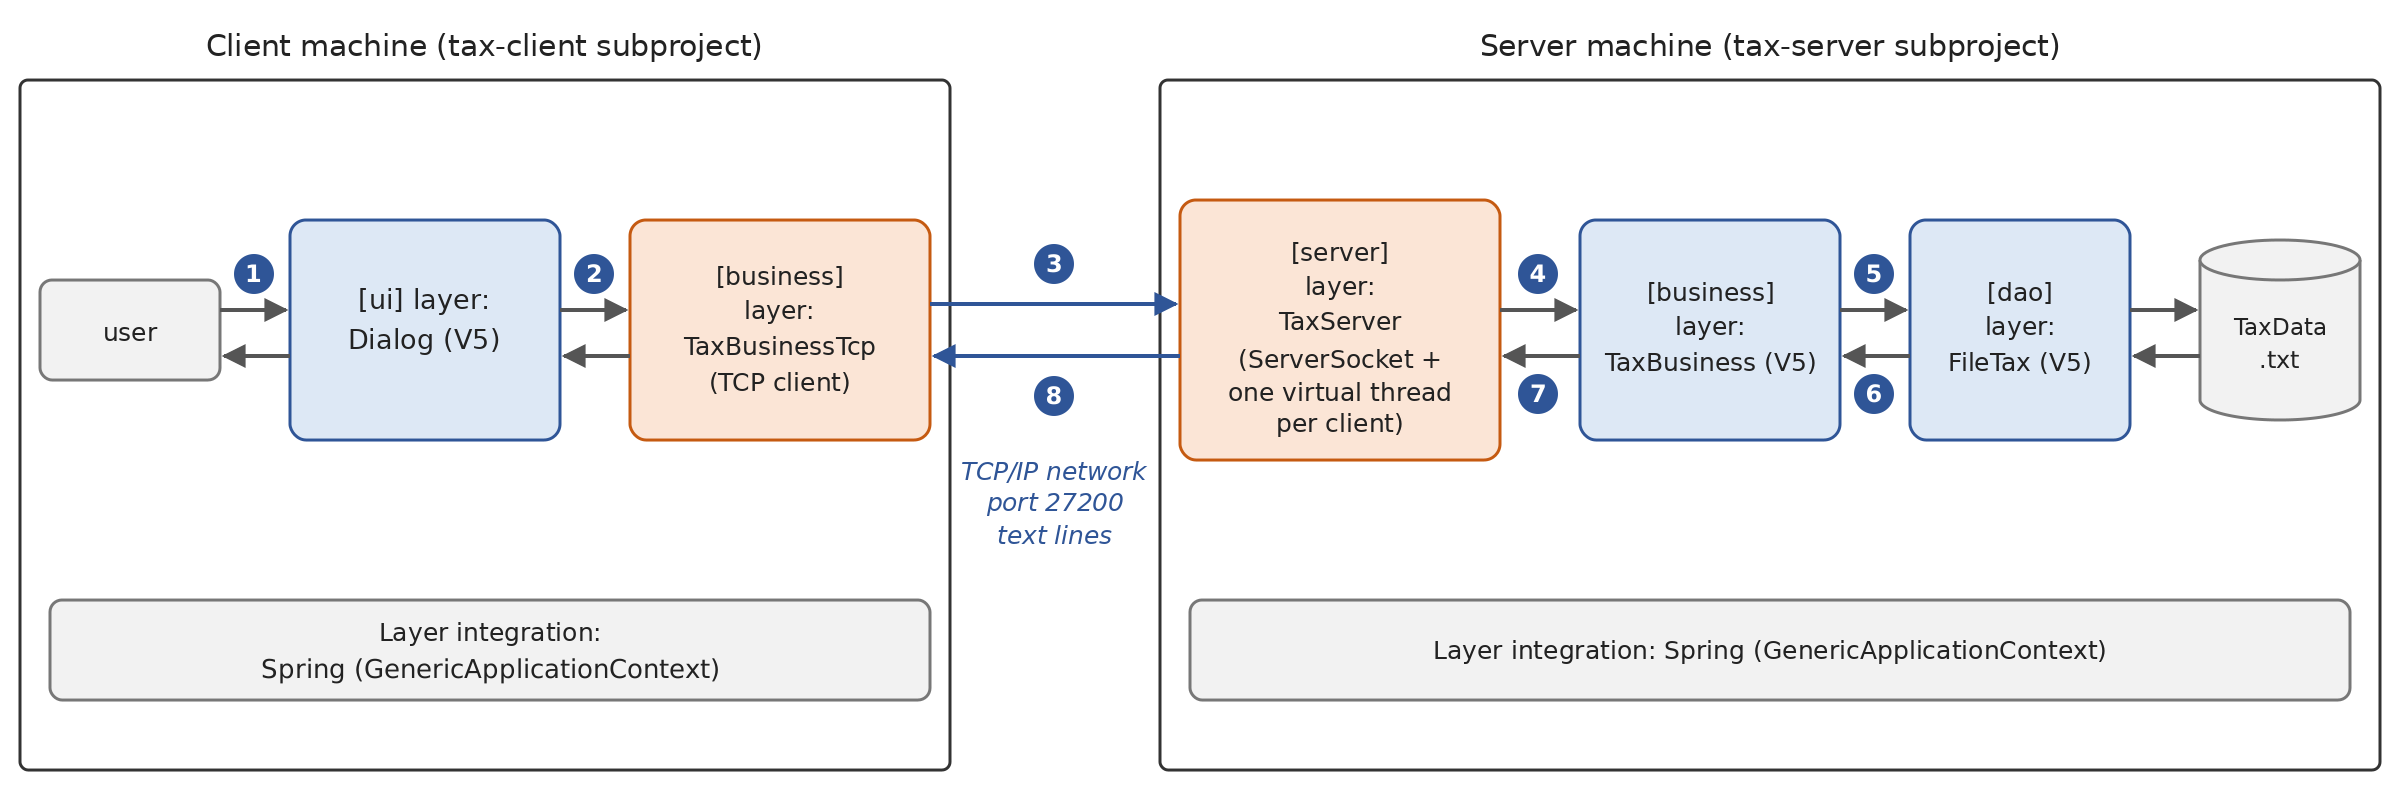
- Uma máquina [server] hospeda as camadas [business] e [dao] da versão 5. Uma camada chamada [server] é construída para permitir que clientes na rede consultem o serviço de cálculo de imposto por meio de um protocolo textual chamado TCP;
- uma máquina chamada [client] hospeda a camada [ui] da versão 5. Uma nova camada, [business] — que atua como cliente da camada TCP do servidor — permite consultar o serviço de cálculo de imposto no servidor.
A arquitetura passa por uma grande mudança: a versão 5 era uma aplicação monousuário; a versão 8 torna-se uma aplicação cliente/servidor, e o servidor poderá atender vários clientes simultaneamente. No entanto, escreveremos apenas duas novas classes, [TaxServer] e [TaxBusinessTcp] — uma para os dados de opções —e dois programas principais; todo o resto é reutilizado sem modificação.
A aplicação [TaxV8] é composta de dois subprojetos Gradle dentro do projeto [12-internet], que usam os subprojetos da versão 5 por meio de um composite build, assim como as versões 6 e 7 (Capítulos 10 e 11):
O arquivo [settings.gradle.kts] do projeto [12-internet] é o seguinte:
- Linhas 1–4: o plugin que permite ao Gradle baixar o próprio JDK 25 caso não o encontre na máquina (Capítulo 2);
- linha 6: o nome do projeto raiz, que é o projeto [InternetNN];
- linha 9: os dois subprojetos da versão 8, identificados por seus caminhos: [TaxV8:tax-server] é a pasta [TaxV8/tax-server]. A pasta intermediária [TaxV8], que não tem arquivo de build, é um projeto implícito;
- linha 12: o composite build. O build do Capítulo 6 é incluído neste: uma dependência declarada por suas coordenadas, como [examples.tax:tax-business:5.0], é satisfeita pelo subprojeto do build incluído que tem essas coordenadas ([group], nome, [version]), compilado conforme necessário. Não há nada para instalar previamente: este é o equivalente mais simples do [mvn install] exigido pela versão Maven do curso de Java.
O projeto raiz ([12-internet/build.gradle.kts]) aplica o plugin [kotlin("jvm") version "2.4.20"]: sua versão vale para os subprojetos, que usam o plugin sem especificar a versão novamente.
12.9.2. O protocolo de comunicação
Uma vez conectado o cliente, o servidor envia-lhe uma mensagem de boas-vindas e depois aceita os comandos a seguir, um por linha, sem distinção entre maiúsculas e minúsculas:
Comando | Resposta do servidor |
help | a lista dos comandos aceitos, em quatro linhas |
tax married nbChildren annualSalary | o imposto de uma pessoa casada (married é [y]) ou solteira ([n]) com [nbChildren] filhos e salário anual de [annualSalary] euros, por exemplo, [4282] em resposta a [tax y 2 60000]; ou uma mensagem de erro, em uma linha |
goodbye | a mensagem [Goodbye...]; em seguida, o servidor fecha a conexão |
Qualquer outro comando recebe a resposta [Command not recognized. Use the help command.]
12.9.3. O servidor de cálculo de imposto
12.9.3.1. O subprojeto
O arquivo [build.gradle.kts] do subprojeto [tax-server] é o seguinte:
- linha 4: o plugin Kotlin, sem versão — esta é fornecida pelo projeto raiz;
- linha 5: o plugin de aplicações, que fornece a tarefa [run];
- linhas 8–9: as coordenadas do subprojeto, para a versão 8.0 da aplicação;
- linha 18: a camada [business] da versão 5, identificada por suas coordenadas e fornecida pelo composite build. Ela declara a camada [dao] em sua API (configuração [api], Capítulo 6): o servidor também tem, portanto, acesso às classes de [tax-dao] ([ITaxDao], [FileTax]…), sem precisar declará-la;
- Linha 20: o contêiner de injeção de dependência do Spring. O plugin [kotlin("plugin.spring")] não é necessário: como no programa [Main.kt] da versão 5, os objetos são registrados no contêiner por código, sem anotações, e o Spring não precisa criar subclasses de nossas classes, que podem permanecer final;
- linhas 23–27: a configuração comum do compilador (JDK 25, avisos tratados como erros, nomes de parâmetros preservados);
- Linha 33: a classe principal executada por [gradlew -q :TaxV8:tax-server:run]. A tarefa [run] executa o programa na pasta do subprojeto: como na versão 5, o programa lê sua configuração e o arquivo de faixas de imposto na pasta atual, onde estão os arquivos [server.properties] e [TaxData.txt];
- Linhas 36–39: os programas iniciados pelo Gradle escrevem sua saída em UTF-8 para que os caracteres acentuados sejam exibidos corretamente no Windows (Capítulo 2).
O arquivo de configuração [server.properties]:
- linhas 3–4: a configuração da camada [dao], idêntica à da versão 5: as faixas de imposto são lidas do arquivo de texto [TaxData.txt];
- linhas 6–7: a porta de escuta do servidor e o eco do diálogo com os clientes no log do servidor. Em vez de um console de administração (com comandos como [start], [stop], [echo]…), optamos por um arquivo de configuração e pelo encerramento com Ctrl-C, que são mais simples e mais condizentes com o funcionamento dos servidores modernos.
12.9.3.2. O programa principal
As opções do servidor formam uma data class:
O arquivo [Main.kt] do servidor é o seguinte:
Reconhecemos o programa principal da versão 5:
- linhas 23–28: leitura da configuração. Os valores são strings: a porta e o eco são convertidos por [toInt] e [toBoolean], com valores padrão fornecidos;
- linhas 31–42: as camadas [dao] e [business] são registradas no contêiner exatamente como na versão 5, com as funções de extensão [registerBean] que o Spring fornece para Kotlin;
- linhas 45–46: a novidade. As opções do servidor (porta, eco) são registradas como uma função que as constrói; o tipo do bean, [ServerOptions], é inferido a partir do tipo retornado pela lambda. Em seguida vem a própria camada [server]. O construtor de
*[TaxServer]espera um*[ITaxBusiness]e um*[ServerOptions]*: o contêiner os fornecerá; - Linha 49: a inicialização do contêiner cria o servidor, o que provoca a criação da camada [business], que por sua vez provoca a criação da camada [dao]; é nesse momento que o arquivo [TaxData.txt] é lido. Um erro (arquivo ausente ou malformado) é exibido e o programa termina (linhas 51–57). [try] é uma expressão cujo valor — o de sua última expressão, [context.getBean<TaxServer>()] — inicializa [val server]; o bloco [catch] não retorna valor: [exitProcess] é do tipo [Nothing], e o compilador sabe que ela nunca retorna. A cadeia de exceções é percorrida por [generateSequence<Throwable>(e) { it.cause \}]: o tipo [Throwable] é especificado porque a sequência começa com uma [Exception], mas as causas são [Throwable];
- linhas 61–64: Ctrl-C aciona um stop hook que pede a parada do servidor e depois espera o término da thread principal, como no servidor de eco;
- linha 67: o servidor funciona até receber a ordem de parar.
12.9.3.3. A camada [server]
A classe [TaxServer] é a seguinte:
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 33 34 35 36 37 38 39 40 41 42 43 44 45 46 47 48 49 50 51 52 53 54 55 56 57 58 59 60 61 62 63 64 65 66 67 68 69 70 71 72 73 74 75 76 77 78 79 80 81 82 83 84 85 86 87 88 89 90 91 92 93 94 95 96 97 98 99 100 101 102 103 104 105 106 107 108 109 110 111 112 113 114 115 116 117 118 119 120 121 122 123 124 125 126 127 128 129 130 131 132 133 134 135 136 137 138 139 140 141 142 143 144 145 146 147 148 | |
- linha 15: a classe recebe a camada [business] e suas opções por meio de seu construtor primário, que as converte diretamente em propriedades privadas. Ela conhece apenas a interface [ITaxBusiness] da camada [business] e nada sabe sobre a camada [dao];
- Linhas 19–23: o serviço de escuta, mantido em uma propriedade para que a função [stop] possa fechá-lo ([null] até que o servidor tenha iniciado), as conexões atuais e o indicador de encerramento. [listener] e [stopping] são modificados e lidos por threads diferentes: são anotados com [@Volatile];
- linhas 26–55: o laço de espera por clientes. É o laço do servidor de eco: cada cliente é atendido por uma thread virtual que não é aguardada (linha 41); o fechamento do serviço de escuta encerra a espera por um cliente (linha 37); em seguida fechamos as conexões atuais (linha 48) e esperamos o término dos serviços antes de encerrar (fechamento do [ExecutorService] ao sair de seu bloco [use]). Nenhuma thread de sistema fica bloqueada por um cliente lento;
- linha 31: o parâmetro [listener] da função lambda [use] oculta a propriedade de mesmo nome: [this.listener] refere-se à propriedade;
- Linhas 59–62: a função [stop], chamada pelo stop hook em outra thread. A chamada segura [listener?.close()] não faz nada se o serviço de escuta ainda não existe; onde o Java testava [listener != null] e interceptava a verificada [IOException] lançada por [close], agora basta uma única linha;
- linhas 66–108: o serviço prestado a um cliente:
- linhas 74–76: uma função local, definida dentro do bloco [use], que envia uma resposta ao cliente e também a escreve no log se o eco estiver ativado. Ela tem acesso às variáveis do bloco que a envolve ([writer], [clientNum]). O programa em Java usava uma lambda do tipo [Consumer<String>], chamada por [write.accept(...)]; a função local é chamada como qualquer outra função;
- linha 80: assim que o cliente se conecta, o servidor lhe envia uma mensagem de boas-vindas;
- linha 83: o laço de leitura de comandos, que termina se o cliente fechar a conexão ([null]) ou se o servidor for encerrado (exceção);
- linha 86: o comando, sem os espaços no início e no fim e convertido para minúsculas, é decomposto em campos. A expressão regular [\s+] (um ou mais espaços) evita campos vazios causados por vários espaços consecutivos;
- linhas 87–89: o comando é composto apenas da palavra [goodbye]; o operador [==] compara o conteúdo das duas listas. O servidor responde e sai do laço: a conexão é fechada ao sair do bloco [use];
- linhas 92–95: uma expressão [when] escolhe a resposta com base no primeiro campo: [help] sozinho, um comando começando por [tax], ou qualquer outro comando. Uma linha vazia, decomposta em um único campo vazio, recebe a resposta [Command not recognized];
- linhas 113–125: cálculo do imposto:
- linhas 115–118: o comando deve ter quatro campos, sendo o segundo [o] ou [n] e os dois últimos números inteiros. [getOrNull(2)?.toIntOrNull()] retorna [null] se o campo estiver ausente ou não for um inteiro ([toIntOrNull] também retorna [null] se o número for grande demais para um [Int]): ao contrário do Java, não é preciso validar antes o formato com uma expressão regular para garantir que a conversão não falhe. Depois do teste, [nbChildren] e [salary] são instâncias não anuláveis de [Int] (smart cast);
- linha 122: o cálculo é solicitado à camada [business]. Uma única instância de [TaxBusiness] atende todos os clientes — potencialmente de forma simultânea — a partir de threads diferentes: isso é possível porque essa classe não modifica nenhum dado depois de construída (sua lista de faixas é somente leitura);
- Linhas 123–125: se a camada [business] lançar uma exceção (por exemplo, uma [IllegalArgumentException] lançada por [require] devido a um número negativo de filhos), sua mensagem é devolvida ao cliente. Essa mensagem pode conter quebras de linha: elas são substituídas por espaços ([\R] designa qualquer quebra de linha), pois o protocolo exige uma resposta de uma única linha. A mensagem de uma exceção é do tipo [String?]; caso contrário, devolve-se a descrição da exceção;
- linhas 129–146: as constantes da classe, em um companion object privado (os campos [private static final] do Java). As strings conhecidas em tempo de compilação são [const val]. A resposta ao comando [help], escrita como string bruta com a indentação removida por [trimIndent], contém quebras de linha: será recebida pelo cliente como quatro linhas. As expressões regulares, compiladas uma única vez, são strings brutas, nas quais [\s] e [\R] são escritos sem duplicar a barra invertida;
- Linha 146: o log do servidor no console: cada linha é precedida da hora, o que permite ver a sequência dos serviços concorrentes. [println] pode ser chamado sem cuidados especiais a partir de várias threads: suas escritas não entram em conflito.
12.9.4. O cliente do servidor de cálculo de imposto
O cliente usa a interface de console da versão 5 — o objeto [tax.ui.Dialog] — sem modificá-la.
12.9.4.1. A camada [business] do cliente
A camada [ui] se comunica com uma camada [business], da qual conhece apenas a interface [ITaxBusiness] da versão 5, reduzida a uma única função: [fun calculateTax(married: Boolean, nbChildren: Int, salary: Int): Int].
Basta, portanto, fornecer-lhe outra implementação dessa interface que, em vez de calcular o imposto, o solicite ao servidor. É a classe [TaxBusinessTcp]:
- Linha 11: a classe implementa [ITaxBusiness]. Ela implementa também [AutoCloseable]: mantém uma conexão de rede, que precisará ser fechada. Os parâmetros de seu construtor primário, [machine] e [port], não são propriedades (não são [val] nem [var]): servem apenas para a inicialização;
- Linhas 13–19: a conexão com o servidor e seus fluxos de leitura e escrita, inicializados na ordem em que são declarados. Abrimos uma única conexão, usada para todos os cálculos de uma sessão, em vez de uma conexão por cálculo: é mais eficiente, e o servidor enxerga um cliente por sessão de usuário. Um erro de conexão é encapsulado em uma [TaxException], a exceção da aplicação, com o código 21;
- linhas 21–27: o bloco [init], executado depois que as propriedades anteriores foram inicializadas, lê a mensagem de boas-vindas do servidor. Se essa leitura falhar, a conexão é fechada e o erro é informado como erro de conexão;
- linhas 32–40: cálculo do imposto. O comando [tax y 2 60000] é enviado ao servidor (linha 34) e sua resposta é lida; [try] é uma expressão que devolve essa resposta. Se for um inteiro, é o imposto; caso contrário, é uma mensagem de erro do servidor, que é repassada em uma [TaxException]: o operador Elvis lança a exceção quando [toIntOrNull] resulta em [null] ([throw] é uma expressão do tipo [Nothing]). O código 23 é passado por um argumento nomeado, pois a exceção não tem causa;
- linhas 44–45: [readLine] retorna [null] quando o servidor fechou a conexão: uma [TaxException] é então lançada;
- linhas 48–55: o fim da conexão. O cliente se despede do servidor com o comando [goodbye], lê sua resposta e depois fecha a conexão (bloco [client.use]). Se o servidor já tiver encerrado a conexão, a [IOException] resultante é ignorada.
Esta classe usa os métodos bloqueantes de [Socket], como todos os clientes deste capítulo: a interface [ITaxBusiness] da versão 5 é síncrona ([calculateTax] devolve um [Int]; não é uma função [suspend]), e para um programa de console que atende um único usuário isso é perfeitamente adequado: a thread principal não tem nada a fazer senão esperar a resposta. Se vários cálculos precisassem ser feitos em paralelo, chamaríamos [calculateTax] a partir de várias threads virtuais, ou de corrotinas em [Dispatchers.IO] (com uma conexão por thread ou por corrotina, já que [TaxBusinessTcp] não foi projetada para ser usada por várias threads ao mesmo tempo).
12.9.4.2. O programa principal do cliente
O subprojeto [tax-client] depende da camada [business] e da camada [ui] da versão 5:
- linhas 17–18: a interface da camada [business] e a camada [ui] da versão 5, fornecidas pelo composite build;
- linha 20: o contêiner Spring;
- linhas 36–38: o programa iniciado por [gradlew run] precisa poder ler o teclado;
- linhas 41–44: os programas iniciados pelo Gradle escrevem sua saída em UTF-8 para que os caracteres acentuados sejam exibidos corretamente no Windows (Capítulo 2).
O subprojeto [tax-ui] da versão 5 contém uma aplicação (seu arquivo [Main.kt]); no entanto, ele pode ser usado como biblioteca por seu objeto público [tax.ui.Dialog]. O arquivo [Main.kt] do cliente é o seguinte:
- linhas 12–13: a máquina e a porta do servidor, passadas como argumentos, com valores padrão: [args.getOrElse(0) { "localhost" \}] retorna o primeiro argumento se ele existir; caso contrário, o valor da lambda;
- linha 18: o contêiner Spring é fechado ao sair do bloco [use] (ele é [AutoCloseable]). Quando é fechado, ao final do programa, chama o método [close] dos objetos [AutoCloseable] que criou: a conexão de [TaxBusinessTcp] será fechada corretamente;
- linha 20: a camada [business] armazenada no contêiner passa a ser [TaxBusinessTcp]. Como seu construtor espera dois parâmetros que o contêiner desconhece, é fornecida uma função de criação; o tipo do bean é especificado explicitamente como [ITaxBusiness], porque a camada [ui] o solicita com esse tipo;
- linha 22: quando o contêiner é iniciado, ele cria a camada [business], conectando-se assim ao servidor;
- linha 26: o diálogo da versão 5, inalterado. A camada [ui] ignora que o imposto é calculado por um servidor remoto;
- linhas 28–30: um erro de conexão ou de comunicação é exibido pela função [displayError] da versão 5.
12.9.5. Execuções
O servidor é iniciado em uma janela de comando, a partir da pasta [12-internet], com [gradlew -q :TaxV8:tax-server:run]; o Gradle compila os subprojetos da versão 5 conforme necessário, graças ao composite build. Em outra janela, o cliente é iniciado, também a partir da pasta [12-internet]. Como antes, as entradas do usuário foram enviadas por redirecionamento da entrada padrão e depois reinseridas após as perguntas:
O diálogo é exatamente o mesmo da versão 5: inclui os valores de validação (4282 e 2959 para uma pessoa casada com 2 ou 3 filhos e salário de 60.000 euros, 11519 para uma pessoa solteira sem filhos) e as mesmas mensagens de erro para entradas incorretas. Essas mensagens são geradas pela camada [ui] do cliente, que valida a entrada antes de solicitar o cálculo: entradas incorretas nunca chegam ao servidor.
Vamos agora iniciar dois clientes, A e B, em duas janelas, com B começando enquanto A ainda está conectado. Cada um faz dois cálculos. Na janela do cliente A:
Na janela do cliente B:
Para ver as respostas do servidor a comandos incorretos, é preciso um cliente que envie os comandos exatamente como são digitados: o cliente TCP genérico ([Internet06.kt]) funciona perfeitamente. O servidor fala primeiro, o que esse cliente sabe tratar:
- Linha 3: a mensagem de boas-vindas, exibida imediatamente após a conexão;
- linhas 5–8: a resposta ao comando [help], em quatro linhas;
- linhas 11–12: a caixa (maiúsculas ou minúsculas) do comando é ignorada;
- linhas 13–16: dois comandos de cálculo malformados;
- linhas 17–18: o comando está bem formado, mas a camada [business] rejeita um número negativo de filhos; a mensagem da exceção foi devolvida;
- linhas 19–20: um comando desconhecido;
- linhas 21–23: após o comando [goodbye], o servidor fechou a conexão e o cliente encerrou por conta própria.
Em seguida, o servidor é encerrado por Ctrl-C (enviado diretamente ao processo do servidor; veja a nota sobre o servidor de eco), enquanto um último cliente ainda está conectado. Esse cliente fez um primeiro cálculo antes do encerramento e envia sua segunda solicitação depois:
A leitura da resposta produziu [null]: a camada [business] gerou uma [TaxException], que o programa principal exibiu. Com o servidor parado, um novo cliente não consegue mais se conectar:
O construtor de [TaxBusinessTcp] lançou uma [TaxException], causada pela [ConnectException] do socket. Como foi chamado pelo contêiner Spring durante a inicialização, o contêiner a encapsulou em uma [BeanCreationException], no topo da cadeia de exceções. As duas primeiras linhas são um aviso escrito pelo Spring em seu log (na saída de erro, no formato padrão de log do Java): a inicialização do contêiner falhou.
Por fim, eis o log do servidor para todos esses testes:
- Linhas 3–13: o cliente da primeira execução. Com o comando echo, vemos todos os comandos recebidos e todas as respostas enviadas. Observe o comando [goodbye] (linha 11), enviado pela função [close] de [TaxBusinessTcp] quando o contêiner Spring foi encerrado: a sessão foi fechada corretamente;
- linhas 14–31: os clientes A (cliente 1) e B (cliente 2). O cliente 2 chegou (linha 18) enquanto o cliente 1 ainda estava sendo atendido, e suas solicitações foram processadas de forma alternada, conforme chegavam: o servidor realmente atende vários clientes simultaneamente;
- linhas 32–53: a sessão do cliente TCP genérico;
- linhas 54–61: o último cliente, atendido no momento do encerramento. O Ctrl-C fechou o serviço de escuta, o que encerrou a espera por um novo cliente; o servidor fechou a conexão do cliente 4, cuja thread de serviço — que aguardava um comando — terminou, e então o servidor foi encerrado.
12.9.6. Conclusão
Mais uma vez, conseguimos reutilizar código existente sem modificá-lo: as camadas [dao] e [business] da versão 5 no lado do servidor e a camada [ui] no lado do cliente, usadas como bibliotecas graças ao composite build do Gradle. Isso foi possível pelo uso sistemático de interfaces e de injeção de dependência: para implantar a aplicação em duas máquinas, bastou acrescentar uma camada [server] sobre a camada [business] e fornecer à camada [ui] uma implementação diferente de [ITaxBusiness]. Se a versão 1 tivesse reunido o cálculo do imposto e a interação com o usuário no mesmo programa, nada disso seria reutilizável. Observe que a camada [ui] não sabe que um servidor remoto calcula o valor do imposto.
Nosso protocolo caseiro tem, no entanto, seus limites: precisamos escrever o servidor, gerenciar as conexões, analisar os comandos, converter as respostas, e um cliente escrito em outra linguagem precisaria conhecer esse protocolo específico. A versão 9, no próximo capítulo, substituirá o servidor TCP por um serviço web: o protocolo será o HTTP, os dados serão trocados em JSON e o cliente usará [HttpClient].
12.10. Conclusão
Este capítulo apresentou a programação para a Internet em Kotlin, partindo dos fundamentos e avançando até as classes de alto nível. O Kotlin não tem uma biblioteca de rede própria em sua biblioteca padrão: ele usa diretamente as classes do JDK ([java.net], [java.net.http]), às quais acrescenta suas funções de extensão ([use], [bufferedReader], [lineSequence]…), a segurança em relação a [null], e a ausência de exceções verificadas:
- a primeira parte revisou o funcionamento dos protocolos da Internet (IP, TCP, UDP, DNS) e dos protocolos de aplicação textuais (HTTP, SMTP, POP, FTP), depois apresentou as classes [InetAddress] e [NetworkInterface], e as classes [Socket] e [ServerSocket]. Com elas, e com uma thread virtual por cliente, escrevemos servidores que atendem vários clientes simultaneamente, um cliente e um servidor genéricos (TCP) e clientes web que se comunicavam em HTTP “manualmente”;
- a segunda parte apresentou as classes especializadas em um protocolo. Para o HTTP, a classe [HttpClient] do Java 11 substitui [URL] e [HttpURLConnection]: ela realiza com poucas instruções o que nosso cliente TCP fazia em dezenas de linhas de código; trata redirecionamentos, formulários, timeouts, cancelamentos e requisições assíncronas, e foi projetada para ser reutilizada entre requisições; quando usada com o Jackson, troca objetos no formato JSON. Para o SMTP, a biblioteca Jakarta Mail constrói as mensagens MIME e cuida da comunicação com o servidor;
- A aplicação de exemplo tornou-se uma aplicação cliente/servidor sem nenhuma alteração em suas camadas existentes.
As threads virtuais, vistas no Capítulo 8, encontraram aqui sua principal aplicação: um servidor atende um grande número de clientes com apenas algumas threads de sistema, mantendo a estrutura de código simples de uma thread por cliente. As corrotinas do Capítulo 9 se integram sem atrito, desde que nenhuma operação de rede bloqueante seja executada em outro lugar que não um dispatcher concebido para isso. No entanto, escrever um servidor TCP e inventar seu próprio protocolo continua sendo exceção: a maioria das aplicações distribuídas hoje se comunica por HTTP, com serviços web que trocam dados JSON. Esse é o assunto do próximo capítulo.