5. Classes Kotlin de uso frequente
Apresentamos aqui algumas classes e funções de uso frequente: strings, arrays, coleções, arquivos e expressões regulares. O Kotlin oferece duas bibliotecas para isso: a sua própria biblioteca padrão (pacotes [kotlin.text], [kotlin.collections], [kotlin.io]…), que acrescenta centenas de funções aos tipos básicos — a maioria na forma de funções de extensão (Capítulo 4) — e o JDK (a API Java SE), que o Kotlin usa diretamente, sem nenhuma adaptação. A isso somamos as operações funcionais sobre coleções ([filter], [map], [groupBy]…) e as sequências, que são a maneira padrão em Kotlin de pesquisar, ordenar, agrupar ou transformar os elementos de uma coleção: elas têm o mesmo propósito da API Stream do Java. Anteriormente, mostramos como encontrar informações sobre os milhares de classes e funções disponíveis. Esse recurso é indispensável para os desenvolvedores Kotlin, mesmo os experientes.
Os exemplos deste capítulo, exceto a aplicação de exemplo no final, são programas de arquivo único, organizados como no Capítulo 3 dentro do projeto Gradle [05-classes-kotlin] do código do curso: o programa [Strings01.kt] está no pacote [strings01] (pasta [src/main/kotlin/strings01]) e pode ser executado com o comando [gradlew -q run -Pmain=strings01.Strings01Kt] ou clicando no triângulo verde no IntelliJ ou no IDEA. Diferentemente dos capítulos anteriores, eles são executados em uma máquina configurada para o inglês (locale inglês). Observe que todo arquivo Kotlin importa automaticamente os pacotes [kotlin.*], [kotlin.text.*], [kotlin.collections.*], [kotlin.ranges.*], [kotlin.sequences.*], [kotlin.io.*]… bem como [java.lang.*]: as funções da biblioteca padrão podem, portanto, ser usadas sem a instrução [import]. No entanto, as classes dos demais pacotes do JDK ([java.util], [java.text], [java.time], [java.nio.file]…) precisam ser importadas, ao passo que no curso de Java isso era tratado pelos arquivos-fonte compactos.
5.1. Buscando ajuda sobre as classes Kotlin
A biblioteca padrão do Kotlin contém vários milhares de funções, e um programa Kotlin para a JVM também tem acesso às mais de 4.000 classes públicas do JDK. Ninguém as conhece todas: os desenvolvedores Kotlin consultam constantemente a documentação. Essa documentação está disponível on-line, gratuitamente, e é mantida atualizada para cada versão.
5.1.1. Documentação on-line
O ponto de partida é o site kotlinlang.org da JetBrains. Lá você encontrará:
- a referência da biblioteca padrão: https://kotlinlang.org/api/core/kotlin-stdlib/. Ela descreve, pacote por pacote ([kotlin.text], [kotlin.collections], [kotlin.io]…), todas as classes, interfaces e funções da biblioteca — inclusive as funções de extensão — classificadas pelo tipo que estendem: a página de [String] lista, assim, tanto os seus membros ([length], [get]…) quanto as dezenas de funções de extensão que se aplicam a ela ([substringBefore], [padStart], [lines]…);
- uma caixa de pesquisa no topo de cada página, na qual você pode digitar o nome de uma classe ou função ([buildString], [joinToString]…);
- a documentação da linguagem (Language Guide), com páginas sobre strings, coleções, sequências e mais, além de uma página “What’s New” que descreve os novos recursos de cada versão. As mudanças na linguagem são discutidas publicamente na forma de propostas, o KEEP (Kotlin Evolution and Enhancement Process), disponível em github.com/Kotlin/KEEP;
- play.kotlinlang.org, o “playground” do Kotlin: nele você pode digitar e executar um programa no navegador sem instalar nada.
Para as classes do JDK usadas por um programa Kotlin ([java.time.LocalDate], [java.text.Collator], [java.nio.file.Files]…), a referência continua sendo a da API Java SE 25: https://docs.oracle.com/en/java/javase/25/docs/api/. Ela descreve as classes usando a sintaxe Java, que deve ser convertida: um [int] é um [Int], um [String[]] é um [Array<String>], um método [getName()] é usado como uma propriedade [name]…
A página de uma classe ou função, por exemplo kotlin.String, fornece:
- o pacote da classe e as plataformas em que ela existe (o Kotlin também roda em JavaScript e em código nativo: algumas funções são específicas da JVM);
- sua declaração, seus tipos pai e as interfaces que ela implementa;
- uma descrição geral, muitas vezes acompanhada de exemplos executáveis;
- uma lista de seus construtores, propriedades, funções, membros e extensões, seguida de detalhes de cada um: parâmetros, valor de retorno, possíveis exceções e a versão do Kotlin em que foi introduzido (na seção “Since Kotlin”).
A documentação está em inglês. Uma pesquisa com o nome da função precedido de "kotlin" ("kotlin joinToString") geralmente leva direto à página correta.
5.1.2. KDoc e a ajuda do editor
Assim como o Javadoc para Java, essa documentação é gerada a partir de comentários de documentação escritos no código-fonte, chamados de KDoc em Kotlin. Tal comentário começa com [/**] e é colocado imediatamente antes de uma classe, propriedade ou função. A função de cálculo do imposto do exemplo de aplicação deste capítulo poderia ser documentada da seguinte forma:
O comentário começa com uma frase-resumo; as [@param] tags descrevem os parâmetros, e [@return] descreve o valor de retorno ([@throws] descreveria uma exceção, e [@property] descreveria uma propriedade de classe). Diferentemente do Javadoc, que usa tags HTML, o texto de um comentário KDoc é escrito em Markdown: [*italic*], [**bold**], listas e links para outros elementos do código escritos entre colchetes, como [[salary]] ou [[TaxBracket]]. A ferramenta Dokka da JetBrains, adicionada ao projeto como um plugin do Gradle ([id("org.jetbrains.dokka")]), gera páginas HTML semelhantes às da referência do Kotlin.
O editor de código (IntelliJ IDEA, Visual Studio Code com a extensão Kotlin) aproveita esses comentários e oferece assistência imediata sem sair do código:
- autocompletar: depois de digitar [aString.], o editor sugere uma lista de propriedades e funções aplicáveis ao objeto, incluindo membros e funções de extensão (estas últimas são indicadas pelo tipo que estendem, por exemplo [for String in kotlin.text]), juntamente com seus parâmetros e tipos de retorno;
- Documentação rápida: passar o mouse sobre o nome de uma classe ou função (ou pressionar Ctrl+Q no IntelliJ IDEA) exibe seu KDoc ou, para uma classe do JDK, seu Javadoc;
- Ajuda de parâmetros: ao digitar o parêntese de abertura de uma chamada (ou pressionar Ctrl+P no IntelliJ IDEA), o editor exibe as diversas sobrecargas da função, o nome e o papel de cada parâmetro e os eventuais valores padrão;
- Go to Definition (Ctrl+B no IntelliJ IDEA, F12 no VS Code): exibe o código-fonte da classe ou função. O Gradle baixa o código-fonte da biblioteca padrão do Kotlin, e o JDK vem com o código-fonte de sua própria biblioteca (arquivo [lib/src.zip]): isso permite ler o código de [joinToString] ou de [java.util.ArrayList], o que é muito instrutivo. O código da biblioteca padrão do Kotlin costuma ser muito curto, pois se apoia em classes do JDK;
- Show Kotlin Bytecode (menu Tools > Kotlin > Show Kotlin Bytecode , depois o botão Decompile): exibe, na forma de código Java equivalente, o que o compilador gerou a partir do código Kotlin. É assim que se entende no que se transforma uma função de extensão, uma propriedade ou um [when].
Por fim, para testar uma função sem escrever um programa, o IntelliJ IDEA oferece os arquivos scratch (File > New > Scratch File > Kotlin): você digita instruções ali, e os resultados são exibidos ao lado de cada linha. Na linha de comando, o launcher do compilador (Capítulo 2) avalia uma expressão: [kotlinr -e 'println("abc".repeat(3))'] exibe [abcabcabc].
5.2. Strings
5.2.1. O tipo String
O tipo [String] (pacote [kotlin]) representa strings. Na JVM, uma string Kotlin é um objeto [java.lang.String]: o compilador mapeia os dois tipos, e uma string é passada do Kotlin para o Java (e vice-versa) sem nenhuma conversão. No entanto, o tipo [String] como visto pelo Kotlin tem apenas quatro membros ([length], [get], [subSequence], [compareTo]) e o operador [plus]: todas as outras operações são funções de extensão da biblioteca padrão (pacote [kotlin.text]), que são chamadas como métodos. Os métodos Java de [java.lang.String] que têm um equivalente em Kotlin ficam ocultos: ["abc".strip()] é rejeitado pelo compilador ([unresolved reference 'strip' on receiver of type 'String']); em vez disso, use ["abc".trim()]. Eis alguns exemplos:
propriedade ou função | papel |
[length: Int] | propriedade: número de caracteres da string |
[operator fun get(index: Int): Char] | Caractere nº [index]; o primeiro caractere é o nº 0. Escrito como [s[index]] |
[startsWith(prefix: String, ignoreCase = false)] | retorna [true] se a string começar com [prefix] |
[endsWith(suffix: String, ignoreCase = false)] | retorna [true] se a string terminar com [suffix] |
[contains(other: CharSequence, ignoreCase = false)] | retorna [true] se a string contiver [other]; também pode ser escrito como [other in s] |
[equals(other: String?, ignoreCase = false)] | retorna [true] se a string tiver o mesmo conteúdo que [other]; o operador [==] chama [equals] |
[indexOf(string: String, startIndex = 0, ignoreCase = false)] | primeira ocorrência de [string] na string, a partir da posição [startIndex], ou -1. Outra sobrecarga procura um caractere |
[lastIndexOf(char: Char, ...)] | Igual a [indexOf] mas retorna a última posição em vez da primeira |
[joinToString(separator = ", ", prefix = "", postfix = "")] | função de extensão de coleções e arrays: concatena os elementos, separando-os com [separator] |
[replace(oldChar: Char, newChar: Char, ignoreCase = false)] | Retorna uma cópia da string em que o caractere [oldChar] foi substituído por [newChar]; uma versão sobrecarregada substitui uma string por outra |
[split(vararg delimiters: String, ...): List<String>] | a string é tratada como uma sequência de campos separados por um dos separadores [delimiters], considerados literalmente; o resultado é a lista desses campos. Uma função sobrecarregada recebe uma expressão regular [Regex] |
[substring(startIndex: Int, endIndex: Int)] | uma substring formada pelos caracteres da posição [startIndex] (inclusive) até a posição [endIndex] (exclusive); [substring(range: IntRange)] aceita um intervalo |
[substringBefore(delimiter)], [substringAfter(delimiter)] | da string anterior, após a primeira ocorrência de [delimiter] ([substringBeforeLast], [substringAfterLast]: a última) |
[lowercase()], [uppercase()] | converte a string para minúsculas, maiúsculas |
[trim()] | remove os espaços iniciais e finais da string ([trimStart], [trimEnd]: somente de um lado) |
[repeat(n: Int)] | repete a string [n] vezes |
[reversed()] | inverte a string |
[isEmpty()], [isBlank()] | retorna [true] se a string estiver vazia ou se contiver apenas espaços |
[lines(): List<String>] | retorna a lista de linhas da string |
[format(vararg args: Any?)] | retorna a string, usada como formato, em que as posições [%s], [%d]… foram substituídas pelos argumentos |
Observe os numerosos parâmetros [ignoreCase], que têm o valor padrão [false]: o Kotlin não exige, como o Java, métodos separados [equals] e [equalsIgnoreCase]; escrevemos [s.equals(other, ignoreCase = true)] usando argumentos nomeados (Capítulo 3).
É importante observar que uma string do tipo [String] é imutável; ela não pode ser modificada depois de criada. Quando uma função retorna uma string, essa string é diferente daquela à qual a função foi aplicada. Assim, [s1.trim()] retorna a string [s2], e [s1] e [s2] são duas strings diferentes: [s1] não mudou.
Uma string Kotlin não é um array, mas graças ao operador [get] (Capítulo 4), podemos acessar seu n-ésimo caractere com a mesma notação usada para um elemento de array, ao passo que o Java exige uma notação diferente. Da mesma forma, o número de caracteres é a propriedade [c.length], e o tamanho de um array é a propriedade [array.size]: o Kotlin não tem a inconsistência existente no Java entre o método [length()] das strings e o campo [length] dos arrays.
O programa [Strings01.kt] é o seguinte:
Resultados:
Comentários:
- linhas 7–8: length é uma propriedade, e o operador [[10]] retorna o caractere nº 10, que é o 11º caractere da string;
- linhas 10, 12: uma busca sem sucesso retorna -1;
- linha 13: os dois parâmetros de [substring] são as posições do primeiro caractere a ser mantido e do primeiro caractere a ser descartado: isso retorna os 7 caracteres das posições 4 a 10. Essa é a convenção geral, tanto no Kotlin quanto no Java, para especificar um intervalo de índices (início incluído, fim excluído): ela é usada em muitas funções;
- linha 14: uma sobrecarga de
*[substring]recebe um intervalo*[IntRange]*(Capítulo 3), em que ambas as extremidades são incluídas: [4..10] refere-se aos mesmos caracteres que os parâmetros [(4, 11)]. Também poderíamos ter escrito [4 until 11] ou [4..<11]*; - Linha 15: [uppercase] e [lowercase] (Kotlin 1.5) não dependem do idioma da máquina (usam as regras do Unicode, que independem do idioma); as antigas funções herdadas do Java [toUpperCase] e [toLowerCase], que dependiam dele (em turco, o "i" minúsculo se torna "İ"), estão obsoletas no Kotlin;
- Linhas 18–22: o tipo [String] não tem função de inserção: concatenamos o início da string, o texto inserido e o fim da string, ou usamos [replaceRange], que substitui os caracteres de um intervalo por um texto: substituir o intervalo vazio que começa na posição 9 equivale a inserir. Veremos que a classe [StringBuilder] tem uma função [insert];
- linha 24: [split] divide a string em campos e retorna uma lista ([List<String>], descrita mais adiante), e não um array como no Java. Observe que essa é uma diferença importante em relação ao Java: com um parâmetro [String], o separador de [split] é tratado literalmente; para torná-lo uma expressão regular — assunto que abordaremos no final do capítulo — é preciso passar um objeto [Regex]. [\s+] refere-se a uma sequência de um ou mais caracteres de espaço em branco (espaço, tabulação, quebra de linha etc.). Ela é escrita em uma string bruta (raw string) delimitada por três aspas, em que o caractere [\] é um caractere comum e não precisa ser duplicado (voltaremos a isso mais tarde);
- linha 25: a propriedade [indices] de uma lista (ou array) é o intervalo de seus índices, neste caso [0..5];
- linha 28: [joinToString] faz o inverso de [split]. É uma função de extensão para listas e arrays, ao passo que o Java oferece o método estático [String.join];
- linha 29: [trim] remove os espaços iniciais e finais. O [trim] do Kotlin reconhece todos os espaços Unicode (ele usa a função [Char.isWhitespace]): ele corresponde, portanto, ao método Java [strip], e não ao método Java [trim], que reconhece apenas os espaços do código ASCII;
- Linhas 31–35: algumas funções da biblioteca Kotlin que não têm equivalente direto na classe Java [String]: [substringBefore] e [substringAfterLast] retornam o que vem antes do primeiro espaço e o que vem depois do último, sem calcular posições; [reversed] inverte a string; [count] conta os caracteres que satisfazem uma condição, expressa por uma lambda: [{ it == 'e' }] é uma função anônima cujo parâmetro implícito [it] é o caractere examinado (as lambdas são abordadas no Capítulo 7). Como sua lambda é o último argumento de [count], ela é escrita depois do nome da função, sem parênteses; por fim, [lines] divide um texto em linhas, independentemente do terminador de linha usado ([\n], [\r\n] ou [\r]), e retorna a lista de linhas;
- linha 37: todas as funções anteriores retornaram novas strings: [aString] não foi modificada (última linha dos resultados);
- linhas 41–42: uma função de alto nível, chamada pela função [main] como no Capítulo 3.
5.2.2. As funções split e joinToString
O programa [Strings02.kt] aprofunda a divisão de uma string em campos. Os leitores familiarizados com o Java encontrarão duas diferenças significativas em relação ao método [split] do Java:
Resultados:
Comentários:
- Linha 7: os campos são separados pelo caractere [:]. Dois [:] consecutivos delimitam um campo vazio (linha 3 dos resultados), e o [:] final da string delimita um quinto campo — também vazio — que é mantido (linha 5 dos resultados). Essa é a primeira diferença em relação ao Java, em que o método
*[split]remove os campos vazios do final: em Kotlin,*[joinToString]sempre reconstrói a string original (linha 6 dos resultados). O comportamento do Kotlin é mais consistente: uma string contendo n separadores sempre produz n + 1 campos. Para reproduzir o comportamento do Java, escreveríamos [line.split(":").dropLastWhile { it.isEmpty() }]; - linha 8: a função [withIndex] permite percorrer uma lista usando ao mesmo tempo o índice e o elemento, que é obtido por desestruturação (Capítulo 3);
- linha 15: o parâmetro opcional [limit] de [split] define o número máximo de campos: a divisão para no primeiro separador, e o último campo contém todo o restante da string. Um delimitador é usado, por exemplo, para separar o nome de um parâmetro de seu valor em uma linha [name=value] quando o próprio valor pode conter o delimitador. Observe que, quando uma lista é exibida por meio de um template ([$fields]), seus elementos aparecem entre colchetes, separados por vírgulas: esse é o [toString] das listas;
- linha 19: a segunda diferença em relação ao Java: um separador do tipo [String] é tratado literalmente; para descrever um separador por meio de uma expressão regular, é preciso passar um objeto [Regex]. [":+"] denota um ou mais caracteres [:] consecutivos. Os dois caracteres [:] consecutivos formam um único separador, e o campo vazio intermediário desaparece; o último campo vazio, porém, permanece;
- linha 24: [split] aceita vários separadores ([vararg], Capítulo 3), caracteres ou strings: neste caso, a vírgula e o ponto e vírgula. A função [map] aplica então a lambda [{ it.trim() }] a cada campo e retorna a lista de resultados: em uma única instrução, obtemos os três campos “limpos”. As funções [map], [filter], e suas muitas congêneres são apresentadas mais adiante neste capítulo;
- linha 27: o mesmo resultado usando uma expressão regular: o padrão [\s*[,;]\s*] corresponde a uma vírgula ou ponto e vírgula, precedidos e seguidos de qualquer quantidade de espaços; os espaços que cercam os separadores são removidos junto com eles. Os do início e do fim da string são removidos antes por [trim]. O padrão é escrito em uma string bruta, sem duplicar o [\]; a linha seguinte também usa uma string bruta para exibir o padrão tal como está;
- linhas 32–36: para remover tanto os espaços ao redor dos campos quanto os campos vazios, os campos podem ser processados um a um: o campo formado por dois espaços entre duas vírgulas fica vazio depois de [trim] e não é mantido. A lista editável criada por [mutableListOf] para armazenar os campos mantidos será apresentada um pouco mais adiante;
- linha 41: o mesmo resultado em uma única instrução: [map] remove os espaços de cada campo, e depois [filter] mantém apenas os campos não vazios. Essa é a maneira idiomática de escrever isso em Kotlin;
- linha 46: o separador [" | "] contém o caractere [|], que tem um significado especial em uma expressão regular (“ou”). Como o separador é tratado literalmente, não são necessárias precauções especiais, ao passo que em Java seria preciso escrever [split(Pattern.quote(" | "))]. Se for necessário construir uma expressão regular a partir de um texto arbitrário, a função [Regex.escape] tem a mesma finalidade que [Pattern.quote];
- Linhas 49–51: diferentemente de [String.join] do Java, que aceita apenas strings, [joinToString] aceita elementos de qualquer tipo; aqui, um array de inteiros [IntArray]: cada elemento é convertido por sua função [toString]. Seus parâmetros opcionais [prefix] e [postfix] acrescentam texto no início e no fim, e seu último parâmetro, [transform], é uma lambda que converte cada elemento em texto; escrita depois dos parênteses, ela produz os textos “no.1”, “no.2” etc. O que o Java faz com um [StringJoiner] ou com a API Stream pode ser feito com uma única chamada.
5.2.3. Pesquisa e comparação de strings
A comparação de strings é mais sutil do que parece: as letras maiúsculas e minúsculas devem ser distinguidas? Como comparar “éclair” com “essay”? E o que o operador [==] compara? Nesse último ponto, o Kotlin corrigiu uma armadilha conhecida do Java. O programa [Strings03.kt] demonstra as funções de pesquisa e comparação:
Resultados:
Comentários:
- linhas 3–4: as classes do JDK usadas pelo programa devem ser importadas;
- linhas 11–14: por padrão, [contains], [startsWith]e [endsWith] fazem uma comparação exata, caractere por caractere: “LANGUAGE” não é encontrado;
- linha 16: essas funções têm um parâmetro opcional, [ignoreCase], que instrui o programa a ignorar a diferença entre maiúsculas e minúsculas. O Java não tem um equivalente: ambas as strings devem ser colocadas em minúsculas;
- linha 18: o operador [in] chama a função [contains] (Capítulo 4): ["Kotlin" in title] lê-se naturalmente como “Kotlin está no título”;
- Linhas 19–21: a função [regionMatches] compara uma parte de uma string com uma parte de outra string. Seus parâmetros são a posição inicial na string, a outra string, a posição inicial na outra string e o número de caracteres a comparar; o último parâmetro, que é opcional, indica se a diferença entre maiúsculas e minúsculas deve ser ignorada (em Java, esse parâmetro vem primeiro em uma das sobrecargas);
- linhas 23–29: a parte mais importante deste programa. Uma variável do tipo [String] contém uma referência a um objeto string (Capítulo 4). A variável [yes] refere-se a uma string “yes” construída em tempo de execução: ela é um objeto diferente da string literal “yes” do programa. Em Kotlin, o operador [] compara o conteúdo: ele chama a função [equals], e [yes == "yes"] resulta em [true] (linha 8 dos resultados). Para comparar referências — isto é, para determinar se duas variáveis se referem ao mesmo objeto — o Kotlin tem outro operador, [=], e [yes === "yes"] é igual a [false] (linha 9 dos resultados). Em Java, é o contrário: [] compara referências ali, e o erro comum de escrever [answer == "yes"] em vez de [answer.equals("yes")] não existe em Kotlin. A comparação que ignora maiúsculas e minúsculas é escrita como [equals(..., ignoreCase = true)], que é a maneira correta de validar uma resposta “yes” digitada no teclado em maiúsculas ou minúsculas. Você quase nunca precisa de [=] com strings;
- Linhas 32–37: a função [compareTo] retorna um inteiro negativo, zero ou positivo conforme a string preceda, seja igual ou suceda a string passada como parâmetro. Ela compara os códigos dos caracteres: “éclair” vem depois de “essay” porque o código do caractere “é” (233) é maior que o do caractere “e” (101); aqui, ela retorna a diferença entre os dois códigos, 132. Como [String] implementa [Comparable<String>], os operadores [<], [>], [<=] e [>=] se aplicam a strings e chamam [compareTo]: [a < b] é igual a [false]. Para ordenar palavras de acordo com as regras de um idioma, usa-se um objeto [java.text.Collator] derivado do JDK: para o francês, o caractere “é” é ordenado junto com “e”, e “éclair” vem antes de “essay” (linha 14 dos resultados). Usaremos a ordem especificada por um [Collator] para ordenar palavras destinadas a um usuário, e [compareTo] para comparar identificadores técnicos (nomes de arquivos, chaves etc.). A função [compareTo] também tem um parâmetro [ignoreCase];
- linhas 40–48: [isEmpty] verifica se há uma string vazia, e [isBlank] verifica se há uma string vazia ou que contenha apenas espaços. Uma string também pode estar ausente: nesse caso, sua variável é do tipo [String?] e tem o valor [null] (Capítulo 3). Aqui, [System.getenv] — um método Java que retorna o valor de uma variável de ambiente — retorna [null] porque a variável solicitada não existe. O compilador proíbe a chamada a [absent.isBlank()], que poderia lançar uma exceção [NullPointerException]. A biblioteca fornece funções de extensão para o tipo [String?], que aceitam [null]: [isNullOrBlank] (e [isNullOrEmpty]) verificam o que o Java escreve como [absent == null || absent.isBlank()], e [orEmpty] retorna a string, ou uma string vazia se ela for [null]. A chamada segura a [absent?.length] retorna [null];
- linha 51: [padStart] preenche uma string à esquerda até um comprimento de 8 caracteres com espaços ou com o caractere especificado ([padStart(5, '0')]), e [padEnd] a preenche à direita; [repeat] repete uma string. Os formatos ["%8s"] e ["%-8s"], mostrados adiante, também poderiam ser usados.
5.2.4. Templates, formatos e strings brutas
Desde o Capítulo 3, temos construído as strings a serem exibidas usando templates de string: em uma string, [$name] é substituído pelo valor da variável [name], e [${expression}] pelo valor de uma expressão qualquer. Isso é a interpolação de strings, um recurso que o Java não tem (uma proposta, “String Templates”, foi apresentada em prévia no Java 21 e 22, mas depois removida) e que o C# escreve como [$"{name}"]. O compilador transforma um template em concatenações: não há nenhuma sobrecarga adicional em tempo de execução.
Para alinhar valores em colunas, definir o número de casas decimais de um número ou exibir uma data, usam-se também formatos, seja com a função [String.format] ou com a função de extensão [format] aplicada ao próprio formato, que fazem a mesma coisa (e chamam o método Java [String.format]). O formato é uma string de texto em que os especificadores [%[-][width][.precision]conversion] indicam onde e como inserir os parâmetros seguintes. O programa [Strings04.kt] fornece exemplos deles, juntamente com as strings brutas do Kotlin:
Resultados:
Comentários:
- Linha 17: um template: [$name] e [$age] são substituídos pelos valores das variáveis, e [${2026 - age}] pelo valor da expressão. As chaves são obrigatórias sempre que o que vem depois de [$] não é um simples nome de variável: [$person.name] inseriria o valor de [person] seguido do texto “.name”, ao passo que [${person.name}] insere a propriedade [name];
- linha 19: uma largura alinha o valor à direita dentro de um campo de 10 caracteres; precedida do sinal [-], alinha-o à esquerda;
- linhas 19–21: as conversões mais comuns:
especificador | significado | exemplo (locale inglês) |
[%s] | string; qualquer objeto é convertido por sua função [toString] | dupont |
[%d], [%5d] | inteiro, com possivelmente 5 caracteres de largura | 45 |
[%05d] | inteiro com pelo menos 5 dígitos, preenchido com zeros | 00045 |
[%X] | inteiro hexadecimal ([%x]: em minúsculas) | 2D |
[%.2f], [%12.2f] | número real com 2 casas decimais, com possivelmente 12 caracteres de largura | 2345.68 |
[%,.2f], [%,d] | igual ao anterior, com separador de milhares | 2,345.68 |
[%e] | número real em notação científica | 2.345678e+03 |
[%n] | quebra de linha do sistema | |
[%%] | o caractere % | % |
- Os números são formatados de acordo com o idioma atual, neste caso o inglês: ponto decimal, vírgula como separador de milhares. Em francês ([Locale.FRANCE], linhas 29–32), o separador de milhares é um espaço fino não separável (caractere U+202F), que parece um espaço comum, mas impede a quebra de linha no meio de um número; da mesma forma, um espaço não separável (U+00A0) precede o símbolo € e o símbolo %. Isso deve ser levado em conta ao comparar esses textos com strings escritas com espaços comuns. Os tipos dos parâmetros só são verificados em tempo de execução: passar um [Int] para a conversão [%f] lança uma exceção [IllegalFormatConversionException];
- linha 23: ["...".format(...)] equivale a [String.format("...", ...)] (e ao método Java [formatted]). Como [if] é uma expressão em Kotlin (Capítulo 3), ele pode fornecer um parâmetro, ao passo que o Java usa o operador condicional [? :];
- Linha 25: um template não formata números; ele chama a função [toString] sobre o valor, que exibe um [Double] com ponto decimal e todas as suas casas decimais, independentemente do idioma da máquina. Para uma exibição destinada a um usuário, combinam-se o template e o formato: [${"%.2f".format(salary)}]. Uma sobrecarga de [format] recebe como primeiro parâmetro o idioma a ser usado: [Locale.US] resulta em um ponto decimal;
- Linhas 29–32: valores monetários e porcentagens são formatados usando objetos [java.text.NumberFormat] do JDK, que são obtidos para um dado idioma e país ([Locale.FRANCE]). O formato de porcentagem multiplica o valor por 100. Observe a linha 31: o método Java [setMinimumFractionDigits(2)] é usado em Kotlin como uma atribuição de propriedade. O Kotlin trata os pares de métodos Java [getXxx()]/[setXxx(...)] como propriedades [xxx];
- linhas 34–37: a API de datas [java.time] do JDK é formatada por um objeto [DateTimeFormatter] construído a partir de um modelo: [dd] dia, [MM] mês, [yyyy] ano, [HH] hora, [mm] minutos, [ss] segundos, [EEEE] dia da semana por extenso, [MMMM] mês por extenso. Cuidado com maiúsculas e minúsculas: [MM] é o mês, [mm] são os minutos. Os nomes dos dias e dos meses são os usados na linguagem cotidiana. Os templates podem conter expressões que, por sua vez, contêm strings: ["[${date.format(DateTimeFormatter.ofPattern("dd/MM/yyyy"))}] "];
- linhas 40–43: as larguras permitem exibir os dados em colunas;
- linha 47: em uma string comum, o caractere [\] introduz uma sequência de escape ([\n], [\t], [\"], [\$]…); para obter o próprio caractere [\] , é preciso duplicá-lo;
- Linha 50: uma string bruta é delimitada por três aspas. Sequências de escape não existem em strings brutas: o caractere [\] é tratado como um caractere comum. Essa é uma maneira conveniente de escrever caminhos do Windows e expressões regulares, o que o Java não oferece (seus blocos de texto mantêm as sequências de escape). No entanto, não é possível escrever uma quebra de linha como [\n] aqui; é preciso uma quebra de linha de verdade;
- Linhas 54–61: uma string bruta pode se estender por várias linhas e conter aspas sem escape. Ela preserva tudo o que está escrito entre as aspas, inclusive a indentação do código e as linhas vazias no início e no fim. A função [trimIndent] remove a primeira e a última linhas se estiverem em branco e, em seguida, remove a indentação comum a todas as linhas (a da linha menos indentada): o texto JSON é exibido sem a margem do código e sem a quebra de linha final, resultando em [println]. Isso equivale aos blocos de texto do Java 15, mas implementado por meio de uma função de biblioteca. Diferentemente dos blocos de texto do Java, os templates funcionam em strings brutas: ["$name"] e [${prices[0]}] são substituídos por seus valores, o que elimina a necessidade de [format]; o [\] em ["C:\data"] não precisa ser duplicado;
- Linha 59: como as sequências de escape não existem em uma string bruta, não é possível escrever
***[\\$]para obter um*[$]seguido de um nome sem que seja interpretado como um template: em vez disso, escrevemos [${'$'}], um template cuja expressão é o caractere [$]. A partir do Kotlin 2.2, também podemos prefixar a string com vários [$]* ([$$"""..."""]): somente sequências de dois [$] passam então a introduzir um template, o que é conveniente para escrever textos que contêm muitos [$]*; - Linhas 64–68: a função [trimMargin] oferece outra maneira de especificar a margem: cada linha começa — após eventuais espaços — com um caractere de margem ([|] por padrão), e tudo o que precede esse caractere, inclusive ele próprio, é removido. Escolha a função mais legível: [trimIndent] para texto copiado tal como está, e [trimMargin] quando a primeira coluna do texto precisa estar claramente visível.
Existe também a classe [java.text.MessageFormat], cujos formatos se referem aos parâmetros por seus números: [MessageFormat.format("{0} is {1} years old", name, age)]. Ela é usada para mensagens traduzidas em vários idiomas, nas quais a ordem dos parâmetros pode variar de um idioma para outro; é usada em Kotlin exatamente como em Java.
5.2.5. A classe StringBuilder
Observamos que as funções do tipo [String] que operam sobre uma string do tipo [s1] retornam outra string do tipo [s2]. A classe [StringBuilder] permite modificar uma string sem criar uma nova string a cada operação. Isso melhora o desempenho ao construir uma string por meio de muitas adições sucessivas, evitando a proliferação de strings de vida muito curta. Em Kotlin, para a JVM, [kotlin.text.StringBuilder] é um apelido de tipo ([typealias]) para a classe [java.lang.StringBuilder] do JDK: é a mesma classe, que a biblioteca padrão estende com algumas funções de extensão ([appendLine], o operador [[]] …). Ela pode ser usada sem [import].
A classe oferece vários construtores:
construtor | papel |
[StringBuilder()] | cria um objeto vazio com capacidade inicial de 16 caracteres |
[StringBuilder(str: String)] | constrói e inicializa com [str]; a capacidade inicial é o comprimento de [str] mais 16 |
[StringBuilder(capacity: Int)] | constrói um objeto vazio com capacidade inicial de [capacity] caracteres |
Um objeto [StringBuilder] armazena seus caracteres em um array cujo tamanho — sua capacidade — é ajustado automaticamente conforme o texto cresce. O programa [Strings05.kt] ilustra esse conceito de capacidade:
Resultados:
Comentários:
- linha 5: criação de um objeto [StringBuilder] contendo “test”: sua capacidade inicial é 4 + 16 = 20 caracteres. Como em qualquer classe em Kotlin, não existe o operador [new];
- linha 6: [length] é o número atual de caracteres. O Kotlin o representa como uma propriedade (sem parênteses), como em [String]: o método Java [length()] da interface [CharSequence] é tratado em Kotlin como a propriedade [length]. [capacity()], que não faz parte dessa interface e não segue a convenção [getXxx()], continua sendo um método: ele representa o número de caracteres que o objeto pode conter antes de precisar expandir seu array;
- linha 7: a função [repeat] da biblioteca padrão executa a lambda que a segue 10 vezes (Capítulo 3);
- linha 8: [append] acrescenta uma string ao final do texto;
- linha 12: criação de um objeto [StringBuilder] vazio com capacidade inicial de 10, ao qual “test” é imediatamente acrescentado. O método [append] retorna o próprio objeto: ele pode ser chamado diretamente sobre o resultado do construtor.
Os resultados, que são idênticos aos do programa Java, já que se trata da mesma classe, mostram que, quando a capacidade é insuficiente, ela é um pouco mais que dobrada: a nova capacidade é a antiga multiplicada por 2, mais 2 (20, 42, 86 para o primeiro objeto; 10, 22, 46 para o segundo). Cada expansão aloca um novo array e copia os caracteres para ele. Se o tamanho aproximado do texto for conhecido de antemão, defini-lo na construção evita essas expansões sucessivas.
Estas são algumas das funções da classe:
função | papel |
[append(str: String?): StringBuilder] | adiciona [str] ao final do texto. Sobrecarregada para aceitar os tipos [Int], [Double], [Char], [Boolean], [Any?]… |
[appendLine(value)] | Extensão do Kotlin: adiciona [value] seguido de uma quebra de linha [\n]; sem parâmetros, adiciona apenas a quebra de linha |
[insert(offset: Int, str: String?)] | Insere [str] na posição [offset]; sobrecarregada como [append] |
[delete(start: Int, end: Int)] | remove os caracteres das posições [start] (inclusive) até [end] (exclusive); [deleteCharAt] remove um único caractere |
[replace(start: Int, end: Int, str: String)] | substitui os caracteres das posições [start] (inclusive) até [end] (exclusive) por [str] |
[reverse()] | inverte a ordem dos caracteres |
[sb[index]], [sb[index] = ch] | lê e substitui o caractere de número [index] (operadores [get] e [set]; [set] é uma extensão do Kotlin para o método Java [setCharAt]) |
[indexOf(str: String)] | posição de [str] no texto, ou -1 |
[toString()] | retorna o texto como uma string [String] |
O programa [Strings06.kt] usa essas funções, assim como a função [buildString], que é a forma idiomática de construir uma string em Kotlin:
Resultados:
Comentários:
- Linha 6: os métodos de modificação retornam o próprio objeto [StringBuilder], o que permite encadeá-los. Acompanhemos as etapas: "test" vira "testabCD " ([append]), depois "texyZTstabCD" ([insert] na posição 2), depois "xyZTstabCD " ([delete] para os caracteres 0 e 1) e, por fim, "XYZTstabCD" ([replace] para os caracteres 0 e 1, com "XY"). Observe que, ao contrário da função [replace] de [String], a função de [StringBuilder] não procura texto: ela substitui um intervalo de posições. [println] exibe o objeto chamando sua função [toString];
- linhas 8 e 9: o operador [[]] lê e modifica um caractere, como em um array; [str3[0] = 'x'] chama [str3.setCharAt(0, 'x')]. No template, [$str3] chama [toString];
- linha 11: [reverse] inverte o texto. Para uma string [String], a função [reversed], vista em [Strings01.kt], é mais simples;
- linhas 14 a 16: construção de um texto de várias linhas por adições sucessivas; este é o uso típico de [StringBuilder]. As adições são encadeadas em uma única linha de código;
- linhas 19 e 20: a função [joinTo] é a contraparte de [joinToString]: em vez de criar uma nova string, ela acrescenta os elementos, separados pelo delimitador, a um [StringBuilder] existente (mais precisamente, a qualquer objeto [Appendable]); [appendLine] adiciona então uma quebra de linha;
- linha 23: uma string formatada é adicionada. A conversão [%f] exige um número real: passar o inteiro [total] lançaria uma exceção [IllegalFormatConversionException] em tempo de execução, daí a conversão [total.toDouble()];
- linha 25: o texto final é obtido como uma string [String];
- linhas 30 a 35: a função [buildString] cria um [StringBuilder], executa a lambda que a segue e, em seguida, retorna o texto construído como uma [String]. Na lambda, o [StringBuilder] é o receptor implícito ([this]): escrevemos [appendLine(...)] em vez de [sb.appendLine(...)]. Esse tipo de lambda, chamado de lambda com receptor, é abordado no Capítulo 7; ele permite escrever "blocos de construção" muito legíveis. A variável [table] é uma [String] imutável, declarada com [val], e o [StringBuilder] intermediário nem sequer é visível. Observe também como [padStart] alinha os números à direita dentro das colunas;
- linha 40: para uma sequência de elementos separados por um delimitador, com prefixo e sufixo, [joinToString] oferece a funcionalidade da classe Java [java.util.StringJoiner], que continua utilizável, mas tem pouco interesse em Kotlin.
Para poucas concatenações, o operador [+] e os templates bastam: o compilador os otimiza. [StringBuilder] (ou [buildString]) é a escolha preferida quando o número de adições é grande ou desconhecido, tipicamente dentro de um laço: a concatenação [s += ...] em um laço com n iterações cria n strings e copia, a cada iteração, toda a string construída anteriormente. Em códigos Java mais antigos, você poderá encontrar a classe [StringBuffer], que tem os mesmos métodos que [StringBuilder] , mas os torna utilizáveis simultaneamente por várias threads, ao custo de alguma sobrecarga de desempenho: hoje, [StringBuilder] é preferido a ela.
5.2.6. Análise de uma string sem copiá-la
Cada chamada a [substring] ou [split] cria novas strings na memória. Em códigos críticos para o desempenho (como a análise de arquivos grandes ou de requisições de rede), pode ser desejável evitar a criação de novas strings. Nem Kotlin nem Java têm um tipo "substring" embutido na linguagem, mas várias funções operam sobre uma parte de uma string sem copiá-la. O programa [Strings07.kt] compara várias maneiras de analisar uma linha no formato "sobrenome:nome:idade":
Resultados:
Comentários:
- linha 10: a abordagem mais legível e mais comum em Kotlin: [split] retorna uma lista de três strings, que a desestruturação (Capítulo 3) atribui a três variáveis; [toInt] converte então a idade em inteiro. No entanto, ela cria uma lista e três strings;
- linhas 16 e 17: com [substring], cada chamada cria uma nova string, mesmo que, como no caso da idade, ela seja usada apenas por um instante;
- linha 21: a função Kotlin [toInt] aplica-se apenas a uma string; mas o método estático [Integer.parseInt] do JDK tem uma sobrecarga (Java 9) que analisa os caracteres entre duas posições da string, na base especificada (aqui 10), sem criar uma substring. Um programa Kotlin pode chamá-lo diretamente: é esse todo o sentido da interoperabilidade com Java;
- Linha 23: [regionMatches], que já vimos, compara uma parte da string com outra string sem copiá-la;
- linha 27: [CharBuffer.wrap] (pacote [java.nio] do JDK) retorna uma view dos caracteres de 0 até [p1] - 1 da string: um objeto que não contém uma cópia dos caracteres, mas oferece um meio de acessá-los. Ele implementa a interface [CharSequence], assim como [String] e [StringBuilder]. Observe que a função [subSequence] de [String], membro dessa interface, não é uma view: para uma string, ela cria uma cópia dos caracteres, assim como [substring] (ela retorna uma view para um
*[CharBuffer]). Kotlin trata o método Java***[charAt]dessa interface como o operador***[[]], e seu método[length()]como a propriedade*[length]; - linhas 30 e 31: muitas das funções de extensão de
*[kotlin.text]são definidas não em*[String]*, mas em[CharSequence]: [startsWith], [count], [contains], [indexOf], [split], [lines]… aplicam-se, portanto, também a uma view ou a um [StringBuilder], sem convertê-los antes em [String]. As expressões regulares, que veremos no final do capítulo, também aceitam um [CharSequence]*; - linha 34: o segundo parâmetro de [indexOf] é a posição inicial da busca;
- linha 37: uma string só é criada se for realmente necessária.
Essas técnicas são ferramentas de otimização: para um programa comum, [split] e [substring] são perfeitamente adequados. Além disso, a máquina virtual armazena as strings que contêm apenas caracteres do conjunto Latin-1 (como é o caso do texto em francês) usando um byte por caractere em vez de dois ("strings compactas", Java 9), o que reduz pela metade a memória que ocupam; as strings do Kotlin, que são strings Java, se beneficiam disso. Só tentaremos evitar cópias em códigos cujo desempenho crítico tenha sido medido.
5.3. Arrays
5.3.1. Funções de extensão de arrays
Vimos no Capítulo 3 que Kotlin tem dois tipos de arrays: arrays de objetos [Array<T>] (criados por [arrayOf]) e arrays de tipos primitivos [IntArray], [DoubleArray], [CharArray]… (criados por [intArrayOf], [doubleArrayOf]…), compilados em arrays de tipos primitivos Java ([int[]], [double[]]…). Em Java, os arrays não têm métodos úteis: além do campo [length], todas as operações são métodos estáticos da classe utilitária [java.util.Arrays]. Em Kotlin, os arrays têm uma propriedade [size], operadores [[]]e, principalmente, dezenas de funções de extensão da biblioteca padrão (pacote [kotlin.collections]), chamadas como métodos: [array.sort()] em vez de [Arrays.sort(array)]. Elas permitem ordenar um array, buscar um elemento nele, copiá-lo, preenchê-lo… Existem para todos os tipos de arrays ([IntArray], [DoubleArray]…, [Array<T>]) e, na maioria das vezes, chamam, via JVM, os métodos da classe [Arrays].
função | papel |
[binarySearch(element, fromIndex = 0, toIndex = size)] | Retorna a posição de [element] no array, que deve estar ordenado; um número negativo se [element] não existir |
[copyOf(newSize: Int)] | retorna um novo array de [newSize] elementos contendo os primeiros elementos do array, preenchido com zeros conforme a necessidade ([false] para booleanos); para um [Array<T>], o resultado é um [Array<T?>] preenchido com [null]. Sem parâmetros, retorna uma cópia do mesmo tamanho |
[copyOfRange(fromIndex: Int, toIndex: Int)] | retorna um novo array formado pelos elementos de [fromIndex] (inclusive) até [toIndex] (exclusive); [sliceArray(range)] faz o mesmo com um intervalo |
[copyInto(destination, destinationOffset = 0, startIndex = 0, endIndex = size)] | copia os elementos do array para outro array já existente (equivalente a [System.arraycopy]) |
[contentEquals(other)] | retorna [true] se os dois arrays têm os mesmos elementos na mesma ordem |
[fill(element, fromIndex = 0, toIndex = size)] | Atribui [element] a todos os elementos do array ou a um intervalo de índices |
[sort()], [sort(fromIndex, toIndex)] | ordena o array, ou um intervalo de índices, segundo a ordem natural de seus elementos; [sortWith(comparator)] ordena um array de objetos segundo um [Comparator] (Capítulo 4); [sortDescending()] ordena em ordem decrescente |
[sorted()], [sortedWith(comparator)] | retorna uma lista ordenada sem modificar o array |
[reverse()], [reversed()] | inverte o array; retorna uma lista invertida |
[contentToString()] | converte os elementos do array em uma string [[e1, e2, ...]]; [contentDeepToString] faz o mesmo para um array de arrays |
[indexOf(element)], [lastIndexOf(element)], [contains(element)] | busca linear: primeira ou última posição de [element], ou -1; presença de [element] ([element in array]) |
[asList()] | retorna uma lista que é uma view do array |
[toList()], [toMutableList()] | retorna uma nova lista, somente leitura ou editável, contendo os elementos do array |
[plus(element)] | retorna um novo array, um elemento maior, formado pelos elementos do array seguidos de [element]; escrito como [array + element] |
Além disso, existem funções comuns a arrays e coleções ([sum], [max], [count], [filter], [map], [joinToString]…), que veremos mais adiante.
O programa [Arrays01.kt] ilustra o uso de algumas dessas funções:
Comentários:
- linha 4: uma enumeração (Capítulo 3), declarada no nível do arquivo;
- linhas 23 a 40: a função [input] lê os elementos de um array digitados no teclado. Como o número de elementos não é conhecido de antemão, a função começa com um array vazio (linha 25) e o expande em um elemento a cada nova entrada (linha 38). O tamanho de um array é fixado quando ele é criado: o operador [+] ([plus]) na verdade cria um novo array um elemento maior, copia para ele os elementos do array antigo e adiciona o novo elemento; [elements += element] significa aqui [elements = elements + element], daí a declaração de [elements] com [var]. Isso equivale, em uma única instrução, às duas instruções Java [elements = Arrays.copyOf(elements, elements.length + 1)] e [elements[elements.length - 1] = element]. Um algoritmo mais eficiente alocaria espaço em grupos de N elementos. Um array não foi concebido para ser redimensionado: esse cenário é mais bem tratado com uma lista mutável, como veremos em breve;
- linhas 32 a 35: a conversão da string digitada em número de ponto flutuante por [toDoubleOrNull], que retorna [null] se a string não for um número (Capítulo 3). Após a verificação [element == null] seguida de [continue], o compilador sabe que [element] não é [null]: seu tipo passa a ser [Double] (conversão inteligente de tipo), e ele pode ser adicionado ao array. [toDoubleOrNull] não depende do idioma da máquina: sempre espera um ponto decimal e rejeita a entrada "3,6" (linha 4 dos resultados);
- linhas 52 a 69: a função [search] busca no array os valores digitados no teclado. A função [when] (linha 64) seleciona o método de busca de acordo com o tipo solicitado; como ela opera sobre uma enumeração e trata todos os seus valores, não exige o ramo [else]. Para um array não ordenado, realiza-se uma busca linear, examinando os elementos um a um. A biblioteca padrão não tem uma função [indexOf] para arrays de números reais [DoubleArray]: ela foi removida porque a comparação de igualdade entre números reais apresenta problemas para os valores especiais [NaN] e [-0.0]; [elements.indexOf(element)] é rejeitado pelo compilador ([unresolved reference 'indexOf']). Usamos, portanto, [indexOfFirst], que retorna a posição do primeiro elemento que satisfaz a condição expressa por uma lambda, ou -1; ao contrário do Java, não é preciso escrever a função de busca. Para um array ordenado, fazemos uma busca binária com [binarySearch], que reduz o intervalo de busca pela metade a cada passo: ela encontra um elemento entre um milhão em cerca de vinte comparações;
- linha 15: o array é ordenado, aqui segundo a ordem natural dos números. [elements] é declarado com [val] em [main]: a variável sempre se refere ao mesmo array, mas seu conteúdo pode ser modificado. [val] torna constante a referência , não o objeto;
- linhas 44 a 47: exibição de um array. [println] exibe um [Double] com ponto decimal, independentemente do idioma da máquina, e sempre com pelo menos uma casa decimal: -7 é exibido como -7.0;
- linhas 74 a 76: [print] exibe o prompt sem passar para a linha seguinte e, depois, [readlnOrNull] lê uma linha digitada no teclado; retorna [null] se a entrada padrão estiver esgotada, por exemplo quando vem de um arquivo. A chamada segura [?.trim()] e o operador Elvis [?: ""] retornam então uma string vazia.
Resultados:
Quando o elemento procurado não existe, [indexOfFirst] retorna -1 e [binarySearch] retorna um número negativo (última busca): trata-se de [-(p + 1)], em que p é a posição em que o elemento deveria ser inserido para manter o array ordenado. Aqui, -3 = -(2 + 1): o número 0 deveria ser inserido na posição 2, entre -1.5 e 3.6. Observação: [binarySearch] em um array não ordenado retorna um resultado sem sentido.
5.3.2. Outras funções de arrays
O programa [Arrays02.kt] apresenta outras funções de extensão de arrays:
Resultados:
Comentários:
- linha 9: [contentToString] exibe um array em uma única linha. Exibir um array diretamente com [println(numbers)] ou ["$numbers"] resultaria em um texto como [[I@1b6d3586]]: o tipo ([[I]], um array de inteiros da JVM) e um identificador do objeto, sem seus elementos. Os arrays Kotlin são arrays Java e têm o mesmo [toString];
- linha 12: apenas os elementos de índices 1 a 3 são ordenados, com o segundo índice excluído: 10, 30, 20 viram 10, 20, 30;
- linhas 16 e 17: [IntArray(5)] cria um array de 5 inteiros zerados. [copyInto] copia os 3 primeiros elementos de [numbers] para o início de [copy], enquanto os demais elementos mantêm o valor inicial 0. Seus parâmetros têm valores padrão e são nomeados aqui, o que torna a chamada muito mais legível que a de [System.arraycopy(numbers, 0, copy, 0, 3)] em Java;
- linhas 20 e 21: [copyOf] e [copyOfRange] criam um novo array. Um array maior que o original é preenchido com zeros;
- linhas 24 a 26: [fill] preenche o array e, em seguida, redefine para 0 os elementos dos índices 1 e 2 (excluindo o índice 3). Observe que a ordem dos parâmetros é diferente da do Java: primeiro vem o valor, depois o intervalo de índices;
- linhas 30 e 31: para arrays, ao contrário de strings e coleções, o operador [] compara referências: os arrays não têm uma função [equals] que compare o conteúdo. O compilador sabe disso e sinaliza o provável erro com um aviso se você escrever [copy == other]: **[warning: '' on arrays compares only references. Replace '' with 'contentEquals' to compare the arrays' contents or use '=' to remove the warning.] (como nossos projetos tratam avisos como erros, a compilação falha). Por isso, escrevemos [===] para comparar referências e [contentEquals] para comparar conteúdos. [contentEquals] é chamada aqui com a notação infixa* ([copy contentEquals other]*), sem ponto nem parênteses, o que é permitido pelo modificador [infix] em sua declaração (Capítulo 4);
- linhas 34 a 36: os arrays de objetos oferecem suporte direto às funções de busca [indexOf] e [lastIndexOf], bem como ao operador [in]. Em Java, é preciso usar [Arrays.asList] para acessá-los;
- linhas 38 a 40: [asList] retorna uma [List] (apresentada na próxima seção), que é uma view do array: ela não copia o array, mas dá acesso a ele por meio de funções de lista. A função [reverse] inverte o próprio array; como a lista é uma view do array, seus elementos ficam invertidos (linha 10 dos resultados). Ao contrário do Java, [reverse] existe para todos os tipos de arrays, inclusive [IntArray];
- linhas 42 a 44: [toList], por outro lado, retorna uma cópia dos elementos do array na forma de uma lista. Depois de modificar o elemento de índice 0 do array, a view reflete a alteração, mas a cópia não (linha 11 dos resultados). Este ponto é importante: uma view é eficiente, mas reflete todas as alterações do objeto original; uma cópia é independente dele;
- linha 49: um array de strings é ordenado segundo a ordem da função [compareTo] vista acima, ou seja, pelos códigos dos caracteres: as letras maiúsculas (códigos 65 a 90) vêm antes das minúsculas (97 a 122), que vêm antes das letras acentuadas (é: 233). "Zoé" é a primeira palavra e "éclair" a última. [sorted] retorna uma lista ordenada e deixa o array intacto;
- linha 51: para ordenar segundo as regras do francês, passamos um objeto
[Collator]*, que é um*[Comparator]de strings, para[sortWith]; o próprio array é ordenado; - linhas 55 e 56: os arrays também compartilham com as coleções funções comuns de cálculo: soma, média, máximo, número de elementos que satisfazem uma condição… Veremos essas funções ao tratar das coleções;
- linhas 59 a 62: Kotlin, assim como Java, não tem arrays retangulares bidimensionais: um array de arrays é criado com [Array(2) { IntArray(3) }], um array de 2 elementos, cada um dos quais é criado pela lambda: um array de 3 inteiros. [matrix.size] é o número de linhas, [matrix[0].size] é o número de elementos da linha 0. [contentDeepToString] exibe um array de arrays;
- linha 64: de forma mais geral, os construtores [Array], [IntArray]… recebem um tamanho e uma lambda que calcula cada elemento a partir de seu índice: aqui, os quadrados dos inteiros de 0 a 4.
Tenha em mente que, em Kotlin, os arrays são usados principalmente por razões de desempenho (arrays de tipos primitivos), para argumentos [vararg] e para a interação com bibliotecas Java. Para todo o resto, preferem-se as coleções, em especial as listas, tratadas na próxima seção.
5.4. Coleções
Além dos arrays, Kotlin oferece diversas coleções para armazenar conjuntos de elementos. Na JVM, Kotlin não reescreveu as classes de coleções: ele usa as do Java Collections Framework (pacotes [java.util], [ArrayList], [HashMap], [LinkedHashMap], [HashSet]…, disponibilizadas sem [import] por meio de apelidos de tipo do pacote [kotlin.collections]. Em vez disso, ele as apresenta por meio de suas próprias interfaces, organizadas em torno de uma distinção que o Java não faz em seus tipos: coleções somente leitura e coleções mutáveis.
interface | papel | implementações e funções construtoras |
[List<E>] [MutableList<E>] | uma sequência ordenada de elementos, acessíveis por sua posição | [ArrayList]; [listOf], [mutableListOf], [arrayListOf], [buildList], [emptyList] |
[Set<E>] [MutableSet<E>] | um conjunto: sem duplicatas | [LinkedHashSet], [HashSet], [java.util.TreeSet]; [setOf], [mutableSetOf], [hashSetOf], [sortedSetOf] |
[Map<K, V>] [MutableMap<K, V>] | um dicionário: pares (chave, valor), em que as chaves são únicas | [LinkedHashMap], [HashMap], [java.util.TreeMap]; [mapOf], [mutableMapOf], [hashMapOf], [sortedMapOf] |
[ArrayDeque<E>] | uma fila de duas pontas, utilizável como fila ou como pilha (uma classe específica do Kotlin) | [ArrayDeque] |
As interfaces [List] e [Set] derivam da interface [Collection<E>] ([size], [isEmpty], [contains]…), que por sua vez deriva de [Iterable<E>], a interface dos objetos que podem ser percorridos por um laço [for]. Essas interfaces têm apenas funções de leitura: uma [List<String>] não tem nem a função [add] nem a função [remove]. As funções de modificação ([add], [remove], [clear], [[i] = value]…) são declaradas pelas interfaces derivadas [MutableIterable], [MutableCollection], [MutableList], [MutableSet], e [MutableMap]. Uma [ArrayList] implementa [MutableList]e, portanto, também [List]. A regra de [val] e [var] aplica-se, assim, às coleções: escolhe-se o tipo somente leitura sempre que a coleção não precisa ser modificada (por exemplo, nos parâmetros de funções), e o compilador proíbe qualquer modificação por meio desse tipo.
No caso da JVM, essas interfaces existem apenas em tempo de compilação: [List] e [MutableList] são ambas compiladas na interface [java.util.List]. É isso que permite passar uma lista Kotlin a um método Java, e vice-versa, sem conversão. Uma coleção recebida de um método Java tem, em Kotlin, um tipo de plataforma, indicado como [(Mutable)List<String!>] nas mensagens do compilador: Kotlin não sabe se ela é mutável nem se seus elementos podem ser do tipo [null], e deixa essa decisão a cargo do programador.
Como em Java, a boa prática é declarar variáveis e parâmetros com o tipo de uma interface e escolher a implementação no momento da criação, na maioria das vezes por meio de um construtor: [val cities: MutableList<String> = mutableListOf()]. Observe que as funções construtoras do Kotlin escolhem, para conjuntos e dicionários, implementações que preservam a ordem em que os elementos são adicionados ([LinkedHashSet], [LinkedHashMap]): um ponto que muitas vezes distingue um programa Kotlin de seu equivalente em Java, que usa, em vez disso, [HashSet] e [HashMap].
Uma coleção contém apenas objetos. Kotlin não tem tipos primitivos visíveis na linguagem, e escrevemos [List<Int>]; mas, na JVM, os elementos dessa lista são objetos [java.lang.Integer], e o compilador converte automaticamente um [Int] em um [Integer] ao adicionar um elemento e vice-versa ao lê-lo ("boxing" e "unboxing"). Essa conversão, transparente em Kotlin, tem a mesma sobrecarga que em Java: uma lista de um milhão de inteiros contém um milhão de objetos [Integer]. Para grandes volumes de números, é preferível um array [IntArray].
O pacote [java.util] também contém as coleções do Java 1.0: [Vector] (uma lista), [Hashtable] (um dicionário) e [Stack] (uma pilha). Elas são obsoletas: como são sincronizadas em cada operação, são mais lentas que suas substitutas e não devem mais ser usadas. Quanto aos tipos brutos do Java (uma coleção genérica sem parâmetro de tipo, [List] em vez de [List<String>]), eles não existem em Kotlin: o parâmetro de tipo é obrigatório ou inferido pelo compilador.
5.4.1. Listas e a classe ArrayList
A classe [ArrayList<E>] implementa uma lista modificável de objetos do tipo [E], cujo tamanho varia durante a execução do programa. Ela armazena seus elementos em um array interno que expande automaticamente, de forma semelhante a [StringBuilder]. Esta é a implementação criada por [mutableListOf] e [arrayListOf]. As listas somente leitura criadas por [listOf] são, na JVM, listas de tamanho fixo da biblioteca Java ([Arrays.asList] sobre o array de argumentos, ou uma lista especializada para um único elemento, ou uma lista vazia). O elemento i de uma lista [l] é obtido por [l[i]] e modificado (se a lista for modificável) por [l[i] = value]: os operadores [get] e [set] (Capítulo 4) substituem os métodos Java [get(i)] e [set(i, value)].
Estas são algumas das funções das interfaces [List<E>] e [MutableList<E>] :
Função | papel |
[size: Int] | propriedade: número de elementos da lista; [indices] é o intervalo de índices, [lastIndex] é o último índice |
[l[index]], [getOrNull(index)], [getOrElse(index) { ... }] | lê o elemento de número [index]; uma exceção [IndexOutOfBoundsException] é lançada se o índice for inválido, exceto com [getOrNull] (que retorna [null]) e [getOrElse] (que retorna o valor calculado pela lambda) |
[first()], [last()], [firstOrNull()], [lastOrNull()] | o primeiro e o último elementos, respectivamente; uma exceção é lançada se a lista estiver vazia, exceto com as variantes [OrNull] |
[contains(element)] | retorna [true] se [element] estiver na lista; escrito como [element in list] |
[indexOf(element)], [lastIndexOf(element)] | retorna a primeira ou a última posição de [element] na lista, ou -1 |
[subList(fromIndex, toIndex)] | retorna uma view dos elementos de [fromIndex] (inclusive) até [toIndex] (exclusive); [slice(range)] retorna uma cópia |
[sorted()], [sortedDescending()], [sortedWith(comparator)], [reversed()] | retorna uma nova lista ordenada, ordenada em ordem decrescente, ordenada segundo um [Comparator], invertida |
[binarySearch(element)] | busca binária em uma lista ordenada |
[toTypedArray()], [toMutableList()] | retorna os elementos da lista como um array, uma nova lista editável |
[add(element)], [add(index, element)] | ([MutableList]) adiciona [element] ao final da lista, na posição [index]; o operador [+=] adiciona um elemento ou uma coleção |
[addAll(elements)] | ([MutableList]) adiciona ao final da lista os elementos de uma coleção |
[l[index] = element] | ([MutableList]) substitui o elemento de número [index] |
[remove(element)], [removeAt(index)] | ([MutableList]) remove a primeira ocorrência de [element] (resulta em [true] se a operação for bem-sucedida), o elemento de número [index] (retorna o elemento removido) |
[removeFirst()], [removeLast()], [removeIf { ... }] | ([MutableList]) remove o primeiro elemento, o último elemento e os elementos que satisfazem uma condição |
[clear()] | ([MutableList]) remove todos os elementos da lista |
[sort()], [sortDescending()], [sortWith(comparator)], [reverse()], [shuffle()] | ([MutableList]) ordena, inverte e embaralha a própria lista |
Observe a convenção de nomenclatura da biblioteca, que já vimos com os arrays: um verbo ([sort], [reverse], [shuffle]) modifica a própria coleção e existe apenas para coleções modificáveis; um particípio passado ([sorted], [reversed], [shuffled]) retorna uma nova coleção e deixa a original intacta. As funções da classe utilitária Java [java.util.Collections] ([Collections.sort(list)]…) continuam utilizáveis, mas essas funções de extensão as tornam desnecessárias.
Vamos retomar o exemplo visto anteriormente com um array e processá-lo agora com uma lista mutável de números reais, [MutableList<Double>]. Como uma lista é semelhante a um array, o código muda muito pouco. Eis o programa [Collections01.kt]:
Comentários:
- linha 27: a lista é criada vazia pela função [mutableListOf], que cria uma [ArrayList]. O tipo dos elementos, [Double], é especificado como parâmetro de tipo da função, pois não pode ser inferido de uma lista vazia; poderíamos também ter escrito [val elements: MutableList<Double> = mutableListOf()] ou [val elements = ArrayList<Double>()];
- linha 40: não há mais expansão a gerenciar; a lista se expande automaticamente. Poderíamos ter escrito [elements += element]: para uma lista mutável declarada com [val], o operador [+=] adiciona o elemento à lista ([plusAssign]), ao passo que, para o array declarado com [var] em [Arrays01.kt], ele criava um novo array. A variável [elements] é aqui um [val]: ela sempre se refere à mesma lista, cujo conteúdo muda;
- linha 25: a função [input] retorna uma lista modificável, porque o programa principal precisa poder ordená-la;
- linha 11: o número de elementos da lista é a propriedade [size], assim como nos arrays. Ao contrário de [StringBuilder], [ArrayList] não permite consultar sua capacidade; o método [ensureCapacity] permite apenas defini-la antecipadamente;
- linhas 17, 67 e 68: a ordenação e a busca binária são realizadas pelas funções de extensão da lista [sort] e [binarySearch], enquanto a busca linear é realizada por sua função [indexOf]. Para uma lista de tipo [Double], [indexOf] existe, ao contrário do array [DoubleArray]: ela compara os elementos por meio de sua função [equals], como em Java;
- linha 54: a função [search] não modifica a lista: seu parâmetro é declarado com o tipo [List<Double>], que é somente leitura. É possível passar-lhe uma [MutableList<Double>], que é uma [List<Double>]. Se ela tentasse modificar a lista, por exemplo com [elements.add(element)], o compilador a rejeitaria: [unresolved reference 'add' on receiver of type 'List<Double>']. O tipo do parâmetro documenta e garante, assim, que a função não altera a lista;
- linhas 46 a 49: a função genérica [display] recebe dois parâmetros:
- o primeiro é um texto a ser escrito;
- o segundo é um objeto que implementa a interface genérica [Iterable<T>], cuja única função é [operator fun iterator(): Iterator<T>].
O laço [for (element in elements)] é válido para qualquer objeto que tenha uma função [operator fun iterator()], seja ela membro ou extensão: é o caso de todas as coleções, que implementam [Iterable], bem como de arrays, strings, intervalos e assim por diante… Os arrays não implementam [Iterable]: a função [display] não é adequada para um array, a menos que se passe a ela [array.asList()]. Voltaremos a essa interface ao tratar das sequências.
Resultados (na linha de comando; a entrada pelo teclado aparece após os prompts):
Os resultados são os mesmos obtidos com o array.
5.4.2. Funções de lista
O programa [Collections02.kt] usa as demais funções de lista:
Resultados:
Comentários:
- linha 6: [mutableListOf] cria uma lista mutável contendo os elementos informados; o tipo dos elementos, [String], é inferido dos argumentos. Isso equivale ao código Java [new ArrayList<>(List.of("Paris", "Lyon", "Angers"))];
- linhas 10 a 12: três maneiras de adicionar elementos;
- linhas 14 e 15: em uma lista mutável, os operadores [+=] e [-=] adicionam e removem um elemento (ou todos os elementos de uma coleção);
- linha 19: o elemento de índice 0 é substituído pelo operador [[]], que chama a função [set];
- linhas 20 e 21: o operador [[]] lê um elemento; [first] e [last] retornam o primeiro e o último elementos, respectivamente, e a propriedade [lastIndex] equivale a [size - 1];
- linha 23: um índice inválido lança uma exceção [IndexOutOfBoundsException], assim como em Java. As funções [getOrNull] e [getOrElse] permitem evitá-la: a primeira retorna [null], e a segunda retorna o valor calculado por uma lambda que recebe o índice como argumento. No template, o texto
***[{ \\"?\\" }]é simplesmente um texto exibido, enquanto a expressão***[cities.getOrElse(10) { "?" }]chama a função; - linhas 26 e 27: busca de um elemento com o operador [in] ([contains]) ou com [indexOf];
- linha 30: [remove] retorna [true] se o elemento foi encontrado e removido;
- linha 31: [removeAt] remove o elemento de uma posição dada e o retorna;
- linhas 35 a 38: [sort] ordena a própria lista segundo a ordem natural de seus elementos, definida por [compareTo], e [reverse] faz a ordenação inversa;
- linha 39: [subList] retorna uma view dos elementos 1 e 2 (excluindo o 3), não uma cópia: modificar a view modificaria a lista;
- linhas 42 a 44: [sorted] retorna uma nova lista ordenada, e [sortedBy] retorna uma nova lista ordenada por uma chave calculada por uma expressão lambda, neste caso o comprimento dos nomes. A ordenação é estável: as cidades de mesmo comprimento (Tours, Lille, Brest) permanecem em sua ordem original. A lista [cities] não mudou. [sortedBy] evita ter de escrever um [Comparator]; também poderíamos escrever [cities.sortedWith(compareBy({ it.length }, { it }))] para ordenar por comprimento e, em seguida, em ordem alfabética (Capítulo 4);
- linhas 47 e 48: conversão de uma lista em array e de um array em lista. Graças aos genéricos [reified] (Capítulo 4), [toTypedArray] pode criar um array de strings do tamanho correto sem precisar da ajuda fornecida pelo método Java [toArray(String[]::new)];
- linhas 52 a 54: uma armadilha do Java evitada. Em Java, a interface [List] tem dois métodos [remove], um por posição e outro por valor, e [numbers.remove(1)], quando aplicado a uma [List<Integer>], remove o elemento de índice 1. Kotlin dá nomes diferentes às duas operações: [removeAt] remove por posição, e [remove] remove por valor. [numbers.remove(1)] remove, portanto, de fato o valor 1;
- linhas 58 a 60: [listOf] cria uma lista somente leitura; [days.add("thursday")] seria rejeitado em tempo de compilação. O operador [+], por outro lado, está disponível: ele cria uma nova lista formada pelos elementos de [days] seguidos de "thursday", e [days] permanece inalterada;
- linhas 64 e 65: [clear] esvazia a lista; [isEmpty] verifica se ela está vazia;
- linha 68: a função [display] aceita qualquer objeto ([Any], Capítulo 4): uma lista de strings, uma lista de inteiros ou um texto. Uma coleção é exibida diretamente: sua função [toString] retorna seus elementos entre colchetes.
5.4.3. Dicionários: Map e MutableMap
Um dicionário é um conjunto de pares (chave, valor). Ele pode ser visto como uma tabela de duas colunas:
chave | valor |
chave1 | valor1 |
chave2 | valor2 |
... | ... |
Na interface [Map<K, V>], as chaves são do tipo [K] e os valores são do tipo [V]. As chaves são únicas: não pode haver duas chaves idênticas (conforme definido pela função [equals]). Um dicionário desse tipo poderia ter esta aparência se os tipos [K] e [V] representassem classes:
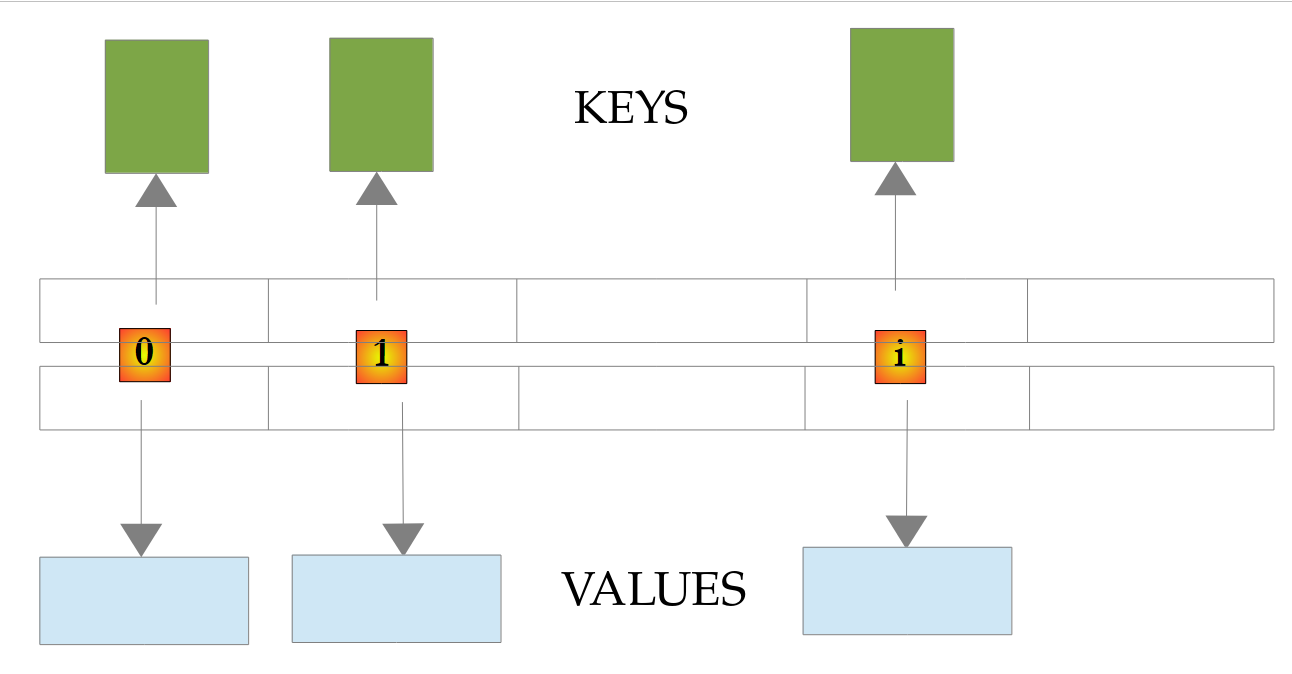
Como nas listas, Kotlin distingue a interface somente leitura *[Map<K, V>] da interface mutável *[MutableMap<K, V>]. As implementações são as do Java:
- um [HashMap] armazena seus pares chave-valor em uma tabela hash: a posição de um par na tabela é calculada com base no código hash de sua chave (função [hashCode], Capítulo 4). Recuperar o valor associado a uma chave é, assim, muito rápido, qualquer que seja o tamanho do dicionário. Em contrapartida, a ordem das tuplas na tabela não tem relação com a ordem em que foram adicionadas;
- um [LinkedHashMap] é um [HashMap] que, além disso, encadeia suas tuplas na ordem em que foram adicionadas: é igualmente rápido, usa um pouco mais de memória e enumera suas tuplas na ordem em que foram adicionadas. Esta é a implementação escolhida pelas funções de criação
***[mutableMapOf]e*[mapOf]*: por padrão, um dicionário Kotlin preserva, portanto, a ordem em que suas chaves foram adicionadas. Para obter um [HashMap], use [hashMapOf]* ou seu construtor.
Os pares de um dicionário criado por [mapOf] são escritos como [key to value]: [to] é uma função infixa da biblioteca padrão que cria um par [Pair(key, value)] (Capítulo 3). As principais funções dos dicionários são as seguintes:
função | papel |
[size] | propriedade: número de pares (chave, valor) do dicionário |
[dict[key]] | retorna o valor associado a [key], ou [null] se a chave não existir (função [get]); o tipo do resultado é, portanto, [V?] |
[getValue(key)] | retorna o valor associado a [key], do tipo [V]; lança uma exceção [NoSuchElementException] se a chave não existir |
[getOrDefault(key, defaultValue)], [getOrElse(key) { ... }] | retorna o valor associado a [key], ou [defaultValue], ou o valor calculado pela lambda se a chave não existir |
[containsKey(key)], [containsValue(value)] | retorna [true] se [key] for uma chave do dicionário ([key in dict]) e se [value] for um de seus valores |
[keys], [values], [entries] | propriedades: o conjunto das chaves, a coleção dos valores, o conjunto das tuplas do dicionário; um par [Map.Entry] tem as propriedades [key] e [value] e pode ser desempacotado: [for ((key, value) in dict)] |
[dict[key] = value] | ([MutableMap]) associa [value] a [key]: adiciona o par se a chave não existir; caso contrário, substitui o valor (função [set]); [dict += key to value] faz o mesmo |
[put(key, value)] | ([MutableMap]) faz o mesmo, mas retorna o valor antigo, ou [null] |
[putIfAbsent(key, value)] | ([MutableMap]) adiciona o par somente se a chave não existir; retorna o valor existente, ou [null] |
[getOrPut(key) { ... }] | ([MutableMap]) retorna o valor associado a [key]; se a chave não existir, calcula o valor com a lambda, adiciona o par e retorna o valor |
[remove(key)] | ([MutableMap]) remove o par chave-valor [key] e retorna seu valor, ou [null]; [dict -= key] faz o mesmo |
[clear()] | ([MutableMap]) remove todas as entradas do dicionário |
Considere o programa de exemplo [Collections03.kt]:
Comentários:
- linha 6: um array de strings que será usado para inicializar o dicionário [<String, Int>];
- linha 7: o dicionário vazio criado por [mutableMapOf]: é um [LinkedHashMap];
- linha 9: o mesmo dicionário, desta vez implementado por um [HashMap], criado por seu construtor;
- linhas 10 a 13: inicialização dos dois dicionários a partir do array de strings. Cada elemento é dividido por [split], e a desestruturação da lista resultante atribui seus dois campos às variáveis [name] e [age]. Adicionar um par é escrito como [dict[name] = value], exatamente como atribuir um elemento de array;
- linha 16: um dicionário é exibido diretamente, com seus pares entre chaves. As tuplas de
[dict]aparecem na ordem em que foram adicionadas; as de[dictHash]aparecem na ordem da tabela hash, que depende dos códigos hash das chaves (linha 1 dos resultados): um*[HashMap]não garante nenhuma ordem específica. O programa Java deste capítulo, que usa um [HashMap]*, exibia suas chaves nessa segunda ordem; - linha 18: o número de pares do dicionário;
- linhas 20 a 22: as chaves e os valores do dicionário. As propriedades [dict.keys] e [dict.values] são coleções e, portanto, [Iterable]: a função [display] que já encontramos é adequada;
- linhas 25 e 26: percorrer as chaves e obter o valor de cada uma com o operador [[]];
- linha 30: remoção de um par do dicionário;
- linhas 33 e 34: um dicionário não é, em si, uma coleção, mas o laço [for] sabe percorrê-lo: a biblioteca lhe fornece uma função de extensão [iterator] que enumera suas tuplas ([entries]). Cada par, do tipo [Map.Entry<String, Int>], é desempacotado em [(key, value)], por meio das funções de extensão [component1] e [component2] de [Map.Entry]. Essa abordagem é mais eficiente que a anterior, que busca o valor de cada chave, e mais legível que seu equivalente em Java ([for (Map.Entry<String, Integer> entry : dict.entrySet())], depois [entry.getKey()] e [entry.getValue()]);
- linha 37: [put] adiciona um par chave-valor ou substitui o valor de uma chave existente, sem lançar exceção nem emitir aviso; o valor retornado, que é o valor antigo ou [null], indica o que aconteceu. Quando esse valor não é necessário, use [dict[key] = value];
- linha 39: [putIfAbsent] não substitui o valor de uma chave existente;
- linhas 41 e 42: ler uma chave inexistente não causa erro: o operador [[]] retorna [null]. Seu resultado é do tipo [Int?], e o compilador exige que o caso [null] seja tratado antes de o valor ser usado. [getOrDefault] e [getOrElse] permitem escolher o valor retornado nesse caso, e o operador [in] ([containsKey]) permite verificar a existência de uma chave;
- linhas 44 a 47: a maneira padrão de contar ocorrências: somamos 1 ao valor da chave, ou 0 + 1 se ela estiver ausente, usando o operador Elvis [?:]. A chave "zoé" passa de 12 para 13; a chave "léa" é criada com o valor 1. O método Java [merge] também pode ser usado: [dict.merge(name, 1, Int::plus)];
- linhas 49 e 50: [getOrPut] retorna o valor associado a uma chave; se a chave não existir, calcula um valor com a lambda, adiciona o par ao dicionário e retorna o valor. A chave "max" é criada com o valor 30; a chave "jean" já existe, e seu valor 21 é retornado sem que a lambda seja executada. Esta é a função ideal para um cache ou para agrupar elementos em listas: [groups.getOrPut(key) { mutableListOf() }.add(element)];
- linhas 52 e 53: um dicionário somente leitura, criado por [mapOf] a partir dos pares chave-valor em [key to value]. [capitals["Spain"] = "Madrid"] seria rejeitado em tempo de compilação;
- linhas 55 a 65: busca de uma chave no dicionário. [dict[searchedName]] retorna um [Int?]: o caso [null] é verificado antes de usar o valor; no ramo [age != null], o compilador sabe que [age] é um [Int] (conversão inteligente de tipo). Em Java, [int age = dict.get(searchedName);] compila, mas lança uma exceção [NullPointerException] para uma chave ausente; em Kotlin, [val age: Int = dict[searchedName]] é rejeitado em tempo de compilação.
Resultados:
Ao contrário do programa Java, em que [HashMap] enumerava as chaves em uma ordem imprevisível, as chaves do dicionário são enumeradas na ordem em que foram adicionadas: "zoé" e "léa" aparecem no final. Se for necessário que as chaves permaneçam ordenadas, use um [TreeMap], mostrado a seguir.
5.4.4. Outras coleções
A biblioteca padrão do Kotlin e o pacote [java.util] contêm outras coleções, cada uma adequada a uma finalidade específica:
classe (construtor) | papel |
[LinkedHashSet<E>] ([setOf], [mutableSetOf]) | um conjunto: sem duplicatas, verificação de pertinência muito rápida; preserva a ordem em que seus elementos foram adicionados. Este é o conjunto padrão do Kotlin |
[HashSet<E>] ([hashSetOf]) | um conjunto sem ordem, um pouco mais econômico em memória |
[java.util.TreeSet<E>] ([sortedSetOf], [toSortedSet]) | um conjunto cujos elementos são mantidos ordenados |
[ArrayDeque<E>] | Uma classe específica do Kotlin ([kotlin.collections.ArrayDeque], a não confundir com [java.util.ArrayDeque]): uma fila de duas pontas que também implementa [MutableList]. Quando usada como fila, os elementos são removidos na ordem em que foram adicionados (FIFO, first in first out); quando usada como pilha, o último elemento adicionado é o primeiro a ser removido (LIFO, last in first out) |
[LinkedHashMap<K, V>] ([mapOf], [mutableMapOf]) | Um dicionário que preserva a ordem em que suas chaves são adicionadas. Este é o dicionário padrão do Kotlin |
[java.util.TreeMap<K, V>] ([sortedMapOf], [toSortedMap]) | um dicionário cujas chaves são mantidas ordenadas |
[java.util.PriorityQueue<E>] | uma fila de prioridade: o elemento removido é o menor segundo a ordem da fila |
[java.util.LinkedList<E>] | uma lista duplamente encadeada: inserções e remoções rápidas nas extremidades e durante a travessia |
Para os conjuntos, a distinção entre somente leitura e modificável é a mesma das listas: [Set<E>] tem apenas funções de leitura, enquanto [MutableSet<E>] acrescenta [add], [remove]…
O programa [Collections04.kt] apresenta uma visão geral rápida dessas coleções:
Resultados:
Comentários:
- linhas 3 e 4: as classes [PriorityQueue] e [TreeMap] do JDK não têm apelidos na biblioteca Kotlin e precisam ser importadas. [ArrayDeque] não é um apelido: é a classe Kotlin que é utilizada;
- linha 7: um paciente é representado por uma data class (Capítulo 4), o equivalente ao [record] do Java;
- linha 12: um conjunto mutável, inicializado com três elementos;
- linha 14: [add] retorna [false] se o elemento já estiver no conjunto, que permanece inalterado;
- linhas 18 a 21: [setOf] cria um conjunto somente leitura. As funções infixas [intersect] (interseção), [union] (união) e [subtract] (diferença) retornam um novo conjunto e não modificam [languages]: ao contrário do Java com [retainAll], [addAll] e [removeAll], não é necessário trabalhar sobre uma cópia. O conjunto criado preserva a ordem dos elementos: primeiro os de [languages], seguidos dos de [web] que não estavam originalmente nele;
- linhas 23 e 24: um [HashSet] apresenta seus elementos em uma ordem sem significado, a de sua tabela hash; um [TreeSet] os apresenta ordenados;
- linha 26: [toSet] retorna um conjunto formado pelos elementos de uma lista: esta é a maneira mais simples de remover duplicatas, preservando a ordem de sua primeira ocorrência ([distinct] retornaria uma lista);
- linhas 29 a 34: [ArrayDeque] é usado como fila: [addLast] insere um elemento no final da fila, [removeFirst] remove o elemento mais antigo e [first] obtém um elemento sem removê-lo. As expressões de um template são avaliadas da esquerda para a direita: [first], depois os dois [removeFirst], depois [size];
- linhas 37 a 42: [ArrayDeque] é usado como pilha: [addLast] empilha um elemento, [removeLast] desempilha o elemento mais recente e [last] obtém o topo da pilha. As classes do Java 1.0 [Stack], e até mesmo [java.util.ArrayDeque] e seus métodos [push]/[pop]/[offer]/[poll], não são relevantes em Kotlin: os nomes [addFirst], [addLast], [removeFirst], [removeLast], [first] e [last] são os mesmos para [ArrayDeque] e para todas as listas mutáveis;
- linhas 44 a 49: em uma pilha vazia, [removeLast] lança uma exceção [NoSuchElementException], ao passo que [removeLastOrNull] retorna [null]. Isso segue a convenção de nomenclatura da biblioteca: uma função [xxx] lança uma exceção quando não pode retornar um resultado, enquanto sua variante [xxxOrNull] retorna [null] ([first]/[firstOrNull], [removeFirst]/[removeFirstOrNull], [toInt]/[toIntOrNull]…). [e::class.simpleName] é o nome simples da classe da exceção (Capítulo 4);
- linhas 53 a 58: as tuplas de um [TreeMap] são listadas na ordem das chaves. Ele é preenchido com o operador [[]], como qualquer dicionário mutável. A ordenação das chaves permite operações que uma tabela hash não pode oferecer: [firstKey] retorna a menor chave, e [headMap] retorna a parte do dicionário cujas chaves precedem um valor dado;
- linhas 60 e 61: [sortedMapOf] cria um [TreeMap] a partir de pares ordenados por chave; [mutableMapOf] preserva a ordem em que os elementos foram adicionados;
- linhas 64 a 75: uma [PriorityQueue] precisa ser capaz de comparar seus elementos. Aqui, passa-se a ela um [Comparator] que compara prioridades: [compareBy<Emergency> { it.priority }] (Capítulo 4) lê-se "compare as emergências com base em sua propriedade [priority]". Os pacientes recebem alta em ordem crescente de prioridade, independentemente da ordem de chegada. O método [poll] retorna o elemento de menor prioridade, ou [null] se a fila estiver vazia: o operador Elvis [?: break] encerra então o laço. Esta é uma sintaxe idiomática, pois [break] é uma expressão em Kotlin. Em Java, escreveríamos [while ((emergency = emergencies.poll()) != null)]; Kotlin não permite atribuições dentro de uma expressão.
5.4.5. Views somente leitura, imutáveis e cópias
Uma classe que gerencia uma coleção muitas vezes precisa expô-la externamente sem permitir que seja modificada. Java não tem uma interface "somente leitura" distinta de [List]: ele usa coleções imutáveis, que implementam a interface [List] completa, mas cujos métodos de modificação lançam uma exceção [UnsupportedOperationException] em tempo de execução. Kotlin atende a essa necessidade principalmente por meio de seus tipos: basta declarar a coleção com o tipo [List], e o compilador impedirá qualquer modificação. No entanto, é importante entender o que esse tipo garante e o que não garante. O programa [Collections05.kt] demonstra as três maneiras de representar uma coleção: um tipo somente leitura, uma view não modificável e uma cópia:
Resultados:
Comentários:
- linhas 6 a 23: a classe [Classroom] gerencia uma lista de alunos. A própria lista mutável é privada; somente a função [enroll] permite modificá-la;
- linhas 11 e 12: a propriedade [students] torna a lista privada, mas, sob o tipo [List<String>], ela é somente leitura. Esta é a prática padrão em Kotlin: uma lista mutável privada e uma propriedade pública somente leitura. O código externo pode ler a lista, mas [students.add("intruder")] é rejeitado em tempo de compilação ([unresolved reference 'add' on receiver of type 'List<String>']), ao passo que o Java só o rejeita em tempo de execução;
- linha 36: a propriedade [students] não cria nenhum objeto; ela torna visível a própria lista privada, uma [java.util.ArrayList]. Ela vê, portanto, as alterações feitas pela classe proprietária (linha 3 dos resultados);
- linhas 41 a 43: somente leitura não significa imutável. O tipo
*[List]proíbe a modificação por meio dessa referência, mas o objeto é um*[ArrayList]totalmente modificável: convertê-lo para [MutableList] (ou passar a lista a um método Java, para o qual ela é um [java.util.List] comum) permite modificá-lo, e o aluno "intruder" é adicionado à lista da classe (linha 4 dos resultados). O tipo somente leitura protege contra erros, não contra más intenções; - linhas 15 e 16 e 44 a 48: para uma proteção completa, retornamos uma view somente leitura criada pelo método [Collections.unmodifiableList] do JDK: mesmo após uma conversão de tipo, qualquer tentativa de modificá-la lança uma exceção [UnsupportedOperationException]. Como a anterior, essa view não copia a lista e reflete as alterações feitas na classe proprietária;
- linhas 19 e 20 e 52 a 54: [toList], por outro lado, retorna uma cópia da lista: a lista [copy] não vê a adição de "petit". Uma cópia é independente do original, mas tem um custo: o getter cria uma nova lista a cada leitura da propriedade;
- linhas 57 e 58: [mapOf], assim como [listOf] e [setOf], cria uma coleção inicializada em uma única instrução, sob um tipo somente leitura: [grades["durand"] = 9] não compila ([no 'set' operator method providing array access]). Essas coleções equivalem a [List.of], [Set.of] e [Map.of] do Java, com a mesma ressalva anterior: são somente leitura pelo tipo, mas [mapOf] cria um [LinkedHashMap] comum;
- linhas 61 e 62: as coleções criadas por
***[List.of]em Java rejeitam o valor*[null]em tempo de execução. Em Kotlin, é o tipo que determina isso: uma***[List<String>]não pode conter um[null](o compilador o rejeita), ao passo que uma***[List<String?>]***pode. [filterNotNull] retorna uma lista de elementos não [null], do tipo [List<String>]*; - linhas 64 a 67 e 71 a 74: uma cópia defensiva. A classe [Group] recebe uma lista em seu construtor; se a mantivesse como está, quem a passou poderia modificá-la depois, neste caso adicionando "intruder" à lista [members]. O parâmetro do construtor [students] não é, portanto, uma propriedade (não é precedido de [val]): ele serve para inicializar a propriedade [students] com uma cópia. O grupo não é afetado pela adição (última linha dos resultados). Essa abordagem não pode ser usada com as propriedades do construtor primário de uma data class; se uma data class recebe uma coleção, o chamador lhe passará uma coleção que ele não modifica mais, por exemplo uma criada por [listOf] ou [toList].
O tipo [List<String>] especifica, portanto, o que o código que o recebe pode fazer, não o que a lista realmente é. Para coleções verdadeiramente imutáveis, existe a biblioteca [kotlinx.collections.immutable] da JetBrains ([persistentListOf], [persistentMapOf]…), e também é possível usar as coleções imutáveis do Java ([java.util.List.copyOf(list)]). Uma boa prática comum, tanto em Kotlin quanto em Java, é tornar as coleções somente leitura e criar uma nova coleção sempre que se quiser modificar uma ([list + element], [list - element], [list.filter { ... }]…): os operadores e as funções da biblioteca padrão tornam essa prática natural.
5.4.6. Ordenação, primeiro e último elementos, iteração
O programa [Collections06.kt] demonstra três aspectos úteis do trabalho com coleções: ordenação por critérios, acesso às extremidades de uma coleção (o que o Java 21 chamou de coleções sequenciadas) e remoção de elementos durante uma iteração:
Resultados:
Comentários:
- linha 8: um aluno é representado por uma data class;
- linha 11: a função [names] retorna uma lista com os nomes dos alunos. A função [map], que já usamos sem apresentá-la, aplica uma lambda a cada elemento de uma coleção e retorna uma lista de resultados: em Java, isso exigiria um laço ou a API Stream. A função é escrita como uma função de corpo de expressão ([= expression], Capítulo 3);
- linha 21: [sortBy] ordena a própria lista com base em uma chave extraída de cada elemento por uma lambda — neste caso, o nome. Os nomes são comparados segundo a ordem natural das strings: “Durand”, que começa com letra maiúscula, vem primeiro, e “élise” vem por último;
- linha 23: [sortWith] ordena segundo um [Comparator]. A função [compareBy] (Capítulo 4) constrói um comparador a partir da função que extrai a chave; um método sobrecarregado recebe como primeiro parâmetro o comparador a ser usado para comparar as chaves, neste caso um
*[Collator]: a ordem segue a de um dicionário francês. Isso equivale a***[Comparator.comparing(Student::name, collator)]** em Java; - linha 25: os comparadores são definidos da seguinte forma: [compareByDescending] compara as notas em ordem decrescente, e [thenBy] adiciona um critério secundário usado para classificar os alunos com a mesma nota: seus nomes, ignorando maiúsculas e minúsculas ([String.CASE_INSENSITIVE_ORDER]). Durand e Martin, que têm ambos nota 15, são classificados pelo nome. O parâmetro de tipo [<Student>] de [compareByDescending] é obrigatório aqui, porque o compilador não consegue inferir o tipo dos elementos em uma expressão que continua com [thenBy];
- linhas 29–32: as funções [first] e [last] retornam, respectivamente, o primeiro e o último elemento, e [asReversed] retorna uma view da lista em ordem inversa sem copiá-la ([reversed] retornaria uma cópia invertida). [first] e [lastOrNull] também aceitam uma condição: retornam o primeiro (ou o último) elemento que a satisfaz; [first] lança uma exceção [NoSuchElementException] se não houver nenhum; [lastOrNull] retorna [null]. O Kotlin oferece essas funções em todas as coleções desde a sua primeira versão: os métodos [getFirst], [getLast] e [reversed], que o Java 21 adicionou às suas coleções sequenciadas ([SequencedCollection], [SequencedSet], [SequencedMap]), não acrescentam muito;
- linhas 33–36: [linkedSetOf] cria um [LinkedHashSet], declarado aqui com o tipo da sua classe. Podemos então usar os métodos que o Java 21 adicionou a essa classe: [addFirst] adiciona “Lyon” ao início do conjunto. Observe um ponto sutil: quando uma classe Java tem um método com o mesmo nome de uma função de extensão, o método membro sempre tem precedência (Capítulo 4). Aqui,
[cities.reversed()]chama o método do Java 21[reversed]*, que retorna uma view invertida do conjunto, e não a função de extensão do Kotlin[reversed], que retornaria uma lista. Em contrapartida, [cities.last()] chama a extensão do Kotlin, que percorre o conjunto até o último elemento, porque o método Java se chama [getLast]; o Kotlin o expõe como uma propriedade, [cities.last]*, que retorna o último elemento sem iteração. Os resultados são os mesmos; só o custo difere; - linhas 37–39: um
*[TreeMap]*inicializado com os pares chave-valor de um dicionário, e seus métodos[firstEntry],[lastEntry], e *[descendingMap]*(que oferece uma view dos pares em ordem decrescente das chaves); - linhas 42–50: não se deve modificar uma coleção enquanto ela é percorrida por um laço [for]: o iterador usado pelo laço detecta a modificação e lança uma exceção [ConcurrentModificationException] no elemento seguinte. O teste é feito sobre uma cópia da lista. O comportamento é o mesmo do Java, já que a lista é uma [ArrayList];
- linhas 53–60: uma abordagem correta é escrever explicitamente o laço usando um iterador e remover o elemento atual com o método [remove] do iterador. Para uma lista mutável, [iterator] retorna um [MutableIterator], que possui essa função; um [Iterator] comum (o de uma [List]) não a possui. Como o Kotlin não tem o laço [for] de três cláusulas, o laço é escrito com [while];
- linha 62: de forma mais simples, a função [removeAll] remove os elementos que satisfazem uma condição, expressa por uma lambda [{ it.grade < 15 }], que se lê “a função que, dado um aluno [it], associa o booleano [it.grade < 15]”. O método Java [removeIf] também pode ser usado, enquanto [retainAll], por outro lado, mantém os elementos que satisfazem a condição. As lambdas serão discutidas em detalhe no Capítulo 7; por ora, basta saber lê-las. Vamos encontrá-las em cada linha da seção seguinte;
- linha 65: a função [forEach] executa uma lambda para cada elemento; um laço com [for] funcionaria igualmente bem. Exibir uma data class por meio de sua função [toString] retorna o nome da classe e os valores de suas propriedades: [Student(name=Durand, grade=15)].
5.5. Operações sobre coleções e sequências
O curso de Java apresentava aqui a API Stream (pacote [java.util.stream]), que permite processar os elementos de uma coleção como se estivéssemos consultando um banco de dados: filtrar, ordenar, agrupar, calcular totais… O Kotlin não precisa disso: em sua biblioteca padrão, essas operações são funções de extensão das próprias coleções ([Iterable<T>], [List<T>], [Map<K, V>]…). Escreve-se [persons.filter { it.age >= 18 }] onde o Java escreve [persons.stream().filter(p -> p.age() >= 18).toList()]: não é preciso passar por um stream, nem por um collector final — o resultado é diretamente uma lista.
Essas operações sobre coleções são imediatas: cada uma percorre a coleção inteira e constrói uma nova coleção. Para obter a avaliação lazy dos streams do Java (em que os elementos são calculados um a um, sob demanda, sem coleções intermediárias), o Kotlin oferece as sequências ([Sequence<T>]), que aceitam as mesmas operações. Por fim, os streams do Java ainda podem ser usados a partir do Kotlin, como qualquer classe do pacote do JDK: trataremos disso no final da seção.
Os programas desta seção mantêm os nomes de seus equivalentes em Java: [Streams01.kt] a [Streams05.kt].
5.5.1. As interfaces Iterable e Iterator
Vamos primeiro rever a interface [Iterable<T>], que define objetos que podem ser percorridos por um laço [for]. Como em Java, ela contém apenas um método abstrato, [iterator], que retorna um iterador [Iterator<T>]: um objeto que indica se ainda há elementos restantes ([hasNext]) e retorna o próximo elemento ([next]).
Um objeto [Iterable] não precisa conter seus elementos: seu iterador pode produzi-los um a um, sob demanda. O programa [Streams01.kt] fornece um exemplo disso, apresenta os geradores do Kotlin — que o Java não tem — e uma sequência infinita:
Resultados:
Comentários:
- A partir da linha 37: a classe
[Evens]implementa a interface*[Iterable<Int>]: seu método [iterator], que é sobrescrito ([override]), retorna um iterador que gera os números pares de 0 a [max]*. Ele não constrói nenhuma lista: o iterador armazena apenas o próximo número a ser gerado (linha 44); - linha 42: o iterador é um objeto anônimo: uma expressão de objeto [object : Iterator<Int> { ... }], que declara e instancia uma classe sem nome que implementa a interface em uma única expressão. Isso equivale à classe anônima do Java [new Iterator<>() { ... }]. Ele tem acesso à propriedade [max] do objeto [Evens];
- linhas 46–51: [hasNext] indica se ainda há um elemento a ser produzido;
- linhas 54–61: [next] produz o próximo elemento. Se for chamado quando não houver mais elementos, deve lançar uma [NoSuchElementException] (em Kotlin, [NoSuchElementException] é um alias da classe Java [java.util.NoSuchElementException], disponível sem [import]);
- linhas 7–8: os resultados (linhas 2–11) mostram que a produção de um elemento pelo iterador e o consumo desse elemento pelo laço [for] se alternam;
- linhas 13–15: o que o laço [for] realmente faz: ele solicita um iterador ao objeto, chama [hasNext] enquanto esse método retornar [true], e obtém cada elemento com [next];
- linhas 68–77: os mesmos números pares, gerados por um gerador. A função [sequence] da biblioteca padrão recebe um bloco de código (uma lambda) e retorna uma sequência [Sequence<Int>]. Cada chamada a [yield(n)] (linha 74) passa um elemento ao consumidor e suspende o bloco, que será retomado imediatamente após [yield] quando o próximo elemento for solicitado. Isso permite escrever um iterador como um simples laço, sem precisar gerenciar o estado entre as chamadas a
*[next]. É o equivalente ao [yield return] do C#, que o Java não tem: o curso de Java exigia que os alunos escrevessem a classe do iterador ou usassem [Stream.iterate]*. Esse mecanismo de suspensão é o das corrotinas, que estudaremos no Capítulo 9; - os resultados (linhas 22–29) mostram que o gerador e o laço [for] se alternam exatamente como no iterador escrito à mão: nada é gerado antecipadamente;
- linhas 26–27: uma sequência infinita, a sequência de Fibonacci. [generateSequence(seed) { function }] produz a semente, depois o resultado da função aplicada à semente, depois o resultado da função aplicada a esse resultado, e assim por diante. Cada elemento aqui é um par ([Pair<Long, Long>], criado por [to]) de dois números consecutivos da sequência; a expressão lambda desempacota o par recebido [(a, b)] e retorna o próximo par. [map] mantém apenas o primeiro número, [takeWhile] interrompe a sequência no primeiro número maior que 100, e [joinToString] concatena os números restantes com um separador. A sequência nunca é calculada por inteiro: apenas os elementos solicitados são calculados;
- linha 31: ao contrário do Java, uma string é percorrida diretamente com [for], caractere por caractere: a biblioteca padrão do Kotlin define uma função [operator fun CharSequence.iterator()];
- linhas 81–82: essa é a regra geral: o laço [for] do Kotlin aceita qualquer objeto que tenha uma função [operator fun iterator()] (membro ou de extensão) que retorne um objeto com as funções [operator fun hasNext()] e [operator fun next()]. A classe [Counter] não implementa [Iterable]; sua função [iterator], marcada como [operator], é suficiente ([(1..n).iterator()] é o iterador do intervalo [1..n]). Trata-se de uma convenção, semelhante às da sobrecarga de operadores discutidas no Capítulo 4.
Resumindo: um [Iterable] é percorrido com [for], e é muito fácil obter um objeto que produz seus elementos sob demanda com [sequence { ... yield(x) ... }] ou [generateSequence]. Esse mecanismo de geração sob demanda é usado por todas as sequências.
5.5.2. Filtrar, projetar, ordenar
Os exemplos a seguir trabalham com uma pequena lista de pessoas. Uma pessoa é representada por uma data class ([data class]), apresentada no Capítulo 4, que é o equivalente em Kotlin da classe Java [record]: em uma única linha, obtém-se uma classe com construtor e propriedades somente leitura ([p.lastName], [p.age]…), um método [toString] que exibe as propriedades, um operador de igualdade que compara seus valores e uma função [copy].
O programa [Streams02.kt] demonstra operações básicas sobre coleções:
Resultados:
Comentários:
- linhas 6–13: a lista somente leitura de pessoas criada por [listOf]. A vírgula após o último elemento (“vírgula final”) é permitida em Kotlin: ela facilita a adição de um elemento;
- linha 64: a data class [Person], declarada no nível do arquivo, ao lado das funções;
- linha 17: a função [filter] filtra a lista: mantém apenas os elementos que satisfazem uma condição. Essa condição lhe é passada na forma de uma lambda [{ p -> p.age >= 18 }], “a função que, dada uma pessoa p, retorna o booleano [p.age >= 18]”. [filter] chama essa função para cada pessoa. Quando o último parâmetro de uma função é uma função, a lambda é escrita após os parênteses, que são omitidos se estiverem vazios: [persons.filter { ... }], e não [persons.filter({ ... })];
- o resultado de
*[filter]é uma nova lista,[List<Person>]: a lista[persons]* permanece inalterada. Isso vale para todas as operações apresentadas nesta seção, que se aplicam tanto a listas somente leitura quanto a listas mutáveis; - linhas 58–60: a função genérica [display] percorre uma coleção com [forEach] e exibe cada elemento; uma pessoa é exibida por meio do método [toString] da data class: [Person(lastName=dupont, ...)] (parênteses onde o Java usava colchetes);
- linha 21: a função [map] projeta cada elemento em um novo valor, neste caso uma string. O resultado é uma lista [List<String>]. Uma lambda com um único parâmetro pode omitir o nome do parâmetro; nesse caso, ele se chama [it];
- linhas 25–28: as operações retornam coleções, às quais outras operações podem ser aplicadas. As operações costumam ser escritas uma por linha: essa cadeia de chamadas se lê de cima para baixo como uma receita. [Person::lastName] é uma referência de propriedade, uma notação abreviada para a lambda [{ it.lastName }];
- linha 28: [sorted] ordena segundo a ordem natural dos elementos, neste caso strings ([sortedDescending] ordena em ordem inversa);
- linha 32: [sortedBy] ordena por uma chave calculada por uma lambda ([sortedByDescending] em ordem decrescente); [take(3)] mantém os três primeiros elementos;
- linha 35: para ordenar com base em vários critérios, [sortedWith] aceita um [Comparator], construído com as funções do Kotlin vistas no Capítulo 4: [compareByDescending<Person> { it.age }] (idade em ordem decrescente), seguida de [thenBy { it.lastName }] para distinguir pessoas da mesma idade. Durand e Laurent, que têm ambos 32 anos, são ordenados pelo sobrenome. O tipo [Person] deve ser especificado em [compareByDescending], porque o compilador não consegue inferi-lo apenas a partir da lambda;
- linha 39: para numerar, [mapIndexed] passa à lambda o índice do elemento além do próprio elemento; de forma semelhante, existem [filterIndexed], [forEachIndexed]… Em Java, seria preciso percorrer os índices com um [IntStream.range];
- linhas 40–41: [withIndex] converte cada elemento em um objeto [IndexedValue] (propriedades [index] e [value]), que pode ser filtrado e depois desempacotado em [(i, p)] dentro do laço;
- linhas 45–46: uma lista, como qualquer coleção, pode ser percorrida quantas vezes se quiser: o resultado de [filter] é uma lista de verdade, não um cálculo pendente;
- linhas 48–53: um stream do Java ([java.util.stream.Stream]), obtido com o método [stream] da lista (uma lista do Kotlin é, em tempo de execução, uma [java.util.List]), pode ser usado a partir do Kotlin; as lambdas do Kotlin são convertidas automaticamente em interfaces funcionais do Java. No entanto, ele continua sendo de uso único: depois de percorrido por uma operação terminal (aqui, [count]), lança uma [IllegalStateException]. [e.javaClass.simpleName] é a notação do Kotlin para [e.getClass().getSimpleName()].
As operações de coleção do Kotlin, portanto, não distinguem entre operações intermediárias e terminais: cada uma produz um resultado completo. Essa simplicidade tem um custo: uma cadeia de n operações cria n coleções intermediárias. Isso não é um problema para coleções pequenas, que são de longe as mais comuns; para coleções grandes, ou para operações que podem terminar antecipadamente, usam-se sequências (programa [Streams05.kt]). Como o Java, e ao contrário do C# (LINQ), o Kotlin não tem uma sintaxe de consulta semelhante ao SQL: os processamentos são escritos como cadeias de chamadas de função.
5.5.3. Quantificadores, agregados, seleção de elementos
O programa [Streams03.kt] inclui operações que retornam um único valor e operações que selecionam um subconjunto de uma coleção:
Resultados:
Comentários:
- linhas 15–17: [any] retorna [true] se pelo menos um elemento satisfaz a condição, [all] se todos a satisfazem, e [none] se nenhum a satisfaz (os [anyMatch], [allMatch] e [noneMatch] dos streams do Java). Sem parâmetros, [any()] indica se a coleção tem pelo menos um elemento. Em um template de string, [${ ... }] pode conter qualquer expressão, inclusive uma chamada de função com uma lambda;
- linha 20: [count] conta os elementos; com uma condição, conta os que a satisfazem, sem necessidade de filtrar antes. Para uma coleção, a propriedade [size] é obviamente preferível a [count()];
- linhas 21–23: [sumOf { it.age }] soma um valor calculado para cada elemento. Em uma coleção de números ([List<Int>]), as funções [sum] e [average] se aplicam diretamente: não é preciso, como em Java, passar por um stream especializado ([mapToInt(...)] seguido de [IntStream]). [average] retorna um [Double], que é [NaN] (“not a number”) para uma coleção vazia. ["%.2f".format(x)] formata o número usando o idioma do sistema: daí o ponto decimal;
- linha 24: [min] e [max] retornam o menor e o maior elemento de uma coleção de elementos comparáveis; [minOf { it.age }] retorna o menor dos valores calculados. Essas funções lançam [NoSuchElementException] se a coleção estiver vazia; suas variantes [minOrNull], [maxOrNull], [minOfOrNull]… retornam então [null];
- linha 26: [minBy] e [maxBy] retornam o elemento (neste caso, a pessoa) com a chave mínima ou máxima, e não o valor da chave em si. Enquanto o Java retorna um [Optional<Person>] que precisa ser aberto com [get], o Kotlin retorna diretamente a pessoa (e lança uma exceção se a coleção estiver vazia; [minByOrNull] retorna então [null]);
- linhas 28–30: [fold] calcula um agregado arbitrário: parte de um valor inicial (aqui, 0), depois chama a lambda para cada elemento usando o resultado anterior ([total]) e o elemento ([p]), e retorna o resultado final. [reduce] faz o mesmo, usando o primeiro elemento como valor inicial: aqui, a cada passo, o mais longo dos dois nomes é mantido. [sum], [count], [max]… são simplesmente casos particulares dessas duas funções;
- linhas 32–35: [first] retorna o primeiro elemento — com uma condição: o primeiro elemento que a satisfaz. [last] retorna o último;
- linhas 37–38: não há ninguém em Brest. [firstOrNull] retorna então [null]: seu tipo de retorno é [Person?]. Onde o Java usa um [Optional], o Kotlin usa um tipo anulável e seus operadores: [brestResident?.lastName ?: "nobody"] retorna o sobrenome se houver uma pessoa, e “nobody” caso contrário. Isso é o equivalente exato de [map(Person::lastName).orElse("nobody")] em Java;
- linhas 39–43: [first] exige que exista um elemento; caso contrário, lança uma [NoSuchElementException]. Ele é usado quando a ausência de um valor é um erro; quando é algo normal, usa-se [firstOrNull]. A mesma convenção de nomenclatura se aplica em toda a biblioteca: [last]/[lastOrNull], [single]/[singleOrNull], [elementAt]/[elementAtOrNull], [getOrNull] (para um índice)…;
- linhas 45–47: [single] exige que haja exatamente um elemento (que satisfaça a condição); caso contrário, lança uma exceção. [singleOrNull] retorna [null] se não houver nenhum, ou se houver vários, como é o caso aqui em Paris. Os streams do Java não têm equivalente;
- linha 50: [distinct] remove as duplicatas (conforme definido pelo método [equals]);
- linha 51: [distinctBy] remove os elementos cuja chave já foi vista: assim, mantemos a primeira ocorrência de cada cidade. O curso de Java precisava implementar essa operação por conta própria, usando um conjunto de cidades já vistas;
- linhas 54–58: [take(n)] mantém os n primeiros elementos, enquanto [drop(n)] os ignora ([limit] e [skip] em Java); [takeLast] e [dropLast] fazem o mesmo a partir do fim. Combinadas, [drop] e [take] extraem uma “página” de resultados; para uma lista, [slice(2..3)] extrai diretamente os elementos de um intervalo de índices. [takeWhile] mantém os elementos enquanto uma condição for verdadeira e para no primeiro elemento que não a satisfaz; [dropWhile] faz o oposto: ignora esses elementos e mantém todos os seguintes;
- linha 61: [chunked(3)] divide a coleção em listas de 3 elementos, podendo a última lista ser menor: isso é paginação. O Java 24 teve de introduzir os “gatherers” ([gather(Gatherers.windowFixed(3))]) para essa finalidade; o Kotlin tem [chunked] desde a versão 1.2;
- linhas 62–63: [windowed(3)] gera janelas deslizantes de 3 elementos consecutivos: elementos 0–2, depois 1–3, depois 2–4… (o [windowSliding(3)] do Java 24). Como [chunked], [windowed] aceita uma expressão lambda que transforma cada janela: aqui, calculamos a média móvel das idades de três pessoas.
5.5.4. Data classes locais, agrupamentos, junções
O programa [Streams04.kt] apresenta operações mais complexas. Enquanto o Java realiza a maioria delas com a operação terminal [collect] e os collectors da classe [Collectors], o Kotlin tem uma função separada para cada um:
Resultados:
Comentários:
- linha 22: uma data class local, declarada dentro da função em que é usada (o equivalente ao record local do Java 16). Ela permite atribuir um nome e um tipo aos resultados intermediários de um processamento sem precisar declarar uma classe no nível do arquivo: linha 26: cada pessoa com mais de 40 anos é convertida em um [Summary] que retém apenas os dados relevantes;
- linha 27: a expressão lambda desempacota o [Summary] recebido: [(name, decade)] entre parênteses declara dois parâmetros que recebem as duas propriedades do objeto, na ordem especificada pelo construtor. Isso é possível para qualquer data class (Capítulo 3), bem como para tuplas e entradas de dicionário;
- linha 31: [groupBy] agrupa os elementos que têm a mesma chave, neste caso a cidade. O resultado é um dicionário [Map<String, List<Person>>]: cada cidade é associada a uma lista de seus moradores. Os dicionários criados pela biblioteca padrão do Kotlin ([groupBy], [associate], [mapOf]…) são [LinkedHashMap]: mantêm as chaves na ordem de sua primeira aparição. O Java, que por padrão cria um [HashMap] com ordem imprevisível, precisava solicitá-lo explicitamente ([LinkedHashMap::new]);
- linhas 32–34: um laço [for] percorre as entradas do dicionário, que são desempacotadas em [(city, group)]. Para cada grupo, são exibidos seu tamanho, a idade média e os nomes; [joinToString(", ") { it.lastName }] concatena os nomes com um separador: sua função lambda converte cada elemento em string, o que dispensa um [map] prévio;
- linha 37: uma segunda lambda, opcional, transforma os elementos classificados em cada grupo: aqui, apenas os nomes são mantidos (esse é o collector [mapping] do Java);
- linhas 42–45: uma junção (join). Como os streams do Java, as coleções do Kotlin não têm uma operação de junção; nós a obtemos com [flatMap], cuja lambda retorna uma lista para cada elemento: [flatMap] concatena todas essas listas. Cada pessoa é substituída aqui pela lista de cidades com o mesmo nome (uma ou nenhuma), convertida em strings. Como em uma junção interna (inner join) do SQL, apenas os pares correspondentes são mantidos: Laurent, que mora em Lyon — ausente da lista de cidades — não aparece, nem Brest, que não tem moradores. Esse código percorre a lista inteira de cidades para cada pessoa;
- linhas 47–51: a mesma junção, porém mais eficiente. [associateBy { it.name }] constrói um dicionário de cidades, em que a chave é o nome da cidade e o valor é a própria cidade (o collector Java [toMap(City::name, v -> v)]); em seguida, procuramos nesse dicionário a cidade de cada adulto. [citiesByName[p.city]] retorna um [City?] ou [null] se a cidade não for encontrada; [?.let { ... }] constrói a string apenas se a cidade foi encontrada, e [mapNotNull] é um [map] que elimina os resultados [null]: a filtragem e a projeção são feitas em uma única operação. Ao contrário de [toMap] em Java, [associateBy] não sinaliza chaves duplicadas: o último valor prevalece;
- linhas 55–57: [associate] constrói um dicionário a partir de uma lambda que retorna, para cada elemento, um par chave-valor, escrito como [it.lastName to it.age]. [associateWith] toma os elementos como chaves e calcula os valores: neste caso, o comprimento de cada palavra;
- linhas 58–59: [partition] divide os elementos em duas listas com base em uma condição: os que a satisfazem e os demais. O resultado é um par de listas, imediatamente desempacotado em [(adults, minors)]; o Java retornava um dicionário com as chaves [true] e [false] ([partitioningBy]);
- linhas 60–61: [zip] emparelha os elementos de mesma posição das duas coleções e para no fim da mais curta. Sem lambda, retorna uma lista de pares ([(1, a)]…); com uma lambda, combina cada par de elementos — neste caso, em um nome seguido de um sobrenome. Os streams do Java não têm equivalente;
- linha 64: contar os elementos de cada grupo. [groupingBy { it.city }] não constrói os grupos: retorna um objeto [Grouping] capaz de calcular a chave de cada elemento; [eachCount] percorre então a coleção uma única vez, contando os elementos de cada chave (o collector Java [counting]). [toSortedMap] copia o dicionário para um dicionário ordenado por chave (um [TreeMap]) para exibição;
- linhas 65–66: somar um valor por grupo: os grupos são construídos com [groupBy], depois [mapValues] transforma cada valor do dicionário (aqui, uma lista de pessoas) em outro valor (aqui, a soma de suas idades), preservando as chaves. A função lambda recebe uma entrada do dicionário, desempacotada por [(_, group)]: o sublinhado [_] indica que não nos interessamos pela chave;
- linhas 67–68: um [Grouping] também tem [fold], [reduce] e [aggregate], que calculam um agregado por grupo em uma única passagem, sem construir as listas dos grupos: aqui, a idade máxima de cada cidade;
- linhas 71–72: [flatMap] novamente, que transforma cada cidade em uma lista de duas strings concatenadas; [flatten] “achata” uma lista de listas;
- linha 76: a posição de cada elemento em uma lista filtrada: [forEachIndexed] passa o índice à lambda. O Java teria de armazenar o stream em uma lista e depois percorrer seus índices.
A tabela a seguir resume as correspondências entre os collectors do Java e as funções do Kotlin encontradas neste programa:
Java (streams e collectors) | Kotlin (coleções) |
[collect(toList())], [toList()] | Desnecessário: o resultado já é uma lista; [toList()], [toMutableList()] para copiar |
[groupingBy(f)] | [groupBy(f)]; [groupBy(f, g)] para [groupingBy(f, mapping(g, toList()))] |
[groupingBy(f, counting())] | [groupingBy(f).eachCount()] |
[groupingBy(f, summingInt(g))] | [groupBy(f).mapValues { (_, l) -> l.sumOf(g) }] |
[toMap(f, v -> v)] | [associateBy(f)] |
[toMap(f, g)] | [associate { f(it) to g(it) }], [associateBy(f, g)] |
[partitioningBy(p)] | [partition(p)] (um par de listas) |
[joining(", ")] | [joinToString(", ")] |
[flatMap(e -> stream)] | [flatMap { list }], [flatten()] |
5.5.5. Avaliação lazy: as sequências
As operações sobre coleções são executadas imediatamente, cada uma por inteiro. As operações sobre sequências ([Sequence<T>]) não são executadas quando são escritas, mas quando uma operação terminal percorre a sequência: trata-se da avaliação lazy, como nos streams do Java. O programa [Streams05.kt] compara as duas, usando lambdas que exibem o que fazem:
Resultados:
Comentários:
- linhas 13–16: a cadeia [filter] + [map] aplicada a uma lista. As lambdas exibem uma mensagem antes de retornar seu valor: o corpo de uma lambda pode conter várias instruções (separadas aqui por ponto e vírgula, já que estão na mesma linha), e é o valor da última expressão que é retornado: não há [return];
- linhas 2–10 dos resultados: [filter] examina os seis números e constrói uma lista intermediária [[2, 4, 6]]; só então [map] calcula os três quadrados e constrói a lista de resultados. Cada etapa é executada por inteiro antes da seguinte;
- linhas 20–29: o mesmo processamento sobre uma sequência, obtida por [numbers.asSequence()]. As expressões lambda são escritas aqui em várias linhas;
- linha 13 dos resultados: depois que a sequência é definida, nada foi exibido ainda: nem [filter] nem [map] examinaram um único elemento até agora. [evenSquares] não contém resultados, mas sim a descrição de um cálculo;
- linhas 15–26 dos resultados: o cálculo é executado durante a operação terminal [forEach] (linha 33), elemento por elemento: cada número passa por [filter], depois por [map] se for par, e então entra em [forEach] antes que o próximo número seja examinado. Nenhuma lista intermediária é construída;
- linhas 36–39: ao contrário de um stream do Java, uma sequência obtida de uma coleção pode ser percorrida várias vezes: cada operação terminal ([toList] neste caso) reinicia o cálculo desde o começo, com base no estado atual da coleção. A sequência criada antes da adição do 10 leva isso em conta. O Java teria de armazenar uma lambda que recria o stream ([Supplier<Stream<Integer>>]); uma sequência desse tipo já é um padrão reutilizável. Algumas sequências, porém, são percorridas apenas uma vez: as construídas sobre um iterador ou um fluxo de entrada, por exemplo; [constrainOnce()] retorna uma sequência que lança uma [IllegalStateException] na segunda passagem;
- linhas 42–44: [toList] realiza o processamento e armazena seus resultados: [snapshot] é uma lista que não enxerga a adição do 20;
- linhas 48–50: [first] interrompe a iteração assim que obtém um elemento: os números seguintes ao 3 nunca são examinados. [any], [take], [takeWhile], [firstOrNull]… também interrompem a iteração o mais cedo possível; é isso que permite processar sequências infinitas. Em uma lista, [filter { ... }.first()] examinaria os oito números antes de retornar o primeiro; por isso escrevemos, em vez disso, [first { ... }], que para no primeiro elemento encontrado;
- linhas 55–58: algumas operações intermediárias não conseguem processar os elementos um a um: [sorted] precisa conhecer todos os elementos para retornar o menor. [sequenceOf(3, 1, 2)] cria uma sequência a partir de valores; a operação [onEach], que executa uma lambda em cada elemento à medida que ele passa, sem modificá-lo (o equivalente Java de [peek]), mostra que os três elementos são recebidos por [sorted] antes que ele transmita um único;
- linhas 61–64: sequências infinitas criadas por [generateSequence], já vistas em [Streams01.kt]: as potências de 2, das quais os dez primeiros são mantidos com [take(10)], e os números ímpares, entre os quais procuramos o primeiro cujo quadrado excede 200. Uma operação que precisa percorrer a sequência inteira ([toList], [count], [sorted]…) nunca terminaria em uma sequência infinita: é preciso limitá-la antes;
- linha 67: os streams do Java continuam utilizáveis a partir do Kotlin, inclusive os streams de tipos primitivos ([IntStream], [LongStream], [DoubleStream]); [IntStream.rangeClosed(1, 10)] gera os inteiros de 1 a 10. A linha 68 mostra o mesmo cálculo em Kotlin, sobre o intervalo [1..10]. Em Kotlin, não há coleções nem sequências especializadas para tipos primitivos: uma [List<Int>] contém objetos [Integer]. Para volumes muito grandes de números, usamos um array [IntArray] (que por sua vez contém [filter], [map], [sum]…);
- linhas 71–72: as funções de extensão [asSequence] e [asStream] do pacote [kotlin.streams] (importado na linha 4) convertem um stream do Java em uma sequência, e vice-versa. Elas são usadas na interface com uma biblioteca Java que produz ou espera streams. [boxed] transforma um [IntStream] em um [Stream<Integer>].
Quando usar uma sequência em vez de uma coleção?
- As operações sobre coleções são a escolha padrão: são simples e rápidas para coleções pequenas e médias, em que o custo das coleções intermediárias é desprezível;
- passe para sequências ([asSequence()]) quando a cadeia de operações for longa e a coleção for grande (sem coleções intermediárias), quando o processamento puder parar antecipadamente ([first], [take], [any]…), ou quando os elementos são gerados sob demanda (sequências infinitas, geradores, linhas de um arquivo grande: veremos isso com [useLines]);
- os streams do Java ([stream()]) têm pouca utilidade em um programa Kotlin, exceto para interagir com uma biblioteca Java e por sua versão paralela: o método [parallelStream] de uma coleção retorna um stream cujos elementos são processados simultaneamente por várias threads (Capítulo 8), algo que as sequências não podem fazer. Ele só acelera operações demoradas sobre grandes volumes de dados e exige lambdas sem efeitos colaterais: deve ser usado somente após avaliar seus benefícios.
A tabela a seguir compara as três ferramentas:
Coleções do Kotlin | Sequências do Kotlin | Streams do Java | |
Avaliação | imediata, operação por operação | lazy, elemento por elemento | lazy, elemento por elemento |
coleções intermediárias | uma por operação | nenhuma | nenhuma |
várias passagens | sim | sim (exceto sequências de uso único) | não: um stream por percurso |
elementos infinitos | não | sim ([generateSequence], [sequence]) | sim ([Stream.iterate], [Stream.generate]) |
processamento paralelo | não | não | sim ([parallelStream]) |
tipos primitivos | não (exceto os arrays [IntArray]…) | não | sim ([IntStream]…) |
Encontraremos essas operações ao longo do curso e, no Capítulo 7, veremos como são construídos os tipos funcionais e as funções de ordem superior que os utilizam.
5.6. Arquivos de texto
O Kotlin não tem sua própria API de arquivos: ele usa as do JDK e as complementa com funções de extensão que simplificam seu uso. Para relembrar, o Java tem duas APIs para arquivos: o pacote [java.io], disponível desde o Java 1.0 ([File], [FileReader], [FileInputStream]…), e o pacote [java.nio.file], introduzido no Java 7 ([Path], [Files]…), que é mais completo e oferece melhor relatório de erros. A biblioteca padrão do Kotlin oferece extensões para ambos:
- o pacote [kotlin.io] (importado automaticamente) estende a classe [java.io.File]: [File("infos.txt").readText()], [readLines()], [forEachLine { }], [useLines { }], [writeText(text)], [appendText(text)], [bufferedReader()], [printWriter()]…;
- o pacote [kotlin.io.path] (que precisa ser importado) estende a interface [java.nio.file.Path] com funções de mesmo nome e adiciona uma função de criação [Path("infos.txt")], o operador [/] para construir caminhos, propriedades ([name], [extension]…) e funções que reproduzem as da classe [Files] ([exists], [createDirectories], [listDirectoryEntries], [walk]…).
Como em Java, [Path] é hoje a opção preferida: usaremos [kotlin.io.path]. Um caminho relativo, como [Path("infos.txt")], é completado pelo diretório atual do programa — aquele a partir do qual ele foi iniciado.
Todas essas funções usam por padrão a codificação UTF-8, independentemente do sistema operacional, e o fazem desde a primeira versão do Kotlin; um parâmetro opcional permite especificar outra. Do lado do Java, a codificação padrão de classes como [java.io] ([FileReader], [PrintWriter]…) é UTF-8 desde o Java 18 (JEP 400); antes, ela dependia do sistema (muitas vezes Windows-1252 no Windows em francês). Com o Kotlin e o JDK 25, isso deixou de ser um problema.
Por fim, lembre-se de que o Kotlin não tem exceções verificadas (checked exceptions, Capítulo 3): os erros de E/S são sinalizados por exceções derivadas de [java.io.IOException], que o compilador não exige que sejam capturadas nem declaradas. Cabe ao programador decidir onde tratá-las.
5.6.1. Leitura de um arquivo de texto
A classe [java.io.BufferedReader] permite ler o conteúdo de um arquivo de texto, linha por linha. Na verdade, ela é capaz de processar fluxos que não são arquivos (uma conexão de rede, por exemplo). Ela lê o arquivo em blocos, que armazena em um buffer: a maioria das leituras é feita em memória, sem acessar o disco. O Kotlin adiciona a [Path] (e a [File]) funções que criam esse leitor ou o utilizam para nós:
função | finalidade |
[path.bufferedReader(charset = Charsets.UTF_8)] | abre o arquivo [path] para leitura e retorna um [BufferedReader]; o parâmetro opcional especifica a codificação: [path.bufferedReader(Charsets.ISO_8859_1)] |
[reader.readLine(): String?] | retorna a próxima linha, sem o caractere de fim de linha, ou [null] se chegou ao fim do fluxo (método Java) |
[reader.lineSequence()], [reader.readLines()], [reader.readText()] | as linhas restantes na forma de uma sequência (lida sob demanda, percorrível uma só vez) ou de uma lista; todo o texto restante (extensões do Kotlin) |
[reader.close()] | fecha o fluxo e libera os recursos alocados para seu gerenciamento. Isso deve ser feito depois que o fluxo foi processado, o que é tratado pela função [use] |
[path.readText()], [path.readLines()] | abre o arquivo, retorna todo o seu conteúdo (uma string, uma lista de linhas) e o fecha |
[path.forEachLine { line -> ... }] | abre o arquivo, chama a lambda para cada linha e o fecha |
[path.useLines { lines -> ... }] | abre o arquivo, passa à lambda a sequência [Sequence<String>] de suas linhas — lidas sob demanda —, fecha o arquivo e retorna o resultado da lambda |
O programa [Files01.kt] é o seguinte:
Comentários:
- linhas 5–11: as funções de extensão de [kotlin.io.path] devem ser importadas uma a uma (ou todas juntas por meio de [import kotlin.io.path.*], como faremos mais adiante); o IntelliJ e o IDEA adicionam essas linhas automaticamente;
- linha 14: a função [main] recebe aqui os argumentos da linha de comando, no array [args];
- linha 16: exibe o nome da pasta atual, aquela a partir da qual o programa foi iniciado. [Path("")] designa a pasta atual; [absolute()] a converte em um caminho completo, do qual a propriedade [name] retém apenas o último elemento, para não poluir os resultados com um caminho completo;
- linha 18: o arquivo lido é o passado como argumento, ou [infos.txt]. [args.firstOrNull()] retorna o primeiro argumento, ou [null] se não houver nenhum; o operador Elvis [?:] fornece então o valor padrão. Como se trata de um caminho relativo, o arquivo é procurado no diretório atual;
- linha 22: [bufferedReader()] abre o arquivo e retorna um [BufferedReader]. A função de extensão [use] (Capítulo 3) executa a lambda que lhe é passada, entregando-lhe o objeto ([reader]) e, em seguida, fecha esse objeto ao sair da lambda, mesmo que uma exceção tenha ocorrido nela. Esse é o equivalente em Kotlin da instrução Java [try] com recursos; ela se aplica a qualquer objeto que implemente a interface [AutoCloseable] (ou [Closeable]), ou seja, que tenha um método [close] que libera recursos (arquivo, conexão de rede, conexão com banco de dados etc.);
- linhas 23–26: o arquivo é lido linha por linha. Em Java, escrevemos [while ((line = reader.readLine()) != null)], mas em Kotlin uma atribuição não é uma expressão: ela não pode ser avaliada. Por isso, escrevemos um laço infinito e [val line = reader.readLine() ?: break]: [readLine] retorna um [String?]; se retornar [null] (fim do arquivo), o operador Elvis executa [break], que sai do laço; caso contrário, [line] é uma [String] não anulável. Outra notação, mais funcional, é [reader.lineSequence().forEach { println(it) }];
- linha 32: [readText] lê o arquivo inteiro de uma só vez e o fecha. Linha 36: [forEachLine] abre o arquivo, chama a lambda para cada linha e o fecha: é o equivalente em uma linha da leitura 1;
- linha 40: [useLines] abre o arquivo e passa à função lambda a sequência de suas linhas, que as lê sob demanda à medida que processa o arquivo; o arquivo é fechado ao final da função lambda, e [useLines] retorna o resultado (neste caso, o número de linhas não vazias). Isso permite processar um arquivo de vários gigabytes, realizando todas as operações sobre a sequência, sem carregá-lo na memória. A sequência não deve sair da lambda: uma vez fechado o arquivo, ela não pode mais ser percorrida;
- linhas 42–47: os erros de entrada/saída são sinalizados por exceções derivadas de [java.io.IOException]. Um arquivo ausente dispara uma [NoSuchFileException] (derivada de [java.nio.file]), que por sua vez dispara essa exceção; portanto, ela deve ser capturada primeiro. Sua propriedade [file] (o método Java [getFile]) retorna o caminho do arquivo procurado. As funções que estendem [java.io.File] sinalizam o mesmo erro por meio de uma [FileNotFoundException]. O compilador não exige essas cláusulas [catch]: sem elas, um erro encerraria o programa e exibiria a exceção.
O arquivo [infos.txt] é o seguinte:
Ele está localizado na raiz do projeto Gradle [05-classes-kotlin], que é o diretório atual para o comando [gradlew run]:
Com um arquivo inexistente (os argumentos do programa são passados a [gradlew run] por meio da opção [--args]):
Quando uma pasta é usada no lugar de um arquivo, lê-la causa outra exceção, [IOException], cuja mensagem é fornecida pelo sistema operacional:
Esses testes foram executados no Linux; no Windows, a mensagem desse último erro seria diferente. Por isso, colocaremos os arquivos de dados de nossos programas e da aplicação de exemplo no diretório raiz do projeto. Quando iniciados a partir do IntelliJ e do IDEA, os programas também têm o diretório do projeto como diretório atual.
5.6.2. Escrita de um arquivo de texto
A classe [java.io.BufferedWriter] permite escrever em um arquivo de texto. Como o [BufferedReader], ela usa um buffer e é capaz de lidar com fluxos que não são arquivos.
Função | finalidade |
[path.bufferedWriter(charset = Charsets.UTF_8, vararg options)] | abre o arquivo [path] para escrita e retorna um [BufferedWriter]. O arquivo é criado ou, se já existir, esvaziado. Parâmetros opcionais especificam a codificação e o modo de abertura: [path.bufferedWriter(options = arrayOf(StandardOpenOption.APPEND))] acrescenta os dados ao final do arquivo existente |
[writer.write(str)] | escreve [str] no arquivo |
[writer.newLine()] | escreve um caractere de fim de linha: o padrão do sistema, “\r\n” no Windows, “\n” no Linux e no macOS |
[writer.flush()] | grava o conteúdo do buffer no arquivo sem esperar que ele esteja cheio |
[writer.close()] | fecha o fluxo após gravar o conteúdo do buffer no arquivo. Deve ser feito depois de processar o fluxo: [use] cuida disso |
[path.writeText(text)], [path.appendText(text)] | cria (ou sobrescreve) o arquivo e escreve [text] nele; adiciona [text] ao final do arquivo |
[file.printWriter()] | (para [java.io.File]) abre o arquivo e retorna um [PrintWriter], que possui os métodos [print], [println], e [printf] |
As escritas em um arquivo [BufferedWriter] não são imediatas: o texto é escrito primeiro no buffer e depois no arquivo, quando o buffer está cheio, quando é descarregado explicitamente com o método [flush] ou quando o fluxo é fechado. Esse é o modo mais eficiente para arquivos, pois limita os acessos ao disco. Ele não é adequado a todos os fluxos, particularmente aos fluxos de rede: em um diálogo entre dois parceiros, o que um escreve deve ser lido imediatamente pelo outro, e o buffer deve ser descarregado após cada mensagem. A classe [java.io.PrintWriter], que usaremos mais adiante, adiciona os métodos [print], [println] e [printf], e pode descarregar automaticamente seu buffer após cada [println] (construtor [PrintWriter(writer, true)]).
O programa [Files02.kt] é o seguinte:
Resultados (as linhas digitadas no teclado foram inseridas após os prompts):
Comentários:
- linha 15: [bufferedWriter()] cria o arquivo e retorna um [BufferedWriter]; novamente, a função [use] fecha automaticamente o fluxo ao sair da lambda (chave de fechamento na linha 28). É esse fechamento que grava no arquivo o texto restante no buffer: sem ele, o arquivo poderia ficar incompleto;
- linha 16: a codificação padrão do JDK é UTF-8. As funções do Kotlin, por sua vez, usam UTF-8 por padrão, independentemente da codificação do JDK;
- linhas 19–20: o prompt é exibido com [print], que não passa para a linha seguinte, e depois [readlnOrNull] lê uma linha do teclado; ele retorna [null] se a entrada padrão estiver fechada (fim do arquivo), daí [?.trim() ?: ""];
- linhas 25–26: escreve uma linha no arquivo de texto, seguida de um caractere de quebra de linha;
- linha 31: a função [fileSize] (o método Java [Files.size]) retorna o tamanho de um arquivo em bytes. Os 18 bytes se decompõem assim: 16 caracteres, mais duas quebras de linha de um byte (“\n” no Linux, onde os testes foram executados; no Windows, cada quebra de linha “\r\n” ocuparia 2 bytes). Um objeto [Path] inserido em um template de string é exibido por meio de seu método [toString]: o caminho;
- linha 33: por que um [try / catch], que o compilador não exige? Poderíamos especificar um nome de arquivo da forma [dir1/dir2/file] com um diretório [dir1/dir2] que não existe, o que impossibilitaria a criação do arquivo. Uma exceção [NoSuchFileException], derivada de [IOException], seria então lançada. Há outros casos possíveis de exceção (disco cheio, permissões insuficientes etc.). Um programa que escreve um arquivo deve prever esses erros: [try / catch] os converte aqui em uma mensagem clara, em vez de provocar o encerramento do programa.
5.6.3. Caminhos e funções de kotlin.io.path
Para as operações comuns, as funções de [kotlin.io.path] eliminam a necessidade de manipular fluxos: uma única função abre o arquivo, o lê ou escreve por inteiro e depois o fecha. Elas também permitem criar, copiar, mover e excluir arquivos e pastas. A maioria dessas funções chama um método da classe Java [Files], tornando-as mais amigáveis: [path.exists()] em vez de [Files.exists(path)].
função | finalidade |
[Path("data", "cities.txt")], [folder / "cities.txt"] | constrói um caminho usando o separador do sistema (o operador [/] chama o método Java [folder.resolve("cities.txt")]) |
[path.name], [path.nameWithoutExtension], [path.extension], [path.parent], [path.absolute()] | o nome do arquivo (sem a extensão), a extensão, a pasta e o caminho completo |
[path.readText()], [path.readLines()], [path.useLines { }] | retorna o conteúdo do arquivo como uma string, uma lista de linhas ou uma sequência de linhas lidas sob demanda |
[path.writeText(text)], [path.appendText(text)] | cria (ou sobrescreve) o arquivo e escreve [text] nele; acrescenta [text] ao final do arquivo |
[path.writeLines(lines)], [path.appendLines(lines)] | escreve, ou acrescenta, uma coleção (ou sequência) de linhas, cada uma seguida de uma quebra de linha |
[path.readBytes()], [path.writeBytes(bytes)] | lê e escreve o arquivo como um array de bytes |
[path.exists()], [path.isDirectory()], [path.fileSize()], [path.deleteExisting()], [path.deleteIfExists()], [path.copyTo(target)], [path.moveTo(target)] | verifica se um arquivo existe; se é uma pasta, retorna seu tamanho, o exclui, o copia ou o move |
[path.createDirectories()] | cria a pasta e suas pastas pai, caso não existam |
[folder.listDirectoryEntries(glob)], [folder.walk()] | os elementos da pasta (uma lista, eventualmente filtrada por um padrão como ["*.txt"]), de toda a sua estrutura em árvore (uma sequência) |
O programa [Files03.kt] as utiliza:
Resultados:
Comentários:
- linha 5: todas as funções de [kotlin.io.path] são importadas;
- linhas 10–13: o operador [/] (função [operator fun Path.div(other: String)]; veja a sobrecarga de operadores no Capítulo 4) constrói o caminho [data/cities.txt] usando o separador de caminhos do sistema. Os exercícios do curso foram executados no Linux: o caminho resultante é [data/cities.txt]; no Windows, seria [data\cities.txt]. Construir caminhos dessa forma, em vez de concatenar strings, torna o código portável. As propriedades [name], [parent], [nameWithoutExtension], e [extension] decompõem o caminho; as duas últimas não existem em Java, onde é preciso procurar o ponto com [lastIndexOf];
- linha 16: criar a pasta [data] não causa erro se ela já existir;
- linhas 19–26: escrever, acrescentar e ler, cada operação em uma única instrução. [appendLines] escreve cada elemento da lista seguido de uma quebra de linha;
- linhas 28–30: [useLines] fornece as linhas como uma sequência: elas são lidas uma a uma à medida que o laço avança, e todas as operações de sequência podem ser aplicadas a elas. Isso nos permite processar um arquivo de vários gigabytes sem carregá-lo na memória, o que [readLines] faria. O arquivo permanece aberto durante a iteração, e [useLines] o fecha ao final da lambda: isso equivale a [Files.lines(path)] em um [try] com recursos;
- linhas 33–37: a classe [java.io.File] tem as mesmas funções de extensão ([readText], [readLines], [writeText]…) e algumas outras, como [printWriter], que retorna um [PrintWriter] (métodos [print] e [println]). Passamos de um [File] para um [Path] por meio de [toPath()], e vice-versa por meio de [toFile()];
- linhas 40–47: o mesmo texto “café” é escrito com três codificações; em seguida, os bytes dos arquivos são exibidos em hexadecimal com a função do Kotlin [toHexString], configurada por um objeto [HexFormat] (em maiúsculas). Observe que a classe [HexFormat] usada aqui é a classe do Kotlin ([kotlin.text.HexFormat], importada automaticamente), e não a classe do Java ([java.util.HexFormat]):
- em UTF-8, a codificação padrão, os caracteres acentuados ocupam 2 bytes (é = C3 A9) e os demais 1 byte: 5 bytes para 4 caracteres;
- em UTF-8 com BOM (Byte Order Mark), o arquivo começa com os três bytes EF BB BF, que indicam aos programas que o arquivo está codificado em UTF-8. Nem o Java nem o Kotlin escrevem o BOM por conta própria: ele é obtido escrevendo o caractere U+FEFF no início do texto, representado por ["\uFEFF"];
- em Latin-1 (ISO-8859-1), a codificação tradicional dos textos da Europa Ocidental, cada caractere ocupa um byte (é = E9). O objeto Kotlin [Charsets] dá acesso às codificações comuns ([UTF_8], [ISO_8859_1], [UTF_16]…), assim como a classe Java [StandardCharsets];
- linhas 50–57: ler um arquivo com uma codificação diferente da usada na sua escrita corrompe os caracteres acentuados: o byte E9 no final do arquivo é inválido em UTF-8. Nem todas as funções de [kotlin.io.path] se comportam da mesma forma, como mostra a execução: [readLines] (que chama [Files.readAllLines]) rejeita esse arquivo lançando uma exceção [MalformedInputException] (derivada de [IOException]), ao passo que [readText] substitui cada byte inválido pelo caractere �, sem sinalizar erro. Verificamos que [useLines] e [forEachLine] são tão rigorosas quanto [readLines], e que [bufferedReader] e as funções de [java.io.File] são tolerantes, assim como [readText];
- linha 58: lido com a codificação correta, o arquivo está correto;
- linha 60: na leitura, nem o Java nem o Kotlin reconhecem o BOM: ele é lido como um caractere invisível no início do texto, que passa a ter 5 caracteres em vez de 4. Se você precisar ler arquivos UTF-8 gerados com BOM (por certos programas do Windows), deve remover esse caractere por conta própria ([text.removePrefix("\uFEFF")]). Hoje, a regra é simples: os arquivos de texto são escritos e lidos em UTF-8, sem BOM;
- linhas 63–65: [exists] verifica se um arquivo existe; [listDirectoryEntries("*.txt")] retorna uma lista dos itens da pasta cujos nomes correspondem ao padrão (um “glob”: [*] corresponde a qualquer sequência de caracteres). Essa função não garante a ordem dos nomes: [sorted] os ordena. Ao contrário de [Files.list], ela retorna uma lista em vez de um stream: não há nada a fechar;
- linhas 69–72: exclusão da pasta. [deleteExisting] (o método Java [Files.delete]) se recusa a excluir uma pasta não vazia: percorremos toda a árvore com [walk], que retorna uma sequência. Por padrão, [walk] retorna apenas arquivos; a opção [PathWalkOption.INCLUDE_DIRECTORIES] faz com que retorne também as pastas. Os caminhos são ordenados em ordem inversa ([sortedDescending]) para excluir o conteúdo de uma pasta antes da própria pasta. O Kotlin também tem uma função [deleteRecursively()] que faz tudo isso, mas ela ainda é experimental: o compilador exige que você a habilite explicitamente com a anotação [@OptIn(ExperimentalPathApi::class)].
As funções de arquivo bloqueiam a thread que as chama até que a operação termine. No Capítulo 9, dedicado às corrotinas, veremos como evitar o bloqueio de um programa durante uma operação de E/S demorada.
5.7. Arquivos binários
5.7.1. As classes DataOutputStream e DataInputStream
As classes [java.io.DataOutputStream] e [java.io.DataInputStream] servem para escrever e ler arquivos binários. Em um arquivo desse tipo, os dados não são escritos como texto, mas em sua forma interna: um [Int] ocupa sempre 4 bytes, qualquer que seja seu valor. Trata-se de fluxos de bytes: derivam das classes [OutputStream] e [InputStream], enquanto os fluxos de texto derivam de [Writer] e [Reader]. O Kotlin não tem um equivalente próprio: usa as classes do JDK, com algumas funções de extensão para criá-las ([path.outputStream()], [path.inputStream()], [stream.buffered()]…) e a função [use] para fechá-las.
Considere a seguinte aplicação:
O arquivo de texto [persons1.txt], localizado no diretório raiz do projeto, tem o seguinte conteúdo:
O programa [Files04.kt] é o seguinte:
Vejamos mais de perto as operações envolvendo a classe [DataOutputStream]:
- linha 26: o objeto [DataOutputStream] é construído em torno de outro fluxo de bytes, seguindo o princípio dos fluxos aninhados (o padrão de projeto “decorator”):
- [Path(binary).outputStream()] (o método Java [Files.newOutputStream]) escreve um fluxo de bytes no arquivo, que é criado ou, se já existir, truncado;
- [buffered()] adiciona um buffer a ele, de modo que não acesse o disco a cada escrita: é uma função de extensão do Kotlin que retorna um [BufferedOutputStream(this)];
- [DataOutputStream] adiciona métodos para escrever os tipos de dados básicos;
- linhas 62–63: as operações de escrita. A classe [DataOutputStream] tem um método para cada tipo de dado simples: [writeInt], [writeDouble], [writeLong], [writeBoolean], [writeUTF] para uma string…;
- linhas 25–27: os três arquivos são abertos por três chamadas aninhadas a
*[use]: o Kotlin não tem um equivalente à instrução Java*[try]que declara vários recursos separados por ponto e vírgula. Cada [use] fecha seu fluxo ao sair de sua lambda: os três arquivos são, portanto, fechados na ordem inversa àquela em que foram abertos, mesmo que ocorra uma exceção. Fechar o fluxo externo ([DataOutputStream]) fecha os fluxos que ele contém. O arquivo de log é escrito por meio de um [Writer] ([writer()]) equipado com um buffer ([buffered()], que aqui retorna um [BufferedWriter]); - linha 22: a desestruturação também se aplica a arrays: os três primeiros elementos de
*[args]* são armazenados em três variáveis com nomes explícitos; - linhas 32–33: uma função local (Capítulo 3), declarada dentro da lambda, que grava uma mensagem de erro no arquivo de log. Ela tem acesso às variáveis do entorno ([logs], [lineNumber], [text]), o que evita repetir o início da mensagem. [appendLine] é uma função de extensão do Kotlin que grava uma string seguida de uma quebra de linha (["\n"], independentemente do sistema) em qualquer [Appendable] objeto e, portanto, em qualquer
*[Writer]*; - linha 35: o arquivo de texto é lido linha a linha por [forEachLine], que é uma extensão de [BufferedReader] ([Reader]). O corpo do laço é uma lambda: para passar à linha seguinte, não escrevemos [continue] mas [return@forEachLine] (linhas 39 e 45), um return com rótulo que encerra a execução da lambda para a linha atual. Um simples [return] encerraria a função [main];
- linha 41: o separador é o caractere [:], cercado por quaisquer espaços, que são removidos junto com ele. A função Kotlin [split] recebe aqui uma expressão regular ([Regex], abordada mais adiante neste capítulo), escrita como uma string bruta ["""..."""] em que a barra invertida não precisa ser duplicada. Atenção: [split(":")] com uma string dividiria segundo essa string tomada literalmente, e não segundo uma expressão regular, ao contrário do método [split] do Java;
- linha 49: desempacotamento de uma lista: seus dois elementos são armazenados em duas variáveis;
- linha 55: a idade deve ser um inteiro positivo ou zero. Enquanto o programa Java precisava escrever um método que captura a exceção [NumberFormatException], o Kotlin usa [toIntOrNull], que retorna [null] se a string não for um inteiro; o operador Elvis a substitui então por -1, que é um valor inválido para uma idade;
- linhas 20, 74, 77: [exitProcess(n)] (pacote [kotlin.system]) encerra o programa com o código de saída n, que um script pode verificar (0: sucesso; é o código de saída de um programa cuja função [main] termina normalmente). Ela chama [System.exit(n)] e tem o tipo de retorno [Nothing]: o compilador sabe que as instruções que a seguem nunca serão executadas.
Os três argumentos do programa são passados pela opção [--args] de [gradlew run]. Os resultados são os seguintes:
O arquivo de log [logs.txt] contém o seguinte:
Sem argumentos, ou com um arquivo de texto inexistente:
O conteúdo do arquivo binário [persons1.bin] pode ser exibido em hexadecimal com o comando Linux [od] (no Windows, o comando PowerShell [Format-Hex] produz uma exibição semelhante):
Isso mostra como [DataOutputStream] grava os dados:
- uma string é gravada por [writeUTF], precedida de seu comprimento em bytes, em 2 bytes: 00 04, seguido dos 4 bytes de “paul” (70 61 75 6c). Os caracteres são codificados com uma variante do UTF-8;
- um inteiro [Int] é gravado em 4 bytes, com o byte mais significativo primeiro (a chamada ordem “big-endian”, usada nos protocolos de rede): 10 é gravado como 00 00 00 0a. Esse formato é o mesmo em todas as máquinas: um arquivo gravado por [DataOutputStream] no Windows pode ser lido no Linux;
- os dados são gravados consecutivamente, sem separadores nem quebras de linha: o arquivo tem 48 bytes (última linha: com a opção [-A d], [od] exibe as posições em decimal).
Para ler esse arquivo, é preciso, portanto, conhecer a ordem e o tipo exatos dos dados gravados. Para cada método [writeXX] de [DataOutputStream], a classe [DataInputStream] tem um método correspondente [readXX]: [readUTF], [readInt], [readDouble]… No entanto, ela não consegue indicar quantos bytes ainda restam para ler: um arquivo lido por [DataInputStream] deve começar com o número de registros que contém, ou ser lido até que ocorra a exceção [EOFException], que sinaliza o fim do fluxo. Porém, uma exceção deve continuar sendo excepcional, e o fim de um arquivo não é.
5.7.2. A classe RandomAccessFile
A classe [java.io.RandomAccessFile] lê e grava em um arquivo por acesso direto: é possível posicionar o cursor em qualquer ponto do arquivo antes de ler ou gravar. Ela tem os mesmos métodos de leitura e gravação que [DataInputStream] e [DataOutputStream] (implementa as mesmas interfaces, [DataInput] e [DataOutput]) e, além disso:
método | função |
[RandomAccessFile(name: String, mode: String)] | abre o arquivo para leitura ([mode] "r") ou para leitura e gravação ("rw") |
[length(): Long] | o tamanho do arquivo, em bytes |
[filePointer: Long] | a posição atual no arquivo (o método Java [getFilePointer], visto pelo Kotlin como uma propriedade) |
[seek(pos: Long)] | move para a posição [pos] no arquivo |
O programa [Files05.kt] realiza a operação inversa do programa anterior: lê o arquivo binário para criar um arquivo de texto. Se o arquivo de texto resultante contiver os dados corretos do arquivo original, saberemos que a conversão texto → binário → texto foi bem-sucedida.
Vamos examinar mais de perto as operações que envolvem a classe [RandomAccessFile]:
- linha 24: o objeto [RandomAccessFile] é aberto em modo somente leitura (modo “r”). Ele implementa [Closeable]: [use] o fechará. O arquivo de texto é aberto por um segundo [use], aninhado no primeiro, e será fechado antes dele;
- linha 28: a leitura continua até que a posição atual no arquivo alcance o fim do arquivo. O Kotlin representa os métodos Java da forma [getXxx()] como propriedades [xxx]: escrevemos [input.filePointer] e não [input.getFilePointer()]. Como [length] não tem a forma [getXxx], continua sendo um método;
- linhas 30–31: as operações de leitura, [readUTF] e [readInt]. Elas devem ser chamadas na ordem das gravações;
- linha 33: gravação de uma linha no arquivo de texto;
- linhas 39–40: acesso direto: [seek] reposiciona o cursor no início do arquivo, e o primeiro registro é lido novamente. Se todos os registros tivessem o mesmo tamanho, poderíamos ler diretamente o n-ésimo registro posicionando-nos em n × tamanho: esse é o princípio dos arquivos de acesso direto, precursores dos bancos de dados;
- linha 42: a exceção [EOFException] agora sinaliza uma anomalia real: um arquivo que termina no meio de um registro. Como a própria exceção não é usada, ela é chamada de [_];
- linha 46: [RandomAccessFile], uma subclasse de [java.io], informa a ausência de um arquivo por meio de uma [FileNotFoundException], cuja mensagem, fornecida pelo sistema, contém o nome do arquivo.
Vamos executar o programa sobre o arquivo [persons1.bin] gerado anteriormente:
O conteúdo de [persons2.txt] é o seguinte:
Encontramos as 4 pessoas válidas do arquivo [persons1.txt]. Com um arquivo chamado [truncated.bin] formado pelos primeiros 33 bytes de [persons1.bin] (comando Linux [head -c 33 persons1.bin > truncated.bin]), a tentativa de ler a idade de Jacques falha:
E com um arquivo inexistente:
O Java também tem um mecanismo de serialização binária de objetos: as classes [ObjectOutputStream] e [ObjectInputStream] gravam e leem objetos inteiros, desde que sua classe implemente a interface [java.io.Serializable]. Ele pode ser usado a partir do Kotlin, mas é atualmente desaconselhado: a desserialização de dados de origem não confiável permitiu inúmeros ataques, pois a desserialização pode executar código escolhido pelo atacante. Prefere-se, em seu lugar, um formato de texto como o JSON.
5.7.3. Serialização JSON com Jackson
Gravar e ler um arquivo binário byte a byte é trabalhoso, e a menor divergência entre a gravação e a leitura produz resultados incorretos. Em geral, é preferível serializar os objetos: convertê-los automaticamente em uma sequência de caracteres e, depois, desserializá-los para reconstruí-los.
JSON (JavaScript Object Notation) é um formato textual, legível por humanos e universal: é o formato de troca dos serviços web (Capítulo 13) e de muitos arquivos de configuração. Um objeto é escrito entre chaves, como pares “propriedade”: valor, e um array é delimitado por colchetes.
Nem a biblioteca padrão do Java nem a biblioteca padrão do Kotlin sabem ler ou gravar JSON. Usa-se uma biblioteca externa. Um programa Kotlin tem três opções:
- Jackson, a biblioteca Java mais usada, que o Spring Boot emprega por padrão. Sua versão 3 (2025) mudou de pacotes: [tools.jackson.*] em vez de [com.fasterxml.jackson.*] da versão 2, que ainda é muito encontrada; suas anotações permanecem no pacote [com.fasterxml.jackson.annotation]. Como qualquer biblioteca Java, ela pode ser usada diretamente a partir do Kotlin: é a que usamos aqui, como no curso de Java;
- O Jackson é complementado pelo módulo [jackson-module-kotlin] ([tools.jackson.module:jackson-module-kotlin] para o Jackson 3), que o ensina as particularidades do Kotlin: valores padrão de parâmetros, tipos anuláveis, classes [object] … No final desta seção, veremos o que falta ao Jackson sem esse módulo;
- kotlinx.serialization, a biblioteca de serialização da JetBrains, escrita para o Kotlin: um plugin do compilador ([kotlin("plugin.serialization")]) gera, para cada classe anotada com [@Serializable], o código que a serializa, sem reflexão em tempo de execução. Ela oferece suporte natural a valores padrão e tipos anuláveis, e funciona também fora da JVM (Kotlin Multiplatform). É a escolha natural para um projeto puramente Kotlin; o Jackson continua sendo a escolha para projetos Spring e para projetos que misturam Java e Kotlin.
Uma biblioteca externa é declarada no arquivo de build do projeto (Capítulo 2). O projeto Gradle [05-classes-kotlin] declara a dependência do Jackson em seu arquivo [build.gradle.kts]:
Comentários:
- Linhas 14–17: a dependência da biblioteca [jackson-databind]. O Gradle a baixa do repositório central (Maven Central, linha 11), junto com as bibliotecas das quais ela própria depende ([jackson-core] e [jackson-annotations]);
- linha 27: o compilador preserva no bytecode os nomes dos parâmetros das funções e dos construtores. Isso é essencial aqui: sem o módulo Kotlin, o Jackson cria uma data class chamando seu construtor primário, e é graças aos nomes dos parâmetros que ele associa cada um à propriedade JSON de mesmo nome. Isso equivale à opção [-parameters] do compilador Java;
- linhas 31–34: o programa executado por [gradlew run] é especificado pela propriedade [main] da linha de comando ([-Pmain=...]);
- linhas 42–45: os programas iniciados pelo Gradle gravam sua saída em UTF-8 para que os caracteres acentuados sejam exibidos corretamente no Windows (Capítulo 2).
O objeto central do Jackson é [JsonMapper], que tem dois métodos principais:
método | função |
[writeValueAsString(value: Any?): String] | retorna o texto JSON que representa o objeto [value] |
[readValue(content: String, valueType: Class<T>): T] | reconstrói um objeto do tipo [T] a partir do texto JSON [content]; lança uma [JacksonException] se o texto estiver incorreto. Uma sobrecarga recebe um [TypeReference] em vez de uma [Class] |
O programa [Files06.kt] os utiliza:
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 33 34 35 36 37 38 39 40 41 42 43 44 45 46 47 48 49 50 51 52 53 54 55 56 57 58 59 60 61 62 63 64 65 66 67 68 69 70 71 72 73 74 75 76 77 78 79 80 81 82 83 84 85 86 87 88 89 90 91 92 93 94 95 96 97 98 99 100 101 102 103 104 105 106 107 | |
Ele é executado na pasta do projeto ou a partir da IDE:
Comentários:
- Linhas 3–13: as classes do Jackson utilizadas. Ao contrário do programa Java, que precisava ser um projeto Maven separado, [Files06.kt] faz parte do projeto Gradle do capítulo, como os demais: a dependência do Jackson é declarada para todo o projeto;
- Linha 18: a data class [Person] a ser serializada. O Jackson não reconhece o Kotlin, mas vê o que o compilador produziu: uma classe Java com métodos de acesso [getName], [getAge], [getHobbies] e um construtor de três parâmetros. Cada método de acesso retorna uma propriedade JSON de mesmo nome ([getName] → [name]);
- linha 21: a anotação [@JsonProperty] define o nome da propriedade JSON como [reference] em vez de [code]. Quando colocada em um parâmetro do construtor primário que declara uma propriedade, a anotação poderia se aplicar ao parâmetro, à propriedade, ao campo ou ao método de acesso: o Kotlin 2.4 a aplica aqui ao parâmetro do construtor e ao campo privado que armazena a propriedade (verificamos isso no código compilado com o comando [javap -v]; versões mais antigas do Kotlin a aplicavam apenas ao parâmetro). O Jackson, que associa o parâmetro, o campo e o método de acesso [getCode] à mesma propriedade, usa o nome [reference] tanto na gravação quanto na leitura. É possível especificar o alvo: [@param:JsonProperty], [@get:JsonProperty], [@field:JsonProperty];
- Linhas 40–41: um [JsonMapper] é criado por um builder de objeto: [JsonMapper.builder()] retorna um objeto ao qual as opções desejadas são passadas e, em seguida, [build] cria o [JsonMapper]. Com as opções padrão, o texto é escrito em uma única linha e os caracteres acentuados são escritos como estão (linha 1 dos resultados). [persons[1]] é a versão Kotlin de [persons.get(1)];
- linhas 43–44: a opção [ESCAPE_NON_ASCII] instrui o programa a escrever os caracteres não ASCII como sequências de escape: [é] torna-se [é]. O texto continua correto, mas é difícil de ler; isso é útil quando o texto JSON precisa passar por um sistema que só reconhece ASCII;
- linha 47: a opção [INDENT_OUTPUT] produz um texto indentado, distribuído em várias linhas. Uma lista é serializada como um array JSON;
- linhas 49–52: o texto JSON é gravado em um arquivo de texto por [writeText]e depois lido novamente para ser exibido: é assim que hoje se substitui a serialização binária;
- linha 57: a desserialização reconstrói a lista. O Jackson cria os objetos [Person] chamando o construtor da data class, cujos parâmetros são associados às propriedades JSON de mesmo nome. Para uma lista, é preciso informar ao Jackson o tipo de seus elementos. Porém, a expressão [List<Person>::class.java] não existe: os genéricos são apagados em tempo de compilação (“type erasure”), no Kotlin como no Java, e em tempo de execução existe apenas uma classe [List], sem nenhum parâmetro de tipo. O truque com [TypeReference] consiste em criar um objeto anônimo ([object : TypeReference<List<Person>>() {}]) de uma classe derivada de [TypeReference<List<Person>>]: o tipo pai de uma classe é preservado no código compilado, e o Jackson consegue lê-lo;
- linhas 59–60: o laço desempacota cada pessoa à medida que é lida;
- linha 30: o Kotlin permite escrever esse truque de uma vez por todas. [readJson] é uma função de extensão de [JsonMapper] e [inline], com um parâmetro de tipo [reified] (Capítulo 4): seu código é copiado a cada chamada, com o tipo real no lugar de [T]. A chamada a [mapper.readJson<List<Person>>(text)] (linha 63) cria, portanto, um objeto chamado [TypeReference<List<Person>>], e não [TypeReference<T>]. O módulo [jackson-module-kotlin] fornece uma função semelhante, [readValue<T>()], e uma função [jacksonTypeRef<T>()];
- linha 64: para um array, que é mais simples, passamos diretamente a classe [Array<Person>::class.java] (o [Person[].class] do Java). A linha seguinte verifica que as duas listas lidas de volta são iguais, no sentido da igualdade das data classes;
- linha 68: serialização de um [Article]: a propriedade [reference] tem o nome especificado pela anotação. Um [BigDecimal] é gravado como um número JSON;
- Linhas 70–74: com a opção [ACCEPT_CASE_INSENSITIVE_PROPERTIES], o Jackson ignora a diferença entre maiúsculas e minúsculas nos nomes das propriedades durante a análise: [REFERENCE] e [Price] são aceitos. O texto JSON é escrito em uma string bruta ["""..."""], em que as aspas não precisam ser precedidas por uma barra invertida;
- Linhas 76–82: um documento JSON inválido (neste caso, uma string onde se espera um número) provoca uma exceção derivada de [JacksonException], mais precisamente [InvalidFormatException]. No Jackson 3, essas exceções derivam de [RuntimeException], enquanto no Jackson 2 derivavam de [IOException]; para o Kotlin, que não tem exceções verificadas, a diferença não é perceptível. [originalMessage] retorna a mensagem sem as informações de localização, que [location] e [pathReference] fornecem separadamente: linha 1, coluna 23, propriedade [age] da classe [Person]. O Kotlin trata os métodos Java [getOriginalMessage()], [getLocation()], [getLineNr()]… como propriedades.
A última parte do programa mostra o que o Jackson, sem o módulo Kotlin, não reconhece nas classes Kotlin. Verificamos isso com o Jackson 3.1.5:
- linha 87: uma propriedade JSON desconhecida da classe ([city]) é ignorada. Essa é uma mudança do Jackson 3: a opção [DeserializationFeature.FAIL_ON_UNKNOWN_PROPERTIES], que era habilitada por padrão no Jackson 2, é desabilitada por padrão no Jackson 3; ela pode ser reabilitada com [JsonMapper.builder().enable(DeserializationFeature.FAIL_ON_UNKNOWN_PROPERTIES)] se você quiser que o documento seja rejeitado;
- Linha 24: a classe [Subscriber] tem valores padrão para [age] (18) e [hobbies] (uma lista contendo “reading”). Esses valores não são calculados pelo próprio construtor, mas por um segundo construtor sintético que o compilador adiciona à classe e que é usado pelas chamadas escritas em Kotlin: o Jackson, que chama diretamente o construtor principal por reflexão, os ignora. Para uma propriedade ausente do documento JSON, ele passa ao construtor o valor “vazio” do tipo: [null] para um objeto e, para um tipo primitivo como [Int]… um erro, porque o Jackson 3 habilita por padrão a opção [FAIL_ON_NULL_FOR_PRIMITIVES] (ela era desabilitada no Jackson 2, que passava 0);
- Linhas 90–97: os quatro documentos de teste produzem o seguinte (linhas 27–30 dos resultados):
- um documento completo: o objeto é criado normalmente;
- sem [hobbies]: o Jackson passa [null] ao parâmetro [hobbies], que é do tipo não anulável [List<String>]. O construtor Kotlin verifica seus parâmetros não anuláveis e lança uma [NullPointerException] (“Parameter specified as non-null is null”), que o Jackson propaga como uma [ValueInstantiationException]. O valor padrão [listOf("reading")] não foi usado;
- sem [age]: [MismatchedInputException], não há valor para o tipo primitivo [int]. O valor padrão 18 não foi usado;
- com ["name": null]: a mesma verificação do construtor rejeita [null] para [name]. Esse comportamento é, na verdade, uma boa notícia: a segurança do Kotlin em relação a [null] não é contornada pelo Jackson;
- linhas 27, 100–105: uma propriedade booleana cujo nome começa com [is], como [isActive], tem o método de acesso [isActive()] (o Kotlin não o chama de [getIsActive]); o Jackson, seguindo as convenções JavaBeans, infere uma propriedade JSON [active]. Mas o parâmetro do construtor se chama [isActive]: o Jackson não encontra essa propriedade no documento que ele próprio escreveu, e a validação falha.
O módulo [jackson-module-kotlin] corrige esses três problemas (valores padrão utilizados, propriedades [isXxx] que mantêm seus nomes, mensagens de erro claras para [null]); o kotlinx.serialization também os trata corretamente. Sem eles, tenha em mente a seguinte regra: ao usar o Jackson sozinho, uma data class destinada ao JSON não deve depender de seus valores padrão nem de nomes de propriedades que comecem com [is]. É o que faremos no restante do curso, no qual nossas classes JSON continuarão simples.
Um [JsonMapper] é caro de criar, mas, uma vez criado, é reutilizável e pode ser compartilhado entre várias threads: um programa normalmente cria apenas um, armazenado em uma constante (uma propriedade de nível superior ou uma propriedade de um [object]). Usaremos o JSON na aplicação de exemplo no final do capítulo e, depois, ao longo de todo o curso.
5.8. Expressões regulares
A biblioteca padrão do Kotlin fornece a classe [kotlin.text.Regex], que permite o uso de expressões regulares. Elas permitem validar o formato de uma string. Por exemplo, é possível verificar se uma string que representa uma data está de fato no formato dd/mm/aa. Para isso, usa-se um padrão e compara-se a string com esse padrão. Neste exemplo, d, m e a devem ser dígitos. O padrão de um formato de data válido é, portanto, [\d\d/\d\d/\d\d], em que o símbolo [\d] representa um dígito. Na JVM, a classe [Regex] é um wrapper em torno da classe [java.util.regex.Pattern] do JDK: a sintaxe dos padrões e o mecanismo de busca são exatamente os mesmos do Java; só muda a interface de programação. Os símbolos que podem ser usados em um padrão são os seguintes:
caractere | descrição |
[\] | marca o caractere seguinte como caractere especial ou literal. Por exemplo, [n] corresponde ao caractere n, [\n] corresponde a um caractere de nova linha, [\\] corresponde a \ e [\(] corresponde a ( |
[^] | corresponde ao início da string |
[$] | corresponde ao fim da string |
[*] | corresponde ao elemento anterior zero ou mais vezes. Assim, [zo*] corresponde a z ou zoo |
[+] | corresponde ao elemento anterior uma ou mais vezes. Assim, [zo+] corresponde a "zoo", mas não a "z" |
[?] | corresponde ao elemento anterior zero ou uma vez. Por exemplo, [a?ve?] corresponde a “ve” em “lever” |
[.] | corresponde a qualquer caractere isolado, exceto um caractere de nova linha |
[(pattern)] | procura o padrão e armazena a correspondência (um grupo). A substring correspondente pode ser extraída do resultado por meio da propriedade [groupValues] ou [groups]. Para encontrar correspondências com caracteres entre parênteses, use [\(] ou [\)] |
[x|y] | corresponde a x ou a y. Por exemplo, [z|foot] corresponde a z ou foot; [(z|f)oo] corresponde a zoo ou foo |
[{n}] | n é um inteiro não negativo. Corresponde exatamente n vezes ao elemento anterior. Por exemplo, [o{2}] não corresponde ao o de Bob, mas aos dois primeiros o de fooooot |
[{n,}] | corresponde ao elemento anterior pelo menos n vezes. Por exemplo, [o{2,}] não corresponde ao 'o' de 'Bob', mas corresponde a todos os 'o' de 'fooooot'. [o{1,}] equivale a [o+], e [o{0,}] equivale a [o*] |
[{n,m}] | corresponde ao elemento anterior pelo menos n vezes e no máximo m vezes. Por exemplo, [o{1,3}] corresponde aos três primeiros “o” de “foooooot”; [o{0,1}] equivale a [o?] |
[[xyz]] | conjunto de caracteres: corresponde a um dos caracteres especificados. Por exemplo, [[abc]] corresponde à letra “a” em “plat” |
[[^xyz]] | conjunto negativo de caracteres: corresponde a qualquer caractere não listado. Por exemplo, [[^abc]] corresponde a "p" em "plat" |
[[a-z]] | Intervalo de caracteres: corresponde a qualquer caractere do intervalo especificado, neste caso uma letra minúscula sem acento |
[[^m-z]] | intervalo negativo de caracteres: corresponde a qualquer caractere que não esteja entre m e z |
[\b] | corresponde a um limite de palavra, isto é, à posição entre um caractere de palavra e um caractere que não seja de palavra. Por exemplo, [er\b] corresponde a "er" em "lever", mas não a "er" em "verb" |
[\B] | corresponde a uma posição que não é um limite de palavra. [en*t\B] corresponde a “ent” em “entry” |
[\d] | corresponde a um dígito; equivale a [[0-9]] |
[\D] | corresponde a um caractere que não é um dígito |
[\f], [\n], [\r], [\t] | correspondem, respectivamente, aos caracteres de quebra de página, nova linha, retorno de carro e tabulação |
[\s] | corresponde a qualquer espaço em branco: espaço, tabulação, quebra de página, quebra de linha… Equivale a [[ \t\n\x0B\f\r]] |
[\S] | corresponde a qualquer caractere que não seja um espaço em branco |
[\w] | corresponde a qualquer caractere de palavra: por padrão, uma letra sem acento, um dígito ou um sublinhado; equivale a [[a-zA-Z_0-9]]. Com a opção [(?U)] (veja abaixo), ele também reconhece letras acentuadas |
[\W] | corresponde a qualquer caractere que não seja um caractere de palavra |
[\num] | num é um inteiro positivo: refere-se ao grupo de número num. Por exemplo, [(.)\1] corresponde a dois caracteres idênticos consecutivos |
[\xnn], [\unnnn] | corresponde ao caractere hexadecimal nn (2 dígitos) ou nnnn (4 dígitos). Por exemplo, [\x41] corresponde a A |
Um elemento de um padrão pode aparecer uma ou várias vezes. Vejamos alguns exemplos com o símbolo [\d], que representa um único dígito:
padrão | Significado |
[\d] | um dígito |
[\d?] | 0 ou 1 dígito |
[\d*] | 0 ou mais dígitos |
[\d+] | 1 ou mais dígitos |
[\d{2}] | 2 dígitos |
[\d{3,}] | Pelo menos 3 dígitos |
[\d{5,7}] | entre 5 e 7 dígitos |
Imaginemos agora um padrão capaz de descrever o formato esperado de uma string:
string alvo | padrão |
uma data no formato dd/mm/aa | [\d{2}/\d{2}/\d{2}] |
uma hora no formato hh:mm:ss | [\d{2}:\d{2}:\d{2}] |
um inteiro sem sinal | [\d+] |
uma sequência de espaços, possivelmente vazia | [\s*] |
um inteiro sem sinal que pode ser precedido ou seguido de espaços | [\s*\d+\s*] |
um inteiro que pode ter sinal e ser precedido ou seguido de espaços | [\s*[+-]?\s*\d+\s*] |
um número real sem sinal que pode ser precedido ou seguido de espaços | [\s*\d+(\.\d*)?\s*] |
um número real que pode ter sinal e ser precedido ou seguido de espaços | [\s*[+-]?\s*\d+(\.\d*)?\s*] |
uma string que contém a palavra "just" | [\bjust\b] |
Observe que, entre colchetes, o caractere [|] não tem significado especial: o padrão [[+|-]], às vezes usado para o sinal, também aceita o caractere | antes de um número. Da mesma forma, o ponto decimal deve ser escapado, [\.]: um ponto sem escape corresponde a qualquer caractere.
É possível especificar em que parte da string o padrão deve ser procurado:
padrão | significado |
[^pattern] | O padrão inicia a string |
[pattern$] | O padrão termina a string |
[^pattern$] | O padrão inicia e termina a string |
[pattern] | O padrão é procurado em qualquer ponto da string, a partir do início da string |
string de busca | padrão |
uma string que termina com um ponto de exclamação | [!$] |
uma string que termina com um ponto | [\.$] |
uma string que começa com a sequência // | [^//] |
uma string formada por uma única palavra, possivelmente precedida ou seguida de espaços | [^\s*\w+\s*$] |
uma string formada por exatamente duas palavras, possivelmente precedidas ou seguidas de espaços | [^\s*\w+\s+\w+\s*$] |
uma string que contém a palavra "secret" | [\bsecret\b] |
É possível “extrair” subconjuntos de um padrão. Assim, não apenas podemos verificar se uma string corresponde a um determinado padrão, como também extrair dessa string os elementos que correspondem aos subconjuntos do padrão colocados entre parênteses. Por exemplo, se analisarmos uma string que contém uma data no formato dd/mm/aa e quisermos também extrair dessa data os elementos dd, mm e aa, usaremos o padrão [(\d\d)/(\d\d)/(\d\d)].
Resta escrever o padrão no código. Em uma string comum, delimitada por aspas duplas em cada lado, o caractere [\] é, como em Java, um caractere de escape: cada ocorrência de [\] no padrão deve ser duplicada, e o padrão [\d+] é escrito como ["\\d+"]. O Kotlin oferece uma solução melhor: as strings brutas, delimitadas por aspas triplas (que já encontramos), nas quais [\] é um caractere comum. O padrão é escrito como está: ["""\d+"""], e o padrão [\\], que representa o caractere \, é escrito como ["""\\"""] em vez de ["\\\\"]. Essa é a prática corrente em Kotlin, que seguiremos. Um aviso: em uma string bruta, o caractere [$] seguido de um identificador ou de uma chave introduz um template. O [$] no fim da string, seguido de aspas, não causa problema; para os demais casos, o Kotlin 2.2 introduziu as strings de interpolação com “múltiplos cifrões”, que veremos no programa [Regex03.kt]. O editor facilita a leitura: o IntelliJ IDEA reconhece as strings passadas a [Regex] ou [toRegex], destaca-as como expressões regulares e permite testá-las (Alt+Enter, Check RegExp).
5.8.1. Verificar se uma string corresponde a um determinado padrão
Um padrão é primeiro compilado em um objeto [Regex], que então fornece as funções de busca. Enquanto o Java usa um objeto intermediário [Matcher] para armazenar o estado de uma busca, o Kotlin retorna os resultados diretamente:
função | função |
[Regex(pattern: String)] | compila o padrão [pattern]; lança uma exceção [PatternSyntaxException] se o padrão estiver incorreto |
[Regex(pattern, option)], [Regex(pattern, options)] | o mesmo que acima, com uma opção [RegexOption] ou um conjunto [Set<RegexOption>] de opções (veja abaixo) |
[String.toRegex()] | Função de extensão: ["""\d+""".toRegex()] equivale a [Regex("""\d+""")] |
[containsMatchIn(input)] | retorna [true] se a string [input] contiver uma ocorrência do padrão |
[matches(input)] | retorna [true] se a string inteira corresponder ao padrão |
[CharSequence.matches(regex)] | Função de extensão infixa de [String]: ["18/05/97" matches date] |
[toPattern()] | retorna o objeto [java.util.regex.Pattern] encapsulado pelo objeto [Regex] |
O programa [Regex01.kt] é o seguinte:
Resultados:
Comentários:
- Linha 6: o padrão é um inteiro sem sinal, possivelmente cercado de espaços, que ocupa a string inteira (âncoras [^] e [$]). Graças à string bruta, as ocorrências de [\] não são duplicadas: o padrão é escrito exatamente como aparece nos resultados;
- linha 7: o padrão é compilado pelo construtor da classe [Regex];
- linha 10: [containsMatchIn] procura o padrão na string. A string “123a”, cercada de espaços, não corresponde ao padrão: o caractere “a” não pode ser um dígito nem um espaço. Sem as âncoras [^] e [$], a string corresponderia, pois contém um número. Isso equivale a [regex1.matcher(sample).find()] em Java;
- linha 17: a função de extensão [toRegex] de [String] é outra forma de compilar um padrão;
- linhas 18–19: a diferença entre [containsMatchIn], que procura o padrão na string, e [matches], que exige que a string inteira corresponda ao padrão, como se estivesse delimitada por [^] e [$];
- Linhas 21–23: a função de extensão [matches] de [String] recebe um objeto [Regex]; ela é declarada como [infix] e pode ser escrita sem ponto nem parênteses (linha 22). Ao contrário do Java, o Kotlin não oferece uma função [matches(String)] que receba o padrão como string e o compile a cada chamada: a chamada ["5/1/01".matches("\\d{2}")] é rejeitada pelo compilador ([argument type mismatch: actual type is 'String', but 'Regex' was expected]). O padrão deve ser compilado explicitamente, o que incentiva a fazê-lo uma única vez;
- Linhas 25–26: o objeto
[Regex]encapsula um objeto[java.util.regex.Pattern]*, retornado pela função*[toPattern]. Todo o código Java daAPIpermanece, assim, acessível; inversamente, a função de extensão [toRegex] de [Pattern] transforma um [Pattern] em um [Regex]. Usaremos isso no programa [Regex06.kt].
5.8.2. Encontrar todas as ocorrências de um padrão em uma string
A função [find] retorna a primeira ocorrência do padrão em uma string ou [null] se não houver nenhuma. A função [findAll] retorna todas as ocorrências como uma sequência ([Sequence], avaliada de forma tardia: cada ocorrência só é procurada quando solicitada). Uma ocorrência é um objeto [MatchResult], que fornece informações sobre o elemento encontrado:
- [value]: o texto da ocorrência, isto é, um elemento que corresponde ao padrão;
- [range]: o intervalo [IntRange] das posições do elemento na string pesquisada; [range.first] é a posição em que o elemento foi encontrado e [range.last] é a posição de seu último caractere;
- [next()]: a próxima ocorrência ou [null] se não houver mais nenhuma.
O programa [Regex02.kt] é o seguinte:
Resultados:
Comentários:
- Linha 5: o padrão procurado é uma sequência de dígitos;
- linha 7: a string na qual esse padrão é procurado;
- Linhas 10–15: o laço [for] percorre a sequência de ocorrências retornada por [findAll]. Cada ocorrência e sua posição são exibidas. Não há nem um objeto [Matcher] nem chamadas repetidas a [find], como em Java;
- linhas 17–20: o mesmo percurso passo a passo: [find] retorna a primeira ocorrência, do tipo [MatchResult?], e [next] retorna a seguinte, até chegar a [null]. Dentro do laço, o compilador sabe que [result] não é [null] (conversão inteligente de tipo, Capítulo 4). A exibição de [range] mostra os intervalos de posições: 2..4 para 123;
- linha 24: a sequência de ocorrências se presta a todas as operações de sequência; aqui, somamos os números encontrados com [sumOf]. Em Java, é preciso usar o método [results] de [Matcher], que retorna um fluxo da API Stream;
- Linha 26: o número de ocorrências do padrão [[aeiouy]], que designa uma vogal, é o número de elementos da sequência, retornado por [count].
5.8.3. Recuperar partes de um padrão
Como mencionado, as partes de um padrão colocadas entre parênteses são armazenadas: são os grupos. Um objeto [MatchResult] os fornece de várias maneiras:
- [groups]: a coleção de grupos, do tipo [MatchGroupCollection]. Seu elemento nº 0 é a ocorrência inteira; os elementos seguintes são os grupos nº 1, nº 2, … Cada grupo é um objeto [MatchGroup], que tem as propriedades [value] (o texto capturado) e [range] (suas posições); ele é do tipo [MatchGroup?], pois um grupo opcional, como [(\.\d+)?], pode não capturar nada;
- [groupValues]: a lista dos textos capturados, do tipo [List<String>]; um grupo que não capturou nada é representado nela por uma string vazia;
- [destructured]: os grupos nº 1 e seguintes, prontos para serem desestruturados: [val (h, m, s) = result.destructured].
O programa [Regex03.kt] os utiliza:
Resultados:
Comentários:
- Linha 12: a string [sample4] é comparada com o padrão [regex3]; [find] procura a primeira ocorrência do padrão e retorna [null] se nenhuma for encontrada. O teste da linha 13 determina então que [result] pode ser usado sem cautela;
- linhas 16–17: a coleção [groups] é percorrida por meio de seu índice: o elemento nº 0 é a ocorrência inteira, e os elementos nº 1 a nº 3 são os grupos entre parênteses. Como os elementos são do tipo [MatchGroup?], eles são acessados com o operador [?.]; aqui, todos os grupos capturaram algum texto. [range.first] é a posição desse texto dentro da string explorada;
- Linha 20: a propriedade [destructured] permite recuperar os grupos nº 1, nº 2 e nº 3 em três variáveis em uma única instrução, por meio de desestruturação (Capítulo 3). É a maneira mais concisa de processar um padrão quando se conhecem seus grupos;
- linha 27: um grupo pode ser nomeado com a sintaxe [(?<name>...)]. Aqui, o padrão reconhece uma data no formato d/m/aaaa, com dia e mês de um ou dois dígitos;
- linhas 32–34: um grupo nomeado é referenciado por seu nome, e não por seu número, usando o operador de indexação [groups]: o código fica mais legível e não depende da ordem dos parênteses. O resultado é do tipo [MatchGroup?] (um nome desconhecido provoca uma exceção [IllegalArgumentException]; um grupo que não capturou nada resulta em [null]); aqui, os três grupos sempre capturam texto quando o padrão é encontrado, e o operador [!!] expressa essa certeza;
- linhas 35–36: a classe [java.time.LocalDate] representa uma data sem hora. Ela é exibida com o padrão [EEEE d MMMM yyyy]: o dia da semana aparece em inglês. O Kotlin usa diretamente as classes [java.time] e do JDK;
- linha 41: a função [replace] substitui cada ocorrência do padrão por uma string em que [${name}] (ou [$1], [$2]… para grupos numerados) designa o valor de um grupo. As datas são assim reformatadas para o formato ano-mês-dia. Mas, em Kotlin, [${year}] em uma string é um template, que inseriria o valor de uma variável [year]! Poderíamos escrever ["\${year}-\${month}-\${day}"]. A string é escrita aqui com a interpolação com múltiplos cifrões do Kotlin 2.2: em uma string precedida por [$$], um template é escrito como [$${...}], e o caractere isolado [$] é um caractere comum. Com
***[$$$]***, seriam necessários três, e assim por diante; - linhas 44–46: uma variante de
*[replace]recebe uma lambda (Capítulo 7) que calcula o texto de substituição a partir de cada ocorrência, do tipo*[MatchResult]. Escrita após os parênteses, conforme a convenção do Kotlin para o último parâmetro de uma função, a lambda recupera os grupos por desestruturação, constrói a data e retorna sua forma normalizada ISO 8601, produzida pela função [toString] de [LocalDate]: dias e meses sempre têm dois dígitos. Isso equivale ao método*[replaceAll]de*[Matcher], que recebe uma função (Java 9); - Linhas 50–51: a função [matchEntire], como [matches], exige que a string inteira corresponda ao padrão, mas retorna o resultado da comparação ([MatchResult]) ou [null] se a comparação falhar: é a função a usar para verificar uma string e extrair partes dela. Aqui, a propriedade [groupValues] do resultado é exibida: a ocorrência inteira, seguida do valor de cada grupo.
5.8.4. Um programa de aprendizado
Encontrar a expressão regular que verifica se uma string corresponde a um determinado padrão pode, às vezes, ser um verdadeiro desafio. O programa [Regex04.kt] permite praticar. Ele recebe como entrada um padrão e uma string e indica se a string corresponde ou não ao padrão.
Comentários:
- Linhas 15–19: compilação do padrão digitado no teclado. Um padrão incorreto provoca uma exceção [java.util.regex.PatternSyntaxException]: a classe [Regex] repassa a exceção da classe [Pattern] que ela encapsula. Suas propriedades [description] e [index] (os métodos Java [getDescription] e [getIndex], tratados como propriedades pelo Kotlin) fornecem a descrição do erro e sua posição no padrão. Sua mensagem completa, a propriedade [message], ocupa várias linhas e exibe o padrão com um marcador abaixo do erro. Observe que [try] é uma expressão (Capítulo 3): seu valor é o do bloco [try], o objeto [Regex], ou o do bloco [catch]. Esse bloco termina com [continue], uma expressão do tipo [Nothing] que nunca retorna um valor: o compilador infere que [regex] é do tipo [Regex];
- linhas 28–30: a busca não é feita diretamente sobre a string digitada, mas sobre um objeto [TimeLimitedString] (linhas 55–69), que limita a duração da busca a um segundo: se a busca demorar mais, uma exceção [TimeoutExceededException] é lançada e depois capturada na linha 40. Veremos mais adiante por que isso é útil e como funciona. O limite de tempo é calculado com as classes de [kotlin.time] da biblioteca padrão: [TimeSource.Monotonic.markNow()] é o instante atual, medido por um relógio monotônico (insensível a mudanças na hora do sistema), e [1.seconds] é uma duração [Duration], escrita por meio de uma propriedade de extensão de [Int];
- linhas 35–36: para cada correspondência, são exibidos os grupos nº 1 e seguintes, se houver: [drop(1)] exclui da coleção [groups]o elemento nº 0, a ocorrência inteira;
- linha 40: o nome [_] indica que a exceção interceptada não é usada;
- linhas 48–50: ao contrário dos programas anteriores, a linha digitada não tem seus espaços removidos; eles podem fazer parte do padrão ou da string a testar. No fim do fluxo de entrada, [readlnOrNull] retorna [null], substituído por uma string vazia, o que encerra o programa.
Eis um exemplo do programa em ação (a entrada, redirecionada de um arquivo, foi reinserida após os prompts):
Os padrões [^\s*\d+\s*$] e [^\s*(\d+)\s*$] demonstram a utilidade dos grupos: o primeiro reconhece a string “1456” precedida de três espaços, incluindo os espaços; o segundo permite, além disso, extrair o número sem os espaços. Os padrões [^(a+)+$] e [^(a+)+\1$] são examinados mais adiante. O último padrão, que é incorreto, é rejeitado: falta um parêntese de fechamento (“Unclosed group”), que o mecanismo detecta na posição 4, no fim do padrão. A mensagem da exceção, gerada pelo JDK, está em inglês.
5.8.5. A função split
Já encontramos a função [split] da classe [String]. A classe [Regex] tem a mesma função, que usa o padrão já compilado:
função | função |
[split(input, limit = 0)] | A string [input] é dividida em campos, cada campo separado por um delimitador que corresponde ao padrão; retorna uma lista [List<String>]. Se [limit] for positivo, define o número máximo de campos |
[splitToSequence(input)] | O mesmo que acima, mas os campos são retornados como uma sequência, avaliada de forma tardia |
[CharSequence.split(regex)] | função de extensão de [String]: [line.split(separator)] equivale a [separator.split(line)] |
Suponha, por exemplo, que um arquivo de texto contenha linhas da forma campo1, campo2, ..., campon. Os campos são separados por uma vírgula, mas a vírgula pode ser precedida ou seguida de espaços. O padrão [\s*,\s*] descreve exatamente esse separador, como mostra o programa [Regex05.kt]:
Resultados:
Comentários:
- linha 7: o separador: uma vírgula precedida e seguida de qualquer número de espaços. Os espaços são removidos junto com o separador. Uma vez compilado, o padrão pode dividir quantas linhas se desejar sem ser recompilado: é o método para dividir todas as linhas de um arquivo;
- linha 9: o resultado de [split] é uma lista, percorrida por seus índices por [forEachIndexed];
- linha 11: um separador que pode assumir várias formas: um ponto e vírgula ou uma barra vertical ([[;|]]), ou ([|]) uma sequência de espaços ([\s+]). O padrão é passado à função [split] de [String] na forma de um objeto [Regex];
- Linha 14: observe que esta é uma diferença importante em relação ao Java. Quando a função Kotlin [split] recebe uma string ([String]), ela é tratada como um separador literal, e não como um padrão: ["1.5.2".split(".")] divide a string com base no caractere ponto e retorna [[1, 5, 2]]. Em Java, o método [split] de [String] sempre interpreta seu parâmetro como uma expressão regular, na qual o ponto corresponde a qualquer caractere: ["1.5.2".split(".")] retorna um array vazio, uma armadilha clássica. Em Kotlin, não há margem para erro: um padrão é passado como um objeto [Regex], e uma string é sempre tomada literalmente;
- Linha 16: outra diferença em relação ao Java: os campos vazios no fim da string são preservados. A string “a,b,,” produz quatro campos, os dois últimos vazios, enquanto o método [split] do Java retorna apenas dois. O número de campos de uma linha malformada nunca é, portanto, distorcido: uma linha terminada por um separador a mais tem um campo a mais;
- linha 17: o parâmetro [limit] limita o número de campos; o último campo contém então o restante da string;
- linha 18: [splitToSequence] retorna os campos como uma sequência, à qual se aplica aqui a operação [map], antes de convertê-la em uma lista. Os campos só são divididos conforme a necessidade, o que é útil para uma string muito longa da qual apenas os primeiros campos são usados. Isso equivale ao método [splitAsStream] de [Pattern].
5.8.6. Padrões pré-compilados, opções e buscas que demoram demais
Ao contrário de outras plataformas, nem o Java nem o Kotlin têm um mecanismo que gere o código de uma busca por expressão regular na compilação do programa: um padrão é sempre analisado em tempo de execução pelo construtor de [Regex]. Essa compilação tem um custo; por isso, a boa prática é compilar cada padrão conhecido uma única vez e de antemão e armazenar o objeto [Regex] em uma propriedade somente leitura ([val]), no nível superior ou dentro de um *[companion object], como faz o programa *[Regex06.kt] . Em particular, evite escrever ["""\\d+""".toRegex()] dentro de um laço: o padrão seria recompilado a cada iteração. Um objeto [Regex] é imutável e pode ser usado simultaneamente por várias threads: ao contrário do objeto [Matcher] do Java, ele não armazena o estado de uma busca, pois cada busca produz seus próprios resultados.
Resultados:
Comentários:
- Linhas 12–16: os padrões do programa são compilados uma única vez e armazenados em propriedades de nível superior, escritas em maiúsculas como é costume para constantes. Elas não podem ser declaradas [const]: só podem sê-lo valores de tipos básicos e strings, conhecidos em tempo de compilação; um objeto [Regex] é criado em tempo de execução, na primeira vez que o arquivo é usado;
- Linhas 20–23: as propriedades são usadas da mesma forma que os objetos [Regex] dos programas anteriores. A função [let], chamada pelo operador [?.], executa seu bloco somente se [find] encontrou uma correspondência; a linha 22 recupera os três grupos nomeados em uma única instrução, usando uma projeção [map] seguida de uma desestruturação;
- Linha 14: o segundo parâmetro do construtor de [Regex] é uma opção da enumeração [RegexOption]. [IGNORE_CASE] ignora a diferença entre maiúsculas e minúsculas: “YES” e “Yes” correspondem ao padrão (linha 3 dos resultados). Várias opções são especificadas como um conjunto: [Regex(pattern, setOf(RegexOption.MULTILINE, RegexOption.IGNORE_CASE))], enquanto o Java combina inteiros com o operador [|];
- linhas 31–33: na JVM, o Kotlin sempre adiciona a opção [UNICODE_CASE] do Java à opção [IGNORE_CASE]; a diferença entre maiúsculas e minúsculas das letras acentuadas também é ignorada, e “ÉCLAIR” corresponde a “éclair” (linha 4 dos resultados). Em Java, [CASE_INSENSITIVE] sozinha não faria isso;
- linhas 35–36: [MULTILINE] faz [^] e [$] corresponderem ao início e ao fim de cada linha da string, e não apenas ao início e ao fim da própria string. No entanto, com as opções padrão, [\w] reconhece apenas letras sem acento: a linha “café: 3” não é reconhecida (linha 5 dos resultados);
- linha 38: a enumeração [RegexOption] não inclui a opção Java [UNICODE_CHARACTER_CLASS], que dá a [\w], [\d], [\s]e [\b] seus significados Unicode. Isso se obtém escrevendo [(?U)] no início do padrão: as letras acentuadas passam então a ser tratadas como caracteres de palavra (linha 6 dos resultados). Isso deve ser usado em todo texto em francês;
- linhas 40–41: outra solução é compilar o padrão com a classe Java [Pattern], que oferece todas as opções disponíveis (combinadas aqui com o operador [or], o operador “ou” bit a bit do Kotlin) e depois converter o objeto [Pattern] em [Regex] com a função de extensão [toRegex] (linha 7 dos resultados). As outras opções de [RegexOption] são [DOT_MATCHES_ALL] ([.] também corresponde a uma quebra de linha), [COMMENTS] (os espaços no padrão são ignorados, permitindo escrevê-lo em várias linhas, com comentários, em uma string bruta), [LITERAL] (o padrão é texto simples; veja também [Regex.escape] e [Regex.fromLiteral]), [UNIX_LINES] e [CANON_EQ];
- linha 43: as opções também podem ser escritas no início do padrão: [(?i)] para [IGNORE_CASE], [(?m)] para [MULTILINE], [(?s)] para [DOT_MATCHES_ALL], [(?U)]…;
- Linhas 64–66: a função [display] percorre a sequência de valores [destructured] das ocorrências e desestrutura cada uma diretamente no laço [for]: [(name, value)] são os grupos 1 e 2.
O restante do programa trata de um problema de segurança. Alguns padrões são patológicos: quando aplicados a certas strings, eles forçam o mecanismo de expressões regulares a tentar um número enorme de maneiras de casar a string com o padrão antes de chegar a uma conclusão. O mecanismo do Java, que o Kotlin usa na JVM, emprega um processo chamado “backtracking”: quando uma tentativa falha, ele volta à última escolha feita e tenta outra. O padrão [^(a+)+\1$] da linha 16 é um exemplo disso: quando aplicado a uma sequência de “a” terminada por um caractere diferente, ele tenta todas as maneiras possíveis de distribuir os “a” entre as repetições do grupo e sua referência retroativa [\1] antes de concluir que falhou, e o número de tentativas se multiplica a cada “a” adicional. Isso é conhecido como backtracking catastrófico. Quando aplicado a strings digitadas por usuários, um padrão assim constitui uma vulnerabilidade de segurança (conhecida como ReDoS, “regular expression denial of service”): poucas requisições bastam para paralisar um servidor.
- Linhas 46–49: a duração da busca é medida para 10, 15 e 20
a. A função*[measureTimedValue]de*[kotlin.time]executa o bloco que recebe e retorna seu valor e sua duração, um objeto [Duration], na forma de um objeto [TimedValue] que é desestruturado. A duração aumenta muito rapidamente (linhas 9–11 dos resultados; as durações variam de uma execução e de uma máquina para outra). Como o tempo de execução praticamente dobra a cadaaadicional, a busca levaria vários minutos com 30a; - linhas 51–56: nem a classe [Regex] nem a classe [Pattern] têm uma opção de timeout. Usa-se uma técnica padrão: a busca é feita em um objeto [TimeLimitedString] (linhas 72–85), que implementa a interface [CharSequence] aceita pelas funções de [Regex]. O mecanismo de expressões regulares lê a string caractere por caractere por meio do método [charAt] da interface Java [CharSequence], que corresponde ao operador [get] em Kotlin: é isso que verifica o tempo e lança uma exceção [TimeoutExceededException] (linha 89) se o prazo, armazenado quando o objeto foi criado, tiver expirado. A busca é abandonada após 100 ms;
- linhas 72–75: a classe
*[TimeLimitedString]tem duas propriedades, o texto e o prazo, uma marca de tempo do relógio monotônico de*[kotlin.time]([ValueTimeMark]), cuja função [hasPassedNow] indica se ele foi ultrapassado. A cláusula [CharSequence by text] é uma delegação: a classe implementa a interface [CharSequence] delegando todos os membros que não sobrescreve (neste caso, a propriedade [length]) ao objeto [text]. O compilador gera as funções que repassam as chamadas; em Java, elas precisam ser escritas à mão. Os únicos membros redefinidos são o operador [get], que monitora o tempo, e a função [subSequence], que retorna um [TimeLimitedString] sujeito ao mesmo prazo. A função [toString], que é membro de [Any] mas não da interface, não é delegada: ela também é sobrescrita; - linha 89: a exceção [TimeoutExceededException] deriva de [RuntimeException]. Como o Kotlin não tem exceções verificadas, qualquer exceção poderia ser lançada por [get]; derivar de [RuntimeException] continua sendo a prática padrão, e o código Java que chama a classe a trataria como uma exceção não verificada. O campo [serialVersionUID] presente nas exceções Java é desnecessário aqui: o compilador Kotlin não sinaliza sua ausência;
- Linhas 59–60: o runtime Java consegue reconhecer e tratar de forma eficiente casos simples de repetições aninhadas: o padrão [^(a+)+$], problemático em outros runtimes, é resolvido imediatamente aqui. É a referência retroativa [\1] que impede essa otimização no padrão da linha 16. As durações do tipo [Duration] são comparadas com o operador [<].
É importante notar que se deve desconfiar de padrões que contenham repetições aninhadas ([(a+)+], [(\w+\s?)*]…) e limitar a duração das buscas assim que o padrão ou a string pesquisada vier de fora do programa. Os quantificadores possessivos do mecanismo Java ([a++], [a*+]), que impedem o backtracking dentro do elemento que repetem, também permitem escrever padrões seguros, desde que se compreenda plenamente o seu significado.
5.9. Aplicação de exemplo - V3
Retomaremos a aplicação abordada no Capítulo 3 (Versão 1) e no Capítulo 4 (Versão 2). Lembre-se de que se trata de um exercício: a tabela de imposto utilizada é a de 2004 (baseada nos rendimentos de 2003), que permanece inalterada desde o curso original.
5.9.1. Dados em um arquivo
Na Versão 2, o cálculo do imposto era feito na classe abstrata [AbstractTax], que reutilizamos aqui no pacote [taxv3] do projeto: como em Java, a Versão 3 é autônoma e não depende das classes do Capítulo 4. As faixas de imposto são fornecidas por uma propriedade abstrata (uma lista somente leitura) e a divisão é feita com 16 dígitos significativos, o que é mais que suficiente:
A função [calculate] usa as faixas de imposto retornadas pela propriedade abstrata [taxBrackets] (linha 10). A classe [AbstractTax] não sabe de onde vêm essas faixas: cabe às classes derivadas fornecê-las redefinindo a propriedade. Na versão 2, a classe derivada [HardwiredTax] as fixava diretamente em seu código. Os cálculos são feitos com números decimais exatos [java.math.BigDecimal] (Capítulo 3), cujo uso a biblioteca padrão do Kotlin facilita:
- as funções de extensão [toBigDecimal] de [Int] e [String] substituem [BigDecimal.valueOf(...)] e [new BigDecimal(...)] (["0.72".toBigDecimal()], linha 21);
- os operadores [+], [-], [*]e [+=] são definidos para [BigDecimal] (são funções de extensão de [plus], [minus], [times], declaradas com [operator], Capítulo 4): a linha 26 se lê como a fórmula que calcula;
- [BigDecimal] implementa [Comparable<BigDecimal>]: os operadores de comparação se aplicam ([quotient <= it.limit], linha 24) e chamam [compareTo];
- Cuidado, porém, com o operador [/]: ele chama [divide(other, RoundingMode.HALF_EVEN)], que preserva o número de casas decimais do dividendo. Para dois inteiros, o resultado é arredondado para o inteiro mais próximo: [3.toBigDecimal() / 2.toBigDecimal()] é igual a 2, e [1.toBigDecimal() / 2.toBigDecimal()] é igual a 0. As duas divisões da função são, portanto, implementadas com o método [divide]: divisão exata por 2 (linha 15), que lançaria uma exceção se o resultado não fosse um decimal finito, e divisão com 16 dígitos significativos ([MathContext.DECIMAL64], linha 22);
- linha 24: a busca da faixa é escrita com operações de coleção: [dropLast(1)] exclui a última faixa, [firstOrNull] retorna a primeira faixa cujo limite não é excedido pelo quociente familiar, ou [null] se não houver nenhuma, e o operador [?:] seleciona então a última faixa, [last()];
- [toInt] retorna a parte inteira do resultado (método [intValue] de [BigDecimal]).
Uma faixa é representada pela data class [TaxBracket]:
e o cálculo é descrito pela interface [ITax], documentada aqui por um comentário KDoc, o equivalente Kotlin do Javadoc (as mesmas tags, como [@param] e [@return]):
A nova versão armazena os dados em um arquivo, o que permite alterar a tabela sem recompilar o programa. Escrevemos duas novas classes derivadas de [AbstractTax]:
- [FileTax] lê as faixas de um arquivo de texto [TaxData.txt];
- [JsonTax] lê as faixas de um arquivo JSON [TaxData.json].
O arquivo de texto [TaxData.txt] contém uma faixa por linha, no formato limit:coeffR:coeffN :
Os números do arquivo são escritos com ponto decimal. Um arquivo de dados não deve depender do idioma da máquina que o lê: um arquivo escrito com vírgulas decimais e interpretado segundo as regras francesas ([NumberFormat.getInstance(Locale.FRANCE)]) seria rejeitado ou, pior, mal interpretado em uma máquina configurada em inglês. A função [toBigDecimal] de [String], como [toDouble], sempre espera um ponto decimal, independentemente do idioma da máquina. Essa também é a convenção do JSON e da maioria dos formatos de dados.
O arquivo [TaxData.json] contém os mesmos dados, na forma de um array JSON de objetos:
5.9.2. Erros
O processamento desses arquivos pode falhar por causa de um arquivo ausente, uma linha malformada, um número incorreto etc. Criamos uma classe de exceção específica para relatar esses erros, [TaxException]. Ela também será usada para outras fontes de dados (aqui o arquivo JSON e, mais adiante, bancos de dados). Ela transporta um código de erro:
Comentários:
- Linha 6: a classe inteira cabe em seu cabeçalho. O construtor primário recebe a mensagem, o código e a causa do erro; o código se torna uma propriedade somente leitura ([val]), enquanto a mensagem e a causa, que são simples parâmetros, são passadas ao construtor da classe pai
*[RuntimeException]*, que as disponibiliza pelas propriedades*[message]* e*[cause]*; - o parâmetro [cause], a exceção que causou o erro, tem um valor padrão, [null]: um único construtor substitui os dois construtores da versão Java; [TaxException(message, code)] e [TaxException(message, code, e)] são definidos com o mesmo construtor. As versões seguintes da aplicação adotarão essa exceção, que transporta um código inteiro, com um construtor ligeiramente diferente (Capítulo 6);
- Linha 7: a classe estende [RuntimeException]. Como o Kotlin não tem exceções verificadas (Capítulo 3), a escolha da classe pai não impõe nenhuma restrição aqui; no entanto, para o código Java que usa a classe, [TaxException] será uma exceção não verificada, que é o comportamento desejado, como veremos. O campo [serialVersionUID] da versão Java é desnecessário: o compilador Kotlin não emite aviso a respeito.
Os códigos de erro possíveis são definidos por uma enumeração:
Comentários:
- linhas 7–12: códigos de erro possíveis:
- [ACCESS]: erro de acesso ao arquivo de dados;
- [LINE]: linha sem os três campos esperados, ou arquivo sem nenhuma faixa;
- [FIELD1], [FIELD2], [FIELD3]: o campo 1, 2 ou 3 de uma linha está incorreto;
- [JSON]: o documento JSON está incorreto;
- linha 6: um enum do Kotlin ([enum class], Capítulo 3) pode ter propriedades, declaradas em seu construtor primário, e funções. Cada constante é construída com seu valor inteiro, entre parênteses; a lista de constantes termina com ponto e vírgula quando é seguida de outros membros;
- Linhas 14–17: alguns erros podem ocorrer simultaneamente; os três campos de uma linha podem estar incorretos. Por isso, os valores dos códigos são potências de 2: cada um corresponde a um bit do inteiro. Um erro nos campos 2 e 3 resultará no código [8 or 16] = 24 ([or] é o operador “OU” bit a bit do Kotlin). A função [decode], colocada dentro do [companion object] da enumeração para ser chamada por [ErrorCode.decode(code)], faz a operação inversa: converte o conjunto de códigos presentes em um inteiro, testando cada bit com o operador [and]. A propriedade [entries] (Kotlin 1.9) é a lista das constantes do enum, e [filterTo] coloca aquelas que satisfazem a condição na coleção que lhe é passada, neste caso um [java.util.EnumSet] vazio. Essa coleção, especializada nas constantes de um enum, as armazena internamente como os bits de um inteiro; seu método [toString] exibe uma combinação na forma “[FIELD2, FIELD3]”. Poderíamos igualmente retornar um [Set<ErrorCode>] ([entries.filter { ... }.toSet()]), que seria exibido da mesma forma.
5.9.3. A classe FileTax
A classe [FileTax] fornece as faixas lidas de um arquivo de texto:
Comentários:
- linha 8: a classe [FileTax] deriva da classe [AbstractTax], assim como a classe [HardwiredTax] na versão 2. Seu construtor primário recebe o nome do arquivo de texto que contém os dados. O parâmetro [fileName], declarado sem [val], não é uma propriedade: ele é usado apenas durante a construção do objeto;
- linhas 10–16: duas expressões regulares, compiladas uma única vez e armazenadas no [companion object] da classe, o equivalente Kotlin das constantes [private static final] do Java: o separador de campos de uma linha limit:coeffR:coeffN (o caractere [:], precedido e seguido de qualquer quantidade de espaços), e um número positivo ou zero, formado por dígitos seguidos, eventualmente, de um ponto e mais dígitos. As strings brutas evitam a duplicação de [\]. A lista [FIELD_CODES] associa um código de erro a cada campo;
- linha 20: a propriedade que redefine a propriedade abstrata de [AbstractTax]. Ela é declarada sem valor inicial: será inicializada no bloco [init], onde o compilador exige que receba um valor, e apenas um;
- linhas 22–43: o bloco [init] é executado quando o objeto é construído, de forma semelhante ao corpo de um construtor Java. Sua função é preencher a lista [taxBrackets];
- linha 25: o nome do arquivo sem o caminho, usado nas mensagens de erro. O construtor pode de fato receber um caminho completo, que não precisa ser exibido ao usuário. A função [Path] de [kotlin.io.path] cria o objeto [java.nio.file.Path]; [fileName] é o método Java [getFileName] tratado como uma propriedade;
- Linhas 26–33: leitura do arquivo. A função de extensão [useLines] de [Path] abre o arquivo (em UTF-8), passa a sequência de suas linhas para a lambda e, em seguida, fecha o arquivo independentemente da forma como a lambda termina, seja normalmente ou por uma exceção: é o equivalente do [try] com recursos do Java. Como a leitura de um arquivo de texto é sequencial, o número de linhas só é conhecido no final; a sequência se presta ao tratamento de strings:
- [mapIndexed] associa cada linha, com os espaços removidos por [trim], ao seu número (o índice começa em 0, a numeração das linhas em 1), na forma de um par [number to line];
- [filter] remove as linhas vazias; o par é desempacotado nos parâmetros da lambda, [(_, line)], com o número desnecessário substituído por [_];
- [map] converte cada linha em uma faixa por meio da função [bracket];
- [toList] percorre a sequência e armazena as faixas em uma lista. Essa chamada deve ser feita dentro da lambda: uma sequência é avaliada de forma tardia, e uma sequência retornada como está por [useLines] seria percorrida depois que o arquivo fosse fechado;
- o bloco [try] é uma expressão: seu valor é a lista de faixas, armazenada na variável [brackets];
- linhas 35–37: os erros de acesso ao arquivo ([IOException] e suas variantes, como [NoSuchFileException] para um arquivo inexistente, [AccessDeniedException] para permissões insuficientes ou [MalformedInputException] para um arquivo que não está em UTF-8) são encapsulados em uma [TaxException] com o código [ACCESS], e a exceção original passa a ser sua causa. As exceções [TaxException] lançadas pela função [bracket] não são exceções [IOException]: não são interceptadas por esta cláusula [catch] e saem do construtor como estão, embora o arquivo ainda seja fechado por [useLines];
- linhas 40–43: um arquivo vazio é rejeitado; caso contrário, a lista se torna o valor da propriedade [taxBrackets], que era a finalidade do bloco [init];
- linhas 49–51: a função [bracket] analisa uma linha. A linha é dividida em campos por meio de uma expressão regular; se não houver três campos, uma exceção [TaxException] com o código [LINE] é lançada. Observe que [split] mantém os campos vazios no final no Kotlin: uma linha terminada por um separador extra, “4962:0:0: ”, tem quatro campos e é rejeitada, enquanto o método Java [split], que remove os campos vazios no final, a aceitaria;
- Linhas 54–58: validação dos três campos. A função [zip] associa cada código de erro ao campo correspondente, na forma de pares; [filter] mantém os campos que não correspondem ao modelo [NUMBER], e [fold] acumula seus códigos com o operador [or], partindo de 0. Os erros são assim reportados de forma conjunta. A função [matches] exige que o campo inteiro corresponda ao modelo [NUMBER]: sem sinais, sem espaços e sem vírgulas. Números negativos são, portanto, rejeitados, o que valida os dados ao mesmo tempo em que são verificados;
- linhas 61–62: os campos, agora validados, são convertidos em [BigDecimal] por [toBigDecimal], usando um ponto decimal independentemente do idioma da máquina; a lista de três números é desempacotada para construir a faixa.
Encapsular as exceções de baixo nível ([IOException]) em uma exceção específica da aplicação ([TaxException]) permite que o código chamador trate apenas um único tipo de exceção, independentemente da fonte de dados: um arquivo de texto, um arquivo JSON e, mais adiante no curso, um banco de dados. No Java, é também por isso que [TaxException] é uma exceção não verificada: uma exceção verificada precisaria ser declarada por todos os métodos pelos quais passa, o que prenderia o código chamador aos detalhes da fonte de dados. O Kotlin, que não possui exceções verificadas, não impõe essa escolha, mas o encapsulamento continua igualmente importante: o código chamador não precisa conhecer exceções relacionadas a arquivos na API.
5.9.4. A classe JsonTax
A classe [JsonTax] retorna as faixas lidas de um arquivo JSON. Ela usa a biblioteca Jackson 3, já declarada no arquivo [build.gradle.kts] do projeto:
Comentários:
- Linha 15: um único [JsonMapper], armazenado no [companion object], é usado por todos os objetos [JsonTax]. As propriedades JSON [limit], [coeffR] e [coeffN] têm o nome dos parâmetros do construtor da data class [TaxBracket]: nenhuma anotação é necessária, pois o compilador preserva esses nomes no código compilado (opção [javaParameters = true] no arquivo [build.gradle.kts]), e o Jackson 3 consegue lê-los;
- Linhas 29–32: leitura do arquivo com a função de extensão [readText] de [Path]; um erro de acesso é tratado como em [FileTax];
- linha 36: uma única instrução converte o texto JSON em um array de faixas; [Array<TaxBracket>::class.java] é a classe Java do array, equivalente a [TaxBracket[].class]. O Jackson constrói cada faixa chamando o construtor da data class e converte os números JSON em [BigDecimal] sem nenhuma perda de precisão. Como o método Java [readValue] pode retornar [null] (para o documento JSON [null]), o resultado é armazenado em uma variável do tipo [Array<TaxBracket>?]: sem essa declaração, o Kotlin lhe atribuiria um tipo “de plataforma”, e não saberia se esse tipo aceita [null];
- linhas 37–40: um documento inválido causa uma [JacksonException], encapsulada em uma [TaxException] com o código [JSON]. A mensagem indica a posição do erro, dada pela propriedade [location] (método [getLocation]); o operador [?.] protege contra uma posição desconhecida;
- linhas 43–49: a desserialização verifica o formato do documento, não a validade dos dados: resta verificar que existe pelo menos uma faixa (o documento [null] ou [[]] é um JSON válido), o que [isNullOrEmpty] faz em um único teste, e que nenhum valor é negativo, o que é feito pela operação [any], aplicada diretamente ao array. Após o primeiro teste, o compilador sabe que [brackets] não é [null]. Por fim, o array é convertido em lista por [toList];
- linha 18: a função que testa um valor, escrita como uma expressão.
A versão Java também verificava se nenhum valor estava ausente: uma propriedade ausente de um objeto JSON atribui o valor [null] ao componente correspondente de um record. No Kotlin, essa verificação é desnecessária: as propriedades de [TaxBracket] são do tipo *[BigDecimal]*, e não ***[BigDecimal?]. O compilador Kotlin adiciona uma verificação para cada parâmetro não anulável no início do construtor da classe: se o Jackson lhe passar [null], o construtor lança uma exceção, que o Jackson propaga como uma [JacksonException]. A segurança em relação a *[null] se estende, assim, a objetos criados por uma biblioteca Java: uma faixa incompleta não pode existir. Vamos verificar isso mais adiante.
Comparar as duas classes é instrutivo: com um formato de dados estruturado e uma biblioteca que o entende, a análise do arquivo exige quase nenhum código. Observe que existe um módulo do Jackson específico para Kotlin, [jackson-module-kotlin], que leva em conta os valores padrão dos parâmetros e os tipos anuláveis, e oferece funções como [mapper.readValue<Array<TaxBracket>>(json)], em que o tipo é especificado por um parâmetro genérico ([reified], Capítulo 4). A JetBrains também oferece sua própria biblioteca de serialização, [kotlinx.serialization], que gera o código de serialização em tempo de compilação por meio de um plugin do compilador. Para uma data class tão simples quanto [TaxBracket], o Jackson sozinho é suficiente.
5.9.5. O programa principal
Diferentemente da versão Java, que fazia parte de um projeto Maven separado, a versão 3 é um programa com vários arquivos dentro do projeto Gradle do capítulo, organizado em seu próprio pacote, [taxv3]. A parte relevante do projeto tem a seguinte estrutura de diretórios:
Os arquivos de dados são colocados no diretório raiz do projeto, ao lado do arquivo [build.gradle.kts]: esse é o diretório atual do programa quando ele é executado com o comando [gradlew run] ou clicando no triângulo verde no IntelliJ ou no IDEA. A biblioteca Jackson é declarada no arquivo [build.gradle.kts] do projeto, que é usado por todos os programas deste capítulo:
O programa principal é o arquivo [Main.kt]; sua classe JVM é [taxv3.MainKt]:
Comentários:
- Linhas 9–13: o texto de ajuda, em uma string bruta da qual [trimIndent] remove a indentação comum e a primeira linha, vazia. Como o resultado de uma chamada de função não é uma constante de tempo de compilação, a propriedade não pode ser declarada como [const]: [const val SYNTAX = """...""".trimIndent()] é rejeitado pelo compilador ([const 'val' initializer must be a constant value]). O prompt do laço de entrada, um literal de string, é, porém, uma constante [const val] (linha 16);
- linha 20: o separador dos parâmetros digitados, compilado uma única vez;
- linha 24: o nome do arquivo de dados é passado como argumento; por padrão, é [TaxData.txt]. [firstOrNull] retorna o primeiro argumento, ou [null] se não houver nenhum, caso em que ele é substituído pelo valor padrão por meio do operador [?:]. Com o Gradle, os argumentos do programa são passados pela opção [--args]: [gradlew -q run -Pmain=taxv3.MainKt --args="TaxData.json"];
- linhas 28–31: uma expressão [when] (Capítulo 3) seleciona a classe a instanciar com base na extensão do arquivo, extraída do nome do arquivo por [substringAfterLast]. Os dois ramos retornam objetos de tipos diferentes, [JsonTax] e [FileTax], ambos do tipo [ITax], que é o tipo declarado da variável [tax]. O restante do programa conhece apenas a interface [ITax] e desconhece a origem dos dados;
- linhas 33–39: a criação do objeto pode lançar uma [TaxException], que é exibida antes de o programa terminar. O código é decodificado em um conjunto de [ErrorCode] para ser exibido em texto simples; a exceção original, se houver, é indicada por seu tipo: [e.cause?.let { ... } ?: ""] constrói o texto se a causa existir e retorna uma string vazia caso contrário. A função [exitProcess] da biblioteca padrão encerra o programa; ela é do tipo [Nothing]: o compilador sabe que ela nunca devolve o controle e, portanto, que a variável [tax] está inicializada após o bloco [try]. A instrução desnecessária [return], que seguia [System.exit] na versão Java e era exigida pelo compilador Java, foi removida;
- linhas 43–75: o laço de diálogo é o mesmo da versão 2. A linha lida por [readlnOrNull] é [null] no final do fluxo, e é então substituída por uma string vazia (linha 46). O número de filhos e o salário são convertidos por [toIntOrNull], que retorna [null] se a string não for um inteiro, e [takeIf { it >= 0 }] também retorna [null] para um inteiro negativo (linhas 63, 69): um único teste de [null] detecta os dois erros. A expressão é escrita diretamente, sem a função [positiveInteger] da versão 2 (ou a função [integer] da versão Java, que retornava -1 em caso de erro). Após esse teste, o compilador sabe que [nbChildren] e [salary] são do tipo [Int].
5.9.6. Execuções
Com o arquivo [TaxData.txt], por padrão (a entrada, redirecionada de um arquivo, foi reinserida após os prompts):
Os valores são os mesmos das versões anteriores: 4.282 euros para um casal com 2 filhos, 2.959 euros para um casal com 3 filhos e 11.519 euros para uma pessoa solteira sem filhos, com um salário anual de 60.000 euros. As entradas incorretas são sinalizadas como na versão 2.
Com o arquivo [TaxData.json]:
Com um arquivo [xx.txt] inexistente:
Com o seguinte arquivo [TaxDataInvalid.txt], em que a terceira linha usa uma vírgula decimal:
Os campos 2 e 3 da linha 3 são rejeitados: o código de erro é a combinação [[FIELD2, FIELD3]]. O campo 1 (14753), que não tem parte decimal, está correto.
Com o seguinte arquivo, [TaxDataInvalid.json], em que um coeficiente é escrito como string:
A mensagem do Jackson especifica o erro com precisão: a string “0,068” não pode ser convertida em [BigDecimal]. O Jackson aceita uma string onde se espera um número se ela contiver um número válido (“0.068”); o que é rejeitado é a vírgula decimal. O erro está localizado na linha 3 do documento (já que o Jackson numera as linhas a partir de 1) e na coluna 30, no início do valor incorreto.
Por fim, com o seguinte arquivo, [TaxDataIncomplete.json], em que a propriedade [coeffR] da segunda faixa está ausente:
É a verificação adicionada pelo compilador Kotlin ao construtor da data class [TaxBracket] que rejeita o valor [null] para o parâmetro [coeffR] (“Parameter specified as non-null is null”). O Jackson reporta o erro como uma exceção [ValueInstantiationException], derivada de [JacksonException], localizada no final do objeto incompleto (linha 3, coluna 37): a faixa incompleta nunca existiu, e nenhum teste foi escrito para ela.
5.10. Conclusão
Este capítulo apresentou as classes e funções do Kotlin usadas em quase todos os programas:
- as strings imutáveis [String], que são comparadas com [==] (que chama [equals]), suas numerosas funções de extensão, [buildString] e [StringBuilder] para construí-las pouco a pouco, os templates de string, a função [format] e as strings brutas ([trimIndent], [trimMargin]);
- os arrays ([Array], [IntArray]…) e suas funções;
- as coleções do Kotlin [List], [Set], [Map], que são somente leitura ou mutáveis ([MutableList], [MutableSet], [MutableMap]), criadas por [listOf], [mutableListOf], [mapOf]… e baseadas nas coleções do JDK, além de outras coleções ([ArrayDeque], conjuntos e dicionários ordenados…);
- as operações funcionais sobre coleções ([filter], [map], [sortedBy], [groupBy], [associate], [fold], [partition], [zip]…) e as sequências, inclusive suas versões tardias, com a API Java Stream continuando utilizável;
- os arquivos de texto ([File], [Path], e as extensões de [kotlin.io] e [kotlin.io.path]: [readLines], [useLines], [writeText]…), em UTF-8 por padrão, os arquivos binários ([DataOutputStream], [DataInputStream], [RandomAccessFile]) e a serialização JSON com o Jackson e data classes;
- as expressões regulares da classe [Regex], escritas como strings brutas, compiladas uma única vez e protegidas contra buscas excessivamente longas no tratamento de dados externos.
Vale destacar como o Kotlin aproveita a plataforma Java: a biblioteca padrão do Kotlin não substitui o JDK, mas o estende com funções de extensão ([readLines], [toBigDecimal], [toRegex]…), operadores ([BigDecimal]) e interfaces somente leitura, enquanto as classes Java ([Path], [BigDecimal], [LocalDate], [Pattern], Jackson…) podem ser usadas diretamente.
A aplicação de exemplo agora lê seus dados de um arquivo de texto ou JSON. O capítulo seguinte a reorganiza em camadas: a leitura dos dados, o cálculo do imposto e a interação com o usuário se tornarão componentes independentes.