3. Fundamentos da linguagem Kotlin
3.1. Introdução
Começaremos tratando Kotlin como uma linguagem de programação tradicional. Abordaremos as classes no próximo capítulo. Um programa é composto de duas coisas:
- dados;
- as instruções que os manipulam.
Em geral, procuramos separar os dados das instruções:
Todos os exemplos deste capítulo fazem parte do projeto Gradle da pasta [03-basics] do código do curso. Como observado no Capítulo 2, “Configuração do ambiente de desenvolvimento”, cada programa está contido em um arquivo situado em um pacote que leva o nome do programa em minúsculas: o programa [Basics04.kt] fica na pasta [src/main/kotlin/basics04] e começa com a linha [package basics04]. Você pode executá-lo clicando no triângulo verde do IntelliJ IDEA, situado na margem ao lado da função [main], ou pela linha de comando, a partir da pasta do projeto, com o comando [gradlew -q run -Pmain=basics04.Basics04Kt] ([./gradlew] no Linux e no macOS). A opção [-q] (“quiet”) suprime as mensagens do Gradle: resta apenas a saída do programa. Explicaremos o nome [basics04.Basics04Kt] na próxima seção. Os exemplos são executados com as convenções de idioma e formatação do francês (a “locale” fr-FR), como em uma máquina Windows francesa. Veremos que isso afeta apenas números e datas formatados com um format específico: a simples conversão de um número de ponto flutuante em string sempre usa o ponto decimal.
3.2. O programa mínimo
3.2.1. A função main de nível superior
O programa [Basics01.kt] é o seguinte:
Resultados:
Comentários:
- linha 2: o pacote do programa. Um pacote agrupa declarações relacionadas, assim como uma pasta agrupa arquivos. O nome completo de tudo o que é declarado neste arquivo começa com [basics01.]. Em Kotlin, ao contrário de Java, o diretório do arquivo não é ditado pelo nome do pacote; no entanto, é prática comum, que seguimos, fazê-los coincidir;
- linha 4: a função [main] é o ponto de entrada do programa. A palavra-chave [fun] declara uma função; [main()] não tem parâmetros e não retorna nenhum valor. A função é escrita diretamente no arquivo, fora de qualquer classe: é uma função de nível superior. O corpo da função é delimitado por chaves;
- linha 5: a função [println] imprime uma linha na tela. Também é uma função de nível superior, declarada no pacote [kotlin.io] da biblioteca padrão de Kotlin;
- linha 7: a versão Java da mesma operação. [System] é uma classe do JDK, [out] é um de seus campos, que representa a saída padrão (a tela), e [println] é um método desse objeto. Kotlin usa diretamente todas as classes Java: essa é uma de suas grandes vantagens. A função [println] de Kotlin é, na verdade, apenas uma abreviação de [System.out.println]; é a que usaremos;
- linha 9: [words] é uma lista de strings; as listas serão abordadas no Capítulo 5. A palavra-chave [val] declara uma variável cujo valor não mudará; não especificamos seu tipo: o compilador o infere a partir do valor, neste caso [List<String>]. A função [listOf] pertence ao pacote [kotlin.collections], que pode ser usado sem instrução de importação (veja adiante);
- linha 10: uma lista é exibida com seus elementos entre colchetes;
- as instruções não terminam com ponto e vírgula: uma quebra de linha basta. O ponto e vírgula só serve para escrever várias instruções em uma única linha. As linhas que começam com // são comentários, ignorados pelo compilador.
Com dois argumentos de linha de comando, passados ao Gradle pela opção [--args]:
Os argumentos são ignorados porque a função [main()] não tem parâmetros para recebê-los. Para usá-los, declare a função como [fun main(args: Array<String>)]: o array de strings [args] conterá então os argumentos da linha de comando. Voltaremos a isso na seção “Argumentos do programa principal”.
3.2.2. A função main e seus argumentos
O programa [Basics02.kt] é o seguinte:
Resultados:
Comentários:
- linha 4: a função [main] recebe os argumentos da linha de comando no parâmetro [args]. Em Kotlin, o tipo de um parâmetro é escrito depois de seu nome, separado por dois-pontos: [args: Array<String>] lê-se “[args], do tipo array de strings”. Isso equivale a [String[] args] em Java;
- linha 6: o número de elementos do array é [args.size] (o equivalente Java de [args.length]). Na string, [${args.size\}] é substituído pelo valor da expressão entre chaves: trata-se de um template de string, que discutiremos com mais detalhes adiante;
- linha 7: a função [contentToString] constrói uma string a partir dos elementos de um array. Ela substitui o método Java [Arrays.toString] e, como a função anterior, não exige nenhuma importação.
Não escrevemos nenhuma classe. No entanto, a máquina virtual Java (JVM), que executa o programa, só reconhece classes. O compilador Kotlin, portanto, organiza as declarações de nível superior de um arquivo em uma classe que ele mesmo gera, com o nome do arquivo seguido de [Kt]: para o arquivo [Basics02.kt] no pacote [basics02], trata-se da classe [basics02.Basics02Kt]. É por isso que o comando de execução se refere ao programa como [-Pmain=basics02.Basics02Kt]. Você pode verificar isso compilando o arquivo com o compilador de linha de comando [kotlinc] (Capítulo 2) e examinando depois a classe gerada com a ferramenta [javap] do JDK:
- [kotlinc] gerou um único arquivo de código intermediário (“bytecode”), [Basics02Kt.class], no diretório do pacote;
- o comando [kotlinr] (o launcher de Kotlin, Capítulo 2) executa essa classe acrescentando a biblioteca padrão de Kotlin ([kotlin-stdlib.jar]) ao classpath;
- [javap] mostra que a classe gerada é [public final] e que a função [main] se tornou nela um método [public static]: exatamente o método [public static void main(String[] args)] que a JVM espera. Para a JVM, um programa Kotlin é apenas mais uma classe Java;
- quando iniciada com o simples comando [java], a classe falha: o código gerado recorre a classes da biblioteca padrão de Kotlin (neste caso, [kotlin.jvm.internal.Intrinsics], que, entre outras coisas, verifica se os parâmetros não são iguais a [null]), ausente do classpath. O Gradle e o IntelliJ IDEA a adicionam automaticamente; um programa Kotlin isolado deve incluí-la (opção [-include-runtime] do [kotlinc], Capítulo 2, ou scripts do Gradle, veja adiante).
Para o programa [Basics01.kt], cuja função [main] não tem parâmetros, o compilador também gera um método [main(String[])] que simplesmente chama o primeiro. O Gradle coloca as classes que compila na pasta [build/classes/kotlin/main] do projeto; você pode examiná-las ali depois de uma compilação ([gradlew build]):
Uma comparação com o Java 25 é instrutiva. O Java 25 também permite escrever um programa sem declarar uma classe (um “arquivo-fonte compacto”, com um método chamado [void main()]): o compilador Java então envolve o conteúdo do arquivo em uma classe implícita com o nome do arquivo. Kotlin faz o mesmo desde sua primeira versão, com duas diferenças:
- a classe gerada se chama [Basics02Kt] em vez de [Basics02], o que deixa o nome [Basics02] disponível para uma classe que o programador queira escrever no mesmo arquivo. A anotação
***[@file:JvmName("ClassName")]***, colocada no início do arquivo, permite escolher outro nome; - as funções de nível superior são compiladas em métodos [static]: nenhum objeto é criado para chamar [main], ao passo que o método [void main()] em um arquivo Java compacto é um método de instância. O mais importante: em Kotlin, essa sintaxe não se limita a programas pequenos: funções, variáveis e constantes de nível superior são usadas comumente em todos os programas, ao lado das classes.
A função [main] só pode assumir as duas formas encontradas: [fun main()] e [fun main(args: Array<String>)]. Ela não precisa ser declarada como public: em Kotlin, tudo é público por padrão.
3.2.3. Imports padrão
O programa [Basics01.kt] usa as funções [println] e [listOf], e o programa [Basics02.kt] usa a função [contentToString], sem nenhuma diretiva [import]. Isso é possível porque todo arquivo Kotlin importa automaticamente os seguintes pacotes da biblioteca padrão:
Isso fornece os tipos básicos ([Int], [String]... do pacote [kotlin]), listas, conjuntos e dicionários ([kotlin.collections]), entrada e saída de console ([kotlin.io]), intervalos ([kotlin.ranges]), funções de string ([kotlin.text]), bem como classes do pacote Java [java.lang] ([System], [Math], [Thread]...). Quaisquer outras declarações devem ser importadas no início do arquivo, logo após a linha [package]: uma diretiva por classe ou função ([import java.math.BigDecimal]) ou uma diretiva por pacote ([import java.time.*]). Não há equivalente à diretiva [import module java.base;] do Java 25, que um arquivo Java compacto recebe automaticamente: um programa Kotlin que usa as classes [BigDecimal] ou [LocalDate] do JDK deve importá-las. Uma observação sobre a sintaxe: as diretivas [import], como as demais instruções, não terminam com ponto e vírgula.
3.3. Tipos de dados do Kotlin
O Kotlin usa os seguintes tipos de dados:
- números inteiros, com e sem sinal;
- números reais;
- números decimais;
- caracteres e cadeias de caracteres;
- booleanos;
- objetos.
3.3.1. Tipos de dados predefinidos
Tipo Kotlin | Tipo Java correspondente | Dados representados | Sufixo literal | Codificação | Faixa de valores |
[Char] | [char] / [Character] | caractere | 2 bytes | Caractere Unicode (UTF-16), de '\u0000' a '\uFFFF' | |
[Byte] | [byte] / [Byte] | inteiro | 1 byte | [-2⁷, 2⁷-1] ou [-128, 127] | |
[Short] | [short] / [Short] | inteiro | 2 bytes | [-2¹⁵, 2¹⁵-1] ou [-32768, 32767] | |
[Int] | [int] / [Integer] | inteiro | 4 bytes | [-2³¹, 2³¹-1] ou [-2147483648, 2147483647] | |
[Long] | [long] / [Long] | inteiro | L | 8 bytes | [-2⁶³, 2⁶³-1] ou [-9223372036854775808, 9223372036854775807] |
[UByte], [UShort], [UInt], [ULong] | (sem equivalente) | inteiro sem sinal | U, UL | 1, 2, 4, 8 bytes | [0, 2⁸-1], [0, 2¹⁶-1], [0, 2³²-1], [0, 2⁶⁴-1] |
[Float] | [float] / [Float] | número real | F | 4 bytes | [1.4 10⁻⁴⁵, 3.4 10³⁸] em valor absoluto, 7 dígitos significativos |
[Double] | [double] / [Double] | número real | 8 bytes | [4.9 10⁻³²⁴, 1.8 10³⁰⁸] em valor absoluto, 15 a 16 dígitos significativos | |
[Boolean] | [boolean] / [Boolean] | booleano | não definido | [true], [false] | |
[String] | [String] | cadeia de caracteres | referência a uma sequência de caracteres Unicode | ||
[BigDecimal] (classe Java) | [BigDecimal] | número decimal | variável | número decimal exato, de qualquer precisão | |
[Any] | [Object] | referência a objeto | referência a um objeto de qualquer tipo |
Java distingue entre os oito tipos primitivos ([int], [double]...), cujos valores não são objetos, e os tipos de referência (classes), e associa cada tipo primitivo a uma classe wrapper ([Integer] para [int]...). Kotlin elimina essa distinção: em Kotlin, todo valor é um objeto. O tipo [Int] é uma classe que possui métodos; é possível escrever [3.plus(4)] ou [3.toString()], o que Java não permite para o literal 3 do tipo [int]. Os nomes de tipos começam todos com letra maiúscula, assim como os nomes de classes.
Isso não tem impacto no desempenho em tempo de execução. O compilador traduz uma variável do tipo [Int] em uma variável do tipo primitivo [int] da JVM sempre que possível, e usa a classe wrapper *[java.lang.Integer] somente quando um objeto é necessário: quando o valor é passado a um parâmetro do tipo [Any] (o equivalente em Kotlin da classe [Object] do Java), armazenado em uma lista, ou quando pode ser do tipo [null] (veja adiante). O boxing e o unboxing, portanto, continuam presentes, mas são tratados pelo compilador, e o programador Kotlin não precisa se preocupar com isso. Não existe o tipo [Integer] em Kotlin: existe apenas [Int]*.
Os tamanhos em bytes são dados pelas constantes [Int.SIZE_BYTES], [Long.SIZE_BYTES]... (e [Int.SIZE_BITS]... em bits), os limites da faixa de valores por [Int.MIN_VALUE] e [Int.MAX_VALUE], etc.
Ao contrário do Java, o Kotlin possui inteiros sem sinal: [UByte], [UShort], [UInt]e [ULong], que têm o mesmo tamanho que seus equivalentes com sinal, mas representam apenas valores positivos ou nulos. Seus literais recebem o sufixo U ([42U]) ou UL ([42UL]). Eles são usados principalmente para manipular dados binários (bytes de arquivos, endereços, cores); os cálculos comuns são feitos com tipos com sinal. O Kotlin também não possui um tipo decimal: valores monetários são calculados com a classe [BigDecimal] do pacote Java [java.math], que veremos um pouco mais adiante.
O programa [Basics03.kt] ilustra esses diversos pontos:
Resultados:
Comentários:
- Linha 4: a classe [BigDecimal] é uma classe do JDK; ela deve ser importada;
- linha 7: declaração de uma variável [integer] do tipo [Int] inicializada com 2. Em Kotlin, o tipo de uma variável é escrito após o nome, separado por dois-pontos. Veremos que o tipo geralmente pode ser omitido;
- linha 8: o sufixo F é obrigatório: o literal 10.5 é do tipo [Double], e o compilador se recusa a atribuí-lo a uma variável do tipo [Float];
- linha 11: o literal 1000 é aceito para uma variável do tipo [Long], porque o compilador sabe que se trata de uma constante que cabe no tipo. O mesmo vale para as linhas 12–13 com os tipos [Byte] e [Short]. No entanto, como veremos, o Kotlin nunca converte implicitamente uma variável de um tipo numérico para outro;
- linha 16: um número [BigDecimal] é um objeto; aqui, ele é criado a partir de uma string, o que garante um valor exato. O Kotlin não possui um operador [new]: um objeto é criado chamando o construtor de sua classe como uma função;
- linha 18: em uma string, [$integer] é substituído pelo valor da variável [integer], e [${typeName(integer)\}] pelo valor da expressão escrita entre chaves. Esses templates de string são a forma padrão de construir uma string em Kotlin; voltaremos a isso na próxima seção. [Int.SIZE_BYTES] é o tamanho em bytes de um [Int];
- Linha 18: a função [typeName] (linhas 42–43) espera um parâmetro do tipo [Any]. O parâmetro é, portanto, um objeto, e o valor [integer] é encapsulado em um objeto [java.lang.Integer]. A função exibe dois nomes: [o::class.qualifiedName] é o nome completo do tipo para o Kotlin ([kotlin.Int]), e [o.javaClass.name] é o nome da classe do objeto para a JVM ([java.lang.Integer]). Vemos que [kotlin.Int], [kotlin.Double], [kotlin.String]... são representados em tempo de execução por classes Java;
- linha 21: o tamanho de uma string na memória não é acessível: [String] não possui uma constante [SIZE_BYTES];
- linha 26: o tamanho de um booleano não é definido pela JVM: [Boolean] não possui uma constante [SIZE_BYTES];
- linha 27: [BigDecimal] é uma classe Java: seus dois nomes são idênticos;
- linha 29: o literal 3 é um objeto do tipo [Int]: [3::class.simpleName] é o nome curto do seu tipo, e seus métodos podem ser chamados: [plus] e [toString]. Veremos no Capítulo 4 que o operador + é simplesmente outra forma de escrever o método [plus];
- linhas 31–33: as constantes [MIN_VALUE] e [MAX_VALUE] indicam os limites do domínio de valores. Observe: para os números reais, [Double.MIN_VALUE] é o menor valor estritamente positivo (4.9 × 10⁻³²⁴) e não o maior número negativo, que é [-Double.MAX_VALUE];
- linha 35: um inteiro sem sinal de 32 bits. O valor 4.000.000.000 excede a faixa de [Int], mas não a de [UInt], que vai até 2³²-1;
- linhas 37–38: -1 é codificado como 32 bits com valor 1; a função [toUInt] os interpreta como um inteiro sem sinal, igual a 2³²-1;
- Linhas 42–43: uma função de nível superior do arquivo. O tipo de retorno é indicado após a lista de parâmetros: [: String]. Ela retorna ([return]) uma cadeia de caracteres. As funções são descritas na seção “Passagem de parâmetros para uma função”.
Observe que os números reais são exibidos com ponto decimal (10.5, -4.6), embora o programa seja executado em francês. Converter um número em string — seja com um template, com concatenação ou com o método [toString] — não depende do idioma do usuário: sempre produz um ponto decimal. Somente formatos numéricos como %f, que veremos mais adiante, seguem as convenções do idioma.
3.3.2. Notação para dados literais
Dado | Exemplos de literais |
[Int] inteiro (32 bits) | 145, -7, 0xFF (hexadecimal), 0b1010_1010 (binário) |
Inteiro [Long] (64 bits), sufixo L | 100000L, 1_000_000_000_000L, 3_000_000_000 (grande demais para um [Int]) |
inteiro sem sinal [UInt], [ULong], sufixo U, UL | 255U, 0xFFFF_FFFFU, 1UL |
real [Double] | 134.789, -45E-18 (-45 × 10⁻¹⁸), 10.0 |
real [Float], sufixo F ou f | 134.789F, -45E-18F |
número decimal [BigDecimal] | sem literal: [BigDecimal("100000.50")] |
caractere [Char] | 'A', 'b', '\n', '\u00e9' |
cadeia de caracteres [String] | "today", "c:\\chap1", "$name is ${age + 10\} years old", raw string """c:\chap1""" |
booleano [Boolean] | [true], [false] |
data | [LocalDate.of(1954, 10, 13)] (ano, mês, dia) para 13/10/1954 |
No código-fonte, os números de ponto flutuante são sempre escritos com ponto decimal. Como em Java, os inteiros podem ser escritos em hexadecimal (prefixo [0x]) ou em binário (prefixo [0b]), e grupos de dígitos podem ser separados pelo caractere _ para melhorar a legibilidade: [1_000_000] é o inteiro um milhão. O Kotlin difere do Java em alguns pontos, que eliminam outras tantas armadilhas:
- um literal inteiro sem sufixo é do tipo [Int] se couber nesse tipo, e do tipo [Long] caso contrário: [3_000_000_000] é um [Long]. O Java rejeita esse literal sem o sufixo L;
- o sufixo L deve ser escrito em maiúscula: o compilador rejeita [100l] com a mensagem [use 'L' instead of 'l'], porque o l se parece demais com o dígito 1;
- não existe notação octal. A armadilha do Java, em que 017 vale 15, não existe: o compilador rejeita 017 com a mensagem [leading zeros are not allowed in integer literals];
- não existe o sufixo “D” para números de ponto flutuante: um literal que contém um ponto decimal ou um expoente é [Double]; 10.0, portanto, é escrito como 10.0 e não como 10D;
- Os inteiros sem sinal têm seus próprios sufixos, U e UL.
Um literal de string pode conter sequências de escape introduzidas pelo caractere \: "\n" representa o caractere de fim de linha e não a sequência dos dois caracteres \ e n, "\t" representa uma tabulação, "\"" representa uma aspa dupla, "\\" o próprio caractere \, "\$" o caractere $ (veja adiante) e "\u00e9" o caractere Unicode com código hexadecimal 00E9. Para escrever o caminho do Windows c:\chap1\paragraph3, é preciso, portanto, escrever "c:\\chap1\\paragraph3". As classes Java de arquivo também aceitam o separador / no Windows: "c:/chap1/paragraph3" designa o mesmo arquivo.
Para construir uma string a partir de vários valores, o Kotlin oferece três métodos:
- templates de string: em uma string, [$name] é substituído pelo valor da variável [name], e [${expression\}] pelo valor de qualquer expressão: ["in 10 years he will be ${age + 10\}"]. Este é o método mais legível e mais utilizado. Equivale às strings interpoladas do C#, como [$"..."]; o Java, por outro lado, não tem esse recurso (os “string templates” propostos como prévia no Java 21 e 22 foram removidos);
- a concatenação com o operador +: se o operando da esquerda for uma string, o da direita é convertido em string, qualquer que seja o seu tipo. Diferentemente do Java, o operando da esquerda deve ser uma string: [10 + " years"] é rejeitado pelo compilador porque o tipo [Int] não possui um operador + que aceite uma string;
- os formatos: ["format".format(value1, value2, ...)] ou [String.format(format, value1, value2, ...)]. São os formatos do Java, com os mesmos especificadores, substituídos em ordem pelos valores seguintes: %s (qualquer valor convertido em string), %d (um inteiro), %f (um número de ponto flutuante), %.2f (um número de ponto flutuante com duas casas decimais), %x ou %X (um inteiro em hexadecimal), %,d (um inteiro com separador de milhares), %e (notação científica), %n (uma quebra de linha), %10s (uma string alinhada à direita em 10 caracteres), %-10s (alinhada à esquerda)... Os formatos numéricos seguem as convenções do idioma do usuário. Eles são usados quando é preciso controlar a apresentação dos números (número de casas decimais, alinhamento); caso contrário, o template é suficiente.
Por fim, o Kotlin oferece as “raw strings”: uma string delimitada por três aspas, como ["""..."""], pode se estender por várias linhas e conter aspas; mais importante ainda, as sequências de escape não são interpretadas nas raw strings: o caractere \ é tratado como está, de modo que se escreveria ["""c:\chap1"""]. Isso é muito útil para escrever JSON, SQL, HTML ou expressões regulares (Capítulo 5). As raw strings aceitam templates. Os espaços iniciais são preservados como estão; para indentar o texto junto com o código, aplique à string a função [trimIndent()], que remove os espaços comuns a todas as linhas, bem como a primeira e a última linhas se estiverem vazias, ou a função [trimMargin()], que remove tudo o que precede o caractere | (a “margem”). Os blocos de texto do Java 15 foram concebidos com base nesse modelo; eles removem automaticamente a indentação comum, mas interpretam as sequências de escape.
O programa [Basics04.kt] demonstra essas diferentes notações:
Resultados:
Comentários:
- linhas 4–6: as classes do JDK usadas pelo programa são importadas;
- Linha 10: quatro declarações em uma única linha, separadas por ponto e vírgula. [0xFF] vale 255 e [0b1010_1010] vale 170. Os tipos das variáveis não são especificados: o compilador os infere a partir dos valores, neste caso [Int];
- linha 11: o sufixo L transforma 100000 em um [Long]. O literal 3_000_000_000, que é grande demais para um [Int], é um [Long] sem necessidade de sufixo;
- linha 14: dois inteiros sem sinal do tipo [UInt]. 0xFFFF_FFFFU, que tem todos os 32 bits com valor 1, é igual a 2³²-1;
- linha 17: -45E-18 é exibido como -4.5E-17: é o mesmo valor, normalizado. O número de ponto flutuante 10.0 é exibido como 10.0: converter um [Double] em string sempre produz pelo menos uma casa decimal;
- linha 19: um [BigDecimal] mantém o número de casas decimais com que foi escrito: 100000.50, e não 100000.5;
- linha 22: a sequência \u00e9 designa o caractere Unicode com código hexadecimal 00E9, ou seja, é;
- linha 26: uma data. A classe [LocalDate] (pacote [java.time] do JDK) representa uma data sem horário. O Kotlin não possui uma classe de data própria: usa a do Java. Sua conversão em string usa o formato internacional ISO 8601 (ano-mês-dia), independentemente do idioma. Trataremos das datas no Capítulo 5;
- linha 30: cada \\ representa um único caractere \;
- linha 32: uma quebra de linha e uma tabulação;
- linha 34: as sequências \$ e \";
- linha 39: um template. [$name] e [$age] são substituídos pelos valores das variáveis, e [${age + 10\}] pelo valor da expressão. As chaves são obrigatórias sempre que o que segue o $ não é um simples nome de variável;
- linha 40: o mesmo texto construído por concatenação. Os parênteses em torno de [(age + 10)] são essenciais: sem eles, os operadores + seriam avaliados da esquerda para a direita, a string receberia primeiro 23 e depois 10, e o resultado seria “in 10 years he will be 2310”. O template não tem essa armadilha;
- linha 41: o mesmo texto construído com um formato;
- linha 43: alguns especificadores de formato: %.1f (uma casa decimal), %X (hexadecimal em maiúsculas), %,d (separador de milhares). Esses formatos seguem as convenções francesas: uma vírgula decimal e, como separador de milhares, um espaço fino sem quebra. A função [format] da biblioteca Kotlin é aplicada à própria string de formato; ela chama a função Java [String.format];
- linha 44: a função [toString(base)] converte um inteiro em string em qualquer base, aqui 2; a função [uppercase()] converte a string para maiúsculas. Observe que um template pode conter chamadas de função;
- linha 45: um formato de data personalizado: dia da semana (EEEE), dia (d), mês por extenso (MMMM), ano (yyyy). Os nomes dos dias e dos meses estão em francês, o idioma do usuário. Observe que o template pode conter aspas dentro das chaves;
- Linhas 48–53: uma raw string em várias linhas. As aspas são escritas como estão, e \chap1 não precisou ser escrito como \\chap1. A função [trimIndent()] removeu os oito espaços comuns a todas as linhas, bem como a primeira linha (que está vazia, imediatamente após as aspas de abertura) e a última linha (que contém apenas espaços antes das aspas de fechamento);
- linha 56: uma raw string em uma única linha, o que evita ter de escapar as aspas do JSON, com dois templates;
- linhas 59–62: a função [trimMargin()] remove, de cada linha, os espaços e o caractere | que marcam a margem: os três espaços colocados após o | são mantidos. Como as sequências de escape não são interpretadas em uma raw string, o caractere $ é escrito como [${'$'\}]: um template cuja expressão é o caractere '$'. Aqui, como o $ é seguido por uma quebra de linha, ele poderia ter sido escrito sozinho; no entanto, [$name] seria substituído pelo valor de [name]. Desde o Kotlin 2.2, também é possível prefixar a string com vários sinais $: em [$$"""{ "$schema": "$$name" \}"""], dois sinais $ são necessários para introduzir um template, e [$schema] permanece inalterado.
3.3.3. Declaração de dados
3.3.3.1. Papel das declarações
Um programa manipula dados caracterizados por um nome e um tipo. Esses dados são armazenados na memória. Quando o programa é compilado, o compilador atribui a cada dado um local de memória caracterizado por um endereço e um tamanho. Ele faz isso com base nas declarações feitas pelo programador. Além disso, essas declarações permitem ao compilador detectar erros de programação. Assim, a operação [x = x * 2] será declarada inválida se [x] for uma cadeia de caracteres.
3.3.3.2. Variáveis somente leitura e mutáveis
O Kotlin possui duas palavras-chave para declarar uma variável:
- [val] (“value”) declara uma variável somente leitura: ela recebe um valor uma única vez e não pode ser alterada depois. Equivale a uma variável Java [final];
- [var] (“variable”) declara uma variável mutável, à qual podem ser atribuídos novos valores.
A sintaxe é a seguinte:
O tipo geralmente é omitido: o compilador o infere a partir do valor (inferência de tipo). A palavra-chave Kotlin [var] não tem, portanto, o mesmo significado que no Java 10: em Java, [var] significa “tipo inferido”; em Kotlin, significa “mutável”, e o tipo pode ser inferido com [val] assim como com [var]. Uma variável declarada sem ser inicializada deve ter um tipo explícito; ela não pode ser usada até que receba um valor (mensagem [variable 'b' must be initialized]).
A convenção em Kotlin é declarar todas as variáveis com [val], e usar [var] apenas quando o valor da variável realmente deve mudar. Isso melhora a legibilidade do programa: ao ler ***[val total = ...]***, sabe-se que *[total] manterá esse valor. O IntelliJ IDEA também ajuda a identificar qualquer variável declarada como [var] que poderia, na verdade, ser [val]*.
O Kotlin diferencia letras maiúsculas e minúsculas: as variáveis [END] e [end] são diferentes. Por convenção, o nome de uma variável começa com letra minúscula, e cada palavra seguinte começa com letra maiúscula: [priceExclTax], [nbChildren].
3.3.3.3. Declaração de constantes
Uma variável como [val] não muda de valor, mas seu valor pode ser desconhecido até a execução ([val today = LocalDateTime.now()]). Uma constante, a rigor, é um valor conhecido em tempo de compilação. O Kotlin a declara com as palavras-chave [const val]:
Uma constante [const val] é declarada no nível superior do arquivo (fora das funções), ou dentro de um [object] ou de um [companion object], que veremos no Capítulo 4. Ela só pode ser de um tipo básico ([Int], [Double], [Boolean]...) ou do tipo [String], e seu valor deve poder ser calculado pelo compilador. Por exemplo:
O compilador então substitui cada ocorrência de [VAT_RATE] pelo seu valor, assim como o compilador Java faz com um campo [static final] inicializado com uma constante. As tentativas a seguir são rejeitadas:
(o ponto de exclamação em [LocalDate!] será explicado na próxima seção). Por que declarar constantes?
- O programa fica mais fácil de ler se a constante tiver um nome significativo;
- fica mais fácil modificar o programa se a “constante” precisar ser alterada. Assim, se a alíquota do IVA passar para 0.25, a única modificação necessária é na instrução que define o seu valor: [const val VAT_RATE = 0.25]. Se 0.2 tivesse sido usado explicitamente no programa, seria preciso modificar numerosas instruções.
Por convenção, como em Java, o nome de uma constante é escrito em letras maiúsculas, com as palavras separadas pelo caractere _: [VAT_RATE], [MAX_VALUE]. Uma variável local, como [val], mantém um nome comum.
O programa [Basics05.kt] é o seguinte:
Resultados:
Comentários:
- linha 7: uma constante de nível superior. O compilador a classifica na classe [Basics05Kt] como um campo [public static final double];
- linha 11: uma variável local somente leitura, do tipo [String] (inferido);
- linha 13: uma variável mutável. O literal 100.0 dá a [priceExclTax] o tipo [Double]. Com [var priceExclTax = 100], a variável seria do tipo [Int], e a atribuição de 250.0 na linha 15 seria rejeitada;
- linha 14: o resultado é um [Double], exibido com pelo menos uma casa decimal: 120.0;
- linha 15: [priceExclTax] recebe um novo valor;
- linha 19: um dado com tipo explícito;
- linha 20: a função [typeName] (linha 41) exibe o nome curto ([simpleName]) e o nome completo ([qualifiedName]) do tipo do seu parâmetro;
- linha 22: um valor com tipo implícito. Como 3 é do tipo [Int], [j] será do tipo [Int];
- linha 24: como [LocalDateTime.now()] (a data e a hora atuais) é do tipo [LocalDateTime], [today] será do tipo [LocalDateTime]. Observe que o programa chama um método [static] de uma classe Java, exatamente como em Java: [LocalDateTime.now()];
- linhas 26–29: o tipo inferido depende de como o literal é escrito: 3.5 é um [Double], 3.5F é um [Float], 10L é um [Long];
- Linha 33: uma variável declarada sem valor inicial; seu tipo é obrigatório. Embora seja declarada como [val], ela pode receber um valor mais tarde (linha 36), mas apenas uma vez. O Kotlin não permite declarar várias variáveis em uma única instrução, como no [int a = 1, b, c = 3;] do Java: escreve-se uma declaração por linha, ou várias declarações separadas por ponto e vírgula, como no programa anterior;
- Linha 41: uma função cujo corpo se reduz a uma única expressão pode ser escrita com o sinal de igual (=) no lugar das chaves e do return (corpo de expressão). Seria possível até omitir o tipo de retorno, que o compilador inferiria a partir da expressão.
Uma variável [val] não pode receber um novo valor, e uma variável [var] não pode mudar de tipo: seu tipo foi fixado pela declaração. Assim, as instruções a seguir são rejeitadas pelo compilador:
3.3.4. Segurança contra nulos
Às vezes é útil poder expressar a ausência de um valor: uma idade desconhecida, um campo vazio em um banco de dados ou uma busca sem resultado. Em Java, qualquer variável de um tipo de referência pode ter o valor [null], que significa “nenhum objeto”. Tentar acessar um membro dessa variável — por exemplo, seu método [length()] — provoca um erro em tempo de execução, uma [NullPointerException]: esse é o erro mais comum em Java, porque o compilador Java não distingue entre uma referência que pode ser [null] e uma que não pode. Para expressar a ausência de um valor sem [null], o Java 8 adicionou a classe [Optional<T>], uma “caixa” que contém um valor ou está vazia; e, para um número, o Java usa a classe wrapper [Integer], que pode conter [null], em vez do tipo primitivo [int].
O Kotlin resolve esse problema no próprio sistema de tipos, e essa é uma de suas principais contribuições. Um tipo comum não aceita o valor nulo: uma variável do tipo [String] sempre contém uma string, e uma variável do tipo [Int] sempre contém um inteiro. Para permitir [null], é preciso indicá-lo explicitamente acrescentando um ponto de interrogação ao nome do tipo: [String?] é o tipo “string ou null”, e [Int?] é o tipo “inteiro ou null”. Esses são chamados de tipos “anuláveis” (nullable). O compilador então verifica que um membro de um valor anulável não possa ser usado sem antes tratar o caso [null]:
O Kotlin oferece várias maneiras de usar um valor anulável:
- o [if (x != null)] teste: no ramo em que o teste é verdadeiro, o compilador sabe que [x] não é igual a [null], e o trata como um valor do tipo [String] (e não [String?]). Isso é conhecido como “smart cast”;
- a chamada segura [x?.length]: se [x] for igual a [null], a expressão é avaliada como [null] em vez de causar um erro; caso contrário, é avaliada como [x.length]. O resultado é, portanto, do tipo [Int?];
- o operador Elvis [x ?: defaultValue]: ele é avaliado como [x] se [x] não for igual a [null], e como [defaultValue] caso contrário (seu nome vem da semelhança do símbolo “?” com o penteado do cantor, visto de lado). Ele costuma ser combinado com a chamada segura: [x?.length ?: 0];
- a função
**let**:***[x?.let { ... \\}]executa o bloco entre chaves somente se*[x]não for igual a*[null]*; dentro do bloco, o valor é chamado de [it] e é de um tipo não anulável. O bloco é uma lambda**, conceito que estudaremos no Capítulo 7; - a asserção [x!!]: o programador afirma que [x] não é igual a [null]. Se isso for verdade, [x!!] é do tipo [String]; caso contrário, uma [NullPointerException] é lançada. Ela deve ser usada o mínimo possível: é um retorno deliberado ao comportamento do Java.
Os operadores ?, ?: e !! são discutidos com mais detalhes na seção “Operadores de nulos”. O C# adotou uma abordagem semelhante com seus “nullable reference types” (C# 8), na forma de avisos; em Kotlin, são erros de compilação.
Na prática, o erro [NullPointerException] é raro em Kotlin. Agora ele só pode ocorrer em alguns casos: o uso de !!, uma exceção lançada explicitamente e, principalmente, o uso de código Java. O compilador Kotlin não sabe se um método Java pode retornar [null]: ele lhe atribui, portanto, um “tipo de plataforma”, indicado como [String!] nas mensagens do compilador (ele não pode ser escrito no código), que pode ser usado como [String] ou como [String?]. A responsabilidade recai então sobre o programador. Quando se sabe que um método Java retorna [null], seu resultado é armazenado em uma variável anulável ([val path: String? = System.getenv("X")]): o compilador retoma então suas verificações. (Os métodos Java anotados com [@Nullable] ou [@NonNull] — por exemplo, com anotações do projeto JSpecify — recebem um tipo Kotlin específico, e não um tipo de plataforma.)
O que acontece com as classes wrapper e com [Optional]? Um [Int] é compilado como [int], e um [Int?] como [java.lang.Integer], já que somente uma referência pode ser do tipo [null]: as classes wrapper estão lá, mas o compilador cuida delas sozinho. A classe [Optional] continua utilizável, por ser uma classe Java, mas tem pouca utilidade em Kotlin: um [String?] diz o mesmo que um [Optional<String>], sem criar um objeto adicional, e os operadores ?. e ?: substituem seus métodos [map] e [orElse]. As funções da biblioteca Kotlin que podem não retornar nada retornam [null]: [toIntOrNull()], [firstOrNull()], [readlnOrNull()]...
Encontraremos tipos anuláveis já nos primeiros exemplos, porque a função [readlnOrNull()], que lê uma linha digitada no teclado, retorna [null] quando não há mais nada a ler (fim do fluxo de entrada). O programa [Basics06.kt] é o seguinte:
Resultados ao digitar texto pelo teclado:
Resultados quando o usuário pressiona Ctrl-D (Ctrl-Z seguido de Enter no Windows), o que fecha o fluxo de entrada:
Comentários:
- Linha 5: uma função que retorna um primeiro nome, como [null]. O tipo do seu resultado, [String?], informa isso aos usuários. A expressão [if (...) "jean" else null] é um [if] que retorna um valor; voltaremos a isso;
- linhas 9–10: duas variáveis do tipo [String?]. [firstName2] é igual a [null]. O tipo poderia ter sido omitido: ele teria sido inferido a partir do tipo do resultado de [firstNameOf];
- linha 11: um template exibe [null] para um valor nulo; o valor [null] é testado com o operador ==;
- linhas 13–14: dentro do bloco [if], [firstName1] é do tipo [String]: sua propriedade [length] (o comprimento da string) pode ser usada com segurança. Fora do bloco, [firstName1.length] seria rejeitado;
- linha 17: a chamada segura. [firstName2?.length] é igual a [null];
- linha 19: o operador Elvis. [firstName2 ?: "unknown"] é "unknown", e [firstName2?.length ?: 0] é 0;
- linhas 21–22: a função [let]. O primeiro bloco é executado com [it] igual a "jean"; o segundo não;
- linhas 25–26: a função [toIntOrNull()] converte uma string em um inteiro e retorna [null] se a string não representar um inteiro. O tipo [Int?] é compilado como [java.lang.Integer];
- Linha 27: não é possível fazer cálculos com um [Int?]; [unknownAge + 1] seria rejeitado. O operador Elvis retorna um [Int]: 0 se [unknownAge] for igual a [null]. O unboxing de um [Integer] nulo — uma armadilha clássica do Java — é, assim, impossível;
- linha 30: a asserção !! aplicada a um valor não nulo: ela retorna o valor, do tipo [String];
- linhas 31–34: a asserção
!!aplicada a*[null]lança uma*[NullPointerException]. A estrutura[try / catch]*, que captura o erro, é descrita mais adiante; aqui, o nome completo da classe da exceção é exibido.[NullPointerException]* é uma classe Java, que o Kotlin designa pelo mesmo nome; - linha 38: o método Java [System.getenv] retorna o valor de uma variável de ambiente do sistema, ou [null] se ela não existir. Seu resultado é do tipo de plataforma [String!]: [path] é, portanto, desse tipo;
- linha 39: quando usado como [String?], [path] se comporta corretamente;
- linha 42: quando usado como [String], ele é aceito pelo compilador, mas causa uma [NullPointerException] em tempo de execução. A mensagem da exceção (propriedade [message]), gerada pela JVM, especifica exatamente qual expressão era [null]. Se tivéssemos escrito [val path: String? = System.getenv(...)], o compilador teria rejeitado essa linha;
- linha 48: a função [print] escreve na tela sem passar para a linha seguinte; a entrada do usuário virá logo após a mensagem;
- linha 49: a função [readlnOrNull()] lê a linha digitada no teclado. Ela retorna um valor do tipo [String?]: [null] se o fluxo de entrada estiver fechado;
- linha 50: o valor [null] é verificado;
- linha 54: no ramo [else], [line] é do tipo [String]: [line.length] pode ser usado com segurança.
3.3.5. Conversões entre números e strings
Conversão | Função |
número -> string | [number.toString()], um template como ["$number"], ["" + number], ou um formato como ["%d".format(number)] |
string -> int | [string.toInt()], [string.toIntOrNull()] |
string -> Long | [string.toLong()], [string.toLongOrNull()] |
string -> Double | [string.toDouble()], [string.toDoubleOrNull()] |
string -> Float | [string.toFloat()], [string.toFloatOrNull()] |
string -> BigDecimal | [string.toBigDecimal()], [string.toBigDecimalOrNull()] |
string -> Boolean | [string.toBoolean()], [string.toBooleanStrictOrNull()] |
Essas funções de conversão fazem parte da biblioteca Kotlin (pacote [kotlin.text]) e são chamadas diretamente sobre a própria string: ["10".toInt()] em vez da função Java [Integer.parseInt("10")], que continua utilizável. Elas são funções de extensão: funções escritas fora da classe [String], mas chamadas exatamente como se fossem seus métodos. Aprenderemos a escrevê-las no Capítulo 4.
A conversão de uma string em número pode falhar se a string não representar um número válido. Uma função como [toInt()] gera então um erro chamado exceção — neste caso, do tipo [NumberFormatException] — que encerra o programa se não for tratado. Esse erro pode ser tratado pela seguinte cláusula [try / catch]:
Se a função não lançar uma exceção, a execução prossegue para a instrução seguinte; caso contrário, ela passa ao corpo da cláusula [catch] e depois à instrução seguinte. Voltaremos ao tratamento de exceções na seção dedicada a ele.
O Kotlin também oferece, para cada conversão, uma versão que não lança exceção: [toIntOrNull()], [toDoubleOrNull()]... retornam [null] se a conversão falhar. Seus valores de retorno são anuláveis ([Int?], [Double?]...): o compilador exige, portanto, que a falha seja tratada. Combinadas com o operador Elvis, elas permitem escrever uma conversão com valor padrão em uma única linha: [input.toIntOrNull() ?: 0]. O Java não tem equivalente; o curso de Java escreveu seu próprio método, que retornava um [OptionalInt].
Essas funções aceitam um sinal + ou - no início, mas não espaços nem separadores de milhares: use a função [trim()] para remover os espaços iniciais e finais de uma entrada antes de convertê-la.
O programa [Basics07.kt] demonstra várias técnicas de conversão entre números e strings. A função [display] exibe na tela o valor do seu parâmetro:
Resultados:
Comentários:
- linhas 9–12: os dados a converter;
- linhas 15–18: quatro maneiras de converter um número em string. A terceira usa um template, e a última concatena uma string vazia com o número. O template é o método mais comum em Kotlin;
- linha 22: um booleano é exibido como [true] ou [false];
- linhas 25–31: tratamos a exceção que [toInt()] pode lançar. A variável [i1] é declarada com [var] porque recebe um novo valor em [try]. [e.message] é a mensagem de erro associada à exceção [e] (o método Java [getMessage()], visto em Kotlin como uma propriedade). Essas são as mensagens dos métodos Java chamados pelas funções Kotlin: estão em inglês;
- linha 45: [toDouble()] sempre espera um ponto decimal, qualquer que seja o idioma do usuário: a string "100.87" é interpretada da mesma forma em todas as máquinas. Essa é a maneira correta de ler números de arquivos ou em trocas entre programas;
- linha 58: consequentemente, a vírgula decimal é rejeitada;
- linha 65: conversão de uma string em [BigDecimal]; ela também espera um ponto decimal. Equivale a [BigDecimal("100.87")];
- linha 69: [toBoolean()] retorna [true] para a string "true" (sem distinção entre maiúsculas e minúsculas) e [false] para qualquer outra string, inclusive "yes". [toBooleanStrictOrNull()] aceita apenas “true” e “false” e retorna [null] para todo o resto;
- Linhas 72–78: conversões sem exceção. [i2] e [i3] são do mesmo tipo que [Int?]; após o teste [i2 != null], [i2] pode ser usado como um [Int]. Em uma string, uma aspa é escrita como \";
- linha 80: uma conversão com valor padrão, usando o operador Elvis. O template contém uma string, "12x", que por sua vez está entre aspas: isso é permitido dentro das chaves;
- linha 82: " 42 " não é convertido; depois de [trim()], ele é convertido;
- linha 85: [Locale.getDefault()] retorna a localidade (locale) do programa — ou seja, o idioma e o país do usuário, derivados das configurações do sistema: aqui, fr-FR;
- linha 86: um formato usa a localidade atual: o número real é escrito com vírgula decimal;
- linha 87: a função [format] aceita uma localidade como primeiro parâmetro. [Locale.ROOT] é uma localidade neutra que usa o ponto como separador decimal, qualquer que seja a máquina. Ela é usada para escrever números formatados em arquivos ou em trocas entre programas, que não devem depender do idioma do usuário;
- linha 90: para ler um número escrito segundo as convenções francesas, use um objeto [NumberFormat] (do pacote [java.text] do JDK) obtido para a localidade [Locale.FRANCE]. Seu método [parse] retorna um objeto [Number] e pode lançar uma exceção [ParseException]. Em Java, essa é uma exceção checada (checked): o compilador exige que ela seja tratada. O Kotlin não possui exceções checadas: o compilador deixa ao programador a decisão de tratar ou não a exceção. Voltaremos a isso na seção sobre exceções;
- linha 91: [toDouble()] converte [Number] em [Double];
- Linhas 95–96: uma função de nível superior. As funções podem ser escritas em qualquer ordem, antes ou depois de [main]. Ela não retorna resultado: o tipo de retorno é omitido (na verdade, é do tipo [Unit], o equivalente ao [void] do Java).
Observe que as funções [toInt()], [toDouble()]... e [toString()] ignoram o idioma do usuário (ponto decimal), ao passo que os formatos e a classe [NumberFormat] o respeitam. Um programa que lê números deve sempre saber quais convenções foram usadas para escrevê-los.
3.3.6. Arrays de dados
Um array Kotlin é um objeto que permite agrupar dados do mesmo tipo sob um único identificador. O Kotlin distingue dois tipos de arrays:
- o tipo genérico [Array<T>], um array de elementos do tipo [T]: [Array<String>] é um array de strings. Ele corresponde ao array Java de objetos [T[]] ([String[]]);
- tipos especializados para os tipos básicos: [IntArray], [LongArray], [DoubleArray], [BooleanArray], [CharArray]... Um [IntArray] corresponde ao array Java [int[]]: seus elementos são valores primitivos, dispostos lado a lado na memória. Seria possível escrever [Array<Int>], mas isso seria um array de objetos [Integer] ([Integer[]]), que é mais volumoso e mais lento: para números, prefere-se os arrays especializados.
Há várias maneiras de criar um array:
O Kotlin não possui um operador [new] nem a sintaxe [{0, 10, 20\}] para criar um array: tudo é feito com funções ([arrayOf], [intArrayOf]...) ou construtores ([IntArray(n)], [Array(n) { ... \}]). Um [IntArray(n)] contém n zeros, enquanto um [BooleanArray(n)] contém n valores [false]. No entanto, não existe um [Array<String>(n)] cujos elementos seriam [null]: isso violaria a segurança contra nulos, já que os elementos são do tipo [String]. É preciso especificar o valor de cada elemento ou solicitar explicitamente um array de elementos anuláveis com [arrayOfNulls<String>(n)], do tipo [Array<String?>].
O número de elementos de um array é sua propriedade [size] (o campo Java [length]). A sintaxe [array[i]] refere-se ao dado de número i, em que i pertence ao intervalo [0, size-1]. Qualquer referência ao dado [array[i]] em que i não esteja nesse intervalo provoca uma exceção [ArrayIndexOutOfBoundsException]. A propriedade [indices] é o intervalo de índices válidos (de 0 a size-1), e [lastIndex] é o último índice (size-1). Um array não pode mudar de tamanho depois de criado: para uma coleção que cresce, usa-se uma lista (Capítulo 5). Uma variável [val] que faz referência a um array não pode referenciar outro array, mas os elementos do array continuam modificáveis.
O Kotlin também não possui verdadeiros arrays bidimensionais: um array com dois índices é um array de arrays, por exemplo, um [Array<DoubleArray>]. A sintaxe [array[i][j]] refere-se ao elemento j da linha i. [array.size] é o número de linhas, e [array[i].size] é o número de elementos da linha i. Como cada linha é um array independente, as linhas podem ter comprimentos diferentes (fala-se então de um “array em escada”).
A biblioteca Kotlin oferece uma ampla gama de funções para arrays que substituem os métodos da classe [java.util.Arrays] e vão muito além deles: [contentToString()], [contentDeepToString()], [contentEquals()], [first()], [last()], [getOrNull(i)], [copyOf()], [copyOfRange(start, end)], [sliceArray(range)], [sort()], [sorted()], [fill()], [sum()], [max()], [average()], [contains()] (escrita com o operador [in])... Em sua maioria, são as mesmas das listas, que examinaremos no Capítulo 5.
O programa [Basics08.kt] combina esses diferentes arrays:
Resultados:
Comentários:
- linha 6: um array de inteiros inicializado, do tipo [IntArray];
- linha 7: um laço do tipo [for] percorre os índices do array, de 0 até [integers.lastIndex]. O laço do tipo [for] é apresentado mais adiante;
- Linha 8: em um template, [$i] é o valor do índice e [${integers[i]\}] é o valor do elemento. As chaves são necessárias para a expressão [integers[i]]; o colchete que segue [[$i] não as exige, já que não pode fazer parte de um nome de variável;
- linha 12: um array bidimensional (2 linhas, 2 colunas) do tipo [Array<DoubleArray>]. É preciso escrever -6.0 e não -6: a função [doubleArrayOf] espera [Double], e o Kotlin não converte o inteiro -6 em número de ponto flutuante (o Java converte);
- linhas 13–14: [reals.indices] percorre as linhas, [reals[i].indices] percorre as colunas da linha i;
- linha 18: [contentDeepToString()] exibe um array de arrays;
- linha 22: um array em escada de 3 linhas. O construtor [Array(3) { i -> ... \}] cria um array de 3 elementos e calcula o valor de cada um executando o bloco entre chaves com o índice do elemento [i]. Cada elemento aqui é, ele próprio, um array de strings ([i + 1]), cujo elemento de índice [j] é "name" seguido de i e j. O bloco entre chaves é uma lambda (Capítulo 7); por ora, basta lê-lo como “para o índice i, o valor é...”. Em Java, eram necessárias três etapas: criar o array de linhas, criar cada linha e depois preencher os elementos;
- linha 30: um array de 3 booleanos, todos [false];
- linha 31: um array de 2 strings anuláveis, todas [null];
- linha 36: a função [contentToString()] constrói uma string a partir dos elementos do array. Exibir o array diretamente ([println(values)]) resultaria, como em Java, em um texto como [I@6328d34a (o tipo do array e um código numérico), em vez do seu conteúdo;
- linhas 38–39: o primeiro, o último e o penúltimo elementos. As funções [first()] e [last()] substituem as expressões [values[0]] e [values[values.size - 1]]. O Kotlin não possui um índice contado a partir do fim do array (o equivalente em C# de [^1]);
- linha 41: os elementos de índices 1 e 2. Como com [Arrays.copyOfRange] em Java, o limite final é excluído;
- linha 44: os elementos de índice 2 até [lastIndex]. [2..values.lastIndex] é um intervalo (range): o conjunto dos inteiros de 2 a 4, inclusive. A função [sliceArray] retorna um novo array formado pelos elementos cujos índices pertencem ao intervalo. Os intervalos são apresentados junto com o laço [for];
- linhas 47–48: [copyOfRange] cria uma cópia; modificar [extract] não modifica [values];
- linha 50: a soma, o máximo e a média dos elementos. A média é um [Double];
- linha 51: o operador [in] verifica se um valor está presente no array;
- linha 54: um array de objetos, do tipo [Array<String>];
- linha 55: [friends.getOrNull(5)] retorna [null] em vez de lançar uma exceção quando o índice está fora dos limites;
- linhas 58–60: o índice 3 não existe: uma [ArrayIndexOutOfBoundsException] é lançada, com uma mensagem que indica o índice incorreto e o tamanho do array.
3.4. Instruções básicas do Kotlin
Há dois tipos:
- instruções elementares executadas pelo computador;
- instruções que controlam o fluxo do programa.
As instruções básicas ficam claras quando se considera a estrutura de um microcomputador e seus periféricos:
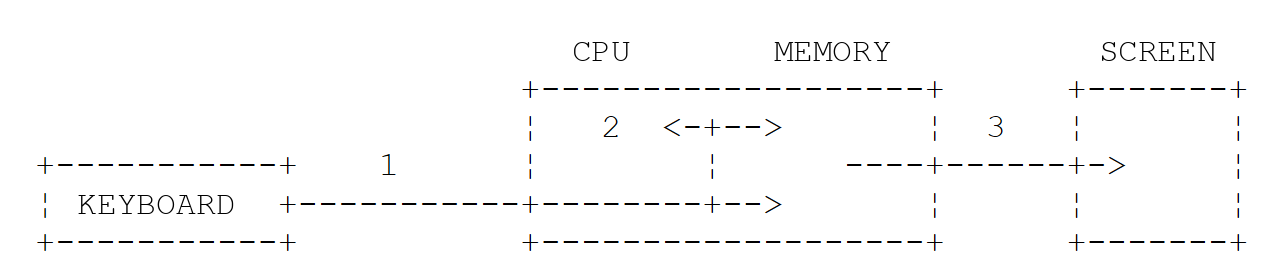
- 1: leitura de informações do teclado;
- 2: processamento das informações;
- 3: escrita de informações na tela.
3.4.1. Escrita na tela
Há diversas instruções para escrever na tela:
em que [expression] é qualquer dado que possa ser convertido em uma cadeia de caracteres para exibição na tela. Todos os objetos possuem um método [toString()] usado para realizar essa conversão. A função [println] escreve o valor e passa para a linha seguinte; a função [print] faz o mesmo sem passar para a linha seguinte; [println()], sem nenhum parâmetro, simplesmente passa para a linha seguinte. Para uma saída formatada, use [println("format".format(value1, ...))], ou use o método Java [System.out.printf(format, value1, ...)].
As funções Kotlin [println] e [print] (no pacote [kotlin.io]) escrevem no fluxo Java [System.out]. A classe [System] dá acesso a dois fluxos de escrita por meio de seus campos estáticos [out] e [err], que são do tipo [PrintStream]:
- [System.out.println()] escreve no fluxo [out], a saída padrão, que geralmente está associada à tela;
- [System.err.println()] escreve no fluxo [err], a saída de erro, que também costuma estar associada à tela.
A biblioteca Kotlin não possui uma função para escrever na saída de erro: [System.err.println] é usado diretamente. Os fluxos [out] e [err] podem ser redirecionados para arquivos em tempo de execução, como veremos em breve.
3.4.2. Leitura de dados digitados no teclado
O fluxo de dados do teclado é representado pelo campo Java [System.in], que é do tipo [InputStream]. Trata-se de um fluxo de bytes, pouco conveniente para uso direto. A biblioteca Kotlin fornece duas funções que leem uma linha de texto desse fluxo:
A linha digitada no teclado, sem o caractere de fim de linha, é armazenada na variável [line] e pode então ser processada pelo programa. As duas funções diferem apenas no comportamento ao final do fluxo de entrada (quando o usuário pressiona Ctrl-D, ou Ctrl-Z seguido de Enter no Windows, ou quando o arquivo redirecionado para o fluxo de entrada se esgota):
- [readln()] lança então uma exceção [ReadAfterEOFException]; ela sempre retorna, portanto, uma string do tipo [String];
- [readlnOrNull()] retorna então [null]; seu resultado é do tipo [String?], o que exige tratar esse caso, como fez o programa [Basics06.kt].
Essas funções não exibem um prompt: ele é especificado antes com [print]. Em programas mais antigos, você também pode encontrar a função [readLine()], que se comporta como [readlnOrNull()], bem como as classes Java [BufferedReader] e [Scanner], que continuam utilizáveis. O fluxo [System.in] pode ser redirecionado para um arquivo, assim como os fluxos [out] e [err]. Por fim, observe a classe Java [Console], obtida de [System.console()], cujo método [readPassword] lê uma senha sem exibi-la.
3.4.3. Exemplo de entrada/saída
O programa [Basics09.kt] ilustra operações de entrada/saída pelo teclado e pela tela:
Resultados:
Comentários:
- Linha 6: [obj] é uma referência a um objeto da classe [Any], a classe raiz de todas as classes Kotlin ([Object] em Java). O objeto é criado chamando o construtor [Any()], sem [new];
- Linha 7: [obj] é impresso na tela. O método [obj.toString()] é chamado para obter o texto a ser exibido;
- linha 11: [err] é o fluxo em que se escreve;
- linha 12: a mesma coisa, mas com um formato. O primeiro parâmetro, "i=%d%n", é o formato de exibição; os demais parâmetros são os valores a exibir: %d é substituído pelo valor de [i], e %n pelo caractere de fim de linha do sistema (\r\n no Windows, \n no Linux e no macOS);
- linha 15: um prompt é exibido sem passar para a linha seguinte;
- linha 16: lê a linha digitada no teclado. [line] é do tipo [String].
Nos resultados:
- linha 2: a saída gerada pela linha 7 do código. O método [toString()] da classe [Any] retorna o nome completo da classe do objeto, seguido do caractere @ e de um código numérico hexadecimal (seu “hash code”), que pode variar de uma execução ou máquina para outra. Vemos que a classe Kotlin
*[Any]*é, em tempo de execução, de fato a classe*[java.lang.Object]*. As classes geralmente sobrescrevem esse método para exibir algo mais útil, como faremos no Capítulo 4; - linhas 3–4: as duas escritas no fluxo [err] aparecem na tela exatamente como as do fluxo [out].
Se o usuário fechar o fluxo de entrada em vez de digitar uma linha, [readln()] lança uma exceção, que encerra o programa:
A mensagem da exceção é seguida da pilha de chamadas (“stack trace”): a lista das funções que estavam em execução no momento do erro, com a mais recente no topo, junto com o arquivo e o número da linha de cada uma. Ela mostra que a função [readln] (arquivo [Console.kt] da biblioteca Kotlin) foi chamada na linha 16 do arquivo [Basics09.kt], por meio do método [main] da classe [Basics09Kt], que por sua vez foi chamado pelo método [main(String[])] gerado pelo compilador. (Com [gradlew run], o Gradle também informa que a tarefa [run] falhou; suas mensagens não são reproduzidas aqui.)
3.4.4. Redirecionamento de entrada/saída
Windows, Linux e macOS reconhecem três dispositivos padrão:
- o dispositivo de entrada padrão, que por padrão se refere ao teclado e é numerado 0;
- o dispositivo de saída padrão, que por padrão se refere à tela e é numerado 1;
- o dispositivo de erro padrão, que por padrão se refere à tela e é numerado 2.
Na JVM, o fluxo de escrita [System.out] (associado às funções [println] e [print]) escreve no dispositivo 1, o fluxo de escrita [System.err] escreve no dispositivo 2, e o fluxo de leitura [System.in] (associado às funções [readln] e [readlnOrNull]) lê dados do dispositivo 0.
Ao executar um programa em uma janela de comandos, é possível especificar quais dispositivos serão 0, 1 e 2 para o programa em execução. Após os argumentos do programa, você pode redirecionar os dispositivos padrão de entrada/saída para arquivos:
Redirecionamento | Significado |
0<in.txt ou <in.txt | O fluxo de entrada padrão nº 0 é redirecionado para o arquivo in.txt. No programa, o fluxo [System.in] lerá, portanto, seus dados do arquivo in.txt |
1>out.txt ou >out.txt | redireciona a saída nº 1 para o arquivo out.txt. No programa, o fluxo [System.out] escreverá, portanto, seus dados no arquivo out.txt |
1>>out.txt ou >>out.txt | Igual ao anterior, mas os dados escritos são acrescentados ao conteúdo atual do arquivo out.txt |
2>err.txt | Redireciona a saída nº 2 para o arquivo err.txt. No programa, o fluxo [System.err] escreverá, portanto, seus dados no arquivo err.txt |
2>>err.txt | Igual ao anterior, mas os dados escritos são acrescentados ao conteúdo atual do arquivo err.txt |
1>out.txt 2>err.txt | Os dispositivos 1 e 2 são ambos redirecionados para arquivos |
Observe que, para redirecionar os fluxos de entrada/saída de um programa para arquivos, não é preciso modificar o programa: é o sistema operacional que determina a natureza dos dispositivos 0, 1 e 2. Considere o seguinte programa, [Basics10.kt]:
Os redirecionamentos se aplicam ao programa iniciado pelo comando digitado no prompt. Com ***[gradlew run]***, esse programa é o próprio Gradle, que então repassa os fluxos ao programa Kotlin: o redirecionamento geralmente funciona, mas os arquivos também podem receber mensagens do Gradle (avisos, erros de compilação etc.). Para observar o comportamento do programa isoladamente, é melhor executá-lo fora do Gradle. Como vimos no Capítulo 2, a tarefa [installDist] prepara uma versão instalável do projeto na pasta [build/install/basics] (cujo nome, [basics], é definido pelo arquivo [settings.gradle.kts]): uma pasta chamada [lib], que contém o arquivo de classes do projeto e a biblioteca padrão do Kotlin, e uma pasta chamada [bin], que contém os scripts de inicialização [basics] (Linux, macOS) e [basics.bat] (Windows). O script inicia a classe especificada pelo arquivo [build.gradle.kts] quando ele é criado; portanto, o programa é selecionado por meio do comando [installDist]:
Eis uma sessão em um terminal Linux (bash), na pasta do projeto:
Comentários:
- linha 1: inserimos a string "test" no arquivo in.txt;
- linha 2: exibimos o conteúdo do arquivo in.txt para verificação;
- linha 4: execução do programa. O fluxo [System.in] é redirecionado para o arquivo in.txt, o fluxo [System.out] para o arquivo out.txt, e o fluxo [System.err] para o arquivo err.txt. A execução não produz nenhuma saída;
- linhas 5–6: o conteúdo do arquivo out.txt mostra que o arquivo in.txt foi lido e que a escrita no fluxo [out] foi redirecionada para out.txt;
- linhas 7–8: verificação semelhante para o arquivo err.txt;
- linhas 9–10: apenas o fluxo [err] é redirecionado: a tela exibe apenas a operação de escrita no fluxo [out];
- linhas 11–12: apenas o fluxo [out] é redirecionado: a tela exibe apenas a operação de escrita no fluxo [err].
Fica claro que os fluxos [out] e [err] não escrevem nos mesmos dispositivos, já que puderam ser redirecionados separadamente. O fluxo [err] destina-se às mensagens de erro: isso permite redirecionar a saída de um programa para um arquivo e ainda ver suas mensagens de erro na tela.
Os operadores >, >> e 2> são escritos da mesma forma no prompt de comando do Windows ([cmd]), no PowerShell e no bash. O operador < é reconhecido pelo [cmd] e pelo bash, mas não pelo PowerShell, que o reserva para uso futuro: no PowerShell, um arquivo é enviado à entrada padrão de um programa por meio de um pipe (|). Os comandos a seguir, fornecidos a título ilustrativo (não foram executados para este curso), fazem no Windows o que a sessão bash acima faz:
3.4.5. Atribuição do valor de uma expressão a uma variável
Aqui nos interessamos pela operação [variable = expression]. A expressão pode ser aritmética, relacional, booleana, de string etc.
3.4.5.1. Interpretação da operação de atribuição
A operação [variable = expression] é executada da seguinte forma:
- O lado direito da atribuição é avaliado: o resultado é um valor V;
- o valor V é atribuído à variável.
Em Java, assim como em C e C#, uma atribuição é ela própria uma expressão, cujo valor é V: podemos então escrever [V1 = V2 = expression], que atribui o valor da expressão a V2 e depois a V1, ou [if ((n = read()) > 0)], que atribui e avalia ao mesmo tempo. Em Kotlin, a atribuição é uma instrução, não uma expressão: ela não tem valor e não pode aparecer onde um valor é esperado. O compilador, portanto, rejeita:
As atribuições múltiplas como [V1 = V2 = expression] são rejeitadas pelo mesmo motivo: elas envolvem escrever duas atribuições. Essa escolha elimina uma fonte comum de erros em C e Java: a confusão entre o operador de atribuição = e o operador de comparação == em um teste como [if (x = 0)] torna-se impossível.
3.4.5.2. Expressões aritméticas
Os operadores usados em expressões aritméticas são os seguintes:
Operador | Papel |
+ | adição |
- | subtração |
* | multiplicação |
/ | divisão: o resultado é o quociente exato se pelo menos um dos operandos for um número real. Se ambos os operandos forem inteiros, o resultado é o quociente inteiro. Assim, 5/2 é igual a 2 e 5.0/2 é igual a 2.5 |
% | resto da divisão, qualquer que seja o tipo dos operandos. O resto tem o mesmo sinal do dividendo: -5 % 2 é igual a -1. O operador % é outra notação para a função [rem] (“remainder”): [a % b] equivale a [a.rem(b)]. A função [mod] retorna o resto no sentido matemático, com o sinal do divisor: [(-5).mod(2)] é igual a 1 |
Em Kotlin, todos esses operadores são, na verdade, formas alternativas de escrever funções: [a + b] equivale a [a.plus(b)], [a - b] a [a.minus(b)], [a * b] equivale a [a.times(b)], e [a / b] equivale a [a.div(b)]. O compilador, é claro, traduz essas operações sobre os tipos básicos nas instruções aritméticas da JVM, sem nenhuma chamada de função. No entanto, esse mecanismo permite dotar outras classes desses operadores (sobrecarga de operadores, Capítulo 4); a biblioteca do Kotlin fez isso, em particular, para a classe Java [BigDecimal].
Existem diversas funções matemáticas. O Kotlin as agrupa no pacote [kotlin.math], que deve ser importado ([import kotlin.math.*] ou [import kotlin.math.sqrt]...). Eis algumas delas:
Função | Papel |
[sqrt(x)] | raiz quadrada |
[cos(x)], [sin(x)], [tan(x)] | cosseno, seno, tangente (ângulo em radianos) |
[x.pow(y)] | x elevado à potência y (y é um número real ou um inteiro) |
[exp(x)] | exponencial |
[ln(x)], [log10(x)], [log(x, base)] | logaritmo natural, logaritmo decimal, logaritmo em qualquer base |
[abs(x)] ou [x.absoluteValue], [max(x, y)], [min(x, y)] | valor absoluto, máximo, mínimo (para os tipos Int, Long, Float, Double) |
[floor(x)], [ceil(x)], [truncate(x)] | parte inteira inferior, parte inteira superior, truncamento em direção a zero |
[x.roundToInt()], [x.roundToLong()] | arredondado para o inteiro mais próximo, com os valores intermediários arredondados para cima |
[round(x)] | arredonda para o inteiro mais próximo, levando os valores exatamente intermediários ao inteiro par mais próximo (resultado real) |
[x.coerceIn(min, max)] | valor limitado ao intervalo [min, max] |
[PI], [E] | as constantes π e e |
Essas são funções de alto nível (ou, como [pow] e [roundToInt], funções de extensão chamadas sobre o próprio número): elas são chamadas sem prefixo. Assim, escrevemos:
Os métodos estáticos da classe Java [Math] ([Math.sqrt(y)], [Math.floorMod(-5, 2)]...) ainda podem ser usados sem importá-los, já que [Math] pertence ao pacote [java.lang]. A descrição completa do pacote [kotlin.math] pode ser encontrada na documentação online do Kotlin em kotlinlang.org/api/core/kotlin-stdlib/kotlin.math/.
Os números reais do tipo [Double] são armazenados em formato binário: a maioria dos números decimais, como 0.1, é apenas aproximada. Isso é irrelevante para cálculos científicos, mas inaceitável para valores monetários. A classe [BigDecimal] (no pacote [java.math] do JDK), por outro lado, representa um número decimal exatamente, com quantos dígitos forem necessários. Em Java, os cálculos são realizados com estes métodos: [add], [subtract], [multiply], [divide]... Em Kotlin, esses métodos continuam disponíveis, mas a biblioteca padrão acrescenta à classe os operadores +, -, *, /, %, e o - unário: escreve-se [a + b] em vez de [a.add(b)]. Ela também acrescenta as funções de conversão ["0.1".toBigDecimal()] e [3.toBigDecimal()]. Um [BigDecimal] é imutável: uma operação não modifica o objeto ao qual é aplicada; em vez disso, ela retorna um novo objeto.
O programa [Basics11.kt] é o seguinte:
Resultados:
Comentários:
- linha 7: todas as declarações do pacote [kotlin.math] são importadas;
- linha 11: a divisão de dois inteiros é uma divisão inteira. Cada operação é escrita em seu próprio template: diferentemente da concatenação em Java, não há necessidade de se preocupar com a precedência dos operadores em relação ao operador +, que constrói a string;
- linha 13: o resto tem o mesmo sinal do dividendo; o operador % também se aplica a números reais;
- linha 14: [rem] é a função do operador %; [mod] retorna um resto com o mesmo sinal do divisor, exatamente como [Math.floorMod] em Java. Os parênteses em [(-5)] são necessários: [-5.mod(2)] seria interpretado como [-(5.mod(2))], porque uma chamada de função usando o operador ponto tem precedência sobre o operador de menos unário;
- linha 17: dividir um número real por zero não causa erro; retorna infinito ([Infinity]) ou o valor especial [NaN] (“Not a Number”) para 0/0. Em [1 / zero], o inteiro 1 é dividido por um número real: a operação é real. O Kotlin não realiza conversões implícitas entre tipos numéricos, mas os operadores aritméticos aceitam operandos de tipos diferentes: a classe [Int] possui uma função [div(other: Double): Double];
- linhas 19–23: no entanto, dividir um inteiro por zero lança uma exceção [ArithmeticException]. O divisor é obtido pela conversão da string "0", de modo que o compilador não conheça seu valor;
- linhas 27–28: o exemplo acima. [sqrt] espera e retorna um [Double]: 2.0. Como o Kotlin não converte implicitamente um [Int] em um [Double], [sqrt(4)] seria rejeitado; escrevemos [sqrt(4.0)];
- linha 30: a função [pow] é chamada sobre o número a ser elevado a uma potência;
- linha 31: [absoluteValue] é uma propriedade de extensão, usada sem parênteses;
- linha 34: [floor] arredonda para baixo, [ceil] arredonda para cima, e [truncate] arredonda em direção a zero. Para obter um inteiro truncando um número real, converta-o usando [toInt()], como veremos adiante;
- linha 36: [roundToInt] arredonda para o inteiro mais próximo; um valor exatamente intermediário entre dois inteiros é arredondado para cima: 2.5 vira 3 e -2.5 vira -2. O resultado é um [Int]. É assim que o [Math.round] do Java se comporta;
- linha 38: observe que a função [round] do Kotlin não se comporta da mesma forma que o [Math.round] do Java: ela arredonda um valor exatamente intermediário para o inteiro par mais próximo (arredondamento “bancário”): 2.5 vira 2 e 3.5 vira 4. O resultado é um [Double]. Esse é o comportamento do [Math.rint] do Java;
- linha 39: [coerceIn] limita 150 ao intervalo [0, 100], exatamente como [Math.clamp] (Java 21). As funções [coerceAtLeast] e [coerceAtMost] definem apenas um limite;
- linha 42: os métodos da classe Java [Math];
- linha 45: precedência dos operadores, mostrada a seguir;
- linha 46: "x" + 1 + 2 é avaliado da esquerda para a direita: "x" + 1 resulta na string "x1", à qual 2 é concatenado. Para realizar a adição primeiro, deve-se escrever "x" + (1 + 2); usando um template, escreveríamos ["x${1 + 2\}"];
- linha 49: 0.1 e 0.2 não têm representações binárias exatas: sua soma não é exatamente 0.3;
- linhas 51–52: dois valores [BigDecimal] criados a partir de strings. Não escreva [BigDecimal(0.1)]: o parâmetro seria o [Double] 0.1, cujo valor exato é 0.1000000000000000055511151231257827021181583404541015625. A função [0.1.toBigDecimal()], que usa a string "0.1", funciona, porém;
- linha 53: a adição exata, escrita com o operador +;
- linhas 54–56: [3.toBigDecimal()] converte um inteiro. Um produto tem tantas casas decimais quanto a soma das casas decimais de seus dois fatores: 59.97 × 1.2 = 71.964;
- linha 58: [setScale(2, RoundingMode.HALF_UP)] arredonda para duas casas decimais, com os valores intermediários entre dois dígitos arredondados para longe de zero: este é o arredondamento comercial;
- linha 61: uma armadilha. O operador / do Kotlin chama o método [divide(divisor, RoundingMode.HALF_EVEN)]: o quociente mantém o número de casas decimais do dividendo, arredondado para o valor mais próximo. Como 10 não tem casas decimais, 10/3 é igual a 3; 10.00/3 é igual a 3.33;
- linha 63: o método Java [divide], com uma precisão especificada por [MathContext.DECIMAL64] (16 dígitos significativos). Sem especificar a precisão ou o modo de arredondamento, o método [divide] lançaria [ArithmeticException]: [Non-terminating decimal expansion; no exact representable decimal result.], porque 10/3 não tem representação decimal finita. Para divisões de [BigDecimal], portanto, escolhemos explicitamente a precisão ou o número de casas decimais e o modo de arredondamento: [a.divide(b, 2, RoundingMode.HALF_UP)].
3.4.5.3. Operadores na avaliação de expressões aritméticas
A ordem de precedência dos operadores ao avaliar uma expressão aritmética é a seguinte (da mais alta para a mais baixa):
Operadores dentro do mesmo bloco [ ] têm a mesma precedência. Quando a precedência é igual, a avaliação prossegue da esquerda para a direita: 10 - 4 - 3 é avaliado como (10 - 4) - 3 = 3. Podem-se usar parênteses para especificar uma ordem de avaliação diferente.
3.4.5.4. Expressões relacionais
Os operadores são os seguintes: <, <=, , !=, >, >=; o Kotlin acrescenta === e ! (veja a seguir). Sua precedência:
- >, >=, <, <=;
- , !=, =, !==.
O resultado de uma expressão relacional é o booleano [false] se a expressão for falsa, e [true] caso contrário.
Comparação de dois caracteres
Sejam C1 e C2 dois caracteres. Eles podem ser comparados com os operadores <, <=, ==, !=, >, >=. Seus códigos Unicode, que são números, são comparados. Segundo a ordem Unicode, valem as seguintes relações:
O código Unicode de um caractere [c] é dado por sua propriedade [c.code], que é do tipo [Int]. Em Kotlin, um [Char] não é um número: não se pode escrever ['a' + 'b'] nem atribuir um caractere a uma variável inteira, o que o Java permite.
Comparação de duas strings
Elas são comparadas caractere por caractere. A primeira desigualdade encontrada entre dois caracteres resulta em uma desigualdade de mesmo sinal para as strings. Considere a comparação das strings "Cart" e "Cat":
Esta última desigualdade nos permite concluir que "Cart" < "Cat". Considere a comparação das strings "Cat" e "Catkin". Elas são iguais até que a string "Cat" se esgote. Nesse caso, a string esgotada é declarada a "menor". Temos, portanto, a relação "Cat" < "Catkin".
Igualdade estrutural e igualdade referencial
Nesse aspecto, o Kotlin corrige uma armadilha clássica do Java. Em Java, quando aplicados a duas strings, ou a quaisquer dois objetos, os operadores == e != comparam as referências: [s1 == s2] é verdadeiro se as duas variáveis apontam para o mesmo objeto na memória, e não se as duas strings contêm os mesmos caracteres; para comparar o conteúdo, é preciso escrever [s1.equals(s2)]. Em Kotlin:
- o operador == compara o conteúdo: [a == b] é traduzido pelo compilador em uma chamada ao método [a.equals(b)], precedida de um teste para [null]: se [a] for igual a [null], [a == b] equivale a [b === null], sem risco de [NullPointerException]. Esta é a igualdade estrutural; != é a sua negação;
- o operador === compara referências: [a === b] é verdadeiro se [a] e [b] se referem ao mesmo objeto. Esta é a igualdade referencial; !== é a sua negação. Raramente precisamos dela.
Para os tipos primitivos ([Int], [Double]...), == simplesmente compara os valores. O C# se comporta da mesma forma que o Kotlin para strings: seu operador == compara o conteúdo delas.
A ordem de duas strings
Os operadores < <= > >= se aplicam a strings, assim como a qualquer objeto comparável: em Kotlin, [a < b] é outra forma de escrever [a.compareTo(b) < 0]. O método [compareTo] retorna um inteiro:
- zero se as duas strings forem iguais;
- positivo se a string nº 1 for maior que a string nº 2;
- negativo se a string nº 1 for menor que a string nº 2.
As funções Kotlin [equals] e [compareTo] aceitam um parâmetro [ignoreCase] para ignorar a diferença entre maiúsculas e minúsculas: [s1.equals(s2, ignoreCase = true)] (as funções Java [equalsIgnoreCase] e [compareToIgnoreCase]). A sintaxe [ignoreCase = true] é a de um argumento nomeado, que reencontraremos com as funções.
[compareTo] compara os códigos Unicode caractere por caractere: seu resultado é a diferença entre os códigos dos dois primeiros caracteres diferentes, ou a diferença de comprimentos se uma das strings for o início da outra. Isso não é a ordem lexicográfica: como o código de 'é' (233) é maior que o de 'f' (102), "élan" vem depois de "face". Para ordenar textos destinados a usuários, usa-se um objeto [Collator] (do pacote [java.text] do JDK), que aplica as regras de ordenação de um idioma específico. [compareTo] continua sendo o método correto para identificadores, palavras-chave e nomes de arquivos.
O programa [Basics12.kt] é o seguinte:
Resultados:
Comentários:
- Linha 10: uma expressão relacional; [end] é do tipo [Boolean];
- linha 14: comparação de caracteres;
- linha 15: a propriedade [code] de um caractere retorna seu código Unicode (em Java, isso se escreve [(int) 'A']);
- linha 20: a variável [n] recebe um inteiro negativo porque "cat" < "dog": a diferença entre os códigos de 'c' (99) e 'd' (100);
- linha 21: a variável [equal] tem o valor [true] se as duas strings tiverem o mesmo conteúdo, e [false] caso contrário;
- linha 22: o operador < aplicado a duas strings;
- linha 23: a string que se esgota primeiro é a mais curta; o resultado é a diferença de comprimentos: 3 - 6. Em um literal de string, \" representa uma aspa;
- linha 26: a função [lowercase()] constrói, em tempo de execução, um novo objeto string que contém "cat";
- linhas 27–28: [string1] and [string3] têm o mesmo conteúdo, mas se referem a dois objetos diferentes: == retorna [true], === retorna [false]. No entanto, [string1 === "cat"] é verdadeiro: dois literais de string idênticos são armazenados apenas uma vez na memória;
- linha 30: o método Java [System.getProperty] retorna o valor de uma propriedade da JVM, ou [null] se ela não existir; seu resultado é armazenado em uma variável do tipo [String?];
- linha 31: o operador == aceita um valor [null] à esquerda: ele retorna [false], ao passo que a chamada Java [absent.equals(string1)] retornaria [NullPointerException];
- linha 34: 233 - 102 = 131: para [compareTo], "élan" vem depois de "face";
- linha 35: 'C' (67) - 'c' (99) = -32;
- linhas 37–39: ignorando a diferença entre maiúsculas e minúsculas, “Cat” e “cat” são iguais;
- linhas 41–43: um [Collator] para o francês: “élan” precede “face”, e “Cat” vem depois de “cat” (quando as letras são as mesmas, a minúscula vem antes da maiúscula). O método [compare] retorna um inteiro negativo, zero ou positivo, exatamente como [compareTo];
- linhas 46–48: como == chama [equals], ele herda as características desse método. O comportamento da classe [BigDecimal] leva em conta o número de casas decimais: 2.0 e 2.00 são diferentes para [equals], mas iguais para [compareTo], e portanto para os operadores <<, <=, >> e >=. Para comparar dois valores [BigDecimal], deve-se, portanto, usar [compareTo(...) == 0], e não ==.
3.4.5.5. Expressões booleanas
Os operadores que podem ser usados são AND (&&), OR (||) e NOT (!). O resultado de uma expressão booleana é um valor booleano. Precedência dos operadores:
- ! ;
- && ;
- ||.
Os operadores relacionais têm precedência mais alta que os operadores && e ||. Esses dois operadores avaliam seu operando da direita apenas se necessário: em [a && b], b não é avaliado se a for falso; em [a || b], b não é avaliado se a for verdadeiro. Isso é chamado de “avaliação em curto-circuito”. Pode-se, portanto, escrever com segurança [text != null && text.length > 0]: no lado direito, o compilador sabe que [text] não é igual a [null] (conversão inteligente de tipo). As funções [and] e [or], quando aplicadas a dois booleanos ([a and b], [a or b]), realizam o mesmo cálculo, mas sempre avaliam ambos os operandos; a função [xor] é o OU exclusivo. O teste para determinar se um valor pertence a um intervalo é escrito de forma mais simples com o operador [in]: [x in 2.0..4.0] é verdadeiro se 2 ≤ x ≤ 4.
3.4.5.6. Operações bit a bit
O Kotlin não possui operadores simbólicos para operações bit a bit: os << >> >>> & | ^ ~ do Java são substituídos por funções infixas, isto é, funções de um único argumento escritas entre seus dois operandos, sem ponto nem parênteses: [i shl 4] é outra forma de escrever [i.shl(4)]. Sejam [i] e [j] dois inteiros ([Int] ou [Long]):
Operação | Em Java | Papel |
i shl n | i << n | desloca i n bits para a esquerda. Os bits que entram são zeros |
i shr n | i >> n | desloca i n bits para a direita. O bit de sinal é preservado |
i ushr n | i >>> n | Deslocamento à direita sem sinal: os bits que entram são zeros, mesmo que i seja negativo |
i and j | i & j | realiza o AND lógico bit a bit de i e j |
i or j | i|j | realiza o OR lógico bit a bit de i e j |
i xor j | i ^ j | realiza a operação de OU exclusivo bit a bit entre i e j |
i.inv() | ~i | complementa i a 1 |
Os deslocamentos são definidos apenas para os tipos [Int] e [Long] (e para os tipos sem sinal [UInt] e [ULong], para os quais o deslocamento [shr] sempre preenche com zeros): para um [Short] ou um [Byte], o valor é primeiro convertido em [Int]. O compilador rejeita, portanto, [s shl 1] se [s] for um [Short]: [unresolved reference 'shl' on receiver of type 'Short']. Essas operações são usadas principalmente para manipular dados binários; os nomes explícitos têm a vantagem de não serem confundidos com os operadores booleanos && e ||.
O programa [Basics13.kt] é o seguinte:
Resultados:
Comentários:
- linhas 5–6: dois inteiros do tipo [Int] (32 bits);
- linha 8: o especificador %08x exibe um inteiro hexadecimal (x) de 8 dígitos preenchido com zeros (08), representando seus 32 bits: -13 torna-se fffffff3;
- linha 9: deslocar 100 (0x64) 4 bits para a esquerda equivale a multiplicá-lo por 2⁴ (0x640); deslocá-lo para a direita equivale a dividi-lo por 2⁴ (0x6);
- linhas 10–11: AND, OR, XOR (OU exclusivo bit a bit) e o complemento de um. Observe que a função [inv] é chamada como um método comum, com ponto e parênteses;
- linha 12: deslocamentos de um número negativo. [shr] preserva o bit de sinal: -13 deslocado 2 bits para a direita resulta em -4 (0xfffffffc);
- linha 14: a função [binary] (linhas 26–28) exibe os n bits menos significativos de um inteiro. O AND lógico de i e j é verificado bit a bit;
- linhas 16–19: o deslocamento [shr] preserva o bit de sinal de m, que é negativo; o deslocamento [ushr] preenche com zeros;
- linhas 21–22: um inteiro sem sinal [UInt], cujo bit mais significativo é 1: ele é igual a 4.045.602.816, enquanto um [Int] com os mesmos bits seria negativo. Seu deslocamento [shr] insere zeros. A função [toString(16)] o escreve em hexadecimal;
- linha 26: a função [buildString] constrói uma string por adições sucessivas: no bloco a seguir, a função [append] acrescenta um elemento à string em construção. Ela será apresentada no Capítulo 5. O laço [for (rank in n - 1 downTo 0)] percorre [rank] de n-1 a 0 em ordem decrescente; os laços serão descritos mais adiante;
- linha 28: [(value ushr rank) and 1] coloca o bit nº [rank] na posição 0 e depois o isola dos demais.
3.4.5.7. Combinação de operadores
[a = a + b] pode ser escrito como [a += b]; [a = a - b] pode ser escrito como [a -= b]. O mesmo vale para os operadores *, / e %. Assim, [a = a / 2] pode ser escrito como [a /= 2]. Como as operações bit a bit são funções, elas não têm operador combinado: escrevemos [a = a shl 2]. Assim como as atribuições simples, as atribuições compostas são instruções, não expressões. Elas não realizam nenhuma conversão implícita: se [s] for um [Short], [s += 1] é rejeitado, assim como [s = s + 1], pois o resultado da adição é um [Int]; escrevemos [s = (s + 1).toShort()]. [Short] e [Byte] são, na verdade, raramente usados em cálculos.
3.4.5.8. Operadores de incremento e decremento
A notação [variable++] significa [variable = variable + 1] ou [variable += 1]. A notação [variable--] significa [variable = variable - 1] ou [variable -= 1]. Eles se aplicam a uma variável [var]. Quando usados em uma expressão, esses operadores têm duas formas:
- [i++] (pós-fixado): o valor da expressão é o valor de i antes do incremento;
- [++i] (pré-fixado): o valor da expressão é o valor de
idepois do incremento.
O Kotlin os manteve, embora a atribuição não seja uma expressão; no entanto, deve-se evitar usá-los dentro de expressões maiores, onde prejudicam a legibilidade.
3.4.5.9. Sem operador ternário: a expressão if
O Java, como o C e o C#, tem um operador ternário: a expressão [cond ? expr1 : expr2] é avaliada como [expr1] se a condição [cond] for verdadeira, e como [expr2] caso contrário. O Kotlin não tem operador ternário; o compilador rejeita [val z = x > 4 ? x + 1 : x - 1] com a mensagem [syntax error: Unexpected tokens (use ';' to separate expressions on the same line)]. Ele não precisa de um, porque sua instrução *[if] também é uma expressão* que tem um valor:
A expressão [if (cond) expr1 else expr2] é avaliada da seguinte forma:
- A expressão [cond] é avaliada. Ela é uma expressão booleana;
- se for verdadeira, o valor da expressão é o de [expr1], e [expr2] não é avaliada;
- se for falsa, ocorre o oposto: o valor da expressão é o de [expr2], e [expr1] não é avaliada.
A operação acima atribuirá o valor j+1 à variável [i] se j > 4, e j-1 caso contrário. É o mesmo que escrever [if (j > 4) i = j + 1 else i = j - 1], mas é mais conciso, e [i] pode ser declarada com [val]. Quando usado como expressão, [if] deve ter um ramo [else] para que a expressão seja avaliada como um valor em todos os casos. Encontraremos [if] na seção “Estrutura de seleção simples”, e [when], que também é uma expressão, na seção “Estrutura de casos”.
3.4.5.10. Operadores de nulidade
Diferentemente do Java, o Kotlin tem operadores dedicados ao valor [null]. Nós os vimos na seção “Segurança contra nulos”; eis um resumo. Seja [a] uma expressão anulável:
Operador | Papel |
[a?.member] | Chamada segura: é avaliada como [a.member] se a não for [null], e como [null] caso contrário (o membro então não é avaliado: uma função não é chamada). As chamadas seguras podem ser encadeadas: [a?.b?.c] é avaliada como [null] assim que qualquer um dos elos for avaliado como [null] |
[a ?: b] | Operador Elvis: é avaliado como a se a não for igual a [null], e como b caso contrário (b é então avaliado somente se a for igual a [null]). É usado para fornecer um valor de reserva |
[a!!] | asserção: é avaliada como a se a não for igual a [null]; lança uma [NullPointerException] caso contrário |
[a?.let { ... \}] | executa o bloco, no qual o valor de a é chamado de [it], somente se a não for igual a [null] |
Esses são os equivalentes dos operadores ?. e ?? do C#. O Java, que não os tem, usa em seu lugar o operador ternário ([a != null ? a : b]), o método [Objects.requireNonNullElse(a, b)], ou a classe [Optional] e seu método [map]. O lado direito do operador Elvis também pode ser uma instrução que interrompe a execução normal: [val n = input ?: return] sai da função se [input] for avaliado como [null], e [val n = input ?: throw IllegalArgumentException("missing input")] lança uma exceção; voltaremos a essa forma ao tratar das exceções.
O programa [Basics14.kt] combina esses diferentes operadores:
Resultados:
Comentários:
- linha 5: uma função que retorna uma string para a chave "title", e [null] para qualquer outra chave. Ela fornece ao programa valores do tipo [String?];
- linha 10: uma expressão booleana;
- linha 12: o mesmo teste de intervalo, escrito com o operador [in]; [valid xor true] é o OU exclusivo de dois booleanos;
- linhas 15–26: operadores combinados: 10 + 5 = 15, 15 × 2 = 30, 30 ÷ 4 = 7 (divisão inteira), 7 % 4 = 3, 3 shl 2 = 12. A variável [a] é declarada com [var], já que seu valor muda;
- linha 30: [j] recebe 5, e então [i] passa a valer 6;
- linha 31: [i] passa a 7, e então [k] recebe 7;
- linhas 38–39: duas expressões [if], que substituem os operadores ternários do Java;
- linhas 43–44: [input] é igual a [null]: [name] recebe “unknown”. Seu tipo é [String], e não [String?]: o operador Elvis garante que [name] nunca seja [null];
- linha 46: [age], do tipo [Int?], é igual a [null]: [displayedAge], do tipo [Int], recebe -1. Não há unboxing e não há risco de exceção;
- linhas 49–51: a atribuição ocorre somente se [title] for igual a [null]. Poderíamos ter escrito isso de forma mais simples como [val title = valueOf("subtitle") ?: "Untitled"];
- linha 56: [text] é igual a [null]; [text?.length] é igual a [null], sem que a propriedade [length] tenha sido lida; um template exibe [null];
- linha 58: [text] é "Kotlin by example": seu comprimento é 17. O operador Elvis retornaria -1 para um valor [null];
- linha 60: uma cadeia de chamadas seguras. [split(" ")] divide a string em uma lista de palavras (Capítulo 5), [first()] retorna a primeira palavra, e [uppercase()] a converte em maiúsculas;
- linha 61: a mesma sequência de chamadas aplicada a um valor [null]: nenhuma chamada é feita, a expressão é avaliada como [null], e o operador Elvis a substitui por "none";
- linha 63: a asserção !!. [valueOf("title")] é do tipo [String?], mas o programador sabe que ela não é igual a [null] para a chave “title”; a asserção permite usar [length] diretamente. Para a chave "author", ela teria retornado uma [NullPointerException].
3.4.5.11. Precedência geral dos operadores
A tabela a seguir lista a precedência dos operadores em Kotlin, da mais alta para a mais baixa:
Operadores | Associatividade |
[x.y] [x?.y] [f(x)] [a[i]] [x++] [x--] [x!!] (pós-fixados) | LR |
[+x] [-x] [!x] [++x] [--x] (pré-fixados) | RL |
[as] [as?] (mudança de tipo) | LR |
[*] [/] [%] | LR |
[+] [-] | LR |
[..] [..<] (intervalos) | LR |
funções infixas: [shl] [shr] [ushr] [and] [or] [xor] [downTo] [step] [until]... | LR |
[?:] (Elvis) | LR |
[in] [!in] [is] [!is] | LR |
[<] [<=] [>] [>=] | LR |
[==] [!=] [===] [!==] | LR |
[&&] | LR |
[||] | LR |
[=] [+=] [-=] [*=] [/=] [%=] (instruções) |
"LR" indica que, quando os operadores têm igual precedência, segue-se a ordem da esquerda para a direita: quando uma expressão contém operadores de mesma precedência, o operador mais à esquerda é avaliado primeiro. "RL" indica a ordem da direita para a esquerda. Três pontos importantes a observar:
- as funções infixas têm precedência menor que os operadores aritméticos: [1 shl 2 + 3] é igual a [1 shl 5], que é 32;
- elas têm precedência maior que as comparações: [x and 1 == 0] é avaliada como [(x and 1) == 0], que é exatamente o pretendido (em Java, [x & 1 == 0] é rejeitada porque == tem precedência maior que &);
- o operador Elvis tem precedência menor que os operadores aritméticos: [a ?: 0 + 1] é avaliada como [a ?: (0 + 1)]. Para somar 1 ao resultado, é preciso escrever [(a ?: 0) + 1], como fez o programa [Basics06.kt].
Em caso de dúvida, não hesite em usar parênteses: eles também tornam a expressão mais fácil de ler.
3.4.5.12. Conversões de tipo
Em uma expressão, é possível alterar temporariamente a codificação de um valor. Isso se chama mudança de tipo de dado, ou “type casting”. O Java faz isso de duas maneiras:
- as conversões de ampliação, de um [int] para um [long] ou um [double], por exemplo, são realizadas automaticamente pelo compilador;
- as conversões de redução, que podem resultar em perda de informação, como de um [double] para um [int], são especificadas pelo programador por meio da notação [(type) value].
O Kotlin é mais rigoroso: ele não realiza nenhuma conversão implícita entre tipos numéricos, nem mesmo as de ampliação. Toda conversão deve ser solicitada explicitamente por meio de uma das funções [toByte()], [toShort()], [toInt()], [toLong()], [toFloat()] ou [toDouble()], que cada tipo numérico possui (e [toUInt()], [toULong()]... para os tipos sem sinal). O compilador rejeita, portanto:
É preciso escrever [val l: Long = i.toLong()]. Esse rigor evita que conversões ocorram sem o conhecimento do programador, em particular aquelas que perdem precisão sem aviso (como um [long] convertido em [float] ou [double] em Java). Ele tem dois modos:
- um literal é aceito para qualquer tipo no qual caiba: [val l: Long = 1000] e [val b: Byte = 5] são aceitos;
- os operadores aritméticos e as comparações aceitam operandos de tipos numéricos diferentes: [i + l], em que [i] é um [Int], [l] é um [Long], o resultado é um [Long]; [i * 1.5] é um [Double]. Isso não é uma conversão implícita, mas sim a existência, na classe [Int], das funções [plus(other: Long): Long], [times(other: Double): Double], etc.
As conversões que podem perder informação têm, com as funções [toXxx()], o mesmo efeito dos type casts do Java: [toInt()] aplicado a um número de ponto flutuante trunca a parte decimal (em direção a zero); aplicado a um [Long], retém apenas os 32 bits menos significativos. A conversão de tipo do Kotlin, o operador [as], é reservada a objetos (Capítulo 4): [d as Int], em que [d] é um [Double], não converte um número de ponto flutuante em inteiro: o compilador emite um aviso ([this cast can never succeed. Use 'toInt' to perform numeric conversion.]), e a execução lançaria uma exceção ([ClassCastException]).
Caracteres não são números: converte-se de um caractere para seu código Unicode usando a propriedade [code], e de um código para um caractere usando o construtor [Char(code)]. No entanto, pode-se somar um inteiro a um caractere (['A' + 2] é igual a 'C') e subtrair dois caracteres (['C' - 'A'] é igual a 2).
Um estouro (overflow) em um cálculo com inteiros ou em uma conversão entre inteiros nunca é sinalizado: o resultado simplesmente fica incorreto. O compilador Kotlin também não o sinaliza, mesmo quando só há constantes envolvidas ([Int.MAX_VALUE + 1]). Quando esse risco existe, deve-se realizar o cálculo com um tipo maior ([Long], ou [BigInteger] do JDK) ou usar os métodos [addExact], [subtractExact], [multiplyExact], [toIntExact]... da classe Java [Math], que lançam uma exceção [ArithmeticException] se o limite for excedido. A biblioteca do Kotlin não tem equivalente.
O programa [Basics15.kt] é o seguinte:
Resultados:
Comentários:
- linha 9: [f1] terá o valor 0.0. A divisão 3/4 é uma divisão inteira, pois ambos os operandos são do tipo [Int]; seu resultado, 0, é então convertido em [Float] pela função [toFloat()];
- linha 10: [i.toFloat()] é o valor de [i] convertido em [Float]. Temos agora uma divisão entre um número real do tipo [Float] e um inteiro do tipo [Int], cujo resultado é [Float]: a divisão dos dois números reais é realizada, e [f2] tem o valor 0.75. Na operação [i.toFloat()], [i] é um valor codificado exatamente como um número real de 4 bytes, enquanto [i.toFloat()] é o mesmo valor codificado como um número real aproximado de 4 bytes. Essa transcodificação ocorre apenas durante o cálculo: a variável [i] mantém sempre o tipo [Int];
- linhas 14–15: upcasts, que devem ser solicitados explicitamente;
- linhas 18–19: operações entre tipos diferentes. O tipo do resultado é exibido por meio de [::class.simpleName]: [Long] e [Double];
- linha 24: converter um número real em inteiro trunca a parte decimal em direção a zero: 3.99 vira 3 e -3.99 vira -3;
- linha 25: para arredondar, usamos [roundToInt()] do pacote [kotlin.math], importado na linha 4, que retorna diretamente um [Int];
- linha 27: 3 bilhões excedem o intervalo de [Int]: o literal é do tipo [Long], com ou sem o sufixo L;
- linha 28: 3 bilhões não cabem em um [Int]: apenas os 32 bits menos significativos são retidos, e o resultado deixa de fazer sentido;
- linha 31: um número de ponto flutuante grande demais para um [Int] é reduzido a [Int.MAX_VALUE]; o valor [NaN] torna-se 0;
- linhas 34–36: conversões entre caracteres e códigos Unicode, e aritmética de caracteres;
- linha 38: a função [digitToInt()] retorna o valor de um dígito (7), que não deve ser confundido com seu código Unicode (55);
- linha 42: o estouro passa despercebido: o resultado é o menor valor de [Int]. O mesmo cálculo realizado com [Long] produz o resultado correto;
- linha 46: com [Math.addExact], o estouro dispara uma exceção [ArithmeticException];
- linha 52: [Math.toIntExact] converte um [Long] em um [Int] e também lança uma exceção se o valor não couber em um [Int].
3.5. Instruções de controle do fluxo do programa
3.5.1. Parada
A função [exitProcess] do pacote [kotlin.system] permite interromper a execução de um programa:
[exitProcess] encerra o processo atual e devolve o controle ao processo chamador, normalmente o interpretador de comandos. O valor de [status], conhecido como código de retorno, pode ser usado pelo interpretador de comandos. Por convenção, 0 indica que o programa foi executado com sucesso, enquanto qualquer outro valor sinaliza um erro. No Windows, o código de retorno está disponível na variável [%ERRORLEVEL%] no prompt de comando e na variável [$LASTEXITCODE] do PowerShell; no Linux e no macOS, na variável [$?] do shell. Assim, [exitProcess(0)] encerrará a execução do programa com um código de retorno 0.
[exitProcess] chama o método Java [System.exit], que também pode ser usado diretamente. No entanto, ela tem uma vantagem sobre esse método: seu tipo de retorno é [Nothing]. [Nothing] é o tipo das expressões que nunca retornam um valor porque não terminam normalmente (encerramento do programa, exceção lançada, laço infinito). O compilador sabe, portanto, que a instrução que segue uma chamada a [exitProcess] nunca será executada, e leva isso em conta em suas verificações, como veremos.
Sem uma chamada a [exitProcess], um programa termina com código de retorno 0 quando sua função [main] termina, possivelmente com uma instrução [return]. Se ele for encerrado por uma exceção que ninguém capturou, exibe essa exceção e termina com código de retorno 1. Como em Java, a função [main] não pode retornar um inteiro: [exitProcess] é a única maneira de especificar o código de retorno.
O programa [Basics16.kt] recebe seu código de retorno como argumento:
Para ver o código de retorno, o programa deve ser o processo iniciado pelo shell. Com [gradlew -q run -Pmain=basics16.Basics16Kt --args="3"], o processo iniciado é o Gradle: um código de retorno diferente de zero faz a tarefa [run] falhar, o Gradle exibe sua própria mensagem de erro, e é o código de retorno do Gradle que recebemos. Construímos, então, um arquivo executável usando o compilador [kotlinc], como no Capítulo 2 ([kotlinc Basics16.kt -include-runtime -d basics16.jar]), e o executamos com [java -jar].
Resultados em um terminal bash:
Comentários:
- linha 6: a função [main] recebe os argumentos de linha de comando no array [args]. Os argumentos do programa são listados a seguir;
- linha 10: [args.firstOrNull()] retorna o primeiro argumento, ou [null] se não houver nenhum; o operador [?.] chama [toIntOrNull()] somente se ele não for [null], e [toIntOrNull()] retorna [null] se a string não for um inteiro. Assim, tanto a ausência de argumento quanto um argumento não numérico resultam em [null], que é do tipo [Int?], sem que nenhuma exceção seja lançada. O programa Java correspondente precisava capturar a exceção [NumberFormatException] de [Integer.parseInt];
- linha 13: o programa termina com código de retorno 1. A mensagem de erro é escrita na saída de erro [System.err];
- linha 16: o compilador sabe que só chegamos a este ponto se [code] não for [null], já que o bloco [if] termina com uma chamada a uma função do tipo [Nothing]. A variável [code], declarada com o tipo [Int?], é, portanto, tratada como um [Int] a partir desta linha: isso é conhecido como “smart cast”. Sem ele, a chamada a [exitProcess(code)] na linha seguinte, que espera um [Int], seria rejeitada. Em Java, o compilador não sabia que [System.exit] nunca devolve o controle, de modo que era preciso acrescentar uma instrução [return] redundante depois dele;
- linha 17: encerramento com o código de retorno passado como argumento. A linha seguinte não é executada. O compilador Kotlin 2.4 a aceita sem aviso; o IntelliJ IDEA a sinaliza como “unreachable code”;
- Resultados: o comando [echo $?] exibe o código de retorno do último programa executado: 3, e depois 1 nos dois casos de erro.
3.5.2. Estrutura de decisão simples
Notas:
- a condição é delimitada por parênteses. Ela deve ser do tipo [Boolean]: como o Java, e diferentemente da linguagem C, o Kotlin rejeita [if (n)] quando [n] é um inteiro;
- as ações não terminam com ponto e vírgula: em Kotlin, o fim da linha encerra a instrução. O ponto e vírgula só é usado para escrever várias instruções em uma única linha;
- as chaves só são obrigatórias se houver mais de uma instrução; no entanto, elas costumam ser usadas mesmo para uma única instrução, por legibilidade e para evitar erros ao acrescentar uma instrução. Como em Java, a convenção é colocar a chave de abertura no fim da linha;
- a cláusula [else] pode ser omitida;
- não existe a palavra-chave [then].
O equivalente algorítmico dessa estrutura é a estrutura if...then...else:
Exemplo:
A principal diferença em relação ao Java é que o [if] do Kotlin também é uma expressão: ele retorna o valor do ramo executado. Podemos, portanto, escrever [val max = if (a > b) a else b]. É por isso que o Kotlin não tem operador ternário [condition ? value1 : value2]: o [if] serve como seu equivalente. Quando usado como expressão, [if] deve ter uma cláusula [else]; caso contrário, ele não teria valor quando a condição fosse falsa.
As estruturas de escolha podem ser aninhadas. Isso às vezes levanta o problema ilustrado pelo programa [Basics17.kt]:
Resultados:
Comentários:
- linhas 7–11: a qual [if] se refere o [else] da linha 10? A regra é que um [else] sempre se refere ao [if] mais próximo: [if (n > 6)], linha 8. A indentação do código, que não tem efeito sobre o compilador, foi escolhida para ilustrar isso;
- linhas 15–20: aqui, queríamos colocar um [else] junto de [if (n2 > 1)], e não um [else] junto de [if (n2 > 6)]. Por causa da regra anterior, somos obrigados a colocar chaves em torno de [if (n2 > 1) { ... }];
- linhas 26–33: uma sequência de escolhas mutuamente exclusivas é escrita com instruções [else if] sucessivas. As condições são testadas em ordem; a primeira que for avaliada como verdadeira determina a ação a ser executada. A variável [honours] é declarada como [val] sem valor na linha 25: o compilador verifica que ela recebe um valor, uma única vez, em cada ramo antes de ser usada na linha 35. Na próxima seção, veremos uma forma mais concisa de escrever essa sequência de escolhas;
- linha 39: [if] é usado como expressão. Seu valor, a string selecionada, é atribuído a [honours2]. Isso evita declarar a variável sem valor;
- linha 42: [if] substitui o operador ternário do Java, aqui dentro de um template de string [${...}];
- linhas 44–49: quando um ramo é um bloco, seu valor é o da última expressão do bloco: [n] para o primeiro ramo, [n2] para o segundo. As instruções anteriores são executadas normalmente.
3.5.3. Estrutura de casos
3.5.3.1. A instrução when
O Kotlin não tem a instrução [switch]. Ele a substitui pela instrução [when], que é mais simples e mais poderosa. Sua sintaxe é a seguinte:
Notas:
- A expressão de controle é delimitada por parênteses. Ela pode ser de qualquer tipo: um inteiro, um caractere, uma string, um valor de enumeração, bem como [Long], [Double], [Boolean], ou qualquer objeto. Os valores são comparados com o operador [==], isto é, com o método [equals];
- cada cláusula associa um ou mais valores, separados por vírgulas, a uma ação. A ação, colocada após a seta [->], é uma única instrução ou um bloco delimitado por chaves;
- os valores vi não são necessariamente constantes: podem ser quaisquer expressões, avaliadas na ordem das cláusulas;
- somente a ação da primeira cláusula cujo valor corresponde é executada: não é preciso escrever [break], nem há encadeamento de uma cláusula para a seguinte. O erro clássico da sintaxe histórica do [switch] do Java, esquecer o [break], é, portanto, impossível. É assim que funciona a sintaxe com seta introduzida no Java 14, que é a única forma usada em Kotlin;
- a cláusula [else], o equivalente ao [default] do Java, pode ser omitida quando [when] é usado como instrução.
Exemplo algorítmico:
3.5.3.2. A expressão when e suas diversas cláusulas
Muito frequentemente, uma estrutura de casos é usada unicamente para selecionar um valor. Como [if], [when] pode ser usado como expressão para essa finalidade:
A expressão [when] deve ser exaustiva: ela deve especificar um valor para todos os valores possíveis da expressão de controle, o que geralmente exige uma cláusula [else]. Sem ela, o compilador rejeita o programa:
A cláusula [else] só é desnecessária quando o compilador consegue verificar por conta própria que todos os valores são tratados: para uma expressão do tipo [Boolean] ([true] e [false]), uma enumeração (todas as suas constantes; veja a seção sobre enumerações adiante) ou uma classe selada (Capítulo 4). Quando uma cláusula exige várias instruções, escreve-se um bloco, cujo valor é o de sua última expressão. Não há equivalente à instrução Java [yield].
Em vez de um valor, uma cláusula pode conter:
- um teste de pertinência [in range]: [in 1..10 -> "small"] é avaliada se a expressão estiver entre 1 e 10. Escrevemos [!in] para não pertinência;
- um teste de tipo [is Type]: [is String -> ...] é selecionada se o objeto examinado for do tipo [String]. Na ação, o objeto é então automaticamente tratado como um [String] (conversão inteligente de tipo): não é preciso introduzir uma nova variável, como no [case String s] do Java. [!is] verifica que um objeto não é de um determinado tipo;
- um guard: desde o Kotlin 2.2, uma cláusula pode ser complementada por uma condição introduzida por [if]: [is Int if o > 0 -> ...] só é avaliada para um inteiro positivo. Isso equivale aos guards [when] do Java 21.
Por fim, [when] pode ser usado sem argumento. Nesse caso, cada cláusula é uma condição booleana qualquer, e a primeira condição verdadeira é selecionada. Essa é uma forma mais legível de escrever uma sequência de cláusulas [if ... else if].
As cláusulas são avaliadas em ordem: a primeira que satisfaz a condição é selecionada. Diferentemente do [switch] do Java, o [when] do Kotlin trata tanto tipos primitivos ([Int], [Double]...) quanto objetos: não é preciso passar por um [Integer] para classificar um inteiro com guards.
O programa [Basics18.kt] é o seguinte:
Resultados:
Comentários:
- linhas 7–11: a implementação em Kotlin do algoritmo acima. Uma cláusula pode conter uma atribuição quando [when] é usado como instrução;
- linha 8: [return] encerra a função [main] e, portanto, o programa;
- linha 18: dois valores para as mesmas ações, separados por vírgula;
- linhas 23–26: uma expressão [when] sobre uma string. A cláusula [else] a torna exaustiva;
- linhas 30–35: uma cláusula cuja ação é um bloco: o valor da última expressão do bloco, [hours + 1] (linha 35), é o valor da expressão [when];
- linhas 71–76: a função [classify] classifica um inteiro por meio de intervalos. [Int.MIN_VALUE..<0] é o intervalo dos inteiros que vai do menor [Int] até 0 excluído, isto é, os inteiros negativos; [1..10] contém os inteiros de 1 a 10 inclusive. A constante 0 está incluída entre os intervalos. A cláusula [else] trata os valores restantes, no caso, os inteiros maiores ou iguais a 100. O corpo da função é uma expressão, escrita após o sinal [=]: voltaremos a essas funções com corpo de expressão mais adiante;
- linhas 48–52: um [when] sem argumentos, que reescreve a sequência de [else if] do programa [Basics17.kt]: a primeira condição verdadeira atribui seu valor à expressão;
- linha 56: um array de objetos de tipos diferentes. O tipo de seus elementos, [Any?] (qualquer objeto, ou [null]), é especificado explicitamente: sem isso, o compilador inferiria um tipo complexo a partir dos valores e rejeitaria o programa (“type argument for reified type parameter 'T' was inferred to the intersection of ['Comparable<*>?' & 'Serializable?']”);
- linhas 79–84: a função [describe] seleciona com base no tipo do objeto. Na linha 80, o valor [null] é apenas mais um valor para [when]. Na linha 81, o guard [if o > 0] pode comparar [o] com 0 porque, após o teste [is Int], [o] é tratado como um [Int]. Da mesma forma, na linha 83, a propriedade [length] da string pode ser usada sem conversão. A cláusula sem guard, [is Int] (linha 82), deve ser colocada depois da cláusula com guard, que ela esconderia caso contrário. Na linha 84, [o::class.simpleName] fornece o nome simples da classe do objeto: [Double];
- linhas 63–68: duas funções chamadas pela primeira, [when].
A tabela a seguir resume as correspondências entre as duas linguagens:
Java | Kotlin |
[switch (x) { case 1: ... break; default: ... }] | [when (x) { 1 -> ... ; else -> ... }] |
[case "saturday", "sunday" -> ...] | ["saturday", "sunday" -> ...] |
[default -> ...] | [else -> ...] |
[yield value;] | última expressão do bloco |
[case Integer i when i > 0 -> ...] | [is Int if x > 0 -> ...] |
[case null -> ...] | [null -> ...] |
(sem equivalente) | [in 1..10 -> ...] |
cadeia de [if ... else if] | [when { condition -> ... }] |
3.5.4. Estruturas de repetição
3.5.4.1. Número conhecido de repetições
Estrutura for
O Kotlin não possui o laço de “três argumentos” encontrado em C e Java ([for (i = id; i <= if; i = i + ip)]). Seu laço [for] percorre os elementos de um intervalo, de um array ou de uma coleção; é o equivalente ao laço for-each do Java. Para percorrer um inteiro, percorre-se um intervalo:
Notas:
- [id..if] é o intervalo de inteiros de [id] a [if], inclusive. [step ip] define o tamanho do passo da sequência; é opcional e o padrão é 1;
- [id..<if], que também pode ser escrito como [id until if], é o intervalo de [id] a [if], excluindo o limite superior. É conveniente para percorrer os índices de um array de [n] elementos: [for (i in 0..<n)];
- [if downTo id] é a sequência decrescente de [if] a [id];
- a variável de laço [i] é declarada por [for], sem [val] nem [var]: ela existe apenas dentro do laço e não pode ser modificada no corpo do laço;
- as chaves só são necessárias se houver mais de uma ação.
O equivalente algorítmico é a estrutura “for”:
que pode ser traduzida em uma estrutura "while":
Os intervalos não são uma sintaxe específica do laço [for]: são objetos ([IntRange], [IntProgression], [CharRange]...) que podem ser atribuídos a uma variável, passados a uma função, avaliados com o operador [in] ([if (x in 1..10)], como em [when]) ou manipulados por funções da biblioteca padrão ([(1..10).sum()]). Também existem intervalos de caracteres: ['a'..'z'].
Laço for sobre um array ou uma coleção
A sintaxe é a seguinte:
Notas:
- [collection] é um array ou uma coleção de objetos iteráveis (na verdade, qualquer objeto que tenha uma função [iterator()]). Trataremos das coleções ([List], [Set], [Map]...) no Capítulo 5;
- o tipo de
*[variable]* é inferido a partir do tipo dos elementos da coleção: ele não é especificado explicitamente; - [variable] é uma variável local do laço que assumirá sucessivamente todos os valores da coleção. Ela é somente leitura, como se tivesse sido declarada como [val]: não é possível atribuir-lhe um valor diferente dentro do laço;
- Para percorrer os índices de um array, use sua propriedade [indices]: [for (i in array.indices)]; para obter o índice e o elemento ao mesmo tempo, use a função [withIndex()]: [for ((i, element) in array.withIndex())].
A função repeat
Quando se quer executar um bloco de instruções exatamente [n] vezes, a função [repeat] da biblioteca padrão é a mais simples:
Dentro do bloco, o nome [it] designa o número da iteração atual, que vai de 0 a n-1. Esse bloco é, na verdade, uma lambda, uma função anônima passada como parâmetro para a função [repeat]: trataremos das lambdas no Capítulo 7.
3.5.4.2. Número desconhecido de iterações
Laço while
O laço continua enquanto a condição for verdadeira. O laço pode nunca ser executado. As notas são as mesmas do [for]. A estrutura algorítmica correspondente é a estrutura while:
Laço "do while"
A sintaxe é a seguinte:
O laço continua até que a condição seja avaliada como falsa. Aqui, o laço é executado pelo menos uma vez. Uma particularidade do Kotlin: uma variável declarada no corpo do laço é visível na condição do [while], o que permite escrever [do { val line = readln() } while (line != "end")]. A estrutura algorítmica correspondente é a estrutura "repeat...until":
Sem estrutura para o laço "geral"
O laço Java [for (start_instructions; condition; end_of_loop_instructions)] não existe em Kotlin. Quando um intervalo não é suficiente, escrevemos o laço equivalente [while]:
3.5.4.3. Instruções de controle de laço
Instrução | Papel |
[break] | Sai do laço [for], [while], [do ... while] |
[continue] | passa para a próxima iteração dos laços [for], [while], [do ... while] |
[break@label] | Sai do laço precedido pelo rótulo [label@], mesmo que a instrução esteja dentro de um laço aninhado |
[continue@label] | avança para a próxima iteração do laço precedido pelo rótulo [label@] |
Um rótulo é um identificador seguido do caractere [@], colocado antes do laço: [search@ for (...)]. Ele é referenciado, sem espaço, após [break] ou [continue]: [break@search]. Em Java, o rótulo era seguido de dois-pontos ([search:]).
3.5.4.4. Exemplos
O programa [Basics19.kt] é o seguinte:
Resultados:
Comentários:
- linhas 6–29: quatro maneiras de calcular a soma dos 10 primeiros inteiros;
- linhas 8–11: o laço [for] percorre o intervalo [1..n], incluindo 10. A variável de laço [i] existe apenas dentro do laço: a variável [i] declarada na linha 13 é uma variável diferente;
- linhas 15–17: o laço equivalente [while]: a inicialização, a verificação da condição e o incremento de [i] são escritos explicitamente. Essa é a tradução para Kotlin de um laço Java geral [for];
- linha 24: [i++] retorna o valor de [i] antes de ele ser incrementado: [i] é somado a [sum], e depois [i] é incrementado. Os operadores [++] e [--] existem tanto em Kotlin quanto em Java;
- linha 29: o intervalo [1..n] é um objeto; sua função [sum()] retorna a soma de seus elementos. Essa é a forma mais idiomática de escrever isso em Kotlin. Os parênteses em torno do intervalo são necessários: a chamada de função tem precedência sobre o operador [..];
- linhas 33–36: o cálculo de 5! = 1 × 2 × 3 × 4 × 5;
- linha 37: um intervalo cujo limite superior é excluído: [k] varia de 0 a 4. Quando o corpo do laço consiste em uma única instrução, ele pode ser escrito na mesma linha do [for];
- linha 39: uma sequência decrescente, de 10 a 0, com passo de 2;
- linha 41: um intervalo de caracteres;
- linhas 44–45: o bloco é executado 3 vezes; [it] vale sucessivamente 0, 1 e 2;
- linhas 51–52: o laço [for] percorre os elementos do array [friends];
- linhas 55–56: [friends.indices] é o intervalo dos índices do array, que neste caso é [0..3] . O comprimento de cada nome é exibido;
- linhas 60–61: [friends.withIndex()] retorna tuplas (índice, elemento). A sintaxe [(j, name)] as decompõe em duas variáveis: isso é uma atribuição por desestruturação, que revisitaremos no final deste capítulo;
- linhas 65–74: [continue] passa para a próxima iteração nos números pares; [break] interrompe o laço assim que [k] ultrapassa 7;
- linhas 80–86: um laço infinito [while (true)], do qual se sai por meio de [break]. Essa forma é conveniente quando a condição de término é calculada no meio do laço. Nós a usaremos para a entrada pelo teclado;
- linhas 89–94: encontrar o primeiro número negativo em um array bidimensional, um array de arrays de inteiros ([IntArray]). O rótulo [search@] (linha 90) nomeia o laço externo; a instrução [break@search] (linha 94) sai de ambos os laços de uma só vez. Um simples [break] sairia apenas do laço interno. O Kotlin não tem uma instrução [goto]: os rótulos cumprem essa função neste caso específico.
3.6. Tratamento de exceções
Muitas funções em Kotlin e Java são capazes de lançar exceções, isto é, erros. Quando uma função é capaz de lançar uma exceção, o programador deve tratá-la para tornar os programas mais tolerantes a erros: deve-se sempre evitar o encerramento abrupto de uma aplicação.
3.6.1. A estrutura try/catch/finally
O tratamento de exceções segue este modelo:
Se o código do bloco [try] não lançar uma exceção, a execução prossegue para a instrução seguinte; caso contrário, a execução passa ao corpo do bloco [catch] e, em seguida, à instrução seguinte. Observe os seguintes pontos:
- [e] é um objeto do tipo [Exception] ou de um tipo derivado. Como em qualquer declaração em Kotlin, o nome precede o tipo: [e: Exception]. Existem muitos tipos de exceções: [ArrayIndexOutOfBoundsException], [NumberFormatException], [ArithmeticException], [IllegalArgumentException], [IllegalStateException], [NullPointerException], [IOException] etc. Essas são classes de exceção do Java que o Kotlin usa diretamente (as mais comuns também estão disponíveis no pacote [kotlin], com o mesmo nome, sem [import]). Ao escrever [catch (e: Exception)], você indica que deseja tratar todos os tipos de exceção. Se o código da cláusula [try] puder gerar vários tipos de exceção, convém ser mais específico e tratar a exceção com várias cláusulas [catch]:
As cláusulas [catch] são avaliadas em ordem; a primeira cujo tipo corresponde à exceção é executada. Uma cláusula que trata um tipo específico de exceção deve, portanto, preceder a que trata um tipo mais geral. Observação: diferentemente do compilador Java, o compilador Kotlin não rejeita uma cláusula que nunca poderia ser alcançada; cabe ao programador garantir isso (voltaremos a este ponto);
- O Kotlin não tem a cláusula [catch] múltipla do Java ([catch (IOException | NumberFormatException e)]). Você pode escrever várias cláusulas ou uma única cláusula para um tipo mais geral, na qual testa o tipo da exceção, por exemplo com um [when];
- Você pode acrescentar uma cláusula [finally] às cláusulas [try / catch]:
Ocorrendo ou não uma exceção, o código da cláusula [finally] é sempre executado. Normalmente, é ali que se fecha um arquivo; veremos que há uma forma mais simples de fazer isso, com a função [use];
- na cláusula [catch], você pode não querer usar o objeto de exceção. Nesse caso, pode nomeá-lo como _: [catch (_: NumberFormatException)], em que o caractere _ designa uma variável anônima que não será usada;
- Uma exceção tem uma propriedade chamada [message] (o equivalente ao método [getMessage()] do Java) que contém a mensagem detalhando o erro ocorrido. Ela é do tipo [String?]: algumas exceções não têm mensagem. Para exibi-la, escreva:
- O método [toString()] de uma exceção retorna o nome completo de sua classe seguido de sua mensagem; seu método [printStackTrace()] exibe, além disso, a pilha de chamadas — isto é, a lista das funções que estavam em execução no momento do erro — junto com o nome do arquivo-fonte e o número da linha. Essa é a informação mais útil para o desenvolvedor, mas não se destina ao usuário. Neste curso, exibiremos na maioria das vezes o nome da classe da exceção — [ex.javaClass.name] ou [ex.javaClass.simpleName] — e sua mensagem. [ex.javaClass] é a classe Java do objeto, aquela retornada pelo método [getClass()] em Java;
- Por fim, e esta é uma diferença importante em relação ao Java, [try] é uma expressão: seu valor é o da última expressão do bloco [try] se não ocorrer exceção, e o da última expressão do bloco [catch] se ocorrer uma exceção. A cláusula [finally] não afeta esse valor. Podemos, portanto, escrever [val n = try { text.toInt() } catch (_: NumberFormatException) { 0 }].
3.6.2. Um primeiro exemplo
O programa [Basics20.kt] demonstra uma exceção gerada pelo uso de um elemento de array inexistente:
Resultados:
Comentários:
- linha 16: esta instrução lança uma exceção porque o array [tab] não tem um elemento no índice 100. O compilador não verifica índices, nem mesmo constantes: o erro só é detectado em tempo de execução pela Máquina Virtual Java;
- linha 17: a cláusula [catch (e: Exception)] captura todas as exceções;
- linha 18: a exceção é do tipo [java.lang.ArrayIndexOutOfBoundsException], e sua mensagem indica o índice incorreto e o tamanho do array (penúltima linha dos resultados);
- linha 19: a função [main] é encerrada e, com ela, o programa;
- linhas 20–21: a cláusula [finally] foi executada (última linha dos resultados), embora a cláusula [catch] contivesse uma instrução [return]. Observe que a cláusula [finally] é sempre executada;
- linha 23: por causa do [return], esta linha não é executada.
3.6.3. Uma entrada controlada
Eis outro exemplo, [Basics21.kt], em que tratamos a exceção causada pela conversão em inteiro de uma string que não representa um inteiro:
Resultados (as entradas, digitadas no teclado, foram inseridas na exibição):
Comentários:
- linha 7: se o fluxo de entrada estiver fechado, [readlnOrNull] retorna [null]: o operador [?:] o substitui por uma string vazia;
- Linhas 11–21: o laço de entrada da idade;
- linha 15: a linha digitada no teclado é convertida em inteiro pela função [toInt]. Essa função lança uma exceção [NumberFormatException] se a conversão não for possível. Por isso a operação foi colocada dentro de um [try / catch]. A função [readln], por outro lado, lança uma exceção se o fluxo de entrada estiver fechado: não capturamos essa exceção, pois isso faria o programa terminar;
- linha 16: se chegamos a esta linha, a conversão foi bem-sucedida. No entanto, verificamos se o inteiro resultante é de fato maior ou igual a 1;
- linha 17: se uma exceção [NumberFormatException] for lançada, desviamos para o [catch], onde nada é feito. Assim, a variável booleana [ageOK], inicializada com [false], permanece em [false]. A variável de exceção, que não é usada, é a variável anônima _. Apenas a exceção esperada é capturada: uma cláusula [catch (_: Exception)] também mascararia erros que não foram previstos;
- linhas 20–21: uma mensagem de erro é exibida se a idade for incorreta;
- linhas 28–40: a mesma entrada, escrita usando [try] como expressão. Se a conversão tiver êxito, o valor de [try] é o inteiro resultante; caso contrário, é o valor do bloco [catch], 0, que será rejeitado pelo teste da linha 37. O laço infinito [while (true)], do qual se sai por meio de [break], dispensa a variável booleana [ageOK]. O compilador sabe que o laço só é encerrado depois que um valor foi atribuído a [age2]; por isso, permite seu uso na linha 40, embora tenha sido declarada sem valor.
Um número grande demais para um [Int] — como 99999999999 — também provoca uma [NumberFormatException]: ele é, portanto, tratado como as demais entradas inválidas (segunda execução).
Usar uma exceção para validar uma entrada é prática comum em Java, mas o Kotlin oferece uma solução melhor: a função [toIntOrNull()], apresentada no início deste capítulo, retorna [null] em vez de lançar uma exceção. Escreveríamos então [val age = readln().toIntOrNull()] seguido de [if (age != null && age >= 1)], sem [try]. É o que faremos na aplicação de exemplo a seguir. As exceções devem ser reservadas para situações excepcionais.
3.6.4. Várias cláusulas catch e lançamento de exceções
O próprio programa pode lançar uma exceção usando a instrução [throw]:
Não existe o operador [new] em Kotlin: um objeto é criado simplesmente chamando o construtor de sua classe. A execução da função atual é interrompida e a exceção se propaga pelas funções chamadoras até que uma cláusula [catch] a trate; se nenhuma o fizer, o programa termina, exibindo a exceção e a pilha de chamadas. Em uma cláusula [catch], a instrução [throw e] relança a exceção atual, por exemplo depois de registrá-la em log.
Em Kotlin, [throw] é uma expressão do tipo [Nothing] (como [exitProcess]). Ela pode, portanto, ser usada em qualquer lugar em que um valor é esperado, por exemplo depois do operador [?:]: [val name = input ?: throw IllegalArgumentException("missing name")].
O Kotlin, como o Java, não oferece um filtro para as cláusulas [catch]: para tratar uma exceção apenas em certos casos, testa-se a condição na cláusula e relança-se a exceção, se necessário.
Para as verificações mais comuns, a biblioteca padrão do Kotlin fornece funções que lançam a exceção por nós:
Função | Finalidade |
[require(condition) { message }] | verifica um argumento: lança uma [IllegalArgumentException] com a mensagem calculada pelo bloco se a condição for falsa |
[requireNotNull(value) { message }] | lança uma [IllegalArgumentException] se [value] for igual a [null]; caso contrário, retorna o valor como um tipo não anulável. Equivale ao [Objects.requireNonNull] do Java, que por sua vez lança uma [NullPointerException] |
[check(condition) { message }] | verifica uma condição: lança uma [IllegalStateException] se a condição for falsa |
[checkNotNull(value) { message }] | lança uma [IllegalStateException] se [value] for igual a [null]e, caso contrário, retorna o valor |
[error(message)] | sempre lança uma [IllegalStateException]; do tipo [Nothing], é usada para sinalizar um caso que não deveria ocorrer |
A mensagem é gerada por um bloco (uma lambda), executado somente se a verificação falhar: uma string não é calculada desnecessariamente quando tudo está certo.
O programa [Basics22.kt] ilustra essas possibilidades:
Resultados:
Comentários:
- linha 5: entradas simuladas, válidas ou inválidas;
- linha 8: a função [readAge] (linhas 49–56) pode disparar vários tipos de exceção;
- linha 10: as entradas "abc", "" e "99999999999" disparam uma [NumberFormatException];
- linhas 12–15: na ausência de um filtro, a entrada vazia é distinguida dentro da cláusula [catch];
- linha 17: a exceção lançada pela própria função [readAge];
- Linha 26: [requireNotNull] lança [IllegalArgumentException] se [name] for igual a [null]; sua mensagem é a calculada pelo bloco (linha 9 dos resultados). Caso contrário, retorna [name] com o tipo [String]: a variável [valid] não é anulável;
- linha 54: a função [readAge] lança uma exceção se a idade estiver fora dos limites;
- linha 62: a mesma verificação, escrita com [require]. A condição usa o operador [in] e um intervalo;
- linha 68: [check] verifica se o objeto está em um estado que permite a operação;
- linha 71: [error] lança uma [IllegalStateException]. Como seu tipo é [Nothing], ela pode encerrar um ramo de uma expressão [when] do tipo [String].
A ordem das cláusulas [catch] nas linhas 10 e 17 é importante: a classe [NumberFormatException] deriva da classe [IllegalArgumentException] (uma [NumberFormatException] é um caso particular de argumento incorreto). Se invertermos as duas cláusulas, a cláusula [IllegalArgumentException] também intercepta as [NumberFormatException], e a cláusula [NumberFormatException] nunca mais é executada. O compilador Java rejeita essa cláusula, que se tornou inacessível ([error: exception NumberFormatException has already been caught]); já o compilador Kotlin 2.4 a aceita sem nenhum erro ou aviso. A entrada vazia seria então exibida como [[] : NumberFormatException - For input string: ""], e o erro passaria despercebido.
3.6.5. Sem exceções verificadas em Kotlin
Esta é uma das diferenças mais marcantes entre Java e Kotlin. As exceções são objetos cujas classes formam uma hierarquia. Trata-se de classes Java: a classe [kotlin.Throwable] é simplesmente outro nome para [java.lang.Throwable], e o mesmo vale para as classes [Exception], [RuntimeException], [IllegalArgumentException]...:
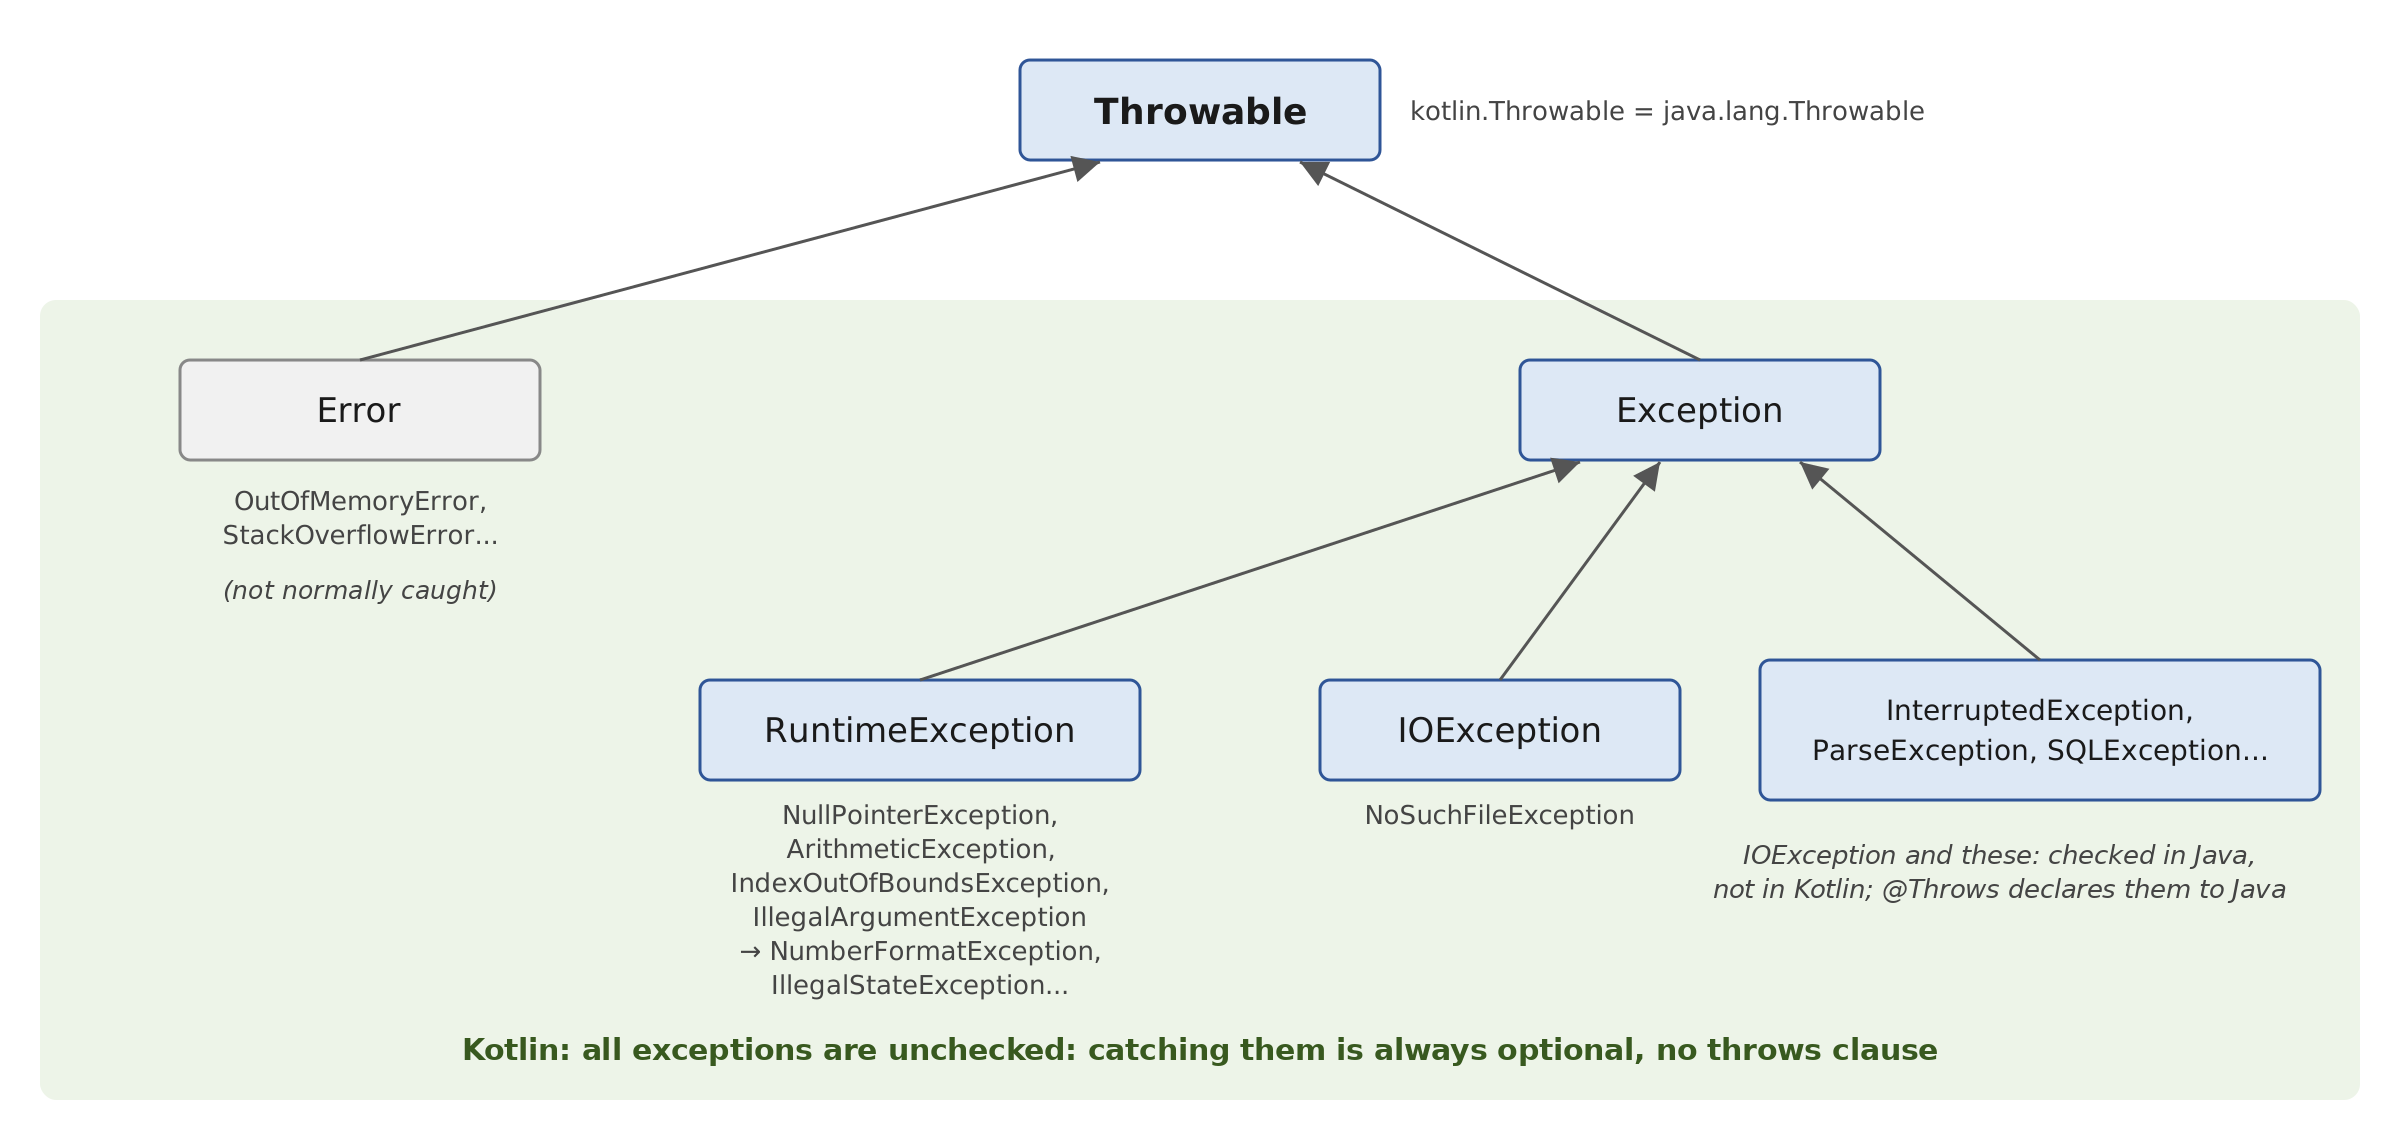
- a classe raiz é [Throwable];
- a classe [Error] e suas classes derivadas indicam problemas graves da máquina virtual ([OutOfMemoryError], [StackOverflowError]...), que um programa normalmente não tentaria interceptar;
- a classe [RuntimeException] e suas derivadas ([NullPointerException], [ArithmeticException], [ArrayIndexOutOfBoundsException], [IllegalArgumentException], [NumberFormatException], [IllegalStateException]...) geralmente indicam erros de programação ou dados incorretos;
- as demais classes derivadas de [Exception] ([IOException], [InterruptedException], [ParseException], [SQLException]...) relatam incidentes causados pelo ambiente do programa (arquivo ausente, queda de rede, banco de dados fora do ar) que um programa bem escrito deve prever.
Em Java, as exceções dessa última categoria são chamadas de “exceções verificadas” (checked exceptions): o compilador Java verifica se um método capaz de lançar uma delas — diretamente ou ao chamar outro método — a captura por meio de uma cláusula [catch] ou a declara em sua assinatura com a palavra-chave [throws]:
A responsabilidade é então repassada aos métodos chamadores, e assim por diante. As exceções derivadas de [RuntimeException] e de [Error] são chamadas de “não verificadas” (unchecked): podem ser capturadas, mas o compilador não exige isso.
O Kotlin não tem exceções verificadas. Como em C#, todas as exceções são não verificadas: o compilador nunca exige que uma exceção seja capturada ou declarada, e a palavra-chave [throws] não existe. Uma [IOException] lançada por um método Java é, para o Kotlin, apenas mais uma exceção. Essa escolha dos projetistas da linguagem baseia-se na experiência adquirida com o Java:
- em programas grandes, a exigência de declarar exceções se propaga de método em método, e as assinaturas dos métodos ficam inchadas com cláusulas [throws] que informam pouco;
- sem saber o que fazer com uma exceção verificada, muitos programadores a capturam com um bloco [catch] vazio apenas para silenciar o compilador: o erro desaparece silenciosamente, o que é o pior resultado possível;
- As exceções verificadas não combinam bem com lambdas (Capítulo 7): uma lambda passada a uma função de biblioteca não pode lançar uma exceção verificada sem algumas contorções;
- Por fim, muitas bibliotecas recentes do ecossistema Java (Spring, Hibernate, que usaremos mais adiante) já usam apenas exceções não verificadas. No curso de Java, frequentemente encapsulávamos uma exceção verificada em uma exceção não verificada: em Kotlin, isso é desnecessário.
A contrapartida é que o compilador deixa de nos lembrar de que uma função pode falhar: cabe ao programador saber quais exceções uma função pode lançar (a documentação as especifica) e capturá-las onde possam ser tratadas.
Quando uma função Kotlin precisa ser chamada a partir de código Java, a anotação [@Throws(IOException::class)] gera no bytecode a cláusula [throws IOException] que o compilador Java espera. Sem ela, um programa Java que chama a função e captura a exceção [IOException] é rejeitado pelo compilador Java, que presume que a exceção não pode ocorrer ([error: exception IOException is never thrown in body of corresponding try statement]). A anotação não tem efeito sobre chamadores Kotlin.
O programa [Basics23.kt] cobre os vários casos do programa Java correspondente:
Resultados:
Comentários:
- linhas 41–42: a função de extensão [readText()] do pacote [kotlin.io.path] (Capítulo 5) lê todo o conteúdo de um arquivo, especificado por um caminho [Path]; ela pode lançar uma [IOException]. A função [readFile] não a intercepta e não tem nada a declarar para o Kotlin. A anotação [@Throws] existe para um eventual chamador Java;
- linhas 12–16: a função [main] intercepta [IOException] porque assim escolhe, não porque o compilador exige. Como o arquivo não existe, a exceção lançada é uma
*[NoSuchFileException]*, classe derivada de*[IOException]*, cuja mensagem é o nome do arquivo; - linhas 45–46: [Thread.sleep] suspende o programa pela duração especificada em milissegundos; pode lançar uma [InterruptedException], que abordaremos no Capítulo 8. Em Java, essa é uma exceção verificada; em Kotlin, a função [pause] não exige nenhuma declaração;
- linha 19: a chamada a [pause] não está aninhada em um [try / catch]. O programa Java correspondente era obrigado a fazer isso;
- linha 50: uma divisão inteira pode lançar uma [ArithmeticException];
- linhas 22–25: o chamador captura a exceção porque assim escolhe;
- linhas 53–57: em Java, encapsular uma
*[IOException]dentro de uma*[UncheckedIOException]permitia omiti-la da declaração. Em Kotlin, essa razão deixa de existir, mas a técnica continua útil por outro motivo: a nova exceção carrega uma mensagem mais explícita para o chamador (“unreadable configuration”), e a exceção original lhe é passada como a causa; - linha 31: a propriedade [cause] (o método Java [getCause()]) retorna a exceção original. Ela é do tipo [Throwable?]: daí o operador [?.];
- Linhas 62–72: a função [ancestors] percorre a cadeia de classes ascendentes de um objeto (propriedade [superclass], o método Java [getSuperclass()]) até a classe [Object], a raiz de todas as classes Java. A variável [cls] é do tipo [Class<*>?] (uma classe de qualquer tipo, ou [null]), porque [superclass] retorna [null] para a classe [Object];
- Linhas 34–36: os resultados (as três últimas linhas) refletem a hierarquia descrita acima. Em Kotlin, a raiz de todas as classes é [Any], que corresponde à classe Java [Object].
Se removermos a anotação [@Throws] e até o [try / catch] da função [main], o programa continua sendo aceito pelo compilador Kotlin. A exceção não capturada encerraria então o programa, que exibiria a exceção e a pilha de chamadas e terminaria com código de retorno 1. Isso é aceitável para um pequeno programa de teste, mas não para uma aplicação real. Neste curso, capturamos uma exceção onde sabemos tratá-la.
3.6.6. Liberação de recursos: a função use
Um recurso (um arquivo aberto, uma conexão de rede, uma conexão com banco de dados) deve ser fechado após o uso, mesmo que ocorra um erro durante sua utilização. Ele pode ser fechado dentro de uma cláusula [finally], o que exige várias linhas de código que podem ser delicadas de escrever. O Java 7 introduziu o **try com recursos ([try (Type resource = ...) { ... }]*) com essa finalidade. O Kotlin não tem essa sintaxe; em vez disso, usa uma função simples de sua biblioteca padrão, a função *[use] :
A função [use] se aplica a qualquer recurso cujo tipo implemente a interface Java [AutoCloseable] (ou [Closeable], que deriva dela), uma interface que contém apenas o método [close()]; é o caso de todas as classes Java de arquivo, rede e banco de dados. Ela executa o bloco que lhe é passado (uma lambda, Capítulo 7), cujo parâmetro [r] se refere ao recurso, e depois fecha o recurso (chamando seu método [close()]), quer o bloco termine normalmente, quer com uma exceção. Ela retorna o valor do bloco. Se o nome do parâmetro for omitido, o recurso é referenciado no bloco como [it].
[use] é uma função de extensão: uma função escrita em Kotlin, fora da interface [AutoCloseable], mas chamada como se fosse um método dessa interface. Aprenderemos a escrever essas funções no Capítulo 4. Vários recursos são tratados com blocos [use] aninhados: o mais interno é fechado primeiro. O [use] pode ser colocado dentro de um [try] junto com cláusulas [catch] e [finally] , que são executadas depois que os recursos foram fechados.
Mencionamos anteriormente que o Kotlin não tem o recurso de multi-catch do Java ([catch (NumberFormatException | ArithmeticException e)]). Para tratar vários tipos de exceção da mesma maneira, capturamos um tipo comum e depois separamos as exceções usando um [when].
O programa [Basics24.kt] é o seguinte:
Resultados:
Comentários:
- Linhas 55–57: um recurso de demonstração. Trata-se de uma data class (Capítulo 4), uma classe muito simples em que cada objeto tem um nome; ela implementa a interface [AutoCloseable] redefinindo ([override]) o método [close()], que exibe uma mensagem;
- linhas 61–63: a função [openResource] exibe uma mensagem e cria um recurso;
- linhas 8–9: o recurso [r] é fechado automaticamente no fim do bloco (linha 4 dos resultados);
- Linhas 14–17: dois recursos, com duas [use] aninhadas. Uma exceção é lançada enquanto eles estão sendo usados (linha 17). Os resultados (linhas 5–11) mostram que R3 é fechado antes de R2 e que ambos são fechados antes de as cláusulas [catch] e [finally] serem executadas;
- linha 26: um [BufferedReader] que aqui lê uma string como se fosse um arquivo. A função de extensão [buffered()] cria um [BufferedReader] a partir do [StringReader], sem escrever [BufferedReader(StringReader(...))]. Leremos arquivos de verdade no Capítulo 5;
- linha 29: [readLine()] retorna a próxima linha, ou [null] no fim do texto. Em Kotlin, uma atribuição não é uma expressão: não é possível escrever [while ((line = reader.readLine()) != null)], como se faz em Java. O operador [?:] seguido de [break] (uma expressão do tipo [Nothing], assim como [throw]) encerra o laço quando [readLine()] resulta em [null]. A variável [line] passa então a ser do tipo [String], que não é anulável. No Capítulo 5, veremos funções que leem todas as linhas sem um laço ([readLines], [forEachLine], [useLines]);
- linha 34: [use] retorna o valor de seu bloco — neste caso, o número de linhas lidas por [readLines()] — após fechar o leitor;
- linhas 43–48: substituição do bloco multi-catch: a classe-mãe comum [RuntimeException] é interceptada e, em seguida, um [when] aplica o mesmo tratamento aos dois tipos esperados (uma cláusula [when] pode listar vários testes [is], separados por vírgulas). As demais exceções são relançadas; erros inesperados não são suprimidos;
- linha 46: [operation.contentToString()] retorna o conteúdo do array na forma “[10, zero]”, de modo semelhante a [Arrays.toString] em Java. A propriedade [e.javaClass.simpleName] fornece o nome da classe da exceção (linhas 16 e 17 dos resultados).
3.7. Aplicação de exemplo - V1
Nosso objetivo é escrever um programa para calcular o imposto de um contribuinte. Consideraremos o caso simplificado de um contribuinte que tem apenas um salário a declarar. Os números são extraídos da tabela do imposto de 2004 para a renda de 2003 e são usados como estão: trata-se de um exercício de programação, não de um cálculo de impostos atuais. Esta aplicação será nosso fio condutor: voltaremos a ela nos capítulos seguintes, incorporando classes, arquivos, um banco de dados, corrotinas e, por fim, funcionalidades de rede.
- Calculamos o número de cotas do empregado: cotas = nbChildren/2 + 1 se o empregado for solteiro, nbChildren/2 + 2 se for casado, em que nbChildren é o número de filhos;
- se ele tiver pelo menos três filhos, recebe meia cota adicional;
- sua renda tributável R é calculada como R = 0,72 * S, em que S é seu salário anual;
- seu quociente familiar é calculado como QF = R / cotas;
- seu imposto I é calculado usando a tabela a seguir:
limite | coeffR | coeffN |
4962 | 0 | 0 |
8382 | 0.068 | 291.09 |
14,753 | 0.191 | 1,322.92 |
23,888 | 0.283 | 2,668.39 |
38,868 | 0.374 | 4,846.98 |
47,932 | 0.426 | 6,883.66 |
0 | 0.481 | 9,505.54 |
Cada linha tem 3 campos. Para calcular o imposto I, procure a primeira linha em que QF é menor ou igual ao limite. Por exemplo, se QF = 5.000, a linha encontrada será:
O imposto I é então igual a 0,068 * R - 291,09 * cotas, arredondado para o euro mais próximo. Se QF for tal que a condição QF <= limite nunca seja satisfeita, usam-se os coeficientes da última linha: I = 0,481 * R - 9505,54 * cotas. O limite 0 da última linha nunca é, portanto, utilizado.
Os cálculos envolvem valores monetários e coeficientes decimais: nós os realizamos com a classe Java [BigDecimal], que o Kotlin usa diretamente — e de forma ainda mais cômoda que o Java: a biblioteca padrão do Kotlin define os operadores [+], [-], [*] e os operadores de comparação [<], [>]... se aplicam a qualquer objeto comparável. O programa Kotlin correspondente [Tax1.kt] é o seguinte:
Comentários:
- Linhas 10–12: os três arrays de [BigDecimal] são construídos pela função [decimals] (linhas 78–79) a partir de strings: cada valor, como 0.068, é, portanto, exato. Com [Double], 0.068 seria apenas uma aproximação binária. A função [decimals] aceita qualquer número de parâmetros ([vararg values: String]), que ela recebe em um array; essa notação é explicada na seção “Passagem de parâmetros para uma função”. O array de resultado é construído por [Array(size) { i -> value }], que calcula cada elemento com base em seu índice;
- linha 15: a entrada do estado civil é tratada pela função [readMaritalStatus] (linhas 55–60). O programa Java realizava todas as entradas em seu método [main], usando variáveis declaradas sem valores iniciais; em Kotlin, cada entrada é uma função que retorna o valor digitado, e as variáveis [married], [nbChildren] e [salary] podem ser [val];
- Linha 49: a função [read] exibe o prompt com [print] (sem quebra de linha) e lê a resposta; se o fluxo de entrada estiver fechado, o valor [null] retornado por [readlnOrNull] é substituído por uma string vazia. A função [trim()] remove os espaços iniciais e finais da string lida;
- linhas 56–60: um laço [while (true)] que termina com [return] quando a resposta está correta. O [when] opera sobre a resposta convertida em minúsculas por [lowercase()]: isso permite aceitar tanto Y quanto y. Em Kotlin, as strings são comparadas com o operador [==], que compara seus conteúdos (é o que o [when] faz); o método Java [equals] não é necessário;
- linha 60: as mensagens de erro são escritas no fluxo [System.err];
- Linhas 66–73: entrada de um inteiro positivo ou zero, usada para o número de filhos e para o salário: o programa Java repetia o mesmo laço duas vezes. [toIntOrNull()] retorna [null] se a entrada não for um inteiro: não há nem [try] nem exceção a tratar. Na linha 70, depois do teste [number != null], o compilador sabe que [number] não é [null]: ele aceita a comparação [number >= 0] e a instrução [return number] em uma função que retorna um [Int] (smart cast);
- Linha 22: o número de cotas é calculado como [BigDecimal]. Não é possível simplesmente escrever [nbChildren / 2]: se nbChildren for 3, obteríamos 3/2, uma divisão inteira que resultaria em 1 em vez de 1,5. A função de extensão [toBigDecimal()] converte o inteiro, [divide(BigDecimal.TWO)] o divide exatamente por dois, e o operador [+] soma 2 ou 1, conforme determinado por uma expressão [if]. Observação: o operador Kotlin [/] aplicado a [BigDecimal] preserva o número de casas decimais do dividendo e arredonda o resultado: [3.toBigDecimal() / 2.toBigDecimal()] é 2, não 1,5. Para uma divisão envolvendo [BigDecimal], usa-se sempre o método [divide];
- linha 24: um [BigDecimal] é imutável: o operador [+=] não modifica o objeto; ele cria um novo objeto [shares + BigDecimal("0.5")] e o atribui à variável, daí a declaração [var] de [shares]. Em Java, seria necessário escrever [shares = shares.add(...)], e esquecer a atribuição era uma armadilha clássica;
- linha 28: a renda tributável, calculada com o operador [*];
- linha 31: o quociente familiar. Dividir a renda por 1,5 ou 3,5 cotas geralmente não resulta em uma representação decimal finita: definimos uma precisão, aqui [MathContext.DECIMAL128] (34 dígitos significativos), mais do que suficiente;
- linhas 35–37: determinação da faixa de tributação. A busca para no primeiro limite superior maior ou igual ao quociente familiar e, no máximo, na última faixa, usando a condição [i < limits.size - 1]. Em Kotlin, o operador [>] se aplica a [BigDecimal]: [quotient > limits[i]] é traduzido pelo compilador em [quotient.compareTo(limits[i]) > 0], que é como o teríamos escrito em Java. No entanto, não comparamos duas expressões [BigDecimal] com [==], que chama [equals] e leva em conta o número de casas decimais: 2.0 e 2.00 não são “iguais” para [equals];
- Linha 41: o imposto é truncado para o euro inteiro pela função [toInt()], que descarta a parte decimal.
Eis alguns exemplos de saída (as entradas, digitadas no teclado, foram incluídas na exibição):
Para um salário anual de 60.000 euros, um contribuinte casado com 2 filhos paga 4.282 euros, com 3 filhos 2.959 euros, e uma pessoa solteira sem filhos 11.519 euros: esses são os resultados da versão Java. Na segunda execução, a entrada “60000 euros” é rejeitada: [toIntOrNull] aceita apenas strings que representam um inteiro exato (os espaços iniciais e finais foram removidos por [trim()]).
3.8. Argumentos do programa principal
A função principal [main] pode aceitar como parâmetro um array de strings [Array<String>]. Esse array contém os argumentos de linha de comando usados para iniciar a aplicação. Assim, se iniciarmos o programa P com o comando:
e se a função [main] for declarada da seguinte forma:
teremos args[0]="arg0", args[1]="arg1" e assim por diante. Quando o programa não precisa de seus argumentos, basta escrever [fun main()], como fizemos até agora. Com o Gradle, os argumentos destinados ao programa são passados à tarefa [run] por meio da opção [--args], na forma de uma única string entre aspas; as opções do próprio Gradle (como [-q] ou [-P]) são colocadas ao lado dela:
No IntelliJ IDEA, os argumentos são informados na configuração de execução do programa (no campo “Program arguments”).
Eis um exemplo, [Basics25.kt]:
Resultados:
Um argumento que contém espaços deve ser colocado entre aspas; dentro da string [--args], usam-se aspas simples:
Sem argumento, o array [args] está vazio; ele nunca é igual a [null]:
Comentários:
- linha 4: o ponto de entrada do programa. O compilador gera uma classe [Basics25Kt] contendo um método [public static void main(String[] args)]: este é exatamente o ponto de entrada padrão do Java;
- linha 5: o tamanho de um array é especificado por sua propriedade [size] (o campo [length] em Java);
- linhas 6–7: iteração pelos índices do array.
Em Java, o método [main] padrão é um método estático de uma classe. O Kotlin não tem métodos estáticos; no entanto, se você quiser que o ponto de entrada seja uma classe com um nome específico (por exemplo, para uma ferramenta que o exija), coloque a função [main] dentro de um object, declarado com a palavra-chave [object] (Capítulo 4), e anote-a com [@JvmStatic]. É o que faz o programa [Basics26.kt]:
Resultados:
Comentários:
- linha 4: um objeto [Basics26]. O compilador gera uma classe [Basics26], com um único objeto;
- Linhas 5–6: a anotação [@JvmStatic] instrui o compilador a tornar [main] um método estático da classe [Basics26], que é o que a Máquina Virtual Java espera. A classe a ser executada é, portanto, [basics26.Basics26], não [basics26.Basics26Kt];
- linhas 8–9: iteração pelo array usando a função [withIndex()], que retorna ao mesmo tempo o índice e o elemento.
Essa forma é rara em Kotlin: uma função [main] de alto nível, fora de qualquer classe, é a norma. Por fim, observe que, como em Java, a função [main] não retorna um valor: o código de saída do programa é definido com [exitProcess].
3.9. Enumerações
Uma enumeração é um tipo de dados cujo domínio de valores consiste em um conjunto de constantes nomeadas. Considere um programa que precisa tratar menções de aprovação em exames. Há cinco menções possíveis: Pass, Fairly Good, Good, Very Good e Excellent. Podemos então definir uma enumeração para essas cinco constantes:
O Kotlin escreve [enum class]*** onde o Java escreve [enum]*: [enum] não é uma palavra-chave reservada, mas um modificador** de declaração de classe. Por convenção, os nomes das constantes são escritos em maiúsculas. Uma variável pode ser declarada para assumir seus valores a partir da enumeração:
Você pode comparar uma variável com os diferentes valores possíveis da enumeração usando o operador ==:
Como em Java, e diferentemente de outras linguagens em que um enum é apenas um conjunto de inteiros nomeados, um enum do Kotlin é uma classe, compilada em uma classe derivada de [java.lang.Enum], cujos únicos objetos são as constantes declaradas. Cada constante é um objeto único, criado uma vez por todas. Cada constante conhece seu nome (propriedade [name], ou [toString()]) e seu número de ordem na declaração (propriedade [ordinal], começando em 0). As constantes são comparáveis nessa ordem: é possível escrever [m1 < m2]. Toda enumeração também tem:
- [Honours.entries]: a lista (não modificável) das constantes da enumeração [Honours], na ordem em que foram declaradas. É uma alternativa melhor à função [Honours.values()] — herdada do Java e ainda disponível — que cria um novo array a cada chamada;
- [Honours.valueOf(name)]: retorna a constante chamada [name] e lança uma [IllegalArgumentException] se nenhuma constante tiver esse nome.
Uma enumeração não pode ser convertida em inteiro, nem um inteiro em enumeração: usamos [ordinal] e [entries].
O programa [Basics27.kt] ilustra o que acabou de ser descrito:
Resultados:
Comentários:
- linha 4: a declaração da enumeração. Ela fica no início do arquivo, ao lado das funções; como alternativa, tal como uma classe (Capítulo 4), pode ser declarada em seu próprio arquivo, [Honours.kt];
- linha 8: uma variável do tipo [Honours], com o tipo inferido a partir do valor atribuído;
- linha 10: uma constante de enumeração é listada pelo nome;
- linhas 16–17: a lista de constantes, seus nomes e seus números de ordem;
- linha 20: a conversão de um número de ordem em constante: [entries] é uma lista, indexada como um array;
- linha 23: conversão de uma string em constante de enumeração;
- linha 24: as constantes são comparadas com base na ordem de declaração: GOOD vem depois de PASS. O operador [>] é traduzido pelo compilador em uma chamada ao método [compareTo], que teria de ser escrita em Java;
- linhas 25–28: [valueOf] diferencia maiúsculas de minúsculas: “Good” não é o nome de uma constante. A mensagem da exceção fornece o nome completo da enumeração, [basics27.Honours];
- linha 31: para evitar a exceção, você pode procurar a constante em [entries] usando a função [find], que retorna o primeiro elemento que satisfaz a condição escrita entre chaves (uma lambda, Capítulo 7; em que [it] designa o elemento examinado), ou [null] se não houver nenhum;
- linhas 34–37: as enumerações se prestam bem a expressões [when]. Como todas as constantes são tratadas, a expressão é exaustiva sem uma cláusula [else]. Se uma constante for acrescentada à enumeração mais tarde, o compilador rejeitará a expressão [when], que se tornou incompleta, indicando o nome da constante omitida. Por exemplo, sem a linha 37: [error: 'when' expression must be exhaustive. Add the 'EXCELLENT' branch or an 'else' branch.]. Esse é um bom motivo para não incluir uma cláusula [else] em um [when] sobre uma enumeração. Diferentemente do [switch] do Java, as constantes são prefixadas com o nome da enumeração; uma instrução [import basics27.Honours.*] permitiria escrever seus nomes isoladamente;
- linha 40: o nome completo do enum é [basics27.Honours]: ele é declarado no nível do arquivo, no pacote [basics27]. [Honours::class.java] é a classe Java do enum;
- linha 41: a classe-mãe de qualquer enumeração é [java.lang.Enum].
3.9.1. Enumerações enriquecidas
Como uma enumeração é uma classe, ela pode ter propriedades, um construtor e métodos. O Kotlin torna isso particularmente conciso: as propriedades são declaradas com [val] entre os parênteses que seguem o nome do enum (o construtor primário, Capítulo 4), e cada constante é criada chamando esse construtor com os valores escritos entre parênteses após seu nome. Trata-se de um recurso muito usado, que elimina a necessidade de gerenciar arrays separados de valores associados às constantes.
Para representar um conjunto de opções, como as permissões de acesso a um arquivo (leitura, escrita, execução), costumava-se combinar potências de 2 com o operador [or] (OU bit a bit). Em vez disso, usamos um enum e a classe Java [EnumSet], um conjunto de constantes de um enum, tão eficiente quanto uma combinação bit a bit (internamente, é uma), mas muito mais legível. A classe [EnumMap] é, da mesma forma, um dicionário cujas chaves são as constantes de uma enumeração. O Kotlin as usa diretamente.
O programa [Basics28.kt] é o seguinte:
Resultados:
Comentários:
- Linha 8: a enumeração e seu construtor primário. As palavras-chave [val] tornam [minimumGrade] e [label] propriedades somente leitura de cada constante. O programa Java teria de declarar dois campos [private final], escrever o construtor que os inicializa e, em seguida, escrever dois métodos, [getMinimumGrade] e [getLabel], para lê-los: o Kotlin gera tudo isso. O construtor de um enum é privado: não é possível criar constantes adicionais;
- linhas 9–13: as constantes da enumeração, cada uma com seus dois parâmetros. O ponto e vírgula após a última constante é obrigatório quando há membros em seguida: este é um dos pouquíssimos pontos e vírgulas exigidos em Kotlin;
- linha 16: um método que se aplica a uma constante ([m.next()]). Ele usa a propriedade [ordinal] da constante e a lista [entries]; [getOrNull] retorna o elemento no índice dado, ou [null] se o índice estiver fora dos limites: a última constante não tem sucessora. O tipo de retorno [Honour?] indica isso;
- linhas 19–20: uma função chamada na própria enumeração ([Honour.forGrade(grade)]), semelhante a um método estático em Java. O Kotlin não tem métodos estáticos: eles são colocados no companion object da classe ([companion object]), apresentado no Capítulo 4. Como as constantes são declaradas em ordem crescente de nota, a última cuja nota mínima é atingida é a correta: [lastOrNull] retorna o último elemento da lista que satisfaz a condição, ou [null] se não houver nenhum. O resultado é do tipo [Honour?], ou [null] se a nota for inferior a 10: onde o Java usava um [Optional], o Kotlin usa um tipo anulável;
- linha 25: uma enumeração simples para os direitos de acesso;
- linhas 28–29: a lista de entradas com suas propriedades: escrevemos [m.label], e não [m.getLabel()];
- linha 31: um array de números reais [DoubleArray]. As notas são escritas como 12.0 e 19.0, e não 12 e 19: o Kotlin não converte implicitamente um [Int] em um [Double];
- linha 33: o operador [?.] lê a propriedade [label] somente se [Honour.forGrade(grade)] não for [null]; o operador [?:] retorna um texto caso contrário. Isso equivale ao [map(Honour::getLabel).orElse("no honours")] do Java;
- linha 38: um conjunto de dois direitos;
- linha 39: o operador [in] verifica se uma constante pertence ao conjunto, assim como se verificaria um bit. Ele é traduzido pelo compilador em uma chamada ao método [contains];
- linhas 40–41: constantes são adicionadas ao conjunto e removidas dele;
- linhas 43–44: o conjunto de todas as constantes, o conjunto vazio e o complemento de um conjunto. [Permission::class.java] é a classe Java da enumeração, que esses métodos Java chamam ([Permission.class] em Java);
- linha 45: as constantes entre duas constantes, na ordem em que foram declaradas;
- linhas 48–50: um [EnumMap] associa um conjunto de elementos a certas entradas. A notação [headcounts[key] = value] substitui a chamada [headcounts.put(key, value)]. As chaves de um [EnumMap] são sempre percorridas na ordem em que as constantes são declaradas: PASS aparece antes de GOOD, mesmo tendo sido adicionada depois. Os dicionários são abordados no Capítulo 5.
3.10. Passagem de parâmetros para uma função
Em Kotlin, uma função pode ser declarada no nível superior de um arquivo, fora de qualquer classe, como nossas funções [main]: elas são chamadas de funções de nível superior. Uma função declarada dentro de uma classe é um método (Capítulo 4). Aqui, vamos nos concentrar na forma como os parâmetros são passados a uma função. Considere a seguinte função:
Na definição da função, na linha 1, [a] é chamado de parâmetro formal. Ele existe apenas para os fins da definição da função [changeInt]. Poderia muito bem ter sido chamado de [b]. Seu tipo é obrigatório: a inferência de tipos não se aplica aos parâmetros. Vamos agora considerar uma chamada dessa função:
Aqui, na instrução da linha 2, [age] é o parâmetro real (também chamado de argumento) que passará seu valor ao parâmetro formal [a]. Interessa-nos saber como um parâmetro formal obtém o valor de um parâmetro real.
3.10.1. Passagem por valor e parâmetros imutáveis
Assim como o Java, o Kotlin tem apenas um modo de passagem de parâmetros: a passagem por valor. O valor do parâmetro real é copiado para o parâmetro formal correspondente. São duas entidades distintas.
O Kotlin vai um passo além do Java: um parâmetro formal é sempre um [val]. Não é possível atribuir-lhe um novo valor dentro da função; é como se, em Java, todos os parâmetros fossem declarados como [final]. A pergunta “A função pode modificar o parâmetro real modificando seu parâmetro formal?” nem sequer se coloca. Se a função precisa de uma variável que ela modifica, ela declara uma variável local inicializada com o valor do parâmetro.
Quando o parâmetro é um array ou um objeto, o valor passado é a referência ao objeto: o parâmetro formal e o parâmetro real passam então a se referir ao mesmo objeto. A função pode, portanto, modificar esse objeto, se ele for mutável, e o chamador verá a alteração; no entanto, ela não pode fazer com que a variável do chamador passe a se referir a outro objeto.
O Kotlin não oferece passagem por referência, na qual o parâmetro formal e o parâmetro real seriam uma única e mesma variável (como os parâmetros [ref] e [out] do C#): uma função não pode modificar uma variável local de seu chamador, nem “retornar” resultados ao chamador por meio de seus parâmetros. Em vez disso, usamos:
- o valor de retorno da função, que o chamador atribui à sua variável;
- uma data class ou uma tupla ([Pair], [Triple]) quando a função precisa retornar vários valores;
- um array ou um objeto mutável passado como parâmetro, no qual a função coloca seus resultados.
O programa [Basics29.kt] ilustra esses diferentes casos:
Resultados:
Comentários:
- Linhas 8–10: o valor 20 do parâmetro real [age] foi copiado para o parâmetro formal [a] (linha 53). A função não pode modificar [a]: ela cria uma cópia local, [copy] (linha 55), que então modifica. O parâmetro real permanece inalterado;
- linhas 13–15: a função [changeInt2] (linhas 60–62) retorna um novo valor, que o chamador atribui à sua própria variável [age2], declarada como [var] para esse fim;
- linha 51: uma data class ([data class]) declara, em uma única linha, uma classe cujos objetos consistem em dois valores imutáveis, [succeeded] e [value]. O compilador adiciona, entre outros, um método chamado [toString()], que exibe seus componentes, bem como os métodos [equals()] e [hashCode()]. É o equivalente Kotlin dos records do Java; as data classes são abordadas no Capítulo 4. Seus componentes são propriedades: escrevemos [c1.succeeded], e não [c1.succeeded()] como em um record;
- Linhas 18–22: a função [convert] (linhas 65–69) retorna duas informações — se a conversão foi bem-sucedida e o valor resultante — combinadas em um único objeto [Conversion]. Seu corpo é uma expressão [try], que resulta em um ou outro objeto [Conversion]. Observe que, em Kotlin, normalmente se escreveria uma função do tipo [Int?] que retorna [null] em caso de falha: é exatamente o que [toIntOrNull()] faz;
- linhas 26–28: troca de dois valores. Uma função do tipo [swap(a: Int, b: Int)] não teria utilidade para o chamador; por isso, os dois valores são armazenados em um array, que a função [swap] (linhas 72–75) modifica;
- linhas 30–32: para trocar duas variáveis locais, o Kotlin oferece um idioma: [x = y.also { y = x }]. A função [also] executa o bloco, que atribui o valor de [x] a [y], e então retorna o valor de [y] antes de o bloco ser executado, valor que é atribuído a [x]. Funções como [also] são abordadas no Capítulo 7;
- linhas 36–38: a referência ao array é passada por valor. A função [modifyArray] opera, portanto, sobre o mesmo array do chamador: a modificação feita por [t[0]] (linha 80) é visível para o chamador. No entanto, é impossível fazer [t] apontar para outro array: [t] é um [val];
- Linhas 41–43: um objeto [StringBuilder] é uma string mutável: a função [complete] (linhas 85–86) acrescenta texto a ele, e o chamador vê o resultado. Com uma [String], isso teria sido impossível: os objetos [String] são imutáveis;
- linhas 46–47: a função [inclTax] (linhas 89–91) calcula um preço com todos os impostos incluídos. O produto de dois [BigDecimal] objetos tem tantas casas decimais quanto a soma das de seus dois fatores: 100 × 1,2 = 120,0, exibido como 120.0.
Se o comentário da linha 90 for substituído pela instrução [amount = BigDecimal.ZERO], o compilador rejeita o programa:
3.10.2. Valores padrão, argumentos nomeados, sobrecarga, número variável de parâmetros
O Java não tem parâmetros opcionais nem argumentos nomeados e precisa simulá-los por meio de sobrecarga de métodos: várias versões do mesmo método, com as versões curtas chamando a versão completa com valores padrão. O Kotlin, como o C#, tem ambos:
- um parâmetro pode ter um valor padrão: [fun greet(name: String, greeting: String = "Hello")]. O chamador pode então omitir o parâmetro real correspondente: [greet("Pierre")];
- ao chamar o método, um argumento pode ser nomeado: [greet("Pierre", upperCase = true)]. Isso permite omitir um parâmetro que tem valor padrão e ainda passar os seguintes, passar os argumentos em qualquer ordem e, principalmente, tornar a chamada legível: [upperCase = true] é mais claro do que um [true] isolado em uma lista de argumentos.
Valores padrão e argumentos nomeados tornam a maior parte da sobrecarga — e dos “builders” do Java — desnecessária. A sobrecarga existe, porém, em Kotlin: várias funções podem ter o mesmo nome se suas listas de parâmetros diferirem no número ou no tipo dos parâmetros; o compilador seleciona a adequada com base nos parâmetros reais. Isso é usado quando o processamento difere conforme o tipo dos parâmetros. Para permitir que uma função Kotlin com parâmetros padrão seja chamada a partir do Java com menos argumentos, a anotação [@JvmOverloads] instrui o compilador a gerar as sobrecargas correspondentes.
Por fim, uma função pode ter um número variável de parâmetros: o parâmetro formal é precedido pela palavra-chave [vararg], [vararg numbers: Int]. O chamador pode passar uma lista de valores — que pode ser vazia — que o compilador organiza em um array; dentro da função, o parâmetro é um array ([IntArray] para [Int], [Array<String>] para [String]...). Diferentemente do Java, não é possível passar diretamente um array no lugar da lista de valores: é preciso “espalhá-lo” com o operador de espalhamento ([*]), [sum(*values)], que também permite misturar arrays e valores individuais.
O programa [Basics30.kt] é o seguinte:
Resultados:
Comentários:
- Linhas 33–35: uma única função, [greet], em que dois parâmetros têm valores padrão. O programa Java exigia três métodos sobrecarregados. O corpo da função retorna o valor de uma expressão, [if];
- Linha 6: [greeting] e [upperCase] assumem seus valores padrão, "Hello" e [false];
- linha 7: [greeting] recebe “Good evening” e [upperCase] recebe seu valor padrão;
- linha 9: graças ao argumento nomeado, passamos [upperCase] sem passar [greeting], que mantém seu valor padrão. Em Java, a saudação também precisava ser passada;
- linha 11: todos os argumentos são nomeados, em uma ordem diferente da da declaração;
- linhas 39–43: três funções [describe] que diferem no tipo de seu parâmetro. São funções com corpo de expressão: o corpo, reduzido a uma única expressão, é escrito imediatamente após o sinal [=], sem chaves nem [return]. O tipo de retorno é então inferido a partir da expressão ([Unit] aqui; o tipo de [println]: a função não retorna um valor útil);
- linhas 14–16: o compilador seleciona a função com base no tipo do parâmetro real. O caractere ["] é escrito como [\"] em uma string (linha 43);
- linhas 45–51: [sum] aceita qualquer número de inteiros, recebidos no array [numbers] do tipo [IntArray];
- linhas 19–24: [sum] é chamada sem parâmetros, com três inteiros, com os elementos de um array espalhados pelo operador [*] e, depois, com uma combinação das duas formas;
- linhas 26–29: muitas funções do Kotlin têm um número variável de parâmetros: [listOf], [setOf], [arrayOf], [format], [maxOf]... A função de extensão [format] se aplica à string de formato, e não à classe [String] como o método estático [String.format] do Java. O Kotlin não tem métodos estáticos: [String.join(" - ", "a", "b", "c")] não existe em Kotlin (escreveríamos [listOf("a", "b", "c").joinToString(" - ")], Capítulo 5). O conjunto criado por [setOf] elimina o "a" duplicado.
3.11. Funções locais e tuplas: as soluções do Kotlin
3.11.1. Funções locais, lambdas e classes locais
Diferentemente do Java, o Kotlin permite definir uma função local — isto é, uma função escrita dentro de outra função e utilizável apenas nesse escopo. Isso é útil para dividir uma função longa sem poluir todo o arquivo com funções visíveis. Uma função local tem acesso às variáveis locais da função que a contém e pode modificá-las.
Dentro de uma função, você também tem acesso a:
- lambdas, que são pequenas funções anônimas que podem ser armazenadas em uma variável: [val cube = { x: Int -> x * x * x }]. A variável tem então um tipo funcional, neste caso [(Int) -> Int], e a lambda é chamada como uma função: [cube(3)]. As lambdas são abordadas no Capítulo 7, “Tipos funcionais, lambdas e eventos”. Diferentemente do Java, uma lambda Kotlin pode modificar as variáveis locais [var] que a cercam;
- classes locais, declaradas dentro da função e utilizáveis apenas nela.
3.11.2. Pares, triplas, desestruturação e tipos de dados
Outras linguagens têm tuplas, que agrupam vários valores sem a necessidade de declarar um tipo. O Kotlin não tem uma sintaxe específica para elas, mas sua biblioteca padrão fornece duas data classes genéricas, [Pair<A, B>] e [Triple<A, B, C>], cujos componentes se chamam [first], [second], e [third]. Um par é criado com [Pair(1, "one")] ou, de forma mais legível, com a função infixa [to]: [1 to "one"].
Os componentes de um par, de uma tripla e de qualquer data class podem ser extraídos em uma única instrução com uma declaração de desestruturação: [val (number, name) = pair] declara duas variáveis, inicializadas com o primeiro e o segundo componentes. Um componente desnecessário é substituído por _: [val (_, age, _) = triple]. A desestruturação também é usada em um laço, como [for] (como vimos com [withIndex()]), e nos parâmetros de uma lambda. Ela se baseia na posição dos componentes, não em seus nomes: [val (name, number) = pair] colocaria o número em [name].
Para dar nomes aos componentes de uma tupla, declara-se uma data class: [data class Couple(val number: Int, val name: String)]. Isso equivale a um record do Java, mas é mais flexível (uma data class pode ter componentes como [var], ser desestruturada etc.). As tuplas são convenientes para uso local quando a relação entre os dois valores é óbvia; assim que uma função pública retorna vários valores, uma data class — cujos componentes têm nomes — torna o código mais legível.
O programa [Basics31.kt] é o seguinte:
Resultados:
Comentários:
- linha 6: uma função local com corpo de expressão, declarada na função [main] e chamada na linha 7;
- linha 9: uma lambda. [{ x: Int -> x * x * x }] lê-se “a função que associa x * x * x a um inteiro x”. O tipo das variáveis [cube] e [(Int) -> Int] é inferido pelo compilador;
- linha 10: a lambda é chamada como uma função. Em Java, era preciso conhecer o método da interface funcional ([applyAsInt]);
- linhas 13–21: a função local [increment] e a lambda [increment2] modificam ambas a variável local [counter] da função [main]: 1 + 1 + 10 = 12. Em Java, uma lambda não podia modificar uma variável local, por isso era necessário usar um array de um único elemento;
- linhas 24–29: uma classe local
*[Accumulator]*, com uma propriedade*[total]e um método*[add]. [private set] torna a propriedade gravável apenas dentro da classe: ela pode ser lida a partir de [main] (linha 35), mas não modificada. As classes são abordadas no Capítulo 4; - linhas 32–34: um objeto do tipo [Accumulator] é criado chamando seu construtor — sem o operador [new] — e, em seguida, seu método é chamado;
- linhas 38–40: dois pares, criados com o construtor [Pair] e com a função [to]. O método [toString()] de um par o exibe entre parênteses;
- linhas 41–42: uma tripla de três tipos diferentes;
- linha 44: o par [pair2] é dividido em duas variáveis, [number] e [name];
- linha 46: apenas o segundo componente da tripla é mantido;
- linhas 49–50: desempacotamento de cada par de uma lista dentro do laço [for];
- linha 55: uma data class local;
- linha 57: o método [toString()] de uma data class exibe o nome da classe e seus componentes; as propriedades [number] e [name] retornam os componentes;
- linhas 59–62: após a verificação [obj is Couple], [obj] é tratado como um [Couple] (smart cast) e pode ser desestruturado. O Kotlin não tem um equivalente aos record patterns do Java 21 ([obj instanceof Couple(int number, String name)]), mas a verificação de tipo seguida de uma atribuição por desestruturação produz o mesmo resultado;
- linhas 66–71: as funções [divide] e [minMax] (linhas 85–95) retornam, cada uma, dois valores: a primeira em uma data class [IntegerDivision] (linha 83), e a segunda como um par. O chamador pode desestruturar o resultado (linhas 66 e 70) ou armazená-lo em uma variável e usar os nomes dos componentes (linhas 68–69);
- linhas 74–78: troca de duas variáveis com um par. O Kotlin não permite atribuir a variáveis existentes em uma única instrução por meio de desestruturação ([(a, b) = b to a] é rejeitado): desestruturamos em duas novas variáveis, que depois atribuímos. O idioma [a = b.also { b = a }] do programa [Basics29.kt] é mais curto;
- linhas 92–93: uma instrução [if] cuja única ação é escrita na mesma linha, sem chaves.
Em um programa maior, definimos classes, que agrupam dados e as funções que os manipulam: este é o assunto do próximo capítulo.