11. Hibernate
O capítulo anterior mostrou como uma aplicação Kotlin interage com um banco de dados por meio de um driver JDBC: uma conexão é aberta, comandos SQL são executados, as linhas do resultado são lidas coluna por coluna e copiadas para objetos. Esse processo de cópia — das linhas para os objetos e dos objetos para os comandos [INSERT], [UPDATE] e [DELETE] — é repetitivo. Ele pode ser automatizado por uma ferramenta: um “mapeador objeto-relacional” (ORM). Este capítulo apresenta o ORM mais utilizado no mundo Java, o Hibernate, e o padrão que ele implementa, o Jakarta Persistence. Kotlin não tem um ORM próprio de mesmo calibre: ele usa diretamente os da plataforma Java — o Hibernate em primeiro lugar — assim como usa os ORMs. Basta conhecer algumas regras para escrever entidades Kotlin que funcionem com o Hibernate: este capítulo as apresenta ao longo do caminho.
O capítulo retoma o código de exemplo dos artigos do Capítulo 10 e termina com a versão 7 da aplicação de cálculo do imposto, cuja camada [dao] usa o Hibernate.
11.1. O que é um ORM?
11.1.1. Objetos e tabelas
Uma aplicação Kotlin trabalha com objetos: um artigo tem um nome, um preço e um estoque; um pedido tem um cliente e uma lista de itens, cada um dos quais se refere a um artigo. Um banco de dados relacional armazena essas mesmas informações em tabelas: uma linha na tabela [articles] por artigo, uma linha na tabela [orders] por pedido, com os relacionamentos entre linhas expressos por chaves estrangeiras. Os dois mundos não se alinham perfeitamente:
- um objeto referencia diretamente outros objetos ([order.client]); uma linha contém o valor da chave primária de outra linha ([client_id]);
- um objeto pode conter uma coleção ([order.lines]); uma tabela contém apenas valores simples; a coleção é representada pelas linhas de outra tabela que apontam para o pedido;
- os tipos Kotlin ([String], [BigDecimal], [LocalDate], [Boolean]) e os tipos SQL ([varchar(30)], [decimal(10,2)], [date], [bit]) não são os mesmos;
- os objetos são consultados com Kotlin (as operações [filter], [map]... sobre coleções) e as tabelas são consultadas com SQL.
Um ORM faz a ponte entre os dois mundos. Definimos a correspondência entre classes e tabelas (o modelo, ou “mapeamento”) uma vez por todas; ele então se encarrega de:
- traduzir as consultas escritas em uma linguagem orientada a objetos (HQL) ou construídas por código (API Criteria) em comandos SQL e [SELECT] ;
- criar objetos a partir das linhas lidas (isso se chama materialização);
- armazenar os objetos lidos e detectar os que foram modificados, adicionados ou excluídos;
- gerar os comandos [INSERT], [UPDATE], e [DELETE] que refletem essas alterações no banco de dados;
- e, se necessário, criar e atualizar o esquema do banco de dados (tabelas, colunas, índices) com base nas classes.
A arquitetura de uma aplicação que usa o Hibernate com o MySQL é a seguinte:
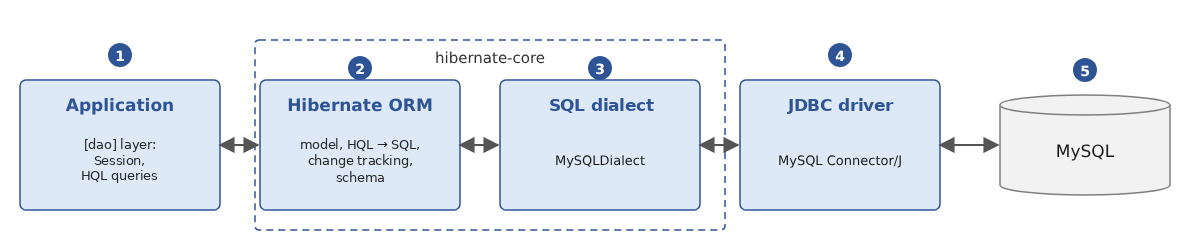
- [1]: a aplicação. Sua camada [dao] não se comunica mais diretamente com o driver JDBC, mas com o Hibernate, por meio de um objeto [Session] e de consultas HQL;
- [2]: o Hibernate, independente do SGBD: modelo, tradução de consultas, rastreamento de alterações, geração de esquema;
- [3]: o dialeto específico do SGBD (aqui, [MySQLDialect]): ele conhece a sintaxe SQL do SGBD, seus tipos de coluna e suas funções. Os dialetos dos principais SGBDs fazem parte do próprio Hibernate: nada precisa ser adicionado ao projeto;
- [4]: o driver JDBC do SGBD, o discutido no Capítulo 10 (MySQL Connector/J): o Hibernate não substitui o JDBC; ele o utiliza;
- [5]: o SGBD.
Que a aplicação seja escrita em Java ou em Kotlin não muda esse padrão: o Hibernate é uma biblioteca Java que o código Kotlin chama como qualquer outra biblioteca Java (Capítulo 5), e as classes Kotlin compiladas são, para o Hibernate, classes Java como quaisquer outras.
11.1.2. Jakarta Persistence e Hibernate
O Hibernate foi criado em 2001 por Gavin King em resposta à complexidade dos “entity beans” da plataforma Java EE da época. Seu sucesso foi tamanho que suas ideias foram incorporadas a um padrão, o JPA (Java Persistence API), lançado em 2006 com o Java EE 5. Quando o Java EE foi transferido para a Eclipse Foundation e renomeado Jakarta EE, o JPA tornou-se Jakarta Persistence, e seus pacotes passaram de [javax.persistence] para [jakarta.persistence] (versão 3.0, 2020). A versão atual é o Jakarta Persistence 3.2 (2024).
O Jakarta Persistence é uma especificação: um conjunto de interfaces ([EntityManagerFactory], [EntityManager]...), anotações ([@Entity], [@Id], [@Column]...) e uma linguagem de consulta, a JPQL. Ele é implementado por vários produtos: Hibernate ORM (o mais utilizado, presente no Spring Boot e no Quarkus), EclipseLink (a implementação de referência)... Este curso usa o Hibernate ORM 7.4.5, que implementa o Jakarta Persistence 3.2.
O Hibernate oferece duas maneiras de ser usado:
- exclusivamente por meio das interfaces padrão: nesse caso, o código depende apenas de [jakarta.persistence], e seria, em princípio, possível trocar de implementação;
- por meio de sua própria API (“nativa”), mais rica em recursos e cujas interfaces estendem as do padrão: um [SessionFactory] é um [EntityManagerFactory], e um [Session] é um [EntityManager].
Usamos a API própria do Hibernate, como recomendado em sua documentação: ela oferece todos os métodos padrão ([persist], [find], [merge], [remove]...) além das extensões do Hibernate. As anotações, porém, são sempre as definidas pelo padrão. A tabela a seguir mostra as correspondências:
Jakarta Persistence | Hibernate | Papel |
[EntityManagerFactory] | [SessionFactory] | Configuração do Hibernate para um banco de dados: um objeto pesado, criado uma só vez e compartilhado por toda a aplicação |
[EntityManager] | [Session] | Uma sessão de banco de dados: um objeto leve e de curta duração |
[EntityTransaction] | [Transaction] | uma transação |
JPQL | HQL | a linguagem de consulta; a HQL é um superconjunto da JPQL |
[CriteriaBuilder] | [HibernateCriteriaBuilder] | construção de consultas por código |
No ecossistema Kotlin, você também encontrará bibliotecas de acesso a dados de natureza diferente, como o Exposed (da JetBrains), que permite escrever consultas SQL usando uma linguagem Kotlin dedicada. Elas são mais leves que um ORM completo; o Hibernate continua sendo o padrão das aplicações Spring, tanto em Java quanto em Kotlin, e é ele que estudamos.
11.1.3. Bibliotecas
As bibliotecas usadas neste capítulo são as seguintes (elas estão resumidas no apêndice sobre dependências):
Dependência Gradle | Papel |
[org.hibernate.orm:hibernate-core] 7.4.5.Final | O próprio Hibernate; inclui a API do Jakarta Persistence 3.2 ([jakarta.persistence-api]) e suas próprias dependências (Byte Buddy para geração de classes, ANTLR para análise de consultas, JBoss Logging para logs etc.) |
[com.mysql:mysql-connector-j] 9.7.0 | o driver JDBC do MySQL, o do Capítulo 10 |
[ch.qos.logback:logback-classic] 1.5.38 | O Logback, que receberá o log do Hibernate |
O Hibernate escreve seu log (comandos SQL executados, avisos etc.) por meio do JBoss Logging, uma pequena biblioteca que simplesmente encaminha as mensagens ao sistema de log que encontra no classpath: Log4j 2, ou Logback (via SLF4J), ou, na falta deles, o do JDK ou [java.util.logging]. Sem configuração, este último exibe cada mensagem em duas linhas, em vermelho na maioria dos consoles, o que dificulta a leitura da saída do programa. Por isso adicionamos o Logback aos nossos projetos e o configuramos por meio de um arquivo [logback.xml].
Além dessas bibliotecas, há dois plugins do compilador Kotlin que adaptam as classes Kotlin às exigências do Hibernate: [kotlin("plugin.jpa")] e [kotlin("plugin.allopen")]. Veremos por que são necessários ao examinar a primeira entidade.
11.1.4. Code-first ou database-first
O modelo (o mapeamento entre classes e tabelas) pode ser construído de duas maneiras:
- code-first: você escreve as classes Kotlin e o Hibernate deduz delas o esquema do banco de dados, que ele mesmo pode criar. Esta é a abordagem adotada neste capítulo;
- database-first: o banco de dados já existe e as classes são geradas a partir do seu esquema com as ferramentas de engenharia reversa do Hibernate (Hibernate Tools) ou com as oferecidas pelos ambientes de desenvolvimento (o IntelliJ IDEA pode gerar entidades a partir de tabelas do banco de dados, tanto em Java quanto em Kotlin). Esta é a abordagem usada em aplicações que precisam trabalhar com um banco de dados existente. O código gerado é semelhante ao que escreveríamos à mão.
11.2. Um primeiro exemplo
11.2.1. O projeto
Os exemplos deste capítulo são subprojetos de um build Gradle multiprojeto (veja o Capítulo 6), localizados na pasta [11-hibernate]:
O arquivo [settings.gradle.kts] declara os subprojetos:
- linhas 3–6: o plugin que permite ao Gradle baixar o próprio JDK 25 caso não o encontre na máquina (Capítulo 2);
- linha 8: o nome do projeto raiz;
- linha 11: as duas bibliotecas comuns aos exemplos;
- linhas 13–14: um subprojeto, por exemplo. O Gradle não exige que eles sejam listados na ordem de suas dependências; ele a deduz sozinho a partir das dependências declaradas entre os subprojetos;
- Linha 16: os dois subprojetos da versão 7 da aplicação de cálculo de imposto. O nome [TaxV7:tax-dao-hibernate] refere-se à pasta [TaxV7/tax-dao-hibernate];
- Linha 19: a estrutura composta do Capítulo 6, cuja aplicação TaxV7 reutilizará as camadas [business] e [ui].
O projeto raiz declara, com suas versões, os plugins usados pelos subprojetos:
- linha 3: o plugin Kotlin para a JVM;
- linhas 4–5: os dois plugins do compilador Kotlin exigidos pelas entidades (descritos adiante);
- linha 6: o plugin “all-open” configurado para o Spring (Capítulo 6), usado pelo exemplo [injection];
- [apply false]: os plugins são apenas declarados aqui, com suas versões; cada subprojeto aplica os de que precisa, sem repetir a versão.
O primeiro exemplo é o subprojeto [first]. Ele é independente dos demais:
- linhas 3–8: os plugins aplicados: Kotlin, os dois plugins de entidade e [application] para executar o programa;
- linhas 17–20: o Hibernate, o driver JDBC do MySQL e o Logback. O driver e o Logback são usados apenas em tempo de execução ([runtimeOnly]): o código do programa não referencia nenhuma de suas classes;
- linhas 24–27: a configuração do plugin [allopen] (descrito adiante);
- linhas 31–34: as opções de compilação padrão do curso (JDK 25, avisos tratados como erros);
- linha 40: a classe principal do subprojeto. Um arquivo [Main.kt] do pacote [first] é compilado em uma classe [first.MainKt] (Capítulo 3);
- linhas 43–46: os programas iniciados pelo Gradle escrevem sua saída em UTF-8 para que os caracteres acentuados sejam exibidos corretamente no Windows (Capítulo 2).
Para executar um exemplo, vá até a pasta [11-hibernate] e indique a tarefa [run] do subprojeto pelo seu caminho ([:first:run]); o Gradle primeiro compila os subprojetos dos quais ele depende (no Linux e no macOS, digite [./gradlew]):
O programa é executado na pasta do subprojeto ([11-hibernate/first]). O banco de dados usado é o [hbfirst] do servidor MySQL local, que é o servidor do Laragon (veja os apêndices). Ele não precisa existir: o MySQL o criará.
11.2.2. A entidade [Article]
Uma classe cujos objetos são armazenados em uma tabela é chamada de entidade. Nossa primeira entidade é um item de loja, como na tabela [articles] do Capítulo 10:
- Linha 10: a anotação [@Entity] (pacote [jakarta.persistence]) transforma a classe em uma entidade. Trata-se de uma classe Kotlin comum, que não estende nenhuma classe do Hibernate; ela é chamada de POJO (“Plain Old Java Object”);
- linhas 13–16: as propriedades declaradas no construtor primário (Capítulo 4). Elas são [var]: o Hibernate precisa poder modificar seus valores, e a aplicação também (para alterar um preço ou um nível de estoque). Cada propriedade se torna uma coluna com o mesmo nome;
- linhas 19–21: a chave primária é designada pela anotação [@Id]. Não há convenção de nomenclatura: a anotação é obrigatória. [@GeneratedValue(strategy = GenerationType.IDENTITY)] indica que seus valores serão gerados pelo SGBD (a coluna [AUTO_INCREMENT] do MySQL). O identificador não é um parâmetro do construtor: ele será fornecido pelo SGBD. Seu tipo é [Int?] e seu valor inicial é [null], o que significa “ainda não registrado no banco de dados”. O tipo [Int?] é compilado em [java.lang.Integer], e o tipo [Int] em [int] (Capítulo 3);
- linha 24: uma exibição conveniente do item. O formato [%.2f] exibe o preço com duas casas decimais, de acordo com as convenções culturais usuais (uma vírgula na França, um ponto no locale inglês usado nos resultados).
Onde vão as anotações? No bytecode, uma propriedade Kotlin corresponde a vários elementos Java: um campo privado, um acessor ([getX]), um modificador ([setX]) e, neste caso, um parâmetro de construtor. Uma anotação colocada antes de uma propriedade, sem outra especificação, é posicionada pelo Kotlin 2.4 conforme os alvos que ela aceita: no parâmetro do construtor, se for uma propriedade de construtor e a anotação permitir; adicionalmente na própria propriedade Kotlin, se a anotação permitir; caso contrário, no campo. As anotações do Jakarta Persistence ([@Id], [@Column]...) não se aplicam a parâmetros ou propriedades Kotlin, mas apenas a campos e métodos Java: por isso são colocadas no campo. É exatamente o que queremos: como a anotação [@Id] está em um campo, o Hibernate acessa os campos diretamente (ele os lê e escreve por reflexão, mesmo que sejam privados). Você pode verificar isso com a ferramenta [javap] do JDK, que exibe o conteúdo de um arquivo [.class]. Também é possível especificar o alvo de uma anotação com um prefixo: [@field:Column(length = 30)] a coloca no campo, [@get:Transient] no acessor.
O Jakarta Persistence exige duas coisas que as classes Kotlin não oferecem de saída:
- um construtor sem parâmetros, que o Hibernate usa para criar os objetos lidos do banco de dados (em seguida ele preenche seus campos). Nossa classe tem apenas um construtor, com quatro parâmetros. Em Java, adiciona-se manualmente um construtor protegido sem parâmetros. Em Kotlin, é o plugin [no-arg] do compilador, configurado para JPA ([kotlin("plugin.jpa")]), que o adiciona a toda classe anotada com [@Entity], [@Embeddable], ou [@MappedSuperclass]. Esse construtor existe no bytecode, onde o Hibernate o encontra por reflexão, mas não é visível a partir do código Kotlin: [Article()] continua sendo um erro de compilação (“[no value passed for parameter 'name'.]”). Observe que ele não executa os inicializadores de propriedades: uma propriedade declarada como [var x = "a"] vale [null] em um objeto criado pelo Hibernate, enquanto o Hibernate não lhe atribuir um valor (a opção [noArg { invokeInitializers = true }] no arquivo de build altera esse comportamento). Isso não é um problema para as propriedades armazenadas no banco de dados, já que o Hibernate lhes atribui o valor lido;
- não finais classes e métodos. Para implementar o carregamento tardio (que veremos ao tratar dos relacionamentos), o Hibernate cria proxies em tempo de execução: classes derivadas das entidades, cujos métodos carregam o objeto do banco de dados na primeira chamada. Para que isso funcione, a classe e seus métodos precisam poder ser sobrescritos. Em Java, esse é o comportamento padrão; em Kotlin, as classes e seus membros são final por padrão (Capítulo 4). O [all-open] ([kotlin("plugin.allopen")]) plugin, configurado pelo bloco [allOpen] do arquivo de build, torna não finais ([open]) as classes que trazem uma das anotações listadas, bem como suas propriedades e métodos. O plugin [plugin.spring] do Capítulo 6 é o mesmo plugin, configurado para as anotações do Spring.
Com esses dois plugins, a entidade é escrita como uma classe Kotlin comum. Sem eles, seria preciso escrever [open class Article(...)], declarar [open] em cada propriedade e adicionar um construtor secundário sem parâmetros: faremos isso com uma classe sem anotações no exemplo seguinte.
Por que não usar uma data class ([data class], Capítulo 4)? Ela pareceria ideal para representar uma linha de tabela. No entanto, é uma má ideia para uma entidade, por várias razões:
- Os métodos gerados [equals] e [hashCode] comparam todas as propriedades do construtor primário, que são modificáveis. O hash code de uma entidade muda, portanto, assim que seu preço é modificado: um item armazenado em um [HashSet] ou usado como chave de um [HashMap] torna-se impossível de encontrar. O próprio Hibernate armazena os elementos das coleções de relacionamentos ([Set]) usando esses métodos;
- dois objetos que representam duas linhas diferentes (com dois identificadores diferentes), mas com os mesmos valores, seriam considerados iguais, ao passo que um item lido do banco de dados e depois modificado deixaria de ser igual a si mesmo quando lido novamente;
- o método [toString] gerado exibe todas as propriedades: com relacionamentos, ele percorre os objetos associados, o que pode causar o carregamento deles a partir do banco de dados (consultas SQL inesperadas), uma exceção se a sessão estiver fechada ou até uma recursão infinita entre duas entidades que se referenciam mutuamente;
- o método [copy] cria um novo objeto com o mesmo identificador, desconhecido da sessão: isso resulta em dois objetos para a mesma linha, o que pode gerar confusão;
- Uma data class não pode ser declarada como aberta ([open]) pelo programador. O plugin [all-open] a abre mesmo assim, o que permite criar proxies (verificamos isso com a ferramenta [javap]), mas não corrige nenhum dos problemas anteriores.
Uma entidade é, portanto, uma classe comum: sua identidade é a da linha da tabela, não o valor de suas propriedades. Como em Java, ela mantém o [equals]/[hashCode] herdado de [Any] (identidade do objeto), o que é adequado desde que você não misture objetos de sessões diferentes. As data classes continuam muito úteis com o Hibernate para resultados de consultas que não são entidades (projeções), como veremos. Essa é a mesma regra de Java, onde uma entidade não pode ser um record.
Uma última observação: o Hibernate não reconhece os tipos anuláveis do Kotlin. O fato de a propriedade [name] ser do tipo [String] (não anulável) não informa ao Hibernate que a coluna é obrigatória; somente a anotação [@Column(nullable = false)] informa isso, como veremos nos resultados.
11.2.3. [SessionFactory] e [Session]
O programa usa três objetos do Hibernate:
- a [SessionFactory] representa o Hibernate configurado para um banco de dados: a lista de entidades, o banco de dados e as opções. Sua criação é custosa (o Hibernate analisa as entidades, conecta-se ao servidor para determinar sua versão e prepara o SQL das operações comuns): cria-se apenas uma por banco de dados e por aplicação, na inicialização. Ela é thread-safe: todas as threads da aplicação podem usá-la;
- a [Session] representa uma sessão de trabalho com o banco de dados. Ela obtém uma conexão quando necessário, armazena as entidades que leu ou salvou e sabe como confirmar suas alterações no banco de dados. É um objeto leve, de vida curta e que não é thread-safe: abre-se uma para cada unidade de trabalho e depois a fecha;
- [Transaction]: com o Hibernate, todas as escritas no banco de dados ocorrem dentro de uma transação explícita, aberta por [session.beginTransaction()] e encerrada por [commit] (confirmação) ou [rollback] (reversão).
[SessionFactory] e [Session] implementam a interface [AutoCloseable]: são usadas com a função Kotlin [use] (Capítulo 3), que as fecha ao final do bloco, quer ele termine normalmente ou com uma exceção (o equivalente da instrução [try] com recursos em Java).
11.2.4. O programa
- linhas 8–16: criação da [SessionFactory]. Há várias maneiras de configurar o Hibernate (falaremos delas adiante); usamos a classe [HibernatePersistenceConfiguration] do Hibernate 7, uma versão aprimorada da classe [PersistenceConfiguration] introduzida com o Jakarta Persistence 3.2, que permite configurar tudo por código. Seu parâmetro é o nome da unidade de persistência, um nome livremente escolhido que aparece nas mensagens do Hibernate. Cada método retorna a própria configuração, o que permite encadear as chamadas;
- linha 10: a lista de entidades. [Article::class.java] é o objeto Java [Class] (a classe Kotlin [KClass] não serve: o Hibernate é uma biblioteca Java);
- linhas 12–13: a URL JDBC do banco de dados [hbfirst], no mesmo formato do Capítulo 10, e o usuário ([root], sem senha no Laragon). O parâmetro [createDatabaseIfNotExist=true] da URL é uma opção do driver MySQL: ele cria o banco de dados se este não existir;
- linha 15: [showSql(true, true, false)] instrui o Hibernate a imprimir no console cada comando SQL que executa, formatado em várias linhas (segundo parâmetro), sem cores (terceiro parâmetro). Examinar o SQL enviado ao servidor é a melhor maneira de entender o que o Hibernate faz: faremos isso em todos os exemplos;
- linha 16: [createEntityManagerFactory] constrói a [SessionFactory] (o nome do método segue o padrão; o tipo retornado é o do Hibernate). A função [use] a fechará ao final do programa; dentro do bloco, ela é chamada de [sessionFactory];
- linhas 19–20: o objeto [SchemaManager] da [SessionFactory] (Jakarta Persistence 3.2) gerencia as tabelas das entidades: [drop(false)] as exclui se existirem, enquanto [create(false)] as cria (o parâmetro [false] especifica que o próprio banco de dados não deve ser excluído nem criado). Isso é conveniente para exemplos e testes; uma aplicação real gerencia seu banco de dados de outra forma, como veremos. O Kotlin apresenta o método Java [getSchemaManager()] como uma propriedade, [schemaManager] (Capítulo 4);
- linha 23: [openSession()] abre uma sessão, que é fechada ao final do bloco [use];
- linha 24: o início de uma transação;
- linhas 26–28: [persist] adiciona três novos itens à sessão: eles serão armazenados no banco de dados. Nenhum valor é especificado para o identificador; ele será gerado pelo SGBD;
- linha 30: [commit] confirma a transação. Antes disso, a sessão envia ao servidor os comandos SQL ainda necessários para salvar as alterações que armazenou: isso é chamado de “flush” da sessão para o banco de dados;
- linhas 36–38: uma consulta escrita em HQL, a linguagem de consulta do Hibernate: os artigos em ordem alfabética de nome. Ela se refere à entidade [Article] e à sua propriedade [name], não à tabela. O segundo parâmetro de [createSelectionQuery] é o tipo do resultado: a propriedade [resultList] (o método Java [getResultList]) retorna uma [List<Article>];
- Linha 39: exibição dos itens.
Se ocorresse uma exceção entre [beginTransaction] e [commit], a transação não seria confirmada nem revertida explicitamente pelo nosso código: veremos adiante uma forma mais segura de escrever uma transação usando uma função de ordem superior.
O arquivo [src/main/resources/logback.xml] do subprojeto configura o Logback. Ele exibe as mensagens do Hibernate de nível [INFO] ou superior, uma por linha (nível, nome do log, mensagem):
Resultados:
Comentários:
- linhas 2–17: mensagens informativas do Hibernate: o nome da unidade de persistência, a versão do Hibernate e as características do banco de dados (URL, driver, dialeto selecionado, versão do servidor, nível de isolamento das transações, tamanho do pool de conexões). O Hibernate consultou o servidor para selecionar o dialeto [MySQLDialect] adequado à sua versão;
- linha 4: um aviso. O Hibernate gerencia seu próprio pequeno pool de conexões, que não se destina a uma aplicação de produção. Veremos, com o Spring, como fornecer a ele o pool HikariCP do Capítulo 10; para nossos exemplos, o pool embutido é suficiente;
- linhas 18–28: exclusão e depois criação da tabela [Article] com base na entidade: o nome da tabela é o mesmo da entidade, as colunas têm o nome das propriedades e a coluna [id] é a chave primária, com valor gerado ([auto_increment]). As colunas das propriedades do tipo [Int] são [not null]: compilado em [int], um [Int] não pode ser igual a [null]. As propriedades dos tipos [String] e [BigDecimal] aceitam o valor [NULL], embora esses tipos não sejam anuláveis em Kotlin: para o Hibernate, são referências Java ([java.lang.String], [java.math.BigDecimal]), que podem receber [null];
- observe os tipos padrão: [varchar(255)] para uma string e [decimal(38,2)] para um [BigDecimal] (38 dígitos, incluindo 2 casas decimais). Raramente são os que você deseja: o parágrafo seguinte mostra como especificá-los;
- linhas 29–51: os três comandos [INSERT] configurados foram executados assim que [persist] foi chamado, antes de [commit]. Isso é consequência de a chave ser gerada pelo SGBD ([IDENTITY]): a sessão precisa conhecer o identificador de uma entidade assim que passa a gerenciá-la e, para obtê-lo, precisa executar a inserção (o driver JDBC retorna a chave gerada; veja o Capítulo 10). Com outros métodos de geração, as inserções são adiadas até a sincronização da sessão. Os valores dos parâmetros ([?]) não são exibidos: veremos como fazê-los aparecer;
- linhas 53–63: a consulta HQL [from Article order by name] foi traduzida em uma instrução [SELECT ... ORDER BY]. O Hibernate atribuiu o alias [a1_0] à tabela e criou um objeto [Article] para cada linha lida (linhas 64–66), usando o construtor sem parâmetros adicionado pelo plugin [no-arg].
Não escrevemos nenhuma instrução SQL nem nenhum código de leitura de colunas: esse é todo o objetivo de um ORM. Vemos também que isso não elimina a necessidade de entender SQL: para determinar se o SQL gerado é correto e eficiente, é preciso saber lê-lo.
11.3. O modelo
O Hibernate constrói seu modelo a partir das entidades em três etapas:
- primeiro, aplica suas regras padrão: tudo o que não é especificado recebe um valor razoável (isso é conhecido como “configuração por exceção”);
- em seguida, complementa ou corrige esses valores com as anotações colocadas nas entidades;
- por fim, aplica os arquivos de mapeamento XML ([orm.xml]), que podem descrever completamente uma classe sem anotações ou modificar o que suas anotações especificam.
11.3.1. Regras padrão
Vimos o essencial disso no primeiro exemplo:
- uma entidade traz a anotação [@Entity] e tem um identificador designado por [@Id]; ambas as anotações são obrigatórias;
- a posição da anotação [@Id] determina o modo de acesso: quando colocada em um campo, o Hibernate lê e escreve os campos diretamente; quando colocada em um getter ou setter ([getId]), o acesso passa pelos getters e setters ([getX]/[setX]). O acesso por campos é o mais comum: ele permite que a classe tenha os métodos que quiser. Em Kotlin, uma anotação colocada antes de uma propriedade é aplicada ao campo (como vimos): isso fornece acesso por campos sem nenhuma especificação explícita. Para o acesso por getters e setters, seria preciso escrever [@get:Id];
- toda propriedade que tem um campo de apoio é armazenada em uma coluna, a menos que traga a anotação [@Transient] do Jakarta Persistence ou a anotação [@kotlin.jvm.Transient] (que adiciona o modificador Java [transient] ao campo); uma propriedade calculada, cujo acessor personalizado não usa [field] (Capítulo 4), não tem campo: ela nunca é armazenada;
- o nome da tabela é o nome da entidade (o nome simples da classe) e o nome da coluna é o nome da propriedade. Esses nomes passam então por uma estratégia de nomenclatura: a estratégia do Hibernate mantém os nomes como estão, enquanto outra estratégia, que experimentaremos adiante, os converte para “snake case” ([currentStock] torna-se [current_stock]). O Spring Boot usa esta última por padrão;
- uma coluna de um tipo compilado para um tipo primitivo ([Int], [Double], [Boolean] não anuláveis) torna-se [NOT NULL]; uma coluna de um tipo compilado para uma referência ([Int?], [String], [BigDecimal], [LocalDate], anuláveis ou não para o Kotlin) aceita o valor [NULL]. Para tornar obrigatória a coluna de uma propriedade do tipo [String], é preciso, portanto, usar a anotação [@Column(nullable = false)], mesmo que o tipo Kotlin já proíba o valor [null];
- Os tipos SQL são selecionados de acordo com o dialeto. Com o MySQL: [integer] para [Int], [bigint] para [Long], [bit] para [Boolean], [varchar(255)] para [String], [decimal(38,2)] para [BigDecimal], [date] para [LocalDate], [datetime(6)] (até o microssegundo) para [LocalDateTime]. Uma enumeração ([enum class]) é registrada por padrão pelo seu número de ordem (veja o Capítulo 3); a anotação [@Enumerated(EnumType.STRING)] a registra pelo nome, o que é mais confiável;
- uma propriedade que se refere a outra entidade, ou a uma coleção de entidades, define um relacionamento (falaremos dele adiante).
11.3.2. As anotações e o arquivo de mapeamento XML
O subprojeto [model] define duas entidades configuradas de duas maneiras diferentes. Seu arquivo de build é o de [first], com a dependência do Logback substituída por uma dependência da biblioteca [tools] descrita adiante (que fornece o Logback e sua configuração). A primeira entidade é configurada por anotações:
- linhas 3–9: as anotações do Jakarta Persistence. A importação explícita de [jakarta.persistence.Transient] tem precedência sobre a anotação [kotlin.jvm.Transient], que tem o mesmo nome e é importada por padrão pelo Kotlin;
- linha 15: [@Table] especifica o nome da tabela;
- linhas 18–19: [@Column] especifica a coluna; [nullable = false] a torna obrigatória ([NOT NULL]); [length = 50] define seu comprimento ([varchar(50)]);
- linhas 22–23: [@Column] também especifica o nome da coluna ([price_excl_tax]) e, para um número decimal, sua precisão (o número total de dígitos) e sua escala (o número de dígitos após a vírgula decimal): [decimal(10,2)];
- linhas 26–27: uma descrição opcional de até 200 caracteres: a coluna aceitará o valor [NULL]. A propriedade é do tipo [String?], com o valor padrão [null]: o tipo Kotlin corresponde à coluna. É uma boa prática fazer o tipo anulável ou não anulável da propriedade corresponder ao caráter opcional ou obrigatório da coluna, mesmo que o Hibernate leia apenas a anotação;
- linha 30: uma data opcional. O tipo [LocalDate] (Capítulo 5) representa uma data sem hora: ele é associado aos tipos SQL e [date];
- linhas 32–35: a chave primária, designada por [@Id] independentemente de seu nome;
- linhas 38–39: [@Transient] exclui uma propriedade do modelo: neste caso, uma informação útil à interface do usuário que não pertence ao banco de dados;
- linhas 42–43: uma propriedade calculada. Seu acessor não usa um campo: não há nada a salvar, e o Hibernate, que acessa os campos, a ignora. O operador [*] entre dois [BigDecimal] é a função [times] que a biblioteca padrão do Kotlin adiciona a [BigDecimal] (Capítulo 4, Sobrecarga de operadores): escrevemos [priceExclTax * BigDecimal("1.2")] em vez do [priceExclTax.multiply(new BigDecimal("1.2"))] do Java.
A segunda entidade não tem anotações:
- Linha 8: como a classe não é anotada com [@Entity], os plugins [no-arg] e [all-open] não a reconhecem. Por isso nós mesmos a declaramos como [open], para que o Hibernate possa derivar proxies dela;
- linhas 9–13: propriedades privadas: o Kotlin não gera acessores nem modificadores para elas, apenas um campo privado, que o Hibernate lerá e escreverá. É o equivalente exato de campos privados em uma classe Java;
- Linha 16: o construtor sem parâmetros exigido pelo Hibernate, escrito à mão: um construtor secundário que chama o construtor primário (Capítulo 4) com valores arbitrários, que o Hibernate substituirá pelos lidos do banco de dados. Ele é protegido: o código da aplicação não o usará.
Seu mapeamento para a tabela é descrito por um arquivo chamado XML, localizado na pasta [src/main/resources/META-INF] do subprojeto (é o mesmo arquivo que em Java):
- linhas 3–7: o esquema XML dos arquivos de mapeamento do Jakarta Persistence 3.2;
- linha 8: a classe descrita, com acesso por campos;
- linhas 9–12: a tabela e um índice único sobre o nome da empresa: dois fornecedores não podem ter o mesmo. A anotação equivalente é [@Table(name = "suppliers", indexes = [Index(...)])] (em Kotlin, um array passado como argumento de anotação é escrito entre colchetes);
- linhas 14–16: o identificador, gerado pelo SGBD;
- linhas 17–18: uma coluna obrigatória com no máximo 60 caracteres;
- linhas 20–21: a propriedade [phone] é armazenada na coluna [tel];
- linhas 24–26: a data de criação tem um valor padrão, calculado pelo SGBD. O atributo [column-definition] fornece o texto SQL da definição da coluna, copiado literalmente no comando [CREATE TABLE]; [insertable="false"] e [updatable="false"] indicam que o Hibernate nunca deve escrever nessa coluna, o que permite ao SGBD usar [current_timestamp(6)].
Tudo o que as anotações fazem pode ser feito em XML. As anotações têm a vantagem de colocar a configuração ao lado da propriedade, e essa é a abordagem mais comum; o arquivo XML, por sua vez, mantém as classes independentes do Jakarta Persistence e centraliza a configuração em um único local. As duas abordagens podem ser combinadas: o arquivo XML prevalece em caso de conflito. O Jakarta Persistence não permite configurar o modelo por código, como fazem outros frameworks de ORM (por exemplo, o Entity Framework em C# ou o Exposed em Kotlin).
O programa exibe o modelo construído pelo Hibernate, seguido do script SQL que criaria as tabelas:
- linha 11: um [StringWriter] (pacote [java.io]), um fluxo de escrita em uma string na memória, receberá o script SQL;
- linhas 15–16: a entidade anotada é declarada por [managedClass] e o arquivo XML por [mappingFile];
- linhas 18–20: o banco de dados nunca existirá: esta [SessionFactory] serve unicamente para examinar o modelo. Portanto, não há URL nem JDBC. Para selecionar o dialeto SQL sem consultar o servidor, o Hibernate precisa do nome do SGBD e de sua versão; a propriedade [ALLOW_METADATA_ON_BOOT] ([hibernate.boot.allow_jdbc_metadata_access]) impede que ele se conecte na inicialização. Os nomes das propriedades de configuração são constantes da interface [AvailableSettings];
- linha 22: a convenção de nomenclatura “snake case”, designada pelo nome de sua classe ([::class.java.name]);
- linhas 25–28: o Hibernate escreverá o script de criação das tabelas (["create"]) no objeto [script] sem executá-lo; os comandos terminam com ponto e vírgula e são formatados em várias linhas;
- linha 32: a propriedade [metamodel] (o método [getMetamodel] do Jakarta Persistence) dá acesso ao modelo: suas entidades ([EntityType]) e, para cada uma, seus atributos ([Attribute]);
- linhas 33–37: para cada entidade, seu nome e sua classe; para cada atributo, seu nome, seu tipo Java e se ele é o identificador. Na linha 35, o teste [attribute is SingularAttribute<*, *>] é seguido de uma conversão inteligente de tipo (Capítulo 4): na continuação da expressão [&&], [attribute] é um [SingularAttribute], do qual se pode ler a propriedade [isId]. A projeção [<*, *>] substitui o [<?, ?>] do Java;
- linhas 42–45: o script como exibido, sem os quatro espaços que o Hibernate adiciona às suas linhas ([removePrefix] remove o prefixo somente se ele estiver presente).
Resultados:
- Linha 2: o aviso do Hibernate confirma que ele não tem como estabelecer uma conexão;
- linhas 3–13: as duas entidades e seus atributos (o identificador primeiro, depois os demais em ordem alfabética; a ordem das entidades não é significativa). A propriedade [selected] e a propriedade calculada [priceInclTax] não aparecem no modelo. Os tipos são os tipos Java: [Integer] para [Int?];
- linhas 15–21: a tabela [suppliers], descrita pelo arquivo XML. A estratégia de nomenclatura mudou [companyName] e [creationDate] para [company_name] e [creation_date]; a coluna [tel], cujo nome é fixo, permanece inalterada. A definição da coluna [creation_date] é a do arquivo XML, complementada por [not null];
- linhas 23–30: a tabela [products]. Os tipos SQL vêm das anotações ([varchar(50)], [decimal(10,2)]) ou de escolhas do dialeto para um tipo ([integer], [date]);
- linhas 32–33: o índice único, criado no MySQL por uma restrição de unicidade ([unique]).
11.3.3. Identificadores gerados
A anotação [@GeneratedValue] indica que o valor do identificador é gerado. Seu parâmetro [strategy] especifica como:
Estratégia | Geração do identificador |
[IDENTITY] | pelo SGBD, na inserção da linha (coluna [AUTO_INCREMENT] do MySQL, [IDENTITY] do SQL Server e do PostgreSQL) |
[SEQUENCE] | por uma sequência do SGBD (PostgreSQL, Oracle), que o Hibernate consulta antes da inserção |
[TABLE] | por uma tabela de contadores gerenciada pelo Hibernate |
[UUID] | pelo Hibernate: um identificador universal aleatório, como [java.util.UUID] |
[AUTO] (por padrão) | o Hibernate escolhe; com o MySQL, que não tem sequências, ele as simula por meio de uma tabela chamada [<table>_SEQ] |
Com o MySQL, usamos sempre [IDENTITY], que corresponde ao comportamento natural da coluna [AUTO_INCREMENT]. Vimos o resultado disso: o comando [INSERT] é executado assim que [persist] é chamado, e o Hibernate não consegue agrupar várias inserções em um lote (falaremos de lotes adiante). A estratégia [SEQUENCE], que permite conhecer o ID antes da inserção, é a preferida para os SGBDs que usam sequências.
Em Kotlin, o identificador gerado deve preferencialmente ser declarado como [var id: Int? = null]: o valor [null] indica claramente “ainda não registrado”. Também encontramos [var id: Int = 0], em que o valor 0 cumpre esse papel; o Hibernate o aceita (para um identificador de tipo primitivo, ele trata 0 como o valor “ainda não registrado”), mas essa convenção é menos legível.
11.3.4. Valores opcionais e colunas [NULL]
Se uma coluna é opcional, portanto, é determinado pelo tipo da propriedade (compilado como tipo primitivo ou referência) e pelo atributo [nullable] de [@Column]; em Kotlin, o tipo da propriedade também especifica se o valor pode estar ausente ([String?]) ou não ([String]). É preciso escolher com cuidado e garantir que os dois correspondam: a regra expressa tanto uma restrição de código (“este valor pode estar ausente”) quanto uma restrição de banco de dados. Algumas observações:
- [@Column(nullable = false)] representa a restrição [NOT NULL] do esquema criado pelo Hibernate, e o Hibernate também a usa antes de enviar um comando [INSERT] ou [UPDATE]: se o campo for [null], ele não envia o comando e lança um erro [PropertyValueException] (“not-null property references a null or transient value”). Essa verificação do Hibernate é desativada por padrão quando o Jakarta Validation (abaixo) está presente: a validação passa então a depender de suas anotações ou, na falta delas, do SGBD, que rejeita o comando. Em Kotlin, esse cenário é menos comum que em Java: o compilador proíbe atribuir [null] a uma propriedade do tipo [String];
- para uma validação mais completa, realizada antes de qualquer acesso ao banco de dados, usamos o Jakarta Validation (biblioteca [hibernate-validator]) e suas anotações [@NotNull], [@Size(max = 30)], [@Positive]... Quando presentes no classpath, o Hibernate valida as entidades antes de salvá-las e usa essas anotações para criar as colunas. Em Kotlin, essas anotações também aceitam parâmetros como alvos: ao serem aplicadas a uma propriedade de construtor, o Kotlin 2.4 as aplica tanto ao parâmetro quanto ao campo, que o validador lê. As versões anteriores as colocavam apenas no parâmetro: era preciso especificar o alvo field, [@field:Size(max = 30)], uma forma que ainda é encontrada em muitos exemplos;
- não há necessidade de usar [Optional] (Capítulo 4): o tipo anulável do Kotlin ([var description: String? = null]) indica diretamente que um valor é opcional, e ele é lido com os operadores [?.] e [?:] (Capítulo 3): [product.description ?: "(no description)"].
11.4. Os exemplos seguintes: duas bibliotecas comuns
Os exemplos dos parágrafos seguintes usam quase todos o banco de dados [hbarticles] e sua tabela [articles], preenchida com as seis entradas do Capítulo 10. Em vez de repetir a entidade e a configuração do Hibernate em cada subprojeto, nós as colocamos em uma biblioteca, o subprojeto [articles], da qual os demais subprojetos dependem. Também substituímos o log SQL de [showSql], que é detalhado demais para nossos exemplos, por um log mais compacto, colocado em uma segunda biblioteca, o subprojeto [tools].
11.4.1. O log SQL compacto
Em vez de escrever diretamente no console ([showSql]), o Hibernate pode encaminhar sua atividade ao sistema de logging (neste caso, o Logback), com cada categoria de mensagem escrita em um log diferente:
Log | Nível | Mensagens |
[org.hibernate.SQL] | [DEBUG] | comandos SQL executados |
[org.hibernate.orm.jdbc.bind] | [TRACE] | o valor de cada parâmetro de um comando SQL |
[org.hibernate.orm.resource.jdbc] | [TRACE] | incluindo, entre outras coisas, o início, a confirmação e o cancelamento de transações |
[org.hibernate.orm.jdbc.batch] | [TRACE] | execução de lotes de comandos SQL |
[org.hibernate.orm.jdbc.error] | [WARN] | erros informados pelo SGBD |
Um log só registra mensagens de nível igual ou superior ao seu. Portanto, basta definir o nível desejado para esses logs no arquivo [logback.xml] para capturar essas mensagens. Nós as processamos por meio de uma classe de layout que as torna mais compactas:
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 33 34 35 36 37 38 39 40 41 42 43 44 45 46 47 48 49 50 51 52 53 54 55 56 57 58 59 60 61 62 63 64 65 66 67 68 69 70 71 72 73 74 75 76 77 78 79 80 81 82 83 84 85 86 87 88 89 90 91 92 93 94 95 96 97 98 99 100 101 102 103 104 105 106 107 108 109 110 111 112 113 114 115 | |
- linha 10: um layout do Logback deriva da classe Java [LayoutBase<ILoggingEvent>] (observe os parênteses: a chamada ao construtor da classe pai, Capítulo 4); seu método [doLayout] (linhas 13–21) recebe cada mensagem (um [ILoggingEvent]) e retorna o texto a ser escrito. O Logback cria o objeto por conta própria, por reflexão, a partir do nome da classe: ele exige um construtor sem parâmetros, que é o construtor primário implícito da classe;
- linhas 15–21: o processamento depende do log que enviou a mensagem (um
***[when]sobre um canal, Capítulo 3). Os ramos usam as constantes do***[companion object]; - linha 25: os membros “estáticos” da classe são armazenados em seu companion object (Capítulo 4);
- linhas 27–31: os nomes dos logs do Hibernate usados e as constantes de compilação públicas ([const val]); os outros subprojetos se referem a elas como [SqlLog.SQL]...;
- linhas 37–40: duas expressões regulares (Capítulo 5), escritas como raw strings (["""..."""]), o que evita ter de duplicar as barras invertidas, como o Java exige (["\\((\\d+)..."]);
- linhas 43–71: o comando SQL, como formatado pelo Hibernate ([format_sql]), distribuído em muitas linhas, com uma coluna por linha. Nós o tornamos mais compacto. As linhas não vazias são agrupadas em cláusulas (linhas 47–51): uma cláusula começa com uma linha de nível superior ([select], [from], [where]...) e inclui as linhas indentadas que a seguem. [minOfOrNull] fornece a menor indentação, ou [null] se não houver nenhuma linha, caso em que ela é substituída por 0 por meio do operador [?:]. Cada cláusula é então escrita em uma única linha, precedida de [SQL>], se não ultrapassar 100 caracteres (linhas 63–64); caso contrário, suas linhas são mantidas (linhas 67–68). As cláusulas [insert] e [delete] são combinadas com a seguinte (linhas 58–61). O texto é construído por [buildString] (Capítulo 5), cujo bloco tem um [StringBuilder] como receptor: [append] é chamado nele sem prefixo;
- linhas 80–82: a mensagem do Hibernate que informa o valor de um parâmetro se parece com [binding parameter (1:VARCHAR) <- [bike]]. [matchEntire] retorna um [MatchResult] se a mensagem inteira corresponder à expressão regular e [null] caso contrário; [?.let] constrói o texto a partir dos grupos capturados (o número do parâmetro e seu valor) e [?: ""] retorna uma string vazia quando não há correspondência;
- linhas 85–89: entre as muitas mensagens do log [org.hibernate.orm.resource.jdbc], apenas as que indicam o início, a confirmação e a reversão de uma transação são mantidas. Cada mensagem do Hibernate começa com um código ([HHH10003002]...) que a identifica de forma única. Um [when] sem argumentos (Capítulo 3) substitui a sequência de [if] do Java;
- linhas 93–94: um erro do SGBD. O Hibernate o escreve como duas mensagens: uma com os códigos de erro (que ignoramos) e a outra com o texto do erro;
- linhas 97–99: execução de um lote de comandos SQL, que encontraremos no final do capítulo;
- linhas 102–111: a função [withoutLog] executa uma ação SQL sem log. É uma função de ordem superior (Capítulo 7): seu parâmetro é uma função [() -> T], e ela retorna o resultado da ação (o Java, que usa um [Runnable], não permite isso com tanta facilidade). Ela usa a API do Logback: cada log ([Logger]) tem um nível, que pode ser modificado em tempo de execução (a propriedade [level], que corresponde aos métodos Java [getLevel]/[setLevel]). Definimos os cinco logs com o nível [OFF], executamos a ação e depois restauramos os níveis originais em uma cláusula [finally], para que voltem a esses níveis mesmo que a ação lance uma exceção. O nível original pode ser [null] (um log que herda o nível de seu pai), daí o tipo [List<Level?>]; [zip] associa cada log ao seu nível original, e a decomposição [(logger, level)] (Capítulo 3) dá nome aos dois elementos de cada par;
- linha 104: [LoggerFactory] é a classe do SLF4J que retorna um log; como o Logback é a implementação atual do SLF4J, o objeto retornado é um [ch.qos.logback.classic.Logger], como indica a conversão de tipo [as Logger].
O subprojeto [tools] também contém o arquivo [logback.xml] usado pelos exemplos (é o mesmo arquivo que em Java). Colocado na raiz do classpath ([src/main/resources]), ele é encontrado pelo Logback quando o programa inicia:
- linhas 6–10: um “appender” escreve as mensagens, neste caso no console. Ele usa nosso layout, identificado pelo nome de sua classe ([tools.SqlLog]);
- linhas 13–17: um segundo “appender” para as demais mensagens: nível, nome curto do log, texto;
- linhas 20–34: os logs do Hibernate da tabela anterior, com seus níveis. Suas mensagens são enviadas ao “appender” [SQL] e somente a ele ([additivity="false"]: elas não são encaminhadas adicionalmente ao log raiz);
- linha 37: o aviso sobre o pool de conexões embutido do Hibernate é suprimido;
- linha 40: o Hibernate exclui as tabelas começando por suas chaves estrangeiras; em um banco de dados vazio, essas exclusões falham sem consequências, mas o Hibernate as registra de forma extensa. Essas mensagens são suprimidas;
- linhas 43–45: os demais logs registram apenas avisos e erros.
O arquivo de build do subprojeto [tools] é o de uma biblioteca (Capítulo 6):
- linha 5: o plugin de biblioteca, que adiciona a configuração [api];
- linha 15: a única dependência, o Logback. Ela é declarada por [api] e não por [implementation]: a classe [SqlLog] deriva de uma classe do Logback, e os subprojetos que a usam precisam poder ver essa classe pai em tempo de compilação. Uma dependência [api] é fornecida aos usuários da biblioteca, tanto para compilação quanto para execução.
Uma biblioteca normalmente não impõe sua configuração de logging às aplicações que a utilizam; fazemos isso aqui para evitar repetir esse arquivo em cada exemplo.
11.4.2. A entidade e o banco de dados de artigos
A entidade [Article] do subprojeto [articles] usa as anotações do parágrafo anterior:
- linhas 13–14: um lembrete do que os plugins [jpa] e [allopen] fazem por esta classe;
- linhas 16–18: a tabela se chama [articles], como no Capítulo 10. O parâmetro [uniqueConstraints] declara uma restrição de unicidade, chamada [uk_articles_name], sobre a coluna [name]: dois itens não podem ter o mesmo nome. Sem um nome explícito, o Hibernate geraria um ilegível ([UK3f8k...]), que apareceria nas mensagens de erro. Os parâmetros de anotação do tipo array são escritos em Kotlin entre colchetes ([[UniqueConstraint(...)]], [["name"]]); uma anotação usada como argumento de outra anotação é escrita sem [@];
- linhas 22–23: um nome obrigatório de no máximo 30 caracteres;
- linhas 25–26: um preço no formato [decimal(10,2)];
- linhas 28–29: os dois níveis de estoque, do tipo [Int]: colunas [NOT NULL];
- linhas 32–36: o identificador. O modificador da propriedade é declarado como [protected]: a aplicação pode ler o identificador, mas não pode alterá-lo, já que ele é gerenciado pelo Hibernate (a classe Java não tem um método [setId], pelo mesmo motivo). Ele não poderia ser [private]: a propriedade é pública ([all-open]), e o Kotlin proíbe um modificador private em uma propriedade pública, que uma classe derivada poderia redefinir (“[private setters for open properties are prohibited.]”);
- linha 39: o mesmo método [toString] do primeiro exemplo.
A versão Java desta classe tem quase noventa linhas, incluindo os dois construtores e cerca de dez acessores ([getX]/[setX]); em Kotlin, as propriedades do construtor primário e os dois plugins cumprem essa função.
O objeto [BaseArticles] contém a configuração do Hibernate para o banco de dados [hbarticles]:
- linha 11: um [object] (Capítulo 4): um singleton, criado no primeiro uso. Equivale a uma classe utilitária Java (uma classe [final] com membros estáticos e um construtor privado);
- linhas 14–16: a URL do banco de dados e a URL do usuário, que são públicas para que os outros subprojetos possam usá-las;
- linhas 19–24: a configuração do Hibernate. Ela é retornada por uma função pública, o que permitirá a um exemplo completá-la antes de criar a [SessionFactory]. A propriedade [FORMAT_SQL] ([hibernate.format_sql]) instrui o Hibernate a formatar o SQL, que ele então passa ao log [org.hibernate.SQL]: é essa saída formatada que a classe [SqlLog] condensa em seguida;
- linha 27: a [SessionFactory] do banco [hbarticles], uma função cujo corpo é uma expressão;
- linhas 30–41: uma função que recria a tabela [articles] com suas seis entradas, sem o log SQL: não queremos ver o SQL dessa inicialização nos resultados do exemplo. O bloco passado a [withoutLog] é uma lambda escrita após os parênteses, que aqui são omitidos (Capítulo 7);
- linha 35: [sessionFactory.inTransaction { session -> ... }] abre uma sessão, inicia uma transação, executa a lambda passando-lhe a sessão, confirma a transação (ou a reverte se a lambda lançar uma exceção) e fecha a sessão. Esta é a maneira mais curta de escrever uma unidade de trabalho; vamos usá-la com frequência, junto com suas variantes [inSession] (uma sessão sem transação), [fromTransaction], e [fromSession] (que retornam o resultado da lambda). O parâmetro desses métodos Java é uma interface funcional ([Consumer<Session>], [Function<Session, R>]): o Kotlin aceita diretamente uma lambda ali (conversão SAM, Capítulo 7);
- linhas 36–41: [BigDecimal(500)] chama o construtor de [BigDecimal], que recebe um inteiro; ele retorna o mesmo valor que o método Java [BigDecimal.valueOf(500)].
O subprojeto [articles] depende do subprojeto [tools], do Hibernate e do driver JDBC:
- linhas 5–9: a biblioteca define uma entidade; ela aplica os dois plugins de entidade e o plugin de biblioteca;
- linha 18: a dependência de outro subprojeto do build, identificado pelo seu caminho ([":tools"]);
- linha 20: o Hibernate, declarado por [api]: os subprojetos que usam a biblioteca manipulam diretamente seus tipos ([SessionFactory], [Session]...);
- linha 22: o driver JDBC, necessário apenas em tempo de execução;
- linhas 26–29: a configuração do plugin [all-open].
Os subprojetos de exemplo exigem então apenas uma dependência: o subprojeto [articles]. O Gradle adiciona as dependências dele (conhecidas como dependências transitivas): as dependências [api] para compilação e execução, e a dependência [runtimeOnly] para execução. Eis o arquivo de build do subprojeto [crud]:
- linha 4: o subprojeto não define nenhuma entidade: ele não precisa dos plugins [jpa] e [allopen], que são usados na compilação de classes anotadas, neste caso as do subprojeto [articles];
- linha 15: a única dependência;
- linhas 31–34: os programas iniciados pelo Gradle escrevem sua saída em UTF-8 para que os caracteres acentuados sejam exibidos corretamente no Windows (Capítulo 2).
11.4.3. Outras maneiras de configurar o Hibernate
Configuramos o Hibernate programaticamente com [HibernatePersistenceConfiguration]. Há outras maneiras de fazê-lo, que podem ser encontradas em aplicações e na documentação:
- um arquivo [META-INF/persistence.xml], a abordagem tradicional do Jakarta Persistence: ele descreve uma ou mais unidades de persistência (classes de entidade, propriedades de conexão, opções), e a factory é criada por meio de [Persistence.createEntityManagerFactory("articles")];
- um arquivo [hibernate.properties] (ou [hibernate.cfg.xml]), específico do Hibernate, lido pela classe [org.hibernate.cfg.Configuration]: [Configuration().addAnnotatedClass(Article::class.java).buildSessionFactory()]. Essa é a abordagem usada nas versões mais antigas do Hibernate;
- em uma aplicação Spring Boot, as propriedades [spring.datasource.*] e [spring.jpa.*] do arquivo [application.properties]: o Spring Boot cria a factory por conta própria.
As propriedades são as mesmas em todos os casos ([hibernate.format_sql], [jakarta.persistence.jdbc.url]...): muda apenas a maneira de especificá-las.
11.5. Operações básicas: adicionar, ler, atualizar, excluir
11.5.1. O [crud] programa
O subprojeto [crud] demonstra as quatro operações básicas (CRUD: Create, Read, Update, Delete), bem como o rastreamento de entidades pela sessão. Para tornar esse rastreamento visível, ele usa alguns métodos internos do Hibernate (seu “SPI”, Service Provider Interface), destinados a extensões do Hibernate e não a aplicações: eles são agrupados nas funções utilitárias no final do arquivo, escritas como funções de extensão de [Session] (Capítulo 4). As transações são escritas com o método [inTransaction] da sessão, uma função de ordem superior: [session.inTransaction { ... }] inicia uma transação, executa o bloco e depois confirma a transação ou a reverte se o bloco lançar uma exceção. O código não pode mais omitir [commit] ou [rollback] em caso de erro.
Resultados:
Comentários:
- linha 17: [session.find(Article::class.java, 1)] busca o registro de chave primária 1. Ela retorna [null] se a chave não existir; o operador [?:] então lança uma exceção ([error], Capítulo 3), e [bike] é do tipo [Article], que não é anulável. O SQL gerado (linhas 3–6 dos resultados) é um [SELECT] parametrizado, cujo parâmetro vale 1: o log compacto agora exibe os valores dos parâmetros;
- linha 20: a segunda chamada a [find(Article::class.java, 1)] não envia nenhum comando SQL e retorna o mesmo objeto (linha 9). O operador [===] compara referências (o operador [] do Java), ao passo que [] chamaria [equals] (Capítulo 3). A sessão armazena as entidades que leu ou salvou em seu contexto de persistência, também conhecido como cache de primeiro nível: antes de consultar o banco de dados, [find] verifica se a entidade solicitada já está lá. Uma sessão nunca contém dois objetos para a mesma linha do banco de dados;
- linhas 25–29: adição de um item. Antes de [persist], o objeto é [TRANSIENT] (“transitório”): a sessão não o reconhece, e seu identificador é [null] (linha 12). [persist] o traz para a sessão, que executa imediatamente o comando [INSERT] (linhas 13–18) para obter a chave gerada, e a coloca no campo [id] (o Hibernate escreve diretamente no campo: o modificador protected da propriedade não impede isso). O item passa então a ser [MANAGED] (“gerenciado” ou “persistente”), e seu identificador é 7 (linha 19). A transação é aberta no início do bloco [inTransaction] e confirmada no final dele (linhas 11 e 20 dos resultados). O parâmetro do bloco ([Transaction]) não é usado: ele não recebe nome;
- linha 35: para modificar uma linha do banco de dados, basta modificar o objeto. Nenhum método [update] é necessário: a sessão guardou uma cópia dos valores lidos ou salvos (o estado original) e compara os valores atuais com eles. Isso é conhecido como “dirty checking”. O operador [*=] é traduzido aqui pelo Kotlin em [x.price = x.price * BigDecimal("1.1")]: um novo objeto [BigDecimal] (que é imutável) é atribuído à propriedade;
- linhas 36–37: a propriedade [isDirty] (o método Java [isDirty()]) indica se a sessão contém alterações que ainda não foram confirmadas no banco de dados: é o caso aqui (linha 23). A função [originalValue] (linhas 84–85) lê o valor original do preço, 100, a partir do contexto de persistência, enquanto o valor atual é 110.0;
- linha 38: o fim do bloco. O [commit] subsequente sincroniza a sessão com o banco de dados (“flush”): o comando [UPDATE] é executado (linhas 25–32) e, em seguida, a transação é confirmada. Depois disso, a sessão não tem nenhuma alteração pendente (linha 34);
- Observe que o comando [UPDATE] escreve todas as colunas da tabela, e não apenas a que foi alterada. Esse é o comportamento padrão do Hibernate: um único comando SQL, preparado de uma vez por todas, é usado para todas as modificações de artigos. Em contrapartida, a anotação [@DynamicUpdate] colocada na entidade o instrui a gerar, a cada vez, um comando limitado às colunas modificadas;
- linhas 45–48: exclusão. [remove] muda o status do artigo para [DELETED] (linha 37); [commit] envia o comando [DELETE] (linhas 38–40). O objeto deixa então de ser reconhecido pela sessão: ele passa a ser [DETACHED] (“desanexado”, linha 42);
- linhas 52–55: o arco é lido (linhas 44–47) e depois desanexado da sessão por [detach]: a sessão o esquece (linha 48). Qualquer alteração em seu preço é então ignorada. Um objeto desanexado é algo comum em uma aplicação: é um objeto lido por uma sessão que agora está fechada (por exemplo, durante uma requisição HTTP anterior) e depois modificado pelo usuário;
- linha 57: [session.merge(bow)] mescla o objeto desanexado com a sessão. A sessão lê o item do banco de dados (linhas 50–53), copia o estado do objeto desanexado para a entidade que ela gerencia e retorna esta última: não é o mesmo objeto (linha 54). O objeto passado a [merge] continua desanexado; o objeto retornado é o que deve ser usado a partir daí. [commit] registra o novo preço (linhas 55–62);
- linha 64: o estoque da bicicleta é atualizado, sem transação;
- linhas 71–72: o contexto de persistência da sessão, obtido por meio de uma propriedade de extensão: nas funções seguintes, [trackingContext] é tratada como uma propriedade da sessão. [unwrap] dá acesso à interface interna da sessão [SessionImplementor];
- linhas 75–80: o status de um item, calculado por um [when] sem argumentos. Primeiro, [isEntryFor] é usado para verificar se a sessão está associada ao item: o método [getEntry], que retorna [null] para um objeto desconhecido (que é o que o código Java testa), é, no entanto, anotado como [@NonNull] no Hibernate. O Kotlin leva em conta essas anotações de nulabilidade das bibliotecas Java: ele considera que [getEntry] retorna um [EntityEntry] não anulável e sinaliza como desnecessária uma verificação com [?.] sobre seu resultado (“[unnecessary safe call on a non-null receiver of type 'EntityEntry'.]”) (um aviso e, portanto, um erro com nossas opções de compilação). Este é um caso raro, mas instrutivo: os tipos de uma biblioteca Java são sempre exatamente o que suas anotações especificam;
- linhas 88–101: exibição do contexto de persistência. Para cada entidade rastreada ([EntityEntry]), são exibidos seu nome, identificador e estado, seguidos do valor atual de cada propriedade e de seu valor original, se diferente. O objeto [EntityPersister] é o do Hibernate que conhece o mapeamento entre uma entidade e sua tabela: ele fornece os nomes das propriedades e seus valores. O laço [for ((entity, entry) in ...)] desestrutura cada elemento do array, um [Map.Entry] (Capítulo 5); [forEachIndexed] percorre os nomes das propriedades junto com seus índices. O operador [==] entre dois valores, que podem ser [null]—substitui o [Objects.equals] do Java. Em uma função de extensão, [isDirty] refere-se à propriedade do receptor, a sessão;
- linhas 65–75 dos resultados: a sessão rastreia a bicicleta, cujo estoque passou de 10 para 9, e o arco. A alteração na bicicleta não é salva: a sessão é fechada sem sincronização. Não há [commit], e uma sessão não se sincroniza automaticamente ao ser fechada.
11.5.2. Os estados de uma entidade
Uma entidade está, em relação a uma sessão, em um dos seguintes estados (o Jakarta Persistence os chama de “new”, “managed”, “detached” e “removed”):
Estado | Significado |
transitório ([TRANSIENT]) | O objeto foi criado por uma chamada de construtor e nunca foi registrado: ele não tem identificador e nenhuma sessão o conhece |
Gerenciado ([MANAGED]) | O objeto foi lido ou salvo pela sessão, que o rastreia: as alterações feitas nele serão refletidas no banco de dados na próxima sincronização |
Excluído ([DELETED]) | O objeto foi marcado para exclusão ([remove]): a próxima sincronização enviará o comando [DELETE] |
desanexado ([DETACHED]) | O objeto corresponde a uma linha do banco de dados, mas a sessão que o leu está fechada ou o esqueceu ([detach], [clear]): suas alterações são ignoradas, a menos que ele seja mesclado com uma sessão ([merge]) |
Sincronizar (“flush”) a sessão envia ao SGBD os comandos SQL que propagam as alterações das entidades gerenciadas. Isso ocorre:
- durante a fase de [commit] da transação;
- antes de executar uma consulta cujo resultado possa depender de alterações ainda não confirmadas (modo [FlushMode.AUTO], o modo padrão): a consulta enxerga assim os dados da sessão;
- durante uma chamada explícita a [session.flush()]. Os comandos são então executados, mas só serão salvos de forma permanente no [commit] da transação.
Eis uma visão geral do fluxo de trabalho com o Hibernate: abrimos uma sessão e uma transação, lemos entidades, as modificamos como objetos comuns, as adicionamos ([persist]) e as excluímos ([remove]), e então confirmamos a transação, que envia todos os comandos necessários ao banco de dados em um único lote. A sessão atua como uma “unidade de trabalho”. É um objeto leve, projetado para ter vida curta: uma unidade de trabalho, como uma requisição HTTP em uma aplicação web. Não se usa a mesma sessão durante todo o tempo de vida de uma aplicação: ela acumularia as entidades rastreadas em seu contexto de persistência.
Em Kotlin, esse ciclo é implementado naturalmente com as funções de ordem superior do Hibernate: [sessionFactory.inTransaction { session -> ... }] para uma unidade de trabalho completa (sessão e transação), [sessionFactory.fromTransaction { session -> ... }] quando ela retorna um resultado, e [session.inTransaction { ... }] para uma transação dentro de uma sessão já aberta. Em resumo, são os equivalentes da função [use] para transações.
11.6. As consultas HQL
11.6.1. HQL e JPQL
Para recuperar entidades de outra forma que não pela chave primária, escrevem-se consultas em uma linguagem semelhante ao SQL, mas que se refere a entidades e atributos em vez de tabelas e colunas: o HQL (Hibernate Query Language). O Jakarta Persistence define uma linguagem semelhante, o JPQL (Jakarta Persistence Query Language), da qual o HQL é um superconjunto: uma consulta JPQL é uma consulta HQL válida. O Hibernate traduz a consulta para SQL, no dialeto do SGBD, e é o SGBD que a executa.
Algumas diferenças em relação ao SQL:
- usamos o nome da entidade ([Article]), e não o nome da tabela ([articles]), e os nomes dos atributos ([currentStock]), e não os nomes das colunas. Os nomes de entidades e de atributos diferenciam maiúsculas de minúsculas, assim como em Kotlin. Com nossas entidades Kotlin, o nome de um atributo é o mesmo da propriedade (o Hibernate acessa o campo que a armazena, e esse campo tem o nome da propriedade);
- a cláusula [select] é opcional em HQL: [from Article] retorna entidades [Article]. O JPQL exige escrever [select a from Article a];
- os relacionamentos entre entidades são percorridos com um ponto ([p.category.name]), e o Hibernate escreve os joins por conta própria, como veremos.
Uma consulta é criada pelo método [createSelectionQuery] da sessão, que recebe o texto HQL e o tipo do resultado ([Article::class.java], a classe Java da entidade) e devolve um objeto [SelectionQuery<T>]. Em seguida, é possível atribuir valores aos seus parâmetros e executá-la com [getResultList] (uma lista), [getSingleResult] (um único resultado; uma exceção se houver zero ou mais de um), [getSingleResultOrNull] ([null] se não houver nenhum) ou [getResultStream] (um stream). Como sempre ocorre com as classes Java, o Kotlin permite escrever como propriedades esses métodos [getXxx] sem parâmetros: [query.resultList], [query.singleResult], [query.singleResultOrNull]. O método [createQuery] do Jakarta Persistence também existe; ele serve tanto para consultas de leitura quanto para atualizações.
11.6.2. O programa [hql]
O subprojeto [hql] apresenta vários exemplos de consultas. Ele tem apenas uma dependência: a biblioteca [articles] (que fornece o Hibernate, o driver do MySQL e o log SQL compacto); não define nenhuma entidade e, portanto, não precisa nem do plugin [jpa] nem do plugin [allopen]:
O programa:
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 33 34 35 36 37 38 39 40 41 42 43 44 45 46 47 48 49 50 51 52 53 54 55 56 57 58 59 60 61 62 63 64 65 66 67 68 69 70 71 72 73 74 75 76 77 78 79 80 81 82 83 84 85 86 87 88 89 90 91 92 93 94 95 96 97 98 99 100 101 102 103 104 | |
Resultados:
Comentários:
- Linhas 24–26: a cláusula [where] compara dois atributos da entidade; a cláusula [order by] ordena pelo nome: elas se tornam as cláusulas [WHERE] e [ORDER BY] do comando SQL. A consulta é executada por [resultList] (o método [getResultList]), que devolve um [List<Article>]; [forEach(::println)] exibe cada item por meio de seu método [toString];
- linhas 30–38: uma projeção. A consulta não devolve entidades, mas dois valores por item: o nome e o valor do estoque. O SQL gerado recupera apenas as colunas necessárias e faz o cálculo por conta própria. O tipo do resultado é a data class [StockValue] da linha 11: o Hibernate cria um objeto por linha, passando em ordem ao seu construtor os valores da cláusula [select] (o curso de Java usava um record). Esses objetos não são entidades: a sessão não os rastreia. Uma data class é perfeitamente adequada para esse papel, e aproveitamos sua desestruturação: [for ((name, value) in values)] (linha 37);
- linhas 32–34: a consulta é escrita em uma raw string (["""..."""], Capítulo 5), que é mais legível do que uma string longa em uma única linha. Ao contrário dos blocos de texto do Java, uma raw string preserva a indentação das linhas e a quebra de linha inicial; isso é irrelevante aqui, pois espaços e quebras de linha não importam em HQL: não é necessário chamar [trimIndent];
- linhas 44–53: uma consulta escrita como em JPQL, com um alias ([a]). [:minPrice] é um parâmetro nomeado, cujo valor é informado por [setParameter]. Ele se torna um parâmetro do comando SQL (o [?] da cláusula [WHERE], cujo valor é exibido pelo log): assim, não há com que se preocupar com injeções de SQL, pois o valor é passado separadamente do texto do comando. Essa é a regra que o Capítulo 10 aplicou às instruções preparadas. [setMaxResults(1)] limita o resultado a uma única linha: a cláusula [LIMIT] do MySQL. [singleResultOrNull] devolve um [Article?]: o tipo anulável indica claramente que pode não haver resultado, e o operador Elvis [?:] exibe [none] nesse caso;
- É importante destacar uma armadilha específica do Kotlin. Suas string templates tornam muito tentador escrever ["... where a.price > $minPrice"]. O programa funcionaria, mas o valor seria então copiado para o texto da consulta: é justamente essa concatenação que abre a porta para injeções (Capítulo 10), e o Hibernate teria de analisar uma nova consulta para cada valor. Nós nunca usamos o caractere [$] para definir um valor em uma consulta HQL: os valores são passados por parâmetros nomeados. Um valor literal escrito no texto da consulta (como ['b%'] na linha 72) também é copiado para o texto do comando SQL, como mostra o log: isso é aceitável para uma constante do programa, mas nunca para um valor vindo de uma fonte externa;
- Linhas 57–63: os agregados [count] e [sum] são calculados pelo SGBD: apenas o resultado é transferido, não as linhas. [Long::class.java] refere-se à classe do tipo primitivo [long] do Java (o tipo Kotlin [Long] é compilado para [long]), enquanto o curso de Java usava [Long.class], a classe wrapper [java.lang.Long]; o Hibernate aceita ambas (a classe wrapper seria escrita como [Long::class.javaObjectType]). O HQL também reconhece [avg], [min], [max] e as cláusulas [group by] e [having];
- linhas 67–76: o operador [like] do SQL e o operador [in], cujo operando é um parâmetro que aceita uma lista Kotlin (uma [List] do Kotlin é uma [java.util.List] do Hibernate): o Hibernate a expande em tantos parâmetros SQL quantos forem os elementos da lista. O HQL oferece suporte a numerosas funções sobre strings ([upper], [length], [substring]...), datas e números, que ele traduz para o dialeto do SGBD;
- linhas 82–85: paginação, para exibir uma lista longa página por página. [setFirstResult] ignora as entradas das páginas anteriores, enquanto [setMaxResults] mantém as da página solicitada: a cláusula [LIMIT ?, ?] do MySQL, cujos dois parâmetros são 4 e 2. A paginação só faz sentido em uma lista ordenada ([order by]). As linhas 86–87 constroem a exibição da página com [joinToString] e sua função de transformação (Capítulo 5);
- linhas 91–94: uma consulta que usa um atributo [stock] que não existe. O erro é detectado assim que a consulta é criada, antes de qualquer execução, porque o Hibernate analisa o texto HQL e o compara com o modelo: ele lança uma [SemanticException] (as mensagens do Hibernate estão em inglês). Um erro de sintaxe resultaria em uma [SyntaxException]. Observe que o valor devolvido por [createSelectionQuery] é ignorado: em Kotlin, não há obrigação de usar o resultado de uma função;
- linhas 15 e 99–100: uma consulta não pode usar uma função Kotlin, como a função de extensão [isOutOfStock]: o Hibernate não conhece seu código e, mesmo que conhecesse, não saberia necessariamente como escrevê-la em SQL. É possível ler todas as entidades e filtrá-las em memória: [resultStream] (o método [getResultStream]) devolve um [Stream<Article>] Java, que mantém um recurso JDBC aberto e deve ser fechado após o uso: a função [use] cuida disso, já que um [Stream] é um [AutoCloseable]. O resultado está correto, mas a tabela inteira foi transferida (o último comando SQL não tem cláusula [WHERE]): com uma tabela grande, isso deve ser evitado. É melhor escrever a condição na consulta, como mostra a linha 24. A função de extensão também demonstra uma maneira muito “Kotlin” de escrever uma regra de negócio sobre uma entidade sem modificar sua classe (Capítulo 4).
11.6.3. Consultas nomeadas e validação em tempo de compilação
Uma consulta escrita em uma string só é analisada em tempo de execução. Há duas maneiras de detectar erros mais cedo:
- Consultas nomeadas: a anotação [@NamedQuery(name = "Article.outOfStock", query = "from Article where currentStock < minimumStock")], aplicada à entidade, declara uma consulta que o Hibernate analisa na inicialização, ao criar o [SessionFactory]. Ela é então executada pelo seu nome: [session.createNamedSelectionQuery("Article.outOfStock", Article::class.java)]. É escrita em Kotlin exatamente da mesma forma que em Java; a anotação é repetível: ela é aplicada tantas vezes quantas forem as consultas a declarar;
- o processador de anotações do Hibernate (“Hibernate Processor”, biblioteca [org.hibernate.orm:hibernate-processor]). Em Java, ele é executado pelo [javac] durante a compilação: verifica as consultas nas anotações e gera, para cada entidade, uma classe de “metamodelo” ([Article_] para [Article]), que veremos novamente com a API Criteria. Esse mecanismo não se aplica apenas ao Kotlin: voltaremos a ele mais adiante, ao tratar do metamodelo estático.
11.7. A API Criteria
11.7.1. Consultas construídas com código
Uma consulta HQL é uma string que pode ser construída por concatenação (ou, em Kotlin, com templates): essa abordagem é pouco confiável e difícil de ler assim que a consulta depende de muitos critérios opcionais (um formulário de pesquisa, por exemplo). O Jakarta Persistence oferece outra maneira de escrever consultas: a API Criteria, em que a consulta é uma árvore de objetos construída por chamadas de métodos. O Hibernate traduz essa árvore em SQL, exatamente como uma consulta HQL (ele também traduz o HQL em uma árvore desse tipo). O subprojeto [criteria] (cujo [build.gradle.kts] é o do subprojeto [hql], exceto pelo nome do programa) reúne várias consultas do programa anterior:
Resultados:
Comentários:
- linha 26: a sessão devolve um [HibernateCriteriaBuilder] ([criteriaBuilder], o método [getCriteriaBuilder]), a versão aprimorada pelo Hibernate do [CriteriaBuilder] do Jakarta Persistence: ele é a fábrica de todos os elementos de uma consulta (condições, expressões, ordenações);
- linhas 30–34: a consulta do primeiro exemplo, em HQL. [createQuery(Article::class.java)] cria uma consulta que devolve artigos; [from(Article::class.java)] declara a entidade consultada e devolve sua raiz ([Root<Article>]), que é o equivalente do alias [a] em [from Article a]; [a.get<Int>("currentStock")] designa um atributo. A condição é construída por [cb.lt(x, y)] (“less than”, [x < y]), e a ordenação por [cb.asc(...)]. O argumento de tipo explícito [<Int>] (em Java: [a.<Integer>get(...)]) especifica o tipo do atributo, que não pode ser determinado a partir da string ["currentStock"]. O compilador não consegue verificar se está correto: ele confia na nossa palavra;
- linha 35: a consulta é executada pela sessão, como uma consulta HQL. O SQL gerado é o mesmo da consulta HQL;
- linha 18: uma função de extensão da interface [Path] do Jakarta Persistence, que designa um atributo por meio de uma referência de propriedade ([Article::price], do tipo [KProperty1<Article, BigDecimal>], Capítulo 7) em vez de uma string. Ela simplesmente passa o nome da propriedade ([property.name], aqui ["price"]) ao método [get] original, mas oferece duas garantias: o compilador verifica que a propriedade existe, e o tipo do caminho devolvido ([Path<BigDecimal>]) é inferido a partir do da propriedade, sem argumento de tipo explícito. Isso se baseia no fato de que o nome do atributo JPA é o mesmo que o nome da propriedade Kotlin, o que ocorre com as nossas entidades;
- Linhas 39–46: uma projeção para a data class [StockValue], usando a função de extensão: [p.get(Article::price)]. [cb.prod(x, y)] é o produto de duas expressões; [
as(BigDecimal::class.java)] especifica o tipo do resultado ([as] é uma palavra-chave do Kotlin: para chamar o método Java com esse nome, ele é colocado entre acentos graves); [cb.construct(StockValue::class.java, ...)] indica que cada linha do resultado deve ser passada ao construtor da data class; - Linhas 73–83: é aqui que a API Criteria é mais útil. A função [search] constrói uma consulta com base nos critérios fornecidos. Seus critérios são parâmetros anuláveis com valor padrão ([maxPrice: BigDecimal? = null]), o que permite as chamadas com argumentos nomeados das linhas 51 e 53 (em Java, era preciso passar [null] explicitamente). A lista de condições é construída por [buildList]: cada condição só é adicionada a ela se o critério correspondente não for [null] ([maxPrice?.let { ... \}]), e a cláusula [where] recebe a lista inteira ([where(conditions)], uma sobrecarga introduzida com o Jakarta Persistence 3.2), com as condições combinadas por [and]. A primeira chamada produz uma consulta com uma condição; a segunda produz uma consulta com duas condições. Observe que, com a API Criteria, o Hibernate passa os valores ([150], [d%]) como parâmetros no comando SQL: o template ["$it%"] da linha 80 constrói o valor para o parâmetro (o padrão para [like]), e não o texto da consulta;
- Linhas 57–64: os agregados [count] e [sum].
11.7.2. O metamodelo estático
O ponto fraco das consultas do primeiro exemplo é que os atributos são designados por strings ([a.get<Int>("currentStock")]): um erro de digitação só será detectado em tempo de execução, e o compilador ignora o tipo do atributo. Para resolver isso, o Jakarta Persistence oferece um metamodelo estático: para cada entidade [Article], existe uma classe [Article_] que contém um campo por atributo, descrevendo seu nome e seu tipo. Em Java, escreve-se então ***[cb.lt(a.get(Article\_.currentStock), a.get(Article\_.minimumStock))]***, que o compilador valida por completo. Essas classes não são escritas à mão: elas são geradas durante a compilação pelo processador de anotações do Hibernate. Essa é a abordagem recomendada em um projeto Java que usa a API Criteria.
Em Kotlin, a situação não é tão simples. O processador de anotações do Hibernate é um processador de anotações Java: ele é executado pelo [javac] sobre código-fonte Java, mas nossas entidades são compiladas pelo compilador Kotlin. A ferramenta Kotlin para esse tipo de geração de código é o KSP (Kotlin Symbol Processing), mas o Hibernate não fornece um processador KSP. Resta o kapt (“Kotlin annotation processing tool”), que executa processadores Java sobre “stubs” gerados a partir do código Kotlin; porém, o kapt está em modo de manutenção na JetBrains (que recomenda o KSP), deixa a compilação mais lenta, e a combinação kapt + Hibernate Processor não é uma configuração documentada pelo Hibernate. Por isso, não a usamos. As referências de propriedades do Kotlin oferecem boa parte do benefício sem nenhuma ferramenta: com a função de extensão do programa, um erro de digitação é detectado em tempo de compilação. Eis o que o compilador diz para [a.get(Article::stock)], compilado em um arquivo de teste:
(O compilador também exibe, antes disso, a lista dos métodos [get] candidatos, nenhum dos quais é adequado.) No entanto, a verificação não é completa: uma propriedade Kotlin que não seja um atributo persistente (uma propriedade calculada, por exemplo) seria aceita pelo compilador, mas rejeitada pelo Hibernate em tempo de execução.
Para uma consulta fixa, o HQL é mais legível do que a API Criteria; para uma consulta construída conforme as circunstâncias, a API Criteria é mais segura. As duas podem ser combinadas: o Hibernate permite criar uma consulta Criteria a partir de uma string HQL ([cb.createQuery(hql, Article::class.java)]) e depois complementá-la com código.
11.8. Relacionamentos
11.8.1. O modelo da loja
As tabelas de um banco de dados estão ligadas umas às outras. O Hibernate representa essas ligações como associações: propriedades que referenciam outra entidade ou uma coleção de entidades. O subprojeto [relations] usa um banco de dados [hbshop] que descreve uma pequena loja com seis entidades. Como define entidades, seu [build.gradle.kts] aplica os plugins [jpa] e [allopen] , assim como o da biblioteca [articles]; ele depende diretamente da biblioteca [tools] (o log SQL), do Hibernate e do driver do MySQL:
Uma categoria agrupa produtos:
Um produto pertence a uma categoria e tem tags:
Uma tag é atribuída a vários produtos:
Um cliente faz pedidos:
Um pedido pertence a um cliente e contém itens:
Um item de pedido tem um identificador, uma quantidade e duas associações muitos-para-um: uma com o seu pedido e outra com o seu produto:
Ele contém três tipos de associações:
- um relacionamento muitos-para-um ([@ManyToOne]): um produto pertence a uma categoria (a propriedade [category] de [Product]). No banco de dados, isso é representado por uma chave estrangeira, a coluna [category_id] da tabela [products], em que [@JoinColumn] especifica o nome e o nome da restrição ([fk_products_category]). [optional = false] torna o relacionamento obrigatório: a coluna será [NOT NULL]. Observe a sintaxe das anotações aninhadas em Kotlin: uma anotação passada como argumento de outra é escrita sem [@] ([foreignKey = ForeignKey(name = ...)]), e um array de anotações é escrito entre colchetes ([joinColumns = [JoinColumn(name = "product_id")]]), assim como o array [cascade = [CascadeType.PERSIST]];
- o relacionamento inverso, um-para-muitos ([@OneToMany]): uma categoria contém vários produtos (a propriedade [products] de [Category]). Ele não cria nada no banco de dados: [mappedBy = "category"] indica que ele é descrito pela propriedade [category] da entidade [Product]. [Product.category] é dita o lado proprietário do relacionamento, e [Category.products] o seu lado inverso: o Hibernate armazena o valor do lado proprietário. No entanto, os dois lados devem ser mantidos consistentes em memória: esse é o papel da função [add] de [Category], que adiciona o produto à lista ([products += product], o operador [+=] para uma coleção mutável, Capítulo 5) e define a sua categoria;
- um relacionamento muitos-para-muitos ([@ManyToMany]): um produto tem várias tags, e uma tag está associada a vários produtos. Ele é armazenado em uma tabela de associação, [products_tags], para a qual [@JoinTable] especifica o nome, os nomes das duas colunas e os nomes das duas chaves estrangeiras (a propriedade [tags] de [Product]). O lado inverso é [Tag.products] ([mappedBy = "tags"]). Em um relacionamento muitos-para-muitos, prefere-se um conjunto ([MutableSet]) a uma lista ([MutableList]): com uma lista, o Hibernate exclui e reinsere todas as linhas da tabela de associação a cada modificação da coleção;
- [fetch = FetchType.LAZY] solicita o carregamento tardio da categoria de um produto: ela só será lida quando for usada. Esse é o comportamento padrão para coleções ([@OneToMany], [@ManyToMany]), mas não para relacionamentos com uma única entidade ([@ManyToOne]), que o padrão carrega imediatamente por default ([EAGER]): [fetch = FetchType.LAZY] é adicionado sistematicamente a eles, como recomenda a documentação do Hibernate;
- [cascade = [CascadeType.PERSIST]] propaga a operação [persist]: persistir uma categoria persiste seus produtos, e persistir um produto persiste suas tags. Os outros valores ([MERGE], [REMOVE], [ALL]...) propagam as outras operações.
A transição para o Kotlin merece alguns comentários:
- As coleções são declaradas com as interfaces mutáveis do Kotlin, [MutableList] e [MutableSet], que são inicializadas por [mutableListOf()] e [mutableSetOf()]. Essa escolha é obrigatória: o Hibernate substitui a coleção de uma entidade que ele lê por uma coleção própria (um [PersistentBag] ou um [PersistentSet]), que é um [java.util.List] ou [java.util.Set] mutável e que pode ser carregada sob demanda. Uma [List] somente leitura do Kotlin seria aceita pelo compilador, mas não representaria fielmente um objeto que o Hibernate e a função [add] modificam. As propriedades são [val]: modificamos o conteúdo da coleção, nunca a referência;
- um relacionamento com uma única entidade, que é obrigatório, é declarado como [lateinit var category: Category] (em [Product]; o mesmo vale para [CustomerOrder.client] e [OrderLine.order]). O tipo não é anulável, porque um produto registrado sempre tem uma categoria; porém, no momento de sua criação, ele ainda não tem uma: [Category.add] a preencherá. [lateinit] expressa exatamente isso: a propriedade será inicializada depois, e lê-la antes disso lançaria uma [UninitializedPropertyAccessException], mais descritiva do que uma [NullPointerException]. O curso de Java recorria a [null] até então. Também poderíamos ter escrito [var category: Category? = null], ao custo de ter de usar [?.] ou [!!] a cada vez;
- o modificador [internal set] colocado sob essas propriedades reserva a modificação da categoria de um produto (do cliente de um pedido, do pedido de um item de pedido) para o módulo — ou seja, para o subprojeto Gradle [relations]: somente a função [add] a utiliza. Em Java, o método [setCategory] era visível apenas dentro do pacote; o Kotlin não tem visibilidade de “pacote”, e [internal] é o equivalente mais próximo;
- As tags de um produto são passadas ao seu construtor por meio de um parâmetro [vararg], que não é uma propriedade (não há [val] nem [var]): ele é usado apenas no bloco [init], que as adiciona ao conjunto. Nesse bloco, [tags] refere-se ao parâmetro e [this.tags] à propriedade; o bloco [init] é colocado depois da declaração da propriedade, porque as inicializações são executadas na ordem em que aparecem no texto. O operador [+=] adiciona todos os elementos de um array a uma coleção mutável;
- o construtor sem parâmetros adicionado pelo plugin [jpa] (aquele que o Hibernate usa para criar as entidades que lê) não executa as inicializações de propriedades: a coleção [tags] de um produto lido pelo Hibernate, portanto, não é criada por [mutableSetOf()]. Isso não é um problema, porque o próprio Hibernate preenche todas as associações das entidades que lê com suas coleções de carregamento tardio;
- as entidades continuam sendo classes comuns, não data classes. Os relacionamentos fornecem mais uma razão para isso: as funções [toString], [equals] e [hashCode] geradas para uma data class usam todas as propriedades de seu construtor primário; se incluíssem associações, percorreriam as coleções tardias (disparando consultas ou uma [LazyInitializationException] fora da sessão), e duas entidades que se referenciam mutuamente chamariam uma à outra indefinidamente ([StackOverflowError]);
- Por fim, o plugin [allopen] é essencial aqui: em um relacionamento tardio com uma única entidade, o Hibernate coloca na propriedade um proxy — um objeto de uma subclasse da entidade gerada em tempo de execução —, o que exige que a classe e seus acessores não sejam final. Veremos esse proxy em ação no programa.
O objeto [Shop] configura o Hibernate para o banco de dados [hbshop] e cria nele um conjunto inicial de dados:
- Linha 11: como [BaseArticles], um [object] substitui a classe utilitária do Java;
- linhas 16–18: as seis entidades, declaradas por [managedClasses];
- linha 26: a função é uma expressão: o resultado de [SqlLog.withoutLog], à qual se passa o processamento a executar sem log (SQL);
- linhas 31–42: um grafo de objetos: três categorias, seus produtos e as tags dos produtos;
- linhas 44–46: basta persistir as categorias: graças à cascata, o Hibernate percorre as associações e persiste todas as entidades que alcança, na ordem correta (as categorias antes dos produtos que as referenciam), preenchendo as chaves estrangeiras e a tabela de associação;
- linhas 48–53: um cliente, seu pedido e os dois itens do pedido, persistidos em uma única operação.
As tabelas criadas pelo Hibernate são as seguintes:
- a lista de tabelas: uma tabela por entidade e a tabela de associação [products_tags];
- a tabela [products]: sua chave estrangeira [category_id] referencia a tabela [categories]. Ela é [NOT NULL] ([optional = false]). O MySQL cria um índice em cada chave estrangeira (linha [KEY]). Ao contrário de outros ORMs, o Hibernate não exige a exclusão em cascata no banco de dados ([ON DELETE CASCADE]): ela pode ser obtida com a anotação [@OnDelete(action = OnDeleteAction.CASCADE)];
- a tabela de associação tem duas colunas — chaves estrangeiras para as duas tabelas ligadas — que, juntas, formam sua chave primária.
O esquema é exatamente o mesmo do curso de Java: as anotações, escritas em Kotlin, são idênticas.
11.8.2. O programa
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 33 34 35 36 37 38 39 40 41 42 43 44 45 46 47 48 49 50 51 52 53 54 55 56 57 58 59 60 61 62 63 64 65 66 67 68 69 70 71 72 73 74 75 76 77 78 79 80 81 82 83 84 85 86 87 88 89 90 91 92 93 94 95 96 97 98 99 100 101 102 103 104 105 106 107 108 109 110 111 112 113 114 115 116 117 118 119 120 121 122 123 124 125 126 127 128 129 130 131 132 133 134 135 136 137 138 | |
Resultados:
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 33 34 35 36 37 38 39 40 41 42 43 44 45 46 47 48 49 50 51 52 53 54 55 56 57 58 59 60 61 62 63 64 65 66 67 68 69 70 71 72 73 74 75 76 77 78 79 80 81 82 83 84 85 86 87 88 89 90 91 92 93 94 95 96 97 98 99 100 101 102 103 104 105 106 107 108 109 110 111 112 113 114 115 116 117 118 119 120 121 | |
Comentários:
- Linhas 11–15: as data classes que receberão os resultados das projeções. Seus tipos correspondem aos devolvidos pelo SGBD: [Long] para [count], [Double] para [avg];
- linhas 135–138: o produto com o nome informado, lido por uma função de extensão da interface [Session] do Hibernate: dentro dela, [createSelectionQuery] é chamado na própria sessão ([this], implícito). Ela é chamada como um método da sessão: [session.product("bike")] (linha 25), enquanto o código Java definia anteriormente um método estático [product(session, "bike")];
- linhas 24–33: um cliente, seu pedido e suas duas linhas são persistidos com uma única chamada a [persist]. O SQL mostra a ordem das inserções: primeiro o cliente, depois o pedido — cuja chave estrangeira [client_id] recebe a chave gerada do cliente (2) — e por fim as linhas, cuja chave estrangeira [order_id] recebe a chave do pedido. [inTransaction] recebe uma lambda Kotlin onde o Hibernate espera uma interface funcional Java ([Consumer<Session>]): é a conversão SAM do Capítulo 7;
- linhas 39–45: carregamento tardio. A consulta lê apenas os pedidos: o cliente e as linhas de cada pedido só são lidos quando o programa os utiliza, por meio de consultas adicionais (duas para o primeiro pedido, duas para o segundo). Para o cliente, o Hibernate colocou um proxy na propriedade [client] — um objeto de uma subclasse de [Client] gerada pelo Hibernate (com o Byte Buddy) —, que contém apenas o identificador e lê o cliente na primeira chamada a um acessor ([order.client.name], isto é, [getName()]). A linha 48 mostra isso: a classe do objeto é [relations.Client$HibernateProxy]. É por isso que uma entidade não pode ser uma classe final, nem seus acessores métodos final: em Kotlin, onde classes e membros são final por padrão, é o plugin [allopen] que os torna não final. Para as linhas, a lista é uma coleção do Hibernate, carregada no primeiro uso ([size]);
- Linhas 53–57: o pedido é lido por uma sessão que é fechada imediatamente ([fromSession], que devolve o resultado da lambda). Suas linhas não foram carregadas e, com a sessão fechada, não podem mais ser: acessar a coleção dispara uma [LazyInitializationException], uma das exceções mais comuns em aplicações que usam o Hibernate. Nada no tipo [MutableList<OrderLine>] da propriedade sinaliza esse risco ao compilador Kotlin: a segurança de tipos termina onde começa o carregamento sob demanda. É preciso carregar o que será necessário enquanto a sessão está aberta;
- linhas 63–69: pré-carregamento por meio de uma consulta. [join fetch] instrui o Hibernate a carregar, junto com os pedidos, seus clientes, suas linhas e o produto de cada linha: uma única consulta com joins. A saída mostra os dois pedidos e suas linhas. O join com as linhas produz uma linha SQL por item de pedido; o Hibernate deriva um único pedido para cada identificador: a lista devolvida de fato contém dois pedidos. O texto da consulta, distribuído em várias linhas, é uma raw string;
- linhas 82–88: um “entity graph” (Jakarta Persistence) descreve, fora de qualquer consulta, as associações a carregar com uma entidade: aqui, os produtos da categoria, identificados pela referência de propriedade [Category::products.name] em vez da string ["products"]. [session.find(graph, 2)] (Jakarta Persistence 3.2) lê a categoria 2 junto com seus produtos em uma única consulta (um join externo, [left join]). Depois que a sessão é fechada, os produtos permanecem acessíveis. Para carregar uma associação mais tarde, com a sessão aberta, use [Hibernate.initialize(category.products)]. Observe a chamada a [addAttributeNodes] (no plural) em vez de [addAttributeNode]: este último, que é genérico, devolve um
*[AttributeNode<Y>]*, e o Kotlin não consegue inferir o tipo*[Y]* quando o resultado não é usado (“cannot infer type for type parameter 'Y'”); - Linhas 95–100: as associações são usadas em consultas: [join p.tags e] percorre o relacionamento muitos-para-muitos (dois joins, com a tabela de associação e a tabela de rótulos), e [p.category.name] é traduzido em um join implícito com a tabela de categorias. O texto do rótulo é passado por um parâmetro nomeado (o curso de Java o escrevia como literal na consulta); cada resultado é desempacotado nos parâmetros da lambda: [{ (product, category) -> ... \}];
- linhas 108–114: um cálculo envolvendo duas relações — o valor de cada pedido — inteiramente executado pelo SGBD: joins, [sum] e [group by];
- linhas 123–128: um agrupamento. [group by p.category.name] agrupa os produtos pelo nome da categoria; para cada grupo, o número de produtos ([count], do tipo [Long]) e o preço médio ([avg], do tipo [Double]) são calculados pelo SGBD. A categoria [diving], que não tem nenhum produto, não aparece: o join com a tabela de categorias é um join interno ([join]).
11.8.3. O problema das N+1 consultas
O carregamento tardio do exemplo ilustra um problema que afeta qualquer usuário de um ORM, conhecido como o problema das “N+1 consultas”: uma consulta para ler os N pedidos e, depois, uma consulta por pedido para ler seu cliente (e outra para seus itens). Com mil pedidos, isso resulta em mil e uma idas e vindas ao servidor, quando uma só teria bastado. O problema é ainda mais insidioso porque é invisível no código: [order.client.name] não parece uma consulta, e a sintaxe de propriedades do Kotlin a esconde ainda melhor do que a chamada Java [getClient().getName()]. As soluções são as mostradas no exemplo: [join fetch], um entity graph ou, melhor ainda, uma projeção em uma data class que recupera apenas os dados necessários. O Hibernate também oferece o carregamento em lote ([@BatchSize(size = 20)] aplicado a uma coleção ou à classe da entidade referenciada, no caso [Client]), que, por exemplo, recupera os clientes de vinte pedidos em uma única consulta. O log SQL ajuda a identificar o problema: a mesma consulta repetida numerosas vezes.
11.9. Alterações no esquema do banco de dados
11.9.1. O problema
Até agora, as tabelas eram criadas pelo Hibernate depois de excluídas. Isso é impossível em uma aplicação em produção: seu banco de dados contém dados que devem ser preservados quando o modelo evolui (uma nova coluna, uma nova tabela). Deve ser possível migrar o banco de dados de uma versão do esquema para a seguinte, de maneira segura e reproduzível, tanto na máquina do desenvolvedor quanto no servidor de produção. Isso é chamado de migração de esquema.
O Hibernate não oferece suporte a migrações de esquema: ele pode criar um esquema, validá-lo e fazer atualizações limitadas nele. A prática padrão, como ocorre na JVM (tanto em Java quanto em Kotlin), é delegar as migrações a scripts SQL versionados, aplicados por uma ferramenta dedicada — na maioria das vezes o Flyway ou o Liquibase — e fazer o Hibernate verificar se o esquema resultante corresponde às entidades.
11.9.2. Gerenciamento do esquema pelo Hibernate
A propriedade [hibernate.hbm2ddl.auto] (ou o método [schemaToolingAction] na configuração, que é o usado pelo programa abaixo) especifica o que o Hibernate deve fazer com o esquema ao criar o [SessionFactory]:
Valor | Constante [Action] | Efeito |
[none] | [NONE] | nenhum (valor padrão) |
[create-only] | [CREATE_ONLY] | criação das tabelas |
[create] | [CREATE] | exclusão e depois criação das tabelas |
[create-drop] | [CREATE_DROP] | como [create], e exclusão das tabelas ao fechar o [SessionFactory]: para testes |
[drop] | [DROP] | exclusão das tabelas |
[validate] | [VALIDATE] | verifica se as tabelas e colunas das entidades existem, com tipos compatíveis; caso contrário, lança uma exceção |
[update] | [UPDATE] | cria as tabelas e colunas que estiverem faltando |
O Jakarta Persistence define uma propriedade relacionada, [jakarta.persistence.schema-generation.database.action], com os valores [none], [create], [drop-and-create], e [drop]. As mesmas ações estão disponíveis programaticamente, como fizemos com o [SchemaManager] obtido do [SessionFactory] ([create], [drop], [validate], [truncate]).
A opção [update] é tentadora: o Hibernate compara as entidades com o esquema do banco de dados e adiciona o que está faltando. Ela tem limitações que a tornam inadequada para uma aplicação em produção:
- ela apenas adiciona: nunca exclui uma coluna ou tabela que se tornou desnecessária, não modifica o tipo nem o tamanho de uma coluna existente e não consegue renomear (renomear uma propriedade cria uma nova coluna vazia, enquanto a antiga permanece com seus dados);
- ela não consegue transformar dados (preencher uma nova coluna obrigatória, dividir uma coluna em duas);
- o que ela faz depende do estado do banco de dados que encontra: é impossível saber de antemão quais comandos serão executados, nem em que ordem, e nenhum registro disso é mantido.
Por isso, reservamos [create], [create-drop] e [update] para o desenvolvimento e os testes, e usamos [validate] (ou [none]) em produção, com o esquema gerenciado por scripts.
11.9.3. Scripts SQL versionados
O princípio das migrações baseadas em scripts é simples:
- cada alteração do esquema é descrita por um script SQL, numerado sequencialmente: [V1__create_clients.sql], [V2__add_phone.sql]... Depois que um script é aplicado a um banco de dados, ele nunca mais é modificado: qualquer correção é objeto de um novo script;
- o banco de dados contém uma tabela de histórico que lista as versões que foram aplicadas a ele;
- quando a aplicação inicia (ou durante a implantação), uma ferramenta compara os scripts disponíveis com o histórico e aplica, em ordem, os que ainda não foram aplicados.
Os scripts fazem parte do código-fonte da aplicação: são armazenados e gerenciados junto com o restante do código (em um repositório Git, por exemplo). Para entender como isso funciona, o subprojeto [clients] implementa um pequeno executor de scripts versionados, inspirado no Flyway; depois apresentaremos o próprio Flyway.
11.9.4. Subprojeto [clients]
O subprojeto [clients] usa o banco de dados [hbclients]. Ele tem dois programas: [clients.MainKt], que é executado por padrão, e [clients.GenerateScriptKt], que é especificado conforme a necessidade pela propriedade [main], como nos capítulos anteriores. Seu [build.gradle.kts] é igual ao do subprojeto [relations], com uma exceção:
A entidade é um cliente:
Na primeira versão da aplicação, o cliente não tem telefone: as linhas 18–20 ainda não existem. Vamos adicioná-las na segunda versão. O telefone é opcional, o que o Kotlin expressa com o tipo anulável [String?] e o valor padrão [null] (assim, podemos criar um cliente sem telefone: [Client("Durand", "durand@example.com")]). O Hibernate, porém, não reconhece os tipos do Kotlin: é a ausência de ***[nullable = false] em *[@Column] que torna a coluna opcional (inversamente, uma [String] Kotlin não anulável só produz uma coluna [NOT NULL] se isso for solicitado explicitamente, como é o caso de [name] e [email]). A função [toString] (linha 27) usa o operador Elvis para exibir a ausência de telefone.
Os scripts ficam na pasta [src/main/resources/db/migration] do subprojeto, que o Gradle copia para o classpath (para a pasta [build/resources/main]). São os scripts do curso de Java: um script SQL não depende da linguagem de programação da aplicação. O primeiro cria a tabela:
O segundo adiciona a coluna do telefone:
A classe [Migrations] aplica os scripts usando JDBC (Capítulo 10), independentemente do Hibernate:
- linhas 14–17: o banco de dados é descrito pelas propriedades privadas do construtor primário;
- linhas 20–21: um script é descrito por uma data class aninhada, [Migrations.Script]: sua versão, descrição e caminho; seu método [toString] é sobrescrito para a exibição;
- linhas 24–34: as constantes da classe, em um companion object privado. Linha 26: o nome de um script segue a convenção do Flyway: [V] — o número da versão, dois sublinhados e uma descrição. A expressão regular é escrita como uma raw string, em que a barra invertida não precisa ser duplicada (["""V(\d+)__(\w+)\.sql"""]; em Java: ["V(\\d+)__(\\w+)\\.sql"]). A tabela de histórico (uma linha por versão aplicada, com sua descrição e a data em que foi aplicada) é criada por um comando escrito como uma raw string, uma constante [const val];
- linhas 41–50: a lista de scripts. [getResource("/db/migration")] devolve a URL do diretório no classpath, ou [null] se ele não existir: o operador Elvis então devolve imediatamente uma lista vazia ([?: return emptyList()]). O diretório é listado pela função de extensão [listDirectoryEntries] de [kotlin.io.path] (Capítulo 5). Cada arquivo é confrontado com a expressão regular por [matchEntire], que devolve [null] se o nome não corresponder: [mapNotNull] descarta esses arquivos, e os grupos da expressão são recuperados por desestruturação ([destructured], Capítulo 5). Esse código pressupõe que o diretório seja um diretório real (o que ocorre quando o programa é executado pelo Gradle a partir do diretório [build/resources/main]); o Flyway também consegue ler scripts de um arquivo [.jar]. Os scripts são ordenados pelo número da versão ([sortedBy]): a ordenação alfabética colocaria [V10] antes de [V2];
- Linhas 54–59: as versões que já foram aplicadas, recuperadas da tabela de histórico, que é criada conforme a necessidade ([create table if not exists]). Os três recursos JDBC (conexão, statement, resultados) são fechados por três [use] aninhados. A função devolve um conjunto ordenado ([sortedSetOf], um [TreeSet] Java), preenchido por [apply];
- linhas 66–68: os scripts restantes a aplicar: o operador [!in] verifica a ausência de uma versão no conjunto;
- linhas 72–73: aplicação dos scripts pendentes, até uma determinada versão (todos por padrão: [target: Int = Int.MAX_VALUE]). [takeWhile] mantém os scripts enquanto sua versão não ultrapassar o alvo; [onEach] aplica cada um deles e devolve a própria lista: a função cabe em uma única expressão, enquanto o Java teria escrito um laço com [break];
- linhas 76–97: aplicação de um script: seus comandos (linhas de comentário removidas por [filterNot], o texto dividido nos pontos e vírgulas), depois a adição de sua versão à tabela de histórico, dentro de uma transação ([cnx.autoCommit = false], a propriedade Kotlin correspondente a [setAutoCommit]). Uma ressalva, anotada no comentário da linha 95: no MySQL, um comando de modificação do esquema ([CREATE TABLE], [ALTER TABLE]) confirma implicitamente a transação em andamento e não pode ser revertido. Se ocorrer um erro no meio de um script, o banco de dados pode ficar em um estado intermediário. Por isso é aconselhável usar scripts curtos, cada um realizando uma única operação.
Observe que nenhuma função da classe declara as exceções que pode lançar: a versão Java precisava especificar [throws SQLException, IOException, URISyntaxException] na maioria de seus métodos, bem como no método [main] que os chama. O Kotlin não tem exceções verificadas (Capítulo 3): uma [SQLException] simplesmente se propaga até quem quiser tratá-la.
O programa principal aplica as migrações e, em seguida, pede ao Hibernate que valide o esquema:
- linha 9: a URL do banco de dados, uma constante de nível superior no pacote [clients], que o segundo programa também usará;
- linha 13: é possível especificar, como argumento, a versão até a qual aplicar as migrações; por padrão, todas são aplicadas. [args.firstOrNull()?.toInt() ?: Int.MAX_VALUE] combina a chamada segura e o operador Elvis;
- linhas 16–22: o status das migrações, seguido de sua aplicação;
- linhas 27–34: o [SessionFactory] é criado com a ação [VALIDATE]: o Hibernate verifica se o esquema do banco de dados corresponde à entidade [Client]. Se não corresponder, a criação do [SessionFactory] falha com uma [PersistenceException], cuja causa é o erro de validação (linhas 46–49). [e.cause ?: e] captura a causa, ou a própria exceção se ela não tiver causa;
- linhas 37–43: a nova coluna é usada.
11.9.5. Geração de scripts com o Hibernate
Os scripts SQL são escritos à mão. No entanto, o Hibernate pode ajudar a escrevê-los: ele pode gerar — sem executá-lo — o script de criação do esquema ou, comparando as entidades com um banco de dados existente, o script para atualizá-lo. É isso que faz o programa [GenerateScript.kt]:
- linha 10: a ação, passada como argumento: [create] ou [update];
- linhas 14–23: o [SessionFactory] é criado unicamente para gerar o script: ele é fechado logo após a criação, sem sequer ser armazenado em uma variável (o curso de Java o declarava em uma instrução [try] com recursos, usando a variável Java anônima [_] do Java 22);
- linhas 18–21: as propriedades de geração de script, já encontradas no subprojeto [model]. Desta vez, o Hibernate se conecta ao banco de dados: para a ação [update], ele precisa conhecer seu esquema;
- linhas 25–27: o script, com a indentação de 4 espaços removida de suas linhas por [removePrefix], que só remove o prefixo se ele estiver presente.
Observe que os dois programas do subprojeto têm, cada um, uma função [main] de nível superior no mesmo pacote: isso é permitido para a função [main], pois cada uma é compilada em sua própria classe de arquivo ([clients.MainKt], [clients.GenerateScriptKt]).
O script de criação, gerado a partir da versão atual da entidade, serve para criar um novo banco de dados de uma só vez (para testes, por exemplo):
Com a primeira versão da entidade (sem telefone), ele teria produzido, na mesma ordem das colunas, o script [V1__create_clients.sql].
11.9.6. Aplicar as migrações
Suponhamos que o banco de dados ainda não exista. Aplicamos somente a primeira migração, passando a versão 1 como argumento (opção [--args] da tarefa [run]):
- Nenhuma versão foi aplicada; dois scripts estão pendentes (a lista Kotlin é exibida da mesma forma que a lista Java, entre colchetes). A tabela de histórico foi criada pela função [appliedVersions], e o banco de dados [hbclients] pelo MySQL ([createDatabaseIfNotExist=true]);
- o script [V1] é aplicado;
- O Hibernate detecta que a coluna [phone] da entidade não existe na tabela: isso é normal, pois o banco de dados está na versão 1 e a entidade está na versão 2. Com a entidade da versão 1, a validação teria sido bem-sucedida.
A aplicação evolui: adicionamos o telefone à entidade. Para escrever o script da versão 2, pedimos ao Hibernate que compare a entidade com o banco de dados, que ainda está na versão 1:
Isso é, exceto pela formatação, igual ao script [V2__add_phone.sql]. Agora aplicamos todas as migrações pendentes:
- A versão 1 é aplicada, a versão 2 está pendente e é aplicada;
- A validação é bem-sucedida;
- a nova coluna está pronta para uso: o cliente é salvo com seu telefone e depois recuperado.
A tabela de histórico agora contém as duas versões:
Executar o programa novamente não aplica nenhuma alteração: as duas versões aparecem no histórico (no entanto, ele adiciona um segundo cliente chamado Dupont, que não mostramos):
11.9.7. Flyway
O Flyway é a ferramenta de migração mais utilizada na JVM (o Spring Boot a executa automaticamente quando uma aplicação inicia, se ela estiver presente no classpath). Ele funciona exatamente segundo o mesmo princípio do nosso executor, mas é mais completo: os scripts [V<version>__<description>.sql] são procurados por padrão na pasta [db/migration] do classpath, a tabela de histórico [flyway_schema_history] é utilizada, e os scripts pendentes são aplicados na ordem das versões. Em particular, ele adiciona um checksum a cada script, o que detecta alterações em um script já aplicado; scripts “repetíveis” ([R__description.sql], reaplicados a cada alteração, para views, por exemplo); migrações escritas na linguagem da aplicação (classes Java ou Kotlin); um lock que impede que duas instâncias da aplicação migrem o banco de dados ao mesmo tempo; e um plugin do Gradle (tarefas [flywayMigrate], [flywayInfo]).
Para usá-lo no subprojeto [clients], basta adicionar as dependências [org.flywaydb:flyway-core] e [org.flywaydb:flyway-mysql] (em suas versões mais recentes) ao [build.gradle.kts], manter os dois scripts como estão — já que eles seguem a sua convenção — e substituir o uso da classe [Migrations] por uma única linha: [Flyway.configure().dataSource(URL, "root", "").load().migrate()].
O Liquibase, a outra ferramenta comumente utilizada, descreve as alterações do esquema em arquivos XML, YAML ou SQL (os “changelogs”) e pode gerar o SQL específico de cada SGBD. Em ambos os casos, o Hibernate é configurado com [validate] ou [none] e deixa de modificar o esquema.
11.10. Hibernate e threads virtuais
Uma consulta ao banco de dados é uma operação de E/S: enquanto o servidor processa a requisição, a thread que espera não faz nada. Os Capítulos 8 e 9 apresentaram duas maneiras de evitar o desperdício de threads durante essas esperas: as threads virtuais do JDK e as corrotinas do Kotlin. A API do Hibernate, como o JDBC que ele usa, é bloqueante: [getResultList] (a propriedade [resultList] em Kotlin) não devolve o controle até que as linhas tenham sido lidas. Com threads virtuais, isso deixa de ser um inconveniente: uma thread virtual bloqueada em E/S libera a thread do sistema que a executava, e é possível criar milhares delas. Escreve-se, então, código bloqueante comum, executado por threads virtuais. Com corrotinas, confiamos de forma semelhante esse código bloqueante a um dispatcher concebido para E/S, [Dispatchers.IO] (Capítulo 9), por meio de [withContext]: a corrotina que aguarda o resultado é suspensa, sem bloquear sua thread.
Uma regra deve ser seguida nos dois casos: uma sessão não é thread-safe. Ela nunca é compartilhada entre várias threads ou várias corrotinas: cada thread, cada tarefa e cada corrotina abre sua própria sessão a partir do [SessionFactory], que, esse sim, é compartilhado. Com corrotinas, essa regra exige atenção especial: uma corrotina pode retomar a execução, após uma suspensão, em uma thread diferente daquela em que começou; uma sessão aberta antes de uma chamada suspensa e usada depois dela passaria, portanto, de uma thread para outra. A abordagem mais simples é abrir e fechar a sessão dentro do bloco [withContext], que não contém pontos de suspensão. O Hibernate nem sempre detecta o uso concorrente de uma mesma sessão; os erros resultantes são imprevisíveis.
O subprojeto [async] aplica essa regra. Além da biblioteca [articles], ele depende do kotlinx-coroutines:
- linha 14: a entidade [Article] e o banco de dados [hbarticles], como nos exemplos anteriores;
- linha 16: a biblioteca de corrotinas (Capítulo 9);
- linhas 32–35: os programas iniciados pelo Gradle gravam sua saída em UTF-8, para que os caracteres acentuados sejam exibidos corretamente no Windows (Capítulo 2).
O programa:
Resultados:
Comentários:
- linha 23: um executor que cria uma thread virtual por tarefa (Capítulo 8). Um [ExecutorService] é [AutoCloseable]: a função [use] o fecha ao final do bloco, e esse fechamento espera que todas as tarefas terminem;
- Linhas 24–33: duas tarefas submetidas ao executor. Cada uma abre sua própria sessão ([fromSession]) e executa uma consulta; as duas consultas rodam simultaneamente, em duas conexões do pool. Sua ordem no log (linhas 3–9 dos resultados) pode, portanto, variar de uma execução para outra. O tipo do resultado é especificado em [submit] ([submit<List<Article>>]): caso contrário, a lambda poderia ser interpretada como um [Runnable] — que não devolve nada — e não como um [Callable];
- Linha 33: o tipo do resultado da consulta de contagem. [Long::class.java] aqui se refere ao tipo primitivo Java [long]; o Hibernate o aceita e devolve o valor como um [java.lang.Long], que o Kotlin trata como um [Long];
- linhas 36–38: [get()] espera que cada tarefa termine e devolve seu resultado (linhas 10–13);
- linhas 44–53: um [CompletableFuture] (Capítulo 9) cuja primeira etapa — uma transação completa — é executada por uma thread virtual ([supplyAsync(..., executor)]), e a segunda etapa exibe seu resultado. A função [apply] modifica o registro lido e o devolve: esse é o valor da lambda e, portanto, o resultado da transação. O registro devolvido pela transação está desanexado (sua sessão está fechada): podemos ler suas propriedades, mas não carregar suas associações;
- linhas 58–68: a mesma ideia com corrotinas. [runBlocking] cria uma corrotina principal; [async] inicia duas corrotinas filhas, que chamam a função de suspensão [countArticles]. As duas requisições rodam simultaneamente (linhas 30–35), e [await] suspende a corrotina principal até que cada uma retorne (linhas 36–37);
- linhas 95–96: a função de suspensão delega o trabalho bloqueante ao dispatcher [Dispatchers.IO], cujas threads são concebidas para esperar operações de E/S. A sessão é aberta e fechada por [fromSession] dentro do bloco [withContext]: ela é usada por uma única corrotina e em uma única thread. Essa é a abordagem a adotar ao chamar o Hibernate a partir de código suspenso. Também seria possível usar um dispatcher construído sobre threads virtuais ([Executors.newVirtualThreadPerTaskExecutor().asCoroutineDispatcher()], Capítulo 9);
- linhas 73–76: a propriedade [resultStream] (o método [getResultStream]) devolve um stream Java: as entidades são processadas à medida que são lidas, sem formar uma lista (linhas 42–44). Um stream é [AutoCloseable]: [use] o fecha, o que libera o cursor JDBC. Ele também poderia ser convertido em uma sequência Kotlin ([asSequence()], Capítulo 5). Isso é útil para processar um grande número de linhas. Com o MySQL, observe que, por padrão, o driver lê todas as linhas do resultado antes de devolver a primeira; para uma leitura realmente progressiva, é preciso instruí-lo a usar um cursor (parâmetro [useCursorFetch=true] da URL e tamanho do lote definido por [setFetchSize]);
- Linhas 83–87: um tempo máximo de execução, em segundos, definido por [setTimeout]. A consulta (uma consulta SQL nativa, da qual trataremos mais adiante) leva cinco segundos; após um segundo, o driver JDBC a interrompe, e o Hibernate lança uma [QueryTimeoutException] (linhas 46–48).
A duração da última requisição merece uma observação. No Capítulo 9, cancelamos corrotinas ([job.cancel()], [withTimeout]) e tarefas ([Future.cancel]). Esses cancelamentos não teriam efeito sobre a requisição aqui: cancelar uma corrotina é cooperativo, e uma corrotina bloqueada no driver JDBC não verifica se foi cancelada; quanto a interromper uma thread bloqueada no driver, isso não interrompe a requisição em andamento no servidor. Um [withTimeout(1000) { countArticles(...) }] de fato lançaria uma [TimeoutCancellationException]... mas só depois que a requisição terminasse, passados cinco segundos: o bloco [withContext] de [countArticles] não devolve o controle até concluir sua operação bloqueante. Para limitar a duração de uma requisição, é preciso, portanto, atuar sobre o driver JDBC por meio de [setTimeout].
Para aplicações que exigem uma API realmente não bloqueante, existe o Hibernate Reactive, uma variante do Hibernate que se baseia em drivers reativos (os do Vert.x) em vez do JDBC, e cujos métodos devolvem [CompletionStage] ou objetos da biblioteca Mutiny; um [CompletionStage] é aguardado em uma corrotina com a função de extensão [await] do kotlinx-coroutines. As threads virtuais e o dispatcher [Dispatchers.IO] eliminam essa complexidade na maioria dos casos: essa é a abordagem adotada neste curso.
11.11. Transações e concorrência
11.11.1. Transações
O Capítulo 10 apresentou as transações: um conjunto de operações que ou todas têm êxito ou todas falham. Com o Hibernate:
- toda operação de escrita é executada dentro de uma transação, aberta por [session.beginTransaction()] e encerrada por [commit] ou [rollback]. Os métodos [inTransaction] e [fromTransaction] do [SessionFactory] cuidam disso para nós: eles confirmam a transação se a lambda terminar normalmente e a revertem se ela lançar uma exceção, que então é relançada;
- todos os comandos enviados durante a transação (comandos imediatos via [INSERT], sincronizações explícitas via [flush] e a sincronização via [commit]) são confirmados ou revertidos em conjunto;
- Um erro do SGBD é propagado como uma exceção do Hibernate, derivada de [JDBCException], que encapsula a [SQLException] do driver: [ConstraintViolationException] para uma violação de restrição (chave primária, unicidade, chave estrangeira, [NOT NULL]), [SQLGrammarException] para um erro no comando SQL, e assim por diante. São exceções não verificadas, tanto em Java quanto em Kotlin (que, como lembrete, não tem exceções verificadas: Capítulo 3); só capturamos aquelas que sabemos tratar.
O subprojeto [transactions] ilustra as duas maneiras de tratar uma transação:
Resultados:
Comentários:
- Linhas 18–20: dois itens são adicionados em uma transação gerenciada por [inTransaction]; o segundo item tem o mesmo nome de um item existente. Os dois comandos [INSERT] são executados imediatamente (linhas 4–15); o segundo viola a restrição de unicidade da coluna [name]: o MySQL o rejeita (linha 16), [persist] lança uma [ConstraintViolationException], [inTransaction] reverte a transação (linha 17) e relança a exceção;
- linhas 22–23: a exceção é capturada; a propriedade [constraintName] (o método [getConstraintName]) devolve o nome da restrição violada (linha 18). Isso demonstra a utilidade de ter nomeado a restrição;
- linha 25: a raquete, que havia sido inserida com sucesso, não está no banco de dados (linha 23): a reversão da transação a excluiu;
- Linhas 29–45: uma transação gerenciada pelo código, em uma sessão aberta por [openSession] e fechada por [use] ([Session] é [AutoCloseable]). Duas bicicletas são vendidas ([bike.currentStock -= 2]: o operador [-=] é aplicado a uma propriedade [var] assim como a uma variável), e a alteração é enviada ao SGBD por um [flush] explícito (linhas 29–36); em seguida, um item cujo nome já existe é adicionado: a inserção falha (linha 43);
- linha 41: o commit nunca é alcançado;
- linhas 42–45: no [catch], a transação é revertida (linha 45 dos resultados). A propriedade [sqlException] devolve a exceção original do driver JDBC, e sua mensagem é a do MySQL (linha 44);
- linha 49: a venda das bicicletas, embora enviada ao SGBD por [flush], foi cancelada: o estoque de bicicletas continua sendo 10 (linha 50);
- linhas 54–60: uma função que relê um registro com uma nova sessão para ver o estado real do banco de dados, e não as entidades da sessão de trabalho atual. A propriedade [singleResultOrNull] vale [null] se a consulta não encontrar nada; o operador Elvis ([?:]) exibe então “missing”.
Após uma exceção, uma sessão não deve mais ser usada: seu contexto de persistência pode conter entidades em um estado inconsistente com o banco de dados. Revertemos a transação, fechamos a sessão e, se necessário, recomeçamos com uma nova sessão. É isso que [inTransaction] faz, e o que nosso código faz ao sair do bloco [use], que fecha a sessão.
O nível de isolamento das transações é o da conexão JDBC: [REPEATABLE_READ], o valor padrão do MySQL, como mostrado no primeiro exemplo. É possível alterá-lo para todo o [SessionFactory] por meio do método [jdbcTransactionIsolation] na configuração.
11.11.2. Concorrência otimista
Dois usuários estão lendo o mesmo item, cujo estoque é 10. O primeiro usuário vende uma unidade e atualiza o estoque para 9. O segundo usuário, que leu o valor do estoque antes dessa atualização, vende três unidades e atualiza o estoque para 7: a venda do primeiro usuário é perdida. Esse é o problema das atualizações perdidas.
Uma solução seria bloquear a linha durante toda a duração da operação de cada usuário (concorrência “pessimista”): isso bloqueia os outros usuários, às vezes por muito tempo. Com o Hibernate, geralmente se prefere a concorrência otimista: nada é bloqueado, mas uma verificação é feita no momento da gravação para garantir que a linha não foi modificada desde que foi lida. A maneira padrão de fazer isso é adicionar um número de versão à entidade — uma propriedade anotada com [@Version]. O Hibernate incrementa esse número a cada modificação da linha e adiciona a condição “a versão ainda tem o valor lido” à cláusula [WHERE] dos comandos [UPDATE] e [DELETE]. Se a transação não modificar nenhuma linha, isso significa que outro usuário já alterou os dados: o Hibernate lança uma [OptimisticLockException].
O subprojeto [concurrency] usa seu próprio banco de dados, [hbconcurrency], e sua própria entidade, [Article], reduzida ao essencial:
- linhas 15–17: o número de versão, do tipo [Int] (também é possível usar [Long] ou uma data do tipo [Instant]). A aplicação nunca o modifica por conta própria: seu modificador é protegido ([protected set]), assim como o do identificador; o Hibernate, que acessa o campo diretamente, não é afetado por isso. O valor inicial [0] é o de um artigo criado pela aplicação; para um artigo lido do banco de dados, o construtor sem parâmetros adicionado pelo plugin [jpa] não realiza essa inicialização (como vimos), mas o Hibernate atribui imediatamente à propriedade o valor lido.
Como a entidade é definida no próprio subprojeto, seu arquivo de build aplica os plugins [jpa] e [allopen] e depende diretamente do Hibernate e da biblioteca [tools]:
- linhas 5–6: os dois plugins de entidade, configurados pelo bloco [allOpen] (linhas 23–26);
- linhas 16–19: o log SQL compacto, o Hibernate e o driver JDBC do MySQL;
- linhas 42–45: os programas iniciados pelo Gradle gravam sua saída em UTF-8, para que os caracteres acentuados sejam exibidos corretamente no Windows (Capítulo 2).
O programa simula os dois usuários com duas sessões:
Resultados:
Comentários:
- linhas 10–15: a configuração do Hibernate para o banco de dados [hbconcurrency] e sua única entidade;
- linhas 18–21: a tabela é recriada com um único artigo, a bicicleta, na versão 0. A função [withoutLog] da biblioteca [tools] recebe a ação a ser executada na forma de uma lambda, escrita sem parênteses por ser seu único parâmetro (Capítulo 7);
- linhas 28–29: cada usuário lê a bicicleta em sua própria sessão; as duas sessões são abertas por duas funções [use] aninhadas e fechadas na ordem inversa de sua abertura. A coluna [version] é lida junto com as demais (linhas 3–10);
- linhas 33–35: o comando [UPDATE] do primeiro usuário (linhas 13–20) grava a nova versão (1) e contém a condição [version=?] com a versão lida (0). A linha é modificada; a propriedade [version] da entidade passa a valer 1 (linha 22);
- linhas 41–44: a requisição do segundo usuário contém a mesma condição, com a versão que ele leu, 0, ao passo que a versão da linha no banco de dados agora é 1. Nenhuma linha é modificada, e o Hibernate lança uma [OptimisticLockException] (linha 33). Sincronizamos a sessão explicitamente ([flush]) antes do [commit] para provocar essa exceção tal como ela é; se fosse lançada durante o [commit], ela seria encapsulada em uma [RollbackException];
- Linhas 54–59: a resolução depende da aplicação: abortar, notificar o usuário ou, como aqui, reler o artigo usando uma nova sessão (a sessão que recebeu a exceção não deve mais ser utilizada) e repetir a operação. O estoque reabastecido é 9 na versão 1 (linha 41), e a venda das três bicicletas resulta em um estoque de 6 na versão 2 (linha 50);
- linha 65: uma função de extensão (Capítulo 4) que formata o estado de um artigo para exibição. Ela é definida dentro do programa, sem modificar a entidade.
Duas variantes:
- sem uma coluna de versão, o Hibernate pode verificar os valores antigos das próprias colunas: com as anotações [@OptimisticLocking(type = OptimisticLockType.DIRTY)] e [@DynamicUpdate] na entidade, a cláusula [WHERE] do [UPDATE] contém o valor lido de cada coluna modificada ([where id=? and currentStock=?]). Isso é útil para um banco de dados existente que não pode ser modificado;
- a concorrência pessimista continua possível quando os conflitos são frequentes: [session.find(Article::class.java, 1, LockModeType.PESSIMISTIC_WRITE)] lê a linha com um comando [select ... for update], que a bloqueia até o fim da transação.
11.12. O SQL nativo
O Hibernate gera o SQL a partir do HQL ou da Criteria API, mas ainda é possível escrever você mesmo o SQL de uma consulta, para usar um recurso específico do SGBD ou para otimizar uma consulta complexa: fala-se então de consulta nativa. O subprojeto [rawsql] lista os métodos disponíveis:
Resultados:
Comentários:
- Linhas 17–24: [createNativeQuery] executa uma consulta (SQL) que retorna linhas da tabela de uma entidade, e o segundo parâmetro ([Article::class.java]) instrui o Hibernate a materializá-las como entidades gerenciadas pela sessão. Os nomes das colunas no resultado devem corresponder aos do modelo: [select *] é adequado aqui. A consulta é escrita como uma string bruta (["""]), da qual [trimIndent] remove a indentação comum (Capítulo 5). Ela é passada ao SGBD tal como está (linhas 3–6), exceto que o parâmetro nomeado [:minPrice] se torna um parâmetro JDBC ([?]);
- linhas 29–34: uma tentativa de injeção de SQL. O valor de [name] é passado como parâmetro: ele é comparado literalmente com a coluna [name], e nenhum artigo corresponde (linha 16);
- linhas 37–38: a mesma consulta construída com um template de string (['$name']). Os templates são tão convenientes em Kotlin que é tentador usá-los para montar uma consulta: isso é um erro grave. O valor de [name] se torna código SQL, a condição é sempre verdadeira (linha 20), e a consulta retorna seis artigos (linha 21): trata-se de uma injeção de SQL bem-sucedida. Como no Capítulo 10, uma consulta nativa deve conter apenas texto constante, com os valores passados como parâmetros;
- Linhas 43–52: consultas que retornam valores simples ([String], [BigDecimal]): o segundo parâmetro de [createNativeQuery] é então o tipo do valor. Para várias colunas, é possível especificar uma data class (cujo construtor recebe as colunas em ordem) ou usar [Array<Any>::class.java];
- linhas 56–65: [createNativeMutationQuery] prepara um comando de atualização, executado por [executeUpdate], que retorna o número de linhas modificadas. Ele é executado dentro de uma transação: o método [fromTransaction] da sessão a abre, faz o commit e retorna o resultado da lambda. A lambda recebe a transação como parâmetro; como não a utiliza, esse parâmetro se chama [_];
- linhas 71–77: [doWork] dá acesso à conexão JDBC da sessão ([java.sql.Connection]) para código JDBC padrão (Capítulo 10): chamada de uma stored procedure, uso de um recurso do driver... Ele inclui a função [use], que fecha o comando ([Statement]) e o [ResultSet]. O preço do arco foi de fato reduzido em 10% (linha 40).
Uma observação sobre a linha 71: o tipo do parâmetro da lambda ([connection: Connection]) é especificado explicitamente aqui, o que não é uma prática comum em Kotlin. Sem ele, o compilador rejeita o programa:
A interface do Hibernate [Work], que a lambda implementa, traz anotações de tipo da biblioteca Checker Framework em seu tipo de parâmetro; essas anotações são usadas pelos desenvolvedores do Hibernate para verificar o uso de [null] em seu código. Essa biblioteca não faz parte das dependências do Hibernate; portanto, suas anotações são desconhecidas pelo compilador, que se recusa a inferir um tipo que as carregue. Ao especificar nós mesmos o tipo do parâmetro, evitamos a inferência — e o erro. Esse tipo de problema surge às vezes ao usar uma biblioteca Java a partir de Kotlin: o próprio código Java ignora essas anotações.
Uma consulta nativa não é portável de um SGBD para outro, e o Hibernate não consegue validá-la antes da execução: ela é reservada para os casos em que o HQL é insuficiente. O HQL, aliás, cobre grande parte do SQL (junções de todos os tipos, subconsultas, funções de janela, [union]...), e permite chamar uma função do SGBD que ele não reconhece.
11.13. Atualizações em massa, modo somente leitura e lotes
O rastreamento de alterações tem um custo: para aumentar o preço de 100 artigos, é preciso ler os 100 artigos, modificá-los um a um, e a sincronização da sessão enviará 100 comandos [UPDATE]. O Hibernate oferece várias maneiras de processar com eficiência grandes quantidades de linhas. O subprojeto [bulkupdate] as apresenta:
Resultados (o final repetitivo foi abreviado):
Comentários:
- Linhas 17–23: um comando [update] escrito em HQL, preparado por [createMutationQuery], e executado por [executeUpdate]. Ele se torna um único comando SQL [UPDATE] (linhas 4–6), executado pelo SGBD em todas as linhas afetadas, sem que nenhuma entidade seja carregada na memória. O novo valor pode depender da própria linha ([minimumStock * 2]). Esse comando é executado dentro de uma transação (linhas 2 e 18);
- linhas 27–29: um aumento de 10% nos preços baixos. As constantes da consulta HQL ([1.1], [150]) são escritas diretamente no texto do comando SQL (linhas 10–11);
- linhas 34–36: um comando HQL [delete] remove o arco, o único artigo com preço superior a 550 euros (linhas 14–16);
- linhas 43–50: uma operação somente leitura ([setReadOnly(true)]). As entidades lidas são gerenciadas pela sessão, mas a sessão não guarda seu estado original nem as monitora: isso é mais rápido e consome menos memória para dados que são lidos sem serem modificados (exibição, cálculos). Em contrapartida, qualquer modificação em tal entidade é ignorada (linha 49): a sessão não tem nada a sincronizar ([session.isDirty] é igual a [false], linha 29) e o [commit] não envia nenhum comando. Também é possível definir uma sessão inteira como somente leitura ([session.isDefaultReadOnly = true]);
- linhas 56–62: uma armadilha. Um comando [update] HQL opera diretamente no banco de dados: ele não modifica as entidades já carregadas pela sessão. A bomba gerenciada pela sessão mantém seu preço antigo (linha 37) até ser lida novamente com [session.refresh(pump)] (linhas 38–42);
- Linhas 68–76: uma sessão sem estado ([StatelessSession]), aberta aqui com uma transação por meio de [inStatelessTransaction]. Ela não tem contexto de persistência: sem cache de primeiro nível, sem rastreamento de alterações, sem carregamento tardio e sem cascatas. Cada operação é solicitada explicitamente ([insert], [update], [delete], [get]) e executada tal como está. É a ferramenta para o processamento em massa: importar um arquivo grande, recalcular todas as linhas de uma tabela;
- linha 69: os comandos SQL serão enviados ao SGBD em lotes (veja o Capítulo 10) de três: o driver JDBC transmite três comandos em uma única troca com o servidor. Em Kotlin, o par [getJdbcBatchSize]/[setJdbcBatchSize] é usado como uma propriedade. O log mostra os três primeiros [UPDATE], seguidos da execução do lote (linha 58), e termina com o último lote de dois comandos (linha 63). Uma aplicação define o tamanho do lote para todas as suas sessões por meio da propriedade [hibernate.jdbc.batch_size] (tipicamente entre 10 e 50). Observe que as inserções em uma tabela cuja chave é gerada por [IDENTITY] não podem ser agrupadas em lotes.
Para o processamento em massa com uma sessão comum, é preciso impedir que seu contexto de persistência acumule entidades: sincronize e esvazie a sessão regularmente, por exemplo a cada cinquenta registros ([session.flush(); session.clear()]). Em Kotlin, a função [chunked] de sequências e coleções (Capítulo 5) divide convenientemente os dados em blocos desse tamanho.
11.14. Hibernate e injeção de dependência: Spring
11.14.1. O [SessionFactory] no contêiner
Os exemplos anteriores criavam suas próprias sessões. Em uma aplicação em camadas (Capítulo 6), e em todas as aplicações Spring, o [SessionFactory] é um objeto do contêiner de injeção de dependência, assim como as camadas que o utilizam. Para isso, o Spring Framework fornece, em sua biblioteca [spring-orm]:
- a classe [LocalSessionFactoryBean], que constrói o [SessionFactory] a partir de uma fonte de dados ([DataSource], Capítulo 10) e de uma lista de entidades;
- a classe [HibernateTransactionManager], um gerenciador de transações que abre uma sessão do Hibernate para cada transação, a associa à thread atual e a fecha ao final da transação;
- a anotação [@Transactional] (biblioteca [spring-tx]): aplicada a um método, ou a uma classe para todos os seus métodos públicos, ela instrui o Spring a executar o método dentro de uma transação, que sofre commit se o método terminar normalmente e rollback se ele lançar uma exceção não tratada. Essas são as transações declarativas. Uma observação sobre Kotlin: por padrão, o Spring não faz rollback da transação para uma exceção verificada (checked), conforme definida pelo Java (uma [IOException], por exemplo). O Kotlin não distingue essas exceções das demais, mas o Spring sim: uma função Kotlin que lança uma [IOException] dentro de um método transacional terá sua transação confirmada! Por isso escrevemos [@Transactional(rollbackFor = [Exception::class])] para garantir que a transação sofra rollback em todos os casos.
Dentro de um método transacional, ***[sessionFactory.currentSession]*** (o método *[getCurrentSession] ) devolve a sessão da transação atual. Uma camada [dao] pode então ser um singleton que recebe o [SessionFactory] (thread-safe) e lhe pede, em cada método, a sessão atual: a regra “uma sessão por unidade de trabalho, nunca compartilhada entre threads” é respeitada sem esforço. Cuidado, porém, com as corrotinas: a sessão atual está associada à thread, e uma função de suspensão que troque de thread no meio de uma transação perderia sua sessão. Por isso, mantemos os métodos transacionais bloqueantes e os chamamos a partir de uma corrotina dentro de um bloco [withContext(Dispatchers.IO)], como mostrado no exemplo [async]*.
11.14.2. O [injection] subprojeto
O [injection] subprojeto depende do Spring e do HikariCP, além da biblioteca [articles]:
- Linha 5: o plugin [all-open] configurado para o Spring (Capítulo 6). Ele torna abertas as classes anotadas com [@Configuration], bem como com [@Transactional] e algumas outras ([@Component], [@Service], [@Async]...), assim como seus métodos. Veremos por que isso é essencial;
- linha 15: a entidade [Article] e o banco de dados [hbarticles] (incluindo o Hibernate, o MySQL e o log de SQL);
- Linhas 17–18: o contêiner Spring e a integração com o Hibernate; [spring-orm] inclui [spring-tx], a biblioteca de transações;
- linha 19: o pool de conexões HikariCP (Capítulo 10);
- linhas 36–39: os programas iniciados pelo Gradle gravam sua saída em UTF-8 para que os caracteres acentuados sejam exibidos corretamente no Windows (Capítulo 2).
A configuração do Spring é escrita em Kotlin, usando as anotações [@Configuration] e [@Bean] do Capítulo 6:
- linha 18: habilita a anotação [@Transactional]: o Spring substituirá todo objeto que tenha um método com essa anotação por um proxy que abre e confirma a transação em torno da chamada;
- linhas 22–26: o pool de conexões HikariCP do Capítulo 10, configurado em um bloco [apply]: os modificadores [setJdbcUrl], [setUsername] e [setPassword] são usados como propriedades. O atributo [destroyMethod] especifica o método a ser chamado quando o contêiner for encerrado. O tipo de retorno inferido da função é [HikariDataSource]: é o tipo sob o qual o Spring registra o bean;
- linhas 31–34: [SessionFactory]. Um
*[LocalSessionFactoryBean]é uma fábrica de*[SessionFactory]*: o Spring registra no contêiner o objeto que ela produz, e é um*[SessionFactory]que se obtém ao solicitar esse bean. Ela recebe o pool de conexões (que substitui o pool embutido do Hibernate), as entidades e as propriedades do Hibernate. Escrevemos [setDataSource(dataSource)] em vez de [dataSource = dataSource], que atribuiria o parâmetro a si mesmo (e seria rejeitado, pois um parâmetro é somente leitura); - linha 39: o gerenciador de transações;
- linha 43: a camada [dao], que recebe o [SessionFactory].
A camada [dao]:
- linha 9: todos os métodos públicos da classe são transacionais;
- linha 12: o [SessionFactory], recebido pelo construtor primário;
- linha 16: dentro de uma mesma transação, duas solicitações da sessão atual retornam a mesma sessão? O operador [===] compara as referências (Capítulo 3);
- linha 19: a sessão da transação, devolvida ao chamador (para o experimento seguinte: isso não se faz em uma aplicação real);
- linhas 22–25: uma transação somente leitura ([readOnly = true]): o Spring define a sessão como somente leitura e não a sincroniza;
- linhas 37–41: a venda de uma quantidade de um artigo. Se o estoque ficar negativo, a função Kotlin [check] (Capítulo 3) lança uma [IllegalStateException], uma exceção não tratada: o Spring faz o rollback da transação. A chamada ao método [article] (linha 38) é uma chamada interna ao objeto, que não passa pelo proxy: ela é executada dentro da transação de [sell].
O proxy criado pelo Spring para a classe [ArticlesDao] é uma subclasse dela, gerada em tempo de execução pela biblioteca CGLIB, que redefine cada método público para envolvê-lo em uma transação. Sem o plugin [plugin.spring], a classe Kotlin seria final, e o Spring não conseguiria derivá-la. Se você compilar o subprojeto sem esse plugin (declarando manualmente a classe [Config] e suas funções [open] para contornar o primeiro erro, que já encontramos no Capítulo 6), o contêiner se recusa a iniciar:
Uma armadilha mais insidiosa espera quem abre manualmente a classe ([open class ArticlesDao]) sem abrir seus métodos: o proxy é então criado, mas não consegue sobrescrever os métodos que permanecem final. Chamar esses métodos diretamente executa o código da classe [ArticlesDao]... no objeto proxy, cujos campos não foram inicializados (o Spring o cria sem chamar o construtor da classe). O resultado, obtido ao compilar o subprojeto dessa maneira, é desconcertante:
A propriedade [sessionFactory], de um tipo não anulável, vale [null]! O plugin evita esses dois erros: com ele, a classe e todos os seus métodos são abertos.
O programa principal:
Resultados:
Comentários:
- Linha 12: o contêiner Spring, configurado pela classe [Config]. Ele é fechado ao final do bloco [use], que fecha o [SessionFactory] e o pool de conexões;
- linha 14: o [SessionFactory] construído pelo Spring, obtido por meio da função de extensão [getBean<T>()] do Spring (Capítulo 6); ele é usado para recriar a tabela de produtos;
- linha 20: uma transação (linhas 3–4): dentro da mesma transação, a sessão atual continua sendo a mesma (linha 5);
- linhas 22–25: duas chamadas, duas transações (linhas 6–9), duas sessões diferentes; a primeira está fechada, pois sua transação terminou (linha 10). A propriedade [isOpen] corresponde ao método [isOpen()] da sessão;
- linhas 28–29: fora de uma transação, não há sessão atual: [getCurrentSession] lança uma [HibernateException] (linha 11). Esse é o erro clássico de um método que esqueceu a anotação [@Transactional];
- linha 35: uma transação somente leitura (linhas 13–17);
- linha 37: a venda de duas bicicletas. A transação sofre commit, e a sincronização da sessão envia o [UPDATE] (linhas 20–33);
- linhas 40–41: a venda de cinquenta bombas provoca uma exceção: o Spring faz o rollback da transação (linha 40), e o [UPDATE] nunca é enviado, pois a sessão não foi sincronizada;
- linhas 45–46: estado do banco de dados: o estoque de bicicletas passou a 8, enquanto o estoque de bombas permanece em 10 (linhas 49 e 56).
Em uma aplicação Spring Boot, tudo isso acontece automaticamente: o Spring Boot cria o pool de conexões, a fábrica (em sua forma Jakarta Persistence, uma [EntityManagerFactory]) e o gerenciador de transações a partir do arquivo [application.properties]. O Spring Data JPA costuma ser usado sobre o Hibernate; ele gera a camada [dao] a partir de uma simples interface: [interface ArticleRepository : JpaRepository<Article, Int>] fornece [findAll], [findById], [save], [delete]..., e um método declarado [fun findByPriceLessThan(price: BigDecimal): List<Article>] é traduzido automaticamente em uma consulta. O Spring Data acrescenta algumas funções de extensão para Kotlin, como [findByIdOrNull], que retorna um [Article?] em vez de um [Optional<Article>].
11.15. Aplicação de exemplo - versão 7
11.15.1. A arquitetura
A versão 6 da aplicação de cálculo de imposto (Capítulo 10) lia as faixas de imposto de um banco de dados MySQL usando JDBC. A versão 7 faz o mesmo usando o Hibernate. Como na versão 6, apenas a camada [dao] muda: as camadas [business] e [ui] da versão 5 (Capítulo 6) são reutilizadas sem alterações, graças à arquitetura em camadas.
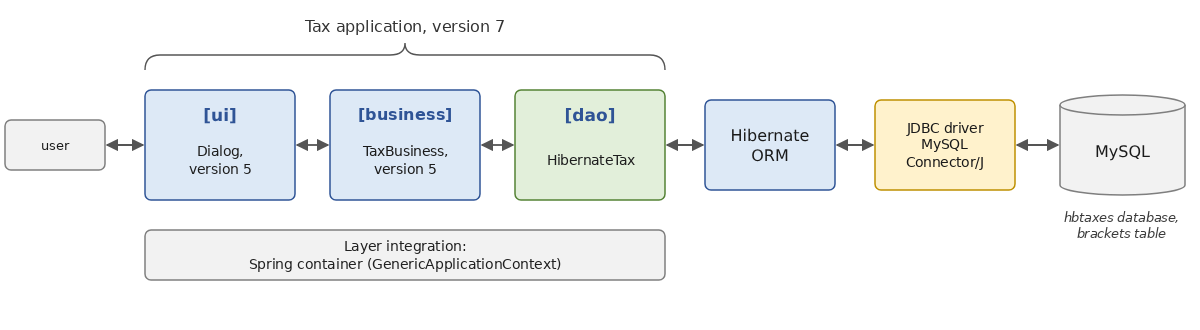
A versão 7 é composta por dois subprojetos da estrutura do Capítulo 11, armazenados na pasta [TaxV7]:
A pasta [TaxV7] não tem um arquivo de build: como a pasta [TaxV5] do Capítulo 6, ela é simplesmente um conjunto de subprojetos. Os módulos da versão 5 ([tax-dao], [tax-business], [tax-ui], na versão 5.0) são fornecidos pelo build do Capítulo 6, incluído pela linha [includeBuild("../06-architectures")] do arquivo [settings.gradle.kts]: o Gradle substitui qualquer dependência [examples.tax:tax-xxx:5.0] pelo subprojeto correspondente desse build, que ele compila conforme a necessidade. Não há nada a instalar previamente, ao contrário do Maven, em que era preciso antes digitar [mvn install] na pasta da versão 5.
11.15.2. A camada [dao]
O subprojeto [tax-dao-hibernate] depende da camada [dao] da versão 5, que contém as entidades da aplicação ([TaxBracket], [TaxException]) e a interface [ITaxDao]:
- linhas 5–6: plugins de entidades: o subprojeto define a entidade [Bracket];
- linha 8: o subprojeto é uma biblioteca que expõe algumas de suas dependências por meio da configuração [api];
- linha 10: o plugin [application], usado para criar o banco de dados (linha 47);
- linha 23: a camada [dao] da versão 5. Trata-se de uma dependência de [api]: a classe [HibernateTax] implementa a interface [ITaxDao] dessa biblioteca, que seus usuários, portanto, também precisam enxergar;
- linhas 25–27: o Hibernate, o driver JDBC do MySQL e o Logback. O Hibernate é uma dependência de [implementation]: ele é usado internamente pela biblioteca, mas não aparece em sua interface pública;
- linhas 31–34: a configuração padrão do plugin [allopen];
- linhas 50–53: os programas iniciados pelo Gradle gravam sua saída em UTF-8 para que os caracteres acentuados sejam exibidos corretamente no Windows (Capítulo 2).
A data class [TaxBracket] da versão 5 não pode ser uma entidade do Hibernate: ela é uma data class (já vimos por que isso não é uma boa ideia para uma entidade), é imutável e não tem identificador. Não a modificamos, porque ela faz parte do contrato entre as camadas, compartilhado por todas as versões. Criamos uma entidade, específica da camada [dao], cujo papel é representar uma linha da tabela:
- linha 3: a tabela [brackets];
- linhas 6–12: as três colunas, declaradas no construtor primário, com tipos [decimal] apropriados: o limite e o coeficiente [coeffN] são valores monetários com duas casas decimais, e [coeffR] é uma taxa com quatro casas decimais. Os nomes das colunas estão em minúsculas. As propriedades são privadas: a entidade serve apenas para popular a tabela ([CreateDatabase]) e escrever consultas; o restante da aplicação nunca a vê. O Hibernate, que acessa os campos diretamente, não exige que eles sejam públicos;
- linhas 15–17: a chave primária, que também serve para ordenar as faixas.
A classe [HibernateTax] implementa a interface [ITaxDao]:
- linhas 11–14: os códigos de erro dessa implementação, como em [FileTax] e [JsonTax];
- linha 9: a camada [dao] recebe a URL do banco de dados, junto com o usuário e sua senha. São simples parâmetros do construtor ([val] não é escrito: eles não se tornam propriedades, pois são usados apenas na construção). Ela lê as faixas uma única vez, durante a construção: será um singleton;
- linha 18: a propriedade [taxBrackets] da interface [ITaxDao], inicializada por uma expressão [try] (Capítulo 3): seu valor é o do bloco [try]; se ocorrer um erro, [catch] lança uma exceção;
- Linhas 20–25: um [SessionFactory] de vida curta — apenas o tempo de ler a tabela — fechado imediatamente por [use]. Como a camada acessa o banco de dados uma única vez, não há necessidade de mantê-lo; uma camada [dao] que acessasse o banco de dados a cada chamada receberia, em vez disso, um [SessionFactory] criado uma única vez, como no exemplo anterior;
- Linhas 27–29: leitura da tabela na ordem da chave primária. A consulta é uma projeção sobre a data class [TaxBracket]: o Hibernate solicita ao SGBD apenas as três colunas relevantes e cria diretamente os objetos da aplicação chamando o construtor de
*[TaxBracket]com os três valores, sem passar pelas entidades*[Bracket]. O valor retornado por [fromSession], e depois por [use], é a lista lida: esse é o valor da propriedade; - Linhas 32–35: um erro do Hibernate ou do SGBD (banco de dados inacessível, tabela ausente etc.) se manifesta como uma [PersistenceException] (a classe base das exceções do Jakarta Persistence, da qual derivam as exceções do Hibernate). Como nas outras implementações, ela é encapsulada em uma
*[TaxException]. A exceção pode ocorrer já na criação do*[SessionFactory]*(linha 24), que se conecta ao servidor: ela também está contida no bloco***[try]** ; - linhas 38–41: uma tabela vazia também é um erro: a camada [business] exige pelo menos uma linha. O bloco [init] é executado após a inicialização da propriedade, que o precede na classe. O código de erro é passado por um argumento nomeado ([code = EMPTY_TABLE]), já que a exceção não tem causa (Capítulo 6).
11.15.3. O banco de dados
O banco de dados [hbtaxes] é criado pelo programa [CreateDatabase.kt]. Para evitar reescrever as faixas da tabela de alíquotas, ele reutiliza as da classe [HardwiredTax] da versão 5:
- linha 10: o banco de dados [hbtaxes], criado pelo MySQL caso não exista;
- linha 13: exibe os comandos SQL, sem formatação;
- linha 15: a tabela é excluída e depois recriada quando o [SessionFactory] é criado;
- linhas 19–21: uma entidade [Bracket] por faixa da classe [HardwiredTax], persistida em uma transação. O laço [for] decompõe cada [TaxBracket] em seus três componentes ([(limit, coeffR, coeffN)]) por meio das funções [component1], [component2] e [component3], que são geradas para uma data class (Capítulo 4).
O subprojeto também contém um arquivo chamado [logback.xml], usado por [CreateDatabase.kt] e pela aplicação, que deixa passar apenas os seguintes erros:
- linha 10: os erros do SGBD, que o Hibernate registra no log antes de lançar uma exceção, não são exibidos: a própria aplicação os reporta;
- linha 11: os demais logs registram apenas erros.
Execução:
Verificamos o conteúdo da tabela:
Vemos as faixas da tabela de alíquotas, sendo que a última tem limite zero (ela não é usada pela camada [business], que seleciona a última faixa quando nenhuma outra se aplica).
Para criar o banco de dados em seu próprio sistema:
- inicie o MySQL (no Laragon; veja o apêndice; usuário [root] sem senha);
- vá até a pasta [11-hibernate] e digite o comando [gradlew -q :TaxV7:tax-dao-hibernate:run] (ou execute [CreateDatabase.kt] no IntelliJ IDEA, com o triângulo verde posicionado diante de sua função [main]). O Gradle compila ao mesmo tempo os módulos da versão 5, na pasta vizinha [06-architectures].
O banco de dados [hbtaxes] é então criado, com sua tabela [brackets] populada. Se o comando falhar, verifique se o MySQL está em execução e se a URL de [CreateDatabase.kt] corresponde ao seu servidor (porta 3306, usuário [root], senha vazia). Se preferir, você também pode criar a tabela e suas linhas por meio de um script SQL, conforme descrito no Capítulo 10.
11.15.4. Integração das camadas
O subprojeto [tax-ui-hibernate] reúne as seguintes camadas:
- linhas 16–17: as camadas [business] e [ui] da versão 5. O subprojeto [tax-ui] contém o programa principal da versão 5; aqui ele é usado como biblioteca, especificamente por seu objeto [Dialog];
- linha 19: a nova camada [dao], que inclui o Hibernate, o driver JDBC e o Logback;
- linha 21: o contêiner Spring;
- linha 34: a classe principal;
- linhas 37–39: o programa lê do teclado (Capítulo 6);
- linhas 42–45: os programas iniciados pelo Gradle gravam sua saída em UTF-8, para que os caracteres acentuados sejam exibidos corretamente no Windows (Capítulo 2).
O arquivo de configuração [tax-hibernate.properties], localizado na pasta do subprojeto, especifica o banco de dados:
O arquivo [tax-hibernate-error.properties] referencia um banco de dados chamado [hbtaxesmissing], que não existe:
O programa principal é o da versão 5, no qual apenas a composição da camada [dao] muda:
- O arquivo não se chama [Main.kt]: ele seria compilado em uma classe chamada [tax.ui.MainKt], que já existe no módulo [tax-ui] da versão 5, do qual dependemos. O arquivo [MainHibernate.kt] gera uma classe chamada [tax.ui.MainHibernateKt];
- linhas 26–29: a URL do banco de dados, o nome de usuário e a senha, obrigatórios, lidos da configuração. [getProperty] retorna [null] para uma chave ausente: o operador Elvis ([?:]) então avalia para [TaxException] ([throw] é uma expressão em Kotlin);
- linha 34: a camada [dao] é um [HibernateTax], criado por uma lambda que lhe passa os parâmetros do banco de dados;
- linha 36: a camada [business] da versão 5: o contêiner passará a camada [dao] ao seu construtor;
- linha 48: o diálogo da versão 5.
11.15.5. Execuções
As entradas do usuário, redirecionadas para o programa para obter esses resultados, foram colocadas após as perguntas:
Os valores de controle das versões anteriores são mantidos: 4.282 euros para um casal com dois filhos e renda conjunta de 60.000 euros, 2.959 euros com três filhos e 11.519 euros para uma pessoa solteira sem filhos.
Com o arquivo de configuração [tax-hibernate-error.properties], que se refere a um banco de dados inexistente:
- linha 12: a exceção original, lançada pelo driver JDBC;
- linhas 8 e 10: as exceções do Hibernate que a encapsulam: o erro ocorreu durante a criação do [SessionFactory], quando o Hibernate se conectou ao servidor para determinar sua versão;
- linha 6: a camada [dao] encapsulou o erro em uma [TaxException];
- linha 4: o contêiner Spring, que estava criando a camada [dao], encapsulou por sua vez a exceção em uma [BeanCreationException], que foi exibida pelo programa principal.
Trocar de SGBD equivale a alterar a URL do banco de dados e a dependência do driver JDBC: o Hibernate seleciona automaticamente o dialeto SQL a partir do SGBD encontrado, e o código da classe [HibernateTax], escrito em HQL, permanece inalterado. Apenas a criação do banco de dados — que depende dos tipos das colunas — precisa ser refeita, o que o programa [CreateDatabase.kt] faz sem nenhuma modificação além da própria URL.
11.16. Conclusão: JDBC, JdbcClient, jOOQ — Exposed ou Hibernate?
Agora temos duas maneiras de acessar um banco de dados: JDBC (Capítulo 10) e Hibernate (este capítulo). Existem outras abordagens intermediárias bastante utilizadas:
- JdbcClient, do Spring Framework (biblioteca [spring-jdbc]), acrescenta ao JDBC uma API flexível que executa uma consulta SQL escrita à mão e transforma automaticamente as linhas do resultado em objetos: [jdbcClient.sql("select * from articles where price > :price").param("price", 200).query(Article::class.java).list()]. Você escreve o SQL; o Spring cuida dos parâmetros e copia as colunas para os objetos (inclusive data classes, cujos construtores recebem as colunas). É um “micro-ORM”;
- O jOOQ gera, a partir do esquema do banco de dados, classes que permitem escrever SQL em Java ou Kotlin verificado pelo compilador: [dsl.selectFrom(ARTICLES).where(ARTICLES.PRICE.gt(price)).fetch()]. Você mantém o controle total sobre o SQL, com a segurança da verificação de tipos;
- O Exposed, da JetBrains, é a biblioteca de acesso a banco de dados escrita em Kotlin e para Kotlin. As tabelas são descritas nela por meio de objetos Kotlin ([object Articles : Table("articles")], com colunas como [val price = decimal("price", 10, 2)]), sem geração de código, e as consultas são escritas em uma linguagem dedicada (“DSL”), semelhante ao SQL e verificada pelo compilador: [Articles.selectAll().where { Articles.price greater minPrice }]. O Exposed também oferece uma segunda API, uma versão leve de ORM (classes de entidade vinculadas a tabelas), e se apoia no JDBC ou, opcionalmente, em drivers não bloqueantes (R2DBC) que podem ser usados a partir de corrotinas. Ele aproveita tudo o que vimos sobre Kotlin: funções de extensão, lambdas com receptor, funções infixas ([greater]) e tipos anuláveis para colunas opcionais.
Pontos fortes | Pontos fracos | |
JDBC | Controle total sobre o SQL; desempenho; nenhuma dependência | muito código repetitivo (parâmetros, leitura de colunas), simplificado em Kotlin por [use] e funções de extensão; SQL em strings, não verificado pelo compilador |
JdbcClient | SQL escrito à mão, sem código de copiar e colar; desempenho semelhante ao do JDBC | Sem rastreamento de alterações nem geração de [INSERT]/[UPDATE]; SQL não verificado |
jOOQ | SQL verificado pelo compilador; todos os recursos do SGBD | Geração de código a cada alteração do esquema; sem rastreamento de alterações; licença paga necessária para certas versões comerciais de SGBD |
Exposed | Projetado para Kotlin; consultas verificadas pelo compilador, sem geração de código; leve | Específico de Kotlin; menos difundido que o Hibernate e com menos documentação; o esquema é descrito manualmente no código |
Hibernate | modelo orientado a objetos; rastreamento de alterações; relacionamentos; HQL e Criteria API; padrão Jakarta Persistence; independente do SGBD | uma camada adicional a compreender (sessões, estados, carregamento tardio); código SQL gerado a monitorar; menos adequado ao processamento em massa complexo; algumas adaptações para Kotlin (plugins [jpa] e [allopen] , sem data classes para entidades) |
As seguintes diretrizes podem ser sugeridas:
- O Hibernate (muitas vezes por meio do Spring Data JPA) é adequado para a maioria das aplicações de negócio: um modelo de entidades interligadas, operações de leitura e atualização de entidades e um esquema que evolui com a aplicação. É a escolha padrão para aplicações Spring Boot, tanto em Kotlin quanto em Java;
- JDBC, JdbcClient, jOOQ ou Exposed são adequados quando se deseja controle preciso sobre o SQL executado: consultas estatísticas complexas, stored procedures, processamento de volumes muito grandes ou um banco de dados existente com um esquema pouco adequado a um modelo orientado a objetos. O Exposed é uma escolha natural para uma aplicação escrita inteiramente em Kotlin, particularmente fora do Spring (usando o framework web Ktor da JetBrains, por exemplo);
- essas abordagens podem ser combinadas: uma aplicação pode usar o Hibernate para a maior parte de suas operações e código SQL escrito à mão — na forma de consultas nativas — com [JdbcClient] ou JDBC ([doWork]), para algumas consultas críticas.
De todo modo, o ORM não elimina a necessidade de entender o SQL e o funcionamento do SGBD: o log dos comandos SQL executados, que exibimos ao longo deste capítulo, é a principal ferramenta para verificar o que o Hibernate realmente está fazendo.
Para se aprofundar, a documentação do Hibernate é abrangente, e seu guia introdutório é o melhor ponto de partida: Hibernate ORM - documentation. A especificação Jakarta Persistence é publicada pela Eclipse Foundation: Jakarta Persistence. O guia do Spring sobre o uso de JPA em Kotlin resume os conceitos abordados neste capítulo (plugins, entidades, nulabilidade): Building web applications with Spring Boot and Kotlin. O Exposed é apresentado em sua página no GitHub, que contém links para sua documentação: JetBrains Exposed.