6. Arquiteturas em camadas
6.1. Introdução
Vamos revisitar a última versão da aplicação de cálculo de imposto (versão 3, Capítulo 5). Reduzido ao essencial, seu programa principal tinha a seguinte estrutura (diagrama simplificado):
Esse programa combina três tipos de processamento encontrados na maioria das aplicações:
- a recuperação de dados armazenados em arquivos, bancos de dados etc.: linhas 1–9;
- a interação com o usuário: linhas 13–14 (entrada) e 17 (saída);
- o uso de um algoritmo de negócio, o cálculo do imposto: linha 17. Esse cálculo era realizado anteriormente pela classe abstrata [AbstractTax], a classe pai de [FileTax] e [JsonTax]: na versão 3, a leitura dos dados e o cálculo ainda estão combinados em um único objeto.
A experiência prática mostrou que isolar essas diferentes etapas de processamento em classes separadas melhora a manutenibilidade da aplicação. A arquitetura de uma aplicação estruturada dessa forma é a seguinte:
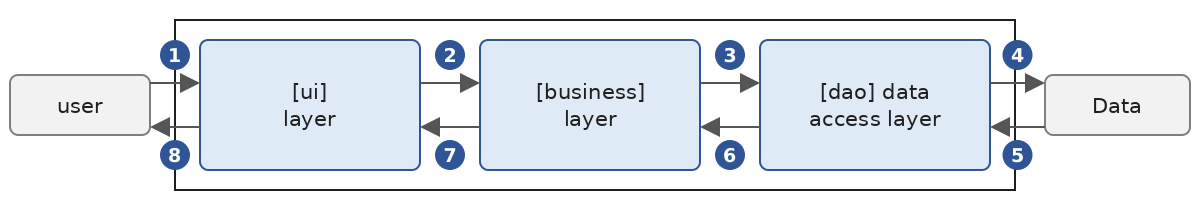
Essa arquitetura é chamada de “arquitetura de três camadas” (three-tier). O termo “tier” normalmente designa uma parte da aplicação que é executada em uma máquina diferente. Quando as partes estão na mesma máquina, usa-se o termo “arquitetura em camadas” (layered):
- A camada [business] contém as regras de negócio da aplicação. Em nossa aplicação, são as regras usadas para calcular o imposto de um contribuinte. Essa camada precisa de dados para funcionar:
- as faixas de imposto, que mudam todo ano;
- o número de filhos, o estado civil do contribuinte e a renda anual;
- a camada de acesso a dados, ou [dao] (DAO = Data Access Object), fornece os dados já armazenados em arquivos ou bancos de dados. Isso inclui as faixas de imposto, como na versão 3 da aplicação;
- a camada de interface com o usuário, ou [ui] (UI = User Interface), fornece os dados digitados pelo usuário e exibe os resultados para ele. Aqui, isso se aplica ao número de filhos, ao estado civil e à renda anual do contribuinte.
Em geral:
- a camada [dao] cuida do acesso a dados persistentes (arquivos, bancos de dados) ou não persistentes (rede, sensores etc.);
- a camada [ui] cuida das interações com o usuário, se houver;
- as três camadas se tornam independentes umas das outras por meio do uso de interfaces.
Vamos revisitar a aplicação [Tax], que já examinamos várias vezes, para dar a ela uma arquitetura em camadas. Primeiro, precisamos definir as interfaces das diversas camadas da aplicação.
6.2. As interfaces da aplicação [Tax]
Lembre-se de que uma interface define um conjunto de assinaturas de funções e propriedades. As classes que implementam a interface fornecem sua implementação.
Voltemos à arquitetura em camadas de nossa aplicação:
Nesse tipo de arquitetura, o usuário frequentemente toma a iniciativa. O usuário faz uma requisição em [1] e recebe uma resposta em [8]. Isso é chamado de ciclo requisição-resposta. Tomemos o exemplo do cálculo do imposto de um contribuinte. Isso exigirá várias etapas:
- A camada [ui] pergunta ao usuário seu estado civil, o número de filhos e o salário anual. Essa é a operação [1] descrita acima;
- Feito isso, a camada [ui] pede à camada [business] que calcule o imposto. Para isso, envia a ela os dados recebidos do usuário. Essa é a operação [2];
- A camada [business] precisa de certas informações para realizar sua tarefa: as faixas de imposto. Ela as solicita à camada [dao] pelo caminho [3, 4, 5, 6]: [3] é a requisição inicial e [6] é a resposta a essa requisição;
- Com todos os dados de que precisava, a camada [business] calcula o imposto;
- A camada [business] pode agora responder à requisição feita pela camada [ui] em [2]. Esse é o caminho [7];
- a camada [ui] formata esse resultado e depois o apresenta ao usuário. Esse é o caminho [8];
- Poderíamos imaginar que o usuário executasse simulações de imposto e quisesse salvá-las. Ele usaria o mesmo caminho, [1-8], para isso.
Como se vê nesta descrição, uma camada usa os recursos da camada à sua direita, nunca os da camada à sua esquerda. Consideremos duas camadas adjacentes:
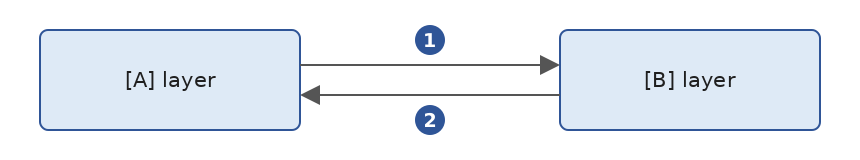
A camada [A] faz requisições à camada [B]. Nos casos mais simples, uma camada é implementada por uma única classe. Mas uma aplicação evolui ao longo do tempo, e a camada [B] pode ter sucessivamente diferentes classes de implementação: [B1], [B2] e assim por diante. Se a camada [B] for a camada [dao], ela pode ter uma implementação inicial, [B1], que obtém os dados de um arquivo. Alguns anos depois, pode-se querer armazenar esses dados em um banco de dados: nesse caso, cria-se uma segunda classe de implementação, [B2]. Se, na aplicação inicial, a camada [A] trabalhasse diretamente com a classe [B1], seríamos obrigados a reescrever parcialmente o código da camada [A]. Por exemplo, suponha que tenhamos escrito algo como o seguinte na camada [A]:
- Linha 1: uma instância da classe [B1] é criada;
- linha 3: os dados são solicitados a essa instância.
Se a nova classe de implementação [B2] tiver funções com a mesma assinatura da classe [B1], será preciso alterar todas as ocorrências de [B1] para [B2]. Esse é o melhor cenário, e é bastante improvável se não se tomou cuidado com essas assinaturas. Na prática, é comum que as classes [B1] e [B2] tenham assinaturas de funções diferentes, o que significa que uma parte considerável da camada [A] precisa ser reescrita.
Esse problema pode ser atenuado inserindo-se uma interface entre as camadas [A] e [B]. Isso fixa, dentro de uma interface, as assinaturas de funções que a camada [B] expõe à camada [A]. O diagrama anterior passa a ser o seguinte:
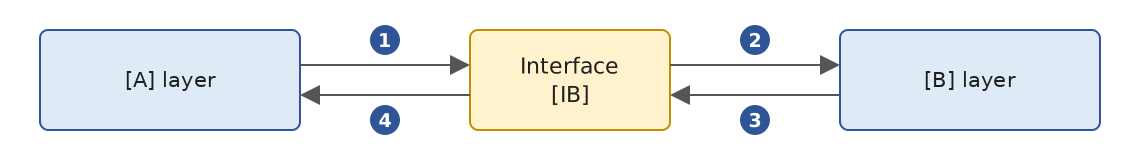
A camada [A] não se comunica mais diretamente com a camada [B], mas com sua interface, [IB]. No código da camada [A], a classe de implementação [Bi] da camada [B] agora aparece apenas uma vez, quando o objeto que implementa a interface [IB] é criado. Depois disso, é a interface [IB], e não sua classe de implementação, que é usada. O código anterior passa a ser:
- Linha 1: uma instância de [ib] que implementa a interface [IB] é criada instanciando-se a classe [B1]. O tipo da variável é declarado explicitamente: sem isso, a inferência de tipos atribuiria o tipo [B1] a [ib];
- Linha 3: os dados são solicitados à instância [ib].
Agora, se substituirmos a implementação [B1] da camada [B] por uma implementação [B2], e ambas as implementações obedecerem à mesma interface [IB], somente a linha 1 da camada [A] precisará ser modificada. Essa é uma grande vantagem que, por si só, justifica o uso sistemático de interfaces entre duas camadas.
Podemos ir ainda mais longe e tornar a camada [A] completamente independente da camada [B]. No código acima, a linha 1 é um problema porque fixa no código o nome da classe [B1]. Idealmente, a camada [A] deveria receber uma implementação da interface [IB] sem precisar especificar o nome de uma classe. Isso seria coerente com o diagrama acima: a camada [A] se relaciona com a interface [IB], e não há razão para que precise conhecer o nome da classe que implementa essa interface.
É isso que a injeção de dependência (DI) permite. A arquitetura anterior evolui da seguinte forma:
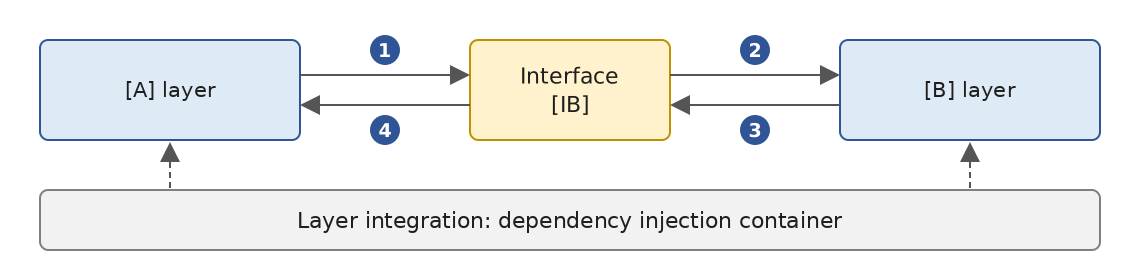
Um componente transversal, o contêiner de injeção de dependência, cria os objetos que implementam as camadas e os conecta uns aos outros: ele passa à camada [A] uma referência ao objeto que implementa a camada [B]. O código da camada [A] passa então a ter a seguinte forma:
- Linha 2: a camada [A] recebe, por meio de seu construtor primário, uma instância [ib] que implementa a interface [IB]. A palavra-chave
***[val]***antes do parâmetro o transforma em uma propriedade privada da classe: onde o Java exige um campo, um construtor e uma atribuição, o Kotlin exige apenas uma linha. Não é a camada*[A]* que cria essa instância, mas o contêiner; - Linha 6: os dados são solicitados à instância [ib].
A classe de implementação [B1] não aparece mais em nenhum lugar do código da camada [A]. Quando a implementação [B1] for substituída por uma nova implementação [B2], nada mudará no código da camada [A]: a única coisa que mudará é o único ponto da aplicação em que se informa ao contêiner qual classe implementa [IB]. Esse ponto pode até ler o nome da implementação a usar em um arquivo de configuração.
Na JVM, a injeção de dependência foi popularizada no início dos anos 2000 pelo framework Spring, cuja configuração era então escrita em arquivos XML. O Spring Framework, agora na versão 7, continua sendo o padrão do mercado e trata o Kotlin como uma linguagem de primeira classe: fornece extensões Kotlin para sua API, e o Kotlin é uma das duas linguagens usadas em sua documentação. Ele é a base do Spring Boot, que usaremos no Capítulo 13, “Web Services”. Usaremos seu contêiner na versão 5 da aplicação (existem outros: CDI, o padrão do Jakarta EE, Google Guice ou, específicos do Kotlin, Koin e Kodein). A combinação de “interfaces e injeção de dependência” melhora significativamente a manutenibilidade da aplicação ao tornar as camadas independentes umas das outras.
Voltemos à arquitetura em camadas de nossa aplicação. Em casos simples, podemos começar pela camada [business] para descobrir as interfaces da aplicação. Para funcionar, a aplicação precisa de dados:
- já disponíveis em arquivos, bancos de dados ou pela rede. Esses dados são fornecidos pela camada [dao];
- ainda não disponíveis. Nesse caso, eles são fornecidos pela camada [ui], que os obtém do usuário.
Qual interface a camada [dao] deve oferecer à camada [business]? A camada [dao] deve fornecer as faixas de imposto à camada [business]. Em nossa aplicação, a camada [dao] usa dados existentes, mas não cria novos dados. Sua interface poderia ser a seguinte:
- Linha 1: a interface está no pacote [dao]. Como veremos, armazenaremos o arquivo [ITaxDao.kt] em uma pasta [dao];
- Linha 9: a interface [ITaxDao] declara a propriedade [taxBrackets], que fornece as faixas de imposto à camada [business]. Uma interface Kotlin pode declarar propriedades, e não apenas funções: uma propriedade de interface [val] é abstrata; cada classe que a implementa especifica como obtém seu valor. Enquanto o Java expunha dados somente leitura por meio de um método [getTaxBrackets()], seguindo a convenção JavaBeans, o Kotlin a declara pelo que ela é: uma propriedade somente leitura. Do ponto de vista do Java, essa propriedade é, na verdade, um método [getTaxBrackets()];
- as faixas são retornadas como uma lista [List<TaxBracket>] em vez de um array. No Kotlin, [List] é uma interface somente leitura: ela não tem [add], [set] nem [remove], que pertencem à interface [MutableList] (Capítulo 5). O destinatário da lista não pode, portanto, modificá-la, ao passo que os elementos de um array sempre podem ser modificados pelo destinatário;
- linha 3: importa o tipo [TaxBracket], definido no pacote [entities]:
Uma faixa de imposto é representada por uma data class ([data class], Capítulo 4), o equivalente Kotlin de um record Java. O compilador gera as propriedades [limit], [coeffR] e [coeffN], assim como as funções [equals], [hashCode], [toString], [copy] e [component1]…[component3] (para desestruturação). Escrevemos [TaxBracket(limit, coeffR, coeffN)] para criar uma faixa. As propriedades são declaradas como [val]: uma faixa não pode ser alterada depois de criada (uma data class pode ter propriedades [var], mas essa não é uma prática comum). As três propriedades são do tipo [BigDecimal], a classe Java para números decimais exatos, que o Kotlin usa diretamente: um [Double] não consegue representar exatamente 0,068 nem 291,09. Como um *[BigDecimal] é, ele próprio, imutável, uma faixa é completamente imutável. Uma classe com propriedades [var] teria permitido modificá-la; veremos que essa impossibilidade elimina um efeito colateral de uma forma mais antiga de escrever a camada [business]*.
Qual interface a camada [business] deve apresentar à camada [ui]? Vamos rever as interações entre essas duas camadas:
- A camada [ui] pergunta ao usuário seu estado civil, o número de filhos e o salário anual. Essa é a operação [1] do esquema;
- Feito isso, a camada [ui] pede à camada [business] que calcule o imposto. Para isso, envia à camada [business] os dados recebidos do usuário. Essa é a operação [2].
A interface da camada [business] poderia ser assim:
- Linha 1: tudo o que se refere à camada [business] é colocado no pacote [business];
- Linha 6: a interface [ITaxBusiness] declara apenas uma função, que calcula o imposto de um contribuinte com base em seu estado civil, número de filhos e salário anual. Uma função de interface sem corpo é abstrata e, como qualquer membro Kotlin sem modificador de visibilidade, é pública: não é preciso escrever [public abstract]. O resultado é [Int]: o imposto em euros, sem os centavos.
Examinaremos agora uma primeira implementação dessa arquitetura em camadas.
6.3. Aplicação de exemplo — versão 4
6.3.1. O projeto
A versão 4 é um programa composto por vários arquivos-fonte que não usa nenhuma biblioteca externa. O Kotlin não tem um equivalente simples ao launcher de código-fonte do Java ([java Main.java]), que compila um programa de vários arquivos em memória e o executa: um programa Kotlin de vários arquivos é compilado antes de ser executado. Portanto, criamos um projeto Gradle, [TaxV4], que é um dos subprojetos do build Gradle do capítulo (Capítulo 2). A pasta [06-architectures] contém todos os projetos do capítulo; seu arquivo [settings.gradle.kts] os lista:
- linhas 3–6: o plugin que permite ao Gradle baixar o próprio JDK 25 se não o encontrar na máquina (Capítulo 2);
- linha 8: o nome do projeto raiz;
- linha 11: os cinco subprojetos deste capítulo. Um subprojeto é identificado por seu caminho, cujos elementos são separados por dois-pontos: [TaxV5:tax-dao] é o subprojeto da pasta [TaxV5/tax-dao]. Falaremos de [DemoTests] e dos três subprojetos da versão 5 mais adiante.
O arquivo [build.gradle.kts] do projeto raiz declara os plugins usados pelos subprojetos, junto com suas versões, sem aplicá-los:
- linha 4: o plugin Kotlin para JVM, versão 2.4.20. A referência a [apply false] o torna disponível aos subprojetos, que o aplicarão sem repetir sua versão;
- linha 5: um plugin do compilador Kotlin de que a versão 5 precisará para o Spring. Explicaremos isso quando chegar a hora.
O subprojeto [TaxV4] tem a seguinte estrutura de diretórios. Cada camada ocupa uma pasta:
- A pasta [entities] contém tipos comuns às camadas [ui], [business], e [dao] : a data class [TaxBracket], a exceção [TaxException], e a enumeração [ErrorCode] de seus códigos de erro;
- a pasta [dao] contém a interface e as classes da camada [dao]. Usaremos duas implementações da interface [ITaxDao]: a classe [HardwiredTax], cujos dados são fixos no código (versão 2), e a classe [FileTax], que lê os dados de um arquivo de texto (versão 3). A leitura de um arquivo JSON, a outra opção da versão 3, será tratada na versão 5;
- a pasta [business] contém a interface e a classe da camada [business];
- a pasta [ui] contém a classe da camada [ui];
- o arquivo [Main.kt] cria as camadas e as liga entre si;
- o arquivo [TaxData.txt] contém as faixas de imposto lidas pela implementação [FileTax] da camada [dao]. Ele está na raiz do subprojeto, que é o diretório atual do programa iniciado pelo Gradle.
No Java, os nomes das pastas importam: uma classe do pacote [dao] deve estar em uma pasta chamada [dao]. O Kotlin é mais flexível: o pacote é o declarado pela diretiva [package] do arquivo, independentemente da pasta em que ele se encontra. No entanto, a convenção, seguida pelo IntelliJ, pelo IDEA e por este curso, continua sendo organizar os arquivos em pastas que espelham os pacotes: um arquivo do pacote [tax.dao] em uma pasta [tax/dao] (em um projeto em que todos os pacotes começam com a mesma raiz, as pastas dessa raiz comum são simplesmente omitidas). Já os arquivos [.class] produzidos pelo compilador são sempre organizados por pacote: é assim que a máquina virtual localiza as classes a partir de seus nomes completos.
O arquivo [Main.kt] não tem uma diretiva [package]: ele pertence ao pacote raiz, que não tem nome. Sua função [main] é compilada na classe [MainKt], o nome que o arquivo de build do subprojeto atribui ao plugin [application]:
- linhas 2–4: o subprojeto aplica o plugin Kotlin, sem versão (que é fornecida pelo projeto raiz), e o plugin [application], que adiciona a tarefa [run];
- linhas 7–8: os detalhes do projeto;
- linhas 14–21: a configuração do compilador, a mesma dos capítulos anteriores;
- linhas 25–27: a classe principal, [MainKt], sem nome de pacote. Há apenas um programa neste subprojeto: a propriedade [main] dos capítulos anteriores é desnecessária;
- linhas 30–32: o programa lê do teclado;
- linhas 35–38: os programas iniciados pelo Gradle escrevem sua saída em
UTF-8para que os caracteres acentuados sejam exibidos corretamente no Windows (Capítulo 2).
Diferentemente do Java, o Kotlin permite importar uma declaração do pacote raiz a partir de outro pacote, nomeando-a sem prefixo ([import declarationName]). A convenção continua sendo colocar ali apenas o programa principal, que não é importado por ninguém.
Execute o programa a partir da pasta do capítulo usando [gradlew -q :TaxV4:run]: o caminho [:TaxV4] refere-se ao subprojeto, e a tarefa [run] é executada com a pasta do subprojeto como diretório atual. O IntelliJ IDEA abre a pasta [06-architectures] como um projeto Gradle e executa [Main.kt] clicando no triângulo verde ao lado de sua função [main].
6.3.2. Entidades da aplicação
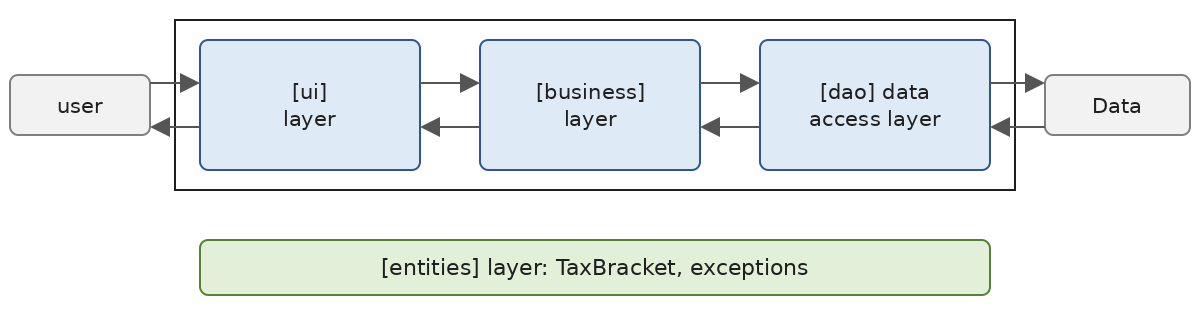
Chamamos de entidades os tipos que atravessam várias camadas. Geralmente são as classes que encapsulam os dados da camada [dao]. Essas entidades costumam se estender até a camada [ui]. As entidades da aplicação são a data class [TaxBracket], já apresentada, e a exceção [TaxException], junto com a enumeração de seus códigos de erro:
- linha 4: uma enumeração ([enum class]). Como no Java, os valores de uma enumeração são objetos, instâncias únicas da classe [ErrorCode], e uma enumeração pode ter propriedades e métodos;
- linha 5: os cinco códigos de erro. O ponto e vírgula que termina a lista é obrigatório quando outros membros a seguem. A propriedade [ordinal], herdada da classe [Enum], retorna a posição do valor na lista: 0 para [ACCESS], 4 para [FIELD3];
- linhas 8–9: cada código é associado a um bit. [bit] é uma propriedade calculada: não tem campo; seu acessor, [get()], a calcula a cada leitura. O Kotlin não tem operadores de deslocamento: [1 shl ordinal] (“shift left”) equivale ao [1 << ordinal] do Java e é igual a 1, 2, 4, 8 e 16. Essas potências de 2 podem ser combinadas com a função infixa [or] (o [|] do Java): o código [FIELD2.bit or FIELD3.bit] (8 + 16 = 24) significa que os campos 2 e 3 de uma linha estão incorretos. O código de erro da exceção continua sendo um simples inteiro, que todas as implementações da camada [dao] podem usar;
- Linhas 11–14: a função [names] converte os nomes dos códigos contidos em uma cadeia de bits, “FIELD2, FIELD3” para 24. Ela não usa nenhum valor específico do enum: é colocada no companion object e é chamada como um método estático Java, [ErrorCode.names(24)]. A propriedade [entries] (Kotlin 1.9) é a lista dos valores do enum; ela substitui a função [values()], que cria um novo array a cada chamada. [(code and it.bit) != 0] é verdadeiro se o bit correspondente ao valor de [it] estiver presente em [code] ([and] é o equivalente Java de [&]). Os valores obtidos por [filter] são então reunidos por [joinToString], usando o separador [", "] e uma lambda que retorna o nome ([name]) de cada valor. O corpo da função é uma expressão: a função não tem chaves, e seu resultado vem depois do sinal [=].
- linha 5: uma exceção específica da aplicação deriva da classe [RuntimeException]. No Kotlin, a questão de escolher entre exceções verificadas e não verificadas não se coloca: a linguagem não tem exceções verificadas (Capítulo 3), nenhuma função declara as exceções que lança e nenhum chamador é obrigado a capturá-las. Derivar de
*[RuntimeException]* em vez de*[Exception]*continua sendo a prática padrão, pois isso garante que uma exceção seja vista de forma consistente pelo código Java; - linhas 6–10: o construtor primário tem três parâmetros. [message] e [cause] são parâmetros simples repassados ao construtor da classe pai (linha 11); [code], declarado como [val], é também uma propriedade somente leitura da exceção. A causa, a exceção original, se houver, estará acessível pela propriedade [cause], herdada de [Throwable];
- linhas 8–10: graças aos valores padrão dos parâmetros, esse único construtor substitui os dois construtores da versão Java, um com mensagem e código, o outro com a causa também. Com argumentos nomeados, escrevemos [TaxException(message, code = 2)] quando não há causa, e [TaxException(message, e, 1)] quando há;
- linha 10: a vírgula após o último parâmetro (“trailing comma”) é permitida; ela facilita a adição de um parâmetro;
- Uma exceção é serializável (a classe [Throwable] implementa a interface [Serializable]). A versão Java declarava um campo [serialVersionUID] para evitar um aviso do [javac -Xlint:all]; o compilador Kotlin não emite esse aviso, portanto não declaramos esse campo.
Nesta versão, apenas a classe [FileTax] da camada [dao] lança [TaxException].
6.3.3. A camada [dao]
Vamos rever a interface da camada [dao]:
Implementamos essa interface de duas maneiras diferentes. Primeiro, com a classe [HardwiredTax]:
- Linha 6: a classe [HardwiredTax] implementa a interface [ITaxDao]. No Kotlin, os dois-pontos são usados tanto para herança de classe quanto para implementação de interface: não existe a palavra-chave [implements]. Observe que a interface é nomeada sem parênteses, enquanto uma classe pai é nomeada com os argumentos de seu construtor ([RuntimeException(message, cause)]): uma interface não tem construtor;
- Linhas 9–16: a implementação da propriedade da interface. A palavra-chave [override] é obrigatória: o compilador verifica se a propriedade de fato implementa um membro da interface, de forma semelhante à anotação opcional [@Override] do Java. A propriedade é inicializada em sua declaração por [listOf], que cria uma lista somente leitura. Novamente, uma vírgula após o último elemento é permitida;
- Linhas 20–22: uma função privada que cria uma faixa a partir de três strings. Ela é declarada no nível do arquivo, fora da classe: [private] a torna visível apenas dentro do arquivo [HardwiredTax.kt]. A função de extensão [toBigDecimal] da biblioteca padrão converte uma string em [BigDecimal]; esse é o construtor [BigDecimal(String)]. Um [BigDecimal] construído a partir de uma string é exato: ["0.068".toBigDecimal()] é exatamente 0,068, ao passo que um [BigDecimal] construído a partir de um [Double] herda sua imprecisão: [0.068.toBigDecimal()], que é obtido convertendo o [Double] em string, de fato resulta em 0,068, mas [(0.1 + 0.2).toBigDecimal()] resulta em 0,30000000000000004. O tipo do resultado da função, [TaxBracket], é inferido a partir da expressão que segue o sinal [=].
A interface [ITaxDao] também é implementada pela classe [FileTax], que lê as faixas de imposto de um arquivo de texto. O arquivo [TaxData.txt] é o seguinte:
Cada linha descreve uma faixa de imposto no formato [limit:coeffR:coeffN]. Os números são escritos com ponto decimal, independentemente do idioma do sistema; isso garante que o arquivo seja legível em todas as máquinas. Os valores são os da tabela de 2004 para a renda de 2003, mantidos como estão: trata-se de um exercício. A classe [FileTax] é a seguinte:
- Linhas 3–7: o Kotlin não tem imports estáticos ([import static] do Java): a diretiva padrão [import] importa classes, valores de enum e funções indistintamente. Passamos então a escrever [FIELD1] em vez de [ErrorCode.FIELD1];
- linhas 13–15: as funções do pacote [kotlin.io.path] (Capítulo 5), que complementam as funções da API Java NIO;
- linha 19: o construtor primário recebe o nome do arquivo de faixas de imposto. Declarado como [val], esse parâmetro é também uma propriedade pública somente leitura, [fileName]: ela substitui o campo e o método [getFileName] da versão Java;
- linha 22: a propriedade da interface. Ela não é inicializada em sua declaração: o compilador verifica que recebe um valor, uma única vez, no bloco [init] seguinte;
- linhas 24–39: o bloco [init] é executado quando o objeto é construído. Ele lê o arquivo e depois extrai as faixas dele;
- linhas 26–34: no Kotlin,
[try]é uma expressão: seu valor é o da última expressão do bloco[try]***, neste caso a lista de linhas do arquivo, ou o do bloco[catch]. O bloco [catch] lança uma exceção: seu tipo é [Nothing], o tipo das expressões que nunca devolvem um valor, e a variável [lines] tem o tipo [List<String>]*; - linha 27: a função [Path] de [kotlin.io.path] cria o caminho do arquivo; ela equivale a [Path.of]. Um caminho relativo é relativo ao diretório atual;
- Linhas 28–29: se o arquivo não existir, uma [NoSuchFileException] (pacote [java.nio.file]) é lançada com uma mensagem explícita. Seu construtor de três parâmetros recebe o nome do arquivo, o nome de um possível segundo arquivo (aqui, [null]) e o motivo do erro. Sem essa verificação, a própria operação de leitura lançaria uma [NoSuchFileException], cuja mensagem consistiria apenas no nome do arquivo;
- Linha 31: a função de extensão [readLines] lê o arquivo inteiro em UTF-8 e retorna uma lista de suas linhas. Ela mesma abre e fecha o arquivo. Para um arquivo grande, preferiríamos uma leitura baseada em fluxo com [useLines];
- Linhas 32–34: todos os erros de entrada/saída decorrem de [IOException]: arquivo ausente ([NoSuchFileException]), permissões insuficientes ([AccessDeniedException]), arquivo que não está em UTF-8 ([MalformedInputException]) etc. O erro é encapsulado em uma [TaxException] com o código [ACCESS]; a exceção original é mantida como causa (segundo argumento);
- linhas 37–39: a leitura das linhas e a sua análise são operações separadas, o que não acontecia no Java. [withIndex] associa cada linha ao seu índice (começando em 0) em um objeto [IndexedValue] com as propriedades [index] e [value]; [filter] remove as linhas vazias ou formadas só por espaços ([isNotBlank]) sem perder os índices das demais; [map] transforma cada uma das linhas restantes em uma faixa. A função lambda de [map] desempacota seu parâmetro [IndexedValue] em seus dois componentes, [(index, line)]. O número da linha, [index + 1], e a linha sem espaços no início e no fim ([trim]) são passados à função [bracket]. O resultado de [map] é uma [List] somente leitura;
- linha 43: a função que retorna a faixa descrita por uma linha, ou lança uma [TaxException] se a linha for inválida. Essa exceção não é uma [IOException]: ela é repassada ao chamador como está;
- linha 45: a linha é dividida por [split] usando a expressão regular [SEPARATOR]: o separador é um dois-pontos, que pode estar cercado de espaços. Atenção: no Kotlin,
***[split(":")]** com uma string divide pela própria string, sem interpretá-la como expressão regular; é preciso passar um objeto*[Regex]para isso; - Linhas 46–47: uma linha que não tem três campos é inválida. O código de erro é passado por um argumento nomeado, [code = LINE.bit]: não há causa, e o parâmetro [cause] mantém seu valor padrão, [null];
- linha 50: conversão dos três campos. [fields.map(::number)] aplica a função [number] a cada campo ([::number] é uma referência de função; veja o Capítulo 7) e retorna uma lista de três [BigDecimal?] valores, que a atribuição por desestruturação distribui em três variáveis;
- linhas 51–57: se um campo estiver incorreto, cada campo incorreto adiciona seu bit ao código de erro por meio da função infixa [or], e uma [TaxException] é lançada. Sua mensagem informa o número da linha e o conteúdo da linha;
- linha 60: neste ponto, o compilador sabe que [limit], [coeffR] e [coeffN] não são [null]; caso contrário, o [if] anterior teria lançado uma exceção. Por meio do smart cast, essas variáveis do tipo [BigDecimal?] são tratadas como [BigDecimal], o tipo esperado pelo construtor de [TaxBracket]: nem [!!] nem qualquer conversão é necessária;
- linhas 65–66: as duas expressões regulares são criadas uma única vez no companion object, em vez de a cada chamada. Elas são escritas como strings brutas (["""..."""]), em que a barra invertida não precisa ser duplicada: [\s*] corresponde a zero ou mais espaços;
- Linhas 69–70: conversão de um campo em [BigDecimal]. [NUMBER.matches(field)] verifica se a string inteira corresponde à expressão regular [\d+(\.\d+)?]: um ou mais dígitos, seguidos, opcionalmente, de um ponto e mais dígitos. Assim, “0,191” é rejeitado, assim como qualquer número negativo. A função [toBigDecimal] não depende do idioma do usuário: ela sempre espera um ponto decimal. Em caso de erro, a função retorna [null], daí o seu tipo [BigDecimal?]. Poderíamos ter usado [toBigDecimalOrNull], que retorna [null] para uma string inválida, mas que também aceita “-1” ou “1e3”.
6.3.4. A camada [business]
Vamos rever a interface desta camada:
Sua implementação, [TaxBusiness], é a seguinte:
- Linha 8: a classe [TaxBusiness] implementa a interface [ITaxBusiness]. A camada [business] deve colaborar com a camada [dao]: por isso, ela recebe, por meio de seu construtor primário, uma referência [dao] ao objeto que implementa a interface [ITaxDao]. Esse parâmetro não é declarado como [val]: ele é usado apenas durante a construção do objeto e não se torna uma propriedade;
- Linha 11: na construção do objeto, a camada [business] solicita as faixas de imposto à camada [dao] uma única vez e as armazena em uma propriedade privada somente leitura. Seu tipo, [List<TaxBracket>], é inferido. Observe que a camada [business] conhece a camada [dao] apenas por meio de sua interface [ITaxDao]: ela não sabe se as faixas de imposto vêm do código, de um arquivo ou, mais adiante, de um banco de dados;
- linha 14: a implementação da função da interface, com a palavra-chave obrigatória [override];
- linhas 16–17: a camada [business] não confia em seus chamadores. A função [require] da biblioteca padrão (Capítulo 3) lança uma [IllegalArgumentException] se a condição for falsa; a mensagem da exceção é calculada pela lambda, que só é executada em caso de erro. A mensagem identifica o parâmetro incorreto;
- linhas 19–21: o número de partes. [nbChildren.toBigDecimal()] converte o inteiro em [BigDecimal]. Uma classe Java como [BigDecimal] não tem operadores aritméticos, mas a biblioteca padrão do Kotlin os adiciona por meio de funções de extensão marcadas com [operator] (Capítulo 4): [a + b], [a - b] e [a * b] chamam [add], [subtract] e [multiply], e [shares += HALF] é escrito em Java como [shares = shares.add(HALF)]. Como um [BigDecimal] é imutável, cada operação retorna um novo objeto: é por isso que [shares] é uma variável ([var]). O número de filhos é multiplicado por 0,5 em vez de dividido por 2, pelo motivo exposto a seguir: 3 filhos equivalem a 1,5 parte;
- linhas 24–25: a renda tributável e o quociente familiar. A divisão pelo número de partes pode resultar em um número infinito de casas decimais (a divisão por 3, por exemplo): sem um limite especificado, o método [divide] lançaria então uma [ArithmeticException]. [MathContext.DECIMAL128] limita o resultado a 34 dígitos significativos;
- Linha 28: procuramos a primeira faixa de renda cujo limite seja maior ou igual ao quociente familiar, entre todas as faixas, exceto a última ([dropLast(1)]). [firstOrNull] retorna o primeiro elemento que satisfaz a condição, ou [null] se não houver nenhum; o operador Elvis [?:] substitui então [null] pela última faixa, [brackets.last()], cujo limite (0) não é usado. As classes [BigDecimal] implementam a interface [Comparable]: o Kotlin traduz [qf <= it.limit] para [qf.compareTo(it.limit) <= 0]. Essa linha substitui o laço [for] e o [break] da versão Java;
- linha 30: o imposto. A função [toInt()] de um [BigDecimal] (o método Java [intValue()]) retorna a parte inteira do resultado;
- linhas 33–36: duas constantes, armazenadas em um companion object privado. Elas não podem ser declaradas como [const]: somente tipos primitivos e strings podem.
Uma observação sobre o operador [/]. A biblioteca padrão também define o operador [/] para [BigDecimal], mas ele chama [divide(other, RoundingMode.HALF_EVEN)]: o resultado tem o mesmo número de casas decimais que o dividendo. Assim, [3.toBigDecimal() / BigDecimal.TWO] resulta em 2, e não em 1,5, ao passo que [3.toBigDecimal().divide(BigDecimal.TWO)] de fato resulta em 1,5. É por isso que o código acima evita esse operador: ele multiplica por 0,5 e chama explicitamente [divide] com um [MathContext]. Com as funções de [BigDecimal], é sempre melhor saber exatamente o que faz uma operação de divisão.
Uma abordagem comum no passado era modificar, antes da busca, o limite da última faixa (algo como [brackets[brackets.size - 1].limit = qf + 1]) para que o laço de busca sempre parasse. Essa instrução modificava o array fornecido pela camada [dao]: um efeito colateral sobre dados compartilhados por todas as camadas. Não poderíamos mais escrever isso aqui: a propriedade [limit] de um [TaxBracket] é somente leitura, e a lista que contém as faixas também é somente leitura. O código moderno simplesmente pega a última faixa quando nenhum limite é adequado, sem modificar os dados que recebe.
6.3.5. A camada [ui]
Nas versões 2 e 3, a interface com o usuário era escrita no programa principal, após a criação do objeto de cálculo. A única diferença era a forma como esse objeto era criado. Agora isolamos essa interface com o usuário na camada [ui], que conhece a camada [business] apenas por meio de sua interface:
- Linha 6: o diálogo não tem estado próprio. No Java, criávamos uma classe [final] com um construtor privado, contendo apenas membros estáticos. O Kotlin usa para isso a declaração de objeto ([object], Capítulo 4): [Dialog] é ao mesmo tempo uma classe e sua única instância, criada no primeiro uso. Suas funções são chamadas como métodos estáticos: [Dialog.run(business)];
- linhas 9–10: a pergunta feita ao usuário, uma constante privada ([const val]);
- linhas 13–18: a mensagem de ajuda é uma string bruta, delimitada por três aspas. Ela pode se estender por várias linhas; [trimIndent] (Capítulo 5) remove a indentação comum das linhas, bem como a primeira e a última linhas, se estiverem vazias: o texto não começa nem termina com uma quebra de linha. O resultado de [trimIndent] é calculado em tempo de execução: a string não pode ser declarada como [const];
- linha 24: a função [run] recebe a camada [business] na forma de sua interface [ITaxBusiness]. Ela não sabe nada sobre a classe que a implementa nem sobre a camada [dao];
- Linhas 27–28: a pergunta é exibida por [print], sem quebra de linha, e depois [readlnOrNull] lê uma linha do teclado. Isso retorna [null] no final do fluxo de entrada; a chamada segura a [?.trim()] também retorna então [null], que o operador Elvis substitui pela string vazia: o fim do fluxo encerra o diálogo exatamente como uma linha vazia;
- linha 34: a linha digitada é dividida por espaços; a expressão regular [\s+] (um ou mais espaços) ignora espaços múltiplos;
- linhas 40–41: no Kotlin, o operador [] (e [!=]) compara o conteúdo das strings: ele chama [equals]*. É o operador *[=] que compara referências. A armadilha do Java, em que [==] compara referências, não existe;
- linhas 46–54: o número de filhos e o salário devem ser inteiros positivos ou zero. [toIntOrNull] retorna [null] se o campo não for um inteiro, e o operador Elvis substitui então [null] por -1. Um número negativo e uma entrada inválida são, assim, rejeitados pela mesma verificação. O método [integer] da versão Java, com suas variantes [try]/[catch] de [NumberFormatException], tornou-se obsoleto;
- linha 58: os parâmetros estão corretos: o cálculo é solicitado à camada [business]. A chamada é escrita diretamente no template de string, entre [${...}].
6.3.6. Integração das camadas
Resta apenas criar as camadas e ligá-las entre si. Esse é o papel do programa principal [Main.kt]:
- linhas 1 a 9: o arquivo não contém uma diretiva [package]; seus imports indicam as classes dos outros quatro pacotes;
- linha 14: a função [main] recebe os argumentos da linha de comando no array [args]. O argumento seleciona a implementação da camada [dao]: [hardwired] para a classe [HardwiredTax]; caso contrário, o nome do arquivo lido pela classe [FileTax], tendo [TaxData.txt] como padrão;
- linha 15: [firstOrNull] retorna o primeiro argumento, ou [null] se não houver nenhum, valor que o operador Elvis substitui pelo nome de arquivo padrão;
- linha 16: a variável [business] é inicializada com uma expressão [try]. Seu tipo é declarado: é a interface [ITaxBusiness], e não a classe [TaxBusiness] que a inferência produziria;
- linha 18: criação da camada [dao]. [if] é uma expressão: seu valor é uma ou outra das duas implementações. Este é o único lugar do programa onde as classes [HardwiredTax] e [FileTax] são citadas pelo nome;
- linha 20: criação da camada [business], que recebe a camada [dao]. É a última expressão do bloco [try]e, portanto, seu valor;
- linhas 21 a 26: a criação da camada [dao] pode lançar uma [TaxException]. Um erro é então exibido, junto com a mensagem da exceção original (se houver), e o programa termina com código de saída 1. O código de erro é exibido em texto simples por meio da função [ErrorCode.names]. Se [e.cause] não for [null], [let] constrói a descrição da exceção original; caso contrário, o operador Elvis retorna uma string vazia;
- linha 26: a função [exitProcess] da biblioteca padrão chama [System.exit]. Seu tipo de retorno é [Nothing]: o compilador sabe que ela nunca devolve o controle e, portanto, que o bloco [catch] não produz nenhum valor. A expressão [try] tem, assim, o tipo [ITaxBusiness]. A versão Java precisava acrescentar uma instrução [return] (que nunca é executada) depois de [System.exit(1)], para que o compilador reconhecesse que a variável [business] foi inicializada;
- linha 30: as camadas estão prontas: a camada [ui] interage com o usuário.
6.3.7. Execuções
A partir da pasta do capítulo, usando o arquivo [TaxData.txt] (implementação [FileTax]) e testando a validação das entradas do usuário (nos resultados deste capítulo, as entradas do usuário foram fornecidas ao programa por redirecionamento de entrada e depois colocadas após as perguntas, no ponto em que o usuário as digita):
Com a implementação [HardwiredTax]. Os argumentos do programa são passados pela opção [--args] da tarefa [run]:
Com um arquivo que não existe:
O código de erro é [ACCESS], e a mensagem da exceção original, [NoSuchFileException], é exibida: ela consiste no nome do arquivo, seguido do motivo fornecido ao seu construtor. O programa termina com código de saída 1: o Gradle então relata a falha da tarefa [run] com algumas linhas adicionais, que não reproduziremos aqui.
Com o seguinte arquivo, [TaxDataInvalid.txt], em que a linha 3 está escrita com vírgulas decimais:
obtemos:
Os campos 2 e 3 da linha 3 estão incorretos: o código de erro combina os bits de [FIELD2] e [FIELD3], e a função [ErrorCode.names] o exibe como “FIELD2, FIELD3.”
6.3.8. Conclusão
A arquitetura em camadas e o uso de interfaces trouxeram certa flexibilidade à nossa aplicação. Isso fica evidente na maneira como o programa principal cria as camadas [dao] e [business]:
Mudar a implementação da camada [dao] afeta apenas a linha 2. Depois que as camadas são criadas, o código da camada [ui] é o mesmo nos dois casos: a camada [business] é manipulada ali por meio de sua interface [ITaxBusiness], e não por meio de sua classe de implementação.
A mesma flexibilidade é evidente na camada [business]: ela é construída a partir de uma referência à interface da camada [dao]. Mudar a implementação desta última, portanto, não tem impacto na camada [business]. É por isso que nossa única classe [TaxBusiness] pôde funcionar sem modificação com duas implementações diferentes da camada [dao].
6.4. Aplicação de exemplo - Versão 5
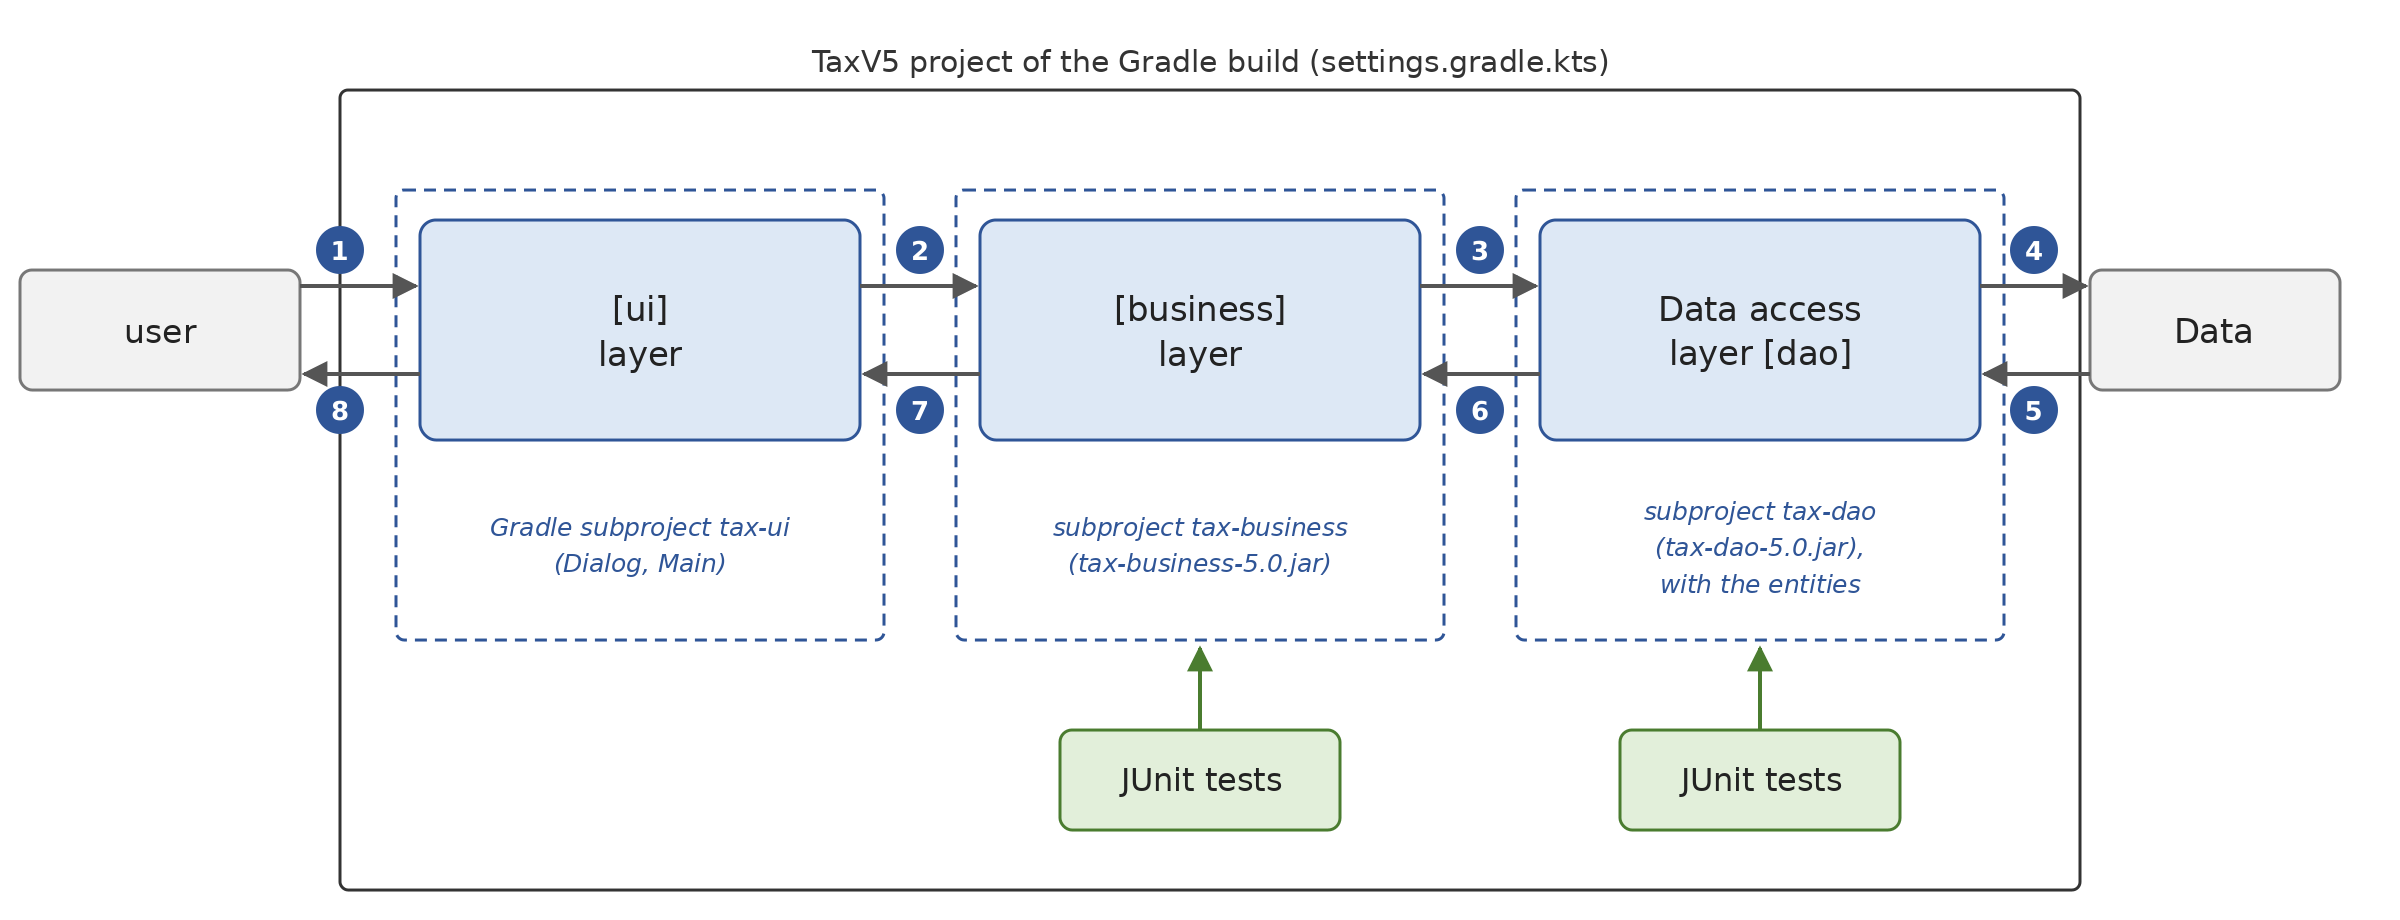
Esta nova versão se baseia na anterior, com as seguintes mudanças:
- As camadas [dao] e [business] são colocadas cada uma em um subprojeto Gradle que produz uma biblioteca (um arquivo JAR) e são testadas com o framework de testes unitários JUnit;
- A camada [dao] recebe uma terceira implementação, [JsonTax], que lê as faixas de imposto de um arquivo JSON usando a biblioteca Jackson;
- A integração das camadas fica a cargo do contêiner de injeção de dependência do Spring, e a implementação da camada [dao] é selecionada a partir de um arquivo de configuração.
Em grandes projetos, vários desenvolvedores trabalham na mesma aplicação. As arquiteturas em camadas facilitam esse modo de trabalho: como as camadas se comunicam por meio de interfaces bem definidas, um desenvolvedor que trabalha em uma camada não precisa se preocupar com o trabalho dos outros desenvolvedores nas demais camadas. Basta que todos respeitem as interfaces.
Assim, para testar a camada [business], o desenvolvedor precisa de uma implementação da camada [dao]. Até que essa implementação esteja concluída, ele pode usar uma implementação fictícia da camada [dao], desde que respeite a interface [ITaxDao]. Esta é outra vantagem da arquitetura em camadas: um atraso na camada [dao] não impede que a camada [business] seja testada. A implementação fictícia (mock) também tem a vantagem de ser muito mais simples de montar do que a camada [dao] real, que pode exigir um SGBD, conexões de rede etc.
Quando a camada [dao] está concluída e testada, ela é fornecida aos desenvolvedores da camada [business] na forma de uma biblioteca (um arquivo JAR), e não de código-fonte a ser copiado. No final, a aplicação é entregue como um programa principal (o da camada [ui]) e bibliotecas de classes (as outras camadas).
6.4.1. Os subprojetos Gradle da versão 5
A versão 5 consiste em três subprojetos do build Gradle do capítulo, um por camada, localizados na pasta [TaxV5]. Os testes não formam um projeto separado: a convenção do Gradle (a mesma do Maven) coloca os testes de um subprojeto em sua pasta [src/test/kotlin]. Eles são compilados e executados pelo Gradle, mas não fazem parte do arquivo JAR do subprojeto. Isso resulta na seguinte estrutura de diretórios:
Os pacotes agora têm o prefixo [tax]: [tax.entities], [tax.dao], [tax.business], [tax.ui]. Os subprojetos [tax-dao] e [tax-business] serão, de fato, reutilizados por outros projetos (capítulos 10 a 13), e duas bibliotecas usadas pelo mesmo programa não podem definir duas classes com o mesmo nome totalmente qualificado. Em projetos profissionais, os pacotes têm como prefixo o nome de domínio invertido da organização ([org.springframework], [tools.jackson]…), o que garante nomes únicos.
A própria pasta [TaxV5] não tem arquivo de build: é uma simples pasta de agrupamento, que o Gradle trata como um projeto vazio, [:TaxV5], pai dos três subprojetos [:TaxV5:tax-dao], [:TaxV5:tax-business] e [:TaxV5:tax-ui] declarados no arquivo [settings.gradle.kts] deste capítulo. Enquanto o Maven exige um projeto pai para agrupar módulos, o Gradle precisa apenas desse arquivo. Cada subprojeto tem seu próprio arquivo [build.gradle.kts], que veremos junto com a respectiva camada. Esses arquivos repetem algumas linhas (o repositório Maven Central, a configuração do compilador e a configuração dos testes); em um projeto maior, fatoraríamos essas linhas em um plugin de convenção (pasta [buildSrc]) e reuniríamos as versões das bibliotecas em um catálogo de versões ([gradle/libs.versions.toml]).
A aplicação é compilada e testada com o seguinte comando, digitado na pasta do capítulo:
O Gradle compila cada subprojeto, compila e executa seus testes e, em seguida, cria seu arquivo JAR na pasta [build/libs] do subprojeto, por exemplo [TaxV5/tax-dao/build/libs/tax-dao-5.0.jar]. Os subprojetos são processados na ordem ditada por suas dependências: [tax-dao], depois [tax-business], depois [tax-ui]. Se um teste falhar, o build é interrompido. O comando [gradlew :TaxV5:tax-business:build] compila apenas o subprojeto [tax-business]… e aqueles dos quais ele depende: o Gradle sabe que [tax-business] precisa de [tax-dao] e compila este último primeiro, caso tenha sido alterado (sem executar seus testes). Diferentemente do Maven, não há repositório local que precise ser mantido atualizado por um comando [install]: dentro de um build, os subprojetos são visíveis entre si diretamente.
As aplicações dos capítulos 10 a 13 reutilizarão as camadas da versão 5 sem copiar seu código-fonte. O arquivo [settings.gradle.kts] delas incluirá o build do capítulo 6 como um build composto:
e seus arquivos [build.gradle.kts] declararão dependências de [examples.tax:tax-business:5.0] e, para o objeto [Dialog], de [examples.tax:tax-ui:5.0], exatamente como fariam para o Jackson ou o Spring:
O Gradle reconhece os subprojetos com essas coordenadas (grupo [examples.tax], nome do subprojeto, versão [5.0]) no build incluído e os usa no lugar de uma biblioteca baixada: ele os compila conforme necessário, e uma mudança na versão 5 se reflete imediatamente nas versões seguintes. É por isso que os três subprojetos declaram o grupo [group = "examples.tax"] e a versão [version = "5.0"].
6.4.2. A camada [dao]
O subprojeto [tax-dao] contém a camada [dao] e as entidades da aplicação. Seu arquivo [build.gradle.kts] é o seguinte:
- linhas 2 a 5: o subprojeto aplica o plugin Kotlin e o plugin [java-library], que é o plugin de bibliotecas. Este último, fornecido pelo Gradle, é escrito entre crases porque seu nome contém um hífen. Ele adiciona a configuração de dependência [api], que o subprojeto [tax-business] usará;
- linhas 9 e 10: as coordenadas da biblioteca, [examples.tax:tax-dao:5.0];
- linha 18: a biblioteca Jackson 3, que lê o arquivo JSON. Ela é declarada com [implementation]: é um detalhe interno da camada [dao], cujos tipos não aparecem em sua interface pública. Um projeto que dependa de [tax-dao] terá o Jackson disponível em tempo de execução, mas não poderá usar suas classes em seu próprio código;
- linhas 20 a 23: as dependências de teste, que apresentaremos junto com os testes. As configurações [testImplementation] e [testRuntimeOnly] são usadas apenas para compilar e executar os testes: não fazem parte das dependências da biblioteca gerada;
- linhas 26 a 31: a configuração do compilador. Os nomes dos parâmetros mantidos no código compilado são usados pelo Jackson para mapear as propriedades do JSON para os parâmetros do construtor de [TaxBracket], e pelo JUnit para exibir os testes parametrizados;
- linhas 35 a 38: a configuração da tarefa [test], que apresentaremos junto com os testes;
- linhas 43 a 45: uma tarefa adicional, [trial], do tipo [JavaExec] (execução de uma classe Java), que inicia o programa de teste apresentado a seguir. Esse programa é armazenado junto com os testes: seu classpath ([classpath]) é, portanto, o dos testes, [sourceSets["test"].runtimeClasspath], que inclui as classes principais, as classes de teste e todas as dependências;
- Linhas 48 a 51: os programas iniciados pelo Gradle escrevem sua saída em UTF-8, para que os caracteres acentuados sejam exibidos corretamente no Windows (capítulo 2).
6.4.2.1. As entidades
A data class [TaxBracket] vem da versão 4 (pacote [tax.entities]). A enumeração [ErrorCode] é removida, e a exceção [TaxException] passa a ser a exceção de toda a aplicação, seja qual for a camada que a lança:
- linha 10: o código de erro continua sendo um simples inteiro: cada implementação da camada [dao] define seus próprios códigos. Seu valor padrão, 0, significa “sem código”;
- linhas 6 a 10: graças aos valores padrão, este único construtor aceita as quatro formas de chamada para as quais a versão Java tinha quatro construtores: [TaxException(message)], [TaxException(message, cause)], [TaxException(message, code = 2)], e [TaxException(message, cause, 2)]. Quando o código é fornecido sem uma causa, ele deve ser nomeado: sem o nome, o compilador tentaria passar o inteiro ao parâmetro [cause]. Também seria possível implementar a classe com um construtor secundário ([constructor(message: String, code: Int) : this(message, null, code)]), mas o argumento nomeado torna a chamada mais legível.
6.4.2.2. A implementação [FileTax]
A interface [ITaxDao] e a classe [HardwiredTax] são as da versão 4. A classe [FileTax] difere apenas na forma como seus códigos de erro são escritos:
- linhas 3 a 7: os códigos de erro, que antes estavam na enumeração [ErrorCode] do pacote de entidades, tornaram-se constantes da classe [FileTax]: são, de fato, códigos específicos desta implementação da interface [ITaxDao] ([JsonTax] tem os seus). O Kotlin não possui membros estáticos: as constantes de classe são declaradas em seu objeto companheiro, com a palavra-chave [const], que as torna constantes de tempo de compilação (o equivalente a um campo Java chamado [static final]). Elas são escritas como [FIELD1] dentro da classe e como [FileTax.FIELD1] fora dela. Os imports dos valores de [ErrorCode] da versão 4 não são mais necessários.
Mais acima na classe:
- linha 3: o erro de acesso ao arquivo é encapsulado em uma [TaxException], com a causa e o código [ACCESS];
- linha 16: uma linha que não tem três campos lança uma exceção com o código [LINE];
- linhas 22 a 25: os códigos são inteiros combinados diretamente com a função infixa [or].
6.4.2.3. A implementação [JsonTax]
Como na versão 3 do capítulo 5, a terceira implementação da camada [dao] lê as faixas de imposto de um arquivo JSON usando a biblioteca Jackson. O arquivo [TaxData.json] é o seguinte:
A classe [JsonTax] é a seguinte:
- linha 14: como em [FileTax], a classe recebe o nome do arquivo, que se torna a propriedade [fileName];
- linhas 21 a 28: o arquivo é lido como em [FileTax]. A função de extensão [readText] lê o arquivo inteiro, em UTF-8, para uma string. Um erro de E/S resulta em uma [TaxException] com o código [ACCESS];
- linhas 32 a 35: desserialização (capítulo 5). [JsonMapper.builder().build()] cria o objeto do Jackson que converte JSON em objetos, e seu método [readValue] lê o texto JSON como um array de [TaxBracket]. O tipo array é escrito como [Array<TaxBracket>::class.java]: [::class] especifica a classe Kotlin ([KClass]) do tipo, e [.java] especifica a classe Java correspondente, que é a que o Jackson espera. Para criar cada faixa, o Jackson chama o construtor da data class [TaxBracket], mapeando as propriedades JSON [limit], [coeffR], e [coeffN] para os nomes de seus parâmetros, que são preservados graças à opção de compilador [javaParameters]. Os números JSON são convertidos em [BigDecimal], o tipo do parâmetro, sem passar por um [Double]: a conversão é exata. Um erro de sintaxe ou de conteúdo causa uma [JacksonException], encapsulada em uma [TaxException] com o código [FORMAT];
- linha 37: [readValue] é um método Java: o Kotlin não sabe se ele pode retornar [null] e atribui ao seu resultado um tipo de plataforma, indicado como [Array<TaxBracket>!] nas mensagens do compilador, que pode ser tratado como anulável ou não anulável. Na realidade, ele retorna [null] se o arquivo contiver o texto JSON [null]: a chamada segura [?.toList()] e o operador Elvis transformam esse caso em uma [TaxException] com o código [FORMAT]. Caso contrário, [toList] converte o array em uma lista somente leitura;
- linhas 42 e 43: os códigos de erro desta implementação.
O capítulo 5 mencionou a existência do módulo [jackson-module-kotlin], que informa ao Jackson sobre os recursos específicos do Kotlin (valores padrão de parâmetros, tipos anuláveis), e da biblioteca kotlinx.serialization da JetBrains. Nossa simples data class não precisa deles.
6.4.2.4. Um programa de teste
Antes de escrever testes automatizados, vamos fazer um primeiro teste visual da camada [dao]. O programa [TrialDao.kt] exibe as faixas fornecidas pelas três implementações. Nós o colocamos nas fontes de teste do subprojeto ([src/test/kotlin]): ele não será incluído no arquivo JAR da camada [dao]:
- linha 6: uma função [main] de nível superior, sem parâmetros, no pacote [tax.dao]: sua classe é [tax.dao.TrialDaoKt]. Colocado no mesmo pacote das classes testadas, o programa as usa sem importá-las;
- linha 8: uma lista das três implementações da interface [ITaxDao]. O compilador infere o tipo mais específico comum aos três elementos: [List<ITaxDao>];
- linha 10: [dao::class] retorna a classe real do objeto, cujo nome (sem o pacote) é [simpleName];
- linha 11: cada faixa é passada à função [println] (referência de função [::println]), que a exibe por meio de sua função [toString], gerada pelo compilador para uma data class;
- linhas 13 a 16: tratamento de uma eventual [TaxException].
O programa é executado com a pasta do subprojeto [tax-dao] como pasta atual, por meio da tarefa [trial] declarada no arquivo de build:
As três implementações retornam as mesmas faixas. A função [toString] de uma data class exibe o nome da classe seguido de suas propriedades entre parênteses (um record Java as exibia entre colchetes); a função [BigDecimal] escreve sempre um ponto decimal, independentemente do idioma do usuário. No IntelliJ IDEA, o programa também é iniciado pelo triângulo verde situado diante de sua função [main].
6.4.3. A camada [business]
O arquivo [build.gradle.kts] do subprojeto [tax-business] é o seguinte:
- linha 18: a camada [business] usa a camada [dao]. A notação [project(":TaxV5:tax-dao")] refere-se a outro subprojeto da estrutura por meio de seu caminho. A dependência é declarada com [api] e não com [implementation]: a interface [ITaxDao] aparece na API pública da camada [business], já que o construtor de [TaxBusiness] recebe uma [ITaxDao]. Um projeto que dependa de [tax-business] deve, portanto, poder usar os tipos de [tax-dao] em seu código: com [api], ele os recebe automaticamente, sem precisar declarar ele próprio a dependência de [tax-dao]. O Jackson, declarado com [implementation] em [tax-dao], é incluído apenas em tempo de execução;
- linhas 42 a 44: a tarefa [trial] deste subprojeto;
- linhas 47 a 50: os programas iniciados pelo Gradle escrevem sua saída em UTF-8, para que os caracteres acentuados sejam exibidos corretamente no Windows (capítulo 2).
A interface [ITaxBusiness] e a classe [TaxBusiness] são as da versão 4 (pacote [tax.business]). O programa de teste [TrialBusiness.kt], localizado nas fontes de teste do subprojeto, realiza alguns cálculos de imposto:
- linha 10: criação das camadas [dao] e [business]. A camada [dao] é implementada pela classe [FileTax]. Como o programa é executado na pasta [tax-business], o caminho relativo [../tax-dao/TaxData.txt] refere-se ao arquivo de dados do subprojeto [tax-dao];
- linhas 11 a 14: chamadas repetidas à única função da interface [ITaxBusiness].
Resultados:
Um casal com 2 filhos e uma pessoa solteira com 3 filhos têm o mesmo número de partes (3): seus impostos são iguais.
6.4.4. Testes unitários com JUnit
6.4.4.1. O princípio
Os testes realizados até agora se baseavam em verificação visual: conferíamos se a tela exibia os resultados esperados. Esse método é impraticável quando há muitos testes a executar: o ser humano está sujeito ao cansaço, e sua capacidade de verificar resultados diminui ao longo do dia. Os testes devem, portanto, ser automatizados e dispensar qualquer intervenção humana.
Uma aplicação evolui com o tempo. A cada atualização, é preciso verificar se ela não “regride”, isto é, se continua passando nos testes de funcionalidade realizados durante seu desenvolvimento inicial. Esses testes são chamados de testes de não regressão. Uma aplicação de porte moderado pode exigir centenas de testes: na verdade, toda função de toda classe da aplicação é testada. Esses são os chamados testes unitários.
Foram desenvolvidos frameworks de teste para automatizar esses testes. Para a JVM, o framework de referência é o JUnit, criado no final da década de 1990 por Kent Beck e Erich Gamma. Ele pode ser usado tanto em Kotlin quanto em Java. Usamos a versão 6, lançada em setembro de 2025 (aqui, a versão 6.0.3); sua API, a do pacote [org.junit.jupiter.api], é a mesma do JUnit 5, também conhecido como JUnit Jupiter. O Kotlin acrescenta sua própria biblioteca de testes, kotlin.test: um conjunto de asserções escritas para o Kotlin ([assertEquals], [assertFailsWith], [assertIs]…), que delegam o trabalho ao framework de testes em uso, no caso o JUnit. Os testes são executados pelo comando [gradlew test] na linha de comando: isso permite iniciá-los automaticamente, por exemplo, sempre que alterações de código são enviadas a um servidor de integração contínua. O IntelliJ IDEA também os executa e exibe seus resultados em uma estrutura em árvore. O Kotest é outro framework de testes, escrito para o Kotlin, que funciona segundo o mesmo princípio.
6.4.4.2. Um primeiro exemplo
Vamos examinar o princípio dos testes JUnit por meio de um exemplo. O subprojeto [DemoTests] contém apenas testes, localizados na pasta [src/test/kotlin/demotests]. Seu arquivo [build.gradle.kts] é o seguinte:
- linhas 2 e 3: o plugin Kotlin; é só isso, pois o projeto não tem programa principal;
- linha 15: a biblioteca kotlin.test. A notação [kotlin("test")] refere-se ao artefato [org.jetbrains.kotlin:kotlin-test], na versão do plugin Kotlin. Quando a tarefa [test] usa a plataforma JUnit (linha 35), o plugin Kotlin adiciona automaticamente o adaptador que liga as asserções de kotlin.test às do JUnit;
- linha 17: o JUnit é composto de vários módulos (a API, o engine, os testes parametrizados, a plataforma etc.), que devem ter versões compatíveis. Sua lista de materiais (BOM), [junit-bom], especifica as versões de todos esses módulos: as dependências seguintes são declaradas sem versão;
- linha 19: o artefato [junit-jupiter] reúne o artefato da API de testes ([@Test], [@BeforeEach]…), o artefato dos testes parametrizados e o engine Jupiter que os executa;
- linha 21: o launcher da plataforma JUnit, por meio do qual o Gradle inicia os testes. Ele só é necessário em tempo de execução ([testRuntimeOnly]);
- linha 29: o compilador preserva os nomes dos parâmetros das funções, que o JUnit exibe nos testes parametrizados;
- linhas 33 a 43: a configuração da tarefa [test]. [useJUnitPlatform()] instrui a tarefa a executar os testes usando a plataforma JUnit. Por padrão, o Gradle exibe apenas os testes que falharam e um resumo; [events("passed", "skipped", "failed")] instrui-o a relatar cada teste, seja ele aprovado, ignorado ou reprovado; [showStandardStreams = true] instrui-o a exibir na tela a saída dos testes, e as linhas 42 e 43 instruem-no a exibir, para um teste reprovado, a mensagem de erro completa sem a pilha de chamadas (por padrão, o Gradle exibe apenas o nome da exceção e o local do erro).
A classe de teste [Tests1] é a seguinte:
- linhas 3 e 4: a anotação [Test] e a asserção [assertEquals] de kotlin.test. Com o JUnit, [kotlin.test.Test] é um apelido de tipo ([typealias]) para a anotação [org.junit.jupiter.api.Test]: é a mesma anotação. As asserções são funções de nível superior, importadas como se fossem classes;
- linhas 5 a 8: anotações do ciclo de vida dos testes, específicas do JUnit;
- linha 11: a função que está sendo testada. Em um projeto real, ela estaria no código-fonte principal do projeto ([src/main/kotlin]);
- linha 14: uma classe de teste é uma classe comum, sem nenhuma anotação;
- linhas 17 e 18: o bloco [init], executado quando o objeto é construído. Ele serve apenas para exibir uma mensagem na tela: queremos ver quando o objeto é criado;
- linha 22: a anotação [@BeforeEach] designa uma função executada antes de cada teste;
- linha 28: a anotação [@AfterEach] designa uma função executada depois de cada teste;
- linhas 34 e 35: a anotação [@Test] indica uma função de teste. Uma função de teste não retorna nada, não é privada e, com uma exceção que veremos, não tem parâmetros. Seu nome é escrito entre crases: o Kotlin permite, assim, dar a uma função um nome que contém espaços e caracteres acentuados, o que é desaconselhado no código comum, mas é prática corrente nos testes, pois o nome do teste diz claramente o que ele verifica. Na JVM, esse nome não pode conter certos caracteres ([. ; [ ] / < > :] e a barra invertida). O Java obtém o mesmo efeito com a anotação [@DisplayName];
- linha 37: a função [assertEquals(expected, actual)] verifica se o valor obtido é igual ao valor esperado. Caso contrário, ela lança uma exceção [AssertionFailedError] e o teste falha. Aqui, a asserção deve passar;
- linha 44: esta asserção deve falhar. O terceiro parâmetro é a mensagem exibida em caso de falha: como no JUnit, a mensagem é o último parâmetro das asserções de kotlin.test;
- linhas 49 a 59: as anotações [@BeforeAll] e [@AfterAll] designam funções executadas uma única vez, antes do primeiro teste e depois do último teste da classe. O JUnit exige que sejam métodos estáticos. O Kotlin não possui membros estáticos: essas funções são colocadas no objeto companheiro da classe e anotadas com [@JvmStatic], o que instrui o compilador a gerar adicionalmente um verdadeiro método estático na classe [Tests1]. Sem [@JvmStatic], essas funções seriam simplesmente métodos da classe do objeto companheiro: o JUnit, que procura funções anotadas na classe [Tests1], não as encontraria, e elas nunca seriam executadas.
Os testes são executados com o comando [gradlew test], que executa os testes de todos os subprojetos, ou com [gradlew :DemoTests:test], que executa apenas os do subprojeto [DemoTests]. A seguir reproduzimos os relatórios dos testes e suas saídas, na ordem em que foram executados, mas não as demais mensagens do Gradle:
- As linhas da forma [Tests1 > two and two make four() PASSED] são os relatórios dos testes: a classe, o teste e, depois, o resultado, [PASSED] (aprovado) ou [FAILED] (reprovado). Os testes das classes [Tests2] e [Tests3], mostrados mais adiante, foram todos aprovados. A ordem de execução das classes e das funções é fixa, mas intencionalmente pouco evidente: os testes não devem depender da ordem de execução;
- O Gradle agrupa as saídas sob uma linha que indica seu autor seguido da notação [STANDARD_OUT]: a classe ([Tests1 STANDARD_OUT]) para o código escrito fora de um teste, e o próprio teste para o código escrito dentro do teste;
- A linha [before all the tests]: a função [@BeforeAll] é executada uma vez, antes do primeiro teste da classe [Tests1];
- Em seguida vêm as saídas do teste [two and two make five]: o construtor foi executado (a linha [constructor], escrita antes do início do teste, é colocada em [Tests1 STANDARD_OUT]), seguido da função [before], do teste e, por fim, da função [after];
- depois, a saída do teste [two and two make four]. Observe que o construtor foi executado novamente: o JUnit cria uma nova instância da classe de teste para cada teste. Os testes são, assim, independentes uns dos outros: um teste não pode ser afetado pelo estado deixado por outro (a classe [Tests3] mostrará como solicitar, em vez disso, uma única instância para todos os testes da classe);
- O teste [two and two make five] falhou. A mensagem de erro contém a mensagem passada a [assertEquals], o valor esperado e o valor obtido: trata-se de [AssertionFailedError], uma classe filha do JUnit, à qual o kotlin.test delegou a verificação. As mensagens do JUnit estão em inglês. Sem as configurações [exceptionFormat] e [showStackTraces] no arquivo [build.gradle.kts], o Gradle exibiria apenas o local da asserção que falhou ([org.opentest4j.AssertionFailedError at Tests1.kt:44], linha 44 do arquivo [Tests1.kt]). Por fim, o Gradle relata que a tarefa [test] falhou (“14 tests completed, 1 failed”): o comando [gradlew test] termina então com uma falha de build (“BUILD FAILED”) e um código de saída diferente de zero, o que permite a um script detectar a falha. O Gradle também gera um relatório HTML detalhado dos testes na pasta [build/reports/tests/test] do subprojeto;
- a linha [after all the tests], a última linha da classe [Tests1]: a função [@AfterAll] é executada uma vez, depois do último teste da classe.
Para executar apenas um subconjunto dos testes, use a opção [--tests] da tarefa [test]: [gradlew :DemoTests:test --tests demotests.Tests2] executa apenas os testes da classe [Tests2] (o nome pode conter o caractere curinga [*]). Por padrão, o JUnit executa os testes sequencialmente; a execução em paralelo pode ser especificada em um arquivo de configuração [junit-platform.properties].
6.4.4.3. Asserções adicionais
A biblioteca kotlin.test tem muitas asserções, e o JUnit acrescenta outras. A classe [Tests2] fornece alguns exemplos:
- linhas 28 e 29: verificam se uma expressão booleana é verdadeira ou falsa;
- linhas 33 e 34: verificam se uma referência é não nula ou nula. [obj2] deve ser declarado com um tipo anulável, [Any?];
- linhas 35 e 36: verificam se duas referências apontam para o mesmo objeto (o operador [===]);
- linhas 42 a 45: os cálculos com números reais [Double] são aproximados: [0.1 + 0.2] não é exatamente igual a [0.3]. Comparamos, portanto, dois números reais com uma tolerância, aqui de um milionésimo. O parâmetro [absoluteTolerance] é nomeado: a chamada especifica claramente o que é o terceiro número;
- linhas 53 a 58: a função [assertAll] do JUnit recebe expressões lambda, cada uma contendo uma asserção: todas as asserções são executadas, mesmo que uma delas falhe, e as falhas são relatadas em conjunto. Sem [assertAll], a primeira falha interrompe o teste. Essa função de nível superior, do pacote [org.junit.jupiter.api], faz parte das extensões que o JUnit oferece para o Kotlin: ela aceita lambdas Kotlin ([{ ... }]) em vez de objetos [Executable]. [assertContains] verifica se uma string contém uma substring, ou se uma coleção contém um elemento. As listas Kotlin são comparadas com [==] (função [equals]): duas listas são iguais se tiverem os mesmos elementos na mesma ordem, e [assertEquals] basta onde o Java usava [assertIterableEquals];
- linha 66: [assertFailsWith<Type> { action }] executa a ação (uma lambda) e verifica se ela lança uma exceção do tipo [Type] ou de um tipo derivado. O tipo é um parâmetro de tipo reificado ([reified], capítulo 4): ele é escrito entre sinais de menor e maior, sem [::class]. Aqui, a operação de leitura [numbers[3]] lança uma [ArrayIndexOutOfBoundsException], classe derivada de [IndexOutOfBoundsException]: a asserção é bem-sucedida;
- linhas 67 e 68: [assertFailsWith] retorna a exceção, o que permite verificar suas propriedades em seguida. Seu tipo é o solicitado, [NumberFormatException]: nenhuma conversão de tipo é necessária. O kotlin.test não tem equivalente a [assertThrowsExactly], que exige o tipo exato da exceção; pode-se usar a do JUnit ou verificar depois [e::class];
- linhas 70 a 72: [assertIs<Type>(obj)] verifica se o objeto é do tipo especificado ou de um tipo derivado. Ela também informa ao compilador que, depois da asserção, [obj] é desse tipo: por meio do smart cast, a linha seguinte usa a propriedade [length] de uma [String] em uma variável declarada como [Any];
- linhas 76 a 79: um teste parametrizado. A anotação [@ParameterizedTest] substitui [@Test]; a função tem parâmetros, e a anotação [@CsvSource] fornece conjuntos de valores, uma string por conjunto, com os valores separados por vírgulas. Em Kotlin, se o parâmetro [value] de uma anotação é um array, ele é escrito como uma lista de argumentos. O JUnit converte os valores para o tipo do parâmetro. O teste é executado uma vez por conjunto de valores;
- linhas 84 a 86: para um teste com um único parâmetro, a anotação [@ValueSource] fornece diretamente a lista de valores ([ints], [strings], [doubles]…). Um array passado a um parâmetro nomeado de anotação é escrito entre colchetes: [ints = [2, 4, 6]].
Nos resultados anteriores, cada conjunto de valores de um teste parametrizado gerou um relatório, numerado entre colchetes e acompanhado dos nomes e valores dos parâmetros: [Tests2 > sum of two integers(int, int, int) > [1] a = "1", b = "1", sum = "2" PASSED]. O teste é identificado primeiro pelo nome da função seguido dos tipos de seus parâmetros, vistos a partir do Java ([int] para um [Int]do Kotlin). Os valores fornecidos por [@CsvSource] são exibidos exatamente como estão escritos na anotação, entre aspas, antes de sua conversão; os de [@ValueSource], que já são inteiros, são exibidos sem aspas ([even numbers(int) > [1] n = 2]).
Resumimos as principais asserções de kotlin.test (pacote [kotlin.test]):
Função | Verifica que |
[assertEquals(expected, actual)] | os dois valores são iguais (função [equals], portanto isso também vale para listas) |
[assertEquals(real1, real2, absoluteTolerance)] | os dois números reais são iguais dentro da tolerância |
[assertNotEquals(v1, v2)] | Os dois valores são diferentes |
[assertSame(o1, o2)], [assertNotSame(o1, o2)] | As duas referências apontam (ou não) para o mesmo objeto |
[assertNull(o)], [assertNotNull(o)] | A referência é nula (ou não); [assertNotNull] retorna o valor, que não é anulável |
[assertTrue(b)], [assertFalse(b)] | a expressão booleana é verdadeira (ou falsa) |
[assertIs<Type>(o)] | o objeto é do tipo [Type] ou de um tipo derivado (e faz o cast) |
[assertContains(c, e)] | a coleção, o array ou a string [c] contém [e] |
[assertContentEquals(t1, t2)] | os dois arrays (ou sequências) têm os mesmos elementos, na mesma ordem |
[assertFailsWith<Type> { action }] | A ação lança uma exceção do tipo [Type] ou de um tipo derivado |
[assertFails { action }] | A ação lança uma exceção, seja qual for o seu tipo |
[fail(message)] | (sempre falha) |
Todas essas funções aceitam um parâmetro opcional [message]: a mensagem exibida em caso de falha. A função [assertAll] existe apenas no JUnit. As asserções do JUnit (classe [org.junit.jupiter.api.Assertions]) continuam utilizáveis em Kotlin; o kotlin.test tem a vantagem de ser mais conciso, de aproveitar os tipos reificados e o smart cast e de não depender do framework de testes.
6.4.4.4. Uma instância por classe de teste
As funções [@BeforeAll] da classe [Tests1] precisavam ser colocadas no objeto companheiro. O JUnit oferece outra solução, como mostra a classe [Tests3]:
- linha 9: a anotação [@TestInstance(Lifecycle.PER_CLASS)] instrui o JUnit a criar uma única instância da classe para todos os seus testes, em vez de uma instância por teste. As funções [@BeforeAll] e [@AfterAll] podem então ser funções comuns da classe;
- linha 13: dados compartilhados pelos testes. O modificador [lateinit] permite declarar uma propriedade [var] como não anulável sem inicializá-la: ela receberá seu valor mais tarde, antes de ser lida pela primeira vez (uma leitura prematura lançaria uma [UninitializedPropertyAccessException]);
- linhas 16 a 19: a função, executada uma vez antes do primeiro teste, prepara os dados: a lista dos quadrados dos inteiros de 0 a 10;
- linhas 23 a 29: dois testes usam esses dados.
Os resultados anteriores mostram que a preparação foi feita uma única vez. Esse modo é útil quando a preparação é custosa (conexão a um banco de dados, leitura de um arquivo grande); nesses casos, os testes devem tomar cuidado para não modificar o estado compartilhado. Ele também pode ser escolhido para o projeto inteiro no arquivo [junit-platform.properties] ([junit.jupiter.testinstance.lifecycle.default = per_class]), o que costuma ser feito em projetos Kotlin.
6.4.4.5. Testes da camada [dao]
Voltemos à aplicação [Tax]. A classe [DaoTests], que testa a camada [dao], está localizada na pasta [src/test/kotlin/tax/dao] do subprojeto [tax-dao]. Ela pertence ao mesmo pacote das classes testadas. As fontes de teste de um subprojeto também incluem suas declarações [internal], que são visíveis no único módulo que as declara. As dependências de teste foram declaradas no arquivo de build do subprojeto, exatamente como no de [DemoTests]. O arquivo de dados inválido [TaxDataInvalid.txt] é colocado na pasta do subprojeto: essa é a pasta atual durante a execução dos testes.
- linhas 61 a 67: uma função que cria uma camada [dao] a partir do nome de sua classe, usando uma expressão [when]: cada ramo retorna, depois da seta [->], o valor da expressão. Ela é colocada em um objeto companheiro privado, mas poderia muito bem ser uma função privada da classe ou do arquivo;
- linhas 18 a 27: o mesmo teste é realizado para as três implementações, com a anotação [@ValueSource]. Ele verifica que há 7 faixas e confere o valor da faixa nº 2 (a terceira). A declaração de desestruturação [val (limit, coeffR, coeffN) = brackets[2]] distribui as três propriedades da faixa em três variáveis, usando as funções [component1] a [component3] geradas para uma data class. Os valores [BigDecimal] são comparados com [compareTo] e não com [equals]: o método [equals] de um [BigDecimal] leva em conta o número de casas decimais escritas (sua escala, “scale”) e trata 0.191 e 0.1910 como diferentes, ao passo que [compareTo] compara apenas os valores. Observação: em Kotlin, [a == b] chama [equals] e, portanto, tem esse problema com os valores [BigDecimal]; são os operadores [<], [<=]… que chamam [compareTo];
- linhas 32 a 35: as três implementações produzem exatamente as mesmas faixas. [assertEquals] compara as listas por meio de sua função [equals], que compara os elementos um a um; a função [equals] de uma data class, gerada pelo compilador, compara suas propriedades. A comparação é bem-sucedida porque as três fontes escrevem os números da mesma maneira;
- linhas 40 a 43: um arquivo ausente lança uma [TaxException] com o código [ACCESS], que encapsula uma [NoSuchFileException]. [assertFailsWith] também aceita classes derivadas do tipo solicitado, mas uma classe Kotlin é final por padrão: [TaxException] não tem classes derivadas, e o teste verifica corretamente o tipo exato da exceção. [assertIs] verifica o tipo da causa;
- linhas 48 a 51: o arquivo [TaxDataInvalid.txt] lança uma [TaxException], cujo código combina os códigos [FIELD2] e [FIELD3], e cuja mensagem começa com “Line no. 3.” A propriedade [message] de uma exceção é do tipo [String?]: o operador [!!] afirma que ela não é [null] (caso contrário, lançaria uma [NullPointerException], o que também faria o teste falhar);
- linhas 56 a 58: a mesma verificação para a implementação [JsonTax].
6.4.4.6. Testes da camada [business]
A classe [BusinessTests] do subprojeto [tax-business] testa a camada [business]:
- linhas 17 e 18: a camada [business] testada é construída sobre a camada [dao] e a classe [HardwiredTax] , que não dependem de nenhum arquivo. As propriedades são inicializadas quando o objeto é criado; como o JUnit cria uma nova instância da classe para cada teste, cada teste tem camadas novas em folha;
- linhas 21 a 31: cálculos cujos resultados são conhecidos, fornecidos por [@CsvSource]. São os valores de controle da aplicação, já obtidos nas versões anteriores: eles devem continuar corretos em todas as versões futuras. As strings [true] e [false] são convertidas em [Boolean]. O nome do teste, [tax calculation], contém um espaço: isso é permitido entre crases;
- linhas 36 a 39: o cálculo do imposto não modifica as faixas de imposto fornecidas pela camada [dao]. Uma cópia das faixas ([toList]) é salva antes de um cálculo que usa a última faixa e, em seguida, é feita uma comparação. O teste acompanha o antigo defeito descrito acima: se alguém o reintroduzisse, este teste o apontaria. Observe que uma [List] do Kotlin é somente leitura para o compilador, mas o objeto real pode ser uma lista mutável: um código que a convertesse para [MutableList] poderia modificá-la;
- linhas 44 a 46: parâmetros negativos são rejeitados por uma
*[IllegalArgumentException], a lançada por*[require]; - linhas 53 a 55: uma camada [dao] fictícia, como a que o desenvolvedor da camada [business] usaria antes que a camada [dao] real esteja pronta: uma única faixa de imposto, com 10% de imposto sobre a renda tributável. A interface [ITaxDao] é implementada sem escrever uma classe, por meio de uma expressão de objeto ([object : ITaxDao { ... }]): um objeto de uma classe anônima que implementa a interface, o equivalente às classes anônimas do Java. A versão Java, cuja interface tinha apenas um método abstrato, usava uma expressão lambda; nossa interface declara uma propriedade, e uma lambda só pode implementar uma interface funcional do Kotlin ([fun interface], capítulo 7), que declara apenas uma função abstrata. O tipo da propriedade redefinida, [List<TaxBracket>], é inferido;
- linhas 57 a 59: a camada [business] funciona com a camada [dao] fictícia. A camada [business] é, assim, testada isoladamente, independentemente das implementações reais da camada [dao].
6.4.4.7. Execução dos testes
O comando [gradlew test], digitado na pasta do capítulo, executa os testes de todos os subprojetos; [gradlew :TaxV5:tax-dao:test] executa apenas os testes do subprojeto [tax-dao]. Aqui estão os relatórios dos testes deste subprojeto (incluímos apenas estas linhas):
e os do subprojeto [tax-business]:
Todos os 16 testes foram aprovados: cada conjunto de valores de um teste parametrizado conta como um teste, e o JUnit os exibe junto com os nomes e valores de seus parâmetros (esses nomes estão disponíveis por meio da opção de compilador [javaParameters]). Consideramos agora as camadas [dao] e [business] operacionais. Os arquivos JAR gerados por [gradlew build] (ou [gradlew jar]) contêm apenas o código das camadas: as classes de teste, compiladas na pasta [build/classes/kotlin/test], não são incluídas. Por fim, observe que [gradlew build] executa os testes: uma regressão faz o build falhar. O Gradle só repete o trabalho necessário: se nem o código nem os testes de um subprojeto mudaram desde a última execução bem-sucedida, seus testes não são executados novamente (a tarefa é marcada como “UP-TO-DATE”); a opção [--rerun] ([gradlew :TaxV5:tax-dao:test --rerun]) força sua execução.
6.4.5. A camada [ui]
O arquivo [build.gradle.kts] do subprojeto [tax-ui] é o seguinte:
- linhas 2 a 6: o plugin Kotlin, o plugin de compilador Kotlin [plugin.spring], cujo papel veremos ao configurar o Spring com uma classe anotada, e o plugin [application];
- linha 19: a camada [ui] usa a camada [business] e, por meio da dependência [api] desta última, a camada [dao];
- linha 21: o contêiner de injeção de dependência do Spring, o artefato [spring-context], que traz consigo os outros módulos do Spring de que precisa ([spring-core], [spring-beans] etc.);
- linhas 32 a 35: o subprojeto tem vários programas principais; a propriedade [main] seleciona o que será executado por [gradlew run] e [tax.ui.MainKt] é o padrão;
- linhas 43 a 46: os programas iniciados pelo Gradle escrevem sua saída em UTF-8, para que os caracteres acentuados sejam exibidos corretamente no Windows (capítulo 2).
O objeto [Dialog] vem da versão 4 (pacote [tax.ui]), acrescido de uma função que exibe uma exceção e todas as exceções que ela encapsula:
- linha 2: o parâmetro é do tipo [Throwable], a classe pai de todas as exceções;
- linha 3: uma string de 40 hifens, criada pela função [repeat];
- linha 5: cada exceção dá acesso, por meio de sua propriedade [cause], à exceção que ela encapsula, até a última, cuja causa é [null]. A função [generateSequence] (capítulo 5) gera essa cadeia como uma sequência: ela começa com o valor inicial, [exception], e calcula cada elemento seguinte a partir do anterior por meio da lambda [{ it.cause }]; a sequência termina no primeiro [null]. O laço [for] da versão Java, com sua variável modificada a cada iteração, torna-se uma simples enumeração;
- linha 6: para cada exceção, são exibidos o nome completo de sua classe (incluindo o pacote) e sua mensagem.
O objeto [Dialog] é público: as versões seguintes da aplicação, que mudarão a camada [dao], poderão reutilizar a camada [ui] dependendo do subprojeto [tax-ui] e chamando [Dialog.run(business)].
6.4.6. Integração das camadas por injeção de dependência
Na versão 4, o programa principal criava as camadas [dao] e [business] nomeando suas classes de implementação:
Fora essas linhas, nada na aplicação muda quando a implementação de uma camada muda, já que cada camada se comunica com a seguinte por meio de uma interface. Podemos levar a independência das camadas um passo adiante, confiando sua criação a um contêiner de injeção de dependência e colocando a escolha da implementação da camada [dao] em um arquivo de configuração. Mudar a implementação dessa camada passa a consistir simplesmente em modificar esse arquivo, sem recompilar a aplicação.
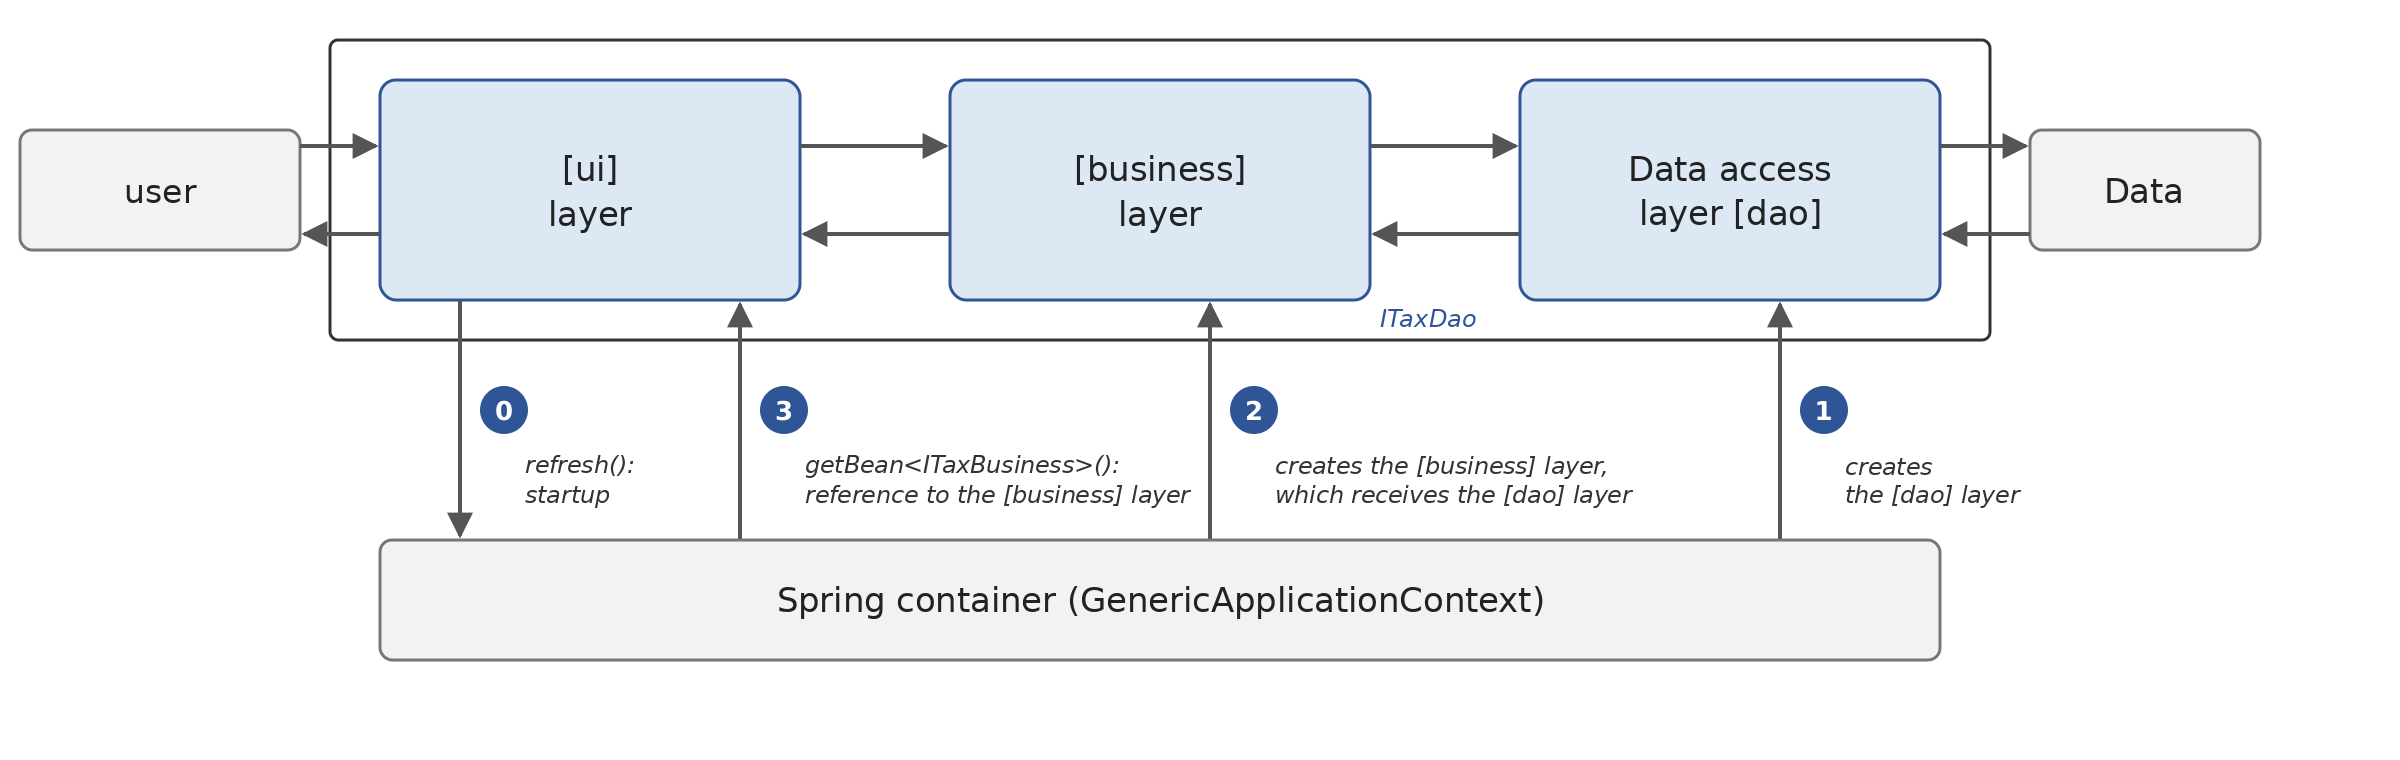
No exemplo acima, o programa principal da camada [ui] inicia o contêiner Spring, [0]. O contêiner Spring cria a camada [dao] [1], depois a camada [business] [2], à qual passa a camada [dao]. Por fim, a camada [ui] solicita ao contêiner a camada [business] e recebe uma referência a ela: [3].
6.4.6.1. O arquivo de configuração
A escolha da implementação da camada [dao] é especificada no arquivo [tax.properties] da pasta [tax-ui]:
- linha 1: um comentário começa com o caractere [#];
- linha 2: a classe que implementa a camada [dao]: [HardwiredTax], [FileTax], ou [JsonTax];
- linha 3: o arquivo de dados, para as implementações que leem um.
Um arquivo “properties” é o formato de configuração tradicional da JVM: uma propriedade por linha, na forma [key=value], lido pela classe Java [java.util.Properties]. As chaves costumam ter um prefixo para formar grupos, como o prefixo [dao.] aqui. O subprojeto contém três outros arquivos de configuração, que o programa usa se seus nomes forem passados como argumentos:
Os arquivos [TaxData.txt] e [TaxData.json] foram copiados para a pasta [tax-ui]: seus caminhos são relativos à pasta atual, e [gradlew run] executa o programa na pasta do subprojeto.
6.4.6.2. O programa principal
O programa principal [Main.kt] do subprojeto [tax-ui] é o seguinte:
- linhas 14 a 16: o Spring fornece funções de extensão para o Kotlin, que tornam sua API mais natural nessa linguagem. [getBean] e [registerBean] são importadas como funções de nível superior a partir de seus pacotes;
- linha 19: a função [main] do pacote [tax.ui], compilada na classe [tax.ui.MainKt];
- linha 21: o nome do arquivo de configuração: [tax.properties] por padrão, ou o que for passado como argumento;
- linha 24: como na versão 4, a camada [business] é o valor de uma expressão [try];
- linhas 26 a 29: leitura da configuração. A função de extensão [bufferedReader] de [kotlin.io.path] abre o arquivo em UTF-8, e [use] o fecha ao final do bloco, mesmo em caso de exceção ([try] com um recurso Java). [Properties.load] lê as linhas no formato [key=value]. Um arquivo ausente lança uma [NoSuchFileException], que é interceptada mais abaixo. [getProperty] retorna o valor de uma chave, ou o valor padrão fornecido como segundo parâmetro se a chave não existir;
- linha 32: o contêiner Spring. O Spring chama de “bean” um objeto criado e gerenciado pelo contêiner, e de “application context” o próprio contêiner. [GenericApplicationContext] é um contêiner configurado de forma programática;
- linhas 34 a 39: a entrada da camada [dao]. A função de extensão [registerBean<ITaxDao> { ... }] especifica que o bean do tipo [ITaxDao] será criado pela lambda seguinte, um “supplier” sem parâmetros que retorna o objeto. O tipo do bean é um parâmetro de tipo reificado: escrevemos [registerBean<ITaxDao>] onde o Java escreve [registerBean(ITaxDao.class, ...)]. O bean é um singleton, o escopo padrão do Spring: ele será criado uma única vez, e todas as solicitações retornarão o mesmo objeto; há apenas uma camada [dao] na aplicação. O supplier seleciona a classe de acordo com a configuração, usando a expressão [when]. Uma implementação desconhecida resulta em uma [TaxException]. Observe que a lambda usa as variáveis [implementation] e [file] da função [main]: ela as “captura” (capítulo 7) e as usará quando o contêiner a chamar;
- linha 43: o registro da camada [business]: o contêiner criará ele próprio o objeto [TaxBusiness]. Para isso, examina o construtor da classe [TaxBusiness], vê que ele espera uma [ITaxDao] e lhe passa o bean desse tipo registrado acima: isso é a injeção de dependência, neste caso por construtor. A camada [dao] é uma dependência da camada [business];
- linha 46: [refresh()] inicia o contêiner. O Spring então cria todos os beans singleton na ordem em que foram registrados: a camada [dao], seguida da camada [business]. Um erro de criação ocorre, portanto, nesta linha;
- linha 47: pede-se ao contêiner um bean do tipo [ITaxBusiness]. O contêiner encontra o bean [TaxBusiness], que implementa essa interface. A função de extensão [getBean<T>()] substitui a chamada Java [getBean(ITaxBusiness.class)], e seu resultado é do tipo solicitado. [getBean] lança uma exceção se nenhum bean tiver esse tipo ou se vários tiverem. Observe que a camada [ui] obtém a camada [business] sem especificar a classe que a implementa. Esta é a última expressão do bloco [try] e, portanto, o valor da variável [business];
- linhas 48 a 51: qualquer erro na leitura da configuração ([IOException]) ou na criação das camadas (exceções do Spring e nossa [TaxException]) é exibido junto com a pilha da exceção, e o programa termina. O Kotlin não admite múltiplos tipos em um bloco catch ([catch (IOException | RuntimeException e)] em Java); capturar [Exception], a classe pai de ambas, produz aqui o mesmo resultado;
- linha 55: a interface com o usuário, idêntica à da versão 4.
As primeiras versões do Spring liam os nomes completos das classes a instanciar em um arquivo XML e as criavam por reflexão; veremos um exemplo disso mais adiante. Aqui, optamos por definir as implementações possíveis no provider: o arquivo de configuração apenas seleciona entre elas, e o compilador verifica que as classes existem e têm os construtores necessários. Nos dois casos, o código das camadas [ui] e [business] nunca especifica a classe que implementa a camada [dao]. Vale observar também que as classes das camadas não sabem nada sobre o Spring: nenhuma delas importa classes do Spring; apenas o programa principal o faz.
6.4.6.3. Execuções
A partir da pasta do capítulo, com o arquivo [tax.properties] (implementação [FileTax]):
Com a implementação [JsonTax]:
Com a implementação [HardwiredTax]:
Trocamos a implementação da camada [dao] sem alterar uma única linha de código nem recompilar a aplicação.
Com o arquivo [tax-error.properties], que se refere a um arquivo de dados inexistente:
- as duas primeiras linhas: antes de propagar a exceção, o Spring escreve um aviso em seu log. Como não há biblioteca de logging no projeto, esse log é tratado pelo mecanismo de logging padrão do JDK ([java.util.logging]), que escreve na saída de erro a data, a classe emissora, depois o nível da mensagem e a própria mensagem (em inglês);
- a exceção original (a última exibida, do tipo [NoSuchFileException]) foi lançada pela classe [FileTax];
- a camada [dao] a encapsulou em uma [TaxException];
- o próprio Spring encapsulou a [TaxException] em uma [BeanCreationException], cuja mensagem especifica o bean que não pôde ser criado: o do tipo [ITaxDao], que a função [registerBean] nomeou com o nome completo do tipo, [tax.dao.ITaxDao]. Foi essa exceção que se propagou até o programa principal por meio da chamada a [refresh].
O ponto principal dessa cadeia é que muitas vezes a exceção mais grave, a última exibida, é a mais significativa.
Por fim, com um arquivo de configuração que não existe, o erro ocorre antes mesmo de o contêiner ser criado:
A mensagem de [NoSuchFileException], lançada pelo JDK, contém apenas o nome do arquivo.
6.4.6.4. Uma variação: a configuração em XML
As primeiras versões do Spring descreviam os beans em um arquivo XML, e muitas aplicações ainda o fazem. O subprojeto [tax-ui] contém um exemplo disso, o arquivo [tax-beans.xml]:
- linhas 3 a 6: o elemento raiz [beans] e o namespace XML do Spring. O atributo [xsi:schemaLocation] associa a esse namespace o esquema que descreve os elementos permitidos; o Spring o encontra em seus próprios arquivos JAR, sem precisar de acesso à rede;
- linhas 9 a 11: o bean da camada [dao]. O atributo [id] lhe dá um nome, o atributo [class] fornece o nome completo da classe a instanciar, e o elemento [constructor-arg] especifica o valor ([value]) a passar ao seu construtor: o nome do arquivo de dados. Mudar a implementação consiste em modificar essas linhas;
- linhas 14 e 15: o bean da camada [business]. Seu construtor recebe uma referência ([ref]) ao bean chamado [dao]: isso é a injeção de dependência, descrita no arquivo XML.
O programa principal [MainXml.kt] usa essa configuração:
- linha 11: o nome do arquivo XML: [tax-beans.xml] por padrão, ou o que for passado como argumento;
- linha 14: [GenericXmlApplicationContext] é um contêiner configurado por arquivos XML. Seu construtor lê os arquivos especificados, registra os beans que eles descrevem e inicia o contêiner. O prefixo [file:] refere-se a um arquivo do sistema de arquivos, relativo ao diretório atual; o prefixo [classpath:] referir-se-ia a um recurso localizado no arquivo JAR. O contêiner implementa a interface [AutoCloseable] (e [Closeable]): a função [use] o fecha ao final do bloco, o que libera os beans;
- linha 16: a camada [business] é obtida como antes, sem especificar o nome de sua classe;
- linhas 19 a 22: tratamento de erros.
Resultados:
O arquivo XML não escolhe mais entre as implementações especificadas no código: ele nomeia a própria classe, que o Spring cria por reflexão. Isso é mais flexível, pois uma implementação pode ser acrescentada sem modificar o programa principal; porém, o compilador deixa de fazer qualquer verificação. O arquivo [tax-beans-error.xml] difere do anterior apenas por um erro de digitação no nome da classe da camada [dao] ([tax.dao.FileTaxes]). O erro só aparece em tempo de execução:
A [CannotLoadBeanClassException] do Spring especifica o bean, a classe que não pode ser encontrada e o arquivo que a descreve; ela encapsula a [ClassNotFoundException] da máquina virtual. Observe que a configuração XML não exigiu nenhuma adaptação ao Kotlin: para o Spring, as classes [FileTax] e [TaxBusiness] são classes Java comuns com um construtor público.
6.4.6.5. Uma alternativa: a configuração por meio de uma classe anotada
Aplicações Spring modernas costumam descrever seus beans em uma classe de configuração anotada. O subprojeto [tax-ui] contém um exemplo disso, a classe [TaxConfig]:
- linha 16: a anotação [@Configuration] indica que a classe descreve beans;
- linha 18: a anotação [@PropertySource] instrui o Spring a ler ele próprio o arquivo [tax.properties] a partir do diretório atual (prefixo [file:]);
- linhas 22 a 30: uma função anotada com [@Bean] cria um bean cujo nome é o nome da função ([dao]) e cujo tipo é o tipo de retorno da função. O Spring chama a função, fornecendo seus parâmetros. A anotação [@Value] solicita o valor de uma propriedade: [${dao.implementation}] é o valor da chave [dao.implementation], e [${dao.file:}] é o valor da chave [dao.file], com a string vazia (colocada após os dois-pontos) como valor padrão. Observação: em uma string Kotlin, [${...}] é um marcador de posição, que o compilador substituiria pelo valor da expressão que ele contém; por isso o caractere [$] deve ser escapado com uma barra invertida, ["\${dao.implementation}"], para que a string passada ao Spring contenha de fato [${dao.implementation}]. O corpo da função é uma expressão [when];
- linhas 34–35: o bean da camada [business]. A função espera um [ITaxDao]: o Spring passa a ela o bean criado pela função [dao]. Desta vez, trata-se de injeção por meio de um parâmetro de função.
Para garantir que um bean singleton seja criado apenas uma vez — mesmo que uma função [@Bean] chame outra função —, o Spring deriva, em tempo de execução, uma subclasse da classe de configuração, que sobrescreve suas funções [@Bean]: portanto, nem a classe nem essas funções devem ser final. No entanto, em Kotlin, as classes e seus métodos são final por padrão (Capítulo 4). Seria necessário escrever [open class TaxConfig] e [open fun dao(...)]… Este é o papel do plugin de compilador [plugin.spring], aplicado no arquivo de build do subprojeto: ele torna automaticamente open as classes anotadas com [@Configuration], [@Component], [@Service], [@Transactional]… e seus membros. É uma especialização do plugin [all-open] específica para o Spring, que abre as classes anotadas selecionadas. Veja o que acontece ao compilar o mesmo código sem esse plugin:
O Spring rejeita a classe final assim que o contêiner é iniciado, com uma mensagem de erro explícita.
O programa principal [MainConfig.kt] usa esta configuração:
- Linha 12: [AnnotationConfigApplicationContext] é um contêiner configurado por classes anotadas. Seu construtor registra os beans descritos pela classe [TaxConfig] e inicia o contêiner. A classe é passada como classe Java, [TaxConfig::class.java]; a função [use] encerra o contêiner ao final do bloco;
- linha 14: a camada [business] é obtida como antes;
- Linhas 17–20: tratamento de erros.
Resultados:
Com uma configuração incorreta (neste caso, um arquivo [tax.properties] cujo conteúdo seria o de [tax-error.properties]), a cadeia de exceções agora inclui um nível adicional: o Spring relata a falha da função [dao] por meio de uma [BeanInstantiationException], encapsulada na [BeanCreationException]:
O Spring também pode descobrir automaticamente quais classes instanciar: com a anotação [@ComponentScan] na classe de configuração, ele cria um bean para cada classe de um pacote anotada com [@Component] (ou [@Service], [@Repository]). Não fizemos isso aqui, pois seria necessário anotar as classes das camadas, tornando-as dependentes do Spring. O Spring Boot, no Capítulo 13, faz amplo uso desse mecanismo. Por fim, vale observar que o Spring também oferece uma linguagem dedicada para declarar beans programaticamente em Kotlin ([BeanRegistrarDsl]), ainda mais concisa que as chamadas a [registerBean] em nosso programa [Main.kt].
A injeção de dependência mereceria um capítulo só para ela. Usamos apenas o essencial: registrar beans ([registerBean], arquivo XML, [@Bean]), iniciar o contêiner ([refresh]) e obter um bean ([getBean]). O contêiner também pode criar um novo objeto a cada solicitação (escopo [prototype]), um objeto por requisição (HTTP) ou um por sessão em uma aplicação web (escopos [request] e [session]). Você pode saber mais sobre o assunto na documentação do Spring: The IoC Container, e em suas páginas dedicadas ao Kotlin: Kotlin.
6.5. Conclusão
Este capítulo deu à aplicação [Tax]a arquitetura que ela manterá até o final do curso:
- uma camada [dao] que fornece as faixas de imposto por meio da interface [ITaxDao];
- uma camada [business] que calcula o imposto e conhece a camada [dao] apenas por meio de sua interface;
- uma camada [ui] que interage com o usuário e conhece a camada [business] apenas por meio de sua interface [ITaxBusiness];
- um programa principal — o único que conhece as classes de implementação — que cria as camadas e as conecta, neste caso por meio do contêiner de injeção de dependência do Spring e de um arquivo de configuração;
- testes unitários automatizados, escritos com JUnit e kotlin.test, que verificam cada camada independentemente das outras e garantem a não regressão da aplicação.
Os benefícios dessa arquitetura ficarão plenamente evidentes nos próximos capítulos, nos quais os subprojetos [tax-dao], [tax-business] e [tax-ui] da Versão 5 serão reutilizados sem alterações, por meio de um composite build, como dependências comuns:
- Versão 6 (Capítulo 10, “Acesso a banco de dados com JDBC”): uma nova implementação da camada [dao] lê as faixas de imposto de um banco de dados MySQL. As camadas [business] e [ui] permanecem inalteradas;
- Versão 7 (Capítulo 11, “Hibernate”): outra implementação da camada [dao] usa o ORM Hibernate para acessar o mesmo banco de dados;
- Versão 8 (Capítulo 12, “Programação para a Internet”): a camada [business] é instalada em um servidor TCP, que calcula impostos para clientes remotos cuja camada [ui] é a da Versão 5. As camadas ficam assim distribuídas em várias máquinas, restabelecendo o sentido original do termo “tier”;
- Versão 9 (Capítulo 13, “Web Services”): a camada [business] é exposta por um web service REST/JSON escrito com Spring Boot, cujo cliente de console usa a classe [HttpClient] do JDK.
Em cada caso, o trabalho se limitará a escrever a nova camada e a modificar o programa que integra as camadas: este é todo o objetivo de uma arquitetura em camadas.