10. Acesso a bancos de dados com JDBC
Pré-requisitos: a versão 6 da aplicação [Tax], descrita no final deste capítulo, reutiliza os módulos [tax-dao], [tax-business] e [tax-ui] da versão 5 (Capítulo 6). Antes de compilar ou abrir seus projetos, você deve ter instalado a versão 5 no repositório Maven local usando o comando [mvn install] digitado na pasta [06-architectures/TaxV5] (veja o Capítulo 6, seção sobre [mvn install]).
10.1. O driver JDBC
Vamos retomar a arquitetura em camadas usada em várias ocasiões desde o Capítulo 6. Até agora, a camada [dao] da aplicação [Tax] utilizou três tipos de fontes de dados:
- dados fixados diretamente no código ([HardwiredTax]);
- dados provenientes de um arquivo de texto ([FileTax]);
- dados provenientes de um arquivo JSON ([JsonTax]).
Neste capítulo, examinamos o caso em que os dados vêm de um banco de dados. A arquitetura passa a ser a seguinte:
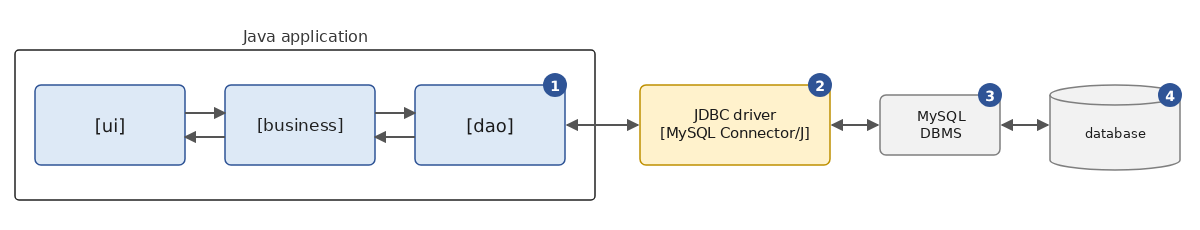
No diagrama acima, a camada [dao] [1] comunica-se com o SGBD (Sistema de Gerenciamento de Banco de Dados) [3], que gerencia o banco de dados [4], por meio de uma biblioteca de classes [2] específica do SGBD utilizado. Essa biblioteca implementa uma API padrão da plataforma Java, JDBC (“Java DataBase Connectivity”), que faz parte do JDK desde a versão 1.1, de 1997. Ela é chamada de driver JDBC (“JDBC driver”). Todos os SGBDs comuns têm um driver JDBC, distribuído como um arquivo [.jar].
JDBC é, antes de tudo, um conjunto de interfaces, definidas nos pacotes [java.sql] e [javax.sql] do módulo [java.sql] do JDK: [Connection], [Statement], [PreparedStatement], [ResultSet], [DataSource]… Um driver JDBC fornece classes que implementam essas interfaces. O código da aplicação, por sua vez, interage apenas com as interfaces: em geral, ele não contém os nomes das classes do driver. Isso difere de outras plataformas, em que o código frequentemente usa diretamente as classes específicas de cada SGBD ([MySqlConnection], [SqlConnection]…): em Java, a abstração é a norma desde o início, e trocar de SGBD consiste essencialmente em mudar o driver e o endereço do banco de dados, como veremos. No entanto, cada SGBD tem seu próprio dialeto SQL: essa independência tem seus limites, que também examinaremos.
Usamos um único SGBD, MySQL 8, que o apêndice “O SGBD MySQL com Laragon” instala no Windows, junto com seu driver JDBC oficial, o MySQL Connector/J, versão 9.7.0. Os bancos de dados são criados por scripts SQL executados com o cliente de linha de comando [mysql]; o apêndice também mostra como criá-los usando o cliente gráfico HeidiSQL incluído no Laragon.
10.2. As duas maneiras de usar uma fonte de dados
Um banco de dados pode ser acessado de duas maneiras diferentes:
- modo conectado;
- modo desconectado.
No modo conectado, a aplicação:
- abre uma conexão com a fonte de dados;
- trabalha com a fonte de dados em modo de leitura/escrita;
- fecha a conexão.
No modo desconectado, a aplicação:
- abre uma conexão com a fonte de dados;
- obtém na memória uma cópia de todos ou de parte dos dados da fonte;
- fecha a conexão;
- trabalha com a cópia dos dados em memória, lendo e escrevendo nela;
- quando o trabalho termina, abre uma conexão, envia os dados modificados à fonte de dados para que ela seja atualizada e fecha a conexão.
O modo conectado é o da interface [ResultSet] do JDBC: as linhas do resultado de uma consulta são lidas enquanto a conexão está aberta. O modo desconectado é o da interface [CachedRowSet] do pacote [javax.sql.rowset] (Java 5): uma tabela em memória que é preenchida a partir de uma consulta, modificada offline e, depois, envia suas alterações de volta ao banco de dados. Esses componentes “RowSet” ainda estão presentes no JDK 25, mas raramente são usados em aplicações novas: trabalhar sobre uma cópia dos dados em memória, com posterior gravação das alterações, é hoje tarefa de um ORM (“Object-Relational Mapper”), que manipula objetos Java comuns em vez de linhas de tabelas. O ORM mais utilizado em Java, Hibernate, é o tema do Capítulo 11. Portanto, vamos nos concentrar principalmente no modo conectado, no qual o Hibernate se baseia, e demonstraremos o modo desconectado apenas por meio de um único exemplo no final do capítulo.
10.3. Os conceitos básicos de operações com bancos de dados
10.3.1. O banco de dados de exemplo
Vamos explicar os principais conceitos de uso de um banco de dados com um banco de dados MySQL. Ele contém uma única tabela, [articles], em que cada linha descreve um item de uma loja:
- [ID]: um identificador único do item, que é a chave primária da tabela;
- [NAME]: o nome do item, que também é único;
- [PRICE]: seu preço;
- [CURRENTSTOCK]: seu estoque atual;
- [MINIMUMSTOCK]: o nível mínimo de estoque abaixo do qual o item deve ser reabastecido.
O banco de dados é criado pelo seguinte script SQL [sql/dbarticles.sql]:
- Linha 5: o script é um arquivo de texto codificado em UTF-8. [SET NAMES utf8mb4] informa isso ao servidor; caso contrário, os caracteres acentuados das linhas 31–36 poderiam ser mal interpretados pelo cliente [mysql];
- Linhas 8–9: o banco de dados é excluído, se existir, e depois recriado. Assim, o script pode ser executado várias vezes para restaurar o banco de dados ao seu estado inicial. [utf8mb4] é a codificação Unicode completa do MySQL (a codificação legada [utf8] do MySQL codifica apenas caracteres de até três bytes);
- linha 12: [dbarticles] passa a ser o banco de dados atual: os comandos SQL seguintes serão executados nele;
- linhas 15–27: a definição da tabela [articles]:
- linha 16: a coluna [ID] é a chave primária da tabela ([PRIMARY KEY]). O atributo [AUTO_INCREMENT], específico do MySQL, indica que seu valor é gerado pelo próprio SGBD quando uma linha é inserida: 1, 2, 3… Os outros SGBDs têm conceitos equivalentes, mas com sintaxe diferente ([IDENTITY] no SQL Server, [GENERATED … AS IDENTITY] no PostgreSQL e no Oracle);
- Linha 18: o preço é um número decimal exato de 10 dígitos, com 2 dígitos após a vírgula decimal. Evite usar tipos de ponto flutuante para valores monetários, como [DOUBLE] (veja a diferença entre [double] e [BigDecimal] no Capítulo 3). O tipo SQL [DECIMAL] corresponde à classe Java [BigDecimal];
- Linhas 22–26: restrições de integridade. [UNQ_NAME] impede que dois itens tenham o mesmo nome; as restrições [CHECK] impedem um nome vazio, um preço negativo ou zero e um nível de estoque negativo. O MySQL ignorava silenciosamente as restrições [CHECK] até a versão 8.0.16; desde então, ele as aplica;
- Linhas 30–36: inserção de seis linhas. A coluna [ID] não é inicializada: o SGBD atribui um valor a ela.
O script é executado usando o cliente de linha de comando [mysql], na pasta [sql] (o usuário [root] do MySQL não tem senha na instalação do apêndice; caso contrário, acrescente a opção [-p] e o cliente a solicitará):
O comando não exibe nada se tudo correr bem. Você pode verificar a estrutura e o conteúdo da tabela usando o mesmo cliente:
- Linha 1: a opção [-t] especifica a exibição em formato de tabela; a opção [-e] especifica os comandos SQL a executar, e a opção [--default-character-set=utf8mb4] garante que os caracteres acentuados sejam exibidos corretamente em um terminal UTF-8;
- linhas 3–9: a estrutura da tabela, obtida usando o comando MySQL [describe];
- linhas 12–19: o conteúdo da tabela. Os valores da coluna [ID] foram gerados pelo SGBD.
Uma observação sobre diferenciação de maiúsculas e minúsculas: os nomes de colunas nunca diferenciam maiúsculas de minúsculas ([name] e [NAME] referem-se à mesma coluna), mas os nomes de tabelas são nomes de arquivos do servidor. Eles não diferenciam maiúsculas de minúsculas no Windows, mas diferenciam no Linux. Para garantir que os exemplos funcionem em qualquer lugar, a tabela se chama [articles], em minúsculas, e as consultas a escrevem assim.
Os programas deste capítulo modificam a tabela [articles]. Os resultados mostrados aqui foram obtidos reexecutando o script [dbarticles.sql] antes de cada programa; os leitores que quiserem reproduzir exatamente os mesmos resultados devem fazer o mesmo.
Agora que temos um banco de dados, poderemos utilizá-lo. Antes disso, vamos rever alguns pontos sobre SQL.
10.3.2. Os quatro comandos básicos da linguagem SQL
SQL (“Structured Query Language”) é uma linguagem parcialmente padronizada para consultar e atualizar bancos de dados. Todos os dialetos dos SGBDs respeitam a parte padronizada do SQL, mas acrescentam à linguagem extensões proprietárias que aproveitam seus recursos específicos. Já vimos dois exemplos disso: a geração automática de chaves primárias e os tipos de dados permitidos para as colunas das tabelas frequentemente dependem do SGBD.
Os quatro comandos básicos da linguagem SQL que apresentamos aqui são padronizados e aceitos por todos os SGBDs:
Comando | Função |
[select col1, col2, … from table1, table2, … where condition order by expression] | A consulta usada para recuperar dados de um banco de dados. Somente as palavras-chave [select] e [from] são obrigatórias. É feita uma junção com todas as tabelas que seguem a palavra-chave [from]; somente as colunas que seguem a palavra-chave [select] são mantidas; somente as linhas que satisfazem a condição da palavra-chave [where] são mantidas; as linhas resultantes, ordenadas de acordo com a expressão da palavra-chave [order by], formam o resultado da consulta. Esse resultado é uma tabela. |
[insert into table(col1, col2, …) values (val1, val2, …)] | Insere uma linha em [table]. [(col1, col2, …)] especifica as colunas da linha a serem inicializadas com os valores [(val1, val2, …)]. |
[update table set col1=val1, col2=val2, … where condition] | Atualiza as linhas de [table] de acordo com [condition] (todas as linhas, se não houver [where]). Para essas linhas, a coluna [coli] recebe o valor [vali]. |
[delete from table where condition] | Exclui todas as linhas de [table] que correspondam a [condition] (todas as linhas, se não houver [where]). |
Vamos escrever uma aplicação de console que emite comandos SQL sobre [dbarticles]. Eis um exemplo de saída. Recomenda-se que o leitor compreenda os comandos SQL emitidos e seus resultados:
- linha 2: a URL do banco de dados e o usuário JDBC: são os parâmetros usados para se conectar ao banco de dados;
- linha 4: o conteúdo da tabela [articles] é recuperado;
- linha 17: uma nova linha é inserida. Observe que a coluna [id] não é inicializada nessa operação, pois o SGBD gerará seu valor;
- linha 20: verificação. Linha 32: a linha foi de fato adicionada, com [id] 7. Com [select *], os nomes das colunas são os da tabela, em maiúsculas;
- Linha 34: aumentamos em 10% o preço do item que acabou de ser adicionado;
- Linha 43: o aumento de preço foi efetivado;
- linha 45: o item adicionado anteriormente é excluído;
- linha 48: verificamos que restam apenas seis itens;
- Linha 56: o programa aceita somente os quatro comandos [select], [insert], [update], e [delete];
- linha 60: um erro informado pelo SGBD: a tabela [article] não existe;
- linha 63: a restrição de unicidade [UNQ_NAME] impede a adição de um segundo item [bike]. As mensagens de erro do MySQL, assim como as do driver, estão em inglês.
10.3.3. As interfaces básicas do JDBC para o modo conectado
Voltemos ao diagrama de uma aplicação que acessa um banco de dados por meio de um driver JDBC:
No modo conectado, a aplicação:
- abre uma conexão com a fonte de dados;
- trabalha com a fonte de dados em modo de leitura/escrita;
- fecha a conexão.
Três tipos de objetos participam principalmente dessas operações:
- a conexão ([Connection]), que encapsula as propriedades e os métodos da conexão com o banco de dados;
- o comando SQL ([Statement], ou [PreparedStatement] para um comando parametrizado), que encapsula as propriedades e os métodos do comando SQL executado;
- o resultado ([ResultSet]), que encapsula as propriedades e os métodos do resultado de um comando SQL ou [select].
Essas são interfaces do pacote [java.sql]. O driver MySQL as implementa com classes de seus próprios pacotes ([com.mysql.cj.jdbc.ConnectionImpl], [ClientPreparedStatement], [ResultSetImpl]…), que a aplicação não precisa conhecer: ela obtém seus objetos por meio de métodos que retornam interfaces. A conexão é obtida da classe [DriverManager] (ou de uma fonte de dados [DataSource], da qual trataremos mais adiante), o comando SQL é criado pela conexão e o resultado é retornado pelo comando SQL.
10.3.3.1. A interface Connection
Ela serve para gerenciar a conexão com o banco de dados. Uma conexão é obtida por meio do método estático [DriverManager.getConnection(url, user, password)], que recebe a URL do banco de dados e o JDBC (por exemplo, [jdbc:mysql://localhost:3306/dbarticles]) e as credenciais do usuário. A conexão retornada já está aberta. Os métodos da interface [Connection] que usaremos são os seguintes:
Método | Função |
[createStatement] | Cria um comando SQL associado a esta conexão. |
[prepareStatement] | [prepareStatement(sql)] cria um comando SQL configurado como [PreparedStatement] associado a esta conexão. |
[prepareCall] | [prepareCall("{call name(?, ?)}")] cria um comando [CallableStatement] que executa um procedimento armazenado no banco de dados. |
[setAutoCommit] | [setAutoCommit(false)] inicia uma transação (veja abaixo). |
[commit], [rollback] | confirma ou desfaz a transação atual. |
[getMetaData] | retorna um objeto [DatabaseMetaData] que descreve o SGBD e o driver. |
[isValid] | [isValid(seconds)] verifica se a conexão ainda é utilizável. |
[close] | fecha a conexão, junto com os comandos SQL e os resultados que eles produziram. |
A abertura de uma conexão tem a seguinte forma (os trechos de código deste parágrafo são extraídos da classe [Models] do projeto, que compila, mas não é executada):
10.3.3.2. A interface Statement
Ela serve para executar um comando SQL. Os métodos desta interface que usaremos são os seguintes:
Método | Função |
[executeQuery] | [executeQuery(sql)] executa um comando SQL [select]. O resultado é um objeto [ResultSet] que representa o resultado do [select]. |
[executeUpdate] | [executeUpdate(sql)] executa um comando SQL [update], [insert], [delete] (ou um comando de definição, como [create table]). Retorna o número de linhas afetadas pela operação (atualizações, inserções, exclusões). [executeLargeUpdate] (Java 8) retorna esse número na forma de um [long]. |
[execute] | [execute(sql)] executa qualquer comando SQL. Retorna [true] se o comando produziu um [ResultSet], que é então obtido por [getResultSet], e [false] se produziu um número de linhas, obtido por meio de [getUpdateCount]. |
[addBatch], [executeBatch] | adicionam um comando a um lote e executam o lote (veja abaixo). |
[getGeneratedKeys] | retorna as chaves primárias geradas pelo SGBD durante a execução de um [insert]. |
[setQueryTimeout] | [setQueryTimeout(seconds)] define o tempo máximo de execução do comando. |
[close] | fecha o comando SQL, bem como seu [ResultSet]. |
A interface [PreparedStatement] deriva de [Statement]: é um comando SQL parametrizado, cujo texto é definido na criação e cujos parâmetros recebem valores por meio de métodos [setXxx]. Examinaremos isso na seção “Consultas parametrizadas”. A execução de comandos SQL sem transação tem a seguinte forma:
10.3.3.3. A interface ResultSet
Ela encapsula os resultados de um comando SQL ou [select]. Um objeto [ResultSet] representa uma tabela com linhas e colunas, que é processada sequencialmente: primeiro a primeira linha, depois a segunda, e assim por diante, sem possibilidade de retroceder (esse é o tipo padrão, [TYPE_FORWARD_ONLY]; o JDBC também admite resultados que podem ser percorridos nos dois sentidos, mas eles raramente são usados). O [ResultSet] tem um cursor inicialmente posicionado antes da primeira linha: é preciso chamar [next] para ler a primeira linha. Os métodos desta interface que usaremos são os seguintes:
Método | Função |
[next] | Avança para a próxima linha da tabela de resultados. Retorna [true] se a linha foi lida com sucesso e [false] se não há mais linhas. |
[getInt] | [getInt(i)] retorna o valor inteiro da coluna de número i da linha atual. As colunas são numeradas a partir de 1, e não de 0. [getInt("name")] retorna o valor da coluna chamada [name]. Outros métodos semelhantes são [getBoolean], [getBigDecimal], [getDouble], [getLong], [getString]… |
[getObject] | [getObject(i)] retorna o valor da coluna i na forma de um [Object], do tipo escolhido pelo driver; [getObject(i, LocalDate.class)] (Java 7) o retorna no tipo solicitado. |
[wasNull] | retorna [true] se a última coluna lida não tinha valor, o que é representado pelo valor SQL [NULL]. Os métodos que retornam um objeto ([getString], [getBigDecimal], [getObject]…) retornam então [null]; os que retornam um tipo primitivo ([getInt], [getDouble]…) retornam 0: somente [wasNull] permite distinguir 0 de [NULL]. |
[getMetaData] | retorna um objeto [ResultSetMetaData] que descreve as colunas do resultado: [getColumnCount] (o número de colunas), [getColumnLabel(i)] (o nome da coluna de número i), [getColumnTypeName(i)] (seu tipo SQL)… |
[close] | fecha o resultado. |
A consulta a um objeto [ResultSet] costuma ter a seguinte aparência:
Com o MySQL Connector/J, as linhas do resultado são, por padrão, todas transferidas do servidor para a memória da aplicação assim que a consulta é executada; [next] então as percorre. Para um resultado com vários milhões de linhas, é possível instruir o driver a recebê-las à medida que são lidas (parâmetro [useCursorFetch=true] na URL e [setFetchSize(n)] no comando SQL): trata-se de uma configuração específica do driver que não usaremos.
10.3.4. Tratamento de erros
A camada [dao] pode encontrar numerosos erros ao operar o banco de dados: servidor fora do ar, banco de dados inexistente, senha incorreta, erro de sintaxe SQL, violação de restrição de integridade etc. Eles são informados como exceções [SQLException]. [SQLException] é uma exceção checked (Capítulo 3): todos os métodos do JDBC a declaram em sua cláusula [throws], e o compilador exige que o código que os chama a capture ou, por sua vez, a declare. O código da camada [dao] deve tratar esses erros e, em qualquer caso, liberar os recursos que adquiriu: a conexão, o comando SQL e o resultado devem ser fechados. Antes do Java 7, o código mostrado acima para processar o resultado de um comando [select] era assim:
Esse código é verboso: o fechamento da conexão pode, ele próprio, disparar uma [SQLException] (linha 24), que precisa ser interceptada na cláusula [finally]. Desde o Java 7, a instrução try-with-resources (Capítulo 3) automatiza esses fechamentos: os objetos [Connection], [Statement], e [ResultSet] implementam a interface [AutoCloseable], e os recursos declarados entre os parênteses do [try] são fechados ao sair do bloco, qualquer que seja a forma de saída:
- linhas 2–4: três recursos são declarados, separados por ponto e vírgula. Cada um pode usar os anteriores. Eles são fechados na ordem inversa de sua declaração: o resultado, depois o comando SQL, depois a conexão. Uma exceção lançada por um fechamento não apaga a que possa ter provocado a saída do bloco: ela é anexada a esta como exceção “suprimida” ([getSuppressed]);
- linha 9: a cláusula [catch] captura os erros de conexão e de execução, bem como os dos fechamentos.
A vantagem do try-with-resources não é apenas economizar linhas de código: ele evita que o desenvolvedor tenha de fechar a conexão manualmente. No entanto, esquecer de fechar uma conexão pode passar despercebido e fazer a aplicação “travar” de maneira aparentemente aleatória quando o SGBD (ou o pool de conexões, que veremos mais adiante) atinge o número máximo de conexões abertas que suporta. No restante deste curso, todo recurso JDBC é aberto dentro de um bloco try-with-resources.
A classe [SQLException] fornece três informações sobre o erro:
- [getMessage]: a mensagem de erro;
- [getErrorCode]: o código de erro específico do SGBD (números de erro do MySQL: 1049, 1062…);
- [getSQLState]: um código de erro de cinco caracteres definido pelo padrão SQL (“SQLSTATE”), comum a todos os SGBDs para os erros mais frequentes: a classe [42] designa um erro de sintaxe ou de acesso, [23] designa uma violação de restrição de integridade, [08] designa um erro de conexão…
Desde o Java 6 (JDBC 4.0), [SQLException] também tem classes derivadas padrão, que os drivers lançam conforme a natureza do erro. As principais são as seguintes:
Classe | Erro |
[SQLSyntaxErrorException] | Erro de sintaxe SQL, tabela ou banco de dados inexistente, permissões insuficientes (SQLSTATE, classe 42) |
[SQLIntegrityConstraintViolationException] | Violação de restrição de integridade: chave duplicada, chave estrangeira, coluna [NOT NULL] (SQLSTATE, classe 23) |
[SQLDataException] | Dados inválidos: valor grande demais, conversão impossível (SQLSTATE, classe 22) |
[SQLTimeoutException] | Timeout ([setQueryTimeout]) |
[SQLTransactionRollbackException] | Transação desfeita pelo SGBD, por exemplo devido a um deadlock |
[SQLNonTransientConnectionException], [SQLRecoverableException] | Problema de conexão |
O programa [Jdbc02.java] dispara vários erros e os exibe:
Resultados:
- Linhas 13–15: os parâmetros de conexão com o banco de dados, especificados no início do programa;
- linha 18: o número de erro MySQL “Duplicate entry”, conforme nomeado na documentação do MySQL;
- linhas 22–30: seis operações que falham: banco de dados inexistente; servidor inacessível (nenhum servidor MySQL está escutando na porta 3399, o que produz o mesmo erro de um servidor parado); erro de sintaxe; tabela inexistente; nome de item duplicado; preço negativo. O parâmetro [connectTimeout=5000] da URL da linha 23 limita o tempo de espera da conexão a 5 segundos (5000 ms);
- linha 34: o método [execute] executa o comando SQL [query] no banco de dados com a URL [url];
- Linhas 36–37: a conexão e o comando SQL são abertos dentro de um bloco
try-with-resources; - linha 38: o método [execute] executa qualquer um dos comandos SQL: [select] ou [insert];
- linha 41: um [switch] sobre a exceção, com padrões de tipo (Java 21, Capítulo 3);
- linha 43: um padrão com guarda ([when]) permite tratar separadamente um erro específico: uma violação de restrição de integridade ([SQLIntegrityConstraintViolationException]) com código MySQL igual a 1062, isto é, uma chave duplicada. Nesse caso, uma aplicação exibiria uma mensagem que o usuário possa entender;
- linhas 46–50: outros erros. Exibimos a classe da exceção, o código de erro MySQL e o código SQLSTATE, seguidos da primeira linha da mensagem ([lines], Java 11, divide uma string em linhas): algumas mensagens do driver ocupam várias linhas.
Os resultados mostram que o driver MySQL usa as classes padrão: [SQLSyntaxErrorException] para um banco de dados inexistente (1049), um erro de sintaxe (1064) ou uma tabela inexistente (1146), todos tratados pelo SQLSTATE e [42xxx]. Um servidor inacessível gera uma [CommunicationsException], uma classe do driver (derivada de [SQLRecoverableException]): não há código de erro MySQL, pois o servidor não respondeu, mas o SQLSTATE e [08S01] indicam uma falha de conexão. Uma violação de uma restrição [CHECK] (erro 3819) é simplesmente uma [SQLException], derivada do SQLSTATE e [HY000] (“general error”): o MySQL não lhe atribui um SQLSTATE da classe 23. Portanto, não se pode confiar totalmente nas classes derivadas: o código de erro e o SQLSTATE continuam úteis.
Uma camada [dao] que deseja permanecer independente do SGBD usa apenas as classes padrão e o SQLSTATE; os códigos de erro ([getErrorCode]) são específicos de cada SGBD.
10.3.5. Configuração do projeto de exemplo
O driver JDBC do MySQL é uma biblioteca publicada no Maven Central, o repositório central do Maven (Capítulo 2). Os programas deste capítulo formam um projeto Maven, [jdbc], localizado na pasta [10-jdbc/jdbc]:
Seu arquivo [pom.xml] é o seguinte:
- Linhas 8–10: os detalhes do projeto;
- linhas 13–14: a versão do Java e a codificação dos arquivos-fonte, como em todos os projetos deste curso;
- linha 16: a propriedade [exec.mainClass] especifica a classe executada por [mvn exec:java] (linha 59). Seu valor padrão é [jdbc.Jdbc01]; para executar outro programa, redefina a propriedade na linha de comando: [mvn -q compile exec:java -Dexec.mainClass=jdbc.Jdbc02];
- Linhas 21–25: o driver JDBC do MySQL, MySQL Connector/J, com as coordenadas [com.mysql:mysql-connector-j]. Até a versão 8.0.30, ele era publicado com o identificador [mysql:mysql-connector-java], que ainda é encontrado em muitos projetos;
- linhas 27–31: o pool de conexões HikariCP, que usaremos a partir do programa [Jdbc03];
- linhas 33–37: o HikariCP grava suas mensagens de log por meio da API SLF4J (“Simple Logging Facade for Java”), que requer uma implementação: usamos o Logback. Sem ela, o SLF4J exibiria um aviso na inicialização. O arquivo [src/main/resources/logback.xml], mostrado abaixo, exibe apenas avisos e erros;
- linhas 42–52: o compilador, configurado como em todos os projetos do curso: nomes dos parâmetros preservados nas classes compiladas ([parameters]) e todos os avisos habilitados ([-Xlint:all]);
- linhas 54–61: o plugin [exec-maven-plugin], que executa a classe especificada pela propriedade [exec.mainClass].
O arquivo de configuração do Logback é o seguinte:
- linhas 4–8: as mensagens são gravadas no console no formato “classe nível - mensagem”;
- linha 9: somente as mensagens com nível [WARN] (aviso) ou [ERROR] são exibidas. Com o nível [INFO], você veria as mensagens de inicialização e encerramento do pool HikariCP.
Há dois drivers JDBC comuns para o MySQL:
- [com.mysql:mysql-connector-j] (“Connector/J”), lançado pela Oracle, proprietária do MySQL, sob a licença GPL v2 com uma exceção (“Universal FOSS Exception”) que permite usá-lo com software distribuído sob outras licenças livres; uma licença comercial cobre todos os demais casos. Esse é o driver oficial, que usamos;
- [org.mariadb.jdbc:mariadb-java-client], o driver do MariaDB (uma variante livre do MySQL), sob licença LGPL, que também funciona com o MySQL.
Ambos os drivers implementam as mesmas interfaces JDBC: passar de um para o outro exige apenas alterar a dependência no [pom.xml] e o início da URL ([jdbc:mariadb:] em vez de [jdbc:mysql:]).
Uma nota histórica: até o Java 5, era preciso carregar a classe do driver antes de abrir uma conexão, usando uma instrução como [Class.forName("com.mysql.jdbc.Driver")], que ainda pode ser encontrada em muitos exemplos na Internet. Desde o Java 6 (JDBC 4.0), isso não é mais necessário: cada arquivo de driver declara sua classe em um arquivo [META-INF/services/java.sql.Driver], e o [DriverManager] carrega automaticamente todos os drivers presentes no classpath por meio do mecanismo de serviços ([ServiceLoader]).
Os parâmetros de conexão não devem ser fixados no código de uma aplicação real: eles dependem da máquina em que a aplicação está instalada. O primeiro programa deste capítulo os lê de um arquivo de propriedades (Capítulo 6), [dbarticles.properties], localizado na pasta do projeto:
- Linha 2: a URL JDBC do banco de dados. Uma URL JDBC tem a forma [jdbc:subprotocol:details]. O subprotocolo identifica o driver ([mysql]), e os detalhes, cujo formato depende do driver, identificam o banco de dados. Para o MySQL, são eles:
- [//localhost]: o nome da máquina em que o SGBD MySQL está; neste caso, [localhost] é a máquina em que o programa está sendo executado;
- [:3306]: a porta em que o servidor MySQL escuta as conexões; o padrão é 3306;
- [/dbarticles]: o nome do banco de dados;
- Parâmetros opcionais do driver podem vir em seguida, após um ponto de interrogação, na forma [?param1=value1¶m2=value2]. Encontraremos [connectTimeout], [rewriteBatchedStatements], e [allowMultiQueries];
- linha 3: o usuário MySQL, aqui [root], o administrador do SGBD;
- linha 4: sua senha, aqui deixada em branco.
A documentação do Connector/J fornece uma lista completa dos parâmetros de URL: Connector/J Configuration Properties.
Os demais programas deste capítulo, que são mais curtos, armazenam seus parâmetros de conexão em constantes no início do programa, como em [Jdbc02.java]: isso é mais simples para exemplos, mas não deve ser feito em uma aplicação real.
Para executar os programas, vá até a pasta [jdbc] e digite:
O primeiro comando executa [Jdbc01], e o segundo executa [Jdbc02]. A opção [-q] (“quiet”) suprime as mensagens do Maven: resta apenas a saída do programa. Naturalmente, você também pode executar os programas diretamente pela IDE. Nas próximas seções, mostraremos somente a saída dos programas.
10.3.6. O programa de exemplo
O programa [Jdbc01.java], do qual vimos um exemplo de execução, é o seguinte (programa principal):
- Linhas 7–12: as interfaces JDBC utilizadas, todas do pacote [java.sql]. O programa não contém o nome de nenhuma classe do driver MySQL: somente a URL e o usuário JDBC, lidos da configuração, fazem referência ao MySQL;
- linha 21: os quatro comandos SQL aceitos, em um conjunto imutável criado por [Set.of] (Java 9, Capítulo 5);
- linha 23: o método [main]. Como nos outros projetos Maven deste curso, ele tem a forma padrão [public static void main(String[] args)], reconhecida por todas as ferramentas;
- linhas 25–31: leitura do arquivo [dbarticles.properties], como no Capítulo 6. O arquivo é procurado no diretório atual, aquele a partir do qual o programa é iniciado, que é o diretório do projeto quando você digita [mvn exec:java];
- linhas 32–38: os três parâmetros de conexão. [getProperty(key, defaultValue)] retorna um valor padrão se a chave estiver ausente; a URL, por sua vez, é obrigatória;
- linha 44: o laço de entrada dos comandos SQL digitados no teclado e de sua execução no banco de dados;
- linha 46: [IO.readln] (Java 25) exibe o prompt e lê uma linha digitada no teclado. Retorna [null] se a entrada padrão estiver fechada;
- linha 53: a primeira palavra da consulta, obtida dividindo-se a consulta nos espaços (expressão regular [\s+], Capítulo 5). Ela é convertida em minúsculas para a comparação, mas a consulta em si não é modificada: converter a consulta inteira em minúsculas impediria a inserção de um artigo chamado “Bike”;
- linhas 54–58: se a consulta for inválida, uma mensagem de erro é exibida e o programa passa para a consulta seguinte;
- linhas 60–64: o comando SQL digitado é executado. A execução assume uma forma diferente conforme se trate de um comando [select] ou de um comando [insert], [update] ou [delete] : no primeiro caso, o comando recupera dados do banco de dados sem modificá-lo; no segundo, ele atualiza o banco de dados sem recuperar nenhum dado. Em ambos os casos, a execução é delegada a um método que recebe os parâmetros de conexão e o comando SQL a ser executado.
10.3.7. Execução de uma consulta SELECT
A execução de comandos SQL envolve as seguintes etapas:
- conexão com o banco de dados;
- envio dos comandos SQL ao banco de dados;
- processamento dos resultados dos comandos SQL;
- fechamento da conexão.
As etapas 2 e 3 podem ser repetidas; a conexão só é fechada ao final do processamento do banco de dados. Conexões abertas são recursos limitados em um SGBD: devem ser poupadas, e procuramos sempre limitar o tempo de vida de uma conexão aberta. Em nosso programa, a conexão é fechada após cada comando SQL, e uma nova conexão é aberta para o comando seguinte.
No entanto, abrir uma conexão é custoso: é preciso estabelecer uma conexão de rede com o servidor, possivelmente negociar a criptografia e autenticar-se. [DriverManager] não faz nada para reduzir esse custo: cada chamada a [getConnection] abre uma nova conexão de rede, e cada [close] a fecha de fato. Para uma ferramenta interativa como esta, isso não é um problema. Uma aplicação que executa muitos comandos SQL, um servidor web, por exemplo, usa, em vez disso, um pool de conexões: quando a aplicação fecha uma conexão, o pool não a fecha de fato, mas a devolve ao pool; quando a aplicação solicita uma nova conexão, ela recebe uma das conexões do pool que já estão estabelecidas. A vantagem desse sistema é que ele é transparente para o desenvolvedor: o código que abre e fecha conexões usando um bloco try-with-resources não precisa ser modificado. Veremos como usá-lo na seção “Fontes de dados e pools de conexões”. Abrir uma conexão no início de cada operação e fechá-la no final é, portanto, a prática recomendada.
Primeiro, vamos nos concentrar na execução dos comandos SQL e [select]. O método [executeSelect] de nosso programa de exemplo e o método [displayResultSet] que ele utiliza são os seguintes:
- linha 2: o método recebe os parâmetros de conexão e o comando SQL [select] [query] a ser executado;
- Linhas 4–6: uma instrução
try-with-resourcesabre três recursos:- linha 4: a conexão com o banco de dados, obtida de [DriverManager]. [DriverManager] consulta cada driver do classpath: o primeiro que reconhece a URL abre a conexão. É nesse momento que os parâmetros de conexão são usados e que ocorrem os erros de conexão. A conexão é do tipo definido pela interface [Connection]: o código não sabe que se trata de um objeto do driver MySQL;
- linha 5: o comando SQL, um objeto [Statement] criado pela conexão. O mesmo tipo de objeto é usado para executar um comando [select] e comandos [update], [insert] e [delete] ;
- Linha 6: o comando [select] é executado pelo método [executeQuery], que retorna um objeto [ResultSet];
- linha 8: os resultados são exibidos por meio do método [displayResultSet];
- Linhas 9–11: qualquer operação de banco de dados pode disparar uma [SQLException]. Isso é ainda mais provável aqui, pois os comandos SQL digitados pelo usuário podem conter erros de sintaxe. Precisamos poder informá-lo disso: a exceção é capturada e sua mensagem é exibida. Ao sair do [try], normalmente ou por meio de uma exceção, o resultado, o comando SQL e a conexão são fechados;
- linha 15: o método recebe um objeto [ResultSet]. Ele declara a exceção checked [SQLException] que pode ser lançada pelos métodos de [ResultSet]: o método chamador a trata;
- Linhas 17–25: os nomes das colunas da tabela de resultados do [select] são exibidos. São as colunas [coli] da consulta [select col1, col2, … from table …]. Elas são fornecidas pelos metadados do resultado, um objeto [ResultSetMetaData] (linha 17): [getColumnCount] retorna o número de colunas, e [getColumnLabel(i)] retorna o nome da coluna de número i, ou seu alias, se a consulta fornecer um ([select count(*) as total …]). Observe o laço das linhas 20–22: as colunas são numeradas a partir de 1, enquanto o array [names] é numerado a partir de 0. [String.join] concatena os nomes, separando-os por vírgulas, e ["-".repeat(n)] (Java 11) produz uma string de n hifens;
- Linhas 27–33: percorremos a tabela de resultados e exibimos os valores de cada linha;
- linha 30: o tipo da coluna i do resultado é desconhecido, pois a consulta digitada pelo usuário é desconhecida. Portanto, não é possível usar a sintaxe [result.getXxx(i)], em que [Xxx] é o tipo da coluna. Usamos então [getObject(i)], que retorna o valor na forma de um [Object]; [StringBuilder.append(Object)] o adiciona usando seu método [toString]. Para a coluna [PRICE], do tipo SQL [DECIMAL(10,2)], o objeto é um [BigDecimal] com duas casas decimais, que seu método [toString] exibe com ponto decimal ([500.00]): diferentemente de [String.format], [toString] não depende do idioma da estação de trabalho. Uma exibição “ao estilo francês” usaria [String.format("%.2f", price)] ou a classe [NumberFormat] (Capítulo 5).
10.3.8. Execução de um comando de atualização: INSERT, UPDATE, DELETE
O código do método [executeUpdate] é o seguinte:
A execução de um comando de atualização difere da de um comando [select] apenas pelo método usado para o comando SQL: [executeQuery] para [select], [executeUpdate] para [update], [insert], [delete]:
- linhas 3–4: desta vez há apenas dois recursos: a conexão e o comando SQL;
- linha 6: o comando [update], [insert] ou [delete] é executado pelo método [executeUpdate]. Em caso de sucesso, esse método retorna o número de linhas atualizadas ([update]), inseridas ([insert]) ou excluídas ([delete]);
- Linha 8: esse número de linhas é exibido.
Recomenda-se que o leitor reveja o exemplo de execução apresentado na seção “Os quatro comandos básicos da linguagem SQL”.
10.4. JDBC e independência em relação ao SGBD
10.4.1. Os drivers JDBC atuais
O código que examinamos não contém o nome de nenhuma classe do driver MySQL: ele usa apenas as interfaces de [java.sql]. Para fazê-lo funcionar com outro SGBD, em princípio basta adicionar ao projeto o driver desse SGBD e alterar a URL JDBC. Eis os principais drivers JDBC atuais, todos publicados no Maven Central:
SGBD | Dependência Maven | URL JDBC | Observações |
MySQL | [com.mysql:mysql-connector-j] | [jdbc:mysql://host:3306/database] | O driver oficial usado neste curso |
MariaDB, MySQL | [org.mariadb.jdbc:mariadb-java-client] | [jdbc:mariadb://host:3306/database] | |
PostgreSQL | [org.postgresql:postgresql] | [jdbc:postgresql://host:5432/database] | |
SQL Server, Azure SQL | [com.microsoft.sqlserver:mssql-jdbc] | [jdbc:sqlserver://host:1433;databaseName=database] | o driver da Microsoft |
Oracle | [com.oracle.database.jdbc:ojdbc11] | [jdbc:oracle:thin:@//host:1521/service] | |
H2 | [com.h2database:h2] | [jdbc:h2:mem:database] ou [jdbc:h2:./file] | um SGBD escrito em Java, embutido na aplicação: em memória ou baseado em arquivo, sem servidor; muito usado para testes |
SQLite | [org.xerial:sqlite-jdbc] | [jdbc:sqlite:file.db] | Um banco de dados em um arquivo, sem servidor |
Observe que o formato da URL, após [jdbc:], é específico de cada driver.
A estrutura é a seguinte:
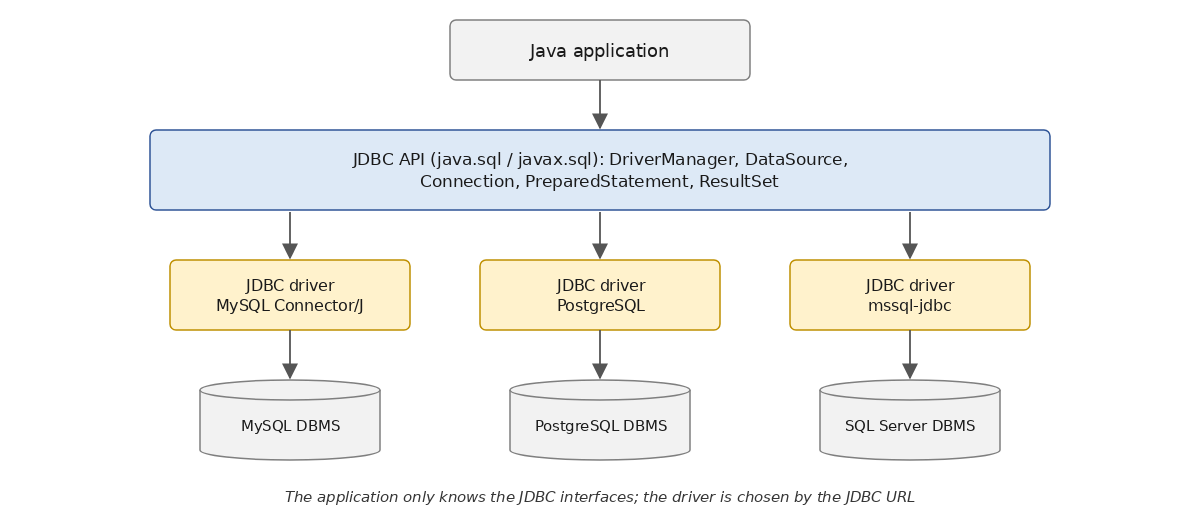
A aplicação conhece apenas as interfaces do JDBC. Os objetos concretos são criados pelo driver, que o [DriverManager] seleciona com base na URL: cada driver presente no classpath declara sua classe principal, uma implementação da interface [java.sql.Driver], cujo método [connect(url, info)] retorna [null] se a URL não se destina a ele ([acceptsURL(url)] também permite perguntar isso). O programa [Jdbc03.java] demonstra isso. Ele recebe como argumento a URL JDBC do banco de dados:
Resultados com a URL do MySQL (valor padrão):
Resultados com a URL de um banco de dados PostgreSQL, cujo driver não está no classpath:
Aqui comentamos a primeira parte do programa (linhas 1–39 e 59–73); a segunda parte é discutida na seção seguinte:
- Linha 20: a URL JDBC do banco de dados, passada como argumento; o padrão é o MySQL [dbarticles]. Com o Maven, o argumento é passado por meio da propriedade [exec.args];
- linhas 23–25: [DriverManager.drivers] (Java 9) retorna um stream ([Stream], Capítulo 5) dos drivers carregados. Há apenas um driver no classpath: o do MySQL, da classe [com.mysql.cj.jdbc.Driver], versão 9.7 (linha 3 dos resultados);
- linha 28: [DriverManager] procura um driver que aceite a URL. Se nenhum aceitar, [getConnection] lança uma [SQLException] “No suitable driver found” (linha 4 do segundo conjunto de resultados). Esse é o erro que você obtém quando omitiu a dependência do driver no [pom.xml]ou cometeu um erro de digitação na URL;
- linhas 29–34: os metadados da conexão, um objeto [DatabaseMetaData], descrevem o SGBD (nome, versão), o driver e a versão do JDBC que ele implementa: JDBC 4.2, a versão do Java 8. O JDK 25 define o JDBC 4.3 (Java 9), que inclui apenas acréscimos menores; [DatabaseMetaData] também descreve os recursos do SGBD (transações, lotes etc.), suas tabelas e suas colunas;
- linha 35: execução de uma consulta parametrizada por meio do método [displayArticles];
- linhas 61–63: a consulta tem um parâmetro, denotado por [?], que recebe seu valor por meio de [setInt(1, 200)]. As consultas parametrizadas são discutidas mais adiante;
- linhas 65–66: os resultados mostram que os objetos manipulados por meio das interfaces são objetos do driver MySQL: [ConnectionImpl], [ClientPreparedStatement], [ResultSetImpl] (linha 6 dos resultados);
- Linhas 67–70: como os tipos das colunas são conhecidos, são usados os métodos [getInt], [getString] e [getBigDecimal] , que retornam diretamente um valor do tipo esperado.
Para que este programa funcione com o PostgreSQL, basta adicionar a dependência [org.postgresql:postgresql] ao [pom.xml] e criar o banco de dados [dbarticles] no PostgreSQL: [DriverManager] encontraria então dois drivers e selecionaria o do PostgreSQL para uma URL [jdbc:postgresql:…]. Somente o MySQL está instalado na máquina usada para escrever este curso: não fizemos isso.
10.4.2. Fontes de dados e pools de conexões
[DriverManager] é a forma tradicional de obter uma conexão. Desde o JDBC 2.0, as aplicações preferem usar uma fonte de dados, um objeto que implementa a interface [javax.sql.DataSource]. Uma fonte de dados é configurada uma vez por todas (URL, nome de usuário, senha, configurações do driver) e depois fornece conexões por meio de seu método [getConnection()], sem nenhum parâmetro. O código que usa a fonte de dados desconhece tanto a URL quanto as credenciais: em uma aplicação, é a própria fonte de dados que é registrada no contêiner de injeção de dependência (Capítulo 6), e não os parâmetros de conexão. Há duas famílias principais de fontes de dados:
- as fornecidas pelos drivers, como [com.mysql.cj.jdbc.MysqlDataSource] para o MySQL. Assim como [DriverManager], elas abrem uma nova conexão de rede a cada chamada de [getConnection];
- as que gerenciam um pool de conexões. A mais usada é o HikariCP, o pool de conexões padrão do Spring Boot. Seu [getConnection] retorna uma conexão do pool, e o [close] dessa conexão a devolve ao pool em vez de fechá-la.
A segunda parte do programa [Jdbc03] compara os dois (linhas 41–56 e 75–90 do programa acima):
- linhas 42–45: uma fonte de dados [MysqlDataSource], configurada por seus métodos [setURL], [setUser] e [setPassword]. Essa é a única parte do programa que faz referência a uma classe do driver MySQL;
- linha 46: o método [measure] recebe a fonte de dados como do tipo da interface [DataSource]: ele serviria para qualquer driver;
- Linhas 49–53: um objeto [HikariConfig] define a configuração do pool: URL e usuário JDBC, junto com as credenciais do pool e o tamanho máximo (5 conexões; o padrão é 10). O HikariCP usa [DriverManager] para abrir suas conexões: ele funciona com qualquer driver JDBC;
- linha 54: a fonte de dados [HikariDataSource] é criada com base nessa configuração. Ela abre imediatamente suas primeiras conexões. Como tem conexões abertas, deve ser fechada no final do programa, o que é feito aqui pela instrução
try-with-resources; - Linhas 76–90: o método [measure] solicita uma conexão à fonte de dados 100 vezes e a fecha imediatamente, medindo o tempo total com [System.nanoTime]. Os resultados falam por si (linhas 10–11 dos resultados iniciais): sem pool, abrir uma conexão leva cerca de 50 ms para a conexão de rede e a autenticação; com o pool, a conexão é obtida em uma fração de milissegundo. Os tempos dependem da máquina, mas a proporção permanece aproximadamente a mesma;
- linha 82: com o HikariCP, a conexão retornada é um objeto [HikariProxyConnection], um “proxy” que envolve a conexão do driver e cujo método [close] a devolve ao pool.
Uma aplicação que atende a muitos usuários usa, portanto, sempre um pool de conexões. Voltaremos a um caso de uso na seção sobre threads virtuais.
10.4.3. Que nível de abstração escolher?
A independência do JDBC em relação ao SGBD parece ideal. Na prática, o JDBC não consegue ocultar todas as características específicas de um SGBD:
- o próprio SQL difere de um SGBD para outro assim que se vai além das operações básicas: geração de chaves primárias, limitação do número de linhas retornadas ([limit 10] no MySQL e no PostgreSQL, [top 10] ou [offset … fetch] no SQL Server), tipos de colunas, funções de data etc.;
- os tipos Java retornados por [getObject] podem variar: veremos que [count(*)] do MySQL retorna um [Long];
- os códigos de erro ([getErrorCode]) são específicos de cada SGBD, e os códigos SQLSTATE nem sempre são usados da mesma maneira;
- a URL e os parâmetros de configuração são específicos de cada driver.
Os parâmetros de consulta, por outro lado, são uniformes: o JDBC impõe a notação [?] (parâmetros posicionais, sem nomes), que cada driver traduz para a sintaxe de seu SGBD.
Para superar essas limitações ou simplificar a escrita do código JDBC, usa-se hoje principalmente o seguinte:
- um ORM, na maioria das vezes o Hibernate, como discutido no Capítulo 11, em que a camada [dao] manipula objetos Java e escreve suas consultas em HQL, uma linguagem de consulta orientada a objetos; o Hibernate gera o SQL específico de cada SGBD (seu “dialeto”);
- bibliotecas que preservam o SQL, mas eliminam o código repetitivo do JDBC: [JdbcTemplate] e [JdbcClient] do Spring (este último desde o Spring Framework 6.1), que transformam diretamente linhas de [select] em objetos Java e convertem [SQLException] em exceções não verificadas; jOOQ, que constrói consultas SQL em Java com validação em tempo de compilação; MyBatis, que mapeia consultas SQL escritas em arquivos XML ou em anotações para métodos Java.
Todas essas ferramentas se baseiam no JDBC: compreender o JDBC continua sendo útil para entender o que elas fazem e diagnosticar problemas com elas.
10.5. Consultas parametrizadas
10.5.1. O conceito
Uma consulta parametrizada é um comando SQL em que certos valores são substituídos por parâmetros, cujos valores são fornecidos separadamente do texto da consulta. Com o JDBC, um parâmetro é denotado por um ponto de interrogação [?], e o comando SQL é um objeto [PreparedStatement], criado por [connection.prepareStatement(query)]. Os parâmetros são designados por sua posição na consulta, começando em 1, e recebem seus valores pelos métodos [setXxx] na seguinte ordem: [setString(1, "bike")], [setInt(2, 10)]…
Os programas a seguir representam uma linha da tabela [articles] por meio de um objeto [Article], definido no arquivo [Article.java] do projeto:
- Linha 6: um [record] (Java 16, Capítulo 4): uma classe não modificável cujo cabeçalho define os campos, com um construtor, acessores ([id()], [name()]…) e métodos [equals], [hashCode] e [toString] gerados pelo compilador. O preço é um [BigDecimal], assim como a coluna correspondente [DECIMAL].
O programa [Jdbc04.java] implementa as consultas parametrizadas: ele esvazia a tabela [articles], insere nela cinco registros usando uma consulta parametrizada e depois os lê de volta usando outra consulta parametrizada:
Resultados:
- Linhas 24–27: uma lista de cinco itens. O [id] 0 é irrelevante: ele não será inserido no banco de dados;
- Linha 31: todos os itens são excluídos da tabela. O método [executeUpdate] (linha 87) retorna, desta vez, o número de linhas excluídas;
- linha 35: [forEach(IO::println)] exibe cada item da lista por meio de uma referência de método (Capítulo 7). Os resultados mostram o método [toString] gerado para o record;
- linha 45: o método de inserção de uma lista de itens:
- linha 47: a consulta de inserção de um item. Ela tem quatro parâmetros, indicados por [?]: o nome (parâmetro nº 1), o preço (nº 2), o estoque atual (nº 3) e o estoque mínimo (nº 4);
- linha 49: [prepareStatement] cria o comando configurado. O segundo argumento, [Statement.RETURN_GENERATED_KEYS], instrui o driver a recuperar as chaves primárias geradas pelo SGBD durante as inserções;
- Linhas 51–56: os itens são inseridos um a um. Cada um dos quatro parâmetros recebe um valor pelo método [setXxx] correspondente ao seu tipo, e então a consulta, agora completa, é executada por [executeUpdate], desta vez sem nenhum argumento: o texto da consulta foi especificado na criação do comando. Os valores dos parâmetros são mantidos de uma execução para outra até serem alterados (ou até que [clearParameters] seja chamado);
- linhas 58–61: [getGeneratedKeys] retorna, na forma de um [ResultSet], a chave primária gerada pelo SGBD para a linha inserida. Os resultados mostram os [id] de 7 a 11: o MySQL não reutiliza os valores de 1 a 6 das linhas excluídas. É assim que se determina o identificador de uma linha que acabou de ser inserida;
- linha 67: o método que retorna os artigos cujos nomes correspondem a um padrão [like] do SQL (o caractere [%] representa qualquer sequência de caracteres: [%3] designa os nomes terminados em 3):
- linhas 68–69: a consulta tem um parâmetro, o modelo;
- linha 72: o parâmetro recebe um valor;
- linhas 73–81: cada linha do resultado se torna um objeto [Article]. Os tipos das colunas são conhecidos: usam-se os métodos [getXxx]. Eles aceitam o número da coluna (linhas 77–78) ou o seu nome (linhas 78–79). O acesso por nome é mais legível e lida melhor com mudanças na consulta; o acesso por número é ligeiramente mais rápido.
O nome [PreparedStatement] (comando “preparado”) vem do fato de que um SGBD pode “preparar” uma consulta parametrizada, isto é, compilá-la de uma vez por todas. Quando um SGBD executa um comando SQL, ele realiza análise e otimização antes de executá-lo (estabelece um “plano de execução”). Uma consulta parametrizada se destina a ser executada várias vezes com parâmetros diferentes, mas seu texto não muda: esse trabalho precisa ser feito apenas uma vez. Com o MySQL Connector/J, a preparação é simulada pelo driver por padrão: ele insere os valores dos parâmetros, devidamente escapados, no próprio texto da consulta antes de enviá-la. O parâmetro [useServerPrepStmts=true] da URL faz com que ele use a preparação fornecida pelo servidor MySQL. Em ambos os casos, o código Java é o mesmo.
As principais correspondências entre os tipos SQL e MySQL, os métodos do JDBC e os tipos Java são as seguintes:
Tipo de coluna MySQL | Métodos JDBC | Tipo Java |
[INT] | [setInt], [getInt] | [int] ([Integer] para [getObject]) |
[BIGINT] | [setLong], [getLong] | [long] ([Long]) |
[DECIMAL(p,d)] | [setBigDecimal], [getBigDecimal] | [BigDecimal] |
[DOUBLE] | [setDouble], [getDouble] | [double] ([Double]) |
[VARCHAR(n)], cadeia de caracteres de comprimento variável | [setString], [getString] | [String] |
[DATETIME] | [setObject(i, value)], [getObject(i, LocalDateTime.class)] | [LocalDateTime] |
[DATE] | [setObject(i, value)], [getObject(i, LocalDate.class)] | [LocalDate] |
[BOOL] (sinônimo de [TINYINT(1)]) | [setBoolean], [getBoolean] | [boolean] ([Boolean]) |
As datas são representadas pelas classes de [java.time] (Capítulo 5), que o JDBC suporta desde a versão 4.2 (Java 8) por meio de [setObject] e [getObject]. As classes mais antigas [java.sql.Date], [java.sql.Time] e [java.sql.Timestamp], derivadas de [java.util.Date], e os métodos [getDate] e [getTimestamp] que as implementam não devem mais ser usados em código novo. Para atribuir o valor SQL [NULL] a um parâmetro, escreva [setNull(i, Types.INTEGER)], em que a classe [java.sql.Types] (ou o enum [JDBCType], Java 8) especifica o tipo SQL do parâmetro.
10.5.2. A injeção de SQL
A preparação não é a única vantagem das consultas parametrizadas, nem a mais importante. Considere a busca de um artigo pelo nome. Você poderia construir o texto da consulta programaticamente, inserindo nele o termo de busca:
(esta é a linha 30 do programa [Jdbc05] abaixo). Se o nome for “bicicleta”, a consulta se torna:
Mas se o nome for “cilindros de oxigênio de mergulhador” (diver's oxygen tanks), ela se torna:
e é sintaticamente incorreta por causa do apóstrofo no nome. Pior ainda: se o nome vier de uma entrada do usuário, o usuário poderia digitar um texto que altera o significado da consulta. Essa é a injeção de SQL, uma das vulnerabilidades de segurança mais difundidas e graves em aplicações que usam um banco de dados. O programa [Jdbc05.java] demonstra isso com a busca de um item pelo nome:
Resultados:
- linha 20: três nomes que um usuário poderia digitar: um nome comum, um nome contendo um apóstrofo e um texto malicioso;
- linha 29: o primeiro método de busca insere o nome no texto da consulta (linha 30), executada por um [Statement] padrão:
- linha 3 dos resultados: com um nome comum, tudo funciona bem;
- linha 6: o apóstrofo no nome encerra prematuramente a cadeia SQL; a consulta é inválida (linha 7). Um artigo cujo nome contém um apóstrofo não pode ser encontrado;
- linha 8: o usuário digitou um texto contendo apóstrofos posicionados de modo a produzir uma consulta válida, mas para a qual a condição [name = 'x' or '1'='1'] é verdadeira para todas as linhas: a consulta retorna a tabela inteira (linha 15). Se a consulta estivesse verificando um nome de usuário e uma senha, o mesmo procedimento permitiria ao usuário entrar sem conhecer a senha. Com um driver que aceita vários comandos SQL em uma única consulta, o usuário poderia até acrescentar, depois de um ponto e vírgula, um comando de sua escolha, como um [delete]. O Connector/J rejeita isso por padrão (configuração [allowMultiQueries=false]), o que limita o alcance da injeção sem eliminá-la;
- Linha 42: o segundo método usa uma consulta parametrizada (linhas 45–47). O valor do parâmetro nunca é interpretado como "SQL"; é simplesmente um dado, qualquer que seja o seu conteúdo. O nome com apóstrofo é encontrado (linha 22 dos resultados), e o texto malicioso é simplesmente o nome de um artigo que não existe (linha 25).
Poderíamos “neutralizar” os apóstrofos duplicando-os, mas as regras dependem do SGBD, e é fácil esquecer algum caso. A regra é simples: os valores fornecidos pelo usuário (ou por qualquer fonte externa) nunca devem ser concatenados ao texto de uma requisição SQL; usamos sempre um PreparedStatement e parâmetros. O programa interativo [Jdbc01.java] não segue essa regra por sua própria natureza: ele executa os comandos SQL digitados pelo usuário. É uma ferramenta de administrador, não um exemplo a seguir.
10.6. Transações
10.6.1. Informações gerais
Uma transação é uma sequência de comandos SQL executados de forma “atômica”:
- ou todas as operações são bem-sucedidas;
- ou uma delas falha, caso em que todas as operações anteriores são desfeitas.
Em última análise, ou todas as operações de uma transação são aplicadas com sucesso, ou nenhuma é. O exemplo clássico é uma transferência bancária: o débito de uma conta e o crédito em outra devem ser ambos concluídos ou nenhum dos dois. Quando a própria aplicação controla a transação, ela a confirma com um comando [COMMIT] ou a desfaz com um comando [ROLLBACK].
Em nossos exemplos anteriores, não usamos uma transação. E, no entanto, havia transações, pois em um SGBD um comando SQL é sempre executado dentro de uma transação. Se a aplicação não inicia ela mesma uma transação explícita, o SGBD usa uma transação implícita. Há então dois casos:
- cada comando SQL faz parte de uma transação, aberta pelo SGBD antes do comando e confirmada depois dele. Isso é chamado de modo autocommit. Tudo se passa como se a aplicação criasse uma transação para cada comando SQL;
- o SGBD não está em modo autocommit: ele inicia uma transação implícita com o primeiro comando SQL emitido fora de uma transação e deixa que a aplicação a conclua. Todos os comandos SQL seguintes fazem parte dessa transação implícita, que pode terminar devido a diversos eventos (fechamento da conexão, início de uma nova transação etc.), conforme regras específicas de cada SGBD. Esse modo deve ser evitado.
O JDBC impõe o primeiro caso: uma conexão JDBC está em modo autocommit quando é aberta, independentemente da configuração do SGBD (o MySQL, com o mecanismo de armazenamento InnoDB usado por padrão, também está em modo autocommit).
Os comandos SQL de diferentes usuários são executados simultaneamente, em transações que rodam em paralelo. As operações realizadas por uma transação podem afetar as realizadas por outra. Há quatro níveis de isolamento entre transações de usuários diferentes:
- Read Uncommitted;
- Read Committed;
- Repeatable Read;
- Serializable.
Read Uncommitted
Esse nível de isolamento também é conhecido como “Dirty Read” (leitura suja). Eis um exemplo do que pode acontecer nesse modo:
- um usuário chamado U1 inicia uma transação na tabela T;
- um usuário chamado U2 inicia uma transação na mesma tabela T;
- o usuário U1 modifica linhas da tabela T, mas ainda não confirmou as alterações;
- o usuário U2 “vê” essas alterações e toma decisões com base no que vê;
- o usuário U1 desfaz sua transação com [ROLLBACK].
No passo 4, o usuário U2 tomou uma decisão com base em dados que depois se revelaram incorretos.
Read Committed
Esse nível de isolamento evita a armadilha anterior: no passo 4, o usuário U2 não “vê” as alterações feitas pelo usuário U1 na tabela T. Ele só as verá depois que U1 confirmar sua transação com um [COMMIT]. Nesse modo, porém, a seguinte situação pode ocorrer:
- um usuário U1 inicia uma transação na tabela T;
- um usuário U2 inicia uma transação na mesma tabela T;
- o usuário U2 executa um [select] para calcular a média da coluna C das linhas de T que atendem a certa condição;
- o usuário U1 modifica ([update]) certos valores da coluna C de T e confirma as alterações ([commit]);
- o usuário U2 repete o mesmo [select] do passo 3. Ele descobre que a média da coluna C mudou devido às modificações feitas por U1.
O usuário U2 agora vê apenas as alterações confirmadas por U1, mas, ainda dentro da mesma transação, duas operações idênticas produzem resultados diferentes. Essa situação é chamada de “leitura não repetível” (non-repeatable read). Ela é problemática para quem deseja uma visão consistente da tabela T.
Repeatable Read
Nesse nível de isolamento, um usuário tem a garantia de obter os mesmos resultados nas leituras do banco de dados enquanto permanecer na mesma transação. Ele trabalha sobre um “instantâneo” (snapshot) dos dados que não reflete as alterações feitas por outras transações, mesmo que elas tenham sido confirmadas. Ele só verá essas alterações depois de concluir a sua própria transação.
Esse nível de isolamento ainda não é perfeito na teoria: outra transação pode adicionar ([insert]) linhas que satisfazem a condição do passo 3, o que alteraria o resultado de uma leitura posterior. Essas linhas são chamadas de “leituras fantasma” (phantom reads). Esse é o nível de isolamento padrão do MySQL (InnoDB), que também evita leituras fantasma em leituras simples.
Serializable
Nesse modo de isolamento, as transações ficam completamente isoladas umas das outras: o resultado de duas transações executadas simultaneamente é o mesmo que se elas tivessem sido executadas uma após a outra. Para isso, o SGBD bloqueia os dados lidos e faz com que as transações que tentam modificá-los esperem (ou falhem). Esse nível reduz o paralelismo e, consequentemente, o desempenho.
Os quatro níveis de isolamento não estão disponíveis em todos os SGBDs. O nível de isolamento padrão costuma ser Read Committed (SQL Server, PostgreSQL, Oracle) ou Repeatable Read (MySQL). O nível de isolamento desejado pode ser especificado explicitamente pela aplicação.
10.6.2. Gerenciamento de transações (API)
Com o JDBC, as transações são gerenciadas pela conexão. Não existe um objeto “transação”: uma conexão tem no máximo uma transação ativa, e todos os comandos SQL executados nessa conexão fazem parte dela. Os métodos relevantes da interface [Connection] são os seguintes:
Método | Função |
[setAutoCommit] | [setAutoCommit(false)] sai do modo autocommit: os comandos SQL seguintes fazem parte de uma transação, que começa com o primeiro deles e termina com [commit] ou [rollback]. Uma nova transação começa então com o comando seguinte. [setAutoCommit(true)] volta ao modo autocommit, confirmando a transação atual. |
[commit] | confirma a transação: os resultados dos comandos SQL emitidos na transação tornam-se definitivos e visíveis para as outras transações. |
[rollback] | Desfaz a transação: os resultados dos comandos SQL emitidos na transação são anulados. |
[setSavepoint] | Define um ponto de salvamento (um objeto [Savepoint]) na transação atual. |
[rollback(Savepoint)] | desfaz os comandos SQL executados desde o ponto de salvamento, sem desfazer os que o precederam: a transação continua. |
[setTransactionIsolation] | define o nível de isolamento das transações da conexão. Deve ser chamado antes do início de uma transação. |
O nível de isolamento é uma das constantes da interface [Connection]:
Valor | Significado |
[TRANSACTION_READ_UNCOMMITTED] | A transação pode ler dados escritos por outra transação que ainda não os confirmou. Deve ser evitado. |
[TRANSACTION_READ_COMMITTED] | A transação não pode ler dados escritos por outra transação que ainda não os confirmou. No entanto, dados lidos duas vezes seguidas dentro da transação podem mudar, porque outra transação pode tê-los modificado nesse meio-tempo; outra transação também pode ter adicionado linhas (linhas fantasma). |
[TRANSACTION_REPEATABLE_READ] | Os dados lidos pela transação não mudam até que a transação termine. Em teoria, isso não impede que outra transação adicione linhas. |
[TRANSACTION_SERIALIZABLE] | Tudo se comporta como se a transação estivesse sendo executada sozinha. Isso reduz o desempenho, pois as transações deixam de ser executadas em paralelo. |
Uma conexão que saiu do modo autocommit deve ser fechada depois que a transação for confirmada ou desfeita. Se ela for fechada enquanto uma transação está em andamento, o resultado depende do driver (o MySQL Connector/J a desfaz): você deve sempre confirmar explicitamente uma transação.
10.6.3. O programa de exemplo
O programa [Jdbc06.java] demonstra o efeito de uma transação:
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 33 34 35 36 37 38 39 40 41 42 43 44 45 46 47 48 49 50 51 52 53 54 55 56 57 58 59 60 61 62 63 64 65 66 67 68 69 70 71 72 73 74 75 76 77 78 79 80 81 82 83 84 85 86 87 88 89 90 91 92 93 94 95 96 97 98 99 100 101 102 103 104 105 106 107 108 109 110 111 112 113 114 115 116 117 118 119 120 121 122 123 124 125 126 127 128 129 130 131 132 133 134 135 136 137 138 139 140 141 142 143 144 145 146 147 148 149 | |
Resultados:
- Linhas 24–25: uma lista de dois itens com o mesmo nome, [article]. A restrição de unicidade [UNQ_NAME] na tabela [articles] impede que ambos existam no banco de dados ao mesmo tempo: a inserção do segundo provocará uma [SQLException]. Para demonstrar o efeito de uma transação, os dois itens serão inseridos de três maneiras:
- primeiro, fora de qualquer transação explícita. Como a conexão está em modo autocommit, cada inserção é executada em sua própria transação. O primeiro item será inserido, mas o segundo não;
- depois, dentro de uma transação que engloba as duas inserções. Como a segunda inserção falhará, a primeira será desfeita: no final, nenhuma das inserções será efetivada;
- por fim, dentro de uma transação com um ponto de salvamento antes de cada inserção: a falha da segunda inserção desfará apenas ela mesma, e a transação será confirmada com a primeira;
- linhas 28–36: a tabela é esvaziada, e então os dois itens são inseridos sem transação explícita. Como sabemos que a segunda inserção lançará uma exceção, ela é capturada por um [try] / [catch]; por fim, a tabela é exibida;
- linhas 38–42: repetimos a mesma sequência, mas com uma transação. Desta vez, a exceção é tratada no método [insertArticlesInTransaction];
- linhas 44–48: o mesmo vale para os pontos de salvamento;
- linha 55: o método de inserção sem transação. Ele usa dois métodos: [createInsertStatement] (linha 113), que cria o comando de inserção parametrizado, e [insertArticle] (linha 119), que atribui valores aos parâmetros e executa o comando;
- linha 65: o método de inserção dentro de uma transação:
- linha 68: o nível de isolamento [TRANSACTION_READ_COMMITTED], definido antes do início da transação;
- linha 69: a conexão sai do modo autocommit; a transação começará com a primeira inserção;
- linhas 71–73: as inserções;
- linha 75: tudo correu bem: a transação é confirmada, e as inserções são adicionadas permanentemente ao banco de dados;
- linhas 77–80: uma inserção falhou: a transação é desfeita;
- linha 87: o método de inserção com pontos de salvamento:
- linha 93: um ponto de salvamento é definido antes de cada inserção;
- linha 98: se a inserção falhar, voltamos ao ponto de salvamento: apenas a inserção que falhou é desfeita, e o laço continua;
- Linha 103: a transação é confirmada, com as inserções bem-sucedidas.
Nos resultados:
- linha 5: exibida pelo comando [delete]: havia seis linhas na tabela;
- linha 7: a exceção causada pela segunda inserção. A mensagem indica que a restrição [UNQ_NAME] na tabela [articles] não foi respeitada;
- linha 9: a tabela não está vazia: o primeiro registro foi inserido;
- linha 12: exibida pelo comando [delete]: havia uma linha na tabela;
- Linha 13: a primeira inserção foi bem-sucedida… dentro da transação;
- linha 14: a mensagem exibida quando a transação falha;
- linha 15: a tabela está vazia: o [rollback] da transação desfez a primeira inserção;
- linhas 19–21: graças aos pontos de salvamento, a segunda inserção foi desfeita e a transação foi confirmada;
- linha 23: a tabela contém o primeiro item. Seu valor de [id] é 11, não 8: cada tentativa de inserção, mesmo desfeita ou rejeitada, consumiu um valor da coluna [AUTO_INCREMENT], e o MySQL não reutiliza esses valores.
Com o MySQL, a falha de um comando SQL cancela apenas esse comando, e a transação pode continuar: o ponto de salvamento, portanto, não é essencial aqui. Isso não vale para todos os SGBDs: com o PostgreSQL, o menor erro torna a transação inutilizável até que ela seja desfeita ou até que se volte a um ponto de salvamento. O código com pontos de salvamento funciona com ambos.
10.7. Consultas que retornam um único valor
Algumas consultas retornam apenas um valor, como [select count(*) from articles]: uma linha de uma única coluna. O JDBC não tem um método específico para isso: você executa a consulta com [executeQuery] e lê a primeira coluna da primeira linha do resultado. O programa [Jdbc07.java] implementa um método para isso e demonstra algumas maneiras de usá-lo:
Resultados:
- Linha 48: o método [singleValue] executa a consulta e retorna a primeira coluna da primeira linha por meio de [getObject(1)], ou [null] se a consulta não retornar nenhuma linha (linha 52);
- linha 21: o preço médio dos itens. O tipo Java do resultado depende do tipo SQL do valor: a média de uma coluna [DECIMAL] é um [BigDecimal], neste caso com seis casas decimais (linha 2 dos resultados);
- linha 23: o número de itens. O MySQL retorna um inteiro do tipo [BIGINT], que se torna um [Long] em Java (linha 3);
- linhas 25–26: o nome do item mais caro, uma cadeia de caracteres. A consulta contém uma subconsulta, entre parênteses;
- linha 28: se a consulta não retornar nenhuma linha, o método retorna [null] (linha 5);
- linha 30: se a consulta retornar uma linha cujo valor é SQL [NULL] (o máximo de um conjunto vazio), [getObject] também retorna [null] (linha 6). Nosso método, portanto, não distingue entre os dois casos, nenhuma linha ou um valor [NULL]; se a distinção for importante, é preciso testar você mesmo o resultado de [next];
- linha 57: uma segunda versão, genérica, do método (Capítulo 4) recebe o tipo desejado na forma de um objeto [Class<T>] e retorna um valor desse tipo. [getObject(1, type)] (linha 61) instrui o driver a converter o valor para esse tipo;
- linhas 34–35: o próprio driver converte o valor para o tipo solicitado: a média para [BigDecimal], e o número de itens ([BIGINT]) para [Integer]. [setScale(2, RoundingMode.HALF_UP)] arredonda a média para duas casas decimais (linha 7);
- Linha 39: uma conversão direta falha porque o objeto é um [Long]: a conversão [(int)] de um [Object] exige um [Integer], que depois sofre "unboxing", e um [Long] não é um [Integer]. Uma [ClassCastException] é lançada (linha 8). Esse código funcionaria com um SGBD cujo [count] retornasse um inteiro do tipo [INT], mas falha com o MySQL: este é um exemplo das peculiaridades dos SGBDs que o JDBC não esconde. A leitura por meio de [getInt], [getLong] ou [getObject(i, type)], que deixa a conversão a cargo do driver, é mais segura;
- linha 41: uma cláusula [catch] múltipla (Java 7) captura os dois tipos de exceção.
10.8. O JDBC é bloqueante: threads virtuais
O Capítulo 9 mostrou que as operações de E/S não devem bloquear uma thread da aplicação em aplicações que atendem muitos usuários (servidores, serviços web): enquanto um comando SQL está sendo executado no servidor, a thread que o emitiu fica esperando. Ora, o JDBC é uma API bloqueante: [getConnection], [executeQuery], [next], [commit]… não devolvem o controle até que o SGBD tenha respondido. Não existe versão assíncrona do JDBC: um projeto de API assíncrona (ADBA) foi abandonado em 2019, e a API reativa R2DBC, que existe fora do JDK, não substituiu o JDBC.
Desde o Java 21, a solução da plataforma Java é a thread virtual (Capítulo 8): uma thread leve, gerenciada pela JVM, da qual milhares podem ser criadas. Quando uma thread virtual está esperando uma resposta da rede, a JVM a coloca de lado e libera a thread do sistema que a executava, permitindo que essa thread execute outra thread virtual. O código continua sequencial e bloqueante, simples de escrever e de ler, mas a espera deixa de ter qualquer custo adicional. Os drivers JDBC recentes, incluindo o Connector/J 9, são escritos para funcionar com threads virtuais, e, desde o Java 24 (JEP 491), uma thread virtual que espera dentro de um bloco [synchronized] não monopoliza mais a thread do sistema.
Uma limitação permanece: o número de conexões. Mil threads virtuais consultando o banco de dados não têm mil conexões; elas compartilham as conexões do pool e esperam que uma conexão fique disponível. O programa [Jdbc08.java] demonstra isso, usando um pool HikariCP de quatro conexões:
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 33 34 35 36 37 38 39 40 41 42 43 44 45 46 47 48 49 50 51 52 53 54 55 56 57 58 59 60 61 62 63 64 65 66 67 68 69 70 71 72 73 74 75 76 77 78 79 80 81 82 83 84 85 86 87 88 89 90 91 92 93 94 95 96 97 98 99 100 101 102 103 104 105 | |
Resultados:
- linhas 24–28: configuração de um pool com no máximo quatro conexões;
- linha 30: o data source [HikariDataSource], fechado ao final do programa pela instrução
try-with-resources; - linhas 32–41: um comando de atualização dentro de uma transação, usando uma conexão obtida do pool. O [close] implícito na linha 41 devolve a conexão ao pool. Os resultados mostram que os três preços abaixo de 200 euros foram aumentados em 10% (linha 2 dos resultados);
- linha 93: o método [getArticleSlowly] lê um artigo em uma consulta que leva um segundo: a função MySQL [sleep(1)] (linhas 95–96) espera um segundo antes de retornar 0. Isso simula uma consulta lenta;
- linhas 44–56: seis leituras de artigos, executadas simultaneamente:
- linha 46: [Executors.newVirtualThreadPerTaskExecutor] (Java 21, Capítulo 8) cria um executor que lança cada tarefa em uma nova thread virtual. O executor é fechado ao final do bloco
try-with-resources(linha 51), e seu método*[close]*(Java 19) espera que todas as tarefas terminem; - linha 49: cada tarefa é uma lambda que retorna um [Article]: um
*[Callable<Article>]*, cujo método*[call]*pode lançar exceções verificadas, neste caso a*[SQLException]de*[getArticleSlowly]*. [submit] retorna um [Future<Article>]. A lambda usa a cópia [articleId]* da variável do laço (linha 48), porque uma lambda só pode usar variáveis locais que não são modificadas; - linhas 52–54: os itens são exibidos na ordem das tarefas. [Future.get] retorna o resultado da tarefa; se a tarefa lançou uma exceção, [get] lança uma [ExecutionException] que a encapsula (interceptada na linha 87). [get] também pode lançar uma [InterruptedException], que [main] declara (linha 22);
- Linhas 55–56: duração total. Seis consultas de um segundo executadas uma após a outra levariam seis segundos; executadas simultaneamente com seis conexões, levariam um segundo. Com quatro conexões, leva cerca de dois segundos (linha 9 dos resultados): quatro threads virtuais obtêm uma conexão e executam suas requisições ao mesmo tempo, enquanto as outras duas esperam em [getConnection] que uma conexão seja devolvida ao pool, para então executar as suas. O tempo restante é gasto na abertura de conexões do pool. Uma thread que espera demais por uma conexão (30 segundos por padrão, configuração [connectionTimeout] no HikariCP) recebe uma [SQLTransientConnectionException];
- linha 46: [Executors.newVirtualThreadPerTaskExecutor] (Java 21, Capítulo 8) cria um executor que lança cada tarefa em uma nova thread virtual. O executor é fechado ao final do bloco
- linhas 59–64: um único valor, o valor do estoque;
- linhas 69–86: abandono de uma consulta que está demorando demais:
- linhas 69–73: uma primeira conexão sai do modo autocommit e modifica o item nº 1 sem concluir sua transação. O SGBD bloqueou a linha modificada até o fim da transação;
- linhas 76–79: uma segunda conexão tenta modificar a mesma linha. Ela precisa esperar a conclusão da primeira transação… o que não acontecerá. [setQueryTimeout(1)] (linha 78) limita o tempo de execução do comando a um segundo: após um segundo, o Connector/J instrui o servidor a abortar a requisição (comando MySQL [KILL QUERY]), e [executeUpdate] lança uma [SQLTimeoutException], neste caso da classe [MySQLTimeoutException] do driver (linha 11 dos resultados). Sem esse timeout, a consulta teria esperado o tempo limite de bloqueio do MySQL, de 50 segundos por padrão, e então falharia;
- linha 85: a transação [blocking] nunca é confirmada; ela é desfeita. A conexão é então devolvida ao pool.
As threads virtuais não trazem benefício algum a um pequeno programa de console que executa uma tarefa por vez: elas não tornam uma requisição mais rápida. Mas permitem que uma aplicação servidora, como os serviços web Spring Boot do Capítulo 13 (em que a propriedade [spring.threads.virtual.enabled=true] é suficiente), atenda muitos usuários ao mesmo tempo usando código JDBC comum. O tamanho do pool de conexões passa então a ser o verdadeiro controle do paralelismo em relação ao banco de dados.
10.9. Execução em lote
Cada execução de um comando SQL envolve uma ida e volta entre a aplicação e o servidor. Quando vários comandos SQL precisam ser executados, eles podem ser enviados ao SGBD em uma única troca, na forma de um lote (batch). O JDBC suporta isso desde a versão 2.0:
- para um [Statement], [addBatch(sql)] adiciona um comando SQL ao lote;
- para um [PreparedStatement], [addBatch()] adiciona ao lote os valores atuais dos parâmetros: o lote contém o mesmo comando SQL executado com valores diferentes;
- [executeBatch] executa o lote e retorna um array de inteiros: o número de linhas modificadas por cada comando do lote. Se um comando falhar, ela lança uma [BatchUpdateException], cujo método [getUpdateCounts] retorna os resultados dos comandos executados.
O programa [Jdbc09.java] usa os lotes a seguir:
Resultados:
- linhas 21–22: o método [supportsBatchUpdates] dos metadados da conexão indica se o driver pode executar lotes;
- Linhas 25–34: um lote de três comandos de atualização diferentes, adicionados ao lote de um [Statement] por [addBatch]:
- linha 31: os três comandos são executados. [executeBatch] retorna o número de linhas modificadas por cada um: uma inserção ([canoe]), uma atualização (o estoque de flechas, que está abaixo do estoque mínimo) e uma exclusão ([pump]);
- Linhas 32–33: [Arrays.toString] exibe o array, [Arrays.stream] o converte em um stream de inteiros ([IntStream]), e [sum] calcula a soma (linha 3 dos resultados);
- linhas 37–38: o método [insertBatch] é chamado duas vezes, com duas instâncias diferentes de URL;
- linha 68: o método [insertBatch] insere [n] itens com um lote:
- linha 70: as inserções são realizadas em uma única transação, o que também é muito mais rápido do que confirmar cada uma individualmente;
- Linhas 74–81: para cada item, os parâmetros recebem seus valores, e então [addBatch()] adiciona esses valores ao lote;
- linhas 82–83: o lote é executado, e então a transação é confirmada;
- linhas 84–86: são exibidos o número de inserções, a duração e os três primeiros elementos do array retornado por [executeBatch];
- linhas 89–92: os itens inseridos são excluídos para restaurar a tabela ao estado anterior;
- Linha 4 dos resultados: com a URL simples, o driver MySQL envia as 1.000 inserções uma após a outra: o processamento em lote quase não traz benefício. Cada elemento do array é 1;
- Linha 5 dos resultados: com o parâmetro [rewriteBatchedStatements=true] da URL, o driver Connector/J reescreve o lote em vários comandos [insert into articles(…) values (…), (…), (…)…], cada um dos quais insere numerosas linhas. A execução é dez vezes mais rápida. Os elementos do array passam então a -2, o valor da constante [Statement.SUCCESS_NO_INFO]: o comando foi bem-sucedido, mas o driver não sabe quantas linhas cada elemento do lote modificou. Essa é uma configuração importante a conhecer: sem ela, os lotes têm pouca utilidade com o MySQL;
- linhas 43–64: dois comandos [select] enviados em uma única troca:
- linhas 44–45: a conexão é aberta com o parâmetro [allowMultiQueries=true], que permite vários comandos SQL separados por ponto e vírgula em uma única requisição. Como vimos, isso é desabilitado por padrão para limitar o alcance das injeções de SQL;
- linhas 47–48: os dois comandos são executados por [execute], que aceita qualquer comando;
- linha 50: [getResultSet] retorna o resultado do primeiro comando;
- linha 56: [getMoreResults] passa para o resultado seguinte (fecha o resultado atual e retorna [true] se o próximo resultado for um [ResultSet]);
- linha 57: o resultado da segunda consulta: uma linha com duas colunas.
Os lotes são úteis para inserções e atualizações em grande escala (como importações de dados). O Hibernate (Capítulo 11) também os suporta.
10.10. Modo offline: CachedRowSet
O modo offline do JDBC baseia-se na interface [javax.sql.rowset.CachedRowSet], derivada de [ResultSet]: um [CachedRowSet] é um resultado de consulta copiado para a memória, que pode ser percorrido nos dois sentidos e modificado offline, após o que as alterações são enviadas de volta ao banco de dados. O programa [Jdbc10.java] demonstra isso:
Resultados:
- Linhas 23–24: [RowSetProvider.newFactory] (Java 7) retorna uma fábrica ([RowSetFactory]) dos diversos tipos de RowSet derivados do JDK, da qual [createCachedRowSet] cria um [CachedRowSet]. Um [CachedRowSet] é um recurso fechado pela instrução try-with-resources;
- linhas 26–29: o [CachedRowSet] recebe os parâmetros de conexão e a consulta que o preencherá;
- linhas 31–32: para poder confirmar as alterações no banco de dados, ele precisa conhecer a tabela modificada e sua chave primária, neste caso a coluna 1, [id];
- linha 34: [execute] abre uma conexão, executa a consulta, copia todas as linhas do resultado para a memória e fecha a conexão. O restante do trabalho é feito offline;
- Linhas 38–47: um [CachedRowSet] é um [ResultSet]: ele é percorrido com [next], e as colunas são lidas com [getXxx]. Os métodos [updateXxx] modificam uma coluna da linha atual, e [updateRow] grava a alteração… na cópia em memória. O estoque de flechas, que está abaixo do estoque mínimo, é aumentado para 30 (linha 3 dos resultados);
- linhas 49–56: adição de uma linha. [moveToInsertRow] coloca o cursor em uma linha especial, a “linha de inserção”, cujas colunas são especificadas por [updateXxx]; [insertRow] a adiciona ao [CachedRowSet], e [moveToCurrentRow] devolve o cursor à sua posição anterior. [CachedRowSet] exige um valor para todas as colunas [NOT NULL], incluindo [id]: um valor 0, inserido em uma coluna [AUTO_INCREMENT], instrui o MySQL a gerar um;
- linhas 58–60: [absolute(2)] coloca o cursor na segunda linha, o que é possibilitado pelo [CachedRowSet], que pode ser percorrido em qualquer sentido, e [deleteRow] a exclui;
- linha 63: o banco de dados ainda não foi modificado (linhas 5–11 dos resultados);
- Linhas 65–68: [acceptChanges] confirma as alterações no banco de dados: um [update], um [insert] e um [delete], todos executados dentro de uma transação confirmada no final. Para cada linha modificada, a implementação do JDK verifica se a linha do banco de dados não foi modificada por outra pessoa desde que foi lida (uma verificação “otimista”); caso contrário, ela lança uma [SyncProviderException]. A versão sem parâmetros de [acceptChanges] abre a conexão por conta própria, mas a deixa em modo autocommit e depois chama [commit], o que o Connector/J recusa; por isso, passa-se a ela uma conexão que saiu do modo autocommit;
- linha 70: o banco de dados foi modificado (linhas 12–18 dos resultados).
O [CachedRowSet] tem a vantagem de ser uma API padrão derivada do JDK, mas suas limitações são evidentes: ele manipula linhas e números de coluna, não objetos de negócio; as modificações são feitas por uma implementação cujo SQL não compreendemos totalmente. É por isso que ele raramente é usado hoje: trabalhar com objetos em memória e salvar as alterações depois é o domínio de frameworks ORM como o Hibernate (Capítulo 11).
10.11. Aplicação de exemplo: versão 6
Vamos retomar a aplicação de exemplo [Tax]. A última versão, a versão 5, foi vista no Capítulo 6. Era uma aplicação de três camadas cuja camada [dao] obtinha seus dados de um arquivo de texto, de um arquivo JSON ou do próprio código, e cujas camadas eram integradas pelo contêiner de injeção de dependência do Spring. Vamos escrever uma nova camada, [dao], que obtém seus dados de um banco de dados, o MySQL:
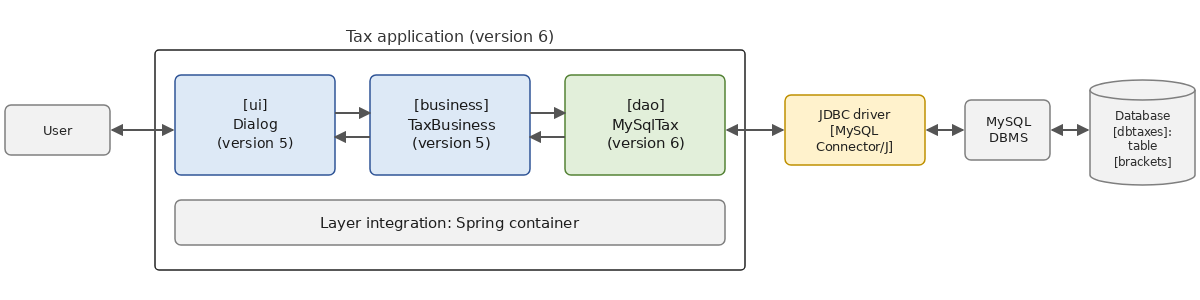
Reutilizamos os módulos da versão 5 sem alterações, por meio de dependências Maven, e escrevemos apenas o que é novo: a camada [dao] e o programa que integra as camadas.
10.11.1. O banco de dados
As faixas do imposto são armazenadas na tabela [brackets] do banco de dados MySQL [dbtaxes], criado pelo script [sql/dbtaxes.sql]:
- Linhas 13–18: a tabela [brackets] tem quatro colunas: a chave primária [id], gerada pelo SGBD, seguida das três colunas [limits], [coeffr] e [coeffn], que representam uma faixa de imposto do tipo [DECIMAL]: são valores e coeficientes que devem ser exatos. Eles serão lidos em Java como [BigDecimal], o tipo dos campos do record [TaxBracket];
- linhas 19–26: as sete faixas da tabela de imposto de 2004 para a renda de 2003, usada desde o início do curso (é um exercício: a tabela não está atualizada). As faixas são listadas em ordem crescente de seus limites, e a coluna [id] reflete essa ordem;
- linhas 29–30: criação de um usuário MySQL [admtaxes], com a senha [pwdtaxes], a quem são concedidas todas as permissões ([GRANT ALL PRIVILEGES]) sobre todos os objetos do banco de dados [dbtaxes] ([dbtaxes.*]), e somente sobre eles. A aplicação será executada com esse usuário, e não com o administrador [root]: se a senha do administrador fosse comprometida, apenas o banco de dados [dbtaxes] estaria em risco. [IF NOT EXISTS] permite que o script seja executado várias vezes.
O script é executado pelo administrador:
em seguida, verificamos que o usuário [admtaxes] tem acesso às faixas (a opção [-p] sozinha solicita a senha, que não é exibida enquanto é digitada):
10.11.2. O projeto TaxV6
A versão 6 é um projeto Maven composto por dois módulos, localizado na pasta [10-jdbc/TaxV6], que usa três módulos da versão 5:
Os módulos da versão 5 não fazem parte do projeto [TaxV6]: eles são dependências, como o driver JDBC ou o Spring. Para que o Maven os encontre, é preciso primeiro instalá-los no repositório Maven local (a pasta [.m2/repository] no diretório pessoal do usuário), onde o Maven armazena todas as bibliotecas que baixa. É isso que faz o comando [mvn install], digitado uma única vez na pasta da versão 5:
Ele compila os três módulos, executa seus testes, cria seus arquivos [tax-dao-5.0.jar], [tax-business-5.0.jar] e [tax-ui-5.0.jar], e os copia, junto com o [pom.xml] do projeto pai, para o repositório local sob os identificadores [examples.tax:tax-dao:5.0], [examples.tax:tax-business:5.0] e [examples.tax:tax-ui:5.0]. Qualquer projeto Maven da máquina pode então usá-los como qualquer biblioteca do Maven Central.
Isso demonstra o valor de uma arquitetura em camadas. As camadas [business] e [ui] conhecem apenas a interface [ITaxDao], definida no módulo [tax-dao] da versão 5; a nova camada [dao] implementa essa interface em um novo módulo. Nenhuma linha de código da versão 5 é modificada, e seus arquivos-fonte nem sequer são recompilados.
O [pom.xml] do projeto pai é o seguinte:
- linhas 8–11: o projeto pai, empacotamento [pom]: ele não produz um arquivo; agrupa módulos e fornece a eles uma configuração comum;
- linhas 14–17: os dois módulos do projeto;
- linhas 25–65: a seção [dependencyManagement] especifica as versões das dependências dos módulos, que são então declaradas sem versão:
- linhas 28–42: os três módulos da versão 5, instalados no repositório local por [mvn install];
- linhas 44–48: o novo módulo [dao], do qual o módulo [ui] depende;
- linhas 49–63: o driver JDBC para MySQL, o Spring e o JUnit;
- linhas 67–93: a configuração comum dos plugins de compilação, teste e execução.
10.11.3. A camada [dao]
O arquivo [pom.xml] do módulo [tax-dao-mysql] é o seguinte:
- linhas 8–12: o projeto pai;
- linhas 18–21: o módulo [tax-dao] da versão 5, que contém as entidades ([TaxBracket], [TaxException]) e a interface [ITaxDao];
- linhas 23–27: o driver JDBC para MySQL, com o escopo ([scope]) [runtime]: ele não é usado em tempo de compilação, mas está presente em tempo de execução e durante os testes. Isso oferece uma garantia: se o código usasse por engano uma classe do driver, ele não compilaria. A camada [dao] depende apenas do JDBC;
- linhas 29–38: somente para testes (escopo [test]), a camada [business] da versão 5 e o JUnit.
A classe [MySqlTax] implementa a interface [ITaxDao]:
- linha 1: a classe está no pacote [tax.dao], como as outras implementações de [ITaxDao], embora esteja em um arquivo diferente;
- linha 15: a classe [MySqlTax] implementa a interface [ITaxDao] da versão 5: um método [getTaxBrackets] que retorna a lista de faixas (linha 54);
- linha 18: códigos de erro específicos desta implementação, modelados a partir dos de [FileTax] e [JsonTax]: 101 para um erro de acesso ao banco de dados, 102 para dados incorretos;
- Linha 21: a consulta que retorna as faixas. A cláusula [order by id] é importante: a camada [business] espera as faixas em ordem crescente de seus limites, e um [select] sem [order by] retorna as linhas em uma ordem que o SQL não garante;
- linhas 27–29: um construtor que usa a consulta padrão, chamando o outro construtor por meio de [this(…)];
- linha 32: o construtor recebe os parâmetros de conexão e a consulta. As faixas são lidas uma vez e para sempre dentro do construtor: a camada [dao] é um singleton na aplicação, e o banco de dados não é consultado novamente depois disso. Uma conexão aberta por [DriverManager] é, portanto, suficiente; um pool de conexões não teria utilidade;
- Linhas 34–36: a conexão, a consulta SQL e o resultado, como nos exemplos anteriores;
- linhas 38–40: cada linha do resultado se torna um objeto [TaxBracket], construído pelo método [readBracket];
- linhas 41–44: um erro de acesso ao banco de dados é encapsulado em uma [TaxException] com o código [ACCESS], assim como [FileTax] e [JsonTax] faziam com os erros de entrada/saída. [TaxException] é uma exceção não verificada: a camada [ui] não precisa conhecer as [SQLException], que são exceções verificadas do JDBC;
- linhas 46–48: uma tabela vazia é um erro de dados;
- linha 50: a lista se torna somente leitura por meio de [List.copyOf] (Java 10);
- linhas 59–72: leitura de uma faixa:
- linhas 61–63: [getBigDecimal(i)] lê a coluna nº i como um [BigDecimal];
- linhas 64–66: uma coluna com o valor [NULL] produz um [BigDecimal] [null]: isso é um erro de dados;
- linhas 68–71: uma consulta que retorna menos de três colunas, ou uma coluna não numérica, resulta em uma [SQLException] em [getBigDecimal]: isso também é um erro de dados. A [TaxException] lançada na linha 65 não é uma [SQLException]: ela atravessa a cláusula [catch] da linha 68 sem ser interceptada, e depois a da linha 41; o bloco
try-with-resourcesdo construtor fecha, mesmo assim, a conexão.
Observe que o nome da classe é o único lugar em que o MySQL aparece: o código usa apenas as interfaces de [java.sql]. Voltaremos a isso.
10.11.4. Testes da camada [dao]
Os testes da camada [dao] estão na pasta [src/test/java] do módulo:
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 33 34 35 36 37 38 39 40 41 42 43 44 45 46 47 48 49 50 51 52 53 54 55 56 57 58 59 60 61 62 63 64 65 66 67 68 69 70 71 72 73 74 75 76 77 78 79 80 81 82 83 84 85 86 87 88 89 90 91 92 93 94 95 96 97 98 99 100 101 102 103 104 | |
- Linhas 22–24: os testes usam o banco de dados [dbtaxes], que deve ter sido criado pelo script [dbtaxes.sql]. Portanto, deixam de ser testes unitários no sentido estrito, que testariam uma classe isoladamente, e passam a ser testes de integração: verificam o funcionamento da camada [dao] com o SGBD. Para esses testes, costuma-se usar um banco de dados H2 em memória, criado no início dos testes, ou uma instância de SGBD lançada em um contêiner Docker pela biblioteca Testcontainers; aqui, usaremos simplesmente o banco de dados MySQL da máquina;
- Linhas 28–40: os registros lidos do banco de dados são os da versão “hard-coded” [HardwiredTax]… mas não no sentido de [equals] (linha 32)! O método [equals] de um record compara seus campos com o método [equals] deles, e o método [BigDecimal] compara o valor e a escala (o número de casas decimais): os valores [BigDecimal] lidos do banco de dados têm duas casas decimais ([4962.00]), assim como a coluna [DECIMAL(10,2)], ao passo que os de [HardwiredTax] não têm nenhuma ([4962]). [compareTo], por outro lado, compara apenas os valores (linhas 35–39). Essa é uma armadilha clássica do [BigDecimal] (Capítulo 3);
- linhas 43–52: a camada [business] da versão 5 calcula os impostos esperados usando a nova camada [dao]. [@CsvSource] fornece os parâmetros das três execuções do teste;
- linhas 55–61: um banco de dados inexistente provoca uma [TaxException] com o código [ACCESS], que encapsula a [SQLException] original ([assertInstanceOf] aceita uma classe derivada);
- linhas 64–69: o mesmo vale para uma senha incorreta;
- linhas 72–77: um servidor inacessível (nenhum servidor está escutando na porta 3399) também causa um erro de acesso;
- métodos [incorrectQuery] (linha 81), [noBracket] (linha 89) e [nullValue] (linha 98): uma consulta que retorna apenas duas colunas, não retorna nenhuma linha ou tem uma coluna com o valor [NULL] provoca um erro [TaxException] com o código [DATA].
Os testes são executados com [mvn test] na pasta do módulo (ou [mvn install] na pasta [TaxV6], que também executa os testes). O Maven exibe apenas o resumo; o script da IDE e o launcher do JUnit em modo console exibem a árvore a seguir (o resumo que segue a árvore está abreviado):
10.11.5. Integração das camadas
O módulo [tax-ui-mysql] contém o programa que integra as camadas. Seu arquivo [pom.xml] é o seguinte:
- Linhas 18–21: a nova camada [dao]. Por transitividade, o driver JDBC para MySQL, uma dependência de escopo [runtime] neste módulo, faz parte das bibliotecas da aplicação;
- Linhas 23–30: as camadas [business] e [ui] da versão 5. O módulo [tax-ui] contém o programa principal da versão 5, mas usamos apenas sua classe pública [Dialog];
- linhas 32–35: o contêiner de injeção de dependência do Spring, como na versão 5;
- linhas 41–47: a classe executada por [mvn exec:java].
O arquivo de configuração [tax.properties] é o seguinte:
- linha 2: a implementação da camada [dao];
- Linhas 3–5: a URL JDBC do banco de dados [dbtaxes] e as credenciais do usuário [admtaxes];
- linha 6: a consulta que retorna as faixas. Colocá-la na configuração permite usar outro banco de dados, mesmo um com tabelas ou colunas de nomes diferentes, sem modificar o código.
A classe [Main] é a da versão 5, com exceção do registro na camada [dao]:
- Linha 1: a classe está em um pacote específico da versão 6, [tax.ui.mysql], para evitar confusão com a classe [tax.ui.Main] da versão 5, que também está presente no classpath;
- Linha 22: o arquivo de configuração, [tax.properties] por padrão, ou o passado como argumento;
- linhas 28–31: leitura do arquivo de propriedades a partir do diretório atual;
- linhas 32–39: os parâmetros da camada [dao]. A ausência da URL é um erro; a consulta tem um valor padrão;
- linhas 44–49: a camada [dao] é registrada no contêiner do Spring sob a interface [ITaxDao], com um [Supplier] que a cria de acordo com a configuração: um [MySqlTax] (linha 45) ou, para comparação, a versão “hard-coded” da versão 5 (linha 46). As implementações [FileTax] e [JsonTax] da versão 5 poderiam ser acrescentadas da mesma forma: elas estão no classpath;
- linha 51: a camada [business] da versão 5;
- linha 54: quando o contêiner é iniciado, ele cria a camada [dao], e portanto lê o banco de dados, seguida da camada [business];
- linhas 56–61: um erro de configuração ou de acesso ao banco de dados é exibido pelo método [displayError] da versão 5, e o programa termina;
- linha 64: a caixa de diálogo da versão 5, inalterada.
Para executar a aplicação, instale primeiro os módulos da versão 6 no repositório local (a camada [dao] deve estar disponível para o módulo [tax-ui-mysql]), depois execute o programa a partir da pasta [tax-ui-mysql], que contém os arquivos de configuração:
Execução com o arquivo [tax.properties]:
Os valores de referência do curso são os seguintes: 4.282 euros para um casal com dois filhos, 2.959 euros para um casal com três filhos e 11.519 euros para uma pessoa solteira sem filhos, com um salário anual de 60.000 euros.
Com o arquivo [tax-base.properties], em que a URL se refere a um banco de dados [dbtaxesunknown]:
- linhas 2–3: uma mensagem de log do Spring escrita na saída de erro: o contêiner informa que a criação da camada [dao] falhou. Isso já ocorria na versão 5;
- linhas 6–10: a cadeia de exceções exibida por [Dialog.displayError]: o contêiner do Spring encapsulou a exceção [TaxException] lançada pela camada [dao], que por sua vez encapsula a exceção [SQLException] do driver, em uma exceção [BeanCreationException]. O usuário [admtaxes] tem permissões apenas sobre o banco de dados [dbtaxes]: o MySQL nega acesso a qualquer outro banco de dados, exista ele ou não (linha 10).
Com o arquivo [tax-password.properties], que tem uma senha incorreta:
Com o arquivo [tax-server.properties], em que a URL especifica a porta 3399, na qual nenhum servidor está escutando (é o que aconteceria se o servidor MySQL fosse parado):
A cadeia de exceções aqui mostra que a própria exceção do driver encapsula outras exceções, até chegar à exceção de rede [ConnectException]: a conexão foi recusada.
Com o arquivo [tax-query.properties], cuja consulta pede apenas as colunas [limits] e [coeffr]:
Em todos os casos, a camada [dao] encapsulou a exceção original em uma [TaxException], que é exibida pelo método [Dialog.displayError] da versão 5, e o programa termina.
10.11.6. Mudança de banco de dados
A camada [dao] [MySqlTax] usa apenas as interfaces do JDBC: apesar do nome, ela não é específica do MySQL (um nome como [JdbcTax] seria mais adequado). Para usar um banco de dados PostgreSQL (ou SQL Server, ou Oracle), bastaria:
- criar a tabela de faixas em um banco de dados PostgreSQL, por exemplo, uma tabela chamada [data] com as colunas [data1], [data2] e [data3], para destacar a vantagem de colocar a consulta na configuração;
- adicionar ao [pom.xml] do módulo [tax-ui-mysql] a dependência do driver JDBC do PostgreSQL, [org.postgresql:postgresql] (ou [com.microsoft.sqlserver:mssql-jdbc], [com.oracle.database.jdbc:ojdbc11]), com escopo [runtime];
- escrever um arquivo de configuração semelhante a [tax.properties], como o arquivo [tax-postgresql.properties] do módulo:
Apenas o MySQL está instalado na máquina usada para escrever este curso: não implementamos essa configuração. As camadas [business] e [ui], a classe [MySqlTax] e o programa [Main] não precisam ser modificados: mudam apenas a configuração e o driver no classpath. Observe que a consulta de [MySqlTax] não tem parâmetros e usa apenas SQL padrão: isso é o que permite que seja executada por qualquer SGBD. Uma camada [dao] mais rica em recursos (buscas, atualizações) logo esbarraria nas características específicas de cada SQL, como vimos acima: é aí que um ORM como o Hibernate assume.
10.12. Conclusão
Este capítulo tratou do acesso a bancos de dados com o JDBC:
- o JDBC é um conjunto de interfaces ([Connection], [Statement], [PreparedStatement], [ResultSet], [DataSource]…), dos pacotes [java.sql] e [javax.sql] , implementadas por um driver específico de cada SGBD (MySQL Connector/J para o MySQL), que o [DriverManager] seleciona com base na URL JDBC do banco de dados;
- uma conexão é aberta o mais tarde possível e fechada o mais cedo possível, por meio de uma instrução
**try-with-resources; um pool de conexões como o HikariCP, por meio da interface [DataSource], torna essa prática economicamente viável; - [executeQuery] executa um [select] e retorna um [ResultSet], que é percorrido linha a linha com [next], lendo as colunas, numeradas a partir de 1, com os métodos [getXxx]; [executeUpdate] executa um [insert], [update], ou [delete] e retorna o número de linhas modificadas;
- os erros são [SQLException], exceções verificadas (checked), que trazem um código de erro específico do SGBD e um código SQLSTATE padronizado;
- os valores externos são sempre passados por meio dos parâmetros de um [PreparedStatement] e nunca são concatenados ao texto da consulta, o que protege contra a injeção de SQL;
- as transações ([setAutoCommit(false)], [commit], [rollback], pontos de salvamento) tornam atômica uma sequência de comandos SQL;
- o JDBC é bloqueante: as threads virtuais do Java 21 permitem atender muitos usuários com código JDBC padrão, dentro dos limites do tamanho do pool; os lotes ([addBatch], [executeBatch]) reduzem o número de trocas com o servidor;
- o modo offline ([CachedRowSet]) existe, mas trabalhar com objetos em memória é hoje o domínio dos ORMs.
A versão 6 da aplicação [Tax] demonstrou que, graças à arquitetura em camadas, passar de um arquivo para um banco de dados exige apenas escrever uma nova camada [dao] e modificar a configuração. O próximo capítulo criará uma sétima versão dessa camada usando o Hibernate, que gera ele mesmo os comandos SQL.
Para saber mais:
- o tutorial de JDBC da Oracle: JDBC Database Access (escrito para o Java 8, mas a API quase não mudou desde então);
- a documentação do MySQL Connector/J: MySQL Connector/J Developer Guide;
- a documentação do HikariCP: HikariCP;
- a injeção de SQL, explicada pela OWASP: SQL Injection Prevention Cheat Sheet.