5. Classes Java de uso comum
Apresentamos aqui algumas classes frequentemente usadas da plataforma Java: cadeias de caracteres, arrays, coleções, arquivos e expressões regulares. Incluímos também a API Stream (Java 8), que é atualmente a forma mais comum de pesquisar, ordenar, agrupar ou transformar elementos de uma coleção Java. Antes disso, mostraremos como encontrar informações sobre as milhares de classes disponíveis. Esse recurso é indispensável para qualquer desenvolvedor Java, mesmo os experientes.
Com exceção de dois (o exemplo de JSON e a aplicação de exemplo no final), os exemplos deste capítulo são arquivos-fonte compactos executados pelo iniciador de código-fonte: [java File.java]. Eles estão na pasta [05-classes-java] do código do curso e são executados em uma localidade em inglês. Observe que um arquivo-fonte compacto importa automaticamente todas as classes públicas do módulo [java.base]: [java.util], [java.io], [java.nio.file], [java.util.regex], [java.util.stream], [java.time]… É por isso que os programas a seguir não contêm nenhuma instrução [import].
5.1. Buscando ajuda sobre as classes Java
A biblioteca padrão do Java (a API Java SE) inclui mais de 4.000 classes públicas. Ninguém conhece todas: os desenvolvedores Java consultam constantemente a documentação. Essa documentação está disponível on-line, gratuitamente, e é publicada para cada versão do Java.
5.1.1. Documentação on-line
O ponto de partida é o site da Oracle em docs.oracle.com/en/java/javase/25. Lá você encontra:
- a referência do Java 25: https://docs.oracle.com/en/java/javase/25/docs/api/. Ela descreve, módulo por módulo e pacote por pacote, todas as classes e interfaces Java: seus construtores, campos e métodos;
- uma caixa de busca no topo de cada página da referência, na qual você pode digitar o nome de uma classe ou método ([StringBuilder], [Matcher.find]…): a lista de resultados é atualizada enquanto você digita;
- a especificação da linguagem Java (JLS) e guias temáticos (ferramentas do JDK, segurança, expressões regulares…);
- uma página “New Features” que descreve as novidades de cada versão. As próprias novidades são descritas pelas JEPs (JDK Enhancement Proposals), disponíveis em openjdk.org/jeps: por exemplo, a JEP 512 descreve os arquivos-fonte compactos usados neste capítulo.
A página de uma classe, como java.lang.String, fornece:
- o módulo e o pacote da classe;
- sua declaração, suas classes pai e as interfaces que ela implementa;
- uma descrição geral, muitas vezes longa e detalhada, com exemplos;
- uma lista resumida de seus campos, construtores e métodos, seguida dos detalhes de cada um: parâmetros, valor de retorno, possíveis exceções e a versão do Java em que foi introduzido (sob o título “Since”).
A documentação está em inglês. Uma busca em um mecanismo de busca usando o nome completo da classe e a versão (“java.lang.StringBuilder 25”) normalmente leva diretamente à página correta.
5.1.2. Javadoc e a ajuda do editor
Essa documentação é gerada pela ferramenta [javadoc] do JDK a partir dos comentários de documentação escritos no código-fonte das classes. Esse tipo de comentário começa com [/**] e é colocado imediatamente antes de uma classe, campo ou método. Por exemplo, eis o método de cálculo do imposto da aplicação de exemplo deste capítulo, documentado da seguinte forma:
O comentário começa com uma frase-resumo; as tags [@param] descrevem os parâmetros, e a tag [@return] descreve o valor retornado ([@throws] descreveria uma exceção). Você pode documentar seu próprio código dessa maneira; o comando [javadoc] (ou [mvn javadoc:javadoc] em um projeto Maven) gera páginas HTML semelhantes às da documentação do Java. A partir do Java 23, os comentários de documentação também podem ser escritos em Markdown, com linhas começando por [///].
O editor de código (IntelliJ IDEA, Visual Studio Code com o Extension Pack for Java) aproveita esses comentários e oferece ajuda imediata sem sair do código:
- autocompletar: depois de digitar [aString.], o editor exibe uma lista dos métodos do objeto, com seus parâmetros e tipos de retorno;
- documentação rápida: ao passar o mouse sobre o nome de uma classe ou método (ou pressionar Ctrl+Q no IntelliJ IDEA), o Javadoc é exibido;
- ajuda de parâmetros: ao digitar o parêntese de abertura de uma chamada (ou pressionar Ctrl+P no IntelliJ IDEA), o editor exibe as diferentes sobrecargas do método e a função de cada parâmetro;
- Ir para a definição (Ctrl+B no IntelliJ IDEA, F12 no VS Code): exibe o código-fonte da classe ou do método. O JDK vem com o código-fonte de toda a sua biblioteca (arquivo [lib/src.zip]): isso permite ler o código de [ArrayList] ou de [HashMap], escrito por grandes especialistas em Java, o que é muito educativo.
Por fim, a ferramenta [jshell] do JDK permite testar um método sem escrever um programa: você digita uma expressão e ela exibe seu valor. Assim, ["abc".repeat(3)] exibe ["abcabcabc"]. O comando [/help] do [jshell] lista suas opções.
5.2. Cadeias de caracteres
5.2.1. A classe String
O tipo [String] (pacote [java.lang]) representa cadeias de caracteres. Ele oferece numerosos métodos. Eis alguns deles:
Método | função |
[int length()] | número de caracteres da cadeia |
[char charAt(int index)] | caractere de número [index]; o primeiro caractere tem o número 0 |
[boolean startsWith(String prefix)] | retorna [true] se a cadeia começa com [prefix] |
[boolean endsWith(String suffix)] | retorna [true] se a cadeia termina com [suffix] |
[boolean contains(CharSequence s)] | retorna [true] se a cadeia contém [s] |
[boolean equals(Object other)] | retorna [true] se a cadeia tem o mesmo conteúdo que [other]; [equalsIgnoreCase] não diferencia maiúsculas de minúsculas |
[int indexOf(String str)] | a primeira ocorrência de [str] na cadeia, ou -1. Outra sobrecarga inicia a busca na posição [fromIndex] |
[int indexOf(int ch)] | o mesmo para o caractere [ch] |
[int lastIndexOf(int ch)] | igual a [indexOf] mas retorna a última posição em vez da primeira |
[static String join(CharSequence delimiter, CharSequence... elements)] | método de classe: concatena os elementos, separando-os com [delimiter] |
[String replace(char oldChar, char newChar)] | retorna uma cópia da cadeia em que o caractere [oldChar] foi substituído por [newChar]; uma sobrecarga substitui uma cadeia por outra |
[String[] split(String regex)] | a cadeia é tratada como uma sequência de campos separados por um separador descrito pela expressão regular [regex]; o resultado é um array desses campos |
[String substring(int beginIndex, int endIndex)] | subcadeia formada pelos caracteres da posição [beginIndex] (inclusive) até a posição [endIndex] (exclusive) |
[String toLowerCase()], [String toUpperCase()] | converte a cadeia em minúsculas, maiúsculas |
[String strip()] | remove os espaços iniciais e finais da cadeia (Java 11; [stripLeading], [stripTrailing]: apenas de um dos lados) |
[String repeat(int count)] | repete a cadeia [count] vezes (Java 11) |
[boolean isEmpty()], [boolean isBlank()] | retorna [true] se a cadeia está vazia ou contém apenas espaços (Java 11) |
[Stream<String> lines()] | retorna as linhas da cadeia como um stream (Java 11; veja a API Stream adiante) |
[String formatted(Object... args)] | retorna a cadeia, usada como modelo, em que os marcadores [%s], [%d]… foram substituídos pelos argumentos (Java 15) |
É importante observar que uma cadeia do tipo [String] é imutável; ela não pode ser modificada depois de criada. Quando um método retorna uma cadeia, essa cadeia é diferente da cadeia à qual o método foi aplicado. Assim, [s1.strip()] retorna a cadeia [s2], e [s1] e [s2] são duas cadeias diferentes: [s1] não mudou.
Ao contrário de outras linguagens, uma cadeia Java não é um array: não se escreve [c[i]] mas [c.charAt(i)], e o número de caracteres é obtido com o método [c.length()] (com parênteses, ao passo que o tamanho de um array é o campo [array.length], sem parênteses).
O programa [Strings01.java] é o seguinte:
Resultados:
Comentários:
- linha 6: caractere de número 10, ou seja, o 11º caractere da cadeia;
- Linhas 8, 10: uma busca malsucedida retorna -1;
- Linha 11: os dois parâmetros de [substring] são as posições do primeiro caractere mantido e do primeiro caractere não mantido: isso resulta nos 7 caracteres das posições 4 a 10. Essa é a convenção geral de Java para especificar um intervalo de índices (início incluído, fim excluído): ela aparece em muitos métodos;
- Linhas 16–17: a classe [String] não tem um método de inserção: concatenamos o início da cadeia, o texto inserido e o fim da cadeia. Veremos que a classe [StringBuilder] tem um método [insert];
- Linha 19: [split] divide a cadeia em campos. Seu parâmetro não é um único caractere, mas uma expressão regular, que examinaremos no final do capítulo: ["\\s+"] denota uma sequência de um ou mais caracteres de espaço em branco (espaço, tabulação, quebra de linha etc.). O caractere [\] deve ser duplicado em uma cadeia Java, daí a notação [\\s];
- linha 23: o método estático [join] realiza o inverso de [split];
- linha 24: [strip] (Java 11) remove os espaços iniciais e finais. Existe também o método mais antigo [trim], que reconhece apenas os espaços do código ASCII; [strip] reconhece todos os espaços Unicode e deve ser preferido;
- linha 26: todos os métodos anteriores retornaram novas cadeias: [aString] permaneceu inalterada (linha 22 dos resultados);
- Linhas 30–32: um método do arquivo-fonte compacto, chamado pelo método [main] como no Capítulo 3.
5.2.2. Os métodos split e join
O programa [Strings02.java] realiza uma divisão mais detalhada de uma cadeia em campos:
Resultados:
Comentários:
- Linha 5: os campos são separados pelo caractere [:]. Dois caracteres [:] consecutivos delimitam um campo vazio (linha 4 dos resultados). Mas atenção: [split] remove os campos vazios do final. O [:] final da cadeia delimita um quinto campo, vazio, que foi removido: obtêm-se apenas 4 campos, e [join] não reconstrói a cadeia original (linha 6 dos resultados). Essa é uma armadilha comum;
- linha 13: o segundo parâmetro de [split] é um limite. Um limite negativo instrui o programa a manter todos os campos, inclusive os campos vazios do final: de fato obtemos 5 campos, e [join] reconstrói a cadeia original;
- linha 17: como o separador é uma expressão regular, podemos definir separadores complexos: [":+"] corresponde a um ou mais caracteres [:] consecutivos. Os dois [:]s consecutivos formam um único separador, e o campo vazio desaparece;
- Linha 22: o padrão [\\s*[,;]\\s*] corresponde a uma vírgula ou ponto e vírgula, precedidos e seguidos de qualquer quantidade de espaços: os espaços ao redor dos separadores são removidos junto com eles. Os do início e do fim da cadeia são removidos antes por [strip]. Isso produz os três campos “limpos” em uma única instrução;
- linhas 27–35: para remover tanto os espaços ao redor dos campos quanto os campos vazios, também é possível processar os campos um a um: o campo formado por dois espaços entre duas vírgulas torna-se vazio após [strip] e não é mantido. A lista [ArrayList] usada aqui para armazenar os campos mantidos será discutida um pouco mais adiante. Veremos também que a API Stream permite escrever esse processamento em uma única instrução;
- linha 39: o separador [" | "] contém o caractere [|], que tem um significado especial em uma expressão regular (“ou”). O método [Pattern.quote] converte qualquer cadeia em uma expressão regular que corresponde literalmente a ela. Vamos usá-lo sempre que um separador contiver um dos caracteres [\ ^ $ . | ? * + ( ) [ ] { }];
- Linhas 43–48: [join] aceita apenas cadeias (mais precisamente, objetos [CharSequence], uma interface implementada por [String] e [StringBuilder]): um array de inteiros deve primeiro ser convertido em um array de cadeias. Veremos que, com a API Stream, [Arrays.stream(numbers).mapToObj(String::valueOf).collect(Collectors.joining(" + "))] faz a mesma coisa em uma única instrução.
5.2.3. Pesquisa e comparação de cadeias
A comparação de cadeias é mais sutil do que parece: letras maiúsculas e minúsculas devem ser distinguidas? Como comparar “éclair” com “essay”? E, principalmente, em Java, o que o operador [==] compara? O programa [Strings03.java] demonstra os métodos de pesquisa e comparação:
Resultados:
Comentários:
- linhas 6–9: [contains], [startsWith] e [endsWith] realizam uma comparação exata, caractere por caractere: “LANGUAGE” não é encontrado;
- linhas 12–14: esses métodos não têm uma variante que ignore maiúsculas e minúsculas. A maneira mais simples de fazer uma busca sem diferenciar maiúsculas de minúsculas é converter as duas cadeias em minúsculas;
- linhas 16–17: o método [regionMatches] compara uma parte de uma cadeia com uma parte de outra cadeia. Seu primeiro parâmetro especifica se maiúsculas e minúsculas devem ser ignoradas; os parâmetros seguintes são a posição inicial na cadeia, a outra cadeia, a posição inicial na outra cadeia e o número de caracteres a comparar;
- linhas 20–25: a parte mais importante deste programa. Uma variável do tipo [String] contém uma referência a um objeto cadeia (Capítulo 4). O operador [] compara as referências: ele retorna [true] se as duas variáveis se referem ao mesmo objeto, e não a dois objetos com o mesmo conteúdo. A variável [yes] (linha 21) refere-se a uma cadeia “yes” construída em tempo de execução: esse é um objeto diferente da cadeia literal “yes” do programa, e [yes == "yes"] é avaliada como [false] (linha 9 dos resultados), embora as duas cadeias tenham o mesmo conteúdo. Para comparar conteúdos, sempre usamos o método [equals], ou [equalsIgnoreCase] para ignorar maiúsculas e minúsculas, que é a maneira correta de testar uma resposta “yes” digitada no teclado em maiúsculas ou minúsculas. A comparação com [] “funciona” às vezes, quando ambas as cadeias são literais do programa, dos quais Java armazena uma única instância: é isso que torna o erro difícil de detectar;
- linhas 28–31: o método [compareTo] retorna um inteiro negativo, zero ou positivo conforme a cadeia preceda, seja igual ou suceda a cadeia passada como parâmetro. Ele compara os códigos dos caracteres: “éclair” vem depois de “essay” porque o código do caractere é (233) é maior que o do caractere e (101); aqui, ele retorna a diferença entre os dois códigos, 132. Para ordenar palavras segundo as regras de uma língua, use um objeto [java.text.Collator]: em francês, o caractere “é” é agrupado com “e”, e “éclair” vem antes de “essay” (linha 13 dos resultados). Usaremos a ordem definida por um [Collator] para ordenar palavras destinadas a um usuário, e [compareTo] para comparar identificadores técnicos (nomes de arquivos, chaves etc.);
- linhas 34–40: [isEmpty] verifica se a cadeia está vazia, enquanto [isBlank] (Java 11) verifica se a cadeia está vazia ou contém apenas espaços. Uma variável do tipo [String] também pode ser [null] (nenhuma cadeia): chamar um método em [null] lança uma exceção [NullPointerException]. Por isso, testamos primeiro [missing == null]; graças ao curto-circuito do operador [||], [missing.isBlank()] não é avaliado quando [missing] é [null];
- Linhas 43–44: [String.format("%8s", ...)] preenche uma cadeia com espaços até o comprimento de 8 caracteres, à esquerda ou à direita, usando o formato [%-8s]; [repeat] repete uma cadeia.
5.2.4. Formatos e blocos de texto
Até agora, construímos as cadeias a serem exibidas por concatenação com o operador [+]. Para alinhar valores em colunas, definir o número de casas decimais de um número ou exibir uma data, use o método [String.format] ou o método de instância [formatted] (Java 15), que faz a mesma coisa. O primeiro parâmetro é um formato: uma cadeia na qual os [%[-][width][.precision]conversion] especificadores indicam onde e como inserir os parâmetros seguintes. O programa [Strings04.java] fornece exemplos disso, bem como dos blocos de texto do Java 15:
Resultados:
Comentários:
- linha 12: uma largura alinha o valor à direita em um campo de 10 caracteres; quando precedida pelo [-] símbolo, alinha-o à esquerda;
- Linhas 12–14: as conversões mais comuns:
especificador | Significado | exemplo |
[%s] | string; qualquer objeto é convertido por meio de seu [toString] método | dupont |
[%d], [%5d] | inteiro, possivelmente com 5 caracteres | 45 |
[%05d] | inteiro com pelo menos 5 dígitos, preenchido com zeros | 00045 |
[%X] | inteiro hexadecimal ([%x]: em minúsculas) | 2D |
[%.2f], [%12.2f] | número real com 2 casas decimais, possivelmente com 12 caracteres | 2345.68 |
[%,.2f], [%,d] | igual ao anterior, com separador de milhares | 2,345.68 |
[%e] | número real em notação científica | 2.345678e+03 |
[%n] | quebra de linha do sistema | |
[%%] | o caractere % | % |
- Os números são formatados de acordo com o idioma atual, neste caso o inglês: ponto decimal e vírgula como separador de milhares. Nos formatos franceses das linhas 19–22, o separador de milhares é um espaço: um espaço fino não separável (caractere U+202F), que se parece com um espaço comum, mas impede uma quebra de linha no meio de um número; da mesma forma, um espaço não separável (U+00A0) precede o símbolo € e o símbolo %. Isso deve ser levado em conta ao comparar esses textos com strings escritas com espaços comuns;
- linha 16: ["...".formatted(...)] equivale a [String.format("...", ...)]. Uma expressão condicional pode fornecer um parâmetro;
- linhas 19–22: valores monetários e porcentagens são formatados por objetos [java.text.NumberFormat], obtidos para um determinado idioma e país ([Locale.FRANCE]). O formato de porcentagem multiplica o valor por 100;
- linhas 25–27: as datas da API [java.time] (Java 8) são formatadas por um objeto [DateTimeFormatter] construído a partir de um padrão: [dd] dia, [MM] mês, [yyyy] ano, [HH] hora, [mm] minutos, [ss] segundos, [EEEE] dia da semana por extenso, [MMMM] mês por extenso. Atenção à diferença entre maiúsculas e minúsculas: [MM] é o mês, [mm] são os minutos. Os nomes dos dias e dos meses são os da linguagem cotidiana;
- linhas 30–34: as larguras das colunas permitem exibir os dados em colunas;
- Linha 37: em uma string, o caractere [\] introduz uma sequência de escape ([\n], [\t], [\"]…); para obter o próprio caractere [\] , é preciso duplicá-lo. Java não possui strings "brutas" (raw), nas quais [\] seria um caractere comum, o que torna um pouco incômoda a escrita de caminhos do Windows e de expressões regulares;
- Linhas 41–46: um bloco de texto (Java 15) é delimitado por três aspas; o texto começa na linha seguinte às aspas de abertura. Ele pode se estender por várias linhas e conter aspas sem escape. A indentação comum a todas as linhas (a da linha menos indentada, contando a partir das aspas de fechamento) é removida: o texto JSON é exibido sem a margem do código. As sequências de escape continuam ativas aqui: [\] ainda deve ser duplicada (linha 44). Como as aspas de fechamento estão em uma linha própria, o texto termina com uma quebra de linha: daí o uso de [IO.print] na linha 47 ([IO.println] acrescentaria uma linha em branco após a chave de fechamento);
- linhas 49–50: Java não oferece suporte à interpolação de strings, isto é, a expressões escritas diretamente no texto, como [${name}] em outras linguagens (uma proposta, "String Templates", foi testada como preview no Java 21 e 22 e depois removida). Com um bloco de texto, usam-se marcadores como [%s], [%d]…, preenchidos por [formatted]. Colocar as aspas de fechamento ao final do texto evita uma quebra de linha final.
Há também a classe [java.text.MessageFormat], cujos formatos se referem aos parâmetros pelos seus números: [MessageFormat.format("{0} is {1} years old", name, age)]. Ela é usada em mensagens traduzidas para vários idiomas, nas quais a ordem dos parâmetros pode variar de um idioma para outro.
5.2.5. A classe StringBuilder
Vimos que os métodos da classe [String] aplicados a uma string [s1] retornam outra string [s2]. A classe [java.lang.StringBuilder] permite modificar uma string sem criar uma nova a cada operação. Isso melhora o desempenho ao construir uma string por meio de muitas adições sucessivas, evitando a proliferação de strings de vida muito curta.
A classe oferece diversos construtores:
construtor | função |
[StringBuilder()] | cria um objeto vazio com capacidade inicial de 16 caracteres |
[StringBuilder(String str)] | constrói e inicializa com [str]; a capacidade inicial é o comprimento de [str] mais 16 |
[StringBuilder(int capacity)] | constrói um objeto vazio com capacidade inicial de [capacity] caracteres |
Um objeto [StringBuilder] armazena seus caracteres em um array cujo tamanho — a sua capacidade — é ajustado automaticamente conforme o texto cresce. O programa [Strings05.java] ilustra esse conceito de capacidade:
Resultados:
Comentários:
- linha 3: criação de um objeto [StringBuilder] contendo "test": sua capacidade inicial é 4 + 16 = 20 caracteres;
- linha 4: [length] é o número atual de caracteres; [capacity] é o número de caracteres que o objeto pode conter antes de precisar expandir seu array;
- linha 6: [append] acrescenta uma string ao final do texto;
- linha 10: criação de um objeto [StringBuilder] vazio com capacidade inicial de 10, ao qual "test" é adicionado imediatamente. O método [append] retorna o próprio objeto: ele pode ser chamado diretamente sobre o resultado do construtor.
Os resultados mostram que, quando a capacidade é insuficiente, ela é um pouco mais que dobrada: a nova capacidade é a anterior multiplicada por 2, mais 2 (20, 42, 86 para o primeiro objeto; 10, 22, 46 para o segundo). Cada redimensionamento aloca um novo array e copia os caracteres para ele. Se o tamanho aproximado do texto for conhecido de antemão, defini-lo na construção evita esses redimensionamentos sucessivos.
Eis alguns dos métodos da classe:
método | função |
[StringBuilder append(String str)] | Adiciona [str] ao final do texto. Sobrecarregado para aceitar os tipos [int], [double], [char], [boolean], [Object]… |
[StringBuilder insert(int offset, String str)] | Insere [str] na posição [offset]; sobrecarregado como [append] |
[StringBuilder delete(int start, int end)] | remove os caracteres das posições [start] (inclusive) até [end] (exclusive); [deleteCharAt] remove um único caractere |
[StringBuilder replace(int start, int end, String str)] | substitui os caracteres das posições [start] (inclusive) até [end] (exclusive) por [str] |
[StringBuilder reverse()] | inverte a ordem dos caracteres |
[void setCharAt(int index, char ch)] | substitui o caractere de número [index] por [ch] |
[int indexOf(String str)] | posição de [str] no texto, ou -1 |
[String toString()] | converte o texto em uma string [String] |
O programa [Strings06.java] os utiliza:
Resultados:
Comentários:
- Linha 4: os métodos de modificação retornam o próprio objeto [StringBuilder], o que permite encadeá-los. Acompanhemos as etapas: "test" se torna "testabCD " ([append]), depois "texyZTstabCD" ([insert] na posição 2), depois "xyZTstabCD " ([delete] para os caracteres 0 e 1) e, por fim, "XYZTstabCD" ([replace] para os caracteres 0 e 1, com "XY"). Observe que, ao contrário do método [replace] de [String], o método de [StringBuilder] não procura texto: ele substitui um intervalo de posições. [IO.println] exibe o objeto chamando seu método [toString];
- linha 6: [reverse] inverte o texto. Como [String] não possui um método [reverse], essa é a maneira padrão de inverter uma string;
- linhas 9–12: construção de um texto de várias linhas por adições sucessivas — esse é o uso típico de [StringBuilder]. As adições são encadeadas em uma única linha de código;
- linha 14: [StringBuilder] não tem equivalente a [join]: o resultado de [String.join] é acrescentado;
- linha 17: uma string formatada é adicionada. A conversão [%f] exige um número real: passar o inteiro [total] lançaria uma exceção [IllegalFormatConversionException] em tempo de execução, daí a conversão [(double) total];
- linha 19: o texto final é obtido como uma string [String];
- linhas 24–28: a classe [java.util.StringJoiner] constrói uma string formada por elementos separados por um separador, com prefixo e sufixo opcionais. [String.join] cumpre a mesma função, sem prefixo nem sufixo.
Para poucas concatenações, o operador [+] é suficiente: o compilador as otimiza. [StringBuilder] é necessário quando o número de adições é grande ou desconhecido, tipicamente dentro de um laço: a concatenação [s = s + ...] em um laço de n iterações cria n strings e copia toda a string construída anteriormente a cada iteração. Em códigos mais antigos, você encontrará a classe [StringBuffer], que tem os mesmos métodos de [StringBuilder] mas os torna utilizáveis simultaneamente por várias threads, ao custo de alguma sobrecarga de desempenho: hoje, [StringBuilder] é preferido a ela.
5.2.6. Análise de uma string sem copiá-la
Cada chamada a [substring] cria uma nova string na memória. Em códigos críticos para o desempenho (como a análise de arquivos grandes ou de requisições de rede), pode ser desejável evitar essas criações. Java não possui, na linguagem, um tipo de "visão de um trecho de string", mas vários métodos operam sobre uma parte de uma string sem copiá-la. O programa [Strings07.java] compara as duas maneiras de analisar uma linha no formato "sobrenome:nome:idade":
Resultados:
Comentários:
- linhas 8–9: cada chamada a [substring] cria uma nova string, mesmo que, como no caso da idade, ela seja usada apenas por um instante;
- linha 13: uma versão sobrecarregada de [Integer.parseInt] (Java 9) analisa os caracteres entre duas posições da string, na base especificada (aqui 10), sem criar uma substring;
- linha 15: [regionMatches], que já encontramos, compara uma parte da string com outra string sem copiá-la;
- linha 19: [CharBuffer.wrap] (pacote [java.nio]) retorna uma visão dos caracteres de 0 a [p1] - 1 da string: um objeto que não contém uma cópia dos caracteres, mas oferece uma forma de acessá-los. Ele implementa a interface [CharSequence], assim como [String] e [StringBuilder]: muitos métodos Java aceitam uma [CharSequence] ([String.join], [contains], [append]e as expressões regulares, por exemplo);
- linha 24: uma versão sobrecarregada de [indexOf] (Java 21) limita a busca a um intervalo de posições;
- linha 27: uma string só é criada se for realmente necessária.
Essas técnicas são ferramentas de otimização: para um programa comum, [substring] funciona perfeitamente bem. Desde o Java 9, a máquina virtual também armazena as strings que contêm apenas caracteres do conjunto Latin-1 (como é o caso do texto em francês) com um byte por caractere em vez de dois ("compact strings"), o que reduz pela metade a memória que ocupam. Só tentaremos evitar cópias em códigos cuja criticidade para o desempenho tenha sido medida.
5.3. Arrays
5.3.1. A classe Arrays
Os arrays em Java são objetos, mas não têm métodos úteis: além do campo [length], todas as operações sobre arrays são métodos estáticos da classe utilitária [java.util.Arrays]. Esses métodos permitem ordenar um array, procurar um elemento nele, copiá-lo, preenchê-lo e assim por diante… Quase todos são sobrecarregados: há uma versão para cada tipo primitivo ([int[]], [double[]], [char[]]…) e uma versão para arrays de objetos.
método | função |
[static int binarySearch(int[] a, int key)] | Retorna a posição de [key] em [a], que deve estar ordenado; um número negativo se [key] estiver ausente |
[static int[] copyOf(int[] original, int newLength)] | retorna um novo array de [newLength] elementos contendo os primeiros elementos de [original], preenchido com zeros se necessário ([false] para booleanos, [null] para referências) |
[static int[] copyOfRange(int[] original, int from, int to)] | retorna um novo array formado pelos elementos de [from] (inclusive) até [to] (exclusive) |
[static boolean equals(int[] a, int[] a2)] | Retorna [true] se os dois arrays têm os mesmos elementos na mesma ordem |
[static void fill(int[] a, int val)] | atribui [val] a todos os elementos de [a]; uma sobrecarga preenche apenas um intervalo de índices |
[static void sort(int[] a)] | ordena [a] segundo a ordem natural de seus elementos; uma sobrecarga ordena apenas um intervalo de índices; para um array de objetos, uma sobrecarga recebe um [Comparator] que define a ordem (Capítulo 4) |
[static String toString(int[] a)] | retorna os elementos do array como uma string [[e1, e2, ...]]; [deepToString] faz o mesmo para um array de arrays |
[static <T> List<T> asList(T... a)] | retorna uma lista que é uma visão do array de objetos [a] |
[static IntStream stream(int[] array)] | retorna um stream dos elementos do array (veja a seção API Stream mais adiante) |
Além disso, existe o método [System.arraycopy(source, sourceStart, destination, destinationStart, count)], que copia elementos de um array para outro array já existente.
O programa [Arrays01.java] ilustra o uso de alguns métodos da classe [Arrays]:
Comentários:
- Linhas 18–42: o método [input] insere elementos de um array digitados no teclado. Como o número de elementos não é conhecido de antemão, o programa começa com um array vazio (linha 20) e o expande em um elemento a cada nova entrada (linha 37). O tamanho de um array em Java é fixo na criação: [Arrays.copyOf] na verdade cria um novo array, um elemento maior, e copia para ele os elementos do antigo. Um algoritmo mais eficiente alocaria espaço em grupos de N elementos. Um array não foi concebido para ser expandido: esse cenário é mais bem tratado com uma lista [ArrayList], como veremos em breve;
- linha 39: o último elemento de um array tem o índice [length - 1];
- linhas 30–35: a conversão da string digitada em um número real por [Double.parseDouble], que lança uma exceção [NumberFormatException] se a string não for um número. [Double.parseDouble] não depende do idioma do sistema: sempre espera um ponto decimal e rejeita a entrada "3,6" (linha 5 dos resultados);
- linhas 53–75: o método [search] procura no array os caracteres digitados no teclado. Para um array não ordenado, faz-se uma busca linear (linha 71), que examina os elementos um a um. A classe [Arrays] não tem um método chamado [indexOf]: nós o escrevemos (linhas 78–85). Para um array ordenado, faz-se uma busca binária com [Arrays.binarySearch] (linha 70), que divide o intervalo de busca ao meio a cada passo: ela encontra um elemento entre um milhão em cerca de vinte comparações;
- linha 10: ordenamos o array. Aqui usamos uma variante de [sort] que tem apenas um parâmetro: o array a ser ordenado. A relação de ordem usada para comparar os elementos do array é então a implícita desses elementos: neste caso, a ordem natural dos números;
- Linhas 45–50: exibição de um array. [IO.println] exibe um [double] com ponto decimal, independentemente do idioma da máquina, e sempre com pelo menos uma casa decimal: -7 é exibido como -7.0;
- linhas 88–91: [IO.readln] (Java 25) exibe um prompt e depois lê uma linha digitada no teclado; retorna [null] se a entrada padrão estiver esgotada, por exemplo quando vem de um arquivo;
- linha 94: uma enumeração, declarada no arquivo-fonte compacto da mesma forma que os métodos.
Resultados:
Quando o elemento procurado está ausente, o método [indexOf] retorna -1 e [binarySearch] retorna um número negativo (linha 27): é [-(p + 1)], em que p é a posição em que o elemento deveria ser inserido para manter o array ordenado. Aqui, -3 = -(2 + 1): o número 0 deveria ser inserido na posição 2, entre -1.5 e 3.6. Atenção: [binarySearch] em um array não ordenado retorna um resultado sem sentido.
5.3.2. Outros métodos da classe Arrays
O programa [Arrays02.java] demonstra outros métodos da classe [Arrays]:
Resultados:
Comentários:
- Linha 4: [Arrays.toString] exibe um array em uma única linha. Exibir um array diretamente com [IO.println(numbers)] resultaria em um texto semelhante a [[I@1b6d3586]]: o tipo ([[I]], array de inteiros) e um identificador de objeto, sem seus elementos;
- linha 7: apenas os elementos com índices de 1 a 3 são ordenados, excluindo-se o segundo índice: 10, 30, 20 se tornam 10, 20, 30;
- linha 12: copia os 3 primeiros elementos de [numbers] para o início de [copy], enquanto os demais elementos mantêm seu valor inicial 0;
- linhas 15–16: [copyOf] e [copyOfRange] criam um novo array. Um array maior que o original é preenchido com zeros;
- linhas 19–22: [fill] preenche o array e depois redefine para 0 os elementos dos índices 1 e 2 (excluindo o 3);
- linhas 25–27: assim como nas strings, o operador [==] compara as referências de dois arrays, e não o seu conteúdo: é preciso usar [Arrays.equals];
- linha 31: [Arrays.asList] retorna uma [List] (apresentada na seção seguinte), que é uma visão de um array de objetos: ela não copia o array, mas dá acesso a ele por meio de métodos de lista. Obtêm-se assim [indexOf] e [lastIndexOf] (linha 32);
- linha 35: o método [Collections.reverse] inverte a ordem dos elementos de uma lista. Como a lista é uma visão do array, é o próprio array que é invertido (linha 11 dos resultados). A classe [Arrays] não tem um método de inversão; esse procedimento se aplica apenas a arrays de objetos, e não a arrays de tipos primitivos como [int[]];
- linha 40: um array de strings é ordenado segundo a ordem do método [compareTo] descrito acima, isto é, pelos códigos dos caracteres: as letras maiúsculas (códigos 65 a 90) vêm antes das minúsculas (97 a 122), que vêm antes das letras acentuadas (é: 233). "Zoé" é a primeira palavra e "éclair" é a última;
- linha 43: para ordenar segundo as regras do francês, passamos um objeto do tipo [Collator] — que compara strings — para [sort];
- Linhas 47–50: Java não possui arrays retangulares bidimensionais: [new int[2][3]] cria um array de 2 elementos, cada um dos quais é um array de 3 inteiros. [matrix.length] é o número de linhas, e [matrix[0].length] é o número de elementos da linha 0. [Arrays.deepToString] exibe um array de arrays.
A API Stream, que veremos mais adiante, oferece outras maneiras de procurar, ordenar ou transformar os elementos de um array, por exemplo, [Arrays.stream(numbers).sum()].
5.4. Coleções
Além dos arrays, Java oferece diversas classes para armazenar coleções de elementos. Elas formam o Collections Framework no pacote [java.util], introduzido no Java 1.2 e tornado genérico no Java 5. Ele se organiza em torno de interfaces, que descrevem o que uma coleção faz, e de classes que as implementam, cada uma à sua maneira:
interface | função | Principais implementações |
[List<E>] | uma sequência ordenada de elementos, acessíveis por sua posição | [ArrayList], [LinkedList] |
[Set<E>] | um conjunto: sem duplicatas | [HashSet], [LinkedHashSet], [TreeSet] |
[Map<K,V>] | um dicionário: pares (chave, valor), em que as chaves são únicas | [HashMap], [LinkedHashMap], [TreeMap] |
[Deque<E>] | uma fila de duas pontas, utilizável como fila ou como pilha | [ArrayDeque], [LinkedList] |
[Queue<E>] | uma fila | [ArrayDeque], [PriorityQueue] |
As interfaces [List], [Set] e [Queue] derivam da interface [Collection<E>] ([size], [isEmpty], [contains], [add], [remove], [clear]…), que por sua vez deriva de [Iterable<E>], a interface dos objetos que podem ser percorridos por um laço [for]. A boa prática é declarar variáveis e parâmetros com o tipo da interface e usar o nome da classe apenas no momento da criação: [List<String> cities = new ArrayList<>();]. Isso permite trocar a implementação sem modificar o restante do código.
Uma coleção Java contém apenas objetos. Os genéricos de Java não aceitam tipos primitivos: não se escreve [List<int>] , mas sim [List<Integer>], em que [Integer] é a classe wrapper do tipo [int] (da mesma forma, [Double] para [double], [Boolean] para [boolean]…). O compilador converte automaticamente um [int] em [Integer] em uma atribuição ("autoboxing") e um [Integer] em um [int] em uma leitura ("unboxing"). Essa conversão tem um custo em memória e tempo: uma lista de um milhão de inteiros contém um milhão de objetos [Integer]. Para grandes volumes de números, é preferível usar um array [int[]] ou os streams primitivos ([IntStream]) introduzidos com a API Stream.
O pacote [java.util] também contém as coleções do Java 1.0: [Vector] (uma lista), [Hashtable] (um dicionário) e [Stack] (uma pilha). Elas agora são obsoletas: como são sincronizadas em cada operação, são mais lentas que suas substitutas [ArrayList], [HashMap] e [ArrayDeque]. Não devem mais ser usadas em código novo. Da mesma forma, evite os "raw types" — isto é, coleções genéricas usadas sem parâmetros de tipo ([List list = new ArrayList();]) — como se fazia antes do Java 5: o compilador deixa de poder verificar o tipo dos elementos adicionados e emite um aviso a cada uso.
5.4.1. A interface List e a classe ArrayList
A classe [java.util.ArrayList<E>] implementa uma lista de objetos do tipo [E] cujo tamanho varia durante a execução do programa. Ela armazena seus elementos em um array interno que redimensiona automaticamente, como faz [StringBuilder]. O elemento i de uma lista [l] é obtido por [l.get(i)] e modificado por [l.set(i, value)].
Eis alguns dos métodos da interface [List<E>]:
método | função |
[int size()] | número de itens da lista |
[boolean add(E e)] | Adiciona [e] ao final da lista |
[void add(int index, E element)] | Insere [element] na posição [index] da lista |
[boolean addAll(Collection<? extends E> c)] | adiciona os itens de [c] ao final da lista |
[E get(int index)], [E set(int index, E element)] | lê e substitui o elemento de número [index] |
[E getFirst()], [E getLast()] | o primeiro e o último elementos (Java 21) |
[void clear()] | remove todos os elementos da lista |
[boolean contains(Object o)] | retorna [true] se [o] estiver na lista, [false] caso contrário |
[int indexOf(Object o)] | retorna a posição de [o] na lista, ou -1 se [o] não for encontrado; [lastIndexOf] retorna a última posição |
[boolean remove(Object o)] | remove a primeira ocorrência de [o]; retorna [true] se a operação for bem-sucedida, [false] caso contrário |
[E remove(int index)] | remove o elemento de número [index] e o retorna |
[List<E> subList(int from, int to)] | retorna uma visão dos elementos de [from] (inclusive) até [to] (exclusive) |
[void sort(Comparator<? super E> c)] | ordena a lista segundo a ordem definida por [c]; [sort(null)] usa a ordem natural dos elementos |
[<T> T[] toArray(IntFunction<T[]> generator)] | retorna os elementos da lista como um array (Java 11) |
[static <E> List<E> of(E... elements)] | cria uma lista imutável contendo os elementos informados (Java 9) |
A classe utilitária [java.util.Collections] complementa esses métodos, assim como [Arrays] faz para os arrays: [sort], [binarySearch], [reverse], [shuffle], [max], [min]…
Retomemos o exemplo visto anteriormente com um array e processemo-lo agora com um objeto do tipo [ArrayList<Double>]. Como uma lista se assemelha a um array, o código muda muito pouco. Este é o programa [Collections01.java]:
Comentários:
- linha 22: a lista é criada vazia. O operador diamante [<>] (Java 7) evita repetir o tipo dos elementos: o compilador o infere a partir do tipo da variável;
- linha 39: não é mais necessário cuidar da expansão da lista; ela se expande automaticamente. O valor [element], do tipo [double], é convertido automaticamente em um objeto [Double];
- linha 6: o número de elementos da lista. Ao contrário de [StringBuilder], [ArrayList] não permite descobrir sua capacidade; o método [ensureCapacity] apenas permite defini-la antecipadamente;
- linhas 12, 70, 71: a ordenação e a busca binária são feitas com os métodos estáticos [Collections.sort] e [Collections.binarySearch]; a busca linear, com o método [indexOf] da lista, que os arrays não tinham;
- Linhas 45–50: o método genérico [display] aceita dois parâmetros:
- o primeiro é o texto a ser escrito;
- o segundo é um objeto que implementa a interface genérica [java.lang.Iterable<T>], cujo único método abstrato é [Iterator<T> iterator()].
O laço [for (T element : elements)] é válido para qualquer objeto [elements] que implemente a interface [Iterable<T>], assim como para arrays. Todas as coleções implementam [Iterable]; os arrays, porém, não a implementam, e o método [display] não é adequado para um array: por isso não o utilizamos em [Arrays01.java]. Voltaremos a essa interface com a API Stream.
Resultados:
Os resultados são os mesmos obtidos com o array.
5.4.2. Métodos da interface List
O programa [Collections02.java] usa os outros métodos da interface [List]:
Resultados:
Comentários:
- linha 4: [List.of(...)] (Java 9) cria uma lista somente leitura (veja abaixo); ela é copiada para um [ArrayList], que é gravável. Essa é a maneira mais curta de inicializar uma lista com valores;
- Linhas 8–10: três maneiras de adicionar elementos;
- linha 14: o elemento de número 0 é substituído por [set];
- linha 15: [get] lê um elemento; [getLast] (Java 21) retorna o último elemento, que antes precisava ser escrito como [cities.get(cities.size() - 1)];
- linha 22: [remove] retorna [true] se o elemento foi encontrado e removido;
- linha 27: as strings são ordenadas em sua ordem natural, a de [compareTo];
- linha 31: [subList] retorna uma visão dos elementos 1 e 2 (excluindo o 3), e não uma cópia: modificar a visão modificaria a lista;
- linhas 35–36: conversão de uma lista em um array e de um array em uma lista. O parâmetro de [toArray] é uma referência a construtor [String[]::new], que a lista usa para criar um array de strings do tamanho correto. As referências a métodos e a construtores serão vistas no Capítulo 7;
- Linhas 41–43: uma armadilha com listas de inteiros. A interface [List] tem dois métodos [remove]: [remove(int index)] remove por posição, e [remove(Object o)] remove por valor. Para uma [List<Integer>], [numbers.remove(1)] chama o primeiro e remove o elemento de número 1 (o valor 20). Para remover o valor 1, é preciso passar um objeto [Integer]: [numbers.remove(Integer.valueOf(1))];
- linhas 47–48: [clear] esvazia a lista; [isEmpty] verifica se ela está vazia;
- linha 51: o tipo [List<?>] denota uma lista de elementos de qualquer tipo ("wildcard", Capítulo 4): o método [display] aceita uma [List<String>] da mesma forma que aceitaria uma [List<Integer>]. Uma coleção é exibida diretamente: seu método [toString] retorna seus elementos entre colchetes.
5.4.3. A interface Map e a classe HashMap
A classe [java.util.HashMap<K,V>] permite implementar um dicionário. Um dicionário pode ser visto como um array de duas colunas:
chave | valor |
key1 | value1 |
key2 | value2 |
... | ... |
Na interface [Map<K,V>], as chaves são do tipo [K] e os valores são do tipo [V]. As chaves são únicas: não pode haver duas chaves idênticas (conforme definido pelo método [equals]). Um dicionário desse tipo poderia ter esta aparência se os tipos [K] e [V] se referissem a classes:
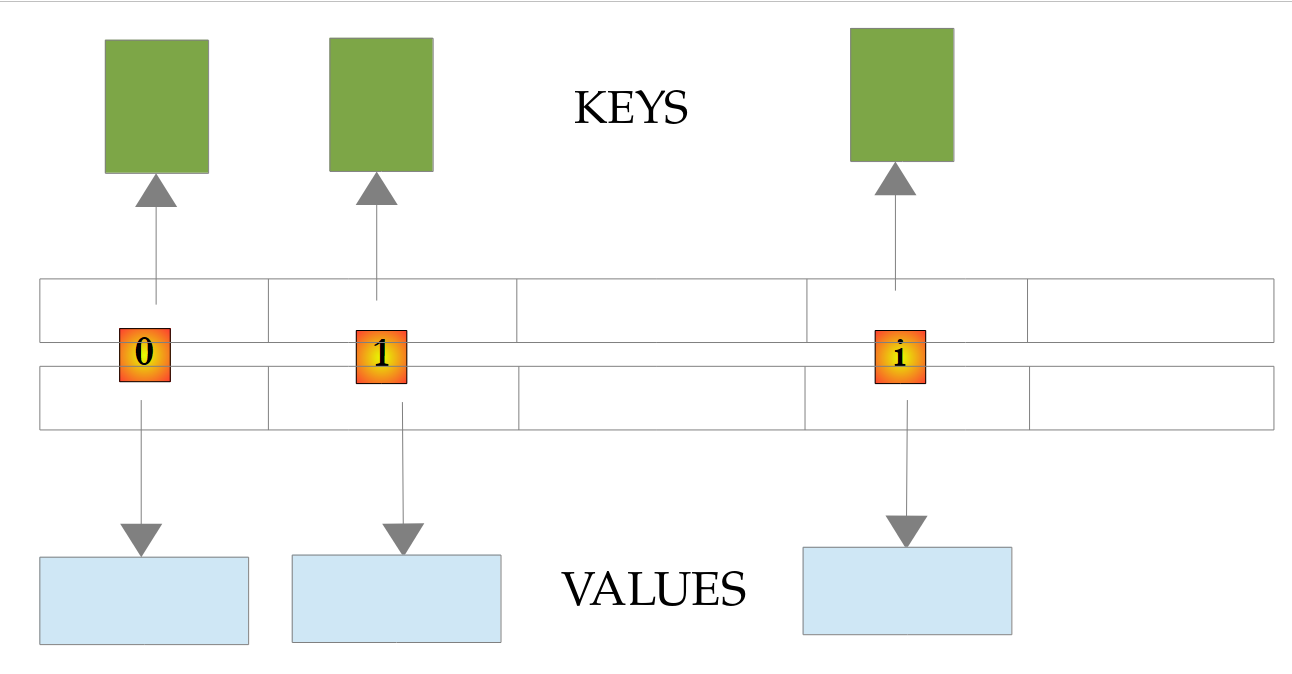
Um [HashMap] armazena seus pares chave-valor em uma tabela hash: a posição de um par chave-valor na tabela é calculada a partir do código hash de sua chave (método [hashCode], Capítulo 4). Recuperar o valor associado a uma chave é, portanto, muito rápido, qualquer que seja o tamanho do dicionário. No entanto, a ordem dos pares chave-valor na tabela não tem relação com a ordem em que foram adicionados.
Os principais métodos da interface [Map<K,V>] são os seguintes:
método | função |
[int size()] | número de pares (chave, valor) do dicionário |
[V put(K key, V value)] | Associa [value] a [key]: adiciona o par se a chave não existir, caso contrário substitui o valor; retorna o valor antigo, ou [null] |
[V putIfAbsent(K key, V value)] | adiciona o par chave-valor somente se a chave não existir; retorna o valor existente, ou [null] |
[V get(Object key)] | retorna o valor associado a [key], ou [null] se a chave não existir |
[V getOrDefault(Object key, V defaultValue)] | igual ao anterior, mas retorna [defaultValue] se a chave não existir |
[boolean containsKey(Object key)] | retorna [true] se [key] for uma chave do dicionário; [containsValue] testa um valor |
[V remove(Object key)] | remove o par chave-valor [key] e retorna seu valor, ou [null] |
[Set<K> keySet()] | todas as chaves do dicionário |
[Collection<V> values()] | a coleção dos valores do dicionário |
[Set<Map.Entry<K,V>> entrySet()] | o conjunto dos pares chave-valor do dicionário; um par [Map.Entry] tem os métodos [getKey] e [getValue] |
[V merge(K key, V value, BiFunction<...> remappingFunction)] | adiciona o par se a chave não existir; caso contrário, substitui o valor pela combinação do valor antigo com [value] |
[void clear()] | remove todas as entradas do dicionário |
Considere o programa de exemplo [Collections03.java]:
Comentários:
- linha 4: um array de strings que será usado para inicializar o dicionário <String,Integer>;
- linha 5: o dicionário, que está vazio;
- linhas 6–9: sua inicialização a partir do array de strings;
- linha 11: o número de pares chave-valor do dicionário;
- linhas 13–15: as chaves e os valores do dicionário. [dico.keySet()] e [dico.values()] são coleções, portanto [Iterable]: o método [display] que já vimos funciona aqui;
- linha 23: remoção de um par do dicionário;
- Linhas 26–28: um dicionário não é, ele próprio, uma coleção, mas [entrySet] retorna o conjunto de seus pares chave-valor, que são do tipo [Map.Entry<K,V>]. Essa abordagem é mais eficiente que a das linhas 18–20, que busca o valor de cada chave com [get];
- linhas 30–31: [put] adiciona um par ou substitui o valor de uma chave existente, sem exceção nem aviso; o valor retornado — o valor antigo ou [null] — indica o que aconteceu;
- linhas 33–34: [putIfAbsent] não substitui o valor de uma chave existente;
- linhas 36–37: ler uma chave inexistente não causa erro: [get] retorna [null]. [getOrDefault] permite escolher o valor retornado nesse caso, e [containsKey] permite verificar se uma chave existe;
- Linhas 39–40: [merge] adiciona a chave "léa" com o valor 1 e soma 1 ao valor da chave "zoé", que já existe. O terceiro parâmetro é a função que combina os valores antigo e novo — neste caso, a soma de dois inteiros — passada como uma referência a método [Integer::sum] (Capítulo 7). Essa é a maneira padrão de contar ocorrências: [counters.merge(word, 1, Integer::sum)];
- linhas 51–56: busca de uma chave no dicionário. [get] retorna um [Integer], e não um [int], porque precisa poder retornar [null]: esse caso é testado antes de o valor ser usado. Escrever [int age = dico.get(searchedName);] geraria uma [NullPointerException] para uma chave ausente durante a conversão automática de [null] em [int].
Resultados:
As chaves não são listadas na ordem em que foram adicionadas, mas na ordem da tabela hash, que depende dos códigos hash das chaves: um [HashMap] não garante nenhuma ordem específica. Se a ordem das chaves importa, use um [LinkedHashMap], que preserva a ordem em que foram adicionadas, ou um [TreeMap], que mantém as chaves ordenadas: eles são mostrados a seguir.
5.4.4. Outras coleções
O pacote [java.util] contém outras coleções, cada uma adaptada a um uso específico:
classe | função |
[HashSet<E>] | um conjunto: sem duplicatas, sem ordem, teste de pertinência muito rápido; operações de conjuntos (união [addAll], interseção [retainAll], diferença [removeAll]) |
[LinkedHashSet<E>] | um conjunto que preserva a ordem em que seus elementos foram adicionados |
[TreeSet<E>] | um conjunto cujos elementos são mantidos ordenados |
[ArrayDeque<E>] | uma fila de duas pontas: quando usada como fila, os elementos são removidos na ordem em que foram adicionados (FIFO, first in first out); quando usada como pilha, o último elemento adicionado é o primeiro a ser removido (LIFO, last in first out) |
[LinkedHashMap<K,V>] | um dicionário que preserva a ordem em que suas chaves foram adicionadas |
[TreeMap<K,V>] | um dicionário cujas chaves são mantidas ordenadas |
[PriorityQueue<E>] | uma fila de prioridade: o elemento removido é o menor segundo a ordem da fila |
[LinkedList<E>] | uma lista duplamente encadeada: inserções e remoções rápidas nas extremidades e durante a travessia |
O programa [Collections04.java] oferece uma visão geral rápida:
Resultados:
Comentários:
- linha 4: um conjunto inicializado com os elementos de uma lista;
- linha 6: [add] retorna [false] se o elemento já está no conjunto, que permanece inalterado;
- Linhas 9–14: [retainAll] mantém apenas os elementos presentes na outra coleção (interseção), enquanto [addAll] adiciona os da outra coleção (união). Esses métodos modificam o conjunto: trabalhamos, portanto, sobre uma cópia de [languages]. [Set.of] (Java 9) cria um conjunto imutável. A ordem em que os elementos de um [HashSet] são exibidos não tem significado;
- linha 16: um
*[TreeSet]* construído a partir do conjunto exibe seus elementos em ordem; - linhas 19–24: [ArrayDeque] usada como fila: [offer] insere um elemento no fim da fila, [poll] remove o elemento mais antigo e [peek] obtém um elemento sem removê-lo. Os operandos da concatenação passada a [IO.println] são avaliados da esquerda para a direita: [peek], depois os dois [poll], depois [size];
- linhas 27–32: [ArrayDeque] é usada como pilha: [push] empilha um elemento e [pop] desempilha o elemento mais recente. A classe [Stack] do Java 1.0 não deve mais ser usada;
- linhas 34–40: em uma pilha vazia, [pop] lança uma exceção [NoSuchElementException], enquanto [poll] retorna [null]. A maioria das operações de [Deque] existe, portanto, em duas versões: uma lança uma exceção ([push], [pop], [getFirst]…), enquanto a outra retorna um valor especial ([offer], [poll], [peek]…);
- linhas 43–48: os pares de um [TreeMap] são listados na ordem das chaves;
- linhas 50–54: os de um [LinkedHashMap] são listados na ordem em que foram adicionados;
- linhas 57–67: uma [PriorityQueue] precisa poder comparar seus elementos. Aqui, ela recebe um [Comparator] que compara prioridades: [Comparator.comparingInt(Emergency::priority)] significa "comparar as urgências com base no valor inteiro retornado por seu [priority] método". Os pacientes recebem alta em ordem crescente de prioridade, independentemente da ordem de chegada. O laço termina quando [poll] retorna [null], indicando que a fila está vazia;
- linhas 71–72: um paciente é representado por um [record] (Capítulo 4).
5.4.5. Coleções imutáveis
Uma classe que gerencia uma coleção frequentemente precisa expô-la externamente sem permitir que seja modificada. Java não possui uma interface "somente leitura" distinta de [List]: uma coleção não modificável implementa a interface [List] completa, mas seus métodos de modificação ([add], [remove], [set]…) lançam uma exceção [UnsupportedOperationException]. Há dois tipos:
- visões não modificáveis, obtidas por meio de [Collections.unmodifiableList(list)] ([unmodifiableSet], [unmodifiableMap]…): elas não copiam a coleção, mas impedem que os destinatários a modifiquem;
- As coleções somente leitura criadas por [List.of(...)], [Set.of(...)], [Map.of(...)] (Java 9), ou copiadas por [List.copyOf(collection)] (Java 10): seu conteúdo é fixado de uma vez por todas.
O programa [Collections05.java] as utiliza:
Resultados:
Comentários:
- linhas 44–61: a classe [Classroom] gerencia uma lista de alunos. A própria lista é privada; apenas o método [enroll] permite modificá-la;
- linhas 49–51: o método [getStudents] retorna uma visão somente leitura da lista. Retornar a própria lista [students] permitiria que o código externo a modificasse sem que a classe soubesse;
- linhas 10–14: a visão tem todos os métodos de
*[List]*, e***[students.add("intruder")]** é aceito pelo compilador; a exceção*[UnsupportedOperationException]é lançada em tempo de execução; - linha 15: a classe real da visão é uma classe interna de [Collections], conhecida apenas por meio da interface [List];
- linhas 17–18: a visão não copia a lista; ela enxerga as alterações feitas pela classe proprietária;
- linhas 54–56 e 21–23: [List.copyOf], por outro lado, retorna uma cópia somente leitura: a lista [copy] não enxerga a adição de "petit";
- linhas 26–33: [Map.of] cria um dicionário somente leitura a partir de pares chave-valor;
- linhas 35–40: as coleções criadas por [of] e [copyOf] rejeitam o valor [null], o que provoca uma [NullPointerException] imediatamente na criação.
O tipo de uma variável como [List<String>] não indica, portanto, se a lista é mutável: cabe à documentação do método que a retorna especificar isso. Uma boa prática comum é retornar coleções imutáveis e criar uma nova coleção sempre que se quiser modificar uma. Os [record], cujos campos são somente leitura, combinam bem com essa prática: [record Classroom(String name, List<String> students)] se beneficia de copiar sua lista em seu construtor com [List.copyOf].
5.4.6. Ordenação, iteração, coleções sequenciadas
O programa [Collections06.java] demonstra três aspectos úteis do trabalho com coleções: escrever um [Comparator], as coleções sequenciadas do Java 21 e a remoção de elementos durante uma iteração:
Resultados:
Comentários:
- Linha 8: o método [sort] de uma lista recebe um [Comparator], um objeto que compara dois elementos (Capítulo 4). O método estático [Comparator.comparing] constrói um comparador a partir de uma função que extrai uma chave de cada elemento — neste caso, o nome ([Student::name] refere-se ao método [name] do record). Os nomes são comparados segundo a ordem natural das strings: "Durand", que começa com letra maiúscula, vem primeiro, e "élise" vem por último;
- linha 10: um segundo parâmetro especifica como comparar as chaves — neste caso, com [Collator] — com a ordem seguindo a de um dicionário francês;
- linhas 12–13: os comparadores são definidos da seguinte forma: [comparingInt] compara as notas, [reversed] inverte a ordem (notas em ordem decrescente) e [thenComparing] acrescenta um critério secundário usado para desempatar alunos com a mesma nota: os nomes, ignorando maiúsculas e minúsculas ([String.CASE_INSENSITIVE_ORDER]). Durand e Martin, que têm ambos nota 15, são classificados pelo nome;
- Linhas 17–25: o Java 21 introduziu as coleções sequenciadas: as interfaces [SequencedCollection], [SequencedSet] e [SequencedMap], implementadas por coleções cujos elementos têm uma ordem definida ([List], [Deque], [LinkedHashSet], [TreeSet], [LinkedHashMap], [TreeMap]…). Elas compartilham métodos comuns para acessar as duas extremidades: [getFirst], [getLast], [addFirst], [addLast], [removeFirst], [removeLast] ([firstEntry], [lastEntry]… para um dicionário), e o método [reversed], que retorna uma visão da coleção em ordem inversa, sem copiá-la. Anteriormente, obter o último elemento de um [LinkedHashSet] exigia percorrer toda a coleção;
- linhas 28–37: não se deve modificar uma coleção enquanto se itera sobre ela com um laço [for]: o iterador usado pelo laço detecta a modificação e lança uma exceção [ConcurrentModificationException] no elemento seguinte. O teste é feito sobre uma cópia da lista;
- linhas 39–44: a abordagem correta é escrever explicitamente o laço com um [Iterator] (apresentado com a API Stream) e remover o elemento atual com o método [remove] do iterador;
- linha 47: de forma mais simples, o método [removeIf] (Java 8) remove os elementos que satisfazem uma condição, expressa por uma função anônima (lambda) [student -> student.grade() < 15], que se lê "a função que associa a um aluno o booleano [student.grade() < 15]". As lambdas serão estudadas em detalhes no Capítulo 7; por ora, basta saber lê-las. Vamos encontrá-las em todas as linhas da próxima seção;
- linha 50: o método
*[forEach]* de qualquer coleção executa uma lambda para cada elemento; - linhas 63–64: chamar o método [toString] em um [record] retorna o nome do record e os valores de seus componentes: [Student[name=Durand, grade=15]].
5.5. A API Stream
A API Stream (pacote [java.util.stream], Java 8) é um conjunto de métodos que permitem processar os elementos de uma coleção como se estivéssemos consultando um banco de dados: filtrar, ordenar, agrupar, calcular totais etc. Um stream [Stream<T>] é uma sequência de elementos do tipo [T] que passam por uma cadeia de operações. Ele é obtido a partir de uma coleção ([list.stream()]), de um array ([Arrays.stream(array)]), de valores ([Stream.of(1, 2, 3)]), de linhas de um arquivo ([Files.lines(path)]), de ocorrências de uma expressão regular e, com o Hibernate (Capítulo 11), de linhas de uma tabela de banco de dados.
Esses streams não devem ser confundidos com os streams de entrada e saída ([InputStream], [OutputStream]) que encontraremos com os arquivos: são dois conceitos sem relação entre si.
5.5.1. As interfaces Iterable e Iterator
Antes de apresentar os streams, retomemos a interface [Iterable<T>], que se aplica a objetos percorridos por um laço [for]. Ela contém apenas um método abstrato, [iterator], que retorna um iterador [Iterator<T>]: um objeto que indica se ainda há elementos ([hasNext]) e retorna o próximo elemento ([next]).
Um objeto [Iterable] não precisa conter seus elementos: seu iterador pode gerá-los um a um, sob demanda. O programa [Streams01.java] fornece um exemplo disso e apresenta um stream infinito:
Resultados:
Comentários:
- linhas 34–64: o record [Evens] implementa a interface [Iterable<Integer>]: seu método [iterator] retorna um iterador que produz os números pares de 0 a [max]. Ele não constrói nenhuma lista: apenas guarda o próximo número a ser gerado (linha 41);
- linha 39: o iterador é uma classe anônima — uma classe sem nome, declarada e instanciada em uma única expressão [new Iterator<>() { ... }], que implementa os dois métodos da interface. Ela tem acesso ao componente [max] do record;
- linhas 44–50: [hasNext] indica se há mais um elemento a gerar;
- linhas 53–61: [next] produz o próximo elemento. Quando chamado depois que não há mais elementos, deve lançar uma [NoSuchElementException];
- linhas 5–7: os resultados (linhas 3–12) mostram que a produção de um elemento pelo iterador e seu consumo pelo laço [for] se alternam;
- linhas 11–15: o que o laço [for] realmente faz: ele solicita um iterador ao objeto, chama [hasNext] enquanto esse método retornar [true] e obtém cada elemento por meio de [next];
- linhas 19–22: uma sequência infinita, a sequência de Fibonacci. [Stream.iterate(seed, function)] produz a semente, depois o resultado da função aplicada à semente, depois o resultado da função aplicada a esse resultado, e assim por diante. Cada elemento aqui é um array de dois números consecutivos da sequência; [map] mantém apenas o primeiro, [takeWhile] interrompe o stream no primeiro número maior que 100 e [forEach] exibe cada número. O stream inteiro nunca é calculado; apenas os elementos solicitados são computados;
- Linhas 26–30: uma lista é [Iterable]. Uma string não é: ela não pode ser percorrida diretamente com [for]. Seu método [chars] retorna o stream de seus caracteres como códigos inteiros, que são então convertidos de volta em strings de um caractere, e [Collectors.joining("-")] os concatena com um separador. Também é possível percorrer o array retornado por ["abc".toCharArray()].
Java não possui uma instrução que permita definir um iterador como um simples método que produz seus elementos um a um ([yield return] em outras linguagens): é preciso implementar a classe do iterador, como mostrado aqui, ou usar os métodos de criação de streams ([Stream.iterate], [Stream.generate]), que também produzem seus elementos sob demanda. Esse mecanismo de geração sob demanda é usado em toda a API Stream.
5.5.2. Filtrar, projetar, ordenar
Os exemplos a seguir trabalham sobre uma pequena lista de pessoas. Uma pessoa é representada por um [record] (Java 16), apresentado no Capítulo 4: em uma única linha, obtemos uma classe com um construtor, métodos de acesso aos componentes ([p.lastName()], [p.age()]…), um método [toString] que exibe os componentes e um operador de igualdade que compara seus valores.
O programa [Streams02.java] demonstra as operações básicas da API Stream:
Resultados:
Comentários:
- linhas 4–11: a lista de pessoas, que não pode ser modificada, criada por [List.of];
- linha 55: o record [Person]. Um arquivo-fonte compacto coloca suas declarações de tipos ao lado de seus métodos;
- Linha 14: [persons.stream()] retorna o stream dos elementos da lista. O método [filter] filtra o stream: ele retém apenas os elementos que satisfazem uma condição. Essa condição lhe é passada na forma de uma lambda [p -> p.age() >= 18], "a função que, para uma pessoa p, retorna o booleano [p.age() >= 18]". [filter] chama essa função para cada pessoa;
- o resultado de [filter] é um novo stream [Stream<Person>]: a lista [persons] permanece inalterada. Isso vale para todas as operações da API Stream;
- Linhas 49–52: o método [display] percorre o stream com a operação [forEach] e exibe cada pessoa com o método [toString] do record: [Person[lastName=dupont, ...]];
- linha 18: o método [map] projeta cada elemento do stream em um novo valor, neste caso uma string. O resultado é um stream [Stream<String>];
- linhas 22–26: as operações retornam streams, aos quais outras operações podem ser aplicadas. As operações costumam ser escritas uma por linha: essa cadeia de chamadas lê-se de cima para baixo como uma receita. [Person::lastName] é uma referência a método, uma notação abreviada para a lambda [p -> p.lastName()];
- linha 25: [sorted] sem parâmetros ordena o stream segundo a ordem natural de seus elementos, neste caso strings;
- linha 26: [toList] (Java 16) coloca os elementos do stream em uma lista imutável. Também encontramos a sintaxe mais antiga [collect(Collectors.toList())], que na prática retorna uma lista mutável (uma [ArrayList]), embora a documentação não garanta isso;
- Linhas 30–31: [sorted] aceita um [Comparator], construído como em [Collections06.java]: idade em ordem decrescente, depois nome em ordem crescente para distinguir pessoas da mesma idade. Durand e Laurent, que têm ambos 32 anos, são ordenados pelo sobrenome (linhas 23–24 dos resultados);
- linha 35: os streams não fornecem as posições de seus elementos. Para numerá-los, percorremos os índices com um stream de inteiros [IntStream.range(0, 3)] (0, 1, 2; o 3 é excluído) e convertemos cada índice em uma string com [mapToObj];
- linhas 39–45: um stream é de uso único: depois de percorrido por uma operação terminal (aqui, [count], que conta os elementos), ele não pode mais ser usado e provoca uma [IllegalStateException]. É preciso solicitar um novo stream à coleção.
Há dois tipos de operações em um stream: as operações intermediárias ([filter], [map], [sorted]…) retornam um novo stream; as operações terminais ([forEach], [toList], [count], [collect]…) percorrem o stream e produzem um resultado. Uma cadeia de operações sempre termina com uma operação terminal. Diferentemente de outras linguagens, Java não possui uma sintaxe de consulta semelhante ao SQL: o processamento é sempre escrito como uma cadeia de chamadas de métodos.
5.5.3. Quantificadores, agregados, seleção de elementos
O programa [Streams03.java] inclui operações que retornam um único valor e operações que selecionam uma parte do stream:
Resultados:
Comentários:
- linhas 13–15: [anyMatch] retorna [true] se pelo menos um elemento satisfaz a condição, [allMatch] se todos a satisfazem e [noneMatch] se nenhum a satisfaz;
- linhas 18–19: [count] conta os elementos do stream; para contar os que satisfazem uma condição, o stream é filtrado primeiro. Para uma coleção, o método [size] é obviamente preferível a [stream().count()];
- linhas 20–22: [mapToInt(Person::age)] transforma o stream de pessoas em um [IntStream], um stream de valores [int], que possui métodos de cálculo: [sum], [average], [min], [max]. [average] retorna um [OptionalDouble], porque a média de um stream vazio não existe; [orElse(0)] fornece o valor a ser usado nesse caso;
- linhas 23–24: [summaryStatistics] calcula a contagem, a soma, o mínimo, a média e o máximo em uma única passagem;
- linhas 26–28: [min] e [max], derivados de um [Stream], recebem um [Comparator] e retornam o elemento mínimo ou máximo (neste caso, a pessoa), e não o valor da chave. O resultado é um [Optional<Person>]: uma caixa contendo uma pessoa, ou uma caixa vazia se o stream estava vazio. [get] retorna o conteúdo da caixa;
- linhas 31–34: [findFirst] retorna o primeiro elemento do stream, em um [Optional]; quando filtrado, o stream retorna o primeiro elemento que satisfaz uma condição. Para o último elemento de uma lista, basta o método [getLast] da lista;
- linhas 35–37: não há ninguém em Brest: [Optional] está vazio ([isPresent] retorna [false]). Em vez de testá-lo, nós o transformamos: [map(Person::lastName)] transforma seu conteúdo, se houver; [orElse("nobody")] fornece o valor a usar se estiver vazio;
- linhas 38–43: [orElseThrow] retorna o conteúdo do [Optional], ou lança uma [NoSuchElementException] se ele estiver vazio. É usado quando a ausência de um valor constitui um erro. [get], usado anteriormente, faz o mesmo, mas seu nome não indica que pode lançar uma exceção; [orElseThrow] é preferido. Não existe nenhuma operação que exija que um stream tenha exatamente um elemento; é possível verificar o tamanho da lista retornada por [toList];
- linha 46: [distinct] remove as duplicatas (conforme definido pelo método [equals]);
- linhas 49–50: não existe uma operação pronta para manter uma pessoa por cidade. Aqui, usamos um conjunto de cidades já encontradas: [add] retorna [true] para uma cidade nova (a pessoa é mantida) e [false] para uma cidade já encontrada. Uma lambda que modifica uma variável externa, como esta, deve ser reservada para streams processados sequencialmente, que é o comportamento padrão;
- linhas 54–58: [limit(n)] mantém os n primeiros elementos, enquanto [skip(n)] os descarta. Combinados, extraem uma "página" de resultados. [takeWhile] (Java 9) mantém os elementos enquanto uma condição for verdadeira e para no primeiro elemento que não a satisfaz; [dropWhile] faz o oposto: descarta esses elementos e mantém todos os seguintes;
- Linha 61: a operação [gather] (Java 24) aplica ao stream um coletor intermediário ("gatherer"), que pode agrupar, acumular ou filtrar elementos com base nos elementos anteriores. A classe [Gatherers] fornece vários deles; [Gatherers.windowFixed(3)] divide o stream em listas de 3 elementos, sendo que a última lista pode ser menor. Há outros, como [windowSliding(n)] (janelas deslizantes), e é possível escrever os seus próprios.
5.5.4. Records locais, agrupamentos, junções
O programa [Streams04.java] realiza operações mais complexas, a maioria das quais é feita com a operação terminal [collect] e com os coletores da classe [Collectors]:
Resultados:
Comentários:
- Linhas 18–19: um record local (Java 16), declarado dentro do método em que é usado. Ele permite atribuir um nome e um tipo aos resultados intermediários de um processamento sem precisar declarar uma classe no programa: na linha 23, cada pessoa com mais de 40 anos é convertida em um [Summary] que retém apenas os dados relevantes;
- linhas 28–29: o coletor [groupingBy] agrupa elementos com a mesma chave — neste caso, a cidade. O resultado é um dicionário do tipo [Map<String, List<Person>>]: cada cidade é associada a uma lista de seus moradores. Sem outros parâmetros, [groupingBy] cria um [HashMap], no qual a ordem das chaves é imprevisível; aqui pedimos que ele crie um
*[LinkedHashMap]*(***[LinkedHashMap::new]***, referência a construtor), que mantém as cidades na ordem de sua primeira aparição. O terceiro parâmetro é o coletor aplicado aos elementos de cada grupo, neste caso*[toList]*; - linhas 30–32: o método [forEach] de um dicionário recebe uma lambda com dois parâmetros: a chave e o valor. Para cada grupo, ele exibe o tamanho, a idade média e os nomes; o coletor [Collectors.joining(", ")] concatena strings usando um separador;
- linhas 36–40: a API Stream não tem uma operação de junção (join). Ela é obtida com [flatMap], que substitui cada elemento por um stream e depois concatena todos esses streams: cada pessoa é substituída pelo stream das cidades com o mesmo nome que o dela (uma ou nenhuma), convertidas em strings. Como em uma junção interna (inner join) do SQL, apenas os pares correspondentes são mantidos: Laurent, que mora em Lyon — ausente da lista de cidades — não aparece, nem Brest, que não tem moradores. Esse código percorre a lista inteira de cidades para cada pessoa;
- linhas 42–47: a mesma junção, porém mais eficiente: o coletor [toMap] constrói um dicionário de cidades, em que a chave é o nome da cidade ([City::name]) e o valor é a própria cidade ([v -> v]); em seguida, procuramos nesse dicionário a cidade de cada adulto. Uma chave duplicada faria [IllegalStateException] ser lançada por [toMap];
- linhas 50–54: [toList] e [toMap] realizam o processamento e armazenam os resultados em uma lista e em um dicionário, respectivamente;
- linhas 55–59: [partitioningBy] divide os elementos em dois grupos com base em uma condição; o resultado é um dicionário cujas chaves são [true] e [false]. O coletor [mapping(Person::lastName, toList())] converte cada pessoa em seu nome antes de adicioná-la à lista de seu grupo;
- linhas 62–68: o terceiro parâmetro de [groupingBy] pode ser qualquer collector, aplicado a cada grupo: [counting] conta os elementos do grupo, [summingInt] soma um valor inteiro ([averagingInt] calcula a média, [maxBy] encontra o máximo…). Com [TreeMap::new], as cidades ficam ordenadas;
- linhas 72–73: a posição de cada elemento em um stream filtrado: o stream é armazenado em uma lista e, em seguida, os índices são percorridos.
5.5.5. Avaliação tardia
As operações intermediárias de um stream não são executadas quando são escritas, mas quando uma operação terminal percorre o stream: é a chamada “avaliação tardia” (lazy evaluation). O programa [Streams05.java] demonstra isso com expressões lambda que exibem o que fazem:
Resultados:
Comentários:
- linhas 7–15: um stream que mantém os números pares e depois calcula seus quadrados. As lambdas aqui são escritas com um corpo entre chaves, que exibe uma mensagem antes de retornar seu valor com [return];
- Linha 3 dos resultados: depois de definir o fluxo, nada foi exibido: nem [filter] nem [map] processou ainda um único elemento. [evenSquares] não contém resultados, mas sim uma descrição de um cálculo;
- Linhas 4–16 dos resultados: o cálculo é executado durante a operação terminal [forEach], elemento por elemento: cada número passa por [filter], depois por [map] se for par, e então chega a [forEach] antes que o número seguinte seja examinado. Nenhuma lista intermediária é construída;
- linhas 23–26: como um stream só pode ser percorrido uma vez, armazenamos em vez disso o meio de criá-lo: uma lambda sem parâmetros [() -> numbers.stream().filter(...)], do tipo [Supplier<Stream<Integer>>], cujo método [get] cria um novo stream a cada chamada. O fluxo criado após a adição de 10 leva em conta esse novo elemento;
- linhas 29–31: [toList] executa o processamento e armazena seus resultados: [snapshot] é uma lista que não enxerga a adição de 20;
- linhas 35–42: [findFirst] interrompe a iteração assim que encontra um elemento: os números posteriores a 3 nunca são examinados. [anyMatch], [limit], [takeWhile]… também interrompem a iteração o mais cedo possível; é isso que permite processar streams infinitos;
- Linhas 46–49: algumas operações intermediárias não conseguem processar os elementos um a um: [sorted] precisa conhecer todos os elementos para transmitir o menor deles. A operação [peek], que executa uma lambda em cada elemento à medida que ele passa, sem modificá-lo, mostra que os três elementos são recebidos por [sorted] antes que ele transmita um único;
- linhas 52–55: os streams primitivos [IntStream], [LongStream], e [DoubleStream] evitam a criação de objetos [Integer], [Long]e [Double]. [IntStream.rangeClosed(1, 10)] gera os inteiros de 1 a 10 (inclusive). [boxed] converte um [IntStream] em [Stream<Integer>], e [asDoubleStream] em [DoubleStream]. Um [double] concatenado com uma string é exibido com todas as suas casas decimais e um ponto decimal; para limitar o número de casas decimais, usaríamos [formatted].
A avaliação tardia tem duas consequências práticas:
- um stream só pode ser percorrido uma vez. Se o resultado de um cálculo for necessário várias vezes, ele é armazenado em uma lista com [toList];
- as operações podem ser encadeadas sem custo: encadear [filter], [map]e [limit] não cria nenhuma coleção intermediária, e apenas os elementos necessários são calculados.
Por fim, observe que o método [parallelStream] de uma coleção retorna um stream cujos elementos são processados simultaneamente por várias threads (Capítulo 8). Ele só acelera operações demoradas sobre grandes volumes de dados e exige lambdas sem efeitos colaterais: deve ser usado somente depois de avaliar seus benefícios. Encontraremos a API stream ao longo de todo o curso e, no Capítulo 7, veremos como as interfaces funcionais que ela utiliza são construídas.
5.6. Arquivos de texto
Java possui dois pacotes de API para arquivos: o pacote [java.io], disponível desde o Java 1.0 ([File], [FileReader], [FileInputStream]…), e o pacote [java.nio.file], introduzido com o Java 7 ([Path], [Files]…). Este último é mais completo e oferece melhor relato de erros: é o que se deve usar hoje. Ele se apoia nas classes de leitura e escrita de [java.io] ([BufferedReader], [BufferedWriter]…), que são obtidas por meio de métodos da classe [Files].
Um arquivo é representado por um objeto [java.nio.file.Path], criado por [Path.of("infos.txt")] (Java 11). Um caminho relativo, como este, é completado pelo diretório atual do programa, aquele a partir do qual ele foi iniciado.
Desde o Java 18 (JEP 400), a codificação padrão dos arquivos de texto é UTF-8, independentemente do sistema operacional. Antes, ela dependia do sistema (frequentemente Windows-1252 no Windows em francês), e o mesmo programa podia interpretar o mesmo arquivo de maneira diferente conforme a máquina. Os métodos da classe [Files] já usavam UTF-8 por padrão desde o Java 8.
5.6.1. A classe BufferedReader
A classe [java.io.BufferedReader] permite ler o conteúdo de um arquivo de texto linha por linha. Na verdade, ela é capaz de processar fluxos que não são arquivos (uma conexão de rede, por exemplo). Ela lê o arquivo em blocos, que armazena em um buffer: a maior parte das leituras é feita em memória, sem acesso ao disco.
Método | Papel |
[static BufferedReader Files.newBufferedReader(Path path)] | abre o arquivo [path] para leitura em UTF-8; uma sobrecarga permite especificar a codificação: [Files.newBufferedReader(path, StandardCharsets.ISO_8859_1)] |
[String readLine()] | retorna a próxima linha do fluxo, sem o marcador de fim de linha, ou [null] se o fim do fluxo foi atingido |
[int read()] | retorna o próximo caractere do fluxo, ou -1 no fim do fluxo |
[Stream<String> lines()] | retorna as linhas restantes como um stream da API stream |
[void close()] | fecha o fluxo e libera os recursos alocados para seu gerenciamento. Isso deve ser feito após o processamento do fluxo, o que é tratado pela instrução [try] com recursos |
O programa [Files01.java] é o seguinte:
Comentários:
- linha 2: o método [main] recebe aqui os argumentos da linha de comando, no array [args];
- Linha 4: exibe o nome da pasta atual, aquela a partir da qual o comando [java] foi iniciado. [Path.of("")] designa a pasta atual; [toAbsolutePath] a converte em um caminho completo, do qual [getFileName] mantém apenas o último elemento, para não poluir os resultados com um caminho completo;
- linha 6: o arquivo lido é [infos.txt] ou aquele passado como argumento. Como se trata de um caminho relativo, ele é procurado no diretório atual;
- linha 10: a instrução [try (resource declaration) { ... }], conhecida como bloco “try-with-resources” (Java 7), garante que o fluxo seja fechado ao sair do bloco, mesmo que ocorra uma exceção dentro dele. Ela elimina a necessidade de chamar explicitamente o método [close]. Aplica-se a qualquer objeto que implemente a interface [AutoCloseable], isto é, qualquer objeto com um método [close] que libere recursos (arquivo, conexão de rede, conexão com banco de dados etc.). Antes do Java 7, o fluxo tinha de ser fechado em uma cláusula [finally] após verificar que ele havia de fato sido aberto;
- linhas 13–15: o arquivo é lido linha por linha. A atribuição [line = reader.readLine()] é uma expressão cujo valor é o de [line]: ele é comparado a [null], que indica o fim do arquivo;
- Linha 20: [Files.readString] (Java 11) lê o arquivo inteiro de uma só vez e o fecha;
- Linhas 21–27: os erros de entrada/saída são sinalizados por exceções derivadas de [java.io.IOException]. Trata-se de exceções checked (Capítulo 4): o compilador exige que sejam capturadas ou declaradas. Um arquivo ausente provoca uma [NoSuchFileException], que é derivada dela; portanto, ela deve ser capturada primeiro. Seu método [getFile] retorna o caminho do arquivo procurado. As classes mais antigas de [java.io] relatam o mesmo erro como uma [FileNotFoundException].
O arquivo [infos.txt] é o seguinte:
Ele está localizado na pasta [05-classes-java], a partir da qual o programa é executado:
Com um arquivo que não existe:
Quando se usa uma pasta em vez de um arquivo, a operação de leitura provoca outra exceção, [IOException], cuja mensagem é fornecida pelo sistema operacional:
Escolher o diretório atual para localizar os arquivos de dados é natural para um arquivo-fonte compacto executado a partir de seu próprio diretório. Em um projeto Maven, o comando [mvn exec:java] é executado no diretório do projeto: é ali que colocaremos os arquivos de dados da aplicação de exemplo.
5.6.2. A classe BufferedWriter
A classe [java.io.BufferedWriter] permite escrever em um arquivo de texto. Assim como [BufferedReader], ela usa um buffer e é capaz de lidar com fluxos que não são arquivos.
Método | Papel |
[static BufferedWriter Files.newBufferedWriter(Path path)] | Abre o arquivo [path] para escrita em UTF-8. O arquivo é criado ou, se já existir, é esvaziado. Parâmetros opcionais permitem especificar a codificação e o modo de abertura: [Files.newBufferedWriter(path, StandardOpenOption.APPEND)] acrescenta as escritas ao final do arquivo existente |
[void write(String str)] | escreve [str] no arquivo |
[void newLine()] | escreve um caractere de fim de linha: o padrão do sistema, “\r\n” no Windows, “\n” no Linux e no macOS |
[void flush()] | escreve o conteúdo do buffer no arquivo sem esperar que ele esteja cheio |
[void close()] | fecha o fluxo após escrever o conteúdo do buffer no arquivo. Isso deve ser feito após o processamento do fluxo |
As escritas em um [BufferedWriter] não são imediatas: o texto é escrito primeiro no buffer e depois no arquivo, quando o buffer está cheio, quando é descarregado explicitamente com o método [flush] ou quando o fluxo é fechado. Este é o modo mais eficiente para arquivos, pois minimiza os acessos ao disco. Ele não é adequado a todos os fluxos de dados, em particular aos fluxos de rede: em um diálogo entre dois parceiros, o que um escreve deve ser lido imediatamente pelo outro, e o buffer deve ser descarregado após cada mensagem. A classe [java.io.PrintWriter], que usaremos mais adiante, acrescenta os métodos [print], [println]e [printf], e pode descarregar automaticamente seu buffer após cada chamada a [println] (construtor [new PrintWriter(writer, true)]).
O programa [Files02.java] é o seguinte:
Resultados:
Comentários:
- linha 6: mais uma vez, usamos a instrução [try] com recursos para não precisar fechar o fluxo explicitamente. O fechamento ocorre automaticamente ao final do bloco (chave de fechamento na linha 19). É esse fechamento que grava no arquivo o texto restante no buffer; sem ele, o arquivo poderia ficar incompleto;
- linha 7: a codificação padrão, UTF-8;
- linhas 16–17: escreve uma linha no arquivo de texto, seguida de uma quebra de linha;
- linha 22: o método [Files.size] retorna o tamanho de um arquivo em bytes. Os 18 bytes se decompõem assim: 16 caracteres, mais duas quebras de linha de um byte (“\n” no Linux, onde os testes foram executados; no Windows, cada quebra de linha “\r\n” ocuparia 2 bytes);
- Linha 24: por que [try / catch]? Poderíamos usar um nome de arquivo na forma [folder1/folder2/file] com uma pasta chamada [folder1/folder2] que não existe, o que tornaria impossível criar o arquivo. Uma exceção [NoSuchFileException], derivada de [IOException], seria então lançada. Há outros cenários possíveis de exceção (disco cheio, permissões insuficientes etc.). De qualquer modo, o compilador exige que as exceções checked [IOException] lançadas por [newBufferedWriter], [write], ou [size] sejam tratadas.
5.6.3. As classes Files e Path
Para as operações comuns, a classe utilitária [Files] dispensa o tratamento de fluxos: um único método abre o arquivo, lê ou escreve todo o seu conteúdo e depois o fecha. Ela também permite criar, copiar, mover e excluir arquivos e pastas. A interface [Path] trata dos caminhos.
Método | Papel |
[Files.readString(path)] | retorna o conteúdo do arquivo como uma string (Java 11) |
[Files.readAllLines(path)] | retorna as linhas do arquivo em uma lista [List<String>] |
[Files.lines(path)] | retorna as linhas do arquivo como um stream ([Stream<String>]) lido sob demanda e que deve ser fechado após o uso |
[Files.writeString(path, text, options...)] | cria (ou sobrescreve) o arquivo e escreve nele [text] (Java 11); com a opção [StandardOpenOption.APPEND], acrescenta o texto ao final do arquivo |
[Files.write(path, lines, options...)] | escreve uma coleção de linhas, cada uma seguida de uma quebra de linha |
[Files.readAllBytes(path)], [Files.write(path, bytes)] | lê e escreve o arquivo como um array de bytes |
[Files.exists(path)], [Files.size(path)], [Files.delete(path)], [Files.copy(source, target)], [Files.move(source, target)] | verifica se um arquivo existe, retorna seu tamanho, exclui, copia, move |
[Files.createDirectories(path)] | cria a pasta e suas pastas pai, caso não existam |
[Files.list(folder)], [Files.walk(folder)] | os elementos da pasta e de toda a sua estrutura em árvore, na forma de um stream [Stream<Path>] |
[path.resolve(other)] | constrói um caminho acrescentando [other] a [path], usando o separador do sistema |
[path.getFileName()], [path.getParent()], [path.toAbsolutePath()] | o nome do arquivo, sua pasta e seu caminho completo |
O programa [Files03.java] os utiliza:
Resultados:
Comentários:
- Linha 2: os métodos de [Files] throw [IOException]. Para manter este programa de demonstração enxuto, o método [main] as declara por meio da cláusula [throws IOException] em vez de interceptá-las: um erro encerraria o programa e exibiria a exceção;
- Linhas 4–8: [resolve] usa o separador de caminho do sistema. As execuções do curso foram feitas no Linux: o caminho resultante é [data/cities.txt]; no Windows, seria [data\cities.txt]. Construir caminhos com [resolve] (ou [Path.of("data", "cities.txt")]) em vez de concatenar strings torna o código portável. Como [Path] não tem um método que retorne a extensão de um arquivo, ela é separada do nome com [lastIndexOf];
- Linha 11: criar a pasta [data] não provoca erro se ela já existir;
- Linhas 14–21: escrita, acréscimo e leitura, cada uma em uma única instrução;
- Linhas 23–26: [Files.lines] retorna um stream: as linhas são lidas uma a uma à medida que o programa as processa. É possível aplicar a API stream a ele e, assim, processar um arquivo de vários gigabytes sem carregá-lo na memória, o que [readAllLines] faria. O stream mantém o arquivo aberto: ele deve ser fechado, daí a instrução [try] com recursos ([Stream] implementa [AutoCloseable]);
- linhas 29–37: o mesmo texto “café” é escrito em três codificações e, em seguida, os bytes dos arquivos são exibidos em hexadecimal com a classe [HexFormat] (Java 17):
- Em UTF-8, a codificação padrão do Java, os caracteres acentuados ocupam 2 bytes (é = C3 A9) e os demais 1 byte: 5 bytes para 4 caracteres;
- em UTF-8 com BOM (Byte Order Mark), o arquivo começa com os 3 bytes EF BB BF, que sinalizam aos programas que o arquivo está codificado em UTF-8. O Java nunca escreve o BOM por conta própria: ele é obtido escrevendo o caractere U+FEFF no início do texto, denotado por [""];
- em Latin-1 (ISO-8859-1), a codificação tradicional dos textos da Europa Ocidental, cada caractere ocupa um byte (é = E9);
- Linhas 39–44: ler um arquivo com uma codificação diferente da usada para escrevê-lo altera os caracteres acentuados: o byte E9 no final do arquivo é inválido em UTF-8. [Files.readString] e [Files.readAllLines] rejeitam tal arquivo lançando uma exceção [MalformedInputException] (derivada de [IOException]);
- Linhas 46–47: a conversão de um array de bytes em string pelo construtor [new String(bytes, encoding)] é menos rigorosa: cada byte inválido é substituído pelo caractere �. Um [InputStreamReader] se comporta da mesma maneira; já o [BufferedReader] retornado por [Files.newBufferedReader] é rigoroso, como [Files.readString], e também lança uma [MalformedInputException];
- linha 48: lido com a codificação correta, o arquivo está correto;
- linha 50: na leitura, o Java não reconhece o BOM: ele é lido como um caractere invisível no início do texto, que passa a ter 5 caracteres em vez de 4. Se for preciso ler arquivos UTF-8 gerados com BOM (por certos programas do Windows), é necessário remover esse caractere por conta própria. Hoje, a regra é simples: escreva e leia arquivos de texto em UTF-8, sem BOM;
- linhas 53–59: os arquivos da pasta. [Files.list] retorna um stream que deve ser fechado, assim como o de [Files.lines], e não garante a ordem dos nomes: [sorted] os ordena;
- linhas 62–67: exclusão da pasta. [Files.delete] se recusa a excluir uma pasta não vazia: percorremos toda a árvore de diretórios com [Files.walk] e ordenamos os caminhos em ordem inversa ([Comparator.reverseOrder()]) para excluir o conteúdo de uma pasta antes da própria pasta.
Os métodos de [Files] bloqueiam a thread que os chama até que a operação termine. No Capítulo 9, dedicado à programação assíncrona, veremos como evitar bloquear um programa durante uma operação de E/S demorada.
5.7. Arquivos binários
5.7.1. As classes DataOutputStream e DataInputStream
As classes [java.io.DataOutputStream] e [java.io.DataInputStream] servem para escrever e ler arquivos binários. Em tal arquivo, os dados não são escritos como texto, mas em sua forma interna: um [int] ocupa sempre 4 bytes, qualquer que seja seu valor. Trata-se de fluxos de bytes: eles derivam das classes [OutputStream] e [InputStream], ao passo que os fluxos de texto derivam de [Writer] e [Reader].
Considere a seguinte aplicação:
O arquivo de texto [persons1.txt] tem o seguinte conteúdo:
O programa [Files04.java] é o seguinte:
Vejamos mais de perto as operações relacionadas à classe [DataOutputStream]:
- Linhas 13–14: o objeto [DataOutputStream] é construído em torno de outro fluxo de bytes, seguindo o princípio de fluxos aninhados (o padrão de projeto “decorator”):
- [Files.newOutputStream(Path.of(args[1]))] escreve um fluxo de bytes no arquivo, que é criado ou esvaziado se já existir;
- [BufferedOutputStream] acrescenta um buffer a ele, para não acessar o disco a cada escrita;
- [DataOutputStream] acrescenta métodos para escrever os tipos de dados básicos;
- Linhas 50–51: as operações de escrita. A classe [DataOutputStream] tem um método por tipo de dado simples: [writeInt], [writeDouble], [writeLong], [writeBoolean], [writeUTF] para uma string…;
- Linhas 12–15: os três fluxos são abertos em uma única instrução [try] com recursos, com suas declarações separadas por ponto e vírgula. Eles serão fechados ao final do bloco [try], na ordem inversa àquela em que foram abertos. Fechar o fluxo mais externo ([DataOutputStream]) fecha os fluxos que ele contém. O arquivo de log é escrito por meio de um [PrintWriter], para aproveitar o método [println];
- linha 27: o separador é o caractere [:], cercado por eventuais espaços, que são removidos junto com ele;
- Linhas 42–47: a idade deve ser um inteiro positivo ou zero. O Java não possui um método que converta uma string em inteiro sem lançar uma exceção em caso de erro: o método [integer] (linhas 67–73) captura a exceção [NumberFormatException] e retorna -1, que é um valor inválido para uma idade;
- linhas 9, 59, 62: [System.exit(n)] encerra o programa com o código de saída n, que um script pode verificar (0: sucesso; é o código de saída de um programa cujo método [main] termina normalmente).
Os três argumentos do programa são passados após o nome do arquivo-fonte no comando [java]. Os resultados são os seguintes:
O arquivo de log [logs.txt] tem o seguinte conteúdo:
O conteúdo do arquivo binário [persons1.bin] pode ser exibido em hexadecimal com o comando Linux [od] (no Windows, o comando PowerShell [Format-Hex] produz uma exibição semelhante):
Isso mostra como [DataOutputStream] escreve os dados:
- uma string é escrita por [writeUTF], precedida de seu comprimento em bytes, em 2 bytes: 00 04, seguido dos 4 bytes de “paul” (70 61 75 6c). Os caracteres são codificados com uma variante do UTF-8;
- um inteiro [int] é escrito em 4 bytes, com o byte mais significativo primeiro (a chamada ordem “big-endian”, usada em protocolos de rede): 10 é escrito como 00 00 00 0a. Esse formato é o mesmo em todas as máquinas: um arquivo escrito por [DataOutputStream] no Windows pode ser lido no Linux;
- os dados são escritos consecutivamente, sem separadores nem quebras de linha: o arquivo tem 48 bytes (linha 5: com a opção [-A d], [od] exibe as posições em decimal).
Para ler esse arquivo, é preciso, portanto, conhecer a ordem e o tipo exatos dos dados escritos. Para cada método [writeXX] de [DataOutputStream], a classe [DataInputStream] possui um método correspondente [readXX]: [readUTF], [readInt], [readDouble]… No entanto, ela não consegue indicar quantos bytes ainda restam a ler: um arquivo lido por [DataInputStream] deve começar com o número de registros que contém, ou ser lido até que ocorra a exceção [EOFException], que sinaliza o fim do fluxo. Porém, uma exceção deve continuar sendo excepcional, e o fim de um arquivo não é.
5.7.2. A classe RandomAccessFile
A classe [java.io.RandomAccessFile] lê e escreve em um arquivo por acesso direto: é possível posicionar o cabeçote de leitura/escrita em qualquer ponto do arquivo antes de ler ou escrever. Ela tem os mesmos métodos de leitura e escrita que [DataInputStream] e [DataOutputStream] (ela implementa as mesmas interfaces, [DataInput] e [DataOutput]) e, além disso:
Método | Papel |
[RandomAccessFile(String name, String mode)] | abre o arquivo para leitura ([mode] "r") ou para leitura e escrita ("rw") |
[long length()] | o tamanho do arquivo, em bytes |
[long getFilePointer()] | a posição atual no arquivo |
[void seek(long pos)] | move para a posição [pos] no arquivo |
O programa [Files05.java] executa a operação inversa à do programa anterior: ele lê o arquivo binário para criar um arquivo de texto. Se o arquivo de texto resultante contiver os dados corretos do arquivo original, saberemos que a conversão texto → binário → texto foi bem-sucedida.
Vejamos mais de perto as operações envolvendo a classe [RandomAccessFile]:
- linha 12: o objeto [RandomAccessFile] é aberto em modo somente leitura (modo “r”);
- linhas 18–19: as operações de leitura, [readUTF] e [readInt]. Elas devem ser chamadas na ordem das escritas;
- linha 16: a leitura continua até que a posição atual no arquivo alcance o fim do arquivo;
- linhas 26–27: acesso direto: [seek] reposiciona o cursor no início do arquivo, e o primeiro registro é lido novamente. Se todos os registros tivessem o mesmo tamanho, poderíamos ler diretamente o n-ésimo registro movendo-nos para a posição n × tamanho: é o princípio dos arquivos de acesso direto, precursores dos bancos de dados;
- linha 28: a exceção [EOFException] agora sinaliza uma anomalia verdadeira: um arquivo que termina no meio de um registro;
- linha 32: [RandomAccessFile], uma subclasse de [java.io], sinaliza um arquivo ausente por meio de uma [FileNotFoundException], cuja mensagem, fornecida pelo sistema, contém o nome do arquivo.
Vamos executar o programa sobre o arquivo [persons1.bin] gerado anteriormente:
O conteúdo de [persons2.txt] é o seguinte:
Encontramos as 4 pessoas válidas do arquivo [persons1.txt]. Com um arquivo [truncated.bin] formado pelos primeiros 33 bytes de [persons1.bin], a leitura da idade de Jacques falha:
E com um arquivo inexistente:
O Java também possui um mecanismo de serialização binária de objetos: as classes *[ObjectOutputStream] e [ObjectInputStream] escrevem e leem objetos inteiros, desde que sua classe implemente a interface *[java.io.Serializable] . Esse mecanismo é hoje desaconselhado: a desserialização de dados de uma fonte não confiável possibilitou numerosos ataques, pois a desserialização pode executar código escolhido pelo atacante. Prefere-se, em vez disso, um formato textual como o JSON. No entanto, a interface [Serializable] ainda é encontrada em muitas classes, em particular nas exceções, que a herdam da classe [Throwable]: por isso o compilador, com a opção [-Xlint:all], exige que elas declarem um campo [serialVersionUID], como veremos na aplicação de exemplo.
5.7.3. Serialização JSON com Jackson
Escrever em um arquivo binário e ler dele um dado de cada vez é trabalhoso, e a menor discrepância entre a escrita e a leitura produz resultados incorretos. Geralmente é preferível serializar os objetos: convertê-los automaticamente em uma sequência de caracteres e depois desserializá-los para reconstruí-los.
JSON (JavaScript Object Notation) é um formato textual, legível por humanos e universal: é o formato de troca dos serviços web (Capítulo 13) e de muitos arquivos de configuração. Um objeto é escrito entre chaves, como pares "propriedade": valor, ou como um array entre colchetes.
A biblioteca padrão do Java não sabe ler nem escrever JSON. Usa-se uma biblioteca externa; a mais comum é Jackson, que o Spring Boot usa por padrão. A versão 3 (2025) mudou os pacotes: [tools.jackson.*] em vez de [com.fasterxml.jackson.*] da versão 2, que ainda é comumente encontrada; suas anotações permanecem no pacote [com.fasterxml.jackson.annotation]. Uma biblioteca externa é obtida com o Maven (Capítulo 2): o programa é, portanto, um projeto Maven, [Files06], com a seguinte estrutura de diretórios:
O arquivo [pom.xml] declara a dependência do Jackson:
Comentários:
- linhas 7–9: os detalhes do projeto;
- linhas 11–14: a versão do Java e a codificação dos arquivos-fonte;
- linhas 16–23: a dependência da biblioteca [jackson-databind]. O Maven a baixa do repositório central (Maven Central), junto com as bibliotecas das quais ela própria depende ([jackson-core] e [jackson-annotations]);
- linhas 27–37: o compilador, configurado como em todos os projetos do curso: avisos habilitados ([-Xlint:all]) e nomes de parâmetros preservados no código compilado;
- linhas 39–46: o plugin [exec-maven-plugin], que executa a classe principal com o comando [mvn exec:java].
O objeto central do Jackson é o [JsonMapper], que possui dois métodos principais:
Método | Papel |
[String writeValueAsString(Object value)] | retorna o texto JSON que representa o objeto [value] |
[<T> T readValue(String content, Class<T> valueType)] | reconstrói um objeto do tipo [T] a partir do texto JSON [content]; lança uma [JacksonException] se o texto estiver incorreto. Uma sobrecarga recebe um [TypeReference] em vez de uma [Class] |
O programa [Files06.java] os utiliza:
Ele é executado na pasta do projeto com o comando [mvn compile exec:java], ou a partir da IDE. Não reproduzimos as mensagens do Maven, apenas a saída do programa:
Comentários:
- linha 1: em um projeto Maven, as classes são organizadas em pacotes: a classe [Files06] do pacote [json] está localizada no arquivo [src/main/java/json/Files06.java];
- Linhas 3–14: ao contrário de um arquivo-fonte compacto, uma classe comum deve importar as classes que utiliza, inclusive as da biblioteca padrão;
- linhas 20–21: o record [Person] a ser serializado, declarado na classe [Files06]. O Jackson 3 consegue serializar um record: cada componente se torna uma propriedade JSON com o mesmo nome;
- linhas 24–25: a anotação [@JsonProperty] define o nome da propriedade JSON de um componente como [reference] em vez de [code];
- linha 27: o método [main] é um método estático de uma classe. Ele declara a exceção [IOException], que pode ser lançada por métodos de [Files];
- linhas 34–36: um [JsonMapper] é criado por um construtor de objetos (builder): [JsonMapper.builder()] retorna um objeto ao qual se especificam as opções desejadas, e então [build] cria o [JsonMapper]. Com as opções padrão, o texto é escrito em uma única linha, e os caracteres acentuados são escritos como estão (linha 2 dos resultados);
- Linhas 38–39: a opção [ESCAPE_NON_ASCII] instrui o sistema a escrever os caracteres não ASCII como sequências de escape: [é] torna-se [\u00E9]. O texto continua correto, mas é difícil de ler; isso é útil quando o texto JSON precisa passar por um sistema que só reconhece ASCII;
- linhas 42–43: a opção [INDENT_OUTPUT] produz um texto indentado, distribuído em várias linhas. Uma lista é serializada como um array JSON;
- linhas 45–48: o texto JSON é escrito em um arquivo de texto e depois relido para ser exibido: é assim que hoje se substitui a serialização binária;
- linhas 53–54: a desserialização reconstrói a lista. O Jackson cria os objetos [Person] chamando o construtor do record, cujos parâmetros são associados às propriedades JSON de mesmo nome. Para uma lista, é preciso informar ao Jackson o tipo de seus elementos. No entanto, a expressão [List<Person>.class] não existe: os genéricos do Java são apagados em tempo de compilação (“type erasure”), e em tempo de execução existe apenas uma classe [List], sem nenhum parâmetro de tipo. O truque com
[TypeReference]consiste em criar uma classe anônima ([new TypeReference<List<Person>>() { }]***) derivada de[TypeReference<List<Person>>]***: o tipo pai de uma classe é preservado no código compilado, e o Jackson consegue lê-lo. Para um array, que é mais simples, escrevemos [Person[].class]; - linhas 61–62: serialização de um [Article]: a propriedade [reference] tem o nome especificado pela anotação. Um [BigDecimal] é escrito como um número JSON;
- linhas 64–69: com a opção [ACCEPT_CASE_INSENSITIVE_PROPERTIES], o Jackson ignora a diferença entre maiúsculas e minúsculas nos nomes das propriedades durante a análise: [REFERENCE] e [Price] são aceitos;
- linhas 72–79: um documento JSON inválido, neste caso uma string onde se espera um número, provoca uma exceção derivada de [JacksonException], aqui [InvalidFormatException]. No Jackson 3, essas exceções são unchecked (derivam de [RuntimeException]), ao passo que no Jackson 2 derivavam de [IOException]. [getOriginalMessage] retorna a mensagem sem as informações de localização, que [getLocation] e [getPathReference] fornecem separadamente: linha 1, coluna 23, propriedade [age] do record [Person].
Um [JsonMapper] é custoso de criar, mas, uma vez criado, é reutilizável e pode ser compartilhado entre várias threads: um programa normalmente cria apenas um, armazenado em uma constante. Usaremos JSON na aplicação de exemplo a seguir e ao longo de todo o curso.
5.8. Expressões regulares
O pacote [java.util.regex] oferece suporte ao uso de expressões regulares. Elas permitem validar o formato de uma string. Por exemplo, é possível verificar que uma string que representa uma data está de fato no formato dd/mm/aa. Para isso, usa-se um padrão (pattern) e compara-se a string com esse padrão. Neste exemplo, d, m e a devem ser dígitos. O padrão de um formato de data válido é, portanto, [\d\d/\d\d/\d\d], em que o símbolo [\d] representa um dígito. Os símbolos que podem ser usados em um padrão são os seguintes:
Caractere | Descrição |
[\] | marca o caractere seguinte como um caractere especial ou literal. Por exemplo, [n] corresponde ao caractere n, [\n] corresponde a um caractere de nova linha, [\\] corresponde a \ e [\(] corresponde a ( |
[^] | corresponde ao início da string |
[$] | corresponde ao fim da string |
[*] | corresponde ao elemento anterior zero ou mais vezes. Assim, [zo*] corresponde a z ou zoo |
[+] | corresponde ao elemento anterior uma ou mais vezes. Assim, [zo+] corresponde a "zoo", mas não a "z" |
[?] | corresponde ao elemento anterior zero ou uma vez. Por exemplo, [a?ve?] corresponde a "ve" em "lever" |
[.] | corresponde a qualquer caractere isolado, exceto o caractere de nova linha |
[(pattern)] | procura o padrão e armazena a correspondência (um grupo). A subcadeia correspondente pode ser extraída do resultado com o método [group]. Para encontrar correspondências com caracteres entre parênteses, use [\(] ou [\)] |
[x|y] | corresponde a x ou a y. Por exemplo, [z|foot] corresponde a z ou foot; [(z|f)oo] corresponde a zoo ou foo |
[{n}] | n é um inteiro não negativo. Corresponde exatamente n vezes ao elemento anterior. Por exemplo, [o{2}] não corresponde ao o de Bob, mas aos dois primeiros o de fooooot |
[{n,}] | corresponde ao elemento anterior pelo menos n vezes. Por exemplo, [o{2,}] não corresponde ao 'o' de "Bob", mas corresponde a todos os 'o' de "fooooot". [o{1,}] equivale a [o+], e [o{0,}] equivale a [o*] |
[{n,m}] | corresponde ao elemento anterior pelo menos n vezes e no máximo m vezes. Por exemplo, [o{1,3}] corresponde aos três primeiros “o” de “foooooot”; [o{0,1}] equivale a [o?] |
[[xyz]] | conjunto de caracteres: corresponde a um dos caracteres especificados. Por exemplo, [[abc]] corresponde à letra “a” em “plain” |
[[^xyz]] | conjunto negativo de caracteres: corresponde a qualquer caractere não listado. Por exemplo, [[^abc]] corresponde a "p" em "plain" |
[[a-z]] | Intervalo de caracteres: corresponde a qualquer caractere do intervalo especificado, neste caso uma letra minúscula sem acento |
[[^m-z]] | intervalo negativo de caracteres: corresponde a qualquer caractere que não esteja entre 'm' e 'z' |
[\b] | corresponde a um limite de palavra, isto é, a posição entre um caractere de palavra e um caractere que não é de palavra. Por exemplo, [er\b] corresponde a "er" em "lever", mas não a "er" em "verb" |
[\B] | corresponde a uma posição que não é um limite de palavra. [en*t\B] corresponde a “ent” em “mentor” |
[\d] | corresponde a um dígito; equivale a [[0-9]] |
[\D] | corresponde a um caractere que não é um dígito |
[\f], [\n], [\r], [\t] | correspondem, respectivamente, aos caracteres de quebra de página, nova linha, retorno de carro e tabulação |
[\s] | corresponde a qualquer espaço em branco: espaço, tabulação, quebra de página, quebra de linha… Equivale a [[ \t\n\x0B\f\r]] |
[\S] | corresponde a qualquer caractere que não seja um espaço em branco |
[\w] | corresponde a qualquer caractere de palavra: por padrão, em Java, uma letra sem acento, um dígito ou um sublinhado; equivale a [[a-zA-Z_0-9]]. Com a opção [UNICODE_CHARACTER_CLASS] (veja adiante), reconhece também letras acentuadas |
[\W] | corresponde a qualquer caractere que não seja um caractere de palavra |
[\num] | num é um inteiro positivo: refere-se ao grupo de número num. Por exemplo, [(.)\1] corresponde a dois caracteres idênticos consecutivos |
[\xnn], [\unnnn] | corresponde ao caractere hexadecimal nn (2 dígitos) ou nnnn (4 dígitos). Por exemplo, [\x41] corresponde a A |
Um elemento de um padrão pode aparecer uma ou várias vezes. Vejamos alguns exemplos com o símbolo [\d], que representa um único dígito:
Padrão | Significado |
[\d] | um dígito |
[\d?] | 0 ou 1 dígito |
[\d*] | 0 ou mais dígitos |
[\d+] | 1 ou mais dígitos |
[\d{2}] | 2 dígitos |
[\d{3,}] | Pelo menos 3 dígitos |
[\d{5,7}] | entre 5 e 7 dígitos |
Imaginemos agora um padrão capaz de descrever o formato esperado para uma string:
string-alvo | padrão |
uma data no formato dd/mm/aa | [\d{2}/\d{2}/\d{2}] |
uma hora no formato hh:mm:ss | [\d{2}:\d{2}:\d{2}] |
um inteiro sem sinal | [\d+] |
uma sequência de espaços, possivelmente vazia | [\s*] |
um inteiro sem sinal que pode ser precedido ou seguido de espaços | [\s*\d+\s*] |
um inteiro que pode ter sinal e ser precedido ou seguido de espaços | [\s*[+-]?\s*\d+\s*] |
um número real sem sinal que pode ser precedido ou seguido de espaços | [\s*\d+(\.\d*)?\s*] |
um número real que pode ter sinal e ser precedido ou seguido de espaços | [\s*[+-]?\s*\d+(\.\d*)?\s*] |
uma string que contém a palavra "just" | [\bjust\b] |
Observe que, entre colchetes, o caractere [|] não tem significado específico: o padrão [[+|-]], às vezes usado para o sinal, também aceita o caractere | antes de um número. Da mesma forma, o ponto decimal deve ser escapado, [\.]: um ponto sem escape corresponde a qualquer caractere.
É possível especificar onde procurar o padrão na string:
Padrão | Significado |
[^pattern] | o padrão está no início da string |
[pattern$] | O padrão está no fim da string |
[^pattern$] | O padrão está no início e no fim da string |
[pattern] | O padrão é procurado em qualquer ponto da string, a partir do início da string |
string pesquisada | padrão |
uma string que termina com um ponto de exclamação | [!$] |
uma string que termina com um ponto final | [\.$] |
uma string que começa com a sequência // | [^//] |
uma string formada por uma única palavra, possivelmente precedida ou seguida de espaços | [^\s*\w+\s*$] |
uma string formada por exatamente duas palavras, possivelmente precedidas ou seguidas de espaços | [^\s*\w+\s+\w+\s*$] |
uma string que contém a palavra "secret" | [\bsecret\b] |
É possível “extrair” subconjuntos de um padrão. Assim, podemos não só verificar que uma string corresponde a um determinado padrão, mas também extrair dessa string os elementos correspondentes aos subconjuntos do padrão que foram colocados entre parênteses. Por exemplo, se analisarmos uma string que contém uma data no formato dd/mm/aa e quisermos também extrair os elementos dd, mm e aa dessa data, usaremos o padrão [(\d\d)/(\d\d)/(\d\d)].
No código Java, um padrão é escrito como uma string comum: cada caractere [\] do padrão deve ser duplicado. O padrão [\d+] é escrito como ["\\d+"], e o padrão [\\], que representa o caractere \, é escrito como ["\\\\"]. Os blocos de texto não mudam isso: [\] também é um caractere de escape neles. O editor facilita a leitura: o IntelliJ IDEA reconhece as strings passadas a [Pattern.compile], destaca-as como expressões regulares e permite testá-las.
5.8.1. Verificar se uma string corresponde a um padrão
Um padrão é primeiro compilado em um objeto [java.util.regex.Pattern], que então fornece objetos [Matcher] responsáveis pela busca em uma string dada:
Método | Papel |
[static Pattern compile(String regex)] | compila o padrão [regex]; lança uma exceção [PatternSyntaxException] se o padrão for inválido |
[static Pattern compile(String regex, int flags)] | igual ao anterior, com opções (veja adiante) |
[Matcher matcher(CharSequence input)] | retorna um objeto [Matcher] que procura o padrão em [input] |
[boolean find()] (classe [Matcher]) | procura a próxima ocorrência do padrão na string; retorna [true] se encontrar uma |
[boolean matches()] (classe [Matcher]) | retorna [true] se toda a string corresponder ao padrão |
[static boolean matches(String regex, CharSequence input)] | compila o padrão e verifica se a string inteira corresponde a ele |
O programa [Regex01.java] é o seguinte:
Resultados:
Comentários:
- linha 3: o padrão de um inteiro sem sinal, possivelmente cercado de espaços, que ocupa a string inteira (âncoras [^] e [$]). As ocorrências de [\] são duplicadas;
- linha 4: a compilação do padrão;
- linha 7: [find] procura o padrão na string. A string “123a”, cercada de espaços, não corresponde ao padrão: o caractere “a” não pode ser um dígito nem um espaço. Sem as âncoras [^] e [$], a string corresponderia, pois ela contém um número;
- linhas 14–16: a diferença entre [find], que procura o padrão dentro da string, e [matches], que exige que toda a string corresponda ao padrão, como se ela fosse delimitada por [^] e [$];
- Linhas 18–20: o método estático [Pattern.matches] e o método [matches] da classe [String] também testam a string inteira. Eles compilam o padrão a cada chamada: embora úteis para um teste isolado, devem ser evitados em um laço. O método [split] de [String], que já encontramos, também compila seu padrão a cada chamada, exceto para separadores formados por um único caractere comum, que ele processa sem expressão regular.
5.8.2. Encontrar todas as ocorrências de um padrão em uma string
O método [find] de um objeto [Matcher] pode ser chamado várias vezes: cada chamada procura a próxima ocorrência do padrão. Após uma chamada bem-sucedida, o objeto [Matcher] fornece informações sobre a ocorrência encontrada:
- [group()]: o texto da ocorrência, isto é, um elemento que corresponde ao padrão;
- [start()]: a posição em que o elemento foi encontrado na string pesquisada; [end()]: a posição seguinte ao elemento.
O programa [Regex02.java] é o seguinte:
Resultados:
Comentários:
- Linha 3: o padrão procurado é uma sequência de dígitos;
- linha 5: a string na qual esse padrão é procurado;
- linhas 8–13: cada chamada a [find] encontra a próxima ocorrência; o laço termina quando não há mais nenhuma. Cada ocorrência e sua posição são exibidas;
- linha 16: o método [results] (Java 9) retorna o stream das ocorrências como objetos [MatchResult] (que possuem os métodos [group], [start], [end]): a API Stream é aplicada a ele. Aqui, calcula-se a soma dos números encontrados;
- linha 18: o número de ocorrências do padrão [[aeiouy]], que designa uma vogal, é o número de elementos do stream.
5.8.3. Recuperação de partes de um padrão
Como mencionado, as partes de um padrão entre parênteses são armazenadas: são os grupos. O programa [Regex03.java] os utiliza:
Resultados:
Comentários:
- linhas 7–8: a string [sample4] é comparada com o padrão [regex3]; [find] procura a primeira ocorrência do padrão. Após uma chamada bem-sucedida, usamos dois novos métodos de [Matcher]:
- [groupCount] (linha 11): o número de grupos entre parênteses do padrão;
- [group(i)] (linha 12): o texto capturado pelo grupo nº i; [group(0)], ou [group()], é a ocorrência inteira do padrão. [start(i)] é a posição desse texto na string analisada. O laço vai, portanto, de 0 a [groupCount], inclusive;
- linha 20: um grupo pode ser nomeado com a sintaxe [(?<name>...)]. Aqui, o padrão reconhece uma data no formato d/m/aaaa, com dia e mês de um ou dois dígitos;
- linhas 26–28: um grupo nomeado é referenciado pelo nome e não pelo número: o código fica mais legível e não depende da ordem dos parênteses;
- linhas 29–31: a classe [LocalDate] (Java 8) representa uma data sem hora. Ela é exibida com o padrão [EEEE d MMMM yyyy]: o dia da semana aparece em inglês, o idioma da máquina;
- linha 35: o método [replaceAll] substitui cada ocorrência do padrão por uma string na qual [${name}] (ou [$1], [$2]… para grupos numerados) designa o valor de um grupo. As datas são assim reescritas no formato ano-mês-dia;
- linhas 38–39: uma versão sobrecarregada de [replaceAll] (Java 9) recebe uma função que calcula o texto de substituição a partir de cada ocorrência, do tipo [MatchResult]. Aqui, a data é construída e substituída por sua notação padronizada ISO 8601, retornada pelo método [toString] de [LocalDate]: dias e meses sempre têm dois dígitos.
5.8.4. Um programa de aprendizado
Encontrar a expressão regular que verifica se uma string corresponde a um determinado padrão pode, às vezes, ser um verdadeiro desafio. O programa [Regex04.java] permite praticar. Ele recebe um padrão e uma string como entrada e indica se a string corresponde ou não ao padrão.
Comentários:
- linha 13: compilação do padrão digitado no teclado. Um padrão incorreto provoca uma exceção [PatternSyntaxException], para a qual [getDescription] retorna a descrição do erro e [getIndex] retorna sua posição no padrão (linha 15). Sua mensagem completa, retornada por [getMessage], ocupa várias linhas e mostra o padrão com um marcador abaixo do erro;
- linha 28: a busca não é feita diretamente na string digitada, mas em um objeto [TimeLimitedString] (linhas 58–87), que limita a duração da busca a um segundo: se a busca demorar mais, uma exceção [TimeoutExceededException] é lançada e depois capturada na linha 44. Veremos adiante por que isso é útil e como funciona;
- linhas 36–39: para cada correspondência, são exibidos o grupo nº 1 e os grupos seguintes, se houver;
- linhas 52–55: ao contrário dos programas anteriores, os espaços não são removidos da linha digitada; eles podem fazer parte do padrão ou da string a ser testada.
Eis um exemplo de saída:
Os padrões [^\s*\d+\s*$] e [^\s*(\d+)\s*$] mostram as vantagens de usar grupos: o primeiro reconhece a string “1456” precedida de três espaços, incluindo os espaços; o segundo também extrai o número sem os espaços. Os padrões [^(a+)+$] e [^(a+)+\1$] são discutidos adiante.
5.8.5. O método split
Já encontramos o método [split] da classe [String], cujo separador é uma expressão regular. A classe [Pattern] tem o mesmo método, que usa o padrão pré-compilado:
Método | Papel |
[String[] split(CharSequence input)] | A string [input] é dividida em campos, separados por um separador que corresponde ao padrão |
[Stream<String> splitAsStream(CharSequence input)] | igual ao anterior, mas os campos são retornados como um stream |
Suponha, por exemplo, que um arquivo de texto contenha linhas da forma campo1, campo2, ..., campon. Os campos são separados por uma vírgula, mas essa vírgula pode ser precedida ou seguida de espaços. O padrão [\s*,\s*] descreve exatamente esse separador, como mostra o programa [Regex05.java]:
Resultados:
Comentários:
- linha 5: o separador: uma vírgula precedida e seguida de qualquer número de espaços. Os espaços são removidos junto com o separador. Uma vez compilado, o padrão pode dividir quantas linhas se queira sem ser recompilado: é assim que se dividem todas as linhas de um arquivo;
- linha 11: um separador que pode assumir várias formas: um ponto e vírgula ou uma barra vertical ([[;|]]), ou ([|]) uma sequência de espaços ([\s+]);
- linha 14: [splitAsStream] retorna os campos como um stream, ao qual aqui se aplica a operação [map].
5.8.6. Padrões pré-compilados, opções e buscas que demoram demais
Ao contrário de outras plataformas, o Java não possui um mecanismo que gere o código de uma busca por expressão regular em tempo de compilação do programa: um padrão é sempre analisado em tempo de execução por [Pattern.compile]. Essa compilação tem um custo; por isso, a boa prática é compilar cada padrão conhecido uma única vez e de antemão e guardar o objeto [Pattern] em uma constante, como faz o programa [Regex06.java]. Um objeto [Pattern] é imutável e pode ser usado simultaneamente por várias threads; um objeto [Matcher], que guarda o estado de uma busca, não pode.
Resultados:
Comentários:
- linhas 4–8: os padrões do programa são compilados uma única vez e armazenados em constantes [static final] (Capítulo 4), escritas em maiúsculas, como é costume. Em um arquivo-fonte compacto, essas constantes são campos da classe implícita que contém os métodos do arquivo;
- linhas 12–16: as constantes são usadas da mesma forma que os objetos [Pattern] nos programas anteriores;
- linha 6: o segundo parâmetro de [compile] é uma combinação de opções. [CASE_INSENSITIVE] ignora a diferença entre maiúsculas e minúsculas: “YES” e “Yes” correspondem ao padrão (linha 4 dos resultados);
- Linhas 23–27: as opções são combinadas com o operador [|]. [MULTILINE] faz [^] e [$] corresponderem ao início e ao fim de cada linha da string, e não apenas ao início e ao fim da própria string. Contudo, com as opções padrão, [\w] reconhece apenas letras sem acento: a linha “entrée: 3” não é reconhecida (linha 5 dos resultados). A opção [UNICODE_CHARACTER_CLASS] (Java 7) atribui os significados Unicode corretos a [\w], [\d], [\s]e [\b]: as letras acentuadas passam a ser tratadas como caracteres de palavra (linha 6 dos resultados). Essa opção deve ser usada para todo texto em francês. Outras opções úteis: [DOTALL] ([.] também trata quebras de linha), [COMMENTS] (os espaços no padrão são ignorados, permitindo escrevê-lo em várias linhas, com comentários), [UNICODE_CASE] (junto com [CASE_INSENSITIVE], ignora também a diferença entre maiúsculas e minúsculas das letras acentuadas: É e é);
- linha 29: as opções também podem ser escritas no início do padrão: [(?i)] para [CASE_INSENSITIVE], [(?m)] para [MULTILINE], [(?U)] para [UNICODE_CHARACTER_CLASS]…
O restante do programa trata de um problema de segurança. Alguns padrões são patológicos: quando aplicados a certas strings, forçam o mecanismo de expressões regulares a tentar um número enorme de maneiras de casar a string com o padrão antes de chegar a uma conclusão. O mecanismo do Java usa um processo chamado “backtracking”: quando uma tentativa falha, ele volta à última escolha feita e tenta outra. O padrão [^(a+)+\1$] da linha 8 é um exemplo: aplicado a uma sequência de “a” terminada por outro caractere, ele tenta todas as maneiras possíveis de distribuir os “a” entre as repetições do grupo e sua referência retroativa [\1] antes de concluir que a correspondência falhou, e o número de possibilidades se multiplica a cada “a” adicional. É o chamado backtracking catastrófico. Quando aplicado a strings digitadas por usuários, esse padrão constitui uma vulnerabilidade de segurança (conhecida como ReDoS, “regular expression denial of service”): bastam algumas requisições para paralisar um servidor.
- Linhas 32–37: a duração da busca é medida para 10, 15 e 20
a. Ela aumenta muito rapidamente (linhas 8–10 dos resultados; as durações variam de uma execução e de uma máquina para outra). Como a duração praticamente dobra a cadaaadicional, a busca levaria vários minutos com 30a; - linhas 38–43: a classe [Pattern] não tem opção de tempo limite. Usa-se uma técnica padrão: a busca é feita em um objeto do tipo [TimeLimitedString] (linhas 61–89), que implementa a interface [CharSequence] aceita por [matcher]. O mecanismo de expressões regulares lê a string caractere por caractere com o método [charAt]: esse método verifica o tempo e lança uma exceção [TimeoutExceededException] (linhas 92–95) se o prazo, armazenado quando o objeto foi criado, tiver sido ultrapassado. A busca é abandonada após 100 ms;
- linhas 61–65: o record [TimeLimitedString] tem dois componentes: o texto e o prazo, expresso como o valor do relógio [System.nanoTime], que não deve ser ultrapassado. O construtor adicional calcula esse prazo a partir de um tempo limite, um objeto [java.time.Duration];
- linha 92: a exceção [TimeoutExceededException] deriva de [RuntimeException]: é uma exceção unchecked que [charAt] pode lançar sem declará-la. Ela é declarada como [static] para poder ser criada no record, que é ele próprio implicitamente estático. O campo [serialVersionUID] evita um aviso do compilador, já que uma exceção é serializável;
- linhas 45–48: o mecanismo do Java consegue reconhecer e tratar com eficiência casos simples de repetições aninhadas: o padrão [^(a+)+$], que é catastrófico em outros mecanismos, responde imediatamente aqui. É a referência retroativa [\1] que impede essa otimização no padrão da linha 8.
É importante desconfiar de padrões que contenham repetições aninhadas ([(a+)+], [(\w+\s?)*]…) e limitar a duração das buscas assim que o padrão ou a string pesquisada vier de fora do programa. Os quantificadores possessivos do Java ([a++], [a*+]), que impedem o backtracking dentro do elemento que repetem, também permitem escrever padrões seguros, desde que se compreenda plenamente o seu significado.
5.9. Aplicação de exemplo - V3
Voltaremos à aplicação discutida no Capítulo 3 (Versão 1) e no Capítulo 4 (Versão 2). Lembre-se de que se trata de um exercício: a tabela de imposto usada é a de 2004 (renda de 2003), que permanece inalterada desde o curso original.
5.9.1. Dados em um arquivo
Na Versão 2, o cálculo do imposto era feito na classe abstrata [AbstractTax], que reutilizamos aqui no pacote [tax] do projeto, com duas pequenas diferenças: as faixas de imposto agora são fornecidas na forma de um array ([TaxBracket[]]) em vez de uma lista, e a divisão é feita com 16 dígitos significativos em vez de 34, o que é mais que suficiente:
O método [calculate] usa as faixas de imposto retornadas pelo método abstrato [getTaxBrackets] (linha 10). A classe [AbstractTax] não sabe de onde essas faixas vêm: cabe às classes derivadas fornecê-las. Na versão 2, a classe derivada [HardwiredTax] as fixava diretamente em seu código. Os cálculos são feitos com números decimais exatos [java.math.BigDecimal] (Capítulo 3): [BigDecimal.TWO] (Java 19) é a constante 2; a divisão da renda pelo número de quotas é feita com 16 dígitos significativos ([MathContext.DECIMAL64]); e [intValue] retorna a parte inteira do resultado. Uma faixa é representada, como na versão 2, pelo record [TaxBracket]:
e o cálculo é descrito pela interface [ITax], documentada aqui por um comentário Javadoc:
A nova versão armazena os dados em um arquivo, o que permite alterar a tabela de alíquotas sem recompilar o programa. Escrevemos duas novas classes derivadas de [AbstractTax]:
- [FileTax] lê as faixas de um arquivo de texto [TaxData.txt];
- [JsonTax] as lê de um arquivo JSON chamado [TaxData.json].
O arquivo de texto [TaxData.txt] contém uma faixa por linha, no formato limite:coeffR:coeffN:
Os números no arquivo são escritos com ponto decimal. Um arquivo de dados não deve depender do idioma da máquina que o lê: um arquivo escrito com vírgulas decimais e interpretado segundo as regras do francês ([NumberFormat.getInstance(Locale.FRANCE)]) seria rejeitado ou, pior, mal interpretado em uma máquina em inglês. O construtor [new BigDecimal(String)], assim como [Double.parseDouble], sempre espera um ponto decimal, independentemente do idioma da máquina. Essa também é a convenção do JSON e da maioria dos formatos de dados.
O arquivo [TaxData.json] contém os mesmos dados, na forma de um array JSON de objetos:
5.9.2. Erros
O processamento desses arquivos pode falhar por causa de um arquivo ausente, uma linha malformada, um número incorreto etc. Criamos uma classe de exceção específica para relatar esses erros, [TaxException]. Ela também será usada para outras fontes de dados (aqui o arquivo JSON e, mais adiante, bancos de dados). Ela carrega um código de erro:
Comentários:
- Linha 7: a classe [TaxException] deriva da classe [RuntimeException]: é uma exceção unchecked (Capítulo 4). O compilador não exigirá que o código que cria um objeto [FileTax] ou [JsonTax] capture essa exceção; esse código a capturará onde for capaz de tratá-la;
- Linhas 10–11: toda exceção é serializável por herdar da classe [Throwable]. Uma classe serializável deve declarar um número de versão [serialVersionUID], usado para verificar que um objeto serializado é desserializado pela mesma versão da classe; caso contrário, o compilador, com a opção [-Xlint:all], emite um aviso. A anotação [@Serial] (Java 14) indica que o campo faz parte do mecanismo de serialização;
- linha 14: o código de erro, definido quando a exceção é criada;
- linhas 16–24: dois construtores. O primeiro recebe uma mensagem de erro e um código; o segundo recebe também a exceção que causou o erro (a causa), que será acessível por meio do método [getCause]. É essa forma de exceção, com um código inteiro, que as versões seguintes da aplicação usarão.
Os códigos de erro possíveis são descritos por uma enumeração:
Comentários:
- Linhas 7–12: códigos de erro possíveis:
- [ACCESS]: erro de acesso ao arquivo de dados;
- [LINE]: linha sem os três campos esperados, ou arquivo sem nenhuma faixa;
- [FIELD1], [FIELD2], [FIELD3]: o campo 1, 2 ou 3 de uma linha está incorreto;
- [JSON]: o documento JSON está incorreto;
- Linhas 15–23: um enum do Java é uma classe; pode ter campos, um construtor (privado) e métodos. Cada constante é construída com seu valor inteiro, entre parênteses;
- linhas 26–34: alguns erros podem ocorrer em combinação: os três campos de uma linha podem estar incorretos. Por isso, os valores dos códigos de erro são potências de 2: cada um corresponde a um bit do inteiro. Um erro nos campos 2 e 3 resultará no código 8 | 16 = 24. O método estático [decode] faz a operação inversa: converte o conjunto de códigos em um inteiro testando cada bit com o operador [&]. O resultado é um
*[EnumSet]*, um conjunto especializado para as constantes de uma enumeração, que as armazena como os bits de um inteiro: é a maneira Java de lidar com combinações de opções. Seu método [toString] exibe uma combinação na forma “[FIELD2, FIELD3]”.
5.9.3. A classe FileTax
A classe [FileTax] fornece as faixas lidas de um arquivo de texto:
Comentários:
- linha 13: a classe [FileTax] deriva da classe [AbstractTax], assim como a classe [HardwiredTax] na versão 2;
- linhas 16–18: duas expressões regulares, compiladas uma única vez e armazenadas como constantes: o separador de campos de uma linha de faixa limite:coeffR:coeffN (o caractere [:], precedido e seguido de qualquer quantidade de espaços) e um número positivo ou zero, formado por dígitos seguidos, opcionalmente, de um ponto e mais dígitos;
- linhas 21–27: as faixas lidas, retornadas pelo método [getTaxBrackets], que implementa o método abstrato [AbstractTax];
- linha 29: o construtor recebe o nome do arquivo de texto que contém os dados. Sua função é preencher o array [taxBrackets];
- linha 32: o nome do arquivo sem o caminho, usado nas mensagens de erro. O construtor pode, de fato, receber um caminho completo, que não precisa ser exibido ao usuário;
- linha 34: a leitura de um arquivo de texto é sequencial: o número de linhas só é conhecido depois que o arquivo inteiro é lido. Por isso, o array não pode ter o tamanho definido de antemão; as faixas são armazenadas temporariamente em uma lista;
- linhas 35–38: o arquivo é lido linha a linha com um [BufferedReader], aberto por uma instrução [try] com recursos;
- linhas 46–50: a linha é dividida em campos por meio de uma expressão regular; se não houver três campos, uma exceção [TaxException] com o código [LINE] é lançada imediatamente. O arquivo é fechado em qualquer caso: a instrução [try] com recursos fecha o [BufferedReader] independentemente de como o bloco termina, normalmente ou por uma exceção;
- linhas 52–58: validação dos três campos. Os erros são acumulados na variável [code] com o operador [|=] e depois informados em conjunto. O método [matches] exige que o campo inteiro obedeça ao padrão [NUMBER]: sem sinal, sem espaços e sem ponto decimal. Os números negativos são, assim, rejeitados, o que valida os dados ao mesmo tempo em que são verificados;
- linhas 60–61: os campos, agora validados, são convertidos em [BigDecimal], com ponto decimal, independentemente do idioma da máquina;
- linhas 63–67: os erros de acesso ao arquivo ([IOException] e suas variantes, como [NoSuchFileException] para um arquivo inexistente, [AccessDeniedException] para permissões insuficientes ou [MalformedInputException] para um arquivo que não está em UTF-8) são encapsulados em uma [TaxException] com o código [ACCESS], e a exceção original passa a ser sua causa. As exceções [TaxException] lançadas dentro do laço não são exceções [IOException]: não são interceptadas por esta cláusula [catch] e saem do construtor como estão;
- linhas 69–74: um arquivo vazio é rejeitado; caso contrário, a lista é transferida para o array de faixas, que era a finalidade do construtor.
Encapsular as exceções de baixo nível ([IOException]) em uma exceção específica da aplicação ([TaxException]) permite que o código chamador trate apenas um tipo de exceção, qualquer que seja a fonte de dados: um arquivo de texto, um arquivo JSON e, mais adiante no curso, um banco de dados. É também por isso que [TaxException] é não verificada: uma exceção verificada teria de ser declarada por todos os métodos pelos quais passa, o que acoplaria o código chamador aos detalhes da fonte de dados.
5.9.4. A classe JsonTax
A classe [JsonTax] fornece as faixas lidas de um arquivo JSON:
Comentários:
- linha 15: um único [JsonMapper], armazenado em uma constante, é usado por todos os objetos [JsonTax]. As propriedades JSON [limit], [coeffR] e [coeffN] têm o nome dos componentes do record [TaxBracket]: nenhuma anotação é necessária;
- linhas 31–37: leitura do arquivo; um erro de acesso é tratado como em [FileTax];
- linha 41: uma única instrução converte o texto JSON em um array de faixas de imposto. O Jackson constrói cada record chamando seu construtor e converte os números JSON em [BigDecimal] sem nenhuma perda de precisão;
- linhas 42–46: um documento inválido provoca uma [JacksonException], encapsulada em uma [TaxException] com o código [JSON]. A mensagem indica a posição do erro, identificada por [getLocation];
- linhas 48–56: a desserialização verifica o formato do documento, não a validade dos dados: ainda é preciso verificar se há pelo menos uma faixa (o documento [null] ou [[]] é um JSON válido) e se nenhum valor é negativo ou está ausente. Se uma propriedade estiver ausente de um objeto JSON, o componente correspondente recebe o valor [null]. A operação [anyMatch] da API Stream realiza essa verificação final em uma única instrução, com [Arrays.stream(brackets)] retornando o stream dos elementos do array;
- linhas 61–63: o método que testa um valor.
Comparar as duas classes é instrutivo: com um formato de dados estruturado e uma biblioteca que o compreende, a análise do arquivo exige quase nenhum código.
5.9.5. O programa principal
O projeto Maven [TaxV3] tem a seguinte estrutura de diretórios:
Os arquivos de dados ficam na raiz do projeto, ao lado do arquivo [pom.xml]: esse é o diretório atual do programa quando ele é executado com o comando [mvn exec:java] a partir do diretório do projeto. O arquivo [pom.xml] corresponde ao do projeto [Files06], diferindo apenas nas coordenadas e na classe principal:
O [groupId] [examples.tax] será usado em todas as versões da aplicação de exemplo. A classe principal, declarada no plugin [exec-maven-plugin], é [tax.Main]:
Comentários:
- linhas 7–11: o texto de ajuda, em um bloco de texto armazenado em uma constante;
- linha 15: o nome do arquivo de dados é passado como argumento; por padrão, é [TaxData.txt]. Com o Maven, os argumentos do programa são passados pela propriedade [exec.args]: [mvn exec:java -Dexec.args="TaxData.json"];
- linhas 21–25: uma expressão [switch] (Capítulo 3) seleciona a classe a instanciar de acordo com a extensão do arquivo, extraída do nome do arquivo com [lastIndexOf] e [substring]. Os dois ramos retornam objetos de tipos diferentes, [JsonTax] e [FileTax], ambos do tipo [ITax]. O restante do programa conhece apenas a interface [ITax] e ignora a origem dos dados;
- linhas 26–35: a criação do objeto pode lançar uma [TaxException], que é exibida antes do término do programa. O código é decodificado em um conjunto de mensagens [ErrorCode] a serem exibidas em texto simples; a exceção original, se houver, é indicada pelo seu tipo. A instrução [return] que vem após [System.exit] nunca é executada, mas o compilador, que não sabe que [System.exit] não devolve o controle, a exige: sem ela, a variável [tax] não seria considerada inicializada na linha 73;
- linhas 38–74: o laço de diálogo é o da versão 2.
5.9.6. Execuções
Com o arquivo [TaxData.txt], por padrão:
Os valores das versões anteriores são mantidos: 4.282 euros para um casal com 2 filhos, 2.959 euros com 3 filhos e 11.519 euros para uma pessoa solteira sem filhos, com um salário anual de 60.000 euros. As entradas incorretas são sinalizadas como na versão 2.
Com o arquivo [TaxData.json]:
Com um arquivo [xx.txt] inexistente:
Com o seguinte arquivo [TaxDataInvalid.txt], em que a terceira linha usa vírgula decimal:
Os campos 2 e 3 da linha 3 são rejeitados: o código de erro é a combinação [[FIELD2, FIELD3]]. O campo 1 (14753), que não tem parte decimal, está correto.
Com o seguinte arquivo, [TaxDataInvalid.json], em que um coeficiente é escrito como string:
A mensagem do Jackson especifica o erro com precisão: a string “0,068” não pode ser convertida em [BigDecimal]. O Jackson aceita uma string onde se espera um número se ela contiver um número válido (“0.068”); é a vírgula decimal que é rejeitada. O erro está localizado na linha 3 do documento (o Jackson numera as linhas a partir de 1) e na coluna 30, imediatamente após o valor incorreto.
5.10. Conclusão
Este capítulo apresentou as classes Java usadas em quase todos os programas:
- as strings imutáveis [String], que são comparadas com [equals] e não com [==], e [StringBuilder] para construí-las pouco a pouco; os formatos [String.format] e [formatted], os blocos de texto;
- os arrays e a classe [Arrays];
- as coleções [List], [Map], [Set], [Deque], e suas implementações [ArrayList], [HashMap], [LinkedHashMap], [TreeMap], [HashSet], [ArrayDeque], [PriorityQueue]; as coleções imutáveis ([List.of], [List.copyOf], [Collections.unmodifiableList]), as coleções sequenciadas do Java 21 e os comparadores ([Comparator]); as coleções do Java 1.0 ([Vector], [Hashtable], [Stack]) estão obsoletas;
- a API Stream, suas operações intermediárias e terminais, seus coletores e sua avaliação tardia;
- os arquivos de texto ([Files], [Path], [BufferedReader], [BufferedWriter]), sempre em UTF-8, os arquivos binários ([DataOutputStream], [DataInputStream], [RandomAccessFile]) e a serialização JSON com o Jackson, que substitui a serialização binária do Java, obsoleta;
- as expressões regulares, compiladas uma única vez e protegidas contra buscas excessivamente longas no processamento de dados externos.
A aplicação de exemplo agora lê seus dados de um arquivo de texto ou JSON. O capítulo seguinte a reorganiza em camadas: a leitura dos dados, o cálculo do imposto e a interação com o usuário se tornarão componentes independentes.