11. Hibernate
Pré-requisitos: a versão 7 da aplicação [Tax], apresentada no final deste capítulo, reutiliza os módulos [tax-dao], [tax-business] e [tax-ui] da versão 5 (Capítulo 6). Antes de compilar ou abrir seus projetos, você deve ter instalado a versão 5 no repositório Maven local com o comando [mvn install] digitado na pasta [06-architectures/TaxV5] (veja o Capítulo 6, seção sobre [mvn install]).
O capítulo anterior mostrou como uma aplicação Java se comunica com um banco de dados por meio de um driver JDBC: abre-se uma conexão, emitem-se comandos SQL, leem-se as linhas do resultado coluna por coluna e copiam-se os dados para objetos. Esse processo de cópia, das linhas para os objetos e dos objetos para os comandos [INSERT], [UPDATE] e [DELETE] , é repetitivo. Ele pode ser automatizado por uma ferramenta: um “mapeador objeto-relacional” (ORM). Este capítulo apresenta o ORM mais utilizado no mundo Java, o Hibernate, e o padrão que ele implementa, o Jakarta Persistence.
O capítulo retoma o banco de dados de exemplo dos artigos do Capítulo 10 e termina com a versão 7 da aplicação de cálculo de imposto, cuja camada ORM usa o Hibernate.
11.1. O que é um ORM?
11.1.1. Objetos e tabelas
Uma aplicação Java trabalha com objetos: um item tem um nome, um preço e um nível de estoque; um pedido tem um cliente e uma lista de linhas, cada uma das quais se refere a um item. Um banco de dados relacional armazena essas mesmas informações em tabelas: uma linha na tabela [articles] por item, uma linha na tabela [orders] por pedido, com os relacionamentos entre as linhas expressos por chaves estrangeiras. Os dois mundos não se alinham perfeitamente:
- um objeto referencia diretamente outros objetos ([order.getClient()]); uma linha contém o valor da chave primária de outra linha ([client_id]);
- um objeto pode conter uma coleção ([order.getLines()]); uma tabela contém apenas valores simples; a coleção é representada pelas linhas de outra tabela que apontam para o pedido;
- os tipos Java ([String], [BigDecimal], [LocalDate], [boolean]) e os tipos SQL ([varchar(30)], [decimal(10,2)], [date], [bit]) não são os mesmos;
- os objetos são consultados com Java (e a API stream), enquanto as tabelas são consultadas com SQL.
Um ORM faz a ponte entre os dois mundos. Definimos de uma vez por todas a correspondência entre classes e tabelas (o modelo, ou “mapeamento”); ele então se encarrega de:
- traduzir consultas escritas em uma linguagem que se refere a objetos (HQL) ou construídas por código Java (a API Criteria);
- criar objetos a partir das linhas lidas (isso se chama materialização);
- armazenar os objetos lidos e detectar aqueles que foram modificados, adicionados ou excluídos;
- gerar os comandos [INSERT], [UPDATE], e [DELETE] que refletem essas alterações no banco de dados;
- e, se necessário, criar e atualizar o esquema do banco de dados (tabelas, colunas, índices) com base nas classes.
A arquitetura de uma aplicação que usa o Hibernate com o MySQL é a seguinte:
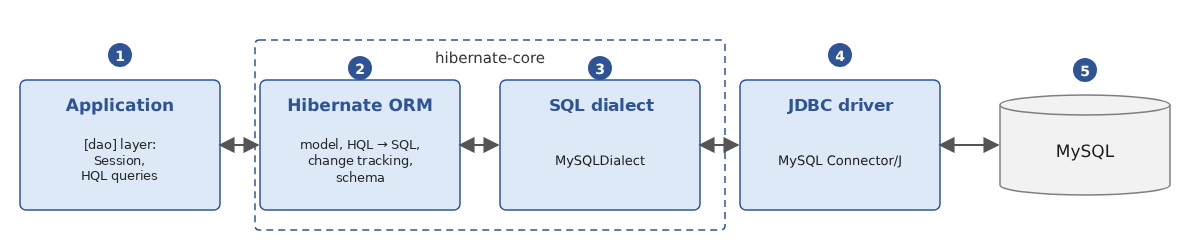
- [1]: a aplicação. Sua camada [dao] não se comunica mais diretamente com o driver JDBC, mas com o Hibernate, por meio de um objeto [Session] e de consultas HQL;
- [2]: o Hibernate, independente do SGBD: modelo, tradução de consultas, rastreamento de alterações, geração de esquema;
- [3]: o dialeto específico do SGBD (aqui, [MySQLDialect]): ele conhece a sintaxe SQL do SGBD, seus tipos de coluna e suas funções. Os dialetos dos principais SGBDs fazem parte do próprio Hibernate: não é preciso acrescentar nada ao projeto;
- [4]: o driver JDBC do SGBD, o do Capítulo 10 (MySQL Connector/J): o Hibernate não substitui o JDBC; ele o utiliza;
- [5]: o SGBD.
11.1.2. Jakarta Persistence e Hibernate
O Hibernate foi criado em 2001 por Gavin King em reação à complexidade dos “entity beans” da plataforma Java EE da época. Seu sucesso foi tal que seus conceitos foram incorporados a um padrão, o JPA (Java Persistence API), lançado em 2006 com o Java EE 5. Quando o Java EE foi transferido para a Eclipse Foundation e renomeado Jakarta EE, o JPA passou a se chamar Jakarta Persistence, e seus pacotes mudaram de [javax.persistence] para [jakarta.persistence] (versão 3.0, 2020). A versão atual é o Jakarta Persistence 3.2 (2024).
O Jakarta Persistence é uma especificação: um conjunto de interfaces ([EntityManagerFactory], [EntityManager]...), anotações ([@Entity], [@Id], [@Column]...) e uma linguagem de consulta, a JPQL. Ele é implementado por vários produtos: o Hibernate ORM (o mais utilizado, empregado no Spring Boot e no Quarkus), o EclipseLink (a implementação de referência)... Este curso usa o Hibernate ORM 7.4.5, que implementa o Jakarta Persistence 3.2.
O Hibernate oferece duas formas de utilização:
- exclusivamente por meio das interfaces padrão: nesse caso, o código depende apenas de [jakarta.persistence], e seria possível, em princípio, trocar de implementação;
- por meio de sua própria API “nativa”, mais rica em recursos, cujas interfaces estendem as do padrão: um [SessionFactory] é um [EntityManagerFactory], e uma [Session] é um [EntityManager].
Usamos a API própria do Hibernate, como recomenda a sua documentação: ela oferece todos os métodos padrão ([persist], [find], [merge], [remove]...) além das extensões do Hibernate. As anotações, porém, são sempre as definidas pelo padrão. A tabela a seguir mostra as correspondências:
Jakarta Persistence | Hibernate | Papel |
[EntityManagerFactory] | [SessionFactory] | Configuração do Hibernate para um banco de dados: um objeto pesado, criado uma única vez e compartilhado por toda a aplicação |
[EntityManager] | [Session] | Uma sessão com o banco de dados: um objeto leve e de curta duração |
[EntityTransaction] | [Transaction] | uma transação |
JPQL | HQL | a linguagem de consulta; HQL é um superconjunto de JPQL |
[CriteriaBuilder] | [HibernateCriteriaBuilder] | Construção de consultas por meio de código Java |
11.1.3. Bibliotecas
As bibliotecas usadas neste capítulo são as seguintes (elas estão resumidas no apêndice sobre as dependências Maven):
Dependência Maven | Papel |
[org.hibernate.orm:hibernate-core] 7.4.5.Final | O próprio Hibernate; inclui a API do Jakarta Persistence 3.2 ([jakarta.persistence-api]) e suas próprias dependências (Byte Buddy para geração de classes, ANTLR para análise de consultas, JBoss Logging para logs etc.) |
[com.mysql:mysql-connector-j] 9.7.0 | o driver JDBC para MySQL, o mesmo do Capítulo 10 |
[ch.qos.logback:logback-classic] 1.5.38 | Logback, que receberá o log do Hibernate |
O Hibernate escreve seu log (comandos SQL executados, avisos etc.) por meio do JBoss Logging, uma pequena biblioteca que simplesmente encaminha as mensagens para o sistema de log que encontrar no classpath: Log4j 2, ou Logback (via SLF4J) ou, na falta deles, o do JDK, [java.util.logging]. Sem configuração, este último exibe cada mensagem em duas linhas, em vermelho na maioria dos consoles, o que dificulta a leitura da saída do programa. Por isso adicionamos o Logback aos nossos projetos e o configuramos por meio de um arquivo [logback.xml].
11.1.4. Code first ou database first
O modelo (o mapeamento entre classes e tabelas) pode ser construído de duas maneiras:
- code-first: escrevemos as classes Java e o Hibernate deriva delas o esquema do banco de dados, que ele mesmo pode criar. É a abordagem adotada neste capítulo;
- database-first: o banco de dados já existe e as classes são geradas a partir de seu esquema, usando as ferramentas de engenharia reversa do Hibernate (Hibernate Tools) ou as dos ambientes de desenvolvimento (o IntelliJ IDEA pode gerar entidades a partir das tabelas do banco de dados). É a abordagem para aplicações que precisam trabalhar com um banco de dados existente. O código gerado é semelhante ao que escreveríamos à mão.
11.2. Um primeiro exemplo
11.2.1. O projeto
Os exemplos deste capítulo são módulos de um projeto Maven multimódulo (veja o Capítulo 6), localizado na pasta [11-hibernate]:
| 11-hibernate/
pom.xml the parent project
tools/ library: the compact SQL log
articles/ library: the Article entity and the [hbarticles] database
first/ a first example
model/ the model: annotations, XML file, creation script
crud/ persist, find, merge, remove
hql/ HQL queries
criteria/ Criteria API queries
relations/ relationships between entities
clients/ the evolution of the database schema
async/ Hibernate and virtual threads
transactions/ transactions
concurrency/ optimistic concurrency
rawsql/ native SQL
bulkupdate/ bulk updates
injection/ Hibernate and Spring
TaxV7/ the tax calculation application, version 7 (separate project)
|
O projeto pai define as versões das bibliotecas e das extensões Maven para todos os módulos:
| <?xml version="1.0" encoding="UTF-8"?>
<!-- os exemplos do capítulo 11: Hibernate; um módulo Maven por exemplo -->
<project xmlns="http://maven.apache.org/POM/4.0.0"
xmlns:xsi="http://www.w3.org/2001/XMLSchema-instance"
xsi:schemaLocation="http://maven.apache.org/POM/4.0.0 https://maven.apache.org/xsd/maven-4.0.0.xsd">
<modelVersion>4.0.0</modelVersion>
<groupId>examples.hibernate</groupId>
<artifactId>hibernate</artifactId>
<version>1.0</version>
<packaging>pom</packaging>
<!-- os módulos, na ordem de suas dependências -->
<modules>
<module>tools</module>
<module>articles</module>
<module>first</module>
<module>model</module>
<module>crud</module>
<module>hql</module>
<module>criteria</module>
<module>relations</module>
<module>clients</module>
<module>async</module>
<module>transactions</module>
<module>concurrency</module>
<module>rawsql</module>
<module>bulkupdate</module>
<module>injection</module>
</modules>
<properties>
<maven.compiler.release>25</maven.compiler.release>
<project.build.sourceEncoding>UTF-8</project.build.sourceEncoding>
</properties>
<!-- as versões das bibliotecas, comuns a todos os módulos -->
<dependencyManagement>
<dependencies>
<!-- as duas bibliotecas comuns do capítulo -->
<dependency>
<groupId>examples.hibernate</groupId>
<artifactId>tools</artifactId>
<version>1.0</version>
</dependency>
<dependency>
<groupId>examples.hibernate</groupId>
<artifactId>articles</artifactId>
<version>1.0</version>
</dependency>
<!-- Hibernate ORM (Jakarta Persistence 3.2) -->
<dependency>
<groupId>org.hibernate.orm</groupId>
<artifactId>hibernate-core</artifactId>
<version>7.4.5.Final</version>
</dependency>
<!-- o driver JDBC do MySQL -->
<dependency>
<groupId>com.mysql</groupId>
<artifactId>mysql-connector-j</artifactId>
<version>9.7.0</version>
</dependency>
<!-- logging: Logback (por meio do SLF4J) -->
<dependency>
<groupId>ch.qos.logback</groupId>
<artifactId>logback-classic</artifactId>
<version>1.5.38</version>
</dependency>
<!-- Spring Framework: injeção de dependência e transações -->
<dependency>
<groupId>org.springframework</groupId>
<artifactId>spring-context</artifactId>
<version>7.0.9</version>
</dependency>
<dependency>
<groupId>org.springframework</groupId>
<artifactId>spring-orm</artifactId>
<version>7.0.9</version>
</dependency>
<!-- o pool de conexões HikariCP -->
<dependency>
<groupId>com.zaxxer</groupId>
<artifactId>HikariCP</artifactId>
<version>7.0.2</version>
</dependency>
</dependencies>
</dependencyManagement>
<build>
<pluginManagement>
<plugins>
<plugin>
<groupId>org.apache.maven.plugins</groupId>
<artifactId>maven-compiler-plugin</artifactId>
<version>3.15.0</version>
<configuration>
<parameters>true</parameters>
<compilerArgs>
<arg>-Xlint:all</arg>
</compilerArgs>
</configuration>
</plugin>
<plugin>
<groupId>org.apache.maven.plugins</groupId>
<artifactId>maven-surefire-plugin</artifactId>
<version>3.5.6</version>
</plugin>
<!-- mvn exec:java executa a classe ${exec.mainClass}, definida por cada módulo -->
<plugin>
<groupId>org.codehaus.mojo</groupId>
<artifactId>exec-maven-plugin</artifactId>
<version>3.5.1</version>
<configuration>
<mainClass>${exec.mainClass}</mainClass>
</configuration>
</plugin>
</plugins>
</pluginManagement>
</build>
</project>
|
- linhas 14–30: os módulos, na ordem em que o Maven deve construí-los: primeiro as duas bibliotecas compartilhadas;
- linhas 38–87: a seção [dependencyManagement] especifica a versão de cada biblioteca. Um módulo que precisa de uma biblioteca a referencia sem indicar a versão;
- linhas 108–116: a extensão [exec-maven-plugin] executará a classe especificada pela propriedade [exec.mainClass], que cada módulo define.
O primeiro exemplo é o módulo [first]. Ele é independente dos demais:
| <?xml version="1.0" encoding="UTF-8"?>
<!-- um primeiro exemplo: uma entidade, um banco de dados, algumas instruções SQL geradas pelo Hibernate -->
<project xmlns="http://maven.apache.org/POM/4.0.0"
xmlns:xsi="http://www.w3.org/2001/XMLSchema-instance"
xsi:schemaLocation="http://maven.apache.org/POM/4.0.0 https://maven.apache.org/xsd/maven-4.0.0.xsd">
<modelVersion>4.0.0</modelVersion>
<parent>
<groupId>examples.hibernate</groupId>
<artifactId>hibernate</artifactId>
<version>1.0</version>
</parent>
<artifactId>first</artifactId>
<properties>
<!-- o programa executado por mvn exec:java -->
<exec.mainClass>first.Main</exec.mainClass>
</properties>
<dependencies>
<!-- Hibernate e o driver JDBC do MySQL -->
<dependency>
<groupId>org.hibernate.orm</groupId>
<artifactId>hibernate-core</artifactId>
</dependency>
<dependency>
<groupId>com.mysql</groupId>
<artifactId>mysql-connector-j</artifactId>
</dependency>
<!-- Logback: ele recebe o log do Hibernate -->
<dependency>
<groupId>ch.qos.logback</groupId>
<artifactId>logback-classic</artifactId>
</dependency>
</dependencies>
<build>
<plugins>
<plugin>
<groupId>org.codehaus.mojo</groupId>
<artifactId>exec-maven-plugin</artifactId>
</plugin>
</plugins>
</build>
</project>
|
- linhas 8–12: o projeto pai;
- linha 18: a classe principal do módulo;
- linhas 22–35: o Hibernate, o driver JDBC para MySQL e o Logback, sem número de versão (fornecido pelo projeto pai).
Para executar um exemplo, construa de uma vez por todas todos os módulos na pasta [11-hibernate] ([mvn install] instala as bibliotecas compartilhadas no repositório Maven local) e, em seguida, vá até a pasta do módulo:
| > cd 11-hibernate
> mvn install
> cd first
> mvn compile exec:java
|
O banco de dados usado é o banco [hbfirst] do servidor MySQL local, que é o servidor do Laragon (veja os apêndices). Ele ainda não precisa existir: o MySQL o criará.
11.2.2. A entidade [Article]
Uma classe cujos objetos são armazenados em uma tabela é chamada de entidade. Nossa primeira entidade é um item de loja, como na tabela [articles] do Capítulo 10:
| package first;
import jakarta.persistence.Entity;
import jakarta.persistence.GeneratedValue;
import jakarta.persistence.GenerationType;
import jakarta.persistence.Id;
import java.math.BigDecimal;
// um artigo da loja: uma classe Java comum, mais algumas anotações
@Entity
public class Article {
// a chave primária, gerada pelo SGBD
@Id
@GeneratedValue(strategy = GenerationType.IDENTITY)
private Integer id;
// as demais colunas da tabela
private String name;
private BigDecimal price;
private int currentStock;
private int minimumStock;
// o construtor sem parâmetros exigido pelo Hibernate
protected Article() {
}
// o construtor usado pelo programa
public Article(String name, BigDecimal price, int currentStock, int minimumStock) {
this.name = name;
this.price = price;
this.currentStock = currentStock;
this.minimumStock = minimumStock;
}
// exibição
@Override
public String toString() {
return "[%d, %s, %.2f, %d, %d]".formatted(id, name, price, currentStock, minimumStock);
}
}
|
- Linha 10: a anotação [@Entity] (pacote [jakarta.persistence]) designa a classe como uma entidade. Ela é quase uma classe Java comum, que não deriva de nenhuma classe do Hibernate: é chamada de POJO (“Plain Old Java Object”);
- linhas 14–16: a chave primária é designada pela anotação [@Id]. Não há convenção de nomenclatura: a anotação é obrigatória. [@GeneratedValue(strategy = GenerationType.IDENTITY)] indica que seus valores serão gerados pelo SGBD (coluna [AUTO_INCREMENT] do MySQL). Seu tipo é [Integer], e não [int]: o valor [null] significa “ainda não registrado no banco de dados”;
- linhas 18–21: cada campo da classe se torna uma coluna com o mesmo nome. Como a anotação [@Id] é aplicada a um campo, o Hibernate acessa os campos diretamente (lê e grava por reflexão, mesmo que sejam privados): a classe não precisa de métodos de acesso;
- linhas 24–25: o Jakarta Persistence exige um construtor sem parâmetros, que o Hibernate usa para criar os objetos lidos do banco de dados. Ele pode ser protegido ([protected]): o código da aplicação não o utilizará;
- linhas 28–33: o construtor usado pelo programa. Nenhum identificador é fornecido; ele será gerado pelo SGBD;
- linhas 36–39: uma exibição conveniente do item. O formato [%.2f] exibe o preço com duas casas decimais, de acordo com as convenções locais (uma vírgula na França).
Uma entidade não pode ser um record (Capítulo 4): o Hibernate precisa poder criar o objeto vazio, preencher seus campos e modificá-los quando a aplicação os altera, algo que a imutabilidade de um record impede. Os records continuam muito úteis com o Hibernate para resultados de consultas que não são entidades (projeções), como veremos.
11.2.3. [SessionFactory] e [Session]
O programa usa três objetos do Hibernate:
- [SessionFactory] representa o Hibernate configurado para um banco de dados: a lista de entidades, o banco de dados e as opções. Sua criação consome muitos recursos (o Hibernate analisa as entidades, conecta-se ao servidor para determinar sua versão e prepara o SQL das operações comuns): só se cria um por banco de dados e por aplicação, na inicialização. Ele é thread-safe: todas as threads da aplicação podem usá-lo;
- a [Session] representa uma sessão de trabalho com o banco de dados. Ela obtém uma conexão quando necessário, armazena as entidades que leu ou salvou e sabe como confirmar suas alterações no banco de dados. É um objeto leve e de curta duração, que não é thread-safe: abre-se uma para cada unidade de trabalho e, depois, fecha-se;
- [Transaction]: com o Hibernate, todas as gravações no banco de dados ocorrem dentro de uma transação explícita, aberta por [session.beginTransaction()] e encerrada por [commit] (confirmação) ou [rollback] (cancelamento).
[SessionFactory] e [Session] implementam a interface [AutoCloseable]: são criados em uma instrução [try] com recursos, que os fecha ao final do bloco.
11.2.4. O programa
| package first;
import java.math.BigDecimal;
import java.util.List;
import org.hibernate.Session;
import org.hibernate.SessionFactory;
import org.hibernate.Transaction;
import org.hibernate.jpa.HibernatePersistenceConfiguration;
public class Main {
public static void main(String[] args) {
// a SessionFactory: o Hibernate configurado para o banco de dados [hbfirst]
try (SessionFactory sessionFactory = new HibernatePersistenceConfiguration("first")
// as entidades
.managedClass(Article.class)
// o banco de dados; o MySQL o cria se ele não existir
.jdbcUrl("jdbc:mysql://localhost:3306/hbfirst?createDatabaseIfNotExist=true")
.jdbcCredentials("root", "")
// exibição das instruções SQL, formatadas, sem cores
.showSql(true, true, false)
.createEntityManagerFactory()) {
// as tabelas são excluídas e depois recriadas a partir das entidades
sessionFactory.getSchemaManager().drop(false);
sessionFactory.getSchemaManager().create(false);
// adição de três artigos, em uma transação
try (Session session = sessionFactory.openSession()) {
Transaction transaction = session.beginTransaction();
IO.println("--- persist");
session.persist(new Article("bike", BigDecimal.valueOf(500), 10, 5));
session.persist(new Article("pump", BigDecimal.valueOf(10), 10, 2));
session.persist(new Article("bow", BigDecimal.valueOf(600), 4, 1));
IO.println("--- commit");
transaction.commit();
}
// leitura da tabela, com uma nova sessão
IO.println("--- reading the articles");
try (Session session = sessionFactory.openSession()) {
List<Article> articles = session
.createSelectionQuery("from Article order by name", Article.class)
.getResultList();
for (Article article : articles) {
IO.println(article);
}
}
}
}
}
|
- linhas 14–22: criação do [SessionFactory]. Há várias maneiras de configurar o Hibernate (falaremos delas mais adiante); usamos a classe [HibernatePersistenceConfiguration] do Hibernate 7, uma versão aprimorada da classe [PersistenceConfiguration] introduzida com o Jakarta Persistence 3.2, que permite configurar tudo por meio de código. Seu parâmetro é o nome da unidade de persistência, um nome livremente escolhido que aparece nas mensagens do Hibernate. Cada método retorna a própria configuração, o que permite encadear as chamadas;
- linha 16: a lista de entidades;
- linhas 18–19: a URL JDBC do banco de dados [hbfirst], no mesmo formato do Capítulo 10, e o usuário ([root], sem senha no Laragon). O parâmetro [createDatabaseIfNotExist=true] da URL é uma opção do driver MySQL: ele cria o banco de dados caso não exista;
- Linha 21: [showSql(true, true, false)] instrui o Hibernate a imprimir no console cada comando SQL que executa, formatado em várias linhas (segundo parâmetro), sem cores (terceiro parâmetro). Observar o SQL enviado ao servidor é a melhor maneira de entender o que o Hibernate faz: faremos isso em todos os exemplos;
- Linha 22: [createEntityManagerFactory] constrói o [SessionFactory] (o nome do método é o do padrão; o tipo retornado é o do Hibernate);
- Linhas 25–26: o objeto [SchemaManager] do [SessionFactory] (Jakarta Persistence 3.2) gerencia as tabelas das entidades: [drop(false)] as exclui se existirem, [create(false)] as cria (o parâmetro [false] especifica que o próprio banco de dados não deve ser excluído nem criado). Isso é conveniente para exemplos e testes; uma aplicação real gerencia seu banco de dados de outra forma, como veremos;
- linha 29: [openSession()] abre uma sessão;
- linha 30: o início de uma transação;
- linhas 32–34: [persist] adiciona três novos itens à sessão: eles serão salvos no banco de dados. Nenhum valor é especificado para o identificador; ele será gerado pelo SGBD;
- linha 36: [commit] confirma a transação. Antes disso, a sessão envia ao servidor os comandos SQL ainda necessários para salvar as alterações que armazenou: isso é chamado de “flush” da sessão para o banco de dados;
- linhas 42–44: uma consulta escrita em HQL, a linguagem de consulta do Hibernate: os itens em ordem alfabética de nome. Ela se refere à entidade [Article] e ao seu campo [name], e não à tabela. O segundo parâmetro de [createSelectionQuery] é o tipo do resultado: [getResultList] retorna uma [List<Article>].
O arquivo [src/main/resources/logback.xml] do módulo configura o Logback. Ele exibe as mensagens do Hibernate de nível [INFO] ou superior, uma por linha (nível, nome do log, mensagem):
| <?xml version="1.0" encoding="UTF-8"?>
<!-- configuração do Logback: mensagens informativas do Hibernate, uma linha cada -->
<configuration>
<appender name="CONSOLE" class="ch.qos.logback.core.ConsoleAppender">
<encoder>
<pattern>%-5level %logger - %msg%n</pattern>
</encoder>
</appender>
<root level="INFO">
<appender-ref ref="CONSOLE"/>
</root>
</configuration>
|
Resultados:
| > mvn compile exec:java
INFO org.hibernate.orm.jpa - HHH008540: Processing PersistenceUnitInfo [name: first]
INFO org.hibernate.orm.core - HHH000001: Hibernate ORM core version 7.4.5.Final
WARN org.hibernate.orm.connections.pooling - HHH10001002: Using built-in connection pool (not intended for production use)
INFO org.hibernate.orm.connections.pooling - HHH10001005: Database info:
Database JDBC URL [jdbc:mysql://localhost:3306/hbfirst?createDatabaseIfNotExist=true]
Database driver: MySQL Connector/J
Database dialect: MySQLDialect
Database version: 8.0.46
Default catalog/schema: hbfirst/undefined
Autocommit mode: false
Isolation level: REPEATABLE_READ
JDBC fetch size: none
Pool: DriverManagerConnectionProvider
Minimum pool size: 1
Maximum pool size: 20
INFO org.hibernate.orm.core - HHH000489: No JTA platform available (set 'hibernate.transaction.jta.platform' to enable JTA platform integration)
Hibernate:
drop table if exists Article
Hibernate:
create table Article (
id integer not null auto_increment,
currentStock integer not null,
minimumStock integer not null,
name varchar(255),
price decimal(38,2),
primary key (id)
) engine=InnoDB
--- persist
Hibernate:
insert
into
Article
(currentStock, minimumStock, name, price)
values
(?, ?, ?, ?)
Hibernate:
insert
into
Article
(currentStock, minimumStock, name, price)
values
(?, ?, ?, ?)
Hibernate:
insert
into
Article
(currentStock, minimumStock, name, price)
values
(?, ?, ?, ?)
--- commit
--- reading the articles
Hibernate:
select
a1_0.id,
a1_0.currentStock,
a1_0.minimumStock,
a1_0.name,
a1_0.price
from
Article a1_0
order by
a1_0.name
[1, bike, 500.00, 10, 5]
[3, bow, 600.00, 4, 1]
[2, pump, 10.00, 10, 2]
|
Comentários:
- Linhas 2–17: mensagens informativas do Hibernate: o nome da unidade de persistência, a versão do Hibernate e as características do banco de dados (URL, driver, dialeto selecionado, versão do servidor, nível de isolamento das transações, tamanho do pool de conexões). O Hibernate consultou o servidor para selecionar o dialeto [MySQLDialect] adequado à sua versão;
- linha 4: um aviso. O Hibernate gerencia seu próprio pequeno pool de conexões, que não se destina a uma aplicação em produção. Veremos, com o Spring, como fornecer a ele o pool HikariCP do Capítulo 10; para nossos exemplos, o pool embutido é suficiente;
- Linhas 18–28: exclusão e, em seguida, criação da tabela [Article] com base na entidade: o nome da tabela é o mesmo da entidade, as colunas têm os mesmos nomes dos campos e a coluna [id] é a chave primária, com valor gerado ([auto_increment]). As colunas dos campos de tipo primitivo ([int]) são [not null]: um [int] não pode ser igual a [null]. As dos campos de tipo de referência ([String], [BigDecimal]) aceitam o valor [NULL];
- observe os tipos padrão: [varchar(255)] para uma string e [decimal(38,2)] para um [BigDecimal] (38 dígitos, incluindo 2 casas decimais). Raramente são os que você deseja: o parágrafo seguinte mostra como especificá-los;
- Linhas 29–51: os três comandos [INSERT] configurados foram executados assim que [persist] foi chamado, antes do [commit]. Isso é consequência de a chave ser gerada pelo SGBD ([IDENTITY]): a sessão precisa conhecer o identificador de uma entidade assim que passa a gerenciá-la e, para obtê-lo, deve executar a inserção (o driver JDBC retorna a chave gerada; veja o Capítulo 10). Com outros métodos de geração, as inserções são adiadas até que a sessão seja sincronizada. Os valores dos parâmetros ([?]) não são exibidos: veremos como fazê-los aparecer;
- linhas 53–63: a consulta HQL [from Article order by name] foi traduzida em um comando [SELECT ... ORDER BY]. O Hibernate atribuiu o alias [a1_0] à tabela e criou um objeto [Article] para cada linha lida (linhas 64–66).
Não escrevemos nenhum comando SQL nem código de leitura de colunas: esse é justamente o objetivo de um ORM. Também vemos que isso não significa que não seja necessário conhecer SQL: para determinar se o SQL gerado está correto e eficiente, é preciso saber lê-lo.
11.3. O modelo
O Hibernate constrói seu modelo a partir das entidades em três etapas:
- primeiro, aplica suas regras padrão: tudo o que não é especificado recebe um valor razoável (isso é conhecido como “configuração por exceção”);
- em seguida, complementa ou corrige esses valores usando as anotações colocadas nas entidades;
- por fim, aplica os arquivos de mapeamento XML ([orm.xml]), que podem descrever completamente uma classe sem anotações ou modificar o que suas anotações especificam.
11.3.1. Regras padrão
Vimos o essencial no primeiro exemplo:
- uma entidade leva a anotação [@Entity] e tem um identificador designado por [@Id]; ambas as anotações são obrigatórias;
- a posição da anotação [@Id] determina o modo de acesso: quando colocada em um campo, o Hibernate lê e grava os campos diretamente; quando colocada em um método de acesso ([getId]), ele usa os métodos de acesso ([getX]/[setX]). O acesso por campos é o mais comum: ele permite que a classe tenha os métodos que quiser;
- qualquer campo não estático é armazenado em uma coluna, a menos que tenha a anotação [@Transient] ou a palavra-chave [transient];
- o nome da tabela é o nome da entidade (o nome simples da classe) e o nome da coluna é o nome do campo. Esses nomes passam então por uma estratégia de nomenclatura: a estratégia do Hibernate mantém os nomes como estão, enquanto outra estratégia, que experimentaremos adiante, os converte para “snake case” ([currentStock] se torna [current_stock]). O Spring Boot usa esta última por padrão;
- uma coluna de tipo primitivo ([int], [double], [boolean]) torna-se [NOT NULL]; uma coluna de tipo de referência ([Integer], [String], [BigDecimal], [LocalDate]) aceita o valor [NULL];
- os tipos SQL são selecionados pelo dialeto. Com o MySQL: [integer] para [int], [bigint] para [long], [bit] para [boolean], [varchar(255)] para [String], [decimal(38,2)] para [BigDecimal], [date] para [LocalDate], [datetime(6)] (com precisão de microssegundos) para [LocalDateTime]. Por padrão, uma enumeração é registrada pelo seu número de ordem (veja o Capítulo 3); a anotação [@Enumerated(EnumType.STRING)] a registra pelo nome, o que é mais confiável;
- um campo que se refere a outra entidade, ou a uma coleção de entidades, define um relacionamento (falaremos dele mais adiante).
11.3.2. As anotações e o arquivo de mapeamento XML
O módulo [model] define duas entidades configuradas de duas maneiras diferentes. A primeira é configurada por meio de anotações:
| package model;
import jakarta.persistence.Column;
import jakarta.persistence.Entity;
import jakarta.persistence.GeneratedValue;
import jakarta.persistence.GenerationType;
import jakarta.persistence.Id;
import jakarta.persistence.Table;
import jakarta.persistence.Transient;
import java.math.BigDecimal;
import java.time.LocalDate;
// uma entidade configurada por anotações
@Entity
@Table(name = "products")
public class Product {
// a chave primária: @Id, qualquer que seja seu nome
@Id
@GeneratedValue(strategy = GenerationType.IDENTITY)
private Integer code;
// string obrigatória de no máximo 50 caracteres
@Column(nullable = false, length = 50)
private String name;
// string opcional (coluna NULL) de no máximo 200 caracteres
@Column(length = 200)
private String description;
// nome e tipo SQL da coluna impostos
@Column(name = "price_excl_tax", nullable = false, precision = 10, scale = 2)
private BigDecimal priceExclTax;
// uma data opcional: um objeto pode ser null
private LocalDate withdrawalDate;
// um campo sem coluna
@Transient
private boolean selected;
protected Product() {
}
// um método nunca é salvo: aqui o Hibernate acessa os campos, não os métodos
public BigDecimal getPriceInclTax() {
return priceExclTax.multiply(new BigDecimal("1.2"));
}
public boolean isSelected() {
return selected;
}
}
|
- linhas 3–9: anotações do Jakarta Persistence;
- linha 15: [@Table] especifica o nome da tabela;
- linhas 19–21: a chave primária, designada por [@Id] independentemente de seu nome;
- Linhas 24–25: [@Column] especifica a coluna; [nullable = false] torna-a obrigatória ([NOT NULL]); [length = 50] define seu comprimento ([varchar(50)]);
- linhas 28–29: uma descrição opcional de até 200 caracteres; a coluna aceitará o valor [NULL];
- linhas 32–33: [@Column] também especifica o nome da coluna ([price_excl_tax]) e, para um número decimal, sua precisão (o número total de dígitos) e sua escala (o número de dígitos após a vírgula decimal): [decimal(10,2)];
- linha 36: uma data opcional. O tipo [LocalDate] (Capítulo 5) representa uma data sem hora: ele é associado ao tipo SQL [date];
- linhas 39–40: [@Transient] exclui um campo do modelo: neste caso, uma informação útil para a interface com o usuário que não pertence ao banco de dados;
- linhas 46–48: um método, mesmo que nomeado como um getter, não é registrado, já que o Hibernate acessa os campos diretamente. Se o acesso fosse feito por getters, seria preciso acrescentar a ele a anotação [@Transient].
A segunda entidade não tem anotações:
| package model;
import java.time.LocalDateTime;
// uma classe sem nenhuma anotação: seu mapeamento é descrito pelo arquivo [supplier.orm.xml]
public class Supplier {
private Integer number;
private String companyName;
private String phone;
private LocalDateTime creationDate;
protected Supplier() {
}
public Supplier(String companyName, String phone) {
this.companyName = companyName;
this.phone = phone;
}
}
|
Seu mapeamento para a tabela é descrito por um arquivo XML, localizado na pasta [src/main/resources/META-INF] do módulo:
| <?xml version="1.0" encoding="UTF-8"?>
<!-- o mapeamento da classe [Supplier] para sua tabela, descrito em XML (Jakarta Persistence 3.2) -->
<entity-mappings xmlns="https://jakarta.ee/xml/ns/persistence/orm"
xmlns:xsi="http://www.w3.org/2001/XMLSchema-instance"
xsi:schemaLocation="https://jakarta.ee/xml/ns/persistence/orm
https://jakarta.ee/xml/ns/persistence/orm/orm_3_2.xsd"
version="3.2">
<entity class="model.Supplier" access="FIELD">
<table name="suppliers">
<!-- um índice único: dois fornecedores não podem ter a mesma razão social -->
<index name="ix_suppliers_company_name" column-list="companyName" unique="true"/>
</table>
<attributes>
<id name="number">
<generated-value strategy="IDENTITY"/>
</id>
<basic name="companyName">
<column nullable="false" length="60"/>
</basic>
<basic name="phone">
<column name="tel" length="20"/>
</basic>
<!-- um valor padrão calculado pelo SGBD: o Hibernate nunca escreve esta coluna -->
<basic name="creationDate">
<column nullable="false" insertable="false" updatable="false"
column-definition="datetime(6) default current_timestamp(6)"/>
</basic>
</attributes>
</entity>
</entity-mappings>
|
- linhas 3–7: o esquema XML dos arquivos de mapeamento do Jakarta Persistence 3.2;
- linha 8: a classe descrita, com acesso por campos;
- linhas 9–12: a tabela e um índice único sobre o nome da empresa: dois fornecedores não podem ter o mesmo nome. A anotação equivalente é [@Table(name = "suppliers", indexes = @Index(...))];
- linhas 14–16: o identificador, gerado pelo SGBD;
- linhas 17–19: uma coluna obrigatória de no máximo 60 caracteres;
- linhas 20–22: o campo [phone] é armazenado na coluna [tel];
- linhas 24–27: a data de criação tem um valor padrão, calculado pelo SGBD. O atributo [column-definition] fornece o texto SQL da definição da coluna, copiado literalmente no comando [CREATE TABLE]; [insertable="false"] e [updatable="false"] indicam que o Hibernate nunca deve gravar nessa coluna, o que permite ao SGBD usar [current_timestamp(6)].
Tudo o que as anotações fazem pode ser feito em XML. As anotações têm a vantagem de colocar a configuração junto ao campo, e essa é a abordagem mais comum; o arquivo XML, por outro lado, mantém as classes independentes do Jakarta Persistence e concentra a configuração em um único lugar. As duas abordagens podem ser combinadas: o arquivo XML prevalece em caso de conflito. O Jakarta Persistence não permite configurar o modelo por meio de código Java, como fazem outros frameworks (por exemplo, o Entity Framework em C#).
O programa exibe o modelo construído pelo Hibernate, seguido do script SQL que criaria as tabelas:
| package model;
import jakarta.persistence.metamodel.Attribute;
import jakarta.persistence.metamodel.EntityType;
import jakarta.persistence.metamodel.SingularAttribute;
import java.io.StringWriter;
import org.hibernate.SessionFactory;
import org.hibernate.boot.model.naming.PhysicalNamingStrategySnakeCaseImpl;
import org.hibernate.cfg.AvailableSettings;
import org.hibernate.jpa.HibernatePersistenceConfiguration;
public class Main {
public static void main(String[] args) {
// o script de criação das tabelas será escrito neste objeto
StringWriter script = new StringWriter();
// uma SessionFactory que nunca se conecta ao servidor
try (SessionFactory sessionFactory = new HibernatePersistenceConfiguration("model")
// uma entidade anotada e um mapeamento descrito em XML
.managedClass(Product.class)
.mappingFile("META-INF/supplier.orm.xml")
// sem banco de dados: o SGBD e sua versão são informados, para o dialeto SQL
.property(AvailableSettings.JAKARTA_HBM2DDL_DB_NAME, "MySQL")
.property(AvailableSettings.JAKARTA_HBM2DDL_DB_MAJOR_VERSION, "8")
.property(AvailableSettings.ALLOW_METADATA_ON_BOOT, false)
// os nomes das colunas em "snake case": companyName -> company_name
.property(AvailableSettings.PHYSICAL_NAMING_STRATEGY,
PhysicalNamingStrategySnakeCaseImpl.class.getName())
// o script de criação das tabelas, sem executá-lo
.property(AvailableSettings.JAKARTA_HBM2DDL_SCRIPTS_ACTION, "create")
.property(AvailableSettings.JAKARTA_HBM2DDL_SCRIPTS_CREATE_TARGET, script)
.property(AvailableSettings.HBM2DDL_DELIMITER, ";")
.property(AvailableSettings.FORMAT_SQL, true)
.createEntityManagerFactory()) {
// o modelo construído pelo Hibernate: entidades e atributos (Jakarta Persistence API)
for (EntityType<?> entity : sessionFactory.getMetamodel().getEntities()) {
IO.println("entity %s (%s)".formatted(entity.getName(), entity.getJavaType().getName()));
for (Attribute<?, ?> attribute : entity.getAttributes()) {
boolean id = attribute instanceof SingularAttribute<?, ?> s && s.isId();
IO.println(" %-14s %s%s".formatted(attribute.getName(),
attribute.getJavaType().getSimpleName(), id ? " (identifier)" : ""));
}
}
}
// o script de criação das tabelas, sem a indentação de 4 espaços de suas linhas
IO.println("--- creation script");
script.toString().strip().lines()
.map(line -> line.startsWith(" ") ? line.substring(4) : line)
.forEach(line -> IO.println(line.stripTrailing()));
}
}
|
- linha 16: um [StringWriter] (pacote [java.io]), um fluxo de escrita em uma string na memória, receberá o script SQL;
- linhas 20–21: a entidade anotada é declarada por [managedClass] e o arquivo XML por [mappingFile];
- linhas 23–25: o banco de dados [hbmodel] nunca existirá; este [SessionFactory] é usado unicamente para examinar o modelo. Por isso, não há URL JDBC. Para selecionar o dialeto SQL sem consultar o servidor, o Hibernate precisa do nome do SGBD e de sua versão; a propriedade [ALLOW_METADATA_ON_BOOT] ([hibernate.boot.allow_jdbc_metadata_access]) impede que ele se conecte na inicialização. Os nomes das propriedades de configuração são constantes da interface [AvailableSettings];
- linhas 27–28: a convenção de nomenclatura “snake case”;
- linhas 30–33: o Hibernate gravará o script de criação das tabelas (["create"]) no objeto [script] sem executá-lo; os comandos terminam com ponto e vírgula e são formatados em várias linhas;
- linha 37: o método [getMetamodel] (Jakarta Persistence) dá acesso ao modelo: suas entidades ([EntityType]) e, para cada uma, seus atributos ([Attribute]);
- Linhas 38–43: para cada entidade, seu nome e sua classe; para cada atributo, seu nome, seu tipo Java e se é o identificador. O filtro por padrão (pattern matching) na linha 40 ([instanceof SingularAttribute<?, ?> s && s.isId()], Capítulo 4) verifica o tipo do atributo e, se for o caso, o utiliza imediatamente;
- linhas 48–50: o script como exibido, sem a indentação de quatro espaços que o Hibernate acrescenta às suas linhas.
Resultados:
| > mvn compile exec:java
WARN connection - HHH102003: No appropriate connection provider encountered; client must supply connections
entity Supplier (model.Supplier)
number Integer (identifier)
companyName String
creationDate LocalDateTime
phone String
entity Product (model.Product)
code Integer (identifier)
description String
name String
priceExclTax BigDecimal
withdrawalDate LocalDate
--- creation script
create table products (
code integer not null auto_increment,
price_excl_tax decimal(10,2) not null,
withdrawal_date date,
name varchar(50) not null,
description varchar(200),
primary key (code)
) engine=InnoDB;
create table suppliers (
number integer not null auto_increment,
creation_date datetime(6) default current_timestamp(6) not null,
tel varchar(20),
company_name varchar(60) not null,
primary key (number)
) engine=InnoDB;
alter table suppliers
add constraint ix_suppliers_company_name unique (company_name);
|
- linha 2: o aviso do Hibernate confirma que ele não tem como obter uma conexão;
- linhas 3–13: as duas entidades e seus atributos (o identificador primeiro, depois os outros em ordem alfabética). O campo [selected] e o método [getPriceInclTax] não aparecem no modelo;
- linhas 15–21: a tabela [suppliers], descrita pelo arquivo XML. A estratégia de nomenclatura converteu [companyName] e [creationDate] em [company_name] e [creation_date]; a coluna [tel], cujo nome é fixo, permanece inalterada. A definição da coluna [creation_date] é a do arquivo XML, complementada por [not null];
- linhas 23–30: a tabela [products]. Os tipos SQL vêm das anotações ([varchar(50)], [decimal(10,2)]) ou das escolhas do dialeto para um tipo Java ([integer], [date]);
- linhas 32–33: o índice único, criado no MySQL por uma restrição de unicidade ([unique]).
11.3.3. Identificadores gerados
A anotação [@GeneratedValue] indica que o valor do identificador é gerado. Seu parâmetro [strategy] especifica como:
Estratégia | Geração do identificador |
[IDENTITY] | pelo SGBD, na inserção da linha (coluna [AUTO_INCREMENT] do MySQL, [IDENTITY] do SQL Server e do PostgreSQL) |
[SEQUENCE] | por uma sequência do SGBD (PostgreSQL, Oracle), que o Hibernate consulta antes da inserção |
[TABLE] | por uma tabela de contadores gerenciada pelo Hibernate |
[UUID] | pelo Hibernate: um identificador universal aleatório, como [java.util.UUID] |
[AUTO] (padrão) | o Hibernate escolhe; com o MySQL, que não tem sequências, ele as simula por meio de uma tabela chamada [<table>_SEQ] |
Com o MySQL, continuamos usando [IDENTITY], que corresponde ao comportamento natural da coluna [AUTO_INCREMENT]. Já vimos o resultado disso: o comando [INSERT] é executado assim que [persist] é chamado, e o Hibernate não consegue agrupar várias inserções em um lote (trataremos dos lotes mais adiante). A estratégia [SEQUENCE], que permite conhecer o ID antes da inserção, é preferível para os SGBDs que usam sequências.
11.3.4. Valores opcionais e colunas [NULL]
Portanto, o fato de uma coluna ser opcional é determinado em Java pelo tipo do campo (primitivo ou de referência) e pelo atributo [nullable] de [@Column]. Essa escolha deve ser feita com cuidado: a regra expressa ao mesmo tempo uma restrição no código Java (“este valor pode estar ausente”) e uma restrição no banco de dados. Algumas observações:
- [@Column(nullable = false)] define a restrição [NOT NULL] no esquema criado pelo Hibernate, e o Hibernate também a utiliza antes de enviar um comando [INSERT] ou [UPDATE] : se o campo for [null], ele não envia o comando e dispara uma [PropertyValueException] (“not-null property references a null or transient value”). Essa verificação do Hibernate é desativada por padrão quando o Jakarta Validation (abaixo) está presente: a validação passa então a depender de suas anotações ou, na falta delas, do SGBD, que rejeita o comando;
- Para uma validação mais completa, feita pelo Java antes de qualquer acesso ao banco de dados, usamos o Jakarta Validation (biblioteca [hibernate-validator]) e suas anotações [@NotNull], [@Size(max = 30)], [@Positive].... Quando presente no classpath, o Hibernate valida as entidades antes de salvá-las e leva essas anotações em conta ao criar as colunas;
- um campo não pode ser do tipo [Optional] (Capítulo 4), que não se destina a esse uso; no entanto, um método de acesso pode retornar um [Optional] construído a partir de um campo opcional: [return Optional.ofNullable(description);].
11.4. Os exemplos seguintes: duas bibliotecas comuns
Os exemplos dos parágrafos seguintes usam quase todos o banco de dados [hbarticles] e sua tabela [articles], populada com os seis itens do Capítulo 10. Em vez de repetir a entidade e a configuração do Hibernate em cada módulo, colocamos tudo em uma biblioteca, o módulo [articles], do qual os demais módulos dependem. Também substituímos o log SQL de [showSql], que é detalhado demais para nossos exemplos, por um log mais compacto, colocado em uma segunda biblioteca, o módulo [tools].
11.4.1. O log SQL compacto
Em vez de escrever diretamente no console ([showSql]), o Hibernate pode encaminhar sua atividade ao sistema de log (neste caso, o Logback), com cada categoria de mensagem escrita em um logger diferente:
Log | Nível | Mensagens |
[org.hibernate.SQL] | [DEBUG] | comandos SQL executados |
[org.hibernate.orm.jdbc.bind] | [TRACE] | o valor de cada parâmetro de um comando SQL |
[org.hibernate.orm.resource.jdbc] | [TRACE] | incluindo, entre outras coisas, o início, a confirmação e o cancelamento de transações |
[org.hibernate.orm.jdbc.batch] | [TRACE] | execução de lotes de comandos SQL |
[org.hibernate.orm.jdbc.error] | [WARN] | erros informados pelo SGBD |
Um log só registra mensagens de nível igual ou superior ao seu. Portanto, basta definir o nível desejado para esses logs no arquivo [logback.xml] para capturar essas mensagens. Nós as processamos por meio de uma classe de layout que as torna mais compactas:
| package tools;
import ch.qos.logback.classic.Level;
import ch.qos.logback.classic.Logger;
import ch.qos.logback.classic.spi.ILoggingEvent;
import ch.qos.logback.core.LayoutBase;
import java.util.ArrayList;
import java.util.List;
import java.util.regex.Matcher;
import java.util.regex.Pattern;
import java.util.stream.Collectors;
import java.util.stream.Stream;
import org.slf4j.LoggerFactory;
// um log compacto das instruções SQL executadas pelo Hibernate: um layout do Logback
public class SqlLog extends LayoutBase<ILoggingEvent> {
// os loggers do Hibernate usados
public static final String SQL = "org.hibernate.SQL";
public static final String PARAMETERS = "org.hibernate.orm.jdbc.bind";
public static final String TRANSACTIONS = "org.hibernate.orm.resource.jdbc";
public static final String ERRORS = "org.hibernate.orm.jdbc.error";
public static final String BATCHES = "org.hibernate.orm.jdbc.batch";
// o comprimento máximo de uma cláusula escrita em uma única linha
private static final int WIDTH = 100;
// a execução de um lote de instruções SQL: "Executing JDBC batch (3 / 3) - [...]"
private static final Pattern BATCH = Pattern.compile("Executing JDBC batch \\((\\d+) / \\d+\\).*");
// um parâmetro vinculado a uma instrução SQL: "binding parameter (1:VARCHAR) <- [bike]"
private static final Pattern PARAMETER =
Pattern.compile("binding parameter \\((\\d+):\\w+\\) <- \\[(.*)]");
// layout de uma mensagem: o texto a escrever é retornado ("": nada é escrito)
@Override
public String doLayout(ILoggingEvent event) {
String message = event.getFormattedMessage();
return switch (event.getLoggerName()) {
case SQL -> sqlStatement(message);
case PARAMETERS -> parameter(message);
case TRANSACTIONS -> transaction(message);
case ERRORS -> error(message);
case BATCHES -> batch(message);
default -> "";
};
}
// a instrução SQL formatada pelo Hibernate, tornada mais compacta: uma linha por cláusula (select, from...)
private static String sqlStatement(String sql) {
// as linhas não vazias, sem os espaços finais
List<String> lines = sql.lines().map(String::stripTrailing).filter(l -> !l.isBlank()).toList();
// as cláusulas: uma linha de nível superior (a menos indentada) e as linhas que a seguem
int indent = lines.stream().mapToInt(SqlLog::indent).min().orElse(0);
List<List<String>> clauses = new ArrayList<>();
for (String line : lines) {
if (clauses.isEmpty() || indent(line) == indent) {
clauses.add(new ArrayList<>());
}
clauses.getLast().add(line.substring(indent));
}
// cada cláusula é escrita em uma linha, se não for longa demais
StringBuilder text = new StringBuilder();
String start = "";
for (List<String> clause : clauses) {
String line = start + clause.stream().map(String::strip).collect(Collectors.joining(" "));
if (line.equals("insert") || line.equals("delete")) {
// [insert into ...], [delete from ...]: uma única linha
start = line + " ";
continue;
}
if (line.length() <= WIDTH) {
text.append(" SQL> ").append(line).append('\n');
} else {
// cláusula longa demais: as linhas do Hibernate são mantidas
for (int i = 0; i < clause.size(); i++) {
text.append(" SQL> ").append(i == 0 ? start : "").append(clause.get(i)).append('\n');
}
}
start = "";
}
return text.toString();
}
// o número de espaços no início da linha
private static int indent(String line) {
return line.length() - line.stripLeading().length();
}
// o valor de um parâmetro da instrução SQL
private static String parameter(String message) {
Matcher m = PARAMETER.matcher(message);
return m.matches() ? " SQL> -- parameter " + m.group(1) + " = " + m.group(2) + "\n" : "";
}
// início, commit e rollback das transações (as outras mensagens são ignoradas)
private static String transaction(String message) {
if (message.startsWith("HHH10003002")) {
return " SQL> -- start of transaction\n";
}
if (message.startsWith("HHH10003004")) {
return " SQL> -- transaction committed (COMMIT)\n";
}
if (message.startsWith("HHH10003006")) {
return " SQL> -- transaction rolled back (ROLLBACK)\n";
}
return "";
}
// o erro informado pelo SGBD (a linha que dá seus códigos de erro é ignorada)
private static String error(String message) {
return message.startsWith("HHH000247") ? "" : " SQL> -- failure: " + message + "\n";
}
// a execução de um lote de instruções SQL (as outras mensagens são ignoradas)
private static String batch(String message) {
Matcher m = BATCH.matcher(message);
return m.matches() ? " SQL> -- execution of a batch of " + m.group(1) + " statement(s)\n" : "";
}
// executa uma ação sem log SQL
public static void withoutLog(Runnable action) {
List<Logger> loggers = Stream.of(SQL, PARAMETERS, TRANSACTIONS, ERRORS, BATCHES)
.map(SqlLog::logger)
.toList();
// os níveis atuais, restaurados no fim
List<Level> levels = loggers.stream().map(Logger::getLevel).toList();
loggers.forEach(l -> l.setLevel(Level.OFF));
try {
action.run();
} finally {
for (int i = 0; i < loggers.size(); i++) {
loggers.get(i).setLevel(levels.get(i));
}
}
}
// o logger do Logback com o nome informado
private static Logger logger(String name) {
return (Logger) LoggerFactory.getLogger(name);
}
}
|
- linha 16: uma classe de layout do Logback deriva da classe [LayoutBase<ILoggingEvent>]; seu método [doLayout] (linhas 36–47) recebe cada mensagem (um [ILoggingEvent]) e retorna o texto a ser escrito;
- linhas 19–23: os nomes dos logs do Hibernate utilizados;
- linhas 39–46: o processamento depende do log que enviou a mensagem ([switch] sobre uma string, usando a sintaxe de “seta” do Java 14);
- linhas 50–83: o comando SQL, como formatado pelo Hibernate ([format_sql]), distribuído em várias linhas, com uma coluna por linha. Nós o tornamos mais compacto. As linhas não vazias são divididas em cláusulas (linhas 54–61): uma cláusula começa com uma linha de nível superior ([select], [from], [where]...) e inclui as linhas indentadas que a seguem. Cada cláusula é então escrita em uma única linha, precedida por [SQL>], se não exceder 100 caracteres (linhas 72–73); caso contrário, suas linhas são mantidas (linhas 76–78). As cláusulas [insert] e [delete] são combinadas com a seguinte (linhas 67–71);
- linhas 91–94: a mensagem do Hibernate que informa o valor de um parâmetro tem o formato [binding parameter (1:VARCHAR) <- [bike]]. A expressão regular das linhas 32–33 (Capítulo 5) extrai o número do parâmetro e seu valor;
- linhas 97–108: entre as muitas mensagens do log [org.hibernate.orm.resource.jdbc], apenas as que indicam o início, a confirmação e o cancelamento de uma transação são mantidas. Cada mensagem do Hibernate começa com um código ([HHH10003002]...) que a identifica de forma única;
- linhas 111–113: um erro do SGBD. O Hibernate o escreve em duas mensagens: uma contendo os códigos de erro (que ignoramos) e outra contendo o texto do erro;
- linhas 116–119: execução de um lote de comandos SQL, que encontraremos no final do capítulo;
- Linhas 122–136: o método [withoutLog] executa uma ação sem log (SQL). Ele usa a API do Logback: cada log ([Logger]) tem um nível que pode ser modificado durante a execução. Definimos os cinco logs com o nível [OFF], executamos a ação e depois restauramos os níveis originais em uma cláusula [finally], de modo que eles voltem a esses níveis mesmo que a ação lance uma exceção;
- linhas 139–141: [LoggerFactory] é a classe do SLF4J que retorna um log; como o Logback é a implementação atual do SLF4J, o objeto retornado é um [ch.qos.logback.classic.Logger].
O módulo [tools] também contém o arquivo [logback.xml] usado nos exemplos. Colocado na raiz do classpath ([src/main/resources]), ele é encontrado pelo Logback quando o programa é iniciado:
| <?xml version="1.0" encoding="UTF-8"?>
<!-- configuração do Logback para os exemplos do capítulo -->
<configuration>
<!-- o log SQL compacto: layout pela classe [tools.SqlLog] -->
<appender name="SQL" class="ch.qos.logback.core.ConsoleAppender">
<encoder class="ch.qos.logback.core.encoder.LayoutWrappingEncoder">
<layout class="tools.SqlLog"/>
</encoder>
</appender>
<!-- as outras mensagens: nível, nome curto do logger, texto -->
<appender name="CONSOLE" class="ch.qos.logback.core.ConsoleAppender">
<encoder>
<pattern>%-5level %logger{0} - %msg%n</pattern>
</encoder>
</appender>
<!-- as instruções SQL (DEBUG), seus parâmetros, as transações, os lotes (TRACE) e os erros -->
<logger name="org.hibernate.SQL" level="DEBUG" additivity="false">
<appender-ref ref="SQL"/>
</logger>
<logger name="org.hibernate.orm.jdbc.bind" level="TRACE" additivity="false">
<appender-ref ref="SQL"/>
</logger>
<logger name="org.hibernate.orm.resource.jdbc" level="TRACE" additivity="false">
<appender-ref ref="SQL"/>
</logger>
<logger name="org.hibernate.orm.jdbc.batch" level="TRACE" additivity="false">
<appender-ref ref="SQL"/>
</logger>
<logger name="org.hibernate.orm.jdbc.error" level="WARN" additivity="false">
<appender-ref ref="SQL"/>
</logger>
<!-- o pool de conexões embutido do Hibernate basta para nossos exemplos: seu aviso é silenciado -->
<logger name="org.hibernate.orm.connections.pooling" level="ERROR"/>
<!-- excluir as tabelas de um banco de dados vazio causa erros inofensivos: eles são silenciados -->
<logger name="org.hibernate.tool.schema" level="OFF"/>
<!-- todos os outros loggers: somente avisos e erros -->
<root level="WARN">
<appender-ref ref="CONSOLE"/>
</root>
</configuration>
|
- linhas 6–10: um “appender” escreve as mensagens, neste caso no console. Ele usa nossa formatação;
- linhas 13–17: um segundo “appender” para as demais mensagens: nível, nome curto do log, texto;
- linhas 20–34: os logs do Hibernate da tabela anterior, com seus níveis. Suas mensagens vão para o “appender” [SQL] e somente para ele ([additivity="false"]: elas não são encaminhadas adicionalmente ao log raiz);
- linha 37: o aviso sobre o pool de conexões embutido do Hibernate é suprimido;
- linha 40: o Hibernate exclui as tabelas começando pelas chaves estrangeiras; em um banco de dados vazio, essas exclusões falham sem consequências, mas o Hibernate registra isso de forma extensa. Essas mensagens são suprimidas;
- linhas 43–45: os demais logs registram apenas avisos e erros.
O módulo [tools] tem apenas uma dependência: o Logback. Uma biblioteca normalmente não impõe sua configuração de log às aplicações que a usam; fazemos isso aqui para evitar repetir esse arquivo em cada exemplo.
11.4.2. A entidade e o banco de dados de artigos
A entidade [Article] do módulo [articles] usa as anotações do parágrafo anterior. Eis o início do código; o restante contém os dois construtores da entidade do primeiro exemplo, os métodos [getX]/[setX] (getters e setters) de cada campo (exceto [setId]: o identificador é gerenciado pelo Hibernate) e o mesmo método [toString]:
| package articles;
import jakarta.persistence.Column;
import jakarta.persistence.Entity;
import jakarta.persistence.GeneratedValue;
import jakarta.persistence.GenerationType;
import jakarta.persistence.Id;
import jakarta.persistence.Table;
import jakarta.persistence.UniqueConstraint;
import java.math.BigDecimal;
// um artigo da loja, com as anotações que especificam sua tabela
@Entity
@Table(name = "articles",
uniqueConstraints = @UniqueConstraint(name = "uk_articles_name", columnNames = "name"))
public class Article {
// chave primária, gerada pelo SGBD (AUTO_INCREMENT)
@Id
@GeneratedValue(strategy = GenerationType.IDENTITY)
private Integer id;
// nome do artigo: obrigatório, no máximo 30 caracteres, único (ver @Table)
@Column(nullable = false, length = 30)
private String name;
// preço: 10 dígitos, dos quais 2 após a vírgula decimal
@Column(nullable = false, precision = 10, scale = 2)
private BigDecimal price;
// estoque atual e estoque mínimo abaixo do qual é preciso repor
private int currentStock;
private int minimumStock;
// o construtor sem parâmetros exigido pelo Hibernate (pode ser protected)
protected Article() {
}
|
- linhas 14–15: a tabela chama-se [articles], como no Capítulo 10. O parâmetro [uniqueConstraints] declara uma restrição de unicidade, chamada [uk_articles_name], sobre a coluna [name]: dois itens não podem ter o mesmo nome. Sem um nome explícito, o Hibernate geraria um nome ilegível ([UK3f8k...]), que apareceria nas mensagens de erro;
- linhas 24–25: um nome obrigatório de no máximo 30 caracteres;
- linhas 28–29: um preço em [decimal(10,2)].
A classe [BaseArticles] contém a configuração do Hibernate para o banco de dados [hbarticles]:
| package articles;
import java.math.BigDecimal;
import org.hibernate.SessionFactory;
import org.hibernate.cfg.AvailableSettings;
import org.hibernate.jpa.HibernatePersistenceConfiguration;
import tools.SqlLog;
// o banco de dados [hbarticles]: configuração do Hibernate e inicialização do banco de dados
public final class BaseArticles {
// o banco de dados; o MySQL o cria se ele não existir (createDatabaseIfNotExist)
public static final String URL = "jdbc:mysql://localhost:3306/hbarticles?createDatabaseIfNotExist=true";
public static final String USER = "root";
public static final String PASSWORD = "";
// classe utilitária: sem instância
private BaseArticles() {
}
// a configuração do Hibernate: entidades, banco de dados, formatação do SQL registrado no log
public static HibernatePersistenceConfiguration configuration() {
return new HibernatePersistenceConfiguration("articles")
.managedClass(Article.class)
.jdbcUrl(URL)
.jdbcCredentials(USER, PASSWORD)
.property(AvailableSettings.FORMAT_SQL, true);
}
// uma SessionFactory para o banco de dados [hbarticles], com a configuração anterior
public static SessionFactory createSessionFactory() {
return configuration().createEntityManagerFactory();
}
// (re)criação da tabela [articles] com seus seis artigos, sem log SQL
public static void initialize(SessionFactory sessionFactory) {
SqlLog.withoutLog(() -> {
// exclusão e depois criação das tabelas das entidades
sessionFactory.getSchemaManager().drop(false);
sessionFactory.getSchemaManager().create(false);
// os seis artigos, adicionados em uma transação
sessionFactory.inTransaction(session -> {
session.persist(new Article("bike", BigDecimal.valueOf(500), 10, 5));
session.persist(new Article("pump", BigDecimal.valueOf(10), 10, 2));
session.persist(new Article("bow", BigDecimal.valueOf(600), 4, 1));
session.persist(new Article("arrows - set of 6", BigDecimal.valueOf(100), 12, 20));
session.persist(new Article("diving suit", BigDecimal.valueOf(300), 8, 2));
session.persist(new Article("diver's oxygen tanks", BigDecimal.valueOf(120), 10, 5));
});
});
}
}
|
- linhas 13–15: a URL do banco de dados e o usuário, ambos públicos para que outros módulos possam usá-los;
- linhas 22–28: a configuração do Hibernate. Ela é retornada por um método público, o que permitirá a uma instância completá-la antes de criar o [SessionFactory]. A propriedade [FORMAT_SQL] ([hibernate.format_sql]) instrui o Hibernate a formatar o SQL, que ele então passa ao log [org.hibernate.SQL]: são esses dados formatados que a classe [SqlLog]condensa em seguida;
- linhas 31–33: o [SessionFactory] do banco de dados [hbarticles];
- linhas 36–51: um método que recria a tabela [articles] com seus seis itens, sem o log SQL: não queremos ver o SQL dessa inicialização nos resultados dos exemplos;
- linha 42: [sessionFactory.inTransaction(session -> ...)] abre uma sessão, inicia uma transação, executa a lambda (Capítulo 7) passando-lhe a sessão, confirma a transação (ou a cancela se a lambda lançar uma exceção) e fecha a sessão. É a maneira mais curta de escrever uma unidade de trabalho; nós a usaremos com frequência, junto com suas variantes [inSession] (uma sessão sem transação), [fromTransaction], e [fromSession] (que retornam o resultado da lambda).
O módulo [articles] depende do módulo [tools], do Hibernate e do driver JDBC:
| <dependencies>
<!-- o log SQL compacto (e o Logback) -->
<dependency>
<groupId>examples.hibernate</groupId>
<artifactId>tools</artifactId>
</dependency>
<!-- Hibernate e o driver JDBC do MySQL -->
<dependency>
<groupId>org.hibernate.orm</groupId>
<artifactId>hibernate-core</artifactId>
</dependency>
<dependency>
<groupId>com.mysql</groupId>
<artifactId>mysql-connector-j</artifactId>
</dependency>
</dependencies>
|
Os módulos de exemplo precisam, portanto, de apenas uma dependência, a do módulo [articles]; o Maven adiciona as dependências desse módulo (chamadas de dependências transitivas). Eis as dependências do módulo [crud]:
| <dependencies>
<!-- a entidade [Article] e o banco de dados [hbarticles] (Hibernate, MySQL e o log SQL incluídos) -->
<dependency>
<groupId>examples.hibernate</groupId>
<artifactId>articles</artifactId>
</dependency>
</dependencies>
|
11.4.3. Outras maneiras de configurar o Hibernate
Configuramos o Hibernate de forma programática por meio de [HibernatePersistenceConfiguration]. Há outras maneiras de fazê-lo, que você encontrará em aplicações e na documentação:
- um arquivo [META-INF/persistence.xml], a abordagem tradicional do Jakarta Persistence: ele descreve uma ou mais unidades de persistência (classes de entidades, propriedades de conexão, opções) e a factory é criada por meio de [Persistence.createEntityManagerFactory("articles")];
- um arquivo [hibernate.properties] (ou [hibernate.cfg.xml]), específico do Hibernate, lido pela classe [org.hibernate.cfg.Configuration]: [new Configuration().addAnnotatedClass(Article.class).buildSessionFactory()]. Essa é a abordagem usada nas versões mais antigas do Hibernate;
- em uma aplicação Spring Boot, as propriedades [spring.datasource.*] e [spring.jpa.*] do arquivo [application.properties]: o Spring Boot cria a factory por conta própria.
As propriedades são as mesmas em todos os casos ([hibernate.format_sql], [jakarta.persistence.jdbc.url]...): só muda a maneira de especificá-las.
11.5. Operações básicas: adicionar, ler, atualizar, excluir
11.5.1. O programa [crud]
O módulo [crud] demonstra as quatro operações básicas (CRUD: Create, Read, Update, Delete), bem como o rastreamento de entidades pela sessão. Para tornar esse rastreamento visível, ele usa alguns métodos internos do Hibernate (seu “SPI”, Service Provider Interface), destinados a extensões do Hibernate e não a aplicações: eles estão agrupados nos métodos utilitários no final do programa.
| package crud;
import articles.Article;
import articles.BaseArticles;
import java.math.BigDecimal;
import java.util.Map;
import java.util.Objects;
import org.hibernate.Session;
import org.hibernate.SessionFactory;
import org.hibernate.Transaction;
import org.hibernate.engine.spi.EntityEntry;
import org.hibernate.engine.spi.PersistenceContext;
import org.hibernate.engine.spi.SessionImplementor;
import org.hibernate.persister.entity.EntityPersister;
public class Main {
public static void main(String[] args) {
try (SessionFactory sessionFactory = BaseArticles.createSessionFactory()) {
// a tabela [articles] é recriada com seus seis artigos
BaseArticles.initialize(sessionFactory);
try (Session session = sessionFactory.openSession()) {
// 1 - busca pela chave primária
IO.println("--- find(1)");
Article bike = session.find(Article.class, 1);
IO.println(bike);
IO.println("--- find(1) a second time");
Article bike2 = session.find(Article.class, 1);
IO.println("same object: " + (bike == bike2));
// 2 - adição de um artigo
IO.println("--- persist");
Transaction transaction = session.beginTransaction();
Article x = new Article("x", BigDecimal.valueOf(100), 10, 1);
IO.println("before persist: state=" + state(session, x) + ", id=" + x.getId());
session.persist(x);
IO.println("after persist: state=" + state(session, x) + ", id=" + x.getId());
transaction.commit();
// 3 - modificação: basta modificar o objeto
IO.println("--- modification of the price");
transaction = session.beginTransaction();
x.setPrice(x.getPrice().multiply(new BigDecimal("1.1")));
IO.println("session modified: %s, original price=%s, current price=%s"
.formatted(session.isDirty(), originalValue(session, x, "price"), x.getPrice()));
IO.println("--- commit");
transaction.commit();
IO.println("after commit: session modified: " + session.isDirty());
// 4 - exclusão
IO.println("--- remove");
transaction = session.beginTransaction();
session.remove(x);
IO.println("before commit: state=" + state(session, x));
transaction.commit();
IO.println("after commit: state=" + state(session, x));
// 5 - um objeto detached, modificado e depois mesclado com a sessão
IO.println("--- detach and merge");
Article bow = session.find(Article.class, 3);
session.detach(bow);
IO.println("after detach: state=" + state(session, bow));
bow.setPrice(BigDecimal.valueOf(550));
transaction = session.beginTransaction();
Article managedBow = session.merge(bow);
IO.println("merge: same object=%s, state of the returned object=%s"
.formatted(bow == managedBow, state(session, managedBow)));
transaction.commit();
// 6 - as entidades rastreadas pela sessão
IO.println("--- the tracked entities");
bike.setCurrentStock(bike.getCurrentStock() - 1);
displayTrackedEntities(session);
}
}
}
// o estado de um artigo em relação à sessão (API interna do Hibernate)
private static String state(Session session, Article article) {
EntityEntry entry = context(session).getEntry(article);
if (entry != null) {
// MANAGED, DELETED...
return entry.getStatus().name();
}
// um objeto desconhecido da sessão: nunca salvo (sem identificador) ou detached
return article.getId() == null ? "TRANSIENT" : "DETACHED";
}
// o valor de uma propriedade tal como foi lido do banco de dados (API interna do Hibernate)
private static Object originalValue(Session session, Object entity, String property) {
return context(session).getEntry(entity).getLoadedValue(property);
}
// as entidades do contexto de persistência da sessão (API interna do Hibernate)
private static void displayTrackedEntities(Session session) {
for (Map.Entry<Object, EntityEntry> pair : context(session).reentrantSafeEntityEntries()) {
EntityEntry entry = pair.getValue();
EntityPersister persister = entry.getPersister();
IO.println("%s #%s %s".formatted(persister.getEntityName(), entry.getId(), entry.getStatus()));
// valores atuais das propriedades, comparados com os valores lidos do banco de dados
String[] names = persister.getPropertyNames();
Object[] current = persister.getValues(pair.getKey());
Object[] originals = entry.getLoadedState();
for (int i = 0; i < names.length; i++) {
String modification = Objects.equals(current[i], originals[i]) ? ""
: " (modified, original value: " + originals[i] + ")";
IO.println(" %s : %s%s".formatted(names[i], current[i], modification));
}
}
IO.println("session modified: " + session.isDirty());
}
// o contexto de persistência da sessão (API interna do Hibernate)
private static PersistenceContext context(Session session) {
return session.unwrap(SessionImplementor.class).getPersistenceContext();
}
}
|
Resultados:
| > mvn compile exec:java
--- find(1)
SQL> select a1_0.id, a1_0.currentStock, a1_0.minimumStock, a1_0.name, a1_0.price
SQL> from articles a1_0
SQL> where a1_0.id=?
SQL> -- parameter 1 = 1
[1, bike, 500.00, 10, 5]
--- find(1) a second time
same object: true
--- persist
SQL> -- start of transaction
before persist: state=TRANSIENT, id=null
SQL> insert into articles (currentStock, minimumStock, name, price)
SQL> values (?, ?, ?, ?)
SQL> -- parameter 1 = 10
SQL> -- parameter 2 = 1
SQL> -- parameter 3 = x
SQL> -- parameter 4 = 100
after persist: state=MANAGED, id=7
SQL> -- transaction committed (COMMIT)
--- modification of the price
SQL> -- start of transaction
session modified: true, original price=100, current price=110.0
--- commit
SQL> update articles
SQL> set currentStock=?, minimumStock=?, name=?, price=?
SQL> where id=?
SQL> -- parameter 1 = 10
SQL> -- parameter 2 = 1
SQL> -- parameter 3 = x
SQL> -- parameter 4 = 110.0
SQL> -- parameter 5 = 7
SQL> -- transaction committed (COMMIT)
after commit: session modified: false
--- remove
SQL> -- start of transaction
before commit: state=DELETED
SQL> delete from articles
SQL> where id=?
SQL> -- parameter 1 = 7
SQL> -- transaction committed (COMMIT)
after commit: state=DETACHED
--- detach and merge
SQL> select a1_0.id, a1_0.currentStock, a1_0.minimumStock, a1_0.name, a1_0.price
SQL> from articles a1_0
SQL> where a1_0.id=?
SQL> -- parameter 1 = 3
after detach: state=DETACHED
SQL> -- start of transaction
SQL> select a1_0.id, a1_0.currentStock, a1_0.minimumStock, a1_0.name, a1_0.price
SQL> from articles a1_0
SQL> where a1_0.id=?
SQL> -- parameter 1 = 3
merge: same object=false, state of the returned object=MANAGED
SQL> update articles
SQL> set currentStock=?, minimumStock=?, name=?, price=?
SQL> where id=?
SQL> -- parameter 1 = 4
SQL> -- parameter 2 = 1
SQL> -- parameter 3 = bow
SQL> -- parameter 4 = 550
SQL> -- parameter 5 = 3
SQL> -- transaction committed (COMMIT)
--- the tracked entities
articles.Article #1 MANAGED
currentStock : 9 (modified, original value: 10)
minimumStock : 5
name : bike
price : 500.00
articles.Article #3 MANAGED
currentStock : 4
minimumStock : 1
name : bow
price : 550
session modified: true
|
Comentários:
- Linha 25: [session.find(Article.class, 1)] procura o registro de chave primária 1. Retorna [null] se a chave não existir. O SQL gerado (linhas 3–6 dos resultados) é um [SELECT] parametrizado, em que o parâmetro vale 1: o log compacto agora exibe os valores dos parâmetros;
- linha 28: a segunda chamada a [find(Article.class, 1)] não envia nenhum comando SQL e retorna o mesmo objeto (linha 9). A sessão armazena as entidades que leu ou salvou em seu contexto de persistência, também conhecido como cache de primeiro nível: antes de consultar o banco de dados, [find] verifica se a entidade solicitada já está ali. Uma sessão nunca contém dois objetos para a mesma linha do banco de dados;
- Linhas 34–37: adição de um item. Antes de [persist], o objeto está [TRANSIENT] (“transiente”): a sessão não o conhece e seu identificador é [null] (linha 12). [persist] o traz para a sessão, que executa imediatamente o comando [INSERT] (linhas 13–18) para obter a chave gerada e a coloca no campo [id]. O item passa então ao estado [MANAGED] (“gerenciado” ou “persistente”) e seu identificador é 7 (linha 19). A transação é aberta na linha 33 e confirmada na linha 38 (linhas 11 e 20 dos resultados);
- linha 43: para modificar uma linha no banco de dados, basta modificar o objeto. Nenhum método [update] é necessário: a sessão guardou uma cópia dos valores lidos ou salvos (o estado original) e compara os valores atuais com ela. Isso é conhecido como “dirty checking”;
- linhas 44–45: [session.isDirty()] indica se a sessão contém alterações que ainda não foram confirmadas no banco de dados: é o caso aqui (linha 23). O método [originalValue] (linhas 90–92) lê do contexto de persistência o valor original do preço, 100, enquanto o valor atual é 110.0;
- Linha 47: [commit] sincroniza a sessão com o banco de dados (“flush”): o comando [UPDATE] é executado (linhas 25–32) e, em seguida, a transação é confirmada. Depois disso, a sessão não tem alterações pendentes (linha 34);
- observe que o comando [UPDATE] grava todas as colunas da tabela, e não apenas a que mudou. Esse é o comportamento padrão do Hibernate: um único comando SQL, preparado de uma vez por todas, é usado para todas as atualizações de artigos. Em contrapartida, a anotação [@DynamicUpdate] colocada na entidade instrui o Hibernate a gerar a cada vez um comando limitado às colunas modificadas;
- Linhas 53–56: exclusão. [remove] muda o estado do artigo para [DELETED] (linha 37); [commit] envia o comando [DELETE] (linhas 38–40). O objeto deixa então de ser reconhecido pela sessão: ele passa ao estado [DETACHED] (“desanexado”, linha 42);
- linhas 60–63: o arco (bow) é lido (linhas 44–47) e depois desanexado da sessão por [detach]: a sessão o esquece (linha 48). Qualquer alteração em seu preço é, então, ignorada. Um objeto desanexado é algo comum em uma aplicação: é um objeto lido por uma sessão que agora está fechada (por exemplo, durante uma requisição HTTP anterior) e posteriormente modificado pelo usuário;
- linha 65: [session.merge(bow)] mescla o objeto desanexado com a sessão. A sessão lê o registro no banco de dados (linhas 50–53), copia o estado do objeto desanexado para a entidade que gerencia e retorna esta última: não se trata do mesmo objeto (linha 54). O objeto passado a [merge] continua desanexado; o objeto retornado é o que deve ser usado em seguida. [commit] salva o novo preço (linhas 55–62);
- linha 72: o estoque da bicicleta (bike) é atualizado, sem salvar;
- linhas 95–111: exibição do contexto de persistência. Para cada entidade rastreada ([EntityEntry]), são exibidos seu nome, ID e estado, seguidos do valor atual de cada propriedade e de seu valor original, se diferente. O objeto [EntityPersister] é aquele, no Hibernate, que conhece o mapeamento entre uma entidade e sua tabela: ele fornece os nomes das propriedades e seus valores;
- Linhas 65–75 dos resultados: a sessão rastreia a bicicleta, cujo estoque passou de 10 para 9, e o arco. A alteração na bicicleta não é salva: a sessão é fechada sem sincronização. Não há [commit], e uma sessão não se sincroniza automaticamente ao ser fechada.
11.5.2. Os estados de uma entidade
Em relação a uma sessão, uma entidade está em um dos seguintes estados (o Jakarta Persistence os chama de “new”, “managed”, “detached” e “removed”):
Estado | Significado |
Transiente ([TRANSIENT]) | O objeto foi criado por [new] e nunca foi salvo: não tem identificador e nenhuma sessão o conhece |
Gerenciado ([MANAGED]) | O objeto foi lido ou salvo pela sessão, que o rastreia: as alterações feitas nele serão refletidas no banco de dados na próxima sincronização |
Excluído ([DELETED]) | O objeto foi marcado para exclusão ([remove]): a próxima sincronização enviará o comando [DELETE] |
Desanexado ([DETACHED]) | O objeto corresponde a uma linha do banco de dados, mas a sessão que o leu foi fechada ou o esqueceu ([detach], [clear]): suas alterações são ignoradas, a menos que ele seja mesclado a uma sessão ([merge]) |
A sincronização (“flush”) da sessão envia ao SGBD os comandos SQL que propagam as alterações das entidades gerenciadas. Ela ocorre:
- durante a fase de [commit] da transação;
- antes de executar uma consulta cujo resultado possa depender de alterações ainda não confirmadas (modo [FlushMode.AUTO], o modo padrão): a consulta enxerga, assim, os dados da sessão;
- durante uma chamada explícita a [session.flush()]. Os comandos são então executados, mas só serão confirmados definitivamente no [commit] da transação.
Eis uma visão geral do fluxo de trabalho com o Hibernate: abrimos uma sessão e uma transação, lemos entidades, modificamos como objetos comuns, adicionamos ([persist]) e excluímos ([remove]) e, então, confirmamos a transação, que envia ao banco de dados, em um único lote, todos os comandos necessários. A sessão funciona como uma “unidade de trabalho”. É um objeto leve, concebido para ter vida curta: uma unidade de trabalho, como uma requisição HTTP em uma aplicação web. Não se usa a mesma sessão durante toda a vida de uma aplicação; do contrário, ela acumularia as entidades rastreadas em seu contexto de persistência.
11.6. Consultas HQL
11.6.1. HQL e JPQL
Para recuperar entidades de outra forma que não pela chave primária, as consultas são escritas em uma linguagem semelhante ao SQL, mas que se refere a entidades e atributos em vez de tabelas e colunas: HQL (Hibernate Query Language). O Jakarta Persistence define uma linguagem semelhante, JPQL (Jakarta Persistence Query Language), da qual o HQL é um superconjunto: uma consulta JPQL é uma consulta HQL válida. O Hibernate traduz a consulta para SQL, no dialeto do SGBD, e o SGBD a executa.
Algumas diferenças em relação ao SQL:
- usamos o nome da entidade ([Article]), e não o nome da tabela ([articles]), e os nomes dos atributos ([currentStock]), e não os nomes das colunas. Os nomes de entidades e de atributos diferenciam maiúsculas de minúsculas, assim como em Java;
- a cláusula [select] é opcional em HQL: [from Article] retorna entidades [Article]. O JPQL exige escrever [select a from Article a];
- os relacionamentos entre entidades são percorridos por meio de um ponto ([p.category.name]), e o Hibernate escreve os joins por conta própria, como veremos.
Uma consulta é criada pelo método [createSelectionQuery] da sessão (Hibernate 6), que recebe como argumentos o texto HQL e o tipo do resultado e retorna um objeto [SelectionQuery<T>]. Em seguida, é possível definir seus parâmetros e executá-la com [getResultList] (uma lista), [getSingleResult] (um único resultado; uma exceção se houver zero ou vários), [getSingleResultOrNull] ([null] se não houver nenhum) ou [getResultStream] (um stream). O método [createQuery] do Jakarta Persistence também existe; ele serve tanto para consultas de leitura quanto para atualizações.
11.6.2. O programa [hql]
O módulo [hql] traz vários exemplos de consultas:
| package hql;
import articles.Article;
import articles.BaseArticles;
import java.math.BigDecimal;
import java.util.List;
import java.util.stream.Collectors;
import java.util.stream.Stream;
import org.hibernate.Session;
import org.hibernate.SessionFactory;
import org.hibernate.query.SemanticException;
public class Main {
// uma projeção: o nome de um artigo e o valor de seu estoque
record StockValue(String name, BigDecimal value) {
}
public static void main(String[] args) {
try (SessionFactory sessionFactory = BaseArticles.createSessionFactory()) {
// a tabela [articles] é recriada com seus seis artigos
BaseArticles.initialize(sessionFactory);
try (Session session = sessionFactory.openSession()) {
// 1 - filtragem e ordenação
IO.println("--- the articles to restock, in alphabetical order");
String hql = "from Article where currentStock < minimumStock order by name";
List<Article> toOrder = session.createSelectionQuery(hql, Article.class).getResultList();
toOrder.forEach(IO::println);
// 2 - projeção: somente as colunas úteis são solicitadas
IO.println("--- value of the stock of each article");
List<StockValue> values = session
.createSelectionQuery("""
select name, price * currentStock from Article
order by price * currentStock desc""", StockValue.class)
.getResultList();
for (StockValue v : values) {
IO.println("%s : %.2f euros".formatted(v.name(), v.value()));
}
// 3 - um único resultado; o valor [minPrice] é passado por um parâmetro nomeado
IO.println("--- the first article over 200 euros");
BigDecimal minPrice = BigDecimal.valueOf(200);
Article article = session
.createSelectionQuery("""
select a from Article a
where a.price > :minPrice order by a.price""", Article.class)
.setParameter("minPrice", minPrice)
.setMaxResults(1)
.getSingleResultOrNull();
IO.println(article == null ? "none" : article);
// 4 - agregados: o cálculo é feito pelo SGBD
IO.println("--- aggregates");
long nbArticles = session.createSelectionQuery("select count(*) from Article", Long.class)
.getSingleResult();
BigDecimal stockValue = session
.createSelectionQuery("select sum(price * currentStock) from Article", BigDecimal.class)
.getSingleResult();
IO.println("%d articles, value of the stock: %.2f euros".formatted(nbArticles, stockValue));
// 5 - like e in; uma lista Java como valor de um parâmetro
IO.println("--- like and in");
List<String> names = List.of("bow", "pump", "racket");
List<String> results = session
.createSelectionQuery("""
select name from Article
where name like 'b%' or name in :names""", String.class)
.setParameter("names", names)
.getResultList();
IO.println(String.join(", ", results));
// 6 - paginação: a terceira página de dois artigos, por preço crescente
IO.println("--- pagination");
int pageSize = 2, pageNumber = 3;
List<Article> page = session.createSelectionQuery("from Article order by price", Article.class)
.setFirstResult((pageNumber - 1) * pageSize)
.setMaxResults(pageSize)
.getResultList();
IO.println("page %d : %s".formatted(pageNumber, page.stream()
.map(a -> "%s (%.2f euros)".formatted(a.getName(), a.getPrice()))
.collect(Collectors.joining(", "))));
// 7 - uma consulta incorreta é rejeitada assim que é criada, antes de qualquer execução
IO.println("--- incorrect query");
try {
session.createSelectionQuery("from Article where stock < minimumStock", Article.class);
} catch (SemanticException e) {
IO.println(e.getClass().getSimpleName() + " : " + e.getMessage());
}
// 8 - uma regra escrita em Java não pode ser traduzida para SQL: filtragem em memória
IO.println("--- in-memory filtering");
try (Stream<Article> stream = session
.createSelectionQuery("from Article", Article.class)
.getResultStream()) {
stream.filter(Rules::isOutOfStock).forEach(IO::println);
}
}
}
}
// uma regra de negócio escrita em Java
static final class Rules {
private Rules() {
}
// um artigo está fora de estoque se seu estoque for inferior ao estoque mínimo
static boolean isOutOfStock(Article a) {
return a.getCurrentStock() < a.getMinimumStock();
}
}
}
|
Resultados:
| > mvn compile exec:java
--- the articles to restock, in alphabetical order
SQL> select a1_0.id, a1_0.currentStock, a1_0.minimumStock, a1_0.name, a1_0.price
SQL> from articles a1_0
SQL> where a1_0.currentStock<a1_0.minimumStock
SQL> order by a1_0.name
[4, arrows - set of 6, 100.00, 12, 20]
--- value of the stock of each article
SQL> select a1_0.name, (a1_0.price*a1_0.currentStock)
SQL> from articles a1_0
SQL> order by (a1_0.price*a1_0.currentStock) desc
bike : 5000.00 euros
bow : 2400.00 euros
diving suit : 2400.00 euros
arrows - set of 6 : 1200.00 euros
diver's oxygen tanks : 1200.00 euros
pump : 100.00 euros
--- the first article over 200 euros
SQL> select a1_0.id, a1_0.currentStock, a1_0.minimumStock, a1_0.name, a1_0.price
SQL> from articles a1_0
SQL> where a1_0.price>?
SQL> order by a1_0.price
SQL> limit ?
SQL> -- parameter 1 = 200
SQL> -- parameter 2 = 1
[5, diving suit, 300.00, 8, 2]
--- aggregates
SQL> select count(*)
SQL> from articles a1_0
SQL> select sum((a1_0.price*a1_0.currentStock))
SQL> from articles a1_0
6 articles, value of the stock: 12300.00 euros
--- like and in
SQL> select a1_0.name
SQL> from articles a1_0
SQL> where a1_0.name like 'b%' escape '' or a1_0.name in (?, ?, ?)
SQL> -- parameter 1 = bow
SQL> -- parameter 2 = pump
SQL> -- parameter 3 = racket
bike, bow, pump
--- pagination
SQL> select a1_0.id, a1_0.currentStock, a1_0.minimumStock, a1_0.name, a1_0.price
SQL> from articles a1_0
SQL> order by a1_0.price
SQL> limit ?, ?
SQL> -- parameter 1 = 4
SQL> -- parameter 2 = 2
page 3 : bike (500.00 euros), bow (600.00 euros)
--- incorrect query
SemanticException : Could not interpret path expression 'stock'
--- in-memory filtering
SQL> select a1_0.id, a1_0.currentStock, a1_0.minimumStock, a1_0.name, a1_0.price
SQL> from articles a1_0
[4, arrows - set of 6, 100.00, 12, 20]
|
Comentários:
- Linhas 26–27: a cláusula [where] compara dois atributos da entidade; a cláusula [order by] ordena por nome: elas se tornam as cláusulas [WHERE] e [ORDER BY] do comando SQL (linhas 5–6). A consulta é executada por [getResultList];
- linhas 32–36: uma projeção. A consulta não retorna entidades, mas dois valores por item: o nome e o valor do estoque. O SQL gerado (linha 9) solicita apenas as colunas necessárias e faz o próprio cálculo. O tipo do resultado é o record [StockValue] das linhas 16–17: o Hibernate cria um record por linha, passando ao seu construtor, em ordem, os valores da cláusula [select]. Esses objetos não são entidades: a sessão não os rastreia. A consulta é escrita em um bloco de texto (Java 15, Capítulo 3), mais legível que uma string longa;
- linhas 44–50: uma consulta escrita como em JPQL, com um alias ([a]). [:minPrice] é um parâmetro nomeado, cujo valor é fornecido por [setParameter]. Ele se torna um parâmetro do comando SQL (linha 21): portanto, não precisamos nos preocupar com injeções de SQL, já que o valor é transmitido separadamente do texto do comando. Essa é a regra que o Capítulo 10 aplicou às consultas preparadas. [setMaxResults(1)] limita o resultado a uma linha: a cláusula [LIMIT] do MySQL (linha 23). Um valor literal escrito no texto da consulta (como ['b%'] na linha 68: linha 36 dos resultados) é, por outro lado, copiado para o texto do comando SQL: valores provenientes de fora do programa devem sempre ser passados como parâmetros;
- linhas 55–59: os agregados [count] e [sum] são calculados pelo SGBD (linhas 28–31): apenas o resultado é transferido, e não as linhas. O HQL também oferece [avg], [min], [max], as cláusulas [group by], e [having];
- Linhas 65–70: o operador [like] do SQL e o operador [in], cujo operando é um parâmetro que aceita uma lista Java: o Hibernate o expande em tantos parâmetros SQL quantos forem os elementos da lista (linha 36). O HQL oferece muitas funções sobre strings ([upper], [length], [substring]...), datas e números, que ele traduz para o dialeto do SGBD;
- linhas 76–79: paginação, para exibir uma lista longa página por página. [setFirstResult] ignora as entradas das páginas anteriores, enquanto [setMaxResults] mantém as da página solicitada: a cláusula [LIMIT ?, ?] do MySQL (linhas 45–47). A paginação só faz sentido em uma lista ordenada ([order by]). As linhas 80–82 constroem a exibição da página usando um stream e [Collectors.joining] (Capítulo 5);
- linhas 86–90: uma consulta que usa um atributo [stock] que não existe. O erro é detectado assim que a consulta é criada, antes de qualquer execução, porque o Hibernate analisa o texto HQL e o compara com o modelo: ele lança uma [SemanticException] (linha 50; as mensagens do Hibernate estão em inglês). Um erro de sintaxe resultaria em uma [SyntaxException];
- linhas 94–98: uma consulta não pode usar um método Java, como [Rules.isOutOfStock] (linhas 110–112): o Hibernate não conhece o código e, mesmo que conhecesse, não saberia necessariamente escrevê-lo em SQL. É possível ler todas as entidades e filtrá-las na memória usando a API Stream: [getResultStream] retorna um [Stream<Article>] (que deve ser fechado após o uso, daí a instrução [try] com recursos). O resultado é correto (linha 54), mas a tabela inteira foi transferida (linhas 52–53): com uma tabela grande, isso deve ser evitado. É melhor incluir a condição na consulta, como mostra a linha 26.
11.6.3. Consultas nomeadas e validação em tempo de compilação
Uma consulta escrita em uma string só é analisada em tempo de execução. Há duas maneiras de detectar erros mais cedo:
- consultas nomeadas: a anotação
***[@NamedQuery(name = "Article.outOfStock", query = "from Article where currentStock < minimumStock")]***, colocada na entidade, declara uma consulta que o Hibernate analisa na inicialização, ao criar o *[SessionFactory]*. Ela é então executada pelo seu nome: [session.createNamedSelectionQuery("Article.outOfStock", Article.class)];
- o processador de anotações do Hibernate (“Hibernate Processor”, biblioteca [org.hibernate.orm:hibernate-processor]), declarado na configuração do compilador ([annotationProcessorPaths] do [maven-compiler-plugin]). Executado pelo [javac] durante a compilação, ele verifica as consultas das anotações e gera, para cada entidade, uma classe de “metamodelo” ([Article_] para [Article]), que reencontraremos com a API Criteria. Não o utilizamos neste curso.
11.7. A API Criteria
11.7.1. Consultas construídas por meio de código
Uma consulta HQL é uma string que pode ser construída por concatenação: isso é pouco confiável e difícil de ler assim que a consulta depende de muitos critérios opcionais (um formulário de busca, por exemplo). O Jakarta Persistence oferece outra maneira de escrever consultas: a API Criteria, em que a consulta é uma árvore de objetos construída por chamadas de métodos. O Hibernate traduz essa árvore para SQL, assim como faz com uma consulta HQL (ele também traduz o HQL em uma árvore desse tipo). O módulo [criteria] reutiliza várias consultas do programa anterior:
| package criteria;
import articles.Article;
import articles.BaseArticles;
import jakarta.persistence.criteria.CriteriaQuery;
import jakarta.persistence.criteria.Expression;
import jakarta.persistence.criteria.Predicate;
import jakarta.persistence.criteria.Root;
import java.math.BigDecimal;
import java.util.ArrayList;
import java.util.List;
import org.hibernate.Session;
import org.hibernate.SessionFactory;
import org.hibernate.query.criteria.HibernateCriteriaBuilder;
public class Main {
// uma projeção: o nome de um artigo e o valor de seu estoque
record StockValue(String name, BigDecimal value) {
}
public static void main(String[] args) {
try (SessionFactory sessionFactory = BaseArticles.createSessionFactory()) {
// a tabela [articles] é recriada com seus seis artigos
BaseArticles.initialize(sessionFactory);
try (Session session = sessionFactory.openSession()) {
// a fábrica dos elementos da consulta
HibernateCriteriaBuilder cb = session.getCriteriaBuilder();
// 1 - filtragem e ordenação
IO.println("--- the articles to restock, in alphabetical order");
CriteriaQuery<Article> query = cb.createQuery(Article.class);
Root<Article> a = query.from(Article.class);
query.select(a)
.where(cb.lt(a.<Integer>get("currentStock"), a.<Integer>get("minimumStock")))
.orderBy(cb.asc(a.get("name")));
session.createSelectionQuery(query).getResultList().forEach(IO::println);
// 2 - projeção em um record
IO.println("--- value of the stock of each article");
CriteriaQuery<StockValue> projection = cb.createQuery(StockValue.class);
Root<Article> p = projection.from(Article.class);
Expression<BigDecimal> value = cb
.prod(p.<BigDecimal>get("price"), p.<Integer>get("currentStock"))
.as(BigDecimal.class);
projection.select(cb.construct(StockValue.class, p.get("name"), value))
.orderBy(cb.desc(value));
for (StockValue v : session.createSelectionQuery(projection).getResultList()) {
IO.println("%s : %.2f euros".formatted(v.name(), v.value()));
}
// 3 - uma consulta construída de acordo com os critérios informados
IO.println("--- search: maximum price 150 euros");
search(session, BigDecimal.valueOf(150), null).forEach(IO::println);
IO.println("--- search: maximum price 150 euros and name starting with [d]");
search(session, BigDecimal.valueOf(150), "d").forEach(IO::println);
// 4 - agregados
IO.println("--- aggregates");
CriteriaQuery<Long> count = cb.createQuery(Long.class);
count.select(cb.count(count.from(Article.class)));
long nbArticles = session.createSelectionQuery(count).getSingleResult();
CriteriaQuery<BigDecimal> sum = cb.createQuery(BigDecimal.class);
Root<Article> s = sum.from(Article.class);
sum.select(cb.sum(cb
.prod(s.<BigDecimal>get("price"), s.<Integer>get("currentStock"))
.as(BigDecimal.class)));
BigDecimal stockValue = session.createSelectionQuery(sum).getSingleResult();
IO.println("%d articles, value of the stock: %.2f euros".formatted(nbArticles, stockValue));
}
}
}
// os artigos cujo preço não excede [maxPrice] e cujo nome começa com [nameStart],
// sendo cada critério usado somente se não for null
static List<Article> search(Session session, BigDecimal maxPrice, String nameStart) {
HibernateCriteriaBuilder cb = session.getCriteriaBuilder();
CriteriaQuery<Article> query = cb.createQuery(Article.class);
Root<Article> a = query.from(Article.class);
// as condições, adicionadas uma a uma
List<Predicate> conditions = new ArrayList<>();
if (maxPrice != null) {
conditions.add(cb.le(a.get("price"), maxPrice));
}
if (nameStart != null) {
conditions.add(cb.like(a.get("name"), nameStart + "%"));
}
query.select(a).where(conditions.toArray(Predicate[]::new)).orderBy(cb.asc(a.get("price")));
return session.createSelectionQuery(query).getResultList();
}
}
|
Resultados:
| > mvn compile exec:java
--- the articles to restock, in alphabetical order
SQL> select a1_0.id, a1_0.currentStock, a1_0.minimumStock, a1_0.name, a1_0.price
SQL> from articles a1_0
SQL> where a1_0.currentStock<a1_0.minimumStock
SQL> order by a1_0.name
[4, arrows - set of 6, 100.00, 12, 20]
--- value of the stock of each article
SQL> select a1_0.name, (a1_0.price*a1_0.currentStock)
SQL> from articles a1_0
SQL> order by (a1_0.price*a1_0.currentStock) desc
bike : 5000.00 euros
bow : 2400.00 euros
diving suit : 2400.00 euros
arrows - set of 6 : 1200.00 euros
diver's oxygen tanks : 1200.00 euros
pump : 100.00 euros
--- search: maximum price 150 euros
SQL> select a1_0.id, a1_0.currentStock, a1_0.minimumStock, a1_0.name, a1_0.price
SQL> from articles a1_0
SQL> where a1_0.price<=?
SQL> order by a1_0.price
SQL> -- parameter 1 = 150
[2, pump, 10.00, 10, 2]
[4, arrows - set of 6, 100.00, 12, 20]
[6, diver's oxygen tanks, 120.00, 10, 5]
--- search: maximum price 150 euros and name starting with [d]
SQL> select a1_0.id, a1_0.currentStock, a1_0.minimumStock, a1_0.name, a1_0.price
SQL> from articles a1_0
SQL> where a1_0.price<=? and a1_0.name like ? escape ''
SQL> order by a1_0.price
SQL> -- parameter 1 = 150
SQL> -- parameter 2 = d%
[6, diver's oxygen tanks, 120.00, 10, 5]
--- aggregates
SQL> select count(a1_0.id)
SQL> from articles a1_0
SQL> select sum((a1_0.price*a1_0.currentStock))
SQL> from articles a1_0
6 articles, value of the stock: 12300.00 euros
|
Comentários:
- linha 28: a sessão retorna um [HibernateCriteriaBuilder], a versão aprimorada pelo Hibernate do [CriteriaBuilder] do Jakarta Persistence: ele é a fábrica de todos os elementos de uma consulta (condições, expressões, ordenações);
- Linhas 32–36: a consulta do primeiro exemplo, em HQL. [createQuery(Article.class)] cria uma consulta que retorna artigos; [from(Article.class)] declara a entidade consultada e retorna sua raiz ([Root<Article>]), que é o equivalente do alias [a] em [from Article a]; [a.get("currentStock")] designa um atributo. A condição é construída por [cb.lt(x, y)] (“less than”, [x < y]) e a ordenação por [cb.asc(...)]. A notação [a.<Integer>get(...)] informa ao compilador o tipo do atributo, que a string ["currentStock"] não lhe permite determinar;
- linha 37: a consulta é executada pela sessão como uma consulta HQL. O SQL gerado (linhas 3–6) é o mesmo da consulta HQL;
- Linhas 41–47: uma projeção sobre o record [StockValue]. [cb.prod(x, y)] é o produto de duas expressões; [as(BigDecimal.class)] especifica o tipo do resultado; [cb.construct(StockValue.class, ...)] indica que cada linha do resultado deve ser passada ao construtor do record;
- Linhas 76–90: é aqui que a API Criteria é mais útil. O método [search] constrói uma consulta com base nos critérios que recebe: cada condição é adicionada à lista de condições somente se o critério correspondente não for [null], e a cláusula [where] recebe todas as condições da lista, combinadas por [and]. A primeira chamada (linha 54) produz uma consulta com uma condição (linha 21), enquanto a segunda (linha 56) produz uma consulta com duas condições (linha 30). Observe que, com a API Criteria, o Hibernate passa os valores ([150], [d%]) como parâmetros do comando SQL;
- linhas 60–68: os agregados [count] e [sum].
O ponto fraco dessas consultas é que os atributos são designados por strings ([a.get("currentStock")]): um erro de digitação só será detectado em tempo de execução, e o compilador ignora o tipo do atributo. Para resolver isso, o Jakarta Persistence oferece um metamodelo estático: para cada entidade [Article], existe uma classe [Article_] que contém um campo por atributo, descrevendo seu nome e tipo. Escreve-se então ***[cb.lt(a.get(Article\_.currentStock), a.get(Article\_.minimumStock))]***, que o compilador valida por completo. Essas classes não são escritas à mão: são geradas durante a compilação pelo processador de anotações do Hibernate mencionado acima. Essa é a abordagem recomendada em um projeto real que usa a API Criteria.
Para uma consulta fixa, o HQL é mais legível que a API Criteria; para uma consulta construída conforme as circunstâncias, a API Criteria é mais segura. As duas podem ser combinadas: o Hibernate permite criar uma consulta Criteria a partir de uma string HQL ([cb.createQuery(hql, Article.class)]) e depois complementá-la com código.
11.8. Relacionamentos
11.8.1. O modelo da loja
As tabelas de um banco de dados estão ligadas entre si. O Hibernate representa essas ligações como associações: campos que referenciam outra entidade ou uma coleção de entidades. O módulo [relations] usa um banco de dados [hbshop] que descreve uma pequena loja com seis entidades. Uma categoria agrupa produtos:
| // uma categoria agrupa vários produtos (relacionamento um-para-muitos)
@Entity
@Table(name = "categories")
public class Category {
@Id
@GeneratedValue(strategy = GenerationType.IDENTITY)
private Integer id;
@Column(nullable = false, length = 30)
private String name;
// os produtos da categoria: o lado inverso do relacionamento, descrito por Product.category
@OneToMany(mappedBy = "category", cascade = CascadeType.PERSIST)
private List<Product> products = new ArrayList<>();
protected Category() {
}
public Category(String name) {
this.name = name;
}
// adição de um produto: os dois lados do relacionamento são atualizados
public void add(Product product) {
products.add(product);
product.setCategory(this);
}
public Integer getId() {
return id;
}
public String getName() {
return name;
}
public List<Product> getProducts() {
return products;
}
}
|
Um produto pertence a uma categoria e tem tags:
| // um produto pertence a uma categoria e possui várias tags
@Entity
@Table(name = "products")
public class Product {
@Id
@GeneratedValue(strategy = GenerationType.IDENTITY)
private Integer id;
@Column(nullable = false, length = 30)
private String name;
@Column(nullable = false, precision = 10, scale = 2)
private BigDecimal price;
// relacionamento muitos-para-um: a chave estrangeira [category_id] da tabela [products]
@ManyToOne(fetch = FetchType.LAZY, optional = false)
@JoinColumn(name = "category_id", foreignKey = @ForeignKey(name = "fk_products_category"))
private Category category;
// relacionamento muitos-para-muitos, armazenado em uma tabela de associação
@ManyToMany(cascade = CascadeType.PERSIST)
@JoinTable(name = "products_tags",
joinColumns = @JoinColumn(name = "product_id"),
inverseJoinColumns = @JoinColumn(name = "tag_id"),
foreignKey = @ForeignKey(name = "fk_products_tags_product"),
inverseForeignKey = @ForeignKey(name = "fk_products_tags_tag"))
private Set<Tag> tags = new HashSet<>();
protected Product() {
}
public Product(String name, BigDecimal price, Tag... tags) {
this.name = name;
this.price = price;
// somente o lado proprietário do relacionamento é preenchido: é ele que o Hibernate salva
this.tags.addAll(List.of(tags));
}
|
Uma tag é atribuída a vários produtos:
| // uma tag (promo, new...) é possuída por vários produtos
@Entity
@Table(name = "tags")
public class Tag {
@Id
@GeneratedValue(strategy = GenerationType.IDENTITY)
private Integer id;
@Column(nullable = false, length = 20)
private String label;
// o lado inverso do relacionamento descrito por Product.tags
@ManyToMany(mappedBy = "tags")
private Set<Product> products = new HashSet<>();
protected Tag() {
}
public Tag(String label) {
this.label = label;
}
|
Um pedido pertence a um cliente e contém itens de pedido:
| // um pedido de um cliente, composto de linhas
@Entity
@Table(name = "orders")
public class CustomerOrder {
@Id
@GeneratedValue(strategy = GenerationType.IDENTITY)
private Integer id;
private LocalDate date;
@ManyToOne(fetch = FetchType.LAZY, optional = false)
@JoinColumn(name = "client_id")
private Client client;
@OneToMany(mappedBy = "order", cascade = CascadeType.PERSIST)
private List<OrderLine> lines = new ArrayList<>();
protected CustomerOrder() {
}
public CustomerOrder(LocalDate date) {
this.date = date;
}
// adição de uma linha: os dois lados do relacionamento são atualizados
public void add(OrderLine line) {
lines.add(line);
line.setOrder(this);
}
|
As entidades [Client] e [OrderLine] seguem o mesmo modelo. Um cliente tem um ID, um nome e uma lista de pedidos ([@OneToMany(mappedBy = "client", cascade = CascadeType.PERSIST)]), com um método [add(CustomerOrder)]; um item de pedido tem um ID, uma quantidade e duas associações muitos-para-um, uma para o pedido e outra para o produto:
| // uma linha de pedido: uma quantidade de um produto
@Entity
@Table(name = "order_lines")
public class OrderLine {
@Id
@GeneratedValue(strategy = GenerationType.IDENTITY)
private Integer id;
private int quantity;
@ManyToOne(fetch = FetchType.LAZY, optional = false)
@JoinColumn(name = "order_id")
private CustomerOrder order;
@ManyToOne(fetch = FetchType.LAZY, optional = false)
@JoinColumn(name = "product_id")
private Product product;
protected OrderLine() {
}
public OrderLine(Product product, int quantity) {
this.product = product;
this.quantity = quantity;
}
|
Este exemplo inclui os três tipos de associação:
- um relacionamento muitos-para-um ([@ManyToOne]): um produto pertence a uma categoria (Product, linhas 17–19). No banco de dados, isso é representado por uma chave estrangeira, a coluna [category_id] da tabela [products], em que [@JoinColumn] especifica o nome e o nome da restrição ([fk_products_category]). [optional = false] torna o relacionamento obrigatório: a coluna será [NOT NULL];
- o relacionamento inverso, um-para-muitos ([@OneToMany]): uma categoria contém vários produtos (Category, linhas 14–15). Ele não cria nada no banco de dados: [mappedBy = "category"] indica que ele é descrito pelo campo [category] da entidade [Product]. [Product.category] é chamado de lado proprietário (owner) do relacionamento, e [Category.products] de lado inverso: o Hibernate salva o valor do lado proprietário. No entanto, os dois lados devem ser mantidos consistentes na memória: esse é o papel do método [add] (Category, linhas 25–28), que adiciona o produto à lista e define sua categoria;
- um relacionamento muitos-para-muitos ([@ManyToMany]): um produto tem várias tags, e uma tag está associada a vários produtos. Ele é armazenado em uma tabela de associação, [products_tags], cujo nome, os nomes das duas colunas e os nomes das duas chaves estrangeiras são fornecidos por [@JoinTable] (Product, linhas 22–28). O lado inverso é [Tag.products] ([mappedBy = "tags"]). Em um relacionamento muitos-para-muitos, prefere-se um [Set] a uma [List]: com uma lista, o Hibernate exclui e reinsere todas as linhas da tabela de associação sempre que a coleção é modificada;
- [fetch = FetchType.LAZY] exige o carregamento tardio (lazy) da categoria de um produto: ela só será lida se for usada. Esse é o comportamento padrão para coleções ([@OneToMany], [@ManyToMany]), mas não para relacionamentos com uma única entidade ([@ManyToOne]), que o padrão carrega imediatamente por default ([EAGER]): [fetch = FetchType.LAZY] é acrescentado a eles sistematicamente, como recomenda a documentação do Hibernate;
- [cascade = CascadeType.PERSIST] propaga a operação [persist]: persistir uma categoria persiste seus produtos, e persistir um produto persiste suas tags. Os outros valores ([MERGE], [REMOVE], [ALL]...) propagam as outras operações;
- as coleções são inicializadas com uma coleção vazia, e o campo de um relacionamento com uma única entidade permanece [null] até ser preenchido. Os métodos [setCategory], [setClient]e [setOrder] não são públicos: somente os métodos [add] do mesmo pacote os chamam.
A classe [Shop] configura o Hibernate para o banco de dados [hbshop] e cria nele um conjunto de dados inicial:
| package relations;
import java.math.BigDecimal;
import java.time.LocalDate;
import org.hibernate.SessionFactory;
import org.hibernate.cfg.AvailableSettings;
import org.hibernate.jpa.HibernatePersistenceConfiguration;
import tools.SqlLog;
// o banco de dados [hbshop]: configuração do Hibernate e primeiro conjunto de dados
public final class Shop {
private Shop() {
}
// uma SessionFactory para o banco de dados [hbshop] e suas seis entidades
public static SessionFactory createSessionFactory() {
return new HibernatePersistenceConfiguration("shop")
.managedClasses(Category.class, Product.class, Tag.class,
Client.class, CustomerOrder.class, OrderLine.class)
.jdbcUrl("jdbc:mysql://localhost:3306/hbshop?createDatabaseIfNotExist=true")
.jdbcCredentials("root", "")
.property(AvailableSettings.FORMAT_SQL, true)
.createEntityManagerFactory();
}
// (re)criação das tabelas e de um primeiro conjunto de dados, sem log SQL
public static void initialize(SessionFactory sessionFactory) {
SqlLog.withoutLog(() -> {
sessionFactory.getSchemaManager().drop(false);
sessionFactory.getSchemaManager().create(false);
sessionFactory.inTransaction(session -> {
// duas tags
Tag promo = new Tag("promo");
Tag novelty = new Tag("new");
// três categorias e seus produtos: um grafo de objetos
Category cycles = new Category("cycles");
cycles.add(new Product("bike", BigDecimal.valueOf(500), promo));
Product pump = new Product("pump", BigDecimal.valueOf(10));
cycles.add(pump);
Category archery = new Category("archery");
Product bow = new Product("bow", BigDecimal.valueOf(600), novelty);
archery.add(bow);
archery.add(new Product("arrows - set of 6", BigDecimal.valueOf(100),
promo, novelty));
Category diving = new Category("diving");
// a persistência é propagada aos produtos e às tags (cascade)
session.persist(cycles);
session.persist(archery);
session.persist(diving);
// um cliente e seu pedido de duas linhas
CustomerOrder order = new CustomerOrder(LocalDate.of(2026, 9, 28));
order.add(new OrderLine(pump, 2));
order.add(new OrderLine(bow, 1));
Client martin = new Client("Martin");
martin.add(order);
session.persist(martin);
});
});
}
}
|
- linhas 19–20: as seis entidades, declaradas por [managedClasses];
- linhas 34–46: um grafo de objetos: três categorias, seus produtos e as tags dos produtos;
- linhas 48–50: basta persistir as categorias: graças à cascata, o Hibernate percorre as associações e persiste todas as entidades que alcança, na ordem correta (as categorias antes dos produtos que as referenciam), preenchendo as chaves estrangeiras e a tabela de associação;
- linhas 52–57: um cliente, seu pedido e os dois itens do pedido, persistidos em uma única operação.
As tabelas criadas pelo Hibernate são as seguintes:
| > mysql -uroot hbshop -e "SHOW TABLES; SHOW CREATE TABLE products\G SHOW CREATE TABLE products_tags\G"
Tables_in_hbshop
categories
clients
order_lines
orders
products
products_tags
tags
*************************** 1. row ***************************
Table: products
Create Table: CREATE TABLE `products` (
`id` int NOT NULL AUTO_INCREMENT,
`name` varchar(30) NOT NULL,
`price` decimal(10,2) NOT NULL,
`category_id` int NOT NULL,
PRIMARY KEY (`id`),
KEY `fk_products_category` (`category_id`),
CONSTRAINT `fk_products_category` FOREIGN KEY (`category_id`) REFERENCES `categories` (`id`)
) ENGINE=InnoDB AUTO_INCREMENT=5 DEFAULT CHARSET=utf8mb4 COLLATE=utf8mb4_0900_ai_ci
*************************** 1. row ***************************
Table: products_tags
Create Table: CREATE TABLE `products_tags` (
`product_id` int NOT NULL,
`tag_id` int NOT NULL,
PRIMARY KEY (`product_id`,`tag_id`),
KEY `fk_products_tags_tag` (`tag_id`),
CONSTRAINT `fk_products_tags_product` FOREIGN KEY (`product_id`) REFERENCES `products` (`id`),
CONSTRAINT `fk_products_tags_tag` FOREIGN KEY (`tag_id`) REFERENCES `tags` (`id`)
) ENGINE=InnoDB DEFAULT CHARSET=utf8mb4 COLLATE=utf8mb4_0900_ai_ci
|
- Linhas 3–9: uma tabela por entidade e a tabela de associação [products_tags];
- Linhas 16–19: a chave estrangeira [category_id] da tabela [products] referencia a tabela [categories]. Ela é [NOT NULL] ([optional = false]). O MySQL cria um índice em cada chave estrangeira (linha 18). Diferentemente de outros ORMs, o Hibernate não exige a exclusão em cascata no banco de dados ([ON DELETE CASCADE]): ela pode ser obtida com a anotação [@OnDelete(action = OnDeleteAction.CASCADE)];
- linhas 23–30: a tabela de associação tem duas colunas, chaves estrangeiras para as duas tabelas relacionadas, que juntas formam sua chave primária.
11.8.2. O programa
| package relations;
import jakarta.persistence.EntityGraph;
import java.math.BigDecimal;
import java.time.LocalDate;
import java.util.List;
import java.util.stream.Collectors;
import org.hibernate.LazyInitializationException;
import org.hibernate.Session;
import org.hibernate.SessionFactory;
public class Main {
// os resultados das consultas de projeção
record ProductCategory(String product, String category) {
}
record OrderAmount(Integer id, String client, BigDecimal amount) {
}
record CategoryStatistics(String category, Long count, Double averagePrice) {
}
public static void main(String[] args) {
try (SessionFactory sessionFactory = Shop.createSessionFactory()) {
// 1 - criação das tabelas e de um primeiro conjunto de dados, sem log
Shop.initialize(sessionFactory);
// 2 - um cliente, seu pedido e suas linhas, adicionados de uma só vez
IO.println("--- addition of a client, an order and its two lines");
sessionFactory.inTransaction(session -> {
Product bike = product(session, "bike");
Product arrows = product(session, "arrows - set of 6");
CustomerOrder order = new CustomerOrder(LocalDate.of(2026, 10, 1));
order.add(new OrderLine(bike, 1));
order.add(new OrderLine(arrows, 3));
Client client = new Client("Dupont");
client.add(order);
session.persist(client);
IO.println("client no. %d, order no. %d".formatted(client.getId(), order.getId()));
});
// 3 - carregamento tardio (lazy loading): os relacionamentos são lidos sob demanda
IO.println("--- lazy loading");
sessionFactory.inSession(session -> {
List<CustomerOrder> orders = session
.createSelectionQuery("from CustomerOrder order by id", CustomerOrder.class)
.getResultList();
for (CustomerOrder order : orders) {
IO.println("order no. %d : client=%s, %d line(s)".formatted(order.getId(),
order.getClient().getName(), order.getLines().size()));
}
});
// 4 - um relacionamento que não foi carregado deixa de ser acessível quando a sessão é fechada
IO.println("--- after the session is closed");
CustomerOrder detachedOrder = sessionFactory.fromSession(s -> s.find(CustomerOrder.class, 1));
try {
IO.println(detachedOrder.getLines().size() + " line(s)");
} catch (LazyInitializationException e) {
IO.println(e.getClass().getSimpleName() + " : " + e.getMessage());
}
// 5 - join fetch: os pedidos, seu cliente, suas linhas e seus produtos em uma única consulta
IO.println("--- join fetch");
sessionFactory.inSession(session -> {
List<CustomerOrder> orders = session.createSelectionQuery("""
from CustomerOrder c
join fetch c.client
join fetch c.lines l
join fetch l.product
order by c.id""", CustomerOrder.class).getResultList();
for (CustomerOrder order : orders) {
IO.println("order no. %d of %s for %s".formatted(order.getId(), order.getDate(),
order.getClient().getName()));
for (OrderLine line : order.getLines()) {
Product product = line.getProduct();
IO.println(" %d x %s at %.2f euros"
.formatted(line.getQuantity(), product.getName(), product.getPrice()));
}
}
});
// 6 - um entity graph: o que deve ser carregado com a entidade, descrito fora da consulta
IO.println("--- entity graph");
Category category = sessionFactory.fromSession(session -> {
EntityGraph<Category> graph = session.createEntityGraph(Category.class);
graph.addAttributeNode("products");
return session.find(graph, 2);
});
// a sessão está fechada, mas os produtos foram carregados
IO.println("%s : %s".formatted(category.getName(),
category.getProducts().stream().map(Product::getName).collect(Collectors.joining(", "))));
// 7 - o relacionamento muitos-para-muitos em uma consulta
IO.println("--- the products on promotion");
sessionFactory.inSession(session -> session.createSelectionQuery("""
select p.name, p.category.name from Product p join p.tags e
where e.label = 'promo' order by p.name""", ProductCategory.class)
.getResultList()
.forEach(p -> IO.println("%s (%s)".formatted(p.product(), p.category()))));
// 8 - um cálculo através dos relacionamentos, feito pelo SGBD
IO.println("--- amount of the orders");
sessionFactory.inSession(session -> session.createSelectionQuery("""
select c.id, c.client.name, sum(l.quantity * l.product.price)
from CustomerOrder c join c.lines l
group by c.id, c.client.name order by c.id""", OrderAmount.class)
.getResultList()
.forEach(m -> IO.println("order no. %d (%s) : %.2f euros"
.formatted(m.id(), m.client(), m.amount()))));
// 9 - um agrupamento: número de produtos e preço médio por categoria
IO.println("--- products per category");
sessionFactory.inSession(session -> session.createSelectionQuery("""
select p.category.name, count(*), avg(p.price) from Product p
group by p.category.name order by p.category.name""", CategoryStatistics.class)
.getResultList()
.forEach(s -> IO.println("%s : %d product(s), average price %.2f euros".formatted(
s.category(), s.count(), s.averagePrice()))));
}
}
// o produto com o nome informado
private static Product product(Session session, String name) {
return session.createSelectionQuery("from Product where name = :name", Product.class)
.setParameter("name", name)
.getSingleResult();
}
}
|
Resultados:
| > mvn compile exec:java
--- addition of a client, an order and its two lines
SQL> -- start of transaction
SQL> select p1_0.id, p1_0.category_id, p1_0.name, p1_0.price
SQL> from products p1_0
SQL> where p1_0.name=?
SQL> -- parameter 1 = bike
SQL> select p1_0.id, p1_0.category_id, p1_0.name, p1_0.price
SQL> from products p1_0
SQL> where p1_0.name=?
SQL> -- parameter 1 = arrows - set of 6
SQL> insert into clients (name)
SQL> values (?)
SQL> -- parameter 1 = Dupont
SQL> insert into orders (client_id, date)
SQL> values (?, ?)
SQL> -- parameter 1 = 2
SQL> -- parameter 2 = 2026-10-01
SQL> insert into order_lines (order_id, product_id, quantity)
SQL> values (?, ?, ?)
SQL> -- parameter 1 = 2
SQL> -- parameter 2 = 1
SQL> -- parameter 3 = 1
SQL> insert into order_lines (order_id, product_id, quantity)
SQL> values (?, ?, ?)
SQL> -- parameter 1 = 2
SQL> -- parameter 2 = 4
SQL> -- parameter 3 = 3
client no. 2, order no. 2
SQL> -- transaction committed (COMMIT)
--- lazy loading
SQL> select co1_0.id, co1_0.client_id, co1_0.date
SQL> from orders co1_0
SQL> order by co1_0.id
SQL> select c1_0.id, c1_0.name
SQL> from clients c1_0
SQL> where c1_0.id=?
SQL> -- parameter 1 = 1
SQL> select l1_0.order_id, l1_0.id, l1_0.product_id, l1_0.quantity
SQL> from order_lines l1_0
SQL> where l1_0.order_id=?
SQL> -- parameter 1 = 1
order no. 1 : client=Martin, 2 line(s)
SQL> select c1_0.id, c1_0.name
SQL> from clients c1_0
SQL> where c1_0.id=?
SQL> -- parameter 1 = 2
SQL> select l1_0.order_id, l1_0.id, l1_0.product_id, l1_0.quantity
SQL> from order_lines l1_0
SQL> where l1_0.order_id=?
SQL> -- parameter 1 = 2
order no. 2 : client=Dupont, 2 line(s)
--- after the session is closed
SQL> select co1_0.id, co1_0.client_id, co1_0.date
SQL> from orders co1_0
SQL> where co1_0.id=?
SQL> -- parameter 1 = 1
LazyInitializationException : Cannot lazily initialize collection of role 'relations.CustomerOrder.lines' with key '1' (no session)
--- join fetch
SQL> select
SQL> co1_0.id,
SQL> co1_0.client_id,
SQL> c1_0.id,
SQL> c1_0.name,
SQL> co1_0.date,
SQL> l1_0.order_id,
SQL> l1_0.id,
SQL> l1_0.product_id,
SQL> p1_0.id,
SQL> p1_0.category_id,
SQL> p1_0.name,
SQL> p1_0.price,
SQL> l1_0.quantity
SQL> from orders co1_0
SQL> join clients c1_0 on c1_0.id=co1_0.client_id
SQL> join order_lines l1_0 on co1_0.id=l1_0.order_id
SQL> join products p1_0 on p1_0.id=l1_0.product_id
SQL> order by co1_0.id
order no. 1 of 2026-09-28 for Martin
2 x pump at 10.00 euros
1 x bow at 600.00 euros
order no. 2 of 2026-10-01 for Dupont
1 x bike at 500.00 euros
3 x arrows - set of 6 at 100.00 euros
--- entity graph
SQL> select c1_0.id, c1_0.name, p1_0.category_id, p1_0.id, p1_0.name, p1_0.price
SQL> from categories c1_0
SQL> left join products p1_0 on c1_0.id=p1_0.category_id
SQL> where c1_0.id=?
SQL> -- parameter 1 = 2
archery : bow, arrows - set of 6
--- the products on promotion
SQL> select p1_0.name, c1_0.name
SQL> from products p1_0
SQL> join products_tags t1_0 on p1_0.id=t1_0.product_id
SQL> join tags t1_1 on t1_1.id=t1_0.tag_id
SQL> join categories c1_0 on c1_0.id=p1_0.category_id
SQL> where t1_1.label='promo'
SQL> order by p1_0.name
arrows - set of 6 (archery)
bike (cycles)
--- amount of the orders
SQL> select co1_0.id, c1_0.name, sum((l1_0.quantity*p1_0.price))
SQL> from orders co1_0
SQL> join order_lines l1_0 on co1_0.id=l1_0.order_id
SQL> join products p1_0 on p1_0.id=l1_0.product_id
SQL> join clients c1_0 on c1_0.id=co1_0.client_id
SQL> group by co1_0.id, c1_0.name
SQL> order by co1_0.id
order no. 1 (Martin) : 620.00 euros
order no. 2 (Dupont) : 800.00 euros
--- products per category
SQL> select c1_0.name, count(*), avg(p1_0.price)
SQL> from products p1_0
SQL> join categories c1_0 on c1_0.id=p1_0.category_id
SQL> group by c1_0.name
SQL> order by c1_0.name
archery : 2 product(s), average price 350.00 euros
cycles : 2 product(s), average price 255.00 euros
|
Comentários:
- linhas 15–22: os records que receberão os resultados das projeções;
- linhas 32–39: a saída é lida pelo método [product] (linhas 125–129); um cliente, seu pedido e as duas linhas do pedido são persistidos com uma única chamada a [persist]. O SQL (linhas 12–28 dos resultados) mostra a ordem das inserções: o cliente, depois o pedido, cuja chave estrangeira [client_id] recebe a chave gerada para o cliente (2) e, em seguida, as linhas, cuja chave estrangeira [order_id] recebe a chave do pedido;
- Linhas 46–52: carregamento tardio. A consulta lê apenas os pedidos (linhas 32–34): o cliente e as linhas de cada pedido só são lidos quando o programa os usa, por meio de consultas adicionais (linhas 35–42 para o primeiro pedido, 44–51 para o segundo). Para o cliente, o Hibernate colocou um proxy no campo [client], um objeto de uma subclasse de [Client] gerada pelo Hibernate (com o Byte Buddy), que contém apenas o identificador e carrega o cliente na primeira chamada a um método ([getName()]). É por isso que uma entidade não deve ser uma classe [final]. Para as linhas, a lista é uma coleção do Hibernate, carregada no primeiro uso ([size()]);
- linhas 57–62: o pedido é lido por uma sessão que é fechada imediatamente ([fromSession]). Essas linhas não foram carregadas e, uma vez fechada a sessão, não podem mais ser carregadas: acessar a coleção dispara uma [LazyInitializationException] (linha 58), uma das exceções mais comuns em aplicações que usam o Hibernate. É preciso carregar o que for necessário enquanto a sessão está aberta;
- Linhas 67–72: pré-carregamento por meio de uma consulta. [join fetch] instrui o Hibernate a carregar, junto com os pedidos, seus clientes, suas linhas e o produto de cada linha: uma única consulta com joins (linhas 60–78). A exibição mostra os dois pedidos e seus itens (linhas 79–84). O join com os itens produz uma linha SQL por item de pedido; o Hibernate deriva um único pedido para cada identificador: a lista obtida contém, de fato, dois pedidos;
- linhas 86–90: um “entity graph” (Jakarta Persistence) descreve, independentemente de qualquer consulta, as associações a serem carregadas com uma entidade: neste caso, os produtos da categoria. [session.find(graph, 2)] (Jakarta Persistence 3.2) recupera a categoria 2 junto com seus produtos em uma única consulta (linhas 86–90 dos resultados). Depois que a sessão é fechada, os produtos continuam acessíveis (linhas 92–93). Para carregar uma associação mais tarde, enquanto a sessão está aberta, escrevemos [Hibernate.initialize(category.getProducts())];
- linhas 97–101: as associações são usadas em consultas: [join p.tags e] percorre o relacionamento muitos-para-muitos (dois joins, com a tabela de associação e a tabela de tags, linhas 95–96), e [p.category.name] é traduzido em um join implícito com a tabela de categorias (linha 97);
- linhas 105–111: um cálculo envolvendo duas relações, o valor total de cada pedido, inteiramente realizado pelo SGBD: joins, [sum] e [group by] (linhas 103–109);
- linhas 115–120: um agrupamento. [group by p.category.name] agrupa os produtos pelo nome da categoria; para cada grupo, o número de produtos ([count]) e o preço médio ([avg], do tipo [Double]) são calculados pelo SGBD (linhas 113–117). A categoria [diving], que não tem produtos, não aparece: o join com a tabela de categorias é um inner join ([join]).
11.8.3. O problema das N+1 consultas
O carregamento tardio do exemplo ilustra um problema que aflige qualquer usuário de um ORM, conhecido como o problema das “N+1 consultas”: uma consulta para ler os N pedidos e, em seguida, uma consulta por pedido para ler seu cliente (e outra para suas linhas). Com mil pedidos, isso resulta em mil e uma idas e vindas ao servidor, quando uma só teria bastado. O problema é ainda mais insidioso porque é invisível no código: [order.getClient().getName()] não parece uma consulta. As soluções são as mostradas no exemplo: [join fetch], um entity graph ou, melhor ainda, uma projeção que recupera apenas os dados relevantes. O Hibernate também oferece o carregamento em lote ([@BatchSize(size = 20)] aplicado a uma coleção ou à classe da entidade referenciada, neste caso [Client]), que, por exemplo, recupera os clientes de vinte pedidos em uma única consulta. O log SQL ajuda a identificar o problema: a mesma consulta repetida inúmeras vezes.
11.9. Alterações no esquema do banco de dados
11.9.1. O problema
Até agora, as tabelas eram criadas pelo Hibernate depois de serem excluídas. Isso é impossível para uma aplicação em produção: seu banco de dados contém dados que devem ser preservados quando o modelo evolui (uma nova coluna, uma nova tabela). É preciso poder migrar o banco de dados de uma versão do esquema para a seguinte, de forma segura e reproduzível, tanto na máquina do desenvolvedor quanto no servidor de produção. Fala-se aqui de migração de esquema.
O Hibernate não oferece suporte a migrações: ele pode criar um esquema, validá-lo e fazer atualizações limitadas nele. No mundo Java, a prática padrão é tratar as migrações com scripts SQL versionados, aplicados por uma ferramenta dedicada — na maioria das vezes Flyway ou Liquibase — e fazer o Hibernate verificar se o esquema resultante corresponde às entidades.
11.9.2. Gerenciamento do esquema pelo Hibernate
A propriedade [hibernate.hbm2ddl.auto] (ou o método [schemaToolingAction] na configuração, que o programa abaixo utiliza) especifica o que o Hibernate deve fazer com o esquema ao criar o [SessionFactory]:
Valor | Constante [Action] | Efeito |
[none] | [NONE] | nenhum (valor padrão) |
[create-only] | [CREATE_ONLY] | criação das tabelas |
[create] | [CREATE] | Exclusão e, em seguida, criação das tabelas |
[create-drop] | [CREATE_DROP] | como [create], e exclusão das tabelas ao fechar o [SessionFactory]: para testes |
[drop] | [DROP] | Excluir as tabelas |
[validate] | [VALIDATE] | Verificar se as tabelas e colunas das entidades existem e têm tipos compatíveis; lançar uma exceção caso contrário |
[update] | [UPDATE] | Criar as tabelas e colunas ausentes |
O Jakarta Persistence define uma propriedade relacionada, [jakarta.persistence.schema-generation.database.action], com os valores [none], [create], [drop-and-create], e [drop]. As mesmas ações estão disponíveis de forma programática, como fizemos com o [SchemaManager] a partir do [SessionFactory] ([create], [drop], [validate], [truncate]).
O valor [update] é tentador: o Hibernate compara as entidades com o esquema do banco de dados e adiciona o que falta. Ele tem limitações que o tornam inadequado para uma aplicação em produção:
- ele apenas adiciona: nunca exclui uma coluna ou tabela que se tornou desnecessária, não modifica o tipo ou o tamanho de uma coluna existente e não consegue renomear (renomear um campo cria uma nova coluna vazia, enquanto a antiga permanece com seus dados);
- ele não consegue transformar dados (preencher uma nova coluna obrigatória, dividir uma coluna em duas);
- o que ele faz depende do estado do banco de dados que encontra: é impossível saber de antemão quais comandos serão executados, nem em que ordem, e nenhum registro disso é mantido.
Por isso, reservamos [create], [create-drop] e [update] para desenvolvimento e testes, e usamos [validate] (ou [none]) em produção, com o esquema gerenciado por scripts.
11.9.3. Scripts SQL versionados
O princípio por trás das migrações baseadas em scripts é simples:
- cada alteração do esquema é descrita por um script SQL numerado: [V1__create_clients.sql], [V2__add_phone.sql]... Depois que um script é aplicado a um banco de dados, ele nunca mais é modificado: qualquer correção é objeto de um novo script;
- o banco de dados contém uma tabela de histórico que lista as versões que foram aplicadas a ele;
- quando a aplicação inicia (ou durante a implantação), uma ferramenta compara os scripts disponíveis com o histórico e aplica, em ordem, aqueles que ainda não foram aplicados.
Os scripts fazem parte do código-fonte da aplicação: são armazenados e gerenciados junto com o restante do código (em um repositório Git, por exemplo). Para entender como isso funciona, o módulo [clients] implementa um pequeno executor de scripts versionados, inspirado no Flyway; em seguida apresentaremos o próprio Flyway.
11.9.4. O módulo [clients]
O módulo [clients] baseia-se no projeto [hbclients]. A entidade é um cliente:
| // um cliente
@Entity
@Table(name = "clients")
public class Client {
@Id
@GeneratedValue(strategy = GenerationType.IDENTITY)
private Integer id;
@Column(nullable = false, length = 50)
private String name;
@Column(nullable = false, length = 100)
private String email;
@Column(length = 20)
private String phone;
protected Client() {
}
public Client(String name, String email, String phone) {
this.name = name;
this.email = email;
this.phone = phone;
}
@Override
public String toString() {
String tel = phone == null ? "no phone" : phone;
return "[%d, %s, %s, %s]".formatted(id, name, email, tel);
}
}
|
Na primeira versão da aplicação, o cliente não tem telefone: as linhas 16–17 ainda não existem. Vamos adicioná-las na segunda versão. Os scripts ficam na pasta [src/main/resources/db/migration] do módulo, que será copiada para o classpath. O primeiro script cria a tabela:
| -- versão 1: a tabela de clientes
create table clients (
id integer not null auto_increment,
name varchar(50) not null,
email varchar(100) not null,
primary key (id)
) engine=InnoDB;
|
O segundo adiciona a coluna do telefone:
| -- versão 2: o telefone (opcional) dos clientes
alter table clients
add column phone varchar(20);
|
A classe [Migrations] executa os scripts por meio de JDBC (Capítulo 10), independentemente do Hibernate:
| package clients;
import java.io.IOException;
import java.net.URISyntaxException;
import java.net.URL;
import java.nio.file.Files;
import java.nio.file.Path;
import java.sql.Connection;
import java.sql.DriverManager;
import java.sql.PreparedStatement;
import java.sql.ResultSet;
import java.sql.SQLException;
import java.sql.Statement;
import java.util.ArrayList;
import java.util.Comparator;
import java.util.List;
import java.util.Set;
import java.util.TreeSet;
import java.util.regex.Matcher;
import java.util.regex.Pattern;
import java.util.stream.Stream;
// um pequeno executor de scripts SQL versionados, inspirado no Flyway: os scripts
// [db/migration/V<version>__<description>.sql] são aplicados uma única vez, na ordem das versões,
// e a tabela [migration_history] do banco de dados registra os que foram aplicados
public class Migrations {
// um script de migração
public record Script(int version, String description, Path path) {
@Override
public String toString() {
return "V" + version + " (" + description + ")";
}
}
// o nome de um script: V1__create_clients.sql
private static final Pattern NAME = Pattern.compile("V(\\d+)__(\\w+)\\.sql");
// a tabela de histórico
private static final String CREATE_HISTORY = """
create table if not exists migration_history (
version integer not null primary key,
description varchar(100) not null,
applied_on datetime not null default current_timestamp
) engine=InnoDB""";
// o banco de dados
private final String url;
private final String user;
private final String password;
public Migrations(String url, String user, String password) {
this.url = url;
this.user = user;
this.password = password;
}
// os scripts da pasta [db/migration] do classpath, em ordem de versão
public List<Script> scripts() throws IOException, URISyntaxException {
URL folder = Migrations.class.getResource("/db/migration");
if (folder == null) {
return List.of();
}
List<Script> scripts = new ArrayList<>();
try (Stream<Path> files = Files.list(Path.of(folder.toURI()))) {
for (Path file : files.toList()) {
Matcher m = NAME.matcher(file.getFileName().toString());
if (m.matches()) {
int version = Integer.parseInt(m.group(1));
scripts.add(new Script(version, m.group(2).replace('_', ' '), file));
}
}
}
scripts.sort(Comparator.comparingInt(Script::version));
return scripts;
}
// as versões já aplicadas ao banco de dados (a tabela de histórico é criada se necessário)
public Set<Integer> appliedVersions() throws SQLException {
try (Connection connection = DriverManager.getConnection(url, user, password);
Statement statement = connection.createStatement()) {
statement.execute(CREATE_HISTORY);
Set<Integer> versions = new TreeSet<>();
try (ResultSet rows = statement.executeQuery("select version from migration_history")) {
while (rows.next()) {
versions.add(rows.getInt(1));
}
}
return versions;
}
}
// os scripts que ainda faltam aplicar
public List<Script> pending() throws SQLException, IOException, URISyntaxException {
Set<Integer> applied = appliedVersions();
return scripts().stream().filter(s -> !applied.contains(s.version())).toList();
}
// aplicação dos scripts pendentes, até a versão [target] inclusive; os scripts aplicados são retornados
public List<Script> apply(int target) throws SQLException, IOException, URISyntaxException {
List<Script> applied = new ArrayList<>();
for (Script script : pending()) {
if (script.version() > target) {
break;
}
apply(script);
applied.add(script);
}
return applied;
}
// aplicação de um script e adição de sua versão ao histórico, em uma transação
private void apply(Script script) throws SQLException, IOException {
// as instruções do script, separadas por ponto e vírgula, sem as linhas de comentário
String text = Files.readString(script.path()).lines()
.filter(line -> !line.strip().startsWith("--"))
.reduce("", (a, b) -> a + "\n" + b);
try (Connection connection = DriverManager.getConnection(url, user, password)) {
connection.setAutoCommit(false);
try (Statement statement = connection.createStatement();
PreparedStatement history = connection.prepareStatement(
"insert into migration_history(version, description) values (?, ?)")) {
for (String sql : text.split(";")) {
if (!sql.isBlank()) {
statement.execute(sql);
}
}
history.setInt(1, script.version());
history.setString(2, script.description());
history.executeUpdate();
connection.commit();
} catch (SQLException e) {
// atenção: com o MySQL, uma instrução de modificação de esquema não pode ser desfeita
connection.rollback();
throw e;
}
}
}
}
|
- Linhas 29–34: um script é descrito por um record: sua versão, descrição e caminho;
- linha 37: o nome de um script segue a convenção do Flyway: [V], o número da versão, dois sublinhados e uma descrição;
- linhas 40–45: a tabela de histórico: uma linha por versão aplicada, com sua descrição e a data em que foi aplicada;
- linhas 59–76: a lista dos scripts. [getResource("/db/migration")] obtém a URL da pasta no classpath, que é listada com [Files.list] (Capítulo 5). Esse código pressupõe que a pasta seja uma pasta real (o que ocorre quando o programa é executado pelo Maven a partir da pasta [target/classes]); o Flyway também consegue ler scripts de um arquivo [.jar]. Os scripts são ordenados por número de versão: a ordenação alfabética colocaria [V10] antes de [V2];
- linhas 79–91: versões já aplicadas, lidas da tabela de histórico, que é criada conforme necessário ([create table if not exists]);
- linhas 94–97: os scripts que ainda precisam ser aplicados;
- linhas 100–110: a aplicação dos scripts pendentes, até uma determinada versão;
- linhas 113–138: a aplicação de um script: seus comandos (separados por ponto e vírgula, ignorando as linhas de comentário), seguida da adição de sua versão à tabela de histórico, dentro de uma transação. Um ponto de atenção, indicado no comentário da linha 133: no MySQL, um comando de modificação de esquema ([CREATE TABLE], [ALTER TABLE]) confirma implicitamente a transação atual e não pode ser revertido. Se ocorrer um erro no meio de um script, o banco de dados pode permanecer em um estado intermediário. Por isso é recomendável usar scripts curtos, cada um contendo apenas uma alteração.
O programa principal aplica as migrações e, em seguida, pede ao Hibernate que valide o esquema:
| package clients;
import jakarta.persistence.PersistenceException;
import org.hibernate.SessionFactory;
import org.hibernate.cfg.AvailableSettings;
import org.hibernate.jpa.HibernatePersistenceConfiguration;
import org.hibernate.tool.schema.Action;
public class Main {
// o banco de dados de clientes; o MySQL o cria se ele não existir
public static final String URL = "jdbc:mysql://localhost:3306/hbclients?createDatabaseIfNotExist=true";
public static void main(String[] args) throws Exception {
// a versão visada: a última por padrão, ou a passada como argumento
int target = args.length > 0 ? Integer.parseInt(args[0]) : Integer.MAX_VALUE;
// o estado das migrações
Migrations migrations = new Migrations(URL, "root", "");
IO.println("applied versions: " + migrations.appliedVersions());
IO.println("pending migrations: " + migrations.pending());
// aplicação das migrações pendentes
for (Migrations.Script script : migrations.apply(target)) {
IO.println("migration applied: " + script);
}
// o Hibernate verifica se o esquema do banco de dados corresponde às entidades (validate)
try (SessionFactory sessionFactory = new HibernatePersistenceConfiguration("clients")
.managedClass(Client.class)
.jdbcUrl(URL)
.jdbcCredentials("root", "")
.property(AvailableSettings.FORMAT_SQL, true)
.schemaToolingAction(Action.VALIDATE)
.createEntityManagerFactory()) {
IO.println("the database schema matches the entities");
// a nova coluna é utilizável
sessionFactory.inTransaction(session ->
session.persist(new Client("Dupont", "dupont@example.com", "01 23 45 67 89")));
sessionFactory.inSession(session -> session
.createSelectionQuery("from Client", Client.class)
.getResultList()
.forEach(IO::println));
} catch (PersistenceException e) {
// o erro de validação é a causa da exceção
Throwable cause = e.getCause() == null ? e : e.getCause();
IO.println(cause.getClass().getSimpleName() + " : " + cause.getMessage());
}
}
}
|
- linha 16: é possível especificar, como argumento, a versão até a qual aplicar as migrações; por padrão, todas são aplicadas;
- linhas 19–26: o estado das migrações, seguido de sua aplicação;
- linhas 29–35: o [SessionFactory] é criado com a ação [VALIDATE]: o Hibernate verifica se o esquema do banco de dados corresponde à entidade [Client]. Caso contrário, a criação do [SessionFactory] falha, resultando em [PersistenceException], causada pelo erro de validação (linhas 44–48);
- linhas 38–43: a nova coluna é utilizada.
Os scripts SQL são escritos à mão. No entanto, o Hibernate pode ajudar a escrevê-los: ele pode gerar — sem executá-lo — o script de criação do esquema ou, comparando as entidades com um banco de dados existente, o script de atualização. É isso que a classe [GenerateScript] faz:
| package clients;
import java.io.StringWriter;
import org.hibernate.SessionFactory;
import org.hibernate.cfg.AvailableSettings;
import org.hibernate.jpa.HibernatePersistenceConfiguration;
// geração pelo Hibernate do script SQL que cria (create) ou atualiza (update) o esquema do banco de dados
public class GenerateScript {
public static void main(String[] args) {
// a ação: create (padrão) ou update
String action = args.length > 0 ? args[0] : "create";
StringWriter script = new StringWriter();
// uma SessionFactory que escreve o script sem executá-lo
try (SessionFactory _ = new HibernatePersistenceConfiguration("clients")
.managedClass(Client.class)
.jdbcUrl(Main.URL)
.jdbcCredentials("root", "")
.property(AvailableSettings.JAKARTA_HBM2DDL_SCRIPTS_ACTION, action)
.property(AvailableSettings.JAKARTA_HBM2DDL_SCRIPTS_CREATE_TARGET, script)
.property(AvailableSettings.HBM2DDL_DELIMITER, ";")
.property(AvailableSettings.FORMAT_SQL, true)
.createEntityManagerFactory()) {
// o script, sem a indentação de 4 espaços de suas linhas
script.toString().strip().lines()
.map(line -> line.startsWith(" ") ? line.substring(4) : line)
.forEach(line -> IO.println(line.stripTrailing()));
}
}
}
|
- linha 13: a ação, passada como argumento: [create] ou [update];
- linha 16: o [SessionFactory] é criado apenas para gerar o script; a variável que o contém nunca é usada. O Java 22 permite chamá-la de [_] (variável anônima);
- linhas 20–23: as propriedades de geração de script, que já vimos no módulo [model]. Desta vez, o Hibernate se conecta ao banco de dados: para a ação [update], ele precisa conhecer o esquema do banco de dados.
O script de criação, gerado a partir da versão atual da entidade, serve para criar de uma só vez um banco de dados totalmente novo (para testes, por exemplo):
| > mvn compile exec:java -Dexec.mainClass=clients.GenerateScript
create table clients (
id integer not null auto_increment,
phone varchar(20),
name varchar(50) not null,
email varchar(100) not null,
primary key (id)
) engine=InnoDB;
|
Com a primeira versão da entidade (sem telefone), ele teria gerado — com a mesma ordem das colunas — o script [V1__create_clients.sql].
11.9.6. Aplicar as migrações
Suponha que o banco de dados ainda não exista. Aplicamos apenas a primeira migração, passando a versão 1 como argumento:
| > mvn compile exec:java -Dexec.args="1"
applied versions: []
pending migrations: [V1 (create clients), V2 (add phone)]
migration applied: V1 (create clients)
SchemaManagementException : Schema validation: missing column [phone] in table [clients]
|
- Linhas 2–3: nenhuma versão foi aplicada; dois scripts estão pendentes. A tabela de histórico foi criada pelo método [appliedVersions], e o banco de dados [hbclients] pelo MySQL ([createDatabaseIfNotExist=true]);
- linha 4: o script [V1] é aplicado;
- Linha 5: o Hibernate detecta que a coluna [phone] da entidade não existe na tabela: isso é normal, pois o banco de dados está na versão 1 e a entidade na versão 2. Com a entidade da versão 1, a validação teria sido bem-sucedida.
A aplicação está evoluindo: estamos adicionando o telefone à entidade. Para escrever o script da versão 2, pedimos ao Hibernate que compare a entidade com o banco de dados, que ainda está na versão 1:
| > mvn compile exec:java -Dexec.mainClass=clients.GenerateScript -Dexec.args="update"
alter table clients
add column phone varchar(20);
|
Isso é, exceto pela formatação, igual ao script [V2__add_phone.sql]. Agora aplicamos todas as migrações pendentes:
| > mvn compile exec:java
applied versions: [1]
pending migrations: [V2 (add phone)]
migration applied: V2 (add phone)
the database schema matches the entities
SQL> -- start of transaction
SQL> insert into clients (email, name, phone)
SQL> values (?, ?, ?)
SQL> -- parameter 1 = dupont@example.com
SQL> -- parameter 2 = Dupont
SQL> -- parameter 3 = 01 23 45 67 89
SQL> -- transaction committed (COMMIT)
SQL> select c1_0.id, c1_0.email, c1_0.name, c1_0.phone
SQL> from clients c1_0
[1, Dupont, dupont@example.com, 01 23 45 67 89]
|
- Linhas 2–4: a versão 1 é aplicada, a versão 2 está pendente e é aplicada;
- linha 5: a validação é bem-sucedida;
- linhas 6–15: a nova coluna está pronta para uso.
A tabela de histórico agora contém as duas versões:
| > mysql -uroot -t hbclients -e "SELECT * FROM migration_history"
+---------+----------------+---------------------+
| version | description | applied_on |
+---------+----------------+---------------------+
| 1 | create clients | 2026-10-03 17:27:22 |
| 2 | add phone | 2026-10-03 17:27:27 |
+---------+----------------+---------------------+
|
Executar o programa novamente não aplicará nenhuma alteração: as duas versões constam do histórico.
11.9.7. Flyway
O Flyway é a ferramenta de migração mais usada no mundo Java (o Spring Boot a executa automaticamente quando uma aplicação inicia, se ela estiver presente no classpath). Ele funciona exatamente segundo o mesmo princípio do nosso executor, mas é mais completo: scripts [V<version>__<description>.sql] são procurados por padrão na pasta [db/migration] do classpath, a tabela de histórico [flyway_schema_history] e a aplicação dos scripts pendentes na ordem das versões. Em particular, ele adiciona um checksum a cada script, o que detecta alterações em um script que já foi aplicado; scripts “repetíveis” ([R__description.sql], reaplicados a cada alteração, para views, por exemplo); migrações escritas em Java, um bloqueio que impede que duas instâncias da aplicação migrem o banco de dados ao mesmo tempo e uma extensão do Maven ([mvn flyway:migrate], [mvn flyway:info]).
Para usá-lo no módulo [clients], basta adicionar as dependências [org.flywaydb:flyway-core] e [org.flywaydb:flyway-mysql] (nas versões mais recentes), manter os dois scripts como estão — pois já seguem sua convenção — e substituir o uso da classe [Migrations] por uma única linha: [Flyway.configure().dataSource(URL, "root", "").load().migrate();]
O Liquibase, a outra ferramenta de uso comum, descreve as alterações do esquema em arquivos XML, YAML ou SQL (os “changelogs”) e pode gerar o SQL específico de cada SGBD. Em ambos os casos, o Hibernate é configurado com [validate] ou [none] e não modifica mais o esquema.
11.10. Hibernate e threads virtuais
Uma consulta ao banco de dados é uma operação de E/S: enquanto o servidor processa a requisição, a thread em espera não faz nada. O Capítulo 9 apresentou duas maneiras de evitar o desperdício de threads durante essas esperas: a programação assíncrona ([CompletableFuture]) e as threads virtuais (Java 21). A API do Hibernate, assim como o JDBC que ela utiliza, é bloqueante: [getResultList] não devolve o controle até que as linhas tenham sido lidas. Com threads virtuais, isso deixa de ser um inconveniente: uma thread virtual bloqueada em E/S libera a thread do sistema que a executava, e milhares delas podem ser criadas. Portanto, escrevemos código bloqueante comum, executado por threads virtuais.
Uma regra deve ser seguida: uma sessão não é thread-safe. Ela nunca deve ser compartilhada entre várias threads: cada thread (cada tarefa) abre sua própria sessão com o [SessionFactory], que este sim é compartilhado. O Hibernate nem sempre detecta o uso simultâneo da mesma sessão; os erros resultantes são imprevisíveis.
O módulo [async] aplica essa regra:
| package async;
import articles.Article;
import articles.BaseArticles;
import jakarta.persistence.QueryTimeoutException;
import java.math.BigDecimal;
import java.util.List;
import java.util.concurrent.CompletableFuture;
import java.util.concurrent.ExecutionException;
import java.util.concurrent.ExecutorService;
import java.util.concurrent.Executors;
import java.util.concurrent.Future;
import java.util.stream.Stream;
import org.hibernate.SessionFactory;
public class Main {
public static void main(String[] args) throws InterruptedException, ExecutionException {
try (SessionFactory sessionFactory = BaseArticles.createSessionFactory()) {
// a tabela [articles] é recriada com seus seis artigos
BaseArticles.initialize(sessionFactory);
// 1 - duas consultas executadas ao mesmo tempo por duas threads virtuais, cada uma com sua própria sessão
IO.println("--- two queries in parallel");
try (ExecutorService executor = Executors.newVirtualThreadPerTaskExecutor()) {
Future<List<Article>> lowPrices = executor.submit(() -> sessionFactory.fromSession(s -> s
.createSelectionQuery("from Article where price < 200 order by price", Article.class)
.getResultList()));
String hql = "select count(*) from Article where currentStock < minimumStock";
Future<Long> outOfStock = executor.submit(() -> sessionFactory.fromSession(s -> s
.createSelectionQuery(hql, Long.class)
.getSingleResult()));
// get() espera o fim de cada tarefa
lowPrices.get().forEach(IO::println);
IO.println(outOfStock.get() + " article(s) out of stock");
}
// 2 - uma transação executada por uma thread virtual, seguida de um processamento de seu resultado
IO.println("--- CompletableFuture");
try (ExecutorService executor = Executors.newVirtualThreadPerTaskExecutor()) {
CompletableFuture<Void> processing = CompletableFuture
.supplyAsync(() -> sessionFactory.fromTransaction(session -> {
Article bow = session
.createSelectionQuery("from Article where name = 'bow'", Article.class)
.getSingleResult();
bow.setPrice(BigDecimal.valueOf(550));
return bow;
}), executor)
.thenAccept(bow -> IO.println("new price of the bow: " + bow.getPrice()));
processing.join();
}
// 3 - um stream: as entidades são processadas à medida que são lidas
IO.println("--- getResultStream");
sessionFactory.inSession(session -> {
try (Stream<Article> articles = session
.createSelectionQuery("from Article where price >= 300", Article.class)
.getResultStream()) {
articles.forEach(article -> IO.println("read: " + article.getName()));
}
});
// 4 - uma consulta longa demais é interrompida após o timeout definido (em segundos)
IO.println("--- timeout exceeded");
try {
sessionFactory.inSession(session -> session
.createNativeQuery("select sleep(5)", Integer.class)
.setTimeout(1)
.getSingleResult());
} catch (QueryTimeoutException e) {
IO.println(e.getClass().getSimpleName() + " : " + e.getMessage());
}
}
}
}
|
Resultados:
| > mvn compile exec:java
--- two queries in parallel
SQL> select a1_0.id, a1_0.currentStock, a1_0.minimumStock, a1_0.name, a1_0.price
SQL> from articles a1_0
SQL> where a1_0.price<200
SQL> order by a1_0.price
SQL> select count(*)
SQL> from articles a1_0
SQL> where a1_0.currentStock<a1_0.minimumStock
[2, pump, 10.00, 10, 2]
[4, arrows - set of 6, 100.00, 12, 20]
[6, diver's oxygen tanks, 120.00, 10, 5]
1 article(s) out of stock
--- CompletableFuture
SQL> -- start of transaction
SQL> select a1_0.id, a1_0.currentStock, a1_0.minimumStock, a1_0.name, a1_0.price
SQL> from articles a1_0
SQL> where a1_0.name='bow'
SQL> update articles
SQL> set currentStock=?, minimumStock=?, name=?, price=?
SQL> where id=?
SQL> -- parameter 1 = 4
SQL> -- parameter 2 = 1
SQL> -- parameter 3 = bow
SQL> -- parameter 4 = 550
SQL> -- parameter 5 = 3
SQL> -- transaction committed (COMMIT)
new price of the bow: 550
--- getResultStream
SQL> select a1_0.id, a1_0.currentStock, a1_0.minimumStock, a1_0.name, a1_0.price
SQL> from articles a1_0
SQL> where a1_0.price>=300
read: bike
read: bow
read: diving suit
--- timeout exceeded
SQL> select sleep(5)
SQL> -- failure: Statement cancelled due to timeout or client request
QueryTimeoutException : JDBC exception executing SQL [Statement cancelled due to timeout or client request] [select sleep(5)]
|
Comentários:
- Linha 25: um executor que cria uma thread virtual para cada tarefa (Capítulo 9). A instrução [try] com recursos aguarda o término de todas as tarefas antes de fechá-lo;
- Linhas 26–32: duas tarefas submetidas ao executor. Cada uma abre sua própria sessão ([fromSession]) e executa uma consulta; as duas consultas são executadas simultaneamente, usando duas conexões do pool. A ordem delas no log (linhas 3–9) pode, portanto, variar de uma execução para outra;
- linhas 34–35: [get()] aguarda a conclusão de cada tarefa e devolve seu resultado (linhas 10–13);
- linhas 41–50: um [CompletableFuture] (Capítulo 9) cuja primeira etapa — uma transação completa — é executada por uma thread virtual ([supplyAsync(..., executor)]), e a segunda etapa exibe seu resultado. O record devolvido pela transação está desanexado (sua sessão está fechada): seus campos podem ser lidos, mas suas associações não podem ser carregadas;
- Linhas 56–60: [getResultStream] devolve um stream: as entidades são processadas à medida que são lidas, sem formar uma lista (linhas 33–35). Isso é útil para processar um grande número de linhas. Com o MySQL, observe que, por padrão, o driver lê todas as linhas do resultado antes de devolver a primeira; para uma leitura realmente progressiva, é preciso instruí-lo a usar um cursor (parâmetro [useCursorFetch=true] da URL e tamanho do lote definido por [setFetchSize]);
- Linhas 66–69: um tempo máximo de execução, em segundos, definido por [setTimeout]. A consulta (uma consulta SQL nativa, da qual trataremos mais adiante) leva cinco segundos; após um segundo, o driver JDBC a interrompe, e o Hibernate lança uma [QueryTimeoutException] (linhas 37–39). Isso equivale, para uma consulta, a cancelar uma tarefa ([Future.cancel], Capítulo 9), o que não teria efeito aqui: interromper uma thread bloqueada no driver JDBC não interrompe a consulta que está em execução no servidor.
Para aplicações que exigem uma API realmente não bloqueante, existe o Hibernate Reactive, uma variante do Hibernate que se apoia em drivers reativos (os do Vert.x) em vez do JDBC, e cujos métodos devolvem [CompletionStage] ou objetos da biblioteca Mutiny. As threads virtuais eliminam essa complexidade na maioria dos casos: é a abordagem adotada neste curso.
11.11. Transações e concorrência
11.11.1. Transações
O Capítulo 10 introduziu as transações: um conjunto de operações que ou são todas bem-sucedidas ou todas falham. Com o Hibernate:
- toda escrita ocorre dentro de uma transação, aberta por [session.beginTransaction()] e encerrada por [commit] ou [rollback]. Os métodos [inTransaction] e [fromTransaction] do [SessionFactory] cuidam disso para nós: eles confirmam a transação se a lambda terminar normalmente e a revertem se ela lançar uma exceção, que então é relançada;
- todos os comandos enviados durante a transação (comandos imediatos via [INSERT], sincronizações explícitas via [flush] e sincronização via [commit]) são confirmados ou revertidos em conjunto;
- um erro do SGBD é propagado como uma exceção do Hibernate, derivada de [JDBCException], que encapsula a [SQLException] do driver: [ConstraintViolationException] para uma violação de restrição (chave primária, unicidade, chave estrangeira, [NOT NULL]), [SQLGrammarException] para um erro no comando SQL, etc.
O módulo [transactions] ilustra as duas maneiras de tratar uma transação:
| package transactions;
import articles.Article;
import articles.BaseArticles;
import java.math.BigDecimal;
import org.hibernate.Session;
import org.hibernate.SessionFactory;
import org.hibernate.Transaction;
import org.hibernate.exception.ConstraintViolationException;
public class Main {
public static void main(String[] args) {
try (SessionFactory sessionFactory = BaseArticles.createSessionFactory()) {
// a tabela [articles] é recriada com seus seis artigos
BaseArticles.initialize(sessionFactory);
// 1 - inTransaction: commit se tudo der certo, rollback em caso de exceção
IO.println("--- two additions, the second of which violates the uniqueness of the name");
try {
sessionFactory.inTransaction(session -> {
session.persist(new Article("racket", BigDecimal.valueOf(80), 5, 2));
session.persist(new Article("bike", BigDecimal.valueOf(450), 3, 1));
});
} catch (ConstraintViolationException e) {
IO.println("%s : constraint [%s] violated"
.formatted(e.getClass().getSimpleName(), e.getConstraintName()));
}
display(sessionFactory, "racket");
// 2 - uma transação gerenciada pelo código: várias escritas, confirmadas ou desfeitas em conjunto
IO.println("--- transaction rolled back");
try (Session session = sessionFactory.openSession()) {
Transaction transaction = session.beginTransaction();
try {
// venda de duas bicicletas: o UPDATE é enviado por flush
Article bike = session
.createSelectionQuery("from Article where name = 'bike'", Article.class)
.getSingleResult();
bike.setCurrentStock(bike.getCurrentStock() - 2);
session.flush();
// adição de um artigo cujo nome já existe: erro
session.persist(new Article("pump", BigDecimal.valueOf(12), 5, 1));
// commit do conjunto (não é alcançado aqui)
transaction.commit();
} catch (ConstraintViolationException e) {
IO.println(e.getClass().getSimpleName() + " : " + e.getSQLException().getMessage());
// rollback de todas as operações da transação
transaction.rollback();
}
}
// a venda das bicicletas foi desfeita
display(sessionFactory, "bike");
}
}
// exibição de um artigo lido do banco de dados, com uma nova sessão
private static void display(SessionFactory sessionFactory, String name) {
Article article = sessionFactory.fromSession(session -> session
.createSelectionQuery("from Article where name = :name", Article.class)
.setParameter("name", name)
.getSingleResultOrNull());
IO.println("article [%s] in the database: %s".formatted(name, article == null ? "missing" : article));
}
}
|
Resultados:
| > mvn compile exec:java
--- two additions, the second of which violates the uniqueness of the name
SQL> -- start of transaction
SQL> insert into articles (currentStock, minimumStock, name, price)
SQL> values (?, ?, ?, ?)
SQL> -- parameter 1 = 5
SQL> -- parameter 2 = 2
SQL> -- parameter 3 = racket
SQL> -- parameter 4 = 80
SQL> insert into articles (currentStock, minimumStock, name, price)
SQL> values (?, ?, ?, ?)
SQL> -- parameter 1 = 3
SQL> -- parameter 2 = 1
SQL> -- parameter 3 = bike
SQL> -- parameter 4 = 450
SQL> -- failure: Duplicate entry 'bike' for key 'articles.uk_articles_name'
SQL> -- transaction rolled back (ROLLBACK)
ConstraintViolationException : constraint [articles.uk_articles_name] violated
SQL> select a1_0.id, a1_0.currentStock, a1_0.minimumStock, a1_0.name, a1_0.price
SQL> from articles a1_0
SQL> where a1_0.name=?
SQL> -- parameter 1 = racket
article [racket] in the database: missing
--- transaction rolled back
SQL> -- start of transaction
SQL> select a1_0.id, a1_0.currentStock, a1_0.minimumStock, a1_0.name, a1_0.price
SQL> from articles a1_0
SQL> where a1_0.name='bike'
SQL> update articles
SQL> set currentStock=?, minimumStock=?, name=?, price=?
SQL> where id=?
SQL> -- parameter 1 = 8
SQL> -- parameter 2 = 5
SQL> -- parameter 3 = bike
SQL> -- parameter 4 = 500.00
SQL> -- parameter 5 = 1
SQL> insert into articles (currentStock, minimumStock, name, price)
SQL> values (?, ?, ?, ?)
SQL> -- parameter 1 = 5
SQL> -- parameter 2 = 1
SQL> -- parameter 3 = pump
SQL> -- parameter 4 = 12
SQL> -- failure: Duplicate entry 'pump' for key 'articles.uk_articles_name'
ConstraintViolationException : Duplicate entry 'pump' for key 'articles.uk_articles_name'
SQL> -- transaction rolled back (ROLLBACK)
SQL> select a1_0.id, a1_0.currentStock, a1_0.minimumStock, a1_0.name, a1_0.price
SQL> from articles a1_0
SQL> where a1_0.name=?
SQL> -- parameter 1 = bike
article [bike] in the database: [1, bike, 500.00, 10, 5]
|
Comentários:
- Linhas 21–24: dois itens são adicionados em uma transação gerenciada por [inTransaction]; o segundo item tem o mesmo nome de um item existente. Os dois comandos [INSERT] são executados imediatamente (linhas 4–15); o segundo viola a restrição de unicidade da coluna [name]: o MySQL o rejeita (linha 16), [persist] lança uma [ConstraintViolationException]; [inTransaction] reverte a transação (linha 17) e relança a exceção;
- linhas 25–28: a exceção é capturada; [getConstraintName] fornece o nome da restrição violada (linha 18). Isso demonstra a vantagem de ter nomeado a restrição;
- linha 29: a raquete, que havia sido inserida com sucesso, não está no banco de dados (linha 23): a reversão da transação a excluiu;
- linhas 33–51: uma transação gerenciada pelo código. Duas bicicletas são vendidas, e a atualização é enviada ao SGBD por meio de um [flush] explícito (linhas 29–36); em seguida, um item com um nome já existente é adicionado: a inserção falha (linha 43);
- linha 45: a confirmação nunca é alcançada;
- Linhas 46–50: no [catch], a transação é revertida (linha 45 dos resultados). [getSQLException] informa a exceção original do driver JDBC, e sua mensagem é a do MySQL (linha 44);
- linha 53: a venda das bicicletas, embora enviada ao SGBD por [flush], foi cancelada: o estoque de bicicletas continua em 10 (linha 50);
- Linhas 58–64: um método que relê um registro com uma nova sessão para ver o estado real do banco de dados, em vez das entidades da sessão atual.
Depois de uma exceção, uma sessão não deve mais ser usada: seu contexto de persistência pode conter entidades em um estado inconsistente com o banco de dados. Revertemos a transação, fechamos a sessão e, se necessário, recomeçamos com uma nova sessão. É o que [inTransaction] faz, e o que nosso código faz ao sair do bloco [try], que fecha a sessão.
O nível de isolamento da transação é o da conexão JDBC: [REPEATABLE_READ], o valor padrão do MySQL, como mostrado no primeiro exemplo. É possível alterá-lo para todo o [SessionFactory] usando o método [jdbcTransactionIsolation] na configuração.
11.11.2. Concorrência otimista
Dois usuários estão lendo o mesmo item, que tem um estoque de 10. O primeiro usuário vende uma unidade e atualiza o estoque para 9. O segundo usuário, que leu o valor do estoque antes dessa atualização, vende três unidades e atualiza o estoque para 7: a venda do primeiro usuário é perdida. Esse é o problema das atualizações perdidas.
Uma solução seria bloquear a linha durante toda a operação de cada usuário (concorrência “pessimista”): isso bloqueia os outros usuários, às vezes por muito tempo. Com o Hibernate, geralmente se prefere a concorrência otimista: nada é bloqueado, mas uma verificação é feita no momento da gravação para garantir que a linha não foi modificada desde que foi lida. A maneira padrão de fazer isso é adicionar um número de versão à entidade — um campo anotado com [@Version]. O Hibernate incrementa esse número a cada modificação da linha e adiciona a condição “a versão ainda tem o valor lido” à cláusula [WHERE], junto com os comandos [UPDATE] e [DELETE]. Se o comando não modificar nenhuma linha, significa que outro usuário já acessou os dados: o Hibernate lança uma [OptimisticLockException].
O módulo [concurrency] usa seu próprio banco de dados, [hbconcurrency], e sua própria entidade, [Article], reduzida ao essencial:
| // um artigo cujas modificações são controladas por um número de versão
@Entity
@Table(name = "articles")
public class Article {
@Id
@GeneratedValue(strategy = GenerationType.IDENTITY)
private Integer id;
@Column(nullable = false, length = 30)
private String name;
private int currentStock;
// o número de versão: incrementado pelo Hibernate a cada modificação da linha
@Version
private int version;
protected Article() {
}
public Article(String name, int currentStock) {
this.name = name;
this.currentStock = currentStock;
}
public int getCurrentStock() {
return currentStock;
}
public void setCurrentStock(int currentStock) {
this.currentStock = currentStock;
}
public int getVersion() {
return version;
}
}
|
- linhas 16–17: o número de versão, do tipo [int] (também é possível usar [long], ou uma data do tipo [Instant]). A aplicação nunca o modifica por conta própria.
O programa simula os dois usuários com duas sessões:
| package concurrency;
import jakarta.persistence.OptimisticLockException;
import org.hibernate.Session;
import org.hibernate.SessionFactory;
import org.hibernate.Transaction;
import org.hibernate.cfg.AvailableSettings;
import org.hibernate.jpa.HibernatePersistenceConfiguration;
import tools.SqlLog;
public class Main {
public static void main(String[] args) {
try (SessionFactory sessionFactory = new HibernatePersistenceConfiguration("concurrency")
.managedClass(Article.class)
.jdbcUrl("jdbc:mysql://localhost:3306/hbconcurrency?createDatabaseIfNotExist=true")
.jdbcCredentials("root", "")
.property(AvailableSettings.FORMAT_SQL, true)
.createEntityManagerFactory()) {
// a tabela [articles] é recriada com um único artigo, sem log
SqlLog.withoutLog(() -> {
sessionFactory.getSchemaManager().drop(false);
sessionFactory.getSchemaManager().create(false);
sessionFactory.inTransaction(session -> session.persist(new Article("bike", 10)));
});
// dois usuários, duas sessões: cada um lê o mesmo artigo
try (Session session1 = sessionFactory.openSession();
Session session2 = sessionFactory.openSession()) {
IO.println("--- the two users read the bike");
Article bike1 = session1.find(Article.class, 1);
Article bike2 = session2.find(Article.class, 1);
// o usuário 1 vende 1 bicicleta
IO.println("--- user 1 sells 1 bike");
Transaction transaction1 = session1.beginTransaction();
bike1.setCurrentStock(bike1.getCurrentStock() - 1);
transaction1.commit();
IO.println("stock saved by user 1: %d (version %d)"
.formatted(bike1.getCurrentStock(), bike1.getVersion()));
// o usuário 2 vende 3 bicicletas com base em dados desatualizados (estoque = 10, versão 0)
IO.println("--- user 2 sells 3 bikes");
Transaction transaction2 = session2.beginTransaction();
bike2.setCurrentStock(bike2.getCurrentStock() - 3);
try {
session2.flush();
transaction2.commit();
} catch (OptimisticLockException e) {
IO.println(e.getClass().getSimpleName() + " : " + e.getMessage());
transaction2.rollback();
}
}
// resolução: o usuário 2 relê o artigo, com uma nova sessão, e recomeça
IO.println("--- user 2 rereads the bike and starts again");
sessionFactory.inTransaction(session -> {
Article bike = session.find(Article.class, 1);
IO.println("reread stock: %d (version %d)"
.formatted(bike.getCurrentStock(), bike.getVersion()));
bike.setCurrentStock(bike.getCurrentStock() - 3);
session.flush();
IO.println("stock saved by user 2: %d (version %d)"
.formatted(bike.getCurrentStock(), bike.getVersion()));
});
}
}
}
|
Resultados:
| > mvn compile exec:java
--- the two users read the bike
SQL> select a1_0.id, a1_0.currentStock, a1_0.name, a1_0.version
SQL> from articles a1_0
SQL> where a1_0.id=?
SQL> -- parameter 1 = 1
SQL> select a1_0.id, a1_0.currentStock, a1_0.name, a1_0.version
SQL> from articles a1_0
SQL> where a1_0.id=?
SQL> -- parameter 1 = 1
--- user 1 sells 1 bike
SQL> -- start of transaction
SQL> update articles
SQL> set currentStock=?, name=?, version=?
SQL> where id=? and version=?
SQL> -- parameter 1 = 9
SQL> -- parameter 2 = bike
SQL> -- parameter 3 = 1
SQL> -- parameter 4 = 1
SQL> -- parameter 5 = 0
SQL> -- transaction committed (COMMIT)
stock saved by user 1: 9 (version 1)
--- user 2 sells 3 bikes
SQL> -- start of transaction
SQL> update articles
SQL> set currentStock=?, name=?, version=?
SQL> where id=? and version=?
SQL> -- parameter 1 = 7
SQL> -- parameter 2 = bike
SQL> -- parameter 3 = 1
SQL> -- parameter 4 = 1
SQL> -- parameter 5 = 0
OptimisticLockException : Unexpected row count (expected row count 1 but was 0) [update articles set currentStock=?,name=?,version=? where id=? and version=?] for entity [concurrency.Article with id '1']
SQL> -- transaction rolled back (ROLLBACK)
--- user 2 rereads the bike and starts again
SQL> -- start of transaction
SQL> select a1_0.id, a1_0.currentStock, a1_0.name, a1_0.version
SQL> from articles a1_0
SQL> where a1_0.id=?
SQL> -- parameter 1 = 1
reread stock: 9 (version 1)
SQL> update articles
SQL> set currentStock=?, name=?, version=?
SQL> where id=? and version=?
SQL> -- parameter 1 = 6
SQL> -- parameter 2 = bike
SQL> -- parameter 3 = 2
SQL> -- parameter 4 = 1
SQL> -- parameter 5 = 1
stock saved by user 2: 6 (version 2)
SQL> -- transaction committed (COMMIT)
|
Comentários:
- linhas 21–25: a tabela é recriada com um único item, a bicicleta, versão 0;
- linhas 31–32: cada usuário lê a bicicleta em sua própria sessão. A coluna [version] é lida junto com as demais (linhas 3–10);
- Linhas 36–38: o comando [UPDATE] do primeiro usuário (linhas 13–20) grava a nova versão (1) e contém a condição [version=?] com a versão lida (0). A linha é modificada; o campo [version] da entidade passa a valer 1 (linha 22);
- linhas 44–48: a requisição do segundo usuário contém a mesma condição, com a versão que ele leu, 0, enquanto a versão da linha no banco de dados agora é 1. Nenhuma linha é modificada, e o Hibernate dispara uma [OptimisticLockException] (linha 33). Sincronizamos explicitamente a sessão ([flush]) antes do [commit] para obter essa exceção sem encapsulamento; se ela fosse lançada durante o [commit], seria encapsulada em uma [RollbackException];
- Linhas 57–65: a resolução depende da aplicação: abortar, notificar o usuário ou, como aqui, reler o item usando uma nova sessão (a sessão que recebeu a exceção não deve mais ser usada) e repetir a operação. O estoque reabastecido é 9 na versão 1 (linha 41), e a venda das três bicicletas resulta em um estoque de 6 na versão 2 (linha 50).
Duas variações:
- Sem uma coluna de versão, o Hibernate pode verificar os valores antigos das próprias colunas: com as anotações [@OptimisticLocking(type = OptimisticLockType.DIRTY)] e [@DynamicUpdate] na entidade, a cláusula [WHERE] do [UPDATE] contém o valor lido de cada coluna modificada ([where id=? and currentStock=?]). Isso é útil para um banco de dados existente que não pode ser modificado;
- A concorrência pessimista continua possível quando os conflitos são frequentes: [session.find(Article.class, 1, LockModeType.PESSIMISTIC_WRITE)] lê a linha com um comando [select ... for update], que a bloqueia até o fim da transação.
11.12. O SQL nativo
O Hibernate gera o SQL a partir do HQL ou da API Criteria, mas ainda é possível escrever você mesmo o SQL de uma consulta, para usar um recurso específico do SGBD ou para otimizar uma consulta complexa: fala-se então de consulta nativa. O módulo [rawsql] lista os métodos disponíveis:
| package rawsql;
import articles.Article;
import articles.BaseArticles;
import java.math.BigDecimal;
import java.sql.ResultSet;
import java.sql.Statement;
import java.util.List;
import org.hibernate.Session;
import org.hibernate.SessionFactory;
public class Main {
public static void main(String[] args) {
try (SessionFactory sessionFactory = BaseArticles.createSessionFactory()) {
// a tabela [articles] é recriada com seus seis artigos
BaseArticles.initialize(sessionFactory);
try (Session session = sessionFactory.openSession()) {
// 1 - uma consulta SQL escrita à mão que retorna entidades
IO.println("--- createNativeQuery: entities");
BigDecimal minPrice = BigDecimal.valueOf(200);
List<Article> expensive = session
.createNativeQuery("""
select * from articles
where price > :minPrice order by name""", Article.class)
.setParameter("minPrice", minPrice)
.getResultList();
expensive.forEach(IO::println);
// 2 - um valor passado como parâmetro: nenhuma injeção de SQL é possível
IO.println("--- SQL injection attempt with a parameter");
String name = "x' or '1'='1";
long nb = session
.createNativeQuery("select count(*) from articles where name = :name", Long.class)
.setParameter("name", name)
.getSingleResult();
IO.println(nb + " article(s) found");
// a mesma consulta construída por concatenação: nunca faça isso
IO.println("--- the same attempt with a concatenation");
String sql = "select count(*) from articles where name = '" + name + "'";
nb = session.createNativeQuery(sql, Long.class).getSingleResult();
IO.println(nb + " article(s) found");
// 3 - resultados que não são entidades
IO.println("--- createNativeQuery: values");
List<String> names = session
.createNativeQuery("""
select name from articles
where currentStock < minimumStock""", String.class)
.getResultList();
IO.println("out of stock: " + String.join(", ", names));
BigDecimal value = session
.createNativeQuery("select sum(price * currentStock) from articles", BigDecimal.class)
.getSingleResult();
IO.println("stock value: %.2f euros".formatted(value));
// 4 - uma instrução update
IO.println("--- createNativeMutationQuery");
int nbRows = session.fromTransaction(transaction -> session
.createNativeMutationQuery("""
update articles set price = price * :coefficient
where name = :name""")
.setParameter("coefficient", new BigDecimal("0.9"))
.setParameter("name", "bow")
.executeUpdate());
IO.println(nbRows + " row(s) modified");
// 5 - a conexão JDBC da sessão, para código JDBC comum
IO.println("--- doWork: the JDBC connection");
session.doWork(connection -> {
String query = "select name, price from articles where name = 'bow'";
try (Statement statement = connection.createStatement();
ResultSet rows = statement.executeQuery(query)) {
while (rows.next()) {
IO.println("%s : %.2f euros"
.formatted(rows.getString("name"), rows.getBigDecimal("price")));
}
}
});
}
}
}
}
|
Resultados:
| > mvn compile exec:java
--- createNativeQuery: entities
SQL> select *
SQL> from articles
SQL> where price > ?
SQL> order by name
SQL> -- parameter 1 = 200
[1, bike, 500.00, 10, 5]
[3, bow, 600.00, 4, 1]
[5, diving suit, 300.00, 8, 2]
--- SQL injection attempt with a parameter
SQL> select count(*)
SQL> from articles
SQL> where name = ?
SQL> -- parameter 1 = x' or '1'='1
0 article(s) found
--- the same attempt with a concatenation
SQL> select count(*)
SQL> from articles
SQL> where name = 'x' or '1'='1'
6 article(s) found
--- createNativeQuery: values
SQL> select name
SQL> from articles
SQL> where currentStock < minimumStock
out of stock: arrows - set of 6
SQL> select sum(price * currentStock)
SQL> from articles
stock value: 12300.00 euros
--- createNativeMutationQuery
SQL> -- start of transaction
SQL> update articles
SQL> set price = price * ?
SQL> where name = ?
SQL> -- parameter 1 = 0.9
SQL> -- parameter 2 = bow
SQL> -- transaction committed (COMMIT)
1 row(s) modified
--- doWork: the JDBC connection
bow : 540.00 euros
|
Comentários:
- Linhas 22–27: [createNativeQuery] executa uma consulta (SQL) que devolve linhas da tabela de uma entidade, e o segundo parâmetro ([Article.class]) instrui o Hibernate a materializá-las como entidades gerenciadas pela sessão. Os nomes das colunas do resultado devem corresponder aos do modelo: [select *] é adequado aqui. A consulta é repassada tal como está ao SGBD (linhas 3–6), exceto que o parâmetro nomeado [:minPrice] se torna um parâmetro JDBC ([?]);
- linhas 32–36: uma tentativa de injeção de SQL. O valor de [name] é passado como parâmetro: ele é comparado tal como está com a coluna [name], e nenhum registro corresponde (linha 16);
- linhas 40–41: a mesma consulta construída por concatenação. O valor de [name] se torna código SQL, a condição permanece verdadeira (linha 20) e a consulta conta os seis itens (linha 21): trata-se de uma injeção de SQL bem-sucedida. Como no Capítulo 10, uma consulta nativa deve conter apenas texto constante, com os valores passados como parâmetros;
- linhas 46–54: consultas que devolvem valores únicos ([String], [BigDecimal]): o segundo parâmetro de [createNativeQuery] é então o tipo do valor. Para várias colunas, é possível especificar um record (seus componentes recebem as colunas em ordem) ou usar [Object[].class];
- linhas 59–65: [createNativeMutationQuery] prepara um comando de atualização, executado por [executeUpdate], que devolve o número de linhas modificadas. Ele é executado dentro de uma transação: o método [fromTransaction] da sessão a abre, a confirma e devolve o resultado da lambda;
- linhas 70–79: [doWork] fornece acesso à conexão JDBC da sessão ([java.sql.Connection]) para código JDBC padrão (Capítulo 10): chamar uma procedure armazenada, usar um recurso do driver... O preço do arco foi de fato reduzido em 10% (linha 40).
Uma consulta nativa não é portável de um SGBD para outro, e o Hibernate não pode verificá-la antes de executá-la: ela é reservada para os casos em que o HQL não é suficiente. O HQL também cobre uma grande parte do SQL (junções de todos os tipos, subconsultas, funções de janela, [union]...) e permite chamar uma função do SGBD que ele não reconhece.
11.13. Atualizações em massa, modo somente leitura e lotes
O rastreamento de alterações tem um custo: para aumentar o preço de 100 itens, é preciso ler os 100 itens, modificá-los um a um, e a sincronização da sessão enviará 100 comandos [UPDATE]. O Hibernate oferece várias maneiras de processar eficientemente grandes quantidades de linhas. O módulo [bulkupdate] as apresenta:
| package bulkupdate;
import articles.Article;
import articles.BaseArticles;
import java.math.BigDecimal;
import java.util.List;
import org.hibernate.Session;
import org.hibernate.SessionFactory;
import org.hibernate.Transaction;
public class Main {
public static void main(String[] args) {
try (SessionFactory sessionFactory = BaseArticles.createSessionFactory()) {
// a tabela [articles] é recriada com seus seis artigos
BaseArticles.initialize(sessionFactory);
try (Session session = sessionFactory.openSession()) {
Transaction transaction = session.beginTransaction();
// 1 - update em HQL: uma única instrução UPDATE, nenhuma entidade carregada em memória
IO.println("--- restocking of the out-of-stock articles");
int nbRows = session
.createMutationQuery("""
update Article set currentStock = minimumStock * 2
where currentStock < minimumStock""")
.executeUpdate();
IO.println(nbRows + " article(s) modified");
IO.println("--- 10 % increase of the prices below 150 euros");
nbRows = session
.createMutationQuery("update Article set price = price * 1.1 where price < 150")
.executeUpdate();
IO.println(nbRows + " article(s) modified");
// 2 - delete em HQL: uma única instrução DELETE
IO.println("--- deletion of the articles over 550 euros");
nbRows = session
.createMutationQuery("delete from Article where price > 550")
.executeUpdate();
IO.println(nbRows + " article(s) deleted");
transaction.commit();
// 3 - somente leitura: as entidades lidas não são monitoradas
IO.println("--- read-only");
transaction = session.beginTransaction();
List<Article> articles = session
.createSelectionQuery("from Article order by id", Article.class)
.setReadOnly(true)
.getResultList();
articles.forEach(IO::println);
// a modificação de uma entidade somente leitura é ignorada
articles.getFirst().setPrice(BigDecimal.ZERO);
IO.println("session modified: " + session.isDirty());
transaction.commit();
// 4 - uma instrução update em HQL não modifica as entidades já carregadas pela sessão
IO.println("--- HQL update and loaded entities");
transaction = session.beginTransaction();
Article pump = session.find(Article.class, 2);
session.createMutationQuery("update Article set price = 9.5 where id = :id")
.setParameter("id", pump.getId())
.executeUpdate();
IO.println("price in memory: " + pump.getPrice());
session.refresh(pump);
IO.println("price after refresh: " + pump.getPrice());
transaction.commit();
}
// 5 - uma sessão stateless (StatelessSession) e instruções enviadas em lotes
IO.println("--- StatelessSession and batches of 3 statements");
sessionFactory.inStatelessTransaction(session -> {
session.setJdbcBatchSize(3);
List<Article> articles = session
.createSelectionQuery("from Article order by id", Article.class)
.getResultList();
for (Article article : articles) {
article.setCurrentStock(article.getCurrentStock() + 1);
// cada modificação é solicitada explicitamente: as entidades não são monitoradas
session.update(article);
}
});
}
}
}
|
Resultados (o final repetitivo foi abreviado):
| > mvn compile exec:java
SQL> -- start of transaction
--- restocking of the out-of-stock articles
SQL> update articles a1_0
SQL> set currentStock=(a1_0.minimumStock*2)
SQL> where a1_0.currentStock<a1_0.minimumStock
1 article(s) modified
--- 10 % increase of the prices below 150 euros
SQL> update articles a1_0
SQL> set price=(a1_0.price*1.1)
SQL> where a1_0.price<150
3 article(s) modified
--- deletion of the articles over 550 euros
SQL> delete a1_0
SQL> from articles a1_0
SQL> where a1_0.price>550
1 article(s) deleted
SQL> -- transaction committed (COMMIT)
--- read-only
SQL> -- start of transaction
SQL> select a1_0.id, a1_0.currentStock, a1_0.minimumStock, a1_0.name, a1_0.price
SQL> from articles a1_0
SQL> order by a1_0.id
[1, bike, 500.00, 10, 5]
[2, pump, 11.00, 10, 2]
[4, arrows - set of 6, 110.00, 40, 20]
[5, diving suit, 300.00, 8, 2]
[6, diver's oxygen tanks, 132.00, 10, 5]
session modified: false
SQL> -- transaction committed (COMMIT)
--- HQL update and loaded entities
SQL> -- start of transaction
SQL> update articles a1_0
SQL> set price=9.5
SQL> where a1_0.id=?
SQL> -- parameter 1 = 2
price in memory: 11.00
SQL> select a1_0.id, a1_0.currentStock, a1_0.minimumStock, a1_0.name, a1_0.price
SQL> from articles a1_0
SQL> where a1_0.id=?
SQL> -- parameter 1 = 2
price after refresh: 9.50
SQL> -- transaction committed (COMMIT)
--- StatelessSession and batches of 3 statements
SQL> -- start of transaction
SQL> select a1_0.id, a1_0.currentStock, a1_0.minimumStock, a1_0.name, a1_0.price
SQL> from articles a1_0
SQL> order by a1_0.id
SQL> update articles
SQL> set currentStock=?, minimumStock=?, name=?, price=?
SQL> where id=?
SQL> -- parameter 1 = 11
SQL> -- parameter 2 = 5
SQL> -- parameter 3 = bike
SQL> -- parameter 4 = 500.00
SQL> -- parameter 5 = 1
...
SQL> -- execution of a batch of 3 statement(s)
SQL> update articles
SQL> set currentStock=?, minimumStock=?, name=?, price=?
SQL> where id=?
...
SQL> -- execution of a batch of 2 statement(s)
SQL> -- transaction committed (COMMIT)
|
Comentários:
- Linhas 22–26: um comando [update] escrito em HQL, preparado por [createMutationQuery], e executado por [executeUpdate]. Ele se torna um único comando SQL [UPDATE] (linhas 4–6), executado pelo SGBD em todas as linhas afetadas, sem que nenhuma entidade seja carregada na memória. O novo valor pode depender da própria linha ([minimumStock * 2]). Esse comando é executado dentro de uma transação (linha 18);
- linhas 30–32: um aumento de 10% nos preços baixos. As constantes da consulta HQL ([1.1], [150]) são escritas diretamente no texto do comando SQL (linhas 10–11);
- linhas 37–39: um comando HQL [delete] remove o arco, o único item com preço superior a 550 euros (linhas 14–16);
- Linhas 46–49: uma leitura somente leitura ([setReadOnly(true)]). As entidades lidas são gerenciadas pela sessão, mas a sessão não guarda seu estado original nem as monitora: isso é mais rápido e consome menos memória para dados que são lidos sem serem modificados (exibição, cálculos). Em contrapartida, qualquer modificação em uma entidade assim é ignorada (linha 52): a sessão não tem nada a sincronizar (linha 29), e o comando [commit] não envia nenhuma instrução. Também é possível definir uma sessão inteira como somente leitura ([session.setDefaultReadOnly(true)]);
- linhas 59–65: uma armadilha. Um comando HQL [update] atua diretamente no banco de dados: ele não modifica as entidades já carregadas pela sessão. A bomba gerenciada pela sessão mantém seu preço antigo (linha 37) até ser lida novamente com [session.refresh(pump)] (linhas 38–42);
- linhas 71–81: uma sessão sem estado ([StatelessSession]), aberta aqui com uma transação por meio de [inStatelessTransaction]. Ela não tem contexto de persistência: sem cache de primeiro nível, sem rastreamento de alterações, sem carregamento tardio, sem cascatas. Cada operação é solicitada explicitamente ([insert], [update], [delete], [get]) e executada tal como está. É a ferramenta para o processamento em massa: importar um arquivo grande, recalcular todas as linhas de uma tabela;
- linha 72: os comandos SQL serão enviados ao SGBD em lotes (ver Capítulo 10) de três: o driver JDBC transmite três comandos em uma única troca com o servidor. O log mostra os três primeiros [UPDATE], seguidos da execução do lote (linha 58), e termina com o lote final de dois comandos (linha 63). Uma aplicação define o tamanho do lote para todas as suas sessões por meio da propriedade [hibernate.jdbc.batch_size] (tipicamente entre 10 e 50). Observe que as inserções em uma tabela cuja chave é gerada por [IDENTITY] não podem ser agrupadas em lotes.
Para o processamento em massa com uma sessão comum, é preciso impedir que seu contexto de persistência acumule entidades: sincronize e limpe a sessão regularmente, por exemplo a cada cinquenta registros ([session.flush(); session.clear();]).
11.14. Hibernate e injeção de dependência: Spring
11.14.1. O [SessionFactory] no contêiner
Os exemplos anteriores criavam suas próprias sessões. Em uma aplicação em camadas (Capítulo 6) e em todas as aplicações Spring, o [SessionFactory] é um objeto do contêiner de injeção de dependência, assim como as camadas que o utilizam. Para isso, o Spring Framework oferece, em sua biblioteca [spring-orm]:
- a classe [LocalSessionFactoryBean], que constrói o [SessionFactory] a partir de uma fonte de dados ([DataSource], Capítulo 10) e de uma lista de entidades;
- a classe [HibernateTransactionManager], um gerenciador de transações que abre uma sessão do Hibernate para cada transação, a associa à thread atual e a fecha ao final da transação;
- a anotação [@Transactional] (biblioteca [spring-tx]): quando aplicada a um método, ou a uma classe para todos os seus métodos públicos, ela instrui o Spring a executar o método dentro de uma transação, que é confirmada se o método terminar normalmente e revertida se ele lançar uma exceção não tratada. Essas são conhecidas como transações declarativas.
Dentro de um método transacional, [sessionFactory.getCurrentSession()] devolve a sessão da transação atual. Uma camada [dao] pode então ser um singleton que recebe o [SessionFactory] (thread-safe) e solicita a ele a sessão atual em cada método: a regra “uma sessão por unidade de trabalho, nunca compartilhada entre threads” é cumprida sem esforço.
11.14.2. O módulo [injection]
O módulo [injection] depende, além do módulo [articles], do Spring e do HikariCP:
| <dependencies>
<!-- a entidade [Article] e o banco de dados [hbarticles] (Hibernate, MySQL e o log SQL incluídos) -->
<dependency>
<groupId>examples.hibernate</groupId>
<artifactId>articles</artifactId>
</dependency>
<!-- Spring: contêiner, transações declarativas, integração com o Hibernate -->
<dependency>
<groupId>org.springframework</groupId>
<artifactId>spring-context</artifactId>
</dependency>
<dependency>
<groupId>org.springframework</groupId>
<artifactId>spring-orm</artifactId>
</dependency>
<!-- o pool de conexões HikariCP -->
<dependency>
<groupId>com.zaxxer</groupId>
<artifactId>HikariCP</artifactId>
</dependency>
</dependencies>
|
A configuração do Spring é escrita em Java, usando as anotações [@Configuration] e [@Bean] do Capítulo 6:
| package injection;
import articles.Article;
import articles.BaseArticles;
import com.zaxxer.hikari.HikariDataSource;
import java.util.Properties;
import javax.sql.DataSource;
import org.hibernate.SessionFactory;
import org.hibernate.cfg.AvailableSettings;
import org.springframework.context.annotation.Bean;
import org.springframework.context.annotation.Configuration;
import org.springframework.orm.jpa.hibernate.HibernateTransactionManager;
import org.springframework.orm.jpa.hibernate.LocalSessionFactoryBean;
import org.springframework.transaction.annotation.EnableTransactionManagement;
// a configuração do Spring: pool de conexões, SessionFactory, gerenciador de transações, camada [dao]
@Configuration
@EnableTransactionManagement
public class Config {
// o pool de conexões HikariCP (capítulo 10)
@Bean(destroyMethod = "close")
public HikariDataSource dataSource() {
HikariDataSource dataSource = new HikariDataSource();
dataSource.setJdbcUrl(BaseArticles.URL);
dataSource.setUsername(BaseArticles.USER);
dataSource.setPassword(BaseArticles.PASSWORD);
return dataSource;
}
// a SessionFactory, construída pelo Spring com o pool de conexões
@Bean
public LocalSessionFactoryBean sessionFactory(DataSource dataSource) {
LocalSessionFactoryBean factory = new LocalSessionFactoryBean();
factory.setDataSource(dataSource);
factory.setAnnotatedClasses(Article.class);
Properties properties = new Properties();
properties.put(AvailableSettings.FORMAT_SQL, "true");
factory.setHibernateProperties(properties);
return factory;
}
// o gerenciador de transações: uma sessão do Hibernate por transação
@Bean
public HibernateTransactionManager transactionManager(SessionFactory sessionFactory) {
return new HibernateTransactionManager(sessionFactory);
}
// a camada [dao]: um singleton que recebe a SessionFactory
@Bean
public ArticlesDao articlesDao(SessionFactory sessionFactory) {
return new ArticlesDao(sessionFactory);
}
}
|
- Linha 18: [@EnableTransactionManagement] habilita a anotação [@Transactional]: o Spring substituirá todo objeto que tenha um método com essa anotação por um proxy que abre e confirma a transação em torno da chamada;
- linhas 22–29: o pool de conexões HikariCP do Capítulo 10. O atributo [destroyMethod] especifica o método a ser chamado quando o contêiner é fechado;
- Linhas 32–41: o [SessionFactory]. Um [LocalSessionFactoryBean] é uma fábrica de [SessionFactory]: o Spring registra no contêiner o objeto que ela cria, e solicitar esse bean devolve um [SessionFactory]. Ela recebe o pool de conexões (que substitui o pool embutido do Hibernate), as entidades e as propriedades do Hibernate;
- linhas 44–47: o gerenciador de transações;
- linhas 50–53: a camada [dao], que recebe o [SessionFactory].
A camada [dao]:
| package injection;
import articles.Article;
import java.util.List;
import org.hibernate.Session;
import org.hibernate.SessionFactory;
import org.springframework.transaction.annotation.Transactional;
// a camada [dao]: cada método público é executado em uma transação aberta pelo Spring
@Transactional
public class ArticlesDao {
// a SessionFactory, compartilhada por todas as threads
private final SessionFactory sessionFactory;
public ArticlesDao(SessionFactory sessionFactory) {
this.sessionFactory = sessionFactory;
}
// duas requisições da sessão atual, na mesma transação, retornam a mesma sessão?
public boolean sameSession() {
return sessionFactory.getCurrentSession() == sessionFactory.getCurrentSession();
}
// a sessão da transação
public Session session() {
return sessionFactory.getCurrentSession();
}
// os artigos a repor; uma transação somente leitura
@Transactional(readOnly = true)
public List<String> articlesOutOfStock() {
String hql = "select name from Article where currentStock < minimumStock";
return sessionFactory.getCurrentSession().createSelectionQuery(hql, String.class).getResultList();
}
// o artigo com o nome informado
@Transactional(readOnly = true)
public Article article(String name) {
return sessionFactory.getCurrentSession()
.createSelectionQuery("from Article where name = :name", Article.class)
.setParameter("name", name)
.getSingleResult();
}
// a venda de uma quantidade de um artigo: uma exceção desfaz a transação
public void sell(String name, int quantity) {
Article article = article(name);
article.setCurrentStock(article.getCurrentStock() - quantity);
if (article.getCurrentStock() < 0) {
throw new IllegalStateException("insufficient stock for the article [" + name + "]");
}
}
}
|
- linha 10: todos os métodos públicos da classe são transacionais;
- linhas 21–23: durante a mesma transação, duas solicitações da sessão atual devolvem a mesma sessão?
- linhas 26–28: a sessão da transação é devolvida ao chamador (para o experimento seguinte — isso não é feito em uma aplicação real);
- linhas 31–35: uma transação somente leitura ([readOnly = true]): o Spring define a sessão como somente leitura e não a sincroniza;
- Linhas 47–53: a venda de uma quantidade de um item. Se o estoque ficar negativo, o método lança uma [IllegalStateException], uma exceção não tratada: o Spring reverte a transação. A chamada ao método [article] (linha 48) é uma chamada interna dentro do objeto que não passa pelo proxy: ela é executada dentro da transação de [sell].
O programa principal:
| package injection;
import articles.BaseArticles;
import org.hibernate.HibernateException;
import org.hibernate.Session;
import org.hibernate.SessionFactory;
import org.springframework.context.annotation.AnnotationConfigApplicationContext;
public class Main {
public static void main(String[] args) {
// o contêiner do Spring, configurado pela classe [Config]
try (var context = new AnnotationConfigApplicationContext(Config.class)) {
// a tabela [articles] é recriada com seus seis artigos
SessionFactory sessionFactory = context.getBean(SessionFactory.class);
BaseArticles.initialize(sessionFactory);
ArticlesDao dao = context.getBean(ArticlesDao.class);
// 1 - durante uma transação, a sessão atual é sempre a mesma
IO.println("--- sessions and transactions");
IO.println("one transaction: same session = " + dao.sameSession());
// 2 - duas transações: duas sessões, fechadas no fim de sua transação
Session session1 = dao.session();
Session session2 = dao.session();
IO.println("two transactions: same session = %s, first session open = %s"
.formatted(session1 == session2, session1.isOpen()));
// 3 - fora de uma transação, não há sessão atual
try {
sessionFactory.getCurrentSession();
} catch (HibernateException e) {
IO.println(e.getClass().getSimpleName() + " : " + e.getMessage());
}
// 4 - métodos transacionais da camada [dao]
IO.println("--- articles out of stock");
IO.println("out of stock: " + dao.articlesOutOfStock());
IO.println("--- sale of 2 bikes");
dao.sell("bike", 2);
IO.println("--- sale of 50 pumps");
try {
dao.sell("pump", 50);
} catch (IllegalStateException e) {
IO.println(e.getClass().getSimpleName() + " : " + e.getMessage());
}
IO.println("--- state of the database");
IO.println(dao.article("bike"));
IO.println(dao.article("pump"));
}
}
}
|
Resultados:
| > mvn compile exec:java
--- sessions and transactions
SQL> -- start of transaction
SQL> -- transaction committed (COMMIT)
one transaction: same session = true
SQL> -- start of transaction
SQL> -- transaction committed (COMMIT)
SQL> -- start of transaction
SQL> -- transaction committed (COMMIT)
two transactions: same session = false, first session open = false
HibernateException : Could not obtain transaction-synchronized Session for current thread
--- articles out of stock
SQL> -- start of transaction
SQL> select a1_0.name
SQL> from articles a1_0
SQL> where a1_0.currentStock<a1_0.minimumStock
SQL> -- transaction committed (COMMIT)
out of stock: [arrows - set of 6]
--- sale of 2 bikes
SQL> -- start of transaction
SQL> select a1_0.id, a1_0.currentStock, a1_0.minimumStock, a1_0.name, a1_0.price
SQL> from articles a1_0
SQL> where a1_0.name=?
SQL> -- parameter 1 = bike
SQL> update articles
SQL> set currentStock=?, minimumStock=?, name=?, price=?
SQL> where id=?
SQL> -- parameter 1 = 8
SQL> -- parameter 2 = 5
SQL> -- parameter 3 = bike
SQL> -- parameter 4 = 500.00
SQL> -- parameter 5 = 1
SQL> -- transaction committed (COMMIT)
--- sale of 50 pumps
SQL> -- start of transaction
SQL> select a1_0.id, a1_0.currentStock, a1_0.minimumStock, a1_0.name, a1_0.price
SQL> from articles a1_0
SQL> where a1_0.name=?
SQL> -- parameter 1 = pump
SQL> -- transaction rolled back (ROLLBACK)
IllegalStateException : insufficient stock for the article [pump]
--- state of the database
SQL> -- start of transaction
SQL> select a1_0.id, a1_0.currentStock, a1_0.minimumStock, a1_0.name, a1_0.price
SQL> from articles a1_0
SQL> where a1_0.name=?
SQL> -- parameter 1 = bike
SQL> -- transaction committed (COMMIT)
[1, bike, 500.00, 8, 5]
SQL> -- start of transaction
SQL> select a1_0.id, a1_0.currentStock, a1_0.minimumStock, a1_0.name, a1_0.price
SQL> from articles a1_0
SQL> where a1_0.name=?
SQL> -- parameter 1 = pump
SQL> -- transaction committed (COMMIT)
[2, pump, 10.00, 10, 2]
|
Comentários:
- Linha 13: o contêiner Spring, configurado pela classe [Config]. Ele é fechado ao final do bloco [try], que fecha o [SessionFactory] e o pool de conexões;
- linha 15: o [SessionFactory] criado pelo Spring; ele é usado para recriar a tabela de produtos;
- linha 21: uma transação (linhas 3–4): dentro da mesma transação, a sessão atual permanece a mesma (linha 5);
- linhas 23–26: duas chamadas, duas transações (linhas 6–9), duas sessões diferentes; a primeira é fechada, pois sua transação está concluída (linha 10);
- linhas 28–32: fora de uma transação, não há sessão atual: [getCurrentSession] lança uma [HibernateException] (linha 11). Este é o erro clássico causado por um método que omitiu a anotação [@Transactional];
- linha 36: uma transação somente leitura (linhas 13–17);
- linha 38: a venda de duas bicicletas. A transação é confirmada, e a sincronização da sessão envia o [UPDATE] (linhas 20–33);
- linhas 40–44: a venda de cinquenta bombas dispara uma exceção: o Spring reverte a transação (linha 40), e o [UPDATE] nunca é enviado, pois a sessão não foi sincronizada;
- linhas 46–47: estado do banco de dados: o estoque de bicicletas passou para 8, enquanto o estoque de bombas continua em 10 (linhas 49 e 56).
Em uma aplicação Spring Boot, tudo isso acontece automaticamente: o Spring Boot cria o pool de conexões, a fábrica (em sua forma Jakarta Persistence, um [EntityManagerFactory]) e o gerenciador de transações a partir do arquivo [application.properties]. O Spring Data JPA é frequentemente usado sobre o Hibernate; ele gera a camada [dao] a partir de uma interface simples: [interface ArticleRepository extends JpaRepository<Article, Integer>] fornece [findAll], [findById], [save], [delete]..., e um método declarado [List<Article> findByPriceLessThan(BigDecimal price)] é traduzido automaticamente em uma consulta.
11.15. Aplicação de exemplo - versão 7
11.15.1. A arquitetura
A versão 6 da aplicação de cálculo de imposto (Capítulo 10) lia as faixas de imposto de um banco de dados MySQL usando JDBC. A versão 7 faz o mesmo usando o Hibernate. Assim como na versão 6, apenas a camada [dao] muda: as camadas [business] e [ui] da versão 5 (Capítulo 6) são reutilizadas como estão por meio de dependências Maven.
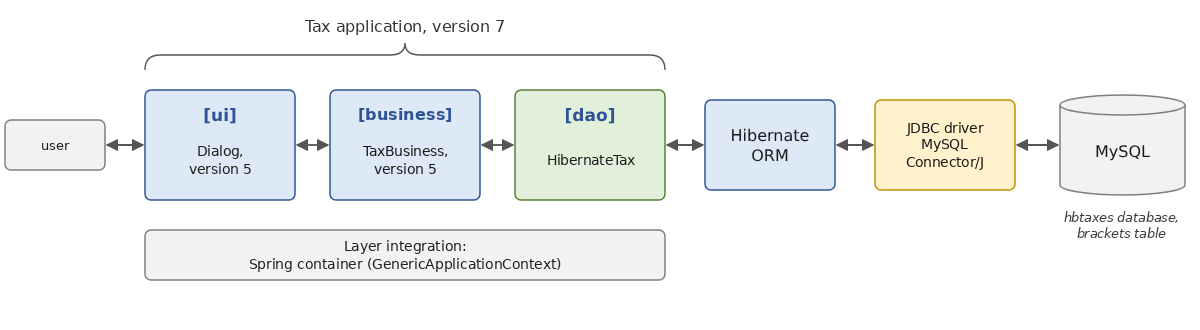
O projeto Maven [TaxV7], localizado na pasta [11-hibernate], é composto por dois módulos:
| TaxV7/
pom.xml the parent project
tax-dao-hibernate/ library: the Hibernate [dao] layer
pom.xml
src/main/java/tax/dao/
Bracket.java the entity
HibernateTax.java the implementation of ITaxDao
CreateDatabase.java the creation of the database [hbtaxes]
src/main/resources/
logback.xml
tax-ui-hibernate/ executable: integration of the layers
pom.xml
src/main/java/tax/ui/
MainHibernate.java
tax-hibernate.properties
tax-hibernate-error.properties
|
O projeto pai ([examples.tax:tax-v7:7.0]) é estruturado como o da versão 5: ele declara os dois módulos e especifica as versões das bibliotecas, incluindo as dos módulos da versão 5 ([tax-dao], [tax-business], [tax-ui], versão 5.0), que são instalados no repositório Maven local com o comando [mvn install] executado na pasta [06-architectures/TaxV5].
11.15.2. A camada [dao]
O módulo [tax-dao-hibernate] depende da camada [dao] da versão 5, que contém as entidades da aplicação ([TaxBracket], [TaxException]) e a interface [ITaxDao]:
| <dependencies>
<!-- a camada [dao] da versão 5: entidades, interface ITaxDao, HardwiredTax -->
<dependency>
<groupId>examples.tax</groupId>
<artifactId>tax-dao</artifactId>
</dependency>
<!-- Hibernate, o driver JDBC do MySQL e o Logback -->
<dependency>
<groupId>org.hibernate.orm</groupId>
<artifactId>hibernate-core</artifactId>
</dependency>
<dependency>
<groupId>com.mysql</groupId>
<artifactId>mysql-connector-j</artifactId>
</dependency>
<dependency>
<groupId>ch.qos.logback</groupId>
<artifactId>logback-classic</artifactId>
</dependency>
</dependencies>
<build>
<plugins>
<!-- mvn exec:java cria o banco de dados [hbtaxes] -->
<plugin>
<groupId>org.codehaus.mojo</groupId>
<artifactId>exec-maven-plugin</artifactId>
<configuration>
<mainClass>tax.dao.CreateDatabase</mainClass>
</configuration>
</plugin>
</plugins>
</build>
|
- linhas 3–6: a camada [dao] da versão 5;
- linhas 8–19: Hibernate, o driver JDBC para MySQL e Logback;
- linhas 25–31: a classe executada por [mvn exec:java] no diretório do módulo: ela cria o banco de dados, como veremos.
O record [TaxBracket] da versão 5 não pode ser uma entidade do Hibernate: ele é um record, somente leitura, e não tem identificador. Ele não é modificado porque faz parte do contrato entre as camadas, compartilhado por todas as versões. Criamos uma entidade específica para a camada [dao], cujo papel é representar uma linha da tabela:
| // uma faixa do imposto tal como é armazenada no banco de dados: uma entidade Hibernate
@Entity
@Table(name = "brackets")
public class Bracket {
// a chave primária, que não existe no record TaxBracket
@Id
@GeneratedValue(strategy = GenerationType.IDENTITY)
private Integer id;
@Column(name = "limits", nullable = false, precision = 10, scale = 2)
private BigDecimal limit;
@Column(name = "coeffr", nullable = false, precision = 6, scale = 4)
private BigDecimal coeffR;
@Column(name = "coeffn", nullable = false, precision = 10, scale = 2)
private BigDecimal coeffN;
protected Bracket() {
}
public Bracket(BigDecimal limit, BigDecimal coeffR, BigDecimal coeffN) {
this.limit = limit;
this.coeffR = coeffR;
this.coeffN = coeffN;
}
}
|
- linha 3: a tabela [brackets];
- linhas 7–9: a chave primária, que também é usada para ordenar as faixas;
- linhas 11–18: as três colunas, com tipos de dados [decimal] apropriados: o limite e o coeficiente ([coeffN]) são valores com duas casas decimais, e [coeffR] é uma taxa com quatro casas decimais. Os nomes das colunas estão em minúsculas;
- Linhas 23–27: um construtor, que será usado para popular a tabela. A entidade não tem acessores: o restante da aplicação nunca a vê.
A classe [HibernateTax] implementa a interface [ITaxDao]:
| package tax.dao;
import tax.entities.TaxException;
import tax.entities.TaxBracket;
import jakarta.persistence.PersistenceException;
import java.util.List;
import org.hibernate.SessionFactory;
import org.hibernate.jpa.HibernatePersistenceConfiguration;
// uma camada [dao] que lê as faixas do imposto em um banco de dados com o Hibernate
public class HibernateTax implements ITaxDao {
// códigos de erro específicos desta implementação
public static final int ACCESS_ERROR = 1;
public static final int EMPTY_TABLE = 2;
// faixas de imposto
private final List<TaxBracket> taxBrackets;
// construtor: o banco de dados é designado por sua URL JDBC
public HibernateTax(String url, String user, String password) {
// uma SessionFactory de vida curta, apenas o tempo de ler a tabela
try (SessionFactory sessionFactory = new HibernatePersistenceConfiguration("tax")
.managedClass(Bracket.class)
.jdbcUrl(url)
.jdbcCredentials(user, password)
.createEntityManagerFactory()) {
// as linhas da tabela são projetadas no record TaxBracket da aplicação
String hql = "select b.limit, b.coeffR, b.coeffN from Bracket b order by b.id";
taxBrackets = sessionFactory.fromSession(session -> session
.createSelectionQuery(hql, TaxBracket.class)
.getResultList());
} catch (PersistenceException e) {
// erro do Hibernate ou do SGBD: ele é encapsulado em uma TaxException
throw new TaxException("Error while reading the tax brackets from the database",
e, ACCESS_ERROR);
}
// a camada [business] precisa de pelo menos uma faixa
if (taxBrackets.isEmpty()) {
throw new TaxException("The tax brackets table is empty", EMPTY_TABLE);
}
}
@Override
public List<TaxBracket> getTaxBrackets() {
return taxBrackets;
}
}
|
- linhas 14–15: os códigos de erro desta implementação, como em [FileTax] e [JsonTax];
- linha 21: a camada [dao] recebe a URL do banco de dados, junto com o usuário e sua senha. Ela lê as faixas de uma vez por todas em seu construtor; será um singleton;
- linhas 23–27: um [SessionFactory] de vida curta, que dura apenas o tempo necessário para ler a tabela e é fechado imediatamente. Como a camada acessa o banco de dados apenas uma vez, não há necessidade de mantê-lo; uma camada [dao] que acessasse o banco de dados a cada chamada receberia, em vez disso, um [SessionFactory] criado uma vez por todas, como no exemplo anterior;
- linhas 29–32: a leitura da tabela na ordem da chave primária. A consulta é uma projeção sobre o record [TaxBracket]: o Hibernate solicita ao SGBD apenas as três colunas relevantes e cria diretamente os objetos da aplicação, sem passar por entidades [Bracket];
- Linhas 33–37: um erro do Hibernate ou do SGBD (banco de dados inacessível, tabela ausente etc.) se manifesta como uma [PersistenceException] (a classe base das exceções do Jakarta Persistence, da qual derivam as exceções do Hibernate). Como nas outras implementações, ela é encapsulada em uma [TaxException]. A exceção pode ocorrer já na criação do [SessionFactory] (linha 27), que se conecta ao servidor: a cláusula [catch] de uma instrução [try] com recursos também intercepta as exceções lançadas durante a criação dos recursos;
- linhas 39–41: uma tabela vazia também é um erro: a camada [business] exige pelo menos uma faixa.
11.15.3. O banco de dados
O banco de dados [hbtaxes] é criado pela classe [CreateDatabase]. Para evitar reescrever as faixas da tabela, ele reutiliza as da classe [HardwiredTax] da versão 5:
| package tax.dao;
import tax.entities.TaxBracket;
import org.hibernate.SessionFactory;
import org.hibernate.jpa.HibernatePersistenceConfiguration;
import org.hibernate.tool.schema.Action;
// criação do banco de dados [hbtaxes]: a tabela [brackets], preenchida com as faixas da classe HardwiredTax
public class CreateDatabase {
public static void main(String[] args) {
try (SessionFactory sessionFactory = new HibernatePersistenceConfiguration("tax")
.managedClass(Bracket.class)
.jdbcUrl("jdbc:mysql://localhost:3306/hbtaxes?createDatabaseIfNotExist=true")
.jdbcCredentials("root", "")
// exibição das instruções SQL, sem formatação
.showSql(true, false, false)
// a tabela é excluída e depois recriada quando a SessionFactory é criada
.schemaToolingAction(Action.CREATE)
.createEntityManagerFactory()) {
// as faixas da tabela do imposto, as da versão 5, numeradas a partir de 1 pelo SGBD
sessionFactory.inTransaction(session -> {
for (TaxBracket bracket : new HardwiredTax().getTaxBrackets()) {
session.persist(new Bracket(bracket.limit(), bracket.coeffR(), bracket.coeffN()));
}
});
}
}
}
|
- Linha 14: o banco de dados [hbtaxes], criado pelo MySQL se não existir;
- Linha 17: exibe os comandos SQL, sem formatação;
- linha 19: a tabela é excluída e depois recriada quando o [SessionFactory] é criado;
- linhas 22–26: uma entidade [Bracket] por faixa da classe [HardwiredTax], persistida dentro de uma transação.
O módulo também contém um arquivo chamado [logback.xml], usado por [CreateDatabase] e pela aplicação, que deixa passar apenas os erros:
| <?xml version="1.0" encoding="UTF-8"?>
<!-- configuração do Logback: somente os erros do Hibernate são exibidos -->
<configuration>
<appender name="CONSOLE" class="ch.qos.logback.core.ConsoleAppender">
<encoder>
<pattern>%-5level %logger{0} - %msg%n</pattern>
</encoder>
</appender>
<!-- os erros do SGBD são passados à aplicação por exceções: eles não são registrados no log -->
<logger name="org.hibernate.orm.jdbc.error" level="OFF"/>
<root level="ERROR">
<appender-ref ref="CONSOLE"/>
</root>
</configuration>
|
- linha 10: os erros do SGBD, que o Hibernate registra no log antes de lançar uma exceção, não são exibidos: a aplicação os relata por conta própria;
- Linha 11: os demais logs registram apenas erros.
Execução:
| > mvn compile exec:java
Hibernate: drop table if exists brackets
Hibernate: create table brackets (coeffn decimal(10,2) not null, coeffr decimal(6,4) not null, id integer not null auto_increment, limits decimal(10,2) not null, primary key (id)) engine=InnoDB
Hibernate: insert into brackets (coeffn,coeffr,limits) values (?,?,?)
Hibernate: insert into brackets (coeffn,coeffr,limits) values (?,?,?)
Hibernate: insert into brackets (coeffn,coeffr,limits) values (?,?,?)
Hibernate: insert into brackets (coeffn,coeffr,limits) values (?,?,?)
Hibernate: insert into brackets (coeffn,coeffr,limits) values (?,?,?)
Hibernate: insert into brackets (coeffn,coeffr,limits) values (?,?,?)
Hibernate: insert into brackets (coeffn,coeffr,limits) values (?,?,?)
|
Verificamos o conteúdo da tabela:
| > mysql -uroot -t hbtaxes -e "SELECT id, limits, coeffr, coeffn FROM brackets"
+----+----------+--------+---------+
| id | limits | coeffr | coeffn |
+----+----------+--------+---------+
| 1 | 4962.00 | 0.0000 | 0.00 |
| 2 | 8382.00 | 0.0680 | 291.09 |
| 3 | 14753.00 | 0.1910 | 1322.92 |
| 4 | 23888.00 | 0.2830 | 2668.39 |
| 5 | 38868.00 | 0.3740 | 4846.98 |
| 6 | 47932.00 | 0.4260 | 6883.66 |
| 7 | 0.00 | 0.4810 | 9505.54 |
+----+----------+--------+---------+
|
Encontramos as faixas da tabela de imposto, sendo que a última tem limite zero (ela não é usada pela camada [business], que adota a última faixa quando nenhuma outra se aplica).
Para criar o banco de dados no seu próprio sistema:
- inicie o MySQL (no Laragon, veja o apêndice; usuário [root] sem senha);
- se ainda não o fez, instale os módulos da versão 5 no repositório Maven local: [mvn install] na pasta [06-architectures/TaxV5];
- compile a versão 7: [mvn install] na pasta [11-hibernate/TaxV7];
- acesse a pasta [11-hibernate/TaxV7/tax-dao-hibernate] e digite o comando [mvn exec:java].
O banco de dados [hbtaxes] é então criado, com sua tabela [brackets] populada. Se o comando falhar, verifique se o MySQL está em execução e se a URL na classe [CreateDatabase] corresponde ao seu servidor (porta 3306, usuário [root], senha vazia). Como alternativa, se preferir, você pode criar a tabela e suas linhas por meio de um script SQL, conforme descrito no Capítulo 10.
11.15.4. Integração das camadas
O módulo [tax-ui-hibernate] combina as seguintes camadas:
| <dependencies>
<!-- as camadas [business] e [ui] da versão 5, inalteradas -->
<dependency>
<groupId>examples.tax</groupId>
<artifactId>tax-business</artifactId>
</dependency>
<dependency>
<groupId>examples.tax</groupId>
<artifactId>tax-ui</artifactId>
</dependency>
<!-- a nova camada [dao] -->
<dependency>
<groupId>examples.tax</groupId>
<artifactId>tax-dao-hibernate</artifactId>
</dependency>
<!-- o contêiner de injeção de dependência Spring -->
<dependency>
<groupId>org.springframework</groupId>
<artifactId>spring-context</artifactId>
</dependency>
</dependencies>
<build>
<plugins>
<!-- mvn exec:java executa a classe principal -->
<plugin>
<groupId>org.codehaus.mojo</groupId>
<artifactId>exec-maven-plugin</artifactId>
<configuration>
<mainClass>tax.ui.MainHibernate</mainClass>
</configuration>
</plugin>
</plugins>
</build>
|
- linhas 3–10: as camadas [business] e [ui] da versão 5. O módulo [tax-ui] contém o programa principal da versão 5; ele é usado aqui como biblioteca, especificamente por sua classe [Dialog];
- linhas 12–15: a nova camada [dao], que inclui o Hibernate, o driver JDBC e o Logback;
- linhas 17–20: o contêiner Spring;
- linha 30: a classe principal.
O arquivo de configuração [tax-hibernate.properties], localizado na pasta do módulo, especifica o banco de dados:
| # configuração da aplicação [Tax], versão 7: o banco de dados das faixas do imposto
jdbc.url=jdbc:mysql://localhost:3306/hbtaxes
jdbc.user=root
jdbc.password=
|
O arquivo [tax-hibernate-error.properties] especifica um banco de dados chamado [hbtaxesmissing], que não existe:
| # um banco de dados que não existe
jdbc.url=jdbc:mysql://localhost:3306/hbtaxesmissing
jdbc.user=root
jdbc.password=
|
O programa principal é o da versão 5, no qual apenas a composição da camada [dao] muda:
| package tax.ui;
import tax.dao.HibernateTax;
import tax.dao.ITaxDao;
import tax.entities.TaxException;
import tax.business.ITaxBusiness;
import tax.business.TaxBusiness;
import java.io.IOException;
import java.io.Reader;
import java.nio.file.Files;
import java.nio.file.Path;
import java.util.Properties;
import org.springframework.context.support.GenericApplicationContext;
public class MainHibernate {
public static void main(String[] args) {
// o arquivo de configuração: tax-hibernate.properties por padrão, ou o passado como argumento
String configFile = args.length > 0 ? args[0] : "tax-hibernate.properties";
// integração das camadas
ITaxBusiness business;
try {
// lendo a configuração, na pasta atual
Properties config = new Properties();
try (Reader reader = Files.newBufferedReader(Path.of(configFile))) {
config.load(reader);
}
String url = config.getProperty("jdbc.url");
if (url == null) {
throw new TaxException("Database URL [jdbc.url] missing from the file " + configFile);
}
String user = config.getProperty("jdbc.user", "root");
String password = config.getProperty("jdbc.password", "");
// o contêiner Spring: as camadas são registradas nele
GenericApplicationContext context = new GenericApplicationContext();
// a camada [dao]: HibernateTax, com o banco de dados da configuração
context.registerBean(ITaxDao.class, () -> new HibernateTax(url, user, password));
// a camada [business] da versão 5: o contêiner passará a camada [dao] a ela
context.registerBean(TaxBusiness.class);
// iniciando o contêiner: ele cria a camada [dao], depois a camada [business]
context.refresh();
business = context.getBean(ITaxBusiness.class);
} catch (IOException | RuntimeException e) {
// exibição do erro e fim do programa
Dialog.displayError(e);
System.exit(1);
return;
}
// o diálogo com o usuário, o da versão 5
Dialog.run(business);
}
}
|
- linha 15: a classe não se chama [Main]: o módulo [tax-ui] da versão 5, do qual dependemos, já contém uma classe chamada [tax.ui.Main];
- Linhas 29–34: a URL do banco de dados, obrigatória, o nome de usuário e a senha, lidos da configuração;
- linha 39: a camada [dao] é um [HibernateTax], criado por uma lambda que lhe passa os parâmetros do banco de dados;
- Linha 41: a camada [business] da versão 5: o contêiner passará a camada [dao] ao seu construtor;
- Linha 54: a caixa de diálogo da versão 5.
11.15.5. Execuções
| > mvn compile exec:java
Tax calculation parameters in the format: Married (y/n) NbChildren Salary, or nothing to stop: y 2 60000
Tax=4282 euros
Tax calculation parameters in the format: Married (y/n) NbChildren Salary, or nothing to stop: y 3 60000
Tax=2959 euros
Tax calculation parameters in the format: Married (y/n) NbChildren Salary, or nothing to stop: n 0 60000
Tax=11519 euros
Tax calculation parameters in the format: Married (y/n) NbChildren Salary, or nothing to stop:
|
Os valores de referência das versões anteriores são mantidos: 4.282 euros para um casal com dois filhos e renda conjunta de 60.000 euros; 2.959 euros para uma família com três filhos; e 11.519 euros para uma pessoa solteira sem filhos.
Com o arquivo de configuração [tax-hibernate-error.properties], que se refere a um banco de dados inexistente:
| > mvn compile exec:java -Dexec.args="tax-hibernate-error.properties"
Exception chain:
----------------------------------------
org.springframework.beans.factory.BeanCreationException: Error creating bean with name 'tax.dao.ITaxDao': Instantiation of supplied bean failed
----------------------------------------
tax.entities.TaxException: Error while reading the tax brackets from the database
----------------------------------------
org.hibernate.service.spi.ServiceException: Unable to create requested service [org.hibernate.engine.jdbc.env.spi.JdbcEnvironment] due to: Error calling Driver.connect() [Unknown database 'hbtaxesmissing']
----------------------------------------
org.hibernate.exception.SQLGrammarException: Error calling Driver.connect() [Unknown database 'hbtaxesmissing']
----------------------------------------
java.sql.SQLSyntaxErrorException: Unknown database 'hbtaxesmissing'
----------------------------------------
|
- linha 12: a exceção original, lançada pelo driver JDBC;
- linhas 8 e 10: as exceções do Hibernate que a encapsulam: o erro ocorreu durante a criação do [SessionFactory], quando o Hibernate se conectou ao servidor para determinar sua versão;
- linha 6: a camada [dao] encapsulou o erro em uma [TaxException];
- Linha 4: o contêiner Spring, que estava criando a camada [dao], encapsulou por sua vez a exceção em uma [BeanCreationException], que foi exibida pelo programa principal.
Trocar de SGBD equivale a mudar a URL do banco de dados e a dependência do driver JDBC: o Hibernate seleciona automaticamente o dialeto SQL a partir do SGBD encontrado, e o código da classe [HibernateTax], escrito em HQL, permanece inalterado. Apenas a criação do banco de dados — que depende dos tipos das colunas — precisa ser refeita, o que a classe [CreateDatabase] faz sem nenhuma alteração além de sua URL.
11.16. Conclusão: JDBC, JdbcClient, jOOQ ou Hibernate?
Agora temos duas maneiras de acessar um banco de dados: JDBC (Capítulo 10) e Hibernate (este capítulo). Há outras abordagens intermediárias amplamente utilizadas:
- O JdbcClient, do Spring Framework (biblioteca [spring-jdbc]), acrescenta ao JDBC uma API flexível que executa uma consulta SQL escrita à mão e transforma automaticamente as linhas do resultado em objetos: [jdbcClient.sql("select * from articles where price > :price").param("price", 200).query(Article.class).list()]. Você escreve o SQL; o Spring cuida dos parâmetros e copia as colunas para os objetos (inclusive records). É um “micro-ORM”;
- O jOOQ gera, com base no esquema do banco de dados, classes que permitem escrever em Java um SQL verificado pelo compilador: [dsl.selectFrom(ARTICLES).where(ARTICLES.PRICE.gt(price)).fetch()]. Você mantém controle total sobre o SQL, com a segurança da verificação de tipos.
| | Pontos fortes | Pontos fracos |
JDBC | controle total sobre o SQL; desempenho; nenhuma dependência | muito código repetitivo (parâmetros, leitura de colunas); SQL em strings, não verificado pelo compilador |
JdbcClient | SQL escrito à mão, sem código de copiar e colar; desempenho semelhante ao do JDBC | Sem rastreamento de alterações nem geração de [INSERT]/[UPDATE]; SQL não verificado |
jOOQ | SQL verificado pelo compilador; todos os recursos do SGBD | Geração de código a cada alteração do esquema; sem rastreamento de alterações; licença paga necessária para certas versões comerciais de SGBD |
Hibernate | modelo orientado a objetos; rastreamento de alterações; relacionamentos; HQL e API Criteria; padrão Jakarta Persistence; independente do SGBD | uma camada adicional a compreender (sessões, estados, carregamento tardio); SQL gerado a monitorar; menos adequado para processamento em massa complexo |
Podem-se sugerir as seguintes orientações:
- O Hibernate (muitas vezes via Spring Data JPA) é adequado para a maioria das aplicações de negócio: um modelo de entidades interligadas, operações de leitura e atualização de entidades e um esquema que evolui com a aplicação. É a escolha padrão para aplicações Spring Boot;
- O JDBC, o JdbcClient ou o jOOQ são adequados quando se deseja controle preciso sobre o código SQL executado: consultas estatísticas complexas, procedures armazenadas, processamento de volumes muito grandes ou um banco de dados existente com um esquema pouco adequado a um modelo orientado a objetos;
- Essas abordagens podem ser combinadas: uma aplicação pode usar o Hibernate na maior parte e código SQL escrito à mão, em consultas nativas, com o [JdbcClient] ou com JDBC ([doWork]), para algumas consultas críticas.
De qualquer forma, o ORM não elimina a necessidade de entender o SQL e o funcionamento do SGBD: o log dos comandos SQL executados, que exibimos ao longo deste capítulo, é a principal ferramenta para verificar o que o Hibernate realmente faz.
Para saber mais, a documentação do Hibernate é completa, e seu guia introdutório é o melhor lugar para começar: Hibernate ORM - documentation. A especificação Jakarta Persistence é publicada pela Eclipse Foundation: Jakarta Persistence.