8. Threads de execução
Este capítulo apresenta a execução simultânea de vários trechos de código dentro de um mesmo programa: as threads (threads de execução) e as ferramentas usadas para sincronizá-las. Há cerca de vinte anos, a maioria das máquinas tinha apenas um processador, e o paralelismo era em grande parte uma ilusão mantida pelo sistema operacional. Hoje, até o laptop mais básico tem vários núcleos: várias threads realmente executam ao mesmo tempo, o que torna os problemas de sincronização discutidos aqui ainda mais frequentes.
O Java oferece suporte a threads desde a sua primeira versão (1996): a classe [Thread], a palavra-chave [synchronized] e os métodos [wait] / [notify] da classe [Object]. O Java 5 (2004) acrescentou o pacote [java.util.concurrent] e seus subpacotes [java.util.concurrent.locks] e [java.util.concurrent.atomic]: locks, semáforos, coleções concorrentes, pools de threads etc. O Java 7 acrescentou o framework [Fork/Join], o Java 8 introduziu os streams paralelos e o Java 21 introduziu as threads virtuais, tudo isso mudando profundamente a maneira de escrever servidores. O Java 25, por fim, introduz os valores vinculados a um escopo ([ScopedValue]). Exploraremos todas essas ferramentas neste capítulo.
Os exemplos são arquivos-fonte compactos ([java Threads01.java]) localizados na pasta [08-threads]. Lembre-se de que um arquivo-fonte compacto importa automaticamente todo o módulo [java.base]: as classes dos pacotes [java.util.concurrent], [java.util.concurrent.locks], [java.util.concurrent.atomic] e [java.time] podem, portanto, ser usadas sem a diretiva [import].
Um aviso antes de começar: os resultados de um programa multithread variam de uma execução para outra. A ordem em que as threads recebem o processador depende do sistema operacional, do número de processadores e da carga da máquina. Os resultados mostrados neste capítulo foram obtidos em uma máquina Linux com dois processadores, compartilhada com outros programas muito ativos. Se você executar os exemplos, obterá resultados semelhantes, mas raramente idênticos. Indicaremos em cada caso o que é reproduzível e o que não é.
8.1. A classe Thread
Quando uma aplicação é iniciada, ela é executada em um fluxo de execução chamado thread. A classe Java que modela uma thread é a classe [java.lang.Thread]. Seus principais construtores e métodos são os seguintes:
Membro | Papel |
[Thread(Runnable task)], [Thread(Runnable task, String name)] | Cria uma thread que executará o método [run] de [task]. [Runnable] é a interface funcional de [void run()]: o mais comum é passar-lhe uma lambda ou uma referência de método |
[static Thread.Builder.OfPlatform ofPlatform()], [static Thread.Builder.OfVirtual ofVirtual()] | (Java 21) retornam um builder para threads de plataforma ou threads virtuais, que você configura (nome, daemon etc.) antes de criar a thread |
[static Thread currentThread()] | a thread que executa o código que chamou este método |
[String getName()], [void setName(String name)] | o nome da thread, útil para rastreamento |
[long threadId()] | (Java 19) um identificador numérico único da thread; substitui [getId()], que está obsoleto |
[boolean isDaemon()], [void setDaemon(boolean b)] | Indica (e define) se a thread é uma thread daemon (veja abaixo) |
[int getPriority()], [void setPriority(int p)] | a prioridade da thread, de 1 ([MIN_PRIORITY]) a 10 ([MAX_PRIORITY]), sendo 5 ([NORM_PRIORITY]) o padrão |
[Thread.State getState()], [boolean isAlive()] | o estado da thread ([NEW], [RUNNABLE], [BLOCKED], [WAITING], [TIMED_WAITING], [TERMINATED]); [isAlive] indica se ela foi iniciada, mas ainda não terminou |
[boolean isVirtual()] | (Java 21) indica se a thread é uma thread virtual |
[void start()] | inicia a execução da thread |
[void join()], [boolean join(Duration timeout)] | A thread T1, que executa [T2.join()], fica bloqueada até que a thread T2 termine. A segunda forma (Java 19) limita o tempo de espera e indica se T2 terminou |
[static void sleep(long ms)], [static void sleep(Duration d)] | a thread que executa o método é suspensa por [ms] milissegundos (pela duração [d]). Ela perde a CPU, que é dada a outra thread |
[void interrupt()], [boolean isInterrupted()] | pede à thread que se suspenda; verifica se uma suspensão foi solicitada (veja abaixo) |
Os métodos [join] e [sleep] lançam a exceção verificada [InterruptedException] se a thread for interrompida durante a espera: o compilador exige que ela seja tratada ou declarada. Discutiremos seu significado na seção sobre interrupções.
A classe [Thread] também tem um método, [stop], que servia para encerrar uma thread à força. Ele está obsoleto desde o Java 1.2 e, desde o Java 20, simplesmente lança a exceção [UnsupportedOperationException]: interromper abruptamente uma thread poderia deixar os dados que ela manipulava em um estado inconsistente. Hoje, pedimos a uma thread que pare de forma cooperativa , interrompendo-a: veremos isso um pouco mais adiante.
Eis uma primeira aplicação que demonstra a existência de uma thread de execução principal, aquela que executa o método [main]. O programa [Threads01.java] é o seguinte:
Resultados:
Comentários:
- linha 5: obtém-se uma referência à thread que executa o programa;
- linhas 7–10: exibimos seu nome, o modificamos e o exibimos novamente. Inicialmente, a thread principal se chama [main] (linha 2 dos resultados): o launcher do Java atribuiu esse nome a ela;
- Linhas 12–18: algumas propriedades da thread. Nesta execução, a thread principal tem o ID 3: a máquina virtual cria algumas threads para seu próprio uso antes de executar [main], e esse ID pode variar de uma versão do Java para outra. Ela não é uma thread daemon ([isDaemon()] é igual a [false]) nem uma thread virtual (discutiremos esses dois conceitos adiante); sua prioridade é a prioridade normal, 5; ela está em execução no momento ([RUNNABLE]). O método [toString] da thread (linha 17) exibe seu ID, nome, prioridade e o nome de seu grupo de threads ([main]);
- linha 18: a máquina que executou o exemplo tem 2 processadores;
- linhas 21–26: um laço que exibe uma saída a cada segundo. [Thread.sleep(1000)] suspende a thread principal por um segundo. Como [sleep] pode lançar a exceção verificada [InterruptedException], o método [main] a declara em sua cláusula [throws] (linha 3). Observe o formato [HH:mm:ss] (horas de 0 a 23): o formato [hh] exibiria as horas de 1 a 12.
8.2. Criação de threads de execução
É possível ter aplicações em que trechos de código são executados "simultaneamente" em diferentes threads de execução. Se a máquina tiver menos processadores do que threads prontas para executar, as threads compartilham os processadores: cada uma tem acesso a um processador por vez, por um breve momento (alguns milissegundos). Em uma máquina multiprocessada, várias threads realmente executam ao mesmo tempo. O tempo concedido a uma thread depende de diversos fatores, entre eles sua prioridade, que tem um valor padrão, mas pode ser definida por programação ([setPriority]); isso é apenas uma indicação, que o sistema operacional é livre para ignorar (o Linux a ignora por padrão). Uma thread que tem acesso ao processador pode liberá-lo antes do tempo:
- aguardando um evento (o término de outra thread por meio de [join], a espera por um sinal);
- dormindo por um período determinado ([sleep]).
Uma thread T é criada primeiro, por exemplo, pelo construtor [new Thread(task, name)], em que [task] é um objeto que implementa a interface funcional [Runnable], cujo único método é [void run()]. Esse objeto é, na maioria das vezes, uma lambda ou uma referência de método (as interfaces funcionais foram apresentadas no Capítulo 7). Em códigos mais antigos, você também pode encontrar classes derivadas de *[Thread]* que redefinem seu método *[run]*: isso não é recomendado, pois mistura a tarefa a ser executada com o meio de executá-la.
Criar uma thread não a inicia:
- a execução da thread T é iniciada por [T.start()]: o método [run] da tarefa passada ao construtor de T será então executado pela thread T. O código que executa a instrução [T.start()] não espera a thread T terminar: ele passa imediatamente para a instrução seguinte. Temos agora duas threads executando em paralelo. Elas frequentemente precisam se comunicar para acompanhar o andamento do trabalho compartilhado: esse é o problema da sincronização de threads;
- uma vez iniciada, a thread T executa de forma autônoma. Ela para quando o método que está executando termina;
- podemos esperar o fim de sua execução por meio de [T.join()]. Essa é uma instrução bloqueante: a thread que a executa fica bloqueada até que a thread T termine seu trabalho. Esse é um método básico de sincronização.
O programa [Threads02.java] é o seguinte:
Comentários:
- linha 5: damos um nome à thread principal;
- linhas 8–14: 5 threads são criadas e iniciadas. Suas referências são armazenadas em um array para que possam ser recuperadas depois. Cada thread executa o método [display] das linhas 21–30;
- Linha 11: a referência de método [this::display] é convertida automaticamente em um objeto [Runnable]: o método [display] não tem parâmetros e não retorna resultado, assim como [run]. Escrevemos [this::display] porque, em um arquivo-fonte compacto, os métodos declarados fora de qualquer classe são métodos de instância da classe implícita, cujo nome não pode ser usado no código. O segundo parâmetro do construtor é o nome da thread;
- linha 13: a thread nº i é lançada. Essa operação não é bloqueante: a thread nº i executa em paralelo com a thread principal que a lançou;
- linha 17: a thread principal chega ao fim do programa;
- Linhas 21–30: o método [display] exibe o nome e o ID da thread que o executa, bem como os horários de início e fim (em milissegundos) da execução;
- linha 27: qualquer thread que execute o método [display] faz uma pausa de 1 segundo. O processador é então cedido a outra thread que aguardava o processador. Ao fim da pausa de 1 segundo, a thread pausada volta a ser elegível para o processador. Ela o obterá quando chegar a sua vez;
- linhas 33–40: o método [sleep] encapsula [Thread.sleep]. O método [run] de [Runnable] não declara nenhuma exceção verificada: portanto, o método [display] não pode deixar escapar a exceção [InterruptedException] lançada por [sleep] . O método [sleep] a intercepta e restaura o indicador de interrupção da thread (linha 38); explicaremos essa ação na seção sobre interrupções. Encontraremos esse pequeno método na maioria dos programas deste capítulo;
- linhas 43–45: o método [time] retorna a hora atual no formato [HH:mm:ss.SSS] ([SSS]: os milissegundos).
Resultados:
Esses resultados são muito instrutivos:
- Primeiro, vemos que lançar uma thread não é bloqueante. A thread principal lançou 5 threads e chegou ao fim do programa (linha 6) mesmo antes de a thread 3 ter exibido sua primeira mensagem;
- a ordem de execução das threads é imprevisível: nesta execução, a thread 4 exibiu sua mensagem de início antes da thread 0. O sistema operacional tem aqui 6 threads e 2 processadores; ele distribui os processadores entre essas threads segundo suas próprias regras;
- Notamos também que a ordem das exibições nem sempre segue a ordem dos horários exibidos: a thread principal exibiu seu fim às 13.725, depois de mensagens datadas de 13.727 a 13.732. O horário é calculado antes da saída e, nesse intervalo, outra thread pode ter escrito no console. [IO.println] (assim como [System.out.println]) é thread-safe: duas linhas escritas por duas threads não se misturam, mas sua ordem não é garantida;
- os IDs das threads criadas (22 a 26) mostram que a máquina virtual já havia criado cerca de vinte threads para seu próprio uso (coleta de lixo, compilador just-in-time etc.);
- cada thread faz uma pausa de um segundo em [sleep] e depois conclui a execução do método [display];
- Por fim, o programa não parou quando a thread principal terminou seu trabalho: a máquina virtual esperou todas as cinco threads terminarem. Isso ocorre porque essas threads não são threads daemon: a máquina virtual Java para quando todas as suas threads não daemon terminaram.
Inversamente, uma thread pode ser declarada uma thread daemon por meio de [setDaemon(true)] antes de ser lançada. As threads daemon são threads de serviço que não impedem a máquina virtual de parar: quando a última thread não daemon termina, elas são encerradas. O programa [Threads03.java] é o seguinte:
Comentários:
- Linha 8: a partir do Java 21, o método [Thread.ofPlatform()] retorna um construtor de threads do tipo [Thread.Builder], que é configurado por meio de chamadas encadeadas: [daemon()] solicita threads daemon; [name("", 0)] especifica que as threads recebam um nome formado por um prefixo (neste caso, a string vazia) seguido de um número que começa em 0 e é incrementado de um a cada thread criada. As threads de plataforma são as threads "clássicas" que usamos desde o início deste capítulo, em oposição às threads virtuais discutidas adiante;
- linha 12: o método [start(Runnable)] do construtor cria uma thread e a inicia imediatamente. Seu método [unstarted(Runnable)] cria uma thread sem iniciá-la;
- linha 16: a thread principal espera 100 ms para dar tempo às threads de iniciar e, em seguida, termina.
Resultados:
Três das cinco threads iniciaram a execução e, então, a thread principal terminou (linha 4). A thread 3 havia calculado a hora de sua mensagem antes de a thread principal terminar, mas só conseguiu exibi-la depois (linha 5), enquanto a máquina virtual estava sendo encerrada. As threads daemon foram então encerradas durante o período de um segundo em que dormiam: nenhuma mensagem de fim foi exibida. Duas threads nem sequer tiveram tempo de exibir suas mensagens de início: como a máquina estava muito carregada, 100 ms não foram suficientes para que obtivessem a CPU (outra execução produzirá um número diferente de mensagens de início, mas nunca mensagens de fim). O mesmo efeito é obtido encerrando [main] com [System.exit(0)], que desliga a máquina virtual e, portanto, todas as threads da aplicação, sejam daemon ou não. As threads virtuais, que discutiremos adiante, são sempre threads daemon.
Se a thread principal quiser esperar o término das threads que criou, ela usa o método [join]. O programa [Threads04.java] também demonstra outra forma de especificar o código que uma thread deve executar: uma lambda.
Comentários:
- Linha 13: a thread executa a lambda [() -> display(number, 1000 + 100 * number)]. Uma lambda sem parâmetros e sem valor de retorno é compatível com a interface [Runnable]. Essa sintaxe permite chamar um método com parâmetros tipados (neste caso, um [int] e um [long]), enquanto [run] não tem nenhum;
- Linha 11: a lambda usa uma cópia da variável de laço [i]. Isso é obrigatório: uma lambda só pode usar variáveis locais que sejam efetivamente final, ou seja, que nunca sejam modificadas após a inicialização. A variável [i] é modificada pelo laço ([i++]): se a lambda a usasse, o compilador rejeitaria o programa ("local variables referenced from a lambda expression must be final or effectively final"). A variável [number], declarada no corpo do laço, é, por outro lado, uma nova variável a cada iteração e nunca é modificada. Essa regra protege contra uma armadilha comum: sem ela, uma thread que iniciasse tarde poderia ler o valor de [i] de uma iteração posterior, ou até mesmo o valor final 5;
- Linhas 18–21: a thread principal espera cada uma das threads. Ela fica bloqueada primeiro à espera da thread 0, depois da thread 1, e assim por diante. Ao sair do laço, as 5 threads que ela lançou terminaram todas. Como [join] pode lançar [InterruptedException], [main] propaga essa exceção (linha 3);
- linha 31: a tarefa nº i dorme por 1.000 + 100 × i milissegundos, de modo que as threads terminam em uma ordem conhecida.
Resultados:
As mensagens de início aparecem em qualquer ordem, mas as mensagens de fim aparecem em ordem numérica, já que as durações de espera são crescentes: essa parte do resultado é reproduzível. A última linha mostra que a thread principal terminou depois das threads que lançou, no momento em que a última delas terminou.
8.3. Interrompendo uma thread: a interrupção
Como parar uma thread antes de ela terminar seu trabalho, por exemplo, quando o usuário cancela uma operação demorada? O Java não permite matar uma thread; em vez disso, oferece um mecanismo cooperativo chamado interrupção:
- cada thread tem um indicador de interrupção, um booleano inicialmente definido como [false];
- uma thread T1 que deseja parar a thread T2 chama [T2.interrupt()]. Isso define o indicador de interrupção de T2. Trata-se de uma solicitação de encerramento: T2 não é encerrada; cabe a essa thread decidir quando e como se encerrar, de modo a deixar seus dados em um estado consistente;
- se T2 estiver bloqueada em um método de espera ([sleep], [join], [wait] e a maioria dos métodos bloqueantes de [java.util.concurrent]), ela é despertada: o método lança a exceção [InterruptedException], e o indicador de interrupção é redefinido como [false];
- se T2 executa um cálculo sem nunca esperar, ela deve verificar o próprio indicador usando [Thread.currentThread().isInterrupted()] em intervalos regulares.
É por isso que os métodos bloqueantes declaram a exceção verificada [InterruptedException]: o compilador obriga o programador a decidir o que fazer com uma solicitação de parada. Há duas respostas corretas: deixar a exceção se propagar ao chamador (declarando-a na cláusula [throws]) ou interceptá-la e concluir a tarefa de forma limpa. Quando nenhuma das opções é possível, como no método [sleep] do programa anterior, o indicador é restaurado com [Thread.currentThread().interrupt()] para que o código chamador ainda possa ver a solicitação. A única resposta incorreta é ignorar a exceção. O programa [Threads05.java] demonstra os três casos:
Comentários:
- Linhas 5–18: a thread [sleeper] passa a maior parte do tempo em [Thread.sleep]. O laço [while (true)] não tem condição de saída: é a exceção [InterruptedException], lançada por [sleep] quando a thread é interrompida, que faz o laço terminar (linha 14). A lambda é uma instrução [try] que engloba todo o trabalho da thread: ao receber a exceção, a thread exibe uma mensagem e então termina;
- linhas 20–27: a thread [calculator] nunca espera. Ela verifica seu indicador de interrupção a cada iteração do laço (linha 23);
- Linhas 29–38: a thread [deaf] intercepta [InterruptedException] e continua como se nada tivesse acontecido. A solicitação de parada se perde: esse é o erro que se deve evitar. Ela é uma thread daemon, para que o programa possa terminar sem esperar por ela;
- Linha 41: a thread principal deixa as outras threads executarem por um segundo;
- linhas 43–45: ela solicita o encerramento das três threads;
- linhas 47–50: ela espera cada thread terminar por no máximo um segundo. O método [join(Duration)] (Java 19) retorna [true] se a thread terminou dentro desse prazo e [false] caso contrário. [Duration.ofSeconds(1)] representa uma duração de um segundo (classe [java.time.Duration]).
Resultados:
As threads [sleeper] e [calculator] terminaram alguns milissegundos após a solicitação; a thread [deaf] ignorou a solicitação e ainda não havia terminado um segundo depois ([false], última linha). O número de iterações do calculator varia bastante de uma execução para outra, dependendo da fatia de tempo de CPU que ele recebeu; o restante do resultado é reproduzível.
A interrupção é o mecanismo que interrompe toda a biblioteca Java: veremos adiante que o método [cancel] de uma tarefa ([Future]) e o encerramento abrupto de um pool de threads ([shutdownNow]) interrompem as threads afetadas. O próximo capítulo apresentará outras formas de cancelar um processamento assíncrono, como os timeouts.
8.4. Threads virtuais
As threads que criamos até agora são threads de plataforma: cada uma é um invólucro em torno de uma thread do sistema operacional, que ela ocupa durante toda a sua existência. Uma thread de sistema é um recurso custoso: criá-la leva tempo, sua pilha reserva memória (da ordem de um megabyte) e o sistema não consegue gerenciar com eficiência mais do que alguns milhares delas. No entanto, um servidor que dedica uma thread a cada cliente (veja o diagrama no parágrafo seguinte) passa a maior parte do tempo esperando: por uma resposta de um banco de dados, pela próxima requisição do cliente… Durante essas esperas, a thread de sistema fica bloqueada e inutilizável.
O Java 21 introduziu as threads virtuais ("virtual threads", JEP 444). Uma thread virtual é um objeto [Thread] como qualquer outro, mas é gerenciada pela máquina virtual Java e não pelo sistema operacional:
- para executar, uma thread virtual é montada em uma thread de plataforma, chamada de sua "thread portadora" (carrier thread). As threads portadoras formam um pequeno pool, cujo tamanho padrão é o número de processadores;
- quando uma thread virtual é bloqueada ([sleep], espera por E/S de rede, por um lock, por uma fila bloqueante etc.), ela é desmontada: sua pilha é posta de lado na memória da máquina virtual, e a thread portadora fica imediatamente disponível para outra thread virtual. Quando a espera termina, a thread virtual é reanexada a uma thread portadora, não necessariamente a mesma;
- uma thread virtual ocupa algumas centenas de bytes: é possível criar milhões delas.
O programa [Threads06.java] compara o lançamento de 10.000 threads de plataforma e de 10.000 threads virtuais, cada uma das quais dorme por um segundo:
Comentários:
- linhas 6–7: o método [measure] é chamado duas vezes, primeiro com um construtor de threads de plataforma ([Thread.ofPlatform()]) e depois com um construtor de threads virtuais ([Thread.ofVirtual()]). Os dois construtores compartilham o tipo comum [Thread.Builder]: o restante do código é idêntico;
- linhas 20–31: o método [measure] lança [nbThreads] threads que dormem por um segundo, espera que terminem e exibe a duração total. O método [System.nanoTime()] retorna um instante em nanossegundos, usado apenas para medir durações;
- linhas 10–14: uma thread virtual chamada [virtual] exibe sua representação textual antes e depois de dormir;
- linha 16: uma thread virtual é sempre uma thread daemon.
Resultados:
- 10.000 threads de plataforma levaram vários segundos para fazer o que deveria ter levado um segundo: criar as threads de sistema e gerenciar suas pilhas teve um custo elevado. Com 100.000 threads, o programa provavelmente falharia por falta de memória ou de threads de sistema disponíveis;
- 10.000 threads virtuais concluíram a mesma tarefa em pouco mais de um segundo: enquanto dormiam, elas não ocuparam nenhuma thread de sistema. Os tempos exatos variam de uma execução para outra, mas a diferença entre os dois tipos de threads é reproduzível;
- a representação textual de uma thread virtual ([VirtualThread[#…,virtual]]) indica, após o caractere [@], a thread portadora na qual ela está montada: uma thread do pool [ForkJoinPool-1], que revisitaremos adiante. Depois de suspensa, a thread virtual pode retomar a execução em outra portadora.
As threads virtuais não tornam os cálculos mais rápidos: um cálculo que mantém o processador ocupado sem nunca esperar não executa mais rápido em uma thread virtual do que em uma thread de plataforma, e o número de cálculos concorrentes continua limitado pelo número de processadores. Seu benefício está na possibilidade de dedicar, sem se preocupar com o custo, uma thread a cada tarefa que passa a maior parte do tempo esperando: é o caso dos servidores, do parágrafo seguinte e dos Capítulos 12 e 13. Tudo o que veremos sobre sincronização de threads se aplica igualmente às threads virtuais e às threads de plataforma.
8.5. Benefícios das threads
Agora que destacamos a existência de uma thread padrão, aquela que executa o método [main], e sabemos como criar outras, vamos considerar os benefícios das threads. Elas têm dois usos principais:
- aproveitar todos os processadores da máquina em um cálculo demorado: o trabalho é dividido em partes atribuídas a diferentes threads. Faremos isso com os streams paralelos e o framework [Fork/Join] no final deste capítulo;
- executar várias tarefas simultaneamente, especialmente quando algumas delas consistem principalmente em esperar (por uma resposta da rede, uma leitura de disco ou uma entrada do usuário). É o caso das aplicações cliente/servidor da Internet, que abordaremos no Capítulo 12.
Em uma aplicação cliente/servidor da Internet, um servidor localizado em uma máquina S1 responde às requisições de clientes localizados em máquinas remotas C1, C2, …, Cn:
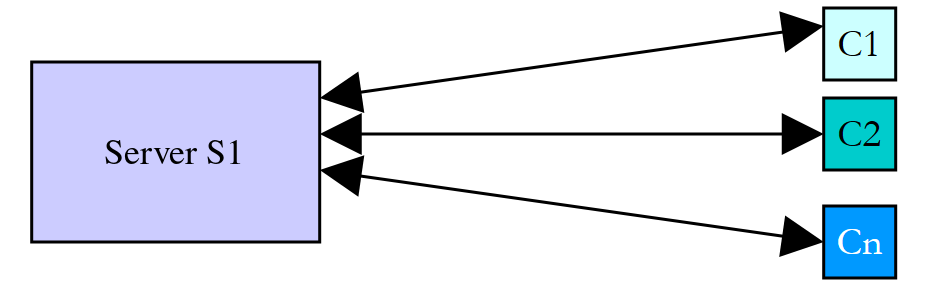
Usamos todos os dias aplicações da Internet que seguem esse modelo: serviços web, e-mail, transferência de arquivos etc. No diagrama acima, o servidor S1 deve atender os clientes Ci simultaneamente. Se tomarmos o exemplo de um servidor de arquivos, sabemos que uma transferência pode às vezes levar vários minutos. Está fora de questão que um único cliente monopolize o servidor por um período tão longo. Uma solução comum é o servidor criar tantas threads de execução quantos forem os clientes. Cada thread fica então responsável por atender um cliente específico:
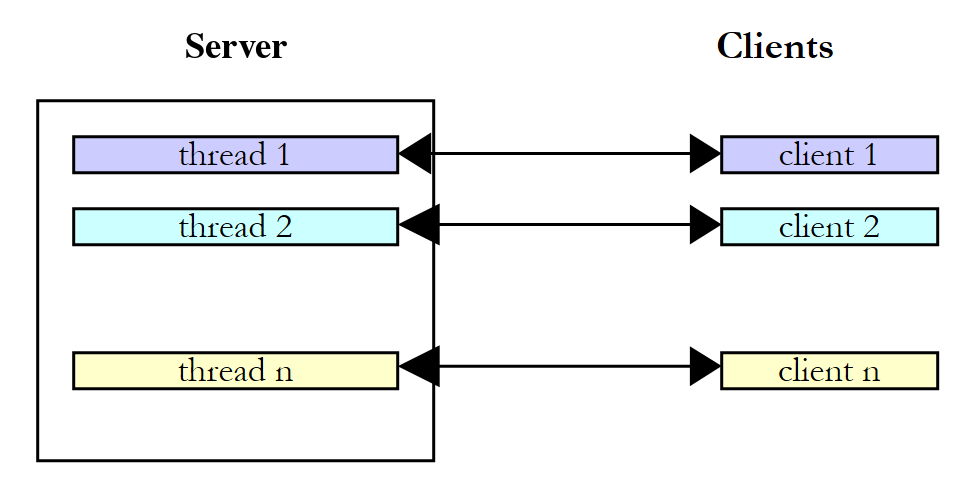
Com threads de plataforma, o servidor usa, na prática, um pool de threads, discutido adiante, cujo número limitado de threads restringe o número de clientes atendidos simultaneamente. Com threads virtuais, o esquema acima volta a ser a solução correta: uma thread virtual por cliente, mesmo que haja dezenas de milhares de clientes, já que um cliente que está esperando não ocupa nenhuma thread de sistema. É isso que os servidores web Java modernos, como o Tomcat, que usaremos no Capítulo 13, permitem hoje.
8.6. Troca de informações entre threads
Nos exemplos anteriores, as threads executavam um método sem parâmetros ou uma lambda que chamava um método com parâmetros. Como o método *[run]* de [Runnable] não tem parâmetros nem valor de retorno, é a lambda que passa informações à thread lançada: ela captura as variáveis de que precisa. Se a variável capturada se refere a um objeto, a thread lançada também pode armazenar nele resultados que a thread que a lançou lerá. O programa [Threads07.java] é o seguinte:
Comentários:
- linhas 48–75: a informação trocada com cada thread é um objeto [Data]. Há uma troca de informações nos dois sentidos entre a thread que lança e a thread lançada. [start] e [duration] são campos [final]: são definidos de uma vez por todas pelo construtor:
- [start]: a hora de início da execução da thread, definida pela thread que a lança;
- [duration]: duração, em segundos, da espera da thread lançada, definida pela thread que a lança;
- [end]: a hora de término da execução da thread, definida pela thread lançada;
- linha 12: um objeto [Data] é criado e armazenado no array [data] (linha 13);
- linha 15: a lambda [() -> sleep(d)] captura a variável [d], que é efetivamente final: a thread lançada executará o método [sleep] das linhas 36–45 com o objeto [d] como parâmetro;
- linhas 21–30: a thread principal espera o término de cada uma das threads que lançou e então recupera o objeto [data[i]] da thread nº i e exibe seu conteúdo. A duração real é calculada por [Duration.between(d.getStart(), d.getEnd())];
- linha 39: o campo [duration] do parâmetro define a duração da espera;
- linha 44: o campo [end] do parâmetro é preenchido.
Resultados:
Este exemplo mostra que duas threads podem trocar informações:
- a thread chamadora pode controlar a execução da thread chamada fornecendo-lhe informações;
- a thread lançada pode devolver resultados à thread que a lançou.
Para que a thread chamadora saiba quando os resultados que ela espera estão disponíveis, ela precisa ser avisada quando a thread chamada terminar. Aqui, ela esperou o término da thread usando o método [join]. Isso não é apenas uma questão de momento: como veremos na seção sobre a palavra-chave [volatile], uma escrita feita por uma thread não é necessariamente visível para outra. O modelo de memória do Java garante que tudo o que foi escrito por uma thread é visível para a thread que esperou seu término usando [join], e que tudo o que foi escrito pela thread que lança antes de [start] é visível para a thread lançada. Exploraremos outras formas de sincronização mais adiante.
Em vez de uma lambda, poderíamos escrever uma classe que implementa [Runnable] e cujos campos contêm as informações trocadas. A lambda é mais concisa; é a abordagem mais comum hoje. Para recuperar o resultado de um processamento, veremos também mais adiante a interface [Callable<V>], cujo método [V call()] retorna um resultado.
8.7. Acesso concorrente a recursos compartilhados
8.7.1. Acesso concorrente não sincronizado
Na seção anterior, as informações eram trocadas apenas entre duas threads e em momentos bem específicos: era um exemplo clássico de passagem de parâmetros. Há outros casos em que as informações são compartilhadas por várias threads que podem querer lê-las ou atualizá-las ao mesmo tempo. Isso levanta a questão da integridade dessas informações. Suponha que a informação compartilhada seja uma estrutura S contendo várias informações I1, I2, …, In:
- uma thread T1 começa a atualizar a estrutura S: ela modifica o campo I1 e é interrompida antes de concluir a atualização completa da estrutura S;
- uma thread T2 que obtém o processador lê então a estrutura S para tomar decisões. Ela lê uma estrutura em estado instável: alguns campos estão atualizados, outros não.
Essa situação é chamada de acesso concorrente a um recurso compartilhado, neste caso a estrutura S. Ela costuma ser difícil de gerenciar. Consideremos o exemplo a seguir para ilustrar os problemas que podem surgir:
- uma aplicação gerará n threads, em que n é passado como parâmetro;
- o recurso compartilhado é um contador que deve ser incrementado por cada thread gerada;
- ao final da aplicação, o valor do contador é exibido. Ele deve, portanto, ser igual a n.
O programa [Threads08.java] é o seguinte:
Comentários:
- Linhas 5–11: o número de threads é passado como argumento. O método [integer] (linhas 28–34) retorna o inteiro contido em uma string, ou -1 se a string não contiver nenhum; a condição da linha 7 rejeita, portanto, tanto um argumento ausente ou inválido quanto um número fora do intervalo [1, 100]. Em caso de erro, o programa escreve uma mensagem na saída de erro ([System.err]) e termina com o código de saída 1 ([System.exit(1)]);
- linha 16: cada thread executa o método estático [increment] da classe [Counter]. A referência de método [Counter::increment] é válida aqui porque [Counter] é uma classe nomeada;
- linhas 37–58: o recurso compartilhado é o campo estático [value] da classe [Counter]. O contador é encapsulado em uma classe aninhada estática, com o método [increment] executado por cada thread;
- linha 49: o contador é lido;
- linha 52: a thread faz uma pausa de 1 segundo. Ela perde, portanto, a CPU;
- linha 54: o contador é incrementado.
A pausa de um segundo existe apenas para forçar a thread a perder a CPU entre a leitura e a escrita do contador. Na prática, não há garantia de que uma thread não será interrompida entre esses dois momentos e, em uma máquina multiprocessada, duas threads podem até ler o contador exatamente ao mesmo tempo. A pausa de um segundo apenas sistematiza esse risco.
Os argumentos do programa são colocados depois do nome do arquivo-fonte. Sem argumentos, uma mensagem de erro é exibida (o comando de shell Linux ***[echo $?]*** exibe o código de saída do último programa executado):
Com 5 threads:
Observando esses resultados, fica claro o que está acontecendo:
- uma primeira thread lê o contador. Encontra 0. Faz uma pausa de 1 segundo e, assim, perde a CPU;
- uma segunda thread também lê o valor do contador. Ele ainda é 0, já que a thread anterior ainda não o incrementou. Ela também faz uma pausa de 1 segundo;
- em menos de um segundo, todas as 5 threads têm tempo de ler o valor 0;
- ao acordar, elas incrementam o valor 0 que leram e todas escrevem o valor 1 no contador, como confirma a última linha (linha 12). Esse resultado incorreto é reproduzível: apenas a ordem das threads muda de uma execução para outra.
Pode-se objetar que o exemplo é artificial. Vamos então remover o sleep e usar o operador [++], que dá a ilusão de uma única instrução. O programa [Threads09.java] é o seguinte:
Comentários:
- linhas 5–6: O número de threads (4 por padrão) e o número de incrementos realizados por cada thread (50 milhões por padrão) podem ser passados como argumentos. O separador [_] torna a constante [50_000_000] legível;
- linha 14: as threads são criadas e iniciadas por [Thread.ofPlatform().start(…)]; elas não precisam de nomes;
- Linha 17: cada thread incrementa o contador compartilhado sem fazer pausas;
- linha 27: na string de formato, [%,d] exibe um inteiro usando o separador de milhares do idioma atual (neste caso, o inglês: uma vírgula). O método de instância [formatted(…)] (Java 15) de uma string equivale a [String.format(string, …)].
Resultados:
Dezenas de milhões de atualizações foram perdidas, e o número varia de um teste para outro. A operação de alto nível [Counter.value++] é na verdade traduzida em várias instruções básicas do processador: ler o valor da memória, incrementá-lo em um registrador e gravar o resultado na memória. Se duas threads leem o mesmo valor antes que uma delas tenha gravado o seu, um incremento é perdido, exatamente como no exemplo anterior.
O teste 3 merece uma explicação: ele perdeu quase exatamente 150 milhões de atualizações, o que representa o trabalho de três das quatro threads. Após alguns segundos de execução, o compilador just-in-time (JIT) da máquina virtual otimizou o laço das linhas 15–18: ele determinou que nenhuma outra thread deveria ver o contador durante o laço (nada no código exige isso) e colocou o contador em um registrador do processador. Cada thread então lê o contador uma vez, soma 50 milhões a ele em seu registrador e o grava de volta uma única vez no final. Se as quatro threads leem o valor 0 antes que qualquer uma delas tenha gravado, três dos quatro resultados são perdidos; se, por outro lado, o trabalho delas não se sobrepõe, o resultado é correto. Em outras execuções deste programa, os testes 2 e 3 chegaram de fato ao valor exato de 200.000.000. Somente o primeiro teste, executado antes dessa otimização, perde atualizações de forma consistente. É isso que torna esses erros tão perigosos: um programa pode funcionar por meses e então falhar justamente no dia em que a máquina está sob maior carga ou rodando mais rápido.
De onde vem o problema? Uma thread leu um valor desatualizado porque outra thread havia sido interrompida (ou estava trabalhando simultaneamente em outro processador) antes de concluir sua tarefa de atualizar o contador. Isso nos leva aos conceitos de recursos críticos e seções críticas em um programa:
- um recurso crítico é um recurso que pode ser mantido por apenas uma thread por vez. Aqui, o recurso crítico é o contador;
- uma seção crítica de um programa é uma sequência de instruções no fluxo de execução de uma thread durante a qual ela acessa um recurso crítico. Devemos garantir que, durante essa seção crítica, a thread seja a única com acesso ao recurso.
No programa [Threads08.java], a seção crítica é o código entre a leitura do contador e a gravação do seu novo valor:
Para executar esse código, é preciso garantir que a thread seja a única em execução. Ela pode ser interrompida, mas, durante essa interrupção, nenhuma outra thread deve poder executar esse mesmo código. Java oferece diversas ferramentas para garantir a entrada de uma única thread por vez em seções críticas de código. Veremos algumas delas agora.
8.7.2. A palavra-chave synchronized
O bloco [synchronized] delimita uma seção crítica da seguinte forma: [synchronized (lock) { …critical section… }]***. [lock]* é um objeto visível a todas as threads que executam a seção crítica. Em Java, todo objeto possui um bloqueio interno, também conhecido como monitor. O bloco [synchronized] garante que apenas uma thread por vez mantenha o monitor do objeto [lock], ou seja, que apenas uma thread por vez execute a seção crítica: uma thread que encontra um monitor mantido por outra thread fica bloqueada até que o monitor seja liberado. O monitor é liberado ao sair do bloco, seja a saída normal ou causada por uma exceção.
O exemplo anterior é reescrito da seguinte forma em [Threads10.java]:
Comentários:
- linha 45: [lock] é o objeto que permitirá a sincronização de todas as threads. Ele não tem nenhuma outra finalidade: é um simples [Object]. Ele é [final]: a referência nunca deve mudar, caso contrário duas threads poderiam bloquear dois objetos diferentes;
- linhas 59–69: a seção crítica do método [increment] é envolvida pelo bloco [synchronized]. A thread mantém o bloqueio enquanto dorme por um segundo: as outras threads não podem entrar;
- linhas 47–51: a leitura do contador pela thread principal também é protegida pelo bloqueio. Aqui, isso não é estritamente necessário, já que a thread principal esperou o término das outras threads com [join]; mas é uma boa prática: os dados protegidos por um bloqueio devem ser lidos e gravados sob a proteção desse bloqueio;
- Linhas 20–26: a thread principal espera as threads na ordem inversa de sua criação.
Resultados com 3 threads:
- As três threads solicitam a entrada na seção crítica quase ao mesmo tempo;
- apenas uma entra, neste caso a thread 2 (a ordem de entrada não é garantida: não é necessariamente a primeira a chegar que entra primeiro). Ela lê o contador, dorme por um segundo, grava o novo valor e sai da seção crítica;
- as outras duas threads ficam bloqueadas até que a primeira saia da seção crítica e depois prosseguem uma após a outra. Cada uma lê o valor gravado pela anterior. Observe (linhas 8–9) que a Thread 1 leu o contador antes que a Thread 2 indicasse que havia saído da seção crítica: a Thread 2 de fato liberou o bloqueio, mas só exibe sua mensagem depois do bloco [synchronized], e a Thread 1 foi mais rápida;
- a thread principal estava esperando o término da Thread 2. Ao ser notificada de que a Thread 2 havia terminado, esperou o término da Thread 1 e depois o da Thread 0;
- O número de threads está correto (linha 20). Independentemente da ordem em que as threads são executadas, esse resultado é reproduzível.
A palavra-chave [synchronized] também pode ser aplicada a um método inteiro: [synchronized void m() {…}] equivale a um bloco [synchronized (this) {…}] que engloba todo o corpo do método, e [static synchronized void m() {…}] a um bloco [synchronized (Counter.class) {…}], que bloqueia o objeto de classe [Class]. Essa é a notação mais curta e é de uso corrente. No entanto, ela tem um inconveniente: o objeto bloqueado ([this], ou o objeto [Class]) é visível externamente, e código externo pode adquirir o mesmo bloqueio e bloquear o nosso. Por isso, muitas vezes é preferível bloquear um objeto private, como no exemplo. Pela mesma razão, nunca se bloqueia uma string (literais de string idênticos são um único objeto compartilhado por todo o programa) nem, desde o Java 16, um objeto de uma classe “baseada em valor”, como [Integer] ou [LocalDate] (o compilador emite um aviso nesse caso).
Uma thread que já mantém um monitor pode entrar novamente em um bloco [synchronized] sobre o mesmo objeto sem se bloquear: diz-se que o bloqueio é reentrante. Um método [synchronized] pode, assim, chamar outro método [synchronized] sobre o mesmo objeto.
8.7.3. A classe ReentrantLock
O bloqueio [synchronized] é simples, mas rígido: uma thread que espera por um monitor espera indefinidamente, sem poder desistir após certo tempo e sem poder ser interrompida. A classe [java.util.concurrent.locks.ReentrantLock] (Java 5) é um bloqueio explícito, também reentrante, que oferece esses recursos. Ela implementa a interface [Lock]. Usaremos os seguintes construtores e métodos:
Membro | Função |
[ReentrantLock()], [ReentrantLock(boolean fair)] | cria um bloqueio. Um bloqueio justo ([true]) é concedido às threads na ordem em que o solicitaram; um bloqueio não justo (o padrão) é mais rápido, mas uma thread pode furar a fila |
[void lock()] | A thread T1, que está executando [V.lock()], solicita o bloqueio V. Se V não é mantido por nenhuma thread, ele é concedido a T1. Se uma thread T2 realiza então a mesma operação, ela fica bloqueada: um bloqueio só pode pertencer a uma thread. T2 será desbloqueada quando T1 liberar V. Assim, várias threads podem ficar bloqueadas à espera de V |
[boolean tryLock()], [boolean tryLock(long timeout, TimeUnit unit)] | solicita o bloqueio imediatamente, ou esperando no máximo [timeout]. O método retorna [false] se o bloqueio não pôde ser obtido |
[void lockInterruptibly()] | como [lock], mas a espera pode ser interrompida ([InterruptedException]) |
[void unlock()] | A thread que mantém V o libera. Uma das threads que esperam por V o adquire então |
[boolean isHeldByCurrentThread()] | indica se a thread atual mantém o bloqueio |
[Condition newCondition()] | cria uma condição associada ao bloqueio (veja abaixo) |
A sincronização de uma seção crítica sempre segue o mesmo padrão: [V.lock(); try { …critical section… } finally { V.unlock(); }]. Não se esqueça de liberar o bloqueio; caso contrário, as threads que o aguardam permanecerão bloqueadas indefinidamente: por isso o bloqueio é liberado em uma cláusula [finally], que é executada independentemente de ter ocorrido uma exceção ou não. O bloco [synchronized] faz isso automaticamente; com um [ReentrantLock], cabe ao programador fazê-lo. O programa [Threads11.java] continua o exemplo anterior com um [ReentrantLock]:
O programa principal é o de [Threads08.java]. Comentários:
- linha 41: o objeto de sincronização das threads agora é um bloqueio justo, [ReentrantLock];
- linha 58: início da seção crítica. A thread fica bloqueada até que o bloqueio seja liberado;
- linhas 59–73: como um bloqueio deve sempre ser liberado, ocorra ou não uma exceção, a seção crítica é colocada dentro de um [try], cuja cláusula [finally] libera o bloqueio (linha 72);
- Linhas 43–50: o mesmo padrão protege a leitura do contador. A instrução [return value;] é executada antes da cláusula [finally]: o valor retornado é lido enquanto o bloqueio é mantido.
Resultados:
Os resultados são semelhantes aos anteriores: as threads entram na seção crítica uma a uma, e o valor final do contador é correto. Como o bloqueio é justo, as threads o adquiriram na ordem em que o solicitaram: a ordem de suas chamadas a [lock], que as marcas de tempo da mensagem “waiting for permission”, calculadas um pouco antes, apenas aproximam.
Quando usar [ReentrantLock] em vez de [synchronized]? Quando for necessário um de seus recursos adicionais: tempo limite ([tryLock], que usaremos para evitar o deadlock), espera interrompível, justiça ou várias condições. Caso contrário, o bloco [synchronized], que é mais simples e elimina o risco de esquecer [unlock], funciona muito bem. Desde o Java 24, ele não causa mais nenhum problema com threads virtuais: antes, uma thread virtual bloqueada em um bloco [synchronized] não podia liberar sua thread hospedeira, o que tornava [ReentrantLock] a escolha preferida.
8.7.4. Sincronização de processos: o bloqueio de arquivo
Os bloqueios descritos acima sincronizam threads dentro da mesma máquina virtual, ou seja, dentro do mesmo processo. Às vezes, processos diferentes precisam compartilhar um recurso, como um arquivo, ou você pode querer impedir que duas instâncias da mesma aplicação sejam iniciadas. Java não fornece um objeto de sincronização nomeado compartilhado entre processos; em vez disso, usa-se um bloqueio de arquivo gerenciado pelo sistema operacional: a classe [java.nio.channels.FileLock]. Um bloqueio é obtido sobre um arquivo aberto na forma de um canal [FileChannel]:
- [FileLock lock()]: espera o bloqueio ficar disponível e o adquire;
- [FileLock tryLock()]: tenta adquirir o bloqueio sem esperar e retorna [null] se ele estiver mantido por outro processo;
- [void release()]: libera o bloqueio. O bloqueio também é liberado quando o canal é fechado ou quando o processo termina, mesmo que de forma abrupta: um bloqueio não pode ficar “abandonado”.
O programa [Threads12.java] é iniciado duas vezes, em dois processos diferentes, que compartilham uma seção crítica:
Comentários:
- linha 5: o arquivo que serve de bloqueio. Todos os processos que bloqueiam esse arquivo se sincronizam entre si. Ele é colocado na pasta de arquivos temporários do sistema, indicada pela propriedade de sistema [java.io.tmpdir] ([/tmp] no Linux). Seu conteúdo é irrelevante: ele pode permanecer vazio;
- linha 10: o arquivo é aberto para escrita (um bloqueio exclusivo exige isso) e criado se ainda não existir ([CREATE]). A instrução [try] com recurso fechará o canal no final;
- linha 13: o processo tenta adquirir o bloqueio sem esperar. Se falhar, ele informa a falha e depois espera pelo bloqueio indefinidamente (linha 17);
- Linhas 19–26: a seção crítica, que dura 3 segundos, seguida da liberação do bloqueio.
Um bloqueio de arquivo pertence ao processo inteiro, e não a uma única thread: ele não serve para sincronizar threads dentro do mesmo processo (dois pedidos de bloqueio sobre o mesmo arquivo dentro do mesmo processo provocam a exceção [OverlappingFileLockException]). Iniciamos o processo A, esperamos 1,5 segundo e depois iniciamos o processo B em um segundo terminal. Resultados do processo A:
Resultados do processo B:
O processo B encontrou o bloqueio mantido pelo processo A e esperou. Ele adquiriu o bloqueio no exato momento em que A o liberou. Um uso comum desse mecanismo é impedir o início de duas instâncias da mesma aplicação: a segunda instância, incapaz de adquirir o bloqueio com [tryLock], termina imediatamente.
8.7.5. Uma barreira: a classe Semaphore
Um semáforo é um contador de permissões (ou vagas). A classe [java.util.concurrent.Semaphore] oferece os seguintes métodos:
Membro | Função |
[Semaphore(int permits)], [Semaphore(int permits, boolean fair)] | cria um semáforo com [permits] permissões; o segundo parâmetro tem o mesmo significado que em [ReentrantLock] |
[void acquire()] | adquire uma permissão. Se não restam permissões, a thread fica bloqueada até que uma permissão seja liberada. A espera pode ser interrompida ([InterruptedException]) |
[void acquireUninterruptibly()] | igual ao anterior, mas a espera não pode ser interrompida |
[boolean tryAcquire()], [boolean tryAcquire(long timeout, TimeUnit unit)] | Obtém uma permissão imediatamente, ou em no máximo [timeout]; retorna [false] se a tentativa falhar |
[void release()] | devolve (adiciona) uma permissão; uma das threads em espera pode então obtê-la |
[int availablePermits()] | o número de permissões disponíveis |
Ao contrário de um bloqueio, uma permissão não pertence a nenhuma thread específica: qualquer thread pode chamar [release], mesmo que nunca tenha adquirido uma permissão. Um semáforo criado com zero permissões é, portanto, uma barreira fechada, na qual as threads que chamam [acquire] ficam bloqueadas. Outra thread a abrirá no momento oportuno, chamando [release]. Esse momento depende inteiramente do problema a ser resolvido. A thread que adquiriu a única permissão atravessou a barreira, que se fechou atrás dela; ao devolver a permissão, ela abre a barreira para outra thread. Se, no exemplo anterior, substituirmos o bloqueio por essa barreira, o código fica como a seguir ([Threads13.java]):
Comentários:
- linha 47: a barreira é criada no estado fechado. Ela será aberta pela thread principal na linha 24;
- linha 20: a thread principal espera meio segundo para dar tempo às threads de chegarem à barreira;
- linha 59: a thread responsável por incrementar o contador solicita permissão para entrar na seção crítica. As várias threads se acumulam diante da barreira fechada. Quando a thread principal a abre, uma das threads em espera passa, e a barreira se fecha novamente. O método [acquireUninterruptibly] evita ter de tratar aqui a exceção [InterruptedException];
- linha 73: ao terminar seu trabalho, a thread reabre a barreira, permitindo a entrada de outra thread.
Resultados:
Os resultados são semelhantes aos anteriores. Vemos que as três threads esperam na barreira até que a thread principal a abra (linha 5).
8.7.6. As classes CountDownLatch e Semaphore
Dois usos adicionais das ferramentas de sincronização complementam os exemplos anteriores.
Um objeto [java.util.concurrent.CountDownLatch] é um contador: ele é criado com um valor inicial N; cada chamada ao seu método [countDown] o decrementa; seu método [await] bloqueia a thread chamadora até que o contador chegue a 0. Uma vez que chega a 0, ele permanece nesse valor: a barreira fica aberta de forma permanente e deixa passar todas as threads. Com N = 1, serve como “sinal de largada” de uma corrida; com N = número de tarefas, é uma forma de esperar a conclusão de N tarefas, cada uma das quais chama [countDown] ao terminar. O programa [Threads14.java] é o seguinte:
Comentários:
- linha 5: a contagem regressiva começa em 1: o portão está fechado;
- linha 15: cada thread espera a contagem regressiva chegar a 0. O método [await] pode lançar [InterruptedException]; se a thread for interrompida durante a espera, ela abandona a corrida (linha 18);
- linha 27: a thread principal decrementa a contagem regressiva em uma unidade após um segundo; ela passa a 0;
- linha 32: o método [getCount] retorna o valor atual da contagem regressiva.
Resultados:
Os quatro corredores largaram juntos, com poucos milissegundos de diferença entre si, após o sinal de largada. Um [CountDownLatch] é usado apenas uma vez; a classe [CyclicBarrier] oferece um ponto de encontro reutilizável (as N threads esperam umas pelas outras e depois partem juntas), e a classe [Phaser] generaliza essas duas ferramentas.
Voltemos ao semáforo em seu uso mais comum: um semáforo de N permissões permite que no máximo N threads entrem em uma seção de código ao mesmo tempo. Isso é útil para limitar o acesso a um recurso disponível em quantidade limitada (conexões de banco de dados, requisições simultâneas a um servidor etc.). O programa [Threads15.java] é o seguinte:
Comentários:
- linha 5: o semáforo tem 2 permissões: 2 vagas;
- linha 14: uma thread solicita uma vaga. Se houver uma disponível, ela a toma e continua; caso contrário, fica bloqueada até que uma vaga fique disponível;
- linha 17: o número de vagas ainda disponíveis;
- linha 23: a thread devolve sua vaga, em uma cláusula [finally].
Resultados:
Todas as cinco threads solicitam uma vaga; duas a obtêm imediatamente, enquanto as outras três esperam. Cada vez que uma thread libera sua vaga, uma thread em espera a obtém. Nunca há mais de duas threads na seção de código. Um semáforo de uma única permissão funciona como um bloqueio, como no programa [Threads13.java]. Com threads virtuais, o semáforo é a ferramenta natural para limitar a concorrência: em vez de limitar o número de threads, cria-se uma thread virtual para cada tarefa e usa-se um semáforo para limitar o número de tarefas que utilizam simultaneamente o recurso escasso.
8.7.7. Visibilidade das gravações: a palavra-chave volatile
Os bloqueios não servem apenas para tornar indivisível um grupo de operações. Eles resolvem um segundo problema, mais insidioso: a visibilidade das gravações. Para ganhar velocidade, o processador guarda valores em seus registradores e caches, e o compilador reordena ou elimina leituras e gravações dinamicamente, como vimos com o programa [Threads09.java]. Com isso, um valor gravado por uma thread pode não ser visto por outra thread até mais tarde, ou talvez nunca.
O Modelo de Memória de Java define com precisão quando uma gravação tem garantia de ser visível: quando existe uma relação “happens-before” entre a gravação e a leitura. As principais são as seguintes:
- tudo o que uma thread fez antes de liberar um bloqueio (fim de um bloco [synchronized], [unlock]) é visível para a thread que adquire esse bloqueio em seguida;
- o que a thread chamadora fez antes de [start] é visível para a thread chamada; o que uma thread fez é visível para a thread que esperou seu término por meio de [join];
- uma gravação em um campo [volatile] é visível para qualquer leitura posterior desse campo;
- as ferramentas de [java.util.concurrent] oferecem garantias semelhantes: o que uma thread fez antes de [release()], [countDown()], ou da inserção de um elemento em uma coleção concorrente é visível para a thread que executa em seguida [acquire()], [await()], ou remove o elemento.
Quando nenhuma dessas relações existe, diz-se que o programa contém uma “corrida de dados” (data race), e não há nenhuma garantia. O programa [Threads16.java] ilustra isso com um cenário comum: um flag que instrui uma thread a parar.
Comentários:
- linhas 5–11: a thread T1 é executada enquanto o campo comum [Flags.stop] for igual a [false];
- linhas 13–19: a thread T2 faz o mesmo com os campos [volatile] e [Flags.volatileStop];
- linhas 24–25: após um segundo, a thread principal passa os dois flags para [true];
- linhas 27–30: ela espera cada uma das duas threads por no máximo 2 segundos. Ambas as threads são daemons, para que o programa possa terminar mesmo que uma delas ainda esteja em execução;
- linhas 34–39: os dois flags. A palavra-chave [volatile] (linha 38) especifica que toda operação de leitura do campo deve ler da memória e que toda operação de gravação deve ser executada imediatamente.
Resultados:
A thread T2 viu o pedido de parada imediatamente. A thread T1, porém, nunca o viu: ela ainda estava em execução dois segundos depois e só parou quando a máquina virtual foi encerrada. O compilador just-in-time, ao notar que o laço das linhas 7–9 não modifica [stop] e que nenhuma sincronização exige que ele seja relido, leu esse campo apenas uma vez, antes do laço: o laço se tornou, assim, um laço infinito. Esse comportamento é reproduzível com a máquina virtual HotSpot usada aqui, mas não é garantido: outra máquina virtual, ou outra versão, poderia permitir que T1 parasse. É justamente esse o problema: sem uma relação happens-before, o comportamento do programa é indefinido.
A palavra-chave [volatile] garante a visibilidade, mas não a atomicidade: [value++] em um campo [volatile] continua sendo uma leitura seguida de uma gravação, e duas threads ainda podem perder uma atualização. [volatile] é, portanto, adequado para um flag gravado por uma thread e lido por outras, mas não para um contador compartilhado. Para parar uma thread, a interrupção descrita anteriormente é, na verdade, preferível a um flag: ela também acorda uma thread que está bloqueada em uma espera.
8.7.8. Classes atômicas
O pacote [java.util.concurrent.atomic] (Java 5) fornece classes que tornam atômicas operações simples sobre uma variável: a operação é executada inteiramente pela thread, sem que nenhuma outra thread possa observar ou modificar a variável no meio da operação. As ferramentas anteriores ([synchronized], [ReentrantLock], [Semaphore]) destinam-se todas a tornar atômico um grupo de operações, ao custo de bloquear outras threads. Para operações simples, porém frequentes, as classes atômicas evitam esse bloqueio usando instruções especiais do processador. Os principais métodos da classe [AtomicInteger] são os seguintes:
Método | Função |
[int get()], [void set(int v)] | Lê e grava o valor (com a semântica de um campo [volatile]) |
[int incrementAndGet()], [int decrementAndGet()] | incrementa (decrementa) o valor em 1 e retorna o novo valor |
[int getAndIncrement()], [int getAndDecrement()] | o mesmo que acima, mas retorna o valor anterior (como em [x++] e [x--]) |
[int addAndGet(int delta)] | soma [delta] ao valor e retorna o novo valor |
[int getAndSet(int v)] | atribui [v] e retorna o valor antigo |
[boolean compareAndSet(int expectedValue, int newValue)] | atribui [newValue] somente se o valor for [expectedValue]; retorna [true] se a atribuição ocorreu |
[int updateAndGet(IntUnaryOperator f)] | substitui o valor v por f(v) de forma atômica e retorna o novo valor |
O pacote também oferece [AtomicLong], [AtomicBoolean], [AtomicReference<V>] (uma referência atômica a um objeto) e arrays atômicos ([AtomicIntegerArray]…). A classe [LongAdder] (Java 8) é um contador projetado para atualizações muito frequentes feitas por muitas threads: em vez de uma única variável disputada por todas as threads, ela distribui os incrementos por várias células, que só são somadas quando a soma é solicitada ([sum]).
O programa [Threads17.java] parte do experimento do programa [Threads09.java] e compara cinco maneiras de incrementar o contador compartilhado:
Comentários:
- linhas 4–5: em um arquivo-fonte compacto, os campos podem ser declarados fora de qualquer classe; são campos da classe implícita. Eles são usados pelos métodos de instância [main] e [measure];
- linhas 14–18: o método [measure] é chamado com cinco métodos de incremento diferentes, passados como [Runnable], e com uma função que retorna o valor resultante, do tipo [LongSupplier] (uma interface funcional do tipo [long getAsLong()]). As referências de método [Counter.atomic::get] e [Counter.adder::sum] referem-se a métodos de dois objetos específicos;
- linhas 22–47: o método [measure] inicia [nbThreads] threads, cada uma das quais chama o método recebido [nbIncrements] vezes, e mede o tempo total. O formato [%,12d] alinha o valor à direita em 12 caracteres, com separador de milhares;
- linhas 25, 30 e 41: as threads esperam todas atrás de um [CountDownLatch], que é aberto quando todas foram iniciadas. Elas começam, assim, seu trabalho ao mesmo tempo, tornando os acessos concorrentes muito mais prováveis do que com threads iniciadas uma após a outra;
- linha 52: o contador é [volatile]. Isso impede que o compilador realize dinamicamente a otimização que observamos com [Threads09.java]: cada incremento realmente lê da memória e grava nela;
- linha 67: o incremento não sincronizado;
- linhas 72–74 e 79–84: o incremento dentro de uma seção crítica protegida por [synchronized] ou por um [ReentrantLock];
- linha 89: incremento atômico;
- linha 94: incremento de um [LongAdder].
Resultados:
- Sem sincronização, o resultado é novamente incorreto: o campo [volatile] não tornou [value++] atômico;
- os outros quatro métodos retornam o resultado correto;
- As classes atômicas são significativamente mais rápidas que os bloqueios nesta execução. Os bloqueios são custosos aqui porque quatro threads competem constantemente por eles em uma operação minúscula. Os tempos de execução medidos dependem muito da máquina e de sua carga: apenas sua ordem de grandeza é significativa. [LongAdder] foi o mais rápido: suas threads interferem menos umas nas outras do que aquelas que disputam a única variável de um [AtomicInteger], e sua vantagem de desempenho aumenta com o número de processadores.
O método [compareAndSet] (“CAS”) é o bloco de construção dos algoritmos “sem bloqueio” (lock-free): lemos o valor, calculamos o novo e só então o gravamos se a variável não tiver mudado nesse meio-tempo; caso contrário, recomeçamos. É isso que [updateAndGet] faz, e as coleções concorrentes apresentadas mais adiante fazem amplo uso dele.
8.8. Acesso concorrente a vários recursos compartilhados
8.8.1. Deadlock
Em nossos exemplos anteriores, um único recurso era compartilhado entre as diferentes threads. A situação se complica se houver vários recursos e eles dependerem uns dos outros. Em particular, pode ocorrer um deadlock: duas threads esperam uma pela outra. Considere as ações a seguir, que ocorrem sequencialmente:
- uma thread T1 adquire o bloqueio V1 para acessar um recurso compartilhado R1;
- uma thread T2 adquire o bloqueio V2 para acessar um recurso compartilhado R2;
- a thread T1 solicita o bloqueio V2. Ela fica bloqueada;
- a thread T2 solicita o bloqueio V1. Ela fica bloqueada.
As threads T1 e T2 esperam uma pela outra indefinidamente. Várias soluções são possíveis:
- solicitar os dois recursos ao mesmo tempo usando um único bloqueio. Isso nem sempre é possível, se resultar em um bloqueio longo sobre um recurso custoso;
- sempre adquirir os bloqueios na mesma ordem: se todas as threads adquirem V1 antes de V2, o deadlock é impossível. Essa é a regra mais usada;
- uma thread que mantém V1 e não consegue adquirir V2 libera V1 para evitar o deadlock.
O programa [Threads18.java] provoca um deadlock e implementa a última solução, usando o método [tryLock] de [ReentrantLock]:
Comentários:
- linhas 5–6: os bloqueios dos dois recursos. Aqui são variáveis locais, capturadas pelas lambdas das linhas 9 e 11;
- Linha 9: a thread T1 adquire R1 e depois solicita R2; ela espera no máximo 2 segundos;
- linha 11: a thread T2 adquire R2 e depois solicita R1, ou seja, na ordem inversa; ela espera no máximo 5 segundos;
- linha 20: o método [work] adquire bloqueios do tipo definido pela interface [Lock], que é implementada por [ReentrantLock];
- linha 22: a thread adquire seu primeiro recurso. A cláusula [finally] da linha 42 o liberará em qualquer caso;
- linha 26: ela espera meio segundo, o que dá tempo à outra thread de adquirir seu próprio primeiro recurso: o deadlock é então certo;
- linha 29: em vez de um [lock], que esperaria indefinidamente, a thread solicita o segundo bloqueio com um tempo máximo de espera. [tryLock] retorna [true] se o bloqueio foi obtido e [false] se o tempo limite expirou. O tempo limite é expresso por um número e uma unidade ([TimeUnit.MILLISECONDS]); o método [toMillis()] converte a duração [timeout] em milissegundos;
- linha 34: um bloqueio adquirido por [tryLock] deve ser liberado por [unlock], dentro de uma cláusula [finally];
- linhas 36–39: se o segundo bloqueio não pôde ser adquirido, a thread aborta. Ao sair do método, ela libera seu primeiro recurso (linha 43);
- linhas 40–41: [sleep] e [tryLock], com um tempo limite, podem lançar [InterruptedException].
Resultados:
Cada uma das duas threads obteve seu primeiro recurso e depois solicitou o segundo: elas estão em deadlock. Após 2 segundos, T1 desiste e libera R1; T2, que ainda estava esperando, obtém imediatamente R1 e pode fazer seu trabalho. Sem um tempo limite, o programa nunca teria terminado. Essa sequência de eventos é reproduzível; apenas a ordem das linhas 2 e 3 e a das linhas 4 e 5 podem mudar. Não seria possível escrever este programa usando blocos [synchronized], já que seu tempo de espera não pode ser limitado.
Quando um programa Java parece travado, o comando [jcmd <pid> Thread.print] do JDK exibe a pilha de chamadas de cada uma de suas threads ([pid] é o ID do processo, retornado pelo comando [jcmd] sem nenhum parâmetro); ele detecta deadlocks entre bloqueios e os relata com a mensagem “Found one Java-level deadlock”, seguida das threads e dos bloqueios envolvidos.
8.8.2. Um exemplo: leitores e escritores
Considere o seguinte exemplo:
- temos um array no qual algumas threads gravam dados (os escritores) e outras os leem (os leitores);
- os escritores são iguais entre si, mas exclusivos: apenas um escritor por vez pode gravar dados no array;
- os leitores são iguais entre si, mas exclusivos: apenas um leitor por vez pode ler os dados armazenados no array;
- um leitor só pode ler dados do array quando um escritor colocou alguns lá, e um escritor só pode colocar novos dados no array quando os dados que já estão lá foram lidos por um leitor.
Há dois tipos de recursos compartilhados:
- a tabela de escrita: apenas um escritor por vez pode acessá-la;
- a tabela de leitura: apenas um leitor por vez pode acessá-la.
e uma ordem de utilização desses recursos:
- um leitor deve sempre seguir um escritor;
- um escritor deve sempre seguir um leitor, exceto na primeira vez.
O acesso a esses dois recursos pode ser controlado usando duas barreiras do tipo [Semaphore]:
- a barreira [canWrite] controla o acesso dos escritores ao array;
- a barreira [canRead] controla o acesso dos leitores ao array;
- a barreira [canWrite] é criada aberta (uma permissão), deixando passar o primeiro escritor e bloqueando todos os outros;
- a barreira [canRead] é criada no estado fechado (nenhuma permissão), bloqueando todos os leitores;
- quando um escritor termina seu trabalho, ele abre a barreira [canRead] para deixar entrar um leitor;
- quando um leitor termina seu trabalho, ele abre a barreira [canWrite] para deixar entrar um escritor.
Vemos aqui a vantagem de uma barreira que não pertence a nenhuma thread: a barreira [canRead] é fechada por um leitor (que toma a permissão) e aberta por um escritor (que a devolve). Isso é impossível com um bloqueio, que só pode ser liberado pela thread que o mantém. O programa [Threads19.java] que ilustra essa sincronização é o seguinte:
Comentários:
- linhas 8–14: criação e início de duas threads leitoras, seguidas de duas threads escritoras. Nenhuma referência às threads é mantida: a thread principal não espera por elas;
- linha 16: a thread principal termina imediatamente. O processo continua até que as quatro threads, que não são daemons, tenham terminado;
- linha 22: o array [data] é o recurso compartilhado entre as threads leitoras e escritoras;
- linha 24: a barreira [canRead] sinaliza aos leitores que eles podem ler o array. Ela é aberta pelo escritor que preencheu o array. Ela é criada no estado fechado: um escritor deve primeiro preencher o array;
- linha 26: a barreira [canWrite] avisa aos escritores que eles podem gravar no array. Ela é aberta pelo leitor que leu o array inteiro. Ela é criada aberta: o array é gravável desde o início;
- linha 33: um leitor espera que um escritor sinalize que o array foi preenchido. Quando esse sinal chega, apenas um dos leitores em espera prossegue;
- linhas 35–39: o array é lido, com uma pausa de meio segundo a cada elemento para forçar a thread a ceder a CPU;
- linha 41: o leitor notifica os escritores de que o array foi lido e pode ser preenchido novamente;
- o método [write] é simétrico ao método [read];
- linha 56: os números gravados são gerados aleatoriamente. O método [ThreadLocalRandom.current()] (Java 7) retorna um gerador de números aleatórios específico da thread atual: as threads não competem por um único gerador. O método [nextInt(0, 1000)] retorna um inteiro do intervalo [0, 1000[;
- o array [data] não é protegido por nenhum bloqueio. No entanto, não há corrida de dados: as gravações do escritor precedem seu [canRead.release()], que precede (relação happens-before) o [canRead.acquireUninterruptibly()] do leitor e, portanto, suas leituras.
Resultados:
Os seguintes pontos podem ser observados:
- há apenas um leitor por vez, embora ele perca a CPU na seção crítica [read];
- há apenas um escritor por vez, embora ele perca o processador na seção crítica [write];
- um leitor só lê quando há algo para ler no array;
- um escritor só grava quando o array foi totalmente lido;
- Por outro lado, não temos nenhum controle sobre a ordem em que eles aparecem: não havia razão para que o escritor W0 viesse antes do escritor W1, nem para que o leitor R0 viesse antes do leitor R1. Uma execução diferente pode resultar em uma ordem diferente.
8.8.3. Os métodos wait e notifyAll
No exemplo anterior, quando os escritores estão bloqueados na instrução [canWrite.acquireUninterruptibly()], um deles (qualquer um) é desbloqueado pela operação [canWrite.release()]. Se quisermos abrir a barreira para um escritor específico, as coisas se complicam.
Considere a analogia de uma repartição pública com guichês de atendimento. Quando um cliente chega, ele retira uma senha numerada do dispensador e depois vai se sentar. Os clientes são chamados pelo número por um alto-falante. Enquanto espera, o cliente pode fazer o que quiser: pode ler ou cochilar. Ele é acordado toda vez que o alto-falante anuncia um número. Se for o seu número, o cliente se levanta e vai ao guichê; caso contrário, volta ao que estava fazendo. Podemos proceder de forma semelhante com as threads. Tomemos o exemplo dos escritores:
No guichê | Com threads |
vários escritores esperam pelo mesmo guichê | suas threads estão bloqueadas |
o guichê fica disponível e o número do próximo escritor é chamado | a thread que estava lendo o array notifica os escritores de que o array está disponível. Essa thread ou outra determinou qual escritor deve prosseguir |
Cada escritor verifica seu número; apenas aquele cujo número foi chamado vai ao guichê; os outros voltam à fila de espera | Cada thread verifica se é a selecionada. Se for, ela atravessa a barreira; caso contrário, volta à fila de espera |
Java permite implementar esse cenário usando métodos disponíveis para todo objeto, já que são definidos na classe [Object]:
Método | Função |
[void wait()] | devolve o monitor do objeto e bloqueia a thread até que outra thread sinalize uma mudança por meio de [notify] ou [notifyAll]; a thread deve então readquirir o monitor antes de continuar. A espera pode ser interrompida ([InterruptedException]) |
[void wait(long ms)] | igual ao anterior, com um tempo máximo de espera |
[void notify()] | Acorda uma das threads bloqueadas por [wait] neste objeto |
[void notifyAll()] | acorda todas as threads bloqueadas por [wait] neste objeto |
Vamos agora descrever um padrão canônico, apresentado em particular no livro de Brian Goetz et al., [Java Concurrency in Practice], que pode resolver problemas de barreiras com condições de entrada.
As threads que compartilham um recurso (o guichê) o acessam por meio de um objeto que chamaremos de token: é um objeto simples ([new Object()]) cujo monitor é utilizado. Para atravessar a barreira que leva ao guichê, é preciso ter o token, e há apenas um. As threads devem, portanto, passar o token de uma para outra.
Para ir ao guichê, uma thread primeiro solicita o token usando um bloco [synchronized (token)]. Se obtém o token, ela verifica se atende à condição para seguir ao guichê em um laço [while (!iAmTheExpectedOne) { token.wait(); }] e depois segue ao guichê, ainda dentro do bloco [synchronized]. Se a thread não é a esperada no guichê, ela cede sua vez devolvendo o token por meio de [token.wait()] e entra no estado bloqueado. Ela será acordada quando outra thread sinalizar uma mudança na condição de acesso; então recuperará o token e verificará a condição novamente. É por isso que o teste é um laço ([while]) e não um simples [if]. Há uma segunda razão, específica de Java: a especificação permite os “despertares espúrios” (spurious wakeups), em que [wait] termina sem que nenhuma thread tenha chamado [notify]; o laço os torna inofensivos. A operação [token.wait()] só pode ser realizada por uma thread que mantém o monitor do token; caso contrário, uma exceção [IllegalMonitorStateException] é lançada. Nesse esquema, o token só é liberado após a conclusão da transação.
A thread que modifica a condição de acesso ao guichê também deve manter o token e notificar as threads em espera: dentro de um bloco [synchronized (token)], ela modifica a condição de acesso ao guichê e depois acorda as threads em espera usando [token.notifyAll()].
Acordar as threads significa que as threads em espera se tornam candidatas ao token; elas não o recebem imediatamente. O token só fica disponível no final do bloco [synchronized]. Todas as threads acordadas o receberão então, uma de cada vez, em ordem indeterminada, o que lhes dá a oportunidade de verificar novamente a condição de acesso. A primeira que satisfizer a condição mantém o token e segue para a fila.
Com essas informações, podemos reescrever a aplicação de leitores e escritores especificando a ordem em que leitores e escritores seguem para seus respectivos guichês ([Threads20.java]):
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 33 34 35 36 37 38 39 40 41 42 43 44 45 46 47 48 49 50 51 52 53 54 55 56 57 58 59 60 61 62 63 64 65 66 67 68 69 70 71 72 73 74 75 76 77 78 79 80 81 82 83 84 85 86 87 88 89 90 91 92 93 94 95 96 97 98 99 100 101 102 103 104 105 106 107 108 109 110 111 112 113 114 115 116 117 | |
O acesso ao guichê de leitura é determinado pelo seguinte:
- linha 35: o token [canRead];
- linha 38: o valor booleano [readingAllowed];
- Linha 43: a lista ordenada dos nomes dos leitores. Os leitores seguem para o posto de leitura na ordem listada aqui;
- linha 40: [nextReader] é o índice, nessa lista, do próximo leitor autorizado a seguir ao guichê.
O acesso ao guichê de escrita é controlado de forma semelhante pelo token [canWrite], pelo booleano [writingAllowed], pela lista [writeOrder], e pelo índice [nextWriter].
O programa principal:
- linhas 8–10: os leitores seguirão ao guichê na ordem inversa de sua criação (R2, R1, R0), e os escritores na ordem em que foram criados (W0, W1, W2). As listas são construídas por meio de um pipeline: [IntStream.range(0, nbThreads)] gera os inteiros 0, 1, 2; [mapToObj] converte cada um deles em um nome de thread; e [toList()] (Java 16) reúne os nomes em uma lista somente leitura;
- Linhas 17–22: criação e início dos leitores, seguidos dos escritores. Todos ficarão bloqueados, já que nem a leitura nem a escrita são permitidas;
- linha 25: a escrita é habilitada, e os escritores são notificados de que algo mudou (método [allowWriting], linhas 47–53).
O método [read]:
- linhas 60–83: todo o processo no posto de leitura é controlado pelo bloco [synchronized] sobre o token [canRead]. O leitor que o obtém o mantém durante toda a sua permanência no posto;
- linhas 63–65: um leitor que adquiriu o token o devolve se a leitura não estiver autorizada ou se não for a sua vez. Os nomes são comparados por [equals];
- linhas 66–68: se a thread for interrompida durante a espera, ela aborta;
- linhas 70–73: processamento no guichê (leitura da tabela);
- linhas 75–76: o leitor altera as condições de acesso da fila de leitura. Ele ainda mantém o token de leitura, e essas alterações impedem que qualquer leitor prossiga;
- linhas 78–81: o leitor altera as condições de acesso da fila de escrita e notifica todos os escritores em espera de que algo mudou. Para isso, ele toma o token [canWrite]: vemos aqui que a thread mantém dois tokens ao mesmo tempo. Os escritores fazem o mesmo na ordem inversa (eles mantêm [canWrite] e solicitam [canRead]), o que é a situação de deadlock descrita acima. No entanto, não há risco aqui: uma thread solicita o segundo token somente no final de sua passagem pelo guichê, os dois guichês nunca estão ocupados ao mesmo tempo, e as outras threads mantêm um token apenas o tempo necessário para verificar a condição de acesso, sem solicitar o outro token.
O método [write] é simétrico ao método [read]. Observe o uso de [notifyAll] em vez de [notify], que acorda apenas uma thread: se essa thread não fosse o escritor esperado, ela voltaria a dormir, e o escritor esperado poderia nunca ser acordado. Com uma condição de acesso que especifica uma thread em particular, é preciso usar [notifyAll].
Aqui está um exemplo de execução:
Escritores e leitores se revezam em seus respectivos guichês, cada um na ordem especificada: W0, R2, W1, R1, W2, R0. Diferentemente do programa anterior, essa ordem de passagem é reproduzível; apenas a ordem das mensagens “started” varia de uma execução para outra.
8.8.4. Condições: a interface Condition
Os métodos [wait] e [notifyAll] estão associados ao monitor de um objeto e, portanto, aos blocos [synchronized]. Para um bloqueio [ReentrantLock], o equivalente é a interface [java.util.concurrent.locks.Condition]: um objeto [Condition] é criado pelo método [newCondition()] do bloqueio e fornece os métodos [await()] (o equivalente de [wait]), [await(long time, TimeUnit unit)], [signal()] (o equivalente de [notify]) e [signalAll()] (o equivalente de [notifyAll]). Seu uso segue as mesmas regras: a thread deve manter o bloqueio, e a condição de acesso é testada dentro de um laço [while].
A principal vantagem é que um único bloqueio pode ter várias condições, ou seja, várias filas distintas. No nosso problema, um único bloqueio pode proteger os dois guichês, com uma condição para os leitores e outra para os escritores: um leitor que termina acorda os escritores, e somente os escritores. Não há mais dois tokens e, portanto, não há mais aninhamento de bloqueios a vigiar. O programa [Threads21.java] tem o mesmo programa principal que [Threads20.java]; sua classe [Board] é a seguinte:
Comentários:
- linha 35: um único bloqueio, não justo;
- linhas 37–38: duas condições criadas a partir desse bloqueio;
- linhas 49–58: para abrir o canal de escrita, o bloqueio é adquirido, a condição de acesso é modificada e os escritores são acordados por meio de [canWrite.signalAll()];
- linhas 64–86: a passagem para o canal de leitura é feita mantendo o bloqueio, segundo a sequência [lock] / [try] / [finally] / [unlock];
- linhas 67–69: até que seja a sua vez, o leitor espera na condição [canRead]. O método [await] libera o bloqueio durante a espera e o readquire antes de devolver o controle;
- linhas 79–80: o leitor autoriza a escrita e acorda os escritores. Ele já mantém o bloqueio: não precisa adquirir um segundo token;
- linhas 82–83: se a thread for interrompida durante a espera, ela restaura seu flag de interrupção e termina; a cláusula [finally] libera o bloqueio.
Resultados:
O comportamento é idêntico ao do programa anterior: W0, R2, W1, R1, W2, R0.
8.8.5. Vários leitores simultâneos: ReadWriteLock
Nos exemplos anteriores, os leitores eram exclusivos. Em muitas aplicações, isso é restritivo sem necessidade: várias threads podem ler dados ao mesmo tempo, desde que ninguém os esteja modificando. Apenas as escritas precisam ser exclusivas: enquanto um escritor modifica os dados, nenhum leitor ou outro escritor deve poder acessá-los. Este é o problema clássico de leitura e escrita, que é resolvido pela interface [java.util.concurrent.locks.ReadWriteLock]. Um objeto [ReadWriteLock] fornece dois bloqueios vinculados:
- [readLock()]: o bloqueio de leitura, que pode ser mantido por várias threads ao mesmo tempo, desde que nenhuma thread mantenha o bloqueio de escrita;
- [writeLock()]: o bloqueio de escrita, que é exclusivo.
O programa [Threads22.java] é o seguinte:
Comentários:
- linhas 23–59: o recurso compartilhado é um catálogo de preços, armazenado em um dicionário chamado [HashMap] (linha 24);
- linha 26: a implementação [ReentrantReadWriteLock] da interface [ReadWriteLock];
- linhas 29–42: o método [read] adquire um bloqueio de leitura para uma operação de leitura que dura um segundo;
- linhas 45–58: o método [modify] adquire o bloqueio de escrita durante uma modificação que dura um segundo;
- linhas 7–12: três leitores leem o preço do teclado duas vezes seguidas;
- linhas 14–15: um escritor, iniciado meio segundo depois, modifica esse preço.
Resultados:
- os três leitores leem ao mesmo tempo (linhas 2–4 e 6–8): com um bloqueio comum, a primeira série de leituras teria levado três segundos em vez de um;
- o escritor, que chegou enquanto as leituras estavam em andamento, esperou o término delas. Em seguida, alterou o preço sozinho;
- a segunda série de leituras, que começou depois da chegada do escritor, esperou o término da modificação e então leu o novo preço. O bloqueio [ReentrantReadWriteLock] impede, assim, que um fluxo contínuo de leitores impeça indefinidamente um escritor de gravar: um leitor que chega enquanto um escritor espera fica atrás do escritor. Essa sequência é reproduzível.
Um bloqueio de leitura e escrita só é útil se as leituras forem numerosas e suficientemente longas. Para leituras muito curtas, a classe [StampedLock] (Java 8) oferece uma leitura “otimista”, sem bloqueio, que é validada depois. E, para uma coleção lida com muita frequência, mas modificada raramente, as coleções concorrentes descritas no parágrafo seguinte costumam ser a melhor solução.
8.9. Coleções concorrentes
Os exemplos anteriores protegiam dados compartilhados muito simples (um contador, um array, um pequeno dicionário). Quando as threads compartilham uma coleção (lista, dicionário, fila), poderíamos proteger cada acesso com um bloqueio. No entanto, as coleções padrão ([ArrayList], [HashMap], [ArrayDeque]) não foram projetadas para serem modificadas por várias threads simultaneamente: o uso sem proteção pode resultar na perda de elementos, disparar exceções inesperadas ([ConcurrentModificationException]) ou até corromper a estrutura interna da coleção. Os métodos [Collections.synchronizedList(…)], [Collections.synchronizedMap(…)]… envolvem uma coleção comum em um objeto em que todo método é [synchronized]: isso é seguro, mas todas as threads competem por um único bloqueio, e a iteração sobre a coleção ainda precisa ser protegida manualmente. Desde o Java 5, o pacote [java.util.concurrent] oferece coleções projetadas para serem compartilhadas entre threads sem um bloqueio explícito:
Coleção | Função |
[ConcurrentHashMap<K,V>] | Um dicionário cujas operações, inclusive as atualizações condicionais ([merge], [compute], [putIfAbsent]…), são seguras e atômicas. Várias threads podem lê-lo e modificá-lo simultaneamente |
[ConcurrentSkipListMap<K,V>] | um dicionário ordenado por chave |
[CopyOnWriteArrayList<E>] | uma lista que copia seu array interno a cada modificação: as leituras e os percursos, que são muito rápidos, nunca são afetados pelas modificações. É adequada para listas lidas com frequência e modificadas raramente (playlists, por exemplo) |
[ConcurrentLinkedQueue<E>], [ConcurrentLinkedDeque<E>] | Uma fila (primeiro a entrar, primeiro a sair), uma fila de duas pontas |
[BlockingQueue<E>] | uma interface de fila que bloqueia o consumidor quando a fila está vazia e, se sua capacidade é limitada, bloqueia o produtor quando ela está cheia. Implementações: [ArrayBlockingQueue], [LinkedBlockingQueue], [PriorityBlockingQueue], [SynchronousQueue]… |
8.9.1. ConcurrentHashMap e CopyOnWriteArrayList
No programa [Threads23.java], quatro threads geram números aleatórios e contam o número de vezes que cada número aparece em um dicionário compartilhado:
Comentários:
- linha 5: o dicionário compartilhado associa cada dígito ao seu número de ocorrências;
- linha 7: uma lista na qual cada thread armazena um relatório ao final de seu trabalho;
- linha 17: o método [merge(key, value, function)] adiciona a chave [digit] com o valor 1 se ela não existir e, caso contrário, substitui seu valor v por [function(v, 1)], neste caso a soma [Integer::sum]. Em um [ConcurrentHashMap], a operação é atômica. Não poderíamos escrever [draws.put(digit, draws.get(digit) + 1)]: essa expressão lê o valor e depois grava o novo, em duas operações, e duas threads poderiam perder uma atualização, como no exemplo [Threads09.java];
- linha 20: cada thread adiciona seu relatório à lista;
- linhas 29–31: a thread principal itera sobre a lista. A iteração sobre uma [CopyOnWriteArrayList] é feita sobre um instantâneo do array interno: ela nunca lança [ConcurrentModificationException], mesmo que outras threads modifiquem a lista durante a iteração;
- linhas 33–34: o dicionário é copiado para um dicionário ordenado [TreeMap] para exibir os números em ordem; o método [forEach] recebe cada par chave/valor;
- linha 35: a soma dos valores, calculada por um stream;
- linha 38: o método
[computeIfAbsent(key, function)]retorna o valor associado à chave, após calculá-lo com a função e adicioná-lo caso a chave não existisse. Como em [merge], a verificação e a adição formam uma única operação atômica: uma verificação com [containsKey] seguida de um [put] não seria segura, já que outra thread poderia adicionar a chave nesse intervalo.
Resultados:
O número total de sorteios está correto: nenhuma atualização foi perdida. Os relatórios aparecem na ordem em que as threads concluíram seu trabalho, que varia de uma execução para outra.
8.9.2. Produtor e consumidores: BlockingQueue
O problema dos leitores e escritores é uma variação do clássico problema do produtor-consumidor: algumas threads produzem dados que outras threads consomem. A interface [BlockingQueue<E>] resolve isso sem nenhuma ferramenta explícita de sincronização:
- [put(element)] adiciona um elemento à fila. Se a fila tem capacidade limitada e está cheia, o produtor fica bloqueado até que uma vaga fique disponível;
- [take()] remove o elemento da cabeça da fila. Se a fila está vazia, o consumidor fica bloqueado até que um elemento chegue;
- [offer(element, timeout, unit)] e [poll(timeout, unit)] fazem o mesmo, com um tempo máximo de espera; [offer(element)] e [poll()], que não têm tempo limite, nunca bloqueiam: retornam [false] ou [null] em caso de falha.
A fila não sabe que a produção terminou. Uma técnica clássica consiste em colocar na fila, ao final da produção, um valor especial, conhecido no mundo anglófono como “poison pill”: o consumidor que o recupera sabe que deve parar. Outra técnica é interromper os consumidores, já que [take] é interrompível. O programa [Threads24.java] é o seguinte:
Comentários:
- linha 4: o valor que marca o fim da produção. É uma constante, declarada fora de qualquer classe: é um campo estático da classe implícita;
- linha 8: uma fila com no máximo 3 elementos. [ArrayBlockingQueue] armazena os elementos em um array de tamanho fixo; [LinkedBlockingQueue] tem capacidade ilimitada por padrão;
- linhas 12–29: o produtor coloca os números de 1 a 8 na fila, um a cada décimo de segundo, seguidos de um marcador de fim para cada consumidor (linhas 22–24);
- linhas 34–51: dois consumidores recuperam os números e gastam 0,6 segundo processando cada um. Eles os consomem mais lentamente do que o produtor os gera;
- linha 39: remoção bloqueante. Cada número é removido por apenas um dos dois consumidores;
- linhas 40–42: um consumidor que recupera o token de fim sai de seu laço. Cada consumidor recupera um, daí um token ser depositado por consumidor;
- o produtor e os consumidores são lambdas que contêm a instrução [try], porque [put], [take], e [sleep] podem lançar [InterruptedException].
Resultados:
Vemos o produtor adicionando rapidamente os primeiros números e depois, assim que a fila contém 3 elementos, só adicionando um número quando um consumidor remove um: ele fica bloqueado por [put] quando a fila está cheia. Os consumidores dividem os números entre si e param quando removem o marcador de fim. Esse ritmo é reproduzível; a atribuição de cada número a C1 ou C2 não é. O produtor exibe “P has finished” somente depois que seus dois marcadores de fim foram colocados, isto é, depois que C2 removeu o número 7 e liberou uma vaga.
Voltaremos às filas bloqueantes no próximo capítulo, ao tratar da transferência de dados entre processos assíncronos. Com threads virtuais, um consumidor bloqueado em [take] não ocupa nenhuma thread do sistema.
8.10. Pools de threads: ExecutorService
8.10.1. O princípio
Até agora, para gerenciar threads, nós as criamos e depois as iniciamos por meio de [start()]. Criar uma thread de plataforma é uma operação relativamente custosa: em particular, o sistema precisa alocar uma pilha para ela, e cada thread ocupa memória enquanto existir. Veremos no Capítulo 10 que existem pools de conexões: conexões abertas são mantidas em reserva e emprestadas às threads que as solicitam, já que abrir uma conexão é custoso. Um sistema semelhante existe para threads: o pool de threads.
Java representa um pool de threads por meio da interface [java.util.concurrent.ExecutorService] (um “executor”): as threads não são mais criadas; em vez disso, tarefas são atribuídas ao executor, que faz suas threads as executarem. Uma thread que concluiu uma tarefa não é destruída; ela passa para a tarefa seguinte. A classe [ThreadPoolExecutor], a implementação mais comum, funciona da seguinte forma:
- ela tem um número fixo de threads (“core pool size”): enquanto esse número não for atingido, cada nova tarefa provoca a criação de uma nova thread;
- além disso, as tarefas são colocadas em uma fila (uma [BlockingQueue]) da qual as threads as retiram;
- se a fila estiver cheia, o pool cria threads adicionais, até um número máximo (“maximum pool size”). Essas threads adicionais são destruídas se permanecerem inativas por mais de certo tempo;
- se o máximo for atingido e a fila estiver cheia, a tarefa é rejeitada: por padrão, o método que a submeteu lança a exceção [RejectedExecutionException].
O pool de threads oferece duas vantagens: economiza o tempo gasto na criação de threads (algumas threads podem atender centenas de requisições) e, ao limitar o número de threads, impede que a aplicação seja sobrecarregada por requisições em excesso.
Um executor é encerrado por meio de seu método [shutdown] (ele deixa de aceitar novas tarefas, e suas threads param quando as tarefas já submetidas terminam), possivelmente seguido de [awaitTermination] (que espera o término das tarefas), ou por [shutdownNow] (que interrompe as tarefas em andamento). A partir do Java 19, [ExecutorService] estende a interface [AutoCloseable]: seu método [close] chama [shutdown] e depois espera o término de todas as tarefas. Portanto, é possível declarar um executor em uma instrução [try] com recurso: ao sair do bloco, todas as tarefas atribuídas foram concluídas. O programa [Threads25.java] é o seguinte:
Comentários:
- linha 6: o pool tem 3 threads permanentes, com um máximo de 5 threads; qualquer thread adicional que tenha ficado inativa por 60 segundos é destruída; a fila de tarefas é uma [ArrayBlockingQueue] com 2 vagas. O pool é criado em uma instrução [try] com recurso;
- linhas 8–15: o pool recebe 8 tarefas, cada uma com duração de 3 segundos. O método [execute(Runnable)] atribui uma tarefa ao pool sem esperar;
- linha 9: cada tarefa recebe um objeto [Data]; trata-se de um [record] (linha 40), que também é definido fora de qualquer classe;
- linhas 12–14: uma tarefa rejeitada pelo pool dispara a exceção [RejectedExecutionException];
- linha 18: a saída do bloco [try] fecha o pool e espera o término das tarefas atribuídas;
- linhas 23–37: a tarefa executada por uma thread do pool. Os nomes das threads ([pool-1-thread-1]…) são fornecidos pelo pool;
- linha 27: o estado do pool: o número de suas threads ([getPoolSize]), o número de threads que estão executando uma tarefa no momento ([getActiveCount]) e o número de tarefas esperando na fila ([getQueue().size()]);
- linha 45: os tempos são exibidos em centésimos de segundo ([SS]).
Resultados:
- As tarefas 0, 1 e 2 foram atribuídas às três threads permanentes criadas para esse fim;
- as tarefas 3 e 4 foram colocadas na fila, que agora está cheia;
- As tarefas 5 e 6 provocaram a criação de duas threads adicionais ([pool-1-thread-4] e [pool-1-thread-5]): elas começaram imediatamente, antes das tarefas 3 e 4, que esperavam na fila. Essa é a regra de [ThreadPoolExecutor]: primeiro a fila, depois as threads adicionais, o que costuma surpreender;
- A tarefa 7 foi rejeitada: 5 threads ocupadas, fila cheia;
- As tarefas 3 e 4 tiveram de esperar que uma thread ficasse disponível após o término das primeiras tarefas: elas reutilizaram as threads 3 e 4. No total, levaram pouco mais de 6 segundos a partir do momento da solicitação: 3 segundos de espera e 3 segundos de processamento;
- Os valores exibidos por cada job ao iniciar (número de threads, fila) dependem do instante exato em que ele obteve o processador: variam de uma execução para outra. No entanto, o resultado de cada job (execução imediata, espera na fila ou rejeição) é reproduzível.
Raramente você constrói um *[ThreadPoolExecutor] por conta própria: a classe *[Executors] oferece métodos de construção para os casos comuns:
Método | Executor retornado |
[newFixedThreadPool(n)] | um pool de n threads permanentes, com uma fila de capacidade ilimitada |
[newCachedThreadPool()] | um pool sem threads permanentes, que cria quantas threads forem necessárias e destrói as que permanecem inativas por 60 segundos |
[newSingleThreadExecutor()] | uma única thread que executa as tarefas uma após a outra, na ordem em que foram submetidas |
[newScheduledThreadPool(n)] | Um pool capaz de executar tarefas após um atraso ou periodicamente (interface [ScheduledExecutorService]) |
[newVirtualThreadPerTaskExecutor()] | (Java 21) um executor sem pool, que cria uma nova thread virtual para cada tarefa |
O último executor merece uma observação: as threads virtuais não são colocadas em um pool. Elas são tão baratas que uma nova é criada para cada tarefa; para limitar o uso de recursos, utiliza-se um semáforo, como no programa [Threads15.java].
8.10.2. Tarefas com resultado: Callable e Future
O método [execute] passa um [Runnable] ao pool, o que não devolve resultado. O método [submit(task)] também aceita um [Callable<V>], uma interface funcional cujo método [V call() throws Exception] devolve um resultado do tipo V e pode lançar exceções verificadas. Ele devolve um objeto [Future<V>] que permite acompanhar a tarefa:
Método de Future<V> | Função |
[V get()], [V get(long timeout, TimeUnit unit)] | espera a conclusão da tarefa (no máximo pela duração de [timeout]) e devolve seu resultado. Se a tarefa lança uma exceção, [get] lança uma [ExecutionException] que a encapsula (método [getCause]) |
[boolean isDone()] | indica se a tarefa foi concluída (normalmente, por uma exceção ou por cancelamento) |
[Future.State state()] | (Java 19) o estado da tarefa: [RUNNING], [SUCCESS], [FAILED], ou [CANCELLED] |
[V resultNow()], [Throwable exceptionNow()] | (Java 19) o resultado ou a exceção de uma tarefa já concluída, sem esperar |
[boolean cancel(boolean mayInterruptIfRunning)] | cancela a tarefa; se ela já foi iniciada e [mayInterruptIfRunning] é igual a [true], a thread que a executa é interrompida |
O método [invokeAll(collection of Callable)] do executor submete todas as tarefas de uma coleção, espera que todas terminem e devolve a lista de seus valores [Future], na ordem da coleção. O método [invokeAny] devolve o resultado da primeira tarefa concluída com sucesso e cancela as demais. O programa [Threads26.java] é o seguinte:
Comentários:
- linha 7: um pool de 2 threads, criado por [Executors.newFixedThreadPool(2)] e fechado ao final do bloco [try];
- linhas 12–19: cada tarefa é uma lambda que exibe a thread que a executa, dorme por 0,5, 1 ou 1,5 segundo e depois devolve um resultado inteiro. Como a lambda devolve um valor, o compilador a interpreta como um [Callable<Integer>], e [submit] produz um [Future<Integer>]. O [sleep] da linha 16 não precisa ser envolvido em um [try]: o método [call] de [Callable] declara [throws Exception];
- linha 25: [future.get()] espera o término da tarefa e devolve seu resultado; [future.state()] devolve seu estado;
- linha 32: uma tarefa que executa o método [fail] (linhas 61–63), que lança uma exceção;
- linhas 34–38: a exceção lançada na tarefa não se perde: ela é armazenada no objeto [Future] e depois relançada na thread que solicita o resultado, encapsulada em uma [ExecutionException] cujo método [getCause] devolve a exceção original;
- linhas 44–57: um executor que cria uma thread virtual por tarefa. O método [invokeAll] (linha 53) atribui a ele os três jobs da lista [jobs] e espera que terminem. Quando as tarefas terminam, [resultNow] (linha 55) devolve seus resultados imediatamente.
Resultados:
- as tarefas são executadas nas threads do pool ([pool-1-thread-1] e [pool-1-thread-2]);
- A Tarefa 2 só começou depois que a Tarefa 0 terminou, na thread que a Tarefa 0 liberou: o pool tem apenas 2 threads, e a Tarefa 2 esperou na fila. Esse comportamento é reproduzível;
- os resultados são obtidos depois que as tarefas terminam, e seu estado é [SUCCESS];
- a exceção da tarefa que falhou foi capturada pela thread principal, e o estado da tarefa é [FAILED];
- os três jobs da segunda parte foram executados por três threads virtuais diferentes, montadas nas threads portadoras [ForkJoinPool-1-worker-1] e [ForkJoinPool-1-worker-2].
Bloquear uma thread em [get] para esperar um resultado é simples, mas não é possível encadear operações de processamento à conclusão de uma tarefa sem esperar. A classe [CompletableFuture], apresentada no próximo capítulo, permite isso. Por fim, observe que o Java 25 oferece, em caráter de prévia, a concorrência estruturada ([StructuredTaskScope]), que trata um grupo de subtarefas como uma única unidade de trabalho (se uma falha, as outras são abortadas); como ainda não é final, ela não é usada neste curso.
8.11. Paralelismo de dados
8.11.1. Streams paralelos
Voltemos ao primeiro uso das threads: utilizar todos os processadores em um cálculo demorado. Os streams da API Stream (Capítulo 5) podem ser executados em paralelo: basta chamar [parallel()] em um stream, ou [parallelStream()] em vez de [stream()] em uma coleção. O stream então divide os dados em blocos, faz com que os blocos sejam processados por várias threads e depois combina os resultados parciais. As threads utilizadas são as do pool compartilhado ([ForkJoinPool.commonPool()]), às quais se junta a thread que executa o stream. Por padrão, o pool compartilhado tem tantas threads quanto processadores, menos um: a thread chamadora participa da contagem.
Esses streams só são adequados se o processamento de cada elemento for independente dos demais: a ordem de processamento é indefinida e, se o processamento atualiza dados compartilhados, eles precisam ser protegidos. O programa [Threads27.java] é o seguinte:
Comentários:
- linhas 7–15: os números primos menores que 5.000.000 são contados com um laço [for] comum. A função [isPrime] (linhas 48–58) testa os divisores até a raiz quadrada do número: é um processamento demorado, e as iterações são independentes;
- linhas 18–20: o mesmo cálculo com um stream sequencial: [IntStream.range(2, N)] gera os inteiros de 2 a N–1, [filter] mantém apenas os números primos e [count] os conta;
- linhas 23–25: o mesmo stream, tornado paralelo por [parallel()]. Nada mais precisa ser alterado: cada thread conta os números primos em seus segmentos, e o stream soma as contagens parciais. Nenhum dado é compartilhado entre as threads;
- linhas 28–33: para determinar quais threads concluíram seu trabalho, o stream paralelo conta, para cada thread, os números primos que ela encontrou e os armazena em um [ConcurrentHashMap] compartilhado. São dados compartilhados, atualizados por uma operação atômica ([merge]);
- linhas 36–42: o método
***[parallelStream()], que recebe uma lista de nomes de arquivos, devolve um stream paralelo;*[forEach]processa cada arquivo (o processamento é simulado por uma pausa de meio segundo). Com um stream paralelo, [forEach] não preserva a ordem da lista; [forEachOrdered] a preservaria, ao custo de parte do paralelismo; - Linha 44: o número de threads do pool compartilhado.
Resultados:
- As três versões encontram a mesma quantidade de números primos;
- duas threads participaram do processamento paralelo: a thread [main] e a única thread do pool compartilhado ([ForkJoinPool.commonPool-worker-1]): nesta máquina de dois processadores, o pool compartilhado tem apenas uma thread (linha 13);
- o processamento dos arquivos ocorre em pares, com meio segundo de intervalo, e em uma ordem que não corresponde à da lista;
- o stream paralelo foi mais rápido, mas não duas vezes mais rápido: as threads do nosso programa dividiam os dois processadores com outros programas muito ativos no momento da captura, e os tempos medidos variaram bastante de uma execução para outra. Em uma máquina pouco carregada com n processadores, um stream paralelo como este pode ser quase n vezes mais rápido que o stream sequencial. Meça sempre antes de tirar conclusões: a paralelização tem um custo (divisão do trabalho, sincronização, combinação dos resultados) que só compensa se o processamento de cada elemento exigir uma quantidade significativa de cálculo.
8.11.2. Dividir para conquistar: ForkJoinPool e RecursiveTask
Os streams paralelos se baseiam no framework Fork/Join (Java 7), que também pode ser usado diretamente. Ele é adequado para algoritmos de “dividir para conquistar”: uma tarefa grande demais é decomposta em subtarefas, que por sua vez são decompostas, até que as partes sejam pequenas o bastante para serem processadas diretamente; os resultados das subtarefas são então combinados. Uma tarefa é uma classe derivada de [RecursiveTask<V>] (uma tarefa que devolve um resultado do tipo V) ou de [RecursiveAction] (sem resultado), na qual o método [compute] é sobrescrito. Em [compute], o método [fork()] de uma subtarefa a submete imediatamente ao pool, e seu método [join()] espera pelo resultado.
As tarefas são executadas por um [ForkJoinPool], no qual cada thread tem sua própria fila de tarefas. Uma thread que não tem mais nada a fazer “rouba” tarefas da fila de outra thread (“work stealing”): a carga é assim distribuída automaticamente. As threads que transportam as threads virtuais também formam um [ForkJoinPool]: é o que vimos na representação textual das threads virtuais ([ForkJoinPool-1-worker-1]). O programa [Threads28.java] conta números primos usando uma tarefa recursiva:
Comentários:
- linhas 24–64: a tarefa [CountPrimes] conta os números primos no intervalo [start, end[. Ela deriva de [RecursiveTask<Integer>];
- linhas 25–26: as tarefas Fork/Join são serializáveis: a opção de compilador [-Xlint:all] exige, portanto, a declaração do número de versão de serialização [serialVersionUID], com a anotação [@Serial] (Java 14);
- linha 28: para menos de 100.000 números, um intervalo é processado diretamente;
- linha 30: para cada thread, o número de blocos que ela processou;
- linhas 43–52: um bloco suficientemente pequeno é processado sequencialmente;
- linhas 54–56: um bloco grande demais é dividido em duas subtarefas. A expressão [(start + end) >>> 1] calcula o valor do meio usando um deslocamento à direita sem sinal, o que evita um estouro caso a soma exceda a capacidade de um [int];
- linha 58: a metade esquerda é atribuída ao pool; outra thread pode “roubá-la”;
- linha 60: a metade direita é processada pela thread atual por meio de uma chamada direta a [compute]. Não há necessidade de atribuir as duas metades ao pool: a thread atual não teria mais nada a fazer além de esperar;
- linha 62: a thread espera o resultado da metade esquerda (que ela mesma processará se ninguém a tiver “roubado”) e combina os dois resultados;
- linha 7: a tarefa é executada primeiro pelo pool compartilhado. O método [invoke(task)] submete a tarefa e espera seu resultado;
- linhas 11–17: depois, por um pool de 4 threads, criado em uma instrução [try] com recurso ([ForkJoinPool] é um [ExecutorService]). O método [getStealCount] devolve o número de tarefas roubadas por uma thread de outra;
- linhas 19–20: a distribuição dos blocos entre as threads deste pool.
Resultados:
- o pool compartilhado não foi mais rápido que um laço sequencial (compare com o programa anterior): nesta máquina, ele tem apenas uma thread, e a thread principal — que espera o resultado em [invoke] — não participa do cálculo como ocorre em um stream paralelo;
- o pool de 4 threads utilizou os dois processadores e foi cerca de duas vezes mais rápido. Ter mais threads que processadores não traz benefício para um cálculo puro, mas aqui não custa muito;
- Os 64 blocos (5.000.000 / 100.000, arredondado para a próxima potência de 2 por causa das divisões ao meio) foram distribuídos de modo aproximadamente igual entre as 4 threads, graças ao roubo de tarefas. Essa distribuição varia de uma execução para outra.
Os streams paralelos bastam na maioria dos casos; uma tarefa Fork/Join só é escrita para um algoritmo recursivo que não pode ser facilmente expresso como um stream (ordenação, percurso de árvore etc.).
8.12. Dados locais da thread
8.12.1. O princípio
Considere uma aplicação em três camadas:
Suponha que a aplicação seja multiusuário, como uma aplicação web. Cada requisição de usuário é tratada por uma thread. O ciclo de vida da thread é o seguinte:
- a thread é criada (thread virtual) ou solicitada a um pool de threads para atender à requisição de um usuário;
- se essa requisição precisa de dados, a thread executa um método da camada [ui], que chama um método da camada [business], que por sua vez chama um método da camada [dao];
- a thread devolve a resposta ao usuário. Em seguida, ela termina ou é devolvida ao pool de threads.
Durante a segunda etapa, pode ser útil que a thread tenha dados próprios, isto é, dados não compartilhados com outras threads. Esses dados podem, por exemplo, pertencer ao usuário específico que a thread está atendendo e ser usados nas diversas camadas [ui, business, dao] sem serem passados como parâmetro a cada método.
Java oferece duas ferramentas para esse fim:
- a classe [ThreadLocal<T>] (Java 1.2): um objeto cujo valor — lido por [get()] e escrito por [set(value)] — é diferente para cada thread. O construtor [ThreadLocal.withInitial(supplier)] fornece o valor inicial para cada thread; o método [remove()] apaga o valor da thread atual. A classe derivada [InheritableThreadLocal<T>] repassa à thread recém-criada o valor mantido pela thread criadora;
- a classe [ScopedValue<T>] (final no Java 25): um valor vinculado, durante um escopo delimitado do código, a uma thread, e que não pode ser modificado dentro desse escopo.
8.12.2. A classe ThreadLocal
O programa [Threads29.java] compara um campo estático comum, um [ThreadLocal], e um [InheritableThreadLocal]:
Comentários:
- linha 51: um campo estático comum. Existe apenas uma instância dele, compartilhada por todas as threads. Ele é [volatile], para que cada thread veja o último valor escrito pelas outras;
- linha 53: um objeto [ThreadLocal<Integer>]. Cada thread tem seu próprio valor; enquanto uma thread não escrever nele, [get] devolve [null];
- linhas 55–56: um objeto [ThreadLocal<String>] criado por [ThreadLocal.withInitial(…)]. A lambda passada a esse método é executada na primeira vez que uma thread lê o valor sem tê-lo escrito; ela fornece o valor inicial para essa thread;
- linha 58: um objeto [InheritableThreadLocal<String>]: quando uma thread é criada, seu valor inicial é uma cópia do valor que a thread criadora tinha naquele momento;
- linhas 6–9: a thread principal escreve seus próprios valores;
- linhas 17–26: cada thread escreve seus próprios valores, exceto a thread T2, que não define um usuário, e a thread T1, que é a única a alterar o idioma;
- linha 28: cada thread espera que as outras escrevam antes de ler os valores novamente;
- linhas 42–46: os dados vistos pela thread atual são exibidos.
Resultados:
- o campo comum [shared] tem o mesmo valor para todas as threads: o último valor escrito (nesta execução, o da thread T2; outra execução pode produzir um valor diferente);
- [perThread] manteve, em cada thread, o valor que essa thread escreveu nele;
- [user] tem o valor escrito por cada thread; a thread T2, que não havia escrito nele, obteve o valor inicial fornecido pela lambda de [withInitial];
- [language] é igual a [fr] para as threads T0 e T2, que o herdaram da thread principal sem nunca escrever nele. A thread T1 o alterou para [en] apenas para si mesma: a thread principal e as outras threads não veem essa alteração.
Um [ThreadLocal] exige algumas precauções. O valor de uma thread só existe enquanto a própria thread existir: com um pool de threads, a thread que trata uma requisição tratará depois outras requisições, e [remove] deve ser chamado ao final de cada requisição; caso contrário, a requisição seguinte encontraria os dados da anterior (e a memória nunca seria liberada). Com threads virtuais, é possível criar milhões de threads, cada uma com sua própria cópia dos dados: [InheritableThreadLocal] copia então seus valores para cada uma delas. Por fim, um valor que pode ser modificado por qualquer método da thread dificulta o acompanhamento do código. A classe [ScopedValue] evita esses problemas.
8.12.3. A classe ScopedValue
Um valor [ScopedValue<T>] é vinculado a um valor durante a execução de um trecho de código, chamado de seu escopo:
- [ScopedValue.newInstance()] cria um valor vinculável, tipicamente armazenado em um campo [static final];
- [ScopedValue.where(sv, value).run(action)] executa a ação (um [Runnable]) vinculando [sv] a [value]. Durante a execução da ação — e de todos os métodos que ela chama — na thread atual, [sv.get()] devolve [value]. Quando a ação termina, o vínculo desaparece: não há nada a limpar;
- [ScopedValue.where(sv, value).call(op)] faz o mesmo com uma operação que devolve um resultado;
- Dentro do escopo, o valor não pode ser modificado; ele só pode ser vinculado a outro valor em um escopo aninhado;
- [isBound()] indica se o valor está vinculado na thread atual; [orElse(other)] devolve o valor ou, se ele não estiver vinculado, [other]. Fora de qualquer escopo, [get()] lança a exceção [NoSuchElementException].
O programa [Threads30.java] é o seguinte:
Comentários:
- linha 4: o valor vinculável [USER], um campo estático da classe implícita;
- linhas 7–12: fora de qualquer escopo, o valor não está vinculado, e [get] lança uma exceção;
- linhas 15–16: duas threads virtuais executam o método [process], cada uma em um escopo no qual [USER] está vinculado a um usuário diferente;
- linhas 44–52: o método [process] (a camada [business]) chama o método [dao] (a camada [dao]) sem lhe passar o usuário: cada um o obtém por meio de [USER.get()] (linha 56);
- linhas 21–33: um escopo em que [USER] é igual a [admin] contém um escopo aninhado (linha 23) em que ele é igual a [guest]. Ao sair do escopo aninhado, encontramos novamente [admin];
- linhas 26–27: uma thread criada dentro do escopo não vê o vínculo: ao contrário de um
*[InheritableThreadLocal]*, um*[ScopedValue]não é repassado às threads criadas por*[Thread]. Em contrapartida, ele é repassado às subtarefas da concorrência estruturada ([StructuredTaskScope], em prévia no Java 25), que garante que essas subtarefas terminem antes do fim do escopo; - linha 36: [call] executa uma operação dentro de um escopo e devolve seu resultado;
- linhas 39–40: depois dos escopos, o valor não está mais vinculado.
Resultados:
As mensagens das threads virtuais nas linhas 4–7 podem aparecer em outra ordem (bob antes de alice); o restante é reproduzível. Um [ScopedValue] é adequado para dados de contexto passados “para baixo”, do chamador para os métodos chamados: usuário autenticado, transação, configurações regionais etc. Quando um método chamado precisa modificar os dados para o processamento posterior, é necessário um [ThreadLocal].
8.12.4. Aplicação: uma transação compartilhada entre camadas
Considere a seguinte aplicação em três camadas, na qual a camada [dao] gerencia uma tabela de artigos:
Suponha que a interface da camada [dao] seja inicialmente a seguinte:
Mais tarde, surge a necessidade de inserir uma lista de artigos dentro de uma transação, porque o sistema deve operar no regime de tudo ou nada: ou todos os artigos são inseridos, ou nenhum. Um método chamado [insertArticles(List<Article> articles)] pode ser adicionado à interface. Depois, para outra aplicação, surge a necessidade de excluir uma lista de artigos, novamente dentro de uma transação… Para atender a diferentes necessidades de negócio, a camada [dao] vai crescer. Podemos adotar outra abordagem:
- incluir na camada [dao] apenas as operações básicas (inserir, atualizar, excluir, ler um artigo);
- mover para a camada [business] as operações que atualizam vários artigos simultaneamente. Essas operações utilizam as operações básicas da camada [dao].
A vantagem dessa solução é que a mesma camada [dao] pode ser usada, sem modificação, com diferentes camadas [business]. Ela traz um desafio no gerenciamento da transação que agrupa as atualizações a serem realizadas de forma atômica:
- a transação deve ser iniciada pela camada [business] antes que ela chame os métodos da camada [dao];
- os métodos da camada [dao] devem conhecer a existência da transação para participar dela;
- a transação deve ser concluída (confirmada ou cancelada) pela camada [business].
Para garantir que os métodos da camada [dao] conheçam qualquer transação em andamento, a transação poderia ser adicionada como parâmetro a cada método da camada [dao]. Esse parâmetro apareceria então na assinatura dos métodos da interface, vinculando-a a uma fonte de dados específica. Os dados locais da thread oferecem uma solução mais elegante: a camada [business] coloca a transação nos dados locais da thread, e é ali que a camada [dao] a recupera. As assinaturas dos métodos da camada [dao] não precisam ser alteradas. Várias threads (vários usuários) podem trabalhar simultaneamente: cada uma tem sua própria transação.
Os bancos de dados serão abordados nos Capítulos 10 e 11. Para manter o foco nas threads, usamos aqui uma tabela em memória e uma transação simulada. O programa [Threads31.java] reúne todas as camadas em um único arquivo-fonte compacto. As entidades são as seguintes:
- linha 68: um artigo é um [record] cujo identificador [id] é definido pela camada [dao];
- linhas 72–98: uma transação simulada. Cada atualização feita dentro da transação registra a operação que permite desfazê-la (método [log]); [commit] confirma a transação ignorando essas operações; [rollback] a desfaz executando as operações de reversão, da última à primeira. As operações são armazenadas em uma pilha: o método [push] de um [Deque] adiciona no topo, enquanto o método [poll] remove do topo (e devolve [null] se a pilha estiver vazia). Um banco de dados real funciona de modo semelhante, usando um log de transações;
- linha 75: cada transação recebe um número único. Como as transações podem ser criadas por várias threads simultaneamente, o contador é um [AtomicInteger], incrementado de forma atômica;
- linhas 101–104: os dados locais da thread compartilhados pelas camadas: a transação atual da thread, ou [null] se não houver nenhuma.
A camada [dao] é a seguinte:
- linha 117: a tabela de artigos, compartilhada por todas as threads. O acesso a ela é protegido pelo lock da linha 118;
- linha 124: o método [insertArticle] recupera a eventual transação que a camada [business] colocou nos dados locais da thread atual;
- linhas 126–128: a tabela tem uma restrição de unicidade sobre os nomes dos artigos: inserir um artigo com um nome que já existe lança uma exceção;
- linhas 129–131: o artigo inserido é uma cópia do artigo recebido, com um identificador atribuído pela camada [dao]. Como um objeto [record] é somente leitura, um novo objeto é criado;
- linhas 133–139: se houver uma transação, a camada [dao] participa dela registrando como desfazer a inserção. A lambda de reversão captura a variável [inserted];
- linhas 140–144: uma saída de rastreamento mostra a thread, o artigo inserido e a eventual transação;
- linhas 150–154: a lista de artigos devolvida é uma cópia somente leitura da tabela ([List.copyOf]), para que o chamador não a percorra enquanto outra thread a modifica.
A camada [business] é a seguinte:
- linhas 176–180: a camada [dao] é injetada pelo construtor;
- linhas 186–187: o método [insertArticlesInTransaction] inicia uma transação e a guarda nos dados locais da thread;
- linha 191: o método de inserção da camada [dao] é chamado para cada artigo, sem que a transação lhe seja passada;
- linha 193: uma pausa simula um processamento, a fim de dar tempo para que outra thread intervenha durante a transação (terceira parte do programa de teste);
- linha 195: se o programa chega a este ponto, nenhuma exceção ocorreu: a transação é confirmada;
- linhas 198–203: se ocorre uma exceção, a transação é desfeita e a exceção é relançada ao chamador;
- linha 206: em todos os casos, a thread deixa de ter uma transação ativa: [remove()] remove a transação da thread. Isso é essencial se a thread for reutilizada (uma thread de pool);
- Linhas 212–216: a mesma inserção, sem transação.
O programa de teste é o seguinte:
- Linha 10: criamos uma lista de dois artigos com o mesmo nome. A tentativa de inserir o segundo artigo será rejeitada. Se a inserção for feita fora de uma transação, o primeiro artigo é inserido e permanece na lista. Se for feita dentro de uma transação, o primeiro artigo é inserido e depois removido quando a transação é desfeita;
- Linhas 13–16: inserimos a lista fora de uma transação e depois exibimos a tabela;
- Linhas 18–22: o mesmo procedimento dentro de uma transação;
- linhas 24–37: duas threads trabalham simultaneamente. A thread A insere três artigos dentro de uma transação (o terceiro viola a restrição de unicidade); enquanto isso, a thread B insere um artigo fora de uma transação;
- linhas 41–48: o método [execute] executa uma ação e exibe a eventual exceção, precedida do nome da thread.
Resultados:
- A inserção fora da transação deixou o primeiro registro na tabela (linha 6). O método [toString] de um [record] exibe o nome e o valor de cada um de seus componentes;
- A inserção feita dentro de uma transação não deixou nenhum registro na tabela: o registro com id 2 foi removido pelo rollback;
- Na terceira parte, a thread B inseriu o monitor enquanto a transação 2 da thread A estava em andamento: ela o fez fora da transação, já que a transação é uma variável local da thread A. O rollback da transação 2 removeu o teclado e o mouse inseridos por A, mas não o monitor inserido por B. Esse resultado é reproduzível.
8.12.5. Conclusão
O exemplo anterior demonstrou a utilidade dos dados locais da thread para o gerenciamento de transações. Ele não deve ser replicado exatamente como foi mostrado, mas descreve com precisão o funcionamento dos frameworks: o gerenciamento de transações do Spring (anotação [@Transactional]) coloca a transação e a conexão com o banco de dados em [ThreadLocal], que as camadas de acesso a dados consultam sem que seu código precise manipular a transação; o Hibernate pode, de forma semelhante, associar a sessão de trabalho à thread atual. Retomaremos essas ferramentas no Capítulo 11. Em código novo, sobretudo ao usar threads virtuais, um *[ScopedValue]* é a forma recomendada de passar esse tipo de informação de contexto.
8.13. Para saber mais
A sincronização de threads é um campo difícil. Este capítulo apresentou as principais ferramentas; para se aprofundar:
- o livro de Brian Goetz et al., [Java Concurrency in Practice] (Addison-Wesley), que continua sendo a referência definitiva sobre o assunto, embora seja anterior às threads virtuais;
- a seção “Concurrency” do tutorial Java da Oracle: Lesson: Concurrency, que está desatualizado, mas continua correto quanto ao básico;
- a documentação do pacote [java.util.concurrent]: Package java.util.concurrent, cuja seção “Memory Consistency Properties” resume as relações “happens-before”;
- as propostas de aprimoramento do Java (JEP) que introduziram as threads virtuais e os valores com escopo: JEP 444: Virtual Threads e JEP 506: Scoped Values.
No código moderno, os objetos [Thread] raramente são manipulados diretamente. Preferem-se, em vez disso, os executores ([ExecutorService]), os streams paralelos para cálculos e as threads virtuais para processos de espera. O capítulo seguinte apresenta a programação assíncrona com a classe [CompletableFuture], que permite encadear processamentos à conclusão de uma operação demorada (acesso à rede, banco de dados, arquivo) sem bloquear uma thread. Mesmo assim, os conceitos abordados neste capítulo continuam essenciais: todas essas tarefas são executadas em threads, e os dados que elas compartilham devem ser protegidos com as mesmas ferramentas ([synchronized], locks, classes atômicas, coleções concorrentes).