4. JPA 简要介绍
我们将通过几个示例来介绍 JPA(Java 持久化 API)。JPA 在以下课程中进行了讲解:
- 《Java 5 持久化实践:[http://tahe.developpez.com/java/jpa]》——该课程提供了使用 JPA 构建数据访问层的工具
4.1. JPA在分层架构中的定位
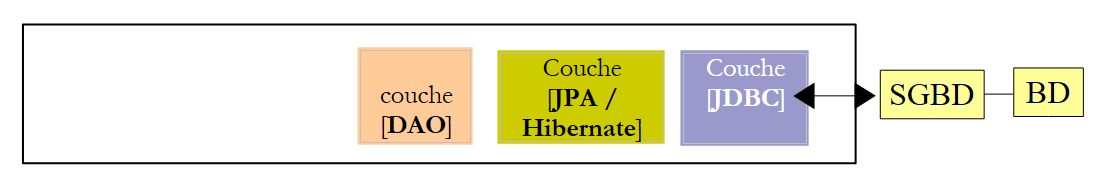
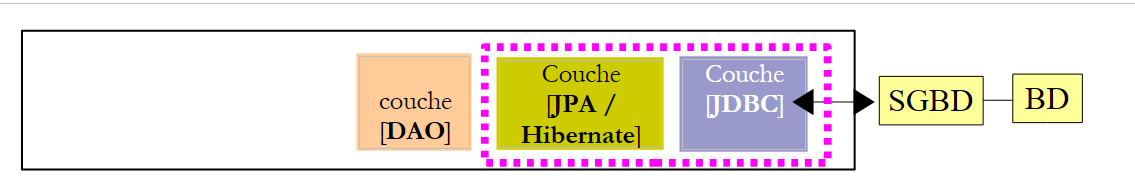
建议读者重读本文开头(第 2 段),其中阐述了 JPA 层在分层架构中的作用。JPA 层位于数据访问层之中:
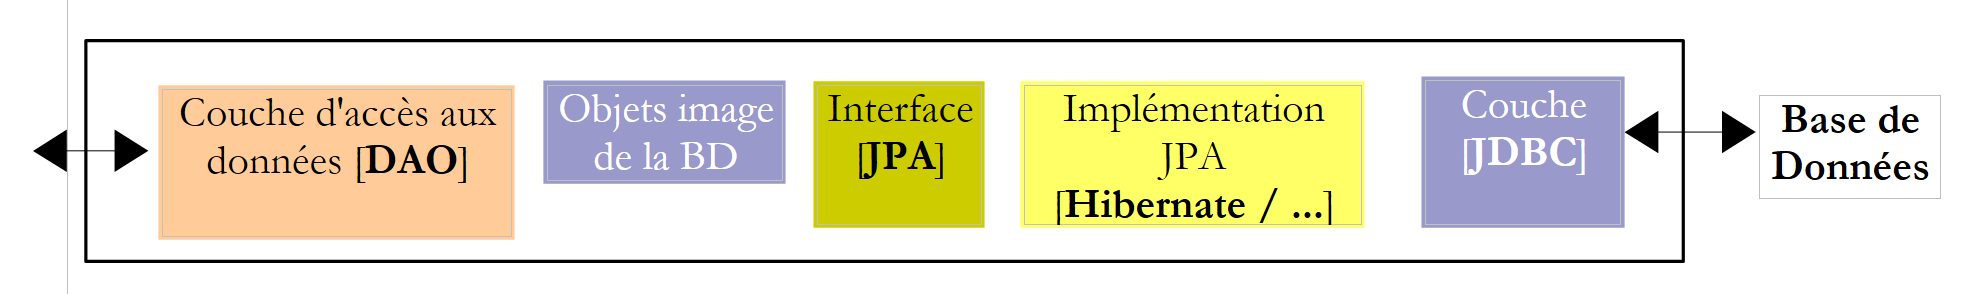 |
[DAO]层与JPA规范进行交互。 无论由何种产品实现该规范,JPA 层向 [DAO] 层展示的接口均保持一致。 接下来,我们将介绍一些来自 [ref1] 的示例,这些示例将帮助我们构建自己的 JPA 层。
4.2. JPA - 示例
4.2.1. 示例 1 - 单张表的对象表示
4.2.1.1. 表 [personne]
假设有一个数据库,其中包含一个名为 [personne] 的表,其作用是存储一些关于个人的信息:
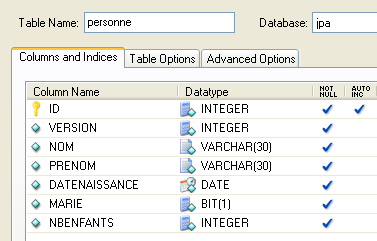 |
表的主键 | |
表中该行的版本号。每当该人的信息发生修改时,其版本号就会递增。 | |
人员姓名 | |
其名字 | |
出生日期 | |
整数 0(未婚)或 1(已婚) | |
该人的子女数 |
4.2.1.2. 实体 [Personne]
我们处于以下运行环境中:
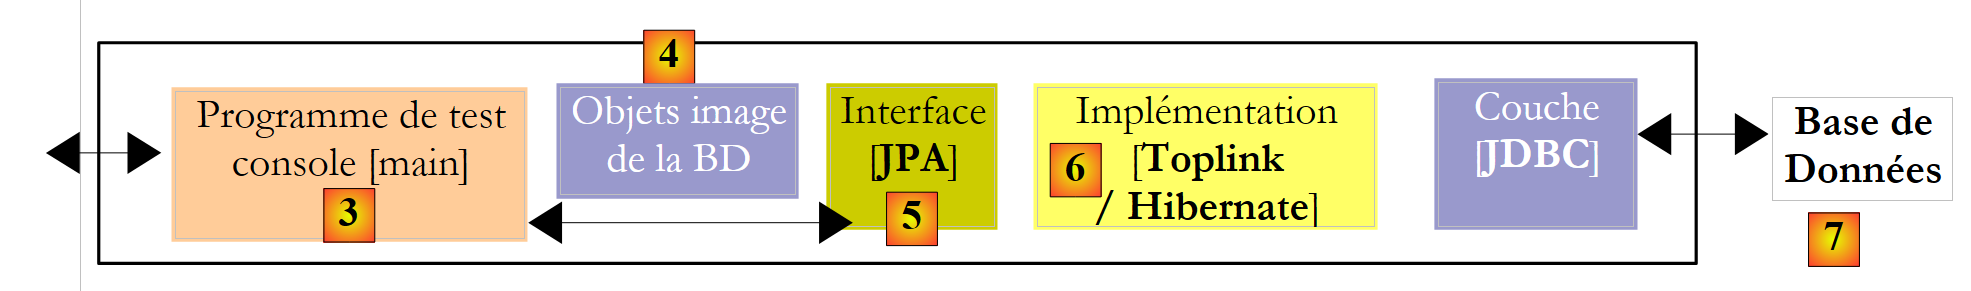 |
JPA [5] 层必须在 [7] 数据库的关系世界与由 Java 程序 [4] 操作的对象世界之间建立桥梁369ZQX所处理的对象世界之间建立桥梁。这种连接是通过配置实现的,主要有两种方式:
- 使用 XML 文件。在 JDK 1.5 版本推出之前,这几乎是唯一的方法
- 自 JDK 1.5 起,通过 Java 注解
本文将仅使用第二种方法。
前文所述的 [personne] 表的 [Personne] 映像对象可能如下所示:
...

@SuppressWarnings("unused")
@Entity
@Table(name="Personne")
public class Personne implements Serializable{

    @Id
    @Column(name = "ID", nullable = false)
    @GeneratedValue(strategy = GenerationType.AUTO)
    private Integer id;

    @Column(name = "VERSION", nullable = false)
    @Version
    private int version;

    @Column(name = "NOM", length = 30, nullable = false, unique = true)
    private String nom;

    @Column(name = "PRENOM", length = 30, nullable = false)
    private String prenom;

    @Column(name = "DATENAISSANCE", nullable = false)
    @Temporal(TemporalType.DATE)
    private Date datenaissance;

    @Column(name = "MARIE", nullable = false)
    private boolean marie;

    @Column(name = "NBENFANTS", nullable = false)
    private int nbenfants;

    // 制造商
    public Personne() {
    }

    public Personne(String nom, String prenom, Date datenaissance, boolean marie,
            int nbenfants) {
        setNom(nom);
        setPrenom(prenom);
        setDatenaissance(datenaissance);
        setMarie(marie);
        setNbenfants(nbenfants);
    }

    // toString
    public String toString() {
...
    }

    // 获取器和设置器
...
}
配置通过 Java @Annotation 注解实现。 Java注解可在编译时由编译器处理,也可在运行时由专用工具处理。除第3行面向编译器的注解外,此处所有注解均面向所使用的JPA实现(即Hibernate或Toplink)。因此,这些注解将在运行时被利用。 若缺乏能够解析这些注解的工具,这些注解将被忽略。因此,上文中的 [Personne] 类可在非 JPA 环境中被调用。
在关联表 T 的 C 类中使用 JPA 注解时,需区分以下两种情况:
- 表 T 已存在:此时 JPA 注释必须复现现有内容(列名与定义、完整性约束、外键、主键等)
- 表 T 不存在,并将根据类 C 中找到的注解进行创建。
情况 2 最容易处理。借助 JPA 注解,我们可以指定所需的表 T 结构。情况 1 通常更为复杂。表 T 可能是在很久以前、脱离任何 JPA 上下文的情况下构建的。 因此,其结构可能与JPA的关系型/面向对象桥梁不匹配。为简化起见,我们假设处于情况2,即与类C关联的表T将根据类C的注解JPA创建。
下面对类 [Personne] 的注解进行说明:
- 第 4 行:@Entity 注解是第一个必不可少的注解。它位于声明类的行之前,表明该类应由持久层 JPA 管理。如果没有此注解,所有其他注解 JPA 都将被忽略。
- 第5行:@Table注解用于指定该类所表示的数据库表。其主要参数是name,用于指定表名。如果省略该参数,表将采用类名,即[Personne]。因此,在本例中,@Table注解是多余的。
- 第 8 行:@Id 注解用于指定类中作为表主键映射的字段。该注解是必填的。此处表明第 11 行中的 id 字段是表主键的映射。
- 第 9 行:@Column 注解用于建立类中字段与该字段所映射的表列之间的关联。name 属性指定表中列的名称。若未指定该属性,则列名与字段名相同。因此,在本例中,name 参数并非必需。 nullable=false 参数表示与该字段关联的列不能为空(即不能取值为 NULL),因此该字段必须有值。
- 第 10 行:注释 @GeneratedValue 说明了当主键由 SGBD 自动生成时,其生成方式。在所有示例中均采用此方式。 这并非强制要求。因此,我们的“person”实体可能拥有一个用作主键的学生编号,该编号并非由 SGBD 生成,而是由应用程序设定。在这种情况下,注解 @GeneratedValue 将不存在。 strategy参数指定了当主键由SGBD生成时,其生成方式。并非所有SGBD都采用相同的主键值生成技术。例如:
在每次插入前都会调用一个值生成器 | |
主键字段被定义为类型 Identity。其效果与 Firebird 的值生成器类似,只是主键值需在行插入完成后才确定。 | |
使用名为 SEQUENCE 的对象,该对象同样充当值生成器 |
JPA层必须根据不同的SGBD生成不同的SQL命令,以创建值生成器。 通过配置,向其指定了需要管理的 SGBD 类型。因此,它能够识别该 SGBD 的主键值生成常规策略。 参数 strategy = GenerationType.AUTO 指示 JPA 层必须使用该常规策略。在本文档的所有示例中,该技术对所使用的七个 SGBD 均有效。
- 第 14 行:@Version 注解指定了用于管理对表中同一行并发访问的字段。
为理解[personne]表中同一行数据并发访问的问题,假设某个Web应用程序允许更新某人的信息,并分析以下情况:
在时间点 T1,用户 U1 进入某人 P 的修改界面。此时,子女数量为 0。 他将该数字改为1,但在提交修改之前,用户U2进入同一人员P的编辑界面。由于U1尚未提交修改, U2 在屏幕上看到子女数为 0。U2 将人员 P 的姓名改为大写。随后,U1 和 U2 按此顺序提交了修改。 最终生效的是 U2 的修改:在数据库中,姓名将变为大写,而子女数量仍保持为零,尽管 U1 认为自己已将其改为 1。
“人员版本”的概念有助于解决此问题。我们继续使用相同的用例:
在时间点 T1,用户 U1 进入对人员 P 的修改界面。此时,子女数量为 0,版本号为 V1。 他将子女数改为1,但在提交修改前,用户U2进入同一人员P的编辑界面。由于U1尚未提交修改, U2 看到的子女数为 0,版本号为 V1。U2 将人员 P 的姓名改为大写。 随后,U1 和 U2 按此顺序提交了修改。在提交修改前,系统会验证修改人员 U1 是否持有与当前已记录人员 P 相同的版本。该用户确实持有相同版本。 因此其修改被接受,随后将该人员的版本号从 V1 更改为 V2,以标记该人员已发生变更。在验证 U2 的修改时, 将发现 U2 持有人员 P 的版本 V1,而当前该人员的版本为 V2。 此时,我们可以告知用户U2,有人在他之前进行了操作,他必须基于人员P的新版本重新开始。他将照做,获取版本为V2的人员P(该人员现在已有一个孩子),将姓名改为大写,并提交。 如果已保存的P仍处于版本V2,则其修改将被接受。最终,U1和U2所做的修改都将被保留,而在没有版本控制的用例中,其中一项修改会丢失。
客户端应用程序的 [DAO] 层可以自行管理 [Personne] 类的版本。每当对象 P 发生修改时,该对象在表中的版本号将递增 1。 通过 @Version 注解,可以将此管理职责转移至 JPA 层。相关字段完全不必像示例中那样命名为 version,可以是任意名称。
与注解 @Id 和 @Version 对应的字段是因持久化需求而存在的。如果类 [Personne] 无需持久化,则无需这些字段。由此可见,根据对象是否需要持久化,其表示形式会有所不同。
- 第 17 行:再次使用 @Column 注解,用于提供与类 Personne 的字段 nom 关联的表 [personne] 的列信息。此处出现了两个新参数:
- unique=true 表示人员姓名必须唯一。这将在数据库中体现为:在表 [personne] 的 NOM 列上添加唯一性约束。
- length=30 将列 NOM 的字符数设置为 30。这意味着该列的类型将为 VARCHAR(30)。
- 第 24 行:注解 @Temporal 用于指定日期/时间类型的列/字段应采用哪种 SQL 类型。类型 TemporalType.DATE 表示仅包含日期且不包含时间。 其他可能的类型包括用于编码时间的 TemporalType.TIME,以及用于编码带时间日期的 TemporalType.TIMESTAMP。
现在我们来分析 [Personne] 类的其余代码:
- 第 6 行:该类实现了 Serializable 接口。对象的 sérialisation 操作是指将其转换为一串二进制位。désérialisation 则是该操作的逆向操作。 序列化/反序列化主要应用于客户端/服务器应用程序,其中对象通过网络进行交换。 客户端或服务器端应用程序无需了解此操作,该操作由 JVM 透明地完成。但要实现这一功能,交换对象的类必须使用关键字 Serializable 进行“标记”。
- 第 37 行:该类的构造函数。请注意,id 和 version 字段不属于参数。实际上,这两个字段由 JPA 层管理,而非由应用程序管理。
- 第 51 行及之后:类中各个字段的 get 和 set 方法。需要注意的是,JPA 注解可以放置在字段的 get 方法上,而不是直接放置在字段本身。 注解的位置决定了 JPA 访问字段时应采用的模式:
- 如果注解位于字段级别,JPA 将直接访问字段进行读写
- 如果注解位于 get 方法级别,JPA 将通过 get/set 方法访问字段以进行读写
正是 @Id 注解的位置决定了类中 JPA 注解的位置。 若置于字段级别,则表示直接访问字段;若置于类级别,则表示通过 set 和 get 方法访问字段。其他注解应与 @Id 注解采用相同的放置方式。
4.2.2. JPA层的配置
JPA 层的测试可采用以下架构:
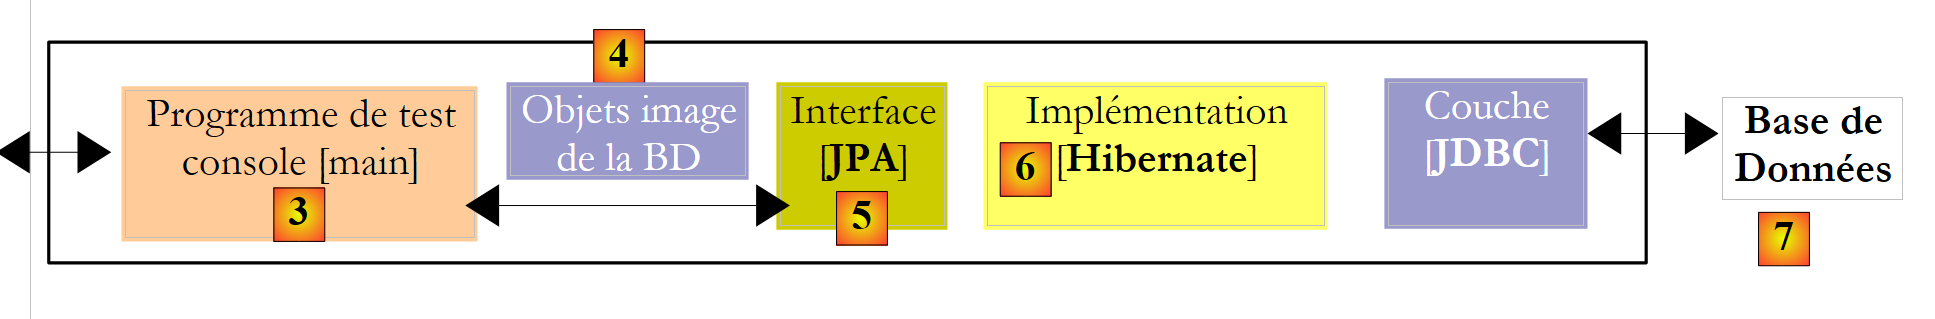 |
- 在 [7] 中:该数据库将基于实体 [Personne] 的注解以及在名为 [persistence.xml] 的文件中进行的补充配置生成
- [5, 6]:由Hibernate实现的JPA层
- 生成 [4]:实体 [Personne]
- [3]:一个控制台类型的测试程序
JPA 层的配置由文件 [META-INF/persistence.xml] 负责:
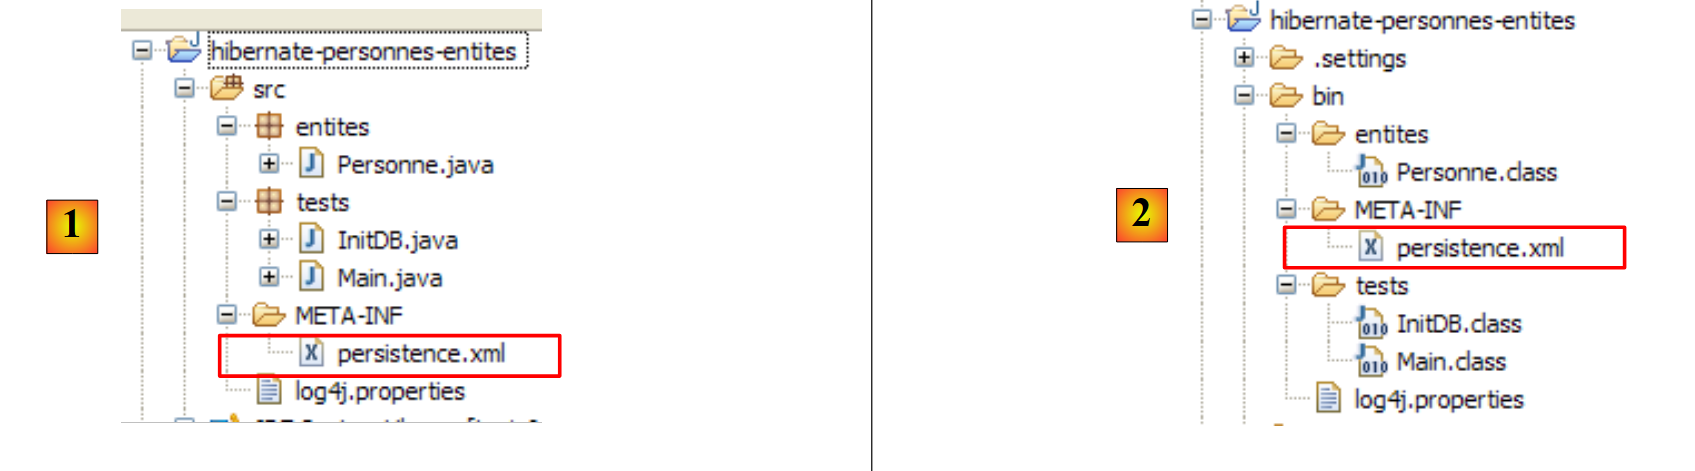 |
运行时,系统会在应用程序的 Classpath 中查找 [META-INF/persistence.xml] 文件。
让我们查看项目中 [persistence.xml] 文件中配置的 JPA 层:
<?xml version="1.0" encoding="UTF-8"?>
<persistence version="1.0" xmlns="http://java.sun.com/xml/ns/persistence">
    <persistence-unit name="jpa" transaction-type="RESOURCE_LOCAL">
        <!--  提供者 -->
        <provider>org.hibernate.ejb.HibernatePersistence</provider>
        <properties>
            <!-- 持久化类 -->
            <property name="hibernate.archive.autodetection" value="class, hbm" />
            <!-- 日志SQL
                <property name="hibernate.show_sql" value="true"/>
                <property name="hibernate.format_sql" value="true"/>
                <property name="use_sql_comments" value="true"/>
            -->
            <!-- 连接JDBC -->
            <property name="hibernate.connection.driver_class" value="com.mysql.jdbc.Driver" />
            <property name="hibernate.connection.url" value="jdbc:mysql://localhost:3306/jpa" />
            <property name="hibernate.connection.username" value="jpa" />
            <property name="hibernate.connection.password" value="jpa" />
            <!--  自动创建模式 -->
            <property name="hibernate.hbm2ddl.auto" value="create" />
            <!-- 方言 -->
            <property name="hibernate.dialect" value="org.hibernate.dialect.MySQL5InnoDBDialect" />
            <!-- 属性 DataSource c3p0 -->
            <property name="hibernate.c3p0.min_size" value="5" />
            <property name="hibernate.c3p0.max_size" value="20" />
            <property name="hibernate.c3p0.timeout" value="300" />
            <property name="hibernate.c3p0.max_statements" value="50" />
            <property name="hibernate.c3p0.idle_test_period" value="3000" />
        </properties>
    </persistence-unit>
</persistence>
要理解这一配置,我们需要回顾应用程序的数据访问架构:
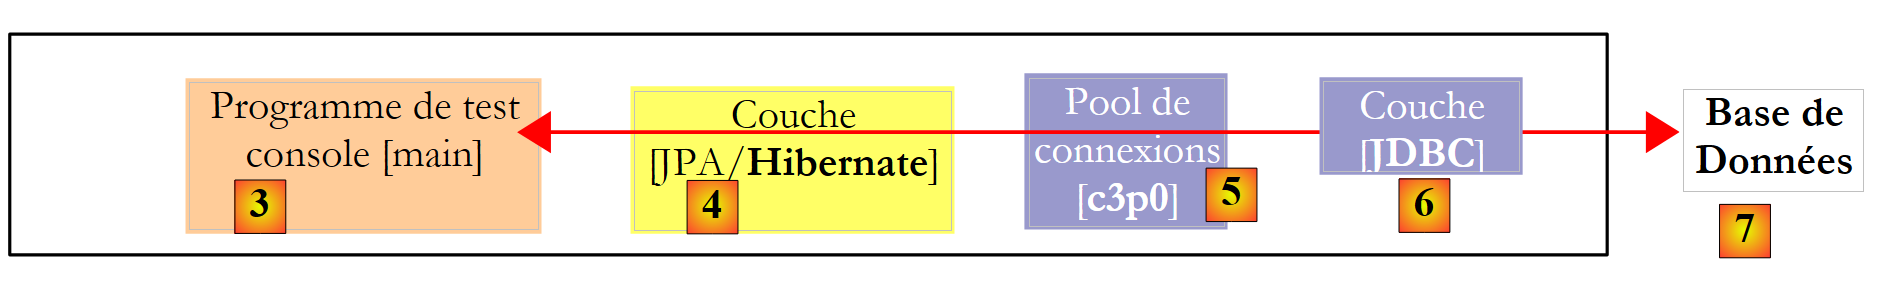 |
- 文件 [persistence.xml] 将配置以下层:[4, 5, 6]
- [4]:JPA的Hibernate实现
- [5]:Hibernate 通过连接池访问数据库。连接池是一组已与 SGBD 建立连接的连接。 一个 SGBD 实例可能被多个用户访问,但出于性能考虑,其同时打开的连接数不能超过上限 N。 编写良好的代码会在最短时间内与 SGBD 建立连接:它发送 SQL 命令,然后关闭连接。每当需要操作数据库时,它都会重复这一过程。 建立和关闭连接的开销不容忽视,而连接池的作用正体现在此。在应用程序启动时,连接池会与 SGBD 建立 N1 个连接。 当应用程序需要连接时,将向该池请求一个已建立的连接。一旦应用程序不再需要该连接,便会将其归还给连接池,且应尽可能快地归还。该连接不会被关闭,而是保持可用状态,供下一位用户使用。因此,连接池是一种已建立连接的共享系统。
- [6]:SGBD所使用的驱动程序JDBC
现在让我们看看文件 [persistence.xml] 是如何配置上述 [4, 5, 6] 层的:
- 第 2 行:文件 XML 的根标签是 <persistence>。
- 第 3 行:<persistence-unit> 用于定义持久化单元。可以存在多个持久化单元。每个单元都有一个名称(name 属性)和一个事务类型(transaction-type 属性)。应用程序将通过其名称(此处为 jpa)访问该持久化单元。 事务类型 RESOURCE_LOCAL 表示应用程序将自行管理与 SGBD 相关的事务。本例中即采用此方式。当应用程序在 EJB3 容器中运行时,可使用该容器的事务服务。 在此情况下,应设置 transaction-type=JTA(Java事务 API)。当 transaction-type 属性缺失时,默认值为 JTA。
- 第5行:<provider>标签用于定义一个实现[javax.persistence.spi.PersistenceProvider]接口的类,该接口允许应用程序初始化持久层。 由于我们使用的是 JPA / Hibernate 实现,因此此处使用的类是 Hibernate 类。
- 第 6 行:<properties> 标签引入了针对所选特定 provider 的专属属性。因此,根据所选的 Hibernate、Toplink、Kodo 等,属性会有所不同。以下属性专属于 Hibernate。
- 第 8 行:要求 Hibernate 扫描项目中的 classpath,查找带有 @Entity 注解的类以便进行管理。 @Entity类也可以通过<class>nom_de_la_classe</class>标签进行声明,该标签直接位于<persistence-unit>标签之下。这就是我们在provider / Toplink中将要采用的做法。
- 第 10-12 行(此处已注释)用于配置 Hibernate 的控制台日志:
- 第 10 行:用于控制是否显示 Hibernate 在 SGBD 上发出的 SQL 命令。这在学习阶段非常有用。 由于关系型/对象型的桥梁作用,应用程序在持久化对象上运行,并对这些对象执行 [persist, merge, remove] 类型的操作。了解这些操作实际生成的 SQL 命令非常有意义。 通过研究这些命令,我们逐渐能够推测出当对持久化对象执行特定操作时,Hibernate将生成的SQL命令,从而在脑海中逐渐形成对关系/对象桥接机制的清晰认知。
- 第 11 行:控制台上显示的 SQL 命令可以进行美观的格式化,以便于阅读
- 第 12 行:显示的 SQL 命令还将添加注释
- 第15-19行定义了JDBC层(在架构中为[6]层):
- 第 15 行:SGBD 的驱动程序类 JDBC,此处为 MySQL5
- 第 16 行:所用数据库的 URL
- 第 17、18 行:连接用户及其密码
- 第22行:Hibernate需要知道它面前的SGBD。事实上,所有SGBD都带有专有的SQL扩展名,这是一种管理主键值自动生成的独特方式, ……这导致 Hibernate 必须知道当前正在处理的 SGBD,以便向其发送该对象能够理解的 SQL 指令。 [MySQL5InnoDBDialect] 指代 SGBD MySQL5,其包含支持事务的 InnoDB 类型表。
- 第 24-28 行配置连接池 c3p0(架构中的 [5] 层):
- 第24、25行:连接池中的最小(默认3)和最大连接数(默认15)。默认初始连接数为3。
- 第26行:等待客户端连接请求的最大时长(以毫秒为单位)。超过此时间,c3p0将向客户端抛出异常。
- 第27行:为了访问BD,Hibernate使用预编译的SQL命令(PreparedStatement),c3p0可以将其缓存。 这意味着,如果应用程序再次请求一个已缓存的预编译 SQL 语句,则无需重新预编译(预编译一个 SQL 语句是有成本的),而是直接使用缓存中的语句。 此处指定了缓存中可容纳的已准备 SQL 命令的最大数量,涵盖所有连接(一个已准备的 SQL 命令属于一个连接)。
- 第28行:以毫秒为单位,检查连接有效性的频率。连接池中的连接可能因各种原因失效(例如驱动程序JDBC因连接超时而使其失效,或驱动程序JDBC存在“错误”等)。
- 第20行:此处要求在持久化单元初始化时,生成@Entity对象的数据库映射。Hibernate现已具备所有工具,可发出生成数据库表的命令:
- @Entity 对象的配置使其能够确定需要生成的表
- 第 15-18 行和第 24-28 行使其能够建立与 SGBD 的连接
- 第 22 行使其能够确定生成表时应使用的 SQL 方言
因此,此处使用的 [persistence.xml] 文件会在每次应用程序重新运行时重建一个全新的数据库。如果表已存在,则先将其删除(drop table),然后重新创建(create table)。需要注意的是,这显然不适用于生产环境中的数据库……
4.2.3. 示例 2:一对多关系
4.2.3.1. 数据库模式
1 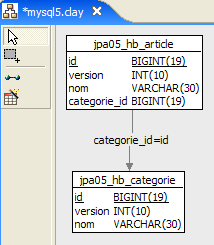 | 2 |
- 在 [1] 数据库中,以及在 [2] 中,其 DDL (MySQL5)
一个商品 A(id, version, name) 仅属于一个类别 C(id, version, name)。一个类别 C 可以包含 0、1 或多个商品。这里存在一对多关系(类别 -> 商品)及其逆向的多对一关系(商品 -> 类别)。 该关系通过表 [article] 对表 [categorie] 的外键实现(参见 DDL 的第 24-28 行)。
4.2.3.2. 代表数据库的 @Entity 对象
一个商品由以下 @Entity [Article] 表示:
package entites;

...
@Entity
@Table(name="jpa05_hb_article")
public class Article implements Serializable {

    // 字段
    @Id
    @GeneratedValue(strategy = GenerationType.AUTO)
    private Long id;

    @SuppressWarnings("unused")
    @Version
    private int version;

    @Column(length = 30)
    private String nom;

    // 主关系 产品 (多) -> 类别 (一)
    // 通过 Article 中的外键 (categorie_id) 实现
    // 1 个商品必须有 1 个分类(可为空=false)
    @ManyToOne(fetch=FetchType.LAZY)
    @JoinColumn(name = "categorie_id", nullable = false)
    private Categorie categorie;

    // 构造函数
    public Article() {
    }

    // 获取器和设置器
    ...
    // toString
    public String toString() {
        return String.format("Article[%d,%d,%s,%d]", id, version, nom, categorie.getId());
    }

}
- 第 9-11 行:@Entity 的主键
- 第13-15行:其版本号
- 第 17-18 行:文章名称
- 第20-25行:将@Entity Article与@Entity Categorie关联的多对一关系:
- 第 23 行:注解 ManyToOne。 “Many”指当前所在的@Entity Article,“One”指@Entity Categorie(第25行)。一个类别(One)可以包含多个商品(Many)。
- 第 24 行:注解 ManyToOne 定义了表 [article] 中的外键列。 该列名为 categorie_id,且每行都必须在此列中包含一个值。
- 第 25 行:商品所属的类别。当商品被放入持久化上下文时,要求其类别不要立即被放入(fetch=FetchType.LAZY,第 23 行)。尚不清楚此要求是否有意义。我们拭目以待。
一个类别由以下 @Entity [Categorie] 表示:
package entites;
...
@Entity
@Table(name="jpa05_hb_categorie")
public class Categorie implements Serializable {

    // 字段
    @Id
    @GeneratedValue(strategy = GenerationType.AUTO)
    private Long id;

    @SuppressWarnings("unused")
    @Version
    private int version;

    @Column(length = 30)
    private String nom;

    // 关系“文章(多)→ 分类(一)”的反向关系“分类(一)→ 文章(多)”
    // 级联插入:分类 -> 插入文章
    // 级联更新 分类 -> 更新文章
    // 类别 -> 文章的删除级联
    @OneToMany(mappedBy = "categorie", cascade = { CascadeType.ALL })
    private Set<Article> articles = new HashSet<Article>();

    // 构造函数
    public Categorie() {
    }

    // 获取器和设置器
...
    // toString
    public String toString() {
        return String.format("Categorie[%d,%d,%s]", id, version, nom);
    }

    // 类别 <--> 文章的双向关联
    public void addArticle(Article article) {
        // 将商品添加到该类别的商品集合中
        articles.add(article);
        // 文章更改分类
        article.setCategorie(this);
    }
}
- 第 8-11 行:@Entity 的主键
- 第12-14行:其版本号
- 第16-17行:类别名称
- 第 19-24 行:该类别的文章集合(set)
- 第 23 行:注解 @OneToMany 表示一对多关系。 “One”指代当前所在的@Entity [Categorie],“Many”指代第24行的类型[Article]:一个(One)类别包含多个(Many)文章。
- 第23行:该注解是注解ManyToOne的反向关系(mappedBy),该注解位于@Entity Article的字段categorie上: mappedBy=categorie。位于@Entity Article的categorie字段上的关系ManyToOne是主关系。它是必不可少的。 它实现了将 @Entity Article 与 @Entity Categorie 关联的外键关系。 定义在 @Entity Categorie 的 articles 字段上的 OneToMany 关系是反向关系。该关系并非必需。 这是为了方便获取某类别的文章。如果没有这一便利,这些文章将通过查询 JPQL 来获取。
- 第 23 行:cascadeType.ALL 要求对 @Entity Categorie 执行的操作(persist、merge、remove)应级联到其文章上。
- 第 24 行:某类别的商品将被放入一个 Set<Article> 类型的对象中。Set 类型不接受重复项。因此,不能将同一件商品放入 Set<Article> 对象中两次。什么是“同一件商品”? 为了表示商品 a 与商品 b 相同,Java 使用表达式 a.equals(b)。在所有类的父类 Object 中,如果 a==b,则 a.equals(b) 为真,即 c.a.d。 如果对象 a 和 b 具有相同的内存位置。我们可能希望表示,如果对象 a 和 b 具有相同的名称,则它们是相同的。在这种情况下,开发人员必须在 [Article] 类中重定义两个方法:
- equals:当两个对象名称相同时,该方法应返回true
- hashCode:当两个对象 [Article] 被 equals 方法视为相同时,该方法应返回相同的整数值。在此情况下,该值将根据文章名称生成。 hashCode 返回的值可以是任意整数。该值用于各种对象容器中,特别是哈希表(Hashtable)。
关系 OneToMany 可以使用除 Set 以外的其他类型来存储“多”方,例如 List 对象。本文档中将不讨论这些情况。读者可在 [ref1] 中找到相关内容。
- 第 38 行:方法 [addArticle] 允许我们将一篇文章添加到某个类别中。 该方法会自动更新连接 [Categorie] 与 [Article] 的 OneToMany 关系的两端。
4.3. JPA 层中的 API
让我们详细说明客户端 JPA 的运行环境:
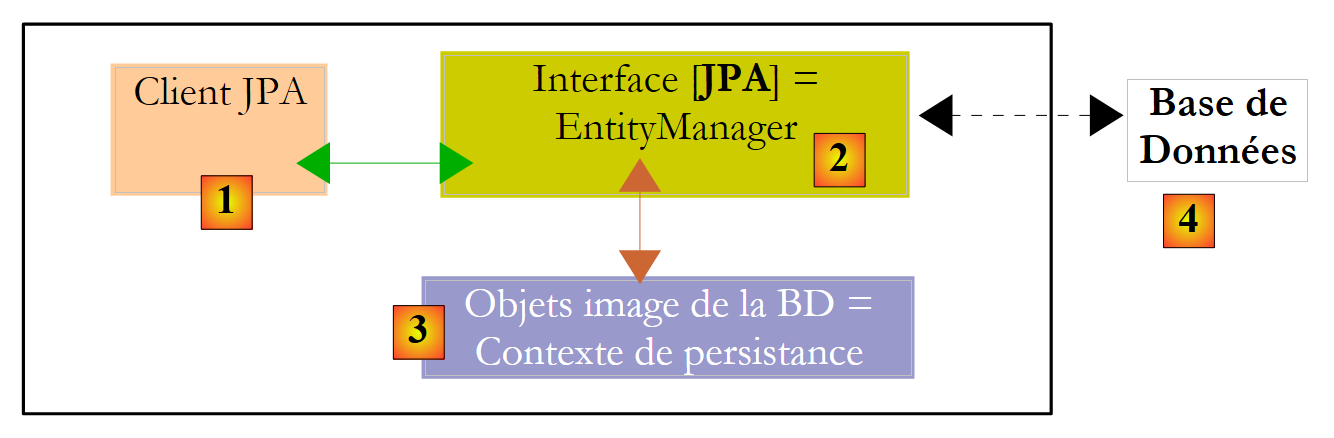 |
我们知道,JPA 层通过 [2] 创建了一个 [3] 对象与 [4] 关系之间的桥梁。 在该对象/关系桥接框架下,由 JPA 层管理的所有对象统称为“持久化上下文”。 要访问持久化上下文中的数据,JPA [1] 客户端必须通过 JPA [2] 层:
- 它可创建一个对象,并请求 JPA 层将其持久化。此时,该对象即成为持久化上下文的一部分。
- 它可向 [JPA] 层请求现有持久化对象的引用。
- 他可以修改从 JPA 层获取的持久化对象。
- 它可以请求 JPA 层从持久化上下文中删除一个对象。
JPA 层向客户端提供了一个名为 [EntityManager] 的接口,顾名思义,该接口用于管理持久化上下文中的 @Entity 对象。下面介绍该接口的主要方法:
将 entity 放入持久化上下文 | |
将 entity 从持久化上下文中移除 | |
将持久化上下文未管理的客户端对象 entity 与持久化上下文中具有相同主键的对象 entity 合并。 生成的结果是持久化上下文中的对象 entity。 | |
将通过主键在数据库中检索到的对象 。该对象的类型 T 使 JPA 层 确定应查询哪个表。由此创建的持久化对象将返回给客户端。 | |
根据 JPQL 查询(Java Persistence 查询语言)。如果 ,只是它查询的是对象而非表。 | |
与前一个方法类似,只是 queryText 是 SQL 而非 JPQL。 | |
与 createQuery 相同的方法,只是 JPQL queryText 命令 已外包至配置文件并关联了一个名称。 该名称即为该方法的参数。 |
一个 EntityManager 对象的生命周期未必与应用程序的生命周期一致。它有开始和结束。因此,一个 JPA 客户端可以依次与不同的 EntityManager 对象进行交互。 与 EntityManager 关联的持久化上下文与其具有相同的生命周期。二者密不可分。当 EntityManager 对象关闭时,其持久化上下文会在必要时与数据库同步,随后便不复存在。 若要重新获得持久化上下文,必须创建一个新的 EntityManager。
客户端 JPA 可以通过以下语句创建一个 EntityManager,从而建立一个持久化上下文:
EntityManagerFactory emf = Persistence.createEntityManagerFactory("nom d'une unité de persistance");
- javax.persistence.Persistence 是一个静态类,用于获取 EntityManager 对象的工厂。该工厂与特定的持久化单元相关联。 需要提醒的是,配置文件 [META-INF/persistence.xml] 用于定义持久化单元,且这些单元都有一个名称:
<persistence-unit name="elections-dao-jpa-mysql-01PU" transaction-type="RESOURCE_LOCAL">
上文中的持久化单元名为 elections-dao-jpa-mysql-01PU。该单元附带其专属的完整配置,特别是与其协同工作的 SGBD。 指令 [Persistence.createEntityManagerFactory("elections-dao-jpa-mysql-01PU")] 创建了一个 EntityManagerFactory 类型的对象工厂,该工厂能够提供 EntityManager 对象,用于管理与名为 elections-dao-jpa-mysql-01PU 的持久化上下文。获取 EntityManager 对象(即持久化上下文)需通过 EntityManagerFactory 对象,具体操作如下:
[EntityManager] 接口中的以下方法可用于管理持久化上下文的生命周期:
关闭持久化上下文。强制持久化上下文与数据库同步:
| |
持久化上下文中的所有对象已被清空,但尚未关闭。 | |
持久化上下文将按照 close() 中描述的方式与数据库同步 |
客户端 JPA 可通过方法 [EntityManager] 强制将持久化上下文与数据库进行同步(如前文 flush 所述)。 同步可以是显式的,也可以是隐式的。在第一种情况下,由客户端在需要同步时执行 flush 操作;否则,同步将在我们后续说明的特定时刻自动进行。同步模式由 [EntityManager] 接口的以下方法管理:
flushmode 有两种可能的值: FlushModeType.AUTO(默认):在 SELECT: FlushModeType.COMMIT:仅在 数据库事务结束时才进行。 | |
返回当前的同步模式 |
总结一下。在默认模式 FlushModeType.AUTO 下,持久化上下文将在以下时刻与数据库同步:
- 每次数据库操作之前
- 数据库事务结束时
- 在持久化上下文中执行 flush 或 close 操作之后
在 FlushModeType.COMMIT 模式下,情况相同,但操作 1 不会发生。与 JPA 层交互的标准模式是事务模式。 客户端在事务内部对持久化上下文执行各种操作。在此情况下,持久化上下文与数据库的同步时机在 AUTO 模式下对应上述情况 1 和 2,而在 COMMIT 模式下仅对应情况 2。
最后介绍查询接口(Query)中的API,该接口可用于向持久化上下文发出JPQL命令,或直接向数据库发出SQL命令以检索数据。 Query 接口如下:
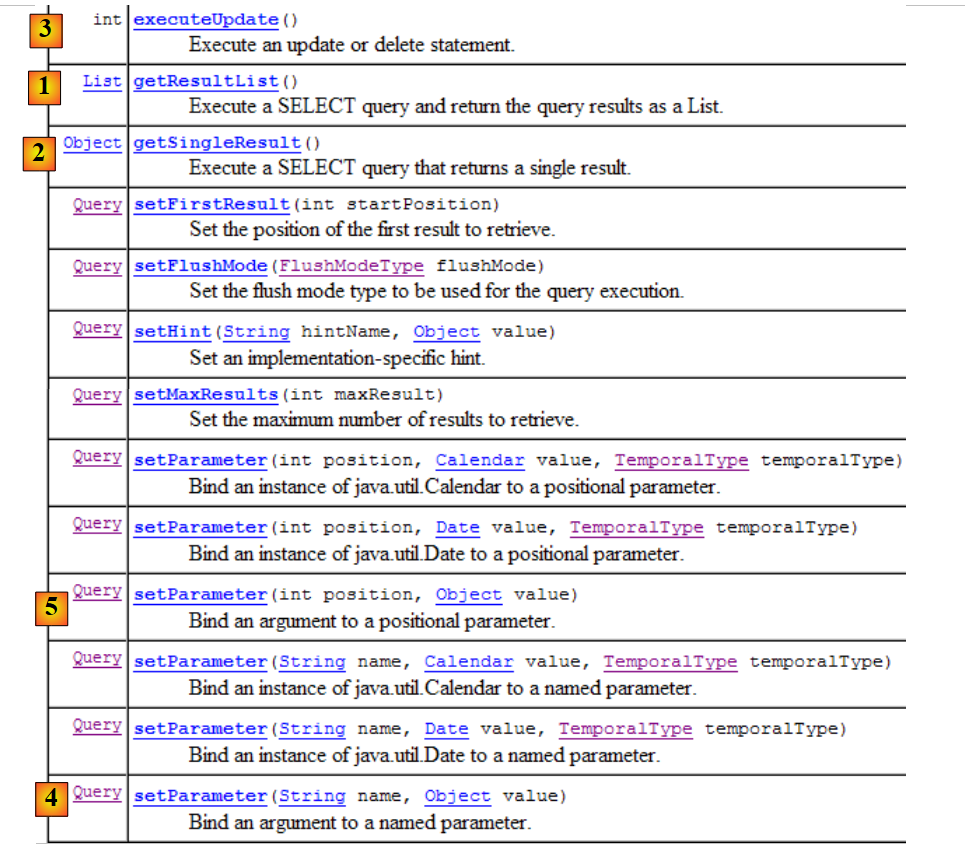 |
- 1 - 方法 getResultList 执行一个 SELECT,该方法返回多个对象。这些对象将存储在一个 List 对象中。 该对象是一个接口。该接口提供了一个 Iterator 对象,可用于以以下形式遍历列表 L 中的元素:
        Iterator iterator = L.iterator();
        while (iterator.hasNext()) {
             // 调用表示列表中当前元素的对象 iterator.next()
...
}
列表 L 也可通过 for 进行操作:
        for (Object o : L) {
             // 调用对象 o
}
- 2 - 方法 getSingleResult 执行命令 JPQL / SQL / SELECT,该命令返回一个单一对象。
- 3 - 方法 executeUpdate 执行 SQL 命令(更新或删除),并返回该操作所涉及的行数。
- 4 - 方法 setParameter(String, Object) 用于为已配置的 JPQL 命令中的命名参数赋值
- 5 - 方法 setParameter(int, Object) 中的参数并非通过名称指定,而是通过其在 JPQL 命令中的位置来指定。
4.4. 查询 JPQL
JPQL(Java持久化查询语言)是JPA层的查询语言。JPQL语言与数据库的SQL语言相关。 SQL 处理的是表,而 JPQL 处理的是这些表中的图像对象。我们将通过以下架构中的一个示例进行探讨:
 |
我们将该数据库命名为 [dbrdvmedecins2] ,它是一个包含四个表的 MySQL5 数据库:
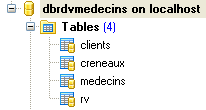 |
该数据库汇集了用于管理某医生团队预约的信息。
4.4.1. 表 [MEDECINS]
该表包含关于医生的信息。
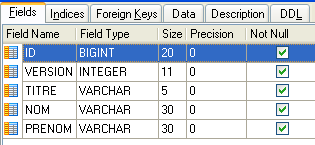 | 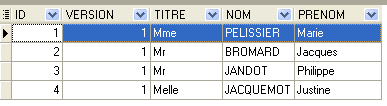 |
- ID:医生标识号——该表的主键
- VERSION:表中该行的版本标识号。每次对该行进行修改时,该数字都会增加 1。
- NOM:医生姓名
- PRENOM:其名字
- TITRE:其称谓(小姐、女士、先生)
4.4.2. 表 [CLIENTS]
各医生的患者信息存储在表 [CLIENTS] 中:
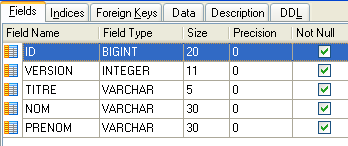 | 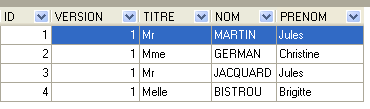 |
- ID:客户标识号——该表的主键
- VERSION:标识表中该行版本的编号。每次对该行进行修改时,该数字会递增1。
- NOM:客户姓名
- PRENOM:客户名字
- TITRE:其称谓(小姐、女士、先生)
4.4.3. 表 [CRENEAUX]
该表列出了可进行 RV 操作的时间段:
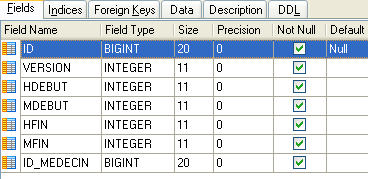 |
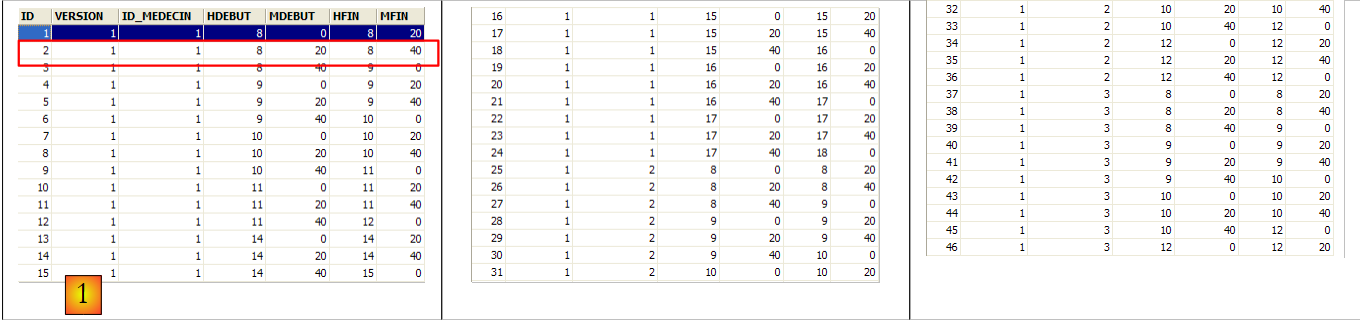 |
- ID:时间段标识号——该表的主键(第8行)
- VERSION:表中该行的版本标识号。每次对该行进行修改时,该数字会递增1。
- ID_MEDECIN:标识该时段所属医生的编号——MEDECINS(ID)列的外键。
- HDEBUT:时段开始时间
- MDEBUT:时段开始分钟
- HFIN:时段结束时间
- MFIN:时段结束分钟
例如,表 [CRENEAUX](参见上文 [1])的第二行显示,第 2 号时段于 8 点 20 分开始,8 点 40 分结束,并归属于第 1 号医生 (玛丽女士 PELISSIER)。
4.4.4. 表 [RV]
该表列出了每位医生所分配的 RV:
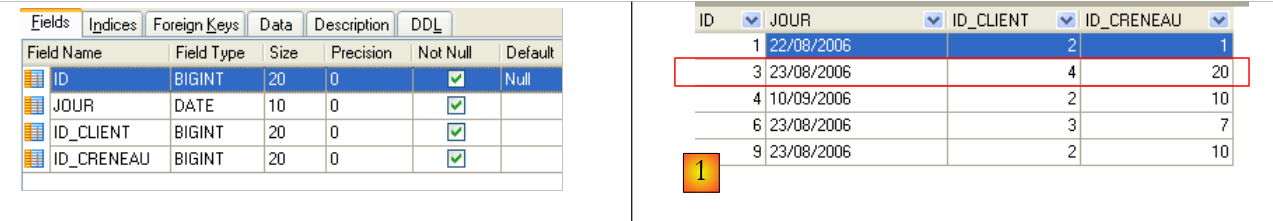 |
- ID:唯一标识RV的编号——主键
- JOUR:RV的日期
- ID_CRENEAU:RV的时间段——作为外键关联至[ID]字段(该字段位于[CRENEAUX]表中)——同时确定了时间段和相关医生。
- ID_CLIENT:预订对象的客户编号——作为表[CLIENTS]中字段[ID]的外键
该表的 对关联列(JOUR、ID_CRENEAU)的值施加了唯一性约束:
如果表[RV]中某行具有值 (JOUR1, ID_CRENEAU1) 作为列 (JOUR, ID_CRENEAU) 的值,则该值在其他任何地方都不能出现。 否则,这意味着同一时间针对同一位医生生成了两个 RV。从 Java 编程的角度来看,当这种情况发生时,数据库中的 JDBC 驱动程序会触发一个 SQLException。
id 行值为 3(参见上文的 [1]),表示在 2006 年 8 月 23 日,第 20 个时段和第 4 号客户被分配了一个 RV。 [CRENEAUX]表显示,第20号时段对应16:20-16:40的时间段,由第1号医生(Marie女士,PELISSIER)负责。 表[CLIENTS]显示,第4号客户是布里吉特·BISTROU女士。
4.4.5. 数据库生成
要创建并填充这些表,可以使用脚本 [dbrdvmedecins2.sql]。使用 [WampServer] 时,操作步骤如下:
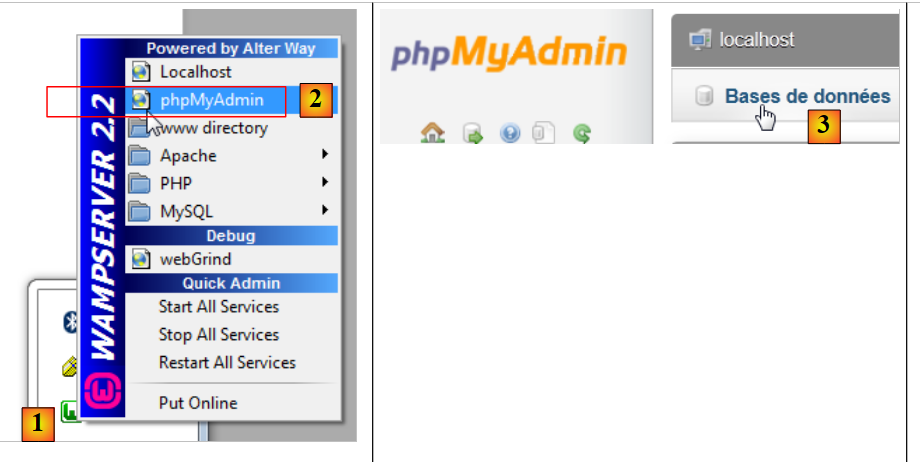 |
- 在 [1] 中,点击 [WampServer] 图标,然后选择 [PhpMyAdmin] [2] 选项,
- 在 [3] 中,在弹出的窗口中,选择链接 [Bases de données],
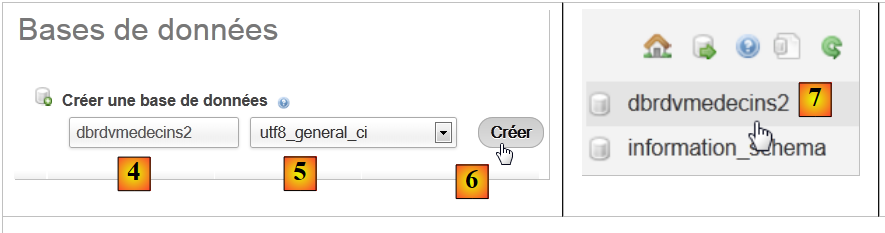 |
- 转为 [2],创建一个数据库,将其命名为 [4],编码设为 [5],
- 在 [7] 中,数据库已创建。点击其链接,
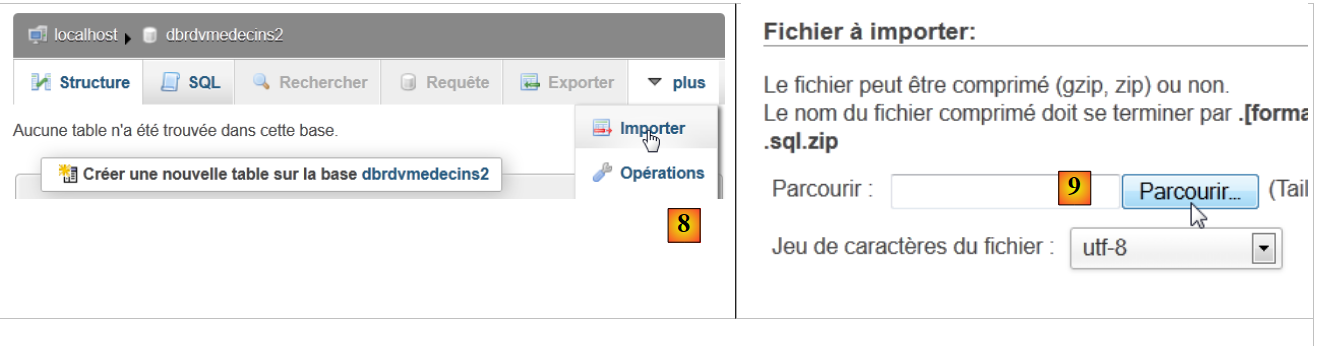 |
- 在 [8] 中,导入一个文件 SQL,
- 通过按钮在文件系统中指定该文件 [9],
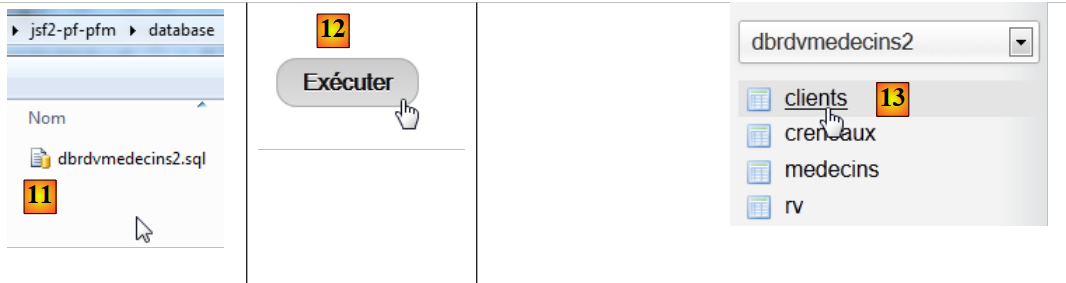 |
- 在 [11] 中,选择脚本 SQL,并在 [12] 中执行它,
- 在 [13] 中,数据库的四个表已创建完成。点击其中一个链接,
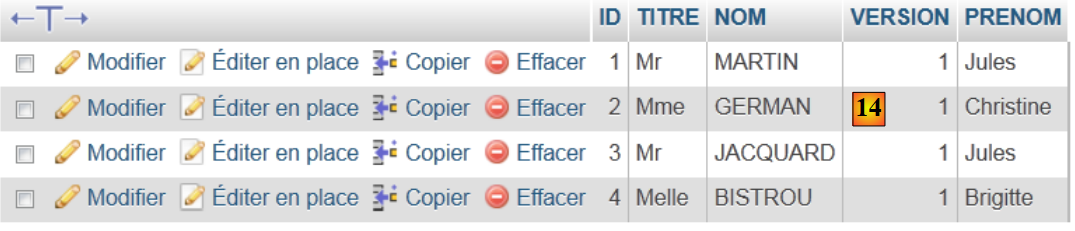 |
- 在 [14] 中,显示了表的内容。
此后,我们将不再提及该数据库。但建议读者通过程序的执行过程关注其演变,尤其是在程序无法正常运行时。
4.4.6. [JPA]层
让我们回到示例的架构:
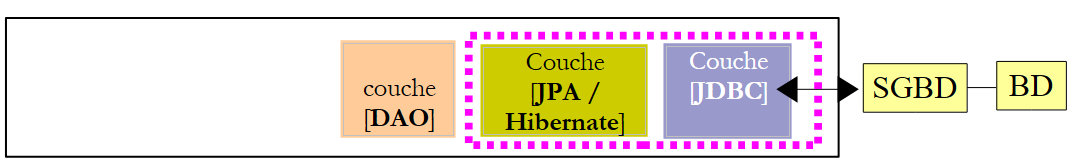 |
现在我们开始构建 [JPA] 层的 Maven 项目。
4.4.7. NetBeans 项目
如下所示:
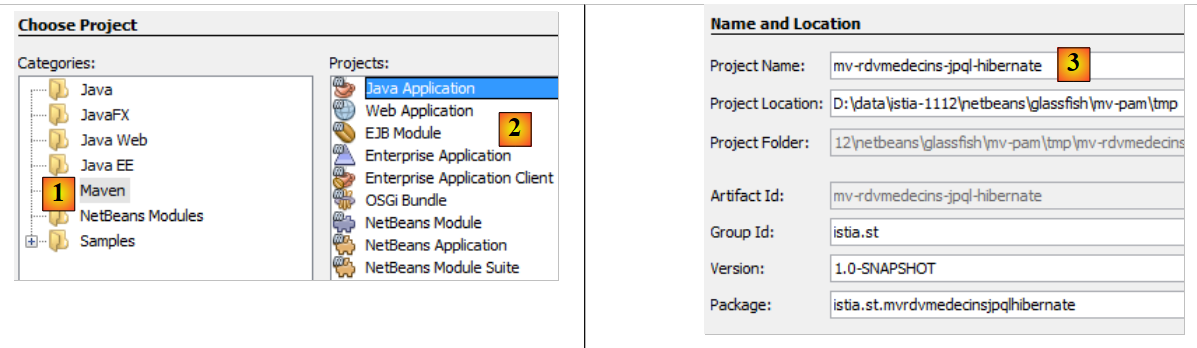 |
- 在 [1] 中,构建一个类型为 [Java Application] [2] 的 Maven 项目,
- 在 [3] 中,为项目命名,
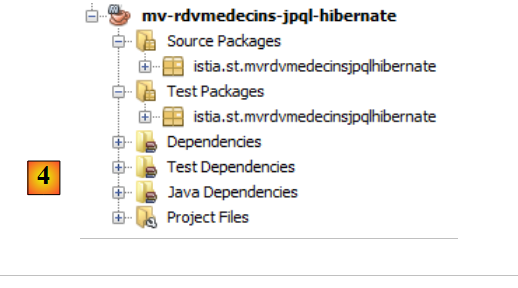 |
- 在 [4] 中,生成的项目。
4.4.8. 生成 [JPA] 层
让我们回到需要构建的架构:
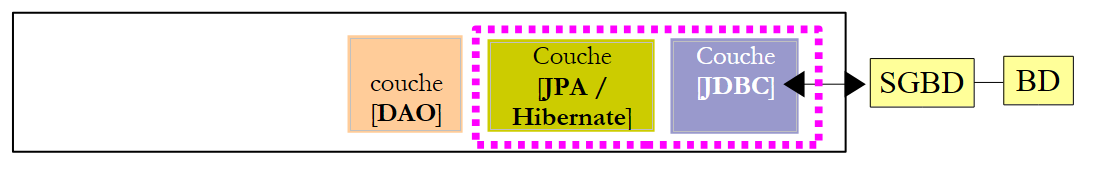 |
借助 NetBeans,可以自动生成 [JPA] 层。了解这些自动生成方法很有意义,因为生成的代码为编写 JPA 实体提供了宝贵的参考。
4.4.9. 创建 NetBeans 与数据库的连接
- 运行 SGBD MySQL 5 以使 BD 可用,
- 在 [dbrdvmedecins2] 数据库上创建 NetBeans 连接,
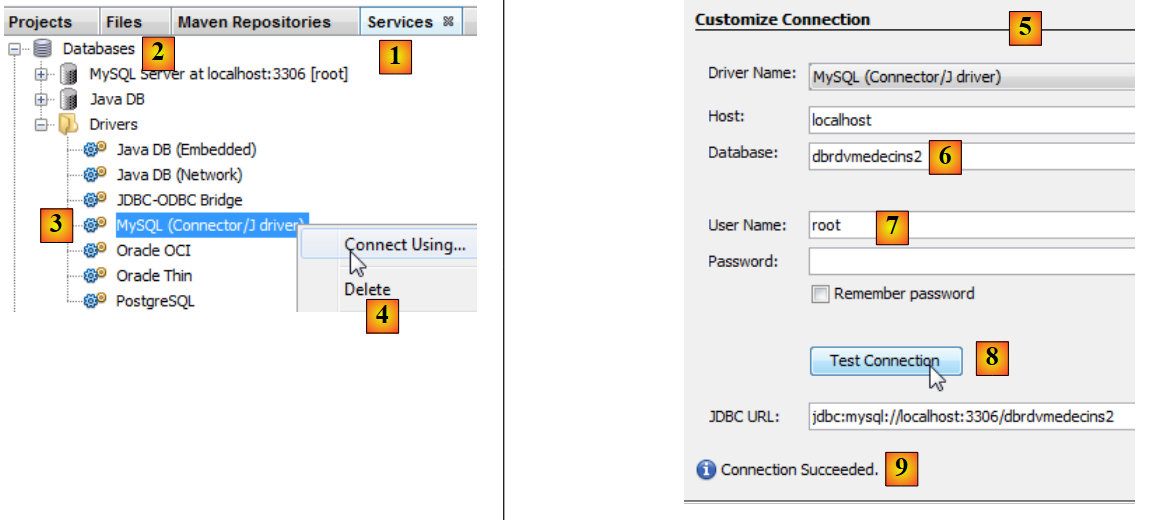 |
- 在 [Services] [1] 选项卡中, 在分支 [Databases] [2] 中,选择驱动程序 JDBC MySQL [3],
- 然后选择选项 [4] “Connect Using”,用于建立与数据库 MySQL 的连接,
- 在 [5] 处,输入所需的信息。在 [6] 处输入数据库名称,在 [7] 处输入数据库用户名及其密码,
- 在 [8] 中,可验证所提供的信息,
- 在 [9] 中,若信息正确,将显示预期提示信息,
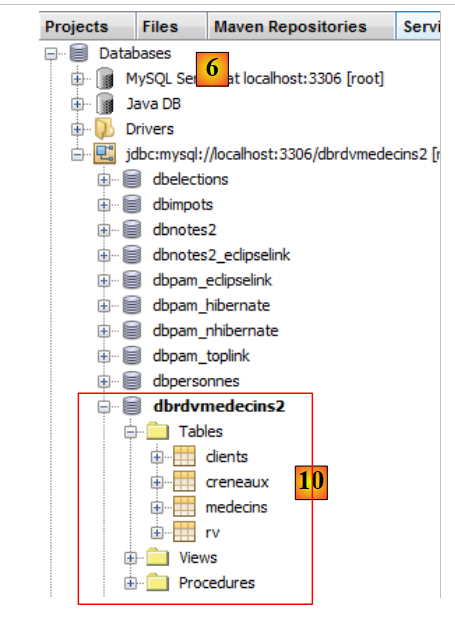 |
- 在 [10] 中,连接已建立。可以看到所连接数据库中的四个表。
4.4.10. 创建持久化单元
让我们回到正在构建的架构:
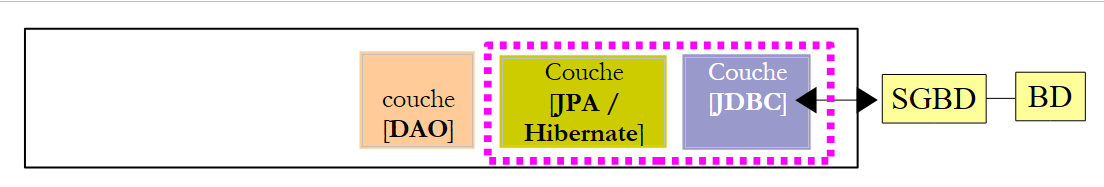 |
我们正在构建 [JPA] 层。该层的配置在 [persistence.xml] 文件中完成,其中定义了持久化单元。每个单元都需要以下信息:
- 数据库访问参数(JDBC,包括URL、用户名、密码),
- 将作为数据库表映射的类,
- 所使用的实现(JPA)。实际上,JPA 是一项由多种产品实现的规范。在此,我们将使用 Hibernate。
NetBeans可以通过向导生成此持久化文件。
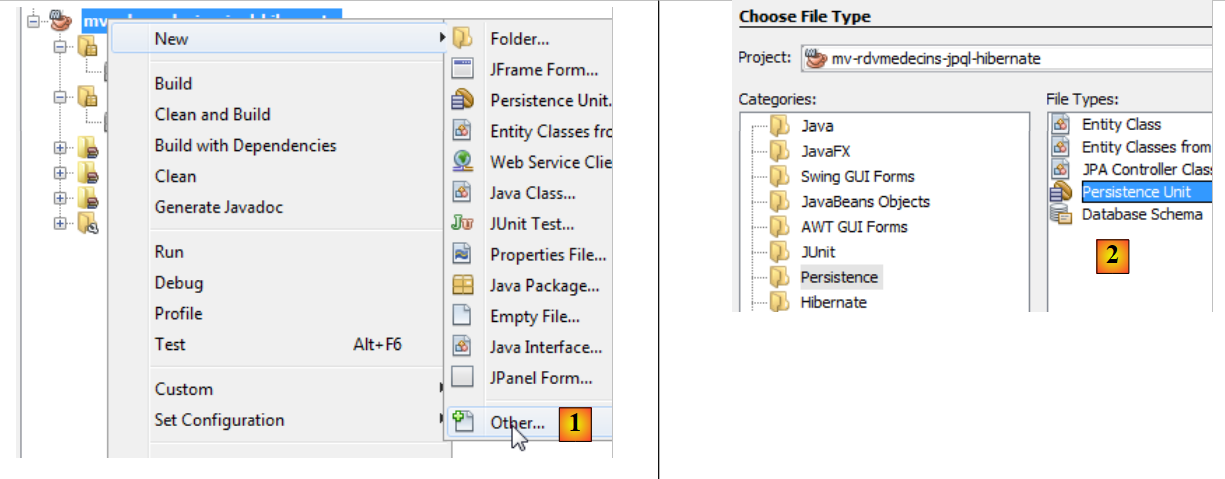 |
- 右键单击项目并选择创建持久化单元 [1],
- 在 [2] 中,创建一个持久化单元,
|
- 在 [3] 中,为创建的持久化单元命名,
- 在 [4] 中,选择 JPA Hibernate 实现(JPA 2.0),
- 在 [5] 中,指定 BD 中的表已创建,因此不再创建。确认向导,
- 在 [6] 中,新项目
- 在 [7] 中,文件 [persistence.xml] 已生成在文件夹 [META-INF] 中,
- 在 [8] 中,Maven 项目已添加了新的依赖项。
生成的 [META-INF/persistence.xml] 文件如下:
<?xml version="1.0" encoding="UTF-8"?>
<persistence version="2.0" xmlns="http://java.sun.com/xml/ns/persistence" xmlns:xsi="http://www.w3.org/2001/XMLSchema-instance" xsi:schemaLocation="http://java.sun.com/xml/ns/persistence http://java.sun.com/xml/ns/persistence/persistence_2_0.xsd">
  <persistence-unit name="mv-rdvmedecins-jpql-hibernatePU" transaction-type="RESOURCE_LOCAL">
    <provider>org.hibernate.ejb.HibernatePersistence</provider>
    <properties>
      <property name="javax.persistence.jdbc.url" value="jdbc:mysql://localhost:3306/dbrdvmedecins2"/>
      <property name="javax.persistence.jdbc.password" value=""/>
      <property name="javax.persistence.jdbc.driver" value="com.mysql.jdbc.Driver"/>
      <property name="javax.persistence.jdbc.user" value="root"/>
      <property name="hibernate.cache.provider_class" value="org.hibernate.cache.NoCacheProvider"/>
    </properties>
  </persistence-unit>
</persistence>
该文件包含向导中提供的信息:
- 第 3 行:持久化单元的名称,
- 第 3 行:数据库事务类型。此处 RESOURCE_LOCAL 表示应用程序将自行管理事务,
- 第 6-9 行:数据源的 JDBC 属性。
在“[Design]”选项卡中,可以全面查看 [persistence.xml] 文件:
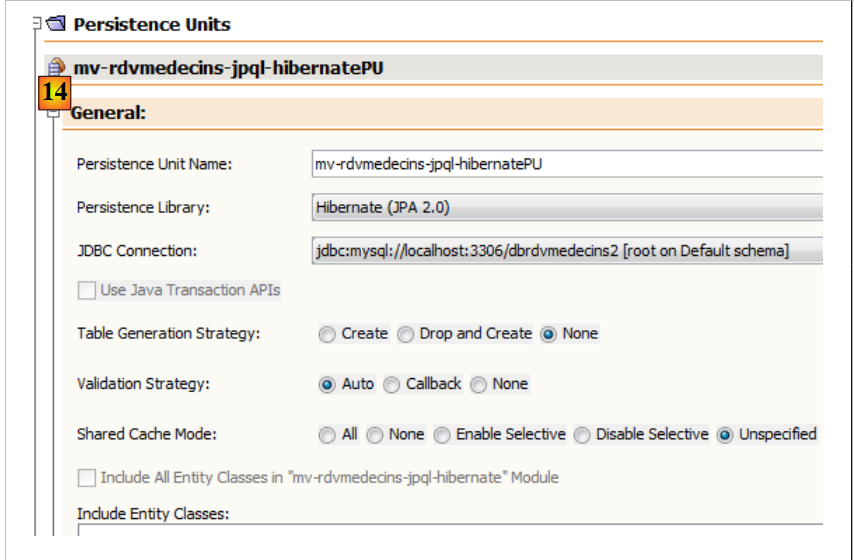 |
为了获取 Hibernate 日志,我们按以下方式补充 [persistence.xml] 文件:
<?xml version="1.0" encoding="UTF-8"?>
<persistence version="2.0" xmlns="http://java.sun.com/xml/ns/persistence" xmlns:xsi="http://www.w3.org/2001/XMLSchema-instance" xsi:schemaLocation="http://java.sun.com/xml/ns/persistence http://java.sun.com/xml/ns/persistence/persistence_2_0.xsd">
  <persistence-unit name="mv-rdvmedecins-jpql-hibernatePU" transaction-type="RESOURCE_LOCAL">
    <provider>org.hibernate.ejb.HibernatePersistence</provider>
    <properties>
      <property name="javax.persistence.jdbc.url" value="jdbc:mysql://localhost:3306/dbrdvmedecins2"/>
      <property name="javax.persistence.jdbc.password" value=""/>
      <property name="javax.persistence.jdbc.driver" value="com.mysql.jdbc.Driver"/>
      <property name="javax.persistence.jdbc.user" value="root"/>
      <property name="hibernate.cache.provider_class" value="org.hibernate.cache.NoCacheProvider"/>
      <property name="hibernate.show_sql" value="true"/>
      <property name="hibernate.format_sql" value="true"/>
    </properties>
  </persistence-unit>
</persistence>
- 第11行:请求查看Hibernate生成的SQL命令,
- 第12行:此属性可实现对这些命令的格式化显示。
项目中已添加了依赖项。文件 [pom.xml] 内容如下:
<project xmlns="http://maven.apache.org/POM/4.0.0" xmlns:xsi="http://www.w3.org/2001/XMLSchema-instance"
  xsi:schemaLocation="http://maven.apache.org/POM/4.0.0 http://maven.apache.org/xsd/maven-4.0.0.xsd">
  <modelVersion>4.0.0</modelVersion>

  <groupId>istia.st</groupId>
  <artifactId>mv-rdvmedecins-jpql-hibernate</artifactId>
  <version>1.0-SNAPSHOT</version>
  <packaging>jar</packaging>

  <name>mv-rdvmedecins-jpql-hibernate</name>
  <url>http://maven.apache.org</url>

  <properties>
    <project.build.sourceEncoding>UTF-8</project.build.sourceEncoding>
  </properties>

  <dependencies>
    <dependency>
      <groupId>junit</groupId>
      <artifactId>junit</artifactId>
      <version>3.8.1</version>
      <scope>test</scope>
    </dependency>
    <dependency>
      <groupId>org.hibernate</groupId>
      <artifactId>hibernate-entitymanager</artifactId>
      <version>4.1.2</version>
    </dependency>
    <dependency>
      <groupId>org.jboss.logging</groupId>
      <artifactId>jboss-logging</artifactId>
      <version>3.1.0.GA</version>
    </dependency>
    <dependency>
      <groupId>org.jboss.spec.javax.transaction</groupId>
      <artifactId>jboss-transaction-api_1.1_spec</artifactId>
      <version>1.0.0.Final</version>
    </dependency>
    <dependency>
      <groupId>org.hibernate</groupId>
      <artifactId>hibernate-core</artifactId>
      <version>4.1.2</version>
    </dependency>
    <dependency>
      <groupId>antlr</groupId>
      <artifactId>antlr</artifactId>
      <version>2.7.7</version>
    </dependency>
    <dependency>
      <groupId>dom4j</groupId>
      <artifactId>dom4j</artifactId>
      <version>1.6.1</version>
    </dependency>
    <dependency>
      <groupId>org.hibernate.javax.persistence</groupId>
      <artifactId>hibernate-jpa-2.0-api</artifactId>
      <version>1.0.1.Final</version>
    </dependency>
    <dependency>
      <groupId>org.javassist</groupId>
      <artifactId>javassist</artifactId>
      <version>3.15.0-GA</version>
    </dependency>
    <dependency>
      <groupId>org.hibernate.common</groupId>
      <artifactId>hibernate-commons-annotations</artifactId>
      <version>4.0.1.Final</version>
    </dependency>
  </dependencies>
</project>
新增的依赖项均与 Hibernate 相关。我们将为 MySQL 添加 JDBC 驱动程序的依赖项:
    <dependency>
      <groupId>mysql</groupId>
      <artifactId>mysql-connector-java</artifactId>
      <version>5.1.6</version>
    </dependency>
4.4.11. 生成 JPA 实体
JPA 实体可通过 NetBeans 向导生成:
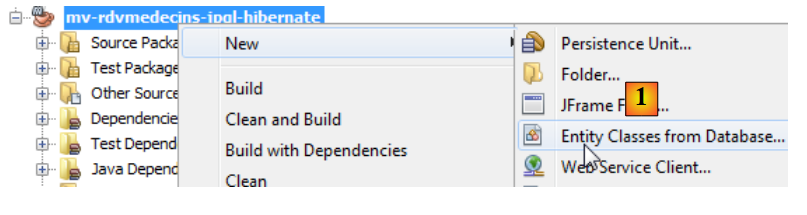 |
- 在 [1] 中,从数据库创建 JPA 实体,
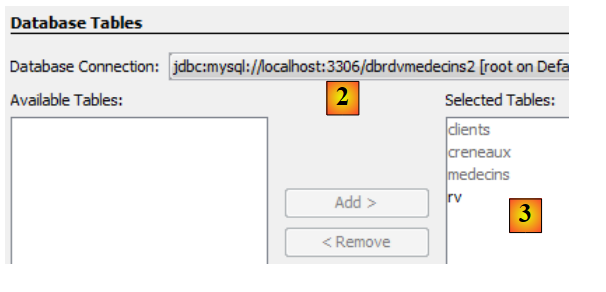 |
- 生成 [2],选择之前创建的连接 [dbrdvmedecins2],
- 在 [3] 中,选择关联数据库中的所有表,
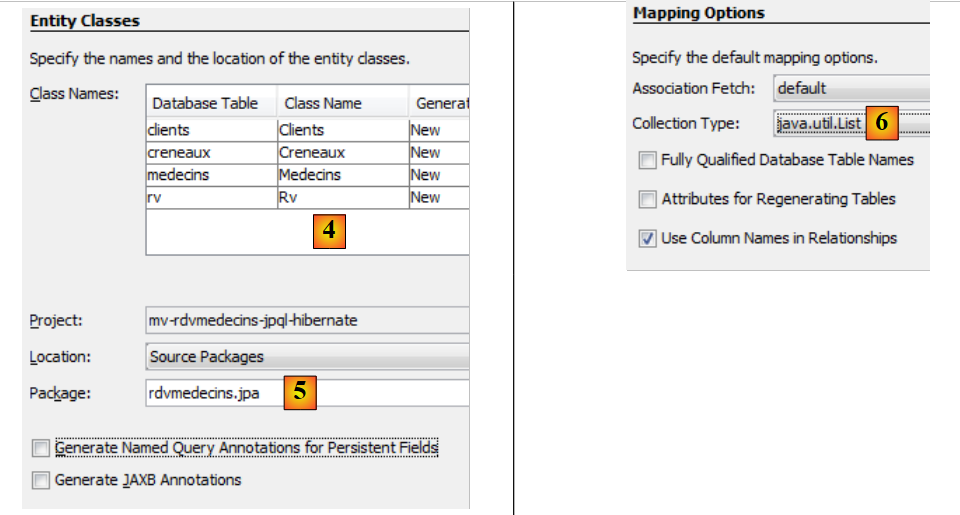 |
- 在 [4] 中,为与这四个表关联的 Java 类命名,
- 以及包名 [5],
- 在 [6] 中,JPA 将 BD 中的表行聚合到集合中。我们选择列表作为集合,
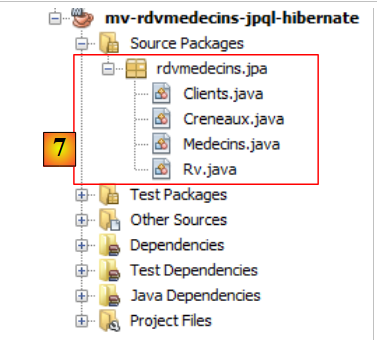 |
- 在 [7] 中,由向导生成的 Java 类。
4.4.12. 生成的 JPA 实体
实体 [Medecin] 是表 [medecins] 的映射。Java 类中充斥着大量注解,导致代码乍看之下难以理解。若仅保留理解该实体作用所必需的内容,则得到以下代码:
package rdvmedecins.jpa;

...
@Entity
@Table(name = "medecins")
public class Medecin implements Serializable {

@Id
  @GeneratedValue(strategy = GenerationType.IDENTITY)
  @Column(name = "ID")
  private Long id;

  @Column(name = "TITRE")
  private String titre;

  @Column(name = "NOM")
  private String nom;

  @Column(name = "VERSION")
  private int version;

  @Column(name = "PRENOM")
  private String prenom;

  @OneToMany(cascade = CascadeType.ALL, mappedBy = "idMedecin")
  private List<Creneau> creneauList;

// 构造函数
....

   // 获取器和设置器
....

  @Override
  public int hashCode() {
  ...
  }

  @Override
  public boolean equals(Object object) {
  ...
  }

  @Override
  public String toString() {
    ...
  }

}
- 第 4 行,@Entity 注解将类 [Medecin] 定义为实体 JPA、c.a.d。 一个通过 API 和 JPA 与 BD 表关联的类,
- 第 5 行,BD 表的名称,该表与实体 JPA 相关联。表中的每个字段都对应 Java 类中的一个字段,
- 第 6 行,该类实现了 Serializable 接口。这在客户端/服务器应用程序中是必要的,因为实体会在客户端和服务器之间进行序列化。
- 第 10-11 行:类 [Medecin] 的 id 字段对应于表 [medecins] 中的字段 [ID](第 10 行),
- 第 13-14 行:类 [Medecin] 的 titre 字段对应于表 [medecins] 中的 [TITRE] 字段(第 13 行),
- 第16-17行:类[Medecin]的“名称”字段对应于表[medecins]中的字段[NOM](第16行),
- 第 19-20 行:类 [Medecin] 的 version 字段对应于表 [medecins] 中的 [VERSION] 字段(第 19 行)。 在此,向导未能识别该列实际上是一个版本列,该列应在所属行每次修改时递增。为赋予其此功能,需添加 @Version 注释。我们将在后续步骤中进行此操作,
- 第22-23行:类[Medecin]中的prenom字段对应于表[medecins]中的[PRENOM]字段,
- 第 10-11 行:id 字段对应于该表的主键 [ID]。第 8-9 行的注解对此进行了说明,
- 第 8 行:注解 @Id 表示被注解的字段与表的主键相关联,
- 第 9 行:[JPA] 层将生成其插入到 [Medecins] 表中的行所对应的primary key。 有多种策略可供选择。此处策略 GenerationType.IDENTITY 表示,层 JPA 将使用表 MySQL 的模式 auto_increment,
- 第25-26行:表[creneaux]对表[medecins]设置了外键。一个时段属于一位医生。反之,一位医生则关联有多个时段。 因此,这是一种“一对多”关系(即一位医生对应多个时段),该关系由注释 @OneToMany 通过 JPA 进行限定(第25行)。 第26行的字段将包含该医生的所有时段。这无需编程即可实现。为了完全理解第25行,我们需要介绍类[Creneau]。
该类定义如下:
package rdvmedecins.jpa;

import java.io.Serializable;
import java.util.List;
import javax.persistence.*;
import javax.validation.constraints.NotNull;

@Entity
@Table(name = "creneaux")
public class Creneau implements Serializable {
  @Id
  @GeneratedValue(strategy = GenerationType.IDENTITY)
  @Column(name = "ID")
  private Long id;

  @Column(name = "MDEBUT")
  private int mdebut;

  @Column(name = "HFIN")
  private int hfin;

  @Column(name = "HDEBUT")
  private int hdebut;

  @Column(name = "MFIN")
  private int mfin;

  @Column(name = "VERSION")
  private int version;

  @JoinColumn(name = "ID_MEDECIN", referencedColumnName = "ID")
  @ManyToOne(optional = false)
  private Medecin idMedecin;

  @OneToMany(cascade = CascadeType.ALL, mappedBy = "idCreneau")
  private List<Rv> rvList;

// 构造函数
...
// getter 和 setter
...

  @Override
  public int hashCode() {
    ...
  }

  @Override
  public boolean equals(Object object) {
    ...
  }

  @Override
  public String toString() {
    ...
  }

}
我们仅对新注释进行说明:
- 我们曾提到,表 [creneaux] 拥有指向表 [medecins] 的外键:一个时段与一位医生相关联。多位医生可以关联多个时段。 表 [creneaux] 与表 [medecins] 之间存在一种关系,该关系被定义为多对一(多个时段对应一名医生)。 第32行中的注释 @ManyToOne 用于限定外键,
- 第31行带有注释@JoinColumn,明确了外键关系: 表 [creneaux] 的列 [ID_MEDECIN] 是表 [medecins] 的列 [ID] 的外键,
- 第 33 行:指向该时段所属医生的引用。此处同样无需编程即可获取。
因此,实体 [Creneau] 与实体 [Medecin] 之间的外键关系通过以下两条注释体现:
- 在实体 [Creneau] 中:
@JoinColumn(name = "ID_MEDECIN", referencedColumnName = "ID")
  @ManyToOne(optional = false)
private Medecin idMedecin;
- 在实体 [Medecin] 中:
@OneToMany(cascade = CascadeType.ALL, mappedBy = "idMedecin")
private List<Creneau> creneauList;
这两个注释反映了相同的关系:即表 [creneaux] 到表 [medecins] 的外键关系。我们说它们是彼此的逆关系。 只有关系 @ManyToOne 是必不可少的。它明确地定义了外键关系。关系 @OneToMany 是可选的。如果存在,它仅引用与其关联的关系 @ManyToOne。 这就是实体 [Medecin] 第 1 行中 mappedBy 属性的含义。 该属性的值是实体 [Creneau] 中那个带有 @ManyToOne 注释的字段名称,该注释指定了外键。同样在实体 [Medecin] 的第 1 行中, 属性 cascade=CascadeType.ALL 确定了实体 [Medecin] 相对于实体 [Creneau] 的行为:
- 如果向数据库中插入新的实体 [Medecin],则第 2 行字段中的实体 [Creneau] 也必须被插入,
- 如果修改数据库中的实体 [Medecin],则第 2 行字段中的实体 [Creneau] 也必须被修改,
- 如果从数据库中删除实体 [Medecin],则第 2 行字段中的实体 [Creneau] 也必须被删除。
由于另外两个实体的代码未引入新的标记,因此在此不作特别说明。
实体 [Client]
package rdvmedecins.jpa;

...
@Entity
@Table(name = "clients")
public class Client implements Serializable {
  @Id
  @GeneratedValue(strategy = GenerationType.IDENTITY)
  @Column(name = "ID")
  private Long id;

  @Column(name = "TITRE")
  private String titre;

  @Column(name = "NOM")
  private String nom;

  @Column(name = "VERSION")
  private int version;

  @Column(name = "PRENOM")
  private String prenom;

  @OneToMany(cascade = CascadeType.ALL, mappedBy = "idClient")
  private List<Rv> rvList;

// 构造函数
...
// getter 和 setter
...

  @Override
  public int hashCode() {
    ...
  }

  @Override
  public boolean equals(Object object) {
    ...
  }

  @Override
  public String toString() {
    ...
  }

}
- 第24-25行反映了表[rv]与表[clients]之间的外键关系。
实体 [Rv]:
package rdvmedecins.jpa;

...
@Entity
@Table(name = "rv")
public class Rv implements Serializable {
  @Id
  @GeneratedValue(strategy = GenerationType.IDENTITY)
  @Column(name = "ID")
  private Long id;

  @Column(name = "JOUR")
  @Temporal(TemporalType.DATE)
  private Date jour;

  @JoinColumn(name = "ID_CRENEAU", referencedColumnName = "ID")
  @ManyToOne(optional = false)
  private Creneau idCreneau;

  @JoinColumn(name = "ID_CLIENT", referencedColumnName = "ID")
  @ManyToOne(optional = false)
  private Client idClient;

   // 构造函数
...

   // getter 和 setter
...

  @Override
  public int hashCode() {
    ...
  }

  @Override
  public boolean equals(Object object) {
    ...
  }

  @Override
  public String toString() {
    ...
  }

}
- 第13行定义了Java类型字段“日”的Date。说明在表[rv]中,列[JOUR](第12行)的类型为日期(不含时间),
- 第16-18行:定义了表[rv]与表[creneaux]之间的外键关系,
- 第20-22行:定义了表[rv]与表[clients]之间的外键关系。
通过自动生成实体 JPA,我们可以获得一个工作基础。有时这已足够,有时则不然。本例即属后者:
- 需要为各实体的版本字段添加 @Version 注解,
- 需要编写比生成的方法更明确的 toString 方法,
- 实体 [Medecin] 和 [Client] 性质相似。我们将让它们继承自类 [Personne],
- 我们将删除 @OneToMany 关系(作为 @ManyToOne 关系的反向关系)。这些关系并非必需,且会增加编程复杂度,
- 我们将移除 @NotNull 对主键的验证。当将实体 JPA 与 MySQL 进行持久化时,原始实体的主键为 null。 只有在数据写入数据库后,被持久化的元素的主键才会获得具体值。
根据这些规范,各类定义如下:
Personne 类用于表示医生和客户:
package rdvmedecins.jpa;

import java.io.Serializable;
import javax.persistence.*;

@MappedSuperclass
public class Personne implements Serializable {
  private static final long serialVersionUID = 1L;
  @Id
  @GeneratedValue(strategy = GenerationType.IDENTITY)
  @Column(name = "ID")
  private Long id;

  @Basic(optional = false)
  @Column(name = "TITRE")
  private String titre;

  @Basic(optional = false)
  @Column(name = "NOM")
  private String nom;

  @Basic(optional = false)
  @Column(name = "VERSION")
  @Version
  private int version;

  @Basic(optional = false)
  @Column(name = "PRENOM")
  private String prenom;
// 构造函数
...

// getter 和 setter
  ...

  @Override
  public String toString() {
    return String.format("[%s,%s,%s,%s,%s]", id, version, titre, prenom, nom);
  }

}
- 第 6 行:请注意,类 [Personne] 本身并非实体 (@Entity)。它将作为实体的父类。注解 @MappedSuperClass 指明了这种情况。
实体 [Client] 封装了表 [clients] 的行。它继承自前面的类 [Personne]:
package rdvmedecins.jpa;

import java.io.Serializable;
import javax.persistence.*;

@Entity
@Table(name = "clients")
public class Client extends Personne implements Serializable {
  private static final long serialVersionUID = 1L;

// 构造函数
...

  @Override
  public int hashCode() {
...
  }

  @Override
  public boolean equals(Object object) {
  ...
  }

  @Override
  public String toString() {
    return String.format("Client[%s,%s,%s,%s]", getId(), getTitre(), getPrenom(), getNom());
  }

}
- 第 6 行:类 [Client] 是一个 JPA 实体,
- 第 7 行:它与表 [clients] 相关联,
- 第 8 行:它继承自类 [Personne]。
封装表 [medecins] 行数据的实体 [Medecin] 遵循相同的模式:
package rdvmedecins.jpa;

import java.io.Serializable;
import javax.persistence.*;

@Entity
@Table(name = "medecins")
public class Medecin extends Personne implements Serializable {
  private static final long serialVersionUID = 1L;

  // 构造函数
...

  @Override
  public int hashCode() {
    ...
  }

  @Override
  public boolean equals(Object object) {
    ...
  }

  @Override
  public String toString() {
    return String.format("Médecin[%s,%s,%s,%s]", getId(), getTitre(), getPrenom(), getNom());
  }

}
实体 [Creneau] 封装了表 [creneaux] 的行:
package rdvmedecins.jpa;

import java.io.Serializable;
import java.util.List;
import javax.persistence.*;

@Entity
@Table(name = "creneaux")
public class Creneau implements Serializable {

  private static final long serialVersionUID = 1L;
  @Id
  @GeneratedValue(strategy = GenerationType.IDENTITY)
  @Basic(optional = false)
  @Column(name = "ID")
  private Long id;

  @Basic(optional = false)
  @Column(name = "MDEBUT")
  private int mdebut;

  @Basic(optional = false)
  @Column(name = "HFIN")
  private int hfin;

  @Basic(optional = false)
  @NotNull
  @Column(name = "HDEBUT")
  private int hdebut;

  @Basic(optional = false)
  @Column(name = "MFIN")
  private int mfin;

  @Basic(optional = false)
  @Column(name = "VERSION")
  @Version
  private int version;

  @JoinColumn(name = "ID_MEDECIN", referencedColumnName = "ID")
  @ManyToOne(optional = false)
  private Medecin medecin;

  // 构造函数
  ...

  // getter 和 setter
  ...

  @Override
  public int hashCode() {
    ...
  }

  @Override
  public boolean equals(Object object) {
    // TODO:警告——如果 id 字段未设置,此方法将无法工作
    ...
  }

  @Override
  public String toString() {
    return String.format("Creneau [%s, %s, %s:%s, %s:%s,%s]", id, version, hdebut, mdebut, hfin, mfin, medecin);
  }
}
- 第 40-42 行建模了数据库中表 [creneaux] 与表 [medecins] 之间存在的“多对一”关系:一名医生拥有多个时段,而一个时段仅属于一名医生。
实体 [Rv] 封装了表 [rv] 的行:
package rdvmedecins.jpa;

import java.io.Serializable;
import java.util.Date;
import javax.persistence.*;

@Entity
@Table(name = "rv")
public class Rv implements Serializable {

  private static final long serialVersionUID = 1L;
  @Id
  @GeneratedValue(strategy = GenerationType.IDENTITY)
  @Basic(optional = false)
  @Column(name = "ID")
  private Long id;

  @Basic(optional = false)
  @Column(name = "JOUR")
  @Temporal(TemporalType.DATE)
  private Date jour;

  @JoinColumn(name = "ID_CRENEAU", referencedColumnName = "ID")
  @ManyToOne(optional = false)
  private Creneau creneau;

  @JoinColumn(name = "ID_CLIENT", referencedColumnName = "ID")
  @ManyToOne(optional = false)
  private Client client;

   // 构造函数
...

   // 获取器和设置器
...

  @Override
  public int hashCode() {
    ...
  }

  @Override
  public boolean equals(Object object) {
    ...
  }

  @Override
  public String toString() {
    return String.format("Rv[%s, %s, %s]", id, creneau, client);
  }
}
- 第27-29行建模了[rv]表与[clients]表之间存在的“多对一”关系 (一个客户可能出现在多个 Rv 中),而第 23-25 行则描述了表 [rv] 与表 [creneaux] 之间存在的“多对一”关系(一个时段可能出现在多个 Rv 中)。
4.4.13. 数据访问代码
现在,我们将通过 JPA 层向项目中添加数据访问代码:
 |
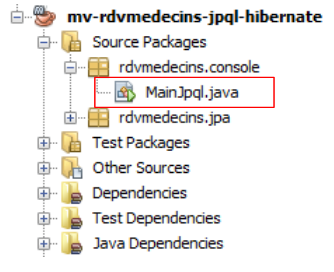 |
[MainJpql] 类如下:
package rdvmedecins.console;

import java.util.Scanner;
import javax.persistence.EntityManager;
import javax.persistence.EntityManagerFactory;
import javax.persistence.Persistence;

public class MainJpql {

  public static void main(String[] args) {
    // EntityManagerFactory
    EntityManagerFactory emf = Persistence.createEntityManagerFactory("mv-rdvmedecins-jpql-hibernatePU");
    // entityManager
    EntityManager em = emf.createEntityManager();
    // 键盘扫描器
    Scanner clavier = new Scanner(System.in);
    // 查询输入循环JPQL
    System.out.println("Requete JPQL sur la base dbrdvmedecins2 (* pour arrêter) :");
    String requete = clavier.nextLine();
    while (!requete.trim().equals("*")) {
      try {
        // 查询结果显示
        for (Object o : em.createQuery(requete).getResultList()) {
          System.out.println(o);
        }
      } catch (Exception e) {
        System.out.println("L'exception suivante s'est produite : " + e);
      }
      // 清空持久化上下文
      em.clear();
      // 新查询
      System.out.println("---------------------------------------------");
      System.out.println("Requete JPQL sur la base dbrdvmedecins2 (* pour arrêter) :");
      requete = clavier.nextLine();
    }
    // 关闭资源
    em.close();
    emf.close();
  }
}
- 第 12 行:创建与之前创建的持久化单元关联的 EntityManagerFactory。方法 createEntityManagerFactory 的参数即为该持久化单元的名称:
  <persistence-unit name="mv-rdvmedecins-jpql-hibernatePU" transaction-type="RESOURCE_LOCAL">
    ...
</persistence-unit>
- 第 14 行:创建管理持久层的方法 EntityManager,
- 第 19 行:输入查询 JPQL select,
- 第23-28行:显示查询结果,
- 第20行:当用户输入*时,输入操作停止。
问题:请给出能够获取以下信息的 JPQL 查询:
- 按姓名降序排列的医生列表
- 标题为“Mr”的医生列表
- 佩利西耶女士的预约时段列表
- 已预约的就诊时间列表(按日期升序排列)
- 2006年8月24日预约了RV的客户(姓名)列表
- 2006年8月24日PELISSIER女士的客户数量
- 未预约的客户
- 未预约的医生
我们将参考[ref1]第2.7段的示例。以下是一个执行示例:
- 第2行:查询JPQL,
- 第3-11行:对应的查询SQL,
- 第12-15行:查询JPQL的结果。
4.5. 持久化上下文与 SGBD 之间的关联
4.5.1. Personne 类
4.5.2. 测试程序
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 33 34 35 36 37 38 39 40 41 42 43 44 45 46 47 48 49 50 51 52 53 54 55 56 57 58 59 60 61 62 63 64 65 66 67 68 69 70 71 72 73 74 75 76 77 78 79 80 81 82 83 84 85 86 87 88 89 90 91 92 93 94 95 96 97 98 99 100 101 102 103 104 105 106 107 108 109 110 111 112 113 114 115 116 117 118 119 120 121 122 123 124 125 126 127 128 129 130 131 132 133 134 135 136 137 | |
4.5.3. Hibernate配置
4.5.4. log4j.properties的配置
4.5.5. 结果
问题:请说明Java代码与显示结果之间的关联。