3. Java 语言基础
3.1. 简介
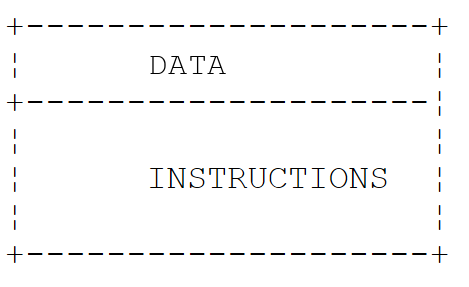
我们先把 Java 当作一种传统的编程语言来对待。类将在下一章讲解。一个程序由两部分构成:
我们通常力求把数据与指令分离:
本章的所有示例都是紧凑源文件:即单个名为 [.java]的文件,没有 Maven 项目,使用命令 [java Basics01.java]运行。随后 [java]启动器在内存中编译该文件并执行它,不生成 [.class]文件。这一能力已在第 2 章“搭建开发环境”中介绍过。这些示例位于课程代码的 [03-basics]文件夹中。它们使用法语语言和惯例(即“区域设置”fr-FR)运行,就像在法语版 Windows 机器上一样。我们会看到,这只影响用特定 格式格式化的数字和日期:把浮点数简单转换为字符串时始终使用小数点。
3.2. 最小程序
3.2.1. 紧凑源文件
程序 [Basics01.java] 如下:
| // 以精简源文件编写的最小程序(Java 25)
// 没有类声明,没有 public 和 static 关键字:只有一个 main 方法
void main() {
IO.println("Hello world!");
// 传统写法:System 类的 out 字段,然后调用其 println 方法
System.out.println("Hello world!");
// List(java.util 包)在精简文件中无需 import 即可使用
List<String> words = List.of("Hello", "the", "world");
IO.println(words);
}
|
结果:
| > java Basics01.java
Hello world!
Hello world!
[Hello, the, world]
|
说明:
- 该文件不包含任何类声明——只有一个名为 [main]的方法。这是一个紧凑源文件 (Java 25)。编译器自行把文件内容包装进一个以文件名命名的隐式声明类中:[Basics01]。这一特性在 Java 21 到 Java 24 中以预览形式引入,之后在 Java 25 中成为正式特性;
- 第 3 行:[main] 方法是程序的入口点:启动器 [java] 执行的就是这个方法。从 Java 25 起,它可以简单地写成 [void main()],不带关键字 [public] 和 [static] ,也不带任何参数。方法体由花括号括起来;
- 第 4 行:[IO] 类(Java 25)的 [println] 方法向屏幕写入一行;
- 第 6 行:同一操作的传统形式。[System] 是一个类,[out] 是它的一个字段,表示标准输出(屏幕),[println] 是该对象的一个方法。[IO.println(x)] 只是[System.out.println(x)]的简写形式。我们会在紧凑文件中使用 [IO.println] ,在常规类中使用 [System.out.println] ,因为它遍布现有的 Java 代码;
- 第 8 行:[List] 是字符串列表;列表将在第 5 章讲解。[List] 属于 [java.util]包:包 把相关的类组织在一起,就像文件夹把文件组织在一起。该类的全名是 [java.util.List]。由于该文件是紧凑文件,无需 import 语句即可使用它(见下文);
- 第 9 行:列表显示时,其元素用方括号括起来;
- 每条语句以分号结尾;以 // 开头的行是注释,会被编译器忽略。
带两个命令行参数(放在文件名之后):
| > java Basics01.java a0 a1
Hello world!
Hello world!
[Hello, the, world]
|
参数被忽略,因为 [void main()] 方法没有用来接收它们的参数。要使用它们,应把方法声明为 [void main(String[] args)]:这样字符串数组 [args] 就包含命令行参数。我们将在“主程序的参数”一节回到这个问题。
3.2.2. 带类和 main 方法的经典形式
直到 Java 24,同一个程序都必须这样写:[Basics02.java]:
| // 程序的经典形式(Java 24 之前唯一的标准形式)
import java.util.Arrays;
public class Basics02 {
// main 方法是程序的入口点
public static void main(String[] args) {
System.out.println("Hello world!");
System.out.println("Number of arguments received: " + args.length);
// 在普通类中必须导入 Arrays(java.util 包)
System.out.println("Arguments: " + Arrays.toString(args));
}
}
|
结果:
| > java Basics02.java a0 a1
Hello world!
Number of arguments received: 2
Arguments: [a0, a1]
|
说明:
- 第 2 行:[import] 指令从 [Arrays] 包 [java.util]中导入类。之后你可以写 [Arrays] 而不是 [java.util.Arrays]。在常规类中,只有 [java.lang]包中的类([System]、[String]、[Math]、[Integer]、[IO]……)无需导入即可使用;
- 第 4 行:在 Java 中,所有代码都属于某个类。这里的类名为 [Basics02]。声明为 [public] 的类必须位于以该名称命名的文件中:[Basics02.java];
- 第 6 行:[main] 方法是程序的入口点。它是 [public] (可从类外部访问,特别是通过启动器 [java]),[static] (无需创建该类的对象即可执行),不返回结果([void]),并通过数组 [args]接收命令行参数;
- 第 8 行:数组 [args] 的元素个数是 [args.length]。这里的 + 运算符连接字符串和数字:数字首先被转换为字符串;
- 第 10 行:[Arrays.toString]方法用数组的元素构造一个字符串。
包含常规类的文件也可以由启动器直接执行([java Basics02.java])。你也可以先用 [javac]编译器编译它,生成一个 [Basics02.class]文件,其中包含该类的中间代码 (“字节码”),然后使用命令 [java] 后跟类名(不带扩展名)来执行该类。Maven 和各种开发环境就是在幕后这样做的:
| > javac Basics02.java
> ls
Basics02.class Basics02.java
> java Basics02 a0 a1
Hello world!
Number of arguments received: 2
Arguments: [a0, a1]
|
这两个程序 [Basics01.java] 和 [Basics02.java] 本质上是相似的。遇到紧凑文件时,编译器会自行生成一个以文件名命名的 [final]类,其方法和字段就是文件中所写的那些。因此紧凑文件只是标准形式的简写版本。它非常适合本章的小程序;一旦程序包含多个类,就需要使用标准形式,从第 4 章开始就会如此。
自 Java 25 起,[main]方法可以有四种形式:[static void main(String[] args)]、[static void main()]、[void main(String[] args)]、以及 [void main()];如果一个类包含其中几种,启动器会优先选择带 [String[]]参数的那个。最后两种形式是实例方法:启动器先创建该类的一个对象,然后调用它的 [main]方法。关键字 [public] 不再是必需的。
3.2.3. java.base 模块的自动导入
程序 [Basics01.java] 使用了类 [List] ,却没有 [import java.util.List;]指令。这是可行的,因为编译器会自动在每个紧凑文件中添加如下指令(Java 25):
Java 标准库中的类被组织成包,而包又被归入模块。[java.base]模块是核心模块:它包含最常用的包。指令 [import module java.base;] 一次性导入该模块导出的所有包中的所有公共类,这尤其等价于以下指令:
| import java.io.*;
import java.math.*;
import java.net.*;
import java.nio.file.*;
import java.text.*;
import java.time.*;
import java.time.format.*;
import java.util.*;
import java.util.function.*;
import java.util.regex.*;
import java.util.stream.*;
...
|
因此,在紧凑文件中,你无需写任何一行代码,就可以使用列表和字典([java.util])、文件([java.io]、[java.nio.file])、大数([java.math])、日期([java.time])等。来自其他模块的类——例如 [java.sql]模块中的 JDBC 类——必须始终显式导入。在常规类中,[java.lang]包之外的任何内容都不会被自动导入:你可以按类写一条指令([import java.util.Arrays;]),按包写一条指令([import java.util.*;]),或者自Java 25 起按模块写一条指令([import module java.base;])。类 [IO] 属于包 [java.lang]:它可以在任何地方使用。
3.3. Java 数据
Java 使用以下数据类型:
- 整数;
- 实数;
- 十进制数;
- 字符和字符串;
- 布尔值;
- 对象。
3.3.1. 预定义的数据类型
Java 类型 | 包装类 | 所表示的数据 | 字面量后缀 | 编码 | 取值范围 |
[char] | [Character] | 字符 | | 2 字节 | Unicode 字符(UTF-16),从 '\u0000' 到 '\uffff' |
[byte] | [Byte] | 整数 | | 1 字节 | [-2⁷, 2⁷-1], 或 [-128, 127] |
[short] | [Short] | 整数 | | 2 字节 | [-2¹⁵, 2¹⁵-1] 或 [-32768, 32767] |
[int] | [Integer] | 整数 | | 4 字节 | [-2³¹, 2³¹-1] 或 [-2147483648, 2147483647] |
[long] | [Long] | 整数 | L | 8 字节 | [-2⁶³, 2⁶³-1] 或 [-9223372036854775808, 9223372036854775807] |
[float] | [Float] | 实数 | F | 4 字节 | [1.4 10⁻⁴⁵, 3.4 10³⁸] 绝对值,7 位有效数字 |
[double] | [Double] | 实数 | D(可选) | 8 字节 | [4.9 10⁻³²⁴, 1.8 10³⁰⁸] 绝对值,15 至 16 位有效数字 |
[boolean] | [Boolean] | 布尔值 | | 未定义 | [true]、[false] |
[String] (类) | | 字符串 | | | 对 Unicode 字符序列的引用 |
[BigDecimal] (类) | | 十进制数 | | 可变 | 任意精度的精确十进制数 |
[Object] (类) | | 对象引用 | | | 对任意类型对象的引用 |
表中的前八种类型,其名称以小写书写,是 Java 的基本类型。所有其他类型都是引用类型:类([String]、[BigDecimal]、[Object]……),以及数组、枚举、接口和记录,我们稍后会讲到。两者的区别至关重要:
- 基本类型的变量直接包含它的值;
- 引用类型的变量包含对象的地址(即它的引用),对象本身存储在内存的其他位置。
基本类型的值不是对象:它既没有字段,也没有方法。不过,每种基本类型在 [java.lang]包中都对应一个“包装类”:[Integer] 对应 [int],[Double] 对应 [double],[Character] 对应 [char],依此类推。[Integer] 对象包装一个 [int]值。这些类还提供了有用的常量和方法:[Integer.MAX_VALUE]、[Integer.BYTES]、[Integer.parseInt]……自 Java 5 起,编译器会自动把基本类型转换为其包装类(装箱),反之亦然(拆箱)。因此,我们可以这样写:
| String typeName = Integer.valueOf(3).getClass().getName();
|
字面量 3 的类型是 [int]。由于它没有方法,我们不能写 [3.getClass()]:必须先用 [Integer]对象通过 [Integer.valueOf(3)]把它包装起来。每个对象都有一个 [getClass()] 方法,返回描述其类的对象;该对象的 [getName()] 方法返回类的全名,这里是 [java.lang.Integer]。
除了 [char] 类型(16 位)之外,Java 没有无符号整数。不过,包装类提供了把整数的位解释为无符号数的方法:[Integer.toUnsignedString]、[Integer.parseUnsignedInt]、[Integer.compareUnsigned]、[Byte.toUnsignedInt]……它也没有基本的十进制类型:金额使用 [BigDecimal]类(位于 [java.math]包中)来计算,我们稍后会讨论它。
程序 [Basics03.java] 演示了这几点:
| // 基本类型:包装类和以字节为单位的大小
void main() {
int integer = 2;
float fl = 10.5F;
double d = -4.6;
String s = "test";
long l = 1000;
byte aByte = 5;
short sh = -4;
char c = 'A';
boolean b = true;
BigDecimal dec = new BigDecimal("10.67");
// %s 被替换为转换成字符串的值,%d 被替换为整数
IO.println("Type of integer[%s] : [%s,%d]".formatted(integer, typeName(integer), Integer.BYTES));
IO.println("Type of fl[%s] : [%s,%d]".formatted(fl, typeName(fl), Float.BYTES));
IO.println("Type of d[%s] : [%s,%d]".formatted(d, typeName(d), Double.BYTES));
IO.println("Type of s[%s] : [%s]".formatted(s, typeName(s)));
IO.println("Type of l[%s] : [%s,%d]".formatted(l, typeName(l), Long.BYTES));
IO.println("Type of aByte[%s] : [%s,%d]".formatted(aByte, typeName(aByte), Byte.BYTES));
IO.println("Type of sh[%s] : [%s,%d]".formatted(sh, typeName(sh), Short.BYTES));
IO.println("Type of c[%s] : [%s,%d]".formatted(c, typeName(c), Character.BYTES));
IO.println("Type of b[%s] : [%s]".formatted(b, typeName(b)));
IO.println("Type of dec[%s] : [%s]".formatted(dec, typeName(dec)));
// 字面量 3 不是对象:必须装箱为 Integer
IO.println("Type of the boxed literal 3: " + Integer.valueOf(3).getClass().getName());
// 极值
IO.println("int : [" + Integer.MIN_VALUE + ", " + Integer.MAX_VALUE + "]");
IO.println("long : [" + Long.MIN_VALUE + ", " + Long.MAX_VALUE + "]");
IO.println("double : [" + Double.MIN_VALUE + ", " + Double.MAX_VALUE + "]");
// 没有无符号整数,但有将位按无符号解释的方法
int minusOne = -1;
IO.println("-1 read as an unsigned integer: " + Integer.toUnsignedString(minusOne));
}
// 返回所接收对象所属类的完整名称
String typeName(Object o) {
return o.getClass().getName();
}
|
结果:
| > java Basics03.java
Type of integer[2] : [java.lang.Integer,4]
Type of fl[10.5] : [java.lang.Float,4]
Type of d[-4.6] : [java.lang.Double,8]
Type of s[test] : [java.lang.String]
Type of l[1000] : [java.lang.Long,8]
Type of aByte[5] : [java.lang.Byte,1]
Type of sh[-4] : [java.lang.Short,2]
Type of c[A] : [java.lang.Character,2]
Type of b[true] : [java.lang.Boolean]
Type of dec[10.67] : [java.math.BigDecimal]
Type of the boxed literal 3: java.lang.Integer
int : [-2147483648, 2147483647]
long : [-9223372036854775808, 9223372036854775807]
double : [4.9E-324, 1.7976931348623157E308]
-1 read as an unsigned integer: 4294967295
|
说明:
- 第 3 行:声明一个初始化为 2 的整数 [integer] ;
- 第 4 行:后缀 F 是必需的:字面量 10.5 的类型是 [double],编译器会拒绝 [float fl = 10.5;],因为这会导致精度损失;
- 第 7 行:字面量 1000 的类型是 [int];它会被自动转换为 [long];
- 第 12 行:[BigDecimal]数是一个对象;这里它由字符串创建,这保证了值是精确的;
- 第 14 行:[formatted]方法(Java 15)应用于一个格式化字符串:每个 %s 占位符被后面的参数转换成字符串后的值替换,每个 %d 被整数的值替换。参数按顺序取用。我们将在下一节讨论格式;
- 第 14 行:[typeName]方法(第 36–38 行)需要一个 [Object]类型的参数。类型为 [int]的变量 [integer]会被自动包装成一个 [Integer]对象,其类是 [java.lang.Integer]:这就是输出中显示的是包装类而不是基本类型名称的原因。[Integer.BYTES] (Java 8)是 [int]的字节大小;
- 第 17 行:[String] 是类,不是基本类型:在 Java 中无法获得对象的内存大小;
- 第 22 行:[boolean] 的大小在 Java 规范中没有定义:[Boolean]类没有 [BYTES]常量;
- 第 25 行:字面量 3 被显式包装成 [Integer];
- 第 27–29 行:包装类的常量 [MIN_VALUE] 和 [MAX_VALUE] 定义了取值范围的边界。注意:对于实数,[Double.MIN_VALUE] 是最小的严格正值(4.9 × 10⁻³²⁴),而不是最大的负数,后者是 [-Double.MAX_VALUE];
- 第 31–32 行:-1 被编码为 32 个置 1 的位;按无符号整数解释,这 32 位等于 2³²–1;
- 第 36–38 行:紧凑文件中的一个方法。它以字符串([return])的形式返回[String]。方法将在“向函数传递参数”一节中介绍。
注意,实数以小数点显示(10.5、-4.6),尽管程序是在法语环境下运行的。通过连接把数字转换为字符串——使用 [String.valueOf]、[toString]或 %s 说明符——并不取决于用户的语言:它始终生成小数点。只有像 %f 这样的数值格式(我们将会讨论)才遵循语言的惯例。
3.3.2. 字面量数据的表示法
数据 | 字面量示例 |
整数 [int] (32 位) | 145, -7, 0xFF(十六进制), 0b1010_1010(二进制) |
整数 [long] (64 位),后缀 L | 100000L, 1_000_000_000_000L |
浮点数 [double],可选后缀 D | 134.789, -45E-18 (-45 × 10⁻¹⁸), 10D |
实数 [float],后缀 F | 134.789F, -45E-18F |
十进制数 [BigDecimal] | 无字面量:[new BigDecimal("100000.50")] |
字符 [char] | 'A', 'b', '\n', '\u00e9' |
字符串 [String] | "today", "c:\\chap1", 文本块 """...""" |
布尔值 [boolean] | [true]、[false] |
日期 | [LocalDate.of(1954, 10, 13)] (年、月、日),表示 1954 年 10 月 13 日 |
在源代码中,浮点数始终用小数点书写。自 Java 7 起,整数可以用二进制书写(以 [0b]为前缀),并且数字组之间可以用 _ 字符分隔以提高可读性:[1_000_000] 是整数一百万。后缀 L 可以小写,但 l 太像数字 1。最后,要小心一个从 C 语言继承来的陷阱:以 0 开头书写的整数会被解释为八进制 (8 进制):017 等于 15。
字符串字面量可以包含以 \ 字符引入的转义序列 :"\n" 表示行尾字符,而不是 \ 和 n 这两个字符的序列,"\t" 表示制表符,"\"" 表示双引号,"\\" 表示 \ 字符本身。因此,要写出 Windows 路径 c:\chap1\paragraph3,你必须写成 "c:\\chap1\\paragraph3"。Java 没有 \ 字符按原样解释的“原始”字符串;不过,Java 的文件类在 Windows 上也接受 / 分隔符:"c:/chap1/paragraph3" 指的是同一个文件。
要用多个值构造字符串,Java 提供两种方法:
- 使用 + 运算符进行连接 :只要两个操作数之一是字符串,另一个就会被转换为字符串;
- 格式化:[String.format(format, value1, value2, ...)],或等价的 [format.formatted(value1, value2, ...)] (Java 15),以及用于直接显示的 [System.out.printf(format, value1, ...)]。格式字符串包含占位符,它们按顺序被后面的值替换:%s(任意值转换为字符串)、%d(整数)、%f(浮点数)、%.2f(保留两位小数的浮点数)、%x 或 %X(十六进制整数)、%,d(带千位分隔符的整数)、%e(科学计数法)、%n(换行)、%10s(右对齐到 10 个字符的字符串)、%-10s(左对齐)……数值格式遵循用户语言的惯例。
Java 不支持在花括号内包含表达式的“插值”字符串:这样的特性(称为“字符串模板”)曾在 Java 21 和 22 中作为预览提出,但后来被移除。连接和格式化仍然是仅有的选择。
自 Java 15 起,可以使用“文本块”把字符串写成多行:它以三个引号加换行开始,以三个引号结束。它可以包含未转义的引号。所有行开头的前导空白(包括含有结束引号的那一行)都会被去除,因此文本可以与代码一起缩进。不过,转义序列的解释方式与普通字符串相同:要得到 \,仍然必须写 \\。文本块非常适合编写 JSON、SQL 或 HTML。
程序 [Basics04.java] 演示了这些不同的表示法:
| // 字面量数据的写法
void main() {
// 整数:十进制、十六进制(0x)、二进制(0b),分隔符 _
int i1 = 145, i2 = -7, i3 = 0xFF, i4 = 0b1010_1010;
long l1 = 100000L, l2 = 1_000_000_000_000L;
IO.println("integers: " + i1 + " " + i2 + " " + i3 + " " + i4 + " " + l1 + " " + l2);
// 实数
double d1 = 134.789, d2 = -45E-18, d3 = 10D;
float f1 = 134.789F;
BigDecimal m1 = new BigDecimal("100000.50");
IO.println("reals: " + d1 + " " + d2 + " " + d3 + " " + f1 + " " + m1);
// 字符和布尔值
char c1 = 'A', c2 = '\u00e9';
boolean b1 = true;
IO.println("characters: " + c1 + " " + c2 + ", boolean: " + b1);
// 日期:(年,月,日)
LocalDate birth = LocalDate.of(1954, 10, 13);
IO.println("date: " + birth);
// 字符 \ 引入转义序列
String path = "c:\\chap1\\paragraph3";
IO.println(path);
IO.println("line 1\nline 2\t[tab]");
// 构建字符串:拼接或 format
String name = "dupont";
int age = 23;
IO.println(name + " is " + age + " years old, in 10 years he will be " + (age + 10) + " years old");
IO.println(String.format("%s is %d years old, in 10 years he will be %d years old", name, age, age + 10));
// formatted 方法(Java 15)作用于格式字符串本身
IO.println("d1=%.1f, i3 in hexadecimal=%X, l2=%,d".formatted(d1, i3, l2));
IO.println("i4 in binary=" + Integer.toBinaryString(i4));
IO.println("date=" + birth.format(DateTimeFormatter.ofPattern("EEEE d MMMM yyyy")));
// 文本块(Java 15):双引号无需转义
String json = """
{
"name": "dupont",
"path": "c:\\chap1"
}
""";
IO.print(json);
// 文本块和其他字符串一样:它也接受 formatted
String json2 = """
{ "name": "%s", "age": %d }""".formatted(name, age);
IO.println(json2);
}
|
结果:
| > java Basics04.java
integers: 145 -7 255 170 100000 1000000000000
reals: 134.789 -4.5E-17 10.0 134.789 100000.50
characters: A é, boolean: true
date: 1954-10-13
c:\chap1\paragraph3
line 1
line 2 [tab]
dupont is 23 years old, in 10 years he will be 33 years old
dupont is 23 years old, in 10 years he will be 33 years old
d1=134,8, i3 in hexadecimal=FF, l2=1 000 000 000 000
i4 in binary=10101010
date=mercredi 13 octobre 1954
{
"name": "dupont",
"path": "c:\chap1"
}
{ "name": "dupont", "age": 23 }
|
说明:
- 第 4 行:[0xFF] 是 255,[0b1010_1010] 是 170;
- 第 5 行:对于超出 [int]范围的字面量,后缀 L 是必需的。没有它,编译器会拒绝这一行,并给出消息 [error: integer number too large];
- 第 8 行:-45E-18 显示为 -4.5E-17:这是同一个值,只是经过了规范化。浮点数 10D 显示为 10.0:把 [double] 转换为字符串时,始终至少生成一位小数;
- 第 10 行:[BigDecimal] 保留书写时的小数位数:100000.50,而不是 100000.5;
- 第 13 行:序列 \u00e9 表示十六进制编码为 00E9 的 Unicode 字符,即 é;
- 第 17 行:日期。[LocalDate] 类(位于 [java.time]包中,Java 8)表示不含时间的日期。它转换为字符串时使用国际格式 ISO 8601(年-月-日),与语言无关。我们将在第 5 章讲解日期;
- 第 21 行:每个 \\ 表示单个 \ 字符;
- 第 23 行:一个换行符和一个制表符;
- 第 28 行:连接。[(age + 10)] 中的括号必不可少:没有它们,+ 运算符会从左到右求值,字符串会先接收 23,再接收 10,结果就会是“he will be 2310 years old”;
- 第 29 行:使用格式构造的同一段文本;
- 第 31 行:几个格式说明符:%.1f(一位小数)、%X(大写十六进制)、%,d(千位分隔符)。这些格式遵循法语惯例:小数逗号,以及作为千位分隔符的窄不换行空格;
- 第 32 行:没有二进制的说明符;由 [Integer.toBinaryString]方法执行转换;
- 第 33 行:自定义日期格式:星期几(EEEE)、日(d)、用文字表示的月份(MMMM)、年(yyyy)。星期和月份的名称是法语的,即用户的语言;
- 第 36–41 行:多行文本块。引号按原样书写。所有行共有的八个空格已被去除。序列 \\ 得到单个 \。由于结束引号单独占一行,该块以换行符结束:因此用 [IO.print]显示,它不会再换到下一行;
- 第 44–45 行:结束引号紧跟在文本之后的文本块;它不以换行符结束。[formatted] 方法用 [name] 和 [age]的值替换 %s 和 %d:这就是 Java 向文本中插入值的方式。
3.3.3. 数据声明
3.3.3.1. 声明的作用
程序操作的数据以名称和类型为特征。这些数据存储在内存中。程序编译时,编译器根据程序员所作的声明,为每个数据分配一个以地址和大小为特征的内存位置。此外,这些声明还使编译器能够检测编程错误。因此,如果 [x] 是字符串,操作 [x = x * 2;] 就会被标记为错误。
3.3.3.2. 常量声明
在 Java 中,常量是用关键字 [final]声明的变量:它只能被赋值一次。语法如下:
在整个程序中使用的常量声明在方法之外,作为类的 [static final] 字段。例如:
| static final double VAT_RATE = 0.2;
|
为什么要声明常量?
- 如果给常量起一个有意义的名称,程序更容易阅读;
- 如果需要更改“常量”,程序更容易修改。因此,如果增值税税率改为 0.25,唯一需要修改的就是定义其值的语句:[static final double VAT_RATE = 0.25;]。如果在程序中显式使用了 0.2,就需要修改许多语句。
按照惯例,在 Java 中,[static final] 常量的名称用大写字母书写,单词之间用 _ 字符分隔:[VAT_RATE]、[MAX_VALUE]。局部变量也可以声明为 [final];在这种情况下,它保留常规名称。单词 [const] 在 Java 中是保留字,但并未使用。
3.3.3.3. 变量声明
变量由名称标识,并与数据类型相关联。Java 区分大小写:变量 [END] 和 [end] 是不同的。按照惯例,变量名以小写字母开头,其后每个单词以大写字母开头:[priceExclTax], [nbChildren]。
变量可以在声明时初始化。声明一个或多个变量的语法是:
| type variable1 = value1, variable2 = value2, ...;
|
其中 [type] 是预定义类型或程序员定义的类型。初始化是可选的;不过,Java 不允许使用尚未赋值的局部变量(错误消息 [variable x might not have been initialized])。
自 Java 10 起,你还可以用关键字 [var] 代替类型,省略局部变量的类型:
[var] 并不表示变量没有特定的类型:它的类型是编译器所确定的、赋给它的值的类型。这里必须初始化,编译器才能推断出类型。[var] 只能用于局部变量(不能用于字段或方法参数)。当类型从值上就能一目了然时,尤其是变量名很长时,可以使用它。
程序 [Basics05.java] 如下:
| // 常量和变量
// 类常量:static final,名称大写
static final double VAT_RATE = 0.2;
void main() {
// 局部常量:final
final String currency = "euros";
double priceExclTax = 100;
IO.println("Price incl. tax: " + priceExclTax * (1 + VAT_RATE) + " " + currency);
// 显式指定类型的数据
int i = 2;
IO.println("Type of int i=2: " + typeName(i));
// 使用 var 的隐式类型数据(Java 10)
var j = 3;
IO.println("Type of var j=3: " + typeName(j));
var today = LocalDateTime.now();
IO.println("Type of var today: " + typeName(today));
var x = 3.5;
var y = 3.5F;
var z = 10L;
var name = "dupont";
IO.println("x : " + typeName(x) + ", y : " + typeName(y));
IO.println("z : " + typeName(z) + ", name : " + typeName(name));
// 在同一行声明多个变量
int a = 1, b, c = 3;
b = a + c;
IO.println("a=" + a + ", b=" + b + ", c=" + c);
}
// 返回所接收对象所属类的短名称和完整名称
String typeName(Object o) {
return o.getClass().getSimpleName() + "," + o.getClass().getName();
}
|
结果:
| > java Basics05.java
Price incl. tax: 120.0 euros
Type of int i=2: Integer,java.lang.Integer
Type of var j=3: Integer,java.lang.Integer
Type of var today: LocalDateTime,java.time.LocalDateTime
x : Double,java.lang.Double, y : Float,java.lang.Float
z : Long,java.lang.Long, name : String,java.lang.String
a=1, b=4, c=3
|
说明:
- 第 3 行:类常量。在紧凑文件中,在方法之外声明的变量是隐式类的字段 ;
- 第 7 行:局部常量;
- 第 9 行:结果是一个 [double],显示时至少带一位小数:120.0;
- 第 12 行:显式指定类型的值;
- 第 13 行:[getSimpleName()] (第 33 行)是类的短名称;[getName()] 是它的全名。与上一个程序一样,[int] 被包装成 [Integer] 后传递给 [typeName];
- 第 15 行:隐式指定类型的值。因为 3 的类型是 [int],所以 [j] 的类型将是 [int]。显示结果为 [Integer] ,原因与第 13 行相同;
- 第 17 行:因为 [LocalDateTime.now()] (当前日期和时间)的类型是 [LocalDateTime],所以 [today] 的类型将是 [LocalDateTime];
- 第 19–22 行:推断出的类型取决于字面量的写法:3.5 是 [double],3.5F 是 [float],10L 是 [long];
- 第 26 行:在同一行声明三个变量;只有 [a] 和 [c] 被初始化。[b] 在下一行被赋值。
隐式类型为 [var] 的变量之后不能改变其类型。因此,在第 17 行之后,语句 [today = "today";] 会被编译器拒绝:
| error: incompatible types: String cannot be converted to LocalDateTime
|
3.3.4. 缺失的值:null、包装类和 Optional
基本类型的变量,例如 [int],总是包含一个值。有时需要能够表示值不存在:未知的年龄、数据库中的空字段。在这种情况下,我们使用包装类:类型为 [Integer] 的变量是一个引用,它可以是 [null]——也就是“没有对象”。
事实上,任何引用类型的变量都可以取值 [null]:此时它不引用任何对象。尝试使用这样一个变量的成员——例如它的 [length()]方法——会导致运行时错误,即 [NullPointerException]:这是 Java 中最常见的错误。自 Java 15 起,错误消息会准确指出是哪个表达式的值为 [null]。Java 编译器不区分可能为 [null] 的引用和不可能为 null 的引用;诸如 JSpecify 项目中的注解([@Nullable]、[@NonNull])由分析工具使用,有助于弥补这一缺陷,但我们不会使用它们。
为了表明某个方法可能什么也不返回,Java 8 增加了 [Optional<T>]类:[Optional<String>]对象是一个“盒子”,其中包含一个字符串,或者为空。它通过 [Optional.of(value)]、[Optional.empty()]、或 [Optional.ofNullable(valueOrNull)]创建;通过 [isPresent()]、[isEmpty()] (Java 11)、[get()]、[orElse(defaultValue)]……来查询。[OptionalInt]、[OptionalLong]、和 [OptionalDouble] 类对基本类型起同样的作用。
从最初的示例开始,我们就会遇到值 [null] ,因为读取键盘输入的一行的方法 [IO.readln()]在没有内容可读(输入流结束)时会返回 [null] 。程序 [Basics06.java] 如下:
| // 缺失值:null、包装类和 Optional
void main() {
// int 始终有值;Integer 可以为 null
Integer age = null;
IO.println("age is null: " + (age == null));
// 自动装箱(autoboxing):int 23 变成 Integer
age = 23;
IO.println("age=" + age);
// 自动拆箱:Integer 变成 int
int n = age;
IO.println("n=" + n);
// 对值为 null 的 Integer 拆箱会抛出 NullPointerException
Integer unknown = null;
try {
int m = unknown;
IO.println("m=" + m);
} catch (NullPointerException e) {
IO.println("Unboxing null: " + e.getClass().getName());
}
// 对象引用可以为 null:此时它不指向任何对象
String firstName = null;
IO.println("firstName is null: " + (firstName == null));
// Optional(Java 8):一个包含值或为空的容器
Optional<String> name = Optional.of("dupont");
Optional<String> nickname = Optional.empty();
IO.println("name present: " + name.isPresent() + ", name has " + name.get().length() + " characters");
IO.println("nickname present: " + nickname.isPresent() + ", nickname: " + nickname.orElse("none"));
// 如果输入流已耗尽,IO.readln(Java 25)返回 null
String line = IO.readln("Type a line: ");
if (line == null) {
IO.println();
IO.println("No line: the input stream is closed");
} else {
IO.println("You typed [" + line + "]: " + line.length() + " character(s)");
}
}
|
从键盘输入时的结果:
| > java Basics06.java
age is null: true
age=23
n=23
Unboxing null: java.lang.NullPointerException
firstName is null: true
name present: true, name has 6 characters
nickname present: false, nickname: none
Type a line: hello
You typed [hello]: 5 character(s)
|
当用户按下 Ctrl-D(在 Windows 上是 Ctrl-Z 再按 Enter)关闭输入流时的结果:
| > java Basics06.java
age is null: true
age=23
n=23
Unboxing null: java.lang.NullPointerException
firstName is null: true
name present: true, name has 6 characters
nickname present: false, nickname: none
Type a line:
No line: the input stream is closed
|
说明:
- 第 4 行:[age] 不引用任何对象;
- 第 7 行:[int] 23 被自动包装:编译器为我们生成了 [age = Integer.valueOf(23);];
- 第 10 行:[Integer] 被自动拆包:编译器写出了 [int n = age.intValue();];
- 第 13–19 行:对等于 [Integer]的
*[null]* 拆包,等价于对空引用调用[intValue()]* :会抛出[NullPointerException]` 。由于第 15 行看不到任何方法调用,这个陷阱就更加隐蔽。拦截该错误的 [try / catch]*结构稍后介绍;这里显示异常的完整类名;
- 第 22 行:不引用任何对象的字符串;
- 第 25 行:包含字符串 "dupont" 的 [Optional] 。[get()]方法(第 27 行)返回其内容;应用于空的 [Optional]时,它会抛出 [NoSuchElementException]异常;
- 第 26 行:一个空的 [Optional];
- 第 28 行:[orElse] 返回 [Optional]的内容,如果它为空,则返回作为参数传入的替代值;
- 第 31 行:[IO.readln(prompt)] (Java 25)显示提示符但不换行,然后读取键盘输入的一行。如果输入流已关闭,它返回 [null] ;
- 第 32 行:检查值 [null];
- 第 36 行:在 [else]分支中,[line] is not equal to [null]: [line.length()]可以安全地使用。
3.3.5. 数字与字符串之间的转换
转换 | 方法 |
number -> string | [String.valueOf(number)]、[Integer.toString(number)]、["" + number]、或类似 [String.format("%d", number)] 的格式 |
string -> int | [Integer.parseInt(string)] |
string -> long | [Long.parseLong(string)] |
string -> double | [Double.parseDouble(string)] |
string -> float | [Float.parseFloat(string)] |
string -> BigDecimal | [new BigDecimal(string)] |
string -> boolean | [Boolean.parseBoolean(string)] |
如果字符串不表示有效的数字,把字符串转换为数字可能会失败。转换方法此时会产生一种称为异常的错误——这里是 [NumberFormatException]类型——如果不处理,它会终止程序。可以用下面的 [try / catch]子句处理这个错误:
| try {
call the method likely to throw the exception
} catch (NumberFormatException e) {
handle the exception e
}
next statement
|
如果方法没有产生异常,程序继续执行下一条语句;否则,它进入 [catch]子句的主体,然后继续执行下一条语句。我们将在专门讲解异常处理的一节回到这个主题。
方法 [parseInt]、[parseDouble]……接受前导的 + 或 - 号,但不接受空格或千位分隔符:转换之前,请使用 [trim()]方法(来自 [String]类)去除输入的前导和尾随空格。Java 库中没有一种尝试转换并返回成功标志而不是抛出异常的方法;编写一个在失败时返回空 [OptionalInt] 的方法很容易:下面的程序中的 [tryParseInt]方法就是这样做的。
程序 [Basics07.java] 演示了数字与字符串之间转换的一些技巧。该程序中的 [display] 方法把其参数的值输出到屏幕:
| // 数字与字符串之间的转换
void main() {
// 数据
final int i = 10;
final long l = 100000;
final float f = 45.78F;
double d = -14.98;
// 数字 → 字符串
display(String.valueOf(i));
display(Long.toString(l));
display(String.valueOf(f));
display("" + d);
// 布尔值 → 字符串
final boolean b = false;
display(String.valueOf(b));
// 字符串 → int
int i1 = Integer.parseInt("10");
display(String.valueOf(i1));
try {
i1 = Integer.parseInt("10.67");
display(String.valueOf(i1));
} catch (NumberFormatException e) {
display("Error: " + e.getMessage());
}
// 字符串 → long
long l1 = Long.parseLong("100");
display(String.valueOf(l1));
try {
l1 = Long.parseLong("10.675");
display(String.valueOf(l1));
} catch (NumberFormatException e) {
display("Error: " + e.getMessage());
}
// 字符串 → double:小数分隔符始终是点
double d1 = Double.parseDouble("100.87");
display(String.valueOf(d1));
try {
d1 = Double.parseDouble("abcd");
display(String.valueOf(d1));
} catch (NumberFormatException e) {
display("Error: " + e.getMessage());
}
// 字符串 → float
float f1 = Float.parseFloat("100.87");
display(String.valueOf(f1));
try {
f1 = Float.parseFloat("100,87");
display(String.valueOf(f1));
} catch (NumberFormatException e) {
display("Error: " + e.getMessage());
}
// 字符串 → BigDecimal
BigDecimal m1 = new BigDecimal("100.87");
display(m1.toString());
// 不抛异常的转换:我们的方法返回 OptionalInt
OptionalInt i2 = tryParseInt("123");
if (i2.isPresent()) {
display("tryParseInt(\"123\") succeeded: " + i2.getAsInt());
}
OptionalInt i3 = tryParseInt("12x");
if (i3.isEmpty()) {
display("tryParseInt(\"12x\") failed");
}
// 用户的语言(“locale”)只在格式化时起作用
display("Current locale: " + Locale.getDefault().toLanguageTag());
display(String.format("%.2f", d1));
display(String.format(Locale.ROOT, "%.2f", d1));
// 读取法式写法的数字:NumberFormat 类
try {
Number number = NumberFormat.getInstance(Locale.FRANCE).parse("100,87");
display("NumberFormat : " + number.doubleValue());
} catch (ParseException e) {
display("Error: " + e.getMessage());
}
}
// 显示其参数的方法
void display(String s) {
IO.println("S=" + s);
}
// 将字符串转换为整数而不抛出异常
OptionalInt tryParseInt(String text) {
try {
return OptionalInt.of(Integer.parseInt(text));
} catch (NumberFormatException _) {
return OptionalInt.empty();
}
}
|
结果:
| > java Basics07.java
S=10
S=100000
S=45.78
S=-14.98
S=false
S=10
S=Error: For input string: "10.67"
S=100
S=Error: For input string: "10.675"
S=100.87
S=Error: For input string: "abcd"
S=100.87
S=Error: For input string: "100,87"
S=100.87
S=tryParseInt("123") succeeded: 123
S=tryParseInt("12x") failed
S=Current locale: fr-FR
S=100,87
S=100.87
S=NumberFormat : 100.87
|
说明:
- 第 4–7 行:要转换的数据;
- 第 10–13 行:把数字转换为字符串的四种方法。最后一种是把空字符串与数字连接起来;
- 第 17 行:显示布尔值——[true] 或 [false];
- 第 22–27 行:处理 [Integer.parseInt]可能抛出的异常。[e.getMessage()] 是与异常 [e]关联的错误消息。JDK 的异常消息是英文的:它们不会被翻译;
- 第 40 行:[Double.parseDouble] 始终要求使用小数点,与用户的语言无关:字符串“100.87”在所有机器上的解释都相同。这是从文件中读取数字或在程序之间交换数据时的正确做法;
- 第 53 行:因此,小数逗号会被拒绝;
- 第 60 行:使用 [BigDecimal]转换字符串;该方法同样要求使用小数点;
- 第 64–71 行:[tryParseInt] 方法(第 92–98 行)返回一个 [OptionalInt] ,如果转换成功,它包含该整数,否则为空。[getAsInt()] 返回其中包含的整数;
- 第 74 行:[Locale.getDefault()] 返回程序的区域设置——即由系统设置确定的用户语言和国家:这里是 fr-FR;
- 第 75 行:格式使用当前区域设置:浮点数用小数逗号书写;
- 第 76 行:[Locale.ROOT] 是一个中性的区域设置,无论机器如何,都使用句点作为小数分隔符。它用于在文件中或程序间交换时写出格式化的数字,这些场合不得依赖用户的语言;
- 第 79 行:要读取按法语惯例书写的数字,请使用针对 [NumberFormat]区域设置 [java.text]获得的 [Locale.FRANCE]对象(位于 [parse] 包中)。它的 [Number]方法返回一个 [ParseException]对象,并可能抛出 受检异常。这是一个受检异常:编译器要求必须处理它,我们将在异常一节中解释;
- 第 87–89 行:紧凑文件中的一个方法。方法可以按任意顺序书写,在 [main]之前或之后均可;
- 第 92–98 行:[tryParseInt]方法。[catch]子句中的变量名为 _:自 Java 22 起,这个字符表示匿名变量,声明它是因为语法要求,但实际上并不使用它。
请记住,[parseXXX] 和 [toString] 方法忽略用户的语言(使用小数点),而格式和 [NumberFormat]类则遵循用户的语言。读取数字的程序必须始终知道这些数字是按哪种惯例书写的。
3.3.6. 数据数组
Java 数组是一个对象,可以把相同类型的数据归并在同一个标识符之下。它的声明如下:
| Type[] array = new Type[n];
|
[n] 是数组可以包含的数据元素个数。语法 [array[i]] 表示第 i 个数据元素,其中 i 属于区间 [0, n-1]。任何对数据项 [array[i]] 的引用,如果 i 不在 [0, n-1] 范围内,就会导致 [ArrayIndexOutOfBoundsException]异常。创建时,数组的每个元素都会被赋予其类型的默认值:数值为 0,布尔值为 [false] ,引用类型为 [null] 。数组可以在声明的同时初始化:
| int[] integers = new int[]{0, 10, 20, 30};
|
或者,在声明中更简单地写成:
| int[] values = {0, 10, 20, 30, 40};
|
数组有一个字段 [length] (不带括号),表示元素个数。数组创建之后不能改变大小:对于会增长的集合,要使用列表(第 5 章)。你还会遇到从 C 语言继承来的写法 [int integers[]]:它可以被接受,但不推荐。
Java 没有真正的二维数组:带有两个下标的数组是一个数组的数组。声明
| Type[][] array = new Type[n][m];
|
创建一个包含 [n] 个元素的数组,其中每个元素都是对一个包含 [m] 个元素的数组的引用:[n] 行和 [m] 列。语法 [array[i][j]] 表示第 i 行的第 j 个元素。[array.length] 是行数,[array[i].length] 是第 i 行的元素个数。数组也可以在声明的同时初始化:
| double[][] reals = {{0.5, 1.7}, {8.4, -6}};
|
由于每一行都是独立的数组,各行的长度可以不同(这称为“阶梯数组”)。声明
| Type[][] array = new Type[n][];
|
创建一个包含 n 个元素的数组,其中每个元素都是一个一维数组的引用。上面的声明并不会初始化这些引用:它们的值为 [null]。
Java 不提供从数组末尾开始计数的下标,也没有提取一段元素范围的记法。最后一个元素写作 [array[array.length - 1]],而方法 [Arrays.copyOfRange(array, start, end)] 返回一个新数组,由下标从 [start](含)到 [end] (不含)的元素组成。[java.util.Arrays]类还提供许多其他工具方法:[toString]、[deepToString]、[sort]、[fill]、[equals]、[copyOf]……更灵活的列表自 Java 21 起拥有 [getFirst()] 和 [getLast()] 方法。
程序 [Basics08.java] 结合使用了这几种数组:
| // 数组
void main() {
// 已初始化的一维数组
int[] integers = new int[]{0, 10, 20, 30};
for (int i = 0; i < integers.length; i++) {
IO.println("integers[" + i + "]=" + integers[i]);
}
// 二维数组:由等长数组组成的数组
double[][] reals = {{0.5, 1.7}, {8.4, -6}};
for (int i = 0; i < reals.length; i++) {
for (int j = 0; j < reals[i].length; j++) {
IO.println("reals[" + i + "][" + j + "]=" + reals[i][j]);
}
}
IO.println("reals=" + Arrays.deepToString(reals));
// 由不等长数组组成的数组(锯齿数组)
String[][] names = new String[3][];
for (int i = 0; i < names.length; i++) {
names[i] = new String[i + 1];
}
// 初始化
for (int i = 0; i < names.length; i++) {
for (int j = 0; j < names[i].length; j++) {
names[i][j] = "name" + i + j;
}
}
// 显示
for (int i = 0; i < names.length; i++) {
for (int j = 0; j < names[i].length; j++) {
IO.println("names[" + i + "][" + j + "]=" + names[i][j]);
}
}
// 不带初始值创建的数组:元素为该类型的默认值
boolean[] flags = new boolean[3];
String[] strings = new String[2];
IO.println("flags[0]=" + flags[0] + ", strings[0] is null: " + (strings[0] == null));
// 初始化的简写形式
int[] values = {0, 10, 20, 30, 40};
// Arrays.toString 用数组的元素构建字符串
IO.println("values=" + Arrays.toString(values));
// 最后一个和倒数第二个元素
IO.println("last=" + values[values.length - 1] + ", second-to-last=" + values[values.length - 2]);
// 数组的一部分:下标 1 和 2 的元素(不含结束边界)
int[] slice = Arrays.copyOfRange(values, 1, 3);
IO.println("copyOfRange(values, 1, 3)=" + Arrays.toString(slice));
int[] end = Arrays.copyOfRange(values, 2, values.length);
IO.println("copyOfRange(values, 2, length)=" + Arrays.toString(end));
// 切片是副本:原数组不会被修改
slice[0] = 100;
IO.println("slice[0]=" + slice[0] + ", values[1]=" + values[1]);
// 列表(第 5 章)提供 getFirst 和 getLast(Java 21)
List<String> friends = List.of("paul", "hélène", "jacques");
IO.println("first friend=" + friends.getFirst() + ", last friend=" + friends.getLast());
}
|
结果:
| > java Basics08.java
integers[0]=0
integers[1]=10
integers[2]=20
integers[3]=30
reals[0][0]=0.5
reals[0][1]=1.7
reals[1][0]=8.4
reals[1][1]=-6.0
reals=[[0.5, 1.7], [8.4, -6.0]]
names[0][0]=name00
names[1][0]=name10
names[1][1]=name11
names[2][0]=name20
names[2][1]=name21
names[2][2]=name22
flags[0]=false, strings[0] is null: true
values=[0, 10, 20, 30, 40]
last=40, second-to-last=30
copyOfRange(values, 1, 3)=[10, 20]
copyOfRange(values, 2, length)=[20, 30, 40]
slice[0]=100, values[1]=10
first friend=paul, last friend=jacques
|
说明:
- 第 4 行:初始化一个一维数组;
- 第 5 行:[for] 循环遍历从 0 到 [integers.length - 1]的下标。[for] 循环将在下文介绍;
- 第 10 行:二维数组(2 行 2 列)。整数 -6 被转换为浮点数 -6.0;
- 第 11–12 行:[reals.length] 是行数,[reals[i].length] 是第 i 行的列数;
- 第 16 行:[Arrays.deepToString] 显示数组的数组;
- 第 19 行:包含 3 个元素的数组 [names] 。每个元素都是对 [String[]]类型数组的引用,目前为 [null];
- 第 21 行:数组 [names] 的 3 个元素被初始化。[names[i]] 现在引用一个包含 i+1 个字符串的数组;
- 第 26 行:[names[i][j]] 是由 [names[i]]引用的数组的第 j 个元素。表达式 "name" + i + j 从左到右求值:"name" + i 得到一个字符串,再把 j 连接到它后面;
- 第 37–38 行:不带初始值创建的数组:其元素具有各自类型的默认值;
- 第 42 行:初始化的简写形式;
- 第 44 行:[Arrays.toString] 方法用数组的元素构造一个字符串。如果直接显示数组([IO.println(values)]),得到的将是类似 [I@6328d34a 的文本(数组的类型和一个数字编码),而不是它的内容;
- 第 46 行:最后一个和倒数第二个元素;
- 第 48 行:下标为 1 和 2 的元素;
- 第 50 行:从下标 2 开始直到末尾的元素;
- 第 53–54 行:[copyOfRange] 创建一个副本:修改 [slice] 不会修改 [values];
- 第 56–57 行:由 [List.of]创建的不可修改列表,以及它的 [getFirst()] 和 [getLast()] 方法(Java 21)。
3.4. Java 的基本语句
有两类:
考虑微型计算机及其外围设备的结构,就能清楚地理解基本指令:
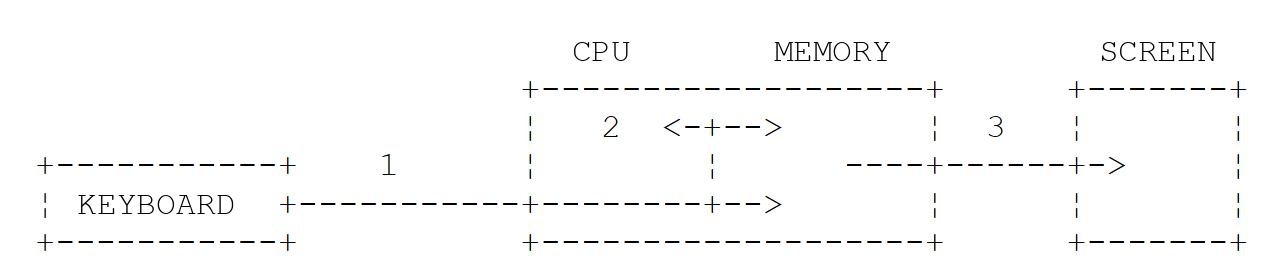
- 1:从键盘读取信息;
- 2:处理信息;
- 3:把信息写到屏幕上。
3.4.1. 写到屏幕
有多种向屏幕写入的指令:
| System.out.println(expression);
System.err.println(expression);
IO.println(expression);
|
其中 [expression] 是可以转换为字符串以便在屏幕上显示的任何数据。所有 Java 对象都有一个 [toString()]方法用于完成这种转换;基本类型的值由 [String.valueOf]转换。[print]方法的作用与 [println] 相同,只是不换到下一行,而 [printf(format, value1, ...)]方法则以特定格式写出结果。
[System]类提供对两个写入流的访问,即它的静态字段 [out] 和 [err],类型为 [PrintStream]:
- [System.out.println()] 写入流 [out],即标准输出,它通常与屏幕相关联;
- [System.err.println()] 写入 [err]流,即错误输出,它通常也与屏幕相关联。
[IO]类(Java 25)提供了 [println] 和 [print]方法,它们写入 [System.out]。[out] 和 [err] 流可以在运行时重定向到文件,我们稍后会看到。
3.4.2. 读取从键盘输入的数据
来自键盘的数据流由字段 [System.in]标识,类型为 [InputStream]。它是字节流,直接使用并不方便。很长一段时间里,要读取一行文本,必须把它包装进其他对象:
| BufferedReader keyboard = new BufferedReader(new InputStreamReader(System.in));
String line = keyboard.readLine();
|
或者使用 [Scanner]类(Java 5)。从 Java 25 开始,[IO]类提供了一个简单得多的方法 [readln],有两种形式:
| String line = IO.readln();
String line = IO.readln("prompt: ");
|
在键盘上输入的一行(不含行尾字符)被存入变量 [line] ,随后程序就可以处理它。第二种形式先显示提示符,但不换行。如前所述,输入流耗尽时 [readln] 返回 [null] 。流 [System.in] 可以重定向到文件,就像 [out] 和 [err]流一样。最后,请注意由 [Console]类,它派生自 [System.console()],其方法 [readPassword] 可以在不显示密码的情况下读取密码。
3.4.3. 输入/输出示例
程序 [Basics09.java] 演示了键盘和屏幕的输入/输出操作:
| // 键盘/屏幕输入输出
void main() {
// 写入 System.out 流
Object obj = new Object();
System.out.println(obj);
// 写入 System.err 流
int i = 10;
System.err.println("i=" + i);
System.err.printf("i=%d%n", i);
// 显示提示后读取键盘输入的一行
String line = IO.readln("Type a line: ");
IO.println("line=" + line);
}
|
结果:
| > java Basics09.java
java.lang.Object@32464a14
i=10
i=10
Type a line: here I am
line=here I am
|
说明:
- 第 4 行:[obj] 是一个对象引用;
- 第 5 行:[obj] 显示在屏幕上。调用 [obj.toString()] 方法来获取要显示的文本;
- 第 9 行:数据被写入 [err]流;
- 第 10 行:同样的事情,但使用格式。第一个参数 "i=%d%n," 是显示格式;其他参数是要显示的值:%d 被 [i]的值替换,%n 被系统的行尾字符替换(Windows 上是 \r\n,Linux 和 macOS 上是 \n);
- 第 13 行:显示提示符但不换行,然后读取在键盘上输入的一行;
- 第 14 行:如果 [line] 等于 [null],连接会产生字符串 "null"。
在结果中:
- 第 2 行:由代码第 5 行产生的输出。[Object]类的 [toString()]方法返回对象的完整类名,后跟 @ 字符和一个十六进制数字编码(它的“哈希码”),在不同的执行或机器上可能不同。类通常会重写该方法,以显示更有用的内容,我们将在第 4 章这样做;
- 第 3–4 行:对 [err]流的两次写入,与对 [out]流的写入一样显示在屏幕上。
3.4.4. 输入/输出重定向
Windows、Linux 和 macOS 识别三个标准设备:
- 标准输入设备,默认指键盘,编号为 0;
- 标准输出设备,默认指屏幕,编号为 1;
- 标准错误设备,默认指屏幕,编号为 2。
在 Java 中,写入流 [System.out] 写入设备 1,写入流 [System.err] 写入设备 2,读取流 [System.in] 从设备 0 读取数据。
在命令窗口中运行程序时,可以指定被执行程序的设备 0、1 和 2 分别是什么。在程序参数之后,可以把标准输入和输出设备重定向到文件:
重定向 | 含义 |
0<in.txt 或 <in.txt | 标准输入流 0 被重定向到文件 in.txt。因此在程序中,流 [System.in] 将从文件 in.txt 读取数据 |
1>out.txt 或 >out.txt | 把输出 1 重定向到文件 out.txt。因此在程序中,流 [System.out] 将把数据写入文件 out.txt |
1>>out.txt 或 >>out.txt | 同上,但写入的数据会追加到 out.txt 文件的现有内容之后 |
2>err.txt | 把输出 2 重定向到文件 err.txt。因此在程序中,流 [System.err] 将把数据写入文件 err.txt |
2>>err.txt | 同上,但写入的数据会追加到文件 err.txt 的现有内容之后 |
1>out.txt 2>err.txt | 设备 1 和 2 都被重定向到文件 |
请注意,要把程序的输入/输出流重定向到文件,无需修改程序:设备 0、1 和 2 的性质由操作系统决定。看下面的程序 [Basics10.java]:
| // 输入输出流的重定向
void main() {
// 读取 System.in 流
String data = IO.readln();
// 写入 System.out 流
System.out.println("writing to the out stream: " + data);
// 写入 System.err 流
System.err.println("writing to the err stream: " + data);
}
|
重定向作用于由 [java]命令启动的程序。下面是在 Linux 终端(bash)中的一次会话:
| > echo test > in.txt
> cat in.txt
test
> java Basics10.java < in.txt > out.txt 2> err.txt
> cat out.txt
writing to the out stream: test
> cat err.txt
writing to the err stream: test
> java Basics10.java < in.txt 2> err.txt
writing to the out stream: test
> java Basics10.java < in.txt > out.txt
writing to the err stream: test
|
说明:
- 第 1 行:我们把字符串 "test" 放入文件 in.txt;
- 第 2 行:显示文件 in.txt 的内容以便验证;
- 第 4 行:运行程序。流 [System.in] 被重定向到文件 in.txt,流 [System.out] 被重定向到文件 out.txt,流 [System.err] 被重定向到文件 err.txt。执行时没有任何输出;
- 第 5–6 行:文件 out.txt 的内容表明读取了文件 in.txt,并且对 [out] 流的写入被重定向到了 out.txt;
- 第 7–8 行:对文件 err.txt 的类似验证;
- 第 9–10 行:只有 [err]流被重定向:屏幕只显示对 [out]流的写入操作;
- 第 11–12 行:只有 [out]流被重定向:屏幕只显示对 [err]流的写入操作。
很明显,[out] 和 [err] 流并不写入同一个设备,因为它们可以被分别重定向。[err]流用于错误消息:这样你可以把程序的输出重定向到文件,同时仍然在屏幕上看到它的错误消息。
运算符 >、>> 和 2> 在 Windows 命令提示符([cmd])、PowerShell 和 bash 中的写法相同。< 运算符被 [cmd] 和 bash 识别,但 PowerShell 不识别,它把这个运算符保留供将来使用:在 PowerShell 中,要通过管道(|)把文件送入程序的标准输入。下面这些命令仅作说明之用(本课程中并未执行),它们在 Windows 上完成上面 bash 会话所做的事:
| rem Windows command prompt (cmd)
echo test>in.txt
java Basics10.java <in.txt >out.txt 2>err.txt
type out.txt
type err.txt
# PowerShell
"test" > in.txt
Get-Content in.txt | java Basics10.java > out.txt 2> err.txt
Get-Content out.txt
Get-Content err.txt
|
3.4.5. 把表达式的值赋给变量
这里我们关注的是 [variable = expression;]操作。表达式可以是算术、关系、布尔、字符串等各种类型。
3.4.5.1. 赋值操作的解释
操作 [variable = expression;] 本身就是一个表达式,其求值过程如下:
- 计算赋值号右侧:结果是一个值 V;
- 把值 V 赋给变量;
- 值 V 同时也是该赋值的值,此时把赋值看作表达式。
这就是操作 [V1 = V2 = expression] 有效的原因。由于 = 运算符从右到左求值,我们得到 [V1 = (V2 = expression)]。表达式 [V2 = expression] 被求值,其值为 V。它的求值使 V 被赋给 V2。接着下一个 = 运算符被求值为 [V1 = V]。该表达式的值仍然是 V;它的求值使 V 被赋给 V1。因此,操作 [V1 = V2 = expression] 是一个表达式,它的求值:
- 使 [expression]的值被赋给变量 V1 和 V2;
- 返回 [expression]的值。
这可以推广到形如 [V1 = V2 = ... = Vn = expression]的表达式。
3.4.5.2. 算术表达式
算术表达式中使用的运算符如下:
运算符 | 作用 |
+ | 加法 |
- | 减法 |
* | 乘法 |
/ | 除法:如果至少有一个操作数是实数,结果是精确的商。如果两个操作数都是整数,结果是整数商。因此,5/2 等于 2,而 5.0/2 等于 2.5 |
% | 除法的余数(取模),与操作数的性质无关。余数与被除数同号:-5 % 2 等于 -1。方法 [Math.floorMod(-5, 2)] 返回数学意义上的余数,与除数同号:1 |
有各种数学函数。下面列出几个:
函数 | 作用 |
[double sqrt(double x)] | 平方根 |
[double cos(double x)]、[sin]、[tan] | 余弦、正弦、正切(角度以弧度计) |
[double pow(double x, double y)] | x 的 y 次幂 |
[double exp(double x)] | 指数 |
[double log(double x)]、[log10] | 自然对数、常用对数 |
[abs(x)]、[max(x, y)]、[min(x, y)] | 绝对值、最大值、最小值(适用于 int、long、float 和 double 类型) |
[double floor(double x)]、[ceil] | 向下取整、向上取整 |
[long round(double x)]、[double rint(double x)] | 四舍五入到最接近的整数 |
[clamp(value, min, max)] | 把值限制到区间 [min, max](Java 21) |
[Math.PI]、[Math.E] | 常量 π 和 e |
所有这些函数都是名为 [Math] 的 Java 类(位于 [java.lang]包中)的静态方法。使用它们时,必须在前面加上定义它们的类的名称。因此,你应该这样写:
| double x, y = 4;
x = Math.sqrt(y);
|
[Math]类的完整说明可以在 Java 在线文档中找到:docs.oracle.com/en/java/javase/25/docs/api/java.base/java/lang/Math.html。
[double] 类型的实数 以二进制编码:大多数十进制数,例如 0.1,在这种表示中只有近似值。这对科学计算无关紧要,但对金额来说是不可接受的。相反,[BigDecimal]类(位于 [java.math]包中)可以精确地表示十进制数,位数不限。由于 Java 不允许重新定义运算符,计算通过方法来进行:[add]、[subtract]、[multiply]、[divide]、[compareTo]……[BigDecimal] 是不可变的:一个操作不会修改被施加该操作的对象,而是返回一个新对象。
程序 [Basics11.java] 如下:
| // 算术表达式
void main() {
// 整数除法和实数除法
IO.println("5 / 2 = " + 5 / 2 + ", 5.0 / 2 = " + 5.0 / 2 + ", 5 / 2.0 = " + 5 / 2.0);
// 除法的余数(取模)
IO.println("5 % 2 = " + 5 % 2 + ", -5 % 2 = " + -5 % 2 + ", 5.5 % 2 = " + 5.5 % 2);
IO.println("Math.floorMod(-5, 2) = " + Math.floorMod(-5, 2));
// 实数除以零:不报错,得到无穷大或 NaN(Not a Number)
double zero = 0;
IO.println("1 / 0.0 = " + 1 / zero + ", 0 / 0.0 = " + 0 / zero);
// 整数除以零:抛出异常
int integerZero = 0;
try {
IO.println(1 / integerZero);
} catch (ArithmeticException e) {
IO.println("1 / 0 : " + e.getClass().getSimpleName() + " - " + e.getMessage());
}
// Math 类的若干方法
double x, y = 4;
x = Math.sqrt(y);
IO.println("Math.sqrt(4) = " + x);
IO.println("Math.pow(2, 10) = " + Math.pow(2, 10));
IO.println("Math.abs(-3.5) = " + Math.abs(-3.5) + ", Math.max(3, 7) = " + Math.max(3, 7));
IO.println("Math.PI = " + Math.PI + ", Math.cos(Math.PI) = " + Math.cos(Math.PI));
IO.println("Math.exp(1) = " + Math.exp(1) + ", Math.log(Math.E) = " + Math.log(Math.E));
IO.println("Math.floor(-2.5) = " + Math.floor(-2.5) + ", Math.ceil(-2.5) = " + Math.ceil(-2.5));
// Math.round 四舍五入到最接近的整数,对半向上取整;返回 long
IO.println("Math.round(2.5) = " + Math.round(2.5) + ", Math.round(-2.5) = " + Math.round(-2.5));
// Math.rint 对半取最接近的偶数
IO.println("Math.rint(2.5) = " + Math.rint(2.5) + ", Math.rint(3.5) = " + Math.rint(3.5));
// Math.clamp(Java 21)将值限制在一个区间内
IO.println("Math.clamp(150, 0, 100) = " + Math.clamp(150, 0, 100));
// 优先级:* / % 先于 + -
IO.println("2 + 3 * 4 = " + (2 + 3 * 4) + ", (2 + 3) * 4 = " + (2 + 3) * 4);
IO.println("10 - 4 - 3 = " + (10 - 4 - 3) + ", \"x\" + 1 + 2 = " + "x" + 1 + 2);
// 赋值是表达式:连续赋值
int v1, v2;
v1 = v2 = 7 * 6;
IO.println("v1=" + v1 + ", v2=" + v2);
// double 实数是二进制近似值
IO.println("0.1 + 0.2 = " + (0.1 + 0.2));
// BigDecimal 以十进制精确计算
BigDecimal a = new BigDecimal("0.1"), b = new BigDecimal("0.2");
IO.println("BigDecimal : 0.1 + 0.2 = " + a.add(b));
BigDecimal price = new BigDecimal("19.99");
BigDecimal total = price.multiply(BigDecimal.valueOf(3));
IO.println("3 x 19.99 = " + total + ", with VAT = " + total.multiply(new BigDecimal("1.2")));
// 舍入到 2 位小数,对半向上取整(商业舍入)
IO.println("2.565 rounded = " + new BigDecimal("2.565").setScale(2, RoundingMode.HALF_UP));
// 除不尽的除法需要指定精度
IO.println("10 / 3 = " + BigDecimal.TEN.divide(BigDecimal.valueOf(3), MathContext.DECIMAL64));
}
|
结果:
| > java Basics11.java
5 / 2 = 2, 5.0 / 2 = 2.5, 5 / 2.0 = 2.5
5 % 2 = 1, -5 % 2 = -1, 5.5 % 2 = 1.5
Math.floorMod(-5, 2) = 1
1 / 0.0 = Infinity, 0 / 0.0 = NaN
1 / 0 : ArithmeticException - / by zero
Math.sqrt(4) = 2.0
Math.pow(2, 10) = 1024.0
Math.abs(-3.5) = 3.5, Math.max(3, 7) = 7
Math.PI = 3.141592653589793, Math.cos(Math.PI) = -1.0
Math.exp(1) = 2.718281828459045, Math.log(Math.E) = 1.0
Math.floor(-2.5) = -3.0, Math.ceil(-2.5) = -2.0
Math.round(2.5) = 3, Math.round(-2.5) = -2
Math.rint(2.5) = 2.0, Math.rint(3.5) = 4.0
Math.clamp(150, 0, 100) = 100
2 + 3 * 4 = 14, (2 + 3) * 4 = 20
10 - 4 - 3 = 3, "x" + 1 + 2 = x12
v1=42, v2=42
0.1 + 0.2 = 0.30000000000000004
BigDecimal : 0.1 + 0.2 = 0.3
3 x 19.99 = 59.97, with VAT = 71.964
2.565 rounded = 2.57
10 / 3 = 3.333333333333333
|
说明:
- 第 4 行:两个整数相除是整数除法。在这个连接表达式中,除法先于 + 运算符执行,因为 / 运算符的优先级更高(见下文);
- 第 6 行:余数与被除数同号;% 运算符也适用于实数;
- 第 7 行:[Math.floorMod] 返回与除数同号的余数;
- 第 10 行:实数除以零不会导致错误;它返回无穷大([Infinity]),对于 0/0 则返回特殊值 [NaN] (“Not a Number”);
- 第 12–17 行:不过,把整数除以零会抛出 [ArithmeticException]异常;
- 第 20–21 行:上面的例子。[Math.sqrt] 被转换为 [double]:2.0;
- 第 27 行:[floor] 向下取整,[ceil] 向上取整。要把实数向零截断,需要把它转换为整数,我们稍后会看到;
- 第 29 行:[Math.round] 四舍五入到最接近的整数;恰好位于两个整数正中间的值向上取整:2.5 变为 3,-2.5 变为 -2。结果是 [long];
- 第 31 行:[Math.rint] 把位于正中间的值舍入到最接近的偶数整数(“银行家”舍入):2.5 变为 2,3.5 变为 4。结果是 [double];
- 第 33 行:[Math.clamp] (Java 21)把 150 拉回到区间 [0, 100];
- 第 36 行:运算符优先级,见下文;
- 第 37 行:"x" + 1 + 2 从左到右求值:"x" + 1 得到字符串 "x1",再把 2 连接到它后面。要先执行加法,必须写成 "x" + (1 + 2);
- 第 41 行:多重赋值;
- 第 45 行:0.1 和 0.2 没有精确的二进制表示:它们的和并不恰好等于 0.3;
- 第 47 行:由字符串创建的两个 [BigDecimal] 对象。不要写 [new BigDecimal(0.1)]:这样参数会是 [double] 0.1,它的精确值是 0.1000000000000000055511151231257827021181583404541015625。不过,使用字符串 "0.1" 的 [BigDecimal.valueOf(0.1)]是可行的;
- 第 48 行:精确的加法;
- 第 49–51 行:[BigDecimal.valueOf(3)] 转换一个整数。乘积的小数位数等于两个因子小数位数之和:59.97 × 1.2 = 71.964;
- 第 53 行:[setScale(2, RoundingMode.HALF_UP)] 舍入到两位小数,位于两个数字正中间的值向远离零的方向舍入:这是商业舍入;
- 第 55 行:10/3 没有有限的十进制表示。因此 [divide]方法需要指定精度,这里给出的是 [MathContext.DECIMAL64] (16 位有效数字)。没有它,除法会导致 [ArithmeticException]:[Non-terminating decimal expansion; no exact representable decimal result.]
3.4.5.3. 算术表达式求值时的运算顺序
求值算术表达式时,运算符的优先级顺序如下(从高到低):
| [functions], [( )], [*, /, %], [+, -]
|
同一方括号 [ ] 块内的运算符具有相同的优先级。优先级相同时,从左到右求值:10 - 4 - 3 的计算结果为 (10 - 4) - 3 = 3。
3.4.5.4. 关系表达式
运算符有:<、<=、==、!=、>、>=。它们的优先级是:
如果表达式为假,关系表达式的结果是布尔值 [false] ,否则是 [true] 。
| int x = 5;
boolean end = x > 4;
|
比较两个字符
设 C1 和 C2 是两个字符。可以使用运算符 <、<=、==、!=、>、>= 比较它们。比较的是它们的 Unicode 编码——也就是数字。按照 Unicode 顺序,有如下关系:
| space < .. < '0' < '1' < .. < '9' < .. < 'A' < 'B' < .. < 'Z' < .. < 'a' < 'b' < .. < 'z' < .. < 'é'
|
比较两个字符串
逐个字符进行比较。两个字符之间遇到的第一个不相等之处,决定字符串之间同方向的不等关系。考虑比较字符串 "Cart" 和 "Cat":
| "Cart" "Cat"
---------------------
'C' = 'C'
'a' = 'a'
'r' < 't'
|
最后这个不等式使我们能够得出 "Cart" < "Cat"。再考虑比较字符串 "Cat" 和 "Catkin"。它们在字符串 "Cat" 耗尽之前都相等。在这种情况下,先耗尽的字符串被判定为“较小”。因此我们有关系 "Cat" < "Catkin"。
比较两个字符串的方法
警告:这是 Java 中的一个经典陷阱。应用于两个字符串——或任意两个对象——时,运算符 == 和 != 比较的是引用,而不是内容。[s1 == s2] 为真,表示两个变量引用内存中的同一个对象,而不是两个字符串包含相同的字符。要测试两个字符串是否相等,请使用 [equals]方法(来自 [String]类),或者用 [equalsIgnoreCase] 来忽略大小写差异。运算符 <、<=、> 和 >= 不适用于字符串:必须使用 [compareTo]方法(或 [compareToIgnoreCase])。它返回一个整数:
- 如果两个字符串相等,返回零;
- 如果字符串 1 大于字符串 2,返回正数;
- 如果字符串 1 小于字符串 2,返回负数。
[compareTo] 逐个字符比较 Unicode 编码:结果是前两个不同字符的编码之差,或者当其中一个字符串是另一个的开头部分时,结果是长度之差。这不是字典顺序:因为 'é' 的编码(233)大于 'f' 的编码(102),所以 "élan" 排在 "face" 之后。要对面向用户的文本排序,请使用 [Collator]对象([java.text]包),它应用特定语言的排序规则。[compareTo] 仍然是标识符、关键字和文件名的正确比较方法。
程序 [Basics12.java]如下:
| // 关系表达式和字符串比较
void main() {
int x = 5;
boolean end = x > 4;
IO.println("x > 4 : " + end + ", x == 5 : " + (x == 5) + ", x != 5 : " + (x != 5));
// 比较字符:比较它们的 Unicode 码
IO.println("'a' < 'b' : " + ('a' < 'b') + ", 'Z' < 'a' : " + ('Z' < 'a')
+ ", '9' < 'A' : " + ('9' < 'A'));
IO.println("codes: 'A'=" + (int) 'A' + ", 'a'=" + (int) 'a' + ", 'é'=" + (int) 'é');
// 用 equals 和 compareTo 比较字符串
String string1 = "cat", string2 = "dog";
int n = string1.compareTo(string2);
boolean equal = string1.equals(string2);
IO.println("n=" + n + ", equal=" + equal);
IO.println("\"Cat\".compareTo(\"Catkin\") : " + "Cat".compareTo("Catkin"));
// == 比较的是引用,而不是字符串的内容
String string3 = "ca".concat("t");
IO.println("string3=" + string3 + ", string1 == string3 : " + (string1 == string3)
+ ", string1.equals(string3) : " + string1.equals(string3));
// compareTo 逐字符比较 Unicode 码
IO.println("\"élan\".compareTo(\"face\") : " + "élan".compareTo("face"));
IO.println("\"Cat\".compareTo(\"cat\") : " + "Cat".compareTo("cat"));
// 忽略大小写(大写/小写)
IO.println("\"Cat\".compareToIgnoreCase(\"cat\") : " + "Cat".compareToIgnoreCase("cat"));
IO.println("\"Cat\".equals(\"cat\") : " + "Cat".equals("cat"));
IO.println("\"Cat\".equalsIgnoreCase(\"cat\") : " + "Cat".equalsIgnoreCase("cat"));
// Collator 按某种语言的排序规则进行比较
Collator collator = Collator.getInstance(Locale.FRENCH);
IO.println("collator.compare(\"élan\", \"face\") : " + collator.compare("élan", "face"));
IO.println("collator.compare(\"Cat\", \"cat\") : " + collator.compare("Cat", "cat"));
}
|
结果:
| > java Basics12.java
x > 4 : true, x == 5 : true, x != 5 : false
'a' < 'b' : true, 'Z' < 'a' : true, '9' < 'A' : true
codes: 'A'=65, 'a'=97, 'é'=233
n=-1, equal=false
"Cat".compareTo("Catkin") : -3
string3=cat, string1 == string3 : false, string1.equals(string3) : true
"élan".compareTo("face") : 131
"Cat".compareTo("cat") : -32
"Cat".compareToIgnoreCase("cat") : 0
"Cat".equals("cat") : false
"Cat".equalsIgnoreCase("cat") : true
collator.compare("élan", "face") : -1
collator.compare("Cat", "cat") : 1
|
说明:
- 第 4 行:关系表达式;
- 第 8–9 行:字符比较;
- 第 10 行:字符的 [(int)]转换返回它的 Unicode 编码;
- 第 14 行:变量 [n] 被赋予一个负整数,因为 "cat" < "dog":即 'c'(99)和 'd'(100)的编码之差;
- 第 15 行:如果两个字符串相等,变量 [equal] 的值为 [true] ,否则为 [false] ;
- 第 17 行:先耗尽的字符串是较短的那个;结果是长度之差:3 - 6。在字符串字面量中,\" 表示一个引号;
- 第 20 行:[concat] 方法在运行时构造一个包含 "cat" 的新字符串对象;
- 第 21–22 行:[string1] 和 [string3] 内容相同,但引用两个不同的对象:== 返回 [false],[equals] 返回 [true]。这个陷阱之所以更加隐蔽,是因为两个相同的字符串字面量在内存中只存储一次,所以 ["cat" == "cat"] 为真:使用 == 的测试在测试期间看起来可能有效。我们将始终使用 [equals];
- 第 25 行:233 - 102 = 131:对于 [compareTo],“élan”排在“face”之后;
- 第 26 行:'C'(67)- 'c'(99)= -32;
- 第 28–30 行:忽略大小写时,“Cat”和“cat”相等;
- 第 32–34 行:法语的 [Collator] :“élan”排在“face”之前,而“Cat”排在“cat”之后(字母相同时,小写字母排在大写字母之前)。[compare]方法与 [compareTo]一样,返回负整数、零或正整数。
3.4.5.5. 布尔表达式
可以使用的运算符有与(&&)、或(||)和非(!)。布尔表达式的结果是布尔值。运算符优先级:
| double x = 3.5;
boolean valid = x > 2 && x < 4;
|
关系运算符的优先级高于 && 和 || 运算符。这两个运算符只在必要时才对右侧操作数求值:在 [a && b]中,如果 a 为假,则不对 b 求值;在 [a || b]中,如果 a 为真,则不对 b 求值。这称为“短路求值”。因此,可以放心地写 [text != null && text.length() > 0]。& 和 | 运算符应用于两个布尔值时执行相同的计算,但总是对两个操作数都求值。
3.4.5.6. 位运算
设 [i] 和 [j] 是两个整数:
运算 | 作用 |
i << n | 把 i 向左移动 n 位。移入的位为零 |
i >> n | 把 i 向右移动 n 位。符号位保持不变 |
i >>> n | 无符号右移:移入的位为零,即使 i 为负数 |
i & j | 按位对 i 和 j 执行逻辑与 |
i|j | 按位对 i 和 j 执行逻辑或 |
~i | 对 i 求反码 |
i ^ j | 按位对 i 和 j 执行异或运算 |
程序 [Basics13.java] 如下:
| // 位操作
void main() {
short i = 100, j = -13;
// char 是 Java 中唯一的无符号整数类型(16 位)
char k = 0xF123;
IO.println(String.format("i=0x%04x, j=0x%04x, k=0x%04x", i, j, (int) k));
IO.println(String.format("i<<4=0x%04x, i>>4=0x%04x, k>>4=0x%04x", i << 4, i >> 4, k >> 4));
IO.println(String.format("i&j=0x%04x, i|j=0x%04x, i^j=0x%04x, ~i=0x%04x",
(short) (i & j), (short) (i | j), (short) (i ^ j), (short) ~i));
IO.println(String.format("j<<2=0x%04x, j>>2=0x%04x", (short) (j << 2), (short) (j >> 2)));
// 相同的值的二进制形式
IO.println("i=" + binary(i, 16) + ", j=" + binary(j, 16) + ", i&j=" + binary(i & j, 16));
// 无符号右移 >>>:移入的位为 0
int m = -16;
IO.println("m=" + binary(m, 32) + ", m>>2=" + binary(m >> 2, 32) + ", m>>>2=" + binary(m >>> 2, 32));
}
// value 的低 n 位,表示为由 0 和 1 组成的字符串
String binary(int value, int n) {
StringBuilder bits = new StringBuilder();
for (int rank = n - 1; rank >= 0; rank--) {
bits.append((value >>> rank) & 1);
}
return bits.toString();
}
|
结果:
| > java Basics13.java
i=0x0064, j=0xfff3, k=0xf123
i<<4=0x0640, i>>4=0x0006, k>>4=0x0f12
i&j=0x0060, i|j=0xfff7, i^j=0xff97, ~i=0xff9b
j<<2=0xffcc, j>>2=0xfffc
i=0000000001100100, j=1111111111110011, i&j=0000000001100000
m=11111111111111111111111111110000, m>>2=11111111111111111111111111111100, m>>>2=00111111111111111111111111111100
|
说明:
- 第 3 行:两个 [short]整数;
- 第 5 行:值 0xF123(61731)放不进 [short],它的最大值是 32767。[char]类型是 16 位无符号整数,可以容纳它;
- 第 6 行:%04x 说明符以 4 位十六进制(x)显示整数,并用零填充(04)。应用于 [short]时,它显示其 16 位:-13 变为 fff3。%x 说明符不接受 [char]:它会被转换为 [int];
- 第 7 行:对 [short] 或 [char] 的运算是在 [int]上执行的:操作数首先被转换为 [int] (这称为提升),结果是 [int];
- 第 9 行:然后把结果转换回 [short] 以显示 4 位十六进制数字。如果不转换,~i 会显示为 8 位数字(ffffff9b);
- 第 12 行:[binary]方法(第 19–25 行)显示整数的低 n 位。我们逐位检查 i 和 j 的逻辑与;
- 第 15 行:[>>]移位保留 m 的符号位(m 为负数);[>>>]移位用零填充;
- 第 22 行:[(value >>> rank) & 1] 把第 [rank] 位 移到位置 0,然后把它与其他位分离。第 5 章介绍的 [StringBuilder]类通过连续添加来构造字符串。
3.4.5.7. 运算符的组合
[a = a + b] 可以写成 [a += b];[a = a - b] 可以写成 [a -= b]。运算符 /、%、*、<<、>>、>>>、&、|、^ 同样如此。因此,[a = a / 2;] 可以写成 [a /= 2;]。有一点小小的区别:组合运算符包含向变量类型的隐式转换。如果 [s] 是 [short],[s = s + 1;] 会被拒绝(加法的结果是 [int]),而 [s += 1;] 则被接受。
3.4.5.8. 自增和自减运算符
记法 [variable++] 表示 [variable = variable + 1] 或 [variable += 1]。记法 [variable--] 表示 [variable = variable - 1] 或 [variable -= 1]。在表达式中使用时,这些运算符有两种形式:
- [i++] (后缀):表达式的值是自增之前i 的值;
- [++i] (前缀):表达式的值是自增之后i 的值。
3.4.5.9. 三元运算符 ?
表达式 [expr_cond ? expr1 : expr2] 的求值过程如下:
- 先对表达式 [expr_cond] 求值。它是一个布尔表达式;
- 如果它为真,表达式的值就是 [expr1]的值,并且不对 [expr2] 求值;
- 如果它为假,则情况相反:表达式的值是 [expr2]的值,并且不对 [expr1] 求值。
操作 [i = (j > 4 ? j + 1 : j - 1);] 在 j > 4 时把 j+1 赋给变量 i,否则赋 j-1。这与写 [if (j > 4) i = j + 1; else i = j - 1;] 相同,但更简洁。
3.4.5.10. 空值:没有专门的运算符
与 C# 或 Kotlin 等其他语言不同,Java 没有针对值 [null] 的专用运算符(替代值、对成员的条件访问)。我们改用:
- 三元运算符 [a != null ? a : b],或者 [Objects.requireNonNullElse(a, b)]方法(Java 9),如果 a 不等于 [null],它就返回 a,否则返回 b。它用于赋一个后备值:[String name = Objects.requireNonNullElse(IO.readln(), "");];
- 简单的测试 [if (a == null) a = b;],仅当变量等于 [null]时才给它赋值;
- 类
*[Optional] 及其方法 *[map] ,仅当对象存在时才访问其成员:[Optional.ofNullable(text).map(String::length)] 在 [text] [Optional] 等于 [null]时返回空的 [Optional] ,否则返回包含文本长度的 Optional。
程序 [Basics14.java] 组合使用了这些运算符:
| // 其他运算符
void main() {
// 布尔表达式
double x = 3.5;
boolean valid = x > 2 && x < 4;
IO.println("valid=" + valid + ", !valid=" + !valid + ", valid || x > 10 : " + (valid || x > 10));
// 复合运算符
int a = 10;
a += 5;
IO.print("a += 5 : " + a);
a *= 2;
IO.print(", a *= 2 : " + a);
a /= 4;
IO.print(", a /= 4 : " + a);
a %= 4;
IO.print(", a %= 4 : " + a);
a <<= 2;
IO.println(", a <<= 2 : " + a);
// 自增和自减
int i = 5;
int j = i++; // j 得到 i 的旧值,然后 i 自增
int k = ++i; // i 先自增,然后 k 得到 i 的新值
IO.println("i=" + i + ", j=" + j + ", k=" + k);
i--;
IO.println("i=" + i);
// 三元运算符
int n = 5;
int p = n > 4 ? n + 1 : n - 1;
String parity = n % 2 == 0 ? "even" : "odd";
IO.println("p=" + p + ", " + n + " is " + parity);
// 引用为 null 时的替代值
String input = null;
String name = Objects.requireNonNullElse(input, "unknown");
Integer age = null;
int displayedAge = age != null ? age : -1;
IO.println("name=" + name + ", displayedAge=" + displayedAge);
// 仅当变量为 null 时才赋值
String title = null;
if (title == null) {
title = "Untitled";
}
IO.println("title=" + title);
// 仅当对象不为 null 时才访问成员:Optional 和 map
String text = null;
Optional<Integer> length = Optional.ofNullable(text).map(String::length);
IO.println("length=" + length.map(String::valueOf).orElse("null"));
text = "hello";
IO.println("length=" + Optional.ofNullable(text).map(String::length).orElse(-1));
}
|
结果:
| > java Basics14.java
valid=true, !valid=false, valid || x > 10 : true
a += 5 : 15, a *= 2 : 30, a /= 4 : 7, a %= 4 : 3, a <<= 2 : 12
i=7, j=5, k=7
i=6
p=6, 5 is odd
name=unknown, displayedAge=-1
title=Untitled
length=null
length=5
|
说明:
- 第 5 行:布尔表达式;
- 第 9–19 行:组合运算符:10+5=15,15*2=30,30/4=7(整数除法),7%4=3,3<<2=12;
- 第 23 行:[j] 被赋值为 5,然后 [i] 被设为 6;
- 第 24 行:[i] 变为 7,然后 [k] 得到 7;
- 第 31–32 行:两个三元运算符;
- 第 37 行:[input] equals [null]: [name] 被赋值为 "unknown";
- 第 39 行:三元运算符允许从 [Integer] 切换到 [int] 而没有异常风险:[age] 只有在不等于 [null]时才会被拆包;
- 第 43–45 行:只有当 [title] 等于 [null]时才会赋值;
- 第 49 行:[text] equals [null]: [Optional.ofNullable(text)] 为空,[map] 返回空的 [Optional] 而不调用 [length()]。记法 [String::length] 是一个方法引用:它指向 [length] 类 [String]的方法。我们将在第 7 章研究它;
- 第 50 行:如果 [length] 为空,则显示字符串 "null";
- 第 52 行:[text] is "hello":[map] 应用 [length()],结果是 5。
3.4.5.11. 运算符的一般优先级
下表按从高到低的顺序列出了运算符的优先级:
运算符 | 结合性 |
[x.y] [f(x)] [a[i]] [x++] [x--] [new] | lr |
[+x] [-x] [!x] [~x] [++x] [--x] [(T)x] (类型转换) | rl |
[*] [/] [%] | lr |
[+] [-] | lr |
[<<] [>>] [>>>] | lr |
[<] [<=] [>] [>=] [instanceof] | lr |
[==] [!=] | lr |
[&] | lr |
[^] | lr |
[|] | lr |
[&&] | lr |
[||] | lr |
[? :] (三元) | rl |
[=] [+=] [-=] 等,[->] (lambda) | rl |
lr 表示当运算符优先级相等时,按从左到右的顺序结合:当表达式中包含优先级相同的运算符时,最靠左的运算符先求值。rl 表示从右到左结合。拿不准时,不要犹豫,使用括号:它们也会让表达式更易读。
3.4.5.12. 类型转换
在表达式中,可以临时改变一个值的表示方式。这称为类型转换。在表达式中改变值的类型的语法如下:
随后该值具有指定的类型。这会导致值的表示发生变化。我们区分:
- “拓宽”转换,由编译器自动执行:[byte] 到 [short]、[short] 到 [int]、[char] 到 [int]、[int] 到 [long]、[long] 到 [float] 或 [double]、[float] 到 [double]……它们保持值的数量级。不过,从 [int] 到 [float],或从 [long] 到 [float] 或 [double]的转换可能会损失精度:[float] 只有 7 位有效数字,而 [double] 有 15 到 16 位;
- “收窄”转换,可能导致信息丢失,必须由程序员使用 (type) 记法显式要求:从 [double] 到 [int] (小数部分丢失),从 [long] 到 [int] (高位丢失),等等。
整数运算中的溢出或整数之间的转换从不会被报告:结果只是不正确。Java 没有可以要求检查的关键字。当存在这种风险时,请使用 [Math] 类(Java 8)中的 [addExact]、[subtractExact]、[multiplyExact]、[incrementExact]、[toIntExact]……方法,超出限制时它们会抛出 [ArithmeticException]异常。
程序 [Basics15.java] 如下:
| // 类型转换
void main() {
int i = 3, j = 4;
float f1 = i / j;
float f2 = (float) i / j;
IO.println("f1=" + f1 + ", f2=" + f2);
// 隐式转换(拓宽):不丢失信息
long l = i;
double d = l;
IO.println("l=" + l + ", d=" + d);
// 显式转换(强制转换):可能丢失信息
double real = 3.99;
int truncated = (int) real;
int rounded = (int) Math.round(real);
IO.println("(int) 3.99=" + truncated + ", (int) Math.round(3.99)=" + rounded);
long large = 3_000_000_000L;
int overflowed = (int) large;
IO.println("(int) 3000000000L=" + overflowed);
// 过大的实数会被收缩为最大的整数值
IO.println("(int) 1e10=" + (int) 1e10 + ", (int) Double.NaN=" + (int) Double.NaN);
// 字符和整数
char c = (char) 65;
int code = 'é';
IO.println("(char) 65=" + c + ", code of 'é'=" + code);
// 容量溢出:静默发生
int max = Integer.MAX_VALUE;
int next = max + 1;
IO.println("Integer.MAX_VALUE + 1 = " + next);
// Math 的 ...Exact 方法通过异常报告溢出
try {
int verified = Math.addExact(max, 1);
IO.println("verified=" + verified);
} catch (ArithmeticException e) {
IO.println("Math.addExact(max, 1) : " + e.getClass().getSimpleName() + " - " + e.getMessage());
}
try {
int conversion = Math.toIntExact(large);
IO.println("conversion=" + conversion);
} catch (ArithmeticException e) {
IO.println("Math.toIntExact(large) : " + e.getClass().getSimpleName() + " - " + e.getMessage());
}
}
|
结果:
| > java Basics15.java
f1=0.0, f2=0.75
l=3, d=3.0
(int) 3.99=3, (int) Math.round(3.99)=4
(int) 3000000000L=-1294967296
(int) 1e10=2147483647, (int) Double.NaN=0
(char) 65=A, code of 'é'=233
Integer.MAX_VALUE + 1 = -2147483648
Math.addExact(max, 1) : ArithmeticException - integer overflow
Math.toIntExact(large) : ArithmeticException - integer overflow
|
说明:
- 第 4 行:[f1] 的值为 0.0。除法 3/4 是整数除法,因为两个操作数的类型都是 [int];它的结果 0 随后被转换为 [float];
- 第 5 行:[(float) i] 是 [i] 转换为 [float]后的值。现在我们得到一个 [float] 类型的实数与一个 [int]类型的整数之间的除法:[j] 的值也被转换为 [float],然后两个实数相除。[f2] 的值为 0.75。在操作 [(float) i]中,[i] 是以 4 个字节精确编码的值,而 [(float) i] 是同一个值以 4 个字节近似编码为实数。这种转码只发生在计算期间:变量 [i] 始终保持其类型 [int];
- 第 9–10 行:向上转换;
- 第 15 行:把实数转换为整数会截断小数部分(向零截断);
- 第 16 行:要对数字四舍五入,我们使用 [Math.round],它得到 [long],然后再把它转换为 [int];
- 第 18 行:后缀 L 是必不可少的:30 亿超出了 [int]的范围;
- 第 19 行:30 亿放不进 [int]:只保留低 32 位,结果不再有意义;
- 第 22 行:对 [int] 来说过大的实数被缩减为 [Integer.MAX_VALUE];值 [NaN] 变为 0;
- 第 25–26 行:字符与 Unicode 编码之间的转换;第二个是隐式的;
- 第 31 行:容量溢出未被察觉:得到的是最小的 [int]值;
- 第 35 行:使用 [Math.addExact]时,溢出会触发 [ArithmeticException]异常;
- 第 41 行:[Math.toIntExact] 把 [long] 转换为 [int] ,如果该值放不进 [int],也会抛出异常。
即使溢出发生在仅由常量组成的表达式中,例如 [Integer.MAX_VALUE + 1],编译器也会毫无警告地接受它:它自己算出该值,即 -2147483648。
3.5. 程序流程控制语句
3.5.1. 停止
[System]类的 [exit]方法可以让你停止程序的执行:
[exit] 终止当前进程,并把控制权交还给调用进程,通常是命令解释器。命令解释器可以使用 [status]的值,它称为返回码。按照惯例,0 表示程序成功执行,任何其他值都表示出现错误。在 Windows 上,返回码在命令提示符中位于 [%ERRORLEVEL%]变量中,在 PowerShell 中位于 [$LASTEXITCODE]变量中;在 Linux 和 macOS 上,位于 shell 的 [$?]变量中。因此,[System.exit(0);] 将以返回码 0 终止程序的执行。
如果不调用 [System.exit],程序在其 [main]方法结束时(可能通过 [return]语句)以返回码 0 终止。如果它因没有人捕获的异常而终止,它会显示该异常并以返回码 1 终止。在 Java 中,[main]方法不能返回整数:[System.exit] 是指定返回码的唯一方式。
程序 [Basics16.java] 把它的返回码作为参数接收:
| // 以退出码停止程序
void main(String[] args) {
IO.println("Start of the program");
// 退出码作为参数传入(参见关于程序参数的小节)
int code;
try {
// 没有参数时,空字符串被转换,转换会失败
code = Integer.parseInt(args.length > 0 ? args[0] : "");
} catch (NumberFormatException e) {
System.err.println("Syntax: java Basics16.java exit_code");
System.exit(1);
return;
}
IO.println("Stopping with the exit code " + code);
System.exit(code);
IO.println("This line is never executed");
}
|
在 bash 终端中的结果:
| > java Basics16.java 3
Start of the program
Stopping with the exit code 3
> echo $?
3
> java Basics16.java
Start of the program
Syntax: java Basics16.java exit_code
> echo $?
1
|
说明:
- 第 2 行:[main]方法通过 [args]数组接收命令行参数。程序的参数将在下文介绍;
- 第 8 行:如果至少有一个参数,就把第一个参数转换为整数;否则转换空字符串,这会失败。因此,没有参数和参数不是数字这两种情况由同一个 [catch]子句处理;
- 第 11 行:程序以返回码 1 终止;
- 第 12 行:这条指令永远不会被执行,但编译器并不知道 [System.exit] 永远不会返回控制权。如果没有它,编译器会认为第 14 行可能在 [code]变量未初始化的情况下被执行到,从而拒绝该程序:[error: variable code might not have been initialized];
- 第 15 行:以作为参数传入的返回码退出。下一行不会被执行;
- 结果的第 4–5 行和第 9–10 行:命令 [echo $?] 显示最后执行的程序的返回码:先是 3,然后是 1。
3.5.2. 简单判断结构
| if (condition) {
actions_condition_true;
} else {
actions_condition_false;
}
|
注意:
- 条件用括号括起来。它必须是 [boolean]类型:与 C 语言不同,当 [n] 是整数时,Java 会拒绝 [if (n)] ;
- 每个动作以分号结尾;
- 花括号之后不加分号;
- 只有在动作多于一个时才必须使用花括号;不过,即使只有一个动作也常常使用,这是为了可读性,并避免在增加动作时出错。在 Java 中,习惯把左花括号放在行尾;
- [else] 子句可以省略;
- 没有 [then]关键字。
这种结构在算法中的等价形式是 if...then...else 结构:
| if condition
then actions_condition_true
else actions_condition_false
endif
|
示例:
| if (x > 0) { nx = nx + 1; sx = sx + x; } else dx = dx - x;
|
选择结构可以嵌套。这有时会导致程序 [Basics17.java]所演示的问题:
| // 简单选择结构 if
void main() {
int n = 5;
// else 总是与最近的 if 配对
if (n > 1)
if (n > 6)
IO.println(">6");
else
IO.println("<=6");
// 加上花括号后,else 属于第一个 if
int n2 = 0;
if (n2 > 1) {
if (n2 > 6) {
IO.println(">6");
}
} else {
IO.println("<=1");
}
// 一系列选择:else if
int grade = 13;
String honours;
if (grade < 10) {
honours = "failed";
} else if (grade < 12) {
honours = "pass";
} else if (grade < 14) {
honours = "fairly good";
} else {
honours = "good";
}
IO.println("grade=" + grade + ", honours=" + honours);
}
|
结果:
| > java Basics17.java
<=6
<=1
grade=13, honours=fairly good
|
说明:
- 第 5–9 行:第 8 行的 [else]属于哪个 [if] ?规则是:[else] 总是属于最近的 [if],即第 6 行的 [if (n > 6)]。代码缩进对编译器没有影响,这里选择这样的缩进是为了说明这一点;
- 第 13–19 行:这里,我们想把 [else] 放在 [if (n2 > 1)], 旁边,而不是把 [else] 放在 [if (n2 > 6)]旁边。由于前面的规则,我们不得不用花括号把 [if (n2 > 1) { ... }] 括起来;
- 第 24–32 行:一系列互斥的选择用连续的 [else if]语句来书写。条件按顺序测试;第一个求值为真的条件决定要执行的动作。编译器会验证在第 23 行不带值声明的变量 [honours],在第 33 行使用之前已在所有分支中被赋值。
3.5.3. 分支选择结构
3.5.3.1. switch 语句
传统的语法如下:
| switch (expression) {
case v1:
actions1;
break;
case v2:
actions2;
break;
...
default:
actions_otherwise;
break;
}
|
注意:
- [switch] 的控制表达式的值可以是整数([int]、[short]、[byte]、[char],或它们的包装类)、字符串(Java 7)、枚举值,以及自 Java 21 起的任意对象(见下文的模式过滤)。不接受 [long]、[float]、[double]和 [boolean] 类型;
- 控制表达式用括号括起来;
- [default] 子句可以省略;
- 值 vi 是表达式的可能取值。如果表达式的值为 vi,就执行 [case vi] 子句之后的动作。自 Java 14 起,一个子句可以列出多个值:[case "saturday", "sunday":];
- [break]语句退出分支选择结构。注意:如果省略它,执行会继续执行后面 [case]子句的动作(“贯穿”)。编译器接受这种写法;使用 [-Xlint:all]选项时,它只会发出 [warning: [fallthrough] possible fall-through into case]警告。这种遗漏是常见的错误,下面介绍的箭头形式可以避免它。
算法中的示例:
| depending on the value of choice
case 0
end of the module
case 1
execute module M1
case 2
execute module M2
otherwise
error <- true
endcase
|
3.5.3.2. 箭头形式和 switch 表达式
Java 14 引入了子句的第二种形式 [case v1, v2 -> action],箭头后面是单条语句或用花括号括起来的块。只执行被选中子句的动作:无需写 [break],各子句之间也不会相互贯穿。
很多时候,分支选择结构只是用来选择一个值。在这种情况下,可以把 [switch] 用作表达式 (Java 14):
| result = switch (expression) {
case v1 -> value1;
case v2, v3 -> value2;
...
default -> value_otherwise;
};
|
switch 表达式必须是穷尽的:它必须为控制表达式的所有可能取值提供一个值,这通常需要一个 [default]子句。当某个子句需要多条语句时,就写一个块,它通过 [yield]语句返回其值。
自 Java 21 起,[case]子句可以包含模式而不是常量。类型模式 [case Integer i]在被检查的对象类型为 [Integer]时匹配;此后,该对象以该类型存放在变量 [i]中。守卫 [when condition] 增加一个条件:[case Integer i when i > 0] 只在整数为正数时才被选中。[case null] 子句处理值 [null],否则它会触发 [NullPointerException]。各子句按顺序求值:第一个匹配的子句被选中。同样的过滤也适用于 [instanceof]运算符(Java 16):[if (o instanceof String s && s.length() > 3)]。
Java 25 还不允许对基本类型书写这样的模式([case int i when i > 0]):该特性在预览版本中提供,我们不会使用。要用守卫对 [int] 进行分类,我们把 [switch] 应用于 [Integer]。
程序 [Basics18.java]如下:
| // 分支结构:switch 语句和 switch 表达式
void main() {
int choice = 2;
boolean error = false;
switch (choice) {
case 0:
return;
case 1:
m1();
break;
case 2:
m2();
break;
default:
error = true;
break;
}
IO.println("error=" + error);
// 同一个 case 对应多个值,String 类型的表达式
String day = "saturday";
switch (day) {
case "saturday", "sunday":
IO.println(day + " : weekend");
break;
default:
IO.println(day + " : week");
break;
}
// 箭头形式(Java 14):没有 break,case 之间不会贯穿
switch (day) {
case "saturday", "sunday" -> IO.println(day + " : weekend");
default -> IO.println(day + " : week");
}
// switch 表达式(Java 14):它返回一个值
String dayType = switch (day) {
case "saturday", "sunday" -> "weekend";
case "monday", "tuesday", "wednesday", "thursday", "friday" -> "week";
default -> "unknown day";
};
IO.println(day + " : " + dayType);
// 语句块用 yield 返回其值
int nbHours = switch (day) {
case "saturday" -> 4;
case "sunday" -> 0;
default -> {
int hours = 7;
yield hours + 1;
}
};
IO.println(day + " : " + nbHours + " opening hour(s)");
// 带 when 守卫的模式匹配(Java 21)
IO.println("-5 : " + classify(-5));
IO.println("0 : " + classify(0));
IO.println("7 : " + classify(7));
IO.println("42 : " + classify(42));
IO.println("1000 : " + classify(1000));
// 按对象类型匹配
Object[] objects = {12, -3, "java", 2.5, null};
for (Object o : objects) {
IO.println(o + " : " + describe(o));
}
}
// 上面用到的方法
void m1() {
IO.println("M1");
}
void m2() {
IO.println("M2");
}
String classify(Integer n) {
return switch (n) {
case Integer i when i < 0 -> "negative";
case 0 -> "zero";
case Integer i when i <= 10 -> "small";
case Integer i when i < 100 -> "medium";
default -> "large";
};
}
String describe(Object o) {
return switch (o) {
case null -> "no object";
case Integer i when i > 0 -> "positive integer";
case Integer i -> "negative or zero integer";
case String s -> "string of " + s.length() + " characters";
default -> "object of type " + o.getClass().getSimpleName();
};
}
|
结果:
| > java Basics18.java
M2
error=false
saturday : weekend
saturday : weekend
saturday : weekend
saturday : 4 opening hour(s)
-5 : negative
0 : zero
7 : small
42 : medium
1000 : large
12 : positive integer
-3 : negative or zero integer
java : string of 4 characters
2.5 : object of type Double
null : no object
|
说明:
- 第 5–17 行:上述算法的 Java 实现;
- 第 7 行:[return] 终止 [main]方法,从而终止程序;
- 第 23 行:两个值对应相同的动作。在 Java 14 之前,我们会写两个连续的子句 [case "saturday":] and [case "sunday":],第一个子句为空,“贯穿”到第二个子句;
- 第 31–34 行:使用箭头的同一个分支选择结构;不再需要 [break];
- 第 37–41 行:对字符串的
switch 表达式。它像任何赋值语句一样以分号结尾。*[default] 子句使它成为穷尽的;*
- 第 44–51 行:动作为块的子句:语句 [yield] (第 49 行)计算表达式的值;
- 第 76–84 行:[classify]方法。它的 [Integer] 参数接收被自动包装的整数 -5、0、7……(第 55–59 行)。[when]守卫对整数进行分类,常量 0 也包含在模式中。[default]子句处理其余的值,这里是大于或等于 100 的整数;
- 第 61 行:由不同类型对象组成的数组:数字 12、-3 和 2.5 被包装成 [Integer] 和 [Double];
- 第 86–94 行:[describe] 方法根据对象的类型进行选择。在第 91 行,变量 [s] 的类型是 [String]:无需转换就可以调用它的 [length()]方法。不带守卫的子句 [case Integer i] (第 90 行)必须放在带守卫的子句(第 89 行)之后,否则它会把后者遮蔽:编译器会拒绝该程序;
- 第 68–74 行:被第一个方法调用的两个方法,[switch]。
3.5.4. 重复结构
3.5.4.1. 已知重复次数
“for”结构
语法如下:
| for (i = id; i <= if; i = i + ip) {
actions;
}
|
注意:
- [for] 的三个参数用括号括起来,并用分号分隔;
- [for] 中的每个动作以分号结尾;
- 只有在动作多于一个时才必须使用花括号;
- 花括号之后不加分号。
算法中的等价形式是 for 结构:
| for i varying from id to if in steps of ip
actions
endfor
|
它可以被转换为 while 结构:
| i <- id
while i <= if
actions
i <- i + ip
endwhile
|
for-each 结构
语法如下:
| for (Type variable : collection) {
instructions;
}
|
注意:
- [collection] 是数组或可迭代的对象集合(实现了 [Iterable]接口)。我们将在第 5 章讲解集合([List]、[Set]、[Map]……);
- [Type] 是集合元素的类型。对于数组,它就是数组元素的类型。你也可以改写成 [var];
- [variable] 是循环的局部变量,它会依次取集合中的所有值。在循环内给它赋另一个值不会修改集合;可以把它声明为 [final] 以防止这种情况。
3.5.4.2. 重复次数未知
while 循环
| while (condition) {
actions;
}
|
只要条件为真,循环就继续。循环可能一次也不执行。注意事项与 [for]相同。对应的算法结构是 while 结构:
| while condition
actions
endwhile
|
“do while”循环
语法如下:
| do {
instructions;
} while (condition);
|
循环一直持续到条件变为假。这里,循环至少执行一次。对应的算法结构是“repeat … until”结构:
| repeat
actions
until not condition
|
通用循环结构(for)
语法如下:
| for (start_instructions; condition; end_of_loop_instructions) {
instructions;
}
|
只要条件为真(在每次迭代之前求值),循环就继续。[start_instructions]语句在第一次进入循环之前执行。[end_of_loop_instructions]语句在循环的每次迭代之后执行。[start_instructions] 和 [end_of_loop_instructions] 中的各条指令用逗号分隔。对应的算法结构如下:
| start_instructions
while condition
actions
end_of_loop_instructions
endwhile
|
3.5.4.3. 循环控制语句
指令 | 作用 |
[break] | 退出 [for]、[while]、[do ... while] 循环 |
[continue] | 进入 [for]、[while]、[do ... while] 循环的下一次迭代 |
[break label] | 退出前面带有标签 [label:]的循环,即使该语句位于嵌套循环内 |
[continue label] | 进入前面带有标签 [label:] 的循环的下一次迭代 |
3.5.4.4. 示例
程序 [Basics19.java] 如下:
| // 循环结构
void main() {
// 计算前 10 个整数之和的四种方法
int i, sum, n = 10;
for (i = 1, sum = 0; i <= n; i = i + 1) {
sum = sum + i;
}
IO.println("for (1) : sum=" + sum);
for (i = 1, sum = 0; i <= n; sum = sum + i, i = i + 1) {
}
IO.println("for (2) : sum=" + sum);
i = 1;
sum = 0;
while (i <= n) {
sum += i;
i++;
}
IO.println("while : sum=" + sum);
i = 1;
sum = 0;
do {
sum += i++;
} while (i <= n);
IO.println("do while : sum=" + sum);
// 循环变量可以在 for 中声明:它只在循环内存在
int product = 1;
for (int k = 1; k <= 5; k++) {
product *= k;
}
IO.println("5! = " + product);
// for-each:遍历数组或集合的所有元素
String[] friends = {"paul", "hélène", "jacques", "sylvie"};
for (String name : friends) {
IO.println(name);
}
// break 和 continue
for (int k = 1; k <= 10; k++) {
// 跳过偶数
if (k % 2 == 0) {
continue;
}
// 到 7 停止
if (k > 7) {
break;
}
IO.print(k + " ");
}
IO.println();
// 用 break 退出的无限循环:大于 50 的第一个 7 的倍数
int multiple = 50;
while (true) {
multiple++;
if (multiple % 7 == 0) {
break;
}
}
IO.println("first multiple of 7 greater than 50: " + multiple);
// 带标签的 break:同时退出两层循环
int[][] grid = {{1, 2, 3}, {4, -5, 6}, {7, 8, 9}};
search:
for (int row = 0; row < grid.length; row++) {
for (int column = 0; column < grid[row].length; column++) {
if (grid[row][column] < 0) {
IO.println("first negative at [" + row + "][" + column + "]");
break search;
}
}
}
}
|
结果:
| > java Basics19.java
for (1) : sum=55
for (2) : sum=55
while : sum=55
do while : sum=55
5! = 120
paul
hélène
jacques
sylvie
1 3 5 7
first multiple of 7 greater than 50: 56
first negative at [1][1]
|
说明:
- 第 3–27 行:计算前 10 个整数之和的四种方法;
- 第 5–7 行:标准的 [for];
- 第 10–11 行:所有工作都在循环结束语句中完成;循环体为空。Java 也接受没有循环体的 [for (...);]语法,但在 [for] 之后误加分号是一个难以察觉的经典错误。空块 { } 可以毫不含糊地表达同样的意思;
- 第 25 行:[i++] 返回 [i] 自增之前的值:[i] 被加到 [sum]上,然后 [i] 自增;
- 第 31 行:[for]最常见的形式:循环变量在 [for] 中声明,并且只在循环内存在;
- 第 38–40 行:for-each 循环遍历数组 [friends]的元素;
- 第 43–53 行:[continue] 对偶数跳到下一次迭代;[break] 在 [k] 一超过 7 时就终止循环;
- 第 58–63 行:无限循环 [while (true)],通过 [break]退出。当终止条件在循环中间才计算出来时,这种形式很方便。我们将用它来处理键盘输入;
- 第 67–76 行:在二维数组中查找第一个负数。标签 [search:] (第 68 行)为外层循环命名;语句 [break search;] (第 73 行)一次退出两层循环。简单的 [break] 只会退出内层循环。Java 没有 [goto]语句(该关键字是保留的但未使用):在这种特定情况下,标签起到这个作用。
3.6. 异常处理
许多 Java 方法都有可能抛出异常,即错误。当某个方法有可能抛出异常时,程序员应该处理它,以便创建容错性更强的程序:应始终避免应用程序突然终止。
3.6.1. try/catch/finally 结构
异常处理遵循如下模式:
| try {
code likely to throw an exception
} catch (Exception e) {
handle the exception e
}
next statement
|
如果 [try]块中的代码没有抛出异常,执行就继续下一条语句;否则,执行进入 [catch]块的主体,然后继续下一条语句。请注意以下几点:
- [e] 是类型为 [Exception] 或其派生类型的对象。异常有许多类型:[ArrayIndexOutOfBoundsException]、[NumberFormatException]、[ArithmeticException]、[IllegalArgumentException]、[NullPointerException]、[IOException]等。写成 [catch (Exception e)],表示你想处理所有类型的异常。如果 [try] 子句的代码可能产生多种类型的异常,你可能想更具体一些,用多个 [catch]子句来处理异常:
| try {
code likely to throw the exceptions
} catch (ArrayIndexOutOfBoundsException e1) {
handle the exception e1
} catch (NumberFormatException e2) {
handle the exception e2
}
next statement
|
[catch]子句按顺序求值;第一个类型与异常匹配的子句被执行。因此,处理特定异常类型的子句必须位于处理更一般类型的子句之前:编译器会拒绝永远无法到达的子句;
- 可以在 [finally] 子句之外再添加 [try / catch]子句:
| try {
code likely to throw an exception
} catch (Exception e) {
handle the exception e
} finally {
code executed after try or catch
}
next statement
|
无论是否发生异常,[finally]子句中的代码总是会被执行。这个子句过去用来关闭文件;我们将看到现在有一种更简单的形式,即带资源的 [try] ;
- 在 [catch]子句中,你可能不想使用异常对象。不过,必须给它起一个名字:自 Java 22 起,可以写成 [catch (NumberFormatException _)],其中 _ 字符表示不会被使用的匿名变量;
- [Exception] 类有一个方法 [getMessage()],返回详细说明所发生错误的消息。要显示它,请写:
| } catch (Exception ex) {
System.err.println("The following error occurred: " + ex.getMessage());
...
}
|
- 异常的 [toString()]方法返回其类的全名,后面跟着它的消息;它的 [printStackTrace()]方法还会显示调用栈——即错误发生时正在执行的方法列表——以及源文件名和行号。这是对开发人员最有用的信息,但并不是给用户看的。在本课程中,我们通常会显示异常类的名称——[ex.getClass().getName()] 或 [ex.getClass().getSimpleName()]——及其消息。
3.6.2. 第一个示例
程序 [Basics20.java] 演示了使用不存在的数组元素所产生的异常:
| // 由错误的数组下标引起的异常
void main() {
int[] tab = {0, 1, 2, 3};
// 用 for 显示数组
for (int i = 0; i < tab.length; i++) {
IO.println("tab[" + i + "]=" + tab[i]);
}
// 用 for-each 显示数组
for (int elmt : tab) {
IO.println(elmt);
}
// 生成异常
try {
tab[100] = 6;
} catch (Exception e) {
System.err.println("The following error occurred: "
+ e.getClass().getName() + " - " + e.getMessage());
return;
} finally {
IO.println("finally ...");
}
IO.println("This line is not executed");
}
|
结果:
| > java Basics20.java
tab[0]=0
tab[1]=1
tab[2]=2
tab[3]=3
0
1
2
3
The following error occurred: java.lang.ArrayIndexOutOfBoundsException - Index 100 out of bounds for length 4
finally ...
|
说明:
- 第 14 行:这条语句抛出异常,因为数组 [tab] 没有下标为 100 的元素;
- 第 15 行:[catch (Exception e)]子句捕获所有异常;
- 第 16–17 行:异常的类型是 [java.lang.ArrayIndexOutOfBoundsException],它的消息指出了错误的下标和数组的大小(结果的第 10 行);
- 第 18 行:程序退出 [main]方法,从而结束程序;
- 第 19–20 行:[finally]子句被执行了(结果的第 11 行),尽管 [catch]子句中包含 [return]语句。请注意,[finally]子句总是会被执行;
- 第 22 行:由于 [return],这一行不会被执行。
3.6.3. 经过验证的输入
这是另一个示例 [Basics21.java],其中我们处理把不表示整数的字符串转换为整数时引起的异常:
| // 输入年龄并处理转换异常
void main() {
// 询问姓名
String name = Objects.requireNonNullElse(IO.readln("Name: "), "");
// 询问年龄
int age = 0;
boolean ageOK = false;
while (!ageOK) {
// 提问,读取并检查答案
try {
age = Integer.parseInt(IO.readln("age: "));
ageOK = age >= 1;
} catch (NumberFormatException _) {
// ageOK 仍为 false
}
if (!ageOK) {
IO.println("Incorrect age, try again...");
}
}
// 最终显示
IO.println("Your name is " + name + " and you are " + age + " year(s) old");
}
|
结果:
| > java Basics21.java
Name: dupont
age: 23
Your name is dupont and you are 23 year(s) old
|
| > java Basics21.java
Name: durand
age: x
Incorrect age, try again...
age: -4
Incorrect age, try again...
age: 99999999999
Incorrect age, try again...
age: 12
Your name is durand and you are 12 year(s) old
|
说明:
- 第 4 行:如果输入流已关闭,[IO.readln] 返回 [null];[Objects.requireNonNullElse] 用空字符串替换它;
- 第 8–19 行:年龄输入循环;
- 第 11 行:通过键盘输入的行由 [Integer.parseInt]方法转换为整数。如果无法转换,包括字符串为 [null] 时,该方法会抛出 [NumberFormatException]异常。这就是把该操作放在 [try / catch]中的原因;
- 第 12 行:如果执行到这一行,说明转换成功。不过,我们还要验证得到的整数确实大于或等于 1;
- 第 13 行:如果抛出 [NumberFormatException]异常,控制流转到 [catch], ,其中什么也不做。因此,初始化为 [false]的布尔变量 [ageOK]仍然保持为 [false]。未被使用的异常变量是匿名变量 _。只捕获预期的异常:[catch (Exception _)]子句还会掩盖没有预料到的错误;
- 第 16–18 行:如果年龄不正确,显示错误消息。
对于 [int]来说过大的数字,例如 99999999999,同样会触发 [NumberFormatException]:因此它与其他不正确的输入一样被处理(第二次执行)。
3.6.4. 多个 catch 子句和异常抛出
程序本身可以使用 [throw]语句抛出异常:
| throw new IllegalArgumentException("error message");
|
当前方法的执行停止,异常沿着调用它的各个方法向上传播,直到某个 [catch]子句处理它;如果没有子句处理,程序就会终止,并显示异常和调用栈。在 [catch]子句中,[throw e;]语句会重新抛出当前异常——例如在记录日志之后。
Java 没有针对 [catch]子句的过滤器:要只在某些情况下处理异常,需要在子句内测试条件,必要时重新抛出异常。要检查不得为 [null]的参数,请使用 [Objects.requireNonNull(value, message)]方法:如果值不为 null,它就返回该值,否则抛出带有指定消息的 [NullPointerException] 。
程序 [Basics22.java] 演示了这些可能性:
| // 多个 catch 子句,抛出异常
void main() {
String[] inputs = {"12", "abc", "", "99999999999", "-3", "150"};
for (String input : inputs) {
try {
int age = readAge(input);
IO.println("[" + input + "] : age=" + age);
} catch (NumberFormatException e) {
// catch 子句上没有过滤条件:我们在子句内部进行测试
if (input.isEmpty()) {
IO.println("[" + input + "] : empty input");
} else {
IO.println("[" + input + "] : " + e.getClass().getSimpleName() + " - " + e.getMessage());
}
} catch (IllegalArgumentException e) {
IO.println("[" + input + "] : " + e.getClass().getSimpleName() + " - " + e.getMessage());
}
}
// 如果引用为 null,Objects.requireNonNull 抛出 NullPointerException
String[] names = {"dupont", null};
for (String name : names) {
try {
String valid = Objects.requireNonNull(name, "the name is mandatory");
IO.println("name=" + valid);
} catch (NullPointerException e) {
IO.println(e.getClass().getSimpleName() + " - " + e.getMessage());
}
}
}
// 抛出异常的方法
int readAge(String text) {
// Integer.parseInt 抛出 NumberFormatException
int age = Integer.parseInt(text);
// 如果年龄超出范围,我们自己抛出异常
if (age < 0 || age > 130) {
throw new IllegalArgumentException("age out of bounds [0,130]: " + age);
}
return age;
}
|
结果:
| > java Basics22.java
[12] : age=12
[abc] : NumberFormatException - For input string: "abc"
[] : empty input
[99999999999] : NumberFormatException - For input string: "99999999999"
[-3] : IllegalArgumentException - age out of bounds [0,130]: -3
[150] : IllegalArgumentException - age out of bounds [0,130]: 150
name=dupont
NullPointerException - the name is mandatory
|
说明:
- 第 3 行:模拟的输入,有效或无效;
- 第 6 行:[readAge]方法(第 33–41 行)可以抛出几种类型的异常;
- 第 8 行:输入 "abc"、"" 和 "99999999999" 会触发 [NumberFormatException];
- 第 10–14 行:由于没有过滤器,空输入是在 [catch]子句内部区分出来的;
- 第 15 行:由 [readAge] 自身抛出的异常;
- 第 24 行:如果 [Objects.requireNonNull] [name] 等于 [null],它就抛出 [NullPointerException] ;它的消息是作为第二个参数传入的消息(结果的第 9 行);
- 第 38 行:如果年龄超出范围,[readAge]方法会抛出异常。
第 8 行和第 15 行的 [catch]子句的顺序很重要:类 [NumberFormatException] 派生自类 [IllegalArgumentException] ([NumberFormatException] 是不正确参数的一种特殊情况)。如果把这两个子句颠倒,[IllegalArgumentException] 子句也会拦截 [NumberFormatException],编译器就会拒绝变得无法到达的子句:
| Basics22.java:10: error: exception NumberFormatException has already been caught
} catch (NumberFormatException e) {
^
1 error
|
3.6.5. 受检异常和非受检异常
这是 Java 的一个重要特性。异常是对象,它们的类构成一个层次结构:
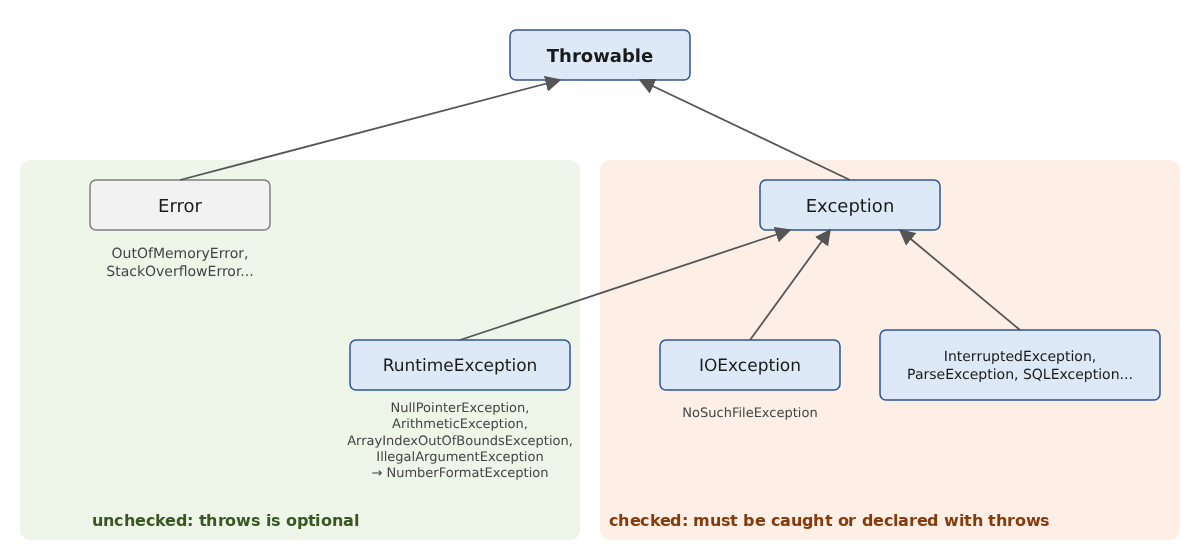
- 根类是 [Throwable];
- [Error] 类及其子类表示虚拟机的严重问题([OutOfMemoryError]、[StackOverflowError]……),程序通常不会尝试捕获它们;
- [RuntimeException] 类及其派生类([NullPointerException]、[ArithmeticException]、[ArrayIndexOutOfBoundsException]、[IllegalArgumentException]、[NumberFormatException]……)通常表示编程错误或不正确的数据;
- 从 [Exception] 派生的其他类([IOException]、[InterruptedException]、[ParseException]、[SQLException]……)报告由程序环境引起的事件(文件缺失、网络中断、数据库宕机),正确的程序必须预见到这些事件。
后一类异常称为“受检异常”:编译器会验证,能够抛出这类异常的方法——无论是直接抛出还是通过调用另一个方法——要么用 [catch]子句捕获它,要么用关键字 在其签名中声明它 [throws]:
| String readFile(String name) throws IOException { ... }
|
这样,责任就传递给了调用它的方法。派生自 [RuntimeException] 和 [Error] 的异常称为“非受检”异常:它们可以被捕获,但编译器并不要求这样做,也不需要声明它们。许多其他语言,例如 C# 或 Kotlin,只有非受检异常。
程序 [Basics23.java] 演示了这几种不同的情况:
| // 受检异常和非受检异常
void main() {
// 1 - readFile 声明了一个受检异常(IOException):必须捕获它
try {
String content = readFile("missing.txt");
IO.println(content);
} catch (IOException e) {
IO.println("readFile : " + e.getClass().getName() + " - " + e.getMessage());
}
// 2 - waitFor 声明的 InterruptedException 同理
try {
waitFor(100);
IO.println("wait of 100 ms finished");
} catch (InterruptedException e) {
IO.println("wait interrupted");
}
// 3 - 非受检异常不必声明也不必捕获
try {
IO.println("divide(1, 0) = " + divide(1, 0));
} catch (ArithmeticException e) {
IO.println("divide : " + e.getClass().getName() + " - " + e.getMessage());
}
// 4 - 包装在非受检异常中的受检异常
try {
IO.println(readConfiguration("absent.properties"));
} catch (UncheckedIOException e) {
IO.println(e.getMessage() + " ; cause : " + e.getCause().getClass().getSimpleName());
}
// 5 - 若干异常在类层次结构中的位置
IO.println(ancestors(new NoSuchFileException("x")));
IO.println(ancestors(new NumberFormatException()));
IO.println(ancestors(new OutOfMemoryError()));
}
// Files.readString 抛出 IOException(受检):我们声明它
String readFile(String name) throws IOException {
return Files.readString(Path.of(name));
}
// Thread.sleep 抛出 InterruptedException(受检)
void waitFor(long milliseconds) throws InterruptedException {
Thread.sleep(milliseconds);
}
// ArithmeticException 是非受检异常:没有 throws 子句
int divide(int a, int b) {
return a / b;
}
// 捕获 IOException,然后作为非受检异常重新抛出
String readConfiguration(String name) {
try {
return Files.readString(Path.of(name));
} catch (IOException e) {
throw new UncheckedIOException("unreadable configuration: " + name, e);
}
}
// 对象所属类的父类链
String ancestors(Object o) {
StringBuilder chain = new StringBuilder();
for (Class<?> type = o.getClass(); type != null; type = type.getSuperclass()) {
if (!chain.isEmpty()) {
chain.append(" -> ");
}
chain.append(type.getSimpleName());
}
return chain.toString();
}
|
结果:
| > java Basics23.java
readFile : java.nio.file.NoSuchFileException - missing.txt
wait of 100 ms finished
divide : java.lang.ArithmeticException - / by zero
unreadable configuration: absent.properties ; cause : NoSuchFileException
NoSuchFileException -> FileSystemException -> IOException -> Exception -> Throwable -> Object
NumberFormatException -> IllegalArgumentException -> RuntimeException -> Exception -> Throwable -> Object
OutOfMemoryError -> VirtualMachineError -> Error -> Throwable -> Object
|
说明:
- 第 36–38 行:[Files.readString]方法(第 5 章)读取文件的全部内容;它可能引发 [IOException],这是受检异常。[readFile]方法没有拦截它:因此它必须用 [throws IOException]声明它;
- 第 4–9 行:反过来,调用 [main]的 [readFile], 方法必须处理 [IOException]。由于文件不存在,抛出的异常是 [NoSuchFileException]——派生自 [IOException]的类——它的消息是文件名;
- 第 41–43 行:[Thread.sleep] 使程序暂停指定的毫秒数;它可能抛出(受检的)[InterruptedException],我们将在第 8 章讨论;
- 第 11–16 行:因此,对 [waitFor] 的调用也必须放在 [try / catch]中;
- 第 46–48 行:整数除法可能触发非受检的 [ArithmeticException];不需要 [throws]子句;
- 第 18–22 行:调用方仍然捕获该异常,因为它选择这样做;
- 第 51–57 行:当方法无法或不想声明受检异常时的常用技巧:拦截它,改为抛出非受检异常——这里是 [UncheckedIOException] (Java 8)——并把原始异常作为它的原因传入;
- 第 27 行:[getCause()] 重新抛出原始异常;
- 第 60–69 行:[ancestors] 方法遍历对象的父类链([getSuperclass()]),直到所有类的根类 [Object];
- 第 30–32 行:上述层次结构反映在结果中(第 6–8 行)。
如果从第 36 行删除 [throws IOException]子句,编译器会拒绝该程序。它既报告 [readFile] 中未处理的异常,也报告 [catch]子句在 [main]中已变得多余,因为不再有任何被调用的方法声明 [IOException]:
| Basics23.java:7: error: exception IOException is never thrown in body of corresponding try statement
} catch (IOException e) {
^
Basics23.java:37: error: unreported exception IOException; must be caught or declared to be thrown
return Files.readString(Path.of(name));
^
2 errors
|
[main]方法本身可以抛出异常:[void main() throws IOException]。这时,未捕获的异常会终止程序,程序显示异常和调用栈,并以返回码 1 退出。这对小型测试程序是可以接受的,但对生产应用则不行。受检异常有时被认为限制过多,许多较新的库(我们稍后将使用的 Spring、Hibernate)只使用非受检异常。在本课程中,在知道如何处理受检异常的地方我们就捕获它,否则就把它包装成非受检异常。
3.6.6. 资源释放:带资源的 try 块
资源 (打开的文件、网络连接、数据库连接)在使用之后必须关闭,即使在使用过程中出现错误也是如此。在 Java 7 之前,它是在 [finally]子句中关闭的,这需要写好几行复杂的代码。Java 7 引入了 try-with-resources 语句:
| try (Type resource = ...) {
use of the resource
}
|
在括号中声明的资源会在块结束时自动关闭(通过调用其 [close()]方法),无论块是正常结束还是因异常而结束。资源类型必须实现 [AutoCloseable]接口,它只包含 [close()]方法;Java 所有的文件、网络和数据库类都是如此。可以声明多个资源,用分号分隔:它们按打开的相反顺序关闭。这样的 [try] 可以带有 [catch] 和 [finally] 子句,它们在资源关闭之后执行。
Java 7 还引入了多重捕获:单个 [catch]子句可以处理多种异常类型,类型之间用 | 字符分隔:[catch (NumberFormatException | ArithmeticException e)]。列出的类型之间不能有派生关系。
程序 [Basics24.java] 如下:
| // try-with-resources 和多重 catch
void main() throws IOException {
// 1 - 离开 try 时资源自动关闭
try (Resource r = open("R1")) {
IO.println("using " + r.name());
}
// 2 - 多个资源:按与打开顺序相反的顺序关闭,
// 即使发生异常也是如此,并且在执行 catch 和 finally 子句之前
try (Resource r2 = open("R2"); Resource r3 = open("R3")) {
IO.println("using " + r2.name() + " and " + r3.name());
throw new IllegalStateException("incident during use");
} catch (IllegalStateException e) {
IO.println("catch : " + e.getMessage());
} finally {
IO.println("finally");
}
// 3 - BufferedReader 是一种资源;readLine 抛出 IOException(受检)
try (BufferedReader reader = new BufferedReader(new StringReader("line 1\nline 2"))) {
String line;
while ((line = reader.readLine()) != null) {
IO.println("read: " + line);
}
}
// 4 - 多重 catch(Java 7):对多种异常类型采用相同的处理
String[][] operations = {{"10", "2"}, {"10", "zero"}, {"10", "0"}};
for (String[] operation : operations) {
try {
int a = Integer.parseInt(operation[0]);
int b = Integer.parseInt(operation[1]);
IO.println(a + " / " + b + " = " + a / b);
} catch (NumberFormatException | ArithmeticException e) {
IO.println(Arrays.toString(operation) + " : "
+ e.getClass().getSimpleName() + " - " + e.getMessage());
}
}
}
// 资源:实现 AutoCloseable 接口的对象(第 4 章)
record Resource(String name) implements AutoCloseable {
@Override
public void close() {
IO.println("closing " + name);
}
}
Resource open(String name) {
IO.println("opening " + name);
return new Resource(name);
}
|
结果:
| > java Basics24.java
opening R1
using R1
closing R1
opening R2
opening R3
using R2 and R3
closing R3
closing R2
catch : incident during use
finally
read: line 1
read: line 2
10 / 2 = 5
[10, zero] : NumberFormatException - For input string: "zero"
[10, 0] : ArithmeticException - / by zero
|
说明:
- 第 2 行:[main]方法声明了受检异常 [IOException],它可能由第 20 行的 [readLine]方法抛出,而我们并不捕获它;
- 第 39–44 行:一个演示用的资源。这是一个记录 (第 4 章),一种非常简单的类,其中每个对象都有一个名称;它通过定义显示一条消息的 [close()]方法来实现 [AutoCloseable]接口;
- 第 46–49 行:[open]方法显示一条消息并创建一个资源;
- 第 4–6 行:资源 [r] 在块结束时自动关闭(结果的第 4 行);
- 第 9–16 行:两个资源。在使用它们的过程中抛出了异常(第 11 行)。结果(第 5–11 行)表明 R3 先于 R2 关闭,并且两者都在执行 [catch] 和 [finally]子句之前关闭;
- 第 18 行:这里的 [BufferedReader] 像读取文件一样读取一个字符串。我们将在第 5 章用它来读取真正的文件;
- 第 20 行:[readLine()] 返回下一行,在文本结束时返回 [null] 。赋值发生在 [while]的条件之内:表达式 [(line = reader.readLine())] 的值就是被赋的值;
- 第 31 行:多重捕获:对 [NumberFormatException] (结果的第 15 行)和 [ArithmeticException] (第 16 行)执行相同的动作。
3.7. 示例应用程序 - V1
我们的目标是编写一个计算纳税人应纳税额的程序。我们考虑一种简化的情形:纳税人只有一份工资需要申报。所用数字取自 2004 年针对 2003 年收入的税率表,并原样使用:这是一个编程练习,而不是对现行税款的计算。这个应用程序将作为我们的主线:在接下来的各章中,我们会回到它,依次加入类、文件、数据库,然后是网络功能。
- 我们计算雇员的份数:如果未婚,份数 = nbChildren/2 + 1;如果已婚,份数 = nbChildren/2 + 2,其中 nbChildren 是他的子女数;
- 如果他至少有三个子女,则额外增加半份;
- 他的应税收入 R 按 R = 0.72 * S 计算,其中 S 是他的年薪;
- 他的家庭商数按 QF = R / 份数 计算;
- 他的税额 I 使用下表计算:
上限 | coeffR | coeffN |
4962 | 0 | 0 |
8382 | 0.068 | 291.09 |
14,753 | 0.191 | 1,322.92 |
23,888 | 0.283 | 2,668.39 |
38,868 | 0.374 | 4,846.98 |
47,932 | 0.426 | 6,883.66 |
0 | 0.481 | 9,505.54 |
每行有 3 个字段。要计算税额 I,我们查找第一个满足 QF 小于或等于上限的行。例如,如果 QF = 5000,我们会找到这一行:
于是税额 I 等于 0.068 * R - 291.09 * 份数,四舍五入到整欧元。如果 QF 使得条件 QF <= 上限 永远得不到满足,就使用最后一行的系数:I = 0.481 * R - 9505.54 * 份数。因此,最后一行中的上限 0 永远不会被用到。
计算涉及金额和十进制系数:我们使用 [BigDecimal]类来执行它们。对应的 Java 程序 [Tax1.java] 如下:
| // 税款计算 - 版本 1
// 2004 年税率表(2003 年收入):这只是练习,不是现行税率表
void main() {
// 税款计算所需的数据数组
BigDecimal[] limits = decimals("4962", "8382", "14753", "23888", "38868", "47932", "0");
BigDecimal[] coeffR = decimals("0", "0.068", "0.191", "0.283", "0.374", "0.426", "0.481");
BigDecimal[] coeffN = decimals("0", "291.09", "1322.92", "2668.39", "4846.98", "6883.66", "9505.54");
// 婚姻状况
String answer;
while (true) {
answer = read("Are you married (Y/N)? ").toLowerCase();
if (answer.equals("y") || answer.equals("n")) {
break;
}
System.err.println("Incorrect answer. Try again");
}
boolean married = answer.equals("y");
// 子女数
int nbChildren;
while (true) {
try {
nbChildren = Integer.parseInt(read("Number of children: "));
if (nbChildren >= 0) {
break;
}
} catch (NumberFormatException _) {
// 输入不是数字:重新开始
}
System.err.println("Incorrect answer. Try again");
}
// 年薪
int salary;
while (true) {
try {
salary = Integer.parseInt(read("Annual salary: "));
if (salary >= 0) {
break;
}
} catch (NumberFormatException _) {
// 输入不是数字:重新开始
}
System.err.println("Incorrect answer. Try again");
}
// 份额数
BigDecimal shares = BigDecimal.valueOf(nbChildren).divide(BigDecimal.TWO)
.add(BigDecimal.valueOf(married ? 2 : 1));
if (nbChildren >= 3) {
shares = shares.add(new BigDecimal("0.5"));
}
// 应税收入
BigDecimal income = new BigDecimal("0.72").multiply(BigDecimal.valueOf(salary));
// 家庭商数(除法可能除不尽:已设定精度)
BigDecimal quotient = income.divide(shares, MathContext.DECIMAL128);
// 查找税率档:第一个满足 quotient <= limit 的档,
// 如果没有合适的则取最后一档
int i = 0;
while (i < limits.length - 1 && quotient.compareTo(limits[i]) > 0) {
i++;
}
// 税款(舍去到欧元)
int tax = coeffR[i].multiply(income).subtract(coeffN[i].multiply(shares)).intValue();
// 显示结果
IO.println("Tax to pay: " + tax + " euros");
}
// 显示提示,读取一行并返回,去掉首尾空格
// (如果输入流已耗尽则返回空字符串)
String read(String prompt) {
return Objects.requireNonNullElse(IO.readln(prompt), "").trim();
}
// 将字符串转换为精确的 BigDecimal 数字
BigDecimal[] decimals(String... values) {
BigDecimal[] numbers = new BigDecimal[values.length];
for (int i = 0; i < values.length; i++) {
numbers[i] = new BigDecimal(values[i]);
}
return numbers;
}
|
说明:
- 第 5–7 行:[BigDecimal] 的三个数组由 [decimals] 方法(第 82–88 行)根据字符串构造:因此每个值,例如 0.068,都是精确的。如果使用 [double],0.068 就只是一个二进制近似值。[decimals] 方法接受任意数量的参数([String... values]),并以数组形式接收它们;这种记法将在“向函数传递参数”一节中解释;
- 第 10–18 行:输入婚姻状况,使用 [while (true)] 循环,当答案正确时通过 [break] 退出;
- 第 12 行:[read] 方法(第 77–79 行)显示提示并读取回答;如果输入流已关闭,则把值 [null] 替换为空字符串。[trim()] 方法去掉所读字符串的前导和尾随空格,[toLowerCase()] 把它转换为小写。这样 Y 和 y 都能被接受;
- 第 13 行:字符串使用 [equals]比较,绝不使用 ==;
- 第 16 行:错误消息写入 [System.err]流;
- 第 18 行:布尔变量 [married] 由表达式 [answer.equals("y")]的值 [true] 或 [false] 赋值;
- 第 21–32 行:输入子女数。如果输入不是整数,[Integer.parseInt] 会触发 [NumberFormatException] :程序随后进入 [catch]子句(第 28 行),它什么也不做,然后显示错误消息并重新开始。如果转换成功并且数字为正数或零,就退出循环(第 26 行)。在第 21 行不带值声明的变量 [nbChildren],在退出循环时总是有值:编译器会检查这一点;
- 第 35–46 行:对工资做同样的处理;
- 第 49–50 行:份数用 [BigDecimal]计算。不能简单地写 [nbChildren / 2]:如果 nbChildren 是 3,就会得到 3/2,这是整数除法,结果是 1 而不是 1.5。[BigDecimal.valueOf(nbChildren)] 转换整数,[divide(BigDecimal.TWO)] 把它除以二(常量 [TWO] 自 Java 19 起就存在),[add] 再加上 2 或 1。方法调用被链接在一起:每一个都作用于前一个的结果;
- 第 52 行:[BigDecimal] 是不可变的:[add] 不会修改 [shares] ,而是返回一个新对象,必须把它赋给变量。如果只写 [shares.add(new BigDecimal("0.5"));] ,就不会有任何效果:这是一个经典陷阱;
- 第 56 行:应税收入;
- 第 59 行:家庭商数。把收入除以 1.5 或 3.5 份,通常不会得到有限的十进制表示:我们设置一个精度,这里是 [MathContext.DECIMAL128] (34 位有效数字),这已经绰绰有余;
- 第 63–66 行:确定税率档。搜索在第一个大于或等于家庭商数的上限处停止,并且由于条件 [i < limits.length - 1],最迟在最后一档处停止。运算符 < 和 > 不适用于 [BigDecimal]:[quotient.compareTo(limits[i]) > 0] 表示“quotient > limits[i]”。两个 [BigDecimal] 值不用 [equals]比较,因为它会考虑小数位数:2.0 和 2.00 对 [equals]来说并不“相等”;
- 第 69 行:税额使用 [intValue()]方法四舍五入到整欧元,该方法会舍弃小数部分。
下面是一些输出示例:
| > java Tax1.java
Are you married (Y/N)? y
Number of children: 2
Annual salary: 60000
Tax to pay: 4282 euros
|
| > java Tax1.java
Are you married (Y/N)? yes
Incorrect answer. Try again
Are you married (Y/N)? y
Number of children: three
Incorrect answer. Try again
Number of children: 3
Annual salary: 60000 euros
Incorrect answer. Try again
Annual salary: 60000
Tax to pay: 2959 euros
> java Tax1.java
Are you married (Y/N)? n
Number of children: 0
Annual salary: 60000
Tax to pay: 11519 euros
|
对于 60,000 欧元的年薪,有 2 个子女的已婚纳税人缴纳 4,282 欧元;有 3 个子女时缴纳 2,959 欧元;没有子女的单身者缴纳 11,519 欧元。在第二次运行中,输入“60000 euros”被拒绝:[Integer.parseInt] 只接受表示精确整数的字符串(前导和尾随空格已被 [trim()]去掉)。
3.8. 主程序的参数
主方法 [main] 可以接受一个字符串数组 [String[]]作为参数。该数组包含启动应用程序所用的命令行参数。因此,如果我们用如下命令启动程序 P:
| java P arg0 arg1 ... argn
|
并且方法 [main] 声明如下:
| public static void main(String[] args) {
|
我们就会得到 args[0]="arg0"、args[1]="arg1",依此类推。在紧凑文件中,你可以通过声明 [void main(String[] args)]来获得同样的数组。使用源文件启动器时,程序的参数放在文件名之后;[java]命令本身的选项(例如 [-cp] 或 [-D])放在前面:
这是一个示例 [Basics25.java]:
| // 精简源文件中的命令行参数
void main(String[] args) {
IO.println("There are " + args.length + " argument(s)");
for (int i = 0; i < args.length; i++) {
IO.println("args[" + i + "]=" + args[i]);
}
}
|
结果:
| > java Basics25.java a0 a1 a2 a3
There are 4 argument(s)
args[0]=a0
args[1]=a1
args[2]=a2
args[3]=a3
|
包含空格的参数必须用引号括起来:
| > java Basics25.java "jean dupont" 23
There are 2 argument(s)
args[0]=jean dupont
args[1]=23
|
使用类和标准方法编写的同一个程序:
| // 经典 main 方法中的命令行参数
public class Basics26 {
public static void main(String[] args) {
System.out.println("There are " + args.length + " argument(s)");
for (int i = 0; i < args.length; i++) {
System.out.println("args[" + i + "]=" + args[i]);
}
}
}
|
结果:
| > java Basics26.java a0 a1 a2 a3
There are 4 argument(s)
args[0]=a0
args[1]=a1
args[2]=a2
args[3]=a3
|
说明:
- 第 2 行:公共类,位于文件 [Basics26.java] 中;
- 第 3 行:程序的入口点,采用标准形式;
- 第 4–7 行:其余部分与 [Basics25.java] 相同,只是用 [System.out.println] 替换了 [IO.println]。
按包组织的应用程序,把它的类放在与包名相符的文件夹中(第 4 章);Maven 项目也是这样组织的,我们将从第 5 章开始使用它。最后请注意,在 Java 中,[main] 方法不返回值:程序的退出码通过 [System.exit]设置。
3.9. 枚举
枚举是一种数据类型,其值域由一组具名常量构成。设想一个需要处理考试成绩评语的程序。共有五种可能的评语:及格(Pass)、较好(Fairly Good)、良好(Good)、优秀(Very Good)和卓越(Excellent)。我们可以为这五个常量定义一个枚举:
| enum Honours { PASS, FAIRLY_GOOD, GOOD, VERY_GOOD, EXCELLENT }
|
按照惯例,常量的名称用大写字母书写。可以声明一个变量,使其取值来自该枚举:
| Honours myHonours = Honours.PASS;
|
可以使用 == 运算符把变量与枚举的各个可能值进行比较:
| if (myHonours == Honours.PASS) {
IO.println("Could do better");
}
|
与其他语言中枚举只是一组具名整数不同,Java 的枚举是一个类——派生自 [java.lang.Enum]类——它仅有的对象就是所声明的那些常量。每个常量都是一个唯一的对象,一次性创建;这就是它们可以用 == 比较的原因。每个常量都知道自己的名称([name()],或 [toString()])以及它在声明中的序号([ordinal()],从 0 开始)。编译器会为每个枚举添加两个静态方法:
- [Honours.values()] 按声明顺序返回枚举 [Honours]的常量数组;
- [Honours.valueOf(name)] 返回名为 [name]的常量,如果没有常量具有该名称,则抛出 [IllegalArgumentException] 。
枚举不能转换为整数,整数也不能转换为枚举:必须使用 [ordinal()] 和 [values()]。
程序 [Basics27.java] 突出展示了刚才所写的内容:
| // 枚举
enum Honours { PASS, FAIRLY_GOOD, GOOD, VERY_GOOD, EXCELLENT }
void main() {
// 取值来自 Honours 枚举的变量
Honours myHonours = Honours.PASS;
// 显示变量的值
IO.println("honours=" + myHonours);
// 用枚举的一个值进行测试
    if (myHonours == Honours.PASS) {
        IO.println("Could do better");
    }
// 荣誉等级列表:名称和序号
for (Honours m : Honours.values()) {
IO.println(m + " = " + m.ordinal());
}
// 序号 → 枚举
Honours m3 = Honours.values()[3];
IO.println("Honours.values()[3] = " + m3);
// 字符串 → 枚举
Honours m2 = Honours.valueOf("GOOD");
IO.println("m2=" + m2 + ", m2 after PASS : " + (m2.compareTo(Honours.PASS) > 0));
try {
Honours.valueOf("Good");
} catch (IllegalArgumentException e) {
IO.println("valueOf(\"Good\") : " + e.getMessage());
}
// switch 表达式中的枚举:如果处理了所有情况,则不需要 default
String assessment = switch (myHonours) {
case PASS, FAIRLY_GOOD -> "correct";
case GOOD, VERY_GOOD -> "very correct";
case EXCELLENT -> "remarkable";
};
IO.println("assessment: " + assessment);
IO.println("type: " + Honours.class.getName());
IO.println("parent class: " + Honours.class.getSuperclass().getName());
}
|
结果:
| > java Basics27.java
honours=PASS
Could do better
PASS = 0
FAIRLY_GOOD = 1
GOOD = 2
VERY_GOOD = 3
EXCELLENT = 4
Honours.values()[3] = VERY_GOOD
m2=GOOD, m2 after PASS : true
valueOf("Good") : No enum constant Basics27.Honours.Good
assessment: correct
type: Basics27$Honours
parent class: java.lang.Enum
|
说明:
- 第 2 行:枚举声明。在紧凑文件中,它与方法并列放置;在按类组织的程序中,它像类(第 4 章)一样,声明在自己的文件 [Honours.java] 中;
- 第 6 行:类型为 [Honours] 的变量;
- 第 8 行:枚举常量以其名称显示;
- 第 14–16 行:常量列表及其序号;
- 第 18 行:把序号转换为常量;
- 第 21 行:把字符串转换为枚举常量;
- 第 22 行:常量按声明顺序用 [compareTo] 比较:GOOD 排在 PASS 之后;
- 第 23–27 行:[valueOf] 区分大小写:“Good”不是常量名;
- 第 29–33 行:枚举与 switch 语句配合得很好。[case] 子句使用常量名,不加 [Honours]. 前缀。由于所有常量都已覆盖,该表达式无需 [default]子句即为穷尽的;如果以后向枚举添加了常量,编译器会把 switch 表达式标记为不完整;
- 第 35 行:枚举的全名是 [Basics27$Honours]:在紧凑文件中,枚举是隐式类 [Basics27]的成员类型,$ 字符分隔这两个名称;
- 第 36 行:任何枚举的父类都是 [java.lang.Enum]。
3.9.1. 增强的枚举
由于枚举是类,它可以有字段、构造函数和方法。每个常量随后通过调用构造函数来创建,参数写在其名称后面的括号中。这是 Java 中广泛使用的特性,无需再单独管理与常量相关联的值数组。
要表示一组选项,例如文件访问权限(读、写、执行),人们过去是用 | 运算符(按位或)组合 2 的幂。在 Java 中,我们使用枚举和 [EnumSet]类——枚举内常量的集合——它与按位组合一样高效(它在内部就是按位组合),但可读性好得多。[EnumMap]类同样是一个键为枚举常量的字典。
程序 [Basics28.java] 如下:
| // 增强枚举:字段、构造函数、方法;EnumSet 和 EnumMap
// 每个荣誉等级有一个最低分数和一个标签
enum Honour {
PASS(10, "Pass"),
FAIRLY_GOOD(12, "Fairly good"),
GOOD(14, "Good"),
VERY_GOOD(16, "Very good"),
EXCELLENT(18, "Excellent");
// 每个常量的字段
private final int minimumGrade;
private final String label;
// 每个常量调用一次构造函数
Honour(int minimumGrade, String label) {
this.minimumGrade = minimumGrade;
this.label = label;
}
int getMinimumGrade() {
return minimumGrade;
}
String getLabel() {
return label;
}
// 静态方法:与分数对应的荣誉等级(如果分数 < 10 则为空)
static Optional<Honour> forGrade(double grade) {
Honour result = null;
for (Honour m : values()) {
if (grade >= m.minimumGrade) {
result = m;
}
}
return Optional.ofNullable(result);
}
}
// 访问权限:一组值将用 EnumSet 表示
enum Right { READ, WRITE, EXECUTE }
void main() {
for (Honour m : Honour.values()) {
IO.println(m + " : \"" + m.getLabel() + "\" from " + m.getMinimumGrade());
}
double[] grades = {8.5, 12, 15.5, 19};
for (double grade : grades) {
String label = Honour.forGrade(grade).map(Honour::getLabel).orElse("no honours");
IO.println("grade " + grade + " : " + label);
}
// EnumSet:枚举值的集合(取代位组合)
EnumSet<Right> rights = EnumSet.of(Right.READ, Right.WRITE);
IO.println("rights=" + rights + ", read : " + rights.contains(Right.READ)
+ ", execute : " + rights.contains(Right.EXECUTE));
rights.add(Right.EXECUTE);
rights.remove(Right.WRITE);
IO.println("rights=" + rights);
IO.println("all=" + EnumSet.allOf(Right.class) + ", none=" + EnumSet.noneOf(Right.class)
+ ", complement of [READ]=" + EnumSet.complementOf(EnumSet.of(Right.READ)));
IO.println("from FAIRLY_GOOD to VERY_GOOD : " + EnumSet.range(Honour.FAIRLY_GOOD, Honour.VERY_GOOD));
// EnumMap:键为枚举值的字典(第 5 章)
EnumMap<Honour, Integer> headcounts = new EnumMap<>(Honour.class);
headcounts.put(Honour.GOOD, 7);
headcounts.put(Honour.PASS, 12);
IO.println("headcounts=" + headcounts);
}
|
结果:
| > java Basics28.java
PASS : "Pass" from 10
FAIRLY_GOOD : "Fairly good" from 12
GOOD : "Good" from 14
VERY_GOOD : "Very good" from 16
EXCELLENT : "Excellent" from 18
grade 8.5 : no honours
grade 12.0 : Fairly good
grade 15.5 : Good
grade 19.0 : Excellent
rights=[READ, WRITE], read : true, execute : false
rights=[READ, EXECUTE]
all=[READ, WRITE, EXECUTE], none=[], complement of [READ]=[WRITE, EXECUTE]
from FAIRLY_GOOD to VERY_GOOD : [FAIRLY_GOOD, GOOD, VERY_GOOD]
headcounts={PASS=12, GOOD=7}
|
说明:
- 第 4–8 行:枚举的常量,每个常量带两个参数。当最后一个常量之后还有成员时,其后的分号是必需的;
- 第 11–12 行:每个常量的字段。它们是 [private] (只能在枚举内部访问)和 [final] (一次性设定);
- 第 15–18 行:构造函数,在首次使用枚举时为每个常量调用一次。关键字 [this] 指正在构造的对象:[this.minimumGrade] 是字段,而 [minimumGrade] 是参数。枚举的构造函数是隐式私有的:不能创建额外的常量;
- 第 20–26 行:返回字段值的两个方法。名称 [getMinimumGrade] 和 [getLabel] 遵循 Java 的 getter 和 setter 约定,如第 4 章所述;
- 第 29–37 行:一个静态方法,在枚举本身上调用([Honour.forGrade(grade)])。由于常量是按分数升序声明的,最后一个达到最低分数的常量就是正确的那个。结果是 [Optional],如果分数小于 10,它为空;
- 第 41 行:用于访问权限的简单枚举;
- 第 44–46 行:各项及其字段的列表;
- 第 49 行:[map(Honour::getLabel)] 把 [Optional<Honour>] 转换为包含评语标签的 [Optional<String>] ;当 [orElse] [Optional] 为空时提供文本;
- 第 54 行:由两个权限组成的集合;
- 第 55–56 行:[contains] 方法检查某个常量是否属于该集合,就像检查某一位一样;
- 第 57–58 行:添加和删除常量;
- 第 60–61 行:所有常量的集合、空集合以及集合的补集;
- 第 62 行:两个常量之间的各个常量,按声明的顺序;
- 第 65–68 行:[EnumMap] 把一组值与某些条目关联起来。它的键总是按常量声明的顺序遍历:PASS 出现在 GOOD 之前,尽管它是后来才添加的。字典将在第 5 章讨论。
3.10. 向函数传递参数
在 Java 中,函数称为方法:它们总是属于某个类,可能是紧凑文件的隐式类。这里我们关注参数是如何传递给方法的。考虑下面的方法:
| void changeInt(int a) {
a = 30;
IO.println("Formal parameter a=" + a);
}
|
在方法定义中,第 1 行的 [a] 称为形式参数。它的存在只是为了定义 [changeInt]方法。它同样可以命名为 [b]。现在我们来看这个方法的一个调用:
| int age = 20;
changeInt(age);
IO.println("Actual parameter age=" + age);
|
这里,在第 2 行的语句中,[age] 是实际参数 ,它把值传递给形式参数 [a]。我们关心的是形式参数如何获得实际参数的值。
3.10.1. 按值传递:Java 唯一的参数传递方式
Java 只有一种参数传递方式:按值传递。实际参数的值被复制到对应的形式参数中。它们是两个不同的实体:如果方法修改了形式参数,实际参数保持不变。
当参数是引用类型(数组、对象)时,被复制的值是引用:此时形式参数和实际参数引用同一个对象。因此,如果该对象是可修改的,方法可以修改它,调用方会看到这一变化;但是,方法不能使调用方的变量引用另一个对象。
与其他语言不同,Java 不支持按引用传递,即形式参数和实际参数是同一个变量:方法不能修改其调用方的局部变量,也不能通过参数向调用方“返回”结果。我们改用:
- 方法的返回值,由调用方把它赋给自己的变量;
- 当方法需要返回多个值时,使用记录;
- 作为参数传入的数组或可变对象,方法把结果放入其中。
此外,声明为 [final] 的参数在方法内不能被赋予新值:这样编译器就确保它保持调用方传入的值。
程序 [Basics29.java] 演示了这几种不同的情况:
| // 参数传递:始终按值传递
void main() {
// 1 - 按值传递:实参不会被修改
int age = 20;
changeInt(age);
IO.println("Actual parameter age=" + age);
// 2 - 要修改调用者的变量:方法返回新值
int age2 = 20;
age2 = changeInt2(age2);
IO.println("Actual parameter age2=" + age2);
// 3 - 要返回多个值:使用记录
Conversion c1 = convert("123");
Conversion c2 = convert("12x");
IO.println("c1=" + c1 + ", c2=" + c2);
if (c1.succeeded()) {
IO.println("value of c1: " + c1.value());
}
// 4 - 交换值:将值存放在数组中
int[] xy = {1, 2};
swap(xy);
IO.println("after swap: x=" + xy[0] + ", y=" + xy[1]);
// 5 - 按值传递的数组:被复制的是它的引用
int[] array = {1, 2, 3};
modifyArray(array);
IO.println("array=" + Arrays.toString(array));
// 6 - 可修改(可变)的对象:方法修改被引用的对象
StringBuilder message = new StringBuilder("Hello");
complete(message);
IO.println("message=" + message);
// 7 - final 参数不能在方法中接收新值
BigDecimal price = new BigDecimal("100");
IO.println("InclTax(" + price + ")=" + inclTax(price));
}
// 转换结果:是否成功以及得到的值
record Conversion(boolean succeeded, int value) {}
void changeInt(int a) {
    a = 30;
    IO.println("Formal parameter a=" + a);
}
int changeInt2(int a2) {
a2 = 30;
IO.println("Formal parameter a2=" + a2);
return a2;
}
Conversion convert(String text) {
try {
return new Conversion(true, Integer.parseInt(text));
} catch (NumberFormatException _) {
return new Conversion(false, 0);
}
}
void swap(int[] t) {
int temp = t[0];
t[0] = t[1];
t[1] = temp;
}
void modifyArray(int[] t) {
// 我们修改被引用的数组:调用者能看到这一修改
t[0] = 100;
// 我们让 t 指向另一个数组:调用者看不到这一点
t = new int[]{7, 8, 9};
IO.println("in modifyArray: t=" + Arrays.toString(t));
}
void complete(StringBuilder text) {
text.append(" everyone");
}
BigDecimal inclTax(final BigDecimal amount) {
// amount = BigDecimal.ZERO; 会被拒绝:该参数是 final
return amount.multiply(new BigDecimal("1.2"));
}
|
结果:
| > java Basics29.java
Formal parameter a=30
Actual parameter age=20
Formal parameter a2=30
Actual parameter age2=30
c1=Conversion[succeeded=true, value=123], c2=Conversion[succeeded=false, value=0]
value of c1: 123
after swap: x=2, y=1
in modifyArray: t=[7, 8, 9]
array=[100, 2, 3]
message=Hello everyone
InclTax(100)=120.0
|
说明:
- 第 4–6 行:实际参数 [age] 的值 20 被复制到形式参数 [a] 中(第 44 行)。随后该参数被修改(第 45 行)。实际参数保持不变;
- 第 9–11 行:[changeInt2] 方法(第 49–53 行)返回它的新值,由调用方把它赋给自己的变量 [age2];
- 第 42 行:记录 (Java 16)用一行声明一个类,其对象包含两个不可变的值 [succeeded] 和 [value]。编译器会添加一个构造函数、针对这两个值各一个的 getter 方法([succeeded()]、[value()]),以及一个名为 [toString()]的方法。记录将在第 4 章讨论;
- 第 14–19 行:[convert] 方法(第 55–61 行)返回两条信息——转换是否成功以及转换得到的值——它们被组合成一个 [Conversion]对象。它的 [toString()] 方法显示其各个组成部分;
- 第 22–24 行:交换两个值。名为 [swap(int a, int b)] 的方法交换的是副本,对调用方没有影响;因此,两个值被存放在数组中,由 [swap] 方法(第 63–67 行)修改;
- 第 27–29 行:数组引用是按值传递的。因此 [modifyArray] 方法操作的是与调用方相同的数组:由 [t[0]] (第 71 行)所作的修改对调用方是可见的。然而,让 [t]指向另一个数组(第 73 行)只会修改引用的局部副本;
- 第 32–34 行:[StringBuilder] 对象是可变字符串:[complete] 方法(第 77–79 行)向它追加文本,调用方可以看到结果。如果是 [String],这就不可能做到:[String]对象是不可变的;
- 第 37–38 行:[inclTax]方法(第 81–84 行)有一个 [final]参数。两个 [BigDecimal] 对象之积的小数位数等于两个因子小数位数之和:100 × 1.2 = 120.0,显示为 120.0。
如果把第 82 行的注释替换为语句 [amount = BigDecimal.ZERO;],编译器就会拒绝该程序:
| Basics29.java:82: error: final parameter amount may not be assigned
amount = BigDecimal.ZERO;
^
1 error
|
3.10.2. 方法重载、可变数量的参数
Java 没有带默认值的可选参数,也没有命名参数。可选参数的等价功能是通过方法重载实现的:如果参数列表在参数个数或类型上不同,多个方法可以同名;编译器根据提供的实际参数选择合适的那个。最常见的做法是让简短的版本调用完整的版本,并向它传递默认值。当可选参数很多时,更倾向于使用配置对象或“构建器”;我们将在课程后面看到它们的示例。
Java 5 引入了带有可变数量参数(“varargs”)的方法:最后一个形式参数用省略号声明,即 [int... numbers]。调用方既可以传入数组,也可以传入一列值(可以为空),编译器会把它们整理成数组;在方法内部,该参数是一个数组。
程序 [Basics30.java] 如下:
| // 方法重载,可变数量的参数
void main() {
// Java 中没有可选参数:使用方法重载
IO.println(greet("Pierre"));
IO.println(greet("Pierre", "Good evening"));
IO.println(greet("Pierre", "Hello", true));
IO.println(greet("Paul", "Hi", true));
// varargs:可变数量的参数
IO.println("sum()=" + sum());
IO.println("sum(1, 2, 3)=" + sum(1, 2, 3));
int[] values = {10, 20, 30};
IO.println("sum(values)=" + sum(values));
// JDK 中参数数量可变的方法
IO.println(String.join(" - ", "a", "b", "c"));
IO.println(String.format("%s, %s and %s", "one", "two", "three"));
IO.println(List.of(1, 2, 3, 4));
}
// 三个同名方法,它们的参数不同
String greet(String name) {
return greet(name, "Hello");
}
String greet(String name, String greeting) {
return greet(name, greeting, false);
}
String greet(String name, String greeting, boolean uppercase) {
String message = greeting + " " + name;
return uppercase ? message.toUpperCase() : message;
}
int sum(int... numbers) {
// numbers 是一个数组
int sum = 0;
for (int number : numbers) {
sum += number;
}
return sum;
}
|
结果:
| > java Basics30.java
Hello Pierre
Good evening Pierre
HELLO PIERRE
HI PAUL
sum()=0
sum(1, 2, 3)=6
sum(values)=60
a - b - c
one, two and three
[1, 2, 3, 4]
|
说明:
- 第 21–32 行:三个参数个数不同的 [greet]方法。只有最后一个完成实际工作;另外两个用缺失参数的默认值来调用它;
- 第 4 行:[greet("Pierre")] 调用单参数版本(第 21 行),后者用字符串 "Hello," 调用双参数版本,双参数版本又用 [false]调用完整版本;
- 第 6–7 行:由于没有命名参数,要传递 [uppercase], 也必须传递 [greeting];
- 第 34–41 行:[sum] 接受任意数量的整数,并通过数组 [numbers]接收;
- 第 10–13 行:调用 [sum]时,分别不带参数、带三个整数,以及带一个数组;
- 第 15–17 行:JDK 的许多方法都有可变数量的参数:[String.join]、[String.format]、[List.of]……
3.11. 局部函数和元组:Java 的解决方案
3.11.1. 方法、lambda 和局部类
有些语言允许定义局部函数——即写在另一个函数内部、只能在该上下文中使用的函数。Java 不允许这样做。在我们的紧凑文件中,文件里的方法起这个作用;在类中,我们编写私有方法。在方法内部,我们有两种工具可用:
- lambda (Java 8),一种小型匿名函数,存放在合适类型的变量中,该类型称为函数式接口:[IntUnaryOperator cube = x -> x * x * x;]。lambda 在第 7 章“函数式接口、lambda 和事件”中讲解。lambda 可以读取其周围的局部变量,但前提是这些变量从不被修改([final]变量或“实际上是 final”的变量);它不能修改它们;
- 局部类,声明在方法内部,只能在方法内使用。
3.11.2. 用记录代替元组
其他语言有元组,它们无需类型声明就能把多个值组合在一起。Java 没有元组:它使用记录 (Java 16)。声明 [record Couple(int number, String name) {}] 用一行创建一个类,其中每个对象由一个整数和一个字符串组成,同时还有一个构造函数、访问器方法 [number()] 和 [name()],以及 [toString()]、[equals()]、和 [hashCode()]方法。记录可以在方法内部声明(局部记录)。可以使用记录模式(Java 21)提取它的组成部分,既可以配合 [instanceof]运算符,也可以在 [switch]中使用。记录是让方法返回多个值的自然方式;由于其组成部分有名称,它们比元组更易读。
程序 [Basics31.java] 如下:
| // 代替局部函数和元组:方法、lambda、局部类和记录
void main() {
// 精简文件的私有方法
IO.println("square(7)=" + square(7));
// 存储在变量中的 lambda(第 7 章)
IntUnaryOperator cube = x -> x * x * x;
IO.println("cube(3)=" + cube.applyAsInt(3));
// lambda 不能修改局部变量:我们借助一个对象
int[] counter = {0};
Runnable increment = () -> counter[0]++;
increment.run();
increment.run();
IO.println("counter=" + counter[0]);
// 局部类:在方法中声明,只能在方法内使用
class Accumulator {
private int total;
void add(int value) {
total += value;
}
}
Accumulator acc = new Accumulator();
acc.add(5);
acc.add(8);
IO.println("total=" + acc.total);
// 局部记录将若干具名值组合在一起
record Couple(int number, String name) {}
Couple t1 = new Couple(1, "one");
IO.println("t1=" + t1 + ", t1.number()=" + t1.number() + ", t1.name()=" + t1.name());
// 用记录模式解构(Java 21)
Object object = new Couple(3, "three");
if (object instanceof Couple(int number, String name)) {
IO.println("number=" + number + ", name=" + name);
}
// 现成的键值对:Map.entry
Map.Entry<Integer, String> pair = Map.entry(2, "two");
IO.println("pair=" + pair + ", key=" + pair.getKey() + ", value=" + pair.getValue());
// 返回多个值的方法:使用记录
IntegerDivision d = divide(17, 5);
IO.println("17 = 5 * " + d.quotient() + " + " + d.remainder());
MinMax mm = minMax(new int[]{12, -4, 35, 7});
IO.println("min=" + mm.min() + ", max=" + mm.max());
// 交换两个变量:使用临时变量
int a = 1, b = 2;
int temp = a;
a = b;
b = temp;
IO.println("a=" + a + ", b=" + b);
}
int square(int x) {
return x * x;
}
record IntegerDivision(int quotient, int remainder) {}
record MinMax(int min, int max) {}
IntegerDivision divide(int a, int b) {
return new IntegerDivision(a / b, a % b);
}
MinMax minMax(int[] values) {
int min = values[0], max = values[0];
for (int v : values) {
if (v < min) min = v;
if (v > max) max = v;
}
return new MinMax(min, max);
}
|
结果:
| > java Basics31.java
square(7)=49
cube(3)=27
counter=2
total=13
t1=Couple[number=1, name=one], t1.number()=1, t1.name()=one
number=3, name=three
pair=2=two, key=2, value=two
17 = 5 * 3 + 2
min=-4, max=35
a=2, b=1
|
说明:
- 第 4 行:紧凑文件中的 [square]方法(第 56–58 行);
- 第 6 行:一个 lambda。[x -> x * x * x] 读作“把 x 映射到 x * x * x 的函数”。它存放在类型为 [IntUnaryOperator]的变量中,该类型表示从 [int] 到 [int] 的函数(位于 [java.util.function]包中);
- 第 7 行:lambda 由 [applyAsInt]方法(来自 [IntUnaryOperator]接口)调用;
- 第 10–14 行:类型为 [Runnable] 的 lambda(没有参数或返回值),由 [run()]调用。它不能修改局部变量 [int];不过,它可以修改对象的内容,这里是只有一个元素的数组。如果写 [int counter = 0;] 和 [() -> counter++],,编译器就会拒绝该程序:[error: local variables referenced from a lambda expression must be final or effectively final];
- 第 17–23 行:局部类 [Accumulator],带有字段 [total] 和方法 [add]。类将在第 4 章讨论;
- 第 24–27 行:[Accumulator]对象使用运算符 [new]创建,然后调用它的方法。私有字段 [total] 对于包含该类的方法内的代码始终是可访问的;
- 第 30 行:局部记录;
- 第 32 行:记录的 [toString()]方法显示记录的名称及其组成部分;[number()] 和 [name()] 方法返回这些组成部分;
- 第 34–37 行:记录模式:如果 [object] 是一个 [Couple],它的两个组成部分就存放在模式中声明的变量 [number] 和 [name]中。Java 25 没有可以直接把记录拆分到多个变量中的语句;
- 第 39–40 行:对于简单的键值对,库提供了 [Map.entry(key, value)],,其组成部分通过 [getKey()] 和 [getValue()]获得;
- 第 43–46 行:[divide] 和 [minMax] 方法(第 64–75 行)各自返回两个值,它们被组合成第 60 行和第 62 行声明的记录。组成部分的名称([quotient()]、[remainder()], [min()]、[max()])使调用代码含义明确;
- 第 49–53 行:没有元组时,使用临时变量来交换两个变量;
- 第 71–72 行:[if]语句,其唯一的动作写在同一行,不带花括号。
在较大的程序中,我们定义类,它把数据和操作数据的方法组织在一起:这是下一章的主题。