5. 常用的 Java 类
这里我们介绍 Java 平台中几个常用的类:字符串、数组、集合、文件和正则表达式。我们还介绍流 API (Java 8),它是目前在 Java 集合中搜索、排序、分组或转换元素最常用的方式。在此之前,我们先说明如何查找关于数以千计的可用类的信息。这一资源对任何 Java 开发者都不可或缺,即使是有经验的开发者也是如此。
除了两个例子(JSON 示例和末尾的示例应用程序)之外,本章的示例都是由源代码启动器执行的紧凑源文件 :[java File.java]。它们位于课程代码的[05-classes-java]文件夹中,并在英文区域设置下运行。请注意,紧凑源文件会自动导入[java.base]模块中所有的公共类:[java.util]、[java.io]、[java.nio.file]、[java.util.regex]、[java.util.stream]、[java.time]……这就是为什么下面的程序不包含任何[import]语句。
5.1. 查找 Java 类的帮助
Java 标准库(Java SE API)包含 4,000 多个公共类。没有人能记住它们全部:Java 开发者经常查阅它们的文档。这份文档可以在线免费获取,并且针对每个 Java 版本都有发布。
5.1.1. 在线文档
起点是 Oracle 的网站docs.oracle.com/en/java/javase/25。在那里你会找到:
类页面,例如java.lang.String,提供:
- 该类所属的模块和包;
- 它的声明、它的父类以及它实现的接口;
- 一般性的描述,通常篇幅较长且详细,附有示例;
- 其字段、构造函数和方法的汇总列表,随后是每一项的详细信息:参数、返回值、可能抛出的异常,以及引入它的 Java 版本(在“Since”标题下)。
文档是英文的。在搜索引擎上用类的完整名称和版本(“java.lang.StringBuilder 25”)进行搜索,通常可以直接找到正确的页面。
5.1.2. Javadoc 和编辑器的帮助
这份文档由 JDK 的[javadoc]工具根据写在类的源代码中的文档注释 生成。这样的注释以[/**] 开头,并紧挨着放在类、字段或方法之前。例如,下面是本章示例应用程序中的税款计算方法,其文档注释如下:
| /**
* Calculates the tax of a taxpayer.
*
* @param married true if the taxpayer is married
* @param nbChildren number of children
* @param salary annual salary in euros
* @return the amount of the tax, in euros
*/
int calculate(boolean married, int nbChildren, int salary);
|
注释以一句摘要开头;[@param] 标签描述参数,而[@return] 描述返回值([@throws] 则描述异常)。你可以用这种方式为自己的代码编写文档;命令[javadoc] (在 Maven 项目中为[mvn javadoc:javadoc] )会生成与 Java 官方文档类似的 HTML 页面。从 Java 23 开始,文档注释也可以用 Markdown 编写,各行以[///]开头。
代码编辑器(IntelliJ IDEA,以及安装了 Extension Pack for Java 的 Visual Studio Code)会利用这些注释,在不离开代码的情况下提供即时帮助:
- 自动补全:输入[aString.]之后,编辑器会显示该对象的方法列表,以及它们的参数和返回类型;
- 快速文档:将鼠标悬停在类名或方法名上(或在 IntelliJ IDEA 中按 Ctrl+Q)会显示其 Javadoc;
- 参数提示:当你输入调用的左括号时(或在 IntelliJ IDEA 中按 Ctrl+P),编辑器会显示方法的不同重载以及每个参数的作用;
- 转到定义 (IntelliJ IDEA 中为 Ctrl+B,VS Code 中为 F12):显示类或方法的源代码。JDK 附带其整个库的源代码(文件[lib/src.zip]):这使你可以阅读由顶尖 Java 专家编写的[ArrayList] 或[HashMap]的代码,这非常有教育意义。
最后,JDK 的[jshell]工具让你无需编写程序就可以测试方法:你输入一个表达式,它就显示其值。例如,["abc".repeat(3)] 显示["abcabcabc"]。[/help] 命令(在[jshell] 中)会列出其选项。
5.2. 字符串
5.2.1. String 类
[String]类型([java.lang]包)表示字符串。它提供了许多方法。下面是其中的一些:
方法 | 作用 |
[int length()] | 字符串中的字符数 |
[char charAt(int index)] | 第[index]号字符;第一个字符是第 0 号 |
[boolean startsWith(String prefix)] | 返回[true] ,如果字符串以[prefix]开头 |
[boolean endsWith(String suffix)] | 返回[true] ,如果字符串以[suffix]结尾 |
[boolean contains(CharSequence s)] | 返回[true] ,如果字符串包含[s] |
[boolean equals(Object other)] | 返回[true] ,如果字符串与[other]内容相同;[equalsIgnoreCase] 不区分大小写 |
[int indexOf(String str)] | [str] 在字符串中第一次出现的位置,否则为 -1。另一个重载从位置[fromIndex]开始搜索 |
[int indexOf(int ch)] | 对字符[ch]同样适用 |
[int lastIndexOf(int ch)] | 与[indexOf] 相同,但返回最后一个位置而不是第一个 |
[static String join(CharSequence delimiter, CharSequence... elements)] | 类方法:连接各个元素,用[delimiter]分隔它们 |
[String replace(char oldChar, char newChar)] | 返回字符串的副本,其中字符[oldChar] 已被[newChar]替换;另一个重载用一个字符串替换另一个字符串 |
[String[] split(String regex)] | 把字符串视为由分隔符分隔的字段序列,分隔符由正则表达式 [regex]描述;结果是这些字段组成的数组 |
[String substring(int beginIndex, int endIndex)] | 由从位置[beginIndex] (包含)到位置[endIndex] (不包含)的字符组成的子串 |
[String toLowerCase()]、[String toUpperCase()] | 把字符串转换为小写、大写 |
[String strip()] | 去除字符串的首尾空格(Java 11;[stripLeading]、[stripTrailing]:仅去除一侧) |
[String repeat(int count)] | 把字符串重复[count] 次(Java 11) |
[boolean isEmpty()]、[boolean isBlank()] | 返回[true] ,如果字符串为空或只包含空格(Java 11) |
[Stream<String> lines()] | 以流的形式返回字符串的各行(Java 11;见下面的流 API) |
[String formatted(Object... args)] | 返回作为模板使用的字符串,其中的占位符[%s]、[%d]……已被参数替换(Java 15) |
需要注意的是,[String] 类型的字符串是不可变的;创建之后不能被修改。当方法返回一个字符串时,该字符串与调用该方法的字符串是不同的。因此,[s1.strip()] 返回字符串[s2],而[s1] 和[s2] 是两个不同的字符串:[s1] 没有改变。
与其他语言不同,Java 的字符串不是数组:你不写[c[i]] 而是写[c.charAt(i)],字符数通过[c.length()]方法获得(带括号,而数组的长度是[array.length]字段,不带括号)。
程序[Strings01.java] 如下:
| // String 类的若干方法
void main() {
String aString = "the bird flies above the clouds";
display("aString=" + aString);
display("aString.length()=" + aString.length());
display("aString.charAt(10)=" + aString.charAt(10));
display("aString.indexOf(\"flies\")=" + aString.indexOf("flies"));
display("aString.indexOf(\"x\")=" + aString.indexOf("x"));
display("aString.lastIndexOf('a')=" + aString.lastIndexOf('a'));
display("aString.lastIndexOf('x')=" + aString.lastIndexOf('x'));
display("aString.substring(4, 11)=" + aString.substring(4, 11));
display("aString.toUpperCase()=" + aString.toUpperCase());
display("aString.toLowerCase()=" + aString.toLowerCase());
display("aString.replace('a', 'A')=" + aString.replace('a', 'A'));
// 没有 insert 方法:把两个子字符串重新拼接起来
display("insertion of \"never \" at position 9=" + aString.substring(0, 9) + "never "
+ aString.substring(9));
// 将字符串拆分为单词(分隔符:一串空格)
String[] fields = aString.split("\\s+");
for (int i = 0; i < fields.length; i++) {
display("fields[" + i + "]=[" + fields[i] + "]");
}
display("String.join(\":\", fields)=" + String.join(":", fields));
display("\" abc \".strip()=[" + " abc ".strip() + "]");
// 原字符串没有被修改
display("aString=" + aString);
}
// 显示方法
void display(String msg) {
IO.println(msg);
}
|
结果:
| > java Strings01.java
aString=the bird flies above the clouds
aString.length()=31
aString.charAt(10)=l
aString.indexOf("flies")=9
aString.indexOf("x")=-1
aString.lastIndexOf('a')=15
aString.lastIndexOf('x')=-1
aString.substring(4, 11)=bird fl
aString.toUpperCase()=THE BIRD FLIES ABOVE THE CLOUDS
aString.toLowerCase()=the bird flies above the clouds
aString.replace('a', 'A')=the bird flies Above the clouds
insertion of "never " at position 9=the bird never flies above the clouds
fields[0]=[the]
fields[1]=[bird]
fields[2]=[flies]
fields[3]=[above]
fields[4]=[the]
fields[5]=[clouds]
String.join(":", fields)=the:bird:flies:above:the:clouds
" abc ".strip()=[abc]
aString=the bird flies above the clouds
|
说明:
- 第 6 行:第 10 号字符,即字符串中的第 11 个字符;
- 第 8、10 行:搜索不成功时返回 -1;
- 第 11 行:[substring] 的两个参数是第一个保留字符和第一个不保留字符的位置:由此得到第 4 到第 10 位的 7 个字符。这是 Java 指定索引范围的通用约定(包含起点,不包含终点):它出现在许多方法中;
- 第 16–17 行:[String]类没有插入方法:我们把字符串的开头、插入的文本和字符串的结尾连接起来。我们将看到[StringBuilder]类有[insert]方法;
- 第 19 行:[split] 把字符串拆分为各个字段。它的参数不是单个字符,而是正则表达式,我们将在本章末尾研究它:["\\s+"] 表示由一个或多个空白字符(空格、制表符、换行符等)组成的序列。字符[\] 在 Java 字符串中必须双写,因此写作[\\s];
- 第 23 行:静态方法[join] 执行[split]的逆操作;
- 第 24 行:[strip] (Java 11)去除首尾空格。还有较老的方法[trim],它只识别 ASCII 码中的空格;[strip] 识别所有 Unicode 空格,应当优先使用;
- 第 26 行:前面所有的方法都返回新的字符串:[aString] 保持不变(结果的第 22 行);
- 第 30–32 行:紧凑源文件中的一个方法,由[main] 方法像第 3 章中那样调用。
5.2.2. split 和 join 方法
程序[Strings02.java] 对字符串拆分为字段进行了更详细的演示:
| // split 和 join
void main() {
String line = "one:two::three:";
// 用 ':' 分隔符拆分
String[] fields = line.split(":");
for (int i = 0; i < fields.length; i++) {
IO.println("fields[" + i + "]=[" + fields[i] + "]");
}
// 反向操作得不到原字符串:末尾的空字段消失了
IO.println("join=[" + String.join(":", fields) + "]");
// limit 为负数时,split 保留末尾的空字段
fields = line.split(":", -1);
IO.println("split(\":\", -1) : " + fields.length + " fields, join=[" + String.join(":", fields) + "]");
// 分隔符是正则表达式:":+" 表示一串 ':'
fields = line.split(":+");
IO.println("split(\":+\") : " + fields.length + " fields [" + String.join("|", fields) + "]");
// 多个分隔符,并去除字段两侧的空格
String person = " dupont , jean ; 45 ";
fields = person.strip().split("\\s*[,;]\\s*");
IO.println("split(\"\\\\s*[,;]\\\\s*\") : " + fields.length + " fields ["
+ String.join("|", fields) + "]");
// 逐个字段去除空格和空字段
String list = " red ,, green , , blue ";
List<String> colors = new ArrayList<>();
for (String field : list.split(",")) {
String color = field.strip();
if (!color.isEmpty()) {
colors.add(color);
}
}
IO.println("strip + isEmpty : " + colors.size() + " fields [" + String.join("|", colors) + "]");
// 包含正则表达式特殊字符的分隔符
String text = "apple | pear | apricot";
fields = text.split(Pattern.quote(" | "));
IO.println("Pattern.quote : [" + String.join(", ", fields) + "]");
// join 只接受字符串:必须先转换整数
int[] numbers = {1, 2, 3, 4};
String[] texts = new String[numbers.length];
for (int i = 0; i < numbers.length; i++) {
texts[i] = String.valueOf(numbers[i]);
}
IO.println("join on integers: " + String.join(" + ", texts));
}
|
结果:
| > java Strings02.java
fields[0]=[one]
fields[1]=[two]
fields[2]=[]
fields[3]=[three]
join=[one:two::three]
split(":", -1) : 5 fields, join=[one:two::three:]
split(":+") : 3 fields [one|two|three]
split("\\s*[,;]\\s*") : 3 fields [dupont|jean|45]
strip + isEmpty : 3 fields [red|green|blue]
Pattern.quote : [apple, pear, apricot]
join on integers: 1 + 2 + 3 + 4
|
说明:
- 第 5 行:各字段由字符[:]分隔。两个连续的[:] 字符界定出一个空字段(结果的第 4 行)。但要小心:[split] 会删除末尾的空字段。字符串末尾的[:] 界定出第五个空字段,该字段已被删除:只得到 4 个字段,因此[join] 无法重建原始字符串(结果的第 6 行)。这是一个常见的陷阱;
- 第 13 行:[split] 的第二个参数是限制数。负的限制数指示程序保留所有字段,包括末尾的空字段:我们确实得到了 5 个字段,并且[join] 重建了原始字符串;
- 第 17 行:由于分隔符是正则表达式,我们可以定义复杂的分隔符:[":+"] 匹配一个或多个连续的[:]字符。两个连续的[:] 构成单个分隔符,空字段随之消失;
- 第 22 行:模式[\\s*[,;]\\s*] 匹配逗号或分号,其前后可以有任意数量的空格:分隔符周围的空格会随它们一起被删除。字符串开头和结尾的空格事先由[strip]去除。这样一条语句就产生了三个“清理过”的字段;
- 第 27–35 行:要同时删除字段周围的空格和空字段,也可以逐个处理字段:位于两个逗号之间、由两个空格组成的字段在[strip] 之后变为空,因而不被保留。这里用于存储保留字段的列表[ArrayList] 稍后会讨论。我们还会看到,流 API 允许用一条指令写出这种处理;
- 第 39 行:分隔符[" | "]包含字符[|],它在正则表达式中具有特殊含义(“或”)。[Pattern.quote]方法把任意字符串转换为按字面匹配它的正则表达式。每当分隔符包含字符[\ ^ $ . | ? * + ( ) [ ] { }]之一时,我们就会使用它;
- 第 43–48 行:[join] 只接受字符串(更准确地说,是[CharSequence]对象,这是由[String] 和[StringBuilder]实现的接口):整数数组必须先转换为字符串数组。我们将看到,使用流 API,[Arrays.stream(numbers).mapToObj(String::valueOf).collect(Collectors.joining(" + "))] 用一条指令就能完成同样的事情。
5.2.3. 搜索和比较字符串
字符串比较比看上去要微妙:是否要区分大写和小写字母?应当如何比较“éclair”和“essay”?最重要的是,在 Java 中,运算符[==]比较的是什么?程序[Strings03.java] 演示了搜索和比较方法:
| // 搜索和比较字符串
void main() {
String title = "Learning the Java language, version 25";
// contains、startsWith、endsWith:精确比较
IO.println("contains(\"language\") : " + title.contains("language"));
IO.println("contains(\"LANGUAGE\") : " + title.contains("LANGUAGE"));
IO.println("startsWith(\"Learning\") : " + title.startsWith("Learning"));
IO.println("endsWith(\"25\") : " + title.endsWith("25"));
// 忽略大小写:我们比较转换为小写后的字符串
String searched = "LANGUAGE";
IO.println("toLowerCase().contains(searched.toLowerCase()) : "
+ title.toLowerCase().contains(searched.toLowerCase()));
// regionMatches(ignoreCase, start, other, start in other, length)
IO.println("regionMatches(true, 0, \"learning\", 0, 8) : "
+ title.regionMatches(true, 0, "learning", 0, 8));
// 相等性:equals 比较内容,== 比较引用
String answer = "YES";
String yes = new StringBuilder("ye").append('s').toString();
IO.println("yes.equals(\"yes\") : " + yes.equals("yes"));
IO.println("yes == \"yes\" : " + (yes == "yes"));
IO.println("answer.equals(\"yes\") : " + answer.equals("yes"));
IO.println("answer.equalsIgnoreCase(\"yes\") : " + answer.equalsIgnoreCase("yes"));
// 字母顺序:按字符码或按语言
String a = "éclair", b = "essay";
IO.println("\"" + a + "\".compareTo(\"" + b + "\") : " + a.compareTo(b));
Collator collator = Collator.getInstance(Locale.FRANCE);
IO.println("collator.compare(\"" + a + "\", \"" + b + "\") : " + collator.compare(a, b));
// 空字符串或空白字符串
String empty = "";
String blank = " ";
String missing = null;
IO.println("\"\".isEmpty() : " + empty.isEmpty());
IO.println("\" \".isEmpty() : " + blank.isEmpty());
IO.println("\" \".isBlank() : " + blank.isBlank());
IO.println("missing == null || missing.isBlank() : " + (missing == null || missing.isBlank()));
// 对齐和重复
IO.println("[" + String.format("%8s", "abc") + "] [" + String.format("%-8s", "abc") + "] ["
+ "-".repeat(8) + "]");
}
|
结果:
| > java Strings03.java
contains("language") : true
contains("LANGUAGE") : false
startsWith("Learning") : true
endsWith("25") : true
toLowerCase().contains(searched.toLowerCase()) : true
regionMatches(true, 0, "learning", 0, 8) : true
yes.equals("yes") : true
yes == "yes" : false
answer.equals("yes") : false
answer.equalsIgnoreCase("yes") : true
"éclair".compareTo("essay") : 132
collator.compare("éclair", "essay") : -1
"".isEmpty() : true
" ".isEmpty() : false
" ".isBlank() : true
missing == null || missing.isBlank() : true
[ abc] [abc ] [--------]
|
说明:
- 第 6–9 行:[contains]、[startsWith],和[endsWith] 执行精确的逐字符比较:找不到“LANGUAGE”;
- 第 12–14 行:这些方法没有不区分大小写的变体。执行不区分大小写搜索最简单的方法是把两个字符串都转换为小写;
- 第 16–17 行:[regionMatches]方法把一个字符串的一部分与另一个字符串的一部分进行比较。它的第一个参数指定是否忽略大小写;后面的参数依次是在该字符串中的起始位置、另一个字符串、在另一个字符串中的起始位置,以及要比较的字符数;
- 第 20–25 行:本程序中最重要的部分。类型为[String] 的变量包含对字符串对象的引用 (第 4 章)。运算符[] 比较引用:如果两个变量引用同一个对象,它返回[true] ,而不是在两个对象内容相同时返回 true。变量[yes](第 21 行)引用在运行时构造的字符串“yes”:它与程序中的字面量字符串“yes”是不同的对象,因此[yes == "yes"] 的计算结果为[false] (结果的第 9 行),尽管这两个字符串内容相同。要比较内容,我们始终使用方法[equals],或者使用[equalsIgnoreCase] 来忽略大小写,这是测试从键盘输入的大写或小写“yes”响应的正确方式。使用[] 的比较有时“有效”,即当两个字符串都是程序字面量时,Java 只存储其中的一个实例:这使得该错误难以被发现;
- 第 28–31 行:方法[compareTo] 根据字符串位于参数字符串之前、与之相等还是位于其之后,返回负整数、零或正整数。它比较的是字符编码:“éclair”排在“essay”之后,因为字符 é 的编码(233)大于字符 e 的编码(101);这里它返回两个编码之差 132。要按照某种语言的规则对单词排序,请使用[java.text.Collator]对象:在法语中,字符“é”与“e”归为一组,“éclair”排在“essay”之前(结果的第 13 行)。对于面向用户的单词排序,我们将使用由[Collator] 定义的顺序,而对于技术标识符(文件名、键等)的比较,则使用[compareTo] ;
- 第 34–40 行:[isEmpty] 检查空字符串,而[isBlank] (Java 11)检查空字符串或只包含空格的字符串。类型为[String] 的变量也可以是[null] (没有字符串):对[null] 调用方法会抛出[NullPointerException]异常。因此,我们首先测试[missing == null];得益于[||]运算符的短路行为,[missing.isBlank()] 在 [missing] 为 [null]时不会被计算;
- 第 43–44 行:[String.format("%8s", ...)] 用空格把字符串填充到 8 个字符的长度,可以填充在左侧或右侧,右侧使用格式[%-8s];[repeat] 重复字符串。
5.2.4. 格式和文本块
到目前为止,我们一直使用[+]运算符进行连接来构建要显示的字符串。要把值按列对齐、设置数字的小数位数或显示日期,请使用[String.format]方法,或者使用[formatted]实例方法(Java 15),它们作用相同。第一个参数是格式:一个字符串,其中的[%[-][width][.precision]conversion] 说明符指明在何处以及如何插入后面的参数。[Strings04.java]程序提供了这方面的示例,以及 Java 15 的文本块:
| // 格式,文本块
void main() {
String name = "dupont";
int age = 45;
double salary = 2345.678;
double rate = 0.0525;
LocalDateTime date = LocalDateTime.of(2026, 10, 3, 14, 5, 9);
// 简单拼接
IO.println(name + " is " + age + " years old");
// %[-]width:width > 0 右对齐,- 号表示左对齐
IO.println(String.format("[%10s] [%-10s] [%5d]", name, name, age));
IO.println(String.format("[%12.2f] [%-12.1f] [%,.2f]", salary, salary, salary));
IO.println(String.format("[%05d] [%X] [%,d] [%e]", age, age, 1234567, salary));
// formatted 实例方法(Java 15):结果相同
IO.println("%s is %s".formatted(name, age >= 18 ? "an adult" : "a minor"));
// 货币和百分比:NumberFormat 类
NumberFormat currency = NumberFormat.getCurrencyInstance(Locale.FRANCE);
NumberFormat percentage = NumberFormat.getPercentInstance(Locale.FRANCE);
percentage.setMinimumFractionDigits(2);
IO.println("[" + currency.format(salary) + "] [" + percentage.format(rate) + "]");
// 日期:DateTimeFormatter 类
IO.println("[" + date.format(DateTimeFormatter.ofPattern("dd/MM/yyyy")) + "] ["
+ date.format(DateTimeFormatter.ofPattern("HH:mm:ss")) + "] ["
+ date.format(DateTimeFormatter.ofPattern("EEEE d MMMM yyyy")) + "]");
// 对齐的表格
String[] products = {"apple", "pear", "apricot"};
double[] prices = {2.5, 3.15, 12};
for (int i = 0; i < products.length; i++) {
IO.println("%-10s|%8.2f €".formatted(products[i], prices[i]));
}
// 字符串中的 \ 字符必须写两次
String path = "C:\\data\\courses\\infos.txt";
IO.println(path);
// 文本块(Java 15):以 """ 分隔,可跨多行
String json = """
{
"name": "dupont",
"path": "C:\\data"
}
""";
IO.print(json);
// 带 %s 和 %d 占位符、由 formatted 填充的文本块
String json2 = """
{ "name": "%s", "age": %d }""".formatted(name, age);
IO.println(json2);
}
|
结果:
| > java Strings04.java
dupont is 45 years old
[ dupont] [dupont ] [ 45]
[ 2345.68] [2345.7 ] [2,345.68]
[00045] [2D] [1,234,567] [2.345678e+03]
dupont is an adult
[2 345,68 €] [5,25 %]
[03/10/2026] [14:05:09] [Saturday 3 October 2026]
apple | 2.50 €
pear | 3.15 €
apricot | 12.00 €
C:\data\courses\infos.txt
{
"name": "dupont",
"path": "C:\data"
}
{ "name": "dupont", "age": 45 }
|
说明:
- 第 12 行:宽度使值在 10 个字符的字段内右对齐;当前面带有[-]符号时,则使其左对齐;
- 第 12–14 行:最常见的转换:
说明符 | 含义 | 示例 |
[%s] | 字符串;任何对象都使用其[toString]方法转换 | dupont |
[%d], [%5d] | 整数,可指定长度为 5 个字符 | 45 |
[%05d] | 至少 5 位的整数,用零填充 | 00045 |
[%X] | 十六进制整数([%x]:小写) | 2D |
[%.2f], [%12.2f] | 保留 2 位小数的实数,可指定长度为 12 个字符 | 2345.68 |
[%,.2f], [%,d] | 同上,带千位分隔符 | 2,345.68 |
[%e] | 科学记数法表示的实数 | 2.345678e+03 |
[%n] | 系统换行符 | |
[%%] | 字符 % | % |
- 数字按照当前语言格式化,这里是英语:小数点,逗号作为千位分隔符。在第 19–22 行的法语格式中,千位分隔符是空格:一个窄的不换行空格(字符 U+202F),它看上去像普通空格,但可以防止在数字中间换行;同样,€ 符号和 % 符号之前也有一个不换行空格(U+00A0)。把这些文本与用普通空格写成的字符串比较时,要考虑到这一点;
- 第 16 行:["...".formatted(...)] 等价于[String.format("...", ...)]。可以用条件表达式提供参数;
- 第 19–22 行:金额和百分比使用[java.text.NumberFormat]对象进行格式化,这些对象针对给定的语言和国家([Locale.FRANCE])派生。百分比格式会把值乘以 100;
- 第 25–27 行:来自 [java.time] API(Java 8)的日期使用由模板构造的[DateTimeFormatter]对象进行格式化:[dd] 表示日,[MM] 表示月,[yyyy] 表示年,[HH] 表示小时,[mm] 表示分钟,[ss] 表示秒,[EEEE] 表示完整拼写的星期几,[MMMM] 表示完整拼写的月份。要注意大小写:[MM] 是月,[mm] 是分钟。日期和月份的名称是日常语言中使用的名称;
- 第 30–34 行:列宽使数据可以按列显示;
- 第 37 行:在字符串中,字符[\] 引入转义序列 ([\n]、[\t]、[\"]……);要得到字符[\] 本身,必须把它双写。Java 没有“原始”字符串,其中[\] 是普通字符,这使得编写 Windows 路径和正则表达式有些麻烦;
- 第 41–46 行:文本块 (Java 15)由三个引号界定;文本从开头引号之后的下一行开始。它可以跨越多行,并且可以包含未转义的引号。所有行共有的缩进(以最小缩进行为准,并从结束引号开始计算)会被去除:JSON 文本显示时不带代码的边距。转义序列在这里仍然有效:[\] 仍然必须双写(第 44 行)。由于结束引号单独占一行,文本以换行符结尾:因此在第 47 行使用[IO.print] ([IO.println] 会在右花括号之后多出一个空行);
- 第 49–50 行:Java 不支持字符串插值,即像其他语言中的[${name}] 那样直接在文本中写表达式(一项名为“字符串模板”的提案曾在 Java 21 和 22 中作为预览功能进行测试,随后被移除)。对于文本块,使用诸如[%s]、[%d]……之类的占位符,由[formatted]填充。把结束引号放在文本末尾可以避免末尾的换行符。
还有类[java.text.MessageFormat],其格式通过编号引用参数:[MessageFormat.format("{0} is {1} years old", name, age)]。它用于翻译成多种语言的消息,因为参数的顺序在不同语言之间可能有所不同。
5.2.5. StringBuilder 类
我们提到过,应用于字符串[String]类的方法[s1]会返回另一个字符串[s2]。[java.lang.StringBuilder]类允许你修改字符串,而无需为每次操作创建新的字符串。通过连续多次添加来构造字符串时,这避免了大量生命周期极短的字符串的产生,从而提高性能。
该类支持多种构造函数:
构造函数 | 作用 |
[StringBuilder()] | 创建一个初始容量为 16 个字符的空对象 |
[StringBuilder(String str)] | 构造并用[str]初始化;初始容量是[str] 的长度加 16 |
[StringBuilder(int capacity)] | 构造一个初始容量为[capacity] 个字符的空对象 |
[StringBuilder]对象把其字符存储在一个数组中,该数组的大小,即其容量,会随着文本的增长而自动调整。程序[Strings05.java] 说明了容量的概念:
| // StringBuilder 的大小和容量
void main() {
StringBuilder str = new StringBuilder("test");
IO.println("size=" + str.length() + ", capacity=" + str.capacity());
for (int i = 0; i < 10; i++) {
str.append("test");
IO.println("size=" + str.length() + ", capacity=" + str.capacity());
}
// 初始容量为 10 的 StringBuilder
StringBuilder str2 = new StringBuilder(10).append("test");
IO.println("size=" + str2.length() + ", capacity=" + str2.capacity());
for (int i = 0; i < 10; i++) {
str2.append("test");
IO.println("size=" + str2.length() + ", capacity=" + str2.capacity());
}
}
|
结果:
| > java Strings05.java
size=4, capacity=20
size=8, capacity=20
size=12, capacity=20
size=16, capacity=20
size=20, capacity=20
size=24, capacity=42
size=28, capacity=42
size=32, capacity=42
size=36, capacity=42
size=40, capacity=42
size=44, capacity=86
size=4, capacity=10
size=8, capacity=10
size=12, capacity=22
size=16, capacity=22
size=20, capacity=22
size=24, capacity=46
size=28, capacity=46
size=32, capacity=46
size=36, capacity=46
size=40, capacity=46
size=44, capacity=46
|
说明:
- 第 3 行:创建一个包含“test”的[StringBuilder]对象:它的初始容量是 4 + 16 = 20 个字符;
- 第 4 行:[length] 是当前的字符数;[capacity] 是对象在需要扩展其数组之前能够容纳的字符数;
- 第 6 行:[append] 把字符串追加到文本末尾;
- 第 10 行:创建一个初始容量为 10 的空[StringBuilder]对象,并立即向其中添加“test”。方法[append] 返回对象本身:因此可以直接对构造函数的结果调用它。
结果表明,当容量不足时,它会比翻倍略多一点:新容量是旧容量乘以 2 再加 2(第一个对象为 20、42、86;第二个对象为 10、22、46)。每次调整大小都会分配一个新数组并把字符复制进去。如果事先知道文本的大致大小,在构造时设置它可以避免这些连续的调整。
下面是该类的一些方法:
方法 | 作用 |
[StringBuilder append(String str)] | 把[str] 添加到文本末尾。被重载以接受类型[int]、[double]、[char]、[boolean]、[Object]…… |
[StringBuilder insert(int offset, String str)] | 把[str] 插入到[offset]所指的位置;与[append]一样被重载 |
[StringBuilder delete(int start, int end)] | 删除从位置[start] (包含)到[end] (不包含)的字符;[deleteCharAt] 删除一个字符 |
[StringBuilder replace(int start, int end, String str)] | 把位置[start] (包含)到[end] (不包含)的字符替换为[str] |
[StringBuilder reverse()] | 反转字符的顺序 |
[void setCharAt(int index, char ch)] | 把第[index] 号字符替换为[ch] |
[int indexOf(String str)] | [str] 在文本中的位置,否则为 -1 |
[String toString()] | 把文本转换为字符串[String] |
程序[Strings06.java] 使用了这些方法:
| // StringBuilder 的方法返回 StringBuilder 对象本身:可以链式调用
void main() {
StringBuilder str3 = new StringBuilder("test");
IO.println(str3.append("abCD").insert(2, "xyZT").delete(0, 2).replace(0, 2, "XY"));
// reverse 反转字符的顺序
IO.println(new StringBuilder("éclair").reverse());
// 逐段构建字符串
StringBuilder lines = new StringBuilder();
for (int i = 1; i <= 3; i++) {
lines.append("line ").append(i).append('\n');
}
// 用 String.join 添加以逗号分隔的元素
lines.append(String.join(", ", "a", "b", "c")).append('\n');
// 格式化后的字符串
int total = 42;
lines.append("total=%6.1f".formatted((double) total));
// 最终字符串
String result = lines.toString();
IO.println(result);
IO.println(result.length() + " characters");
// StringJoiner:分隔符、前缀和后缀
StringJoiner joiner = new StringJoiner(", ", "[", "]");
for (String color : new String[]{"red", "green", "blue"}) {
joiner.add(color);
}
IO.println(joiner);
}
|
结果:
| > java Strings06.java
XYZTstabCD
rialcé
line 1
line 2
line 3
a, b, c
total= 42.0
41 characters
[red, green, blue]
|
说明:
- 第 4 行:修改方法返回[StringBuilder]对象本身,这使它们可以链接在一起。让我们逐步来看:“test”变成“testabCD ”([append]),然后变成“texyZTstabCD”([insert] 在位置 2),再变成“xyZTstabCD ”([delete] 删除第 0 和第 1 个字符),最后变成“XYZTstabCD”([replace] 对第 0 和第 1 个字符,用“XY”替换)。请注意,与[replace]方法在[String]中的行为不同,[StringBuilder] 的该方法不搜索文本:它替换的是一个位置范围。[IO.println] 通过调用对象的[toString]方法来显示它;
- 第 6 行:[reverse] 反转文本。由于[String] 没有[reverse]方法,这是反转字符串的标准方式;
- 第 9–12 行:通过连续添加来构造多行文本——这是[StringBuilder]的典型用法。各次添加被链接在同一行代码上;
- 第 14 行:[StringBuilder] 没有与[join]等价的方法:追加的是[String.join]的结果;
- 第 17 行:添加一个格式化的字符串。转换[%f] 需要实数:传入整数[total] 会在运行时抛出[IllegalFormatConversionException]异常,因此需要转换[(double) total];
- 第 19 行:最终文本以字符串[String]的形式获得;
- 第 24–28 行:类[java.util.StringJoiner] 构造由分隔符分隔的元素组成的字符串,可带有可选的前缀和后缀。[String.join] 执行相同的功能,但不带前缀和后缀。
对于少量的连接,[+]运算符就足够了:编译器会对它们进行优化。当添加的次数很多或不确定时,通常是在循环内,就需要[StringBuilder] :在有 n 次迭代的循环中进行[s = s + ...]连接,会创建 n 个字符串,并且在每次迭代中复制之前构造的整个字符串。在较旧的代码中,你会看到[StringBuffer]类,它与[StringBuilder] 具有相同的方法,但使其可以被多个线程同时使用,代价是一些性能开销:如今更推荐使用[StringBuilder]。
5.2.6. 不复制地解析字符串
每次调用[substring] 都会在内存中创建一个新字符串。在对性能要求严格的代码中(例如解析大文件或网络请求),你可能希望避免这些创建。Java 语言本身没有内置“字符串片段视图”类型,但有若干方法可以在不复制的情况下对字符串的一部分进行操作。程序[Strings07.java] 比较了解析“姓:名:年龄”格式的一行的两种方式:
| // 解析字符串而不创建子字符串
void main() {
String line = "dupont:jean:45";
// 用 substring:每个字段都是在内存中分配的新字符串
int p1 = line.indexOf(':');
int p2 = line.lastIndexOf(':');
String lastName = line.substring(0, p1);
int age = Integer.parseInt(line.substring(p2 + 1));
IO.println("substring : last name=" + lastName + ", age=" + age);
// 对字符串的一部分使用 parseInt(Java 9):没有中间字符串
age = Integer.parseInt(line, p2 + 1, line.length(), 10);
// regionMatches 将字符串的一部分与另一个字符串比较,不进行复制
boolean du = line.regionMatches(0, "du", 0, 2);
IO.println("parseInt(line, start, end, radix) : age=" + age + ", the last name starts with \"du\": " + du);
// 字符串一部分的视图:CharBuffer.wrap 不复制字符
CharSequence lastNameView = CharBuffer.wrap(line, 0, p1);
IO.println("view: last name=" + lastNameView + ", length of the view=" + lastNameView.length()
+ ", lastNameView.charAt(0)=" + lastNameView.charAt(0));
// 带搜索范围的 indexOf(Java 21):在 p1+1 和末尾之间搜索 ':'
IO.println("indexOf(':', p1 + 1, line.length())=" + line.indexOf(':', p1 + 1, line.length()));
// 只有在确实需要时才创建字符串
String firstName = line.substring(p1 + 1, p2);
IO.println("first name=" + firstName);
}
|
结果:
| > java Strings07.java
substring : last name=dupont, age=45
parseInt(line, start, end, radix) : age=45, the last name starts with "du": true
view: last name=dupont, length of the view=6, lastNameView.charAt(0)=d
indexOf(':', p1 + 1, line.length())=11
first name=jean
|
说明:
- 第 8–9 行:每次调用[substring] 都会创建一个新字符串,即使像年龄那样只是短暂地使用一下;
- 第 13 行:[Integer.parseInt] 的一个重载版本(Java 9)按指定的基数(这里是 10)解析字符串中两个位置之间的字符,而无需创建子字符串;
- 第 15 行:我们已经遇到过的[regionMatches]会在不复制的情况下,把字符串的一部分与另一个字符串进行比较;
- 第 19 行:[CharBuffer.wrap] (包[java.nio])返回一个视图 ,即字符串中从 0 到[p1] - 1 的字符的视图:这个对象不包含字符的副本,而是提供访问它们的途径。它实现了[CharSequence]接口,就像[String] 和[StringBuilder]一样:许多 Java 方法都接受[CharSequence] (例如[String.join]、[contains]、[append]和正则表达式);
- 第 24 行:[indexOf] 的一个重载版本(Java 21)把搜索限制在一个位置范围内;
- 第 27 行:只有在真正需要时才创建字符串。
这些技术是优化工具:对于普通程序,[substring] 完全够用。自 Java 9 起,虚拟机还会把仅包含 Latin-1 字符集字符的字符串(如法语文本)按每个字符一个字节而不是两个字节来存储(“紧凑字符串”),这使它们占用的内存减少了一半。我们只会在经过测量确认对性能至关重要的代码中才尝试避免复制。
5.3. 数组
5.3.1. Arrays 类
Java 数组是对象,但它们没有有用的方法:除了[length]字段之外,对数组的所有操作都是工具类[java.util.Arrays]的静态方法。这些方法允许你对数组排序、在其中搜索元素、复制、填充等等……几乎所有方法都是重载的:每种基本类型都有一个版本([int[]]、[double[]]、[char[]]……),对象数组也有一个版本。
方法 | 作用 |
[static int binarySearch(int[] a, int key)] | 返回[key] 在[a]中的位置,a 必须已排序;如果缺少[key] 则返回负数 |
[static int[] copyOf(int[] original, int newLength)] | 返回一个包含[newLength] 个元素的新数组,其中包含[original]的前几个元素,必要时用零填充(布尔值用[false] ,引用用[null] ) |
[static int[] copyOfRange(int[] original, int from, int to)] | 返回一个由从[from] (包含)到[to] (不包含)的元素组成的新数组 |
[static boolean equals(int[] a, int[] a2)] | 如果两个数组具有相同顺序的相同元素,则返回[true] |
[static void fill(int[] a, int val)] | 把[val] 赋给[a]的所有元素;一个重载只填充一个索引范围 |
[static void sort(int[] a)] | 按照元素的自然顺序对[a] 排序;一个重载只对一个索引范围排序;对于对象数组,一个重载接收定义顺序的[Comparator] (第 4 章) |
[static String toString(int[] a)] | 以字符串[[e1, e2, ...]]的形式返回数组的元素;[deepToString] 对数组的数组做同样的事 |
[static <T> List<T> asList(T... a)] | 返回对象数组[a]的视图列表 |
[static IntStream stream(int[] array)] | 返回数组元素的流(见下面的流 API 一节) |
此外,还有[System.arraycopy(source, sourceStart, destination, destinationStart, count)]方法,它把一个数组中的元素复制到另一个已存在的数组中。
程序[Arrays01.java] 说明了[Arrays]类某些方法的用法:
| // Arrays 类:扩容、排序、搜索
void main() {
// 读取从键盘输入的数组元素
double[] elements = input();
// 显示未排序的数组
display("Unsorted array", elements);
// 在未排序的数组中线性搜索
search(elements, SearchType.LINEAR);
// 对数组排序
Arrays.sort(elements);
// 显示已排序的数组
display("Sorted array", elements);
// 在已排序的数组中二分搜索
search(elements, SearchType.BINARY);
}
// 输入数组的值:返回创建的数组
double[] input() {
// 开始时,数组为空
double[] elements = {};
// 数组元素的输入循环
while (true) {
String answer = read("Element (real) " + elements.length + " of the array (nothing to finish): ");
// 如果是空字符串则输入结束
if (answer.isEmpty()) {
break;
}
// 检查输入
double element;
try {
element = Double.parseDouble(answer);
} catch (NumberFormatException e) {
IO.println("Incorrect input, try again");
continue;
}
// 多一个元素:数组扩大一格
elements = Arrays.copyOf(elements, elements.length + 1);
// 并把新元素存入其中
elements[elements.length - 1] = element;
}
return elements;
}
// 显示数组的元素
void display(String text, double[] elements) {
IO.println(text + "-".repeat(50 - text.length()));
for (double element : elements) {
IO.println(element);
}
}
// 在数组中搜索从键盘输入的元素
void search(double[] elements, SearchType type) {
while (true) {
String answer = read("Element searched for (nothing to stop): ");
// 结束了吗?
if (answer.isEmpty()) {
break;
}
// 检查
double element;
try {
element = Double.parseDouble(answer);
} catch (NumberFormatException e) {
IO.println("Error, try again...");
continue;
}
// 我们在数组中搜索该元素
int i = type == SearchType.BINARY
? Arrays.binarySearch(elements, element) // 已排序的数组
: indexOf(elements, element); // 任意数组
// 显示答案
IO.println(i >= 0 ? "Found at position " + i : "Not in the array (" + i + ")");
}
}
// 线性搜索:Arrays 类没有 indexOf 方法
int indexOf(double[] elements, double element) {
for (int i = 0; i < elements.length; i++) {
if (elements[i] == element) {
return i;
}
}
return -1;
}
// 读取键盘上的一行,去掉两侧空格;流结束时返回 ""
String read(String prompt) {
String line = IO.readln(prompt);
return line == null ? "" : line.strip();
}
// 搜索类型
enum SearchType { LINEAR, BINARY }
|
说明:
- 第 18–42 行:[input]方法输入从键盘键入的数组元素。由于事先不知道元素的数量,程序从一个空数组开始(第 20 行),每输入一个新元素就把数组扩展一个元素(第 37 行)。Java 数组的大小在创建时就已固定:[Arrays.copyOf] 实际上创建了一个大一个元素的新数组,并把旧数组中的元素复制到其中。更高效的算法会按每组 N 个元素来分配空间。数组并不是为扩展而设计的:这种场景用列表[ArrayList]来处理更好,我们稍后就会看到;
- 第 39 行:数组的最后一个元素的索引是[length - 1];
- 第 30–35 行:通过[Double.parseDouble]把输入的字符串转换为实数,如果字符串不是数字,则抛出异常[NumberFormatException] 。[Double.parseDouble] 不依赖于系统的语言:它始终期望小数点,并拒绝输入“3,6”(结果的第 5 行);
- 第 53–75 行:方法[search] 在数组中搜索键盘上键入的字符。对于未排序的数组,执行线性搜索(第 71 行),逐个检查元素。类[Arrays] 没有名为[indexOf]的方法:我们自己来写(第 78–85 行)。对于已排序的数组,我们使用[Arrays.binarySearch] 执行二分查找(第 70 行),它在每一步都把搜索范围减半:在一百万个元素中大约二十次比较就能找到一个元素;
- 第 10 行:我们对数组排序。这里我们使用只有一个参数(要排序的数组)的[sort] 变体。用于比较数组元素的排序关系是这些元素的隐式关系:这里是数字的自然顺序;
- 第 45–50 行:显示数组。[IO.println] 无论机器的语言如何,都用小数点显示[double] ,并且始终至少有一位小数:-7 显示为 -7.0;
- 第 88–91 行:[IO.readln] (Java 25)显示提示符,然后读取键盘上键入的一行;如果标准输入已耗尽(例如输入来自文件时),它返回[null] ;
- 第 94 行:枚举,像方法一样声明在紧凑源文件中。
结果:
| > java Arrays01.java
Element (real) 0 of the array (nothing to finish): 3.6
Element (real) 1 of the array (nothing to finish): 7.4
Element (real) 2 of the array (nothing to finish): -1.5
Element (real) 3 of the array (nothing to finish): 3,6
Incorrect input, try again
Element (real) 3 of the array (nothing to finish): -7
Element (real) 4 of the array (nothing to finish):
Unsorted array------------------------------------
3.6
7.4
-1.5
-7.0
Element searched for (nothing to stop): 7.4
Found at position 1
Element searched for (nothing to stop): 0
Not in the array (-1)
Element searched for (nothing to stop):
Sorted array--------------------------------------
-7.0
-1.5
3.6
7.4
Element searched for (nothing to stop): 7.4
Found at position 3
Element searched for (nothing to stop): 0
Not in the array (-3)
Element searched for (nothing to stop):
|
当要查找的元素缺失时,方法[indexOf] 返回 -1,而[binarySearch]返回负数(第 27 行):这个负数是[-(p + 1)],其中 p 是为保持数组有序而应当插入该元素的位置。这里,-3 = -(2 + 1):数字 0 应当插入到位置 2,即 -1.5 和 3.6 之间。注意:对未排序的数组使用[binarySearch] 会返回毫无意义的结果。
5.3.2. Arrays 类的其他方法
程序[Arrays02.java] 演示了[Arrays]类的其他方法:
| // Arrays 类的其他方法
void main() {
int[] numbers = {40, 10, 30, 20, 50};
display("numbers", Arrays.toString(numbers));
// 对数组的一部分排序:下标 1 到 3 的元素(不含 4)
Arrays.sort(numbers, 1, 4);
display("after sort(numbers, 1, 4)", Arrays.toString(numbers));
// 将 3 个元素复制到另一个数组
int[] copy = new int[5];
System.arraycopy(numbers, 0, copy, 0, 3);
display("arraycopy", Arrays.toString(copy));
// copyOf、copyOfRange:副本是新数组,被截短或用 0 填充
display("copyOf(numbers, 7)", Arrays.toString(Arrays.copyOf(numbers, 7)));
display("copyOfRange(numbers, 1, 3)", Arrays.toString(Arrays.copyOfRange(numbers, 1, 3)));
// fill:用一个值填充数组或数组的一部分
Arrays.fill(copy, 7);
display("after fill(copy, 7)", Arrays.toString(copy));
Arrays.fill(copy, 1, 3, 0);
display("after fill(copy, 1, 3, 0)", Arrays.toString(copy));
// 两个数组的相等性:== 比较引用,Arrays.equals 比较内容
int[] other = {7, 0, 0, 7, 7};
IO.println("copy == other : " + (copy == other) + ", Arrays.equals(copy, other) : "
+ Arrays.equals(copy, other));
// 视为列表的对象数组:indexOf、lastIndexOf、reverse
String[] colors = {"red", "green", "blue", "green"};
List<String> view = Arrays.asList(colors);
IO.println("indexOf(green)=" + view.indexOf("green") + ", lastIndexOf(green)=" + view.lastIndexOf("green")
+ ", indexOf(black)=" + view.indexOf("black"));
// 该列表是数组的视图:反转列表就会反转数组
Collections.reverse(view);
display("after reverse", Arrays.toString(colors));
// 对字符串数组排序:按字符码顺序
String[] words = {"essay", "Zoé", "éclair", "apricot"};
Arrays.sort(words);
display("sorted words", Arrays.toString(words));
// 按法语规则排序
Arrays.sort(words, Collator.getInstance(Locale.FRANCE));
display("sorted words (Collator)", Arrays.toString(words));
// 二维数组是由数组组成的数组
int[][] matrix = new int[2][3];
matrix[1][2] = 5;
IO.println("matrix.length=" + matrix.length + ", matrix[0].length=" + matrix[0].length
+ ", deepToString=" + Arrays.deepToString(matrix));
}
// 在一行中显示文本和数组
void display(String text, String array) {
IO.println("%-28s: %s".formatted(text, array));
}
|
结果:
| > java Arrays02.java
numbers : [40, 10, 30, 20, 50]
after sort(numbers, 1, 4) : [40, 10, 20, 30, 50]
arraycopy : [40, 10, 20, 0, 0]
copyOf(numbers, 7) : [40, 10, 20, 30, 50, 0, 0]
copyOfRange(numbers, 1, 3) : [10, 20]
after fill(copy, 7) : [7, 7, 7, 7, 7]
after fill(copy, 1, 3, 0) : [7, 0, 0, 7, 7]
copy == other : false, Arrays.equals(copy, other) : true
indexOf(green)=1, lastIndexOf(green)=3, indexOf(black)=-1
after reverse : [green, blue, green, red]
sorted words : [Zoé, apricot, essay, éclair]
sorted words (Collator) : [apricot, éclair, essay, Zoé]
matrix.length=2, matrix[0].length=3, deepToString=[[0, 0, 0], [0, 0, 5]]
|
说明:
- 第 4 行:[Arrays.toString] 在一行上显示数组。如果直接用[IO.println(numbers)] 显示数组,会得到类似于[[I@1b6d3586]]的文本:即类型([[I]],整数数组)和对象标识符,而没有其元素;
- 第 7 行:只有索引 1 到 3 的元素被排序,不包含第二个索引:10、30、20 变为 10、20、30;
- 第 12 行:把[numbers] 的前 3 个元素复制到 [copy] 的开头,而其他元素保留其初始值 0;
- 第 15–16 行:[copyOf] 和[copyOfRange] 创建新数组。比原数组更长的数组用零填充;
- 第 19–22 行:[fill] 填充数组,然后把索引 1 和 2(不含 3)处的元素重置为 0;
- 第 25–27 行:与字符串一样,运算符[==] 比较的是两个数组的引用而不是它们的内容:必须使用[Arrays.equals];
- 第 31 行:[Arrays.asList] 返回一个[List] (将在下一节介绍),它是对象数组的视图 :它不复制数组,而是提供使用列表方法对其进行访问的途径。这样就得到了[indexOf] 和[lastIndexOf] (第 32 行);
- 第 35 行:方法[Collections.reverse] 反转列表中元素的顺序。由于该列表是数组的视图,被反转的就是数组本身(结果的第 11 行)。类[Arrays] 没有反转方法;这种处理只适用于对象数组,而不适用于诸如[int[]]之类的基本类型数组;
- 第 40 行:字符串数组按照前面描述的[compareTo]方法的顺序排序,即按字符编码:大写字母(编码 65 到 90)排在小写字母(97 到 122)之前,小写字母又排在带重音的字母(é:233)之前。“Zoé”是第一个单词,“éclair”是最后一个;
- 第 43 行:为了按法语规则排序,我们把一个比较字符串的[Collator]类型对象传给[sort];
- 第 47–50 行:Java 没有二维矩形数组:[new int[2][3]] 创建一个包含 2 个元素的数组,其中每个元素都是由 3 个整数组成的数组。[matrix.length] 是行数,而[matrix[0].length] 是第 0 行的元素个数。[Arrays.deepToString] 显示数组的数组。
我们稍后将讨论的流 API 提供了搜索、排序或转换数组元素的其他方式,例如[Arrays.stream(numbers).sum()]。
5.4. 集合
除了数组之外,Java 还提供了各种用于存储元素集合的类。它们构成了集合框架 ,位于[java.util]包中,该框架在 Java 1.2 中引入,并在 Java 5 中支持泛型。它围绕接口组织,接口描述集合能做什么,而类 以各自的方式实现这些接口:
接口 | 作用 | 主要实现 |
[List<E>] | 有序的元素序列,可通过位置访问元素 | [ArrayList],[LinkedList] |
[Set<E>] | 集:不含重复元素 | [HashSet],[LinkedHashSet],[TreeSet] |
[Map<K,V>] | 字典:(键,值)对,其中键是唯一的 | [HashMap],[LinkedHashMap],[TreeMap] |
[Deque<E>] | 双端队列,既可用作队列,也可用作栈 | [ArrayDeque],[LinkedList] |
[Queue<E>] | 队列 | [ArrayDeque],[PriorityQueue] |
接口 [List]、[Set]和 [Queue] 派生自接口 [Collection<E>]([size]、[isEmpty]、[contains]、[add]、[remove]、[clear]……),而 [Iterable<E>] 又是它的父接口,该接口表示可以使用 [for] 循环遍历的对象。最佳实践是使用接口类型来声明变量和参数,仅在创建时使用类名:[List<String> cities = new ArrayList<>();]。这样就可以在不修改其余代码的情况下更换实现。
Java 集合只能包含对象。Java 泛型不支持基本类型:不能写成 [List<int>] ,而应写成 [List<Integer>],其中 [Integer] 是类型 [int] 的包装类(同样,[Double] 对应 [double],[Boolean] 对应 [boolean]……)。编译器在赋值时会自动将 [int] 转换为 [Integer] (“自动装箱”),在读取时会自动将 [Integer] 转换为 [int] (“自动拆箱”)。这种转换会带来内存和时间上的开销:一个包含一百万个整数的列表包含一百万个 [Integer] 对象。对于大量数值,最好使用 [int[]] 数组或基本类型流([IntStream]),它们随 Stream API 一同引入。
[java.util] 包中还包含 Java 1.0 的集合:[Vector] (列表)、[Hashtable] (字典)和 [Stack] (栈)。它们现在已经过时:由于每个操作都进行同步,它们比其替代品 [ArrayList]、[HashMap] 和 [ArrayDeque] 更慢。新代码中不应再使用它们。同样,应避免使用“原始类型”(raw type),即不带类型参数使用的泛型集合([List list = new ArrayList();]),这是 Java 5 之前的写法:编译器无法再验证所添加元素的类型,并且每次使用都会发出警告。
5.4.1. List 接口与 ArrayList 类
类 [java.util.ArrayList<E>] 实现了一个 [E] 类型对象的列表,其大小在程序运行期间可以变化。它把元素存储在一个内部数组中,并自动调整该数组的大小,与 [StringBuilder] 类似。列表 [l] 的第 i 个元素通过 [l.get(i)] 读取,通过 [l.set(i, value)] 修改。
下面是 [List<E>] 接口的一些方法:
方法 | 作用 |
[int size()] | 列表中的元素个数 |
[boolean add(E e)] | 将 [e] 添加到列表末尾 |
[void add(int index, E element)] | 将 [element] 插入到列表的 [index] 位置 |
[boolean addAll(Collection<? extends E> c)] | 将 [c] 中的元素添加到列表末尾 |
[E get(int index)],[E set(int index, E element)] | 读取并替换第 [index] 个元素 |
[E getFirst()],[E getLast()] | 第一个和最后一个元素(Java 21) |
[void clear()] | 删除列表中的所有元素 |
[boolean contains(Object o)] | 如果 [o] 在列表中,则返回 [true],否则返回 [false] |
[int indexOf(Object o)] | 返回 [o] 在列表中的位置,如果未找到 [o] 则返回 -1;[lastIndexOf] 返回最后一次出现的位置 |
[boolean remove(Object o)] | 删除 [o] 的第一次出现;如果操作成功则返回 [true],否则返回 [false] |
[E remove(int index)] | 删除第 [index] 个元素并返回该元素 |
[List<E> subList(int from, int to)] | 返回从 [from] (含)到 [to] (不含)的元素视图 |
[void sort(Comparator<? super E> c)] | 按照 [c] 定义的顺序对列表排序;[sort(null)] 使用元素的自然顺序 |
[<T> T[] toArray(IntFunction<T[]> generator)] | 以数组形式返回列表元素(Java 11) |
[static <E> List<E> of(E... elements)] | 创建包含给定元素的不可变列表(Java 9) |
工具类 [java.util.Collections] 对这些方法作了补充,就像 [Arrays] 之于数组一样:[sort]、[binarySearch]、[reverse]、[shuffle]、[max]、[min]……
让我们回顾前面用数组处理的示例,现在改用 [ArrayList<Double>] 类型的对象来处理。由于列表与数组相似,代码改动很小。下面是程序 [Collections01.java]:
| // ArrayList 类:用列表重写 Arrays01.java 程序
void main() {
// 读取从键盘输入的列表元素
List<Double> elements = input();
// 元素个数
IO.println("The list has " + elements.size() + " elements");
// 显示未排序的列表
display("Unsorted list", elements);
// 在未排序的列表中线性搜索
search(elements, SearchType.LINEAR);
// 按元素的自然顺序对列表排序
Collections.sort(elements);
// 显示已排序的列表
display("Sorted list", elements);
// 在已排序的列表中二分搜索
search(elements, SearchType.BINARY);
}
// 输入列表的值:返回创建的列表
List<Double> input() {
// 开始时,列表为空
List<Double> elements = new ArrayList<>();
// 列表元素的输入循环
while (true) {
String answer = read("Element (real) " + elements.size() + " of the list (nothing to finish): ");
// 如果是空字符串则输入结束
if (answer.isEmpty()) {
break;
}
// 检查输入
double element;
try {
element = Double.parseDouble(answer);
} catch (NumberFormatException e) {
IO.println("Incorrect input, try again");
continue;
}
// 列表多了一个元素:它自动增长
elements.add(element);
}
return elements;
}
// 显示任意集合元素的泛型方法
<T> void display(String text, Iterable<T> elements) {
IO.println(text + "-".repeat(50 - text.length()));
for (T element : elements) {
IO.println(element);
}
}
// 在列表中搜索从键盘输入的元素
void search(List<Double> elements, SearchType type) {
while (true) {
String answer = read("Element searched for (nothing to stop): ");
// 结束了吗?
if (answer.isEmpty()) {
break;
}
// 检查
double element;
try {
element = Double.parseDouble(answer);
} catch (NumberFormatException e) {
IO.println("Error, try again...");
continue;
}
// 我们在列表中搜索该元素
int i = type == SearchType.BINARY
? Collections.binarySearch(elements, element) // 已排序的列表
: elements.indexOf(element); // 任意列表
// 显示答案
IO.println(i >= 0 ? "Found at position " + i : "Not in the list (" + i + ")");
}
}
// 读取键盘上的一行,去掉两侧空格;流结束时返回 ""
String read(String prompt) {
String line = IO.readln(prompt);
return line == null ? "" : line.strip();
}
// 搜索类型
enum SearchType { LINEAR, BINARY }
|
注释:
- 第 22 行:创建了一个空列表。菱形运算符 [<>] (Java 7)避免重复写元素类型:编译器根据变量的类型推断出它;
- 第 39 行:不再需要处理列表扩容,列表会自动扩展。[element] 的值类型为 [double],它会被自动转换为 [Double] 对象;
- 第 6 行:列表中的元素个数。与 [StringBuilder] 不同,[ArrayList] 不允许查询其容量;[ensureCapacity] 方法只能用来预先设定容量;
- 第 12、70、71 行:排序和二分查找通过静态方法 [Collections.sort] 和 [Collections.binarySearch] 完成;线性查找使用列表上的 [indexOf] 方法,数组没有这个方法;
- 第 45–50 行:泛型方法 [display] 接受两个参数:
- 第一个是要输出的文本;
- 第二个是实现泛型接口 [java.lang.Iterable<T>] 的对象,该接口唯一的抽象方法是 [Iterator<T> iterator()]。
只要 [for (T element : elements)] 循环中的 [elements] 对象实现了 [Iterable<T>] 接口,该循环就有效,对数组也同样有效。所有集合都实现了 [Iterable];但数组并没有实现它,因此 [display] 方法不适用于数组:这就是我们在 [Arrays01.java] 中没有使用它的原因。我们将在讲解 Stream API 时再回到这个接口。
结果:
| > java Collections01.java
Element (real) 0 of the list (nothing to finish): 3.6
Element (real) 1 of the list (nothing to finish): 7.4
Element (real) 2 of the list (nothing to finish): -1.5
Element (real) 3 of the list (nothing to finish): -7
Element (real) 4 of the list (nothing to finish):
The list has 4 elements
Unsorted list-------------------------------------
3.6
7.4
-1.5
-7.0
Element searched for (nothing to stop): 7.4
Found at position 1
Element searched for (nothing to stop): 0
Not in the list (-1)
Element searched for (nothing to stop):
Sorted list---------------------------------------
-7.0
-1.5
3.6
7.4
Element searched for (nothing to stop): 7.4
Found at position 3
Element searched for (nothing to stop): 0
Not in the list (-3)
Element searched for (nothing to stop):
|
结果与使用数组时相同。
5.4.2. List 接口的方法
程序 [Collections02.java] 使用了 [List] 接口的其他方法:
| // List 接口的主要方法
void main() {
// 可修改的列表,由不可修改的 List.of 列表初始化
List<String> cities = new ArrayList<>(List.of("Paris", "Lyon", "Angers"));
display("start", cities);
// 添加
cities.add("Nantes"); // 在末尾
cities.add(1, "Brest"); // 在位置 1
cities.addAll(List.of("Lille", "Tours")); // 在末尾添加多个元素
display("after add, add(1, ...), addAll", cities);
// 按下标访问,用于写入(set)和读取(get)
cities.set(0, "Marseille");
IO.println("get(0)=" + cities.get(0) + ", getLast()=" + cities.getLast() + ", size()=" + cities.size());
// 搜索
IO.println("contains(\"Lyon\")=" + cities.contains("Lyon") + ", indexOf(\"Angers\")="
+ cities.indexOf("Angers") + ", indexOf(\"Nice\")=" + cities.indexOf("Nice"));
// 删除
boolean removed = cities.remove("Lyon"); // 按值
cities.remove(0); // 按位置
display("after remove(\"Lyon\") (" + removed + "), remove(0)", cities);
// 排序、反转、子列表
Collections.sort(cities);
display("after sort", cities);
Collections.reverse(cities);
display("after reverse", cities);
List<String> slice = cities.subList(1, 3);
display("subList(1, 3)", slice);
// 转换为数组再转换回来
String[] array = cities.toArray(String[]::new);
List<String> other = new ArrayList<>(Arrays.asList(array));
IO.println("array of " + array.length + " elements, new list of " + other.size()
+ " elements");
// 整数列表:remove(int) 按位置删除,remove(Object) 按值删除
List<Integer> numbers = new ArrayList<>(List.of(10, 20, 30, 1));
numbers.remove(1); // 删除第 1 个元素(20)
numbers.remove(Integer.valueOf(1)); // 删除值 1
display("numbers", numbers);
// clear 清空列表
cities.clear();
IO.println("after clear: size()=" + cities.size() + ", isEmpty()=" + cities.isEmpty());
}
void display(String text, List<?> list) {
IO.println("%-38s: %s".formatted(text, list));
}
|
结果:
| > java Collections02.java
start : [Paris, Lyon, Angers]
after add, add(1, ...), addAll : [Paris, Brest, Lyon, Angers, Nantes, Lille, Tours]
get(0)=Marseille, getLast()=Tours, size()=7
contains("Lyon")=true, indexOf("Angers")=3, indexOf("Nice")=-1
after remove("Lyon") (true), remove(0): [Brest, Angers, Nantes, Lille, Tours]
after sort : [Angers, Brest, Lille, Nantes, Tours]
after reverse : [Tours, Nantes, Lille, Brest, Angers]
subList(1, 3) : [Nantes, Lille]
array of 5 elements, new list of 5 elements
numbers : [10, 30]
after clear: size()=0, isEmpty()=true
|
注释:
- 第 4 行:[List.of(...)] (Java 9)创建一个只读列表(见下文);它被复制到一个 [ArrayList] 中,后者是可写的。这是用值初始化列表的最简短写法;
- 第 8–10 行:三种添加元素的方式;
- 第 14 行:第 0 个元素被 [set] 替换;
- 第 15 行:[get] 读取一个元素;[getLast] (Java 21)返回最后一个元素,以前必须写成 [cities.get(cities.size() - 1)];
- 第 22 行:如果找到并删除了该元素,[remove] 则返回 [true];
- 第 27 行:字符串按其自然顺序排序,即 [compareTo] 的顺序;
- 第 31 行:[subList] 返回第 1 和第 2 个元素(不含第 3 个)的视图 ,而不是副本:修改该视图会修改原列表;
- 第 35–36 行:列表到数组以及数组到列表的转换。[toArray] 的参数是一个构造函数引用 [String[]::new],列表用它来创建大小正确的字符串数组。方法引用和构造函数引用将在第 7 章中介绍;
- 第 41–43 行:整数列表的一个陷阱。[List] 接口有两个 [remove] 方法:[remove(int index)] 按位置删除,而 [remove(Object o)] 按值删除。对于 [List<Integer>],[numbers.remove(1)] 调用的是第一个方法,删除第 1 个元素(值 20)。要删除值 1,必须传入一个 [Integer] 对象:[numbers.remove(Integer.valueOf(1))];
- 第 47–48 行:[clear] 清空列表;[isEmpty] 检查列表是否为空;
- 第 51 行:类型 [List<?>] 表示元素为任意类型的列表(“通配符”,第 4 章):方法 [display] 既接受 [List<String>] ,也接受 [List<Integer>]。集合可以直接输出:其方法 [toString] 会返回方括号括起来的各元素。
5.4.3. Map 接口与 HashMap 类
类 [java.util.HashMap<K,V>] 用于实现字典。字典可以看作一个两列的数组:
键 | 值 |
key1 | value1 |
key2 | value2 |
... | ... |
在 [Map<K,V>] 接口中,键的类型为 [K],值的类型为 [V]。键是唯一的:不能有两个相同的键(以 [equals] 方法的判断为准)。如果类型 [K] 和 [V] 指的是类,这样的字典可能如下所示:
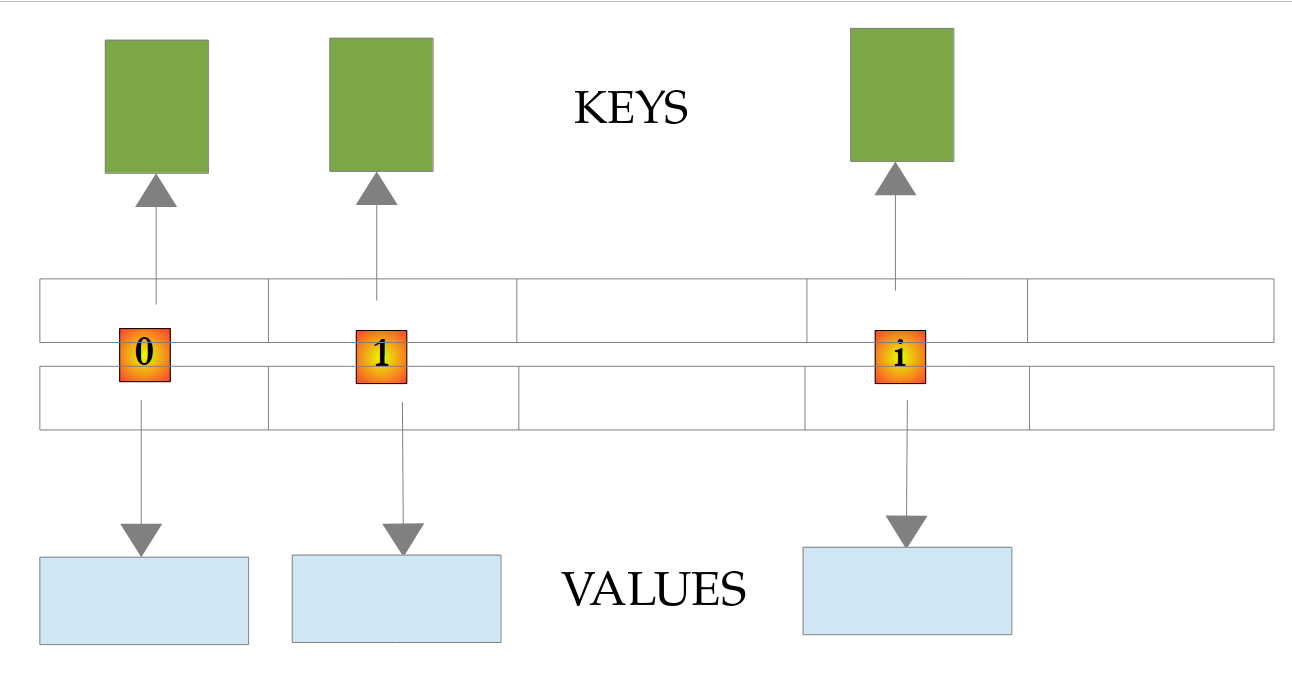
[HashMap] 将其键值对存储在哈希表中:键值对在表中的位置根据其键的哈希码计算得出(方法 [hashCode],第 4 章)。因此,无论字典多大,检索与某个键关联的值都非常快。但是,键值对在表中的顺序与它们被添加的顺序没有关系。
[Map<K,V>] 接口的主要方法如下:
方法 | 作用 |
[int size()] | 字典中(键,值)对的数量 |
[V put(K key, V value)] | 将 [value] 与 [key] 关联:如果键不存在则添加该键值对,否则替换其值;返回旧值,或返回 [null] |
[V putIfAbsent(K key, V value)] | 仅当键不存在时才添加该键值对;返回已有的值,或返回 [null] |
[V get(Object key)] | 返回与 [key] 关联的值,如果键不存在则返回 [null] |
[V getOrDefault(Object key, V defaultValue)] | 与上面相同,但如果键不存在则返回 [defaultValue] |
[boolean containsKey(Object key)] | 如果 [key] 是字典中的键,则返回 [true];[containsValue] 用于测试某个值 |
[V remove(Object key)] | 删除键值对 [key] 并返回其值,或返回 [null] |
[Set<K> keySet()] | 字典中的所有键 |
[Collection<V> values()] | 字典值的集合 |
[Set<Map.Entry<K,V>> entrySet()] | 字典中键值对的集合;一个键值对 [Map.Entry] 具有方法 [getKey] 和 [getValue] |
[V merge(K key, V value, BiFunction<...> remappingFunction)] | 如果键不存在则添加该键值对;否则,将值替换为旧值与 [value] 合并后的结果 |
[void clear()] | 删除字典中的所有条目 |
来看示例程序 [Collections03.java]:
| // Map 接口和 HashMap 类
void main() {
// 由“name:age”字符串数组创建 <String,Integer> 字典
String[] list = {"jean:20", "paul:18", "mélanie:10", "violette:15"};
Map<String, Integer> dico = new HashMap<>();
for (String element : list) {
String[] fields = element.split(":");
dico.put(fields[0], Integer.parseInt(fields[1]));
}
// 字典的元素个数
IO.println("The dictionary has " + dico.size() + " elements");
// 键列表
display("[List of keys]", dico.keySet());
// 值列表
display("[List of values]", dico.values());
// 键和值的列表
IO.println("[List of keys & values]");
for (String key : dico.keySet()) {
IO.println("key=" + key + " value=" + dico.get(key));
}
// 我们删除键 "paul"
IO.println("[Removing a key]");
dico.remove("paul");
// 遍历(键,值)对
IO.println("[List of keys & values]");
for (Map.Entry<String, Integer> entry : dico.entrySet()) {
IO.println("key=" + entry.getKey() + " value=" + entry.getValue());
}
// put 替换已存在键的值并返回旧值
IO.println("put(\"jean\", 21) returns " + dico.put("jean", 21)
+ ", put(\"zoé\", 12) returns " + dico.put("zoé", 12));
// putIfAbsent 仅在键不存在时才添加
IO.println("putIfAbsent(\"jean\", 22) returns " + dico.putIfAbsent("jean", 22)
+ ", get(\"jean\")=" + dico.get("jean"));
// 键不存在时 get 返回 null;getOrDefault 返回默认值
IO.println("get(\"x\")=" + dico.get("x") + ", getOrDefault(\"x\", -1)=" + dico.getOrDefault("x", -1)
+ ", containsKey(\"x\")=" + dico.containsKey("x"));
// merge:以给定值添加该键,或将旧值与新值合并
dico.merge("zoé", 1, Integer::sum);
dico.merge("léa", 1, Integer::sum);
IO.println("after merge: " + dico);
// 在字典中搜索
while (true) {
String input = IO.readln("Name searched for (nothing to stop): ");
String searchedName = input == null ? "" : input.strip();
if (searchedName.isEmpty()) {
break;
}
// get 返回与键关联的值,如果键不存在则返回 null
Integer age = dico.get(searchedName);
if (age != null) {
IO.println(searchedName + "," + age);
} else {
IO.println("Name " + searchedName + " unknown");
}
}
}
// 显示集合元素的泛型方法
<T> void display(String text, Iterable<T> elements) {
IO.println(text + "-".repeat(50 - text.length()));
for (T element : elements) {
IO.println(element);
}
}
|
注释:
- 第 4 行:一个字符串数组,用于初始化 <String,Integer> 字典;
- 第 5 行:字典,初始为空;
- 第 6–9 行:使用该字符串数组对其初始化;
- 第 11 行:字典中键值对的数量;
- 第 13–15 行:字典的键和值。[dico.keySet()] 和 [dico.values()] 都是集合,因此也是 [Iterable]:我们之前遇到过的 [display] 方法在这里同样适用;
- 第 23 行:从字典中删除一个键值对;
- 第 26–28 行:字典本身不是集合,但 [entrySet] 返回其键值对的集合,这些键值对的类型为 [Map.Entry<K,V>]。这种方式比第 18–20 行的方式更高效,后者要通过 [get] 查找每个键的值;
- 第 30–31 行:[put] 添加一个键值对,或替换已有键的值,不会抛出异常也不会给出警告;返回值(旧值或 [null])表明了发生了什么;
- 第 33–34 行:[putIfAbsent] 不会替换已有键的值;
- 第 36–37 行:读取不存在的键不会导致错误:[get] 返回 [null]。[getOrDefault] 允许你选择这种情况下返回的值,而 [containsKey] 可用于检查键是否存在;
- 第 39–40 行:[merge] 添加键“léa”,其值为 1,并给已存在的键“zoé”的值加 1。第三个参数是合并旧值和新值的函数(这里是两个整数之和),以方法引用 [Integer::sum] (第 7 章)的形式传入。这是统计出现次数的标准方式:[counters.merge(word, 1, Integer::sum)];
- 第 51–56 行:在字典中查找键。[get] 返回的是 [Integer],而不是 [int],因为它必须能够返回 [null]:在使用该值之前要先测试这种情况。如果写成 [int age = dico.get(searchedName);] ,则对于不存在的键,在将 [null] 自动转换为 [int] 时会产生 [NullPointerException]。
结果:
| > java Collections03.java
The dictionary has 4 elements
[List of keys]------------------------------------
violette
jean
mélanie
paul
[List of values]----------------------------------
15
20
10
18
[List of keys & values]
key=violette value=15
key=jean value=20
key=mélanie value=10
key=paul value=18
[Removing a key]
[List of keys & values]
key=violette value=15
key=jean value=20
key=mélanie value=10
put("jean", 21) returns 20, put("zoé", 12) returns null
putIfAbsent("jean", 22) returns 21, get("jean")=21
get("x")=null, getOrDefault("x", -1)=-1, containsKey("x")=false
after merge: {violette=15, léa=1, zoé=13, jean=21, mélanie=10}
Name searched for (nothing to stop): violette
violette,15
Name searched for (nothing to stop): x
Name x unknown
Name searched for (nothing to stop): jean
jean,21
Name searched for (nothing to stop):
|
键并不是按添加的顺序列出,而是按哈希表的顺序列出,该顺序取决于键的哈希码:[HashMap] 不保证任何特定的顺序。如果键的顺序很重要,请使用 [LinkedHashMap](它保留键的添加顺序)或 [TreeMap](它让键保持有序):下面将演示这两者。
5.4.4. 其他集合
[java.util] 包中还有其他集合,每种都针对特定用途:
类 | 作用 |
[HashSet<E>] | 集:无重复元素、无顺序,成员测试非常快;支持集合运算(并集 [addAll],交集 [retainAll],差集 [removeAll]) |
[LinkedHashSet<E>] | 保留元素添加顺序的集 |
[TreeSet<E>] | 元素保持有序的集 |
[ArrayDeque<E>] | 双端队列:用作队列时,元素按添加的顺序被取出(FIFO,先进先出);用作栈时,最后添加的元素最先被取出(LIFO,后进先出) |
[LinkedHashMap<K,V>] | 保留键添加顺序的字典 |
[TreeMap<K,V>] | 键保持有序的字典 |
[PriorityQueue<E>] | 优先队列:被取出的元素是按队列顺序最小的那个 |
[LinkedList<E>] | 双向链表:在两端以及遍历过程中插入和删除都很快 |
程序 [Collections04.java] 提供了一个快速概览:
| // 其他集合概览
void main() {
// HashSet:无重复、无顺序的集合
Set<String> languages = new HashSet<>(List.of("C#", "Java", "PHP"));
boolean added1 = languages.add("Python");
boolean added2 = languages.add("Java"); // 已存在:被拒绝
IO.println("HashSet : add(Python)=" + added1 + ", add(Java)=" + added2 + ", size()=" + languages.size()
+ ", contains(PHP)=" + languages.contains("PHP"));
Set<String> web = Set.of("PHP", "JavaScript", "Python");
Set<String> common = new HashSet<>(languages);
common.retainAll(web); // 交集
IO.println("HashSet : intersection = " + common);
common.addAll(List.of("Go")); // 并集
IO.println("HashSet : after union = " + common);
// TreeSet:元素保持有序的集合
IO.println("TreeSet : " + new TreeSet<>(languages));
// 用作队列的 ArrayDeque:先进先出
Deque<String> queue = new ArrayDeque<>();
queue.offer("client1");
queue.offer("client2");
queue.offer("client3");
IO.println("queue: peek=" + queue.peek() + ", poll=" + queue.poll() + ", poll=" + queue.poll()
+ ", remaining " + queue.size());
// 用作栈的 ArrayDeque:后进先出
Deque<Integer> stack = new ArrayDeque<>();
stack.push(1);
stack.push(2);
stack.push(3);
IO.println("stack: peek=" + stack.peek() + ", pop=" + stack.pop() + ", pop=" + stack.pop()
+ ", remaining " + stack.size());
// 对空栈调用 pop 会抛出异常,poll 返回 null
stack.pop();
IO.println("stack: poll on an empty stack = " + stack.poll());
try {
stack.pop();
} catch (NoSuchElementException e) {
IO.println("stack: pop on an empty stack: " + e.getClass().getSimpleName());
}
// TreeMap:键保持有序的字典
Map<String, Integer> ages = new TreeMap<>();
ages.put("violette", 15);
ages.put("jean", 20);
ages.put("mélanie", 10);
ages.put("paul", 18);
IO.println("TreeMap : " + ages);
// LinkedHashMap:保持键的插入顺序的字典
Map<String, Integer> order = new LinkedHashMap<>();
order.put("violette", 15);
order.put("jean", 20);
order.put("mélanie", 10);
IO.println("LinkedHashMap : " + order);
// PriorityQueue:优先级值最小的元素总是最先出队
PriorityQueue<Emergency> emergencies = new PriorityQueue<>(Comparator.comparingInt(Emergency::priority));
emergencies.offer(new Emergency("sprain", 3));
emergencies.offer(new Emergency("cardiac arrest", 1));
emergencies.offer(new Emergency("cold", 5));
emergencies.offer(new Emergency("fracture", 2));
IO.print("PriorityQueue :");
Emergency emergency;
while ((emergency = emergencies.poll()) != null) {
IO.print(" " + emergency.patient() + " (" + emergency.priority() + ")");
}
IO.println();
}
// 患者及其护理的优先级
record Emergency(String patient, int priority) {
}
|
结果:
| > java Collections04.java
HashSet : add(Python)=true, add(Java)=false, size()=4, contains(PHP)=true
HashSet : intersection = [PHP, Python]
HashSet : after union = [Go, PHP, Python]
TreeSet : [C#, Java, PHP, Python]
queue: peek=client1, poll=client1, poll=client2, remaining 1
stack: peek=3, pop=3, pop=2, remaining 1
stack: poll on an empty stack = null
stack: pop on an empty stack: NoSuchElementException
TreeMap : {jean=20, mélanie=10, paul=18, violette=15}
LinkedHashMap : {violette=15, jean=20, mélanie=10}
PriorityQueue : cardiac arrest (1) fracture (2) sprain (3) cold (5)
|
注释:
- 第 4 行:用列表中的元素初始化的一个集;
- 第 6 行:如果元素已在集中,[add] 则返回 [false] ,集保持不变;
- 第 9–14 行:[retainAll] 只保留同时存在于另一个集合中的元素(交集),而 [addAll] 则添加另一个集合中的元素(并集)。这些方法会修改集本身:因此我们操作的是 [languages] 的副本。[Set.of] (Java 9)创建一个不可变的集。[HashSet] 中元素的显示顺序没有意义;
- 第 16 行:由该集构造的
*[TreeSet]* 会按排序后的顺序显示其元素;
- 第 19–24 行:[ArrayDeque] 用作队列:[offer] 在队尾插入一个元素,[poll] 移除最早的元素,[peek] 获取一个元素但不移除它。传给 [IO.println] 的拼接表达式的各操作数按从左到右的顺序求值:先是 [peek],然后是两次 [poll],最后是 [size];
- 第 27–32 行:[ArrayDeque] 用作栈:[push] 将一个元素压入栈,[pop] 弹出最近压入的元素。Java 1.0 的类 [Stack] 不应再使用;
- 第 34–40 行:对于空栈,[pop] 会抛出 [NoSuchElementException] 异常,而 [poll] 则返回 [null]。因此 [Deque] 的大多数操作都有两个版本:一个抛出异常([push]、[pop]、[getFirst]……),另一个返回特殊值([offer]、[poll]、[peek]……);
- 第 43–48 行:[TreeMap] 的键值对按键的顺序列出;
- 第 50–54 行:[LinkedHashMap] 的键值对按添加的顺序列出;
- 第 57–67 行:[PriorityQueue] 需要能够比较其元素。这里传给它一个 [Comparator] 来比较优先级:[Comparator.comparingInt(Emergency::priority)] 读作“根据各紧急情况的 [priority] 方法返回的整数值来比较它们”。患者按优先级从小到大的顺序出院,与到达顺序无关。当 [poll] 返回 [null](表示队列已空)时循环停止;
- 第 71–72 行:患者用一个 [record] (第 4 章)表示。
5.4.5. 不可变集合
管理集合的类通常需要把集合暴露给外部,同时又不允许外部修改它。Java 没有与 [List] 相区别的“只读”接口:不可修改的集合实现了完整的 [List] 接口,但其修改方法([add]、[remove]、[set]……)会抛出 [UnsupportedOperationException] 异常。有两种类型:
- 不可修改视图,通过 [Collections.unmodifiableList(list)] ([unmodifiableSet]、[unmodifiableMap]……)获得:它们不复制集合,只是阻止接收方修改它;
- 由 只读集合 [List.of(...)]、[Set.of(...)]、[Map.of(...)] (Java 9)创建,或由 [List.copyOf(collection)] (Java 10)复制得到的集合:其内容一经确定便永不改变。
程序 [Collections05.java] 使用了它们:
| // 不可修改的集合
void main() {
Classroom classroom = new Classroom();
classroom.enroll("dupont");
classroom.enroll("martin");
// 外部代码可以读取学生列表……
List<String> students = classroom.getStudents();
IO.println(students.size() + " students: " + students + ", get(0)=" + students.get(0));
// ……但不能修改它:修改方法会抛出异常
try {
students.add("intruder");
} catch (UnsupportedOperationException e) {
IO.println("add on the view: " + e.getClass().getSimpleName());
}
IO.println("class of the view: " + students.getClass().getName());
// 该视图反映所属类所做的修改
classroom.enroll("durand");
IO.println(students.size() + " students: " + students);
// List.copyOf:不可修改的副本,不再看到原列表的修改
List<String> copy = classroom.getStudentsCopy();
classroom.enroll("petit");
IO.println("copy: " + copy + ", view: " + students);
// List.of、Set.of、Map.of:一条语句创建的不可修改集合
Map<String, Integer> grades = Map.of("dupont", 12, "martin", 15);
IO.println("grades.get(\"martin\")=" + grades.get("martin") + ", containsKey(\"durand\")="
+ grades.containsKey("durand"));
try {
grades.put("durand", 9);
} catch (UnsupportedOperationException e) {
IO.println("put on Map.of: " + e.getClass().getSimpleName());
}
// 用 of 创建的集合拒绝 null 值
try {
List<String> list = List.of("a", null);
IO.println(list);
} catch (NullPointerException e) {
IO.println("List.of(\"a\", null) : " + e.getClass().getSimpleName());
}
}
// 掌控自己列表的类
class Classroom {
// 列表是私有的:只有该类可以修改它
private final List<String> students = new ArrayList<>();
// 列表的不可修改视图
public List<String> getStudents() {
return Collections.unmodifiableList(students);
}
// 列表的不可修改副本
public List<String> getStudentsCopy() {
return List.copyOf(students);
}
public void enroll(String name) {
students.add(name);
}
}
|
结果:
| > java Collections05.java
2 students: [dupont, martin], get(0)=dupont
add on the view: UnsupportedOperationException
class of the view: java.util.Collections$UnmodifiableRandomAccessList
3 students: [dupont, martin, durand]
copy: [dupont, martin, durand], view: [dupont, martin, durand, petit]
grades.get("martin")=15, containsKey("durand")=false
put on Map.of: UnsupportedOperationException
List.of("a", null) : NullPointerException
|
注释:
- 第 44–61 行:类 [Classroom] 管理一个学生列表。列表本身是私有的;只有方法 [enroll] 允许修改它;
- 第 49–51 行:方法 [getStudents] 返回列表的只读视图。如果直接返回列表 [students] 本身,外部代码就可以在类毫不知情的情况下修改它;
- 第 10–14 行:该视图拥有
*[List]* 的所有方法,编译器接受 ***[students.add("intruder")]** ;而 *[UnsupportedOperationException] 异常是在运行时抛出的;
- 第 15 行:该视图的实际类是 [Collections] 的一个内部类,只能通过 [List] 接口来了解它;
- 第 17–18 行:该视图不会复制列表;它能看到所属类所做的修改;
- 第 54–56 行和第 21–23 行:而 [List.copyOf] 返回的是只读副本:列表 [copy] 看不到“petit”的添加;
- 第 26–33 行:[Map.of] 根据键值对创建一个只读字典;
- 第 35–40 行:由 [of] 和 [copyOf] 创建的集合拒绝值 [null],在创建时会立即触发 [NullPointerException] 。
因此,像 [List<String>] 这样的变量类型并不能表明该列表是否可变:这需要由返回它的方法的文档来说明。一种常见的最佳实践是返回不可变集合,并在需要修改集合时创建一个新的集合。[record](其字段是只读的)与这种做法非常契合:[record Classroom(String name, List<String> students)] 适合在其构造函数中使用 [List.copyOf] 复制它的列表。
5.4.6. 排序、迭代与有序集合
程序 [Collections06.java] 演示了使用集合时三个有用的方面:编写 [Comparator]、Java 21 的有序集合(sequenced collection),以及在迭代过程中删除元素:
| // 用 Comparator 排序、有序集合、迭代与删除
void main() {
List<Student> students = new ArrayList<>(List.of(
new Student("martin", 15), new Student("dupont", 12), new Student("Durand", 15),
new Student("élise", 9), new Student("petit", 12)));
// 1 - Comparator 定义一种顺序;它的方法可以组合顺序
students.sort(Comparator.comparing(Student::name));
IO.println("by name : " + names(students));
students.sort(Comparator.comparing(Student::name, Collator.getInstance(Locale.FRANCE)));
IO.println("by name (Collator) : " + names(students));
students.sort(Comparator.comparingInt(Student::grade).reversed()
.thenComparing(Student::name, String.CASE_INSENSITIVE_ORDER));
IO.println("descending grade, name : " + names(students));
// 2 - 有序集合(Java 21):首元素、尾元素、反向顺序
IO.println("getFirst()=" + students.getFirst().name() + ", getLast()=" + students.getLast().name()
+ ", reversed()=" + names(students.reversed()));
LinkedHashSet<String> cities = new LinkedHashSet<>(List.of("Angers", "Paris", "Nantes"));
cities.addFirst("Lyon");
IO.println("LinkedHashSet : " + cities + ", getLast()=" + cities.getLast() + ", reversed()="
+ cities.reversed());
TreeMap<String, Integer> grades = new TreeMap<>(Map.of("martin", 15, "dupont", 12, "petit", 12));
IO.println("TreeMap : firstEntry()=" + grades.firstEntry() + ", lastEntry()=" + grades.lastEntry()
+ ", reversed()=" + grades.reversed());
// 3 - 在 for 循环中删除元素:异常(在副本上尝试)
List<Student> copy = new ArrayList<>(students);
try {
for (Student student : copy) {
if (student.grade() == 12) {
copy.remove(student);
}
}
} catch (ConcurrentModificationException e) {
IO.println("remove in a for: " + e.getClass().getSimpleName());
}
// 正确的方法:显式迭代器及其 remove 方法……
for (Iterator<Student> iterator = students.iterator(); iterator.hasNext(); ) {
Student student = iterator.next();
if (student.grade() < 10) {
iterator.remove();
}
}
IO.println("after iterator.remove() : " + names(students));
// ……或者更简单地,使用 removeIf
students.removeIf(student -> student.grade() < 15);
IO.println("after removeIf : " + names(students));
// forEach:用 lambda 表达的迭代
students.forEach(student -> IO.println(" " + student));
}
// 列表中学生的姓名
List<String> names(List<Student> students) {
List<String> names = new ArrayList<>();
for (Student student : students) {
names.add(student.name());
}
return names;
}
// 一名学生及其成绩
record Student(String name, int grade) {
}
|
结果:
| > java Collections06.java
by name : [Durand, dupont, martin, petit, élise]
by name (Collator) : [dupont, Durand, élise, martin, petit]
descending grade, name : [Durand, martin, dupont, petit, élise]
getFirst()=Durand, getLast()=élise, reversed()=[élise, petit, dupont, martin, Durand]
LinkedHashSet : [Lyon, Angers, Paris, Nantes], getLast()=Nantes, reversed()=[Nantes, Paris, Angers, Lyon]
TreeMap : firstEntry()=dupont=12, lastEntry()=petit=12, reversed()={petit=12, martin=15, dupont=12}
remove in a for: ConcurrentModificationException
after iterator.remove() : [Durand, martin, dupont, petit]
after removeIf : [Durand, martin]
Student[name=Durand, grade=15]
Student[name=martin, grade=15]
|
注释:
- 第 8 行:列表的 [sort] 方法接受一个 [Comparator],即比较两个元素的对象(第 4 章)。静态方法 [Comparator.comparing] 根据一个从每个元素中提取键 的函数来构造比较器,这里提取的是名字([Student::name] 指的是记录的方法 [name] )。名字按字符串的自然顺序比较:以大写字母开头的“Durand”排在最前面,而“élise”排在最后;
- 第 10 行:第二个参数指定如何比较键,这里使用 [Collator],其顺序遵循法语词典的顺序;
- 第 12–13 行:比较器的定义如下:[comparingInt] 比较成绩,[reversed] 反转顺序(成绩降序),而 [thenComparing] 添加一个次要条件,用于为成绩相同的学生决定先后:按名字比较,忽略大小写([String.CASE_INSENSITIVE_ORDER])。成绩同为 15 分的 Durand 和 Martin 按名字排序;
- 第 17–25 行:Java 21 引入了有序集合(sequenced collection):接口 [SequencedCollection]、[SequencedSet] 和 [SequencedMap],由元素具有确定顺序的集合实现([List]、[Deque]、[LinkedHashSet]、[TreeSet]、[LinkedHashMap]、[TreeMap]……)。它们共享用于访问两端的通用方法:[getFirst]、[getLast]、[addFirst]、[addLast]、[removeFirst]、[removeLast] ([firstEntry]、[lastEntry]……用于字典),以及方法 [reversed],它返回集合按逆序排列的视图 而无需复制。以前,要获取 [LinkedHashSet] 的最后一个元素,需要遍历整个集合;
- 第 28–37 行:在用 [for] 循环遍历集合时,不能修改该集合:循环使用的迭代器会检测到修改,并在处理下一个元素时抛出 [ConcurrentModificationException] 异常。测试是在列表的副本上进行的;
- 第 39–44 行:正确的做法是显式地使用 [Iterator] (随 Stream API 引入)来编写循环,并使用迭代器的 [remove] 方法删除当前元素;
- 第 47 行:更简单的做法是,[removeIf] 方法(Java 8)删除满足某个条件的元素,该条件由匿名(lambda)函数 [student -> student.grade() < 15]表示,读作“将学生映射为布尔值 [student.grade() < 15] 的函数”。lambda 将在第 7 章中详细学习;目前只需知道如何阅读它们即可。在下一节中我们几乎每一行都会遇到它们;
- 第 50 行:任何集合的方法
*[forEach]* 会对每个元素执行一个 lambda;
- 第 63–64 行:对 [record] 调用 [toString] 方法会返回记录的名称及其各组件的值:[Student[name=Durand, grade=15]]。
5.5. Stream API
Stream API([java.util.stream] 包,Java 8)是一组方法,可以让你像查询数据库一样处理集合中的元素:过滤、排序、分组、计算总数等。[Stream<T>] 流是 [T] 类型元素的序列,这些元素会依次经过一条操作链。流可以从集合([list.stream()])、数组([Arrays.stream(array)])、若干值([Stream.of(1, 2, 3)])、文件的行([Files.lines(path)])、正则表达式的匹配结果获得,在使用 Hibernate 时(第 11 章),还可以从数据库表的行获得。
不要将这些流与我们在处理文件时会遇到的输入输出流([InputStream]、[OutputStream])混淆:它们是两个互不相关的概念。
5.5.1. Iterable 和 Iterator 接口
在介绍流之前,让我们先回顾 [Iterable<T>] 接口,它适用于使用 [for] 循环遍历的对象。它只包含一个抽象方法 [iterator],该方法返回一个迭代器 [Iterator<T>]:这个对象会指出是否还有剩余元素([hasNext]),并返回下一个元素([next])。
[Iterable] 对象不必包含其元素:它的迭代器可以按需逐个生成它们。程序 [Streams01.java] 给出了一个例子,并展示了一个无限流:
| // Iterable 和 Iterator 接口;无限流
void main() {
// 1 - 对按需产生元素的 Iterable 对象使用 for
IO.println("[for on new Evens(6)]");
for (int n : new Evens(6)) {
IO.println(" received " + n);
}
// 2 - for 所做的事:向 Iterable 对象请求一个迭代器
IO.println("[iteration by hand]");
Iterable<Integer> sequence = new Evens(4);
Iterator<Integer> iterator = sequence.iterator();
while (iterator.hasNext()) {
IO.println(" next()=" + iterator.next());
}
// 3 - 无限流:它的元素只在需要时才计算
IO.println("[infinite stream]");
Stream.iterate(new long[]{0, 1}, f -> new long[]{f[1], f[0] + f[1]})
.map(f -> f[0])
.takeWhile(f -> f <= 100)
.forEach(f -> IO.print(f + " "));
IO.println();
// 4 - 列表是 Iterable,字符串不是:我们遍历其字符流
Iterable<String> words = List.of("one", "two");
String letters = "abc".chars()
.mapToObj(c -> String.valueOf((char) c))
.collect(Collectors.joining("-"));
IO.println("[other sequences] " + letters + " " + String.join("-", words));
}
// 从 0 到 max 的偶数,由迭代器逐个产生
record Evens(int max) implements Iterable<Integer> {
@Override
public Iterator<Integer> iterator() {
IO.println(" (start of the iteration)");
return new Iterator<>() {
// 下一个要产生的数
private int next = 0;
@Override
public boolean hasNext() {
boolean more = next <= max;
if (!more) {
IO.println(" (end of the iteration)");
}
return more;
}
@Override
public Integer next() {
if (next > max) {
throw new NoSuchElementException();
}
IO.println(" (producing " + next + ")");
int n = next;
next += 2;
return n;
}
};
}
}
|
结果:
| > java Streams01.java
[for on new Evens(6)]
(start of the iteration)
(producing 0)
received 0
(producing 2)
received 2
(producing 4)
received 4
(producing 6)
received 6
(end of the iteration)
[iteration by hand]
(start of the iteration)
(producing 0)
next()=0
(producing 2)
next()=2
(producing 4)
next()=4
(end of the iteration)
[infinite stream]
0 1 1 2 3 5 8 13 21 34 55 89
[other sequences] a-b-c one-two
|
注释:
- 第 34–64 行:记录 [Evens] 实现了接口 [Iterable<Integer>]:它的方法 [iterator] 返回一个迭代器,生成从 0 到 [max] 的偶数。它不构造任何列表,只是存储下一个要生成的数(第 41 行);
- 第 39 行:该迭代器是一个匿名类——一个没有名字的类,在单个表达式 [new Iterator<>() { ... }] 中声明并实例化,它实现了接口的两个方法。它可以访问记录的 [max] 组件;
- 第 44–50 行:[hasNext] 指出是否还有一个元素可以生成;
- 第 53–61 行:[next] 生成下一个元素。如果在没有更多元素之后被调用,它必须抛出 [NoSuchElementException];
- 第 5–7 行:结果(第 3–12 行)表明,迭代器生成元素与 [for] 循环消费元素是交替进行的;
- 第 11–15 行:[for] 循环实际所做的事情:它向对象请求一个迭代器,只要 [hasNext] 方法返回 [true] 就继续调用它,并通过 [next] 获取每个元素;
- 第 19–22 行:一个无限序列,即斐波那契数列。[Stream.iterate(seed, function)] 先生成种子,然后是对种子应用函数的结果,再是对该结果应用函数的结果,依此类推。这里每个元素是数列中两个连续数字组成的数组;[map] 只保留第一个数字,[takeWhile] 在第一个大于 100 的数字处终止流,而 [forEach] 显示每个数字。整个流从不会被完整计算;只有被请求的元素才会被计算;
- 第 26–30 行:列表是 [Iterable],而字符串不是:不能直接用 [for] 遍历它。它的方法 [chars] 以整数码的形式返回其字符流,随后这些整数码被转换回单字符字符串,再由 [Collectors.joining("-")] 用分隔符把它们连接起来。你也可以遍历 ["abc".toCharArray()] 返回的数组。
Java 没有这样一种语句,可以把迭代器定义为一个逐个生成其元素的简单方法(其他语言中的 [yield return] ):你要么像这里所示那样实现迭代器类,要么使用流的创建方法([Stream.iterate]、[Stream.generate]),它们同样按需生成元素。这种按需生成的机制贯穿整个 Stream API。
5.5.2. 过滤、投影、排序
以下示例处理一个包含几个人的小列表。一个人用 [record] (Java 16)表示,第 4 章已介绍过:只需一行,我们就得到一个带有构造函数、组件访问方法([p.lastName()]、[p.age()]……)、显示各组件的 [toString] 方法,以及按值比较各组件的相等运算符的类。
程序 [Streams02.java] 演示了 Stream API 的基本操作:
| // Stream API:过滤(filter)、投影(map)、排序(sorted)
void main() {
// 数据:人员列表
List<Person> persons = List.of(
new Person("dupont", "jean", 45, "Angers"),
new Person("martin", "marie", 17, "Paris"),
new Person("durand", "paul", 32, "Angers"),
new Person("leroy", "sophie", 28, "Nantes"),
new Person("moreau", "luc", 15, "Paris"),
new Person("simon", "julie", 52, "Angers"),
new Person("laurent", "marc", 32, "Lyon"));
// filter:成年人;p -> p.age() >= 18 是一个匿名函数
Stream<Person> adults = persons.stream().filter(p -> p.age() >= 18);
display("[filter: the adults]", adults);
// map:投影,这里每个人变成一个字符串
Stream<String> names = persons.stream().map(p -> p.firstName() + " " + p.lastName().toUpperCase());
display("[map: firstName LASTNAME]", names);
// 这些操作被链接起来:来自 Angers 的人的姓名,按字母顺序
List<String> angersPeople = persons.stream()
.filter(p -> p.city().equals("Angers"))
.map(Person::lastName)
.sorted()
.toList();
display("[filter + map + sorted: the people from Angers]", angersPeople.stream());
// 按多个条件排序:年龄降序,然后姓名升序
Stream<Person> sorted = persons.stream()
.sorted(Comparator.comparingInt(Person::age).reversed().thenComparing(Person::lastName));
display("[sorted with a Comparator]", sorted);
// 元素的位置:我们用 IntStream 遍历下标
Stream<String> numbered = IntStream.range(0, 3).mapToObj(i -> (i + 1) + ". " + persons.get(i).lastName());
display("[IntStream.range: numbering]", numbered);
// 流只能遍历一次
Stream<Person> stream = persons.stream().filter(p -> p.age() < 18);
IO.println("[a stream already traversed] " + stream.count() + " minors");
try {
stream.count();
} catch (IllegalStateException e) {
IO.println(" " + e.getClass().getSimpleName() + " : " + e.getMessage());
}
}
// 显示流的元素
<T> void display(String title, Stream<T> stream) {
IO.println(title);
stream.forEach(element -> IO.println(" " + element));
}
// 一个人
record Person(String lastName, String firstName, int age, String city) {
}
|
结果:
| > java Streams02.java
[filter: the adults]
Person[lastName=dupont, firstName=jean, age=45, city=Angers]
Person[lastName=durand, firstName=paul, age=32, city=Angers]
Person[lastName=leroy, firstName=sophie, age=28, city=Nantes]
Person[lastName=simon, firstName=julie, age=52, city=Angers]
Person[lastName=laurent, firstName=marc, age=32, city=Lyon]
[map: firstName LASTNAME]
jean DUPONT
marie MARTIN
paul DURAND
sophie LEROY
luc MOREAU
julie SIMON
marc LAURENT
[filter + map + sorted: the people from Angers]
dupont
durand
simon
[sorted with a Comparator]
Person[lastName=simon, firstName=julie, age=52, city=Angers]
Person[lastName=dupont, firstName=jean, age=45, city=Angers]
Person[lastName=durand, firstName=paul, age=32, city=Angers]
Person[lastName=laurent, firstName=marc, age=32, city=Lyon]
Person[lastName=leroy, firstName=sophie, age=28, city=Nantes]
Person[lastName=martin, firstName=marie, age=17, city=Paris]
Person[lastName=moreau, firstName=luc, age=15, city=Paris]
[IntStream.range: numbering]
1. dupont
2. martin
3. durand
[a stream already traversed] 2 minors
IllegalStateException : stream has already been operated upon or closed
|
注释:
- 第 4–11 行:由 [List.of] 创建的、不可修改的人员列表;
- 第 55 行:[Person] 记录。紧凑源文件把它的类型声明放在方法旁边;
- 第 14 行:[persons.stream()] 返回列表元素的流。方法 [filter] 对流进行过滤:只保留满足某个条件的元素。该条件以 lambda [p -> p.age() >= 18] 的形式传给它,即“对于一个人 p,返回布尔值 [p.age() >= 18] 的函数”。[filter] 会对每个人调用这个函数;
- [filter] 的结果是一个新的流 [Stream<Person>]:列表 [persons] 保持不变。Stream API 中的所有操作都是如此;
- 第 49–52 行:[display] 方法使用 [forEach] 操作遍历流,并使用记录的 [toString] 方法显示每个人:[Person[lastName=dupont, ...]];
- 第 18 行:[map] 方法将流的每个元素投影为一个新值,这里是字符串。结果是一个 [Stream<String>] 流;
- 第 22–26 行:这些操作返回流,因此可以对其继续应用其他操作。各操作通常每行写一个:这条调用链像菜谱一样自上而下阅读。[Person::lastName] 是一个方法引用,是 lambda [p -> p.lastName()] 的简写形式;
- 第 25 行:[sorted] 不带参数时,按元素的自然顺序对流排序,这里的元素是字符串;
- 第 26 行:[toList] (Java 16)把流的元素放入一个不可变列表。我们还会遇到较旧的写法 [collect(Collectors.toList())],它在实践中返回的是可变列表([ArrayList]),尽管文档并不保证这一点;
- 第 30–31 行:[sorted] 接受一个 [Comparator],其构造方式与 [Collections06.java] 中相同:年龄降序,然后姓名升序,以区分同龄的人。同为 32 岁的 Durand 和 Laurent 按姓氏排序(结果的第 23–24 行);
- 第 35 行:流不提供其元素的位置。为了给它们编号,我们使用整数流 [IntStream.range(0, 3)] (0、1、2;不含 3)遍历索引,并使用 [mapToObj] 把每个索引转换为字符串;
- 第 39–45 行:流只能使用一次:一旦被终端操作(这里是 [count],用于统计元素个数)遍历过,就不能再使用,否则会触发 [IllegalStateException]。必须重新从集合请求一个新的流。
流中有两类操作:中间操作([filter]、[map]、[sorted]……)返回一个新的流;终端操作([forEach]、[toList]、[count]、[collect]……)遍历流并产生结果。操作链总是以终端操作结束。与其他语言不同,Java 没有类似 SQL 的查询语法:处理过程总是写成一条方法调用链。
5.5.3. 量词、聚合、元素选取
程序 [Streams03.java] 包含返回单个值的操作和选取流的一部分的操作:
| // Stream API:量词、聚合、选取元素、切片
void main() {
List<Person> persons = List.of(
new Person("dupont", "jean", 45, "Angers"),
new Person("martin", "marie", 17, "Paris"),
new Person("durand", "paul", 32, "Angers"),
new Person("leroy", "sophie", 28, "Nantes"),
new Person("moreau", "luc", 15, "Paris"),
new Person("simon", "julie", 52, "Angers"),
new Person("laurent", "marc", 32, "Lyon"));
// 量词:anyMatch(至少一个)、allMatch(全部)、noneMatch(没有)
IO.println("anyMatch(minor)=" + persons.stream().anyMatch(p -> p.age() < 18)
+ ", allMatch(minor)=" + persons.stream().allMatch(p -> p.age() < 18)
+ ", noneMatch(Brest)=" + persons.stream().noneMatch(p -> p.city().equals("Brest")));
// 聚合;mapToInt 得到 int 流,它有 sum、average、min、max
IO.println("count()=" + persons.stream().count()
+ ", count(Angers)=" + persons.stream().filter(p -> p.city().equals("Angers")).count());
double average = persons.stream().mapToInt(Person::age).average().orElse(0);
IO.println("sum(age)=" + persons.stream().mapToInt(Person::age).sum()
+ ", average(age)=%.2f".formatted(average));
IntSummaryStatistics stats = persons.stream().mapToInt(Person::age).summaryStatistics();
IO.println("min(age)=" + stats.getMin() + ", max(age)=" + stats.getMax() + ", " + stats);
// 带 Comparator 的 min、max 在 Optional 中返回元素本身
Optional<Person> youngest = persons.stream().min(Comparator.comparingInt(Person::age));
Optional<Person> oldest = persons.stream().max(Comparator.comparingInt(Person::age));
IO.println("min(Comparator)=" + youngest.get().lastName() + ", max(Comparator)=" + oldest.get().lastName());
// 选取元素:findFirst 返回 Optional,如果没有元素则为空
String first = persons.stream().findFirst().get().lastName();
String parisian = persons.stream().filter(p -> p.city().equals("Paris")).findFirst().get().lastName();
IO.println("findFirst()=" + first + ", first from Paris=" + parisian
+ ", getLast()=" + persons.getLast().lastName());
Optional<Person> fromBrest = persons.stream().filter(p -> p.city().equals("Brest")).findFirst();
IO.println("Brest : isPresent()=" + fromBrest.isPresent() + ", map + orElse : "
+ fromBrest.map(Person::lastName).orElse("nobody"));
try {
// orElseThrow 要求必须存在值
fromBrest.orElseThrow();
} catch (NoSuchElementException e) {
IO.println("Brest : orElseThrow() : " + e.getClass().getSimpleName() + " : " + e.getMessage());
}
// distinct:去除重复项
List<String> cities = persons.stream().map(Person::city).distinct().toList();
IO.println("distinct(cities)=" + cities);
// 每个城市一个人:第一个;对已出现过的城市,Set.add 返回 false
Set<String> seen = new HashSet<>();
List<String> onePerCity = persons.stream().filter(p -> seen.add(p.city())).map(Person::lastName).toList();
IO.println("one person per city=" + onePerCity);
// 切片:limit、skip、takeWhile、dropWhile
List<String> names = persons.stream().map(Person::lastName).toList();
IO.println("limit(2)=" + names.stream().limit(2).toList() + ", skip(5)=" + names.stream().skip(5).toList());
IO.println("skip(2).limit(2)=" + names.stream().skip(2).limit(2).toList()
+ ", takeWhile(length 6)=" + names.stream().takeWhile(n -> n.length() == 6).toList()
+ ", dropWhile(length 6)=" + names.stream().dropWhile(n -> n.length() == 6).toList());
// Gatherers.windowFixed(Java 24):切分为固定大小的数据包(分页)
List<List<String>> pages = names.stream().gather(Gatherers.windowFixed(3)).toList();
for (int i = 0; i < pages.size(); i++) {
IO.println("page " + (i + 1) + " : " + String.join(", ", pages.get(i)));
}
}
record Person(String lastName, String firstName, int age, String city) {
}
|
结果:
| > java Streams03.java
anyMatch(minor)=true, allMatch(minor)=false, noneMatch(Brest)=true
count()=7, count(Angers)=3
sum(age)=221, average(age)=31.57
min(age)=15, max(age)=52, IntSummaryStatistics{count=7, sum=221, min=15, average=31.571429, max=52}
min(Comparator)=moreau, max(Comparator)=simon
findFirst()=dupont, first from Paris=martin, getLast()=laurent
Brest : isPresent()=false, map + orElse : nobody
Brest : orElseThrow() : NoSuchElementException : No value present
distinct(cities)=[Angers, Paris, Nantes, Lyon]
one person per city=[dupont, martin, leroy, laurent]
limit(2)=[dupont, martin], skip(5)=[simon, laurent]
skip(2).limit(2)=[durand, leroy], takeWhile(length 6)=[dupont, martin, durand], dropWhile(length 6)=[leroy, moreau, simon, laurent]
page 1 : dupont, martin, durand
page 2 : leroy, moreau, simon
page 3 : laurent
|
注释:
- 第 13–15 行:如果至少有一个元素满足条件,[anyMatch] 返回 [true] ;如果所有元素都满足条件,[allMatch] 返回 true;如果没有元素满足条件,[noneMatch] 返回 true;
- 第 18–19 行:[count] 统计流中的元素个数;要统计满足某个条件的元素,需要先对流进行过滤。对于集合,显然 [size] 方法比 [stream().count()] 更可取;
- 第 20–22 行:[mapToInt(Person::age)] 把人员流转换为 [IntStream],即 [int] 值的流,它具有计算方法:[sum]、[average]、[min]、[max]。[average] 返回一个 [OptionalDouble],因为空流的平均值不存在;[orElse(0)] 提供这种情况下要使用的值;
- 第 23–24 行:[summaryStatistics] 一次遍历即可计算出个数、总和、最小值、平均值和最大值;
- 第 26–28 行:[min] 和 [max], 来自 [Stream],接收一个 [Comparator] 并返回最小或最大的元素 (这里是那个人),而不是键的值。结果是一个 [Optional<Person>]:一个装有一个人的盒子,如果流为空则是一个空盒子。[get] 返回盒子里的内容;
- 第 31–34 行:[findFirst] 在 [Optional] 中返回流的第一个元素;经过过滤后,流返回第一个满足条件的元素。对于列表的最后一个元素,使用列表的 [getLast] 方法就足够了;
- 第 35–37 行:布雷斯特没有人:[Optional] 为空([isPresent] 返回 [false])。与其对它进行测试,不如对它进行转换:[map(Person::lastName)] 在其有内容时转换其内容;[orElse("nobody")] 提供它为空时要使用的值;
- 第 38–43 行:[orElseThrow] 返回 [Optional] 的内容,如果为空则抛出 [NoSuchElementException] 。当值的缺失构成错误时使用它。[get](前面用过)作用相同,但其名称并未表明它可能抛出异常;[orElseThrow] 更受推荐。没有要求流恰好包含一个元素的操作;可以检查 [toList] 返回的列表的大小;
- 第 46 行:[distinct] 删除重复项(按 [equals] 方法的判断);
- 第 49–50 行:没有现成的操作可以让每个城市只保留一个人。这里我们使用一个记录已遇到城市的集:对于新城市,[add] 返回 [true] (该人被保留),对于已遇到过的城市则返回 [false] 。像这样修改外部变量的 lambda,应当只用于按顺序处理的流,这也是默认行为;
- 第 54–58 行:[limit(n)] 保留前 n 个元素,而 [skip(n)] 则跳过它们。将两者组合,就可以提取结果的一“页”。[takeWhile] (Java 9)在条件为真期间保留元素,并在第一个不满足条件的元素处停止;[dropWhile] 则相反:它跳过这些元素,并保留之后的所有元素;
- 第 61 行:[gather] (Java 24)操作对流应用一个中间收集器 (“gatherer”),它可以根据前面的元素对元素进行分组、累积或过滤。[Gatherers] 类提供了其中的若干个;[Gatherers.windowFixed(3)] 把流拆分为每个含 3 个元素的列表,最后一个列表可能更短。还有其他的,例如 [windowSliding(n)] (滑动窗口),你也可以编写自己的收集器。
5.5.4. 局部记录、分组、连接
程序 [Streams04.java] 执行更复杂的操作,其中大多数通过终端操作 [collect] 和类 [Collectors] 的收集器完成:
| // Stream API:局部记录、分组、连接、收集器
void main() {
List<Person> persons = List.of(
new Person("dupont", "jean", 45, "Angers"),
new Person("martin", "marie", 17, "Paris"),
new Person("durand", "paul", 32, "Angers"),
new Person("leroy", "sophie", 28, "Nantes"),
new Person("moreau", "luc", 15, "Paris"),
new Person("simon", "julie", 52, "Angers"),
new Person("laurent", "marc", 32, "Lyon"));
List<City> cities = List.of(
new City("Angers", "Maine-et-Loire"),
new City("Nantes", "Loire-Atlantique"),
new City("Paris", "Paris"),
new City("Brest", "Finistère"));
// 1 - 局部记录:在方法中声明的类型,用于中间结果
record Summary(String name, int decade) {
}
IO.println("[local record]");
persons.stream()
.filter(p -> p.age() > 40)
.map(p -> new Summary(p.lastName(), p.age() / 10 * 10))
.forEach(r -> IO.println(" " + r.name() + " is over " + r.decade() + " years old"));
// 2 - groupingBy:按城市对人员分组,按首次出现的顺序
IO.println("[groupingBy]");
Map<String, List<Person>> byCity = persons.stream()
.collect(Collectors.groupingBy(Person::city, LinkedHashMap::new, Collectors.toList()));
byCity.forEach((city, group) -> IO.println(" %s : %d person(s), average age %.1f (%s)".formatted(
city, group.size(), group.stream().mapToInt(Person::age).average().orElse(0),
group.stream().map(Person::lastName).collect(Collectors.joining(", ")))));
// 3 - 连接:每个人与同名的城市关联
IO.println("[join with flatMap]");
persons.stream()
.flatMap(p -> cities.stream()
.filter(v -> v.name().equals(p.city()))
.map(v -> p.lastName() + " lives in the department " + v.department()))
.forEach(line -> IO.println(" " + line));
// 用城市字典做同样的连接,效率更高:每个人只查找一次
Map<String, City> citiesByName = cities.stream().collect(Collectors.toMap(City::name, v -> v));
String join = persons.stream()
.filter(p -> p.age() >= 18 && citiesByName.containsKey(p.city()))
.map(p -> p.lastName() + "/" + citiesByName.get(p.city()).department())
.collect(Collectors.joining(", "));
IO.println("[join with a dictionary] " + join);
// 4 - 收集器:toList、toMap、partitioningBy
List<String> adultNames = persons.stream().filter(p -> p.age() >= 18).map(Person::lastName).toList();
Map<String, Integer> agesByName = persons.stream()
.collect(Collectors.toMap(Person::lastName, Person::age));
IO.println("[toList] " + adultNames.size() + " adults; [toMap] agesByName.get(\"leroy\")="
+ agesByName.get("leroy"));
Map<Boolean, List<String>> adultsMinors = persons.stream()
.collect(Collectors.partitioningBy(p -> p.age() >= 18,
Collectors.mapping(Person::lastName, Collectors.toList())));
IO.println("[partitioningBy] adults=" + adultsMinors.get(true)
+ ", minors=" + adultsMinors.get(false));
// 5 - 带下游收集器的 groupingBy:计数、求和
Map<String, Long> countByCity = persons.stream()
.collect(Collectors.groupingBy(Person::city, TreeMap::new, Collectors.counting()));
IO.println("[groupingBy + counting] " + countByCity);
Map<String, Integer> sumByCity = persons.stream()
.collect(Collectors.groupingBy(Person::city, TreeMap::new,
Collectors.summingInt(Person::age)));
IO.println("[groupingBy + summingInt] " + sumByCity);
// 6 - 过滤后流中每个元素的位置
IO.println("[position]");
List<Person> young = persons.stream().filter(p -> p.age() < 30).toList();
IntStream.range(0, young.size()).forEach(i -> IO.println(" " + i + " : " + young.get(i).lastName()));
}
record Person(String lastName, String firstName, int age, String city) {
}
record City(String name, String department) {
}
|
结果:
| > java Streams04.java
[local record]
dupont is over 40 years old
simon is over 50 years old
[groupingBy]
Angers : 3 person(s), average age 43.0 (dupont, durand, simon)
Paris : 2 person(s), average age 16.0 (martin, moreau)
Nantes : 1 person(s), average age 28.0 (leroy)
Lyon : 1 person(s), average age 32.0 (laurent)
[join with flatMap]
dupont lives in the department Maine-et-Loire
martin lives in the department Paris
durand lives in the department Maine-et-Loire
leroy lives in the department Loire-Atlantique
moreau lives in the department Paris
simon lives in the department Maine-et-Loire
[join with a dictionary] dupont/Maine-et-Loire, durand/Maine-et-Loire, leroy/Loire-Atlantique, simon/Maine-et-Loire
[toList] 5 adults; [toMap] agesByName.get("leroy")=28
[partitioningBy] adults=[dupont, durand, leroy, simon, laurent], minors=[martin, moreau]
[groupingBy + counting] {Angers=3, Lyon=1, Nantes=1, Paris=2}
[groupingBy + summingInt] {Angers=129, Lyon=32, Nantes=28, Paris=32}
[position]
0 : martin
1 : leroy
2 : moreau
|
注释:
- 第 18–19 行:一个局部记录(Java 16),声明在使用它的方法内部。它让你无需在程序中声明一个类,就能为处理过程的中间结果指定名称和类型:第 23 行,每个 40 岁以上的人都被转换为一个只保留相关数据的 [Summary] ;
- 第 28–29 行:[groupingBy] 收集器将具有相同键的元素分组,这里的键是城市。结果是一个名为 [Map<String, List<Person>>] 的字典:每个城市关联一个其居民的列表。在没有其他参数时,[groupingBy] 会创建一个 [HashMap],其中键的顺序不可预测;这里我们让它创建一个
*[LinkedHashMap]*(***[LinkedHashMap::new]***,构造函数引用),它按城市首次出现的顺序保存城市。第三个参数是应用于每个分组元素的收集器,这里是 *[toList]*;
- 第 30–32 行:字典的 [forEach] 方法接受一个带两个参数的 lambda:键和值。对于每个分组,它显示分组的大小、平均年龄和姓名;[Collectors.joining(", ")] 收集器使用分隔符连接字符串;
- 第 36–40 行:Stream API 没有连接操作。这里通过 [flatMap] 来实现,它把每个元素替换为一个流,然后把所有这些流连接起来:每个人被替换为与其同名的城市所组成的流(一个或零个),并转换为字符串。与 SQL 的内连接一样,只保留匹配的配对:住在里昂的 Laurent 没有出现,因为里昂不在城市列表中;没有居民的布雷斯特也没有出现。这段代码对每个人都要遍历整个城市列表;
- 第 42–47 行:同样的连接,但效率更高:收集器 [toMap] 构建一个城市字典,其中键是城市的名称([City::name]),值是城市本身([v -> v]);然后我们在这个字典中查找每个成年人所在的城市。重复的键会导致 [IllegalStateException] 在 [toMap] 处抛出异常;
- 第 50–54 行:[toList] 和 [toMap] 执行处理,并分别把结果存入列表和字典;
- 第 55–59 行:[partitioningBy] 根据条件把元素分成两组;结果是一个键为 [true] 和 [false] 的字典。收集器 [mapping(Person::lastName, toList())] 在把每个人加入其所在组的列表之前,先将其转换为姓名;
- 第 62–68 行:[groupingBy] 的第三个参数可以是任何应用于每个分组的收集器:[counting] 统计分组中的元素个数,[summingInt] 对整数值求和([averagingInt] 计算平均值,[maxBy] 查找最大值……)。使用 [TreeMap::new] 时,城市会被排序;
- 第 72–73 行:过滤后的流中每个元素的位置:先把流存入列表,然后遍历索引。
5.5.5. 惰性求值
流中的中间操作并不是在编写时执行,而是在终端操作遍历流时才执行:这称为“惰性求值”。程序 [Streams05.java] 使用会显示自身行为的 lambda 表达式来演示这一点:
| // Stream API:惰性求值
void main() {
List<Integer> numbers = new ArrayList<>(List.of(1, 2, 3, 4, 5, 6));
// 1 - 定义流并不会执行它
IO.println("[definition of the stream]");
Stream<Integer> evenSquares = numbers.stream()
.filter(n -> {
IO.println(" filter examines " + n);
return n % 2 == 0;
})
.map(n -> {
IO.println(" map computes " + n + "*" + n);
return n * n;
});
IO.println("[the stream is defined, nothing has been executed yet]");
// 2 - 它在终端操作时逐个元素地执行
IO.println("[forEach]");
evenSquares.forEach(c -> IO.println(" forEach receives " + c));
// 3 - 流不能重复使用:要重新运行计算,需要重新创建流
Supplier<Stream<Integer>> large = () -> numbers.stream().filter(n -> n > 4);
IO.println("[before adding] large=" + large.get().toList());
numbers.add(10);
IO.println("[after adding 10] large=" + large.get().toList());
// 4 - toList 在某一时刻存储结果
List<Integer> snapshot = large.get().toList();
numbers.add(20);
IO.println("[after adding 20] large=" + large.get().toList() + ", snapshot=" + snapshot);
// 5 - findFirst 一旦找到元素就停止遍历
IO.println("[findFirst on a stream]");
int first = numbers.stream()
.filter(n -> {
IO.println(" filter examines " + n);
return n > 2;
})
.findFirst()
.orElseThrow();
IO.println(" first=" + first);
// 6 - sorted 必须先知道所有元素,才能传递出第一个
IO.println("[sorted]");
Stream.of(3, 1, 2)
.peek(n -> IO.println(" before sorted: " + n))
.sorted()
.forEach(n -> IO.println(" after sorted: " + n));
// 7 - int 流:没有 Integer 对象,有计算方法
int sumOfSquares = IntStream.rangeClosed(1, 10).filter(n -> n % 2 == 0).map(n -> n * n).sum();
IO.println("[IntStream] sum of the squares of the even numbers from 1 to 10 = " + sumOfSquares);
IO.println("[IntStream] boxed : " + IntStream.of(5, 3, 8).boxed().toList()
+ ", asDoubleStream().average() : " + IntStream.of(5, 3, 8).asDoubleStream().average().orElse(0));
}
|
结果:
| > java Streams05.java
[definition of the stream]
[the stream is defined, nothing has been executed yet]
[forEach]
filter examines 1
filter examines 2
map computes 2*2
forEach receives 4
filter examines 3
filter examines 4
map computes 4*4
forEach receives 16
filter examines 5
filter examines 6
map computes 6*6
forEach receives 36
[before adding] large=[5, 6]
[after adding 10] large=[5, 6, 10]
[after adding 20] large=[5, 6, 10, 20], snapshot=[5, 6, 10]
[findFirst on a stream]
filter examines 1
filter examines 2
filter examines 3
first=3
[sorted]
before sorted: 3
before sorted: 1
before sorted: 2
after sorted: 1
after sorted: 2
after sorted: 3
[IntStream] sum of the squares of the even numbers from 1 to 10 = 220
[IntStream] boxed : [5, 3, 8], asDoubleStream().average() : 5.333333333333333
|
注释:
- 第 7–15 行:一个保留偶数然后计算其平方的流。这里的 lambda 带有用花括号括起来的方法体,它先显示一条消息,然后通过 [return] 返回其值;
- 结果的第 3 行:在定义流之后,没有显示任何内容:[filter] 和 [map] 都还没有处理任何一个元素。[evenSquares] 并不包含结果,而是包含对一个计算的描述;
- 结果的第 4–16 行:计算在终端操作 [forEach] 期间逐个元素地进行:每个数字先经过 [filter],如果是偶数再经过 [map] ,然后进入 [forEach] ,之后才检查下一个数字。不会构造任何中间列表;
- 第 23–26 行:由于流只能遍历一次,我们改为存储创建它的方式:一个无参数的 lambda [() -> numbers.stream().filter(...)],其类型为 [Supplier<Stream<Integer>>],它的 [get] 方法在每次调用时创建一个新的流。添加 10 之后创建的流会把这个新元素考虑在内;
- 第 29–31 行:[toList] 执行处理并存储其结果:[snapshot] 是一个列表,看不到 20 的添加;
- 第 35–42 行:[findFirst] 一找到元素就停止迭代:3 之后的数字从不会被检查。[anyMatch]、[limit]、[takeWhile]……同样会尽早停止迭代;这正是能够处理无限流的原因;
- 第 46–49 行:有些中间操作无法逐个处理元素:[sorted] 必须知道所有元素,才能传递出最小的那个。[peek]操作会在每个元素经过时对其执行一个 lambda 而不修改它,它表明三个元素都被 [sorted] 接收之后,它才传递出第一个元素;
- 第 52–55 行:基本类型流 [IntStream]、[LongStream], 和 [DoubleStream] 避免创建 [Integer]、[Long] 和 [Double] 对象。[IntStream.rangeClosed(1, 10)] 生成从 1 到 10(含 10)的整数。[boxed] 将 [IntStream] 转换为 [Stream<Integer>],而 [asDoubleStream] 则将其转换为 [DoubleStream]。与字符串拼接的 [double] 会显示全部小数位和小数点;若要限制小数位数,需要使用 [formatted]。
惰性求值有两个实际影响:
- 流只能遍历一次。如果某个计算的结果需要多次使用,就用 [toList] 把它存入列表;
- 操作可以零成本地链接在一起:链接 [filter]、[map] 和 [limit] 不会创建任何中间集合,只会计算必要的元素。
最后请注意,集合的 [parallelStream] 方法返回一个流,其元素由多个线程同时处理(第 8 章)。它只能加速对大量数据的耗时操作,并且要求 lambda 没有副作用:应当在评估其收益之后才使用它。我们将在整个课程中遇到 Stream API,并将在第 7 章中看到它所使用的函数式接口是如何构造的。
5.6. 文本文件
Java 有两个用于文件的 API 包:自 Java 1.0 起就可用的 [java.io] 包([File]、[FileReader]、[FileInputStream]……),以及随 Java 7 引入的 [java.nio.file] 包([Path]、[Files]……)。后者功能更全面,并提供更好的错误报告:它是如今应当使用的包。它依赖于 [java.io] 中的读写类([BufferedReader]、[BufferedWriter]……),这些类通过 [Files] 类的方法获得。
文件由一个 [java.nio.file.Path] 对象表示,该对象通过 [Path.of("infos.txt")] (Java 11)创建。相对路径(如这个)会以程序的当前目录(即启动程序时所在的目录)作为补充。
自 Java 18(JEP 400)起,无论操作系统如何,文本文件的默认编码都是 UTF-8。此前,默认编码取决于系统(在法语版 Windows 上通常是 Windows-1252),同一个程序在不同机器上可能会以不同方式解释同一个文件。[Files] 类的方法自 Java 8 起就已经默认使用 UTF-8。
5.6.1. BufferedReader 类
[java.io.BufferedReader] 类可以逐行读取文本文件的内容。实际上它也能够处理不是文件的流(例如网络连接)。它以块为单位读取文件,并把这些块存储在缓冲区中:大多数读取都在内存中完成,无需访问磁盘。
方法 | 作用 |
[static BufferedReader Files.newBufferedReader(Path path)] | 以 UTF-8 打开文件 [path] 进行读取;重载方法允许指定编码:[Files.newBufferedReader(path, StandardCharsets.ISO_8859_1)] |
[String readLine()] | 返回流的下一行(不含行尾标记),如果已到达流的末尾则返回 [null] |
[int read()] | 返回流中的下一个字符,在流的末尾返回 -1 |
[Stream<String> lines()] | 以 Stream API 中的流的形式返回剩余的行 |
[void close()] | 关闭流并释放为管理该流而分配的资源。必须在处理完流之后执行此操作,这由带资源的 [try] 语句来负责 |
程序 [Files01.java] 如下:
| // 用 BufferedReader 读取文本文件
void main(String[] args) {
// 当前文件夹:以相对名称指定的文件在这里查找
IO.println("Current folder: " + Path.of("").toAbsolutePath().getFileName());
// 文件名可以作为参数传入;否则为 infos.txt
Path file = Path.of(args.length > 0 ? args[0] : "infos.txt");
try {
// 读取方式 1:逐行读取
IO.println("Reading 1----------------");
try (BufferedReader reader = Files.newBufferedReader(file)) {
String line;
// 到达文件末尾时 readLine 返回 null
while ((line = reader.readLine()) != null) {
IO.println(line);
}
} // 到这里流已关闭
// 读取方式 2:一次读取整个文件
IO.println("Reading 2----------------");
IO.print(Files.readString(file));
} catch (NoSuchFileException e) {
// e.getFile() 是未找到的文件的路径
IO.println(e.getClass().getSimpleName() + " : the file [" + e.getFile() + "] does not exist");
} catch (IOException e) {
// 其他输入输出错误
IO.println(e.getClass().getSimpleName() + " : " + e.getMessage());
}
}
|
注释:
- 第 2 行:[main] 方法在这里通过 [args] 数组接收命令行参数;
- 第 4 行:显示当前文件夹的名称,即启动 [java] 命令时所在的文件夹。[Path.of("")] 表示当前文件夹;[toAbsolutePath] 将其转换为完整路径,而 [getFileName] 只保留其中最后一个元素,以免完整路径使结果显得杂乱;
- 第 6 行:被读取的文件是 [infos.txt] 或作为参数传入的文件。由于这是相对路径,会在当前目录中查找它;
- 第 10 行:[try (resource declaration) { ... }] 语句,称为“带资源的 try”(try-with-resources)块 (Java 7),确保在退出该块时关闭流,即使块内发生异常也是如此。它免去了显式调用 [close] 方法的必要。它适用于任何实现了 [AutoCloseable] 接口的对象,也就是任何拥有释放资源的 [close] 方法的对象(文件、网络连接、数据库连接等)。在 Java 7 之前,必须在验证流确实已打开之后,在 [finally] 子句中关闭流;
- 第 13–15 行:逐行读取文件。赋值 [line = reader.readLine()] 是一个表达式,其值就是 [line] 的值:将它与 [null] 比较,null 表示文件结束;
- 第 20 行:[Files.readString] (Java 11)一次性读取整个文件并将其关闭;
- 第 21–27 行:输入/输出错误通过派生自 [java.io.IOException] 的异常来表示。这些是受检异常(第 4 章):编译器要求捕获或声明它们。文件缺失会触发 [NoSuchFileException],它派生自 IOException,因此必须先捕获它。它的 [getFile] 方法返回被查找文件的路径。[java.io] 中较旧的类则将同一错误报告为 [FileNotFoundException]。
[infos.txt] 文件如下:
| 12620:0:0
13190:0,05:631
15640:0,1:1290,5
|
它位于 [05-classes-java] 文件夹中,程序就是从该文件夹运行的:
| > java Files01.java
Current folder: 05-classes-java
Reading 1----------------
12620:0:0
13190:0,05:631
15640:0,1:1290,5
Reading 2----------------
12620:0:0
13190:0,05:631
15640:0,1:1290,5
|
对于一个不存在的文件:
| > java Files01.java xx.txt
Current folder: 05-classes-java
Reading 1----------------
NoSuchFileException : the file [xx.txt] does not exist
|
当使用文件夹而不是文件时,读取操作会触发另一个异常 [IOException],其消息由操作系统提供:
| > java Files01.java .
Current folder: 05-classes-java
Reading 1----------------
IOException : Is a directory
|
对于从自身所在目录运行的紧凑源文件来说,选择当前目录来定位数据文件是很自然的。对于 Maven 项目,命令 [mvn exec:java] 在项目目录中运行:我们将把示例应用程序的数据文件放在那里。
5.6.2. BufferedWriter 类
[java.io.BufferedWriter] 类可以写入文本文件。与 [BufferedReader] 一样,它使用缓冲区,并且能够处理不是文件的流。
方法 | 作用 |
[static BufferedWriter Files.newBufferedWriter(Path path)] | 以 UTF-8 打开文件 [path] 进行写入。文件会被创建;如果已存在则被清空。可选参数允许指定编码和打开模式:[Files.newBufferedWriter(path, StandardOpenOption.APPEND)] 将写入的内容追加到现有文件的末尾 |
[void write(String str)] | 将 [str] 写入文件 |
[void newLine()] | 写入行结束符:采用系统默认值,Windows 上为“\r\n”,Linux 和 macOS 上为“\n” |
[void flush()] | 不等缓冲区写满,就将缓冲区的内容写入文件 |
[void close()] | 在将缓冲区的内容写入文件之后关闭流。必须在处理完流之后执行此操作 |
对 [BufferedWriter] 的写入不是立即生效的:文本首先写入缓冲区,然后在缓冲区写满时、使用 [flush] 方法显式刷新时,或在流关闭时才写入文件。这是对文件最高效的模式,因为它把磁盘访问降到最低。它并不适用于所有数据流,尤其是网络流:在两个对等方的对话中,一方写入的内容必须立即被另一方读取,因此每条消息之后都必须刷新缓冲区。我们稍后将使用的 [java.io.PrintWriter] 类增加了方法 [print]、[println] 和 [printf],并且可以在每次调用 [println] 之后自动清空其缓冲区(构造函数 [new PrintWriter(writer, true)])。
程序 [Files02.java] 如下:
| // 用 BufferedWriter 写入文本文件
void main() {
Path file = Path.of("infos2.txt");
try {
// 创建文本文件(如果已存在,则被覆盖)
try (BufferedWriter writer = Files.newBufferedWriter(file)) {
IO.println("default encoding: " + Charset.defaultCharset());
// 只要输入的行不为空就循环
while (true) {
String input = IO.readln("line (nothing to stop): ");
String line = input == null ? "" : input.strip();
if (line.isEmpty()) {
break;
}
// 将该行写入文本文件,后跟一个行结束符
writer.write(line);
writer.newLine();
}
} // 关闭流:缓冲区被写入文件
// 检查:我们重新读取所创建的文件
IO.println("Content of " + file + " (" + Files.size(file) + " bytes):");
IO.print(Files.readString(file));
} catch (IOException e) {
IO.println("The following error occurred: " + e);
}
}
|
结果:
| > java Files02.java
default encoding: UTF-8
line (nothing to stop): 1st line
line (nothing to stop): 2nd line
line (nothing to stop):
Content of infos2.txt (18 bytes):
1st line
2nd line
|
注释:
- 第 6 行:我们再次使用带资源的 [try] 语句,这样就不必显式关闭流。关闭会在块结束时(第 19 行的右花括号处)自动发生。正是这次关闭把缓冲区中剩余的文本写入文件;没有它,文件可能保持不完整;
- 第 7 行:默认编码,UTF-8;
- 第 16–17 行:向文本文件写入一行,后面跟一个换行符;
- 第 22 行:[Files.size] 方法返回文件的大小(以字节为单位)。这 18 个字节的构成如下:16 个字符,加上两个单字节的换行符(在运行测试的 Linux 上为"\n";在 Windows 上,每个"\r\n"换行符会占用 2 个字节);
- 第 24 行:为什么用 [try / catch]?我们可能使用形如 [folder1/folder2/file] 的文件名,而名为 [folder1/folder2] 的文件夹并不存在,因而无法创建文件。这时将抛出一个派生自 [NoSuchFileException] 的异常,即 [IOException]。还有其他可能的异常情形(磁盘已满、权限不足等)。无论如何,编译器都要求处理由 [newBufferedWriter] 、[write] 或 [size] 抛出的受检异常 [IOException]。
5.6.3. Files 和 Path 类
对于常见操作,工具类 [Files] 使你无需处理流:一个方法就能打开文件,完整地读取或写入它,然后关闭它。它还允许创建、复制、移动和删除文件与文件夹。[Path] 接口负责处理路径。
方法 | 作用 |
[Files.readString(path)] | 以字符串形式返回文件的内容(Java 11) |
[Files.readAllLines(path)] | 以列表 [List<String>] 的形式返回文件的各行 |
[Files.lines(path)] | 以流([Stream<String>])的形式返回文件的各行,该流按需读取,使用后必须关闭 |
[Files.writeString(path, text, options...)] | 创建(或覆盖)文件并向其写入 [text] (Java 11);使用 [StandardOpenOption.APPEND] 选项时,把文本追加到文件末尾 |
[Files.write(path, lines, options...)] | 写入一个行的集合,每行后面跟一个换行符 |
[Files.readAllBytes(path)],[Files.write(path, bytes)] | 以字节数组的形式读取和写入文件 |
[Files.exists(path)],[Files.size(path)],[Files.delete(path)],[Files.copy(source, target)], [Files.move(source, target)] | 检查文件是否存在、返回其大小、删除、复制、移动 |
[Files.createDirectories(path)] | 创建文件夹及其不存在的父文件夹 |
[Files.list(folder)], [Files.walk(folder)] | 以 [Stream<Path>] 流的形式返回文件夹的元素及其整个树形结构 |
[path.resolve(other)] | 通过将 [other] 追加到 [path] 来构建路径,使用系统分隔符 |
[path.getFileName()],[path.getParent()],[path.toAbsolutePath()] | 文件名、所在文件夹和完整路径 |
程序 [Files03.java] 使用了它们:
| // Path 和 Files 类
void main() throws IOException {
// resolve 用系统分隔符构建路径(Windows 上为 \,Linux 上为 /)
Path folder = Path.of("data");
Path path = folder.resolve("cities.txt");
String name = path.getFileName().toString();
IO.println("path=" + path + ", name=" + name + ", folder=" + path.getParent()
+ ", without extension=" + name.substring(0, name.lastIndexOf('.')));
// createDirectories 在文件夹(及其父文件夹)不存在时创建它
Files.createDirectories(folder);
// writeString:用给定文本创建(或覆盖)文件,使用 UTF-8
Files.writeString(path, "Angers\nNantes\n");
// 使用 APPEND 选项写入:在文件末尾添加行
Files.write(path, List.of("Paris", "Lyon"), StandardOpenOption.APPEND);
// readAllLines:所有行放入一个列表
List<String> lines = Files.readAllLines(path);
IO.println("readAllLines : " + lines.size() + " lines " + lines);
// readString:整个文件放入一个字符串
IO.println("readString : " + Files.readString(path).length() + " characters");
// lines:按需读取行的流,使用后需要关闭
try (Stream<String> stream = Files.lines(path)) {
stream.filter(l -> l.startsWith("N") || l.startsWith("L"))
.forEach(city -> IO.println("lines + filter : " + city));
}
// 编码:默认 UTF-8;也可以指定其他编码
String text = "café";
Files.writeString(folder.resolve("utf8.txt"), text);
Files.writeString(folder.resolve("utf8bom.txt"), "\uFEFF" + text);
Files.writeString(folder.resolve("latin1.txt"), text, StandardCharsets.ISO_8859_1);
HexFormat hex = HexFormat.of().withUpperCase();
for (String file : List.of("utf8.txt", "utf8bom.txt", "latin1.txt")) {
byte[] bytes = Files.readAllBytes(folder.resolve(file));
IO.println("%-12s: %2d bytes: %s".formatted(file, bytes.length, hex.formatHex(bytes)));
}
// 用 UTF-8 重新读取 Latin-1 文件:readString 会拒绝无效字节
Path latin1 = folder.resolve("latin1.txt");
try {
IO.println(Files.readString(latin1));
} catch (MalformedInputException e) {
IO.println("latin1.txt read as UTF-8: " + e.getClass().getSimpleName() + " : " + e.getMessage());
}
// new String(bytes, UTF_8) 把每个无效字节替换为 � 字符
IO.println("latin1.txt decoded as UTF-8: "
+ new String(Files.readAllBytes(latin1), StandardCharsets.UTF_8));
IO.println("latin1.txt read as Latin-1: " + Files.readString(latin1, StandardCharsets.ISO_8859_1));
// 读取时不会去掉 BOM:它只是多出的一个字符
IO.println("utf8bom.txt : " + Files.readString(folder.resolve("utf8bom.txt")).length() + " characters");
// exists、list
IO.println("exists(cities.txt)=" + Files.exists(path) + ", exists(xx.txt)="
+ Files.exists(folder.resolve("xx.txt")));
try (Stream<Path> files = Files.list(folder)) {
for (Path file : files.sorted().toList()) {
IO.println(" %-12s %3d bytes".formatted(file.getFileName(), Files.size(file)));
}
}
// 清理:文件夹必须为空才能删除;先删除其内容
try (Stream<Path> tree = Files.walk(folder)) {
for (Path p : tree.sorted(Comparator.reverseOrder()).toList()) {
Files.delete(p);
}
}
IO.println("after deletion: exists(data)=" + Files.exists(folder));
}
|
结果:
| > java Files03.java
path=data/cities.txt, name=cities.txt, folder=data, without extension=cities
readAllLines : 4 lines [Angers, Nantes, Paris, Lyon]
readString : 25 characters
lines + filter : Nantes
lines + filter : Lyon
utf8.txt : 5 bytes: 636166C3A9
utf8bom.txt : 8 bytes: EFBBBF636166C3A9
latin1.txt : 4 bytes: 636166E9
latin1.txt read as UTF-8: MalformedInputException : Input length = 1
latin1.txt decoded as UTF-8: caf�
latin1.txt read as Latin-1: café
utf8bom.txt : 5 characters
exists(cities.txt)=true, exists(xx.txt)=false
cities.txt 25 bytes
latin1.txt 4 bytes
utf8.txt 5 bytes
utf8bom.txt 8 bytes
after deletion: exists(data)=false
|
注释:
- 第 2 行:[Files] 中的方法会抛出 [IOException]。为了使这个演示程序保持简洁,[main] 方法使用 [throws IOException] 子句声明它们,而不是拦截它们:出错时程序会终止并显示异常;
- 第 4–8 行:[resolve] 使用系统的路径分隔符。课程中的运行是在 Linux 上进行的:得到的路径是 [data/cities.txt];在 Windows 上则是 [data\cities.txt]。使用 [resolve] (或 [Path.of("data", "cities.txt")])构建路径,而不是拼接字符串,可以使代码具有可移植性。由于 [Path] 没有返回文件扩展名的方法,因此使用 [lastIndexOf] 将扩展名与名称分开;
- 第 11 行:创建文件夹 [data] 时,如果它已存在,不会导致错误;
- 第 14–21 行:写入、追加和读取,每一项都只需一条语句;
- 第 23–26 行:[Files.lines] 返回一个流:各行在程序处理时被逐一读取。你可以对它应用 Stream API,从而处理几 GB 大小的文件而无需将其加载到内存中,而 [readAllLines] 则会这样做。该流会保持文件处于打开状态:必须将其关闭,因此使用带资源的 [try] 语句([Stream] 实现了 [AutoCloseable]);
- 第 29–37 行:同一段文本“café”使用三种编码写入,然后使用 [HexFormat] 类(Java 17)以十六进制显示文件中的字节:
- 在 Java 的默认编码 UTF-8 中,带重音的字符占 2 个字节(é = C3 A9),其他字符占 1 个字节:4 个字符共 5 个字节;
- 在带 BOM(字节顺序标记,Byte Order Mark)的 UTF-8 中,文件以 3 个字节 EF BB BF 开头,向软件表明该文件采用 UTF-8 编码。Java 从不自行写入 BOM:它是通过在文本开头写入字符 U+FEFF 得到的,记作 ["\uFEFF"];
- 在 Latin-1(ISO-8859-1)这种西欧文本的传统编码中,每个字符占一个字节(é = E9);
- 第 39–44 行:使用与写入时不同的编码读取文件会破坏带重音的字符:文件末尾的字节 E9 在 UTF-8 中是无效的。[Files.readString] 和 [Files.readAllLines] 会通过抛出 [MalformedInputException] 异常(派生自 [IOException])来拒绝这样的文件;
- 第 46–47 行:[new String(bytes, encoding)] 构造函数将字节数组转换为字符串时没有那么严格:每个无效字节都会被替换为字符 �。[InputStreamReader] 的行为也一样;相比之下,由 [BufferedReader] 返回的 [Files.newBufferedReader] 是严格的,与 [Files.readString] 一样,并且也会抛出 [MalformedInputException];
- 第 48 行:使用正确的编码读取时,文件内容是正确的;
- 第 50 行:读取时,Java 不识别 BOM:它被当作文本开头的一个不可见字符读入,因此文本有 5 个字符而不是 4 个。如果需要读取带 BOM 的 UTF-8 文件(由某些 Windows 软件生成),必须自己去掉这个字符。如今的规则很简单:以不带 BOM 的 UTF-8 写入和读取文本文件;
- 第 53–59 行:文件夹中的文件。[Files.list] 返回一个必须关闭的流,与 [Files.lines] 返回的流一样,并且不保证名称的顺序:[sorted] 对它们排序;
- 第 62–67 行:删除文件夹。[Files.delete] 拒绝删除非空文件夹:我们使用 [Files.walk] 遍历整个目录树,并将路径按逆序排序([Comparator.reverseOrder()]),以便先删除文件夹的内容,再删除文件夹本身。
[Files] 的方法会阻塞调用它们的线程,直到操作完成。在介绍异步编程的第 9 章中,我们将看到如何在长时间 I/O 操作期间避免阻塞程序。
5.7. 二进制文件
类 [java.io.DataOutputStream] 和 [java.io.DataInputStream] 用于写入和读取二进制文件。在这种文件中,数据不是以文本形式写入,而是以其内部形式写入:[int] 无论其值是多少,始终占 4 个字节。它们是字节流:派生自类 [OutputStream] 和 [InputStream],而文本流派生自 [Writer] 和 [Reader]。
考虑以下应用程序:
| // syntax: java Files04.java text binary logs
// we read a text file (text) and store its content in a binary file (binary)
// the text file has lines of the form name : age which are written as (String, int)
// (logs) is a text file of logs
|
文本文件 [persons1.txt] 的内容如下:
| paul : 10
helene : 15
jacques : 11
sylvain : 12
xx : -1
xx: yy : zz
xx : yy
|
程序 [Files04.java] 如下:
| // 语法:java Files04.java text binary logs
// 我们读取一个文本文件(text)并把其内容存入二进制文件(binary)
// 文本文件的各行形如 name : age,它们被写成(String, int)
// (logs)是日志文本文件
void main(String[] args) {
// 需要 3 个参数
if (args.length != 3) {
IO.println("syntax: java Files04.java text binary logs");
System.exit(1);
}
// 打开这三个文件;它们将在 try 结束时按相反顺序关闭
try (BufferedReader input = Files.newBufferedReader(Path.of(args[0]));
DataOutputStream output = new DataOutputStream(
new BufferedOutputStream(Files.newOutputStream(Path.of(args[1]))));
PrintWriter logs = new PrintWriter(Files.newBufferedWriter(Path.of(args[2])))) {
// 处理文本文件
String line;
int lineNumber = 0, nbPersons = 0;
while ((line = input.readLine()) != null) {
// 多了一行
lineNumber++;
// 空行?忽略它
if (line.isBlank()) {
continue;
}
// 一行 name : age
String[] fields = line.strip().split("\\s*:\\s*");
// 需要 2 个字段
if (fields.length != 2) {
logs.println("Line no. [" + lineNumber + "] of the file [" + args[0]
+ "] has an incorrect number of fields");
continue;
}
// 第 1 个字段不能为空
boolean error = false;
String name = fields[0];
if (name.isEmpty()) {
logs.println("Line no. [" + lineNumber + "] of the file [" + args[0] + "] has an empty name");
error = true;
}
// 第二个字段必须是 >= 0 的整数
int age = integer(fields[1]);
if (age < 0) {
logs.println("Line no. [" + lineNumber + "] of the file [" + args[0] + "] has an incorrect age ["
+ fields[1] + "]");
error = true;
}
// 如果没有错误,数据被写入二进制文件
if (!error) {
output.writeUTF(name);
output.writeInt(age);
nbPersons++;
}
}
IO.println(lineNumber + " lines read, " + nbPersons + " persons written to [" + args[1]
+ "], errors in [" + args[2] + "]");
} catch (NoSuchFileException e) {
IO.println("The file [" + e.getFile() + "] does not exist");
System.exit(2);
} catch (IOException e) {
IO.println("The following error occurred: " + e);
System.exit(3);
}
}
// 正整数或零,如果字符串不是则为 -1
int integer(String field) {
try {
return Integer.parseInt(field);
} catch (NumberFormatException e) {
return -1;
}
}
|
让我们仔细看看与类 [DataOutputStream] 相关的操作:
- 第 13–14 行:[DataOutputStream] 对象是围绕另一个字节流构建的,遵循嵌套流 (“装饰器”设计模式)的原则:
- [Files.newOutputStream(Path.of(args[1]))] 向文件写入字节流,文件会被创建,如果已存在则被清空;
- [BufferedOutputStream] 为它增加一个缓冲区,以免每次写入都访问磁盘;
- [DataOutputStream] 增加了用于写入基本数据类型的方法;
- 第 50–51 行:写入操作。[DataOutputStream] 类为每种简单数据类型都提供一个方法:[writeInt]、[writeDouble]、[writeLong]、[writeBoolean]、[writeUTF] 用于字符串……;
- 第 12–15 行:这三个流在同一个带资源的 [try] 语句中打开,它们的声明用分号分隔。它们将在 [try] 块结束时,按与打开相反的顺序关闭。关闭最外层的流([DataOutputStream])会同时关闭它所包含的流。日志文件通过 [PrintWriter] 写入,以便使用 [println] 方法;
- 第 27 行:分隔符是字符 [:],其前后可以有任意数量的空格,这些空格会一并被去除;
- 第 42–47 行:年龄必须是正整数或零。Java 没有在出错时不抛出异常就能把字符串转换为整数的方法:方法 [integer] (第 67–73 行)捕获异常 [NumberFormatException] 并返回 -1,这是年龄的一个无效值;
- 第 9、59、62 行:[System.exit(n)] 以退出码 n 终止程序,脚本可以检查该退出码(0 表示成功;这也是 [main] 方法正常结束的程序的退出码)。
程序的三个参数在 [java] 命令中跟在源文件名之后传入。结果如下:
| > java Files04.java persons1.txt persons1.bin logs.txt
9 lines read, 4 persons written to [persons1.bin], errors in [logs.txt]
|
日志文件 [logs.txt] 的内容如下:
| > cat logs.txt
Line no. [6] of the file [persons1.txt] has an incorrect age [-1]
Line no. [8] of the file [persons1.txt] has an incorrect number of fields
Line no. [9] of the file [persons1.txt] has an incorrect age [yy]
|
二进制文件 [persons1.bin] 的内容可以使用 Linux 命令 [od] 以十六进制显示(在 Windows 上,PowerShell 命令 [Format-Hex] 会产生类似的显示):
| > od -A d -t x1z persons1.bin
0000000 00 04 70 61 75 6c 00 00 00 0a 00 06 68 65 6c 65 >..paul......hele<
0000016 6e 65 00 00 00 0f 00 07 6a 61 63 71 75 65 73 00 >ne......jacques.<
0000032 00 00 0b 00 07 73 79 6c 76 61 69 6e 00 00 00 0c >.....sylvain....<
0000048
|
由此可以看出 [DataOutputStream] 是如何写入数据的:
- 字符串由 [writeUTF] 写入,前面是以 2 个字节表示的字节长度:00 04,后面是“paul”的 4 个字节(70 61 75 6c)。字符使用 UTF-8 的一种变体编码;
- 整数 [int] 以 4 个字节写入,最高有效字节在前(称为“大端”顺序,用于网络协议):10 被写为 00 00 00 0a。这种格式在所有机器上都相同:在 Windows 上由 [DataOutputStream] 写入的文件可以在 Linux 上读取;
- 数据是连续写入的,没有任何分隔符或换行符:文件长度为 48 个字节(第 5 行:使用 [-A d] 选项时,[od] 以十进制显示位置)。
因此,要读取这个文件,必须知道所写数据的确切顺序和类型。对于 [writeXX] 的每个 [DataOutputStream] 方法,类 [DataInputStream] 都有一个对应的方法 [readXX]:[readUTF]、[readInt]、[readDouble]……但是,它无法指出还剩多少字节要读取:由 [DataInputStream] 读取的文件必须以其包含的记录数开头,或者一直读取到出现 [EOFException] 异常为止,该异常表示流已结束。然而,异常应当保持其“异常”的本意,而文件结束并不是异常情况。
5.7.2. RandomAccessFile 类
[java.io.RandomAccessFile] 类使用直接访问方式读写文件:在读取或写入之前,可以把读写头定位到文件中的任意位置。它具有与 [DataInputStream] 和 [DataOutputStream] 相同的读写方法(它实现了相同的接口 [DataInput] 和 [DataOutput]),此外还有:
方法 | 作用 |
[RandomAccessFile(String name, String mode)] | 以只读方式([mode] 为 "r")或读写方式("rw")打开文件 |
[long length()] | 文件大小,以字节为单位 |
[long getFilePointer()] | 文件中的当前位置 |
[void seek(long pos)] | 移动到文件中的位置 [pos] |
程序 [Files05.java] 执行与前一个程序相反的操作:它读取二进制文件来创建文本文件。如果生成的文本文件包含原始文件中的正确数据,就说明文本 → 二进制 → 文本的转换成功。
| // 语法:java Files05.java binary text
// 我们读取一个二进制文件(binary)并把其内容存入文本文件(text)
// 二进制文件包含(String, int)对
// 文本文件的各行形如 name:age
void main(String[] args) {
// 需要 2 个参数
if (args.length != 2) {
IO.println("syntax: java Files05.java binary text");
System.exit(1);
}
// 以读取方式("r")打开二进制文件,以写入方式打开文本文件
try (RandomAccessFile input = new RandomAccessFile(args[0], "r");
PrintWriter output = new PrintWriter(Files.newBufferedWriter(Path.of(args[1])))) {
// 处理二进制文件,直到到达文件末尾
int nbPersons = 0;
while (input.getFilePointer() < input.length()) {
// 先读取姓名,再读取年龄:按写入时的顺序
String name = input.readUTF();
int age = input.readInt();
// 写入文本文件
output.println(name + ":" + age);
nbPersons++;
}
IO.println(nbPersons + " persons read from [" + args[0] + "] and written to [" + args[1] + "]");
// 随机访问:回到文件开头并重新读取第一个人
input.seek(0);
IO.println("first person: " + input.readUTF() + ", " + input.readInt() + " years old");
} catch (EOFException e) {
// 文件在某条记录中间结束
IO.println("The file [" + args[0] + "] is truncated");
System.exit(2);
} catch (FileNotFoundException e) {
// RandomAccessFile 通过 FileNotFoundException 报告文件缺失
IO.println(e.getMessage());
System.exit(3);
} catch (IOException e) {
IO.println("The following error occurred: " + e);
System.exit(4);
}
}
|
让我们仔细看看涉及 [RandomAccessFile] 类的操作:
- 第 12 行:[RandomAccessFile] 对象以只读模式(“r”模式)打开;
- 第 18–19 行:读取操作 [readUTF] 和 [readInt]。它们必须按写入的顺序调用;
- 第 16 行:持续读取,直到文件中的当前位置到达文件末尾;
- 第 26–27 行:直接访问:[seek] 将位置重置到文件开头,并再次读取第一条记录。如果所有记录大小相同,就可以通过移动到位置 n × 大小直接读取第 n 条记录:这就是直接访问文件的原理,它们是数据库的前身;
- 第 28 行:异常 [EOFException] 现在表示一种真正的异常情况:文件在一条记录的中间结束;
- 第 32 行:[RandomAccessFile] 是 [java.io] 的子类,它通过 [FileNotFoundException] 来表示文件缺失,该异常的消息由系统提供,其中包含文件名。
让我们在前面生成的 [persons1.bin] 文件上运行该程序:
| > java Files05.java persons1.bin persons2.txt
4 persons read from [persons1.bin] and written to [persons2.txt]
first person: paul, 10 years old
|
[persons2.txt] 的内容如下:
| > cat persons2.txt
paul:10
helene:15
jacques:11
sylvain:12
|
我们从文件 [persons1.txt] 中找回了 4 个有效的人员。对于由 [truncated.bin] 文件(由 [persons1.bin] 的前 33 个字节组成),读取 Jacques 的年龄会失败:
| > java Files05.java truncated.bin truncated.txt
The file [truncated.bin] is truncated
|
而对于一个不存在的文件:
| > java Files05.java xx.bin xx.txt
xx.bin (No such file or directory)
|
Java 还有一种对象的二进制序列化 机制:类 *[ObjectOutputStream] 和 [ObjectInputStream] 可以写入和读取整个对象,前提是其类实现了 *[java.io.Serializable] 接口。这种机制现在已被弃用:对来自不受信任来源的数据进行反序列化已引发了大量攻击,因为反序列化可以执行攻击者选定的代码。人们转而更倾向于使用 JSON 这样的文本格式。不过,[Serializable] 接口仍然存在于许多类中,特别是异常,它们从 [Throwable] 类继承了它:因此,在使用 [-Xlint:all] 选项时,编译器要求它们声明一个 [serialVersionUID] 字段,我们将在示例应用程序中看到这一点。
5.7.3. 使用 Jackson 进行 JSON 序列化
一次一个数据项地写入和读取二进制文件很繁琐,而且写入与读取之间哪怕最细微的差异都会产生错误的结果。通常更好的做法是序列化 对象:把它们自动转换为字符序列,然后再反序列化它们以重建对象。
JSON(JavaScript Object Notation)是一种基于文本、人类可读的通用格式:它是 Web 服务(第 13 章)和许多配置文件的交换格式。对象写在花括号内,由 "property": value 键值对组成,或者写成用方括号括起来的数组。
Java 标准库无法读写 JSON,需要使用外部库;最常用的是 Jackson,Spring Boot 默认使用它。版本 3(2025 年)更改了包名:[tools.jackson.*] 取代了版本 2 的 [com.fasterxml.jackson.*] (版本 2 目前仍然很常见);它的注解仍位于 [com.fasterxml.jackson.annotation] 包中。外部库通过 Maven(第 2 章)获取:因此该程序是一个 Maven 项目,[Files06],其目录结构如下:
| 05-classes-java/
Files06/
pom.xml
src/main/java/json/
Files06.java
|
文件 [pom.xml] 声明了对 Jackson 的依赖:
| <?xml version="1.0" encoding="UTF-8"?>
<project xmlns="http://maven.apache.org/POM/4.0.0"
xmlns:xsi="http://www.w3.org/2001/XMLSchema-instance"
xsi:schemaLocation="http://maven.apache.org/POM/4.0.0 https://maven.apache.org/xsd/maven-4.0.0.xsd">
<modelVersion>4.0.0</modelVersion>
<groupId>examples.classes</groupId>
<artifactId>files06</artifactId>
<version>1.0</version>
<properties>
<maven.compiler.release>25</maven.compiler.release>
<project.build.sourceEncoding>UTF-8</project.build.sourceEncoding>
</properties>
<dependencies>
<!-- Jackson 3:JSON 序列化 -->
<dependency>
<groupId>tools.jackson.core</groupId>
<artifactId>jackson-databind</artifactId>
<version>3.1.5</version>
</dependency>
</dependencies>
<build>
<plugins>
<plugin>
<groupId>org.apache.maven.plugins</groupId>
<artifactId>maven-compiler-plugin</artifactId>
<version>3.15.0</version>
<configuration>
<parameters>true</parameters>
<compilerArgs>
<arg>-Xlint:all</arg>
</compilerArgs>
</configuration>
</plugin>
<!-- mvn exec:java 运行主类 -->
<plugin>
<groupId>org.codehaus.mojo</groupId>
<artifactId>exec-maven-plugin</artifactId>
<version>3.5.1</version>
<configuration>
<mainClass>json.Files06</mainClass>
</configuration>
</plugin>
</plugins>
</build>
</project>
|
注释:
- 第 7–9 行:项目详细信息;
- 第 11–14 行:Java 版本和源文件的编码;
- 第 16–23 行:对 [jackson-databind] 库的依赖。Maven 从中央仓库(Maven Central)下载它,以及它自身所依赖的库([jackson-core] 和 [jackson-annotations]);
- 第 27–37 行:编译器,其配置与课程中所有项目相同:启用警告([-Xlint:all])并在编译后的代码中保留参数名;
- 第 39–46 行:插件 [exec-maven-plugin],它使用命令 [mvn exec:java] 执行主类。
Jackson 中的核心对象是 [JsonMapper],它有两个主要方法:
方法 | 作用 |
[String writeValueAsString(Object value)] | 返回表示对象 [value] 的 JSON 文本 |
[<T> T readValue(String content, Class<T> valueType)] | 根据 JSON 文本 [content] 重建 [T] 类型的对象;如果文本不正确,则抛出 [JacksonException] 。有一个重载方法接收 [TypeReference] 而不是 [Class] |
程序 [Files06.java] 使用了它们:
| package json;
import com.fasterxml.jackson.annotation.JsonProperty;
import java.io.IOException;
import java.math.BigDecimal;
import java.nio.file.Files;
import java.nio.file.Path;
import java.util.List;
import tools.jackson.core.JacksonException;
import tools.jackson.core.json.JsonWriteFeature;
import tools.jackson.core.type.TypeReference;
import tools.jackson.databind.MapperFeature;
import tools.jackson.databind.SerializationFeature;
import tools.jackson.databind.json.JsonMapper;
// 用 Jackson 3 进行 JSON 序列化
public class Files06 {
// 一个人:记录,其组件成为 JSON 属性
record Person(String name, int age, List<String> hobbies) {
}
// 一篇文章:@JsonProperty 注解设置 JSON 属性的名称
record Article(@JsonProperty("reference") String code, BigDecimal price) {
}
public static void main(String[] args) throws IOException {
List<Person> persons = List.of(
new Person("paul", 10, List.of("football")),
new Person("hélène", 15, List.of("piano", "tennis")),
new Person("jacques", 11, List.of()));
// 1 - 使用默认配置的 JsonMapper:只需一行
JsonMapper mapper = JsonMapper.builder().build();
String json = mapper.writeValueAsString(persons.get(1));
IO.println("[default] " + json);
// 非 ASCII 字符可以被转义
JsonMapper ascii = JsonMapper.builder().enable(JsonWriteFeature.ESCAPE_NON_ASCII).build();
IO.println("[ESCAPE_NON_ASCII] " + ascii.writeValueAsString(persons.get(1)));
// 2 - 一个选项:缩进
JsonMapper indented = JsonMapper.builder().enable(SerializationFeature.INDENT_OUTPUT).build();
json = indented.writeValueAsString(persons);
// 写入文本文件
Path file = Path.of("persons.json");
Files.writeString(file, json);
IO.println("[persons.json]");
IO.println(Files.readString(file));
// 3 - 反序列化:从 JSON 文本到对象
String text = Files.readString(file);
// TypeReference 将完整类型 List<Person> 传给 Jackson
List<Person> readBack = mapper.readValue(text, new TypeReference<List<Person>>() {
});
IO.println("[read back] " + readBack.size() + " persons");
for (Person p : readBack) {
IO.println(" " + p.name() + ", " + p.age() + " years old, hobbies: " + p.hobbies());
}
// 4 - 由注解设置的属性名
String jsonArticle = mapper.writeValueAsString(new Article("A12", new BigDecimal("12.5")));
IO.println("[@JsonProperty] " + jsonArticle);
// 读取时可以忽略属性名的大小写
JsonMapper caseMapper = JsonMapper.builder()
.enable(MapperFeature.ACCEPT_CASE_INSENSITIVE_PROPERTIES)
.build();
Article article = caseMapper.readValue("""
{ "REFERENCE": "B7", "Price": 3 }""", Article.class);
IO.println("[ACCEPT_CASE_INSENSITIVE_PROPERTIES] " + article);
// 5 - 不正确的 JSON 文档会引发 JacksonException
try {
mapper.readValue("""
{ "name": "x", "age": "twelve" }""", Person.class);
} catch (JacksonException e) {
IO.println("[error] " + e.getClass().getSimpleName() + " : " + e.getOriginalMessage());
IO.println("[error] line " + e.getLocation().getLineNr() + ", column "
+ e.getLocation().getColumnNr() + ", path: " + e.getPathReference());
}
}
}
|
在项目文件夹中使用命令 [mvn compile exec:java] 运行它,或从 IDE 中运行。我们不重现 Maven 的消息,只给出程序的输出:
| > mvn compile exec:java
[default] {"name":"hélène","age":15,"hobbies":["piano","tennis"]}
[ESCAPE_NON_ASCII] {"name":"h\u00E9l\u00E8ne","age":15,"hobbies":["piano","tennis"]}
[persons.json]
[ {
"name" : "paul",
"age" : 10,
"hobbies" : [ "football" ]
}, {
"name" : "hélène",
"age" : 15,
"hobbies" : [ "piano", "tennis" ]
}, {
"name" : "jacques",
"age" : 11,
"hobbies" : [ ]
} ]
[read back] 3 persons
paul, 10 years old, hobbies: [football]
hélène, 15 years old, hobbies: [piano, tennis]
jacques, 11 years old, hobbies: []
[@JsonProperty] {"reference":"A12","price":12.5}
[ACCEPT_CASE_INSENSITIVE_PROPERTIES] Article[code=B7, price=3]
[error] InvalidFormatException : Cannot deserialize value of type `int` from String "twelve": not a valid `int` value
[error] line 1, column 23, path: json.Files06$Person["age"]
|
注释:
- 第 1 行:在 Maven 项目中,类被组织到包中:包 [Files06] 中的类 [json] 位于文件 [src/main/java/json/Files06.java] 中;
- 第 3–14 行:与紧凑源文件不同,常规类必须导入它所使用的类,包括标准库中的类;
- 第 20–21 行:要序列化的 [Person] 记录,声明在 [Files06] 类中。Jackson 3 可以序列化记录:每个组件都成为一个同名的 JSON 属性;
- 第 24–25 行:注解 [@JsonProperty] 将组件的 JSON 属性名设置为 [reference] 而不是 [code];
- 第 27 行:方法 [main] 是类的静态方法。它声明了异常 [IOException],该异常可能由 [Files] 的方法抛出;
- 第 34–36 行:[JsonMapper] 由对象构建器创建:[JsonMapper.builder()] 返回一个对象,在其上指定所需的选项,然后 [build] 创建 [JsonMapper]。使用默认选项时,文本写在一行上,带重音的字符按原样写入(结果的第 2 行);
- 第 38–39 行:[ESCAPE_NON_ASCII] 选项指示系统将非 ASCII 字符写成转义序列:[é] 变为 [\u00E9]。文本仍然是正确的,但难以阅读;当 JSON 文本必须经过只识别 ASCII 的系统时,这很有用;
- 第 42–43 行:选项 [INDENT_OUTPUT] 生成带缩进、分布在多行上的文本。列表被序列化为 JSON 数组;
- 第 45–48 行:JSON 文本被写入文本文件,然后读回并显示:如今二进制序列化就是这样被取代的;
- 第 53–54 行:反序列化重建列表。Jackson 通过调用记录的构造函数来创建 [Person] 对象,构造函数的参数与同名的 JSON 属性相关联。对于列表,必须向 Jackson 指定其元素的类型。然而,表达式 [List<Person>.class] 并不存在:Java 泛型在编译时被擦除 (“类型擦除”),在运行时只有一个 [List] 类,没有任何类型参数。使用
[TypeReference] 的技巧是创建一个匿名类([new TypeReference<List<Person>>() { }]***),它派生自 [TypeReference<List<Person>>]***:类的父类型会保留在编译后的代码中,Jackson 可以读取它。对于数组则更简单,我们写 [Person[].class];
- 第 61–62 行:序列化一个 [Article]:属性 [reference] 使用注解指定的名称。[BigDecimal] 被写成 JSON 数值;
- 第 64–69 行:使用 [ACCEPT_CASE_INSENSITIVE_PROPERTIES] 选项时,Jackson 在解析时忽略属性名的大小写:[REFERENCE] 和 [Price] 都被接受;
- 第 72–79 行:无效的 JSON 文档(这里是在期望数字的位置出现了字符串)会触发派生自 [JacksonException] 的异常,这里是 [InvalidFormatException]。在 Jackson 3 中,这些异常是非受检的 (它们派生自 [RuntimeException]),而在 Jackson 2 中它们派生自 [IOException]。[getOriginalMessage] 返回不含位置信息的消息,位置信息由 [getLocation] 和 [getPathReference] 分别提供:第 1 行,第 23 列,记录 [age] 的属性 [Person]。
创建 [JsonMapper] 的代价很高,但一旦创建,它就可以重复使用,并且可以在多个线程之间共享:程序通常只创建一个,并将其存储在常量中。我们将在后面的示例应用程序以及整个课程中使用 JSON。
5.8. 正则表达式
[java.util.regex] 包支持使用正则表达式。它们可以用来验证字符串的格式。例如,可以验证表示日期的字符串确实是 dd/mm/yy 格式。为此,使用一个模式 ,并将字符串与该模式进行比较。在这个例子中,d、m 和 y 必须是数字。因此,有效日期格式的模式是 [\d\d/\d\d/\d\d], ,其中符号 [\d] 表示一个数字。模式中可以使用的符号如下:
字符 | 说明 |
[\] | 将其后的字符标记为特殊字符或字面字符。例如,[n] 对应字符 n,[\n] 对应换行符,[\\] 对应 \,而 [\(] 对应 ( |
[^] | 对应字符串的开头 |
[$] | 对应字符串的结尾 |
[*] | 匹配前面的元素零次或多次。因此,[zo*] 匹配 z 或 zoo |
[+] | 匹配前面的元素一次或多次。因此,[zo+] 匹配 "zoo",但不匹配 "z" |
[?] | 匹配前面的元素零次或一次。例如,[a?ve?] 匹配 "lever" 中的 "ve" |
[.] | 匹配除换行符以外的任何单个字符 |
[(pattern)] | 搜索该模式并存储匹配结果(一个组)。可以使用 [group] 方法从结果中提取匹配的子字符串。要匹配圆括号字符,请使用 [\(] 或 [\)] |
[x|y] | 匹配 x 或 y。例如,[z|foot] 匹配 z 或 foot;[(z|f)oo] 匹配 zoo 或 foo |
[{n}] | n 是非负整数。与前一个元素恰好匹配 n 次。例如,[o{2}] 不匹配 Bob 中的 o,但匹配 fooooot 中的前两个 o |
[{n,}] | 匹配前一个元素至少 n 次。例如,[o{2,}] 不匹配 "Bob" 中的 'o',但匹配 "fooooot" 中的所有 'o'。[o{1,}] 等价于 [o+], ,而 [o{0,}] 等价于 [o*] |
[{n,m}] | 匹配前一个元素至少 n 次、至多 m 次。例如,[o{1,3}] 匹配 “foooooot” 中的前三个 “o”;[o{0,1}] 等价于 [o?] |
[[xyz]] | 字符集:匹配指定字符中的任意一个。例如,[[abc]] 匹配 “plain” 中的字母 “a” |
[[^xyz]] | 反向字符集:匹配未列出的任何字符。例如,[[^abc]] 匹配 "plain" 中的 "p" |
[[a-z]] | 字符范围:匹配指定范围内的任何字符,这里是一个不带重音的小写字母 |
[[^m-z]] | 反向字符范围:匹配不在 'm' 和 'z' 之间的任何字符 |
[\b] | 匹配单词边界,即单词字符与非单词字符之间的位置。例如,[er\b] 匹配 "lever" 中的 "er",但不匹配 "verb" 中的 "er" |
[\B] | 对应不是单词边界的位置。[en*t\B] 对应 “mentor” 中的 “ent” |
[\d] | 匹配一个数字;等价于 [[0-9]] |
[\D] | 对应不是数字的字符 |
[\f], [\n], [\r], [\t] | 分别对应换页符、换行符、回车符和制表符 |
[\s] | 对应任何空白字符:空格、制表符、换页符、换行符……等价于 [[ \t\n\x0B\f\r]] |
[\S] | 匹配任何不是空白字符的字符 |
[\w] | 匹配任何单词字符:在 Java 中默认是不带重音的字母、数字或下划线;等价于 [[a-zA-Z_0-9]]。使用 [UNICODE_CHARACTER_CLASS] 选项(见下文)时,它也能识别带重音的字母 |
[\W] | 匹配任何不是单词字符的字符 |
[\num] | num 是正整数:引用编号为 num 的组。例如,[(.)\1] 对应两个连续的相同字符 |
[\xnn],[\unnnn] | 对应十六进制字符 nn(2 位数字)或 nnnn(4 位数字)。例如,[\x41] 对应 A |
模式中的元素可以出现一次或多次。让我们看几个使用符号 [\d], (表示单个数字)的例子:
模式 | 含义 |
[\d] | 一个数字 |
[\d?] | 0 或 1 个数字 |
[\d*] | 0 个或多个数字 |
[\d+] | 1 个或多个数字 |
[\d{2}] | 2 个数字 |
[\d{3,}] | 至少 3 个数字 |
[\d{5,7}] | 5 到 7 个数字 |
现在让我们设想一种能够描述字符串预期格式的模型:
目标字符串 | 模式 |
dd/mm/yy 格式的日期 | [\d{2}/\d{2}/\d{2}] |
hh:mm:ss 格式的时间 | [\d{2}:\d{2}:\d{2}] |
无符号整数 | [\d+] |
一串空格,可以为空 | [\s*] |
前后可以有空格的无符号整数 | [\s*\d+\s*] |
可以带符号、前后可以有空格的整数 | [\s*[+-]?\s*\d+\s*] |
前后可以有空格的无符号实数 | [\s*\d+(\.\d*)?\s*] |
可以带符号、前后可以有空格的实数 | [\s*[+-]?\s*\d+(\.\d*)?\s*] |
包含单词 "just" 的字符串 | [\bjust\b] |
请注意,在方括号内,字符 [|] 没有特殊含义:有时用于表示符号的 [[+|-]] 模式也会接受数字前的字符 |。同样,小数点必须转义,即 [\.]:未转义的句点可匹配任何字符。
可以指定在字符串中的什么位置搜索该模式:
模式 | 含义 |
[^pattern] | 该模式位于字符串的开头 |
[pattern$] | 该模式位于字符串的结尾 |
[^pattern$] | 该模式同时位于字符串的开头和结尾 |
[pattern] | 在字符串中的任何位置搜索该模式,从字符串的开头开始 |
搜索字符串 | 模式 |
以感叹号结尾的字符串 | [!$] |
以句点结尾的字符串 | [\.$] |
以序列 // 开头的字符串 | [^//] |
由单个单词组成的字符串,前后可以有空格 | [^\s*\w+\s*$] |
恰好由两个单词组成的字符串,前后可以有空格 | [^\s*\w+\s+\w+\s*$] |
包含单词 "secret" 的字符串 | [\bsecret\b] |
模式的子集可以被“提取”。因此,我们不仅可以验证字符串是否与某个特定模式匹配,还可以从该字符串中提取与模式中用圆括号括起来的子集相对应的元素。例如,如果我们解析一个包含 dd/mm/yy 格式日期的字符串,并且还想从该日期中提取 dd、mm 和 yy 这几个元素,就可以使用模式 [(\d\d)/(\d\d)/(\d\d)]。
在 Java 代码中,模式写成普通字符串:模式中的每个字符 [\] 都必须重复一次。模式 [\d+] 写作 ["\\d+"],而表示 \ 字符的模式 [\\] 写作 ["\\\\"]。文本块不会改变这一点:[\] 在这里同样是转义字符。编辑器使阅读更容易:IntelliJ IDEA 能识别传给 [Pattern.compile] 的字符串,将它们高亮显示为正则表达式,并允许你测试它们。
5.8.1. 检查字符串是否与给定模式匹配
模式首先被编译 为一个 [java.util.regex.Pattern] 对象,然后由它提供负责在给定字符串中进行搜索的 [Matcher] 对象:
方法 | 作用 |
[static Pattern compile(String regex)] | 编译 [regex] 模式;如果模式无效,则抛出 [PatternSyntaxException] 异常 |
[static Pattern compile(String regex, int flags)] | 与上面相同,但带有选项(见下文) |
[Matcher matcher(CharSequence input)] | 返回一个 [Matcher] 对象,用于在 [input] 中查找该模式 |
[boolean find()] (类 [Matcher]) | 在字符串中搜索该模式的下一次出现;如果找到,则返回 [true] |
[boolean matches()] (类 [Matcher]) | 如果[true] 整个字符串与该模式匹配,则返回 true |
[static boolean matches(String regex, CharSequence input)] | 编译该模式并检查整个字符串是否与之匹配 |
程序 [Regex01.java] 如下:
| // 检查字符串是否匹配某个模式
void main() {
String pattern1 = "^\\s*\\d+\\s*$";
Pattern regex1 = Pattern.compile(pattern1);
// 将样本与模式进行比较
for (String sample : List.of(" 123 ", " 123a ", "4567")) {
if (regex1.matcher(sample).find()) {
IO.println("[" + sample + "] matches the pattern [" + pattern1 + "]");
} else {
IO.println("[" + sample + "] does not match the pattern [" + pattern1 + "]");
}
}
// find 在字符串中搜索该模式;matches 要求整个字符串都匹配
Pattern number = Pattern.compile("\\d+");
IO.println("find(\"abc 123\") : " + number.matcher("abc 123").find()
+ ", matches(\"abc 123\") : " + number.matcher("abc 123").matches());
// 静态方法 Pattern.matches 和 String 的 matches 方法:整个字符串
IO.println("Pattern.matches(date, \"18/05/97\") : "
+ Pattern.matches("\\d{2}/\\d{2}/\\d{2}", "18/05/97"));
IO.println("\"5/1/01\".matches(date) : " + "5/1/01".matches("\\d{2}/\\d{2}/\\d{2}"));
}
|
结果:
| > java Regex01.java
[ 123 ] matches the pattern [^\s*\d+\s*$]
[ 123a ] does not match the pattern [^\s*\d+\s*$]
[4567] matches the pattern [^\s*\d+\s*$]
find("abc 123") : true, matches("abc 123") : false
Pattern.matches(date, "18/05/97") : true
"5/1/01".matches(date) : false
|
注释:
- 第 3 行:无符号整数的模式,其前后可以有空格,并且占据整个字符串(锚点 [^] 和 [$])。其中的 [\] 都写了两遍;
- 第 4 行:模式的编译;
- 第 7 行:[find] 在字符串中搜索该模式。前后有空格的字符串“123a”与该模式不匹配:字符“a”既不是数字也不是空格。如果没有锚点 [^] 和 [$],该字符串就会匹配,因为它包含一个数字;
- 第 14–16 行:[find](在字符串内部搜索模式)与 [matches](要求整个字符串与模式匹配,就好像它被 [^] 和 [$] 所界定)之间的区别;
- 第 18–20 行:静态方法 [Pattern.matches] 和类 [matches] [String] 的方法同样测试整个字符串。它们在每次调用时都会编译模式:虽然对独立的测试很有用,但应避免在循环中使用。我们已经遇到过的 [split] 方法(属于 [String])同样会在每次调用时编译其模式,但由单个普通字符构成的分隔符除外,它在处理这种分隔符时不使用正则表达式。
5.8.2. 在字符串中查找模式的所有出现位置
[find] 对象的 [Matcher] 方法可以被多次调用:每次调用都搜索该模式的下一次出现。调用成功之后,[Matcher] 对象会提供有关所找到的出现位置的信息:
- [group()]:该出现位置的文本,即与模式匹配的元素;
- [start()]:该元素在被搜索字符串中被找到的位置;[end()]:该元素之后的位置。
程序 [Regex02.java] 如下:
| // 在字符串中找出某个模式的所有出现位置
void main() {
String pattern2 = "\\d+";
Pattern regex2 = Pattern.compile(pattern2);
String sample3 = " 123 456 789 ";
IO.println("Pattern=[" + pattern2 + "], sample=[" + sample3 + "]");
// find 逐个出现位置向前推进
Matcher matcher = regex2.matcher(sample3);
int nbOccurrences = 0;
while (matcher.find()) {
nbOccurrences++;
IO.println("[" + matcher.group() + "] found at position " + matcher.start());
}
IO.println("There are " + nbOccurrences + " occurrences of the pattern in the sample");
// results(Java 9):出现位置的流,可对其应用 Stream API
int sum = regex2.matcher(sample3).results().mapToInt(m -> Integer.parseInt(m.group())).sum();
IO.println("sum of the numbers found: " + sum);
long vowels = Pattern.compile("[aeiouy]").matcher("antidisestablishmentarianism").results().count();
IO.println("number of vowels of \"antidisestablishmentarianism\": " + vowels);
}
|
结果:
| > java Regex02.java
Pattern=[\d+], sample=[ 123 456 789 ]
[123] found at position 2
[456] found at position 7
[789] found at position 12
There are 3 occurrences of the pattern in the sample
sum of the numbers found: 1368
number of vowels of "antidisestablishmentarianism": 11
|
注释:
- 第 3 行:要搜索的模式是一串数字;
- 第 5 行:在其中搜索该模式的字符串;
- 第 8–13 行:每次调用 [find] 都会找到下一次出现;当没有更多出现时循环停止。每个出现及其位置都会被显示;
- 第 16 行:[results] 方法(Java 9)以 [MatchResult] 对象(具有方法 [group]、[start]、[end])的形式返回出现位置的流:对它应用 Stream API。这里计算的是找到的数字之和;
- 第 18 行:模式 [[aeiouy]](表示元音)的出现次数就是流中的元素个数。
5.8.3. 获取模式的各个部分
如前所述,模式中用圆括号括起来的部分会被存储:这些就是组。程序 [Regex03.java] 使用了它们:
| // 获取模式的各个部分:分组
void main() {
String pattern3 = "(\\d\\d):(\\d\\d):(\\d\\d)";
Pattern regex3 = Pattern.compile(pattern3);
String sample4 = "It is 18:05:49";
// find 搜索模式的第一个出现位置
Matcher result = regex3.matcher(sample4);
if (result.find()) {
IO.println("The sample [" + sample4 + "] matches the pattern [" + pattern3 + "]");
// 我们显示括号中的分组;分组 0 是整个匹配
for (int i = 0; i <= result.groupCount(); i++) {
IO.println("groups[" + i + "]=[" + result.group(i) + "] found at position "
+ result.start(i));
}
} else {
IO.println("The sample [" + sample4 + "] does not match the pattern [" + pattern3 + "]");
}
// 命名分组:(?<name>...)
Pattern regexDate = Pattern.compile("(?<day>\\d{1,2})/(?<month>\\d{1,2})/(?<year>\\d{4})");
String text = "Appointment on 3/10/2026, then on 15/11/2026.";
DateTimeFormatter format = DateTimeFormatter.ofPattern("EEEE d MMMM yyyy");
Matcher m = regexDate.matcher(text);
while (m.find()) {
// 用名称而不是编号来指定分组
int day = Integer.parseInt(m.group("day"));
int month = Integer.parseInt(m.group("month"));
int year = Integer.parseInt(m.group("year"));
LocalDate date = LocalDate.of(year, month, day);
IO.println("[" + m.group() + "] : day=" + day + ", month=" + month + ", year=" + year + " -> "
+ date.format(format));
}
// replaceAll:替换字符串中可以重用分组
String reversed = regexDate.matcher(text).replaceAll("${year}-${month}-${day}");
IO.println("replaceAll(string) : " + reversed);
// 带函数的 replaceAll(Java 9):为每个出现位置计算替换内容
String iso = regexDate.matcher(text).replaceAll(r -> LocalDate.of(Integer.parseInt(r.group(3)),
Integer.parseInt(r.group(2)), Integer.parseInt(r.group(1))).toString());
IO.println("replaceAll(function) : " + iso);
}
|
结果:
| > java Regex03.java
The sample [It is 18:05:49] matches the pattern [(\d\d):(\d\d):(\d\d)]
groups[0]=[18:05:49] found at position 6
groups[1]=[18] found at position 6
groups[2]=[05] found at position 9
groups[3]=[49] found at position 12
[3/10/2026] : day=3, month=10, year=2026 -> Saturday 3 October 2026
[15/11/2026] : day=15, month=11, year=2026 -> Sunday 15 November 2026
replaceAll(string) : Appointment on 2026-10-3, then on 2026-11-15.
replaceAll(function) : Appointment on 2026-10-03, then on 2026-11-15.
|
注释:
- 第 7–8 行:字符串 [sample4] 与模式 [regex3] 进行比较;[find] 搜索该模式的第一次出现。调用成功之后,我们使用 [Matcher] 的两个新方法:
- [groupCount] (第 11 行):模式中圆括号组的数量;
- [group(i)] (第 12 行):第 i 组捕获的文本;[group(0)],或 [group()],是模式的整个出现内容。[start(i)] 是该文本在被解析字符串中的位置。因此循环从 0 运行到 [groupCount], (含);
- 第 20 行:可以使用语法 为组命名 [(?<name>...)]。这里的模式识别 d/m/yyyy 格式的日期,日和月可以是一位或两位数字;
- 第 26–28 行:命名组通过名称而不是编号来引用:代码更易读,并且不依赖于圆括号的顺序;
- 第 29–31 行:类 [LocalDate] (Java 8)表示不含时间的日期。它使用模式 [EEEE d MMMM yyyy] 显示:星期几以英语显示,即机器所用的语言;
- 第 35 行:[replaceAll] 方法用一个字符串替换模式的每个出现,在该字符串中 [${name}] (或 [$1]、[$2]……用于编号的组)表示某个组的值。日期因此被改写为年-月-日格式;
- 第 38–39 行:[replaceAll] 的一个重载版本(Java 9)接受一个函数,该函数根据每个出现位置(类型为 [MatchResult])计算替换文本。这里构造出日期,并将其替换为标准化的 ISO 8601 表示法,该表示法由 [toString] 方法(属于 [LocalDate])返回:日和月始终是两位数字。
5.8.4. 学习程序
找到能够验证字符串是否符合某种模式的正则表达式,有时可能是一个真正的挑战。程序 [Regex04.java] 可以让你进行练习。它以一个模式和一个字符串作为输入,并指出该字符串是否与该模式匹配。
| // 用于学习正则表达式的程序
void main() {
while (true) {
// 我们询问模式
String pattern = read("Type the pattern to test or nothing to stop: ");
// 结束了吗?
if (pattern.isBlank()) {
break;
}
// 我们编译正则表达式;不正确的模式会引发异常
Pattern regex;
try {
regex = Pattern.compile(pattern);
} catch (PatternSyntaxException e) {
IO.println("Error: " + e.getDescription() + " (position " + e.getIndex() + ")");
continue;
}
// 我们询问要与模式比较的样本
while (true) {
String input = read("Type the string to compare to the pattern [" + pattern
+ "] or nothing to stop: ");
// 结束了吗?
if (input.isBlank()) {
break;
}
try {
// 我们进行比较,限时一秒
Matcher m = regex.matcher(new TimeLimitedString(input, Duration.ofSeconds(1)));
boolean found = false;
while (m.find()) {
found = true;
// 我们显示与模式匹配的元素
IO.println("I found the match [" + m.group() + "] at position ["
+ m.start() + "]");
// 及其子元素(分组 1、2、……)
for (int j = 1; j <= m.groupCount(); j++) {
IO.println(" sub-element [" + m.group(j) + "] at position ["
+ m.start(j) + "]");
}
}
if (!found) {
IO.println("I did not find any matches");
}
} catch (TimeoutExceededException e) {
IO.println("The search was abandoned: it lasted more than one second");
}
}
}
}
// 读取键盘上的一行;流结束时返回 ""
String read(String prompt) {
String line = IO.readln(prompt);
return line == null ? "" : line;
}
// 一个超过截止时间后拒绝继续读取的字符串
record TimeLimitedString(CharSequence text, long deadline) implements CharSequence {
TimeLimitedString(CharSequence text, Duration delay) {
this(text, System.nanoTime() + delay.toNanos());
}
@Override
public char charAt(int index) {
// 正则表达式引擎逐字符读取字符串
if (System.nanoTime() > deadline) {
throw new TimeoutExceededException();
}
return text.charAt(index);
}
@Override
public int length() {
return text.length();
}
@Override
public CharSequence subSequence(int start, int end) {
return new TimeLimitedString(text.subSequence(start, end), deadline);
}
@Override
public String toString() {
return text.toString();
}
}
// 超过截止时间时抛出的异常(static:可在记录中使用)
static class TimeoutExceededException extends RuntimeException {
@Serial
private static final long serialVersionUID = 1L;
}
|
注释:
- 第 13 行:对通过键盘输入的模式进行编译。不正确的模式会触发异常 [PatternSyntaxException],其 [getDescription] 返回错误描述,[getIndex] 返回错误在模式中的位置(第 15 行)。它的完整消息由 [getMessage] 返回,跨越多行,并在错误下方用一个标记显示该模式;
- 第 28 行:搜索不是直接在键入的字符串上进行的,而是在一个 [TimeLimitedString] 对象(第 58–87 行)上进行的,它把搜索时间限制为一秒:如果搜索时间更长,就会抛出 [TimeoutExceededException] 异常,并在第 44 行被捕获。稍后我们会看到这为什么有用以及它如何工作;
- 第 36–39 行:对于每个匹配,如果存在第 1 组及之后的各组,则显示它们;
- 第 52–55 行:与前面的程序不同,输入行中的空格不会被去除;它们可能是模式或待测字符串的一部分。
下面是一个输出示例:
| > java Regex04.java
Type the pattern to test or nothing to stop: \d+
Type the string to compare to the pattern [\d+] or nothing to stop: 123 456 789
I found the match [123] at position [0]
I found the match [456] at position [4]
I found the match [789] at position [8]
Type the string to compare to the pattern [\d+] or nothing to stop:
Type the pattern to test or nothing to stop: (\d{2}):(\d\d)
Type the string to compare to the pattern [(\d{2}):(\d\d)] or nothing to stop: 14:15 abcd 17:18 xyzt
I found the match [14:15] at position [0]
sub-element [14] at position [0]
sub-element [15] at position [3]
I found the match [17:18] at position [11]
sub-element [17] at position [11]
sub-element [18] at position [14]
Type the string to compare to the pattern [(\d{2}):(\d\d)] or nothing to stop:
Type the pattern to test or nothing to stop: ^\s*\d+\s*$
Type the string to compare to the pattern [^\s*\d+\s*$] or nothing to stop: 1456
I found the match [ 1456] at position [0]
Type the string to compare to the pattern [^\s*\d+\s*$] or nothing to stop:
Type the pattern to test or nothing to stop: ^\s*(\d+)\s*$
Type the string to compare to the pattern [^\s*(\d+)\s*$] or nothing to stop: 1456
I found the match [1456] at position [0]
sub-element [1456] at position [0]
Type the string to compare to the pattern [^\s*(\d+)\s*$] or nothing to stop: abcd 1456
I did not find any matches
Type the string to compare to the pattern [^\s*(\d+)\s*$] or nothing to stop:
Type the pattern to test or nothing to stop: ^(a+)+$
Type the string to compare to the pattern [^(a+)+$] or nothing to stop: aaaaaaaaaaaaaaaaaaaaaaaaaaaaaaaaaaaa!
I did not find any matches
Type the string to compare to the pattern [^(a+)+$] or nothing to stop:
Type the pattern to test or nothing to stop: ^(a+)+\1$
Type the string to compare to the pattern [^(a+)+\1$] or nothing to stop: aaaaaaaaaaaaaaaaaaaaaaaaaaaaaaaaaaaa!
The search was abandoned: it lasted more than one second
Type the string to compare to the pattern [^(a+)+\1$] or nothing to stop:
Type the pattern to test or nothing to stop: (\d+
Error: Unclosed group (position 4)
Type the pattern to test or nothing to stop:
|
模式 [^\s*\d+\s*$] 和 [^\s*(\d+)\s*$] 展示了使用组的好处:第一个模式识别前面有三个空格的字符串“1456”,包括这些空格;第二个模式还能提取不带空格的数字。模式 [^(a+)+$] 和 [^(a+)+\1$] 将在下文讨论。
5.8.5. split 方法
我们已经遇到过 [split] 方法,它属于 [String] 类,其分隔符是一个正则表达式。[Pattern] 类也有同样的方法,它使用预先编译的模式:
方法 | 作用 |
[String[] split(CharSequence input)] | 字符串 [input] 被拆分为多个字段,这些字段由与该模式相对应的分隔符分隔 |
[Stream<String> splitAsStream(CharSequence input)] | 与上面相同,但字段以流的形式返回 |
例如,假设一个文本文件包含形如 field1, field2, ..., fieldn 的行。字段由逗号分隔,但这个逗号前后可能有空格。模式 [\s*,\s*] 准确地描述了这种分隔符,如程序 [Regex05.java] 所示:
| // split:分隔符由模式定义
void main() {
String line = "abc , def ,ghi , jkl";
// 一个逗号,前后可以有任意数量的空格
Pattern separator = Pattern.compile("\\s*,\\s*");
String[] fields = separator.split(line);
for (int i = 0; i < fields.length; i++) {
IO.println("fields[" + i + "]=[" + fields[i] + "]");
}
// 多种可能的分隔符:; 或 | 或一串空格
String[] words = "one;two|three four".split("[;|]|\\s+");
IO.println("words=" + Arrays.toString(words));
// splitAsStream:以流的形式得到各字段
IO.println("splitAsStream : " + separator.splitAsStream(line).map(String::toUpperCase).toList());
}
|
结果:
| > java Regex05.java
fields[0]=[abc]
fields[1]=[def]
fields[2]=[ghi]
fields[3]=[jkl]
words=[one, two, three, four]
splitAsStream : [ABC, DEF, GHI, JKL]
|
注释:
- 第 5 行:分隔符:前后有任意数量空格的逗号。这些空格会随分隔符一起被去除。模式一经编译,就可以拆分任意多行而无需重新编译:这就是拆分文件中所有行的方法;
- 第 11 行:一个可以有多种形式的分隔符:分号或竖线([[;|]]),或者([|])一串空格([\s+]);
- 第 14 行:[splitAsStream] 以流的形式返回这些字段,这里对该流应用了 [map] 操作。
5.8.6. 预编译模式、选项以及耗时过长的搜索
与其他平台不同,Java 没有在程序编译时生成正则表达式搜索代码的机制:模式总是在运行时由 [Pattern.compile] 解析。这种编译是有代价的;因此,最佳实践是把每个已知的模式提前一次性编译好,并将 [Pattern] 对象存储在常量中,就像程序 [Regex06.java] 所做的那样。[Pattern] 对象是不可变的,可以被多个线程同时使用;而存储搜索状态的 [Matcher] 对象则不行。
| // 一次性编译的模式、选项、防止耗时过长的搜索
// 带命名分组的时间 hh:mm:ss
static final Pattern TIME = Pattern.compile("(?<h>\\d\\d):(?<m>\\d\\d):(?<s>\\d\\d)");
// 是,不区分大小写
static final Pattern YES = Pattern.compile("^\\s*yes\\s*$", Pattern.CASE_INSENSITIVE);
// 病态模式:一个重复的分组,后面跟着对该分组的反向引用
static final Pattern CATASTROPHIC = Pattern.compile("^(a+)+\\1$");
void main() {
// 1 - 模式只编译一次,存储在常量中
IO.println("TIME.matcher(\"It is 18:05:49\").find() : " + TIME.matcher("It is 18:05:49").find());
Matcher m = TIME.matcher("departure at 07:45:00");
if (m.find()) {
IO.println("hours=" + m.group("h") + ", minutes=" + m.group("m") + ", seconds=" + m.group("s"));
}
// 2 - 选项:这里是 CASE_INSENSITIVE,在编译模式时设置
for (String answer : List.of("yes", "YES", "Yes", "no", "yesss")) {
IO.print(answer + "=" + YES.matcher(answer).matches() + " ");
}
IO.println();
// MULTILINE:^ 和 $ 匹配每一行的开头和结尾;\w 只识别 [a-zA-Z0-9_]
String text = "price: 10\nentrée: 3\ntotal: 30";
display(Pattern.compile("^(\\w+): (\\d+)$", Pattern.MULTILINE), text);
// UNICODE_CHARACTER_CLASS:\w 也识别带重音的字母
display(Pattern.compile("^(\\w+): (\\d+)$", Pattern.MULTILINE | Pattern.UNICODE_CHARACTER_CLASS), text);
// 选项也可以写在模式中:(?i) 表示 CASE_INSENSITIVE,(?m) 表示 MULTILINE
IO.println("(?i)yes on \"YES\" : " + "YES".matches("(?i)yes"));
// 4 - 带灾难性回溯的模式,先不限时,再限时
for (int n : new int[]{10, 15, 20}) {
String input = "a".repeat(n) + "!";
long start = System.nanoTime();
boolean found = CATASTROPHIC.matcher(input).find();
IO.println(n + " a : " + found + " in " + (System.nanoTime() - start) / 1_000_000 + " ms");
}
String input = "a".repeat(30) + "!";
try {
IO.println(CATASTROPHIC.matcher(new TimeLimitedString(input, Duration.ofMillis(100))).find());
} catch (TimeoutExceededException e) {
IO.println("30 a : " + e.getClass().getSimpleName() + " : search abandoned after 100 ms");
}
// Java 引擎识别不带反向引用的模式 (a+)+,并立即给出答案
long start = System.nanoTime();
boolean found = Pattern.compile("^(a+)+$").matcher(input).find();
IO.println("^(a+)+$ on 30 a : " + found + ", answer in less than one second: "
+ ((System.nanoTime() - start) / 1_000_000 < 1000));
}
// 显示在文本中找到的 name=value 对
void display(Pattern pattern, String text) {
Matcher line = pattern.matcher(text);
while (line.find()) {
IO.print("[" + line.group(1) + "=" + line.group(2) + "] ");
}
IO.println();
}
// 一个超过截止时间后拒绝继续读取的字符串
record TimeLimitedString(CharSequence text, long deadline) implements CharSequence {
TimeLimitedString(CharSequence text, Duration delay) {
this(text, System.nanoTime() + delay.toNanos());
}
@Override
public char charAt(int index) {
if (System.nanoTime() > deadline) {
throw new TimeoutExceededException();
}
return text.charAt(index);
}
@Override
public int length() {
return text.length();
}
@Override
public CharSequence subSequence(int start, int end) {
return new TimeLimitedString(text.subSequence(start, end), deadline);
}
@Override
public String toString() {
return text.toString();
}
}
// 超过截止时间时抛出的异常
static class TimeoutExceededException extends RuntimeException {
@Serial
private static final long serialVersionUID = 1L;
}
|
结果:
| > java Regex06.java
TIME.matcher("It is 18:05:49").find() : true
hours=07, minutes=45, seconds=00
yes=true YES=true Yes=true no=false yesss=false
[price=10] [total=30]
[price=10] [entrée=3] [total=30]
(?i)yes on "YES" : true
10 a : false in 0 ms
15 a : false in 2 ms
20 a : false in 39 ms
30 a : TimeoutExceededException : search abandoned after 100 ms
^(a+)+$ on 30 a : false, answer in less than one second: true
|
注释:
- 第 4–8 行:程序的模式只编译一次,并存储在 [static final] 常量中(第 4 章),按惯例用大写字母书写。在紧凑源文件中,这些常量是包含该文件各方法的隐式类的字段;
- 第 12–16 行:这些常量的使用方式与前面程序中的 [Pattern] 对象相同;
- 第 6 行:[compile] 的第二个参数是选项的组合。[CASE_INSENSITIVE] 表示不区分大小写:“YES”和“Yes”都与该模式匹配(结果的第 4 行);
- 第 23–27 行:选项使用运算符 [|] 组合。[MULTILINE] 使 [^] 和 [$] 匹配字符串中每一行的开头和结尾,而不是只匹配字符串本身的开头和结尾。然而,使用默认选项时,[\w] 只识别不带重音的字母:行“entrée: 3”无法被识别(结果的第 5 行)。选项 [UNICODE_CHARACTER_CLASS] (Java 7)会为 [\w]、[\d]、[\s] 和 [\b] 赋予正确的 Unicode 含义:带重音的字母被视为单词字符(结果的第 6 行)。所有法语文本都应使用此选项。其他有用的选项包括:[DOTALL] ([.] 也处理换行符)、[COMMENTS] (忽略模式中的空格,使其可以跨多行书写并带有注释)、[UNICODE_CASE] (与 [CASE_INSENSITIVE] 一起使用时,还会忽略带重音字母的大小写:É 和 é);
- 第 29 行:选项也可以写在模式的开头:[(?i)] 表示 [CASE_INSENSITIVE],[(?m)] 表示 [MULTILINE],[(?U)] 表示 [UNICODE_CHARACTER_CLASS]……
程序的其余部分涉及一个安全问题。有些模式是病态的:当应用于某些字符串时,它们会迫使正则表达式引擎在得出结论之前尝试数量巨大的方式,来使字符串与模式匹配。Java 引擎使用一种称为“回溯”(backtracking)的过程:当一次尝试失败时,它会回到最近一次所做的选择并尝试另一种。第 8 行的模式 [^(a+)+\1$] 就是一个例子:当它应用于以另一个字符结尾的一串“a”时,它会尝试把这些“a”分配给该组的各次重复及其反向引用 [\1] 的所有可能方式,然后才得出匹配失败的结论,并且每多一个“a”,可能性的数量就成倍增加。这被称为灾难性回溯。当应用于用户输入的字符串时,这样的模式构成安全漏洞(称为 ReDoS,即“正则表达式拒绝服务”):只需几个请求就足以让服务器陷入停滞。
- 第 32–37 行:对 10、15 和 20 个
a 测量搜索时间。它增长得非常快(结果的第 8–10 行;时间会因每次执行和每台机器而异)。由于每增加一个 a,时间大约翻倍,因此对 30 个 a 的搜索将需要几分钟;
- 第 38–43 行:[Pattern] 类没有超时选项。这里使用了一种标准技术:搜索在类型为 [TimeLimitedString] (第 61–89 行)的对象中进行,该对象实现了 [CharSequence] 接口,该接口被 [matcher] 所接受。正则表达式引擎使用 [charAt] 方法逐个字符地读取字符串:该方法会检查时间,如果超过了在对象创建时存储的截止时间,就抛出 [TimeoutExceededException] 异常(第 92–95 行)。搜索在 100 毫秒后被放弃;
- 第 61–65 行:[TimeLimitedString] 记录有两个组件:文本和截止时间,截止时间以 [System.nanoTime] 时钟的值表示,不得超过该值。附加的构造函数根据超时时间(一个 [java.time.Duration] 对象)计算这个截止时间;
- 第 92 行:异常 [TimeoutExceededException] 派生自 [RuntimeException]:它是一个非受检异常,[charAt] 可以不声明就抛出它。它被声明为 [static] ,以便能够在记录中创建,而记录本身是隐式静态的。字段 [serialVersionUID] 可避免编译器警告,因为异常是可序列化的;
- 第 45–48 行:Java 运行时可以识别并高效处理嵌套重复的简单情形:模式 [^(a+)+$] 在其他运行时中是灾难性的,而在这里立即就有响应。正是反向引用 [\1] 阻止了第 8 行的模式使用这种优化。
需要注意的是,应当提防包含嵌套重复的模式([(a+)+]、[(\w+\s?)*]……),并且一旦模式或被搜索的字符串来自程序外部,就应限制搜索的持续时间。Java 的占有型量词([a++]、[a*+])可防止在其所重复的元素内部进行回溯,只要你完全理解它们的含义,也可以用它们来编写安全的模式。
5.9. 示例应用程序 - V3
我们将回顾第 3 章(版本 1)和第 4 章(版本 2)中讨论的应用程序。请记住这是一个练习:所使用的税率表是 2004 年版本(2003 年收入),自原始课程以来一直没有改变。
5.9.1. 文件中的数据
在版本 2 中,税款计算是在抽象类 [AbstractTax] 中执行的,我们在这里将它复用于项目的 [tax] 包 中,只有两处细微差别:税率档现在以数组([TaxBracket[]])而不是列表的形式提供,并且除法以 16 位有效数字而不是 34 位执行,这已经绰绰有余:
| package tax;
import java.math.BigDecimal;
import java.math.MathContext;
public abstract class AbstractTax implements ITax {
// 计算所需的税率档来自外部来源
// 只有派生类知道
protected abstract TaxBracket[] getTaxBrackets();
// 税款计算
@Override
public int calculate(boolean married, int nbChildren, int salary) {
// 计算份额数
BigDecimal shares = BigDecimal.valueOf(nbChildren).divide(BigDecimal.TWO)
.add(married ? BigDecimal.TWO : BigDecimal.ONE);
if (nbChildren >= 3) {
shares = shares.add(new BigDecimal("0.5"));
}
// 计算应税收入和家庭商数
BigDecimal income = new BigDecimal("0.72").multiply(BigDecimal.valueOf(salary));
BigDecimal quotient = income.divide(shares, MathContext.DECIMAL64);
// 查找税率档:如果没有合适的上限,则使用最后一档
TaxBracket[] brackets = getTaxBrackets();
TaxBracket bracket = brackets[brackets.length - 1];
for (int i = 0; i < brackets.length - 1; i++) {
if (quotient.compareTo(brackets[i].limit()) <= 0) {
bracket = brackets[i];
break;
}
}
// 税款计算
return income.multiply(bracket.coeffR()).subtract(shares.multiply(bracket.coeffN())).intValue();
}
}
|
[calculate] 方法使用由抽象方法 [getTaxBrackets] 返回的税率档(第 10 行)。[AbstractTax] 类并不知道这些税率档来自何处:由派生类负责提供它们。在版本 2 中,派生类 [HardwiredTax] 把它们硬编码在其代码中。计算使用精确的十进制数 [java.math.BigDecimal] 执行(第 3 章):[BigDecimal.TWO] (Java 19)是常量 2;用收入除以份数时采用 16 位有效数字([MathContext.DECIMAL64]);而 [intValue] 返回结果的整数部分。与版本 2 一样,一个税率档用记录 [TaxBracket] 表示:
| package tax;
import java.math.BigDecimal;
// 税率表中的一档
public record TaxBracket(BigDecimal limit, BigDecimal coeffR, BigDecimal coeffN) {
}
|
而计算由 [ITax] 接口描述,这里用 Javadoc 注释对其进行了说明:
| package tax;
/**
* The tax calculation.
*/
public interface ITax {
    /**
     * Calculates the tax of a taxpayer.
     *
     * @param married    true if the taxpayer is married
     * @param nbChildren number of children
     * @param salary     annual salary in euros
     * @return the amount of the tax, in euros
     */
    int calculate(boolean married, int nbChildren, int salary);
}
|
新版本把数据存储在文件中,这样就可以在不重新编译程序的情况下更改税率表。我们编写两个派生自 [AbstractTax] 的新类:
- [FileTax] 从文本文件 [TaxData.txt] 中读取税率档;
- [JsonTax] 从名为 JSON 的文件 [TaxData.json] 中读取它们。
文本文件 [TaxData.txt] 每行包含一个税率档,格式为 limit:coeffR:coeffN:
| 4962:0:0
8382:0.068:291.09
14753:0.191:1322.92
23888:0.283:2668.39
38868:0.374:4846.98
47932:0.426:6883.66
0:0.481:9505.54
|
文件中的数字使用小数点书写。数据文件不能依赖于读取它的机器的语言:用小数逗号写成、并按法语规则解释([NumberFormat.getInstance(Locale.FRANCE)])的文件,在英语机器上会被拒绝,或者更糟,被错误解释。[new BigDecimal(String)] 生成器与 [Double.parseDouble] 一样,无论机器的语言是什么,始终期望使用小数点。这也是 JSON 和大多数数据格式的约定。
文件 [TaxData.json] 包含相同的数据,形式为 JSON 对象数组:
| [
{ "limit": 4962, "coeffR": 0, "coeffN": 0 },
{ "limit": 8382, "coeffR": 0.068, "coeffN": 291.09 },
{ "limit": 14753, "coeffR": 0.191, "coeffN": 1322.92 },
{ "limit": 23888, "coeffR": 0.283, "coeffN": 2668.39 },
{ "limit": 38868, "coeffR": 0.374, "coeffN": 4846.98 },
{ "limit": 47932, "coeffR": 0.426, "coeffN": 6883.66 },
{ "limit": 0, "coeffR": 0.481, "coeffN": 9505.54 }
]
|
5.9.2. 错误
处理这些文件可能会因文件缺失、行格式错误、数字不正确等而失败。我们创建一个专门的异常类来报告这些错误,即 [TaxException]。它也将用于其他数据源(这里的 JSON 文件,以及后面的数据库)。它带有一个错误代码:
| package tax;
import java.io.Serial;
// 读取税率档的类所抛出的异常
// 它派生自 RuntimeException:是非受检异常
public class TaxException extends RuntimeException {
// 用于序列化的类版本(异常是可序列化的)
@Serial
private static final long serialVersionUID = 1L;
// 错误码(ErrorCode 值的组合)
private final int code;
public TaxException(String message, int code) {
super(message);
this.code = code;
}
public TaxException(String message, Throwable cause, int code) {
super(message, cause);
this.code = code;
}
public int getCode() {
return code;
}
}
|
注释:
- 第 7 行:[TaxException] 类派生自 [RuntimeException] 类:这是一个非受检异常(第 4 章)。编译器不会要求创建 [FileTax] 或 [JsonTax] 对象的代码去捕获该异常;该代码将在能够处理它的地方捕获它;
- 第 10–11 行:每个异常都通过继承 [Throwable] 类而成为可序列化的。可序列化的类应声明一个版本号 [serialVersionUID],用于验证序列化的对象是由同一版本的类反序列化的;否则,在使用 [-Xlint:all] 选项时,编译器会发出警告。[@Serial] 注解(Java 14)表示该字段是序列化机制的一部分;
- 第 14 行:错误代码,在创建异常时设置;
- 第 16–24 行:两个构造函数。第一个接受错误消息和代码;第二个还接受导致该错误的异常(即原因),可通过 [getCause] 方法访问。应用程序的后续版本将使用这种带有整数代码的异常形式。
可能的错误代码由一个枚举来描述:
| package tax;
import java.util.EnumSet;
// 错误码:2 的幂,可以组合
public enum ErrorCode {
ACCESS(1), // 无法读取文件
LINE(2), // 某一行没有三个字段
FIELD1(4), // 字段 1(limit)不正确
FIELD2(8), // 字段 2(coeffR)不正确
FIELD3(16), // 字段 3(coeffN)不正确
JSON(32); // JSON 文档不正确
// 码的整数值
private final int value;
ErrorCode(int value) {
this.value = value;
}
public int getValue() {
return value;
}
// 码组合中包含的码
public static EnumSet<ErrorCode> decode(int code) {
EnumSet<ErrorCode> codes = EnumSet.noneOf(ErrorCode.class);
for (ErrorCode c : values()) {
if ((code & c.value) != 0) {
codes.add(c);
}
}
return codes;
}
}
|
注释:
- 第 7–12 行:可能的错误代码:
- [ACCESS]:访问数据文件时出错;
- [LINE]:某行缺少预期的三个字段,或文件不包含任何时间段;
- [FIELD1], [FIELD2], [FIELD3]:某行中的字段 1、2 或 3 不正确;
- [JSON]:JSON 文档不正确;
- 第 15–23 行:Java 枚举是一个类;它可以有字段、(私有的)构造函数和方法。每个常量都用括在圆括号中的整数值来构造;
- 第 26–34 行:有些错误可能同时出现:一行中的三个字段可能都不正确。因此,错误代码的值是 2 的幂:每个值对应整数的一个位。字段 2 和 3 出错将得到代码 8 | 16 = 24。静态方法 [decode] 执行相反的操作:它通过使用运算符 [&] 测试每一位,把整数转换为代码集合。结果是一个
*[EnumSet]*,这是专用于枚举常量的集,它把这些常量存储为整数的各个位:这就是 Java 处理选项组合的方式。它的 [toString] 方法以“[FIELD2, FIELD3]”的形式显示一个组合。
5.9.3. FileTax 类
[FileTax] 类提供从文本文件中读取的税率档:
| package tax;
import java.io.BufferedReader;
import java.io.IOException;
import java.math.BigDecimal;
import java.nio.file.Files;
import java.nio.file.Path;
import java.util.ArrayList;
import java.util.List;
import java.util.regex.Pattern;
// 从由 limit:coeffR:coeffN 行组成的文本文件中读取的税率档
public class FileTax extends AbstractTax {
// 字段分隔符:字符 :,两侧可有可选的空格
private static final Pattern SEPARATOR = Pattern.compile("\\s*:\\s*");
// 正数或零:数字,后面可选地跟一个点和数字
private static final Pattern NUMBER = Pattern.compile("\\d+(\\.\\d+)?");
// 从文件中读取的税率档
private final TaxBracket[] taxBrackets;
// 实现父类的抽象方法
@Override
protected TaxBracket[] getTaxBrackets() {
return taxBrackets;
}
public FileTax(String fileName) {
// 文件名,不含路径,用于错误消息
Path path = Path.of(fileName);
String name = path.getFileName().toString();
// 读取到的税率档;其数量事先未知
List<TaxBracket> brackets = new ArrayList<>();
try (BufferedReader reader = Files.newBufferedReader(path)) {
int lineNumber = 0;
String lineRead;
while ((lineRead = reader.readLine()) != null) {
lineNumber++;
String line = lineRead.strip();
// 空行被忽略
if (line.isEmpty()) {
continue;
}
// 该行必须有三个字段
String[] fields = SEPARATOR.split(line);
if (fields.length != 3) {
throw new TaxException("Line no. " + lineNumber + " is incorrect (" + line + ")",
ErrorCode.LINE.getValue());
}
// 三个正的或为零的小数,用小数点书写
int code = 0;
if (!NUMBER.matcher(fields[0]).matches()) code |= ErrorCode.FIELD1.getValue();
if (!NUMBER.matcher(fields[1]).matches()) code |= ErrorCode.FIELD2.getValue();
if (!NUMBER.matcher(fields[2]).matches()) code |= ErrorCode.FIELD3.getValue();
if (code != 0) {
throw new TaxException("Line no. " + lineNumber + " is incorrect (" + line + ")", code);
}
// 我们存储新的税率档
brackets.add(new TaxBracket(new BigDecimal(fields[0]), new BigDecimal(fields[1]),
new BigDecimal(fields[2])));
}
} catch (IOException e) {
// 文件访问错误:它被包装在 TaxException 中
throw new TaxException("Error while reading the file " + name, e,
ErrorCode.ACCESS.getValue());
}
// 至少需要一档
if (brackets.isEmpty()) {
throw new TaxException("The file " + name + " contains no bracket",
ErrorCode.LINE.getValue());
}
// 列表被转移到税率档数组中
taxBrackets = brackets.toArray(TaxBracket[]::new);
}
}
|
注释:
- 第 13 行:类 [FileTax] 派生自类 [AbstractTax],就像版本 2 中的类 [HardwiredTax] 一样;
- 第 16–18 行:两个一次性编译好并存储为常量的正则表达式:用于 limit:coeffR:coeffN 这种税率档行的字段分隔符(字符 [:],其前后可以有任意数量的空格),以及一个正数或零,由数字组成,后面可以跟一个句点和更多数字;
- 第 21–27 行:读取到的税率档,由方法 [getTaxBrackets], 返回,该方法实现了 [AbstractTax] 的抽象方法;
- 第 29 行:构造函数接收包含数据的文本文件的名称。它的作用是填充 [taxBrackets] 数组;
- 第 32 行:不含路径的文件名,用于错误消息。构造函数确实可能接收完整路径,而没有必要向用户显示它;
- 第 34 行:读取文本文件是顺序进行的:在读完整个文件之前,并不知道行数。因此无法预先确定数组的大小;税率档被临时存储在列表中;
- 第 35–38 行:使用 [BufferedReader] 逐行读取文件,它由带资源的 [try] 语句打开;
- 第 46–50 行:使用正则表达式把行拆分为字段;如果不是三个字段,就立即抛出代码为 [TaxException] 的异常 [LINE] 。无论如何文件都会被关闭:带资源的 [try] 语句无论以何种方式退出块(正常退出还是通过异常退出)都会关闭 [BufferedReader] ;
- 第 52–58 行:验证这三个字段。错误使用运算符 [|=] 累积在变量 [code] 中,然后统一报告。方法 [matches] 要求整数字段符合模式 [NUMBER]:没有符号、没有空格,也没有小数点。因此负数会被拒绝,这样在检查数据的同时也完成了数据验证;
- 第 60–61 行:现在已验证的字段被转换为 [BigDecimal],使用小数点,与机器的语言无关;
- 第 63–67 行:文件访问错误([IOException] 及其变体,例如文件缺失时的 [NoSuchFileException] 、权限不足时的 [AccessDeniedException] ,或文件不是 UTF-8 编码时的 [MalformedInputException] )被包装在一个代码为 [TaxException] 的 [ACCESS] 异常中,原始异常成为其原因。在循环中抛出的 [TaxException] 异常不是 [IOException] 异常:它们不会被这个 [catch] 子句拦截,而是原样退出构造函数;
- 第 69–74 行:空文件会被拒绝;否则,列表被转移到税率档数组中,这正是构造函数的目的。
把底层异常([IOException])封装为应用程序专用的异常([TaxException]),使调用代码无论数据源是什么(文本文件、JSON 文件,以及课程后面的数据库),都只需处理一种类型的异常。这也是 [TaxException] 是非受检异常的原因:受检异常需要由它所经过的每个方法声明,这会使调用代码与数据源的细节绑定在一起。
5.9.4. JsonTax 类
[JsonTax] 类提供从 JSON 文件中读取的税率档:
| package tax;
import java.io.IOException;
import java.math.BigDecimal;
import java.nio.file.Files;
import java.nio.file.Path;
import java.util.Arrays;
import tools.jackson.core.JacksonException;
import tools.jackson.databind.json.JsonMapper;
// 从 JSON 文件中读取的税率档
public class JsonTax extends AbstractTax {
// JsonMapper 可重用且可被多个线程使用:只创建一个
private static final JsonMapper MAPPER = JsonMapper.builder().build();
// 从文件中读取的税率档
private final TaxBracket[] taxBrackets;
// 实现父类的抽象方法
@Override
protected TaxBracket[] getTaxBrackets() {
return taxBrackets;
}
public JsonTax(String fileName) {
// 文件名,不含路径,用于错误消息
Path path = Path.of(fileName);
String name = path.getFileName().toString();
String json;
try {
// 读取文件
json = Files.readString(path);
} catch (IOException e) {
throw new TaxException("Error while reading the file " + name, e,
ErrorCode.ACCESS.getValue());
}
TaxBracket[] brackets;
try {
// 反序列化税率档数组
brackets = MAPPER.readValue(json, TaxBracket[].class);
} catch (JacksonException e) {
throw new TaxException("The file " + name + " is incorrect: " + e.getOriginalMessage()
+ " (line " + e.getLocation().getLineNr() + ", column " + e.getLocation().getColumnNr()
+ ")", e, ErrorCode.JSON.getValue());
}
// 至少需要一档,且没有负值
if (brackets == null || brackets.length == 0) {
throw new TaxException("The file " + name + " contains no bracket",
ErrorCode.JSON.getValue());
}
if (Arrays.stream(brackets).anyMatch(t -> negative(t.limit()) || negative(t.coeffR())
|| negative(t.coeffN()))) {
throw new TaxException("The file " + name + " contains a negative or missing value",
ErrorCode.JSON.getValue());
}
taxBrackets = brackets;
}
// 缺失(null)或为负的值是不正确的
private static boolean negative(BigDecimal value) {
return value == null || value.signum() < 0;
}
}
|
注释:
- 第 15 行:存储在常量中的单个 [JsonMapper] 供所有 [JsonTax] 对象使用。JSON 属性 [limit]、[coeffR] 和 [coeffN] 以 [TaxBracket] 记录的组件命名:不需要任何注解;
- 第 31–37 行:读取文件;访问错误的处理方式与 [FileTax] 中相同;
- 第 41 行:一条指令就把 JSON 文本转换为税率档数组。Jackson 通过调用构造函数来构造每个记录,并把 JSON 数字转换为 [BigDecimal] 而不会损失任何精度;
- 第 42–46 行:无效的文档会引发 [JacksonException],它被封装在代码为 [TaxException] 的 [JSON] 异常中。消息指出了错误的位置,该位置由 [getLocation] 确定;
- 第 48–56 行:反序列化检查的是文档的格式,而不是数据的有效性:还需要验证至少有一个税率档(文档 [null] 或 [[]] 都是有效的 JSON),并且没有负值或缺失值。如果 JSON 对象中缺少某个属性,对应的组件会被赋值为 [null]。Stream API 的 [anyMatch] 操作用一条语句完成最后这项检查,其中 [Arrays.stream(brackets)] 返回数组元素的流;
- 第 61–63 行:测试某个值的方法。
比较这两个类很有启发性:有了结构化的数据格式和能理解它的库,解析文件几乎不需要任何代码。
5.9.5. 主程序
Maven 项目 [TaxV3] 的目录结构如下:
| 05-classes-java/
TaxV3/
pom.xml
TaxData.json
TaxData.txt
TaxDataInvalid.json
TaxDataInvalid.txt
src/main/java/tax/
AbstractTax.java
ErrorCode.java
FileTax.java
ITax.java
JsonTax.java
Main.java
TaxBracket.java
TaxException.java
|
数据文件位于项目的根目录,紧挨着文件 [pom.xml]:当在项目目录中使用命令 [mvn exec:java] 运行程序时,这里就是程序的当前目录。文件 [pom.xml] 与项目 [Files06] 的相同,只是坐标和主类不同:
| <groupId>examples.tax</groupId>
<artifactId>tax-v3</artifactId>
<version>3.0</version>
<properties>
<maven.compiler.release>25</maven.compiler.release>
<project.build.sourceEncoding>UTF-8</project.build.sourceEncoding>
</properties>
<dependencies>
<!-- Jackson 3:读取税率档的 JSON 文件 -->
<dependency>
<groupId>tools.jackson.core</groupId>
<artifactId>jackson-databind</artifactId>
<version>3.1.5</version>
</dependency>
</dependencies>
|
[groupId] [examples.tax] 将用于示例应用程序的所有版本。在 [exec-maven-plugin] 插件中声明的主类是 [tax.Main]:
| package tax;
// 税款计算,版本 3:税率档从文件中读取
// 语法:mvn exec:java [-Dexec.args="file"] ;file:默认为 TaxData.txt,或一个 .json 文件
public class Main {
private static final String SYNTAX = """
syntax: Married NbChildren Salary
Married: y for married, n for not married
NbChildren: number of children
Salary: annual salary in euros""";
public static void main(String[] args) {
// 在当前文件夹中查找数据文件
String fileName = args.length > 0 ? args[0] : "TaxData.txt";
IO.println("Tax brackets read from [" + fileName + "]");
// 创建 ITax 对象;所用的类取决于文件的扩展名
ITax tax;
try {
String extension = fileName.substring(fileName.lastIndexOf('.') + 1).toLowerCase();
tax = switch (extension) {
case "json" -> new JsonTax(fileName);
default -> new FileTax(fileName);
};
} catch (TaxException e) {
// 显示错误;代码以 ErrorCode 值集合的形式显示
String origin = e.getCause() == null ? ""
: ", original exception: " + e.getCause().getClass().getSimpleName();
IO.println("The following error occurred: [Code=" + ErrorCode.decode(e.getCode())
+ ", Message=" + e.getMessage() + origin + "]");
// 停止程序
System.exit(1);
return;
}
// 输入循环
while (true) {
// 我们询问税款计算的参数
String input = IO.readln("Tax calculation parameters in the format: "
+ "Married (y/n) NbChildren Salary, or nothing to stop: ");
String parameters = input == null ? "" : input.strip();
// 有事可做吗?
if (parameters.isEmpty()) {
break;
}
// 检查所输入行的字段数
String[] fields = parameters.split("\\s+");
if (fields.length != 3) {
IO.println(SYNTAX);
continue;
}
// 检查参数的有效性
// married
String married = fields[0].toLowerCase();
if (!married.equals("y") && !married.equals("n")) {
IO.println(SYNTAX + "\nIncorrect married argument: type y or n");
continue;
}
// nbChildren
int nbChildren = integer(fields[1]);
if (nbChildren < 0) {
IO.println(SYNTAX + "\nIncorrect NbChildren argument: type a positive or zero integer");
continue;
}
// salary
int salary = integer(fields[2]);
if (salary < 0) {
IO.println(SYNTAX + "\nIncorrect salary argument: type a positive or zero integer");
continue;
}
// 参数正确:我们计算税款
IO.println("Tax=" + tax.calculate(married.equals("y"), nbChildren, salary) + " euros");
}
}
// 正整数或零,如果字符串不是则为 -1
private static int integer(String field) {
try {
return Integer.parseInt(field);
} catch (NumberFormatException e) {
return -1;
}
}
}
|
注释:
- 第 7–11 行:帮助文本,位于存储在常量中的文本块里;
- 第 15 行:数据文件的名称作为参数传入;默认是 [TaxData.txt]。使用 Maven 时,程序的参数通过属性 [exec.args] 传递:[mvn exec:java -Dexec.args="TaxData.json"];
- 第 21–25 行:[switch] 表达式(第 3 章)根据文件扩展名选择要实例化的类,扩展名使用 [lastIndexOf] 和 [substring] 从文件名中提取。两个分支返回不同类型的对象 [JsonTax] 和 [FileTax],它们都属于 [ITax] 类型。程序的其余部分只认识 [ITax] 接口,并不知道数据来自何处;
- 第 26–35 行:创建对象可能会引发 [TaxException],它会在程序终止之前显示出来。代码被解码为一组要以纯文本显示的 [ErrorCode] 消息 ;如果有原始异常,则通过其类型来指明。[return] 语句跟在 [System.exit] 之后,永远不会被执行,但编译器并不知道 [System.exit] 不会交还控制权,因而要求写上它:没有它,变量 [tax] 在第 73 行就不会被视为已初始化;
- 第 38–74 行:对话循环与版本 2 中的相同。
5.9.6. 运行
默认使用文件 [TaxData.txt]:
| > mvn compile exec:java
Tax brackets read from [TaxData.txt]
Tax calculation parameters in the format: Married (y/n) NbChildren Salary, or nothing to stop: y 2 60000
Tax=4282 euros
Tax calculation parameters in the format: Married (y/n) NbChildren Salary, or nothing to stop: y 3 60000
Tax=2959 euros
Tax calculation parameters in the format: Married (y/n) NbChildren Salary, or nothing to stop: n 0 60000
Tax=11519 euros
Tax calculation parameters in the format: Married (y/n) NbChildren Salary, or nothing to stop: q s d
syntax: Married NbChildren Salary
Married: y for married, n for not married
NbChildren: number of children
Salary: annual salary in euros
Incorrect married argument: type y or n
Tax calculation parameters in the format: Married (y/n) NbChildren Salary, or nothing to stop: y 2 d
syntax: Married NbChildren Salary
Married: y for married, n for not married
NbChildren: number of children
Salary: annual salary in euros
Incorrect salary argument: type a positive or zero integer
Tax calculation parameters in the format: Married (y/n) NbChildren Salary, or nothing to stop: y 2
syntax: Married NbChildren Salary
Married: y for married, n for not married
NbChildren: number of children
Salary: annual salary in euros
Tax calculation parameters in the format: Married (y/n) NbChildren Salary, or nothing to stop:
|
之前版本中的值保持不变:对于年薪 60,000 欧元的情况,有 2 个孩子的已婚夫妇为 4,282 欧元,有 3 个孩子的为 2,959 欧元,没有孩子的单身人士为 11,519 欧元。不正确的输入会像版本 2 中一样被标出。
使用文件 [TaxData.json]:
| > mvn -q exec:java -Dexec.args="TaxData.json"
Tax brackets read from [TaxData.json]
Tax calculation parameters in the format: Married (y/n) NbChildren Salary, or nothing to stop: y 2 60000
Tax=4282 euros
Tax calculation parameters in the format: Married (y/n) NbChildren Salary, or nothing to stop: y 3 60000
Tax=2959 euros
Tax calculation parameters in the format: Married (y/n) NbChildren Salary, or nothing to stop: n 0 60000
Tax=11519 euros
Tax calculation parameters in the format: Married (y/n) NbChildren Salary, or nothing to stop:
|
使用不存在的 [xx.txt] 文件:
| > mvn -q exec:java -Dexec.args="xx.txt"
Tax brackets read from [xx.txt]
The following error occurred: [Code=[ACCESS], Message=Error while reading the file xx.txt, original exception: NoSuchFileException]
|
使用下面的 [TaxDataInvalid.txt] 文件,其中第三行使用了小数逗号:
| 4962:0:0
8382:0.068:291.09
14753:0,191:1322,92
23888:0.283:2668.39
|
| > mvn -q exec:java -Dexec.args="TaxDataInvalid.txt"
Tax brackets read from [TaxDataInvalid.txt]
The following error occurred: [Code=[FIELD2, FIELD3], Message=Line no. 3 is incorrect (14753:0,191:1322,92)]
|
第 3 行的字段 2 和 3 被拒绝:错误代码是组合 [[FIELD2, FIELD3]]。没有小数部分的字段 1(14753)是正确的。
使用下面的文件 [TaxDataInvalid.json],其中一个系数被写成字符串:
| [
{ "limit": 4962, "coeffR": 0, "coeffN": 0 },
{ "limit": 8382, "coeffR": "0,068", "coeffN": 291.09 }
]
|
| > mvn -q exec:java -Dexec.args="TaxDataInvalid.json"
Tax brackets read from [TaxDataInvalid.json]
The following error occurred: [Code=[JSON], Message=The file TaxDataInvalid.json is incorrect: Cannot deserialize value of type `java.math.BigDecimal` from String "0,068": not a valid representation (line 3, column 30), original exception: InvalidFormatException]
|
Jackson 的消息精确地指明了错误:字符串“0,068”无法转换为 [BigDecimal]。如果字符串包含有效的数字(“0.068”),Jackson 会在期望数字的位置接受该字符串;被拒绝的是小数逗号。错误位于文档的第 3 行(Jackson 的行号从 1 开始)、第 30 列,紧跟在不正确的值之后。
5.10. 结论
本章介绍了几乎所有程序都会用到的 Java 类:
- 不可变字符串 [String],它们用 [equals] 而不是 [==] 来比较,以及用于逐段构造字符串的 [StringBuilder] ;格式化方法 [String.format] 和 [formatted],以及文本块;
- 表和 [Arrays] 类;
- 集合 [List]、[Map]、[Set]、[Deque], 及其实现 [ArrayList]、[HashMap]、[LinkedHashMap]、[TreeMap]、[HashSet]、[ArrayDeque]、[PriorityQueue];不可变集合([List.of]、[List.copyOf]、[Collections.unmodifiableList])、Java 21 的有序集合,以及比较器([Comparator]);Java 1.0 的集合([Vector]、[Hashtable]、[Stack])已被弃用;
- Stream API、它的中间操作和终端操作、它的收集器,以及它的惰性求值;
- 文本文件([Files]、[Path]、[BufferedReader]、[BufferedWriter]),始终使用 UTF-8;二进制文件([DataOutputStream]、[DataInputStream]、[RandomAccessFile]);以及使用 Jackson 的 JSON 序列化,它取代了已被弃用的 Java 二进制序列化;
- 正则表达式,一次性编译好,并在处理外部数据时防范耗时过长的搜索。
示例应用程序现在从文本文件或 JSON 中读取数据。下一章将把它重新组织为层:数据读取、税款计算和用户交互将成为相互独立的组件。