11. Hibernate
先决条件:本章末尾介绍的 [Tax] 应用程序第 7 版,复用了第 5 版(第 6 章)的 [tax-dao]、[tax-business] 和 [tax-ui] 模块。在构建或打开你的项目之前,你必须已经使用命令 [mvn install] (在 [06-architectures/TaxV5] 文件夹中输入)把第 5 版安装到本地 Maven 仓库中(参见第 6 章中关于 [mvn install] 的部分)。
上一章演示了 Java 应用程序如何通过 JDBC 驱动程序与数据库通信:打开连接,发出 SQL 命令,逐列读取结果行,并把它们复制到对象中。这种复制过程——从行到对象,以及从对象到 [INSERT]、[UPDATE]和 [DELETE] 命令——是重复性的。它可以借助一种工具来自动完成:“对象关系映射器”(ORM)。本章介绍 Java 世界中使用最广泛的 ORM,即 Hibernate,以及它所实现的标准 Jakarta Persistence。
本章再次使用第 10 章中关于商品的示例数据库,并以税款计算应用程序的第 7 版收尾,其 ORM 层使用 Hibernate。
11.1. 什么是 ORM?
11.1.1. 对象与表
Java 应用程序处理的是对象:商品有名称、价格和库存;订单有客户和订单行列表,每个订单行引用一件商品。关系数据库则把同样的信息存储在表中:[articles] 表中每件商品一行,[orders] 表中每个订单一行,行与行之间的关系由外键表示。这两个世界并不完全对应:
- 对象直接引用其他对象([order.getClient()]);而一行包含另一行的主键值([client_id]);
- 对象可以包含集合([order.getLines()]);而表只包含单个值;集合由另一张表中指向该订单的若干行来表示;
- Java 类型([String]、[BigDecimal]、[LocalDate]、[boolean])与 SQL 类型([varchar(30)]、[decimal(10,2)]、[date]、[bit])并不相同;
- 查询对象使用 Java(以及流 API),而查询表则使用 SQL。
ORM 在这两个世界之间架起桥梁。我们一次性定义类与表之间的对应关系(模型,即“映射”);之后它负责:
- 翻译用引用对象的语言(HQL)编写的查询,或由 Java 代码(Criteria API)构造的查询;
- 根据读取的行创建对象(这称为物化);
- 存储所读取的对象,并检测其中被修改、添加或删除的对象;
- 生成 [INSERT]、[UPDATE]、和 [DELETE] 命令,把这些更改反映到数据库中;
- 并在必要时根据类创建和更新数据库模式(表、列、索引)。
使用 Hibernate 和 MySQL 的应用程序的架构如下:
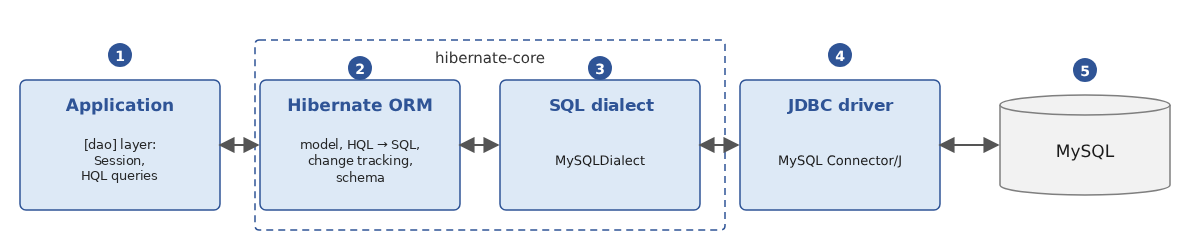
- [1]:应用程序。其 [dao] 层不再直接与 JDBC 驱动程序通信,而是通过 [Session] 对象和 HQL 查询与 Hibernate 通信;
- [2]:Hibernate,独立于 DBMS:模型、查询翻译、变更跟踪、模式生成;
- [3]:DBMS 专用的方言 (此处为 [MySQLDialect]):它了解该 DBMS 的 SQL 语法、列类型和函数。主要 DBMS 的方言是 Hibernate 自身的一部分:无需向项目中添加任何东西;
- [4]:DBMS 的 JDBC 驱动程序,即第 10 章中的那个(MySQL Connector/J):Hibernate 并不取代 JDBC;它使用 JDBC;
- [5]:DBMS。
11.1.2. Jakarta Persistence 与 Hibernate
Hibernate 由 Gavin King 于 2001 年创建,起因是当时 Java EE 平台中“实体 Bean”过于繁琐。它大获成功,其概念被纳入一项标准,即 JPA (Java Persistence API),于 2006 年随 Java EE 5 发布。当 Java EE 被移交给 Eclipse 基金会并更名为 Jakarta EE 时,JPA 变成了 Jakarta Persistence,其包名从 [javax.persistence] 变为 [jakarta.persistence] (3.0 版,2020 年)。当前版本是 Jakarta Persistence 3.2 (2024 年)。
Jakarta Persistence 是一个规范:一组接口([EntityManagerFactory]、[EntityManager]……)、注解([@Entity]、[@Id]、[@Column]……)和一种查询语言 JPQL。它由多个产品实现:Hibernate ORM (使用最广泛,Spring Boot 和 Quarkus 都使用它)、EclipseLink (参考实现)……本课程使用 Hibernate ORM 7.4.5,它实现了 Jakarta Persistence 3.2。
Hibernate 有两种使用方式:
- 完全通过标准接口:这种情况下,代码只依赖 [jakarta.persistence],原则上可以切换实现;
- 通过其自身功能更丰富的“原生”API,其接口扩展了标准接口:[SessionFactory] 就是 [EntityManagerFactory],而 [Session] 就是 [EntityManager]。
我们使用 Hibernate 自己的 API,这也是其文档所推荐的:它提供了所有标准方法([persist]、[find]、[merge]、[remove]……)以及 Hibernate 的扩展。不过,注解始终是标准定义的注解。下表给出了对应关系:
Jakarta Persistence | Hibernate | 作用 |
[EntityManagerFactory] | [SessionFactory] | 针对某个数据库的 Hibernate 配置:一个重量级对象,只创建一次,由整个应用程序共享 |
[EntityManager] | [Session] | 数据库会话:一个轻量级、生存期短的对象 |
[EntityTransaction] | [Transaction] | 事务 |
JPQL | HQL | 查询语言;HQL 是 JPQL 的超集 |
[CriteriaBuilder] | [HibernateCriteriaBuilder] | 使用 Java 代码构造查询 |
11.1.3. 库
本章使用的库如下(它们汇总在关于 Maven 依赖的附录中):
Maven 依赖 | 作用 |
[org.hibernate.orm:hibernate-core] 7.4.5.Final | Hibernate 本身;它包含 Jakarta Persistence 3.2 的 API([jakarta.persistence-api])及其自身的依赖(用于生成类的 Byte Buddy、用于查询分析的 ANTLR、用于日志的 JBoss Logging 等) |
[com.mysql:mysql-connector-j] 9.7.0 | MySQL 的 JDBC 驱动程序,即第 10 章中的那个 |
[ch.qos.logback:logback-classic] 1.5.38 | Logback,它将接收 Hibernate 的日志 |
Hibernate 通过 JBoss Logging 写日志(执行的 SQL 命令、警告等),这是一个小型库,只是把消息转发给它在类路径中找到的日志系统:Log4j 2,或 Logback(通过 SLF4J),或者在都没有时转发给 JDK 自带的日志系统,即 [java.util.logging]。在没有配置的情况下,后者会把每条消息显示为两行,在大多数控制台中还是红色的,这使得程序输出难以阅读。因此,我们在项目中添加 Logback,并用 [logback.xml] 文件对其进行配置。
11.1.4. 代码优先还是数据库优先
模型(类与表之间的映射)可以通过两种方式构建:
- 代码优先:我们编写 Java 类,Hibernate 据此推导出数据库模式,并且可以自行创建它。本章采用的就是这种方法;
- 数据库优先:数据库已经存在,你使用 Hibernate 的逆向工程工具(Hibernate Tools)或开发环境自带的工具,根据其模式生成类(IntelliJ IDEA 可以根据数据库表生成实体)。这是需要与现有数据库协同工作的应用程序所采用的方法。生成的代码与我们手工编写的类似。
11.2. 第一个示例
11.2.1. 项目
本章的示例是一个多模块 Maven 项目(参见第 6 章)的各个模块,位于 [11-hibernate] 文件夹中:
| 11-hibernate/
pom.xml the parent project
tools/ library: the compact SQL log
articles/ library: the Article entity and the [hbarticles] database
first/ a first example
model/ the model: annotations, XML file, creation script
crud/ persist, find, merge, remove
hql/ HQL queries
criteria/ Criteria API queries
relations/ relationships between entities
clients/ the evolution of the database schema
async/ Hibernate and virtual threads
transactions/ transactions
concurrency/ optimistic concurrency
rawsql/ native SQL
bulkupdate/ bulk updates
injection/ Hibernate and Spring
TaxV7/ the tax calculation application, version 7 (separate project)
|
父项目为所有模块设置库和 Maven 扩展的版本:
| <?xml version="1.0" encoding="UTF-8"?>
<!-- 第 11 章的示例:Hibernate;每个示例一个 Maven 模块 -->
<project xmlns="http://maven.apache.org/POM/4.0.0"
xmlns:xsi="http://www.w3.org/2001/XMLSchema-instance"
xsi:schemaLocation="http://maven.apache.org/POM/4.0.0 https://maven.apache.org/xsd/maven-4.0.0.xsd">
<modelVersion>4.0.0</modelVersion>
<groupId>examples.hibernate</groupId>
<artifactId>hibernate</artifactId>
<version>1.0</version>
<packaging>pom</packaging>
<!-- 模块,按其依赖关系的顺序排列 -->
<modules>
<module>tools</module>
<module>articles</module>
<module>first</module>
<module>model</module>
<module>crud</module>
<module>hql</module>
<module>criteria</module>
<module>relations</module>
<module>clients</module>
<module>async</module>
<module>transactions</module>
<module>concurrency</module>
<module>rawsql</module>
<module>bulkupdate</module>
<module>injection</module>
</modules>
<properties>
<maven.compiler.release>25</maven.compiler.release>
<project.build.sourceEncoding>UTF-8</project.build.sourceEncoding>
</properties>
<!-- 库的版本,所有模块共用 -->
<dependencyManagement>
<dependencies>
<!-- 本章的两个公共库 -->
<dependency>
<groupId>examples.hibernate</groupId>
<artifactId>tools</artifactId>
<version>1.0</version>
</dependency>
<dependency>
<groupId>examples.hibernate</groupId>
<artifactId>articles</artifactId>
<version>1.0</version>
</dependency>
<!-- Hibernate ORM(Jakarta Persistence 3.2) -->
<dependency>
<groupId>org.hibernate.orm</groupId>
<artifactId>hibernate-core</artifactId>
<version>7.4.5.Final</version>
</dependency>
<!-- MySQL JDBC 驱动程序 -->
<dependency>
<groupId>com.mysql</groupId>
<artifactId>mysql-connector-j</artifactId>
<version>9.7.0</version>
</dependency>
<!-- 日志:Logback(通过 SLF4J) -->
<dependency>
<groupId>ch.qos.logback</groupId>
<artifactId>logback-classic</artifactId>
<version>1.5.38</version>
</dependency>
<!-- Spring Framework:依赖注入和事务 -->
<dependency>
<groupId>org.springframework</groupId>
<artifactId>spring-context</artifactId>
<version>7.0.9</version>
</dependency>
<dependency>
<groupId>org.springframework</groupId>
<artifactId>spring-orm</artifactId>
<version>7.0.9</version>
</dependency>
<!-- HikariCP 连接池 -->
<dependency>
<groupId>com.zaxxer</groupId>
<artifactId>HikariCP</artifactId>
<version>7.0.2</version>
</dependency>
</dependencies>
</dependencyManagement>
<build>
<pluginManagement>
<plugins>
<plugin>
<groupId>org.apache.maven.plugins</groupId>
<artifactId>maven-compiler-plugin</artifactId>
<version>3.15.0</version>
<configuration>
<parameters>true</parameters>
<compilerArgs>
<arg>-Xlint:all</arg>
</compilerArgs>
</configuration>
</plugin>
<plugin>
<groupId>org.apache.maven.plugins</groupId>
<artifactId>maven-surefire-plugin</artifactId>
<version>3.5.6</version>
</plugin>
<!-- mvn exec:java 执行类 ${exec.mainClass},由每个模块定义 -->
<plugin>
<groupId>org.codehaus.mojo</groupId>
<artifactId>exec-maven-plugin</artifactId>
<version>3.5.1</version>
<configuration>
<mainClass>${exec.mainClass}</mainClass>
</configuration>
</plugin>
</plugins>
</pluginManagement>
</build>
</project>
|
- 第 14–30 行:各模块,按 Maven 应构建的顺序排列:先是两个共享库;
- 第 38–87 行:[dependencyManagement] 部分指定每个库的版本。需要某个库的模块在引用它时不带版本;
- 第 108–116 行:[exec-maven-plugin] 扩展将执行由 [exec.mainClass] 属性指定的类,该属性由每个模块自行定义。
第一个示例是模块 [first]。它独立于其他模块:
| <?xml version="1.0" encoding="UTF-8"?>
<!-- 第一个示例:一个实体、一个数据库、Hibernate 生成的几条 SQL 语句 -->
<project xmlns="http://maven.apache.org/POM/4.0.0"
xmlns:xsi="http://www.w3.org/2001/XMLSchema-instance"
xsi:schemaLocation="http://maven.apache.org/POM/4.0.0 https://maven.apache.org/xsd/maven-4.0.0.xsd">
<modelVersion>4.0.0</modelVersion>
<parent>
<groupId>examples.hibernate</groupId>
<artifactId>hibernate</artifactId>
<version>1.0</version>
</parent>
<artifactId>first</artifactId>
<properties>
<!-- 由 mvn exec:java 执行的程序 -->
<exec.mainClass>first.Main</exec.mainClass>
</properties>
<dependencies>
<!-- Hibernate 和 MySQL JDBC 驱动程序 -->
<dependency>
<groupId>org.hibernate.orm</groupId>
<artifactId>hibernate-core</artifactId>
</dependency>
<dependency>
<groupId>com.mysql</groupId>
<artifactId>mysql-connector-j</artifactId>
</dependency>
<!-- Logback:它接收 Hibernate 的日志 -->
<dependency>
<groupId>ch.qos.logback</groupId>
<artifactId>logback-classic</artifactId>
</dependency>
</dependencies>
<build>
<plugins>
<plugin>
<groupId>org.codehaus.mojo</groupId>
<artifactId>exec-maven-plugin</artifactId>
</plugin>
</plugins>
</build>
</project>
|
- 第 8–12 行:父项目;
- 第 18 行:模块的主类;
- 第 22–35 行:Hibernate、MySQL 的 JDBC 驱动程序和 Logback,不带版本号(版本号由父项目提供)。
要运行某个示例,先在 [11-hibernate] 文件夹中一次性构建所有模块([mvn install] 会把共享库安装到本地 Maven 仓库中),然后进入该模块的文件夹:
| > cd 11-hibernate
> mvn install
> cd first
> mvn compile exec:java
|
所使用的数据库是本地 MySQL 服务器上的 [hbfirst] 数据库,该服务器是 Laragon 服务器(见附录)。它不需要预先存在:MySQL 会创建它。
11.2.2. 实体 [Article]
其对象存储在表中的类称为实体。我们的第一个实体是商店中的商品,对应第 10 章中的表 [articles] :
| package first;
import jakarta.persistence.Entity;
import jakarta.persistence.GeneratedValue;
import jakarta.persistence.GenerationType;
import jakarta.persistence.Id;
import java.math.BigDecimal;
// 商店的一件商品:一个普通的 Java 类,外加几个注解
@Entity
public class Article {
// 主键,由 DBMS 生成
@Id
@GeneratedValue(strategy = GenerationType.IDENTITY)
private Integer id;
// 表的其他列
private String name;
private BigDecimal price;
private int currentStock;
private int minimumStock;
// Hibernate 所需的无参构造函数
protected Article() {
}
// 程序使用的构造函数
public Article(String name, BigDecimal price, int currentStock, int minimumStock) {
this.name = name;
this.price = price;
this.currentStock = currentStock;
this.minimumStock = minimumStock;
}
// 显示
@Override
public String toString() {
return "[%d, %s, %.2f, %d, %d]".formatted(id, name, price, currentStock, minimumStock);
}
}
|
- 第 10 行:注解 [@Entity] (包 [jakarta.persistence])将该类指定为实体。它几乎就是一个普通的 Java 类,不派生自任何 Hibernate 类:这称为 POJO (“Plain Old Java Object”,普通的旧式 Java 对象);
- 第 14–16 行:主键由 [@Id] 注解指定。没有命名约定:该注解是必需的。[@GeneratedValue(strategy = GenerationType.IDENTITY)] 表示其值将由 DBMS 生成(MySQL 的 [AUTO_INCREMENT] 列)。其类型是 [Integer],而不是 [int]:值 [null] 表示“尚未记录到数据库中”;
- 第 18–21 行:类中的每个字段都变成同名的列。由于注解 [@Id] 应用于字段,Hibernate 直接访问字段(即使字段是私有的,它也通过反射读写它们):该类不需要访问器;
- 第 24–25 行:Jakarta Persistence 要求有一个无参构造函数,Hibernate 用它来创建从数据库读取的对象。它可以是受保护的([protected]):应用程序代码不会使用它;
- 第 28–33 行:程序所使用的构造函数。没有提供标识符;它将由 DBMS 生成;
- 第 36–39 行:方便地显示商品。[%.2f] 格式按本地惯例显示带两位小数的价格(在法国使用逗号)。
实体不能是记录 (第 4 章):Hibernate 必须能够创建空对象、填充其字段,并在应用程序更改这些字段时修改它们,而记录的不可变性使这一切无法做到。不过,对于不是实体的查询结果(投影),记录在 Hibernate 中仍然非常有用,我们稍后会看到。
11.2.3. [SessionFactory] 与 [Session]
程序使用三个 Hibernate 对象:
- [SessionFactory] 表示针对某个数据库配置好的 Hibernate:实体列表、数据库和各种选项。它的创建开销很大(Hibernate 要分析实体、连接服务器以确定其版本,并为常见操作准备 SQL):每个数据库、每个应用程序只在启动时创建一个。它是线程安全的:应用程序的所有线程都可以使用它;
- [Session] 表示与数据库的一个工作会话 。它在需要时获取连接,存储其读取或保存的实体,并知道如何把这些实体的更改提交到数据库。它是一个轻量级、生存期短且非线程安全的对象:每个工作单元打开一个,然后关闭;
- [Transaction]:在 Hibernate 中,所有对数据库的写操作都发生在显式事务中,该事务由 [session.beginTransaction()] 开启,并由 [commit] (提交)或 [rollback] (回滚)结束。
[SessionFactory] 和 [Session] 都实现了 [AutoCloseable] 接口:它们在带资源的 [try] 语句中创建,该语句会在块结束时关闭它们。
11.2.4. 程序
| package first;
import java.math.BigDecimal;
import java.util.List;
import org.hibernate.Session;
import org.hibernate.SessionFactory;
import org.hibernate.Transaction;
import org.hibernate.jpa.HibernatePersistenceConfiguration;
public class Main {
public static void main(String[] args) {
// SessionFactory:为 [hbfirst] 数据库配置的 Hibernate
try (SessionFactory sessionFactory = new HibernatePersistenceConfiguration("first")
// 各实体
.managedClass(Article.class)
// 数据库;如果不存在,MySQL 会创建它
.jdbcUrl("jdbc:mysql://localhost:3306/hbfirst?createDatabaseIfNotExist=true")
.jdbcCredentials("root", "")
// 显示 SQL 语句,已格式化,不带颜色
.showSql(true, true, false)
.createEntityManagerFactory()) {
// 先删除表,再根据实体重新创建
sessionFactory.getSchemaManager().drop(false);
sessionFactory.getSchemaManager().create(false);
// 在事务中添加三件商品
try (Session session = sessionFactory.openSession()) {
Transaction transaction = session.beginTransaction();
IO.println("--- persist");
session.persist(new Article("bike", BigDecimal.valueOf(500), 10, 5));
session.persist(new Article("pump", BigDecimal.valueOf(10), 10, 2));
session.persist(new Article("bow", BigDecimal.valueOf(600), 4, 1));
IO.println("--- commit");
transaction.commit();
}
// 用新的会话读取表
IO.println("--- reading the articles");
try (Session session = sessionFactory.openSession()) {
List<Article> articles = session
.createSelectionQuery("from Article order by name", Article.class)
.getResultList();
for (Article article : articles) {
IO.println(article);
}
}
}
}
}
|
- 第 14–22 行:创建 [SessionFactory]。配置 Hibernate 有多种方式(我们稍后讨论);我们使用 Hibernate 7 的 [HibernatePersistenceConfiguration] 类,它是 Jakarta Persistence 3.2 引入的 [PersistenceConfiguration] 类的增强版,允许通过代码配置一切。其参数是持久化单元的名称,这是一个可自由选择的名称,会出现在 Hibernate 的消息中。每个方法都返回配置本身,因此可以链式调用;
- 第 16 行:实体列表;
- 第 18–19 行:[hbfirst] 数据库的 JDBC URL(格式与第 10 章相同)和用户([root],在 Laragon 中没有密码)。URL 的参数 [createDatabaseIfNotExist=true] 是 MySQL 驱动程序的选项:如果数据库不存在,就创建它;
- 第 21 行:[showSql(true, true, false)] 指示 Hibernate 把它执行的每条 SQL 命令打印到控制台,格式化为多行(第二个参数),不带颜色(第三个参数)。查看发送到服务器的 SQL 是理解 Hibernate 行为的最佳方式:我们将在所有示例中这样做;
- 第 22 行:[createEntityManagerFactory] 构造 [SessionFactory] (方法名是标准中的名称;返回的类型是 Hibernate 的类型);
- 第 25–26 行:[SchemaManager] 对象来自 [SessionFactory] (Jakarta Persistence 3.2),它管理实体表:[drop(false)] 在表存在时删除它们,[create(false)] 创建它们([false] 参数指定不应删除或创建数据库本身)。这对示例和测试很方便;实际应用程序以不同的方式管理其数据库,我们稍后会看到;
- 第 29 行:[openSession()] 打开一个会话;
- 第 30 行:事务的开始;
- 第 32–34 行:[persist] 向会话中添加三件新商品:它们将被保存到数据库中。没有为标识符指定值;它将由 DBMS 生成;
- 第 36 行:[commit] 提交事务。在此之前,会话会把保存其所存储的更改仍然需要的 SQL 命令发送给服务器:这就是 所谓的 将 会话 “刷新”(flush)到数据库;
- 第 42–44 行:用 HQL(Hibernate 的查询语言)编写的查询:按名称字母顺序排列的商品。它引用的是实体 [Article] 及其字段 [name],而不是表。[createSelectionQuery] 的第二个参数是结果类型:[getResultList] 返回 [List<Article>]。
模块中的 [src/main/resources/logback.xml] 文件配置 Logback。它显示级别为 [INFO] 或更高的 Hibernate 消息,每条一行(级别、日志名称、消息):
| <?xml version="1.0" encoding="UTF-8"?>
<!-- Logback 配置:Hibernate 的信息消息,每条一行 -->
<configuration>
<appender name="CONSOLE" class="ch.qos.logback.core.ConsoleAppender">
<encoder>
<pattern>%-5level %logger - %msg%n</pattern>
</encoder>
</appender>
<root level="INFO">
<appender-ref ref="CONSOLE"/>
</root>
</configuration>
|
结果:
| > mvn compile exec:java
INFO org.hibernate.orm.jpa - HHH008540: Processing PersistenceUnitInfo [name: first]
INFO org.hibernate.orm.core - HHH000001: Hibernate ORM core version 7.4.5.Final
WARN org.hibernate.orm.connections.pooling - HHH10001002: Using built-in connection pool (not intended for production use)
INFO org.hibernate.orm.connections.pooling - HHH10001005: Database info:
Database JDBC URL [jdbc:mysql://localhost:3306/hbfirst?createDatabaseIfNotExist=true]
Database driver: MySQL Connector/J
Database dialect: MySQLDialect
Database version: 8.0.46
Default catalog/schema: hbfirst/undefined
Autocommit mode: false
Isolation level: REPEATABLE_READ
JDBC fetch size: none
Pool: DriverManagerConnectionProvider
Minimum pool size: 1
Maximum pool size: 20
INFO org.hibernate.orm.core - HHH000489: No JTA platform available (set 'hibernate.transaction.jta.platform' to enable JTA platform integration)
Hibernate:
drop table if exists Article
Hibernate:
create table Article (
id integer not null auto_increment,
currentStock integer not null,
minimumStock integer not null,
name varchar(255),
price decimal(38,2),
primary key (id)
) engine=InnoDB
--- persist
Hibernate:
insert
into
Article
(currentStock, minimumStock, name, price)
values
(?, ?, ?, ?)
Hibernate:
insert
into
Article
(currentStock, minimumStock, name, price)
values
(?, ?, ?, ?)
Hibernate:
insert
into
Article
(currentStock, minimumStock, name, price)
values
(?, ?, ?, ?)
--- commit
--- reading the articles
Hibernate:
select
a1_0.id,
a1_0.currentStock,
a1_0.minimumStock,
a1_0.name,
a1_0.price
from
Article a1_0
order by
a1_0.name
[1, bike, 500.00, 10, 5]
[3, bow, 600.00, 4, 1]
[2, pump, 10.00, 10, 2]
|
说明:
- 第 2–17 行:Hibernate 的信息性消息:持久化单元的名称、Hibernate 版本以及数据库特征(URL、驱动程序、所选方言、服务器版本、事务隔离级别、连接池大小)。Hibernate 查询了服务器,以选择适合其版本的 [MySQLDialect] 方言;
- 第 4 行:一条警告。Hibernate 管理它自己的小型连接池,它不适用于生产应用程序。我们将在 Spring 中看到如何为它提供第 10 章中的 HikariCP 连接池;对于我们的示例,内置的连接池已经够用;
- 第 18–28 行:根据实体删除并随后创建表 [Article] :表名与实体名相同,各列与字段同名,而 [id] 列是主键,带有生成的值([auto_increment])。基本类型字段([int])对应的列是 [not null]:[int] 不能等于 [null]。引用类型字段([String]、[BigDecimal])对应的列接受值 [NULL];
- 请注意默认类型:字符串对应 [varchar(255)] ,[decimal(38,2)] 对应 [BigDecimal] (38 位数字,包括 2 位小数)。这些很少是你想要的类型:下一段说明如何指定类型;
- 第 29–51 行:三条已配置的 [INSERT] 命令在 一调用 [persist] 时就被执行了,早于 [commit]。这是键由 DBMS 生成([IDENTITY])的结果:会话一接管某个实体,就必须知道其标识符,而要获得标识符,就必须执行插入操作(JDBC 驱动程序返回生成的键;见第 10 章)。对于其他生成方式,插入操作会推迟到会话同步时才执行。参数值([?])没有显示:我们将看到如何让它们显示出来;
- 第 53–63 行:HQL 查询 [from Article order by name] 被翻译成 [SELECT ... ORDER BY] 语句。Hibernate 给表分配了别名 [a1_0] ,并为读取的每一行创建了一个 [Article] 对象(第 64–66 行)。
我们没有编写任何 SQL 命令或读取列的代码:这正是 ORM 的全部意义所在。我们同样可以看到,这并不意味着你不需要了解 SQL:要判断所生成的 SQL 是否正确、是否高效,你需要会阅读它。
11.3. 模型
Hibernate 分三步根据实体构建其模型:
- 首先,它应用其默认规则:任何未指定的内容都会被赋予一个合理的值(这称为“约定优于配置”,即“按例外配置”);
- 然后,它使用放在实体上的注解 来补充或修正这些值;
- 最后,它应用 XML 映射文件 ([orm.xml]),这些文件可以在没有注解的情况下完整描述一个类,或者修改其注解所指定的内容。
11.3.1. 默认规则
我们在第一个示例中已经看到了基本规则:
- 实体带有注解 [@Entity] ,并且有一个由 [@Id] 指定的标识符;这两个注解都是必需的;
- 注解 [@Id] 的位置决定访问模式:放在字段上时,Hibernate 直接读写字段;放在访问器([getId])上时,它使用访问器([getX]/[setX])。通过字段访问最为常见:它允许类拥有任何它想要的方法;
- 任何非静态字段都存储在一列中,除非它带有注解 [@Transient] 或关键字 [transient];
- 表名是实体名(类的简单名称),列名是字段名。这些名称随后要经过命名策略的处理:Hibernate 的策略保持名称不变,而另一种策略(我们将在下面尝试)会把它们转换为“蛇形命名”([currentStock] 变成 [current_stock])。Spring Boot 默认使用后一种策略;
- 基本类型([int]、[double]、[boolean])的列变成 [NOT NULL];引用类型([Integer]、[String]、[BigDecimal]、[LocalDate])的列接受值 [NULL];
- SQL 类型由方言选择。对于 MySQL:[integer] 对应 [int],[bigint] 对应 [long],[bit] 对应 [boolean],[varchar(255)] 对应 [String],[decimal(38,2)] 对应 [BigDecimal],[date] 对应 [LocalDate],[datetime(6)] (精确到微秒)对应 [LocalDateTime]。默认情况下,枚举按其序号记录(见第 3 章);注解 [@Enumerated(EnumType.STRING)] 按其名称记录,这样更可靠;
- 引用另一个实体或实体集合的字段定义了一种关系(我们稍后讨论)。
11.3.2. 注解与 XML 映射文件
模块 [model] 定义了两个以不同方式配置的实体。第一个使用注解配置:
| package model;
import jakarta.persistence.Column;
import jakarta.persistence.Entity;
import jakarta.persistence.GeneratedValue;
import jakarta.persistence.GenerationType;
import jakarta.persistence.Id;
import jakarta.persistence.Table;
import jakarta.persistence.Transient;
import java.math.BigDecimal;
import java.time.LocalDate;
// 用注解配置的实体
@Entity
@Table(name = "products")
public class Product {
// 主键:@Id,无论其名称如何
@Id
@GeneratedValue(strategy = GenerationType.IDENTITY)
private Integer code;
// 必填字符串,最多 50 个字符
@Column(nullable = false, length = 50)
private String name;
// 可选字符串(可为 NULL 的列),最多 200 个字符
@Column(length = 200)
private String description;
// 强制指定列的名称和 SQL 类型
@Column(name = "price_excl_tax", nullable = false, precision = 10, scale = 2)
private BigDecimal priceExclTax;
// 可选日期:对象可以为 null
private LocalDate withdrawalDate;
// 没有对应列的字段
@Transient
private boolean selected;
protected Product() {
}
// 方法永远不会被保存:这里 Hibernate 访问的是字段,而不是方法
public BigDecimal getPriceInclTax() {
return priceExclTax.multiply(new BigDecimal("1.2"));
}
public boolean isSelected() {
return selected;
}
}
|
- 第 3–9 行:Jakarta Persistence 注解;
- 第 15 行:[@Table] 指定表名;
- 第 19–21 行:主键,无论其名称如何,都由 [@Id] 指定;
- 第 24–25 行:[@Column] 指定列;[nullable = false] 使其成为必填列([NOT NULL]);[length = 50] 设置其长度([varchar(50)]);
- 第 28–29 行:一个可选的描述,最多 200 个字符;该列接受值 [NULL];
- 第 32–33 行:[@Column] 还指定列名([price_excl_tax]),对于小数,还指定其精度(数字的总位数)和标度(小数点后的位数):[decimal(10,2)];
- 第 36 行:一个可选的日期。类型 [LocalDate] (第 5 章)表示不带时间的日期:它与 SQL 类型 [date] 相关联;
- 第 39–40 行:[@Transient] 将字段排除在模型之外:此处是对用户界面有用但不属于数据库的信息;
- 第 46–48 行:方法即使命名得像 getter,也不会被登记,因为 Hibernate 直接访问字段。如果是通过 getter 访问,就需要给它添加注解 [@Transient]。
第二个实体没有注解:
| package model;
import java.time.LocalDateTime;
// 一个没有任何注解的类:它的映射由 [supplier.orm.xml] 文件描述
public class Supplier {
private Integer number;
private String companyName;
private String phone;
private LocalDateTime creationDate;
protected Supplier() {
}
public Supplier(String companyName, String phone) {
this.companyName = companyName;
this.phone = phone;
}
}
|
它到表的映射由一个位于模块 [src/main/resources/META-INF] 文件夹中的 XML 文件描述:
| <?xml version="1.0" encoding="UTF-8"?>
<!-- [Supplier] 类到其表的映射,用 XML 描述(Jakarta Persistence 3.2) -->
<entity-mappings xmlns="https://jakarta.ee/xml/ns/persistence/orm"
xmlns:xsi="http://www.w3.org/2001/XMLSchema-instance"
xsi:schemaLocation="https://jakarta.ee/xml/ns/persistence/orm
https://jakarta.ee/xml/ns/persistence/orm/orm_3_2.xsd"
version="3.2">
<entity class="model.Supplier" access="FIELD">
<table name="suppliers">
<!-- 唯一索引:两个供应商不能有相同的公司名称 -->
<index name="ix_suppliers_company_name" column-list="companyName" unique="true"/>
</table>
<attributes>
<id name="number">
<generated-value strategy="IDENTITY"/>
</id>
<basic name="companyName">
<column nullable="false" length="60"/>
</basic>
<basic name="phone">
<column name="tel" length="20"/>
</basic>
<!-- 由 DBMS 计算的默认值:Hibernate 从不写入该列 -->
<basic name="creationDate">
<column nullable="false" insertable="false" updatable="false"
column-definition="datetime(6) default current_timestamp(6)"/>
</basic>
</attributes>
</entity>
</entity-mappings>
|
- 第 3–7 行:Jakarta Persistence 3.2 映射文件的 XML 模式;
- 第 8 行:所描述的类,通过字段访问;
- 第 9–12 行:表,以及公司名称上的唯一索引:任何两个供应商都不能同名。等效的注解是 [@Table(name = "suppliers", indexes = @Index(...))];
- 第 14–16 行:标识符,由 DBMS 生成;
- 第 17–19 行:一个必填列,长度不超过 60 个字符;
- 第 20–22 行:字段 [phone] 存储在列 [tel] 中;
- 第 24–27 行:创建日期有一个由 DBMS 计算的默认值。属性 [column-definition] 提供列定义中的 SQL 文本,它会原样复制到 [CREATE TABLE] 命令中;[insertable="false"] 和 [updatable="false"] 表示 Hibernate 绝不能写入该列,这使得 DBMS 可以使用 [current_timestamp(6)]。
注解所能做的一切,都可以用 XML 完成。注解的优点是把配置放在字段旁边,这是最常见的做法;而 XML 文件的优点则是让各个类独立于 Jakarta Persistence,并把配置集中在一处。两种方式可以结合使用:发生冲突时,XML 文件优先。Jakarta Persistence 不支持像其他框架(例如 C# 中的 Entity Framework)那样通过 Java 代码配置模型。
程序显示 Hibernate 所构建的模型,然后是创建这些表的 SQL 脚本:
| package model;
import jakarta.persistence.metamodel.Attribute;
import jakarta.persistence.metamodel.EntityType;
import jakarta.persistence.metamodel.SingularAttribute;
import java.io.StringWriter;
import org.hibernate.SessionFactory;
import org.hibernate.boot.model.naming.PhysicalNamingStrategySnakeCaseImpl;
import org.hibernate.cfg.AvailableSettings;
import org.hibernate.jpa.HibernatePersistenceConfiguration;
public class Main {
public static void main(String[] args) {
// 表创建脚本将被写入此对象
StringWriter script = new StringWriter();
// 从不连接服务器的 SessionFactory
try (SessionFactory sessionFactory = new HibernatePersistenceConfiguration("model")
// 一个带注解的实体和一个用 XML 描述的映射
.managedClass(Product.class)
.mappingFile("META-INF/supplier.orm.xml")
// 没有数据库:给出 DBMS 及其版本,用于确定 SQL 方言
.property(AvailableSettings.JAKARTA_HBM2DDL_DB_NAME, "MySQL")
.property(AvailableSettings.JAKARTA_HBM2DDL_DB_MAJOR_VERSION, "8")
.property(AvailableSettings.ALLOW_METADATA_ON_BOOT, false)
// “蛇形命名”的列名:companyName -> company_name
.property(AvailableSettings.PHYSICAL_NAMING_STRATEGY,
PhysicalNamingStrategySnakeCaseImpl.class.getName())
// 表创建脚本,不执行
.property(AvailableSettings.JAKARTA_HBM2DDL_SCRIPTS_ACTION, "create")
.property(AvailableSettings.JAKARTA_HBM2DDL_SCRIPTS_CREATE_TARGET, script)
.property(AvailableSettings.HBM2DDL_DELIMITER, ";")
.property(AvailableSettings.FORMAT_SQL, true)
.createEntityManagerFactory()) {
// Hibernate 构建的模型:实体和属性(Jakarta Persistence API)
for (EntityType<?> entity : sessionFactory.getMetamodel().getEntities()) {
IO.println("entity %s (%s)".formatted(entity.getName(), entity.getJavaType().getName()));
for (Attribute<?, ?> attribute : entity.getAttributes()) {
boolean id = attribute instanceof SingularAttribute<?, ?> s && s.isId();
IO.println(" %-14s %s%s".formatted(attribute.getName(),
attribute.getJavaType().getSimpleName(), id ? " (identifier)" : ""));
}
}
}
// 表创建脚本,去掉各行 4 个空格的缩进
IO.println("--- creation script");
script.toString().strip().lines()
.map(line -> line.startsWith(" ") ? line.substring(4) : line)
.forEach(line -> IO.println(line.stripTrailing()));
}
}
|
- 第 16 行:一个 [StringWriter] (包 [java.io]),即写入内存中字符串的写入流,将接收 SQL 脚本;
- 第 20–21 行:带注解的实体由 [managedClass] 声明,XML 文件由 [mappingFile] 声明;
- 第 23–25 行:数据库 [hbmodel] 永远不会存在;这个 [SessionFactory] 仅用于检查模型。因此,没有 JDBC URL。为了在不查询服务器的情况下选择 SQL 方言,Hibernate 需要 DBMS 的名称及其版本;[ALLOW_METADATA_ON_BOOT] 属性([hibernate.boot.allow_jdbc_metadata_access])阻止它在启动时进行连接。配置属性的名称是 [AvailableSettings] 接口中的常量;
- 第 27–28 行:“蛇形命名”约定;
- 第 30–33 行:Hibernate 将把建表脚本(["create"])写入 [script] 对象而不执行它;各命令以分号结尾,并格式化为多行;
- 第 37 行:[getMetamodel] 方法(Jakarta Persistence)提供对模型的访问:其实体([EntityType]),以及每个实体的属性([Attribute]);
- 第 38–43 行:对每个实体,显示其名称和类;对每个属性,显示其名称、Java 类型以及它是否为标识符。第 40 行的模式过滤([instanceof SingularAttribute<?, ?> s && s.isId()],第 4 章)检查属性的类型,并在合适时立即使用它;
- 第 48–50 行:显示脚本,不带 Hibernate 为其各行添加的四个空格的缩进。
结果:
| > mvn compile exec:java
WARN connection - HHH102003: No appropriate connection provider encountered; client must supply connections
entity Supplier (model.Supplier)
number Integer (identifier)
companyName String
creationDate LocalDateTime
phone String
entity Product (model.Product)
code Integer (identifier)
description String
name String
priceExclTax BigDecimal
withdrawalDate LocalDate
--- creation script
create table products (
code integer not null auto_increment,
price_excl_tax decimal(10,2) not null,
withdrawal_date date,
name varchar(50) not null,
description varchar(200),
primary key (code)
) engine=InnoDB;
create table suppliers (
number integer not null auto_increment,
creation_date datetime(6) default current_timestamp(6) not null,
tel varchar(20),
company_name varchar(60) not null,
primary key (number)
) engine=InnoDB;
alter table suppliers
add constraint ix_suppliers_company_name unique (company_name);
|
- 第 2 行:Hibernate 的警告确认它无法获得连接;
- 第 3–13 行:两个实体及其属性(先是标识符,然后是其他属性,按字母顺序排列)。字段 [selected] 和方法 [getPriceInclTax] 没有出现在模型中;
- 第 15–21 行:表 [suppliers],由 XML 文件描述。命名策略把 [companyName] 和 [creationDate] 改成了 [company_name] 和 [creation_date];名称是固定的列 [tel] 保持不变。列 [creation_date] 的定义取自 XML 文件,并补充了 [not null];
- 第 23–30 行:表 [products]。SQL 类型来自注解([varchar(50)]、[decimal(10,2)])或方言为某个 Java 类型所做的选择([integer]、[date]);
- 第 32–33 行:唯一索引,在 MySQL 中由唯一性约束([unique])创建。
11.3.3. 生成的标识符
注解 [@GeneratedValue] 表示标识符的值是生成的。它的参数 [strategy] 指定生成方式:
策略 | 标识符的生成方式 |
[IDENTITY] | 由 DBMS 在插入行时生成(MySQL 的 [AUTO_INCREMENT] 列,SQL Server 和 PostgreSQL 的 [IDENTITY] ) |
[SEQUENCE] | 由 DBMS 的序列(PostgreSQL、Oracle)生成,Hibernate 在插入之前查询该序列 |
[TABLE] | 由 Hibernate 管理的计数器表生成 |
[UUID] | 由 Hibernate 生成:一个随机的通用标识符,例如 [java.util.UUID] |
[AUTO] (默认) | 由 Hibernate 选择;对于没有序列的 MySQL,它使用名为 [<table>_SEQ] |
对于 MySQL,我们仍然使用 [IDENTITY],它对应于 [AUTO_INCREMENT] 列的自然行为。我们已经看到了其结果:[INSERT] 命令在调用 [persist] 时就立即执行,Hibernate 无法把多次插入合并为一个批处理(我们稍后讲解批处理)。[SEQUENCE] 策略允许在插入之前就知道 ID,对于使用序列的 DBMS,这是首选的策略。
11.3.4. 可选值与 [NULL] 列
因此,一列是否可选,在 Java 中由字段类型(基本类型还是引用类型)以及 [nullable] 属性(来自 [@Column])决定。这一选择必须慎重:该规则既表达了 Java 代码中的约束(“这个值可能缺失”),也表达了数据库中的约束。几点说明:
- [@Column(nullable = false)] 在 Hibernate 创建的模式中定义 [NOT NULL] 约束,并且 Hibernate 在发送 [INSERT] 或 [UPDATE] 命令之前也会使用它:如果字段为 [null],它就不会发送命令,而是触发 [PropertyValueException] (“not-null property references a null or transient value”)。当存在 Jakarta Validation(见下文)时,Hibernate 的这项检查默认被禁用:此时验证转而依据其注解,或者在没有注解时依据 DBMS,由 DBMS 拒绝该命令;
- 为了在任何数据库访问之前由 Java 执行更全面的验证,我们使用 Jakarta Validation (库 [hibernate-validator])及其注解 [@NotNull]、[@Size(max = 30)]、[@Positive]……。当它们存在于类路径中时,Hibernate 会在保存实体之前验证实体,并在创建列时考虑这些注解;
- 字段不能是 [Optional] 类型(第 4 章),它并不是为此目的而设计的;不过,访问器可以返回由可选字段构造的 [Optional] :[return Optional.ofNullable(description);]。
11.4. 后续示例:两个常用库
以下各段中的示例几乎都使用 [hbarticles] 数据库及其 [articles] 表,表中填入了第 10 章中的六件商品。我们不在每个模块中重复 Hibernate 实体和配置,而是把它们放在一个库中,即 [articles] 模块,其他模块依赖于它。我们还用一种更紧凑的日志取代 [showSql] 输出的 SQL 日志(对我们的示例来说它过于冗长),该紧凑日志放在第二个库,即 [tools] 模块中。
11.4.1. 紧凑的 SQL 日志
Hibernate 不是直接写入控制台([showSql]),而是可以把其活动转发给日志系统(此处为 Logback),每个消息类别写入不同的日志记录器:
日志 | 级别 | 消息 |
[org.hibernate.SQL] | [DEBUG] | 执行的 SQL 命令 |
[org.hibernate.orm.jdbc.bind] | [TRACE] | SQL 命令中每个参数的值 |
[org.hibernate.orm.resource.jdbc] | [TRACE] | 其中包括事务的开始、提交和回滚等 |
[org.hibernate.orm.jdbc.batch] | [TRACE] | SQL 命令批处理的执行 |
[org.hibernate.orm.jdbc.error] | [WARN] | DBMS 报告的错误 |
日志只记录级别等于或高于其自身级别的消息。因此,只需在 [logback.xml] 文件中为这些日志设置所需的级别,就能捕获这些消息。我们通过一个布局类来处理它们,使它们更紧凑:
| package tools;
import ch.qos.logback.classic.Level;
import ch.qos.logback.classic.Logger;
import ch.qos.logback.classic.spi.ILoggingEvent;
import ch.qos.logback.core.LayoutBase;
import java.util.ArrayList;
import java.util.List;
import java.util.regex.Matcher;
import java.util.regex.Pattern;
import java.util.stream.Collectors;
import java.util.stream.Stream;
import org.slf4j.LoggerFactory;
// Hibernate 所执行 SQL 语句的紧凑日志:一个 Logback 布局
public class SqlLog extends LayoutBase<ILoggingEvent> {
// 使用的 Hibernate 日志记录器
public static final String SQL = "org.hibernate.SQL";
public static final String PARAMETERS = "org.hibernate.orm.jdbc.bind";
public static final String TRANSACTIONS = "org.hibernate.orm.resource.jdbc";
public static final String ERRORS = "org.hibernate.orm.jdbc.error";
public static final String BATCHES = "org.hibernate.orm.jdbc.batch";
// 单行书写的子句的最大长度
private static final int WIDTH = 100;
// SQL 语句批处理的执行:"Executing JDBC batch (3 / 3) - [...]"
private static final Pattern BATCH = Pattern.compile("Executing JDBC batch \\((\\d+) / \\d+\\).*");
// 绑定到 SQL 语句的参数:"binding parameter (1:VARCHAR) <- [bike]"
private static final Pattern PARAMETER =
Pattern.compile("binding parameter \\((\\d+):\\w+\\) <- \\[(.*)]");
// 消息的布局:返回要写入的文本("":什么也不写)
@Override
public String doLayout(ILoggingEvent event) {
String message = event.getFormattedMessage();
return switch (event.getLoggerName()) {
case SQL -> sqlStatement(message);
case PARAMETERS -> parameter(message);
case TRANSACTIONS -> transaction(message);
case ERRORS -> error(message);
case BATCHES -> batch(message);
default -> "";
};
}
// 由 Hibernate 格式化的 SQL 语句,使其更紧凑:每个子句一行(select、from……)
private static String sqlStatement(String sql) {
// 非空行,去掉行尾空格
List<String> lines = sql.lines().map(String::stripTrailing).filter(l -> !l.isBlank()).toList();
// 各子句:一个顶层行(缩进最少的行)及其后的各行
int indent = lines.stream().mapToInt(SqlLog::indent).min().orElse(0);
List<List<String>> clauses = new ArrayList<>();
for (String line : lines) {
if (clauses.isEmpty() || indent(line) == indent) {
clauses.add(new ArrayList<>());
}
clauses.getLast().add(line.substring(indent));
}
// 如果不太长,每个子句写在一行
StringBuilder text = new StringBuilder();
String start = "";
for (List<String> clause : clauses) {
String line = start + clause.stream().map(String::strip).collect(Collectors.joining(" "));
if (line.equals("insert") || line.equals("delete")) {
// [insert into ...]、[delete from ...]:单独一行
start = line + " ";
continue;
}
if (line.length() <= WIDTH) {
text.append(" SQL> ").append(line).append('\n');
} else {
// 子句太长:保留 Hibernate 的各行
for (int i = 0; i < clause.size(); i++) {
text.append(" SQL> ").append(i == 0 ? start : "").append(clause.get(i)).append('\n');
}
}
start = "";
}
return text.toString();
}
// 行首的空格数
private static int indent(String line) {
return line.length() - line.stripLeading().length();
}
// SQL 语句参数的值
private static String parameter(String message) {
Matcher m = PARAMETER.matcher(message);
return m.matches() ? " SQL> -- parameter " + m.group(1) + " = " + m.group(2) + "\n" : "";
}
// 事务的开始、提交和回滚(其他消息被忽略)
private static String transaction(String message) {
if (message.startsWith("HHH10003002")) {
return " SQL> -- start of transaction\n";
}
if (message.startsWith("HHH10003004")) {
return " SQL> -- transaction committed (COMMIT)\n";
}
if (message.startsWith("HHH10003006")) {
return " SQL> -- transaction rolled back (ROLLBACK)\n";
}
return "";
}
// DBMS 报告的错误(给出其错误码的那一行被忽略)
private static String error(String message) {
return message.startsWith("HHH000247") ? "" : " SQL> -- failure: " + message + "\n";
}
// SQL 语句批处理的执行(其他消息被忽略)
private static String batch(String message) {
Matcher m = BATCH.matcher(message);
return m.matches() ? " SQL> -- execution of a batch of " + m.group(1) + " statement(s)\n" : "";
}
// 不带 SQL 日志地执行一个动作
public static void withoutLog(Runnable action) {
List<Logger> loggers = Stream.of(SQL, PARAMETERS, TRANSACTIONS, ERRORS, BATCHES)
.map(SqlLog::logger)
.toList();
// 当前级别,在结束时恢复
List<Level> levels = loggers.stream().map(Logger::getLevel).toList();
loggers.forEach(l -> l.setLevel(Level.OFF));
try {
action.run();
} finally {
for (int i = 0; i < loggers.size(); i++) {
loggers.get(i).setLevel(levels.get(i));
}
}
}
// 具有给定名称的 Logback 日志记录器
private static Logger logger(String name) {
return (Logger) LoggerFactory.getLogger(name);
}
}
|
- 第 16 行:Logback 的布局类派生自 [LayoutBase<ILoggingEvent>] 类;其 [doLayout] 方法(第 36–47 行)接收每条消息([ILoggingEvent])并返回要写入的文本;
- 第 19–23 行:所使用的 Hibernate 日志的名称;
- 第 39–46 行:处理方式取决于发送消息的日志(对字符串使用 [switch] ,采用 Java 14 的“箭头”语法);
- 第 50–83 行:由 Hibernate 格式化([format_sql])的 SQL 命令,分布在多行中,每列一行。我们让它更紧凑。非空行被划分为子句(第 54–61 行):子句以顶层行([select]、[from]、[where]……)开头,并包含其后缩进的各行。如果每个子句不超过 100 个字符(第 72–73 行),就把它写在一行上,并以 [SQL>] 开头;否则,保留其各行(第 76–78 行)。[insert] 和 [delete] 子句与其后的子句合并(第 67–71 行);
- 第 91–94 行:提供参数值的 Hibernate 消息形如 [binding parameter (1:VARCHAR) <- [bike]]。第 32–33 行的正则表达式(第 5 章)提取参数编号及其值;
- 第 97–108 行:在 [org.hibernate.orm.resource.jdbc] 日志的众多消息中,只保留表示事务开始、提交和回滚的那些。每条 Hibernate 消息都以一个代码([HHH10003002]……)开头,该代码唯一标识这条消息;
- 第 111–113 行:DBMS 中的错误。Hibernate 把它写成两条消息:一条包含错误代码(我们忽略它),另一条包含错误文本;
- 第 116–119 行:执行一批 SQL 命令,我们将在本章末尾遇到它;
- 第 122–136 行:[withoutLog] 方法在不记录日志(SQL)的情况下执行一个操作。它使用 Logback 的 API:每个日志([Logger])都有一个可以在执行期间修改的级别。我们把这五个日志设为 [OFF] 级别,执行操作,然后在 [finally] 子句中恢复原来的级别,这样即使操作抛出异常,它们也会保持在这些级别;
- 第 139–141 行:[LoggerFactory] 是 SLF4J 中返回日志的类;由于 Logback 是 SLF4J 的当前实现,返回的对象是 [ch.qos.logback.classic.Logger]。
[tools] 模块还包含示例中使用的 [logback.xml] 文件。它位于类路径的根目录([src/main/resources]),程序启动时 Logback 会找到它:
| <?xml version="1.0" encoding="UTF-8"?>
<!-- 本章示例的 Logback 配置 -->
<configuration>
<!-- 紧凑的 SQL 日志:由 [tools.SqlLog] 类提供布局 -->
<appender name="SQL" class="ch.qos.logback.core.ConsoleAppender">
<encoder class="ch.qos.logback.core.encoder.LayoutWrappingEncoder">
<layout class="tools.SqlLog"/>
</encoder>
</appender>
<!-- 其他消息:级别、日志记录器的短名称、文本 -->
<appender name="CONSOLE" class="ch.qos.logback.core.ConsoleAppender">
<encoder>
<pattern>%-5level %logger{0} - %msg%n</pattern>
</encoder>
</appender>
<!-- SQL 语句(DEBUG)、它们的参数、事务、批处理(TRACE)和错误 -->
<logger name="org.hibernate.SQL" level="DEBUG" additivity="false">
<appender-ref ref="SQL"/>
</logger>
<logger name="org.hibernate.orm.jdbc.bind" level="TRACE" additivity="false">
<appender-ref ref="SQL"/>
</logger>
<logger name="org.hibernate.orm.resource.jdbc" level="TRACE" additivity="false">
<appender-ref ref="SQL"/>
</logger>
<logger name="org.hibernate.orm.jdbc.batch" level="TRACE" additivity="false">
<appender-ref ref="SQL"/>
</logger>
<logger name="org.hibernate.orm.jdbc.error" level="WARN" additivity="false">
<appender-ref ref="SQL"/>
</logger>
<!-- Hibernate 内置的连接池足以满足我们的示例:其警告被屏蔽 -->
<logger name="org.hibernate.orm.connections.pooling" level="ERROR"/>
<!-- 删除空数据库的表会产生无害的错误:它们被屏蔽 -->
<logger name="org.hibernate.tool.schema" level="OFF"/>
<!-- 所有其他日志记录器:只显示警告和错误 -->
<root level="WARN">
<appender-ref ref="CONSOLE"/>
</root>
</configuration>
|
- 第 6–10 行:一个“appender”(追加器)写入消息,此处写入控制台。它使用我们的格式化方式;
- 第 13–17 行:第二个“appender”,用于其他消息:级别、日志简称、文本;
- 第 20–34 行:上表中的 Hibernate 日志及其级别。它们的消息被发送到“appender” [SQL] ,并且只发送到它([additivity="false"]:它们不会再额外转发到根日志);
- 第 37 行:抑制关于 Hibernate 内置连接池的警告;
- 第 40 行:Hibernate 从外键开始删除表;在空数据库上,这些删除操作会失败但无碍大局,不过 Hibernate 会对此大量记录日志。这些消息被抑制;
- 第 43–45 行:其他日志只记录警告和错误。
[tools] 模块只有一个依赖:Logback。库通常不会把自己的日志配置强加给使用它的应用程序;我们在这里这样做,是为了避免在每个示例中重复这个文件。
11.4.2. 实体与商品数据库
[articles] 模块中的 [Article] 实体使用上一段中的注解。下面是代码的开头;其余部分包含第一个示例中该实体的两个构造函数、每个字段的 [getX]/[setX] 取值方法和赋值方法([setId] 除外:标识符由 Hibernate 管理),以及同样的 [toString] 方法:
| package articles;
import jakarta.persistence.Column;
import jakarta.persistence.Entity;
import jakarta.persistence.GeneratedValue;
import jakarta.persistence.GenerationType;
import jakarta.persistence.Id;
import jakarta.persistence.Table;
import jakarta.persistence.UniqueConstraint;
import java.math.BigDecimal;
// 商店的一件商品,带有指定其表的注解
@Entity
@Table(name = "articles",
uniqueConstraints = @UniqueConstraint(name = "uk_articles_name", columnNames = "name"))
public class Article {
// 主键,由 DBMS 生成(AUTO_INCREMENT)
@Id
@GeneratedValue(strategy = GenerationType.IDENTITY)
private Integer id;
// 商品名称:必填,最多 30 个字符,唯一(见 @Table)
@Column(nullable = false, length = 30)
private String name;
// 价格:10 位数字,其中小数点后 2 位
@Column(nullable = false, precision = 10, scale = 2)
private BigDecimal price;
// 当前库存和需要补货的最低库存
private int currentStock;
private int minimumStock;
// Hibernate 所需的无参构造函数(可以是 protected)
protected Article() {
}
|
- 第 14–15 行:表名为 [articles],与第 10 章相同。参数 [uniqueConstraints] 声明一个名为 [uk_articles_name] 的唯一性约束,作用于列 [name]:两件商品不能同名。如果没有显式的名称,Hibernate 会生成一个难以阅读的名称([UK3f8k...]),它会出现在错误消息中;
- 第 24–25 行:一个必填的名称,不超过 30 个字符;
- 第 28–29 行:价格,类型为 [decimal(10,2)]。
[BaseArticles] 类包含 [hbarticles] 数据库的 Hibernate 配置:
| package articles;
import java.math.BigDecimal;
import org.hibernate.SessionFactory;
import org.hibernate.cfg.AvailableSettings;
import org.hibernate.jpa.HibernatePersistenceConfiguration;
import tools.SqlLog;
// [hbarticles] 数据库:Hibernate 配置和数据库初始化
public final class BaseArticles {
// 数据库;如果不存在,MySQL 会创建它(createDatabaseIfNotExist)
public static final String URL = "jdbc:mysql://localhost:3306/hbarticles?createDatabaseIfNotExist=true";
public static final String USER = "root";
public static final String PASSWORD = "";
// 工具类:没有实例
private BaseArticles() {
}
// Hibernate 配置:实体、数据库、所记录 SQL 的格式化
public static HibernatePersistenceConfiguration configuration() {
return new HibernatePersistenceConfiguration("articles")
.managedClass(Article.class)
.jdbcUrl(URL)
.jdbcCredentials(USER, PASSWORD)
.property(AvailableSettings.FORMAT_SQL, true);
}
// 使用上述配置的 [hbarticles] 数据库的 SessionFactory
public static SessionFactory createSessionFactory() {
return configuration().createEntityManagerFactory();
}
// (重新)创建带有六件商品的 [articles] 表,不带 SQL 日志
public static void initialize(SessionFactory sessionFactory) {
SqlLog.withoutLog(() -> {
// 先删除再创建各实体的表
sessionFactory.getSchemaManager().drop(false);
sessionFactory.getSchemaManager().create(false);
// 六件商品,在事务中添加
sessionFactory.inTransaction(session -> {
session.persist(new Article("bike", BigDecimal.valueOf(500), 10, 5));
session.persist(new Article("pump", BigDecimal.valueOf(10), 10, 2));
session.persist(new Article("bow", BigDecimal.valueOf(600), 4, 1));
session.persist(new Article("arrows - set of 6", BigDecimal.valueOf(100), 12, 20));
session.persist(new Article("diving suit", BigDecimal.valueOf(300), 8, 2));
session.persist(new Article("diver's oxygen tanks", BigDecimal.valueOf(120), 10, 5));
});
});
}
}
|
- 第 13–15 行:数据库的 URL 和用户,二者都是公开的,以便其他模块使用;
- 第 22–28 行:Hibernate 配置。它由一个公共方法返回,这使得调用方可以在创建 [SessionFactory] 之前对其进行补充。[FORMAT_SQL] 属性([hibernate.format_sql])指示 Hibernate 格式化 SQL,然后把它传递给 [org.hibernate.SQL] 日志:随后由 [SqlLog] 类压缩的正是这些已格式化的数据;
- 第 31–33 行:[hbarticles] 数据库的 [SessionFactory] ;
- 第 36–51 行:一个重建 [articles] 表并填入其六件商品的方法,不记录 SQL 日志:我们不想在示例结果中看到这次初始化的 SQL;
- 第 42 行:[sessionFactory.inTransaction(session -> ...)] 打开一个会话,开始一个事务,把会话传递给 lambda 表达式(第 7 章)并执行它,提交事务(如果 lambda 表达式抛出异常则回滚),然后关闭会话。这是编写工作单元最简短的方式;我们会经常使用它及其变体 [inSession] (不带事务的会话)、[fromTransaction]、和 [fromSession] (返回 lambda 表达式的结果)。
[articles] 模块依赖于 [tools] 模块、Hibernate 和 JDBC 驱动程序:
| <dependencies>
<!-- 紧凑的 SQL 日志(以及 Logback) -->
<dependency>
<groupId>examples.hibernate</groupId>
<artifactId>tools</artifactId>
</dependency>
<!-- Hibernate 和 MySQL JDBC 驱动程序 -->
<dependency>
<groupId>org.hibernate.orm</groupId>
<artifactId>hibernate-core</artifactId>
</dependency>
<dependency>
<groupId>com.mysql</groupId>
<artifactId>mysql-connector-j</artifactId>
</dependency>
</dependencies>
|
因此,示例模块只需要一个依赖,即 [articles] 模块的依赖;Maven 会添加该模块的依赖(它们称为传递依赖)。下面是 [crud] 模块的依赖:
| <dependencies>
<!-- [Article] 实体和 [hbarticles] 数据库(包含 Hibernate、MySQL 和 SQL 日志) -->
<dependency>
<groupId>examples.hibernate</groupId>
<artifactId>articles</artifactId>
</dependency>
</dependencies>
|
11.4.3. 配置 Hibernate 的其他方式
我们使用 [HibernatePersistenceConfiguration] 以编程方式配置 Hibernate。还有其他方式,可以在应用程序和文档中见到:
- [META-INF/persistence.xml] 文件,这是 Jakarta Persistence 中使用的传统方式:它描述一个或多个持久化单元(实体类、连接属性、选项),工厂通过 [Persistence.createEntityManagerFactory("articles")] 创建;
- [hibernate.properties] (或 [hibernate.cfg.xml])文件,是 Hibernate 特有的,由 [org.hibernate.cfg.Configuration] 类读取:[new Configuration().addAnnotatedClass(Article.class).buildSessionFactory()]。这是旧版 Hibernate 中使用的方式;
- 在 Spring Boot 应用程序中,使用属性 [spring.datasource.*] 和 [spring.jpa.*] (来自文件 [application.properties]):Spring Boot 自己创建工厂。
各处的属性都是相同的([hibernate.format_sql]、[jakarta.persistence.jdbc.url]……):变化的只是指定它们的方式。
11.5. 基本操作:添加、读取、更新、删除
11.5.1. [crud] 程序
[crud] 模块演示了四种基本操作(CRUD:创建、读取、更新、删除),以及会话对实体的跟踪。为了让这种跟踪可见,它使用了 Hibernate 的一些内部方法(其“SPI”,即服务提供者接口),这些方法是为 Hibernate 扩展而不是应用程序准备的:它们集中放在程序末尾的工具方法中。
| package crud;
import articles.Article;
import articles.BaseArticles;
import java.math.BigDecimal;
import java.util.Map;
import java.util.Objects;
import org.hibernate.Session;
import org.hibernate.SessionFactory;
import org.hibernate.Transaction;
import org.hibernate.engine.spi.EntityEntry;
import org.hibernate.engine.spi.PersistenceContext;
import org.hibernate.engine.spi.SessionImplementor;
import org.hibernate.persister.entity.EntityPersister;
public class Main {
public static void main(String[] args) {
try (SessionFactory sessionFactory = BaseArticles.createSessionFactory()) {
// [articles] 表被重新创建,并带有六件商品
BaseArticles.initialize(sessionFactory);
try (Session session = sessionFactory.openSession()) {
// 1 - 按主键搜索
IO.println("--- find(1)");
Article bike = session.find(Article.class, 1);
IO.println(bike);
IO.println("--- find(1) a second time");
Article bike2 = session.find(Article.class, 1);
IO.println("same object: " + (bike == bike2));
// 2 - 添加商品
IO.println("--- persist");
Transaction transaction = session.beginTransaction();
Article x = new Article("x", BigDecimal.valueOf(100), 10, 1);
IO.println("before persist: state=" + state(session, x) + ", id=" + x.getId());
session.persist(x);
IO.println("after persist: state=" + state(session, x) + ", id=" + x.getId());
transaction.commit();
// 3 - 修改:只需修改对象即可
IO.println("--- modification of the price");
transaction = session.beginTransaction();
x.setPrice(x.getPrice().multiply(new BigDecimal("1.1")));
IO.println("session modified: %s, original price=%s, current price=%s"
.formatted(session.isDirty(), originalValue(session, x, "price"), x.getPrice()));
IO.println("--- commit");
transaction.commit();
IO.println("after commit: session modified: " + session.isDirty());
// 4 - 删除
IO.println("--- remove");
transaction = session.beginTransaction();
session.remove(x);
IO.println("before commit: state=" + state(session, x));
transaction.commit();
IO.println("after commit: state=" + state(session, x));
// 5 - 游离对象,修改后与会话合并
IO.println("--- detach and merge");
Article bow = session.find(Article.class, 3);
session.detach(bow);
IO.println("after detach: state=" + state(session, bow));
bow.setPrice(BigDecimal.valueOf(550));
transaction = session.beginTransaction();
Article managedBow = session.merge(bow);
IO.println("merge: same object=%s, state of the returned object=%s"
.formatted(bow == managedBow, state(session, managedBow)));
transaction.commit();
// 6 - 会话跟踪的实体
IO.println("--- the tracked entities");
bike.setCurrentStock(bike.getCurrentStock() - 1);
displayTrackedEntities(session);
}
}
}
// 商品相对于会话的状态(Hibernate 内部 API)
private static String state(Session session, Article article) {
EntityEntry entry = context(session).getEntry(article);
if (entry != null) {
// MANAGED、DELETED……
return entry.getStatus().name();
}
// 会话不认识的对象:从未保存(没有标识符)或已游离
return article.getId() == null ? "TRANSIENT" : "DETACHED";
}
// 属性从数据库读取时的值(Hibernate 内部 API)
private static Object originalValue(Session session, Object entity, String property) {
return context(session).getEntry(entity).getLoadedValue(property);
}
// 会话的持久化上下文中的实体(Hibernate 内部 API)
private static void displayTrackedEntities(Session session) {
for (Map.Entry<Object, EntityEntry> pair : context(session).reentrantSafeEntityEntries()) {
EntityEntry entry = pair.getValue();
EntityPersister persister = entry.getPersister();
IO.println("%s #%s %s".formatted(persister.getEntityName(), entry.getId(), entry.getStatus()));
// 属性的当前值,与从数据库读取的值比较
String[] names = persister.getPropertyNames();
Object[] current = persister.getValues(pair.getKey());
Object[] originals = entry.getLoadedState();
for (int i = 0; i < names.length; i++) {
String modification = Objects.equals(current[i], originals[i]) ? ""
: " (modified, original value: " + originals[i] + ")";
IO.println(" %s : %s%s".formatted(names[i], current[i], modification));
}
}
IO.println("session modified: " + session.isDirty());
}
// 会话的持久化上下文(Hibernate 内部 API)
private static PersistenceContext context(Session session) {
return session.unwrap(SessionImplementor.class).getPersistenceContext();
}
}
|
结果:
| > mvn compile exec:java
--- find(1)
SQL> select a1_0.id, a1_0.currentStock, a1_0.minimumStock, a1_0.name, a1_0.price
SQL> from articles a1_0
SQL> where a1_0.id=?
SQL> -- parameter 1 = 1
[1, bike, 500.00, 10, 5]
--- find(1) a second time
same object: true
--- persist
SQL> -- start of transaction
before persist: state=TRANSIENT, id=null
SQL> insert into articles (currentStock, minimumStock, name, price)
SQL> values (?, ?, ?, ?)
SQL> -- parameter 1 = 10
SQL> -- parameter 2 = 1
SQL> -- parameter 3 = x
SQL> -- parameter 4 = 100
after persist: state=MANAGED, id=7
SQL> -- transaction committed (COMMIT)
--- modification of the price
SQL> -- start of transaction
session modified: true, original price=100, current price=110.0
--- commit
SQL> update articles
SQL> set currentStock=?, minimumStock=?, name=?, price=?
SQL> where id=?
SQL> -- parameter 1 = 10
SQL> -- parameter 2 = 1
SQL> -- parameter 3 = x
SQL> -- parameter 4 = 110.0
SQL> -- parameter 5 = 7
SQL> -- transaction committed (COMMIT)
after commit: session modified: false
--- remove
SQL> -- start of transaction
before commit: state=DELETED
SQL> delete from articles
SQL> where id=?
SQL> -- parameter 1 = 7
SQL> -- transaction committed (COMMIT)
after commit: state=DETACHED
--- detach and merge
SQL> select a1_0.id, a1_0.currentStock, a1_0.minimumStock, a1_0.name, a1_0.price
SQL> from articles a1_0
SQL> where a1_0.id=?
SQL> -- parameter 1 = 3
after detach: state=DETACHED
SQL> -- start of transaction
SQL> select a1_0.id, a1_0.currentStock, a1_0.minimumStock, a1_0.name, a1_0.price
SQL> from articles a1_0
SQL> where a1_0.id=?
SQL> -- parameter 1 = 3
merge: same object=false, state of the returned object=MANAGED
SQL> update articles
SQL> set currentStock=?, minimumStock=?, name=?, price=?
SQL> where id=?
SQL> -- parameter 1 = 4
SQL> -- parameter 2 = 1
SQL> -- parameter 3 = bow
SQL> -- parameter 4 = 550
SQL> -- parameter 5 = 3
SQL> -- transaction committed (COMMIT)
--- the tracked entities
articles.Article #1 MANAGED
currentStock : 9 (modified, original value: 10)
minimumStock : 5
name : bike
price : 500.00
articles.Article #3 MANAGED
currentStock : 4
minimumStock : 1
name : bow
price : 550
session modified: true
|
说明:
- 第 25 行:[session.find(Article.class, 1)] 查找主键为 1 的记录。如果该键不存在,则返回 [null] 。生成的 SQL(结果的第 3–6 行)是一条参数化的 [SELECT],其中参数被设置为 1:紧凑日志现在显示了参数值;
- 第 28 行:第二次调用 [find(Article.class, 1)] 不会发送任何 SQL 命令,并返回同一个对象(第 9 行)。会话把它读取或保存的实体存储在其持久化上下文中,也称为一级缓存:在查询数据库之前,[find] 会检查所请求的实体是否已经在其中。会话中绝不会有两个对应于数据库中同一行的对象;
- 第 34–37 行:添加一件商品。在 [persist] 之前,对象处于 [TRANSIENT] (“瞬时”)状态:会话不认识它,其标识符为 [null] (第 12 行)。[persist] 将其纳入会话,会话立即执行 [INSERT] 命令(第 13–18 行)以获取生成的键,并把它放入字段 [id] 中。此后该商品处于 [MANAGED] (“受管”或“持久”)状态,其标识符为 7(第 19 行)。事务在第 33 行开启,在第 38 行提交(结果的第 11 行和第 20 行);
- 第 43 行:要修改数据库中的一行,只需修改对象。不需要 [update] 方法:会话保留了所读取或保存的值的副本(原始状态),并把当前值与之比较。这就是 所谓的 “脏检查”(dirty checking);
- 第 44–45 行:[session.isDirty()] 指示会话中是否有尚未提交到数据库的更改:此处确实有(第 23 行)。[originalValue] 方法(第 90–92 行)从持久化上下文中读取价格的原始值 100,而当前值是 110.0;
- 第 47 行:[commit] 使会话与数据库同步(“flush”):执行 [UPDATE] 命令(第 25–32 行),然后提交事务。之后,会话没有待处理的更改(第 34 行);
- 请注意,[UPDATE] 命令会写入表中的所有列,而不仅仅是改变了的那一列。这是 Hibernate 的默认行为:所有商品的更新都使用一次性准备好的同一条 SQL 命令。相反,放在实体上的 [@DynamicUpdate] 注解会指示它每次都生成只限于被修改列的查询;
- 第 53–56 行:删除。[remove] 把商品的状态改为 [DELETED] (第 37 行);[commit] 发送 [DELETE] 命令(第 38–40 行)。此后会话不再认识该对象:它变成 [DETACHED] (“游离”,第 42 行);
- 第 60–63 行:读取弓(第 44–47 行),然后通过 [detach] 将其从会话中分离:会话忘记了它(第 48 行)。此后对其价格的任何更改都会被忽略。游离对象在应用程序中很常见:它是由现已关闭的会话读取的对象(例如在先前的 HTTP 查询期间),随后被用户修改;
- 第 65 行:[session.merge(bow)] 把游离对象合并到会话中。会话从数据库读取该记录(第 50–53 行),把游离对象的状态复制到它所管理的实体中,并返回后者:这并不是同一个对象(第 54 行)。传给 [merge] 的对象仍然是游离的;返回的对象才是接下来必须使用的对象。[commit] 保存新价格(第 55–62 行);
- 第 72 行:更新自行车的库存,但不保存;
- 第 95–111 行:显示持久化上下文。对于每个被跟踪的实体([EntityEntry]),显示其名称、ID 和状态,然后是每个属性的当前值,以及(如果不同的话)其原始值。[EntityPersister] 对象是 Hibernate 中了解实体与其表之间映射的对象:它提供属性的名称及其值;
- 结果的第 65–75 行:会话跟踪着自行车(其库存已从 10 变为 9)和弓。对自行车的更改没有被保存:会话在未同步的情况下就被关闭了。没有 [commit],而且会话在关闭时不会自动同步。
11.5.2. 实体的状态
相对于某个会话,实体处于以下状态之一(Jakarta Persistence 称之为“新建”“受管”“游离”和“已移除”):
状态 | 含义 |
瞬时([TRANSIENT]) | 该对象由 [new] 创建,从未被保存:它没有标识符,也没有任何会话知道它 |
受管([MANAGED]) | 该对象已被会话读取或保存,会话正在跟踪它:对它的更改将在下一次同步时反映到数据库中 |
已删除([DELETED]) | 该对象已被标记为删除([remove]):下一次同步将发送 [DELETE] 命令 |
游离([DETACHED]) | 该对象对应于数据库中的一行,但读取它的会话已经关闭或已经忘记了它([detach]、[clear]):它的更改会被忽略,除非把它合并到某个会话中([merge]) |
会话同步 (“flush”)把 SQL 命令发送给 DBMS,从而把对受管实体的更改传播出去。这发生在:
- 事务的 [commit] 阶段 ;
- 在执行其结果可能依赖于尚未提交的更改的查询之前([FlushMode.AUTO] 模式,即默认模式):这样,查询就能看到会话中的数据;
- 显式调用 [session.flush()] 时。此时命令会被执行,但要等到事务的 [commit] 时才会被永久提交。
下面概述 Hibernate 的工作流程:我们打开一个会话和一个事务,读取实体,把它们当作普通对象来修改,添加([persist])和删除([remove])实体,然后提交事务,由事务把所有必要的命令一次性批量发送到数据库。会话起着“工作单元”的作用。它是为短生命周期设计的轻量级对象:一个工作单元,例如 Web 应用程序中的一次 HTTP 查询。你不会在应用程序的整个生命周期中使用同一个会话;否则,它会在其持久化上下文中累积被跟踪的实体。
11.6. HQL 查询
11.6.1. HQL 与 JPQL
要通过主键以外的方式获取实体,需要用一种类似 SQL 的语言来编写查询,但这种语言引用的是实体和属性,而不是表和列:HQL (Hibernate Query Language,Hibernate 查询语言)。Jakarta Persistence 定义了一种类似的语言 JPQL (Jakarta Persistence Query Language),HQL 是它的超集:JPQL 查询是有效的 HQL 查询。Hibernate 按 DBMS 的方言把查询翻译成 SQL,再由 DBMS 执行。
与 SQL 的一些区别:
- 我们使用实体名([Article]),而不是表名([articles]),并使用属性名([currentStock]),而不是列名。实体名和属性名区分大小写,就像在 Java 中一样;
- 在 HQL 中,[select] 子句是可选的:[from Article] 返回 [Article] 实体。JPQL 则要求写成 [select a from Article a];
- 实体之间的关系用点号来遍历([p.category.name]),连接由 Hibernate 自己编写,我们稍后会看到。
查询由会话的 [createSelectionQuery] 方法(Hibernate 6)创建,它以 HQL 文本和结果类型为参数,并返回一个 [SelectionQuery<T>] 对象。然后可以设置其参数,并用 [getResultList] (列表)、[getSingleResult] (单个结果;如果没有结果或有多个结果则抛出异常)、[getSingleResultOrNull] (没有结果时返回 [null] ),或 [getResultStream](流)来执行它。Jakarta Persistence 的 [createQuery] 方法也存在;它既用于读取查询,也用于更新。
11.6.2. 程序 [hql]
模块 [hql] 提供了若干查询示例:
| package hql;
import articles.Article;
import articles.BaseArticles;
import java.math.BigDecimal;
import java.util.List;
import java.util.stream.Collectors;
import java.util.stream.Stream;
import org.hibernate.Session;
import org.hibernate.SessionFactory;
import org.hibernate.query.SemanticException;
public class Main {
// 投影:商品的名称及其库存值
record StockValue(String name, BigDecimal value) {
}
public static void main(String[] args) {
try (SessionFactory sessionFactory = BaseArticles.createSessionFactory()) {
// [articles] 表被重新创建,并带有六件商品
BaseArticles.initialize(sessionFactory);
try (Session session = sessionFactory.openSession()) {
// 1 - 过滤与排序
IO.println("--- the articles to restock, in alphabetical order");
String hql = "from Article where currentStock < minimumStock order by name";
List<Article> toOrder = session.createSelectionQuery(hql, Article.class).getResultList();
toOrder.forEach(IO::println);
// 2 - 投影:只请求有用的列
IO.println("--- value of the stock of each article");
List<StockValue> values = session
.createSelectionQuery("""
select name, price * currentStock from Article
order by price * currentStock desc""", StockValue.class)
.getResultList();
for (StockValue v : values) {
IO.println("%s : %.2f euros".formatted(v.name(), v.value()));
}
// 3 - 单个结果;值 [minPrice] 通过命名参数传递
IO.println("--- the first article over 200 euros");
BigDecimal minPrice = BigDecimal.valueOf(200);
Article article = session
.createSelectionQuery("""
select a from Article a
where a.price > :minPrice order by a.price""", Article.class)
.setParameter("minPrice", minPrice)
.setMaxResults(1)
.getSingleResultOrNull();
IO.println(article == null ? "none" : article);
// 4 - 聚合:由 DBMS 完成计算
IO.println("--- aggregates");
long nbArticles = session.createSelectionQuery("select count(*) from Article", Long.class)
.getSingleResult();
BigDecimal stockValue = session
.createSelectionQuery("select sum(price * currentStock) from Article", BigDecimal.class)
.getSingleResult();
IO.println("%d articles, value of the stock: %.2f euros".formatted(nbArticles, stockValue));
// 5 - like 和 in;用 Java 列表作为参数的值
IO.println("--- like and in");
List<String> names = List.of("bow", "pump", "racket");
List<String> results = session
.createSelectionQuery("""
select name from Article
where name like 'b%' or name in :names""", String.class)
.setParameter("names", names)
.getResultList();
IO.println(String.join(", ", results));
// 6 - 分页:按价格升序,每页两件商品的第三页
IO.println("--- pagination");
int pageSize = 2, pageNumber = 3;
List<Article> page = session.createSelectionQuery("from Article order by price", Article.class)
.setFirstResult((pageNumber - 1) * pageSize)
.setMaxResults(pageSize)
.getResultList();
IO.println("page %d : %s".formatted(pageNumber, page.stream()
.map(a -> "%s (%.2f euros)".formatted(a.getName(), a.getPrice()))
.collect(Collectors.joining(", "))));
// 7 - 不正确的查询在创建时就被拒绝,无需等到执行
IO.println("--- incorrect query");
try {
session.createSelectionQuery("from Article where stock < minimumStock", Article.class);
} catch (SemanticException e) {
IO.println(e.getClass().getSimpleName() + " : " + e.getMessage());
}
// 8 - 用 Java 编写的规则无法转换为 SQL:内存中过滤
IO.println("--- in-memory filtering");
try (Stream<Article> stream = session
.createSelectionQuery("from Article", Article.class)
.getResultStream()) {
stream.filter(Rules::isOutOfStock).forEach(IO::println);
}
}
}
}
// 用 Java 编写的业务规则
static final class Rules {
private Rules() {
}
// 如果商品的库存低于最低库存,则该商品缺货
static boolean isOutOfStock(Article a) {
return a.getCurrentStock() < a.getMinimumStock();
}
}
}
|
结果:
| > mvn compile exec:java
--- the articles to restock, in alphabetical order
SQL> select a1_0.id, a1_0.currentStock, a1_0.minimumStock, a1_0.name, a1_0.price
SQL> from articles a1_0
SQL> where a1_0.currentStock<a1_0.minimumStock
SQL> order by a1_0.name
[4, arrows - set of 6, 100.00, 12, 20]
--- value of the stock of each article
SQL> select a1_0.name, (a1_0.price*a1_0.currentStock)
SQL> from articles a1_0
SQL> order by (a1_0.price*a1_0.currentStock) desc
bike : 5000.00 euros
bow : 2400.00 euros
diving suit : 2400.00 euros
arrows - set of 6 : 1200.00 euros
diver's oxygen tanks : 1200.00 euros
pump : 100.00 euros
--- the first article over 200 euros
SQL> select a1_0.id, a1_0.currentStock, a1_0.minimumStock, a1_0.name, a1_0.price
SQL> from articles a1_0
SQL> where a1_0.price>?
SQL> order by a1_0.price
SQL> limit ?
SQL> -- parameter 1 = 200
SQL> -- parameter 2 = 1
[5, diving suit, 300.00, 8, 2]
--- aggregates
SQL> select count(*)
SQL> from articles a1_0
SQL> select sum((a1_0.price*a1_0.currentStock))
SQL> from articles a1_0
6 articles, value of the stock: 12300.00 euros
--- like and in
SQL> select a1_0.name
SQL> from articles a1_0
SQL> where a1_0.name like 'b%' escape '' or a1_0.name in (?, ?, ?)
SQL> -- parameter 1 = bow
SQL> -- parameter 2 = pump
SQL> -- parameter 3 = racket
bike, bow, pump
--- pagination
SQL> select a1_0.id, a1_0.currentStock, a1_0.minimumStock, a1_0.name, a1_0.price
SQL> from articles a1_0
SQL> order by a1_0.price
SQL> limit ?, ?
SQL> -- parameter 1 = 4
SQL> -- parameter 2 = 2
page 3 : bike (500.00 euros), bow (600.00 euros)
--- incorrect query
SemanticException : Could not interpret path expression 'stock'
--- in-memory filtering
SQL> select a1_0.id, a1_0.currentStock, a1_0.minimumStock, a1_0.name, a1_0.price
SQL> from articles a1_0
[4, arrows - set of 6, 100.00, 12, 20]
|
说明:
- 第 26–27 行:[where] 子句比较实体的两个属性;[order by] 子句按名称排序:它们变成 SQL 命令中的 [WHERE] 和 [ORDER BY] 子句(第 5–6 行)。查询由 [getResultList] 执行;
- 第 32–36 行:投影。该查询返回的不是实体,而是每件商品的两个值:名称和库存价值。生成的 SQL(第 9 行)只请求必要的列,并自己完成计算。结果类型是第 16–17 行中的 [StockValue] 记录:Hibernate 为每一行创建一条记录,把 [select] 子句中的值按顺序传给其构造函数。这些对象不是实体:会话不会跟踪它们。查询写在文本块中(Java 15,第 3 章),这比长字符串更易读;
- 第 44–50 行:一个按 JPQL 风格编写、带有别名([a])的查询。[:minPrice] 是一个命名参数,其值由 [setParameter] 给出。它变成 SQL 命令的一个参数(第 21 行):因此我们不必担心 SQL 注入,因为该值与命令文本是分开传输的。这正是第 10 章对预编译查询所应用的规则。[setMaxResults(1)] 将结果限制为一行:即 MySQL 的 [LIMIT] 子句(第 23 行)。另一方面,写在查询文本中的字面值(例如第 68 行的 ['b%'] :结果的第 36 行)会被原样复制到 SQL 命令文本中:来自程序外部的值必须始终作为参数传递;
- 第 55–59 行:聚合函数 [count] 和 [sum] 由 DBMS 计算(第 28–31 行):只传输结果,而不传输各行。HQL 还支持 [avg]、[min]、[max],以及 [group by]、和 [having] 子句;
- 第 65–70 行:SQL 的运算符 [like] ,以及运算符 [in],其操作数是一个接受 Java 列表的参数:Hibernate 会把它展开成与列表元素数量一样多的 SQL 参数(第 36 行)。HQL 支持大量针对字符串([upper]、[length]、[substring]……)、日期和数字的函数,并把它们翻译成 DBMS 的方言;
- 第 76–79 行:分页,用于逐页显示一个很长的列表。[setFirstResult] 跳过前面各页的条目,而 [setMaxResults] 保留所请求页的条目:即 MySQL 的 [LIMIT ?, ?] 子句(第 45–47 行)。分页只有在已排序的列表上才有意义([order by])。第 80–82 行使用流和 [Collectors.joining] (第 5 章)构造页面的显示;
- 第 86–90 行:一个使用不存在的属性 [stock] 的查询。错误在创建查询时、任何执行之前就被检测到,因为 Hibernate 会解析 HQL 文本并将其与模型比较:它抛出 [SemanticException] (第 50 行;Hibernate 的消息是英文的)。语法错误则会导致 [SyntaxException];
- 第 94–98 行:查询不能使用 Java 方法,例如 [Rules.isOutOfStock] (第 110–112 行):Hibernate 不了解这段代码,即使了解,也不一定知道如何把它写成 SQL。可以读取所有实体,并使用流 API 在内存中过滤它们:[getResultStream] 返回 [Stream<Article>] (使用后必须关闭,因此使用带资源的 [try] 语句)。结果是正确的(第 54 行),但整张表都被传输了(第 52–53 行):对于大表,应避免这样做。最好像第 26 行那样把条件放进查询中。
11.6.3. 命名查询与编译时验证
写在字符串中的查询只在运行时才被解析。有两种方法可以更早地发现错误:
- 命名查询:注解
***[@NamedQuery(name = "Article.outOfStock", query = "from Article where currentStock < minimumStock")]***,放在实体上,声明一个查询,Hibernate 在启动时、创建 *[SessionFactory]* 时解析它。随后通过其名称来执行它:[session.createNamedSelectionQuery("Article.outOfStock", Article.class)];
- Hibernate 的注解处理器 (“Hibernate Processor”,库 [org.hibernate.orm:hibernate-processor]),在编译器配置中声明([annotationProcessorPaths] ,位于 [maven-compiler-plugin] 中)。它在编译期间由 [javac] 执行,检查注解中的查询,并为每个实体生成一个“元模型”类([Article_] 对应 [Article]),我们在 Criteria API 中还会再次遇到它。本课程不使用它。
11.7. Criteria API
11.7.1. 用代码构建查询
HQL 查询是一个可以通过拼接构造的字符串:一旦查询依赖于许多可选条件(例如搜索表单),这种做法就既不可靠又难以阅读。Jakarta Persistence 提供了另一种编写查询的方式:Criteria API,其中查询是通过方法调用构造的对象树。Hibernate 把这棵树翻译成 SQL,就像处理 HQL 查询一样(它也会把 HQL 翻译成这样的树)。[criteria] 模块复用了前一个程序中的若干查询:
| package criteria;
import articles.Article;
import articles.BaseArticles;
import jakarta.persistence.criteria.CriteriaQuery;
import jakarta.persistence.criteria.Expression;
import jakarta.persistence.criteria.Predicate;
import jakarta.persistence.criteria.Root;
import java.math.BigDecimal;
import java.util.ArrayList;
import java.util.List;
import org.hibernate.Session;
import org.hibernate.SessionFactory;
import org.hibernate.query.criteria.HibernateCriteriaBuilder;
public class Main {
// 投影:商品的名称及其库存值
record StockValue(String name, BigDecimal value) {
}
public static void main(String[] args) {
try (SessionFactory sessionFactory = BaseArticles.createSessionFactory()) {
// [articles] 表被重新创建,并带有六件商品
BaseArticles.initialize(sessionFactory);
try (Session session = sessionFactory.openSession()) {
// 查询元素的工厂
HibernateCriteriaBuilder cb = session.getCriteriaBuilder();
// 1 - 过滤与排序
IO.println("--- the articles to restock, in alphabetical order");
CriteriaQuery<Article> query = cb.createQuery(Article.class);
Root<Article> a = query.from(Article.class);
query.select(a)
.where(cb.lt(a.<Integer>get("currentStock"), a.<Integer>get("minimumStock")))
.orderBy(cb.asc(a.get("name")));
session.createSelectionQuery(query).getResultList().forEach(IO::println);
// 2 - 投影到记录
IO.println("--- value of the stock of each article");
CriteriaQuery<StockValue> projection = cb.createQuery(StockValue.class);
Root<Article> p = projection.from(Article.class);
Expression<BigDecimal> value = cb
.prod(p.<BigDecimal>get("price"), p.<Integer>get("currentStock"))
.as(BigDecimal.class);
projection.select(cb.construct(StockValue.class, p.get("name"), value))
.orderBy(cb.desc(value));
for (StockValue v : session.createSelectionQuery(projection).getResultList()) {
IO.println("%s : %.2f euros".formatted(v.name(), v.value()));
}
// 3 - 根据所提供的条件构建的查询
IO.println("--- search: maximum price 150 euros");
search(session, BigDecimal.valueOf(150), null).forEach(IO::println);
IO.println("--- search: maximum price 150 euros and name starting with [d]");
search(session, BigDecimal.valueOf(150), "d").forEach(IO::println);
// 4 - 聚合
IO.println("--- aggregates");
CriteriaQuery<Long> count = cb.createQuery(Long.class);
count.select(cb.count(count.from(Article.class)));
long nbArticles = session.createSelectionQuery(count).getSingleResult();
CriteriaQuery<BigDecimal> sum = cb.createQuery(BigDecimal.class);
Root<Article> s = sum.from(Article.class);
sum.select(cb.sum(cb
.prod(s.<BigDecimal>get("price"), s.<Integer>get("currentStock"))
.as(BigDecimal.class)));
BigDecimal stockValue = session.createSelectionQuery(sum).getSingleResult();
IO.println("%d articles, value of the stock: %.2f euros".formatted(nbArticles, stockValue));
}
}
}
// 价格不超过 [maxPrice] 且名称以 [nameStart] 开头的商品,
// 每个条件仅在不为 null 时才使用
static List<Article> search(Session session, BigDecimal maxPrice, String nameStart) {
HibernateCriteriaBuilder cb = session.getCriteriaBuilder();
CriteriaQuery<Article> query = cb.createQuery(Article.class);
Root<Article> a = query.from(Article.class);
// 条件,逐个添加
List<Predicate> conditions = new ArrayList<>();
if (maxPrice != null) {
conditions.add(cb.le(a.get("price"), maxPrice));
}
if (nameStart != null) {
conditions.add(cb.like(a.get("name"), nameStart + "%"));
}
query.select(a).where(conditions.toArray(Predicate[]::new)).orderBy(cb.asc(a.get("price")));
return session.createSelectionQuery(query).getResultList();
}
}
|
结果:
| > mvn compile exec:java
--- the articles to restock, in alphabetical order
SQL> select a1_0.id, a1_0.currentStock, a1_0.minimumStock, a1_0.name, a1_0.price
SQL> from articles a1_0
SQL> where a1_0.currentStock<a1_0.minimumStock
SQL> order by a1_0.name
[4, arrows - set of 6, 100.00, 12, 20]
--- value of the stock of each article
SQL> select a1_0.name, (a1_0.price*a1_0.currentStock)
SQL> from articles a1_0
SQL> order by (a1_0.price*a1_0.currentStock) desc
bike : 5000.00 euros
bow : 2400.00 euros
diving suit : 2400.00 euros
arrows - set of 6 : 1200.00 euros
diver's oxygen tanks : 1200.00 euros
pump : 100.00 euros
--- search: maximum price 150 euros
SQL> select a1_0.id, a1_0.currentStock, a1_0.minimumStock, a1_0.name, a1_0.price
SQL> from articles a1_0
SQL> where a1_0.price<=?
SQL> order by a1_0.price
SQL> -- parameter 1 = 150
[2, pump, 10.00, 10, 2]
[4, arrows - set of 6, 100.00, 12, 20]
[6, diver's oxygen tanks, 120.00, 10, 5]
--- search: maximum price 150 euros and name starting with [d]
SQL> select a1_0.id, a1_0.currentStock, a1_0.minimumStock, a1_0.name, a1_0.price
SQL> from articles a1_0
SQL> where a1_0.price<=? and a1_0.name like ? escape ''
SQL> order by a1_0.price
SQL> -- parameter 1 = 150
SQL> -- parameter 2 = d%
[6, diver's oxygen tanks, 120.00, 10, 5]
--- aggregates
SQL> select count(a1_0.id)
SQL> from articles a1_0
SQL> select sum((a1_0.price*a1_0.currentStock))
SQL> from articles a1_0
6 articles, value of the stock: 12300.00 euros
|
说明:
- 第 28 行:会话返回一个 [HibernateCriteriaBuilder],即 Jakarta Persistence 的 [CriteriaBuilder] 的 Hibernate 增强版:它是构造查询所有元素(条件、表达式、排序)的工厂;
- 第 32–36 行:第一个示例中的查询,即 HQL 查询。[createQuery(Article.class)] 创建一个返回商品的查询;[from(Article.class)] 声明被查询的实体并返回其根([Root<Article>]),它相当于 [from Article a] 中的别名 [a];[a.get("currentStock")] 指定一个属性。条件由 [cb.lt(x, y)] (“小于”,[x < y])构造,排序由 [cb.asc(...)] 构造。记法 [a.<Integer>get(...)] 为编译器提供了属性的类型,而字符串 ["currentStock"] 不允许编译器确定属性的类型;
- 第 37 行:该查询由会话作为 HQL 查询执行。生成的 SQL(第 3–6 行)与 HQL 查询的相同;
- 第 41–47 行:到记录 [StockValue] 上的投影。[cb.prod(x, y)] 是两个表达式的乘积;[as(BigDecimal.class)] 指定结果类型;[cb.construct(StockValue.class, ...)] 表示结果的每一行都必须传给记录的构造函数;
- 第 76–90 行:这正是 Criteria API 最有用的地方。[search] 方法根据提供给它的条件构造查询:只有当相应的条件不是 [null] 时,才会把每个条件添加到条件列表中,而 [where] 子句接收列表中的所有条件,并用 [and] 把它们组合起来。第一次调用(第 54 行)生成带一个条件的查询(第 21 行),而第二次调用(第 56 行)生成带两个条件的查询(第 30 行)。请注意,使用 Criteria API 时,Hibernate 会把这些值([150]、[d%])作为 SQL 命令中的参数传递;
- 第 60–68 行:聚合函数 [count] 和 [sum]。
11.7.2. 静态元模型
这些查询的弱点在于,属性是用字符串指定的([a.get("currentStock")]):拼写错误要到运行时才会被发现,而且编译器无视属性的类型。为了解决这个问题,Jakarta Persistence 提供了静态元模型:对于每个实体 [Article],都有一个类 [Article_] ,其中每个属性对应一个字段,描述其名称和类型。这样你就可以写 ***[cb.lt(a.get(Article\_.currentStock), a.get(Article\_.minimumStock))]***,编译器会对它进行完整验证。这些类不是手工编写的:它们是在编译期间由上面提到的 Hibernate 注解处理器生成的。在使用 Criteria API 的实际项目中,这是推荐的做法。
对于固定的查询,HQL 比 Criteria API 更易读;对于根据具体情况构造的查询,Criteria API 更安全。两者可以结合使用:Hibernate 允许你根据 HQL 字符串([cb.createQuery(hql, Article.class)])创建 Criteria 查询,然后用代码对其进行补充。
11.8. 关系
11.8.1. 商店模型
数据库中的表彼此关联。Hibernate 把这些关联表示为关联:引用另一个实体或实体集合的字段。[relations] 模块使用一个 [hbshop] 数据库,它描述一家有六个实体的小型商店。类别把产品归在一起:
| // 一个类别包含多个产品(一对多关系)
@Entity
@Table(name = "categories")
public class Category {
@Id
@GeneratedValue(strategy = GenerationType.IDENTITY)
private Integer id;
@Column(nullable = false, length = 30)
private String name;
// 类别的产品:关系的反向端,由 Product.category 描述
@OneToMany(mappedBy = "category", cascade = CascadeType.PERSIST)
private List<Product> products = new ArrayList<>();
protected Category() {
}
public Category(String name) {
this.name = name;
}
// 添加产品:关系的两端都被更新
public void add(Product product) {
products.add(product);
product.setCategory(this);
}
public Integer getId() {
return id;
}
public String getName() {
return name;
}
public List<Product> getProducts() {
return products;
}
}
|
产品属于某个类别,并带有标签:
| // 一个产品属于一个类别,并带有多个标签
@Entity
@Table(name = "products")
public class Product {
@Id
@GeneratedValue(strategy = GenerationType.IDENTITY)
private Integer id;
@Column(nullable = false, length = 30)
private String name;
@Column(nullable = false, precision = 10, scale = 2)
private BigDecimal price;
// 多对一关系:[products] 表的外键 [category_id]
@ManyToOne(fetch = FetchType.LAZY, optional = false)
@JoinColumn(name = "category_id", foreignKey = @ForeignKey(name = "fk_products_category"))
private Category category;
// 多对多关系,存储在关联表中
@ManyToMany(cascade = CascadeType.PERSIST)
@JoinTable(name = "products_tags",
joinColumns = @JoinColumn(name = "product_id"),
inverseJoinColumns = @JoinColumn(name = "tag_id"),
foreignKey = @ForeignKey(name = "fk_products_tags_product"),
inverseForeignKey = @ForeignKey(name = "fk_products_tags_tag"))
private Set<Tag> tags = new HashSet<>();
protected Product() {
}
public Product(String name, BigDecimal price, Tag... tags) {
this.name = name;
this.price = price;
// 只填写关系的拥有端:Hibernate 保存的就是它
this.tags.addAll(List.of(tags));
}
|
标签被分配给多个产品:
| // 一个标签(promo、new……)由多个产品携带
@Entity
@Table(name = "tags")
public class Tag {
@Id
@GeneratedValue(strategy = GenerationType.IDENTITY)
private Integer id;
@Column(nullable = false, length = 20)
private String label;
// 由 Product.tags 描述的关系的反向端
@ManyToMany(mappedBy = "tags")
private Set<Product> products = new HashSet<>();
protected Tag() {
}
public Tag(String label) {
this.label = label;
}
|
订单属于某个客户,并包含订单行:
| // 客户的一个订单,由若干行组成
@Entity
@Table(name = "orders")
public class CustomerOrder {
@Id
@GeneratedValue(strategy = GenerationType.IDENTITY)
private Integer id;
private LocalDate date;
@ManyToOne(fetch = FetchType.LAZY, optional = false)
@JoinColumn(name = "client_id")
private Client client;
@OneToMany(mappedBy = "order", cascade = CascadeType.PERSIST)
private List<OrderLine> lines = new ArrayList<>();
protected CustomerOrder() {
}
public CustomerOrder(LocalDate date) {
this.date = date;
}
// 添加一行:关系的两端都被更新
public void add(OrderLine line) {
lines.add(line);
line.setOrder(this);
}
|
实体 [Client] 和 [OrderLine] 建立在同一个模型之上。客户有 ID、姓名和订单列表([@OneToMany(mappedBy = "client", cascade = CascadeType.PERSIST)]),以及方法 [add(CustomerOrder)];订单行有 ID、数量和两个多对一关联:一个指向其订单,另一个指向其产品:
| // 订单行:某个产品的数量
@Entity
@Table(name = "order_lines")
public class OrderLine {
@Id
@GeneratedValue(strategy = GenerationType.IDENTITY)
private Integer id;
private int quantity;
@ManyToOne(fetch = FetchType.LAZY, optional = false)
@JoinColumn(name = "order_id")
private CustomerOrder order;
@ManyToOne(fetch = FetchType.LAZY, optional = false)
@JoinColumn(name = "product_id")
private Product product;
protected OrderLine() {
}
public OrderLine(Product product, int quantity) {
this.product = product;
this.quantity = quantity;
}
|
这个示例包含了全部三种类型的关联:
- 多对一关系([@ManyToOne]):产品属于某个类别(Product,第 17–19 行)。在数据库中,它由外键表示,即 [category_id] 列,位于表 [products] 中,其中 [@JoinColumn] 指定名称和约束名称([fk_products_category])。[optional = false] 强制该关系成立:该列将是 [NOT NULL];
- 反向的一对多关系([@OneToMany]):一个类别包含多个产品(Category,第 14–15 行)。它不会在数据库中创建任何东西:[mappedBy = "category"] 表示它由字段 [category] (属于实体 [Product])描述。[Product.category] 称为关系的拥有方,而 [Category.products] 是其反向方:Hibernate 保存拥有方的值。但是,两方在内存中必须保持一致:这就是 [add] 方法(Category,第 25–28 行)的作用,它把产品添加到列表中并设置其类别;
- 多对多关系([@ManyToMany]):一个产品有多个标签,一个标签与多个产品相关联。它存储在关联表 [products_tags] 中,其名称、两列的名称以及两个外键的名称由 [@JoinTable] 提供(Product,第 22–28 行)。反向的一方是 [Tag.products]([mappedBy = "tags"])。对于多对多关系,优先使用 [Set] 而不是 [List]:使用列表时,每次修改集合,Hibernate 都会删除并重新插入关联表中的所有行;
- [fetch = FetchType.LAZY] 要求对产品的类别进行懒加载:只有在用到时才会读取它。这是集合([@OneToMany]、[@ManyToMany])的默认行为,但不是指向单个实体的关系([@ManyToOne])的默认行为,标准默认会立即加载后者([EAGER]):按照 Hibernate 文档的建议,我们总是给它们加上 [fetch = FetchType.LAZY];
- [cascade = CascadeType.PERSIST] 传播 [persist] 操作:持久化类别会持久化其产品,持久化产品会持久化其标签。其他值([MERGE]、[REMOVE]、[ALL]……)传播其他操作;
- 集合用空集合初始化,而指向单个实体的关系的字段在被填充之前保持为 [null] 。方法 [setCategory]、[setClient]和 [setOrder] 不是公共的:只有同一个包中的 [add] 方法才会调用它们。
[Shop] 类为 [hbshop] 数据库配置 Hibernate,并在其中创建初始数据集:
| package relations;
import java.math.BigDecimal;
import java.time.LocalDate;
import org.hibernate.SessionFactory;
import org.hibernate.cfg.AvailableSettings;
import org.hibernate.jpa.HibernatePersistenceConfiguration;
import tools.SqlLog;
// [hbshop] 数据库:Hibernate 配置和第一批数据
public final class Shop {
private Shop() {
}
// [hbshop] 数据库及其六个实体的 SessionFactory
public static SessionFactory createSessionFactory() {
return new HibernatePersistenceConfiguration("shop")
.managedClasses(Category.class, Product.class, Tag.class,
Client.class, CustomerOrder.class, OrderLine.class)
.jdbcUrl("jdbc:mysql://localhost:3306/hbshop?createDatabaseIfNotExist=true")
.jdbcCredentials("root", "")
.property(AvailableSettings.FORMAT_SQL, true)
.createEntityManagerFactory();
}
// (重新)创建各表和第一批数据,不带 SQL 日志
public static void initialize(SessionFactory sessionFactory) {
SqlLog.withoutLog(() -> {
sessionFactory.getSchemaManager().drop(false);
sessionFactory.getSchemaManager().create(false);
sessionFactory.inTransaction(session -> {
// 两个标签
Tag promo = new Tag("promo");
Tag novelty = new Tag("new");
// 三个类别及其产品:一个对象图
Category cycles = new Category("cycles");
cycles.add(new Product("bike", BigDecimal.valueOf(500), promo));
Product pump = new Product("pump", BigDecimal.valueOf(10));
cycles.add(pump);
Category archery = new Category("archery");
Product bow = new Product("bow", BigDecimal.valueOf(600), novelty);
archery.add(bow);
archery.add(new Product("arrows - set of 6", BigDecimal.valueOf(100),
promo, novelty));
Category diving = new Category("diving");
// 持久化被传播到产品和标签(级联)
session.persist(cycles);
session.persist(archery);
session.persist(diving);
// 一个客户及其包含两行的订单
CustomerOrder order = new CustomerOrder(LocalDate.of(2026, 9, 28));
order.add(new OrderLine(pump, 2));
order.add(new OrderLine(bow, 1));
Client martin = new Client("Martin");
martin.add(order);
session.persist(martin);
});
});
}
}
|
- 第 19–20 行:六个实体,由 [managedClasses] 声明;
- 第 34–46 行:一个对象图:三个类别、它们的产品以及产品的标签;
- 第 48–50 行:只需持久化这些类别即可:得益于级联,Hibernate 会遍历这些关联,并按正确的顺序(先持久化类别,再持久化引用它们的产品)持久化它所到达的所有实体,同时填充外键和关联表;
- 第 52–57 行:一个客户、其订单及订单的两个订单行,在一次操作中被持久化。
Hibernate 创建的表如下:
| > mysql -uroot hbshop -e "SHOW TABLES; SHOW CREATE TABLE products\G SHOW CREATE TABLE products_tags\G"
Tables_in_hbshop
categories
clients
order_lines
orders
products
products_tags
tags
*************************** 1. row ***************************
Table: products
Create Table: CREATE TABLE `products` (
`id` int NOT NULL AUTO_INCREMENT,
`name` varchar(30) NOT NULL,
`price` decimal(10,2) NOT NULL,
`category_id` int NOT NULL,
PRIMARY KEY (`id`),
KEY `fk_products_category` (`category_id`),
CONSTRAINT `fk_products_category` FOREIGN KEY (`category_id`) REFERENCES `categories` (`id`)
) ENGINE=InnoDB AUTO_INCREMENT=5 DEFAULT CHARSET=utf8mb4 COLLATE=utf8mb4_0900_ai_ci
*************************** 1. row ***************************
Table: products_tags
Create Table: CREATE TABLE `products_tags` (
`product_id` int NOT NULL,
`tag_id` int NOT NULL,
PRIMARY KEY (`product_id`,`tag_id`),
KEY `fk_products_tags_tag` (`tag_id`),
CONSTRAINT `fk_products_tags_product` FOREIGN KEY (`product_id`) REFERENCES `products` (`id`),
CONSTRAINT `fk_products_tags_tag` FOREIGN KEY (`tag_id`) REFERENCES `tags` (`id`)
) ENGINE=InnoDB DEFAULT CHARSET=utf8mb4 COLLATE=utf8mb4_0900_ai_ci
|
- 第 3–9 行:每个实体一张表,以及关联表 [products_tags];
- 第 16–19 行:表 [products] 中的外键 [category_id] 引用表 [categories]。它是 [NOT NULL]([optional = false])。MySQL 会为每个外键创建一个索引(第 18 行)。与其他 ORM 不同,Hibernate 不要求在数据库中使用级联删除([ON DELETE CASCADE]):这可以通过 [@OnDelete(action = OnDeleteAction.CASCADE)] 注解实现;
- 第 23–30 行:关联表有两列,即指向两个相关表的外键,它们共同构成其主键。
11.8.2. 程序
| package relations;
import jakarta.persistence.EntityGraph;
import java.math.BigDecimal;
import java.time.LocalDate;
import java.util.List;
import java.util.stream.Collectors;
import org.hibernate.LazyInitializationException;
import org.hibernate.Session;
import org.hibernate.SessionFactory;
public class Main {
// 投影查询的结果
record ProductCategory(String product, String category) {
}
record OrderAmount(Integer id, String client, BigDecimal amount) {
}
record CategoryStatistics(String category, Long count, Double averagePrice) {
}
public static void main(String[] args) {
try (SessionFactory sessionFactory = Shop.createSessionFactory()) {
// 1 - 创建各表和第一批数据,不带日志
Shop.initialize(sessionFactory);
// 2 - 一个客户、其订单及订单行,一次性添加
IO.println("--- addition of a client, an order and its two lines");
sessionFactory.inTransaction(session -> {
Product bike = product(session, "bike");
Product arrows = product(session, "arrows - set of 6");
CustomerOrder order = new CustomerOrder(LocalDate.of(2026, 10, 1));
order.add(new OrderLine(bike, 1));
order.add(new OrderLine(arrows, 3));
Client client = new Client("Dupont");
client.add(order);
session.persist(client);
IO.println("client no. %d, order no. %d".formatted(client.getId(), order.getId()));
});
// 3 - 懒加载:关系按需读取
IO.println("--- lazy loading");
sessionFactory.inSession(session -> {
List<CustomerOrder> orders = session
.createSelectionQuery("from CustomerOrder order by id", CustomerOrder.class)
.getResultList();
for (CustomerOrder order : orders) {
IO.println("order no. %d : client=%s, %d line(s)".formatted(order.getId(),
order.getClient().getName(), order.getLines().size()));
}
});
// 4 - 未加载的关系在会话关闭后无法再访问
IO.println("--- after the session is closed");
CustomerOrder detachedOrder = sessionFactory.fromSession(s -> s.find(CustomerOrder.class, 1));
try {
IO.println(detachedOrder.getLines().size() + " line(s)");
} catch (LazyInitializationException e) {
IO.println(e.getClass().getSimpleName() + " : " + e.getMessage());
}
// 5 - join fetch:订单、其客户、其行及其产品在一次查询中加载
IO.println("--- join fetch");
sessionFactory.inSession(session -> {
List<CustomerOrder> orders = session.createSelectionQuery("""
from CustomerOrder c
join fetch c.client
join fetch c.lines l
join fetch l.product
order by c.id""", CustomerOrder.class).getResultList();
for (CustomerOrder order : orders) {
IO.println("order no. %d of %s for %s".formatted(order.getId(), order.getDate(),
order.getClient().getName()));
for (OrderLine line : order.getLines()) {
Product product = line.getProduct();
IO.println(" %d x %s at %.2f euros"
.formatted(line.getQuantity(), product.getName(), product.getPrice()));
}
}
});
// 6 - 实体图:描述必须随实体一起加载的内容,独立于查询
IO.println("--- entity graph");
Category category = sessionFactory.fromSession(session -> {
EntityGraph<Category> graph = session.createEntityGraph(Category.class);
graph.addAttributeNode("products");
return session.find(graph, 2);
});
// 会话已关闭,但产品已被加载
IO.println("%s : %s".formatted(category.getName(),
category.getProducts().stream().map(Product::getName).collect(Collectors.joining(", "))));
// 7 - 查询中的多对多关系
IO.println("--- the products on promotion");
sessionFactory.inSession(session -> session.createSelectionQuery("""
select p.name, p.category.name from Product p join p.tags e
where e.label = 'promo' order by p.name""", ProductCategory.class)
.getResultList()
.forEach(p -> IO.println("%s (%s)".formatted(p.product(), p.category()))));
// 8 - 跨关系的计算,由 DBMS 完成
IO.println("--- amount of the orders");
sessionFactory.inSession(session -> session.createSelectionQuery("""
select c.id, c.client.name, sum(l.quantity * l.product.price)
from CustomerOrder c join c.lines l
group by c.id, c.client.name order by c.id""", OrderAmount.class)
.getResultList()
.forEach(m -> IO.println("order no. %d (%s) : %.2f euros"
.formatted(m.id(), m.client(), m.amount()))));
// 9 - 分组:每个类别的产品数量和平均价格
IO.println("--- products per category");
sessionFactory.inSession(session -> session.createSelectionQuery("""
select p.category.name, count(*), avg(p.price) from Product p
group by p.category.name order by p.category.name""", CategoryStatistics.class)
.getResultList()
.forEach(s -> IO.println("%s : %d product(s), average price %.2f euros".formatted(
s.category(), s.count(), s.averagePrice()))));
}
}
// 具有给定名称的产品
private static Product product(Session session, String name) {
return session.createSelectionQuery("from Product where name = :name", Product.class)
.setParameter("name", name)
.getSingleResult();
}
}
|
结果:
| > mvn compile exec:java
--- addition of a client, an order and its two lines
SQL> -- start of transaction
SQL> select p1_0.id, p1_0.category_id, p1_0.name, p1_0.price
SQL> from products p1_0
SQL> where p1_0.name=?
SQL> -- parameter 1 = bike
SQL> select p1_0.id, p1_0.category_id, p1_0.name, p1_0.price
SQL> from products p1_0
SQL> where p1_0.name=?
SQL> -- parameter 1 = arrows - set of 6
SQL> insert into clients (name)
SQL> values (?)
SQL> -- parameter 1 = Dupont
SQL> insert into orders (client_id, date)
SQL> values (?, ?)
SQL> -- parameter 1 = 2
SQL> -- parameter 2 = 2026-10-01
SQL> insert into order_lines (order_id, product_id, quantity)
SQL> values (?, ?, ?)
SQL> -- parameter 1 = 2
SQL> -- parameter 2 = 1
SQL> -- parameter 3 = 1
SQL> insert into order_lines (order_id, product_id, quantity)
SQL> values (?, ?, ?)
SQL> -- parameter 1 = 2
SQL> -- parameter 2 = 4
SQL> -- parameter 3 = 3
client no. 2, order no. 2
SQL> -- transaction committed (COMMIT)
--- lazy loading
SQL> select co1_0.id, co1_0.client_id, co1_0.date
SQL> from orders co1_0
SQL> order by co1_0.id
SQL> select c1_0.id, c1_0.name
SQL> from clients c1_0
SQL> where c1_0.id=?
SQL> -- parameter 1 = 1
SQL> select l1_0.order_id, l1_0.id, l1_0.product_id, l1_0.quantity
SQL> from order_lines l1_0
SQL> where l1_0.order_id=?
SQL> -- parameter 1 = 1
order no. 1 : client=Martin, 2 line(s)
SQL> select c1_0.id, c1_0.name
SQL> from clients c1_0
SQL> where c1_0.id=?
SQL> -- parameter 1 = 2
SQL> select l1_0.order_id, l1_0.id, l1_0.product_id, l1_0.quantity
SQL> from order_lines l1_0
SQL> where l1_0.order_id=?
SQL> -- parameter 1 = 2
order no. 2 : client=Dupont, 2 line(s)
--- after the session is closed
SQL> select co1_0.id, co1_0.client_id, co1_0.date
SQL> from orders co1_0
SQL> where co1_0.id=?
SQL> -- parameter 1 = 1
LazyInitializationException : Cannot lazily initialize collection of role 'relations.CustomerOrder.lines' with key '1' (no session)
--- join fetch
SQL> select
SQL> co1_0.id,
SQL> co1_0.client_id,
SQL> c1_0.id,
SQL> c1_0.name,
SQL> co1_0.date,
SQL> l1_0.order_id,
SQL> l1_0.id,
SQL> l1_0.product_id,
SQL> p1_0.id,
SQL> p1_0.category_id,
SQL> p1_0.name,
SQL> p1_0.price,
SQL> l1_0.quantity
SQL> from orders co1_0
SQL> join clients c1_0 on c1_0.id=co1_0.client_id
SQL> join order_lines l1_0 on co1_0.id=l1_0.order_id
SQL> join products p1_0 on p1_0.id=l1_0.product_id
SQL> order by co1_0.id
order no. 1 of 2026-09-28 for Martin
2 x pump at 10.00 euros
1 x bow at 600.00 euros
order no. 2 of 2026-10-01 for Dupont
1 x bike at 500.00 euros
3 x arrows - set of 6 at 100.00 euros
--- entity graph
SQL> select c1_0.id, c1_0.name, p1_0.category_id, p1_0.id, p1_0.name, p1_0.price
SQL> from categories c1_0
SQL> left join products p1_0 on c1_0.id=p1_0.category_id
SQL> where c1_0.id=?
SQL> -- parameter 1 = 2
archery : bow, arrows - set of 6
--- the products on promotion
SQL> select p1_0.name, c1_0.name
SQL> from products p1_0
SQL> join products_tags t1_0 on p1_0.id=t1_0.product_id
SQL> join tags t1_1 on t1_1.id=t1_0.tag_id
SQL> join categories c1_0 on c1_0.id=p1_0.category_id
SQL> where t1_1.label='promo'
SQL> order by p1_0.name
arrows - set of 6 (archery)
bike (cycles)
--- amount of the orders
SQL> select co1_0.id, c1_0.name, sum((l1_0.quantity*p1_0.price))
SQL> from orders co1_0
SQL> join order_lines l1_0 on co1_0.id=l1_0.order_id
SQL> join products p1_0 on p1_0.id=l1_0.product_id
SQL> join clients c1_0 on c1_0.id=co1_0.client_id
SQL> group by co1_0.id, c1_0.name
SQL> order by co1_0.id
order no. 1 (Martin) : 620.00 euros
order no. 2 (Dupont) : 800.00 euros
--- products per category
SQL> select c1_0.name, count(*), avg(p1_0.price)
SQL> from products p1_0
SQL> join categories c1_0 on c1_0.id=p1_0.category_id
SQL> group by c1_0.name
SQL> order by c1_0.name
archery : 2 product(s), average price 350.00 euros
cycles : 2 product(s), average price 255.00 euros
|
说明:
- 第 15–22 行:接收投影结果的记录;
- 第 32–39 行:输出由 [product] 方法读取(第 125–129 行);一个客户、其订单及订单的两个订单行通过一次对 [persist] 的调用被持久化。SQL(结果的第 12–28 行)显示了插入的顺序:先是客户,然后是订单,其外键 [client_id] 接收为客户生成的键(2),再然后是各订单行,其外键 [order_id] 接收订单的键;
- 第 46–52 行:懒加载。该查询只读取订单(第 32–34 行):每个订单的客户和订单行只有在程序使用它们时才通过额外的查询读取(第一个订单为第 35–42 行,第二个订单为第 44–51 行)。对于客户,Hibernate 在 [client] 字段中放置了一个代理,这是 Hibernate(使用 Byte Buddy)生成的 [Client] 子类的对象,它只包含标识符,并在第一次调用方法([getName()])时加载客户。这就是实体不能是 [final] 类的原因。对于订单行,列表是 Hibernate 集合,在第一次使用时加载([size()]);
- 第 57–62 行:订单由一个随即关闭的会话读取([fromSession])。这些订单行没有被加载,而一旦会话关闭,它们就再也无法被加载:访问该集合会触发 [LazyInitializationException] (第 58 行),这是使用 Hibernate 的应用程序中最常见的异常之一。你必须在会话打开期间加载所需的内容;
- 第 67–72 行:通过查询预加载 。[join fetch] 指示 Hibernate 在加载订单的同时,加载它们的客户、它们的订单行以及每个订单行的产品:只用一条带连接的查询(第 60–78 行)。显示的是两个订单及其订单行(第 79–84 行)。与订单行的连接为每个订单行生成一行 SQL;Hibernate 为每个标识符只得到一个订单:返回的列表确实包含两个订单;
- 第 86–90 行:“实体图” (Jakarta Persistence)独立于任何查询,描述要随实体一起加载的关联:此处是该类别中的产品。[session.find(graph, 2)] (Jakarta Persistence 3.2)用一条查询取回类别 2 及其产品(结果的第 86–90 行)。会话关闭后,这些产品仍然可以访问(第 92–93 行)。若要在会话打开时稍后加载某个关联,我们写 [Hibernate.initialize(category.getProducts())];
- 第 97–101 行:在查询中使用关联:[join p.tags e] 遍历多对多关系(两个连接,分别连接关联表和标签表,第 95–96 行),而 [p.category.name] 被翻译成与类别表的隐式连接(第 97 行);
- 第 105–111 行:跨越两个关系的计算,即每个订单的总金额,完全由 DBMS 完成:连接、[sum] 和 [group by] (第 103–109 行);
- 第 115–120 行:分组。[group by p.category.name] 按类别名称对产品分组;每组的产品数量([count])和平均价格([avg],类型为 [Double])由 DBMS 计算(第 113–117 行)。没有产品的类别 [diving] 没有出现:与类别表的连接是内连接([join])。
11.8.3. N+1 查询问题
示例中的懒加载说明了困扰每个 ORM 用户的一个问题,即所谓的“N+1 查询”问题:一条查询读取 N 个订单,然后每个订单再用一条查询读取其客户(还有一条读取其订单行)。对于一千个订单,这会导致与服务器之间往返一千零一次,而其实一次就足够了。这个问题尤其隐蔽,因为它在代码中是看不见的:[order.getClient().getName()] 看起来并不像一次查询。解决方案就是示例中所示的那些:[join fetch]、实体图,或者更好的做法是使用只获取相关数据的投影。Hibernate 还提供批量加载([@BatchSize(size = 20)] ,应用于集合或被引用的实体类,此处为 [Client]),例如,它可以用一条查询取回二十个订单的客户。SQL 日志有助于发现该问题:同一条查询被重复执行很多次。
11.9. 数据库模式的变更
11.9.1. 问题所在
到目前为止,表都是由 Hibernate 在删除之后重新创建的。这对于正在运行的应用程序是不可能的:其数据库中包含的数据必须在模型演进(新增一列、新增一张表)时予以保留。必须能够以安全且可重现的方式,将数据库从一个模式版本迁移到下一个版本,无论是在开发者的机器上还是在生产服务器上。这称为模式迁移。
Hibernate 不支持迁移:它可以创建模式、验证模式,并对其进行有限的更新。在 Java 世界中,标准做法是使用带版本的 SQL 脚本来处理迁移,由专门的工具来应用这些脚本——最常见的是Flyway 或Liquibase——并让 Hibernate 验证最终的模式是否与实体匹配。
11.9.2. Hibernate 的模式管理
属性[hibernate.hbm2ddl.auto](或配置中的[schemaToolingAction]方法,下面的程序使用的就是它)用于指定在创建 [SessionFactory]时 Hibernate 应如何处理模式:
值 | 常量 [Action] | 作用 |
[none] | [NONE] | 无(默认值) |
[create-only] | [CREATE_ONLY] | 创建表 |
[create] | [CREATE] | 先删除再创建表 |
[create-drop] | [CREATE_DROP] | 与 [create] 相同,并在关闭 [SessionFactory] 时删除表:用于测试 |
[drop] | [DROP] | 删除表 |
[validate] | [VALIDATE] | 验证实体对应的表和列是否存在且类型兼容;否则抛出异常 |
[update] | [UPDATE] | 创建缺失的表和列 |
Jakarta Persistence 定义了一个相关的属性 [jakarta.persistence.schema-generation.database.action],其取值为 [none]、[create]、[drop-and-create], 和 [drop]。通过编程方式也可以执行同样的操作,就像我们通过 [SessionFactory] 的 [SchemaManager] 所做的那样([create]、[drop]、[validate]、[truncate])。
值 [update] 很诱人:Hibernate 会将实体与数据库模式进行比较,并添加缺失的部分。但它存在一些局限,使其不适用于生产应用程序:
- 它只会添加:它从不删除已不再需要的列或表,不会修改现有列的类型或长度,也无法重命名(重命名字段会创建一个新的空列,而旧列及其数据仍然保留);
- 它无法转换数据(填充新的必填列、将一列拆分为两列);
- 它的行为取决于其所遇到的数据库状态:无法预先知道将执行哪些命令、以什么顺序执行,而且不会留下任何记录。
因此,我们将 [create]、[create-drop]和 [update] 保留用于开发和测试,而在生产环境中使用 [validate] (或 [none]),由脚本来管理模式。
11.9.3. 带版本的 SQL 脚本
基于脚本的迁移,其原理很简单:
- 每一次模式变更都由一个带编号的 SQL 脚本来描述:[V1__create_clients.sql]、[V2__add_phone.sql]……脚本一旦应用于某个数据库,就绝不再修改:任何更正都通过新的脚本来完成;
- 数据库中包含一张历史表,列出已应用到该数据库的版本;
- 应用程序启动时(或在部署期间),工具会将可用的脚本与历史记录进行比较,并按顺序应用尚未应用的脚本。
这些脚本是应用程序源代码的一部分:它们与其余代码一起存储和管理(例如放在 Git 仓库中)。为了理解其工作原理,[clients]模块实现了一个仿照 Flyway 的小型带版本脚本执行器;随后我们再介绍 Flyway 本身。
11.9.4. [clients]模块
[clients]模块建立在 [hbclients]基础之上。实体是一个客户:
| // 一个客户
@Entity
@Table(name = "clients")
public class Client {
@Id
@GeneratedValue(strategy = GenerationType.IDENTITY)
private Integer id;
@Column(nullable = false, length = 50)
private String name;
@Column(nullable = false, length = 100)
private String email;
@Column(length = 20)
private String phone;
protected Client() {
}
public Client(String name, String email, String phone) {
this.name = name;
this.email = email;
this.phone = phone;
}
@Override
public String toString() {
String tel = phone == null ? "no phone" : phone;
return "[%d, %s, %s, %s]".formatted(id, name, email, tel);
}
}
|
在应用程序的第一个版本中,客户还没有电话号码:第 16–17 行尚不存在。我们将在第二个版本中添加它们。这些脚本位于模块的 [src/main/resources/db/migration]文件夹中,该文件夹将被复制到类路径中。第一个脚本创建表:
| -- version 1: the clients table
create table clients (
id integer not null auto_increment,
name varchar(50) not null,
email varchar(100) not null,
primary key (id)
) engine=InnoDB;
|
第二个脚本添加电话号码列:
| -- version 2: the (optional) phone of the clients
alter table clients
add column phone varchar(20);
|
[Migrations]类使用 JDBC(第 10 章)执行这些脚本,与 Hibernate 无关:
| package clients;
import java.io.IOException;
import java.net.URISyntaxException;
import java.net.URL;
import java.nio.file.Files;
import java.nio.file.Path;
import java.sql.Connection;
import java.sql.DriverManager;
import java.sql.PreparedStatement;
import java.sql.ResultSet;
import java.sql.SQLException;
import java.sql.Statement;
import java.util.ArrayList;
import java.util.Comparator;
import java.util.List;
import java.util.Set;
import java.util.TreeSet;
import java.util.regex.Matcher;
import java.util.regex.Pattern;
import java.util.stream.Stream;
// 一个小型的带版本号的 SQL 脚本运行器,仿照 Flyway:脚本
// [db/migration/V<version>__<description>.sql] 只按版本顺序应用一次,
// 数据库的 [migration_history] 表记录已应用的脚本
public class Migrations {
// 一个迁移脚本
public record Script(int version, String description, Path path) {
@Override
public String toString() {
return "V" + version + " (" + description + ")";
}
}
// 脚本的名称:V1__create_clients.sql
private static final Pattern NAME = Pattern.compile("V(\\d+)__(\\w+)\\.sql");
// 历史表
private static final String CREATE_HISTORY = """
create table if not exists migration_history (
version integer not null primary key,
description varchar(100) not null,
applied_on datetime not null default current_timestamp
) engine=InnoDB""";
// 数据库
private final String url;
private final String user;
private final String password;
public Migrations(String url, String user, String password) {
this.url = url;
this.user = user;
this.password = password;
}
// 类路径中 [db/migration] 文件夹的脚本,按版本顺序
public List<Script> scripts() throws IOException, URISyntaxException {
URL folder = Migrations.class.getResource("/db/migration");
if (folder == null) {
return List.of();
}
List<Script> scripts = new ArrayList<>();
try (Stream<Path> files = Files.list(Path.of(folder.toURI()))) {
for (Path file : files.toList()) {
Matcher m = NAME.matcher(file.getFileName().toString());
if (m.matches()) {
int version = Integer.parseInt(m.group(1));
scripts.add(new Script(version, m.group(2).replace('_', ' '), file));
}
}
}
scripts.sort(Comparator.comparingInt(Script::version));
return scripts;
}
// 数据库中已应用的版本(必要时创建历史表)
public Set<Integer> appliedVersions() throws SQLException {
try (Connection connection = DriverManager.getConnection(url, user, password);
Statement statement = connection.createStatement()) {
statement.execute(CREATE_HISTORY);
Set<Integer> versions = new TreeSet<>();
try (ResultSet rows = statement.executeQuery("select version from migration_history")) {
while (rows.next()) {
versions.add(rows.getInt(1));
}
}
return versions;
}
}
// 尚待应用的脚本
public List<Script> pending() throws SQLException, IOException, URISyntaxException {
Set<Integer> applied = appliedVersions();
return scripts().stream().filter(s -> !applied.contains(s.version())).toList();
}
// 应用待处理的脚本,直到版本 [target](含);返回已应用的脚本
public List<Script> apply(int target) throws SQLException, IOException, URISyntaxException {
List<Script> applied = new ArrayList<>();
for (Script script : pending()) {
if (script.version() > target) {
break;
}
apply(script);
applied.add(script);
}
return applied;
}
// 应用一个脚本并在事务中将其版本添加到历史记录
private void apply(Script script) throws SQLException, IOException {
// 脚本的语句,以分号分隔,不含注释行
String text = Files.readString(script.path()).lines()
.filter(line -> !line.strip().startsWith("--"))
.reduce("", (a, b) -> a + "\n" + b);
try (Connection connection = DriverManager.getConnection(url, user, password)) {
connection.setAutoCommit(false);
try (Statement statement = connection.createStatement();
PreparedStatement history = connection.prepareStatement(
"insert into migration_history(version, description) values (?, ?)")) {
for (String sql : text.split(";")) {
if (!sql.isBlank()) {
statement.execute(sql);
}
}
history.setInt(1, script.version());
history.setString(2, script.description());
history.executeUpdate();
connection.commit();
} catch (SQLException e) {
// 注意:在 MySQL 中,修改模式的语句无法回滚
connection.rollback();
throw e;
}
}
}
}
|
- 第 29–34 行:脚本由一个记录描述:其版本、描述和路径;
- 第 37 行:脚本名称遵循 Flyway 约定:[V]、版本号、两个下划线和一段描述;
- 第 40–45 行:历史表:每个已应用的版本一行,包含其描述和应用日期;
- 第 59–76 行:脚本列表。[getResource("/db/migration")] 获取类路径中该文件夹的 URL,再用 [Files.list] (第 5 章)列出其内容。这段代码假定该文件夹是真实的文件夹(当程序由 Maven 从 [target/classes]文件夹运行时即是如此);Flyway 还可以从 [.jar]归档文件中读取脚本。脚本按版本号排序:按字母顺序排序会把 [V10] 排在 [V2]之前;
- 第 79–91 行:已应用的版本,从历史表中读取,历史表会在需要时创建([create table if not exists]);
- 第 94–97 行:尚待应用的脚本;
- 第 100–110 行:应用待处理的脚本,直至指定的版本;
- 第 113–138 行:应用一个脚本:执行其命令(以分号分隔,忽略注释行),然后在一个事务中将其版本添加到历史表。有一点需要注意,第 133 行的注释已指出:在 MySQL 下,模式修改命令([CREATE TABLE]、[ALTER TABLE])会隐式提交当前事务,且无法回滚。如果脚本执行到一半出错,数据库可能停留在中间状态。因此最好使用简短的脚本,每个脚本只包含一项变更。
主程序应用迁移,然后要求 Hibernate 验证模式:
| package clients;
import jakarta.persistence.PersistenceException;
import org.hibernate.SessionFactory;
import org.hibernate.cfg.AvailableSettings;
import org.hibernate.jpa.HibernatePersistenceConfiguration;
import org.hibernate.tool.schema.Action;
public class Main {
// clients 数据库;如果不存在,MySQL 会创建它
public static final String URL = "jdbc:mysql://localhost:3306/hbclients?createDatabaseIfNotExist=true";
public static void main(String[] args) throws Exception {
// 目标版本:默认为最新版本,或作为参数传入的版本
int target = args.length > 0 ? Integer.parseInt(args[0]) : Integer.MAX_VALUE;
// 迁移的状态
Migrations migrations = new Migrations(URL, "root", "");
IO.println("applied versions: " + migrations.appliedVersions());
IO.println("pending migrations: " + migrations.pending());
// 应用待处理的迁移
for (Migrations.Script script : migrations.apply(target)) {
IO.println("migration applied: " + script);
}
// Hibernate 检查数据库模式是否与实体匹配(validate)
try (SessionFactory sessionFactory = new HibernatePersistenceConfiguration("clients")
.managedClass(Client.class)
.jdbcUrl(URL)
.jdbcCredentials("root", "")
.property(AvailableSettings.FORMAT_SQL, true)
.schemaToolingAction(Action.VALIDATE)
.createEntityManagerFactory()) {
IO.println("the database schema matches the entities");
// 新列可以使用了
sessionFactory.inTransaction(session ->
session.persist(new Client("Dupont", "dupont@example.com", "01 23 45 67 89")));
sessionFactory.inSession(session -> session
.createSelectionQuery("from Client", Client.class)
.getResultList()
.forEach(IO::println));
} catch (PersistenceException e) {
// 验证错误是异常的原因
Throwable cause = e.getCause() == null ? e : e.getCause();
IO.println(cause.getClass().getSimpleName() + " : " + cause.getMessage());
}
}
}
|
- 第 16 行:可以通过参数指定应用迁移所要达到的版本;默认应用全部迁移;
- 第 19–26 行:迁移的状态,随后是迁移的应用;
- 第 29–35 行:[SessionFactory] 使用操作 [VALIDATE]创建:Hibernate 验证数据库模式是否与实体 [Client]匹配。如果不匹配,[SessionFactory] 的创建将失败,并抛出 [PersistenceException],其起因是验证错误(第 44–48 行);
- 第 38–43 行:使用新增的列。
11.9.5. 用 Hibernate 生成脚本
SQL 脚本是手工编写的。不过,Hibernate 可以帮助编写:它可以生成(但不执行)创建模式的脚本,或者通过将实体与现有数据库进行比较,生成更新模式的脚本。这正是 [GenerateScript]类所做的:
| package clients;
import java.io.StringWriter;
import org.hibernate.SessionFactory;
import org.hibernate.cfg.AvailableSettings;
import org.hibernate.jpa.HibernatePersistenceConfiguration;
// 由 Hibernate 生成创建(create)或更新(update)数据库模式的 SQL 脚本
public class GenerateScript {
public static void main(String[] args) {
// 动作:create(默认)或 update
String action = args.length > 0 ? args[0] : "create";
StringWriter script = new StringWriter();
// 只写出脚本而不执行的 SessionFactory
try (SessionFactory _ = new HibernatePersistenceConfiguration("clients")
.managedClass(Client.class)
.jdbcUrl(Main.URL)
.jdbcCredentials("root", "")
.property(AvailableSettings.JAKARTA_HBM2DDL_SCRIPTS_ACTION, action)
.property(AvailableSettings.JAKARTA_HBM2DDL_SCRIPTS_CREATE_TARGET, script)
.property(AvailableSettings.HBM2DDL_DELIMITER, ";")
.property(AvailableSettings.FORMAT_SQL, true)
.createEntityManagerFactory()) {
// 脚本,去掉各行 4 个空格的缩进
script.toString().strip().lines()
.map(line -> line.startsWith(" ") ? line.substring(4) : line)
.forEach(line -> IO.println(line.stripTrailing()));
}
}
}
|
- 第 13 行:作为参数传入的操作:[create] 或 [update];
- 第 16 行:[SessionFactory] 的创建仅仅是为了生成脚本;保存它的变量从未被使用。Java 22 允许将其命名为 [_] (匿名变量);
- 第 20–23 行:脚本生成属性,我们已在 [model]模块中见过。这一次,Hibernate 要连接数据库:对于 [update]操作,它需要了解数据库的模式。
根据实体的当前版本生成的创建脚本,可用于一次性创建全新的数据库(例如用于测试):
| > mvn compile exec:java -Dexec.mainClass=clients.GenerateScript
create table clients (
id integer not null auto_increment,
phone varchar(20),
name varchar(50) not null,
email varchar(100) not null,
primary key (id)
) engine=InnoDB;
|
对于实体的第一个版本(没有电话号码),在列顺序相同的情况下,它会生成脚本 [V1__create_clients.sql]。
11.9.6. 应用迁移
假设数据库尚不存在。我们只应用第一个迁移,将版本 1 作为参数传入:
| > mvn compile exec:java -Dexec.args="1"
applied versions: []
pending migrations: [V1 (create clients), V2 (add phone)]
migration applied: V1 (create clients)
SchemaManagementException : Schema validation: missing column [phone] in table [clients]
|
- 第 2–3 行:没有已应用的版本;有两个脚本待应用。历史表由 [appliedVersions]方法创建,而 [hbclients]数据库由 MySQL 创建([createDatabaseIfNotExist=true]);
- 第 4 行:应用脚本 [V1] ;
- 第 5 行:Hibernate 检测到实体的 [phone]列在表中不存在:这是正常的,因为数据库处于版本 1,而实体处于版本 2。如果使用版本 1 的实体,验证本会成功。
应用程序在演进:我们要把电话号码添加到实体中。为了编写版本 2 的脚本,我们让 Hibernate 将实体与仍处于版本 1 的数据库进行比较:
| > mvn compile exec:java -Dexec.mainClass=clients.GenerateScript -Dexec.args="update"
alter table clients
add column phone varchar(20);
|
除格式之外,这与脚本 [V2__add_phone.sql]相同。现在我们应用所有待处理的迁移:
| > mvn compile exec:java
applied versions: [1]
pending migrations: [V2 (add phone)]
migration applied: V2 (add phone)
the database schema matches the entities
SQL> -- start of transaction
SQL> insert into clients (email, name, phone)
SQL> values (?, ?, ?)
SQL> -- parameter 1 = dupont@example.com
SQL> -- parameter 2 = Dupont
SQL> -- parameter 3 = 01 23 45 67 89
SQL> -- transaction committed (COMMIT)
SQL> select c1_0.id, c1_0.email, c1_0.name, c1_0.phone
SQL> from clients c1_0
[1, Dupont, dupont@example.com, 01 23 45 67 89]
|
- 第 2–4 行:版本 1 已应用,版本 2 待应用,随后将其应用;
- 第 5 行:验证成功;
- 第 6–15 行:新列已可使用。
历史表现在包含这两个版本:
| > mysql -uroot -t hbclients -e "SELECT * FROM migration_history"
+---------+----------------+---------------------+
| version | description | applied_on |
+---------+----------------+---------------------+
| 1 | create clients | 2026-10-03 17:27:22 |
| 2 | add phone | 2026-10-03 17:27:27 |
+---------+----------------+---------------------+
|
再次运行程序不会应用任何变更:两个版本都已记录在历史中。
11.9.7. Flyway
Flyway 是 Java 世界中使用最广泛的迁移工具(如果类路径中存在它,Spring Boot 会在应用程序启动时自动运行它)。它的工作原理与我们的执行器完全相同,但功能更全面:默认在类路径的 [V<version>__<description>.sql]脚本所在的 [db/migration]文件夹中查找脚本,使用 [flyway_schema_history]历史表,并按版本顺序应用待处理的脚本。此外,它还为每个脚本增加了校验和,用于检测已应用脚本的改动;支持“可重复”脚本([R__description.sql],每次变化时重新应用,例如用于视图);支持用 Java 编写的迁移;提供防止两个应用实例同时迁移数据库的锁;以及 Maven 扩展([mvn flyway:migrate]、[mvn flyway:info])。
要在 [clients]模块中使用它,只需添加依赖 [org.flywaydb:flyway-core] 和 [org.flywaydb:flyway-mysql] (使用最新版本),原样保留这两个脚本——因为它们已经遵循其约定——并将对 [Migrations]类的使用替换为一行代码:[Flyway.configure().dataSource(URL, "root", "").load().migrate();]
Liquibase是另一个常用工具,它在 XML、YAML 或 SQL 文件(即“变更日志”)中描述模式变更,并能生成适用于各个 DBMS 的 SQL。无论使用哪种工具,Hibernate 都配置为 [validate] 或 [none],不再修改模式。
11.10. Hibernate 与虚拟线程
数据库查询是一种 I/O 操作:服务器处理请求时,等待中的线程什么也不做。第 9 章介绍了两种避免在这些等待期间浪费线程的方法:异步编程([CompletableFuture])和虚拟线程 (Java 21)。Hibernate 的 API 与它所使用的 JDBC 一样,是阻塞式的:[getResultList] 在读完所有行之前不会交出控制权。有了虚拟线程,这就不再是缺点:在 I/O 上阻塞的虚拟线程会释放执行它的系统线程,而且可以创建成千上万个虚拟线程。因此,我们编写普通的阻塞式代码,并由虚拟线程来执行。
必须遵守一条规则:会话不是线程安全的。绝不能在多个线程之间共享会话:每个线程(每个任务)都使用 [SessionFactory]打开自己的会话,而 SessionFactory 本身是共享的。Hibernate 并不总能检测到同一个会话被同时使用;由此产生的错误是不可预测的。
[async]模块遵循了这条规则:
| package async;
import articles.Article;
import articles.BaseArticles;
import jakarta.persistence.QueryTimeoutException;
import java.math.BigDecimal;
import java.util.List;
import java.util.concurrent.CompletableFuture;
import java.util.concurrent.ExecutionException;
import java.util.concurrent.ExecutorService;
import java.util.concurrent.Executors;
import java.util.concurrent.Future;
import java.util.stream.Stream;
import org.hibernate.SessionFactory;
public class Main {
public static void main(String[] args) throws InterruptedException, ExecutionException {
try (SessionFactory sessionFactory = BaseArticles.createSessionFactory()) {
// [articles] 表被重新创建,并带有六件商品
BaseArticles.initialize(sessionFactory);
// 1 - 两个查询由两个虚拟线程同时执行,各自使用自己的会话
IO.println("--- two queries in parallel");
try (ExecutorService executor = Executors.newVirtualThreadPerTaskExecutor()) {
Future<List<Article>> lowPrices = executor.submit(() -> sessionFactory.fromSession(s -> s
.createSelectionQuery("from Article where price < 200 order by price", Article.class)
.getResultList()));
String hql = "select count(*) from Article where currentStock < minimumStock";
Future<Long> outOfStock = executor.submit(() -> sessionFactory.fromSession(s -> s
.createSelectionQuery(hql, Long.class)
.getSingleResult()));
// get() 等待每个任务结束
lowPrices.get().forEach(IO::println);
IO.println(outOfStock.get() + " article(s) out of stock");
}
// 2 - 由虚拟线程执行的事务,随后处理其结果
IO.println("--- CompletableFuture");
try (ExecutorService executor = Executors.newVirtualThreadPerTaskExecutor()) {
CompletableFuture<Void> processing = CompletableFuture
.supplyAsync(() -> sessionFactory.fromTransaction(session -> {
Article bow = session
.createSelectionQuery("from Article where name = 'bow'", Article.class)
.getSingleResult();
bow.setPrice(BigDecimal.valueOf(550));
return bow;
}), executor)
.thenAccept(bow -> IO.println("new price of the bow: " + bow.getPrice()));
processing.join();
}
// 3 - 流:实体在读取的同时被处理
IO.println("--- getResultStream");
sessionFactory.inSession(session -> {
try (Stream<Article> articles = session
.createSelectionQuery("from Article where price >= 300", Article.class)
.getResultStream()) {
articles.forEach(article -> IO.println("read: " + article.getName()));
}
});
// 4 - 过长的查询在设定的超时(以秒为单位)后被中断
IO.println("--- timeout exceeded");
try {
sessionFactory.inSession(session -> session
.createNativeQuery("select sleep(5)", Integer.class)
.setTimeout(1)
.getSingleResult());
} catch (QueryTimeoutException e) {
IO.println(e.getClass().getSimpleName() + " : " + e.getMessage());
}
}
}
}
|
结果:
| > mvn compile exec:java
--- two queries in parallel
SQL> select a1_0.id, a1_0.currentStock, a1_0.minimumStock, a1_0.name, a1_0.price
SQL> from articles a1_0
SQL> where a1_0.price<200
SQL> order by a1_0.price
SQL> select count(*)
SQL> from articles a1_0
SQL> where a1_0.currentStock<a1_0.minimumStock
[2, pump, 10.00, 10, 2]
[4, arrows - set of 6, 100.00, 12, 20]
[6, diver's oxygen tanks, 120.00, 10, 5]
1 article(s) out of stock
--- CompletableFuture
SQL> -- start of transaction
SQL> select a1_0.id, a1_0.currentStock, a1_0.minimumStock, a1_0.name, a1_0.price
SQL> from articles a1_0
SQL> where a1_0.name='bow'
SQL> update articles
SQL> set currentStock=?, minimumStock=?, name=?, price=?
SQL> where id=?
SQL> -- parameter 1 = 4
SQL> -- parameter 2 = 1
SQL> -- parameter 3 = bow
SQL> -- parameter 4 = 550
SQL> -- parameter 5 = 3
SQL> -- transaction committed (COMMIT)
new price of the bow: 550
--- getResultStream
SQL> select a1_0.id, a1_0.currentStock, a1_0.minimumStock, a1_0.name, a1_0.price
SQL> from articles a1_0
SQL> where a1_0.price>=300
read: bike
read: bow
read: diving suit
--- timeout exceeded
SQL> select sleep(5)
SQL> -- failure: Statement cancelled due to timeout or client request
QueryTimeoutException : JDBC exception executing SQL [Statement cancelled due to timeout or client request] [select sleep(5)]
|
说明:
- 第 25 行:为每个任务创建一个虚拟线程的执行器(第 9 章)。带资源的 [try]语句会等待所有任务完成后再关闭它;
- 第 26–32 行:向执行器提交两个任务。每个任务打开自己的会话([fromSession])并执行一次查询;两次查询同时运行,使用连接池中的两个连接。因此,它们在日志中的顺序(第 3–9 行)在每次执行时可能不同;
- 第 34–35 行:[get()] 等待每个任务完成并返回其结果(第 10–13 行);
- 第 41–50 行:一个 [CompletableFuture] (第 9 章),其第一步——一个完整的事务——由虚拟线程执行([supplyAsync(..., executor)]),第二步显示其结果。事务返回的记录是游离的(其会话已关闭):可以读取它的字段,但无法加载它的关联;
- 第 56–60 行:[getResultStream] 返回一个流:实体在读取时即被处理,而不形成列表(第 33–35 行)。这对于处理大量行很有用。对于 MySQL,请注意默认情况下驱动程序会先读取结果的所有行,然后才返回第一行;要真正实现渐进式读取,必须指示它使用游标(URL 的参数 [useCursorFetch=true] 以及通过 [setFetchSize]设置的批大小);
- 第 66–69 行:通过 [setTimeout]设置以秒为单位的最长执行时间。该查询(一条原生 SQL 查询,我们稍后会讨论)需要五秒;一秒之后,JDBC 驱动程序中断它,Hibernate 抛出 [QueryTimeoutException] (第 37–39 行)。对于查询而言,这相当于取消任务([Future.cancel],第 9 章),而取消任务在这里不会产生任何效果:中断一个在 JDBC 驱动程序中阻塞的线程,并不会中断服务器上正在运行的查询。
对于需要真正非阻塞 API 的应用程序,有 Hibernate Reactive,它是 Hibernate 的一个变体,依赖响应式驱动程序(来自 Vert.x 的驱动程序)而非 JDBC,其方法返回 [CompletionStage] 或 Mutiny 库中的对象。在大多数情况下,虚拟线程消除了这种复杂性:这正是本课程所采用的方法。
11.11. 事务与并发
11.11.1. 事务
第 10 章介绍了事务:一组要么全部成功、要么全部失败的操作。使用 Hibernate 时:
- 每次写入都发生在事务之内,事务由 [session.beginTransaction()] 开启,并由 [commit] 或 [rollback]结束。[SessionFactory] 的 [inTransaction] 和 [fromTransaction] 方法为我们处理这些:如果 lambda 正常完成,它们就提交事务;如果抛出异常,则回滚事务,并重新抛出该异常;
- 事务期间发送的所有命令(通过 [INSERT]执行的即时命令、通过 [flush]进行的显式同步,以及通过 [commit]进行的同步)要么一起提交,要么一起回滚;
- 来自 DBMS 的错误会作为 Hibernate 异常传播,该异常派生自 [JDBCException],它封装了驱动程序的 [SQLException]:违反约束时抛出 [ConstraintViolationException] (主键、唯一性、外键、[NOT NULL]),SQL 语句有错误时抛出 [SQLGrammarException] ,等等。
[transactions]模块演示了处理事务的两种方式:
| package transactions;
import articles.Article;
import articles.BaseArticles;
import java.math.BigDecimal;
import org.hibernate.Session;
import org.hibernate.SessionFactory;
import org.hibernate.Transaction;
import org.hibernate.exception.ConstraintViolationException;
public class Main {
public static void main(String[] args) {
try (SessionFactory sessionFactory = BaseArticles.createSessionFactory()) {
// [articles] 表被重新创建,并带有六件商品
BaseArticles.initialize(sessionFactory);
// 1 - inTransaction:全部成功则提交,出现异常则回滚
IO.println("--- two additions, the second of which violates the uniqueness of the name");
try {
sessionFactory.inTransaction(session -> {
session.persist(new Article("racket", BigDecimal.valueOf(80), 5, 2));
session.persist(new Article("bike", BigDecimal.valueOf(450), 3, 1));
});
} catch (ConstraintViolationException e) {
IO.println("%s : constraint [%s] violated"
.formatted(e.getClass().getSimpleName(), e.getConstraintName()));
}
display(sessionFactory, "racket");
// 2 - 由代码管理的事务:多次写入,一起提交或一起回滚
IO.println("--- transaction rolled back");
try (Session session = sessionFactory.openSession()) {
Transaction transaction = session.beginTransaction();
try {
// 卖出两辆自行车:UPDATE 通过 flush 发送
Article bike = session
.createSelectionQuery("from Article where name = 'bike'", Article.class)
.getSingleResult();
bike.setCurrentStock(bike.getCurrentStock() - 2);
session.flush();
// 添加一件名称已存在的商品:错误
session.persist(new Article("pump", BigDecimal.valueOf(12), 5, 1));
// 整体提交(这里不会执行到)
transaction.commit();
} catch (ConstraintViolationException e) {
IO.println(e.getClass().getSimpleName() + " : " + e.getSQLException().getMessage());
// 回滚事务中的所有操作
transaction.rollback();
}
}
// 自行车的销售已被回滚
display(sessionFactory, "bike");
}
}
// 显示从数据库读取的商品,使用新会话
private static void display(SessionFactory sessionFactory, String name) {
Article article = sessionFactory.fromSession(session -> session
.createSelectionQuery("from Article where name = :name", Article.class)
.setParameter("name", name)
.getSingleResultOrNull());
IO.println("article [%s] in the database: %s".formatted(name, article == null ? "missing" : article));
}
}
|
结果:
| > mvn compile exec:java
--- two additions, the second of which violates the uniqueness of the name
SQL> -- start of transaction
SQL> insert into articles (currentStock, minimumStock, name, price)
SQL> values (?, ?, ?, ?)
SQL> -- parameter 1 = 5
SQL> -- parameter 2 = 2
SQL> -- parameter 3 = racket
SQL> -- parameter 4 = 80
SQL> insert into articles (currentStock, minimumStock, name, price)
SQL> values (?, ?, ?, ?)
SQL> -- parameter 1 = 3
SQL> -- parameter 2 = 1
SQL> -- parameter 3 = bike
SQL> -- parameter 4 = 450
SQL> -- failure: Duplicate entry 'bike' for key 'articles.uk_articles_name'
SQL> -- transaction rolled back (ROLLBACK)
ConstraintViolationException : constraint [articles.uk_articles_name] violated
SQL> select a1_0.id, a1_0.currentStock, a1_0.minimumStock, a1_0.name, a1_0.price
SQL> from articles a1_0
SQL> where a1_0.name=?
SQL> -- parameter 1 = racket
article [racket] in the database: missing
--- transaction rolled back
SQL> -- start of transaction
SQL> select a1_0.id, a1_0.currentStock, a1_0.minimumStock, a1_0.name, a1_0.price
SQL> from articles a1_0
SQL> where a1_0.name='bike'
SQL> update articles
SQL> set currentStock=?, minimumStock=?, name=?, price=?
SQL> where id=?
SQL> -- parameter 1 = 8
SQL> -- parameter 2 = 5
SQL> -- parameter 3 = bike
SQL> -- parameter 4 = 500.00
SQL> -- parameter 5 = 1
SQL> insert into articles (currentStock, minimumStock, name, price)
SQL> values (?, ?, ?, ?)
SQL> -- parameter 1 = 5
SQL> -- parameter 2 = 1
SQL> -- parameter 3 = pump
SQL> -- parameter 4 = 12
SQL> -- failure: Duplicate entry 'pump' for key 'articles.uk_articles_name'
ConstraintViolationException : Duplicate entry 'pump' for key 'articles.uk_articles_name'
SQL> -- transaction rolled back (ROLLBACK)
SQL> select a1_0.id, a1_0.currentStock, a1_0.minimumStock, a1_0.name, a1_0.price
SQL> from articles a1_0
SQL> where a1_0.name=?
SQL> -- parameter 1 = bike
article [bike] in the database: [1, bike, 500.00, 10, 5]
|
说明:
- 第 21–24 行:向由 [inTransaction]管理的事务中添加两个商品;第二个商品与已有商品同名。两个 [INSERT]操作都立即执行(第 4–15 行);第二个违反了 [name]列上的唯一性约束:MySQL 拒绝了它(第 16 行),[persist] 抛出 [ConstraintViolationException];[inTransaction] 回滚事务(第 17 行)并重新抛出该异常;
- 第 25–28 行:异常被捕获;[getConstraintName] 提供被违反约束的名称(第 18 行)。这说明了为约束命名的价值;
- 第 29 行:之前已成功插入的球拍不在数据库中(第 23 行):回滚事务将其删除了;
- 第 33–51 行:由代码管理的事务。卖出两辆自行车,并通过显式的 [flush] 将更新发送给 DBMS(第 29–36 行);然后添加一个名称已存在的商品:插入失败(第 43 行);
- 第 45 行:永远不会执行到验证;
- 第 46–50 行:在 [catch]中回滚事务(结果的第 45 行)。[getSQLException] 返回来自 JDBC 驱动程序的原始异常,其消息是 MySQL 的消息(第 44 行);
- 第 53 行:自行车的销售虽然已通过 [flush]发送给 DBMS,但已被取消:自行车库存仍为 10(第 50 行);
- 第 58–64 行:一个使用新会话重新读取记录的方法,以便查看数据库的实际状态,而不是当前会话中的实体。
发生异常之后,不应再使用该会话:其持久化上下文中可能包含与数据库不一致状态的实体。我们回滚事务,关闭会话,并在需要时用新会话重新开始。这正是 [inTransaction]所做的,也是我们的代码在退出 [try]块(它会关闭会话)时所做的。
事务隔离级别是 JDBC 连接的隔离级别:[REPEATABLE_READ],这是 MySQL 的默认值,如第一个示例所示。你可以在配置中使用 [jdbcTransactionIsolation]方法为整个 [SessionFactory] 修改它。
11.11.2. 乐观并发
两个用户正在读取同一件库存为 10 的商品。第一个用户卖出一件,并将库存更新为 9。第二个用户在此次更新之前读取了库存值,卖出三件,并将库存更新为 7:第一个用户的销售就丢失了。这就是丢失更新问题。
一种解决办法是在每个用户操作的整个期间锁定该行(“悲观”并发):这会阻塞其他用户,有时会阻塞很长时间。对于 Hibernate,通常更倾向于使用乐观并发:不加任何锁,而是在保存时进行检查,以确保该行自读取以来没有被修改。标准的做法是为实体添加一个版本号——一个用 [@Version]注解的字段。每次修改该行时,Hibernate 都会递增这个数字,并在 [WHERE]子句中添加“版本仍为所读取的值”这一条件,与 [UPDATE] 和 [DELETE]命令一起使用。如果命令没有修改任何行,就说明另一个用户已经访问过这些数据:Hibernate 会抛出 [OptimisticLockException]。
[concurrency]模块使用它自己的数据库 [hbconcurrency]和它自己的实体 [Article],已精简到只保留必要部分:
| // 一件商品,其修改由版本号控制
@Entity
@Table(name = "articles")
public class Article {
@Id
@GeneratedValue(strategy = GenerationType.IDENTITY)
private Integer id;
@Column(nullable = false, length = 30)
private String name;
private int currentStock;
// 版本号:Hibernate 在每次修改该行时递增
@Version
private int version;
protected Article() {
}
public Article(String name, int currentStock) {
this.name = name;
this.currentStock = currentStock;
}
public int getCurrentStock() {
return currentStock;
}
public void setCurrentStock(int currentStock) {
this.currentStock = currentStock;
}
public int getVersion() {
return version;
}
}
|
- 第 16–17 行:版本号,类型为 [int] (也可以使用 [long],或 [Instant]形式的日期)。应用程序自己从不修改它。
该程序用两个会话模拟这两个用户:
| package concurrency;
import jakarta.persistence.OptimisticLockException;
import org.hibernate.Session;
import org.hibernate.SessionFactory;
import org.hibernate.Transaction;
import org.hibernate.cfg.AvailableSettings;
import org.hibernate.jpa.HibernatePersistenceConfiguration;
import tools.SqlLog;
public class Main {
public static void main(String[] args) {
try (SessionFactory sessionFactory = new HibernatePersistenceConfiguration("concurrency")
.managedClass(Article.class)
.jdbcUrl("jdbc:mysql://localhost:3306/hbconcurrency?createDatabaseIfNotExist=true")
.jdbcCredentials("root", "")
.property(AvailableSettings.FORMAT_SQL, true)
.createEntityManagerFactory()) {
// [articles] 表被重新创建,只有一件商品,不带日志
SqlLog.withoutLog(() -> {
sessionFactory.getSchemaManager().drop(false);
sessionFactory.getSchemaManager().create(false);
sessionFactory.inTransaction(session -> session.persist(new Article("bike", 10)));
});
// 两个用户,两个会话:各自读取同一件商品
try (Session session1 = sessionFactory.openSession();
Session session2 = sessionFactory.openSession()) {
IO.println("--- the two users read the bike");
Article bike1 = session1.find(Article.class, 1);
Article bike2 = session2.find(Article.class, 1);
// 用户 1 卖出 1 辆自行车
IO.println("--- user 1 sells 1 bike");
Transaction transaction1 = session1.beginTransaction();
bike1.setCurrentStock(bike1.getCurrentStock() - 1);
transaction1.commit();
IO.println("stock saved by user 1: %d (version %d)"
.formatted(bike1.getCurrentStock(), bike1.getVersion()));
// 用户 2 基于过时的数据(库存 = 10,版本 0)卖出 3 辆自行车
IO.println("--- user 2 sells 3 bikes");
Transaction transaction2 = session2.beginTransaction();
bike2.setCurrentStock(bike2.getCurrentStock() - 3);
try {
session2.flush();
transaction2.commit();
} catch (OptimisticLockException e) {
IO.println(e.getClass().getSimpleName() + " : " + e.getMessage());
transaction2.rollback();
}
}
// 解决办法:用户 2 用新会话重新读取该商品,然后重新开始
IO.println("--- user 2 rereads the bike and starts again");
sessionFactory.inTransaction(session -> {
Article bike = session.find(Article.class, 1);
IO.println("reread stock: %d (version %d)"
.formatted(bike.getCurrentStock(), bike.getVersion()));
bike.setCurrentStock(bike.getCurrentStock() - 3);
session.flush();
IO.println("stock saved by user 2: %d (version %d)"
.formatted(bike.getCurrentStock(), bike.getVersion()));
});
}
}
}
|
结果:
| > mvn compile exec:java
--- the two users read the bike
SQL> select a1_0.id, a1_0.currentStock, a1_0.name, a1_0.version
SQL> from articles a1_0
SQL> where a1_0.id=?
SQL> -- parameter 1 = 1
SQL> select a1_0.id, a1_0.currentStock, a1_0.name, a1_0.version
SQL> from articles a1_0
SQL> where a1_0.id=?
SQL> -- parameter 1 = 1
--- user 1 sells 1 bike
SQL> -- start of transaction
SQL> update articles
SQL> set currentStock=?, name=?, version=?
SQL> where id=? and version=?
SQL> -- parameter 1 = 9
SQL> -- parameter 2 = bike
SQL> -- parameter 3 = 1
SQL> -- parameter 4 = 1
SQL> -- parameter 5 = 0
SQL> -- transaction committed (COMMIT)
stock saved by user 1: 9 (version 1)
--- user 2 sells 3 bikes
SQL> -- start of transaction
SQL> update articles
SQL> set currentStock=?, name=?, version=?
SQL> where id=? and version=?
SQL> -- parameter 1 = 7
SQL> -- parameter 2 = bike
SQL> -- parameter 3 = 1
SQL> -- parameter 4 = 1
SQL> -- parameter 5 = 0
OptimisticLockException : Unexpected row count (expected row count 1 but was 0) [update articles set currentStock=?,name=?,version=? where id=? and version=?] for entity [concurrency.Article with id '1']
SQL> -- transaction rolled back (ROLLBACK)
--- user 2 rereads the bike and starts again
SQL> -- start of transaction
SQL> select a1_0.id, a1_0.currentStock, a1_0.name, a1_0.version
SQL> from articles a1_0
SQL> where a1_0.id=?
SQL> -- parameter 1 = 1
reread stock: 9 (version 1)
SQL> update articles
SQL> set currentStock=?, name=?, version=?
SQL> where id=? and version=?
SQL> -- parameter 1 = 6
SQL> -- parameter 2 = bike
SQL> -- parameter 3 = 2
SQL> -- parameter 4 = 1
SQL> -- parameter 5 = 1
stock saved by user 2: 6 (version 2)
SQL> -- transaction committed (COMMIT)
|
说明:
- 第 21–25 行:重新创建表,其中只有一件商品,即自行车,版本为 0;
- 第 31–32 行:每个用户在自己的会话中读取自行车。[version]列与其他列一起被读取(第 3–10 行);
- 第 36–38 行:第一个用户的 [UPDATE] 语句(第 13–20 行)写入新版本(1),并包含条件 [version=?] ,其值为所读取的版本(0)。该行被修改;实体的 [version]字段被设置为 1(第 22 行);
- 第 44–48 行:第二个用户的请求包含相同的条件,其值为他们所读取的版本 0,而数据库中该行的版本现在是 1。没有行被修改,Hibernate 触发 [OptimisticLockException] (第 33 行)。我们在 [commit] 之前显式同步会话([flush]),以便原样得到这个异常;如果它是在 [commit]期间抛出的,则会被封装在 [RollbackException]中;
- 第 57–65 行:解决办法取决于应用程序:中止、通知用户,或者像这里一样,使用新的会话重新读取该商品(收到异常的会话不得再使用),然后重复该操作。重新读取的库存是版本 1 中的 9(第 41 行),而三辆自行车的销售使库存变为版本 2 中的 6(第 50 行)。
两种变体:
- 如果没有版本列,Hibernate 可以自行检查各列的旧值:在实体上使用注解 [@OptimisticLocking(type = OptimisticLockType.DIRTY)] 和 [@DynamicUpdate] ,则 [WHERE]子句会包含[UPDATE] 所修改的每一列所读取的值([where id=? and currentStock=?])。这对于无法修改的现有数据库很有用;
- 当冲突频繁时,仍然可以使用悲观并发:[session.find(Article.class, 1, LockModeType.PESSIMISTIC_WRITE)] 使用 [select ... for update]语句读取该行,从而将其锁定直到事务结束。
11.12. 原生 SQL
Hibernate 根据 HQL 或 Criteria API 生成 SQL,但仍然可以自己编写查询的 SQL,以使用 DBMS 特有的功能或优化复杂的查询:这称为原生查询。[rawsql]模块列出了可用的方法:
| package rawsql;
import articles.Article;
import articles.BaseArticles;
import java.math.BigDecimal;
import java.sql.ResultSet;
import java.sql.Statement;
import java.util.List;
import org.hibernate.Session;
import org.hibernate.SessionFactory;
public class Main {
public static void main(String[] args) {
try (SessionFactory sessionFactory = BaseArticles.createSessionFactory()) {
// [articles] 表被重新创建,并带有六件商品
BaseArticles.initialize(sessionFactory);
try (Session session = sessionFactory.openSession()) {
// 1 - 返回实体的手写 SQL 查询
IO.println("--- createNativeQuery: entities");
BigDecimal minPrice = BigDecimal.valueOf(200);
List<Article> expensive = session
.createNativeQuery("""
select * from articles
where price > :minPrice order by name""", Article.class)
.setParameter("minPrice", minPrice)
.getResultList();
expensive.forEach(IO::println);
// 2 - 作为参数传递的值:不可能发生 SQL 注入
IO.println("--- SQL injection attempt with a parameter");
String name = "x' or '1'='1";
long nb = session
.createNativeQuery("select count(*) from articles where name = :name", Long.class)
.setParameter("name", name)
.getSingleResult();
IO.println(nb + " article(s) found");
// 通过拼接构建的同一个查询:绝对不要这样做
IO.println("--- the same attempt with a concatenation");
String sql = "select count(*) from articles where name = '" + name + "'";
nb = session.createNativeQuery(sql, Long.class).getSingleResult();
IO.println(nb + " article(s) found");
// 3 - 不是实体的结果
IO.println("--- createNativeQuery: values");
List<String> names = session
.createNativeQuery("""
select name from articles
where currentStock < minimumStock""", String.class)
.getResultList();
IO.println("out of stock: " + String.join(", ", names));
BigDecimal value = session
.createNativeQuery("select sum(price * currentStock) from articles", BigDecimal.class)
.getSingleResult();
IO.println("stock value: %.2f euros".formatted(value));
// 4 - 更新语句
IO.println("--- createNativeMutationQuery");
int nbRows = session.fromTransaction(transaction -> session
.createNativeMutationQuery("""
update articles set price = price * :coefficient
where name = :name""")
.setParameter("coefficient", new BigDecimal("0.9"))
.setParameter("name", "bow")
.executeUpdate());
IO.println(nbRows + " row(s) modified");
// 5 - 会话的 JDBC 连接,用于普通的 JDBC 代码
IO.println("--- doWork: the JDBC connection");
session.doWork(connection -> {
String query = "select name, price from articles where name = 'bow'";
try (Statement statement = connection.createStatement();
ResultSet rows = statement.executeQuery(query)) {
while (rows.next()) {
IO.println("%s : %.2f euros"
.formatted(rows.getString("name"), rows.getBigDecimal("price")));
}
}
});
}
}
}
}
|
结果:
| > mvn compile exec:java
--- createNativeQuery: entities
SQL> select *
SQL> from articles
SQL> where price > ?
SQL> order by name
SQL> -- parameter 1 = 200
[1, bike, 500.00, 10, 5]
[3, bow, 600.00, 4, 1]
[5, diving suit, 300.00, 8, 2]
--- SQL injection attempt with a parameter
SQL> select count(*)
SQL> from articles
SQL> where name = ?
SQL> -- parameter 1 = x' or '1'='1
0 article(s) found
--- the same attempt with a concatenation
SQL> select count(*)
SQL> from articles
SQL> where name = 'x' or '1'='1'
6 article(s) found
--- createNativeQuery: values
SQL> select name
SQL> from articles
SQL> where currentStock < minimumStock
out of stock: arrows - set of 6
SQL> select sum(price * currentStock)
SQL> from articles
stock value: 12300.00 euros
--- createNativeMutationQuery
SQL> -- start of transaction
SQL> update articles
SQL> set price = price * ?
SQL> where name = ?
SQL> -- parameter 1 = 0.9
SQL> -- parameter 2 = bow
SQL> -- transaction committed (COMMIT)
1 row(s) modified
--- doWork: the JDBC connection
bow : 540.00 euros
|
说明:
- 第 22–27 行:[createNativeQuery] 执行一条返回实体表中各行的查询(SQL),其第二个参数([Article.class])指示 Hibernate 将这些行具体化为由会话管理的实体。结果中的列名必须与模型中的列名一致:这里适合使用 [select *] 。查询按原样传递给 DBMS(第 3–6 行),只是名为 [:minPrice] 的参数会变成 JDBC 参数([?]);
- 第 32–36 行:一次 SQL 注入尝试。[name] 的值作为参数传递:它被原样与 [name]列比较,没有记录匹配(第 16 行);
- 第 40–41 行:通过拼接构造的同一查询。[name] 的值变成了 SQL 代码,条件始终为真(第 20 行),查询统计出六件商品(第 21 行):这是一次成功的 SQL 注入。正如第 10 章所述,原生查询只能包含常量文本,值必须作为参数传递;
- 第 46–54 行:返回单个值的查询([String]、[BigDecimal]):此时 [createNativeQuery] 的第二个参数就是该值的类型。对于多列,可以指定一个记录(其组件按顺序接收各列),或使用 [Object[].class];
- 第 59–65 行:[createNativeMutationQuery] 准备一条更新语句,由 [executeUpdate]执行,并返回被修改的行数。它在事务中运行:会话的 [fromTransaction]方法开启事务、提交事务,并返回 lambda 的结果;
- 第 70–79 行:[doWork] 提供对会话的 JDBC 连接([java.sql.Connection])的访问,以便编写标准的 JDBC 代码(第 10 章):调用存储过程、使用驱动程序的特性……弓的价格确实降低了 10%(第 40 行)。
原生查询无法在不同 DBMS 之间移植,而且 Hibernate 在执行之前无法对其进行验证:它仅用于 HQL 不够用的情况。HQL 也涵盖了 SQL 的很大一部分(各种连接、子查询、窗口函数、[union]……),并允许你调用它不认识的 DBMS 函数。
11.13. 批量更新、只读模式与批处理
跟踪变更是有代价的:要将 100 件商品的价格上调,就必须读取全部 100 件商品,逐个修改,而会话同步时将发送 100 条 [UPDATE]命令。Hibernate 提供了几种高效处理大量行的方法。[bulkupdate]模块介绍了这些方法:
| package bulkupdate;
import articles.Article;
import articles.BaseArticles;
import java.math.BigDecimal;
import java.util.List;
import org.hibernate.Session;
import org.hibernate.SessionFactory;
import org.hibernate.Transaction;
public class Main {
public static void main(String[] args) {
try (SessionFactory sessionFactory = BaseArticles.createSessionFactory()) {
// [articles] 表被重新创建,并带有六件商品
BaseArticles.initialize(sessionFactory);
try (Session session = sessionFactory.openSession()) {
Transaction transaction = session.beginTransaction();
// 1 - HQL 更新:单条 UPDATE 语句,不会把实体加载到内存
IO.println("--- restocking of the out-of-stock articles");
int nbRows = session
.createMutationQuery("""
update Article set currentStock = minimumStock * 2
where currentStock < minimumStock""")
.executeUpdate();
IO.println(nbRows + " article(s) modified");
IO.println("--- 10 % increase of the prices below 150 euros");
nbRows = session
.createMutationQuery("update Article set price = price * 1.1 where price < 150")
.executeUpdate();
IO.println(nbRows + " article(s) modified");
// 2 - HQL 删除:单条 DELETE 语句
IO.println("--- deletion of the articles over 550 euros");
nbRows = session
.createMutationQuery("delete from Article where price > 550")
.executeUpdate();
IO.println(nbRows + " article(s) deleted");
transaction.commit();
// 3 - 只读:读取的实体不受监视
IO.println("--- read-only");
transaction = session.beginTransaction();
List<Article> articles = session
.createSelectionQuery("from Article order by id", Article.class)
.setReadOnly(true)
.getResultList();
articles.forEach(IO::println);
// 对只读实体的修改被忽略
articles.getFirst().setPrice(BigDecimal.ZERO);
IO.println("session modified: " + session.isDirty());
transaction.commit();
// 4 - HQL 更新语句不会修改会话已加载的实体
IO.println("--- HQL update and loaded entities");
transaction = session.beginTransaction();
Article pump = session.find(Article.class, 2);
session.createMutationQuery("update Article set price = 9.5 where id = :id")
.setParameter("id", pump.getId())
.executeUpdate();
IO.println("price in memory: " + pump.getPrice());
session.refresh(pump);
IO.println("price after refresh: " + pump.getPrice());
transaction.commit();
}
// 5 - 无状态会话(StatelessSession)和分批发送的语句
IO.println("--- StatelessSession and batches of 3 statements");
sessionFactory.inStatelessTransaction(session -> {
session.setJdbcBatchSize(3);
List<Article> articles = session
.createSelectionQuery("from Article order by id", Article.class)
.getResultList();
for (Article article : articles) {
article.setCurrentStock(article.getCurrentStock() + 1);
// 每次修改都要显式请求:实体不受监视
session.update(article);
}
});
}
}
}
|
结果(重复的结尾部分已省略):
| > mvn compile exec:java
SQL> -- start of transaction
--- restocking of the out-of-stock articles
SQL> update articles a1_0
SQL> set currentStock=(a1_0.minimumStock*2)
SQL> where a1_0.currentStock<a1_0.minimumStock
1 article(s) modified
--- 10 % increase of the prices below 150 euros
SQL> update articles a1_0
SQL> set price=(a1_0.price*1.1)
SQL> where a1_0.price<150
3 article(s) modified
--- deletion of the articles over 550 euros
SQL> delete a1_0
SQL> from articles a1_0
SQL> where a1_0.price>550
1 article(s) deleted
SQL> -- transaction committed (COMMIT)
--- read-only
SQL> -- start of transaction
SQL> select a1_0.id, a1_0.currentStock, a1_0.minimumStock, a1_0.name, a1_0.price
SQL> from articles a1_0
SQL> order by a1_0.id
[1, bike, 500.00, 10, 5]
[2, pump, 11.00, 10, 2]
[4, arrows - set of 6, 110.00, 40, 20]
[5, diving suit, 300.00, 8, 2]
[6, diver's oxygen tanks, 132.00, 10, 5]
session modified: false
SQL> -- transaction committed (COMMIT)
--- HQL update and loaded entities
SQL> -- start of transaction
SQL> update articles a1_0
SQL> set price=9.5
SQL> where a1_0.id=?
SQL> -- parameter 1 = 2
price in memory: 11.00
SQL> select a1_0.id, a1_0.currentStock, a1_0.minimumStock, a1_0.name, a1_0.price
SQL> from articles a1_0
SQL> where a1_0.id=?
SQL> -- parameter 1 = 2
price after refresh: 9.50
SQL> -- transaction committed (COMMIT)
--- StatelessSession and batches of 3 statements
SQL> -- start of transaction
SQL> select a1_0.id, a1_0.currentStock, a1_0.minimumStock, a1_0.name, a1_0.price
SQL> from articles a1_0
SQL> order by a1_0.id
SQL> update articles
SQL> set currentStock=?, minimumStock=?, name=?, price=?
SQL> where id=?
SQL> -- parameter 1 = 11
SQL> -- parameter 2 = 5
SQL> -- parameter 3 = bike
SQL> -- parameter 4 = 500.00
SQL> -- parameter 5 = 1
...
SQL> -- execution of a batch of 3 statement(s)
SQL> update articles
SQL> set currentStock=?, minimumStock=?, name=?, price=?
SQL> where id=?
...
SQL> -- execution of a batch of 2 statement(s)
SQL> -- transaction committed (COMMIT)
|
说明:
- 第 22–26 行:用 HQL 编写的 [update]命令,由 [createMutationQuery]准备,并由 [executeUpdate]执行。它变成单条 SQL [UPDATE] 命令(第 4–6 行),由 DBMS 对所有受影响的行执行,而无需将任何实体加载到内存中。新值可以取决于该行本身([minimumStock * 2])。这样的命令在事务中执行(第 18 行);
- 第 30–32 行:对低价商品上调 10%。HQL 查询的常量([1.1]、[150])直接写入 SQL 命令的文本中(第 10–11 行);
- 第 37–39 行:一条 HQL [delete] 语句删除了弓,它是唯一价格超过 550 欧元的商品(第 14–16 行);
- 第 46–49 行:只读读取([setReadOnly(true)])。所读取的实体由会话管理,但会话不保留其原始状态,也不监视它们:对于只读取而不修改的数据(显示、计算),这样更快,也更节省内存。代价是对此类实体的任何修改都会被忽略(第 52 行):会话没有需要同步的内容(第 29 行),[commit] 命令不会发送任何指令。也可以将整个会话设置为只读([session.setDefaultReadOnly(true)]);
- 第 59–65 行:一个陷阱。HQL [update] 命令直接作用于数据库:它不会修改会话已加载的实体。由会话管理的打气筒保留其旧价格(第 37 行),直到用 [session.refresh(pump)] 重新读取它为止(第 38–42 行);
- 第 71–81 行:无状态会话 ([StatelessSession]),这里通过 [inStatelessTransaction]在事务中打开。它没有持久化上下文:没有一级缓存、没有变更跟踪、没有延迟加载、没有级联。每个操作都要显式请求([insert]、[update]、[delete]、[get])并原样执行。这是用于批量处理的工具:导入大型文件、重新计算表中的所有行;
- 第 72 行:SQL 命令将以每三条一批的方式发送给 DBMS(参见第 10 章):JDBC 驱动程序在与服务器的一次交互中传输三条命令。日志显示了前三条 [UPDATE]记录,随后是批处理的执行(第 58 行),最后以两条命令的最终批次结束(第 63 行)。应用程序通过 [hibernate.jdbc.batch_size]属性为其所有会话设置批大小(通常在 10 到 50 之间)。请注意,向主键由 [IDENTITY] 生成的表中插入数据,无法分组为批处理。
对于使用常规会话的批量处理,必须防止其持久化上下文不断积累实体:定期同步并清空会话,例如每五十条记录一次([session.flush(); session.clear();])。
11.14. Hibernate 与依赖注入:Spring
11.14.1. 容器中的 [SessionFactory]
前面的示例都是自己创建会话。在分层应用程序(第 6 章)以及所有 Spring 应用程序中,[SessionFactory] 是依赖注入容器中的一个对象,与使用它的各层一样。为此,Spring Framework 在其 [spring-orm]库中提供了:
- [LocalSessionFactoryBean]类,它根据数据源([SessionFactory] [DataSource],第 10 章)和实体列表构造 SessionFactory;
- [HibernateTransactionManager]类,这是一个事务管理器,它为每个事务打开一个 Hibernate 会话,将其与当前线程关联,并在事务结束时关闭它;
- [@Transactional]注解(库 [spring-tx]):应用于方法,或应用于类以作用于其所有公共方法时,它指示 Spring 在事务中执行该方法;如果方法正常完成,则提交事务,如果抛出未捕获的异常,则回滚事务。这称为声明式事务。
在事务方法内部,[sessionFactory.getCurrentSession()] 返回当前事务的会话。这样,[dao]层就可以是一个单例,它接收(线程安全的)[SessionFactory] ,并在每个方法中向它请求当前会话:“每个工作单元一个会话,绝不在线程之间共享”这条规则就毫不费力地得到了落实。
11.14.2. [injection]模块
除了 [injection]模块依赖 [articles]模块之外,它还依赖 Spring 和 HikariCP:
| <dependencies>
<!-- [Article] 实体和 [hbarticles] 数据库(包含 Hibernate、MySQL 和 SQL 日志) -->
<dependency>
<groupId>examples.hibernate</groupId>
<artifactId>articles</artifactId>
</dependency>
<!-- Spring:容器、声明式事务、Hibernate 集成 -->
<dependency>
<groupId>org.springframework</groupId>
<artifactId>spring-context</artifactId>
</dependency>
<dependency>
<groupId>org.springframework</groupId>
<artifactId>spring-orm</artifactId>
</dependency>
<!-- HikariCP 连接池 -->
<dependency>
<groupId>com.zaxxer</groupId>
<artifactId>HikariCP</artifactId>
</dependency>
</dependencies>
|
Spring 配置是用 Java 编写的,使用第 6 章中的注解 [@Configuration] 和 [@Bean] :
| package injection;
import articles.Article;
import articles.BaseArticles;
import com.zaxxer.hikari.HikariDataSource;
import java.util.Properties;
import javax.sql.DataSource;
import org.hibernate.SessionFactory;
import org.hibernate.cfg.AvailableSettings;
import org.springframework.context.annotation.Bean;
import org.springframework.context.annotation.Configuration;
import org.springframework.orm.jpa.hibernate.HibernateTransactionManager;
import org.springframework.orm.jpa.hibernate.LocalSessionFactoryBean;
import org.springframework.transaction.annotation.EnableTransactionManagement;
// Spring 配置:连接池、SessionFactory、事务管理器、[dao] 层
@Configuration
@EnableTransactionManagement
public class Config {
// HikariCP 连接池(第 10 章)
@Bean(destroyMethod = "close")
public HikariDataSource dataSource() {
HikariDataSource dataSource = new HikariDataSource();
dataSource.setJdbcUrl(BaseArticles.URL);
dataSource.setUsername(BaseArticles.USER);
dataSource.setPassword(BaseArticles.PASSWORD);
return dataSource;
}
// SessionFactory,由 Spring 结合连接池构建
@Bean
public LocalSessionFactoryBean sessionFactory(DataSource dataSource) {
LocalSessionFactoryBean factory = new LocalSessionFactoryBean();
factory.setDataSource(dataSource);
factory.setAnnotatedClasses(Article.class);
Properties properties = new Properties();
properties.put(AvailableSettings.FORMAT_SQL, "true");
factory.setHibernateProperties(properties);
return factory;
}
// 事务管理器:每个事务一个 Hibernate 会话
@Bean
public HibernateTransactionManager transactionManager(SessionFactory sessionFactory) {
return new HibernateTransactionManager(sessionFactory);
}
// [dao] 层:接收 SessionFactory 的单例
@Bean
public ArticlesDao articlesDao(SessionFactory sessionFactory) {
return new ArticlesDao(sessionFactory);
}
}
|
- 第 18 行:[@EnableTransactionManagement] 启用 [@Transactional]注解:Spring 会将每个带有此注解的方法所在的对象替换为一个代理,由代理在调用前后开启并提交事务;
- 第 22–29 行:第 10 章中的 HikariCP 连接池。[destroyMethod]属性指定容器关闭时要调用的方法;
- 第 32–41 行:[SessionFactory]。[LocalSessionFactoryBean] 是 [SessionFactory]的工厂:Spring 将它所创建的对象注册到容器中,请求这个 bean 会返回一个 [SessionFactory]。它接收连接池(取代 Hibernate 内置的连接池)、实体以及 Hibernate 属性;
- 第 44–47 行:事务管理器;
- 第 50–53 行:[dao]层,它接收 [SessionFactory]。
[dao]层:
| package injection;
import articles.Article;
import java.util.List;
import org.hibernate.Session;
import org.hibernate.SessionFactory;
import org.springframework.transaction.annotation.Transactional;
// [dao] 层:每个公共方法都在由 Spring 开启的事务中运行
@Transactional
public class ArticlesDao {
// SessionFactory,由所有线程共享
private final SessionFactory sessionFactory;
public ArticlesDao(SessionFactory sessionFactory) {
this.sessionFactory = sessionFactory;
}
// 在同一个事务中,两次请求当前会话会返回同一个会话吗?
public boolean sameSession() {
return sessionFactory.getCurrentSession() == sessionFactory.getCurrentSession();
}
// 事务的会话
public Session session() {
return sessionFactory.getCurrentSession();
}
// 需要补货的商品;只读事务
@Transactional(readOnly = true)
public List<String> articlesOutOfStock() {
String hql = "select name from Article where currentStock < minimumStock";
return sessionFactory.getCurrentSession().createSelectionQuery(hql, String.class).getResultList();
}
// 具有给定名称的商品
@Transactional(readOnly = true)
public Article article(String name) {
return sessionFactory.getCurrentSession()
.createSelectionQuery("from Article where name = :name", Article.class)
.setParameter("name", name)
.getSingleResult();
}
// 出售某件商品一定数量:异常会回滚事务
public void sell(String name, int quantity) {
Article article = article(name);
article.setCurrentStock(article.getCurrentStock() - quantity);
if (article.getCurrentStock() < 0) {
throw new IllegalStateException("insufficient stock for the article [" + name + "]");
}
}
}
|
- 第 10 行:该类的所有公共方法都是事务性的;
- 第 21–23 行:在同一个事务期间,两次请求当前会话,返回的是同一个会话吗?
- 第 26–28 行:事务的会话被返回给调用者(用于后面的实验——在真实的应用程序中不要这样做);
- 第 31–35 行:只读事务([readOnly = true]):Spring 将会话设置为只读,并且不对其进行同步;
- 第 47–53 行:销售某件商品的一定数量。如果库存变为负数,该方法会抛出 [IllegalStateException],这是一个未处理的异常:Spring 回滚事务。对 [article]方法的调用(第 48 行)是对象内部的调用,不经过代理:它在 [sell] 的事务中执行。
主程序:
| package injection;
import articles.BaseArticles;
import org.hibernate.HibernateException;
import org.hibernate.Session;
import org.hibernate.SessionFactory;
import org.springframework.context.annotation.AnnotationConfigApplicationContext;
public class Main {
public static void main(String[] args) {
// Spring 容器,由 [Config] 类配置
try (var context = new AnnotationConfigApplicationContext(Config.class)) {
// [articles] 表被重新创建,并带有六件商品
SessionFactory sessionFactory = context.getBean(SessionFactory.class);
BaseArticles.initialize(sessionFactory);
ArticlesDao dao = context.getBean(ArticlesDao.class);
// 1 - 在事务期间,当前会话始终是同一个
IO.println("--- sessions and transactions");
IO.println("one transaction: same session = " + dao.sameSession());
// 2 - 两个事务:两个会话,在各自事务结束时关闭
Session session1 = dao.session();
Session session2 = dao.session();
IO.println("two transactions: same session = %s, first session open = %s"
.formatted(session1 == session2, session1.isOpen()));
// 3 - 在事务之外,没有当前会话
try {
sessionFactory.getCurrentSession();
} catch (HibernateException e) {
IO.println(e.getClass().getSimpleName() + " : " + e.getMessage());
}
// 4 - [dao] 层的事务性方法
IO.println("--- articles out of stock");
IO.println("out of stock: " + dao.articlesOutOfStock());
IO.println("--- sale of 2 bikes");
dao.sell("bike", 2);
IO.println("--- sale of 50 pumps");
try {
dao.sell("pump", 50);
} catch (IllegalStateException e) {
IO.println(e.getClass().getSimpleName() + " : " + e.getMessage());
}
IO.println("--- state of the database");
IO.println(dao.article("bike"));
IO.println(dao.article("pump"));
}
}
}
|
结果:
| > mvn compile exec:java
--- sessions and transactions
SQL> -- start of transaction
SQL> -- transaction committed (COMMIT)
one transaction: same session = true
SQL> -- start of transaction
SQL> -- transaction committed (COMMIT)
SQL> -- start of transaction
SQL> -- transaction committed (COMMIT)
two transactions: same session = false, first session open = false
HibernateException : Could not obtain transaction-synchronized Session for current thread
--- articles out of stock
SQL> -- start of transaction
SQL> select a1_0.name
SQL> from articles a1_0
SQL> where a1_0.currentStock<a1_0.minimumStock
SQL> -- transaction committed (COMMIT)
out of stock: [arrows - set of 6]
--- sale of 2 bikes
SQL> -- start of transaction
SQL> select a1_0.id, a1_0.currentStock, a1_0.minimumStock, a1_0.name, a1_0.price
SQL> from articles a1_0
SQL> where a1_0.name=?
SQL> -- parameter 1 = bike
SQL> update articles
SQL> set currentStock=?, minimumStock=?, name=?, price=?
SQL> where id=?
SQL> -- parameter 1 = 8
SQL> -- parameter 2 = 5
SQL> -- parameter 3 = bike
SQL> -- parameter 4 = 500.00
SQL> -- parameter 5 = 1
SQL> -- transaction committed (COMMIT)
--- sale of 50 pumps
SQL> -- start of transaction
SQL> select a1_0.id, a1_0.currentStock, a1_0.minimumStock, a1_0.name, a1_0.price
SQL> from articles a1_0
SQL> where a1_0.name=?
SQL> -- parameter 1 = pump
SQL> -- transaction rolled back (ROLLBACK)
IllegalStateException : insufficient stock for the article [pump]
--- state of the database
SQL> -- start of transaction
SQL> select a1_0.id, a1_0.currentStock, a1_0.minimumStock, a1_0.name, a1_0.price
SQL> from articles a1_0
SQL> where a1_0.name=?
SQL> -- parameter 1 = bike
SQL> -- transaction committed (COMMIT)
[1, bike, 500.00, 8, 5]
SQL> -- start of transaction
SQL> select a1_0.id, a1_0.currentStock, a1_0.minimumStock, a1_0.name, a1_0.price
SQL> from articles a1_0
SQL> where a1_0.name=?
SQL> -- parameter 1 = pump
SQL> -- transaction committed (COMMIT)
[2, pump, 10.00, 10, 2]
|
说明:
- 第 13 行:由 [Config]类配置的 Spring 容器。它在 [try]块结束时关闭,同时关闭 [SessionFactory] 和连接池;
- 第 15 行:由 Spring 创建的 [SessionFactory] ;用它来重新创建商品表;
- 第 21 行:一个事务(第 3–4 行):在同一个事务中,当前会话保持不变(第 5 行);
- 第 23–26 行:两次调用,两个事务(第 6–9 行),两个不同的会话;第一个会话已关闭,因为它的事务已完成(第 10 行);
- 第 28–32 行:在事务之外没有当前会话:[getCurrentSession] 抛出 [HibernateException] (第 11 行)。这是因为某个方法遗漏了注解 [@Transactional]而导致的典型错误;
- 第 36 行:一个只读事务(第 13–17 行);
- 第 38 行:销售两辆自行车。事务被提交,会话同步发送 [UPDATE] (第 20–33 行);
- 第 40–44 行:销售五十个打气筒触发了异常:Spring 回滚事务(第 40 行),而 [UPDATE] 从未发送,因为会话没有被同步;
- 第 46–47 行:数据库状态:自行车库存已变为 8,而打气筒库存仍为 10(第 49 行和第 56 行)。
在 Spring Boot 应用程序中,这一切都是自动完成的:Spring Boot 根据 [EntityManagerFactory](工厂的 Jakarta Persistence 形式)和 [application.properties]文件创建连接池、工厂和事务管理器。Spring Data JPA 常用于 Hibernate 之上;它根据一个简单的接口生成 [dao]层:[interface ArticleRepository extends JpaRepository<Article, Integer>] 提供 [findAll]、[findById]、[save]、[delete]……,而声明的方法 [List<Article> findByPriceLessThan(BigDecimal price)] 会被自动转换为查询。
11.15. 示例应用程序 - 版本 7
11.15.1. 架构
税款计算应用程序的版本 6(第 10 章)使用 JDBC 从 MySQL 数据库中读取税率档。版本 7 使用 Hibernate 完成同样的工作。与版本 6 一样,只有 [dao]层发生变化:版本 5(第 6 章)的 [business] 层和 [ui] 层通过 Maven 依赖原样复用。
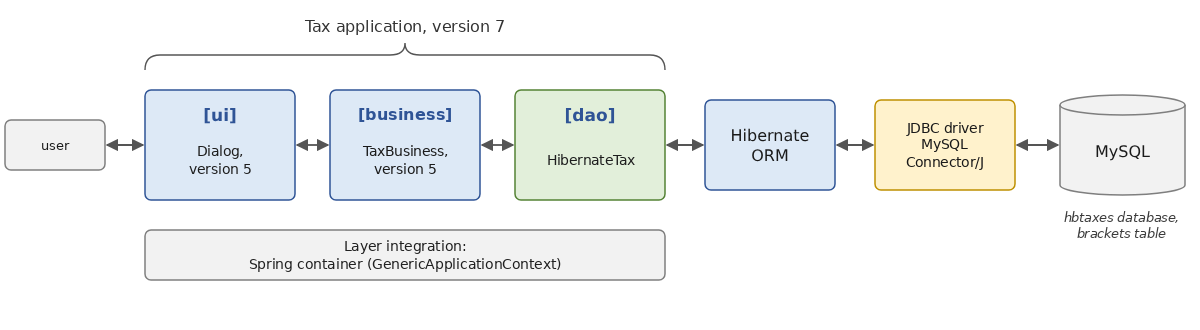
Maven 项目 [TaxV7]位于 [11-hibernate]文件夹中,由两个模块组成:
| TaxV7/
pom.xml the parent project
tax-dao-hibernate/ library: the Hibernate [dao] layer
pom.xml
src/main/java/tax/dao/
Bracket.java the entity
HibernateTax.java the implementation of ITaxDao
CreateDatabase.java the creation of the database [hbtaxes]
src/main/resources/
logback.xml
tax-ui-hibernate/ executable: integration of the layers
pom.xml
src/main/java/tax/ui/
MainHibernate.java
tax-hibernate.properties
tax-hibernate-error.properties
|
父项目([examples.tax:tax-v7:7.0])的结构与版本 5 的父项目相同:它声明这两个模块并指定库的版本,包括版本 5 模块的版本([tax-dao]、[tax-business]、[tax-ui],版本 5.0),这些模块通过在 [06-architectures/TaxV5]文件夹中输入 [mvn install] 命令安装到本地 Maven 仓库中。
11.15.2. [dao]层
[tax-dao-hibernate]模块依赖版本 5 的 [dao]层,该层包含应用程序的实体([TaxBracket]、[TaxException])和 [ITaxDao] 接口:
| <dependencies>
<!-- 第 5 版的 [dao] 层:实体、ITaxDao 接口、HardwiredTax -->
<dependency>
<groupId>examples.tax</groupId>
<artifactId>tax-dao</artifactId>
</dependency>
<!-- Hibernate、MySQL JDBC 驱动程序和 Logback -->
<dependency>
<groupId>org.hibernate.orm</groupId>
<artifactId>hibernate-core</artifactId>
</dependency>
<dependency>
<groupId>com.mysql</groupId>
<artifactId>mysql-connector-j</artifactId>
</dependency>
<dependency>
<groupId>ch.qos.logback</groupId>
<artifactId>logback-classic</artifactId>
</dependency>
</dependencies>
<build>
<plugins>
<!-- mvn exec:java 创建 [hbtaxes] 数据库 -->
<plugin>
<groupId>org.codehaus.mojo</groupId>
<artifactId>exec-maven-plugin</artifactId>
<configuration>
<mainClass>tax.dao.CreateDatabase</mainClass>
</configuration>
</plugin>
</plugins>
</build>
|
- 第 3–6 行:版本 5 的 [dao]层;
- 第 8–19 行:Hibernate、MySQL 的 JDBC 驱动程序和 Logback;
- 第 25–31 行:在模块目录中由 [mvn exec:java] 执行的类:它创建数据库,我们稍后会看到。
版本 5 中的 [TaxBracket]记录不能作为 Hibernate 实体:它是一个记录,只读,且没有标识符。它没有被修改,因为它是各层之间契约的一部分,被所有版本共享。我们为 [dao]层创建一个专用的实体,其作用是表示表中的一行:
| // 数据库中存储的税率档:一个 Hibernate 实体
@Entity
@Table(name = "brackets")
public class Bracket {
// 主键,TaxBracket 记录中并不存在
@Id
@GeneratedValue(strategy = GenerationType.IDENTITY)
private Integer id;
@Column(name = "limits", nullable = false, precision = 10, scale = 2)
private BigDecimal limit;
@Column(name = "coeffr", nullable = false, precision = 6, scale = 4)
private BigDecimal coeffR;
@Column(name = "coeffn", nullable = false, precision = 10, scale = 2)
private BigDecimal coeffN;
protected Bracket() {
}
public Bracket(BigDecimal limit, BigDecimal coeffR, BigDecimal coeffN) {
this.limit = limit;
this.coeffR = coeffR;
this.coeffN = coeffN;
}
}
|
- 第 3 行:表 [brackets];
- 第 7–9 行:主键,同时也用于对税率档排序;
- 第 11–18 行:三列,使用合适的 [decimal]数据类型:上限和系数([coeffN]) 是保留两位小数的金额,而 [coeffR] 是保留四位小数的比率。列名为小写;
- 第 23–27 行:一个构造函数,用于填充该表。该实体没有访问器:应用程序的其余部分永远看不到它。
类 [HibernateTax] 实现接口 [ITaxDao]:
| package tax.dao;
import tax.entities.TaxException;
import tax.entities.TaxBracket;
import jakarta.persistence.PersistenceException;
import java.util.List;
import org.hibernate.SessionFactory;
import org.hibernate.jpa.HibernatePersistenceConfiguration;
// 用 Hibernate 从数据库读取税率档的 [dao] 层
public class HibernateTax implements ITaxDao {
// 此实现特有的错误码
public static final int ACCESS_ERROR = 1;
public static final int EMPTY_TABLE = 2;
// 税率档
private final List<TaxBracket> taxBrackets;
// 构造函数:数据库由其 JDBC URL 指定
public HibernateTax(String url, String user, String password) {
// 一个短生命周期的 SessionFactory,仅够读取该表
try (SessionFactory sessionFactory = new HibernatePersistenceConfiguration("tax")
.managedClass(Bracket.class)
.jdbcUrl(url)
.jdbcCredentials(user, password)
.createEntityManagerFactory()) {
// 表的各行被投影为应用程序的 TaxBracket 记录
String hql = "select b.limit, b.coeffR, b.coeffN from Bracket b order by b.id";
taxBrackets = sessionFactory.fromSession(session -> session
.createSelectionQuery(hql, TaxBracket.class)
.getResultList());
} catch (PersistenceException e) {
// Hibernate 或 DBMS 错误:它被包装在 TaxException 中
throw new TaxException("Error while reading the tax brackets from the database",
e, ACCESS_ERROR);
}
// [business] 层至少需要一个税率档
if (taxBrackets.isEmpty()) {
throw new TaxException("The tax brackets table is empty", EMPTY_TABLE);
}
}
@Override
public List<TaxBracket> getTaxBrackets() {
return taxBrackets;
}
}
|
- 第 14–15 行:此实现的错误代码,与 [FileTax] 和 [JsonTax] 相同;
- 第 21 行:[dao]层接收数据库的 URL,以及用户名和密码。它在构造函数中一次性读取税率档;它将是一个单例;
- 第 23–27 行:一个短暂存在的 [SessionFactory],其存在时间仅够读取该表,随后立即关闭。由于该层只访问数据库一次,因此无需保留它;而在每次调用时都访问数据库的 [dao]层则应接收一个一次性创建的 [SessionFactory] ,就像前面的示例那样;
- 第 29–32 行:按主键顺序读取该表。该查询是对记录 [TaxBracket]的投影:Hibernate 只向 DBMS 请求相关的三列,并直接创建应用程序对象,而无需经过 [Bracket] 实体;
- 第 33–37 行:Hibernate 或 DBMS 的错误(数据库无法访问、表缺失等)表现为 [PersistenceException] (Jakarta Persistence 异常的基类,Hibernate 的异常由它派生)。与其他实现一样,它被封装在 [TaxException]中。异常最早可能发生在创建 [SessionFactory] 时(第 27 行),此时会连接服务器:带资源的 [catch]子句所属的 [try]语句也会捕获资源创建期间抛出的异常;
- 第 39–41 行:空表也是一种错误:[business]层至少需要一个税率档。
11.15.3. 数据库
数据库 [hbtaxes] 由类 [CreateDatabase] 创建。为避免重写税率档,它复用版本 5 中 [HardwiredTax] 类的税率档:
| package tax.dao;
import tax.entities.TaxBracket;
import org.hibernate.SessionFactory;
import org.hibernate.jpa.HibernatePersistenceConfiguration;
import org.hibernate.tool.schema.Action;
// 创建 [hbtaxes] 数据库:[brackets] 表,填入 HardwiredTax 类的税率档
public class CreateDatabase {
public static void main(String[] args) {
try (SessionFactory sessionFactory = new HibernatePersistenceConfiguration("tax")
.managedClass(Bracket.class)
.jdbcUrl("jdbc:mysql://localhost:3306/hbtaxes?createDatabaseIfNotExist=true")
.jdbcCredentials("root", "")
// 显示 SQL 语句,不格式化
.showSql(true, false, false)
// 创建 SessionFactory 时,先删除再重新创建该表
.schemaToolingAction(Action.CREATE)
.createEntityManagerFactory()) {
// 税率表的各税率档,即第 5 版的税率档,由 DBMS 从 1 开始编号
sessionFactory.inTransaction(session -> {
for (TaxBracket bracket : new HardwiredTax().getTaxBrackets()) {
session.persist(new Bracket(bracket.limit(), bracket.coeffR(), bracket.coeffN()));
}
});
}
}
}
|
- 第 14 行:数据库 [hbtaxes],如果不存在则由 MySQL 创建;
- 第 17 行:显示 SQL 语句,不做格式化;
- 第 19 行:创建 [SessionFactory]时,表先被删除再重新创建;
- 第 22–26 行:为 [HardwiredTax] 类的每个税率档创建一个 [Bracket] 实体,并在事务中持久化。
该模块还包含一个名为 [logback.xml]的文件,由 [CreateDatabase] 和应用程序使用,它只允许错误日志通过:
| <?xml version="1.0" encoding="UTF-8"?>
<!-- Logback 配置:只显示 Hibernate 的错误 -->
<configuration>
<appender name="CONSOLE" class="ch.qos.logback.core.ConsoleAppender">
<encoder>
<pattern>%-5level %logger{0} - %msg%n</pattern>
</encoder>
</appender>
<!-- DBMS 的错误通过异常传递给应用程序:不记录日志 -->
<logger name="org.hibernate.orm.jdbc.error" level="OFF"/>
<root level="ERROR">
<appender-ref ref="CONSOLE"/>
</root>
</configuration>
|
- 第 10 行:来自 DBMS 的错误,Hibernate 在抛出异常之前会记录日志,但这里不显示:应用程序自己会报告它们;
- 第 11 行:其他日志只记录错误。
执行:
| > mvn compile exec:java
Hibernate: drop table if exists brackets
Hibernate: create table brackets (coeffn decimal(10,2) not null, coeffr decimal(6,4) not null, id integer not null auto_increment, limits decimal(10,2) not null, primary key (id)) engine=InnoDB
Hibernate: insert into brackets (coeffn,coeffr,limits) values (?,?,?)
Hibernate: insert into brackets (coeffn,coeffr,limits) values (?,?,?)
Hibernate: insert into brackets (coeffn,coeffr,limits) values (?,?,?)
Hibernate: insert into brackets (coeffn,coeffr,limits) values (?,?,?)
Hibernate: insert into brackets (coeffn,coeffr,limits) values (?,?,?)
Hibernate: insert into brackets (coeffn,coeffr,limits) values (?,?,?)
Hibernate: insert into brackets (coeffn,coeffr,limits) values (?,?,?)
|
我们检查表的内容:
| > mysql -uroot -t hbtaxes -e "SELECT id, limits, coeffr, coeffn FROM brackets"
+----+----------+--------+---------+
| id | limits | coeffr | coeffn |
+----+----------+--------+---------+
| 1 | 4962.00 | 0.0000 | 0.00 |
| 2 | 8382.00 | 0.0680 | 291.09 |
| 3 | 14753.00 | 0.1910 | 1322.92 |
| 4 | 23888.00 | 0.2830 | 2668.39 |
| 5 | 38868.00 | 0.3740 | 4846.98 |
| 6 | 47932.00 | 0.4260 | 6883.66 |
| 7 | 0.00 | 0.4810 | 9505.54 |
+----+----------+--------+---------+
|
我们看到了税率档,最后一档的上限为零([business] 层不使用它,当没有其他税率档适用时,它会取最后一档)。
在你自己的系统上创建数据库:
- 启动 MySQL(在 Laragon 中,参见附录;用户 [root] ,无密码);
- 如果尚未安装,请将版本 5 的模块安装到本地 Maven 仓库中:在 [06-architectures/TaxV5]文件夹中执行 [mvn install] ;
- 构建版本 7:在 [11-hibernate/TaxV7]文件夹中执行 [mvn install] ;
- 进入 [11-hibernate/TaxV7/tax-dao-hibernate]文件夹,输入命令 [mvn exec:java]。
随后会创建数据库 [hbtaxes] 及其填充好数据的表 [brackets] 。如果命令失败,请检查 MySQL 是否正在运行,以及 [CreateDatabase] 类中的 URL是否与你的服务器相符(端口 3306,用户名 [root],空密码)。或者,如果你愿意,也可以按照第 10 章所述,使用 SQL 脚本创建该表及其各行。
11.15.4. 整合各层
[tax-ui-hibernate]模块整合了以下各层:
| <dependencies>
<!-- 第 5 版的 [business] 层和 [ui] 层,保持不变 -->
<dependency>
<groupId>examples.tax</groupId>
<artifactId>tax-business</artifactId>
</dependency>
<dependency>
<groupId>examples.tax</groupId>
<artifactId>tax-ui</artifactId>
</dependency>
<!-- 新的 [dao] 层 -->
<dependency>
<groupId>examples.tax</groupId>
<artifactId>tax-dao-hibernate</artifactId>
</dependency>
<!-- Spring 依赖注入容器 -->
<dependency>
<groupId>org.springframework</groupId>
<artifactId>spring-context</artifactId>
</dependency>
</dependencies>
<build>
<plugins>
<!-- mvn exec:java 执行主类 -->
<plugin>
<groupId>org.codehaus.mojo</groupId>
<artifactId>exec-maven-plugin</artifactId>
<configuration>
<mainClass>tax.ui.MainHibernate</mainClass>
</configuration>
</plugin>
</plugins>
</build>
|
- 第 3–10 行:版本 5 的 [business] 层和 [ui] 层。[tax-ui]模块包含版本 5 的主程序;这里将它用作库,具体来说是使用它的 [Dialog]类;
- 第 12–15 行:新的 [dao]层,其中包含 Hibernate、JDBC 驱动程序和 Logback;
- 第 17–20 行:Spring 容器;
- 第 30 行:主类。
配置文件 [tax-hibernate.properties]位于模块文件夹中,用于指定数据库:
| # [Tax] 应用程序第 7 版的配置:税率档数据库
jdbc.url=jdbc:mysql://localhost:3306/hbtaxes
jdbc.user=root
jdbc.password=
|
文件 [tax-hibernate-error.properties] 指定了一个名为 [hbtaxesmissing]的数据库,该数据库并不存在:
| # 不存在的数据库
jdbc.url=jdbc:mysql://localhost:3306/hbtaxesmissing
jdbc.user=root
jdbc.password=
|
主程序就是版本 5 中的那个,只是 [dao]层的组成有所变化:
| package tax.ui;
import tax.dao.HibernateTax;
import tax.dao.ITaxDao;
import tax.entities.TaxException;
import tax.business.ITaxBusiness;
import tax.business.TaxBusiness;
import java.io.IOException;
import java.io.Reader;
import java.nio.file.Files;
import java.nio.file.Path;
import java.util.Properties;
import org.springframework.context.support.GenericApplicationContext;
public class MainHibernate {
public static void main(String[] args) {
// 配置文件:默认为 tax-hibernate.properties,或作为参数传入的文件
String configFile = args.length > 0 ? args[0] : "tax-hibernate.properties";
// 各层的集成
ITaxBusiness business;
try {
// 读取配置,在当前文件夹中
Properties config = new Properties();
try (Reader reader = Files.newBufferedReader(Path.of(configFile))) {
config.load(reader);
}
String url = config.getProperty("jdbc.url");
if (url == null) {
throw new TaxException("Database URL [jdbc.url] missing from the file " + configFile);
}
String user = config.getProperty("jdbc.user", "root");
String password = config.getProperty("jdbc.password", "");
// Spring 容器:各层在其中注册
GenericApplicationContext context = new GenericApplicationContext();
// [dao] 层:HibernateTax,使用配置中的数据库
context.registerBean(ITaxDao.class, () -> new HibernateTax(url, user, password));
// 第 5 版的 [business] 层:容器会把 [dao] 层传给它
context.registerBean(TaxBusiness.class);
// 启动容器:它先创建 [dao] 层,再创建 [business] 层
context.refresh();
business = context.getBean(ITaxBusiness.class);
} catch (IOException | RuntimeException e) {
// 显示错误并结束程序
Dialog.displayError(e);
System.exit(1);
return;
}
// 与用户的对话,即第 5 版的对话
Dialog.run(business);
}
}
|
- 第 15 行:这个类没有命名为 [Main]:我们所依赖的版本 5 的 [tax-ui]模块中已经包含一个名为 [tax.ui.Main]的类;
- 第 29–34 行:数据库的 URL(必需)、用户名和密码,均从配置中读取;
- 第 39 行:[dao]层是一个 [HibernateTax],由一个向其传递数据库参数的 lambda 创建;
- 第 41 行:版本 5 的 [business]层:容器会将 [dao]层传递给它的构造函数;
- 第 54 行:版本 5 的对话框。
11.15.5. 执行
| > mvn compile exec:java
Tax calculation parameters in the format: Married (y/n) NbChildren Salary, or nothing to stop: y 2 60000
Tax=4282 euros
Tax calculation parameters in the format: Married (y/n) NbChildren Salary, or nothing to stop: y 3 60000
Tax=2959 euros
Tax calculation parameters in the format: Married (y/n) NbChildren Salary, or nothing to stop: n 0 60000
Tax=11519 euros
Tax calculation parameters in the format: Married (y/n) NbChildren Salary, or nothing to stop:
|
沿用之前版本的临界值:夫妻两人有两个孩子且合计收入为 60,000 欧元时为 4,282 欧元;有三个孩子的家庭为 2,959 欧元;无孩子的单身人士为 11,519 欧元。
使用配置文件 [tax-hibernate-error.properties],它指向一个不存在的数据库:
| > mvn compile exec:java -Dexec.args="tax-hibernate-error.properties"
Exception chain:
----------------------------------------
org.springframework.beans.factory.BeanCreationException: Error creating bean with name 'tax.dao.ITaxDao': Instantiation of supplied bean failed
----------------------------------------
tax.entities.TaxException: Error while reading the tax brackets from the database
----------------------------------------
org.hibernate.service.spi.ServiceException: Unable to create requested service [org.hibernate.engine.jdbc.env.spi.JdbcEnvironment] due to: Error calling Driver.connect() [Unknown database 'hbtaxesmissing']
----------------------------------------
org.hibernate.exception.SQLGrammarException: Error calling Driver.connect() [Unknown database 'hbtaxesmissing']
----------------------------------------
java.sql.SQLSyntaxErrorException: Unknown database 'hbtaxesmissing'
----------------------------------------
|
- 第 12 行:原始异常,由 JDBC 驱动程序抛出;
- 第 8 行和第 10 行:封装它的 Hibernate 异常:错误发生在创建 [SessionFactory]期间,此时 Hibernate 连接服务器以确定其版本;
- 第 6 行:[dao]层将该错误包装在 [TaxException]中;
- 第 4 行:正在创建 [dao]层的 Spring 容器,自身又将该异常封装在 [BeanCreationException]中,由主程序显示出来。
更换 DBMS 相当于更改数据库的 URL 和对 JDBC 驱动程序的依赖:Hibernate 会根据所遇到的 DBMS 自动选择 SQL 方言,而 [HibernateTax]类的代码,由于是用 HQL 编写的,保持不变。只需要重新创建数据库——它取决于列的类型——而 [CreateDatabase]类除了 URL 之外无需任何更改即可完成这项工作。
11.16. 结论:JDBC、JdbcClient、jOOQ 还是 Hibernate?
我们现在有两种访问数据库的方式:JDBC(第 10 章)和 Hibernate(本章)。还有其他被广泛使用的折中方案:
- JdbcClient来自 Spring Framework(库 [spring-jdbc]),它为 JDBC 增加了一个灵活的 API,可执行手写的 SQL 查询,并自动将结果行转换为对象:[jdbcClient.sql("select * from articles where price > :price").param("price", 200).query(Article.class).list()]。SQL 由你编写;Spring 负责处理参数,并把各列复制到对象中(包括记录)。它是一种“微型 ORM”;
- jOOQ 根据数据库模式生成一些类,让你可以在 Java 中编写由编译器验证的 SQL:[dsl.selectFrom(ARTICLES).where(ARTICLES.PRICE.gt(price)).fetch()]。你既完全掌控 SQL,又享有类型检查带来的安全性。
| | 优点 | 缺点 |
JDBC | 完全掌控 SQL;性能;无依赖 | 大量重复代码(参数、读取列);SQL 写在字符串中,编译器不检查 |
JdbcClient | 手写 SQL,无需复制粘贴的代码;性能与 JDBC 相近 | 没有变更跟踪,也不生成 [INSERT]/[UPDATE];SQL 未经验证 |
jOOQ | SQL 由编译器验证;支持 DBMS 的所有功能 | 每次模式变更都要重新生成代码;没有变更跟踪;某些商业 DBMS 版本需要付费许可 |
Hibernate | 面向对象的模型;变更跟踪;关系;HQL 和 Criteria API;Jakarta Persistence 标准;独立于 DBMS | 需要额外理解一层(会话、状态、延迟加载);需要监控生成的 SQL;不太适合复杂的批量处理 |
可以提出以下指导原则:
- Hibernate (通常通过 Spring Data JPA)适合大多数业务应用程序:由相互关联的实体构成的模型、读取和更新实体的操作,以及随应用程序演进的模式。它是 Spring Boot 应用程序的默认选择;
- JDBC、JdbcClient 或 jOOQ 适用于需要精确控制所执行的 SQL 代码的情况:复杂的统计查询、存储过程、处理超大数据量,或者模式不太适合面向对象模型的现有数据库;
- 这些方法可以结合使用:应用程序可以在大部分场合使用 Hibernate,而对少数关键查询使用手写的 SQL 代码,即通过原生查询、[JdbcClient] 或 JDBC([doWork])。
无论如何,ORM 并不能消除理解 SQL 和 DBMS 工作原理的必要性:本章中我们一直在显示的已执行 SQL 命令日志,是验证 Hibernate 实际所做工作的首要工具。
要进一步学习,Hibernate 文档内容全面,其入门指南是最好的起点:Hibernate ORM - documentation。Jakarta Persistence 规范由 Eclipse Foundation 发布:Jakarta Persistence。