8. Threads de execução
Este capítulo apresenta a execução simultânea de várias partes de código em um mesmo programa: as threads (threads de execução) e as ferramentas usadas para sincronizá-las. Em 2008, a maioria das máquinas tinha apenas um processador, e o paralelismo era em grande parte uma ilusão mantida pelo sistema operacional. Hoje, até o laptop mais simples tem vários núcleos: várias threads de fato executam ao mesmo tempo, tornando os problemas de sincronização discutidos aqui ainda mais frequentes.
Os exemplos são aplicações de arquivo único ([dotnet run threads-01.cs]) localizadas na pasta [08-threads]. Observe que as diretivas [using] implícitas dessas aplicações incluem [System.Threading] e [System.Threading.Tasks]: as classes [Thread], [Lock], [Mutex], [Monitor], [Interlocked], [Task]… podem ser usadas sem a diretiva [using].
Um aviso antes de começar: os resultados de um programa com várias threads variam de uma execução para outra. A ordem em que as threads recebem o processador depende do sistema operacional, do número de processadores e da carga da máquina. Os resultados mostrados neste capítulo foram obtidos em uma máquina Linux com dois processadores, compartilhada com outros programas. Se você executar os exemplos, obterá resultados semelhantes, mas raramente idênticos.
8.1. A classe Thread
Quando uma aplicação é iniciada, ela é executada em um fluxo de execução chamado thread. A classe .NET que modela uma thread é a classe [System.Threading.Thread]. Seus principais construtores, propriedades e métodos são os seguintes:
Membro | Função |
[Thread(ThreadStart start)] | cria uma thread que executará o método [start]. O delegate [ThreadStart] refere-se a um método sem parâmetros e sem valor de retorno: [void M()] |
[Thread(ParameterizedThreadStart start)] | o mesmo que acima, mas com um método que tem um parâmetro do tipo [object?]: [void M(object? obj)] |
[static Thread CurrentThread] | a thread que executa o código que solicitou essa propriedade |
[string? Name] | o nome da thread, útil para acompanhamento |
[int ManagedThreadId] | um identificador numérico único da thread |
[bool IsBackground] | indica se a thread é uma thread em segundo plano (ver adiante) |
[bool IsAlive] | indica se a thread está em execução no momento |
[void Start()], [void Start(object? obj)] | inicia a execução da thread, opcionalmente passando a ela uma informação do tipo [object] |
[void Join()], [bool Join(TimeSpan timeout)] | A thread T1, que executa [T2.Join()], fica bloqueada até que a thread T2 termine. A segunda forma limita a duração da espera |
[static void Sleep(int ms)] | A thread que executa o método é suspensa por [ms] milissegundos. Ela perde a CPU, que é entregue a outra thread |
O curso de 2008 também abordava o método [Abort], que encerrava uma thread à força. Na prática, ele não existe mais: desde o .NET Core, lança a exceção [PlatformNotSupportedException]. Interromper bruscamente uma thread podia deixar os dados que ela manipulava em um estado inconsistente. Hoje, pede-se a uma thread que pare de forma cooperativa, usando um token de cancelamento ([CancellationToken]) que a thread verifica regularmente: veremos isso no próximo capítulo.
Eis uma primeira aplicação que demonstra a existência de uma thread de execução principal — aquela que executa as instruções de nível superior do programa (o equivalente ao método [Main]). O programa [threads-01.cs] é o seguinte:
Resultados:
Comentários:
- Linha 4: obtém-se uma referência à thread que executa o programa;
- Linhas 5–9: exibimos seu nome, o modificamos e o exibimos novamente. Inicialmente, a thread principal não tem nome (linha 2 dos resultados);
- linhas 11–15: algumas propriedades da thread. A thread principal tem o ID 1; é uma thread em primeiro plano ([IsBackground] é igual a [False]) que não pertence ao pool de threads (falaremos desses dois conceitos mais adiante); ela está em execução no momento ([Running]);
- Linha 16: a máquina que executou o exemplo tem 2 processadores;
- linhas 19–23: um laço que exibe uma mensagem a cada segundo. [Thread.Sleep(1000)] suspende a thread principal por um segundo. O curso de 2008 usava aqui um laço infinito encerrado com Ctrl-C; nos limitamos a cinco exibições. Observe o formato [HH:mm:ss] (horas de 0 a 23): o curso de 2008 usava [hh], que exibe horas de 1 a 12.
8.2. Criação de threads de execução
É possível ter aplicações em que partes do código são executadas "simultaneamente" em diferentes threads de execução. Se a máquina tem menos processadores do que threads prontas para executar, as threads compartilham os processadores: cada uma usa um processador por vez durante um curto período (alguns milissegundos). Em uma máquina multiprocessada, várias threads de fato executam ao mesmo tempo. O tempo concedido a uma thread depende de vários fatores, entre eles sua prioridade, que tem um valor padrão, mas pode ser definida por programação (propriedade [Priority]). Uma thread que tem o processador pode liberá-lo antes do tempo:
- ao esperar por um evento (término de outra thread com [Join], espera por um sinal);
- ao entrar em estado de suspensão por um tempo determinado ([Sleep]).
Uma thread T é criada primeiro com um dos construtores apresentados acima, por exemplo:
onde [Display] é um método com uma das duas assinaturas a seguir:
Criar uma thread não a inicia:
- a execução da thread T é iniciada por [T.Start()]: o método passado ao construtor de T é então executado pela thread T. O código que executa a instrução [T.Start()] não espera a thread T terminar; passa imediatamente à instrução seguinte. Temos então duas threads em execução paralela. Elas muitas vezes precisam se comunicar para acompanhar o andamento do trabalho compartilhado: esse é o problema da sincronização de threads;
- Uma vez iniciada, a thread T executa de forma autônoma. Ela para quando o método que executa termina;
- podemos esperar o término de sua execução com [T.Join()]. Trata-se de uma instrução bloqueante: a thread que a executa fica bloqueada até que a thread T conclua seu trabalho. Esse é um método básico de sincronização.
O programa [threads-02.cs] é o seguinte:
Comentários:
- linha 4: damos um nome à thread principal;
- linhas 7–15: 5 threads são criadas e iniciadas. Suas referências são armazenadas em um array para que possam ser recuperadas depois. Cada thread executa o método [Display] das linhas 22–29;
- linha 11: o nome do método [Display] é convertido automaticamente em um delegate do tipo [ThreadStart] (os delegates foram apresentados no capítulo anterior);
- linha 15: a thread nº i é lançada. Essa operação não é bloqueante: a thread nº i executa em paralelo com a thread principal que a lançou;
- linha 19: a thread principal chega ao fim do programa;
- linhas 22–29: o método [Display] exibe o nome e o ID da thread que o executa, bem como os horários de início e fim (em milissegundos) da execução;
- linha 28: qualquer thread que execute o método [Display] faz uma pausa de 1 segundo. O processador é então entregue a outra thread que o aguarda. Ao fim da pausa de 1 segundo, a thread pausada volta a ser elegível para o processador. Ela o obterá quando chegar a sua vez.
Resultados:
Esses resultados são muito instrutivos:
- Primeiro, vemos que lançar uma thread não é bloqueante. A thread principal lançou 5 threads e chegou ao fim do programa (linha 4) mesmo que três das threads lançadas ainda não tivessem exibido sua primeira mensagem;
- a ordem de execução das threads é imprevisível: nesta execução, as threads 2 e 4 exibiram suas mensagens de início antes da thread 0. O sistema operacional tem aqui 6 threads e 2 processadores; ele distribui os processadores entre essas threads segundo suas próprias regras;
- Notamos também que a ordem das exibições nem sempre segue a ordem dos horários exibidos: o horário é calculado antes de ser exibido e, nesse meio-tempo, outra thread pode ter escrito no console. [Console.WriteLine] é thread-safe: duas linhas escritas por duas threads não se misturam, mas sua ordem não é garantida;
- cada thread faz uma pausa de um segundo com [Sleep] e depois conclui a execução do método [Display];
- Por fim, o programa não parou quando a thread principal terminou seu trabalho: o processo esperou o término das 5 threads. Isso ocorre porque essas threads são threads em primeiro plano: um processo .NET termina quando todas as suas threads em primeiro plano terminaram.
Inversamente, uma thread pode ser declarada em segundo plano definindo sua propriedade [IsBackground] como [true] antes de lançá-la. As threads em segundo plano não impedem o processo de terminar: quando a última thread em primeiro plano termina, elas são interrompidas. O programa [threads-03.cs] é o seguinte:
Comentários:
- linha 14: as 5 threads são threads em segundo plano. As propriedades [Name] e [IsBackground] são definidas por meio de um inicializador de objeto;
- linha 20: a thread principal espera 100 ms para dar tempo às threads de iniciar e depois termina.
Resultados:
As 5 threads começaram a execução e depois a thread principal terminou (linha 7). As threads em segundo plano foram então interrompidas durante sua suspensão de um segundo: nenhuma mensagem de fim é exibida. O curso de 2008 obtinha o mesmo resultado terminando [Main] com [Environment.Exit(0)], uma instrução que interrompe todas as threads da aplicação, e não apenas a que a executa. As threads do pool de threads, das quais falaremos adiante, são threads em segundo plano.
Se a thread principal quiser esperar o término das threads que criou, ela usa o método [Join]. O programa [threads-04.cs] também demonstra outra forma de especificar o código que uma thread deve executar: um lambda.
Comentários:
- Linha 13: a thread executa o lambda [() => Display(number, 1000 + 100 * number)]. Um lambda sem parâmetros e sem valor de retorno é compatível com o delegate [ThreadStart]. Essa sintaxe permite chamar um método com parâmetros tipados (aqui, dois [int]) em vez da assinatura imposta [void M(object? obj)];
- Linha 11: o lambda usa uma cópia da variável de laço [i]. Isso é essencial: um lambda captura a variável, não seu valor. Em um laço [for], a variável [i] é única para todas as iterações; se o lambda usasse [i], uma thread que iniciasse tarde poderia ler o valor de [i] de uma iteração posterior, ou até o valor final 5. A variável [number], declarada dentro do corpo do laço, é, por outro lado, uma nova variável a cada iteração (a variável de um laço [foreach] também é nova a cada iteração, desde o C# 5);
- linhas 18–21: a thread principal espera cada uma das threads. Ela fica primeiro bloqueada esperando a thread 0, depois a thread 1, e assim por diante. Ao sair do laço, as 5 threads que ela lançou terminaram;
- linha 31: a tarefa nº i dorme por 1.000 + 100 × i milissegundos, de modo que as threads terminem em uma ordem conhecida.
Resultados:
A última linha mostra que a thread principal terminou depois das threads que havia lançado, no momento em que a última delas terminou.
8.3. As vantagens das threads
Agora que destacamos a existência de uma thread padrão — a que executa o programa principal — e sabemos criar threads adicionais, vamos considerar as vantagens das threads. Elas têm dois usos principais:
- aproveitar todos os processadores da máquina em um cálculo demorado: o trabalho é dividido em partes atribuídas a diferentes threads. Faremos isso com a biblioteca [Parallel] no fim deste capítulo;
- realizar várias tarefas simultaneamente, particularmente quando algumas delas consistem principalmente em esperar (por uma resposta da rede, uma leitura de disco ou uma entrada do usuário). É o caso das aplicações cliente/servidor da Internet, que abordaremos em um capítulo posterior.
Em uma aplicação cliente/servidor da Internet, um servidor localizado em uma máquina chamada S1 responde a solicitações de clientes localizados em máquinas remotas C1, C2, ..., Cn:
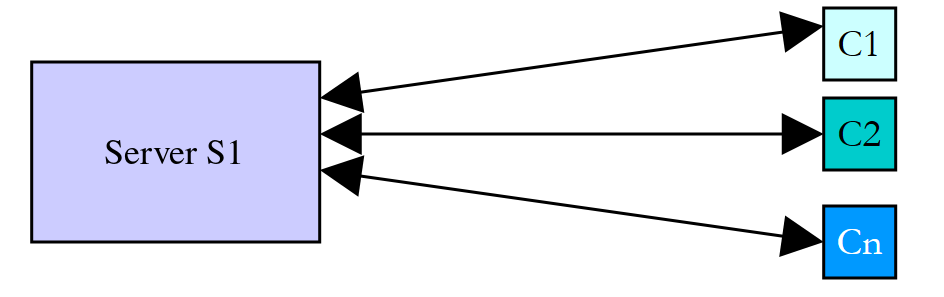
Usamos todos os dias aplicações da Internet que seguem esse modelo: serviços web, e-mail, transferência de arquivos etc. No diagrama acima, o servidor S1 deve atender simultaneamente os clientes Ci. Tomando o exemplo de um servidor de arquivos, sabemos que uma transferência pode às vezes durar vários minutos. Está fora de questão que um único cliente monopolize o servidor por tanto tempo. Uma solução comum é o servidor criar tantas threads de execução quantos forem os clientes. Cada thread fica então responsável por atender um cliente específico:
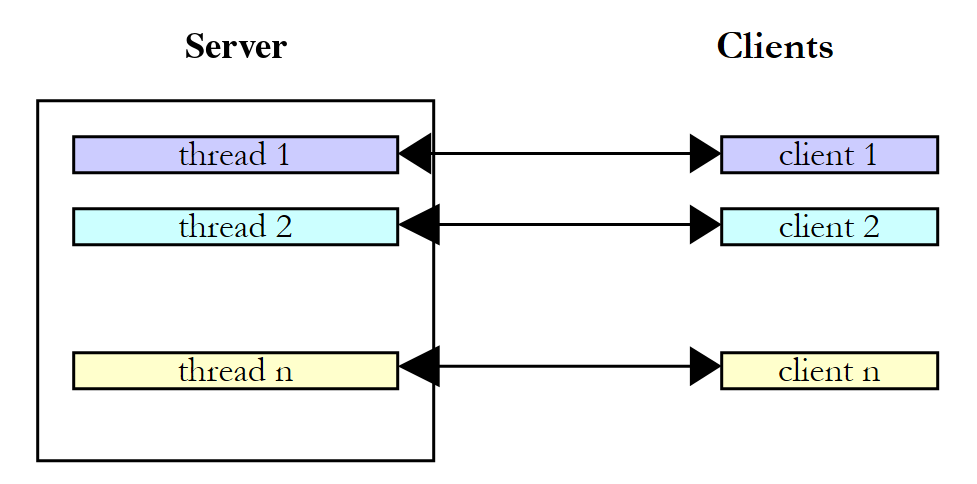
Na prática, o servidor usa um pool de threads com um número limitado de threads, como descrito adiante. Os servidores modernos vão um passo além: enquanto um cliente espera uma resposta da rede, nenhuma thread é reservada para ele. Isso é possível graças à programação assíncrona, tema do próximo capítulo.
8.4. Troca de informações entre threads
Nos exemplos anteriores, as threads executavam um método sem parâmetros. O construtor [Thread(ParameterizedThreadStart)] aceita um método com a assinatura [void M(object? obj)]. Isso permite passar informações à thread lançada:
lança a thread [t], que então executa o método associado a ela na construção, passando-lhe o parâmetro real [obj1]. O programa [threads-05.cs] é o seguinte:
Comentários:
- Linhas 46–52: a informação passada às threads é um objeto [Data]. Há uma troca de informações em duas vias entre a thread que lança e a thread lançada. [Start] e [Duration] são propriedades [init]: só podem ser definidas quando o objeto é criado:
- [Start]: o horário de início da execução da thread, definido pela thread que a lança;
- [Duration]: duração, em segundos, da suspensão da thread lançada, definida pela thread que a lança;
- [End]: horário de término da execução da thread, definido pela thread lançada;
- linha 12: cada thread é associada ao método [Sleep] das linhas 32–42, cuja assinatura [void Sleep(object? state)] corresponde ao delegate [ParameterizedThreadStart];
- linhas 14–16: um objeto [Data] é criado, armazenado no array [data] e depois passado ao método [Start], que lança a thread;
- linhas 20–26: a thread principal espera o término de cada uma das threads que lançou, depois recupera o objeto [data[i]] da thread nº i e exibe seu conteúdo;
- linha 35: o parâmetro recebido é do tipo [object?]; o filtro de padrão [state is not Data info] verifica seu tipo real e o armazena na variável tipada [info]. O curso de 2008 fazia uma conversão de tipo (cast) para [(Data)state], que lança uma exceção se o objeto não for do tipo esperado;
- linha 40: a propriedade [Duration] do parâmetro define a duração da suspensão;
- linha 42: a propriedade [End] do parâmetro é definida.
Resultados:
Este exemplo mostra que duas threads podem trocar informações:
- a thread chamadora pode controlar a execução da thread chamada fornecendo-lhe informações;
- a thread lançada pode devolver resultados à thread que a lançou.
Para que a thread chamadora saiba quando os resultados que espera estão disponíveis, ela precisa ser notificada quando a thread chamada terminar. Aqui, ela esperou o término da thread chamada usando o método [Join]. [Join] também garante que quaisquer escritas feitas pela thread chamada sejam visíveis para a thread que a espera. Veremos outras formas de sincronização mais adiante.
Com um lambda, não é mais necessário usar o tipo [object]: o lambda captura diretamente variáveis tipadas. As linhas 12–16 poderiam ser escritas assim:
com um método [static void Sleep(Data data)] que não precisa mais verificar o tipo de seu parâmetro. Essa é a abordagem mais comum hoje.
8.5. Acesso concorrente a recursos compartilhados
8.5.1. Acesso concorrente não sincronizado
No parágrafo anterior, as informações eram trocadas apenas entre duas threads e em momentos bem específicos: era um exemplo clássico de passagem de parâmetros. Há outros casos em que as informações são compartilhadas por várias threads que podem querer lê-las ou atualizá-las ao mesmo tempo. Isso levanta a questão da integridade dessas informações. Suponha que a informação compartilhada seja uma estrutura S contendo várias informações I1, I2, ..., In:
- uma thread T1 começa a atualizar a estrutura S: modifica o campo I1 e é interrompida antes de concluir a atualização completa da estrutura S;
- uma thread T2 que obtém o processador lê então a estrutura S para tomar decisões. Ela lê uma estrutura em estado instável: alguns campos estão atualizados, outros não.
Essa situação é chamada de acesso concorrente a um recurso compartilhado — neste caso, a estrutura S. Muitas vezes é difícil de gerenciar. Vamos considerar o exemplo a seguir para ilustrar os problemas que podem surgir:
- uma aplicação gerará n threads, onde n é passado como parâmetro;
- o recurso compartilhado é um contador que deve ser incrementado por cada thread gerada;
- ao final da aplicação, o valor do contador é exibido. Ele deveria, portanto, ser igual a n.
O programa [threads-06.cs] é o seguinte:
Comentários:
- Linhas 4–8: o número de threads é passado como argumento. A condição da linha 5 reúne todas as verificações: um argumento é obrigatório; ele é um inteiro ([int.TryParse]); e está entre 1 e 100 (padrão relacional [nbThreads is < 1 or > nbMaxThreads]). O programa retorna o código de saída 1 se ocorrer um erro e 0 caso contrário (linha 25);
- linhas 28–43: o recurso compartilhado é a propriedade estática [Counter.Value]. O contador é encapsulado em uma classe estática, com o método [Increment] executado por cada thread. Uma instrução de nível superior não pode declarar um campo: por isso, os dados compartilhados pelas threads são membros estáticos de uma classe;
- linha 37: o contador é lido;
- linha 40: a thread faz uma pausa de 1 segundo. Ela perde, portanto, a CPU;
- linha 42: o contador é incrementado.
A pausa de um segundo existe apenas para forçar a thread a perder o processador entre a leitura e a escrita do contador. Na prática, não há garantia de que uma thread não seja interrompida entre esses dois momentos, e em uma máquina multiprocessada duas threads podem até ler o contador exatamente ao mesmo tempo. A pausa de um segundo apenas sistematiza esse risco.
Para passar argumentos a uma aplicação de arquivo único, coloque-os depois de [--]:
Olhando esses resultados, fica claro o que acontece:
- Uma primeira thread lê o contador. Encontra 0. Faz uma pausa de 1 segundo e perde assim a CPU;
- uma segunda thread também lê o valor do contador. Ele ainda é 0, pois a thread anterior ainda não o incrementou. Ela também faz uma pausa de 1 segundo;
- em menos de um segundo, todas as 5 threads têm tempo de ler o valor 0;
- ao acordar, elas incrementam o valor 0 que leram e todas escrevem o valor 1 no contador, como confirma a última linha (linha 12).
Poderíamos objetar que o exemplo é artificial. Então vamos remover o [Sleep] e usar o operador [++], que dá a ilusão de uma única instrução. O programa [threads-07.cs] é o seguinte:
Comentários:
- Linhas 4–5: o número de threads (4 por padrão) e o número de incrementos feitos por cada thread (50 milhões por padrão) podem ser passados como argumentos. A expressão [args.Length > 0 && int.TryParse(args[0], out int n) ? n : 4] retorna o argumento se ele existir e for válido; caso contrário, retorna o valor padrão. O separador [_] torna a constante [50_000_000] legível;
- linha 20: cada thread incrementa o contador compartilhado sem nenhuma pausa;
- linha 38: desta vez, o contador é um campo;
- linha 32: o formato [N0] exibe um inteiro com separador de milhares.
Resultados:
Dezenas de milhões de atualizações foram perdidas, e o número varia de um teste para outro. A operação de alto nível [Counter.Value++] é, na verdade, traduzida em várias instruções básicas do processador: ler o valor da memória, incrementá-lo em um registrador e gravar o resultado na memória. Se duas threads leem o mesmo valor antes de uma delas gravar o seu, um incremento é perdido, exatamente como no exemplo anterior. São necessárias muitas iterações para observar isso: com um milhão de incrementos por thread, cada thread muitas vezes já terminou seu trabalho antes que a seguinte comece, e o resultado está correto. É isso que torna esses erros tão perigosos: um programa pode funcionar por meses e falhar justamente no dia em que o sistema está sob maior carga.
De onde vem o problema? Uma thread leu um valor desatualizado porque outra thread havia sido interrompida — ou trabalhava simultaneamente em outro processador — antes de concluir sua tarefa de atualizar o contador. Isso nos leva aos conceitos de recursos críticos e seções críticas em um programa:
- um recurso crítico é um recurso que só pode ser mantido por uma thread por vez. Aqui, o recurso crítico é o contador;
- uma seção crítica de um programa é uma sequência de instruções no fluxo de execução de uma thread durante a qual ela acessa um recurso crítico. Precisamos garantir que, durante essa seção crítica, a thread seja a única com acesso ao recurso.
No programa [threads-06.cs], a seção crítica é o código entre a leitura do contador e a gravação de seu novo valor:
Para executar esse código, é preciso garantir que a thread seja a única em execução. Ela pode ser interrompida, mas, durante essa interrupção, nenhuma outra thread deve poder executar esse mesmo código. A plataforma .NET oferece várias ferramentas para garantir acesso exclusivo a seções críticas de código. Veremos algumas delas agora.
8.5.2. A cláusula [lock] e o tipo [Lock]
A cláusula [lock] delimita uma seção crítica da seguinte forma:
[padlock] é um objeto visível a todas as threads que executam a seção crítica. A cláusula [lock] garante que apenas uma thread por vez execute a seção crítica: uma thread que encontra um lock mantido por outra thread fica bloqueada até que o lock seja liberado.
A partir do C# 13 e do .NET 9, o objeto de sincronização deve preferencialmente ser uma instância do tipo [System.Threading.Lock], projetado para essa finalidade. O exemplo anterior é reescrito da seguinte forma em [threads-08.cs]:
Comentários:
- linha 36: [padlock] é o objeto que permitirá sincronizar todas as threads. Ele é [readonly]: a referência nunca deve mudar; caso contrário, duas threads poderiam bloquear dois objetos diferentes;
- Linhas 44–53: a seção crítica do método [Increment] é envolvida pela cláusula [lock]. A thread mantém o lock enquanto dorme por um segundo: as outras threads não podem entrar;
- Linhas 20–24: a thread principal espera as threads na ordem inversa de sua criação.
Resultados com 3 threads:
- As três threads solicitam entrada na seção crítica quase ao mesmo tempo;
- apenas uma entra — neste caso, a thread 0 (a ordem de entrada não é garantida: não é necessariamente a primeira a chegar que entra primeiro). Ela lê o contador, dorme por um segundo, grava o novo valor e sai da seção crítica;
- as outras duas threads ficam bloqueadas até que a primeira saia da seção crítica e depois prosseguem uma após a outra. Cada uma lê o valor gravado pela anterior;
- a thread principal esperava o término da thread 2. Quando é notificada, ela espera a thread 1, que já terminou: é notificada imediatamente. O mesmo vale para a thread 0;
- o número de threads está correto (linha 20).
O compilador traduz a cláusula [lock (padlock) { ... }] sobre um objeto [Lock] como:
[EnterScope] adquire o lock e retorna uma estrutura cujo método [Dispose] — chamado ao sair do bloco [using] — libera o lock, mesmo que a seção crítica lance uma exceção. O tipo [Lock] também oferece os métodos [Enter], [TryEnter], e [Exit] para os casos em que o lock não pode ser gerenciado por um bloco.
Antes do .NET 9, e em muito código existente, o lock era um objeto genérico, tipicamente do tipo [object]:
Essa forma continua válida: qualquer objeto .NET pode servir de lock. O compilador a traduz então em chamadas à classe [Monitor], que examinaremos mais adiante:
O tipo [Lock] é mais eficiente e torna a intenção explícita. Sempre bloqueamos um objeto privado: bloquear um objeto visível externamente ([this], um tipo com [typeof(...)], uma string) permitiria que código externo adquirisse o mesmo lock e bloqueasse o nosso.
8.5.3. A classe Mutex
A classe [System.Threading.Mutex] também permite delimitar seções críticas. Ela difere da cláusula [lock] quanto à visibilidade:
- a cláusula [lock] sincroniza threads dentro de uma mesma aplicação;
- a classe [Mutex] pode sincronizar threads de aplicações (ou processos) diferentes, se receber um nome.
Um [Mutex] é um objeto do sistema operacional: seu uso consome muito mais recursos que o de um [lock]. Para threads de um mesmo processo, preferimos portanto usar [lock]; [Mutex] é usado principalmente entre processos. Usaremos os seguintes construtores e métodos:
Membro | Função |
[Mutex()] | cria um Mutex M anônimo, utilizável pelas threads do processo |
[Mutex(bool initiallyOwned, string name)] | cria ou abre o mutex nomeado [name], compartilhado por todos os processos que usam esse nome |
[bool WaitOne()] | A thread T1, que executa [M.WaitOne()], solicita a posse do mutex M. Se M não é mantido por nenhuma thread, ele é concedido a T1. Se uma thread T2 tenta então a mesma operação, ela fica bloqueada: um mutex só pode pertencer a uma thread. T2 será desbloqueada quando T1 liberar M. Assim, várias threads podem ficar bloqueadas esperando M |
[bool WaitOne(TimeSpan timeout)] | O mesmo que acima, mas a espera é limitada a [timeout]. O método retorna [false] se o mutex não puder ser adquirido |
[void ReleaseMutex()] | A thread que mantém M o libera. Uma das threads que esperam M o adquire então |
A sincronização de uma seção crítica é feita da seguinte forma:
Não se esqueça de liberar um mutex; caso contrário, as threads que o esperam ficarão bloqueadas indefinidamente. Por isso a liberação é feita em uma instrução [finally], que é executada independentemente de ter ocorrido uma exceção. O programa [threads-09.cs] retoma o exemplo anterior com um mutex:
Comentários:
- linha 33: o objeto de sincronização das threads agora é um mutex;
- linha 41: início da seção crítica. A thread fica bloqueada até que o mutex esteja livre;
- linhas 42–57: como um mutex deve sempre ser liberado, ocorrendo ou não uma exceção, a seção crítica é colocada em um [try], cuja cláusula [finally] libera o mutex (linha 57).
Resultados:
Os resultados são semelhantes aos anteriores: as threads passam pela seção crítica uma a uma, e o valor final do contador está correto.
O verdadeiro valor do mutex se revela com um mutex nomeado. O programa [threads-10.cs] é executado duas vezes, em dois processos diferentes, que compartilham uma seção crítica:
Comentários:
- Linha 4: o nome do mutex. Todos os processos que abrem um mutex com esse nome usam o mesmo objeto do sistema. O prefixo [Global] especifica que o mutex é visível para todas as sessões da máquina (o prefixo padrão [Local] o limita à sessão do usuário);
- Linha 9: o mutex nomeado é criado se ainda não existir; caso contrário, é aberto. O primeiro parâmetro, [false], indica que o processo não solicita a posse dele na criação. A declaração [using] libera o objeto [Mutex] ao final do programa;
- linha 12: o processo tenta adquirir o mutex imediatamente ([TimeSpan.Zero]). Se falhar, informa a falha e depois o espera indefinidamente (linha 16);
- Linhas 18–27: a seção crítica, que dura 3 segundos, seguida da liberação do mutex.
O script de captura lança o processo A, espera 1,5 segundo e depois lança o processo B. Resultados do processo A:
Resultados do processo B:
O processo B encontrou o mutex mantido pelo processo A e esperou. Ele o adquiriu no exato momento em que A o liberou. Um uso comum de um mutex nomeado é impedir que duas instâncias da mesma aplicação sejam iniciadas: a segunda instância, incapaz de adquirir o mutex, termina imediatamente. Se um processo termina sem liberar um mutex que mantém, diz-se que o mutex foi abandonado: o próximo processo a chamar [WaitOne] o adquire, mas lança a exceção [AbandonedMutexException] para sinalizar que o recurso protegido pode estar em um estado inconsistente.
8.5.4. A classe AutoResetEvent
Um objeto [AutoResetEvent] é uma barreira que deixa passar apenas uma thread por vez. Ele é construído da seguinte forma:
O booleano [state] indica se a barreira está fechada ([false]) ou aberta ([true]). Uma thread que deseja passar pela barreira indica isso da seguinte forma:
- Se a barreira está aberta, a thread passa e a barreira se fecha automaticamente atrás dela (daí o nome da classe). Se várias threads esperam, apenas uma passa;
- se a barreira está fechada, a thread fica bloqueada. Outra thread a abrirá no momento oportuno. Esse momento depende inteiramente do problema a ser resolvido. A barreira é aberta pela operação:
Uma thread também pode fechar uma barreira usando [barrier.Reset()]. Diferentemente de um mutex, uma barreira não pertence a nenhuma thread específica: qualquer thread pode abri-la. Se, no exemplo anterior, substituirmos o mutex por um [AutoResetEvent], o código fica assim [threads-11.cs]:
Comentários:
- linha 39: a barreira é criada em estado fechado. Ela será aberta pela thread principal na linha 23;
- linha 19: a thread principal espera meio segundo para dar tempo às threads de chegar à barreira;
- linha 47: a thread responsável por incrementar o contador solicita permissão para entrar na seção crítica. As várias threads se acumulam diante da barreira fechada. Quando a thread principal a abre, uma das threads em espera passa, e a barreira se fecha novamente;
- linha 63: ao terminar seu trabalho, a thread reabre a barreira, permitindo que outra thread entre.
Resultados:
Os resultados são semelhantes aos anteriores. Vemos que as três threads esperam diante da barreira até que a thread principal a abra (linha 5).
8.5.5. As classes ManualResetEventSlim e SemaphoreSlim
Duas outras ferramentas de sincronização complementam as anteriores.
Um objeto [ManualResetEventSlim] é uma barreira que, uma vez aberta por [Set], permanece aberta e deixa passar todas as threads até ser explicitamente fechada por [Reset]. É o "sinal de largada" de uma corrida. O sufixo [Slim] designa as versões leves das ferramentas de sincronização, introduzidas com o .NET 4: elas só recorrem ao sistema operacional se a espera for prolongada e funcionam apenas dentro de um processo. O programa [threads-12.cs] é o seguinte:
Comentários:
- linha 4: a barreira é criada em estado fechado;
- linha 15: cada thread espera a abertura da barreira;
- linha 26: a thread principal abre a barreira após um segundo;
- linha 32: a propriedade [IsSet] indica se a barreira está aberta.
Resultados:
Os quatro corredores partiram juntos, ao milissegundo, após o sinal de largada. Com um [AutoResetEvent], apenas um teria partido.
Um semáforo é uma barreira dotada de um contador: ele permite que no máximo N threads entrem por vez em uma seção de código. Isso é útil para limitar o uso de um recurso disponível em quantidade limitada (conexões de banco de dados, solicitações simultâneas a um servidor etc.). O programa [threads-13.cs] é o seguinte:
Comentários:
- linha 4: o semáforo tem 2 vagas;
- linha 15: uma thread solicita uma vaga. Se houver uma disponível, ela a ocupa e continua; caso contrário, fica bloqueada até que uma vaga fique disponível;
- linha 18: o número de vagas ainda disponíveis;
- linha 26: a thread devolve sua vaga, em uma cláusula [finally].
Resultados:
As cinco threads solicitam uma vaga; duas a obtêm imediatamente, enquanto as outras três esperam. Cada vez que uma thread libera sua vaga, uma thread em espera a obtém. Nunca há mais de duas threads na seção de código. Um semáforo de uma única vaga funciona como um lock. A classe [SemaphoreSlim] também tem um método [WaitAsync] que pode ser usado com [await], que veremos no próximo capítulo; a classe [Semaphore] (sem [Slim]), que consome mais recursos, pode — como [Mutex]—ser nomeada e compartilhada entre processos, mas apenas no Windows.
8.5.6. A classe Interlocked
A classe [Interlocked] torna operações simples sobre uma variável atômicas: a operação é executada por inteiro pela thread, sem que nenhuma outra thread possa observar ou modificar a variável no meio da operação. As ferramentas anteriores ([lock], [Mutex], [AutoResetEvent]) destinam-se todas a tornar atômico um grupo de operações, ao custo de bloquear outras threads. Para operações simples, porém frequentes, a classe [Interlocked] evita esse bloqueio usando instruções especiais do processador. Seus principais métodos estáticos são os seguintes:
Método | Função |
[int Increment(ref int x)] | incrementa [x] em 1 e retorna o novo valor |
[int Decrement(ref int x)] | decrementa [x] em 1 e retorna o novo valor |
[int Add(ref int x, int value)] | soma [value] a [x] e retorna o novo valor |
[int Exchange(ref int x, int value)] | atribui [value] a [x] e retorna o valor antigo |
[int CompareExchange(ref int x, int value, int comparand)] | atribui [value] a [x] somente se [x] for igual a [comparand]; retorna o valor anterior de [x] |
[long Read(ref long x)] | lê atomicamente um valor de 64 bits (útil em um processador de 32 bits) |
Esses métodos estão disponíveis para os tipos [int], [long], [uint], [ulong] e — no caso de [Exchange] e [CompareExchange] — para outros tipos. Os métodos [And] e [Or] (.NET 5) realizam atomicamente uma operação bit a bit "e" ou "ou". O parâmetro é passado por referência ([ref]): [Interlocked] deve operar sobre a própria variável, não sobre uma cópia. Por isso, a variável deve ser um campo ou uma variável local; uma propriedade não pode ser passada por referência.
O programa [threads-14.cs] parte do experimento do programa [threads-07.cs] e compara três formas de incrementar o contador compartilhado:
Comentários:
- linha 3: a classe [Stopwatch], que mede durações, está no namespace [System.Diagnostics];
- linhas 11–13: a função local [Measure] é chamada com três métodos de incremento diferentes, passados como um delegate [Action];
- linhas 16–42: a função [Measure] lança [nbThreads] threads, cada uma das quais chama o método recebido [nbIncrements] vezes, e mede o tempo total com um [Stopwatch]. O formato [{Counter.Value,12:N0}] alinha o valor à direita em 12 caracteres;
- linhas 20–26 e 36: as threads esperam todas atrás de uma barreira [ManualResetEventSlim], que se abre depois que todas foram lançadas. Isso permite que comecem seu trabalho simultaneamente, tornando o acesso concorrente muito mais provável do que com threads lançadas uma após a outra;
- linha 49: o contador é um campo, e não uma propriedade, para que possa ser passado por referência a [Interlocked.Increment];
- linha 53: o incremento não sincronizado;
- linhas 56–60: incremento dentro de uma seção crítica protegida por um [Lock];
- linha 65: incremento atômico.
Resultados:
- Sem sincronização, o resultado está incorreto, mais uma vez;
- os outros dois métodos produzem o resultado correto;
- [Interlocked] é significativamente mais rápido que [lock] nesta execução. O lock é caro aqui porque quatro threads disputam constantemente o mesmo lock por uma operação minúscula. Os tempos medidos dependem muito da máquina e de sua carga: apenas sua ordem de grandeza é significativa.
O método [CompareExchange] é o elemento básico dos algoritmos "lock-free": lê-se o valor, calcula-se o novo e só então o grava, se a variável não tiver mudado nesse meio-tempo; caso contrário, recomeça-se. As coleções concorrentes apresentadas mais adiante o utilizam amplamente.
8.6. Acesso concorrente a vários recursos compartilhados
8.6.1. Deadlock
Em nossos exemplos anteriores, um único recurso era compartilhado entre as várias threads. A situação se complica se houver vários recursos e eles dependerem uns dos outros. Em particular, pode ocorrer um deadlock: duas threads esperam uma pela outra. Considere as seguintes ações, que ocorrem sequencialmente:
- uma thread T1 adquire o lock V1 para acessar um recurso compartilhado R1;
- uma thread T2 adquire o lock V2 para acessar um recurso compartilhado R2;
- a thread T1 solicita o lock V2. Ela fica bloqueada;
- a thread T2 solicita o lock V1. Ela fica bloqueada.
As threads T1 e T2 esperam uma pela outra indefinidamente. Várias soluções são possíveis:
- solicitar os dois recursos ao mesmo tempo com um único lock. Isso nem sempre é possível se resultar em um bloqueio longo de um recurso custoso;
- sempre adquirir os locks na mesma ordem: se todas as threads adquirem V1 antes de V2, o deadlock é impossível. Essa é a regra mais usada;
- uma thread que mantém V1 e não consegue adquirir V2 libera V1 para evitar o deadlock.
O programa [threads-15.cs] provoca um deadlock e implementa a última solução:
Comentários:
- linhas 4–5: os locks dos dois recursos. Aqui são variáveis locais, capturadas pelos lambdas das linhas 8–10;
- linha 8: a thread T1 adquire R1 e depois solicita R2; ela espera no máximo 2 segundos;
- Linha 10: a thread T2 pega R2 e depois solicita R1 — ou seja, na ordem inversa; ela espera no máximo 5 segundos;
- Linha 21: a thread adquire seu primeiro recurso;
- linha 25: ela espera meio segundo, o que dá tempo à outra thread de adquirir seu próprio primeiro recurso: o deadlock é então certo;
- linha 28: em vez de um [lock] que esperaria indefinidamente, a thread solicita o segundo lock com um tempo máximo de espera. [TryEnter] retorna [true] se o lock foi adquirido, ou [false] se o tempo limite expirou;
- linha 36: um lock adquirido por [TryEnter] deve ser liberado por [Exit], dentro de uma cláusula [finally];
- Linhas 39–41: se o segundo lock não pôde ser adquirido, a thread desiste. Ao sair do bloco [lock], ela libera seu primeiro recurso.
Resultados:
Cada uma das duas threads adquiriu seu primeiro recurso e depois solicitou o segundo: estão em deadlock. Após 2 segundos, T1 desiste e libera R1; T2, que ainda esperava, obtém imediatamente R1 e pode fazer seu trabalho. Sem um tempo de espera, o programa nunca teria terminado.
8.6.2. Um exemplo: leitores e escritores
Considere o exemplo a seguir:
- temos um array no qual algumas threads escrevem dados (os escritores) e outras os leem (os leitores);
- os escritores são iguais entre si, mas exclusivos: apenas um escritor por vez pode depositar dados no array;
- os leitores são iguais entre si, mas exclusivos: apenas um leitor por vez pode ler os dados armazenados no array;
- um leitor só pode ler dados do array quando um escritor os colocou ali, e um escritor só pode colocar novos dados no array quando os dados que já estão ali foram lidos por um leitor.
Há dois tipos de recursos compartilhados:
- o array em escrita: apenas um escritor por vez pode acessá-lo;
- o array em leitura: apenas um leitor por vez pode acessá-lo.
e uma ordem de uso desses recursos:
- um leitor deve sempre vir depois de um escritor;
- um escritor deve sempre vir depois de um leitor, exceto na primeira vez.
O acesso a esses dois recursos pode ser controlado por duas barreiras do tipo [AutoResetEvent]:
- a barreira [canWrite] controla o acesso dos escritores ao array;
- a barreira [canRead] controla o acesso dos leitores ao array;
- a barreira [canWrite] é criada aberta, permitindo que o primeiro escritor passe e bloqueando todos os outros;
- A barreira [canRead] é criada no estado fechado, bloqueando todos os leitores;
- quando um escritor termina seu trabalho, ele abre a barreira [canRead] para deixar um leitor passar;
- quando um leitor termina seu trabalho, ele abre a barreira [canWrite] para deixar um escritor passar.
O programa [threads-16.cs] que ilustra essa sincronização é o seguinte:
Comentários:
- linhas 7–14: criação e início de duas threads leitoras, seguidas de duas threads escritoras. Nenhuma referência às threads é mantida: a thread principal não espera por elas;
- linha 17: a thread principal termina imediatamente. O processo continua até que as quatro threads (que são threads de primeiro plano) terminem;
- linha 23: o array [data] é o recurso compartilhado entre as threads leitoras e escritoras;
- linha 25: a barreira [canRead] sinaliza aos leitores que eles podem ler o array. Ela é aberta pelo escritor que preencheu o array. É criada no estado fechado: um escritor precisa primeiro preencher o array;
- linha 27: a barreira [canWrite] avisa aos escritores que eles podem escrever no array. Ela é aberta pelo leitor que leu o array inteiro. É criada no estado aberto: o array pode ser escrito desde o início;
- linha 35: um leitor espera que um escritor sinalize que o array foi preenchido. Quando esse sinal chega, apenas um dos leitores em espera prossegue;
- linhas 37–41: o array é lido, com uma pausa de meio segundo a cada elemento para forçar a thread a ceder a CPU;
- linha 44: o leitor avisa aos escritores que o array foi lido e pode ser preenchido novamente;
- o método [Write] é simétrico ao método [Read];
- linha 61: os números escritos são gerados aleatoriamente. A propriedade [Random.Shared] (.NET 6) fornece um gerador compartilhado que pode ser usado com segurança por várias threads. O curso de 2008 compartilhava entre as threads um objeto [Random] comum, cujos métodos não foram projetados para serem chamados simultaneamente por várias threads.
Resultados:
Vale destacar os seguintes pontos:
- há apenas um leitor por vez, embora esse leitor perca o processador na seção crítica [Read];
- há apenas um escritor por vez, embora ele perca o processador na seção crítica [Write];
- um leitor só lê quando há algo para ler no array;
- um escritor só escreve quando o array foi totalmente lido;
- no entanto, a ordem de execução não pode ser controlada: não havia razão para o escritor W0 vir antes do escritor W1, nem para o leitor R0 vir antes do leitor R1. Uma outra execução pode resultar em uma ordem diferente.
8.6.3. A classe Monitor
No exemplo anterior, quando os escritores estão bloqueados na instrução [canWrite.WaitOne()], um deles (qualquer um) é desbloqueado pela operação [canWrite.Set()]. Se quisermos abrir a barreira para um escritor específico, as coisas se complicam.
Considere a analogia de uma repartição pública com guichês de atendimento. Quando um cliente chega, ele retira uma senha numerada no dispensador e depois vai se sentar. Os clientes são chamados pelo número, por um alto-falante. Enquanto espera, o cliente pode fazer o que quiser: ler ou cochilar. Ele é acordado cada vez que o alto-falante anuncia um número. Se for o seu número, o cliente se levanta e vai ao guichê; caso contrário, volta ao que estava fazendo. Podemos operar de maneira semelhante com threads. Tomemos o exemplo dos escritores:
No guichê | Com threads |
vários escritores esperam pelo mesmo guichê | suas threads estão bloqueadas |
o guichê fica disponível e o número do próximo escritor é chamado | a thread que estava lendo o array avisa aos escritores que o array está disponível. Essa thread, ou outra, determinou qual escritor deve prosseguir |
Cada escritor verifica seu número; apenas aquele cujo número foi chamado vai ao guichê; os demais voltam para a fila de espera | Cada thread verifica se é a selecionada. Se for, ela atravessa a barreira; caso contrário, volta para a fila de espera |
A classe [Monitor] implementa esse cenário. Seus métodos estáticos são os seguintes:
Método | Função |
[Enter(object token)] | Solicita o token: a thread o obtém se ele estiver livre; caso contrário, fica bloqueada até que ele seja liberado |
[bool TryEnter(object token, TimeSpan timeout)] | Igual ao anterior, com um tempo limite máximo |
[Exit(object token)] | devolve o token |
[bool Wait(object token)] | devolve o token e bloqueia a thread até que outra thread sinalize uma mudança por meio de [Pulse] ou [PulseAll]; a thread deve então recuperar o token antes de continuar |
[Pulse(object token)] | acorda uma das threads bloqueadas por [Wait] nesse token |
[PulseAll(object token)] | acorda todas as threads bloqueadas por [Wait] nesse token |
Descreveremos agora um padrão clássico, proposto no capítulo “Threading” do livro de J. e B. Albahari, [C# in a Nutshell], capaz de resolver problemas de barreira com uma condição de entrada.
As threads que compartilham um recurso (o guichê) o acessam por meio de um objeto que chamaremos de token. Para atravessar a barreira que leva ao guichê, é preciso ter o token, e só existe um. As threads devem, portanto, passar o token umas às outras:
Para ir ao guichê, uma thread primeiro solicita o token com [Monitor.Enter(token)], ou, mais simplesmente, com uma cláusula [lock]. Se obtiver o token, ela verifica se atende à condição para ir ao guichê:
Se a thread não for a esperada no guichê, ela cede a vez devolvendo o token por meio de [Monitor.Wait(token)] e entra em estado bloqueado. Ela será acordada quando outra thread sinalizar uma mudança na condição de acesso; então recuperará o token e verificará a condição novamente. É por isso que a verificação é um laço ([while]) e não um simples [if]. A operação [Monitor.Wait(token)] só pode ser executada por uma thread que possua o token; caso contrário, uma exceção [SynchronizationLockException] é lançada. Nesse cenário, o token só é liberado depois que a operação é concluída.
A thread que modifica a condição de acesso ao guichê também deve possuir o token e avisar as threads em espera:
Acordar as threads significa que as threads em espera se tornam candidatas ao token; elas não o recebem imediatamente. O token só fica disponível ao final do bloco [lock]. Todas as threads acordadas receberão então o token, uma de cada vez, em ordem indeterminada, tendo a oportunidade de verificar novamente a condição de acesso. A primeira que satisfizer a condição fica com o token e segue para o guichê.
Uma observação importante: os métodos [Wait], [Pulse] e [PulseAll] de [Monitor] se aplicam a um objeto bloqueado por [lock (obj)] ou [Monitor.Enter(obj)]. Eles não funcionam com o tipo [Lock] do .NET 9, que não tem equivalente. Os tokens deste parágrafo são, portanto, objetos do tipo [object].
De posse dessas informações, podemos reescrever a aplicação de leitores/escritores especificando a ordem em que leitores e escritores acessam seus respectivos guichês [threads-17.cs]:
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 33 34 35 36 37 38 39 40 41 42 43 44 45 46 47 48 49 50 51 52 53 54 55 56 57 58 59 60 61 62 63 64 65 66 67 68 69 70 71 72 73 74 75 76 77 78 79 80 81 82 83 84 85 86 87 88 89 90 91 92 93 94 95 96 97 98 99 100 101 102 103 104 105 106 107 108 109 110 111 112 113 114 115 116 117 118 119 120 121 122 | |
O acesso ao guichê de leitura é condicionado pelos seguintes elementos:
- linha 36: o token [canRead];
- linha 39: o booleano [readingAllowed];
- linha 44: o array ordenado dos nomes dos leitores. Os leitores vão ao posto de leitura na ordem especificada por esse array;
- linha 41: [nextReader] é o índice, nesse array, do próximo leitor autorizado a ir ao guichê.
O acesso ao guichê de escrita é controlado de forma semelhante pelo token [canWrite], o booleano [writingAllowed], o array [WriteOrder] e o índice [nextWriter].
O programa principal:
- linhas 7–9: os leitores irão ao guichê na ordem inversa de sua criação (R2, R1, R0), e os escritores na ordem em que foram criados (W0, W1, W2). Os arrays são construídos com uma expressão de coleção [.. sequence], que cria um array a partir de uma consulta LINQ;
- linhas 18–22: criação e inicialização dos leitores, seguidos dos escritores. Todos ficarão bloqueados, pois nem a leitura nem a escrita são permitidas;
- linha 26: a escrita é habilitada, e os escritores são avisados de que algo mudou (método [AllowWriting], linhas 48–54).
O método [Read]:
- linhas 64–86: todo o processo no posto de leitura é controlado por [lock] no token [canRead]. O leitor que o obtém o mantém durante toda a sua permanência no posto;
- linhas 67–69: um leitor que adquiriu o token o devolve se a leitura não estiver autorizada ou se não for a sua vez;
- linhas 72–75: passagem pelo posto (leitura da tabela);
- linhas 78–79: o leitor altera as condições de acesso ao guichê de leitura. Ele ainda detém o token de leitura, e essas alterações impedem que qualquer outro leitor acesse o guichê;
- linhas 81–84: o leitor altera as condições de acesso ao guichê de escrita e avisa todos os escritores em espera de que algo mudou. Para isso, ele pega o token [canWrite]: aqui vemos que a thread detém dois tokens ao mesmo tempo. Os escritores fazem o mesmo na ordem inversa (eles detêm [canWrite] e solicitam [canRead]), que é a situação de deadlock descrita anteriormente. No entanto, não há risco aqui: uma thread solicita o segundo token apenas ao final de sua passagem pelo guichê; os dois guichês nunca estão ocupados ao mesmo tempo; e as outras threads mantêm um token apenas pelo tempo necessário para verificar a condição de acesso, sem solicitar o outro token.
O método [Write] é simétrico ao método [Read]. O curso de 2008 usava, no programa principal, [Monitor.Pulse], que acorda apenas uma thread: se essa thread não fosse o escritor esperado, ela voltaria a dormir, e o escritor esperado poderia nunca ser acordado. Ao usar uma condição de acesso que especifica uma thread em particular, é preciso usar [PulseAll].
Eis um exemplo de execução:
Escritores e leitores se revezam em seus respectivos guichês, cada um na ordem especificada: W0, R2, W1, R1, W2, R0.
8.7. Coleções concorrentes
Os exemplos anteriores protegiam dados compartilhados muito simples (um contador, um array). Quando threads compartilham uma coleção (lista, dicionário, fila), poderíamos proteger cada acesso com um [lock]. Mas as coleções comuns ([List<T>], [Dictionary<TKey,TValue>], [Queue<T>]) não foram projetadas para serem modificadas por várias threads simultaneamente: o uso sem proteção pode causar perda de elementos, disparar exceções inesperadas ou até corromper a estrutura interna da coleção. A partir do .NET 4, o namespace [System.Collections.Concurrent] oferece coleções projetadas para serem compartilhadas entre threads sem bloqueio explícito:
Coleção | Função |
[ConcurrentDictionary<TKey,TValue>] | um dicionário cujas operações, inclusive as atualizações condicionais, são seguras |
[ConcurrentQueue<T>] | uma fila (primeiro a entrar, primeiro a sair) |
[ConcurrentStack<T>] | uma pilha (último a entrar, primeiro a sair) |
[ConcurrentBag<T>] | uma bolsa: uma coleção não ordenada |
[BlockingCollection<T>] | um encapsulador das coleções anteriores que bloqueia o consumidor quando a coleção está vazia e, opcionalmente, o produtor quando ela está cheia |
8.7.1. ConcurrentDictionary e ConcurrentQueue
No programa [threads-18.cs], quatro threads geram números aleatórios e contam o número de vezes que cada número aparece em um dicionário compartilhado:
Comentários:
- linha 3: o namespace das coleções concorrentes;
- linha 6: o dicionário compartilhado associa cada dígito ao seu número de ocorrências;
- linha 8: uma fila na qual cada thread deposita um relatório ao final de seu trabalho;
- linha 21: o método [AddOrUpdate] adiciona a chave [digit] com o valor 1 se ela não existir e, caso contrário, substitui seu valor pelo calculado pela função [(key, oldValue) => oldValue + 1]. A operação é atômica. Não poderíamos escrever [draws[digit]++]: essa expressão lê o valor e depois grava o novo, em duas operações, e duas threads poderiam perder uma atualização, como no exemplo [threads-07.cs];
- linha 24: cada thread coloca seu relatório na fila;
- linhas 35–37: a thread principal esvazia a fila. [TryDequeue] retorna [false] quando a fila está vazia. As coleções concorrentes oferecem apenas métodos “Try…” que combinam a verificação e a operação: uma verificação de [Count > 0] seguida de uma remoção não seria segura, pois outra thread poderia esvaziar a fila nesse intervalo;
- linha 40: o dicionário é percorrido em ordem de chave; cada par chave/valor é decomposto em duas variáveis;
- linha 46: o método [GetOrAdd] retorna o valor associado à chave, depois de adicionar a chave com o valor fornecido caso ela não existisse.
Resultados:
O número total de sorteios está correto: nenhuma atualização foi perdida. Os relatórios aparecem na ordem em que as threads concluíram seu trabalho.
8.7.2. Produtores e consumidores: BlockingCollection
O problema leitor-escritor é uma variante do clássico problema produtor-consumidor: threads produzem dados que outras threads consomem. A classe [BlockingCollection<T>] o resolve sem nenhuma ferramenta explícita de sincronização:
- [Add(element)] adiciona um elemento. Se a coleção tiver capacidade limitada e estiver cheia, o produtor fica bloqueado até que uma vaga se abra;
- [CompleteAdding()] sinaliza que nenhum outro elemento será adicionado;
- [GetConsumingEnumerable()] retorna uma enumeração que remove os elementos um a um. Se a coleção estiver vazia, o consumidor fica bloqueado até que um elemento chegue; a enumeração termina quando a coleção está vazia e [CompleteAdding] foi chamado.
O programa [threads-19.cs] é o seguinte:
Comentários:
- linha 6: uma fila (a coleção subjacente padrão é uma [ConcurrentQueue<int>]) contendo no máximo 3 elementos. O parâmetro é passado por nome, o que torna a chamada mais legível;
- linhas 9–20: o produtor deposita os números de 1 a 8, um a cada décimo de segundo, e depois sinaliza que terminou;
- linhas 24–37: dois consumidores recuperam os números e levam 0,6 segundo para processar cada um. Eles consomem os números mais lentamente do que o produtor os gera;
- linha 31: a enumeração bloqueante. Cada número é recuperado por apenas um dos dois consumidores.
Resultados:
Vemos o produtor enfileirar rapidamente os primeiros números e depois, assim que a fila contém 3 elementos, só enfileirar um número quando um consumidor retira um: ele fica bloqueado em [Add] quando a fila está cheia. Os consumidores dividem os números entre si e param quando a fila está vazia e o processo está concluído. Observe que o consumidor C2 exibiu a retirada do número 1 antes de o produtor exibir sua inserção: a inserção de fato ocorreu antes, mas o produtor foi interrompido entre [Add] e a sua exibição.
A classe [Channel<T>] no namespace [System.Threading.Channels] oferece o mesmo serviço para a programação assíncrona: um consumidor que espera por um elemento não bloqueia nenhuma thread. Trataremos disso no próximo capítulo.
8.8. O pool de threads
Até agora, para gerenciar threads, nós as criamos com [new Thread(...)] e depois as executamos com [Start()]. Criar uma thread é uma operação relativamente custosa: em particular, o sistema precisa alocar uma pilha para ela, e cada thread ocupa memória enquanto existir. Veremos no capítulo sobre bancos de dados que existem pools de conexões: conexões abertas são mantidas em reserva e emprestadas às threads que as solicitam, já que abrir uma conexão é custoso. Existe um sistema semelhante para threads: o pool de threads (ThreadPool) do .NET.
- Enquanto o número de threads no pool estiver abaixo de um limite mínimo, o pool cria imediatamente uma nova thread para cada tarefa que não encontra uma thread livre. Por padrão, esse mínimo é o número de processadores; ele pode ser lido com [ThreadPool.GetMinThreads(out min1, out min2)] e alterado com [ThreadPool.SetMinThreads(min1, min2)]. O pool gerencia dois tipos de threads: threads de trabalho (min1), que executam os trabalhos que lhes são atribuídos, e threads de E/S assíncrona (min2);
- se esse número for insuficiente, o pool cria threads adicionais de forma incremental, até um máximo que pode ser lido com [ThreadPool.GetMaxThreads(out max1, out max2)] e alterado com [ThreadPool.SetMaxThreads(max1, max2)]. Quando o máximo é atingido, os trabalhos atribuídos ao pool ficam na fila até que uma thread se torne disponível;
- Uma thread que concluiu uma tarefa não é destruída: ela é devolvida ao pool e usada para a próxima tarefa.
O pool de threads oferece duas vantagens: economiza o tempo gasto na criação de threads (algumas threads podem atender centenas de requisições) e, ao limitar o número de threads, impede que a aplicação seja sobrecarregada por requisições em excesso.
Para atribuir uma tarefa ao pool, use o método [ThreadPool.QueueUserWorkItem(WaitCallback callback, object? state)], em que [WaitCallback] é um delegate com a assinatura [void M(object? state)]. A tarefa será executada por uma thread do pool, com o parâmetro [state]. O programa [threads-20.cs] é o seguinte:
Comentários:
- linhas 7–12: lemos e exibimos o número mínimo atual dos dois tipos de threads do pool e, em seguida, definimos o mínimo de threads de trabalho como 3. O parâmetro [out _] é um “parâmetro descartado”: não nos interessa o valor retornado;
- linhas 14–19: fazemos o mesmo para definir o máximo de threads de trabalho como 5. [SetMaxThreads] retorna [false] se o valor solicitado for rejeitado, por exemplo, se for menor que o número de processadores;
- linha 22: um objeto [CountdownEvent] funciona como uma contagem regressiva: cada chamada ao seu método [Signal] a decrementa, e seu método [Wait] bloqueia a thread chamadora até que ela chegue a 0. Aqui, ele permite que a thread principal espere o término dos 7 trabalhos: não é possível chamar [Join] em uma thread do pool, já que ela não pertence a você. O curso de 2008 pedia ao usuário que pressionasse [Enter] quando os trabalhos terminassem;
- linhas 23–26: atribuímos ao pool 7 tarefas, cada uma com duração de 3 segundos, embora o pool nunca vá ter mais de 5 threads de trabalho. Cada tarefa recebe um objeto [Data];
- linha 30: a thread principal espera o término dos 7 trabalhos;
- linhas 34–48: a tarefa executada por uma thread do pool. Trata-se de uma função local não estática, porque ela usa a variável local [remainingJobs];
- linha 41: o número de threads de trabalho ainda disponíveis (o máximo menos o número de threads ocupadas);
- linha 48: o contador é decrementado ao final de cada trabalho.
Resultados:
- Nesta máquina de dois processadores, o pool tinha inicialmente um mínimo de 2 threads de trabalho e um máximo de 32.767;
- os trabalhos 0, 1 e 2 começaram imediatamente: o pool tem um mínimo de 3 threads;
- os trabalhos 3 e 4 começaram com atrasos de um e dois segundos, respectivamente: não restavam threads livres e o pool, depois que ultrapassa seu mínimo, só cria novas threads gradualmente enquanto houver trabalhos esperando. O máximo de 5 threads é então atingido: nenhuma thread permanece disponível;
- os trabalhos 5 e 6 tiveram de esperar que uma thread ficasse disponível depois do término dos trabalhos 0, 1 e 2. Vemos que eles reutilizaram as threads 7 e 4, que tinham executado os primeiros trabalhos;
- No total, os trabalhos 5 e 6 levaram 6 segundos desde o momento em que foram solicitados: 3 segundos de espera e 3 segundos de execução.
Raramente é necessário alterar os limites do pool: seus valores padrão são adequados para a maioria das aplicações. Na verdade, [QueueUserWorkItem] raramente é usado diretamente: trabalhamos por meio de tarefas, que são descritas a seguir.
8.9. Tarefas e a Parallel Library
8.9.1. Task.Run
Desde o .NET 4, a classe [System.Threading.Tasks.Task] representa um trabalho (uma tarefa) executado de forma assíncrona. [Task.Run(action)] atribui um trabalho ao pool de threads, assim como [QueueUserWorkItem], mas retorna um objeto [Task] que permite acompanhar esse trabalho: verificar se terminou, esperar por ele, obter seu resultado ou a exceção que ele lançou. Uma tarefa que retorna um resultado do tipo T é do tipo [Task<T>]. O programa [threads-21.cs] é o seguinte:
Comentários:
- linhas 10–16: cada tarefa executa uma lambda que exibe a thread que a executa, dorme por 0,5, 1 ou 1,5 segundo e depois retorna um resultado do tipo [int]. [Task.Run] retorna, portanto, uma [Task<int>];
- linha 20: a thread principal espera o término das três tarefas. Trata-se de uma espera bloqueante, como [Join];
- linha 24: a propriedade [Status] indica o estado da tarefa; [RanToCompletion] significa que ela terminou normalmente;
- linha 24: a propriedade [Result] é o resultado da tarefa. Se a tarefa não tivesse terminado, a leitura de [Result] bloquearia a thread até que ela terminasse;
- linha 28: uma tarefa que executa o método [Fail], que lança uma exceção;
- linha 32: a exceção lançada na tarefa não se perde: ela é armazenada no objeto [Task], e depois relançada na thread que espera pela tarefa. [Wait] a encapsula em uma [AggregateException] (uma tarefa pode agrupar várias delas), cuja propriedade [InnerException] é a exceção original;
- linha 41: o método que lança a exceção. Poderíamos ter passado a lambda [() => throw new InvalidOperationException(...)] diretamente para [Task.Run].
Resultados:
- As tarefas são executadas em threads do pool (linha 3);
- A tarefa 2 só começou depois que a tarefa 0 terminou, na thread que a tarefa 0 havia liberado: o pool tinha apenas 2 threads (o mínimo padrão nesta máquina) e não criou uma terceira a tempo;
- os resultados são obtidos depois que as tarefas terminam;
- a exceção da tarefa que falhou foi capturada pela thread principal, e o estado da tarefa é [Faulted].
Este exemplo também substitui o da classe [BackgroundWorker] do curso de 2008, que demonstrava como executar um trabalho em segundo plano, obter seu resultado ou sua exceção e cancelá-lo. [BackgroundWorker] foi concebido para interfaces gráficas Windows Forms; hoje ele foi substituído pelas tarefas, com o cancelamento tratado por [CancellationToken] e o acompanhamento do progresso pela interface [IProgress<T>], apresentados no próximo capítulo juntamente com [async] / [await], que permitem esperar por uma tarefa sem bloquear uma thread.
8.9.2. Parallel.For e Parallel.ForEach
A classe [System.Threading.Tasks.Parallel] (.NET 4) distribui automaticamente as iterações de um laço entre várias threads do pool:
- [Parallel.For(start, end, i => ...)] executa o corpo do laço para i variando de [start] a [end] - 1;
- [Parallel.ForEach(collection, element => ...)] executa o corpo do laço para cada elemento da coleção;
- um parâmetro [ParallelOptions] permite limitar o número de iterações executadas simultaneamente (propriedade [MaxDegreeOfParallelism]);
- ambos os métodos só devolvem o controle quando todas as iterações terminam. A thread que os chama participa ela mesma do trabalho.
Esses laços só são adequados se as iterações forem independentes: sua ordem de execução é indefinida e, se elas atualizam dados compartilhados, esses dados precisam ser protegidos. O programa [threads-22.cs] é o seguinte:
Comentários:
- linhas 7–18: contamos os números primos menores que 5.000.000 usando um laço [for] comum. A função [IsPrime] (linhas 68–81) testa os divisores até a raiz quadrada do número: é um processo demorado, e as iterações são independentes;
- linhas 22–31: o mesmo laço com [Parallel.For]. O contador [nbParallel1] é compartilhado por todas as threads: ele é incrementado por [Interlocked.Increment] (uma variável local capturada por uma lambda pode ser passada por referência);
- linhas 36–50: uma versão sobrecarregada de [Parallel.For] permite trabalhar com uma variável local: [Parallel.For] divide o laço em tarefas, cada uma executada por uma única thread, e cada tarefa tem seu próprio contador. A primeira lambda (41) inicializa o contador de uma tarefa; a segunda (43) é o corpo do laço, que recebe o contador e retorna seu novo valor; a terceira (45) é executada uma vez por tarefa, ao final de seu trabalho: ela soma o contador da tarefa ao total compartilhado. Isso reduz significativamente o número de operações atômicas;
- linha 48: para cada thread que participou, registramos o número de números primos que ela encontrou;
- linhas 57–65: [Parallel.ForEach] processa uma coleção de nomes de arquivos (o processamento é simulado por uma pausa de meio segundo), com no máximo 2 processamentos simultâneos.
Resultados:
- Os três laços encontram o mesmo número de números primos;
- várias threads participaram do laço paralelo, inclusive a thread principal (ID 1);
- o processamento de [Parallel.ForEach] ocorre em pares, com meio segundo de intervalo, e em uma ordem que não corresponde à da lista;
- O ganho de tempo nesta execução é decepcionante: há apenas 2 processadores, que as threads do nosso programa estavam dividindo com outros programas muito ativos no momento da captura. Em uma máquina pouco carregada com n processadores, um laço paralelo como este pode ser quase n vezes mais rápido que o laço sequencial. É sempre preciso medir antes de tirar conclusões: a paralelização tem um custo (distribuição do trabalho, sincronização) que só compensa se cada iteração envolver computação suficiente.
8.10. Dados locais a uma thread
8.10.1. O princípio
Considere uma aplicação de três camadas:
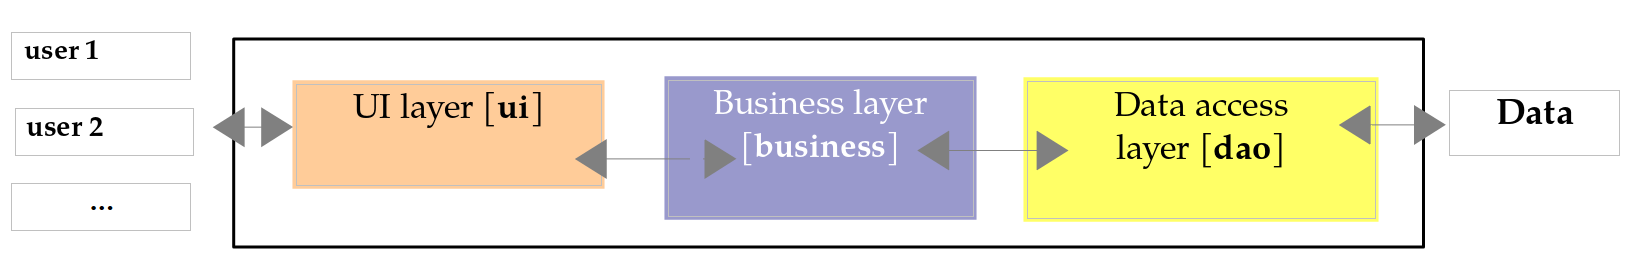
Suponha que a aplicação seja multiusuário, como uma aplicação web. Cada requisição de usuário é tratada por uma thread. O ciclo de vida da thread é o seguinte:
- a thread é criada ou obtida do pool de threads para atender à requisição de um usuário;
- se essa requisição precisa de dados, a thread executa um método da camada [ui], que chama um método da camada [business], que por sua vez chama um método da camada [dao];
- a thread devolve a resposta ao usuário. Em seguida, ela termina ou é devolvida ao pool de threads.
Durante a segunda etapa, pode ser útil que a thread tenha seus próprios dados, ou seja, dados não compartilhados com outras threads. Esses dados podem, por exemplo, pertencer ao usuário específico que a thread está atendendo e ser usados nas diversas camadas [ui, business, dao] sem serem passados como parâmetro a cada método.
O curso de 2008 usava para isso os métodos [Thread.SetData] e [Thread.GetData] , que gerenciam uma espécie de dicionário privado da thread. Eles ainda existem, mas raramente são usados; preferem-se duas ferramentas mais simples e mais eficientes:
- o atributo [[ThreadStatic]] aplicado a um campo estático: cada thread tem sua própria instância do campo;
- a classe [ThreadLocal<T>]: um objeto cuja propriedade [Value] tem um valor diferente para cada thread. Uma função passada ao construtor fornece o valor inicial de cada thread.
O programa [threads-23.cs] compara um campo estático comum com essas duas ferramentas:
Comentários:
- linha 49: um campo estático comum. Existe apenas uma instância dele, compartilhada por todas as threads;
- linhas 51–52: o atributo [[ThreadStatic]] dá a cada thread uma instância do campo;
- linhas 54–55: uma armadilha clássica. O inicializador [= 5] é executado pelo construtor estático da classe, uma única vez, na primeira thread que usa a classe. Para as outras threads, o campo tem o valor padrão de seu tipo, que neste caso é 0;
- linha 57: um objeto [ThreadLocal<string>]. A lambda passada ao construtor é executada na primeira vez que uma thread lê [Value] sem ter escrito nele; ela fornece o valor inicial para essa thread;
- linhas 5–7: a thread principal escreve seus próprios valores;
- linhas 17–22: cada thread escreve seus próprios valores, exceto a thread T2, que não define um usuário;
- linha 25: cada thread espera que as outras escrevam antes de ler os valores novamente.
Resultados:
- o campo comum [Shared] tem o mesmo valor para todas as threads: o último valor escrito (nesta execução, o da thread T2);
- o campo [PerThread] manteve, em cada thread, o valor que essa thread nele escreveu;
- o campo [WithInitializer] vale 5 para a thread principal e 0 para as demais;
- a propriedade [User.Value] tem o valor escrito por cada thread; a thread T2, que não havia escrito nela, recebeu o valor inicial fornecido pela lambda do construtor.
Os dados locais a uma thread têm uma limitação: seu escopo é a thread, não o processo. Com a programação assíncrona, tratada no próximo capítulo, um mesmo fluxo de execução pode começar em uma thread e continuar em outra depois de uma espera. Nesse caso, usamos a classe [AsyncLocal<T>], cujo valor persiste entre as threads.
8.10.2. Aplicação: uma transação compartilhada entre camadas
Considere a seguinte aplicação de três camadas, na qual a camada [dao] gerencia uma tabela de artigos:
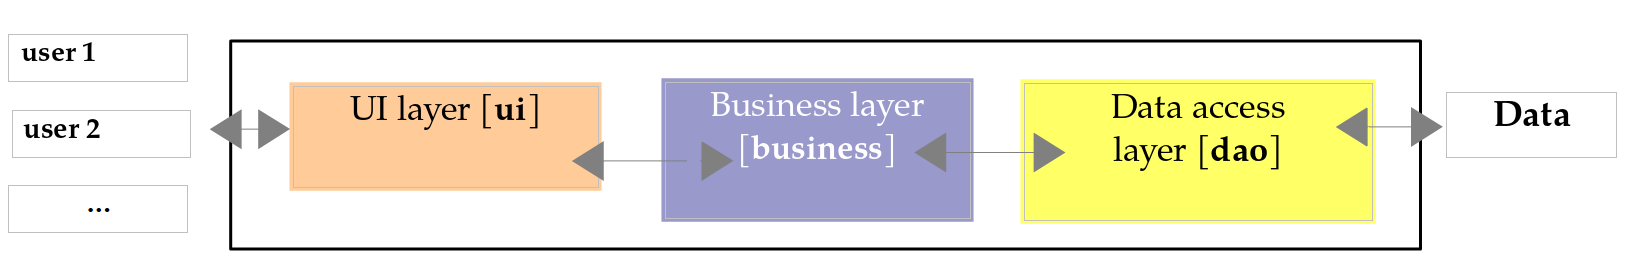
Suponha que a interface da camada [dao] seja inicialmente a seguinte:
Mais tarde, surge a necessidade de inserir um array de artigos dentro de uma transação, porque o sistema deve operar no regime de tudo ou nada: ou todos os artigos são inseridos, ou nenhum. Um método chamado [InsertArticles(Article[] articles)] pode ser adicionado à interface. Depois, para outra aplicação, surge a necessidade de excluir uma lista de artigos, também dentro de uma transação… Para atender a diferentes necessidades de negócio, a camada [dao] vai crescer. Podemos adotar outra abordagem:
- incluir na camada [dao] apenas as operações básicas (inserir, atualizar, excluir, ler um artigo);
- mover para a camada [business] as operações que atualizam simultaneamente vários artigos. Essas operações usam as operações básicas da camada [dao].
A vantagem dessa solução é que a mesma camada [dao] pode ser usada, sem modificação, com diferentes camadas [business]. Ela introduz uma dificuldade na gestão da transação que agrupa as atualizações a serem executadas de forma atômica:
- a transação deve ser iniciada pela camada [business] antes de ela chamar os métodos da camada [dao];
- os métodos da camada [dao] devem saber da existência da transação para participar dela;
- a transação deve ser concluída (confirmada ou revertida) pela camada [business].
Para que os métodos da camada [dao] tomem conhecimento de qualquer transação em andamento, a transação poderia ser adicionada como parâmetro a cada método da camada [dao]. Esse parâmetro apareceria então na assinatura dos métodos da interface, o que vincularia a interface a uma fonte de dados específica. Os dados locais à thread oferecem uma solução mais elegante: a camada [business] coloca a transação nos dados locais da thread, e é ali que a camada [dao] a recupera. As assinaturas dos métodos da camada [dao] não precisam ser alteradas. Várias threads (vários usuários) podem trabalhar simultaneamente: cada uma tem sua própria transação.
O curso de 2008 usava um banco de dados SQL Server Compact, um produto que foi descontinuado. Os bancos de dados serão tratados nos capítulos sobre ADO.NET e Entity Framework Core. Para manter o foco nas threads, usaremos aqui uma tabela em memória e uma transação simulada. O programa [threads-24.cs] reúne todas as camadas em um único arquivo. As entidades são as seguintes:
- linha 60: um artigo é um [record] cujo identificador [Id] é definido pela camada [dao];
- linhas 63–78: uma transação simulada. Cada atualização feita dentro da transação registra a operação necessária para desfazê-la (método [Log]); [Commit] confirma a transação ignorando essas operações; [Rollback] a reverte executando as operações de desfazer, da última para a primeira (daí a pilha [Stack<Action>]). Um banco de dados real opera de maneira semelhante, usando um log de transações;
- linha 67: cada transação recebe um número único. Como transações podem ser criadas por várias threads simultaneamente, o contador é incrementado de forma atômica;
- linhas 84–87: os dados locais à thread compartilhados pelas camadas: a transação atual da thread, ou [null] se não houver nenhuma.
A camada [dao] é a seguinte:
- linha 101: a tabela de artigos, compartilhada por todas as threads. O acesso a ela é protegido pelo lock da linha 102;
- linha 108: o método [InsertArticle] recupera a eventual transação que a camada [business] colocou nos dados locais da thread atual;
- linhas 111–113: a tabela tem uma restrição de unicidade sobre os nomes dos artigos: inserir um artigo com um nome que já existe lança uma exceção;
- linha 115: o artigo inserido é uma cópia do artigo recebido, com um identificador atribuído pela camada [dao]. A expressão [with] cria uma cópia de um [record] modificando certas propriedades;
- linhas 118–122: se uma transação estiver em andamento, a camada [dao] participa dela registrando como desfazer a inserção. O operador [?.] chama [Log] somente se [transaction] não for [null];
- linha 125: uma mensagem de rastreamento exibe a thread, o artigo inserido e a transação, se houver;
- linhas 131–135: a lista de artigos retornada é uma cópia da tabela (expressão de coleção [.. table]), para que o chamador não a percorra enquanto outra thread a modifica.
A camada [business] é a seguinte:
- linha 157: a camada [dao] é injetada pelo construtor primário;
- linhas 163–164: o método [InsertArticlesInTransaction] inicia uma transação e a grava nos dados locais da thread;
- linha 170: o método de inserção da camada [dao] é chamado para cada artigo, sem que a transação lhe seja passada;
- linha 172: uma pausa simula o processamento, para dar tempo a outra thread de intervir durante a transação (terceira parte do programa de teste);
- linha 174: se o programa chega a este ponto, nenhuma exceção ocorreu: a transação é confirmada;
- linhas 177–181: se ocorre uma exceção, a transação é revertida e a exceção é relançada ao chamador;
- linha 186: em qualquer caso, a thread não tem mais uma transação ativa. Isso é importante se a thread for reutilizada (thread do pool);
- linha 191: a mesma inserção, sem transação.
O programa de teste é o seguinte:
- linha 9: criamos um array de dois artigos com o mesmo nome. A inserção do segundo artigo será rejeitada. Se a inserção for feita fora de uma transação, o primeiro artigo é inserido e permanece na tabela. Se for feita dentro de uma transação, o primeiro artigo é inserido e depois removido quando a transação é revertida;
- linhas 11–14: inserimos o array fora de uma transação e depois exibimos a tabela;
- linhas 16–20: o mesmo processo dentro de uma transação;
- linhas 22–34: duas threads trabalham simultaneamente. A thread A insere três artigos dentro de uma transação (o terceiro viola a restrição de unicidade); enquanto isso, a thread B insere um artigo fora de uma transação;
- linhas 37–45: a função [Execute] executa uma ação e exibe a eventual exceção, precedida do nome da thread.
Resultados:
- A inserção fora da transação deixou o primeiro registro na tabela (linha 6);
- a inserção feita dentro de uma transação não deixou nenhum registro na tabela: o registro com ID 2 foi removido pela reversão;
- na terceira parte, a thread B inseriu a tela enquanto a transação 2 da thread A estava em andamento: ela o fez fora da transação, já que a transação é uma variável local da thread A. A reversão da transação 2 removeu o teclado e o mouse inseridos por A, mas não a tela inserida por B.
8.10.3. Conclusão
O exemplo anterior demonstrou a utilidade dos dados locais à thread para o gerenciamento de transações. Ele não deve ser replicado como está. O .NET fornece esse mecanismo pronto com a classe [System.Transactions.TransactionScope]: uma transação “ambiente”, acessível por [Transaction.Current], na qual as conexões de banco de dados participam automaticamente. Frameworks como o Entity Framework Core também gerenciam transações sem que o código da camada [dao] precise cuidar delas. E nas aplicações web de hoje, que são assíncronas, essa informação de contexto é transportada por [AsyncLocal<T>] e não por dados locais à thread.
8.11. Leituras complementares
A sincronização de threads é um campo desafiador. Este capítulo apresentou as principais ferramentas; para saber mais:
- a documentação da Microsoft, capítulo “Threading in .NET”: Managed threading, particularmente a página “Overview of synchronization primitives”;
- a documentação da Microsoft, capítulo “Parallel Programming”: Parallel Programming in .NET, que trata da biblioteca [Parallel], das tarefas e das coleções concorrentes;
- o capítulo “Threading” do livro de Joseph Albahari, [C# in a Nutshell], cuja edição para C# 3.0 o curso de 2008 já recomendava. Uma versão mais antiga, mas ainda instrutiva, desse capítulo está disponível on-line: Threading in C#.
No código moderno, raramente se manipulam diretamente objetos [Thread]. Preferem-se as tarefas ([Task]), que são executadas no pool de threads, e sobretudo a programação assíncrona com as palavras-chave [async] e [await], que permite esperar por uma operação demorada (rede, banco de dados ou acesso a arquivos) sem bloquear uma thread. Esse é o assunto do próximo capítulo. Ainda assim, os conceitos tratados neste capítulo continuam essenciais: as tarefas são executadas em threads, e os dados que elas compartilham devem ser protegidos com as mesmas ferramentas ([lock], [Interlocked], coleções concorrentes).