5. Classes do .NET de uso frequente
Apresentamos aqui algumas classes frequentemente usadas da plataforma .NET: strings, arrays, coleções, arquivos e expressões regulares. Também trataremos do LINQ (Language Integrated Query), que o curso de 2008 omitia, embora já existisse desde o C# 3: ele é hoje a maneira mais comum de manipular coleções em C#. Antes disso, mostraremos como encontrar informações sobre as milhares de classes disponíveis. Este guia é indispensável a qualquer desenvolvedor C#, mesmo os experientes.
Os exemplos deste capítulo, com exceção da aplicação de exemplo no final, são aplicações de arquivo único executadas por [dotnet run file.cs]. Elas estão na pasta [05-classes-dotnet] do código do curso e são executadas na localidade francesa (fr-FR), exceto os exemplos de LINQ e de expressões regulares, que são executados na localidade do inglês americano (en-US).
5.1. Como encontrar ajuda sobre as classes do .NET
O curso de 2008 fornecia uma descrição detalhada, com capturas de tela, da ajuda MSDN instalada com o Visual Studio 2008. Essa ajuda local não está mais disponível: a documentação do .NET agora é online, gratuita e atualizada a cada nova versão.
5.1.1. Documentação online
O ponto de partida é o site learn.microsoft.com da Microsoft. Nele você encontra:
- a documentação da linguagem C#: https://learn.microsoft.com/en-us/dotnet/csharp/. Ela inclui uma visão geral da linguagem, tutoriais, a referência da linguagem (palavras-chave, operadores, instruções) e uma seção “What’s New” que descreve cada versão do C#;
- a referência da API do .NET: https://learn.microsoft.com/en-us/dotnet/api/. Ela descreve, namespace por namespace, todas as classes do .NET: seus construtores, propriedades e métodos, com exemplos;
- o navegador de APIs, na mesma página: uma caixa de pesquisa na qual você pode digitar o nome de uma classe ou de um método ([StringBuilder], [Regex.Match]…). Uma lista suspensa permite selecionar a versão do .NET (aqui, o .NET 10).
A página de uma classe, como System.String, exibe:
- o namespace da classe e o assembly que a contém;
- sua declaração, sua classe pai e as interfaces que ela implementa;
- a lista de seus construtores, propriedades e métodos, cada um com um link para uma página detalhada que mostra suas várias sobrecargas, parâmetros, valores de retorno, possíveis exceções e, muitas vezes, um exemplo;
- observações sobre seu uso.
As páginas estão disponíveis em francês (tradução automática) e em inglês (texto original, às vezes mais preciso). Você pode alternar entre elas substituindo [en-us] por [fr-fr] na URL. Uma pesquisa em um mecanismo de busca com o nome completo da classe (“System.Text.StringBuilder”) geralmente leva direto à página correta.
5.1.2. Ajuda do editor
O editor de código (Visual Studio, Visual Studio Code com a extensão C# Dev Kit, Rider) fornece ajuda imediata sem precisar sair do código:
- autocompletar (IntelliSense): depois de digitar [aString.], o editor sugere uma lista das propriedades e métodos do objeto, com um resumo de cada um;
- Dicas de ferramenta: ao passar o mouse sobre o nome de uma classe, método ou variável, o editor exibe sua declaração e um resumo de sua documentação;
- Ajuda de parâmetros: ao digitar o parêntese de abertura de uma chamada, o editor exibe as diferentes sobrecargas do método e o papel de cada parâmetro;
- Ir para a definição (tecla F12): exibe a declaração da classe ou do método. Para uma classe do .NET, o editor exibe as declarações públicas reconstruídas a partir do assembly, junto com seus comentários de documentação;
- No Visual Studio, pressionar a tecla F1 sobre o nome de uma classe ou método abre a página correspondente na documentação online.
Esses comentários de documentação, visíveis ao passar o mouse sobre um elemento, são os usados para gerar a referência online. Você pode escrever comentários semelhantes em seu próprio código com a sintaxe [/// <summary> ... </summary>] colocada acima de uma classe ou método: o editor os exibirá da mesma maneira.
5.2. Strings
5.2.1. A classe System.String
O tipo C# [string] é um alias da classe [System.String]. Ela tem numerosas propriedades e métodos. Eis alguns deles:
Membro | papel |
[public int Length { get; }] | número de caracteres da string |
[public char this[int index] { get; }] | Caractere nº [index]: [aString[i]] |
[public bool StartsWith(string value)] | retorna [true] se a string começar com [value] |
[public bool EndsWith(string value)] | retorna [true] se a string terminar com [value] |
[public bool Contains(string value)] | retorna [true] se a string contiver [value] |
[public bool Equals(string? value)] | retorna [true] se a string for igual a [value]; equivalente a [aString == value] |
[public int IndexOf(string value)] | a primeira ocorrência de [value] na string, ou -1. Outra sobrecarga inicia a busca na posição [startIndex] |
[public int IndexOf(char value)] | o mesmo vale para o caractere [value] |
[public int LastIndexOf(char value)] | igual a [IndexOf] mas retorna a última posição em vez da primeira |
[public string Insert(int startIndex, string value)] | insere a string [value] na string na posição [startIndex] |
[public static string Join(string separator, params string[] value)] | método de classe: concatena os elementos de [value], separando-os com [separator] |
[public string Replace(char oldChar, char newChar)] | retorna uma cópia da string em que o caractere [oldChar] foi substituído por [newChar]; um método sobrecarregado substitui uma string por outra |
[public string[] Split(params char[] separator)] | a string é tratada como uma sequência de campos separados pelos caracteres de [separator]; o resultado é um array desses campos |
[public string Substring(int startIndex, int length)] | uma substring de [length] caracteres a partir da posição [startIndex] |
[public string ToLower()], [public string ToUpper()] | converte a string em minúsculas, maiúsculas |
[public string Trim()] | remove os espaços no início e no fim da string ([TrimStart], [TrimEnd]: em um dos lados apenas) |
É importante observar que uma string do tipo [string] é imutável; ela não pode ser modificada depois de criada. Quando um método retorna uma string, essa string é diferente daquela à qual o método foi aplicado. Assim, [s1.Trim()] retorna a string [s2], e [s1] e [s2] são duas strings diferentes: [s1] não mudou.
Uma string [c] pode ser considerada um array de caracteres somente leitura:
- [c[i]] é o i-ésimo caractere de [c] (o primeiro caractere é o de número 0);
- [c.Length] é o número de caracteres de [c].
O programa [strings-01.cs] é o seguinte:
Resultados:
Comentários:
- linha 5: o caractere nº 10, ou seja, o 11º caractere da string;
- Linhas 7 e 9: uma busca malsucedida retorna -1;
- linha 10: os 7 caracteres a partir da posição 4;
- linha 14: uma inserção na posição 9, antes da palavra “flies”;
- linha 16: [Split] sem parâmetros divide a string nos caracteres de espaço em branco (espaço, tabulação, quebra de linha etc.). O curso de 2008 usava [Split(null)], o que dá no mesmo;
- linha 21: o método estático [Join] faz o oposto de [Split];
- Linha 23: todos os métodos anteriores retornavam novas strings: [aString] permaneceu inalterada (linha 21 dos resultados);
- Linhas 27 a 29: uma função local, como no Capítulo 3.
5.2.2. Os métodos Split e Join
O programa [strings-02.cs] aprofunda a divisão de uma string em campos:
Resultados:
Comentários:
- Linha 4: os campos são separados pelo caractere [:]. Dois caracteres [:] consecutivos, ou um único [:] no final da string, delimitam um campo vazio: isso resulta em 5 campos, 2 dos quais vazios (linhas 4 e 6 dos resultados). [Join] reconstrói a string original;
- o método [Split] tem numerosas sobrecargas. A versão de 2008, [Split(char[] separator)], agora é escrita como [Split(params char[] separator)]: a palavra-chave [params] permite informar os separadores um a um, [Split(':')] ou [Split(',', ';')], sem criar um array;
- Linha 13: a enumeração [StringSplitOptions] modifica a divisão em campos. [RemoveEmptyEntries] remove os campos vazios;
- linha 18: [TrimEntries] (.NET 5) remove os espaços ao redor de cada campo. Os separadores são passados aqui como uma expressão de coleção [',', ';'];
- linha 23: as duas opções são combinadas por meio do operador [|]. Os espaços são removidos antes da verificação de campos vazios: o campo formado por dois espaços entre duas vírgulas é removido;
- linha 28: o separador pode ser uma string composta por vários caracteres;
- linha 33: [Join] aceita uma coleção de elementos de qualquer tipo; cada elemento é convertido em string por meio de seu método [ToString].
5.2.3. Pesquisa e comparação de strings
A comparação de strings é mais sutil do que parece: maiúsculas e minúsculas devem ser distinguidas? Como “éclair” deve ser classificado em relação a “essay”? O programa [strings-03.cs] apresenta os métodos de pesquisa e comparação:
Resultados:
Comentários:
- linhas 5–8: [Contains], [StartsWith], e [EndsWith] realizam por padrão uma comparação exata, caractere por caractere: “LANGUAGE” não é encontrado;
- Linhas 11–12: um parâmetro do tipo [StringComparison] especifica o modo de comparação. Os valores mais úteis são:
- [Ordinal]: comparação dos códigos dos caracteres;
- [OrdinalIgnoreCase]: igual à anterior, ignorando a diferença entre maiúsculas e minúsculas;
- [CurrentCulture], [CurrentCultureIgnoreCase]: comparação de acordo com as regras do idioma da máquina;
- [InvariantCulture]: comparação baseada em regras independentes da máquina;
- linha 16: o operador [] compara o conteúdo das strings, assim como o método [Equals]. Essa é uma diferença importante em relação ao Java, em que [] compara referências;
- linha 17: a forma estática de [Equals] também aceita um [StringComparison]. Essa é a maneira correta de testar uma resposta “yes” digitada no teclado em maiúsculas ou minúsculas;
- Linhas 21–22: [string.Compare] retorna um inteiro negativo, zero ou positivo, conforme a primeira string venha antes da segunda, seja igual a ela ou venha depois. Em francês, “éclair” vem antes de “essay” (a letra “é” é classificada junto com “e”, linha 10 dos resultados). Na comparação ordinal, “éclair” vem depois de “essay”, porque o código do primeiro caractere, “é” (233), é maior que o do caractere “e” (101): a comparação ordinal retorna aqui a diferença entre os dois códigos, 132. Usaremos a ordem cultural para classificar palavras destinadas a um usuário e a ordem ordinal para comparar identificadores técnicos (nomes de arquivos, chaves etc.);
- linhas 27–29: dois métodos estáticos para testar uma string ausente ([null]), vazia ou contendo apenas espaços;
- Linha 32: [PadLeft] e [PadRight] preenchem uma string até um determinado comprimento; o construtor [new string('-', 8)] repete um caractere.
5.2.4. Interpolação e formatos
A interpolação de strings [$"..."] (C# 6) é usada desde o início deste curso. Assim como o método [string.Format], ela aceita uma largura e um formato para cada expressão: [{expression,width:format}]. O programa [strings-04.cs] traz exemplos disso, bem como das strings brutas do C# 11:
Resultados:
Comentários:
- linha 11: uma largura positiva alinha o valor à direita em um campo de 10 caracteres; uma largura negativa o alinha à esquerda;
- Linhas 12–14: os formatos mais comuns:
formato | Significado | exemplo (fr-FR) |
[F2] | número de ponto fixo, 2 casas decimais | 2345,68 |
[N2] | igual ao anterior, com separador de milhares | 2 345,68 |
[C] | valor monetário para a cultura atual | 2 345,68 € |
[P2] | porcentagem (o valor é multiplicado por 100) | 5,25 % |
[D5] | inteiro de 5 dígitos ou mais, preenchido com zeros | 00045 |
[X] | inteiro hexadecimal | 2D |
[dd/MM/yyyy], [HH:mm:ss] | data e hora (MM: mês, mm: minutos) | 03/10/2026, 14:05:09 |
[dddd d MMMM yyyy] | dia e mês por extenso | samedi 3 octobre 2026 |
- Os números e as datas são formatados de acordo com a localidade atual, neste caso fr-FR: vírgula decimal, espaço como separador de milhares, nomes de dias e meses em francês;
- linha 16: uma expressão condicional colocada dentro de uma interpolação deve ser envolvida por parênteses, pois o caractere [:] introduziria ali um formato;
- linha 19: a notação [{0}], [{1}]… para [string.Format] é a usada no curso de 2008 (e em [Console.WriteLine], que aceita os mesmos parâmetros). Ela ainda é encontrada com frequência; a interpolação é mais legível;
- linhas 24–26: as larguras permitem exibir os dados em colunas;
- linha 30: uma string literal [@"..."] não trata [\] como caractere de escape. Isso é útil para caminhos do Windows e expressões regulares;
- linhas 34–39: uma string bruta (C# 11) é delimitada por pelo menos três aspas. Ela pode ocupar várias linhas e conter aspas e [\] sem escape. A indentação das aspas de fechamento é removida de cada linha: o texto JSON é exibido sem os 4 espaços da margem do código;
- Linha 42: uma string bruta pode ser interpolada. Com [$$], uma expressão interpolada é escrita entre chaves duplas [{{name}}], e as chaves simples, comuns em um texto como JSON, continuam sendo caracteres comuns.
5.2.5. A classe System.Text.StringBuilder
Mencionamos que os métodos da classe [String] que operam sobre uma string [s1] retornam outra string [s2]. A classe [System.Text.StringBuilder] permite modificar uma string sem criar uma nova string a cada operação. Isso melhora o desempenho ao construir uma string por meio de muitas adições sucessivas, evitando a proliferação de strings de vida muito curta.
A classe oferece vários construtores:
construtor | função |
[StringBuilder()] | construtor padrão |
[StringBuilder(string value)] | Construção e inicialização com [value] |
[StringBuilder(string value, int capacity)] | Construção e inicialização com [value], com uma capacidade inicial de [capacity] caracteres |
Um objeto [StringBuilder] armazena seus caracteres em uma área de memória cujo tamanho, sua capacidade, é ajustado automaticamente à medida que o texto cresce. Por padrão, a capacidade inicial é de 16 caracteres. O terceiro construtor permite especificá-la. O programa [strings-05.cs] ilustra esse conceito de capacidade:
Resultados:
Comentários:
- linha 4: criação de um objeto [StringBuilder] com capacidade inicial de 16;
- linha 5: [Length] é o número atual de caracteres; [Capacity] é o número de caracteres que o objeto pode conter antes de precisar ampliar sua área de memória;
- linha 8: [Append] adiciona uma string ao final do texto;
- linha 12: criação de um objeto [StringBuilder] com capacidade inicial de 10.
Os resultados mostram que a capacidade dobra quando é insuficiente: 16, 32, 64 (linhas 6 e 10 dos resultados) e 10, 20, 40, 80 para o segundo objeto. São os mesmos resultados de 2008. Se o tamanho aproximado do texto for conhecido de antemão, defini-lo no momento da construção evita ampliações sucessivas.
Eis alguns dos métodos da classe:
método | função |
[StringBuilder Append(string value)] | Adiciona [value] ao final do texto. Sobrecarregado para aceitar os tipos [int], [double], [decimal], [char]… e uma string interpolada |
[StringBuilder AppendLine()] | adiciona uma quebra de linha (uma sobrecarga adiciona uma string seguida de uma quebra de linha) |
[StringBuilder AppendJoin(string separator, params string[] values)] | adiciona os elementos de [values] separados por [separator] |
[StringBuilder Insert(int index, string value)] | insere [value] na posição [index]; sobrecarregado como [Append] |
[StringBuilder Remove(int index, int length)] | exclui [length] caracteres a partir da posição [index] |
[StringBuilder Replace(string oldValue, string newValue)] | substitui [oldValue] por [newValue]; uma sobrecarga substitui um caractere |
[string ToString()] | converte o texto em uma string [string] |
O programa [strings-06.cs] os utiliza:
Resultados:
Comentários:
- Linha 5: os métodos de modificação retornam o próprio objeto [StringBuilder], o que permite encadeá-los. Acompanhemos as etapas: “test” torna-se “testabCD” ([Append]), depois “texyZTstabCD” ([Insert] na posição 2), depois “xyZTstabCD” ([Remove] dos 2 primeiros caracteres) e, por fim, “XYZTstabCD” ([Replace]). [Console.WriteLine] exibe o objeto chamando seu método [ToString];
- linhas 9–11: construção de um texto de várias linhas por meio de adições sucessivas: esse é o uso típico de [StringBuilder];
- Linha 17: [Append] aceita uma string interpolada, incluindo largura e formato;
- Linha 19: o texto final é obtido como uma string [string].
Para algumas poucas concatenações, o operador [+] ou a interpolação é suficiente: o compilador as otimiza. [StringBuilder] é necessário quando o número de adições é grande ou desconhecido, tipicamente em um laço.
5.2.6. Views sobre uma string: Span<char>
O .NET Core 2.1 (2018) introduziu os tipos [Span<T>] e [ReadOnlySpan<T>]. Um objeto [ReadOnlySpan<char>] é uma view sobre uma sequência de caracteres existente, como uma parte de uma string: ele não contém uma cópia dos caracteres, apenas uma forma de acessá-los. Extrair uma parte de uma string por meio de uma view, portanto, não cria uma nova string. O programa [strings-07.cs] compara as duas maneiras de analisar uma linha no formato “sobrenome:nome:idade”:
Resultados:
Comentários:
- linhas 7–8: cada chamada a [Substring] cria uma nova string na memória, mesmo que, como no caso da idade, ela seja usada apenas por um instante;
- linha 12: [AsSpan] retorna uma view da string inteira;
- Linhas 13–14: os intervalos [start..end] (C# 8), apresentados no Capítulo 3 para arrays, aplicam-se às views: obtêm-se duas novas views, sem cópia;
- linha 16: muitos métodos do .NET aceitam uma view no lugar de uma string ([Parse], [TryParse], [StartsWith], [Contains], [Equals]…);
- Linha 21: uma string só é criada a partir de uma view se for realmente necessária.
As views são uma ferramenta de otimização muito usada no próprio .NET: essa é uma das razões pelas quais as versões recentes são significativamente mais rápidas que o .NET Framework de 2008. Uma view só pode existir na pilha de execução: ela não pode, por exemplo, ser um campo de uma classe. Para um programa comum, [string] e [Substring] são perfeitamente adequados: as views só devem ser usadas em código identificado como crítico em termos de desempenho. Não iremos além disso.
5.3. Arrays
5.3.1. A classe Array
Os arrays derivam da classe [System.Array]. Essa classe fornece diversos métodos para ordenar um array, procurar um elemento nele, redimensioná-lo e assim por diante. Apresentaremos algumas de suas propriedades e métodos. Quase todos são sobrecarregados, ou seja, existem em diferentes variantes. Todo array os herda.
Propriedades:
propriedade | função |
[public int Length { get; }] | número total de elementos do array, independentemente do número de dimensões |
[public int Rank { get; }] | número de dimensões do array |
Métodos:
Método | função |
[public static int BinarySearch<T>(T[] array, T value)] | retorna a posição de [value] em [array], que deve estar ordenado; um número negativo se [value] estiver ausente |
[public static void Clear(Array array, int index, int length)] | define os [length] elementos de [array] a partir do índice [index] com seus valores padrão: 0 para números, [false] para booleanos, [null] para referências |
[public static void Copy(Array source, Array destination, int length)] | copia os primeiros [length] elementos de [source] para [destination] |
[public static void Fill<T>(T[] array, T value)] | atribui [value] a todos os elementos de [array] |
[public int GetLength(int dimension)] | número de elementos na dimensão de número [dimension] do array |
[public static int IndexOf<T>(T[] array, T value)] | retorna a posição de [value] em [array], ou -1 se [value] não for encontrado; [LastIndexOf] retorna a última posição |
[public static void Resize<T>(ref T[]? array, int newSize)] | redimensiona [array] para [newSize] elementos; os elementos já presentes são mantidos |
[public static void Reverse(Array array)] | inverte a ordem dos elementos de [array] |
[public static void Sort<T>(T[] array)] | ordena [array] de acordo com a ordem natural de seus elementos; um método sobrecarregado recebe um objeto [IComparer<T>] que define a ordem (Capítulo 4) |
O programa [arrays-01.cs] ilustra o uso de alguns métodos da classe [Array]:
Comentários:
- Linhas 17–42: o método [Input] lê os elementos de um array digitados no teclado. Como o número de elementos não é conhecido de antemão, o programa começa com um array vazio (linha 20) e o amplia em um elemento a cada nova entrada (linha 38). [Resize] na verdade cria um novo array, copia para ele os elementos do antigo e armazena sua referência na variável passada por [ref]. Um algoritmo mais eficiente alocaria espaço em grupos de N elementos. Um array não foi concebido para ser redimensionado: esse cenário é mais bem tratado com uma lista [List<T>], como veremos em breve;
- linha 40: [^1] refere-se ao último elemento do array (indexação a partir do final, C# 8);
- No curso de 2008, [Input] era um método com um parâmetro [out]; a versão moderna retorna o array criado, o que é mais natural;
- Linhas 56–78: o método [Search] procura no array os elementos digitados no teclado. Para um array não ordenado, é realizada uma busca linear com [IndexOf] (linha 76), que examina os elementos um a um. Para um array ordenado, é realizada uma busca binária com [BinarySearch] (linha 75), que divide o intervalo de busca ao meio a cada etapa: ela encontra um elemento entre um milhão em cerca de vinte comparações;
- linha 10: o array é ordenado. Aqui, usamos uma variante de [Sort] que tem apenas um parâmetro: o array a ser ordenado. A relação de ordem usada para comparar os elementos do array é então a implícita desses elementos: neste caso, a ordem natural dos números;
- linhas 46–51: um método genérico que exibe um array de elementos de qualquer tipo, [T].
Resultados:
Quando o elemento procurado está ausente, [IndexOf] retorna -1 e [BinarySearch] retorna um número negativo (linha 27): é o complemento de um ([~i]) da posição em que o elemento deveria ser inserido para manter o array ordenado. Aqui, [~(-3)] é igual a 2: o número 0 deveria ser inserido na posição 2, entre -1,5 e 3,6. Observação: [BinarySearch] em um array não ordenado retorna um resultado sem sentido.
5.3.2. Outros métodos da classe Array
O programa [arrays-02.cs] demonstra outros métodos da classe [Array]:
Resultados:
Comentários:
- linha 6: [Reverse] inverte a ordem dos elementos do próprio array;
- linha 10: apenas 3 elementos são ordenados a partir da posição 1: 20, 30, 10 tornam-se 10, 20, 30;
- linha 15: copia os 3 primeiros elementos de [numbers] para [copy], enquanto os demais elementos mantêm seu valor inicial 0;
- Linhas 19–21: [Fill] preenche o array; [Clear] zera 2 elementos a partir da posição 1;
- linha 29: as strings são ordenadas em ordem alfabética de acordo com a cultura atual;
- Linha 34: para um array bidimensional, [Rank] é 2, [Length] é o número total de elementos e [GetLength(i)] é o número de elementos na dimensão i;
- Linha 39: [string.Join] exibe um array em uma única linha.
O LINQ, que veremos mais adiante, oferece outras maneiras de pesquisar, ordenar ou transformar os elementos de um array.
5.4. Coleções genéricas
Além dos arrays, existem várias classes para armazenar coleções de elementos. As coleções genéricas, introduzidas com o .NET 2.0, ficam no namespace [System.Collections.Generic], que faz parte dos namespaces [using] implícitos. Apresentaremos primeiro duas coleções muito utilizadas, a lista e o dicionário, e depois trataremos brevemente de outras.
O namespace [System.Collections] contém as versões mais antigas, não genéricas, dessas coleções, que remontam ao .NET 1.0: [ArrayList] (uma lista), [Hashtable] (um dicionário)... O curso de 2008 ainda apresentava [ArrayList]. Essas classes agora são obsoletas: elas armazenam referências do tipo [object], o que exige converter os elementos lidos e fazer o boxing dos números em objetos, com os custos de memória e tempo associados. As coleções genéricas não têm nenhuma dessas desvantagens: uma *[List<int>] armazena seus inteiros diretamente em um array *[int[]] interno, e o compilador verifica o tipo dos elementos adicionados. [ArrayList] e [Hashtable] não devem mais ser usados em código novo.
5.4.1. A classe genérica List<T>
A classe [System.Collections.Generic.List<T>] permite implementar coleções de objetos [T] cujo tamanho varia durante a execução do programa. Um objeto do tipo [List<T>] é manipulado quase como um array. Assim, o elemento i de uma lista [l] é denotado por [l[i]].
Para uma lista do tipo [List<T>] em que [T] é uma classe, a lista armazena referências a objetos do tipo [T], como um array de objetos; se [T] for um tipo de valor ([int], [double], estrutura…), os próprios valores são armazenados na lista.
Eis algumas das propriedades e dos métodos das listas genéricas.
Propriedades:
propriedade | função |
[public int Count { get; }] | número de elementos da lista |
[public int Capacity { get; set; }] | número de elementos que a lista pode conter antes de ser ampliada. Essa ampliação ocorre automaticamente. Esse conceito de capacidade é análogo ao descrito para a classe [StringBuilder] |
Métodos:
Método | função |
[public void Add(T item)] | adiciona [item] ao final da lista |
[public void AddRange(IEnumerable<T> collection)] | adiciona os elementos de [collection] ao final da lista |
[public int BinarySearch(T item)] | retorna a posição de [item] na lista ordenada, se ele estiver presente; caso contrário, retorna um número negativo |
[public void Clear()] | remove todos os elementos da lista |
[public bool Contains(T item)] | retorna [true] se [item] estiver na lista; caso contrário, [false] |
[public List<T> GetRange(int index, int count)] | retorna uma nova lista formada por [count] elementos a partir da posição [index] |
[public int IndexOf(T item)] | retorna a posição de [item] na lista, ou -1 se [item] não for encontrado |
[public void Insert(int index, T item)] | insere [item] na posição [index] da lista |
[public bool Remove(T item)] | remove a primeira ocorrência de [item] da lista; retorna [true] se a operação for bem-sucedida e [false] caso contrário |
[public void RemoveAt(int index)] | remove da lista o item de número [index] |
[public void Reverse()] | inverte a ordem dos itens da lista |
[public void Sort()] | ordena a lista em ordem natural; uma versão sobrecarregada recebe um [IComparer<T>] |
[public T[] ToArray()] | retorna os elementos da lista na forma de um array |
Vamos retomar o exemplo visto anteriormente com um array e processá-lo agora com um objeto do tipo [List<double>]. Como a lista se assemelha a um array, o código muda muito pouco. Este é o programa [collections-01.cs]:
Comentários:
- linha 22: a lista é criada vazia. [new()] (C# 9) é uma forma abreviada de [new List<double>()]: o tipo é inferido a partir da declaração da variável;
- linha 40: não há mais redimensionamento a tratar; a lista se amplia automaticamente;
- linha 6: o número de elementos da lista e sua capacidade;
- linhas 12, 75, 76: os métodos [Sort], [BinarySearch] e [IndexOf] agora são métodos de instância da lista, ao passo que os de [Array] são métodos estáticos;
- linhas 46–51: o método genérico [Display<T>] recebe dois parâmetros:
- o primeiro é um texto a ser escrito;
- o segundo é um objeto que implementa a interface genérica [IEnumerable<T>]:
A estrutura [foreach (T element in elements)] é válida para qualquer objeto [elements] que implemente a interface [IEnumerable<T>]. Arrays e listas implementam essa interface. Portanto, o método [Display] serve tanto para exibir arrays quanto listas. Voltaremos a essa interface, que está no centro do LINQ.
Resultados:
Os resultados são os mesmos obtidos com o array. A capacidade da lista aqui é 4 (linha 7): partindo de 0, ela passou a 4 na primeira adição; passaria a 8 na quinta adição, dobrando como a de um [StringBuilder].
5.4.2. Métodos de List<T> e expressões de coleção
O programa [collections-02.cs] usa os demais métodos da lista e as expressões de coleção do C# 12, que já encontramos com arrays no Capítulo 3:
Resultados:
Comentários:
- linha 4: uma expressão de coleção [a, b, c] inicializa uma lista como se fosse um array;
- linhas 8–10: três maneiras de adicionar elementos;
- linha 14: o elemento de número 0 pode ser lido e escrito; [cities[^1]] é o último elemento, como em um array;
- linha 21: [Remove] retorna [true] se o elemento foi encontrado e removido;
- linha 30: uma nova lista formada por 2 elementos a partir da posição 1;
- linhas 34–35: conversão de uma lista em array e de um array (ou qualquer sequência) em lista;
- linha 40: em uma expressão de coleção, o operador [..] (spread) insere todos os elementos de outra coleção;
- Linha 43: [] designa uma coleção vazia do tipo esperado.
5.4.3. A classe Dictionary<TKey,TValue>
A classe [System.Collections.Generic.Dictionary<TKey,TValue>] é usada para implementar um dicionário. Um dicionário pode ser visto como um array de duas colunas:
chave | valor |
key1 | value1 |
key2 | value2 |
... | ... |
Na classe [Dictionary<TKey,TValue>], as chaves são do tipo [TKey] e os valores são do tipo [TValue]. As chaves são únicas: não pode haver duas chaves idênticas. Um dicionário desse tipo teria esta aparência se os tipos [TKey] e [TValue] se referissem a classes:
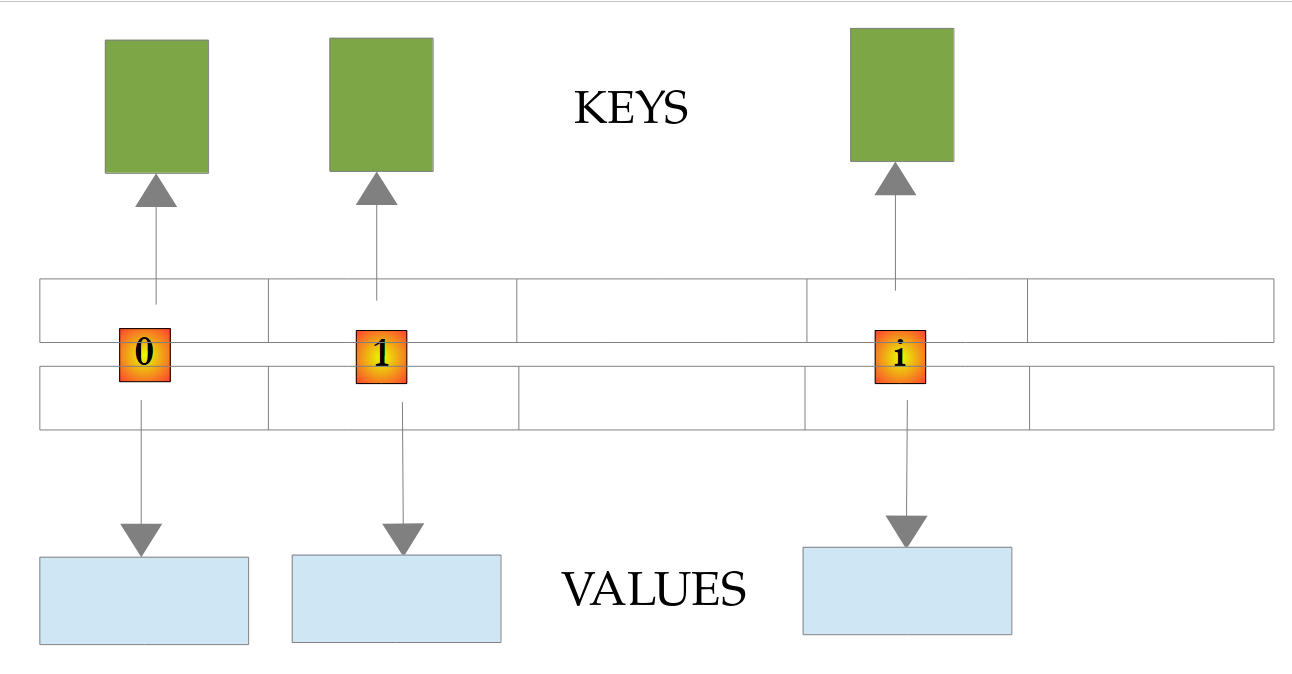
O valor associado à chave [c] em um dicionário [d] é obtido com a notação [d[c]]. Esse valor pode ser lido e escrito. Assim, podemos escrever:
Na escrita, [d[c] = v] adiciona o par (c, v) se a chave [c] não existir e, caso contrário, substitui o valor associado a [c] . Na leitura, se a chave [c] não existir no dicionário [d], a notação [d[c]] lança uma exceção [KeyNotFoundException].
Os principais métodos e propriedades da classe [Dictionary<TKey,TValue>] são os seguintes.
Propriedades:
propriedade | função |
[public int Count { get; }] | número de entradas (chave, valor) do dicionário |
[public KeyCollection Keys { get; }] | coleção das chaves do dicionário |
[public ValueCollection Values { get; }] | coleção dos valores do dicionário |
Métodos:
Método | Função |
[public void Add(TKey key, TValue value)] | Adiciona o par (chave, valor) ao dicionário; lança uma exceção se a chave já existir |
[public bool TryAdd(TKey key, TValue value)] | Igual ao anterior, mas retorna [false] em vez de lançar uma exceção |
[public void Clear()] | remove todos os pares do dicionário |
[public bool ContainsKey(TKey key)] | Retorna [true] se [key] for uma chave do dicionário; caso contrário, retorna [false] |
[public bool ContainsValue(TValue value)] | retorna [true] se [value] for um valor do dicionário e [false] caso contrário |
[public bool Remove(TKey key)] | remove do dicionário o par chave-valor [key]; retorna [true] se a operação for bem-sucedida e [false] caso contrário |
[public bool TryGetValue(TKey key, out TValue value)] | retorna [true] e atribui a [value] o valor associado à chave [key] se esta existir; retorna [false] caso contrário, e [value] recebe o valor padrão do tipo [TValue] |
Consideremos o programa de exemplo [collections-03.cs]:
Comentários:
- linha 4: um array de strings que será usado para inicializar o dicionário <string,int>;
- linha 5: o dicionário, que está vazio;
- linhas 6–9: sua inicialização a partir do array de strings;
- linha 12: o número de entradas do dicionário;
- linhas 14–16: as chaves e os valores do dicionário. [dico.Keys] e [dico.Values] implementam [IEnumerable<T>]: o método [Display] que já encontramos é adequado;
- linha 25: exclusão de uma entrada do dicionário;
- linha 28: um dicionário é uma sequência de pares [KeyValuePair<TKey,TValue>], cada um com uma propriedade [Key] e uma propriedade [Value]. Desde o .NET Core 2.0, tal par pode ser decomposto em duas variáveis, como uma tupla (Capítulo 3);
- linhas 35–42: [Add] rejeita uma chave existente lançando uma exceção; [TryAdd] retorna [false] nesse caso. As mensagens de exceção do .NET estão em inglês: o .NET 10 não fornece mensagens em francês;
- linha 46: tentar ler uma chave ausente lança uma exceção [KeyNotFoundException];
- linha 63: pesquisa de uma chave no dicionário. [TryGetValue] retorna [true] se a chave existir. O curso de 2008 ignorava esse resultado e verificava se o valor retornado era nulo, técnica que só funcionava porque o valor 0 não estava no dicionário. Verificar o valor booleano retornado é a abordagem correta.
Resultados:
As chaves são listadas aqui na ordem em que foram adicionadas, mas isso não é garantido: um *[Dictionary]* não preserva nenhuma ordem. Após exclusões, um novo elemento pode ocupar o lugar de um elemento excluído. Se a ordem das chaves for importante, use um *[SortedDictionary]*, apresentado a seguir.
5.4.4. Outras coleções genéricas
O namespace [System.Collections.Generic] contém outras coleções, cada uma adequada a um propósito específico:
classe | função |
[HashSet<T>] | um conjunto: sem duplicatas, sem ordem, teste de pertinência muito rápido; operações de conjuntos (união, interseção, diferença) |
[SortedSet<T>] | um conjunto cujos elementos são mantidos ordenados |
[Queue<T>] | uma fila: os elementos saem na ordem em que foram inseridos (FIFO, first in, first out) |
[Stack<T>] | uma pilha: o último elemento adicionado é o primeiro a ser removido (LIFO, last in, first out) |
[SortedDictionary<TKey,TValue>] | um dicionário cujas chaves são mantidas ordenadas |
[PriorityQueue<TElement,TPriority>] | uma fila de prioridade (.NET 6): o elemento removido é o de menor prioridade |
[LinkedList<T>] | uma lista duplamente encadeada: inserções e exclusões rápidas no meio da lista |
O programa [collections-04.cs] oferece uma visão geral rápida:
Resultados:
Comentários:
- linha 4: as expressões de coleção também inicializam um conjunto;
- linha 6: [Add] retorna [false] se o elemento já estiver no conjunto, que permanece inalterado;
- Linhas 9–12: [IntersectWith] e [UnionWith] modificam o conjunto; por isso, trabalhamos sobre uma cópia de [languages]. A ordem em que os elementos de um conjunto são exibidos não tem significado (linha 4);
- as chaves duplas [{{] e [}}] em uma string interpolada exibem uma única chave;
- linhas 16–20: [Enqueue] coloca um elemento na fila, [Dequeue] retira o elemento mais antigo, [Peek] consulta o elemento sem retirá-lo da fila;
- linhas 23–30: [Push] empilha um elemento, [Pop] desempilha o elemento mais recente. [Pop] em uma pilha vazia lança uma exceção; [TryPop] retorna [false];
- linhas 33–40: um dicionário inicializado com a sintaxe [[key] = value]; seus pares chave-valor são enumerados na ordem das chaves;
- linhas 43–49: cada elemento entra na fila com uma prioridade; os pacientes saem em ordem crescente de prioridade, independentemente da ordem de chegada.
5.4.5. Coleções somente leitura
Uma classe que gerencia uma coleção muitas vezes precisa expô-la externamente sem permitir que seja modificada. O .NET fornece interfaces somente leitura para essa finalidade: [IReadOnlyCollection<T>] (um [Count] e um [foreach]), [IReadOnlyList<T>] (mais o acesso por índice) e [IReadOnlyDictionary<TKey,TValue>]. As classes [List<T>], [T[]], e [Dictionary<TKey,TValue>] as implementam. O programa [collections-05.cs] as utiliza:
Resultados:
Comentários:
- linhas 37–47: a classe [Classroom] gerencia uma lista de alunos. A própria lista é privada; apenas o método [Enroll] permite modificá-la;
- linha 43: a propriedade [Students] converte a lista para o tipo [IReadOnlyList<string>], que admite apenas operações de leitura: [students.Add("x")] causaria um erro de compilação;
- linha 12: no entanto, essa proteção é apenas superficial: o objeto retornado é a própria lista, e uma conversão de tipo permite acessar seus métodos de modificação;
- linha 45: [AsReadOnly] envolve a lista em um contêiner do tipo [ReadOnlyCollection<T>]. Desta vez, nenhuma modificação é possível: seus métodos de modificação, impostos pela interface [IList<T>], lançam uma exceção [NotSupportedException] (linha 5). O wrapper não copia a lista: ele enxerga as modificações feitas pela classe proprietária (linha 6);
- linha 33: um dicionário visto por meio da interface [IReadOnlyDictionary<TKey,TValue>].
Para dados que nunca devem mudar após a criação, o namespace [System.Collections.Immutable] fornece coleções imutáveis ([ImmutableList<T>], [ImmutableDictionary<TKey,TValue>]…) e [System.Collections.Frozen] oferece coleções congeladas otimizadas para leitura ([FrozenDictionary<TKey,TValue>], .NET 8). Não entraremos em detalhes sobre elas.
5.5. LINQ
O curso de 2008 terminava pouco antes do LINQ, apresentando seus tipos anônimos sem realmente utilizá-los. O LINQ (Language Integrated Query, C# 3, 2007) é um conjunto de métodos que permitem consultar uma coleção assim como se consulta um banco de dados: filtrar, ordenar, agrupar, calcular totais e assim por diante. Ele se aplica a qualquer coleção que implemente a interface [IEnumerable<T>]: arrays, listas, dicionários, conjuntos, linhas de um arquivo, resultados de uma expressão regular e, com o Entity Framework Core (Capítulo 11), tabelas de banco de dados. O namespace [System.Linq] faz parte dos namespaces [using] implícitos.
5.5.1. As sequências IEnumerable<T> e os iteradores
Uma coleção que implementa [IEnumerable<T>] é chamada de sequência: ela pode ser percorrida com [foreach]. A interface contém apenas um método, [GetEnumerator], que retorna um enumerador [IEnumerator<T>]: um objeto que percorre a sequência ([MoveNext]) e retorna o elemento atual ([Current]).
Um método pode produzir uma sequência sem construir uma coleção: trata-se de um iterador. Ele retorna seus elementos um a um por meio da instrução [yield return]. O programa [linq-01.cs] traz dois exemplos:
Resultados:
Comentários:
- Linhas 39–48: o método
[Evens]é um iterador: seu tipo de retorno é*[IEnumerable<int>], e ele contém a instrução[yield return](linha 46). Ele não constrói nenhuma lista: a cada [yield return], devolve um elemento ao código que o percorre e fica em pausa*; ele será retomado na instrução seguinte quando o próximo elemento for solicitado; - linhas 5–7: os resultados (linhas 3–12) mostram que a produção de um elemento pelo iterador e seu consumo pelo laço [foreach] se alternam;
- linhas 12–17: o que o [foreach] realmente faz: ele solicita um enumerador à sequência, chama [MoveNext] enquanto esse método retornar [true] e lê o elemento atual em [Current]. O iterador é liberado no final pela instrução [using] (voltaremos a isso ao tratar de arquivos). Observe que a chamada a [Evens(4)] na linha 12 não faz nada: a mensagem “start of the iterator” só aparece na primeira chamada a [MoveNext];
- linhas 52–58: um iterador pode produzir uma sequência infinita; ele calcula apenas os elementos solicitados. É o laço [foreach] que decide quando parar (linha 25). A linha 58 usa as tuplas do Capítulo 3 para trocar valores;
- linhas 34–35: uma string é uma sequência de caracteres; uma lista é uma sequência de seus elementos. A lista é criada aqui com a sintaxe de [new List<string> { ... }] inicializador de coleção (C# 3), que é encontrada com frequência em código existente.
Esse mecanismo de geração sob demanda é usado por todos os métodos do LINQ.
5.5.2. Filtrar, projetar, ordenar
Os exemplos a seguir trabalham com uma pequena lista de pessoas. Uma pessoa é representada por um [record] (C# 9) record, apresentado no Capítulo 4: em uma única linha, obtemos uma classe com um construtor, propriedades somente leitura, um método [ToString] que exibe as propriedades e um operador de igualdade que compara os valores das propriedades.
O programa [linq-02.cs] demonstra os métodos básicos do LINQ:
Resultados:
Comentários:
- linhas 4–13: a lista de pessoas, inicializada por uma expressão de coleção; [new(...)] cria um objeto do tipo esperado, neste caso [Person];
- linha 56: o record [Person]. Uma aplicação de arquivo único coloca suas declarações de tipos após as instruções de nível superior;
- linha 16: o método [Where] filtra a sequência: ele retém apenas os elementos que satisfazem uma condição. Essa condição lhe é passada na forma de uma função anônima [p => p.Age >= 18], que se lê “a função que, para uma pessoa p, associa o booleano p.Age >= 18”. Essa notação é chamada de expressão lambda. [Where] chama essa função para cada pessoa. As lambdas serão estudadas em detalhes no Capítulo 7 (“Delegates, lambdas e eventos”; por enquanto, basta saber lê-las);
- O resultado de [Where] é uma nova sequência, [IEnumerable<Person>]: a lista [persons] permanece inalterada. Isso vale para todos os métodos do LINQ;
- o método [Display] exibe cada pessoa por meio do método [ToString] gerado para o record: [Person { LastName = dupont, ... }];
- Linha 20: o método [Select] mapeia cada elemento da sequência para um novo valor, neste caso uma string. O resultado é uma sequência [IEnumerable<string>];
- linhas 24–27: os métodos do LINQ retornam sequências, às quais outros métodos do LINQ podem ser aplicados. Os métodos costumam ser escritos um por linha: essa cadeia de chamadas se lê de cima para baixo como uma receita;
- linha 26: [OrderBy] ordena a sequência de acordo com a chave retornada pela lambda, neste caso o nome;
- linha 31: [OrderByDescending] ordena em ordem decrescente; [ThenBy] (ou [ThenByDescending]) adiciona um critério secundário, usado para distinguir elementos iguais segundo o primeiro critério: Durand e Laurent, ambos com 32 anos, são ordenados por nome (linhas 23–24);
- linhas 35–38: a mesma consulta que [angersPeople] escrita com a sintaxe de consulta, semelhante ao SQL. O compilador a traduz exatamente na cadeia de chamadas [Where(...).OrderBy(...).Select(...)]: as duas notações são equivalentes. A sintaxe de consulta é mais legível para junções e agrupamentos; a sintaxe de métodos é mais comum e é a única que dá acesso a todos os métodos do LINQ ([Take], [Count], [First]…);
- Linha 42: uma variante de [Select] passa à lambda o elemento e sua posição na sequência.
5.5.3. Quantificadores, agregações, seleção de elementos
O programa [linq-03.cs] inclui métodos que retornam um único valor e métodos que selecionam uma parte da sequência:
Resultados:
Comentários:
- Linha 15: [Any] retorna [true] se pelo menos um elemento satisfizer a condição, e [All] se todos a satisfizerem. Sem parâmetros, [Any] indica se a sequência não está vazia;
- Linhas 18–20: as agregações [Count], [Sum], [Average], [Min], [Max] calculam um valor com base na sequência inteira. [Count] aceita uma condição (uma lista também tem uma propriedade [Count], que é preferível ao método quando não há condição); [Sum], [Average], [Min] e [Max] aceitam uma lambda que especifica o valor a considerar para cada elemento;
- Linha 22: [MinBy] e [MaxBy] (.NET 6) retornam o elemento (neste caso, a pessoa) cuja chave é mínima ou máxima, e não o valor da chave em si. Para uma sequência vazia de objetos (tipo de referência), retornam [null], daí o operador [?.];
- linha 25: [First] retorna o primeiro elemento da sequência, ou o primeiro que satisfaz uma condição; [Last] retorna o último;
- Linha 26: se nenhum elemento corresponder, [First] lança uma exceção (linha 11 dos resultados), ao passo que [FirstOrDefault] retorna o valor padrão do tipo, neste caso [null];
- Linha 28: [Single] retorna o único elemento que satisfaz a condição e lança uma exceção se houver zero ou mais de um desses elementos (linha 10). Ele é usado quando a unicidade é uma regra dos dados, como na busca de um elemento por sua chave. [SingleOrDefault] retorna o valor padrão se não houver nenhum elemento;
- linha 32: o resultado da chamada não é usado; ele é atribuído ao descarte [_] (C# 7) para sinalizá-lo;
- linha 49: [Distinct] remove duplicatas; [DistinctBy] (.NET 6) mantém o primeiro elemento de cada valor de chave;
- linhas 57–58: [Take(n)] mantém os n primeiros elementos, [Skip(n)] os ignora. Combinados, extraem uma “página” de resultados. [TakeWhile] mantém os elementos enquanto uma condição for satisfeita e para no primeiro elemento que não a satisfaz;
- linha 62: [Chunk] (.NET 6) divide a sequência em arrays de 3 elementos, o último dos quais pode ser mais curto;
- linha 64: a variável [page] é incrementada depois de ser usada na interpolação.
5.5.4. Tipos anônimos, agrupamentos, junções
O programa [linq-04.cs] apresenta os tipos anônimos e operações mais complexas:
Resultados:
Comentários:
- Linha 22: um tipo anônimo (C# 3): a expressão [new { LastName = ..., Age = ... }] cria um objeto cuja classe sem nome é gerada pelo compilador com duas propriedades somente leitura, [LastName] e [Age]. Como esse tipo não tem nome, a variável deve ser declarada como [var]. O compilador, porém, conhece perfeitamente esse tipo: [p1.LastName] é validado em tempo de compilação, e o editor sugere as propriedades de [p1] no preenchimento automático;
- linha 25: o principal uso dos tipos anônimos: em um [Select], manter apenas os dados úteis sem precisar declarar uma classe para eles. [p.LastName] é uma abreviação de [LastName = p.LastName];
- Linha 33: [GroupBy] agrupa os elementos que têm a mesma chave. O resultado é uma sequência de grupos [IGrouping<TKey,TElement>]: cada grupo tem uma propriedade [Key], o valor comum da chave, e é ele próprio a sequência dos elementos do grupo, à qual podemos aplicar [Count], [Average], [Select]… (linha 36);
- linhas 41–44: [Join] associa cada pessoa à cidade de mesmo nome. Seus parâmetros são a segunda sequência, a chave de junção de cada lado e uma lambda que constrói o resultado a partir de um par (pessoa, cidade). Como em uma junção SQL, [Join] retém apenas os pares que correspondem: Laurent, que mora em Lyon, ausente da lista de cidades, não aparece, nem Brest, que não tem nenhum morador;
- linhas 50–53: a junção na sintaxe de consulta, que é mais legível: [join ... in ... on ... equals ...]. Um filtro, [where], é adicionado a ela. A sintaxe de consulta também inclui uma cláusula, [group ... by ...], para os agrupamentos;
- linha 57: [ToList] (e [ToArray]) executa a consulta e armazena seus resultados em uma lista (um array);
- linha 58: [ToDictionary] constrói um dicionário: a primeira lambda fornece a chave de cada elemento, a segunda, seu valor. Uma chave duplicada causa uma exceção;
- Linha 63: [CountBy] (.NET 9) conta os elementos de cada valor de chave. Ele retorna uma sequência de pares [KeyValuePair<string,int>]. É um atalho para [GroupBy(p => p.City).Select(g => (g.Key, g.Count()))];
- Linha 68: [AggregateBy] (.NET 9) acumula um valor para cada valor de chave: partindo de 0, para cada pessoa, sua idade é somada ao total de sua cidade. As tuplas retornadas são decompostas no laço [foreach];
- linha 73: [Index] (.NET 9) associa cada elemento à sua posição na sequência, na forma de uma tupla (posição, elemento).
5.5.5. Execução adiada
Uma consulta LINQ não é executada quando é escrita, mas quando seu resultado é percorrido: é a execução adiada. O programa [linq-05.cs] demonstra isso por meio de lambdas que exibem o que estão fazendo:
Resultados:
Comentários:
- Linhas 7–16: uma consulta que seleciona os números pares e depois calcula seus quadrados. As lambdas aqui são escritas com um corpo delimitado por chaves, que exibe uma mensagem antes de retornar seu valor com [return];
- Linha 3 dos resultados: depois que a consulta foi definida, nada foi exibido: nem [Where] nem [Select] examinou ainda um único elemento. [evenSquares] não contém resultados, mas sim uma descrição de um cálculo;
- Linhas 4–16: a consulta é executada durante o laço [foreach], elemento por elemento: cada número passa por [Where], depois por [Select] se for par e, em seguida, entra no laço antes que o próximo número seja examinado. São iteradores, como [Evens] em [linq-01.cs];
- linhas 28–31: a consulta [large] é reavaliada a cada passagem: ela leva em conta o número 10 adicionado à lista após sua definição;
- linha 34: [ToList] executa a consulta imediatamente e armazena seus resultados: [snapshot] é uma lista que não enxerga a adição do 20 (linha 19);
- linha 39: os métodos que retornam um único valor ([Count], [Sum], [First], [Any]…) também percorrem a sequência imediatamente;
- linhas 45–49: [First] para de percorrer assim que encontra um elemento: os números posteriores ao 3 nunca são examinados.
A execução adiada tem duas consequências práticas:
- uma consulta percorrida várias vezes é executada várias vezes. Se seu cálculo for custoso, ou se for desejado um resultado fixo, ela é convertida de uma vez por todas com [ToList] ou [ToArray];
- as consultas podem ser compostas sem custo: encadear [Where], [Select] e [Take] não cria nenhuma coleção intermediária, e apenas os elementos necessários são calculados.
Encontraremos o LINQ ao longo de todo o curso e veremos no Capítulo 7 como seus métodos são construídos.
5.6. Arquivos de texto
As classes de leitura e escrita de arquivos ficam no namespace [System.IO], que faz parte dos namespaces [using] implícitos.
5.6.1. A classe StreamReader
A classe [System.IO.StreamReader] permite ler o conteúdo de um arquivo de texto. Na verdade, ela é capaz de tratar streams que não são arquivos (uma conexão de rede, por exemplo). Eis algumas de suas propriedades e métodos.
Construtores:
construtor | função |
[public StreamReader(string path)] | Cria um stream de leitura a partir do arquivo no caminho [path]. O conteúdo do arquivo pode ser codificado de várias maneiras; por padrão, é usada a codificação UTF-8. Outra sobrecarga permite especificar a codificação: [new StreamReader(path, Encoding.Latin1)] |
Propriedades:
propriedade | função |
[public bool EndOfStream { get; }] | [true] se o stream foi lido por inteiro |
Métodos:
Método | Função |
[public void Dispose()] | Fecha o stream e libera os recursos alocados para seu gerenciamento. Isso deve ser feito após o processamento do stream, o que é tratado pela instrução [using]. [Close] faz a mesma coisa |
[public int Peek()] | retorna o próximo caractere do stream sem consumi-lo; -1 no final do stream |
[public int Read()] | retorna o próximo caractere do stream e avança um caractere; -1 no final do stream |
[public string? ReadLine()] | retorna a próxima linha do stream, sem o caractere de fim de linha, ou [null] se estiver no final do stream |
[public string ReadToEnd()] | retorna o restante do stream, ou "" se estiver no final do stream |
O programa [files-01.cs] é o seguinte:
Comentários:
- linha 4: exibe o nome do diretório atual, aquele a partir do qual o comando [dotnet run] foi iniciado. Apenas o último elemento do caminho é exibido, com [Path.GetFileName], para não poluir os resultados com um caminho completo;
- linha 6: o arquivo lido é [infos.txt] ou o passado como argumento. Por ser um caminho relativo, ele é procurado na pasta atual;
- linha 11: a estrutura [using (stream = ...) { ... }] garante que o stream seja fechado no final do bloco, mesmo que ocorra uma exceção dentro dele. Isso elimina a necessidade de chamar explicitamente o método de fechamento. Ela se aplica a qualquer objeto que implemente a interface [IDisposable], isto é, qualquer objeto com um método [Dispose] que libere recursos (arquivo, conexão de rede, conexão com banco de dados etc.);
- linhas 15–17: o arquivo é lido linha por linha. A atribuição [line = stream.ReadLine()] é uma expressão cujo valor é o de [line]: ele é comparado a [null], que indica o fim do arquivo. A variável [line] é do tipo [string?]: [ReadLine] pode receber o valor [null];
- linha 23: uma declaração
using(C# 8). Não há mais um bloco: a variável[stream2]será liberada no final do bloco que contém sua declaração, neste caso o bloco*[try]*. Essa sintaxe mais concisa é a mais comum hoje em dia; - linha 24: o arquivo é lido de uma só vez;
- linhas 27–32: os erros de E/S são sinalizados por exceções derivadas de
[IOException]*.*[FileNotFoundException]*é uma dessas exceções; por isso, ela é capturada primeiro. Sua propriedade*[FileName]contém o caminho completo do arquivo procurado.
O arquivo [infos.txt] é o seguinte:
Ele está localizado na pasta [05-classes-dotnet], a partir da qual o programa é executado:
Com um arquivo inexistente:
Escolher a pasta atual para localizar os arquivos de dados é a abordagem natural para uma aplicação de arquivo único executada a partir de sua própria pasta. Em um projeto, o executável fica em uma subpasta [bin/Debug/net10.0] do projeto: veremos na aplicação de exemplo como copiar os arquivos de dados para lá e como localizá-los.
5.6.2. A classe StreamWriter
A classe [System.IO.StreamWriter] permite escrever em um arquivo de texto. Assim como a classe [StreamReader], ela é na verdade capaz de tratar streams que não são arquivos. Eis algumas de suas propriedades e métodos.
Construtores:
construtor | função |
[public StreamWriter(string path)] | cria um stream de escrita para o arquivo no caminho [path]. O arquivo é criado ou sobrescrito, caso exista. Por padrão, o texto é codificado em UTF-8, sem BOM (veja abaixo) |
[public StreamWriter(string path, bool append)] | se [append] for igual a [true], os dados são acrescentados ao final do arquivo existente |
Propriedades:
propriedade | função |
[public bool AutoFlush { get; set; }] | define o modo de escrita no arquivo. Se [AutoFlush] for igual a [false] (valor padrão), a escrita no stream não é imediata: o texto é escrito primeiro em um buffer e depois no arquivo, quando o buffer estiver cheio, quando for esvaziado explicitamente pelo método [Flush] ou quando o stream for fechado. Esse é o modo mais eficiente para arquivos, pois limita os acessos ao disco. Ele não é adequado a todos os streams, em particular aos streams de rede: em um diálogo entre dois parceiros, o que um escreve deve ser lido imediatamente pelo outro, e o stream de escrita deve estar no modo [AutoFlush=true] |
[public string NewLine { get; set; }] | o caractere de fim de linha escrito por [WriteLine]. Por padrão, é o caractere de fim de linha do sistema: "\r\n" no Windows, "\n" no Linux e no macOS |
[public Encoding Encoding { get; }] | a codificação utilizada |
Métodos:
Método | função |
[public void Dispose()] | Fecha o stream depois de gravar o conteúdo do buffer no arquivo. Deve ser feito após o processamento do stream; [Close] executa a mesma ação |
[public void Flush()] | grava o conteúdo do buffer no arquivo sem esperar que ele esteja cheio |
[public void Write(T value)] | escreve [value] no arquivo associado ao stream. Aqui, [T] não é um tipo genérico, mas simboliza o fato de que o método [Write] aceita diferentes tipos de parâmetros ([string], [int], [object]…) |
[public void WriteLine(T value)] | igual a [Write] mas com o marcador de fim de linha ([NewLine]) acrescentado |
O programa [files-02.cs] é o seguinte:
Resultados:
Comentários:
- linha 6: mais uma vez, usamos a instrução [using] para não precisar fechar o stream explicitamente. Esse fechamento ocorre automaticamente no final do bloco (chave de fechamento da linha 21). É esse fechamento que grava no arquivo o texto restante no buffer; sem ele, o arquivo poderia ficar incompleto;
- linha 19: escreve uma linha no arquivo de texto;
- linha 24: a classe [FileInfo] fornece informações sobre um arquivo, neste caso seu tamanho em bytes. Os 18 bytes se dividem assim: 16 caracteres, mais duas quebras de linha de um byte ("\n" no Linux, onde o código foi executado; no Windows, cada quebra de linha "\r\n" ocuparia 2 bytes);
- linha 28: por que um [try / catch]? Poderíamos especificar um nome de arquivo na forma [dir1/dir2/file] com um diretório [dir1/dir2] que não existe, o que impossibilitaria a criação do arquivo. Seria então lançada uma exceção [DirectoryNotFoundException], derivada de [IOException]. Há outros casos possíveis de exceção (disco cheio, permissões insuficientes etc.).
5.6.3. As classes File, Path e Directory
Para operações comuns, a classe estática [File] elimina a necessidade de manipular streams: um único método abre o arquivo, lê ou escreve todo o seu conteúdo e depois o fecha. As classes estáticas [Path] e [Directory] tratam, respectivamente, de caminhos e de diretórios.
método | função |
[File.ReadAllText(path)] | retorna o conteúdo do arquivo como uma string |
[File.ReadAllLines(path)] | retorna as linhas do arquivo em um array [string[]] |
[File.ReadLines(path)] | retorna as linhas do arquivo como uma sequência [IEnumerable<string>] lida sob demanda |
[File.WriteAllText(path, contents)] | cria (ou sobrescreve) o arquivo e escreve nele [contents]; [WriteAllLines] escreve uma coleção de linhas |
[File.AppendAllText(path, contents)], [File.AppendAllLines(path, lines)] | adiciona texto (linhas) ao final do arquivo (que é criado se não existir) |
[File.ReadAllBytes(path)], [File.WriteAllBytes(path, bytes)] | lê e escreve o arquivo como um array de bytes |
[File.Exists(path)], [File.Delete(path)], [File.Copy(source, dest)], [File.Move(source, dest)] | verifica se um arquivo existe, o exclui, o copia ou o move |
[Path.Combine(p1, p2, ...)] | constrói um caminho a partir de seus elementos, usando o separador do sistema |
[Path.GetFileName(path)], [Path.GetExtension(path)], [Path.GetDirectoryName(path)] | extrai de um caminho o nome do arquivo, a extensão do arquivo e a pasta |
[Directory.CreateDirectory(path)] | cria a pasta e suas pastas ancestrais, se não existirem |
[Directory.GetFiles(path, pattern)], [Directory.EnumerateFiles(path, pattern)] | arquivos da pasta cujos nomes correspondem ao padrão ([*.txt]…), em um array ou em uma sequência |
[Directory.Exists(path)], [Directory.Delete(path, recursive)] | verifica a existência de uma pasta e a exclui (juntamente com seu conteúdo se [recursive] for igual a [true]) |
O programa [files-03.cs] os utiliza:
Resultados:
Comentários:
- Linha 7: [Path.Combine] usa o separador de caminhos do sistema. Os exercícios do curso foram executados no Linux: o caminho resultante é [data/cities.txt]; no Windows, seria [data\cities.txt]. Construir caminhos com [Path.Combine] em vez de concatenar strings torna o código portável;
- linha 11: criar a pasta [data] não causa erro se ela já existir;
- Linhas 14–18: escrita, acréscimo e leitura, cada uma em uma única instrução;
- linha 23: [File.ReadLines] retorna uma sequência: as linhas são lidas uma a uma à medida que o laço avança, como os elementos de um iterador. É possível aplicar o LINQ a ela e, assim, processar um arquivo de vários gigabytes sem carregá-lo na memória, o que [ReadAllLines] faria. O arquivo é fechado no final da iteração;
- linhas 29–36: o mesmo texto “café” é escrito usando três codificações, e depois os bytes dos arquivos são exibidos em hexadecimal:
- em UTF-8, a codificação padrão do .NET, os caracteres acentuados ocupam 2 bytes (é = C3 A9) e os demais, 1 byte: 5 bytes para 4 caracteres;
- em UTF-8 com BOM (Byte Order Mark), o arquivo começa com os 3 bytes EF BB BF, que indicam aos programas que o arquivo está codificado em UTF-8. [new UTF8Encoding(true)] instrui o sistema a escrever esse BOM;
- em Latin-1 (ISO-8859-1), a codificação tradicional dos textos da Europa Ocidental, cada caractere ocupa um byte (é = E9);
- Linha 39: ler um arquivo com uma codificação diferente da usada para escrevê-lo altera os caracteres acentuados: o byte E9, no final do arquivo, é inválido em UTF-8, e cada byte inválido é substituído pelo caractere �. Na leitura, [File.ReadAllText] e [StreamReader] reconhecem o BOM, se estiver presente; caso contrário, assumem UTF-8, a menos que outra codificação seja especificada (linha 40). Hoje, a regra é simples: os arquivos de texto são escritos e lidos em UTF-8;
- linha 44: os nomes dos arquivos de texto da pasta. [GetFiles] não garante a ordem dos nomes; o método do LINQ [Order] (.NET 7) os ordena;
- linha 50: exclui a pasta e seu conteúdo. O parâmetro é passado por nome, [recursive: true], o que torna a chamada mais legível que um simples [true] (argumentos nomeados, Capítulo 3).
Todos esses métodos têm versões assíncronas ([File.ReadAllTextAsync], [File.ReadAllLinesAsync]…): vamos utilizá-las no Capítulo 9, dedicado à programação assíncrona.
5.7. Arquivos binários
5.7.1. As classes BinaryWriter e BinaryReader
As classes [System.IO.BinaryWriter] e [System.IO.BinaryReader] são usadas para escrever e ler arquivos binários. Em um arquivo desse tipo, os dados não são escritos como texto, mas em sua forma interna: um [int] sempre ocupa 4 bytes, qualquer que seja seu valor.
Considere a seguinte aplicação:
O arquivo de texto [persons1.txt] tem o seguinte conteúdo:
O programa [files-04.cs] é o seguinte:
Vejamos mais de perto as operações que envolvem a classe [BinaryWriter]:
- Linha 17: o objeto [BinaryWriter] é aberto pela operação [new BinaryWriter(new FileStream(args[1], FileMode.Create, FileAccess.Write))]. O argumento do construtor deve ser um stream ([Stream]). Aqui, é um stream criado a partir de um arquivo ([FileStream]), para o qual especificamos:
- o nome;
- a operação a ser realizada, neste caso [FileMode.Create] para criar o arquivo (ou sobrescrevê-lo, se existir);
- o tipo de acesso, neste caso [FileAccess.Write] para acesso de escrita ao arquivo;
- linhas 57–58: as operações de escrita. A classe [BinaryWriter] tem métodos [Write] sobrecarregados para escrever os diversos tipos de dados simples ([int], [double], [decimal], [bool], [string]...);
- linhas 15–19: os três streams são abertos com declarações [using]. Eles serão fechados no final do bloco [try], na ordem inversa de sua abertura. O curso de 2008 os fechava em uma cláusula [finally] após verificar que não eram [null]: a declaração [using] faz o mesmo em uma única linha;
- linha 10: as instruções de nível superior podem terminar com um [return n]; n é então o código de saída do programa, que um script pode verificar (0: sucesso);
- linha 33: a opção [TrimEntries] remove os espaços ao redor do nome e da idade;
- linha 49: a idade deve ser um inteiro positivo ou zero. Graças ao comportamento de curto-circuito do operador [||], a condição [age < 0] só é avaliada se a conversão tiver sido bem-sucedida.
Os três argumentos do programa são passados após [--] no [dotnet run] comando. Os resultados são os seguintes:
O arquivo de log [logs.txt] contém o seguinte:
O conteúdo do arquivo binário [persons1.bin] pode ser exibido em hexadecimal com o comando Linux [od] (no Windows, o comando PowerShell [Format-Hex] produz uma exibição semelhante):
Isso mostra como [BinaryWriter] grava os dados:
- uma string é gravada precedida de seu comprimento em bytes: o byte 04 seguido dos 4 bytes de “paul” (70 61 75 6c);
- um inteiro [int] é gravado em 4 bytes, com o byte menos significativo primeiro: 10 é gravado como 0a 00 00 00;
- os dados são gravados um após o outro, sem separadores nem quebras de linha: o arquivo tem 44 bytes (linha 5: com a opção [-A d], [od] exibe as posições em decimal).
Para ler esse arquivo, é preciso, portanto, conhecer a ordem e o tipo exatos dos dados gravados. É isso que o programa [files-05.cs] faz; ele realiza a operação inversa: lê o arquivo binário para criar um arquivo de texto. Se o arquivo de texto resultante contiver os dados corretos do arquivo original, saberemos que a conversão texto → binário → texto foi bem-sucedida.
Vamos examinar mais de perto as operações com a classe [BinaryReader]:
- linha 15: o objeto [BinaryReader] é aberto sobre um fluxo [FileStream] usando o modo [FileMode.Open] (para abrir um arquivo existente) e o modo de acesso [FileAccess.Read] (acesso somente leitura);
- Linhas 23–24: operações de leitura. A classe [BinaryReader] fornece os métodos [ReadXX] para ler diversos tipos de dados simples: [ReadString], [ReadInt32], [ReadDouble], [ReadDecimal], [ReadBoolean]... Eles devem ser chamados na ordem das gravações;
- Linha 20: a propriedade [BaseStream] fornece o fluxo subjacente, neste caso [FileStream]. A leitura continua até que a posição atual no arquivo alcance o fim do arquivo. A versão de 2008 lia indefinidamente e detectava o fim do arquivo por meio da exceção [EndOfStreamException]: uma exceção deve permanecer excepcional, e o fim de um arquivo não é;
- linha 31: essa exceção agora sinaliza uma anomalia verdadeira: um arquivo que termina no meio de um registro.
Vamos executar o programa sobre o arquivo [persons1.bin] gerado anteriormente:
O conteúdo de [persons2.txt] é o seguinte:
Encontramos as 4 pessoas válidas do arquivo [persons1.txt]. Com um arquivo [truncated.bin] formado pelos primeiros 30 bytes de [persons1.bin], a leitura da idade de Jacques falha:
5.7.2. A serialização JSON
Gravar e ler um arquivo binário byte a byte é trabalhoso, e a menor discrepância entre a gravação e a leitura produz resultados incorretos. Geralmente é preferível serializar os objetos: convertê-los automaticamente em uma sequência de bytes ou de caracteres e, depois, desserializá-los para reconstruí-los.
O .NET oferecia a classe [BinaryFormatter] para essa finalidade, que serializava objetos em um formato binário específico do .NET. Ela agora foi removida: foi declarada obsoleta no .NET 5 e sua implementação foi removida no .NET 9, porque a desserialização de dados de origem não confiável com [BinaryFormatter] permitia a execução de código arbitrário. A Microsoft recomenda substituí-la pela serialização JSON da biblioteca [System.Text.Json], integrada ao .NET desde o .NET Core 3.0.
JSON (JavaScript Object Notation) é um formato textual, legível por humanos e universal: é o formato de troca dos serviços web (Capítulo 13) e de numerosos arquivos de configuração. Um objeto é escrito entre chaves na forma de pares "propriedade":valor, e os arrays são delimitados por colchetes.
A classe estática [System.Text.Json.JsonSerializer] tem dois métodos principais:
método | função |
[string Serialize<T>(T value, JsonSerializerOptions? options = null)] | retorna o texto JSON que representa o objeto [value] |
[T? Deserialize<T>(string json, JsonSerializerOptions? options = null)] | reconstrói um objeto do tipo [T] a partir do texto JSON [json]; lança uma [JsonException] se o texto estiver incorreto |
O programa [files-06.cs] os utiliza:
Resultados:
Comentários:
- Linha 1: uma diretiva para aplicativos de arquivo único. Por padrão, eles são configurados para compilação nativa (AOT, "ahead of time"), que produz um executável autônomo, mas desabilita os mecanismos que dependem da descoberta de tipos em tempo de execução (reflexão). Ora, [JsonSerializer] usa reflexão por padrão para descobrir as propriedades dos objetos a serem serializados: sem essa diretiva, a compilação produz avisos e a execução falha. Um projeto [.csproj] padrão, como o do aplicativo de exemplo, não tem essa restrição. Para um aplicativo compilado nativamente, [System.Text.Json] oferece um gerador de código-fonte (uma classe derivada de [JsonSerializerContext]) que gera o código de serialização em tempo de compilação: não o abordaremos aqui;
- linhas 60–63: o record [Person] a ser serializado. Suas propriedades levam o atributo [JsonPropertyName], que define o nome da propriedade no texto JSON como [name] em vez de [Name]. Em um record posicional, [property: ...] indica que o atributo se aplica à propriedade gerada e não ao parâmetro do construtor;
- linha 17: serialização de um objeto com as opções padrão: o texto é escrito em uma única linha e os caracteres não ASCII são escapados: [é] torna-se [\u00E9]. O texto continua correto, mas é difícil de ler;
- Linhas 21–26: a opção [WriteIndented] produz um texto indentado em várias linhas; a opção [Encoder] especifica quais caracteres devem ser deixados como estão — neste caso, todos os caracteres Unicode. Uma lista é serializada em um array JSON;
- linha 28: o texto JSON é salvo em um arquivo de texto: é assim que hoje se substitui a serialização binária;
- linha 34: a desserialização reconstrói a lista. [Deserialize] cria os objetos [Person] chamando o construtor do record, cujos parâmetros são associados às propriedades JSON de mesmo nome. O resultado é do tipo [List<Person>?]: o texto JSON [null] é um documento válido que resulta em [null];
- linha 42: as opções “Web” — usadas por padrão pelos serviços web do ASP.NET Core — gravam os nomes das propriedades em camelCase (primeira letra minúscula): [Code] torna-se [code], sem atributo. Na leitura, não diferenciam maiúsculas de minúsculas: [CODE] é aceito (linha 31);
- linha 52: um documento JSON inválido — neste caso, uma string onde se espera um número — dispara uma exceção [JsonException], cuja mensagem indica o local do erro.
Usaremos JSON no próximo aplicativo de exemplo e ao longo do curso.
5.8. Expressões regulares
A classe [System.Text.RegularExpressions.Regex] permite o uso de expressões regulares. Elas permitem validar o formato de uma string. Por exemplo, é possível verificar se uma string que representa uma data está de fato no formato dd/mm/aa. Para isso, usa-se um padrão e compara-se a string com esse padrão. Neste exemplo, d, m e a devem ser dígitos. O padrão de um formato de data válido é, portanto, [\d\d/\d\d/\d\d], em que o símbolo [\d] representa um dígito. Os símbolos que podem ser usados em um padrão são os seguintes:
caractere | descrição |
[\] | marca o caractere seguinte como caractere especial ou literal. Por exemplo, [n] corresponde ao caractere n, [\n] corresponde a um caractere de nova linha, [\\] corresponde a \ e [\(] corresponde a ( |
[^] | corresponde ao início da string |
[$] | corresponde ao fim da string |
[*] | corresponde ao elemento anterior zero ou mais vezes. Assim, [zo*] corresponde a z ou zoo |
[+] | corresponde ao elemento anterior uma ou mais vezes. Assim, [zo+] corresponde a "zoo", mas não a "z" |
[?] | corresponde ao elemento anterior zero ou uma vez. Por exemplo, [a?ve?] corresponde a “ve” em “lever” |
[.] | corresponde a qualquer caractere isolado, exceto o caractere de nova linha |
[(pattern)] | procura o padrão e armazena a correspondência (um grupo). A substring correspondente pode ser extraída da coleção [Groups] do resultado. Para encontrar correspondências com caracteres entre parênteses, use [\(] ou [\)] |
[x|y] | corresponde a x ou y. Por exemplo, [z|foot] corresponde a z ou foot; [(z|f)oo] corresponde a zoo ou foo |
[{n}] | n é um inteiro não negativo. Corresponde exatamente n vezes ao elemento anterior. Por exemplo, [o{2}] não corresponde ao o de Bob, mas aos dois primeiros o de fooooot |
[{n,}] | corresponde ao elemento anterior pelo menos n vezes. Por exemplo, [o{2,}] não corresponde ao 'o' de 'Bob', mas corresponde a todos os 'o' de 'fooooot'. [o{1,}] equivale a [o+], e [o{0,}] equivale a [o*] |
[{n,m}] | corresponde ao elemento anterior pelo menos n vezes e no máximo m vezes. Por exemplo, [o{1,3}] corresponde aos três primeiros “o” de “foooooot”; [o{0,1}] equivale a [o?] |
[xyz] | conjunto de caracteres: corresponde a um dos caracteres especificados. Por exemplo, [abc] corresponde à letra “a” em “plat” |
[^xyz] | conjunto negativo de caracteres: corresponde a qualquer caractere não listado. Por exemplo, [^abc] corresponde a "p" em "plat" |
[a-z] | intervalo de caracteres: corresponde a qualquer caractere do intervalo especificado, neste caso uma letra minúscula sem acento |
[^m-z] | intervalo negativo de caracteres: corresponde a qualquer caractere que não esteja entre 'm' e 'z' |
[\b] | corresponde a um limite de palavra, isto é, à posição entre um caractere de palavra e um caractere que não é de palavra. Por exemplo, [er\b] corresponde a "er" em "lever", mas não a "er" em "verb" |
[\B] | corresponde a uma posição que não é um limite de palavra. [en*t\B] corresponde a “ent” em “entertain” |
[\d] | corresponde a um dígito; equivale a [0-9] (no .NET, também para dígitos de outros alfabetos Unicode) |
[\D] | corresponde a um caractere que não é um dígito |
[\f], [\n], [\r], [\t], [\v] | correspondem, respectivamente, aos caracteres de avanço de página, nova linha, retorno de carro, tabulação e tabulação vertical |
[\s] | corresponde a qualquer espaço em branco: espaço, tabulação, avanço de página, quebra de linha… Equivale a [ \f\n\r\t\v], mais outros caracteres de espaço em branco Unicode (espaço não separável etc.) |
[\S] | corresponde a qualquer caractere que não seja um espaço em branco |
[\w] | corresponde a qualquer caractere de palavra: letra (com ou sem acento), dígito ou sublinhado |
[\W] | corresponde a qualquer caractere que não seja um caractere de palavra |
[\num] | num é um inteiro positivo: refere-se ao grupo de número num. Por exemplo, [(.)\1] corresponde a dois caracteres idênticos consecutivos |
[\xnn], [\unnnn] | corresponde ao caractere hexadecimal nn (2 dígitos) ou nnnn (4 dígitos). Por exemplo, [\x41] corresponde a A |
Um elemento em um padrão pode aparecer uma ou várias vezes. Vejamos alguns exemplos com o símbolo [\d], que representa um único dígito:
padrão | Significado |
[\d] | um dígito |
[\d?] | 0 ou 1 dígito |
[\d*] | 0 ou mais dígitos |
[\d+] | 1 ou mais dígitos |
[\d{2}] | 2 dígitos |
[\d{3,}] | No mínimo 3 dígitos |
[\d{5,7}] | entre 5 e 7 dígitos |
Imaginemos agora um padrão capaz de descrever o formato esperado para uma string:
string-alvo | padrão |
uma data no formato dd/mm/aa | [\d{2}/\d{2}/\d{2}] |
uma hora no formato hh:mm:ss | [\d{2}:\d{2}:\d{2}] |
um inteiro sem sinal | [\d+] |
uma sequência de espaços, que pode ser vazia | [\s*] |
um inteiro sem sinal que pode ser precedido ou seguido de espaços | [\s*\d+\s*] |
um inteiro que pode ter sinal e ser precedido ou seguido de espaços | [\s*[+-]?\s*\d+\s*] |
um número real sem sinal que pode ser precedido ou seguido de espaços | [\s*\d+(\.\d*)?\s*] |
um número real que pode ter sinal e ser precedido ou seguido de espaços | [\s*[+-]?\s*\d+(\.\d*)?\s*] |
uma string que contém a palavra "just" | [\bjust\b] |
O curso de 2008 usava [+|-] para o sinal: entre colchetes, o caractere [|] não tem significado específico, e esse formato aceitava também o sinal | antes de um número. Ele usava ainda [(.\d*)] para a parte decimal: o ponto sem escape ali representa qualquer caractere. Os padrões acima foram corrigidos.
Você pode especificar em que parte da string o padrão deve ser procurado:
padrão | significado |
[^pattern] | o padrão inicia a string |
[pattern$] | o padrão termina a string |
[^pattern$] | o padrão inicia e termina a string |
[pattern] | o padrão é procurado em qualquer lugar da string, a partir do início da string |
string procurada | padrão |
uma string que termina com um ponto de exclamação | [!$] |
uma string que termina com um ponto final | [\.$] |
uma string que começa com a sequência // | [^//] |
uma string formada por uma única palavra, possivelmente precedida ou seguida de espaços | [^\s*\w+\s*$] |
uma string formada por exatamente duas palavras, possivelmente precedidas ou seguidas de espaços | [^\s*\w+\s+\w+\s*$] |
uma string que contém a palavra "secret" | [\bsecret\b] |
É possível “extrair” subconjuntos de um padrão. Assim, não só podemos verificar se uma string corresponde a um determinado padrão, como também extrair dessa string os elementos correspondentes aos subconjuntos do padrão que foram colocados entre parênteses. Por exemplo, se você analisa uma string que contém uma data no formato dd/mm/aa e deseja também extrair os componentes dd, mm e aa dessa data, usaria o padrão [(\d\d)/(\d\d)/(\d\d)].
No código C#, é preferível escrever um padrão como uma string verbatim [@"..."]: assim, os numerosos caracteres [\] dos padrões não precisam ser duplicados. Com uma string comum, seria preciso escrever ***["\\\\d+"] em vez de ***[@"\\d+"].
5.8.1. Verificar se uma string corresponde a um padrão dado
Um objeto do tipo [Regex] é construído da seguinte forma:
construtor | função |
[public Regex(string pattern)] | cria um objeto de “expressão regular” a partir de um padrão passado como parâmetro ([pattern]). Uma exceção [ArgumentException] é lançada se o padrão estiver incorreto |
[public Regex(string pattern, RegexOptions options, TimeSpan matchTimeout)] | igual ao anterior, com opções e um tempo limite (veja abaixo) |
Depois de construída a expressão regular, ela pode ser comparada com strings por meio do método [IsMatch]:
método | função |
[public bool IsMatch(string input)] | true se a string [input] contiver uma substring que corresponda ao padrão da expressão regular |
O programa [regex-01.cs] é o seguinte:
Resultados:
Comentários:
- linha 4: o padrão de um inteiro sem sinal, opcionalmente cercado de espaços, que ocupa a string inteira (âncoras [^] e [$]);
- linha 9: a string “123a”, cercada de espaços, não corresponde ao padrão: o caractere “a” não pode ser um dígito nem um espaço. Sem as âncoras [^] e [$], a string corresponderia, já que ela contém um número;
- linha 19: a classe [Regex] também tem métodos estáticos que recebem o padrão como parâmetro. O .NET guarda na memória os padrões usados mais recentemente: eles podem ser usados em um laço sem receio de que o padrão seja analisado a cada chamada.
5.8.2. Encontrar todas as ocorrências de um padrão em uma string
O método [Matches] recupera os elementos de uma string que correspondem a um padrão:
método | função |
[public MatchCollection Matches(string input)] | retorna a coleção de elementos da string [input] que correspondem ao padrão |
A classe [MatchCollection] tem uma propriedade, [Count], que é o número de elementos da coleção. Se [results] for um objeto [MatchCollection], então [results[i]] é o i-ésimo elemento dessa coleção; ele é do tipo [Match]. A classe [Match] tem várias propriedades, entre elas as seguintes:
- [Value]: o valor do objeto [Match], isto é, um elemento que corresponde ao padrão;
- [Index]: a posição em que o elemento foi encontrado na string examinada.
O programa [regex-02.cs] é o seguinte:
Resultados:
Comentários:
- Linha 4: o padrão procurado é uma sequência de dígitos;
- linha 6: a string em que esse padrão é procurado;
- linha 7: todos os elementos de [sample3] que correspondem ao padrão [pattern2] são recuperados;
- Linhas 10–12: eles são exibidos. Uma [MatchCollection] é percorrida com [foreach], como uma lista;
- linha 15: [MatchCollection] implementa [IEnumerable<Match>]: aplica-se LINQ a ela. Aqui, somamos os números encontrados;
- linha 18: o método [Count] (.NET 7) conta as ocorrências do padrão sem construir uma coleção. O padrão [aeiouy] denota uma vogal.
5.8.3. Recuperando partes de um padrão
Como mencionado anteriormente, as partes de um padrão colocadas entre parênteses são armazenadas: são os grupos. O programa [regex-03.cs] os utiliza:
Resultados:
Comentários:
- Linha 8: a string [sample4] é comparada com o padrão [regex3] por meio do método [Match]. Esse método retorna a primeira ocorrência do padrão como um objeto [Match], já apresentado. Aqui, usamos duas novas propriedades dessa classe:
- [Success] (linha 9): indica se foi encontrada uma correspondência;
- [Groups] (linha 13): uma coleção em que [Groups[0]] corresponde à parte da string que representa o padrão e [Groups[i]] (i >= 1) corresponde ao i-ésimo par de parênteses;
- se [result] for do tipo [Match], então [result.Groups] é do tipo [GroupCollection] e [result.Groups[i]] é do tipo [Group]. A classe [Group] tem, como a classe [Match], as propriedades [Value] (o texto capturado pelo grupo) e [Index] (sua posição na string analisada);
- linha 24: um grupo pode ser nomeado com a sintaxe [(?<name>...)]. Aqui, o padrão reconhece uma data no formato d/m/aaaa, com dia e mês de um ou dois dígitos;
- linhas 29–31: um grupo nomeado é referenciado pelo nome e não pelo número: o código fica mais legível e não depende da ordem dos parênteses;
- linha 32: o tipo [DateOnly] (.NET 6) representa uma data sem hora. Ele é exibido no formato [dddd d MMMM yyyy]: o dia da semana aparece em inglês;
- linha 37: o método [Replace] substitui cada ocorrência do padrão por uma string em que [${name}] (ou [$1], [$2]… para grupos numerados) denota o valor de um grupo. As datas são assim reformatadas no formato ano-mês-dia.
5.8.4. Um programa de aprendizado
Encontrar a expressão regular que verifica se uma string corresponde a um determinado padrão pode, às vezes, ser um verdadeiro desafio. O programa [regex-04.cs] permite praticar. Ele recebe como entrada um padrão e uma string e indica se a string corresponde ou não ao padrão.
Comentários:
- linha 18: a expressão regular é construída com um tempo limite de um segundo: se uma busca demorar mais que isso, ela é abandonada e uma exceção [RegexMatchTimeoutException] é lançada (linha 55). Veremos adiante por que isso é útil;
- linha 20: um padrão inválido causa uma exceção [ArgumentException] (mais especificamente, [RegexParseException], que deriva dela);
- linhas 45–51: para cada correspondência, são exibidos os grupos de número 1 em diante, se houver.
Eis um exemplo da saída:
Os padrões [^\s*\d+\s*$] e [^\s*(\d+)\s*$] mostram a utilidade dos grupos: o primeiro reconhece a string “1456” precedida de três espaços, incluindo os espaços; o segundo extrai, além disso, o número sem os espaços. O padrão [(a+)+$] é examinado adiante.
5.8.5. O método Split
Já encontramos o método [Split] da classe [String]:
método | função |
[public string[] Split(params char[] separator)] | A string é tratada como uma sequência de campos separados pelos caracteres listados no array [separator]. O resultado é um array desses campos |
O método [Split] da classe [Regex] permite especificar o separador por meio de um padrão:
método | função |
[public string[] Split(string input)] | A string [input] é dividida em campos, separados por um separador que corresponde ao padrão do objeto [Regex] atual |
Suponha, por exemplo, que um arquivo de texto contenha linhas da forma campo1, campo2, ..., campon. Os campos são separados por vírgula, mas essa vírgula pode ser precedida ou seguida de espaços. O padrão [\s*,\s*] descreve esse separador exatamente, como mostra o programa [regex-05.cs]:
Resultados:
Comentários:
- linha 6: o separador: uma vírgula precedida e seguida de qualquer quantidade de espaços. Os espaços são removidos junto com o separador. Observe que a opção [TrimEntries] de [string.Split], apresentada anteriormente, agora permite obter o mesmo resultado sem expressão regular;
- Linha 13: um separador que pode assumir várias formas: um ponto e vírgula ou uma barra vertical ([;|]), ou ([|]) uma sequência de espaços ([\s+]). Aqui, uma expressão regular é necessária.
5.8.6. Expressões regulares geradas, opções, tempo limite
Um objeto [Regex] analisa seu padrão em tempo de execução e depois o traduz para uma estrutura interna que ele interpreta, ou compila em código executável se a opção [RegexOptions.Compiled] lhe for passada. A partir do .NET 7, o atributo [GeneratedRegex] permite que esse trabalho seja feito em tempo de compilação: um gerador de código-fonte escreve o código C# da busca, que pode ser visualizado no editor (F12 sobre o método). O padrão é validado em tempo de compilação, não há mais custo de análise na inicialização e o código gerado executa o mais rápido possível. Essa é hoje a forma recomendada de usar um padrão conhecido de antemão. O programa [regex-06.cs] é o seguinte:
Resultados:
Comentários:
- Linhas 39–51: cada padrão é declarado por um método estático partial ([partial]) sem corpo, que gera um [Regex], e é precedido pelo atributo [GeneratedRegex]. O gerador de código-fonte escreve o corpo do método em outra parte da classe, também declarada como [partial]. A partir do C# 13 e do .NET 9, também é possível declarar uma propriedade parcial: [[GeneratedRegex(...)] private static partial Regex Time { get; }];
- linha 5: o método é usado como um objeto [Regex] comum;
- linha 46: o segundo parâmetro do atributo é uma combinação de opções [RegexOptions]. [IgnoreCase] ignora maiúsculas e minúsculas: “YES” e “Yes” correspondem ao padrão;
- linha 17: as opções são usadas da mesma forma com os métodos de [Regex]. [Multiline] faz [^] e [$] corresponderem ao início e ao fim de cada linha da string, e não apenas ao início e ao fim da própria string. Outras opções são úteis: [Singleline] ([.] também corresponde a quebras de linha), [IgnorePatternWhitespace] (os espaços no padrão são ignorados, o que permite escrevê-lo em várias linhas, inclusive com comentários), [ExplicitCapture] (apenas os grupos nomeados são memorizados). Elas podem ser combinadas com o operador [|];
- linha 50: o padrão [^(a+)+$] é patológico: quando aplicado a uma sequência de “a” terminada por outro caractere, o mecanismo de expressões regulares tenta todas as maneiras possíveis de distribuir os “a” entre as repetições do grupo antes de concluir que falhou. O número de possibilidades dobra a cada “a” adicional: com 30 “a”, há aproximadamente um bilhão de possibilidades. Isso é conhecido como um backtracking catastrófico. Um padrão desse tipo, aplicado a strings digitadas por usuários, é uma vulnerabilidade de segurança: poucas requisições bastam para derrubar um servidor. O parâmetro [matchTimeoutMilliseconds] define um tempo limite de 100 ms: depois disso, a busca é abandonada com uma exceção [RegexMatchTimeoutException] (linha 6);
- linha 35: a opção [NonBacktracking] (.NET 7) usa um mecanismo diferente, que garante um tempo de busca proporcional ao comprimento da string. Ele não oferece suporte a certas construções (referências anteriores, como [\1], por exemplo), mas retorna um resultado imediatamente neste caso.
Observe que é preciso definir um tempo limite ou usar [NonBacktracking] sempre que o padrão ou a string pesquisada vier de fora do programa.
5.9. Aplicativo de exemplo - V3
Retomaremos o aplicativo estudado no Capítulo 3 (Versão 1) e no Capítulo 4 (Versão 2). Lembre-se de que se trata de um exercício: a tabela de imposto utilizada é a de 2004 (renda de 2003), que permanece inalterada desde o curso original.
5.9.1. Dados em um arquivo
Na versão 2, o cálculo do imposto era feito na classe abstrata [AbstractTax], que reproduzimos aqui sem alterações, exceto pelo namespace:
O método [Calculate] usa as faixas de imposto retornadas pela propriedade abstrata [TaxBrackets] (linha 7). A classe [AbstractTax] não sabe de onde vêm essas faixas: cabe às classes derivadas fornecê-las. Na versão 2, a classe derivada [HardwiredTax] as fixava diretamente no código. Uma faixa de imposto é representada, como na versão 2, pela estrutura record [TaxBracket]:
e o cálculo é descrito pela interface [ITax]:
A nova versão armazena os dados em um arquivo, o que permite alterar a tabela de faixas sem recompilar o programa. Escrevemos duas novas classes derivadas de [AbstractTax]:
- [FileTax] lê as faixas de um arquivo de texto [TaxData.txt];
- [JsonTax] as lê de um arquivo JSON chamado [TaxData.json].
O arquivo de texto [TaxData.txt] contém uma faixa de imposto por linha, no formato limite:coeffR:coeffN:
O curso de 2008 escrevia os números com vírgula decimal (0,068) e os lia com [decimal.TryParse] na localidade da máquina: o mesmo arquivo, lido em uma máquina britânica ou americana, teria sido rejeitado ou, pior, interpretado incorretamente. Um arquivo de dados não deve depender do idioma da máquina que o lê: escrevemos os números com ponto decimal e os lemos na cultura invariável ([CultureInfo.InvariantCulture]), que também é a usada pelo JSON e pela maioria dos formatos de dados.
O arquivo [TaxData.json] contém os mesmos dados, na forma de um array JSON de objetos:
5.9.2. Erros
O processamento desses arquivos pode falhar: arquivo ausente, linha malformada, número incorreto etc. Como na versão de 2008, criamos uma classe de exceção específica para relatar esses erros. O curso de 2008 a chamava de [FileTaxException]; nós a chamamos de [TaxException], já que ela também será usada para outras fontes de dados (aqui o arquivo JSON e, mais adiante, um banco de dados). Ela carrega um código de erro:
Comentários:
- linhas 16–22: a classe [TaxException] deriva da classe [Exception]. Ela será usada para relatar quaisquer erros que ocorram durante o processamento do arquivo de dados. Tem dois construtores: o primeiro recebe uma mensagem de erro e o segundo recebe também a exceção que causou o erro, que ficará disponível na propriedade [InnerException];
- Linha 19: a propriedade [Code] armazena o código de erro. A palavra-chave [init] permite que ele seja definido apenas na criação do objeto, por meio de um inicializador de objeto: [new TaxException("...") { Code = 2 }]. É essa forma de exceção, com um código inteiro, que as versões seguintes do aplicativo usarão;
- linhas 4–12: uma lista dos códigos de erro possíveis:
- [Access]: erro de acesso ao arquivo de dados;
- [Line]: linha sem os três campos esperados ou arquivo sem nenhuma faixa;
- [Field1], [Field2], [Field3]: o campo 1, 2 ou 3 de uma linha está incorreto;
- [Json]: o documento JSON está incorreto.
Alguns desses erros podem ocorrer em combinação: os três campos de uma linha podem estar incorretos. Por isso, a enumeração [ErrorCode] foi anotada com o atributo [Flags], e seus valores são potências de 2: cada um corresponde a um bit do inteiro. Um erro nos campos 2 e 3 resultará no código [Field2 | Field3], que vale 8 + 16 = 24. Graças ao atributo [Flags], o método [ToString] da enumeração exibe essa combinação na forma “Field2, Field3”.
5.9.3. A classe FileTax
A classe [FileTax] fornece as faixas lidas de um arquivo de texto:
Comentários:
- Linha 7: a classe [FileTax] deriva da classe [AbstractTax], assim como a classe [HardwiredTax] na versão 2. Ela é declarada como [partial] porque contém uma expressão regular gerada;
- linhas 10–11: a expressão regular do separador de campos em uma linha limite:coeffR:coeffN: o caractere [:], precedido e seguido de qualquer quantidade de espaços;
- linhas 14–17: as faixas lidas, retornadas pela propriedade [TaxBrackets], que redefine a propriedade abstrata de [AbstractTax];
- linha 19: o construtor recebe o nome do arquivo de texto que contém os dados. Sua função é preencher o array [taxBrackets];
- linha 22: o nome do arquivo sem o caminho, usado nas mensagens de erro. O construtor na verdade recebe um caminho completo, que não precisa ser exibido ao usuário;
- linha 24: a leitura de um arquivo de texto é sequencial: o número de linhas só é conhecido depois de lido o arquivo inteiro. Por isso, o array não pode ser dimensionado antecipadamente; as faixas são armazenadas temporariamente em uma lista;
- linha 28: o arquivo é lido linha a linha com [File.ReadLines], que abre e fecha o arquivo por conta própria. O curso de 2008 usava [StreamReader];
- linhas 38–43: a linha é dividida em campos por meio de uma expressão regular; se não houver três campos, uma exceção [TaxException] com o código [Line] é lançada. O curso de 2008 armazenava o erro em uma variável, saía do laço e lançava a exceção depois de fechar o arquivo: lançá-la imediatamente é mais simples, e [File.ReadLines] fecha o arquivo em qualquer caso, pois o laço [foreach] libera seu enumerador mesmo quando uma exceção o interrompe;
- linhas 47–55: conversão dos três campos em números decimais. Os erros são acumulados na variável [code] com o operador [|=] e depois relatados em conjunto;
- linhas 83–84: conversão de um campo. [NumberStyles.AllowDecimalPoint] permite apenas dígitos e um ponto decimal: sem sinais, espaços ou separadores de milhar. Os números negativos são, portanto, rejeitados, o que valida os dados ao mesmo tempo em que são convertidos. [CultureInfo.InvariantCulture] impõe o ponto como separador decimal, independentemente da localidade da máquina;
- linhas 62–67: os erros de acesso ao arquivo ([IOException] e suas variantes, como [FileNotFoundException], ou [UnauthorizedAccessException] para permissões insuficientes) são encapsulados em uma [TaxException] com o código [Access]. O [when (...)] filtro de exceção (C# 6) intercepta apenas essas exceções: [TaxException] lançadas dentro do laço não são interceptadas e saem do construtor inalteradas. O padrão [e is IOException or UnauthorizedAccessException] é um padrão combinado com [or] (C# 9);
- linhas 71–79: um arquivo vazio é rejeitado; caso contrário, a lista é transferida para o array de faixas, que era a finalidade do construtor.
Encapsular exceções de baixo nível ([IOException]) em uma exceção específica do aplicativo ([TaxException]) permite que o código chamador trate um único tipo de exceção, qualquer que seja a fonte de dados: um arquivo de texto, um arquivo JSON e, mais adiante no curso, um banco de dados.
5.9.4. A classe JsonTax
A classe [JsonTax] fornece as faixas lidas de um arquivo JSON:
Comentários:
- Linha 9: as opções “Web”: as propriedades JSON [limit], [coeffR] e [coeffN] correspondem às propriedades [Limit], [CoeffR] e [CoeffN] da estrutura [TaxBracket] sem necessidade de modificá-la com atributos. As opções são armazenadas em um campo estático: um objeto [JsonSerializerOptions] guarda informações sobre os tipos que processou, e é recomendável reutilizá-lo;
- linhas 25–31: leitura do arquivo; um erro de acesso é tratado como em [FileTax];
- Linha 38: uma única instrução converte o texto JSON em um array de faixas. [System.Text.Json] sabe construir uma estrutura record chamando seu construtor. Um documento inválido dispara uma [JsonException], encapsulada em uma [TaxException] de código [Json];
- linhas 48–57: a desserialização verifica o formato do documento, não a validade dos dados: resta verificar que há pelo menos uma faixa (o documento [null] ou [] é um JSON válido) e que nenhum valor é negativo. O método LINQ [Any] faz essa última verificação em uma única linha.
Comparar as duas classes é instrutivo: com um formato de dados estruturado e uma biblioteca que o compreende, a análise do arquivo não exige mais nenhum código.
5.9.5. O programa principal
O projeto de console [TaxV3] tem a seguinte estrutura de diretórios:
O arquivo de projeto [TaxV3.csproj] é o criado por [dotnet new console], ao qual foi acrescentado um grupo de elementos:
O elemento [<None Update="..." CopyToOutputDirectory="PreserveNewest" />] (linha 12) especifica que os arquivos de dados devem ser copiados para a pasta do executável ([bin/Debug/net10.0]) durante a compilação, se forem mais recentes que a cópia existente. O caractere [*] permite especificar de uma só vez todos os arquivos [TaxData*.txt] e [TaxData*.json] . Isso equivale à propriedade “Copiar para o diretório de saída” que o curso de 2008 definia nas propriedades do arquivo no Visual Studio.
O programa [Program.cs] é o seguinte:
Comentários:
- linha 14: o nome do arquivo de dados é passado como argumento; por padrão, é [TaxData.txt];
- linha 15: o arquivo é procurado na pasta do executável, [AppContext.BaseDirectory], onde foi copiado durante a compilação. Assim, o programa encontra seus dados independentemente da pasta a partir da qual é iniciado, o que não acontecia com os aplicativos de arquivo único deste capítulo;
- Linhas 22–25: uma expressão [switch] (Capítulo 3) seleciona a classe a instanciar com base na extensão do arquivo. Os dois ramos retornam tipos diferentes, [JsonTax] e [FileTax]: o compilador infere o tipo da expressão a partir da variável de destino [tax], que é do tipo [ITax] (expressão [switch] com tipo de destino). O restante do programa conhece apenas a interface [ITax] e ignora de onde vêm os dados;
- linhas 28–34: a criação do objeto pode disparar uma [TaxException], que é exibida antes de o programa terminar. O código é convertido em [ErrorCode] para ser exibido em texto legível; a exceção original, se houver, é identificada por seu tipo (sua mensagem contém o caminho completo do arquivo);
- Linhas 37–76: o laço de diálogo é exatamente o mesmo da versão 2.
5.9.6. Execuções
Com o arquivo [TaxData.txt], usado por padrão:
Os valores das versões anteriores são reproduzidos: 4.282 euros para um casal com 2 filhos, 2.959 euros com 3 filhos e 11.519 euros para uma pessoa solteira sem filhos, com um salário anual de 60.000 euros. As entradas incorretas são sinalizadas como na Versão 2.
Com o arquivo [TaxData.json]:
Com um arquivo [xx.txt] inexistente:
Com o seguinte arquivo [TaxDataInvalid.txt], em que a terceira linha usa vírgula decimal:
Os campos 2 e 3 da linha 3 são rejeitados: o código de erro é a combinação “Field2, Field3”. O campo 1 (14753), que não tem parte decimal, está correto.
Com o seguinte arquivo, [TaxDataInvalid.json], em que um coeficiente é escrito como string:
A mensagem de [JsonException] especifica o local exato do erro: a propriedade [coeffR] do segundo elemento do array ([$[1].coeffR]), [LineNumber: 2] — isto é, a terceira linha do documento, já que [System.Text.Json] numera as linhas a partir de 0.
5.10. Conclusão
Este capítulo apresentou as classes do .NET usadas em quase todos os programas:
- as strings imutáveis ([string]) e as strings mutáveis ([StringBuilder]) para construí-las aos poucos; interpolação com larguras e formatos, strings brutas; visões ([ReadOnlySpan<char>]) para código crítico;
- os arrays e a classe [Array];
- as coleções genéricas [List<T>], [Dictionary<TKey,TValue>], [HashSet<T>], [Queue<T>], [Stack<T>], [PriorityQueue<TElement,TPriority>] e suas interfaces somente leitura; as coleções não genéricas [ArrayList] e [Hashtable] estão obsoletas;
- o LINQ, suas sequências [IEnumerable<T>], seus iteradores e sua execução adiada;
- os arquivos de texto ([StreamReader], [StreamWriter], [File]), os arquivos binários ([BinaryWriter], [BinaryReader]) e a serialização JSON, que substitui a serialização binária de [BinaryFormatter], removida do .NET;
- as expressões regulares, de preferência geradas em tempo de compilação e sempre protegidas por um tempo limite ao processar dados externos.
O aplicativo de exemplo agora lê seus dados de um arquivo de texto ou JSON. O capítulo seguinte o reorganiza em camadas: a leitura dos dados, o cálculo do imposto e a interação com o usuário passarão a ser componentes independentes.