3. Fundamentos da linguagem C#
3.1. Introdução
Vamos começar tratando o C# como uma linguagem de programação tradicional. As classes serão abordadas no próximo capítulo. Em um programa, há dois componentes principais:
- os dados;
- as instruções que os manipulam.
Em geral, procuramos separar os dados das instruções:
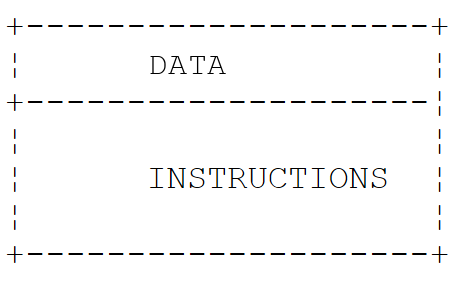
Todos os exemplos deste capítulo são aplicativos de arquivo único: um único arquivo [.cs], sem arquivo de projeto ([.csproj]), executado com o comando [dotnet run basics-01.cs]. Esse recurso, introduzido com o .NET 10, foi apresentado no capítulo anterior. Os exemplos estão na pasta [03-basics] do código do curso. Eles são executados na localidade francesa (fr-FR), como em uma máquina Windows francesa: os números reais são exibidos com vírgula decimal.
3.2. O programa mínimo
3.2.1. Instruções de nível superior
O programa [basics-01.cs] é o seguinte:
Resultados:
Comentários:
- O programa não contém nem classes nem métodos: as instruções são escritas diretamente no arquivo. Elas são chamadas de instruções de nível superior (C# 9, 2020). Um único arquivo do programa pode contê-las;
- Linha 3: o método [WriteLine] da classe [Console] imprime uma linha na tela;
- linha 5: a classe [Console] pertence ao namespace [System]. Seu nome completo é [System.Console]. Um namespace agrupa tipos relacionados, assim como uma pasta agrupa arquivos;
- linha 5: o programa dispõe de um array [args] que contém os argumentos da linha de comando. Voltaremos a isso na seção “Argumentos do programa principal”. O número de elementos do array é [args.Length]. O operador + concatena aqui uma string e um número: o número é antes convertido em string.
Com dois argumentos de linha de comando (tudo o que vem depois de [--] é passado ao programa):
3.2.2. A forma clássica com um método Main
O curso de 2008 (C# 3.0) não tratava das instruções de nível superior. O mesmo programa era escrito assim: [basics-02.cs]:
Resultados:
Comentários:
- linha 2: a diretiva [using] importa o namespace [System]. Assim, é possível escrever [Console] em vez de [System.Console];
- Linha 4: a classe é colocada no namespace [Basics]. A partir do C# 10, é possível escrever [namespace Basics;] (namespace com escopo de arquivo): o arquivo inteiro passa a pertencer a esse namespace, sem chaves nem indentação adicional. Esta é a forma que usaremos daqui em diante;
- Linha 6: em C#, todo código pertence a uma classe. Aqui, a classe se chama [Program];
- Linha 9: o método estático [Main] é o ponto de entrada do programa: é o método que o sistema executa ao iniciar. Seu parâmetro, [args], recebe os argumentos da linha de comando.
Os dois programas são equivalentes. Ao encontrar instruções de nível superior, o compilador gera uma classe e um método chamado [Main] que contêm essas instruções, além do parâmetro [string[] args]. As instruções de nível superior são, portanto, apenas uma forma abreviada da sintaxe padrão. Elas são adequadas para os programas pequenos deste capítulo; a sintaxe padrão continua útil quando se quer inspecionar a classe que contém [Main].
3.2.3. Instruções using implícitas
O programa [basics-01.cs] usa a classe [Console] sem a diretiva [using System;]. Isso é possível porque o SDK do .NET adiciona automaticamente a todo programa de console um arquivo gerado contendo diretivas [global using] (C# 10), que valem para todos os arquivos do programa. Para [basics-01.cs], esse arquivo contém:
São as instruções using implícitas: os namespaces mais usados são importados automaticamente. Um namespace que não consta dessa lista, como [System.Globalization], deve sempre ser importado com uma diretiva [using] no início do arquivo. No programa [basics-02.cs], a diretiva [using System;] é, portanto, redundante: nós a mantivemos para mostrar o formato de 2008.
3.3. Os dados em C#
O C# usa os seguintes tipos de dados:
- números inteiros;
- números reais;
- números decimais;
- caracteres e strings;
- booleanos;
- objetos.
3.3.1. Tipos de dados predefinidos
Tipo C# | Tipo .NET | Dado representado | Sufixo do literal | Codificação | Faixa de valores |
[char] | [Char] (S) | caractere | 2 bytes | caractere Unicode (UTF-16) | |
[string] | [String] (C) | string | referência a uma sequência de caracteres Unicode | ||
[int] | [Int32] (S) | número inteiro | 4 bytes | [-2³¹, 2³¹-1] ou [-2147483648, 2147483647] | |
[uint] | [UInt32] (S) | inteiro sem sinal | U | 4 bytes | [0, 2³²-1] ou [0, 4294967295] |
[long] | [Int64] (S) | número inteiro | L | 8 bytes | [-2⁶³, 2⁶³-1] ou [-9223372036854775808, 9223372036854775807] |
[ulong] | [UInt64] (S) | inteiro sem sinal | UL | 8 bytes | [0, 2⁶⁴-1] ou [0, 18446744073709551615] |
[sbyte] | [SByte] (S) | número inteiro | 1 byte | [-2⁷, 2⁷-1] ou [-128, 127] | |
[byte] | [Byte] (S) | inteiro sem sinal | 1 byte | [0, 2⁸-1] ou [0, 255] | |
[short] | [Int16] (S) | número inteiro | 2 bytes | [-2¹⁵, 2¹⁵-1] ou [-32768, 32767] | |
[ushort] | [UInt16] (S) | inteiro sem sinal | 2 bytes | [0, 2¹⁶-1] ou [0, 65535] | |
[float] | [Single] (S) | número real | F | 4 bytes | [1,5 10⁻⁴⁵, 3,4 10³⁸] em valor absoluto, 7 dígitos significativos |
[double] | [Double] (S) | número real | D | 8 bytes | [5,0 10⁻³²⁴, 1,7 10³⁰⁸] em valor absoluto, 15 a 16 dígitos significativos |
[decimal] | [Decimal] (S) | número decimal | M | 16 bytes | [1,0 10⁻²⁸, 7,9 10²⁸] em valor absoluto, 28 a 29 dígitos significativos |
[bool] | [Boolean] (S) | booleano | 1 byte | [true], [false] | |
[object] | [Object] (C) | referência de objeto | referência a um objeto de qualquer tipo |
Acima, listamos os tipos .NET equivalentes a cada tipo C#, marcados com (S) se o tipo é uma estrutura e (C) se é uma classe. Vemos que há dois nomes possíveis para um inteiro de 32 bits: [int] e [Int32]. O tipo [int] é uma palavra-chave do C#. [Int32] é uma estrutura pertencente ao namespace [System]: seu nome completo é [System.Int32]. O tipo [int] é um alias do C# que se refere à estrutura .NET [System.Int32]. Da mesma forma, o tipo C# [string] é um alias do tipo .NET [System.String]. [System.String] é uma classe, não uma estrutura. Os dois conceitos são semelhantes, mas com a seguinte diferença fundamental:
- uma variável de tipo estrutura contém diretamente o seu valor: dizemos que é um tipo de valor;
- uma variável de um tipo de classe contém o endereço do objeto (sua referência); dizemos que é um tipo de referência.
Além disso, há dois tipos menos comuns:
- [nint] e [nuint] (C# 9) são inteiros com e sem sinal cujo tamanho é o de um endereço de memória: 4 bytes em um sistema de 32 bits, 8 bytes em um sistema de 64 bits. São usados principalmente para interagir com código nativo;
- [System.Half] (.NET 5) é um número de ponto flutuante de 2 bytes e baixa precisão, usado em computação gráfica e aprendizado de máquina. Não é um tipo predefinido da linguagem: não tem palavra-chave em C#.
Uma estrutura, assim como uma classe, é um tipo complexo com propriedades e métodos. Assim, podemos escrever:
O literal 3 é, por padrão, do tipo C# [int] e, portanto, do tipo .NET [System.Int32]. Essa estrutura tem um método [GetType()] que devolve um objeto que descreve o tipo de dado. Entre as propriedades desse objeto, [FullName] é o nome completo do tipo. O literal 3 é, portanto, um objeto mais complexo do que parece à primeira vista. O ponto de interrogação em [string?] será explicado um pouco adiante.
O programa [basics-03.cs] ilustra esses vários pontos:
Resultados:
Comentários:
- linha 2: declaração de um inteiro [integer] inicializado com 2;
- linha 16: a instrução [Console.WriteLine("... {0} ... {1} ...", param0, param1, ...)] exibe na tela o texto especificado como primeiro parâmetro (o formato), substituindo cada {i} pelo valor do i-ésimo parâmetro que segue o formato. Os parâmetros são numerados a partir de 0;
- linha 17: o tipo de uma variável [v] é obtido por [v.GetType().FullName]. O tamanho em bytes de um tipo de valor predefinido [T] é obtido por [sizeof(T)];
- linha 20: como o tipo [string] se refere a uma classe e não a uma estrutura, o operador [sizeof] não pode ser usado;
- linha 33: [sizeof(nint)] não é permitido em código comum porque o tamanho de [nint] só é conhecido em tempo de execução. A propriedade [nint.Size] indica que ele tem 8 bytes na máquina de 64 bits usada;
- linha 35: não é possível escrever [Half h = 1.5;]: não existe conversão implícita de um [double] para um [Half]. A notação [(Half)] é uma conversão explícita (chamada de “cast” em inglês), que examinaremos mais adiante;
- linhas 40–42: as propriedades [MinValue] e [MaxValue] dos tipos numéricos indicam os limites de seus domínios de valores.
A saída exibe os nomes dos tipos .NET em vez dos aliases do C#. Observe a vírgula decimal nos números de ponto flutuante: os números são convertidos em strings de acordo com a localidade do sistema, neste caso a francesa.
3.3.2. Notação dos dados literais
Dado | Exemplos de literais |
[int] inteiro (32 bits) | 145, -7, 0xFF (hexadecimal), 0b1010_1010 (binário) |
inteiro [long] (64 bits), sufixo L | 100000L, 1_000_000_000_000L |
inteiro sem sinal, sufixo U ou UL | 4000000000U, 10UL |
ponto flutuante [double] | 134.789, -45E-18 (-45 × 10⁻¹⁸) |
real [float], sufixo F | 134.789F, -45E-18F |
real [decimal], sufixo M | 100000.50M |
caractere [char] | 'A', 'b', '\n', '\u00e9' |
string [string] | "today", "c:\\chap1", @"c:\chap1", $"{name} is {age} years old", """plain text""" |
booleano [bool] | [true], [false] |
data | [new DateTime(1954, 10, 13)] (ano, mês, dia) para 13/10/1954 |
No código-fonte, os números de ponto flutuante são sempre escritos com ponto decimal, qualquer que seja a localidade do sistema. Desde o C# 7, os inteiros podem ser escritos em binário (com o prefixo [0b]) e os grupos de dígitos podem ser separados pelo caractere _ para melhorar a legibilidade: [1_000_000] é o inteiro um milhão.
Um literal de string padrão pode conter sequências de escape introduzidas pelo caractere \: "\n" representa o caractere de fim de linha e não a sequência dos dois caracteres \ e n, "\t" representa uma tabulação, "\"" representa aspas duplas e "\\" representa o próprio caractere \. Para escrever o caminho do Windows c:\chap1\paragraph3, é preciso, portanto, escrever "c:\\chap1\\paragraph3". Também é possível escrever @"c:\chap1\paragraph3": a sintaxe @"texto" especifica que o texto deve ser tomado exatamente como foi escrito, sem interpretar o caractere \. Isso se chama string literal.
O C# oferece hoje dois outros tipos de strings:
- a string interpolada (C# 6) $"...": as expressões entre chaves são avaliadas e seus valores são inseridos na string. Uma expressão pode ser seguida de um especificador de formato depois dos dois-pontos: [$"{d1:F2}"] exibe o número de ponto flutuante [d1] com duas casas decimais. É a forma mais legível de construir uma string, e a usaremos daqui em diante em lugar dos formatos {0}, {1}, ...;
- A string bruta (C# 11) """...""" : começa e termina com pelo menos três aspas. Pode conter aspas e caracteres \ sem escape e pode ocupar várias linhas. Os espaços que precedem as aspas de fechamento são removidos de cada linha, o que permite indentar o texto junto com o código. É muito útil para escrever JSON, SQL ou HTML.
O programa [basics-04.cs] demonstra essas diferentes notações:
Resultados:
Comentários:
- linha 3: [0xFF] é 255 e [0b1010_1010] é 170;
- linha 7: -45E-18 é exibido como -4,5E-17: é o mesmo valor, normalizado;
- linha 12: a sequência \u00e9 designa o caractere Unicode de código hexadecimal 00E9, isto é, é;
- linha 16: uma data. O método [ToShortDateString] a exibe no formato curto usado na cultura francesa. Para uma data sem hora, o .NET 6 acrescentou o tipo [DateOnly]; voltaremos a isso no Capítulo 5;
- linhas 20–22: as duas strings são idênticas, como mostra a saída;
- linha 30: uma string interpolada. As expressões [name], [age], e [age + 10] são avaliadas e depois inseridas na string;
- linha 32: alguns formatos: F1 (uma casa decimal), X (hexadecimal), B8 (binário de 8 dígitos, .NET 8), N0 (separador de milhares, sem casas decimais);
- linha 33: um formato de data personalizado: dia da semana, dia, mês por extenso, ano;
- linhas 36–41: uma string bruta de várias linhas. As aspas e o caractere \ são escritos como estão. Os quatro espaços que precedem as aspas de fechamento foram removidos de cada linha;
- linha 44: uma string bruta interpolada. Com dois caracteres $, as expressões são escritas entre chaves duplas {{ e }}: as chaves simples, que aparecem com frequência em JSON, permanecem como texto comum.
3.3.3. Declaração de dados
3.3.3.1. Função das declarações
Um programa manipula dados caracterizados por um nome e um tipo. Esses dados são armazenados na memória. Quando o programa é compilado, o compilador atribui a cada dado um local de memória caracterizado por um endereço e um tamanho. Ele faz isso com base nas declarações feitas pelo programador. Além disso, essas declarações permitem ao compilador detectar erros de programação. Assim, a operação [x = x * 2;] será declarada inválida se [x] for uma string.
3.3.3.2. Declaração de constantes
A sintaxe para declarar uma constante é a seguinte:
Por exemplo:
Por que declarar constantes?
- O programa fica mais fácil de ler se a constante receber um nome significativo;
- fica mais fácil modificar o programa se a “constante” precisar ser alterada. Assim, se a alíquota de IVA passar para 0,25, a única modificação necessária será na instrução que define seu valor: [const double VatRate = 0.25;]. Se 0,2 tivesse sido usado explicitamente no programa, seria preciso modificar numerosas instruções.
O valor de uma constante deve ser conhecido em tempo de compilação: um número, uma string, um booleano ou uma expressão que possa ser calculada a partir de outras constantes. Por convenção, no .NET, os nomes de constantes começam com letra maiúscula.
3.3.3.3. Declaração de variáveis
Uma variável é identificada por um nome e associada a um tipo de dado. O C# distingue letras maiúsculas e minúsculas: as variáveis [END] e [end] são diferentes.
As variáveis podem ser inicializadas no momento da declaração. A sintaxe para declarar uma ou mais variáveis é:
em que [type] é um tipo predefinido ou um tipo definido pelo programador. A inicialização é opcional; no entanto, o C# não permite o uso de uma variável local que ainda não recebeu um valor.
Também é possível omitir o tipo de uma variável usando a palavra-chave [var] no lugar do tipo:
A palavra-chave [var] não significa que a variável não tenha um tipo específico: ela tem o tipo do valor que lhe é atribuído, determinado pelo compilador. A inicialização é obrigatória aqui para que o compilador possa deduzir o tipo. Usamos [var] quando o tipo é evidente a partir do valor.
O programa [basics-05.cs] é o seguinte:
Resultados:
Comentários:
- linhas 2–3: duas constantes;
- linha 8: um dado com tipo explícito;
- linha 9: [GetType().Name] é o nome curto do tipo, [GetType().FullName] é seu nome completo;
- linha 11: um valor com tipo implícito. Como 3 é do tipo [int], [j] será do tipo [int];
- linha 13: como [DateTime.Now] (a data e a hora atuais) é do tipo [DateTime], [today] será do tipo [DateTime];
- linhas 15–18: o tipo inferido depende da forma como o literal é escrito: 3.5 é um [double], 3.5F é um [float] e 10L é um [long];
- linha 21: três variáveis declaradas na mesma linha; apenas [a] e [c] são inicializadas. [b] recebe um valor na linha seguinte.
Uma variável com tipo implícito pela palavra-chave [var] não pode mudar de tipo depois. Assim, após a linha 13, não seria possível escrever:
porque [today] é do tipo [DateTime]. Veremos no Capítulo 5, com o LINQ, que é possível criar um tipo “na hora” dentro de uma expressão: é um tipo anônimo, ao qual o programador não atribuiu nome. Se um dado de tipo anônimo precisar ser atribuído a uma variável, a única maneira de declarar essa variável é usar a palavra-chave [var].
3.3.4. Tipos anuláveis
Uma variável de um tipo de valor, como [int], sempre contém um valor. Às vezes é útil poder expressar a ausência de um valor: uma idade desconhecida, um campo vazio em um banco de dados. O tipo [int?] (C# 2) é o tipo [int] ao qual se acrescentou o valor [null], que significa “sem valor”. Fala-se então em tipo de valor anulável. O princípio vale para todos os tipos de valor: [double?], [bool?], [DateTime?], ...
Uma variável de um tipo de referência, como [string], sempre pode ter o valor [null]: isso significa que ela não referencia nenhum objeto. Tentar usar um membro dessa variável — por exemplo, sua propriedade [Length] — provoca um erro em tempo de execução ([NullReferenceException]), um dos erros mais comuns em C#. A partir do C# 8, o compilador pode ajudar a evitá-lo: com os tipos de referência anuláveis — habilitados por padrão nos projetos criados com o comando [dotnet new] e nos aplicativos de arquivo único —
- o tipo [string] designa uma string que nunca vale [null];
- o tipo [string?] designa uma string que pode ser [null].
O compilador acompanha os valores possíveis das variáveis e emite um aviso quando há risco de usar o valor [null]: atribuir [null] a uma variável [string], usar [Length] em uma variável [string?] que não foi testada etc. Ao contrário de [int?], [string?] não cria um novo tipo em tempo de execução: é uma indicação destinada ao compilador.
Encontraremos esses tipos desde os primeiros exemplos, porque o método [Console.ReadLine()], que lê uma linha digitada no teclado, devolve um [string?]: ele devolve [null] quando não há mais nada a ler (fim do fluxo de entrada). O programa [basics-06.cs] é o seguinte:
Resultados ao digitar texto pelo teclado:
Resultados quando o usuário pressiona Ctrl-D (Ctrl-Z seguido de Enter no Windows), o que fecha o fluxo de entrada:
Comentários:
- linha 3: [age] não contém um valor;
- linha 4: a propriedade [HasValue] indica se a variável contém um valor; a propriedade [Value] fornece esse valor;
- linha 8: um [int?] não pode ser atribuído diretamente a um [int] , já que pode ser igual a [null]. É necessária uma conversão explícita, que lança uma exceção se [age] for igual a [null]. Trataremos mais adiante do operador [??], mais seguro;
- linha 12: uma string que pode ser igual a [null];
- linha 15: uma string que nunca é igual a [null]. Escrever [name = null;] provocaria um aviso do compilador;
- linha 20: [Console.ReadLine()] tem o tipo [string?]. Declarar [line] com o tipo [string] provocaria um aviso;
- linha 21: o valor [null] é verificado;
- linha 29: no ramo [else], o compilador sabe que [line] não é igual a [null]: ele não emite aviso para o uso de [line.Length].
3.3.5. Conversões entre números e strings
Conversão | Método |
número -> string | [number.ToString()] ou uma string interpolada [$"{number}"] |
string -> int | [int.Parse(str)] ou [int.TryParse(str, out int number)] |
string -> long | [long.Parse(str)] ou [long.TryParse(str, out long number)] |
string -> double | [double.Parse(str)] ou [double.TryParse(str, out double number)] |
string -> float | [float.Parse(str)] ou [float.TryParse(str, out float number)] |
string -> decimal | [decimal.Parse(str)] ou [decimal.TryParse(str, out decimal number)] |
A conversão de uma string em número pode falhar se a string não representar um número válido. O método [Parse] gera então um erro fatal chamado exceção. Esse erro pode ser tratado pela seguinte cláusula [try / catch]:
Se a função não lançar uma exceção, a execução prossegue para a instrução seguinte; caso contrário, vai para o corpo da cláusula [catch] e depois para a instrução seguinte. Voltaremos ao tratamento de exceções na seção dedicada a ele.
O método [TryParse] (.NET 2.0) evita a exceção: devolve o booleano [true] se a conversão tem êxito, [false] caso contrário, e armazena o número resultante em uma variável passada com a palavra-chave [out]. A partir do C# 7, essa variável pode ser declarada na própria chamada: [int.TryParse(str, out var number)]. O modo de passagem [out] será explicado na seção sobre passagem de parâmetros. Quando se esperam entradas incorretas — por exemplo, vindas do teclado —, [TryParse] é preferível a [Parse]: um erro de digitação não é uma situação excepcional.
O programa [basics-07.cs] demonstra várias técnicas de conversão entre números e strings. A função [Display] exibe na tela o valor de seu parâmetro:
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 33 34 35 36 37 38 39 40 41 42 43 44 45 46 47 48 49 50 51 52 53 54 55 56 57 58 59 60 61 62 63 64 65 66 67 68 69 70 71 72 73 74 75 76 77 78 79 80 81 82 83 84 85 86 87 88 89 90 91 92 93 94 95 96 97 98 99 100 101 102 103 104 105 106 | |
Resultados:
Comentários:
- linha 2: o namespace [System.Globalization], que contém a classe [CultureInfo], não está incluído nas instruções using implícitas;
- linhas 5–8: os dados a converter;
- linhas 11–14: todo objeto tem um método [ToString()] que o converte em string;
- linhas 25–30: a exceção que [int.Parse] pode lançar é tratada. [e.Message] é a mensagem de erro associada à exceção [e]. As mensagens de exceção do .NET estão em inglês: o .NET 10 não oferece tradução para o francês;
- linha 47: a string usa vírgula decimal, de acordo com a localidade francesa do sistema;
- linha 73: [TryParse] tem êxito e armazena 123 na variável [i2], declarada na chamada;
- linha 77: [TryParse] falha e devolve [false]; a variável [i3] recebe então o valor 0;
- linha 83: a localidade atual do programa é fr-FR;
- linha 86: na localidade francesa, o ponto não é um separador decimal: a conversão falha;
- linha 94: a localidade invariante [CultureInfo.InvariantCulture] usa o ponto decimal, qualquer que seja a máquina. Ela serve para ler e escrever números em arquivos ou em trocas entre programas, que não devem depender do idioma do usuário;
- linhas 95–96: o mesmo número convertido em string de acordo com a localidade atual (100,87) e de acordo com a localidade invariante (100.87);
- linha 97: [TryParse] também aceita uma localidade;
- linhas 103–105: uma função local. Em instruções de nível superior, não se podem escrever métodos, já que não há classes; escrevem-se, em vez disso, funções locais, que podem ser chamadas antes de serem definidas. Elas são tratadas na seção “Funções locais e tuplas”.
O curso de 2008 afirmava que os números reais em forma de string devem usar vírgula: isso só vale na cultura francesa. Um programa que lê números deve sempre saber em qual cultura eles foram escritos.
3.3.6. Arrays de dados
Um array em C# é um objeto que permite agrupar dados do mesmo tipo sob um único identificador. Ele é declarado assim:
[n] é o número de elementos de dados que o array pode conter. A sintaxe [array[i]] refere-se ao elemento de número i, em que i pertence ao intervalo [0, n-1]. Qualquer referência ao elemento [array[i]] em que i não esteja no intervalo [0, n-1] provoca uma exceção. Na criação, cada elemento do array recebe o valor padrão de seu tipo: 0 para números, [false] para booleanos e [null] para tipos de referência. Um array pode ser inicializado no momento da declaração:
ou, de forma mais simples:
ou, a partir do C# 12, com uma expressão de coleção:
Usaremos esta última forma daqui em diante. Os arrays têm uma propriedade [Length], que representa o número de elementos que contêm.
Um array bidimensional é declarado assim:
em que [n] é o número de linhas e [m] é o número de colunas. A sintaxe [array[i, j]] refere-se ao elemento j da linha i. O array bidimensional também pode ser inicializado no momento da declaração:
O número de elementos de cada dimensão é obtido com o método [GetLength(i)], em que i=0 representa a dimensão correspondente ao primeiro índice, i=1 representa a dimensão correspondente ao segundo índice, e assim por diante. O número de dimensões é obtido com a propriedade [Rank], e o número total de elementos com a propriedade [Length].
Um array de arrays (também chamado de array irregular, ou “jagged”) é declarado assim:
A declaração acima cria um array de n elementos. Cada elemento, [array[i]], é uma referência a um array unidimensional. Essas referências não são inicializadas pela declaração acima; elas têm o valor [null]. Ao contrário de um array bidimensional, cada linha pode ter um comprimento diferente.
O C# 8 introduziu duas notações práticas:
- indexação inversa: [array[^1]] é o último elemento, [array[^2]] é o penúltimo, e assim por diante. [array[^1]] equivale a [array[array.Length - 1]];
- o intervalo: [array[1..3]] é um novo array formado pelos elementos de índices 1 e 2. O índice inicial é incluído e o final é excluído. Os limites podem ser omitidos: [array[2..]] vai do índice 2 até o fim, e [array[..^1]] vai do início até o penúltimo elemento, inclusive.
O programa [basics-08.cs] combina esses diferentes arrays:
Resultados:
Comentários:
- linha 3: um array unidimensional é inicializado;
- linha 4: um laço [for] percorre os índices de 0 a [integers.Length - 1]. O laço [for] será apresentado mais adiante;
- linha 10: um array bidimensional (2 linhas, 2 colunas);
- linhas 11–13: [GetLength(0)] é o número de linhas, [GetLength(1)] é o número de colunas;
- linha 21: um array [names] com 3 elementos. Cada elemento é uma referência a um array do tipo [string[]], por enquanto [null];
- linha 24: os 3 elementos do array [names] são inicializados. [names[i]] agora referencia um array de i+1 strings;
- linha 31: [names[i][j]] é o j-ésimo elemento do array referenciado por [names[i]]. Como [names[i]] é um array, [names[i].Length] é o número de seus elementos. A expressão “name” + i + j é avaliada da esquerda para a direita: “name” + i produz uma string, à qual j é concatenado;
- linhas 44–45: arrays criados sem valores iniciais. O tipo [string?[]] é um array cujos elementos podem ser [null];
- linha 49: uma expressão de coleção;
- linha 51: o método [string.Join] constrói uma string com os elementos do array, separados pela string passada como primeiro parâmetro;
- linha 53: o último e o penúltimo elementos;
- linha 55: os elementos de índices 1 e 2;
- linhas 60–61: um intervalo cria uma cópia: modificar [slice] não modifica [values].
3.4. Instruções básicas do C#
Existem:
- instruções básicas, executadas pelo computador;
- instruções que controlam o fluxo do programa.
As instruções básicas ficam claras quando se considera a estrutura de um microcomputador e de seus periféricos:
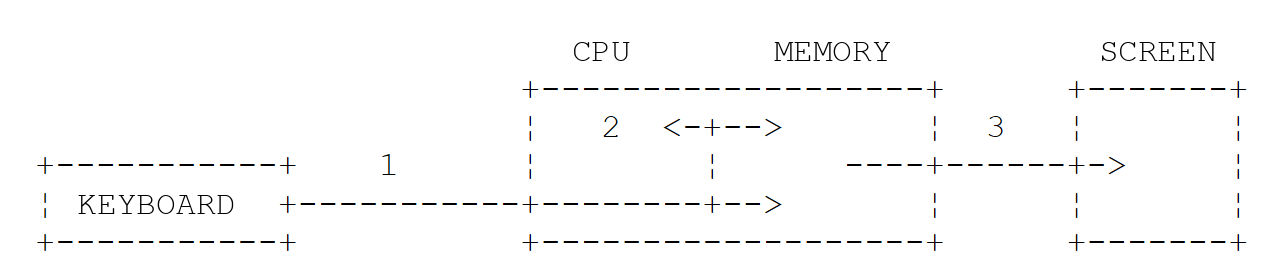
- 1: leitura de informações pelo teclado;
- 2: processamento de informações;
- 3: escrita de informações na tela.
3.4.1. Escrita na tela
Há várias instruções para escrever na tela:
em que [expression] é qualquer dado que possa ser convertido em string para exibição na tela. Todos os objetos C# ou .NET têm um método [ToString()] usado para fazer essa conversão. O método [Write] faz o mesmo que [WriteLine] sem passar para a linha seguinte.
A classe [System.Console] dá acesso às operações de escrita na tela ([Write], [WriteLine]). Ela tem duas propriedades, [Out] e [Error], que são fluxos de escrita do tipo [TextWriter]:
- [Console.WriteLine()] equivale a [Console.Out.WriteLine()] e escreve no fluxo [Out], normalmente associado à tela;
- [Console.Error.WriteLine()] escreve no fluxo [Error], que também costuma estar associado à tela.
Os fluxos [Out] e [Error] podem ser redirecionados para arquivos em tempo de execução, como veremos em breve.
3.4.2. Leitura de dados digitados no teclado
O fluxo de dados do teclado é representado pelo objeto [Console.In] do tipo [TextReader]. Esse tipo de objeto permite ler uma linha de texto com o método [ReadLine]:
A classe [Console] oferece um método, [ReadLine], que está associado por padrão ao fluxo [In]. Portanto, é possível escrever:
A linha digitada no teclado, sem o caractere de fim de linha, é armazenada na variável [line] e pode então ser processada pelo programa. Como vimos, [ReadLine] devolve [null] quando o fluxo de entrada se esgota: por isso a variável é do tipo [string?]. O fluxo [In] pode ser redirecionado para um arquivo, assim como os fluxos [Out] e [Error].
3.4.3. Exemplo de entrada/saída
O programa [basics-09.cs] ilustra operações de entrada e saída pelo teclado e pela tela:
Resultados:
Comentários:
- Linha 4: [obj] é uma referência a objeto;
- Linha 5: [obj] é exibido na tela. O método [obj.ToString()] é chamado para obter o texto a exibir;
- linha 9: o texto é escrito no fluxo [Error];
- linha 10: o mesmo, mas com um formato. O primeiro parâmetro, "i={0}", é o formato de exibição; os demais parâmetros são as expressões a exibir. Os elementos {n} são parâmetros posicionais: em tempo de execução, {n} é substituído pelo valor da n-ésima expressão;
- linhas 13–14: um prompt é exibido sem quebra de linha e, em seguida, lê-se a linha digitada no teclado;
- linha 15: em uma string interpolada, um valor como [null] produziria uma string vazia: nenhum aviso é emitido.
Nos resultados:
- linha 2: a saída gerada pela linha 5 do código. O método
*[obj.ToString()]exibiu o nome do tipo da variável*[obj]*:*[System.Object]*. O tipo [object] é um alias do C# para o tipo .NET [System.Object]*; - linhas 3–4: as duas saídas do fluxo [Error] aparecem na tela como as do fluxo [Out].
3.4.4. Redirecionamento de entrada/saída
O Windows, o Linux e o macOS reconhecem três dispositivos padrão:
- o dispositivo de entrada padrão, que por padrão corresponde ao teclado e é numerado 0;
- o dispositivo de saída padrão, que por padrão corresponde à tela e é numerado 1;
- o dispositivo de erro padrão, que por padrão também corresponde à tela e é numerado 2.
Em C#, o fluxo de escrita [Console.Out] escreve no dispositivo 1, o fluxo de escrita [Console.Error] escreve no dispositivo 2 e o fluxo de leitura [Console.In] lê dados do dispositivo 0.
Ao executar um programa em uma janela de comando, é possível especificar quais dispositivos serão 0, 1 e 2 para o programa em execução. Depois dos argumentos do programa, você pode redirecionar os dispositivos padrão de entrada e saída para arquivos:
Redirecionamento | Significado |
0<in.txt ou <in.txt | O fluxo de entrada padrão nº 0 é redirecionado para o arquivo in.txt. No programa, o fluxo [Console.In] lerá, portanto, seus dados do arquivo in.txt |
1>out.txt ou >out.txt | redireciona a saída nº 1 para o arquivo out.txt. No programa, o fluxo [Console.Out] gravará, portanto, seus dados no arquivo out.txt |
1>>out.txt ou >>out.txt | O mesmo que acima, mas os dados gravados são acrescentados ao conteúdo atual do arquivo out.txt |
2>err.txt | redireciona a saída nº 2 para o arquivo err.txt. No programa, o fluxo [Console.Error] gravará, portanto, seus dados no arquivo err.txt |
2>>err.txt | O mesmo que acima, mas os dados gravados são acrescentados ao conteúdo atual do arquivo err.txt |
1>out.txt 2>err.txt | Os dispositivos 1 e 2 são ambos redirecionados para arquivos |
Observe que, para redirecionar os fluxos de entrada/saída de um programa para arquivos, não é necessário modificá-lo: é o sistema operacional que determina a natureza dos dispositivos 0, 1 e 2. Considere o seguinte programa, [basics-10.cs]:
O curso de 2008 gerava um executável com o Visual Studio e depois o executava em uma janela do DOS. Hoje, o comando [dotnet run] é suficiente: os redirecionamentos são aplicados ao programa iniciado. Eis uma sessão em um terminal Linux (bash):
Comentários:
- linha 1: a cadeia "test" é colocada no arquivo in.txt;
- linha 2: exibe o conteúdo do arquivo in.txt para verificação;
- linha 4: executa o programa. O fluxo [In] é redirecionado para o arquivo in.txt, o fluxo [Out] para o arquivo out.txt e o fluxo [Error] para o arquivo err.txt. A execução não produz nenhuma saída;
- linhas 5–6: o conteúdo do arquivo out.txt mostra que o arquivo in.txt foi lido e que a escrita no fluxo [Out] foi redirecionada para out.txt;
- linhas 7–8: verificação semelhante para o arquivo err.txt;
- linhas 9–10: apenas o fluxo [Error] é redirecionado: a tela exibe somente a operação de escrita no fluxo [Out];
- linhas 11–12: apenas o fluxo [Out] é redirecionado: a tela exibe somente a operação de escrita no fluxo [Error].
Fica claro que os fluxos [Out] e [Error] não gravam nos mesmos dispositivos, já que podem ser redirecionados separadamente. O fluxo [Error] destina-se às mensagens de erro: isso permite redirecionar a saída de um programa para um arquivo e ainda ver suas mensagens de erro na tela.
Os operadores >, >> e 2> têm a mesma grafia no prompt de comando do Windows ([cmd]), no PowerShell e no bash. O operador < é reconhecido pelo [cmd] e pelo bash, mas não pelo PowerShell, que o reserva para uso futuro: no PowerShell, usa-se um pipe (|) para enviar um arquivo à entrada padrão de um programa. Os comandos a seguir, fornecidos a título ilustrativo (não foram executados para este curso), fazem no Windows o que a sessão bash acima faz:
3.4.5. Atribuição do valor de uma expressão a uma variável
Aqui nos interessa a operação [variable = expression;]. A expressão pode ser aritmética, relacional, booleana, de cadeia de caracteres etc.
3.4.5.1. Interpretação da operação de atribuição
A operação [variable = expression;] é ela própria uma expressão, avaliada da seguinte forma:
- o lado direito da atribuição é avaliado: o resultado é um valor V;
- o valor V é atribuído à variável;
- o valor V também é o valor da atribuição, agora vista como uma expressão.
Assim, a operação [V1 = V2 = expression] é válida. Como o operador = é avaliado da direita para a esquerda, temos [V1 = (V2 = expression)]. A expressão [V2 = expression] é avaliada e tem o valor V. Sua avaliação fez com que V fosse atribuído a V2. O próximo operador = é então avaliado como [V1 = V]. O valor dessa expressão continua sendo V; sua avaliação faz com que V seja atribuído a V1. Assim, a operação [V1 = V2 = expression] é uma expressão cuja avaliação:
- faz com que o valor de [expression] seja atribuído às variáveis V1 e V2;
- retorna o valor de [expression].
Isso pode ser generalizado para uma expressão da forma [V1 = V2 = ... = Vn = expression].
3.4.5.2. Expressões aritméticas
Os operadores usados nas expressões aritméticas são os seguintes:
Operador | Função |
+ | adição |
- | subtração |
* | multiplicação |
/ | divisão: o resultado é o quociente exato se pelo menos um dos operandos for um número real. Se ambos os operandos forem inteiros, o resultado é o quociente inteiro. Assim, 5/2 é igual a 2 e 5.0/2 é igual a 2.5 |
% | resto da divisão (módulo), qualquer que seja a natureza dos operandos. O resto tem o mesmo sinal do dividendo: -5 % 2 é igual a -1 |
Existem diversas funções matemáticas. Eis algumas:
Função | Papel |
[double Sqrt(double x)] | raiz quadrada |
[double Cos(double x)], [Sin], [Tan] | cosseno, seno, tangente (ângulo em radianos) |
[double Pow(double x, double y)] | x elevado à potência y |
[double Exp(double x)] | exponencial |
[double Log(double x)], [Log10], [Log2] | logaritmo natural, logaritmo decimal, logaritmo na base 2 |
[Abs(x)], [Max(x, y)], [Min(x, y)] | valor absoluto, máximo, mínimo (para todos os tipos numéricos) |
[Floor(x)], [Ceiling(x)], [Truncate(x)] | parte inteira inferior, parte inteira superior, truncamento |
[Round(x)], [Round(x, n)] | arredondamento para o inteiro mais próximo, para n casas decimais |
[Math.PI], [Math.E] | as constantes π e e |
Todas essas funções são definidas em uma classe .NET chamada Math. Ao utilizá-las, é preciso prefixá-las com o nome da classe em que são definidas. Assim, escreveríamos:
O curso de 2008 trazia aqui a definição completa da classe [Math]: hoje, ela pode ser encontrada na documentação on-line do .NET, learn.microsoft.com/dotnet/api/system.math.
O programa [basics-11.cs] é o seguinte:
Resultados:
Comentários:
- linha 3: a divisão de dois inteiros é uma divisão inteira;
- linha 5: o resto tem o mesmo sinal do dividendo; o operador % também se aplica a números reais;
- linha 8: dividir um número real por zero não causa erro; retorna infinito (exibido como ∞) ou o valor especial NaN (“Not a Number”) para 0/0. Já a divisão de um inteiro por zero lança uma exceção [DivideByZeroException];
- linhas 11–12: o exemplo acima;
- linha 18: [Floor] arredonda para baixo, [Ceiling] arredonda para cima, [Truncate] arredonda em direção a zero;
- linha 20: por padrão, [Math.Round] arredonda um valor exatamente no meio para o número par mais próximo (arredondamento “bancário”): 2.5 vira 2 e 3.5 vira 4;
- linha 21: para o método de arredondamento ensinado na escola (2.5 vira 3), especifique o modo de arredondamento;
- linha 25: precedência dos operadores, conforme mostrado a seguir;
- linha 29: uma atribuição múltipla.
3.4.5.3. Ordem das operações na avaliação de expressões aritméticas
A ordem das operações na avaliação de uma expressão aritmética é a seguinte (da maior para a menor prioridade):
Operadores dentro do mesmo bloco [ ] têm a mesma precedência. Em caso de igualdade de precedência, a avaliação ocorre da esquerda para a direita: 10 - 4 - 3 é avaliado como (10 - 4) - 3 = 3.
3.4.5.4. Expressões relacionais
Os operadores são os seguintes: <, <=, ==, !=, >, >=. Sua precedência é:
- >, >=, <, <=;
- ==, !=.
O resultado de uma expressão relacional é o booleano [false] se a expressão for falsa e [true] caso contrário.
Comparação de dois caracteres
Sejam C1 e C2 dois caracteres. Eles podem ser comparados com os operadores <, <=, ==, !=, >, >=. Nesse caso, são comparados seus códigos Unicode, que são números. Segundo a ordem Unicode, valem as seguintes relações:
Comparação de duas cadeias de caracteres
Elas são comparadas caractere por caractere. A primeira desigualdade encontrada entre dois caracteres resulta em uma desigualdade de mesmo sentido entre as cadeias. Considere a comparação das cadeias "Cart" e "Cat":
Essa última desigualdade permite concluir que "Cart" < "Cat." Considere agora a comparação das cadeias "Cat" e "Catkin." Elas são iguais até que a cadeia "Cat" se esgote. Nesse caso, a cadeia esgotada é declarada a "menor". Temos, portanto, a relação "Cat" < "Catkin."
Funções para comparar duas cadeias de caracteres
Você pode usar os operadores relacionais == e != para testar se duas cadeias são iguais, ou o método [Equals] da classe [System.String]. Para as relações <, <=, > e >=, os operadores não se aplicam a cadeias: é preciso usar o método [CompareTo] da classe [System.String] ou o método estático [string.Compare]. Eles retornam um inteiro:
- zero se as duas cadeias forem iguais;
- positivo se a cadeia nº 1 for maior que a cadeia nº 2;
- negativo se a cadeia nº 1 for menor que a cadeia nº 2.
Há uma sutileza: [CompareTo] e [string.Compare] não comparam simplesmente códigos Unicode. Eles seguem as regras de ordenação da cultura atual, como em um dicionário: em francês, “élan” vem antes de “face”, embora o código de ‘é’ (233) seja maior que o de ‘f’ (102). Para escolher o modo de comparação, [string.Compare] e [Equals] aceitam um parâmetro do tipo [StringComparison]:
- [StringComparison.Ordinal]: comparação caractere por caractere dos códigos Unicode. É a comparação mais rápida e deve ser usada para identificadores, palavras-chave e nomes de arquivo;
- [StringComparison.OrdinalIgnoreCase]: o mesmo que acima, ignorando maiúsculas e minúsculas;
- [StringComparison.CurrentCulture] (o padrão para [CompareTo]): segue as convenções culturais usuais de ordenação de textos destinados aos usuários.
O operador == e o método [Equals] sem parâmetros realizam uma comparação ordinal.
O programa [basics-12.cs] é o seguinte:
Resultados:
Comentários:
- linha 3: uma expressão relacional;
- linha 7: comparação de caracteres;
- linha 8: a conversão [(int)] de um caractere retorna seu código Unicode;
- linha 12: a variável [n] recebe um inteiro negativo porque "cat" < "dog";
- linha 13: a variável [equal] tem o valor [true] se as duas cadeias forem iguais e [false] caso contrário;
- Linha 15: os operadores == e != são usados para verificar se duas cadeias são iguais. Em uma interpolação de cadeia, \" representa aspas;
- linha 16: a cadeia que se esgota primeiro é a menor;
- Linhas 19–20: comparações segundo as convenções do francês: “élan” vem antes de “face” e “Cat” vem depois de “cat” (quando o número de letras é o mesmo, as minúsculas vêm antes das maiúsculas);
- linhas 22–23: comparações ordinais: o resultado aqui é a diferença entre os códigos dos primeiros caracteres distintos: 233 – 102 = 131 e 67 – 99 = –32;
- linhas 25–27: quando se ignora a diferença entre maiúsculas e minúsculas, “Cat” e “cat” são iguais.
3.4.5.5. Expressões booleanas
Os operadores que podem ser usados são E (&&), OU (||) e NÃO (!). O resultado de uma expressão booleana é um valor booleano. Precedência dos operadores:
- ! ;
- && ;
- ||.
Os operadores relacionais têm precedência maior que a dos operadores && e ||. Esses dois operadores avaliam seu operando da direita somente se necessário: em [a && b], b não é avaliado se a for falso; em [a || b], b não é avaliado se a for verdadeiro. Isso se chama “avaliação em curto-circuito”. Portanto, é seguro escrever [text != null && text.Length > 0].
3.4.5.6. Operações bit a bit
Sejam [i] e [j] dois inteiros:
Operação | Função |
i << n | Desloca i em n bits para a esquerda. Os bits que entram são zeros |
i >> n | Desloca i em n bits para a direita. Se i for um inteiro com sinal ([sbyte], [short], [int], [long]), o bit de sinal é preservado |
i >>> n | deslocamento à direita sem sinal (C# 11): os bits que entram são zeros, mesmo que i tenha sinal |
i & j | realiza o E lógico bit a bit de i e j |
i | j | realiza o OU lógico bit a bit de i e j |
~i | complementa i a 1 |
i ^ j | realiza a operação OU EXCLUSIVO sobre i e j bit a bit |
O programa [basics-13.cs] é o seguinte:
Resultados:
Comentários:
- linha 4: o formato {0:x4} exibe o parâmetro nº 0 em hexadecimal (x) com 4 dígitos (4);
- linha 7: as operações sobre os bits de um [short] resultam em um [int]; este é convertido de volta para [short] para exibir 4 dígitos hexadecimais. Sem a conversão, ~i seria exibido com 8 dígitos (ffffff9b);
- linha 10: o formato B16 exibe um inteiro binário de 16 dígitos. Verificamos, bit a bit, o E lógico de i e j;
- linha 13: o deslocamento [>>] preserva o bit de sinal de m, que é negativo; o deslocamento [>>>] preenche com zeros.
3.4.5.7. Combinação de operadores
[a = a + b] pode ser escrito como [a += b]; [a = a - b] pode ser escrito como [a -= b]. O mesmo vale para os operadores /, %, *, <<, >>, >>>, &, |, ^. Assim, [a = a / 2;] pode ser escrito como [a /= 2;].
3.4.5.8. Operadores de incremento e decremento
A notação [variable++] significa [variable = variable + 1] ou [variable += 1]. A notação [variable--] significa [variable = variable - 1] ou [variable -= 1]. Quando usados em uma expressão, esses operadores têm duas formas:
- [i++] (pós-fixado): o valor da expressão é o valor de i antes do incremento;
- [++i] (pré-fixado): o valor da expressão é o valor de i depois do incremento.
3.4.5.9. O operador ternário ?:
A expressão [expr_cond ? expr1 : expr2] é avaliada da seguinte forma:
- A expressão [expr_cond] é avaliada. Trata-se de uma expressão booleana;
- se for verdadeira, o valor da expressão é o de [expr1], e [expr2] não é avaliada;
- se for falsa, ocorre o inverso: o valor da expressão é o de [expr2], e [expr1] não é avaliada.
A operação [i = (j > 4 ? j + 1 : j - 1);] atribuirá j+1 à variável i se j > 4 e j-1 caso contrário. É o mesmo que escrever [if (j > 4) i = j + 1; else i = j - 1;], mas de forma mais concisa.
3.4.5.10. Os operadores ??, ??= e ?.
Esses operadores facilitam o trabalho com valores [null]:
- [a ?? b] (C# 2) resulta em a se a não for igual a [null]e em b caso contrário. Serve para fornecer um valor de reserva: [string name = Console.ReadLine() ?? "";]. O resultado deixa de ser anulável;
- [a ??= b] (C# 8) atribui b a a somente se a for igual a [null];
- [a?.Member] (C# 6) é [null] se a for [null]e, caso contrário, [a.Member]. Assim, [text?.Length] não causa erro quando [text] é igual a [null]; o resultado é do tipo [int?].
O programa [basics-14.cs] combina esses diferentes operadores:
Resultados:
Comentários:
- linha 4: uma expressão booleana;
- linhas 9–17: operadores combinados: 10+5=15, 15*2=30, 30/4=7 (divisão inteira), 7%4=3, 3<<2=12;
- linha 22: [j] recebe 5 e, em seguida, [i] passa a valer 6;
- linha 23: [i] passa a 7 e, em seguida, [k] recebe 7;
- linhas 30–31: dois operadores ternários;
- linha 36: [input] é igual a [null]: [name] recebe "unknown". O tipo de [name] é [string], e não [string?];
- linha 38: o operador ?? permite converter um [int?] em um [int] sem risco de exceção;
- Linhas 42–43: a primeira atribuição ocorre porque [title] é igual a [null]; a segunda atribuição não ocorre;
- linha 47: [text] é igual a [null], portanto [length] também é;
- linha 48: os operadores são combinados: se [length] for igual a [null], a cadeia "null" é exibida.
3.4.5.11. Precedência geral dos operadores
A tabela a seguir lista a precedência dos operadores, da maior para a menor:
Operadores | Associatividade |
[x.y] [x?.y] [f(x)] [a[i]] [x++] [x--] [new] [typeof] [checked] [nameof] | lr |
[+x] [-x] [!x] [~x] [++x] [--x] [^x] [(T)x] (mudança de tipo) | rl |
[x..y] (intervalo) | lr |
[switch] (expressão switch) | lr |
[*] [/] [%] | lr |
[+] [-] | lr |
[<<] [>>] [>>>] | lr |
[<] [<=] [>] [>=] [is] [as] | lr |
[==] [!=] | lr |
[&] | lr |
[^] | lr |
[|] | lr |
[&&] | lr |
[||] | lr |
[??] | rl |
[? :] (ternário) | rl |
[=] [+=] [-=] [??=] etc., [=>] | rl |
lr indica que, quando operadores têm a mesma precedência, aplica-se a precedência da esquerda para a direita: quando uma expressão contém operadores de mesma precedência, o operador mais à esquerda é avaliado primeiro. rl indica precedência da direita para a esquerda. Em caso de dúvida, não hesite em usar parênteses: eles também tornam a expressão mais legível.
3.4.5.12. Conversão de tipo (type casting)
Em uma expressão, é possível mudar temporariamente a representação de um valor. Isso se chama “conversão de tipo” (type casting). A sintaxe para mudar o tipo de um valor em uma expressão é a seguinte:
O valor passa então a ter o tipo especificado. Isso resulta em uma mudança na representação do valor. Distinguimos:
- As conversões implícitas, realizadas automaticamente pelo compilador quando não resultam em nenhuma perda de informação: de um [int] para um [long], de um [int] para um [double], de um [char] para um [int], e assim por diante. A conversão de um [long] para um [double] também é implícita, embora possa perder precisão além de 2⁵³;
- as conversões explícitas, que podem resultar em perda de informação e devem ser solicitadas explicitamente pelo programador com a notação (tipo): de um [double] para um [int] (a parte decimal é perdida), de um [long] para um [int] (os bits mais significativos são perdidos), etc.
Por padrão, um estouro em um cálculo com inteiros ou em uma conversão de inteiros não é sinalizado: o resultado é simplesmente incorreto. A palavra-chave [checked], por outro lado, faz com que um estouro lance uma exceção [OverflowException]. Ela se aplica a uma expressão, [checked(expression)], ou a um bloco de instruções, [checked { ... }].
O programa [basics-15.cs] é o seguinte:
Resultados:
Comentários:
- Linha 3: [f1] terá o valor 0. A divisão 3/4 é uma divisão inteira, pois ambos os operandos são do tipo [int]; seu resultado, 0, é então convertido em [float];
- Linha 4: [(float)i] é o valor de [i] convertido em [float]. Temos agora uma divisão entre um número real do tipo [float] e um inteiro do tipo [int]: o valor de [j] também é transformado em [float]e, em seguida, os dois números reais são divididos. [f2] tem o valor 0.75. Na operação [(float)i], [i] é um valor codificado exatamente como um número de 4 bytes, enquanto [(float)i] é o mesmo valor codificado como um número real aproximado de 4 bytes. Essa transcodificação ocorre apenas durante o cálculo: a variável [i] mantém sempre o tipo [int];
- linhas 8–9: conversões implícitas;
- linha 14: converter um número de ponto flutuante em inteiro trunca a parte decimal;
- linha 15: para arredondar, usamos [Math.Round], que fornece um [double], e depois convertemos;
- linha 18: 3 bilhões não cabem em um [int]: apenas os 32 bits menos significativos são mantidos, e o resultado deixa de fazer sentido;
- Linhas 22–23: conversões entre caracteres e códigos Unicode; a segunda é implícita;
- linha 28: o estouro de capacidade passa despercebido: obtém-se o menor [int] possível;
- linha 33: com [checked], o estouro lança uma exceção [OverflowException];
- linhas 42–45: um bloco [checked]: a conversão de [large] para [int] também lança uma exceção.
Se o estouro ocorrer em uma expressão composta apenas de constantes, como [int.MaxValue + 1], o compilador o detecta e rejeita o programa.
3.5. Instruções de controle de fluxo do programa
3.5.1. Parada
O método [Exit] da classe [Environment] permite interromper a execução de um programa:
[Exit] encerra o processo atual e devolve o controle ao processo chamador, que normalmente é o interpretador de comandos. O valor de [status], conhecido como código de retorno, pode ser utilizado pelo interpretador de comandos. Por convenção, 0 indica que o programa terminou com sucesso, enquanto qualquer outro valor indica um erro. No Windows, o código de retorno está disponível na variável [%ERRORLEVEL%] no prompt de comando e na variável [$LASTEXITCODE] no PowerShell; no Linux e no macOS, está disponível na variável [$?] do shell. Assim:
encerrará o programa com o código de retorno 0. Com instruções de alto nível, uma instrução [return] também encerra o programa (código de retorno 0), a menos que esteja dentro de uma função.
O programa [basics-16.cs] recebe seu código de retorno como argumento:
Resultados em um terminal bash:
Comentários:
- linha 4: verificamos se um argumento foi passado e se ele é um inteiro. Os argumentos do programa são descritos mais adiante;
- linha 7: se não for o caso, o programa termina com o código de retorno 1;
- linha 8: esta instrução nunca será executada, mas o compilador não sabe que [Environment.Exit] nunca devolve o controle. Sem ela, o compilador presumiria que a linha seguinte poderia ser alcançada com uma variável [code] não inicializada e rejeitaria o programa;
- linha 11: termina com o código de retorno passado como argumento. A linha seguinte não é executada;
- linhas 4–9: o comando [echo $?] exibe o código de retorno do último programa executado: 3 e depois 1.
3.5.2. Estrutura de decisão simples
Notas:
- a condição é colocada entre parênteses;
- cada ação termina com um ponto e vírgula;
- as chaves não são seguidas de ponto e vírgula;
- as chaves só são obrigatórias se houver mais de uma ação; no entanto, costumam ser usadas mesmo para uma única ação, por legibilidade e para evitar erros ao acrescentar uma ação;
- a cláusula [else] pode ser omitida;
- não existe a palavra-chave [then].
O equivalente algorítmico dessa estrutura é a estrutura se...então...senão:
Exemplo:
As estruturas de escolha podem ser aninhadas. Isso às vezes leva ao problema ilustrado pelo programa [basics-17.cs]:
Resultados:
Comentários:
- Linhas 4–8: a qual [if] se refere o [else] da linha 7? A regra é que um [else] sempre se refere ao [if] mais próximo: [if (n > 6)], linha 5. A indentação do código, que não tem efeito sobre o compilador, foi escolhida para ilustrar isso;
- linhas 12–21: aqui, queríamos colocar um [else] junto de [if (n2 > 1)], e não um [else] junto de [if (n2 > 6)]. Por causa da regra anterior, somos obrigados a colocar [if (n2 > 1) { ... }] entre chaves;
- linhas 27–41: uma sequência de escolhas mutuamente exclusivas é escrita com [else if] sucessivos. As condições são testadas em ordem; a primeira condição verdadeira determina a ação a ser executada.
3.5.3. Estrutura de casos
3.5.3.1. A instrução switch
A sintaxe é a seguinte:
Notas:
- O valor da expressão de controle em [switch] pode ser um inteiro, um caractere, uma cadeia de caracteres, um valor de enumeração etc.;
- a expressão de controle é colocada entre parênteses;
- a cláusula [default] pode estar ausente;
- os valores vi são valores possíveis da expressão. Se a expressão for avaliada como vi, as ações que seguem a cláusula [case vi] são executadas;
- a instrução [break] sai da estrutura de casos;
- cada bloco de instruções associado a um valor vi deve terminar com uma instrução de desvio ([break], [return], [throw], ...); caso contrário, o compilador informa um erro. No entanto, várias cláusulas [case] podem se suceder sem nenhuma instrução entre elas: nesse caso, compartilham as mesmas ações.
Exemplo em algoritmia:
3.5.3.2. A expressão switch
Muito frequentemente, uma estrutura de casos serve apenas para selecionar um valor. O C# 8 introduziu a expressão switch para essa finalidade:
A expressão é comparada sucessivamente com os padrões; o valor associado ao primeiro padrão correspondente é o resultado. O padrão \_ corresponde a todos os valores: funciona como um curinga. Um padrão pode ser:
- uma constante: [0], ["saturday"];
- um padrão relacional (C# 9): [< 0], [>= 18];
- uma combinação de padrões com [and], [or], e [not] (C# 9): [> 0 and <= 10], ["saturday" or "sunday"].
Esses mesmos padrões são usados com o operador [is]: [day is "saturday" or "sunday"] é verdadeiro se [day] for "saturday" ou "sunday". Veremos outras formas deles nos próximos capítulos.
O programa [basics-18.cs] é o seguinte:
Resultados:
Comentários:
- linhas 4–15: a implementação em C# do algoritmo acima;
- linha 7: nas instruções de alto nível, [return] encerra o programa;
- linhas 24–25: dois valores para as mesmas ações;
- linhas 34–38: uma expressão switch sobre uma cadeia de caracteres. Os padrões são combinados com [or];
- linha 49: o padrão [not] com o operador [is];
- linhas 53–60: duas funções locais;
- linhas 63–69: uma função local cujo corpo é uma expressão switch. A notação => substitui o corpo delimitado por chaves e a instrução [return]; fala-se em corpo de expressão. Os padrões relacionais classificam o inteiro [n].
3.5.4. Estruturas de repetição
3.5.4.1. Número conhecido de repetições
Estrutura for
A sintaxe é a seguinte:
Notas:
- os três argumentos de [for] são colocados entre parênteses e separados por pontos e vírgulas;
- cada ação de [for] termina com um ponto e vírgula;
- as chaves só são obrigatórias se houver mais de uma ação;
- a chave não é seguida de ponto e vírgula.
O equivalente algorítmico é a estrutura para:
que pode ser traduzida em uma estrutura while:
Estrutura foreach
A sintaxe é a seguinte:
Notas:
- [collection] é uma coleção enumerável de objetos. A coleção enumerável que já conhecemos é o array; veremos outras ([List<T>], [Dictionary<K, V>], ...) no Capítulo 5;
- [Type] é o tipo dos objetos da coleção. Para um array, seria o tipo dos elementos do array. Podemos escrever [var] no lugar;
- [variable] é uma variável local do laço que assumirá sucessivamente todos os valores da coleção. Ela não pode ser modificada dentro do laço.
3.5.4.2. Número desconhecido de iterações
Laço while
O laço continua enquanto a condição for verdadeira. O laço pode nunca ser executado. As notas são as mesmas de [for]. A estrutura algorítmica correspondente é a estrutura enquanto:
Laço “do while”
A sintaxe é a seguinte:
O laço continua até que a condição se torne falsa. Aqui, o laço é executado pelo menos uma vez. A estrutura algorítmica correspondente é a estrutura “repita … até que”:
Estrutura geral de laço (for)
A sintaxe é a seguinte:
O laço continua enquanto a condição for verdadeira (avaliada antes de cada iteração). As instruções [start_instructions] são executadas antes de entrar no laço pela primeira vez. As instruções [end_of_loop_instructions] são executadas após cada iteração do laço. As diversas instruções de [start_instructions] e de [end_of_loop_instructions] são separadas por vírgulas. A estrutura algorítmica correspondente é a seguinte:
3.5.4.3. Instruções de controle de laço
Instrução | Função |
[break] | Sai do laço [for], [foreach], [while], [do ... while] |
[continue] | avança para a próxima iteração dos laços [for], [foreach], [while], [do ... while] |
3.5.4.4. Exemplos
O programa [basics-19.cs] é o seguinte:
Resultados:
Comentários:
- linhas 3–30: quatro maneiras de calcular a soma dos 10 primeiros inteiros;
- linhas 4–8: um [for] clássico;
- linhas 10–13: todo o trabalho é feito nas instruções de fim de laço; o corpo do laço é vazio. O curso de 2008 usava [for (...) ;]: o C# aceita essa instrução vazia, mas o compilador emite um aviso (“possible invalid empty statement”), pois um ponto e vírgula colocado por engano após um [for] é um erro clássico. Um bloco vazio { } expressa a mesma coisa sem ambiguidade;
- linha 28: [i++] retorna o valor de [i] antes de ele ser incrementado: [i] é somado a [sum] e depois [i] é incrementado;
- linha 34: a forma mais comum de [for]: a variável do laço é declarada em [for] e existe apenas dentro do laço;
- linhas 41–42: o laço [foreach] percorre os elementos do array [friends];
- linhas 51–58: [continue] passa para a próxima iteração nos números pares; [break] encerra o laço assim que [k] ultrapassa 7;
- Linhas 66–74: um laço infinito [while (true)] que sai por meio de [break]. Essa forma é prática quando a condição de término é calculada no meio do laço. Vamos usá-la para a entrada de dados pelo teclado.
3.6. Tratamento de exceções
Muitos métodos do .NET podem lançar exceções, ou seja, erros. Quando um método pode lançar uma exceção, o programador deve tratá-la para tornar os programas mais tolerantes a erros: deve-se sempre evitar o encerramento brusco de uma aplicação.
3.6.1. A estrutura try/catch/finally
O tratamento de exceções segue este esquema:
Se o código do bloco [try] não lançar uma exceção, a execução prossegue para a instrução seguinte; caso contrário, a execução prossegue para o corpo do bloco [catch] e depois para a instrução seguinte. Observe os seguintes pontos:
- [e] é um objeto do tipo [Exception] ou de um tipo derivado. Existem muitos tipos de exceções: [IndexOutOfRangeException], [FormatException], [OverflowException], [ArgumentException]etc. Ao escrever [catch (Exception e)], você indica que deseja tratar todos os tipos de exceções. Se o código da cláusula [try] puder gerar vários tipos de exceções, convém ser mais específico, tratando a exceção com várias cláusulas [catch]:
as cláusulas [catch] são avaliadas em ordem; a primeira cujo tipo corresponde à exceção é executada. Uma cláusula [catch (Exception e)] deve, portanto, ser colocada por último;
- uma cláusula [finally] pode ser acrescentada às cláusulas [try / catch]:
Ocorrendo ou não uma exceção, o código da cláusula [finally] é sempre executado. Ela pode ser usada, por exemplo, para fechar um arquivo;
- na cláusula [catch], pode ser que você não queira usar o objeto [Exception] disponível. Em vez de escrever [catch (Exception e) { ... }], você escreveria então [catch (Exception) { ... }] ou, mais simplesmente, [catch { ... }];
- a classe [Exception] tem uma propriedade [Message] que detalha o erro ocorrido. Para exibi-la, escreva:
- A classe [Exception] tem um método [ToString] que retorna uma cadeia indicando o tipo da exceção, o valor da propriedade [Message] e a pilha de chamadas, isto é, a lista dos métodos que estavam em execução no momento do erro, com o nome do arquivo-fonte e o número da linha. Essa é a informação mais útil para o desenvolvedor, mas não se destina ao usuário. Neste curso, na maioria das vezes exibiremos o nome do tipo da exceção, [ex.GetType().Name], e sua mensagem.
3.6.2. Um primeiro exemplo
O programa [basics-20.cs] demonstra uma exceção gerada pelo acesso a um elemento inexistente de um array:
Resultados:
Comentários:
- linha 16: esta instrução lança uma exceção porque o array [tab] não tem elemento no índice 100;
- linha 20: a exceção é do tipo [System.IndexOutOfRangeException] (linha 10 dos resultados);
- linha 21: o programa termina;
- Linhas 23–25: a cláusula [finally] foi executada (linha 11 dos resultados), embora a cláusula [catch] contivesse uma instrução [return]. Observe que a cláusula [finally] é sempre executada;
- linha 27: por causa do [return], esta linha não é executada.
3.6.3. Uma entrada controlada
Eis outro exemplo, [basics-21.cs], em que tratamos a exceção causada pela conversão em inteiro de uma cadeia que não representa um inteiro:
Resultados:
Comentários:
- linha 4: se o fluxo de entrada estiver fechado, [ReadLine] retorna [null]: ele é substituído por uma cadeia vazia. A variável [name] pode, assim, ser do tipo [string];
- Linhas 8–23: o laço de entrada da idade;
- linha 15: a linha digitada no teclado é convertida em inteiro com o método [int.Parse]. Esse método lança uma exceção se a conversão não for possível. Por isso a operação foi colocada dentro de um [try / catch];
- linha 16: se esta linha for alcançada, a conversão foi bem-sucedida. Verificamos, porém, se o inteiro obtido é maior ou igual a 1;
- linha 18: se uma exceção [FormatException] for lançada, o controle passa para [catch], onde nenhuma ação é realizada. Assim, a variável booleana [ageOK], inicializada com [false], permanece em [false]. O código do curso de 2008 escrevia [catch { }], que captura todas as exceções: isso não é recomendado, pois mascara também erros que não foram previstos;
- linhas 21–23: uma mensagem de erro é exibida se a idade estiver incorreta.
Este programa tem uma fraqueza: uma idade como 99999999999 causa uma exceção [OverflowException] que não é capturada e provoca o encerramento do programa. Poderíamos acrescentar uma cláusula [catch]; no entanto, é mais simples usar [int.TryParse], como fará a aplicação de exemplo a seguir. Reservaremos as exceções para situações realmente excepcionais.
3.6.4. Várias cláusulas catch, filtros e lançamento de exceções
O próprio programa pode lançar uma exceção com a instrução [throw]:
A execução do método atual é interrompida, e a exceção é propagada pelos métodos chamadores até que uma cláusula [catch] a trate; se nenhuma o fizer, o programa termina e exibe a exceção. Em uma cláusula [catch], a instrução [throw;] (sem parâmetros) relança a exceção atual, por exemplo, após registrá-la em log.
A partir do C# 6, uma cláusula [catch] pode ser seguida de um [when (condition)] filtro: a cláusula só é executada se a condição for verdadeira. A partir do C# 7, [throw] também pode ser usado como expressão, à direita do operador ?? ou dentro de um operador ternário.
O programa [basics-22.cs] ilustra essas possibilidades:
Resultados:
Comentários:
- linha 2: entradas simuladas, algumas válidas, outras não;
- linha 7: a função local [ReadAge] pode lançar vários tipos de exceções;
- linha 11: esta cláusula trata uma [FormatException] somente se a entrada estiver vazia;
- linha 15: a outra [FormatException];
- linha 19: um número grande demais para um [int];
- linha 23: a exceção lançada pela própria [ReadAge];
- linha 35: uma expressão [throw]: se [name] for igual a [null], uma exceção [ArgumentNullException] é lançada. O operador [nameof] (C# 6) retorna o nome de uma variável como cadeia de caracteres; [ArgumentNullException] o acrescenta à sua mensagem (linha 9 dos resultados);
- Linha 52: a função [ReadAge] lança uma exceção se a idade estiver fora dos limites.
3.7. Aplicação de exemplo - V1
Queremos escrever um programa para calcular o imposto de um contribuinte. Consideraremos o caso simplificado de um contribuinte que tem apenas um salário a declarar. Os valores são extraídos da tabela do imposto de 2004 para a renda de 2003 e são usados tal como estão: trata-se de um exercício de programação, não de um cálculo de impostos atual. Esta aplicação será nosso fio condutor: voltaremos a ela nos capítulos seguintes, incorporando classes, arquivos, um banco de dados e, depois, recursos de rede.
- Calculamos o número de cotas do empregado: cotas = nbChildren/2 + 1 se ele for solteiro, nbChildren/2 + 2 se for casado, em que nbChildren é o número de filhos;
- se ele tiver pelo menos três filhos, recebe uma meia cota adicional;
- sua renda tributável R é calculada como R = 0.72 * S, em que S é seu salário anual;
- seu quociente familiar é calculado como QF = R / cotas;
- seu imposto I é calculado com a seguinte tabela:
limite | coeffR | coeffN |
4962 | 0 | 0 |
8382 | 0.068 | 291.09 |
14,753 | 0.191 | 1,322.92 |
23,888 | 0.283 | 2,668.39 |
38,868 | 0.374 | 4,846.98 |
47,932 | 0.426 | 6,883.66 |
0 | 0.481 | 9,505.54 |
Cada linha tem 3 campos. Para calcular o imposto I, procure a primeira linha em que QF seja menor ou igual ao limite. Por exemplo, se QF = 5,000, a linha encontrada será:
O imposto I é então igual a 0.068 * R - 291.09 * cotas, truncado em euros. Se QF for tal que a condição QF ≤ limite nunca seja satisfeita, usam-se os coeficientes da última linha: I = 0.481 * R - 9505.54 * cotas. O limite 0 da última linha, portanto, nunca é utilizado.
O programa C# correspondente [tax-v1.cs] é o seguinte:
Comentários:
- Linhas 5–7: os valores numéricos recebem o sufixo M para serem do tipo [decimal]. O tipo [decimal]codifica números decimais de forma exata, como 0.068; é o tipo usado em cálculos financeiros. Com um [double], 0.068 seria apenas uma aproximação binária;
- linhas 10–21: entrada do estado civil, dentro de um laço [while (true)] que sai por meio de [break] quando a resposta está correta;
- linha 14: [Console.ReadLine()] retorna a cadeia C1 como digitada no teclado, ou [null] (substituído por ""); [C1.Trim()] remove os espaços iniciais e finais de C1 e retorna a cadeia C2; [C2.ToLower()] retorna a cadeia C2 convertida em minúsculas. Assim, aceitam-se tanto Y quanto y;
- linha 15: um padrão combinado com [or];
- linha 19: as mensagens de erro são gravadas no fluxo [Error];
- linha 21: o booleano [married] recebe o valor [true] ou [false] a partir da relação [answer == "y"];
- linha 28: [TryParse] retorna [false] se a entrada não for um inteiro; a condição [nbChildren >= 0] não é então avaliada (o operador && faz curto-circuito). [TryParse] aceita uma cadeia [null]: nesse caso, retorna [false]. Diferentemente da versão de 2008, não se usam exceções;
- linha 40: o mesmo vale para o salário;
- Linha 48: não se pode simplesmente escrever nbChildren / 2: se nbChildren for igual a 3, obteríamos 3/2, uma divisão inteira que resultaria em 1, e não em 1,5. Como o divisor 2M é do tipo [decimal], a divisão é feita em [decimal]. O material do curso de 2008 usava [(decimal)nbChildren / 2], o que dá no mesmo;
- Linhas 62–65: determinação da faixa de imposto. O cálculo para no primeiro limite maior ou igual ao quociente familiar e, no máximo, na última faixa. A versão de 2008 escrevia inicialmente QF na última célula da tabela de limites para garantir a parada: isso alterava os dados da tabela do imposto; a condição [i < limits.Length - 1] evita esse efeito colateral;
- Linha 69: o imposto é truncado em euros ao convertê-lo em [int].
Eis alguns exemplos de saída:
São os mesmos resultados do curso de 2008: 4.282 euros para um contribuinte casado com 2 filhos e 2.959 euros com 3 filhos, para um salário anual de 60.000 euros. Uma pessoa solteira sem filhos e com o mesmo salário paga 11.519 euros. Na segunda execução, a entrada “60000 euros” é rejeitada: [int.TryParse] aceita apenas cadeias que representem exatamente um inteiro (espaços iniciais e finais são permitidos).
3.8. Argumentos do programa principal
A função principal [Main] pode receber como parâmetro um array de cadeias [string[]]. Esse array contém os argumentos da linha de comando usados para iniciar a aplicação. Assim, se o programa P for iniciado com o comando:
e se a função [Main] for declarada da seguinte forma:
teremos args[0]="arg0", args[1]="arg1" e assim por diante. Com instruções de alto nível, não há método [Main] escrito pelo programador, mas o array [args] está disponível da mesma forma: é o parâmetro do método [Main] gerado pelo compilador.
Com [dotnet run], os argumentos do programa são colocados após dois hifens ([--]), que os separam das opções do próprio comando [dotnet run]:
O curso de 2008 especificava os argumentos nas propriedades do projeto do Visual Studio; hoje, a linha de comando é suficiente. Eis um exemplo, [basics-23.cs]:
Resultados:
Um argumento que contém espaços deve ser colocado entre aspas:
O mesmo programa escrito com um método [Main] tradicional: [basics-24.cs]:
Resultados:
Comentários:
- linha 2: um namespace com escopo de arquivo (C# 10);
- linha 4: uma classe estática contém apenas membros estáticos;
- linha 6: o ponto de entrada do programa. Como este arquivo não contém instruções de alto nível, o compilador procura um método estático chamado [Main];
- linha 8: o restante é idêntico a [basics-23.cs].
A assinatura [static void Main()] é válida se a função [Main] não receber parâmetros. [Main] também pode retornar um [int], que passa a ser o código de retorno do programa: [static int Main(string[] args)].
3.9. Enumerações
Uma enumeração é um tipo de dados cujo domínio de valores consiste em um conjunto de constantes inteiras nomeadas. Considere um programa que precisa tratar notas de exames. Há cinco menções possíveis: Pass, FairlyGood, Good, VeryGood e Excellent. Podemos então definir uma enumeração para essas cinco constantes:
Internamente, essas cinco constantes são codificadas como inteiros consecutivos, começando em 0 para a primeira constante, 1 para a seguinte e assim por diante. Também podemos definir esses valores explicitamente: [enum Honours { Pass = 10, FairlyGood = 12, ... }]. Uma variável pode ser declarada para assumir seus valores a partir da enumeração:
Uma variável pode ser comparada com os diferentes valores possíveis da enumeração:
Assim como o tipo simples [int] equivale à estrutura [System.Int32], toda enumeração deriva da classe [System.Enum]. Essa classe tem métodos estáticos que permitem obter os valores e os nomes de um tipo enumerado:
- [Enum.GetValues<Honours>()] (.NET 5) retorna o array de valores da enumeração [Honours];
- [Enum.GetNames<Honours>()] retorna o array de seus nomes;
- [Enum.TryParse(str, out Honours m)] converte uma cadeia em um valor da enumeração.
O curso de 2008 descrevia [Enum.GetValues(typeof(Honours))]: essa forma, que ainda é válida, retorna um array sem tipo que precisa ser convertido em seguida. A forma genérica [GetValues<Honours>()] retorna diretamente um array do tipo [Honours[]].
O programa [basics-25.cs] ilustra o que acabou de ser descrito:
Resultados:
Comentários:
- linha 3: uma variável do tipo [Honours];
- linha 5: um valor de enumeração é exibido pelo seu nome;
- linhas 12–14: a lista de valores. A conversão [(int)m] retorna o valor inteiro da constante;
- linha 17: a lista de nomes;
- linha 19: a conversão inversa, de um inteiro para a enumeração;
- linha 22: a conversão de uma cadeia em um valor de enumeração. Os valores de enumeração são comparados como os inteiros que os codificam;
- linhas 27–31: as enumerações combinam bem com instruções switch;
- linha 34: o tipo inteiro subjacente é [int] por padrão;
- linha 37: a declaração da enumeração. Em um arquivo que contém instruções de alto nível, as declarações de tipos (enumerações, classes etc.) são colocadas depois das instruções.
Uma enumeração cujos valores são potências de 2 (1, 2, 4, 8, ...) pode receber o atributo [Flags]: seus valores são então combinados com o operador | (OU bit a bit) para representar um conjunto de opções, por exemplo os direitos de acesso a um arquivo (leitura | escrita).
3.10. Passagem de parâmetros a uma função
Aqui nos concentramos na maneira como os parâmetros são passados a uma função. Considere a seguinte função:
Na definição da função, na linha 1, [a] é chamado de parâmetro formal. Ele existe apenas para definir a função [ChangeInt]. Poderia muito bem ter sido chamado de [b]. Vejamos agora um exemplo de uso dessa função:
Aqui, na instrução da linha 2, [age] é o parâmetro real que passará seu valor ao parâmetro formal [a]. Interessa-nos saber como um parâmetro formal obtém o valor de um parâmetro real.
3.10.1. Modos de passagem
O C# oferece suporte aos seguintes modos de passagem:
- por valor (o modo padrão): o valor do parâmetro real é copiado para o parâmetro formal correspondente. São duas entidades distintas: se a função modificar o parâmetro formal, o parâmetro real permanece inalterado. Esse modo é adequado para os parâmetros de entrada de uma função;
- por referência com [ref]: o parâmetro real e o parâmetro formal são uma única e mesma entidade. Se a função modificar o parâmetro formal, o parâmetro real também é modificado. A palavra-chave [ref] deve aparecer tanto na definição da função quanto na chamada. O parâmetro real deve ter um valor antes da chamada. Esse modo é adequado para parâmetros de entrada e saída;
- por referência com [out]: o mesmo que [ref], mas o parâmetro é somente de saída: o parâmetro real não precisa de valor inicial, e a função deve atribuir um valor ao parâmetro formal. É o modo usado pelos métodos [TryParse]. A partir do C# 7, a variável pode ser declarada na chamada: [out var x] ou [out int x];
- por referência somente leitura com [in] (C# 7.2): o parâmetro é passado por referência, o que evita a cópia, mas a função não pode modificá-lo. Esse modo só é útil para estruturas grandes; para tipos predefinidos, a passagem por valor é igualmente eficiente.
O programa [basics-26.cs] ilustra esses diferentes modos:
Resultados:
Comentários:
- Linhas 3–5: o valor 20 do parâmetro real [age] foi copiado para o parâmetro formal [a] (linha 35). Esse parâmetro foi então modificado (linha 37). O parâmetro real permaneceu inalterado;
- linhas 8–10: com [ref], o parâmetro real [age2] acompanhou a modificação do parâmetro formal [a2];
- linhas 13–15: a variável [age3] não é inicializada antes da chamada; isso é possível com [out];
- linha 17: a variável [age4] é declarada na chamada;
- linhas 21–22: trocar dois valores exige passagem por referência; com passagem por valor, a função trocaria cópias;
- linha 27: uma passagem somente leitura. A palavra-chave [in] é opcional na chamada. O resultado 120.0 tem uma casa decimal porque o produto de dois valores [decimal] preserva as casas decimais de seus operandos: 100 × 1.2 = 120.0;
- Linhas 30–32: um array é um tipo de referência; o que é passado por valor é a referência do array. A função [ModifyArray] opera, portanto, sobre o mesmo array do chamador: a modificação feita por [t[0]] (linha 69) é visível para o chamador. Já fazer [t] apontar para outro array (linha 71) modifica apenas a cópia local da referência.
Se a linha 8 for substituída por [int age2;], o compilador rejeita o programa:
Esse problema pode ser contornado atribuindo um valor inicial a [age2]ou substituindo a palavra-chave [ref] pela palavra-chave [out]: isso indica que o parâmetro é somente de saída. Da mesma forma, se a função [InclTax] tentar modificar seu parâmetro [in]:
3.10.2. Parâmetros opcionais, argumentos nomeados, número variável de parâmetros
O C# 4 introduziu os parâmetros opcionais: um parâmetro pode receber um valor padrão na definição da função; o chamador pode então omiti-lo. Os parâmetros opcionais são colocados após os parâmetros obrigatórios. Ele também introduziu os argumentos nomeados: ao chamar a função, um parâmetro real pode ser precedido do nome do parâmetro formal seguido de dois-pontos. Isso permite omitir um parâmetro opcional que precede outros parâmetros ou fornecer os parâmetros em qualquer ordem.
A palavra-chave [params] permite escrever uma função com um número variável de parâmetros: o último parâmetro formal é um array, e o chamador pode passar um array ou uma lista de valores (que pode estar vazia), que o compilador organiza em um array. A partir do C# 13, o parâmetro [params] também pode ser de outro tipo de coleção, como [List<T>] ou [ReadOnlySpan<T>].
O programa [basics-27.cs] é o seguinte:
Resultados:
Comentários:
- Linha 17: a função [Greet] tem um parâmetro obrigatório, [name], e dois parâmetros opcionais, [greeting] e [uppercase];
- Linha 3: ambos os parâmetros opcionais assumem seus valores padrão;
- linha 4: apenas [uppercase] assume seu valor padrão;
- linha 6: com o argumento nomeado, passamos [uppercase] sem passar [greeting];
- linha 7: com argumentos nomeados, a ordem é arbitrária;
- linha 23: [Sum] aceita qualquer quantidade de inteiros;
- linhas 10–13: [Sum] é chamada sem nenhum parâmetro, com três inteiros e depois com um array;
- Linha 15: muitos métodos do .NET, como [string.Join] ou [Console.WriteLine] com um formato, têm um parâmetro [params].
3.11. Funções locais e tuplas
3.11.1. Funções locais
Uma função local (C# 7) é uma função definida dentro de um método ou, como em nossos exemplos, entre instruções de nível superior. Ela só pode ser usada nesse local. Como nossos programas não têm mais classes, as funções locais substituem os métodos estáticos dos exemplos de 2008. Uma função local:
- pode ser chamada antes de ser definida;
- pode usar as variáveis locais que a cercam, a menos que seja declarada como [static]: a palavra-chave [static] (C# 8) garante que ela dependa apenas de seus parâmetros, o que facilita a compreensão. Declaramos nossas funções locais como [static] sempre que possível;
- pode ter um corpo de expressão: [static int Square(int x) => x * x;] equivale a um corpo como [{ return x * x; }].
Em um programa maior, escrevemos classes e métodos: esse é o assunto do próximo capítulo.
3.11.2. Tuplas
Uma tupla (C# 7) agrupa vários valores, que podem ser de tipos diferentes, em uma única entidade. O tipo [(int, string)] designa um par formado por um inteiro e uma cadeia; seus elementos são chamados [Item1] e [Item2]. Eles podem receber nomes: [(int Number, string Name)]. Uma tupla pode ser desconstruída: [var (number, name) = t;] atribui seus elementos a duas variáveis.
As tuplas permitem que uma função retorne vários valores sem usar parâmetros [out]: isso costuma ser mais legível.
O programa [basics-28.cs] é o seguinte:
Resultados:
Comentários:
- linha 3: uma função local estática com corpo de expressão;
- linhas 7–8: uma função local não estática: ela modifica a variável do programa [counter];
- linha 14: uma tupla cujos elementos não têm nome. Quando uma tupla é impressa, seus elementos aparecem entre parênteses;
- linhas 17–18: duas tuplas com elementos nomeados: a primeira pelo seu tipo, a segunda pelos nomes dados na expressão;
- linha 21: a decomposição da tupla [t3];
- linha 25: a função [Divide] retorna o quociente e o resto da divisão inteira; o resultado é decomposto diretamente;
- linha 27: aqui, a tupla é mantida, e são usados os nomes de seus elementos, [Min] e [Max];
- linha 30: a partir do .NET 6, [Math.DivRem] também retorna uma tupla (quociente, resto);
- linha 35: a troca de duas variáveis pode ser escrita em uma única linha usando uma tupla, sem variável temporária;
- linha 38: o tipo retornado pela função é uma tupla nomeada;
- linhas 40–48: uma função que calcula o mínimo e o máximo de um array em uma única passagem.