8. Hilos de ejecución
Este capítulo presenta la ejecución simultánea de varios fragmentos de código dentro de un mismo programa: los hilos (hilos de ejecución) y las herramientas que sirven para sincronizarlos. En 2008, la mayoría de las máquinas tenían un solo procesador, y el paralelismo era en gran medida una ilusión mantenida por el sistema operativo. Hoy en día, incluso la computadora portátil más básica tiene varios núcleos: varios hilos se ejecutan realmente al mismo tiempo, lo que hace aún más frecuentes los problemas de sincronización que se tratan aquí.
Los ejemplos son aplicaciones de un solo archivo ([dotnet run threads-01.cs]) ubicadas en la carpeta [08-threads]. Tenga en cuenta que las directivas [using] implícitas de estas aplicaciones incluyen [System.Threading] y [System.Threading.Tasks]: las clases [Thread], [Lock], [Mutex], [Monitor], [Interlocked], [Task]… pueden utilizarse sin la directiva [using].
Una advertencia antes de comenzar: los resultados de un programa multihilo varían de una ejecución a otra. El orden en que se asigna el procesador a los hilos depende del sistema operativo, del número de procesadores y de la carga de la máquina. Los resultados mostrados en este capítulo se obtuvieron en una máquina Linux de dos procesadores compartida con otros programas. Si usted ejecuta los ejemplos, obtendrá resultados similares, pero rara vez idénticos.
8.1. La clase Thread
Cuando se inicia una aplicación, se ejecuta en un flujo de ejecución llamado hilo. La clase de .NET que modela un hilo es la clase [System.Threading.Thread]. Sus principales constructores, propiedades y métodos son los siguientes:
Miembro | Función |
[Thread(ThreadStart start)] | crea un hilo que ejecutará el método [start]. El delegado [ThreadStart] hace referencia a un método sin parámetros y sin valor de retorno: [void M()] |
[Thread(ParameterizedThreadStart start)] | igual que el anterior, pero con un método que tiene un parámetro de tipo [object?]: [void M(object? obj)] |
[static Thread CurrentThread] | el hilo que ejecuta el código que solicitó esta propiedad |
[string? Name] | el nombre del hilo, útil para el seguimiento |
[int ManagedThreadId] | un identificador numérico único del hilo |
[bool IsBackground] | indica si el hilo es un hilo en segundo plano (véase más adelante) |
[bool IsAlive] | indica si el hilo se está ejecutando actualmente |
[void Start()], [void Start(object? obj)] | inicia la ejecución del hilo, pasándole opcionalmente información de tipo [object] |
[void Join()], [bool Join(TimeSpan timeout)] | El hilo T1, que ejecuta [T2.Join()], se bloquea hasta que el hilo T2 haya terminado. La segunda forma limita la duración de la espera |
[static void Sleep(int ms)] | El hilo que ejecuta el método se suspende durante [ms] milisegundos. Pierde la CPU, que se asigna a otro hilo |
El curso de 2008 también trataba el método [Abort], que terminaba forzosamente un hilo. En la práctica ya no existe: desde .NET Core, lanza la excepción [PlatformNotSupportedException]. Detener bruscamente un hilo podía dejar los datos que manejaba en un estado inconsistente. Hoy en día, se le pide a un hilo que se detenga de manera cooperativa, mediante un token de cancelación ([CancellationToken]) que el hilo verifica regularmente: lo veremos en el próximo capítulo.
Esta es una primera aplicación que demuestra la existencia de un hilo de ejecución principal, el que ejecuta las instrucciones de nivel superior del programa (el equivalente del método [Main]). El programa [threads-01.cs] es el siguiente:
Resultados:
Comentarios:
- Línea 4: se obtiene una referencia al hilo que ejecuta el programa;
- Líneas 5–9: se muestra su nombre, se modifica y luego se vuelve a mostrar. Inicialmente, el hilo principal no tiene nombre (línea 2 de los resultados);
- líneas 11–15: algunas propiedades del hilo. El hilo principal tiene el ID 1; es un hilo en primer plano ([IsBackground] es igual a [False]) que no pertenece a la agrupación de hilos (thread pool) (trataremos estos dos conceptos más adelante); se está ejecutando actualmente ([Running]);
- Línea 16: la máquina que ejecutó el ejemplo tiene 2 procesadores;
- líneas 19–23: un bucle que muestra un mensaje cada segundo. [Thread.Sleep(1000)] suspende el hilo principal durante un segundo. El curso de 2008 utilizaba aquí un bucle infinito que se terminaba con Ctrl-C; nosotros nos limitamos a cinco impresiones. Observe el formato [HH:mm:ss] (horas de 0 a 23): el curso de 2008 utilizaba [hh], que muestra las horas de 1 a 12.
8.2. Creación de hilos de ejecución
Es posible tener aplicaciones en las que fragmentos de código se ejecutan "simultáneamente" en distintos hilos de ejecución. Si la máquina tiene menos procesadores que hilos listos para ejecutarse, los hilos comparten los procesadores: cada uno utiliza un procesador por turnos durante un breve lapso (unos pocos milisegundos). En una máquina multiprocesador, varios hilos se ejecutan realmente al mismo tiempo. El tiempo asignado a un hilo depende de varios factores, entre ellos su prioridad, que tiene un valor predeterminado pero puede establecerse por programa (propiedad [Priority]). Un hilo que tiene el procesador puede liberarlo antes de tiempo:
- al esperar un evento (la finalización de otro hilo con [Join], la espera de una señal);
- al entrar en estado de suspensión durante un tiempo determinado ([Sleep]).
Primero se crea un hilo T con uno de los constructores presentados anteriormente, por ejemplo:
donde [Display] es un método con una de las dos firmas siguientes:
Crear un hilo no lo inicia:
- la ejecución del hilo T se inicia con [T.Start()]: el método pasado al constructor de T es entonces ejecutado por el hilo T. El código que ejecuta la instrucción [T.Start()] no espera a que el hilo T termine; pasa inmediatamente a la siguiente instrucción. Tenemos entonces dos hilos en ejecución paralela. A menudo necesitan comunicarse entre sí para seguir el avance del trabajo compartido: este es el problema de la sincronización de hilos;
- Una vez iniciado, el hilo T se ejecuta de forma autónoma. Se detiene cuando el método que ejecuta termina;
- podemos esperar a que termine de ejecutarse mediante [T.Join()]. Esta es una instrucción bloqueante: el hilo que la ejecuta se bloquea hasta que el hilo T haya terminado su trabajo. Es un método básico de sincronización.
El programa [threads-02.cs] es el siguiente:
Comentarios:
- línea 4: le damos un nombre al hilo principal;
- líneas 7–15: se crean e inician 5 hilos. Sus referencias se almacenan en un arreglo para poder recuperarlas más adelante. Cada hilo ejecuta el método [Display] de las líneas 22–29;
- línea 11: el nombre del método [Display] se convierte automáticamente en un delegado de tipo [ThreadStart] (los delegados se introdujeron en el capítulo anterior);
- línea 15: se lanza el hilo n.º i. Esta operación no es bloqueante: el hilo n.º i se ejecuta en paralelo con el hilo principal que lo lanzó;
- línea 19: el hilo principal llega al final del programa;
- líneas 22–29: el método [Display] muestra el nombre y el ID del hilo que lo ejecuta, así como las horas de inicio y de fin (al milisegundo) de la ejecución;
- línea 28: todo hilo que ejecuta el método [Display] hace una pausa de 1 segundo. El procesador se cede entonces a otro hilo que espera el procesador. Al final de la pausa de 1 segundo, el hilo en pausa vuelve a ser elegible para obtener el procesador. Lo obtendrá cuando le llegue su turno.
Resultados:
Estos resultados son muy instructivos:
- En primer lugar, vemos que lanzar un hilo no es bloqueante. El hilo principal lanzó 5 hilos y llegó al final del programa (línea 4) aunque tres de los hilos lanzados aún no habían mostrado su primer mensaje;
- el orden en que se ejecutan los hilos es impredecible: en esta ejecución, los hilos 2 y 4 mostraron sus mensajes de inicio antes que el hilo 0. Aquí el sistema operativo tiene 6 hilos y 2 procesadores; asigna los procesadores a estos hilos según sus propias reglas;
- También observamos que el orden de las impresiones no siempre sigue el orden de las horas mostradas: la hora se calcula antes de mostrarse, y mientras tanto otro hilo puede haber escrito en la consola. [Console.WriteLine] es seguro para hilos (thread-safe): dos líneas escritas por dos hilos no se mezclan, pero su orden no está garantizado;
- cada hilo hace una pausa de un segundo con [Sleep] y luego termina de ejecutar el método [Display];
- Por último, el programa no se detuvo cuando el hilo principal terminó su trabajo: el proceso esperó a que los 5 hilos terminaran. Esto se debe a que estos hilos son hilos en primer plano: un proceso de .NET termina cuando todos sus hilos en primer plano han terminado.
A la inversa, un hilo puede declararse como hilo en segundo plano asignando [true] a su propiedad [IsBackground] antes de lanzarlo. Los hilos en segundo plano no impiden que el proceso termine: cuando termina el último hilo en primer plano, se detienen. El programa [threads-03.cs] es el siguiente:
Comentarios:
- línea 14: los 5 hilos son hilos en segundo plano. Las propiedades [Name] e [IsBackground] se establecen mediante un inicializador de objeto;
- línea 20: el hilo principal espera 100 ms para darles tiempo a los hilos de iniciarse y luego termina.
Resultados:
Los 5 hilos comenzaron su ejecución y luego el hilo principal terminó (línea 7). Los hilos en segundo plano se detuvieron entonces durante su pausa de un segundo: no se muestra ningún mensaje de fin. El curso de 2008 lograba el mismo resultado terminando [Main] con [Environment.Exit(0)], una instrucción que detiene todos los hilos de la aplicación, no solo el que la ejecuta. Los hilos de la agrupación de hilos, de los que hablaremos más adelante, son hilos en segundo plano.
Si el hilo principal desea esperar a que terminen los hilos que creó, utiliza el método [Join]. El programa [threads-04.cs] también demuestra otra forma de especificar el código que debe ejecutar un hilo: una lambda.
Comentarios:
- Línea 13: el hilo ejecuta la lambda [() => Display(number, 1000 + 100 * number)]. Una lambda sin parámetros y sin valor de retorno es compatible con el delegado [ThreadStart]. Esta sintaxis permite llamar a un método con parámetros tipados (en este caso, dos [int]) en lugar de la firma impuesta [void M(object? obj)];
- Línea 11: la lambda utiliza una copia de la variable de bucle [i]. Esto es esencial: una lambda captura la variable, no su valor. En un bucle [for], la variable [i] es única para todas las iteraciones; si la lambda utilizara [i], un hilo que arranque tarde podría leer el valor de [i] de una iteración posterior, o incluso el valor final 5. En cambio, la variable [number], declarada dentro del cuerpo del bucle, es una variable nueva en cada iteración (la variable de un bucle [foreach] también es nueva en cada iteración, a partir de C# 5);
- líneas 18–21: el hilo principal espera a cada uno de los hilos. Primero se bloquea esperando al hilo 0, luego al hilo 1, y así sucesivamente. Al salir del bucle, los 5 hilos que lanzó han terminado;
- línea 31: la tarea n.º i duerme 1000 + 100 × i milisegundos, de modo que los hilos terminen en un orden conocido.
Resultados:
La última línea muestra que el hilo principal terminó después de los hilos que había lanzado, en el momento en que terminó el último de ellos.
8.3. Las ventajas de los hilos
Ahora que hemos puesto de relieve la existencia de un hilo predeterminado (el que ejecuta el programa principal) y sabemos cómo crear hilos adicionales, veamos las ventajas de los hilos. Tienen dos usos principales:
- aprovechar todos los procesadores de la máquina para un cálculo que consume mucho tiempo: el trabajo se divide en fragmentos asignados a distintos hilos. Lo haremos con la biblioteca [Parallel] al final de este capítulo;
- realizar varias tareas simultáneamente, en particular cuando algunas de ellas consisten principalmente en esperar (una respuesta de la red, una lectura de disco o una entrada del usuario). Es el caso de las aplicaciones de Internet cliente/servidor, que trataremos en un capítulo posterior.
En una aplicación de Internet cliente/servidor, un servidor ubicado en una máquina llamada S1 responde a las solicitudes de clientes ubicados en máquinas remotas C1, C2, ..., Cn:
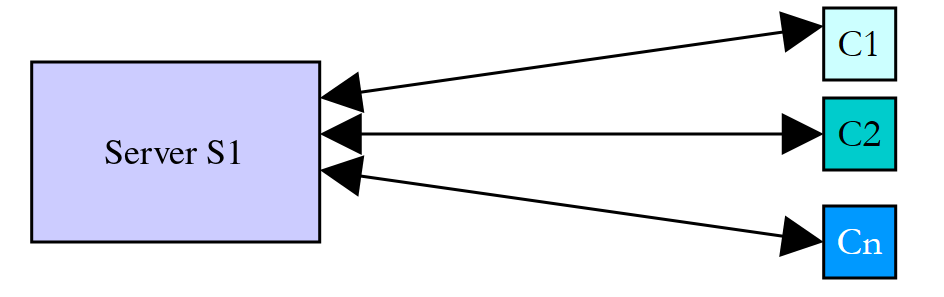
Utilizamos todos los días aplicaciones de Internet que siguen este esquema: servicios web, correo electrónico, transferencia de archivos, etc. En el diagrama anterior, el servidor S1 debe atender a los clientes Ci simultáneamente. Si tomamos el ejemplo de un servidor de archivos, sabemos que una transferencia a veces puede durar varios minutos. Es impensable que un solo cliente monopolice el servidor durante un lapso tan largo. Una solución habitual es que el servidor cree tantos hilos de ejecución como clientes haya. Cada hilo se encarga entonces de atender a un cliente específico:
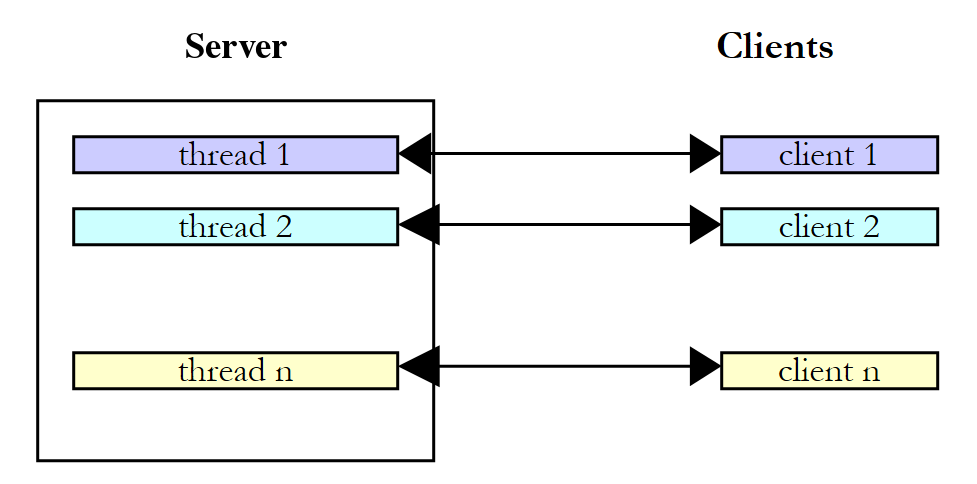
En la práctica, el servidor utiliza una agrupación de hilos con un número limitado de hilos, como se describe más adelante. Los servidores modernos van un paso más allá: mientras un cliente espera una respuesta de la red, no se reserva ningún hilo para él. Esto es posible gracias a la programación asíncrona, que es el tema del próximo capítulo.
8.4. Intercambio de información entre hilos
En los ejemplos anteriores, los hilos ejecutaban un método sin parámetros. El constructor [Thread(ParameterizedThreadStart)] acepta un método con la firma [void M(object? obj)]. Esto permite pasar información al hilo lanzado:
lanza el hilo [t], que ejecuta entonces el método asociado a él por construcción, pasándole el parámetro real [obj1]. El programa [threads-05.cs] es el siguiente:
Comentarios:
- Líneas 46–52: la información pasada a los hilos es un objeto [Data]. Hay un intercambio bidireccional de información entre el hilo que lanza y el hilo lanzado. [Start] y [Duration] son propiedades [init]: solo pueden establecerse al crear el objeto:
- [Start]: la hora de inicio de la ejecución del hilo, establecida por el hilo que lanza;
- [Duration]: duración en segundos de la pausa del hilo lanzado, establecida por el hilo que lanza;
- [End]: la hora de fin de la ejecución del hilo, establecida por el hilo lanzado;
- línea 12: cada hilo se asocia al método [Sleep] de las líneas 32–42, cuya firma [void Sleep(object? state)] corresponde al delegado [ParameterizedThreadStart];
- líneas 14–16: se crea un objeto [Data], se almacena en el arreglo [data] y luego se pasa al método [Start], que lanza el hilo;
- líneas 20–26: el hilo principal espera a que termine cada uno de los hilos que lanzó, luego recupera el objeto [data[i]] del hilo n.º i y muestra su contenido;
- línea 35: el parámetro recibido es de tipo [object?]; el filtro por patrón [state is not Data info] verifica su tipo real y lo almacena en la variable tipada [info]. El curso de 2008 realizaba una conversión de tipo (cast) a [(Data)state], que lanza una excepción si el objeto no es del tipo esperado;
- línea 40: la propiedad [Duration] del parámetro establece la duración de la pausa;
- línea 42: se establece la propiedad [End] del parámetro.
Resultados:
Este ejemplo muestra que dos hilos pueden intercambiar información:
- el hilo que llama puede controlar la ejecución del hilo llamado proporcionándole información;
- el hilo lanzado puede devolver resultados al hilo que lo lanzó.
Para que el hilo que llama sepa cuándo están disponibles los resultados que espera, debe ser notificado cuando el hilo llamado haya terminado. Aquí, esperó a que el hilo llamado terminara mediante el método [Join]. [Join] también garantiza que cualquier escritura realizada por el hilo llamado sea visible para el hilo que lo espera. Más adelante veremos otras formas de sincronizar.
Con una lambda, ya no es necesario utilizar el tipo [object]: la lambda captura directamente variables tipadas. Las líneas 12–16 podrían escribirse de la siguiente manera:
con un método [static void Sleep(Data data)] que ya no necesita verificar el tipo de su parámetro. Este es el enfoque más habitual hoy en día.
8.5. Acceso concurrente a recursos compartidos
8.5.1. Acceso concurrente no sincronizado
En el apartado anterior, la información se intercambiaba solo entre dos hilos y en momentos muy precisos: era un ejemplo clásico de paso de parámetros. Hay otros casos en los que la información es compartida por varios hilos que pueden querer leerla o actualizarla al mismo tiempo. Esto plantea el problema de la integridad de esa información. Supongamos que la información compartida es una estructura S que contiene diversos datos I1, I2, ..., In:
- un hilo T1 comienza a actualizar la estructura S: modifica el campo I1 y es interrumpido antes de completar la actualización de la estructura S;
- un hilo T2 que obtiene el procesador lee entonces la estructura S para tomar decisiones. Lee una estructura en un estado inestable: algunos campos están actualizados y otros no.
Esta situación se denomina acceso concurrente a un recurso compartido, en este caso la estructura S. A menudo es difícil de gestionar. Consideremos el siguiente ejemplo para ilustrar los problemas que pueden surgir:
- una aplicación generará n hilos, donde n se pasa como parámetro;
- el recurso compartido es un contador que debe ser incrementado por cada hilo generado;
- al final de la aplicación, se muestra el valor del contador. Por lo tanto, debería ser igual a n.
El programa [threads-06.cs] es el siguiente:
Comentarios:
- Líneas 4–8: el número de hilos se pasa como argumento. La condición de la línea 5 combina todas las verificaciones: se requiere un argumento; debe ser un entero ([int.TryParse]); y debe estar entre 1 y 100 (patrón relacional [nbThreads is < 1 or > nbMaxThreads]). El programa devuelve un código de salida 1 si se produce un error, 0 en caso contrario (línea 25);
- líneas 28–43: el recurso compartido es la propiedad estática [Counter.Value]. El contador está encapsulado en una clase estática, con el método [Increment] ejecutado por cada hilo. Una instrucción de nivel superior no puede declarar un campo: por lo tanto, los datos compartidos por los hilos son miembros estáticos de una clase;
- línea 37: se lee el contador;
- línea 40: el hilo hace una pausa de 1 segundo. Por lo tanto, pierde la CPU;
- línea 42: se incrementa el contador.
La pausa de un segundo está ahí solo para obligar al hilo a perder el procesador entre la lectura y la escritura del contador. En la práctica, no hay ninguna garantía de que un hilo no sea interrumpido entre esos dos momentos, y en una máquina multiprocesador, dos hilos incluso pueden leer el contador exactamente al mismo tiempo. La pausa de un segundo se limita a sistematizar este riesgo.
Para pasar argumentos a una aplicación de un solo archivo, colóquelos después de [--]:
Al observar estos resultados, se ve claramente lo que ocurre:
- Un primer hilo lee el contador. Encuentra 0. Hace una pausa de 1 segundo y pierde así la CPU;
- un segundo hilo también lee el valor del contador. Sigue siendo 0, ya que el hilo anterior aún no lo ha incrementado. También hace una pausa de 1 segundo;
- en menos de un segundo, los 5 hilos tienen tiempo de leer el valor 0;
- al despertar, incrementan el valor 0 que leyeron y todos escriben el valor 1 en el contador, como confirma la última línea (línea 12).
Se podría objetar que el ejemplo es artificial. Quitemos entonces el [Sleep] y utilicemos el operador [++], que da la ilusión de una sola instrucción. El programa [threads-07.cs] es el siguiente:
Comentarios:
- Líneas 4–5: el número de hilos (4 de forma predeterminada) y el número de incrementos que realiza cada hilo (50 millones de forma predeterminada) pueden pasarse como argumentos. La expresión [args.Length > 0 && int.TryParse(args[0], out int n) ? n : 4] devuelve el argumento si existe y es válido; de lo contrario, devuelve el valor predeterminado. El separador [_] hace legible la constante [50_000_000];
- línea 20: cada hilo incrementa el contador compartido sin ninguna pausa;
- línea 38: esta vez, el contador es un campo;
- línea 32: el formato [N0] muestra un entero con separador de miles.
Resultados:
Se perdieron decenas de millones de actualizaciones, y el número varía de una prueba a otra. La operación de alto nivel [Counter.Value++] se traduce en realidad en varias instrucciones básicas del procesador: leer el valor de la memoria, incrementarlo en un registro y escribir el resultado en la memoria. Si dos hilos leen el mismo valor antes de que uno de ellos haya escrito el suyo, se pierde un incremento, exactamente como en el ejemplo anterior. Se necesitan muchas iteraciones para observarlo: con un millón de incrementos por hilo, cada hilo suele haber terminado su trabajo antes de que el siguiente haya comenzado, y el resultado es correcto. Esto es lo que hace tan peligrosos estos errores: un programa puede funcionar durante meses y fallar justo el día en que el sistema soporta una carga mayor.
¿De dónde proviene el problema? Un hilo leyó un valor desactualizado porque otro hilo había sido interrumpido (o trabajaba simultáneamente en otro procesador) antes de terminar su tarea de actualizar el contador. Esto nos lleva a los conceptos de recurso crítico y sección crítica en un programa:
- un recurso crítico es un recurso que solo puede ser mantenido por un hilo a la vez. Aquí, el recurso crítico es el contador;
- una sección crítica de un programa es una secuencia de instrucciones del flujo de ejecución de un hilo durante la cual accede a un recurso crítico. Debemos asegurarnos de que, durante esta sección crítica, el hilo sea el único con acceso al recurso.
En el programa [threads-06.cs], la sección crítica es el código comprendido entre la lectura del contador y la escritura de su nuevo valor:
Para ejecutar este código, se debe garantizar que un hilo sea el único en ejecución. Puede ser interrumpido, pero durante esa interrupción ningún otro hilo debe poder ejecutar este mismo código. La plataforma .NET ofrece diversas herramientas para garantizar el acceso exclusivo a las secciones críticas de código. Veremos algunas de ellas a continuación.
8.5.2. La cláusula [lock] y el tipo [Lock]
La cláusula [lock] delimita una sección crítica de la siguiente manera:
[padlock] es un objeto visible para todos los hilos que ejecutan la sección crítica. La cláusula [lock] garantiza que un solo hilo a la vez ejecute la sección crítica: un hilo que encuentra un cerrojo en poder de otro hilo se bloquea hasta que el cerrojo se libere.
A partir de C# 13 y .NET 9, el objeto de sincronización debería ser preferentemente una instancia del tipo [System.Threading.Lock], diseñado para este fin. El ejemplo anterior se reescribe de la siguiente manera en [threads-08.cs]:
Comentarios:
- línea 36: [padlock] es el objeto que permitirá sincronizar todos los hilos. Es [readonly]: la referencia nunca debe cambiar; de lo contrario, dos hilos podrían bloquear dos objetos distintos;
- Líneas 44–53: la sección crítica del método [Increment] está encerrada por la cláusula [lock]. El hilo mantiene el cerrojo mientras duerme durante un segundo: los demás hilos no pueden entrar;
- Líneas 20–24: el hilo principal espera a los hilos en el orden inverso al de su creación.
Resultados con 3 hilos:
- Los tres hilos solicitan entrar en la sección crítica casi al mismo tiempo;
- solo uno entra: en este caso, el hilo 0 (el orden de entrada no está garantizado: no es necesariamente el primero en llegar el que entra primero). Lee el contador, duerme durante un segundo, escribe el nuevo valor y sale de la sección crítica;
- los otros dos hilos permanecen bloqueados hasta que el primero sale de la sección crítica, y luego avanzan uno tras otro. Cada uno lee el valor escrito por el anterior;
- el hilo principal esperaba a que terminara el hilo 2. Cuando es notificado, espera a que termine el hilo 1, que ya había terminado: es notificado de inmediato. Lo mismo ocurre con el hilo 0;
- el número de hilos es correcto (línea 20).
El compilador traduce la cláusula [lock (padlock) { ... }] sobre un objeto [Lock] como:
[EnterScope] adquiere el cerrojo y devuelve una estructura cuyo método [Dispose], invocado al salir del bloque [using], libera el cerrojo, incluso si la sección crítica lanza una excepción. El tipo [Lock] también ofrece los métodos [Enter], [TryEnter], y [Exit] para los casos en que el cerrojo no puede gestionarse mediante un bloque.
Antes de .NET 9, y en mucho código existente, el cerrojo era un objeto genérico, normalmente de tipo [object]:
Esta forma sigue siendo válida: cualquier objeto de .NET puede servir como cerrojo. El compilador la traduce entonces a llamadas a la clase [Monitor], que examinaremos más adelante:
El tipo [Lock] es más eficiente y hace explícita la intención. Siempre se bloquea un objeto privado: bloquear un objeto visible externamente ([this], un tipo con [typeof(...)], una cadena) permitiría que código externo adquiriera el mismo cerrojo y bloqueara el nuestro.
8.5.3. La clase Mutex
La clase [System.Threading.Mutex] también permite delimitar secciones críticas. Se diferencia de la cláusula [lock] en cuanto a su visibilidad:
- la cláusula [lock] sincroniza hilos dentro de la misma aplicación;
- la clase [Mutex] puede sincronizar hilos de distintas aplicaciones (o procesos) si se le asigna un nombre.
Un [Mutex] es un objeto del sistema operativo: su uso consume muchos más recursos que el de un [lock]. Para hilos del mismo proceso, preferimos por lo tanto utilizar [lock]; [Mutex] se utiliza principalmente entre procesos. Utilizaremos los siguientes constructores y métodos:
Miembro | Función |
[Mutex()] | crea un Mutex M anónimo, utilizable por los hilos del proceso |
[Mutex(bool initiallyOwned, string name)] | crea o abre el mutex con nombre [name], compartido por todos los procesos que usan este nombre |
[bool WaitOne()] | El hilo T1, que ejecuta [M.WaitOne()], solicita la propiedad del mutex M. Si M no está en poder de ningún hilo, se le concede a T1. Si un hilo T2 intenta entonces la misma operación, se bloquea: un mutex solo puede pertenecer a un hilo. T2 se desbloqueará cuando T1 libere M. Así, varios hilos pueden quedar bloqueados a la espera de M |
[bool WaitOne(TimeSpan timeout)] | Igual que el anterior, pero la espera se limita a [timeout]. El método devuelve [false] si no se pudo adquirir el mutex |
[void ReleaseMutex()] | El hilo que posee M lo libera. Uno de los hilos que esperan M lo adquiere entonces |
La sincronización de una sección crítica se realiza de la siguiente manera:
No olvide liberar un mutex; de lo contrario, los hilos que lo esperan permanecerán bloqueados indefinidamente. Por eso la liberación se realiza en una instrucción [finally], que se ejecuta independientemente de que se haya producido una excepción. El programa [threads-09.cs] retoma el ejemplo anterior utilizando un mutex:
Comentarios:
- línea 33: el objeto de sincronización de hilos es ahora un mutex;
- línea 41: inicio de la sección crítica. El hilo se bloquea hasta que el mutex esté libre;
- líneas 42–57: como un mutex siempre debe liberarse, se produzca o no una excepción, la sección crítica se coloca dentro de un [try], cuya cláusula [finally] libera el mutex (línea 57).
Resultados:
Los resultados son similares a los anteriores: los hilos pasan por la sección crítica uno por uno y el valor final del contador es correcto.
El verdadero valor del mutex se aprecia con un mutex con nombre. El programa [threads-10.cs] se ejecuta dos veces, en dos procesos distintos, que comparten una sección crítica:
Comentarios:
- Línea 4: el nombre del mutex. Todos los procesos que abren un mutex con este nombre utilizan el mismo objeto del sistema. El prefijo [Global] especifica que el mutex es visible para todas las sesiones de la máquina (el prefijo predeterminado [Local] lo limita a la sesión del usuario);
- Línea 9: el mutex con nombre se crea si aún no existe; de lo contrario, se abre. El primer parámetro, [false], indica que el proceso no solicita su propiedad al crearlo. La declaración [using] libera el objeto [Mutex] al final del programa;
- línea 12: el proceso intenta adquirir el mutex de inmediato ([TimeSpan.Zero]). Si falla, informa del fallo y luego lo espera indefinidamente (línea 16);
- Líneas 18–27: la sección crítica, que dura 3 segundos, seguida de la liberación del mutex.
El script de captura lanza el proceso A, espera 1,5 segundos y luego lanza el proceso B. Resultados del proceso A:
Resultados del proceso B:
El proceso B encontró el mutex en poder del proceso A y esperó. Lo adquirió en el mismo instante en que A lo liberó. Un uso habitual de un mutex con nombre es impedir que se inicien dos instancias de la misma aplicación: la segunda instancia, al no poder adquirir el mutex, termina de inmediato. Si un proceso termina sin liberar un mutex que posee, se dice que el mutex está abandonado: el siguiente proceso que llame a [WaitOne] lo adquiere, pero lanza la excepción [AbandonedMutexException] para indicar que el recurso protegido puede estar en un estado inconsistente.
8.5.4. La clase AutoResetEvent
Un objeto [AutoResetEvent] es una barrera que deja pasar un solo hilo a la vez. Se construye de la siguiente manera:
El booleano [state] indica si la barrera está cerrada ([false]) o abierta ([true]). Un hilo que desea atravesar la barrera lo indica de la siguiente manera:
- Si la barrera está abierta, el hilo pasa y la barrera se cierra automáticamente tras él (de ahí el nombre de la clase). Si varios hilos esperan, solo uno pasa;
- si la barrera está cerrada, el hilo se bloquea. Otro hilo la abrirá cuando llegue el momento. Ese momento depende por completo del problema que se resuelve. La barrera se abre mediante la operación:
Un hilo también puede cerrar una barrera con [barrier.Reset()]. A diferencia de un mutex, una barrera no pertenece a ningún hilo en particular: cualquier hilo puede abrirla. Si, en el ejemplo anterior, reemplazamos el mutex por un [AutoResetEvent], el código queda de la siguiente manera [threads-11.cs]:
Comentarios:
- línea 39: la barrera se crea en estado cerrado. Será abierta por el hilo principal en la línea 23;
- línea 19: el hilo principal espera medio segundo para permitir que los hilos lleguen a la barrera;
- línea 47: el hilo encargado de incrementar el contador solicita permiso para entrar en la sección crítica. Los distintos hilos se acumulan frente a la barrera cerrada. Cuando el hilo principal la abre, uno de los hilos en espera pasa y la barrera se cierra de nuevo;
- línea 63: cuando ha terminado su trabajo, el hilo vuelve a abrir la barrera, permitiendo que entre otro hilo.
Resultados:
Los resultados son similares a los anteriores. Vemos que los tres hilos esperan frente a la barrera hasta que el hilo principal la abre (línea 5).
8.5.5. Las clases ManualResetEventSlim y SemaphoreSlim
Otras dos herramientas de sincronización complementan las anteriores.
Un objeto [ManualResetEventSlim] es una barrera que, una vez abierta con [Set], permanece abierta y deja pasar a todos los hilos hasta que se cierra explícitamente con [Reset]. Es la "señal de partida" de una carrera. El sufijo [Slim] designa las versiones ligeras de las herramientas de sincronización, introducidas con .NET 4: solo recurren al sistema operativo si la espera se prolonga y funcionan únicamente dentro de un proceso. El programa [threads-12.cs] es el siguiente:
Comentarios:
- línea 4: la barrera se crea en estado cerrado;
- línea 15: cada hilo espera a que la barrera se abra;
- línea 26: el hilo principal abre la barrera después de un segundo;
- línea 32: la propiedad [IsSet] indica si la barrera está abierta.
Resultados:
Los cuatro corredores partieron juntos, al milisegundo, tras la señal de partida. Con un [AutoResetEvent], solo habría partido uno.
Un semáforo es una barrera provista de un contador: permite que como máximo N hilos entren a la vez en una sección de código. Es útil para limitar el uso de un recurso disponible en cantidades limitadas (conexiones a bases de datos, solicitudes simultáneas a un servidor, etc.). El programa [threads-13.cs] es el siguiente:
Comentarios:
- línea 4: el semáforo tiene 2 espacios;
- línea 15: un hilo solicita un espacio. Si hay uno disponible, lo toma y continúa; de lo contrario, se bloquea hasta que haya un espacio disponible;
- línea 18: el número de espacios aún disponibles;
- línea 26: el hilo devuelve su espacio, en una cláusula [finally].
Resultados:
Los cinco hilos solicitan un espacio; dos lo obtienen de inmediato, mientras que los otros tres esperan. Cada vez que un hilo libera su espacio, un hilo en espera lo obtiene. Nunca hay más de dos hilos en la sección de código. Un semáforo de un solo espacio actúa como un cerrojo. La clase [SemaphoreSlim] también tiene un método [WaitAsync] que puede utilizarse con [await], que veremos en el próximo capítulo; la clase [Semaphore] (sin [Slim]), que consume más recursos, puede, al igual que [Mutex], tener nombre y compartirse entre procesos, pero solo en Windows.
8.5.6. La clase Interlocked
La clase [Interlocked] hace que operaciones simples sobre una variable sean atómicas: la operación la ejecuta el hilo por completo, sin que ningún otro hilo pueda observar o modificar la variable a mitad de la operación. Las herramientas anteriores ([lock], [Mutex], [AutoResetEvent]) están todas diseñadas para hacer atómico un grupo de operaciones, al costo de bloquear a otros hilos. Para operaciones simples pero frecuentes, la clase [Interlocked] evita este bloqueo mediante instrucciones especiales del procesador. Sus principales métodos estáticos son los siguientes:
Método | Función |
[int Increment(ref int x)] | incrementa [x] en 1 y devuelve el nuevo valor |
[int Decrement(ref int x)] | decrementa [x] en 1 y devuelve el nuevo valor |
[int Add(ref int x, int value)] | suma [value] a [x] y devuelve el nuevo valor |
[int Exchange(ref int x, int value)] | asigna [value] a [x] y devuelve el valor anterior |
[int CompareExchange(ref int x, int value, int comparand)] | asigna [value] a [x] solo si [x] es igual a [comparand]; devuelve el valor anterior de [x] |
[long Read(ref long x)] | lee atómicamente un valor de 64 bits (útil en un procesador de 32 bits) |
Estos métodos están disponibles para los tipos [int], [long], [uint], [ulong]y, en el caso de [Exchange] y [CompareExchange], para otros tipos. Los métodos [And] y [Or] (.NET 5) realizan atómicamente una operación "y" u "o" bit a bit. El parámetro se pasa por referencia ([ref]): [Interlocked] debe operar sobre la variable misma, no sobre una copia. Por esta razón, la variable debe ser un campo o una variable local; una propiedad no puede pasarse por referencia.
El programa [threads-14.cs] retoma el experimento del programa [threads-07.cs] y compara tres formas de incrementar el contador compartido:
Comentarios:
- línea 3: la clase [Stopwatch], que mide duraciones, se encuentra en el espacio de nombres [System.Diagnostics];
- líneas 11–13: la función local [Measure] se llama con tres métodos de incremento distintos, pasados como un delegado [Action];
- líneas 16–42: la función [Measure] lanza [nbThreads] hilos, cada uno de los cuales llama [nbIncrements] veces al método recibido, y mide el tiempo total con un [Stopwatch]. El formato [{Counter.Value,12:N0}] alinea el valor a la derecha en 12 caracteres;
- líneas 20–26 y 36: los hilos esperan todos detrás de una barrera [ManualResetEventSlim], que se abre una vez que todos han sido lanzados. Esto les permite comenzar su trabajo simultáneamente, lo que hace el acceso concurrente mucho más probable que con hilos lanzados uno tras otro;
- línea 49: el contador es un campo, no una propiedad, para poder pasarlo por referencia a [Interlocked.Increment];
- línea 53: el incremento sin sincronización;
- líneas 56–60: incremento dentro de una sección crítica protegida por un [Lock];
- línea 65: incremento atómico.
Resultados:
- Sin sincronización, el resultado es incorrecto, una vez más;
- los otros dos métodos producen el resultado correcto;
- [Interlocked] es notablemente más rápido que [lock] en esta ejecución. El cerrojo resulta costoso aquí porque cuatro hilos compiten constantemente por el mismo cerrojo para una operación minúscula. Los tiempos medidos dependen en gran medida de la máquina y de su carga: solo su orden de magnitud es significativo.
El método [CompareExchange] es el componente básico de los algoritmos "sin bloqueo" (lock-free): se lee el valor, se calcula el nuevo y se escribe solo si la variable no ha cambiado mientras tanto; de lo contrario, se vuelve a empezar. Las colecciones concurrentes que se presentan más adelante lo utilizan ampliamente.
8.6. Acceso concurrente a varios recursos compartidos
8.6.1. Interbloqueo (deadlock)
En nuestros ejemplos anteriores, se compartía un único recurso entre los distintos hilos. La situación se complica si hay varios recursos y dependen unos de otros. En particular, puede producirse un interbloqueo (deadlock): dos hilos se esperan mutuamente. Consideremos las siguientes acciones, que ocurren secuencialmente:
- un hilo T1 adquiere el cerrojo V1 para acceder a un recurso compartido R1;
- un hilo T2 adquiere el cerrojo V2 para acceder a un recurso compartido R2;
- el hilo T1 solicita el cerrojo V2. Se bloquea;
- el hilo T2 solicita el cerrojo V1. Se bloquea.
Los hilos T1 y T2 se esperan mutuamente de manera indefinida. Son posibles varias soluciones:
- solicitar ambos recursos al mismo tiempo mediante un único cerrojo. Esto no siempre es posible si implica un bloqueo prolongado de un recurso costoso;
- adquirir siempre los cerrojos en el mismo orden: si todos los hilos adquieren V1 antes que V2, el interbloqueo es imposible. Esta es la regla más utilizada;
- un hilo que tiene V1 y no puede adquirir V2 libera V1 para evitar el interbloqueo.
El programa [threads-15.cs] provoca un interbloqueo e implementa la última solución:
Comentarios:
- líneas 4–5: los cerrojos de los dos recursos. Aquí son variables locales, capturadas por las lambdas de las líneas 8–10;
- línea 8: el hilo T1 adquiere R1 y luego solicita R2; espera como máximo 2 segundos;
- Línea 10: el hilo T2 toma R2 y luego solicita R1, es decir, en orden inverso; espera como máximo 5 segundos;
- Línea 21: el hilo adquiere su primer recurso;
- línea 25: espera medio segundo, lo que da tiempo al otro hilo de adquirir su propio primer recurso: el interbloqueo es entonces seguro;
- línea 28: en lugar de un [lock] que esperaría indefinidamente, el hilo solicita el segundo cerrojo con un tiempo de espera máximo. [TryEnter] devuelve [true] si se adquirió el cerrojo, o [false] si el tiempo de espera expiró;
- línea 36: un cerrojo adquirido mediante [TryEnter] debe liberarse mediante [Exit], dentro de una cláusula [finally];
- Líneas 39–41: si no se pudo adquirir el segundo cerrojo, el hilo se aborta. Al salir del bloque [lock], libera su primer recurso.
Resultados:
Cada uno de los dos hilos adquirió su primer recurso y luego solicitó el segundo: están en un interbloqueo. Después de 2 segundos, T1 se rinde y libera R1; T2, que seguía esperando, obtiene de inmediato R1 y puede hacer su trabajo. Sin un tiempo de espera, el programa nunca habría terminado.
8.6.2. Un ejemplo: lectores y escritores
Consideremos el siguiente ejemplo:
- tenemos un arreglo en el que algunos hilos escriben datos (los escritores) y otros los leen (los lectores);
- los escritores son iguales entre sí pero exclusivos: solo un escritor a la vez puede depositar datos en el arreglo;
- los lectores son iguales entre sí pero exclusivos: solo un lector a la vez puede leer los datos almacenados en el arreglo;
- un lector solo puede leer datos del arreglo cuando un escritor ha colocado algunos allí, y un escritor solo puede colocar nuevos datos en el arreglo cuando los datos que ya están allí han sido leídos por un lector.
Hay dos tipos de recursos compartidos:
- el arreglo en el que se escribe: solo un escritor a la vez puede acceder a él;
- el arreglo que se lee: solo un lector a la vez puede acceder a él.
y un orden de utilización de estos recursos:
- un lector debe siempre seguir a un escritor;
- un escritor debe siempre seguir a un lector, excepto la primera vez.
El acceso a estos dos recursos puede controlarse mediante dos barreras de tipo [AutoResetEvent]:
- la barrera [canWrite] controla el acceso de los escritores al arreglo;
- la barrera [canRead] controla el acceso de los lectores al arreglo;
- la barrera [canWrite] se crea abierta, lo que permite pasar al primer escritor y bloquea a todos los demás;
- La barrera [canRead] se crea en estado cerrado, bloqueando a todos los lectores;
- cuando un escritor termina su trabajo, abre la barrera [canRead] para dejar pasar a un lector;
- cuando un lector termina su trabajo, abre la barrera [canWrite] para dejar pasar a un escritor.
El programa [threads-16.cs] que ilustra esta sincronización es el siguiente:
Comentarios:
- líneas 7–14: creación e inicio de dos hilos lectores, seguidos de dos hilos escritores. No se conserva ninguna referencia a los hilos: el hilo principal no los espera;
- línea 17: el hilo principal termina de inmediato. El proceso continúa hasta que los cuatro hilos —que son hilos de primer plano— hayan terminado;
- línea 23: el arreglo [data] es el recurso compartido entre los hilos lectores y escritores;
- línea 25: la barrera [canRead] indica a los lectores que pueden leer el arreglo. La abre el escritor que ha llenado el arreglo. Se crea en estado cerrado: primero un escritor debe llenar el arreglo;
- línea 27: la barrera [canWrite] notifica a los escritores que pueden escribir en el arreglo. La abre el lector que ha leído todo el arreglo. Se crea abierta: el arreglo es escribible desde el inicio;
- línea 35: un lector espera a que un escritor señale que el arreglo ha sido llenado. Cuando llega esta señal, solo uno de los lectores en espera continúa;
- líneas 37–41: se lee el arreglo, con una pausa de medio segundo en cada elemento para forzar al hilo a ceder la CPU;
- línea 44: el lector notifica a los escritores que el arreglo ha sido leído y que puede llenarse de nuevo;
- el método [Write] es simétrico al método [Read];
- línea 61: los números escritos se generan de forma aleatoria. La propiedad [Random.Shared] (.NET 6) proporciona un generador compartido que puede usarse de forma segura desde varios hilos. El curso de 2008 compartía un objeto [Random] ordinario entre los hilos, cuyos métodos no están diseñados para ser llamados simultáneamente por varios hilos.
Resultados:
Vale la pena destacar los siguientes puntos:
- Solo hay un lector a la vez, aunque ese lector pierde el procesador en la sección crítica [Read];
- solo hay un escritor a la vez, aunque pierde el procesador en la sección crítica [Write];
- un lector solo lee cuando hay algo que leer en el arreglo;
- un escritor solo escribe cuando el arreglo ha sido leído por completo;
- sin embargo, el orden de ejecución no puede controlarse: no había ninguna razón para que el escritor W0 fuera antes que el escritor W1, ni para que el lector R0 fuera antes que el lector R1. Otra ejecución puede dar un orden distinto.
8.6.3. La clase Monitor
En el ejemplo anterior, cuando los escritores están bloqueados en la instrucción [canWrite.WaitOne()], uno de ellos —cualquiera— se desbloquea mediante la operación [canWrite.Set()]. Si se desea abrir la barrera para un escritor específico, las cosas se complican.
Consideremos la analogía de una oficina de atención al público con ventanillas. Cuando llega un cliente, toma un número del dispensador y luego va a sentarse. Los clientes son llamados por su número mediante un altavoz. Mientras espera, el cliente puede hacer lo que quiera: leer o dormitar. Se despierta cada vez que el altavoz anuncia un número. Si es su número, el cliente se levanta y va a la ventanilla; de lo contrario, vuelve a lo que estaba haciendo. Podemos operar de manera similar con los hilos. Tomemos el ejemplo de los escritores:
En la ventanilla | Con hilos |
varios escritores esperan la misma ventanilla | sus hilos están bloqueados |
la ventanilla queda disponible y se llama el número del siguiente escritor | el hilo que leía el arreglo notifica a los escritores que el arreglo está disponible. Ese hilo u otro ha determinado qué escritor debe continuar |
Cada escritor verifica su número; solo el que tiene el número llamado pasa a la ventanilla; los demás vuelven a la cola de espera | Cada hilo verifica si es el seleccionado. Si lo es, atraviesa la barrera; de lo contrario, vuelve a la cola de espera |
La clase [Monitor] implementa este escenario. Sus métodos estáticos son los siguientes:
Método | Función |
[Enter(object token)] | Solicita el token: el hilo lo obtiene si está libre; de lo contrario, se bloquea hasta que quede libre |
[bool TryEnter(object token, TimeSpan timeout)] | Igual que el anterior, con un tiempo de espera máximo |
[Exit(object token)] | devuelve el token |
[bool Wait(object token)] | devuelve el token y bloquea el hilo hasta que otro hilo señale un cambio mediante [Pulse] o [PulseAll]; el hilo debe entonces recuperar el token antes de continuar |
[Pulse(object token)] | despierta a uno de los hilos bloqueados por [Wait] en este token |
[PulseAll(object token)] | despierta a todos los hilos bloqueados por [Wait] en este token |
A continuación describiremos un patrón estándar, propuesto en el capítulo «Threading» del libro de J. y B. Albahari, [C# in a Nutshell], capaz de resolver problemas de barreras con una condición de entrada.
Los hilos que comparten un recurso (la ventanilla) acceden a él mediante un objeto que llamaremos token. Para atravesar la barrera que conduce a la ventanilla se necesita tener el token, y solo hay uno. Por lo tanto, los hilos deben pasarse el token entre sí:
Para ir a la ventanilla, un hilo solicita primero el token mediante [Monitor.Enter(token)], o más simplemente con una cláusula [lock]. Si obtiene el token, verifica que cumple la condición para ir a la ventanilla:
Si el hilo no es el esperado en la ventanilla, cede su turno devolviendo el token mediante [Monitor.Wait(token)] y entra en un estado bloqueado. Será despertado cuando otro hilo señale un cambio en la condición de acceso; entonces recuperará el token y verificará de nuevo la condición. Por eso la verificación es un bucle ([while]) y no un simple [if]. La operación [Monitor.Wait(token)] solo puede ser realizada por un hilo que posea el token; de lo contrario, se lanza una excepción [SynchronizationLockException]. En este escenario, el token solo se libera una vez completada la operación.
El hilo que modifica la condición de acceso a la ventanilla también debe poseer el token y notificar a los hilos en espera:
Despertar a los hilos significa que los hilos en espera pasan a ser candidatos al token; no lo reciben de inmediato. El token solo queda disponible al final del bloque [lock]. Todos los hilos despertados recibirán entonces el token por turnos, en un orden indeterminado, lo que les da la oportunidad de verificar de nuevo la condición de acceso. El primero que cumpla la condición conserva el token y pasa a la ventanilla.
Una nota importante: los métodos [Wait], [Pulse] y [PulseAll] de [Monitor] se aplican a un objeto bloqueado mediante [lock (obj)] o [Monitor.Enter(obj)]. No funcionan con el tipo [Lock] de .NET 9, que no tiene equivalente. Por lo tanto, los tokens de este apartado son objetos de tipo [object].
Con esta información, podemos reescribir la aplicación de lectores/escritores especificando el orden en que los lectores y escritores acceden a sus respectivas ventanillas [threads-17.cs]:
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 33 34 35 36 37 38 39 40 41 42 43 44 45 46 47 48 49 50 51 52 53 54 55 56 57 58 59 60 61 62 63 64 65 66 67 68 69 70 71 72 73 74 75 76 77 78 79 80 81 82 83 84 85 86 87 88 89 90 91 92 93 94 95 96 97 98 99 100 101 102 103 104 105 106 107 108 109 110 111 112 113 114 115 116 117 118 119 120 121 122 | |
El acceso a la ventanilla de lectura está condicionado por los siguientes elementos:
- línea 36: el token [canRead];
- línea 39: el booleano [readingAllowed];
- línea 44: el arreglo ordenado de nombres de lectores. Los lectores pasan a la ventanilla de lectura en el orden especificado por este arreglo;
- línea 41: [nextReader] es el índice en este arreglo del siguiente lector autorizado a pasar a la ventanilla.
El acceso a la ventanilla de escritura se controla de manera similar mediante el token [canWrite], el booleano [writingAllowed], el arreglo [WriteOrder] y el índice [nextWriter].
El programa principal:
- líneas 7–9: los lectores pasarán a la ventanilla en orden inverso al de su creación (R2, R1, R0), y los escritores en el orden en que fueron creados (W0, W1, W2). Los arreglos se construyen mediante una expresión de colección [.. sequence], que crea un arreglo a partir de una consulta LINQ;
- líneas 18–22: creación e inicialización de los lectores, seguidos de los escritores. Todos quedarán bloqueados, ya que no se permite ni leer ni escribir;
- línea 26: se habilita la escritura y se notifica a los escritores que algo ha cambiado (método [AllowWriting], líneas 48–54).
El método [Read]:
- líneas 64–86: todo el proceso en la ventanilla de lectura está controlado por [lock] sobre el token [canRead]. El lector que lo obtiene lo conserva durante todo su paso por la ventanilla;
- líneas 67–69: un lector que ha adquirido el token lo devuelve si la lectura no está autorizada o si no es su turno;
- líneas 72–75: paso por la ventanilla (lectura de la tabla);
- líneas 78–79: el lector cambia las condiciones de acceso a la ventanilla de lectura. Todavía posee el token de lectura, y estos cambios impiden que cualquier otro lector acceda a la ventanilla;
- líneas 81–84: el lector cambia las condiciones de acceso a la ventanilla de escritura y notifica a todos los escritores en espera que algo ha cambiado. Para ello, toma el token [canWrite]: aquí vemos que el hilo posee dos tokens al mismo tiempo. Los escritores hacen lo mismo en orden inverso (poseen [canWrite] y solicitan [canRead]), que es la situación de interbloqueo descrita anteriormente. Sin embargo, aquí no hay riesgo: un hilo solicita el segundo token solo al final de su paso por la ventanilla; las dos ventanillas nunca están ocupadas al mismo tiempo; y los demás hilos poseen un token solo el tiempo necesario para verificar la condición de acceso, sin solicitar el otro token.
El método [Write] es simétrico al método [Read]. El curso de 2008 utilizaba, en el programa principal, [Monitor.Pulse], que despierta solo a un hilo: si ese hilo no era el escritor esperado, volvía a dormirse, y el escritor esperado podía no despertarse nunca. Cuando se utiliza una condición de acceso que especifica un hilo en particular, se debe usar [PulseAll].
Este es un ejemplo de ejecución:
Los escritores y lectores se turnan en sus respectivas ventanillas, cada uno en el orden especificado: W0, R2, W1, R1, W2, R0.
8.7. Colecciones concurrentes
Los ejemplos anteriores protegían datos compartidos muy simples (un contador, un arreglo). Cuando los hilos comparten una colección (lista, diccionario, cola), se podría proteger cada acceso con un [lock]. Pero las colecciones ordinarias ([List<T>], [Dictionary<TKey,TValue>], [Queue<T>]) no están diseñadas para ser modificadas por varios hilos simultáneamente: su uso sin protección puede provocar la pérdida de elementos, desencadenar excepciones inesperadas o incluso corromper la estructura interna de la colección. A partir de .NET 4, el espacio de nombres [System.Collections.Concurrent] ofrece colecciones diseñadas para compartirse entre hilos sin bloqueo explícito:
Colección | Función |
[ConcurrentDictionary<TKey,TValue>] | un diccionario cuyas operaciones, incluidas las actualizaciones condicionales, son seguras |
[ConcurrentQueue<T>] | una cola (primero en entrar, primero en salir) |
[ConcurrentStack<T>] | una pila (último en entrar, primero en salir) |
[ConcurrentBag<T>] | una bolsa: una colección sin orden |
[BlockingCollection<T>] | un envoltorio de las colecciones anteriores que bloquea al consumidor cuando la colección está vacía y, opcionalmente, al productor cuando está llena |
8.7.1. ConcurrentDictionary y ConcurrentQueue
En el programa [threads-18.cs], cuatro hilos generan números aleatorios y cuentan el número de veces que aparece cada número en un diccionario compartido:
Comentarios:
- línea 3: el espacio de nombres de las colecciones concurrentes;
- línea 6: el diccionario compartido asocia cada dígito con su número de ocurrencias;
- línea 8: una cola en la que cada hilo deposita un informe al final de su trabajo;
- línea 21: el método [AddOrUpdate] agrega la clave [digit] con el valor 1 si no existe, y en caso contrario reemplaza su valor por el calculado por la función [(key, oldValue) => oldValue + 1]. La operación es atómica. No podríamos escribir [draws[digit]++]: esta expresión lee el valor y luego escribe el nuevo, en dos operaciones, y dos hilos podrían perder una actualización como en el ejemplo [threads-07.cs];
- línea 24: cada hilo coloca su informe en la cola;
- líneas 35–37: el hilo principal vacía la cola. [TryDequeue] devuelve [false] cuando la cola está vacía. Las colecciones concurrentes solo ofrecen métodos «Try…» que combinan la verificación y la operación: una verificación de [Count > 0] seguida de una extracción no sería segura, ya que otro hilo podría vaciar la cola entre ambas;
- línea 40: el diccionario se recorre en orden de claves; cada par clave/valor se descompone en dos variables;
- línea 46: el método [GetOrAdd] devuelve el valor asociado con la clave, después de agregar la clave con el valor proporcionado si no existía.
Resultados:
El número total de sorteos es correcto: no se perdió ninguna actualización. Los informes aparecen en el orden en que los hilos terminaron su trabajo.
8.7.2. Productores y consumidores: BlockingCollection
El problema de lectores y escritores es una variante del problema clásico de productor-consumidor: unos hilos producen datos que otros hilos consumen. La clase [BlockingCollection<T>] lo resuelve sin ninguna herramienta de sincronización explícita:
- [Add(element)] agrega un elemento. Si la colección tiene una capacidad limitada y está llena, el productor se bloquea hasta que quede un espacio disponible;
- [CompleteAdding()] señala que no se agregarán más elementos;
- [GetConsumingEnumerable()] devuelve una enumeración que extrae los elementos uno a uno. Si la colección está vacía, el consumidor se bloquea hasta que llegue un elemento; la enumeración termina cuando la colección está vacía y se ha llamado a [CompleteAdding] .
El programa [threads-19.cs] es el siguiente:
Comentarios:
- línea 6: una cola (la colección subyacente predeterminada es una [ConcurrentQueue<int>]) que contiene como máximo 3 elementos. El parámetro se pasa por nombre, lo que hace la llamada más legible;
- líneas 9–20: el productor deposita los números del 1 al 8, uno cada décima de segundo, y luego señala que ha terminado;
- líneas 24–37: dos consumidores obtienen los números y dedican 0,6 segundos a procesar cada uno. Los consumen más lentamente de lo que el productor los genera;
- línea 31: la enumeración bloqueante. Cada número es obtenido por uno solo de los dos consumidores.
Resultados:
Vemos que el productor encola rápidamente los primeros números y luego —en cuanto la cola contiene 3 elementos— solo encola un número cuando un consumidor extrae uno: queda bloqueado en [Add] cuando la cola está llena. Los consumidores se reparten los números y se detienen cuando la cola está vacía y el proceso ha terminado. Observe que el consumidor C2 mostró la obtención del número 1 antes de que el productor mostrara su inserción: la inserción ocurrió efectivamente antes, pero el productor fue interrumpido entre [Add] y su visualización.
La clase [Channel<T>] del espacio de nombres [System.Threading.Channels] proporciona el mismo servicio para la programación asíncrona: un consumidor que espera un elemento no bloquea ningún hilo. Lo veremos en el próximo capítulo.
8.8. El grupo de hilos
Hasta ahora, para gestionar hilos, los hemos creado mediante [new Thread(...)] y luego los hemos ejecutado mediante [Start()]. Crear un hilo es una operación relativamente costosa: en particular, el sistema debe asignarle una pila, y cada hilo ocupa memoria mientras exista. Veremos en el capítulo sobre bases de datos que existen grupos de conexiones: las conexiones abiertas se mantienen en reserva y se prestan a los hilos que las solicitan, ya que abrir una conexión es costoso. Existe un sistema similar para los hilos: el grupo de hilos (ThreadPool) de .NET.
- Mientras el número de hilos del grupo esté por debajo de un umbral mínimo, el grupo crea de inmediato un nuevo hilo para cada tarea que no encuentra un hilo libre. De forma predeterminada, este mínimo es el número de procesadores; puede leerse mediante [ThreadPool.GetMinThreads(out min1, out min2)] y modificarse mediante [ThreadPool.SetMinThreads(min1, min2)]. El grupo gestiona dos tipos de hilos: los hilos de trabajo (min1), que ejecutan los trabajos que se les asignan, y los hilos de E/S asíncrona (min2);
- si este número es insuficiente, el grupo crea hilos adicionales de forma incremental, hasta un máximo que puede leerse mediante [ThreadPool.GetMaxThreads(out max1, out max2)] y modificarse mediante [ThreadPool.SetMaxThreads(max1, max2)]. Cuando se alcanza el máximo, los trabajos asignados al grupo se ponen en cola hasta que un hilo quede disponible;
- Un hilo que ha completado una tarea no se destruye: se devuelve al grupo y se utiliza para la siguiente tarea.
El grupo de hilos ofrece dos ventajas: ahorra el tiempo dedicado a crear hilos (unos pocos hilos pueden atender cientos de solicitudes) y, al limitar el número de hilos, evita que la aplicación se vea desbordada por demasiadas solicitudes.
Para asignar una tarea al grupo, se utiliza el método [ThreadPool.QueueUserWorkItem(WaitCallback callback, object? state)], donde [WaitCallback] es un delegado de firma [void M(object? state)]. La tarea será ejecutada por un hilo del grupo, con el parámetro [state]. El programa [threads-20.cs] es el siguiente:
Comentarios:
- líneas 7–12: se lee y se muestra el número mínimo actual de ambos tipos de hilos del grupo, y luego se establece en 3 el número mínimo de hilos de trabajo. El parámetro [out _] es un «parámetro descartado»: no nos interesa el valor devuelto;
- líneas 14–19: hacemos lo mismo para establecer en 5 el número máximo de hilos de trabajo. [SetMaxThreads] devuelve [false] si el valor solicitado es rechazado, por ejemplo, si es menor que el número de procesadores;
- línea 22: un objeto [CountdownEvent] actúa como un temporizador de cuenta regresiva: cada llamada a su método [Signal] lo decrementa, y su método [Wait] bloquea el hilo que llama hasta que llega a 0. Aquí permite que el hilo principal espere a que terminen los 7 trabajos: no se puede llamar a [Join] sobre un hilo del grupo, ya que no es de su propiedad. El curso de 2008 pedía al usuario que presionara [Enter] una vez completados los trabajos;
- líneas 23–26: asignamos al grupo 7 tareas, cada una de 3 segundos de duración, aunque el grupo nunca tendrá más de 5 hilos de trabajo. Cada tarea recibe un objeto [Data];
- línea 30: el hilo principal espera a que terminen los 7 trabajos;
- líneas 34–48: la tarea ejecutada por un hilo del grupo. Es una función local no estática porque utiliza la variable local [remainingJobs];
- línea 41: el número de hilos de trabajo aún disponibles (el máximo menos el número de hilos ocupados);
- línea 48: el contador se decrementa al final de cada trabajo.
Resultados:
- En esta máquina de doble procesador, el grupo tenía inicialmente un mínimo de 2 hilos de trabajo y un máximo de 32 767;
- los trabajos 0, 1 y 2 comenzaron de inmediato: el grupo tiene un mínimo de 3 hilos;
- los trabajos 3 y 4 comenzaron con retrasos de uno y dos segundos, respectivamente: ya no quedaban hilos libres y el grupo —una vez que supera su mínimo— crea nuevos hilos solo gradualmente mientras haya trabajos en espera. Entonces se alcanza el máximo de 5 hilos: no queda ningún hilo disponible;
- Los trabajos 5 y 6 tuvieron que esperar a que un hilo quedara disponible tras terminar los trabajos 0, 1 y 2. Vemos que reutilizaron los hilos 7 y 4, que habían ejecutado los primeros trabajos;
- En total, los trabajos 5 y 6 tardaron 6 segundos desde el momento en que se solicitaron: 3 segundos de espera y 3 segundos de ejecución.
Rara vez es necesario cambiar los límites del grupo: sus valores predeterminados son adecuados para la mayoría de las aplicaciones. De hecho, [QueueUserWorkItem] rara vez se usa directamente: trabajamos mediante tareas, que se describen a continuación.
8.9. Tareas y la biblioteca paralela
8.9.1. Task.Run
Desde .NET 4, la clase [System.Threading.Tasks.Task] representa un trabajo (una tarea) que se ejecuta de forma asíncrona. [Task.Run(action)] asigna un trabajo al grupo de hilos, igual que [QueueUserWorkItem], pero devuelve un objeto [Task] que permite hacer el seguimiento de ese trabajo: verificar si ha terminado, esperarlo, obtener su resultado o la excepción que lanzó. Una tarea que devuelve un resultado de tipo T es de tipo [Task<T>]. El programa [threads-21.cs] es el siguiente:
Comentarios:
- Líneas 10–16: cada tarea ejecuta una lambda que muestra el hilo que la ejecuta, duerme 0,5, 1 o 1,5 segundos y luego devuelve un resultado de tipo [int]. Por lo tanto, [Task.Run] devuelve un [Task<int>];
- línea 20: el hilo principal espera a que terminen las tres tareas. Es una espera bloqueante, como [Join];
- línea 24: la propiedad [Status] indica el estado de la tarea; [RanToCompletion] significa que terminó normalmente;
- línea 24: la propiedad [Result] es el resultado de la tarea. Si la tarea no hubiera terminado, leer [Result] bloquearía el hilo hasta que terminara;
- línea 28: una tarea que ejecuta el método [Fail], que lanza una excepción;
- línea 32: la excepción lanzada en la tarea no se pierde: se almacena en el objeto [Task], y luego se vuelve a lanzar en el hilo que espera la tarea. [Wait] la envuelve en una [AggregateException] (una tarea puede agrupar varias de ellas), cuya propiedad [InnerException] es la excepción original;
- línea 41: el método que lanza la excepción. Habríamos podido pasar la lambda [() => throw new InvalidOperationException(...)] directamente a [Task.Run].
Resultados:
- Las tareas se ejecutan en hilos del grupo (línea 3);
- La tarea 2 no comenzó hasta que la tarea 0 hubo terminado, en el hilo que la tarea 0 había liberado: el grupo solo tenía 2 hilos (el mínimo predeterminado en esta máquina) y no creó un tercero a tiempo;
- los resultados se obtienen después de que las tareas han terminado;
- la excepción de la tarea que falló fue capturada por el hilo principal, y el estado de la tarea es [Faulted].
Este ejemplo también reemplaza al de la clase [BackgroundWorker] del curso de 2008, que mostraba cómo ejecutar un trabajo en segundo plano, obtener su resultado o su excepción, y cancelarlo. [BackgroundWorker] fue diseñada para interfaces gráficas de usuario de Windows Forms; ahora ha sido reemplazada por las tareas, con la cancelación gestionada mediante [CancellationToken] y el seguimiento del progreso mediante la interfaz [IProgress<T>], que se presentan en el capítulo siguiente junto con [async] / [await], que permiten esperar una tarea sin bloquear un hilo.
8.9.2. Parallel.For y Parallel.ForEach
La clase [System.Threading.Tasks.Parallel] (.NET 4) distribuye automáticamente las iteraciones de un bucle entre varios hilos del grupo:
- [Parallel.For(start, end, i => ...)] ejecuta el cuerpo del bucle para i desde [start] hasta [end] - 1;
- [Parallel.ForEach(collection, element => ...)] ejecuta el cuerpo del bucle para cada elemento de la colección;
- un parámetro [ParallelOptions] permite limitar el número de iteraciones ejecutadas simultáneamente (propiedad [MaxDegreeOfParallelism]);
- ambos métodos no devuelven el control hasta que todas las iteraciones han terminado. El hilo que los llama participa él mismo en el trabajo.
Estos bucles solo son adecuados si las iteraciones son independientes: su orden de ejecución no está definido y, si actualizan datos compartidos, esos datos deben protegerse. El programa [threads-22.cs] es el siguiente:
Comentarios:
- líneas 7–18: contamos los números primos menores que 5 000 000 mediante un bucle [for] estándar. La función [IsPrime] (líneas 68–81) prueba los divisores hasta la raíz cuadrada del número: es un proceso que consume mucho tiempo, y las iteraciones son independientes;
- líneas 22–31: el mismo bucle con [Parallel.For]. El contador [nbParallel1] es compartido por todos los hilos: se incrementa mediante [Interlocked.Increment] (una variable local capturada por una lambda puede pasarse por referencia);
- Líneas 36–50: una versión sobrecargada de [Parallel.For] permite trabajar con una variable local: [Parallel.For] descompone el bucle en tareas, cada una ejecutada por un solo hilo, y cada tarea tiene su propio contador. La primera lambda (41) inicializa el contador de una tarea; la segunda (43) es el cuerpo del bucle, que recibe el contador y devuelve su nuevo valor; la tercera (45) se ejecuta una vez por tarea, al final de su trabajo: suma el contador de la tarea al total compartido. Esto reduce significativamente el número de operaciones atómicas;
- línea 48: para cada hilo que participó, registramos el número de números primos que encontró;
- líneas 57–65: [Parallel.ForEach] procesa una colección de nombres de archivo (el procesamiento se simula con una pausa de medio segundo), con un máximo de 2 procesos simultáneos.
Resultados:
- Los tres bucles encuentran la misma cantidad de números primos;
- varios hilos participaron en el bucle paralelo, incluido el hilo principal (ID 1);
- el procesamiento de [Parallel.ForEach] ocurre de a pares, con medio segundo de diferencia, y en un orden que no coincide con el de la lista;
- El ahorro de tiempo en esta ejecución es decepcionante: solo hay 2 procesadores, que los hilos de nuestro programa compartían con otros programas muy activos en el momento de la captura. En una máquina con poca carga y n procesadores, un bucle paralelo como este puede ser casi n veces más rápido que el bucle secuencial. Siempre se debe medir antes de sacar conclusiones: la paralelización tiene un costo (distribución del trabajo, sincronización) que solo vale la pena si cada iteración implica suficiente cálculo.
8.10. Datos locales de un hilo
8.10.1. El principio
Consideremos una aplicación de tres capas:
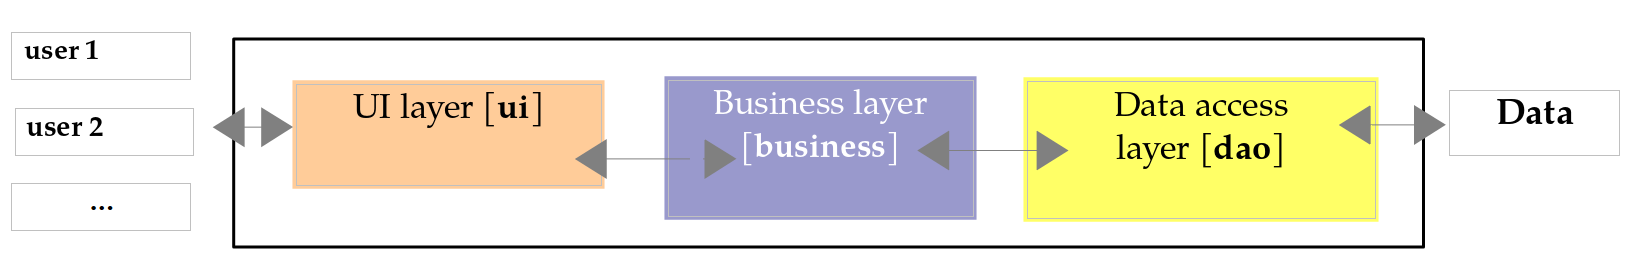
Supongamos que la aplicación es multiusuario, como una aplicación web. Cada solicitud de usuario es atendida por un hilo. El ciclo de vida del hilo es el siguiente:
- el hilo se crea u obtiene del grupo de hilos para atender la solicitud de un usuario;
- si esta solicitud requiere datos, el hilo ejecuta un método de la capa [ui], que llama a un método de la capa [business], que a su vez llama a un método de la capa [dao];
- el hilo devuelve la respuesta al usuario. Luego termina o se devuelve al grupo de hilos.
Durante el segundo paso, puede ser útil que el hilo tenga sus propios datos, es decir, datos no compartidos con otros hilos. Estos datos podrían, por ejemplo, pertenecer al usuario específico al que el hilo atiende y utilizarse en las diversas capas [ui, business, dao] sin pasarse como parámetro a cada método.
El curso de 2008 utilizaba los métodos [Thread.SetData] y [Thread.GetData] para este fin, que gestionan una especie de diccionario privado del hilo. Todavía existen, pero se usan poco; se prefieren dos herramientas más sencillas y eficientes:
- el atributo [[ThreadStatic]] aplicado a un campo estático: cada hilo tiene su propia instancia del campo;
- la clase [ThreadLocal<T>]: un objeto cuya propiedad [Value] tiene un valor distinto para cada hilo. Una función pasada al constructor proporciona el valor inicial para cada hilo.
El programa [threads-23.cs] compara un campo estático ordinario con estas dos herramientas:
Comentarios:
- línea 49: un campo estático ordinario. Solo existe una instancia, compartida por todos los hilos;
- líneas 51–52: el atributo [[ThreadStatic]] da a cada hilo una instancia del campo;
- líneas 54–55: una trampa clásica. El inicializador [= 5] lo ejecuta el constructor estático de la clase, una sola vez, en el hilo que usa la clase primero. Para los demás hilos, el campo tiene el valor predeterminado de su tipo, que en este caso es 0;
- línea 57: un objeto [ThreadLocal<string>]. La lambda pasada al constructor se ejecuta la primera vez que un hilo lee [Value] sin haber escrito en él; proporciona el valor inicial para ese hilo;
- Líneas 5–7: el hilo principal escribe sus propios valores;
- líneas 17–22: cada hilo escribe sus propios valores, excepto el hilo T2, que no establece un usuario;
- línea 25: cada hilo espera a que los demás escriban antes de volver a leer los valores.
Resultados:
- el campo ordinario [Shared] tiene el mismo valor para todos los hilos: el último valor escrito (en esta ejecución, el del hilo T2);
- el campo [PerThread] conservó, en cada hilo, el valor que ese hilo había escrito en él;
- el campo [WithInitializer] vale 5 para el hilo principal y 0 para los demás;
- la propiedad [User.Value] tiene el valor escrito por cada hilo; el hilo T2, que no había escrito en ella, recibió el valor inicial proporcionado por la lambda del constructor.
Los datos locales de un hilo tienen una limitación: su ámbito es el hilo, no el proceso. Con la programación asíncrona, como se verá en el próximo capítulo, un mismo proceso puede comenzar en un hilo y continuar en otro después de una espera. En este caso, se utiliza la clase [AsyncLocal<T>], cuyo valor persiste entre hilos.
8.10.2. Aplicación: una transacción compartida entre capas
Consideremos la siguiente aplicación de tres capas, en la que la capa [dao] gestiona una tabla de artículos:
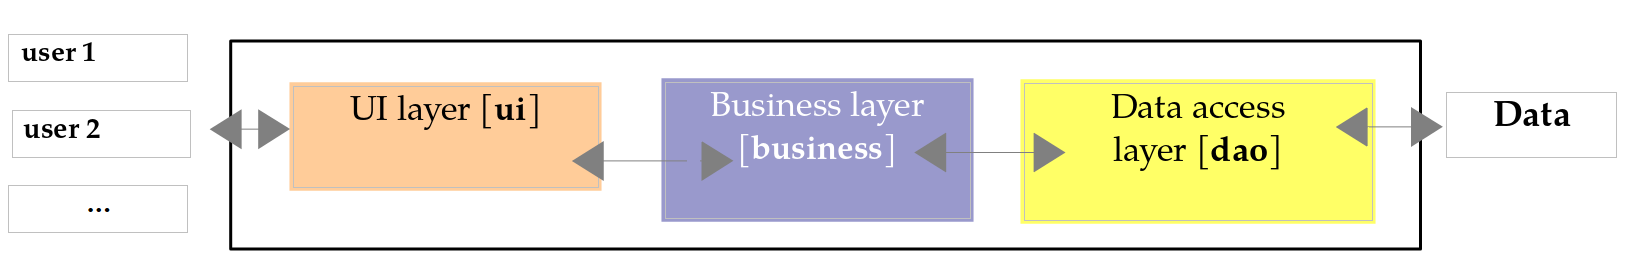
Supongamos que la interfaz de la capa [dao] es inicialmente la siguiente:
Más adelante surge la necesidad de insertar un arreglo de artículos dentro de una transacción, porque el sistema debe operar bajo el principio de todo o nada: o se insertan todos los artículos, o ninguno. Se puede agregar a la interfaz un método llamado [InsertArticles(Article[] articles)]. Luego, para otra aplicación, surge la necesidad de eliminar una lista de artículos, de nuevo dentro de una transacción… Para satisfacer distintos requisitos de negocio, la capa [dao] irá creciendo. Podemos adoptar un enfoque diferente:
- incluir solo las operaciones básicas (insertar, actualizar, eliminar, leer un artículo) en la capa [dao];
- trasladar las operaciones que actualizan simultáneamente varios artículos a la capa [business]. Estas operaciones utilizan las operaciones básicas de la capa [dao].
La ventaja de esta solución es que la misma capa [dao] puede utilizarse sin modificaciones con distintas capas [business]. Esto introduce un desafío en la gestión de la transacción que agrupa las actualizaciones que deben realizarse de forma atómica:
- la transacción debe ser iniciada por la capa [business] antes de que esta llame a los métodos de la capa [dao];
- los métodos de la capa [dao] deben conocer la existencia de la transacción para poder participar en ella;
- la transacción debe ser finalizada (confirmada o revertida) por la capa [business].
Para que los métodos de la capa [dao] conozcan cualquier transacción en curso, la transacción podría agregarse como parámetro a cada método de la capa [dao]. Este parámetro aparecería entonces en la firma de los métodos de la interfaz, lo que vincularía la interfaz a una fuente de datos específica. Los datos locales del hilo ofrecen una solución más elegante: la capa [business] coloca la transacción en los datos locales del hilo, y allí es donde la capa [dao] la recupera. No es necesario cambiar las firmas de los métodos de la capa [dao]. Varios hilos (varios usuarios) pueden trabajar simultáneamente: cada uno tiene su propia transacción.
El curso de 2008 utilizaba una base de datos SQL Server Compact, un producto que desde entonces fue descontinuado. Las bases de datos se tratarán en los capítulos sobre ADO.NET y Entity Framework Core. Para mantener el foco en los hilos, aquí utilizaremos una tabla en memoria y una transacción simulada. El programa [threads-24.cs] combina todas las capas en un solo archivo. Las entidades son las siguientes:
- línea 60: un artículo es un [record] cuyo identificador [Id] es asignado por la capa [dao];
- líneas 63–78: una transacción simulada. Cada actualización realizada dentro de la transacción registra la operación necesaria para deshacerla (método [Log]); [Commit] confirma la transacción ignorando estas operaciones; [Rollback] la revierte ejecutando las operaciones de reversión, de la última a la primera (de ahí la pila [Stack<Action>]). Una base de datos real funciona de manera similar, mediante un registro de transacciones;
- línea 67: a cada transacción se le asigna un número único. Como las transacciones pueden ser creadas por varios hilos simultáneamente, el contador se incrementa de forma atómica;
- líneas 84–87: los datos locales del hilo compartidos por las capas: la transacción actual del hilo, o [null] si no hay ninguna.
La capa [dao] es la siguiente:
- línea 101: la tabla de artículos, compartida por todos los hilos. El acceso a ella está protegido por el bloqueo de la línea 102;
- línea 108: el método [InsertArticle] recupera cualquier transacción que la capa [business] haya colocado en los datos locales del hilo actual;
- Líneas 111–113: la tabla tiene una restricción de unicidad sobre los nombres de los artículos: insertar un artículo con un nombre que ya existe lanza una excepción;
- Línea 115: el artículo insertado es una copia del artículo recibido, con un identificador asignado por la capa [dao]. La expresión [with] crea una copia de un [record] modificando ciertas propiedades;
- Líneas 118–122: si hay una transacción en curso, la capa [dao] participa registrando cómo deshacer la inserción. El operador [?.] llama a [Log] solo si [transaction] no es [null];
- línea 125: un mensaje de traza muestra el hilo, el artículo insertado y la transacción, si existe;
- líneas 131–135: la lista de artículos devuelta es una copia de la tabla (expresión de colección [.. table]), de modo que quien llama no la recorra mientras otro hilo la modifica.
La capa [business] es la siguiente:
- línea 157: la capa [dao] se inyecta mediante el constructor primario;
- líneas 163–164: el método [InsertArticlesInTransaction] inicia una transacción y la guarda en los datos locales del hilo;
- línea 170: se llama al método de inserción de la capa [dao] para cada artículo, sin pasarle la transacción;
- línea 172: una pausa simula el procesamiento, con el fin de dar tiempo a otro hilo para intervenir durante la transacción (tercera parte del programa de prueba);
- línea 174: si el programa llega a este punto, no se ha producido ninguna excepción: la transacción se confirma;
- líneas 177–181: si se produce una excepción, la transacción se revierte y la excepción se vuelve a lanzar a quien llama;
- línea 186: en cualquier caso, el hilo ya no tiene una transacción activa. Esto es importante si el hilo se reutiliza (hilo del grupo);
- línea 191: la misma inserción, sin transacción.
El programa de prueba es el siguiente:
- Línea 9: creamos un arreglo de dos artículos con el mismo nombre. La inserción del segundo artículo será rechazada. Si la inserción se realiza fuera de una transacción, el primer artículo se inserta y permanece en el arreglo. Si se realiza dentro de una transacción, el primer artículo se inserta y luego se elimina cuando la transacción se revierte;
- Líneas 11–14: insertamos el arreglo fuera de una transacción y luego mostramos la tabla;
- Líneas 16–20: el mismo proceso dentro de una transacción;
- líneas 22–34: dos hilos trabajan simultáneamente. El hilo A inserta tres artículos dentro de una transacción (el tercero viola la restricción de unicidad); mientras tanto, el hilo B inserta un artículo fuera de una transacción;
- líneas 37–45: la función [Execute] realiza una acción y muestra cualquier excepción, precedida del nombre del hilo.
Resultados:
- La inserción fuera de la transacción dejó el primer registro en la tabla (línea 6);
- la inserción realizada dentro de una transacción no dejó ningún registro en la tabla: el registro con ID 2 fue eliminado por la reversión;
- En la tercera parte, el hilo B insertó la pantalla mientras la transacción 2 del hilo A estaba en curso: lo hizo fuera de la transacción, ya que la transacción es una variable local del hilo A. La reversión de la transacción 2 eliminó el teclado y el mouse insertados por A, pero no la pantalla insertada por B.
8.10.3. Conclusión
El ejemplo anterior demostró el valor de los datos locales del hilo para la gestión de transacciones. No debe replicarse tal cual. .NET proporciona este mecanismo de forma nativa con la clase [System.Transactions.TransactionScope]: una transacción «ambiental», accesible mediante [Transaction.Current], en la que las conexiones de base de datos participan automáticamente. Frameworks como Entity Framework Core también gestionan las transacciones sin que el código de la capa [dao] tenga que encargarse de ellas. Y en las aplicaciones web actuales, que son asíncronas, esta información de contexto la transporta [AsyncLocal<T>] en lugar de los datos locales del hilo.
8.11. Lecturas adicionales
La sincronización de hilos es un campo difícil. Este capítulo ha presentado las herramientas principales; para profundizar:
- la documentación de Microsoft, capítulo «Threading in .NET»: Managed threading, en particular la página «Overview of synchronization primitives»;
- la documentación de Microsoft, capítulo «Parallel Programming»: Parallel Programming in .NET, que cubre la biblioteca [Parallel], las tareas y las colecciones concurrentes;
- el capítulo «Threading» del libro de Joseph Albahari, [C# in a Nutshell], cuya edición para C# 3.0 ya recomendaba el curso de 2008. Una versión más antigua pero todavía instructiva de este capítulo está disponible en línea: Threading in C#.
En el código moderno, rara vez se manipulan directamente objetos [Thread]. En su lugar, se prefieren las tareas ([Task]), ya que se ejecutan en el grupo de hilos, y sobre todo la programación asíncrona mediante las palabras clave [async] y [await], que permite esperar una operación de larga duración (acceso a la red, a una base de datos o a un archivo) sin bloquear un hilo. Este es el tema del próximo capítulo. No obstante, los conceptos tratados en este capítulo siguen siendo esenciales: las tareas se ejecutan en hilos, y los datos que comparten deben protegerse con las mismas herramientas ([lock], [Interlocked], colecciones concurrentes).