5. Clases de .NET de uso frecuente
Aquí presentamos algunas clases de uso frecuente de la plataforma .NET: cadenas, arreglos, colecciones, archivos y expresiones regulares. También trataremos LINQ (Language Integrated Query), que el curso de 2008 omitía aunque ya estaba disponible desde C# 3: hoy es la forma más común de manipular colecciones en C#. Antes, veremos cómo encontrar información sobre las miles de clases disponibles. Esta guía es indispensable para cualquier desarrollador de C#, incluso con experiencia.
Los ejemplos de este capítulo, con excepción de la aplicación de ejemplo del final, son aplicaciones de un solo archivo ejecutadas con [dotnet run file.cs]. Se encuentran en la carpeta [05-classes-dotnet] del código del curso y se ejecutan con la configuración regional francesa (fr-FR), salvo los ejemplos de LINQ y de expresiones regulares, que se ejecutan con la configuración regional del inglés estadounidense (en-US).
5.1. Cómo encontrar ayuda sobre las clases de .NET
El curso de 2008 ofrecía una descripción detallada, con capturas de pantalla, de la ayuda de MSDN instalada con Visual Studio 2008. Esta ayuda local ya no está disponible: la documentación de .NET ahora está en línea, es gratuita y se actualiza con cada nueva versión.
5.1.1. Documentación en línea
El punto de partida es el sitio web de Microsoft learn.microsoft.com. Allí encontrará:
- la documentación del lenguaje C#: https://learn.microsoft.com/en-us/dotnet/csharp/. Incluye una visión general del lenguaje, tutoriales, la referencia del lenguaje (palabras clave, operadores, instrucciones) y una sección “Novedades” que describe cada versión de C#;
- la referencia de la API de .NET: https://learn.microsoft.com/en-us/dotnet/api/. Describe, espacio de nombres por espacio de nombres, todas las clases de .NET: sus constructores, propiedades y métodos, con ejemplos;
- el explorador de API, en la misma página: un cuadro de búsqueda donde se puede escribir el nombre de una clase o método ([StringBuilder], [Regex.Match]…). Una lista desplegable permite seleccionar la versión de .NET (aquí, .NET 10).
La página de una clase, como System.String, muestra:
- el espacio de nombres de la clase y el ensamblado que la contiene;
- su declaración, su clase padre y las interfaces que implementa;
- una lista de sus constructores, propiedades y métodos, cada uno con un enlace a una página detallada que muestra sus diversas sobrecargas, parámetros, valores de retorno, posibles excepciones y, a menudo, un ejemplo;
- notas sobre su uso.
Las páginas están disponibles en francés (traducción automática) y en inglés (texto original, que a veces es más preciso). Se puede cambiar de uno a otro reemplazando [en-us] por [fr-fr] en la URL. Una búsqueda en un motor de búsqueda con el nombre completo de la clase (“System.Text.StringBuilder”) suele llevar directamente a la página correcta.
5.1.2. Ayuda del editor
El editor de código (Visual Studio, Visual Studio Code con la extensión C# Dev Kit, Rider) ofrece ayuda inmediata sin salir del código:
- el autocompletado (IntelliSense): después de escribir [aString.], el editor sugiere una lista de las propiedades y métodos del objeto, junto con un resumen de cada uno;
- Información sobre herramientas: al colocar el mouse sobre el nombre de una clase, método o variable, se muestra su declaración y un resumen de su documentación;
- Ayuda de parámetros: al escribir el paréntesis de apertura de una llamada, el editor muestra las diferentes sobrecargas del método y la función de cada parámetro;
- Ir a la definición (tecla F12): muestra la declaración de la clase o del método. Para una clase de .NET, el editor muestra las declaraciones públicas reconstruidas a partir del ensamblado, junto con sus comentarios de documentación;
- En Visual Studio, al pulsar la tecla F1 sobre el nombre de una clase o método se abre la página correspondiente de la documentación en línea.
Estos comentarios de documentación, que se ven al colocar el mouse sobre un elemento, son los que se usan para generar la referencia en línea. Se pueden escribir comentarios similares en el código propio mediante la sintaxis [/// <summary> ... </summary>] colocada encima de una clase o método: el editor los mostrará de la misma manera.
5.2. Cadenas
5.2.1. La clase System.String
El tipo [string] de C# es un alias de la clase [System.String]. Tiene numerosas propiedades y métodos. Estos son algunos de ellos:
Miembro | función |
[public int Length { get; }] | número de caracteres de la cadena |
[public char this[int index] { get; }] | Carácter n.º [index]: [aString[i]] |
[public bool StartsWith(string value)] | devuelve [true] si la cadena comienza con [value] |
[public bool EndsWith(string value)] | devuelve [true] si la cadena termina con [value] |
[public bool Contains(string value)] | devuelve [true] si la cadena contiene [value] |
[public bool Equals(string? value)] | devuelve [true] si la cadena es igual a [value]; equivale a [aString == value] |
[public int IndexOf(string value)] | la primera aparición de [value] en la cadena, o -1. Otra sobrecarga inicia la búsqueda en la posición [startIndex] |
[public int IndexOf(char value)] | lo mismo para el carácter [value] |
[public int LastIndexOf(char value)] | igual que [IndexOf] pero devuelve la última posición en lugar de la primera |
[public string Insert(int startIndex, string value)] | inserta la cadena [value] en la cadena en la posición [startIndex] |
[public static string Join(string separator, params string[] value)] | método de clase: concatena los elementos de [value], separándolos con [separator] |
[public string Replace(char oldChar, char newChar)] | devuelve una copia de la cadena en la que el carácter [oldChar] se ha reemplazado por [newChar]; un método sobrecargado reemplaza una cadena por otra |
[public string[] Split(params char[] separator)] | la cadena se trata como una secuencia de campos separados por los caracteres de [separator]; el resultado es un arreglo con estos campos |
[public string Substring(int startIndex, int length)] | una subcadena de [length] caracteres que comienza en la posición [startIndex] |
[public string ToLower()], [public string ToUpper()] | convierte la cadena a minúsculas, mayúsculas |
[public string Trim()] | elimina los espacios iniciales y finales de la cadena ([TrimStart], [TrimEnd]: solo en uno de los extremos) |
Es importante observar que una cadena del tipo [string] es inmutable; no se puede modificar después de crearla. Cuando un método devuelve una cadena, esta es distinta de la cadena a la que se aplicó el método. Así, [s1.Trim()] devuelve la cadena [s2], y [s1] y [s2] son dos cadenas diferentes: [s1] no ha cambiado.
Una cadena [c] puede considerarse un arreglo de caracteres de solo lectura:
- [c[i]] es el i-ésimo carácter de [c] (el primer carácter es el número 0);
- [c.Length] es el número de caracteres de [c].
El programa [strings-01.cs] es el siguiente:
Resultados:
Comentarios:
- línea 5: el carácter n.º 10, es decir, el undécimo carácter de la cadena;
- líneas 7 y 9: una búsqueda fallida devuelve -1;
- línea 10: los 7 caracteres a partir de la posición 4;
- línea 14: una inserción en la posición 9, antes de la palabra “flies”;
- línea 16: [Split] sin parámetros divide la cadena en los caracteres de espacio en blanco (espacio, tabulación, salto de línea, etc.). El curso de 2008 usaba [Split(null)], que equivale a lo mismo;
- línea 21: el método estático [Join] hace lo contrario de [Split];
- Línea 23: todos los métodos anteriores devolvían cadenas nuevas: [aString] permaneció sin cambios (línea 21 de los resultados);
- Líneas 27–29: una función local, como en el capítulo 3.
5.2.2. Los métodos Split y Join
El programa [strings-02.cs] profundiza en la división de una cadena en campos:
Resultados:
Comentarios:
- Línea 4: los campos están separados por el carácter [:]. Dos caracteres [:] consecutivos, o un solo [:] al final de la cadena, delimitan un campo vacío: esto da como resultado 5 campos, 2 de ellos vacíos (líneas 4 y 6 de los resultados). [Join] reconstruye la cadena original;
- el método [Split] tiene numerosas sobrecargas. La versión de 2008, [Split(char[] separator)], ahora se escribe [Split(params char[] separator)]: la palabra clave [params] permite pasar los separadores uno por uno, [Split(':')] o [Split(',', ';')], sin crear un arreglo;
- Línea 13: la enumeración [StringSplitOptions] modifica el desglose de los campos. [RemoveEmptyEntries] elimina los campos vacíos;
- línea 18: [TrimEntries] (.NET 5) elimina los espacios alrededor de cada campo. Aquí los separadores se pasan como una expresión de colección [',', ';'];
- línea 23: las dos opciones se combinan con el operador [|]. Los espacios se eliminan antes de la verificación de campos vacíos: se elimina el campo formado por dos espacios entre dos comas;
- línea 28: el separador puede ser una cadena formada por varios caracteres;
- línea 33: [Join] acepta una colección de elementos de cualquier tipo; cada elemento se convierte en cadena mediante su método [ToString].
5.2.3. Búsqueda y comparación de cadenas
La comparación de cadenas es más sutil de lo que parece: ¿deben distinguirse las mayúsculas de las minúsculas? ¿Cómo se debe ordenar “éclair” respecto de “essay”? El programa [strings-03.cs] presenta los métodos de búsqueda y comparación:
Resultados:
Comentarios:
- líneas 5–8: [Contains], [StartsWith], y [EndsWith] realizan por defecto una comparación exacta, carácter por carácter: “LANGUAGE” no se encuentra;
- Líneas 11–12: un parámetro del tipo [StringComparison] especifica el modo de comparación. Los valores más útiles son:
- [Ordinal]: comparación de códigos de caracteres;
- [OrdinalIgnoreCase]: igual que el anterior, ignorando mayúsculas y minúsculas;
- [CurrentCulture], [CurrentCultureIgnoreCase]: comparación según las reglas del idioma de la máquina;
- [InvariantCulture]: comparación basada en reglas independientes de la máquina;
- línea 16: el operador [] compara el contenido de las cadenas, igual que el método [Equals]. Esta es una diferencia importante con Java, donde [] compara referencias;
- línea 17: la forma estática de [Equals] también acepta un [StringComparison]. Esta es la manera correcta de evaluar una respuesta “yes” ingresada por teclado en mayúsculas o minúsculas;
- Líneas 21–22: [string.Compare] devuelve un entero negativo, cero o positivo según que la primera cadena vaya antes, sea igual o vaya después de la segunda. En francés, “éclair” va antes de “essay” (la letra “é” se clasifica junto con la “e”, línea 10 de los resultados). En la comparación ordinal, “éclair” va después de “essay” porque el código del primer carácter, “é” (233), es mayor que el del carácter “e” (101): la comparación ordinal devuelve aquí la diferencia entre los dos códigos, 132. Usaremos el orden cultural para ordenar palabras destinadas a un usuario y el orden ordinal para comparar identificadores técnicos (nombres de archivo, claves, etc.);
- líneas 27–29: dos métodos estáticos para evaluar una cadena ausente ([null]), vacía o que contiene solo espacios;
- Línea 32: [PadLeft] y [PadRight] rellenan una cadena hasta una longitud dada; el constructor [new string('-', 8)] repite un carácter.
5.2.4. Interpolación y formatos
La interpolación de cadenas [$"..."] (C# 6) se usa desde el comienzo de este curso. Al igual que el método [string.Format], acepta un ancho y un formato para cada expresión: [{expression,width:format}]. El programa [strings-04.cs] ofrece ejemplos de ello, así como de las cadenas sin formato (raw) de C# 11:
Resultados:
Comentarios:
- línea 11: un ancho positivo alinea el valor a la derecha dentro de un campo de 10 caracteres; un ancho negativo lo alinea a la izquierda;
- Líneas 12–14: los formatos más comunes:
formato | significado | ejemplo (fr-FR) |
[F2] | número de punto fijo, 2 decimales | 2345,68 |
[N2] | igual que el anterior, con separador de miles | 2 345,68 |
[C] | importe monetario según la cultura actual | 2 345,68 € |
[P2] | porcentaje (el valor se multiplica por 100) | 5,25 % |
[D5] | entero de 5 dígitos o más, rellenado con ceros | 00045 |
[X] | entero hexadecimal | 2D |
[dd/MM/yyyy], [HH:mm:ss] | fecha y hora (MM: mes, mm: minutos) | 03/10/2026, 14:05:09 |
[dddd d MMMM yyyy] | día y mes escritos con letras | samedi 3 octobre 2026 |
- Los números y las fechas se formatean según la configuración regional actual, en este caso fr-FR: coma decimal, espacio como separador de miles, nombres de días y meses en francés;
- línea 16: una expresión condicional ubicada dentro de una interpolación debe ir entre paréntesis, porque el carácter [:] introduciría allí un formato;
- línea 19: la notación [{0}], [{1}]… para [string.Format] es la que se usaba en el curso de 2008 (y en [Console.WriteLine], que acepta los mismos parámetros). Todavía se encuentra con frecuencia; la interpolación es más legible;
- líneas 24–26: los anchos permiten mostrar los datos en columnas;
- línea 30: una cadena textual [@"..."] no trata [\] como carácter de escape. Esto es útil para rutas de Windows y expresiones regulares;
- líneas 34–39: una cadena sin formato (C# 11) se delimita con al menos tres comillas dobles. Puede abarcar varias líneas y contener comillas sin escapar y [\]. La sangría de la comilla de cierre se elimina de cada línea: el texto JSON se muestra sin los 4 espacios del margen del código;
- Línea 42: una cadena sin formato puede interpolarse. Con [$$], una expresión interpolada se escribe entre llaves dobles [{{name}}], y las llaves simples —habituales en un texto como JSON— siguen siendo caracteres normales.
5.2.5. La clase System.Text.StringBuilder
Mencionamos que los métodos de la clase [String] que operan sobre una cadena [s1] devuelven otra cadena [s2]. La clase [System.Text.StringBuilder] permite modificar una cadena sin crear una nueva en cada operación. Esto mejora el rendimiento al construir una cadena mediante muchas adiciones sucesivas, ya que evita la proliferación de cadenas de vida muy corta.
La clase admite varios constructores:
constructor | función |
[StringBuilder()] | constructor predeterminado |
[StringBuilder(string value)] | Construye e inicializa con [value] |
[StringBuilder(string value, int capacity)] | Construye e inicializa con [value], con una capacidad inicial de [capacity] caracteres |
Un objeto [StringBuilder] almacena sus caracteres en una zona de memoria cuyo tamaño —su capacidad— se ajusta automáticamente a medida que el texto crece. Por defecto, la capacidad inicial es de 16 caracteres. El tercer constructor permite especificarla. El programa [strings-05.cs] ilustra este concepto de capacidad:
Resultados:
Comentarios:
- línea 4: creación de un objeto [StringBuilder] con una capacidad inicial de 16;
- línea 5: [Length] es el número actual de caracteres; [Capacity] es el número de caracteres que el objeto puede contener antes de ampliar su zona de memoria;
- línea 8: [Append] agrega una cadena al final del texto;
- línea 12: creación de un objeto [StringBuilder] con una capacidad inicial de 10.
Los resultados muestran que la capacidad se duplica cuando es insuficiente: 16, 32, 64 (líneas 6 y 10 de los resultados), y 10, 20, 40, 80 para el segundo objeto. Son los mismos resultados que en 2008. Si el tamaño aproximado del texto se conoce de antemano, fijarlo en el momento de la construcción evita ampliaciones sucesivas.
Estos son algunos de los métodos de la clase:
método | función |
[StringBuilder Append(string value)] | Agrega [value] al final del texto. Sobrecargado para aceptar los tipos [int], [double], [decimal], [char]… y una cadena interpolada |
[StringBuilder AppendLine()] | agrega un salto de línea (una sobrecarga agrega una cadena seguida de un salto de línea) |
[StringBuilder AppendJoin(string separator, params string[] values)] | agrega los elementos de [values] separados por [separator] |
[StringBuilder Insert(int index, string value)] | inserta [value] en la posición [index]; sobrecargado como [Append] |
[StringBuilder Remove(int index, int length)] | elimina [length] caracteres a partir de la posición [index] |
[StringBuilder Replace(string oldValue, string newValue)] | reemplaza [oldValue] por [newValue]; una sobrecarga reemplaza un carácter |
[string ToString()] | convierte el texto en una cadena [string] |
El programa [strings-06.cs] los utiliza:
Resultados:
Comentarios:
- Línea 5: los métodos de modificación devuelven el propio objeto [StringBuilder], lo que permite encadenarlos. Sigamos los pasos: “test” pasa a “testabCD” ([Append]), luego a “texyZTstabCD” ([Insert] en la posición 2), luego a “xyZTstabCD” ([Remove] de los 2 primeros caracteres) y, finalmente, a “XYZTstabCD” ([Replace]). [Console.WriteLine] muestra el objeto llamando a su método [ToString];
- líneas 9–11: construcción de un texto de varias líneas mediante adiciones sucesivas: este es el uso típico de [StringBuilder];
- Línea 17: [Append] acepta una cadena interpolada, incluidos el ancho y el formato;
- Línea 19: el texto final se obtiene como una cadena [string].
Para unas pocas concatenaciones, el operador [+] o la interpolación bastan: el compilador las optimiza. [StringBuilder] es necesario cuando el número de adiciones es grande o desconocido, típicamente en un bucle.
5.2.6. Vistas sobre una cadena: Span<char>
.NET Core 2.1 (2018) introdujo los tipos [Span<T>] y [ReadOnlySpan<T>]. Un objeto [ReadOnlySpan<char>] es una vista de una secuencia de caracteres existente, como una porción de una cadena: no contiene una copia de los caracteres, solo una forma de acceder a ellos. Por lo tanto, extraer una porción de una cadena mediante una vista no crea una nueva cadena. El programa [strings-07.cs] compara las dos formas de analizar una línea con el formato “apellido:nombre:edad”:
Resultados:
Comentarios:
- líneas 7–8: cada llamada a [Substring] crea una nueva cadena en memoria, incluso si, como en el caso de la edad, solo se usa un instante;
- línea 12: [AsSpan] devuelve una vista de la cadena completa;
- Líneas 13–14: los rangos [start..end] (C# 8), presentados en el capítulo 3 para los arreglos, se aplican a las vistas: se obtienen dos nuevas vistas, sin copia;
- línea 16: muchos métodos de .NET aceptan una vista en lugar de una cadena ([Parse], [TryParse], [StartsWith], [Contains], [Equals]…);
- Línea 21: solo se crea una cadena a partir de una vista si realmente es necesario.
Las vistas son una herramienta de optimización muy utilizada dentro del propio .NET: esta es una de las razones por las que las versiones recientes son notablemente más rápidas que .NET Framework 2008. Una vista solo puede existir en la pila de ejecución: no puede, por ejemplo, ser un campo de una clase. Para un programa ordinario, [string] y [Substring] son perfectamente adecuados: las vistas solo deben usarse en código identificado como crítico para el rendimiento. No profundizaremos más.
5.3. Arreglos
5.3.1. La clase Array
Los arreglos derivan de la clase [System.Array]. Esta clase ofrece diversos métodos para ordenar un arreglo, buscar un elemento en un arreglo, redimensionarlo, etc. Presentaremos algunas de sus propiedades y métodos. Casi todos están sobrecargados, es decir, existen en distintas variantes. Todo arreglo los hereda.
Propiedades:
propiedad | función |
[public int Length { get; }] | número total de elementos del arreglo, sea cual sea el número de dimensiones |
[public int Rank { get; }] | número de dimensiones del arreglo |
Métodos:
Método | función |
[public static int BinarySearch<T>(T[] array, T value)] | Devuelve la posición de [value] en [array], que debe estar ordenado; un número negativo si [value] no está |
[public static void Clear(Array array, int index, int length)] | asigna a los [length] elementos de [array] a partir del índice [index] sus valores predeterminados: 0 para los números, [false] para los booleanos, [null] para las referencias |
[public static void Copy(Array source, Array destination, int length)] | copia los primeros [length] elementos de [source] a [destination] |
[public static void Fill<T>(T[] array, T value)] | asigna [value] a todos los elementos de [array] |
[public int GetLength(int dimension)] | número de elementos de la dimensión n.º [dimension] del arreglo |
[public static int IndexOf<T>(T[] array, T value)] | devuelve la posición de [value] en [array], o -1 si [value] no se encuentra; [LastIndexOf] devuelve la última posición |
[public static void Resize<T>(ref T[]? array, int newSize)] | redimensiona [array] a [newSize] elementos; los elementos ya presentes se conservan |
[public static void Reverse(Array array)] | invierte el orden de los elementos de [array] |
[public static void Sort<T>(T[] array)] | ordena [array] según el orden natural de sus elementos; un método sobrecargado recibe un objeto [IComparer<T>] que define el orden (capítulo 4) |
El programa [arrays-01.cs] ilustra el uso de ciertos métodos de la clase [Array]:
Comentarios:
- Líneas 17–42: el método [Input] ingresa por teclado los elementos de un arreglo. Como el número de elementos no se conoce de antemano, el programa parte de un arreglo vacío (línea 20) y lo amplía en un elemento por cada nueva entrada (línea 38). [Resize] en realidad crea un nuevo arreglo, copia en él los elementos del anterior y almacena su referencia en la variable pasada por [ref]. Un algoritmo más eficiente reservaría espacio en grupos de N elementos. Un arreglo no está diseñado para redimensionarse: este caso se maneja mejor con una lista [List<T>], como veremos enseguida;
- línea 40: [^1] designa el último elemento del arreglo (indexado desde el final, C# 8);
- En el curso de 2008, [Input] era un método con un parámetro [out]; la versión moderna devuelve el arreglo creado, lo cual es más natural;
- Líneas 56–78: el método [Search] busca en el arreglo los elementos ingresados por teclado. Para un arreglo sin ordenar, se realiza una búsqueda lineal con [IndexOf] (línea 76), que examina los elementos uno por uno. Para un arreglo ordenado, se realiza una búsqueda binaria con [BinarySearch] (línea 75), que reduce a la mitad el rango de búsqueda en cada paso: encuentra un elemento entre un millón en unas veinte comparaciones;
- línea 10: se ordena el arreglo. Aquí se usa una variante de [Sort] que tiene un solo parámetro: el arreglo por ordenar. La relación de orden utilizada para comparar los elementos del arreglo es entonces la implícita de esos elementos: en este caso, el orden natural de los números;
- líneas 46–51: un método genérico que muestra un arreglo de elementos de cualquier tipo, [T].
Resultados:
Cuando el elemento buscado está ausente, [IndexOf] devuelve -1 y [BinarySearch] devuelve un número negativo (línea 27): es el complemento a uno ([~i]) de la posición en la que debería insertarse el elemento para mantener el arreglo ordenado. Aquí, [~(-3)] es igual a 2: el número 0 debería insertarse en la posición 2, entre -1.5 y 3.6. Nota: [BinarySearch] sobre un arreglo sin ordenar devuelve un resultado sin sentido.
5.3.2. Otros métodos de la clase Array
El programa [arrays-02.cs] muestra otros métodos de la clase [Array]:
Resultados:
Comentarios:
- línea 6: [Reverse] invierte el orden de los elementos del propio arreglo;
- línea 10: solo se ordenan 3 elementos a partir de la posición 1: 20, 30, 10 pasan a ser 10, 20, 30;
- línea 15: copia los 3 primeros elementos de [numbers] en [copy], mientras que los demás elementos conservan su valor inicial de 0;
- Líneas 19–21: [Fill] llena el arreglo; [Clear] restablece a 0 dos elementos a partir de la posición 1;
- línea 29: las cadenas se ordenan alfabéticamente según la cultura actual;
- Línea 34: para un arreglo bidimensional, [Rank] es 2, [Length] es el número total de elementos, y [GetLength(i)] es el número de elementos de la dimensión i;
- Línea 39: [string.Join] muestra un arreglo en una sola línea.
LINQ, del que hablaremos más adelante, ofrece otras formas de buscar, ordenar o transformar los elementos de un arreglo.
5.4. Colecciones genéricas
Además de los arreglos, existen diversas clases para almacenar colecciones de elementos. Las colecciones genéricas, introducidas con .NET 2.0, se encuentran en el espacio de nombres [System.Collections.Generic], que forma parte de los espacios de nombres [using] implícitos. Presentaremos primero dos colecciones de uso frecuente —la lista y el diccionario— y luego veremos brevemente otras.
El espacio de nombres [System.Collections] contiene las versiones más antiguas, no genéricas, de estas colecciones, que datan de .NET 1.0: [ArrayList] (una lista), [Hashtable] (un diccionario)... El curso de 2008 todavía presentaba [ArrayList]. Estas clases están ahora obsoletas: almacenan referencias de tipo [object], lo que obliga a convertir los elementos leídos y a empaquetar (boxing) los números en objetos, con los costos asociados de memoria y tiempo. Las colecciones genéricas no tienen ninguno de estos inconvenientes: una *[List<int>] almacena sus enteros directamente en un arreglo interno *[int[]] , y el compilador verifica el tipo de los elementos agregados. [ArrayList] y [Hashtable] ya no deben usarse en código nuevo.
5.4.1. La clase genérica List<T>
La clase [System.Collections.Generic.List<T>] permite implementar colecciones de objetos [T] cuyo tamaño varía durante la ejecución del programa. Un objeto de tipo [List<T>] se maneja casi como un arreglo. Así, el elemento i de una lista [l] se denota [l[i]].
Para una lista de tipo [List<T>] donde [T] es una clase, la lista almacena referencias a objetos de tipo [T], como un arreglo de objetos; si [T] es un tipo de valor ([int], [double], estructura…), los propios valores se almacenan en la lista.
Estas son algunas de las propiedades y métodos de las listas genéricas.
Propiedades:
propiedad | función |
[public int Count { get; }] | número de elementos de la lista |
[public int Capacity { get; set; }] | Número de elementos que la lista puede contener antes de ampliarse. Esta ampliación se produce automáticamente. Este concepto de capacidad es análogo al descrito para la clase [StringBuilder] |
Métodos:
Método | función |
[public void Add(T item)] | agrega [item] al final de la lista |
[public void AddRange(IEnumerable<T> collection)] | agrega los elementos de [collection] al final de la lista |
[public int BinarySearch(T item)] | devuelve la posición de [item] en la lista ordenada si está presente; de lo contrario, devuelve un número negativo |
[public void Clear()] | elimina todos los elementos de la lista |
[public bool Contains(T item)] | devuelve [true] si [item] está en la lista; de lo contrario, [false] |
[public List<T> GetRange(int index, int count)] | devuelve una nueva lista formada por [count] elementos a partir de la posición [index] |
[public int IndexOf(T item)] | Devuelve la posición de [item] en la lista, o -1 si [item] no se encuentra |
[public void Insert(int index, T item)] | inserta [item] en la posición [index] en la lista |
[public bool Remove(T item)] | elimina la primera aparición de [item] de la lista; devuelve [true] si la operación tiene éxito y [false] en caso contrario |
[public void RemoveAt(int index)] | elimina el elemento n.º [index] de la lista |
[public void Reverse()] | invierte el orden de los elementos de la lista |
[public void Sort()] | ordena la lista en orden natural; una versión sobrecargada recibe un [IComparer<T>] |
[public T[] ToArray()] | devuelve los elementos de la lista como un arreglo |
Retomemos el ejemplo que vimos antes con un arreglo y procesémoslo ahora con un objeto de tipo [List<double>]. Como la lista es similar a un arreglo, el código cambia muy poco. Este es el programa [collections-01.cs]:
Comentarios:
- línea 22: la lista se crea vacía. [new()] (C# 9) es una forma abreviada de [new List<double>()]: el tipo se infiere de la declaración de la variable;
- línea 40: ya no hay que manejar ninguna redimensión; la lista se amplía automáticamente;
- línea 6: el número de elementos de la lista y su capacidad;
- líneas 12, 75, 76: los métodos [Sort], [BinarySearch] y [IndexOf] ahora son métodos de instancia de la lista, mientras que los de [Array] son métodos estáticos;
- líneas 46–51: el método genérico [Display<T>] recibe dos parámetros:
- el primero es un texto que se escribe;
- el segundo es un objeto que implementa la interfaz genérica [IEnumerable<T>]:
La estructura [foreach (T element in elements)] es válida para cualquier objeto [elements] que implemente la interfaz [IEnumerable<T>]. Los arreglos y las listas implementan esta interfaz. Por lo tanto, el método [Display] sirve para mostrar tanto arreglos como listas. Volveremos sobre esta interfaz, que está en el corazón de LINQ.
Resultados:
Los resultados son los mismos que con el arreglo. La capacidad de la lista aquí es 4 (línea 7): partiendo de 0, aumentó a 4 en la primera adición; habría aumentado a 8 en la quinta adición, duplicándose como la de un [StringBuilder].
5.4.2. Métodos de List<T> y expresiones de colección
El programa [collections-02.cs] usa los demás métodos de la lista y las expresiones de colección de C# 12, que ya vimos con los arreglos en el capítulo 3:
Resultados:
Comentarios:
- línea 4: una expresión de colección [a, b, c] inicializa una lista como un arreglo;
- líneas 8–10: tres formas de agregar elementos;
- línea 14: el elemento n.º 0 es de lectura y escritura; [cities[^1]] es el último elemento, como con un arreglo;
- línea 21: [Remove] devuelve [true] si el elemento se encontró y se eliminó;
- línea 30: una nueva lista formada por 2 elementos a partir de la posición 1;
- líneas 34–35: conversión de una lista a un arreglo, y de un arreglo (o de cualquier secuencia) a una lista;
- línea 40: en una expresión de colección, el operador [..] (spread) inserta todos los elementos de otra colección;
- Línea 43: [] designa una colección vacía del tipo esperado.
5.4.3. La clase Dictionary<TKey,TValue>
La clase [System.Collections.Generic.Dictionary<TKey,TValue>] se usa para implementar un diccionario. Un diccionario puede concebirse como un arreglo de dos columnas:
clave | valor |
clave1 | valor1 |
clave2 | valor2 |
... | ... |
En la clase [Dictionary<TKey,TValue>], las claves son de tipo [TKey] y los valores son de tipo [TValue]. Las claves son únicas: no puede haber dos claves idénticas. Un diccionario de este tipo se vería así si los tipos [TKey] y [TValue] se refirieran a clases:
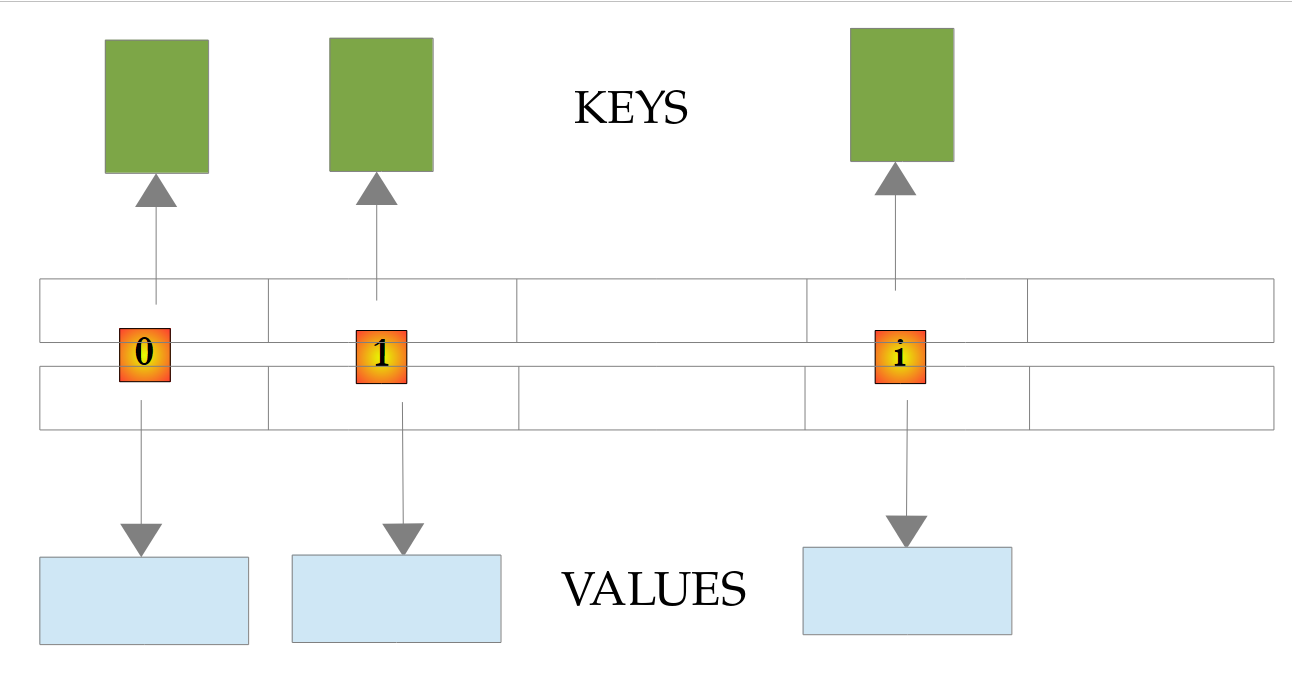
El valor asociado a la clave [c] en un diccionario [d] se obtiene con la notación [d[c]]. Este valor es de lectura y escritura. Así, podemos escribir:
Al escribir, [d[c] = v] agrega el par (c, v) si la clave [c] no existe, y reemplaza el valor asociado a [c] en caso contrario. Al leer, si la clave [c] no existe en el diccionario [d], la notación [d[c]] lanza una excepción [KeyNotFoundException].
Los principales métodos y propiedades de la clase [Dictionary<TKey,TValue>] son los siguientes.
Propiedades:
propiedad | función |
[public int Count { get; }] | número de entradas (clave, valor) del diccionario |
[public KeyCollection Keys { get; }] | colección de las claves del diccionario |
[public ValueCollection Values { get; }] | colección de los valores del diccionario |
Métodos:
Método | Función |
[public void Add(TKey key, TValue value)] | Agrega el par (clave, valor) al diccionario; lanza una excepción si la clave ya existe |
[public bool TryAdd(TKey key, TValue value)] | Igual que el anterior, pero devuelve [false] en lugar de lanzar una excepción |
[public void Clear()] | elimina todos los pares del diccionario |
[public bool ContainsKey(TKey key)] | Devuelve [true] si [key] es una clave del diccionario; de lo contrario, devuelve [false] |
[public bool ContainsValue(TValue value)] | devuelve [true] si [value] es un valor del diccionario, y [false] en caso contrario |
[public bool Remove(TKey key)] | elimina el par clave-valor [key] del diccionario; devuelve [true] si la operación tiene éxito y [false] en caso contrario |
[public bool TryGetValue(TKey key, out TValue value)] | devuelve [true] y asigna a [value] el valor asociado a la clave [key] si esta existe; devuelve [false] en caso contrario, y [value] recibe el valor predeterminado del tipo [TValue] |
Consideremos el programa de ejemplo [collections-03.cs]:
Comentarios:
- línea 4: un arreglo de cadenas que se usará para inicializar el diccionario <string,int>;
- línea 5: el diccionario, que está vacío;
- líneas 6–9: su inicialización a partir del arreglo de cadenas;
- línea 12: el número de entradas del diccionario;
- líneas 14–16: las claves y los valores del diccionario. [dico.Keys] y [dico.Values] implementan [IEnumerable<T>]: el método [Display] que ya vimos es adecuado;
- línea 25: eliminación de una entrada del diccionario;
- línea 28: un diccionario es una secuencia de pares [KeyValuePair<TKey,TValue>], cada uno de los cuales tiene una propiedad [Key] y una propiedad [Value]. Desde .NET Core 2.0, un par de este tipo se descompone en dos variables, como una tupla (capítulo 3);
- líneas 35–42: [Add] rechaza una clave existente lanzando una excepción; [TryAdd] devuelve [false] en ese caso. Los mensajes de excepción de .NET están en inglés: .NET 10 no ofrece mensajes en francés;
- línea 46: intentar leer una clave inexistente lanza una excepción [KeyNotFoundException];
- línea 63: búsqueda de una clave en el diccionario. [TryGetValue] devuelve [true] si la clave existe. El curso de 2008 ignoraba este resultado y verificaba si el valor devuelto era null, una técnica que funcionaba solo porque el valor 0 no estaba en el diccionario. Verificar el valor booleano devuelto es el enfoque correcto.
Resultados:
Aquí las claves aparecen en el orden en que se agregaron, pero esto no está garantizado: un *[Dictionary]* no conserva ningún orden. Tras las eliminaciones, un nuevo elemento puede ocupar el lugar de uno eliminado. Si el orden de las claves es importante, use un *[SortedDictionary]*, que se muestra más adelante.
5.4.4. Otras colecciones genéricas
El espacio de nombres [System.Collections.Generic] contiene otras colecciones, cada una adecuada para un propósito específico:
clase | función |
[HashSet<T>] | un conjunto: sin duplicados, sin orden, prueba de pertenencia muy rápida; operaciones de conjuntos (unión, intersección, diferencia) |
[SortedSet<T>] | un conjunto cuyos elementos se mantienen ordenados |
[Queue<T>] | una cola: los elementos salen en el orden en que se insertaron (FIFO, first in, first out) |
[Stack<T>] | una pila: el último elemento agregado es el primero en salir (LIFO, last in first out) |
[SortedDictionary<TKey,TValue>] | un diccionario cuyas claves se mantienen ordenadas |
[PriorityQueue<TElement,TPriority>] | una cola de prioridad (.NET 6): el elemento que se extrae es el de menor prioridad |
[LinkedList<T>] | una lista doblemente enlazada: inserciones y eliminaciones rápidas en medio de la lista |
El programa [collections-04.cs] ofrece una visión rápida:
Resultados:
Comentarios:
- línea 4: las expresiones de colección también inicializan un conjunto;
- línea 6: [Add] devuelve [false] si el elemento ya está en el conjunto, que permanece sin cambios;
- Líneas 9–12: [IntersectWith] y [UnionWith] modifican el conjunto; por lo tanto, se trabaja sobre una copia de [languages]. El orden en que se muestran los elementos de un conjunto no tiene significado (línea 4);
- las llaves dobles [{{] y [}}] en una cadena interpolada muestran una sola llave;
- líneas 16–20: [Enqueue] encola un elemento, [Dequeue] desencola el elemento más antiguo, [Peek] obtiene el elemento sin desencolarlo;
- líneas 23–30: [Push] apila un elemento, [Pop] extrae el elemento más reciente. [Pop] sobre una pila vacía lanza una excepción; [TryPop] devuelve [false];
- líneas 33–40: un diccionario inicializado con la sintaxis [[key] = value]; sus pares clave-valor se enumeran en orden de clave;
- líneas 43–49: cada elemento entra en la cola con una prioridad; los pacientes salen en orden ascendente de prioridad, sin importar su orden de llegada.
5.4.5. Colecciones de solo lectura
Una clase que gestiona una colección suele necesitar exponerla hacia el exterior sin permitir que se modifique. .NET ofrece para ello interfaces de solo lectura: [IReadOnlyCollection<T>] (un [Count] y un [foreach]), [IReadOnlyList<T>] (más el acceso por índice) e [IReadOnlyDictionary<TKey,TValue>]. Las clases [List<T>], [T[]], y [Dictionary<TKey,TValue>] las implementan. El programa [collections-05.cs] las utiliza:
Resultados:
Comentarios:
- líneas 37–47: la clase [Classroom] gestiona una lista de estudiantes. La lista en sí es privada; solo el método [Enroll] permite modificarla;
- línea 43: la propiedad [Students] convierte la lista al tipo [IReadOnlyList<string>], que solo admite operaciones de lectura: [students.Add("x")] provocaría un error de compilación;
- línea 12: sin embargo, esta protección es solo superficial: el objeto devuelto es la propia lista, y una conversión de tipo (cast) permite acceder a sus métodos de modificación;
- línea 45: [AsReadOnly] envuelve la lista en un contenedor de tipo [ReadOnlyCollection<T>]. Esta vez no es posible ninguna modificación: sus métodos de modificación, impuestos por la interfaz [IList<T>], lanzan una excepción [NotSupportedException] (línea 5). El envoltorio no copia la lista: ve las modificaciones realizadas por la clase propietaria (línea 6);
- línea 33: un diccionario visto a través de la interfaz [IReadOnlyDictionary<TKey,TValue>].
Para los datos que nunca deben cambiar después de su creación, el espacio de nombres [System.Collections.Immutable] ofrece colecciones inmutables ([ImmutableList<T>], [ImmutableDictionary<TKey,TValue>]…) y [System.Collections.Frozen] ofrece colecciones congeladas optimizadas para lectura ([FrozenDictionary<TKey,TValue>], .NET 8). No entraremos en detalles sobre ellas.
5.5. LINQ
El curso de 2008 terminaba justo antes de LINQ, presentando sus tipos anónimos sin utilizarlos realmente. LINQ (Language Integrated Query, C# 3, 2007) es un conjunto de métodos que permiten consultar una colección tal como se consulta una base de datos: filtrar, ordenar, agrupar, calcular totales, etc. Se aplica a cualquier colección que implemente la interfaz [IEnumerable<T>]: arreglos, listas, diccionarios, conjuntos, líneas de un archivo, resultados de una expresión regular y, con Entity Framework Core (capítulo 11), tablas de bases de datos. El espacio de nombres [System.Linq] forma parte de los espacios de nombres [using] implícitos.
5.5.1. Las secuencias IEnumerable<T> y los iteradores
Una colección que implementa [IEnumerable<T>] se denomina secuencia: se puede recorrer con [foreach]. La interfaz contiene un único método, [GetEnumerator], que devuelve un enumerador [IEnumerator<T>]: un objeto que recorre la secuencia ([MoveNext]) y devuelve el elemento actual ([Current]).
Un método puede producir una secuencia sin construir una colección: es un iterador. Devuelve sus elementos uno por uno mediante la instrucción [yield return]. El programa [linq-01.cs] ofrece dos ejemplos:
Resultados:
Comentarios:
- Líneas 39–48: el método
[Evens]es un iterador: su tipo de retorno es*[IEnumerable<int>], y contiene la instrucción[yield return](línea 46). No construye ninguna lista: por cada [yield return], devuelve un elemento al código que lo recorre y se pausa*; se reanudará en la instrucción siguiente cuando se le pida el siguiente elemento; - líneas 5–7: los resultados (líneas 3–12) muestran que la producción de un elemento por el iterador y su consumo por el bucle [foreach] se alternan;
- líneas 12–17: lo que [foreach] hace realmente: solicita un enumerador a la secuencia, llama a [MoveNext] mientras ese método devuelva [true] y lee el elemento actual de [Current]. El iterador se libera al final mediante la instrucción [using] (volveremos sobre esto al hablar de los archivos). Observe que la llamada a [Evens(4)] en la línea 12 no hace nada: el mensaje “start of the iterator” solo aparece en la primera llamada a [MoveNext];
- líneas 52–58: un iterador puede producir una secuencia infinita; calcula solo los elementos solicitados. Es el bucle [foreach] el que decide cuándo detenerse (línea 25). La línea 58 usa las tuplas del capítulo 3 para intercambiar valores;
- líneas 34–35: una cadena es una secuencia de caracteres; una lista es una secuencia de sus elementos. Aquí la lista se crea con la sintaxis [new List<string> { ... }] de inicializador de colección (C# 3), que se encuentra con frecuencia en el código existente.
Este mecanismo de generación bajo demanda lo utilizan todos los métodos de LINQ.
5.5.2. Filtrar, proyectar, ordenar
Los ejemplos siguientes trabajan con una pequeña lista de personas. Una persona se representa mediante un [record] (C# 9), es decir, un record presentado en el capítulo 4: en una sola línea, se obtiene una clase con un constructor, propiedades de solo lectura, un método [ToString] que muestra las propiedades y un operador de igualdad que compara los valores de las propiedades.
El programa [linq-02.cs] muestra los métodos básicos de LINQ:
Resultados:
Comentarios:
- líneas 4–13: la lista de personas, inicializada mediante una expresión de colección; [new(...)] crea un objeto del tipo esperado, en este caso [Person];
- línea 56: el record [Person]. Una aplicación de un solo archivo coloca sus declaraciones de tipos después de las instrucciones de nivel superior;
- línea 16: el método [Where] filtra la secuencia: solo conserva los elementos que cumplen una condición. Esta condición se le pasa en forma de función anónima [p => p.Age >= 18], que se lee “la función que, para una persona p, asocia el booleano p.Age >= 18”. Esta notación se denomina expresión lambda. [Where] llama a esta función para cada persona. Las lambdas se estudiarán en detalle en el capítulo 7 (“Delegados, lambdas y eventos”; por ahora basta con saber leerlas);
- El resultado de [Where] es una nueva secuencia, [IEnumerable<Person>]: la lista [persons] permanece sin cambios. Esto vale para todos los métodos de LINQ;
- el método [Display] muestra cada persona mediante el método [ToString] generado para el record: [Person { LastName = dupont, ... }];
- Línea 20: el método [Select] transforma cada elemento de la secuencia en un nuevo valor, en este caso una cadena. El resultado es una secuencia [IEnumerable<string>];
- líneas 24–27: los métodos de LINQ devuelven secuencias, a las que se pueden aplicar otros métodos de LINQ. Los métodos suelen escribirse uno por línea: esta cadena de llamadas se lee de arriba abajo como una receta;
- línea 26: [OrderBy] ordena la secuencia según la clave devuelta por la lambda, en este caso el nombre;
- línea 31: [OrderByDescending] ordena en orden descendente; [ThenBy] (o [ThenByDescending]) agrega un criterio secundario, que sirve para distinguir los elementos iguales según el primer criterio: Durand y Laurent, que tienen ambos 32 años, se ordenan por nombre (líneas 23–24);
- líneas 35–38: la misma consulta que [angersPeople] escrita con la sintaxis de consulta, similar a SQL. El compilador la traduce exactamente a la cadena de llamadas [Where(...).OrderBy(...).Select(...)]: las dos notaciones son equivalentes. La sintaxis de consulta es más legible para uniones y agrupaciones; la sintaxis de métodos es más común y es la única que da acceso a todos los métodos de LINQ ([Take], [Count], [First]…);
- Línea 42: una variante de [Select] pasa a la lambda el elemento y su posición en la secuencia.
5.5.3. Cuantificadores, agregados, selección de elementos
El programa [linq-03.cs] incluye métodos que devuelven un único valor y métodos que seleccionan una porción de la secuencia:
Resultados:
Comentarios:
- Línea 15: [Any] devuelve [true] si al menos un elemento cumple la condición, y [All] si todos la cumplen. Sin parámetros, [Any] indica si la secuencia no está vacía;
- Líneas 18–20: los agregados [Count], [Sum], [Average], [Min], [Max] calculan un valor a partir de toda la secuencia. [Count] acepta una condición (una lista también tiene una propiedad [Count], que se prefiere al método cuando no hay condición); [Sum], [Average], [Min] y [Max] aceptan una lambda que especifica el valor que se debe considerar para cada elemento;
- Línea 22: [MinBy] y [MaxBy] (.NET 6) devuelven el elemento (en este caso, la persona) cuya clave es mínima o máxima, y no el valor de la clave en sí. Para una secuencia vacía de objetos (tipo de referencia), devuelven [null], de ahí el operador [?.];
- línea 25: [First] devuelve el primer elemento de la secuencia, o el primero que cumple una condición; [Last] devuelve el último;
- Línea 26: si ningún elemento coincide, [First] lanza una excepción (línea 11 de los resultados), mientras que [FirstOrDefault] devuelve el valor predeterminado del tipo, en este caso [null];
- Línea 28: [Single] devuelve el único elemento que cumple la condición y lanza una excepción si hay cero o varios (línea 10). Se usa cuando la unicidad es una regla de los datos, como al buscar un elemento por su clave. [SingleOrDefault] devuelve el valor predeterminado si no hay ningún elemento;
- línea 32: el resultado de la llamada no se utiliza; se asigna al descarte [_] (C# 7) para señalarlo;
- línea 49: [Distinct] elimina los duplicados; [DistinctBy] (.NET 6) conserva el primer elemento de cada valor de clave;
- líneas 57–58: [Take(n)] conserva los primeros n elementos, [Skip(n)] los omite. Combinados, extraen una “página” de resultados. [TakeWhile] conserva los elementos mientras se cumple una condición y se detiene en el primer elemento que no la cumple;
- línea 62: [Chunk] (.NET 6) divide la secuencia en arreglos de 3 elementos, el último de los cuales puede ser más corto;
- línea 64: la variable [page] se incrementa después de usarse en la interpolación.
5.5.4. Tipos anónimos, agrupaciones, uniones
El programa [linq-04.cs] presenta los tipos anónimos y operaciones más complejas:
Resultados:
Comentarios:
- Línea 22: un tipo anónimo (C# 3): la expresión [new { LastName = ..., Age = ... }] crea un objeto cuya clase sin nombre es generada por el compilador con dos propiedades de solo lectura, [LastName] y [Age]. Como este tipo no tiene nombre, la variable debe declararse como [var]. Sin embargo, el compilador conoce perfectamente este tipo: [p1.LastName] se valida en tiempo de compilación, y el editor sugiere las propiedades de [p1] en el autocompletado;
- línea 25: el uso principal de los tipos anónimos: en un [Select], conservar solo los datos útiles sin tener que declarar una clase para ellos. [p.LastName] es una abreviatura de [LastName = p.LastName];
- Línea 33: [GroupBy] agrupa los elementos que tienen la misma clave. El resultado es una secuencia de grupos [IGrouping<TKey,TElement>]: cada grupo tiene una propiedad [Key], el valor común de la clave, y es a su vez la secuencia de los elementos del grupo, a la que se pueden aplicar [Count], [Average], [Select]… (línea 36);
- líneas 41–44: [Join] asocia cada persona con la ciudad del mismo nombre. Sus parámetros son la segunda secuencia, la clave de unión de cada lado y una lambda que construye el resultado a partir de un par (persona, ciudad). Como un join de SQL, [Join] solo conserva los pares que coinciden: Laurent, que vive en Lyon —ausente de la lista de ciudades—, no aparece, ni tampoco Brest, que no tiene residentes;
- líneas 50–53: la unión en sintaxis de consulta, que es más legible: [join ... in ... on ... equals ...]. Se le agrega un filtro, [where]. La sintaxis de consulta incluye también una cláusula, [group ... by ...], para las agrupaciones;
- línea 57: [ToList] (y [ToArray]) ejecuta la consulta y almacena sus resultados en una lista (un arreglo);
- línea 58: [ToDictionary] construye un diccionario: la primera lambda proporciona la clave de cada elemento, la segunda su valor. Una clave duplicada provoca una excepción;
- Línea 63: [CountBy] (.NET 9) cuenta los elementos de cada valor de clave. Devuelve una secuencia de pares [KeyValuePair<string,int>]. Es un atajo para [GroupBy(p => p.City).Select(g => (g.Key, g.Count()))];
- Línea 68: [AggregateBy] (.NET 9) acumula un valor para cada valor de clave: partiendo de 0, para cada persona, su edad se suma al total de su ciudad. Las tuplas devueltas se descomponen en el bucle [foreach];
- línea 73: [Index] (.NET 9) asocia cada elemento con su posición en la secuencia, en forma de tupla (posición, elemento).
5.5.5. Ejecución diferida
Una consulta LINQ no se ejecuta cuando se escribe, sino cuando se recorre su resultado: esta es la ejecución diferida. El programa [linq-05.cs] lo demuestra mediante lambdas que muestran lo que están haciendo:
Resultados:
Comentarios:
- Líneas 7–16: una consulta que selecciona los números pares y luego calcula sus cuadrados. Aquí las lambdas se escriben con un cuerpo entre llaves, que muestra un mensaje antes de devolver su valor mediante [return];
- Línea 3 de los resultados: después de definir la consulta, no se mostró nada: ni [Where] ni [Select] ha examinado aún ningún elemento. [evenSquares] no contiene resultados, sino una descripción de un cálculo;
- Líneas 4–16: la consulta se ejecuta durante el bucle [foreach], elemento por elemento: cada número pasa por [Where], luego por [Select] si es par, y después entra en el bucle antes de que se examine el número siguiente. Son iteradores, como [Evens] en [linq-01.cs];
- líneas 28–31: la consulta [large] se reevalúa en cada recorrido: tiene en cuenta el número 10 agregado a la lista después de su definición;
- línea 34: [ToList] ejecuta la consulta de inmediato y almacena sus resultados: [snapshot] es una lista que no ve la adición de 20 (línea 19);
- línea 39: los métodos que devuelven un único valor ([Count], [Sum], [First], [Any]…) también recorren la secuencia de inmediato;
- líneas 45–49: [First] deja de iterar en cuanto encuentra un elemento: los números posteriores al 3 nunca se examinan.
La ejecución diferida tiene dos consecuencias prácticas:
- una consulta que se recorre varias veces se ejecuta varias veces. Si su cálculo es costoso, o si se desea un resultado fijo, se convierte de una vez por todas con [ToList] o [ToArray];
- las consultas pueden componerse sin costo: encadenar [Where], [Select] y [Take] no crea ninguna colección intermedia, y solo se calculan los elementos necesarios.
Encontraremos LINQ a lo largo de todo el curso, y veremos en el capítulo 7 cómo se construyen sus métodos.
5.6. Archivos de texto
Las clases de lectura y escritura de archivos se encuentran en el espacio de nombres [System.IO], que forma parte de los espacios de nombres [using] implícitos.
5.6.1. La clase StreamReader
La clase [System.IO.StreamReader] permite leer el contenido de un archivo de texto. En realidad, es capaz de manejar flujos que no son archivos (una conexión de red, por ejemplo). Estas son algunas de sus propiedades y métodos.
Constructores:
constructor | función |
[public StreamReader(string path)] | Crea un flujo de lectura a partir del archivo de la ruta [path]. El contenido del archivo puede estar codificado de diversas maneras; por defecto se usa la codificación UTF-8. Otra sobrecarga permite especificar la codificación: [new StreamReader(path, Encoding.Latin1)] |
Propiedades:
propiedad | función |
[public bool EndOfStream { get; }] | [true] si el flujo se ha leído por completo |
Métodos:
Método | Función |
[public void Dispose()] | Cierra el flujo y libera los recursos asignados para su gestión. Esto debe hacerse después de procesar el flujo, lo cual se encarga de hacer la instrucción [using]. [Close] hace lo mismo |
[public int Peek()] | devuelve el siguiente carácter del flujo sin consumirlo; -1 al final del flujo |
[public int Read()] | devuelve el siguiente carácter del flujo y avanza un carácter; -1 al final del flujo |
[public string? ReadLine()] | devuelve la siguiente línea del flujo, sin el carácter de fin de línea, o [null] si se está al final del flujo |
[public string ReadToEnd()] | devuelve el resto del flujo, o "" si se está al final del flujo |
El programa [files-01.cs] es el siguiente:
Comentarios:
- línea 4: muestra el nombre del directorio actual, aquel desde el cual se lanzó el comando [dotnet run]. Solo se muestra el último elemento de la ruta, con [Path.GetFileName], para no saturar los resultados con una ruta completa;
- línea 6: el archivo leído es [infos.txt] o el que se pasa como argumento. Como es una ruta relativa, se busca en la carpeta actual;
- línea 11: la estructura [using (stream = ...) { ... }] garantiza que el flujo se cierre al terminar el bloque, incluso si se produce una excepción dentro del bloque. Esto elimina la necesidad de llamar explícitamente al método de cierre. Se aplica a cualquier objeto que implemente la interfaz [IDisposable] —es decir, cualquier objeto con un método [Dispose] que libera recursos (archivo, conexión de red, conexión a base de datos, etc.);
- líneas 15–17: el archivo se lee línea por línea. La asignación [line = stream.ReadLine()] es una expresión cuyo valor es el de [line]: se compara con [null], que indica el fin del archivo. La variable [line] es de tipo [string?]: [ReadLine] puede devolver [null];
- línea 23: una declaración
using(C# 8). Ya no hay bloque: la variable[stream2]se liberará al final del bloque que contiene su declaración, en este caso el bloque*[try]*. Esta sintaxis más concisa es la más habitual hoy en día; - línea 24: el archivo se lee de una sola vez;
- líneas 27–32: los errores de E/S se señalan mediante excepciones derivadas de
[IOException]*.*[FileNotFoundException]*es una de esas excepciones; por lo tanto, se captura primero. Su propiedad*[FileName]contiene la ruta completa del archivo buscado.
El archivo [infos.txt] es el siguiente:
Se encuentra en la carpeta [05-classes-dotnet], desde la cual se ejecuta el programa:
Con un archivo inexistente:
Seleccionar la carpeta actual para ubicar los archivos de datos es el enfoque natural para una aplicación de un solo archivo que se ejecuta desde su propia carpeta. En un proyecto, el ejecutable se encuentra en una subcarpeta llamada [bin/Debug/net10.0] dentro del proyecto: veremos en la aplicación de ejemplo cómo copiar allí los archivos de datos y cómo ubicarlos.
5.6.2. La clase StreamWriter
La clase [System.IO.StreamWriter] permite escribir en un archivo de texto. Como la clase [StreamReader], en realidad es capaz de manejar flujos que no son archivos. Estas son algunas de sus propiedades y métodos.
Constructores:
constructor | función |
[public StreamWriter(string path)] | crea un flujo de escritura hacia el archivo de la ruta [path]. El archivo se crea, o se sobrescribe si existe. Por defecto, el texto se codifica en UTF-8, sin BOM (véase más adelante) |
[public StreamWriter(string path, bool append)] | Si [append] es igual a [true], las escrituras se agregan al final del archivo existente |
Propiedades:
propiedad | función |
[public bool AutoFlush { get; set; }] | define el modo de escritura en el archivo. Si [AutoFlush] es igual a [false] (valor predeterminado), la escritura en el flujo no es inmediata: el texto se escribe primero en un búfer, y luego en el archivo cuando el búfer está lleno, cuando se vacía explícitamente con el método [Flush] o cuando se cierra el flujo. Este es el modo más eficiente para los archivos, porque limita los accesos al disco. No es adecuado para todos los flujos, en particular los flujos de red: en un diálogo entre dos interlocutores, lo que uno escribe debe ser leído de inmediato por el otro, y el flujo de escritura debe estar configurado con [AutoFlush=true] (modo de vaciado automático) |
[public string NewLine { get; set; }] | el carácter de fin de línea escrito por [WriteLine]. Por defecto, es el carácter de fin de línea del sistema: "\r\n" en Windows, "\n" en Linux y macOS |
[public Encoding Encoding { get; }] | la codificación utilizada |
Métodos:
Método | función |
[public void Dispose()] | Cierra el flujo después de escribir el contenido del búfer en el archivo. Debe ejecutarse después de procesar el flujo; [Close] realiza la misma acción |
[public void Flush()] | escribe el contenido del búfer en el archivo sin esperar a que esté lleno |
[public void Write(T value)] | escribe [value] en el archivo asociado al flujo. Aquí, [T] no es un tipo genérico, sino que simboliza el hecho de que el método [Write] acepta distintos tipos de parámetros ([string], [int], [object]…) |
[public void WriteLine(T value)] | Igual que [Write] pero agregando la marca de fin de línea ([NewLine]) |
El programa [files-02.cs] es el siguiente:
Resultados:
Comentarios:
- línea 6: una vez más, usamos la instrucción [using] para no tener que cerrar explícitamente el flujo. Este cierre se produce automáticamente al final del bloque (llave de cierre de la línea 21). Es este cierre el que escribe en el archivo el texto restante en el búfer; sin él, el archivo podría quedar incompleto;
- línea 19: escribe una línea en el archivo de texto;
- línea 24: la clase [FileInfo] proporciona información sobre un archivo, en este caso su tamaño en bytes. Los 18 bytes se desglosan así: 16 caracteres, más dos saltos de línea de un byte ("\n" en Linux, donde se ejecutó el código; en Windows, cada salto de línea "\r\n" ocuparía 2 bytes);
- línea 28: ¿por qué un [try / catch]? Podríamos especificar un nombre de archivo de la forma [dir1/dir2/file] con un directorio [dir1/dir2] que no existe, lo que haría imposible crear el archivo. Se lanzaría entonces una excepción [DirectoryNotFoundException], derivada de [IOException]. Hay otros casos de excepción posibles (disco lleno, permisos insuficientes, etc.).
5.6.3. Las clases File, Path y Directory
Para las operaciones comunes, la clase estática [File] elimina la necesidad de manejar flujos: un único método abre el archivo, lo lee o lo escribe por completo y luego lo cierra. Las clases estáticas [Path] y [Directory] gestionan las rutas y los directorios, respectivamente.
método | función |
[File.ReadAllText(path)] | devuelve el contenido del archivo como una cadena |
[File.ReadAllLines(path)] | Devuelve las líneas del archivo en un arreglo [string[]] |
[File.ReadLines(path)] | devuelve las líneas del archivo como una secuencia [IEnumerable<string>] leída bajo demanda |
[File.WriteAllText(path, contents)] | crea (o sobrescribe) el archivo y escribe en él [contents]; [WriteAllLines] escribe una colección de líneas |
[File.AppendAllText(path, contents)], [File.AppendAllLines(path, lines)] | agrega texto —líneas— al final del archivo (que se crea si no existe) |
[File.ReadAllBytes(path)], [File.WriteAllBytes(path, bytes)] | lee y escribe el archivo como un arreglo de bytes |
[File.Exists(path)], [File.Delete(path)], [File.Copy(source, dest)], [File.Move(source, dest)] | comprueba si un archivo existe, lo elimina, lo copia o lo mueve |
[Path.Combine(p1, p2, ...)] | construye una ruta a partir de sus elementos, usando el separador del sistema |
[Path.GetFileName(path)], [Path.GetExtension(path)], [Path.GetDirectoryName(path)] | extrae el nombre de archivo, la extensión y la carpeta de una ruta |
[Directory.CreateDirectory(path)] | crea la carpeta y sus carpetas superiores si no existen |
[Directory.GetFiles(path, pattern)], [Directory.EnumerateFiles(path, pattern)] | archivos de la carpeta cuyos nombres coinciden con el patrón ([*.txt]…), en un arreglo o en una secuencia |
[Directory.Exists(path)], [Directory.Delete(path, recursive)] | comprueba si existe una carpeta y la elimina (junto con su contenido si [recursive] es igual a [true]) |
El programa [files-03.cs] los utiliza:
Resultados:
Comentarios:
- Línea 7: [Path.Combine] usa el separador de rutas del sistema. Los ejercicios del curso se ejecutaron en Linux: la ruta resultante es [data/cities.txt]; en Windows, sería [data\cities.txt]. Construir las rutas con [Path.Combine] en lugar de concatenar cadenas hace que el código sea portable;
- línea 11: crear la carpeta [data] no provoca un error si ya existe;
- Líneas 14–18: escritura, adición y lectura, cada una en una sola instrucción;
- línea 23: [File.ReadLines] devuelve una secuencia: las líneas se leen una por una a medida que avanza el bucle, como los elementos de un iterador. Se le puede aplicar LINQ y, por lo tanto, procesar un archivo de varios gigabytes sin cargarlo en memoria, que es lo que haría [ReadAllLines] . El archivo se cierra al final de la iteración;
- líneas 29–36: el mismo texto “café” se escribe con tres codificaciones, y luego los bytes de los archivos se muestran en hexadecimal:
- En UTF-8, la codificación predeterminada de .NET, los caracteres acentuados ocupan 2 bytes (é = C3 A9) y los demás 1 byte: 5 bytes para 4 caracteres;
- en UTF-8 con BOM (Byte Order Mark), el archivo comienza con los 3 bytes EF BB BF, que indican al software que el archivo está codificado en UTF-8. [new UTF8Encoding(true)] indica al sistema que escriba este BOM;
- en Latin-1 (ISO-8859-1), la codificación tradicional de los textos de Europa occidental, cada carácter ocupa un byte (é = E9);
- Línea 39: leer un archivo con una codificación distinta de la utilizada para escribirlo altera los caracteres acentuados: el byte E9, al final del archivo, no es válido en UTF-8, y cada byte inválido se reemplaza por el carácter �. Al leer, [File.ReadAllText] y [StreamReader] reconocen el BOM si está presente; de lo contrario, suponen UTF-8, a menos que se especifique otra codificación (línea 40). Hoy la regla es simple: los archivos de texto se escriben y se leen en UTF-8;
- línea 44: los nombres de los archivos de texto de la carpeta. [GetFiles] no garantiza el orden de los nombres; el método de LINQ [Order] (.NET 7) los ordena;
- línea 50: elimina la carpeta y su contenido. El parámetro se pasa por nombre, [recursive: true], lo que hace la llamada más legible que un simple [true] (argumentos con nombre, capítulo 3).
Todos estos métodos tienen versiones asíncronas ([File.ReadAllTextAsync], [File.ReadAllLinesAsync]…): las usaremos en el capítulo 9, dedicado a la programación asíncrona.
5.7. Archivos binarios
5.7.1. Las clases BinaryWriter y BinaryReader
Las clases [System.IO.BinaryWriter] y [System.IO.BinaryReader] se utilizan para escribir y leer archivos binarios. En un archivo de este tipo, los datos no se escriben como texto sino en su forma interna: un [int] siempre ocupa 4 bytes, sea cual sea su valor.
Consideremos la siguiente aplicación:
El archivo de texto [persons1.txt] tiene el siguiente contenido:
El programa [files-04.cs] es el siguiente:
Veamos con más detalle las operaciones que involucran la clase [BinaryWriter]:
- Línea 17: el objeto [BinaryWriter] se abre mediante la operación [new BinaryWriter(new FileStream(args[1], FileMode.Create, FileAccess.Write))]. El argumento del constructor debe ser un flujo ([Stream]). Aquí es un flujo creado a partir de un archivo ([FileStream]), para el cual se especifica:
- el nombre;
- la operación que se realizará, en este caso [FileMode.Create] para crear el archivo (o sobrescribirlo si existe);
- el tipo de acceso, en este caso [FileAccess.Write] para acceso de escritura al archivo;
- líneas 57–58: las operaciones de escritura. La clase [BinaryWriter] tiene métodos [Write] sobrecargados para escribir los distintos tipos de datos simples ([int], [double], [decimal], [bool], [string]...);
- líneas 15–19: los tres flujos se abren con declaraciones [using]. Se cerrarán al final del bloque [try], en el orden inverso al de su apertura. El curso de 2008 los cerraba en una cláusula [finally] después de comprobar que no fueran [null]: la declaración [using] hace lo mismo en una sola línea;
- línea 10: las instrucciones de nivel superior pueden terminar con un [return n]; n es entonces el código de salida del programa, que un script puede comprobar (0: éxito);
- línea 33: la opción [TrimEntries] elimina los espacios alrededor del nombre y de la edad;
- línea 49: la edad debe ser un entero positivo o cero. Gracias al comportamiento de cortocircuito del operador [||], la condición [age < 0] solo se evalúa si la conversión tuvo éxito.
Los tres argumentos del programa se pasan después de [--] en el [dotnet run] comando. Los resultados son los siguientes:
El archivo de registro [logs.txt] contiene lo siguiente:
El contenido del archivo binario [persons1.bin] puede mostrarse en hexadecimal con el comando de Linux [od] (en Windows, el comando de PowerShell [Format-Hex] produce una visualización similar):
Esto muestra cómo [BinaryWriter] escribe los datos:
- una cadena se escribe precedida de su longitud en bytes: el byte 04 seguido de los 4 bytes de “paul” (70 61 75 6c);
- un entero [int] se escribe en 4 bytes, con el byte menos significativo primero: 10 se escribe como 0a 00 00 00;
- los datos se escriben uno tras otro, sin separadores ni saltos de línea: el archivo mide 44 bytes (línea 5: con la opción [-A d], [od] muestra las posiciones en decimal).
Para leer este archivo, por lo tanto, hay que conocer el orden y el tipo exactos de los datos que se escribieron. Esto es lo que hace el programa [files-05.cs]; realiza la operación inversa: lee el archivo binario para crear un archivo de texto. Si el archivo de texto resultante contiene los datos correctos del archivo original, sabremos que la conversión texto → binario → texto fue exitosa.
Veamos con más detalle las operaciones con la clase [BinaryReader]:
- línea 15: el objeto [BinaryReader] se abre sobre un flujo [FileStream] con el modo [FileMode.Open] (para abrir un archivo existente) y el modo de acceso [FileAccess.Read] (acceso de solo lectura);
- líneas 23–24: operaciones de lectura. La clase [BinaryReader] ofrece los métodos [ReadXX] para leer distintos tipos de datos simples: [ReadString], [ReadInt32], [ReadDouble], [ReadDecimal], [ReadBoolean]... Deben llamarse en el mismo orden en que se escribió;
- línea 20: la propiedad [BaseStream] proporciona el flujo subyacente, en este caso [FileStream]. La lectura continúa hasta que la posición actual en el archivo alcanza el final del archivo. La versión de 2008 leía indefinidamente y detectaba el final del archivo mediante la excepción [EndOfStreamException]: una excepción debe seguir siendo excepcional, y el final de un archivo no lo es;
- línea 31: esta excepción ahora señala una anomalía real: un archivo que termina en medio de un registro.
Ejecutemos el programa con el archivo [persons1.bin] generado anteriormente:
El contenido de [persons2.txt] es el siguiente:
Encontramos las 4 personas válidas del archivo [persons1.txt]. Con un archivo [truncated.bin] formado por los primeros 30 bytes de [persons1.bin], la lectura de la edad de Jacques falla:
5.7.2. La serialización JSON
Escribir y leer un archivo binario byte por byte es tedioso, y la más mínima discrepancia entre la escritura y la lectura produce resultados incorrectos. Por lo general es preferible serializar los objetos: convertirlos automáticamente en una secuencia de bytes o de caracteres y luego deserializarlos para reconstruirlos.
.NET proporcionaba para ello la clase [BinaryFormatter], que serializaba los objetos en un formato binario específico de .NET. Ahora ha sido eliminada: se declaró obsoleta en .NET 5 y su implementación se eliminó en .NET 9, porque deserializar datos de una fuente no confiable con [BinaryFormatter] permitía ejecutar código arbitrario. Microsoft recomienda reemplazarla por la serialización JSON de la biblioteca [System.Text.Json], integrada en .NET desde .NET Core 3.0.
JSON (JavaScript Object Notation) es un formato basado en texto, legible por humanos y universal: es el formato de intercambio de los servicios web (capítulo 13) y de numerosos archivos de configuración. Un objeto se escribe entre llaves con pares "propiedad":valor, y las matrices se encierran entre corchetes.
La clase estática [System.Text.Json.JsonSerializer] tiene dos métodos principales:
método | función |
[string Serialize<T>(T value, JsonSerializerOptions? options = null)] | devuelve el texto JSON que representa el objeto [value] |
[T? Deserialize<T>(string json, JsonSerializerOptions? options = null)] | reconstruye un objeto de tipo [T] a partir del texto JSON [json]; lanza una [JsonException] si el texto es incorrecto |
El programa [files-06.cs] los utiliza:
Resultados:
Comentarios:
- Línea 1: una directiva para aplicaciones de un solo archivo. De forma predeterminada, estas se configuran para la compilación nativa (AOT, "ahead of time"), que produce un ejecutable independiente pero deshabilita los mecanismos que dependen del descubrimiento de tipos en tiempo de ejecución (reflexión). Sin embargo, [JsonSerializer] usa reflexión de forma predeterminada para descubrir las propiedades de los objetos que se van a serializar: sin esta directiva, la compilación produce advertencias y la ejecución falla. Un proyecto [.csproj] estándar, como el de la aplicación de ejemplo, no tiene esta restricción. Para una aplicación compilada de forma nativa, [System.Text.Json] ofrece un generador de código fuente (una clase derivada de [JsonSerializerContext]) que genera el código de serialización en tiempo de compilación: no lo trataremos aquí;
- líneas 60–63: el registro [Person] que se va a serializar. Sus propiedades llevan el atributo [JsonPropertyName], que establece el nombre de la propiedad en el texto JSON como [name] en lugar de [Name]. En un registro posicional, [property: ...] indica que el atributo se aplica a la propiedad generada y no al parámetro del constructor;
- línea 17: serialización de un objeto con las opciones predeterminadas: el texto se escribe en una sola línea y los caracteres no ASCII se escapan: [é] se convierte en [é]. El texto sigue siendo correcto, pero es difícil de leer;
- líneas 21–26: la opción [WriteIndented] produce texto con sangría en varias líneas; la opción [Encoder] especifica qué caracteres se dejan tal cual (en este caso, todos los caracteres Unicode). Una lista se serializa como una matriz JSON;
- línea 28: el texto JSON se guarda en un archivo de texto: así es como hoy se reemplaza la serialización binaria;
- línea 34: la deserialización reconstruye la lista. [Deserialize] crea los objetos [Person] llamando al constructor del registro, cuyos parámetros se asocian con las propiedades JSON del mismo nombre. El resultado es de tipo [List<Person>?]: el texto JSON [null] es un documento válido que produce [null];
- línea 42: las opciones “Web” (que los servicios web de ASP.NET Core usan de forma predeterminada) escriben los nombres de las propiedades en formato camelCase (primera letra en minúscula): [Code] se convierte en [code], sin necesidad de un atributo. Al analizar, no distinguen mayúsculas de minúsculas: [CODE] se acepta (línea 31);
- línea 52: un documento JSON no válido (en este caso, una cadena donde se espera un número) provoca una excepción [JsonException], cuyo mensaje indica la ubicación del error.
Usaremos JSON en la siguiente aplicación de ejemplo y a lo largo del curso.
5.8. Expresiones regulares
La clase [System.Text.RegularExpressions.Regex] permite el uso de expresiones regulares. Estas permiten validar el formato de una cadena. Por ejemplo, se puede verificar que una cadena que representa una fecha tenga efectivamente el formato dd/mm/aa. Para ello, se usa un patrón y se compara la cadena con ese patrón. En este ejemplo, d, m y a deben ser dígitos. El patrón de un formato de fecha válido es, por lo tanto, [\d\d/\d\d/\d\d], donde el símbolo [\d] representa un dígito. Los símbolos que se pueden usar en un patrón son los siguientes:
carácter | descripción |
[\] | marca el carácter siguiente como carácter especial o literal. Por ejemplo, [n] corresponde al carácter n, [\n] corresponde a un carácter de nueva línea, [\\] corresponde a \ y [\(] corresponde a ( |
[^] | corresponde al inicio de la cadena |
[$] | corresponde al final de la cadena |
[*] | coincide con el elemento anterior cero o más veces. Así, [zo*] coincide con z o zoo |
[+] | coincide con el elemento anterior una o más veces. Así, [zo+] coincide con "zoo", pero no con "z" |
[?] | coincide con el elemento anterior cero o una vez. Por ejemplo, [a?ve?] coincide con “ve” en “lever” |
[.] | coincide con cualquier carácter individual, excepto el carácter de nueva línea |
[(pattern)] | busca el patrón y almacena la coincidencia (un grupo). La subcadena coincidente se puede extraer de la colección [Groups] del resultado. Para buscar coincidencias con caracteres entre paréntesis, use [\(] o [\)] |
[x|y] | coincide con x o con y. Por ejemplo, [z|foot] coincide con z o foot; [(z|f)oo] coincide con zoo o foo |
[{n}] | n es un entero no negativo. Coincide exactamente n veces con el elemento anterior. Por ejemplo, [o{2}] no coincide con la o de Bob, pero sí con las dos primeras o de fooooot |
[{n,}] | coincide con el elemento anterior al menos n veces. Por ejemplo, [o{2,}] no coincide con la 'o' de 'Bob', pero sí con todas las 'o' de 'fooooot'. [o{1,}] equivale a [o+], y [o{0,}] equivale a [o*] |
[{n,m}] | coincide con el elemento anterior al menos n veces y como máximo m veces. Por ejemplo, [o{1,3}] coincide con las tres primeras “o” de “foooooot”; [o{0,1}] equivale a [o?] |
[xyz] | conjunto de caracteres: coincide con uno de los caracteres especificados. Por ejemplo, [abc] coincide con la letra “a” en “plat” |
[^xyz] | conjunto negativo de caracteres: coincide con cualquier carácter que no esté en la lista. Por ejemplo, [^abc] coincide con "p" en "plat" |
[a-z] | rango de caracteres: coincide con cualquier carácter del rango especificado, en este caso una letra minúscula sin acento |
[^m-z] | rango negativo de caracteres: coincide con cualquier carácter que no esté entre 'm' y 'z' |
[\b] | coincide con un límite de palabra, es decir, la posición entre un carácter de palabra y un carácter que no es de palabra. Por ejemplo, [er\b] coincide con "er" en "lever", pero no con "er" en "verb" |
[\B] | corresponde a una posición que no es un límite de palabra. [en*t\B] corresponde a “ent” en “entertain” |
[\d] | corresponde a un dígito; equivale a [0-9] (en .NET, también para los dígitos de otros alfabetos Unicode) |
[\D] | corresponde a un carácter que no es un dígito |
[\f], [\n], [\r], [\t], [\v] | corresponden, respectivamente, a los caracteres de salto de página, nueva línea, retorno de carro, tabulación y tabulación vertical |
[\s] | corresponde a cualquier espacio en blanco: espacio, tabulación, salto de página, salto de línea… Equivale a [ \f\n\r\t\v], más otros caracteres de espacio en blanco de Unicode (espacio de no separación, etc.) |
[\S] | coincide con cualquier carácter que no sea un espacio en blanco |
[\w] | coincide con cualquier carácter de palabra: letra (con o sin acentos), dígito o guion bajo |
[\W] | coincide con cualquier carácter que no sea un carácter de palabra |
[\num] | num es un entero positivo: hace referencia al grupo número num. Por ejemplo, [(.)\1] coincide con dos caracteres idénticos consecutivos |
[\xnn], [\unnnn] | corresponde al carácter hexadecimal nn (2 dígitos) o nnnn (4 dígitos). Por ejemplo, [\x41] corresponde a A |
Un elemento de un patrón puede aparecer una o varias veces. Veamos algunos ejemplos con el símbolo [\d], que representa un solo dígito:
patrón | Significado |
[\d] | un dígito |
[\d?] | 0 o 1 dígito |
[\d*] | 0 o más dígitos |
[\d+] | 1 o más dígitos |
[\d{2}] | 2 dígitos |
[\d{3,}] | Al menos 3 dígitos |
[\d{5,7}] | entre 5 y 7 dígitos |
Imaginemos ahora un modelo capaz de describir el formato esperado de una cadena:
cadena objetivo | patrón |
una fecha en formato dd/mm/aa | [\d{2}/\d{2}/\d{2}] |
una hora en formato hh:mm:ss | [\d{2}:\d{2}:\d{2}] |
un entero sin signo | [\d+] |
una secuencia de espacios, que puede estar vacía | [\s*] |
un entero sin signo que puede estar precedido o seguido de espacios | [\s*\d+\s*] |
un entero que puede tener signo y estar precedido o seguido de espacios | [\s*[+-]?\s*\d+\s*] |
un número real sin signo que puede estar precedido o seguido de espacios | [\s*\d+(\.\d*)?\s*] |
un número real que puede tener signo y estar precedido o seguido de espacios | [\s*[+-]?\s*\d+(\.\d*)?\s*] |
una cadena que contiene la palabra "just" | [\bjust\b] |
El curso de 2008 usaba [+|-] para el signo: entre corchetes, el carácter [|] no tiene ningún significado especial, y este formato también aceptaba el signo | antes de un número. También usaba [(.\d*)] para la parte decimal: el punto sin escapar representa allí cualquier carácter. Los patrones anteriores han sido corregidos.
Se puede especificar en qué parte de la cadena se busca el patrón:
patrón | significado |
[^pattern] | el patrón está al inicio de la cadena |
[pattern$] | El patrón está al final de la cadena |
[^pattern$] | El patrón está al inicio y al final de la cadena |
[pattern] | El patrón se busca en cualquier parte de la cadena, comenzando desde el inicio de la cadena |
cadena de búsqueda | patrón |
una cadena que termina con un signo de exclamación | [!$] |
una cadena que termina con un punto | [\.$] |
una cadena que comienza con la secuencia // | [^//] |
una cadena formada por una sola palabra, posiblemente precedida o seguida de espacios | [^\s*\w+\s*$] |
una cadena formada por exactamente dos palabras, posiblemente precedidas o seguidas de espacios | [^\s*\w+\s+\w+\s*$] |
una cadena que contiene la palabra "secret" | [\bsecret\b] |
Se pueden “extraer” subconjuntos de un patrón. Así, no solo podemos verificar que una cadena coincide con un patrón determinado, sino también extraer de esa cadena los elementos que corresponden a los subconjuntos del patrón que se han encerrado entre paréntesis. Por ejemplo, si se analiza una cadena que contiene una fecha en formato dd/mm/aa y se quieren extraer también los componentes dd, mm y aa de esa fecha, se usaría el patrón [(\d\d)/(\d\d)/(\d\d)].
En el código C#, un patrón se escribe de preferencia como una cadena textual [@"..."]: de esta manera, no es necesario duplicar los numerosos caracteres [\] de los patrones. Con una cadena normal, habría que escribir ***["\\\\d+"] en lugar de ***[@"\\d+"].
5.8.1. Verificar si una cadena coincide con un patrón dado
Un objeto de tipo [Regex] se construye de la siguiente manera:
constructor | función |
[public Regex(string pattern)] | crea un objeto de “expresión regular” a partir de un patrón pasado como parámetro ([pattern]). Se lanza una excepción [ArgumentException] si el patrón es incorrecto |
[public Regex(string pattern, RegexOptions options, TimeSpan matchTimeout)] | igual que el anterior, con opciones y un tiempo de espera (véase más adelante) |
Una vez construida la expresión regular, se puede comparar con cadenas de caracteres mediante el método [IsMatch]:
método | función |
[public bool IsMatch(string input)] | true si la cadena [input] contiene una subcadena que coincide con el patrón de la expresión regular |
El programa [regex-01.cs] es el siguiente:
Resultados:
Comentarios:
- línea 4: el patrón de un entero sin signo, opcionalmente rodeado de espacios, que ocupa toda la cadena (anclas [^] y [$]);
- línea 9: la cadena “123a”, rodeada de espacios, no coincide con el patrón: el carácter “a” no puede ser un dígito ni un espacio. Sin las anclas [^] y [$], la cadena coincidiría, ya que contiene un número;
- línea 19: la clase [Regex] también tiene métodos estáticos que reciben el patrón como parámetro. .NET almacena en memoria los patrones usados más recientemente: se pueden utilizar en un bucle sin preocuparse de que el patrón se analice en cada llamada.
5.8.2. Encontrar todas las ocurrencias de un patrón en una cadena
El método [Matches] recupera los elementos de una cadena que coinciden con un patrón:
método | función |
[public MatchCollection Matches(string input)] | devuelve la colección de elementos de la cadena [input] que coinciden con el patrón |
La clase [MatchCollection] tiene una propiedad, [Count], que es el número de elementos de la colección. Si [results] es un objeto [MatchCollection], entonces [results[i]] es el i-ésimo elemento de esa colección; es de tipo [Match]. La clase [Match] tiene varias propiedades, entre ellas las siguientes:
- [Value]: el valor del objeto [Match], es decir, un elemento que coincide con el patrón;
- [Index]: la posición en la que se encontró el elemento en la cadena explorada.
El programa [regex-02.cs] es el siguiente:
Resultados:
Comentarios:
- Línea 4: el patrón buscado es una secuencia de dígitos;
- línea 6: la cadena en la que se busca este patrón;
- línea 7: se recuperan todos los elementos de [sample3] que coinciden con el patrón [pattern2] ;
- líneas 10–12: se muestran. Una [MatchCollection] se recorre con [foreach], como una lista;
- línea 15: [MatchCollection] implementa [IEnumerable<Match>]: se le aplica LINQ. Aquí, sumamos los números encontrados;
- línea 18: el método [Count] (.NET 7) cuenta las ocurrencias del patrón sin construir una colección. El patrón [aeiouy] denota una vocal.
5.8.3. Recuperación de partes de un patrón
Como se mencionó antes, las partes de un patrón encerradas entre paréntesis se almacenan: son los grupos. El programa [regex-03.cs] los utiliza:
Resultados:
Comentarios:
- Línea 8: la cadena [sample4] se compara con el patrón [regex3] mediante el método [Match]. Este método devuelve la primera ocurrencia del patrón como un objeto [Match], que ya se presentó. Aquí usamos dos propiedades nuevas de esta clase:
- [Success] (línea 9): indica si se encontró una coincidencia;
- [Groups] (línea 13): una colección donde [Groups[0]] corresponde a la parte de la cadena que representa el patrón, y [Groups[i]] (i >= 1) corresponde al i-ésimo par de paréntesis;
- si [result] es de tipo [Match], entonces [result.Groups] es de tipo [GroupCollection] y [result.Groups[i]] es de tipo [Group]. La clase [Group] tiene, al igual que la clase [Match], las propiedades [Value] (el texto capturado por el grupo) e [Index] (su posición en la cadena analizada);
- línea 24: un grupo puede nombrarse con la sintaxis [(?<name>...)]. Aquí, el patrón reconoce una fecha en formato d/m/aaaa, con día y mes de uno o dos dígitos;
- líneas 29–31: un grupo con nombre se referencia por su nombre en lugar de por su número: el código es más legible y no depende del orden de los paréntesis;
- línea 32: el tipo [DateOnly] (.NET 6) representa una fecha sin hora. Se muestra en el formato [dddd d MMMM yyyy]: el día de la semana aparece en inglés;
- línea 37: el método [Replace] reemplaza cada ocurrencia del patrón por una cadena en la que [${name}] (o [$1], [$2]… para los grupos numerados) denota el valor de un grupo. Así, las fechas se reformatean al formato año-mes-día.
5.8.4. Un programa de aprendizaje
Encontrar la expresión regular que verifica si una cadena coincide con cierto patrón puede ser a veces un verdadero desafío. El programa [regex-04.cs] permite practicar. Recibe como entrada un patrón y una cadena e indica si la cadena coincide o no con el patrón.
Comentarios:
- línea 18: la expresión regular se construye con un tiempo de espera de un segundo: si una búsqueda tarda más que eso, se abandona y se lanza una excepción [RegexMatchTimeoutException] (línea 55). Veremos más adelante por qué esto es útil;
- línea 20: un patrón no válido provoca una excepción [ArgumentException] (más específicamente, [RegexParseException], que deriva de ella);
- líneas 45–51: para cada coincidencia, se muestran los grupos n.º 1 y siguientes, si los hay.
Este es un ejemplo de la salida:
Los patrones [^\s*\d+\s*$] y [^\s*(\d+)\s*$] demuestran la utilidad de los grupos: el primero reconoce la cadena “1456” precedida de tres espacios, incluidos los espacios; el segundo además extrae el número sin los espacios. El patrón [(a+)+$] se examina más adelante.
5.8.5. El método Split
Ya hemos visto el método [Split] de la clase [String]:
método | función |
[public string[] Split(params char[] separator)] | La cadena se trata como una secuencia de campos separados por los caracteres enumerados en la matriz [separator]. El resultado es una matriz con esos campos |
El método [Split] de la clase [Regex] permite especificar el separador mediante un patrón:
método | función |
[public string[] Split(string input)] | La cadena [input] se divide en campos, separados por un separador que corresponde al patrón del objeto [Regex] actual |
Supongamos, por ejemplo, que un archivo de texto contiene líneas de la forma campo1, campo2, ..., campon. Los campos están separados por una coma, pero esta coma puede estar precedida o seguida de espacios. El patrón [\s*,\s*] describe exactamente este separador, como muestra el programa [regex-05.cs]:
Resultados:
Comentarios:
- línea 6: el separador: una coma precedida y seguida de cualquier cantidad de espacios. Los espacios se eliminan junto con el separador. Observe que la opción [TrimEntries] de [string.Split], presentada anteriormente, permite ahora obtener el mismo resultado sin una expresión regular;
- línea 13: un separador que puede adoptar varias formas: un punto y coma o una barra vertical ([;|]), o ([|]) una secuencia de espacios ([\s+]). Aquí es necesaria una expresión regular.
5.8.6. Expresiones regulares generadas, opciones, tiempo de espera
Un objeto [Regex] analiza su patrón en tiempo de ejecución y luego lo traduce a una estructura interna que interpreta, o lo compila a código ejecutable si se le pasa la opción [RegexOptions.Compiled]. A partir de .NET 7, el atributo [GeneratedRegex] permite realizar este trabajo en tiempo de compilación: un generador de código fuente escribe el código C# de la búsqueda, que se puede ver en el editor (F12 sobre el método). El patrón se valida en tiempo de compilación, ya no hay costo de análisis al iniciar y el código generado se ejecuta lo más rápido posible. Esta es ahora la forma recomendada de usar un patrón conocido de antemano. El programa [regex-06.cs] es el siguiente:
Resultados:
Comentarios:
- Líneas 39–51: cada patrón se declara mediante un método estático partial ([partial]) sin cuerpo, que genera un [Regex], y va precedido del atributo [GeneratedRegex]. El generador de código fuente escribe el cuerpo del método en otra parte de la clase, que también se declara como [partial]. A partir de C# 13 y .NET 9, también se puede declarar una propiedad parcial: [[GeneratedRegex(...)] private static partial Regex Time { get; }];
- línea 5: el método se usa como un objeto [Regex] normal;
- línea 46: el segundo parámetro del atributo es una combinación de opciones [RegexOptions]. [IgnoreCase] ignora las mayúsculas y minúsculas: “YES” y “Yes” coinciden con el patrón;
- línea 17: las opciones se usan de la misma manera con los métodos de [Regex]. [Multiline] hace coincidir [^] y [$] con el inicio y el final de cada línea de la cadena, en lugar de solo con el inicio y el final de la cadena completa. Otras opciones son útiles: [Singleline] ([.] también coincide con los saltos de línea), [IgnorePatternWhitespace] (los espacios en el patrón se ignoran, lo que permite escribirlo en varias líneas, incluso con comentarios), [ExplicitCapture] (solo se recuerdan los grupos con nombre). Se pueden combinar con el operador [|];
- línea 50: el patrón [^(a+)+$] es patológico: cuando se aplica a una secuencia de “a” que termina con otro carácter, el motor de expresiones regulares prueba todas las formas posibles de distribuir las “a” entre las repeticiones del grupo antes de concluir que ha fallado. El número de posibilidades se duplica con cada “a” adicional: con 30 “a” hay aproximadamente mil millones de posibilidades. Esto se conoce como retroceso catastrófico. Un patrón así, aplicado a cadenas ingresadas por los usuarios, es una vulnerabilidad de seguridad: bastan unas pocas solicitudes para hacer caer un servidor. El parámetro [matchTimeoutMilliseconds] establece un tiempo de espera de 100 ms: transcurrido este, la búsqueda se abandona con una excepción [RegexMatchTimeoutException] (línea 6);
- línea 35: la opción [NonBacktracking] (.NET 7) usa un motor distinto, que garantiza un tiempo de búsqueda proporcional a la longitud de la cadena. No admite ciertas construcciones (referencias hacia atrás, como [\1], por ejemplo), pero en este caso devuelve un resultado de inmediato.
Observe que se debe establecer un tiempo de espera o usar [NonBacktracking] siempre que el patrón o la cadena en la que se busca provenga de fuera del programa.
5.9. Aplicación de ejemplo - V3
Retomaremos la aplicación tratada en el capítulo 3 (versión 1) y el capítulo 4 (versión 2). Recuerde que se trata de un ejercicio: la escala de impuestos utilizada es la versión de 2004 (ingresos de 2003), que se ha mantenido sin cambios desde el curso original.
5.9.1. Datos en un archivo
En la versión 2, el cálculo del impuesto se realizaba en la clase abstracta [AbstractTax], que reproducimos aquí sin cambios, salvo por su espacio de nombres:
El método [Calculate] usa los tramos impositivos devueltos por la propiedad abstracta [TaxBrackets] (línea 7). La clase [AbstractTax] no sabe de dónde provienen estos tramos: corresponde a las clases derivadas proporcionarlos. En la versión 2, la clase derivada [HardwiredTax] los incluía directamente en su código. Un tramo impositivo se representa, como en la versión 2, mediante la estructura de tipo registro [TaxBracket]:
y el cálculo se describe mediante la interfaz [ITax]:
La nueva versión almacena los datos en un archivo, lo que permite modificar la escala de tarifas sin recompilar el programa. Escribimos dos nuevas clases derivadas de [AbstractTax]:
- [FileTax] lee los tramos de un archivo de texto [TaxData.txt];
- [JsonTax] los lee de un archivo JSON llamado [TaxData.json].
El archivo de texto [TaxData.txt] contiene un tramo impositivo por línea, con el formato límite:coeffR:coeffN:
El curso de 2008 escribía los números con coma decimal (0,068) y los leía mediante [decimal.TryParse] con la configuración regional de la máquina: el mismo archivo, leído en una máquina británica o estadounidense, habría sido rechazado o, peor aún, mal interpretado. Un archivo de datos no debe depender del idioma de la máquina que lo lee: escribimos los números con punto decimal y los leemos con la referencia cultural invariable ([CultureInfo.InvariantCulture]), que también usan JSON y la mayoría de los formatos de datos.
El archivo [TaxData.json] contiene los mismos datos, en forma de una matriz JSON de objetos:
5.9.2. Errores
El procesamiento de estos archivos puede fallar: archivo inexistente, línea mal formada, número incorrecto, etc. Como en la versión de 2008, creamos una clase de excepción especial para informar de estos errores. El curso de 2008 la llamaba [FileTaxException]; nosotros la llamamos [TaxException], puesto que también se usará para otras fuentes de datos (aquí el archivo JSON y, más adelante, una base de datos). Lleva un código de error:
Comentarios:
- líneas 16–22: la clase [TaxException] deriva de la clase [Exception]. Se usará para informar de cualquier error que ocurra durante el procesamiento del archivo de datos. Tiene dos constructores: el primero recibe un mensaje de error y el segundo recibe además la excepción que causó el error, que estará disponible en la propiedad [InnerException];
- línea 19: la propiedad [Code] almacena el código de error. La palabra clave [init] permite asignarlo solo al crear el objeto, mediante un inicializador de objeto: [new TaxException("...") { Code = 2 }]. Esta es la forma de excepción, con un código entero, que usarán las versiones posteriores de la aplicación;
- líneas 4–12: una lista de los posibles códigos de error:
- [Access]: error al acceder al archivo de datos;
- [Line]: línea que no tiene los tres campos esperados, o archivo que no contiene ningún tramo;
- [Field1], [Field2], [Field3]: el campo 1, 2 o 3 de una línea es incorrecto;
- [Json]: el documento JSON es incorrecto.
Algunos de estos errores pueden ocurrir combinados: los tres campos de una línea pueden ser incorrectos. Por ello, la enumeración [ErrorCode] se ha anotado con el atributo [Flags], y sus valores son potencias de 2: cada uno corresponde a un bit del entero. Un error en los campos 2 y 3 dará como resultado el código [Field2 | Field3], que es 8 + 16 = 24. Gracias al atributo [Flags], el método [ToString] de la enumeración muestra tal combinación en la forma “Field2, Field3”.
5.9.3. La clase FileTax
La clase [FileTax] proporciona los tramos leídos de un archivo de texto:
Comentarios:
- línea 7: la clase [FileTax] deriva de la clase [AbstractTax], al igual que la clase [HardwiredTax] en la versión 2. Se declara como [partial] porque contiene una expresión regular generada;
- líneas 10–11: la expresión regular del separador de campos en una línea limit:coeffR:coeffN: el carácter [:], precedido y seguido de cualquier cantidad de espacios;
- líneas 14–17: los tramos leídos, devueltos por la propiedad [TaxBrackets], que redefine la propiedad abstracta de [AbstractTax];
- línea 19: el constructor recibe el nombre del archivo de texto que contiene los datos. Su función es llenar la matriz [taxBrackets];
- línea 22: el nombre del archivo sin su ruta, que se usa en los mensajes de error. En realidad, el constructor recibe una ruta completa, que no es necesario mostrar al usuario;
- línea 24: la lectura de un archivo de texto es secuencial: el número de líneas no se conoce hasta haber leído todo el archivo. Por lo tanto, no se puede dimensionar la matriz de antemano; los tramos se almacenan temporalmente en una lista;
- línea 28: el archivo se lee línea por línea con [File.ReadLines], que abre y cierra el archivo por sí mismo. El curso de 2008 usaba [StreamReader];
- líneas 38–43: la línea se divide en campos mediante una expresión regular; si no hay tres campos, se lanza una excepción [TaxException] con el código [Line] . El curso de 2008 guardaba el error en una variable, salía del bucle y lanzaba la excepción después de cerrar el archivo: lanzarla de inmediato es más simple, y [File.ReadLines] cierra el archivo en cualquier caso, ya que el bucle [foreach] libera su enumerador incluso cuando una excepción lo interrumpe;
- líneas 47–55: conversión de los tres campos a números decimales. Los errores se acumulan en la variable [code] mediante el operador [|=] y luego se informan juntos;
- líneas 83–84: conversión de un campo. [NumberStyles.AllowDecimalPoint] solo permite dígitos y un punto decimal: sin signos, espacios ni separadores de miles. Por lo tanto, los números negativos se rechazan, lo que valida los datos al mismo tiempo que se convierten. [CultureInfo.InvariantCulture] impone el punto como separador decimal, sea cual sea la configuración regional de la máquina;
- líneas 62–67: los errores de acceso al archivo ([IOException] y sus variantes, como [FileNotFoundException], o [UnauthorizedAccessException] por permisos insuficientes) se encapsulan en una [TaxException] con el código [Access]. El [when (...)] filtro de excepciones (C# 6) intercepta solo estas excepciones: las excepciones [TaxException] lanzadas dentro del bucle no se interceptan y salen del constructor sin cambios. El patrón [e is IOException or UnauthorizedAccessException] es un patrón combinado que usa [or] (C# 9);
- líneas 71–79: un archivo vacío se rechaza; de lo contrario, la lista se transfiere a la matriz de tramos, que era el objetivo del constructor.
Encapsular las excepciones de bajo nivel ([IOException]) en una excepción específica de la aplicación ([TaxException]) permite que el código que llama maneje un solo tipo de excepción, sea cual sea la fuente de datos: un archivo de texto, un archivo JSON y, más adelante en el curso, una base de datos.
5.9.4. La clase JsonTax
La clase [JsonTax] proporciona los tramos leídos de un archivo JSON:
Comentarios:
- línea 9: las opciones “Web”: las propiedades JSON [limit], [coeffR] y [coeffN] corresponden a las propiedades [Limit], [CoeffR] y [CoeffN] de la estructura [TaxBracket] sin necesidad de modificar esta última con atributos. Las opciones se almacenan en un campo estático: un objeto [JsonSerializerOptions] guarda información sobre los tipos que ha procesado, y se recomienda reutilizarlo;
- líneas 25–31: lectura del archivo; un error de acceso se maneja como en [FileTax];
- línea 38: una sola instrucción convierte el texto JSON en una matriz de tramos. [System.Text.Json] sabe construir una estructura de tipo registro llamando a su constructor. Un documento no válido provoca una [JsonException], encapsulada dentro de una [TaxException] con el código [Json];
- líneas 48–57: la deserialización verifica el formato del documento, no la validez de los datos: queda por verificar que haya al menos un tramo (el documento [null] o [] es un JSON válido) y que no haya valores negativos. El método LINQ [Any] realiza esta última verificación en una sola línea.
Comparar las dos clases es instructivo: con un formato de datos estructurado y una biblioteca que lo entiende, el análisis del archivo ya no requiere ningún código.
5.9.5. El programa principal
El proyecto de consola [TaxV3] tiene la siguiente estructura de directorios:
El archivo de proyecto [TaxV3.csproj] es el creado por [dotnet new console], al que se ha añadido un grupo de elementos:
El elemento [<None Update="..." CopyToOutputDirectory="PreserveNewest" />] (línea 12) especifica que los archivos de datos deben copiarse a la carpeta del ejecutable ([bin/Debug/net10.0]) durante la compilación si son más recientes que la copia existente. El carácter [*] permite especificar de una vez todos los archivos [TaxData*.txt] y [TaxData*.json] . Esto equivale a la propiedad “Copiar en el directorio de salida” que el curso de 2008 establecía en las propiedades del archivo en Visual Studio.
El programa [Program.cs] es el siguiente:
Comentarios:
- línea 14: el nombre del archivo de datos se pasa como argumento; de forma predeterminada, es [TaxData.txt];
- línea 15: el archivo se busca en la carpeta del ejecutable, [AppContext.BaseDirectory], donde se copió durante la compilación. Así, el programa encuentra sus datos sea cual sea la carpeta desde la que se lance, lo que no ocurría con las aplicaciones de un solo archivo de este capítulo;
- líneas 22–25: una expresión [switch] (capítulo 3) selecciona la clase que se va a instanciar según la extensión del archivo. Las dos ramas devuelven tipos distintos, [JsonTax] and [FileTax]: el compilador infiere el tipo de la expresión a partir de la variable de destino [tax], que es de tipo [ITax] (expresión [switch] con tipo de destino). El resto del programa solo conoce la interfaz [ITax] y desconoce el origen de los datos;
- líneas 28–34: la creación del objeto puede provocar una [TaxException], que se muestra antes de que el programa termine. El código se convierte a [ErrorCode] para mostrarse en texto legible; la excepción original, si la hay, se identifica por su tipo (su mensaje contiene la ruta completa del archivo);
- líneas 37–76: el bucle de diálogo es exactamente el mismo que en la versión 2.
5.9.6. Ejecuciones
Con el archivo [TaxData.txt], de forma predeterminada:
Se reproducen los valores de las versiones anteriores: 4282 euros para una pareja casada con 2 hijos, 2959 euros con 3 hijos y 11 519 euros para una persona soltera sin hijos, con un salario anual de 60 000 euros. Las entradas incorrectas se señalan como en la versión 2.
Con el archivo [TaxData.json]:
Con un archivo [xx.txt] inexistente:
Con el siguiente archivo [TaxDataInvalid.txt], en el que la tercera línea usa una coma decimal:
Los campos 2 y 3 de la línea 3 se rechazan: el código de error es la combinación “Field2, Field3”. El campo 1 (14753), que no tiene parte decimal, es correcto.
Con el siguiente archivo, [TaxDataInvalid.json], en el que un coeficiente está escrito como cadena:
El mensaje de [JsonException] especifica la ubicación exacta del error: la propiedad [coeffR] del segundo elemento de la matriz ([$[1].coeffR]), [LineNumber: 2], es decir, la tercera línea del documento, ya que [System.Text.Json] numera las líneas a partir de 0.
5.10. Conclusión
Este capítulo ha presentado las clases de .NET que se usan en casi todos los programas:
- las cadenas inmutables ([string]) y las cadenas mutables ([StringBuilder]) para construirlas pieza por pieza; la interpolación con anchos y formatos, las cadenas sin formato (raw); las vistas ([ReadOnlySpan<char>]) para el código crítico;
- las matrices y la clase [Array];
- las colecciones genéricas [List<T>], [Dictionary<TKey,TValue>], [HashSet<T>], [Queue<T>], [Stack<T>], [PriorityQueue<TElement,TPriority>] y sus interfaces de solo lectura; las colecciones no genéricas [ArrayList] y [Hashtable] están obsoletas;
- LINQ, sus secuencias [IEnumerable<T>], sus iteradores y su ejecución diferida;
- los archivos de texto ([StreamReader], [StreamWriter], [File]), los archivos binarios ([BinaryWriter], [BinaryReader]) y la serialización JSON, que reemplaza la serialización binaria de [BinaryFormatter], eliminada de .NET;
- las expresiones regulares, preferentemente generadas en tiempo de compilación y siempre protegidas por un tiempo de espera al procesar datos externos.
La aplicación de ejemplo ahora lee sus datos de un archivo de texto o JSON. El siguiente capítulo la reorganiza en capas: la lectura de datos, el cálculo de impuestos y la interacción con el usuario se convertirán en componentes independientes.