5. Häufig verwendete Java-Klassen
Hier stellen wir einige häufig verwendete Klassen der Java-Plattform vor: Zeichenketten, Arrays, Collections, Dateien und reguläre Ausdrücke. Hinzu kommt die Stream-API (Java 8), die heute die gebräuchlichste Art ist, Elemente einer Java-Collection zu suchen, zu sortieren, zu gruppieren oder zu transformieren. Zuvor zeigen wir, wie Sie Informationen über die Tausenden verfügbaren Klassen finden. Diese Ressource ist für jeden Java-Entwickler unverzichtbar, auch für erfahrene.
Mit Ausnahme von zweien (dem JSON-Beispiel und der Beispielanwendung am Ende) sind die Beispiele dieses Kapitels kompakte Quelldateien, die vom Source-Code-Launcher ausgeführt werden: [java File.java]. Sie befinden sich im Ordner [05-classes-java] des Kurscodes und laufen in einer englischen Locale. Beachten Sie, dass eine kompakte Quelldatei automatisch alle öffentlichen Klassen des Moduls [java.base] importiert: [java.util], [java.io], [java.nio.file], [java.util.regex], [java.util.stream], [java.time] … Deshalb enthalten die folgenden Programme keine [import]-Anweisungen.
5.1. Hilfe zu Java-Klassen finden
Die Java-Standardbibliothek (die Java-SE-API) umfasst mehr als 4.000 öffentliche Klassen. Niemand kennt sie alle: Java-Entwickler schlagen ständig in ihrer Dokumentation nach. Diese Dokumentation ist online kostenlos verfügbar und wird für jede Java-Version veröffentlicht.
5.1.1. Online-Dokumentation
Ausgangspunkt ist die Website von Oracle unter docs.oracle.com/en/java/javase/25. Dort finden Sie:
- die Java-25-Referenz: https://docs.oracle.com/en/java/javase/25/docs/api/. Sie beschreibt, Modul für Modul und Paket für Paket, alle Java-Klassen und -Schnittstellen: ihre Konstruktoren, Felder und Methoden;
- ein Suchfeld am oberen Rand jeder Seite der Referenz, in das Sie den Namen einer Klasse oder Methode eingeben können ([StringBuilder], [Matcher.find] …): Die Ergebnisliste füllt sich bereits während der Eingabe;
- die Java Language Specification (JLS) und themenspezifische Leitfäden (JDK-Werkzeuge, Sicherheit, reguläre Ausdrücke …);
- eine Seite „New Features“, die beschreibt, was in jeder Version neu ist. Die neuen Funktionen selbst werden durch JEPs (JDK Enhancement Proposals) beschrieben, die unter openjdk.org/jeps verfügbar sind: JEP 512 beschreibt zum Beispiel die in diesem Kapitel verwendeten kompakten Quelldateien.
Eine Klassenseite, etwa java.lang.String, enthält:
- das Modul und das Paket der Klasse;
- ihre Deklaration, ihre Elternklassen und die Schnittstellen, die sie implementiert;
- eine allgemeine Beschreibung, oft lang und detailliert, mit Beispielen;
- eine zusammenfassende Liste ihrer Felder, Konstruktoren und Methoden, gefolgt von Details zu jedem Element: Parameter, Rückgabewert, mögliche Ausnahmen und die Java-Version, in der es eingeführt wurde (unter der Überschrift „Since“).
Die Dokumentation ist auf Englisch. Eine Suche mit einer Suchmaschine unter Angabe des vollständigen Klassennamens und der Version („java.lang.StringBuilder 25“) führt meist direkt zur richtigen Seite.
5.1.2. Javadoc und die Hilfe des Editors
Diese Dokumentation wird vom Werkzeug [javadoc] des JDK aus den Dokumentationskommentaren erzeugt, die im Quellcode der Klassen stehen. Ein solcher Kommentar beginnt mit [/**] und steht unmittelbar vor einer Klasse, einem Feld oder einer Methode. Hier ist zum Beispiel die Methode zur Steuerberechnung aus der Beispielanwendung dieses Kapitels, wie folgt dokumentiert:
Der Kommentar beginnt mit einem zusammenfassenden Satz; die Tags [@param] beschreiben die Parameter, und [@return] beschreibt den zurückgegebenen Wert ([@throws] würde eine Ausnahme beschreiben). Sie können Ihren eigenen Code auf diese Weise dokumentieren; der Befehl [javadoc] (oder [mvn javadoc:javadoc] in einem Maven-Projekt) erzeugt HTML-Seiten, die denen der Java-Dokumentation ähneln. Ab Java 23 können Dokumentationskommentare auch in Markdown geschrieben werden, mit Zeilen, die mit [///] beginnen.
Der Code-Editor (IntelliJ IDEA, Visual Studio Code mit dem Extension Pack for Java) nutzt diese Kommentare und bietet sofortige Hilfe, ohne den Code zu verlassen:
- Autovervollständigung: Nach der Eingabe von [aString.] zeigt der Editor eine Liste der Methoden des Objekts samt ihren Parametern und Rückgabetypen an;
- Schnelldokumentation: Fahren Sie mit der Maus über den Namen einer Klasse oder Methode (oder drücken Sie in IntelliJ IDEA Strg+Q), um deren Javadoc anzuzeigen;
- Parameterhilfe: Wenn Sie die öffnende Klammer eines Aufrufs eingeben (oder in IntelliJ IDEA Strg+P drücken), zeigt der Editor die verschiedenen Überladungen der Methode und die Rolle jedes Parameters an;
- Zur Definition springen (Strg+B in IntelliJ IDEA, F12 in VS Code): zeigt den Quellcode der Klasse oder Methode an. Das JDK wird mit dem Quellcode seiner gesamten Bibliothek geliefert (Datei [lib/src.zip]): So können Sie den Code von [ArrayList] oder [HashMap] lesen, geschrieben von Java-Spitzenexperten, was sehr lehrreich ist.
Schließlich erlaubt das JDK-Werkzeug [jshell], eine Methode ohne Programm zu testen: Sie geben einen Ausdruck ein, und es zeigt seinen Wert an. So zeigt ["abc".repeat(3)] den Wert ["abcabcabc"] an. Der Befehl [/help] in [jshell] listet seine Optionen auf.
5.2. Zeichenketten
5.2.1. Die Klasse String
Der Typ [String] (Paket [java.lang]) stellt Zeichenketten dar. Er bietet zahlreiche Methoden. Hier einige davon:
Methode | Aufgabe |
[int length()] | Anzahl der Zeichen der Zeichenkette |
[char charAt(int index)] | Zeichen Nr. [index]; das erste Zeichen hat die Nr. 0 |
[boolean startsWith(String prefix)] | gibt [true] zurück, wenn die Zeichenkette mit [prefix] beginnt |
[boolean endsWith(String suffix)] | gibt [true] zurück, wenn die Zeichenkette mit [suffix] endet |
[boolean contains(CharSequence s)] | gibt [true] zurück, wenn die Zeichenkette [s] enthält |
[boolean equals(Object other)] | gibt [true] zurück, wenn die Zeichenkette denselben Inhalt wie [other] hat; [equalsIgnoreCase] unterscheidet nicht zwischen Groß- und Kleinschreibung |
[int indexOf(String str)] | das erste Vorkommen von [str] in der Zeichenkette oder -1. Eine andere Überladung beginnt die Suche an der Position [fromIndex] |
[int indexOf(int ch)] | dasselbe für das Zeichen [ch] |
[int lastIndexOf(int ch)] | wie [indexOf] , liefert aber die letzte statt der ersten Position |
[static String join(CharSequence delimiter, CharSequence... elements)] | Klassenmethode: verkettet die Elemente und trennt sie durch [delimiter] |
[String replace(char oldChar, char newChar)] | gibt eine Kopie der Zeichenkette zurück, in der das Zeichen [oldChar] durch [newChar] ersetzt wurde; eine Überladung ersetzt eine Zeichenkette durch eine andere |
[String[] split(String regex)] | die Zeichenkette wird als Folge von Feldern behandelt, die durch ein Trennzeichen getrennt sind, das durch den regulären Ausdruck [regex] beschrieben wird; das Ergebnis ist ein Array dieser Felder |
[String substring(int beginIndex, int endIndex)] | Teilzeichenkette aus den Zeichen von Position [beginIndex] (einschließlich) bis Position [endIndex] (ausschließlich) |
[String toLowerCase()], [String toUpperCase()] | wandelt die Zeichenkette in Kleinbuchstaben bzw. Großbuchstaben um |
[String strip()] | entfernt führende und nachgestellte Leerzeichen der Zeichenkette (Java 11; [stripLeading], [stripTrailing]: nur auf einer Seite) |
[String repeat(int count)] | wiederholt die Zeichenkette [count] -mal (Java 11) |
[boolean isEmpty()], [boolean isBlank()] | gibt [true] zurück, wenn die Zeichenkette leer ist oder nur Leerzeichen enthält (Java 11) |
[Stream<String> lines()] | gibt die Zeilen der Zeichenkette als Stream zurück (Java 11; siehe Stream-API weiter unten) |
[String formatted(Object... args)] | gibt die als Vorlage verwendete Zeichenkette zurück, in der die Platzhalter [%s], [%d] … durch die Argumente ersetzt wurden (Java 15) |
Wichtig zu beachten ist, dass eine Zeichenkette vom Typ [String] unveränderlich ist; sie kann nach ihrer Erzeugung nicht mehr geändert werden. Wenn eine Methode eine Zeichenkette zurückgibt, ist diese eine andere als die, auf die die Methode angewendet wurde. So gibt [s1.strip()] die Zeichenkette [s2] zurück, und [s1] und [s2] sind zwei verschiedene Zeichenketten: [s1] hat sich nicht geändert.
Anders als in anderen Sprachen ist eine Java-Zeichenkette kein Array: Sie schreiben nicht [c[i]] , sondern [c.charAt(i)], und die Anzahl der Zeichen erhalten Sie mit der Methode [c.length()] (mit Klammern, während die Länge eines Arrays das Feld [array.length] ist, ohne Klammern).
Das Programm [Strings01.java] lautet wie folgt:
Ergebnisse:
Kommentare:
- Zeile 6: Zeichen Nr. 10, also das 11. Zeichen der Zeichenkette;
- Zeilen 8, 10: Eine erfolglose Suche liefert -1;
- Zeile 11: Die beiden Parameter von [substring] sind die Positionen des ersten beibehaltenen Zeichens und des ersten nicht mehr beibehaltenen Zeichens: Man erhält so die 7 Zeichen an den Positionen 4 bis 10. Das ist die allgemeine Java-Konvention zur Angabe eines Indexbereichs (Anfang eingeschlossen, Ende ausgeschlossen): Sie kommt in vielen Methoden vor;
- Zeilen 16–17: Die Klasse [String] hat keine Methode zum Einfügen: Wir verketten den Anfang der Zeichenkette, den eingefügten Text und das Ende der Zeichenkette. Wir werden sehen, dass die Klasse [StringBuilder] eine Methode [insert] besitzt;
- Zeile 19: [split] zerlegt die Zeichenkette in Felder. Ihr Parameter ist nicht ein einzelnes Zeichen, sondern ein regulärer Ausdruck, den wir am Ende des Kapitels untersuchen: ["\\s+"] bezeichnet eine Folge von einem oder mehreren Leerraumzeichen (Leerzeichen, Tabulator, Zeilenumbruch usw.). Das Zeichen [\] muss in einer Java-Zeichenkette verdoppelt werden, daher die Schreibweise [\\s];
- Zeile 23: Die statische Methode [join] bewirkt das Gegenteil von [split];
- Zeile 24: [strip] (Java 11) entfernt führende und nachgestellte Leerzeichen. Es gibt auch die ältere Methode [trim], die nur die Leerzeichen des ASCII-Codes erkennt; [strip] erkennt alle Unicode-Leerzeichen und sollte bevorzugt werden;
- Zeile 26: Alle vorherigen Methoden haben neue Zeichenketten zurückgegeben: [aString] blieb unverändert (Zeile 22 der Ergebnisse);
- Zeilen 30–32: eine Methode der kompakten Quelldatei, die von der Methode [main] wie in Kapitel 3 aufgerufen wird.
5.2.2. Die Methoden split und join
Das Programm [Strings02.java] zerlegt eine Zeichenkette detaillierter in Felder:
Ergebnisse:
Kommentare:
- Zeile 5: Die Felder sind durch das Zeichen [:] getrennt. Zwei aufeinanderfolgende [:]-Zeichen begrenzen ein leeres Feld (Zeile 4 der Ergebnisse). Aber Vorsicht: [split] entfernt leere Felder am Ende. Das letzte [:] in der Zeichenkette begrenzt ein fünftes, leeres Feld, das entfernt wurde: Man erhält nur 4 Felder, und [join] rekonstruiert die ursprüngliche Zeichenkette nicht (Zeile 6 der Ergebnisse). Das ist eine häufige Falle;
- Zeile 13: Der zweite Parameter von [split] ist ein Limit. Ein negatives Limit weist das Programm an, alle Felder zu behalten, einschließlich der leeren Felder am Ende: Wir erhalten tatsächlich 5 Felder, und [join] rekonstruiert die ursprüngliche Zeichenkette;
- Zeile 17: Da das Trennzeichen ein regulärer Ausdruck ist, können wir komplexe Trennzeichen definieren: [":+"] trifft auf ein oder mehrere aufeinanderfolgende [:]-Zeichen zu. Die beiden aufeinanderfolgenden [:] bilden ein einziges Trennzeichen, und das leere Feld verschwindet;
- Zeile 22: Das Muster [\\s*[,;]\\s*] trifft auf ein Komma oder Semikolon zu, vor und nach dem beliebig viele Leerzeichen stehen: Die Leerzeichen um die Trennzeichen werden mit ihnen entfernt. Diejenigen am Anfang und am Ende der Zeichenkette werden vorher durch [strip] entfernt. So entstehen die drei „bereinigten“ Felder in einer einzigen Anweisung;
- Zeilen 27–35: Um sowohl die Leerzeichen um die Felder als auch die leeren Felder zu entfernen, können Sie die Felder auch einzeln verarbeiten: Das Feld, das aus zwei Leerzeichen zwischen zwei Kommas besteht, wird nach [strip] leer und nicht übernommen. Die Liste [ArrayList] , die hier zum Speichern der übernommenen Felder dient, wird etwas später behandelt. Wir werden auch sehen, dass die Stream-API erlaubt, diese Verarbeitung in einer einzigen Anweisung zu schreiben;
- Zeile 39: Das Trennzeichen [" | "] enthält das Zeichen [|], das in einem regulären Ausdruck eine besondere Bedeutung hat („oder“). Die Methode [Pattern.quote] wandelt jede Zeichenkette in einen regulären Ausdruck um, der sie wörtlich trifft. Wir verwenden sie immer dann, wenn ein Trennzeichen eines der Zeichen [\ ^ $ . | ? * + ( ) [ ] { }] enthält;
- Zeilen 43–48: [join] akzeptiert nur Zeichenketten (genauer gesagt [CharSequence]-Objekte, eine Schnittstelle, die von [String] und [StringBuilder] implementiert wird): Ein Array von Ganzzahlen muss zuerst in ein Array von Zeichenketten umgewandelt werden. Wir werden sehen, dass dasselbe mit der Stream-API durch [Arrays.stream(numbers).mapToObj(String::valueOf).collect(Collectors.joining(" + "))] in einer einzigen Anweisung gelingt.
5.2.3. Zeichenketten suchen und vergleichen
Der Vergleich von Zeichenketten ist subtiler, als es scheint: Sollen Groß- und Kleinbuchstaben unterschieden werden? Wie soll „éclair“ mit „essay“ verglichen werden? Und vor allem: Was vergleicht der Operator [==] in Java? Das Programm [Strings03.java] demonstriert die Such- und Vergleichsmethoden:
Ergebnisse:
Kommentare:
- Zeilen 6–9: [contains], [startsWith] und [endsWith] führen einen exakten Vergleich Zeichen für Zeichen durch: „LANGUAGE“ wird nicht gefunden;
- Zeilen 12–14: Diese Methoden haben keine Variante ohne Unterscheidung von Groß- und Kleinschreibung. Am einfachsten sucht man unabhängig von der Groß- und Kleinschreibung, indem man beide Zeichenketten in Kleinbuchstaben umwandelt;
- Zeilen 16–17: Die Methode [regionMatches] vergleicht einen Teil einer Zeichenkette mit einem Teil einer anderen Zeichenkette. Ihr erster Parameter gibt an, ob die Groß- und Kleinschreibung ignoriert werden soll; die folgenden Parameter sind die Startposition in der Zeichenkette, die andere Zeichenkette, die Startposition in der anderen Zeichenkette und die Anzahl der zu vergleichenden Zeichen;
- Zeilen 20–25: der wichtigste Teil dieses Programms. Eine Variable vom Typ [String] enthält eine Referenz auf ein Zeichenkettenobjekt (Kapitel 4). Der Operator [] vergleicht die Referenzen: Er liefert [true] , wenn beide Variablen auf dasselbe Objekt verweisen, und nicht, wenn es zwei Objekte mit demselben Inhalt sind. Die Variable [yes] (Zeile 21) verweist auf eine zur Laufzeit erzeugte Zeichenkette „yes“: Dies ist ein anderes Objekt als das Literal „yes“ des Programms, und [yes == "yes"] ergibt [false] (Zeile 9 der Ergebnisse), obwohl beide Zeichenketten denselben Inhalt haben. Um Inhalte zu vergleichen, verwenden wir immer die Methode [equals] oder [equalsIgnoreCase] , um die Groß- und Kleinschreibung zu ignorieren; das ist der richtige Weg, um eine über die Tastatur eingegebene Antwort „yes“ in Groß- oder Kleinschreibung zu prüfen. Der Vergleich mit [] „funktioniert“ manchmal, wenn beide Zeichenketten Literale des Programms sind, von denen Java nur eine einzige Instanz speichert: Das macht den Fehler schwer zu entdecken;
- Zeilen 28–31: Die Methode [compareTo] liefert eine negative, null oder positive Ganzzahl, je nachdem, ob die Zeichenkette der Parameter-Zeichenkette vorangeht, gleicht oder folgt. Sie vergleicht die Zeichencodes: „éclair“ kommt nach „essay“, weil der Code des Zeichens é (233) größer ist als der des Zeichens e (101); hier liefert sie die Differenz der beiden Codes, 132. Um Wörter nach den Regeln einer Sprache zu sortieren, verwenden Sie ein [java.text.Collator]-Objekt: Im Französischen wird das Zeichen „é“ mit „e“ gruppiert, und „éclair“ kommt vor „essay“ (Zeile 13 der Ergebnisse). Wir verwenden die von einem [Collator] definierte Ordnung, um für Benutzer bestimmte Wörter zu sortieren, und [compareTo] , um technische Bezeichner (Dateinamen, Schlüssel usw.) zu vergleichen;
- Zeilen 34–40: [isEmpty] prüft auf eine leere Zeichenkette, während [isBlank] (Java 11) auf eine leere oder nur aus Leerzeichen bestehende Zeichenkette prüft. Eine Variable vom Typ [String] kann auch [null] sein (keine Zeichenkette): Der Aufruf einer Methode auf [null] löst eine [NullPointerException] aus. Daher testen wir zuerst [missing == null]; dank der Kurzschlussauswertung des Operators [||] wird [missing.isBlank()] nicht ausgewertet, wenn [missing] [null] ist;
- Zeilen 43–44: [String.format("%8s", ...)] füllt eine Zeichenkette mit Leerzeichen auf eine Länge von 8 Zeichen auf, links oder rechts, mit dem Format [%-8s]; [repeat] wiederholt eine Zeichenkette.
5.2.4. Formate und Textblöcke
Bisher haben wir die anzuzeigenden Zeichenketten durch Verkettung mit dem Operator [+] aufgebaut. Um Werte in Spalten auszurichten, die Anzahl der Nachkommastellen einer Zahl festzulegen oder ein Datum anzuzeigen, verwenden Sie die Methode [String.format] oder die Instanzmethode [formatted] (Java 15), die dasselbe leistet. Der erste Parameter ist ein Format: eine Zeichenkette, in der die Angaben [%[-][width][.precision]conversion] (Spezifizierer) anzeigen, wo und wie die folgenden Parameter eingefügt werden. Das Programm [Strings04.java] liefert Beispiele dafür sowie für die Textblöcke von Java 15:
Ergebnisse:
Kommentare:
- Zeile 12: Eine Breitenangabe richtet den Wert in einem Feld von 10 Zeichen rechtsbündig aus; steht davor das Symbol [-], wird er linksbündig ausgerichtet;
- Zeilen 12–14: Die gebräuchlichsten Konvertierungen:
Spezifizierer | Bedeutung | Beispiel |
[%s] | Zeichenkette; jedes Objekt wird mit seiner [toString]-Methode konvertiert | dupont |
[%d], [%5d] | Ganzzahl, gegebenenfalls 5 Zeichen lang | 45 |
[%05d] | Ganzzahl mit mindestens 5 Stellen, mit Nullen aufgefüllt | 00045 |
[%X] | hexadezimale Ganzzahl ([%x]: in Kleinbuchstaben) | 2D |
[%.2f], [%12.2f] | Dezimalzahl mit 2 Nachkommastellen, gegebenenfalls 12 Zeichen lang | 2345.68 |
[%,.2f], [%,d] | wie oben, mit Tausendertrennzeichen | 2,345.68 |
[%e] | Dezimalzahl in wissenschaftlicher Notation | 2.345678e+03 |
[%n] | systemspezifischer Zeilenumbruch | |
[%%] | das Zeichen % | % |
- Zahlen werden gemäß der aktuellen Sprache formatiert, hier Englisch: Dezimalpunkt, Komma als Tausendertrennzeichen. In den französischen Formaten der Zeilen 19–22 ist das Tausendertrennzeichen ein Leerzeichen: ein schmales geschütztes Leerzeichen (Zeichen U+202F), das wie ein gewöhnliches Leerzeichen aussieht, aber einen Zeilenumbruch mitten in einer Zahl verhindert; ebenso steht ein geschütztes Leerzeichen (U+00A0) vor dem Symbol € und vor dem Symbol %. Dies ist zu berücksichtigen, wenn diese Texte mit Zeichenketten verglichen werden, die mit gewöhnlichen Leerzeichen geschrieben sind;
- Zeile 16: ["...".formatted(...)] ist gleichbedeutend mit [String.format("...", ...)]. Ein bedingter Ausdruck kann einen Parameter liefern;
- Zeilen 19–22: Geldbeträge und Prozentwerte werden mit [java.text.NumberFormat]-Objekten formatiert, die für eine bestimmte Sprache und ein bestimmtes Land abgeleitet werden ([Locale.FRANCE]). Das Prozentformat multipliziert den Wert mit 100;
- Zeilen 25–27: Datumsangaben der API [java.time] (Java 8) werden mit einem [DateTimeFormatter]-Objekt formatiert, das aus einem Muster aufgebaut wird: [dd] Tag, [MM] Monat, [yyyy] Jahr, [HH] Stunde, [mm] Minuten, [ss] Sekunden, [EEEE] ausgeschriebener Wochentag, [MMMM] ausgeschriebener Monat. Achten Sie auf die Groß- und Kleinschreibung: [MM] steht für den Monat, [mm] für die Minuten. Die Namen der Wochentage und Monate sind die der Alltagssprache;
- Zeilen 30–34: Die Spaltenbreiten ermöglichen es, Daten in Spalten anzuzeigen;
- Zeile 37: In einer Zeichenkette leitet das Zeichen [\] eine Escape-Sequenz ein ([\n], [\t], [\"] …); um das Zeichen [\] selbst zu erhalten, muss es verdoppelt werden. Java kennt keine „rohen“ Zeichenketten, in denen [\] ein gewöhnliches Zeichen wäre, was das Schreiben von Windows-Pfaden und regulären Ausdrücken etwas umständlich macht;
- Zeilen 41–46: Ein Textblock (Java 15) wird durch drei Anführungszeichen begrenzt; der Text beginnt in der Zeile nach den öffnenden Anführungszeichen. Er kann sich über mehrere Zeilen erstrecken und Anführungszeichen ohne Escape-Zeichen enthalten. Die allen Zeilen gemeinsame Einrückung (die der am wenigsten eingerückten Zeile, wobei die schließenden Anführungszeichen mitgezählt werden) wird entfernt: Der JSON-Text wird ohne den Code-Rand angezeigt. Escape-Sequenzen bleiben hier wirksam: [\] muss weiterhin verdoppelt werden (Zeile 44). Da die schließenden Anführungszeichen in einer eigenen Zeile stehen, endet der Text mit einem Zeilenumbruch: daher die Verwendung von [IO.print] in Zeile 47 ([IO.println] würde nach der schließenden geschweiften Klammer eine Leerzeile hinzufügen);
- Zeilen 49–50: Java unterstützt keine String-Interpolation, also direkt im Text geschriebene Ausdrücke wie [${name}] in anderen Sprachen (ein Vorschlag, „String Templates“, wurde in Java 21 und 22 als Vorschau getestet und dann wieder entfernt). Bei einem Textblock verwendet man Platzhalter wie [%s], [%d] …, die von [formatted] ausgefüllt werden. Setzt man die schließenden Anführungszeichen ans Ende des Textes, vermeidet man einen abschließenden Zeilenumbruch.
Es gibt außerdem die Klasse [java.text.MessageFormat], deren Formate die Parameter über ihre Nummern ansprechen: [MessageFormat.format("{0} is {1} years old", name, age)]. Sie wird für Meldungen verwendet, die in mehrere Sprachen übersetzt werden, wo die Reihenfolge der Parameter von Sprache zu Sprache variieren kann.
5.2.5. Die Klasse StringBuilder
Wir haben erwähnt, dass die Methoden der Klasse [String], die auf eine Zeichenkette [s1] angewendet werden, eine andere Zeichenkette [s2] zurückgeben. Die Klasse [java.lang.StringBuilder] erlaubt es, eine Zeichenkette zu verändern, ohne für jede Operation eine neue Zeichenkette zu erzeugen. Das verbessert die Leistung, wenn eine Zeichenkette durch viele aufeinanderfolgende Ergänzungen aufgebaut wird, da die Vermehrung von Zeichenketten mit sehr kurzer Lebensdauer vermieden wird.
Die Klasse unterstützt verschiedene Konstruktoren:
Konstruktor | Rolle |
[StringBuilder()] | erzeugt ein leeres Objekt mit einer anfänglichen Kapazität von 16 Zeichen |
[StringBuilder(String str)] | erzeugt ein Objekt und initialisiert es mit [str]; die anfängliche Kapazität ist die Länge von [str] plus 16 |
[StringBuilder(int capacity)] | erzeugt ein leeres Objekt mit einer anfänglichen Kapazität von [capacity] Zeichen |
Ein [StringBuilder]-Objekt speichert seine Zeichen in einem Array, dessen Größe – seine Kapazität – automatisch angepasst wird, wenn der Text wächst. Das Programm [Strings05.java] veranschaulicht dieses Konzept der Kapazität:
Ergebnisse:
Kommentare:
- Zeile 3: Erzeugung eines [StringBuilder]-Objekts, das „test“ enthält: Seine anfängliche Kapazität beträgt 4 + 16 = 20 Zeichen;
- Zeile 4: [length] ist die aktuelle Anzahl der Zeichen; [capacity] ist die Anzahl der Zeichen, die das Objekt aufnehmen kann, bevor es sein Array vergrößern muss;
- Zeile 6: [append] hängt eine Zeichenkette an das Ende des Textes an;
- Zeile 10: Erzeugung eines leeren [StringBuilder]-Objekts mit einer anfänglichen Kapazität von 10, dem sofort „test“ hinzugefügt wird. Die Methode [append] gibt das Objekt selbst zurück: Sie kann direkt auf das Ergebnis des Konstruktors aufgerufen werden.
Die Ergebnisse zeigen: Reicht die Kapazität nicht aus, wird sie etwas mehr als verdoppelt: Die neue Kapazität ist die alte mal 2 plus 2 (20, 42, 86 beim ersten Objekt; 10, 22, 46 beim zweiten). Bei jeder Größenänderung wird ein neues Array angelegt und die Zeichen werden hineinkopiert. Kennt man die ungefähre Größe des Textes im Voraus, vermeidet man diese aufeinanderfolgenden Größenänderungen, indem man sie bei der Konstruktion festlegt.
Hier einige der Methoden der Klasse:
Methode | Rolle |
[StringBuilder append(String str)] | Fügt [str] am Ende des Textes hinzu. Überladen, um die Typen [int], [double], [char], [boolean], [Object] … zu akzeptieren |
[StringBuilder insert(int offset, String str)] | Fügt [str] an der Position [offset] ein; überladen wie [append] |
[StringBuilder delete(int start, int end)] | löscht die Zeichen von Position [start] (einschließlich) bis [end] (ausschließlich); [deleteCharAt] löscht ein einzelnes Zeichen |
[StringBuilder replace(int start, int end, String str)] | ersetzt die Zeichen von Position [start] (einschließlich) bis [end] (ausschließlich) durch [str] |
[StringBuilder reverse()] | kehrt die Reihenfolge der Zeichen um |
[void setCharAt(int index, char ch)] | ersetzt das Zeichen Nr. [index] durch [ch] |
[int indexOf(String str)] | Position von [str] im Text oder -1 |
[String toString()] | wandelt den Text in eine Zeichenkette [String] um |
Das Programm [Strings06.java] verwendet sie:
Ergebnisse:
Kommentare:
- Zeile 4: Die Änderungsmethoden geben das [StringBuilder]-Objekt selbst zurück, sodass sie verkettet werden können. Verfolgen wir die Schritte: „test“ wird zu „testabCD “ ([append]), dann zu „texyZTstabCD“ ([insert] an Position 2), dann zu „xyZTstabCD “ ([delete] für die Zeichen 0 und 1) und schließlich zu „XYZTstabCD“ ([replace] für die Zeichen 0 und 1, mit „XY“). Beachten Sie, dass die Methode von [StringBuilder] im Gegensatz zur Methode [replace] von [String] nicht nach Text sucht: Sie ersetzt einen Bereich von Positionen. [IO.println] zeigt das Objekt an, indem es dessen Methode [toString] aufruft;
- Zeile 6: [reverse] kehrt den Text um. Da [String] keine Methode [reverse] besitzt, ist dies der übliche Weg, eine Zeichenkette umzukehren;
- Zeilen 9–12: Aufbau eines mehrzeiligen Textes durch aufeinanderfolgende Ergänzungen – das ist die typische Verwendung von [StringBuilder]. Die Ergänzungen werden in einer einzigen Codezeile verkettet;
- Zeile 14: [StringBuilder] hat kein Äquivalent zu [join]: Das Ergebnis von [String.join] wird angehängt;
- Zeile 17: Eine formatierte Zeichenkette wird hinzugefügt. Die Konvertierung [%f] erfordert eine Dezimalzahl: Die Übergabe der Ganzzahl [total] würde zur Laufzeit eine [IllegalFormatConversionException]-Ausnahme auslösen, daher die Umwandlung [(double) total];
- Zeile 19: Der endgültige Text wird als Zeichenkette [String] abgerufen;
- Zeilen 24–28: Die Klasse [java.util.StringJoiner] erzeugt eine Zeichenkette aus Elementen, die durch ein Trennzeichen getrennt sind, mit optionalem Präfix und Suffix. [String.join] erfüllt dieselbe Aufgabe ohne Präfix und Suffix.
Für einige wenige Verkettungen genügt der Operator [+]: Der Compiler optimiert sie. [StringBuilder] ist erforderlich, wenn die Zahl der Ergänzungen groß oder unbekannt ist, typischerweise innerhalb einer Schleife: Die Verkettung [s = s + ...] in einer Schleife mit n Durchläufen erzeugt n Zeichenketten und kopiert in jedem Durchlauf die gesamte bisher aufgebaute Zeichenkette. In älterem Code finden Sie die Klasse [StringBuffer], die dieselben Methoden wie [StringBuilder] hat, sie aber gleichzeitig durch mehrere Threads nutzbar macht, auf Kosten eines gewissen Leistungsaufwands: Heute wird [StringBuilder] ihr vorgezogen.
5.2.6. Eine Zeichenkette analysieren, ohne sie zu kopieren
Jeder Aufruf von [substring] erzeugt eine neue Zeichenkette im Speicher. In leistungskritischem Code (etwa beim Analysieren großer Dateien oder von Netzwerkanfragen) möchte man diese Erzeugungen eventuell vermeiden. Java besitzt keinen in die Sprache integrierten Typ für eine „Sicht auf einen Zeichenkettenabschnitt“, aber mehrere Methoden arbeiten auf einem Teil einer Zeichenkette, ohne sie zu kopieren. Das Programm [Strings07.java] vergleicht die beiden Arten, eine Zeile im Format „Nachname:Vorname:Alter“ zu analysieren:
Ergebnisse:
Kommentare:
- Zeilen 8–9: Jeder Aufruf von [substring] erzeugt eine neue Zeichenkette, selbst wenn sie, wie beim Alter, nur einen Augenblick lang verwendet wird;
- Zeile 13: Eine überladene Version von [Integer.parseInt] (Java 9) analysiert die Zeichen zwischen zwei Positionen der Zeichenkette zur angegebenen Basis (hier 10), ohne eine Teilzeichenkette zu erzeugen;
- Zeile 15: [regionMatches], das wir bereits kennengelernt haben, vergleicht einen Teil der Zeichenkette mit einer anderen Zeichenkette, ohne ihn zu kopieren;
- Zeile 19: [CharBuffer.wrap] (Paket [java.nio]) gibt eine Sicht auf die Zeichen von 0 bis [p1] - 1 der Zeichenkette zurück: ein Objekt, das keine Kopie der Zeichen enthält, aber einen Zugriff auf sie bietet. Es implementiert die Schnittstelle [CharSequence], genau wie [String] und [StringBuilder]: Viele Java-Methoden akzeptieren eine [CharSequence] (zum Beispiel [String.join], [contains], [append] und reguläre Ausdrücke);
- Zeile 24: Eine überladene Version von [indexOf] (Java 21) beschränkt die Suche auf einen Positionsbereich;
- Zeile 27: Eine Zeichenkette wird nur erzeugt, wenn sie tatsächlich benötigt wird.
Diese Techniken sind Werkzeuge zur Optimierung: Für ein gewöhnliches Programm funktioniert [substring] einwandfrei. Seit Java 9 speichert die virtuelle Maschine außerdem Zeichenketten, die nur Zeichen des Latin-1-Zeichensatzes enthalten (wie es bei französischem Text der Fall ist), mit einem Byte pro Zeichen statt mit zwei („Compact Strings“), wodurch sich der belegte Speicher halbiert. Kopien versuchen wir nur in Code zu vermeiden, dessen Leistungskritikalität gemessen wurde.
5.3. Arrays
5.3.1. Die Klasse Arrays
Java-Arrays sind Objekte, besitzen aber keine nützlichen Methoden: Abgesehen vom Feld [length] sind alle Operationen auf Arrays statische Methoden der Hilfsklasse [java.util.Arrays]. Mit diesen Methoden kann man ein Array sortieren, ein Element darin suchen, es kopieren, es füllen usw. Fast alle sind überladen: Es gibt eine Version für jeden primitiven Typ ([int[]], [double[]], [char[]] …) und eine Version für Arrays von Objekten.
Methode | Rolle |
[static int binarySearch(int[] a, int key)] | Gibt die Position von [key] in [a] zurück, das sortiert sein muss; eine negative Zahl, wenn [key] fehlt |
[static int[] copyOf(int[] original, int newLength)] | gibt ein neues Array mit [newLength] Elementen zurück, das die ersten Elemente von [original] enthält, bei Bedarf mit Nullen aufgefüllt ([false] bei Booleschen Werten, [null] bei Referenzen) |
[static int[] copyOfRange(int[] original, int from, int to)] | gibt ein neues Array zurück, das aus den Elementen von [from] (einschließlich) bis [to] (ausschließlich) besteht |
[static boolean equals(int[] a, int[] a2)] | Gibt [true] zurück, wenn beide Arrays dieselben Elemente in derselben Reihenfolge enthalten |
[static void fill(int[] a, int val)] | weist allen Elementen von [a] den Wert [val] zu; eine überladene Version füllt nur einen Indexbereich |
[static void sort(int[] a)] | sortiert [a] nach der natürlichen Ordnung seiner Elemente; eine überladene Version sortiert nur einen Indexbereich; für ein Array von Objekten erhält eine überladene Version einen [Comparator], der die Ordnung festlegt (Kapitel 4) |
[static String toString(int[] a)] | gibt die Elemente des Arrays als Zeichenkette [[e1, e2, ...]] zurück; [deepToString] tut dasselbe für ein Array von Arrays |
[static <T> List<T> asList(T... a)] | gibt eine Liste zurück, die eine Sicht auf das Array von Objekten [a] ist |
[static IntStream stream(int[] array)] | gibt einen Stream der Elemente des Arrays zurück (siehe den Abschnitt zur Stream-API weiter unten) |
Außerdem gibt es die Methode [System.arraycopy(source, sourceStart, destination, destinationStart, count)], die Elemente aus einem Array in ein anderes, bereits existierendes Array kopiert.
Das Programm [Arrays01.java] veranschaulicht die Verwendung einiger Methoden der Klasse [Arrays]:
Kommentare:
- Zeilen 18–42: Die Methode [input] liest über die Tastatur eingegebene Array-Elemente ein. Da die Anzahl der Elemente im Voraus nicht bekannt ist, beginnt das Programm mit einem leeren Array (Zeile 20) und vergrößert es bei jeder neuen Eingabe um ein Element (Zeile 37). Die Größe eines Java-Arrays steht bei der Erzeugung fest: [Arrays.copyOf] erzeugt in Wirklichkeit ein neues, um ein Element größeres Array und kopiert die Elemente des alten hinein. Ein effizienterer Algorithmus würde Speicherplatz in Gruppen von N Elementen reservieren. Ein Array ist nicht dafür gedacht, vergrößert zu werden: Dieses Szenario lässt sich besser mit einer Liste [ArrayList] behandeln, wie wir gleich sehen werden;
- Zeile 39: Das letzte Element eines Arrays hat den Index [length - 1];
- Zeilen 30–35: Die Umwandlung der eingegebenen Zeichenkette in eine Dezimalzahl durch [Double.parseDouble], das eine Ausnahme [NumberFormatException] auslöst, wenn die Zeichenkette keine Zahl ist. [Double.parseDouble] hängt nicht von der Sprache des Systems ab: Es erwartet immer einen Dezimalpunkt und weist die Eingabe „3,6“ zurück (Zeile 5 der Ergebnisse);
- Zeilen 53–75: Die Methode [search] sucht im Array nach den über die Tastatur eingegebenen Zeichen. Bei einem unsortierten Array wird eine lineare Suche durchgeführt (Zeile 71), die die Elemente einzeln prüft. Die Klasse [Arrays] besitzt keine Methode namens [indexOf]: Wir schreiben sie selbst (Zeilen 78–85). Bei einem sortierten Array führen wir mit [Arrays.binarySearch] eine binäre Suche durch (Zeile 70), die den Suchbereich bei jedem Schritt halbiert: Sie findet ein Element unter einer Million in etwa zwanzig Vergleichen;
- Zeile 10: Wir sortieren das Array. Hier verwenden wir eine Variante von [sort] mit nur einem Parameter: dem zu sortierenden Array. Die Ordnungsrelation, die zum Vergleichen der Array-Elemente dient, ist dann die für diese Elemente implizite: in diesem Fall die natürliche Ordnung der Zahlen;
- Zeilen 45–50: Anzeige eines Arrays. [IO.println] zeigt einen [double]-Wert unabhängig von der Sprache des Rechners mit Dezimalpunkt und immer mit mindestens einer Nachkommastelle an: -7 wird als -7.0 angezeigt;
- Zeilen 88–91: [IO.readln] (Java 25) zeigt eine Eingabeaufforderung an und liest dann eine über die Tastatur eingegebene Zeile; es gibt [null] zurück, wenn die Standardeingabe erschöpft ist, zum Beispiel wenn sie aus einer Datei stammt;
- Zeile 94: eine Aufzählung (Enumeration), die in der kompakten Quelldatei genauso wie Methoden deklariert wird.
Ergebnisse:
Fehlt das gesuchte Element, gibt die Methode [indexOf] den Wert -1 zurück und [binarySearch] eine negative Zahl (Zeile 27): Das ist [-(p + 1)], wobei p die Position ist, an der das Element eingefügt werden müsste, damit das Array sortiert bleibt. Hier ist -3 = -(2 + 1): Die Zahl 0 müsste an Position 2 eingefügt werden, zwischen -1.5 und 3.6. Achtung: [binarySearch] liefert bei einem unsortierten Array ein bedeutungsloses Ergebnis.
5.3.2. Weitere Methoden der Klasse Arrays
Das Programm [Arrays02.java] zeigt weitere Methoden der Klasse [Arrays]:
Ergebnisse:
Kommentare:
- Zeile 4: [Arrays.toString] zeigt ein Array in einer einzigen Zeile an. Die direkte Anzeige eines Arrays mit [IO.println(numbers)] ergäbe einen Text ähnlich wie [[I@1b6d3586]]: den Typ ([[I]], Array von Ganzzahlen) und eine Objektkennung, ohne seine Elemente;
- Zeile 7: Nur die Elemente mit den Indizes 1 bis 3 werden sortiert, wobei der zweite Index ausgeschlossen ist: 10, 30, 20 werden zu 10, 20, 30;
- Zeile 12: kopiert die ersten 3 Elemente von [numbers] an den Anfang von [copy], während die übrigen Elemente ihren Anfangswert 0 behalten;
- Zeilen 15–16: [copyOf] und [copyOfRange] erzeugen ein neues Array. Ein Array, das länger ist als das Original, wird mit Nullen aufgefüllt;
- Zeilen 19–22: [fill] füllt das Array und setzt dann die Elemente mit den Indizes 1 und 2 (3 ausgeschlossen) auf 0 zurück;
- Zeilen 25–27: Wie bei Zeichenketten vergleicht der Operator [==] die Referenzen zweier Arrays, nicht ihre Inhalte: Es muss [Arrays.equals] verwendet werden;
- Zeile 31: [Arrays.asList] gibt eine [List] (im folgenden Abschnitt vorgestellt) zurück, die eine Sicht auf ein Array von Objekten ist: Sie kopiert das Array nicht, sondern ermöglicht den Zugriff darauf über Listenmethoden. Das liefert [indexOf] und [lastIndexOf] (Zeile 32);
- Zeile 35: Die Methode [Collections.reverse] kehrt die Reihenfolge der Elemente einer Liste um. Da die Liste eine Sicht auf das Array ist, wird das Array selbst umgekehrt (Zeile 11 der Ergebnisse). Die Klasse [Arrays] besitzt keine Methode zum Umkehren; dieses Vorgehen gilt nur für Arrays von Objekten, nicht für Arrays primitiver Typen wie [int[]];
- Zeile 40: Ein Array von Zeichenketten wird nach der Ordnung der weiter oben beschriebenen Methode [compareTo] sortiert, also nach Zeichencodes: Großbuchstaben (Codes 65 bis 90) kommen vor Kleinbuchstaben (97 bis 122), die vor Buchstaben mit Akzent (é: 233) kommen. „Zoé“ ist das erste Wort und „éclair“ das letzte;
- Zeile 43: Um nach französischen Regeln zu sortieren, übergeben wir ein Objekt vom Typ [Collator] – das Zeichenketten vergleicht – an [sort];
- Zeilen 47–50: Java kennt keine zweidimensionalen rechteckigen Arrays: [new int[2][3]] erzeugt ein Array mit 2 Elementen, von denen jedes ein Array aus 3 Ganzzahlen ist. [matrix.length] ist die Anzahl der Zeilen und [matrix[0].length] ist die Anzahl der Elemente in Zeile 0. [Arrays.deepToString] zeigt ein Array von Arrays an.
Die Stream-API, die wir später behandeln, bietet weitere Möglichkeiten, die Elemente eines Arrays zu durchsuchen, zu sortieren oder zu transformieren, zum Beispiel [Arrays.stream(numbers).sum()].
5.4. Collections
Neben Arrays stellt Java verschiedene Klassen zur Verfügung, um Sammlungen von Elementen zu speichern. Sie bilden das Collections Framework im Paket [java.util], das in Java 1.2 eingeführt und in Java 5 generisch gemacht wurde. Es ist um Schnittstellenherum organisiert, die beschreiben, was eine Sammlung tut, und um Klassen, die sie jeweils auf ihre eigene Weise implementieren:
Schnittstelle | Rolle | Hauptimplementierungen |
[List<E>] | eine geordnete Folge von Elementen, auf die über ihre Position zugegriffen wird | [ArrayList], [LinkedList] |
[Set<E>] | eine Menge: keine Duplikate | [HashSet], [LinkedHashSet], [TreeSet] |
[Map<K,V>] | ein Dictionary: (Schlüssel, Wert)-Paare, wobei die Schlüssel eindeutig sind | [HashMap], [LinkedHashMap], [TreeMap] |
[Deque<E>] | eine doppelseitige Warteschlange, verwendbar als Warteschlange oder als Stapel | [ArrayDeque], [LinkedList] |
[Queue<E>] | eine Warteschlange | [ArrayDeque], [PriorityQueue] |
Die Schnittstellen [List], [Set] und [Queue] sind von der Schnittstelle [Collection<E>] abgeleitet ([size], [isEmpty], [contains], [add], [remove], [clear] …), die ihrerseits von [Iterable<E>] abgeleitet ist, der Schnittstelle für Objekte, die mit einer [for]-Schleife durchlaufen werden können. Bewährte Praxis ist es, Variablen und Parameter mit dem Schnittstellentyp zu deklarieren und den Klassennamen nur bei der Erzeugung zu verwenden: [List<String> cities = new ArrayList<>();]. So lässt sich die Implementierung ändern, ohne den übrigen Code anzupassen.
Eine Java-Collection enthält nur Objekte. Java-Generics unterstützen keine primitiven Typen: Man schreibt nicht [List<int>] , sondern [List<Integer>], wobei [Integer] die Wrapper-Klasse für den Typ [int] ist (ebenso [Double] für [double], [Boolean] für [boolean] …). Der Compiler wandelt einen [int] bei einer Zuweisung automatisch in einen [Integer] um („Autoboxing“) und einen [Integer] beim Lesen in einen [int] um („Unboxing“). Diese Umwandlung verursacht Kosten an Speicher und Zeit: Eine Liste mit einer Million Ganzzahlen enthält eine Million [Integer]-Objekte. Für große Mengen von Zahlen ist es vorzuziehen, ein [int[]]-Array oder die primitiven Streams ([IntStream]) zu verwenden, die mit der Stream-API eingeführt wurden.
Das Paket [java.util] enthält außerdem die Collections aus Java 1.0: [Vector] (eine Liste), [Hashtable] (ein Dictionary) und [Stack] (ein Stapel). Diese sind heute veraltet: Da sie bei jeder Operation synchronisiert sind, sind sie langsamer als ihre Nachfolger [ArrayList], [HashMap] und [ArrayDeque]. Sie sollten in neuem Code nicht mehr verwendet werden. Vermeiden Sie ebenso „Raw Types“ – also generische Collections, die ohne Typparameter verwendet werden ([List list = new ArrayList();]) –, wie es vor Java 5 üblich war: Der Compiler kann den Typ der hinzugefügten Elemente nicht mehr prüfen und gibt bei jeder Verwendung eine Warnung aus.
5.4.1. Die Schnittstelle List und die Klasse ArrayList
Die Klasse [java.util.ArrayList<E>] implementiert eine Liste von Objekten des Typs [E] , deren Größe sich während der Programmausführung ändert. Sie speichert ihre Elemente in einem internen Array, dessen Größe sie automatisch anpasst, genau wie [StringBuilder]. Das Element i einer Liste [l] wird mit [l.get(i)] gelesen und mit [l.set(i, value)] geändert.
Hier einige der Methoden der Schnittstelle [List<E>]:
Methode | Rolle |
[int size()] | Anzahl der Elemente der Liste |
[boolean add(E e)] | Fügt [e] am Ende der Liste hinzu |
[void add(int index, E element)] | Fügt [element] an der Position [index] in die Liste ein |
[boolean addAll(Collection<? extends E> c)] | fügt die Elemente von [c] am Ende der Liste hinzu |
[E get(int index)], [E set(int index, E element)] | liest bzw. ersetzt das Element Nr. [index] |
[E getFirst()], [E getLast()] | das erste und das letzte Element (Java 21) |
[void clear()] | löscht alle Elemente der Liste |
[boolean contains(Object o)] | gibt [true] zurück, wenn [o] in der Liste enthalten ist, andernfalls [false] |
[int indexOf(Object o)] | gibt die Position von [o] in der Liste zurück oder -1, wenn [o] nicht gefunden wird; [lastIndexOf] gibt die letzte Position zurück |
[boolean remove(Object o)] | löscht das erste Vorkommen von [o]; gibt [true] zurück, wenn die Operation erfolgreich ist, andernfalls [false] |
[E remove(int index)] | löscht das Element Nr. [index] und gibt es zurück |
[List<E> subList(int from, int to)] | gibt eine Sicht auf die Elemente von [from] (einschließlich) bis [to] (ausschließlich) zurück |
[void sort(Comparator<? super E> c)] | sortiert die Liste nach der durch [c] definierten Ordnung; [sort(null)] verwendet die natürliche Ordnung der Elemente |
[<T> T[] toArray(IntFunction<T[]> generator)] | gibt die Elemente der Liste als Array zurück (Java 11) |
[static <E> List<E> of(E... elements)] | erzeugt eine unveränderliche Liste, die die angegebenen Elemente enthält (Java 9) |
Die Hilfsklasse [java.util.Collections] ergänzt diese Methoden, so wie [Arrays] es für Arrays tut: [sort], [binarySearch], [reverse], [shuffle], [max], [min] …
Greifen wir das zuvor mit einem Array behandelte Beispiel noch einmal auf und verarbeiten es nun mit einem Objekt vom Typ [ArrayList<Double>]. Da eine Liste einem Array ähnelt, ändert sich der Code nur wenig. Dies ist das Programm [Collections01.java]:
Kommentare:
- Zeile 22: Die Liste wird leer erzeugt. Der Diamond-Operator [<>] (Java 7) vermeidet die Wiederholung des Elementtyps: Der Compiler leitet ihn aus dem Typ der Variablen ab;
- Zeile 39: Die Vergrößerung der Liste muss nicht mehr behandelt werden; die Liste wächst automatisch. Der Wert [element] vom Typ [double] wird automatisch in ein [Double]-Objekt umgewandelt;
- Zeile 6: die Anzahl der Elemente der Liste. Anders als [StringBuilder] erlaubt [ArrayList] es nicht, die Kapazität zu ermitteln; die Methode [ensureCapacity] erlaubt nur, sie im Voraus festzulegen;
- Zeilen 12, 70, 71: Sortieren und binäre Suche erfolgen mit den statischen Methoden [Collections.sort] und [Collections.binarySearch]; die lineare Suche mit der Methode [indexOf] der Liste, die die Arrays nicht hatten;
- Zeilen 45–50: Die generische Methode [display] akzeptiert zwei Parameter:
- der erste ist der zu schreibende Text;
- der zweite ist ein Objekt, das die generische Schnittstelle [java.lang.Iterable<T>] implementiert, deren einzige abstrakte Methode [Iterator<T> iterator()] ist.
Die Schleife [for (T element : elements)] ist für jedes Objekt [elements] gültig, das die Schnittstelle [Iterable<T>] implementiert, sowie für Arrays. Alle Collections implementieren [Iterable]; Arrays dagegen nicht, und die Methode [display] eignet sich nicht für ein Array: Deshalb haben wir sie in [Arrays01.java] nicht verwendet. Auf diese Schnittstelle kommen wir bei der Stream-API zurück.
Ergebnisse:
Die Ergebnisse sind dieselben wie mit dem Array.
5.4.2. Methoden der Schnittstelle List
Das Programm [Collections02.java] verwendet die anderen Methoden der Schnittstelle [List]:
Ergebnisse:
Kommentare:
- Zeile 4: [List.of(...)] (Java 9) erzeugt eine schreibgeschützte Liste (siehe unten); sie wird in eine [ArrayList] kopiert, die beschreibbar ist. Das ist der kürzeste Weg, eine Liste mit Werten zu initialisieren;
- Zeilen 8–10: Drei Möglichkeiten, Elemente hinzuzufügen;
- Zeile 14: Das Element Nr. 0 wird durch [set] ersetzt;
- Zeile 15: [get] liest ein Element; [getLast] (Java 21) gibt das letzte Element zurück, das zuvor als [cities.get(cities.size() - 1)] geschrieben werden musste;
- Zeile 22: [remove] gibt [true] zurück, wenn das Element gefunden und gelöscht wurde;
- Zeile 27: Die Zeichenketten werden in ihrer natürlichen Ordnung sortiert, der von [compareTo];
- Zeile 31: [subList] gibt eine Sicht auf die Elemente 1 und 2 (3 ausgeschlossen) zurück, keine Kopie: Eine Änderung der Sicht würde die Liste ändern;
- Zeilen 35–36: Umwandlung einer Liste in ein Array und eines Arrays in eine Liste. Der Parameter von [toArray] ist eine Konstruktorreferenz [String[]::new], mit der die Liste ein Array von Zeichenketten in der richtigen Größe erzeugt. Methoden- und Konstruktorreferenzen werden in Kapitel 7 behandelt;
- Zeilen 41–43: Eine Falle bei Ganzzahllisten. Die Schnittstelle [List] hat zwei Methoden [remove]: [remove(int index)] löscht nach Position, und [remove(Object o)] löscht nach Wert. Bei einer [List<Integer>] ruft [numbers.remove(1)] die erste auf und löscht das Element Nr. 1 (den Wert 20). Um den Wert 1 zu löschen, muss ein [Integer]-Objekt übergeben werden: [numbers.remove(Integer.valueOf(1))];
- Zeilen 47–48: [clear] leert die Liste; [isEmpty] prüft, ob sie leer ist;
- Zeile 51: Der Typ [List<?>] bezeichnet eine Liste mit Elementen eines beliebigen Typs („Wildcard“, Kapitel 4): Die Methode [display] akzeptiert eine [List<String>] ebenso wie eine [List<Integer>]. Eine Collection wird direkt angezeigt: Ihre Methode [toString] gibt ihre Elemente in eckigen Klammern zurück.
5.4.3. Die Schnittstelle Map und die Klasse HashMap
Die Klasse [java.util.HashMap<K,V>] erlaubt es, ein Dictionary zu implementieren. Ein Dictionary lässt sich als Array mit zwei Spalten betrachten:
Schlüssel | Wert |
key1 | value1 |
key2 | value2 |
... | ... |
In der Schnittstelle [Map<K,V>] haben die Schlüssel den Typ [K] und die Werte den Typ [V]. Die Schlüssel sind eindeutig: Es kann nicht zwei identische Schlüssel geben (im Sinne der Methode [equals]). Ein solches Dictionary könnte so aussehen, wenn die Typen [K] und [V] Klassen bezeichneten:
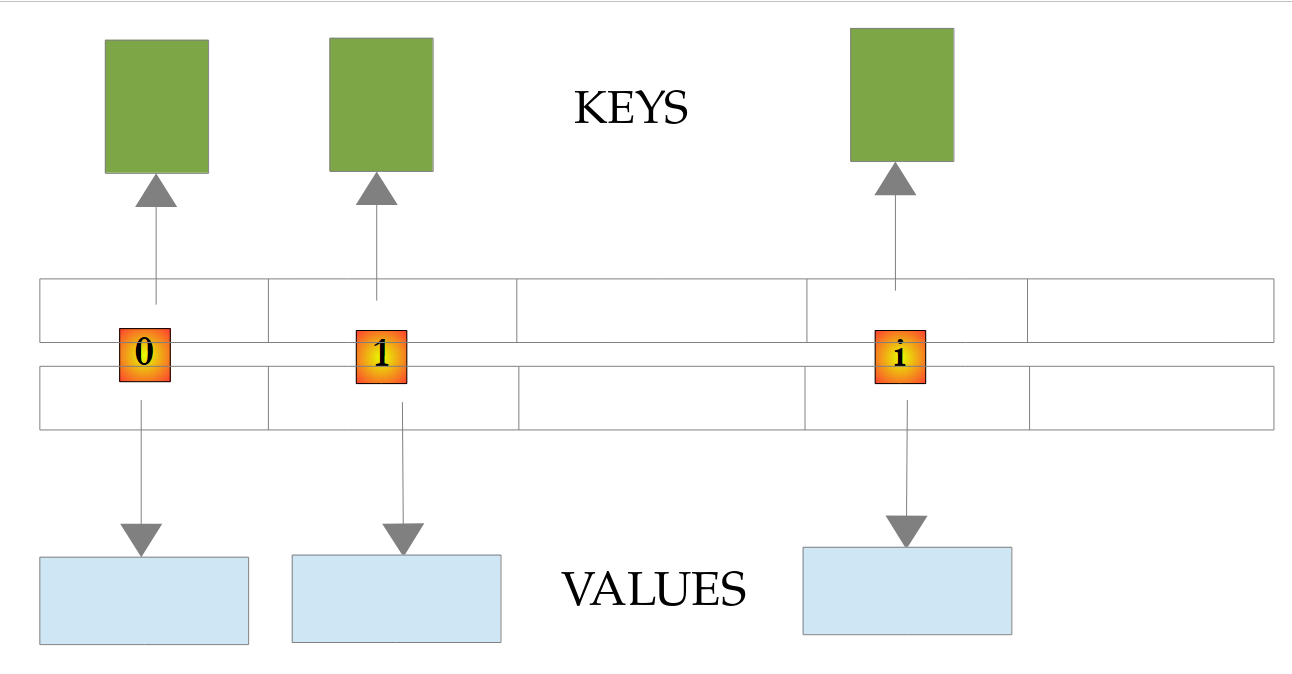
Eine [HashMap] speichert ihre Schlüssel-Wert-Paare in einer Hashtabelle: Die Position eines Schlüssel-Wert-Paares in der Tabelle wird anhand des Hashcodes seines Schlüssels berechnet (Methode [hashCode], Kapitel 4). Das Abrufen des einem Schlüssel zugeordneten Wertes ist daher unabhängig von der Größe des Dictionarys sehr schnell. Die Reihenfolge der Schlüssel-Wert-Paare in der Tabelle hat jedoch keinen Bezug zur Reihenfolge, in der sie hinzugefügt wurden.
Die wichtigsten Methoden der Schnittstelle [Map<K,V>] sind die folgenden:
Methode | Rolle |
[int size()] | Anzahl der (Schlüssel, Wert)-Paare des Dictionarys |
[V put(K key, V value)] | Ordnet [value] dem Schlüssel [key] zu: fügt das Paar hinzu, wenn der Schlüssel fehlt, andernfalls ersetzt es den Wert; gibt den alten Wert zurück oder [null] |
[V putIfAbsent(K key, V value)] | fügt das Schlüssel-Wert-Paar nur hinzu, wenn der Schlüssel fehlt; gibt den vorhandenen Wert zurück oder [null] |
[V get(Object key)] | gibt den dem Schlüssel [key] zugeordneten Wert zurück oder [null] , wenn der Schlüssel fehlt |
[V getOrDefault(Object key, V defaultValue)] | wie oben, gibt aber [defaultValue] zurück, wenn der Schlüssel fehlt |
[boolean containsKey(Object key)] | gibt [true] zurück, wenn [key] ein Schlüssel des Dictionarys ist; [containsValue] prüft einen Wert |
[V remove(Object key)] | löscht das Schlüssel-Wert-Paar [key] und gibt seinen Wert zurück oder [null] |
[Set<K> keySet()] | alle Schlüssel des Dictionarys |
[Collection<V> values()] | die Collection der Werte des Dictionarys |
[Set<Map.Entry<K,V>> entrySet()] | die Menge der Schlüssel-Wert-Paare des Dictionarys; ein Paar [Map.Entry] hat die Methoden [getKey] und [getValue] |
[V merge(K key, V value, BiFunction<...> remappingFunction)] | fügt das Paar hinzu, wenn der Schlüssel fehlt; andernfalls ersetzt es den Wert durch die Kombination aus dem alten Wert und [value] |
[void clear()] | löscht alle Einträge des Dictionarys |
Betrachten wir das Beispielprogramm [Collections03.java]:
Kommentare:
- Zeile 4: ein Array von Zeichenketten, das zur Initialisierung des Dictionarys <String,Integer> dient;
- Zeile 5: das Dictionary, das leer ist;
- Zeilen 6–9: seine Initialisierung mit dem Array von Zeichenketten;
- Zeile 11: die Anzahl der Schlüssel-Wert-Paare des Dictionarys;
- Zeilen 13–15: die Schlüssel und Werte des Dictionarys. [dico.keySet()] und [dico.values()] sind Collections, also [Iterable]: Die bereits bekannte Methode [display] funktioniert hier;
- Zeile 23: Entfernen eines Paares aus dem Dictionary;
- Zeilen 26–28: Ein Dictionary ist selbst keine Collection, aber [entrySet] gibt die Menge seiner Schlüssel-Wert-Paare zurück, die den Typ [Map.Entry<K,V>] haben. Dieser Ansatz ist effizienter als der in den Zeilen 18–20, der den Wert jedes Schlüssels mit [get] nachschlägt;
- Zeilen 30–31: [put] fügt ein Paar hinzu oder ersetzt den Wert eines vorhandenen Schlüssels, ohne Ausnahme oder Warnung; der zurückgegebene Wert – der alte Wert oder [null] – zeigt an, was geschehen ist;
- Zeilen 33–34: [putIfAbsent] ersetzt den Wert eines vorhandenen Schlüssels nicht;
- Zeilen 36–37: Das Lesen eines nicht vorhandenen Schlüssels verursacht keinen Fehler: [get] gibt [null] zurück. [getOrDefault] erlaubt es, den in diesem Fall zurückgegebenen Wert zu wählen, und [containsKey] erlaubt es zu prüfen, ob ein Schlüssel existiert;
- Zeilen 39–40: [merge] fügt den Schlüssel „léa“ mit dem Wert 1 hinzu und addiert 1 zum Wert des bereits vorhandenen Schlüssels „zoé“. Der dritte Parameter ist die Funktion, die den alten und den neuen Wert kombiniert – hier die Summe zweier Ganzzahlen –, übergeben als Methodenreferenz [Integer::sum] (Kapitel 7). Das ist der übliche Weg, Vorkommen zu zählen: [counters.merge(word, 1, Integer::sum)];
- Zeilen 51–56: Suche nach einem Schlüssel im Dictionary. [get] gibt einen [Integer] zurück, keinen [int], weil es [null] zurückgeben können muss: Dieser Fall wird geprüft, bevor der Wert verwendet wird. Die Eingabe von [int age = dico.get(searchedName);] würde bei einem fehlenden Schlüssel bei der automatischen Umwandlung von [null] in [int] eine [NullPointerException] erzeugen.
Ergebnisse:
Die Schlüssel werden nicht in der Reihenfolge aufgelistet, in der sie hinzugefügt wurden, sondern in der Reihenfolge der Hashtabelle, die von den Hashcodes der Schlüssel abhängt: Eine [HashMap] garantiert keine bestimmte Reihenfolge. Kommt es auf die Reihenfolge der Schlüssel an, verwendet man eine [LinkedHashMap], die die Reihenfolge des Hinzufügens beibehält, oder eine [TreeMap], die die Schlüssel sortiert hält: Diese werden unten gezeigt.
5.4.4. Weitere Collections
Das Paket [java.util] enthält weitere Collections, die jeweils auf einen bestimmten Einsatzzweck zugeschnitten sind:
Klasse | Rolle |
[HashSet<E>] | eine Menge: keine Duplikate, keine Ordnung, sehr schneller Mitgliedschaftstest; Mengenoperationen (Vereinigung [addAll], Schnittmenge [retainAll], Differenz [removeAll]) |
[LinkedHashSet<E>] | eine Menge, die die Reihenfolge beibehält, in der ihre Elemente hinzugefügt wurden |
[TreeSet<E>] | eine Menge, deren Elemente sortiert gehalten werden |
[ArrayDeque<E>] | eine doppelseitige Warteschlange: Als Warteschlange verwendet, werden die Elemente in der Reihenfolge entnommen, in der sie hinzugefügt wurden (FIFO, first in first out); als Stapel verwendet, wird das zuletzt hinzugefügte Element als erstes entnommen (LIFO, last in first out) |
[LinkedHashMap<K,V>] | ein Dictionary, das die Reihenfolge beibehält, in der seine Schlüssel hinzugefügt wurden |
[TreeMap<K,V>] | ein Dictionary, dessen Schlüssel sortiert gehalten werden |
[PriorityQueue<E>] | eine Prioritätswarteschlange: Das entnommene Element ist nach der Ordnung der Warteschlange das kleinste |
[LinkedList<E>] | eine doppelt verkettete Liste: schnelle Einfüge- und Löschoperationen an den Enden und während des Durchlaufs |
Das Programm [Collections04.java] bietet einen schnellen Überblick:
Ergebnisse:
Kommentare:
- Zeile 4: eine Menge, die mit den Elementen einer Liste initialisiert wird;
- Zeile 6: [add] gibt [false] zurück, wenn das Element bereits in der Menge enthalten ist, die dann unverändert bleibt;
- Zeilen 9–14: [retainAll] behält nur die Elemente, die in der anderen Collection vorhanden sind (Schnittmenge), während [addAll] die der anderen Collection hinzufügt (Vereinigung). Diese Methoden verändern die Menge: Wir arbeiten daher mit einer Kopie von [languages]. [Set.of] (Java 9) erzeugt eine unveränderliche Menge. Die Reihenfolge, in der die Elemente eines [HashSet] angezeigt werden, hat keine Bedeutung;
- Zeile 16: Ein aus der Menge erzeugtes
*[TreeSet]* zeigt seine Elemente in sortierter Reihenfolge an; - Zeilen 19–24: [ArrayDeque] als Warteschlange verwendet: [offer] fügt ein Element am Ende der Warteschlange ein, [poll] entfernt das älteste Element, und [peek] ruft ein Element ab, ohne es zu entfernen. Die Operanden der an [IO.println] übergebenen Verkettung werden von links nach rechts ausgewertet: [peek], dann die beiden [poll], dann [size];
- Zeilen 27–32: [ArrayDeque] wird als Stapel verwendet: [push] legt ein Element auf den Stapel, und [pop] entnimmt das jüngste Element. Die Klasse [Stack] aus Java 1.0 sollte nicht mehr verwendet werden;
- Zeilen 34–40: Bei einem leeren Stapel löst [pop] eine [NoSuchElementException]-Ausnahme aus, während [poll] den Wert [null] zurückgibt. Die meisten Operationen von [Deque] existieren somit in zwei Versionen: Die eine löst eine Ausnahme aus ([push], [pop], [getFirst] …), während die andere einen Sonderwert zurückgibt ([offer], [poll], [peek] …);
- Zeilen 43–48: Die Paare einer [TreeMap] werden in der Reihenfolge der Schlüssel aufgelistet;
- Zeilen 50–54: Die einer [LinkedHashMap] werden in der Reihenfolge aufgelistet, in der sie hinzugefügt wurden;
- Zeilen 57–67: Eine [PriorityQueue] muss ihre Elemente vergleichen können. Hier erhält sie einen [Comparator] , der die Prioritäten vergleicht: [Comparator.comparingInt(Emergency::priority)] lautet: „Vergleiche die Notfälle anhand des ganzzahligen Wertes, den ihre Methode [priority] zurückgibt.“ Die Patienten werden unabhängig von der Reihenfolge ihres Eintreffens nach aufsteigender Priorität entlassen. Die Schleife endet, wenn [poll] den Wert [null] zurückgibt, was anzeigt, dass die Warteschlange leer ist;
- Zeilen 71–72: Ein Patient wird durch einen [record] dargestellt (Kapitel 4).
5.4.5. Unveränderliche Collections
Eine Klasse, die eine Collection verwaltet, muss sie oft nach außen zugänglich machen, ohne dass sie verändert werden darf. Java besitzt keine eigene „schreibgeschützte“ Schnittstelle neben [List]: Eine nicht veränderbare Collection implementiert die vollständige Schnittstelle [List], aber ihre Änderungsmethoden ([add], [remove], [set] …) lösen eine [UnsupportedOperationException]-Ausnahme aus. Es gibt zwei Arten:
- nicht veränderbare Sichten, die man mit [Collections.unmodifiableList(list)] ([unmodifiableSet], [unmodifiableMap] …) erhält: Sie kopieren die Collection nicht, hindern die Empfänger aber daran, sie zu verändern;
- Die schreibgeschützten Collections , die mit [List.of(...)], [Set.of(...)], [Map.of(...)] (Java 9) erzeugt oder mit [List.copyOf(collection)] (Java 10) kopiert werden: Ihr Inhalt steht ein für alle Mal fest.
Das Programm [Collections05.java] verwendet sie:
Ergebnisse:
Kommentare:
- Zeilen 44–61: Die Klasse [Classroom] verwaltet eine Liste von Schülern. Die Liste selbst ist privat; nur die Methode [enroll] erlaubt es, sie zu ändern;
- Zeilen 49–51: Die Methode [getStudents] gibt eine schreibgeschützte Sicht auf die Liste zurück. Würde die Liste [students] selbst zurückgegeben, könnte externer Code sie ohne Wissen der Klasse ändern;
- Zeilen 10–14: Die Sicht besitzt alle Methoden von
*[List]*, und***[students.add("intruder")]** wird vom Compiler akzeptiert; die Ausnahme*[UnsupportedOperationException]wird zur Laufzeit ausgelöst; - Zeile 15: Die tatsächliche Klasse der Sicht ist eine interne Klasse von [Collections], die nur über die Schnittstelle [List] bekannt ist;
- Zeilen 17–18: Die Sicht kopiert die Liste nicht; sie sieht die Änderungen, die von der besitzenden Klasse vorgenommen werden;
- Zeilen 54–56 und 21–23: [List.copyOf] gibt dagegen eine schreibgeschützte Kopie zurück: Die Liste [copy] sieht das Hinzufügen von „petit“ nicht;
- Zeilen 26–33: [Map.of] erzeugt aus Schlüssel-Wert-Paaren ein schreibgeschütztes Dictionary;
- Zeilen 35–40: Die mit [of] und [copyOf] erzeugten Collections weisen den Wert [null] zurück, was sofort bei ihrer Erzeugung eine [NullPointerException] auslöst.
Der Typ einer Variablen wie [List<String>] zeigt also nicht an, ob die Liste veränderbar ist: Es ist Sache der Dokumentation der Methode, die sie zurückgibt, dies anzugeben. Eine gängige bewährte Praxis besteht darin, unveränderliche Collections zurückzugeben und jedes Mal, wenn man eine Collection ändern möchte, eine neue zu erzeugen. [record], deren Felder schreibgeschützt sind, passen gut zu dieser Praxis: [record Classroom(String name, List<String> students)] profitiert davon, seine Liste im Konstruktor mit [List.copyOf] zu kopieren.
5.4.6. Sortieren, Iterieren, geordnete Collections
Das Programm [Collections06.java] zeigt drei nützliche Aspekte der Arbeit mit Collections: das Schreiben eines [Comparator], die Sequenced Collections aus Java 21 und das Entfernen von Elementen während einer Iteration:
Ergebnisse:
Kommentare:
- Zeile 8: Die Methode [sort] einer Liste nimmt einen [Comparator]entgegen, ein Objekt, das zwei Elemente vergleicht (Kapitel 4). Die statische Methode [Comparator.comparing] erzeugt einen Comparator aus einer Funktion, die aus jedem Element einen Schlüssel extrahiert – hier den Namen ([Student::name] verweist auf die Methode [name] des Records). Die Namen werden nach der natürlichen Ordnung der Zeichenketten verglichen: „Durand“, das mit einem Großbuchstaben beginnt, kommt zuerst, und „élise“ kommt zuletzt;
- Zeile 10: Ein zweiter Parameter legt fest, wie die Schlüssel verglichen werden – hier mit [Collator] –, wobei die Reihenfolge der eines französischen Wörterbuchs entspricht;
- Zeilen 12–13: Die Comparatoren werden wie folgt definiert: [comparingInt] vergleicht Noten, [reversed] kehrt die Ordnung um (Noten in absteigender Reihenfolge), und [thenComparing] fügt ein sekundäres Kriterium hinzu, das bei Studierenden mit gleicher Note als Tie-Breaker dient: die Namen, ohne Beachtung der Groß- und Kleinschreibung ([String.CASE_INSENSITIVE_ORDER]). Durand und Martin, die beide die Note 15 haben, werden nach Namen eingeordnet;
- Zeilen 17–25: Java 21 hat die Sequenced Collections eingeführt: die Schnittstellen [SequencedCollection], [SequencedSet] und [SequencedMap], die von Collections implementiert werden, deren Elemente eine definierte Reihenfolge haben ([List], [Deque], [LinkedHashSet], [TreeSet], [LinkedHashMap], [TreeMap] …). Sie haben gemeinsame Methoden für den Zugriff auf beide Enden: [getFirst], [getLast], [addFirst], [addLast], [removeFirst], [removeLast] ([firstEntry], [lastEntry] … bei einem Dictionary) sowie die Methode [reversed], die eine Sicht auf die Collection in umgekehrter Reihenfolge zurückgibt, ohne sie zu kopieren. Früher musste man, um das letzte Element eines [LinkedHashSet] abzurufen, die gesamte Collection durchlaufen;
- Zeilen 28–37: Eine Collection darf nicht verändert werden, während man sie mit einer [for]-Schleife durchläuft: Der von der Schleife verwendete Iterator erkennt die Änderung und löst beim nächsten Element eine [ConcurrentModificationException]-Ausnahme aus. Der Test wird an einer Kopie der Liste durchgeführt;
- Zeilen 39–44: Der richtige Ansatz besteht darin, die Schleife ausdrücklich mit einem [Iterator] (mit der Stream-API eingeführt) zu schreiben und das aktuelle Element mit der Methode [remove] des Iterators zu entfernen;
- Zeile 47: einfacher noch: Die Methode [removeIf] (Java 8) entfernt Elemente, die eine Bedingung erfüllen, die durch einen anonymen (Lambda-)Ausdruck [student -> student.grade() < 15] ausgedrückt wird, der gelesen wird als „die Funktion, die einem Studierenden den Booleschen Wert [student.grade() < 15] zuordnet“. Lambdas werden in Kapitel 7 ausführlich behandelt; vorerst genügt es zu wissen, wie man sie liest. Wir werden ihnen im folgenden Abschnitt in jeder Zeile begegnen;
- Zeile 50: Die Methode
*[forEach]* jeder Collection führt für jedes Element ein Lambda aus; - Zeilen 63–64: Der Aufruf der Methode [toString] auf einem [record] gibt den Namen des Records und die Werte seiner Komponenten zurück: [Student[name=Durand, grade=15]].
5.5. Die Stream-API
Die Stream-API (Paket [java.util.stream], Java 8) ist eine Menge von Methoden, mit denen man die Elemente einer Collection so verarbeiten kann, als würde man eine Datenbank abfragen: filtern, sortieren, gruppieren, Summen berechnen usw. Ein [Stream<T>]-Stream ist eine Folge von Elementen des Typs [T] , die durch eine Kette von Operationen geleitet werden. Man erhält ihn aus einer Collection ([list.stream()]), einem Array ([Arrays.stream(array)]), Werten ([Stream.of(1, 2, 3)]), Zeilen einer Datei ([Files.lines(path)]), Treffern eines regulären Ausdrucks und, mit Hibernate (Kapitel 11), aus Zeilen einer Datenbanktabelle.
Diese Streams dürfen nicht mit den Ein-/Ausgabe-Streams ([InputStream], [OutputStream]) verwechselt werden, denen wir bei Dateien begegnen werden: Es handelt sich um zwei voneinander unabhängige Konzepte.
5.5.1. Die Schnittstellen Iterable und Iterator
Bevor wir Streams einführen, greifen wir die Schnittstelle [Iterable<T>] noch einmal auf, die für Objekte gilt, die mit einer [for]-Schleife durchlaufen werden. Sie enthält nur eine abstrakte Methode, [iterator], die einen Iterator [Iterator<T>] zurückgibt: ein Objekt, das anzeigt, ob noch Elemente übrig sind ([hasNext]), und das nächste Element liefert ([next]).
Ein [Iterable]-Objekt muss seine Elemente nicht enthalten: Sein Iterator kann sie auf Anforderung nacheinander erzeugen. Das Programm [Streams01.java] liefert dafür ein Beispiel und stellt einen unendlichen Stream vor:
Ergebnisse:
Kommentare:
- Zeilen 34–64: Der Record [Evens] implementiert die Schnittstelle [Iterable<Integer>]: Seine Methode [iterator] gibt einen Iterator zurück, der die geraden Zahlen von 0 bis [max] erzeugt. Er erstellt keine Liste: Er speichert lediglich die nächste zu erzeugende Zahl (Zeile 41);
- Zeile 39: Der Iterator ist eine anonyme Klasse – eine Klasse ohne Namen, die in einem einzigen Ausdruck [new Iterator<>() { ... }] deklariert und instanziiert wird und beide Methoden der Schnittstelle implementiert. Sie hat Zugriff auf die Komponente [max] des Records;
- Zeilen 44–50: [hasNext] gibt an, ob noch ein weiteres Element zu erzeugen ist;
- Zeilen 53–61: [next] erzeugt das nächste Element. Wird es aufgerufen, wenn keine Elemente mehr vorhanden sind, muss es eine [NoSuchElementException] auslösen;
- Zeilen 5–7: Die Ergebnisse (Zeilen 3–12) zeigen, dass die Erzeugung eines Elements durch den Iterator und sein Verbrauch durch die [for]-Schleife einander abwechseln;
- Zeilen 11–15: Was die [for]-Schleife tatsächlich tut: Sie fordert vom Objekt einen Iterator an, ruft [hasNext] so lange auf, wie diese Methode [true] zurückgibt, und erhält jedes Element über [next];
- Zeilen 19–22: eine unendliche Folge, die Fibonacci-Folge. [Stream.iterate(seed, function)] erzeugt den Startwert, dann das Ergebnis der auf den Startwert angewendeten Funktion, dann das Ergebnis der auf dieses Ergebnis angewendeten Funktion und so weiter. Jedes Element ist hier ein Array aus zwei aufeinanderfolgenden Zahlen der Folge; [map] behält nur die erste, [takeWhile] beendet den Stream bei der ersten Zahl, die größer als 100 ist, und [forEach] zeigt jede Zahl an. Der gesamte Stream wird nie berechnet; es werden nur die angeforderten Elemente berechnet;
- Zeilen 26–30: Eine Liste ist [Iterable]. Eine Zeichenkette ist es nicht: Sie kann nicht direkt mit [for] durchlaufen werden. Ihre Methode [chars] gibt den Stream ihrer Zeichen als ganzzahlige Codes zurück, die dann wieder in Zeichenketten aus einem einzelnen Zeichen umgewandelt werden, und [Collectors.joining("-")] verkettet sie mit einem Trennzeichen. Man kann auch das Array durchlaufen, das von ["abc".toCharArray()] zurückgegeben wird.
Java besitzt keine Anweisung, mit der sich ein Iterator als einfache Methode definieren lässt, die ihre Elemente nacheinander erzeugt ([yield return] in anderen Sprachen): Man muss entweder die Iterator-Klasse implementieren, wie hier gezeigt, oder die Methoden zur Erzeugung von Streams verwenden ([Stream.iterate], [Stream.generate]), die ihre Elemente ebenfalls auf Anforderung erzeugen. Dieser Mechanismus der Erzeugung auf Anforderung wird in der gesamten Stream-API verwendet.
5.5.2. Filtern, Projizieren, Sortieren
Die folgenden Beispiele arbeiten mit einer kleinen Liste von Personen. Eine Person wird durch einen [record] (Java 16) dargestellt, der in Kapitel 4 eingeführt wurde: In einer einzigen Zeile erhalten wir eine Klasse mit einem Konstruktor, Methoden für den Zugriff auf die Komponenten ([p.lastName()], [p.age()] …), einer [toString]-Methode, die die Komponenten anzeigt, und einem Gleichheitsoperator, der ihre Werte vergleicht.
Das Programm [Streams02.java] zeigt die grundlegenden Operationen der Stream-API:
Ergebnisse:
Kommentare:
- Zeilen 4–11: die Liste der Personen, die nicht verändert werden kann und mit [List.of] erzeugt wird;
- Zeile 55: der Record [Person]. Eine kompakte Quelldatei stellt ihre Typdeklarationen neben ihre Methoden;
- Zeile 14: [persons.stream()] gibt den Stream der Listenelemente zurück. Die Methode [filter] filtert den Stream: Sie behält nur die Elemente, die eine Bedingung erfüllen. Diese Bedingung wird ihr in Form eines Lambdas [p -> p.age() >= 18] übergeben, „die Funktion, die für eine Person p den Booleschen Wert [p.age() >= 18] zurückgibt“. [filter] ruft diese Funktion für jede Person auf;
- Das Ergebnis von [filter] ist ein neuer Stream [Stream<Person>]: Die Liste [persons] bleibt unverändert. Das gilt für alle Operationen der Stream-API;
- Zeilen 49–52: Die Methode [display] durchläuft den Stream mit der Operation [forEach] und zeigt jede Person mit der Methode [toString] des Records an: [Person[lastName=dupont, ...]];
- Zeile 18: Die Methode [map] projiziert jedes Element des Streams auf einen neuen Wert, hier eine Zeichenkette. Das Ergebnis ist ein [Stream<String>]-Stream;
- Zeilen 22–26: Die Operationen geben Streams zurück, auf die weitere Operationen angewendet werden können. Operationen werden oft einzeln pro Zeile geschrieben: Diese Aufrufkette liest sich von oben nach unten wie ein Rezept. [Person::lastName] ist eine Methodenreferenz, eine Kurzschreibweise für das Lambda [p -> p.lastName()];
- Zeile 25: [sorted] ohne Parameter sortiert den Stream nach der natürlichen Ordnung seiner Elemente, hier Zeichenketten;
- Zeile 26: [toList] (Java 16) legt die Elemente des Streams in einer unveränderlichen Liste ab. Man begegnet auch der älteren Syntax [collect(Collectors.toList())], die in der Praxis eine veränderbare Liste zurückgibt (eine [ArrayList]), obwohl die Dokumentation dies nicht garantiert;
- Zeilen 30–31: [sorted] akzeptiert einen [Comparator], der wie in [Collections06.java]aufgebaut ist: Alter absteigend, dann Name aufsteigend, um Personen gleichen Alters zu unterscheiden. Durand und Laurent, die beide 32 Jahre alt sind, werden nach Nachnamen sortiert (Zeilen 23–24 der Ergebnisse);
- Zeile 35: Die Streams liefern die Positionen ihrer Elemente nicht. Um sie zu nummerieren, durchlaufen wir die Indizes mit einem Ganzzahl-Stream [IntStream.range(0, 3)] (0, 1, 2; 3 ausgeschlossen) und wandeln jeden Index mit [mapToObj] in eine Zeichenkette um;
- Zeilen 39–45: Ein Stream ist nur einmal verwendbar: Nachdem er von einer terminalen Operation durchlaufen wurde (hier [count], die die Elemente zählt), kann er nicht mehr verwendet werden und löst eine [IllegalStateException] aus. Von der Collection muss ein neuer Stream angefordert werden.
Bei Streams gibt es zwei Arten von Operationen: Zwischenoperationen ([filter], [map], [sorted] …) geben einen neuen Stream zurück; terminale Operationen ([forEach], [toList], [count], [collect] …) durchlaufen den Stream und erzeugen ein Ergebnis. Eine Kette von Operationen endet immer mit einer terminalen Operation. Anders als in anderen Sprachen besitzt Java keine SQL-ähnliche Abfragesyntax: Die Verarbeitung wird stets als Kette von Methodenaufrufen geschrieben.
5.5.3. Quantoren, Aggregate, Elementauswahl
Das Programm [Streams03.java] enthält Operationen, die einen einzelnen Wert zurückgeben, und Operationen, die einen Teil des Streams auswählen:
Ergebnisse:
Kommentare:
- Zeilen 13–15: [anyMatch] gibt [true] zurück, wenn mindestens ein Element die Bedingung erfüllt, [allMatch] wenn alle sie erfüllen und [noneMatch] wenn keines sie erfüllt;
- Zeilen 18–19: [count] zählt die Elemente des Streams; um diejenigen zu zählen, die eine Bedingung erfüllen, wird der Stream zuvor gefiltert. Bei einer Collection ist die Methode [size] selbstverständlich [stream().count()] vorzuziehen;
- Zeilen 20–22: [mapToInt(Person::age)] wandelt den Stream von Personen in einen [IntStream] um, einen Stream von [int]-Werten, der über Berechnungsmethoden verfügt: [sum], [average], [min], [max]. [average] gibt ein [OptionalDouble] zurück, weil der Durchschnitt eines leeren Streams nicht existiert; [orElse(0)] liefert den in diesem Fall zu verwendenden Wert;
- Zeilen 23–24: [summaryStatistics] berechnet Anzahl, Summe, Minimum, Durchschnitt und Maximum in einem einzigen Durchlauf;
- Zeilen 26–28: [min] und [max], abgeleitet von einem [Stream], erhalten einen [Comparator] und geben das minimale oder maximale Element (hier die Person) zurück, nicht den Schlüsselwert. Das Ergebnis ist ein [Optional<Person>]: eine Box, die eine Person enthält, oder eine leere Box, wenn der Stream leer war. [get] gibt den Inhalt der Box zurück;
- Zeilen 31–34: [findFirst] gibt das erste Element des Streams in einem [Optional] zurück; bei einem gefilterten Stream liefert es das erste Element, das eine Bedingung erfüllt. Für das letzte Element einer Liste genügt die Methode [getLast] der Liste;
- Zeilen 35–37: In Brest wohnt niemand: [Optional] ist leer ([isPresent] gibt [false] zurück). Statt es zu testen, transformieren wir es: [map(Person::lastName)] transformiert seinen Inhalt, falls vorhanden; [orElse("nobody")] liefert den zu verwendenden Wert, wenn es leer ist;
- Zeilen 38–43: [orElseThrow] gibt den Inhalt des [Optional] zurück oder löst eine [NoSuchElementException] aus, wenn es leer ist. Es wird verwendet, wenn das Fehlen eines Wertes einen Fehler darstellt. [get], das zuvor verwendet wurde, tut dasselbe, aber sein Name weist nicht darauf hin, dass es eine Ausnahme auslösen kann; [orElseThrow] ist vorzuziehen. Es gibt keine Operation, die verlangt, dass ein Stream genau ein Element enthält; man kann die Größe der von [toList] zurückgegebenen Liste prüfen;
- Zeile 46: [distinct] entfernt Duplikate (im Sinne der Methode [equals]);
- Zeilen 49–50: Es gibt keine fertige Operation, um eine Person pro Stadt zu behalten. Hier verwenden wir eine Menge der bereits angetroffenen Städte: [add] gibt [true] für eine neue Stadt zurück (die Person wird behalten) und [false] für eine bereits angetroffene Stadt. Ein Lambda, das wie dieses eine externe Variable verändert, sollte Streams vorbehalten bleiben, die sequenziell verarbeitet werden, was das Standardverhalten ist;
- Zeilen 54–58: [limit(n)] behält die ersten n Elemente, während [skip(n)] sie überspringt. Kombiniert extrahieren sie eine „Seite“ von Ergebnissen. [takeWhile] (Java 9) behält die Elemente, solange eine Bedingung wahr ist, und stoppt beim ersten Element, das sie nicht erfüllt; [dropWhile] tut das Gegenteil: Es überspringt diese Elemente und behält alle nachfolgenden;
- Zeile 61: Die Operation [gather] (Java 24) wendet einen Zwischen-Collector („Gatherer“) auf den Stream an, der Elemente auf Grundlage vorangegangener Elemente gruppieren, akkumulieren oder filtern kann. Die Klasse [Gatherers] stellt mehrere davon bereit; [Gatherers.windowFixed(3)] teilt den Stream in Listen mit je 3 Elementen auf, wobei die letzte Liste kürzer sein kann. Es gibt weitere, etwa [windowSliding(n)] (gleitende Fenster), und man kann eigene schreiben.
5.5.4. Lokale Records, Gruppierungen, Joins
Das Programm [Streams04.java] führt komplexere Operationen aus, von denen die meisten mit der terminalen Operation [collect] und den Collectors der Klasse [Collectors] durchgeführt werden:
Ergebnisse:
Kommentare:
- Zeilen 18–19: Ein lokaler Record (Java 16), der in der Methode deklariert wird, in der er verwendet wird. Er erlaubt es, den Zwischenergebnissen einer Verarbeitung einen Namen und einen Typ zu geben, ohne im Programm eine Klasse deklarieren zu müssen: In Zeile 23 wird jede Person über 40 in ein [Summary] umgewandelt, das nur die relevanten Daten behält;
- Zeilen 28–29: Der Collector [groupingBy] gruppiert Elemente mit demselben Schlüssel – hier der Stadt. Das Ergebnis ist ein Dictionary vom Typ [Map<String, List<Person>>]: Jeder Stadt wird eine Liste ihrer Einwohner zugeordnet. Ohne weitere Parameter erzeugt [groupingBy] eine [HashMap], in der die Reihenfolge der Schlüssel nicht vorhersagbar ist; hier lassen wir eine
*[LinkedHashMap]*erzeugen (***[LinkedHashMap::new]***, Konstruktorreferenz), die die Städte in der Reihenfolge ihres ersten Auftretens behält. Der dritte Parameter ist der Collector, der auf die Elemente jeder Gruppe angewendet wird, hier*[toList]*; - Zeilen 30–32: Die Methode [forEach] eines Dictionarys nimmt ein Lambda mit zwei Parametern entgegen: den Schlüssel und den Wert. Für jede Gruppe zeigt sie Größe, Durchschnittsalter und Namen an; der Collector [Collectors.joining(", ")] verkettet Zeichenketten mit einem Trennzeichen;
- Zeilen 36–40: Die Stream-API kennt keine Join-Operation. Sie wird mit [flatMap] erreicht, das jedes Element durch einen Stream ersetzt und dann alle diese Streams verkettet: Jede Person wird durch den Stream der Städte ersetzt, die denselben Namen wie ihre Stadt tragen (eine oder keine), umgewandelt in Zeichenketten. Wie bei einem internen SQL-Join werden nur übereinstimmende Paare behalten: Laurent, der in Lyon wohnt – das in der Städteliste fehlt –, erscheint nicht, ebenso wenig Brest, das keine Einwohner hat. Dieser Code durchläuft für jede Person die gesamte Städteliste;
- Zeilen 42–47: derselbe Join, aber effizienter: Der Collector [toMap] baut ein Dictionary der Städte auf, in dem der Schlüssel der Name der Stadt ist ([City::name]) und der Wert die Stadt selbst ([v -> v]); in diesem Dictionary suchen wir dann die Stadt jedes Erwachsenen. Ein doppelter Schlüssel würde bei [toMap] eine [IllegalStateException] auslösen;
- Zeilen 50–54: [toList] und [toMap] führen die Verarbeitung durch und speichern die Ergebnisse in einer Liste bzw. in einem Dictionary;
- Zeilen 55–59: [partitioningBy] teilt die Elemente anhand einer Bedingung in zwei Gruppen auf; das Ergebnis ist ein Dictionary, dessen Schlüssel [true] und [false] sind. Der Collector [mapping(Person::lastName, toList())] wandelt jede Person in ihren Namen um, bevor sie zur Liste ihrer Gruppe hinzugefügt wird;
- Zeilen 62–68: Der dritte Parameter von [groupingBy] kann ein beliebiger Collector sein, der auf jede Gruppe angewendet wird: [counting] zählt die Elemente der Gruppe, [summingInt] addiert einen ganzzahligen Wert ([averagingInt] berechnet den Durchschnitt, [maxBy] ermittelt das Maximum …). Mit [TreeMap::new]sind die Städte sortiert;
- Zeilen 72–73: die Position jedes Elements in einem gefilterten Stream: Der Stream wird in einer Liste gespeichert, anschließend werden die Indizes durchlaufen.
5.5.5. Lazy Evaluation
Die Zwischenoperationen eines Streams werden nicht dort ausgeführt, wo sie geschrieben stehen, sondern erst, wenn eine Terminaloperation den Stream durchläuft: Man spricht von „Lazy Evaluation“. Das Programm [Streams05.java] zeigt dies anhand von Lambda-Ausdrücken, die anzeigen, was sie tun:
Ergebnisse:
Kommentare:
- Zeilen 7–15: ein Stream, der die geraden Zahlen behält und anschließend deren Quadrate berechnet. Die Lambdas sind hier mit einem Rumpf in geschweiften Klammern geschrieben, der eine Meldung ausgibt, bevor er seinen Wert mit [return]zurückgibt;
- Zeile 3 der Ergebnisse: Nach der Definition des Streams wurde nichts ausgegeben: Weder [filter] noch [map] hat bisher ein einziges Element verarbeitet. [evenSquares] enthält keine Ergebnisse, sondern eine Beschreibung einer Berechnung;
- Zeilen 4–16 der Ergebnisse: Die Berechnung läuft während der Terminaloperation [forEach] Element für Element ab: Jede Zahl durchläuft [filter], dann [map] , wenn sie gerade ist, und gelangt anschließend in [forEach] , bevor die nächste Zahl untersucht wird. Es wird keine Zwischenliste erzeugt;
- Zeilen 23–26: Da ein Stream nur einmal durchlaufen werden kann, speichern wir stattdessen die Vorschrift zu seiner Erzeugung: ein Lambda ohne Parameter [() -> numbers.stream().filter(...)]vom Typ [Supplier<Stream<Integer>>], dessen Methode [get] bei jedem Aufruf einen neuen Stream erzeugt. Der nach dem Hinzufügen von 10 erzeugte Stream berücksichtigt dieses neue Element;
- Zeilen 29–31: [toList] führt die Verarbeitung aus und speichert ihre Ergebnisse: [snapshot] ist eine Liste, die das Hinzufügen von 20 nicht mitbekommt;
- Zeilen 35–42: [findFirst] beendet die Iteration, sobald ein Element gefunden wurde: Die Zahlen nach 3 werden nie untersucht. [anyMatch], [limit], [takeWhile] … beenden die Iteration ebenfalls so früh wie möglich; dadurch lassen sich unendliche Streams verarbeiten;
- Zeilen 46–49: Manche Zwischenoperationen können Elemente nicht einzeln verarbeiten: [sorted] muss alle Elemente kennen, um das kleinste weiterzugeben. Die Operation [peek], die auf jedes durchlaufende Element ein Lambda anwendet, ohne es zu verändern, zeigt, dass [sorted] alle drei Elemente empfängt, bevor es ein einziges weitergibt;
- Zeilen 52–55: Die primitiven Streams [IntStream], [LongStream] und [DoubleStream] vermeiden die Erzeugung von Objekten [Integer], [Long] und [Double]. [IntStream.rangeClosed(1, 10)] erzeugt die ganzen Zahlen von 1 bis 10 (einschließlich 10). [boxed] wandelt einen [IntStream] in einen [Stream<Integer>]um, und [asDoubleStream] in einen [DoubleStream]. Ein mit einer Zeichenkette verketteter [double] wird mit allen Dezimalstellen und einem Dezimalpunkt ausgegeben; um die Anzahl der Dezimalstellen zu begrenzen, verwenden Sie [formatted].
Die Lazy Evaluation hat zwei praktische Konsequenzen:
- Ein Stream kann nur einmal durchlaufen werden. Wird das Ergebnis einer Berechnung mehrfach benötigt, speichert man es mit [toList] in einer Liste;
- Operationen lassen sich ohne Mehrkosten verketten: Das Verketten von [filter], [map] und [limit] erzeugt keine Zwischenkollektion, und es werden nur die notwendigen Elemente berechnet.
Beachten Sie schließlich, dass die Methode [parallelStream] einer Kollektion einen Stream liefert, dessen Elemente von mehreren Threads gleichzeitig verarbeitet werden (Kapitel 8). Sie beschleunigt nur zeitaufwendige Operationen auf großen Datenmengen und erfordert Lambdas ohne Seiteneffekte: Man sollte sie erst einsetzen, nachdem man ihren Nutzen geprüft hat. Der Stream-API werden wir im Verlauf des Kurses immer wieder begegnen, und in Kapitel 7 sehen wir, wie die von ihm verwendeten funktionalen Schnittstellen aufgebaut sind.
5.6. Textdateien
Java verfügt über zwei API-Pakete für Dateien: das Paket [java.io], das seit Java 1.0 verfügbar ist ([File], [FileReader], [FileInputStream] …), und das Paket [java.nio.file], das mit Java 7 eingeführt wurde ([Path], [Files] …). Letzteres ist umfassender und liefert bessere Fehlermeldungen: Es ist das Paket, das Sie heute verwenden sollten. Es stützt sich auf die Lese- und Schreibklassen von [java.io] ([BufferedReader], [BufferedWriter] …), die über Methoden der Klasse [Files] bezogen werden.
Eine Datei wird durch ein Objekt [java.nio.file.Path] dargestellt, das mit [Path.of("infos.txt")] (Java 11) erzeugt wird. Ein relativer Pfad wie dieser wird um das aktuelle Verzeichnis des Programms ergänzt – dasjenige, aus dem es gestartet wurde.
Seit Java 18 (JEP 400) ist die Standardcodierung für Textdateien unabhängig vom Betriebssystem UTF-8. Zuvor hing sie vom System ab (unter einem französischsprachigen Windows oft Windows-1252), und dasselbe Programm konnte dieselbe Datei je nach Rechner unterschiedlich interpretieren. Die Methoden der Klasse [Files] verwendeten bereits seit Java 8 standardmäßig UTF-8.
5.6.1. Die Klasse BufferedReader
Die Klasse [java.io.BufferedReader] ermöglicht es, den Inhalt einer Textdatei zeilenweise zu lesen. Sie kann tatsächlich auch Datenströme verarbeiten, die keine Dateien sind (zum Beispiel eine Netzwerkverbindung). Sie liest die Datei blockweise und legt diese Blöcke in einem Puffer ab: Der Großteil der Lesevorgänge findet im Speicher statt, ohne Zugriff auf die Festplatte.
Methode | Rolle |
[static BufferedReader Files.newBufferedReader(Path path)] | öffnet die Datei [path] zum Lesen als UTF-8; eine Überladung erlaubt es, die Codierung anzugeben: [Files.newBufferedReader(path, StandardCharsets.ISO_8859_1)] |
[String readLine()] | liefert die nächste Zeile des Datenstroms ohne Zeilenende-Markierung oder [null] am Ende des Datenstroms |
[int read()] | liefert das nächste Zeichen des Datenstroms oder -1 am Ende des Datenstroms |
[Stream<String> lines()] | liefert die verbleibenden Zeilen als Stream der Stream-API |
[void close()] | schließt den Datenstrom und gibt die für seine Verwaltung reservierten Ressourcen frei. Dies muss nach der Verarbeitung des Datenstroms geschehen, was die [try]-Anweisung mit Ressourcen übernimmt |
Das Programm [Files01.java] lautet wie folgt:
Kommentare:
- Zeile 2: Die Methode [main] erhält hier die Kommandozeilenargumente im Array [args];
- Zeile 4: Zeigt den Namen des aktuellen Ordners an, also desjenigen, aus dem der Befehl [java] gestartet wurde. [Path.of("")] bezeichnet den aktuellen Ordner; [toAbsolutePath] wandelt ihn in einen vollständigen Pfad um, von dem [getFileName] nur das letzte Element beibehält, um die Ergebnisse nicht mit einem vollständigen Pfad zu überfrachten;
- Zeile 6: Die gelesene Datei ist [infos.txt] oder die als Argument übergebene. Da es sich um einen relativen Pfad handelt, wird sie im aktuellen Verzeichnis gesucht;
- Zeile 10: Die Anweisung [try (resource declaration) { ... }], bekannt als „try-with-resources“-Block (Java 7), stellt sicher, dass der Datenstrom beim Verlassen des Blocks geschlossen wird, selbst wenn im Block eine Ausnahme auftritt. Sie macht den expliziten Aufruf der Methode [close] überflüssig. Sie gilt für jedes Objekt, das die Schnittstelle [AutoCloseable] implementiert – also jedes Objekt mit einer Methode [close], die Ressourcen freigibt (Datei, Netzwerkverbindung, Datenbankverbindung usw.). Vor Java 7 musste der Datenstrom in einer [finally]-Klausel geschlossen werden, nachdem geprüft worden war, dass er tatsächlich geöffnet worden war;
- Zeilen 13–15: Die Datei wird zeilenweise gelesen. Die Zuweisung [line = reader.readLine()] ist ein Ausdruck, dessen Wert dem von [line] entspricht: Er wird mit [null] verglichen, was das Dateiende anzeigt;
- Zeile 20: [Files.readString] (Java 11) liest die gesamte Datei auf einmal und schließt sie;
- Zeilen 21–27: Ein-/Ausgabefehler werden durch Ausnahmen angezeigt, die von [java.io.IOException] abgeleitet sind. Es handelt sich um geprüfte Ausnahmen (Kapitel 4): Der Compiler verlangt, dass sie abgefangen oder deklariert werden. Eine fehlende Datei löst eine [NoSuchFileException] aus, die von ihr abgeleitet ist und daher zuerst abgefangen werden muss. Ihre Methode [getFile] liefert den Pfad der gesuchten Datei. Die älteren Klassen von [java.io] melden denselben Fehler als [FileNotFoundException].
Die Datei [infos.txt] sieht wie folgt aus:
Sie befindet sich im Ordner [05-classes-java], aus dem das Programm ausgeführt wird:
Mit einer nicht vorhandenen Datei:
Wird statt einer Datei ein Ordner verwendet, löst der Lesevorgang eine andere Ausnahme aus, [IOException], deren Meldung vom Betriebssystem stammt:
Das aktuelle Verzeichnis zur Ablage von Datendateien zu wählen, bietet sich für eine kompakte Quelldatei an, die aus ihrem eigenen Verzeichnis ausgeführt wird. Bei einem Maven-Projekt wird der Befehl [mvn exec:java] im Projektverzeichnis ausgeführt: Dort legen wir die Datendateien der Beispielanwendung ab.
5.6.2. Die Klasse BufferedWriter
Die Klasse [java.io.BufferedWriter] ermöglicht es, in eine Textdatei zu schreiben. Wie [BufferedReader] verwendet sie einen Puffer und kann Datenströme verarbeiten, die keine Dateien sind.
Methode | Rolle |
[static BufferedWriter Files.newBufferedWriter(Path path)] | Öffnet die Datei [path] zum Schreiben als UTF-8. Die Datei wird erstellt oder geleert, falls sie bereits existiert. Optionale Parameter erlauben es, die Codierung und den Öffnungsmodus anzugeben: [Files.newBufferedWriter(path, StandardOpenOption.APPEND)] hängt die Schreibvorgänge an das Ende der vorhandenen Datei an |
[void write(String str)] | schreibt [str] in die Datei |
[void newLine()] | schreibt ein Zeilenende-Zeichen: das des Systems, „\r\n“ unter Windows, „\n“ unter Linux und macOS |
[void flush()] | schreibt den Inhalt des Puffers in die Datei, ohne zu warten, bis er voll ist |
[void close()] | schließt den Datenstrom, nachdem der Inhalt des Puffers in die Datei geschrieben wurde. Dies muss nach der Verarbeitung des Datenstroms geschehen |
Schreibvorgänge in einen [BufferedWriter] erfolgen nicht sofort: Der Text wird zunächst in den Puffer geschrieben und dann in die Datei, wenn der Puffer voll ist, wenn er mit der Methode [flush] explizit geleert wird oder wenn der Datenstrom geschlossen wird. Dies ist der effizienteste Modus für Dateien, weil er Festplattenzugriffe minimiert. Er eignet sich nicht für alle Datenströme, insbesondere nicht für Netzwerkströme: In einem Dialog zwischen zwei Partnern muss das, was der eine schreibt, vom anderen sofort gelesen werden können, und der Puffer muss nach jeder Nachricht geleert werden. Die Klasse [java.io.PrintWriter], die wir später verwenden, ergänzt die Methoden [print], [println] und [printf] und kann ihren Puffer nach jedem Aufruf von [println] automatisch leeren (Konstruktor [new PrintWriter(writer, true)]).
Das Programm [Files02.java] lautet wie folgt:
Ergebnisse:
Kommentare:
- Zeile 6: Wir verwenden erneut die [try]-Anweisung mit Ressourcen, damit wir den Datenstrom nicht explizit schließen müssen. Das Schließen erfolgt automatisch am Ende des Blocks (schließende geschweifte Klammer in Zeile 19). Erst dieses Schließen schreibt den noch im Puffer verbleibenden Text in die Datei; ohne es könnte die Datei unvollständig bleiben;
- Zeile 7: die Standardcodierung UTF-8;
- Zeilen 16–17: schreibt eine Zeile in die Textdatei, gefolgt von einem Zeilenumbruch;
- Zeile 22: Die Methode [Files.size] liefert die Größe einer Datei in Bytes. Die 18 Bytes setzen sich wie folgt zusammen: 16 Zeichen plus zwei Zeilenumbrüche zu je einem Byte („\n“ unter Linux, wo die Tests ausgeführt wurden; unter Windows würde jeder Zeilenumbruch „\r\n“ 2 Bytes belegen);
- Zeile 24: Warum [try / catch]? Man könnte einen Dateinamen der Form [folder1/folder2/file] mit einem Ordner namens [folder1/folder2] verwenden, der nicht existiert, sodass die Datei nicht erstellt werden kann. Es würde dann eine Ausnahme [NoSuchFileException] ausgelöst, die von [IOException] abgeleitet ist. Es gibt weitere mögliche Fehlerfälle (Festplatte voll, unzureichende Berechtigungen usw.). In jedem Fall verlangt der Compiler, dass die von [newBufferedWriter], [write] oder [size] ausgelösten geprüften Ausnahmen [IOException] behandelt werden.
5.6.3. Die Klassen Files und Path
Für gängige Operationen erspart die Hilfsklasse [Files] den Umgang mit Datenströmen: Eine einzige Methode öffnet die Datei, liest oder schreibt sie vollständig und schließt sie anschließend. Sie erlaubt es auch, Dateien und Ordner zu erstellen, zu kopieren, zu verschieben und zu löschen. Die Schnittstelle [Path] verwaltet Pfade.
Methode | Rolle |
[Files.readString(path)] | liefert den Inhalt der Datei als Zeichenkette (Java 11) |
[Files.readAllLines(path)] | liefert die Zeilen der Datei in einer Liste [List<String>] |
[Files.lines(path)] | Liefert die Zeilen der Datei als Stream ([Stream<String>]), der bei Bedarf gelesen wird und nach Gebrauch geschlossen werden muss |
[Files.writeString(path, text, options...)] | erstellt die Datei (oder überschreibt sie) und schreibt [text] (Java 11) hinein; mit der Option [StandardOpenOption.APPEND] wird der Text ans Dateiende angehängt |
[Files.write(path, lines, options...)] | schreibt eine Sammlung von Zeilen, jeweils gefolgt von einem Zeilenumbruch |
[Files.readAllBytes(path)], [Files.write(path, bytes)] | liest und schreibt die Datei als Byte-Array |
[Files.exists(path)], [Files.size(path)], [Files.delete(path)], [Files.copy(source, target)], [Files.move(source, target)] | prüft, ob eine Datei existiert, liefert ihre Größe, löscht sie, kopiert sie, verschiebt sie |
[Files.createDirectories(path)] | erstellt den Ordner und seine übergeordneten Ordner, falls sie nicht existieren |
[Files.list(folder)], [Files.walk(folder)] | die Elemente des Ordners und seiner gesamten Baumstruktur in Form eines Streams [Stream<Path>] |
[path.resolve(other)] | bildet einen Pfad, indem [other] an [path] angehängt wird, unter Verwendung des Systemtrennzeichens |
[path.getFileName()], [path.getParent()], [path.toAbsolutePath()] | der Dateiname, sein Ordner und sein vollständiger Pfad |
Das Programm [Files03.java] verwendet sie:
Ergebnisse:
Kommentare:
- Zeile 2: Die Methoden von [Files] lösen [IOException] aus. Damit dieses Demonstrationsprogramm schlank bleibt, deklariert die Methode [main] sie mit der Klausel [throws IOException], statt sie abzufangen: Ein Fehler würde das Programm beenden und die Ausnahme anzeigen;
- Zeilen 4–8: [resolve] verwendet das Pfadtrennzeichen des Systems. Die Läufe für den Kurs wurden unter Linux durchgeführt: Der resultierende Pfad lautet [data/cities.txt]; unter Windows wäre es [data\cities.txt]. Pfade mit [resolve] (oder [Path.of("data", "cities.txt")]) zu bilden, statt Zeichenketten zu verketten, macht den Code portabel. Da [Path] keine Methode besitzt, die eine Dateiendung liefert, wird sie mit [lastIndexOf] vom Namen getrennt;
- Zeile 11: Das Erstellen des Ordners [data] verursacht keinen Fehler, wenn er bereits existiert;
- Zeilen 14–21: Schreiben, Anhängen und Lesen, jeweils in einer einzigen Anweisung;
- Zeilen 23–26: [Files.lines] liefert einen Stream: Die Zeilen werden nacheinander gelesen, während das Programm sie verarbeitet. Man kann darauf die Stream-API anwenden und so eine mehrere Gigabyte große Datei verarbeiten, ohne sie in den Speicher zu laden, was [readAllLines] tun würde. Der Stream hält die Datei geöffnet: Er muss geschlossen werden, daher die [try]-Anweisung mit Ressourcen ([Stream] implementiert [AutoCloseable]);
- Zeilen 29–37: Derselbe Text „café“ wird in drei Codierungen geschrieben, anschließend werden die Bytes der Dateien mithilfe der Klasse [HexFormat] (Java 17) hexadezimal angezeigt:
- In UTF-8, der Standardcodierung von Java, belegen Zeichen mit Akzent 2 Bytes (é = C3 A9) und die übrigen 1 Byte: 5 Bytes für 4 Zeichen;
- in UTF-8 mit BOM (Byte Order Mark) beginnt die Datei mit den 3 Bytes EF BB BF, die Software signalisieren, dass die Datei in UTF-8 codiert ist. Java schreibt nie von sich aus ein BOM: Man erhält es, indem man das Zeichen U+FEFF an den Textanfang schreibt, notiert als [""];
- in Latin-1 (ISO-8859-1), der traditionellen Codierung für westeuropäische Texte, belegt jedes Zeichen ein Byte (é = E9);
- Zeilen 39–44: Das Lesen einer Datei mit einer anderen Codierung als der beim Schreiben verwendeten verfälscht Zeichen mit Akzent: Das Byte E9 am Dateiende ist in UTF-8 ungültig. [Files.readString] und [Files.readAllLines] weisen eine solche Datei zurück, indem sie eine Ausnahme [MalformedInputException] auslösen (abgeleitet von [IOException]);
- Zeilen 46–47: Die Umwandlung eines Byte-Arrays in eine Zeichenkette durch den Konstruktor [new String(bytes, encoding)] ist weniger streng: Jedes ungültige Byte wird durch das Zeichen � ersetzt. Ein [InputStreamReader] verhält sich ebenso; dagegen ist der von [Files.newBufferedReader] gelieferte [BufferedReader] streng, wie [Files.readString], und löst ebenfalls eine [MalformedInputException] aus;
- Zeile 48: Beim Lesen mit der richtigen Codierung ist die Datei korrekt;
- Zeile 50: Beim Lesen erkennt Java das BOM nicht: Es wird als unsichtbares Zeichen am Textanfang gelesen, sodass der Text 5 statt 4 Zeichen hat. Wenn Sie UTF-8-Dateien lesen müssen, die mit einem BOM erzeugt wurden (von bestimmter Windows-Software), müssen Sie dieses Zeichen selbst entfernen. Heute gilt die einfache Regel: Textdateien in UTF-8 ohne BOM schreiben und lesen;
- Zeilen 53–59: die Dateien im Ordner. [Files.list] liefert einen Stream, der wie der von [Files.lines] geschlossen werden muss und die Reihenfolge der Namen nicht garantiert: [sorted] sortiert sie;
- Zeilen 62–67: das Löschen des Ordners. [Files.delete] weigert sich, einen nicht leeren Ordner zu löschen: Wir durchlaufen den gesamten Verzeichnisbaum mit [Files.walk] und sortieren die Pfade in umgekehrter Reihenfolge ([Comparator.reverseOrder()]), um den Inhalt eines Ordners vor dem Ordner selbst zu löschen.
Die Methoden von [Files] blockieren den aufrufenden Thread, bis die Operation abgeschlossen ist. In Kapitel 9 zur asynchronen Programmierung sehen wir, wie sich vermeiden lässt, ein Programm während einer langen Ein-/Ausgabeoperation zu blockieren.
5.7. Binärdateien
5.7.1. Die Klassen DataOutputStream und DataInputStream
Die Klassen [java.io.DataOutputStream] und [java.io.DataInputStream] dienen dazu, Binärdateien zu schreiben und zu lesen. In einer solchen Datei werden die Daten nicht als Text, sondern in ihrer internen Form geschrieben: Ein [int] belegt unabhängig von seinem Wert stets 4 Bytes. Es handelt sich um Byte-Streams: Sie sind von den Klassen [OutputStream] und [InputStream] abgeleitet, während Text-Streams von [Writer] und [Reader] abgeleitet sind.
Betrachten wir die folgende Anwendung:
Die Textdatei [persons1.txt] hat folgenden Inhalt:
Das Programm [Files04.java] lautet wie folgt:
Betrachten wir die Operationen im Zusammenhang mit der Klasse [DataOutputStream] genauer:
- Zeilen 13–14: Das Objekt [DataOutputStream] wird um einen anderen Byte-Stream herum aufgebaut, nach dem Prinzip verschachtelter Streams (das Entwurfsmuster „Decorator“):
- [Files.newOutputStream(Path.of(args[1]))] schreibt einen Byte-Stream in die Datei, die erstellt oder geleert wird, falls sie bereits existiert;
- [BufferedOutputStream] ergänzt ihn um einen Puffer, um nicht bei jedem Schreibvorgang auf die Festplatte zuzugreifen;
- [DataOutputStream] ergänzt Methoden zum Schreiben elementarer Datentypen;
- Zeilen 50–51: die Schreibvorgänge. Die Klasse [DataOutputStream] hat für jeden einfachen Datentyp eine Methode: [writeInt], [writeDouble], [writeLong], [writeBoolean], [writeUTF] für eine Zeichenkette …;
- Zeilen 12–15: Die drei Streams werden in einer einzigen [try]-Anweisung mit Ressourcen geöffnet, wobei ihre Deklarationen durch Semikolons getrennt sind. Sie werden am Ende des [try]-Blocks in der umgekehrten Reihenfolge geschlossen, in der sie geöffnet wurden. Das Schließen des äußeren Streams ([DataOutputStream]) schließt die darin enthaltenen Streams. Die Protokolldatei wird über einen [PrintWriter]geschrieben, um die Methode [println] nutzen zu können;
- Zeile 27: Das Trennzeichen ist das Zeichen [:], umgeben von beliebig vielen Leerzeichen, die mit ihm entfernt werden;
- Zeilen 42–47: Das Alter muss eine positive ganze Zahl oder null sein. Java besitzt keine Methode, die eine Zeichenkette in eine ganze Zahl umwandelt, ohne im Fehlerfall eine Ausnahme auszulösen: Die Methode [integer] (Zeilen 67–73) fängt die Ausnahme [NumberFormatException] ab und liefert -1, einen für ein Alter ungültigen Wert;
- Zeilen 9, 59, 62: [System.exit(n)] beendet das Programm mit dem Exit-Code n, den ein Skript prüfen kann (0: Erfolg; dies ist der Exit-Code eines Programms, dessen Methode [main] normal endet).
Die drei Argumente des Programms werden im Befehl [java] nach dem Namen der Quelldatei übergeben. Die Ergebnisse lauten wie folgt:
Die Protokolldatei [logs.txt] hat folgenden Inhalt:
Den Inhalt der Binärdatei [persons1.bin] können Sie mit dem Linux-Befehl [od] hexadezimal anzeigen (unter Windows liefert der PowerShell-Befehl [Format-Hex] eine ähnliche Anzeige):
Daran sieht man, wie [DataOutputStream] die Daten schreibt:
- Eine Zeichenkette wird von [writeUTF] geschrieben, vorangestellt ist ihre Länge in Bytes auf 2 Bytes: 00 04, gefolgt von den 4 Bytes von „paul“ (70 61 75 6c). Die Zeichen werden mit einer Variante von UTF-8 codiert;
- Eine ganze Zahl [int] wird auf 4 Bytes geschrieben, mit dem höchstwertigen Byte zuerst (die sogenannte „Big-Endian“-Reihenfolge, wie sie in Netzwerkprotokollen verwendet wird): 10 wird als 00 00 00 0a geschrieben. Dieses Format ist auf allen Rechnern gleich: Eine unter Windows von [DataOutputStream] geschriebene Datei kann unter Linux gelesen werden;
- Die Daten werden aufeinanderfolgend ohne Trennzeichen oder Zeilenumbrüche geschrieben: Die Datei ist 48 Bytes lang (Zeile 5: Mit der Option [-A d] zeigt [od] die Positionen dezimal an).
Um diese Datei zu lesen, muss man daher die genaue Reihenfolge und den Typ der geschriebenen Daten kennen. Für jede Methode [writeXX] von [DataOutputStream] besitzt die Klasse [DataInputStream] eine entsprechende Methode [readXX]: [readUTF], [readInt], [readDouble] … Sie kann jedoch nicht angeben, wie viele Bytes noch zu lesen sind: Eine von [DataInputStream] gelesene Datei muss entweder mit der Anzahl der enthaltenen Datensätze beginnen oder so lange gelesen werden, bis die Ausnahme [EOFException] auftritt, die das Ende des Datenstroms anzeigt. Eine Ausnahme sollte jedoch die Ausnahme bleiben, und das Dateiende ist keine.
5.7.2. Die Klasse RandomAccessFile
Die Klasse [java.io.RandomAccessFile] liest und schreibt eine Datei mit direktem Zugriff: Man kann den Lese-/Schreibkopf vor dem Lesen oder Schreiben an eine beliebige Stelle der Datei setzen. Sie besitzt dieselben Lese- und Schreibmethoden wie [DataInputStream] und [DataOutputStream] (sie implementiert dieselben Schnittstellen, [DataInput] und [DataOutput]) und zusätzlich:
Methode | Rolle |
[RandomAccessFile(String name, String mode)] | öffnet die Datei zum Lesen ([mode] "r") oder zum Lesen und Schreiben ("rw") |
[long length()] | die Dateigröße in Bytes |
[long getFilePointer()] | die aktuelle Position in der Datei |
[void seek(long pos)] | springt an die Position [pos] in der Datei |
Das Programm [Files05.java] führt die umgekehrte Operation des vorherigen Programms aus: Es liest die Binärdatei, um eine Textdatei zu erstellen. Enthält die resultierende Textdatei die korrekten Daten der ursprünglichen Datei, wissen wir, dass die Umwandlung Text → Binär → Text gelungen ist.
Betrachten wir die Operationen mit der Klasse [RandomAccessFile] genauer:
- Zeile 12: Das Objekt [RandomAccessFile] wird im Nur-Lese-Modus geöffnet (Modus „r“);
- Zeilen 18–19: die Lesevorgänge, [readUTF] und [readInt]. Sie müssen in der Reihenfolge der Schreibvorgänge aufgerufen werden;
- Zeile 16: Das Lesen wird fortgesetzt, bis die aktuelle Position in der Datei das Dateiende erreicht;
- Zeilen 26–27: direkter Zugriff: [seek] setzt die Position auf den Dateianfang zurück, und der erste Datensatz wird erneut gelesen. Wären alle Datensätze gleich groß, könnten wir den n-ten Datensatz direkt lesen, indem wir an die Position n × Größe springen: Dies ist das Prinzip der Direktzugriffsdateien, der Vorläufer der Datenbanken;
- Zeile 28: Die Ausnahme [EOFException] zeigt nun eine echte Anomalie an: eine Datei, die mitten in einem Datensatz endet;
- Zeile 32: [RandomAccessFile], eine Unterklasse von [java.io], meldet eine fehlende Datei über eine [FileNotFoundException], deren vom System gelieferte Meldung den Dateinamen enthält.
Führen wir das Programm mit der zuvor erzeugten Datei [persons1.bin] aus:
Der Inhalt von [persons2.txt] lautet wie folgt:
Wir finden die 4 gültigen Personen der Datei [persons1.txt] wieder. Bei einer Datei [truncated.bin] , die aus den ersten 33 Bytes von [persons1.bin] besteht, schlägt das Lesen des Alters von Jacques fehl:
Und mit einer nicht vorhandenen Datei:
Java besitzt außerdem einen Mechanismus zur binären Serialisierung von Objekten: Die Klassen *[ObjectOutputStream] und [ObjectInputStream] schreiben und lesen ganze Objekte, sofern ihre Klasse die Schnittstelle *[java.io.Serializable] implementiert. Dieser Mechanismus gilt heute als veraltet: Das Deserialisieren von Daten aus einer nicht vertrauenswürdigen Quelle hat zahlreiche Angriffe ermöglicht, da die Deserialisierung vom Angreifer gewählten Code ausführen kann. Stattdessen bevorzugt man ein textbasiertes Format wie JSON. Die Schnittstelle [Serializable] findet sich jedoch weiterhin in vielen Klassen, insbesondere in Ausnahmen, die sie von der Klasse [Throwable] erben: Deshalb verlangt der Compiler bei Verwendung der Option [-Xlint:all], dass sie ein Feld [serialVersionUID] deklarieren, wie wir in der Beispielanwendung sehen werden.
5.7.3. JSON-Serialisierung mit Jackson
Eine Binärdatei Datenwert für Datenwert zu schreiben und zu lesen ist mühsam, und schon die kleinste Abweichung zwischen Schreiben und Lesen führt zu falschen Ergebnissen. In der Regel ist es vorzuziehen, Objekte zu serialisieren, also automatisch in eine Zeichenfolge umzuwandeln, und sie anschließend zu deserialisieren, um sie zu rekonstruieren.
JSON (JavaScript Object Notation) ist ein textbasiertes, für Menschen lesbares und universelles Format: Es ist das Austauschformat für Webservices (Kapitel 13) und viele Konfigurationsdateien. Ein Objekt wird in geschweiften Klammern als Paare der Form "property": value geschrieben, oder als Array in eckigen Klammern.
Die Java-Standardbibliothek kann kein JSON lesen oder schreiben. Man verwendet eine externe Bibliothek; die verbreitetste ist Jackson, die Spring Boot standardmäßig verwendet. Version 3 (2025) hat die Pakete geändert: [tools.jackson.*] statt [com.fasterxml.jackson.*] in Version 2, der man noch häufig begegnet; ihre Annotationen bleiben im Paket [com.fasterxml.jackson.annotation]. Eine externe Bibliothek wird über Maven bezogen (Kapitel 2): Das Programm ist daher ein Maven-Projekt, [Files06], mit der folgenden Verzeichnisstruktur:
Die Datei [pom.xml] deklariert die Abhängigkeit von Jackson:
Kommentare:
- Zeilen 7–9: die Projektdaten;
- Zeilen 11–14: die Java-Version und die Codierung der Quelldateien;
- Zeilen 16–23: die Abhängigkeit von der Bibliothek [jackson-databind]. Maven lädt sie aus dem zentralen Repository (Maven Central) herunter, zusammen mit den Bibliotheken, von denen sie selbst abhängt ([jackson-core] und [jackson-annotations]);
- Zeilen 27–37: der Compiler, konfiguriert wie in allen Projekten des Kurses: Warnungen aktiviert ([-Xlint:all]) und Parameternamen im kompilierten Code beibehalten;
- Zeilen 39–46: das Plugin [exec-maven-plugin], das die Hauptklasse mit dem Befehl [mvn exec:java] ausführt.
Das zentrale Objekt in Jackson ist [JsonMapper], das zwei Hauptmethoden besitzt:
Methode | Rolle |
[String writeValueAsString(Object value)] | liefert den JSON-Text, der das Objekt [value] darstellt |
[<T> T readValue(String content, Class<T> valueType)] | rekonstruiert aus dem JSON-Text [content] ein Objekt vom Typ [T]; löst eine [JacksonException] aus, wenn der Text fehlerhaft ist. Eine Überladung erhält statt einer [Class] eine [TypeReference] |
Das Programm [Files06.java] verwendet sie:
Es wird im Projektordner mit dem Befehl [mvn compile exec:java] oder aus der IDE ausgeführt. Wir geben nicht die Maven-Meldungen wieder, sondern nur die Ausgabe des Programms:
Kommentare:
- Zeile 1: In einem Maven-Projekt werden Klassen in Paketen organisiert: Die Klasse [Files06] des Pakets [json] befindet sich in der Datei [src/main/java/json/Files06.java];
- Zeilen 3–14: Anders als eine kompakte Quelldatei muss eine reguläre Klasse die von ihr verwendeten Klassen importieren, auch die der Standardbibliothek;
- Zeilen 20–21: der zu serialisierende Record [Person], deklariert in der Klasse [Files06]. Jackson 3 kann einen Record serialisieren: Jede Komponente wird zu einer JSON-Eigenschaft mit demselben Namen;
- Zeilen 24–25: Die Annotation [@JsonProperty] legt den Namen der JSON-Eigenschaft einer Komponente auf [reference] statt [code] fest;
- Zeile 27: Die Methode [main] ist eine statische Methode einer Klasse. Sie deklariert die Ausnahme [IOException], die von Methoden von [Files] ausgelöst werden kann;
- Zeilen 34–36: Ein [JsonMapper] wird von einem Objekt-Builder erzeugt: [JsonMapper.builder()] liefert ein Objekt, dem die gewünschten Optionen angegeben werden, und anschließend erzeugt [build] den [JsonMapper]. Mit den Standardoptionen wird der Text in einer einzigen Zeile geschrieben, und Zeichen mit Akzent werden unverändert geschrieben (Zeile 2 der Ergebnisse);
- Zeilen 38–39: Die Option [ESCAPE_NON_ASCII] weist das System an, Nicht-ASCII-Zeichen als Escape-Sequenzen zu schreiben: [é] wird zu [\u00E9]. Der Text bleibt korrekt, ist aber schwer lesbar; das ist nützlich, wenn der JSON-Text ein System durchlaufen muss, das nur ASCII kennt;
- Zeilen 42–43: Die Option [INDENT_OUTPUT] erzeugt eingerückten, auf mehrere Zeilen verteilten Text. Eine Liste wird in ein JSON-Array serialisiert;
- Zeilen 45–48: Der JSON-Text wird in eine Textdatei geschrieben und anschließend zur Anzeige wieder gelesen: So wird heute die binäre Serialisierung ersetzt;
- Zeilen 53–54: Die Deserialisierung rekonstruiert die Liste. Jackson erzeugt die Objekte [Person] durch Aufruf des Konstruktors des Records, dessen Parameter den gleichnamigen JSON-Eigenschaften zugeordnet werden. Bei einer Liste muss man Jackson den Typ ihrer Elemente mitteilen. Der Ausdruck [List<Person>.class] existiert jedoch nicht: Die Generics von Java werden zur Kompilierzeit gelöscht („Type Erasure“), und zur Laufzeit gibt es nur eine Klasse [List] ohne Typparameter. Der Trick mit
[TypeReference]besteht darin, eine anonyme Klasse ([new TypeReference<List<Person>>() { }]***) zu erzeugen, die von[TypeReference<List<Person>>]***abgeleitet ist: Der Elterntyp einer Klasse bleibt im kompilierten Code erhalten, und Jackson kann ihn lesen. Für ein Array, das einfacher ist, schreiben wir [Person[].class]; - Zeilen 61–62: Serialisierung eines [Article]: Die Eigenschaft [reference] trägt den von der Annotation festgelegten Namen. Ein [BigDecimal] wird als JSON-Zahl geschrieben;
- Zeilen 64–69: Mit der Option [ACCEPT_CASE_INSENSITIVE_PROPERTIES] ignoriert Jackson beim Parsen die Groß- und Kleinschreibung der Eigenschaftsnamen: [REFERENCE] und [Price] werden akzeptiert;
- Zeilen 72–79: Ein ungültiges JSON-Dokument – hier eine Zeichenkette, wo eine Zahl erwartet wird – löst eine von [JacksonException] abgeleitete Ausnahme aus, hier [InvalidFormatException]. In Jackson 3 sind diese Ausnahmen ungeprüft (sie sind von [RuntimeException] abgeleitet), während sie in Jackson 2 von [IOException] abgeleitet waren. [getOriginalMessage] liefert die Meldung ohne die Ortsangaben, die [getLocation] und [getPathReference] getrennt bereitstellen: Zeile 1, Spalte 23, Eigenschaft [age] des Records [Person].
Ein [JsonMapper] ist aufwendig zu erzeugen, aber nach der Erzeugung wiederverwendbar und kann von mehreren Threads gemeinsam genutzt werden: Ein Programm erzeugt typischerweise nur einen, der in einer Konstanten abgelegt wird. Wir werden JSON in der folgenden Beispielanwendung und im gesamten Kurs verwenden.
5.8. Reguläre Ausdrücke
Das Paket [java.util.regex] unterstützt die Verwendung regulärer Ausdrücke. Mit ihnen lässt sich das Format einer Zeichenkette überprüfen. Beispielsweise können Sie prüfen, ob eine Zeichenkette, die ein Datum darstellt, tatsächlich im Format tt/mm/jj vorliegt. Dazu verwendet man ein Muster und vergleicht die Zeichenkette mit diesem Muster. In diesem Beispiel müssen t, m und j Ziffern sein. Das Muster für ein gültiges Datumsformat lautet daher [\d\d/\d\d/\d\d], wobei das Symbol [\d] für eine Ziffer steht. Die in einem Muster verwendbaren Symbole sind die folgenden:
Zeichen | Beschreibung |
[\] | kennzeichnet das folgende Zeichen als Sonderzeichen oder Literal. Beispielsweise entspricht [n] dem Zeichen n, [\n] einem Zeilenumbruchzeichen, [\\] entspricht \ und [\(] entspricht ( |
[^] | entspricht dem Anfang der Zeichenkette |
[$] | entspricht dem Ende der Zeichenkette |
[*] | entspricht dem vorangehenden Element null- oder mehrmals. So passt [zo*] auf z oder zoo |
[+] | entspricht dem vorangehenden Element ein- oder mehrmals. So passt [zo+] auf „zoo“, aber nicht auf „z“ |
[?] | entspricht dem vorangehenden Element null- oder einmal. Beispielsweise passt [a?ve?] auf „ve“ in „lever“ |
[.] | entspricht einem beliebigen einzelnen Zeichen außer einem Zeilenumbruchzeichen |
[(pattern)] | sucht das Muster und speichert die Übereinstimmung (eine Gruppe). Die übereinstimmende Teilzeichenkette lässt sich mit der Methode [group] aus dem Ergebnis extrahieren. Um Übereinstimmungen mit Zeichen in Klammern zu finden, verwenden Sie [\(] oder [\)] |
[x|y] | entspricht entweder x oder y. Beispielsweise passt [z|foot] auf z oder foot; [(z|f)oo] passt auf zoo oder foo |
[{n}] | n ist eine nichtnegative ganze Zahl. Entspricht dem vorangehenden Element genau n-mal. Beispielsweise entspricht [o{2}] nicht dem o in Bob, aber den ersten beiden o in fooooot |
[{n,}] | entspricht dem vorangehenden Element mindestens n-mal. Beispielsweise passt [o{2,}] nicht auf das „o“ in „Bob“, aber auf alle „o“ in „fooooot“. [o{1,}] ist gleichbedeutend mit [o+], und [o{0,}] ist gleichbedeutend mit [o*] |
[{n,m}] | entspricht dem vorangehenden Element mindestens n-mal und höchstens m-mal. Beispielsweise passt [o{1,3}] auf die ersten drei „o“ in „foooooot“; [o{0,1}] ist gleichbedeutend mit [o?] |
[[xyz]] | Zeichenmenge: entspricht einem der angegebenen Zeichen. Beispielsweise passt [[abc]] auf den Buchstaben „a“ in „plain“ |
[[^xyz]] | negierte Zeichenmenge: entspricht jedem nicht aufgeführten Zeichen. Beispielsweise passt [[^abc]] auf „p“ in „plain“ |
[[a-z]] | Zeichenbereich: entspricht jedem Zeichen im angegebenen Bereich, hier einem Kleinbuchstaben ohne Akzent |
[[^m-z]] | negierter Zeichenbereich: entspricht jedem Zeichen, das nicht zwischen „m“ und „z“ liegt |
[\b] | entspricht einer Wortgrenze, das heißt der Position zwischen einem Wortzeichen und einem Nicht-Wortzeichen. Beispielsweise passt [er\b] auf „er“ in „lever“, aber nicht auf „er“ in „verb“ |
[\B] | entspricht einer Position, die keine Wortgrenze ist. [en*t\B] entspricht „ent“ in „mentor“ |
[\d] | entspricht einer Ziffer; gleichbedeutend mit [[0-9]] |
[\D] | entspricht einem Zeichen, das keine Ziffer ist |
[\f], [\n], [\r], [\t] | entsprechen jeweils den Zeichen Seitenumbruch, Zeilenumbruch, Wagenrücklauf und Tabulator |
[\s] | entspricht jedem Leerraumzeichen: Leerzeichen, Tabulator, Seitenumbruch, Zeilenumbruch … Gleichbedeutend mit [[ \t\n\x0B\f\r]] |
[\S] | entspricht jedem Zeichen, das kein Leerraumzeichen ist |
[\w] | entspricht jedem Wortzeichen: in Java standardmäßig ein Buchstabe ohne Akzent, eine Ziffer oder ein Unterstrich; gleichbedeutend mit [[a-zA-Z_0-9]]. Mit der Option [UNICODE_CHARACTER_CLASS] (siehe unten) erkennt es auch Buchstaben mit Akzent |
[\W] | entspricht jedem Zeichen, das kein Wortzeichen ist |
[\num] | num ist eine positive ganze Zahl: verweist auf die Gruppe mit der Nummer num. Beispielsweise entspricht [(.)\1] zwei aufeinanderfolgenden identischen Zeichen |
[\xnn], [\unnnn] | entspricht dem hexadezimalen Zeichen nn (2 Ziffern) oder nnnn (4 Ziffern). Beispielsweise entspricht [\x41] dem Zeichen A |
Ein Element in einem Muster kann einmal oder mehrfach vorkommen. Sehen wir uns einige Beispiele mit dem Symbol [\d] an, das eine einzelne Ziffer darstellt:
Muster | Bedeutung |
[\d] | eine Ziffer |
[\d?] | 0 oder 1 Ziffer |
[\d*] | 0 oder mehr Ziffern |
[\d+] | 1 oder mehr Ziffern |
[\d{2}] | 2 Ziffern |
[\d{3,}] | mindestens 3 Ziffern |
[\d{5,7}] | zwischen 5 und 7 Ziffern |
Stellen wir uns nun ein Muster vor, das das erwartete Format einer Zeichenkette beschreiben kann:
Zielzeichenkette | Muster |
ein Datum im Format tt/mm/jj | [\d{2}/\d{2}/\d{2}] |
eine Uhrzeit im Format hh:mm:ss | [\d{2}:\d{2}:\d{2}] |
eine vorzeichenlose ganze Zahl | [\d+] |
eine Folge von Leerzeichen, die auch leer sein kann | [\s*] |
eine vorzeichenlose ganze Zahl, der Leerzeichen vorangehen oder folgen können | [\s*\d+\s*] |
eine ganze Zahl, die ein Vorzeichen haben kann und der Leerzeichen vorangehen oder folgen können | [\s*[+-]?\s*\d+\s*] |
eine vorzeichenlose reelle Zahl, der Leerzeichen vorangehen oder folgen können | [\s*\d+(\.\d*)?\s*] |
eine reelle Zahl, die ein Vorzeichen haben kann und der Leerzeichen vorangehen oder folgen können | [\s*[+-]?\s*\d+(\.\d*)?\s*] |
eine Zeichenkette, die das Wort „just“ enthält | [\bjust\b] |
Beachten Sie, dass innerhalb eckiger Klammern das Zeichen [|] keine besondere Bedeutung hat: Das Muster [[+|-]], das bisweilen für das Vorzeichen verwendet wird, akzeptiert vor einer Zahl auch das Zeichen |. Ebenso muss der Dezimalpunkt maskiert werden, [\.]: Ein nicht maskierter Punkt entspricht jedem beliebigen Zeichen.
Sie können angeben, wo in der Zeichenkette nach dem Muster gesucht wird:
Muster | Bedeutung |
[^pattern] | das Muster steht am Anfang der Zeichenkette |
[pattern$] | Das Muster steht am Ende der Zeichenkette |
[^pattern$] | Das Muster steht am Anfang und am Ende der Zeichenkette |
[pattern] | Das Muster wird an beliebiger Stelle der Zeichenkette gesucht, vom Anfang der Zeichenkette an |
Suchzeichenkette | Muster |
eine Zeichenkette, die mit einem Ausrufezeichen endet | [!$] |
eine Zeichenkette, die mit einem Punkt endet | [\.$] |
eine Zeichenkette, die mit der Folge // beginnt | [^//] |
eine Zeichenkette, die aus einem einzigen Wort besteht, dem möglicherweise Leerzeichen vorangehen oder folgen | [^\s*\w+\s*$] |
eine Zeichenkette, die aus genau zwei Wörtern besteht, denen möglicherweise Leerzeichen vorangehen oder folgen | [^\s*\w+\s+\w+\s*$] |
eine Zeichenkette, die das Wort „secret“ enthält | [\bsecret\b] |
Teilmengen eines Musters können „extrahiert“ werden. So können wir nicht nur prüfen, ob eine Zeichenkette einem bestimmten Muster entspricht, sondern auch die Elemente aus dieser Zeichenkette extrahieren, die den in Klammern eingeschlossenen Teilmengen des Musters entsprechen. Wenn wir beispielsweise eine Zeichenkette mit einem Datum im Format tt/mm/jj analysieren und zudem die Elemente tt, mm und jj dieses Datums extrahieren möchten, verwenden wir das Muster [(\d\d)/(\d\d)/(\d\d)].
Im Java-Code wird ein Muster als gewöhnliche Zeichenkette geschrieben: Jedes Zeichen [\] im Muster muss verdoppelt werden. Das Muster [\d+] wird als ["\\d+"]geschrieben, und das Muster [\\], das das Zeichen \ darstellt, als ["\\\\"]. Textblöcke ändern daran nichts: [\] ist auch dort ein Escape-Zeichen. Der Editor erleichtert die Lesbarkeit: IntelliJ IDEA erkennt die an [Pattern.compile] übergebenen Zeichenketten, hebt sie als reguläre Ausdrücke hervor und erlaubt es, sie zu testen.
5.8.1. Prüfen, ob eine Zeichenkette einem gegebenen Muster entspricht
Ein Muster wird zunächst in ein Objekt kompiliert [java.util.regex.Pattern], das dann [Matcher]-Objekte bereitstellt, die für die Suche in einer gegebenen Zeichenkette zuständig sind:
Methode | Rolle |
[static Pattern compile(String regex)] | kompiliert das Muster [regex]; löst eine [PatternSyntaxException] aus, wenn das Muster ungültig ist |
[static Pattern compile(String regex, int flags)] | wie oben, mit Optionen (siehe unten) |
[Matcher matcher(CharSequence input)] | liefert ein Objekt [Matcher], das das Muster in [input] sucht |
[boolean find()] (Klasse [Matcher]) | sucht das nächste Vorkommen des Musters in der Zeichenkette; liefert [true], wenn eines gefunden wird |
[boolean matches()] (Klasse [Matcher]) | liefert [true], wenn die gesamte Zeichenkette dem Muster entspricht |
[static boolean matches(String regex, CharSequence input)] | kompiliert das Muster und prüft, ob die gesamte Zeichenkette ihm entspricht |
Das Programm [Regex01.java] lautet wie folgt:
Ergebnisse:
Kommentare:
- Zeile 3: das Muster für eine vorzeichenlose ganze Zahl, die möglicherweise von Leerzeichen umgeben ist und die gesamte Zeichenkette einnimmt (Anker [^] und [$]). Die Zeichen [\] sind verdoppelt;
- Zeile 4: die Kompilierung des Musters;
- Zeile 7: [find] sucht das Muster in der Zeichenkette. Die von Leerzeichen umgebene Zeichenkette „123a“ entspricht dem Muster nicht: Das Zeichen „a“ kann weder eine Ziffer noch ein Leerzeichen sein. Ohne die Anker [^] und [$] würde die Zeichenkette passen, da sie eine Zahl enthält;
- Zeilen 14–16: der Unterschied zwischen [find], das das Muster innerhalb der Zeichenkette sucht, und [matches], das verlangt, dass die gesamte Zeichenkette dem Muster entspricht, als wäre es von [^] und [$] eingefasst;
- Zeilen 18–20: Die statische Methode [Pattern.matches] und die Methode [matches] der Klasse [String] testen ebenfalls die gesamte Zeichenkette. Sie kompilieren das Muster bei jedem Aufruf neu: Für einen einzelnen Test sind sie nützlich, in einer Schleife sollten sie jedoch vermieden werden. Die Methode [split] von [String], der wir bereits begegnet sind, kompiliert ihr Muster ebenfalls bei jedem Aufruf, außer bei Trennzeichen, die aus einem einzigen gewöhnlichen Zeichen bestehen und die sie ohne regulären Ausdruck verarbeitet.
5.8.2. Alle Vorkommen eines Musters in einer Zeichenkette finden
Die Methode [find] eines Objekts [Matcher] kann mehrfach aufgerufen werden: Jeder Aufruf sucht das nächste Vorkommen des Musters. Nach einem erfolgreichen Aufruf liefert das Objekt [Matcher] Informationen zum gefundenen Vorkommen:
- [group()]: der Text des Vorkommens, also ein Element, das dem Muster entspricht;
- [start()]: die Position, an der das Element in der durchsuchten Zeichenkette gefunden wurde; [end()]: die Position, die auf das Element folgt.
Das Programm [Regex02.java] lautet wie folgt:
Ergebnisse:
Kommentare:
- Zeile 3: Das gesuchte Muster ist eine Folge von Ziffern;
- Zeile 5: die Zeichenkette, in der dieses Muster gesucht wird;
- Zeilen 8–13: Jeder Aufruf von [find] findet das nächste Vorkommen; die Schleife endet, wenn es keine mehr gibt. Jedes Vorkommen und seine Position werden angezeigt;
- Zeile 16: Die Methode [results] (Java 9) liefert den Stream der Vorkommen als Objekte [MatchResult] (die die Methoden [group], [start] und [end] besitzen): Auf ihn wird die Stream-API angewendet. Hier wird die Summe der gefundenen Zahlen berechnet;
- Zeile 18: Die Anzahl der Vorkommen des Musters [[aeiouy]], das einen Vokal bezeichnet, ist die Anzahl der Elemente im Stream.
5.8.3. Teile eines Musters abrufen
Wie erwähnt, werden die in Klammern eingeschlossenen Teile eines Musters gespeichert: Es sind die Gruppen. Das Programm [Regex03.java] verwendet sie:
Ergebnisse:
Kommentare:
- Zeilen 7–8: Die Zeichenkette [sample4] wird mit dem Muster [regex3] verglichen; [find] sucht das erste Vorkommen des Musters. Nach einem erfolgreichen Aufruf verwenden wir zwei neue Methoden von [Matcher]:
- [groupCount] (Zeile 11): die Anzahl der Klammergruppen im Muster;
- [group(i)] (Zeile 12): der von Gruppe Nr. i erfasste Text; [group(0)] oder [group()] ist das gesamte Vorkommen des Musters. [start(i)] ist die Position dieses Textes in der analysierten Zeichenkette. Die Schleife läuft daher von 0 bis [groupCount] einschließlich;
- Zeile 20: Eine Gruppe kann mit der Syntax benannt werden: [(?<name>...)]. Hier erkennt das Muster ein Datum im Format t/m/jjjj mit ein- oder zweistelligem Tag und Monat;
- Zeilen 26–28: Eine benannte Gruppe wird über ihren Namen statt über ihre Nummer angesprochen: Der Code ist lesbarer und hängt nicht von der Reihenfolge der Klammern ab;
- Zeilen 29–31: Die Klasse [LocalDate] (Java 8) stellt ein Datum ohne Uhrzeit dar. Sie wird mit dem Muster [EEEE d MMMM yyyy] angezeigt: Der Wochentag erscheint auf Englisch, der Sprache des Rechners;
- Zeile 35: Die Methode [replaceAll] ersetzt jedes Vorkommen des Musters durch eine Zeichenkette, in der [${name}] (oder [$1], [$2] … bei nummerierten Gruppen) den Wert einer Gruppe bezeichnet. Datumsangaben werden so im Format Jahr-Monat-Tag neu geschrieben;
- Zeilen 38–39: Eine überladene Version von [replaceAll] (Java 9) erhält eine Funktion, die aus jedem Vorkommen den Ersatztext berechnet, vom Typ [MatchResult]. Hier wird das Datum aufgebaut und durch seine standardisierte Notation ISO 8601 ersetzt, die von der Methode [toString] von [LocalDate] geliefert wird: Tage und Monate haben stets zwei Ziffern.
5.8.4. Ein Lernprogramm
Den regulären Ausdruck zu finden, der prüft, ob eine Zeichenkette einem bestimmten Muster entspricht, kann bisweilen eine echte Herausforderung sein. Das Programm [Regex04.java] ermöglicht es Ihnen, dies zu üben. Es nimmt ein Muster und eine Zeichenkette als Eingabe entgegen und zeigt an, ob die Zeichenkette dem Muster entspricht oder nicht.
Kommentare:
- Zeile 13: Kompilierung des über die Tastatur eingegebenen Musters. Ein fehlerhaftes Muster löst eine Ausnahme [PatternSyntaxException] aus, bei der [getDescription] die Fehlerbeschreibung und [getIndex] ihre Position im Muster liefert (Zeile 15). Ihre vollständige Meldung, die von [getMessage] geliefert wird, erstreckt sich über mehrere Zeilen und zeigt das Muster mit einer Markierung unterhalb des Fehlers;
- Zeile 28: Die Suche wird nicht direkt auf der eingegebenen Zeichenkette ausgeführt, sondern auf einem Objekt [TimeLimitedString] (Zeilen 58–87), das die Suchdauer auf eine Sekunde begrenzt: Dauert die Suche länger, wird eine Ausnahme [TimeoutExceededException] ausgelöst und in Zeile 44 abgefangen. Wir werden später sehen, wozu das nützlich ist und wie es funktioniert;
- Zeilen 36–39: Für jeden Treffer werden die Gruppe Nr. 1 und gegebenenfalls die folgenden Gruppen angezeigt;
- Zeilen 52–55: Anders als in den vorherigen Programmen werden aus der eingegebenen Zeile keine Leerzeichen entfernt; sie können Teil des Musters oder der zu testenden Zeichenkette sein.
Hier ein Beispiel für die Ausgabe:
Die Muster [^\s*\d+\s*$] und [^\s*(\d+)\s*$] zeigen den Nutzen von Gruppen: Das erste erkennt die Zeichenkette „1456“ mit drei vorangestellten Leerzeichen einschließlich der Leerzeichen; das zweite extrahiert zusätzlich die Zahl ohne die Leerzeichen. Die Muster [^(a+)+$] und [^(a+)+\1$] werden weiter unten besprochen.
5.8.5. Die Methode split
Der Methode [split] der Klasse [String], deren Trennzeichen ein regulärer Ausdruck ist, sind wir bereits begegnet. Die Klasse [Pattern] besitzt dieselbe Methode, die das vorkompilierte Muster verwendet:
Methode | Rolle |
[String[] split(CharSequence input)] | Die Zeichenkette [input] wird in Felder zerlegt, die durch ein dem Muster entsprechendes Trennzeichen getrennt sind |
[Stream<String> splitAsStream(CharSequence input)] | wie oben, die Felder werden jedoch als Stream geliefert |
Angenommen, eine Textdatei enthält Zeilen der Form field1, field2, ..., fieldn. Die Felder sind durch ein Komma getrennt, dem jedoch Leerzeichen vorangehen oder folgen können. Das Muster [\s*,\s*] beschreibt dieses Trennzeichen genau, wie das Programm [Regex05.java] zeigt:
Ergebnisse:
Kommentare:
- Zeile 5: das Trennzeichen: ein Komma, dem beliebig viele Leerzeichen vorangehen und folgen. Die Leerzeichen werden zusammen mit dem Trennzeichen entfernt. Einmal kompiliert, kann das Muster beliebig viele Zeilen zerlegen, ohne erneut kompiliert zu werden: So zerlegt man alle Zeilen einer Datei;
- Zeile 11: ein Trennzeichen, das mehrere Formen annehmen kann: ein Semikolon oder ein senkrechter Strich ([[;|]]) oder ([|]) eine Folge von Leerzeichen ([\s+]);
- Zeile 14: [splitAsStream] liefert die Felder als Stream, auf den hier die Operation [map] angewendet wird.
5.8.6. Vorkompilierte Muster, Optionen und zu lange dauernde Suchvorgänge
Anders als andere Plattformen besitzt Java keinen Mechanismus, der den Code für eine Suche mit regulärem Ausdruck bereits beim Kompilieren des Programms erzeugt: Ein Muster wird stets zur Laufzeit von [Pattern.compile] analysiert. Diese Kompilierung hat ihren Preis; daher empfiehlt es sich, jedes bekannte Muster ein für alle Mal im Voraus zu kompilieren und das Objekt [Pattern] in einer Konstanten abzulegen, wie es das Programm [Regex06.java] tut. Ein Objekt [Pattern] ist unveränderlich und kann von mehreren Threads gleichzeitig verwendet werden; ein Objekt [Matcher], das den Zustand einer Suche speichert, kann das nicht.
Ergebnisse:
Kommentare:
- Zeilen 4–8: Die Muster des Programms werden einmal kompiliert und in [static final]-Konstanten (Kapitel 4) abgelegt, die wie üblich in Großbuchstaben geschrieben werden. In einer kompakten Quelldatei sind diese Konstanten Felder der impliziten Klasse, die die Methoden der Datei enthält;
- Zeilen 12–16: Die Konstanten werden genauso verwendet wie die Objekte [Pattern] in den vorherigen Programmen;
- Zeile 6: Der zweite Parameter von [compile] ist eine Kombination von Optionen. [CASE_INSENSITIVE] ignoriert die Groß- und Kleinschreibung: „YES“ und „Yes“ passen auf das Muster (Zeile 4 der Ergebnisse);
- Zeilen 23–27: Die Optionen werden mit dem Operator [|] kombiniert. [MULTILINE] lässt [^] und [$] am Anfang und Ende jeder Zeile der Zeichenkette passen, statt nur am Anfang und Ende der Zeichenkette selbst. Mit den Standardoptionen erkennt [\w] jedoch nur Buchstaben ohne Akzent: Die Zeile „entrée: 3“ wird nicht erkannt (Zeile 5 der Ergebnisse). Die Option [UNICODE_CHARACTER_CLASS] (Java 7) weist [\w], [\d], [\s] und [\b] die korrekten Unicode-Bedeutungen zu: Buchstaben mit Akzent werden als Wortzeichen behandelt (Zeile 6 der Ergebnisse). Diese Option sollte für jeden französischen Text verwendet werden. Weitere nützliche Optionen sind: [DOTALL] ([.] erfasst auch Zeilenumbrüche), [COMMENTS] (Leerzeichen im Muster werden ignoriert, sodass es sich über mehrere Zeilen und mit Kommentaren schreiben lässt), [UNICODE_CASE] (zusammen mit [CASE_INSENSITIVE] ignoriert sie auch die Groß- und Kleinschreibung von Buchstaben mit Akzent: É und é);
- Zeile 29: Optionen können auch am Anfang des Musters geschrieben werden: [(?i)] für [CASE_INSENSITIVE], [(?m)] für [MULTILINE], [(?U)] für [UNICODE_CHARACTER_CLASS] …
Der Rest des Programms befasst sich mit einem Sicherheitsproblem. Manche Muster sind pathologisch: Auf bestimmte Zeichenketten angewendet, zwingen sie die Engine für reguläre Ausdrücke dazu, eine enorme Zahl von Möglichkeiten auszuprobieren, die Zeichenkette dem Muster zuzuordnen, bevor sie zu einem Ergebnis kommt. Die Java-Engine verwendet ein Verfahren namens „Backtracking“: Schlägt ein Versuch fehl, kehrt sie zur letzten getroffenen Wahl zurück und probiert eine andere. Das Muster [^(a+)+\1$] in Zeile 8 ist dafür ein Beispiel: Auf eine Folge von „a“ angewendet, die mit einem anderen Zeichen endet, probiert es jede mögliche Verteilung der „a“ auf die Wiederholungen der Gruppe und ihrer Rückreferenz [\1] aus, bevor es feststellt, dass die Suche fehlgeschlagen ist, und die Zahl der Möglichkeiten vervielfacht sich mit jedem weiteren „a“. Man spricht von katastrophalem Backtracking. Auf von Benutzern eingegebene Zeichenketten angewendet, stellt ein solches Muster eine Sicherheitslücke dar (bekannt als ReDoS, „Regular Expression Denial of Service“): Wenige Anfragen genügen, um einen Server lahmzulegen.
- Zeilen 32–37: Die Suchdauer wird für 10, 15 und 20
agemessen. Sie steigt sehr schnell an (Zeilen 8–10 der Ergebnisse; die Dauern variieren von Ausführung zu Ausführung und von Rechner zu Rechner). Da sich die Dauer mit jedem zusätzlichenaungefähr verdoppelt, würde die Suche bei 30amehrere Minuten dauern; - Zeilen 38–43: Die Klasse [Pattern] besitzt keine Timeout-Option. Man greift deshalb auf eine Standardtechnik zurück: Die Suche wird in einem Objekt vom Typ [TimeLimitedString] (Zeilen 61–89) ausgeführt, das die von [matcher] akzeptierte Schnittstelle [CharSequence] implementiert. Die Engine für reguläre Ausdrücke liest die Zeichenkette Zeichen für Zeichen mit der Methode [charAt]: Diese Methode prüft die Uhrzeit und löst eine Ausnahme [TimeoutExceededException] aus (Zeilen 92–95), wenn die bei der Erzeugung des Objekts gespeicherte Frist überschritten wurde. Die Suche wird nach 100 ms abgebrochen;
- Zeilen 61–65: Der Record [TimeLimitedString] hat zwei Komponenten: den Text und die Frist, ausgedrückt als Wert der Uhr [System.nanoTime], die nicht überschritten werden darf. Der zusätzliche Konstruktor berechnet diese Frist anhand eines Timeouts, eines Objekts [java.time.Duration];
- Zeile 92: Die Ausnahme [TimeoutExceededException] ist von [RuntimeException] abgeleitet: Es ist eine ungeprüfte Ausnahme, die [charAt] auslösen kann, ohne sie zu deklarieren. Sie ist als [static] deklariert, damit sie im Record erzeugt werden kann, der selbst implizit statisch ist. Das Feld [serialVersionUID] verhindert eine Compiler-Warnung, da eine Ausnahme serialisierbar ist;
- Zeilen 45–48: Die Java-Laufzeitumgebung kann einfache Fälle verschachtelter Wiederholungen erkennen und effizient behandeln: Das Muster [^(a+)+$], das bei anderen Laufzeitumgebungen katastrophal ist, antwortet hier sofort. Es ist die Rückwärtsreferenz [\1], die diese Optimierung beim Muster in Zeile 8 verhindert.
Wichtig ist, dass Sie Mustern mit verschachtelten Wiederholungen ([(a+)+], [(\w+\s?)*] …) mit Vorsicht begegnen und die Dauer von Suchvorgängen begrenzen, sobald das Muster oder die durchsuchte Zeichenkette von außerhalb des Programms stammt. Die possessiven Quantifizierer von Java ([a++], [a*+]), die Backtracking innerhalb des von ihnen wiederholten Elements verhindern, erlauben ebenfalls, sichere Muster zu schreiben, sofern Sie ihre Bedeutung genau verstehen.
5.9. Beispielanwendung – V3
Wir greifen die in Kapitel 3 (Version 1) und Kapitel 4 (Version 2) behandelte Anwendung wieder auf. Denken Sie daran, dass es sich um eine Übung handelt: Der verwendete Steuertarif ist der von 2004 (Einkommen 2003), der seit dem ursprünglichen Kurs unverändert geblieben ist.
5.9.1. Daten in einer Datei
In Version 2 erfolgte die Steuerberechnung in der abstrakten Klasse [AbstractTax], die wir hier im [tax]-Paket des Projekts wiederverwenden, mit zwei kleinen Unterschieden: Die Steuerstufen werden nun in Form eines Arrays ([TaxBracket[]]) statt einer Liste bereitgestellt, und die Division wird mit 16 statt 34 signifikanten Stellen durchgeführt, was mehr als ausreichend ist:
Die Methode [calculate] verwendet die Steuerstufen, die die abstrakte Methode [getTaxBrackets] (Zeile 10) liefert. Die Klasse [AbstractTax] weiß nicht, woher diese Stufen stammen: Es ist Aufgabe der abgeleiteten Klassen, sie bereitzustellen. In Version 2 hat die abgeleitete Klasse [HardwiredTax] sie fest in ihren Code geschrieben. Die Berechnungen erfolgen mit exakten Dezimalzahlen [java.math.BigDecimal] (Kapitel 3): [BigDecimal.TWO] (Java 19) ist die Konstante 2; die Division des Einkommens durch die Anzahl der Anteile erfolgt mit 16 signifikanten Stellen ([MathContext.DECIMAL64]); und [intValue] liefert den ganzzahligen Anteil des Ergebnisses. Eine Stufe wird wie in Version 2 durch den Record [TaxBracket]dargestellt:
und die Berechnung wird durch die Schnittstelle [ITax] beschrieben, hier mit einem Javadoc-Kommentar dokumentiert:
Die neue Version speichert die Daten in einer Datei, sodass sich der Steuertarif ändern lässt, ohne das Programm neu zu kompilieren. Wir schreiben zwei neue, von [AbstractTax] abgeleitete Klassen:
- [FileTax] liest die Stufen aus einer Textdatei [TaxData.txt];
- [JsonTax] liest sie aus einer JSON-Datei namens [TaxData.json].
Die Textdatei [TaxData.txt] enthält pro Zeile eine Stufe im Format limit:coeffR:coeffN:
Zahlen in der Datei werden mit einem Dezimalpunkt geschrieben. Eine Datendatei darf nicht von der Sprache des lesenden Rechners abhängen: Eine Datei, die mit Dezimalkommas geschrieben und nach französischen Regeln interpretiert wird ([NumberFormat.getInstance(Locale.FRANCE)]), würde auf einem englischsprachigen Rechner abgelehnt oder, schlimmer, falsch interpretiert. Der Konstruktor [new BigDecimal(String)] erwartet wie [Double.parseDouble] stets einen Dezimalpunkt, unabhängig von der Sprache des Rechners. Dies ist auch die Konvention für JSON und die meisten Datenformate.
Die Datei [TaxData.json] enthält dieselben Daten in Form eines JSON-Arrays von Objekten:
5.9.2. Fehler
Die Verarbeitung dieser Dateien kann an einer fehlenden Datei, einer fehlerhaften Zeile, einer falschen Zahl usw. scheitern. Wir erstellen eine eigene Ausnahmeklasse, um diese Fehler zu melden, [TaxException]. Sie wird auch für andere Datenquellen verwendet werden (hier die JSON-Datei, später Datenbanken). Sie trägt einen Fehlercode:
Kommentare:
- Zeile 7: Die Klasse [TaxException] ist von der Klasse [RuntimeException] abgeleitet: Es ist eine ungeprüfte Ausnahme (Kapitel 4). Der Compiler verlangt vom Code, der ein Objekt [FileTax] oder [JsonTax] erzeugt, nicht, diese Ausnahme abzufangen; dieser Code fängt sie dort ab, wo er sie behandeln kann;
- Zeilen 10–11: Jede Ausnahme ist durch Vererbung von der Klasse [Throwable] serialisierbar. Eine serialisierbare Klasse sollte eine Versionsnummer [serialVersionUID] deklarieren, mit der geprüft wird, dass ein serialisiertes Objekt von derselben Version der Klasse deserialisiert wird; andernfalls gibt der Compiler bei Verwendung der Option [-Xlint:all] eine Warnung aus. Die Annotation [@Serial] (Java 14) zeigt an, dass das Feld Teil des Serialisierungsmechanismus ist;
- Zeile 14: der Fehlercode, der bei der Erzeugung der Ausnahme festgelegt wird;
- Zeilen 16–24: zwei Konstruktoren. Der erste erhält eine Fehlermeldung und einen Code; der zweite erhält zusätzlich die Ausnahme, die den Fehler verursacht hat (die Ursache), die über die Methode [getCause] zugänglich ist. Diese Form der Ausnahme mit einem ganzzahligen Code werden die folgenden Versionen der Anwendung verwenden.
Die möglichen Fehlercodes werden durch eine Aufzählung beschrieben:
Kommentare:
- Zeilen 7–12: mögliche Fehlercodes:
- [ACCESS]: Fehler beim Zugriff auf die Datendatei;
- [LINE]: Zeile, in der die drei erwarteten Felder fehlen, oder Datei, die keine Stufen enthält;
- [FIELD1], [FIELD2], [FIELD3]: Feld 1, 2 oder 3 einer Zeile ist fehlerhaft;
- [JSON]: Das JSON-Dokument ist fehlerhaft;
- Zeilen 15–23: Ein Java-enum ist eine Klasse; es kann Felder, einen (privaten) Konstruktor und Methoden besitzen. Jede Konstante wird mit ihrem ganzzahligen Wert in Klammern erzeugt;
- Zeilen 26–34: Manche Fehler können kombiniert auftreten: Alle drei Felder einer Zeile können fehlerhaft sein. Daher sind die Werte der Fehlercodes Zweierpotenzen: Jeder entspricht einem Bit der ganzen Zahl. Ein Fehler in den Feldern 2 und 3 ergibt den Code 8 | 16 = 24. Die statische Methode [decode] führt die umgekehrte Operation aus: Sie wandelt den ganzzahligen Wert in die Menge der Codes um, indem sie jedes Bit mit dem Operator [&] testet. Das Ergebnis ist ein
*[EnumSet]*, eine spezialisierte Menge für die Konstanten einer Aufzählung, die sie als Bits einer ganzen Zahl speichert: So behandelt man in Java Kombinationen von Optionen. Ihre Methode [toString] zeigt eine Kombination in der Form „[FIELD2, FIELD3]“ an.
5.9.3. Die Klasse FileTax
Die Klasse [FileTax] liefert die aus einer Textdatei gelesenen Segmente:
Erläuterungen:
- Zeile 13: Die Klasse [FileTax] ist von der Klasse [AbstractTax] abgeleitet, so wie es in Version 2 die Klasse [HardwiredTax] war;
- Zeilen 16–18: Zwei reguläre Ausdrücke, die einmalig kompiliert und als Konstanten gespeichert werden: das Trennzeichen der Felder einer Stufenzeile limit:coeffR:coeffN (das Zeichen [:], vor und nach dem beliebig viele Leerzeichen stehen dürfen) und eine positive Zahl oder null, bestehend aus Ziffern, denen optional ein Punkt und weitere Ziffern folgen;
- Zeilen 21–27: die gelesenen Segmente, geliefert von der Methode [getTaxBrackets], die die abstrakte Methode von [AbstractTax] implementiert;
- Zeile 29: Der Konstruktor erhält den Namen der Textdatei, die die Daten enthält. Seine Aufgabe ist es, das Array [taxBrackets] zu füllen;
- Zeile 32: der Dateiname ohne Pfad, der in Fehlermeldungen verwendet wird. Der Konstruktor kann nämlich einen vollständigen Pfad erhalten, den man dem Benutzer nicht anzeigen muss;
- Zeile 34: Das Lesen einer Textdatei erfolgt sequenziell: Die Anzahl der Zeilen ist erst bekannt, wenn die gesamte Datei gelesen wurde. Das Array kann daher nicht im Voraus dimensioniert werden; die Stufen werden vorübergehend in einer Liste gespeichert;
- Zeilen 35–38: Die Datei wird zeilenweise mit einem [BufferedReader] gelesen, der in einer [try]-Anweisung mit Ressourcen geöffnet wird;
- Zeilen 46–50: Die Zeile wird mit einem regulären Ausdruck in Felder zerlegt; sind es nicht drei Felder, wird sofort eine [TaxException] mit dem Code [LINE] ausgelöst. Die Datei wird in jedem Fall geschlossen: Die [try]-Anweisung mit Ressourcen schließt den [BufferedReader] unabhängig davon, wie der Block verlassen wird, ob normal oder durch eine Ausnahme;
- Zeilen 52–58: Validierung der drei Felder. Die Fehler werden in der Variablen [code] mit dem Operator [|=] gesammelt und anschließend gemeinsam gemeldet. Die Methode [matches] verlangt, dass das ganzzahlige Feld dem Muster [NUMBER] entspricht: kein Vorzeichen, keine Leerzeichen und kein Dezimalpunkt. Negative Zahlen werden somit abgelehnt, womit die Daten im selben Zug geprüft und validiert sind;
- Zeilen 60–61: Die nun validierten Felder werden in [BigDecimal] umgewandelt, mit Dezimalpunkt, unabhängig von der Sprache des Rechners;
- Zeilen 63–67: Dateizugriffsfehler ([IOException] und ihre Varianten, etwa [NoSuchFileException] bei einer fehlenden Datei, [AccessDeniedException] bei unzureichenden Berechtigungen oder [MalformedInputException] bei einer Datei, die nicht in UTF-8 vorliegt) werden in eine [TaxException] mit dem Code [ACCESS] verpackt, wobei die ursprüngliche Ausnahme zu deren Ursache wird. Die innerhalb der Schleife ausgelösten [TaxException]-Ausnahmen sind keine [IOException]-Ausnahmen: Sie werden von dieser [catch]-Klausel nicht abgefangen und verlassen den Konstruktor unverändert;
- Zeilen 69–74: Eine leere Datei wird abgelehnt; andernfalls wird die Liste in das Stufen-Array übertragen, was der Zweck des Konstruktors war.
Das Kapseln von Low-Level-Ausnahmen ([IOException]) in eine anwendungsspezifische Ausnahme ([TaxException]) ermöglicht es dem aufrufenden Code, unabhängig von der Datenquelle nur einen Ausnahmetyp zu behandeln: eine Textdatei, eine JSON-Datei und, später im Kurs, eine Datenbank. Aus diesem Grund ist [TaxException] auch ungeprüft (unchecked): Eine geprüfte Ausnahme müsste von jeder Methode deklariert werden, die sie durchläuft, was den aufrufenden Code an die Details der Datenquelle binden würde.
5.9.4. Die Klasse JsonTax
Die Klasse [JsonTax] liefert die aus einer JSON-Datei gelesenen Segmente:
Erläuterungen:
- Zeile 15: Ein einziger [JsonMapper], in einer Konstante gespeichert, dient für alle [JsonTax]-Objekte. Die JSON-Eigenschaften [limit], [coeffR] und [coeffN] tragen die Namen der Komponenten des Records [TaxBracket]: Eine Annotation ist nicht nötig;
- Zeilen 31–37: Lesen der Datei; ein Zugriffsfehler wird wie in [FileTax] behandelt;
- Zeile 41: Eine einzige Anweisung wandelt den JSON-Text in ein Array von Steuerstufen um. Jackson erzeugt jeden Record durch Aufruf seines Konstruktors und wandelt die JSON-Zahlen ohne Genauigkeitsverlust in [BigDecimal] um;
- Zeilen 42–46: Ein ungültiges Dokument führt zu einer [JacksonException], die in eine [TaxException] mit dem Code [JSON] verpackt wird. Die Meldung gibt die Fehlerstelle an, die mit [getLocation] ermittelt wird;
- Zeilen 48–56: Die Deserialisierung prüft das Format des Dokuments, nicht die Gültigkeit der Daten: Es bleibt zu prüfen, dass mindestens ein Segment vorhanden ist (das Dokument [null] oder [[]] ist ein gültiges JSON) und dass keine Werte negativ sind oder fehlen. Fehlt in einem JSON-Objekt eine Eigenschaft, erhält die entsprechende Komponente den Wert [null]. Die Operation [anyMatch] der Stream-API führt diese abschließende Prüfung in einer einzigen Anweisung durch, wobei [Arrays.stream(brackets)] den Stream der Array-Elemente liefert;
- Zeilen 61–63: die Methode, die einen Wert prüft.
Der Vergleich der beiden Klassen ist aufschlussreich: Mit einem strukturierten Datenformat und einer Bibliothek, die es versteht, erfordert das Parsen der Datei fast keinen Code.
5.9.5. Das Hauptprogramm
Das Maven-Projekt [TaxV3] hat die folgende Verzeichnisstruktur:
Die Datendateien liegen im Stammverzeichnis des Projekts, neben der Datei [pom.xml]: Dies ist das aktuelle Verzeichnis des Programms, wenn es mit dem Befehl [mvn exec:java] im Projektverzeichnis ausgeführt wird. Die Datei [pom.xml] entspricht der des Projekts [Files06] und unterscheidet sich nur in den Koordinaten und der Hauptklasse:
Die [groupId] [examples.tax] wird für alle Versionen der Beispielanwendung verwendet. Die Hauptklasse, die im Plugin [exec-maven-plugin] deklariert ist, lautet [tax.Main]:
Erläuterungen:
- Zeilen 7–11: der Hilfetext in einem Textblock, der in einer Konstante gespeichert ist;
- Zeile 15: Der Name der Datendatei wird als Argument übergeben; standardmäßig lautet er [TaxData.txt]. Mit Maven werden die Argumente des Programms über die Eigenschaft [exec.args] übergeben: [mvn exec:java -Dexec.args="TaxData.json"];
- Zeilen 21–25: Ein [switch] -Ausdruck (Kapitel 3) wählt anhand der Dateiendung, die mit [lastIndexOf] und [substring] aus dem Dateinamen extrahiert wird, die zu instanziierende Klasse aus. Die beiden Zweige liefern Objekte unterschiedlicher Typen, [JsonTax] und [FileTax], beide vom Typ [ITax]. Der Rest des Programms kennt nur die Schnittstelle [ITax] und weiß nicht, woher die Daten stammen;
- Zeilen 26–35: Das Erzeugen des Objekts kann eine [TaxException] auslösen, die angezeigt wird, bevor das Programm endet. Der Code wird in eine Menge von [ErrorCode]-Meldungen entschlüsselt, die im Klartext angezeigt werden; die ursprüngliche Ausnahme, falls vorhanden, wird mit ihrem Typ angegeben. Die [return]-Anweisung nach [System.exit] wird nie ausgeführt, aber der Compiler, der nicht weiß, dass [System.exit] die Kontrolle nicht zurückgibt, verlangt sie: Ohne sie würde die Variable [tax] in Zeile 73 nicht als initialisiert gelten;
- Zeilen 38–74: Die Dialogschleife ist die aus Version 2.
5.9.6. Ausführungen
Mit der Datei [TaxData.txt], dem Standard:
Die Werte der vorherigen Versionen bleiben erhalten: 4.282 Euro für ein Ehepaar mit 2 Kindern, 2.959 Euro mit 3 Kindern und 11.519 Euro für eine alleinstehende Person ohne Kinder, bei einem Jahresgehalt von 60.000 Euro. Fehlerhafte Eingaben werden wie in Version 2 gemeldet.
Mit der Datei [TaxData.json]:
Mit einer nicht vorhandenen Datei [xx.txt]:
Mit der folgenden Datei [TaxDataInvalid.txt], in der die dritte Zeile ein Dezimalkomma verwendet:
Die Felder 2 und 3 von Zeile 3 werden abgelehnt: Der Fehlercode ist die Kombination [[FIELD2, FIELD3]]. Feld 1 (14753), das keinen Dezimalteil hat, ist korrekt.
Mit der folgenden Datei [TaxDataInvalid.json], in der ein Koeffizient als Zeichenkette geschrieben ist:
Die Meldung von Jackson benennt den Fehler genau: Die Zeichenkette „0,068“ kann nicht in [BigDecimal] umgewandelt werden. Jackson akzeptiert eine Zeichenkette, wo eine Zahl erwartet wird, wenn sie eine gültige Zahl enthält („0.068“); abgelehnt wird das Dezimalkomma. Der Fehler liegt in Zeile 3 des Dokuments (Jackson nummeriert die Zeilen ab 1) und in Spalte 30, unmittelbar nach dem fehlerhaften Wert.
5.10. Fazit
In diesem Kapitel wurden die Java-Klassen vorgestellt, die in fast allen Programmen verwendet werden:
- die unveränderlichen Zeichenketten [String], die mit [equals] und nicht mit [==] verglichen werden, und [StringBuilder] zum stückweisen Aufbau; die Formate [String.format] und [formatted], die Textblöcke;
- Arrays und die Klasse [Arrays];
- die Collections [List], [Map], [Set], [Deque], und ihre Implementierungen [ArrayList], [HashMap], [LinkedHashMap], [TreeMap], [HashSet], [ArrayDeque], [PriorityQueue]; unveränderliche Collections ([List.of], [List.copyOf], [Collections.unmodifiableList]), die Sequenced Collections von Java 21 und Komparatoren ([Comparator]); die Collections aus Java 1.0 ([Vector], [Hashtable], [Stack]) sind veraltet;
- die Stream-API, ihre Zwischen- und Terminaloperationen, ihre Collectors und ihre verzögerte Auswertung;
- Textdateien ([Files], [Path], [BufferedReader], [BufferedWriter]), weiterhin in UTF-8, Binärdateien ([DataOutputStream], [DataInputStream], [RandomAccessFile]) und die JSON-Serialisierung mit Jackson, die die veraltete binäre Java-Serialisierung ersetzt;
- reguläre Ausdrücke, die einmalig kompiliert werden und bei der Verarbeitung externer Daten gegen übermäßig lange Suchvorgänge geschützt sind.
Die Beispielanwendung liest ihre Daten nun aus einer Textdatei oder aus JSON. Das folgende Kapitel gliedert sie in Schichtenum: Datenlesen, Steuerberechnung und Benutzerinteraktion werden zu unabhängigen Komponenten.