5. Häufig verwendete .NET-Klassen
Hier stellen wir einige häufig verwendete Klassen der .NET-Plattform vor: Zeichenketten, Arrays, Sammlungen, Dateien und reguläre Ausdrücke. Außerdem behandeln wir LINQ (Language Integrated Query), das der Kurs von 2008 ausgelassen hat, obwohl es seit C# 3 verfügbar war: Es ist heute die gebräuchlichste Art, Sammlungen in C# zu bearbeiten. Zuvor zeigen wir Ihnen, wie Sie Informationen zu den Tausenden verfügbaren Klassen finden. Diese Anleitung ist für jeden C#-Entwickler unverzichtbar, auch für erfahrene.
Die Beispiele dieses Kapitels – mit Ausnahme der Beispielanwendung am Ende – sind Single-File-Anwendungen , die mit [dotnet run file.cs] ausgeführt werden. Sie befinden sich im Ordner [05-classes-dotnet] des Kurscodes und laufen in der französischen Locale (fr-FR), mit Ausnahme der LINQ- und der Beispiele mit regulären Ausdrücken, die in der amerikanisch-englischen Locale (en-US) laufen.
5.1. Hilfe zu .NET-Klassen finden
Der Kurs von 2008 enthielt eine ausführliche Beschreibung der mit Visual Studio 2008 installierten MSDN-Hilfe samt Screenshots. Diese lokale Hilfe gibt es nicht mehr: Die .NET-Dokumentation ist heute online, kostenlos und wird mit jeder neuen Version aktualisiert.
5.1.1. Online-Dokumentation
Ausgangspunkt ist die Website learn.microsoft.com von Microsoft. Dort finden Sie:
- die Dokumentation der Sprache C#: https://learn.microsoft.com/en-us/dotnet/csharp/. Sie enthält einen Überblick über die Sprache, Tutorials, die Sprachreferenz (Schlüsselwörter, Operatoren, Anweisungen) und einen Abschnitt „Neuigkeiten“, der jede Version von C# beschreibt;
- die .NET-API-Referenz: https://learn.microsoft.com/en-us/dotnet/api/. Sie beschreibt, Namespace für Namespace, alle Klassen von .NET: ihre Konstruktoren, Eigenschaften und Methoden, mit Beispielen;
- den API-Browser auf derselben Seite: ein Suchfeld, in das Sie den Namen einer Klasse oder Methode eingeben können ([StringBuilder], [Regex.Match] …). Über eine Dropdown-Liste wählen Sie die .NET-Version aus (hier .NET 10).
Die Seite zu einer Klasse, etwa System.String, zeigt:
- den Namespace der Klasse und die Assembly, die sie enthält;
- ihre Deklaration, ihre Elternklasse und die Schnittstellen, die sie implementiert;
- eine Liste ihrer Konstruktoren, Eigenschaften und Methoden, jeweils mit einem Link zu einer Detailseite, die die verschiedenen Überladungen, Parameter, Rückgabewerte, möglichen Ausnahmen und oft ein Beispiel zeigt;
- Hinweise zur Verwendung.
Die Seiten sind auf Französisch (maschinelle Übersetzung) und auf Englisch (Originaltext, der manchmal präziser ist) verfügbar. Sie können zwischen beiden wechseln, indem Sie in der URL [en-us] durch [fr-fr] ersetzen. Eine Suche mit einer Suchmaschine über den vollständigen Namen der Klasse („System.Text.StringBuilder“) führt meist direkt zur richtigen Seite.
5.1.2. Hilfe im Editor
Der Code-Editor (Visual Studio, Visual Studio Code mit der Erweiterung C# Dev Kit, Rider) bietet sofortige Hilfe, ohne dass Sie den Code verlassen müssen:
- Autovervollständigung (IntelliSense): Nach der Eingabe von [aString.] schlägt der Editor eine Liste der Eigenschaften und Methoden des Objekts samt einer Kurzbeschreibung vor;
- Tooltips: Wenn Sie den Mauszeiger über den Namen einer Klasse, Methode oder Variablen bewegen, werden ihre Deklaration und eine Zusammenfassung ihrer Dokumentation angezeigt;
- Parameterhilfe: Wenn Sie die öffnende Klammer eines Aufrufs eingeben, zeigt der Editor die verschiedenen Überladungen der Methode und die Rolle jedes Parameters an;
- Gehe zu Definition (Taste F12): Zeigt die Deklaration der Klasse oder Methode an. Bei einer .NET-Klasse zeigt der Editor die aus der Assembly rekonstruierten öffentlichen Deklarationen samt ihren Dokumentationskommentaren an;
- In Visual Studio öffnet ein Druck auf die Taste F1 auf dem Namen einer Klasse oder Methode die entsprechende Seite der Online-Dokumentation.
Diese Dokumentationskommentare, die sichtbar sind, wenn Sie den Mauszeiger über ein Element bewegen, werden auch zur Erzeugung der Online-Referenz verwendet. Ähnliche Kommentare können Sie in Ihrem eigenen Code mit der Syntax [/// <summary> ... </summary>] schreiben, die über einer Klasse oder Methode steht: Der Editor zeigt sie auf dieselbe Weise an.
5.2. Zeichenketten
5.2.1. Die Klasse System.String
Der C#-Typ [string] ist ein Alias für die Klasse [System.String]. Sie hat zahlreiche Eigenschaften und Methoden. Hier sind einige davon:
Mitglied | Aufgabe |
[public int Length { get; }] | Anzahl der Zeichen der Zeichenkette |
[public char this[int index] { get; }] | Zeichen Nr. [index]: [aString[i]] |
[public bool StartsWith(string value)] | liefert [true] , wenn die Zeichenkette mit [value] beginnt |
[public bool EndsWith(string value)] | liefert [true] , wenn die Zeichenkette mit [value] endet |
[public bool Contains(string value)] | liefert [true] , wenn die Zeichenkette [value] enthält |
[public bool Equals(string? value)] | liefert [true] , wenn die Zeichenkette gleich [value] ist; entspricht [aString == value] |
[public int IndexOf(string value)] | das erste Vorkommen von [value] in der Zeichenkette oder -1. Eine weitere Überladung beginnt die Suche an der Position [startIndex] |
[public int IndexOf(char value)] | dasselbe für das Zeichen [value] |
[public int LastIndexOf(char value)] | wie [IndexOf] , liefert aber die letzte statt der ersten Position |
[public string Insert(int startIndex, string value)] | fügt die Zeichenkette [value] an der Position [startIndex] in die Zeichenkette ein |
[public static string Join(string separator, params string[] value)] | Klassenmethode: verkettet die Elemente von [value] und trennt sie durch [separator] |
[public string Replace(char oldChar, char newChar)] | liefert eine Kopie der Zeichenkette, in der das Zeichen [oldChar] durch [newChar] ersetzt wurde; eine überladene Methode ersetzt eine Zeichenkette durch eine andere |
[public string[] Split(params char[] separator)] | die Zeichenkette wird als Folge von Feldern behandelt, die durch die Zeichen in [separator] getrennt sind; das Ergebnis ist ein Array dieser Felder |
[public string Substring(int startIndex, int length)] | eine Teilzeichenkette der Länge [length] ab der Position [startIndex] |
[public string ToLower()], [public string ToUpper()] | wandelt die Zeichenkette in Klein- bzw. Großbuchstaben um |
[public string Trim()] | entfernt führende und nachgestellte Leerzeichen der Zeichenkette ([TrimStart], [TrimEnd]: nur auf einer Seite) |
Wichtig ist, dass eine Zeichenkette vom Typ [string] ist unveränderlich; sie kann nach ihrer Erzeugung nicht mehr geändert werden. Wenn eine Methode eine Zeichenkette liefert, unterscheidet sich diese von der Zeichenkette, auf die die Methode angewendet wurde. So liefert [s1.Trim()] die Zeichenkette [s2], und [s1] und [s2] sind zwei verschiedene Zeichenketten: [s1] hat sich nicht geändert.
Eine Zeichenkette [c] kann als schreibgeschütztes Array von Zeichen betrachtet werden:
- [c[i]] ist das i-te Zeichen von [c] (das erste Zeichen hat die Nummer 0);
- [c.Length] ist die Anzahl der Zeichen von [c].
Das Programm [strings-01.cs] sieht wie folgt aus:
Ergebnisse:
Kommentare:
- Zeile 5: Zeichen Nr. 10, also das 11. Zeichen der Zeichenkette;
- Zeilen 7, 9: Eine erfolglose Suche liefert -1;
- Zeile 10: die 7 Zeichen ab Position 4;
- Zeile 14: ein Einfügen an Position 9, vor dem Wort „flies“;
- Zeile 16: [Split] ohne Parameter zerlegt die Zeichenkette an Leerraumzeichen (Leerzeichen, Tabulator, Zeilenumbruch usw.). Der Kurs von 2008 verwendete [Split(null)], was auf dasselbe hinausläuft;
- Zeile 21: Die statische Methode [Join] bewirkt das Gegenteil von [Split];
- Zeile 23: Alle vorherigen Methoden lieferten neue Zeichenketten: [aString] blieb unverändert (Zeile 21 der Ergebnisse);
- Zeilen 27–29: eine lokale Funktion, wie in Kapitel 3.
5.2.2. Die Methoden Split und Join
Das Programm [strings-02.cs] vertieft die Zerlegung einer Zeichenkette in Felder:
Ergebnisse:
Kommentare:
- Zeile 4: Die Felder sind durch das Zeichen [:] getrennt. Zwei aufeinanderfolgende [:]-Zeichen oder ein einzelnes [:] am Ende der Zeichenkette begrenzen ein leeres Feld: Das ergibt 5 Felder, davon 2 leere (Zeilen 4 und 6 der Ergebnisse). [Join] stellt die ursprüngliche Zeichenkette wieder her;
- Die Methode [Split] hat zahlreiche Überladungen. Die Variante von 2008, [Split(char[] separator)], wird heute als [Split(params char[] separator)] geschrieben: Das Schlüsselwort [params] erlaubt es, die Trennzeichen einzeln anzugeben – [Split(':')] oder [Split(',', ';')] –, ohne ein Array zu erzeugen;
- Zeile 13: Die Aufzählung [StringSplitOptions] verändert die Zerlegung in Felder. [RemoveEmptyEntries] entfernt leere Felder;
- Zeile 18: [TrimEntries] (.NET 5) entfernt die Leerzeichen um jedes Feld. Die Trennzeichen werden hier als Collection-Ausdruck übergeben: [',', ';'];
- Zeile 23: Die beiden Optionen werden mit dem Operator [|] kombiniert. Die Leerzeichen werden vor der Prüfung auf leere Felder entfernt: Das Feld, das aus zwei Leerzeichen zwischen zwei Kommas besteht, wird entfernt;
- Zeile 28: Das Trennzeichen kann eine Zeichenkette aus mehreren Zeichen sein;
- Zeile 33: [Join] akzeptiert eine Sammlung von Elementen beliebigen Typs; jedes Element wird mit seiner Methode [ToString] in eine Zeichenkette umgewandelt.
5.2.3. Zeichenketten suchen und vergleichen
Der Vergleich von Zeichenketten ist subtiler, als es scheint: Soll zwischen Groß- und Kleinbuchstaben unterschieden werden? Wie ist „éclair“ im Verhältnis zu „essay“ einzuordnen? Das Programm [strings-03.cs] stellt die Such- und Vergleichsmethoden vor:
Ergebnisse:
Kommentare:
- Zeilen 5–8: [Contains], [StartsWith] und [EndsWith] führen standardmäßig einen exakten, zeichenweisen Vergleich durch: „LANGUAGE“ wird nicht gefunden;
- Zeilen 11–12: Ein Parameter vom Typ [StringComparison] legt den Vergleichsmodus fest. Die nützlichsten Werte sind:
- [Ordinal]: Vergleich der Zeichencodes;
- [OrdinalIgnoreCase]: wie oben, jedoch ohne Beachtung der Groß- und Kleinschreibung;
- [CurrentCulture], [CurrentCultureIgnoreCase]: Vergleich nach den Regeln der Sprache des Rechners;
- [InvariantCulture]: Vergleich nach rechnerunabhängigen Regeln;
- Zeile 16: Der Operator [] vergleicht wie die Methode [Equals] den Inhalt der Zeichenketten. Das ist ein wichtiger Unterschied zu Java, wo [] Referenzen vergleicht;
- Zeile 17: Die statische Form von [Equals] akzeptiert ebenfalls einen [StringComparison]. So prüft man richtig, ob über die Tastatur ein „yes“ in Groß- oder Kleinschreibung eingegeben wurde;
- Zeilen 21–22: [string.Compare] liefert eine negative Zahl, null oder eine positive Zahl, je nachdem, ob die erste Zeichenkette vor der zweiten steht, ihr gleicht oder nach ihr steht. Im Französischen steht „éclair“ vor „essay“ (der Buchstabe „é“ wird bei „e“ eingeordnet, Zeile 10 der Ergebnisse). Beim ordinalen Vergleich steht „éclair“ nach „essay“, weil der Code des ersten Zeichens „é“ (233) größer ist als der des Zeichens „e“ (101): Der ordinale Vergleich liefert hier die Differenz der beiden Codes, 132. Wir verwenden die kulturabhängige Reihenfolge, um Wörter zu sortieren, die für einen Benutzer bestimmt sind, und die ordinale Reihenfolge, um technische Bezeichner (Dateinamen, Schlüssel usw.) zu vergleichen;
- Zeilen 27–29: zwei statische Methoden, um eine Zeichenkette zu prüfen, die fehlt ([null]), leer ist oder nur Leerzeichen enthält;
- Zeile 32: [PadLeft] und [PadRight] füllen eine Zeichenkette auf eine bestimmte Länge auf; der Konstruktor [new string('-', 8)] wiederholt ein Zeichen.
5.2.4. Interpolation und Formate
Die Zeichenketteninterpolation [$"..."] (C# 6) wird seit Beginn dieses Kurses verwendet. Wie die Methode [string.Format] akzeptiert sie für jeden Ausdruck eine Breite und ein Format: [{expression,width:format}]. Das Programm [strings-04.cs] liefert dazu Beispiele sowie für die Raw-Zeichenketten von C# 11:
Ergebnisse:
Kommentare:
- Zeile 11: Eine positive Breite richtet den Wert rechtsbündig in einem Feld von 10 Zeichen aus; eine negative Breite richtet ihn linksbündig aus;
- Zeilen 12–14: Die gebräuchlichsten Formate:
Format | Bedeutung | Beispiel (fr-FR) |
[F2] | Festkommazahl mit 2 Nachkommastellen | 2345,68 |
[N2] | wie oben, mit Tausendertrennzeichen | 2 345,68 |
[C] | Geldbetrag für die aktuelle Kultur | 2 345,68 € |
[P2] | Prozentwert (der Wert wird mit 100 multipliziert) | 5,25 % |
[D5] | ganze Zahl mit mindestens 5 Stellen, mit Nullen aufgefüllt | 00045 |
[X] | hexadezimale ganze Zahl | 2D |
[dd/MM/yyyy], [HH:mm:ss] | Datum und Uhrzeit (MM: Monat, mm: Minuten) | 03/10/2026, 14:05:09 |
[dddd d MMMM yyyy] | Tag und Monat ausgeschrieben | samedi 3 octobre 2026 |
- Zahlen und Datumsangaben werden gemäß der aktuellen Ländereinstellung formatiert, hier fr-FR: Dezimalkomma, Leerzeichen als Tausendertrennzeichen, französische Tages- und Monatsnamen;
- Zeile 16: Ein bedingter Ausdruck innerhalb einer Interpolation muss in Klammern gesetzt werden, weil das Zeichen [:] dort ein Format einleiten würde;
- Zeile 19: Die Schreibweise [{0}], [{1}] … für [string.Format] ist die im Kurs von 2008 verwendete (und für [Console.WriteLine], das dieselben Parameter akzeptiert). Sie begegnet einem noch häufig; die Interpolation ist besser lesbar;
- Zeilen 24–26: Die Breiten ermöglichen es, Daten in Spalten anzuzeigen;
- Zeile 30: Eine wörtliche Zeichenkette [@"..."] behandelt [\] nicht als Escape-Zeichen. Das ist nützlich für Windows-Pfade und reguläre Ausdrücke;
- Zeilen 34–39: Eine Raw-Zeichenkette (C# 11) wird von mindestens drei Anführungszeichen begrenzt. Sie kann sich über mehrere Zeilen erstrecken und Anführungszeichen sowie [\] ohne Escape-Sequenz enthalten. Die Einrückung des schließenden Anführungszeichens wird von jeder Zeile entfernt: Der JSON-Text wird ohne die 4 Leerzeichen des Code-Randes angezeigt;
- Zeile 42: Eine Raw-Zeichenkette kann interpoliert werden. Mit [$$] wird ein interpolierter Ausdruck zwischen doppelten geschweiften Klammern geschrieben [{{name}}], und einfache geschweifte Klammern – die in einem Text wie JSON häufig vorkommen – bleiben gewöhnliche Zeichen.
5.2.5. Die Klasse System.Text.StringBuilder
Wir haben erwähnt, dass die Methoden der Klasse [String], die auf eine Zeichenkette [s1] wirken, eine andere Zeichenkette [s2] zurückgeben. Die Klasse [System.Text.StringBuilder] erlaubt es, eine Zeichenkette zu verändern, ohne für jede Operation eine neue Zeichenkette zu erzeugen. Das verbessert die Leistung, wenn eine Zeichenkette durch viele aufeinanderfolgende Anfügungen aufgebaut wird, da die Vielzahl kurzlebiger Zeichenketten vermieden wird.
Die Klasse unterstützt mehrere Konstruktoren:
Konstruktor | Funktion |
[StringBuilder()] | Standardkonstruktor |
[StringBuilder(string value)] | Erstellung und Initialisierung mit [value] |
[StringBuilder(string value, int capacity)] | Erstellung und Initialisierung mit [value], mit einer anfänglichen Kapazität von [capacity] Zeichen |
Ein [StringBuilder]-Objekt speichert seine Zeichen in einem Speicherbereich, dessen Größe – seine Kapazität – automatisch angepasst wird, wenn der Text wächst. Standardmäßig beträgt die anfängliche Kapazität 16 Zeichen. Der dritte Konstruktor erlaubt es, sie festzulegen. Das Programm [strings-05.cs] veranschaulicht dieses Konzept der Kapazität:
Ergebnisse:
Kommentare:
- Zeile 4: Erstellung eines [StringBuilder]-Objekts mit einer anfänglichen Kapazität von 16;
- Zeile 5: [Length] ist die aktuelle Anzahl der Zeichen; [Capacity] ist die Anzahl der Zeichen, die das Objekt aufnehmen kann, bevor es seinen Speicherbereich vergrößern muss;
- Zeile 8: [Append] fügt am Ende des Textes eine Zeichenkette an;
- Zeile 12: Erstellung eines Objekts [StringBuilder] mit einer anfänglichen Kapazität von 10.
Die Ergebnisse zeigen, dass sich die Kapazität verdoppelt, wenn sie nicht ausreicht: 16, 32, 64 (Zeilen 6 und 10 der Ergebnisse) sowie 10, 20, 40, 80 beim zweiten Objekt. Das sind dieselben Ergebnisse wie 2008. Wenn die ungefähre Größe des Textes im Voraus bekannt ist, vermeidet man durch ihre Festlegung bei der Erstellung aufeinanderfolgende Vergrößerungen.
Hier einige Methoden der Klasse:
Methode | Funktion |
[StringBuilder Append(string value)] | Fügt [value] am Ende des Textes an. Überladen, um die Typen [int], [double], [decimal], [char] … sowie eine interpolierte Zeichenkette zu akzeptieren |
[StringBuilder AppendLine()] | fügt einen Zeilenumbruch an (eine überladene Methode fügt eine Zeichenkette gefolgt von einem Zeilenumbruch an) |
[StringBuilder AppendJoin(string separator, params string[] values)] | fügt die Elemente von [values] getrennt durch [separator] an |
[StringBuilder Insert(int index, string value)] | fügt [value] an der Position [index] ein; überladen wie [Append] |
[StringBuilder Remove(int index, int length)] | löscht [length] Zeichen ab der Position [index] |
[StringBuilder Replace(string oldValue, string newValue)] | ersetzt [oldValue] durch [newValue]; eine überladene Variante ersetzt ein Zeichen |
[string ToString()] | wandelt den Text in eine Zeichenkette [string] um |
Das Programm [strings-06.cs] verwendet sie:
Ergebnisse:
Kommentare:
- Zeile 5: Die Änderungsmethoden geben das Objekt [StringBuilder] selbst zurück, sodass sie verkettet werden können. Verfolgen wir die Schritte: „test“ wird zu „testabCD“ ([Append]), dann zu „texyZTstabCD“ ([Insert] an Position 2), dann zu „xyZTstabCD“ ([Remove] der ersten 2 Zeichen) und schließlich zu „XYZTstabCD“ ([Replace]). [Console.WriteLine] zeigt das Objekt an, indem es seine Methode [ToString] aufruft;
- Zeilen 9–11: Aufbau eines mehrzeiligen Textes durch aufeinanderfolgende Anfügungen: Das ist die typische Verwendung von [StringBuilder];
- Zeile 17: [Append] akzeptiert eine interpolierte Zeichenkette einschließlich Breite und Format;
- Zeile 19: Der endgültige Text wird als Zeichenkette vom Typ [string] gewonnen.
Für einige wenige Verkettungen genügt der Operator [+] oder die Interpolation: Der Compiler optimiert sie. [StringBuilder] ist notwendig, wenn die Zahl der Anfügungen groß oder unbekannt ist, typischerweise in einer Schleife.
5.2.6. Sichten auf eine Zeichenkette: Span<char>
.NET Core 2.1 (2018) führte die Typen [Span<T>] und [ReadOnlySpan<T>] ein. Ein Objekt [ReadOnlySpan<char>] ist eine Sicht auf eine bestehende Zeichenfolge, etwa auf einen Teil einer Zeichenkette: Es enthält keine Kopie der Zeichen, sondern nur eine Möglichkeit, auf sie zuzugreifen. Das Herausschneiden eines Teils einer Zeichenkette über eine Sicht erzeugt daher keine neue Zeichenkette. Das Programm [strings-07.cs] vergleicht die beiden Arten, eine Zeile im Format „Nachname:Vorname:Alter“ zu zerlegen:
Ergebnisse:
Kommentare:
- Zeilen 7–8: Jeder Aufruf von [Substring] erzeugt eine neue Zeichenkette im Speicher, auch wenn sie, wie beim Alter, nur kurz verwendet wird;
- Zeile 12: [AsSpan] liefert eine Sicht auf die gesamte Zeichenkette;
- Zeilen 13–14: Die Bereiche [start..end] (C# 8), die in Kapitel 3 für Arrays eingeführt wurden, gelten auch für Sichten: Man erhält zwei neue Sichten, ohne zu kopieren;
- Zeile 16: Viele Methoden in .NET akzeptieren anstelle einer Zeichenkette eine Sicht ([Parse], [TryParse], [StartsWith], [Contains], [Equals] …);
- Zeile 21: Eine Zeichenkette wird nur dann aus einer Sicht erzeugt, wenn sie tatsächlich benötigt wird.
Sichten sind ein Optimierungswerkzeug, das innerhalb von .NET selbst intensiv genutzt wird: Das ist einer der Gründe, warum neuere Versionen deutlich schneller sind als das .NET Framework von 2008. Eine Sicht kann nur auf dem Ausführungsstapel existieren: Sie kann zum Beispiel nicht Feld einer Klasse sein. Für ein gewöhnliches Programm sind [string] und [Substring] vollkommen ausreichend: Sichten sollten nur in Code eingesetzt werden, der als leistungskritisch identifiziert wurde. Wir gehen nicht weiter darauf ein.
5.3. Arrays
5.3.1. Die Klasse Array
Arrays leiten sich von der Klasse [System.Array] ab. Diese Klasse stellt verschiedene Methoden zum Sortieren eines Arrays, zum Suchen eines Elements in einem Array, zum Ändern der Größe eines Arrays und mehr bereit. Wir stellen einige ihrer Eigenschaften und Methoden vor. Fast alle sind überladen, das heißt, sie existieren in verschiedenen Varianten. Jedes Array erbt sie.
Eigenschaften:
Eigenschaft | Funktion |
[public int Length { get; }] | Gesamtzahl der Elemente des Arrays, unabhängig von der Zahl der Dimensionen |
[public int Rank { get; }] | Anzahl der Dimensionen des Arrays |
Methoden:
Methode | Funktion |
[public static int BinarySearch<T>(T[] array, T value)] | Liefert die Position von [value] in [array], das sortiert sein muss; eine negative Zahl, wenn [value] fehlt |
[public static void Clear(Array array, int index, int length)] | setzt die [length] Elemente von [array] ab dem Index [index] auf ihre Standardwerte zurück: 0 für Zahlen, [false] für Boolesche Werte, [null] für Referenzen |
[public static void Copy(Array source, Array destination, int length)] | kopiert die ersten [length] Elemente von [source] nach [destination] |
[public static void Fill<T>(T[] array, T value)] | weist [value] allen Elementen von [array] zu |
[public int GetLength(int dimension)] | Anzahl der Elemente in der Dimension Nr. [dimension] des Arrays |
[public static int IndexOf<T>(T[] array, T value)] | liefert die Position von [value] in [array] oder -1, wenn [value] nicht gefunden wird; [LastIndexOf] liefert die letzte Position |
[public static void Resize<T>(ref T[]? array, int newSize)] | ändert die Größe von [array] auf [newSize] Elemente; bereits vorhandene Elemente bleiben erhalten |
[public static void Reverse(Array array)] | kehrt die Reihenfolge der Elemente in [array] um |
[public static void Sort<T>(T[] array)] | sortiert [array] nach der natürlichen Ordnung seiner Elemente; eine überladene Methode nimmt ein Objekt [IComparer<T>] entgegen, das die Reihenfolge festlegt (Kapitel 4) |
Das Programm [arrays-01.cs] veranschaulicht die Verwendung einiger Methoden der Klasse [Array]:
Kommentare:
- Zeilen 17–42: Die Methode [Input] liest die Elemente eines über die Tastatur eingegebenen Arrays ein. Da die Anzahl der Elemente nicht im Voraus bekannt ist, beginnt das Programm mit einem leeren Array (Zeile 20) und vergrößert es bei jeder neuen Eingabe um ein Element (Zeile 38). [Resize] erzeugt tatsächlich ein neues Array, kopiert die Elemente des alten hinein und speichert seine Referenz in der per [ref] übergebenen Variablen. Ein effizienterer Algorithmus würde den Speicherplatz in Gruppen von N Elementen reservieren. Ein Array ist nicht dafür gedacht, in der Größe verändert zu werden: Dieser Fall wird besser mit einer Liste [List<T>] behandelt, wie wir gleich sehen werden;
- Zeile 40: [^1] bezeichnet das letzte Element des Arrays (Indizierung vom Ende her, C# 8);
- Im Kurs von 2008 war [Input] eine Methode mit einem Parameter [out]; die moderne Version gibt das erstellte Array zurück, was natürlicher ist;
- Zeilen 56–78: Die Methode [Search] sucht im Array nach über die Tastatur eingegebenen Elementen. Bei einem unsortierten Array erfolgt eine lineare Suche mit [IndexOf] (Zeile 76), die die Elemente nacheinander untersucht. Bei einem sortierten Array erfolgt eine binäre Suche mit [BinarySearch] (Zeile 75), die den Suchbereich bei jedem Schritt halbiert: Sie findet ein Element unter einer Million in etwa zwanzig Vergleichen;
- Zeile 10: Das Array wird sortiert. Hier verwenden wir eine Variante von [Sort] mit nur einem Parameter: dem zu sortierenden Array. Die zum Vergleich der Array-Elemente verwendete Ordnungsrelation ist dann die für diese Elemente implizite: in diesem Fall die natürliche Ordnung der Zahlen;
- Zeilen 46–51: eine generische Methode, die ein Array von Elementen beliebigen Typs [T] anzeigt.
Ergebnisse:
Wenn das gesuchte Element nicht vorhanden ist, liefert [IndexOf] -1 und [BinarySearch] eine negative Zahl (Zeile 27): Das ist das Einerkomplement ([~i]) der Position, an der das Element eingefügt werden müsste, damit das Array sortiert bleibt. Hier ergibt [~(-3)] den Wert 2: Die Zahl 0 müsste an Position 2 eingefügt werden, zwischen -1.5 und 3.6. Achtung: [BinarySearch] auf einem unsortierten Array liefert ein bedeutungsloses Ergebnis.
5.3.2. Weitere Methoden der Klasse Array
Das Programm [arrays-02.cs] demonstriert weitere Methoden der Klasse [Array]:
Ergebnisse:
Kommentare:
- Zeile 6: [Reverse] kehrt die Reihenfolge der Elemente im Array selbst um;
- Zeile 10: Es werden nur 3 Elemente ab Position 1 sortiert: 20, 30, 10 werden zu 10, 20, 30;
- Zeile 15: kopiert die ersten 3 Elemente von [numbers] nach [copy], während die übrigen Elemente ihren Anfangswert 0 behalten;
- Zeilen 19–21: [Fill] füllt das Array; [Clear] setzt 2 Elemente ab Position 1 auf 0 zurück;
- Zeile 29: Die Zeichenketten werden gemäß der aktuellen Kultur in alphabetischer Reihenfolge sortiert;
- Zeile 34: Bei einem zweidimensionalen Array ist [Rank] gleich 2, [Length] ist die Gesamtzahl der Elemente, und [GetLength(i)] ist die Anzahl der Elemente in der Dimension i;
- Zeile 39: [string.Join] zeigt ein Array in einer einzigen Zeile an.
LINQ, auf das wir später eingehen, bietet weitere Möglichkeiten, die Elemente eines Arrays zu suchen, zu sortieren oder umzuwandeln.
5.4. Generische Collections
Neben Arrays gibt es verschiedene Klassen zum Speichern von Elementsammlungen. Generische Collections, die mit .NET 2.0 eingeführt wurden, befinden sich im Namespace [System.Collections.Generic], der zu den impliziten [using]-Namespaces gehört. Wir stellen zunächst zwei häufig verwendete Collections vor – die Liste und das Dictionary – und gehen dann kurz auf weitere ein.
Der Namespace [System.Collections] enthält die älteren, nicht generischen Versionen dieser Collections, die auf .NET 1.0 zurückgehen: [ArrayList] (eine Liste), [Hashtable] (ein Dictionary) … Der Kurs von 2008 enthielt noch [ArrayList]. Diese Klassen sind heute veraltet: Sie speichern Referenzen vom Typ [object], was erfordert, die gelesenen Elemente umzuwandeln und die Zahlen in Objekte zu verpacken (Boxing), mit entsprechendem Speicher- und Zeitaufwand. Generische Collections haben diese Nachteile nicht: Eine *[List<int>] speichert ihre ganzen Zahlen direkt in einem internen *[int[]] -Array, und der Compiler prüft den Typ der hinzugefügten Elemente. [ArrayList] und [Hashtable] sollten in neuem Code nicht mehr verwendet werden.
5.4.1. Die generische Klasse List<T>
Die Klasse [System.Collections.Generic.List<T>] ermöglicht es, Sammlungen von Objekten vom Typ [T] zu implementieren, deren Größe sich während der Programmausführung ändert. Ein Objekt vom Typ [List<T>] wird fast wie ein Array behandelt. So wird das Element i einer Liste [l] als [l[i]] notiert.
Bei einer Liste vom Typ [List<T>] , bei der [T] eine Klasse ist, speichert die Liste Referenzen auf Objekte vom Typ [T], wie ein Array von Objekten; ist [T] ein Werttyp ([int], [double], Struktur …), werden die Werte selbst in der Liste gespeichert.
Hier einige Eigenschaften und Methoden generischer Listen.
Eigenschaften:
Eigenschaft | Funktion |
[public int Count { get; }] | Anzahl der Elemente in der Liste |
[public int Capacity { get; set; }] | Anzahl der Elemente, die die Liste aufnehmen kann, bevor sie vergrößert wird. Diese Vergrößerung erfolgt automatisch. Dieses Konzept der Kapazität entspricht dem für die Klasse [StringBuilder] beschriebenen |
Methoden:
Methode | Funktion |
[public void Add(T item)] | fügt [item] am Ende der Liste hinzu |
[public void AddRange(IEnumerable<T> collection)] | fügt die Elemente von [collection] am Ende der Liste hinzu |
[public int BinarySearch(T item)] | liefert die Position von [item] in der sortierten Liste, falls vorhanden; andernfalls eine negative Zahl |
[public void Clear()] | entfernt alle Elemente aus der Liste |
[public bool Contains(T item)] | liefert [true] , wenn [item] in der Liste enthalten ist, andernfalls [false] |
[public List<T> GetRange(int index, int count)] | liefert eine neue Liste aus [count] Elementen ab der Position [index] |
[public int IndexOf(T item)] | liefert die Position von [item] in der Liste oder -1, wenn [item] nicht gefunden wird |
[public void Insert(int index, T item)] | fügt [item] an der Position [index] in die Liste ein |
[public bool Remove(T item)] | entfernt das erste Vorkommen von [item] aus der Liste; liefert [true] , wenn der Vorgang gelingt, [false] sonst |
[public void RemoveAt(int index)] | entfernt das Element Nr. [index] aus der Liste |
[public void Reverse()] | kehrt die Reihenfolge der Elemente in der Liste um |
[public void Sort()] | sortiert die Liste in natürlicher Reihenfolge; eine überladene Version nimmt einen [IComparer<T>] entgegen |
[public T[] ToArray()] | liefert die Elemente der Liste als Array |
Greifen wir das zuvor mit einem Array behandelte Beispiel noch einmal auf und verarbeiten es nun mit einem Objekt vom Typ [List<double>]. Da die Liste einem Array ähnelt, ändert sich der Code nur wenig. Das ist das Programm [collections-01.cs]:
Kommentare:
- Zeile 22: Die Liste wird leer erstellt. [new()] (C# 9) ist eine Kurzform von [new List<double>()]: Der Typ wird aus der Variablendeklaration abgeleitet;
- Zeile 40: Die Größenänderung muss nicht mehr behandelt werden; die Liste wächst automatisch;
- Zeile 6: die Anzahl der Elemente der Liste und ihre Kapazität;
- Zeilen 12, 75, 76: Die Methoden [Sort], [BinarySearch] und [IndexOf] sind nun Instanzmethoden der Liste, während die von [Array] statische Methoden sind;
- Zeilen 46–51: Die generische Methode [Display<T>] hat zwei Parameter:
- der erste ist ein auszugebender Text;
- der zweite ist ein Objekt, das die generische Schnittstelle [IEnumerable<T>] implementiert:
Die Struktur [foreach (T element in elements)] ist für jedes Objekt [elements] gültig, das die Schnittstelle [IEnumerable<T>] implementiert. Arrays und Listen implementieren diese Schnittstelle. Daher eignet sich die Methode [Display] sowohl zur Anzeige von Arrays als auch von Listen. Wir werden auf diese Schnittstelle zurückkommen, die das Herzstück von LINQ bildet.
Ergebnisse:
Die Ergebnisse sind dieselben wie beim Array. Die Kapazität der Liste beträgt hier 4 (Zeile 7): Von 0 ausgehend stieg sie beim ersten Hinzufügen auf 4; beim fünften Hinzufügen wäre sie auf 8 gestiegen, sie verdoppelt sich also wie die eines [StringBuilder].
5.4.2. Methoden von List<T> und Collection-Ausdrücke
Das Programm [collections-02.cs] verwendet die übrigen Methoden der Liste und die Collection-Ausdrücke von C# 12, denen wir bei den Arrays in Kapitel 3 bereits begegnet sind:
Ergebnisse:
Kommentare:
- Zeile 4: Ein Collection-Ausdruck [a, b, c] initialisiert eine Liste wie ein Array;
- Zeilen 8–10: drei Möglichkeiten, Elemente hinzuzufügen;
- Zeile 14: Das Element Nr. 0 ist les- und schreibbar; [cities[^1]] ist wie bei einem Array das letzte Element;
- Zeile 21: [Remove] liefert [true] , wenn das Element gefunden und entfernt wurde;
- Zeile 30: eine neue Liste aus 2 Elementen ab Position 1;
- Zeilen 34–35: Umwandlung einer Liste in ein Array und eines Arrays (oder einer beliebigen Sequenz) in eine Liste;
- Zeile 40: In einem Collection-Ausdruck fügt der Operator [..] (Spread) alle Elemente einer anderen Collection ein;
- Zeile 43: [] bezeichnet eine leere Collection des erwarteten Typs.
5.4.3. Die Klasse Dictionary<TKey,TValue>
Die Klasse [System.Collections.Generic.Dictionary<TKey,TValue>] dient zur Implementierung eines Dictionarys. Ein Dictionary lässt sich als zweispaltiges Array auffassen:
Schlüssel | Wert |
key1 | value1 |
key2 | value2 |
... | ... |
In der Klasse [Dictionary<TKey,TValue>] sind die Schlüssel vom Typ [TKey], und die Werte sind vom Typ [TValue]. Schlüssel sind eindeutig: Es kann nicht zwei gleiche Schlüssel geben. Ein solches Dictionary könnte so aussehen, wenn die Typen [TKey] und [TValue] Klassen bezeichneten:
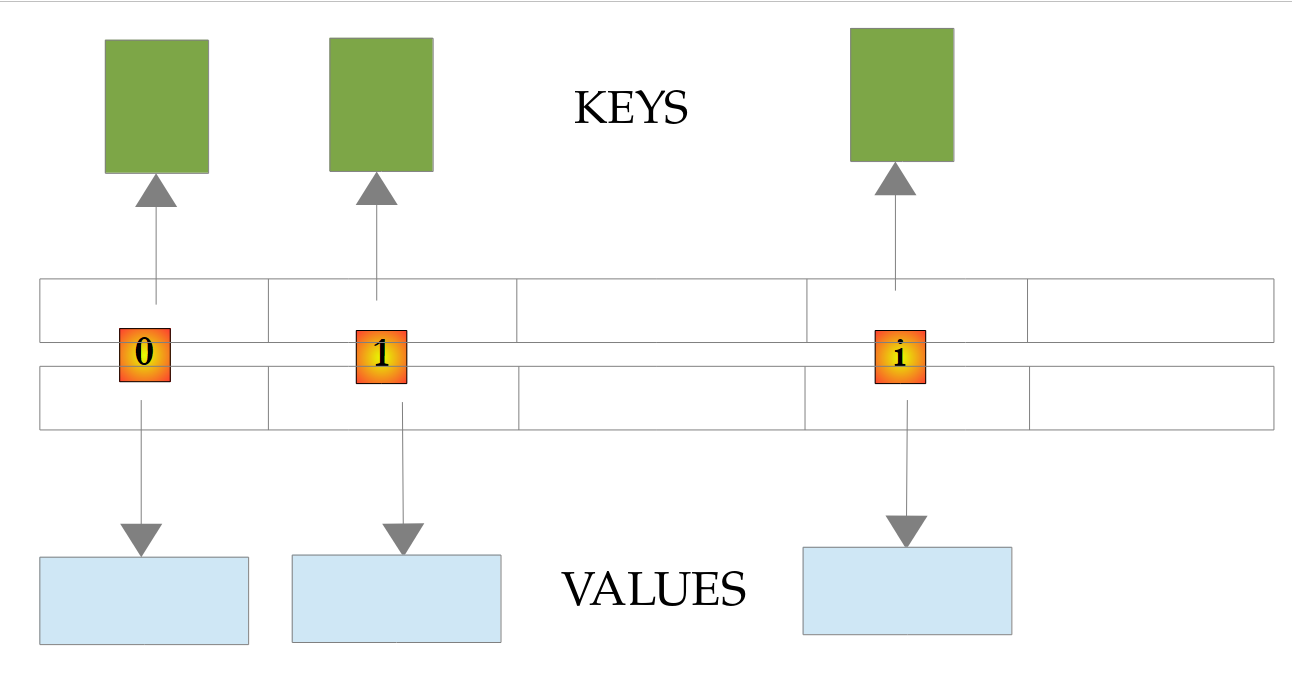
Der dem Schlüssel [c] in einem Dictionary [d] zugeordnete Wert wird mit der Schreibweise [d[c]] ermittelt. Dieser Wert ist les- und schreibbar. So können wir schreiben:
Beim Schreiben fügt [d[c] = v] das Paar (c, v) hinzu, wenn der Schlüssel [c] nicht existiert, und ersetzt andernfalls den [c] zugeordneten Wert. Beim Lesen löst, wenn der Schlüssel [c] im Dictionary [d] nicht existiert, die Schreibweise [d[c]] eine Ausnahme vom Typ [KeyNotFoundException] aus.
Die wichtigsten Methoden und Eigenschaften der Klasse [Dictionary<TKey,TValue>] sind die folgenden.
Eigenschaften:
Eigenschaft | Funktion |
[public int Count { get; }] | Anzahl der Einträge (Schlüssel, Wert) im Dictionary |
[public KeyCollection Keys { get; }] | Collection der Schlüssel des Dictionarys |
[public ValueCollection Values { get; }] | Collection der Werte des Dictionarys |
Methoden:
Methode | Funktion |
[public void Add(TKey key, TValue value)] | Fügt das Paar (Schlüssel, Wert) zum Dictionary hinzu; löst eine Ausnahme aus, wenn der Schlüssel bereits existiert |
[public bool TryAdd(TKey key, TValue value)] | Wie oben, liefert jedoch [false] , statt eine Ausnahme auszulösen |
[public void Clear()] | entfernt alle Paare aus dem Dictionary |
[public bool ContainsKey(TKey key)] | Liefert [true] , wenn [key] ein Schlüssel des Dictionarys ist, andernfalls [false] |
[public bool ContainsValue(TValue value)] | liefert [true] , wenn [value] ein Wert des Dictionarys ist, [false] sonst |
[public bool Remove(TKey key)] | entfernt das Schlüssel-Wert-Paar [key] aus dem Dictionary; liefert [true] , wenn der Vorgang gelingt, [false] sonst |
[public bool TryGetValue(TKey key, out TValue value)] | liefert [true] und setzt [value] auf den dem Schlüssel [key] zugeordneten Wert, falls dieser existiert; liefert andernfalls [false] , und [value] erhält den Standardwert des Typs [TValue] |
Betrachten wir das Beispielprogramm [collections-03.cs]:
Kommentare:
- Zeile 4: ein Array von Zeichenketten, das zur Initialisierung des Dictionarys <string,int> dient;
- Zeile 5: das Dictionary, das leer ist;
- Zeilen 6–9: seine Initialisierung mithilfe des Arrays von Zeichenketten;
- Zeile 12: die Anzahl der Einträge im Dictionary;
- Zeilen 14–16: die Schlüssel und Werte des Dictionarys. [dico.Keys] und [dico.Values] implementieren [IEnumerable<T>]: Die bereits bekannte Methode [Display] eignet sich dafür;
- Zeile 25: Löschen eines Eintrags des Dictionarys;
- Zeile 28: Ein Dictionary ist eine Sequenz von Paaren [KeyValuePair<TKey,TValue>], von denen jedes eine Eigenschaft [Key] und eine Eigenschaft [Value] hat. Seit .NET Core 2.0 wird ein solches Paar wie ein Tupel (Kapitel 3) in zwei Variablen zerlegt ;
- Zeilen 35–42: [Add] weist einen vorhandenen Schlüssel zurück, indem es eine Ausnahme auslöst; [TryAdd] liefert in diesem Fall [false] . Die Ausnahmemeldungen von .NET sind englisch: .NET 10 stellt keine Meldungen auf Französisch bereit;
- Zeile 46: Der Versuch, einen fehlenden Schlüssel zu lesen, löst eine Ausnahme vom Typ [KeyNotFoundException] aus;
- Zeile 63: Suche nach einem Schlüssel im Dictionary. [TryGetValue] liefert [true] , wenn der Schlüssel existiert. Der Kurs von 2008 ignorierte dieses Ergebnis und prüfte, ob der zurückgegebene Wert null war – eine Technik, die nur funktionierte, weil der Wert 0 nicht im Dictionary vorkam. Die Prüfung des zurückgegebenen Booleschen Wertes ist der richtige Weg.
Ergebnisse:
Die Schlüssel werden hier in der Reihenfolge aufgelistet, in der sie hinzugefügt wurden, doch das ist nicht garantiert: Ein *[Dictionary]* behält keinerlei Reihenfolge bei. Nach Löschungen kann ein neues Element den Platz eines gelöschten einnehmen. Wenn die Reihenfolge der Schlüssel wichtig ist, verwenden Sie ein *[SortedDictionary]*, das weiter unten gezeigt wird.
5.4.4. Weitere generische Collections
Der Namespace [System.Collections.Generic] enthält weitere Collections, die jeweils für einen bestimmten Zweck geeignet sind:
Klasse | Funktion |
[HashSet<T>] | eine Menge: keine Duplikate, keine Reihenfolge, sehr schneller Enthaltensein-Test; Mengenoperationen (Vereinigung, Schnitt, Differenz) |
[SortedSet<T>] | eine Menge, deren Elemente sortiert gehalten werden |
[Queue<T>] | eine Warteschlange: Die Elemente werden in der Reihenfolge ausgegeben, in der sie eingefügt wurden (FIFO, first in, first out) |
[Stack<T>] | ein Stapel: Das zuletzt hinzugefügte Element wird als Erstes entfernt (LIFO, last in, first out) |
[SortedDictionary<TKey,TValue>] | ein Dictionary, dessen Schlüssel sortiert gehalten werden |
[PriorityQueue<TElement,TPriority>] | eine Prioritätswarteschlange (.NET 6): Das entfernte Element ist das mit der niedrigsten Priorität |
[LinkedList<T>] | eine doppelt verkettete Liste: schnelles Einfügen und Löschen in der Mitte der Liste |
Das Programm [collections-04.cs] bietet einen kurzen Überblick:
Ergebnisse:
Kommentare:
- Zeile 4: Collection-Ausdrücke initialisieren auch eine Menge;
- Zeile 6: [Add] liefert [false] , wenn das Element bereits in der Menge enthalten ist, die dann unverändert bleibt;
- Zeilen 9–12: [IntersectWith] und [UnionWith] verändern die Menge; wir arbeiten daher mit einer Kopie von [languages]. Die Reihenfolge, in der die Elemente einer Menge angezeigt werden, ist bedeutungslos (Zeile 4);
- Die doppelten geschweiften Klammern [{{] und [}}] geben in einer interpolierten Zeichenkette eine einzelne geschweifte Klammer aus;
- Zeilen 16–20: [Enqueue] reiht ein Element in die Warteschlange ein, [Dequeue] entnimmt das älteste Element, [Peek] liest das Element, ohne es zu entnehmen;
- Zeilen 23–30: [Push] legt ein Element auf den Stapel, [Pop] entnimmt das jüngste Element. [Pop] löst bei einem leeren Stapel eine Ausnahme aus; [TryPop] liefert [false];
- Zeilen 33–40: ein Dictionary, das mit der Syntax [[key] = value] initialisiert wird; seine Schlüssel-Wert-Paare werden in der Reihenfolge der Schlüssel durchlaufen;
- Zeilen 43–49: Jedes Element wird mit einer Priorität in die Warteschlange eingereiht; Patienten verlassen sie in aufsteigender Reihenfolge der Priorität, unabhängig von der Reihenfolge ihrer Ankunft.
5.4.5. Schreibgeschützte Collections
Eine Klasse, die eine Collection verwaltet, muss diese oft nach außen bereitstellen, ohne dass sie verändert werden darf. .NET stellt hierfür schreibgeschützte Schnittstellen bereit: [IReadOnlyCollection<T>] (eine Eigenschaft [Count] und ein [foreach]), [IReadOnlyList<T>] (zusätzlich der indexbasierte Zugriff) und [IReadOnlyDictionary<TKey,TValue>]. Die Klassen [List<T>], [T[]], und [Dictionary<TKey,TValue>] implementieren sie. Das Programm [collections-05.cs] verwendet sie:
Ergebnisse:
Kommentare:
- Zeilen 37–47: Die Klasse [Classroom] verwaltet eine Liste von Schülern. Die Liste selbst ist privat; nur die Methode [Enroll] erlaubt es, sie zu verändern;
- Zeile 43: Die Eigenschaft [Students] wandelt die Liste in den Typ [IReadOnlyList<string>] um, der nur Lesezugriffe unterstützt: [students.Add("x")] würde einen Kompilierungsfehler verursachen;
- Zeile 12: Dieser Schutz ist jedoch nur oberflächlich: Das zurückgegebene Objekt ist die Liste selbst, und eine Typumwandlung verschafft Zugriff auf ihre Änderungsmethoden;
- Zeile 45: [AsReadOnly] verpackt die Liste in einen Container vom Typ [ReadOnlyCollection<T>]. Diesmal sind keine Änderungen möglich: Seine Änderungsmethoden, die von der Schnittstelle [IList<T>] vorgeschrieben werden, lösen eine Ausnahme vom Typ [NotSupportedException] aus (Zeile 5). Der Wrapper kopiert die Liste nicht: Er sieht die Änderungen, die die besitzende Klasse vornimmt (Zeile 6);
- Zeile 33: ein Dictionary, betrachtet über die Schnittstelle [IReadOnlyDictionary<TKey,TValue>].
Für Daten, die nach ihrer Erstellung nie mehr verändert werden dürfen, stellt der Namespace [System.Collections.Immutable] unveränderliche Collections bereit ([ImmutableList<T>], [ImmutableDictionary<TKey,TValue>] …), und [System.Collections.Frozen] bietet auf Lesezugriffe optimierte, eingefrorene Collections ([FrozenDictionary<TKey,TValue>], .NET 8). Wir gehen darauf nicht näher ein.
5.5. LINQ
Der Kurs von 2008 endete unmittelbar vor LINQ und führte dessen anonyme Typen ein, ohne sie tatsächlich zu verwenden. LINQ (Language Integrated Query, C# 3, 2007) ist eine Menge von Methoden, mit denen man eine Collection so abfragen kann, wie man eine Datenbank abfragt: filtern, sortieren, gruppieren, Summen berechnen und so weiter. Es lässt sich auf jede Collection anwenden, die die Schnittstelle [IEnumerable<T>] implementiert: Arrays, Listen, Dictionarys, Mengen, Zeilen einer Datei, Ergebnisse eines regulären Ausdrucks und, mit Entity Framework Core (Kapitel 11), Datenbanktabellen. Der Namespace [System.Linq] gehört zu den impliziten [using]-Namespaces.
5.5.1. Die Sequenzen IEnumerable<T> und Iteratoren
Eine Collection, die [IEnumerable<T>] implementiert, wird als Sequenz bezeichnet: Man kann sie mit [foreach] durchlaufen. Die Schnittstelle enthält nur eine Methode, [GetEnumerator], die einen Enumerator [IEnumerator<T>] zurückgibt: ein Objekt, das sich durch die Sequenz bewegt ([MoveNext]) und das aktuelle Element liefert ([Current]).
Eine Methode kann eine Sequenz erzeugen, ohne eine Collection aufzubauen: Das ist ein Iterator. Er gibt seine Elemente mit der Anweisung [yield return] einzeln zurück. Das Programm [linq-01.cs] liefert zwei Beispiele:
Ergebnisse:
Kommentare:
- Zeilen 39–48: Die Methode
[Evens]ist ein Iterator: Ihr Rückgabetyp ist*[IEnumerable<int>], und sie enthält die Anweisung[yield return](Zeile 46). Sie baut keine Liste auf: Bei jedem [yield return] gibt sie ein Element an den Code zurück, der sie durchläuft, und pausiert*; sie setzt bei der nächsten Anweisung fort, wenn das nächste Element angefordert wird; - Zeilen 5–7: Die Ergebnisse (Zeilen 3–12) zeigen, dass die Erzeugung eines Elements durch den Iterator und sein Verbrauch durch die Schleife [foreach] sich abwechseln;
- Zeilen 12–17: Was [foreach] tatsächlich tut: Es fordert von der Sequenz einen Enumerator an, ruft [MoveNext] so lange auf, wie diese Methode [true] liefert, und liest das aktuelle Element aus [Current]. Der Iterator wird am Ende durch die Anweisung [using] freigegeben (darauf kommen wir bei den Dateien zurück). Beachten Sie, dass der Aufruf von [Evens(4)] in Zeile 12 nichts bewirkt: Die Meldung „start of the iterator“ erscheint erst beim ersten Aufruf von [MoveNext];
- Zeilen 52–58: Ein Iterator kann eine unendliche Sequenz erzeugen; er berechnet nur die angeforderten Elemente. Die Schleife [foreach] entscheidet, wann abgebrochen wird (Zeile 25). Zeile 58 nutzt die Tupel aus Kapitel 3, um Werte zu vertauschen;
- Zeilen 34–35: Eine Zeichenkette ist eine Sequenz von Zeichen; eine Liste ist eine Sequenz ihrer Elemente. Die Liste wird hier mit der Syntax [new List<string> { ... }] Collection-Initialisierer (C# 3) erstellt, die in bestehendem Code häufig anzutreffen ist.
Dieser Mechanismus der Erzeugung bei Bedarf wird von allen Methoden von LINQ genutzt.
5.5.2. Filtern, Projizieren, Sortieren
Die folgenden Beispiele arbeiten mit einer kleinen Liste von Personen. Eine Person wird durch einen [record] (C# 9) Record dargestellt, der in Kapitel 4 eingeführt wurde: In einer einzigen Zeile erhalten wir eine Klasse mit einem Konstruktor, schreibgeschützten Eigenschaften, einer Methode [ToString], die die Eigenschaften anzeigt, und einem Gleichheitsoperator, der die Eigenschaftswerte vergleicht.
Das Programm [linq-02.cs] demonstriert die grundlegenden Methoden von LINQ:
Ergebnisse:
Kommentare:
- Zeilen 4–13: die Liste der Personen, initialisiert durch einen Collection-Ausdruck; [new(...)] erstellt ein Objekt des erwarteten Typs, hier [Person];
- Zeile 56: der Record [Person]. Eine Einzeldatei-Anwendung platziert ihre Typdeklarationen nach den Top-Level-Anweisungen;
- Zeile 16: Die Methode [Where] filtert die Sequenz: Sie behält nur die Elemente, die eine Bedingung erfüllen. Diese Bedingung wird ihr in Form einer anonymen Funktion [p => p.Age >= 18] übergeben, die man liest als „die Funktion, die einer Person p den Booleschen Wert p.Age >= 18 zuordnet“. Diese Schreibweise heißt Lambda-Ausdruck. [Where] ruft diese Funktion für jede Person auf. Lambdas werden in Kapitel 7 („Delegaten, Lambdas und Ereignisse“) ausführlich behandelt; vorerst genügt es, sie lesen zu können;
- Das Ergebnis von [Where] ist eine neue Sequenz, [IEnumerable<Person>]: die Liste [persons] bleibt unverändert. Das gilt für alle Methoden von LINQ;
- die Methode [Display] zeigt jede Person mit der für den Record erzeugten Methode [ToString] an: [Person { LastName = dupont, ... }];
- Zeile 20: Die Methode [Select] bildet jedes Element der Sequenz auf einen neuen Wert ab, hier eine Zeichenkette. Das Ergebnis ist eine Sequenz [IEnumerable<string>];
- Zeilen 24–27: Die Methoden von LINQ liefern Sequenzen, auf die weitere Methoden von LINQ angewendet werden können. Methoden werden oft einzeln pro Zeile geschrieben: Diese Aufrufkette liest sich von oben nach unten wie ein Rezept;
- Zeile 26: [OrderBy] sortiert die Sequenz nach dem Schlüssel, den die Lambda-Funktion liefert, hier dem Namen;
- Zeile 31: [OrderByDescending] sortiert absteigend; [ThenBy] (oder [ThenByDescending]) fügt ein sekundäres Kriterium hinzu, mit dem Elemente unterschieden werden, die nach dem ersten Kriterium gleich sind: Durand und Laurent, die beide 32 Jahre alt sind, werden nach dem Namen sortiert (Zeilen 23–24);
- Zeilen 35–38: dieselbe Abfrage wie [angersPeople] , geschrieben in der Abfragesyntax, die SQL ähnelt. Der Compiler übersetzt sie exakt in die Aufrufkette [Where(...).OrderBy(...).Select(...)]: Die beiden Schreibweisen sind gleichwertig. Die Abfragesyntax ist bei Joins und Gruppierungen besser lesbar; die Methodensyntax ist gebräuchlicher, und nur sie bietet Zugriff auf alle Methoden von LINQ ([Take], [Count], [First] …);
- Zeile 42: Eine Variante von [Select] übergibt der Lambda-Funktion das Element und seine Position in der Sequenz.
5.5.3. Quantoren, Aggregate, Elementauswahl
Das Programm [linq-03.cs] enthält Methoden, die einen einzelnen Wert zurückgeben, und Methoden, die einen Teil der Sequenz auswählen:
Ergebnisse:
Kommentare:
- Zeile 15: [Any] liefert [true] , wenn mindestens ein Element die Bedingung erfüllt, und [All] , wenn alle sie erfüllen. Ohne Parameter zeigt [Any] an, ob die Sequenz nicht leer ist;
- Zeilen 18–20: Die Aggregate [Count], [Sum], [Average], [Min], [Max] berechnen einen Wert auf Grundlage der gesamten Sequenz. [Count] akzeptiert eine Bedingung (eine Liste hat auch eine Eigenschaft [Count], der man ohne Bedingung gegenüber der Methode den Vorzug gibt); [Sum], [Average], [Min] und [Max] akzeptieren eine Lambda-Funktion, die den für jedes Element zu berücksichtigenden Wert angibt;
- Zeile 22: [MinBy] und [MaxBy] (.NET 6) liefern das Element (hier die Person), für das der Schlüssel minimal oder maximal ist, nicht den Schlüsselwert selbst. Bei einer leeren Sequenz von Objekten (Referenztyp) liefern sie [null], daher der Operator [?.];
- Zeile 25: [First] liefert das erste Element der Sequenz oder das erste, das eine Bedingung erfüllt; [Last] liefert das letzte;
- Zeile 26: Wenn kein Element passt, löst [First] eine Ausnahme aus (Zeile 11 der Ergebnisse), während [FirstOrDefault] den Standardwert des Typs liefert, hier [null];
- Zeile 28: [Single] liefert das einzige Element, das die Bedingung erfüllt, und löst eine Ausnahme aus, wenn es null oder mehrere solcher Elemente gibt (Zeile 10). Das verwendet man, wenn Eindeutigkeit eine Regel der Daten ist, etwa bei der Suche nach einem Element anhand seines Schlüssels. [SingleOrDefault] liefert den Standardwert, wenn es kein Element gibt;
- Zeile 32: Das Ergebnis des Aufrufs wird nicht verwendet; es wird dem ignorierten Element [_] (C# 7) zugewiesen, um dies zu kennzeichnen;
- Zeile 49: [Distinct] entfernt Duplikate; [DistinctBy] (.NET 6) behält das erste Element je Schlüsselwert;
- Zeilen 57–58: [Take(n)] behält die ersten n Elemente, [Skip(n)] überspringt sie. Kombiniert extrahieren sie eine „Seite“ von Ergebnissen. [TakeWhile] behält die Elemente, solange eine Bedingung erfüllt ist, und stoppt beim ersten Element, das sie nicht erfüllt;
- Zeile 62: [Chunk] (.NET 6) teilt die Sequenz in Arrays von 3 Elementen auf, von denen das letzte kürzer sein kann;
- Zeile 64: Die Variable [page] wird nach ihrer Verwendung in der Interpolation inkrementiert.
5.5.4. Anonyme Typen, Gruppierungen, Joins
Das Programm [linq-04.cs] führt anonyme Typen und komplexere Operationen ein:
Ergebnisse:
Kommentare:
- Zeile 22: ein anonymer Typ (C# 3): Der Ausdruck [new { LastName = ..., Age = ... }] erzeugt ein Objekt, dessen namenlose Klasse vom Compiler mit zwei schreibgeschützten Eigenschaften generiert wird, [LastName] und [Age]. Da dieser Typ keinen Namen hat, muss die Variable als [var] deklariert werden. Der Compiler kennt diesen Typ jedoch genau: [p1.LastName] wird zur Kompilierzeit überprüft, und der Editor schlägt die Eigenschaften von [p1] in der automatischen Vervollständigung vor;
- Zeile 25: die Hauptverwendung anonymer Typen: in einem [Select] nur die nützlichen Daten behalten, ohne dafür eine Klasse deklarieren zu müssen. [p.LastName] ist eine Abkürzung für [LastName = p.LastName];
- Zeile 33: [GroupBy] gruppiert Elemente mit demselben Schlüssel. Das Ergebnis ist eine Sequenz von Gruppen [IGrouping<TKey,TElement>]: Jede Gruppe hat eine Eigenschaft [Key], den gemeinsamen Wert des Schlüssels, und ist selbst die Sequenz der Elemente der Gruppe, auf die wir [Count], [Average], [Select] … anwenden können (Zeile 36);
- Zeilen 41–44: [Join] ordnet jeder Person die Stadt mit demselben Namen zu. Ihre Parameter sind die zweite Sequenz, der Join-Schlüssel auf jeder Seite und eine Lambda-Funktion, die das Ergebnis aus einem Paar (Person, Stadt) erzeugt. Wie ein SQL-Join [Join] behält es nur die zusammenpassenden Paare: Laurent, der in Lyon wohnt – das in der Liste der Städte fehlt –, erscheint nicht, ebenso wenig Brest, das keine Einwohner hat;
- Zeilen 50–53: der Join in der Abfragesyntax, die besser lesbar ist: [join ... in ... on ... equals ...]. Hinzu kommt ein Filter, [where]. Die Abfragesyntax enthält außerdem eine Klausel [group ... by ...] für Gruppierungen;
- Zeile 57: [ToList] (und [ToArray]) führt die Abfrage aus und speichert ihre Ergebnisse in einer Liste (einem Array);
- Zeile 58: [ToDictionary] erstellt ein Dictionary: Die erste Lambda-Funktion liefert den Schlüssel jedes Elements, die zweite seinen Wert. Ein doppelter Schlüssel löst eine Ausnahme aus;
- Zeile 63: [CountBy] (.NET 9) zählt die Elemente je Schlüsselwert. Es liefert eine Sequenz von Paaren [KeyValuePair<string,int>]. Das ist eine Kurzform für [GroupBy(p => p.City).Select(g => (g.Key, g.Count()))];
- Zeile 68: [AggregateBy] (.NET 9) akkumuliert einen Wert je Schlüsselwert: Ausgehend von 0 wird für jede Person ihr Alter zur Summe ihrer Stadt addiert. Die zurückgegebenen Tupel werden in der Schleife [foreach] zerlegt;
- Zeile 73: [Index] (.NET 9) ordnet jedem Element seine Position in der Sequenz zu, in Form eines Tupels (Position, Element).
5.5.5. Verzögerte Ausführung
Eine LINQ-Abfrage wird nicht ausgeführt, wenn sie geschrieben wird, sondern wenn ihr Ergebnis durchlaufen wird: Das ist die verzögerte Ausführung. Das Programm [linq-05.cs] demonstriert dies anhand von Lambda-Funktionen, die anzeigen, was sie tun:
Ergebnisse:
Kommentare:
- Zeilen 7–16: Eine Abfrage, die gerade Zahlen auswählt und dann deren Quadrate berechnet. Die Lambda-Funktionen sind hier mit einem Rumpf in geschweiften Klammern geschrieben, der eine Meldung anzeigt, bevor er seinen Wert mit [return] zurückgibt;
- Zeile 3 der Ergebnisse: Nachdem die Abfrage definiert wurde, wurde nichts angezeigt: Weder [Where] noch [Select] hat bisher ein einziges Element untersucht. [evenSquares] enthält keine Ergebnisse, sondern eine Beschreibung einer Berechnung;
- Zeilen 4–16: Die Abfrage läuft während der Schleife [foreach] Element für Element: Jede Zahl durchläuft [Where], dann, wenn sie gerade ist, [Select] und gelangt anschließend in die Schleife, bevor die nächste Zahl untersucht wird. Es handelt sich um Iteratoren wie [Evens] in [linq-01.cs];
- Zeilen 28–31: Die Abfrage [large] wird bei jedem Durchlauf neu ausgewertet: Sie berücksichtigt die Zahl 10, die nach ihrer Definition zur Liste hinzugefügt wurde;
- Zeile 34: [ToList] führt die Abfrage sofort aus und speichert ihre Ergebnisse: [snapshot] ist eine Liste, die das Hinzufügen von 20 (Zeile 19) nicht sieht;
- Zeile 39: Methoden, die einen einzelnen Wert zurückgeben ([Count], [Sum], [First], [Any] …), durchlaufen die Sequenz ebenfalls sofort;
- Zeilen 45–49: [First] beendet die Iteration, sobald es ein Element findet: Die auf 3 folgenden Zahlen werden nie untersucht.
Die verzögerte Ausführung hat zwei praktische Folgen:
- Eine Abfrage, die mehrfach durchlaufen wird, wird mehrfach ausgeführt. Wenn ihre Berechnung aufwendig ist oder ein feststehendes Ergebnis gewünscht wird, wandelt man sie einmalig mit [ToList] oder [ToArray] um;
- Abfragen lassen sich ohne Kosten zusammensetzen: Die Verkettung von [Where], [Select] und [Take] erzeugt keine Zwischen-Collection, und es werden nur die notwendigen Elemente berechnet.
Wir werden LINQ im gesamten Kurs begegnen, und in Kapitel 7 werden wir sehen, wie seine Methoden aufgebaut sind.
5.6. Textdateien
Die Klassen zum Lesen und Schreiben von Dateien befinden sich im Namespace [System.IO], der zu den impliziten [using]-Namespaces gehört.
5.6.1. Die Klasse StreamReader
Die Klasse [System.IO.StreamReader] erlaubt es, den Inhalt einer Textdatei zu lesen. Sie kann tatsächlich auch Datenströme verarbeiten, die keine Dateien sind (zum Beispiel eine Netzwerkverbindung). Hier einige ihrer Eigenschaften und Methoden.
Konstruktoren:
Konstruktor | Funktion |
[public StreamReader(string path)] | Erstellt einen Lesestrom für die Datei am Pfad [path]. Der Inhalt der Datei kann unterschiedlich kodiert sein; standardmäßig wird die UTF-8-Kodierung verwendet. Eine andere Überladung erlaubt es, die Kodierung anzugeben: [new StreamReader(path, Encoding.Latin1)] |
Eigenschaften:
Eigenschaft | Funktion |
[public bool EndOfStream { get; }] | [true] , wenn der Datenstrom vollständig gelesen wurde |
Methoden:
Methode | Funktion |
[public void Dispose()] | Schließt den Datenstrom und gibt die für seine Verwaltung reservierten Ressourcen frei. Das muss nach der Verarbeitung des Datenstroms geschehen, was die Anweisung [using] übernimmt. [Close] tut dasselbe |
[public int Peek()] | liefert das nächste Zeichen des Datenstroms, ohne es zu verbrauchen; -1 am Ende des Datenstroms |
[public int Read()] | liefert das nächste Zeichen des Datenstroms und rückt um ein Zeichen vor; -1 am Ende des Datenstroms |
[public string? ReadLine()] | liefert die nächste Zeile des Datenstroms ohne das Zeilenende-Zeichen oder [null] am Ende des Datenstroms |
[public string ReadToEnd()] | liefert den Rest des Datenstroms oder "", wenn das Ende des Datenstroms erreicht ist |
Das Programm [files-01.cs] lautet wie folgt:
Kommentare:
- Zeile 4: zeigt den Namen des aktuellen Verzeichnisses an, also dessen, aus dem der Befehl [dotnet run] gestartet wurde. Mit [Path.GetFileName] wird nur das letzte Element des Pfades angezeigt, um die Ergebnisse nicht mit einem vollständigen Pfad zu überladen;
- Zeile 6: Die gelesene Datei ist [infos.txt] oder die als Argument übergebene. Da es sich um einen relativen Pfad handelt, wird sie im aktuellen Ordner gesucht;
- Zeile 11: Die Struktur [using (stream = ...) { ... }] stellt sicher, dass der Datenstrom am Ende des Blocks geschlossen wird, selbst wenn im Block eine Ausnahme auftritt. Dadurch entfällt der explizite Aufruf der Methode zum Schließen. Sie gilt für jedes Objekt, das die Schnittstelle [IDisposable] implementiert – also jedes Objekt mit einer Methode [Dispose], die Ressourcen freigibt (Datei, Netzwerkverbindung, Datenbankverbindung usw.);
- Zeilen 15–17: Die Datei wird Zeile für Zeile gelesen. Die Zuweisung [line = stream.ReadLine()] ist ein Ausdruck, dessen Wert der von [line] ist: Er wird mit [null] verglichen, was das Dateiende anzeigt. Die Variable [line] hat den Typ [string?]: [ReadLine] kann den Wert [null] zugewiesen bekommen;
- Zeile 23: eine
using-Deklaration (C# 8). Es gibt keinen Block mehr: Die Variable[stream2]wird am Ende des Blocks freigegeben, der ihre Deklaration enthält, hier der Block*[try]*. Diese knappere Syntax ist heute die gebräuchlichste; - Zeile 24: Die Datei wird in einem Zug gelesen;
- Zeilen 27–32: Ein-/Ausgabefehler werden durch Ausnahmen signalisiert, die von
[IOException]*abgeleitet sind.*[FileNotFoundException]*ist eine solche Ausnahme; sie wird daher zuerst abgefangen. Ihre Eigenschaft*[FileName]enthält den vollständigen Pfad der gesuchten Datei.
Die Datei [infos.txt] lautet wie folgt:
Sie befindet sich im Ordner [05-classes-dotnet], aus dem das Programm ausgeführt wird:
Mit einer nicht vorhandenen Datei:
Den aktuellen Ordner zum Auffinden von Datendateien zu wählen, ist der natürliche Ansatz für eine Einzeldatei-Anwendung, die aus ihrem eigenen Ordner ausgeführt wird. Bei einem Projekt befindet sich die ausführbare Datei in einem Unterordner namens [bin/Debug/net10.0] innerhalb des Projekts: Wir werden in der Beispielanwendung sehen, wie man die Datendateien dorthin kopiert und wie man sie findet.
5.6.2. Die Klasse StreamWriter
Die Klasse [System.IO.StreamWriter] erlaubt es, in eine Textdatei zu schreiben. Wie die Klasse [StreamReader] kann sie tatsächlich auch Datenströme verarbeiten, die keine Dateien sind. Hier einige ihrer Eigenschaften und Methoden.
Konstruktoren:
Konstruktor | Funktion |
[public StreamWriter(string path)] | erstellt einen Schreibstrom zur Datei am Pfad [path]. Die Datei wird erstellt oder überschrieben, falls sie existiert. Standardmäßig wird der Text in UTF-8 ohne BOM kodiert (siehe unten) |
[public StreamWriter(string path, bool append)] | Wenn [append] gleich [true] ist, werden die Ausgaben am Ende der bestehenden Datei angehängt |
Eigenschaften:
Eigenschaft | Funktion |
[public bool AutoFlush { get; set; }] | legt den Schreibmodus für die Datei fest. Wenn [AutoFlush] gleich [false] ist (Standardwert), erfolgt das Schreiben in den Datenstrom nicht sofort: Der Text wird zunächst in einen Puffer geschrieben und dann in die Datei, wenn der Puffer voll ist, wenn er mit der Methode [Flush] ausdrücklich geleert wird oder wenn der Datenstrom geschlossen wird. Das ist der effizienteste Modus für Dateien, da er die Plattenzugriffe begrenzt. Er ist nicht für alle Datenströme geeignet, insbesondere nicht für Netzwerkdatenströme: In einem Dialog zwischen zwei Partnern muss das, was der eine schreibt, vom anderen sofort gelesen werden können, und der Schreibstrom muss im Modus [AutoFlush=true] sein |
[public string NewLine { get; set; }] | das von [WriteLine] geschriebene Zeilenende-Zeichen. Standardmäßig ist es das Zeilenende-Zeichen des Systems: "\r\n" unter Windows, "\n" unter Linux und macOS |
[public Encoding Encoding { get; }] | die verwendete Kodierung |
Methoden:
Methode | Funktion |
[public void Dispose()] | Schließt den Datenstrom, nachdem der Inhalt des Puffers in die Datei geschrieben wurde. Muss nach der Verarbeitung des Datenstroms erfolgen; [Close] führt dieselbe Aktion aus |
[public void Flush()] | schreibt den Inhalt des Puffers in die Datei, ohne zu warten, bis er voll ist |
[public void Write(T value)] | schreibt [value] in die mit dem Datenstrom verbundene Datei. Hier ist [T] kein generischer Typ, sondern symbolisiert, dass die Methode [Write] verschiedene Parametertypen akzeptiert ([string], [int], [object] …) |
[public void WriteLine(T value)] | Wie [Write] , jedoch mit angefügtem Zeilenende-Zeichen ([NewLine]) |
Das Programm [files-02.cs] lautet wie folgt:
Ergebnisse:
Kommentare:
- Zeile 6: Wir verwenden erneut die Anweisung [using], damit wir den Datenstrom nicht ausdrücklich schließen müssen. Das Schließen erfolgt automatisch am Ende des Blocks (schließende geschweifte Klammer in Zeile 21). Dieses Schließen schreibt den im Puffer verbliebenen Text in die Datei; ohne es könnte die Datei unvollständig bleiben;
- Zeile 19: schreibt eine Zeile in die Textdatei;
- Zeile 24: Die Klasse [FileInfo] liefert Informationen über eine Datei, hier ihre Größe in Bytes. Die 18 Bytes setzen sich wie folgt zusammen: 16 Zeichen plus zwei einbytige Zeilenumbrüche ("\n" unter Linux, wo der Code ausgeführt wurde; unter Windows würde jeder Zeilenumbruch "\r\n" 2 Bytes belegen);
- Zeile 28: Warum ein [try / catch]? Wir könnten einen Dateinamen in der Form [dir1/dir2/file] mit einem Verzeichnis [dir1/dir2] angeben, das nicht existiert, sodass die Datei nicht erstellt werden kann. Es würde dann eine Ausnahme [DirectoryNotFoundException] ausgelöst, die von [IOException] abgeleitet ist. Es gibt weitere mögliche Ausnahmefälle (Datenträger voll, unzureichende Berechtigungen usw.).
5.6.3. Die Klassen File, Path und Directory
Für häufige Operationen erspart die statische Klasse [File] den Umgang mit Datenströmen: Eine einzige Methode öffnet die Datei, liest oder schreibt sie vollständig und schließt sie dann. Die statischen Klassen [Path] und [Directory] verarbeiten Pfade beziehungsweise Verzeichnisse.
Methode | Funktion |
[File.ReadAllText(path)] | liefert den Inhalt der Datei als Zeichenkette |
[File.ReadAllLines(path)] | Liefert die Zeilen der Datei in einem Array [string[]] |
[File.ReadLines(path)] | liefert die Zeilen der Datei als [IEnumerable<string>]-Sequenz, die bei Bedarf gelesen wird |
[File.WriteAllText(path, contents)] | erstellt die Datei (oder überschreibt sie) und schreibt [contents] hinein; [WriteAllLines] schreibt eine Collection von Zeilen |
[File.AppendAllText(path, contents)], [File.AppendAllLines(path, lines)] | fügt Text – Zeilen – am Ende der Datei an (die erstellt wird, falls sie nicht existiert) |
[File.ReadAllBytes(path)], [File.WriteAllBytes(path, bytes)] | liest und schreibt die Datei als Byte-Array |
[File.Exists(path)], [File.Delete(path)], [File.Copy(source, dest)], [File.Move(source, dest)] | prüft, ob eine Datei existiert, löscht, kopiert oder verschiebt sie |
[Path.Combine(p1, p2, ...)] | erstellt einen Pfad aus seinen Elementen unter Verwendung des Systemtrennzeichens |
[Path.GetFileName(path)], [Path.GetExtension(path)], [Path.GetDirectoryName(path)] | extrahiert aus einem Pfad den Dateinamen, die Dateierweiterung und den Ordner |
[Directory.CreateDirectory(path)] | erstellt den Ordner und seine übergeordneten Ordner, falls sie nicht existieren |
[Directory.GetFiles(path, pattern)], [Directory.EnumerateFiles(path, pattern)] | Dateien im Ordner, deren Namen zum Muster passen ([*.txt] …), in einem Array oder einer Sequenz |
[Directory.Exists(path)], [Directory.Delete(path, recursive)] | prüft, ob ein Ordner existiert, und löscht ihn (samt Inhalt, wenn [recursive] gleich [true] ist) |
Das Programm [files-03.cs] verwendet sie:
Ergebnisse:
Kommentare:
- Zeile 7: [Path.Combine] verwendet das Pfadtrennzeichen des Systems. Die Übungen des Kurses wurden unter Linux ausgeführt: Der resultierende Pfad lautet [data/cities.txt]; unter Windows wäre er [data\cities.txt]. Pfade mit [Path.Combine] statt durch Verkettung von Zeichenketten zu erstellen, macht den Code portabel;
- Zeile 11: Das Erstellen des Ordners [data] verursacht keinen Fehler, wenn er bereits existiert;
- Zeilen 14–18: Schreiben, Anfügen und Lesen, jeweils in einer einzigen Anweisung;
- Zeile 23: [File.ReadLines] liefert eine Sequenz: Die Zeilen werden im Verlauf der Schleife nacheinander gelesen, wie die Elemente eines Iterators. Man kann LINQ darauf anwenden und so eine mehrere Gigabyte große Datei verarbeiten, ohne sie in den Speicher zu laden – was [ReadAllLines] tun würde. Die Datei wird am Ende der Iteration geschlossen;
- Zeilen 29–36: Derselbe Text „café“ wird mit drei Kodierungen geschrieben, anschließend werden die Bytes der Dateien hexadezimal angezeigt:
- In UTF-8, der Standardkodierung von .NET, belegen Zeichen mit Akzent 2 Bytes (é = C3 A9) und die übrigen 1 Byte: 5 Bytes für 4 Zeichen;
- in UTF-8 mit BOM (Byte Order Mark) beginnt die Datei mit den 3 Bytes EF BB BF, die der Software anzeigen, dass die Datei in UTF-8 kodiert ist. [new UTF8Encoding(true)] weist das System an, dieses BOM zu schreiben;
- in Latin-1 (ISO-8859-1), der traditionellen Kodierung für westeuropäische Texte, belegt jedes Zeichen ein Byte (é = E9);
- Zeile 39: Das Lesen einer Datei mit einer anderen Kodierung als der beim Schreiben verwendeten verfälscht Zeichen mit Akzent: Das Byte E9 am Ende der Datei ist in UTF-8 ungültig, und jedes ungültige Byte wird durch das Zeichen � ersetzt. Beim Lesen erkennen [File.ReadAllText] und [StreamReader] ein BOM, falls vorhanden; andernfalls nehmen sie UTF-8 an, sofern keine andere Kodierung angegeben wird (Zeile 40). Heute gilt die einfache Regel: Textdateien werden in UTF-8 geschrieben und gelesen;
- Zeile 44: die Namen der Textdateien im Ordner. [GetFiles] garantiert die Reihenfolge der Namen nicht; die LINQ-Methode [Order] (.NET 7) sortiert sie;
- Zeile 50: Löscht den Ordner und seinen Inhalt. Der Parameter wird namentlich übergeben, [recursive: true], was den Aufruf lesbarer macht als ein einfaches [true] (benannte Argumente, Kapitel 3).
Alle diese Methoden haben asynchrone Versionen ([File.ReadAllTextAsync], [File.ReadAllLinesAsync] …): Wir werden sie in Kapitel 9 verwenden, das der asynchronen Programmierung gewidmet ist.
5.7. Binärdateien
5.7.1. Die Klassen BinaryWriter und BinaryReader
Die Klassen [System.IO.BinaryWriter] und [System.IO.BinaryReader] dienen zum Schreiben und Lesen von Binärdateien. In einer solchen Datei werden die Daten nicht als Text, sondern in ihrer internen Form geschrieben: Ein [int] belegt unabhängig von seinem Wert immer 4 Bytes.
Betrachten Sie die folgende Anwendung:
Die Textdatei [persons1.txt] hat folgenden Inhalt:
Das Programm [files-04.cs] lautet wie folgt:
Sehen wir uns die Operationen mit der Klasse [BinaryWriter] genauer an:
- Zeile 17: Das Objekt [BinaryWriter] wird durch die Operation [new BinaryWriter(new FileStream(args[1], FileMode.Create, FileAccess.Write))] geöffnet. Das Argument des Konstruktors muss ein Datenstrom ([Stream]) sein. Hier ist es ein aus einer Datei erstellter Datenstrom ([FileStream]), für den wir Folgendes angeben:
- den Namen;
- die auszuführende Operation, hier [FileMode.Create] zum Erstellen der Datei (oder zum Überschreiben, falls sie existiert);
- die Zugriffsart, hier [FileAccess.Write] für den Schreibzugriff auf die Datei;
- Zeilen 57–58: die Schreiboperationen. Die Klasse [BinaryWriter] hat überladene Methoden [Write] zum Schreiben der verschiedenen Typen einfacher Daten ([int], [double], [decimal], [bool], [string] ...);
- Zeilen 15–19: Die drei Datenströme werden mit [using]-Deklarationen geöffnet. Sie werden am Ende des Blocks [try] in der umgekehrten Reihenfolge ihrer Öffnung geschlossen. Der Kurs von 2008 schloss sie in einer Klausel [finally] nach der Prüfung, dass sie nicht [null] waren: Die Deklaration mit [using] leistet dasselbe in einer einzigen Zeile;
- Zeile 10: Anweisungen der obersten Ebene können mit [return n] enden; n ist dann der Exit-Code des Programms, den ein Skript prüfen kann (0: Erfolg);
- Zeile 33: Die Option [TrimEntries] entfernt die Leerzeichen um Name und Alter;
- Zeile 49: Das Alter muss eine positive ganze Zahl oder null sein. Dank der Kurzschlussauswertung des Operators [||] wird die Bedingung [age < 0] nur ausgewertet, wenn die Umwandlung erfolgreich war.
Die drei Argumente des Programms werden nach [--] im Befehl [dotnet run] übergeben. Die Ergebnisse sind folgende:
Die Protokolldatei [logs.txt] enthält Folgendes:
Der Inhalt der Binärdatei [persons1.bin] lässt sich unter Linux mit dem Befehl [od] hexadezimal anzeigen (unter Windows erzeugt der PowerShell-Befehl [Format-Hex] eine ähnliche Anzeige):
Daran sehen Sie, wie [BinaryWriter] die Daten schreibt:
- Eine Zeichenkette wird mit vorangestellter Länge in Bytes geschrieben: das Byte 04, gefolgt von den 4 Bytes von „paul“ (70 61 75 6c);
- eine ganze Zahl [int] wird auf 4 Bytes geschrieben, wobei das niederwertigste Byte zuerst steht: 10 wird als 0a 00 00 00 geschrieben;
- die Daten werden ohne Trennzeichen und ohne Zeilenumbrüche aneinandergereiht geschrieben: Die Datei ist 44 Bytes lang (Zeile 5: Mit der Option [-A d] zeigt [od] die Positionen dezimal an).
Um diese Datei zu lesen, müssen Sie also die genaue Reihenfolge und den Typ der geschriebenen Daten kennen. Dies leistet das Programm [files-05.cs], das die umgekehrte Operation ausführt: Es liest die Binärdatei, um eine Textdatei zu erzeugen. Enthält die entstandene Textdatei die korrekten Daten der Ausgangsdatei, wissen Sie, dass die Umwandlung Text → binär → Text gelungen ist.
Sehen wir uns die Operationen mit der Klasse [BinaryReader] genauer an:
- Zeile 15: Das Objekt [BinaryReader] wird auf einem [FileStream]-Datenstrom im Modus [FileMode.Open] (zum Öffnen einer vorhandenen Datei) und mit dem Zugriffsmodus [FileAccess.Read] (nur lesender Zugriff) geöffnet;
- Zeilen 23–24: Leseoperationen. Die Klasse [BinaryReader] stellt die Methoden [ReadXX] zum Lesen verschiedener einfacher Datentypen bereit: [ReadString], [ReadInt32], [ReadDouble], [ReadDecimal], [ReadBoolean] ... Sie müssen in der Reihenfolge der Schreibvorgänge aufgerufen werden;
- Zeile 20: Die Eigenschaft [BaseStream] liefert den zugrunde liegenden Datenstrom, hier den [FileStream]. Es wird gelesen, bis die aktuelle Position in der Datei das Dateiende erreicht. Die Version von 2008 las endlos und erkannte das Dateiende anhand der Ausnahme [EndOfStreamException]: Eine Ausnahme muss die Ausnahme bleiben, und das Ende einer Datei ist keine Ausnahme;
- Zeile 31: Diese Ausnahme signalisiert nun eine echte Anomalie: eine Datei, die mitten in einem Datensatz endet.
Führen wir das Programm mit der zuvor erzeugten Datei [persons1.bin] aus:
Der Inhalt von [persons2.txt] lautet:
Wir finden die 4 gültigen Personen der Datei [persons1.txt] wieder. Bei einer Datei [truncated.bin], die aus den ersten 30 Bytes von [persons1.bin] besteht, schlägt das Lesen des Alters von Jacques fehl:
5.7.2. Die JSON-Serialisierung
Eine Binärdatei Byte für Byte zu schreiben und zu lesen ist mühsam, und schon die kleinste Abweichung zwischen Schreiben und Lesen führt zu falschen Ergebnissen. In der Regel ist es vorzuziehen, Objekte zu serialisieren: Sie werden automatisch in eine Folge von Bytes oder Zeichen umgewandelt und anschließend deserialisiert, um sie wiederherzustellen.
.NET stellte hierfür die Klasse [BinaryFormatter] bereit, die Objekte in ein .NET-spezifisches Binärformat serialisierte. Sie wurde inzwischen entfernt: In .NET 5 wurde sie als veraltet erklärt, und ihre Implementierung wurde in .NET 9 entfernt, da das Deserialisieren von Daten aus einer nicht vertrauenswürdigen Quelle mit [BinaryFormatter] die Ausführung beliebigen Codes erlaubte. Microsoft empfiehlt, sie durch die JSON-Serialisierung der Bibliothek [System.Text.Json] zu ersetzen, die seit .NET Core 3.0 in .NET integriert ist.
JSON (JavaScript Object Notation) ist ein textbasiertes, menschenlesbares und universelles Format: Es ist das Austauschformat für Webdienste (Kapitel 13) und zahlreiche Konfigurationsdateien. Ein Objekt wird in geschweiften Klammern in Form von Paaren "property":value geschrieben, Arrays stehen in eckigen Klammern.
Die statische Klasse [System.Text.Json.JsonSerializer] hat zwei Hauptmethoden:
Methode | Rolle |
[string Serialize<T>(T value, JsonSerializerOptions? options = null)] | liefert den Text JSON, der das Objekt [value] darstellt |
[T? Deserialize<T>(string json, JsonSerializerOptions? options = null)] | rekonstruiert ein Objekt vom Typ [T] aus dem Text JSON [json]; löst eine [JsonException] aus, wenn der Text fehlerhaft ist |
Das Programm [files-06.cs] verwendet sie:
Ergebnisse:
Kommentare:
- Zeile 1: Eine Direktive für Single-File-Anwendungen. Standardmäßig sind diese für die native Kompilierung (AOT, „Ahead of Time“) konfiguriert, die eine eigenständige ausführbare Datei erzeugt, aber Mechanismen deaktiviert, die auf der Typermittlung zur Laufzeit (Reflection) beruhen. [JsonSerializer] verwendet jedoch standardmäßig Reflection, um die Eigenschaften der zu serialisierenden Objekte zu ermitteln: Ohne diese Direktive erzeugt die Kompilierung Warnungen, und die Ausführung schlägt fehl. Ein normales [.csproj]-Projekt, wie das der Beispielanwendung, unterliegt dieser Einschränkung nicht. Für eine nativ kompilierte Anwendung stellt [System.Text.Json] einen Source Generator (eine von [JsonSerializerContext] abgeleitete Klasse) bereit, der den Serialisierungscode zur Kompilierzeit erzeugt: Darauf gehen wir hier nicht ein;
- Zeilen 60–63: der zu serialisierende Record [Person]. Seine Eigenschaften tragen das Attribut [JsonPropertyName], das den Eigenschaftsnamen im Text JSON auf [name] statt [Name] festlegt. In einem positionalen Record gibt [property: ...] an, dass das Attribut für die generierte Eigenschaft und nicht für den Konstruktorparameter gilt;
- Zeile 17: Serialisierung eines Objekts mit Standardoptionen: Der Text wird in einer einzigen Zeile geschrieben, und Nicht-ASCII-Zeichen werden maskiert: [é] wird zu [é]. Der Text bleibt korrekt, ist aber schwer lesbar;
- Zeilen 21–26: Die Option [WriteIndented] erzeugt eingerückten Text über mehrere Zeilen; die Option [Encoder] legt fest, welche Zeichen unverändert bleiben – hier alle Unicode-Zeichen. Eine Liste wird in ein Array JSON serialisiert;
- Zeile 28: Der Text JSON wird in einer Textdatei gespeichert: So wird die binäre Serialisierung heute ersetzt;
- Zeile 34: Die Deserialisierung rekonstruiert die Liste. [Deserialize] erzeugt die [Person]-Objekte durch Aufruf des Konstruktors des Records, dessen Parameter den gleichnamigen JSON-Eigenschaften zugeordnet werden. Das Ergebnis hat den Typ [List<Person>?]: Der Text JSON [null] ist ein gültiges Dokument, das [null] ergibt;
- Zeile 42: Die „Web“-Optionen, die von den Webdiensten in ASP.NET Core standardmäßig verwendet werden, schreiben Eigenschaftsnamen im camelCase-Format (erster Buchstabe klein): [Code] wird ohne Attribut zu [code]. Beim Einlesen wird die Groß- und Kleinschreibung nicht beachtet: [CODE] wird akzeptiert (Zeile 31);
- Zeile 52: Ein ungültiges Dokument JSON – hier eine Zeichenkette, wo eine Zahl erwartet wird – löst eine [JsonException] aus, deren Meldung die Fehlerstelle angibt.
Wir werden JSON im folgenden Beispiel und im weiteren Verlauf des Kurses verwenden.
5.8. Reguläre Ausdrücke
Die Klasse [System.Text.RegularExpressions.Regex] unterstützt die Verwendung regulärer Ausdrücke. Damit lässt sich das Format einer Zeichenkette überprüfen. So können Sie beispielsweise verifizieren, dass eine Zeichenkette, die ein Datum darstellt, tatsächlich das Format dd/mm/yy hat. Dazu verwenden Sie ein Muster und vergleichen die Zeichenkette mit diesem Muster. In diesem Beispiel müssen d, m und y Ziffern sein. Das Muster für ein gültiges Datumsformat lautet daher [\d\d/\d\d/\d\d], wobei das Symbol [\d] für eine Ziffer steht. In einem Muster können folgende Symbole verwendet werden:
Zeichen | Beschreibung |
[\] | markiert das folgende Zeichen als Sonderzeichen oder Literal. Beispielsweise entspricht [n] dem Zeichen n, [\n] einem Zeilenumbruch, [\\] dem Zeichen \ und [\(] dem Zeichen ( |
[^] | entspricht dem Anfang der Zeichenkette |
[$] | entspricht dem Ende der Zeichenkette |
[*] | entspricht dem vorhergehenden Element null- oder mehrmals. So passt [zo*] auf z oder zoo |
[+] | entspricht dem vorhergehenden Element ein- oder mehrmals. So passt [zo+] auf „zoo“, aber nicht auf „z“ |
[?] | entspricht dem vorhergehenden Element null- oder einmal. Beispielsweise passt [a?ve?] auf „ve“ in „lever“ |
[.] | entspricht einem beliebigen einzelnen Zeichen außer einem Zeilenumbruch |
[(pattern)] | sucht das Muster und speichert den Treffer (eine Gruppe). Der passende Teilstring kann aus der Sammlung [Groups] im Ergebnis extrahiert werden. Um Treffer mit Zeichen in Klammern zu finden, verwenden Sie [\(] oder [\)] |
[x|y] | entspricht entweder x oder y. Beispielsweise passt [z|foot] auf z oder foot; [(z|f)oo] passt auf zoo oder foo |
[{n}] | n ist eine nicht negative ganze Zahl. Entspricht genau n-mal dem vorhergehenden Element. Beispielsweise passt [o{2}] nicht auf das o in Bob, wohl aber auf die ersten beiden o in fooooot |
[{n,}] | entspricht dem vorhergehenden Element mindestens n-mal. Beispielsweise passt [o{2,}] nicht auf das „o“ in „Bob“, wohl aber auf alle „o“ in „fooooot“. [o{1,}] ist gleichbedeutend mit [o+], und [o{0,}] ist gleichbedeutend mit [o*] |
[{n,m}] | entspricht dem vorhergehenden Element mindestens n-mal und höchstens m-mal. Beispielsweise passt [o{1,3}] auf die ersten drei „o“ in „foooooot“; [o{0,1}] ist gleichbedeutend mit [o?] |
[xyz] | Zeichenmenge: entspricht einem der angegebenen Zeichen. Beispielsweise passt [abc] auf den Buchstaben „a“ in „plat“ |
[^xyz] | negierte Zeichenmenge: entspricht jedem nicht aufgeführten Zeichen. Beispielsweise passt [^abc] auf „p“ in „plat“ |
[a-z] | Zeichenbereich: entspricht jedem Zeichen im angegebenen Bereich, hier einem Kleinbuchstaben ohne Akzent |
[^m-z] | negierter Zeichenbereich: entspricht jedem Zeichen, das nicht zwischen „m“ und „z“ liegt |
[\b] | entspricht einer Wortgrenze, also der Position zwischen einem Wortzeichen und einem Nicht-Wortzeichen. Beispielsweise passt [er\b] auf „er“ in „lever“, aber nicht auf „er“ in „verb“ |
[\B] | entspricht einer Position, die keine Wortgrenze ist. [en*t\B] entspricht „ent“ in „entertain“ |
[\d] | entspricht einer Ziffer; ist gleichbedeutend mit [0-9] (bei .NET auch für Ziffern aus anderen Unicode-Schriften) |
[\D] | entspricht einem Zeichen, das keine Ziffer ist |
[\f], [\n], [\r], [\t], [\v] | entsprechen den Zeichen Seitenvorschub, Zeilenumbruch, Wagenrücklauf, Tabulator beziehungsweise vertikaler Tabulator |
[\s] | entspricht beliebigem Leerraum: Leerzeichen, Tabulator, Seitenvorschub, Zeilenumbruch … Gleichbedeutend mit [ \f\n\r\t\v], zuzüglich weiterer Unicode-Leerzeichen (geschütztes Leerzeichen usw.) |
[\S] | entspricht jedem Zeichen, das kein Leerraumzeichen ist |
[\w] | entspricht jedem Wortzeichen: Buchstabe (mit oder ohne Akzent), Ziffer oder Unterstrich |
[\W] | entspricht jedem Zeichen, das kein Wortzeichen ist |
[\num] | num ist eine positive ganze Zahl: verweist auf die Gruppe mit der Nummer num. Beispielsweise passt [(.)\1] auf zwei aufeinanderfolgende gleiche Zeichen |
[\xnn], [\unnnn] | entspricht dem hexadezimalen Zeichen nn (2 Ziffern) oder nnnn (4 Ziffern). Beispielsweise entspricht [\x41] dem Zeichen A |
Ein Element in einem Muster kann einmal oder mehrfach vorkommen. Sehen wir uns einige Beispiele mit dem Symbol [\d], an, das eine einzelne Ziffer darstellt:
Muster | Bedeutung |
[\d] | eine Ziffer |
[\d?] | 0 oder 1 Ziffer |
[\d*] | 0 oder mehr Ziffern |
[\d+] | 1 oder mehr Ziffern |
[\d{2}] | 2 Ziffern |
[\d{3,}] | Mindestens 3 Ziffern |
[\d{5,7}] | zwischen 5 und 7 Ziffern |
Stellen wir uns nun ein Muster vor, das das erwartete Format einer Zeichenkette beschreiben kann:
Zielzeichenkette | Muster |
ein Datum im Format dd/mm/yy | [\d{2}/\d{2}/\d{2}] |
eine Uhrzeit im Format hh:mm:ss | [\d{2}:\d{2}:\d{2}] |
eine vorzeichenlose ganze Zahl | [\d+] |
eine Folge von Leerzeichen, die auch leer sein kann | [\s*] |
eine vorzeichenlose ganze Zahl, der Leerzeichen vorausgehen oder folgen können | [\s*\d+\s*] |
eine ganze Zahl, die ein Vorzeichen haben kann und der Leerzeichen vorausgehen oder folgen können | [\s*[+-]?\s*\d+\s*] |
eine vorzeichenlose reelle Zahl, der Leerzeichen vorausgehen oder folgen können | [\s*\d+(\.\d*)?\s*] |
eine reelle Zahl, die ein Vorzeichen haben kann und der Leerzeichen vorausgehen oder folgen können | [\s*[+-]?\s*\d+(\.\d*)?\s*] |
eine Zeichenkette, die das Wort „just“ enthält | [\bjust\b] |
Der Kurs von 2008 verwendete [+|-] für das Vorzeichen: In eckigen Klammern hat das Zeichen [|] keine besondere Bedeutung, und dieses Format akzeptierte auch das Zeichen | vor einer Zahl. Außerdem wurde [(.\d*)] für den Dezimalteil verwendet: Der dort nicht maskierte Punkt steht für ein beliebiges Zeichen. Die obigen Muster wurden korrigiert.
Sie können angeben, an welcher Stelle der Zeichenkette nach dem Muster gesucht wird:
Muster | Bedeutung |
[^pattern] | das Muster steht am Anfang der Zeichenkette |
[pattern$] | Das Muster steht am Ende der Zeichenkette |
[^pattern$] | Das Muster steht am Anfang und am Ende der Zeichenkette |
[pattern] | Das Muster wird an beliebiger Stelle der Zeichenkette gesucht, beginnend am Anfang der Zeichenkette |
zu durchsuchende Zeichenkette | Muster |
eine Zeichenkette, die mit einem Ausrufezeichen endet | [!$] |
eine Zeichenkette, die mit einem Punkt endet | [\.$] |
eine Zeichenkette, die mit der Folge // beginnt | [^//] |
eine Zeichenkette aus einem einzigen Wort, dem Leerzeichen vorausgehen oder folgen können | [^\s*\w+\s*$] |
eine Zeichenkette aus genau zwei Wörtern, denen Leerzeichen vorausgehen oder folgen können | [^\s*\w+\s+\w+\s*$] |
eine Zeichenkette, die das Wort „secret“ enthält | [\bsecret\b] |
Teilmuster eines Musters können „extrahiert“ werden. So können wir nicht nur prüfen, ob eine Zeichenkette einem bestimmten Muster entspricht, sondern auch die Elemente aus dieser Zeichenkette extrahieren, die den in Klammern eingeschlossenen Teilmustern entsprechen. Wenn Sie beispielsweise eine Zeichenkette mit einem Datum im Format dd/mm/yy analysieren und zusätzlich die Bestandteile dd, mm und yy dieses Datums extrahieren möchten, verwenden Sie das Muster [(\d\d)/(\d\d)/(\d\d)].
In C#-Code schreibt man ein Muster vorzugsweise als wörtliche Zeichenkette (Verbatim-String) [@"..."]: So müssen die zahlreichen Zeichen [\] in den Mustern nicht verdoppelt werden. Bei einer normalen Zeichenkette müssten Sie stattdessen ***["\\\\d+"] schreiben statt ***[@"\\d+"].
5.8.1. Prüfen, ob eine Zeichenkette einem bestimmten Muster entspricht
Ein Objekt vom Typ [Regex] wird wie folgt konstruiert:
Konstruktor | Rolle |
[public Regex(string pattern)] | erzeugt aus einem als Parameter übergebenen Muster ([pattern]) ein Objekt für einen „regulären Ausdruck“. Eine [ArgumentException] wird ausgelöst, wenn das Muster fehlerhaft ist |
[public Regex(string pattern, RegexOptions options, TimeSpan matchTimeout)] | wie oben, mit Optionen und einem Timeout (siehe unten) |
Sobald der reguläre Ausdruck konstruiert ist, kann er mit der Methode [IsMatch] mit Zeichenketten verglichen werden:
Methode | Rolle |
[public bool IsMatch(string input)] | true, wenn die Zeichenkette [input] eine Teilzeichenkette enthält, die dem Muster des regulären Ausdrucks entspricht |
Das Programm [regex-01.cs] lautet wie folgt:
Ergebnisse:
Kommentare:
- Zeile 4: das Muster für eine vorzeichenlose ganze Zahl, optional von Leerzeichen umgeben, die die gesamte Zeichenkette einnimmt (Anker [^] und [$]);
- Zeile 9: Die von Leerzeichen umgebene Zeichenkette „123a“ entspricht dem Muster nicht: Das Zeichen „a“ kann weder eine Ziffer noch ein Leerzeichen sein. Ohne die Anker [^] und [$]würde die Zeichenkette passen, da sie eine Zahl enthält;
- Zeile 19: Die Klasse [Regex] hat auch statische Methoden, die das Muster als Parameter erhalten. .NET hält die zuletzt verwendeten Muster im Speicher: Sie können in einer Schleife verwendet werden, ohne dass das Muster bei jedem Aufruf neu analysiert wird.
5.8.2. Alle Vorkommen eines Musters in einer Zeichenkette finden
Die Methode [Matches] ruft die Elemente einer Zeichenkette ab, die einem Muster entsprechen:
Methode | Rolle |
[public MatchCollection Matches(string input)] | liefert die Sammlung der Elemente der Zeichenkette [input] , die dem Muster entsprechen |
Die Klasse [MatchCollection] hat eine Eigenschaft [Count], die Anzahl der Elemente der Sammlung. Ist [results] ein Objekt vom Typ [MatchCollection], dann ist [results[i]] das i-te Element dieser Sammlung; es hat den Typ [Match]. Die Klasse [Match] hat verschiedene Eigenschaften, darunter die folgenden:
- [Value]: der Wert des Objekts [Match], also ein Element, das dem Muster entspricht;
- [Index]: die Position, an der das Element in der durchsuchten Zeichenkette gefunden wurde.
Das Programm [regex-02.cs] lautet wie folgt:
Ergebnisse:
Kommentare:
- Zeile 4: Das gesuchte Muster ist eine Folge von Ziffern;
- Zeile 6: die Zeichenkette, in der dieses Muster gesucht wird;
- Zeile 7: Alle Elemente von [sample3], die dem Muster [pattern2] entsprechen, werden abgerufen;
- Zeilen 10–12: Sie werden angezeigt. Eine [MatchCollection] wird wie eine Liste mit [foreach] durchlaufen;
- Zeile 15: [MatchCollection] implementiert [IEnumerable<Match>]: LINQ lässt sich darauf anwenden. Hier summieren wir die gefundenen Zahlen;
- Zeile 18: Die Methode [Count] (.NET 7) zählt die Vorkommen des Musters, ohne eine Sammlung zu erzeugen. Das Muster [aeiouy] bezeichnet einen Vokal.
5.8.3. Teile eines Musters abrufen
Wie bereits erwähnt, werden die in Klammern eingeschlossenen Teile eines Musters gespeichert: Das sind die Gruppen. Das Programm [regex-03.cs] verwendet sie:
Ergebnisse:
Kommentare:
- Zeile 8: Die Zeichenkette [sample4] wird mit dem Muster [regex3] mithilfe der Methode [Match] verglichen. Diese Methode liefert das erste Vorkommen des Musters als Objekt vom Typ [Match], das bereits vorgestellt wurde. Hier verwenden wir zwei neue Eigenschaften dieser Klasse:
- [Success] (Zeile 9): gibt an, ob ein Treffer gefunden wurde;
- [Groups] (Zeile 13): eine Sammlung, in der [Groups[0]] dem Teil der Zeichenkette entspricht, der das Muster darstellt, und [Groups[i]] (i >= 1) dem i-ten Klammerpaar entspricht;
- Wenn [result] den Typ [Match] hat, dann ist [result.Groups] vom Typ [GroupCollection] und [result.Groups[i]] ist vom Typ [Group]. Die Klasse [Group] hat wie die Klasse [Match]die Eigenschaften [Value] (der von der Gruppe erfasste Text) und [Index] (seine Position in der analysierten Zeichenkette);
- Zeile 24: Eine Gruppe kann mit der Syntax benannt werden: [(?<name>...)]. Das Muster erkennt hier ein Datum im Format d/m/yyyy mit ein- oder zweistelligem Tag und Monat;
- Zeilen 29–31: Auf eine benannte Gruppe wird über ihren Namen statt über ihre Nummer zugegriffen: Der Code ist lesbarer und hängt nicht von der Reihenfolge der Klammern ab;
- Zeile 32: Der Typ [DateOnly] (.NET 6) stellt ein Datum ohne Uhrzeit dar. Er wird im Format [dddd d MMMM yyyy] angezeigt: Der Wochentag erscheint auf Englisch;
- Zeile 37: Die Methode [Replace] ersetzt jedes Vorkommen des Musters durch eine Zeichenkette, in der [${name}] (oder [$1], [$2] … bei nummerierten Gruppen) den Wert einer Gruppe bezeichnet. Die Daten werden so in das Format Jahr-Monat-Tag umformatiert.
5.8.4. Ein Lernprogramm
Den regulären Ausdruck zu finden, der prüft, ob eine Zeichenkette einem bestimmten Muster entspricht, kann mitunter eine echte Herausforderung sein. Das Programm [regex-04.cs] lässt Sie üben. Es nimmt ein Muster und eine Zeichenkette als Eingabe entgegen und zeigt an, ob die Zeichenkette dem Muster entspricht oder nicht.
Kommentare:
- Zeile 18: Der reguläre Ausdruck wird mit einem Timeout von einer Sekunde konstruiert: Dauert eine Suche länger, wird sie abgebrochen, und eine [RegexMatchTimeoutException] wird ausgelöst (Zeile 55). Wir werden später sehen, wozu das nützlich ist;
- Zeile 20: Ein ungültiges Muster löst eine [ArgumentException] aus (genauer gesagt eine [RegexParseException], die von ihr abgeleitet ist);
- Zeilen 45–51: Für jeden Treffer werden die Gruppe Nr. 1 und gegebenenfalls die folgenden Gruppen angezeigt.
Hier ein Beispiel für die Ausgabe:
Die Muster [^\s*\d+\s*$] und [^\s*(\d+)\s*$] zeigen, wie nützlich Gruppen sind: Das erste erkennt die Zeichenkette „1456“ mit drei vorangestellten Leerzeichen, einschließlich der Leerzeichen; das zweite extrahiert zusätzlich die Zahl ohne die Leerzeichen. Das Muster [(a+)+$] wird weiter unten untersucht.
5.8.5. Die Methode Split
Die Methode [Split] der Klasse [String] ist uns bereits begegnet:
Methode | Rolle |
[public string[] Split(params char[] separator)] | Die Zeichenkette wird als Folge von Feldern behandelt, die durch die im Array [separator] aufgeführten Zeichen getrennt sind. Das Ergebnis ist ein Array dieser Felder |
Die Methode [Split] der Klasse [Regex] erlaubt es, das Trennzeichen über ein Muster anzugeben:
Methode | Rolle |
[public string[] Split(string input)] | Die Zeichenkette [input] wird in Felder zerlegt, die durch ein Trennzeichen getrennt sind, das dem Muster des aktuellen [Regex]-Objekts entspricht |
Angenommen, eine Textdatei enthält Zeilen der Form field1, field2, ..., fieldn. Die Felder sind durch ein Komma getrennt, dem jedoch Leerzeichen vorausgehen oder folgen können. Das Muster [\s*,\s*] beschreibt dieses Trennzeichen genau, wie das Programm [regex-05.cs] zeigt:
Ergebnisse:
Kommentare:
- Zeile 6: das Trennzeichen: ein Komma, vor und nach dem beliebig viele Leerzeichen stehen. Die Leerzeichen werden zusammen mit dem Trennzeichen entfernt. Beachten Sie, dass die weiter oben vorgestellte Option [TrimEntries] von [string.Split]es inzwischen erlaubt, dasselbe Ergebnis ohne regulären Ausdruck zu erzielen;
- Zeile 13: Ein Trennzeichen, das mehrere Formen annehmen kann: ein Semikolon oder ein senkrechter Strich ([;|]) oder ([|]) eine Folge von Leerzeichen ([\s+]). Hier ist ein regulärer Ausdruck erforderlich.
5.8.6. Generierte reguläre Ausdrücke, Optionen, Timeout
Ein [Regex]-Objekt analysiert sein Muster zur Laufzeit und übersetzt es dann in eine interne Struktur, die es interpretiert, oder kompiliert es in ausführbaren Code, wenn ihm die Option [RegexOptions.Compiled] übergeben wird. Ab .NET 7 erlaubt das Attribut [GeneratedRegex], diese Arbeit zur Kompilierzeit erledigen zu lassen: Ein Source Generator schreibt den C#-Code für die Suche, der im Editor angezeigt werden kann (F12 auf der Methode). Das Muster wird zur Kompilierzeit validiert, beim Start fällt kein Analyseaufwand mehr an, und der generierte Code läuft so schnell wie möglich. Dies ist inzwischen der empfohlene Weg, ein im Voraus bekanntes Muster zu verwenden. Das Programm [regex-06.cs] lautet wie folgt:
Ergebnisse:
Kommentare:
- Zeilen 39–51: Jedes Muster wird durch eine partielle statische Methode ([partial]) ohne Rumpf deklariert, die ein [Regex] erzeugt und der das Attribut [GeneratedRegex] vorangestellt ist. Der Source Generator schreibt den Methodenrumpf in einen anderen Teil der Klasse, der ebenfalls als [partial] deklariert ist. Ab C# 13 und .NET 9 können Sie auch eine partielle Eigenschaft deklarieren: [[GeneratedRegex(...)] private static partial Regex Time { get; }];
- Zeile 5: Die Methode wird wie ein gewöhnliches [Regex]-Objekt verwendet;
- Zeile 46: Der zweite Parameter des Attributs ist eine Kombination von Optionen [RegexOptions]. [IgnoreCase] ignoriert die Groß- und Kleinschreibung: „YES“ und „Yes“ entsprechen dem Muster;
- Zeile 17: Die Optionen werden bei den Methoden von [Regex] auf dieselbe Weise verwendet. [Multiline] lässt [^] und [$] am Anfang und am Ende jeder Zeile der Zeichenkette passen, nicht nur am Anfang und Ende der Zeichenkette selbst. Weitere Optionen sind nützlich: [Singleline] ([.] passt auch auf Zeilenumbrüche), [IgnorePatternWhitespace] (Leerzeichen im Muster werden ignoriert, sodass es sich über mehrere Zeilen und mit Kommentaren schreiben lässt), [ExplicitCapture] (nur benannte Gruppen werden gespeichert). Sie lassen sich mit dem Operator [|] kombinieren;
- Zeile 50: Das Muster [^(a+)+$] ist pathologisch: Wird es auf eine Folge von „a“ angewendet, die mit einem anderen Zeichen endet, probiert die Engine für reguläre Ausdrücke jede mögliche Verteilung der „a“ auf die Wiederholungen der Gruppe durch, bevor sie feststellt, dass die Suche gescheitert ist. Die Zahl der Möglichkeiten verdoppelt sich mit jedem zusätzlichen „a“: Bei 30 „a“ sind es etwa eine Milliarde Möglichkeiten. Dies nennt man katastrophales Backtracking. Ein solches Muster, das auf von Benutzern eingegebene Zeichenketten angewendet wird, ist eine Sicherheitslücke: Schon wenige Anfragen genügen, um einen Server zum Absturz zu bringen. Der Parameter [matchTimeoutMilliseconds] legt ein Timeout von 100 ms fest: Danach wird die Suche mit einer [RegexMatchTimeoutException] abgebrochen (Zeile 6);
- Zeile 35: Die Option [NonBacktracking] (.NET 7) verwendet eine andere Engine, die eine zur Länge der Zeichenkette proportionale Suchzeit garantiert. Sie unterstützt bestimmte Konstrukte nicht (Rückwärtsverweise wie [\1] zum Beispiel), liefert in diesem Fall aber sofort ein Ergebnis.
Beachten Sie, dass Sie ein Timeout festlegen oder [NonBacktracking] verwenden müssen, sobald das Muster oder die durchsuchte Zeichenkette von außerhalb des Programms stammt.
5.9. Beispielanwendung – V3
Wir greifen die Anwendung aus Kapitel 3 (Version 1) und Kapitel 4 (Version 2) wieder auf. Denken Sie daran, dass es sich um eine Übung handelt: Die verwendete Steuertabelle ist die von 2004 (Einkommen 2003), die seit dem ursprünglichen Kurs unverändert geblieben ist.
5.9.1. Daten in einer Datei
In Version 2 wurde die Steuerberechnung in der abstrakten Klasse [AbstractTax] durchgeführt, die wir hier bis auf ihren Namespace unverändert wiedergeben:
Die Methode [Calculate] verwendet die Steuerstufen, die von der abstrakten Eigenschaft [TaxBrackets] geliefert werden (Zeile 7). Die Klasse [AbstractTax] weiß nicht, woher diese Stufen stammen: Es ist Aufgabe der abgeleiteten Klassen, sie bereitzustellen. In Version 2 hatte die abgeleitete Klasse [HardwiredTax] sie fest in ihren Code geschrieben. Eine Steuerstufe wird wie in Version 2 durch die Record-Struktur [TaxBracket] dargestellt:
und die Berechnung wird durch die Schnittstelle [ITax] beschrieben:
Die neue Version speichert die Daten in einer Datei, sodass sich die Steuertabelle ändern lässt, ohne das Programm neu zu kompilieren. Wir schreiben zwei neue, von [AbstractTax] abgeleitete Klassen:
- [FileTax] liest die Stufen aus einer Textdatei [TaxData.txt];
- [JsonTax] liest sie aus einer JSON-Datei mit dem Namen [TaxData.json].
Die Textdatei [TaxData.txt] enthält pro Zeile eine Steuerstufe im Format limit:coeffR:coeffN:
Der Kurs von 2008 schrieb Zahlen mit Dezimalkomma (0,068) und las sie mit [decimal.TryParse] in der Ländereinstellung des Rechners ein: Dieselbe Datei wäre auf einem britischen oder amerikanischen Rechner abgelehnt oder, schlimmer noch, falsch interpretiert worden. Eine Datendatei darf nicht von der Sprache des lesenden Rechners abhängen: Wir schreiben Zahlen mit Dezimalpunkt und lesen sie in der invarianten Kultur ([CultureInfo.InvariantCulture]) ein, die auch von JSON und den meisten Datenformaten verwendet wird.
Die Datei [TaxData.json] enthält dieselben Daten in Form eines JSON-Arrays von Objekten:
5.9.2. Fehler
Die Verarbeitung dieser Dateien kann scheitern: fehlende Datei, fehlerhafte Zeile, falsche Zahl usw. Wie in der Version von 2008 erstellen wir eine eigene Ausnahmeklasse, um diese Fehler zu melden. Der Kurs von 2008 nannte sie [FileTaxException]; wir nennen sie [TaxException], da sie auch für andere Datenquellen verwendet wird (hier die JSON-Datei, später eine Datenbank). Sie trägt einen Fehlercode:
Kommentare:
- Zeilen 16–22: Die Klasse [TaxException] leitet sich von der Klasse [Exception] ab. Sie dient dazu, alle Fehler zu melden, die bei der Verarbeitung der Datendatei auftreten. Sie hat zwei Konstruktoren: Der erste nimmt eine Fehlermeldung entgegen, der zweite zusätzlich die Ausnahme, die den Fehler verursacht hat und die in der Eigenschaft [InnerException] verfügbar sein wird;
- Zeile 19: Die Eigenschaft [Code] speichert den Fehlercode. Das Schlüsselwort [init] erlaubt es, ihn nur bei der Erzeugung des Objekts mit einem Objektinitialisierer zu setzen: [new TaxException("...") { Code = 2 }]. Genau diese Form der Ausnahme mit einem ganzzahligen Code werden die folgenden Versionen der Anwendung verwenden;
- Zeilen 4–12: eine Liste der möglichen Fehlercodes:
- [Access]: Fehler beim Zugriff auf die Datendatei;
- [Line]: Zeile, in der die drei erwarteten Felder fehlen, oder Datei ohne Steuerstufen;
- [Field1], [Field2], [Field3]: Feld 1, 2 oder 3 einer Zeile ist fehlerhaft;
- [Json]: Das Dokument JSON ist fehlerhaft.
Einige dieser Fehler können gleichzeitig auftreten: Alle drei Felder einer Zeile können fehlerhaft sein. Deshalb wurde die Aufzählung [ErrorCode] mit dem Attribut [Flags] versehen, und ihre Werte sind Zweierpotenzen: Jeder entspricht einem Bit der ganzen Zahl. Ein Fehler in den Feldern 2 und 3 führt zum Code [Field2 | Field3], also 8 + 16 = 24. Dank des Attributs [Flags] zeigt die Methode [ToString] der Aufzählung eine solche Kombination in der Form „Field2, Field3“ an.
5.9.3. Die Klasse FileTax
Die Klasse [FileTax] liefert die aus einer Textdatei gelesenen Stufen:
Kommentare:
- Zeile 7: Die Klasse [FileTax] ist von der Klasse [AbstractTax] abgeleitet, so wie es in Version 2 die Klasse [HardwiredTax] war. Sie ist als [partial] deklariert, weil sie einen generierten regulären Ausdruck enthält;
- Zeilen 10–11: der reguläre Ausdruck für das Feldtrennzeichen in einer Zeile limit:coeffR:coeffN: das Zeichen [:], vor und nach dem beliebig viele Leerzeichen stehen;
- Zeilen 14–17: die gelesenen Stufen, geliefert von der Eigenschaft [TaxBrackets], die die abstrakte Eigenschaft von [AbstractTax] überschreibt;
- Zeile 19: Der Konstruktor erhält den Namen der Textdatei mit den Daten. Seine Aufgabe ist es, das Array [taxBrackets] zu füllen;
- Zeile 22: der Dateiname ohne Pfad, der in Fehlermeldungen verwendet wird. Der Konstruktor erhält tatsächlich einen vollständigen Pfad, der dem Benutzer nicht angezeigt werden muss;
- Zeile 24: Das Lesen einer Textdatei erfolgt sequenziell: Die Anzahl der Zeilen ist erst bekannt, wenn die gesamte Datei gelesen wurde. Das Array kann daher nicht im Voraus dimensioniert werden; die Stufen werden vorübergehend in einer Liste gespeichert;
- Zeile 28: Die Datei wird mit [File.ReadLines] zeilenweise gelesen, wobei die Methode die Datei selbst öffnet und schließt. Der Kurs von 2008 verwendete [StreamReader];
- Zeilen 38–43: Die Zeile wird mithilfe eines regulären Ausdrucks in Felder zerlegt; sind es nicht drei Felder, wird eine [TaxException] mit dem Code [Line] ausgelöst. Der Kurs von 2008 speicherte den Fehler in einer Variablen, verließ die Schleife und löste die Ausnahme erst nach dem Schließen der Datei aus: Sie sofort auszulösen ist einfacher, und [File.ReadLines] schließt die Datei in jedem Fall, da die Schleife [foreach] ihren Enumerator auch dann freigibt, wenn eine Ausnahme sie unterbricht;
- Zeilen 47–55: Umwandlung der drei Felder in Dezimalzahlen. Fehler werden in der Variablen [code] mit dem Operator [|=] gesammelt und anschließend gemeinsam gemeldet;
- Zeilen 83–84: Umwandlung eines Feldes. [NumberStyles.AllowDecimalPoint] lässt nur Ziffern und einen Dezimalpunkt zu: keine Vorzeichen, Leerzeichen oder Tausendertrennzeichen. Negative Zahlen werden daher abgelehnt, wodurch die Daten zugleich mit der Umwandlung validiert werden. [CultureInfo.InvariantCulture] erzwingt den Punkt als Dezimaltrennzeichen, unabhängig von der Ländereinstellung des Rechners;
- Zeilen 62–67: Dateizugriffsfehler ([IOException] und ihre Varianten wie [FileNotFoundException] oder [UnauthorizedAccessException] bei unzureichenden Berechtigungen) werden verpackt in einer [TaxException] mit dem Code [Access]. Der [when (...)] Exception-Filter (C# 6) fängt nur diese Ausnahmen ab: [TaxException]-Ausnahmen, die innerhalb der Schleife ausgelöst werden, werden nicht abgefangen und verlassen den Konstruktor unverändert. Das Muster [e is IOException or UnauthorizedAccessException] ist ein kombiniertes Muster mit [or] (C# 9);
- Zeilen 71–79: Eine leere Datei wird abgelehnt; andernfalls wird die Liste in das Array der Stufen übertragen, was der Zweck des Konstruktors war.
Das Kapseln von Low-Level-Ausnahmen ([IOException]) in eine anwendungsspezifische Ausnahme ([TaxException]) erlaubt es dem aufrufenden Code, unabhängig von der Datenquelle nur einen Ausnahmetyp zu behandeln: eine Textdatei, eine JSON-Datei und, später im Kurs, eine Datenbank.
5.9.4. Die Klasse JsonTax
Die Klasse [JsonTax] liefert die aus einer JSON-Datei gelesenen Stufen:
Kommentare:
- Zeile 9: Die „Web“-Optionen: Die JSON-Eigenschaften [limit], [coeffR] und [coeffN] entsprechen den Eigenschaften [Limit], [CoeffR] und [CoeffN] der Struktur [TaxBracket], ohne dass diese mit Attributen angepasst werden muss. Die Optionen werden in einem statischen Feld gespeichert: Ein [JsonSerializerOptions]-Objekt speichert Informationen über die Typen, die es verarbeitet hat, und es wird empfohlen, es wiederzuverwenden;
- Zeilen 25–31: das Lesen der Datei; ein Zugriffsfehler wird wie in [FileTax] behandelt;
- Zeile 38: Eine einzige Anweisung wandelt den Text JSON in ein Array von Stufen um. [System.Text.Json] versteht es, eine Record-Struktur durch Aufruf ihres Konstruktors zu erzeugen. Ein ungültiges Dokument löst eine [JsonException] aus, die in einer [TaxException] mit dem Code [Json] gekapselt wird;
- Zeilen 48–57: Die Deserialisierung prüft das Format des Dokuments, nicht die Gültigkeit der Daten: Es bleibt zu überprüfen, dass es mindestens eine Stufe gibt (das Dokument [null] oder [] ist ein gültiges JSON) und dass keine Werte negativ sind. Die LINQ-Methode [Any] führt diese letzte Prüfung in einer einzigen Zeile durch.
Der Vergleich der beiden Klassen ist aufschlussreich: Mit einem strukturierten Datenformat und einer Bibliothek, die es versteht, erfordert das Parsen der Datei keinen Code mehr.
5.9.5. Das Hauptprogramm
Das Konsolenprojekt [TaxV3] hat die folgende Verzeichnisstruktur:
Die Projektdatei [TaxV3.csproj] ist die von [dotnet new console] erzeugte, der eine Gruppe von Elementen hinzugefügt wurde:
Das Element [<None Update="..." CopyToOutputDirectory="PreserveNewest" />] (Zeile 12) legt fest, dass die Datendateien bei der Kompilierung in den Ordner der ausführbaren Datei ([bin/Debug/net10.0]) kopiert werden, wenn sie neuer sind als die vorhandene Kopie. Das Zeichen [*] erlaubt es, alle Dateien [TaxData*.txt] und [TaxData*.json] auf einmal anzugeben. Das entspricht der Eigenschaft „In Ausgabeverzeichnis kopieren“, die der Kurs von 2008 in den Dateieigenschaften in Visual Studio setzte.
Das Programm [Program.cs] lautet wie folgt:
Kommentare:
- Zeile 14: Der Name der Datendatei wird als Argument übergeben; standardmäßig ist es [TaxData.txt];
- Zeile 15: Die Datei wird im Ordner der ausführbaren Datei gesucht, [AppContext.BaseDirectory], wohin sie bei der Kompilierung kopiert wurde. So findet das Programm seine Daten unabhängig davon, aus welchem Ordner es gestartet wird, was bei den Single-File-Anwendungen dieses Kapitels nicht der Fall war;
- Zeilen 22–25: Ein [switch] -Ausdruck (Kapitel 3) wählt anhand der Dateierweiterung die zu instanziierende Klasse aus. Die beiden Zweige liefern unterschiedliche Typen, [JsonTax] und [FileTax]: Der Compiler leitet den Typ des Ausdrucks aus der Zielvariablen [tax] ab, die den Typ [ITax] hat ([switch] -Ausdruck mit Zieltyp). Der Rest des Programms kennt nur die Schnittstelle [ITax] und weiß nicht, woher die Daten stammen;
- Zeilen 28–34: Das Erzeugen des Objekts kann eine [TaxException] auslösen, die angezeigt wird, bevor das Programm endet. Der Code wird in [ErrorCode] umgewandelt, um im Klartext angezeigt zu werden; die ursprüngliche Ausnahme, falls vorhanden, wird anhand ihres Typs identifiziert (ihre Meldung enthält den vollständigen Dateipfad);
- Zeilen 37–76: Die Dialogschleife ist exakt dieselbe wie in Version 2.
5.9.6. Ausführungen
Mit der Datei [TaxData.txt], die standardmäßig verwendet wird:
Die Werte der vorherigen Versionen werden reproduziert: 4.282 Euro für ein Ehepaar mit 2 Kindern, 2.959 Euro mit 3 Kindern und 11.519 Euro für eine alleinstehende Person ohne Kinder bei einem Jahresgehalt von 60.000 Euro. Fehlerhafte Eingaben werden wie in Version 2 gemeldet.
Mit der Datei [TaxData.json]:
Mit einer nicht vorhandenen Datei [xx.txt]:
Mit der folgenden Datei [TaxDataInvalid.txt], in der die dritte Zeile ein Dezimalkomma verwendet:
Die Felder 2 und 3 in Zeile 3 werden abgelehnt: Der Fehlercode ist die Kombination „Field2, Field3“. Feld 1 (14753), das keinen Dezimalteil hat, ist korrekt.
Mit der folgenden Datei [TaxDataInvalid.json], in der ein Koeffizient als Zeichenkette geschrieben ist:
Die Meldung der [JsonException] gibt die genaue Fehlerstelle an: die Eigenschaft [coeffR] des zweiten Elements des Arrays ([$[1].coeffR]), [LineNumber: 2] – das heißt die dritte Zeile des Dokuments, da [System.Text.Json] die Zeilen ab 0 nummeriert.
5.10. Fazit
Dieses Kapitel hat die .NET-Klassen vorgestellt, die in fast allen Programmen verwendet werden:
- unveränderliche Zeichenketten ([string]) und veränderliche Zeichenketten ([StringBuilder]) zu ihrem stückweisen Aufbau; Interpolation mit Breiten und Formaten, Raw-Strings; Sichten ([ReadOnlySpan<char>]) für kritischen Code;
- die Arrays und die Klasse [Array];
- die generischen Sammlungen [List<T>], [Dictionary<TKey,TValue>], [HashSet<T>], [Queue<T>], [Stack<T>], [PriorityQueue<TElement,TPriority>] und ihre schreibgeschützten Schnittstellen; die nicht generischen Sammlungen [ArrayList] und [Hashtable] sind veraltet;
- LINQ, seine Sequenzen [IEnumerable<T>], seine Iteratoren und seine verzögerte Ausführung;
- Textdateien ([StreamReader], [StreamWriter], [File]), Binärdateien ([BinaryWriter], [BinaryReader]) und die JSON-Serialisierung, die die binäre Serialisierung von [BinaryFormatter] ersetzt, das aus .NET entfernt wurde;
- reguläre Ausdrücke, vorzugsweise zur Kompilierzeit generiert und bei der Verarbeitung externer Daten stets durch ein Timeout geschützt.
Die Beispielanwendung liest ihre Daten nun aus einer Textdatei oder aus JSON. Das folgende Kapitel gliedert sie in Schichten um: Das Lesen der Daten, die Steuerberechnung und die Benutzerinteraktion werden zu unabhängigen Komponenten.