5. Classes .NET d'usage courant
Nous présentons ici quelques classes de la plate-forme .NET fréquemment utilisées : chaînes de caractères, tableaux, collections, fichiers, expressions régulières. Nous y ajoutons LINQ (Language Integrated Query), que le cours de 2008 laissait de côté alors qu'il était déjà disponible depuis C# 3 : c'est aujourd'hui la façon la plus courante de manipuler des collections en C#. Auparavant, nous montrons comment obtenir des renseignements sur les milliers de classes disponibles. Cette aide est indispensable au développeur C#, même confirmé.
Les exemples de ce chapitre sont, sauf l'application exemple de la fin, des applications fichier unique exécutées par [dotnet run fichier.cs]. Ils se trouvent dans le dossier [05-classes-dotnet] du code du cours et s'exécutent en culture française (fr-FR).
5.1. Chercher de l'aide sur les classes .NET
Le cours de 2008 décrivait longuement, copies d'écran à l'appui, l'aide MSDN installée avec Visual Studio 2008. Cette aide locale n'existe plus : la documentation de .NET est aujourd'hui en ligne, gratuite, et mise à jour à chaque version.
5.1.1. La documentation en ligne
Le point d'entrée est le site learn.microsoft.com de Microsoft. On y trouve :
- la documentation du langage C# : https://learn.microsoft.com/fr-fr/dotnet/csharp/. Elle contient une présentation du langage, des tutoriels, la référence du langage (mots clés, opérateurs, instructions) et une rubrique « Nouveautés » qui décrit chaque version de C# ;
- la référence de l'API .NET : https://learn.microsoft.com/fr-fr/dotnet/api/. Elle décrit, espace de noms par espace de noms, toutes les classes de .NET : leurs constructeurs, propriétés et méthodes, avec des exemples ;
- le navigateur d'API, sur la même page : une zone de recherche dans laquelle on tape un nom de classe ou de méthode ([StringBuilder], [Regex.Match]…). Une liste déroulante permet de choisir la version de .NET (ici .NET 10).
La page d'une classe, par exemple System.String, donne :
- l'espace de noms de la classe et l'assembly qui la contient ;
- sa déclaration, sa classe parente et les interfaces qu'elle implémente ;
- la liste de ses constructeurs, propriétés et méthodes, chacune avec un lien vers une page détaillée qui donne ses différentes surcharges, ses paramètres, la valeur rendue, les exceptions possibles et souvent un exemple ;
- des remarques sur son utilisation.
Les pages sont disponibles en français (traduction automatique) et en anglais (texte original, parfois plus précis). On passe de l'une à l'autre en remplaçant [fr-fr] par [en-us] dans l'adresse. Une recherche sur un moteur de recherche avec le nom complet de la classe (« System.Text.StringBuilder ») mène en général directement à la bonne page.
5.1.2. L'aide de l'éditeur
L'éditeur de code (Visual Studio, Visual Studio Code avec l'extension C# Dev Kit, Rider) fournit une aide immédiate, sans quitter le code :
- l'autocomplétion (IntelliSense) : après avoir tapé [uneChaine.], l'éditeur propose la liste des propriétés et méthodes de l'objet, avec un résumé de chacune ;
- le survol : placer la souris sur un nom de classe, de méthode ou de variable affiche sa déclaration et le résumé de sa documentation ;
- l'aide sur les paramètres : en tapant la parenthèse ouvrante d'un appel, l'éditeur affiche les différentes surcharges de la méthode et le rôle de chaque paramètre ;
- atteindre la définition (touche F12) : affiche la déclaration de la classe ou de la méthode. Pour une classe de .NET, l'éditeur affiche les déclarations publiques reconstituées à partir de l'assembly, avec leurs commentaires de documentation ;
- dans Visual Studio, la touche F1 sur un nom de classe ou de méthode ouvre la page correspondante de la documentation en ligne.
Ces commentaires de documentation, que l'on voit au survol, sont ceux qui servent à générer la référence en ligne. On peut en écrire de semblables dans son propre code, avec la syntaxe [/// <summary> ... </summary>] placée au-dessus d'une classe ou d'une méthode : l'éditeur les affichera de la même façon.
5.2. Les chaînes de caractères
5.2.1. La classe System.String
Le type [string] de C# est un alias de la classe [System.String]. Elle présente de nombreuses propriétés et méthodes. En voici quelques-unes :
membre | rôle |
[public int Length { get; }] | nombre de caractères de la chaîne |
[public char this[int index] { get; }] | le caractère n° [index] : [chaine[i]] |
[public bool StartsWith(string value)] | rend [true] si la chaîne commence par [value] |
[public bool EndsWith(string value)] | rend [true] si la chaîne se termine par [value] |
[public bool Contains(string value)] | rend [true] si la chaîne contient [value] |
[public bool Equals(string? value)] | rend [true] si la chaîne est égale à [value] ; équivalent à [chaine == value] |
[public int IndexOf(string value)] | première position de [value] dans la chaîne, ou -1. Une autre surcharge commence la recherche à la position [startIndex] |
[public int IndexOf(char value)] | idem pour le caractère [value] |
[public int LastIndexOf(char value)] | idem [IndexOf] mais rend la dernière position au lieu de la première |
[public string Insert(int startIndex, string value)] | insère la chaîne [value] dans la chaîne en position [startIndex] |
[public static string Join(string separator, params string[] value)] | méthode de classe : concatène les éléments de [value] en les séparant par [separator] |
[public string Replace(char oldChar, char newChar)] | rend une copie de la chaîne où le caractère [oldChar] a été remplacé par [newChar] ; une surcharge remplace une chaîne par une autre |
[public string[] Split(params char[] separator)] | la chaîne est vue comme une suite de champs séparés par les caractères de [separator] ; le résultat est le tableau de ces champs |
[public string Substring(int startIndex, int length)] | sous-chaîne de [length] caractères commençant à la position [startIndex] |
[public string ToLower()], [public string ToUpper()] | rend la chaîne en minuscules, en majuscules |
[public string Trim()] | rend la chaîne débarrassée de ses espaces de début et de fin ([TrimStart], [TrimEnd] : d'un seul côté) |
On notera un point important : une chaîne de type [string] est immuable, elle ne peut pas être modifiée après sa création. Lorsqu'une méthode rend une chaîne de caractères, celle-ci est une chaîne différente de la chaîne sur laquelle a été appliquée la méthode. Ainsi [s1.Trim()] rend une chaîne [s2], et [s1] et [s2] sont deux chaînes différentes : [s1] n'a pas changé.
Une chaîne [c] peut être considérée comme un tableau de caractères en lecture seule :
- [c[i]] est le caractère n° i de [c] (le premier a le n° 0) ;
- [c.Length] est le nombre de caractères de [c].
Le programme [chaines-01.cs] est le suivant :
Résultats :
Commentaires :
- ligne 5 : le caractère n° 10, donc le 11e caractère de la chaîne ;
- lignes 7, 9 : une recherche infructueuse rend -1 ;
- ligne 10 : les 7 caractères commençant à la position 4 ;
- ligne 14 : une insertion en position 9, avant le mot « vole » ;
- ligne 16 : [Split] sans paramètre découpe la chaîne sur les espaces (espace, tabulation, saut de ligne…). Le cours de 2008 écrivait [Split(null)], ce qui revient au même ;
- ligne 21 : la méthode statique [Join] fait l'inverse de [Split] ;
- ligne 23 : toutes les méthodes précédentes ont rendu de nouvelles chaînes : [uneChaine] n'a pas été modifiée (ligne 21 des résultats) ;
- lignes 27-29 : une fonction locale, comme au chapitre 3.
5.2.2. Les méthodes Split et Join
Le programme [chaines-02.cs] approfondit le découpage d'une chaîne en champs :
Résultats :
Commentaires :
- ligne 4 : les champs sont séparés par le caractère [:]. Deux [:] consécutifs, ou un [:] en fin de chaîne, délimitent un champ vide : on obtient 5 champs dont 2 vides (lignes 4, 6 des résultats). [Join] reconstitue la chaîne de départ ;
- la méthode [Split] a de nombreuses surcharges. Celle de 2008, [Split(char[] separator)], s'écrit aujourd'hui [Split(params char[] separator)] : le mot clé [params] permet de passer les séparateurs un par un, [Split(':')] ou [Split(',', ';')], sans construire de tableau ;
- ligne 13 : l'énumération [StringSplitOptions] modifie le découpage. [RemoveEmptyEntries] supprime les champs vides ;
- ligne 18 : [TrimEntries] (.NET 5) supprime les espaces autour de chaque champ. Les séparateurs sont ici passés sous la forme d'une expression de collection [',', ';'] ;
- ligne 23 : les deux options se combinent avec l'opérateur [|]. Les espaces sont supprimés avant le test des champs vides : le champ formé de deux espaces entre deux virgules disparaît ;
- ligne 28 : le séparateur peut être une chaîne de plusieurs caractères ;
- ligne 33 : [Join] accepte une collection d'éléments de type quelconque ; chaque élément est converti en chaîne par sa méthode [ToString].
5.2.3. Rechercher et comparer des chaînes
La comparaison de chaînes est plus subtile qu'il n'y paraît : faut-il distinguer les majuscules des minuscules ? Comment classer « élève » par rapport à « essai » ? Le programme [chaines-03.cs] présente les méthodes de recherche et de comparaison :
Résultats :
Commentaires :
- lignes 5-8 : [Contains], [StartsWith] et [EndsWith] font par défaut une comparaison exacte, caractère par caractère : « LANGAGE » n'est pas trouvé ;
- lignes 11-12 : un paramètre de type [StringComparison] précise le mode de comparaison. Les valeurs les plus utiles sont :
- [Ordinal] : comparaison des codes des caractères ;
- [OrdinalIgnoreCase] : idem, sans tenir compte de la casse ;
- [CurrentCulture], [CurrentCultureIgnoreCase] : comparaison selon les règles de la langue de la machine ;
- [InvariantCulture] : comparaison selon des règles indépendantes de la machine ;
- ligne 16 : l'opérateur [] compare le contenu des chaînes, comme la méthode [Equals]. C'est une différence importante avec Java, où [] compare les références ;
- ligne 17 : la forme statique de [Equals] accepte elle aussi un [StringComparison]. C'est la bonne façon de tester une réponse « oui » saisie au clavier en majuscules ou en minuscules ;
- lignes 21-22 : [string.Compare] rend un entier négatif, nul ou positif selon que la première chaîne précède, est égale ou suit la seconde. En culture française, « élève » précède « essai » (le é est classé avec le e, ligne 10 des résultats). En comparaison ordinale, « élève » suit « essai » car le code du premier caractère é (233) est supérieur à celui du caractère e (101) : la comparaison ordinale rend ici la différence des deux codes, 132. On utilisera l'ordre de la culture pour trier des mots destinés à un utilisateur et l'ordre ordinal pour comparer des identifiants techniques (noms de fichiers, clés…) ;
- lignes 27-29 : deux méthodes statiques pour tester une chaîne absente ([null]), vide, ou ne contenant que des espaces ;
- ligne 32 : [PadLeft] et [PadRight] complètent une chaîne jusqu'à une longueur donnée ; le constructeur [new string('-', 8)] répète un caractère.
5.2.4. Interpolation et formats
L'interpolation de chaînes [$"..."] (C# 6) a été utilisée depuis le début du cours. Elle accepte, comme la méthode [string.Format], une largeur et un format pour chaque expression : [{expression,largeur:format}]. Le programme [chaines-04.cs] en donne des exemples, ainsi que les chaînes brutes de C# 11 :
Résultats :
Commentaires :
- ligne 11 : une largeur positive cadre la valeur à droite dans un champ de 10 caractères, une largeur négative la cadre à gauche ;
- lignes 12-14 : les formats les plus courants :
format | signification | exemple (fr-FR) |
[F2] | nombre en virgule fixe, 2 décimales | 2345,68 |
[N2] | idem avec séparateur des milliers | 2 345,68 |
[C] | montant monétaire de la culture | 2 345,68 € |
[P2] | pourcentage (la valeur est multipliée par 100) | 5,25 % |
[D5] | entier sur 5 chiffres au moins, complété par des zéros | 00045 |
[X] | entier en hexadécimal | 2D |
[dd/MM/yyyy], [HH:mm:ss] | date et heure (MM : mois, mm : minutes) | 03/10/2026, 14:05:09 |
[dddd d MMMM yyyy] | jour et mois en toutes lettres | samedi 3 octobre 2026 |
- les nombres et les dates sont mis en forme selon la culture courante, ici fr-FR : virgule décimale, espace comme séparateur des milliers, noms des jours et des mois en français ;
- ligne 16 : une expression conditionnelle placée dans une interpolation doit être entourée de parenthèses, car le caractère [:] y introduirait un format ;
- ligne 19 : la notation [{0}], [{1}]… de [string.Format] est celle qu'utilisait le cours de 2008 (et [Console.WriteLine], qui accepte les mêmes paramètres). On la rencontre encore souvent ; l'interpolation est plus lisible ;
- lignes 24-26 : les largeurs permettent d'afficher des données en colonnes ;
- ligne 30 : une chaîne verbatim [@"..."] ne traite pas [] comme un caractère d'échappement. Elle est pratique pour les chemins Windows et les expressions régulières ;
- lignes 34-39 : une chaîne brute (C# 11) est délimitée par au moins trois guillemets. Elle peut s'étendre sur plusieurs lignes et contenir des guillemets et des [] sans échappement. L'indentation du guillemet fermant est retirée de chaque ligne : le texte JSON s'affiche sans les 4 espaces de la marge du code ;
- ligne 42 : une chaîne brute peut être interpolée. Avec [$$], une expression interpolée s'écrit entre doubles accolades [{{nom}}], et les accolades simples, nombreuses dans un texte JSON, restent des caractères ordinaires.
5.2.5. La classe System.Text.StringBuilder
Nous avons dit que les méthodes de la classe [String] qui s'appliquent à une chaîne [s1] rendent une autre chaîne [s2]. La classe [System.Text.StringBuilder] permet de modifier une chaîne sans créer de nouvelle chaîne à chaque opération. Cela améliore les performances lorsqu'on construit une chaîne par de nombreux ajouts successifs, en évitant la multiplication de chaînes à durée de vie très limitée.
La classe admet divers constructeurs :
constructeur | rôle |
[StringBuilder()] | constructeur par défaut |
[StringBuilder(string value)] | construction et initialisation avec [value] |
[StringBuilder(string value, int capacity)] | construction et initialisation avec [value], avec une capacité initiale de [capacity] caractères |
Un objet [StringBuilder] stocke ses caractères dans une zone mémoire dont la taille, sa capacité, est ajustée automatiquement lorsque le texte grandit. Par défaut, la capacité initiale est de 16 caractères. Le troisième constructeur permet de la choisir. Le programme [chaines-05.cs] illustre cette notion de capacité :
Résultats :
Commentaires :
- ligne 4 : création d'un objet [StringBuilder] de capacité initiale 16 ;
- ligne 5 : [Length] est le nombre actuel de caractères ; [Capacity] le nombre de caractères que l'objet peut contenir avant de devoir agrandir sa zone mémoire ;
- ligne 8 : [Append] ajoute une chaîne à la fin du texte ;
- ligne 12 : création d'un objet [StringBuilder] de capacité initiale 10.
Les résultats montrent que la capacité double lorsqu'elle est insuffisante : 16, 32, 64 (lignes 6 et 10 des résultats), et 10, 20, 40, 80 pour le second objet. Ce sont les mêmes résultats qu'en 2008. Si l'on connaît à l'avance la taille approximative du texte, la fixer dès la construction évite les agrandissements successifs.
Voici quelques-unes des méthodes de la classe :
méthode | rôle |
[StringBuilder Append(string value)] | ajoute [value] à la fin du texte. Surchargée pour accepter les types [int], [double], [decimal], [char]…, et une chaîne interpolée |
[StringBuilder AppendLine()] | ajoute une fin de ligne (une surcharge ajoute une chaîne suivie d'une fin de ligne) |
[StringBuilder AppendJoin(string separator, params string[] values)] | ajoute les éléments de [values] séparés par [separator] |
[StringBuilder Insert(int index, string value)] | insère [value] à la position [index] ; surchargée comme [Append] |
[StringBuilder Remove(int index, int length)] | supprime [length] caractères à partir de la position [index] |
[StringBuilder Replace(string oldValue, string newValue)] | remplace [oldValue] par [newValue] ; une surcharge remplace un caractère |
[string ToString()] | rend le texte sous la forme d'une chaîne [string] |
Le programme [chaines-06.cs] les utilise :
Résultats :
Commentaires :
- ligne 5 : les méthodes de modification rendent l'objet [StringBuilder] lui-même, ce qui permet de les enchaîner. Suivons les étapes : « test » devient « testabCD » ([Append]), puis « texyZTstabCD » ([Insert] en position 2), puis « xyZTstabCD » ([Remove] des 2 premiers caractères), enfin « XYZTstabCD » ([Replace]). [Console.WriteLine] affiche l'objet en appelant sa méthode [ToString] ;
- lignes 9-11 : la construction d'un texte de plusieurs lignes par ajouts successifs : c'est l'usage typique de [StringBuilder] ;
- ligne 17 : [Append] accepte une chaîne interpolée, avec largeur et format ;
- ligne 19 : le texte final est obtenu sous la forme d'une chaîne [string].
Pour quelques concaténations, l'opérateur [+] ou l'interpolation suffisent : le compilateur les optimise. [StringBuilder] s'impose lorsque le nombre d'ajouts est grand ou inconnu, typiquement dans une boucle.
5.2.6. Les vues sur une chaîne : Span<char>
.NET Core 2.1 (2018) a introduit les types [Span<T>] et [ReadOnlySpan<T>]. Un objet [ReadOnlySpan<char>] est une vue sur une suite de caractères existante, par exemple une partie d'une chaîne : il ne contient pas de copie des caractères, seulement un moyen d'y accéder. Extraire une partie d'une chaîne avec une vue ne crée donc pas de nouvelle chaîne. Le programme [chaines-07.cs] compare les deux façons d'analyser une ligne « nom:prénom:âge » :
Résultats :
Commentaires :
- lignes 7-8 : chaque appel de [Substring] crée une nouvelle chaîne en mémoire, même si, comme pour l'âge, elle n'est utilisée qu'un instant ;
- ligne 12 : [AsSpan] rend une vue sur toute la chaîne ;
- lignes 13-14 : les plages [début..fin] (C# 8), présentées au chapitre 3 pour les tableaux, s'appliquent aux vues : on obtient deux nouvelles vues, sans copie ;
- ligne 16 : de nombreuses méthodes de .NET acceptent une vue au lieu d'une chaîne ([Parse], [TryParse], [StartsWith], [Contains], [Equals]…) ;
- ligne 21 : on ne crée une chaîne à partir d'une vue que si on en a réellement besoin.
Les vues sont un outil d'optimisation, utilisé intensivement à l'intérieur de .NET lui-même : c'est une des raisons pour lesquelles les versions récentes sont nettement plus rapides que le .NET Framework de 2008. Une vue ne peut exister que dans la pile d'exécution : elle ne peut pas, par exemple, être le champ d'une classe. Pour un programme ordinaire, [string] et [Substring] conviennent parfaitement : on n'utilisera les vues que dans le code dont on a mesuré qu'il est critique pour les performances. Nous n'irons pas plus loin.
5.3. Les tableaux
5.3.1. La classe Array
Les tableaux dérivent de la classe [System.Array]. Celle-ci possède diverses méthodes pour trier un tableau, rechercher un élément dans un tableau, redimensionner un tableau... Nous présentons certaines de ses propriétés et méthodes. Elles sont quasiment toutes surchargées, c'est-à-dire qu'elles existent en différentes variantes. Tout tableau en hérite.
Propriétés :
propriété | rôle |
[public int Length { get; }] | nombre total d'éléments du tableau, quel que soit son nombre de dimensions |
[public int Rank { get; }] | nombre de dimensions du tableau |
Méthodes :
méthode | rôle |
[public static int BinarySearch<T>(T[] array, T value)] | rend la position de [value] dans [array], qui doit être trié ; un nombre négatif si [value] est absent |
[public static void Clear(Array array, int index, int length)] | met les [length] éléments de [array] commençant au n° [index] à leur valeur par défaut : 0 pour les nombres, [false] pour les booléens, [null] pour les références |
[public static void Copy(Array source, Array destination, int length)] | copie les [length] premiers éléments de [source] dans [destination] |
[public static void Fill<T>(T[] array, T value)] | affecte [value] à tous les éléments de [array] |
[public int GetLength(int dimension)] | nombre d'éléments de la dimension n° [dimension] du tableau |
[public static int IndexOf<T>(T[] array, T value)] | rend la position de [value] dans [array], ou -1 si [value] n'est pas trouvé ; [LastIndexOf] rend la dernière position |
[public static void Resize<T>(ref T[]? array, int newSize)] | redimensionne [array] à [newSize] éléments ; les éléments déjà présents sont conservés |
[public static void Reverse(Array array)] | inverse l'ordre des éléments de [array] |
[public static void Sort<T>(T[] array)] | trie [array] selon l'ordre naturel de ses éléments ; une surcharge reçoit un objet [IComparer<T>] qui définit l'ordre (chapitre 4) |
Le programme [tableaux-01.cs] illustre l'utilisation de certaines méthodes de la classe [Array] :
Commentaires :
- lignes 17-42 : la méthode [Saisie] saisit les éléments d'un tableau tapés au clavier. Comme on ne connaît pas à l'avance le nombre d'éléments, on part d'un tableau vide (ligne 20) et on l'agrandit d'une case à chaque nouvel élément (ligne 38). [Resize] crée en fait un nouveau tableau, y recopie les éléments de l'ancien et met sa référence dans la variable passée par [ref]. Un algorithme plus efficace allouerait la place par groupes de N éléments. Un tableau n'est pas fait pour être redimensionné : ce cas est mieux traité avec une liste [List<T>], comme nous le verrons bientôt ;
- ligne 40 : [^1] désigne le dernier élément du tableau (index depuis la fin, C# 8) ;
- le cours de 2008 faisait de [Saisie] une méthode à paramètre [out] ; la version moderne rend le tableau créé, ce qui est plus naturel ;
- lignes 56-78 : la méthode [Recherche] cherche dans le tableau des éléments tapés au clavier. Pour un tableau non trié, on fait une recherche linéaire avec [IndexOf] (ligne 76), qui examine les éléments un par un. Pour un tableau trié, on fait une recherche dichotomique avec [BinarySearch] (ligne 75), qui divise à chaque étape par deux la zone de recherche : elle trouve un élément parmi un million en une vingtaine de comparaisons ;
- ligne 10 : on trie le tableau. On utilise ici une variante de [Sort] qui n'a qu'un paramètre, le tableau à trier. La relation d'ordre utilisée pour comparer les éléments du tableau est alors celle, implicite, de ces éléments : ici, l'ordre naturel des nombres ;
- lignes 46-51 : une méthode générique, qui affiche un tableau d'éléments de type quelconque [T].
Résultats :
Lorsque l'élément cherché est absent, [IndexOf] rend -1 et [BinarySearch] un nombre négatif (ligne 27) : c'est le complément à un ([~i]) de la position où il faudrait insérer l'élément pour garder le tableau trié. Ici [~(-3)] vaut 2 : le nombre 0 devrait être inséré en position 2, entre -1,5 et 3,6. Attention : [BinarySearch] sur un tableau non trié rend un résultat sans signification.
5.3.2. D'autres méthodes de la classe Array
Le programme [tableaux-02.cs] présente d'autres méthodes de la classe [Array] :
Résultats :
Commentaires :
- ligne 6 : [Reverse] inverse l'ordre des éléments du tableau lui-même ;
- ligne 10 : on ne trie que 3 éléments à partir de la position 1 : 20, 30, 10 deviennent 10, 20, 30 ;
- ligne 15 : copie des 3 premiers éléments de [nombres] dans [copie], dont les autres éléments gardent leur valeur initiale 0 ;
- lignes 19-21 : [Fill] remplit le tableau, [Clear] remet 2 éléments à 0 à partir de la position 1 ;
- ligne 29 : les chaînes sont triées selon l'ordre alphabétique de la culture courante ;
- ligne 34 : pour un tableau à deux dimensions, [Rank] vaut 2, [Length] est le nombre total d'éléments et [GetLength(i)] le nombre d'éléments de la dimension i ;
- ligne 39 : [string.Join] permet d'afficher un tableau sur une ligne.
LINQ, que nous présenterons plus loin, offre d'autres façons de chercher, trier ou transformer les éléments d'un tableau.
5.4. Les collections génériques
Outre le tableau, il existe diverses classes pour stocker des collections d'éléments. Les collections génériques, apparues avec .NET 2.0, se trouvent dans l'espace de noms [System.Collections.Generic], qui fait partie des [using] implicites. Nous présenterons d'abord deux collections fréquemment utilisées, la liste et le dictionnaire, puis d'autres plus rapidement.
L'espace de noms [System.Collections] contient les anciennes versions non génériques de ces collections, datant de .NET 1.0 : [ArrayList] (une liste), [Hashtable] (un dictionnaire)... Le cours de 2008 présentait encore [ArrayList]. Ces classes sont aujourd'hui obsolètes : elles stockent des références de type [object], ce qui oblige à transtyper les éléments lus et à encapsuler (boxing) les nombres dans des objets, avec un coût en mémoire et en temps. Les collections génériques n'ont aucun de ces défauts : une [List<int>] range ses entiers directement dans un tableau [int[]] interne, et le compilateur vérifie le type des éléments ajoutés. On ne doit plus utiliser [ArrayList] et [Hashtable] dans du code nouveau.
5.4.1. La classe générique List<T>
La classe [System.Collections.Generic.List<T>] permet d'implémenter des collections d'objets de type [T] dont la taille varie au cours de l'exécution du programme. Un objet de type [List<T>] se manipule presque comme un tableau. Ainsi l'élément i d'une liste [l] est-il noté [l[i]].
Pour une liste [List<T>] où [T] est une classe, la liste stocke les références des objets de type [T], comme un tableau d'objets ; si [T] est un type valeur ([int], [double], structure…), les valeurs elles-mêmes sont stockées dans la liste.
Voici quelques-unes des propriétés et méthodes des listes génériques.
Propriétés :
propriété | rôle |
[public int Count { get; }] | nombre d'éléments de la liste |
[public int Capacity { get; set; }] | nombre d'éléments que la liste peut contenir avant d'être agrandie. Cet agrandissement est automatique. Cette notion de capacité est analogue à celle décrite pour la classe [StringBuilder] |
Méthodes :
méthode | rôle |
[public void Add(T item)] | ajoute [item] à la fin de la liste |
[public void AddRange(IEnumerable<T> collection)] | ajoute les éléments de [collection] à la fin de la liste |
[public int BinarySearch(T item)] | rend la position de [item] dans la liste triée s'il s'y trouve, sinon un nombre négatif |
[public void Clear()] | supprime tous les éléments de la liste |
[public bool Contains(T item)] | rend [true] si [item] est dans la liste, [false] sinon |
[public List<T> GetRange(int index, int count)] | rend une nouvelle liste formée de [count] éléments à partir de la position [index] |
[public int IndexOf(T item)] | rend la position de [item] dans la liste, ou -1 si [item] n'est pas trouvé |
[public void Insert(int index, T item)] | insère [item] à la position [index] de la liste |
[public bool Remove(T item)] | supprime la première occurrence de [item] de la liste ; rend [true] si l'opération réussit, [false] sinon |
[public void RemoveAt(int index)] | supprime l'élément n° [index] de la liste |
[public void Reverse()] | inverse l'ordre des éléments de la liste |
[public void Sort()] | trie la liste selon l'ordre naturel de ses éléments ; une surcharge reçoit un [IComparer<T>] |
[public T[] ToArray()] | rend les éléments de la liste sous forme de tableau |
Reprenons l'exemple traité précédemment avec un tableau et traitons-le maintenant avec un objet de type [List<double>]. Parce que la liste est un objet proche du tableau, le code change peu. C'est le programme [collections-01.cs] :
Commentaires :
- ligne 22 : la liste est créée vide. [new()] (C# 9) est une forme abrégée de [new List<double>()] : le type est déduit de la déclaration de la variable ;
- ligne 40 : il n'y a plus de redimensionnement à gérer : la liste s'agrandit d'elle-même ;
- ligne 6 : le nombre d'éléments de la liste et sa capacité ;
- lignes 12, 75, 76 : les méthodes [Sort], [BinarySearch] et [IndexOf] sont maintenant des méthodes d'instance de la liste, alors que celles de [Array] sont des méthodes statiques ;
- lignes 46-51 : la méthode générique [Affiche<T>] admet deux paramètres :
- le premier est un texte à écrire ;
- le second est un objet implémentant l'interface générique [IEnumerable<T>] :
La structure [foreach (T element in elements)] est valide pour tout objet [elements] implémentant l'interface [IEnumerable<T>]. Les tableaux et les listes implémentent cette interface. Aussi la méthode [Affiche] convient-elle aussi bien pour afficher des tableaux que des listes. Nous reviendrons sur cette interface, qui est au cœur de LINQ.
Résultats :
Les résultats sont les mêmes qu'avec le tableau. La capacité de la liste est ici de 4 (ligne 7) : partie de 0, elle est passée à 4 au premier ajout ; elle serait passée à 8 au cinquième, en doublant comme celle d'un [StringBuilder].
5.4.2. Méthodes de List<T> et expressions de collection
Le programme [collections-02.cs] utilise les autres méthodes de la liste et les expressions de collection de C# 12, déjà rencontrées avec les tableaux au chapitre 3 :
Résultats :
Commentaires :
- ligne 4 : une expression de collection [a, b, c] initialise une liste comme un tableau ;
- lignes 8-10 : trois façons d'ajouter des éléments ;
- ligne 14 : l'élément n° 0 est accessible en lecture et en écriture ; [villes[^1]] est le dernier élément, comme pour un tableau ;
- ligne 21 : [Remove] rend [true] si l'élément a été trouvé et supprimé ;
- ligne 30 : une nouvelle liste formée de 2 éléments à partir de la position 1 ;
- lignes 34-35 : passage d'une liste à un tableau, et d'un tableau (ou de toute séquence) à une liste ;
- ligne 40 : dans une expression de collection, l'opérateur [..] (spread) insère tous les éléments d'une autre collection ;
- ligne 43 : [] désigne une collection vide du type attendu.
5.4.3. La classe Dictionary<TKey,TValue>
La classe [System.Collections.Generic.Dictionary<TKey,TValue>] permet d'implémenter un dictionnaire. On peut voir un dictionnaire comme un tableau à deux colonnes :
clé | valeur |
clé1 | valeur1 |
clé2 | valeur2 |
... | ... |
Dans la classe [Dictionary<TKey,TValue>], les clés sont de type [TKey], les valeurs de type [TValue]. Les clés sont uniques : il ne peut y avoir deux clés identiques. Un tel dictionnaire pourrait ressembler à ceci si les types [TKey] et [TValue] désignaient des classes :
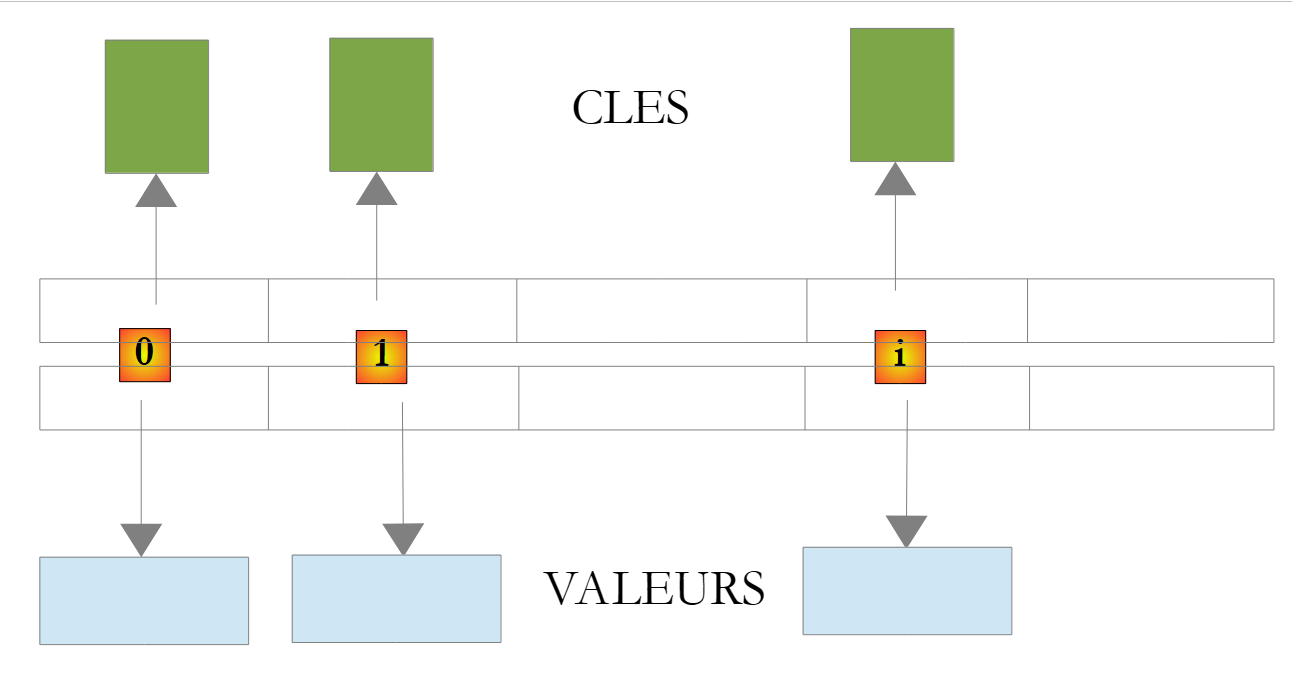
La valeur associée à la clé [c] d'un dictionnaire [d] est obtenue par la notation [d[c]]. Cette valeur est en lecture et écriture. Ainsi on peut écrire :
En écriture, [d[c] = v] ajoute le couple (c, v) si la clé [c] n'existe pas, et remplace la valeur associée à [c] sinon. En lecture, si la clé [c] n'existe pas dans le dictionnaire [d], la notation [d[c]] lance une exception [KeyNotFoundException].
Les méthodes et propriétés principales de la classe [Dictionary<TKey,TValue>] sont les suivantes.
Propriétés :
propriété | rôle |
[public int Count { get; }] | nombre d'entrées (clé, valeur) du dictionnaire |
[public KeyCollection Keys { get; }] | collection des clés du dictionnaire |
[public ValueCollection Values { get; }] | collection des valeurs du dictionnaire |
Méthodes :
méthode | rôle |
[public void Add(TKey key, TValue value)] | ajoute le couple (key, value) au dictionnaire ; lance une exception si la clé existe déjà |
[public bool TryAdd(TKey key, TValue value)] | idem, mais rend [false] au lieu de lancer une exception |
[public void Clear()] | supprime tous les couples du dictionnaire |
[public bool ContainsKey(TKey key)] | rend [true] si [key] est une clé du dictionnaire, [false] sinon |
[public bool ContainsValue(TValue value)] | rend [true] si [value] est une valeur du dictionnaire, [false] sinon |
[public bool Remove(TKey key)] | supprime du dictionnaire le couple de clé [key] ; rend [true] si l'opération réussit, [false] sinon |
[public bool TryGetValue(TKey key, out TValue value)] | rend [true] et met dans [value] la valeur associée à la clé [key] si cette dernière existe ; rend [false] sinon, et [value] reçoit la valeur par défaut du type [TValue] |
Considérons le programme exemple [collections-03.cs] :
Commentaires :
- ligne 4 : un tableau de chaînes qui va servir à initialiser le dictionnaire <string,int> ;
- ligne 5 : le dictionnaire, vide ;
- lignes 6-9 : son initialisation à partir du tableau de chaînes ;
- ligne 12 : le nombre d'entrées du dictionnaire ;
- lignes 14-16 : les clés et les valeurs du dictionnaire. [dico.Keys] et [dico.Values] implémentent [IEnumerable<T>] : la méthode [Affiche] déjà rencontrée convient ;
- ligne 25 : suppression d'une entrée du dictionnaire ;
- ligne 28 : un dictionnaire est une séquence de couples [KeyValuePair<TKey,TValue>], qui ont une propriété [Key] et une propriété [Value]. Depuis .NET Core 2.0, un tel couple se déconstruit en deux variables, comme un tuple (chapitre 3) ;
- lignes 35-42 : [Add] refuse une clé existante en lançant une exception ; [TryAdd] rend [false] dans ce cas. Les messages des exceptions de .NET sont en anglais : .NET 10 n'est pas fourni avec des messages en français ;
- ligne 46 : la lecture d'une clé absente lance une exception [KeyNotFoundException] ;
- ligne 63 : recherche d'une clé dans le dictionnaire. [TryGetValue] rend [true] si la clé existe. Le cours de 2008 ignorait ce résultat et testait si la valeur rendue était nulle, technique qui ne fonctionnait que parce que la valeur 0 n'était pas dans le dictionnaire. Le test du booléen rendu est la bonne façon de faire.
Résultats :
Les clés sont ici énumérées dans leur ordre d'ajout, mais ce n'est pas garanti : un [Dictionary] ne maintient aucun ordre. Après des suppressions, un nouvel élément peut prendre la place d'un élément supprimé. Si l'ordre des clés importe, on utilisera un [SortedDictionary], présenté ci-dessous.
5.4.4. D'autres collections génériques
L'espace de noms [System.Collections.Generic] contient d'autres collections, chacune adaptée à un usage particulier :
classe | rôle |
[HashSet<T>] | un ensemble : pas de doublons, pas d'ordre, test d'appartenance très rapide ; opérations ensemblistes (union, intersection, différence) |
[SortedSet<T>] | un ensemble dont les éléments sont maintenus triés |
[Queue<T>] | une file : les éléments sortent dans l'ordre où ils sont entrés (FIFO, first in first out) |
[Stack<T>] | une pile : le dernier élément entré est le premier sorti (LIFO, last in first out) |
[SortedDictionary<TKey,TValue>] | un dictionnaire dont les clés sont maintenues triées |
[PriorityQueue<TElement,TPriority>] | une file de priorité (.NET 6) : l'élément qui sort est celui de plus petite priorité |
[LinkedList<T>] | une liste doublement chaînée : insertions et suppressions rapides au milieu de la liste |
Le programme [collections-04.cs] en fait un rapide survol :
Résultats :
Commentaires :
- ligne 4 : les expressions de collection initialisent aussi un ensemble ;
- ligne 6 : [Add] rend [false] si l'élément est déjà dans l'ensemble, qui reste inchangé ;
- lignes 9-12 : [IntersectWith] et [UnionWith] modifient l'ensemble ; on travaille donc sur une copie de [langages]. L'ordre d'affichage des éléments d'un ensemble n'a pas de signification (ligne 4) ;
- les doubles accolades [{{] et [}}] d'une chaîne interpolée affichent une accolade ;
- lignes 16-20 : [Enqueue] fait entrer un élément dans la file, [Dequeue] fait sortir le plus ancien, [Peek] le consulte sans le faire sortir ;
- lignes 23-30 : [Push] empile un élément, [Pop] dépile le plus récent. [Pop] sur une pile vide lance une exception, [TryPop] rend [false] ;
- lignes 33-40 : un dictionnaire initialisé avec la syntaxe [[clé] = valeur] ; ses couples sont énumérés dans l'ordre des clés ;
- lignes 43-49 : chaque élément entre dans la file avec une priorité ; les patients sortent par ordre de priorité croissante, quel que soit leur ordre d'arrivée.
5.4.5. Les collections en lecture seule
Une classe qui gère une collection doit souvent la montrer à l'extérieur sans permettre qu'on la modifie. .NET propose pour cela des interfaces en lecture seule : [IReadOnlyCollection<T>] (un [Count] et un [foreach]), [IReadOnlyList<T>] (en plus, un accès par indice) et [IReadOnlyDictionary<TKey,TValue>]. Les classes [List<T>], [T[]] et [Dictionary<TKey,TValue>] les implémentent. Le programme [collections-05.cs] les utilise :
Résultats :
Commentaires :
- lignes 37-47 : la classe [Classe] gère une liste d'élèves. La liste elle-même est privée ; seule la méthode [Inscrire] permet de la modifier ;
- ligne 43 : la propriété [Eleves] rend la liste sous le type [IReadOnlyList<string>], qui n'offre que les opérations de lecture : [eleves.Add("x")] provoquerait une erreur de compilation ;
- ligne 12 : la protection n'est cependant que de surface : l'objet rendu est la liste elle-même, et un transtypage permet de retrouver ses méthodes de modification ;
- ligne 45 : [AsReadOnly] rend une enveloppe de type [ReadOnlyCollection<T>] autour de la liste. Cette fois, aucune modification n'est possible : ses méthodes de modification, imposées par l'interface [IList<T>], lancent une exception [NotSupportedException] (ligne 5). L'enveloppe ne copie pas la liste : elle voit les modifications faites par la classe propriétaire (ligne 6) ;
- ligne 33 : un dictionnaire vu à travers l'interface [IReadOnlyDictionary<TKey,TValue>].
Pour des données qui ne doivent jamais changer après leur création, l'espace de noms [System.Collections.Immutable] propose des collections immuables ([ImmutableList<T>], [ImmutableDictionary<TKey,TValue>]…) et [System.Collections.Frozen] des collections figées optimisées pour la lecture ([FrozenDictionary<TKey,TValue>], .NET 8). Nous ne les détaillerons pas.
5.5. LINQ
Le cours de 2008 s'arrêtait au seuil de LINQ, en annonçant ses types anonymes sans les utiliser. LINQ (Language Integrated Query, C# 3, 2007) est un ensemble de méthodes qui permettent d'interroger une collection comme on interroge une base de données : filtrer, trier, regrouper, calculer des totaux... Il s'applique à toute collection implémentant l'interface [IEnumerable<T>] : tableaux, listes, dictionnaires, ensembles, lignes d'un fichier, résultats d'une expression régulière, et, avec Entity Framework Core (chapitre 11), tables d'une base de données. L'espace de noms [System.Linq] fait partie des [using] implicites.
5.5.1. Les séquences IEnumerable<T> et les itérateurs
Une collection qui implémente [IEnumerable<T>] est appelée une séquence : on peut la parcourir avec [foreach]. L'interface ne contient qu'une méthode, [GetEnumerator], qui rend un énumérateur [IEnumerator<T>] : un objet qui avance dans la séquence ([MoveNext]) et donne l'élément courant ([Current]).
Une méthode peut produire une séquence sans construire de collection : c'est un itérateur. Il rend ses éléments un par un avec l'instruction [yield return]. Le programme [linq-01.cs] en donne deux exemples :
Résultats :
Commentaires :
- lignes 39-48 : la méthode [Pairs] est un itérateur : son type de retour est [IEnumerable<int>] et elle contient l'instruction [yield return] (ligne 46). Elle ne construit aucune liste : à chaque [yield return], elle rend un élément au code qui la parcourt et se met en pause ; elle reprendra à l'instruction suivante quand on lui demandera l'élément suivant ;
- lignes 5-7 : les résultats (lignes 3-12) montrent que la production d'un élément par l'itérateur et sa consommation par la boucle [foreach] alternent ;
- lignes 12-17 : ce que fait réellement [foreach] : il demande un énumérateur à la séquence, appelle [MoveNext] tant que cette méthode rend [true], et lit l'élément courant dans [Current]. L'énumérateur est libéré à la fin par l'instruction [using] (nous y reviendrons avec les fichiers). On remarquera que l'appel [Pairs(4)] de la ligne 12 n'exécute rien : le message « début de l'itérateur » n'apparaît qu'au premier [MoveNext] ;
- lignes 52-58 : un itérateur peut produire une séquence infinie : il n'en calcule que les éléments demandés. C'est la boucle [foreach] qui décide de s'arrêter (ligne 25). La ligne 58 utilise les tuples du chapitre 3 pour échanger les valeurs ;
- lignes 34-35 : une chaîne est une séquence de caractères, une liste une séquence de ses éléments. La liste est créée ici avec la syntaxe d'initialiseur de collection [new List<string> { ... }] (C# 3), que l'on rencontre souvent dans le code existant.
Ce mécanisme de production à la demande est celui de toutes les méthodes de LINQ.
5.5.2. Filtrer, projeter, trier
Les exemples LINQ qui suivent travaillent sur une petite liste de personnes. Une personne est représentée par un enregistrement [record] (C# 9), présenté au chapitre 4 : en une ligne, on obtient une classe avec un constructeur, des propriétés en lecture seule, une méthode [ToString] qui affiche les propriétés, et une égalité qui compare les valeurs des propriétés.
Le programme [linq-02.cs] présente les méthodes de base de LINQ :
Résultats :
Commentaires :
- lignes 4-13 : la liste des personnes, initialisée par une expression de collection ; [new(...)] crée un objet du type attendu, ici [Personne] ;
- ligne 56 : l'enregistrement [Personne]. Une application fichier unique place ses déclarations de types après les instructions de haut niveau ;
- ligne 16 : la méthode [Where] filtre la séquence : elle ne garde que les éléments qui vérifient une condition. Cette condition lui est passée sous la forme d'une fonction anonyme [p => p.Age >= 18], qui se lit « la fonction qui, à une personne p, associe le booléen p.Age >= 18 ». On appelle cette écriture une expression lambda. [Where] appelle cette fonction pour chaque personne. Les lambdas seront étudiées en détail au chapitre 7 (« Délégués, lambdas et événements ») ; il nous suffit ici de savoir les lire ;
- le résultat de [Where] est une nouvelle séquence [IEnumerable<Personne>] : la liste [personnes] n'est pas modifiée. C'est vrai de toutes les méthodes de LINQ ;
- la méthode [Affiche] affiche chaque personne avec la méthode [ToString] générée pour l'enregistrement : [Personne { Nom = dupont, ... }] ;
- ligne 20 : la méthode [Select] projette chaque élément de la séquence sur une nouvelle valeur, ici une chaîne. Le résultat est une séquence [IEnumerable<string>] ;
- lignes 24-27 : les méthodes de LINQ rendent des séquences, auxquelles on peut appliquer d'autres méthodes de LINQ. On écrit souvent une méthode par ligne : cette chaîne d'appels se lit de haut en bas comme une recette ;
- ligne 26 : [OrderBy] trie la séquence selon la clé rendue par la lambda, ici le nom ;
- ligne 31 : [OrderByDescending] trie par ordre décroissant ; [ThenBy] (ou [ThenByDescending]) ajoute un critère secondaire, utilisé pour départager les éléments égaux selon le premier critère : durand et laurent, qui ont tous deux 32 ans, sont classés par nom (lignes 23-24) ;
- lignes 35-38 : la même requête que [angevins] écrite avec la syntaxe de requête, proche de SQL. Le compilateur la traduit exactement en la chaîne d'appels [Where(...).OrderBy(...).Select(...)] : les deux écritures sont équivalentes. La syntaxe de requête est plus lisible pour les jointures et les regroupements ; la syntaxe de méthode est plus courante, et elle seule donne accès à toutes les méthodes de LINQ ([Take], [Count], [First]…) ;
- ligne 42 : une variante de [Select] passe à la lambda l'élément et sa position dans la séquence.
5.5.3. Quantificateurs, agrégats, choix d'éléments
Le programme [linq-03.cs] présente des méthodes qui rendent une seule valeur, et des méthodes qui sélectionnent une partie de la séquence :
Résultats :
Commentaires :
- ligne 15 : [Any] rend [true] si au moins un élément vérifie la condition, [All] si tous la vérifient. Sans paramètre, [Any] indique si la séquence est non vide ;
- lignes 18-20 : les agrégats [Count], [Sum], [Average], [Min], [Max] calculent une valeur à partir de toute la séquence. [Count] accepte une condition (une liste a aussi une propriété [Count], qu'on préférera à la méthode quand il n'y a pas de condition) ; [Sum], [Average], [Min], [Max] acceptent une lambda qui indique la valeur à prendre en compte pour chaque élément ;
- ligne 22 : [MinBy] et [MaxBy] (.NET 6) rendent l'élément (ici la personne) pour lequel la clé est minimale ou maximale, et non la valeur de la clé. Pour une séquence vide d'objets (type référence), elles rendent [null], d'où l'opérateur [?.] ;
- ligne 25 : [First] rend le premier élément de la séquence, ou le premier qui vérifie une condition ; [Last] le dernier ;
- ligne 26 : si aucun élément ne convient, [First] lance une exception (ligne 11 des résultats) alors que [FirstOrDefault] rend la valeur par défaut du type, ici [null] ;
- ligne 28 : [Single] rend l'unique élément vérifiant la condition, et lance une exception s'il y en a zéro ou plusieurs (ligne 10). On l'utilise quand l'unicité est une règle des données, par exemple la recherche d'un élément par sa clé. [SingleOrDefault] rend la valeur par défaut s'il n'y a aucun élément ;
- ligne 32 : le résultat de l'appel n'est pas utilisé : on l'affecte à l'élément ignoré [_] (C# 7) pour le signaler ;
- ligne 49 : [Distinct] élimine les doublons ; [DistinctBy] (.NET 6) garde le premier élément de chaque valeur de la clé ;
- lignes 57-58 : [Take(n)] garde les n premiers éléments, [Skip(n)] les saute. Combinées, elles extraient une « page » de résultats. [TakeWhile] garde les éléments tant qu'une condition est vérifiée et s'arrête au premier élément qui ne la vérifie pas ;
- ligne 62 : [Chunk] (.NET 6) découpe la séquence en tableaux de 3 éléments, le dernier pouvant être plus court ;
- ligne 64 : la variable [page] est incrémentée après avoir été utilisée dans l'interpolation.
5.5.4. Types anonymes, regroupements, jointures
Le programme [linq-04.cs] présente les types anonymes et des opérations plus élaborées :
Résultats :
Commentaires :
- ligne 22 : un type anonyme (C# 3) : l'expression [new { Nom = ..., Age = ... }] crée un objet dont la classe, sans nom, est générée par le compilateur avec deux propriétés en lecture seule [Nom] et [Age]. Comme ce type n'a pas de nom, la variable doit être déclarée avec [var]. Le compilateur connaît néanmoins parfaitement ce type : [p1.Nom] est vérifié à la compilation, et l'éditeur propose les propriétés de [p1] en autocomplétion ;
- ligne 25 : l'usage principal des types anonymes : dans un [Select], ne garder que les données utiles, sans avoir à déclarer une classe pour cela. [p.Nom] est une abréviation de [Nom = p.Nom] ;
- ligne 33 : [GroupBy] regroupe les éléments ayant la même clé. Le résultat est une séquence de groupes [IGrouping<TKey,TElement>] : chaque groupe a une propriété [Key], la valeur commune de la clé, et il est lui-même la séquence des éléments du groupe, à laquelle on peut appliquer [Count], [Average], [Select]… (ligne 36) ;
- lignes 41-44 : [Join] associe chaque personne à la ville de même nom. Ses paramètres sont la seconde séquence, la clé de jointure de chaque côté, et une lambda qui construit le résultat à partir d'un couple (personne, ville). Comme une jointure SQL, [Join] ne garde que les couples qui se correspondent : laurent, qui habite Lyon, absente de la liste des villes, n'apparaît pas, ni Brest, qui n'a pas d'habitant ;
- lignes 50-53 : la jointure en syntaxe de requête, plus lisible : [join ... in ... on ... equals ...]. On y ajoute un filtre [where]. La syntaxe de requête a aussi une clause [group ... by ...] pour les regroupements ;
- ligne 57 : [ToList] (et [ToArray]) exécute la requête et range ses résultats dans une liste (un tableau) ;
- ligne 58 : [ToDictionary] construit un dictionnaire : la première lambda donne la clé de chaque élément, la seconde sa valeur. Une clé en double provoque une exception ;
- ligne 63 : [CountBy] (.NET 9) compte les éléments de chaque valeur de la clé. Il rend une séquence de couples [KeyValuePair<string,int>]. C'est un raccourci pour [GroupBy(p => p.Ville).Select(g => (g.Key, g.Count()))] ;
- ligne 68 : [AggregateBy] (.NET 9) cumule une valeur pour chaque valeur de la clé : on part de 0 et, pour chaque personne, on ajoute son âge à la somme de sa ville. Les couples rendus sont déconstruits dans la boucle [foreach] ;
- ligne 73 : [Index] (.NET 9) associe à chaque élément sa position dans la séquence, sous la forme d'un tuple (position, élément).
5.5.5. L'exécution différée
Une requête LINQ n'est pas exécutée au moment où on l'écrit, mais au moment où on parcourt son résultat : c'est l'exécution différée. Le programme [linq-05.cs] le démontre avec des lambdas qui affichent ce qu'elles font :
Résultats :
Commentaires :
- lignes 7-16 : une requête qui garde les nombres pairs puis calcule leurs carrés. Les lambdas sont ici écrites avec un corps entre accolades, qui affiche un message avant de rendre sa valeur avec [return] ;
- ligne 3 des résultats : après la définition de la requête, rien n'a été affiché : ni [Where] ni [Select] n'ont encore examiné un seul élément. [carresPairs] ne contient pas de résultats, mais la description d'un calcul ;
- lignes 4-16 : la requête s'exécute pendant la boucle [foreach], élément par élément : chaque nombre traverse [Where], puis [Select] s'il est pair, puis arrive dans la boucle avant que le nombre suivant ne soit examiné. Ce sont des itérateurs, comme [Pairs] dans [linq-01.cs] ;
- lignes 28-31 : la requête [grands] est réévaluée à chaque parcours : elle tient compte du nombre 10 ajouté à la liste après sa définition ;
- ligne 34 : [ToList] exécute la requête immédiatement et mémorise ses résultats : [instantane] est une liste, qui ne voit pas l'ajout de 20 (ligne 19) ;
- ligne 39 : les méthodes qui rendent une valeur unique ([Count], [Sum], [First], [Any]…) parcourent elles aussi la séquence immédiatement ;
- lignes 45-49 : [First] arrête le parcours dès qu'il a obtenu un élément : les nombres qui suivent 3 ne sont jamais examinés.
L'exécution différée a deux conséquences pratiques :
- une requête parcourue plusieurs fois est exécutée plusieurs fois. Si son calcul est coûteux, ou si l'on veut un résultat figé, on la convertit une fois pour toutes avec [ToList] ou [ToArray] ;
- les requêtes se composent sans coût : enchaîner [Where], [Select] et [Take] ne crée aucune collection intermédiaire, et seuls les éléments nécessaires sont calculés.
Nous retrouverons LINQ tout au long du cours, et nous verrons au chapitre 7 comment ses méthodes sont construites.
5.6. Les fichiers texte
Les classes de lecture et d'écriture des fichiers se trouvent dans l'espace de noms [System.IO], qui fait partie des [using] implicites.
5.6.1. La classe StreamReader
La classe [System.IO.StreamReader] permet de lire le contenu d'un fichier texte. Elle est en fait capable d'exploiter des flux qui ne sont pas des fichiers (une connexion réseau, par exemple). Voici quelques-unes de ses propriétés et méthodes.
Constructeurs :
constructeur | rôle |
[public StreamReader(string path)] | construit un flux de lecture à partir du fichier de chemin [path]. Le contenu du fichier peut être encodé de diverses façons ; par défaut, c'est l'encodage UTF-8 qui est utilisé. Une autre surcharge permet de préciser l'encodage : [new StreamReader(path, Encoding.Latin1)] |
Propriétés :
propriété | rôle |
[public bool EndOfStream { get; }] | [true] si le flux a été lu entièrement |
Méthodes :
méthode | rôle |
[public void Dispose()] | ferme le flux et libère les ressources allouées pour sa gestion. À faire obligatoirement après exploitation du flux, ce dont se charge l'instruction [using]. [Close] fait la même chose |
[public int Peek()] | rend le caractère suivant du flux sans le consommer ; -1 à la fin du flux |
[public int Read()] | rend le caractère suivant du flux et avance d'un caractère ; -1 à la fin du flux |
[public string? ReadLine()] | rend la ligne suivante du flux, sans la marque de fin de ligne, ou [null] si on était à la fin du flux |
[public string ReadToEnd()] | rend la fin du flux, ou "" si on était à la fin du flux |
Le programme [fichiers-01.cs] est le suivant :
Commentaires :
- ligne 4 : affiche le nom du dossier courant, celui à partir duquel on a lancé la commande [dotnet run]. On n'affiche que le dernier élément du chemin, avec [Path.GetFileName], pour ne pas encombrer les résultats d'un chemin complet ;
- ligne 6 : le fichier lu est [infos.txt] ou celui passé en argument. Comme c'est un nom relatif, il est cherché dans le dossier courant ;
- ligne 11 : la structure [using (flux = ...) { ... }] garantit la fermeture du flux à la sortie du bloc, même si une exception se produit dans le bloc. Elle évite d'avoir à appeler explicitement la méthode de fermeture. Elle s'applique à tout objet implémentant l'interface [IDisposable], c'est-à-dire possédant une méthode [Dispose] qui libère des ressources (fichier, connexion réseau, connexion à une base de données…) ;
- lignes 15-17 : le fichier est lu ligne par ligne. L'affectation [ligne = flux.ReadLine()] est une expression dont la valeur est celle de [ligne] : on la compare à [null], qui signale la fin du fichier. La variable [ligne] est de type [string?] : [ReadLine] peut rendre [null] ;
- ligne 23 : une déclaration using (C# 8). Il n'y a plus de bloc : la variable [flux2] sera libérée à la fin du bloc qui contient sa déclaration, ici le bloc [try]. Cette écriture, plus légère, est la plus courante aujourd'hui ;
- ligne 24 : le fichier est lu d'un seul coup ;
- lignes 27-32 : les erreurs d'entrée-sortie sont signalées par des exceptions dérivées de [IOException]. [FileNotFoundException] en est une : elle est donc interceptée avant. Sa propriété [FileName] contient le chemin complet du fichier cherché.
Le fichier [infos.txt] est le suivant :
Il est placé dans le dossier [05-classes-dotnet], d'où l'on exécute le programme :
Avec un fichier inexistant :
Le choix du dossier courant pour trouver les fichiers de données est naturel pour une application fichier unique, que l'on exécute depuis son dossier. Pour un projet, l'exécutable se trouve dans un sous-dossier [bin/Debug/net10.0] du projet : nous verrons avec l'application exemple comment y faire copier les fichiers de données et comment les y trouver.
5.6.2. La classe StreamWriter
La classe [System.IO.StreamWriter] permet d'écrire dans un fichier texte. Comme la classe [StreamReader], elle est en fait capable d'exploiter des flux qui ne sont pas des fichiers. Voici quelques-unes de ses propriétés et méthodes.
Constructeurs :
constructeur | rôle |
[public StreamWriter(string path)] | construit un flux d'écriture dans le fichier de chemin [path]. Le fichier est créé, ou écrasé s'il existe. Par défaut, le texte est encodé en UTF-8, sans BOM (voir plus loin) |
[public StreamWriter(string path, bool append)] | si [append] vaut [true], les écritures sont ajoutées à la fin du fichier existant |
Propriétés :
propriété | rôle |
[public bool AutoFlush { get; set; }] | fixe le mode d'écriture dans le fichier. Si [AutoFlush] vaut [false] (valeur par défaut), l'écriture dans le flux n'est pas immédiate : le texte est d'abord écrit dans une mémoire tampon, puis dans le fichier lorsque le tampon est plein, lorsqu'on le vide explicitement par la méthode [Flush] ou lorsqu'on ferme le flux. C'est le mode le plus efficace pour les fichiers, parce qu'il limite les accès au disque. Il ne convient pas à tous les flux, notamment aux flux réseau : dans un dialogue entre deux partenaires, ce qui est écrit par l'un doit être immédiatement lu par l'autre, et le flux d'écriture doit être en mode [AutoFlush=true] |
[public string NewLine { get; set; }] | la marque de fin de ligne écrite par [WriteLine]. Par défaut, celle du système : "\r\n" sous Windows, "\n" sous Linux et macOS |
[public Encoding Encoding { get; }] | l'encodage utilisé |
Méthodes :
méthode | rôle |
[public void Dispose()] | ferme le flux, après avoir écrit dans le fichier le contenu du tampon. À faire obligatoirement après exploitation du flux ; [Close] fait la même chose |
[public void Flush()] | écrit dans le fichier le contenu du tampon, sans attendre qu'il soit plein |
[public void Write(T value)] | écrit [value] dans le fichier associé au flux. Ici [T] n'est pas un type générique mais symbolise le fait que la méthode [Write] accepte différents types de paramètres ([string], [int], [object]…) |
[public void WriteLine(T value)] | même chose que [Write] mais avec la marque de fin de ligne ([NewLine]) en plus |
Le programme [fichiers-02.cs] est le suivant :
Résultats :
Commentaires :
- ligne 6 : de nouveau, nous utilisons l'instruction [using] afin de ne pas avoir à fermer explicitement le flux. Cette fermeture est faite automatiquement à la sortie du bloc (accolade fermante de la ligne 21). C'est elle qui écrit dans le fichier le texte resté dans le tampon : sans elle, le fichier pourrait rester incomplet ;
- ligne 19 : écriture d'une ligne dans le fichier texte ;
- ligne 24 : la classe [FileInfo] donne des informations sur un fichier, ici sa taille en octets. Les 25 octets se décomposent ainsi : 21 caractères, plus 1 octet supplémentaire pour chacun des deux [è] (qui occupent 2 octets en UTF-8), plus deux fins de ligne d'un octet ("\n" sous Linux, où ont été faites les exécutions ; sous Windows, chaque fin de ligne "\r\n" occuperait 2 octets) ;
- ligne 28 : pourquoi un [try / catch] ? Nous pourrions donner un nom de fichier de la forme [rep1/rep2/fichier] avec un dossier [rep1/rep2] qui n'existe pas, rendant impossible la création du fichier. Une exception [DirectoryNotFoundException], dérivée de [IOException], serait alors lancée. Il existe d'autres cas d'exception possibles (disque plein, droits insuffisants...).
5.6.3. Les classes File, Path et Directory
Pour les opérations courantes, la classe statique [File] évite de manipuler des flux : une seule méthode ouvre le fichier, le lit ou l'écrit entièrement, puis le ferme. Les classes statiques [Path] et [Directory] manipulent respectivement les chemins et les dossiers.
méthode | rôle |
[File.ReadAllText(path)] | rend le contenu du fichier sous la forme d'une chaîne |
[File.ReadAllLines(path)] | rend les lignes du fichier dans un tableau [string[]] |
[File.ReadLines(path)] | rend les lignes du fichier sous la forme d'une séquence [IEnumerable<string>] lue à la demande |
[File.WriteAllText(path, contents)] | crée (ou écrase) le fichier et y écrit [contents] ; [WriteAllLines] écrit une collection de lignes |
[File.AppendAllText(path, contents)], [File.AppendAllLines(path, lines)] | ajoute du texte, des lignes, à la fin du fichier (créé s'il n'existe pas) |
[File.ReadAllBytes(path)], [File.WriteAllBytes(path, bytes)] | lit, écrit le fichier sous la forme d'un tableau d'octets |
[File.Exists(path)], [File.Delete(path)], [File.Copy(source, dest)], [File.Move(source, dest)] | teste l'existence d'un fichier, le supprime, le copie, le déplace |
[Path.Combine(p1, p2, ...)] | construit un chemin à partir de ses éléments, avec le séparateur du système |
[Path.GetFileName(path)], [Path.GetExtension(path)], [Path.GetDirectoryName(path)] | extrait d'un chemin le nom du fichier, son extension, son dossier |
[Directory.CreateDirectory(path)] | crée le dossier et ses dossiers parents s'ils n'existent pas |
[Directory.GetFiles(path, pattern)], [Directory.EnumerateFiles(path, pattern)] | les fichiers du dossier dont le nom correspond au modèle ([*.txt]…), dans un tableau ou une séquence |
[Directory.Exists(path)], [Directory.Delete(path, recursive)] | teste l'existence d'un dossier, le supprime (avec son contenu si [recursive] vaut [true]) |
Le programme [fichiers-03.cs] les utilise :
Résultats :
Commentaires :
- ligne 7 : [Path.Combine] utilise le séparateur de chemins du système. Les exécutions du cours ont été faites sous Linux : le chemin obtenu est [donnees/villes.txt] ; sous Windows, il serait [donnees\villes.txt]. Construire les chemins avec [Path.Combine] plutôt qu'en concaténant des chaînes rend le code portable ;
- ligne 11 : la création du dossier [donnees] ne provoque pas d'erreur s'il existe déjà ;
- lignes 14-18 : écriture, ajout et lecture en une instruction chacune ;
- ligne 23 : [File.ReadLines] rend une séquence : les lignes sont lues une à une, au fur et à mesure du parcours, comme les éléments d'un itérateur. On peut y appliquer LINQ, et traiter ainsi un fichier de plusieurs gigaoctets sans le charger en mémoire, ce que [ReadAllLines] ferait. Le fichier est fermé à la fin du parcours ;
- lignes 29-36 : le même texte « élève » est écrit avec trois encodages, puis les octets des fichiers sont affichés en hexadécimal :
- en UTF-8, encodage par défaut de .NET, les caractères accentués occupent 2 octets (é = C3 A9) et les autres 1 octet : 7 octets pour 5 caractères ;
- en UTF-8 avec BOM (Byte Order Mark), le fichier commence par les 3 octets EF BB BF, qui signalent aux logiciels que le fichier est encodé en UTF-8. [new UTF8Encoding(true)] demande l'écriture de ce BOM ;
- en Latin-1 (ISO-8859-1), encodage traditionnel des textes d'Europe occidentale, chaque caractère occupe un octet (é = E9) ;
- ligne 39 : relire un fichier avec un autre encodage que celui de son écriture altère les caractères accentués : la suite d'octets E9 6C n'est pas valide en UTF-8, et chaque octet invalide est remplacé par le caractère �. À la lecture, [File.ReadAllText] et [StreamReader] reconnaissent le BOM s'il est présent ; sinon ils supposent l'UTF-8, sauf si on leur indique un autre encodage (ligne 40). Aujourd'hui, la règle est simple : on écrit et on lit les fichiers texte en UTF-8 ;
- ligne 44 : les noms des fichiers texte du dossier. [GetFiles] ne garantit pas l'ordre des noms ; la méthode LINQ [Order] (.NET 7) les trie ;
- ligne 50 : suppression du dossier et de son contenu. Le paramètre est passé par son nom, [recursive: true], ce qui rend l'appel plus lisible qu'un simple [true] (arguments nommés, chapitre 3).
Toutes ces méthodes existent en version asynchrone ([File.ReadAllTextAsync], [File.ReadAllLinesAsync]…) : nous les utiliserons au chapitre 9, consacré à la programmation asynchrone.
5.7. Les fichiers binaires
5.7.1. Les classes BinaryWriter et BinaryReader
Les classes [System.IO.BinaryWriter] et [System.IO.BinaryReader] servent à écrire et lire des fichiers binaires. Dans un tel fichier, les données ne sont pas écrites sous forme de texte mais sous leur forme interne : un [int] occupe toujours 4 octets, quelle que soit sa valeur.
Considérons l'application suivante :
Le fichier texte [personnes1.txt] a le contenu suivant :
Le programme [fichiers-04.cs] est le suivant :
Attardons-nous sur les opérations concernant la classe [BinaryWriter] :
- ligne 17 : l'objet [BinaryWriter] est ouvert par l'opération [new BinaryWriter(new FileStream(args[1], FileMode.Create, FileAccess.Write))]. L'argument du constructeur doit être un flux ([Stream]). Ici c'est un flux construit à partir d'un fichier ([FileStream]) dont on donne :
- le nom ;
- l'opération à faire, ici [FileMode.Create] pour créer le fichier (ou l'écraser s'il existe) ;
- le type d'accès, ici [FileAccess.Write] pour un accès en écriture au fichier ;
- lignes 57-58 : les opérations d'écriture. La classe [BinaryWriter] dispose de méthodes [Write] surchargées pour écrire les différents types de données simples ([int], [double], [decimal], [bool], [string]...) ;
- lignes 15-19 : les trois flux sont ouverts par des déclarations [using]. Ils seront fermés à la fin du bloc [try], dans l'ordre inverse de leur ouverture. Le cours de 2008 les fermait dans une clause [finally] après avoir testé qu'ils n'étaient pas [null] : la déclaration [using] fait la même chose en une ligne ;
- ligne 10 : les instructions de haut niveau peuvent se terminer par un [return n] : n est alors le code de sortie du programme, qu'un script peut tester (0 : succès) ;
- ligne 33 : l'option [TrimEntries] supprime les espaces autour du nom et de l'âge ;
- ligne 49 : l'âge doit être un entier positif ou nul. Grâce au court-circuit de l'opérateur [||], la condition [age < 0] n'est évaluée que si la conversion a réussi.
Les trois arguments du programme sont passés après [--] dans la commande [dotnet run]. Les résultats sont les suivants :
Le fichier de logs [logs.txt] a le contenu suivant :
Le contenu du fichier binaire [personnes1.bin] peut être affiché en hexadécimal avec la commande Linux [od] (sous Windows, la commande PowerShell [Format-Hex] donne un affichage analogue) :
On y lit la façon dont [BinaryWriter] écrit les données :
- une chaîne est écrite précédée de sa longueur en octets : l'octet 04 puis les 4 octets de « paul » (70 61 75 6c) ;
- un entier [int] est écrit sur 4 octets, l'octet de poids faible en premier : 10 s'écrit 0a 00 00 00 ;
- les données sont écrites les unes à la suite des autres, sans séparateur ni fin de ligne : le fichier fait 44 octets (ligne 5 : avec l'option [-A d], [od] affiche les positions en décimal).
Pour relire ce fichier, il faut donc connaître exactement l'ordre et le type des données écrites. C'est ce que fait le programme [fichiers-05.cs], qui réalise l'opération inverse : il lit le fichier binaire pour créer un fichier texte. Si le fichier texte produit contient les données correctes du fichier d'origine, on saura que la conversion texte → binaire → texte s'est bien passée.
Attardons-nous sur les opérations concernant la classe [BinaryReader] :
- ligne 15 : l'objet [BinaryReader] est ouvert sur un flux [FileStream] avec le mode [FileMode.Open], pour ouvrir un fichier existant, et l'accès [FileAccess.Read], pour un accès en lecture ;
- lignes 23-24 : les opérations de lecture. La classe [BinaryReader] dispose de méthodes [ReadXX] pour lire les différents types de données simples : [ReadString], [ReadInt32], [ReadDouble], [ReadDecimal], [ReadBoolean]... Elles doivent être appelées dans l'ordre des écritures ;
- ligne 20 : la propriété [BaseStream] donne le flux sous-jacent, ici le [FileStream]. On lit tant que la position courante dans le fichier n'a pas atteint sa longueur. Le cours de 2008 lisait sans fin et détectait la fin du fichier par l'exception [EndOfStreamException] : une exception doit rester exceptionnelle, et la fin d'un fichier ne l'est pas ;
- ligne 31 : cette exception signale maintenant une vraie anomalie : un fichier qui s'arrête au milieu d'un enregistrement.
Exécutons le programme sur le fichier [personnes1.bin] produit précédemment :
Le contenu de [personnes2.txt] est le suivant :
On retrouve les 4 personnes valides du fichier [personnes1.txt]. Avec un fichier [tronque.bin] formé des 30 premiers octets de [personnes1.bin], la lecture de l'âge de jacques échoue :
5.7.2. La sérialisation JSON
Écrire et relire un fichier binaire donnée par donnée est fastidieux, et le moindre décalage entre l'écriture et la lecture produit des résultats faux. On préfère généralement sérialiser des objets : les transformer automatiquement en une suite d'octets ou de caractères, puis les désérialiser pour les reconstruire.
.NET proposait pour cela la classe [BinaryFormatter], qui sérialisait des objets dans un format binaire propre à .NET. Elle est aujourd'hui supprimée : elle a été déclarée obsolète en .NET 5 et son implémentation a été retirée en .NET 9, car désérialiser des données provenant d'une source non sûre avec [BinaryFormatter] permettait d'exécuter du code arbitraire. Microsoft recommande de la remplacer par la sérialisation JSON de la bibliothèque [System.Text.Json], intégrée à .NET depuis .NET Core 3.0.
JSON (JavaScript Object Notation) est un format texte, lisible, et universel : c'est le format d'échange des services web (chapitre 13) et de nombreux fichiers de configuration. Un objet y est écrit entre accolades sous la forme de couples "propriété": valeur, un tableau entre crochets.
La classe statique [System.Text.Json.JsonSerializer] a deux méthodes principales :
méthode | rôle |
[string Serialize<T>(T value, JsonSerializerOptions? options = null)] | rend le texte JSON représentant l'objet [value] |
[T? Deserialize<T>(string json, JsonSerializerOptions? options = null)] | reconstruit un objet de type [T] à partir du texte JSON [json] ; lance une [JsonException] si le texte est incorrect |
Le programme [fichiers-06.cs] les utilise :
Résultats :
Commentaires :
- ligne 1 : une directive des applications fichier unique. Par défaut, celles-ci sont préparées pour la compilation native AOT (ahead of time), qui produit un exécutable autonome mais interdit les mécanismes reposant sur l'exploration des types à l'exécution (la réflexion). Or [JsonSerializer] utilise par défaut la réflexion pour découvrir les propriétés des objets à sérialiser : sans cette directive, la compilation produit des avertissements et l'exécution échoue. Un projet [.csproj] ordinaire, comme celui de l'application exemple, n'a pas cette restriction. Pour une application compilée en natif, [System.Text.Json] propose un générateur de source (une classe dérivée de [JsonSerializerContext]) qui produit le code de sérialisation à la compilation : nous ne le présenterons pas ;
- lignes 60-63 : l'enregistrement [Personne] à sérialiser. Ses propriétés portent l'attribut [JsonPropertyName], qui fixe le nom de la propriété dans le texte JSON : [nom] au lieu de [Nom]. Dans un enregistrement positionnel, [property: ...] indique que l'attribut s'applique à la propriété générée et non au paramètre du constructeur ;
- ligne 17 : sérialisation d'un objet avec les options par défaut : le texte est écrit sur une seule ligne et les caractères non ASCII sont échappés : [é] devient [\u00E9]. Le texte reste correct, mais il est peu lisible ;
- lignes 21-26 : l'option [WriteIndented] produit un texte indenté, sur plusieurs lignes ; l'option [Encoder] indique quels caractères laisser tels quels, ici tous ceux d'Unicode. Une liste est sérialisée en un tableau JSON ;
- ligne 28 : le texte JSON est enregistré dans un fichier texte : c'est ainsi qu'on remplace aujourd'hui la sérialisation binaire ;
- ligne 34 : la désérialisation reconstruit la liste. [Deserialize] crée les objets [Personne] en appelant le constructeur de l'enregistrement, dont les paramètres sont associés aux propriétés JSON de même nom. Le résultat est de type [List<Personne>?] : le texte JSON [null] est un document valide qui donne [null] ;
- ligne 42 : les options « Web », celles qu'utilisent par défaut les services web d'ASP.NET Core, écrivent les noms de propriétés en camelCase (première lettre en minuscule) : [Code] devient [code], sans attribut. À la lecture, elles ne tiennent pas compte de la casse : [CODE] est accepté (ligne 31) ;
- ligne 52 : un document JSON incorrect, ici une chaîne là où un nombre est attendu, provoque une exception [JsonException] dont le message indique l'emplacement de l'erreur.
Nous utiliserons JSON dans l'application exemple qui suit, puis tout au long du cours.
5.8. Les expressions régulières
La classe [System.Text.RegularExpressions.Regex] permet l'utilisation d'expressions régulières. Celles-ci permettent de tester le format d'une chaîne de caractères. Ainsi on peut vérifier qu'une chaîne représentant une date est bien au format jj/mm/aa. On utilise pour cela un modèle et on compare la chaîne à ce modèle. Dans cet exemple, j, m et a doivent être des chiffres. Le modèle d'un format de date valide est alors [\d\d/\d\d/\d\d] où le symbole [\d] désigne un chiffre. Les symboles utilisables dans un modèle sont les suivants :
caractère | description |
[\] | marque le caractère suivant comme caractère spécial ou littéral. Par exemple, [n] correspond au caractère n, [\n] correspond à un caractère de nouvelle ligne, [\\] correspond à \, [\(] correspond à ( |
[^] | correspond au début de la chaîne |
[$] | correspond à la fin de la chaîne |
[*] | correspond à l'élément précédent zéro fois ou plusieurs fois. Ainsi [zo*] correspond à z ou à zoo |
[+] | correspond à l'élément précédent une ou plusieurs fois. Ainsi [zo+] correspond à zoo, mais pas à z |
[?] | correspond à l'élément précédent zéro ou une fois. Par exemple, [a?ve?] correspond à ve dans lever |
[.] | correspond à tout caractère unique, sauf le caractère de nouvelle ligne |
[(modèle)] | recherche le modèle et mémorise la correspondance (un groupe). La sous-chaîne correspondante peut être extraite de la collection [Groups] du résultat. Pour trouver des correspondances avec des caractères entre parenthèses, utilisez [\(] ou [\)] |
[x|y] | correspond soit à x, soit à y. Par exemple, [z|foot] correspond à z ou à foot ; [(z|f)oo] correspond à zoo ou à foo |
[{n}] | n est un entier non négatif. Correspond exactement n fois à l'élément précédent. Par exemple, [o{2}] ne correspond pas à o dans Bob, mais aux deux premiers o de fooooot |
[{n,}] | correspond au moins n fois à l'élément précédent. Par exemple, [o{2,}] ne correspond pas à o dans Bob, mais à tous les o de fooooot. [o{1,}] équivaut à [o+] et [o{0,}] équivaut à [o*] |
[{n,m}] | correspond au moins n fois et au plus m fois à l'élément précédent. Par exemple, [o{1,3}] correspond aux trois premiers o de foooooot ; [o{0,1}] équivaut à [o?] |
[xyz] | jeu de caractères : correspond à l'un des caractères indiqués. Par exemple, [abc] correspond à a dans plat |
[^xyz] | jeu de caractères négatif : correspond à tout caractère non indiqué. Par exemple, [^abc] correspond à p dans plat |
[a-z] | plage de caractères : correspond à tout caractère de la série spécifiée, ici une lettre minuscule non accentuée |
[^m-z] | plage de caractères négative : correspond à tout caractère ne se trouvant pas entre m et z |
[\b] | correspond à une limite de mot, c'est-à-dire à la position entre un caractère de mot et un caractère qui n'en est pas un. Par exemple, [er\b] correspond à er dans lever, mais pas à er dans verbe |
[\B] | correspond à une position qui n'est pas une limite de mot. [en*t\B] correspond à ent dans « bien entendu » |
[\d] | correspond à un chiffre ; équivaut à [0-9] (avec .NET, aussi aux chiffres des autres alphabets Unicode) |
[\D] | correspond à un caractère qui n'est pas un chiffre |
[\f], [\n], [\r], [\t], [\v] | correspondent respectivement aux caractères saut de page, nouvelle ligne, retour chariot, tabulation, tabulation verticale |
[\s] | correspond à tout espace blanc : espace, tabulation, saut de page, nouvelle ligne… Équivaut à [ \f\n\r\t\v], plus les autres espaces d'Unicode (espace insécable…) |
[\S] | correspond à tout caractère qui n'est pas un espace blanc |
[\w] | correspond à tout caractère de mot : lettre (accentuée ou non), chiffre ou trait de soulignement |
[\W] | correspond à tout caractère qui n'est pas un caractère de mot |
[\num] | num est un entier positif : fait référence au groupe n° num. Par exemple, [(.)\1] correspond à deux caractères identiques consécutifs |
[\xnn], [\unnnn] | correspond au caractère de code hexadécimal nn (2 chiffres) ou nnnn (4 chiffres). Par exemple, [\x41] correspond à A |
Un élément dans un modèle peut être présent en 1 ou plusieurs exemplaires. Considérons quelques exemples autour du symbole [\d] qui représente 1 chiffre :
modèle | signification |
[\d] | un chiffre |
[\d?] | 0 ou 1 chiffre |
[\d*] | 0 ou davantage de chiffres |
[\d+] | 1 ou davantage de chiffres |
[\d{2}] | 2 chiffres |
[\d{3,}] | au moins 3 chiffres |
[\d{5,7}] | entre 5 et 7 chiffres |
Imaginons maintenant le modèle capable de décrire le format attendu pour une chaîne de caractères :
chaîne recherchée | modèle |
une date au format jj/mm/aa | [\d{2}/\d{2}/\d{2}] |
une heure au format hh:mm:ss | [\d{2}:\d{2}:\d{2}] |
un nombre entier non signé | [\d+] |
une suite d'espaces éventuellement vide | [\s*] |
un nombre entier non signé qui peut être précédé ou suivi d'espaces | [\s*\d+\s*] |
un nombre entier qui peut être signé et précédé ou suivi d'espaces | [\s*[+-]?\s*\d+\s*] |
un nombre réel non signé qui peut être précédé ou suivi d'espaces | [\s*\d+(\.\d*)?\s*] |
un nombre réel qui peut être signé et précédé ou suivi d'espaces | [\s*[+-]?\s*\d+(\.\d*)?\s*] |
une chaîne contenant le mot juste | [\bjuste\b] |
Le cours de 2008 écrivait [+|-] pour le signe : entre crochets, le caractère [|] n'a pas de signification particulière, et ce modèle acceptait aussi le signe | devant un nombre. Il écrivait aussi [(.\d*)] pour la partie décimale : le point non échappé y désigne n'importe quel caractère. Les modèles ci-dessus sont corrigés.
On peut préciser où on recherche le modèle dans la chaîne :
modèle | signification |
[^modèle] | le modèle commence la chaîne |
[modèle$] | le modèle finit la chaîne |
[^modèle$] | le modèle commence et finit la chaîne |
[modèle] | le modèle est cherché partout dans la chaîne, en commençant par le début de celle-ci |
chaîne recherchée | modèle |
une chaîne se terminant par un point d'exclamation | [!$] |
une chaîne se terminant par un point | [\.$] |
une chaîne commençant par la séquence // | [^//] |
une chaîne ne comportant qu'un mot, éventuellement suivi ou précédé d'espaces | [^\s*\w+\s*$] |
une chaîne ne comportant que deux mots, éventuellement suivis ou précédés d'espaces | [^\s*\w+\s+\w+\s*$] |
une chaîne contenant le mot secret | [\bsecret\b] |
Les sous-ensembles d'un modèle peuvent être « récupérés ». Ainsi, non seulement on peut vérifier qu'une chaîne correspond à un modèle particulier, mais on peut récupérer dans cette chaîne les éléments correspondant aux sous-ensembles du modèle qui ont été entourés de parenthèses. Ainsi, si on analyse une chaîne contenant une date jj/mm/aa et si on veut de plus récupérer les éléments jj, mm, aa de cette date, on utilisera le modèle [(\d\d)/(\d\d)/(\d\d)].
Dans le code C#, un modèle est écrit de préférence dans une chaîne verbatim [@"..."] : les nombreux caractères [] des modèles n'ont alors pas à être doublés. Avec une chaîne ordinaire, il faudrait écrire ["\\d+"] au lieu de [@"\d+"].
5.8.1. Vérifier qu'une chaîne correspond à un modèle donné
Un objet de type [Regex] se construit de la façon suivante :
constructeur | rôle |
[public Regex(string pattern)] | construit un objet « expression régulière » à partir d'un modèle passé en paramètre ([pattern]). Une exception [ArgumentException] est lancée si le modèle est incorrect |
[public Regex(string pattern, RegexOptions options, TimeSpan matchTimeout)] | idem, avec des options et un délai d'expiration (voir plus loin) |
Une fois l'expression régulière construite, on peut la comparer à des chaînes de caractères avec la méthode [IsMatch] :
méthode | rôle |
[public bool IsMatch(string input)] | vrai si la chaîne [input] contient une partie correspondant au modèle de l'expression régulière |
Le programme [regex-01.cs] est le suivant :
Résultats :
Commentaires :
- ligne 4 : le modèle d'un nombre entier non signé, éventuellement entouré d'espaces, qui occupe toute la chaîne (ancres [^] et [$]) ;
- ligne 9 : la chaîne « 123a », entourée d'espaces, ne correspond pas au modèle : le caractère a ne peut être ni un chiffre, ni un espace. Sans les ancres [^] et [$], la chaîne correspondrait, car elle contient un nombre ;
- ligne 19 : la classe [Regex] a aussi des méthodes statiques, qui reçoivent le modèle en paramètre. .NET garde en mémoire les derniers modèles utilisés : on peut les employer dans une boucle sans craindre que le modèle soit analysé à chaque appel.
5.8.2. Trouver toutes les occurrences d'un modèle dans une chaîne
La méthode [Matches] permet de récupérer les éléments d'une chaîne correspondant à un modèle :
méthode | rôle |
[public MatchCollection Matches(string input)] | rend la collection des éléments de la chaîne [input] correspondant au modèle |
La classe [MatchCollection] a une propriété [Count] qui est le nombre d'éléments de la collection. Si [resultats] est un objet [MatchCollection], [resultats[i]] est l'élément i de cette collection ; il est de type [Match]. La classe [Match] a diverses propriétés dont les suivantes :
- [Value] : la valeur de l'objet [Match], donc un élément correspondant au modèle ;
- [Index] : la position où l'élément a été trouvé dans la chaîne explorée.
Le programme [regex-02.cs] est le suivant :
Résultats :
Commentaires :
- ligne 4 : le modèle recherché est une suite de chiffres ;
- ligne 6 : la chaîne dans laquelle on recherche ce modèle ;
- ligne 7 : on récupère tous les éléments de [exemplaire3] vérifiant le modèle [modele2] ;
- lignes 10-12 : on les affiche. Une [MatchCollection] se parcourt avec [foreach], comme une liste ;
- ligne 15 : [MatchCollection] implémente [IEnumerable<Match>] : LINQ s'y applique. On fait ici la somme des nombres trouvés ;
- ligne 18 : la méthode [Count] (.NET 7) compte les occurrences du modèle sans construire de collection. Le modèle [aeiouy] désigne une voyelle.
5.8.3. Récupérer des parties d'un modèle
Comme nous l'avons dit, les parties d'un modèle entourées de parenthèses sont mémorisées : ce sont les groupes. Le programme [regex-03.cs] les utilise :
Résultats :
Commentaires :
- ligne 8 : la chaîne [exemplaire4] est comparée au modèle [regex3] au travers de la méthode [Match]. Celle-ci rend la première occurrence du modèle, sous la forme d'un objet [Match] déjà présenté. Nous utilisons ici deux nouvelles propriétés de cette classe :
- [Success] (ligne 9) : indique s'il y a eu correspondance ;
- [Groups] (ligne 13) : collection où [Groups[0]] correspond à la partie de la chaîne correspondant au modèle et [Groups[i]] (i >= 1) correspond au groupe de parenthèses n° i ;
- si [resultat] est de type [Match], [resultat.Groups] est de type [GroupCollection] et [resultat.Groups[i]] de type [Group]. La classe [Group] a, comme la classe [Match], les propriétés [Value] (le texte capturé par le groupe) et [Index] (sa position dans la chaîne explorée) ;
- ligne 24 : un groupe peut être nommé avec la syntaxe [(?<nom>...)]. Le modèle reconnaît ici une date au format j/m/aaaa, avec un jour et un mois d'un ou deux chiffres ;
- lignes 29-31 : un groupe nommé se désigne par son nom plutôt que par son numéro : le code est plus lisible et ne dépend pas de l'ordre des parenthèses ;
- ligne 32 : le type [DateOnly] (.NET 6) représente une date sans heure. Il est affiché avec le format [dddd d MMMM yyyy] : le jour de la semaine apparaît, en français ;
- ligne 37 : la méthode [Replace] remplace chaque occurrence du modèle par une chaîne dans laquelle [${nom}] (ou [$1], [$2]… pour les groupes numérotés) désigne la valeur d'un groupe. Les dates sont ainsi récrites au format année-mois-jour.
5.8.4. Un programme d'apprentissage
Trouver l'expression régulière qui permet de vérifier qu'une chaîne correspond bien à un certain modèle est parfois un véritable défi. Le programme [regex-04.cs] permet de s'entraîner. Il demande un modèle et une chaîne et indique si la chaîne correspond ou non au modèle.
Commentaires :
- ligne 18 : l'expression régulière est construite avec un délai d'expiration d'une seconde : si une recherche dure plus longtemps, elle est abandonnée et une exception [RegexMatchTimeoutException] est lancée (ligne 55). Nous verrons plus loin pourquoi c'est utile ;
- ligne 20 : un modèle incorrect provoque une exception [ArgumentException] (plus précisément [RegexParseException], qui en dérive) ;
- lignes 45-51 : pour chaque correspondance, on affiche les groupes n° 1 et suivants, s'il y en a.
Voici un exemple d'exécution :
Les modèles [^\s*\d+\s*$] et [^\s*(\d+)\s*$] montrent l'intérêt des groupes : le premier reconnaît la chaîne « 1456 » précédée de trois espaces, espaces compris ; le second permet en plus d'en extraire le nombre, sans les espaces. Le modèle [(a+)+$] est examiné ci-dessous.
5.8.5. La méthode Split
Nous avons déjà rencontré la méthode [Split] de la classe [String] :
méthode | rôle |
[public string[] Split(params char[] separator)] | la chaîne est vue comme une suite de champs séparés par les caractères présents dans le tableau [separator]. Le résultat est le tableau de ces champs |
La méthode [Split] de la classe [Regex] nous permet d'exprimer le séparateur à l'aide d'un modèle :
méthode | rôle |
[public string[] Split(string input)] | la chaîne [input] est décomposée en champs, ceux-ci étant séparés par un séparateur correspondant au modèle de l'objet [Regex] courant |
Supposons par exemple qu'on ait dans un fichier texte des lignes de la forme champ1, champ2, ..., champn. Les champs sont séparés par une virgule, mais celle-ci peut être précédée ou suivie d'espaces. Le modèle [\s*,\s*] décrit exactement ce séparateur, comme le montre le programme [regex-05.cs] :
Résultats :
Commentaires :
- ligne 6 : le séparateur : une virgule précédée et suivie d'un nombre quelconque d'espaces. Les espaces disparaissent avec le séparateur. On notera que l'option [TrimEntries] de [string.Split], présentée plus haut, permet aujourd'hui d'obtenir le même résultat sans expression régulière ;
- ligne 13 : un séparateur qui peut prendre plusieurs formes : un point-virgule ou une barre verticale ([;|]), ou bien ([|]) une suite d'espaces ([\s+]). Ici, une expression régulière est nécessaire.
5.8.6. Expressions régulières générées, options, délai d'expiration
Un objet [Regex] analyse son modèle à l'exécution, puis le traduit en une structure interne qu'il interprète, ou qu'il compile en code exécutable si on lui passe l'option [RegexOptions.Compiled]. Depuis .NET 7, l'attribut [GeneratedRegex] permet de faire ce travail à la compilation : un générateur de source écrit le code C# de la recherche, que l'on peut consulter dans l'éditeur (F12 sur la méthode). Le modèle est vérifié à la compilation, il n'y a plus de coût d'analyse au démarrage et le code produit est le plus rapide possible. C'est aujourd'hui la façon recommandée d'utiliser un modèle connu à l'avance. Le programme [regex-06.cs] est le suivant :
Résultats :
Commentaires :
- lignes 39-51 : chaque modèle est déclaré par une méthode statique partielle ([partial]), sans corps, rendant un [Regex], et précédée de l'attribut [GeneratedRegex]. Le générateur de source écrit le corps de la méthode dans une autre partie de la classe, elle aussi déclarée [partial]. Depuis C# 13 et .NET 9, on peut aussi déclarer une propriété partielle : [[GeneratedRegex(...)] private static partial Regex Heure { get; }] ;
- ligne 5 : on utilise la méthode comme un objet [Regex] ordinaire ;
- ligne 46 : le second paramètre de l'attribut est une combinaison d'options [RegexOptions]. [IgnoreCase] ignore la casse : « OUI » et « Oui » correspondent au modèle ;
- ligne 17 : les options s'utilisent de la même façon avec les méthodes de [Regex]. [Multiline] fait correspondre [^] et [$] au début et à la fin de chaque ligne de la chaîne, et non plus seulement au début et à la fin de la chaîne. D'autres options sont utiles : [Singleline] ([.] correspond aussi au saut de ligne), [IgnorePatternWhitespace] (les espaces du modèle sont ignorés, ce qui permet de l'écrire sur plusieurs lignes, commentées), [ExplicitCapture] (seuls les groupes nommés sont mémorisés). Elles se combinent avec l'opérateur [|] ;
- ligne 50 : le modèle [^(a+)+$] est pathologique : appliqué à une suite de a terminée par un autre caractère, le moteur d'expressions régulières essaie toutes les façons de répartir les a entre les répétitions du groupe avant de conclure à l'échec. Leur nombre double à chaque a supplémentaire : avec 30 a, il y en a environ un milliard. On parle de retour arrière catastrophique. Un tel modèle, appliqué à des chaînes saisies par des utilisateurs, est une faille de sécurité : quelques requêtes suffisent à bloquer un serveur. Le paramètre [matchTimeoutMilliseconds] fixe un délai d'expiration de 100 ms : au-delà, la recherche est abandonnée avec une exception [RegexMatchTimeoutException] (ligne 6) ;
- ligne 35 : l'option [NonBacktracking] (.NET 7) utilise un autre moteur, qui garantit un temps de recherche proportionnel à la longueur de la chaîne. Il ne permet pas certaines constructions (les références arrière [\1], par exemple), mais il répond ici immédiatement.
On retiendra qu'il faut fixer un délai d'expiration, ou utiliser [NonBacktracking], dès que le modèle ou la chaîne explorée proviennent de l'extérieur du programme.
5.9. Application exemple - V3
Nous reprenons l'application étudiée au chapitre 3 (version 1) et au chapitre 4 (version 2). Rappelons qu'il s'agit d'un exercice : le barème utilisé est celui de 2004 (revenus 2003), conservé tel quel depuis le cours d'origine.
5.9.1. Les données dans un fichier
Dans la version 2, le calcul de l'impôt se faisait dans la classe abstraite [AbstractImpot], que nous recopions ici sans changement, si ce n'est son espace de noms :
La méthode [Calculer] utilise les tranches d'impôt rendues par la propriété abstraite [TranchesImpot] (ligne 7). La classe [AbstractImpot] ne sait pas d'où viennent ces tranches : c'est aux classes dérivées de les fournir. Dans la version 2, la classe dérivée [HardwiredImpot] les plaçait « en dur » dans son code. Une tranche est représentée, comme dans la version 2, par la structure enregistrement [TrancheImpot] :
et le calcul est décrit par l'interface [IImpot] :
La nouvelle version place les données dans un fichier, ce qui permet de changer de barème sans recompiler le programme. Nous écrivons deux nouvelles classes dérivées de [AbstractImpot] :
- [FileImpot] lit les tranches dans un fichier texte [DataImpot.txt] ;
- [JsonImpot] les lit dans un fichier JSON [DataImpot.json].
Le fichier texte [DataImpot.txt] contient une tranche par ligne, sous la forme limite:coeffR:coeffN :
Le cours de 2008 écrivait les nombres avec une virgule décimale (0,068) et les lisait avec [decimal.TryParse] dans la culture de la machine : le même fichier, lu sur une machine anglaise ou américaine, aurait été refusé ou, pire, mal interprété. Un fichier de données ne doit pas dépendre de la langue de la machine qui le lit : nous écrivons les nombres avec un point décimal et les lisons dans la culture invariante ([CultureInfo.InvariantCulture]), celle qu'utilisent aussi JSON et la plupart des formats de données.
Le fichier [DataImpot.json] contient les mêmes données, sous la forme d'un tableau JSON d'objets :
5.9.2. Les erreurs
L'exploitation de ces fichiers peut échouer : fichier absent, ligne mal formée, nombre incorrect... Comme dans la version de 2008, nous créons une classe d'exception spéciale pour signaler ces erreurs. Le cours de 2008 l'appelait [FileImpotException] ; nous la nommons [ImpotException], car elle servira aussi pour les autres sources de données (fichier JSON ici, base de données plus tard). Elle porte un code d'erreur :
Commentaires :
- lignes 16-22 : la classe [ImpotException] dérive de la classe [Exception]. Elle servira à signaler toute erreur survenant lors de l'exploitation du fichier des données. Elle a deux constructeurs : le premier reçoit un message d'erreur, le second reçoit en plus l'exception à l'origine de l'erreur, qui sera disponible dans la propriété [InnerException] ;
- ligne 19 : la propriété [Code] mémorise le code de l'erreur. Le mot clé [init] permet de la fixer uniquement à la création de l'objet, avec un initialiseur d'objet : [new ImpotException("...") { Code = 2 }]. C'est cette forme d'exception, avec un code entier, que reprendront les versions suivantes de l'application ;
- lignes 4-12 : une énumération des codes d'erreur possibles :
- [Acces] : erreur d'accès au fichier des données ;
- [Ligne] : ligne n'ayant pas les trois champs attendus, ou fichier sans aucune tranche ;
- [Champ1], [Champ2], [Champ3] : le champ n° 1, 2 ou 3 d'une ligne est incorrect ;
- [Json] : le document JSON est incorrect.
Certaines de ces erreurs peuvent se combiner : les trois champs d'une ligne peuvent être incorrects. Aussi l'énumération [CodeErreur] a-t-elle été annotée avec l'attribut [Flags], et ses valeurs sont des puissances de 2 : chacune correspond à un bit de l'entier. Une erreur sur les champs 2 et 3 se traduira par le code [Champ2 | Champ3], soit 8 + 16 = 24. Grâce à l'attribut [Flags], la méthode [ToString] de l'énumération affiche une telle combinaison sous la forme « Champ2, Champ3 ».
5.9.3. La classe FileImpot
La classe [FileImpot] fournit les tranches lues dans un fichier texte :
Commentaires :
- ligne 7 : la classe [FileImpot] dérive de la classe [AbstractImpot], comme le faisait dans la version 2 la classe [HardwiredImpot]. Elle est déclarée [partial] parce qu'elle contient une expression régulière générée ;
- lignes 10-11 : l'expression régulière du séparateur des champs d'une ligne limite:coeffR:coeffN : le caractère [:], précédé et suivi d'un nombre quelconque d'espaces ;
- lignes 14-17 : les tranches lues, rendues par la propriété [TranchesImpot] qui redéfinit la propriété abstraite de [AbstractImpot] ;
- ligne 19 : le constructeur reçoit le nom du fichier texte contenant les données. Son rôle est de remplir le tableau [tranchesImpot] ;
- ligne 22 : le nom du fichier sans son chemin, utilisé dans les messages d'erreur. Le constructeur reçoit en effet un chemin complet, qu'il n'est pas utile d'afficher à l'utilisateur ;
- ligne 24 : la lecture d'un fichier texte est séquentielle : on ne connaît le nombre de lignes qu'après avoir lu la totalité du fichier. On ne peut donc pas dimensionner le tableau à l'avance : on mémorise provisoirement les tranches dans une liste ;
- ligne 28 : le fichier est lu ligne par ligne avec [File.ReadLines], qui ouvre et ferme le fichier lui-même. Le cours de 2008 utilisait un [StreamReader] ;
- lignes 38-43 : la ligne est découpée en champs grâce à l'expression régulière ; s'il n'y a pas trois champs, une exception [ImpotException] de code [Ligne] est lancée. Le cours de 2008 mémorisait l'erreur dans une variable, sortait de la boucle, puis lançait l'exception après la fermeture du fichier : la lancer immédiatement est plus simple, et [File.ReadLines] ferme le fichier dans tous les cas, car la boucle [foreach] libère son énumérateur même lorsqu'une exception l'interrompt ;
- lignes 47-55 : conversion des trois champs en nombres décimaux. Les erreurs sont cumulées dans la variable [code] avec l'opérateur [|=], puis signalées ensemble ;
- lignes 83-84 : la conversion d'un champ. [NumberStyles.AllowDecimalPoint] n'autorise que des chiffres et un point décimal : ni signe, ni espaces, ni séparateur des milliers. Les nombres négatifs sont ainsi refusés, ce qui valide les données en même temps qu'on les convertit. [CultureInfo.InvariantCulture] impose le point comme séparateur décimal, quelle que soit la culture de la machine ;
- lignes 62-67 : les erreurs d'accès au fichier ([IOException] et ses dérivées, comme [FileNotFoundException], ou [UnauthorizedAccessException] pour des droits insuffisants) sont encapsulées dans une [ImpotException] de code [Acces]. Le filtre d'exception [when (...)] (C# 6) n'intercepte que ces exceptions : les [ImpotException] lancées dans la boucle ne sont pas interceptées et sortent du constructeur telles quelles. Le motif [e is IOException or UnauthorizedAccessException] est un motif de type combiné par [or] (C# 9) ;
- lignes 71-79 : un fichier vide est refusé ; sinon la liste est transférée dans le tableau des tranches, ce qui était le but du constructeur.
Encapsuler les exceptions de bas niveau ([IOException]) dans une exception propre à l'application ([ImpotException]) permet au code appelant de ne traiter qu'un seul type d'exception, quelle que soit la source des données : un fichier texte, un fichier JSON et, plus tard dans le cours, une base de données.
5.9.4. La classe JsonImpot
La classe [JsonImpot] fournit les tranches lues dans un fichier JSON :
Commentaires :
- ligne 9 : les options « Web » : les propriétés JSON [limite], [coeffR], [coeffN] correspondent aux propriétés [Limite], [CoeffR], [CoeffN] de la structure [TrancheImpot] sans qu'il soit nécessaire de modifier cette dernière avec des attributs. Les options sont stockées dans un champ statique : un objet [JsonSerializerOptions] mémorise des informations sur les types qu'il a traités, et il est recommandé de le réutiliser ;
- lignes 25-31 : la lecture du fichier ; une erreur d'accès est encapsulée comme dans [FileImpot] ;
- ligne 38 : une seule instruction transforme le texte JSON en tableau de tranches. [System.Text.Json] sait construire une structure enregistrement en appelant son constructeur. Un document incorrect provoque une [JsonException], encapsulée dans une [ImpotException] de code [Json] ;
- lignes 48-57 : la désérialisation vérifie le format du document, pas la validité des données : il reste à vérifier qu'il y a au moins une tranche (le document [null] ou [] est un JSON valide) et qu'aucune valeur n'est négative. La méthode LINQ [Any] fait ce dernier test en une ligne.
La comparaison des deux classes est instructive : avec un format de données structuré et une bibliothèque qui le connaît, l'analyse du fichier ne demande plus de code.
5.9.5. Le programme principal
Le projet console [ImpotsV3] a l'arborescence suivante :
Le fichier projet [ImpotsV3.csproj] est celui créé par [dotnet new console], auquel on a ajouté un groupe d'éléments :
L'élément [<None Update="..." CopyToOutputDirectory="PreserveNewest" />] (ligne 12) demande que les fichiers de données soient copiés dans le dossier de l'exécutable ([bin/Debug/net10.0]) lors de la compilation, s'ils sont plus récents que la copie existante. Le caractère [*] permet de désigner tous les fichiers [DataImpot*.txt] et [DataImpot*.json] en une fois. C'est l'équivalent de la propriété « Copy to Output Directory » que le cours de 2008 fixait dans les propriétés du fichier sous Visual Studio.
Le programme [Program.cs] est le suivant :
Commentaires :
- ligne 14 : le nom du fichier de données est passé en argument ; par défaut, c'est [DataImpot.txt] ;
- ligne 15 : le fichier est cherché dans le dossier de l'exécutable, [AppContext.BaseDirectory], où il a été copié lors de la compilation. Ainsi, le programme trouve ses données quel que soit le dossier d'où on le lance, ce qui n'était pas le cas des applications fichier unique de ce chapitre ;
- lignes 22-25 : une expression [switch] (chapitre 3) choisit la classe à instancier selon l'extension du fichier. Les deux branches rendent des types différents, [JsonImpot] et [FileImpot] : le compilateur en déduit le type de l'expression grâce à la variable de destination [impot], de type [IImpot] (expression [switch] à type cible). Le reste du programme ne connaît que l'interface [IImpot] et ignore d'où viennent les données ;
- lignes 28-34 : la création de l'objet peut lancer une [ImpotException], qui est affichée avant l'arrêt du programme. Le code est converti en [CodeErreur] pour être affiché en clair ; l'exception d'origine, s'il y en a une, est indiquée par son type (son message contient le chemin complet du fichier) ;
- lignes 37-76 : la boucle de dialogue est exactement celle de la version 2.
5.9.6. Exécutions
Avec le fichier [DataImpot.txt], par défaut :
On retrouve les valeurs des versions précédentes : 4282 euros pour un couple marié avec 2 enfants, 2959 euros avec 3 enfants, 11519 euros pour une personne seule sans enfant, avec un salaire annuel de 60000 euros. Les saisies incorrectes sont signalées comme dans la version 2.
Avec le fichier [DataImpot.json] :
Avec un fichier [xx.txt] inexistant :
Avec le fichier [DataImpotInvalide.txt] suivant, dont la troisième ligne utilise la virgule décimale :
Les champs 2 et 3 de la ligne 3 sont refusés : le code d'erreur est la combinaison « Champ2, Champ3 ». Le champ 1 (14753), sans partie décimale, est correct.
Avec le fichier [DataImpotInvalide.json] suivant, où un coefficient est écrit sous la forme d'une chaîne :
Le message de la [JsonException] indique précisément l'emplacement de l'erreur : la propriété [coeffR] du deuxième élément du tableau ([$[1].coeffR]), [LineNumber: 2], c'est-à-dire la troisième ligne du document, car [System.Text.Json] numérote les lignes à partir de 0.
5.10. Conclusion
Ce chapitre a présenté les classes de .NET dont on se sert dans presque tous les programmes :
- les chaînes [string], immuables, et [StringBuilder] pour les construire par morceaux ; l'interpolation avec largeurs et formats, les chaînes brutes ; les vues [ReadOnlySpan<char>] pour le code critique ;
- les tableaux et la classe [Array] ;
- les collections génériques [List<T>], [Dictionary<TKey,TValue>], [HashSet<T>], [Queue<T>], [Stack<T>], [PriorityQueue<TElement,TPriority>], et leurs interfaces en lecture seule ; les collections non génériques [ArrayList] et [Hashtable] sont obsolètes ;
- LINQ, ses séquences [IEnumerable<T>], ses itérateurs et son exécution différée ;
- les fichiers texte ([StreamReader], [StreamWriter], [File]), les fichiers binaires ([BinaryWriter], [BinaryReader]) et la sérialisation JSON, qui remplace la sérialisation binaire de [BinaryFormatter], supprimée de .NET ;
- les expressions régulières, de préférence générées à la compilation et toujours protégées par un délai d'expiration lorsqu'elles traitent des données extérieures.
L'application exemple lit maintenant ses données dans un fichier texte ou JSON. Le chapitre suivant la réorganise en couches : la lecture des données, le calcul de l'impôt et le dialogue avec l'utilisateur y deviendront des composants indépendants.