4. [TD]: Arquiteturas em camadas
Palavras-chave: arquitetura em camadas, Spring, injeção de dependências.
4.1. Introduction
Vamos relembrar o que foi feito:
- na parte 1 do exercício ELECTIONS, nenhuma classe foi utilizada. Construímos uma solução da mesma forma que a teríamos construído na linguagem C.
- Na parte 2 do exercício, foram introduzidas duas classes:
- [ListeElectorale], que representa os atributos (id, nome, votos, cadeiras, eliminado) de uma lista de candidatos
- [ElectionsException], uma classe de exceções não controladas. Esse tipo de exceção é utilizado sempre que ocorre um erro fatal no aplicativo eleitoral. Trata-se de uma exceção não controlada, c.a.d, que o desenvolvedor não é obrigado a tratar com um try-catch.
O cálculo do resultado das eleições foi, até agora, confiado a um método [main] de uma classe [MainElections]
A solução anterior inclui três fases clássicas:
- a aquisição dos dados, linhas 17-18
- o cálculo da solução, linhas 19-20
- a exibição e/ou o armazenamento dos resultados, linhas 21-22
Apenas a fase 2 é realmente constante. A fase 1 pode variar: os dados podem vir do teclado, como nos exemplos estudados, de um arquivo de texto, de uma interface gráfica, de um banco de dados, da rede, etc. Da mesma forma, há várias maneiras de apresentar os resultados na fase 3: exibi-los na tela, como foi feito nos exemplos estudados; salvá-los em um arquivo ou em um banco de dados; enviá-los pela rede, etc.
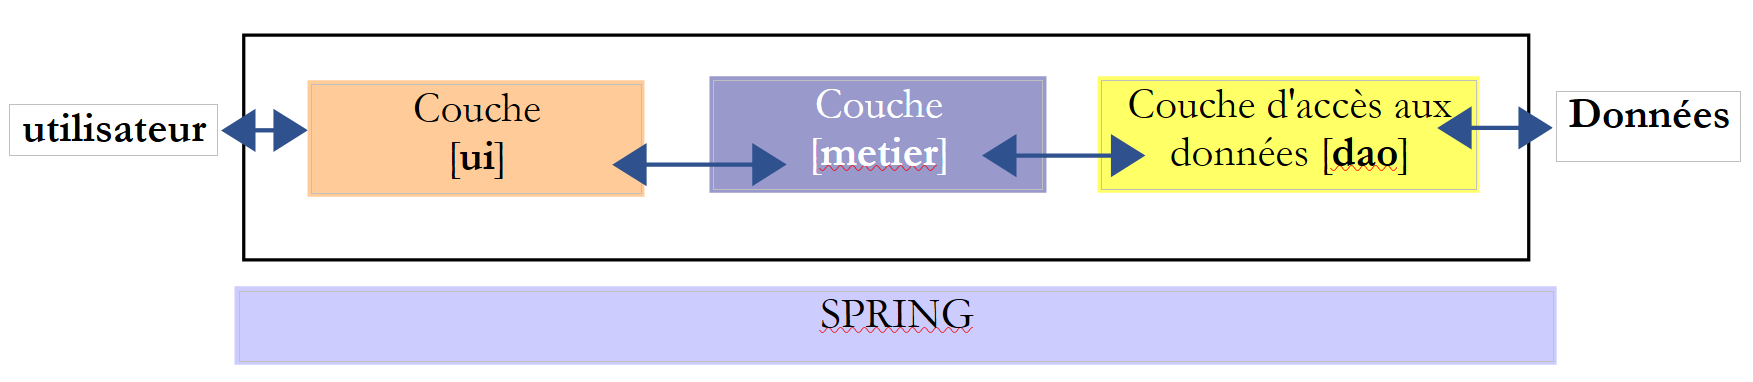
De maneira mais geral, uma aplicação pode frequentemente ser modelada em três camadas, cada uma com uma função bem definida:
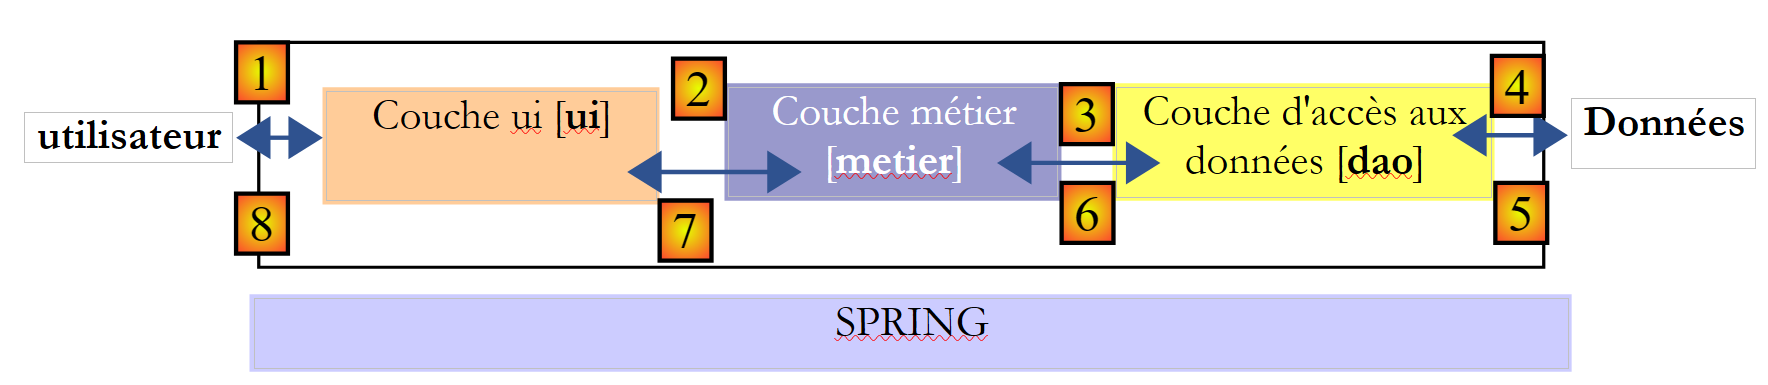 |
Essa arquitetura também é chamada de “arquitetura de três camadas”, tradução do inglês “three-tier architecture”. O termo “três camadas” normalmente se refere a uma arquitetura em que cada camada está em uma máquina diferente. Quando as camadas estão na mesma máquina, a arquitetura passa a ser uma “arquitetura de três camadas”.
- A camada [metier] é aquela que contém as regras de negócio do aplicativo. Para o nosso aplicativo eleitoral, são as regras que permitem calcular os assentos obtidos pelas diferentes listas, uma vez que se conheçam os votos obtidos por cada uma delas. Essa camada precisa de dados para funcionar. Por exemplo, no aplicativo eleitoral:
- as listas, cada uma com seu nome e número de votos
- o número de vagas a serem preenchidas
- o limite eleitoral abaixo do qual uma lista é eliminada
No esquema acima, os dados podem provir de dois locais:
- da camada de acesso aos dados ou [dao] (DAO = Data Access Object) para os dados já registrados em arquivos ou bancos de dados. Esse poderia ser o caso, aqui, dos nomes das listas, do número de cadeiras a serem preenchidas e do limite eleitoral. De fato, essas informações já são conhecidas antes da própria eleição.
- a camada de interface com o usuário ou [ui] (UI = Interface do Usuário) para os dados inseridos pelo usuário ou exibidos ao usuário. Esse poderia ser o caso, aqui, dos votos das listas, que só são conhecidos no último momento, bem como da exibição dos resultados da eleição.
- De maneira geral, a camada [dao] lida com o acesso a dados persistentes (arquivos, bancos de dados) ou não persistentes (rede, sensores, etc.).
- Já a camada [ui] é responsável pelas interações com o usuário, caso haja um.
- As três camadas são tornadas independentes graças ao uso de interfaces Java.
- Para integrar essas camadas na aplicação, existem diferentes métodos. Utilizaremos uma ferramenta chamada “Spring”. No esquema, ela é transversal às outras camadas.
Vamos retomar a aplicação [Elections] desenvolvida anteriormente para lhe conferir uma arquitetura de três camadas. Para isso, vamos analisar as camadas [ui, metier, dao] uma a uma, começando pela camada [dao], que lida com os dados persistentes.
Antes disso, precisamos definir as interfaces das diferentes camadas da aplicação [Elections].
4.2. As interfaces da aplicação [Elections]
Vale lembrar que uma interface define um conjunto de assinaturas de métodos. As classes que implementam a interface fornecem um conteúdo para esses métodos.
Voltemos à arquitetura de três camadas da nossa aplicação:
|
Nesse tipo de arquitetura, geralmente é o usuário quem toma a iniciativa. Ele faz uma solicitação em [1] e recebe uma resposta em [8]. Isso é chamado de ciclo solicitação-resposta. Tomemos como exemplo o cálculo dos assentos obtidos na noite das eleições. Esse processo exigirá várias etapas:
- a camada [ui] precisará solicitar ao usuário o número de votos obtidos por cada uma das listas. Para isso, ela deverá apresentar ao usuário os nomes das listas em disputa. O usuário terá então apenas que inserir o número de votos ao lado de cada lista e, em seguida, solicitar o cálculo dos assentos.
- A camada [ui] não dispõe dos nomes das listas. Estes estão registrados na fonte de dados à direita do esquema. Ela utilizará o caminho [2, 3, 4, 5, 6, 7] para obtê-los. A operação [2] é a solicitação das listas, e a operação [7] é a resposta a essa solicitação. Feito isso, ela pode apresentá-las ao usuário por meio da operação [8].
- O usuário transmitirá à camada [ui] o número de votos obtidos por cada uma das listas. Essa é a operação [1] mencionada acima. Durante essa etapa, o usuário interage apenas com a camada [ui]. É essa camada que verificará, entre outras coisas, a validade dos dados inseridos. Feito isso, o usuário solicitará a lista de cadeiras obtidas por cada uma das listas.
- A camada [ui] solicitará à camada de negócios que faça o cálculo dos assentos. Para isso, ela transmitirá a ela os dados que recebeu do usuário. Trata-se da operação [2].
- A camada [metier] precisa de certas informações para realizar seu trabalho. Ela já possui as listas, provenientes da operação (b). Também precisa do número de cadeiras a serem preenchidas, bem como do valor do limite eleitoral. Ela solicitará essas informações à camada [dao] por meio do caminho [3, 4, 5, 6]. [3] é a solicitação inicial e [6] é a resposta a essa solicitação.
- Com todos os dados de que precisava, a camada [metier] calcula os assentos obtidos por cada uma das listas.
- A camada [metier] agora pode responder à solicitação da camada [ui] feita em (d). Esse é o caminho [7].
- A camada [ui] formatará esses resultados para apresentá-los ao usuário de maneira adequada e, em seguida, os exibirá. Esse é o caminho [8].
- É possível imaginar que esses resultados devam ser armazenados em um arquivo ou em um banco de dados. Isso pode ser feito automaticamente. Nesse caso, após a operação (f), a camada [metier] solicitará à camada [dao] que registre os resultados. Esse será o caminho [3, 4, 5, 6]. Isso também pode ser feito apenas mediante solicitação do usuário. Esse será o caminho [1-8], que será utilizado pelo ciclo solicitação-resposta.
Vemos nessa descrição que uma camada é levada a utilizar os recursos da camada que está à sua direita, nunca da que está à sua esquerda. Consideremos duas camadas contíguas:
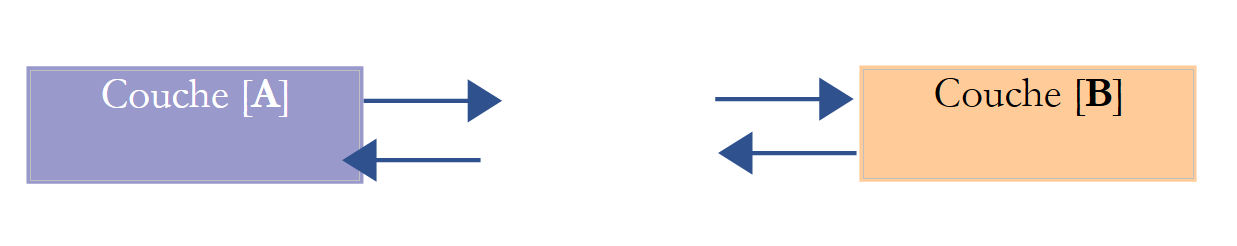 |
A camada [A] faz solicitações à camada [B]. Nos casos mais simples, uma camada é implementada por uma única classe. Um aplicativo evolui ao longo do tempo. Assim, a camada [B] pode ter classes de implementação diferentes, como [B1, B2, ...]. Se a camada [B] for a camada [dao], esta pode ter uma primeira implementação, [B1], que busca dados em um arquivo. Alguns anos depois, pode-se querer armazenar os dados em um banco de dados. Então, criaremos uma segunda classe de implementação, [B2]. Se, na aplicação inicial, a camada [A] trabalhasse diretamente com a classe [B1], seríamos obrigados a reescrever parcialmente o código da camada [A]. Suponhamos, por exemplo, que tenhamos escrito na camada [A] algo como o seguinte:
- linha 1: é criada uma instância da classe [B1]
- linha 3: são solicitados dados a essa instância
Se supusermos que a nova classe de implementação [B2] utilize métodos com a mesma assinatura que os da classe [B1], será necessário alterar todos os [B1] para [B2]. Esse é o caso mais favorável e bastante improvável, caso não se tenha prestado atenção a essas assinaturas de métodos. Na prática, é comum que as classes [B1] e [B2] não tenham as mesmas assinaturas de métodos e que, portanto, boa parte da camada [A] precise ser totalmente reescrita.
É possível melhorar a situação se for inserida uma interface entre as camadas [A] e [B]. Isso significa que as assinaturas dos métodos apresentados pela camada [B] à camada [A] são fixadas em uma interface. O esquema anterior passa então a ser o seguinte:
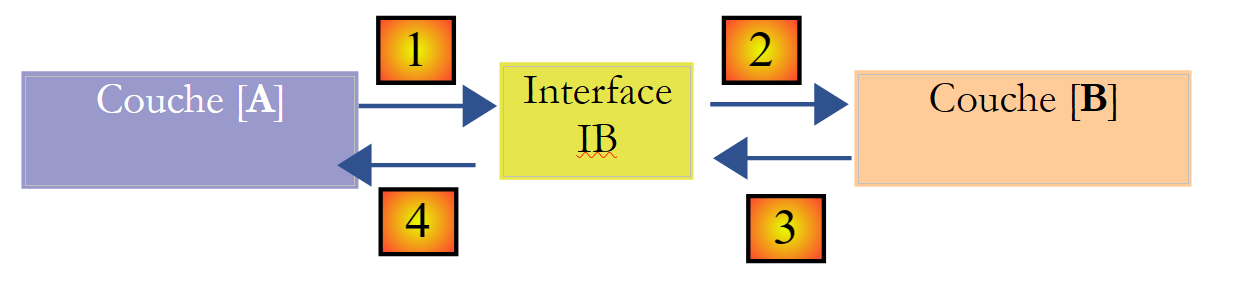 |
A camada [A] não se comunica mais diretamente com a camada [B], mas sim com sua interface [IB]. Assim, no código da camada [A], a classe de implementação [Bi] da camada [B] aparece apenas uma vez, no momento da implementação da interface [IB]. Feito isso, é a interface [IB] — e não sua classe de implementação — que é utilizada no código. O código anterior passa a ser o seguinte:
- linha 1: uma instância [ib], que implementa a interface [IB], é criada por instanciamento da classe [B1]
- linha 3: são solicitados dados à instância [ib]
A partir de agora, se substituirmos a implementação [B1] da camada [B] por uma implementação [B2], e se ambas as implementações respeitarem a mesma interface [IB], então apenas a linha 1 da camada [A] deve ser alterada, e nenhuma outra. Essa é uma grande vantagem que, por si só, justifica o uso sistemático de interfaces entre duas camadas.
É possível ir ainda mais longe e tornar a camada [A] totalmente independente da camada [B]. No código acima, a linha 1 apresenta um problema porque faz referência direta à classe [B1]. O ideal seria que a camada [A] pudesse dispor de uma implementação da interface [IB] sem precisar nomear uma classe. Isso seria coerente com nosso esquema acima. Vemos que a camada [A] se refere à interface [IB] e não vemos por que ela precisaria saber o nome da classe que implementa essa interface. Esse detalhe não é útil para a camada [A].
O framework Spring (http://www.springframework.org) permite alcançar esse resultado. A arquitetura anterior evolui da seguinte maneira:
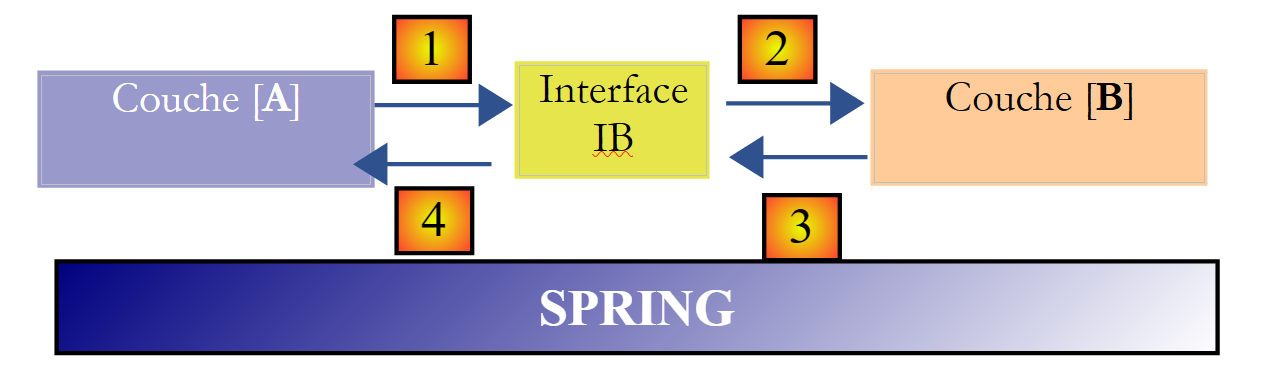 |
A camada transversal [Spring] permitirá que uma camada obtenha, por meio da configuração, uma referência à camada localizada à sua direita, sem precisar conhecer o nome da classe de implementação dessa camada. Esse nome constará nos arquivos de configuração e não no código Java. O código Java da camada [A] assume, então, a seguinte forma:
- linha 1: uma instância [ib] que implementa a interface [IB] da camada [B]. Essa instância é criada pelo Spring com base em informações encontradas em um arquivo de configuração. O Spring se encarregará de criar:
- a instância [b], que implementa a camada [B]
- a instância [a], que implementa a camada [A]. Essa instância será inicializada. O campo [ib] acima receberá como valor a referência [b] do objeto que implementa a camada [B]
- linha 3: são solicitados dados à instância [ib]
Percebe-se agora que a classe de implementação [B1] da camada B não aparece em nenhum lugar no código da camada [A]. Quando a implementação [B1] for substituída por uma nova implementação [B2], nada mudará no código da classe [A]. Bastará alterar os arquivos de configuração do Spring para instanciar [B2] em vez de [B1].
A combinação do Spring com as interfaces Java traz uma melhoria decisiva para a manutenção de aplicativos, tornando suas camadas independentes umas das outras. É essa solução que utilizaremos para o aplicativo [Elections].
Voltemos à arquitetura de três camadas da nossa aplicação:
 |
Em casos simples, podemos partir da camada [metier] para identificar as interfaces da aplicação. Para funcionar, ela precisa de dados:
- já disponíveis em arquivos, bancos de dados ou pela rede. Esses dados são fornecidos pela camada [dao].
- ainda não disponíveis. Nesse caso, são fornecidos pela camada [ui], que os obtém do usuário do aplicativo.
Que interface a camada [dao] deve oferecer à camada [metier]? Quais são as interações possíveis entre essas duas camadas? A camada [dao] deve fornecer os seguintes dados à camada [metier]:
- o número de cadeiras a serem preenchidas
- o valor do limite eleitoral abaixo do qual uma lista é eliminada
- os nomes das listas
Essas informações são, de fato, conhecidas antes da eleição e, portanto, podem ser armazenadas. No sentido [metier] -> [dao], a camada [metier] pode solicitar à camada [dao] que registre o resultado das eleições, notadamente os assentos obtidos pelas diferentes listas.
Com essas informações, seria possível tentar uma primeira definição da interface da camada [dao]:
public interface IElectionsDao {

  public double getSeuilElectoral();

  public int getNbSiegesAPourvoir();

  public ListeElectorale[] getListesElectorales();

  public void setListesElectorales(ListeElectorale[] listesElectorales);
}
- linha 1: a interface se chama [IElectionsDao]. Ela define quatro métodos:
- três métodos para ler dados provenientes da fonte de dados: [getSeuilElectoral, getNbSiegesAPourvoir, getListesElectorales]. Esses três métodos permitirão que a camada [metier] obtenha os dados que caracterizam a eleição atual.
- um método para gravar dados na fonte de dados: [setListesElectorales]. Esse método permitirá que a camada [metier] solicite o registro dos resultados que tiver calculado.
Voltemos à arquitetura de três camadas do nosso aplicativo:
|
Que interface a camada [metier] deve apresentar à camada [ui]? Vamos examinar as possíveis interações entre essas duas camadas.
- A camada [ui] terá a função de solicitar ao usuário os votos para as diferentes listas em disputa. Para isso, ela precisa saber o número de listas. Ela pode solicitar essa informação à camada [metier], que, por sua vez, pode solicitar a tabela das listas em disputa à camada [dao]. Se a camada [metier] tiver essa tabela, é melhor transferi-la para a camada [ui]. Assim, esta última terá os nomes das listas e poderá refinar suas mensagens ao usuário, solicitando, por exemplo, “Número de votos da lista A”.
- Quando a camada [ui] tiver obtido os votos de todas as listas, ela solicitará o cálculo dos assentos à camada [metier]. Esta poderá realizar esse cálculo e enviar o resultado à camada [ui].
- A camada [ui] poderá então apresentar esses resultados ao usuário. Este também poderá solicitar o registro dos mesmos.
- A camada [ui] pode, além disso, querer apresentar informações complementares ao usuário, tais como o limite eleitoral ou o número de cadeiras a serem preenchidas.
Com essas informações, seria possível tentar uma primeira definição da interface da camada [metier] :
public interface IElectionsMetier {

    public ListeElectorale[] getListesElectorales();

    public int getNbSiegesAPourvoir();

    public double getSeuilElectoral();

    public void recordResultats(ListeElectorale[] listesElectorales);

    public ListeElectorale[] calculerSieges(ListeElectorale[] listesElectorales);

}
- linha 1: a interface se chama [IElectionsMetier]. Ela define os seguintes métodos:
- linha 3: um método [getListesElectorales] que permitirá que a camada [ui] obtenha a tabela das listas concorrentes;
- linha 5: o método [getNbSiegesAPourvoir] permite obter o número de cadeiras a serem preenchidas;
- linha 7: o método [getSeuilElectoral] permite obter o limite eleitoral;
- linha 11: um método [calculerSieges] (linha 36) que permitirá que a camada [ui] solicite o cálculo dos assentos assim que os números de votos das diferentes listas forem conhecidos. O parâmetro é a tabela das listas em disputa, sem seus assentos e sem o valor booleano “eliminado”. O resultado retornado é essa mesma tabela, mas desta vez com os campos [sièges, elimine] inicializados;
- linha 9: um método [recordResultats] que permitirá que a camada [ui] solicite o registro dos resultados.
Observação: devido à sua posição, a camada [métier] retoma alguns dos métodos da camada [DAO] para disponibilizá-los à camada [UI]. Devido a essa redundância, pode-se ficar tentado a agrupar tudo em uma única camada que englobaria tanto a lógica de negócio quanto o acesso aos dados. Essa camada única é, às vezes, chamada de modelo, o M da sigla MVC (Modelo - Visão - Controlador). MVC é um padrão de projeto (design pattern) amplamente utilizado em aplicações web.
Vamos examinar a assinatura do método [calculerSieges]:
public ListeElectorale[] calculerSieges(ListeElectorale[] listesElectorales);
Foi mencionado anteriormente: “O parâmetro é a matriz das listas concorrentes, sem seus assentos e sem o valor booleano eliminado. O resultado é essa mesma matriz, mas desta vez com os campos [sièges, elimine]”. A assinatura do método também poderia ser a seguinte:
public void calculerSieges(ListeElectorale[] listesElectorales);
O parâmetro [listesElectorales] é uma referência a um objeto, neste caso, uma matriz. Cada elemento, por sua vez, é uma referência a um objeto, neste caso, do tipo [ListeElectorale]. O método [calculerSieges] alterará os campos [sieges, elimine] de cada um desses objetos. O método chamador possui um ponteiro [listesElectorales] que:
- antes da chamada, é a referência a uma matriz de objetos [ListeElectorale] cujos campos [sieges, elimine] não estão inicializados;
- após a chamada, é a referência (a mesma) a uma matriz de objetos [ListeElectorale] cujos campos [sieges, elimine] estão inicializados;
Então, por que usar a assinatura:
public ListeElectorale[] calculerSieges(ListeElectorale[] listesElectorales);
Ao escrever uma interface, é importante lembrar que ela pode ser usada em dois contextos diferentes: local e distant. No contexto local, o método chamador e o método chamado são executados na mesma JVM (Máquina Virtual Java):
|
Se a camada [ui] chamar o método calculerSieges da camada [DAO], ela possui, de fato, uma referência ao parâmetro [ListeElectorale[] listesElectorales], que ela passa para o método.
No contexto distant, o método chamador e o método chamado são executados em JVM diferentes:
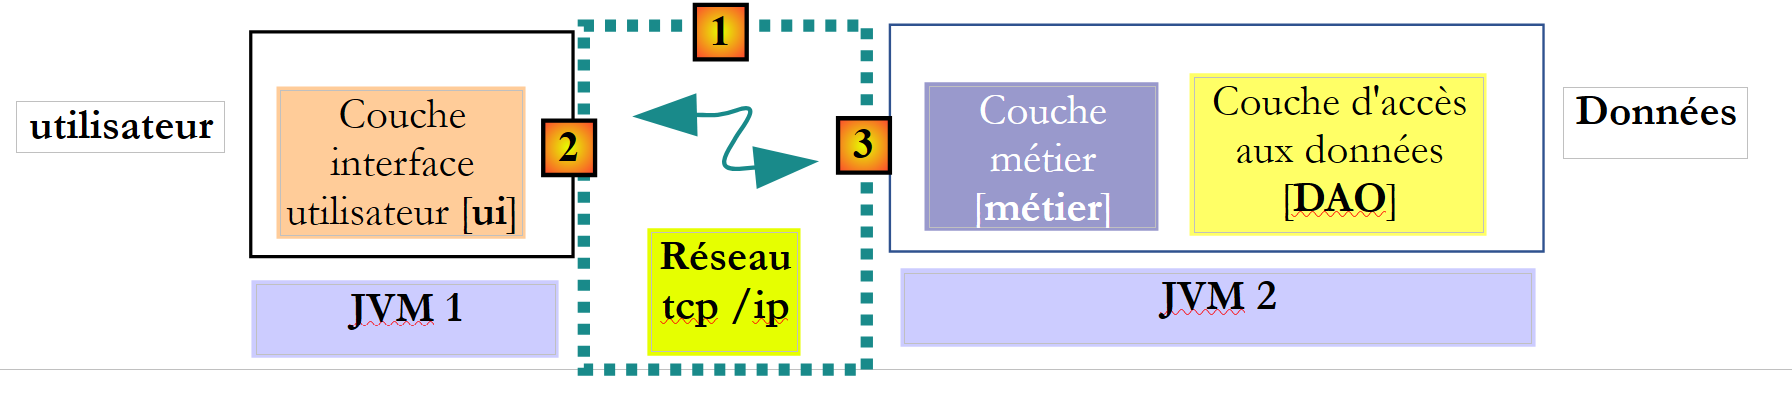 |
No exemplo acima, a camada [ui] é executada na JVM 1 e a camada [métier] na JVM 2, em duas máquinas diferentes. As duas camadas não se comunicam diretamente. Entre elas, intercala-se uma camada que chamaremos de camada de comunicação [1]. Esta é composta por uma camada de transmissão [2] e uma camada de recepção [3]. O desenvolvedor geralmente não precisa escrever essas camadas de comunicação. Elas são geradas automaticamente por ferramentas de software. A camada [metier] é escrita como se fosse executada na mesma JVM que a camada [DAO]. Portanto, não há nenhuma modificação no código.
O mecanismo de comunicação entre a camada [ui] e a camada [métier] é o seguinte:
- a camada [ui] chama o método calculerSieges da camada [métier], passando-lhe o parâmetro [ListeElectorale[] listesElectorales1];
- esse parâmetro é, na verdade, passado para a camada de emissão [2]. Esta transmitirá pela rede o valor do parâmetro listesElectorales1 e não sua referência. A forma exata desse valor depende do protocolo de comunicação utilizado;
- a camada de recepção [3] recuperará esse valor e, a partir dele, reconstruirá um objeto [ListeElectorale[] listesElectorales2] que reflete o parâmetro inicial enviado pela camada [metier]. Agora temos dois objetos idênticos (em termos de conteúdo) em duas camadas JVM diferentes: listesElectorales1 e listesElectorales2.
- A camada de recepção passará o objeto listesElectorales2 para o método calculerSieges da camada [métier], que o armazenará no banco de dados. Após essa operação, a referência listesElectorales2 aponta para uma matriz de objetos [ListeElectorale] cujos campos [sieges, elimine] estão inicializados. . Esse não é o caso do objeto listesElectorales1, ao qual a camada [ui] faz referência. Se quisermos que a camada [ui] tenha uma referência ao objeto listesElectorales2, é preciso enviá-lo a ela. Portanto, somos levados a utilizar a seguinte assinatura para o método [calculerSieges]:
public ListeElectorale[] calculerSieges(ListeElectorale[] listesElectorales);
- Com essa assinatura, o método calculerSieges retornará como resultado a referência listesElectorales2. Esse resultado é retornado à camada de recepção [3], que havia chamado a camada [métier]. Esta, por sua vez, retornará o valor (e não a referência) de listesElectorales2 à camada de emissão [2];
- a camada de emissão [2] recuperará esse valor e, a partir dele, reconstruirá um objeto [ListeElectorale[] listesElectorales3] da imagem resultante do método calculerSieges da camada [métier].
- O objeto [ListeElectorale[] listesElectorales3] é passado para o método da camada [ui], cuja chamada ao método calculerSieges da camada [DAO] havia iniciado todo esse mecanismo;
Nesse processo, objetos do tipo [ListeElectorale] transitam entre as camadas [2] e [3]:
- quando a camada [2] transmite o valor de um objeto [ListeElectorale] para a camada [3], diz-se que o objeto é serializado. A forma exata dessa serialização depende do protocolo de comunicação utilizado;
- quando a camada [3] recupera o valor de um objeto [ListeElectorale] para recriar um objeto [ListeElectorale], diz-se que o objeto é deserializado;
Para que um objeto possa passar por essa serialização/desserialização, alguns protocolos exigem que o objeto implemente a interface [Serializable]. Essa interface é apenas um marcador. Não há métodos a serem implementados. Portanto, a classe [ListeElectorale] passará a ser declarada da seguinte forma:
public abstract class ListeElectorale implements Serializable {
    private static final long serialVersionUID = 1L;
- O campo da linha 2 é obrigatório. É possível mantê-lo como está e utilizá-lo para qualquer classe do tipo [Serializable].
4.3. A classe de exceção
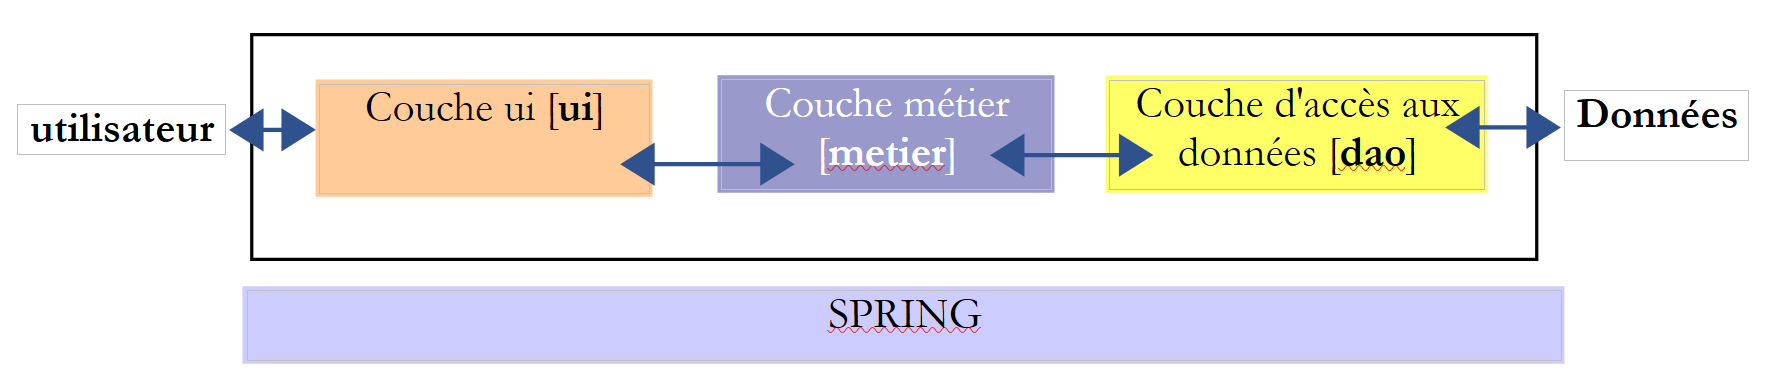
Voltemos à interface da camada [DAO]:
 |
public interface IElectionsDao {

  public double getSeuilElectoral();

  public int getNbSiegesAPourvoir();

  public ListeElectorale[] getListesElectorales();

  public void setListesElectorales(ListeElectorale[] listesElectorales);
}
Esses métodos trabalham com um banco de dados e podem encontrar diversos erros, por exemplo, um SGBD indisponível. Ao escrever um método, é preciso sempre prever os casos de erro. Esses erros são normalmente sinalizados por uma exceção. Já nos deparamos com a classe [ElectionsException] no parágrafo 3.3. Continuaremos a utilizá-la, mas ampliando-a da seguinte maneira:
package ...;

import java.io.Serializable;
import java.util.ArrayList;
import java.util.List;

// classe de exceção para o aplicativo Eleições
// a exceção é não controlada

public class ElectionsException extends RuntimeException implements Serializable {

    // serial ID
    private static final long serialVersionUID = 1L;

    // campos locais
    private int code;
    private List<String> erreurs;

    // construtores
    public ElectionsException() {
        super();
    }

    public ElectionsException(int code, Throwable e) {
        // pai
        super(e);
        // local
        this.code = code;
        this.erreurs = getErreursForException(e);
    }

    public ElectionsException(int code, String message, Throwable e) {
        // pai
        super(message,e);
        // local
        this.code = code;
        this.erreurs = getErreursForException(e);
    }

    public ElectionsException(int code, String message) {
        // pai
        super(message);
        // local
        this.code = code;
        List<String> erreurs = new ArrayList<>();
        erreurs.add(message);
        this.erreurs = erreurs;
    }

    public ElectionsException(int code, List<String> erreurs) {
        // pai
        super();
        // local
        this.code = code;
        this.erreurs = erreurs;
    }

    // lista de mensagens de erro de uma exceção
    private List<String> getErreursForException(Throwable th) {
        // recupera-se a lista de mensagens de erro da exceção
        Throwable cause = th;
        List<String> erreurs = new ArrayList<>();
        while (cause != null) {
            // recupera-se a mensagem somente se ela for !=null e não estiver vazia
            String message = cause.getMessage();
            if (message != null) {
                message = message.trim();
                if (message.length() != 0) {
                    erreurs.add(message);
                }
            }
            // próxima causa
            cause = cause.getCause();
        }
        return erreurs;
    }

    // getters e setters
...
}
- linhas 16-17: o tipo [ElectionsException] encapsula:
- um código de erro, linha 16;
- uma lista de mensagens de erro, linha 17;
A classe suporta cinco construtores:
- linha 20: ElectionsException()
- linha 24: ElectionsException(int code, Throwable e): o segundo parâmetro é do tipo [Throwable], que é a classe pai da classe [Exception]. Esse construtor permite encapsular a exceção e com um código de erro. O tipo [Throwable] (e, portanto, o tipo Exception) permite encapsular uma ou mais exceções. A ideia é:
- interceptar (catch) uma exceção que ocorra;
- enriquecê-la com uma mensagem, encapsulando-a em uma nova exceção;
- lançar novamente a nova exceção;
O encapsulamento ocorre na linha 34 por meio da instrução [super(message,e)]. Esse processo de encapsulamento pode ser repetido, e a exceção inicial pode ser enriquecida com diferentes mensagens. Diz-se, então, que se tem uma pilha de exceções. O método [private List<String> getErreursForException(Throwable th)] permite obter as diversas mensagens associadas às exceções encapsuladas:
- (continuação)
- (continuação)
- a exceção encapsulada é obtida pelo método Throwable [Throwable].getCause();
- a mensagem associada a uma exceção é obtida pelo método String [Throwable].getMessage();
- (continuação)
- linhas 28-29: constroem-se os campos [code, erreurs];
- linha 32: public ElectionsException(int code, String message, Throwable e): esse construtor é análogo ao anterior, exceto que ele enriquece a exceção que irá encapsular com um código e uma mensagem;
- linha 40: public ElectionsException(int código, String mensagem): construtor sem encapsulamento de exceção;
- linha 50: public ElectionsException(int código, List<String> erros): construtor sem encapsulamento de exceção nem mensagem;
A classe [ElectionsException] poderá ser utilizada da seguinte maneira:
onde a mensagem pode ou não estar presente. Uma vez criada, a exceção [ElectionsException] não se destina a encapsular novas exceções. No exemplo acima, ela encapsula a exceção e1 e as exceções que a e1 encapsula. A partir daí, não há mais novos encapsulamentos.
A classe [ElectionsException] também poderá ser utilizada da seguinte maneira: