11. Hibernate
El capítulo anterior mostró cómo una aplicación Kotlin interactúa con una base de datos a través de un controlador JDBC: se abre una conexión, se ejecutan comandos SQL, se leen las filas del resultado columna por columna y se copian en objetos. Este proceso de copia (de las filas a los objetos y de los objetos a los comandos [INSERT], [UPDATE] y [DELETE] ) es repetitivo. Se puede automatizar mediante una herramienta: un «mapeador objeto-relacional» (ORM). Este capítulo presenta el ORM más utilizado en el mundo Java, Hibernate, y el estándar que implementa, Jakarta Persistence. Kotlin no tiene un ORM propio de la misma envergadura: usa directamente los de la plataforma Java (Hibernate en primer lugar), tal como usa sus demás bibliotecas. Solo hay que conocer unas pocas reglas para escribir entidades Kotlin que funcionen con Hibernate: este capítulo las presenta sobre la marcha.
El capítulo retoma el código de ejemplo de los artículos del capítulo 10 y concluye con la versión 7 de la aplicación de cálculo de impuestos, cuya capa [dao] usa Hibernate.
11.1. ¿Qué es un ORM?
11.1.1. Objetos y tablas
Una aplicación Kotlin trabaja con objetos: un artículo tiene un nombre, un precio y un nivel de inventario; un pedido tiene un cliente y una lista de líneas, cada una de las cuales hace referencia a un artículo. Una base de datos relacional almacena esta misma información en tablas: una fila en la tabla [articles] por artículo, una fila en la tabla [orders] por pedido, con las relaciones entre filas expresadas mediante claves externas. Los dos mundos no coinciden del todo:
- un objeto hace referencia directamente a otros objetos ([order.client]); una fila contiene el valor de la clave primaria de otra fila ([client_id]);
- un objeto puede contener una colección ([order.lines]); una tabla contiene solo valores simples; la colección se representa mediante las filas de otra tabla que apuntan al pedido;
- los tipos de Kotlin ([String], [BigDecimal], [LocalDate], [Boolean]) y los tipos SQL ([varchar(30)], [decimal(10,2)], [date], [bit]) no son los mismos;
- los objetos se consultan con Kotlin (las operaciones [filter], [map]... sobre colecciones) y las tablas se consultan con SQL.
Un ORM tiende un puente entre los dos mundos. Se define la correspondencia entre clases y tablas (el modelo, o «mapeo») una vez por todas; luego el ORM se encarga de:
- traducir las consultas escritas en un lenguaje orientado a objetos (HQL) o construidas mediante código (API Criteria) a comandos SQL y [SELECT] ;
- crear objetos a partir de las filas leídas (esto se llama materialización);
- almacenar los objetos leídos y detectar los que se han modificado, agregado o eliminado;
- generar los comandos [INSERT], [UPDATE], y [DELETE] que reflejan estos cambios en la base de datos;
- y, si es necesario, crear y actualizar el esquema de la base de datos (tablas, columnas, índices) a partir de las clases.
La arquitectura de una aplicación que usa Hibernate con MySQL es la siguiente:
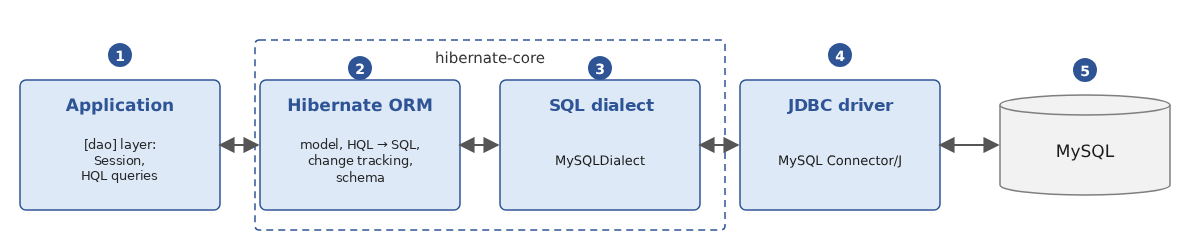
- [1]: la aplicación. Su capa [dao] ya no se comunica directamente con el controlador JDBC sino con Hibernate, a través de un objeto [Session] y de consultas HQL;
- [2]: Hibernate, independiente del DBMS: modelo, traducción de consultas, seguimiento de cambios, generación del esquema;
- [3]: el dialecto específico del DBMS (aquí, [MySQLDialect]): conoce la sintaxis SQL del DBMS, sus tipos de columna y sus funciones. Los dialectos de los principales DBMS forman parte del propio Hibernate: no hace falta agregar nada al proyecto;
- [4]: el controlador JDBC del DBMS, el que se vio en el capítulo 10 (MySQL Connector/J): Hibernate no reemplaza a JDBC; lo usa;
- [5]: el DBMS.
Que la aplicación esté escrita en Java o en Kotlin no cambia este esquema: Hibernate es una biblioteca Java a la que el código Kotlin llama como a cualquier otra biblioteca Java (capítulo 5), y las clases Kotlin compiladas son, para Hibernate, clases Java como cualquier otra.
11.1.2. Jakarta Persistence y Hibernate
Hibernate fue creado en 2001 por Gavin King en respuesta a lo engorrosos que resultaban los «entity beans» de la plataforma Java EE de aquella época. Su éxito fue tal que sus ideas se incorporaron a un estándar, JPA (Java Persistence API), publicado en 2006 con Java EE 5. Cuando Java EE se transfirió a la Fundación Eclipse y se renombró Jakarta EE, JPA pasó a llamarse Jakarta Persistence, y sus paquetes cambiaron de [javax.persistence] a [jakarta.persistence] (versión 3.0, 2020). La versión actual es Jakarta Persistence 3.2 (2024).
Jakarta Persistence es una especificación: un conjunto de interfaces ([EntityManagerFactory], [EntityManager]...), anotaciones ([@Entity], [@Id], [@Column]...) y un lenguaje de consultas, JPQL. Es implementada por varios productos: Hibernate ORM (el más utilizado, empleado en Spring Boot y Quarkus), EclipseLink (la implementación de referencia)... Este curso usa Hibernate ORM 7.4.5, que implementa Jakarta Persistence 3.2.
Hibernate ofrece dos maneras de usarlo:
- exclusivamente a través de las interfaces estándar: en este caso, el código depende solo de [jakarta.persistence], y en principio sería posible cambiar de implementación;
- a través de su propia API («nativa»), más rica en funcionalidades y cuyas interfaces extienden las del estándar: un [SessionFactory] es un [EntityManagerFactory], y un [Session] es un [EntityManager].
Usamos la API propia de Hibernate, como recomienda su documentación: ofrece todos los métodos estándar ([persist], [find], [merge], [remove]...) así como las extensiones de Hibernate. Las anotaciones, en cambio, son siempre las definidas por el estándar. La siguiente tabla muestra las correspondencias:
Jakarta Persistence | Hibernate | Rol |
[EntityManagerFactory] | [SessionFactory] | Configuración de Hibernate para una base de datos: un objeto pesado, creado una sola vez, compartido por toda la aplicación |
[EntityManager] | [Session] | Una sesión de base de datos: un objeto ligero y de corta duración |
[EntityTransaction] | [Transaction] | una transacción |
JPQL | HQL | el lenguaje de consultas; HQL es un superconjunto de JPQL |
[CriteriaBuilder] | [HibernateCriteriaBuilder] | construcción de consultas mediante código |
En el ecosistema de Kotlin también se encuentran bibliotecas de acceso a datos de otra naturaleza, como Exposed (de JetBrains), que permite escribir consultas SQL mediante un lenguaje Kotlin específico. Son más ligeras que un ORM completo; Hibernate sigue siendo el estándar para las aplicaciones Spring, tanto en Java como en Kotlin, y es el que estudiamos.
11.1.3. Bibliotecas
Las bibliotecas utilizadas en este capítulo son las siguientes (se resumen en el apéndice sobre dependencias):
Dependencia de Gradle | Rol |
[org.hibernate.orm:hibernate-core] 7.4.5.Final | Hibernate en sí; incluye la API de Jakarta Persistence 3.2 ([jakarta.persistence-api]) y sus propias dependencias (Byte Buddy para la generación de clases, ANTLR para el análisis de consultas, JBoss Logging para el registro, etc.) |
[com.mysql:mysql-connector-j] 9.7.0 | el controlador JDBC de MySQL, el del capítulo 10 |
[ch.qos.logback:logback-classic] 1.5.38 | Logback, que recibirá el registro de Hibernate |
Hibernate escribe su registro (comandos SQL ejecutados, advertencias, etc.) a través de JBoss Logging, una pequeña biblioteca que simplemente reenvía los mensajes al sistema de registro que encuentra en el classpath: Log4j 2, o Logback (mediante SLF4J) o, en su defecto, el del JDK o [java.util.logging]. Sin configuración, este último muestra cada mensaje en dos líneas, en rojo en la mayoría de las consolas, lo que dificulta la lectura de la salida del programa. Por eso agregamos Logback a nuestros proyectos y lo configuramos mediante un archivo [logback.xml].
Además de estas bibliotecas, hay dos plugins del compilador de Kotlin que adaptan las clases de Kotlin a los requisitos de Hibernate: [kotlin("plugin.jpa")] y [kotlin("plugin.allopen")]. Veremos por qué son necesarios cuando examinemos la primera entidad.
11.1.4. Code-first o database-first
El modelo (el mapeo entre clases y tablas) puede construirse de dos maneras:
- code-first: se escriben las clases de Kotlin e Hibernate infiere de ellas el esquema de la base de datos, que luego puede crear por sí mismo. Este es el enfoque adoptado en este capítulo;
- database-first: la base de datos ya existe y las clases se generan a partir de su esquema mediante las herramientas de ingeniería inversa de Hibernate (Hibernate Tools) o las que ofrecen los entornos de desarrollo (IntelliJ IDEA puede generar entidades a partir de tablas de bases de datos, tanto en Java como en Kotlin). Este es el enfoque utilizado en las aplicaciones que deben trabajar con una base de datos existente. El código generado es similar al que escribiríamos a mano.
11.2. Un primer ejemplo
11.2.1. El proyecto
Los ejemplos de este capítulo son subproyectos de una compilación Gradle multiproyecto (véase el capítulo 6), ubicados en la carpeta [11-hibernate]:
El archivo [settings.gradle.kts] declara los subproyectos:
- líneas 3–6: el plugin que permite a Gradle descargar por sí mismo el JDK 25 si no lo encuentra en la máquina (capítulo 2);
- línea 8: el nombre del proyecto raíz;
- línea 11: las dos bibliotecas comunes a los ejemplos;
- líneas 13–14: un subproyecto, a modo de ejemplo. Gradle no exige que se enumeren según el orden de sus dependencias; las deduce por sí mismo a partir de las dependencias declaradas entre subproyectos;
- Línea 16: los dos subproyectos de la versión 7 de la aplicación de cálculo de impuestos. El nombre [TaxV7:tax-dao-hibernate] hace referencia a la carpeta [TaxV7/tax-dao-hibernate];
- Línea 19: la estructura compuesta del capítulo 6, cuya aplicación TaxV7 reutilizará las capas [business] y [ui].
El proyecto raíz declara, junto con sus versiones, los plugins que utilizan los subproyectos:
- línea 3: el plugin de Kotlin para JVM;
- líneas 4–5: los dos plugins del compilador de Kotlin que requieren las entidades (se describen más adelante);
- línea 6: el plugin “all-open” configurado para Spring (capítulo 6), utilizado por el ejemplo [injection];
- [apply false]: los plugins solo se declaran aquí, junto con sus versiones; cada subproyecto aplica los que necesita, sin repetir la versión.
El primer ejemplo es el subproyecto [first]. Es independiente de los demás:
- líneas 3–8: los plugins aplicados: Kotlin, los dos plugins de entidades y [application] para ejecutar el programa;
- líneas 17–20: Hibernate, el controlador JDBC para MySQL y Logback. El controlador y Logback solo se utilizan en tiempo de ejecución ([runtimeOnly]): el código del programa no hace referencia a ninguna de sus clases;
- líneas 24–27: la configuración del plugin [allopen] (se describe más abajo);
- líneas 31–34: las opciones de compilación estándar del curso (JDK 25, advertencias tratadas como errores);
- línea 40: la clase principal del subproyecto. Un archivo [Main.kt] del paquete [first] se compila en una clase [first.MainKt] (capítulo 3);
- líneas 43–46: los programas lanzados por Gradle escriben su salida en UTF-8 para que los caracteres acentuados se muestren correctamente en Windows (capítulo 2).
Para ejecutar un ejemplo, vaya a la carpeta [11-hibernate] e indique la tarea [run] del subproyecto mediante su ruta ([:first:run]); Gradle primero compila los subproyectos de los que depende (en Linux y macOS, escriba [./gradlew]):
El programa se ejecuta en la carpeta del subproyecto ([11-hibernate/first]). La base de datos utilizada es la base [hbfirst] del servidor MySQL local, que es el servidor de Laragon (véanse los apéndices). No necesita existir: MySQL la creará.
11.2.2. La entidad [Article]
Una clase cuyos objetos se almacenan en una tabla se denomina entidad. Nuestra primera entidad es un artículo de una tienda, como en la tabla [articles] del capítulo 10:
- Línea 10: la anotación [@Entity] (paquete [jakarta.persistence]) convierte la clase en una entidad. Es una clase de Kotlin normal que no extiende ninguna clase de Hibernate; se la denomina POJO (“Plain Old Java Object”);
- líneas 13–16: las propiedades declaradas en el constructor primario (capítulo 4). Son [var]: Hibernate debe poder modificar sus valores, y la aplicación también (para cambiar un precio o un nivel de inventario). Cada propiedad se convierte en una columna con el mismo nombre;
- líneas 19–21: la clave primaria se designa mediante la anotación [@Id]. No existe una convención de nombres: la anotación es obligatoria. [@GeneratedValue(strategy = GenerationType.IDENTITY)] indica que sus valores serán generados por el SGBD (la columna [AUTO_INCREMENT] de MySQL). El identificador no es un parámetro del constructor: lo proporcionará el SGBD. Su tipo es [Int?] y su valor inicial es [null], que significa “aún no registrado en la base de datos”. El tipo [Int?] se compila a [java.lang.Integer], y el tipo [Int] a [int] (capítulo 3);
- línea 24: una presentación cómoda del artículo. El formato [%.2f] muestra el precio con dos decimales, de acuerdo con las convenciones culturales habituales (una coma en Francia, un punto en la configuración regional inglesa utilizada para los resultados).
¿Dónde van las anotaciones? En el bytecode, una propiedad de Kotlin corresponde a varios elementos de Java: un campo privado, un accesor ([getX]), un modificador ([setX]) y, en este caso, un parámetro del constructor. Una anotación colocada antes de una propiedad, sin más especificación, es ubicada por Kotlin 2.4 según los destinos que acepta: en el parámetro del constructor si es una propiedad del constructor y la anotación lo permite, y además en la propia propiedad de Kotlin si la anotación lo permite; en caso contrario, en el campo. Las anotaciones de Jakarta Persistence ([@Id], [@Column]...) no se aplican a parámetros ni a propiedades de Kotlin, sino solo a campos y métodos de Java: por lo tanto, se ubican en el campo. Esto es exactamente lo que queremos: como la anotación [@Id] está en un campo, Hibernate accede directamente a los campos (los lee y escribe mediante reflexión, aunque sean privados). Puede verificarlo con la herramienta [javap] del JDK, que muestra el contenido de un archivo [.class]. También puede especificar el destino de una anotación mediante un prefijo: [@field:Column(length = 30)] la ubica en el campo, [@get:Transient] en el accesor.
Jakarta Persistence exige dos cosas que las clases de Kotlin no ofrecen de manera predeterminada:
- un constructor sin parámetros, que Hibernate utiliza para crear los objetos leídos de la base de datos (luego completa sus campos). Nuestra clase tiene un solo constructor, con cuatro parámetros. En Java, se agrega manualmente un constructor protegido sin parámetros. En Kotlin, es el plugin [no-arg] del compilador, configurado para JPA ([kotlin("plugin.jpa")]), el que lo agrega a toda clase anotada con [@Entity], [@Embeddable], o [@MappedSuperclass]. Este constructor existe en el bytecode, donde Hibernate lo encuentra mediante reflexión, pero no es visible desde el código Kotlin: [Article()] sigue siendo un error de compilación (“[no value passed for parameter 'name'.]”). Observe que no ejecuta las inicializaciones de propiedades: una propiedad declarada como [var x = "a"] vale [null] en un objeto creado por Hibernate, mientras Hibernate no le haya asignado un valor (la opción [noArg { invokeInitializers = true }] del archivo de compilación cambia este comportamiento). Esto no es un problema para las propiedades almacenadas en la base de datos, ya que Hibernate les asigna el valor leído;
- clases y métodos no finales. Para implementar la carga diferida (que trataremos al hablar de las relaciones), Hibernate crea proxies en tiempo de ejecución: clases derivadas de las entidades, cuyos métodos cargan el objeto desde la base de datos en la primera llamada. Para que esto funcione, la clase y sus métodos deben poder redefinirse. En Java, este es el comportamiento predeterminado; en Kotlin, las clases y sus miembros son final de manera predeterminada (capítulo 4). El plugin [all-open] ([kotlin("plugin.allopen")]) , configurado mediante el bloque [allOpen] del archivo de compilación, hace que las clases que llevan una de las anotaciones enumeradas, así como sus propiedades y métodos, no sean finales ([open]). El [plugin.spring] del capítulo 6 es el mismo plugin, configurado para las anotaciones de Spring.
Con estos dos plugins, la entidad se escribe como una clase de Kotlin normal. Sin ellos, habría que escribir [open class Article(...)], declarar [open] en cada propiedad y agregar un constructor secundario sin parámetros: lo haremos con una clase sin anotaciones en el siguiente ejemplo.
¿Por qué no usar una data class ([data class], capítulo 4)? Parecería ideal para representar una fila de una tabla. Sin embargo, es una mala idea para una entidad, por varias razones:
- Los métodos generados [equals] y [hashCode] comparan todas las propiedades del constructor primario, que son modificables. Por lo tanto, el código hash de una entidad cambia en cuanto se modifica su precio: un artículo almacenado en un [HashSet] o que sirve como clave de un [HashMap] se vuelve imposible de localizar. El propio Hibernate almacena los elementos de las colecciones de relaciones ([Set]) mediante estos métodos;
- dos objetos que representan dos filas distintas (con dos identificadores diferentes) pero con los mismos valores se considerarían iguales, mientras que un artículo leído de la base de datos y luego modificado ya no sería igual a sí mismo al leerlo de nuevo;
- el método [toString] generado muestra todas las propiedades: con relaciones, recorre los objetos vinculados, lo que puede provocar que se carguen desde la base de datos (consultas SQL inesperadas), una excepción si la sesión está cerrada, o incluso una recursión infinita entre dos entidades que se referencian mutuamente;
- el método [copy] crea un nuevo objeto con el mismo identificador, que la sesión desconoce: esto da como resultado dos objetos para la misma fila, lo que puede generar confusión;
- El programador no puede declarar una data class como abierta ([open]). El plugin [all-open] la abre de todos modos, lo que permite crear proxies (lo verificamos con la herramienta [javap]), pero no corrige ninguno de los problemas anteriores.
Por lo tanto, una entidad es una clase ordinaria: su identidad es la de la fila de la tabla, no el valor de sus propiedades. Como en Java, conserva el [equals]/[hashCode] heredado de [Any] (identidad del objeto), lo cual es adecuado siempre que no se mezclen objetos de sesiones diferentes. Las data classes siguen siendo muy útiles con Hibernate para los resultados de consultas que no son entidades (proyecciones), como veremos. Es la misma regla que en Java, donde una entidad no puede ser un record.
Una última observación: Hibernate no reconoce los tipos que admiten valores nulos de Kotlin. El hecho de que la propiedad [name] sea de tipo [String] (que no admite nulos) no le indica a Hibernate que la columna es obligatoria; solo la anotación [@Column(nullable = false)] se lo indica, como veremos en los resultados.
11.2.3. [SessionFactory] y [Session]
El programa utiliza tres objetos de Hibernate:
- el [SessionFactory] representa a Hibernate configurado para una base de datos: la lista de entidades, la base de datos y las opciones. Su creación es costosa en recursos (Hibernate analiza las entidades, se conecta al servidor para determinar su versión y prepara el SQL de las operaciones habituales): solo se crea uno por base de datos y por aplicación, al inicio. Es seguro para hilos (thread-safe): todos los hilos de la aplicación pueden utilizarlo;
- la [Session] representa una sesión de trabajo con la base de datos. Obtiene una conexión cuando es necesario, almacena las entidades que ha leído o guardado y sabe cómo confirmar sus cambios en la base de datos. Es un objeto ligero y de corta duración que no es seguro para hilos: se abre una por cada unidad de trabajo y luego se cierra;
- [Transaction]: con Hibernate, todas las escrituras en la base de datos ocurren dentro de una transacción explícita, abierta con [session.beginTransaction()] y cerrada con [commit] (confirmación) o [rollback] (reversión).
[SessionFactory] y [Session] implementan la interfaz [AutoCloseable]: se utilizan con la función de Kotlin [use] (capítulo 3), que las cierra al final del bloque, ya sea que este termine con normalidad o con una excepción (el equivalente de la instrucción [try] con recursos de Java).
11.2.4. El programa
- líneas 8–16: creación del [SessionFactory]. Hay varias maneras de configurar Hibernate (las veremos más adelante); utilizamos la clase [HibernatePersistenceConfiguration] de Hibernate 7, una versión mejorada de la clase [PersistenceConfiguration] introducida con Jakarta Persistence 3.2, que permite configurarlo todo mediante código. Su parámetro es el nombre de la unidad de persistencia, un nombre de libre elección que aparece en los mensajes de Hibernate. Cada método devuelve la propia configuración, lo que permite encadenar las llamadas;
- línea 10: la lista de entidades. [Article::class.java] es el objeto Java [Class] (la clase de Kotlin [KClass] no es adecuada: Hibernate es una biblioteca de Java);
- líneas 12–13: la URL JDBC de la base de datos [hbfirst], en el mismo formato que en el capítulo 10, y el usuario ([root], sin contraseña en Laragon). El parámetro [createDatabaseIfNotExist=true] de la URL es una opción del controlador de MySQL: crea la base de datos si no existe;
- línea 15: [showSql(true, true, false)] indica a Hibernate que imprima en la consola cada comando SQL que ejecuta, con formato en varias líneas (segundo parámetro) y sin colores (tercer parámetro). Observar el SQL enviado al servidor es la mejor manera de entender lo que hace Hibernate: lo haremos en todos los ejemplos;
- línea 16: [createEntityManagerFactory] construye el [SessionFactory] (el nombre del método sigue el estándar; el tipo devuelto es el de Hibernate). La función [use] lo cerrará al final del programa; dentro del bloque, se denomina [sessionFactory];
- líneas 19–20: el objeto [SchemaManager] del [SessionFactory] (Jakarta Persistence 3.2) administra las tablas de las entidades: [drop(false)] las elimina si existen, mientras que [create(false)] las crea (el parámetro [false] especifica que la base de datos en sí no debe eliminarse ni crearse). Esto es cómodo para ejemplos y pruebas; una aplicación real administra su base de datos de otra manera, como veremos. Kotlin presenta el método de Java [getSchemaManager()] como una propiedad, [schemaManager] (capítulo 4);
- línea 23: [openSession()] abre una sesión, que se cierra al final del bloque [use];
- línea 24: el inicio de una transacción;
- líneas 26–28: [persist] agrega tres artículos nuevos a la sesión: se almacenarán en la base de datos. No se especifica ningún valor para el identificador; lo generará el SGBD;
- línea 30: [commit] confirma la transacción. Antes, la sesión envía al servidor los comandos SQL que aún son necesarios para guardar los cambios que ha almacenado: esto se denomina “vaciado” (flush) de la sesión hacia la base de datos;
- líneas 36–38: una consulta escrita en HQL, el lenguaje de consultas de Hibernate: los artículos en orden alfabético por nombre. Hace referencia a la entidad [Article] y a su propiedad [name], no a la tabla. El segundo parámetro de [createSelectionQuery] es el tipo del resultado: la propiedad [resultList] (el método de Java [getResultList]) devuelve un [List<Article>];
- Línea 39: visualización de los artículos.
Si ocurriera una excepción entre [beginTransaction] y [commit], la transacción no se confirmaría ni nuestro código la revertiría explícitamente: más adelante veremos una forma más segura de escribir una transacción mediante una función de orden superior.
El archivo [src/main/resources/logback.xml] del subproyecto configura Logback. Muestra los mensajes de Hibernate de nivel [INFO] o superior, uno por línea (nivel, nombre del log, mensaje):
Resultados:
Comentarios:
- Líneas 2–17: mensajes informativos de Hibernate: el nombre de la unidad de persistencia, la versión de Hibernate y las características de la base de datos (URL, controlador, dialecto seleccionado, versión del servidor, nivel de aislamiento de transacciones, tamaño del grupo de conexiones). Hibernate consultó al servidor para seleccionar el dialecto [MySQLDialect] adecuado para su versión;
- línea 4: una advertencia. Hibernate administra su propio grupo de conexiones pequeño, que no está destinado a una aplicación de producción. Veremos, con Spring, cómo proporcionarle el grupo HikariCP del capítulo 10; para nuestros ejemplos, el grupo integrado es suficiente;
- Líneas 18–28: eliminación y posterior creación de la tabla [Article] a partir de la entidad: el nombre de la tabla es el mismo que el de la entidad, las columnas se nombran según las propiedades y la columna [id] es la clave primaria, con un valor generado ([auto_increment]). Las columnas de las propiedades de tipo [Int] son [not null]: se compilan a [int]; un [Int] no puede ser igual a [null]. Las propiedades de tipo [String] y [BigDecimal] aceptan el valor [NULL], aunque estos tipos no admiten nulos en Kotlin: para Hibernate, son referencias de Java ([java.lang.String], [java.math.BigDecimal]), que pueden valer [null];
- observe los tipos predeterminados: [varchar(255)] para una cadena y [decimal(38,2)] para un [BigDecimal] (38 dígitos, incluidos 2 decimales). Rara vez son los que se desean: el siguiente apartado muestra cómo especificarlos;
- Líneas 29–51: los tres comandos [INSERT] configurados se ejecutaron en cuanto se llamó a [persist] , antes de [commit]. Esto es consecuencia de que la clave la genera el SGBD ([IDENTITY]): la sesión debe conocer el identificador de una entidad en cuanto se hace cargo de ella y, para obtenerlo, debe ejecutar la inserción (el controlador JDBC devuelve la clave generada; véase el capítulo 10). Con otros métodos de generación, las inserciones se aplazan hasta que se sincroniza la sesión. Los valores de los parámetros ([?]) no se muestran: veremos cómo hacer que aparezcan;
- líneas 53–63: la consulta HQL [from Article order by name] se tradujo a una instrucción [SELECT ... ORDER BY]. Hibernate asignó el alias [a1_0] a la tabla y creó un objeto [Article] por cada fila leída (líneas 64–66), utilizando el constructor sin parámetros agregado por el plugin [no-arg].
No escribimos ninguna instrucción SQL ni código para leer columnas: ese es todo el sentido de un ORM. También vemos que esto no elimina la necesidad de entender SQL: para determinar si el SQL generado es correcto y eficaz, hay que saber leerlo.
11.3. El modelo
Hibernate construye su modelo a partir de las entidades en tres pasos:
- primero, aplica sus reglas predeterminadas: a todo lo que no se especifica se le asigna un valor razonable (esto se conoce como “configuración por excepción”);
- luego complementa o corrige esos valores mediante las anotaciones colocadas en las entidades;
- por último, aplica los archivos de mapeo XML ([orm.xml]), que pueden describir completamente una clase sin anotaciones o modificar lo que especifican sus anotaciones.
11.3.1. Reglas predeterminadas
Vimos lo esencial en el primer ejemplo:
- una entidad lleva la anotación [@Entity] y tiene un identificador designado mediante [@Id]; ambas anotaciones son obligatorias;
- la ubicación de la anotación [@Id] determina el modo de acceso: cuando se coloca en un campo, Hibernate lee y escribe los campos directamente; cuando se coloca en un getter o un setter ([getId]), el acceso se realiza mediante los getters y setters ([getX]/[setX]). El acceso mediante campos es el más habitual: permite que la clase tenga los métodos que quiera. En Kotlin, una anotación colocada antes de una propiedad se aplica al campo (como hemos visto): esto proporciona acceso mediante campos sin ninguna especificación explícita. Para el acceso mediante getters y setters, habría que escribir [@get:Id];
- toda propiedad que tenga un campo de respaldo se almacena en una columna, a menos que lleve la anotación de Jakarta Persistence [@Transient] o la anotación [@kotlin.jvm.Transient] (que agrega el modificador de Java [transient] al campo); una propiedad calculada, cuyo accesor personalizado no utiliza [field] (capítulo 4), no tiene campo: nunca se almacena;
- el nombre de la tabla es el nombre de la entidad (el nombre simple de la clase) y el nombre de la columna es el nombre de la propiedad. Estos nombres pasan luego por una estrategia de nomenclatura: la estrategia de Hibernate conserva los nombres tal cual, mientras que otra estrategia, que probaremos más adelante, los convierte a “snake case” ([currentStock] se convierte en [current_stock]). Spring Boot utiliza esta última de manera predeterminada;
- una columna de un tipo compilado a un tipo primitivo ([Int], [Double], [Boolean] que no admiten nulos) se convierte en [NOT NULL]; una columna de un tipo compilado a una referencia ([Int?], [String], [BigDecimal], [LocalDate], admitan o no nulos en Kotlin) acepta el valor [NULL]. Por lo tanto, para hacer obligatoria la columna de una propiedad de tipo [String], debe utilizar la anotación [@Column(nullable = false)], aunque el tipo de Kotlin ya prohíba el valor [null];
- Los tipos SQL se seleccionan según el dialecto. Con MySQL: [integer] para [Int], [bigint] para [Long], [bit] para [Boolean], [varchar(255)] para [String], [decimal(38,2)] para [BigDecimal], [date] para [LocalDate], [datetime(6)] (al microsegundo) para [LocalDateTime]. Una enumeración ([enum class]) se registra de manera predeterminada por su número de orden (véase el capítulo 3); la anotación [@Enumerated(EnumType.STRING)] la registra por su nombre, lo cual es más confiable;
- una propiedad que hace referencia a otra entidad, o a una colección de entidades, define una relación (la trataremos más adelante).
11.3.2. Las anotaciones y el archivo de mapeo XML
El subproyecto [model] define dos entidades configuradas de dos maneras diferentes. Su archivo de compilación es el de [first], con la dependencia de Logback reemplazada por una dependencia de la biblioteca [tools] que se describe más abajo (y que proporciona Logback y su configuración). La primera entidad se configura mediante anotaciones:
- líneas 3–9: las anotaciones de Jakarta Persistence. La importación explícita de [jakarta.persistence.Transient] tiene prioridad sobre la anotación [kotlin.jvm.Transient], que tiene el mismo nombre y que Kotlin importa de manera predeterminada;
- línea 15: [@Table] especifica el nombre de la tabla;
- líneas 18–19: [@Column] especifica la columna; [nullable = false] la hace obligatoria ([NOT NULL]); [length = 50] establece su longitud ([varchar(50)]);
- líneas 22–23: [@Column] también especifica el nombre de la columna ([price_excl_tax]) y, para un número decimal, su precisión (el número total de dígitos) y su escala (el número de dígitos después del punto decimal): [decimal(10,2)];
- líneas 26–27: una descripción opcional de hasta 200 caracteres: la columna aceptará el valor [NULL]. La propiedad es de tipo [String?], con el valor predeterminado [null]: el tipo de Kotlin coincide con la columna. Es una buena práctica hacer coincidir el tipo de la propiedad, que admite o no nulos, con el carácter opcional u obligatorio de la columna, aunque Hibernate solo lee la anotación;
- línea 30: una fecha opcional. El tipo [LocalDate] (capítulo 5) representa una fecha sin hora: se asocia con el tipo SQL [date];
- líneas 32–35: la clave primaria, designada mediante [@Id] independientemente de su nombre;
- líneas 38–39: [@Transient] excluye una propiedad del modelo: en este caso, información útil para la interfaz de usuario que no pertenece a la base de datos;
- líneas 42–43: una propiedad calculada. Su accesor no utiliza un campo: no hay nada que guardar, e Hibernate, que accede a los campos, la ignora. El operador [*] entre dos [BigDecimal] es la función [times] que la biblioteca estándar de Kotlin agrega a [BigDecimal] (capítulo 4, sobrecarga de operadores): escribimos [priceExclTax * BigDecimal("1.2")] en lugar de [priceExclTax.multiply(new BigDecimal("1.2"))]de Java.
La segunda entidad no tiene anotaciones:
- Línea 8: como la clase no está anotada con [@Entity], los plugins [no-arg] y [all-open] no la reconocen. Por eso la declaramos nosotros mismos como [open], para que Hibernate pueda derivar proxies de ella;
- líneas 9–13: propiedades privadas: Kotlin no genera accesores ni modificadores para ellas, solo un campo privado, que Hibernate leerá y escribirá. Es el equivalente exacto de los campos privados de una clase de Java;
- Línea 16: el constructor sin parámetros que exige Hibernate, escrito a mano: un constructor secundario que llama al constructor primario (capítulo 4) con valores arbitrarios, que Hibernate reemplazará por los leídos de la base de datos. Es protegido: el código de la aplicación no lo utilizará.
Su mapeo a la tabla se describe en un archivo XML, ubicado en la carpeta [src/main/resources/META-INF] del subproyecto (es el mismo archivo que en Java):
- líneas 3–7: el esquema XML de los archivos de mapeo de Jakarta Persistence 3.2;
- línea 8: la clase descrita, con acceso mediante campos;
- líneas 9–12: la tabla y un índice único sobre el nombre de la empresa: no puede haber dos proveedores con el mismo nombre. La anotación equivalente es [@Table(name = "suppliers", indexes = [Index(...)])] (en Kotlin, un arreglo pasado como argumento de una anotación se escribe entre corchetes);
- líneas 14–16: el identificador, generado por el SGBD;
- líneas 17–18: una columna obligatoria con un máximo de 60 caracteres;
- líneas 20–21: la propiedad [phone] se almacena en la columna [tel];
- líneas 24–26: la fecha de creación tiene un valor predeterminado, calculado por el SGBD. El atributo [column-definition] proporciona el texto SQL de la definición de la columna, copiado literalmente en la instrucción [CREATE TABLE]; [insertable="false"] y [updatable="false"] indican que Hibernate nunca debe escribir en esta columna, lo que permite que el SGBD utilice [current_timestamp(6)].
Todo lo que hacen las anotaciones puede hacerse en XML. Las anotaciones tienen la ventaja de colocar la configuración junto a la propiedad, y es el enfoque más habitual; el archivo XML, en cambio, mantiene las clases independientes de Jakarta Persistence y centraliza la configuración en un solo lugar. Los dos enfoques pueden combinarse: el archivo XML tiene prioridad en caso de conflicto. Jakarta Persistence no admite la configuración del modelo mediante código, como sí lo hacen otros frameworks ORM (por ejemplo, Entity Framework en C# o Exposed en Kotlin).
El programa muestra el modelo construido por Hibernate, seguido del script SQL que crearía las tablas:
- línea 11: un [StringWriter] (paquete [java.io]), un flujo de escritura hacia una cadena en memoria, recibirá el script SQL;
- líneas 15–16: la entidad anotada se declara con [managedClass] y el archivo XML con [mappingFile];
- líneas 18–20: la base de datos nunca existirá: este [SessionFactory] se utiliza únicamente para examinar el modelo. Por lo tanto, no hay URL ni JDBC. Para seleccionar el dialecto SQL sin consultar al servidor, Hibernate necesita el nombre del SGBD y su versión; la propiedad [ALLOW_METADATA_ON_BOOT] ([hibernate.boot.allow_jdbc_metadata_access]) le impide conectarse al iniciar. Los nombres de las propiedades de configuración son constantes de la interfaz [AvailableSettings];
- línea 22: la convención de nomenclatura “snake case”, designada por el nombre de su clase ([::class.java.name]);
- líneas 25–28: Hibernate escribirá el script de creación de las tablas (["create"]) en el objeto [script] sin ejecutarlo; los comandos terminan con un punto y coma y tienen formato en varias líneas;
- línea 32: la propiedad [metamodel] (el método [getMetamodel] de Jakarta Persistence) da acceso al modelo: sus entidades ([EntityType]) y, para cada una, sus atributos ([Attribute]);
- Líneas 33–37: para cada entidad, su nombre y su clase; para cada atributo, su nombre, su tipo Java y si es el identificador. En la línea 35, la prueba [attribute is SingularAttribute<*, *>] va seguida de una conversión inteligente de tipo (capítulo 4): en la continuación de la expresión [&&], [attribute] es un [SingularAttribute], del cual se puede leer la propiedad [isId]. La proyección [<*, *>] reemplaza a [<?, ?>] de Java;
- Líneas 42–45: el script tal como se muestra, sin los cuatro espacios que Hibernate agrega a sus líneas ([removePrefix] elimina el prefijo solo si está presente).
Resultados:
- Línea 2: la advertencia de Hibernate confirma que no tiene forma de establecer una conexión;
- líneas 3–13: las dos entidades y sus atributos (primero el identificador y luego los demás en orden alfabético; el orden de las entidades no es significativo). La propiedad [selected] y la propiedad calculada [priceInclTax] no aparecen en el modelo. Los tipos son los tipos de Java: [Integer] para [Int?];
- líneas 15–21: la tabla [suppliers], descrita por el archivo XML. La estrategia de nomenclatura cambió [companyName] y [creationDate] a [company_name] y [creation_date]; la columna [tel], cuyo nombre está fijado, permanece sin cambios. La definición de la columna [creation_date] es la del archivo XML, complementada con [not null];
- líneas 23–30: la tabla [products]. Los tipos SQL provienen de las anotaciones ([varchar(50)], [decimal(10,2)]) o de las elecciones del dialecto para un tipo ([integer], [date]);
- líneas 32–33: el índice único, creado en MySQL mediante una restricción de unicidad ([unique]).
11.3.3. Identificadores generados
La anotación [@GeneratedValue] indica que el valor del identificador se genera. Su parámetro [strategy] especifica cómo:
Estrategia | Generación del identificador |
[IDENTITY] | por el SGBD, al insertar la fila (columna [AUTO_INCREMENT] de MySQL, [IDENTITY] de SQL Server y PostgreSQL) |
[SEQUENCE] | mediante una secuencia del SGBD (PostgreSQL, Oracle), que Hibernate consulta antes de la inserción |
[TABLE] | mediante una tabla de contadores administrada por Hibernate |
[UUID] | por Hibernate: un identificador universal aleatorio, como [java.util.UUID] |
[AUTO] (predeterminada) | Hibernate elige; con MySQL, que no tiene secuencias, las simula mediante una tabla llamada [<table>_SEQ] |
Con MySQL, siempre utilizamos [IDENTITY], que corresponde al comportamiento natural de la columna [AUTO_INCREMENT]. Ya vimos el resultado: el comando [INSERT] se ejecuta en cuanto se llama a [persist], e Hibernate no puede agrupar varias inserciones en un lote (trataremos los lotes más adelante). La estrategia [SEQUENCE], que permite conocer el identificador antes de la inserción, se prefiere para los SGBD que utilizan secuencias.
En Kotlin, el identificador generado debe declararse preferiblemente como [var id: Int? = null]: el valor [null] indica claramente “aún no registrado”. También se encuentra [var id: Int = 0], donde el valor 0 cumple esta función; Hibernate lo acepta (para un identificador de tipo primitivo, trata 0 como el valor “aún no registrado”), pero esta convención es menos legible.
11.3.4. Valores opcionales y columnas [NULL]
Por lo tanto, que una columna sea opcional lo determinan el tipo de la propiedad (compilado como tipo primitivo o como referencia) y el atributo [nullable] de [@Column]; en Kotlin, el tipo de la propiedad también especifica si el valor puede faltar ([String?]) o no ([String]). Debe elegir con cuidado y asegurarse de que ambos coincidan: la regla expresa tanto una restricción del código (“este valor puede faltar”) como una restricción de la base de datos. Algunas observaciones:
- [@Column(nullable = false)] representa la restricción [NOT NULL] del esquema creado por Hibernate, y Hibernate también la utiliza antes de enviar un comando [INSERT] o [UPDATE]: si el campo es [null], no envía el comando y lanza un error [PropertyValueException] (“not-null property references a null or transient value”). Esta verificación de Hibernate está deshabilitada de manera predeterminada cuando Jakarta Validation (véase más abajo) está presente: la validación recurre entonces a sus propias anotaciones o, en su defecto, al SGBD, que rechaza el comando. En Kotlin, este escenario es menos común que en Java: el compilador prohíbe asignar [null] a una propiedad de tipo [String];
- para una validación más completa, realizada antes de cualquier acceso a la base de datos, utilizamos Jakarta Validation (biblioteca [hibernate-validator]) y sus anotaciones [@NotNull], [@Size(max = 30)], [@Positive]... Cuando están presentes en el classpath, Hibernate valida las entidades antes de guardarlas y utiliza estas anotaciones para crear las columnas. En Kotlin, estas anotaciones también aceptan parámetros como destinos: cuando se aplican a una propiedad del constructor, Kotlin 2.4 las aplica tanto al parámetro como al campo, que es el que lee el validador. Las versiones anteriores las colocaban solo en el parámetro: había que especificar el destino field, [@field:Size(max = 30)], una forma que todavía se encuentra en muchos ejemplos;
- no es necesario utilizar [Optional] (capítulo 4): el tipo que admite nulos de Kotlin ([var description: String? = null]) indica directamente que un valor es opcional, y se lee mediante los operadores [?.] y [?:] (capítulo 3): [product.description ?: "(no description)"].
11.4. Los ejemplos siguientes: dos bibliotecas comunes
Los ejemplos de los siguientes apartados utilizan casi todos la base de datos [hbarticles] y su tabla [articles], poblada con los seis registros del capítulo 10. En lugar de repetir la entidad y la configuración de Hibernate en cada subproyecto, las colocamos en una biblioteca, el subproyecto [articles], de la que dependen los demás subproyectos. También reemplazamos el log SQL de [showSql], demasiado verboso para nuestros ejemplos, por un log más compacto, ubicado en una segunda biblioteca, el subproyecto [tools].
11.4.1. El log SQL compacto
En lugar de escribir directamente en la consola ([showSql]), Hibernate puede enviar su actividad al sistema de registro (en este caso, Logback), con cada categoría de mensajes escrita en un log distinto:
Log | Nivel | Mensajes |
[org.hibernate.SQL] | [DEBUG] | órdenes SQL ejecutadas |
[org.hibernate.orm.jdbc.bind] | [TRACE] | el valor de cada parámetro de una orden SQL |
[org.hibernate.orm.resource.jdbc] | [TRACE] | entre otros, el inicio, la confirmación y la cancelación de transacciones |
[org.hibernate.orm.jdbc.batch] | [TRACE] | ejecución de lotes de órdenes SQL |
[org.hibernate.orm.jdbc.error] | [WARN] | errores informados por el SGBD |
Un log solo registra los mensajes de un nivel igual o superior al suyo. Por lo tanto, basta con establecer el nivel deseado para estos logs en el archivo [logback.xml] para capturar estos mensajes. Los procesamos mediante una clase de layout que los hace más compactos:
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 33 34 35 36 37 38 39 40 41 42 43 44 45 46 47 48 49 50 51 52 53 54 55 56 57 58 59 60 61 62 63 64 65 66 67 68 69 70 71 72 73 74 75 76 77 78 79 80 81 82 83 84 85 86 87 88 89 90 91 92 93 94 95 96 97 98 99 100 101 102 103 104 105 106 107 108 109 110 111 112 113 114 115 | |
- línea 10: un layout de Logback deriva de la clase de Java [LayoutBase<ILoggingEvent>] (observe los paréntesis: la llamada al constructor de la clase padre, capítulo 4); su método [doLayout] (líneas 13–21) recibe cada mensaje (un [ILoggingEvent]) y devuelve el texto que se escribirá. Logback crea el objeto por sí mismo, mediante reflexión, a partir del nombre de la clase: requiere un constructor sin parámetros, que es el constructor primario implícito de la clase;
- líneas 15–21: el procesamiento depende del log que envió el mensaje (un
***[when]sobre un canal, capítulo 3). Las ramas utilizan las constantes del***[companion object]; - línea 25: los miembros “estáticos” de la clase se almacenan en su objeto complementario (companion object, capítulo 4);
- líneas 27–31: los nombres de los logs de Hibernate utilizados y las constantes de compilación públicas ([const val]); los demás subproyectos se refieren a ellas como [SqlLog.SQL]...;
- líneas 37–40: dos expresiones regulares (capítulo 5), escritas como cadenas sin procesar (["""..."""]), lo que evita tener que duplicar las barras invertidas, como se hace en Java (["\\((\\d+)..."]);
- líneas 43–71: las órdenes SQL, con el formato que les da Hibernate ([format_sql]), distribuidas en muchas líneas, con una columna por línea. Las hacemos más compactas. Las líneas no vacías se agrupan en cláusulas (líneas 47–51): una cláusula comienza con una línea de nivel superior ([select], [from], [where]...) e incluye las líneas con sangría que la siguen. [minOfOrNull] devuelve la sangría más pequeña, o [null] si no hay ninguna línea, en cuyo caso se reemplaza por 0 mediante el operador [?:]. Cada cláusula se escribe entonces en una sola línea, precedida de [SQL>], si no excede los 100 caracteres (líneas 63–64); de lo contrario, se conservan sus líneas (líneas 67–68). Las cláusulas [insert] y [delete] se combinan con la siguiente (líneas 58–61). El texto se construye mediante [buildString] (capítulo 5), cuyo bloque tiene un [StringBuilder] como receptor: [append] se llama allí sin prefijo;
- líneas 80–82: el mensaje de Hibernate que informa el valor de un parámetro se parece a [binding parameter (1:VARCHAR) <- [bike]]. [matchEntire] devuelve un [MatchResult] si todo el mensaje coincide con la expresión regular, y [null] en caso contrario; [?.let] construye el texto a partir de los grupos capturados (el número del parámetro y su valor), y [?: ""] devuelve una cadena vacía cuando no hay coincidencia;
- Líneas 85–89: entre los numerosos mensajes del log [org.hibernate.orm.resource.jdbc], solo se conservan los que indican el inicio, la confirmación y la reversión de una transacción. Cada mensaje de Hibernate comienza con un código ([HHH10003002]...) que lo identifica de manera única. Un [when] sin argumentos (capítulo 3) reemplaza a la secuencia de [if] de Java;
- líneas 93–94: un error del SGBD. Hibernate lo escribe como dos mensajes: uno que proporciona los códigos de error (que ignoramos) y otro que proporciona el texto del error;
- líneas 97–99: ejecución de un lote de comandos SQL, que encontraremos al final del capítulo;
- líneas 102–111: la función [withoutLog] ejecuta una acción SQL sin registro. Es una función de orden superior (capítulo 7): su parámetro es una función [() -> T] y devuelve el resultado de la acción (Java, que utiliza un [Runnable], no lo permite con tanta facilidad). Utiliza la API de Logback: cada log ([Logger]) tiene un nivel, que puede modificarse en tiempo de ejecución (la propiedad [level], que corresponde a los métodos de Java [getLevel]/[setLevel]). Establecemos los cinco logs en el nivel [OFF], ejecutamos la acción y luego restauramos los niveles originales en una cláusula [finally], de modo que se restablezcan incluso si la acción lanza una excepción. El nivel original puede ser [null] (un log que hereda su nivel de su padre), de ahí el tipo [List<Level?>]; [zip] asocia cada log con su nivel original, y la descomposición [(logger, level)] (capítulo 3) da nombre a los dos elementos de cada par;
- línea 104: [LoggerFactory] es la clase de SLF4J que devuelve un log; como Logback es la implementación actual de SLF4J, el objeto devuelto es un [ch.qos.logback.classic.Logger], como lo indica la conversión de tipo [as Logger].
El subproyecto [tools] también contiene el archivo [logback.xml] que utilizan los ejemplos (es el mismo archivo que en Java). Ubicado en la raíz del classpath ([src/main/resources]), Logback lo encuentra cuando se inicia el programa:
- líneas 6–10: un “appender” escribe los mensajes, en este caso en la consola. Utiliza nuestro layout, identificado por el nombre de su clase ([tools.SqlLog]);
- líneas 13–17: un segundo “appender” para los demás mensajes: nivel, nombre corto del log, texto;
- Líneas 20–34: los logs de Hibernate de la tabla anterior, junto con sus niveles. Sus mensajes se envían al “appender” [SQL] y solo a él ([additivity="false"]: no se reenvían además al log raíz);
- línea 37: se suprime la advertencia sobre el grupo de conexiones integrado de Hibernate;
- línea 40: Hibernate elimina las tablas comenzando por sus claves externas; en una base de datos vacía, estas eliminaciones fallan sin consecuencias, pero Hibernate lo registra extensamente. Estos mensajes se suprimen;
- líneas 43–45: los demás logs registran solo advertencias y errores.
El archivo de compilación del subproyecto [tools] es el de una biblioteca (capítulo 6):
- línea 5: el plugin de biblioteca, que agrega la configuración [api];
- línea 15: la única dependencia, Logback. Se declara con [api] y no con [implementation]: la clase [SqlLog] deriva de una clase de Logback, y los subproyectos que la utilizan deben poder ver esta clase padre en tiempo de compilación. Una dependencia de tipo [api] se proporciona a los usuarios de la biblioteca, tanto para la compilación como para la ejecución.
Por lo general, una biblioteca no impone su configuración de registro a las aplicaciones que la utilizan; aquí lo hacemos para evitar repetir este archivo en cada ejemplo.
11.4.2. La entidad y la base de datos de artículos
La entidad [Article] del subproyecto [articles] utiliza las anotaciones del apartado anterior:
- líneas 13–14: un recordatorio de lo que hacen los plugins [jpa] y [allopen] para esta clase;
- líneas 16–18: la tabla se llama [articles], como en el capítulo 10. El parámetro [uniqueConstraints] declara una restricción de unicidad, llamada [uk_articles_name], sobre la columna [name]: dos artículos no pueden tener el mismo nombre. Sin un nombre explícito, Hibernate generaría uno ilegible ([UK3f8k...]), que aparecería en los mensajes de error. Los parámetros de anotación de tipo arreglo se escriben en Kotlin entre corchetes ([[UniqueConstraint(...)]], [["name"]]); una anotación utilizada como argumento de otra anotación se escribe sin [@];
- líneas 22–23: un nombre obligatorio de no más de 30 caracteres;
- líneas 25–26: un precio con el formato [decimal(10,2)];
- líneas 28–29: los dos niveles de inventario, de tipo [Int]: columnas [NOT NULL];
- líneas 32–36: el identificador. El modificador de la propiedad se declara como [protected]: la aplicación puede leer el identificador pero no puede cambiarlo, ya que lo administra Hibernate (la clase de Java no tiene un método [setId], por la misma razón). No podría ser [private]: la propiedad es pública ([all-open]), y Kotlin prohíbe un modificador privado en una propiedad pública, que una clase derivada podría redefinir (“[private setters for open properties are prohibited.]”);
- línea 39: el mismo método [toString] que en el primer ejemplo.
La versión de Java de esta clase tiene casi noventa líneas, incluidos los dos constructores y unos diez accesores ([getX]/[setX]); en Kotlin, las propiedades del constructor primario y los dos plugins cumplen esta función.
El objeto [BaseArticles] contiene la configuración de Hibernate para la base de datos [hbarticles]:
- línea 11: un [object] (capítulo 4): un singleton, creado en el primer uso. Equivale a una clase de utilidades de Java (una clase [final] con miembros estáticos y un constructor privado);
- líneas 14–16: la URL de la base y el usuario, que son públicos para que otros subproyectos puedan utilizarlos;
- Líneas 19–24: la configuración de Hibernate. La devuelve una función pública, lo que permitirá a un ejemplo completarla antes de crear el [SessionFactory]. La propiedad [FORMAT_SQL] ([hibernate.format_sql]) indica a Hibernate que dé formato al SQL, que luego pasa al log [org.hibernate.SQL]: es este resultado formateado el que la clase [SqlLog] condensa a continuación;
- línea 27: el [SessionFactory] de la base [hbarticles], una función cuyo cuerpo es una expresión;
- líneas 30–41: una función que recrea la tabla [articles] con sus seis registros, sin el log SQL: no queremos ver el SQL de esta inicialización en los resultados del ejemplo. El bloque pasado a [withoutLog] es una lambda escrita después de los paréntesis, que aquí se omiten (capítulo 7);
- línea 35: [sessionFactory.inTransaction { session -> ... }] abre una sesión, inicia una transacción, ejecuta la lambda pasándole la sesión, confirma la transacción (o la revierte si la lambda lanza una excepción) y cierra la sesión. Es la forma más breve de escribir una unidad de trabajo; la usaremos con frecuencia, junto con sus variantes [inSession] (una sesión sin transacción), [fromTransaction], y [fromSession] (que devuelven el resultado de la lambda). El parámetro de estos métodos de Java es una interfaz funcional ([Consumer<Session>], [Function<Session, R>]): Kotlin acepta allí directamente una lambda (conversión SAM, capítulo 7);
- líneas 36–41: [BigDecimal(500)] llama al constructor de [BigDecimal], que toma un entero; devuelve el mismo valor que el método de Java [BigDecimal.valueOf(500)].
El subproyecto [articles] depende del subproyecto [tools], de Hibernate y del controlador JDBC:
- líneas 5–9: la biblioteca define una entidad; aplica los dos plugins de entidades y el plugin de biblioteca;
- línea 18: la dependencia de otro subproyecto de la compilación, identificado por su ruta ([":tools"]);
- línea 20: Hibernate, declarado con [api]: los subproyectos que utilizan la biblioteca manipulan directamente sus tipos ([SessionFactory], [Session]...);
- línea 22: el controlador JDBC, necesario solo en tiempo de ejecución;
- líneas 26–29: la configuración del plugin [all-open].
Los subproyectos de ejemplo requieren entonces una sola dependencia: el subproyecto [articles]. Gradle agrega sus dependencias (denominadas dependencias transitivas): las dependencias [api] para la compilación y la ejecución, y la dependencia [runtimeOnly] para la ejecución. Este es el archivo de compilación del subproyecto [crud]:
- línea 4: el subproyecto no define ninguna entidad: no necesita los plugins [jpa] y [allopen], que se utilizan al compilar las clases anotadas, en este caso las del subproyecto [articles];
- línea 15: la única dependencia;
- Líneas 31–34: los programas lanzados por Gradle escriben su salida en UTF-8 para que los caracteres acentuados se muestren correctamente en Windows (capítulo 2).
11.4.3. Otras maneras de configurar Hibernate
Configuramos Hibernate mediante código con [HibernatePersistenceConfiguration]. Hay otras maneras de hacerlo, que se encuentran en aplicaciones y en la documentación:
- un archivo [META-INF/persistence.xml], el enfoque tradicional de Jakarta Persistence: describe una o más unidades de persistencia (clases de entidades, propiedades de conexión, opciones), y la fábrica se crea mediante [Persistence.createEntityManagerFactory("articles")];
- un archivo [hibernate.properties] (o [hibernate.cfg.xml]), específico de Hibernate, leído por la clase [org.hibernate.cfg.Configuration]: [Configuration().addAnnotatedClass(Article::class.java).buildSessionFactory()]. Este es el enfoque utilizado en las versiones antiguas de Hibernate;
- En una aplicación Spring Boot, las propiedades [spring.datasource.*] y [spring.jpa.*] del archivo [application.properties]: Spring Boot crea la fábrica por sí mismo.
Las propiedades son las mismas en todas partes ([hibernate.format_sql], [jakarta.persistence.jdbc.url]...): solo cambia la manera de especificarlas.
11.5. Operaciones básicas: agregar, leer, actualizar, eliminar
11.5.1. El [crud] programa
El subproyecto [crud] muestra las cuatro operaciones básicas (CRUD: Create, Read, Update, Delete), así como el seguimiento de entidades por parte de la sesión. Para hacer visible este seguimiento, utiliza algunos métodos internos de Hibernate (su “SPI”, Service Provider Interface), destinados a las extensiones de Hibernate y no a las aplicaciones: se agrupan en las funciones de utilidad al final del archivo, escritas como funciones de extensión de [Session] (capítulo 4). Las transacciones se escriben mediante el método [inTransaction] de la sesión, una función de orden superior: [session.inTransaction { ... }] inicia una transacción, ejecuta el bloque y luego confirma la transacción o la revierte si el bloque lanza una excepción. El código ya no puede omitir [commit] ni [rollback] en caso de error.
Resultados:
Comentarios:
- Línea 17: [session.find(Article::class.java, 1)] busca el registro con clave primaria 1. Devuelve [null] si la clave no existe; el operador [?:] lanza entonces una excepción ([error], capítulo 3), y [bike] es de tipo [Article], que no admite nulos. El SQL generado (líneas 3–6 de los resultados) es un [SELECT] parametrizado, cuyo parámetro vale 1: el log compacto ahora muestra los valores de los parámetros;
- línea 20: la segunda llamada a [find(Article::class.java, 1)] no envía ningún comando SQL y devuelve el mismo objeto (línea 9). El operador [===] compara referencias (el operador [] de Java), mientras que [] llamaría a [equals] (capítulo 3). La sesión almacena las entidades que ha leído o guardado en su contexto de persistencia, también conocido como caché de primer nivel: antes de consultar la base de datos, [find] verifica si la entidad solicitada ya está allí. Una sesión nunca contiene dos objetos para la misma fila de la base de datos;
- Líneas 25–29: agregar un artículo. Antes de [persist], el objeto es [TRANSIENT] (“transitorio”): la sesión no lo reconoce y su identificador es [null] (línea 12). [persist] lo incorpora a la sesión, que ejecuta de inmediato el comando [INSERT] (líneas 13–18) para obtener la clave generada y la coloca en el campo [id] (Hibernate escribe directamente en el campo: el modificador protected de la propiedad no lo impide). El artículo pasa entonces a estar [MANAGED] (“administrado” o “persistente”), y su identificador es 7 (línea 19). La transacción se abre al inicio del bloque [inTransaction] y se confirma al final (líneas 11 y 20 de los resultados). El parámetro del bloque ([Transaction]) no se utiliza: no se le da nombre;
- línea 35: para modificar una fila de la base de datos, basta con modificar el objeto. No se requiere ningún método [update]: la sesión ha conservado una copia de los valores leídos o guardados (el estado original) y compara los valores actuales con ellos. Esto se conoce como “dirty checking” (detección de cambios). El operador [*=] es traducido aquí por Kotlin a [x.price = x.price * BigDecimal("1.1")]: se asigna a la propiedad un nuevo objeto [BigDecimal] (que es inmutable);
- Líneas 36–37: la propiedad [isDirty] (el método de Java [isDirty()]) indica si la sesión contiene cambios que aún no se han confirmado en la base de datos: es el caso (línea 23). La función [originalValue] (líneas 84–85) lee el valor original del precio, 100, del contexto de persistencia, mientras que el valor actual es 110.0;
- línea 38: el final del bloque. El [commit] posterior sincroniza la sesión con la base de datos (“flush”): se ejecuta el comando [UPDATE] (líneas 25–32) y luego se confirma la transacción. Después, la sesión no tiene cambios pendientes (línea 34);
- Observe que el comando [UPDATE] escribe todas las columnas de la tabla, no solo la que cambió. Este es el comportamiento predeterminado de Hibernate: se utiliza un único comando SQL, preparado de una vez por todas, para todas las modificaciones de artículos. En cambio, la anotación [@DynamicUpdate] colocada en la entidad le indica que genere cada vez una consulta limitada a las columnas modificadas;
- Líneas 45–48: eliminación. [remove] cambia el estado del artículo a [DELETED] (línea 37); [commit] envía el comando [DELETE] (líneas 38–40). El objeto deja entonces de ser reconocido por la sesión: pasa a estar [DETACHED] (“desasociado”, línea 42);
- líneas 52–55: se lee el arco (líneas 44–47) y luego se lo desasocia de la sesión mediante [detach]: la sesión lo olvida (línea 48). Cualquier cambio en su precio es entonces ignorado. Un objeto desasociado es algo habitual en una aplicación: es un objeto leído por una sesión que ya está cerrada (por ejemplo, durante una solicitud HTTP anterior) y modificado posteriormente por el usuario;
- línea 57: [session.merge(bow)] fusiona el objeto desasociado con la sesión. La sesión lee el artículo de la base de datos (líneas 50–53), copia el estado del objeto desasociado en la entidad que administra y devuelve esta última: no es el mismo objeto (línea 54). El objeto pasado a [merge] sigue desasociado; el objeto devuelto es el que debe utilizarse a continuación. [commit] registra el nuevo precio (líneas 55–62);
- línea 64: se actualiza el inventario de la bicicleta, sin transacción;
- líneas 71–72: el contexto de persistencia de la sesión, obtenido mediante una propiedad de extensión: en las funciones siguientes, [trackingContext] se trata como una propiedad de la sesión. [unwrap] da acceso a la interfaz interna de la sesión [SessionImplementor];
- líneas 75–80: el estado de un artículo, calculado mediante un [when] sin argumentos. Primero, se utiliza [isEntryFor] para verificar si la sesión está asociada con el artículo: el método [getEntry], que devuelve [null] para un objeto desconocido (que es lo que prueba el código de Java), está anotado sin embargo como [@NonNull] en Hibernate. Kotlin tiene en cuenta estas anotaciones de nulabilidad de las bibliotecas de Java: considera que [getEntry] devuelve un [EntityEntry] que no admite nulos y señala como innecesaria una verificación con [?.] sobre su resultado (“[unnecessary safe call on a non-null receiver of type 'EntityEntry'.]”) (una advertencia y, por lo tanto, un error con nuestras opciones de compilación). Es un caso poco común pero instructivo: los tipos de una biblioteca de Java son siempre exactamente lo que especifican sus anotaciones;
- Líneas 88–101: visualización del contexto de persistencia. Para cada entidad rastreada ([EntityEntry]), se muestran su nombre, identificador y estado, seguidos del valor actual de cada propiedad y de su valor original si difiere. El objeto [EntityPersister] es el de Hibernate que conoce el mapeo entre una entidad y su tabla: proporciona los nombres de las propiedades y sus valores. El bucle [for ((entity, entry) in ...)] desempaqueta cada elemento del arreglo, un [Map.Entry] (capítulo 5); [forEachIndexed] recorre los nombres de las propiedades junto con sus índices. El operador [==] entre dos valores, que pueden ser [null]—reemplaza a [Objects.equals] de Java. En una función de extensión, [isDirty] hace referencia a la propiedad del receptor, la sesión;
- Líneas 65–75 de los resultados: la sesión rastrea la bicicleta, cuyo inventario pasó de 10 a 9, y el arco. El cambio en la bicicleta no se guarda: la sesión se cierra sin sincronización. No hay ningún [commit], y una sesión no se sincroniza automáticamente al cerrarse.
11.5.2. Los estados de una entidad
Con respecto a una sesión, una entidad se encuentra en uno de los siguientes estados (Jakarta Persistence los denomina “new”, “managed”, “detached” y “removed”):
Estado | Significado |
transitorio ([TRANSIENT]) | El objeto fue creado mediante una llamada a un constructor y nunca se ha registrado: no tiene identificador y ninguna sesión lo conoce |
Administrado ([MANAGED]) | La sesión ha leído o guardado el objeto y le da seguimiento: los cambios que se le hagan se reflejarán en la base de datos en la siguiente sincronización |
Eliminado ([DELETED]) | El objeto ha sido marcado para su eliminación ([remove]): la siguiente sincronización enviará el comando [DELETE] |
desasociado ([DETACHED]) | El objeto corresponde a una fila de la base de datos, pero la sesión que lo leyó está cerrada o lo ha olvidado ([detach], [clear]): sus cambios se ignoran a menos que se fusione con una sesión ([merge]) |
La sincronización (“flushing”) de la sesión envía al SGBD los comandos SQL que propagan los cambios de las entidades administradas. Ocurre:
- durante la fase de [commit] de la transacción;
- antes de ejecutar una consulta cuyo resultado podría depender de cambios que aún no se han confirmado (modo [FlushMode.AUTO], el modo predeterminado): la consulta ve así los datos de la sesión;
- durante una llamada explícita a [session.flush()]. Los comandos se ejecutan entonces, pero no se guardarán de manera permanente hasta el [commit] de la transacción.
Este es un panorama general del flujo de trabajo con Hibernate: se abre una sesión y una transacción, se leen entidades, se modifican como objetos ordinarios, se agregan ([persist]) y se eliminan ([remove]), y luego se confirma la transacción, que envía a la base de datos todos los comandos necesarios en un solo lote. La sesión actúa como una “unidad de trabajo”. Es un objeto ligero diseñado para una vida corta: una unidad de trabajo, como una solicitud HTTP en una aplicación web. No se utiliza la misma sesión durante toda la vida de una aplicación: acumularía las entidades rastreadas en su contexto de persistencia.
En Kotlin, este ciclo se implementa de manera natural mediante las funciones de orden superior de Hibernate: [sessionFactory.inTransaction { session -> ... }] para una unidad de trabajo completa (sesión y transacción), [sessionFactory.fromTransaction { session -> ... }] cuando devuelve un resultado, y [session.inTransaction { ... }] para una transacción dentro de una sesión ya abierta. En resumen, son los equivalentes de la función [use] para las transacciones.
11.6. Las consultas HQL
11.6.1. HQL y JPQL
Para recuperar entidades de otra manera que no sea por su clave primaria, las consultas se escriben en un lenguaje similar a SQL, pero que hace referencia a entidades y atributos en lugar de tablas y columnas: HQL (Hibernate Query Language). Jakarta Persistence define un lenguaje similar, JPQL (Jakarta Persistence Query Language), del cual HQL es un superconjunto: una consulta JPQL es una consulta HQL válida. Hibernate traduce la consulta a SQL, en el dialecto del SGBD, y es el SGBD quien la ejecuta.
Algunas diferencias con SQL:
- Se utiliza el nombre de la entidad ([Article]), no el de la tabla ([articles]), y los nombres de los atributos ([currentStock]), no los de las columnas. Los nombres de entidades y atributos distinguen entre mayúsculas y minúsculas, igual que en Kotlin. Con nuestras entidades de Kotlin, el nombre de un atributo es el mismo que el de la propiedad (Hibernate accede al campo que la almacena, y ese campo lleva el nombre de la propiedad);
- la cláusula [select] es opcional en HQL: [from Article] devuelve entidades [Article]. JPQL exige escribir [select a from Article a];
- las relaciones entre entidades se recorren con un punto ([p.category.name]), y Hibernate escribe por sí mismo las uniones, como veremos.
Una consulta se crea con el método [createSelectionQuery] de la sesión, que recibe el texto HQL y el tipo del resultado ([Article::class.java], la clase Java de la entidad), y devuelve un objeto [SelectionQuery<T>]. Luego se pueden asignar valores a sus parámetros y ejecutarla con [getResultList] (una lista), [getSingleResult] (un único resultado; una excepción si hay cero o más de uno), [getSingleResultOrNull] ([null] si no hay ninguno) o [getResultStream] (un flujo). Como ocurre siempre con las clases Java, Kotlin permite escribir estos métodos [getXxx] sin parámetros como propiedades: [query.resultList], [query.singleResult], [query.singleResultOrNull]. También existe el método [createQuery] de Jakarta Persistence; se utiliza tanto para consultas de lectura como para actualizaciones.
11.6.2. El programa [hql]
El subproyecto [hql] presenta varios ejemplos de consultas. Solo tiene una dependencia: la biblioteca [articles] (que aporta Hibernate, el controlador de MySQL y el registro SQL compacto); no define ninguna entidad y, por lo tanto, no necesita ni el plugin [jpa] ni el plugin [allopen]:
El programa:
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 33 34 35 36 37 38 39 40 41 42 43 44 45 46 47 48 49 50 51 52 53 54 55 56 57 58 59 60 61 62 63 64 65 66 67 68 69 70 71 72 73 74 75 76 77 78 79 80 81 82 83 84 85 86 87 88 89 90 91 92 93 94 95 96 97 98 99 100 101 102 103 104 | |
Resultados:
Comentarios:
- Líneas 24–26: la cláusula [where] compara dos atributos de la entidad; la cláusula [order by] ordena por nombre: se convierten en las cláusulas [WHERE] y [ORDER BY] de la orden SQL. La consulta se ejecuta mediante [resultList] (el método [getResultList]), que devuelve un [List<Article>]; [forEach(::println)] muestra cada elemento mediante su método [toString];
- Líneas 30–38: una proyección. La consulta no devuelve entidades, sino dos valores por elemento: el nombre y el valor del stock. El SQL generado recupera solo las columnas necesarias y realiza el cálculo por sí mismo. El tipo del resultado es la clase de datos [StockValue] de la línea 11: Hibernate crea un objeto por fila, pasando en orden a su constructor los valores de la cláusula [select] (el curso de Java usaba un record). Estos objetos no son entidades: la sesión no les da seguimiento. Una clase de datos es perfectamente adecuada para este papel, y aprovechamos su desestructuración: [for ((name, value) in values)] (línea 37);
- líneas 32–34: la consulta se escribe en una cadena sin procesar (["""..."""], capítulo 5), que es más legible que una cadena larga en una sola línea. A diferencia de los bloques de texto de Java, una cadena sin procesar conserva la sangría de sus líneas y el salto de línea inicial; esto es irrelevante aquí, ya que los espacios y los saltos de línea no importan en HQL: no hace falta llamar a [trimIndent];
- líneas 44–53: una consulta escrita como en JPQL, con un alias ([a]). [:minPrice] es un parámetro con nombre, cuyo valor se asigna mediante [setParameter]. Se convierte en un parámetro de la orden SQL (el [?] de la cláusula [WHERE], cuyo valor muestra el registro): por lo tanto, no hay que preocuparse por las inyecciones SQL, ya que el valor se pasa por separado del texto de la orden. Es la regla que el capítulo 10 aplicó a las sentencias preparadas. [setMaxResults(1)] limita el resultado a una sola fila: la cláusula [LIMIT] de MySQL. [singleResultOrNull] devuelve un [Article?]: el tipo que admite nulos indica claramente que puede no haber resultado, y el operador Elvis [?:] muestra [none] en ese caso;
- Conviene destacar una trampa propia de Kotlin. Sus plantillas de cadena hacen muy tentador escribir ["... where a.price > $minPrice"]. El programa funcionaría, pero el valor se copiaría entonces en el texto de la consulta: es precisamente esta concatenación la que abre la puerta a las inyecciones (capítulo 10), y Hibernate tendría que analizar una nueva consulta para cada valor. Nunca se utiliza el carácter [$] para establecer un valor en una consulta HQL: los valores se pasan mediante parámetros con nombre. Un valor literal escrito en el texto de la consulta (como ['b%'] en la línea 72) también se copia en el texto de la orden SQL, como muestra el registro: esto es aceptable para una constante del programa, pero nunca para un valor que proviene de una fuente externa;
- Líneas 57–63: los agregados [count] y [sum] los calcula el SGBD: solo se transfiere el resultado, no las filas. [Long::class.java] se refiere a la clase del tipo primitivo [long] de Java (el tipo [Long] de Kotlin se compila como [long]), mientras que el curso de Java usaba [Long.class], la clase envoltorio [java.lang.Long]; Hibernate acepta ambas (la clase envoltorio se escribiría [Long::class.javaObjectType]). HQL también reconoce [avg], [min], [max], las cláusulas [group by] y [having];
- líneas 67–76: el operador [like] de SQL y el operador [in], cuyo operando es un parámetro que acepta una lista de Kotlin (una [List] de Kotlin es una [java.util.List] para Hibernate): Hibernate la expande en tantos parámetros SQL como elementos tenga la lista. HQL admite numerosas funciones sobre cadenas ([upper], [length], [substring]...), fechas y números, que traduce al dialecto del SGBD;
- líneas 82–85: la paginación, para mostrar una lista larga página por página. [setFirstResult] omite los elementos de las páginas anteriores, mientras que [setMaxResults] conserva los de la página solicitada: la cláusula [LIMIT ?, ?] de MySQL, cuyos dos parámetros son 4 y 2. La paginación solo tiene sentido sobre una lista ordenada ([order by]). Las líneas 86–87 construyen la visualización de la página con [joinToString] y su función de transformación (capítulo 5);
- líneas 91–94: una consulta que usa un atributo [stock] que no existe. El error se detecta apenas se crea la consulta, antes de cualquier ejecución, porque Hibernate analiza el texto HQL y lo compara con el modelo: lanza una [SemanticException] (los mensajes de Hibernate están en inglés). Un error de sintaxis produciría una [SyntaxException]. Observe que el valor devuelto por [createSelectionQuery] se ignora: en Kotlin no es obligatorio utilizar el resultado de una función;
- líneas 15 y 99–100: una consulta no puede usar una función de Kotlin, como la función de extensión [isOutOfStock]: Hibernate no conoce su código y, aunque lo conociera, no necesariamente sabría cómo escribirlo en SQL. Se pueden leer todas las entidades y filtrarlas en memoria: [resultStream] (el método [getResultStream]) devuelve un [Stream<Article>] de Java, que mantiene abierto un recurso JDBC y debe cerrarse después de usarlo: la función [use] se encarga de ello, ya que un [Stream] es un [AutoCloseable]. El resultado es correcto, pero se transfirió toda la tabla (la última orden SQL no tiene la cláusula [WHERE]): con una tabla grande, esto debe evitarse. Es mejor escribir la condición en la consulta, como se muestra en la línea 24. La función de extensión también ilustra una forma muy “Kotlin” de escribir una regla de negocio sobre una entidad sin modificar su clase (capítulo 4).
11.6.3. Consultas con nombre y validación en tiempo de compilación
Una consulta escrita en una cadena solo se analiza en tiempo de ejecución. Hay dos maneras de detectar los errores antes:
- Las consultas con nombre: la anotación [@NamedQuery(name = "Article.outOfStock", query = "from Article where currentStock < minimumStock")], aplicada a la entidad, declara una consulta que Hibernate analiza al arrancar, al crear el [SessionFactory]. Luego se ejecuta por su nombre: [session.createNamedSelectionQuery("Article.outOfStock", Article::class.java)]. Se escribe en Kotlin exactamente igual que en Java; la anotación es repetible: se aplica tantas veces como consultas haya que declarar;
- el procesador de anotaciones de Hibernate (“Hibernate Processor”, biblioteca [org.hibernate.orm:hibernate-processor]). En Java, lo ejecuta [javac] durante la compilación: verifica las consultas de las anotaciones y genera, para cada entidad, una clase “metamodelo” ([Article_] para [Article]), que volveremos a ver con la API Criteria. Este mecanismo no se aplica únicamente a Kotlin: volveremos sobre ello más adelante al hablar del metamodelo estático.
11.7. La API Criteria
11.7.1. Consultas construidas con código
Una consulta HQL es una cadena que se puede construir mediante concatenación (o, en Kotlin, con plantillas): este enfoque es poco confiable y difícil de leer cuando la consulta depende de muchos criterios opcionales (por ejemplo, un formulario de búsqueda). Jakarta Persistence ofrece otra manera de escribir consultas: la API Criteria, donde la consulta es un árbol de objetos construido mediante llamadas a métodos. Hibernate traduce este árbol a SQL, igual que una consulta HQL (también traduce HQL a un árbol de este tipo). El subproyecto [criteria] (su [build.gradle.kts] es el del subproyecto [hql], salvo por el nombre del programa) incluye varias consultas del programa anterior:
Resultados:
Comentarios:
- línea 26: la sesión devuelve un [HibernateCriteriaBuilder] ([criteriaBuilder], el método [getCriteriaBuilder]), la versión mejorada por Hibernate del [CriteriaBuilder] de Jakarta Persistence: es la fábrica de todos los elementos de una consulta (condiciones, expresiones, ordenamientos);
- líneas 30–34: la consulta del primer ejemplo, en HQL. [createQuery(Article::class.java)] crea una consulta que devuelve artículos; [from(Article::class.java)] declara la entidad consultada y devuelve su raíz ([Root<Article>]), que equivale al alias [a] de [from Article a]; [a.get<Int>("currentStock")] designa un atributo. La condición se construye con [cb.lt(x, y)] (“less than”, es decir, “menor que”, [x < y]) y el ordenamiento con [cb.asc(...)]. El argumento de tipo explícito [<Int>] (en Java: [a.<Integer>get(...)]) especifica el tipo del atributo, que no se puede determinar a partir de la cadena ["currentStock"]. El compilador no puede verificar que sea correcto: confía en nuestra palabra;
- línea 35: la consulta la ejecuta la sesión, como una consulta HQL. El SQL generado es el mismo que el de la consulta HQL;
- línea 18: una función de extensión de la interfaz [Path] de Jakarta Persistence, que se refiere a un atributo mediante una referencia a propiedad ([Article::price], de tipo [KProperty1<Article, BigDecimal>], capítulo 7) en lugar de una cadena. Simplemente pasa el nombre de la propiedad ([property.name], aquí ["price"]) al método [get] original, pero ofrece dos garantías: el compilador verifica que la propiedad existe, y el tipo de la ruta devuelta ([Path<BigDecimal>]) se infiere del de la propiedad, sin un argumento de tipo explícito. Esto se basa en que el nombre del atributo JPA es el mismo que el de la propiedad de Kotlin, lo cual ocurre en nuestras entidades;
- Líneas 39–46: una proyección sobre la clase de datos [StockValue], mediante la función de extensión: [p.get(Article::price)]. [cb.prod(x, y)] es el producto de dos expresiones; [
as(BigDecimal::class.java)] especifica el tipo del resultado ([as] es una palabra clave de Kotlin: para llamar al método Java con este nombre, se encierra entre acentos graves); [cb.construct(StockValue::class.java, ...)] indica que cada fila del resultado debe pasarse al constructor de la clase de datos; - Líneas 73–83: aquí es donde la API Criteria resulta más útil. La función [search] construye una consulta a partir de los criterios proporcionados. Sus criterios son parámetros que admiten nulos con un valor predeterminado ([maxPrice: BigDecimal? = null]), lo que permite las llamadas con argumentos con nombre de las líneas 51 y 53 (en Java había que pasar [null] explícitamente). La lista de condiciones se construye con [buildList]: cada condición se agrega a ella solo si el criterio correspondiente no es [null] ([maxPrice?.let { ... \}]), y la cláusula [where] recibe la lista completa ([where(conditions)], una sobrecarga introducida con Jakarta Persistence 3.2), con las condiciones combinadas mediante [and]. La primera llamada produce una consulta con una condición; la segunda produce una consulta con dos condiciones. Observe que, con la API Criteria, Hibernate pasa los valores ([150], [d%]) como parámetros en la orden SQL: la plantilla ["$it%"] de la línea 80 construye el valor del parámetro (el patrón para [like]), no el texto de la consulta;
- Líneas 57–64: los agregados [count] y [sum].
11.7.2. El metamodelo estático
El punto débil de las consultas del primer ejemplo es que los atributos se designan mediante cadenas ([a.get<Int>("currentStock")]): un error tipográfico no se detectará hasta el tiempo de ejecución, y el compilador ignora el tipo del atributo. Para resolverlo, Jakarta Persistence ofrece un metamodelo estático: para cada entidad [Article], existe una clase [Article_] que contiene un campo por atributo, con su nombre y su tipo. En Java, se escribe entonces ***[cb.lt(a.get(Article\_.currentStock), a.get(Article\_.minimumStock))]***, que el compilador valida por completo. Estas clases no se escriben a mano: las genera durante la compilación el procesador de anotaciones de Hibernate. Este es el enfoque recomendado en un proyecto Java que utiliza la API Criteria.
En Kotlin, no es tan sencillo. El procesador de anotaciones de Hibernate es un procesador de anotaciones de Java: lo ejecuta [javac] sobre código fuente Java, pero nuestras entidades las compila el compilador de Kotlin. La herramienta de Kotlin para este tipo de generación de código es KSP (Kotlin Symbol Processing), pero Hibernate no ofrece un procesador KSP. Queda kapt (“Kotlin annotation processing tool”), que ejecuta procesadores Java sobre “stubs ” generados a partir del código Kotlin; sin embargo, kapt está en modo de mantenimiento en JetBrains (que recomienda KSP), ralentiza la compilación, y la combinación de kapt con Hibernate Processor no es una configuración documentada por Hibernate. Por lo tanto, no la usamos. Las referencias a propiedades de Kotlin aportan gran parte del beneficio sin ninguna herramienta: con la función de extensión del programa, un error tipográfico se detecta en tiempo de compilación. Esto es lo que dice el compilador para [a.get(Article::stock)], compilado en un archivo de prueba:
(El compilador también muestra, antes, la lista de métodos [get] candidatos, ninguno de los cuales es adecuado). Sin embargo, la verificación no es exhaustiva: una propiedad de Kotlin que no sea un atributo persistente (una propiedad calculada, por ejemplo) sería aceptada por el compilador, pero rechazada por Hibernate en tiempo de ejecución.
Para una consulta fija, HQL es más legible que la API Criteria; para una consulta que se construye según las circunstancias, la API Criteria es más segura. Ambas se pueden combinar: Hibernate permite crear una consulta Criteria a partir de una cadena HQL ([cb.createQuery(hql, Article::class.java)]) y luego completarla con código.
11.8. Relaciones
11.8.1. El modelo de la tienda
Las tablas de una base de datos están vinculadas entre sí. Hibernate representa estos vínculos como asociaciones: propiedades que hacen referencia a otra entidad o a una colección de entidades. El subproyecto [relations] utiliza una base de datos [hbshop] que describe una pequeña tienda con seis entidades. Como define entidades, su [build.gradle.kts] aplica los plugins [jpa] y [allopen] , igual que el de la biblioteca [articles]; depende directamente de la biblioteca [tools] (el registro SQL), de Hibernate y del controlador de MySQL:
Una categoría agrupa productos:
Un producto pertenece a una categoría y tiene etiquetas:
Una etiqueta se asigna a varios productos:
Un cliente realiza pedidos:
Un pedido pertenece a un cliente y contiene líneas:
Una línea de pedido tiene un identificador, una cantidad y dos asociaciones muchos a uno: una con su pedido y otra con su producto:
Contiene tres tipos de asociaciones:
- una relación muchos a uno ([@ManyToOne]): un producto pertenece a una categoría (la propiedad [category] de [Product]). En la base de datos, se representa mediante una clave externa, la columna [category_id] de la tabla [products], donde [@JoinColumn] especifica el nombre y el nombre de la restricción ([fk_products_category]). [optional = false] hace obligatoria la relación: la columna será [NOT NULL]. Observe la sintaxis de las anotaciones anidadas en Kotlin: una anotación pasada como argumento de otra se escribe sin [@] ([foreignKey = ForeignKey(name = ...)]), y un arreglo de anotaciones se escribe entre corchetes ([joinColumns = [JoinColumn(name = "product_id")]]), como el arreglo [cascade = [CascadeType.PERSIST]];
- la relación inversa, uno a muchos ([@OneToMany]): una categoría contiene varios productos (la propiedad [products] de [Category]). No crea nada en la base de datos: [mappedBy = "category"] indica que está descrita por la propiedad [category] de la entidad [Product]. Se dice que [Product.category] es el lado propietario de la relación, y [Category.products] su lado inverso: Hibernate almacena el valor del lado propietario. Sin embargo, ambos lados deben mantenerse coherentes en memoria: es la función de [add] en [Category], que agrega el producto a la lista ([products += product], el operador [+=] para una colección mutable, capítulo 5) y establece su categoría;
- una relación muchos a muchos ([@ManyToMany]): un producto tiene varias etiquetas, y una etiqueta está asociada a varios productos. Se almacena en una tabla de asociación, [products_tags], para la cual [@JoinTable] especifica el nombre, los nombres de las dos columnas y los nombres de las dos claves externas (la propiedad [tags] de [Product]). El lado inverso es [Tag.products] ([mappedBy = "tags"]). En una relación muchos a muchos, se prefiere un conjunto ([MutableSet]) a una lista ([MutableList]): con una lista, Hibernate elimina y vuelve a insertar todas las filas de la tabla de asociación cada vez que se modifica la colección;
- [fetch = FetchType.LAZY] solicita la carga diferida de la categoría de un producto: solo se leerá cuando se utilice. Este es el comportamiento predeterminado para las colecciones ([@OneToMany], [@ManyToMany]), pero no para las relaciones con una sola entidad ([@ManyToOne]), que el estándar carga de inmediato de forma predeterminada ([EAGER]): [fetch = FetchType.LAZY] se les agrega sistemáticamente, como recomienda la documentación de Hibernate;
- [cascade = [CascadeType.PERSIST]] propaga la operación [persist]: persistir una categoría persiste sus productos, y persistir un producto persiste sus etiquetas. Los demás valores ([MERGE], [REMOVE], [ALL]...) propagan las demás operaciones.
El paso a Kotlin merece varios comentarios:
- Las colecciones se declaran con las interfaces mutables de Kotlin, [MutableList] y [MutableSet], que se inicializan con [mutableListOf()] y [mutableSetOf()]. Esta elección es obligatoria: Hibernate reemplaza la colección de una entidad que lee por su propia colección (un [PersistentBag] o un [PersistentSet]), que es un [java.util.List] o un [java.util.Set] mutable, y que puede cargarse bajo demanda. Una [List] de solo lectura de Kotlin sería aceptable para el compilador, pero no representaría fielmente un objeto que Hibernate y la función [add] modifican. Las propiedades son [val]: se modifica el contenido de la colección, nunca la referencia;
- una relación con una sola entidad, que es obligatoria, se declara como [lateinit var category: Category] (en [Product]; lo mismo se aplica a [CustomerOrder.client] y [OrderLine.order]). El tipo no admite nulos, porque un producto registrado siempre tiene una categoría; sin embargo, en el momento de su creación todavía no la tiene: [Category.add] la asignará. [lateinit] expresa exactamente eso: la propiedad se inicializará más tarde, y leerla antes lanzaría una [UninitializedPropertyAccessException], que es más descriptiva que una [NullPointerException]. El curso de Java se había apoyado hasta entonces en [null] . También podríamos haber escrito [var category: Category? = null], al costo de tener que usar [?.] o [!!] cada vez;
- el modificador [internal set] colocado bajo estas propiedades reserva la modificación de la categoría de un producto (del cliente de un pedido, de la línea de un pedido) para el módulo, es decir, para el subproyecto de Gradle [relations]: solo la función [add] la utiliza. En Java, el método [setCategory] era visible solo dentro del paquete; Kotlin no tiene visibilidad de “paquete”, y [internal] es el equivalente más cercano;
- Las etiquetas de un producto se pasan a su constructor mediante un parámetro [vararg], que no es una propiedad (no lleva [val] ni [var]): se usa únicamente en el bloque [init], que las agrega al conjunto. En este bloque, [tags] se refiere al parámetro y [this.tags] a la propiedad; el bloque [init] se coloca después de la declaración de la propiedad, porque las inicializaciones se ejecutan en el orden en que aparecen en el texto. El operador [+=] agrega todos los elementos de un arreglo a una colección mutable;
- el constructor sin parámetros agregado por el plugin [jpa] (el que Hibernate usa para crear las entidades que lee) no ejecuta las inicializaciones de propiedades: por lo tanto, la colección [tags] de un producto leído por Hibernate no se crea con [mutableSetOf()]. Esto no es un problema, porque el propio Hibernate completa todas las asociaciones de las entidades que lee con sus colecciones de carga diferida;
- las entidades siguen siendo clases ordinarias, no clases de datos. Las relaciones aportan una razón más para ello: las funciones [toString], [equals] y [hashCode] generadas para una clase de datos usan todas las propiedades de su constructor primario; si incluyeran las asociaciones, recorrerían las colecciones de carga diferida (lo que desencadenaría consultas o una [LazyInitializationException] fuera de la sesión), y dos entidades que se referencian mutuamente se llamarían entre sí indefinidamente ([StackOverflowError]);
- Por último, el plugin [allopen] es esencial aquí: para una relación diferida con una sola entidad, Hibernate coloca en la propiedad un proxy (un objeto de una subclase de la entidad generada en tiempo de ejecución), lo que exige que la clase y sus descriptores de acceso no sean final. Veremos este proxy en acción en el programa.
El objeto [Shop] configura Hibernate para la base de datos [hbshop] y crea allí un conjunto de datos inicial:
- Línea 11: al igual que [BaseArticles], un [object] reemplaza a la clase de utilidades de Java;
- líneas 16–18: las seis entidades, declaradas mediante [managedClasses];
- línea 26: la función es una expresión: el resultado de [SqlLog.withoutLog], a la que se pasa el procesamiento que se ejecutará sin registro (SQL);
- líneas 31–42: un grafo de objetos: tres categorías, sus productos y las etiquetas de los productos;
- líneas 44–46: basta con persistir las categorías: gracias a la cascada, Hibernate recorre las asociaciones y persiste todas las entidades a las que llega, en el orden correcto (las categorías antes que los productos que las referencian), completando las claves externas y la tabla de asociación;
- líneas 48–53: un cliente, su pedido y las dos líneas de este, persistidos en una sola operación.
Las tablas creadas por Hibernate son las siguientes:
- La lista de tablas: una tabla por entidad, y la tabla de asociación [products_tags];
- la tabla [products]: su clave externa [category_id] hace referencia a la tabla [categories]. Es [NOT NULL] ([optional = false]). MySQL crea un índice en cada clave externa (fila [KEY]). A diferencia de otros ORM, Hibernate no exige la eliminación en cascada en la base de datos ([ON DELETE CASCADE]): esta se puede lograr mediante la anotación [@OnDelete(action = OnDeleteAction.CASCADE)];
- la tabla de asociación tiene dos columnas (claves externas hacia las dos tablas vinculadas) que juntas forman su clave primaria.
El esquema es exactamente el mismo que el del curso de Java: las anotaciones, escritas en Kotlin, son idénticas.
11.8.2. El programa
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 33 34 35 36 37 38 39 40 41 42 43 44 45 46 47 48 49 50 51 52 53 54 55 56 57 58 59 60 61 62 63 64 65 66 67 68 69 70 71 72 73 74 75 76 77 78 79 80 81 82 83 84 85 86 87 88 89 90 91 92 93 94 95 96 97 98 99 100 101 102 103 104 105 106 107 108 109 110 111 112 113 114 115 116 117 118 119 120 121 122 123 124 125 126 127 128 129 130 131 132 133 134 135 136 137 138 | |
Resultados:
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 33 34 35 36 37 38 39 40 41 42 43 44 45 46 47 48 49 50 51 52 53 54 55 56 57 58 59 60 61 62 63 64 65 66 67 68 69 70 71 72 73 74 75 76 77 78 79 80 81 82 83 84 85 86 87 88 89 90 91 92 93 94 95 96 97 98 99 100 101 102 103 104 105 106 107 108 109 110 111 112 113 114 115 116 117 118 119 120 121 | |
Comentarios:
- Líneas 11–15: las clases de datos que recibirán los resultados de las proyecciones. Sus tipos corresponden a los que devuelve el SGBD: [Long] para [count], [Double] para [avg];
- líneas 135–138: el producto con el nombre dado, leído mediante una función de extensión de la interfaz [Session] de Hibernate: dentro de ella, [createSelectionQuery] se llama sobre la propia sesión ([this], implícito). Se llama como un método de la sesión: [session.product("bike")] (línea 25), mientras que el código Java definía antes un método estático [product(session, "bike")];
- líneas 24–33: un cliente, su pedido y las dos líneas de este se persisten con una sola llamada a [persist]. El SQL muestra el orden de las inserciones: primero el cliente, luego el pedido (cuya clave externa [client_id] recibe la clave generada del cliente, 2) y, por último, las líneas, cuya clave externa [order_id] recibe la clave del pedido. [inTransaction] recibe una lambda de Kotlin donde Hibernate espera una interfaz funcional de Java ([Consumer<Session>]): es la conversión SAM del capítulo 7;
- líneas 39–45: la carga diferida. La consulta lee solo los pedidos: el cliente y las líneas de cada pedido se leen únicamente cuando el programa los utiliza, mediante consultas adicionales (dos para el primer pedido, dos para el segundo). Para el cliente, Hibernate ha colocado un proxy en la propiedad [client] (un objeto de una subclase de [Client] generada por Hibernate con Byte Buddy) que contiene solo el identificador y lee al cliente en la primera llamada a un descriptor de acceso ([order.client.name], es decir, [getName()]). La línea 48 lo muestra: la clase del objeto es [relations.Client$HibernateProxy]. Por eso una entidad no debe ser una clase final, ni sus descriptores de acceso métodos final: en Kotlin, donde las clases y los miembros son final de forma predeterminada, es el plugin [allopen] el que los hace no final. Para las líneas, la lista es una colección de Hibernate, que se carga en el primer uso ([size]);
- Líneas 53–57: el pedido se lee en una sesión que se cierra de inmediato ([fromSession], que devuelve el resultado de la lambda). Estas líneas no se cargaron y, una vez cerrada la sesión, ya no se pueden cargar: acceder a la colección provoca una [LazyInitializationException], una de las excepciones más comunes en las aplicaciones que usan Hibernate. Nada en el tipo [MutableList<OrderLine>] de la propiedad le señala este riesgo al compilador de Kotlin: la seguridad de tipos termina donde comienza la carga bajo demanda. Hay que cargar lo que se va a necesitar mientras la sesión está abierta;
- líneas 63–69: la precarga mediante una consulta. [join fetch] indica a Hibernate que cargue, junto con los pedidos, sus clientes, sus líneas y el producto de cada línea: una sola consulta con uniones. La salida muestra ambos pedidos y sus líneas. La unión con las líneas produce una fila SQL por línea de pedido; Hibernate deduce un único pedido por cada identificador: la lista devuelta contiene efectivamente dos pedidos. El texto de la consulta, que ocupa varias líneas, es una cadena sin procesar;
- líneas 82–88: un “grafo de entidad” (Jakarta Persistence) describe, fuera de cualquier consulta, las asociaciones que se deben cargar junto con una entidad: aquí, los productos de la categoría, identificados por la referencia a propiedad [Category::products.name] en lugar de la cadena ["products"]. [session.find(graph, 2)] (Jakarta Persistence 3.2) lee la categoría 2 junto con sus productos en una sola consulta (una unión externa, [left join]). Una vez cerrada la sesión, los productos siguen siendo accesibles. Para cargar una asociación más tarde, mientras la sesión está abierta, se usa [Hibernate.initialize(category.products)]. Observe la llamada a [addAttributeNodes] (en plural) en lugar de [addAttributeNode]: este último, que es genérico, devuelve un
*[AttributeNode<Y>]*, y Kotlin no puede inferir el tipo*[Y]* cuando no se usa el resultado (“cannot infer type for type parameter 'Y'”); - Líneas 95–100: las asociaciones se usan en las consultas: [join p.tags e] recorre la relación muchos a muchos (dos uniones, con la tabla de asociación y la tabla de etiquetas), y [p.category.name] se traduce en una unión implícita con la tabla de categorías. El texto de la etiqueta se pasa mediante un parámetro con nombre (el curso de Java lo escribía como un literal en la consulta); cada resultado se desempaqueta en los parámetros de la lambda: [{ (product, category) -> ... \}];
- líneas 108–114: un cálculo que involucra dos relaciones (el monto de cada pedido), realizado íntegramente por el SGBD: uniones, [sum] y [group by];
- líneas 123–128: una agrupación. [group by p.category.name] agrupa los productos por nombre de categoría; para cada grupo, el SGBD calcula el número de productos ([count], de tipo [Long]) y el precio promedio ([avg], de tipo [Double]). La categoría [diving], que no tiene ningún producto, no aparece: la unión con la tabla de categorías es una unión interna ([join]).
11.8.3. El problema de las N+1 consultas
La carga diferida del ejemplo ilustra un problema que afecta a cualquier usuario de un ORM, conocido como el problema de las “N+1 consultas”: una consulta para leer los N pedidos y luego una consulta por pedido para leer su cliente (y otra para sus líneas). Con mil pedidos, esto da como resultado mil una idas y vueltas al servidor, cuando una sola habría bastado. El problema es aún más insidioso porque es invisible en el código: [order.client.name] no parece una consulta, y la sintaxis de propiedades de Kotlin la oculta todavía mejor que la llamada de Java [getClient().getName()]. Las soluciones son las que se muestran en el ejemplo: [join fetch], un grafo de entidad o, mejor aún, una proyección sobre una clase de datos que recupere solo los datos necesarios. Hibernate también ofrece la carga por lotes ([@BatchSize(size = 20)] aplicada a una colección o a la clase de la entidad referenciada, en este caso [Client]), que, por ejemplo, recupera los clientes de veinte pedidos en una sola consulta. El registro SQL ayuda a identificar el problema: la misma consulta repetida numerosas veces.
11.9. Cambios en el esquema de la base de datos
11.9.1. El problema
Hasta ahora, Hibernate creaba las tablas después de eliminarlas. Esto es imposible en una aplicación en producción: su base de datos contiene datos que deben conservarse cuando el modelo evoluciona (una nueva columna, una nueva tabla). Debe ser posible migrar la base de datos de una versión del esquema a la siguiente, de manera segura y reproducible, tanto en la máquina del desarrollador como en el servidor de producción. Esto se denomina migración del esquema.
Hibernate no admite las migraciones de esquema: puede crear un esquema, validarlo y hacerle actualizaciones limitadas. La práctica habitual, tal como se describe en JVM (tanto en Java como en Kotlin), es delegar las migraciones en scripts SQL versionados, aplicados por una herramienta dedicada (la más común es Flyway o Liquibase), y hacer que Hibernate verifique que el esquema resultante coincide con las entidades.
11.9.2. Gestión del esquema por Hibernate
La propiedad [hibernate.hbm2ddl.auto] (o el método [schemaToolingAction] en la configuración, que es el que usa el programa siguiente) especifica lo que Hibernate debe hacer con el esquema al crear el [SessionFactory]:
Valor | Constante [Action] | Efecto |
[none] | [NONE] | ninguno (valor predeterminado) |
[create-only] | [CREATE_ONLY] | creación de las tablas |
[create] | [CREATE] | Eliminación y luego creación de las tablas |
[create-drop] | [CREATE_DROP] | como [create], y eliminación de las tablas al cerrar el [SessionFactory]: para pruebas |
[drop] | [DROP] | Eliminar las tablas |
[validate] | [VALIDATE] | Verificar que las tablas y columnas de las entidades existen, con tipos compatibles; de lo contrario, lanzar una excepción |
[update] | [UPDATE] | Crear las tablas y columnas que falten |
Jakarta Persistence define una propiedad relacionada, [jakarta.persistence.schema-generation.database.action], con los valores [none], [create], [drop-and-create], y [drop]. Las mismas acciones están disponibles de forma programática, como hicimos con el [SchemaManager] de [SessionFactory] ([create], [drop], [validate], [truncate]).
La opción [update] es tentadora: Hibernate compara las entidades con el esquema de la base de datos y agrega lo que falta. Tiene limitaciones que la hacen inadecuada para una aplicación en producción:
- solo agrega: nunca elimina una columna o tabla que se haya vuelto innecesaria, no modifica el tipo ni la longitud de una columna existente y no puede renombrar (renombrar una propiedad crea una nueva columna vacía, mientras que la antigua permanece con sus datos);
- no puede transformar datos (rellenar una nueva columna obligatoria, dividir una columna en dos);
- lo que hace depende del estado de la base de datos que encuentra: es imposible saber de antemano qué comandos se ejecutarán ni en qué orden, y no se conserva ningún registro de ello.
Por lo tanto, reservamos [create], [create-drop] y [update] para el desarrollo y las pruebas, y usamos [validate] (o [none]) en producción, con el esquema gestionado mediante scripts.
11.9.3. Scripts SQL versionados
El principio de las migraciones basadas en scripts es sencillo:
- cada cambio del esquema se describe mediante un script SQL, numerado de forma secuencial: [V1__create_clients.sql], [V2__add_phone.sql]... Una vez que un script se ha aplicado a una base de datos, nunca se vuelve a modificar: toda corrección es objeto de un nuevo script;
- la base de datos contiene una tabla de historial que enumera las versiones que se le han aplicado;
- cuando la aplicación arranca (o durante el despliegue), una herramienta compara los scripts disponibles con el historial y aplica, en orden, los que aún no se han aplicado.
Los scripts forman parte del código fuente de la aplicación: se almacenan y se gestionan junto con el resto del código (en un repositorio Git, por ejemplo). Para entender cómo funciona esto, el subproyecto [clients] implementa un pequeño ejecutor de scripts versionados, basado en Flyway; luego presentaremos el propio Flyway.
11.9.4. El [clients] subproyecto
El subproyecto [clients] usa la base de datos [hbclients]. Tiene dos programas: [clients.MainKt], que se ejecuta de forma predeterminada, y [clients.GenerateScriptKt], que se especifica cuando se necesita mediante la propiedad [main], como en los capítulos anteriores. Su [build.gradle.kts] es el mismo que el del subproyecto [relations], con una excepción:
La entidad es un cliente:
En la primera versión de la aplicación, el cliente no tiene número de teléfono: las líneas 18–20 aún no existen. Las agregaremos en la segunda versión. El número de teléfono es opcional, lo que Kotlin expresa mediante el tipo que admite nulos [String?] y el valor predeterminado [null] (así podemos crear un cliente sin número de teléfono: [Client("Durand", "durand@example.com")]). Sin embargo, Hibernate no reconoce los tipos de Kotlin: es la ausencia de ***[nullable = false] en *[@Column] la que hace que la columna sea opcional (a la inversa, un [String] de Kotlin que no admite nulos solo produce una columna [NOT NULL] si se solicita explícitamente, como ocurre con [name] y [email]). La función [toString] (línea 27) usa el operador Elvis para mostrar la ausencia de número de teléfono.
Los scripts se encuentran en la carpeta [src/main/resources/db/migration] del subproyecto, que Gradle copia al classpath (en la carpeta [build/resources/main]). Son los scripts del curso de Java: un script SQL no depende del lenguaje de programación de la aplicación. El primero crea la tabla:
El segundo agrega la columna del número de teléfono:
La clase [Migrations] aplica los scripts mediante JDBC (capítulo 10), independientemente de Hibernate:
- líneas 14–17: la base de datos se describe mediante las propiedades privadas del constructor primario;
- líneas 20–21: un script se describe mediante una clase de datos anidada, [Migrations.Script]: su versión, descripción y ruta; su método [toString] se sobrescribe para la visualización;
- líneas 24–34: las constantes de la clase, en un objeto complementario privado. Línea 26: el nombre de un script sigue la convención de Flyway: [V], el número de versión, dos guiones bajos y una descripción. La expresión regular se escribe como una cadena sin procesar, donde la barra invertida no necesita duplicarse (["""V(\d+)__(\w+)\.sql"""]; en Java: ["V(\\d+)__(\\w+)\\.sql"]). La tabla de historial (una fila por versión aplicada, con su descripción y la fecha en que se aplicó) se crea mediante una orden escrita como una cadena sin procesar, una constante [const val];
- líneas 41–50: la lista de scripts. [getResource("/db/migration")] devuelve la URL del directorio en el classpath, o [null] si no existe: el operador Elvis devuelve entonces de inmediato una lista vacía ([?: return emptyList()]). El directorio se enumera mediante la función de extensión [listDirectoryEntries] de [kotlin.io.path] (capítulo 5). Cada archivo se compara con la expresión regular mediante [matchEntire], que devuelve [null] si el nombre no coincide: [mapNotNull] descarta esos archivos, y los grupos de la expresión se recuperan mediante desestructuración ([destructured], capítulo 5). Este código supone que el directorio es un directorio real (lo que ocurre cuando Gradle ejecuta el programa desde el directorio [build/resources/main]); Flyway también puede leer scripts desde un archivo [.jar]. Los scripts se ordenan por número de versión ([sortedBy]): un orden alfabético colocaría [V10] antes que [V2];
- Líneas 54–59: las versiones que ya se han aplicado, recuperadas de la tabla de historial, que se crea según sea necesario ([create table if not exists]). Los tres recursos JDBC (conexión, sentencia, resultados) se cierran mediante tres [use] anidados. La función devuelve un conjunto ordenado ([sortedSetOf], un [TreeSet] de Java), que se completa mediante [apply];
- líneas 66–68: los scripts restantes por aplicar: el operador [!in] verifica la ausencia de una versión en el conjunto;
- líneas 72–73: aplicación de los scripts pendientes, hasta una versión dada (todos de forma predeterminada: [target: Int = Int.MAX_VALUE]). [takeWhile] conserva los scripts mientras su versión no supere el objetivo; [onEach] aplica cada uno de ellos y devuelve la propia lista: la función cabe en una sola expresión, mientras que Java habría escrito un bucle con [break];
- líneas 76–97: aplicación de un script: sus comandos (líneas de comentario eliminadas mediante [filterNot], el texto dividido en los puntos y coma), y luego el agregado de su versión a la tabla de historial, dentro de una transacción ([cnx.autoCommit = false], la propiedad de Kotlin correspondiente a [setAutoCommit]). Una advertencia, señalada en el comentario de la línea 95: en MySQL, un comando de modificación del esquema ([CREATE TABLE], [ALTER TABLE]) confirma implícitamente la transacción en curso y no se puede revertir. Si ocurre un error en medio de un script, la base de datos puede quedar en un estado intermedio. Por eso se aconseja usar scripts cortos, cada uno con una sola operación.
Observe que ninguna función de la clase declara las excepciones que puede lanzar: la versión Java debía especificar [throws SQLException, IOException, URISyntaxException] en la mayoría de sus métodos, así como en el método [main] que los llama. Kotlin no tiene excepciones comprobadas (capítulo 3): una [SQLException] simplemente se propaga hacia arriba hasta quien quiera manejarla.
El programa principal aplica las migraciones y luego le pide a Hibernate que valide el esquema:
- línea 9: la URL de la base de datos, una constante de nivel superior en el paquete [clients], que el segundo programa también utilizará;
- línea 13: se puede especificar, como argumento, la versión hasta la cual aplicar las migraciones; de forma predeterminada, se aplican todas. [args.firstOrNull()?.toInt() ?: Int.MAX_VALUE] combina la llamada segura y el operador Elvis;
- líneas 16–22: el estado de las migraciones, seguido de su aplicación;
- líneas 27–34: el [SessionFactory] se crea con la acción [VALIDATE]: Hibernate verifica que el esquema de la base de datos coincide con la entidad [Client]. Si no es así, la creación del [SessionFactory] falla con una [PersistenceException], cuya causa es el error de validación (líneas 46–49). [e.cause ?: e] captura la causa, o la propia excepción si no tiene ninguna;
- líneas 37–43: se usa la nueva columna.
11.9.5. Generación de scripts con Hibernate
Los scripts SQL se escriben a mano. Sin embargo, Hibernate puede ayudar a escribirlos: puede generar, sin ejecutarlo, el script para crear el esquema o, comparando las entidades con una base de datos existente, el script para actualizarlo. Esto es lo que hace el programa [GenerateScript.kt]:
- línea 10: la acción, pasada como argumento: [create] o [update];
- líneas 14–23: el [SessionFactory] se crea únicamente para generar el script: se cierra inmediatamente después de crearse, sin siquiera almacenarse en una variable (el curso de Java lo declaraba en una instrucción [try] con recursos, usando la variable anónima de Java [_] de Java 22);
- líneas 18–21: las propiedades de generación del script, ya vistas en el subproyecto [model]. Esta vez, Hibernate se conecta a la base de datos: para la acción [update], necesita conocer su esquema;
- líneas 25–27: el script, con la sangría de 4 espacios eliminada de sus líneas mediante [removePrefix], que solo elimina el prefijo si está presente.
Observe que los dos programas del subproyecto tienen cada uno una función [main] de nivel superior en el mismo paquete: esto está permitido para la función [main], ya que cada una se compila en su propia clase de archivo ([clients.MainKt], [clients.GenerateScriptKt]).
El script de creación, generado a partir de la versión actual de la entidad, sirve para crear una base de datos nueva de una sola vez (para pruebas, por ejemplo):
Con la primera versión de la entidad (sin número de teléfono), habría producido, con el mismo orden de columnas, el script [V1__create_clients.sql].
11.9.6. Aplicar las migraciones
Supongamos que la base de datos aún no existe. Aplicamos solo la primera migración, pasando la versión 1 como argumento (opción [--args] de la tarea [run]):
- No se ha aplicado ninguna versión; hay dos scripts pendientes (la lista de Kotlin se muestra igual que la lista de Java, entre corchetes). La tabla de historial fue creada por la función [appliedVersions], y la base de datos [hbclients] por MySQL ([createDatabaseIfNotExist=true]);
- se aplica el script [V1] ;
- Hibernate detecta que la columna [phone] de la entidad no existe en la tabla: es normal, ya que la base de datos está en la versión 1 y la entidad en la versión 2. Con la entidad de la versión 1, la validación habría tenido éxito.
La aplicación evoluciona: agregamos el número de teléfono a la entidad. Para escribir el script de la versión 2, le pedimos a Hibernate que compare la entidad con la base de datos, que todavía está en la versión 1:
Esto es, salvo por el formato, igual al script [V2__add_phone.sql]. Ahora aplicamos todas las migraciones pendientes:
- La versión 1 está aplicada, la versión 2 está pendiente y se aplica;
- La validación tiene éxito;
- la nueva columna está lista para usarse: el cliente se guarda con su número de teléfono y luego se recupera.
La tabla de historial contiene ahora ambas versiones:
Al ejecutar de nuevo el programa no se aplica ningún cambio: ambas versiones figuran en el historial (sin embargo, sí agrega un segundo cliente llamado Dupont, que no mostramos):
11.9.7. Flyway
Flyway es la herramienta de migración más utilizada en JVM (Spring Boot la ejecuta automáticamente al iniciar una aplicación si está presente en el classpath). Funciona exactamente según el mismo principio que nuestro ejecutor, pero es más completa: los scripts [V<version>__<description>.sql] se buscan de forma predeterminada en la carpeta [db/migration] del classpath, se usa la tabla de historial [flyway_schema_history] y los scripts pendientes se aplican en orden de versión. En particular, agrega una suma de verificación para cada script, que detecta los cambios en un script ya aplicado; scripts “repetibles” ([R__description.sql], que se vuelven a aplicar con cada cambio, para vistas por ejemplo); migraciones escritas en el lenguaje de la aplicación (clases Java o Kotlin); un bloqueo que impide que dos instancias de la aplicación migren la base de datos al mismo tiempo, y un plugin de Gradle (tareas [flywayMigrate], [flywayInfo]).
Para usarlo en el subproyecto [clients], basta con agregar las dependencias [org.flywaydb:flyway-core] y [org.flywaydb:flyway-mysql] (en sus últimas versiones) a [build.gradle.kts], conservar los dos scripts tal cual (ya que siguen su convención) y reemplazar el uso de la clase [Migrations] por una sola línea: [Flyway.configure().dataSource(URL, "root", "").load().migrate()].
Liquibase, la otra herramienta de uso común, describe los cambios del esquema en archivos XML, YAML o SQL (los “changelogs”) y puede generar el SQL específico de cada SGBD. En ambos casos, Hibernate se configura con [validate] o [none], y ya no modifica el esquema.
11.10. Hibernate e hilos virtuales
Una consulta a una base de datos es una operación de E/S: mientras el servidor procesa la solicitud, el hilo que espera no hace nada. Los capítulos 8 y 9 presentaron dos maneras de evitar desperdiciar hilos durante estas esperas: los hilos virtuales del JDK y las corrutinas de Kotlin. La API de Hibernate, como el JDBC que utiliza, es bloqueante: [getResultList] (la propiedad [resultList] en Kotlin) no cede el control hasta que se han leído las filas. Con los hilos virtuales, esto ya no es un inconveniente: un hilo virtual bloqueado en una operación de E/S libera el hilo del sistema que lo ejecutaba, y se pueden crear miles de ellos. Así, se escribe código bloqueante ordinario, ejecutado por hilos virtuales. Con las corrutinas, de manera similar, se confía este código bloqueante a un despachador concebido para la E/S, [Dispatchers.IO] (capítulo 9), mediante [withContext]: la corrutina que espera el resultado se suspende, sin bloquear su hilo.
Hay una regla que se debe respetar en ambos casos: una sesión no es segura para hilos. Nunca se comparte entre varios hilos ni entre varias corrutinas: cada hilo, cada tarea y cada corrutina abre su propia sesión con el [SessionFactory], que sí se comparte. Con las corrutinas, esta regla exige especial atención: una corrutina puede reanudar su ejecución, tras una suspensión, en un hilo distinto de aquel donde comenzó; una sesión abierta antes de una llamada suspendida y utilizada después de ella cambiaría, por lo tanto, de hilo. Lo más sencillo es abrir y cerrar la sesión dentro del bloque [withContext], que no contiene puntos de suspensión. Hibernate no siempre detecta el uso concurrente de una misma sesión; los errores resultantes son impredecibles.
El subproyecto [async] aplica esta regla. Además de la biblioteca [articles], depende de kotlinx-coroutines:
- línea 14: la entidad [Article] y la base de datos [hbarticles], como en los ejemplos anteriores;
- línea 16: la biblioteca de corrutinas (capítulo 9);
- líneas 32–35: los programas lanzados por Gradle escriben su salida en UTF-8, para que los caracteres acentuados se muestren correctamente en Windows (capítulo 2).
El programa:
Resultados:
Comentarios:
- línea 23: un ejecutor que crea un hilo virtual por tarea (capítulo 8). Un [ExecutorService] es [AutoCloseable]: la función [use] lo cierra al final del bloque, y su cierre espera a que terminen todas las tareas;
- Líneas 24–33: dos tareas enviadas al ejecutor. Cada una abre su propia sesión ([fromSession]) y ejecuta una consulta; ambas consultas se ejecutan simultáneamente, en dos conexiones del grupo. Por lo tanto, su orden en el registro (líneas 3–9 de los resultados) puede variar de una ejecución a otra. El tipo del resultado se especifica en [submit] ([submit<List<Article>>]): de lo contrario, la lambda podría interpretarse como un [Runnable], que no devuelve nada, en lugar de como un [Callable];
- Línea 33: el tipo del resultado de la consulta de conteo. [Long::class.java] aquí se refiere al tipo primitivo [long] de Java; Hibernate lo acepta y devuelve el valor como un [java.lang.Long], que Kotlin trata como un [Long];
- líneas 36–38: [get()] espera a que cada tarea termine y devuelve su resultado (líneas 10–13);
- líneas 44–53: un [CompletableFuture] (capítulo 9) cuyo primer paso, una transacción completa, lo ejecuta un hilo virtual ([supplyAsync(..., executor)]), y el segundo paso muestra su resultado. La función [apply] modifica el registro leído y lo devuelve: este es el valor de la lambda y, por lo tanto, el resultado de la transacción. El registro devuelto por la transacción está desasociado (su sesión está cerrada): podemos leer sus propiedades, pero no cargar sus asociaciones;
- líneas 58–68: la misma idea con corrutinas. [runBlocking] crea una corrutina principal; [async] lanza dos corrutinas hijas, que llaman a la función de suspensión [countArticles]. Ambas solicitudes se ejecutan simultáneamente (líneas 30–35), y [await] suspende la corrutina principal hasta que cada una devuelve su resultado (líneas 36–37);
- líneas 95–96: la función de suspensión delega el trabajo bloqueante en el despachador [Dispatchers.IO], cuyos hilos están concebidos para esperar operaciones de E/S. La sesión la abre y la cierra [fromSession] dentro del bloque [withContext]: la usa una sola corrutina, y en un único hilo. Este es el enfoque que se debe usar al llamar a Hibernate desde código suspendido. También se podría usar un despachador basado en hilos virtuales ([Executors.newVirtualThreadPerTaskExecutor().asCoroutineDispatcher()], capítulo 9);
- líneas 73–76: la propiedad [resultStream] (el método [getResultStream]) devuelve un flujo de Java: las entidades se procesan a medida que se leen, sin formar una lista (líneas 42–44). Un flujo es [AutoCloseable]: [use] lo cierra, lo que libera el cursor JDBC. También se podría convertir en una secuencia de Kotlin ([asSequence()], capítulo 5). Esto es útil para procesar una gran cantidad de filas. Con MySQL, tenga en cuenta que, de forma predeterminada, el controlador lee todas las filas del resultado antes de devolver la primera; para una lectura realmente progresiva, hay que indicarle que use un cursor (parámetro [useCursorFetch=true] de la URL y tamaño de lote establecido mediante [setFetchSize]);
- Líneas 83–87: un tiempo máximo de ejecución, en segundos, establecido mediante [setTimeout]. La consulta (una consulta SQL nativa, de la que hablaremos más adelante) tarda cinco segundos; después de un segundo, el controlador JDBC la interrumpe, y Hibernate lanza una [QueryTimeoutException] (líneas 46–48).
La duración de la última solicitud merece una nota. En el capítulo 9 cancelamos corrutinas ([job.cancel()], [withTimeout]) y tareas ([Future.cancel]). Estas cancelaciones no tendrían ningún efecto sobre la solicitud aquí: cancelar una corrutina es cooperativo, y una corrutina bloqueada en el controlador JDBC no comprueba si ha sido cancelada; en cuanto a interrumpir un hilo bloqueado en el controlador, no interrumpe la solicitud en curso en el servidor. Un [withTimeout(1000) { countArticles(...) }] lanzaría efectivamente una [TimeoutCancellationException]... pero solo una vez completada la solicitud, tras cinco segundos: el bloque [withContext] de [countArticles] no cede el control hasta que termina su operación bloqueante. Para limitar la duración de una solicitud, hay que dirigirse por lo tanto al controlador JDBC mediante [setTimeout].
Para las aplicaciones que requieren una API verdaderamente no bloqueante, existe Hibernate Reactive, una variante de Hibernate que se apoya en controladores reactivos (los de Vert.x) en lugar de JDBC, y cuyos métodos devuelven [CompletionStage] u objetos de la biblioteca Mutiny; un [CompletionStage] se espera en una corrutina con la función de extensión [await] de kotlinx-coroutines. Los hilos virtuales y el despachador [Dispatchers.IO] eliminan esta complejidad en la mayoría de los casos: este es el enfoque adoptado en este curso.
11.11. Transacciones y concurrencia
11.11.1. Transacciones
El capítulo 10 presentó las transacciones: un conjunto de operaciones que, o bien todas tienen éxito, o bien todas fallan. Con Hibernate:
- toda operación de escritura se realiza dentro de una transacción, abierta mediante [session.beginTransaction()] y cerrada mediante [commit] o [rollback]. Los métodos [inTransaction] y [fromTransaction] de [SessionFactory] se encargan de esto por nosotros: confirman la transacción si la lambda termina normalmente, y la revierten si lanza una excepción, que luego se vuelve a lanzar;
- todos los comandos enviados durante la transacción (los comandos inmediatos mediante [INSERT], las sincronizaciones explícitas mediante [flush] y la sincronización mediante [commit]) se confirman o se revierten en conjunto;
- Un error del SGBD se propaga como una excepción de Hibernate, derivada de [JDBCException], que encapsula la [SQLException] del controlador: [ConstraintViolationException] para una violación de restricción (clave primaria, unicidad, clave externa, [NOT NULL]), [SQLGrammarException] para un error en la sentencia SQL, y así sucesivamente. Son excepciones no comprobadas, tanto en Java como en Kotlin (que, como recordatorio, no tiene excepciones comprobadas: capítulo 3); solo capturamos las que sabemos manejar.
El subproyecto [transactions] ilustra las dos maneras de manejar una transacción:
Resultados:
Comentarios:
- Líneas 18–20: se agregan dos artículos en una transacción gestionada por [inTransaction]; el segundo artículo tiene el mismo nombre que uno existente. Ambas operaciones [INSERT] se ejecutan de inmediato (líneas 4–15); la segunda viola la restricción de unicidad de la columna [name]: MySQL la rechaza (línea 16), [persist] lanza una [ConstraintViolationException], [inTransaction] revierte la transacción (línea 17) y vuelve a lanzar la excepción;
- líneas 22–23: se captura la excepción; la propiedad [constraintName] (el método [getConstraintName]) devuelve el nombre de la restricción violada (línea 18). Esto demuestra el valor de haber nombrado la restricción;
- línea 25: la raqueta, que se había insertado con éxito, no está en la base de datos (línea 23): revertir la transacción la eliminó;
- Líneas 29–45: una transacción gestionada por el código, en una sesión abierta mediante [openSession] y cerrada mediante [use] ([Session] es [AutoCloseable]). Se venden dos bicicletas ([bike.currentStock -= 2]: el operador [-=] se aplica a una propiedad [var] igual que a una variable), y el cambio se envía al SGBD mediante un [flush] explícito (líneas 29–36); luego se agrega un artículo cuyo nombre ya existe: la inserción falla (línea 43);
- línea 41: nunca se llega al commit;
- líneas 42–45: en el [catch], se revierte la transacción (línea 45 de los resultados). La propiedad [sqlException] devuelve la excepción original del controlador JDBC, y su mensaje es el de MySQL (línea 44);
- línea 49: la venta de las bicicletas, aunque enviada al SGBD mediante [flush], fue cancelada: el inventario de bicicletas sigue siendo 10 (línea 50);
- líneas 54–60: una función que vuelve a leer un registro con una sesión nueva para ver el estado real de la base de datos en lugar de las entidades de la sesión de trabajo actual. La propiedad [singleResultOrNull] vale [null] si la consulta no encuentra nada; el operador Elvis ([?:]) muestra entonces “missing”.
Después de una excepción, una sesión ya no debe utilizarse: su contexto de persistencia puede contener entidades en un estado incoherente con la base de datos. Se revierte la transacción, se cierra la sesión y, si es necesario, se vuelve a empezar con una sesión nueva. Esto es lo que hace [inTransaction], y lo que hace nuestro código al salir del bloque [use], que cierra la sesión.
El nivel de aislamiento de las transacciones es el de la conexión JDBC: [REPEATABLE_READ], el valor predeterminado de MySQL, como se mostró en el primer ejemplo. Se puede cambiar para todo el [SessionFactory] mediante el método [jdbcTransactionIsolation] de la configuración.
11.11.2. Concurrencia optimista
Dos usuarios leen el mismo artículo, que tiene un stock de 10. El primer usuario vende una unidad y actualiza el stock a 9. El segundo usuario, que leyó el valor del stock antes de esta actualización, vende tres unidades y actualiza el stock a 7: la venta del primer usuario se pierde. Este es el problema de las actualizaciones perdidas.
Una solución sería bloquear la fila durante toda la duración de la operación de cada usuario (concurrencia “pesimista”): esto bloquea a los demás usuarios, a veces durante mucho tiempo. Con Hibernate, generalmente se prefiere la concurrencia optimista: no se bloquea nada, pero al momento de guardar se realiza una comprobación para asegurarse de que la fila no ha sido modificada desde que se leyó. La forma estándar de hacerlo es agregar un número de versión a la entidad: una propiedad anotada con [@Version]. Hibernate incrementa este número cada vez que se modifica la fila, y agrega la condición “la versión todavía tiene el valor leído” a la cláusula [WHERE] de los comandos [UPDATE] y [DELETE]. Si la transacción no modifica ninguna fila, significa que otro usuario ya accedió a los datos: Hibernate lanza una [OptimisticLockException].
El subproyecto [concurrency] usa su propia base de datos, [hbconcurrency], y su propia entidad, [Article], reducida a lo esencial:
- líneas 15–17: el número de versión, de tipo [Int] (también se puede usar [Long], o una fecha de tipo [Instant]). La aplicación nunca lo modifica por sí misma: su modificador es protegido ([protected set]), igual que el del identificador; Hibernate, que accede directamente al campo, no se ve afectado por esto. El valor inicial [0] es el de un artículo creado por la aplicación; para un artículo leído de la base de datos, el constructor sin parámetros agregado por el plugin [jpa] no realiza esta inicialización (como hemos visto), pero Hibernate asigna de inmediato el valor leído a la propiedad.
Como la entidad se define en el propio subproyecto, su archivo de compilación aplica los plugins [jpa] y [allopen] , y depende directamente de Hibernate y de la biblioteca [tools]:
- líneas 5–6: los dos plugins de entidades, configurados mediante el bloque [allOpen] (líneas 23–26);
- líneas 16–19: el registro SQL compacto, Hibernate y el controlador JDBC de MySQL;
- líneas 42–45: los programas lanzados por Gradle escriben su salida en UTF-8, para que los caracteres acentuados se muestren correctamente en Windows (capítulo 2).
El programa simula a los dos usuarios con dos sesiones:
Resultados:
Comentarios:
- líneas 10–15: la configuración de Hibernate para la base de datos [hbconcurrency] y su única entidad;
- líneas 18–21: la tabla se vuelve a crear con un único artículo, la bicicleta, en la versión 0. La función [withoutLog] de la biblioteca [tools] recibe la acción que se va a ejecutar en forma de lambda, escrita sin paréntesis por ser su único parámetro (capítulo 7);
- líneas 28–29: cada usuario lee la bicicleta en su propia sesión; las dos sesiones se abren mediante dos funciones [use] anidadas y se cierran en el orden inverso al de su apertura. La columna [version] se lee junto con las demás (líneas 3–10);
- líneas 33–35: la orden [UPDATE] del primer usuario (líneas 13–20) escribe la nueva versión (1) y contiene la condición [version=?] con la versión leída (0). La fila se modifica; la propiedad [version] de la entidad pasa a 1 (línea 22);
- líneas 41–44: la solicitud del segundo usuario contiene la misma condición, con la versión que leyó, 0, mientras que la versión de la fila en la base de datos es ahora 1. No se modifica ninguna fila y Hibernate lanza una [OptimisticLockException] (línea 33). Sincronizamos explícitamente la sesión ([flush]) antes del [commit] para provocar esta excepción tal cual; si se produjera durante el [commit], quedaría encapsulada en una [RollbackException];
- Líneas 54–59: la resolución depende de la aplicación: abortar, notificar al usuario o, como aquí, volver a leer el artículo mediante una nueva sesión (la sesión que recibió la excepción ya no debe utilizarse) y repetir la operación. El inventario repuesto es de 9 en la versión 1 (línea 41), y la venta de las tres bicicletas deja un inventario de 6 en la versión 2 (línea 50);
- línea 65: una función de extensión (capítulo 4) que da formato al estado de un artículo para mostrarlo. Se define dentro del programa, sin modificar la entidad.
Dos variantes:
- sin columna de versión, Hibernate puede verificar los valores anteriores de las propias columnas: con las anotaciones [@OptimisticLocking(type = OptimisticLockType.DIRTY)] y [@DynamicUpdate] en la entidad, la cláusula [WHERE] de [UPDATE] contiene el valor leído de cada columna modificada ([where id=? and currentStock=?]). Esto es útil para una base de datos existente que no se puede modificar;
- la concurrencia pesimista sigue siendo posible cuando los conflictos son frecuentes: [session.find(Article::class.java, 1, LockModeType.PESSIMISTIC_WRITE)] lee la fila con una orden [select ... for update], que la bloquea hasta el final de la transacción.
11.12. Las consultas SQL nativas
Hibernate genera el SQL a partir de HQL o de la API Criteria, pero también es posible escribir uno mismo el SQL de una consulta, para aprovechar una funcionalidad específica del SGBD o para optimizar una consulta compleja: esto se denomina consulta nativa. El subproyecto [rawsql] enumera los métodos disponibles:
Resultados:
Comentarios:
- Líneas 17–24: [createNativeQuery] ejecuta una consulta (SQL) que devuelve filas de la tabla de una entidad, y el segundo parámetro ([Article::class.java]) indica a Hibernate que las materialice como entidades administradas por la sesión. Los nombres de las columnas del resultado deben coincidir con los del modelo: [select *] resulta adecuado aquí. La consulta se escribe como una cadena literal en bruto (["""]), de la cual [trimIndent] elimina la sangría común (capítulo 5). Se transmite tal cual al SGBD (líneas 3–6), salvo que el parámetro con nombre [:minPrice] se convierte en un parámetro JDBC ([?]);
- líneas 29–34: un intento de inyección SQL. El valor de [name] se pasa como parámetro: se compara tal cual con la columna [name] y ningún artículo coincide (línea 16);
- líneas 37–38: la misma consulta construida con una plantilla de cadena (['$name']). Las plantillas son tan cómodas en Kotlin que resulta tentador usarlas para construir una consulta: es un error grave. El valor de [name] se convierte en código SQL, la condición siempre se evalúa como verdadera (línea 20) y la consulta devuelve seis artículos (línea 21): es una inyección SQL exitosa. Como en el capítulo 10, una consulta nativa debe contener únicamente texto constante, con los valores pasados como parámetros;
- Líneas 43–52: consultas que devuelven valores únicos ([String], [BigDecimal]): el segundo parámetro de [createNativeQuery] es entonces el tipo del valor. Para varias columnas, se puede especificar una clase de datos (cuyo constructor recibe las columnas en orden) o usar [Array<Any>::class.java];
- líneas 56–65: [createNativeMutationQuery] prepara una instrucción de actualización, ejecutada por [executeUpdate], que devuelve el número de filas modificadas. Se ejecuta dentro de una transacción: el método [fromTransaction] de la sesión la abre, la confirma y devuelve el resultado de la lambda. La lambda recibe la transacción como parámetro; como no la utiliza, este parámetro se llama [_];
- líneas 71–77: [doWork] proporciona acceso a la conexión JDBC de la sesión ([java.sql.Connection]) para código JDBC estándar (capítulo 10): llamada a un procedimiento almacenado, uso de una característica del controlador... Incluye la función [use], que cierra la sentencia ([Statement]) y el [ResultSet]. En efecto, el precio del arco se ha reducido un 10 % (línea 40).
Una nota sobre la línea 71: aquí se especifica explícitamente el tipo del parámetro de la lambda ([connection: Connection]), lo cual no es una práctica habitual en Kotlin. Sin él, el compilador rechaza el programa:
La interfaz de Hibernate [Work], que implementa la lambda, lleva anotaciones de tipo de la biblioteca Checker Framework en el tipo de su parámetro; los desarrolladores de Hibernate usan estas anotaciones para verificar el uso de [null] en su código. Esta biblioteca no forma parte de las dependencias de Hibernate; por lo tanto, el compilador desconoce sus anotaciones y se niega a inferir un tipo que las lleve. Al especificar nosotros mismos el tipo del parámetro, evitamos la inferencia y el error. Este tipo de problema surge a veces al usar una biblioteca Java desde Kotlin: el propio código Java ignora estas anotaciones.
Una consulta nativa no es portable de un SGBD a otro y Hibernate no puede validarla antes de su ejecución: se reserva para los casos en que HQL resulta insuficiente. En efecto, HQL cubre una gran parte de SQL (uniones de todo tipo, subconsultas, funciones de ventana, [union]...) y permite llamar a una función del SGBD que no reconoce.
11.13. Actualizaciones masivas, modo de solo lectura y lotes
El seguimiento de cambios tiene un costo: para aumentar el precio de 100 artículos, hay que leer los 100 artículos, modificarlos uno por uno, y la sincronización de la sesión enviará 100 comandos [UPDATE]. Hibernate ofrece varias formas de procesar eficientemente grandes cantidades de filas. El subproyecto [bulkupdate] las presenta:
Resultados (se abrevió el final repetitivo):
Comentarios:
- Líneas 17–23: un comando [update] escrito en HQL, preparado por [createMutationQuery], y ejecutado por [executeUpdate]. Se convierte en una única instrucción SQL [UPDATE] (líneas 4–6), ejecutada por el SGBD sobre todas las filas afectadas, sin cargar ninguna entidad en memoria. El nuevo valor puede depender de la propia fila ([minimumStock * 2]). Un comando de este tipo se ejecuta dentro de una transacción (líneas 2 y 18);
- líneas 27–29: un aumento del 10 % en los precios bajos. Las constantes de la consulta HQL ([1.1], [150]) se escriben directamente en el texto del comando SQL (líneas 10–11);
- líneas 34–36: una instrucción HQL [delete] elimina el arco, el único artículo con precio superior a 550 euros (líneas 14–16);
- líneas 43–50: una operación de solo lectura ([setReadOnly(true)]). Las entidades leídas son administradas por la sesión, pero esta no conserva su estado original ni las vigila: es más rápido y consume menos memoria para datos que se leen sin modificarse (visualización, cálculos). La contrapartida es que cualquier modificación de una entidad de este tipo se ignora (línea 49): la sesión no tiene nada que sincronizar ([session.isDirty] es igual a [false], línea 29) y [commit] no envía ningún comando. También se puede configurar una sesión completa como de solo lectura ([session.isDefaultReadOnly = true]);
- líneas 56–62: una trampa. Un comando [update] HQL actúa directamente sobre la base de datos: no modifica las entidades ya cargadas por la sesión. La bomba administrada por la sesión conserva su precio anterior (línea 37) hasta que se vuelve a leer con [session.refresh(pump)] (líneas 38–42);
- Líneas 68–76: una sesión sin estado ([StatelessSession]), abierta aquí con una transacción mediante [inStatelessTransaction]. No tiene contexto de persistencia: ni caché de primer nivel, ni seguimiento de cambios, ni carga diferida, ni cascadas. Cada operación se solicita explícitamente ([insert], [update], [delete], [get]) y se ejecuta tal cual. Es la herramienta para el procesamiento masivo: importar un archivo grande, recalcular todas las filas de una tabla;
- línea 69: los comandos SQL se enviarán al SGBD en lotes (véase el capítulo 10) de tres: el controlador JDBC transmite tres comandos en un único intercambio con el servidor. En Kotlin, el par [getJdbcBatchSize]/[setJdbcBatchSize] se utiliza como una propiedad. El registro muestra los tres primeros [UPDATE], seguidos de la ejecución del lote (línea 58), y termina con el lote final de dos comandos (línea 63). Una aplicación define el tamaño de lote para todas sus sesiones mediante la propiedad [hibernate.jdbc.batch_size] (normalmente entre 10 y 50). Cabe señalar que las inserciones en una tabla cuya clave se genera mediante [IDENTITY] no pueden agruparse en lotes.
Para el procesamiento masivo con una sesión normal, hay que evitar que su contexto de persistencia acumule entidades: se sincroniza y se vacía la sesión regularmente, por ejemplo cada cincuenta registros ([session.flush(); session.clear()]). Con Kotlin, la función [chunked] de las secuencias y colecciones (capítulo 5) divide cómodamente los datos en fragmentos de este tamaño.
11.14. Hibernate e inyección de dependencias: Spring
11.14.1. El [SessionFactory] en el contenedor
Los ejemplos anteriores creaban sus propias sesiones. En una aplicación en capas (capítulo 6), y en todas las aplicaciones Spring, el [SessionFactory] es un objeto del contenedor de inyección de dependencias, al igual que las capas que lo utilizan. Para ello, Spring Framework proporciona, en su biblioteca [spring-orm]:
- la clase [LocalSessionFactoryBean], que construye el [SessionFactory] a partir de un origen de datos ([DataSource], capítulo 10) y una lista de entidades;
- la clase [HibernateTransactionManager], un administrador de transacciones que abre una sesión de Hibernate por cada transacción, la asocia al hilo actual y la cierra al final de la transacción;
- la anotación [@Transactional] (biblioteca [spring-tx]): aplicada a un método, o a una clase para todos sus métodos públicos, indica a Spring que ejecute el método dentro de una transacción, que se confirma si el método termina normalmente y se revierte si lanza una excepción no capturada. Estas se conocen como transacciones declarativas. Una nota sobre Kotlin: por defecto, Spring no revierte la transacción ante una excepción controlada según la definición de Java (una [IOException], por ejemplo). Kotlin no distingue estas excepciones de las demás, pero Spring sí: ¡una función Kotlin que lanza una [IOException] dentro de un método transaccional tendrá su transacción confirmada! Por eso escribimos [@Transactional(rollbackFor = [Exception::class])] para garantizar que la transacción se revierta en todos los casos.
Dentro de un método transaccional, ***[sessionFactory.currentSession]*** (el método *[getCurrentSession] ) devuelve la sesión de la transacción actual. Una capa [dao] puede entonces ser un singleton que recibe el [SessionFactory] (seguro para hilos) y le pide, en cada método, la sesión actual: la regla «una sesión por unidad de trabajo, nunca compartida entre hilos» se cumple sin esfuerzo. Sin embargo, hay que tener cuidado con las corrutinas: la sesión actual está asociada a el hilo, y una función de suspensión que cambie de hilo en medio de una transacción perdería su sesión. Por lo tanto, mantenemos los métodos transaccionales bloqueantes y los llamamos desde una corrutina dentro de un bloque [withContext(Dispatchers.IO)], como se muestra en el ejemplo [async]*.
11.14.2. El subproyecto [injection]
El subproyecto [injection] depende de Spring y HikariCP, además de la biblioteca [articles]:
- Línea 5: el complemento [all-open] configurado para Spring (capítulo 6). Hace abiertas las clases anotadas con [@Configuration], así como con [@Transactional] y algunas otras ([@Component], [@Service], [@Async]....), junto con sus métodos. Veremos por qué es indispensable;
- línea 15: la entidad [Article] y la base de datos [hbarticles] (que incluye Hibernate, MySQL y el registro SQL);
- Líneas 17–18: el contenedor de Spring y la integración con Hibernate; [spring-orm] incluye [spring-tx], la biblioteca de transacciones;
- línea 19: el grupo de conexiones HikariCP (capítulo 10);
- líneas 36–39: los programas lanzados por Gradle escriben su salida en UTF-8 para que los caracteres acentuados se muestren correctamente en Windows (capítulo 2).
La configuración de Spring se escribe en Kotlin, con las anotaciones [@Configuration] y [@Bean] del capítulo 6:
- línea 18: habilita la anotación [@Transactional]: Spring reemplazará todo objeto que tenga un método con esta anotación por un proxy que abre y confirma la transacción alrededor de la llamada;
- líneas 22–26: el grupo de conexiones HikariCP del capítulo 10, configurado en un bloque [apply]: los modificadores [setJdbcUrl], [setUsername] y [setPassword] se utilizan como propiedades. El atributo [destroyMethod] especifica el método que se debe llamar cuando se cierra el contenedor. El tipo de retorno inferido de la función es [HikariDataSource]: es el tipo con el que Spring registra el bean;
- líneas 31–34: [SessionFactory]. Un
*[LocalSessionFactoryBean]es una fábrica de*[SessionFactory]*: Spring registra en el contenedor el objeto que produce, y es un*[SessionFactory]lo que se obtiene al solicitar este bean. Recibe el grupo de conexiones (que reemplaza al grupo integrado de Hibernate), las entidades y las propiedades de Hibernate. Escribimos [setDataSource(dataSource)] en lugar de [dataSource = dataSource], que asignaría el parámetro a sí mismo (y sería rechazado, ya que un parámetro es de solo lectura); - línea 39: el administrador de transacciones;
- línea 43: la capa [dao], que recibe el [SessionFactory].
La capa [dao]:
- línea 9: todos los métodos públicos de la clase son transaccionales;
- línea 12: el [SessionFactory], recibido por el constructor primario;
- línea 16: dentro de la misma transacción, ¿dos solicitudes de la sesión actual devuelven la misma sesión? El operador [===] compara las referencias (capítulo 3);
- línea 19: la sesión de la transacción, devuelta al llamador (para el siguiente experimento: esto no se hace en una aplicación real);
- líneas 22–25: una transacción de solo lectura ([readOnly = true]): Spring configura la sesión como de solo lectura y no la sincroniza;
- líneas 37–41: la venta de una cantidad de un artículo. Si el inventario se vuelve negativo, la función de Kotlin [check] (capítulo 3) lanza una [IllegalStateException], una excepción no controlada: Spring revierte la transacción. La llamada al método [article] (línea 38) es una llamada interna dentro del objeto, que no pasa por el proxy: se ejecuta dentro de la transacción de [sell].
El proxy que Spring crea para la clase [ArticlesDao] es una subclase de esta, generada en tiempo de ejecución por la biblioteca CGLIB, que redefine cada método público para envolverlo en una transacción. Sin el complemento [plugin.spring], la clase Kotlin sería final y Spring no podría derivar de ella. Si se compila el subproyecto sin este complemento (declarando manualmente la clase [Config] y sus funciones [open] para sortear el primer error, que ya encontramos en el capítulo 6), el contenedor se niega a iniciar:
Una trampa más insidiosa aguarda a quien abre manualmente la clase ([open class ArticlesDao]) sin abrir sus métodos: el proxy se crea, pero no puede sobrescribir los métodos que siguen siendo final. Llamar directamente a estos métodos ejecuta el código de la clase [ArticlesDao]... sobre el objeto proxy, cuyos campos no han sido inicializados (Spring lo crea sin llamar al constructor de la clase). El resultado, obtenido al compilar el subproyecto de esta manera, resulta desconcertante:
¡La propiedad [sessionFactory], que es de un tipo no nulo, vale [null]! El complemento evita estos dos errores: con él, la clase y todos sus métodos son abiertos.
El programa principal:
Resultados:
Comentarios:
- Línea 12: el contenedor de Spring, configurado por la clase [Config]. Se cierra al final del bloque [use], que cierra el [SessionFactory] y el grupo de conexiones;
- línea 14: el [SessionFactory] construido por Spring, obtenido mediante la función de extensión [getBean<T>()] de Spring (capítulo 6); se utiliza para volver a crear la tabla de productos;
- línea 20: una transacción (líneas 3–4): dentro de la misma transacción, la sesión actual sigue siendo la misma (línea 5);
- líneas 22–25: dos llamadas, dos transacciones (líneas 6–9), dos sesiones distintas; la primera está cerrada, pues su transacción ha terminado (línea 10). La propiedad [isOpen] es el método [isOpen()] de la sesión;
- líneas 28–29: fuera de una transacción, no hay sesión actual: [getCurrentSession] lanza una [HibernateException] (línea 11). Este es el error clásico de un método que omitió la anotación [@Transactional];
- línea 35: una transacción de solo lectura (líneas 13–17);
- línea 37: la venta de dos bicicletas. La transacción se confirma y la sincronización de la sesión envía el [UPDATE] (líneas 20–33);
- líneas 40–41: la venta de cincuenta bombas provoca una excepción: Spring revierte la transacción (línea 40), y [UPDATE] nunca se envía, porque la sesión no fue sincronizada;
- líneas 45–46: estado de la base de datos: el inventario de bicicletas ha cambiado a 8, mientras que el inventario de bombas se mantiene en 10 (líneas 49 y 56).
En una aplicación Spring Boot, todo esto ocurre automáticamente: Spring Boot crea el grupo de conexiones, la fábrica (en su forma de Jakarta Persistence, una [EntityManagerFactory]) y el administrador de transacciones a partir del archivo [application.properties]. Spring Data JPA se utiliza a menudo sobre Hibernate; genera la capa [dao] a partir de una interfaz sencilla: [interface ArticleRepository : JpaRepository<Article, Int>] proporciona [findAll], [findById], [save], [delete]..., y un método declarado [fun findByPriceLessThan(price: BigDecimal): List<Article>] se traduce automáticamente en una consulta. Spring Data añade algunas funciones de extensión para Kotlin, como [findByIdOrNull], que devuelve un [Article?] en lugar de un [Optional<Article>].
11.15. Aplicación de ejemplo - Versión 7
11.15.1. La arquitectura
La versión 6 de la aplicación de cálculo del impuesto (capítulo 10) leía los tramos del impuesto desde una base de datos MySQL mediante JDBC. La versión 7 hace lo mismo con Hibernate. Como en la versión 6, solo cambia la capa [dao]: las capas [business] y [ui] de la versión 5 (capítulo 6) se reutilizan tal cual, gracias a la arquitectura compuesta.
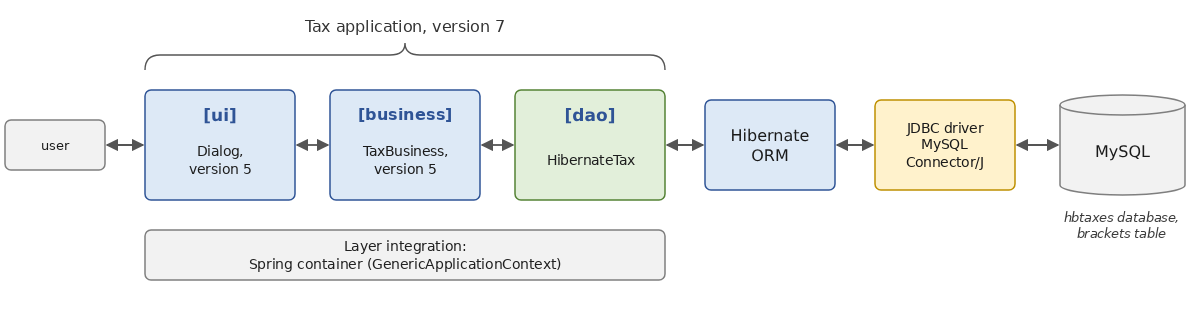
La versión 7 consta de dos subproyectos de la estructura del capítulo 11, almacenados en la carpeta [TaxV7]:
La carpeta [TaxV7] no tiene archivo de compilación: como la carpeta [TaxV5] del capítulo 6, es simplemente un conjunto de subproyectos. Los módulos de la versión 5 ([tax-dao], [tax-business], [tax-ui], en versión 5.0) los proporciona la compilación del capítulo 6, incluida mediante la línea [includeBuild("../06-architectures")] del archivo [settings.gradle.kts]: Gradle reemplaza cualquier dependencia [examples.tax:tax-xxx:5.0] por el subproyecto correspondiente de esta compilación, que compila según sea necesario. No hay nada que instalar previamente, a diferencia de Maven, donde primero había que ejecutar [mvn install] en la carpeta de la versión 5.
11.15.2. La capa [dao]
El subproyecto [tax-dao-hibernate] depende de la capa [dao] de la versión 5, que contiene las entidades de la aplicación ([TaxBracket], [TaxException]) y la interfaz [ITaxDao]:
- líneas 5–6: complementos de entidades: el subproyecto define la entidad [Bracket];
- línea 8: el subproyecto es una biblioteca que expone algunas de sus dependencias mediante la configuración [api];
- línea 10: el complemento [application], utilizado para crear la base de datos (línea 47);
- línea 23: la capa [dao] de la versión 5. Es una dependencia de tipo [api]: la clase [HibernateTax] implementa la interfaz [ITaxDao] de esta biblioteca, que por lo tanto sus usuarios también deben ver;
- líneas 25–27: Hibernate, el controlador JDBC para MySQL y Logback. Hibernate es una dependencia de [implementation]: la biblioteca la usa internamente, pero no aparece en su interfaz pública;
- líneas 31–34: la configuración estándar del complemento [allopen];
- líneas 50–53: los programas lanzados por Gradle escriben su salida en UTF-8 para que los caracteres acentuados se muestren correctamente en Windows (capítulo 2).
La clase de datos [TaxBracket] de la versión 5 no puede ser una entidad de Hibernate: es una clase de datos (ya vimos por qué esto no es buena idea para una entidad), es inmutable y no tiene identificador. No la modificamos, porque forma parte del contrato entre las capas, compartido por todas las versiones. Creamos una entidad, específica de la capa [dao], cuyo papel es representar una fila de la tabla:
- línea 3: la tabla [brackets];
- líneas 6–12: las tres columnas, declaradas en el constructor primario, con tipos [decimal] adecuados: el límite y el coeficiente [coeffN] son montos con dos decimales, y [coeffR] es una tasa con cuatro decimales. Los nombres de las columnas están en minúsculas. Las propiedades son privadas: la entidad solo se usa para poblar la tabla ([CreateDatabase]) y para escribir consultas; el resto de la aplicación nunca la ve. Hibernate, que accede directamente a los campos, no exige que sean públicos;
- líneas 15–17: la clave primaria, que también sirve para ordenar los tramos.
La clase [HibernateTax] implementa la interfaz [ITaxDao]:
- líneas 11–14: los códigos de error de esta implementación, como en [FileTax] y [JsonTax];
- línea 9: la capa [dao] recibe la URL de la base de datos, junto con el usuario y su contraseña. Son simples parámetros del constructor (no se escribe [val] : no se convierten en propiedades, ya que solo se usan para la construcción). Lee los tramos una sola vez, durante la construcción: será un singleton;
- línea 18: la propiedad [taxBrackets] de la interfaz [ITaxDao], inicializada mediante una expresión [try] (capítulo 3): su valor es el del bloque [try]; si se produce un error, [catch] lanza una excepción;
- Líneas 20–25: un [SessionFactory] de vida breve (solo el tiempo necesario para leer la tabla), cerrado de inmediato por [use]. Como la capa accede a la base de datos una sola vez, no hay necesidad de conservarlo; una capa [dao] que accediera a la base de datos en cada llamada recibiría, en cambio, un [SessionFactory] creado una sola vez, como en el ejemplo anterior;
- Líneas 27–29: lectura de la tabla en el orden de la clave primaria. La consulta es una proyección sobre la clase de datos [TaxBracket]: Hibernate solicita al SGBD únicamente las tres columnas pertinentes y crea directamente los objetos de la aplicación llamando al constructor de
*[TaxBracket]con los tres valores, sin pasar por las entidades*[Bracket]. El valor devuelto por [fromSession], y luego por [use], es la lista leída: es el valor de la propiedad; - Líneas 32–35: un error de Hibernate o del SGBD (base de datos inaccesible, tabla inexistente, etc.) se manifiesta como una [PersistenceException] (la clase base de las excepciones de Jakarta Persistence, de la que derivan las excepciones de Hibernate). Como en otras implementaciones, se encapsula en una
*[TaxException]. La excepción puede ocurrir ya al crear el*[SessionFactory]*(línea 24), que se conecta al servidor: también queda contenida dentro del bloque***[try]** ; - líneas 38–41: una tabla vacía también es un error: la capa [business] exige al menos una fila. El bloque [init] se ejecuta después de inicializar la propiedad, que lo precede en la clase. El código de error se pasa mediante un argumento con nombre ([code = EMPTY_TABLE]), ya que la excepción no tiene causa (capítulo 6).
11.15.3. La base de datos
La base de datos [hbtaxes] la crea el programa [CreateDatabase.kt]. Para evitar reescribir los tramos de la escala, reutiliza los de la clase [HardwiredTax] de la versión 5:
- línea 10: la base de datos [hbtaxes], creada por MySQL si no existe;
- línea 13: muestra las instrucciones SQL, sin formato;
- línea 15: la tabla se elimina y luego se vuelve a crear al crear el [SessionFactory];
- líneas 19–21: una entidad [Bracket] por cada tramo de la clase [HardwiredTax], persistida en una transacción. El bucle [for] descompone cada [TaxBracket] en sus tres componentes ([(limit, coeffR, coeffN)]) mediante las funciones [component1], [component2] y [component3], que se generan para una clase de datos (capítulo 4).
El subproyecto también contiene un archivo llamado [logback.xml], utilizado por [CreateDatabase.kt] y por la aplicación, que solo deja pasar los siguientes errores:
- línea 10: los errores del SGBD, que Hibernate registra antes de lanzar una excepción, no se muestran: la propia aplicación los informa;
- línea 11: los demás registros solo anotan errores.
Ejecución:
Verificamos el contenido de la tabla:
Vemos los tramos de la escala, con el último de límite cero (la capa [business] no lo utiliza; selecciona el último tramo cuando ningún otro se aplica).
Para crear la base de datos en su propio sistema:
- inicie MySQL (en Laragon; véase el apéndice; usuario [root] sin contraseña);
- vaya a la carpeta [11-hibernate] e ingrese el comando [gradlew -q :TaxV7:tax-dao-hibernate:run] (o ejecute [CreateDatabase.kt] en IntelliJ IDEA, con el triángulo verde colocado frente a su función [main]). Gradle compila al mismo tiempo los módulos de la versión 5, en la carpeta contigua [06-architectures].
Entonces se crea la base de datos [hbtaxes] con su tabla [brackets] poblada. Si el comando falla, verifique que MySQL esté en ejecución y que la URL de [CreateDatabase.kt] corresponda a su servidor (puerto 3306, usuario [root], contraseña vacía). Como alternativa, si lo prefiere, puede crear la tabla y sus filas mediante un script SQL, como se describe en el capítulo 10.
11.15.4. Integración de las capas
El subproyecto [tax-ui-hibernate] combina las siguientes capas:
- líneas 16–17: las capas [business] y [ui] de la versión 5. El subproyecto [tax-ui] contiene el programa principal de la versión 5; aquí se utiliza como biblioteca, en concreto por su objeto [Dialog];
- línea 19: la nueva capa [dao], que incluye Hibernate, el controlador JDBC y Logback;
- línea 21: el contenedor de Spring;
- línea 34: la clase principal;
- líneas 37–39: el programa lee desde el teclado (capítulo 6);
- líneas 42–45: los programas lanzados por Gradle escriben su salida en UTF-8, para que los caracteres acentuados se muestren correctamente en Windows (capítulo 2).
El archivo de configuración [tax-hibernate.properties], ubicado en la carpeta del subproyecto, especifica la base de datos:
El archivo [tax-hibernate-error.properties] hace referencia a una base de datos llamada [hbtaxesmissing], que no existe:
El programa principal es el de la versión 5, en el que solo cambia la composición de la capa [dao]:
- El archivo no se llama [Main.kt]: se compilaría en una clase llamada [tax.ui.MainKt], que ya existe en el módulo [tax-ui] de la versión 5, del cual dependemos. El archivo [MainHibernate.kt] genera una clase llamada [tax.ui.MainHibernateKt];
- líneas 26–29: la URL de la base de datos requerida, el nombre de usuario y la contraseña, leídos de la configuración. [getProperty] devuelve [null] para una clave ausente: el operador Elvis ([?:]) se evalúa entonces como [TaxException] ([throw] es una expresión de Kotlin);
- línea 34: la capa [dao] es un [HibernateTax], creado por una lambda que le pasa los parámetros de la base de datos;
- línea 36: la capa [business] de la versión 5: el contenedor pasará la capa [dao] a su constructor;
- línea 48: el diálogo de la versión 5.
11.15.5. Ejecuciones
Las entradas del usuario, redirigidas al programa para obtener estos resultados, se colocaron después de las preguntas:
Se conservan los valores de control de las versiones anteriores: 4,282 euros para una pareja casada con dos hijos y un ingreso conjunto de 60,000 euros, 2,959 euros con tres hijos y 11,519 euros para una persona soltera sin hijos.
Con el archivo de configuración [tax-hibernate-error.properties], que hace referencia a una base de datos inexistente:
- línea 12: la excepción original, lanzada por el controlador JDBC;
- líneas 8 y 10: las excepciones de Hibernate que la encapsulan: el error se produjo durante la creación del [SessionFactory], cuando Hibernate se conectó al servidor para determinar su versión;
- línea 6: la capa [dao] envolvió el error en una [TaxException];
- línea 4: el contenedor de Spring, que estaba creando la capa [dao], encapsuló a su vez la excepción en una [BeanCreationException], que el programa principal mostró.
Cambiar de SGBD equivale a cambiar la URL de la base de datos y la dependencia del controlador JDBC: Hibernate selecciona automáticamente el dialecto SQL según el SGBD que encuentra, y el código de la clase [HibernateTax], escrito en HQL, permanece sin cambios. Solo hay que rehacer la creación de la base de datos (que depende de los tipos de columna), lo cual el programa [CreateDatabase.kt] hace sin más modificaciones que la de su propia URL.
11.16. Conclusión: ¿JDBC, JdbcClient, jOOQ, Exposed o Hibernate?
Ahora disponemos de dos formas de acceder a una base de datos: JDBC (capítulo 10) y Hibernate (este capítulo). Existen otros enfoques intermedios muy utilizados:
- JdbcClient, de Spring Framework (biblioteca [spring-jdbc]), añade a JDBC una API flexible que ejecuta una consulta SQL escrita a mano y transforma automáticamente las filas del resultado en objetos: [jdbcClient.sql("select * from articles where price > :price").param("price", 200).query(Article::class.java).list()]. Usted escribe el SQL; Spring se encarga de los parámetros y copia las columnas en los objetos (incluidas las clases de datos, cuyos constructores reciben las columnas). Es un «micro-ORM»;
- jOOQ genera, a partir del esquema de la base de datos, clases que permiten escribir SQL en Java o Kotlin verificado por el compilador: [dsl.selectFrom(ARTICLES).where(ARTICLES.PRICE.gt(price)).fetch()]. Se conserva el control total sobre el SQL, con la seguridad de la verificación de tipos;
- Exposed, de JetBrains, es la biblioteca de acceso a bases de datos escrita en Kotlin y para Kotlin. Las tablas se describen mediante objetos Kotlin ([object Articles : Table("articles")], con columnas como [val price = decimal("price", 10, 2)]), sin generación de código, y las consultas se escriben en un lenguaje dedicado («DSL»), parecido a SQL y verificado por el compilador: [Articles.selectAll().where { Articles.price greater minPrice }]. Exposed ofrece además una segunda API, una versión ligera de ORM (clases de entidad vinculadas a tablas), y se apoya en JDBC o, opcionalmente, en controladores no bloqueantes (R2DBC) que pueden usarse desde corrutinas. Aprovecha todo lo que hemos visto sobre Kotlin: funciones de extensión, lambdas con receptor, funciones infijas ([greater]) y tipos que admiten nulos para las columnas opcionales.
Fortalezas | Debilidades | |
JDBC | Control total sobre el SQL; rendimiento; sin dependencias | mucho código repetitivo (parámetros, lectura de columnas), simplificado en Kotlin mediante [use] y funciones de extensión; SQL en cadenas, no verificado por el compilador |
JdbcClient | SQL escrito a mano, sin código de copiar y pegar; rendimiento similar al de JDBC | Sin seguimiento de cambios ni generación de [INSERT]/[UPDATE]; SQL no verificado |
jOOQ | SQL verificado por el compilador; todas las funcionalidades del SGBD | Generación de código con cada cambio de esquema; sin seguimiento de cambios; se requiere licencia de pago para ciertas versiones comerciales de SGBD |
Exposed | Diseñado para Kotlin; consultas verificadas por el compilador, sin generación de código; ligero | Específico de Kotlin; menos difundido que Hibernate y con menos documentación; el esquema se describe manualmente en el código |
Hibernate | modelo orientado a objetos; seguimiento de cambios; relaciones; HQL y API Criteria; estándar Jakarta Persistence; independiente del SGBD | una capa adicional que comprender (sesiones, estados, carga diferida); código SQL generado que hay que vigilar; menos adecuado para procesamientos masivos complejos; algunas adaptaciones para Kotlin (complementos [jpa] y [allopen] , sin clases de datos para las entidades) |
Se pueden sugerir las siguientes pautas:
- Hibernate (a menudo mediante Spring Data JPA) es adecuado para la mayoría de las aplicaciones empresariales: un modelo de entidades interconectadas, operaciones de lectura y actualización de entidades, y un esquema que evoluciona con la aplicación. Es la opción predeterminada para las aplicaciones Spring Boot, tanto en Kotlin como en Java;
- JDBC, JdbcClient, jOOQ o Exposed son adecuados cuando se desea un control preciso sobre el SQL ejecutado: consultas estadísticas complejas, procedimientos almacenados, procesamiento de volúmenes muy grandes, o una base de datos existente con un esquema poco adecuado para un modelo orientado a objetos. Exposed es una opción natural para una aplicación escrita íntegramente en Kotlin, en particular fuera de Spring (usando, por ejemplo, el framework web Ktor de JetBrains);
- estos enfoques pueden combinarse: una aplicación puede usar Hibernate para la mayor parte de sus operaciones y código SQL escrito a mano (en forma de consultas nativas) con [JdbcClient] o JDBC ([doWork]), para unas pocas consultas críticas.
En cualquier caso, el ORM no elimina la necesidad de comprender SQL y el funcionamiento del SGBD: el registro de los comandos SQL ejecutados, que hemos mostrado a lo largo de este capítulo, es la herramienta principal para verificar lo que Hibernate hace realmente.
Para profundizar, la documentación de Hibernate es completa y su guía introductoria es el mejor punto de partida: Hibernate ORM - documentation. La especificación Jakarta Persistence la publica la Eclipse Foundation: Jakarta Persistence. La guía de Spring sobre el uso de JPA en Kotlin resume los conceptos tratados en este capítulo (complementos, entidades, nulabilidad): Building web applications with Spring Boot and Kotlin. Exposed se presenta en su página de GitHub, que enlaza con su documentación: JetBrains Exposed.