5. Clases de Java de uso frecuente
Aquí presentamos algunas clases de la plataforma Java de uso frecuente: cadenas, arreglos, colecciones, archivos y expresiones regulares. También incluimos la API Stream (Java 8), que actualmente es la forma más común de buscar, ordenar, agrupar o transformar elementos de una colección de Java. Antes de eso, le mostraremos cómo encontrar información sobre las miles de clases disponibles. Este recurso es indispensable para todo desarrollador Java, incluso para los experimentados.
Con la excepción de dos (el ejemplo de JSON y la aplicación de ejemplo del final), los ejemplos de este capítulo son archivos fuente compactos ejecutados por el lanzador de código fuente: [java File.java]. Se encuentran en la carpeta [05-classes-java] del código del curso y se ejecutan en una configuración regional en inglés. Observe que un archivo fuente compacto importa automáticamente todas las clases públicas del módulo [java.base]: [java.util], [java.io], [java.nio.file], [java.util.regex], [java.util.stream], [java.time]… Por eso los programas siguientes no contienen ninguna instrucción [import].
5.1. Búsqueda de ayuda sobre las clases de Java
La biblioteca estándar de Java (la API Java SE) incluye más de 4,000 clases públicas. Nadie las conoce todas: los desarrolladores Java consultan constantemente su documentación. Esta documentación está disponible en línea, de forma gratuita, y se publica para cada versión de Java.
5.1.1. Documentación en línea
El punto de partida es el sitio web de Oracle en docs.oracle.com/en/java/javase/25. Allí encontrará:
- la referencia de Java 25: https://docs.oracle.com/en/java/javase/25/docs/api/. Describe, módulo por módulo y paquete por paquete, todas las clases e interfaces de Java: sus constructores, campos y métodos;
- un cuadro de búsqueda en la parte superior de cada página de la referencia, donde se puede escribir el nombre de una clase o de un método ([StringBuilder], [Matcher.find]…): la lista de resultados se va completando a medida que se escribe;
- la especificación del lenguaje Java (JLS) y guías temáticas (herramientas del JDK, seguridad, expresiones regulares…);
- una página “New Features” que describe las novedades de cada versión. Las propias novedades se describen mediante JEP (JDK Enhancement Proposals), disponibles en openjdk.org/jeps: por ejemplo, el JEP 512 describe los archivos fuente compactos usados en este capítulo.
Una página de clase, como java.lang.String, ofrece:
- el módulo y el paquete de la clase;
- su declaración, sus clases padre y las interfaces que implementa;
- una descripción general, a menudo extensa y detallada, con ejemplos;
- una lista resumen de sus campos, constructores y métodos, seguida de los detalles de cada uno: parámetros, valor de retorno, posibles excepciones y la versión de Java en que se introdujo (bajo el encabezado “Since”).
La documentación está en inglés. Una búsqueda en un buscador con el nombre completo de la clase y la versión (“java.lang.StringBuilder 25”) normalmente lleva directamente a la página correcta.
5.1.2. Javadoc y la ayuda del editor
Esta documentación es generada por la herramienta [javadoc] del JDK a partir de los comentarios de documentación escritos en el código fuente de las clases. Un comentario de este tipo comienza con [/**] y se coloca inmediatamente antes de una clase, un campo o un método. Por ejemplo, este es el método de cálculo del impuesto de la aplicación de ejemplo de este capítulo, documentado de la siguiente manera:
El comentario comienza con una oración de resumen; las etiquetas [@param] (“tags”) describen los parámetros, y [@return] describe el valor devuelto ([@throws] describiría una excepción). Puede documentar su propio código de esta manera; el comando [javadoc] (o [mvn javadoc:javadoc] en un proyecto Maven) genera páginas HTML similares a las de la documentación de Java. A partir de Java 23, los comentarios de documentación también pueden escribirse en Markdown, con líneas que comienzan con [///].
El editor de código (IntelliJ IDEA, Visual Studio Code con el Extension Pack for Java) aprovecha estos comentarios y ofrece ayuda inmediata sin salir del código:
- la autocompletación: después de escribir [aString.], el editor muestra una lista de los métodos del objeto, junto con sus parámetros y tipos de retorno;
- la documentación rápida: al pasar el mouse sobre el nombre de una clase o de un método (o al presionar Ctrl+Q en IntelliJ IDEA), se muestra su Javadoc;
- la ayuda de parámetros: al escribir el paréntesis de apertura de una llamada (o al presionar Ctrl+P en IntelliJ IDEA), el editor muestra las distintas sobrecargas del método y la función de cada parámetro;
- Ir a la definición (Ctrl+B en IntelliJ, IDEA, F12 en VS Code): muestra el código fuente de la clase o del método. El JDK incluye el código fuente de toda su biblioteca (archivo [lib/src.zip]): esto permite leer el código de [ArrayList] o de [HashMap], escrito por grandes expertos de Java, lo cual es muy instructivo.
Por último, la herramienta [jshell] del JDK permite probar un método sin escribir un programa: se ingresa una expresión y se muestra su valor. Así, ["abc".repeat(3)] muestra ["abcabcabc"]. El comando [/help] de [jshell] enumera sus opciones.
5.2. Cadenas de caracteres
5.2.1. La clase String
El tipo [String] (paquete [java.lang]) representa cadenas de caracteres. Ofrece numerosos métodos. Estos son algunos de ellos:
Método | función |
[int length()] | número de caracteres de la cadena |
[char charAt(int index)] | Carácter n.º [index]; el primer carácter es el n.º 0 |
[boolean startsWith(String prefix)] | devuelve [true] si la cadena comienza con [prefix] |
[boolean endsWith(String suffix)] | devuelve [true] si la cadena termina con [suffix] |
[boolean contains(CharSequence s)] | devuelve [true] si la cadena contiene [s] |
[boolean equals(Object other)] | devuelve [true] si la cadena tiene el mismo contenido que [other]; [equalsIgnoreCase] no distingue entre mayúsculas y minúsculas |
[int indexOf(String str)] | la primera aparición de [str] en la cadena, o -1. Otra sobrecarga inicia la búsqueda en la posición [fromIndex] |
[int indexOf(int ch)] | lo mismo para el carácter [ch] |
[int lastIndexOf(int ch)] | igual que [indexOf] pero devuelve la última posición en lugar de la primera |
[static String join(CharSequence delimiter, CharSequence... elements)] | Método de clase: concatena los elementos, separándolos con [delimiter] |
[String replace(char oldChar, char newChar)] | devuelve una copia de la cadena en la que el carácter [oldChar] ha sido reemplazado por [newChar]; una sobrecarga reemplaza una cadena por otra |
[String[] split(String regex)] | la cadena se trata como una secuencia de campos separados por un separador descrito por la expresión regular [regex]; el resultado es un arreglo con estos campos |
[String substring(int beginIndex, int endIndex)] | subcadena formada por los caracteres desde la posición [beginIndex] (inclusive) hasta la posición [endIndex] (exclusive) |
[String toLowerCase()], [String toUpperCase()] | convierte la cadena a minúsculas, a mayúsculas |
[String strip()] | elimina los espacios iniciales y finales de la cadena (Java 11; [stripLeading], [stripTrailing]: solo de un lado) |
[String repeat(int count)] | repite la cadena [count] veces (Java 11) |
[boolean isEmpty()], [boolean isBlank()] | devuelve [true] si la cadena está vacía, o si contiene solo espacios (Java 11) |
[Stream<String> lines()] | devuelve las líneas de la cadena como un flujo (Java 11; véase la API Stream más adelante) |
[String formatted(Object... args)] | devuelve la cadena, usada como plantilla, en la que los marcadores de posición [%s], [%d]… han sido reemplazados por los argumentos (Java 15) |
Es importante tener en cuenta que una cadena de tipo [String] es inmutable; no se puede modificar una vez creada. Cuando un método devuelve una cadena, esa cadena es distinta de aquella sobre la que se aplicó el método. Así, [s1.strip()] devuelve la cadena [s2], y [s1] y [s2] son dos cadenas diferentes: [s1] no ha cambiado.
A diferencia de otros lenguajes, una cadena de Java no es un arreglo: no se escribe [c[i]] sino [c.charAt(i)], y el número de caracteres se obtiene con el método [c.length()] (con paréntesis, mientras que la longitud de un arreglo es el campo [array.length], sin paréntesis).
El programa [Strings01.java] es el siguiente:
Resultados:
Comentarios:
- línea 6: carácter n.º 10, es decir, el undécimo carácter de la cadena;
- Líneas 8, 10: una búsqueda sin éxito devuelve -1;
- Línea 11: los dos parámetros de [substring] son las posiciones del primer carácter que se conserva y del primer carácter que no se conserva: esto produce los 7 caracteres de las posiciones 4 a 10. Esta es la convención general de Java para especificar un rango de índices (inicio incluido, fin excluido): aparece en muchos métodos;
- Líneas 16–17: la clase [String] no tiene un método de inserción: se concatenan el comienzo de la cadena, el texto insertado y el final de la cadena. Veremos que la clase [StringBuilder] tiene un método [insert];
- Línea 19: [split] divide la cadena en campos. Su parámetro no es un solo carácter sino una expresión regular, que examinaremos al final del capítulo: ["\\s+"] denota una secuencia de uno o más caracteres de espacio en blanco (espacio, tabulación, salto de línea, etc.). El carácter [\] debe duplicarse en una cadena de Java, de ahí la notación [\\s];
- línea 23: el método estático [join] realiza la operación inversa de [split];
- línea 24: [strip] (Java 11) elimina los espacios iniciales y finales. También existe el método más antiguo [trim], que solo reconoce los espacios del código ASCII; [strip] reconoce todos los espacios Unicode y debería preferirse;
- línea 26: todos los métodos anteriores devolvieron cadenas nuevas: [aString] permaneció sin cambios (línea 22 de los resultados);
- Líneas 30–32: un método del archivo fuente compacto, invocado por el método [main] como en el capítulo 3.
5.2.2. Los métodos split y join
El programa [Strings02.java] realiza una división más detallada de una cadena en campos:
Resultados:
Comentarios:
- Línea 5: los campos están separados por el carácter [:]. Dos caracteres [:] consecutivos delimitan un campo vacío (línea 4 de los resultados). Pero tenga cuidado: [split] elimina los campos vacíos del final. El último [:] de la cadena delimita un quinto campo vacío que ha sido eliminado: solo se obtienen 4 campos, y [join] no reconstruye la cadena original (línea 6 de los resultados). Este es un error frecuente;
- línea 13: el segundo parámetro de [split] es un límite. Un límite negativo indica que se deben conservar todos los campos, incluidos los campos vacíos del final: efectivamente obtenemos 5 campos, y [join] reconstruye la cadena original;
- línea 17: como el separador es una expresión regular, podemos definir separadores complejos: [":+"] coincide con uno o más caracteres [:] consecutivos. Los dos [:]s consecutivos forman un único separador, y el campo vacío desaparece;
- Línea 22: el patrón [\\s*[,;]\\s*] coincide con una coma o un punto y coma, precedidos y seguidos por cualquier cantidad de espacios: los espacios que rodean a los separadores se eliminan junto con ellos. Los del comienzo y del final de la cadena se eliminan previamente con [strip]. Esto produce los tres campos “limpios” en una sola instrucción;
- líneas 27–35: para eliminar tanto los espacios alrededor de los campos como los campos vacíos, también se pueden procesar los campos uno por uno: el campo formado por dos espacios entre dos comas queda vacío después de [strip] y no se conserva. La lista [ArrayList] usada aquí para almacenar los campos conservados se tratará un poco más adelante. También veremos que la API stream permite escribir este procesamiento en una sola instrucción;
- línea 39: el separador [" | "] contiene el carácter [|], que tiene un significado especial en una expresión regular (“o”). El método [Pattern.quote] convierte cualquier cadena en una expresión regular que coincide literalmente con ella. Lo usaremos siempre que un separador contenga uno de los caracteres [\ ^ $ . | ? * + ( ) [ ] { }];
- Líneas 43–48: [join] acepta solo cadenas (más precisamente, objetos [CharSequence], una interfaz implementada por [String] y [StringBuilder]): un arreglo de enteros debe convertirse primero en un arreglo de cadenas. Veremos que con la API Stream, [Arrays.stream(numbers).mapToObj(String::valueOf).collect(Collectors.joining(" + "))] hace lo mismo en una sola instrucción.
5.2.3. Búsqueda y comparación de cadenas
La comparación de cadenas es más sutil de lo que parece: ¿deben distinguirse las mayúsculas de las minúsculas? ¿Cómo debe compararse “éclair” con “essay”? Y, sobre todo, en Java, ¿qué compara el operador [==]? El programa [Strings03.java] muestra los métodos de búsqueda y comparación:
Resultados:
Comentarios:
- líneas 6–9: [contains], [startsWith], y [endsWith] realizan una comparación exacta, carácter por carácter: “LANGUAGE” no se encuentra;
- líneas 12–14: estos métodos no tienen una variante que no distinga mayúsculas de minúsculas. La forma más sencilla de realizar una búsqueda sin distinguir mayúsculas de minúsculas es convertir ambas cadenas a minúsculas;
- líneas 16–17: el método [regionMatches] compara una parte de una cadena con una parte de otra cadena. Su primer parámetro indica si se ignora la distinción entre mayúsculas y minúsculas; los siguientes son la posición inicial en la cadena, la otra cadena, la posición inicial en la otra cadena y el número de caracteres a comparar;
- líneas 20–25: la parte más importante de este programa. Una variable de tipo [String] contiene una referencia a un objeto cadena (capítulo 4). El operador [] compara las referencias: devuelve [true] si las dos variables hacen referencia al mismo objeto, y no a dos objetos con el mismo contenido. La variable [yes] (línea 21) hace referencia a una cadena “yes” construida en tiempo de ejecución: es un objeto distinto de la cadena literal “yes” del programa, y [yes == "yes"] se evalúa como [false] (línea 9 de los resultados), aunque las dos cadenas tengan el mismo contenido. Para comparar contenidos, siempre usamos el método [equals], o [equalsIgnoreCase] para ignorar la distinción entre mayúsculas y minúsculas, que es la forma correcta de probar una respuesta “yes” ingresada por teclado en mayúsculas o minúsculas. La comparación con [] “funciona” a veces, cuando ambas cadenas son literales del programa, de los que Java almacena una sola instancia: esto es lo que hace difícil detectar el error;
- líneas 28–31: el método [compareTo] devuelve un entero negativo, cero o positivo según la cadena preceda, sea igual o siga a la cadena del parámetro. Compara los códigos de los caracteres: “éclair” va después de “essay” porque el código del carácter é (233) es mayor que el del carácter e (101); aquí devuelve la diferencia entre los dos códigos, 132. Para ordenar palabras según las reglas de un idioma, se usa un objeto [java.text.Collator]: en francés, el carácter “é” se agrupa con “e”, y “éclair” va antes de “essay” (línea 13 de los resultados). Usaremos el orden definido por un [Collator] para ordenar palabras destinadas a un usuario, y [compareTo] para comparar identificadores técnicos (nombres de archivos, claves, etc.);
- líneas 34–40: [isEmpty] verifica si una cadena está vacía, mientras que [isBlank] (Java 11) verifica si una cadena está vacía o contiene solo espacios. Una variable de tipo [String] también puede ser [null] (ninguna cadena): llamar a un método sobre [null] lanza una excepción [NullPointerException]. Por lo tanto, primero probamos [missing == null]; gracias al comportamiento de cortocircuito del operador [||], [missing.isBlank()] no se evalúa cuando [missing] es [null];
- Líneas 43–44: [String.format("%8s", ...)] rellena una cadena con espacios hasta una longitud de 8 caracteres, ya sea a la izquierda o a la derecha, usando el formato [%-8s]; [repeat] repite una cadena.
5.2.4. Formatos y bloques de texto
Hasta ahora, hemos construido las cadenas que se muestran mediante concatenación con el operador [+]. Para alinear valores en columnas, fijar el número de decimales de un número o mostrar una fecha, se usa el método [String.format], o el método de instancia [formatted] (Java 15), que hace lo mismo. El primer parámetro es un formato: una cadena en la que los [%[-][width][.precision]conversion] especificadores indican dónde y cómo insertar los parámetros siguientes. El programa [Strings04.java] ofrece ejemplos de ello, así como de los bloques de texto de Java 15:
Resultados:
Comentarios:
- línea 12: un ancho alinea el valor a la derecha dentro de un campo de 10 caracteres; cuando va precedido del [-] símbolo, lo alinea a la izquierda;
- Líneas 12–14: las conversiones más comunes:
especificador | Significado | ejemplo |
[%s] | cadena; cualquier objeto se convierte mediante su [toString] método | dupont |
[%d], [%5d] | entero, posiblemente de 5 caracteres de longitud | 45 |
[%05d] | entero de al menos 5 dígitos, completado con ceros | 00045 |
[%X] | entero hexadecimal ([%x]: en minúsculas) | 2D |
[%.2f], [%12.2f] | número real con 2 decimales, posiblemente de 12 caracteres de longitud | 2345.68 |
[%,.2f], [%,d] | igual que el anterior, con separador de miles | 2,345.68 |
[%e] | número real en notación científica | 2.345678e+03 |
[%n] | salto de línea del sistema | |
[%%] | el carácter % | % |
- Los números se formatean según el idioma actual, en este caso el inglés: punto decimal y coma como separador de miles. En los formatos franceses de las líneas 19–22, el separador de miles es un espacio: un espacio fino sin salto (carácter U+202F), que parece un espacio normal pero impide un salto de línea en medio de un número; de igual modo, un espacio sin salto (U+00A0) precede al símbolo € y al símbolo %. Esto se tendrá en cuenta al comparar estos textos con cadenas escritas con espacios normales;
- línea 16: ["...".formatted(...)] equivale a [String.format("...", ...)]. Una expresión condicional puede proporcionar un parámetro;
- líneas 19–22: los importes monetarios y los porcentajes se formatean mediante objetos [java.text.NumberFormat], que se obtienen para un idioma y un país determinados ([Locale.FRANCE]). El formato de porcentaje multiplica el valor por 100;
- líneas 25–27: las fechas de la API [java.time] (Java 8) se formatean mediante un objeto [DateTimeFormatter] construido a partir de un patrón: [dd] día, [MM] mes, [yyyy] año, [HH] hora, [mm] minutos, [ss] segundos, [EEEE] día de la semana con todas sus letras, [MMMM] mes con todas sus letras. Hay que tener cuidado con las mayúsculas y minúsculas: [MM] es el mes, [mm] son los minutos. Los nombres de los días y de los meses son los del lenguaje cotidiano;
- líneas 30–34: los anchos de columna permiten mostrar los datos en columnas;
- línea 37: en una cadena, el carácter [\] introduce una secuencia de escape ([\n], [\t], [\"]…); para obtener el carácter [\] en sí, hay que duplicarlo. Java no tiene cadenas «sin procesar» (raw) en las que [\] sería un carácter normal, lo que hace un poco engorrosa la escritura de rutas de Windows y de expresiones regulares;
- líneas 41–46: un bloque de texto (Java 15) está delimitado por tres comillas; el texto comienza en la línea siguiente a las comillas de apertura. Puede abarcar varias líneas y contener comillas sin escape. Se elimina la sangría común a todas las líneas (la de la línea con menos sangría, contando desde las comillas de cierre): el texto JSON se muestra sin el margen del código. Las secuencias de escape siguen activas aquí: [\] debe duplicarse igualmente (línea 44). Como las comillas de cierre están en su propia línea, el texto termina con un salto de línea: de ahí el uso de [IO.print] en la línea 47 ([IO.println] añadiría una línea en blanco después de la llave de cierre);
- líneas 49–50: Java no admite la interpolación de cadenas, es decir, expresiones escritas directamente dentro del texto, como [${name}] en otros lenguajes (una propuesta, «String Templates», se probó como vista previa en Java 21 y 22, y luego se retiró). Con un bloque de texto se usan marcadores de posición como [%s], [%d]…, que se rellenan con [formatted]. Colocar las comillas de cierre al final del texto evita un salto de línea final.
También existe la clase [java.text.MessageFormat], cuyos formatos hacen referencia a los parámetros por su número: [MessageFormat.format("{0} is {1} years old", name, age)]. Se utiliza para mensajes traducidos a varios idiomas, en los que el orden de los parámetros puede variar de un idioma a otro.
5.2.5. La clase StringBuilder
Mencionamos que los métodos de la clase [String] que se aplican a una cadena [s1] devuelven otra cadena [s2]. La clase [java.lang.StringBuilder] permite modificar una cadena sin crear una nueva por cada operación. Esto mejora el rendimiento al construir una cadena mediante muchas adiciones sucesivas, ya que evita la proliferación de cadenas de vida muy corta.
La clase admite varios constructores:
constructor | función |
[StringBuilder()] | crea un objeto vacío con una capacidad inicial de 16 caracteres |
[StringBuilder(String str)] | construye e inicializa con [str]; la capacidad inicial es la longitud de [str] más 16 |
[StringBuilder(int capacity)] | construye un objeto vacío con una capacidad inicial de [capacity] caracteres |
Un objeto [StringBuilder] almacena sus caracteres en un arreglo cuyo tamaño, es decir, su capacidad, se ajusta automáticamente a medida que crece el texto. El programa [Strings05.java] ilustra este concepto de capacidad:
Resultados:
Comentarios:
- línea 3: creación de un objeto [StringBuilder] que contiene «test»: su capacidad inicial es 4 + 16 = 20 caracteres;
- línea 4: [length] es el número actual de caracteres; [capacity] es el número de caracteres que el objeto puede contener antes de tener que ampliar su arreglo;
- línea 6: [append] añade una cadena al final del texto;
- línea 10: creación de un objeto [StringBuilder] vacío con una capacidad inicial de 10, al que se añade de inmediato «test». El método [append] devuelve el propio objeto: puede llamarse directamente sobre el resultado del constructor.
Los resultados muestran que, cuando la capacidad es insuficiente, esta se duplica con un pequeño excedente: la nueva capacidad es la anterior multiplicada por 2, más 2 (20, 42, 86 para el primer objeto; 10, 22, 46 para el segundo). Cada cambio de tamaño asigna un nuevo arreglo y copia en él los caracteres. Si se conoce de antemano el tamaño aproximado del texto, indicarlo en el momento de la construcción evita estos cambios de tamaño sucesivos.
Estos son algunos de los métodos de la clase:
método | función |
[StringBuilder append(String str)] | añade [str] al final del texto. Está sobrecargado para aceptar los tipos [int], [double], [char], [boolean], [Object]… |
[StringBuilder insert(int offset, String str)] | inserta [str] en la posición [offset]; sobrecargado como [append] |
[StringBuilder delete(int start, int end)] | elimina los caracteres desde la posición [start] (inclusive) hasta [end] (exclusive); [deleteCharAt] elimina un solo carácter |
[StringBuilder replace(int start, int end, String str)] | reemplaza los caracteres desde la posición [start] (inclusive) hasta [end] (exclusive) por [str] |
[StringBuilder reverse()] | invierte el orden de los caracteres |
[void setCharAt(int index, char ch)] | reemplaza el carácter número [index] por [ch] |
[int indexOf(String str)] | posición de [str] en el texto, o -1 |
[String toString()] | convierte el texto en una cadena [String] |
El programa [Strings06.java] los utiliza:
Resultados:
Comentarios:
- Línea 4: los métodos de modificación devuelven el propio objeto [StringBuilder], lo que permite encadenarlos. Sigamos los pasos: «test» se convierte en «testabCD » ([append]), luego en «texyZTstabCD» ([insert] en la posición 2), después en «xyZTstabCD » ([delete] para los caracteres 0 y 1) y, por último, en "XYZTstabCD" ([replace] para los caracteres 0 y 1, con "XY"). Observe que, a diferencia del método [replace] de [String], el de [StringBuilder] no busca texto: reemplaza un rango de posiciones. [IO.println] muestra el objeto llamando a su método [toString];
- línea 6: [reverse] invierte el texto. Dado que [String] no tiene un método [reverse], esta es la forma estándar de invertir una cadena;
- líneas 9–12: construcción de un texto de varias líneas mediante adiciones sucesivas; este es el uso típico de [StringBuilder]. Las adiciones se encadenan en una sola línea de código;
- línea 14: [StringBuilder] no tiene un equivalente de [join]: se añade el resultado de [String.join];
- línea 17: se añade una cadena formateada. La conversión [%f] requiere un número real: pasar el entero [total] lanzaría en tiempo de ejecución una excepción [IllegalFormatConversionException], de ahí la conversión [(double) total];
- línea 19: el texto final se obtiene como una cadena [String];
- líneas 24–28: la clase [java.util.StringJoiner] construye una cadena formada por elementos separados por un separador, con un prefijo y un sufijo opcionales. [String.join] cumple la misma función, sin prefijo ni sufijo.
Para unas pocas concatenaciones, el operador [+] es suficiente: el compilador las optimiza. [StringBuilder] es necesario cuando el número de adiciones es grande o desconocido, típicamente dentro de un bucle: la concatenación [s = s + ...] en un bucle de n iteraciones crea n cadenas y copia toda la cadena construida previamente en cada iteración. En código antiguo se encuentra la clase [StringBuffer], que tiene los mismos métodos que [StringBuilder] pero los hace utilizables simultáneamente por varios hilos, a costa de cierta sobrecarga de rendimiento: hoy se prefiere [StringBuilder] en lugar de ella.
5.2.6. Análisis de una cadena sin copiarla
Cada llamada a [substring] crea una nueva cadena en memoria. En el código crítico para el rendimiento (como el análisis de archivos grandes o de solicitudes de red), puede interesar evitar estas creaciones. Java no tiene integrado en el lenguaje un tipo de «vista de un segmento de cadena», pero varios métodos operan sobre una porción de una cadena sin copiarla. El programa [Strings07.java] compara las dos formas de analizar una línea con el formato «apellido:nombre:edad»:
Resultados:
Comentarios:
- líneas 8–9: cada llamada a [substring] crea una nueva cadena, aunque, como en el caso de la edad, solo se use por un instante;
- línea 13: una versión sobrecargada de [Integer.parseInt] (Java 9) analiza los caracteres entre dos posiciones de la cadena, en la base especificada (aquí 10), sin crear una subcadena;
- línea 15: [regionMatches], que ya hemos visto, compara una porción de la cadena con otra cadena sin copiarla;
- línea 19: [CharBuffer.wrap] (paquete [java.nio]) devuelve una vista de los caracteres desde 0 hasta [p1] - 1 de la cadena: un objeto que no contiene una copia de los caracteres, pero ofrece una forma de acceder a ellos. Implementa la interfaz [CharSequence], al igual que [String] y [StringBuilder]: muchos métodos de Java aceptan un [CharSequence] ([String.join], [contains], [append]y las expresiones regulares, por ejemplo);
- línea 24: una versión sobrecargada de [indexOf] (Java 21) limita la búsqueda a un rango de posiciones;
- línea 27: una cadena se crea solo si realmente es necesaria.
Estas técnicas son herramientas de optimización: para un programa corriente, [substring] funciona perfectamente bien. Desde Java 9, la máquina virtual también almacena las cadenas que contienen solo caracteres del conjunto Latin-1 (como es el caso del texto en francés) con un byte por carácter en lugar de dos («cadenas compactas»), lo que reduce a la mitad la memoria que ocupan. Solo intentaremos evitar las copias en el código cuya criticidad para el rendimiento se haya medido.
5.3. Arreglos
5.3.1. La clase Arrays
Los arreglos de Java son objetos, pero no tienen métodos útiles: aparte del campo [length], todas las operaciones sobre arreglos son métodos estáticos de la clase de utilidad [java.util.Arrays]. Estos métodos permiten ordenar un arreglo, buscar un elemento en él, copiarlo, llenarlo, etc. Casi todos están sobrecargados: hay una versión para cada tipo primitivo ([int[]], [double[]], [char[]]…) y una versión para arreglos de objetos.
método | función |
[static int binarySearch(int[] a, int key)] | devuelve la posición de [key] en [a], que debe estar ordenado; un número negativo si [key] no está |
[static int[] copyOf(int[] original, int newLength)] | devuelve un nuevo arreglo de [newLength] elementos que contiene los primeros elementos de [original], completado con ceros si es necesario ([false] para los booleanos, [null] para las referencias) |
[static int[] copyOfRange(int[] original, int from, int to)] | devuelve un nuevo arreglo formado por los elementos desde [from] (inclusive) hasta [to] (exclusive) |
[static boolean equals(int[] a, int[] a2)] | devuelve [true] si ambos arreglos tienen los mismos elementos en el mismo orden |
[static void fill(int[] a, int val)] | asigna [val] a todos los elementos de [a]; una sobrecarga llena solo un rango de índices |
[static void sort(int[] a)] | ordena [a] según el orden natural de sus elementos; una sobrecarga ordena solo un rango de índices; para un arreglo de objetos, una sobrecarga recibe un [Comparator] que define el orden (Capítulo 4) |
[static String toString(int[] a)] | devuelve los elementos del arreglo como una cadena [[e1, e2, ...]]; [deepToString] hace lo mismo con un arreglo de arreglos |
[static <T> List<T> asList(T... a)] | devuelve una lista que es una vista del arreglo de objetos [a] |
[static IntStream stream(int[] array)] | devuelve un flujo (stream) con los elementos del arreglo (véase la sección API Stream más adelante) |
Además, existe el método [System.arraycopy(source, sourceStart, destination, destinationStart, count)], que copia elementos de un arreglo a otro arreglo ya existente.
El programa [Arrays01.java] ilustra el uso de algunos métodos de la clase [Arrays]:
Comentarios:
- Líneas 18–42: el método [input] ingresa los elementos de un arreglo escritos desde el teclado. Como el número de elementos no se conoce de antemano, el programa parte de un arreglo vacío (línea 20) y lo amplía en un elemento por cada nueva entrada (línea 37). El tamaño de un arreglo de Java es fijo desde su creación: [Arrays.copyOf] en realidad crea un nuevo arreglo, un elemento más grande, y copia en él los elementos del anterior. Un algoritmo más eficiente reservaría espacio en grupos de N elementos. Un arreglo no está diseñado para ampliarse: este escenario se resuelve mejor con una lista [ArrayList], como veremos en breve;
- línea 39: el último elemento de un arreglo tiene el índice [length - 1];
- líneas 30–35: la conversión de la cadena ingresada a un número real mediante [Double.parseDouble], que lanza una excepción [NumberFormatException] si la cadena no es un número. [Double.parseDouble] no depende del idioma del sistema: siempre espera un punto decimal y rechaza la entrada «3,6» (línea 5 de los resultados);
- líneas 53–75: el método [search] busca en el arreglo los caracteres escritos en el teclado. Para un arreglo sin ordenar se realiza una búsqueda lineal (línea 71), que examina los elementos uno por uno. La clase [Arrays] no tiene un método llamado [indexOf]: lo escribimos nosotros (líneas 78–85). Para un arreglo ordenado, se realiza una búsqueda binaria mediante [Arrays.binarySearch] (línea 70), que reduce a la mitad el rango de búsqueda en cada paso: encuentra un elemento entre un millón en unas veinte comparaciones;
- línea 10: se ordena el arreglo. Aquí se usa una variante de [sort] que tiene un solo parámetro: el arreglo que se va a ordenar. La relación de orden utilizada para comparar los elementos del arreglo es entonces la implícita de esos elementos: en este caso, el orden natural de los números;
- Líneas 45–50: visualización de un arreglo. [IO.println] muestra un [double] con punto decimal, sea cual sea el idioma de la máquina, y siempre con al menos un decimal: -7 se muestra como -7.0;
- líneas 88–91: [IO.readln] (Java 25) muestra un mensaje de entrada y luego lee una línea escrita en el teclado; devuelve [null] si la entrada estándar se ha agotado, por ejemplo cuando proviene de un archivo;
- línea 94: una enumeración, declarada en el archivo fuente compacto igual que los métodos.
Resultados:
Cuando el elemento buscado no está, el método [indexOf] devuelve -1 y [binarySearch] devuelve un número negativo (línea 27): este es [-(p + 1)], donde p es la posición en la que habría que insertar el elemento para mantener el arreglo ordenado. Aquí, -3 = -(2 + 1): el número 0 debería insertarse en la posición 2, entre -1.5 y 3.6. Nota: [binarySearch] sobre un arreglo sin ordenar devuelve un resultado sin sentido.
5.3.2. Otros métodos de la clase Arrays
El programa [Arrays02.java] muestra otros métodos de la clase [Arrays]:
Resultados:
Comentarios:
- Línea 4: [Arrays.toString] muestra un arreglo en una sola línea. Mostrar un arreglo directamente con [IO.println(numbers)] produciría un texto similar a [[I@1b6d3586]]: el tipo ([[I]], arreglo de enteros) y un identificador de objeto, sin sus elementos;
- línea 7: solo se ordenan los elementos con índices del 1 al 3, con el segundo índice excluido: 10, 30, 20 se convierten en 10, 20, 30;
- línea 12: copia los 3 primeros elementos de [numbers] al principio de [copy], mientras que los demás elementos conservan su valor inicial de 0;
- líneas 15–16: [copyOf] y [copyOfRange] crean un nuevo arreglo. Un arreglo más largo que el original se completa con ceros;
- líneas 19–22: [fill] llena el arreglo y luego restablece a 0 los elementos de los índices 1 y 2 (excluyendo el 3);
- líneas 25–27: igual que con las cadenas, el operador [==] compara las referencias de dos arreglos, no su contenido: hay que usar [Arrays.equals];
- línea 31: [Arrays.asList] devuelve una [List] (que se presenta en la sección siguiente), que es una vista de un arreglo de objetos: no copia el arreglo, sino que da acceso a él mediante los métodos de lista. Esto proporciona [indexOf] y [lastIndexOf] (línea 32);
- línea 35: el método [Collections.reverse] invierte el orden de los elementos de una lista. Como la lista es una vista del arreglo, es el propio arreglo el que se invierte (línea 11 de los resultados). La clase [Arrays] no tiene un método de inversión; este procedimiento se aplica solo a arreglos de objetos, no a arreglos de tipos primitivos como [int[]];
- línea 40: un arreglo de cadenas se ordena según el orden del método [compareTo] descrito anteriormente, es decir, por códigos de caracteres: las letras mayúsculas (códigos 65 a 90) van antes que las minúsculas (97 a 122), que van antes que las letras acentuadas (é: 233). «Zoé» es la primera palabra y «éclair» es la última;
- línea 43: para ordenar según las reglas del francés, se pasa un objeto de tipo [Collator], que compara cadenas, a [sort];
- Líneas 47–50: Java no tiene arreglos rectangulares bidimensionales: [new int[2][3]] crea un arreglo de 2 elementos, cada uno de los cuales es un arreglo de 3 enteros. [matrix.length] es el número de filas, y [matrix[0].length] es el número de elementos de la fila 0. [Arrays.deepToString] muestra un arreglo de arreglos.
La API Stream, que veremos más adelante, ofrece otras formas de buscar, ordenar o transformar los elementos de un arreglo, por ejemplo, [Arrays.stream(numbers).sum()].
5.4. Colecciones
Además de los arreglos, Java ofrece diversas clases para almacenar colecciones de elementos. Estas forman el Collections Framework en el paquete [java.util], que se introdujo en Java 1.2 y se hizo genérico en Java 5. Está organizado en torno a interfaces, que describen lo que hace una colección, y clases que las implementan, cada una a su manera:
interfaz | función | Implementaciones principales |
[List<E>] | una secuencia ordenada de elementos, accesibles por su posición | [ArrayList], [LinkedList] |
[Set<E>] | un conjunto: sin duplicados | [HashSet], [LinkedHashSet], [TreeSet] |
[Map<K,V>] | un diccionario: pares (clave, valor), donde las claves son únicas | [HashMap], [LinkedHashMap], [TreeMap] |
[Deque<E>] | una cola de doble extremo, utilizable como cola o como pila | [ArrayDeque], [LinkedList] |
[Queue<E>] | una cola | [ArrayDeque], [PriorityQueue] |
Las interfaces [List], [Set] y [Queue] derivan de la interfaz [Collection<E>] ([size], [isEmpty], [contains], [add], [remove], [clear]…), que a su vez deriva de [Iterable<E>], la interfaz de los objetos que se pueden recorrer mediante un bucle [for]. La buena práctica consiste en declarar las variables y los parámetros con el tipo de la interfaz y usar el nombre de la clase solo en el momento de la creación: [List<String> cities = new ArrayList<>();]. Esto permite cambiar la implementación sin modificar el resto del código.
Una colección de Java contiene únicamente objetos. Los genéricos de Java no admiten tipos primitivos: no se escribe [List<int>] sino [List<Integer>], donde [Integer] es la clase contenedora (wrapper) del tipo [int] (de igual modo, [Double] para [double], [Boolean] para [boolean]…). El compilador convierte automáticamente un [int] en [Integer] durante una asignación («autoboxing») y un [Integer] en un [int] durante una lectura («unboxing»). Esta conversión tiene un costo en memoria y en tiempo: una lista de un millón de enteros contiene un millón de objetos [Integer]. Para grandes volúmenes de números, es preferible usar un arreglo [int[]] o los flujos primitivos ([IntStream]) introducidos con la API Stream.
El paquete [java.util] también contiene las colecciones de Java 1.0: [Vector] (una lista), [Hashtable] (un diccionario) y [Stack] (una pila). Estas ahora son obsoletas: como están sincronizadas en cada operación, son más lentas que sus reemplazos [ArrayList], [HashMap] y [ArrayDeque]. No deben usarse más en código nuevo. De igual modo, evite los «tipos sin procesar» (raw types), es decir, las colecciones genéricas utilizadas sin parámetros de tipo ([List list = new ArrayList();]), como se hacía antes de Java 5: el compilador ya no puede verificar el tipo de los elementos añadidos y emite una advertencia en cada uso.
5.4.1. La interfaz List y la clase ArrayList
La clase [java.util.ArrayList<E>] implementa una lista de objetos de tipo [E] cuyo tamaño varía durante la ejecución del programa. Almacena sus elementos en un arreglo interno cuyo tamaño ajusta automáticamente, al igual que [StringBuilder]. El elemento i de una lista [l] se obtiene con [l.get(i)] y se modifica con [l.set(i, value)].
Estos son algunos de los métodos de la interfaz [List<E>]:
método | función |
[int size()] | número de elementos de la lista |
[boolean add(E e)] | añade [e] al final de la lista |
[void add(int index, E element)] | inserta [element] en la posición [index] de la lista |
[boolean addAll(Collection<? extends E> c)] | añade los elementos de [c] al final de la lista |
[E get(int index)], [E set(int index, E element)] | lee y reemplaza el elemento número [index] |
[E getFirst()], [E getLast()] | el primer y el último elemento (Java 21) |
[void clear()] | elimina todos los elementos de la lista |
[boolean contains(Object o)] | devuelve [true] si [o] está en la lista, [false] en caso contrario |
[int indexOf(Object o)] | devuelve la posición de [o] en la lista, o -1 si [o] no se encuentra; [lastIndexOf] devuelve la última posición |
[boolean remove(Object o)] | elimina la primera aparición de [o]; devuelve [true] si la operación tiene éxito, [false] en caso contrario |
[E remove(int index)] | elimina el elemento número [index] y lo devuelve |
[List<E> subList(int from, int to)] | devuelve una vista de los elementos desde [from] (inclusive) hasta [to] (exclusive) |
[void sort(Comparator<? super E> c)] | ordena la lista según el orden definido por [c]; [sort(null)] usa el orden natural de los elementos |
[<T> T[] toArray(IntFunction<T[]> generator)] | devuelve los elementos de la lista como un arreglo (Java 11) |
[static <E> List<E> of(E... elements)] | crea una lista inmutable que contiene los elementos dados (Java 9) |
La clase de utilidad [java.util.Collections] complementa estos métodos, del mismo modo que [Arrays] lo hace para los arreglos: [sort], [binarySearch], [reverse], [shuffle], [max], [min]…
Retomemos el ejemplo que vimos antes con un arreglo y procesémoslo ahora con un objeto de tipo [ArrayList<Double>]. Como una lista es similar a un arreglo, el código cambia muy poco. Este es el programa [Collections01.java]:
Comentarios:
- línea 22: la lista se crea vacía. El operador diamante [<>] (Java 7) evita repetir el tipo de los elementos: el compilador lo infiere a partir del tipo de la variable;
- línea 39: ya no hace falta gestionar la ampliación de la lista; esta se amplía automáticamente. El valor [element], de tipo [double], se convierte automáticamente en un objeto [Double];
- línea 6: el número de elementos de la lista. A diferencia de [StringBuilder], [ArrayList] no permite conocer su capacidad; el método [ensureCapacity] solo permite fijarla de antemano;
- líneas 12, 70, 71: la ordenación y la búsqueda binaria se realizan mediante los métodos estáticos [Collections.sort] y [Collections.binarySearch]; la búsqueda lineal, mediante el método [indexOf] de la lista, que los arreglos no tenían;
- Líneas 45–50: el método genérico [display] acepta dos parámetros:
- el primero es el texto que se va a escribir;
- el segundo es un objeto que implementa la interfaz genérica [java.lang.Iterable<T>], cuyo único método abstracto es [Iterator<T> iterator()].
El bucle [for (T element : elements)] es válido para cualquier objeto [elements] que implemente la interfaz [Iterable<T>], así como para los arreglos. Todas las colecciones implementan [Iterable]; los arreglos, en cambio, no la implementan, y el método [display] no es adecuado para un arreglo: por eso no lo usamos en [Arrays01.java]. Retomaremos esta interfaz con la API Stream.
Resultados:
Los resultados son los mismos que con el arreglo.
5.4.2. Métodos de la interfaz List
El programa [Collections02.java] utiliza los demás métodos de la interfaz [List]:
Resultados:
Comentarios:
- línea 4: [List.of(...)] (Java 9) crea una lista de solo lectura (véase más adelante); se copia en un [ArrayList], que admite escritura. Esta es la forma más corta de inicializar una lista con valores;
- Líneas 8–10: tres formas de añadir elementos;
- línea 14: el elemento número 0 se reemplaza mediante [set];
- línea 15: [get] lee un elemento; [getLast] (Java 21) devuelve el último elemento, que antes había que escribir como [cities.get(cities.size() - 1)];
- línea 22: [remove] devuelve [true] si el elemento se encontró y se eliminó;
- línea 27: las cadenas se ordenan en su orden natural, el de [compareTo];
- línea 31: [subList] devuelve una vista de los elementos 1 y 2 (excluyendo el 3), no una copia: modificar la vista modificaría la lista;
- líneas 35–36: conversión de una lista a un arreglo, y de un arreglo a una lista. El parámetro de [toArray] es una referencia a constructor [String[]::new], que la lista utiliza para crear un arreglo de cadenas del tamaño correcto. Las referencias a métodos y a constructores se tratarán en el Capítulo 7;
- Líneas 41–43: una trampa con las listas de enteros. La interfaz [List] tiene dos métodos [remove]: [remove(int index)] elimina por posición, y [remove(Object o)] elimina por valor. Para una [List<Integer>], [numbers.remove(1)] llama al primero y elimina el elemento número 1 (el valor 20). Para eliminar el valor 1, hay que pasar un objeto [Integer]: [numbers.remove(Integer.valueOf(1))];
- líneas 47–48: [clear] vacía la lista; [isEmpty] comprueba si está vacía;
- línea 51: el tipo [List<?>] denota una lista de elementos de cualquier tipo («comodín» o wildcard, Capítulo 4): el método [display] acepta una [List<String>] igual que aceptaría una [List<Integer>]. Una colección se muestra directamente: su método [toString] devuelve sus elementos entre corchetes.
5.4.3. La interfaz Map y la clase HashMap
La clase [java.util.HashMap<K,V>] permite implementar un diccionario. Un diccionario puede verse como una tabla de dos columnas:
clave | valor |
clave1 | valor1 |
clave2 | valor2 |
... | ... |
En la interfaz [Map<K,V>], las claves son de tipo [K] y los valores son de tipo [V]. Las claves son únicas: no puede haber dos claves idénticas (según lo define el método [equals]). Un diccionario así podría tener este aspecto si los tipos [K] y [V] hicieran referencia a clases:
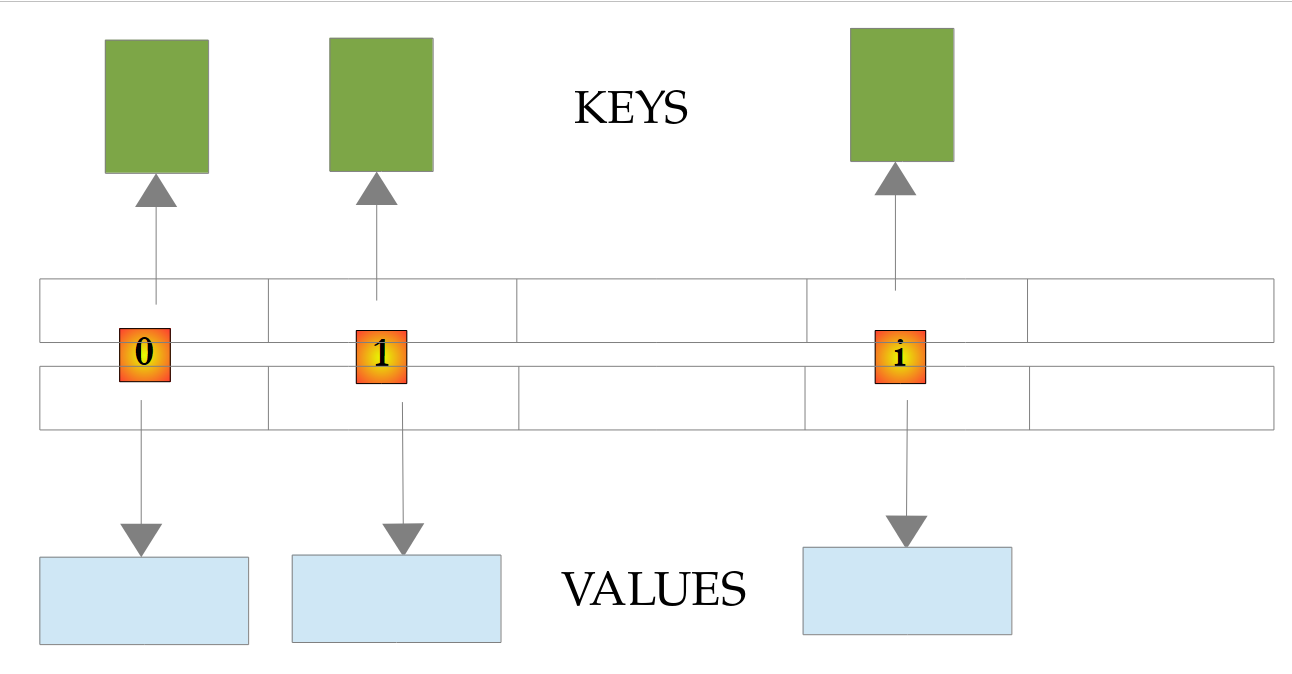
Un [HashMap] almacena sus pares clave-valor en una tabla hash: la posición de un par clave-valor en la tabla se calcula a partir del código hash de su clave (método [hashCode], Capítulo 4). Por ello, recuperar el valor asociado a una clave es muy rápido, sea cual sea el tamaño del diccionario. Sin embargo, el orden de los pares clave-valor en la tabla no guarda relación con el orden en que se añadieron.
Los principales métodos de la interfaz [Map<K,V>] son los siguientes:
método | función |
[int size()] | número de pares (clave, valor) del diccionario |
[V put(K key, V value)] | asocia [value] con [key]: añade el par si la clave no existe; en caso contrario, reemplaza el valor; devuelve el valor anterior, o [null] |
[V putIfAbsent(K key, V value)] | añade el par clave-valor solo si la clave no existe; devuelve el valor existente, o [null] |
[V get(Object key)] | devuelve el valor asociado a [key], o [null] si la clave no existe |
[V getOrDefault(Object key, V defaultValue)] | igual que el anterior, pero devuelve [defaultValue] si la clave no existe |
[boolean containsKey(Object key)] | devuelve [true] si [key] es una clave del diccionario; [containsValue] comprueba un valor |
[V remove(Object key)] | elimina el par clave-valor [key] y devuelve su valor, o [null] |
[Set<K> keySet()] | todas las claves del diccionario |
[Collection<V> values()] | la colección de valores del diccionario |
[Set<Map.Entry<K,V>> entrySet()] | el conjunto de pares clave-valor del diccionario; un par [Map.Entry] tiene los métodos [getKey] y [getValue] |
[V merge(K key, V value, BiFunction<...> remappingFunction)] | añade el par si la clave no existe; en caso contrario, reemplaza el valor por la combinación del valor anterior y [value] |
[void clear()] | elimina todas las entradas del diccionario |
Consideremos el programa de ejemplo [Collections03.java]:
Comentarios:
- línea 4: un arreglo de cadenas que se usará para inicializar el diccionario <String,Integer>;
- línea 5: el diccionario, que está vacío;
- líneas 6–9: su inicialización mediante el arreglo de cadenas;
- línea 11: el número de pares clave-valor del diccionario;
- líneas 13–15: las claves y los valores del diccionario. [dico.keySet()] y [dico.values()] son colecciones, por tanto [Iterable]: el método [display] que ya hemos visto funciona aquí;
- línea 23: eliminación de un par del diccionario;
- Líneas 26–28: un diccionario no es en sí mismo una colección, pero [entrySet] devuelve el conjunto de sus pares clave-valor, que son de tipo [Map.Entry<K,V>]. Este enfoque es más eficiente que el de las líneas 18–20, que busca el valor de cada clave mediante [get];
- líneas 30–31: [put] añade un par o reemplaza el valor de una clave existente, sin excepción ni advertencia; el valor devuelto, ya sea el valor anterior o [null], indica lo que ocurrió;
- líneas 33–34: [putIfAbsent] no reemplaza el valor de una clave existente;
- líneas 36–37: leer una clave inexistente no provoca un error: [get] devuelve [null]. [getOrDefault] permite elegir el valor devuelto en este caso, y [containsKey] permite comprobar si una clave existe;
- Líneas 39–40: [merge] añade la clave «léa» con el valor 1 y suma 1 al valor de la clave «zoé», que ya existe. El tercer parámetro es la función que combina los valores anterior y nuevo (en este caso, la suma de dos enteros), pasada como referencia a método [Integer::sum] (Capítulo 7). Esta es la forma estándar de contar ocurrencias: [counters.merge(word, 1, Integer::sum)];
- líneas 51–56: búsqueda de una clave en el diccionario. [get] devuelve un [Integer], no un [int], porque debe poder devolver [null]: este caso se comprueba antes de usar el valor. Escribir [int age = dico.get(searchedName);] generaría una excepción [NullPointerException] para una clave inexistente durante la conversión automática de [null] a [int].
Resultados:
Las claves no se enumeran en el orden en que se añadieron, sino en el orden de la tabla hash, que depende de los códigos hash de las claves: un [HashMap] no garantiza ningún orden específico. Si el orden de las claves importa, se usa un [LinkedHashMap], que conserva el orden en que se añadieron, o un [TreeMap], que mantiene las claves ordenadas: ambos se muestran más adelante.
5.4.4. Otras colecciones
El paquete [java.util] contiene otras colecciones, cada una adaptada a un uso específico:
clase | función |
[HashSet<E>] | un conjunto: sin duplicados, sin orden, con una prueba de pertenencia muy rápida; operaciones de conjuntos (unión [addAll], intersección [retainAll], diferencia [removeAll]) |
[LinkedHashSet<E>] | un conjunto que conserva el orden en que se añadieron sus elementos |
[TreeSet<E>] | un conjunto cuyos elementos se mantienen ordenados |
[ArrayDeque<E>] | una cola de doble extremo: cuando se usa como cola, los elementos se extraen en el orden en que se añadieron (FIFO, first in first out, el primero en entrar es el primero en salir); cuando se usa como pila, el último elemento añadido es el primero en extraerse (LIFO, last in first out) |
[LinkedHashMap<K,V>] | un diccionario que conserva el orden en que se añadieron sus claves |
[TreeMap<K,V>] | un diccionario cuyas claves se mantienen ordenadas |
[PriorityQueue<E>] | una cola de prioridad: el elemento que se extrae es el menor según el orden de la cola |
[LinkedList<E>] | una lista doblemente enlazada: inserciones y eliminaciones rápidas en los extremos y durante el recorrido |
El programa [Collections04.java] ofrece una visión rápida:
Resultados:
Comentarios:
- línea 4: un conjunto inicializado con los elementos de una lista;
- línea 6: [add] devuelve [false] si el elemento ya está en el conjunto, que permanece sin cambios;
- Líneas 9–14: [retainAll] conserva solo los elementos presentes en la otra colección (intersección), mientras que [addAll] añade los de la otra colección (unión). Estos métodos modifican el conjunto: por eso se trabaja sobre una copia de [languages]. [Set.of] (Java 9) crea un conjunto inmutable. El orden en que se muestran los elementos de un [HashSet] no tiene ningún significado;
- línea 16: un
*[TreeSet]* construido a partir del conjunto muestra sus elementos ordenados; - líneas 19–24: [ArrayDeque] usado como cola: [offer] inserta un elemento al final de la cola, [poll] extrae el elemento más antiguo y [peek] obtiene un elemento sin extraerlo. Los operandos de la concatenación pasada a [IO.println] se evalúan de izquierda a derecha: [peek], luego los dos [poll], luego [size];
- líneas 27–32: [ArrayDeque] se usa como pila: [push] apila un elemento y [pop] desapila el elemento más reciente. La clase [Stack] de Java 1.0 ya no debe usarse;
- líneas 34–40: en una pila vacía, [pop] lanza una excepción [NoSuchElementException], mientras que [poll] devuelve [null]. Así, la mayoría de las operaciones de [Deque] existen en dos versiones: una lanza una excepción ([push], [pop], [getFirst]…), mientras que la otra devuelve un valor especial ([offer], [poll], [peek]…);
- líneas 43–48: los pares de un [TreeMap] se enumeran en el orden de las claves;
- líneas 50–54: los de un [LinkedHashMap] se enumeran en el orden en que se añadieron;
- líneas 57–67: un [PriorityQueue] necesita poder comparar sus elementos. Aquí se le pasa un [Comparator] que compara prioridades: [Comparator.comparingInt(Emergency::priority)] se lee «comparar las urgencias según el valor entero devuelto por su método [priority]». Los pacientes salen de la cola en orden de prioridad creciente, sea cual sea su orden de llegada. El bucle se detiene cuando [poll] devuelve [null], lo que indica que la cola está vacía;
- líneas 71–72: un paciente se representa mediante un [record] (Capítulo 4).
5.4.5. Colecciones inmutables
Una clase que administra una colección suele necesitar exponerla al exterior sin permitir que se modifique. Java no tiene una interfaz «de solo lectura» distinta de [List]: una colección no modificable implementa la interfaz [List] completa, pero sus métodos de modificación ([add], [remove], [set]…) lanzan una excepción [UnsupportedOperationException]. Hay dos tipos:
- vistas no modificables, obtenidas mediante [Collections.unmodifiableList(list)] ([unmodifiableSet], [unmodifiableMap]…): no copian la colección, pero impiden que los destinatarios la modifiquen;
- Las colecciones de solo lectura creadas mediante [List.of(...)], [Set.of(...)], [Map.of(...)] (Java 9), o copiadas mediante [List.copyOf(collection)] (Java 10): su contenido queda fijado de una vez por todas.
El programa [Collections05.java] las utiliza:
Resultados:
Comentarios:
- líneas 44–61: la clase [Classroom] administra una lista de estudiantes. La lista en sí es privada; solo el método [enroll] permite modificarla;
- líneas 49–51: el método [getStudents] devuelve una vista de solo lectura de la lista. Devolver la propia lista [students] permitiría al código externo modificarla sin que la clase lo sepa.
- líneas 10–14: la vista tiene todos los métodos de
*[List]*, y***[students.add("intruder")]** es aceptado por el compilador; la excepción*[UnsupportedOperationException]se lanza en tiempo de ejecución; - línea 15: la clase real de la vista es una clase interna de [Collections], que solo se conoce a través de la interfaz [List];
- líneas 17–18: la vista no copia la lista; ve los cambios realizados por la clase propietaria;
- líneas 54–56 y 21–23: [List.copyOf], en cambio, devuelve una copia de solo lectura: la lista [copy] no ve la adición de «petit»;
- líneas 26–33: [Map.of] crea un diccionario de solo lectura a partir de pares clave-valor;
- líneas 35–40: las colecciones creadas mediante [of] y [copyOf] rechazan el valor [null], lo que provoca una [NullPointerException] inmediatamente al crearlas.
Por tanto, el tipo de una variable como [List<String>] no indica si la lista es mutable: corresponde a la documentación del método que la devuelve especificarlo. Una buena práctica habitual es devolver colecciones inmutables y crear una nueva colección siempre que se quiera modificar una. Los [record], cuyos campos son de solo lectura, encajan bien con esta práctica: [record Classroom(String name, List<String> students)] se beneficia de copiar su lista en su constructor mediante [List.copyOf].
5.4.6. Ordenación, iteración y colecciones secuenciadas
El programa [Collections06.java] muestra tres aspectos útiles del trabajo con colecciones: escribir un [Comparator], las colecciones secuenciadas de Java 21 y la eliminación de elementos durante una iteración:
Resultados:
Comentarios:
- Línea 8: el método [sort] de una lista recibe un [Comparator], un objeto que compara dos elementos (Capítulo 4). El método estático [Comparator.comparing] construye un comparador a partir de una función que extrae una clave de cada elemento; en este caso, el nombre ([Student::name] hace referencia al método [name] del record). Los nombres se comparan según el orden natural de las cadenas: «Durand», que empieza con mayúscula, va primero, y «élise» va al final;
- línea 10: un segundo parámetro especifica cómo comparar las claves (en este caso, mediante [Collator]), con un orden que sigue el de un diccionario francés;
- líneas 12–13: los comparadores se definen de la siguiente manera: [comparingInt] compara las notas, [reversed] invierte el orden (notas en orden descendente) y [thenComparing] añade un criterio secundario que sirve para desempatar a los estudiantes con la misma nota: los nombres, sin distinguir mayúsculas de minúsculas ([String.CASE_INSENSITIVE_ORDER]). Durand y Martin, que tienen ambos una nota de 15, se ordenan por nombre;
- Líneas 17–25: Java 21 introdujo las colecciones secuenciadas: las interfaces [SequencedCollection], [SequencedSet] y [SequencedMap], implementadas por las colecciones cuyos elementos tienen un orden definido ([List], [Deque], [LinkedHashSet], [TreeSet], [LinkedHashMap], [TreeMap]…). Comparten métodos comunes para acceder a ambos extremos: [getFirst], [getLast], [addFirst], [addLast], [removeFirst], [removeLast] ([firstEntry], [lastEntry]… para un diccionario) y el método [reversed], que devuelve una vista de la colección en orden inverso sin copiarla. Antes, obtener el último elemento de un [LinkedHashSet] requería recorrer toda la colección;
- líneas 28–37: no se debe modificar una colección mientras se itera sobre ella con un bucle [for]: el iterador que usa el bucle detecta la modificación y lanza una excepción [ConcurrentModificationException] en el siguiente elemento. La prueba se realiza sobre una copia de la lista;
- líneas 39–44: el enfoque correcto consiste en escribir explícitamente el bucle con un [Iterator] (presentado con la API Stream) y eliminar el elemento actual mediante el método [remove] del iterador;
- línea 47: de forma más sencilla, el método [removeIf] (Java 8) elimina los elementos que cumplen una condición, expresada mediante una función anónima (lambda) [student -> student.grade() < 15], que se lee «la función que asocia a un estudiante el booleano [student.grade() < 15]». Las lambdas se estudiarán en detalle en el Capítulo 7; por ahora, basta con saber leerlas. Las encontraremos en cada línea de la sección siguiente;
- línea 50: el método
*[forEach]* de cualquier colección ejecuta una lambda para cada elemento; - líneas 63–64: llamar al método [toString] de un [record] devuelve el nombre del record y los valores de sus componentes: [Student[name=Durand, grade=15]].
5.5. La API Stream
La API Stream (paquete [java.util.stream], Java 8) es un conjunto de métodos que permiten procesar los elementos de una colección como si se consultara una base de datos: filtrar, ordenar, agrupar, calcular totales, etc. Un flujo [Stream<T>] es una secuencia de elementos de tipo [T] que se hacen pasar por una cadena de operaciones. Se obtiene a partir de una colección ([list.stream()]), un arreglo ([Arrays.stream(array)]), valores ([Stream.of(1, 2, 3)]), las líneas de un archivo ([Files.lines(path)]), las coincidencias de una expresión regular y, con Hibernate (Capítulo 11), las filas de una tabla de una base de datos.
Estos flujos no deben confundirse con los flujos de entrada y salida ([InputStream], [OutputStream]) que encontraremos con los archivos: son dos conceptos sin relación.
5.5.1. Las interfaces Iterable e Iterator
Antes de presentar los flujos, retomemos la interfaz [Iterable<T>], que se aplica a los objetos sobre los que se itera mediante un bucle [for]. Contiene un único método abstracto, [iterator], que devuelve un iterador [Iterator<T>]: un objeto que indica si quedan elementos ([hasNext]) y devuelve el siguiente elemento ([next]).
Un objeto [Iterable] no necesita contener sus elementos: su iterador puede generarlos uno por uno, a demanda. El programa [Streams01.java] ofrece un ejemplo de ello y presenta un flujo infinito:
Resultados:
Comentarios:
- líneas 34–64: el record [Evens] implementa la interfaz [Iterable<Integer>]: su método [iterator] devuelve un iterador que produce los números pares de 0 a [max]. No construye ninguna lista: simplemente almacena el siguiente número que se generará (línea 41);
- línea 39: el iterador es una clase anónima, una clase sin nombre, declarada e instanciada en una sola expresión [new Iterator<>() { ... }], que implementa los dos métodos de la interfaz. Tiene acceso al componente [max] del record;
- líneas 44–50: [hasNext] indica si hay un elemento más por generar;
- líneas 53–61: [next] produce el siguiente elemento. Cuando se llama después de que ya no quedan elementos, debe lanzar una [NoSuchElementException];
- líneas 5–7: los resultados (líneas 3–12) muestran que la producción de un elemento por el iterador y su consumo por el bucle [for] se alternan;
- líneas 11–15: lo que realmente hace el bucle [for]: solicita un iterador al objeto, llama a [hasNext] mientras ese método devuelva [true] y obtiene cada elemento mediante [next];
- líneas 19–22: una secuencia infinita, la sucesión de Fibonacci. [Stream.iterate(seed, function)] produce la semilla, luego el resultado de la función aplicada a la semilla, luego el resultado de la función aplicada a ese resultado, y así sucesivamente. Cada elemento aquí es un arreglo de dos números consecutivos de la sucesión; [map] conserva solo el primero, [takeWhile] detiene el flujo en el primer número mayor que 100 y [forEach] muestra cada número. El flujo completo nunca se calcula; solo se calculan los elementos solicitados;
- Líneas 26–30: una lista es [Iterable]. Una cadena no lo es: no se puede iterar directamente sobre ella mediante [for]. Su método [chars] devuelve el flujo de sus caracteres como códigos enteros, que luego se convierten de nuevo en cadenas de un solo carácter, y [Collectors.joining("-")] las concatena con un separador. También se puede iterar sobre el arreglo devuelto por ["abc".toCharArray()].
Java no tiene una instrucción que permita definir un iterador como un simple método que produce sus elementos uno por uno ([yield return] en otros lenguajes): hay que implementar la clase del iterador, como se muestra aquí, o bien usar los métodos de creación de flujos ([Stream.iterate], [Stream.generate]), que también producen sus elementos a demanda. Este mecanismo de generación a demanda se utiliza en toda la API Stream.
5.5.2. Filtrar, proyectar, ordenar
Los ejemplos siguientes trabajan con una pequeña lista de personas. Una persona se representa mediante un [record] (Java 16), presentado en el Capítulo 4: en una sola línea obtenemos una clase con un constructor, métodos de acceso a los componentes ([p.lastName()], [p.age()]…), un método [toString] que muestra los componentes y un operador de igualdad que compara sus valores.
El programa [Streams02.java] muestra las operaciones básicas de la API Stream:
Resultados:
Comentarios:
- líneas 4–11: la lista de personas, que no se puede modificar, creada mediante [List.of];
- línea 55: el record [Person]. Un archivo fuente compacto coloca sus declaraciones de tipos junto a sus métodos;
- Línea 14: [persons.stream()] devuelve el flujo de elementos de la lista. El método [filter] filtra el flujo: conserva solo los elementos que cumplen una condición. Esta condición se le pasa en forma de una lambda [p -> p.age() >= 18], «la función que, para una persona p, devuelve el booleano [p.age() >= 18]». [filter] llama a esta función para cada persona;
- el resultado de [filter] es un nuevo flujo [Stream<Person>]: la lista [persons] permanece sin cambios. Esto se cumple para todas las operaciones de la API Stream;
- Líneas 49–52: el método [display] recorre el flujo mediante la operación [forEach] y muestra cada persona mediante el método [toString] del record: [Person[lastName=dupont, ...]];
- línea 18: el método [map] proyecta cada elemento del flujo sobre un nuevo valor, en este caso una cadena. El resultado es un flujo [Stream<String>];
- líneas 22–26: las operaciones devuelven flujos, a los que se pueden aplicar otras operaciones. Las operaciones suelen escribirse una por línea: esta cadena de llamadas se lee de arriba abajo como una receta. [Person::lastName] es una referencia a método, una notación abreviada de la lambda [p -> p.lastName()];
- línea 25: [sorted] sin parámetros ordena el flujo según el orden natural de sus elementos, en este caso cadenas;
- línea 26: [toList] (Java 16) coloca los elementos del flujo en una lista inmutable. También se encuentra la sintaxis más antigua [collect(Collectors.toList())], que en la práctica devuelve una lista mutable (un [ArrayList]), aunque la documentación no lo garantiza;
- Líneas 30–31: [sorted] acepta un [Comparator], construido como en [Collections06.java]: edad en orden descendente y luego nombre en orden ascendente para distinguir a las personas de la misma edad. Durand y Laurent, que tienen ambos 32 años, se ordenan por apellido (líneas 23–24 de los resultados);
- línea 35: los flujos no proporcionan las posiciones de sus elementos. Para numerarlos, se itera sobre los índices mediante un flujo de enteros [IntStream.range(0, 3)] (0, 1, 2; el 3 excluido) y se convierte cada índice en una cadena mediante [mapToObj];
- líneas 39–45: un flujo es de un solo uso: una vez recorrido por una operación terminal (aquí, [count], que cuenta los elementos), ya no se puede utilizar y provoca una [IllegalStateException]. Hay que solicitar un nuevo flujo a la colección.
Hay dos tipos de operaciones en un flujo: las operaciones intermedias ([filter], [map], [sorted]…) devuelven un nuevo flujo; las operaciones terminales ([forEach], [toList], [count], [collect]…) recorren el flujo y producen un resultado. Una cadena de operaciones siempre termina con una operación terminal. A diferencia de otros lenguajes, Java no tiene una sintaxis de consulta similar a SQL: el procesamiento siempre se escribe como una cadena de llamadas a métodos.
5.5.3. Cuantificadores, agregados, selección de elementos
El programa [Streams03.java] incluye operaciones que devuelven un único valor y operaciones que seleccionan una porción del flujo:
Resultados:
Comentarios:
- líneas 13–15: [anyMatch] devuelve [true] si al menos un elemento cumple la condición, [allMatch] si todos la cumplen y [noneMatch] si ninguno la cumple;
- líneas 18–19: [count] cuenta los elementos del flujo; para contar los que cumplen una condición, primero se filtra el flujo. Para una colección, el método [size] es obviamente preferible a [stream().count()];
- líneas 20–22: [mapToInt(Person::age)] transforma el flujo de personas en un [IntStream], un flujo de valores [int], que tiene métodos de cálculo: [sum], [average], [min], [max]. [average] devuelve un [OptionalDouble], porque el promedio de un flujo vacío no existe; [orElse(0)] proporciona el valor que se usará en ese caso;
- líneas 23–24: [summaryStatistics] calcula la cantidad, la suma, el mínimo, el promedio y el máximo en una sola pasada;
- líneas 26–28: [min] y [max], derivados de un [Stream], reciben un [Comparator] y devuelven el elemento mínimo o máximo (en este caso, la persona), en lugar del valor de la clave. El resultado es un [Optional<Person>]: una caja que contiene una persona, o una caja vacía si el flujo estaba vacío. [get] devuelve el contenido de la caja;
- líneas 31–34: [findFirst] devuelve el primer elemento del flujo, en un [Optional]; cuando está filtrado, el flujo devuelve el primer elemento que cumple una condición. Para el último elemento de una lista, basta con el método [getLast] de la lista;
- líneas 35–37: no hay nadie en Brest: [Optional] está vacío ([isPresent] devuelve [false]). En lugar de comprobarlo, lo transformamos: [map(Person::lastName)] transforma su contenido si lo hay; [orElse("nobody")] proporciona el valor que se usará si está vacío;
- líneas 38–43: [orElseThrow] devuelve el contenido del [Optional], o lanza una [NoSuchElementException] si está vacío. Se utiliza cuando la ausencia de un valor constituye un error. [get], usado antes, hace lo mismo, pero su nombre no indica que pueda lanzar una excepción; se prefiere [orElseThrow]. No existe ninguna operación que exija que un flujo tenga exactamente un elemento; se puede comprobar el tamaño de la lista devuelta por [toList];
- línea 46: [distinct] elimina los duplicados (según lo define el método [equals]);
- líneas 49–50: no hay una operación predefinida para conservar una persona por ciudad. Aquí usamos un conjunto de las ciudades que ya se han encontrado: [add] devuelve [true] para una ciudad nueva (la persona se conserva) y [false] para una ciudad que ya se ha encontrado. Una lambda que modifica una variable externa, como esta, debe reservarse para flujos procesados de forma secuencial, que es el comportamiento por defecto;
- líneas 54–58: [limit(n)] conserva los primeros n elementos, mientras que [skip(n)] los omite. Combinados, extraen una «página» de resultados. [takeWhile] (Java 9) conserva los elementos mientras una condición sea verdadera y se detiene en el primer elemento que no la cumple; [dropWhile] hace lo contrario: omite esos elementos y conserva todos los siguientes;
- Línea 61: la operación [gather] (Java 24) aplica un recolector intermedio («gatherer») al flujo, que puede agrupar, acumular o filtrar elementos en función de los elementos precedentes. La clase [Gatherers] ofrece varios de ellos; [Gatherers.windowFixed(3)] divide el flujo en listas de 3 elementos, y la última lista puede ser más corta. Hay otros, como [windowSliding(n)] (ventanas deslizantes), y también se pueden escribir recolectores propios.
5.5.4. Records locales, agrupaciones, uniones
El programa [Streams04.java] realiza operaciones más complejas, la mayoría de las cuales se llevan a cabo mediante la operación terminal [collect] y los recolectores de la clase [Collectors]:
Resultados:
Comentarios:
- Líneas 18–19: un record local (Java 16), declarado dentro del método donde se usa. Permite asignar un nombre y un tipo a los resultados intermedios de un procesamiento sin tener que declarar una clase en el programa: en la línea 23, cada persona mayor de 40 años se convierte en un [Summary] que conserva únicamente los datos pertinentes;
- líneas 28–29: el recolector [groupingBy] agrupa los elementos que tienen la misma clave, en este caso la ciudad. El resultado es un diccionario de tipo [Map<String, List<Person>>]: cada ciudad se asocia con una lista de sus habitantes. Sin otros parámetros, [groupingBy] crea un [HashMap], en el que el orden de las claves es impredecible; aquí le pedimos que cree un
*[LinkedHashMap]*(***[LinkedHashMap::new]***, referencia a constructor), que conserva las ciudades en el orden de su primera aparición. El tercer parámetro es el recolector que se aplica a los elementos de cada grupo, en este caso*[toList]*; - líneas 30–32: el método [forEach] de un diccionario recibe una lambda con dos parámetros: la clave y el valor. Para cada grupo, muestra su tamaño, su edad promedio y sus nombres; el recolector [Collectors.joining(", ")] concatena cadenas con un separador;
- líneas 36–40: la API Stream no tiene una operación de unión (join). Esta se logra mediante [flatMap], que reemplaza cada elemento por un flujo y luego concatena todos esos flujos: cada persona se reemplaza por el flujo de las ciudades que tienen el mismo nombre que la suya (una o ninguna), convertidas en cadenas. Como en una unión interna (inner join) de SQL, solo se conservan los pares coincidentes: Laurent, que vive en Lyon (ausente de la lista de ciudades), no aparece, y tampoco Brest, que no tiene habitantes. Este código recorre toda la lista de ciudades para cada persona;
- líneas 42–47: la misma unión, pero más eficiente: el recolector [toMap] construye un diccionario de ciudades, donde la clave es el nombre de la ciudad ([City::name]) y el valor es la propia ciudad ([v -> v]); luego se busca en este diccionario la ciudad de cada adulto. Una clave duplicada haría que [IllegalStateException] lanzara una excepción en [toMap];
- líneas 50–54: [toList] y [toMap] realizan el procesamiento y almacenan los resultados en una lista y en un diccionario, respectivamente;
- líneas 55–59: [partitioningBy] divide los elementos en dos grupos según una condición; el resultado es un diccionario cuyas claves son [true] y [false]. El recolector [mapping(Person::lastName, toList())] convierte cada persona en su nombre antes de añadirla a la lista de su grupo;
- líneas 62–68: el tercer parámetro de [groupingBy] puede ser cualquier recolector, aplicado a cada grupo: [counting] cuenta los elementos del grupo, [summingInt] suma un valor entero ([averagingInt] calcula el promedio, [maxBy] encuentra el máximo…). Con [TreeMap::new], las ciudades quedan ordenadas;
- líneas 72–73: la posición de cada elemento en un flujo filtrado: el flujo se almacena en una lista y luego se recorren los índices.
5.5.5. Evaluación diferida
Las operaciones intermedias de un flujo no se ejecutan cuando se escriben, sino cuando una operación terminal recorre el flujo: esto se denomina «evaluación diferida». El programa [Streams05.java] lo demuestra mediante expresiones lambda que muestran lo que hacen:
Resultados:
Comentarios:
- líneas 7–15: un flujo que conserva los números pares y luego calcula sus cuadrados. Aquí las lambdas se escriben con un cuerpo entre llaves, que muestra un mensaje antes de devolver su valor con [return];
- Línea 3 de los resultados: después de definir el flujo, no se mostró nada: ni [filter] ni [map] ha procesado todavía un solo elemento. [evenSquares] no contiene resultados, sino una descripción de un cálculo;
- Líneas 4–16 de los resultados: el cálculo se ejecuta durante la operación terminal [forEach], elemento por elemento: cada número pasa por [filter], luego por [map] si es par, y después llega a [forEach] antes de que se examine el siguiente número. No se construye ninguna lista intermedia;
- líneas 23–26: como un flujo solo puede recorrerse una vez, almacenamos en su lugar el medio para crearlo: una lambda sin parámetros [() -> numbers.stream().filter(...)], de tipo [Supplier<Stream<Integer>>], cuyo método [get] crea un flujo nuevo en cada llamada. El flujo creado después de agregar 10 toma en cuenta este nuevo elemento;
- líneas 29–31: [toList] ejecuta el procesamiento y almacena sus resultados: [snapshot] es una lista que no ve la adición de 20;
- líneas 35–42: [findFirst] detiene la iteración apenas encuentra un elemento: los números posteriores a 3 nunca se examinan. [anyMatch], [limit], [takeWhile]… detienen igualmente la iteración lo antes posible; esto es lo que permite procesar flujos infinitos;
- Líneas 46–49: algunas operaciones intermedias no pueden procesar los elementos uno por uno: [sorted] debe conocer todos los elementos para transmitir el menor. La operación [peek], que ejecuta una lambda sobre cada elemento a su paso sin modificarlo, muestra que [sorted] recibe los tres elementos antes de transmitir uno solo;
- líneas 52–55: los flujos primitivos [IntStream], [LongStream], y [DoubleStream] evitan la creación de objetos [Integer], [Long]y [Double]. [IntStream.rangeClosed(1, 10)] genera los enteros del 1 al 10 (incluido el 10). [boxed] convierte un [IntStream] en un [Stream<Integer>], y [asDoubleStream] lo convierte en un [DoubleStream]. Un [double] concatenado con una cadena se muestra con todos sus decimales y un punto decimal; para limitar el número de decimales se usaría [formatted].
La evaluación diferida tiene dos consecuencias prácticas:
- un flujo solo puede recorrerse una vez. Si el resultado de un cálculo se necesita varias veces, se almacena en una lista con [toList];
- las operaciones pueden encadenarse sin costo: encadenar [filter], [map]y [limit] no crea ninguna colección intermedia, y solo se calculan los elementos necesarios.
Por último, observe que el método [parallelStream] de una colección devuelve un flujo cuyos elementos son procesados simultáneamente por varios hilos (Capítulo 8). Solo acelera las operaciones costosas sobre grandes volúmenes de datos y exige lambdas sin efectos secundarios: debe usarse únicamente después de evaluar sus beneficios. Encontraremos la API de streams a lo largo del curso, y en el Capítulo 7 veremos cómo se construyen las interfaces funcionales que utiliza.
5.6. Archivos de texto
Java dispone de dos paquetes de API para archivos: el paquete [java.io], disponible desde Java 1.0 ([File], [FileReader], [FileInputStream]…), y el paquete [java.nio.file], introducido con Java 7 ([Path], [Files]…). Este último es más completo y ofrece mejores informes de errores: es el que debe usarse hoy. Se apoya en las clases de lectura y escritura de [java.io] ([BufferedReader], [BufferedWriter]…), que se obtienen mediante métodos de la clase [Files].
Un archivo se representa mediante un objeto [java.nio.file.Path], creado por [Path.of("infos.txt")] (Java 11). Una ruta relativa, como esta, se completa con el directorio actual del programa, es decir, aquel desde el que se lo lanzó.
Desde Java 18 (JEP 400), la codificación predeterminada de los archivos de texto es UTF-8, sea cual sea el sistema operativo. Antes dependía del sistema (a menudo Windows-1252 en Windows en francés), y un mismo programa podía interpretar el mismo archivo de manera distinta según la máquina. Los métodos de la clase [Files] ya usaban UTF-8 de forma predeterminada desde Java 8.
5.6.1. La clase BufferedReader
La clase [java.io.BufferedReader] permite leer el contenido de un archivo de texto línea por línea. En realidad, es capaz de procesar flujos que no son archivos (una conexión de red, por ejemplo). Lee el archivo por bloques, que almacena en un búfer: la mayor parte de las lecturas se realiza en memoria, sin acceder al disco.
Método | Rol |
[static BufferedReader Files.newBufferedReader(Path path)] | abre el archivo [path] para lectura en UTF-8; una sobrecarga permite especificar la codificación: [Files.newBufferedReader(path, StandardCharsets.ISO_8859_1)] |
[String readLine()] | devuelve la siguiente línea del flujo, sin el marcador de fin de línea, o [null] si se llegó al final del flujo |
[int read()] | devuelve el siguiente carácter del flujo, o -1 al final del flujo |
[Stream<String> lines()] | devuelve las líneas restantes como un flujo de la API de streams |
[void close()] | cierra el flujo y libera los recursos asignados para su gestión. Esto debe hacerse después de procesar el flujo, lo que se encarga de hacer la instrucción [try] con recursos |
El programa [Files01.java] es el siguiente:
Comentarios:
- línea 2: el método [main] recibe aquí los argumentos de la línea de comandos, en el arreglo [args];
- Línea 4: muestra el nombre de la carpeta actual, aquella desde la que se lanzó el comando [java]. [Path.of("")] designa la carpeta actual; [toAbsolutePath] la convierte en una ruta completa, de la cual [getFileName] conserva solo el último elemento, para no saturar los resultados con una ruta completa;
- línea 6: el archivo que se lee es [infos.txt] o el que se pasa como argumento. Como se trata de una ruta relativa, se busca en el directorio actual;
- línea 10: la instrucción [try (resource declaration) { ... }], conocida como bloque «try-with-resources» (Java 7), garantiza que el flujo se cierre al salir del bloque, incluso si ocurre una excepción dentro de él. Elimina la necesidad de llamar explícitamente al método [close]. Se aplica a cualquier objeto que implemente la interfaz [AutoCloseable], es decir, cualquier objeto con un método [close] que libere recursos (archivo, conexión de red, conexión a una base de datos, etc.). Antes de Java 7, el flujo debía cerrarse en una cláusula [finally] tras verificar que realmente se había abierto;
- líneas 13–15: el archivo se lee línea por línea. La asignación [line = reader.readLine()] es una expresión cuyo valor es el de [line]: se compara con [null], que indica el final del archivo;
- Línea 20: [Files.readString] (Java 11) lee el archivo completo de una sola vez y lo cierra;
- Líneas 21–27: los errores de entrada/salida se señalan mediante excepciones derivadas de [java.io.IOException]. Son excepciones verificadas (Capítulo 4): el compilador exige que se capturen o se declaren. Un archivo inexistente provoca una [NoSuchFileException], que deriva de ella; por lo tanto, debe capturarse primero. Su método [getFile] devuelve la ruta del archivo buscado. Las clases más antiguas de [java.io] informan el mismo error como una [FileNotFoundException].
El archivo [infos.txt] es el siguiente:
Se encuentra en la carpeta [05-classes-java], desde la cual se ejecuta el programa:
Con un archivo que no existe:
Cuando se usa una carpeta en lugar de un archivo, la operación de lectura provoca otra excepción, [IOException], cuyo mensaje proporciona el sistema operativo:
Elegir el directorio actual para ubicar los archivos de datos es natural para un archivo fuente compacto que se ejecuta desde su propio directorio. En un proyecto Maven, el comando [mvn exec:java] se ejecuta en el directorio del proyecto: allí colocaremos los archivos de datos de la aplicación de ejemplo.
5.6.2. La clase BufferedWriter
La clase [java.io.BufferedWriter] permite escribir en un archivo de texto. Al igual que [BufferedReader], utiliza un búfer y es capaz de manejar flujos que no son archivos.
Método | Rol |
[static BufferedWriter Files.newBufferedWriter(Path path)] | Abre el archivo [path] para escritura en UTF-8. El archivo se crea, o se vacía si ya existe. Parámetros opcionales permiten especificar la codificación y el modo de apertura: [Files.newBufferedWriter(path, StandardOpenOption.APPEND)] agrega las escrituras al final del archivo existente |
[void write(String str)] | escribe [str] en el archivo |
[void newLine()] | escribe un carácter de fin de línea: el predeterminado del sistema, “\r\n” en Windows, “\n” en Linux y macOS |
[void flush()] | escribe el contenido del búfer en el archivo sin esperar a que esté lleno |
[void close()] | cierra el flujo después de escribir el contenido del búfer en el archivo. Esto debe hacerse después de procesar el flujo |
Las escrituras en un [BufferedWriter] no son inmediatas: el texto se escribe primero en el búfer, y luego en el archivo cuando el búfer está lleno, cuando se vacía explícitamente mediante el método [flush], o cuando se cierra el flujo. Este es el modo más eficiente para archivos, porque minimiza los accesos al disco. No es adecuado para todos los flujos de datos, en particular los flujos de red: en un diálogo entre dos interlocutores, lo que uno escribe debe ser leído de inmediato por el otro, y el búfer debe vaciarse después de cada mensaje. La clase [java.io.PrintWriter], que usaremos más adelante, agrega los métodos [print], [println]y [printf], y puede vaciar automáticamente su búfer después de cada llamada a [println] (constructor [new PrintWriter(writer, true)]).
El programa [Files02.java] es el siguiente:
Resultados:
Comentarios:
- línea 6: una vez más, usamos la instrucción [try] con recursos para no tener que cerrar explícitamente el flujo. Este cierre se produce automáticamente al final del bloque (llave de cierre en la línea 19). Es este cierre el que escribe en el archivo el texto restante en el búfer; sin él, el archivo podría quedar incompleto;
- línea 7: la codificación predeterminada, UTF-8;
- líneas 16–17: escribe una línea en el archivo de texto, seguida de un salto de línea;
- línea 22: el método [Files.size] devuelve el tamaño de un archivo en bytes. Los 18 bytes se desglosan así: 16 caracteres, más dos saltos de línea de un byte ("\n" en Linux, donde se ejecutaron las pruebas; en Windows, cada salto de línea "\r\n" ocuparía 2 bytes);
- Línea 24: ¿por qué [try / catch]? Podríamos usar un nombre de archivo de la forma [folder1/folder2/file] con una carpeta llamada [folder1/folder2] que no existe, lo que haría imposible crear el archivo. Entonces se lanzaría una excepción [NoSuchFileException], derivada de [IOException]. Hay otros escenarios de excepción posibles (disco lleno, permisos insuficientes, etc.). En cualquier caso, el compilador exige que se manejen las excepciones verificadas [IOException] lanzadas por [newBufferedWriter], [write] o [size].
5.6.3. Las clases Files y Path
Para las operaciones comunes, la clase utilitaria [Files] elimina la necesidad de manejar flujos: un solo método abre el archivo, lo lee o lo escribe por completo y luego lo cierra. También permite crear, copiar, mover y eliminar archivos y carpetas. La interfaz [Path] maneja las rutas.
Método | Rol |
[Files.readString(path)] | devuelve el contenido del archivo como una cadena (Java 11) |
[Files.readAllLines(path)] | devuelve las líneas del archivo en una lista [List<String>] |
[Files.lines(path)] | devuelve las líneas del archivo como un flujo ([Stream<String>]) que se lee bajo demanda y debe cerrarse después de usarlo |
[Files.writeString(path, text, options...)] | crea (o sobrescribe) el archivo y escribe en él [text] (Java 11); con la opción [StandardOpenOption.APPEND], agrega el texto al final del archivo |
[Files.write(path, lines, options...)] | escribe una colección de líneas, cada una seguida de un salto de línea |
[Files.readAllBytes(path)], [Files.write(path, bytes)] | lee y escribe el archivo como un arreglo de bytes |
[Files.exists(path)], [Files.size(path)], [Files.delete(path)], [Files.copy(source, target)], [Files.move(source, target)] | comprueba si un archivo existe, devuelve su tamaño, lo elimina, lo copia, lo mueve |
[Files.createDirectories(path)] | crea la carpeta y sus carpetas superiores si no existen |
[Files.list(folder)], [Files.walk(folder)] | los elementos de la carpeta y de todo su árbol de directorios, en forma de un flujo [Stream<Path>] |
[path.resolve(other)] | construye una ruta agregando [other] a [path], usando el separador del sistema |
[path.getFileName()], [path.getParent()], [path.toAbsolutePath()] | el nombre del archivo, su carpeta y su ruta completa |
El programa [Files03.java] los utiliza:
Resultados:
Comentarios:
- Línea 2: los métodos de [Files] lanzan [IOException]. Para mantener liviano este programa de demostración, el método [main] las declara mediante la cláusula [throws IOException] en lugar de interceptarlas: un error terminaría el programa y mostraría la excepción;
- Líneas 4–8: [resolve] usa el separador de rutas del sistema. Las ejecuciones del curso se realizaron en Linux: la ruta resultante es [data/cities.txt]; en Windows, sería [data\cities.txt]. Construir rutas con [resolve] (o [Path.of("data", "cities.txt")]) en lugar de concatenar cadenas hace que el código sea portable. Como [Path] no tiene un método que devuelva la extensión de un archivo, esta se separa del nombre con [lastIndexOf];
- Línea 11: crear la carpeta [data] no provoca un error si ya existe;
- Líneas 14–21: escribir, agregar y leer, cada operación en una sola instrucción;
- Líneas 23–26: [Files.lines] devuelve un flujo: las líneas se leen una a una a medida que el programa las procesa. Se le puede aplicar la API de streams y, así, procesar un archivo de varios gigabytes sin cargarlo en memoria, que es lo que haría [readAllLines] . El flujo mantiene abierto el archivo: debe cerrarse, de ahí la instrucción [try] con recursos ([Stream] implementa [AutoCloseable]);
- líneas 29–37: el mismo texto «café» se escribe con tres codificaciones, y luego los bytes de los archivos se muestran en hexadecimal mediante la clase [HexFormat] (Java 17):
- En UTF-8, la codificación predeterminada de Java, los caracteres acentuados ocupan 2 bytes (é = C3 A9) y los demás 1 byte: 5 bytes para 4 caracteres;
- en UTF-8 con BOM (Byte Order Mark), el archivo comienza con los 3 bytes EF BB BF, que indican al software que el archivo está codificado en UTF-8. Java nunca escribe el BOM por sí mismo: se obtiene escribiendo el carácter U+FEFF al comienzo del texto, denotado como ["\uFEFF"];
- en Latin-1 (ISO-8859-1), la codificación tradicional para los textos de Europa occidental, cada carácter ocupa un byte (é = E9);
- Líneas 39–44: leer un archivo con una codificación distinta de la usada para escribirlo altera los caracteres acentuados: el byte E9 al final del archivo no es válido en UTF-8. [Files.readString] y [Files.readAllLines] rechazan un archivo así lanzando una excepción [MalformedInputException] (derivada de [IOException]);
- Líneas 46–47: la conversión de un arreglo de bytes en una cadena mediante el constructor [new String(bytes, encoding)] es menos estricta: cada byte no válido se reemplaza por el carácter �. Un [InputStreamReader] se comporta de la misma manera; en cambio, el [BufferedReader] devuelto por [Files.newBufferedReader] es estricto, como [Files.readString], y también lanza una [MalformedInputException];
- línea 48: cuando se lee con la codificación correcta, el archivo es correcto;
- línea 50: al leer, Java no reconoce el BOM: se lee como un carácter invisible al comienzo del texto, que tiene así 5 caracteres en lugar de 4. Si necesita leer archivos UTF-8 generados con BOM (por ciertos programas de Windows), debe eliminar usted mismo este carácter. Hoy la regla es simple: escribir y leer los archivos de texto en UTF-8, sin BOM;
- líneas 53–59: los archivos de la carpeta. [Files.list] devuelve un flujo que debe cerrarse, igual que el de [Files.lines], y no garantiza el orden de los nombres: [sorted] los ordena;
- líneas 62–67: eliminación de la carpeta. [Files.delete] se niega a eliminar una carpeta que no está vacía: recorremos todo el árbol de directorios con [Files.walk], y ordenamos las rutas en orden inverso ([Comparator.reverseOrder()]) para eliminar el contenido de una carpeta antes que la carpeta misma.
Los métodos de [Files] bloquean el hilo que los llama hasta que la operación termina. En el Capítulo 9, dedicado a la programación asíncrona, veremos cómo evitar bloquear un programa durante una operación de E/S prolongada.
5.7. Archivos binarios
5.7.1. Las clases DataOutputStream y DataInputStream
Las clases [java.io.DataOutputStream] y [java.io.DataInputStream] sirven para escribir y leer archivos binarios. En un archivo así, los datos no se escriben como texto sino en su forma interna: un [int] ocupa siempre 4 bytes, sea cual sea su valor. Son flujos de bytes: derivan de las clases [OutputStream] e [InputStream], mientras que los flujos de texto derivan de [Writer] y [Reader].
Consideremos la siguiente aplicación:
El archivo de texto [persons1.txt] tiene el siguiente contenido:
El programa [Files04.java] es el siguiente:
Veamos con más detalle las operaciones relacionadas con la clase [DataOutputStream]:
- Líneas 13–14: el objeto [DataOutputStream] se construye alrededor de otro flujo de bytes, siguiendo el principio de los flujos anidados (el patrón de diseño «decorator»):
- [Files.newOutputStream(Path.of(args[1]))] escribe un flujo de bytes en el archivo, que se crea o se vacía si ya existe;
- [BufferedOutputStream] le agrega un búfer, para no acceder al disco en cada escritura;
- [DataOutputStream] agrega métodos para escribir los tipos de datos básicos;
- Líneas 50–51: las operaciones de escritura. La clase [DataOutputStream] tiene un método por cada tipo de dato simple: [writeInt], [writeDouble], [writeLong], [writeBoolean], [writeUTF] para una cadena…;
- Líneas 12–15: los tres flujos se abren en una sola instrucción [try] con recursos, con sus declaraciones separadas por punto y coma. Se cerrarán al final del bloque [try], en el orden inverso al de su apertura. Cerrar el flujo exterior ([DataOutputStream]) cierra los flujos que contiene. El archivo de registro se escribe mediante un [PrintWriter], para aprovechar el método [println];
- línea 27: el separador es el carácter [:], rodeado de espacios opcionales, que se eliminan junto con él;
- Líneas 42–47: la edad debe ser un entero positivo o cero. Java no tiene un método que convierta una cadena en un entero sin lanzar una excepción en caso de error: el método [integer] (líneas 67–73) captura la excepción [NumberFormatException] y devuelve -1, que es un valor no válido para una edad;
- líneas 9, 59, 62: [System.exit(n)] termina el programa con el código de salida n, que un script puede verificar (0: éxito; este es el código de salida de un programa cuyo método [main] termina normalmente).
Los tres argumentos del programa se pasan después del nombre del archivo fuente en el comando [java]. Los resultados son los siguientes:
El archivo de registro [logs.txt] tiene el siguiente contenido:
El contenido del archivo binario [persons1.bin] puede mostrarse en hexadecimal con el comando de Linux [od] (en Windows, el comando de PowerShell [Format-Hex] produce una visualización similar):
Esto muestra cómo [DataOutputStream] escribe los datos:
- una cadena se escribe con [writeUTF], precedida por su longitud en bytes, en 2 bytes: 00 04, seguida de los 4 bytes de “paul” (70 61 75 6c). Los caracteres se codifican mediante una variante de UTF-8;
- un entero [int] se escribe en 4 bytes, con el byte más significativo primero (el orden llamado «big-endian», usado en los protocolos de red): 10 se escribe como 00 00 00 0a. Este formato es el mismo en todas las máquinas: un archivo escrito por [DataOutputStream] en Windows puede leerse en Linux;
- los datos se escriben de forma consecutiva, sin separadores ni saltos de línea: el archivo tiene 48 bytes (línea 5: con la opción [-A d], [od] muestra las posiciones en decimal).
Para leer este archivo, es necesario conocer el orden y el tipo exactos de los datos escritos. Para cada método [writeXX] de [DataOutputStream], la clase [DataInputStream] tiene un método correspondiente [readXX]: [readUTF], [readInt], [readDouble]… Sin embargo, no puede indicar cuántos bytes quedan por leer: un archivo leído con [DataInputStream] debe comenzar con el número de registros que contiene, o bien leerse hasta que se produzca la excepción [EOFException], que señala el fin del flujo. Sin embargo, una excepción debe seguir siendo excepcional, y el fin de un archivo no lo es.
5.7.2. La clase RandomAccessFile
La clase [java.io.RandomAccessFile] lee y escribe en un archivo mediante acceso directo: se puede posicionar la cabeza de lectura/escritura en cualquier lugar del archivo antes de leer o escribir. Tiene los mismos métodos de lectura y escritura que [DataInputStream] y [DataOutputStream] (implementa las mismas interfaces, [DataInput] y [DataOutput]), y además:
Método | Rol |
[RandomAccessFile(String name, String mode)] | abre el archivo para lectura ([mode] "r") o para lectura y escritura ("rw") |
[long length()] | el tamaño del archivo, en bytes |
[long getFilePointer()] | la posición actual en el archivo |
[void seek(long pos)] | se desplaza a la posición [pos] del archivo |
El programa [Files05.java] realiza la operación inversa a la del programa anterior: lee el archivo binario para crear un archivo de texto. Si el archivo de texto resultante contiene los datos correctos del archivo original, sabremos que la conversión texto → binario → texto fue exitosa.
Veamos con más detalle las operaciones que involucran a la clase [RandomAccessFile]:
- línea 12: el objeto [RandomAccessFile] se abre en modo de solo lectura (modo “r”);
- líneas 18–19: las operaciones de lectura, [readUTF] y [readInt]. Deben llamarse en el mismo orden de las escrituras;
- línea 16: la lectura continúa hasta que la posición actual en el archivo llega al final del archivo;
- líneas 26–27: acceso directo: [seek] restablece la posición al comienzo del archivo, y se vuelve a leer el primer registro. Si todos los registros tuvieran el mismo tamaño, podríamos leer directamente el n-ésimo registro desplazándonos a la posición n × tamaño: este es el principio de los archivos de acceso directo, precursores de las bases de datos;
- línea 28: la excepción [EOFException] señala ahora una verdadera anomalía: un archivo que termina en medio de un registro;
- línea 32: [RandomAccessFile], una subclase de [java.io], señala un archivo inexistente mediante una [FileNotFoundException], cuyo mensaje, proporcionado por el sistema, contiene el nombre del archivo.
Ejecutemos el programa con el archivo [persons1.bin] generado anteriormente:
El contenido de [persons2.txt] es el siguiente:
Encontramos las 4 personas válidas del archivo [persons1.txt]. Con un archivo [truncated.bin] formado por los primeros 33 bytes de [persons1.bin], la lectura de la edad de Jacques falla:
Y con un archivo inexistente:
Java también dispone de un mecanismo de serialización binaria de objetos: las clases *[ObjectOutputStream] y [ObjectInputStream] escriben y leen objetos completos, siempre que su clase implemente la interfaz *[java.io.Serializable] . Este mecanismo está hoy obsoleto: la deserialización de datos de una fuente no confiable ha permitido numerosos ataques, ya que la deserialización puede ejecutar código elegido por el atacante. En su lugar se prefiere un formato basado en texto como JSON. Sin embargo, la interfaz [Serializable] todavía se encuentra en muchas clases, en particular las excepciones, que la heredan de la clase [Throwable]: por eso el compilador, al usar la opción [-Xlint:all], exige que declaren un campo [serialVersionUID], como veremos en la aplicación de ejemplo.
5.7.3. Serialización JSON con Jackson
Escribir y leer un archivo binario un dato a la vez es tedioso, y la más mínima discrepancia entre la escritura y la lectura produce resultados incorrectos. En general es preferible serializar los objetos: convertirlos automáticamente en una secuencia de caracteres y luego deserializarlos para reconstruirlos.
JSON (JavaScript Object Notation) es un formato basado en texto, legible por humanos y universal: es el formato de intercambio de los servicios web (Capítulo 13) y de muchos archivos de configuración. Un objeto se escribe entre llaves como pares "propiedad": valor, o como un arreglo entre corchetes.
La biblioteca estándar de Java no puede leer ni escribir JSON. Se usa una biblioteca externa; la más común es Jackson, que Spring Boot utiliza de forma predeterminada. La versión 3 (2025) cambió los paquetes: [tools.jackson.*] en lugar de [com.fasterxml.jackson.*] de la versión 2, que todavía se encuentra con frecuencia; sus anotaciones permanecen en el paquete [com.fasterxml.jackson.annotation]. Una biblioteca externa se obtiene mediante Maven (Capítulo 2): el programa es, por lo tanto, un proyecto Maven, [Files06], con la siguiente estructura de directorios:
El archivo [pom.xml] declara la dependencia de Jackson:
Comentarios:
- líneas 7–9: los datos del proyecto;
- líneas 11–14: la versión de Java y la codificación de los archivos fuente;
- líneas 16–23: la dependencia de la biblioteca [jackson-databind]. Maven la descarga del repositorio central (Maven Central), junto con las bibliotecas de las que ella misma depende ([jackson-core] y [jackson-annotations]);
- líneas 27–37: el compilador, configurado como en todos los proyectos del curso: advertencias habilitadas ([-Xlint:all]) y nombres de parámetros conservados en el código compilado;
- líneas 39–46: el complemento [exec-maven-plugin], que ejecuta la clase principal mediante el comando [mvn exec:java].
El objeto central de Jackson es [JsonMapper], que tiene dos métodos principales:
Método | Rol |
[String writeValueAsString(Object value)] | devuelve el texto JSON que representa el objeto [value] |
[<T> T readValue(String content, Class<T> valueType)] | reconstruye un objeto de tipo [T] a partir del texto JSON [content]; lanza una [JacksonException] si el texto es incorrecto. Una sobrecarga recibe un [TypeReference] en lugar de una [Class] |
El programa [Files06.java] los utiliza:
Se ejecuta en la carpeta del proyecto con el comando [mvn compile exec:java], o desde el IDE. No reproducimos los mensajes de Maven, sino solo la salida del programa:
Comentarios:
- línea 1: en un proyecto Maven, las clases se organizan en paquetes: la clase [Files06] del paquete [json] se encuentra en el archivo [src/main/java/json/Files06.java];
- Líneas 3–14: a diferencia de un archivo fuente compacto, una clase normal debe importar las clases que utiliza, incluidas las de la biblioteca estándar;
- líneas 20–21: el record [Person] que se va a serializar, declarado en la clase [Files06]. Jackson 3 puede serializar un record: cada componente se convierte en una propiedad JSON con el mismo nombre;
- líneas 24–25: la anotación [@JsonProperty] establece el nombre de la propiedad JSON de un componente como [reference] en lugar de [code];
- línea 27: el método [main] es un método estático de una clase. Declara la excepción [IOException], que pueden lanzar los métodos de [Files];
- líneas 34–36: un [JsonMapper] se crea mediante un constructor de objetos: [JsonMapper.builder()] devuelve un objeto al que se le especifican las opciones deseadas, y luego [build] crea el [JsonMapper]. Con las opciones predeterminadas, el texto se escribe en una sola línea, y los caracteres acentuados se escriben tal cual (línea 2 de los resultados);
- Líneas 38–39: la opción [ESCAPE_NON_ASCII] indica al sistema que escriba los caracteres no ASCII como secuencias de escape: [é] se convierte en [\u00E9]. El texto sigue siendo correcto, pero es difícil de leer; esto es útil cuando el texto JSON debe pasar por un sistema que solo reconoce ASCII;
- líneas 42–43: la opción [INDENT_OUTPUT] produce un texto con sangría distribuido en varias líneas. Una lista se serializa como un arreglo JSON;
- líneas 45–48: el texto JSON se escribe en un archivo de texto y luego se vuelve a leer para mostrarlo: así es como hoy se reemplaza la serialización binaria;
- líneas 53–54: la deserialización reconstruye la lista. Jackson crea los objetos [Person] llamando al constructor del record, cuyos parámetros se asocian con las propiedades JSON del mismo nombre. Para una lista, hay que especificar a Jackson el tipo de sus elementos. Sin embargo, la expresión [List<Person>.class] no existe: los genéricos de Java se borran en tiempo de compilación («type erasure»), y en tiempo de ejecución solo existe una clase [List], sin ningún parámetro de tipo. El truco con
[TypeReference]consiste en crear una clase anónima ([new TypeReference<List<Person>>() { }]***) derivada de[TypeReference<List<Person>>]***: el tipo padre de una clase se conserva en el código compilado, y Jackson puede leerlo. Para un arreglo, que es más simple, escribimos [Person[].class]; - líneas 61–62: serialización de un [Article]: la propiedad [reference] tiene el nombre especificado por la anotación. Un [BigDecimal] se escribe como un número JSON;
- líneas 64–69: con la opción [ACCEPT_CASE_INSENSITIVE_PROPERTIES], Jackson ignora las mayúsculas y minúsculas en los nombres de propiedades durante el análisis: [REFERENCE] y [Price] se aceptan;
- líneas 72–79: un documento JSON no válido (en este caso, una cadena donde se espera un número) provoca una excepción derivada de [JacksonException], en este caso [InvalidFormatException]. En Jackson 3, estas excepciones son no verificadas (derivan de [RuntimeException]), mientras que en Jackson 2 derivaban de [IOException]. [getOriginalMessage] devuelve el mensaje sin la información de ubicación, que [getLocation] y [getPathReference] proporcionan por separado: fila 1, columna 23, propiedad [age] del record [Person].
Crear un [JsonMapper] es costoso, pero una vez creado es reutilizable y puede compartirse entre varios hilos: un programa suele crear uno solo, almacenado en una constante. Usaremos JSON en la siguiente aplicación de ejemplo y a lo largo del curso.
5.8. Expresiones regulares
El paquete [java.util.regex] permite el uso de expresiones regulares. Estas permiten validar el formato de una cadena. Por ejemplo, se puede verificar que una cadena que representa una fecha esté efectivamente en el formato dd/mm/aa. Para ello, se usa un patrón y se compara la cadena con ese patrón. En este ejemplo, d, m y a deben ser dígitos. Por lo tanto, el patrón de un formato de fecha válido es [\d\d/\d\d/\d\d], donde el símbolo [\d] representa un dígito. Los símbolos que pueden usarse en un patrón son los siguientes:
carácter | descripción |
[\] | marca el carácter siguiente como un carácter especial o literal. Por ejemplo, [n] corresponde al carácter n, [\n] corresponde a un carácter de nueva línea, [\\] corresponde a \, y [\(] corresponde a ( |
[^] | corresponde al comienzo de la cadena |
[$] | corresponde al final de la cadena |
[*] | coincide con el elemento anterior cero o más veces. Así, [zo*] coincide con z o zoo |
[+] | coincide con el elemento anterior una o más veces. Así, [zo+] coincide con "zoo", pero no con "z" |
[?] | coincide con el elemento anterior cero o una vez. Por ejemplo, [a?ve?] coincide con "ve" en "lever" |
[.] | coincide con cualquier carácter individual, excepto un carácter de nueva línea |
[(pattern)] | busca el patrón y almacena la coincidencia (un grupo). La subcadena que coincide puede extraerse del resultado mediante el método [group]. Para encontrar coincidencias con paréntesis como caracteres, use [\(] o [\)] |
[x|y] | coincide con x o con y. Por ejemplo, [z|foot] coincide con z o foot; [(z|f)oo] coincide con zoo o foo |
[{n}] | n es un entero no negativo. Coincide exactamente n veces con el elemento anterior. Por ejemplo, [o{2}] no coincide con la o de Bob, pero sí con las dos primeras o de fooooot |
[{n,}] | coincide con el elemento anterior al menos n veces. Por ejemplo, [o{2,}] no coincide con la 'o' de "Bob", pero sí con todas las 'o' de "fooooot". [o{1,}] equivale a [o+], y [o{0,}] equivale a [o*] |
[{n,m}] | coincide con el elemento anterior al menos n veces y como máximo m veces. Por ejemplo, [o{1,3}] coincide con las tres primeras “o” de “foooooot”; [o{0,1}] equivale a [o?] |
[[xyz]] | conjunto de caracteres: coincide con uno de los caracteres especificados. Por ejemplo, [[abc]] coincide con la letra “a” de “plain” |
[[^xyz]] | conjunto de caracteres negado: coincide con cualquier carácter que no esté en la lista. Por ejemplo, [[^abc]] coincide con la "p" de "plain" |
[[a-z]] | Rango de caracteres: coincide con cualquier carácter del rango especificado, en este caso una letra minúscula sin acento |
[[^m-z]] | rango de caracteres negado: coincide con cualquier carácter que no esté entre 'm' y 'z' |
[\b] | coincide con un límite de palabra, es decir, la posición entre un carácter de palabra y un carácter que no es de palabra. Por ejemplo, [er\b] coincide con "er" en "lever", pero no con "er" en "verb" |
[\B] | corresponde a una posición que no es un límite de palabra. [en*t\B] corresponde a “ent” en “mentor” |
[\d] | coincide con un dígito; equivale a [[0-9]] |
[\D] | corresponde a un carácter que no es un dígito |
[\f], [\n], [\r], [\t] | corresponden a los caracteres de salto de página, nueva línea, retorno de carro y tabulación, respectivamente |
[\s] | corresponde a cualquier espacio en blanco: espacio, tabulación, salto de página, salto de línea… Equivale a [[ \t\n\x0B\f\r]] |
[\S] | coincide con cualquier carácter que no sea un espacio en blanco |
[\w] | coincide con cualquier carácter de palabra: de forma predeterminada en Java, una letra sin acento, un dígito o un guion bajo; equivale a [[a-zA-Z_0-9]]. Con la opción [UNICODE_CHARACTER_CLASS] (véase más adelante), reconoce también las letras acentuadas |
[\W] | coincide con cualquier carácter que no sea un carácter de palabra |
[\num] | num es un entero positivo: se refiere al grupo número num. Por ejemplo, [(.)\1] corresponde a dos caracteres idénticos consecutivos |
[\xnn], [\unnnn] | corresponde al carácter hexadecimal nn (2 dígitos) o nnnn (4 dígitos). Por ejemplo, [\x41] corresponde a A |
Un elemento de un patrón puede aparecer una o varias veces. Veamos algunos ejemplos con el símbolo [\d], que representa un solo dígito:
patrón | Significado |
[\d] | un dígito |
[\d?] | 0 o 1 dígito |
[\d*] | 0 o más dígitos |
[\d+] | 1 o más dígitos |
[\d{2}] | 2 dígitos |
[\d{3,}] | Al menos 3 dígitos |
[\d{5,7}] | entre 5 y 7 dígitos |
Imaginemos ahora un modelo capaz de describir el formato esperado de una cadena:
cadena buscada | patrón |
una fecha en formato dd/mm/aa | [\d{2}/\d{2}/\d{2}] |
una hora en formato hh:mm:ss | [\d{2}:\d{2}:\d{2}] |
un entero sin signo | [\d+] |
una secuencia de espacios, que puede estar vacía | [\s*] |
un entero sin signo que puede estar precedido o seguido de espacios | [\s*\d+\s*] |
un entero que puede tener signo y estar precedido o seguido de espacios | [\s*[+-]?\s*\d+\s*] |
un número real sin signo que puede estar precedido o seguido de espacios | [\s*\d+(\.\d*)?\s*] |
un número real que puede tener signo y estar precedido o seguido de espacios | [\s*[+-]?\s*\d+(\.\d*)?\s*] |
una cadena que contiene la palabra "just" | [\bjust\b] |
Observe que dentro de los corchetes, el carácter [|] no tiene ningún significado especial: el patrón [[+|-]], que a veces se usa para el signo, acepta también el carácter | delante de un número. Del mismo modo, el punto decimal debe escaparse, [\.]: un punto sin escapar coincide con cualquier carácter.
Se puede especificar en qué lugar de la cadena se busca el patrón:
patrón | significado |
[^pattern] | el patrón comienza la cadena |
[pattern$] | el patrón termina la cadena |
[^pattern$] | el patrón comienza y termina la cadena |
[pattern] | el patrón se busca en cualquier lugar de la cadena, a partir del comienzo de la cadena |
cadena buscada | patrón |
una cadena que termina con un signo de exclamación | [!$] |
una cadena que termina con un punto | [\.$] |
una cadena que comienza con la secuencia // | [^//] |
una cadena formada por una sola palabra, posiblemente precedida o seguida de espacios | [^\s*\w+\s*$] |
una cadena formada por exactamente dos palabras, posiblemente precedidas o seguidas de espacios | [^\s*\w+\s+\w+\s*$] |
una cadena que contiene la palabra "secret" | [\bsecret\b] |
Se pueden «extraer» subconjuntos de un patrón. Así, no solo podemos verificar que una cadena coincide con un patrón determinado, sino también extraer de esa cadena los elementos que corresponden a los subconjuntos del patrón que se han encerrado entre paréntesis. Por ejemplo, si analizamos una cadena que contiene una fecha en formato dd/mm/aa y queremos extraer también los elementos dd, mm y aa de esa fecha, usaríamos el patrón [(\d\d)/(\d\d)/(\d\d)].
En el código Java, un patrón se escribe como una cadena normal: cada carácter [\] del patrón debe duplicarse. El patrón [\d+] se escribe como ["\\d+"], y el patrón [\\], que representa el carácter \, se escribe como ["\\\\"]. Los bloques de texto no cambian esto: [\] también es aquí un carácter de escape. El editor facilita la lectura: IntelliJ IDEA reconoce las cadenas pasadas a [Pattern.compile], las resalta como expresiones regulares y permite probarlas.
5.8.1. Verificar si una cadena coincide con un patrón dado
Un patrón se compila primero en un objeto [java.util.regex.Pattern], que luego proporciona objetos [Matcher] encargados de buscar dentro de una cadena dada:
Método | Rol |
[static Pattern compile(String regex)] | compila el patrón [regex]; lanza una excepción [PatternSyntaxException] si el patrón no es válido |
[static Pattern compile(String regex, int flags)] | igual que el anterior, con opciones (véase más adelante) |
[Matcher matcher(CharSequence input)] | devuelve un objeto [Matcher] que busca el patrón en [input] |
[boolean find()] (clase [Matcher]) | busca la siguiente ocurrencia del patrón en la cadena; devuelve [true] si encuentra una |
[boolean matches()] (clase [Matcher]) | devuelve [true] si la cadena completa coincide con el patrón |
[static boolean matches(String regex, CharSequence input)] | compila el patrón y verifica si la cadena completa coincide con él |
El programa [Regex01.java] es el siguiente:
Resultados:
Comentarios:
- línea 3: el patrón de un entero sin signo, posiblemente rodeado de espacios, que ocupa toda la cadena (anclas [^] y [$]). Los caracteres [\] se duplican;
- línea 4: la compilación del patrón;
- línea 7: [find] busca el patrón en la cadena. La cadena “123a”, rodeada de espacios, no coincide con el patrón: el carácter “a” no puede ser un dígito ni un espacio. Sin las anclas [^] y [$], la cadena coincidiría, ya que contiene un número;
- líneas 14–16: la diferencia entre [find], que busca el patrón dentro de la cadena, y [matches], que exige que la cadena completa coincida con el patrón, como si estuviera delimitada por [^] y [$];
- Líneas 18–20: el método estático [Pattern.matches] y el método [matches] de la clase [String] también prueban la cadena completa. Compilan el patrón en cada llamada: aunque son útiles para una prueba aislada, deben evitarse dentro de un bucle. El método [split] de [String], que ya hemos visto, también compila su patrón en cada llamada, salvo para los separadores formados por un único carácter ordinario, que procesa sin una expresión regular.
5.8.2. Búsqueda de todas las ocurrencias de un patrón en una cadena
El método [find] de un objeto [Matcher] puede llamarse varias veces: cada llamada busca la siguiente ocurrencia del patrón. Después de una llamada exitosa, el objeto [Matcher] proporciona información sobre la ocurrencia encontrada:
- [group()]: el texto de la ocurrencia, es decir, un elemento que coincide con el patrón;
- [start()]: la posición donde se encontró el elemento en la cadena buscada; [end()]: la posición siguiente al elemento.
El programa [Regex02.java] es el siguiente:
Resultados:
Comentarios:
- Línea 3: el patrón buscado es una secuencia de dígitos;
- línea 5: la cadena en la que se busca este patrón;
- líneas 8–13: cada llamada a [find] encuentra la siguiente ocurrencia; el bucle se detiene cuando ya no quedan más. Se muestran cada ocurrencia y su posición;
- línea 16: el método [results] (Java 9) devuelve el flujo de ocurrencias como objetos [MatchResult] (que tienen los métodos [group], [start], [end]): se le aplica la API de streams. Aquí se calcula la suma de los números encontrados;
- línea 18: el número de ocurrencias del patrón [[aeiouy]], que denota una vocal, es el número de elementos del flujo.
5.8.3. Recuperación de partes de un patrón
Como se mencionó, las partes de un patrón encerradas entre paréntesis se almacenan: son los grupos. El programa [Regex03.java] los utiliza:
Resultados:
Comentarios:
- líneas 7–8: la cadena [sample4] se compara con el patrón [regex3]; [find] busca la primera ocurrencia del patrón. Después de una llamada exitosa, usamos dos métodos nuevos de [Matcher]:
- [groupCount] (línea 11): el número de grupos entre paréntesis del patrón;
- [group(i)] (línea 12): el texto capturado por el grupo n.º i; [group(0)], o [group()], es la ocurrencia completa del patrón. [start(i)] es la posición de este texto en la cadena analizada. Por lo tanto, el bucle va de 0 a [groupCount], inclusive;
- línea 20: un grupo puede nombrarse con la sintaxis [(?<name>...)]. Aquí, el patrón reconoce una fecha en el formato d/m/aaaa, con día y mes de uno o dos dígitos;
- líneas 26–28: un grupo con nombre se designa por su nombre y no por su número: el código es más legible y no depende del orden de los paréntesis;
- líneas 29–31: la clase [LocalDate] (Java 8) representa una fecha sin hora. Se muestra con el patrón [EEEE d MMMM yyyy]: el día de la semana aparece en inglés, el idioma de la máquina;
- línea 35: el método [replaceAll] reemplaza cada ocurrencia del patrón por una cadena en la que [${name}] (o [$1], [$2]… para los grupos numerados) designa el valor de un grupo. Así, las fechas se reescriben en el formato año-mes-día;
- líneas 38–39: una versión sobrecargada de [replaceAll] (Java 9) recibe una función que calcula el texto de reemplazo a partir de cada ocurrencia, de tipo [MatchResult]. Aquí se construye la fecha y se reemplaza por su notación normalizada ISO 8601, que devuelve el método [toString] de [LocalDate]: los días y los meses siempre tienen dos dígitos.
5.8.4. Un programa de aprendizaje
Encontrar la expresión regular que verifique si una cadena coincide con cierto patrón puede ser a veces un verdadero desafío. El programa [Regex04.java] permite practicar. Recibe un patrón y una cadena como entrada e indica si la cadena coincide o no con el patrón.
Comentarios:
- línea 13: compilación del patrón ingresado por teclado. Un patrón incorrecto provoca una excepción [PatternSyntaxException], para la cual [getDescription] devuelve la descripción del error y [getIndex] devuelve su posición en el patrón (línea 15). Su mensaje completo, devuelto por [getMessage], abarca varias líneas y muestra el patrón con una marca debajo del error;
- línea 28: la búsqueda no se realiza directamente sobre la cadena escrita, sino sobre un objeto [TimeLimitedString] (líneas 58–87), que limita la duración de la búsqueda a un segundo: si la búsqueda tarda más, se lanza una excepción [TimeoutExceededException] que se captura en la línea 44. Veremos más adelante por qué esto es útil y cómo funciona;
- líneas 36–39: por cada coincidencia, se muestran los grupos n.º 1 y siguientes, si los hay;
- líneas 52–55: a diferencia de los programas anteriores, no se eliminan los espacios de la línea ingresada; pueden formar parte del patrón o de la cadena que se va a probar.
Este es un ejemplo de la salida:
Los patrones [^\s*\d+\s*$] y [^\s*(\d+)\s*$] demuestran las ventajas de usar grupos: el primero reconoce la cadena “1456” precedida de tres espacios, incluidos los espacios; el segundo extrae además el número sin los espacios. Los patrones [^(a+)+$] y [^(a+)+\1$] se tratan más adelante.
5.8.5. El método split
Ya hemos visto el método [split] de la clase [String], cuyo separador es una expresión regular. La clase [Pattern] tiene el mismo método, que usa el patrón precompilado:
Método | Rol |
[String[] split(CharSequence input)] | La cadena [input] se divide en campos, separados por un separador que corresponde al patrón |
[Stream<String> splitAsStream(CharSequence input)] | igual que el anterior, pero los campos se devuelven como un flujo |
Supongamos, por ejemplo, que un archivo de texto contiene líneas de la forma field1, field2, ..., fieldn. Los campos están separados por una coma, pero esta coma puede estar precedida o seguida de espacios. El patrón [\s*,\s*] describe exactamente este separador, como muestra el programa [Regex05.java]:
Resultados:
Comentarios:
- línea 5: el separador: una coma precedida y seguida de cualquier cantidad de espacios. Los espacios se eliminan junto con el separador. Una vez compilado, el patrón puede dividir tantas líneas como se desee sin recompilarse: este es el método para dividir todas las líneas de un archivo;
- línea 11: un separador que puede adoptar varias formas: un punto y coma o una barra vertical ([[;|]]), o ([|]) una secuencia de espacios ([\s+]);
- línea 14: [splitAsStream] devuelve los campos como un flujo, al que aquí se le aplica la operación [map].
5.8.6. Patrones precompilados, opciones y búsquedas que tardan demasiado
A diferencia de otras plataformas, Java no tiene un mecanismo que genere el código de una búsqueda con expresión regular en el momento de compilar el programa: un patrón siempre se analiza en tiempo de ejecución mediante [Pattern.compile]. Esta compilación tiene un costo; por lo tanto, la mejor práctica es compilar cada patrón conocido una vez y para siempre de antemano y almacenar el objeto [Pattern] en una constante, como lo hace el programa [Regex06.java]. Un objeto [Pattern] es inmutable y puede ser usado simultáneamente por varios hilos; un objeto [Matcher], que almacena el estado de una búsqueda, no.
Resultados:
Comentarios:
- líneas 4–8: los patrones del programa se compilan una sola vez y se almacenan en constantes [static final] (Capítulo 4), escritas en mayúsculas como es costumbre. En un archivo fuente compacto, estas constantes son campos de la clase implícita que contiene los métodos del archivo;
- líneas 12–16: las constantes se usan de la misma manera que los objetos [Pattern] de los programas anteriores;
- línea 6: el segundo parámetro de [compile] es una combinación de opciones. [CASE_INSENSITIVE] no distingue mayúsculas de minúsculas: “YES” y “Yes” coinciden con el patrón (línea 4 de los resultados);
- Líneas 23–27: las opciones se combinan con el operador [|]. [MULTILINE] hace que [^] y [$] coincidan al comienzo y al final de cada línea de la cadena, y no solo al comienzo y al final de la cadena misma. Sin embargo, con las opciones predeterminadas, [\w] reconoce solo letras sin acento: la línea “entrée: 3” no es reconocida (línea 5 de los resultados). La opción [UNICODE_CHARACTER_CLASS] (Java 7) asigna los significados Unicode correctos a [\w], [\d], [\s]y [\b]: las letras acentuadas se tratan como caracteres de palabra (línea 6 de los resultados). Esta opción debe usarse para todo texto en francés. Otras opciones útiles son: [DOTALL] ([.] también abarca los saltos de línea), [COMMENTS] (se ignoran los espacios del patrón, lo que permite escribirlo en varias líneas, con comentarios), [UNICODE_CASE] (junto con [CASE_INSENSITIVE], también ignora la distinción entre mayúsculas y minúsculas de las letras acentuadas: É y é);
- línea 29: las opciones también pueden escribirse al comienzo del patrón: [(?i)] para [CASE_INSENSITIVE], [(?m)] para [MULTILINE], [(?U)] para [UNICODE_CHARACTER_CLASS]…
El resto del programa aborda un problema de seguridad. Algunos patrones son patológicos: aplicados a ciertas cadenas, obligan al motor de expresiones regulares a probar una enorme cantidad de maneras de hacer coincidir la cadena con el patrón antes de llegar a una conclusión. El motor de Java usa un proceso llamado «backtracking» (retroceso): cuando un intento falla, vuelve a la última elección realizada y prueba otra. El patrón [^(a+)+\1$] de la línea 8 es un ejemplo de ello: aplicado a una secuencia de “a” que termina con otro carácter, prueba todas las maneras posibles de distribuir las “a” entre las repeticiones del grupo y su referencia inversa [\1] antes de concluir que la coincidencia ha fallado, y el número de posibilidades se multiplica con cada “a” adicional. Esto se conoce como retroceso catastrófico. Aplicado a cadenas ingresadas por el usuario, un patrón así constituye una vulnerabilidad de seguridad (conocida como ReDoS, «regular expression denial of service»): bastan unas pocas solicitudes para dejar detenido a un servidor.
- Líneas 32–37: se mide la duración de la búsqueda con 10, 15 y 20
a. Aumenta muy rápidamente (líneas 8–10 de los resultados; las duraciones varían de una ejecución a otra y de una máquina a otra). Como la duración se duplica aproximadamente con cadaaadicional, la búsqueda tardaría varios minutos con 30a; - líneas 38–43: la clase [Pattern] no tiene una opción de tiempo de espera. Se usa una técnica estándar: la búsqueda se realiza en un objeto de tipo [TimeLimitedString] (líneas 61–89), que implementa la interfaz [CharSequence] aceptada por [matcher]. El motor de expresiones regulares lee la cadena carácter por carácter mediante el método [charAt]: este método comprueba la hora y lanza una excepción [TimeoutExceededException] (líneas 92–95) si se ha superado el plazo, almacenado cuando se creó el objeto. La búsqueda se abandona después de 100 ms;
- líneas 61–65: el record [TimeLimitedString] tiene dos componentes: el texto y el plazo, expresado como un valor del reloj [System.nanoTime], que no debe superarse. El constructor adicional calcula este plazo a partir de un tiempo de espera, un objeto [java.time.Duration];
- línea 92: la excepción [TimeoutExceededException] deriva de [RuntimeException]: es una excepción no verificada que [charAt] puede lanzar sin declararla. Se declara como [static] para poder crearla dentro del record, que es en sí mismo implícitamente estático. El campo [serialVersionUID] evita una advertencia del compilador, ya que una excepción es serializable;
- líneas 45–48: el entorno de ejecución de Java puede reconocer y manejar eficientemente los casos simples de repeticiones anidadas: el patrón [^(a+)+$], que es catastrófico con otros entornos de ejecución, responde aquí de inmediato. Es la referencia inversa [\1] la que impide esta optimización en el patrón de la línea 8.
Es importante recordar que hay que desconfiar de los patrones que contienen repeticiones anidadas ([(a+)+], [(\w+\s?)*]…) y limitar la duración de las búsquedas en cuanto el patrón o la cadena buscada provenga de fuera del programa. Los cuantificadores posesivos de Java ([a++], [a*+]), que impiden el retroceso dentro del elemento que repiten, también permiten escribir patrones seguros, siempre que se comprenda bien su significado.
5.9. Aplicación de ejemplo - V3
Retomaremos la aplicación tratada en el Capítulo 3 (Versión 1) y en el Capítulo 4 (Versión 2). Recuerde que se trata de un ejercicio: la escala de impuestos utilizada es la de 2004 (ingresos de 2003), que se ha mantenido sin cambios desde el curso original.
5.9.1. Datos en un archivo
En la Versión 2, el cálculo del impuesto se realizaba en la clase abstracta [AbstractTax], que reutilizamos aquí en el paquete [tax] del proyecto, con dos diferencias menores: los tramos del impuesto ahora se proporcionan en forma de arreglo ([TaxBracket[]]) en lugar de una lista, y la división se realiza con 16 dígitos significativos en lugar de 34, lo cual es más que suficiente:
El método [calculate] utiliza los tramos del impuesto devueltos por el método abstracto [getTaxBrackets] (línea 10). La clase [AbstractTax] no sabe de dónde provienen estos tramos: corresponde a las clases derivadas proporcionarlos. En la versión 2, la clase derivada [HardwiredTax] los fijaba directamente en su código. Los cálculos se realizan con números decimales exactos [java.math.BigDecimal] (Capítulo 3): [BigDecimal.TWO] (Java 19) es la constante 2; la división de los ingresos por el número de partes se realiza con 16 dígitos significativos ([MathContext.DECIMAL64]); e [intValue] devuelve la parte entera del resultado. Un tramo se representa, como en la versión 2, mediante el record [TaxBracket]:
y el cálculo se describe mediante la interfaz [ITax], documentada aquí con un comentario Javadoc:
La nueva versión almacena los datos en un archivo, lo que permite cambiar la escala de tasas sin recompilar el programa. Escribimos dos clases nuevas derivadas de [AbstractTax]:
- [FileTax] lee los tramos de un archivo de texto [TaxData.txt];
- [JsonTax] los lee de un archivo JSON llamado [TaxData.json].
El archivo de texto [TaxData.txt] contiene un tramo por línea, en el formato límite:coeffR:coeffN:
Los números del archivo se escriben con un punto decimal. Un archivo de datos no debe depender del idioma de la máquina que lo lee: un archivo escrito con comas decimales e interpretado según las reglas del francés ([NumberFormat.getInstance(Locale.FRANCE)]) sería rechazado o, peor aún, mal interpretado en una máquina configurada en inglés. El constructor [new BigDecimal(String)], al igual que [Double.parseDouble], siempre espera un punto decimal, sea cual sea el idioma de la máquina. Esta es también la convención de JSON y de la mayoría de los formatos de datos.
El archivo [TaxData.json] contiene los mismos datos, en forma de un arreglo JSON de objetos:
5.9.2. Errores
El procesamiento de estos archivos puede fallar por un archivo inexistente, una línea mal formada, un número incorrecto, etc. Creamos una clase de excepción especial para informar estos errores, [TaxException]. También se usará para otras fuentes de datos (aquí el archivo JSON, y más adelante las bases de datos). Lleva un código de error:
Comentarios:
- Línea 7: la clase [TaxException] deriva de la clase [RuntimeException]: es una excepción no verificada (Capítulo 4). El compilador no exigirá que el código que crea un objeto [FileTax] o [JsonTax] capture esta excepción; ese código la capturará donde pueda manejarla;
- Líneas 10–11: toda excepción es serializable por herencia de la clase [Throwable]. Una clase serializable debe declarar un número de versión [serialVersionUID], que sirve para verificar que un objeto serializado sea deserializado por la misma versión de la clase; de lo contrario, el compilador, al usar la opción [-Xlint:all], emite una advertencia. La anotación [@Serial] (Java 14) indica que el campo forma parte del mecanismo de serialización;
- línea 14: el código de error, definido cuando se crea la excepción;
- líneas 16–24: dos constructores. El primero recibe un mensaje de error y un código; el segundo recibe además la excepción que causó el error (la causa), que será accesible mediante el método [getCause]. Esta es la forma de excepción, con un código entero, que usarán las versiones posteriores de la aplicación.
Los posibles códigos de error se describen mediante una enumeración:
Comentarios:
- Líneas 7–12: posibles códigos de error:
- [ACCESS]: error al acceder al archivo de datos;
- [LINE]: línea que no tiene los tres campos esperados, o archivo que no contiene ningún tramo;
- [FIELD1], [FIELD2], [FIELD3]: el campo 1, 2 o 3 de una línea es incorrecto;
- [JSON]: el documento JSON es incorrecto;
- Líneas 15–23: un enum de Java es una clase; puede tener campos, un constructor (privado) y métodos. Cada constante se construye con su valor entero, indicado entre paréntesis;
- líneas 26–34: algunos errores pueden ocurrir combinados: los tres campos de una línea pueden ser incorrectos. Por ello, los valores de los códigos de error son potencias de 2: cada uno corresponde a un bit del entero. Un error en los campos 2 y 3 producirá el código 8 | 16 = 24. El método estático [decode] realiza la operación inversa: convierte el conjunto de códigos en un entero probando cada bit con el operador [&]. El resultado es un
*[EnumSet]*, un conjunto especializado para las constantes de una enumeración, que las almacena como los bits de un entero: esta es la manera de Java de manejar combinaciones de opciones. Su método [toString] muestra una combinación en la forma “[FIELD2, FIELD3]”.
5.9.3. La clase FileTax
La clase [FileTax] proporciona los tramos leídos de un archivo de texto:
Comentarios:
- línea 13: la clase [FileTax] deriva de la clase [AbstractTax], al igual que la clase [HardwiredTax] en la versión 2;
- líneas 16–18: dos expresiones regulares, compiladas una sola vez y almacenadas como constantes: el separador de campos de una línea límite:coeffR:coeffN (el carácter [:], precedido y seguido de cualquier cantidad de espacios), y un número positivo o cero, formado por dígitos seguidos opcionalmente de un punto y más dígitos;
- líneas 21–27: los tramos leídos, devueltos por el método [getTaxBrackets], que implementa el método abstracto de [AbstractTax];
- línea 29: el constructor recibe el nombre del archivo de texto que contiene los datos. Su función es llenar el arreglo [taxBrackets];
- línea 32: el nombre del archivo sin su ruta, utilizado en los mensajes de error. En efecto, el constructor puede recibir una ruta completa, que no es necesario mostrar al usuario;
- línea 34: la lectura de un archivo de texto es secuencial: el número de líneas no se conoce hasta haber leído todo el archivo. Por lo tanto, el arreglo no puede dimensionarse de antemano; los tramos se almacenan temporalmente en una lista;
- líneas 35–38: el archivo se lee línea por línea con un [BufferedReader], abierto mediante una instrucción [try] con recursos;
- líneas 46–50: la línea se divide en campos mediante una expresión regular; si no hay tres campos, se lanza de inmediato una excepción [TaxException] con el código [LINE] . El archivo se cierra en todos los casos: la instrucción [try] con recursos cierra el [BufferedReader] sin importar cómo se salga del bloque, ya sea normalmente o por una excepción;
- líneas 52–58: validación de los tres campos. Los errores se acumulan en la variable [code] mediante el operador [|=] y luego se informan de forma conjunta. El método [matches] exige que el campo entero se ajuste al patrón [NUMBER]: sin signo, sin espacios y sin punto decimal. Así se rechazan los números negativos, lo que valida los datos al mismo tiempo que se verifican;
- líneas 60–61: los campos, ya validados, se convierten a [BigDecimal], con punto decimal sin importar el idioma de la máquina;
- líneas 63–67: los errores de acceso al archivo ([IOException] y sus variantes, como [NoSuchFileException] para un archivo inexistente, [AccessDeniedException] por permisos insuficientes o [MalformedInputException] para un archivo que no está en UTF-8) se encapsulan en una [TaxException] con el código [ACCESS], y la excepción original pasa a ser su causa. Las excepciones [TaxException] lanzadas dentro del bucle no son excepciones [IOException]: esta cláusula [catch] no las intercepta y salen del constructor tal cual;
- líneas 69–74: se rechaza un archivo vacío; en caso contrario, la lista se transfiere al arreglo de tramos, que era el objetivo del constructor.
Encapsular las excepciones de bajo nivel ([IOException]) en una excepción propia de la aplicación ([TaxException]) permite que el código que realiza la llamada maneje un solo tipo de excepción, sin importar la fuente de datos: un archivo de texto, un archivo JSON y, más adelante en el curso, una base de datos. Por eso mismo [TaxException] es no verificada: una excepción verificada tendría que ser declarada por todos los métodos por los que pasa, lo que ataría el código que realiza la llamada a los detalles de la fuente de datos.
5.9.4. La clase JsonTax
La clase [JsonTax] proporciona los tramos leídos de un archivo JSON:
Comentarios:
- línea 15: un único [JsonMapper], almacenado en una constante, se usa para todos los objetos [JsonTax]. Las propiedades JSON [limit], [coeffR] y [coeffN] se llaman igual que los componentes del record [TaxBracket]: no se necesita ninguna anotación;
- líneas 31–37: lectura del archivo; un error de acceso se maneja como en [FileTax];
- línea 41: una sola instrucción convierte el texto JSON en un arreglo de tramos. Jackson construye cada record llamando a su constructor y convierte los números JSON a [BigDecimal] sin ninguna pérdida de precisión;
- líneas 42–46: un documento no válido provoca una [JacksonException], encapsulada en una [TaxException] con el código [JSON]. El mensaje indica la ubicación del error, obtenida con [getLocation];
- líneas 48–56: la deserialización verifica el formato del documento, no la validez de los datos: aún falta comprobar que haya al menos un tramo (el documento [null] o [[]] es un JSON válido) y que ningún valor sea negativo o falte. Si falta una propiedad en un objeto JSON, al componente correspondiente se le asigna el valor [null]. La operación [anyMatch] de la API Stream realiza esta verificación final en una sola instrucción, donde [Arrays.stream(brackets)] devuelve el flujo de los elementos del arreglo;
- líneas 61–63: el método que prueba un valor.
Comparar las dos clases es instructivo: con un formato de datos estructurado y una biblioteca que lo entiende, el análisis del archivo requiere casi nada de código.
5.9.5. El programa principal
El proyecto Maven [TaxV3] tiene la siguiente estructura de directorios:
Los archivos de datos se encuentran en la raíz del proyecto, junto al archivo [pom.xml]: este es el directorio actual del programa cuando se ejecuta con el comando [mvn exec:java] desde el directorio del proyecto. El archivo [pom.xml] corresponde al proyecto [Files06], y solo difiere en sus coordenadas y en la clase principal:
El [groupId] [examples.tax] se usará para todas las versiones de la aplicación de ejemplo. La clase principal, declarada en el plugin [exec-maven-plugin], es [tax.Main]:
Comentarios:
- líneas 7–11: el texto de ayuda, en un bloque de texto almacenado en una constante;
- línea 15: el nombre del archivo de datos se pasa como argumento; por defecto es [TaxData.txt]. Con Maven, los argumentos del programa se pasan mediante la propiedad [exec.args]: [mvn exec:java -Dexec.args="TaxData.json"];
- líneas 21–25: una expresión [switch] (capítulo 3) selecciona la clase que se va a instanciar según la extensión del archivo, que se extrae del nombre mediante [lastIndexOf] y [substring]. Las dos ramas devuelven objetos de tipos distintos, [JsonTax] y [FileTax], ambos del tipo [ITax]. El resto del programa solo conoce la interfaz [ITax] y ignora el origen de los datos;
- líneas 26–35: la creación del objeto puede provocar una [TaxException], que se muestra antes de que el programa termine. El código se decodifica en un conjunto de mensajes [ErrorCode] que se muestran en texto claro; la excepción original, si la hay, se indica por su tipo. La instrucción [return] que sigue a [System.exit] nunca se ejecuta, pero el compilador, que no sabe que [System.exit] no devuelve el control, la exige: sin ella, la variable [tax] no se consideraría inicializada en la línea 73;
- líneas 38–74: el bucle de diálogo es el de la versión 2.
5.9.6. Ejecuciones
Con el archivo [TaxData.txt], por defecto:
Se conservan los valores de las versiones anteriores: 4282 euros para una pareja casada con 2 hijos, 2959 euros con 3 hijos y 11 519 euros para una persona soltera sin hijos, con un salario anual de 60 000 euros. Las entradas incorrectas se señalan como en la versión 2.
Con el archivo [TaxData.json]:
Con un archivo [xx.txt] inexistente:
Con el siguiente archivo [TaxDataInvalid.txt], donde la tercera línea usa una coma decimal:
Los campos 2 y 3 de la línea 3 se rechazan: el código de error es la combinación [[FIELD2, FIELD3]]. El campo 1 (14753), que no tiene parte decimal, es correcto.
Con el siguiente archivo, [TaxDataInvalid.json], donde un coeficiente está escrito como cadena:
El mensaje de Jackson precisa el error con exactitud: la cadena “0,068” no puede convertirse a [BigDecimal]. Jackson acepta una cadena donde se espera un número si contiene un número válido (“0.068”); lo que se rechaza es la coma decimal. El error se ubica en la línea 3 del documento (Jackson numera las líneas desde 1) y en la columna 30, inmediatamente después del valor incorrecto.
5.10. Conclusión
Este capítulo presentó las clases de Java que se utilizan en casi todos los programas:
- las cadenas inmutables [String], que se comparan con [equals] y no con [==], y [StringBuilder] para construirlas pieza por pieza; los formatos [String.format] y [formatted], los bloques de texto;
- los arreglos y la clase [Arrays];
- las colecciones [List], [Map], [Set], [Deque], y sus implementaciones [ArrayList], [HashMap], [LinkedHashMap], [TreeMap], [HashSet], [ArrayDeque], [PriorityQueue]; las colecciones inmutables ([List.of], [List.copyOf], [Collections.unmodifiableList]), las colecciones secuenciadas de Java 21 y los comparadores ([Comparator]); las colecciones de Java 1.0 ([Vector], [Hashtable], [Stack]) están obsoletas;
- la API Stream, sus operaciones intermedias y terminales, sus colectores y su evaluación diferida;
- los archivos de texto ([Files], [Path], [BufferedReader], [BufferedWriter]), siempre en UTF-8, los archivos binarios ([DataOutputStream], [DataInputStream], [RandomAccessFile]) y la serialización JSON con Jackson, que reemplaza la serialización binaria de Java, ya obsoleta;
- las expresiones regulares, compiladas una sola vez y protegidas contra búsquedas excesivamente largas al procesar datos externos.
La aplicación de ejemplo ahora lee sus datos desde un archivo de texto o JSON. El siguiente capítulo la reorganiza en capas: la lectura de datos, el cálculo del impuesto y la interacción con el usuario pasarán a ser componentes independientes.